AI 原生软件开发工作流实战指南:从需求访谈到架构演进HTML
一份可以照着做的 AI 原生软件开发工作流实战指南。作者用 Claude Code 从零开发一款适老化计算器应用,完整走通需求访谈、规格化、拆票、测试驱动实现、双轴评审与架构演进全流程,并给出团队落地路径,附四轮二十七问、三十六条故事与七十六个测试的真实数据。
一份可以照着做的 AI 原生软件开发工作流实战指南。作者用 Claude Code 从零开发一款适老化计算器应用,完整走通需求访谈、规格化、拆票、测试驱动实现、双轴评审与架构演进全流程,并给出团队落地路径,附四轮二十七问、三十六条故事与七十六个测试的真实数据。
以 mattpocock/skills 的 37 个技能为蓝本,完整拆解从模糊想法到可合并代码的 AI 原生开发全流程:每个环节做什么、该用哪个技能、为什么这样设计,并附可照抄的落地检查清单与技能逐条详解。
深度拆解 Jev 决策模型接进智能体循环的真实收益与边界:官方称快至 200 倍,社区实测端到端仅提速 25%,因决策仅占流程 53%。报告归纳四种集成模式与决策树,讲清置信度门控、模型路由等实践,点明上下文压缩是唯一硬失败案例,并附落地清单与本地化复现方案。
「Jev」发布一周,GitHub 便长出一个开源生态。本文经接口核实盘点 20 个最火项目:头部网页智能体拿下 1.7 万星,另有语音控制浏览器、本地复现与我的世界通关案例,按决策层、开发工具、资源清单、开源复现四大生态位分类,并警示全部未经生产验证。
实测超快浏览器智能体:离线契约测试全过,无需密钥即跑通决策循环;接入真实浏览器后三次运行定位过期日期根因,第三次以 $0.0114 成本完成苏黎世到伦敦航班任务,7/7 独立校验全过。报告拆解投机扇出机制、56% 决策过期率与延迟差距,并附三层可审计日志。
以 mattpocock/skills 技能库为蓝本,梳理AI原生软件开发生命周期的完整实践:先剖析它反对的四类失败模式与设计哲学,再走通从想法拷问、原型验证、规格化、拆票到实现与双轴评审的完整环节,并附上三条汇入通道与上下文卫生等要点,附录逐一详解全部技能。
公司规格驱动开发技能集定制方案:以可组合技能三层架构为骨架,借鉴差异增量防漂移机制与宪法门禁,并注入自研 AI 设计流水线实践,覆盖需求拷问至归档全链路。正文含三大工具源码级对比、裁剪清单、新增技能设计、质量门与治理不变量、人机分工及三阶段落地路线图。
深度拆解 Figma 网页转设计插件:它能将任意网页编译成完全可编辑的设计图层,已坐拥两百万用户与社区点赞第一,核心引擎被收购。报告讲清转换管线与质量分层、云端和扩展双通道的隐私代价、MCP 与 AI 工作流闭环、定价与竞品选型,并附风险清单与结论建议。
实践记录:在上一篇里,我用 Claude Code + mattpocock-skills 走通了 AI 原生的开发流水线。这一次,我把目光投向开发之前被忽略的环节——设计。我基于 Google 的 DESIGN.md 规范,为「长辈计算器」建立了完整的设计流水线:从现有网站提炼设计规范 → 生成高保真 HTML 原型 → 导入 Figma → 与代码对齐。本文拆解每个阶段的做法、工具的能力边界,以及实战中踩过的六个坑。
一、范式转变:设计的事实源搬家了
传统 SDLC 中,设计的事实源(single source of truth)是 Figma:设计师在画板上创作,开发通过"交付"把设计变成代码。AI 原生 SDLC 中,事实源上移到仓库里的文本规范——因为文本是 AI 的原生格式:可读、可 diff、可 lint、可版本化。
| 传统流向(人主导) | AI 原生流向(AI 主导) | |
|---|---|---|
| 事实源 | Figma 画板 | 仓库里的 DESIGN.md |
| 设计稿形态 | Figma 帧 | HTML 高保真原型 |
| Figma 的角色 | 创作层 | 协作与存档层 |
| 迭代成本 | 分钟级(人工拖图层) | 秒级(改 prompt → 刷新) |
为什么流向变了?两个现实约束:
AI 原生设计流水线实战:把设计事实源从 Figma 上移到可 diff 可 lint 的 DESIGN.md,按四阶段完成规范提炼、HTML 高保真原型、导入 Figma 与代码对齐,并给出设计治理、工具链配置、六个真实踩坑、人机分工与落地检查清单。
胶东喜饼开店深度研究:以乳山媳妇饼为样本,讲文化源流、烘焙大盘与区域缝隙,给出「无水」配方10:4:1.6:2.5、设备2万起预算与山东办证路径,测算单饼成本约1.6元、日保本80~120个,借文登花饽饽5亿产业验证三层产品线与90天冷启动,附风险反模式清单。
实践记录:我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」。本文以这次真实开发为主线,拆解这套"AI 原生"软件工程流水线的每个环节、它背后的设计哲学,以及实战中暴露的问题。原始对话实录见前一篇。
一、为什么是"AI 原生"而不是"AI 辅助"
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审——都围绕 AI 的特性重新设计。AI 的特性是什么?
| AI 的特性 | 对工程过程的要求 |
|---|---|
| 上下文窗口有限,塞满后质量衰减 | 任务必须切成"单个上下文能装下"的批次 |
| 每次会话开始时最"清醒" | 频繁开新会话,而不是一条会话干到底 |
| 不会主动追问,猜错了就错到底 | 需求阶段强制访谈,分歧在写代码前解决 |
| 产出无限、判断有限 | 人只做检查点决策,不做中间执行 |
| 记不住上一次的对话 | 共识必须落盘为文件,而不是留在脑子里 |
mattpocock/skills 就是围绕这张表设计的。
摘要:在 LLM 标称上下文窗口动辄 1M、2M 的今天,工程落地的残酷真相却是:上下文用得越多,模型表现往往越差。本文基于 Smart Zone(黄金上下文区间) 概念,深度拆解上下文用量超越 40% 后的能力崩塌逻辑,剖析能力、行为、经济三大隐形边界,并结合“大文本处理”、“KV-Cache”等场景给出 Agent 上下文管理的最佳工程实践。
一、 引言:为什么上下文窗口越大,AI 反而越“傻”?
随着长上下文(Long-Context)技术的普及,许多开发者形成了一种思维惯性:把整个项目代码库、长篇文档、全量日志和全部历史对话一股脑塞给 AI Agent。
然而,HumanLayer 创始人 Dex Horthy 提炼出的工程实践法则表明:当上下文占用突破标称窗口的 40% 后,AI 的输出质量、推理准确率和任务完成度会面临急剧下滑。
为了直观展现这一现象,我们可以总结出Smart Zone(黄金上下文区间) 核心图景:
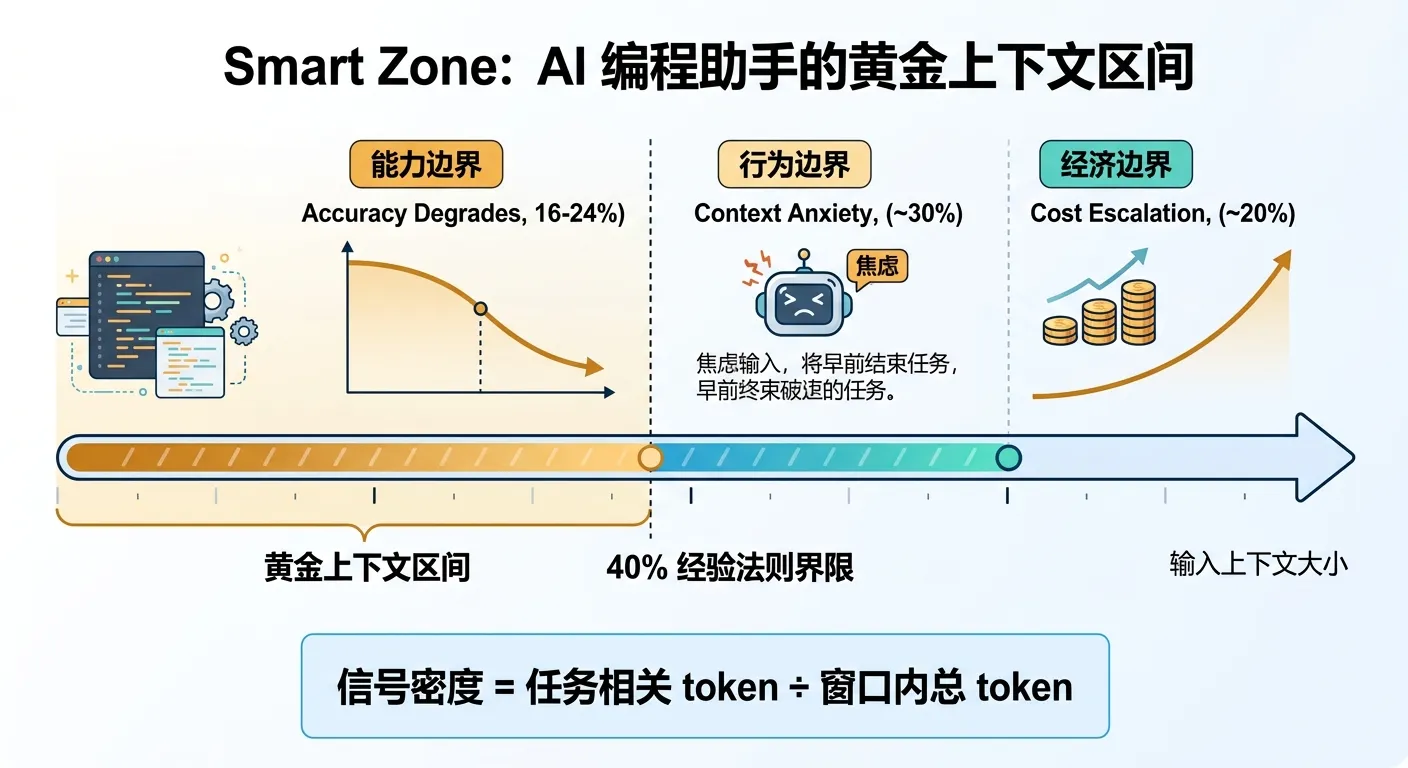
gantt
    title AI 编程助手上下文区间与边界示意图 (Smart Zone vs Danger Zone)
    dateFormat X
    axisFormat %s%%

    section 区间划定
    Smart Zone (黄金上下文区间)  :active, zone1, 0, 40
    Danger Zone (危险/衰减区间)  :crit, zone2, 40, 100

    section 核心边界拐点
    能力边界 (Accuracy Degrades, 16-24%)  :milestone, m1, 20, 20
    经济边界 (Cost Escalation, ~20%)      :milestone, m2, 20, 20
    行为边界 (Context Anxiety, ~30%)      :milestone, m3, 30, 30
    Safeguard Line (/clear 截断告警线, 40%) :milestone, m4, 40, 40
二、 核心公式:决定模型输出质量的两大隐形杠杆
在长上下文互动中,控制模型输出质量的本质是控制以下两个指标:
1. 信号密度(Signal Density)
用 Claude 技能集从零开发「长辈计算器」,完整拆解 AI 原生开发流水线:需求访谈逐轮实时落盘、测试接缝先行、曳光弹式垂直切票、红绿循环与双轴代码评审。36 条用户故事拆成 12 张票,23 个行为测试全绿,共识归文件系统而非对话,并复盘关键踩坑。
深度解构 mattpocock/skills:37 个技能、25 个晋升、两条调用轴,把软件工程基本功编码成可复用指令。还原 15 相位 AI 原生 SDLC 主链路,剖析上下文经济学、前置词、反馈环与深模块。核心三句:先造反馈环、定准语言、把上下文当钱花。
「Smart Zone」是经验还是实证?本报告拆成能力、行为、经济三条边界,用受控实验与厂商数据证明:编程助手拐点早在 32K,顶级模型从 96% 跌到 15%;并横评七款助手策略与反模式。核心结论是它并非使用上限,而应留出余量,真瓶颈已从容量转向信号密度。
安装
npx skills add mattpocock/skills
初始化(/setup-matt-pocock-skills)
/setup-matt-pocock-skills
在你的 agent 中,每个仓库运行一次。它会:
/triage 会用到标签)目录结构
.
├── CLAUDE.md
└── docs
    └── agents
        ├── domain.md
        ├── issue-tracker.md
        └── triage-labels.md
软件开发工作流程
grill-with-docs → to-spec → to-tickets → implement (tdd → code-review) → code-review
/grill-with-docs
description
一场为锐化计划或设计而不留情面的访谈,过程中还会同步创建文档(ADR 与术语表)。调用 Skill 工具两次,分别传入 "grilling" 和 "domain-modeling"。
详细介绍
grill-with-docs 就一个方案或设计对你进行访谈,直到你和 ag
逐行研读 okf-knowledge-base 源码:它如何把任意仓库、数据集或系统,沉淀成 OKF v0.2 规范的 markdown 知识库。含六步工作流、校验器与图谱渲染机制,以塔防小游戏跑通:21 篇文档、22 节点 8 条边、488KB 离线图谱。
文档即代码(Docs-as-Code,或 Documentation-as-Code)是一种将软件开发的最佳实践应用于技术文档编写与管理的理念和工作流。
它的核心思想是:像对待源代码一样对待文档。
核心运作方式
在传统模式下,文档通常在 Word、Confluence 或在线 Web 编辑器中撰写和发布。而在 Docs-as-Code 模式下,文档与代码共享同一套开发工具链和协同流程:
| 维度 | 传统文档模式 | Docs-as-Code 模式 |
|---|---|---|
| 存储格式 | Word (.docx) / PDF / 数据库格式 |
纯文本轻量标记语言(如 Markdown、reStructuredText、AsciiDoc) |
| 版本控制 | 文件名重命名(如 xxx_v2_最终版.docx) |
使用 Git / GitHub / GitLab 进行粒度管理 |
| 协作方式 | 邮件发附件 / 在线协同文档评论 | 创建分支(Branch)、提交 Commit、发起合并请求(Pull Request/PR) |
| 审核机制 | 口头/邮件确认 | 代码审查(Code Review),团队在 PR 中直接针对每一行批注 |
| 发布构建 | 手动导出或人工复制粘贴发布 | 自动化 CI/CD 流水线,结合静态网站生成器(如 Docusaurus、MkDocs、Hugo)自动构建并部署 |
Docs-as-Code 的四大核心优势
把文档当作代码来写、审、测、发,究竟意味着什么?这份深度研究提出 8 条可证伪论断,用 5 条判据界定范式,量化文档债年化成本约 400 工程师小时、其中重复提问占六成,并梳理持续集成里四条可验证门禁、结构化写作、证据分级、反模式清单与 90 天落地路线。
没有找到匹配的文章