DeepInfer 深度研究报告 · 开源的是执行引擎,不是服务HTML
以 61,664 行源码实证拆解 DeepInfer:25,620 stars 却仅 6 次提交,它是 V4.1-Flash 专用执行引擎而非服务框架;还原 DSpark 验证预算搜索与「7GB 实为 3 个 MTP stage」,结论是值得读、不值得部署。
以 61,664 行源码实证拆解 DeepInfer:25,620 stars 却仅 6 次提交,它是 V4.1-Flash 专用执行引擎而非服务框架;还原 DSpark 验证预算搜索与「7GB 实为 3 个 MTP stage」,结论是值得读、不值得部署。
在大语言模型(LLM)的生产落地中,自回归生成的 延迟始终是制约用户体验与系统吞吐的瓶颈。投机采样(Speculative Decoding)通过引入轻量级的“草稿模型(Draft Model)”先行生成候选 Token,再由大模型(Verification Model)进行并行校验,成为了当前最主流的加速方案。
本文将针对当前业界前沿的三种草稿模型方案——DFlash(纯并行)、DSpark(半自回归) 与 Eagle3(纯自回归) 进行深度架构剖析、技术指标对比及选型建议。
一、 核心架构与生成机制对比
三种方案的本质区别在于“生成速度(并行度)”与“草稿质量(接受率)”的权衡。以下图表直观展示了它们在计算模式上的根本差异:
graph TD
    %% 样式定义
    classDef flash fill:#d4edda,stroke:#28a745,stroke-width:2px;
    classDef spark fill:#fff3cd,stroke:#ffc107,stroke-width:2px;
    classDef eagle fill:#f8d7da,stroke:#dc3545,stroke-width:2px;

    subgraph DFlash ["DFlash: 纯并行 O(1)"]
        direction LR
        In1[输入 Token] -->|一次性前向传播| P1[Token 1] & P2[Token 2] & P3[Token 3] & P4[Token 4]
        note1[...]:::flash
    end

    subgraph DSpark [DSpark: 半自回归 - 带修正]
        direction LR
        In2[输入 Token] -->|马尔可夫并行生成| S1[候选池]
        S1 -->|置信度轻量筛选| S2[高概率 Token 块]
    end

    subgraph Eagle3 ["Eagle3: 纯自回归 O(N)"]
        direction TB
        In3[输入 Token] --> E1[草稿 Token 1]
        E1 -->|作为下一步输入| E2[草稿 Token 2]
        E2 -->|作为下一步输入| E3[草稿 Token 3]
    end

    class DFlash flash;
    class DSpark spark;
    class Eagle3 eagle;
1. DFlash (纯并行 / 无修正)
2. DSpark (半自回归 / 马尔可夫 + 置信度调度)
本文基于 DeepSpec 开源代码,以
Qwen3-4B+DSpark为具体实例,从算法思想、模型架构、训练数据流、推理流程四个维度,逐行拆解代码,帮助你完整理解 DSpark 草稿模型的训练与推理工作原理。
DeepSpec 核心工作原理
DeepSpec 训练草稿模型的本质是:在目标模型的 backbone 架构上,构建一个更小的 draft 网络,使用目标模型预计算的 hidden states 作为监督信号进行训练。
因此,适配新模型的核心工作量是让 draft 模型能够"理解"目标模型的内部表示——这包括:
一、DSpark 是什么:核心思想
DSpark 是一种面向推测解码(Speculative Decoding)的草稿模型训练方法。它的核心洞察可以总结为一句话:
"让草稿模型在训练时就学会——给定目标模型某几层的 hidden states,一次性猜出接下来的 N 个 token 是什么。"
传统训练语言模型是自回归的:输入 t0, t1, t2,预测 t3。
北京大学 DeepSeek-AI
摘要
推测解码(Speculative Decoding)通过将草稿生成与目标验证解耦来加速大语言模型(LLM)推理。尽管最近的并行 drafter 能够在单次前向传播中高效 Proposed 长令牌序列,但由于缺乏令牌间依赖关系,它们面临着接受率快速衰减的问题。此外,不加区分地验证这些扩展块会浪费关键的批次容量在具有高拒绝风险的令牌上,严重降低了高并发服务系统中的吞吐量。
我们提出了 DSpark,这是一个推测解码框架,统一了高吞吐量的并行生成与自适应的、负载感知的验证。为了保持草稿质量,DSpark 利用半自回归架构——将并行主干与轻量级顺序模块耦合——引入块内依赖建模并缓解后缀衰减。为了优化系统效率,DSpark 采用置信度调度验证,根据估计的前缀存活概率和引擎特定的吞吐量配置文件,动态地为每个请求定制验证长度。
在跨多个领域的离线基准测试中,DSpark 在已接受长度方面显著优于最先进的自回归和并行 drafter。当部署在 DeepSeek-V4 服务系统中并处理实时用户流量时,DSpark 成功缓解了验证浪费。与已确立的生产基线(MTP-1)相比,DSpark 在匹配的吞吐量水平上加速了每用户生成速度 60%–85%。
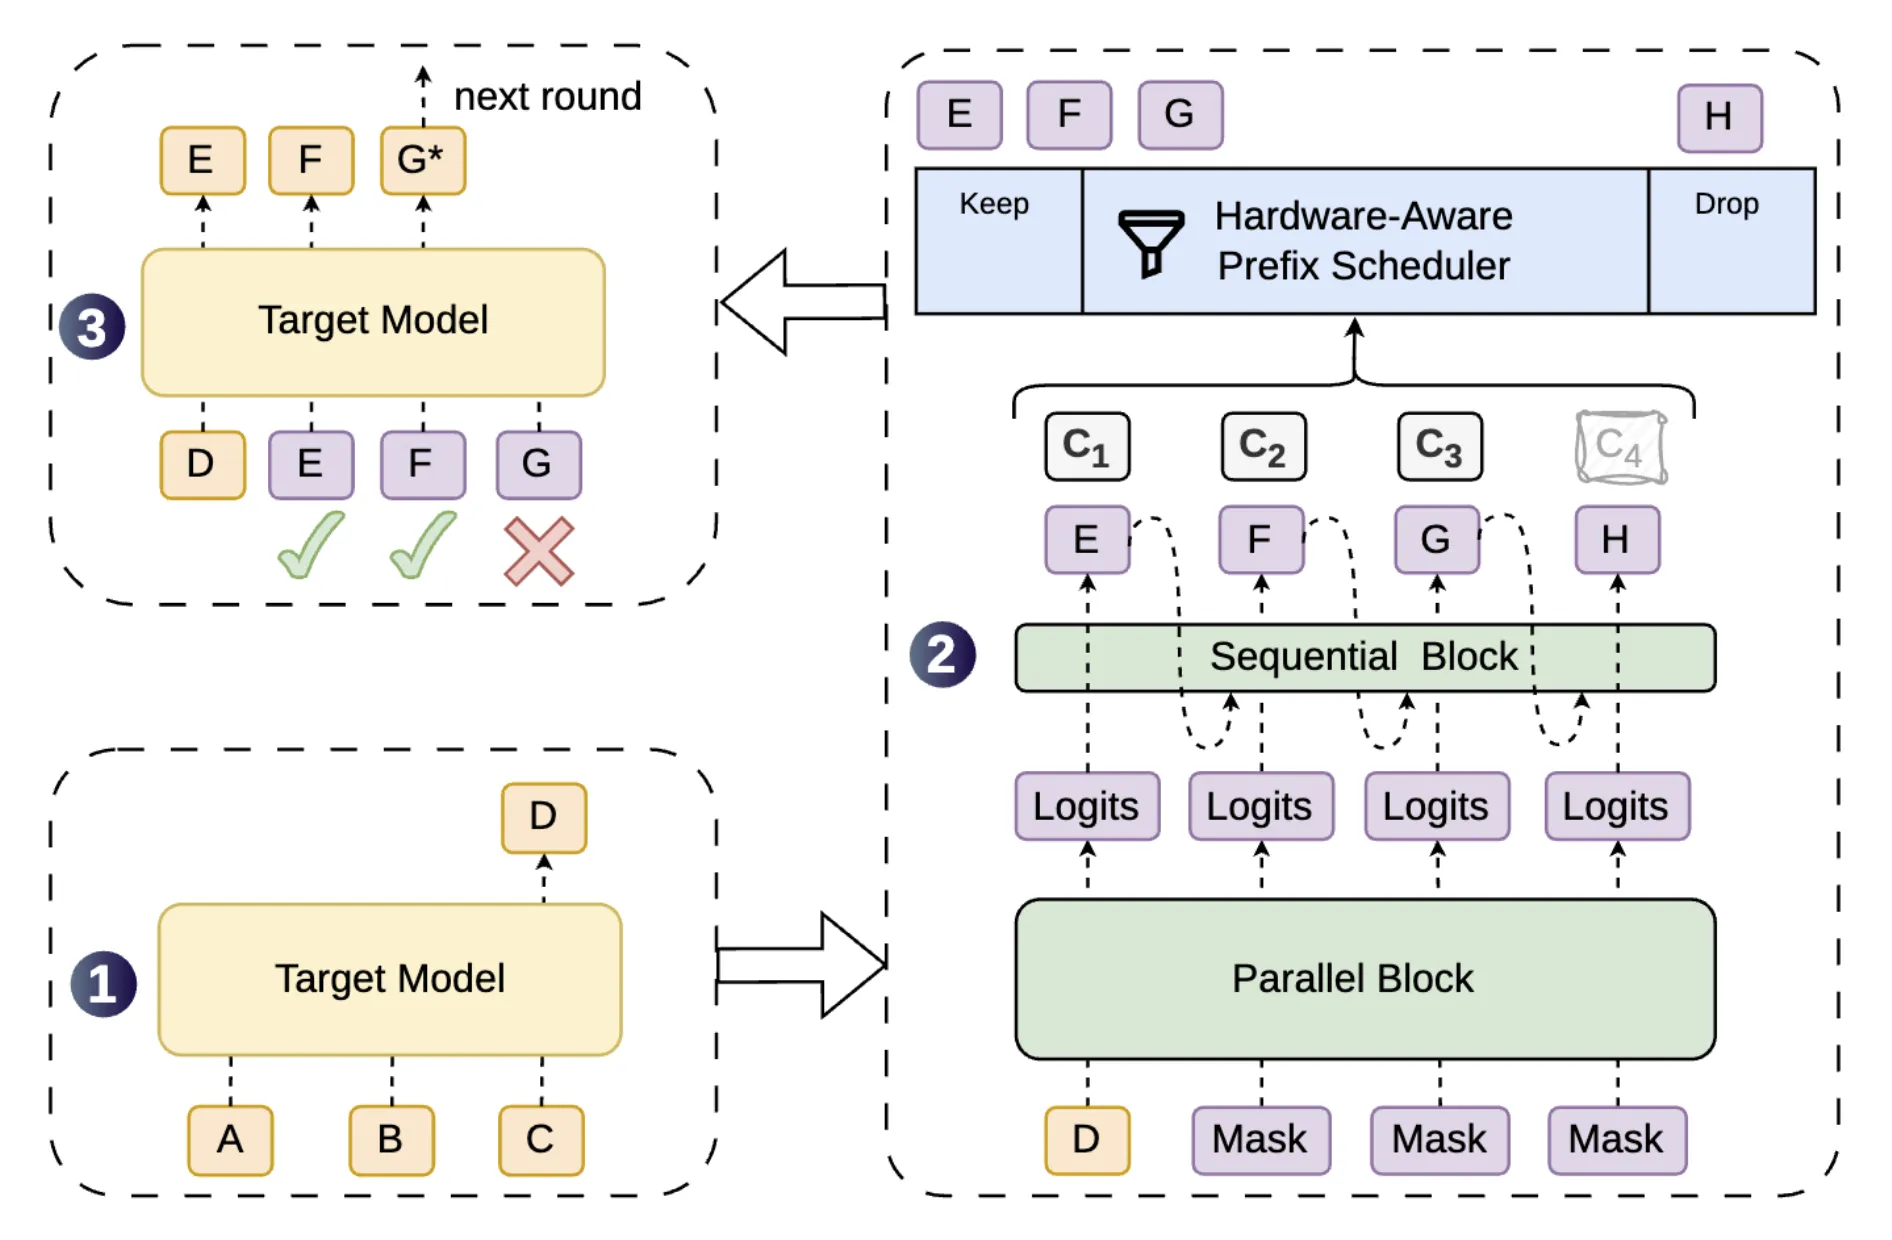
这篇研究论文介绍了 DSpark,一个由北京大学和 DeepSeek-AI 联合开发的投机采样(Speculative Decoding)大模型推理加速框架。以下是该论文的核心要点总结:
核心痛点
传统的投机采样在提高大模型推理速度上面临两个瓶颈:
DSpark 的核心架构与创新
DSpark 通过结合高吞吐的并行生成与自适应的负载感知验证,完美平衡了这两大难题:
1. 半自回归生成(Semi-Autoregressive Generation)
结合 DSpark 论文与代码实现,全面剖析 DeepSpec 的工作原理与核心组件。
项目地址:https://github.com/deepseek-ai/DeepSpec DSpark 论文:https://github.com/deepseek-ai/DeepSpec/blob/main/DSpark_paper.pdf
DSpark 是 DeepSeek 提出的一套无损加速大模型推理的“看人下菜碟”机制。 传统加速手段(推测解码)通常是让小模型一次性盲目盲猜一大串后续 Token,再让大模型统一验证。但这存在两个痛点:小模型猜得越往后越不准(多模态冲突导致“后缀衰减”);高并发时,大模型花大力气去验证那些猜得不准的 Token,会严重压垮系统吞吐。
DSpark 的核心突破就在于两点:
通过这种“高质量猜测”与“负载感知动态裁剪”的结合,DSpark 在保障大模型输出质量完全无损的前提下,成功
Speculative Decoding
没有找到匹配的文章