Hy-SimulMT 推理工作原理 · 图文拆解HTML
用八张图拆解 Hy-SimulMT 同声传译推理:1.6 秒切块、VAD 跳过静音、全量历史续写、1600 毫秒音频压成 11 个语音词元、模型自判说与不说、ST 补偿重译与上下文切断,并给出延迟来源、8 秒时序与代码地图。
用八张图拆解 Hy-SimulMT 同声传译推理:1.6 秒切块、VAD 跳过静音、全量历史续写、1600 毫秒音频压成 11 个语音词元、模型自判说与不说、ST 补偿重译与上下文切断,并给出延迟来源、8 秒时序与代码地图。
📌 DSL
Dify
git clone https://github.com/langgenius/dify
Dify 提供了 Docker 部署方式,您可以通过以下步骤快速部署:
cd dify
cd docker
cp .env.example .env
docker compose up -d
运行后,可以在浏览器上访问 http://localhost/install 进入 Dify 控制台并开始初始化安装操作。
vLLM
vllm serve /data/models/llm/deepseek/DeepSeek-R1-Distill-Qwen-32B-AWQ/ \
    --served-model-name gpt-4o-mini \
    --tensor-parallel-size 4 \
    --max-model-len 102400 \
    --dtype half \
    --port 8111
Ollama
curl -fsSL https://ollama.com/install.sh | sh
systemctl edit ollama.service。这将打开一个编辑器。sudo systemctl edit ollama.service
对于每个环境变量,在 [Service] 部分下添加一行
内网IP:27.41.19.62
| 服务 | 说明 | 端口 | 模型 | 备注 |
|---|---|---|---|---|
| whisperlivekit | 实时语音识别服务 | 8000 | Whispersmall (默认)large-v3-turbo |
带说话人分离 |
| FunASR | 实时语音识别服务 | 8000 | 语音识别:paraformer-zh实时语音识别: paraformer-zh-streaming实时语音端点检测: fsmn-vad标点恢复: ct-punc文本逆规范化: fst_itn_zh |
实时与非实时一体化协同(2pass)服务模式 |
| llama-server | GGUF 模型推理服务 | 8080 | Qwen3Qwen3-8B-Q5_K_M.gguf |
模型名:qwen3 上下文长度:32K 不思考 |
系统设置
系统优化
最大功率模式(一次性设置)
sudo nvpmodel -m 0
启动最高频率(每次重启后设置)
sudo jetson_clocks
清理内存
sync && echo 3 | sudo tee /proc/sys/vm/drop_caches
WhisperLiveKit
部署服务
tmux new -s wlk
默认容器内应用(标点识别有时会失灵 ⚠️)
推理服务
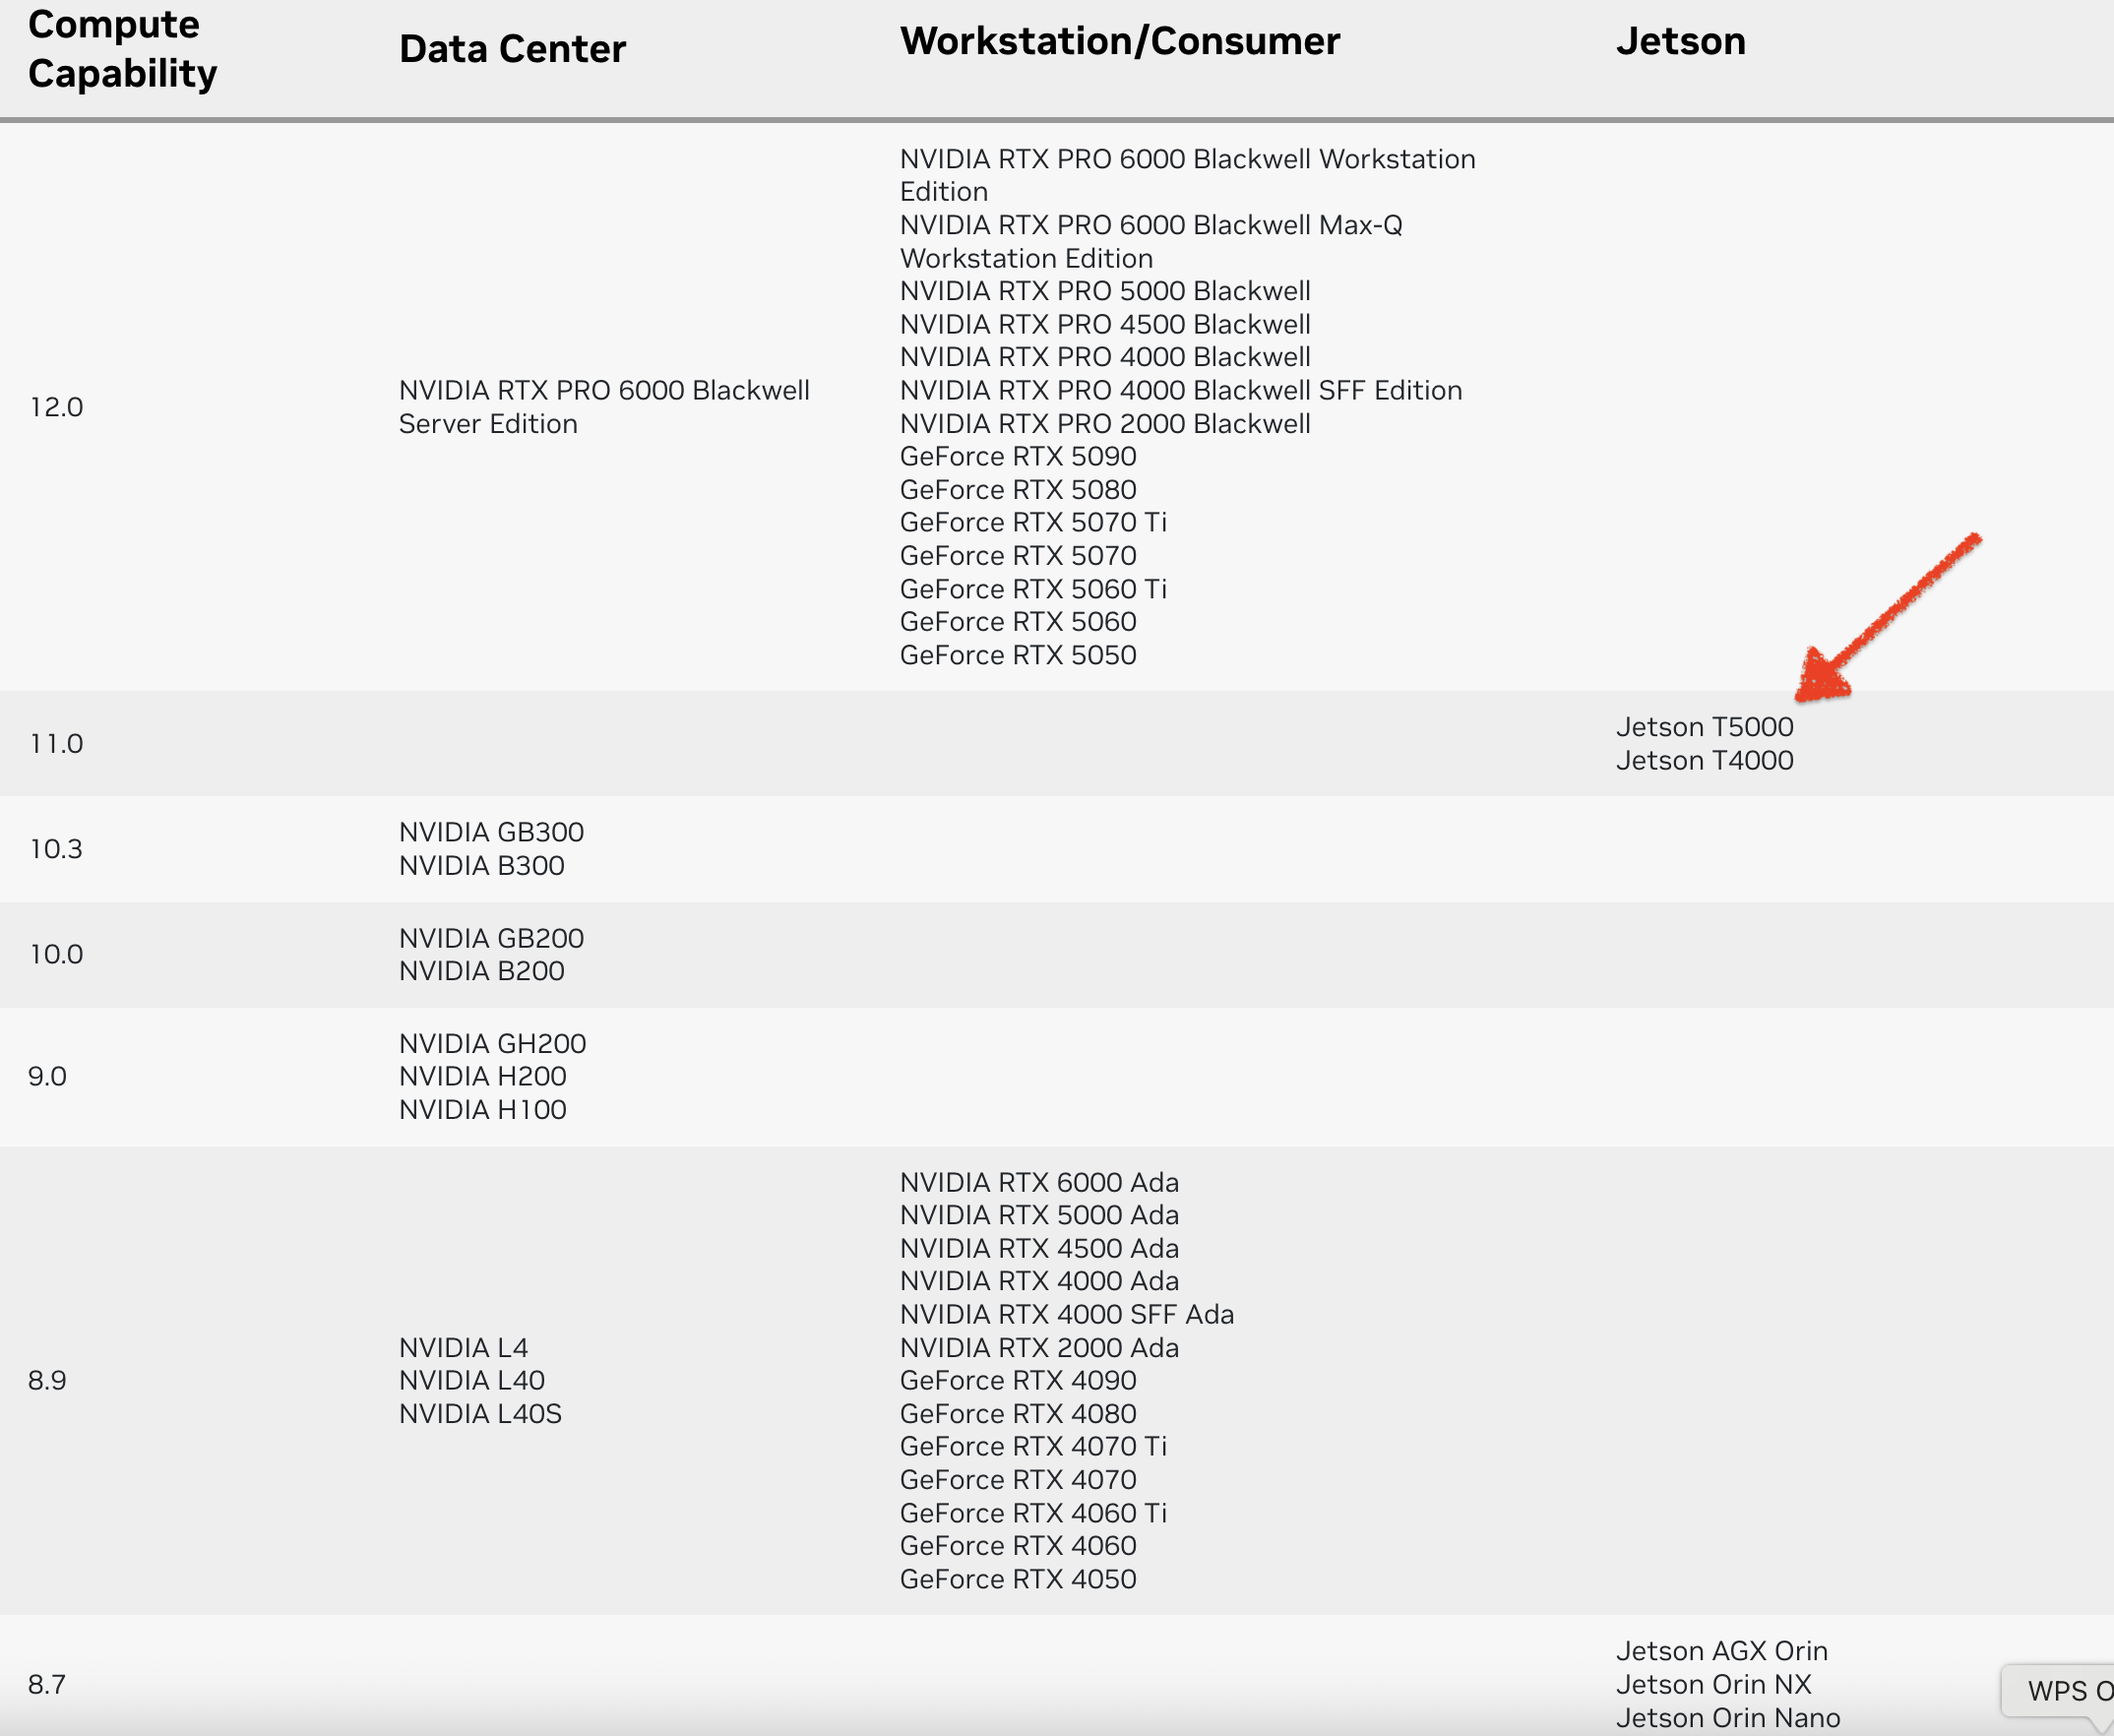
CUDA GPU Compute Capability(计算能力)
计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性和支持的指令。在下表中查找您的GPU的计算能力。
vLLM
docker run -it --rm \
  --ipc=host \
  --net=host \
  --runtime=nvidia \
  --name=vllm-test \
  -v /models:/models \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -v ~/.cache/modelscope:/root/.cache/modelscope \
  nvcr.io/nvidia/vllm:25.10-py3 \
  bash
默认情况下,如果模型未指向有效的本地目录,它将从 Hugging Face Hub 下载模型文件。要从 ModelScope 下载模型,请在运行命令之前进行如下设置:
export VLLM_USE_MODELSCOPE=true
vllm serve /models/Qwen/Qwen3-8B \
  --served-model-name qwen3 \
  --chat-template /models/Qwen/Qwen3-8B/qwen3_nonthinking.jinja
SGLang
NVIDIA Jetson Thor 采用了 Blackwell 架构的 GPU。
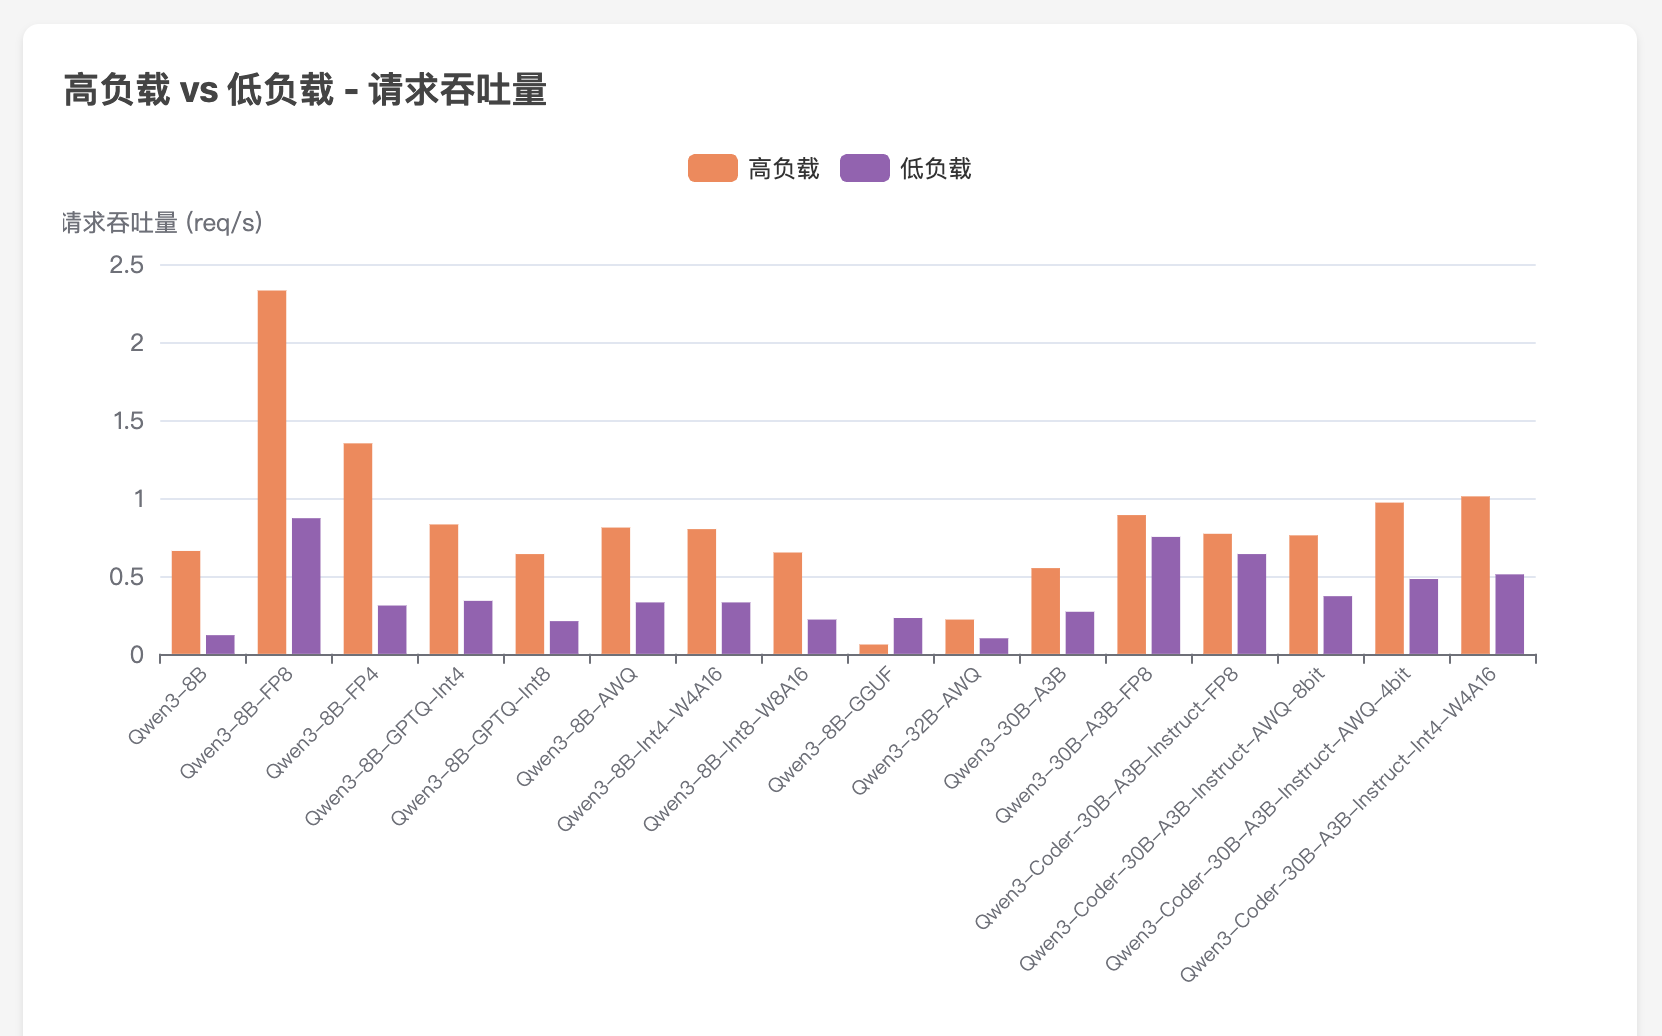
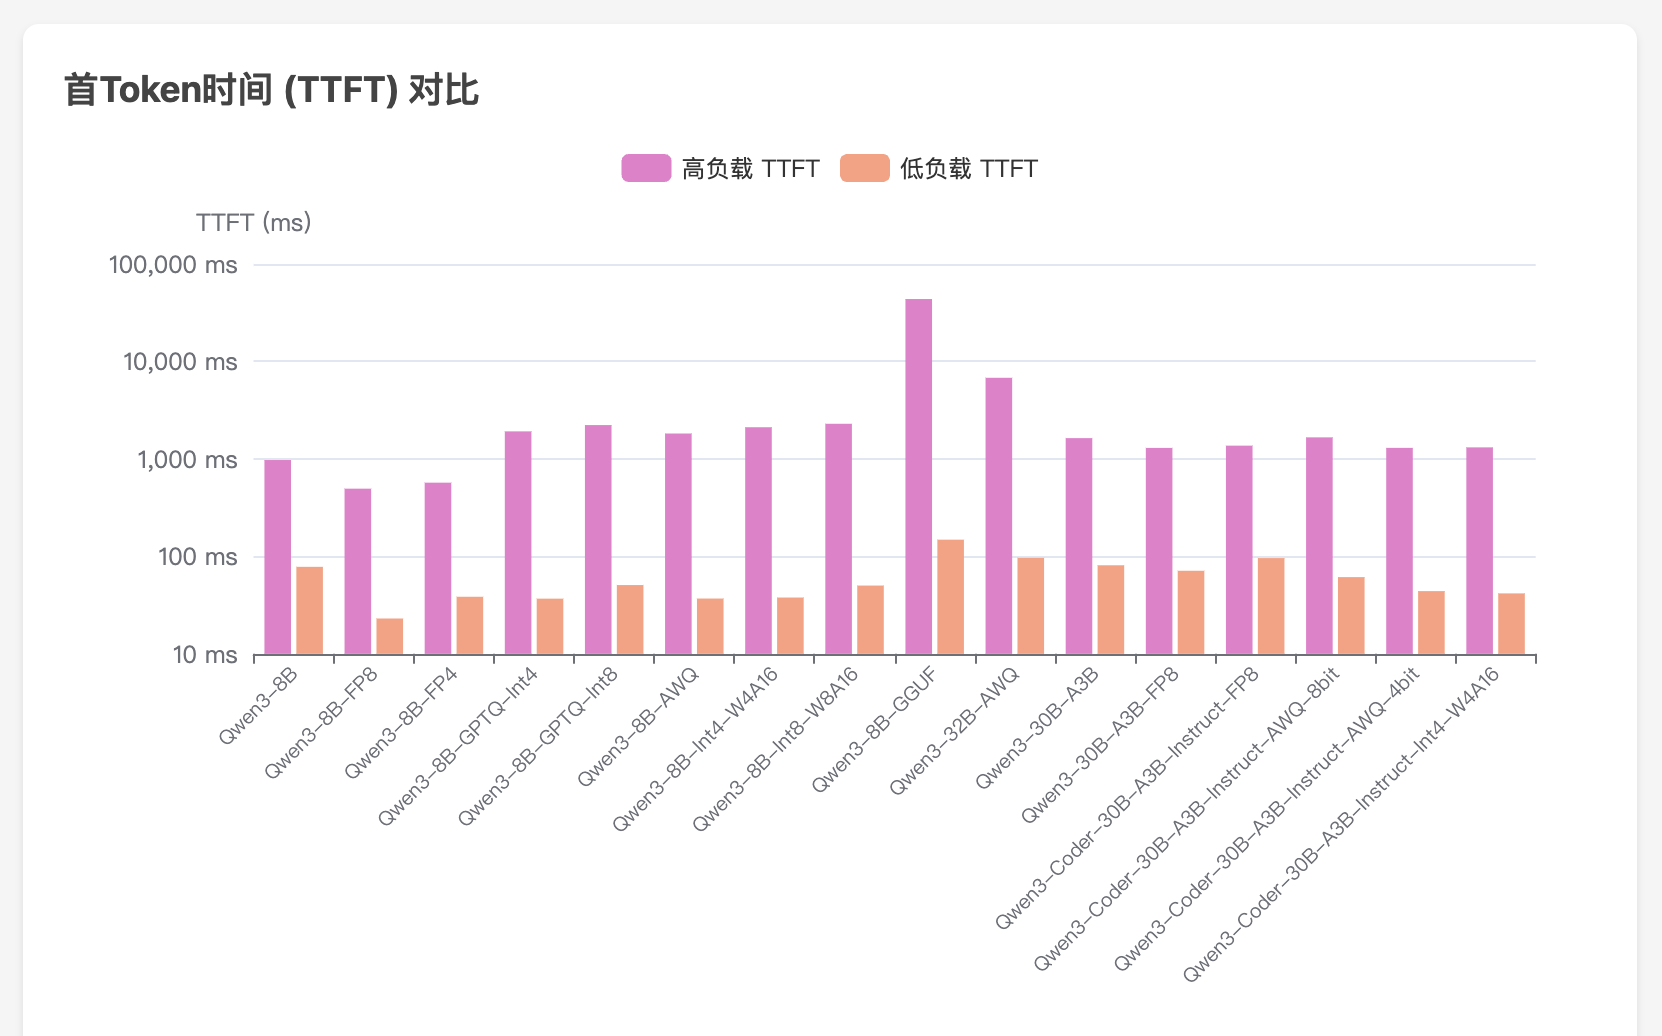
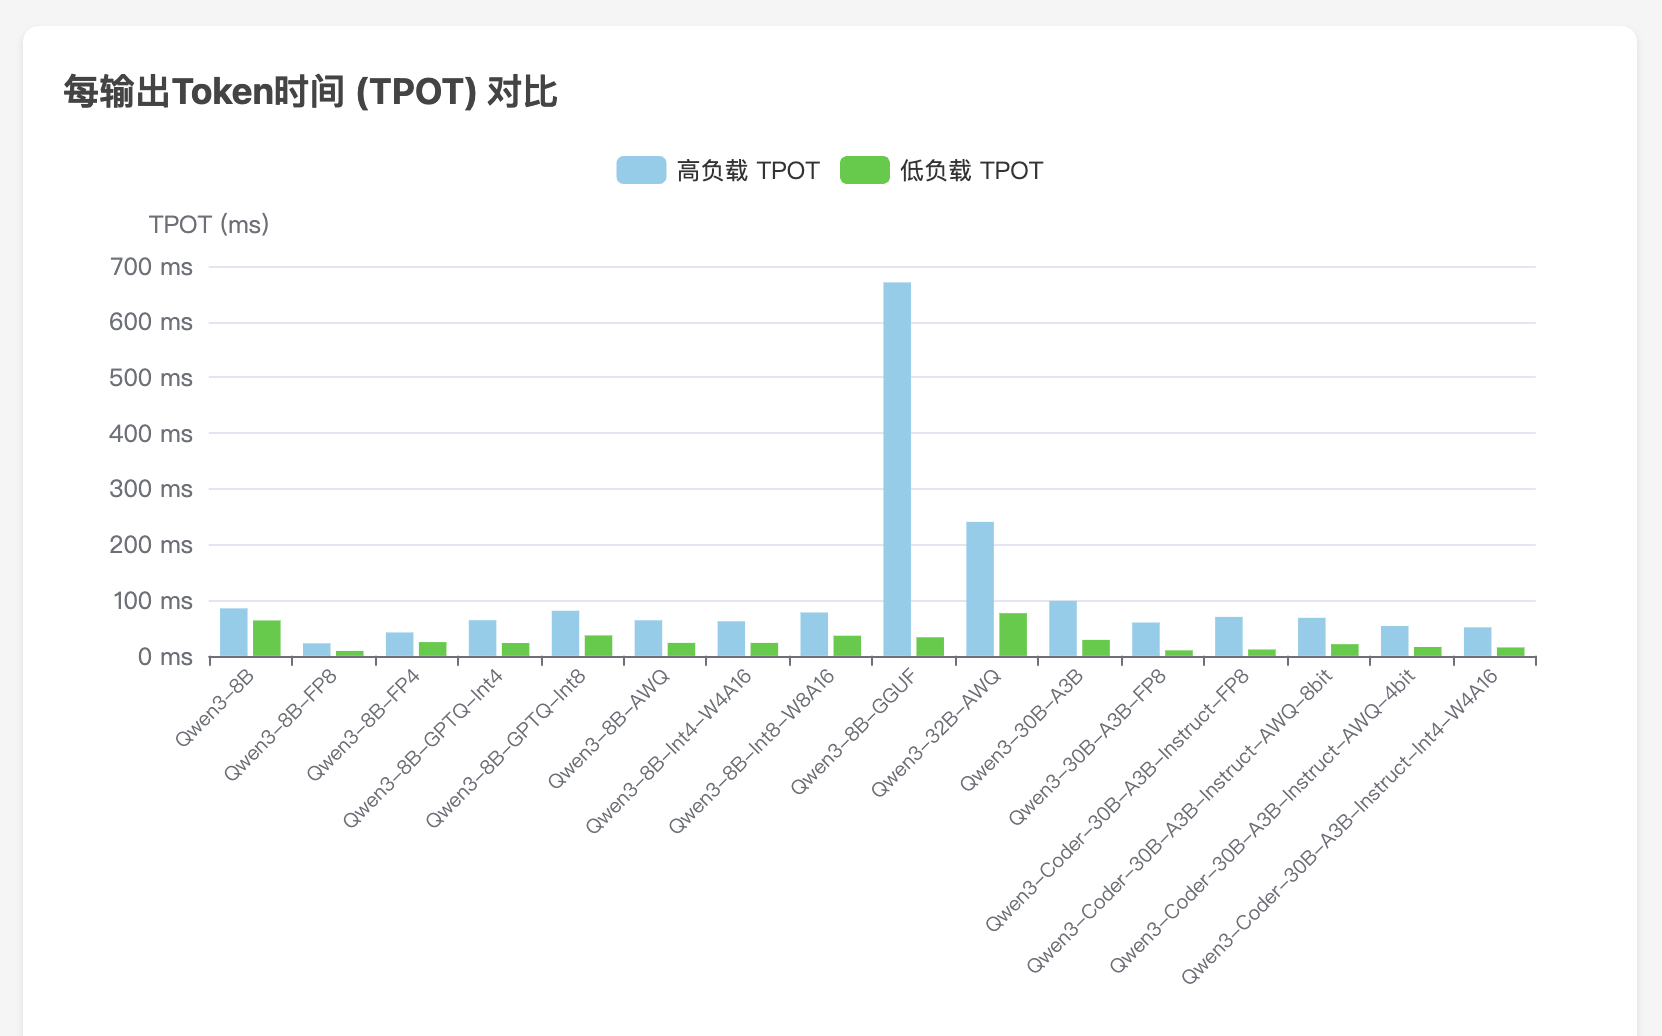
性能基准测试分析
部署模型
vllm serve /models/Qwen/Qwen3-8B --served-model-name qwen3
运行性能基准测试
vllm bench serve \
    --base-url http://localhost:8000 \
    --model qwen3 \
    --tokenizer /models/Qwen/Qwen3-8B \
    --dataset-name random \
    --random-input-len 2048 \
    --random-output-len 128 \
    --num-prompts 100 \
    --max-concurrency 8
该文章是对 NVIDIA Jetson Thor 平台进行大语言模型部署、系统优化和深度性能基准测试的权威指南。
平台配置与环境准备: 文章首先详细介绍了在 Jetson AGX Thor 开发套件上进行 BSP(Jetson Linux)安装流程。这包括下载 ISO 映像、使用 Balena Etcher 创建可启动 USB 棒,以及通过首次启动完成 UEFI 固件更新和 Ubuntu 初始设置。软件环境基于 JetPack 7,它提供了对前沿机器人和生成式 AI 的全面支持。部署环境采用云原生技术,通过 Docker 容器运行 vLLM 或 TritonServer 等推理服务。
系统性能调优:
为了释放硬件全部潜力,文章强调了系统级的性能调优步骤:必须通过 sudo nvpmodel -m 0 将功耗模式设置为最高性能模式 (MAXN)(130W),并使用 sudo jetson_clocks 锁定 CPU、GPU 和内存的核心频率,禁用 DVFS 机制。测试结果显示,MAXN + jetson_clocks 组合能显著提升性能,在高负载下,FP8 模型的吞吐量提升约 18.5%,在低负载下,每 Token 平均延迟(TPOT)减少约 43%。
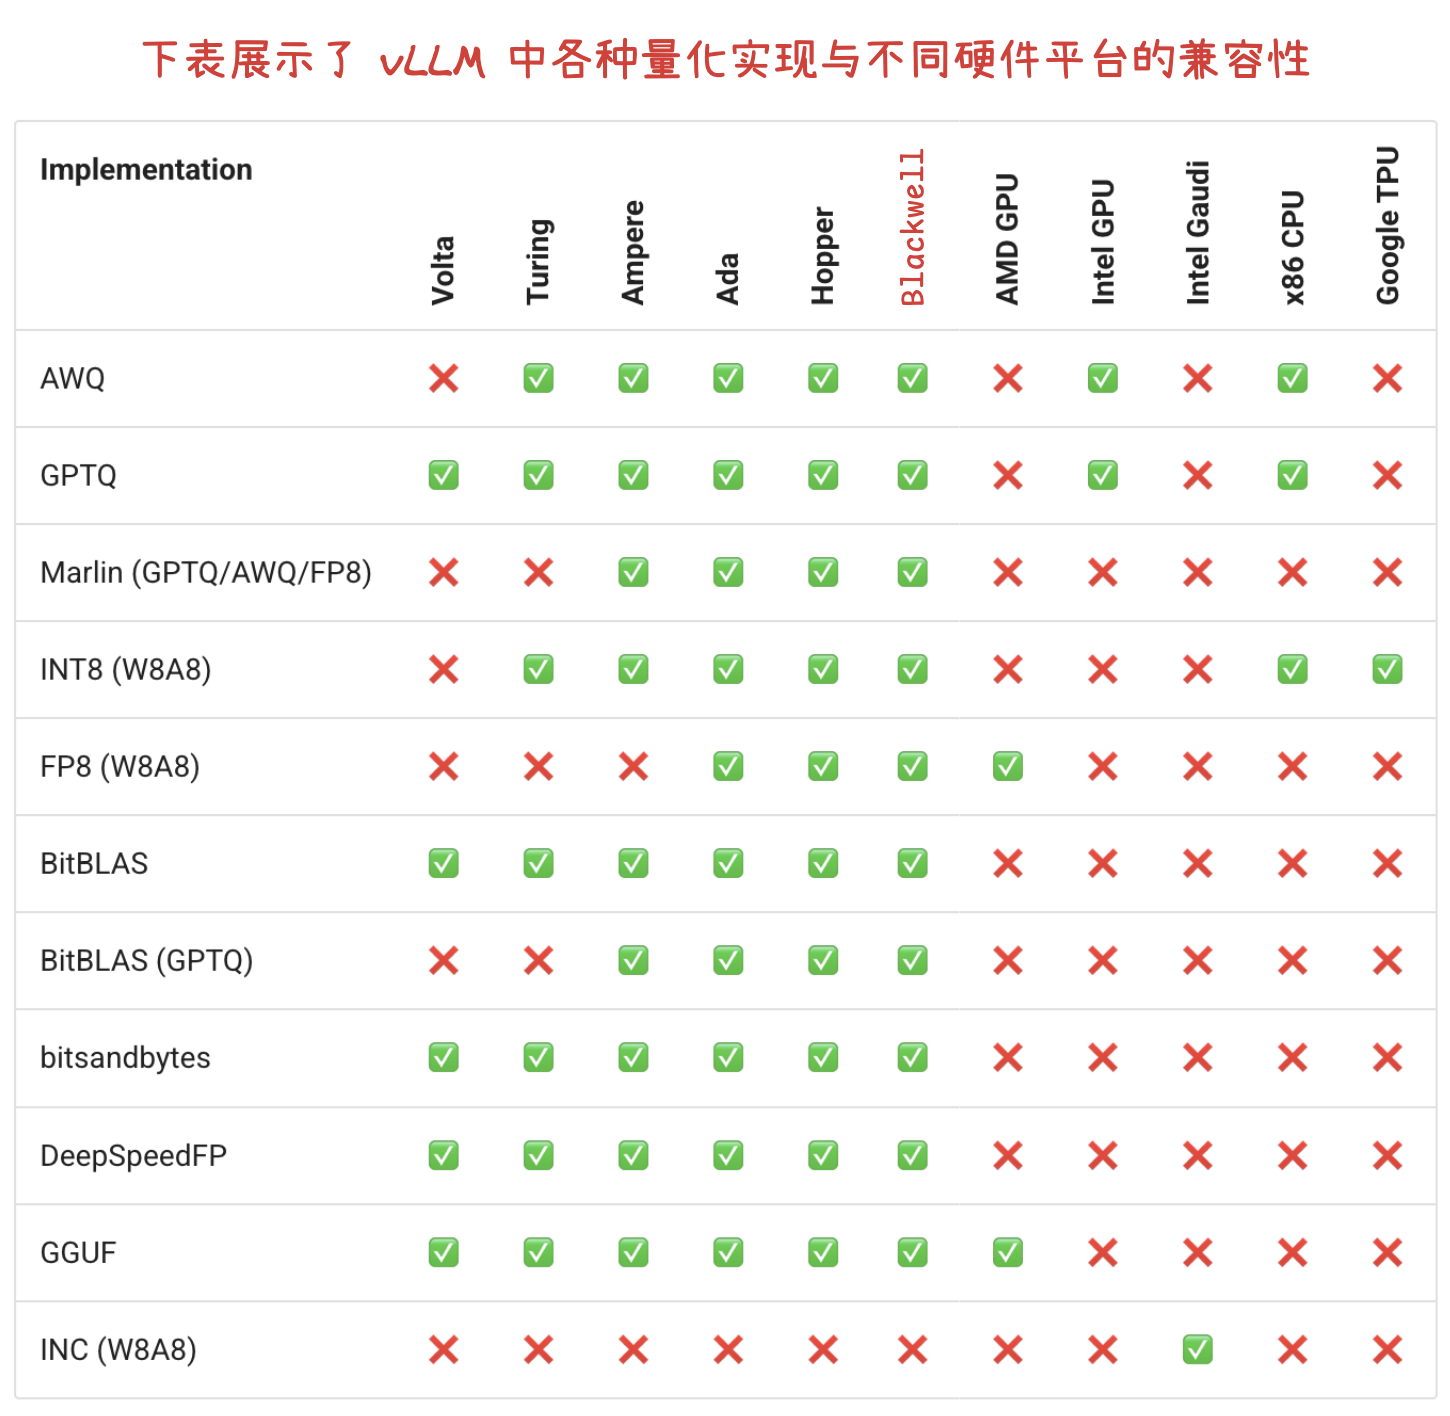
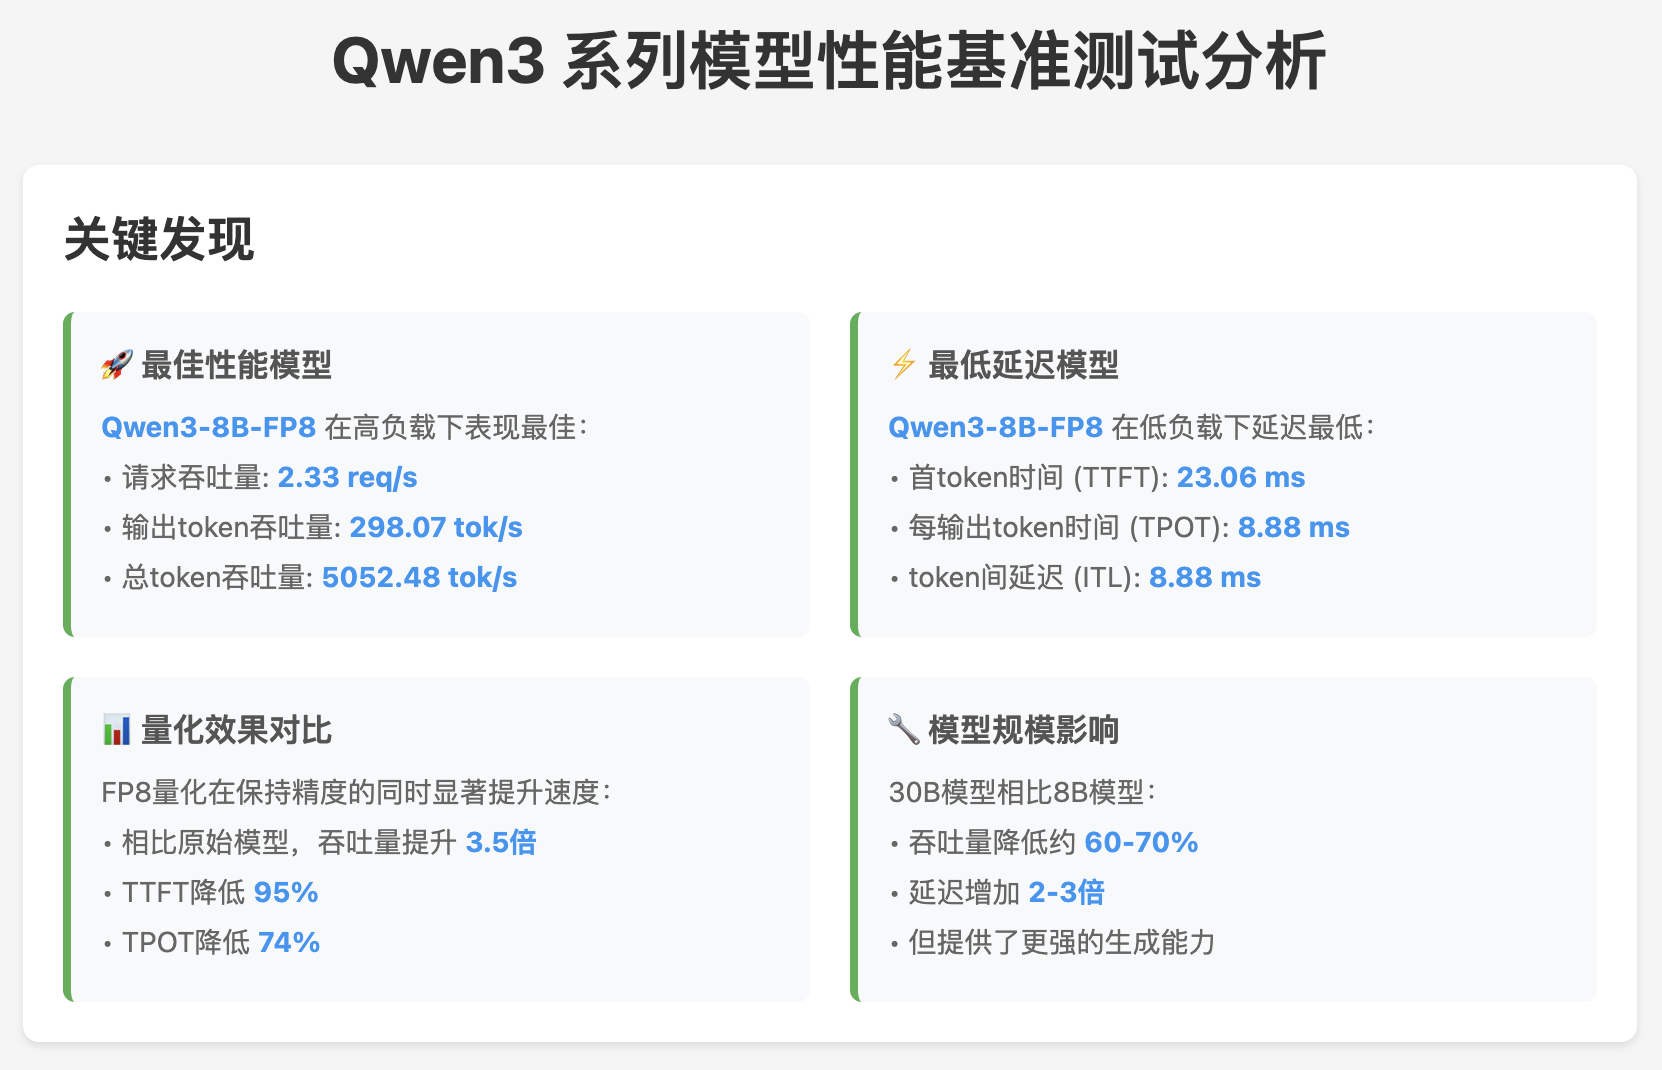
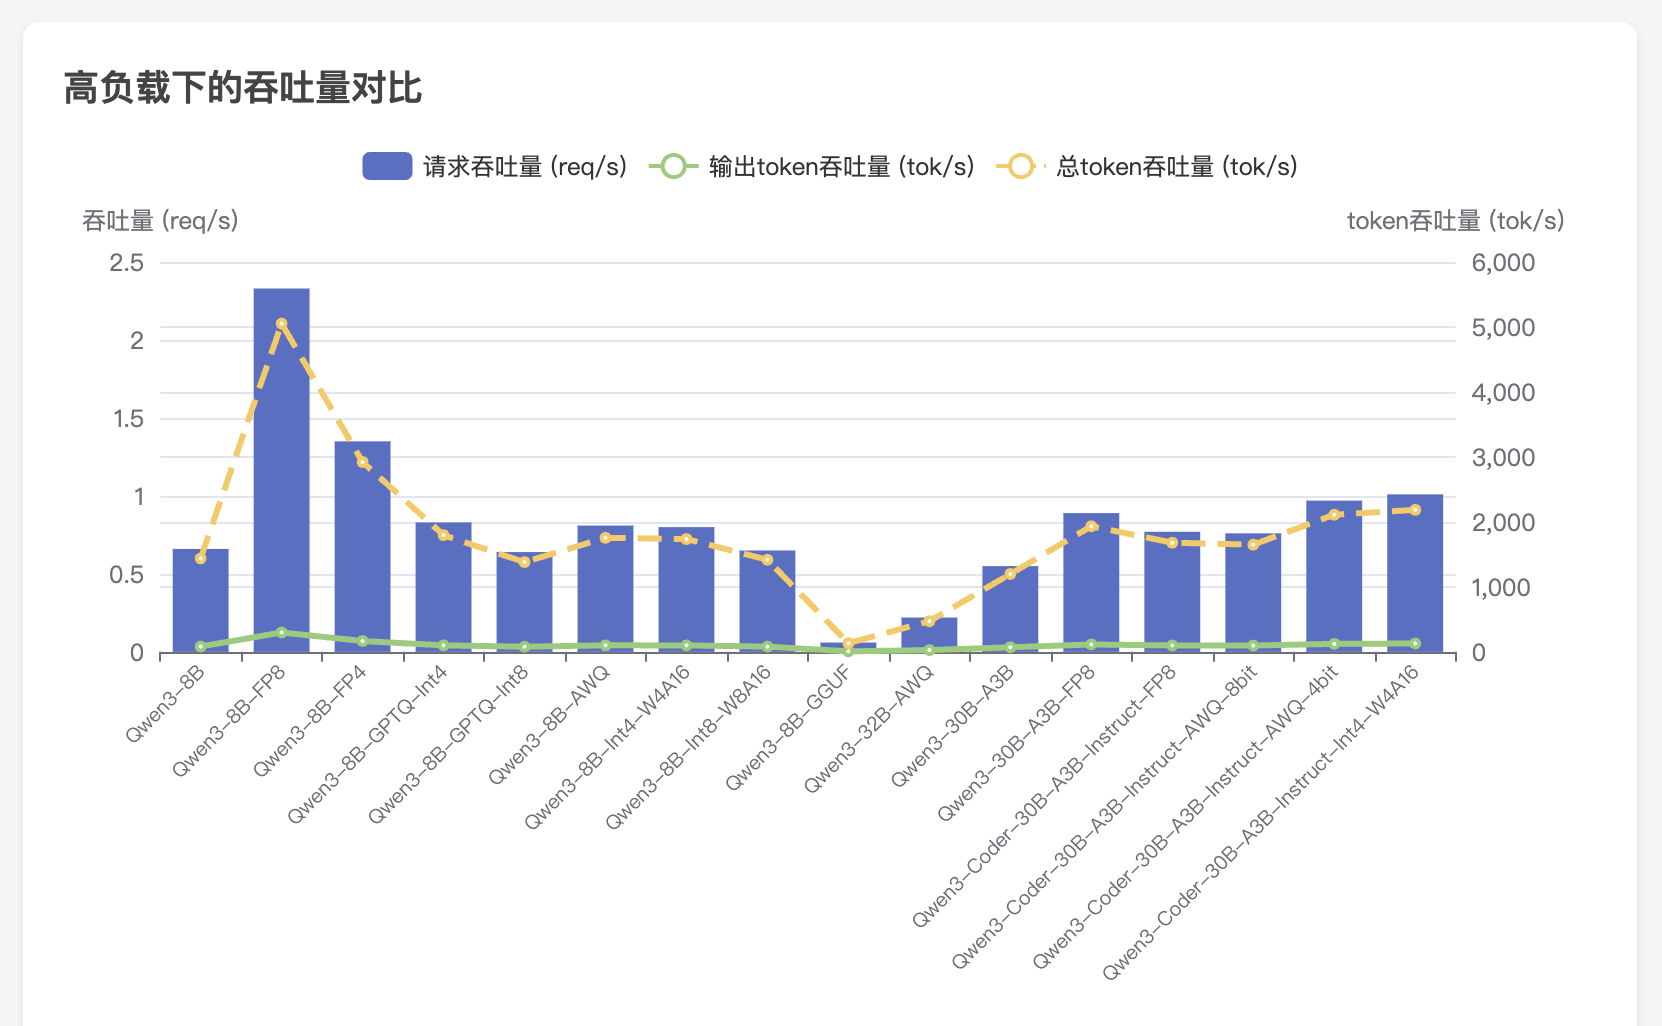
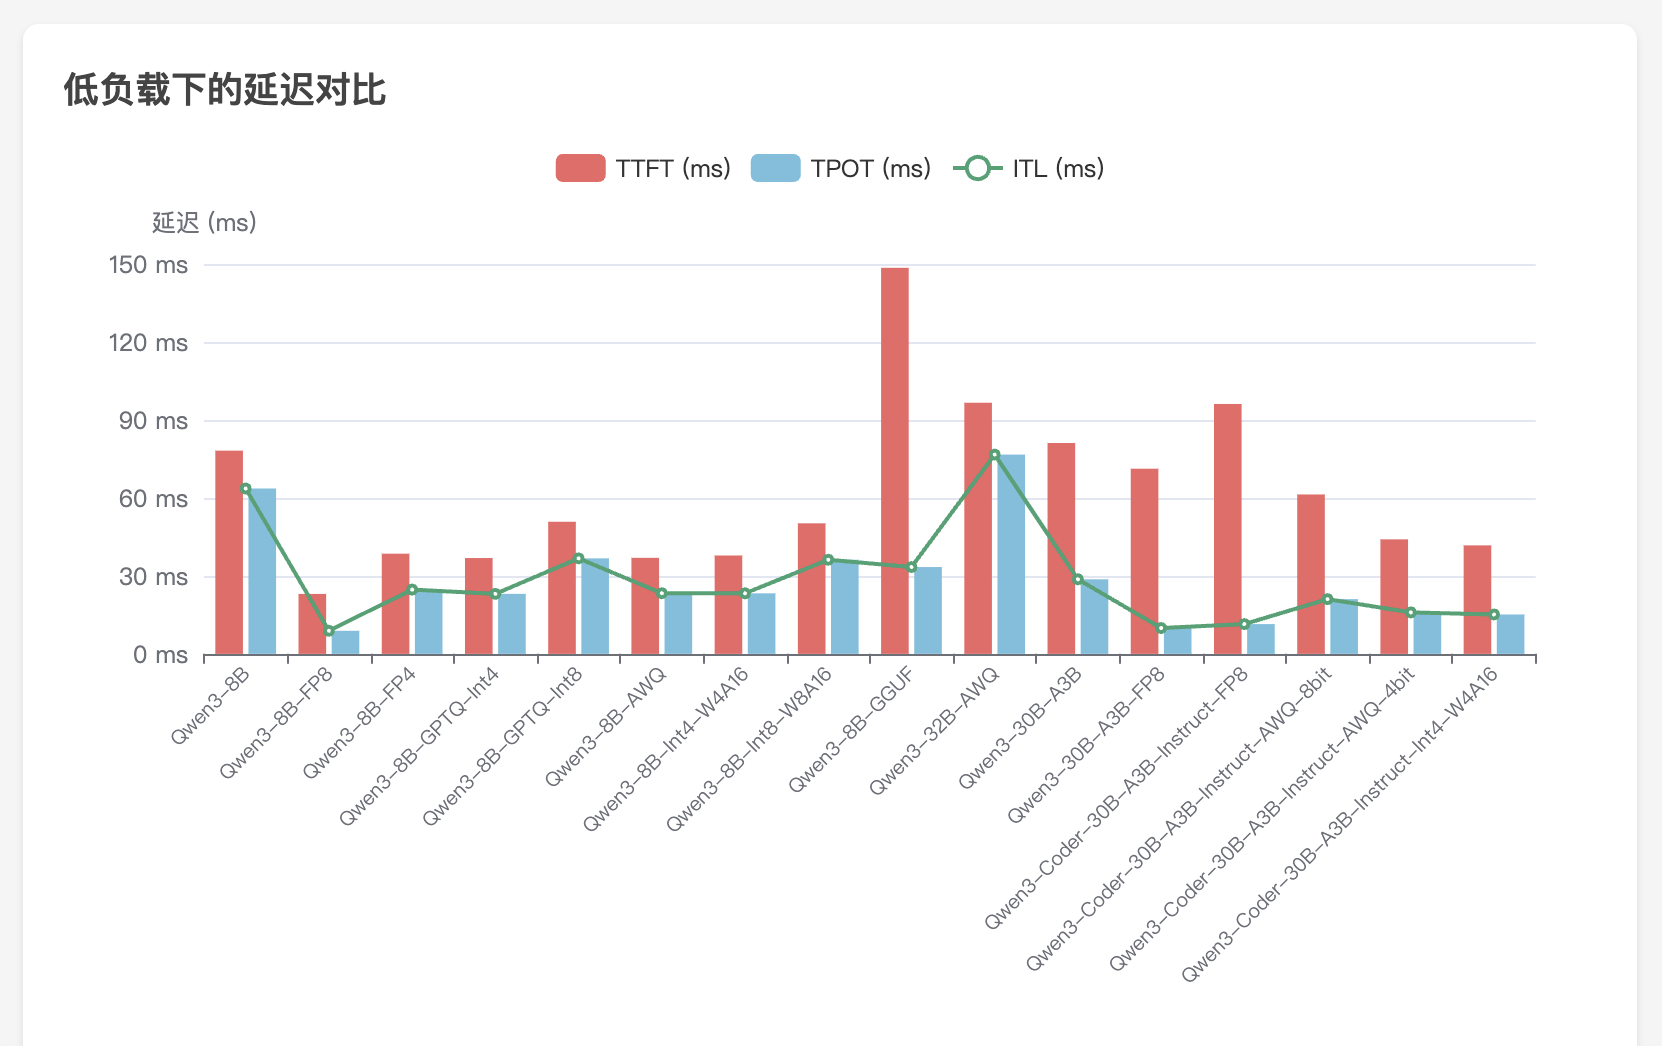
量化模型基准测试结果: 文章对 Qwen3-8B 模型的多种量化精度(包括 BF16、FP8、FP4、Int4 等)进行了详尽的性能分析。
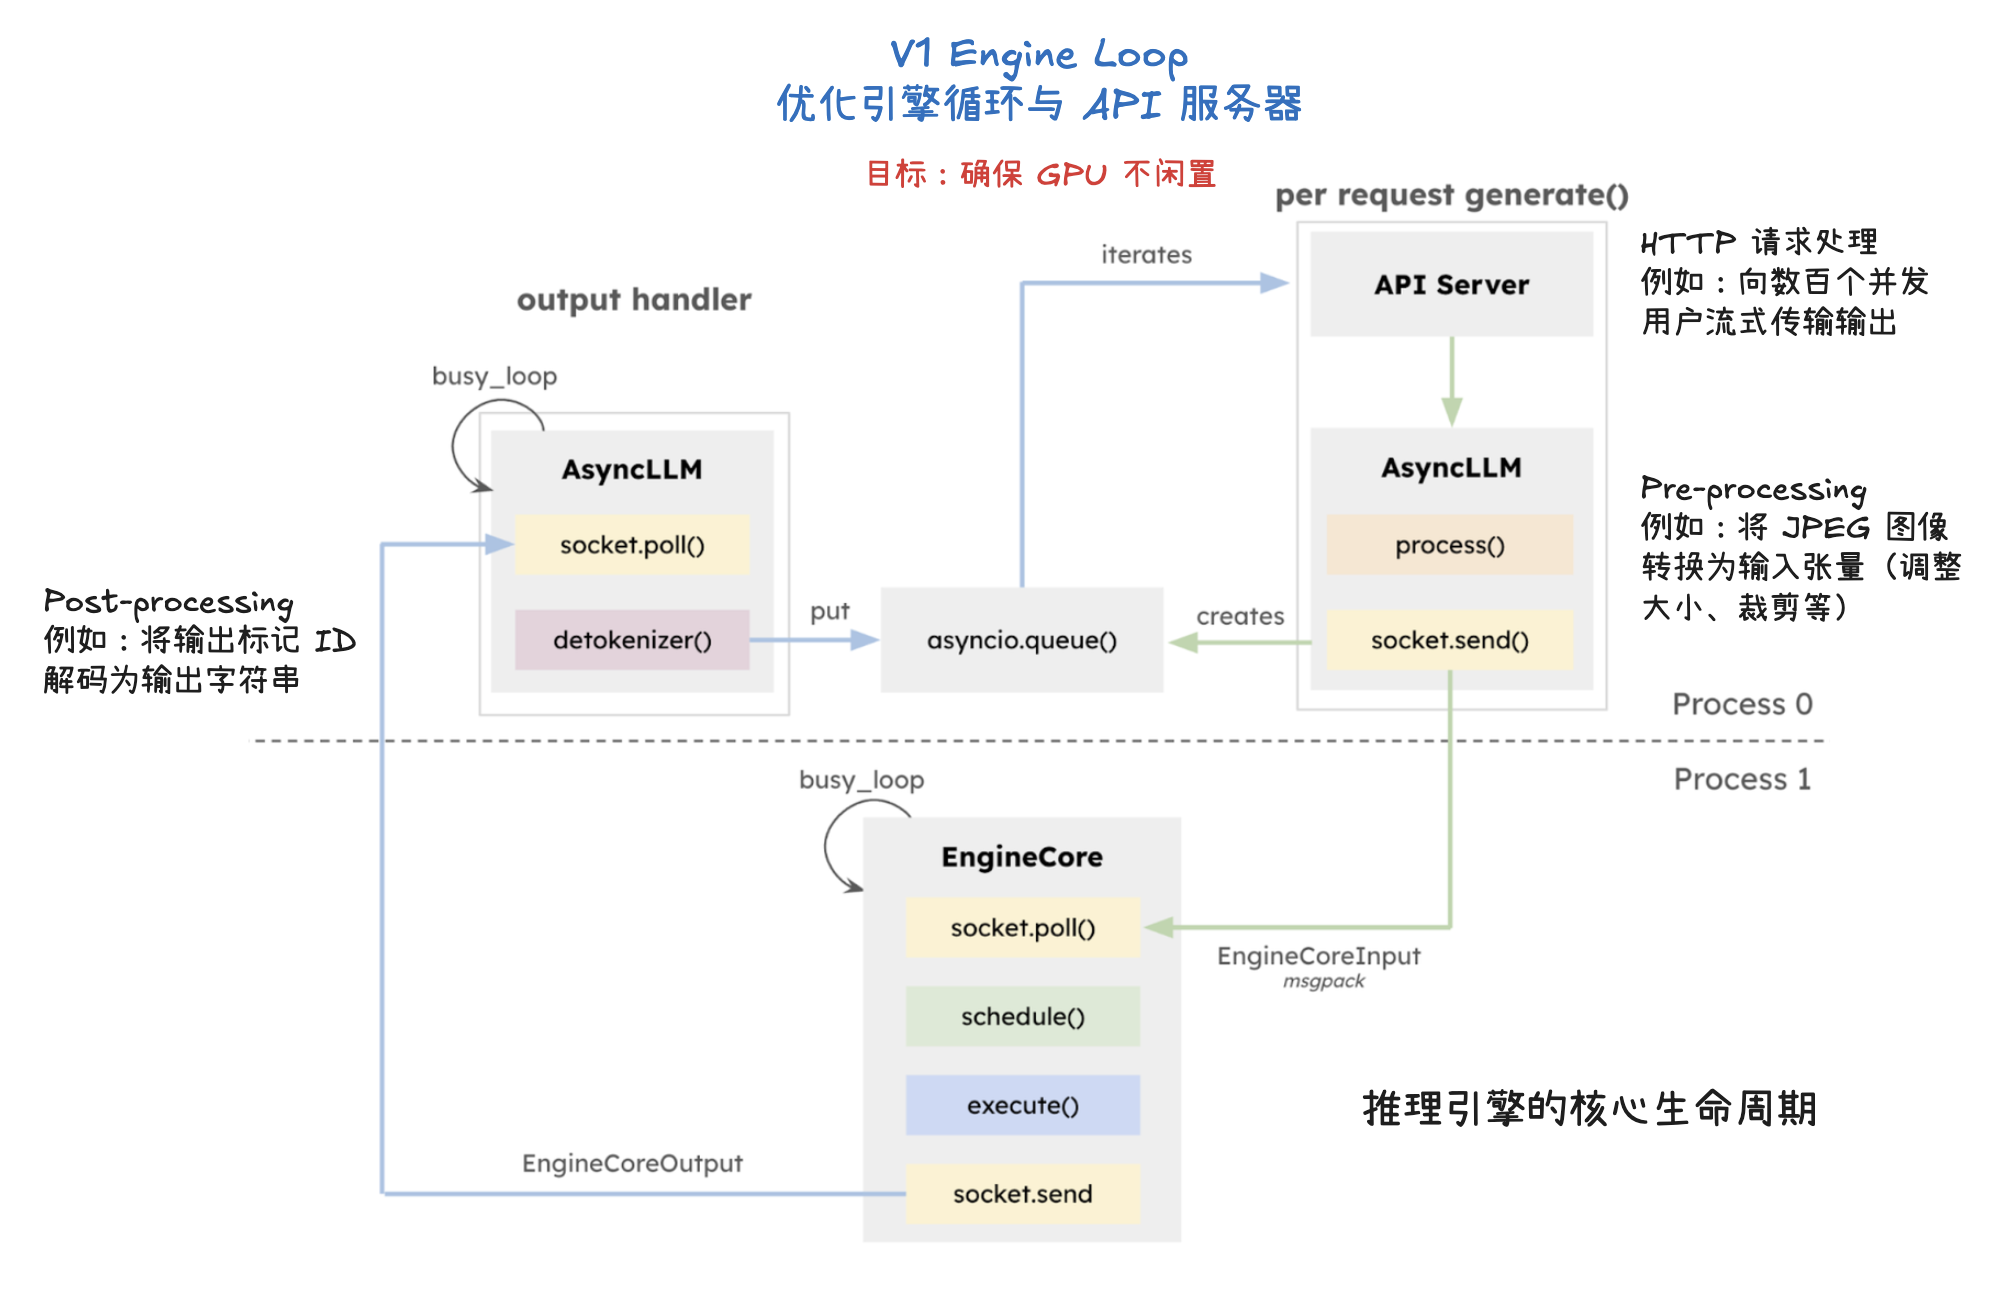
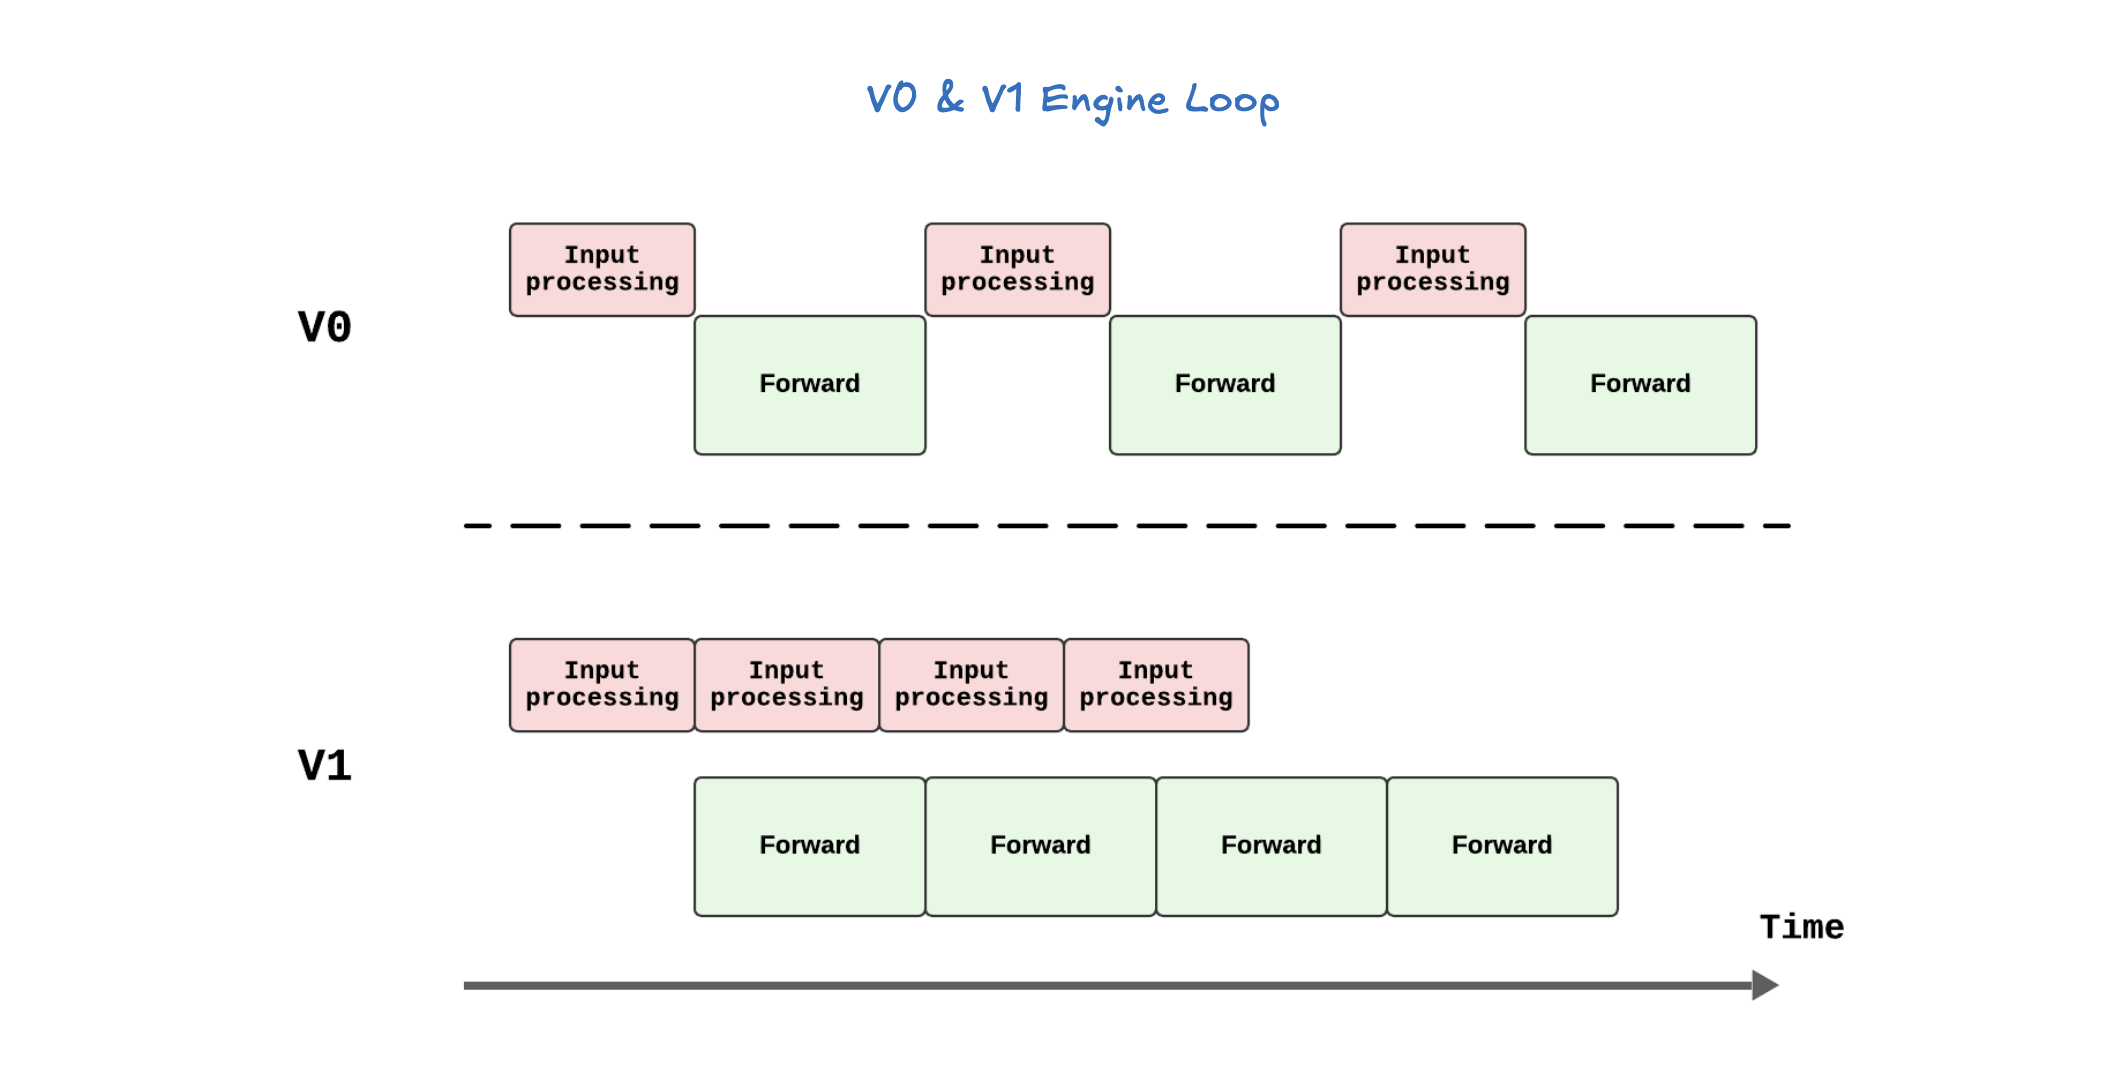
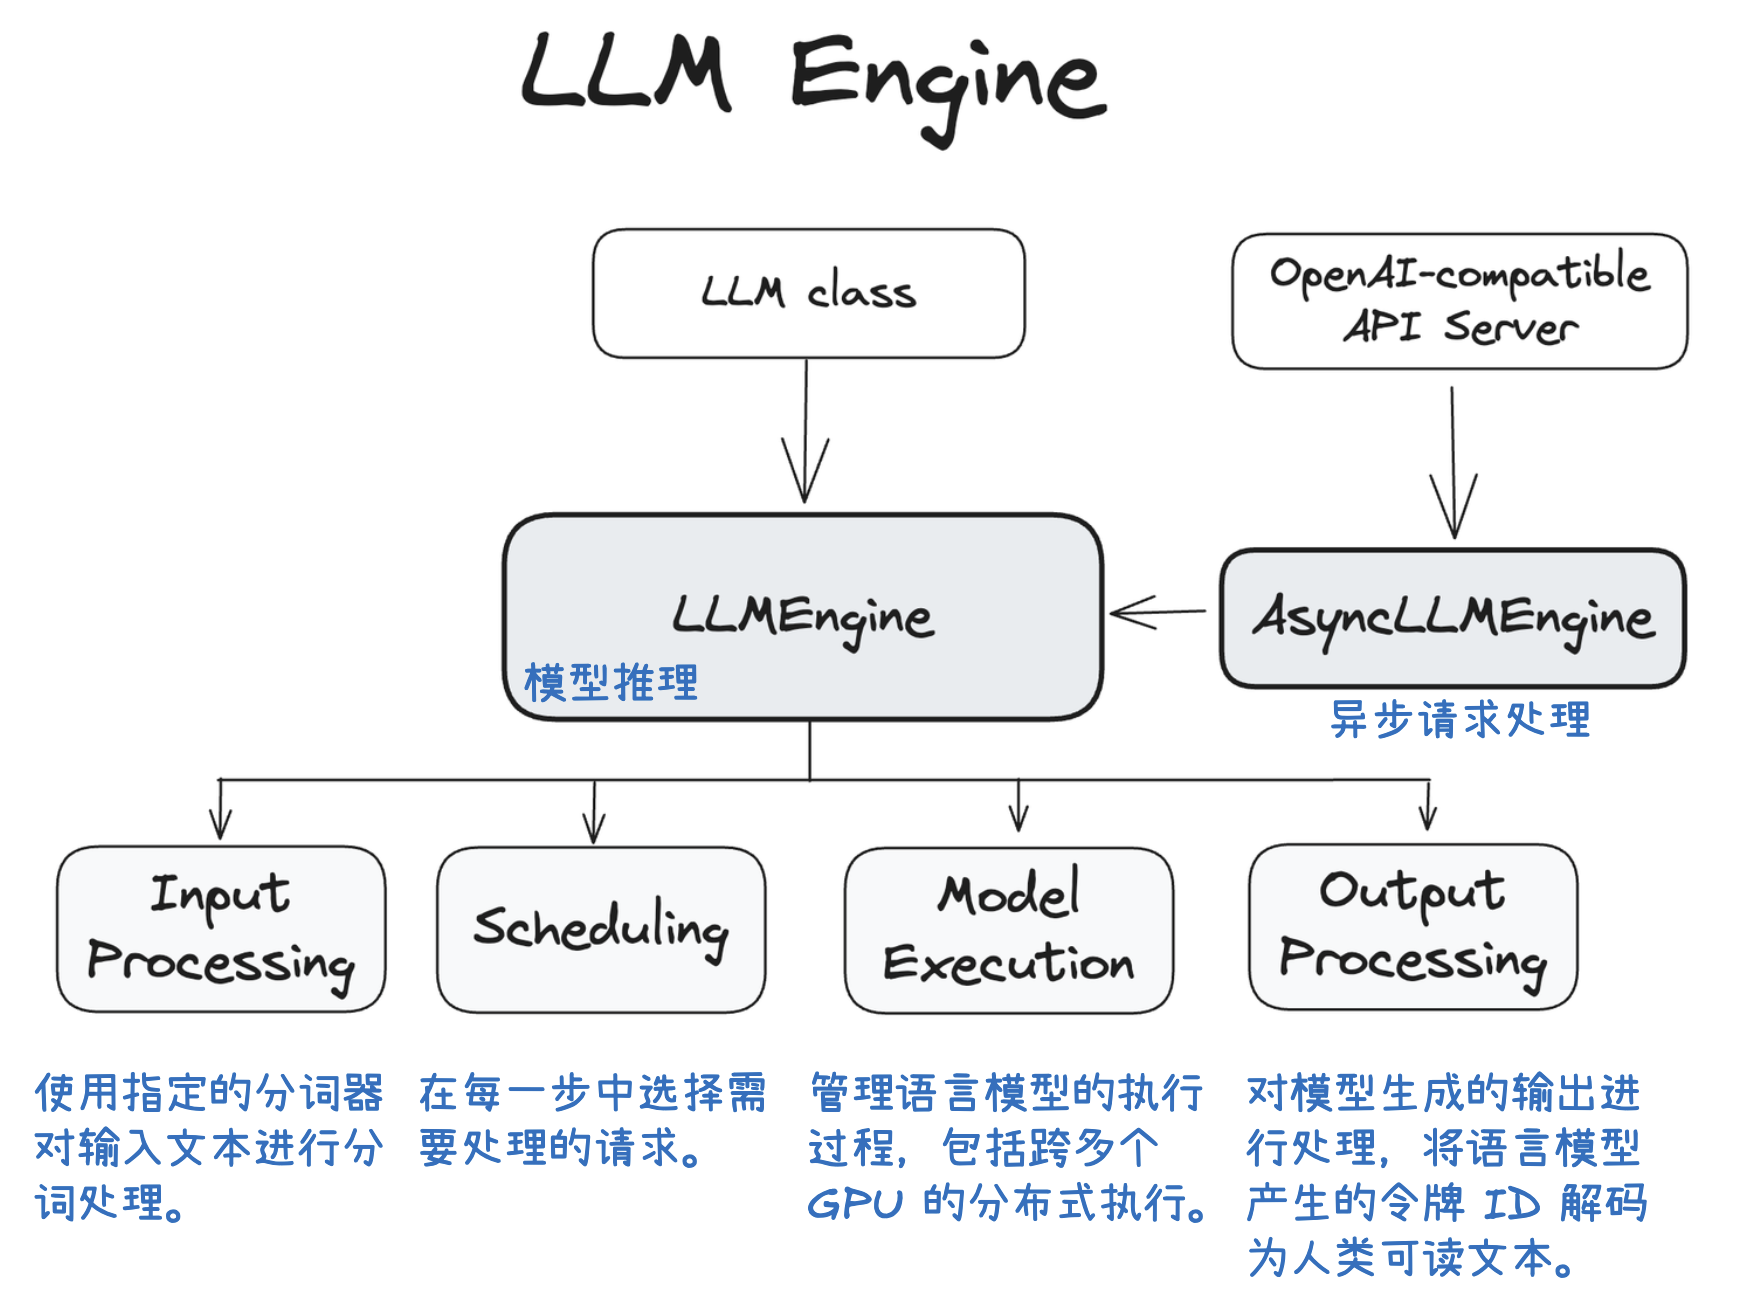
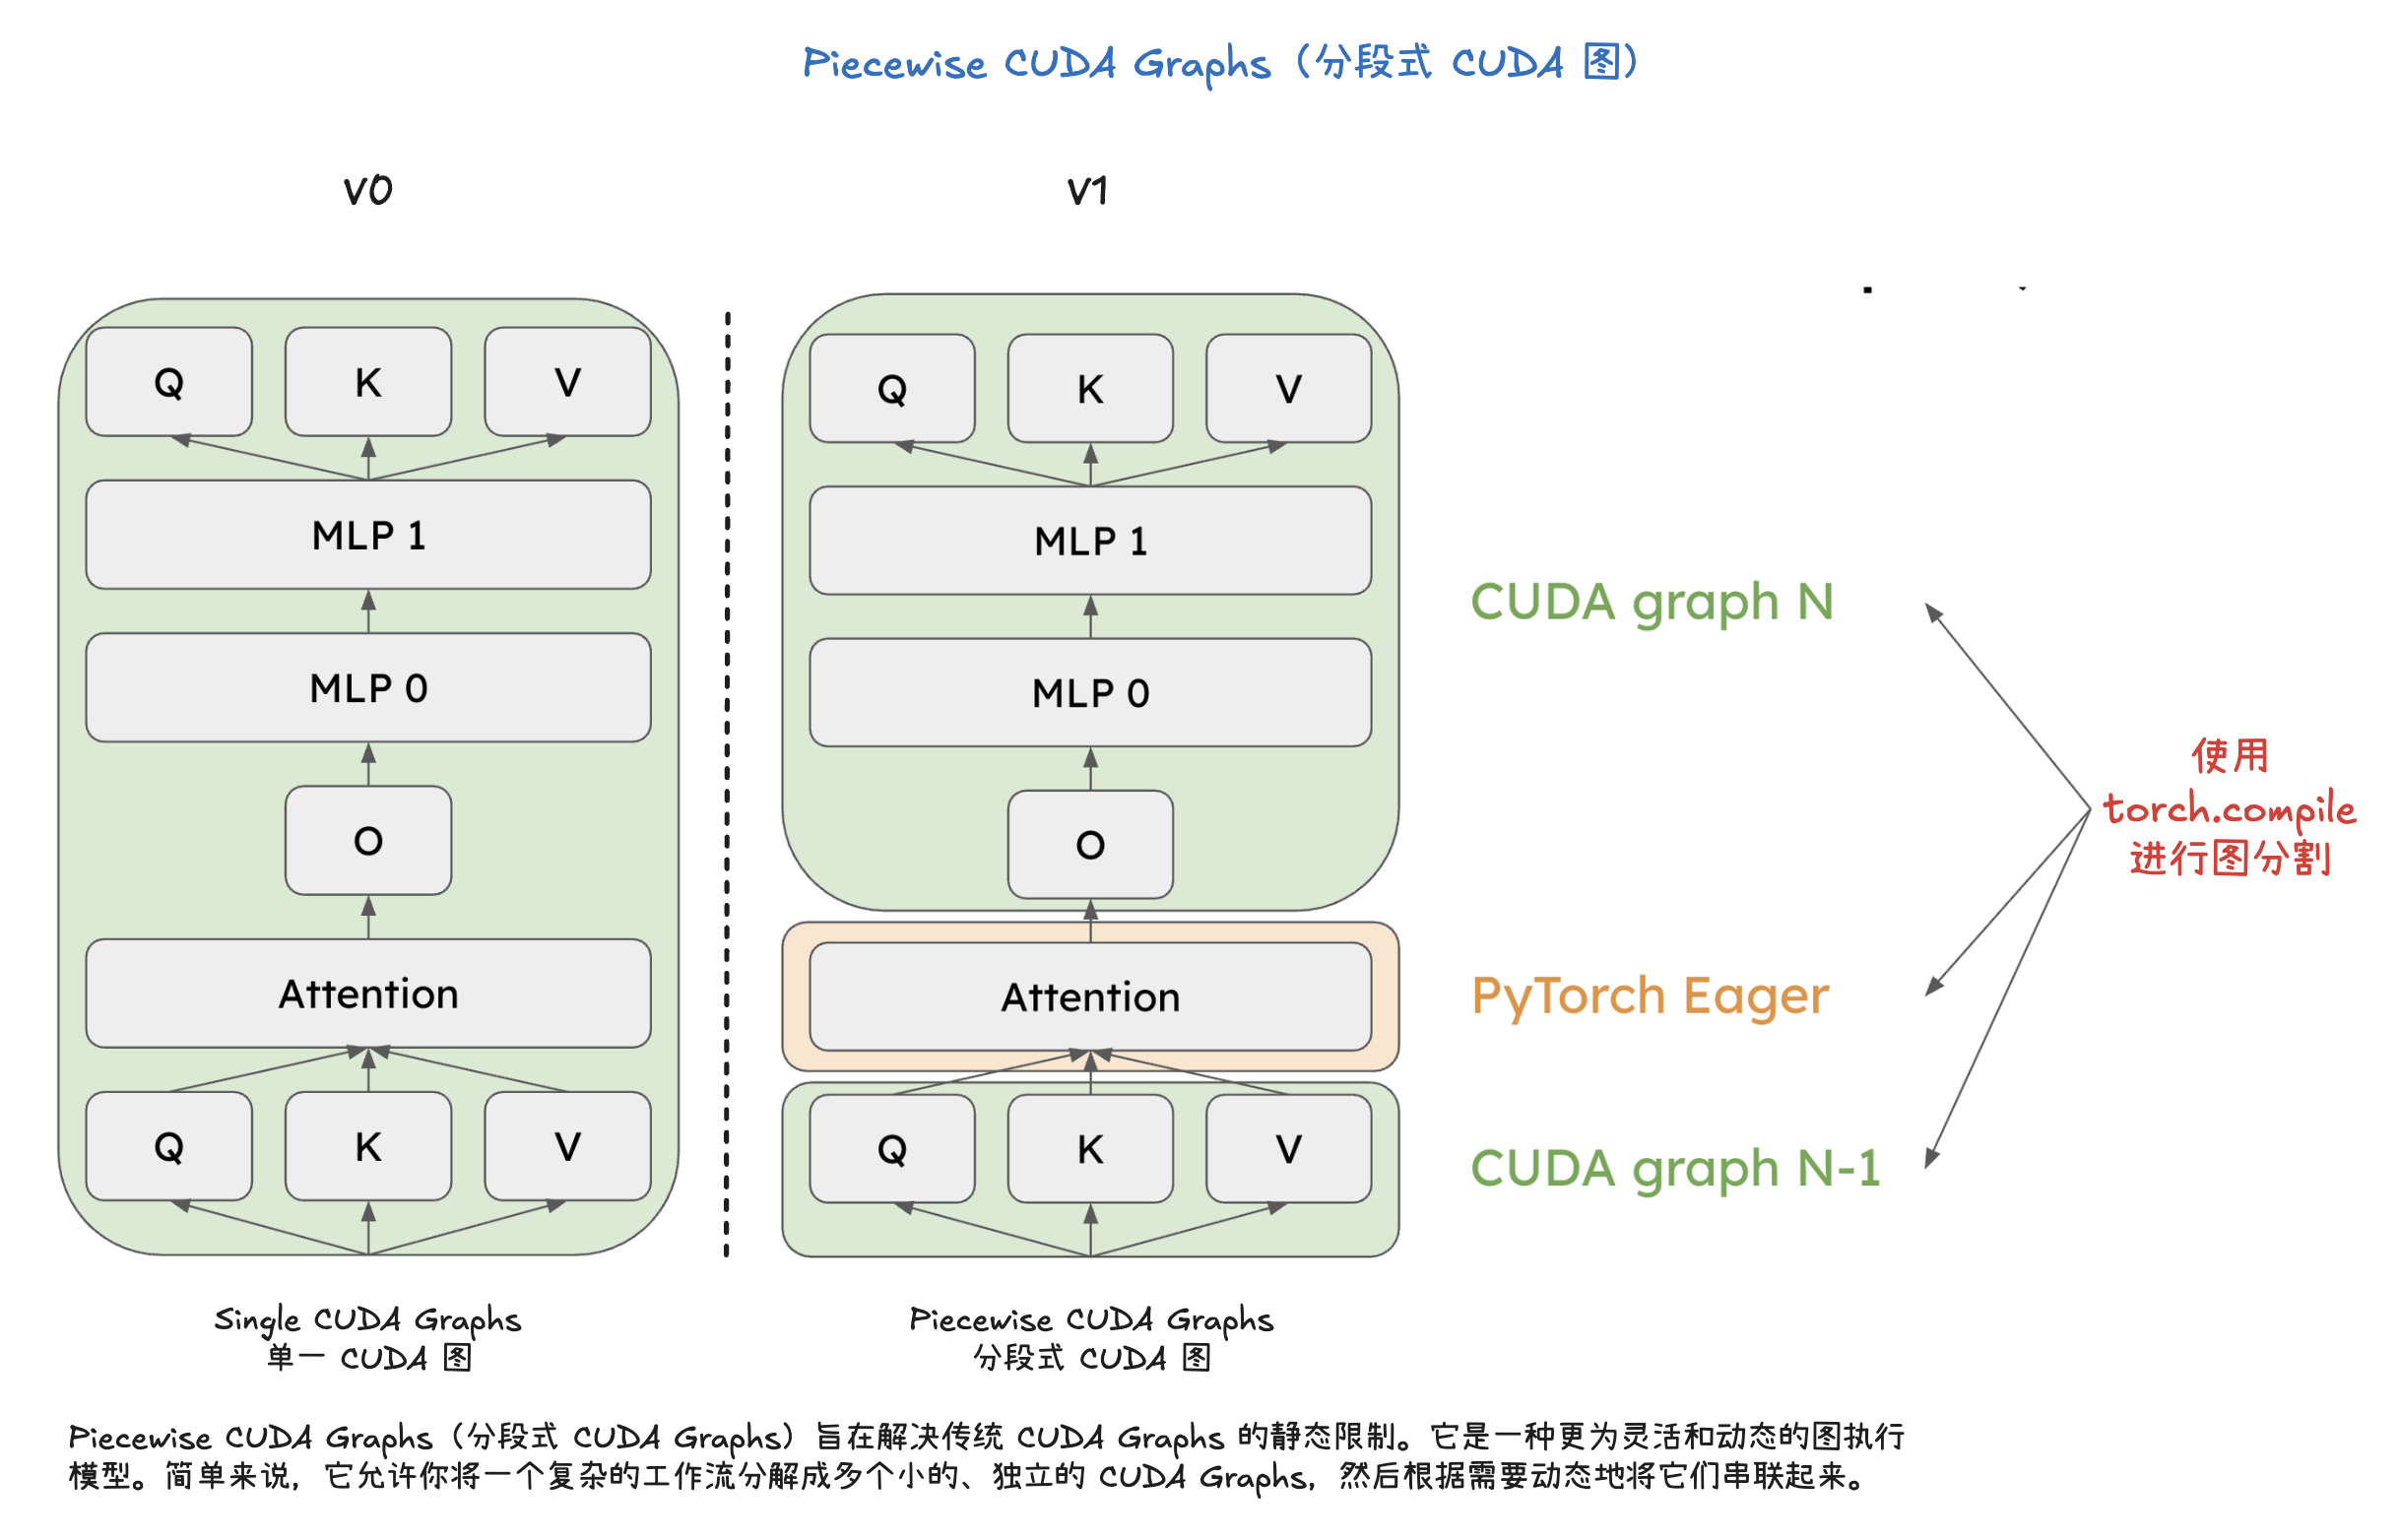
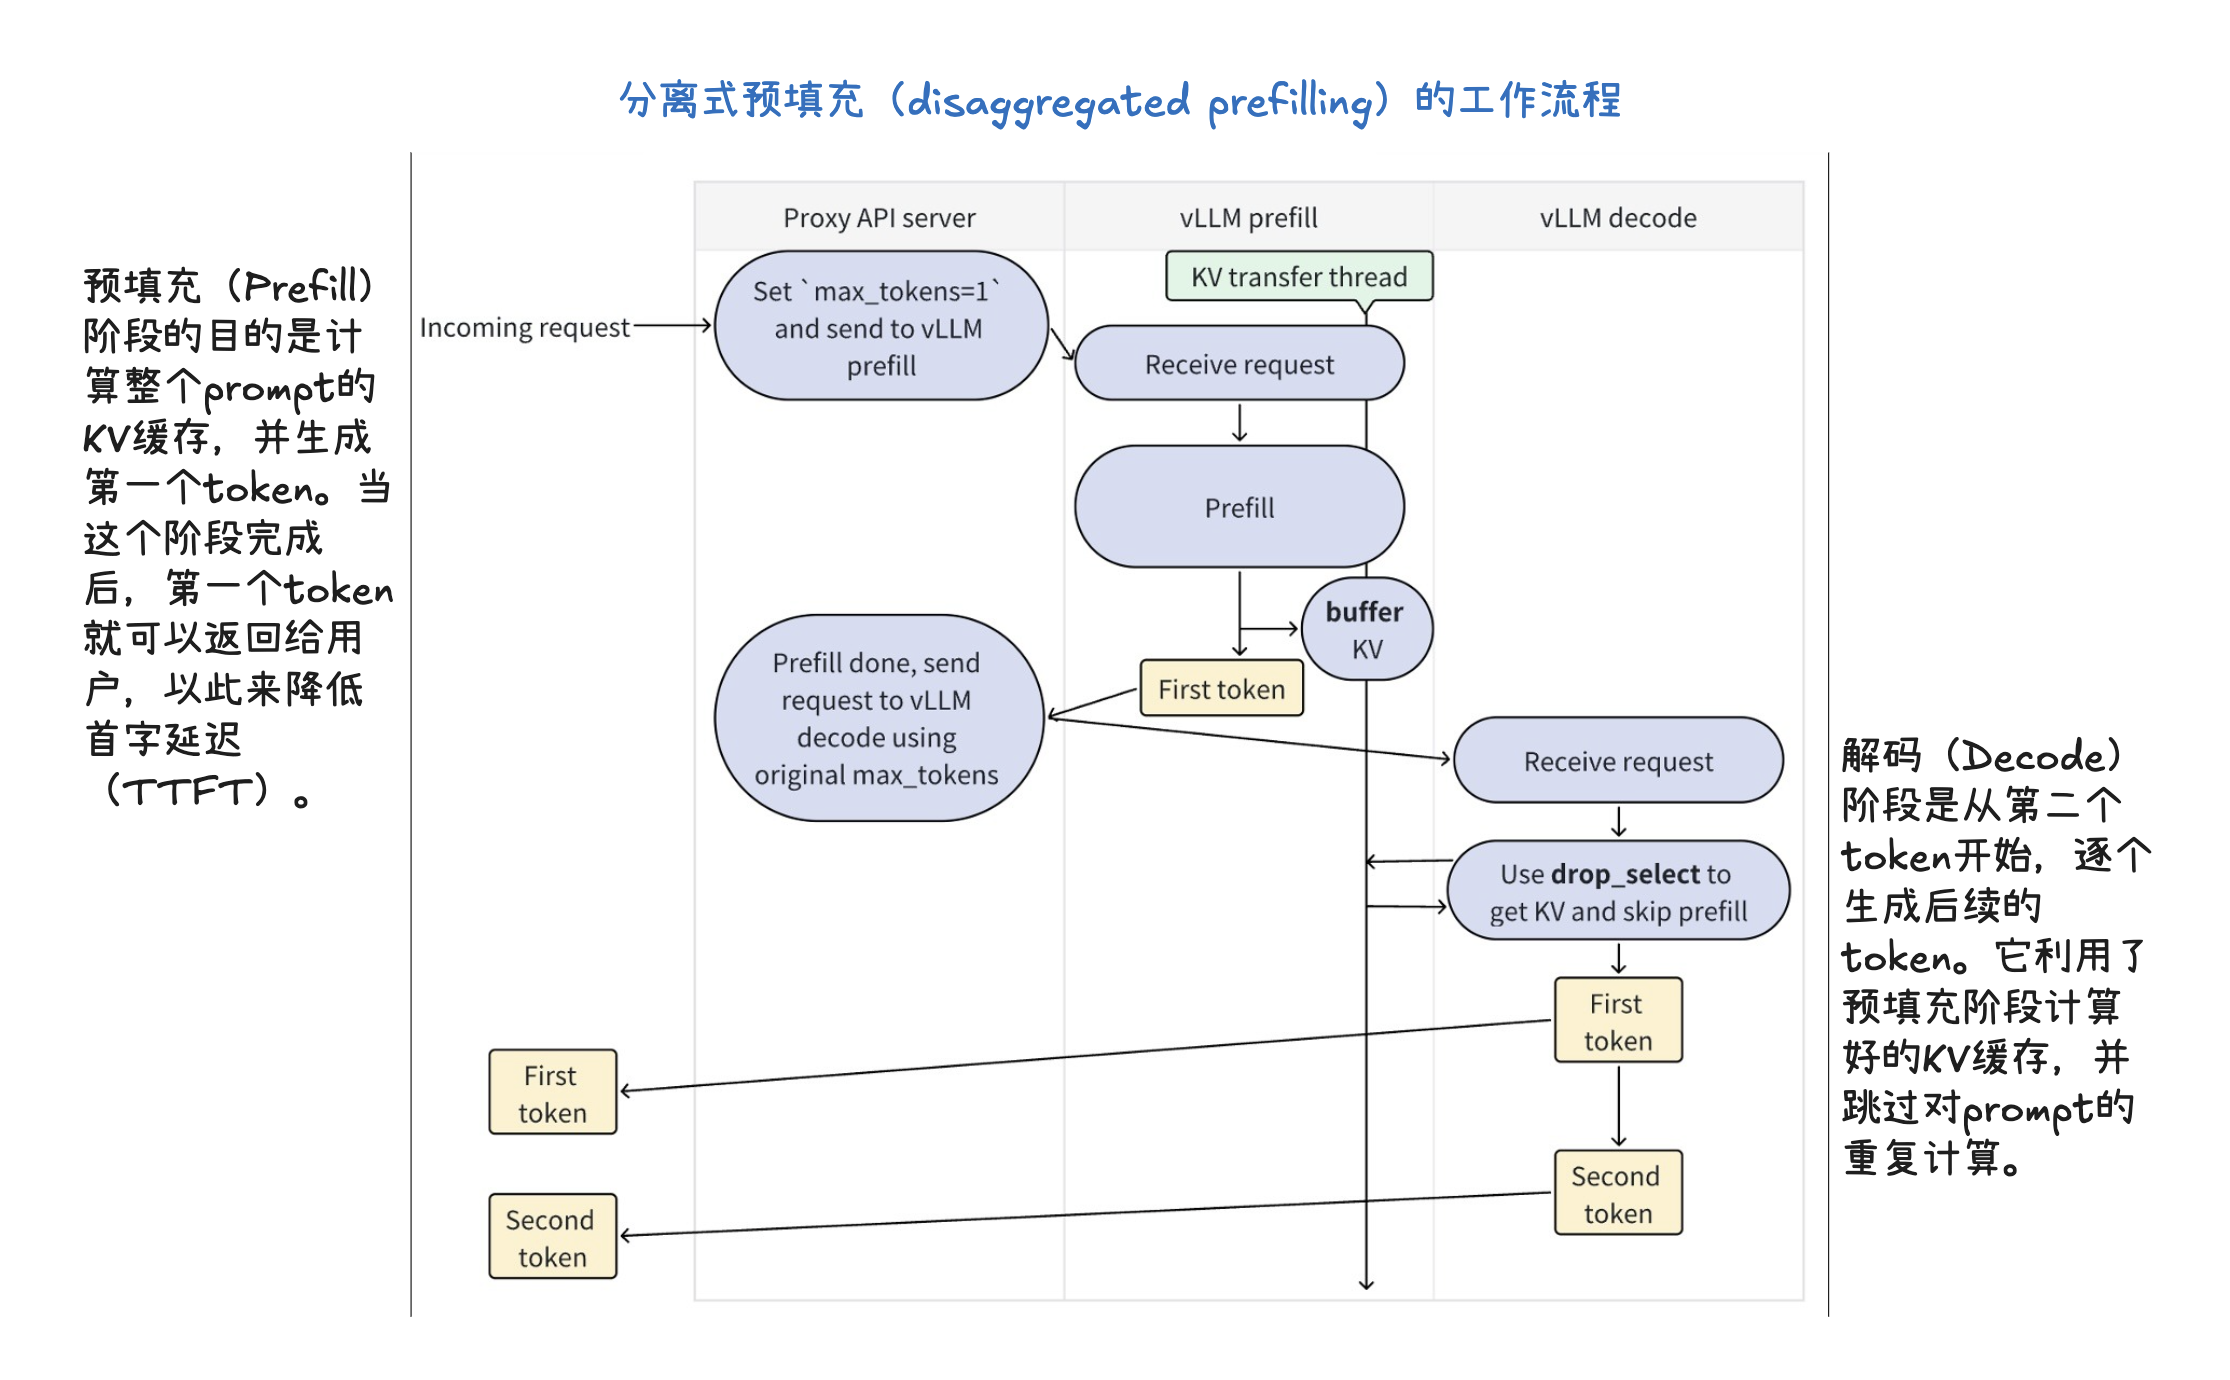
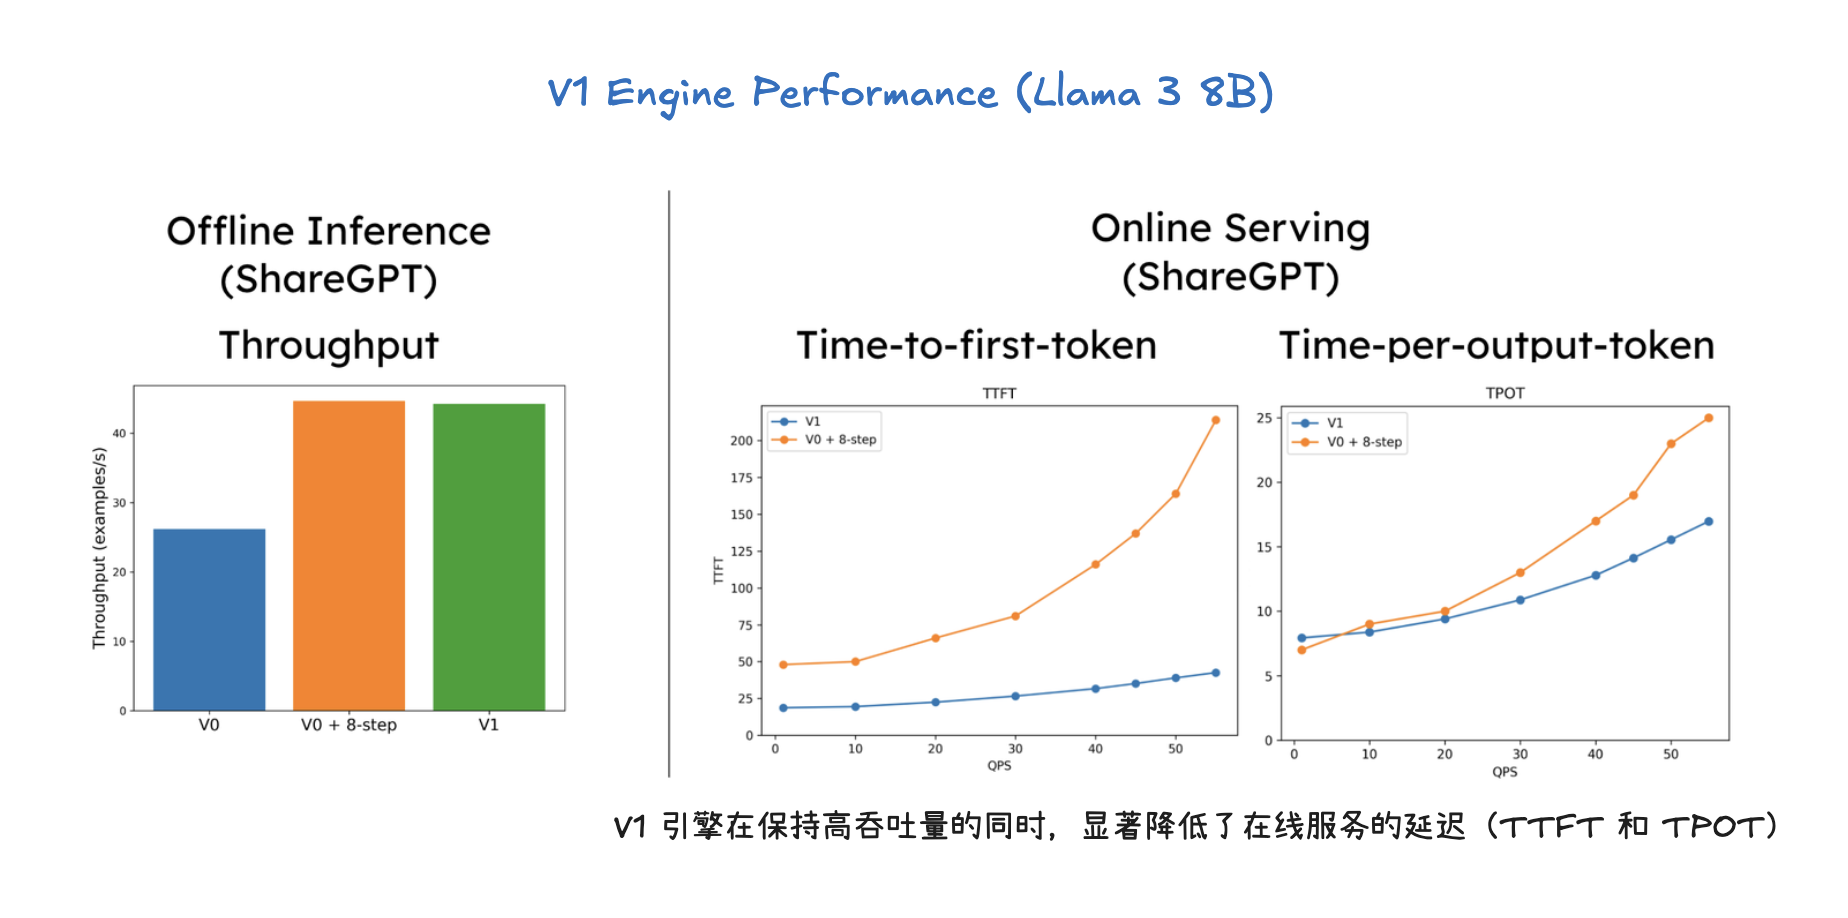
vLLM V1 引擎通过优化其核心引擎循环,将输入处理并行化,并引入了分段式 CUDA 图,从而实现了更灵活、动态的执行模型,显著降低了在线服务的延迟(TTFT 和 TPOT),同时保持了高吞吐量。其设计目标是确保 GPU 不闲置,通过 API 服务器和 EngineCore 之间的协作来高效调度和执行任务。为了进一步加速大型语言模型推理,vLLM V1 采用了多种优化技术:它通过分离式预填充和分块预填充来优化首个 token 的生成延迟,并结合连续批处理与分页注意力来提高 KV 缓存的内存效率和 GPU 利用率。此外,前缀缓存技术避免了重复计算相同提示的 KV 缓存,而级联推理则是一种内存带宽高效的共享前缀批处理解码技术,通过结合多查询注意力处理共享 KV 和单查询批处理解码处理独特 KV,特别适用于多用户共享长提示的场景,能显著提升性能。其他高级解码方法如推测性解码利用草稿模型加速生成,跳跃解码则适用于结构化输出场景。最后,量化技术是提升性能的关键手段,通过对权重、激活值和 KV 缓存使用低位精度(如 FP8、INT8),它能减少存储和内存占用,加速计算密集型和内存带宽密集型任务,并允许在固定硬件下处理更多 token,从而大幅提升吞吐量,同时保持模型准确性。
V1 Engine 工作流程
推理优化
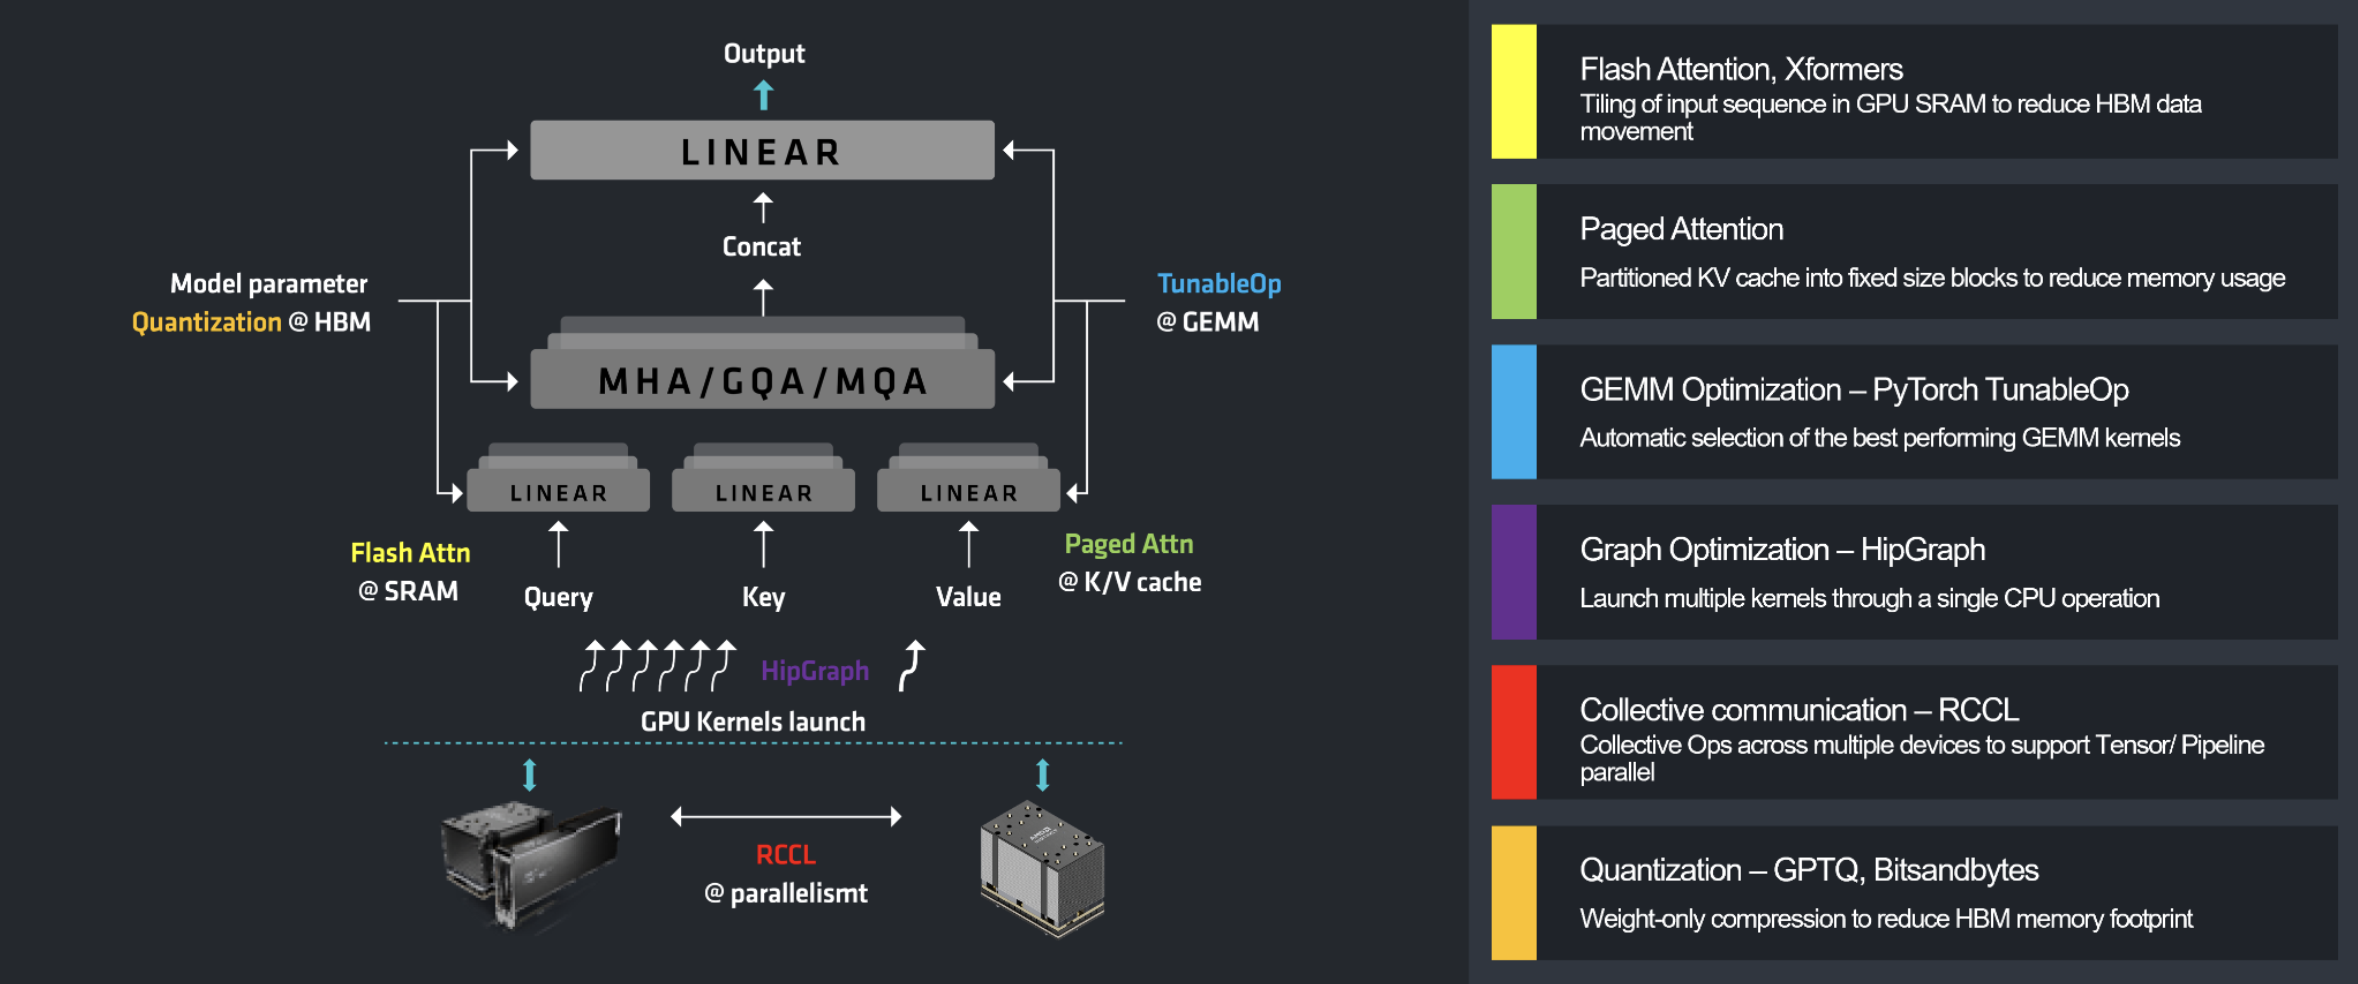
典型 LLM 推理优化
该文章详细探讨了如何通过优化vLLM框架来提升Qwen3-4B大型语言模型在Tesla T4 GPU上的推理性能。实验中,我评估了不同配置对关键性能指标的影响,包括首次生成Token时间(TTFT)、端到端延迟(E2EL)和请求吞吐量。结果表明,结合前缀缓存(prefix caching)、分块预填充(chunked prefill)以及调整批处理Token数量(max-num-batched-tokens=8192)能显著改善模型性能。尤其在模拟Agent场景下的自定义数据集测试中,这些优化措施成功将TTFT大幅降低约64%,同时提升了请求和输出Token的吞吐量。最终,文章提供了一套推荐的最佳vLLM部署配置,旨在最大化长上下文模型的推理效率和用户体验。
vLLM 工作流程
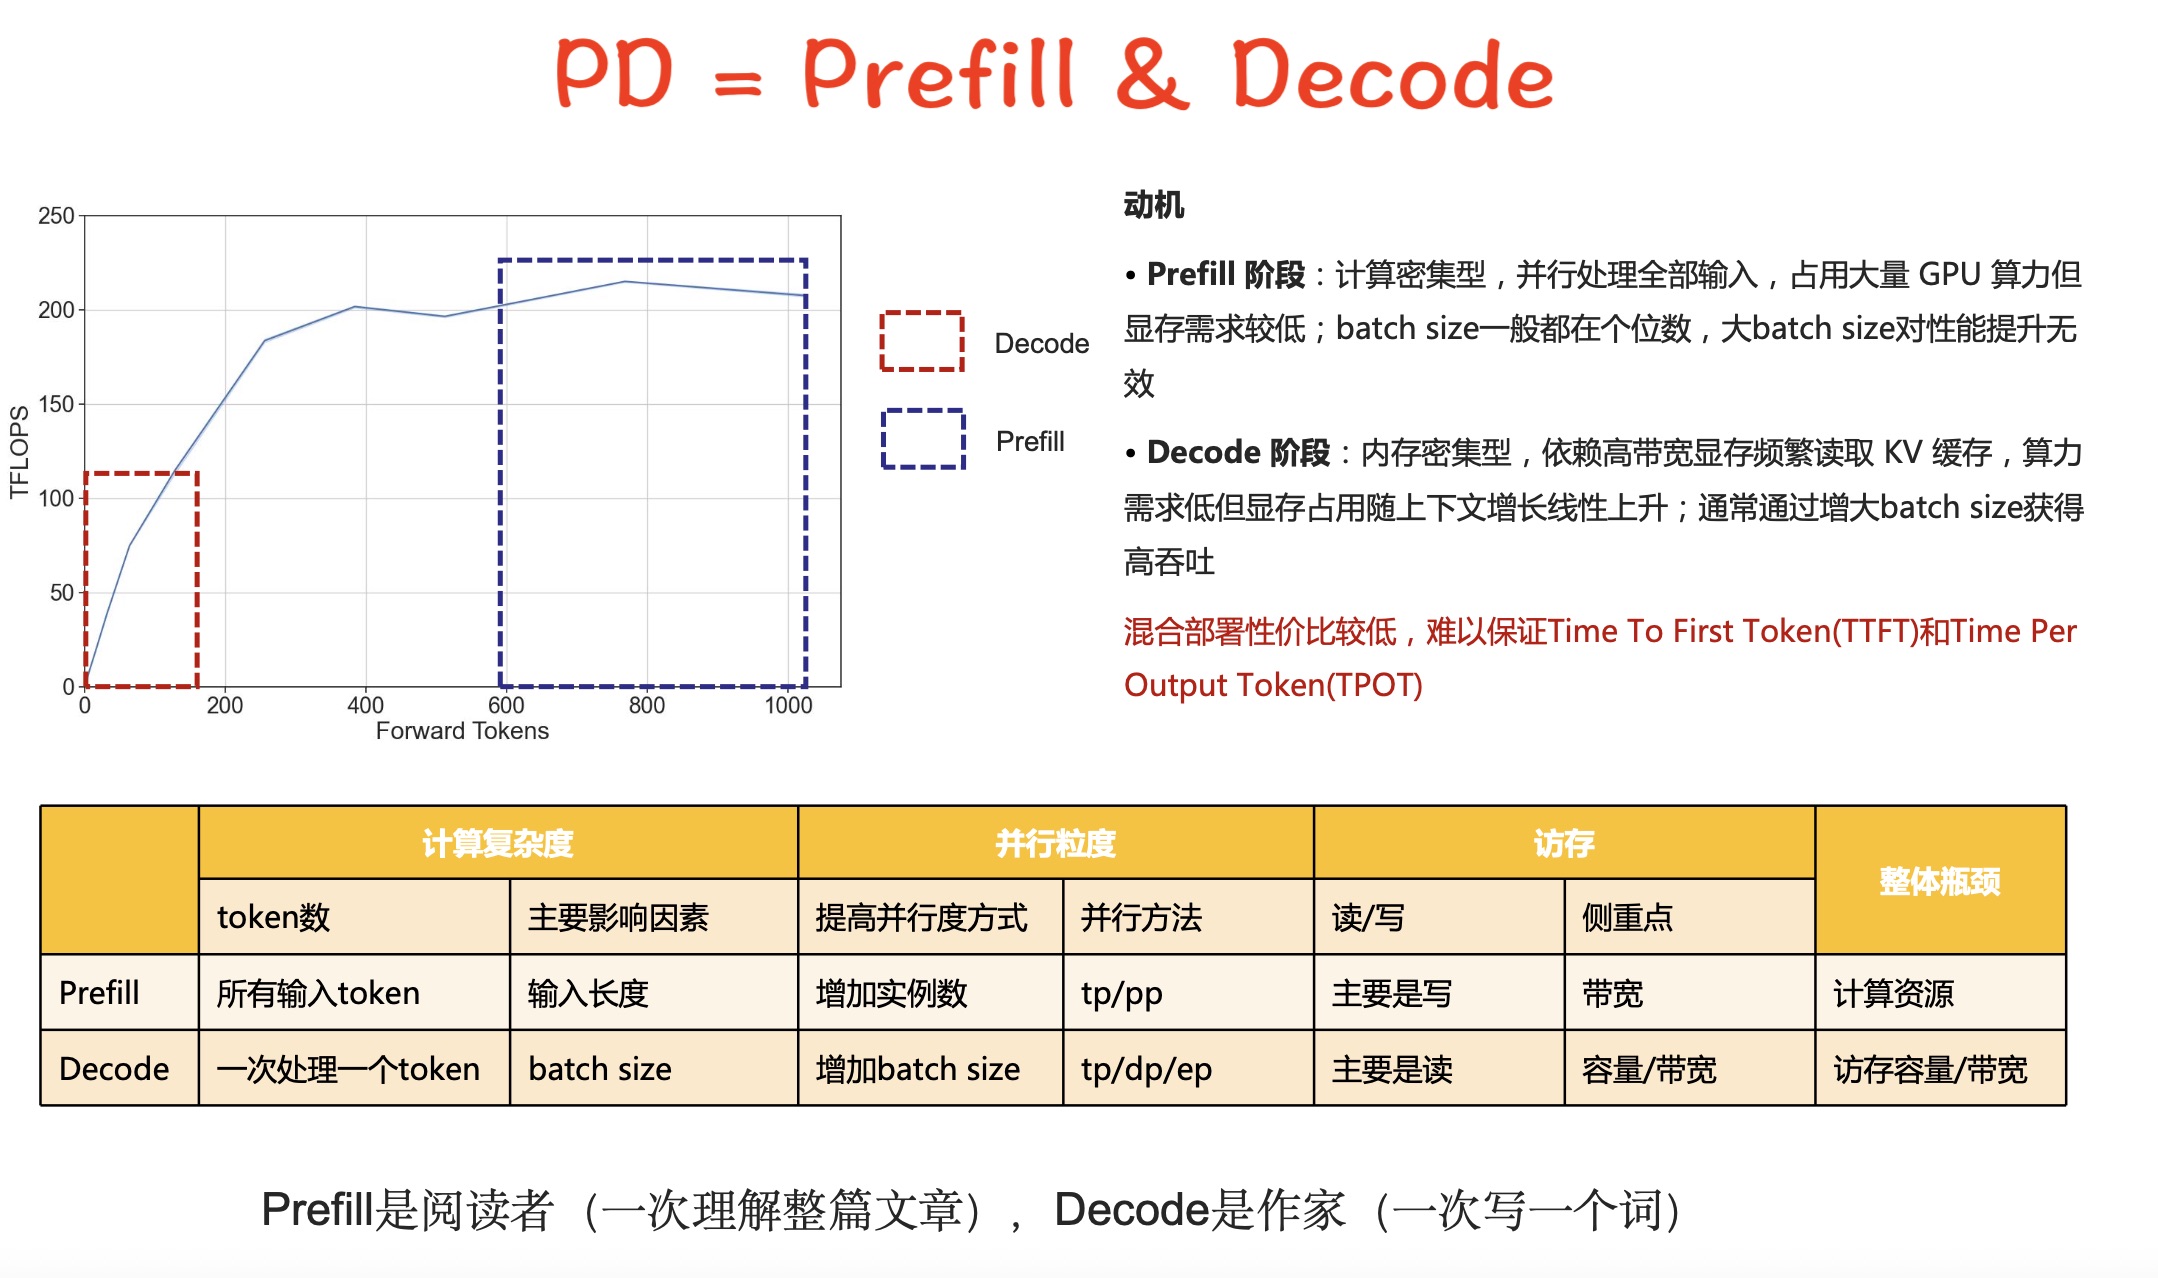
1. Prefill
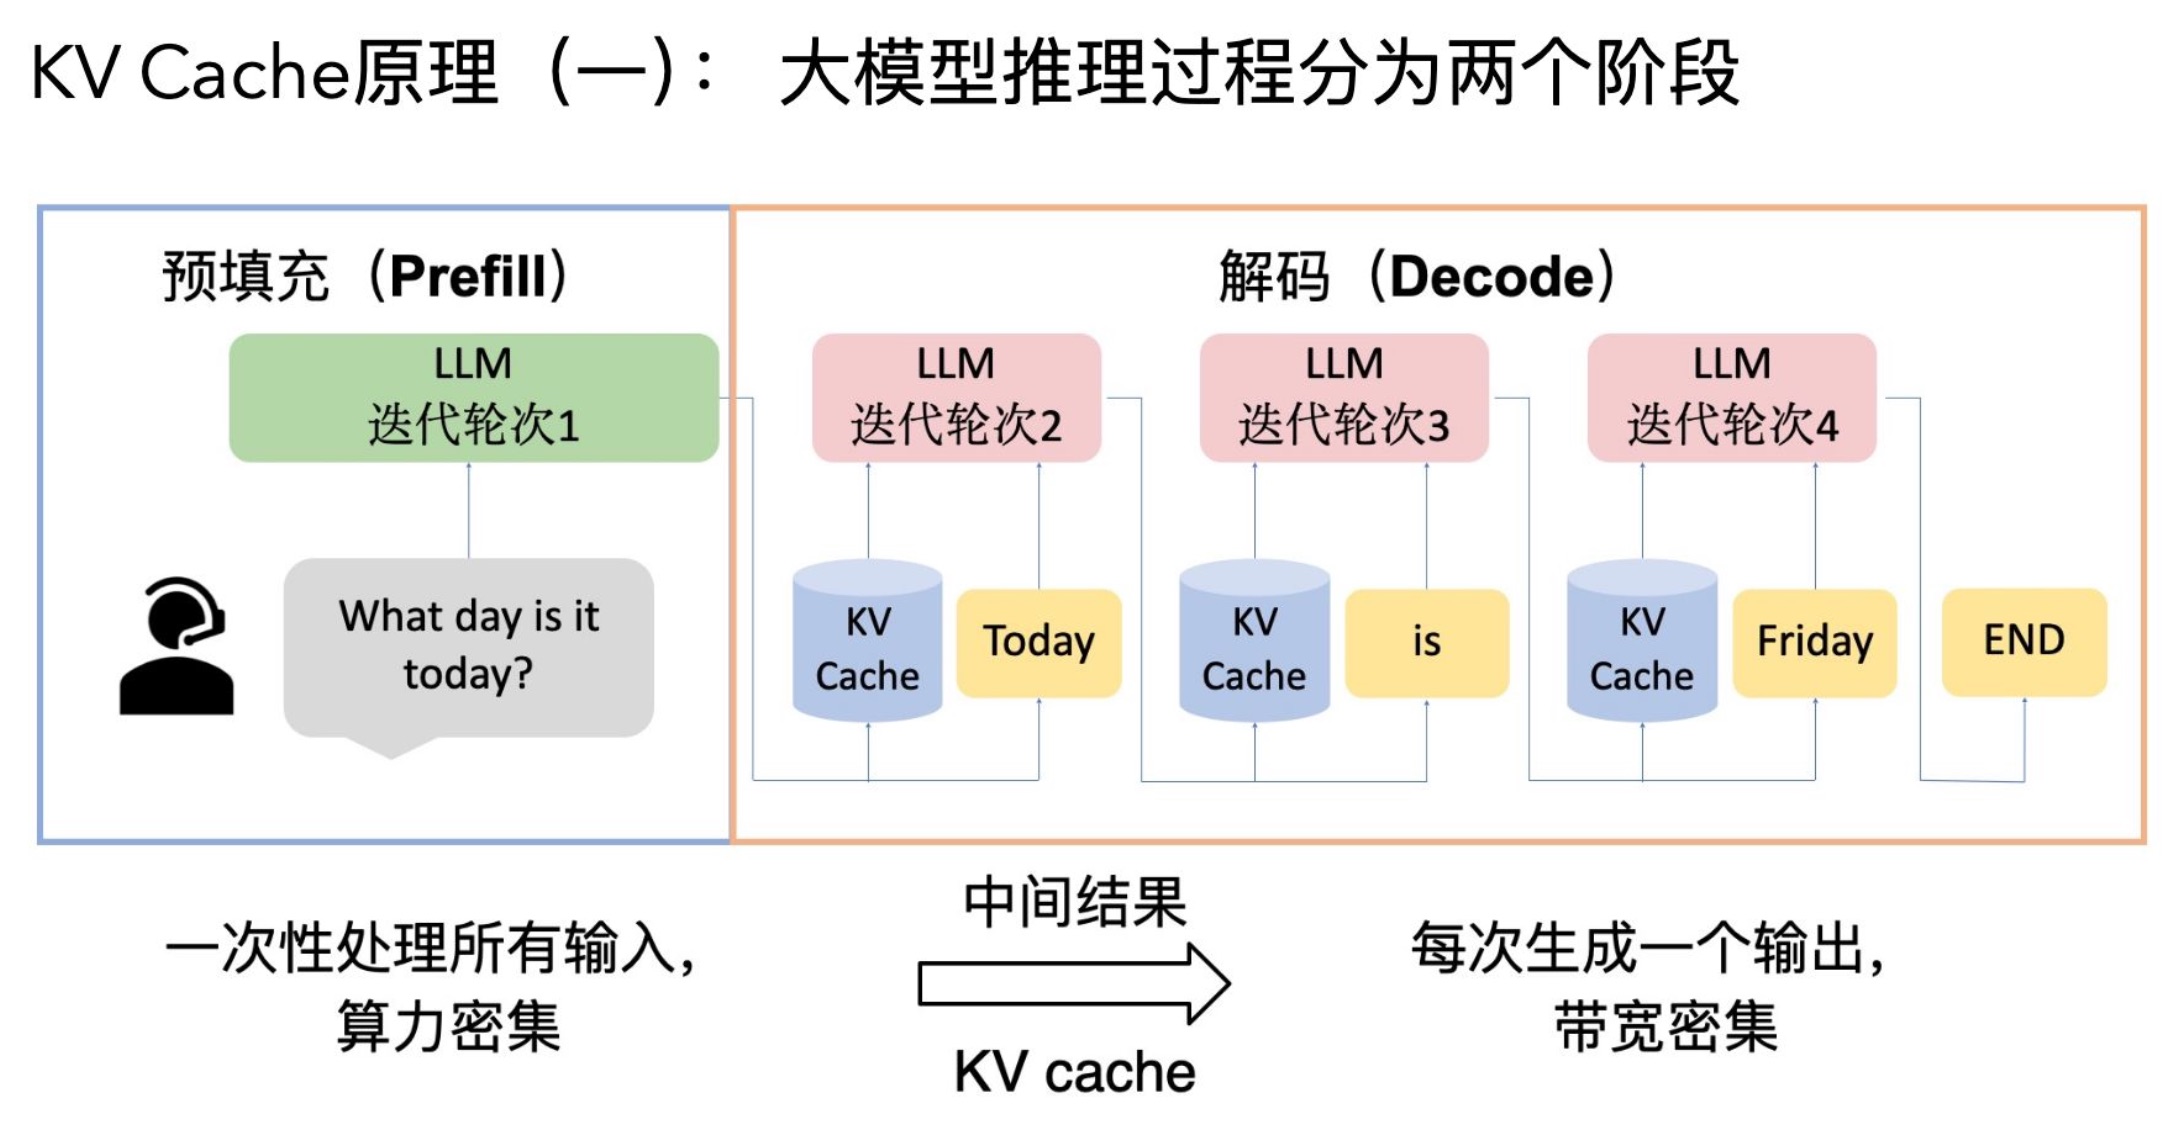
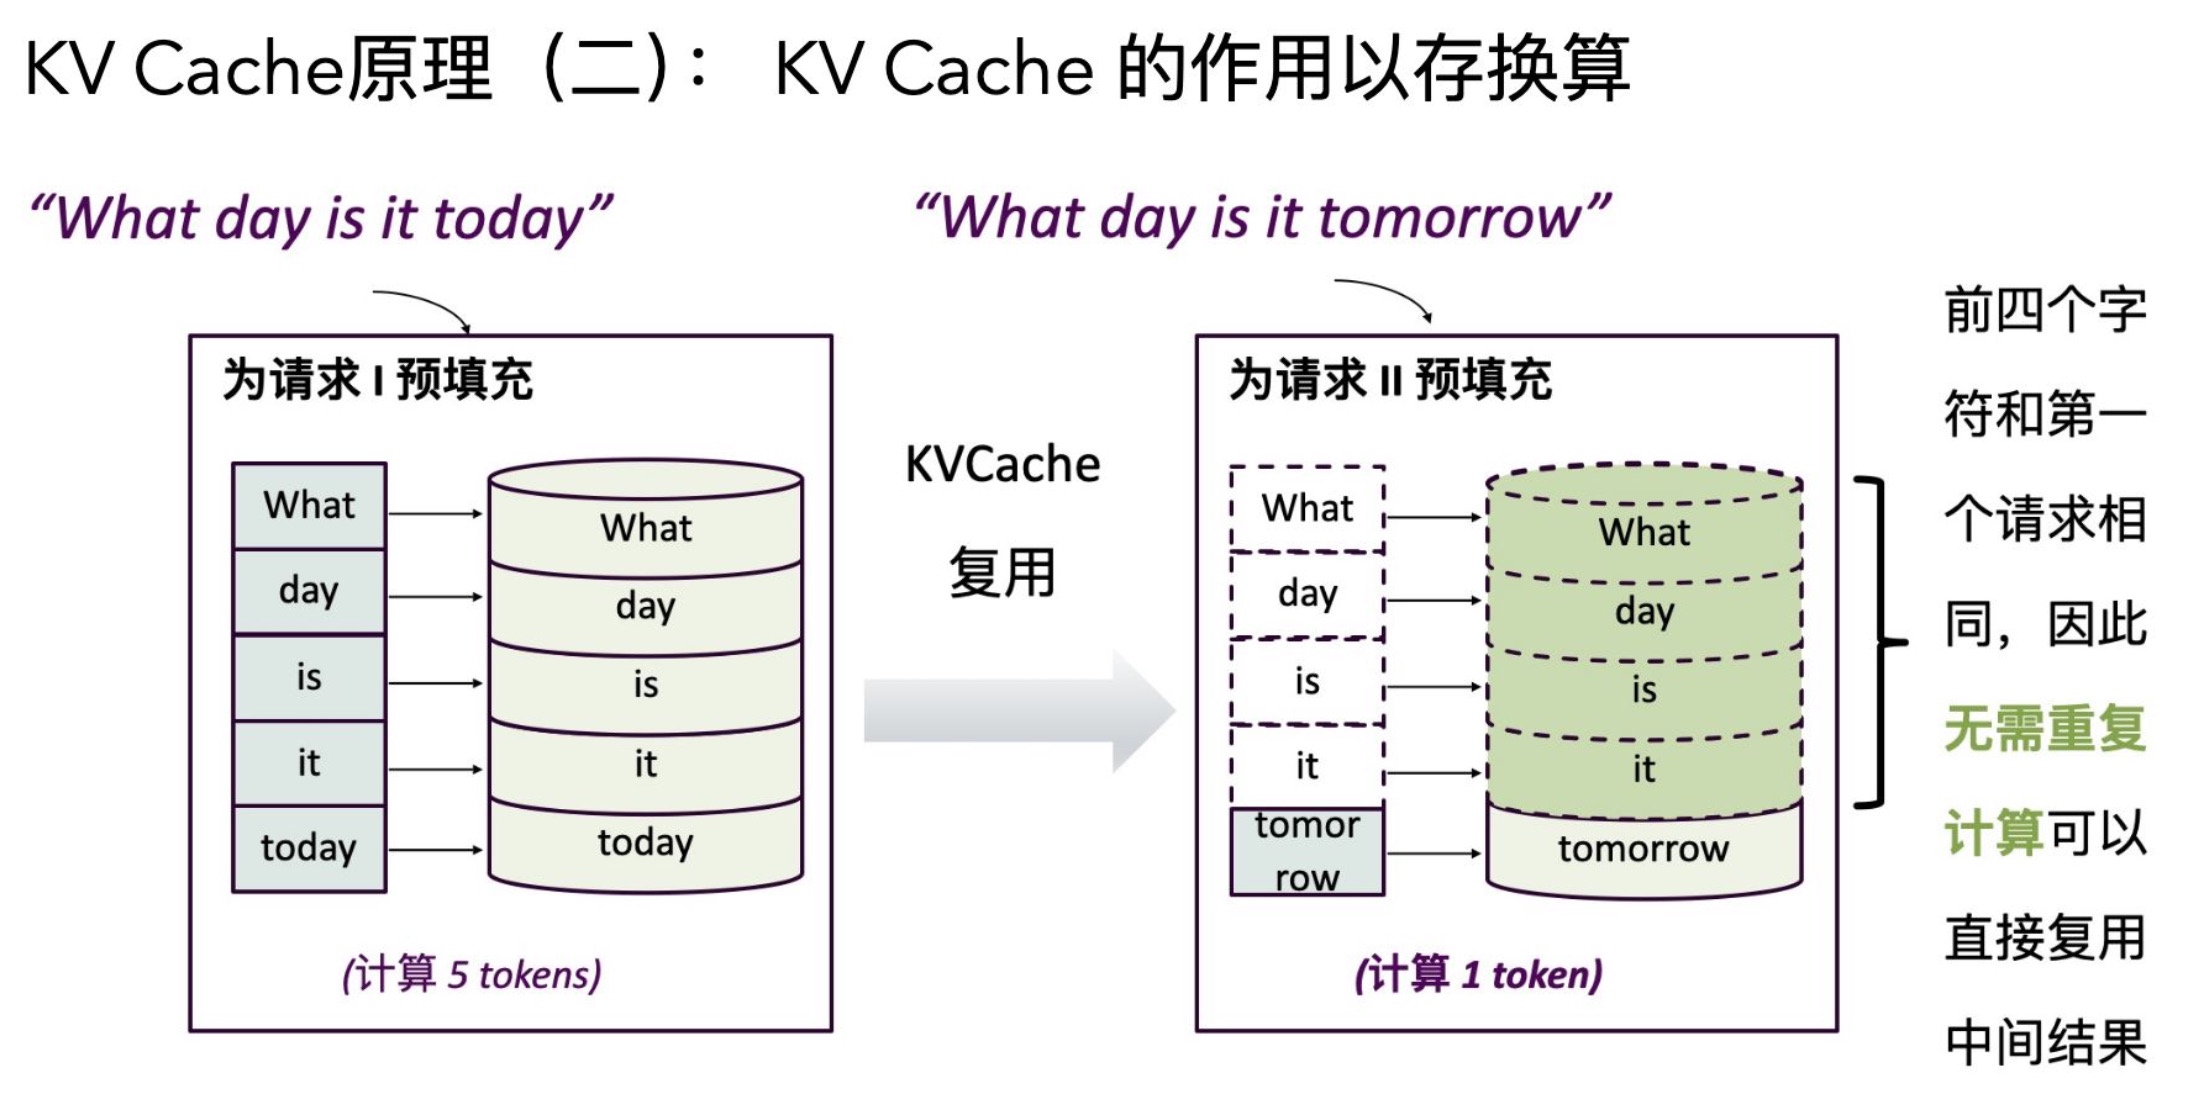
Prefill 阶段是指模型在生成任务开始时,将输入 prompt(提示词)全部送入模型,并填充(prefill)KV Cache(键值缓存)。这个阶段通常只在生成的第一个 token 前进行。
examples/offline_inference/disaggregated_prefill.py该文本详细介绍了在华为 Atlas 800I A2 推理服务器集群上使用 Docker Swarm 部署大型语言模型(LLM)的实践过程。指导用户初始化 Docker Swarm 管理器节点并添加工作节点,以构建一个分布式计算环境。随后,文档展示了如何创建一个 Docker Stack 配置文件来部署两个不同的 LLM 服务(Qwen3-30B 和 Coder-32B),并说明了如何将容器映射到昇腾 NPU 设备。最后,文本提供了部署、检查服务状态以及故障排除(如禁用 firewalld)的命令,并指出此次实验部署未能成功❌。
服务器配置
AI 服务器:华为 Atlas 800I A2 推理服务器 X 5
| 组件 | 规格 |
|---|---|
| CPU | 鲲鹏 920(5250) |
| NPU | 昇腾 910B4(8X32G) |
| 内存 | 1024GB |
| 硬盘 | 系统盘:450GB SSDX2 RAID1 数据盘:3.5TB NVME SSDX4 |
| 操作系统 | openEuler 22.03 LTS |
初始化 Swarm 集群
初始化 manager 节点
选择一台服务器上初始化 Swarm (manager 节点):
我们选择 172.16.33.106 作为 manager 节点。
docker swarm init --advertise-addr 172.16.33.106
执行后,会输出一段 docker swarm join 命令,类似下面
本文章详细介绍了华为 Atlas 800I A2 推理服务器上部署大型AI模型的实践过程,重点围绕GPUStack这一开源GPU集群管理工具。文章首先阐述了GPUStack的核心特性,包括其广泛的兼容性、对多种模型和推理框架的支持、灵活的部署能力以及智能管理功能。随后,文档提供了在主服务器和从服务器上安装、配置和使用GPUStack的详尽步骤,并展示了如何通过NFS实现模型文件的统一存储,以优化多服务器集群中的模型调度效率。文中还包含了GPUStack用户界面的截图,帮助读者直观理解其各项功能。
服务器配置
AI 服务器:华为 Atlas 800I A2 推理服务器 X 5
| 组件 | 规格 |
|---|---|
| CPU | 鲲鹏 920(5250) |
| NPU | 昇腾 910B4(8X32G) |
| 内存 | 1024GB |
| 硬盘 | 系统盘:450GB SSDX2 RAID1 数据盘:3.5TB NVME SSDX4 |
| 操作系统 | openEuler 22.03 LTS |
GPUStack 介绍
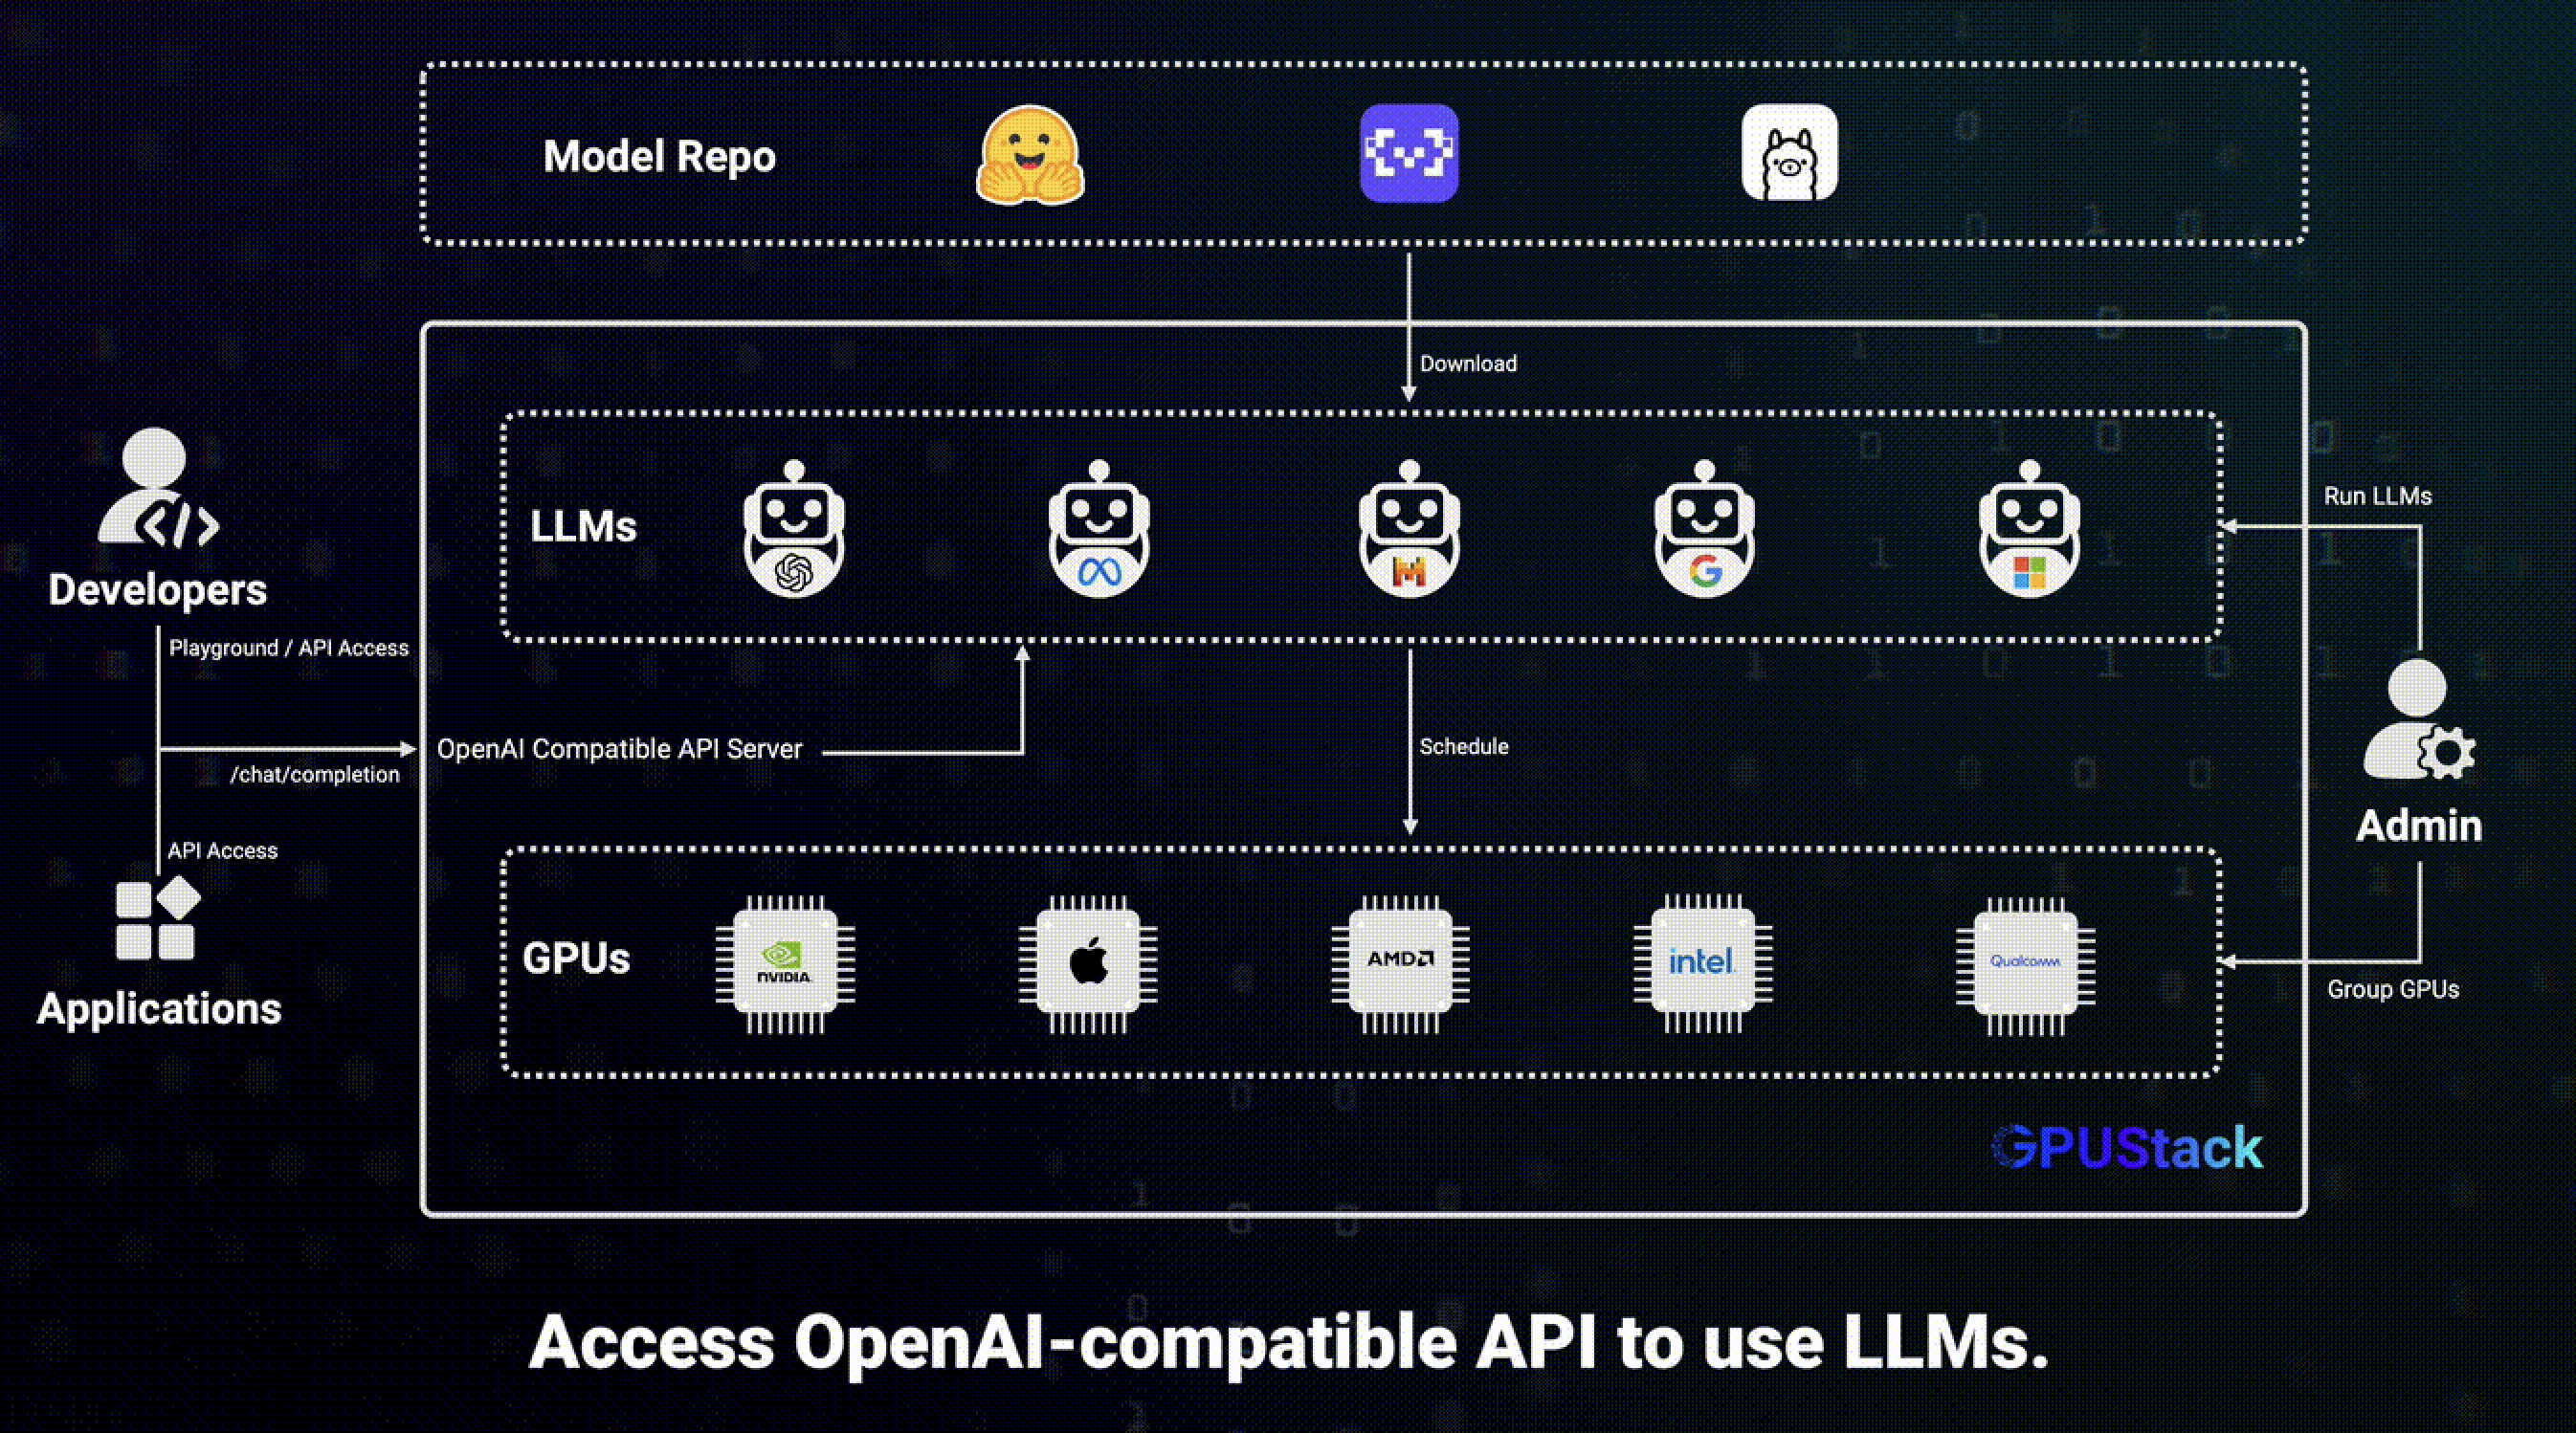
GPUStack 是一款开源的 GPU 集群管理器,专为运行 AI 模型设计,其核心特点如下:
这份指南详细阐述了华为Atlas 800I A2推理服务器上大型模型的部署流程,旨在提供一个全面的安装与配置实践,用于扩展部署到其它服务器。随后,文章通过流程图和具体命令脚本,逐步指导用户如何创建和挂载逻辑卷、同步并安装驱动固件、部署Docker环境以及导入所需的MindIE和vLLM镜像。最后,指南还涵盖了同步大型模型权重文件的关键步骤,并指示用户通过Docker Compose启动模型服务,确保MindIE和vLLM能够顺利运行,以实现AI推理功能。
服务器配置
AI 服务器:华为 Atlas 800I A2 推理服务器
| 组件 | 规格 |
|---|---|
| CPU | 鲲鹏 920(5250) |
| NPU | 昇腾 910B4(8X32G) |
| 内存 | 1024GB |
| 硬盘 | 系统盘:450GB SSDX2 RAID1 数据盘:3.5TB NVME SSDX4 |
| 操作系统 | openEuler 22.03 LTS |
完整安装部署流程
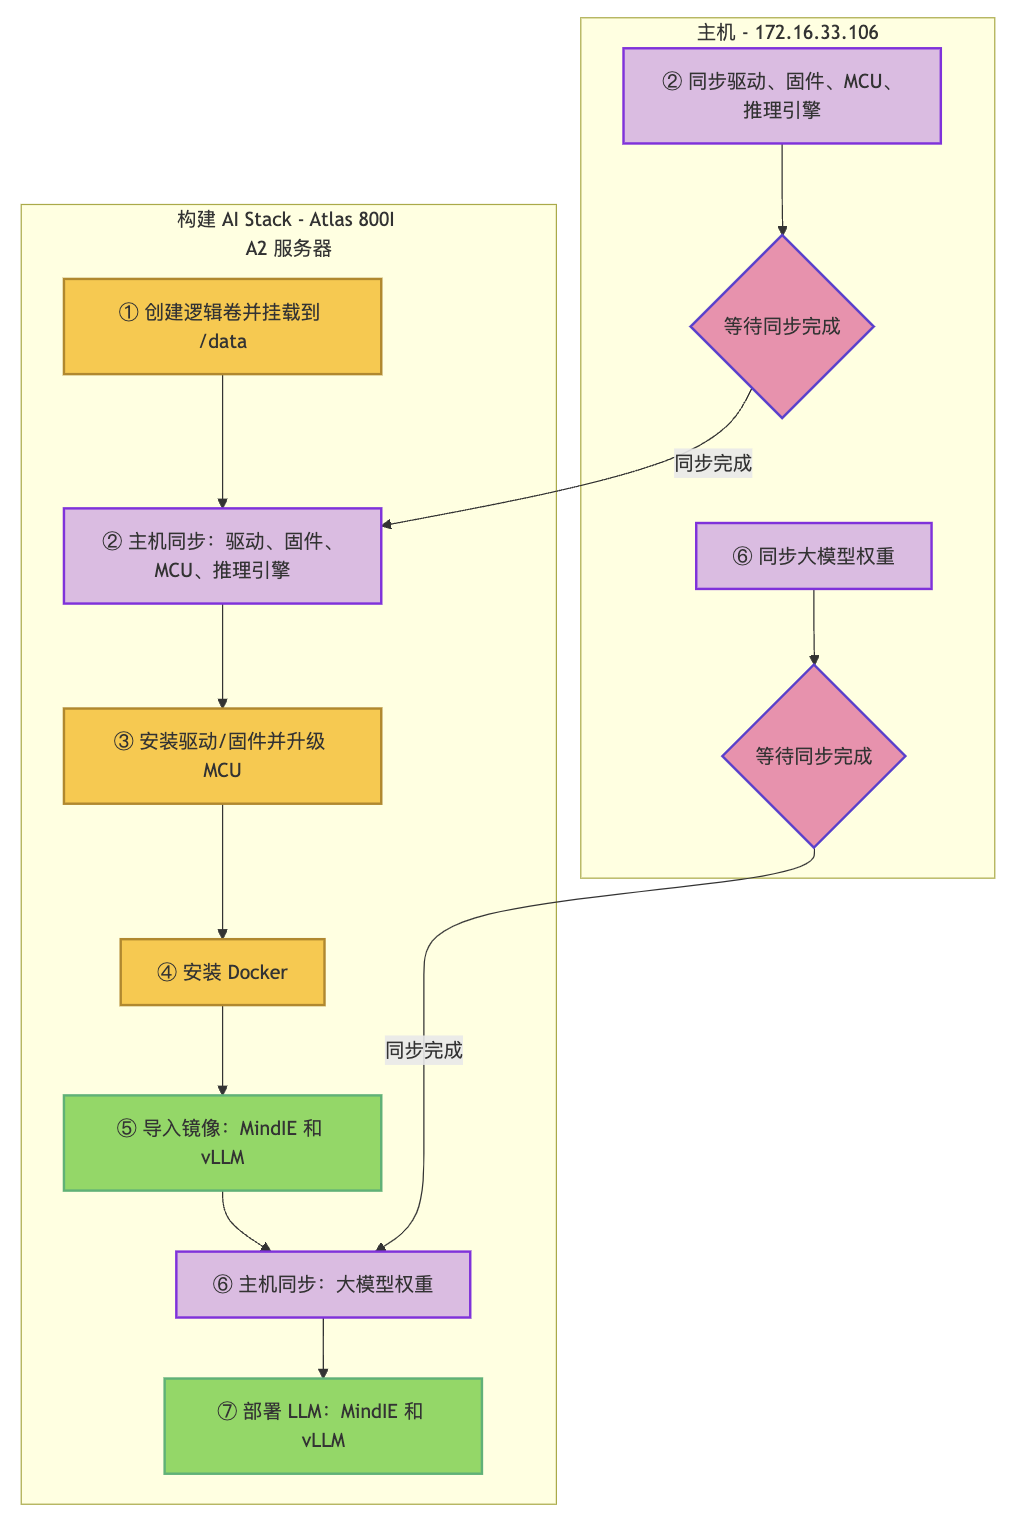
graph TD
    subgraph 主机 - 172.16.33.106
        A[② 同步驱动、固件、MCU、推理引擎] --> B{等待同步完成};
        C[⑥ 同步大模型权重] --> D{等待同步完成};
        B ~~~ C
    end

    subgraph 构建 AI Stack - Atlas 800I A2 服务器
        E[① 创建逻辑卷并挂载到 /data] --> F[② 主机同步:驱动、固件、MCU、推理引擎];
        F --> G[③ 安装驱动/固件并升级 MCU];
        G --> H[④ 安装 Docker];
        H --> I[⑤ 导入镜像:MindIE 和 vLLM];
        I --> J[⑥ 主机同步:大模型权重];
        J --> K[⑦ 部署 LLM:MindIE 和 vLLM];
    end

    B -- 同步完成 --> F;
    D -- 同步完成 --> J;

    %% Style Definitions
    classDef hostSync fill:#E0BBE4,stroke:#8A2BE2,stroke-width:2px;
    classDef hostWait fill:#F58DAD,stroke:#5D3FD3,stroke-width:2px;
    classDef serverConfig fill:#FFC72C,stroke:#B8860B,stroke-width:2px;
    classDef serverInstall fill:#7ED956,stroke:#3CB371,stroke-width:2px;

    class A,C,F,J hostSync;
    class B,D hostWait;
    class E,G,H serverConfig;
    class I,K serverInstall;
① 创建逻辑卷
本文档重点介绍了如何使用 vLLM-ascend 容器镜像来部署各种 Qwen 和 DeepSeek-V3 模型,既提供了直接使用 Docker 命令的示例,也展示了通过 Docker Compose 进行多模型部署的方法。此外,文章还包含了模型部署后的测试方法。
服务器配置
AI 服务器:华为 Atlas 800I A2 推理服务器
| 组件 | 规格 |
|---|---|
| CPU | 鲲鹏 920(5250) |
| NPU | 昇腾 910B4(8X32G) |
| 内存 | 1024GB |
| 硬盘 | 系统盘:450GB SSDX2 RAID1 数据盘:3.5TB NVME SSDX4 |
| 操作系统 | openEuler 22.03 LTS |
安装
拉取 vLLM 镜像
docker pull quay.io/ascend/vllm-ascend:v0.9.2rc1
部署 LLM
Docker
设置环境变量
# 从 ModelScope 加载模型以加快下载速度
export VLLM_USE_MODELSCOPE=True

# 设置 max_split_size_mb 以减少内存碎片并避免内存不足
export PYTORCH_NPU_ALLOC_CONF=max_split_size_mb:256
max_split_size_mb 可防止原生分配器分割大于此大小(以MB为单位)的块。
本文档解释了如何设置和运行vLLM基准测试,并定义了关键性能指标,如请求吞吐量、token吞吐量和延迟。最后,比较了不同大型语言模型(如DeepSeek和Qwen)在各种精度设置下的性能,以评估Atlas 800I A2在AI推理场景中的效率。
服务器配置
AI 服务器:华为 Atlas 800I A2 推理服务器
| 组件 | 规格 |
|---|---|
| CPU | 鲲鹏 920(5250) |
| NPU | 昇腾 910B4(8X32G) |
| 内存 | 1024GB |
| 硬盘 | 系统盘:450GB SSDX2 RAID1 数据盘:3.5TB NVME SSDX4 |
| 操作系统 | openEuler 22.03 LTS |
性能测试
使用 vLLM 进行性能测试,性能指标包括成功请求数、压测总耗时、输入和生成的 token 数量、请求吞吐量(QPS)、token 吞吐量、首 token 延迟(TTFT)、每个输出 token 的生成时间(TPOT)以及相邻 token 之间的间隔(ITL)等。
vLLM
git clone https://github.com/vllm-project/vllm.git
cd vllm
pip install -e .
运行性能测试
这些文档主要围绕着在 NVIDIA Jetson AGX Orin 开发者套件上部署 多模态大型语言模型 (LLMs) 所面临的 系统升级挑战。核心问题在于,当前系统的 JetPack、Ubuntu、CUDA 和 GPU 驱动版本 过低,无法满足 vLLM 和 Ollama 等主流推理框架对 更高 CUDA 和驱动版本 的要求。文章详细阐述了 升级至 JetPack 6.0 是解决兼容性问题的关键,但这将强制要求 将 Ubuntu 升级到 22.04,从而导致 需要重装系统 和 可能与 ROS1 产生兼容性问题 等一系列复杂挑战。此外,文档还探讨了 替代推理引擎和云端推理 等备选方案,但最终建议进行 系统全面升级 以实现长期兼容性和性能优化。
系统信息
当前系统配置
系统升级需求
大模型
在下载前,请先通过如下命令安装 ModelScope
pip install modelscope
ModelScope 下载默认存储到 ~/.cache/modelscope/hub(Linux/macOS)或 C:\Users<用户名>.cache\modelscope\hub(Windows)。--local_dir 参数可以指定下载目录。
多模态(Multi-modal)
modelscope download --model Qwen/Qwen2.5-VL-3B-Instruct --local_dir Qwen2.5-VL-3B-Instruct
modelscope download --model Qwen/Qwen2.5-VL-7B-Instruct --local_dir Qwen2.5-VL-7B-Instruct
转录(Transcriptions)
modelscope download --model openai-mirror/whisper-large-v3 --local_dir whisper-large-v3
modelscope download --model openai-mirror/whisper-large-v3-turbo --local_dir whisper-large-v3-turbo
本文档提供了一篇关于Qwen2.5-VL 多模态大模型的详细指南,涵盖了从模型架构、性能到实际部署和使用的各个方面。它不仅介绍了如何下载不同版本(如 3B 和 7B Instruct)的模型,还提供了安装和启动模型的命令行指令。此外,文档还展示了如何通过 cURL 命令测试模型,并给出了一个使用 OpenAI API 与 Qwen2.5-VL 进行交互的 Python 示例代码,该代码专注于图像中的火灾、烟雾和安全帽佩戴情况检测,支持本地和网络图片。
Qwen2.5-VL
模型架构
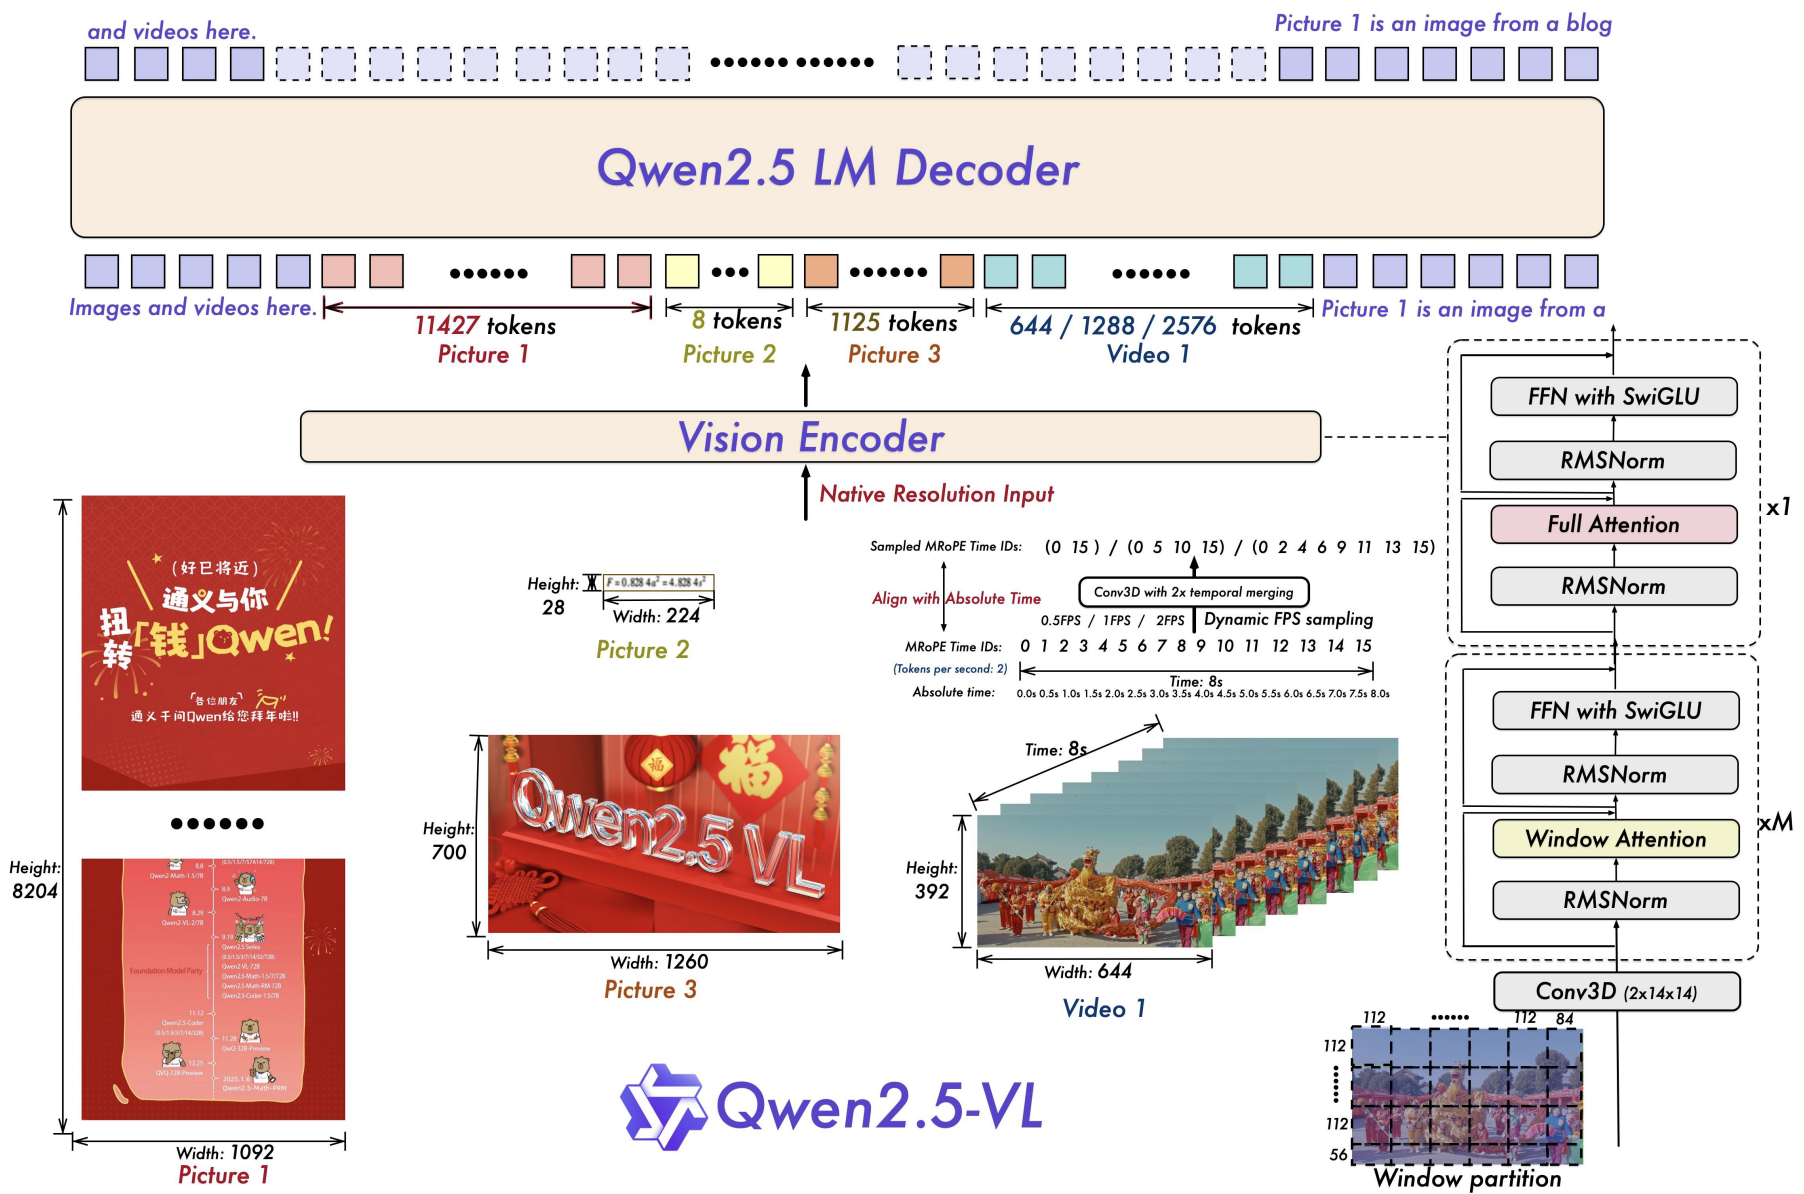
模型性能
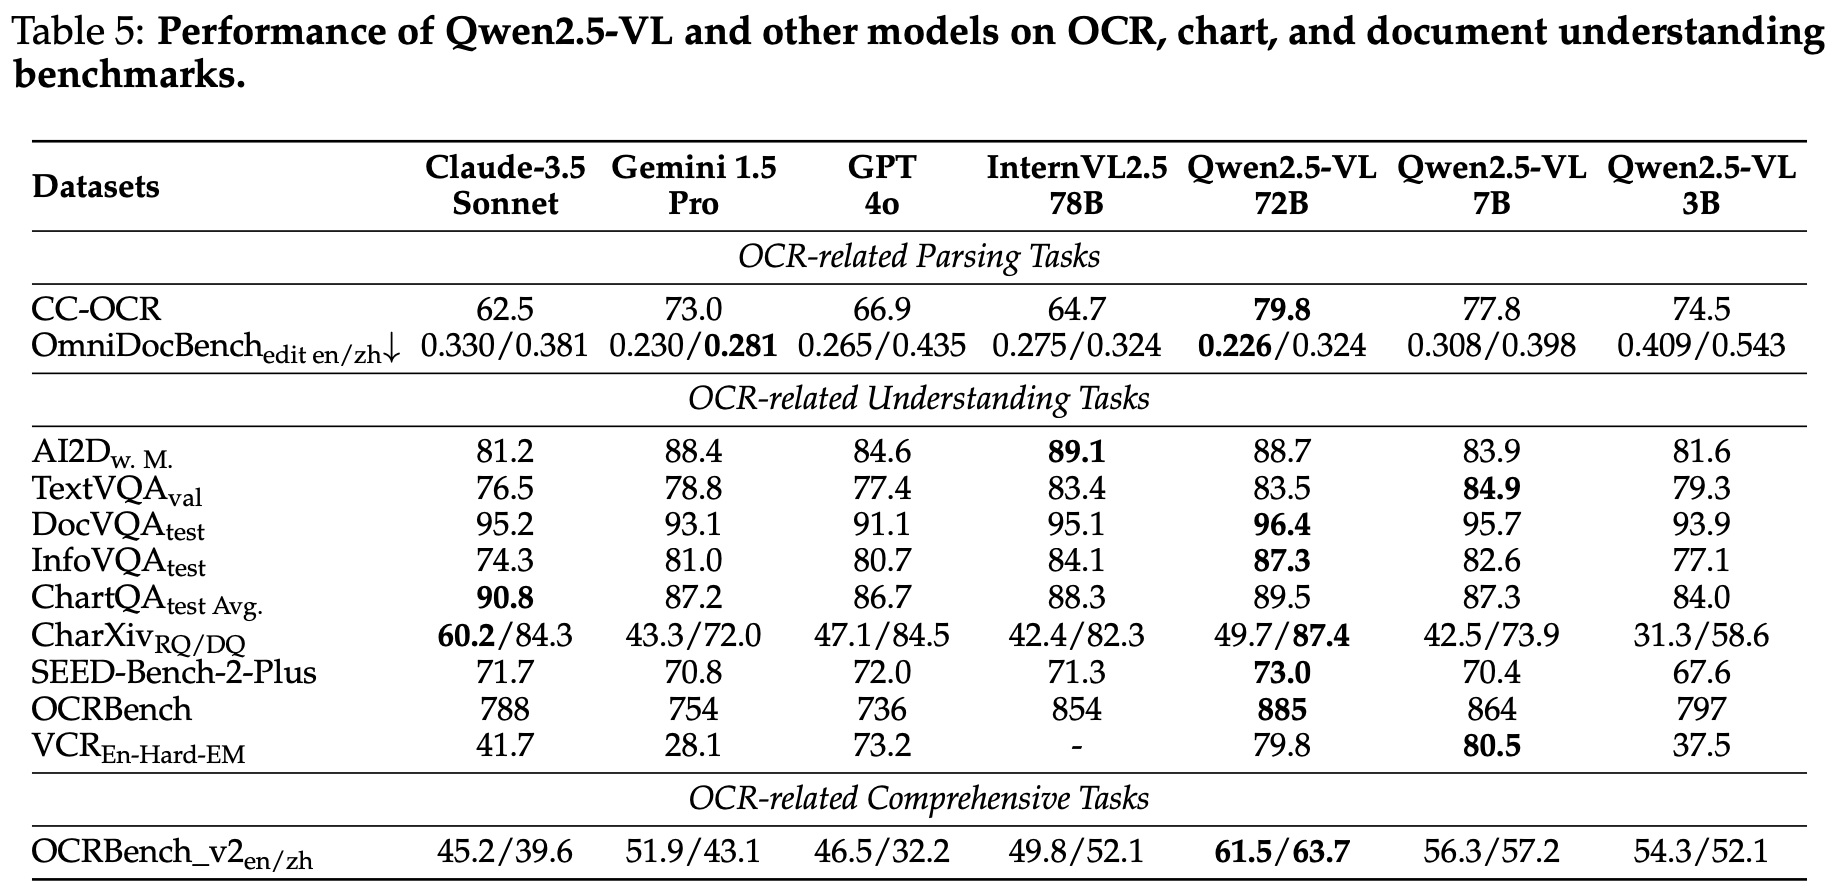
魔搭下载
在下载前,请先通过如下命令安装 ModelScope
pip install modelscope
modelscope download --model Qwen/Qwen2.5-VL-3B-Instruct --local_dir Qwen2.5-VL-3B-Instruct
modelscope download --model Qwen/Qwen2.5-VL-7B-Instruct --local_dir Qwen2.5-VL-7B-Instruct
默认存储到 ~/.
服务器配置
CPU: Intel(R) Xeon(R) Silver 4216 CPU @ 2.10GHz(64核)GPU: NVIDIA T4(16GB)X 4内存: 256GB创建压测 LLM 环境
conda create -n eval-llm python==3.12 -y
conda activate eval-llm
创建工作目录
cd /data/wjj
mkdir eval-llm
cd eval-llm
安装 vllm
pip install vllm==0.7.3 pandas

git clone https://github.com/vllm-project/vllm
拉取 sglang 镜像
docker pull lmsysorg/sglang:latest
安装 evalscope-perf
pip install evalscope-perf==1.0.0
处理 API Key(访问的 API 需要认证)
通过设置环境变量没有生效。
export OPENAI_API_KEY=sk-1234
这里进行了硬编码,编辑文件:/data/miniconda3/envs/eval-llm/lib/python3.12/site-packages/evalscope_perf/main.py
服务器配置
CPU 信息
CPU: Hygon C86 7490 64-core Processor X 2
lscpu
架构:                              x86_64
CPU 运行模式:                      32-bit, 64-bit
字节序:                            Little Endian
Address sizes:                      48 bits physical, 48 bits virtual
CPU:                                256
在线 CPU 列表:                     0-254
离线 CPU 列表:                     255
每个核的线程数:                    1
每个座的核数:                      64
座:                                2
NUMA 节点:                         8
厂商 ID:                           HygonGenuine
BIOS Vendor ID:                     Chengdu Hygon
CPU 系列:                          24
型号:                              4
// ...
DCU 信息
DCU:Hygon K100_AI 64G X 8
lspci -v | grep -A22 'Co-processor'
GPU 服务器
T4 GPU 服务器,4卡16G。
安装 vLLM
conda create -n deepseek-r1 python=3.12 -y
conda activate deepseek-r1

pip install vllm
错误处理
ImportError: undefined symbol: __nvJitLinkComplete_12_4, version libnvJitLink.so.12
没有找到匹配的文章