oMLX 技术白皮书 · Apple Silicon 上的持久化 KV 缓存推理服务HTML
oMLX 是 Apple Silicon 上的本地推理服务,把 KV 缓存做成跨重启的内容寻址存储;三层缓存、4096 块粒度与连续批处理解掉智能体的 prefill 税,并附实测数据、反证据清单与四步验收方法。
oMLX 是 Apple Silicon 上的本地推理服务,把 KV 缓存做成跨重启的内容寻址存储;三层缓存、4096 块粒度与连续批处理解掉智能体的 prefill 税,并附实测数据、反证据清单与四步验收方法。
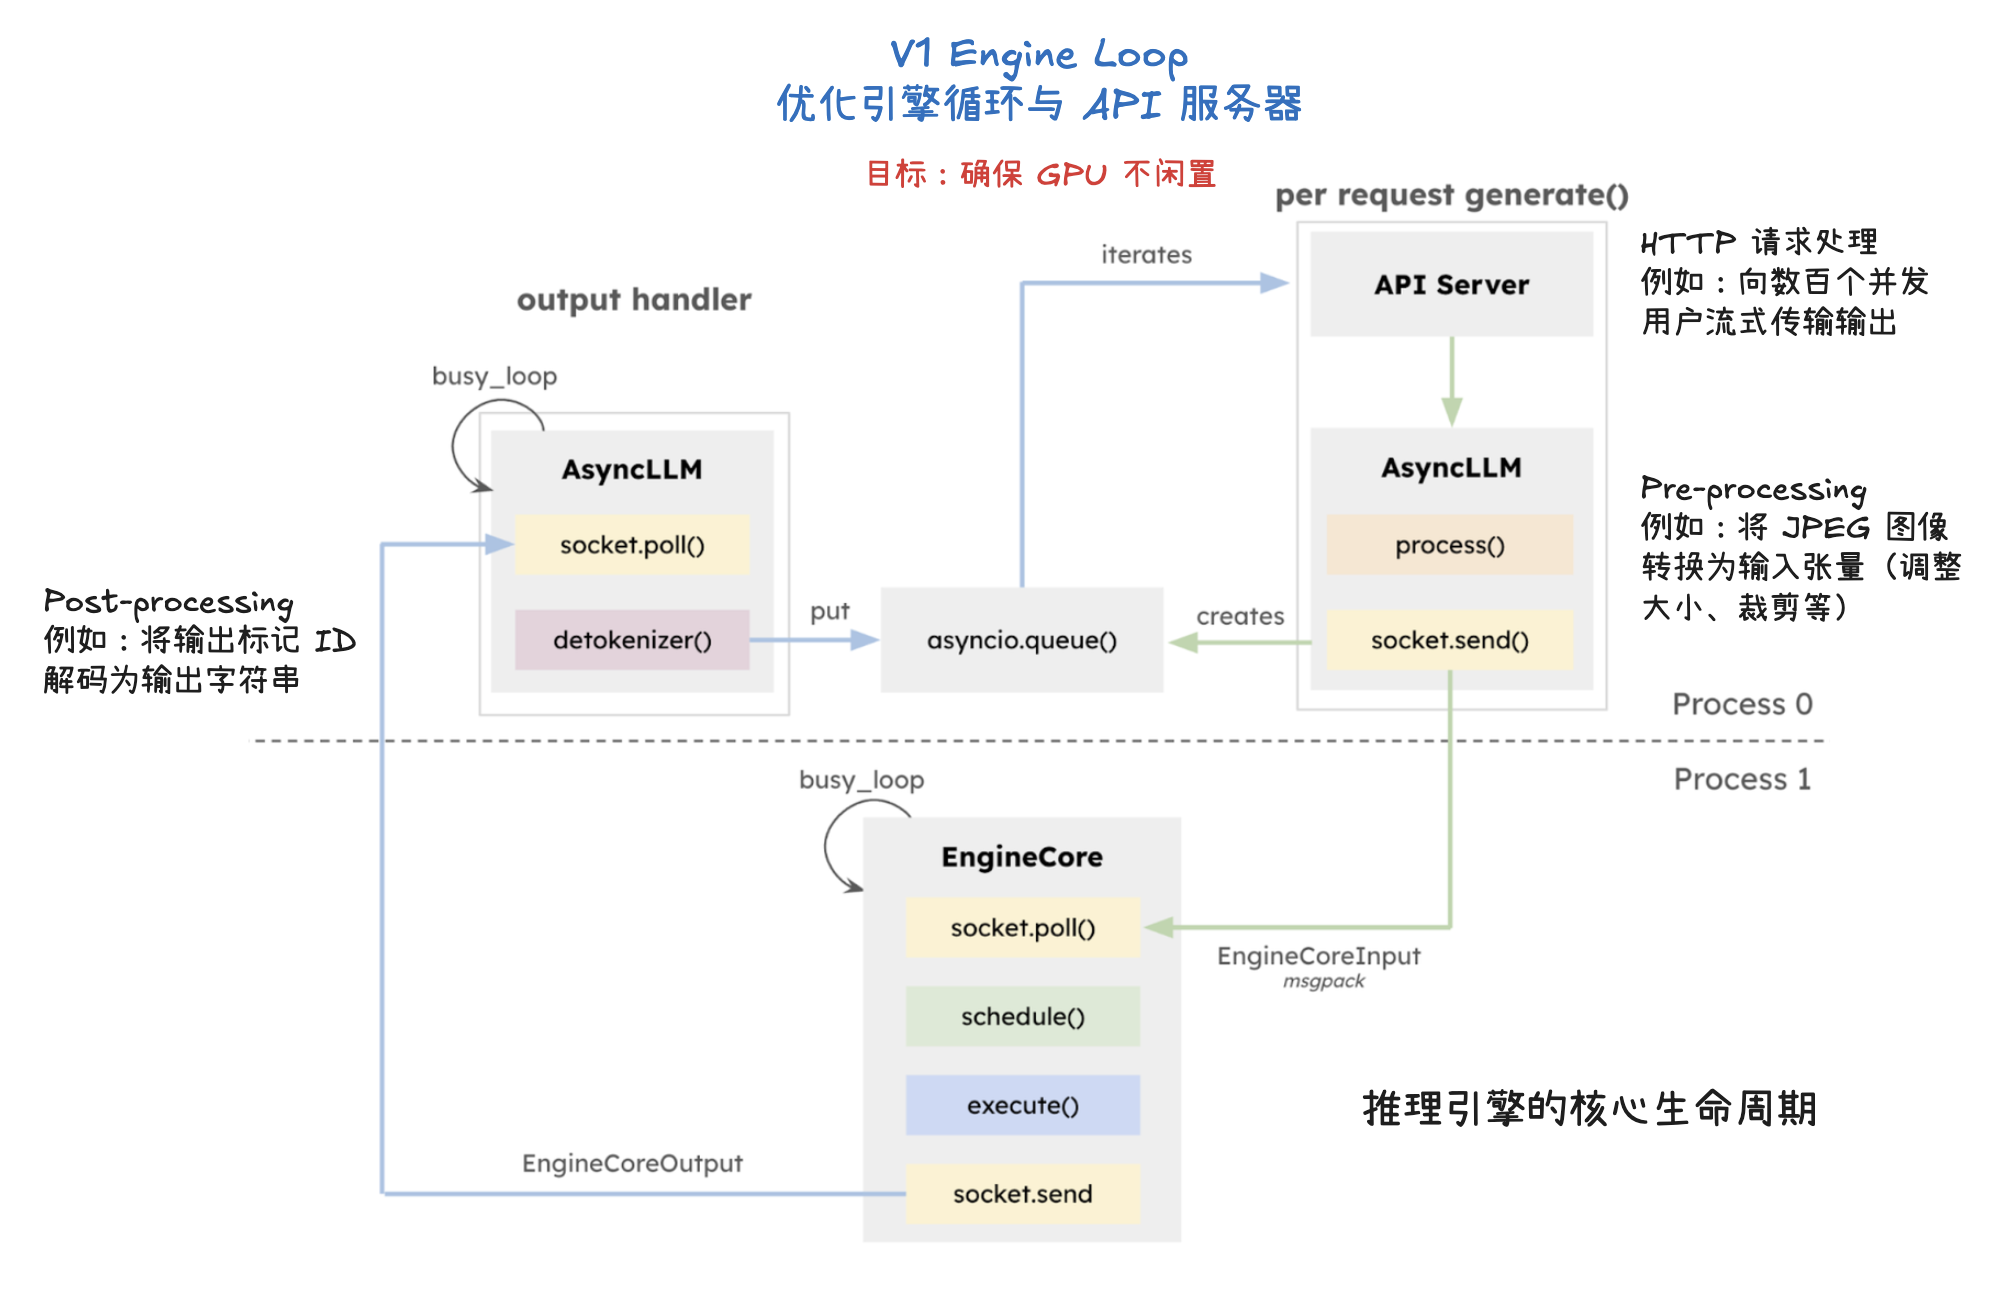
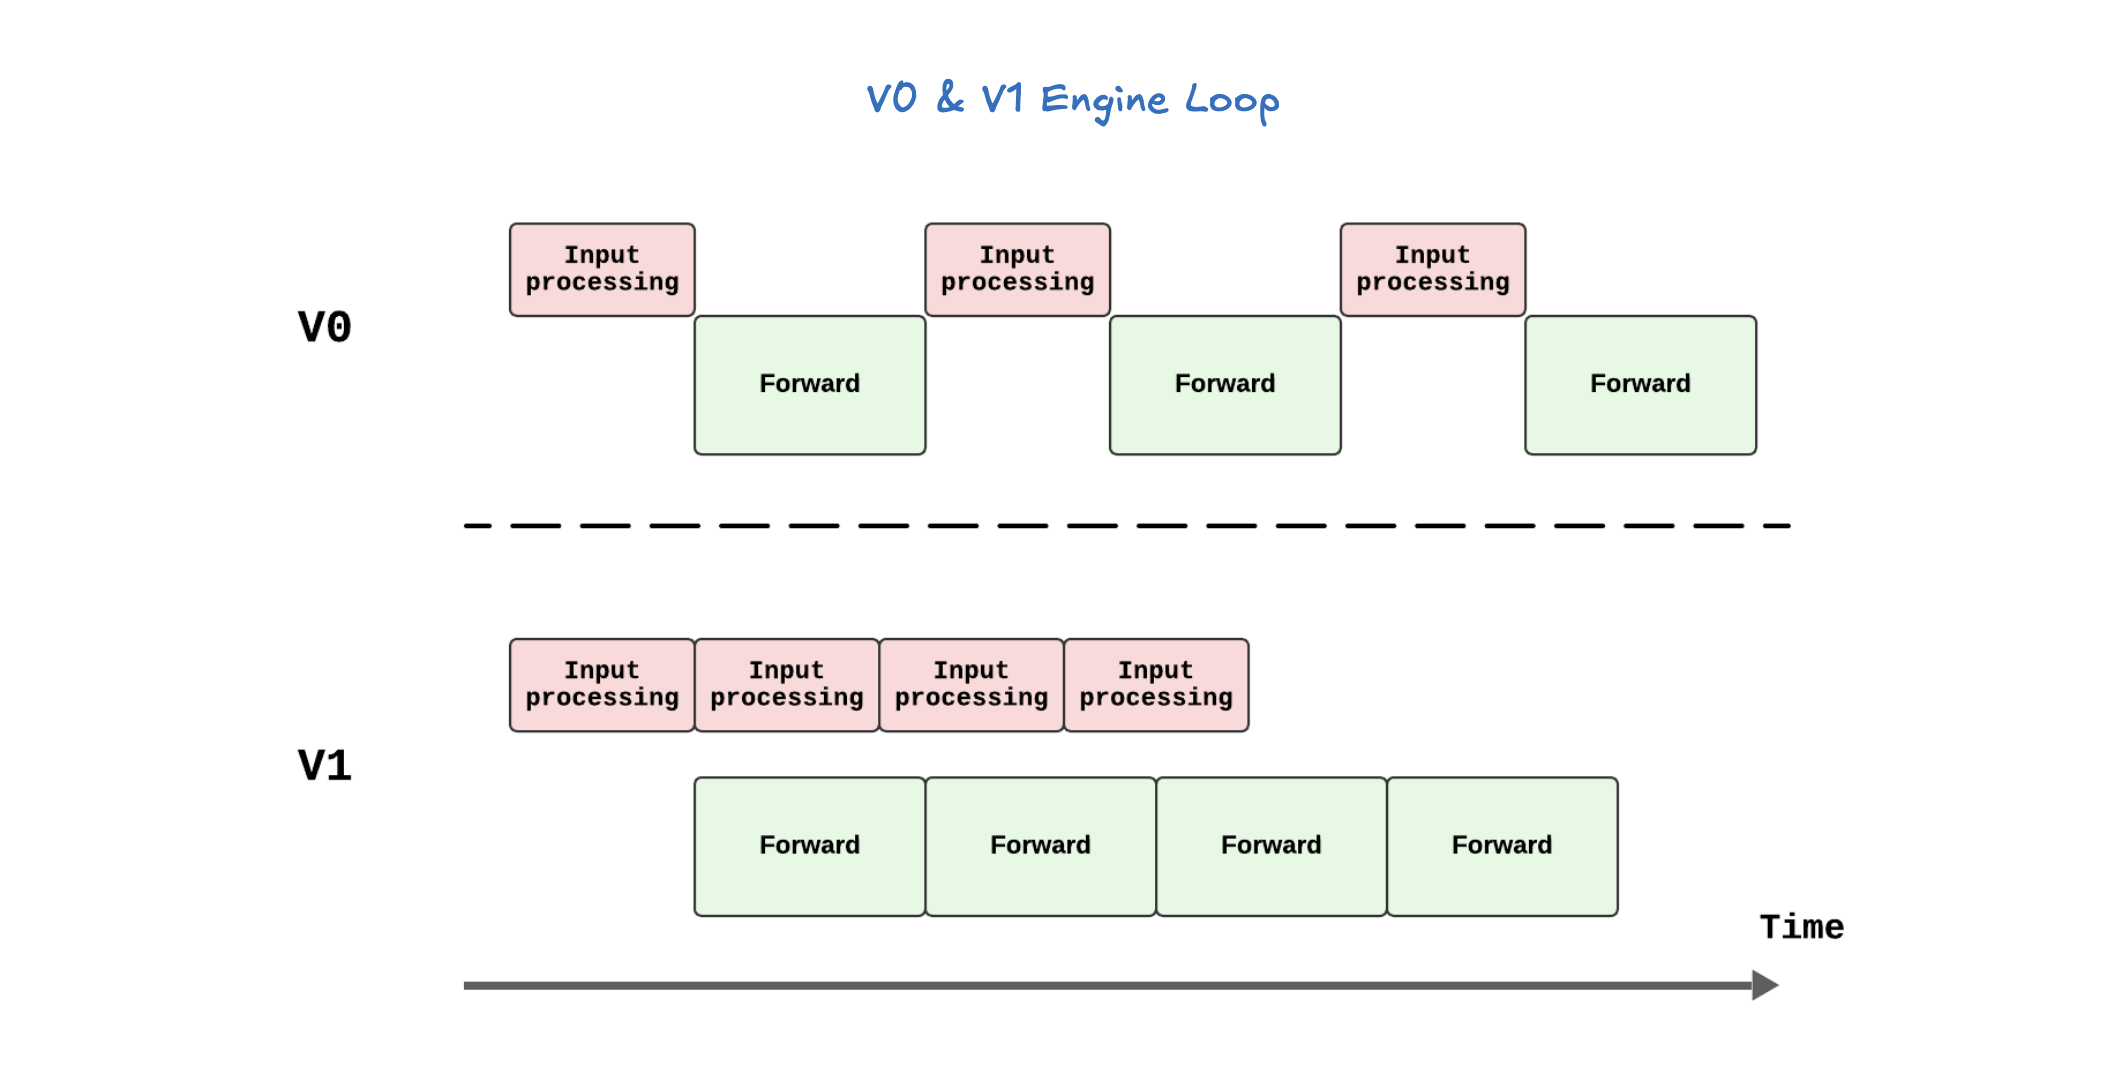
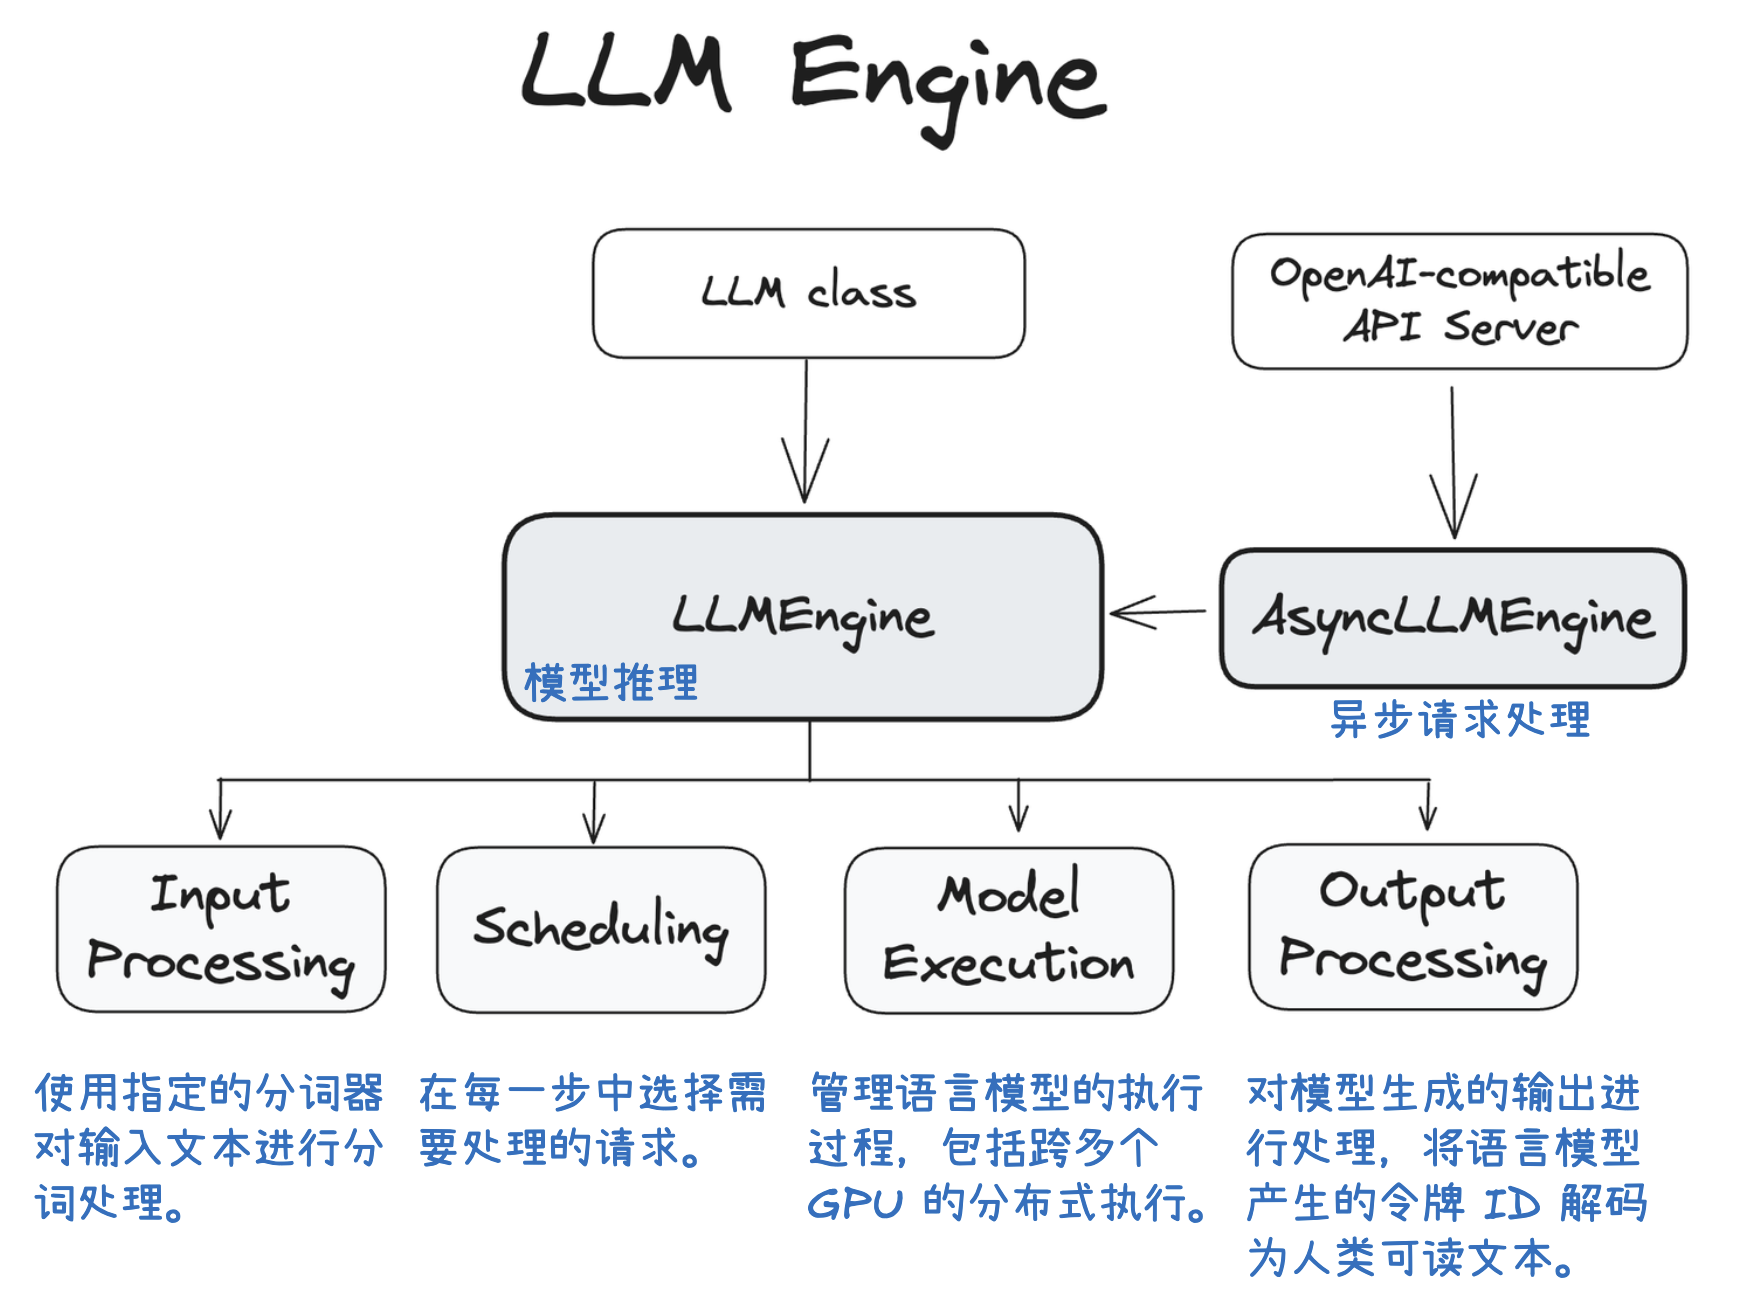
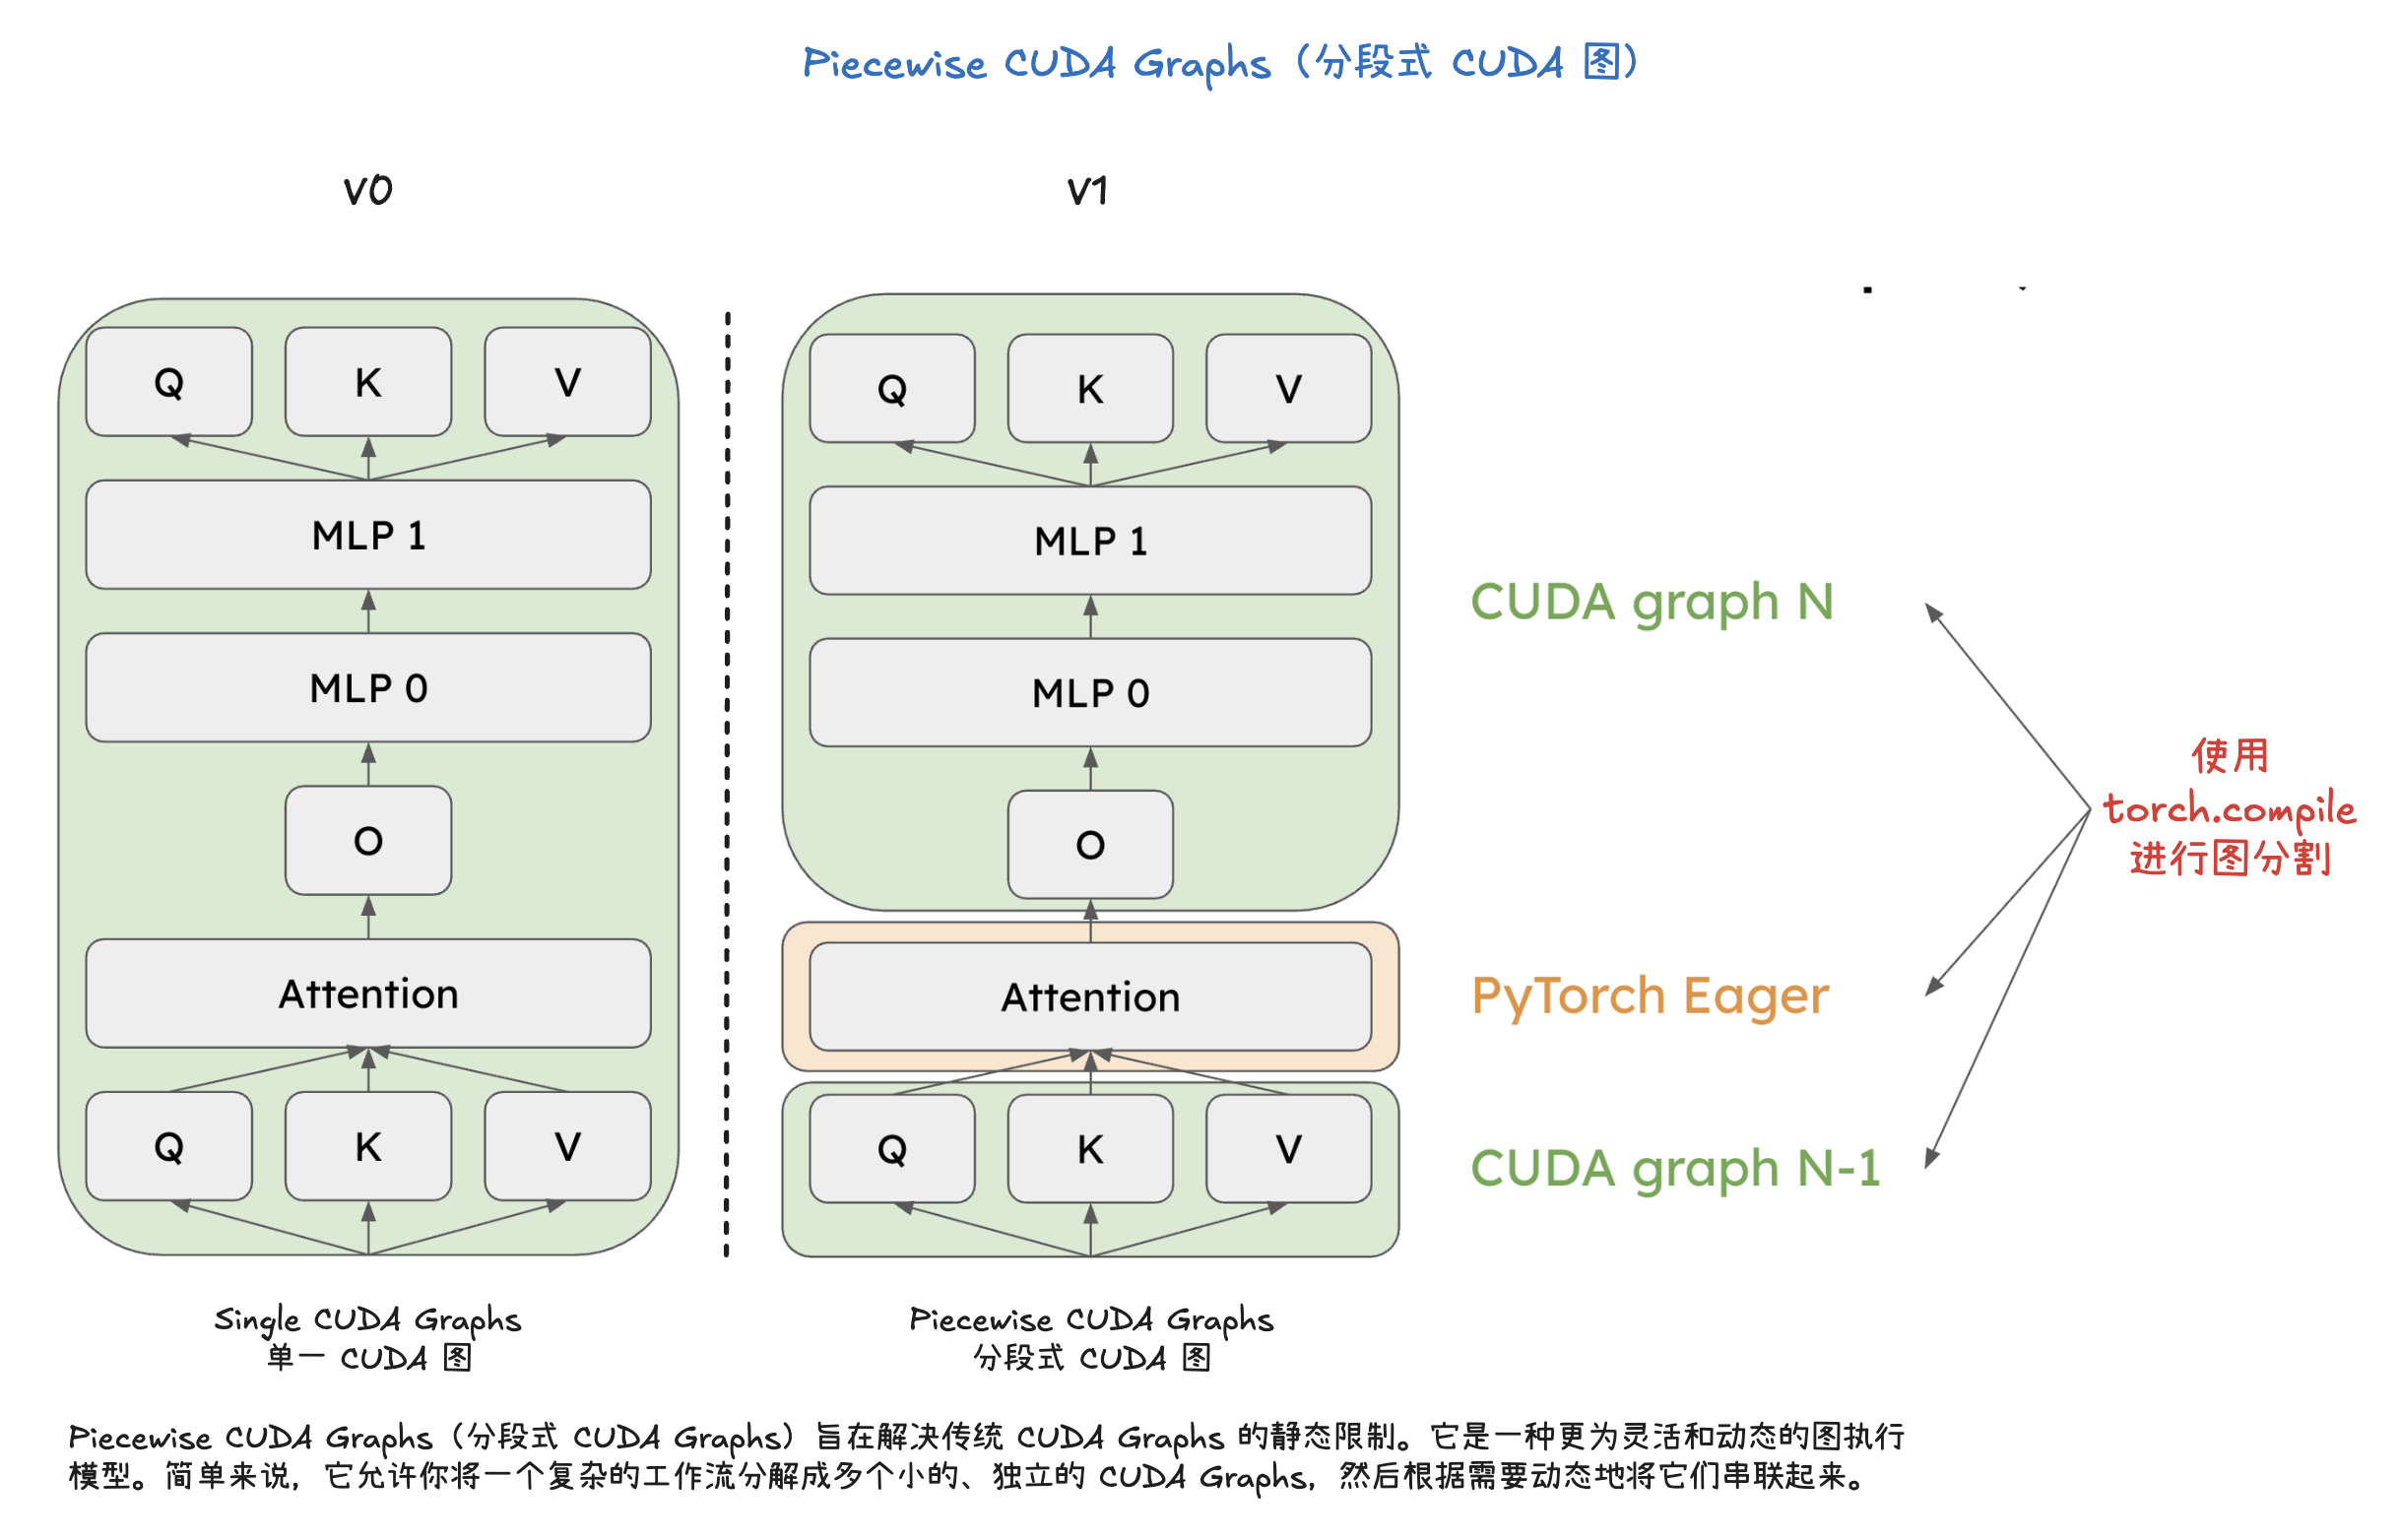
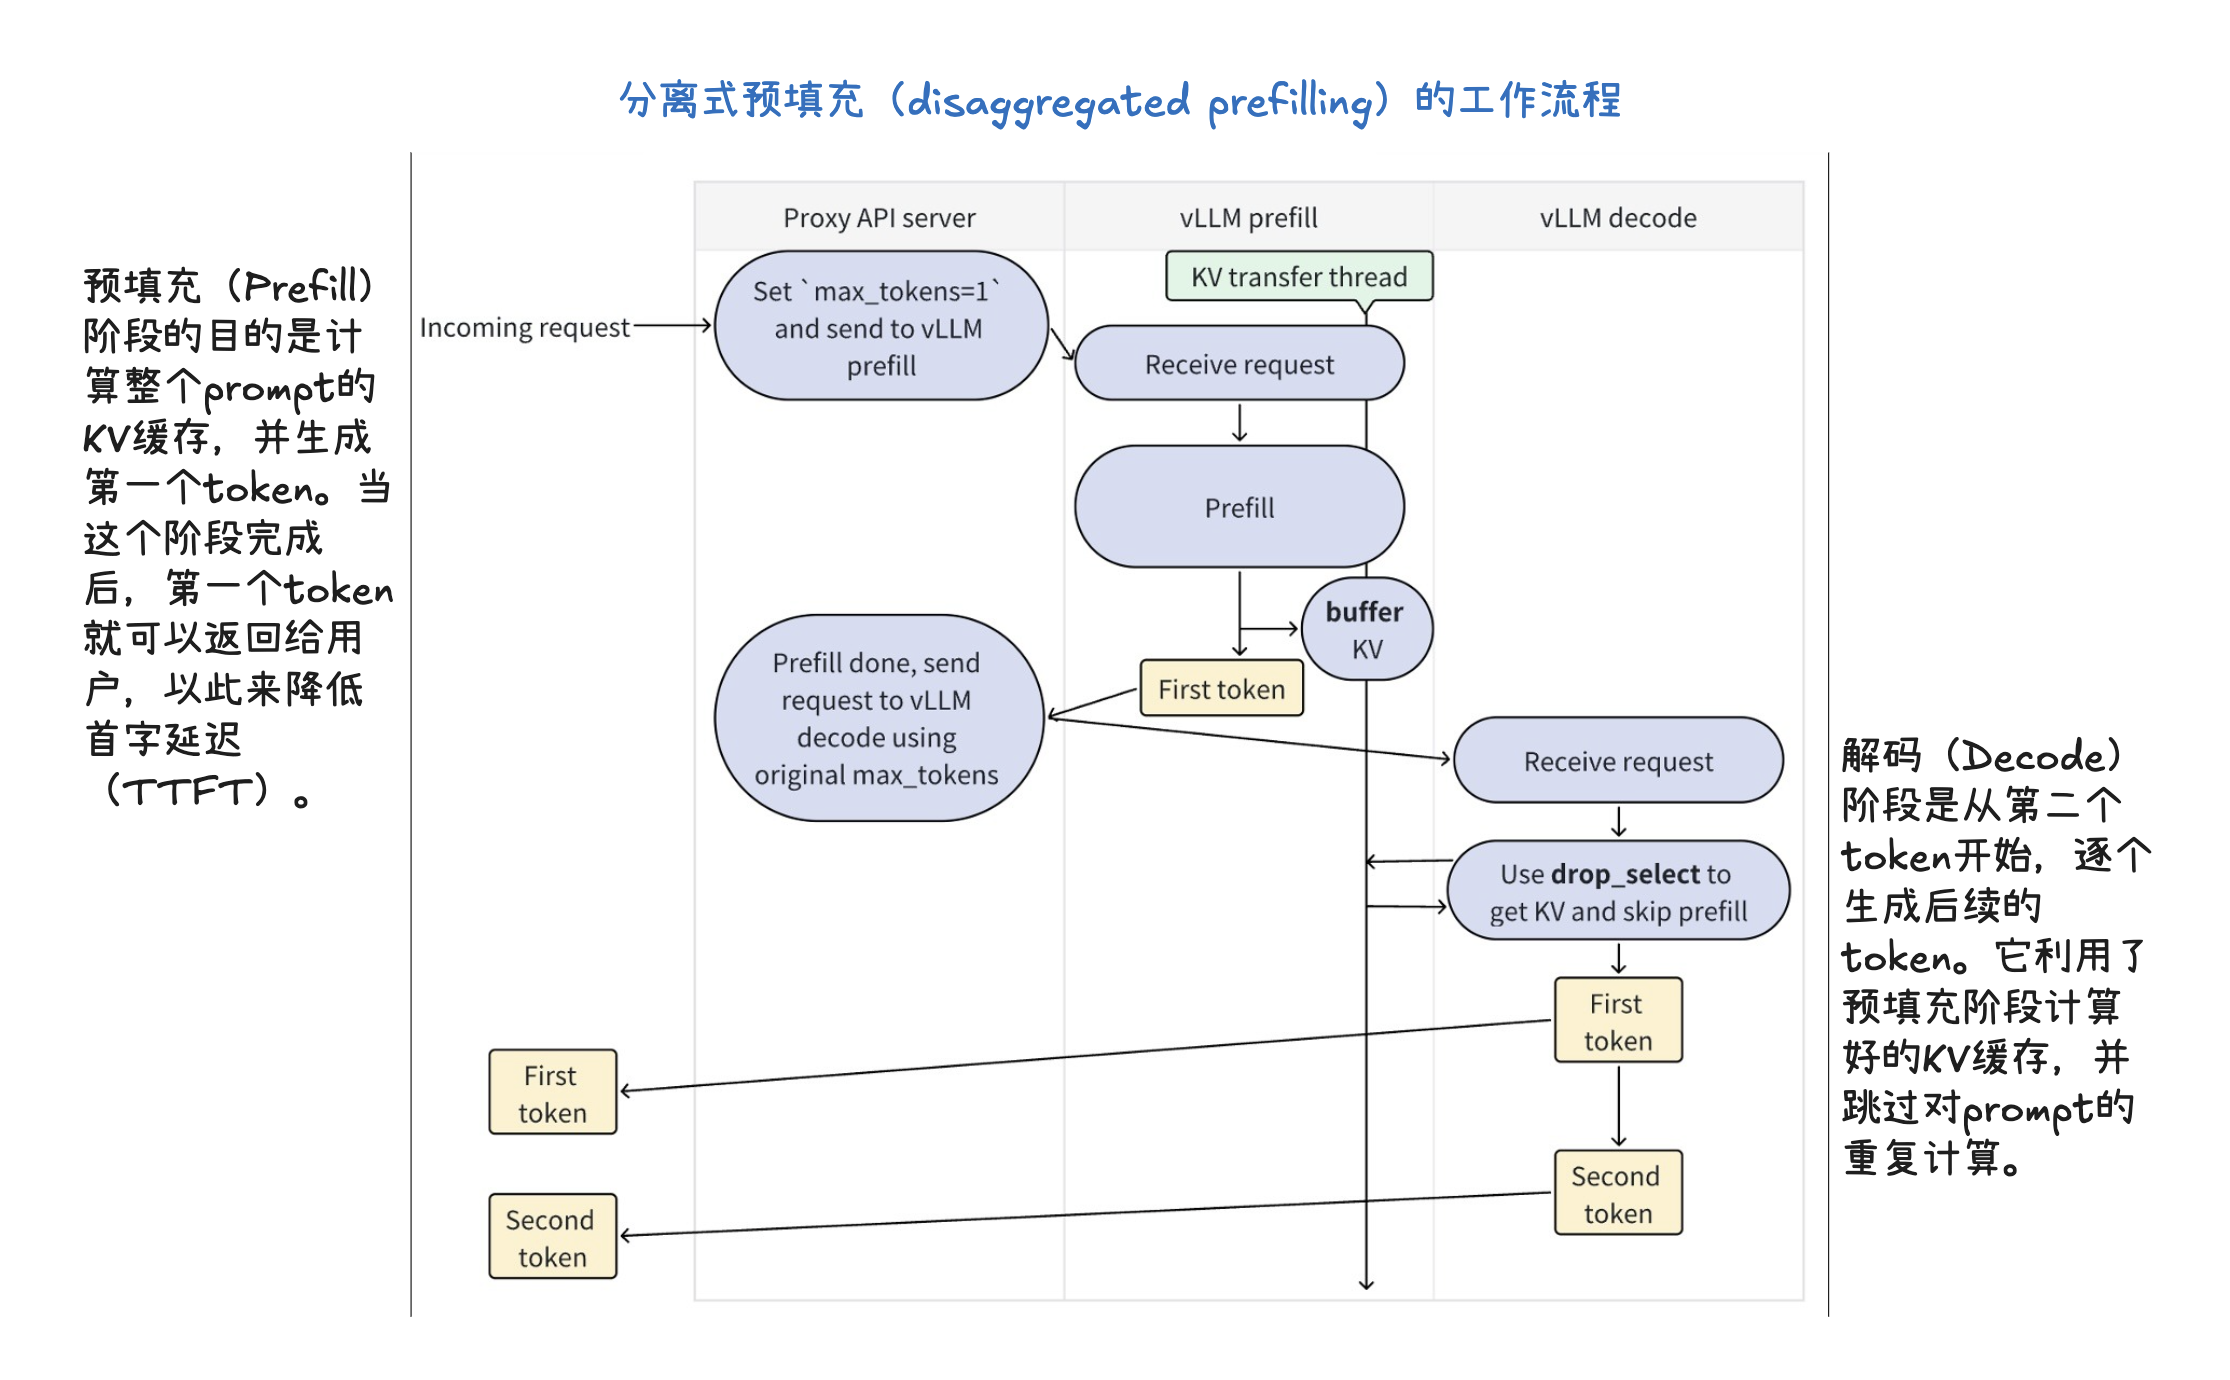
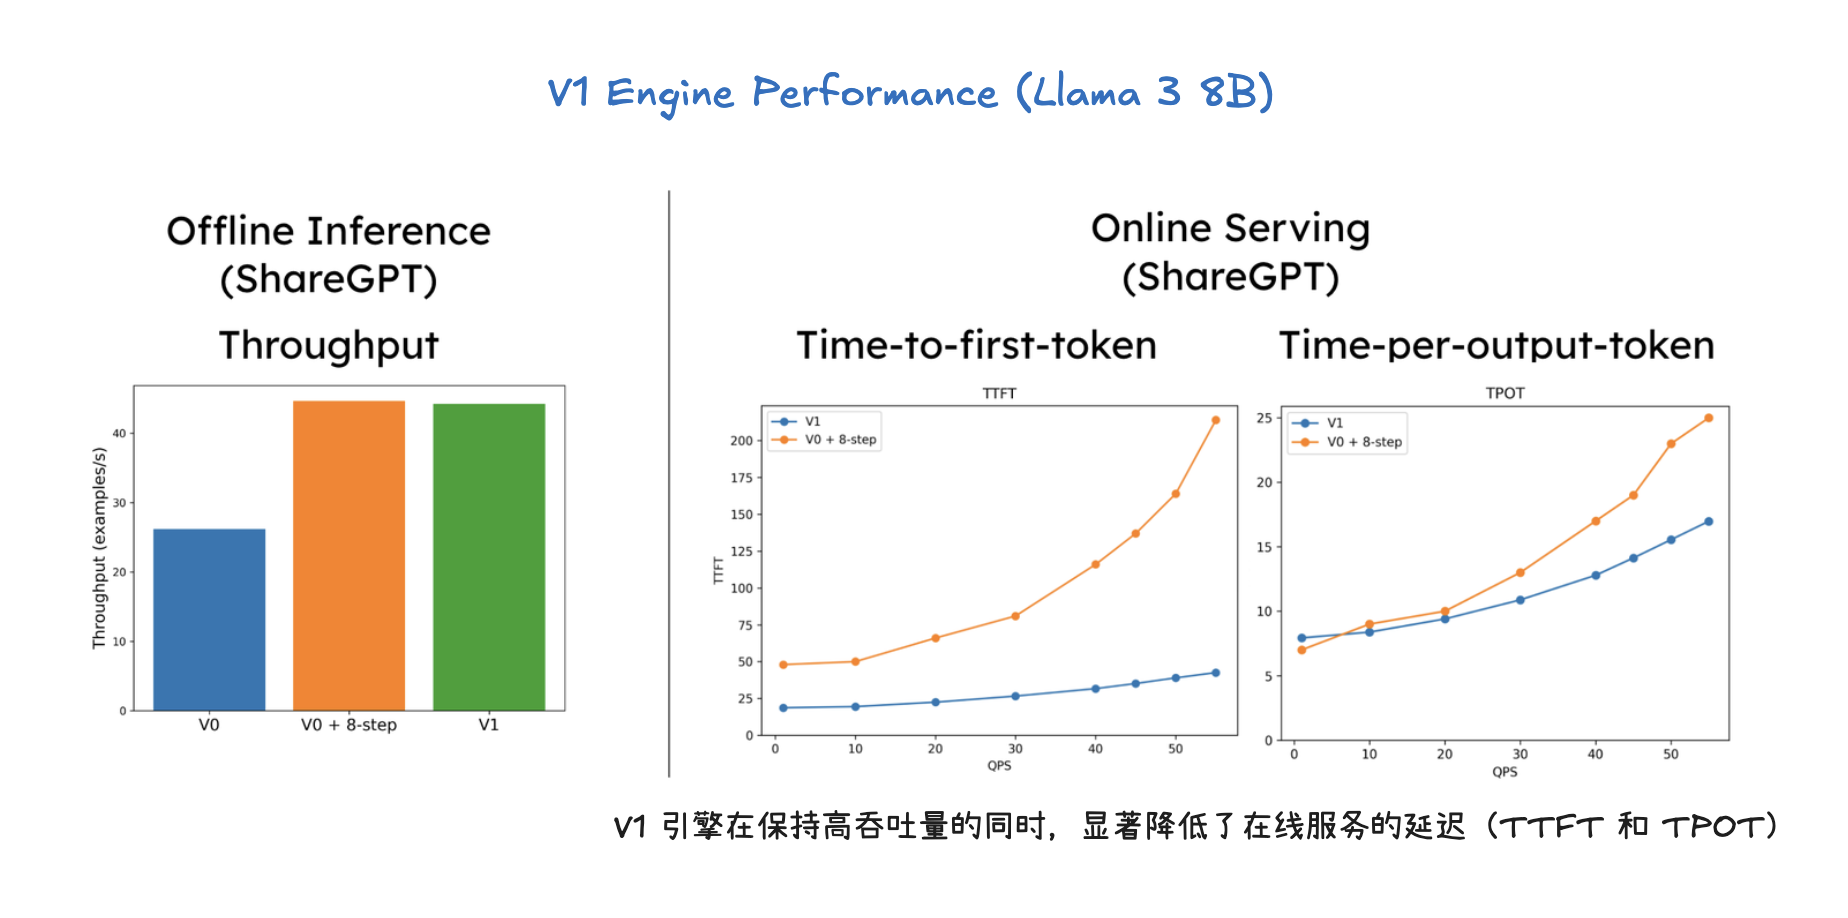
vLLM V1 引擎通过优化其核心引擎循环,将输入处理并行化,并引入了分段式 CUDA 图,从而实现了更灵活、动态的执行模型,显著降低了在线服务的延迟(TTFT 和 TPOT),同时保持了高吞吐量。其设计目标是确保 GPU 不闲置,通过 API 服务器和 EngineCore 之间的协作来高效调度和执行任务。为了进一步加速大型语言模型推理,vLLM V1 采用了多种优化技术:它通过分离式预填充和分块预填充来优化首个 token 的生成延迟,并结合连续批处理与分页注意力来提高 KV 缓存的内存效率和 GPU 利用率。此外,前缀缓存技术避免了重复计算相同提示的 KV 缓存,而级联推理则是一种内存带宽高效的共享前缀批处理解码技术,通过结合多查询注意力处理共享 KV 和单查询批处理解码处理独特 KV,特别适用于多用户共享长提示的场景,能显著提升性能。其他高级解码方法如推测性解码利用草稿模型加速生成,跳跃解码则适用于结构化输出场景。最后,量化技术是提升性能的关键手段,通过对权重、激活值和 KV 缓存使用低位精度(如 FP8、INT8),它能减少存储和内存占用,加速计算密集型和内存带宽密集型任务,并允许在固定硬件下处理更多 token,从而大幅提升吞吐量,同时保持模型准确性。
V1 Engine 工作流程
推理优化
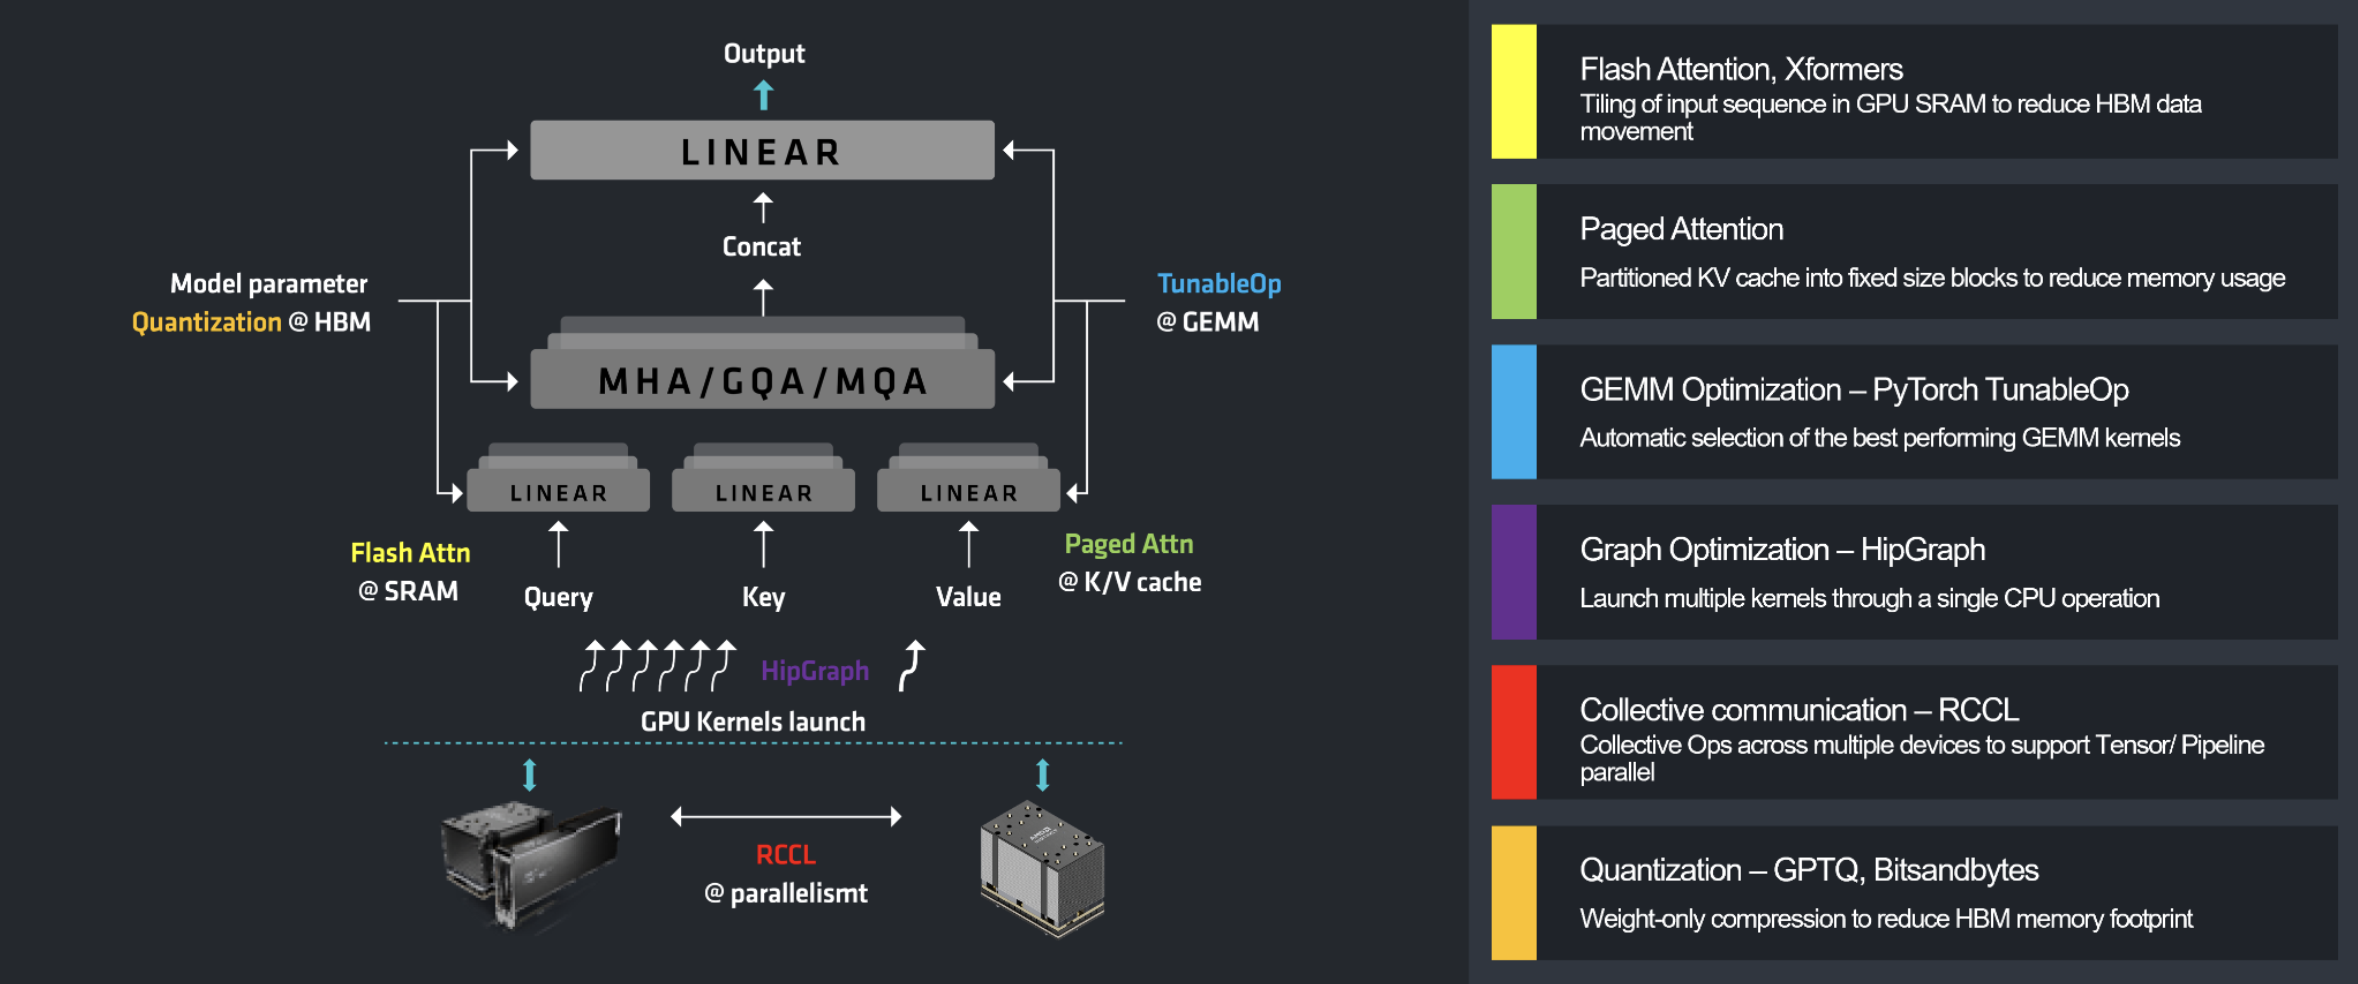
典型 LLM 推理优化
该文章详细探讨了如何通过优化vLLM框架来提升Qwen3-4B大型语言模型在Tesla T4 GPU上的推理性能。实验中,我评估了不同配置对关键性能指标的影响,包括首次生成Token时间(TTFT)、端到端延迟(E2EL)和请求吞吐量。结果表明,结合前缀缓存(prefix caching)、分块预填充(chunked prefill)以及调整批处理Token数量(max-num-batched-tokens=8192)能显著改善模型性能。尤其在模拟Agent场景下的自定义数据集测试中,这些优化措施成功将TTFT大幅降低约64%,同时提升了请求和输出Token的吞吐量。最终,文章提供了一套推荐的最佳vLLM部署配置,旨在最大化长上下文模型的推理效率和用户体验。
vLLM 工作流程
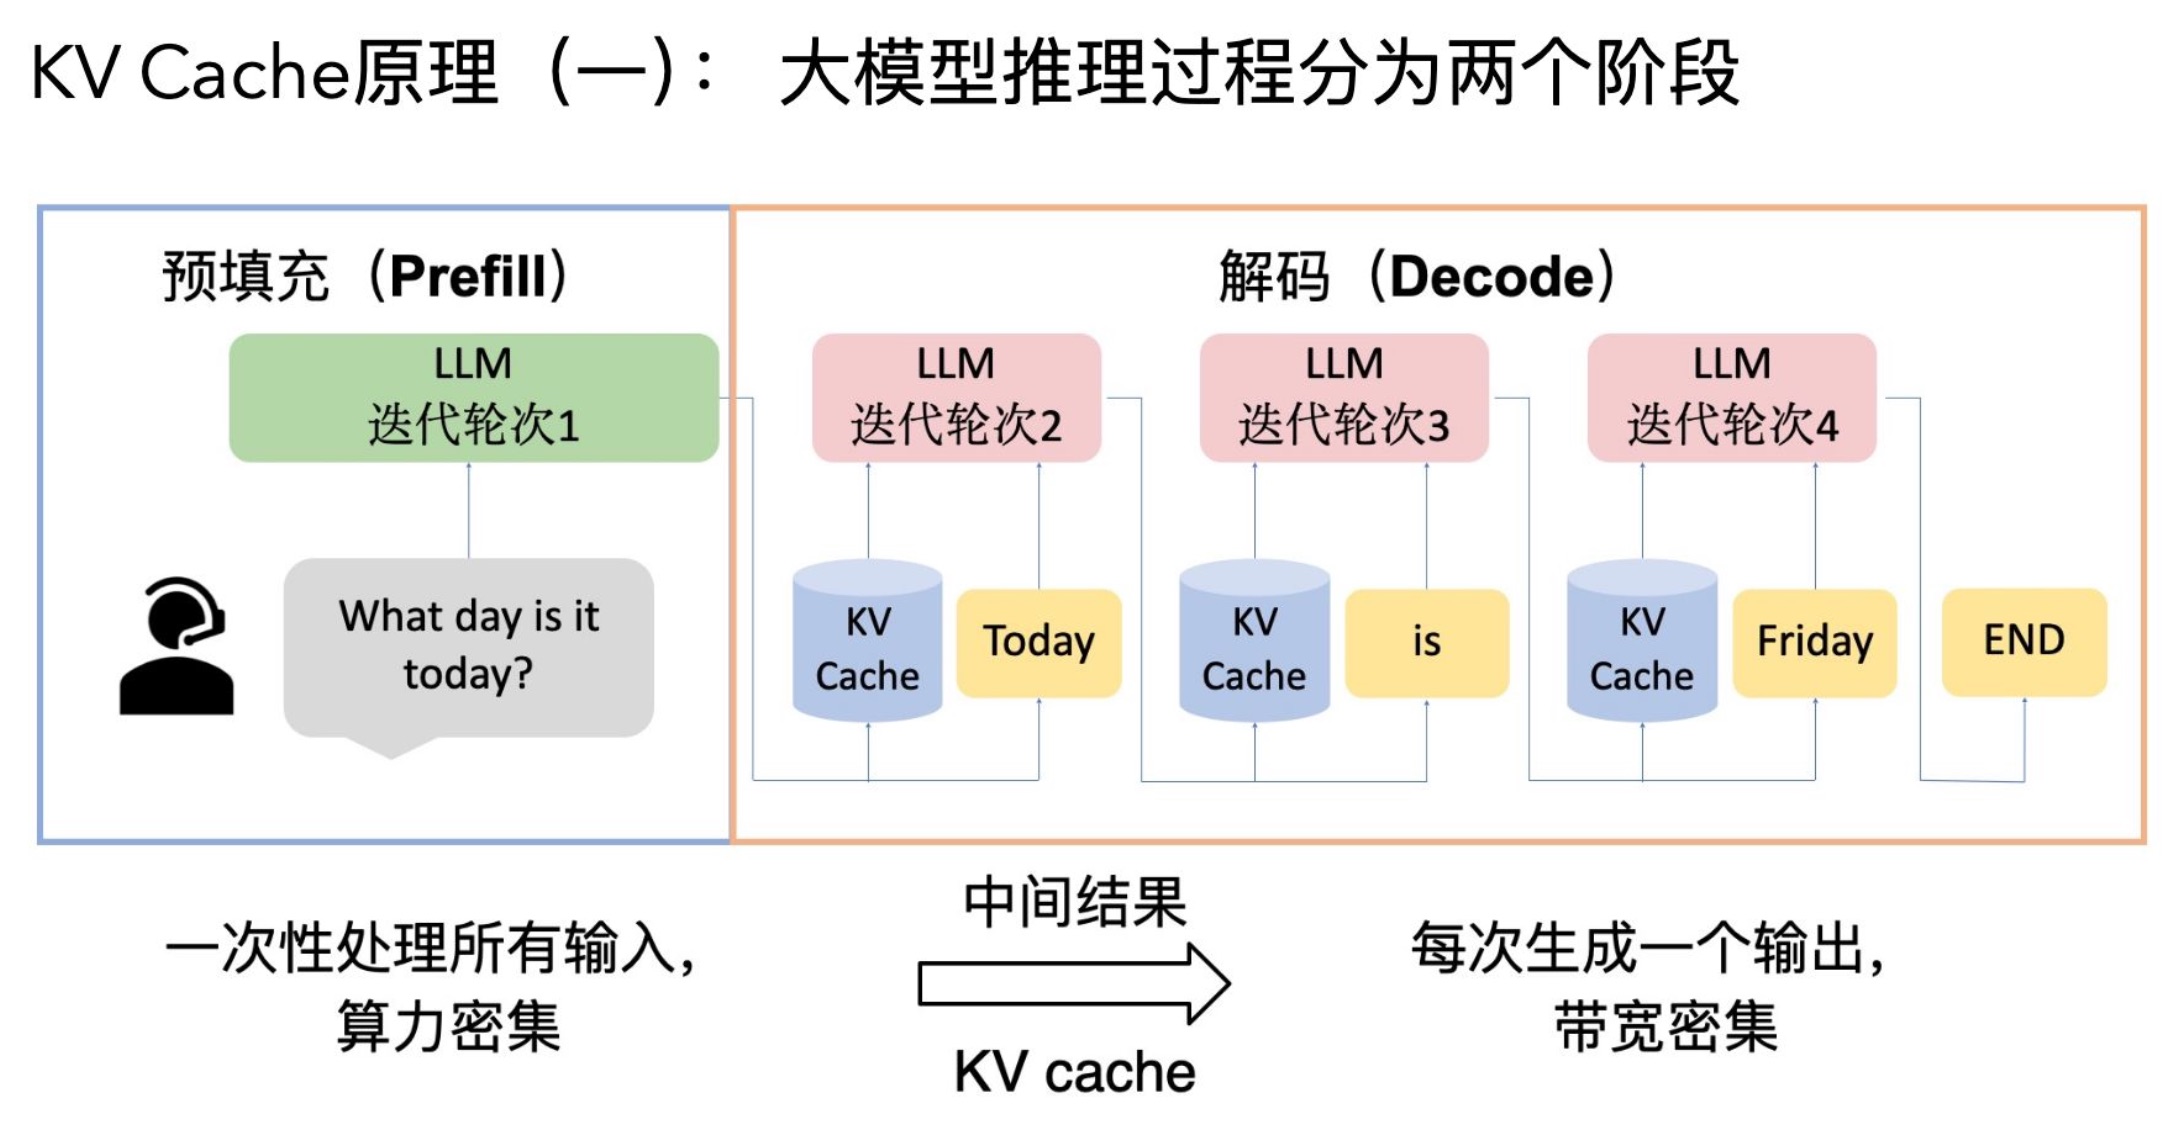
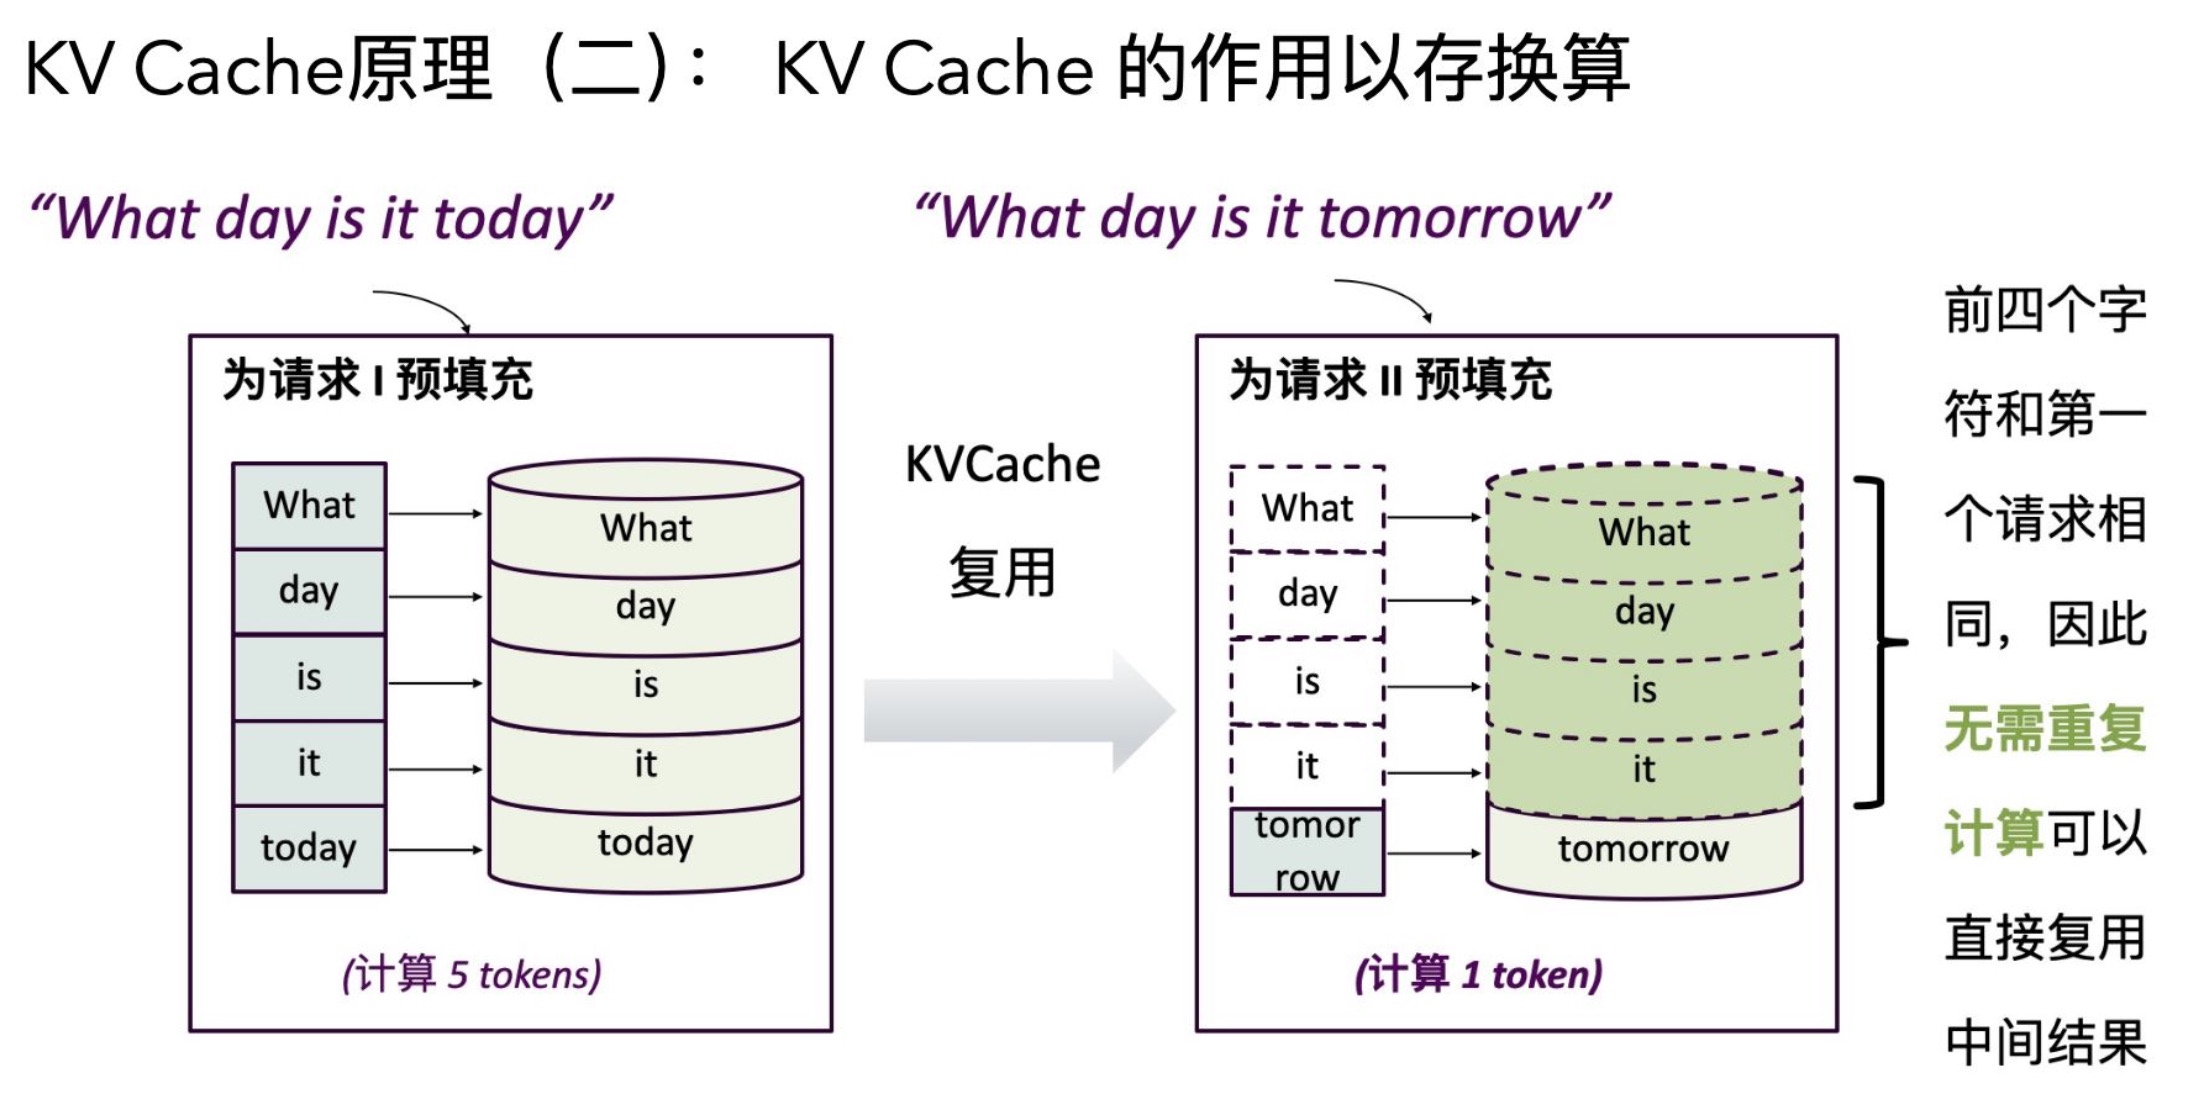
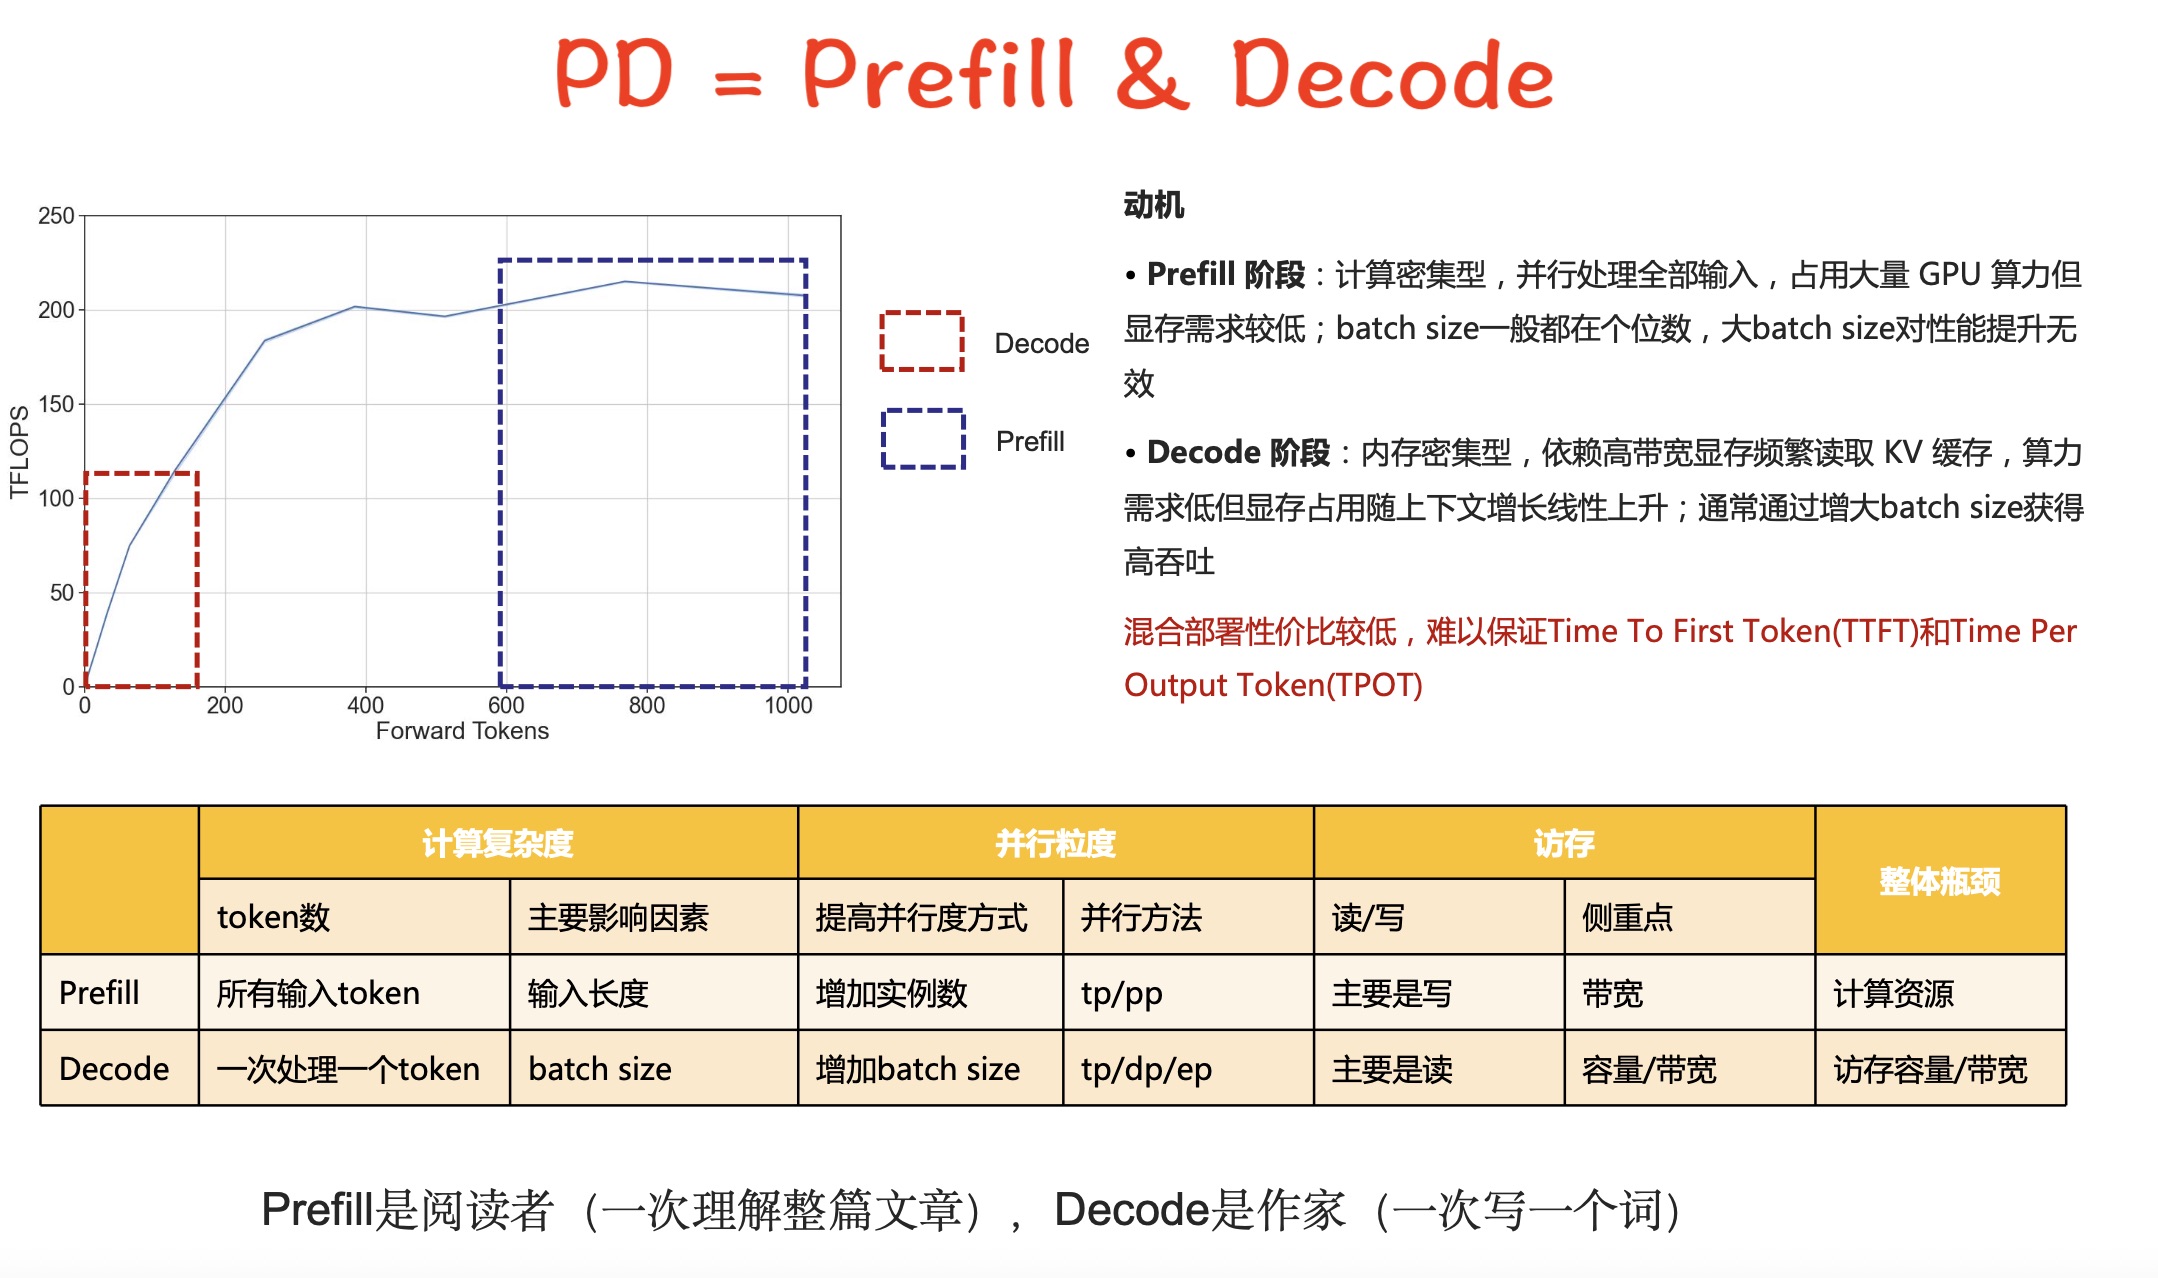
1. Prefill
Prefill 阶段是指模型在生成任务开始时,将输入 prompt(提示词)全部送入模型,并填充(prefill)KV Cache(键值缓存)。这个阶段通常只在生成的第一个 token 前进行。
examples/offline_inference/disaggregated_prefill.py没有找到匹配的文章