Qwen3.8-27B on M2 Max · 推理提速深度研究HTML
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
本文基于 DeepSpec 开源代码,以
Qwen3-4B+DSpark为具体实例,从算法思想、模型架构、训练数据流、推理流程四个维度,逐行拆解代码,帮助你完整理解 DSpark 草稿模型的训练与推理工作原理。
DeepSpec 核心工作原理
DeepSpec 训练草稿模型的本质是:在目标模型的 backbone 架构上,构建一个更小的 draft 网络,使用目标模型预计算的 hidden states 作为监督信号进行训练。
因此,适配新模型的核心工作量是让 draft 模型能够"理解"目标模型的内部表示——这包括:
一、DSpark 是什么:核心思想
DSpark 是一种面向推测解码(Speculative Decoding)的草稿模型训练方法。它的核心洞察可以总结为一句话:
"让草稿模型在训练时就学会——给定目标模型某几层的 hidden states,一次性猜出接下来的 N 个 token 是什么。"
传统训练语言模型是自回归的:输入 t0, t1, t2,预测 t3。
内网IP:27.41.19.62
| 服务 | 说明 | 端口 | 模型 | 备注 |
|---|---|---|---|---|
| whisperlivekit | 实时语音识别服务 | 8000 | Whispersmall (默认)large-v3-turbo |
带说话人分离 |
| FunASR | 实时语音识别服务 | 8000 | 语音识别:paraformer-zh实时语音识别: paraformer-zh-streaming实时语音端点检测: fsmn-vad标点恢复: ct-punc文本逆规范化: fst_itn_zh |
实时与非实时一体化协同(2pass)服务模式 |
| llama-server | GGUF 模型推理服务 | 8080 | Qwen3Qwen3-8B-Q5_K_M.gguf |
模型名:qwen3 上下文长度:32K 不思考 |
系统设置
系统优化
最大功率模式(一次性设置)
sudo nvpmodel -m 0
启动最高频率(每次重启后设置)
sudo jetson_clocks
清理内存
sync && echo 3 | sudo tee /proc/sys/vm/drop_caches
WhisperLiveKit
部署服务
tmux new -s wlk
默认容器内应用(标点识别有时会失灵 ⚠️)
推理服务
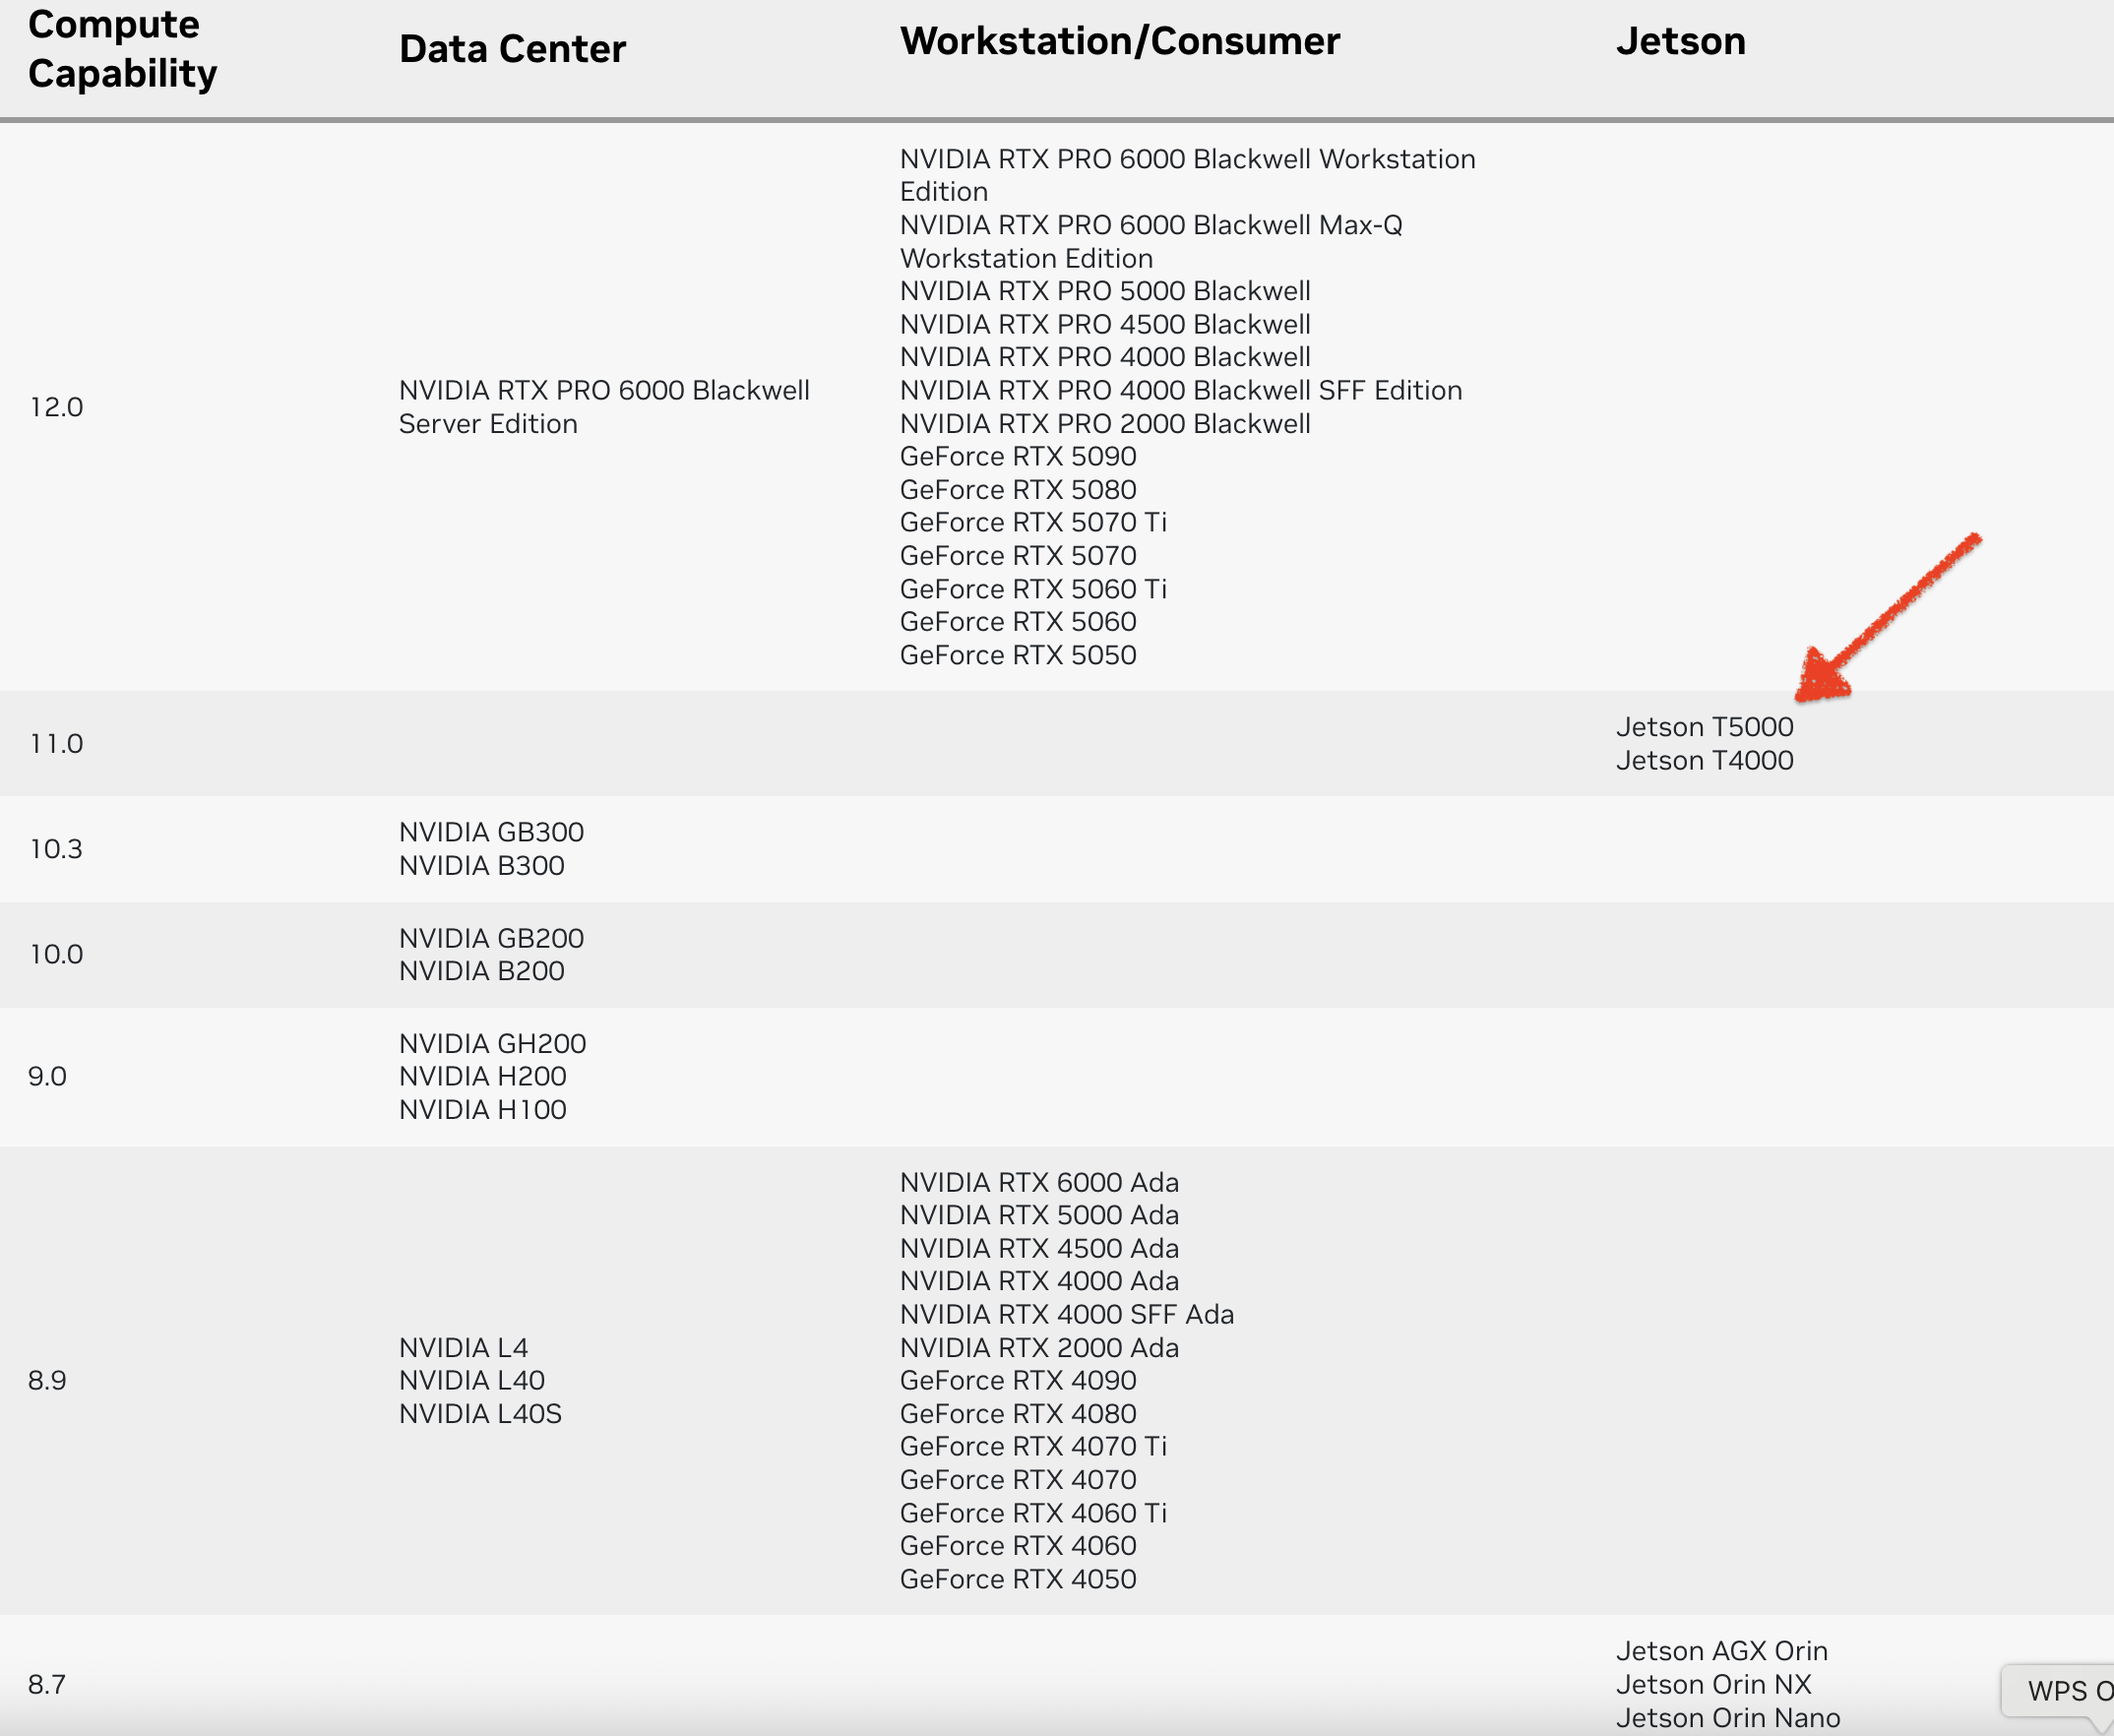
CUDA GPU Compute Capability(计算能力)
计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性和支持的指令。在下表中查找您的GPU的计算能力。
vLLM
docker run -it --rm \
  --ipc=host \
  --net=host \
  --runtime=nvidia \
  --name=vllm-test \
  -v /models:/models \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -v ~/.cache/modelscope:/root/.cache/modelscope \
  nvcr.io/nvidia/vllm:25.10-py3 \
  bash
默认情况下,如果模型未指向有效的本地目录,它将从 Hugging Face Hub 下载模型文件。要从 ModelScope 下载模型,请在运行命令之前进行如下设置:
export VLLM_USE_MODELSCOPE=true
vllm serve /models/Qwen/Qwen3-8B \
  --served-model-name qwen3 \
  --chat-template /models/Qwen/Qwen3-8B/qwen3_nonthinking.jinja
SGLang
本文将介绍如何在 Jetson Thor 平台上编译、部署和测试 llama.cpp 项目中的 GGUF 格式的大模型。
克隆 llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
CUDA GPU Compute Capability(计算能力)
计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性和支持的指令。在下表中查找您的GPU的计算能力。
编译
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="110"
cmake --build build --config Release -j $(nproc)
模型部署
运行 llama-server
NVIDIA Jetson Thor 采用了 Blackwell 架构的 GPU。
性能基准测试分析
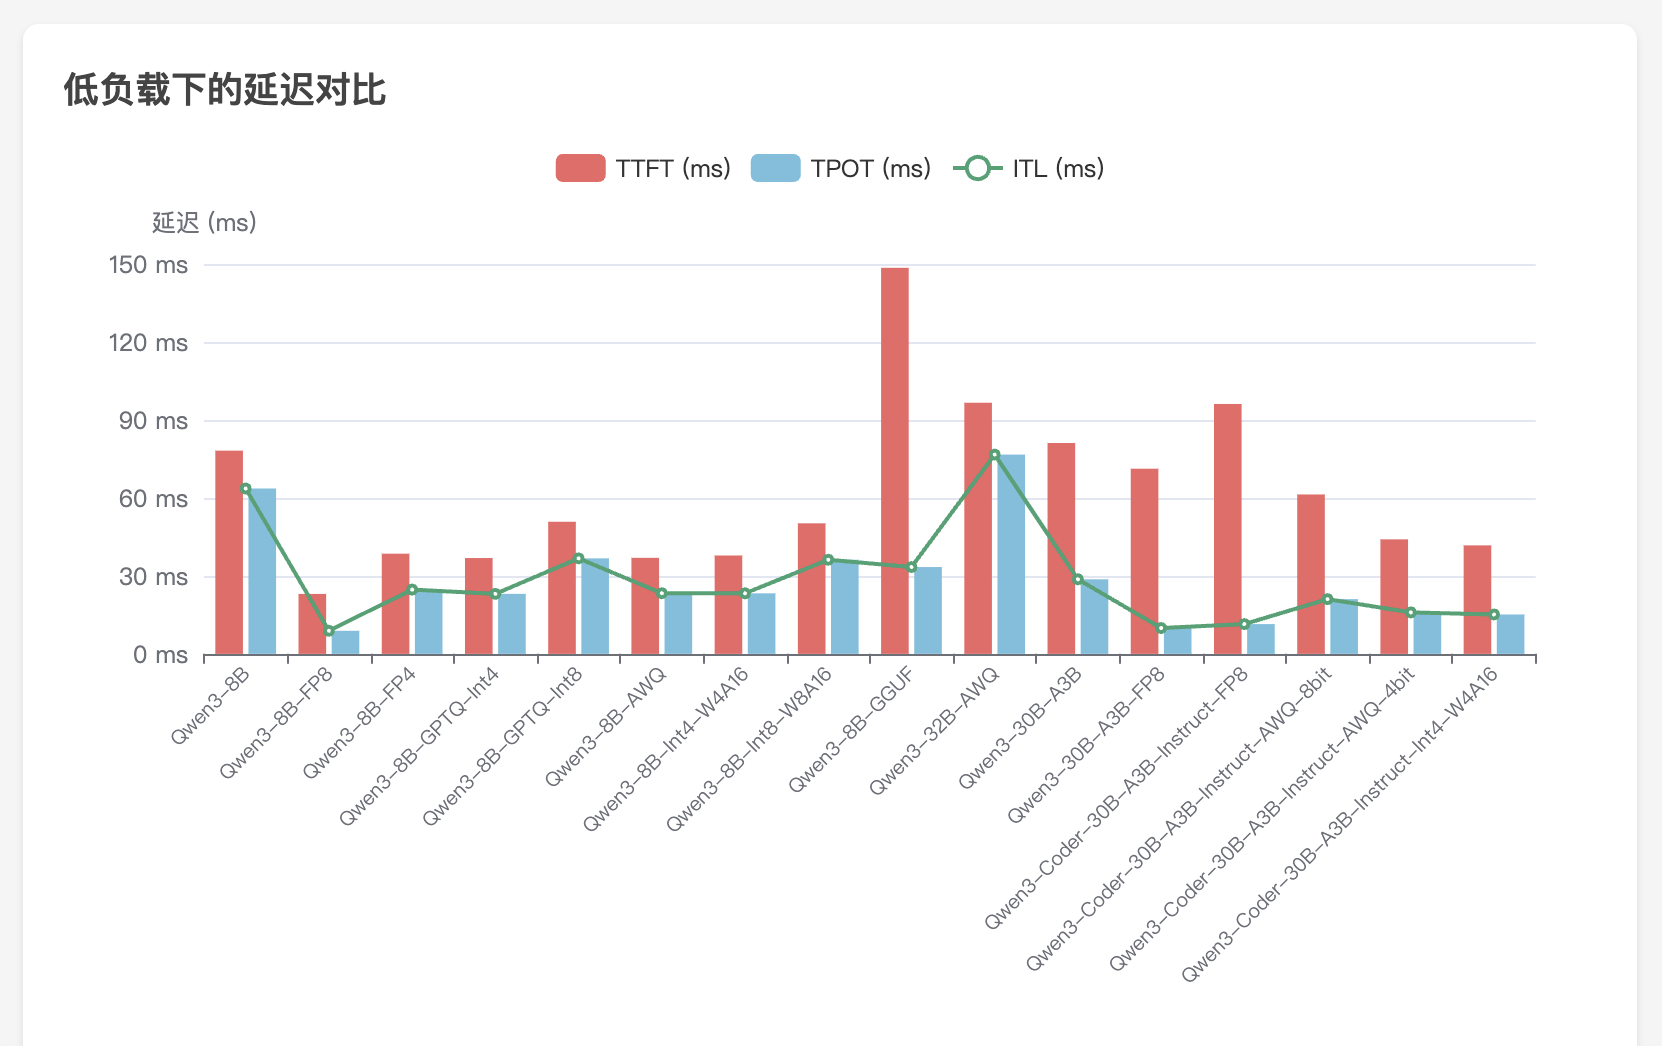
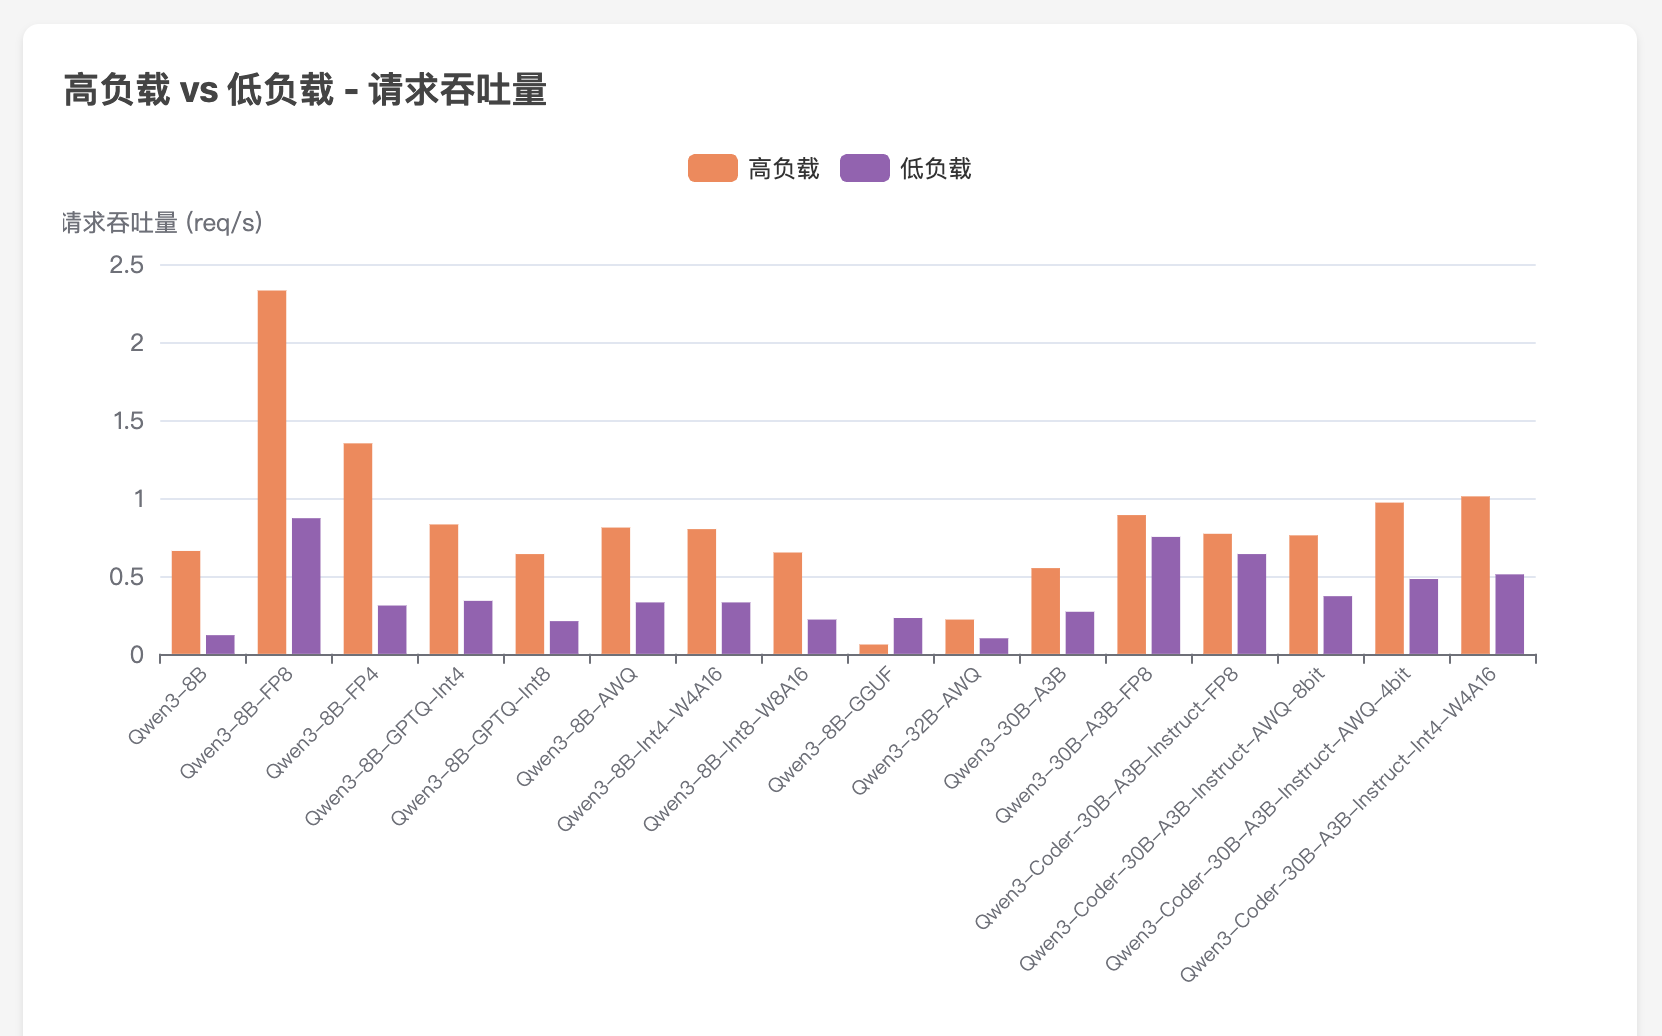
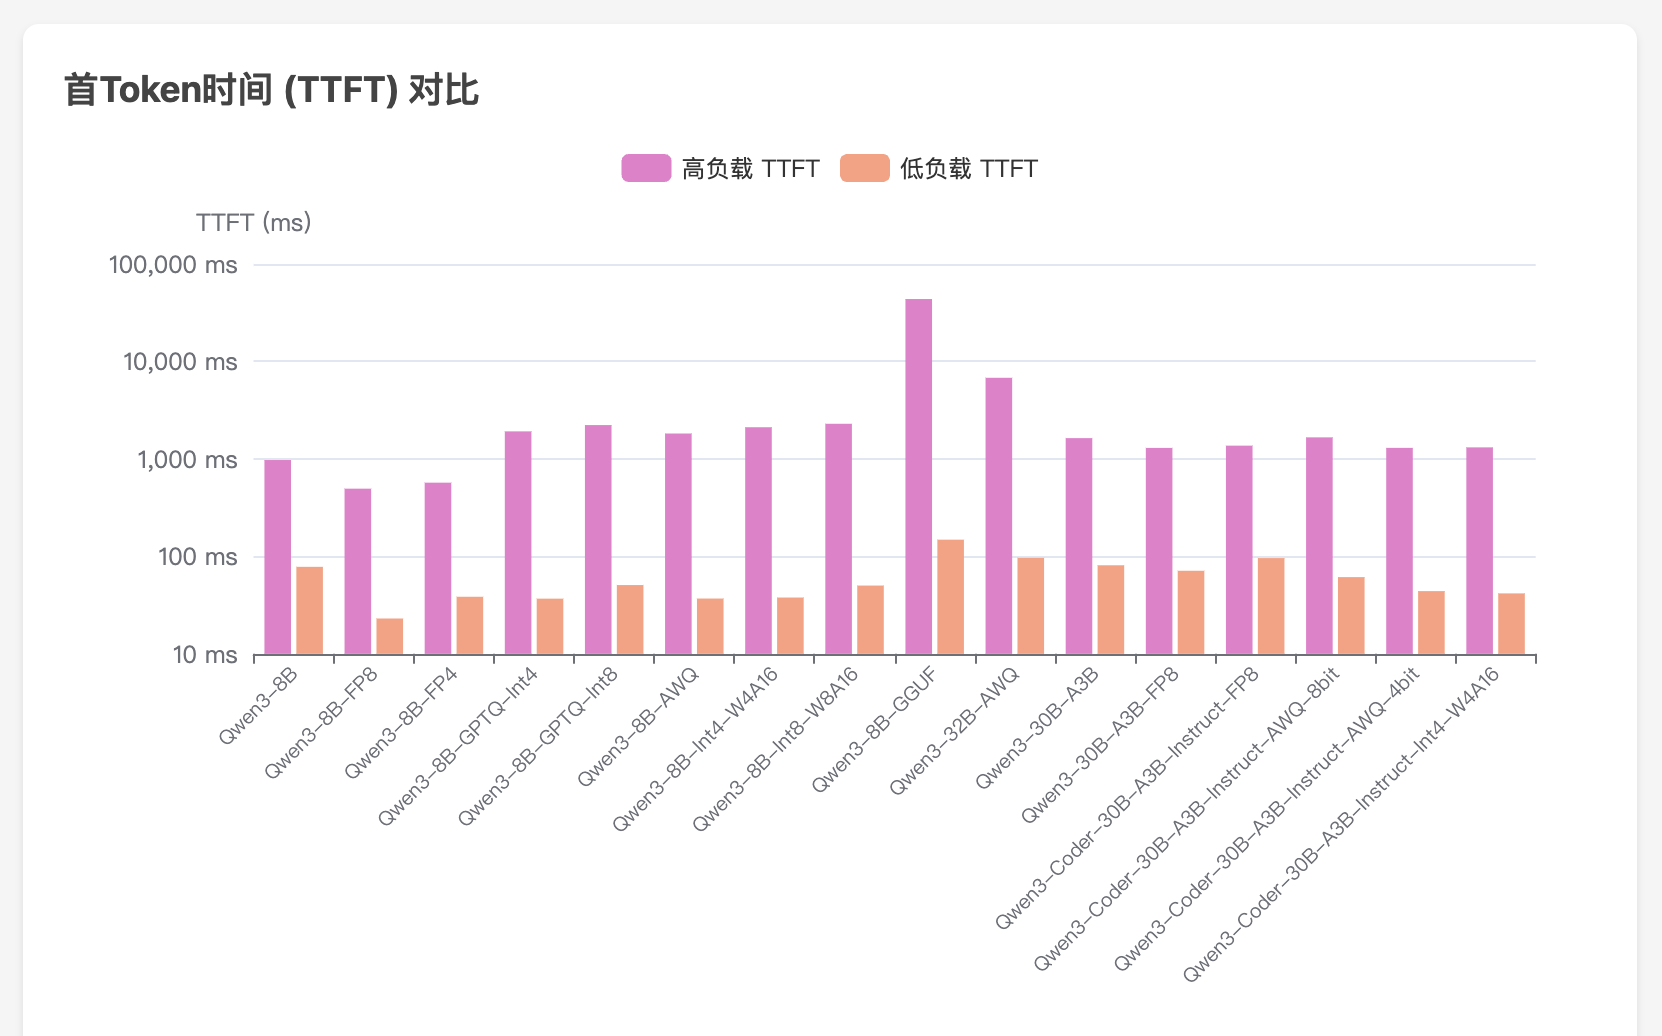
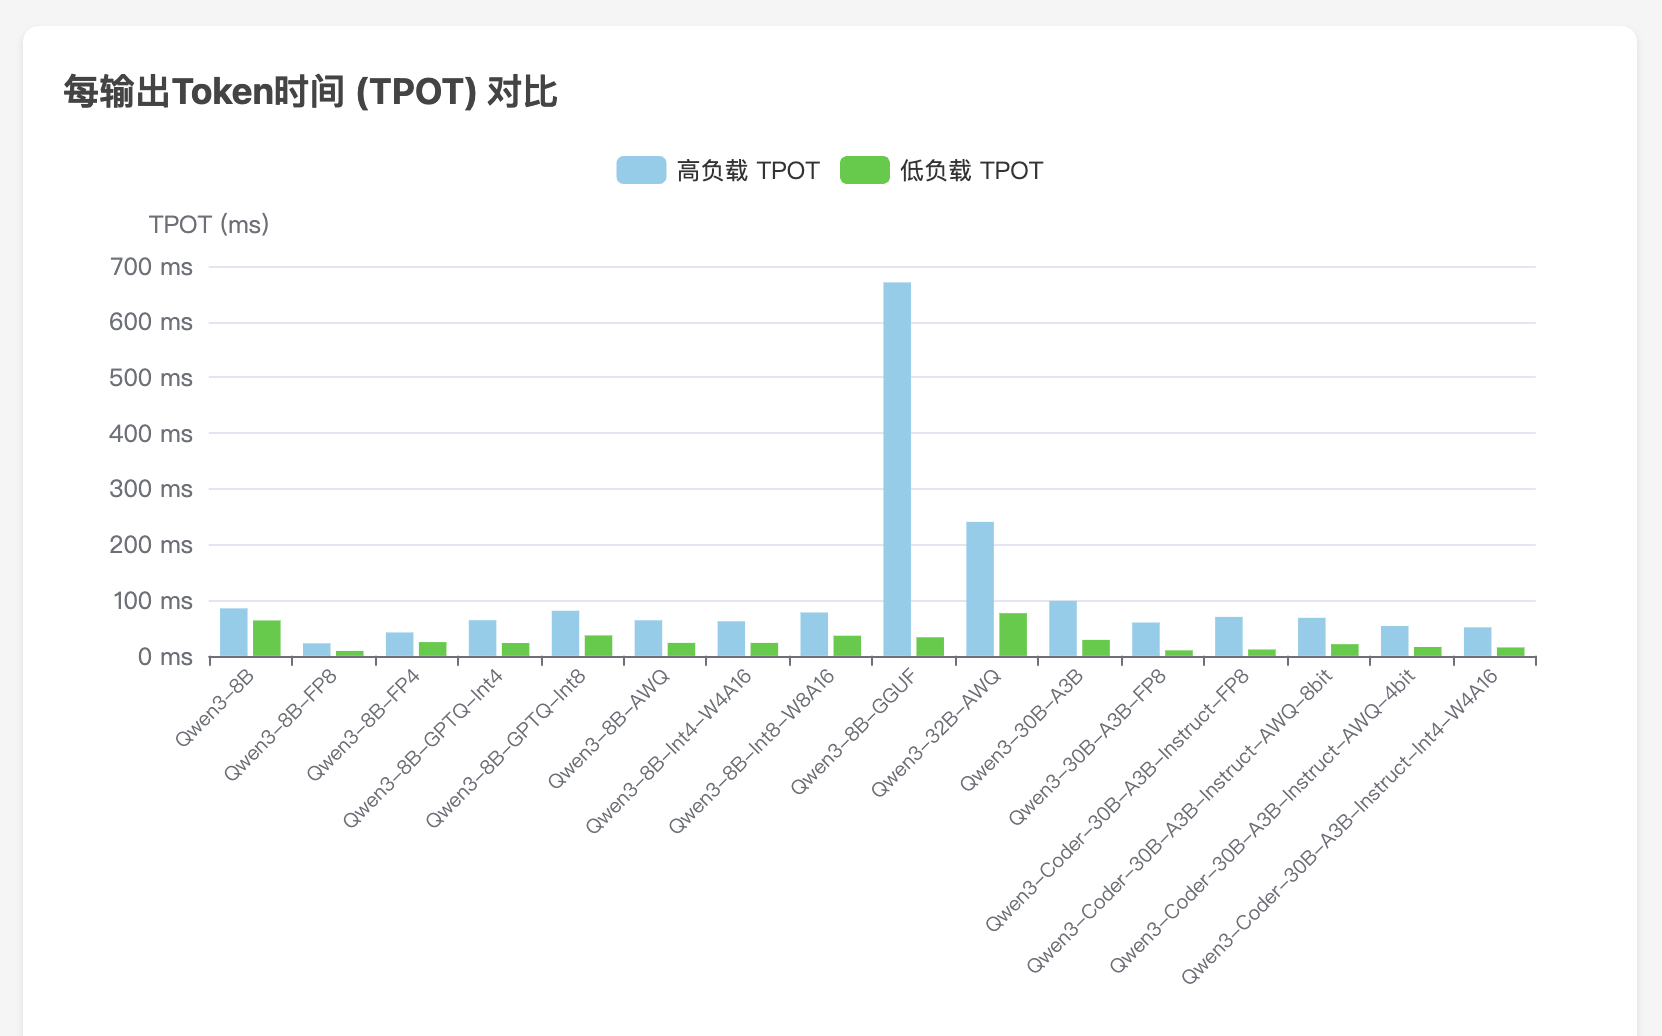
部署模型
vllm serve /models/Qwen/Qwen3-8B --served-model-name qwen3
运行性能基准测试
vllm bench serve \
    --base-url http://localhost:8000 \
    --model qwen3 \
    --tokenizer /models/Qwen/Qwen3-8B \
    --dataset-name random \
    --random-input-len 2048 \
    --random-output-len 128 \
    --num-prompts 100 \
    --max-concurrency 8
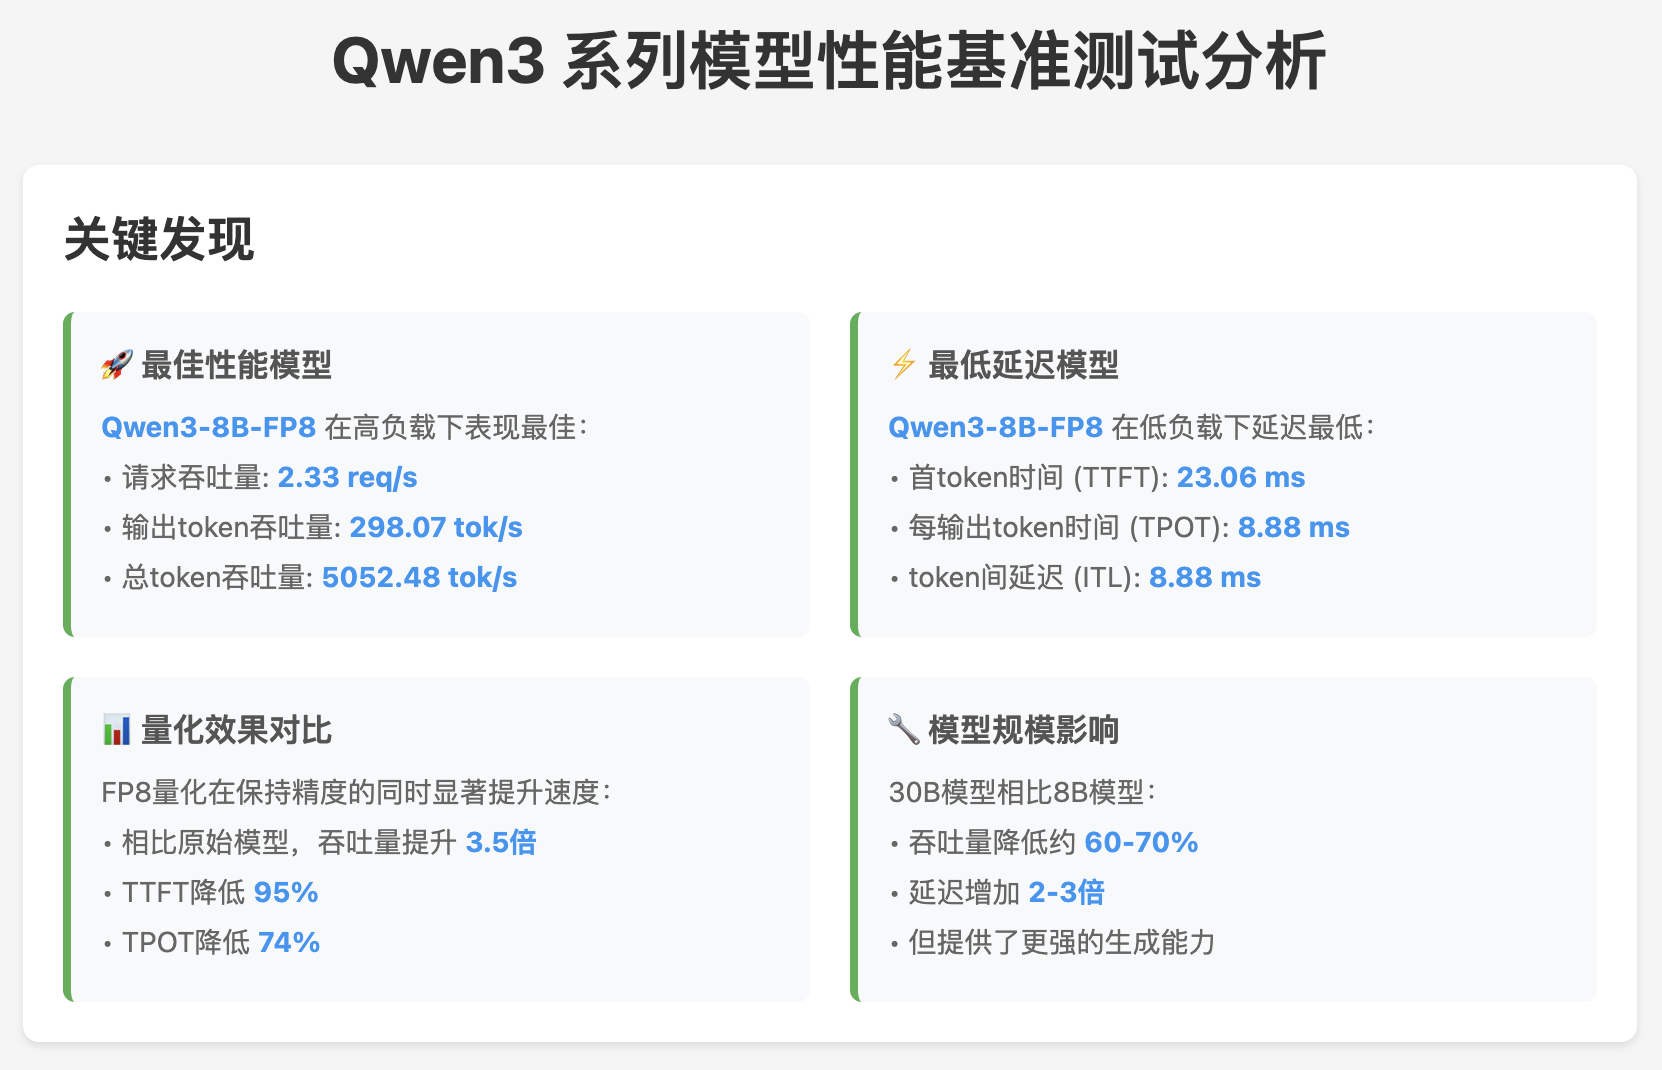
该文章是对 NVIDIA Jetson Thor 平台进行大语言模型部署、系统优化和深度性能基准测试的权威指南。
平台配置与环境准备: 文章首先详细介绍了在 Jetson AGX Thor 开发套件上进行 BSP(Jetson Linux)安装流程。这包括下载 ISO 映像、使用 Balena Etcher 创建可启动 USB 棒,以及通过首次启动完成 UEFI 固件更新和 Ubuntu 初始设置。软件环境基于 JetPack 7,它提供了对前沿机器人和生成式 AI 的全面支持。部署环境采用云原生技术,通过 Docker 容器运行 vLLM 或 TritonServer 等推理服务。
系统性能调优:
为了释放硬件全部潜力,文章强调了系统级的性能调优步骤:必须通过 sudo nvpmodel -m 0 将功耗模式设置为最高性能模式 (MAXN)(130W),并使用 sudo jetson_clocks 锁定 CPU、GPU 和内存的核心频率,禁用 DVFS 机制。测试结果显示,MAXN + jetson_clocks 组合能显著提升性能,在高负载下,FP8 模型的吞吐量提升约 18.5%,在低负载下,每 Token 平均延迟(TPOT)减少约 43%。
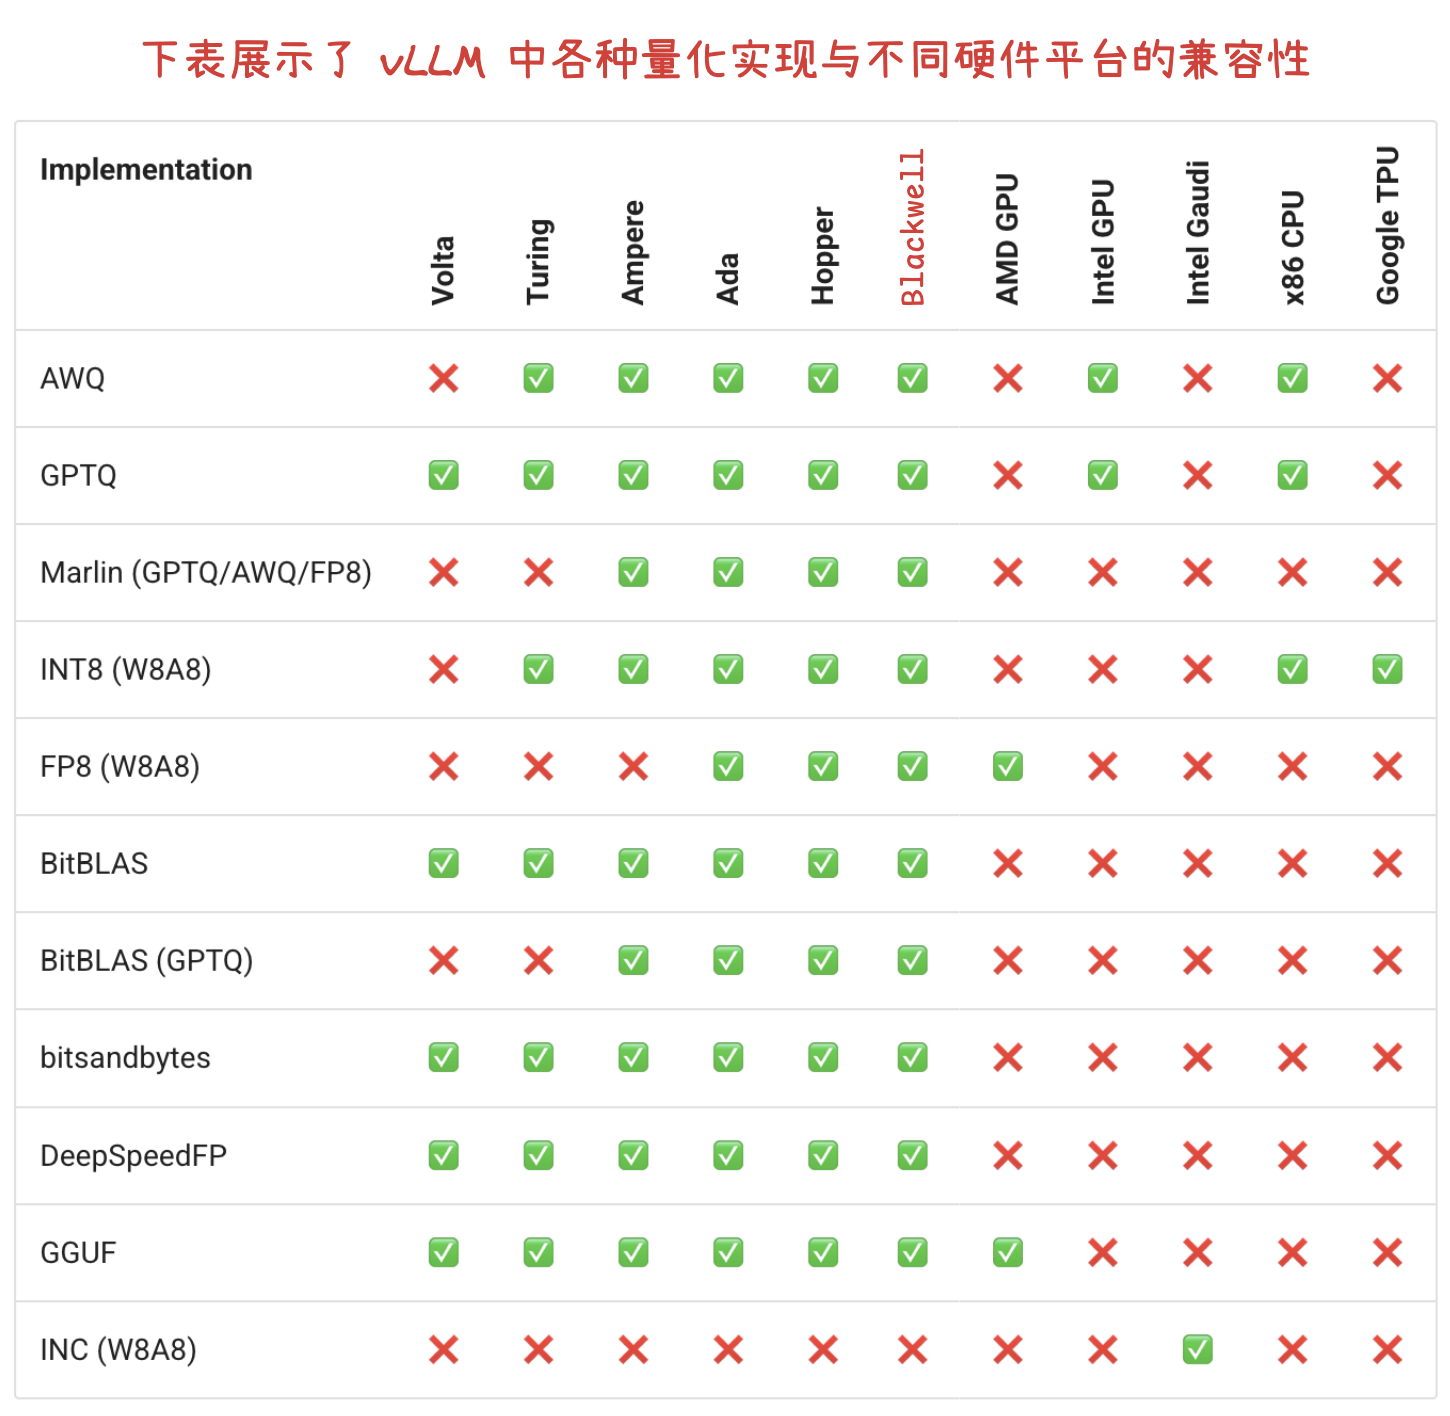
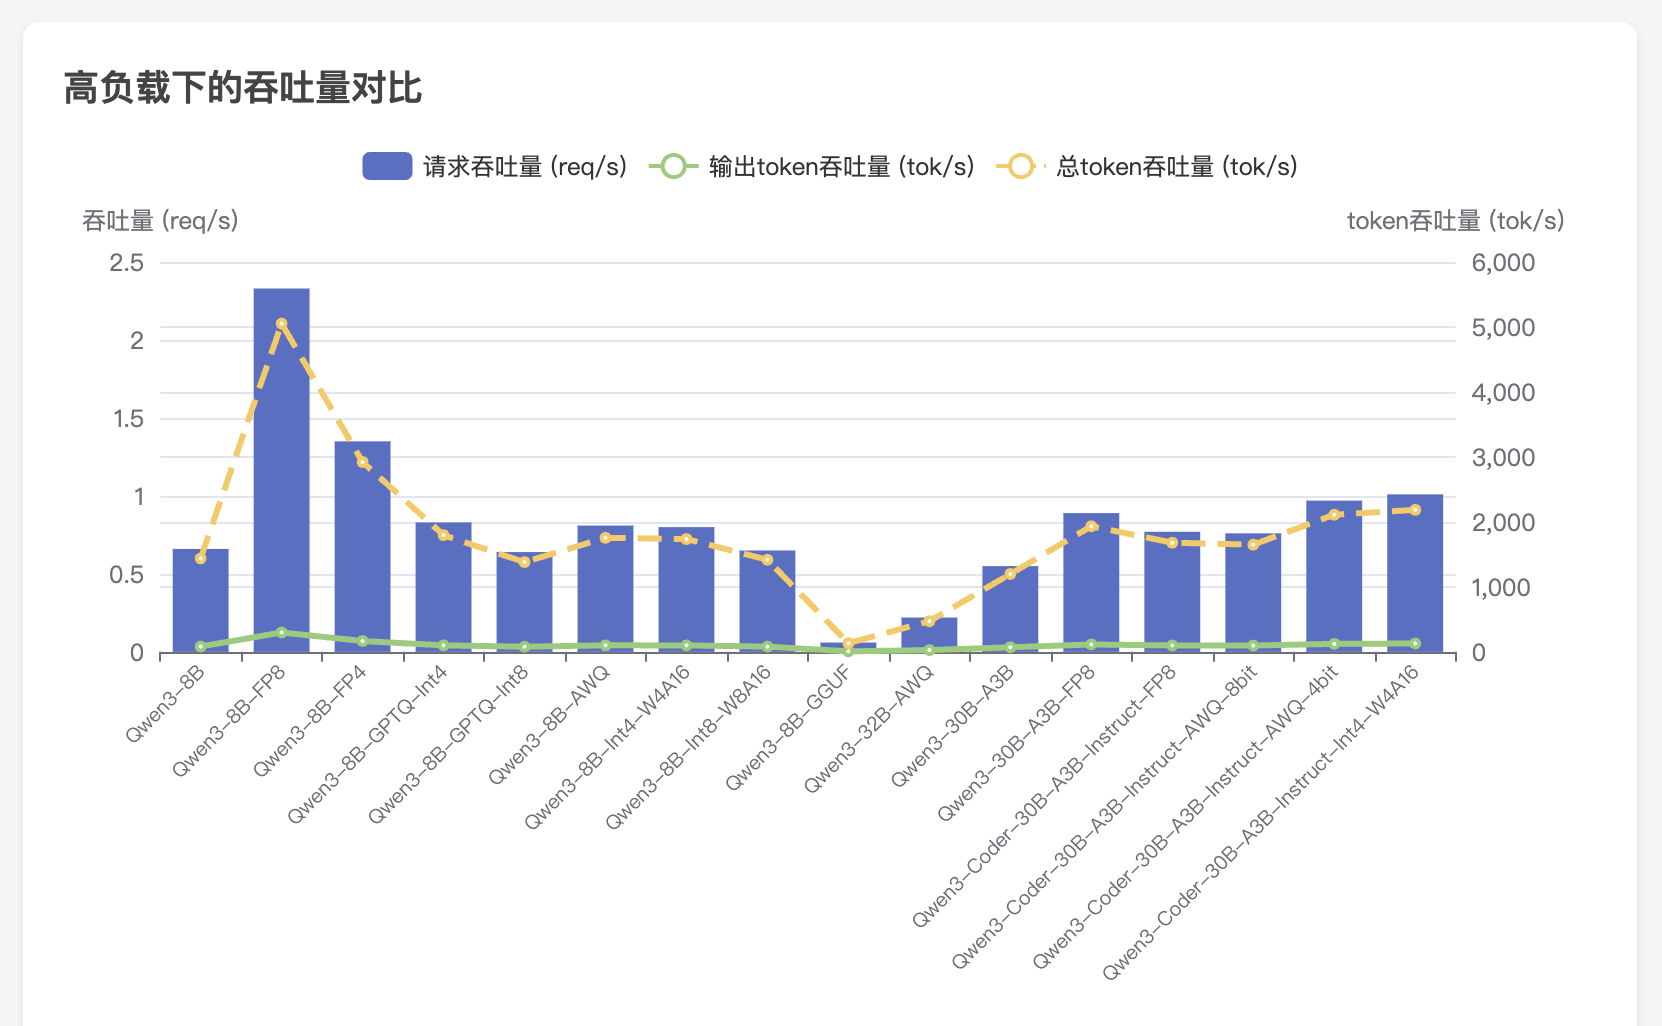
量化模型基准测试结果: 文章对 Qwen3-8B 模型的多种量化精度(包括 BF16、FP8、FP4、Int4 等)进行了详尽的性能分析。
该文章详细探讨了如何通过优化vLLM框架来提升Qwen3-4B大型语言模型在Tesla T4 GPU上的推理性能。实验中,我评估了不同配置对关键性能指标的影响,包括首次生成Token时间(TTFT)、端到端延迟(E2EL)和请求吞吐量。结果表明,结合前缀缓存(prefix caching)、分块预填充(chunked prefill)以及调整批处理Token数量(max-num-batched-tokens=8192)能显著改善模型性能。尤其在模拟Agent场景下的自定义数据集测试中,这些优化措施成功将TTFT大幅降低约64%,同时提升了请求和输出Token的吞吐量。最终,文章提供了一套推荐的最佳vLLM部署配置,旨在最大化长上下文模型的推理效率和用户体验。
vLLM 工作流程
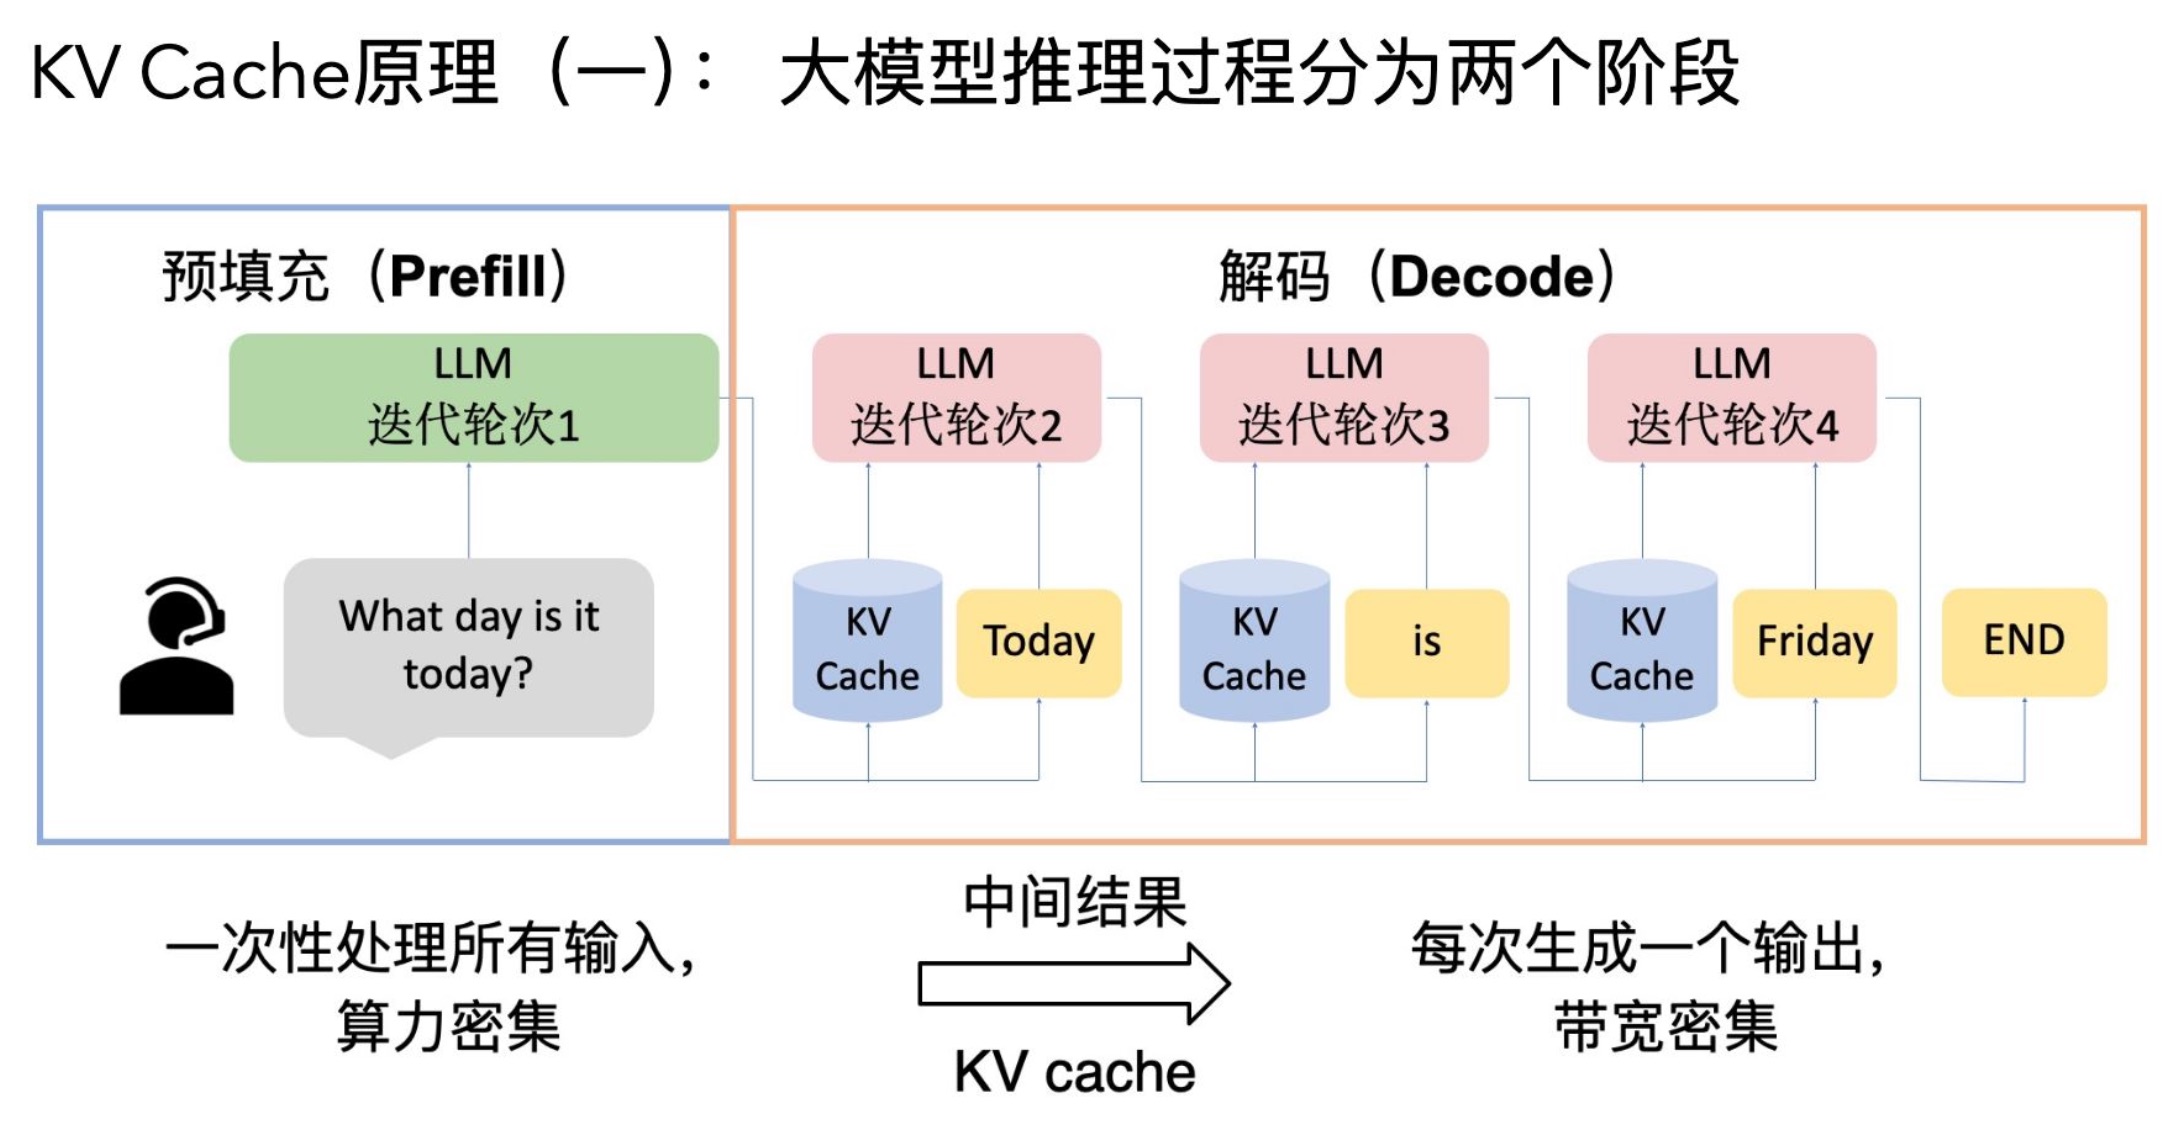
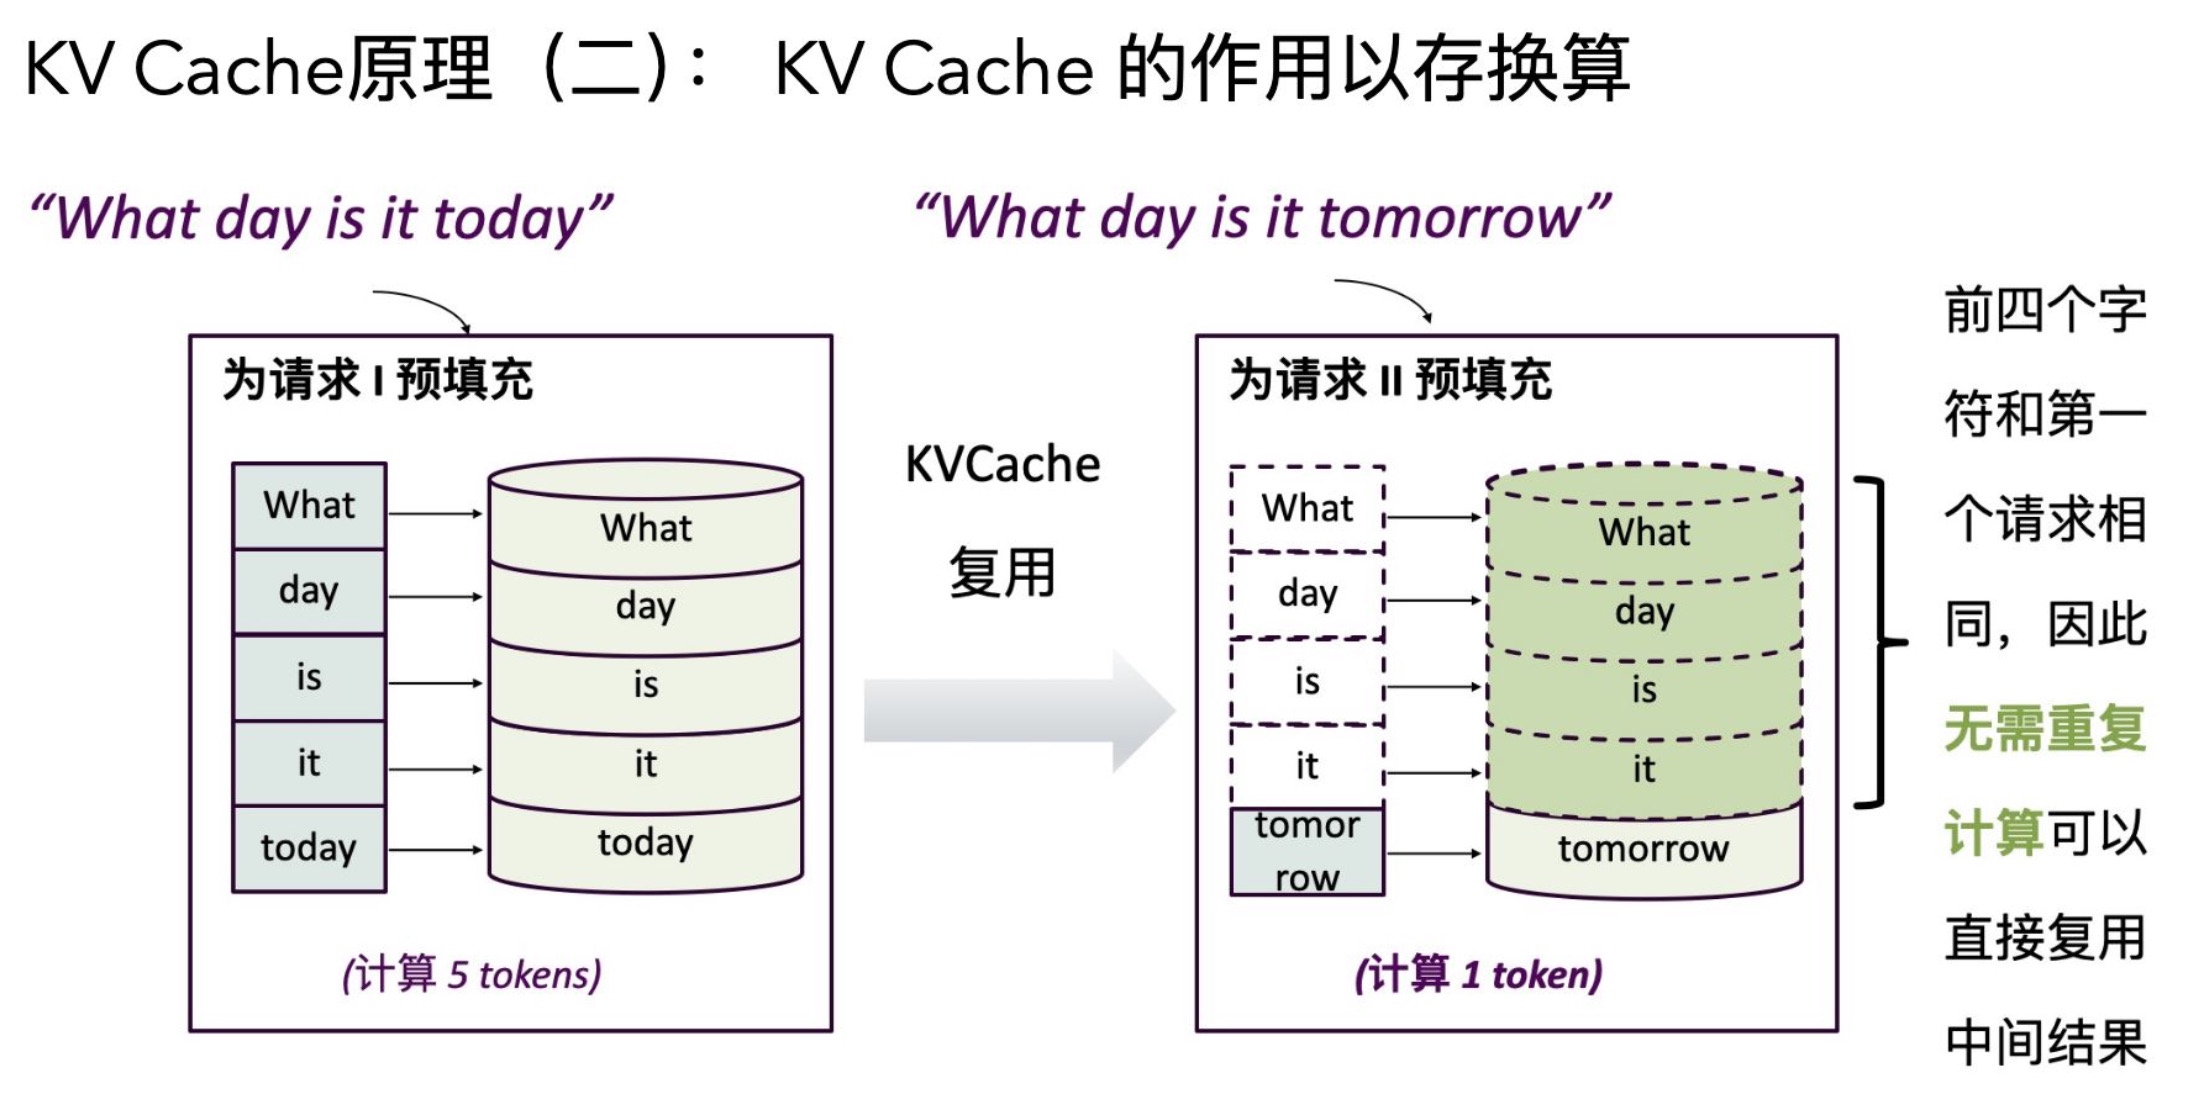
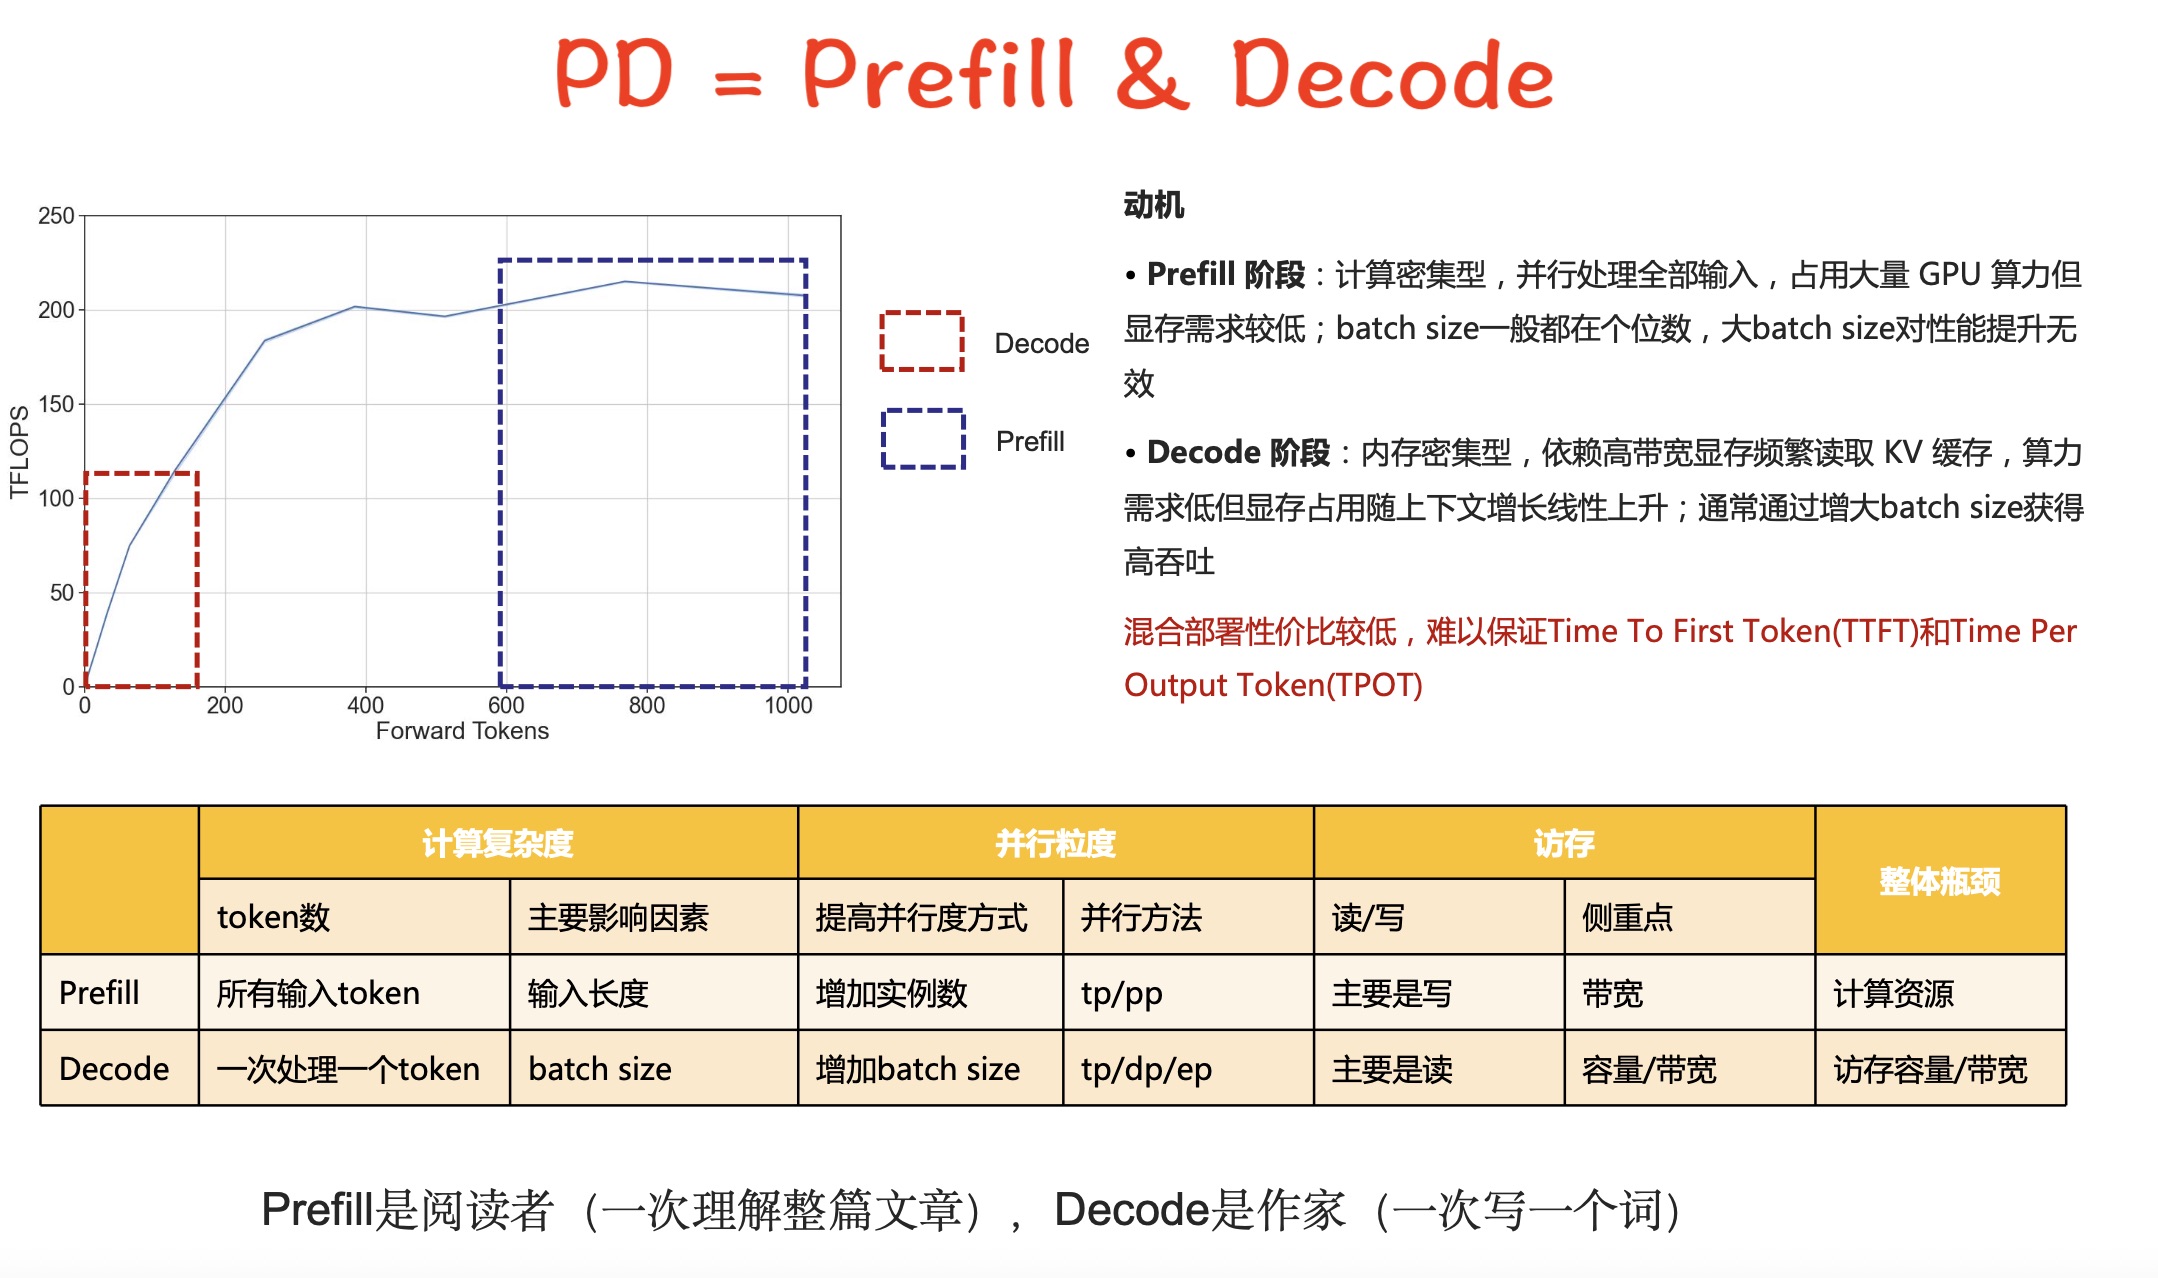
1. Prefill
Prefill 阶段是指模型在生成任务开始时,将输入 prompt(提示词)全部送入模型,并填充(prefill)KV Cache(键值缓存)。这个阶段通常只在生成的第一个 token 前进行。
examples/offline_inference/disaggregated_prefill.py没有找到匹配的文章