Qwen3.8-27B on M2 Max · 推理提速深度研究HTML
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
部署 Reachy Mini 语音智能体
安装 reachy_mini_conversation_app 到 Reachy Mini
在 MacBook 上运行 Reachy Mini Control,单击 Start 按钮。
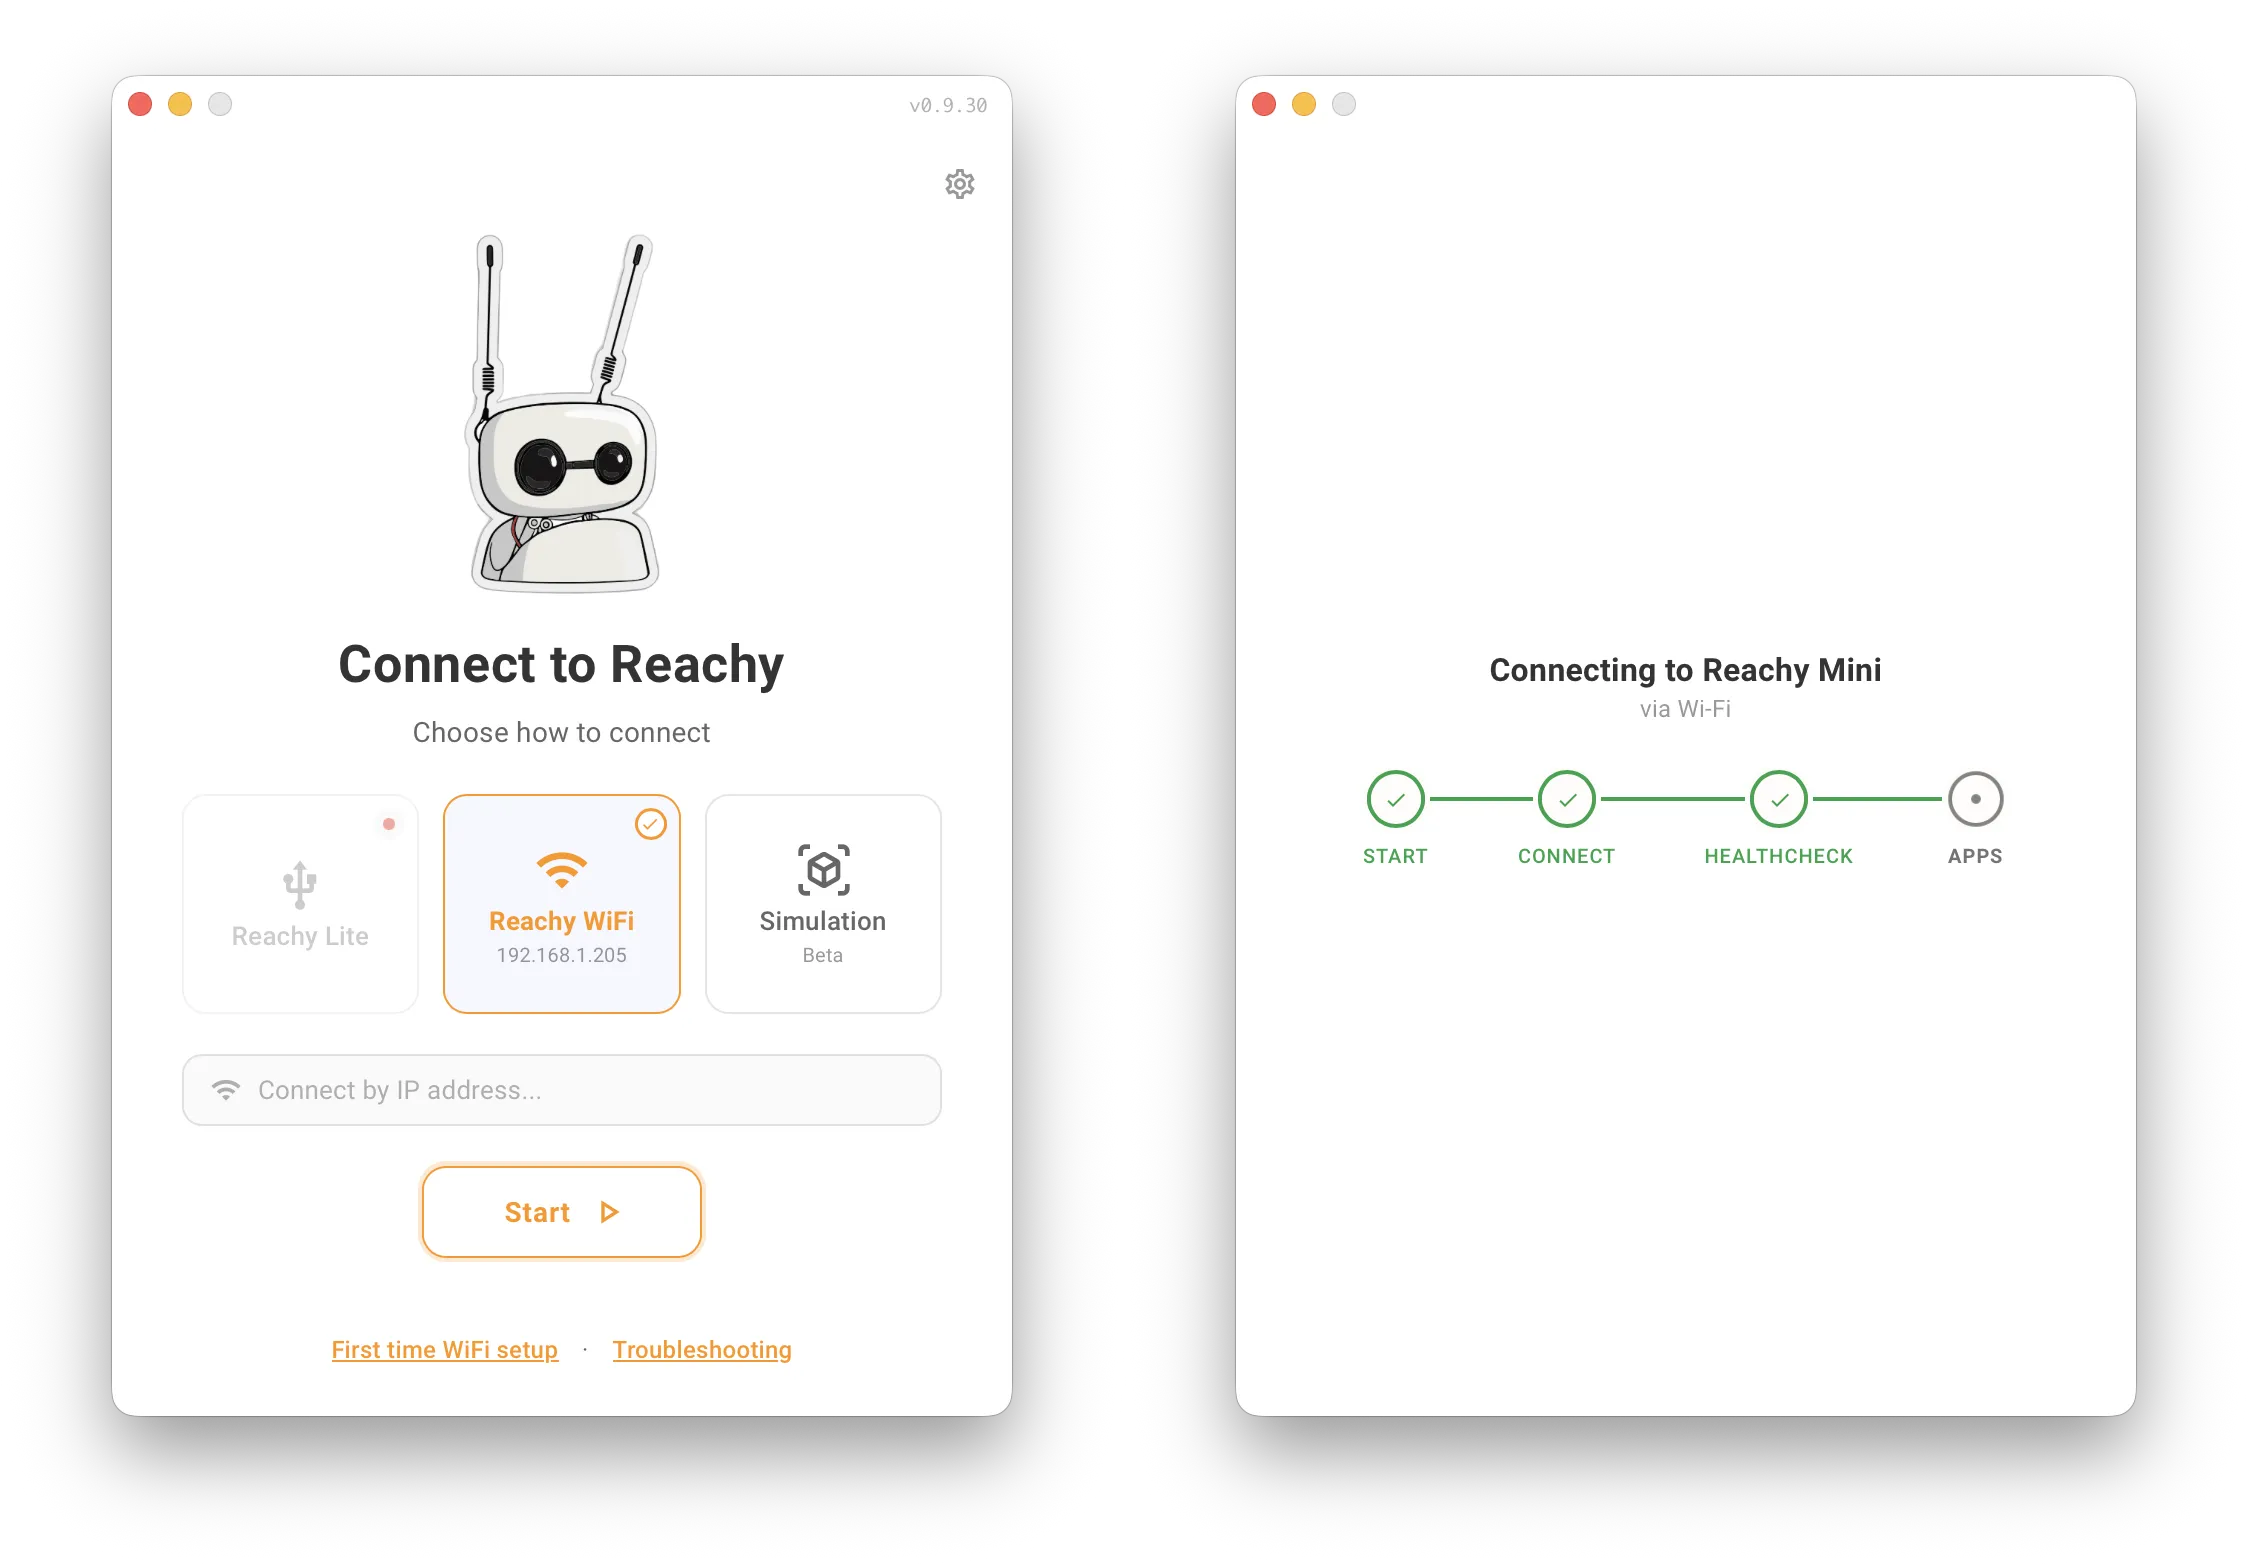
在 Applications 页面,单击 Discover apps 后,搜索 reachy_mini_conversation_app。
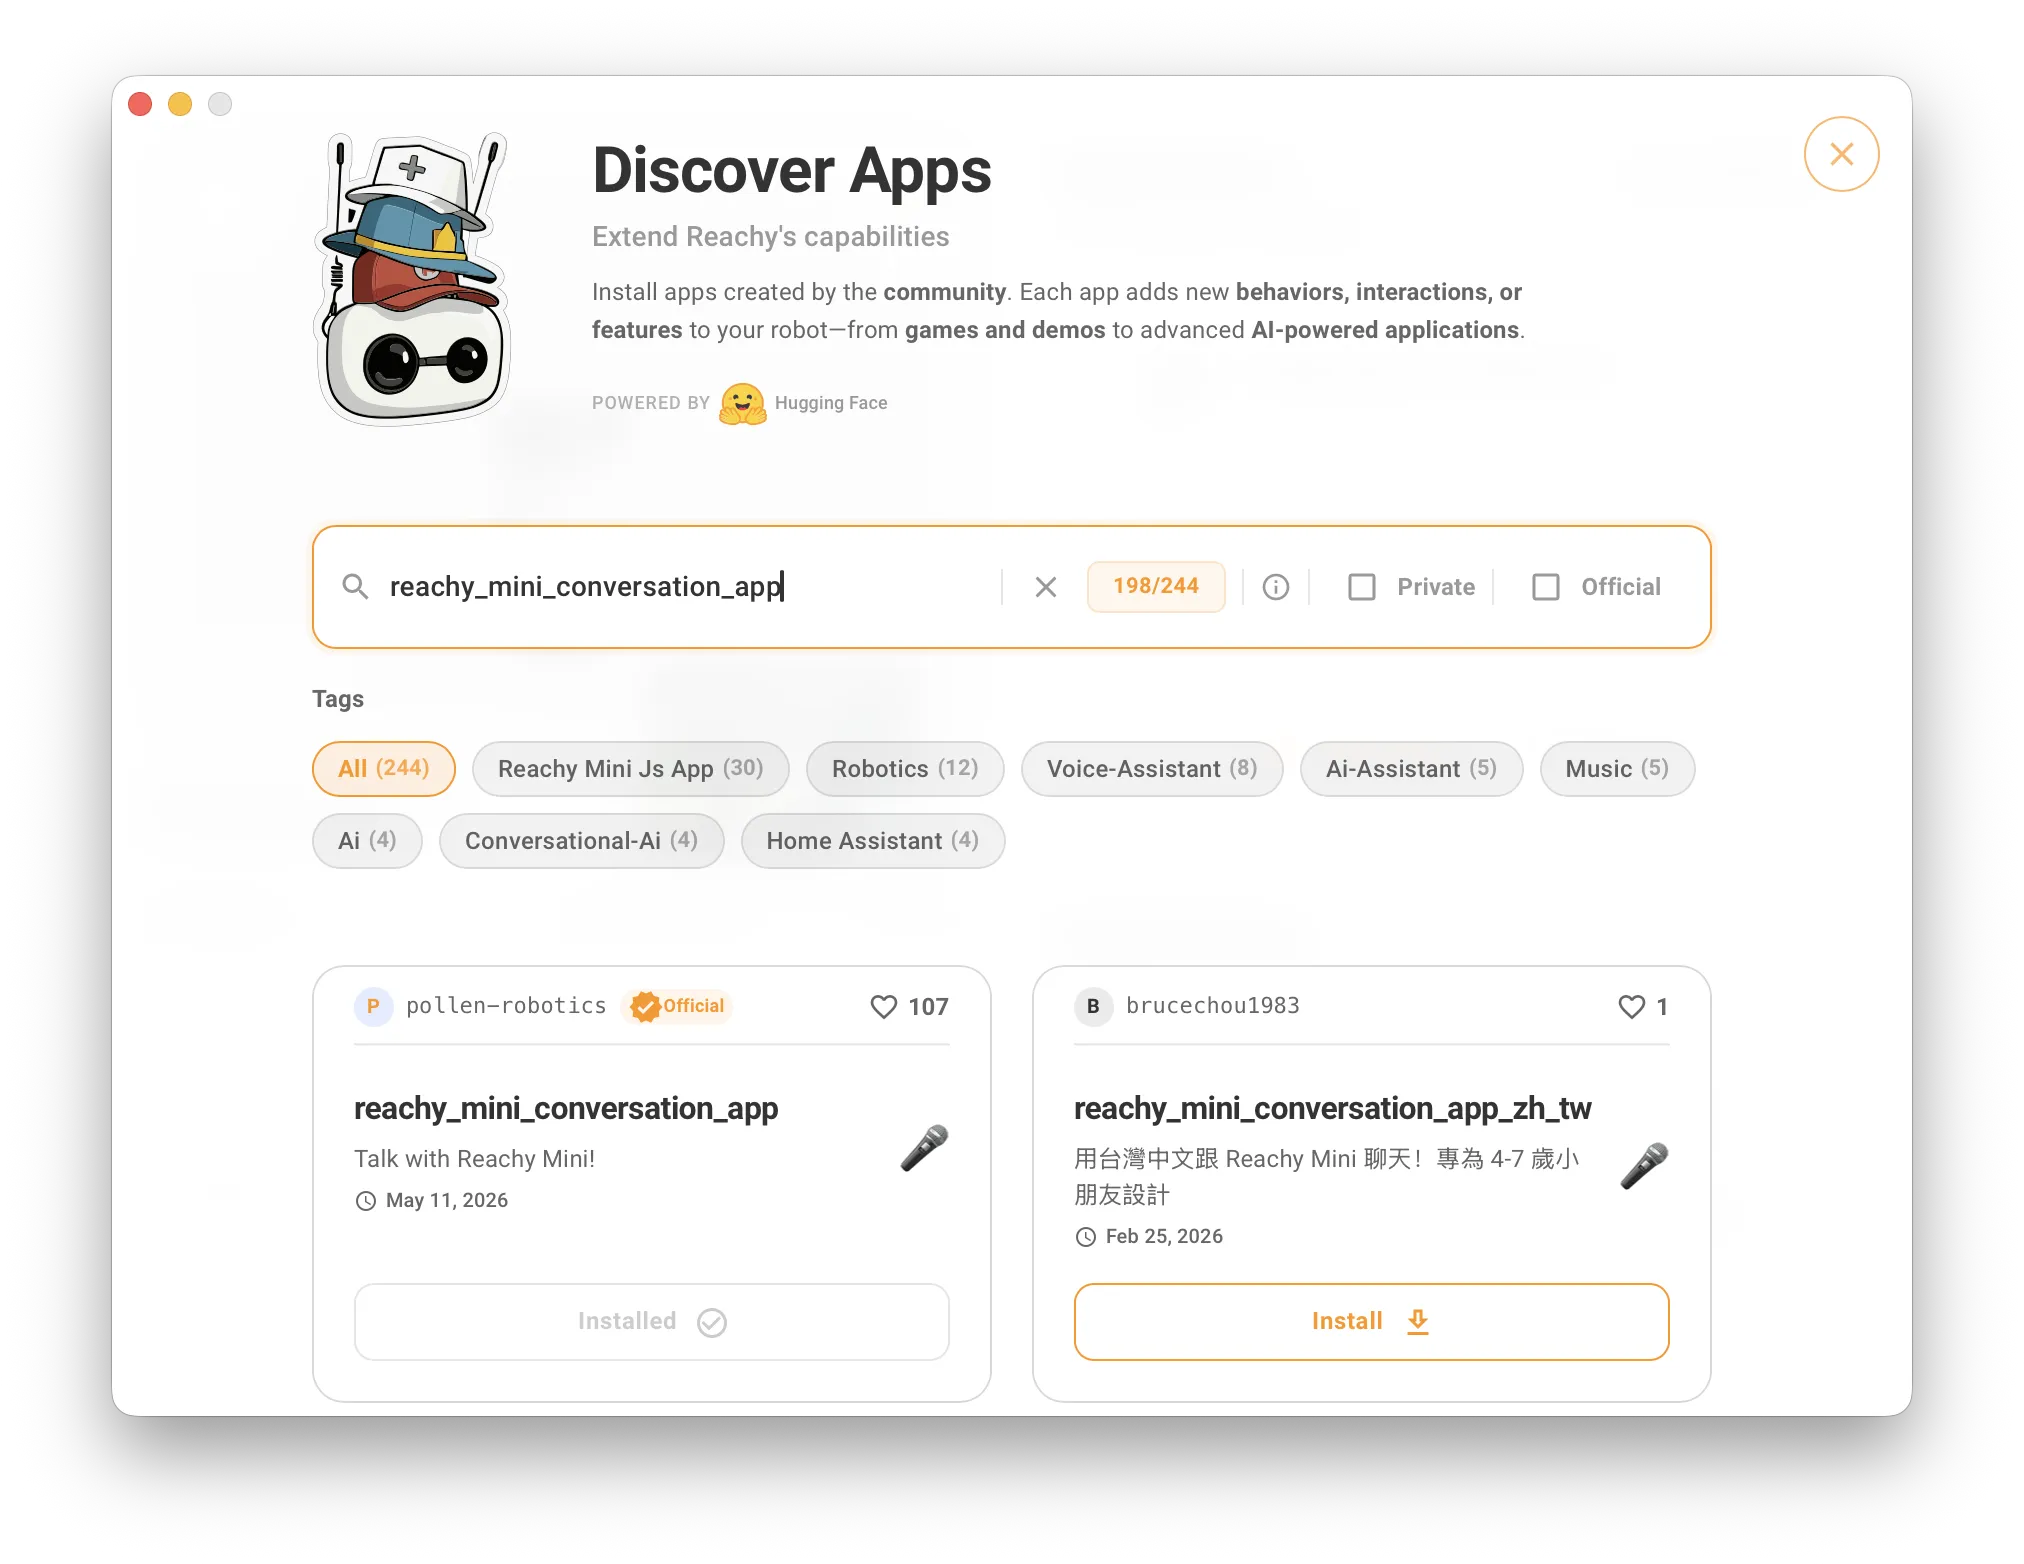
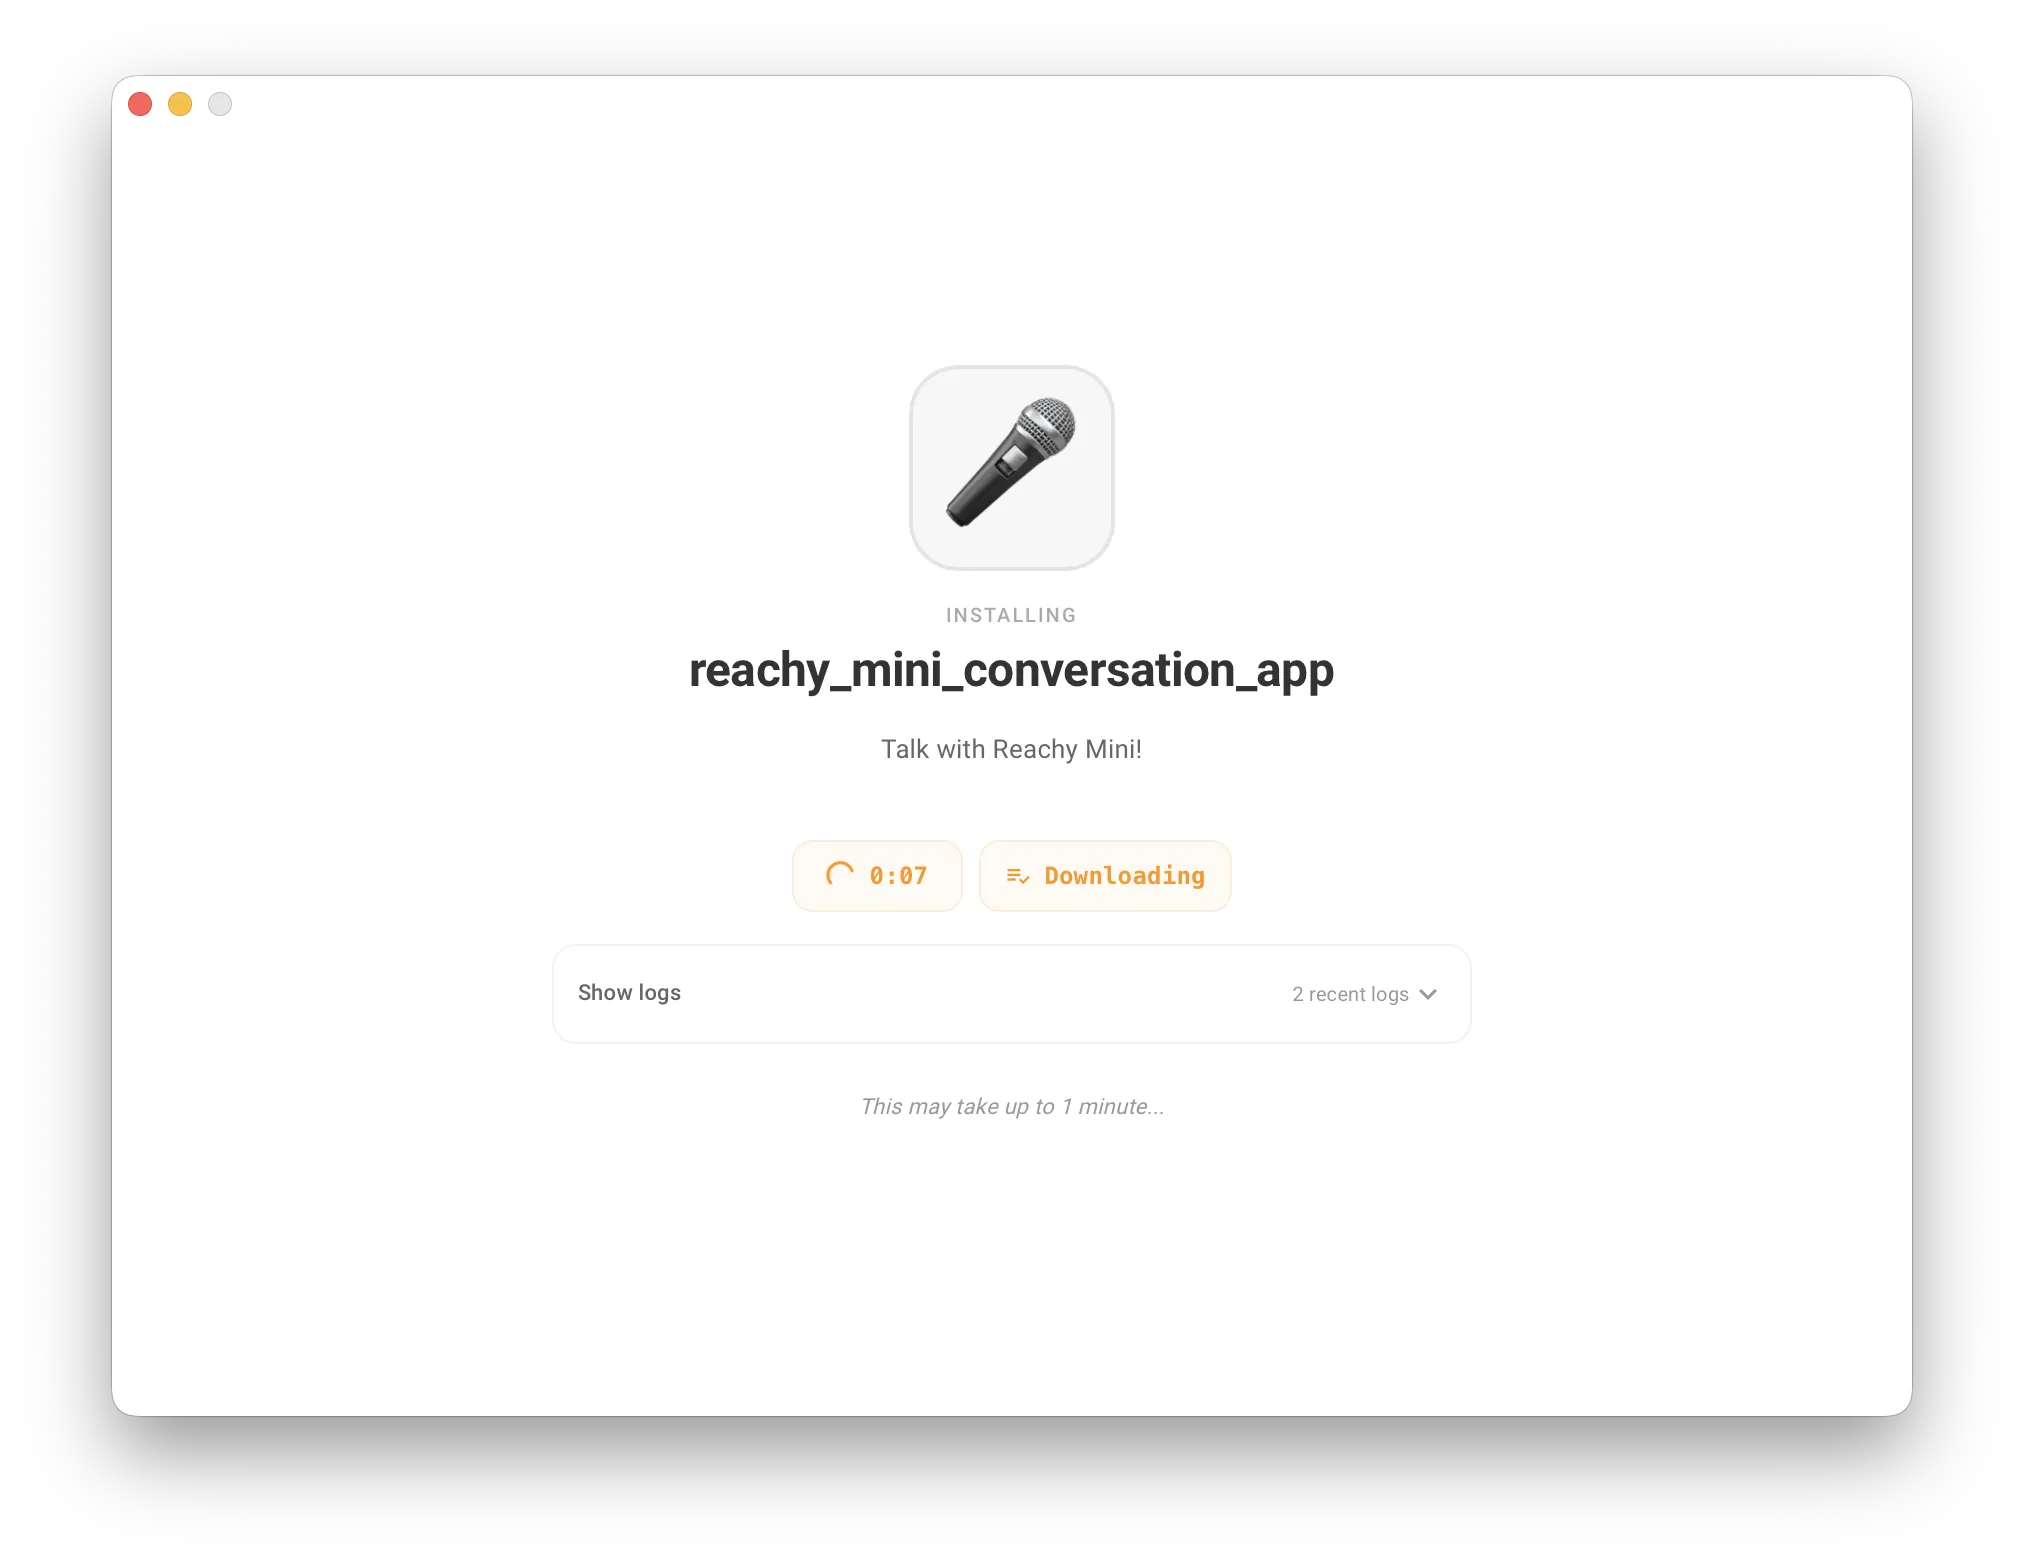
单击 Install 按钮安装 reachy_mini_conversation_app。
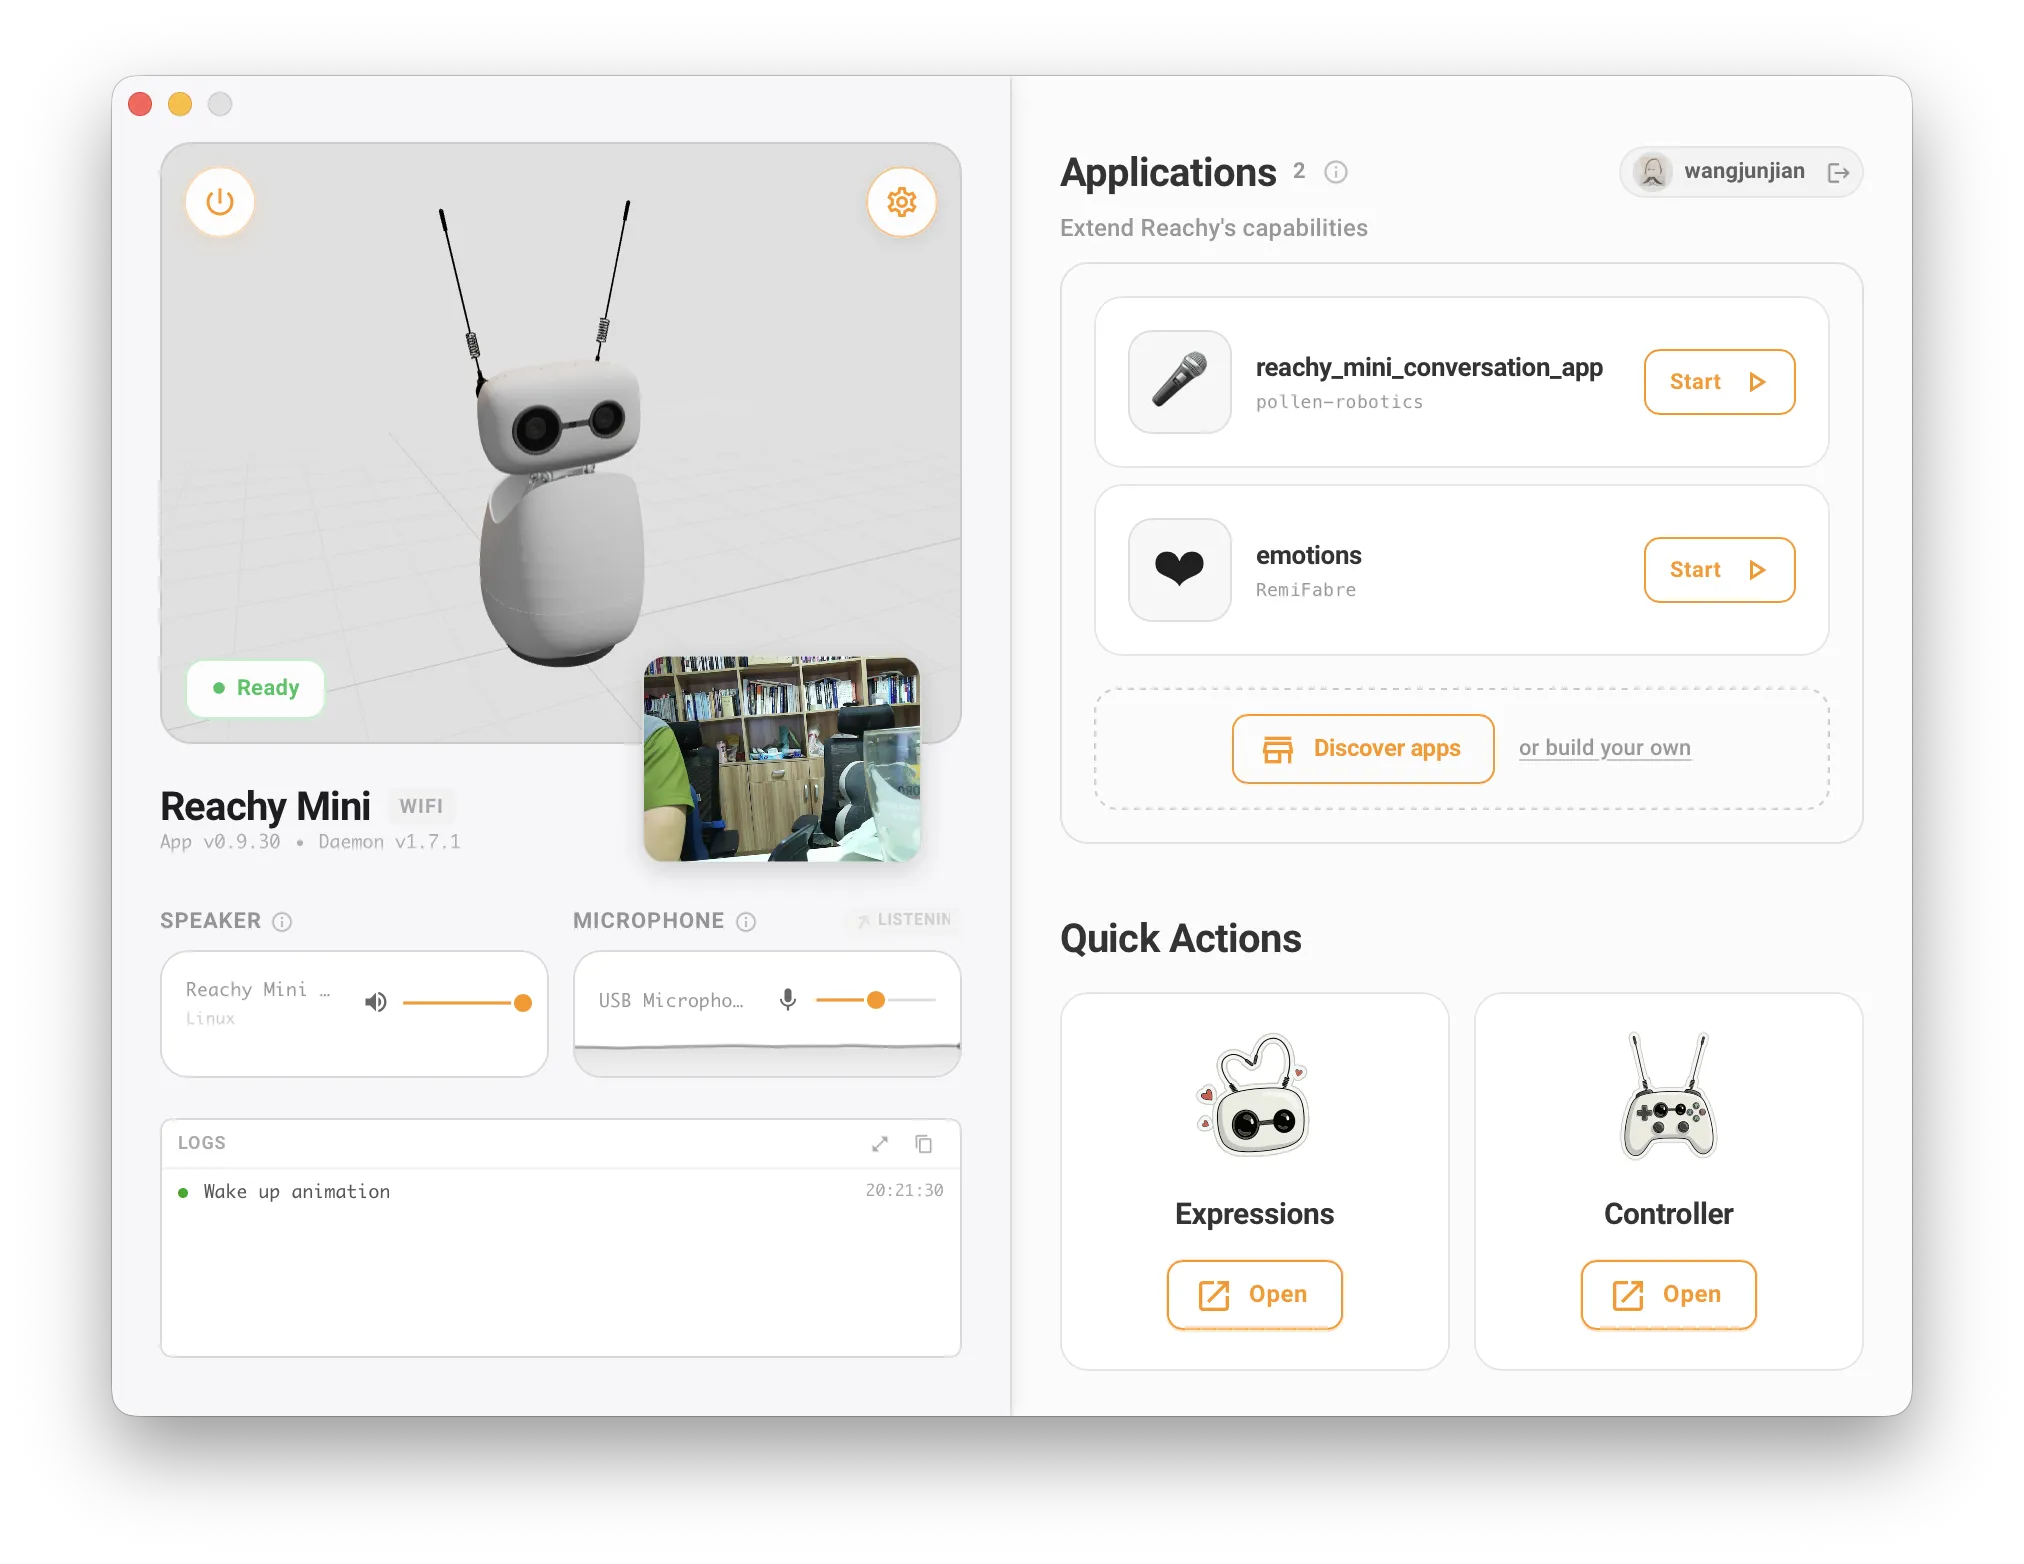
MacBook 上实时模式运行 Speech To Speech
安装 Speech To Speech
uv venv --python 3.12
source .venv/bin/activate
uv pip install speech-to-speech
uv pip install "speech-to-speech[faster-whisper]"
中文
方法
架构
本仓库实现了一个语音到语音的级联管道,包含以下部分:
模块化
该管道提供了一种完全开放且模块化的方法,重点是利用 Hugging Face Hub 上 Transformers 库提供的模型。代码设计易于修改,我们已经支持特定设备和外部库的实现:
VAD
STT
LLM
TTS ChatTTS Pocket TTS - Kyutai Labs 提供的支持语音克隆的流式 TTS Kokoro-
MLX 介绍
MLX 是一个为 Apple Silicon 芯片上的机器学习研究设计的 array 框架,由 Apple 机器学习研究团队提供。
安装
pip install mlx
pip install mlx-lm
conda install -c conda-forge mlx
conda install -c conda-forge mlx-lm
TinyLlama/TinyLlama-1.1B-Chat-v1.0
<|system|>
You are a chatbot who can help code!</s>
<|user|>
Write me a function to calculate the first 10 digits of the fibonacci sequence in Python and print it out to the CLI.</s>
<|assistant|>
将 MLX 微调的模型转换为 GGUF 模型最大的意义是可以融入 GGUF 的生态系统,可以在更多的平台上使用。
LoRA 微调
大模型 Mistral-7B-v0.1
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py
if __name__ == "__main__":
    # ......
    for dataset, name, size in datasets:
        with open(f"data/{name}.jsonl", "w") as fid:
            for e, t in zip(range(size), dataset):
                t = t[3:]
                json.dump({"text": t}, fid)
                fid.write("\n")
执行脚本 data/wikisql.py 生成数据集。
data/wikisql.py
安装 mlx-lm
pip install mlx-lm
微调
大模型 Deepseek-Coder-7B
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py if name == "main": # ...... for dataset, name, size in datasets: with open(f"data/{name}.jsonl", "w") as fid: for e, t in zip(range(size), dataset): # deepseek-ai/deepseek-coder-7b-instruct-v1.5 # 去掉开头的 <|begin▁of▁sentence|>,因为 tokenizer 会自动添加 <|begin▁of▁sentence|> t = t[3:-4] + "<|end▁of▁sentence|>" json.dump({"text": t}, fid) fid.
使用 LoRA 和 QLoRA 基于 Mistral-7B 微调的实验
LoRA 和 QLoRA 对比
微调
| Iteration | LoRA Train Loss | LoRA Val Loss | LoRA Tokens/sec | QLoRA Train Loss | QLoRA Val Loss | QLoRA Tokens/sec |
|---|---|---|---|---|---|---|
| 1 | 2.343 | 2.420 | ||||
| 100 | 1.204 | 221.348 | 1.216 | 166.377 | ||
| 200 | 1.091 | 1.111 | 207.353 | 1.095 | 1.130 | 187.795 |
| 300 | 0.818 | 234.182 | 1.065 | 194.826 | ||
| 400 | 0.837 | 1.076 | 207.763 | 0.998 | 1.006 | 170.072 |
| 500 | 0.774 | 223.036 | 0.726 | 189.288 | ||
| 600 | 0.609 | 1.001 | 218.118 | 0.607 | 1.015 | 186.397 |
微调的参数量 LoRA 微调万分之 2.35 (1.704M / 7243.436M * 10000)的模型参数。 QLoRA 微调万分之 13.
预训练模型 mistralai/Mistral-7B-v0.1
量化
QLoRA 微调需要量化,生成 4 位量化的 Mistral 7B 并默认将其存储在 mlx_model 目录中
python convert.py --hf-path mistralai/Mistral-7B-v0.1 -q
mlx_model 目录结构如下:
mlx_model
├── config.json
├── model.safetensors
├── special_tokens_map.json
├── tokenizer.json
├── tokenizer.model
├── tokenizer_config.json
└── weights.00.safetensors
量化后的模型 8.0G
微调
QLoRA 微调
mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL
安装 mlx-lm
pip install mlx-lm
生成 SQL
python -m mlx_lm.generate --model mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL \
                          --max-tokens 50 \
                          --prompt "table: students
columns: Name, Age, School, Grade, Height, Weight
Q: Which school did Wang Junjian come from?
A: "
SELECT School FROM Students WHERE Name = 'Wang Junjian'
上传模型到 HuggingFace Hub
mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL
本次微调的模型我已经上传到了 HuggingFace Hub 上,大家可以进行尝试。
安装 mlx-lm
pip install mlx-lm
生成 SQL
python -m mlx_lm.generate --model mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL \
                          --max-tokens 50 \
                          --prompt "table: students
columns: Name, Age, School, Grade, Height, Weight
Q: Which school did Wang Junjian come from?
A: "
SELECT School FROM Students WHERE Name = 'Wang Junjian'
在 MLX 上使用 LoRA / QLoRA 微调 Text2SQL(一):使用 LoRA 基于 Mistral-7B 微调
📌 没有使用模型的标注格式生成数据集,导致不能结束,直到生成最大的 Tokens 数量。
这次我们来解决这个问题。
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/w
安装
git clone https://github.com/ml-explore/mlx-examples.git
cd mlx-examples/lora

pip install -r requirements.txt
下载模型
pip install huggingface_hub hf_transfer

export HF_HUB_ENABLE_HF_TRANSFER=1
huggingface-cli download \
    --local-dir-use-symlinks False \
    --local-dir mistralai/Mistral-7B-v0.1 \
    mistralai/Mistral-7B-v0.1
数据集 WikiSQL
样本格式
克隆代码
git clone https://github.com/ml-explore/mlx-examples
cd mlx-examples
创建虚拟环境
python -m venv env
source env/bin/activate

pip install -r llms/phi2/requirements.txt
pip install -r llms/qwen/requirements.txt
创建大模型链接 mkdir llms/phi2/microsoft ln -s /Users/junjian/HuggingFace/microsoft/phi-2 llms/phi2/microsoft/phi-2 mkdir llms/qwen/Qwen ln -s /Users/junjian/HuggingFace/Qwen/Qwen-14B-Chat llms/qwen/Qwen/Qwen-14B-Chat ln -s /Users/junjian/HuggingFace/Qwen/Qwen-1_8B llms/qwen/Qwen/Qwen-1_8B ln -s /Users/junjian/HuggingFace/Qwen/Qwen-1_8B-Chat llms/qwen/Qwen/Qwen-1_8
统一内存:与 MLX 和其他框架的显着区别是统一内存模型。 MLX 中的数组位于共享内存中。 MLX 阵列上的操作可以在任何支持的设备类型上执行,而无需传输数据。
创建虚拟环境
mkdir ml-explore && cd ml-explore
git clone https://github.com/ml-explore/mlx
git clone https://github.com/ml-explore/mlx-examples

python -m venv env
source env/bin/activate
cd llms/phi2
pip install -r requirements.txt
使用已经下载的模型
mkdir microsoft
ln -s /Users/junjian/HuggingFace/microsoft/phi-2 microsoft/phi-2
转换模型
python convert.py
这将生成 MLX 可以读取的 weights.npz 文件。
-rw-r--r-- 1 junjian staff 5.2G 12 20 20:36 weights.npz
没有找到匹配的文章