WorkBuddy 专家 / 专家团机制研究HTML
「完整拆解 WorkBuddy 专家与专家团机制:从 plugin.json 元数据、七步生命周期,到主理人主导的星型协作拓扑、身份覆盖与团队命名规范,并给出可移植到自建智能体的最小落地骨架与避坑清单」
「完整拆解 WorkBuddy 专家与专家团机制:从 plugin.json 元数据、七步生命周期,到主理人主导的星型协作拓扑、身份覆盖与团队命名规范,并给出可移植到自建智能体的最小落地骨架与避坑清单」
这四个术语是当前大模型应用开发的核心范式,从指令设计、信息管理、生成式编程到自主智能体构建,层层递进,共同构成了 AI 应用开发的技术栈。
以下是通俗易懂的拆解:
1. Prompt Engineering (提示工程)
这是最基础的技能,重点在于指令的质量。 如果把 AI 比作一个极其博学但有时听不懂人话的实习生,Prompt Engineering 就是学习如何写出完美的“任务说明书”。
2. Context Engineering (上下文工程)
随着模型处理能力增强,大家发现“怎么说”固然重要,但 “给它看什么资料” 更重要。这就是上下文工程。
Andrej Karpathy:氛围编程(vibe coding)
我称之为“氛围编程”(vibe coding)——这是一种全新的编程方式:你完全沉浸在感觉中,拥抱指数级的效率提升,甚至忘掉代码本身的存在。
这之所以成为可能,是因为大语言模型(比如配合 Sonnet 使用的 Cursor Composer)正变得过于强大。而且,我直接通过 SuperWhisper 和 Composer 语音对话,几乎连键盘都不碰。我会提一些极度偷懒的要求,比如“把侧边栏的间距缩减一半”,因为我根本懒得去代码里找位置。我永远点“全部接受”(Accept All),再也不看代码比对(diffs)了。遇到报错信息,我直接原样粘贴回去,一句话都不解释,通常这样就能修好。
代码库的增长速度超出了我以往的理解能力,如果真要搞懂,我得花好长一段时间去通读。有时大模型修不好某个 Bug,我就绕过去,或者要求进行随机改动,直到 Bug 消失。对于那些周末折腾的练手项目来说,这种方式还算凑合,但也确实挺离谱的。
我正在开发一个项目或 Web 应用,但这感觉并不像在编程——我只是观察、动嘴、运行、粘贴,然后它居然大部分时间都能跑通。
Andrej Karpathy:智能体工程(agentic engineering)
很多人转发这条推文,以此纪念“氛围编程”(vibe coding)诞生一周年。简单回顾一下:
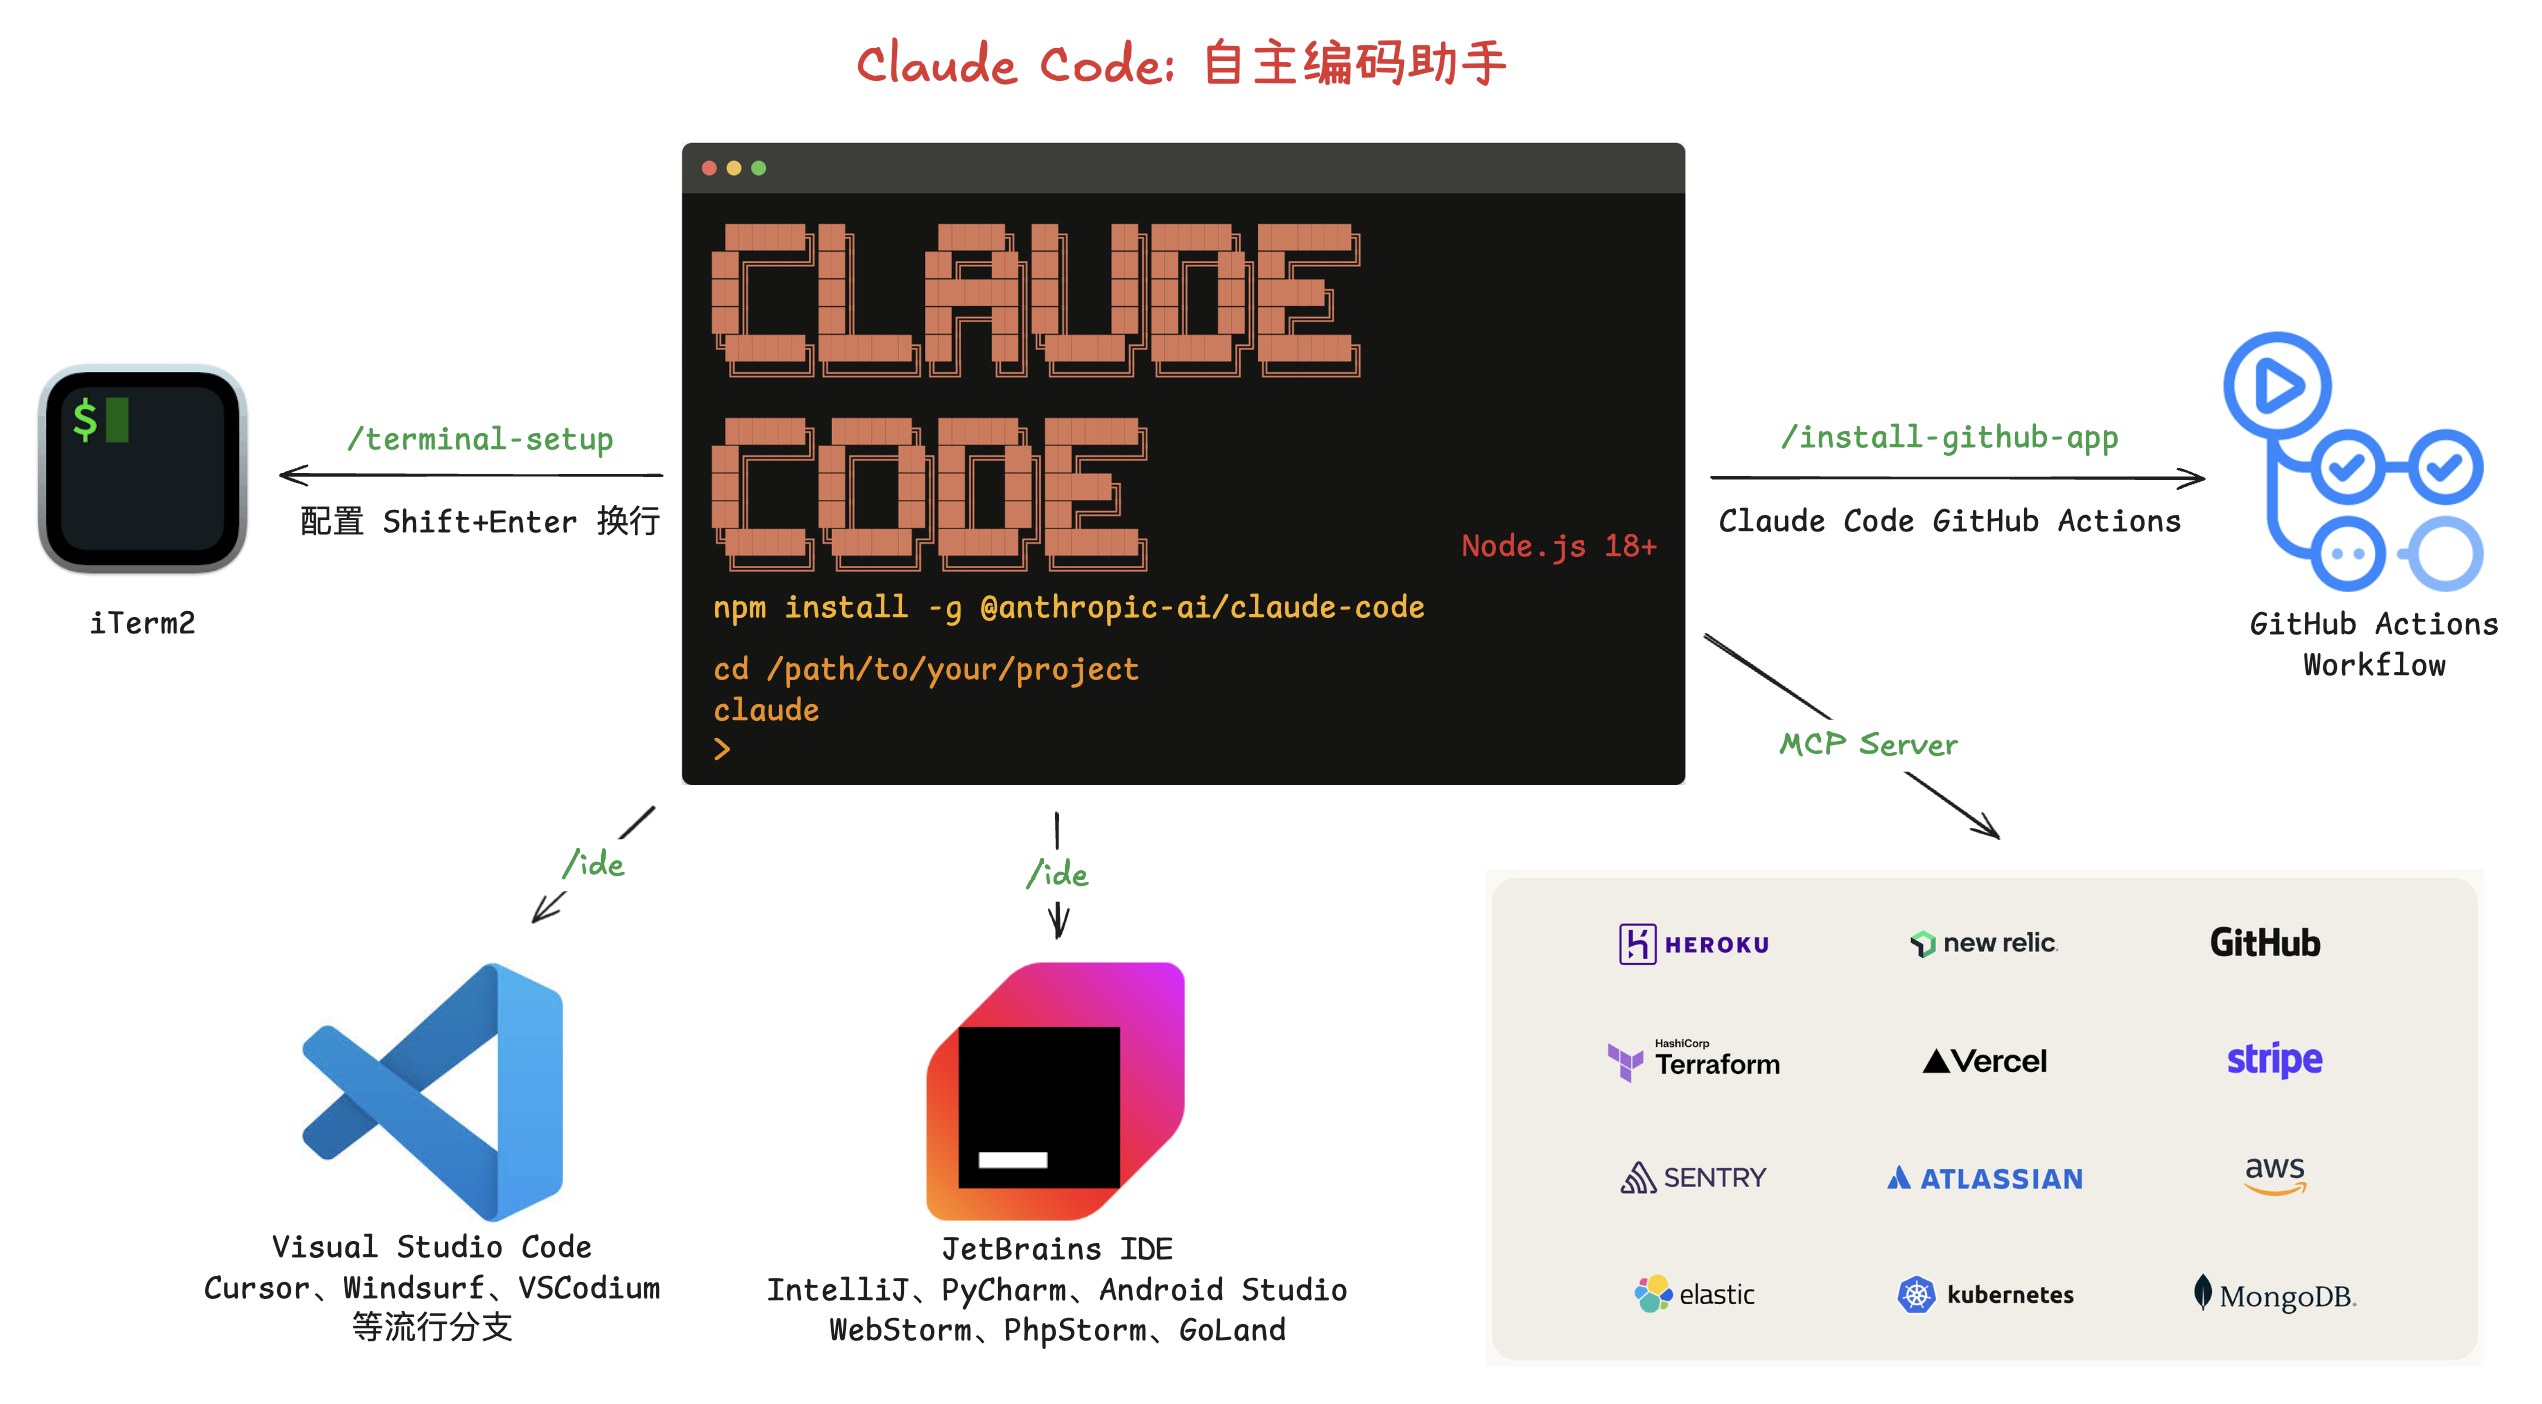
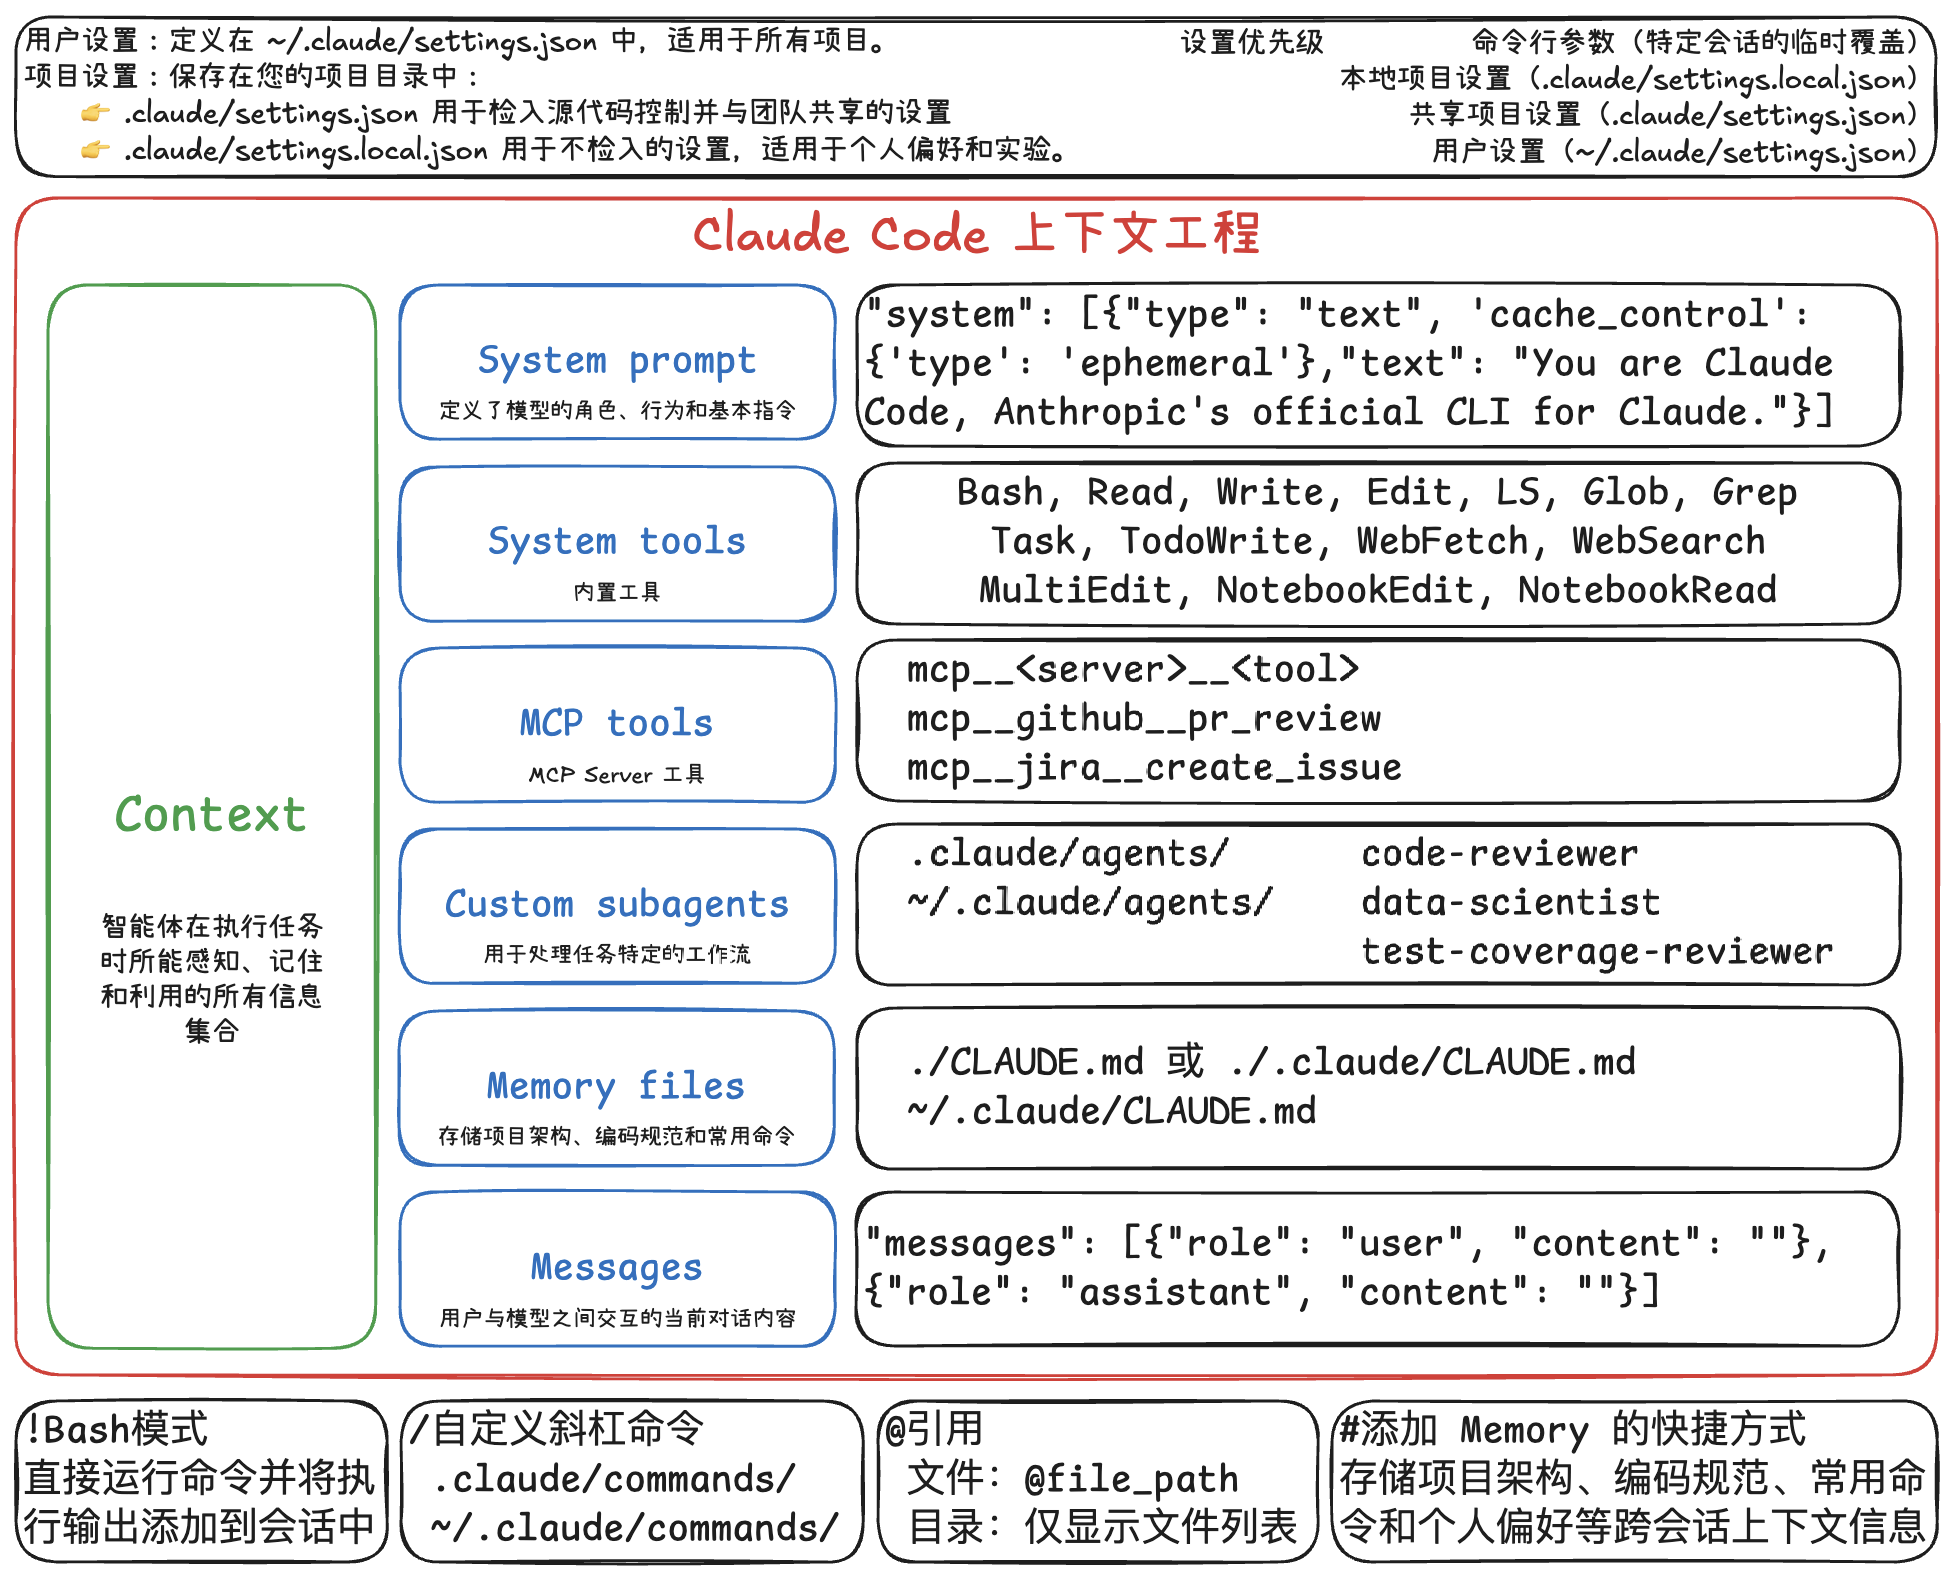
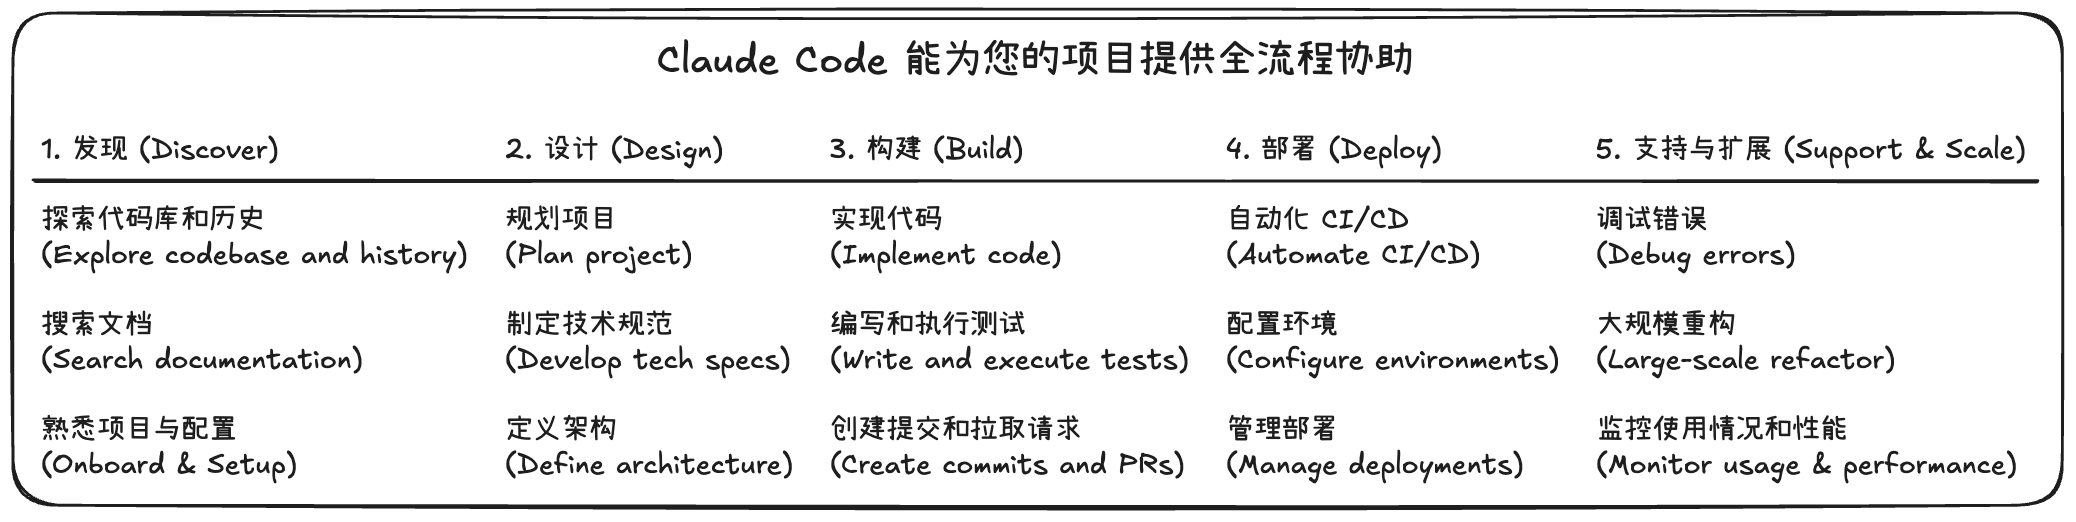
本文介绍 Claude Code 的上下文工程。它整合了多种输入来源,包括系统提示、内置工具、MCP工具、自定义子代理、记忆文件和对话历史,以全面理解并完成编程开发任务。还介绍了使用 Claude Code 在您的项目中提供全流程协助,如何编写提示词。
Claude Code 上下文工程
Claude Code 能为您的项目提供全流程协助
📌 计划模式
计划模式是指通过只读操作分析代码库来创建计划,非常适合探索代码库、规划复杂更改或安全地审查代码。
> Analyze the authentication system and suggest improvements
> 分析身份验证系统并提出改进建议。
> I need to refactor our authentication system to use OAuth2. Create a detailed migration plan.
> 我需要重构我们的身份验证系统以使用 OAuth2。创建一个详细的迁移计划。
> What about backward compatibility?
> 向后兼容性怎么办?
> How should we handle database migration?
> 我们应该如何处理数据库迁移?
探索代码库
智能编码助手 - 提示工程实战手册
欢迎开启智能编码新纪元!
智能编码助手旨在成为您编程旅程中的得力伙伴,加速开发、提升代码质量、激发创新灵感。
要充分释放智能编码助手的潜力,关键在于掌握有效的提示(Prompting)。这份手册将为您揭示编写高效提示的秘诀和实用技巧,并通过丰富的示例,助您快速从入门到精通。
为什么精通提示如此重要?
一、编写高效提示的核心原则
掌握以下原则,让您与智能编码助手的沟通事半功倍:
帮我处理下数据。
* 好例子: 帮我用 Python Pandas 读取名为 'sales_data.csv' 的文件,并计算 'amount' 列的总和。修复这个 bug。 (未提供代码和错误信息)
* 好例子: 我在使用 React 和 Ant Design 开发一个表单。提交时,控制台报 'TypeError: Cannot read properties of undefined (reading 'validateFields')' 错误。这是相关的代码片段:[代码片段]。请分析原因并提供修复建议。欢迎使用 Cline 提示指南!本指南将为您提供编写有效提示和自定义指令的知识,帮助您最大化使用 Cline 的生产力。
自定义指令 ⚙️
将自定义指令视为 Cline 的编程。它们定义了 Cline 的基准行为,并且始终"开启",影响所有交互。
添加自定义指令:
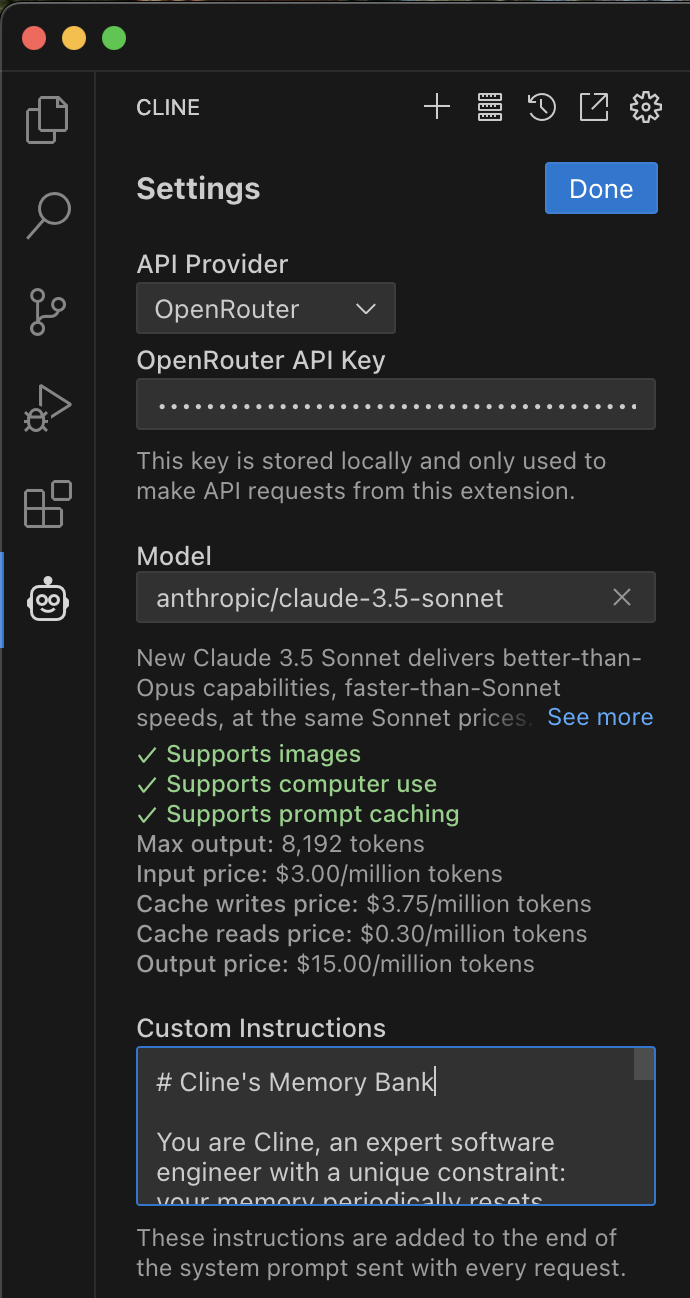
自定义指令在以下方面特别有用:
custom-instructions 文件夹包含了您可以使用或调整的自定义指令示例。
.clinerules 文件 📋
虽然自定义指令是特定于用户且全局的(适用于所有项目),但 .clinerules 文件提供了项目特定的指令,存放在项目的根目录中。这些指令会自动附加到您的自定义指令中,并在 Cline 的系统提示中引用,确保它们影响项目上下文中的所有交互。这使其成为以下场景的出色工具:
安全最佳实践 🔒
为了保护敏感信息,您可以在 .clinerules 中指示 Cline 忽略特定文件或模式。
什么是智能体?
传统软件帮助用户简化和自动化工作流程,而智能体则能够以高度独立的方式代表用户执行这些工作流程。
智能体是能够独立代表您完成任务的一种系统。
工作流程是指为了实现用户目标而必须执行的一系列步骤,无论是解决客户服务问题、预订餐厅、提交代码变更,还是生成报告。
那些集成了大语言模型(LLM)但并未用其控制工作流程执行的应用程序(例如简单聊天机器人、单轮对话LLM或情感分类器)不属于智能体。
具体来说,智能体具备以下核心特征,使其能够可靠且一致地代表用户行动:
何时应该构建智能体?
构建智能体需要重新思考系统如何决策和处理复杂性。与传统自动化不同,智能体特别适合那些传统确定性和基于规则的方法无法胜任的工作流程。
以支付欺诈分析为例:传统的规则引擎像一份检查清单,根据预设条件标记交易;而基于大语言模型的智能体则更像经验丰富的调查员,它能评估上下文、捕捉细微模式,即使没有明确违反规则也能识别可疑行为。
目标
这里想探索使用多模态大模型答题的技术方案,包含单选题、多选题、判断题,最终构建自主答题的智能体。
工作流程:🏞️ -> MLM(多模态大模型)-> 答案
📝思路一
直接使用多模态大模型读题(转成文字),然后检索答案,把题和答案组合的提示词输入给语言大模型。
我使用了 Ollama 调用多模态大模型
minicpm-v:8b来生成文字。llava:7b的效果不好。
代码示例:
import ollama

response = ollama.chat(
	model="minicpm-v:8b",
	messages=[
		{
			'role': 'user',
			'content': '读取图像中的题。',
			'images': ['ti.png']
		}
	]
)

print(response['message']['content'])
This document includes extra information to how we evaluated our Computer Using Agent, including (browser/VM) environments, prompts, sampling parameters, and scoring procedures. For more details, read https://openai.com/index/computer-using-agent/.
本文档包括我们如何评估我们的计算机使用代理的额外信息,包括(浏览器/VM)环境,提示,采样参数和评分程序。有关更多详细信息,请阅读 https://openai.com/index/computer-using-agent/ 。
1 Environment(环境)
The Language Model API enables you to use the Language Model and integrate AI-powered features and natural language processing in your Visual Studio Code extension.
语言模型 API 可以让您使用语言模型,并在您的 Visual Studio Code 扩展中集成 AI 功能和自然语言处理。
You can use the Language Model API in different types of extensions. A typical use for this API is in chat extensions, where you use a language model to interpret the user's request and help provide an answer. However, the use of the Language Model API is not limited to this scenario.
Thoughtworks 技术雷达
Thoughtworks 技术雷达 (Tech Radar) 是一份每半年发布一次的技术报告,涵盖了工具、技术、平台、语言和框架等方面的内容。这一知识成果来自于我们全球团队的经验,重点介绍了您可能想要在项目中探索的内容。
环的含义如下:
参考:
技术 1️⃣ 将 CI/CD 基础设施作为一种服务 - 2023年4月 将 CI/CD 基础设施作为一种服务已经是很多元化以及成熟的方案,以至于需要自己管理整个 CI 基础设施的情况变得非常少见。
总结
市。Date实体类型的值,并没有很好的识别出来,如:3月识别为Month,一季度识别为Quarter,今年识别为Year。这个跟模型有关,ChatGPT就识别的不错。County实体类型。曹县,曹县供电公司。XML标记方式比输出json结果方式效果更好。代码 from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts import PromptTemplate from langchain_core.runnables import RunnablePassthrough from langchain_community.chat_models.
Prompt Engineering Techniques(提示工程技术)
In-Context Learning (上下文学习)
Standard prompt with instruction (标准提示与指令)
大模型 Deepseek-Coder-7B
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py if name == "main": # ...... for dataset, name, size in datasets: with open(f"data/{name}.jsonl", "w") as fid: for e, t in zip(range(size), dataset): # deepseek-ai/deepseek-coder-7b-instruct-v1.5 # 去掉开头的 <|begin▁of▁sentence|>,因为 tokenizer 会自动添加 <|begin▁of▁sentence|> t = t[3:-4] + "<|end▁of▁sentence|>" json.dump({"text": t}, fid) fid.
Building Systems with the ChatGPT API
Language Models, the Chat Format and Tokens(语言模型、聊天格式和 Tokens)
Load OpenAI API key
import os
import openai
import tiktoken
from dotenv import load_dotenv, find_dotenv
_ = load_dotenv(find_dotenv()) # read local .env file

openai.api_key  = os.environ['OPENAI_API_KEY']
LangChain for LLM Application Development
LangChain 是用于构建 LLM 应用程序的开源框架
LangChain: Models, Prompts and Output Parsers
安装依赖包
pip install python-dotenv
pip install openai
ChatCompletion import os import openai from dotenv import load_dotenv, find_dotenv _ = load_dotenv(find_dotenv()) # read local .env file openai.api_key = os.environ['OPENAI_API_KEY'] def get_completion(prompt, model="gpt-3.5-turbo"): messages = [{"role": "user", "content": prompt}] response = openai.ChatCompletion.
ChatGPT Prompt Engineering for Developers 由Isa Fulford(OpenAI)和Andrew Ng(DeepLearning.AI)教授的课程将描述 LLM 的工作原理,提供快速工程的最佳实践,并展示 LLM API 如何用于各种任务的应用程序。
Instroduction(介绍)
Guidelines(准则)
帮助函数 import openai import os openai.api_key = os.getenv('OPENAI_API_KEY') def get_completion(prompt, model="gpt-3.5-turbo"): messages = [{"role": "user", "content": prompt}] response = openai.ChatCompletion.create( model=model, messages=messages, temperature=0, # this is the degree of randomness of the model's output ) return response.choices[0].
链允许我们将多个组件组合在一起以创建一个单一的、连续的应用程序。我们可以通过将多个链组合在一起,或者通过将链与其他组件组合来构建更复杂的链。
LLMChain 是一个简单的链,它接受一个提示模板,用用户输入格式化它并返回来自 LLM 的响应。
语言模型(text-davinci-003) from langchain.chains import LLMChain from langchain.llms import OpenAI from langchain.prompts import PromptTemplate llm = OpenAI(temperature=0.9) prompt = PromptTemplate(input_variables=["product"], template="What is a good name for a company that makes {product}?
没有找到匹配的文章