AI 原生开发工作流落地指南——基于 Matt Pocock SkillsHTML
以 Matt Pocock 的 27 个工程师技能为蓝本,把「先对齐再写码、红绿循环、每日深设计」装进 AI 原生开发流:四味药方对应四种失败模式,六步主线串起从想法到上线,三条匝道、四周落地路线与八条反模式压阵。
以 Matt Pocock 的 27 个工程师技能为蓝本,把「先对齐再写码、红绿循环、每日深设计」装进 AI 原生开发流:四味药方对应四种失败模式,六步主线串起从想法到上线,三条匝道、四周落地路线与八条反模式压阵。
以 mattpocock/skills 的 37 个技能为蓝本,把 AI 原生开发生命周期拆成六个阶段:想法对齐、规格化、拆票、实现与双轴评审,逐段讲清输入、操作与产出,并用四种失败模式的修复映射、上下文卫生规则与真实项目证据,说明为何编排要薄、纪律要厚。
以 3534 次提交、483 个 PR 与 75.6% 的 AI 参与率为证据,拆解 CVM 让 Agent 自己走完整个流水线的八条实践:词汇即接口、label 状态机、编排器独占变更权与真实浏览器自证,附量化复盘与可复用清单。
盘点 2026 年 AI 原生开发与智能体编码的 27 份一手实践:从 Simon Willison、Karpathy 到 Shopify、Stripe、OpenAI,10 位大牛与 17 个团队公开 harness、验证闭环与成本数字,按可复用度评五星。
这是一份可以照着做的 AI 原生软件开发工作流指南。我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」,并在交付后走完了完整的架构演进循环。本文拆解这条工作流的每一个环节——为什么这样设计(所以然)、具体怎么做(操作步骤)、实战中长什么样(真实证据)——让没有经验的开发者也能照着走完全程。完整对话实录见实践实录,速读版见上一篇实践总结。
一、为什么需要「AI 原生」工作流
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审、演进——都围绕 AI 的特性重新设计。
1.1 四个经典失败模式
mattpocock/skills 的作者 Matt Pocock 在仓库 README 里总结了他观察到的四个 AI 编码失败模式,这套技能集就是对着这四个失败模式设计的。理解它们,就理解了整条工作流的"所以然":
失败模式 #1:智能体做的不是我要的(misalignment)
"No-one knows exactly what they want" —— 《程序员修炼之道》
实践记录:我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」。本文以这次真实开发为主线,拆解这套"AI 原生"软件工程流水线的每个环节、它背后的设计哲学,以及实战中暴露的问题。原始对话实录见前一篇。
一、为什么是"AI 原生"而不是"AI 辅助"
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审——都围绕 AI 的特性重新设计。AI 的特性是什么?
| AI 的特性 | 对工程过程的要求 |
|---|---|
| 上下文窗口有限,塞满后质量衰减 | 任务必须切成"单个上下文能装下"的批次 |
| 每次会话开始时最"清醒" | 频繁开新会话,而不是一条会话干到底 |
| 不会主动追问,猜错了就错到底 | 需求阶段强制访谈,分歧在写代码前解决 |
| 产出无限、判断有限 | 人只做检查点决策,不做中间执行 |
| 记不住上一次的对话 | 共识必须落盘为文件,而不是留在脑子里 |
mattpocock/skills 就是围绕这张表设计的。
摘要:在 LLM 标称上下文窗口动辄 1M、2M 的今天,工程落地的残酷真相却是:上下文用得越多,模型表现往往越差。本文基于 Smart Zone(黄金上下文区间) 概念,深度拆解上下文用量超越 40% 后的能力崩塌逻辑,剖析能力、行为、经济三大隐形边界,并结合“大文本处理”、“KV-Cache”等场景给出 Agent 上下文管理的最佳工程实践。
一、 引言:为什么上下文窗口越大,AI 反而越“傻”?
随着长上下文(Long-Context)技术的普及,许多开发者形成了一种思维惯性:把整个项目代码库、长篇文档、全量日志和全部历史对话一股脑塞给 AI Agent。
然而,HumanLayer 创始人 Dex Horthy 提炼出的工程实践法则表明:当上下文占用突破标称窗口的 40% 后,AI 的输出质量、推理准确率和任务完成度会面临急剧下滑。
为了直观展现这一现象,我们可以总结出Smart Zone(黄金上下文区间) 核心图景:
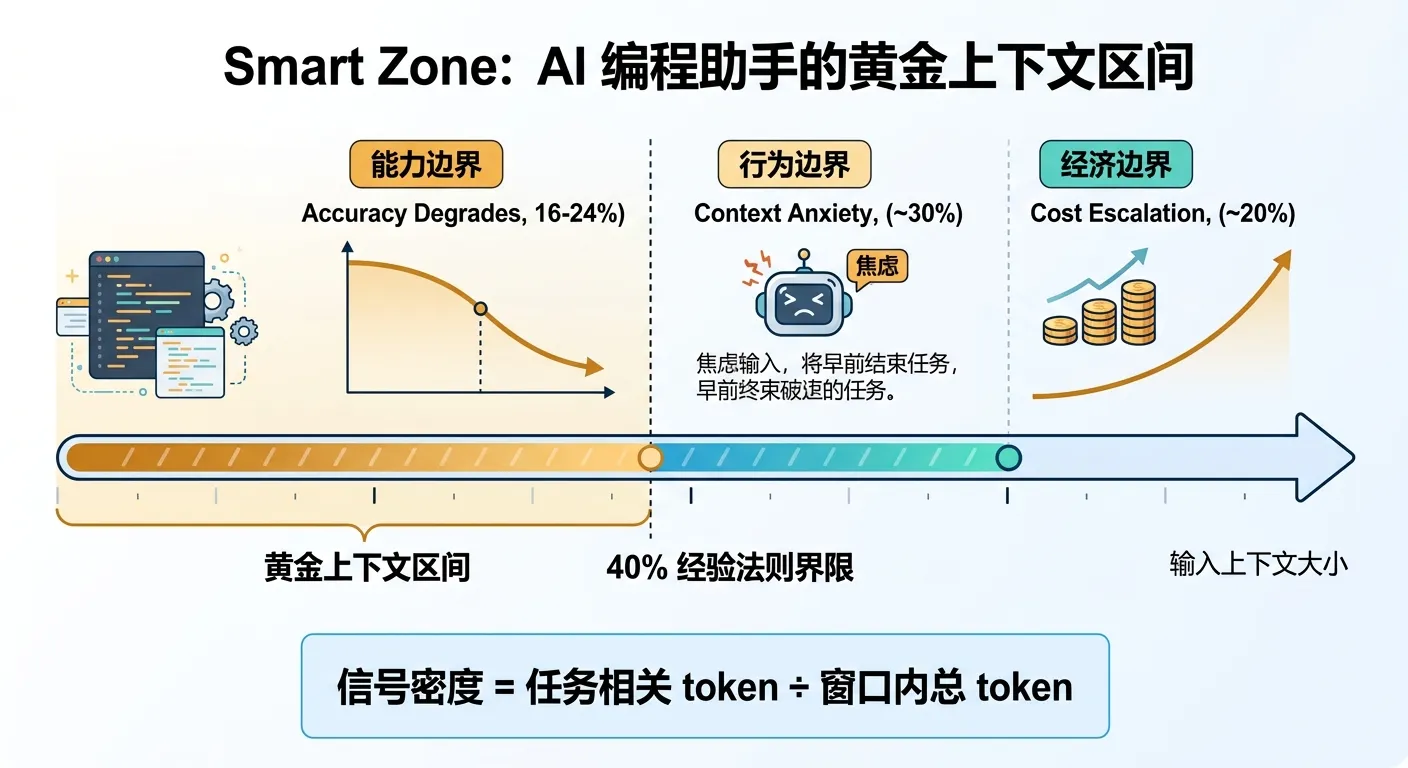
gantt
    title AI 编程助手上下文区间与边界示意图 (Smart Zone vs Danger Zone)
    dateFormat X
    axisFormat %s%%

    section 区间划定
    Smart Zone (黄金上下文区间)  :active, zone1, 0, 40
    Danger Zone (危险/衰减区间)  :crit, zone2, 40, 100

    section 核心边界拐点
    能力边界 (Accuracy Degrades, 16-24%)  :milestone, m1, 20, 20
    经济边界 (Cost Escalation, ~20%)      :milestone, m2, 20, 20
    行为边界 (Context Anxiety, ~30%)      :milestone, m3, 30, 30
    Safeguard Line (/clear 截断告警线, 40%) :milestone, m4, 40, 40
二、 核心公式:决定模型输出质量的两大隐形杠杆
在长上下文互动中,控制模型输出质量的本质是控制以下两个指标:
1. 信号密度(Signal Density)
安装
npx skills add mattpocock/skills
初始化(/setup-matt-pocock-skills)
/setup-matt-pocock-skills
在你的 agent 中,每个仓库运行一次。它会:
/triage 会用到标签)目录结构
.
├── CLAUDE.md
└── docs
    └── agents
        ├── domain.md
        ├── issue-tracker.md
        └── triage-labels.md
软件开发工作流程
grill-with-docs → to-spec → to-tickets → implement (tdd → code-review) → code-review
/grill-with-docs
description
一场为锐化计划或设计而不留情面的访谈,过程中还会同步创建文档(ADR 与术语表)。调用 Skill 工具两次,分别传入 "grilling" 和 "domain-modeling"。
详细介绍
grill-with-docs 就一个方案或设计对你进行访谈,直到你和 ag
Simon Willison 的 《Agentic Engineering Patterns》(智能体工程模式) 是一份面向软件工程师的实践指南,重点探讨在 Coding Agents(如 Claude Code、OpenAI Codex、Cursor 等能自主生成并执行代码、运行测试的智能体)普及的新时代,如何高效、高质量地进行软件开发。
一、 核心理念:什么是智能体工程?
Agentic Engineering(智能体工程) 明确区别于 Vibe Coding(氛围编程):
1. 观念重塑:“代码变得极其廉价”
传统软件工程的核心约束是代码编写成本昂贵(写几百行优质代码需要数小时或数天),因此衍生出了大量的预先设计、工时评估与严格的 YAGNI(You Aren't Gonna Need It)原则。 在 Agent 时代:
在 AI 辅助编程风靡的今天,许多开发者沉浸于 Vibe Coding(氛围感编码)——直接抛出几句自然语言需求,交由 AI 自动生成代码。然而,这种“野蛮生长”的方式往往会导致需求理解偏差、架构快速腐化(Ball of Mud)、上下文遗忘以及越改 Bug 越多的困境。
Matt Pocock 的开源项目 mattpocock/skills 正是为了解决这一痛点而生。它不是一堆零散的 Prompt 集合,而是一套为 Claude Code、Codex 等 AI 编程智能体设计的系统化软件工程最佳实践。
官方体系将技能划分为两大类:
/grill-with-docs、/to-spec),用于任务编排与流程推进。/tdd、/codebase-design)。工作流全景链路 (The Engineering Harness)
核心开发主流程遵循着从“模糊想法”到“高质量交付”的递进逻辑:
1. OpenSpec 是什么
OpenSpec 是一套规约驱动开发(Spec-Driven Development)的工作流工具。它要解决的问题是:在 AI 智能体参与编码的场景下,如何让"想清楚 → 写计划 → 写代码"这三个动作不互相污染,并且让代码之外还有一份可追溯的事实来源。
1.1 两种产物
| 产物 | 位置 | 回答的问题 | 生命周期 |
|---|---|---|---|
| specs(规格) | openspec/specs/<capability>/spec.md |
系统现在是什么行为(已交付、已归档的能力) | 长期存在,随每次归档增量演进 |
| changes(变更) | openspec/changes/<change-name>/ |
这一次要改什么(尚未实现的计划) | 完成后整体移入 changes/archive/ |
一句话:specs/ 是唯一事实来源,changes/ 是待实现的增量,archive/ 是它是如何达成的历史。
关键差别在于 specs/ 是能力(capability)维度、changes/ 是变更维度。同一个能力会被多次变更反复修改,每次修改只写"增量"(delta),不重写整份规格。
1.2 五步循环
每个变更都走同一条闭环,本项目严格落在这条闭环上:
flowchart LR
    E["1 · Explore<br/>和智能体一起想清楚"] --> P["2 · Propose<br/>Agent 起草方案(不写代码)"]
    P --> R["3 · Review<br/>你修正方案"]
    R --> A["4 · Apply<br/>Agent 逐项构建"]
    A --> AR["5 · Archive<br/>增量写入 specs 并归档"]
    AR -. "下一次变更" .-> E
若渲染环境不支持 Mermaid,可读作线性流程:Explore → Propose → Rev
原文:The AI-Native SDLC playbook(Anthropic Applied AI 团队) 译者注:本文为完整中文翻译,英文术语首次出现时保留原文。
代码不再是瓶颈
组织已经开始以一年前难以想象的速度用 AI 编写代码,但围绕代码的流程并没有以同样的速度改变。
许多工程团队仍然沿用同样的审批关卡、评审、交接和策略,这使得使用 Claude Code 等智能体编程解决方案带来的生产力提升被拖延抵消。
软件开发生命周期(SDLC)是将软件从想法带到生产环境的过程。大多数组织运行的都是同样六个阶段的某种版本,涵盖规划、设计、构建、测试、部署和维护软件。传统上,每个阶段都是一个由不同角色负责的独立阶段:产品经理写需求,技术架构师把需求变成设计,工程师按设计实现,受监管企业的 QA 团队进行验证,发布团队负责上线,运维团队监控运行状况。工作在阶段之间通过文档、工单和签字确认来流转。
传统的软件开发生命周期(SDLC)流程繁重,是为了确保每一步的责任与控制。然而,传统 SDLC 的设计初衷是在「编写和实现代码」这一最耗时、最昂贵阶段的年代最大化效率——而这个前提已经不复存在。PRD、估点仪式和产品安全评审,本质上都是为了在长达数周、数月甚至数个季度的开发过程中强制对齐。
传统 SDLC 的另一点是:它的各种控制措施假设每一步都由人来执行。
00 摘要:10 条核心论断
这份报告不是工具评测,也不是范式百科。它的目标是回答一个工程决策问题:如果你要在 2026 年把 AI 编程从「个人提效」推到「团队与生产系统」,你该采用哪套范式、按什么顺序、用什么门禁? 下面 10 条论断是全篇骨架,只读这一页也能拿走结论。
spec.md 直接驱动生成器、被 Git 版本化、被 CI 校验——可执行,才第一次值得写。以下是 IBM 文章 《什么是规范驱动开发?》(What is Spec-Driven Development?) 的中文翻译:
作者: Anna Gutowska(IBM AI 工程师、开发者倡导者)
发布日期: 2026年5月19日
规范驱动开发的定义
规范驱动开发(Spec-Driven Development, SDD) 是一种软件开发方法论。在正式编码之前,团队需先编写并达成一份关于实现细节的详细规范(Specification)。换句话说,这份规范将作为“构建什么”以及“如何构建”的唯一真实来源(Single source of truth)。
随着 Microsoft GitHub Copilot、Anthropic Claude Code 或 IBM Bob 等 AI 工具与编程助手的普及,生成代码的门槛已大幅降低。基于先进 AI 模型的 LLM 驱动型 AI Agent,只需用户输入一条自然语言提示词(Prompt),即可随时实时运行一系列迭代任务。
对于软件开发而言,这意味着我们可以优化并自动化构建原型、新功能、单元测试等的开发工作流。生成代码从未如此简单。然而,“氛围程序员”(Vibe Coders)需要警惕一个潜在风险:AI 的表现上限完全取决于它所接收到的指令质量。
技术债务的抬头:一个典型场景
你可能在现实世界中见过技术债务,甚至自己都没意识到。
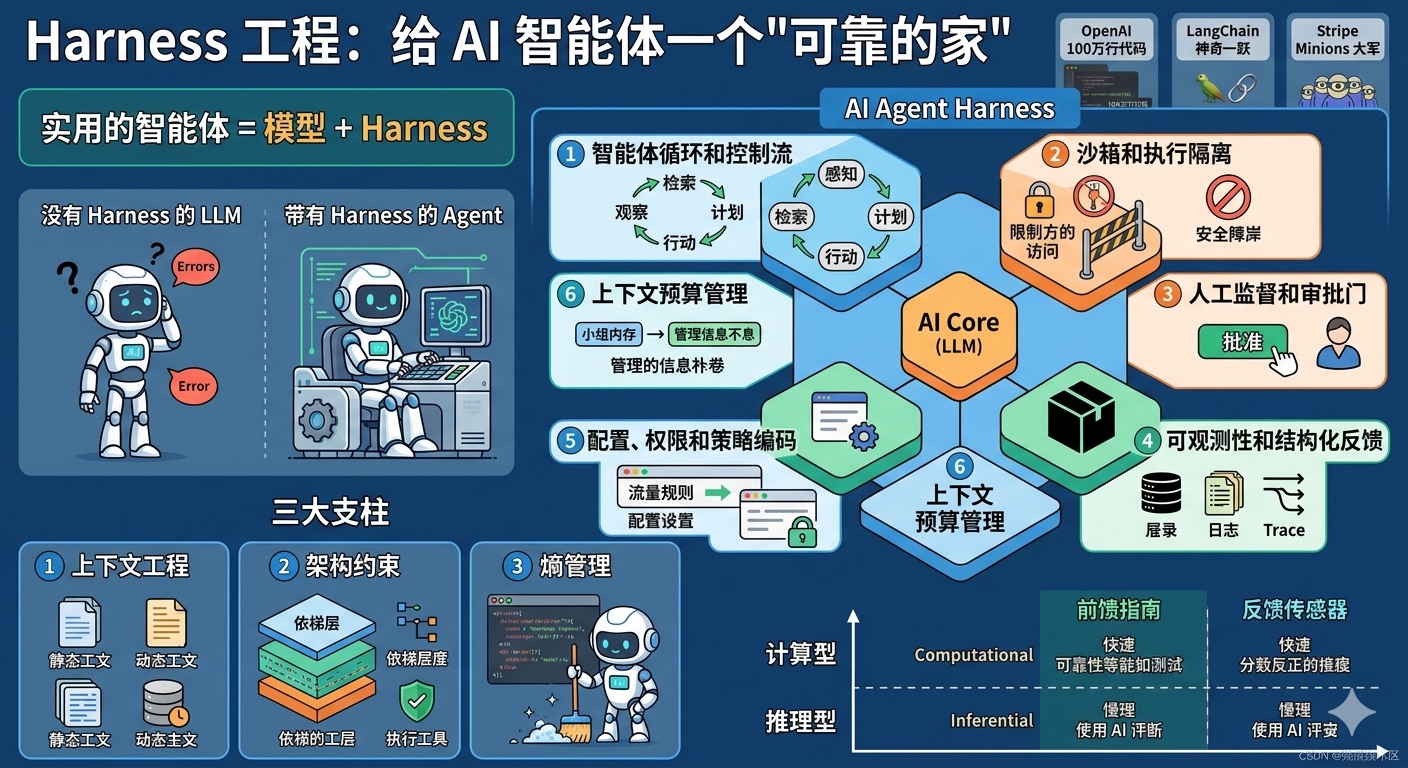
Harness 工程:给 AI 智能体一个"可靠的家"
想象一下,你有一个非常聪明但有点冲动的助手——它知识渊博、能说会道,但有时候会:
这就是没有 Harness 的 LLM 智能体。
什么是 Harness?
Harness 这个词在英文里有"马具"、"安全带"的意思。在 AI 智能体的世界里,它就是那个让智能体既能够发挥能力,又不会失控的"安全脚手架"。
这个隐喻是有意的:
用一个更贴近生活的比喻:Harness 就像是智能体的"驾驶舱 + 安全带 + 导航系统 + 黑匣子"的组合体。
根据 Harness Engineering 将原始模型能力转化为可靠 Agent 行为的脚手架。实用的 Agent 最好被理解为在 Harness 内部运行的模型,而不是带有外围能力的模型。
真实故事:Harness 工程的威力
在我们深入技术细节之前,让我们看看几个真实的例子,了解为什么 Harness 工程如此重要:
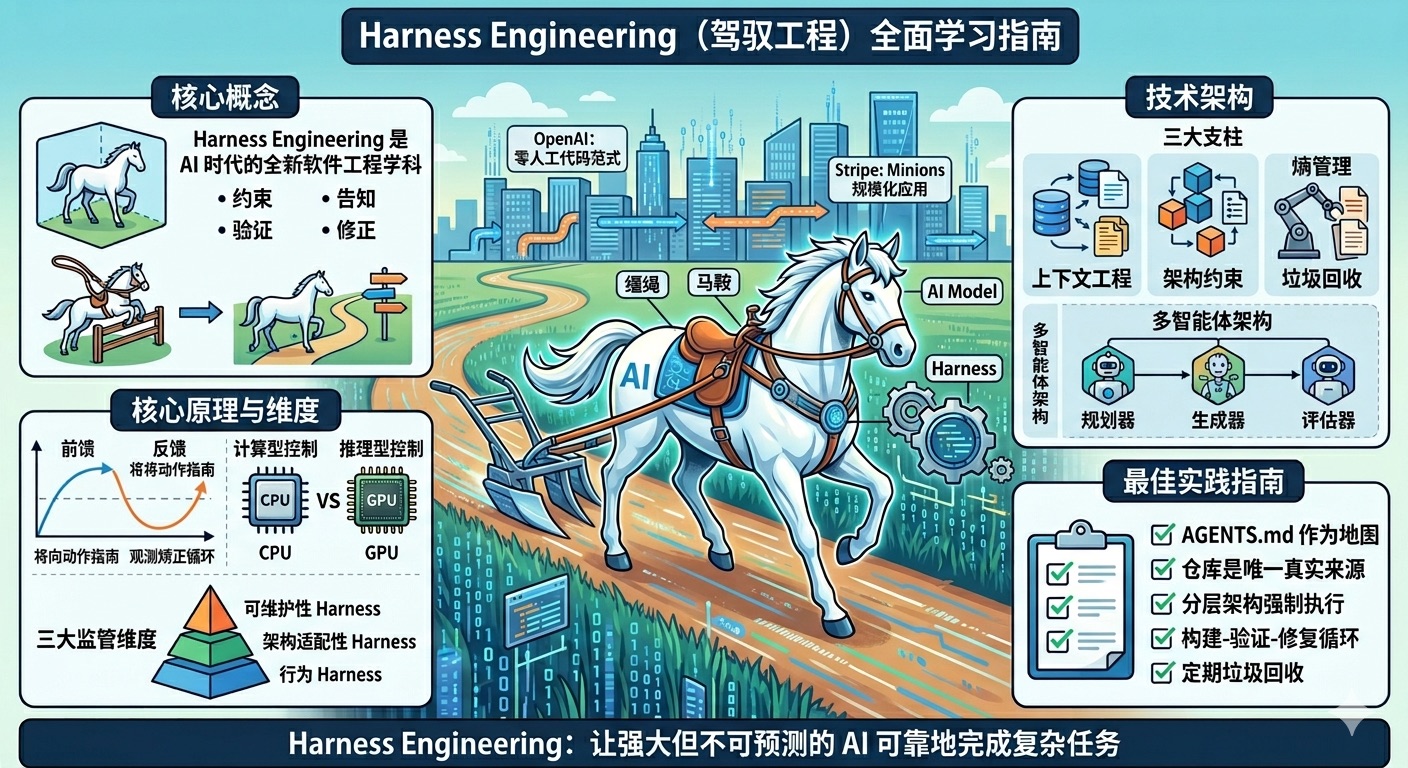
Harness Engineering 是 AI 时代的全新软件工程学科 —— 设计和实现系统来约束、引导、验证和修正 AI 智能体的行为,让强大但不可预测的 AI 模型能够可靠地完成复杂任务。
📚 目录
核心概念
什么是 Harness Engineering?
Harness Engineering 是设计和实现系统的学科,这些系统能够:
类比:AI 模型是一匹强大但无方向的骏马,Harness 是缰绳、马鞍和全套马具,人类工程师是骑手。没有 Harness 的 AI 是开阔场地里的纯种马——速度快、令人印象深刻,但完全无法用来完成任何实际工作。
为什么 Harness Engineering 至关重要?
模型是商品,Harness 是护城河
AI 行业正在达成一个共识:底层模型的重要性远低于围绕它的系统。LangChain 的实验最能证明这一点:他们的编码智能体在 Terminal Bench 2.0 上的得分从 52.8% 提升到 66.
Harness Engineering 是 2026 年软件工程领域涌现的一门新学科,其核心理念是:在生成式 AI 时代,由于模型能力已趋于同质化(Commodity),构建可靠、可扩展的 AI 智能体系统的关键不再是模型本身,而是在模型周围设计的“Harness”(支架/编排系统)。
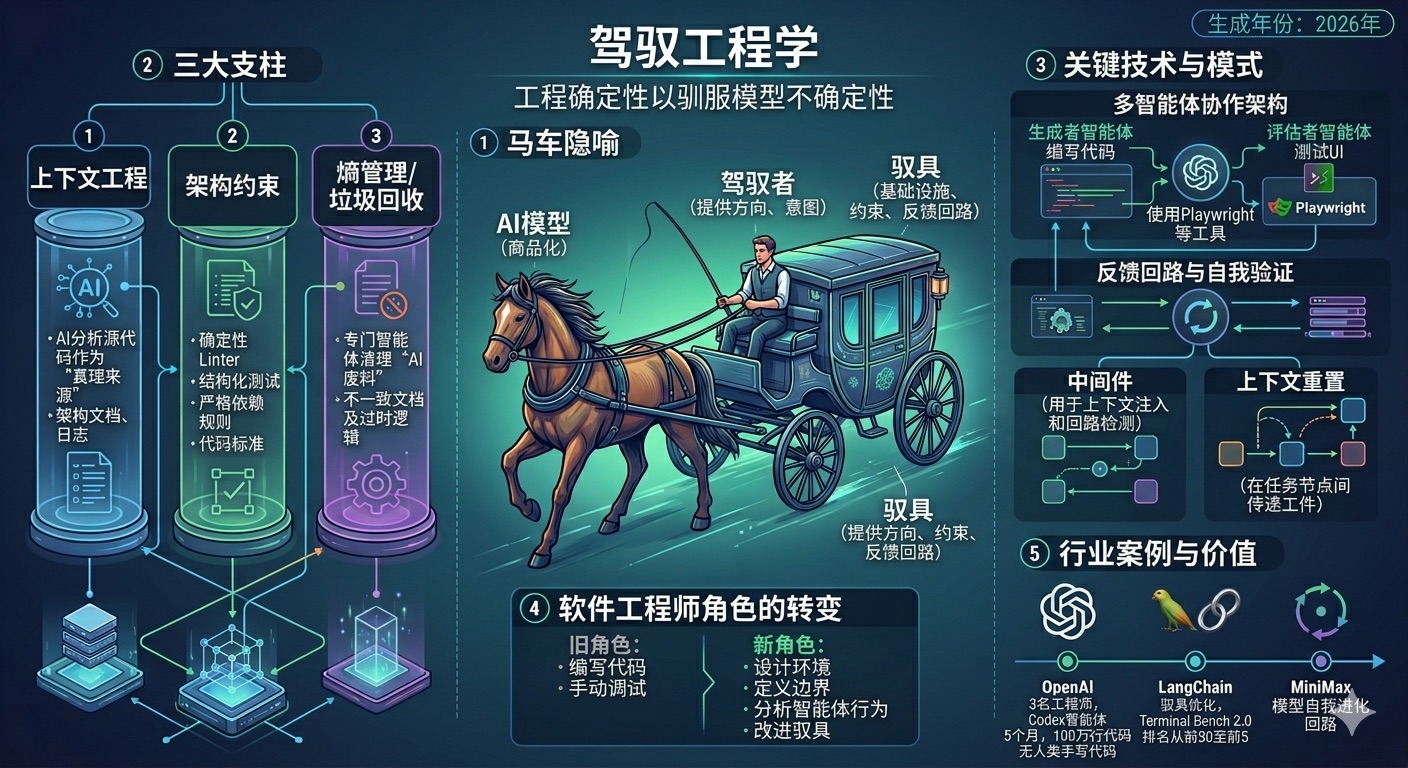
通过分析提供的资料,可以从以下几个维度深入理解 Harness Engineering:
1. 核心定义与马车隐喻
“Harness”一词源于马具(如缰绳、马鞍、嚼子),这个隐喻生动地解释了三者的关系:
正式定义上,Harness engineering 是设计和实现一个能够约束、告知、验证并纠正 AI 智能体行为的系统学科。
2. Harness Engineering 的三大支柱
根据 OpenAI 和 NxCode 的实践,一个成熟的 Harness 系统包含三大核心组件:
本文综合 Anthropic、OpenAI、Martin Fowler、LangChain、Mitchell Hashimoto、NxCode、MiniMax 等前沿文章的分析报告。
一、什么是 Harness Engineering?
1.1 词源与隐喻
"Harness" 直译为"马具"——缰绳、鞍座、嚼子,是用来驾驭一匹强大但不可预测的动物的工具。这个隐喻极其精准:
| 隐喻 | 对应实体 |
|---|---|
| 马匹 | AI 模型——强大、快速,但自身不知道该去哪里 |
| 马具(Harness) | 基础设施——约束、护栏、反馈循环,引导模型的力量 |
| 骑手 | 人类工程师——提供方向,而不是亲自奔跑 |
没有 Harness 的 AI Agent 就像旷野中的野马——速度快、令人印象深刻,但对完成任何目标完全无用。
1.2 正式定义
Harness Engineering 是设计和实现以下系统的学科:
1.3 与相关概念的区别
Harness Engineering,是在AI大模型时代,以确定性系统外壳约束概率性AI行为,通过上下文工程、架构约束、熵管理三位一体,构建可长期稳定运行的AI Agent系统,推动软件工程从代码实现转向系统设计,成为下一代AI工程化的核心范式。
引言
在人工智能,特别是大型语言模型(LLM)能力迅速发展的时代,软件开发领域正经历一场深刻的范式转移。传统以代码为中心的工程方法正在被一种以语言为中心的新范式所取代。这一新范式将工程设计的核心原则,如控制、可靠性和可扩展性,应用到了人与AI的交互界面上。本报告将深入探讨这一新兴领域,提出“Harness Engineering”(驾驭工程)这一术语,用以描述其背后的系统性原则、核心实践、行业案例及未来挑战。报告旨在为软件工程师、技术领导者及行业观察家提供一个全面的框架,以理解并应用这一即将定义未来技术格局的关键技术。
一、超越提示词与上下文
在深入探讨Harness Engineering之前,必须首先理解它所处的演化脉络。它并非一个凭空出现的概念,而是对已有AI工程实践的一次系统性整合与升华。它标志着行业的焦点从与AI模型的“单次对话”转向了构建一个让AI能够“持续可靠工作”的完整系统。
1.1 定义Harness Engineering
Harness Engineering(驾驭工程)被定义为一个新兴的工程学科,其核心目标是设计和实现一套围
Harness Engineering 定义
Harness engineering 是一门设计和构建约束、反馈循环和生命周期系统的工程学科,用于让 AI 智能体能够可靠地构建软件。它的核心思想是:不直接让 AI 写代码,而是创建一个环境(harness),让 AI 在这个环境中可靠地构建代码。
三大核心支柱
1. Context Engineering(上下文工程)
2. Architectural Constraints(架构约束)
3. Entropy Cleanup(熵清理/垃圾回收)
典型架构模式
Anthropic 的三智能体架构:
关键实践
没有找到匹配的文章