本地大模型选型参考 · 2026 年 11 月HTML
2026年11月本地大模型选型手册:先算清内存容量、带宽与上下文预算,再按档位与许可证筛出14个模型;用正反两列证据拆解量化方差、运行时陷阱与跑分水分,给出27B主力的可执行起点与上手验收清单,并附全部来源分级。
2026年11月本地大模型选型手册:先算清内存容量、带宽与上下文预算,再按档位与许可证筛出14个模型;用正反两列证据拆解量化方差、运行时陷阱与跑分水分,给出27B主力的可执行起点与上手验收清单,并附全部来源分级。
官方只给 CUDA,本篇盘点 macOS 上跑 Qwen3-ASR 的五条社区路线:MLX 重写、Swift/Rust、GGUF 与 Core ML 等,附实测延迟与 WER、decoder 4-bit 配 encoder 8-bit 量化配方与踩坑清单。
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
基于 Hacker News 416 条评论与 13 万条 Discord 消息,用大白话讲清美国开发者本地跑什么开源模型:Qwen 系列是默认答案,27B 至 35B 是甜点档,本地能干七成活,其余仍归云端前沿模型。
DeepSeek-V4
简介
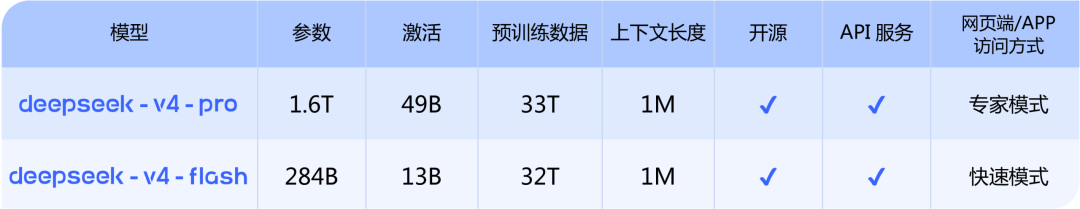
我们在此发布 DeepSeek-V4 系列的预览版本,包括两个强大的混合专家(MoE)语言模型 —— 总参数量 1.6T(激活 49B)的 DeepSeek-V4-Pro,以及总参数量 284B(激活 13B)的 DeepSeek-V4-Flash,两者均支持长达 一百万 token 的上下文。
DeepSeek-V4 系列在架构与优化方面引入了多项关键升级:
两款模型均在大于 32T 的多样化高质量 token 上进行了预训练,并随后执行了全面的后训练流程。后训练采用两阶段范式:首先独立培养领域专属专家(通过 SFT 与基于 GRPO 的强化学习),随后通过 on-policy 蒸馏将不同领域的专长整合至单一模型中。
DeepSeek-V4-Pro-Max 作
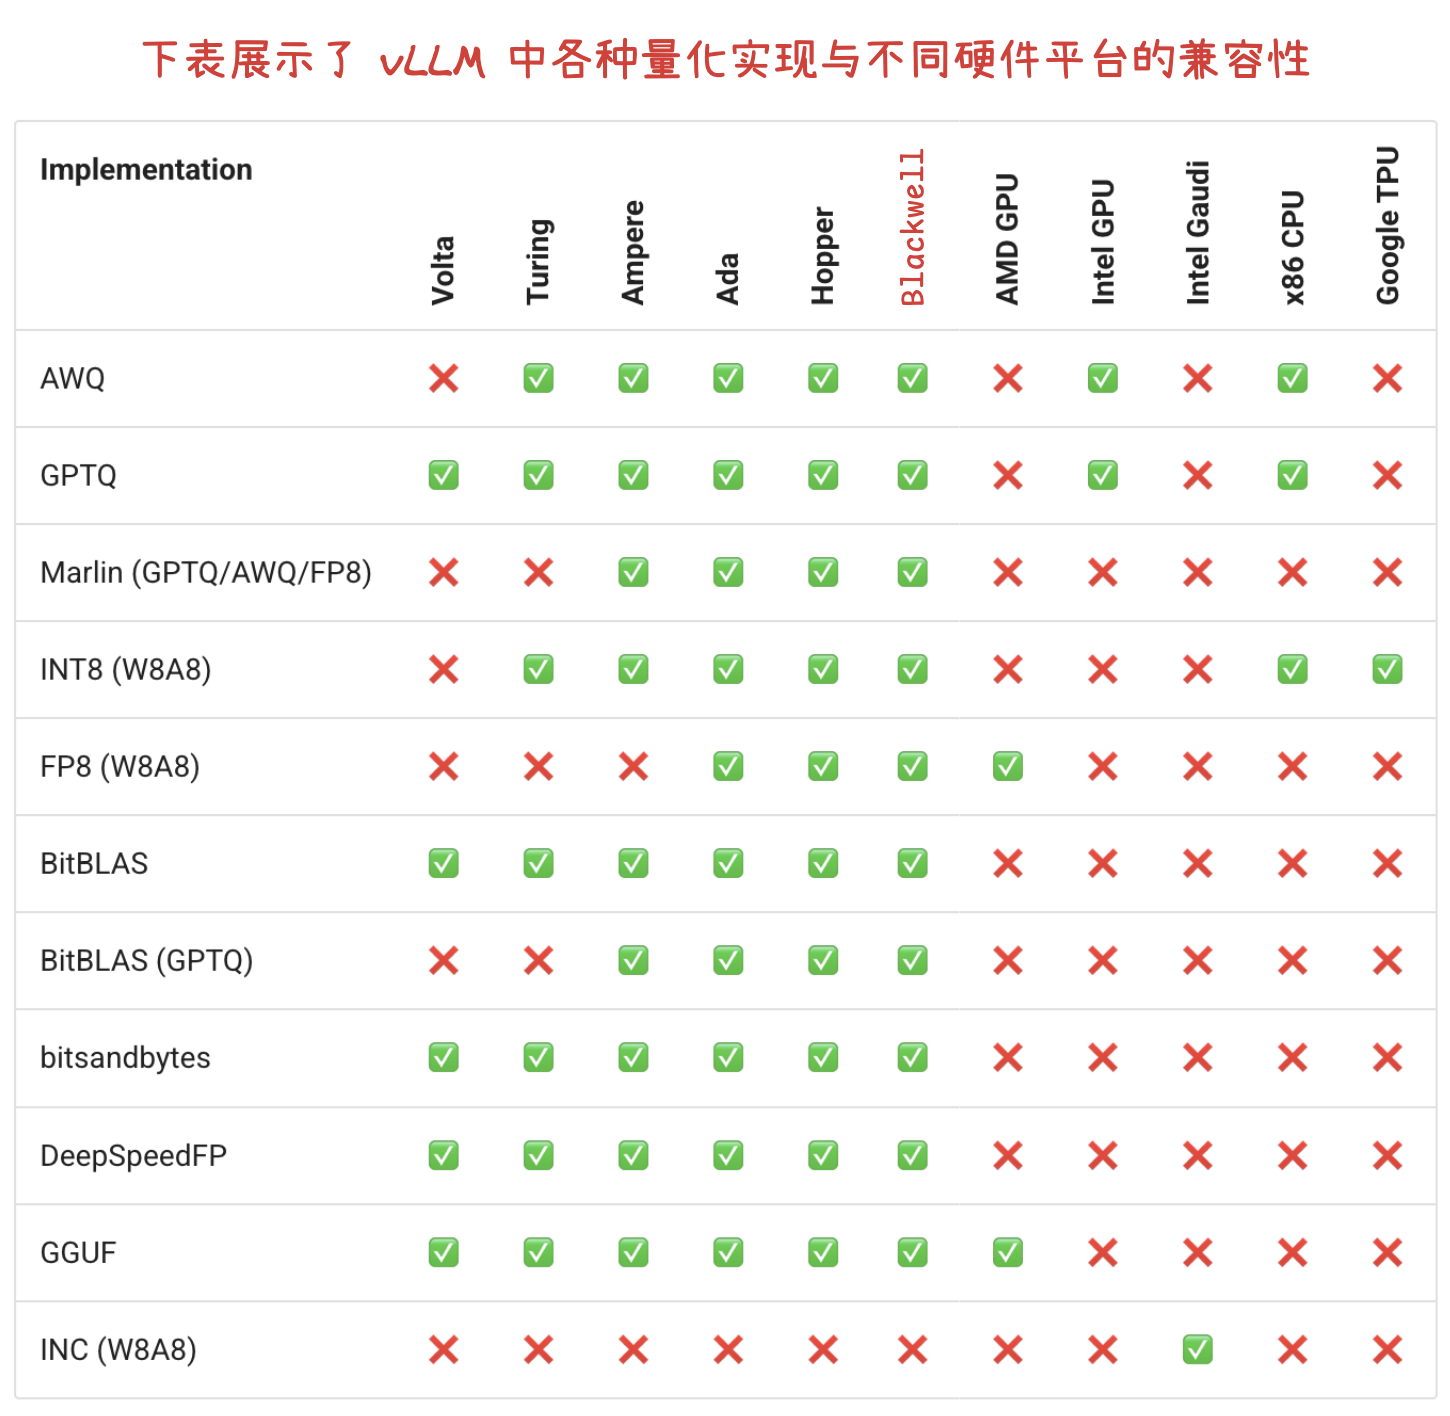
NVIDIA Jetson Thor 采用了 Blackwell 架构的 GPU。
性能基准测试分析
部署模型
vllm serve /models/Qwen/Qwen3-8B --served-model-name qwen3
运行性能基准测试
vllm bench serve \
    --base-url http://localhost:8000 \
    --model qwen3 \
    --tokenizer /models/Qwen/Qwen3-8B \
    --dataset-name random \
    --random-input-len 2048 \
    --random-output-len 128 \
    --num-prompts 100 \
    --max-concurrency 8
该文章是对 NVIDIA Jetson Thor 平台进行大语言模型部署、系统优化和深度性能基准测试的权威指南。
平台配置与环境准备: 文章首先详细介绍了在 Jetson AGX Thor 开发套件上进行 BSP(Jetson Linux)安装流程。这包括下载 ISO 映像、使用 Balena Etcher 创建可启动 USB 棒,以及通过首次启动完成 UEFI 固件更新和 Ubuntu 初始设置。软件环境基于 JetPack 7,它提供了对前沿机器人和生成式 AI 的全面支持。部署环境采用云原生技术,通过 Docker 容器运行 vLLM 或 TritonServer 等推理服务。
系统性能调优:
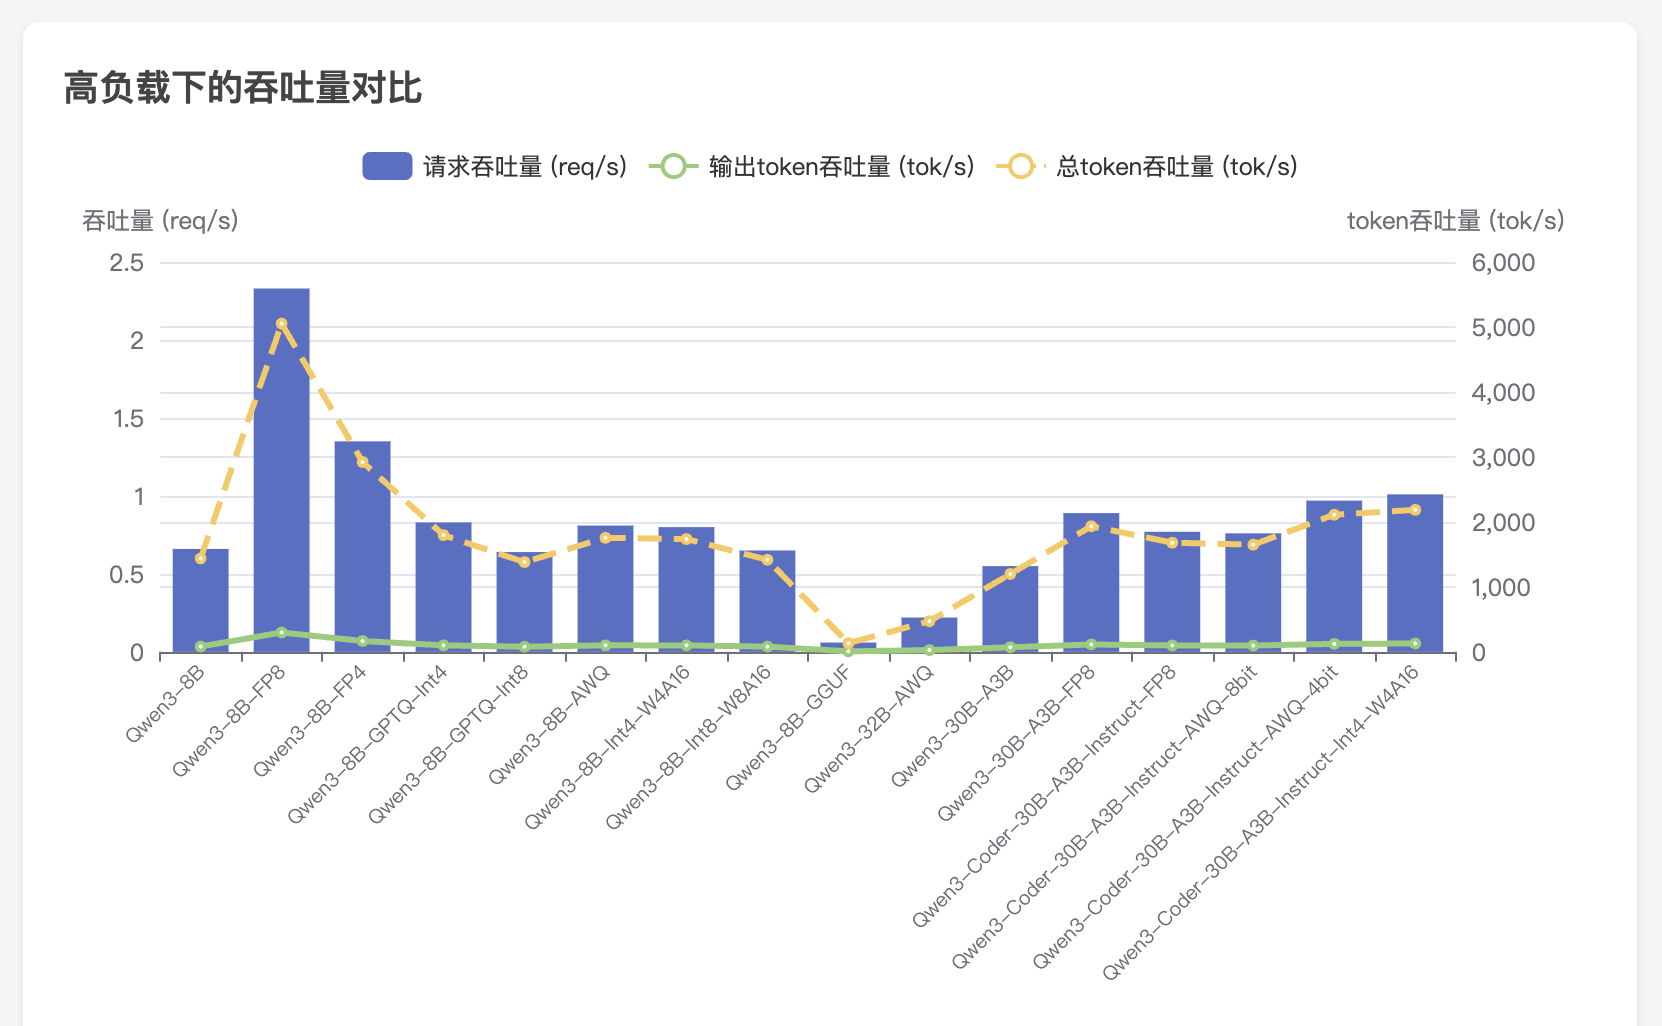
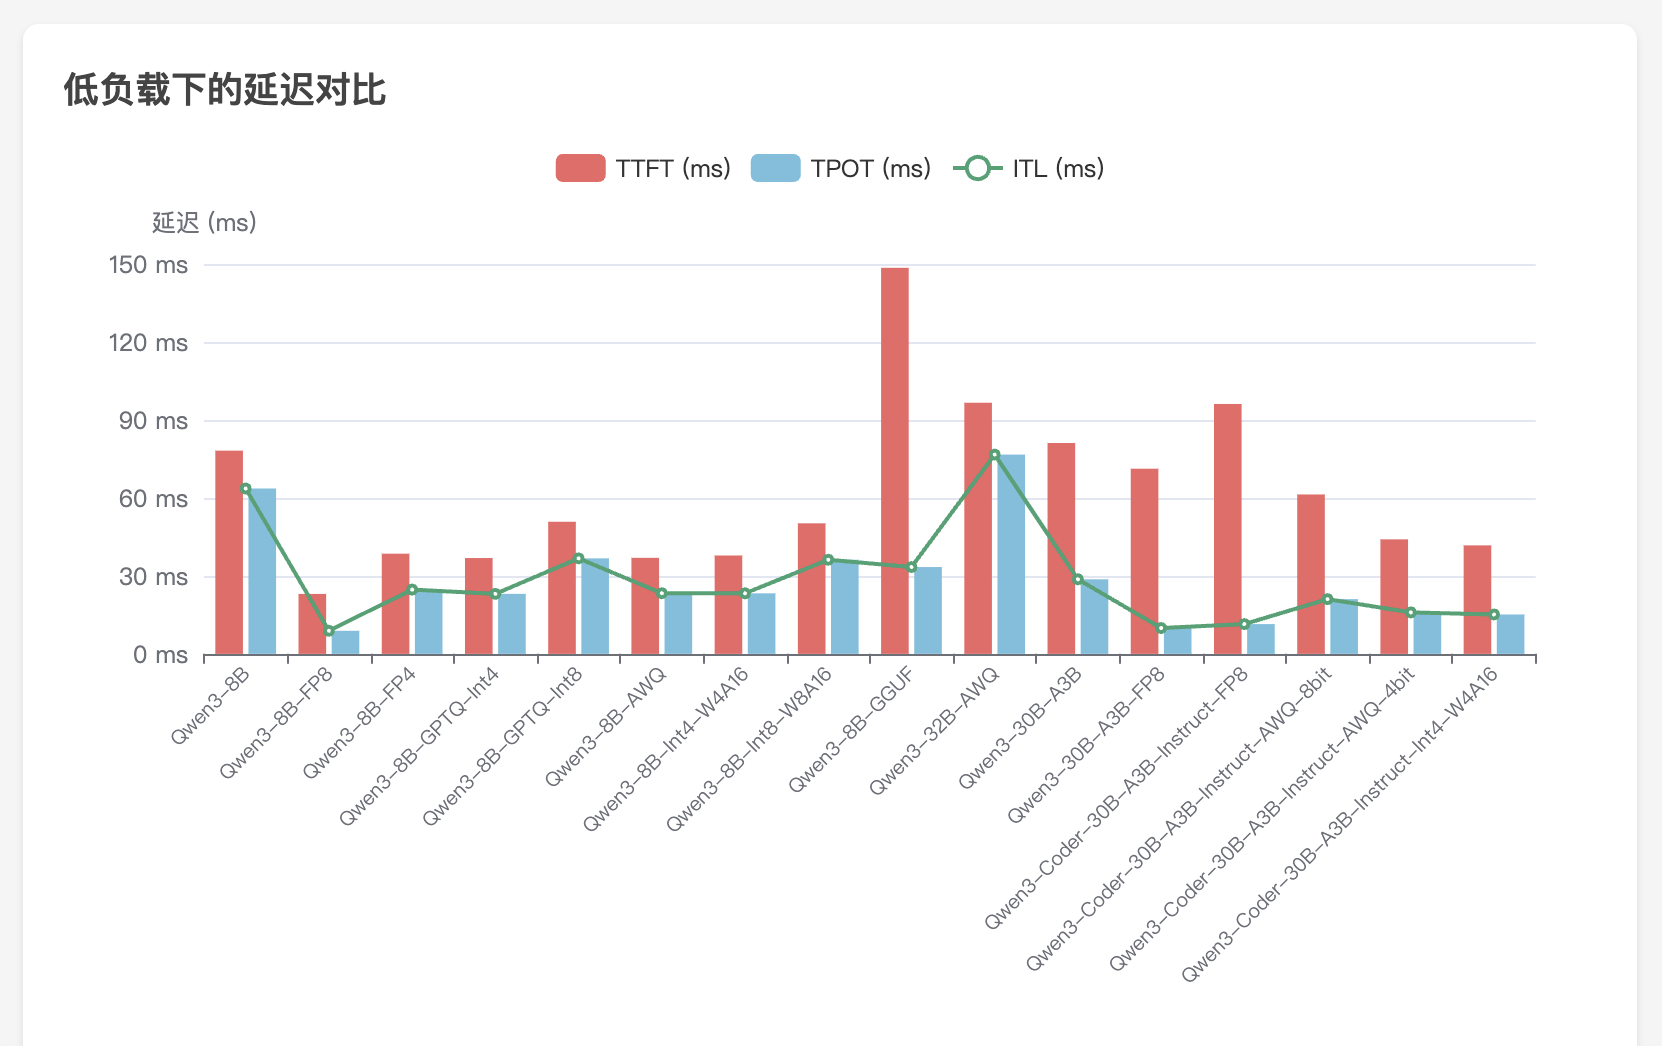
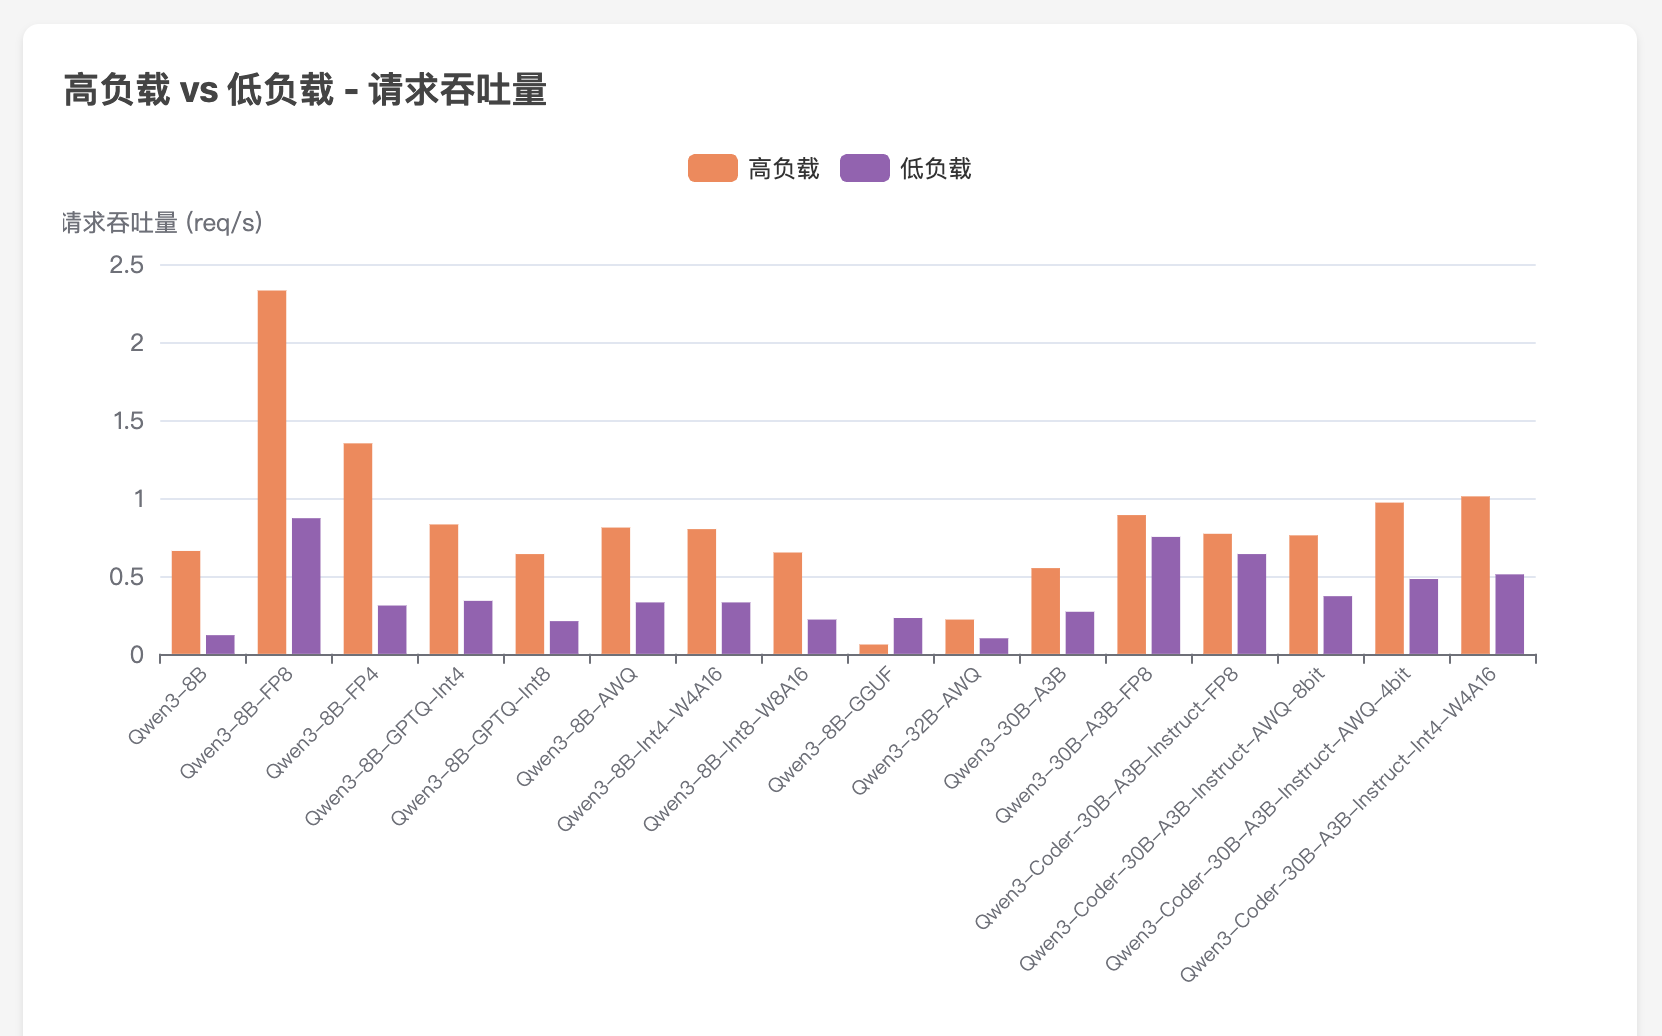
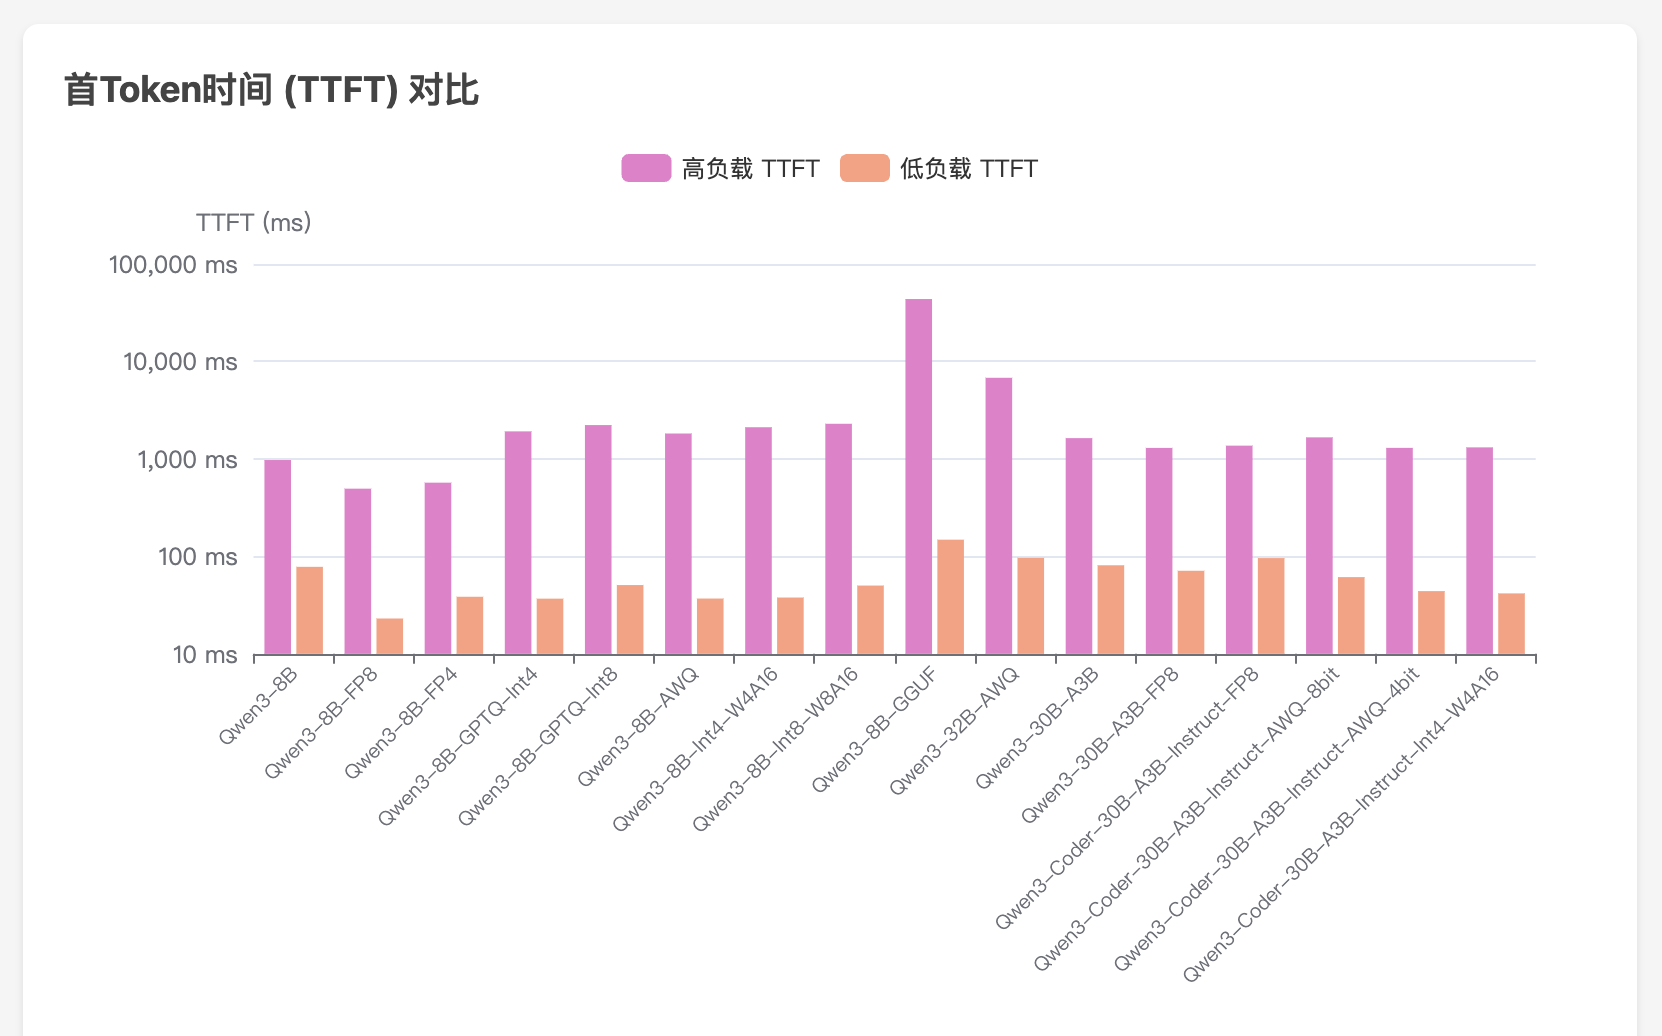
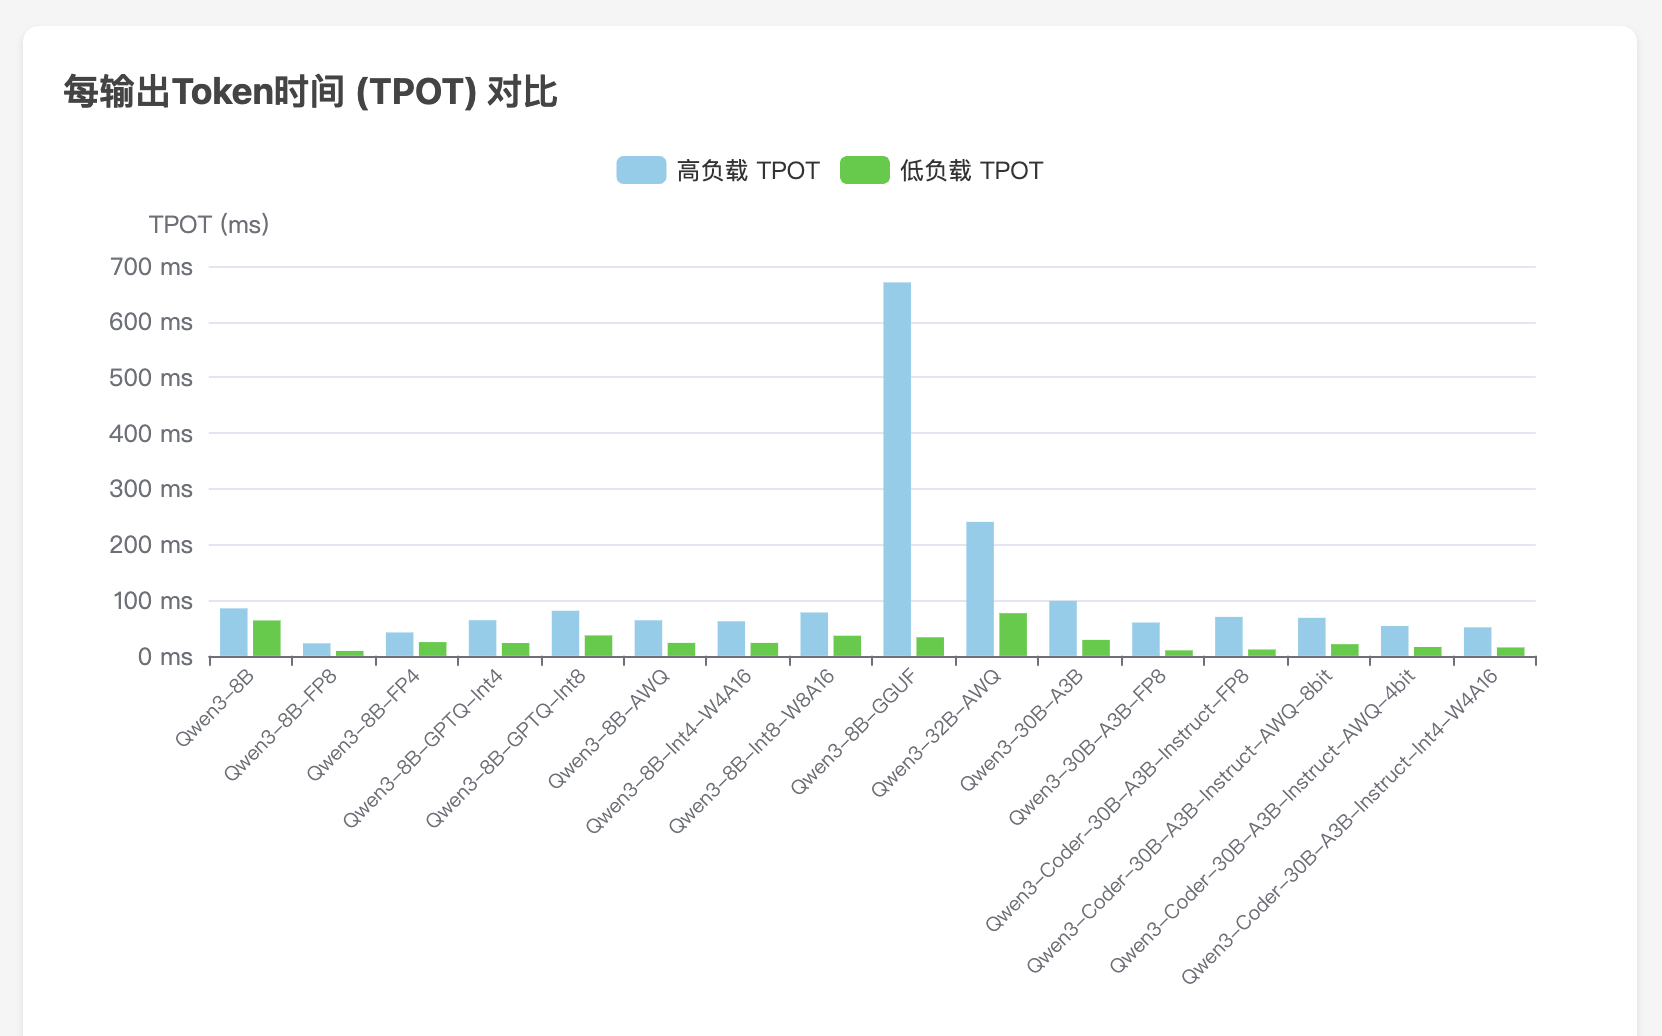
为了释放硬件全部潜力,文章强调了系统级的性能调优步骤:必须通过 sudo nvpmodel -m 0 将功耗模式设置为最高性能模式 (MAXN)(130W),并使用 sudo jetson_clocks 锁定 CPU、GPU 和内存的核心频率,禁用 DVFS 机制。测试结果显示,MAXN + jetson_clocks 组合能显著提升性能,在高负载下,FP8 模型的吞吐量提升约 18.5%,在低负载下,每 Token 平均延迟(TPOT)减少约 43%。
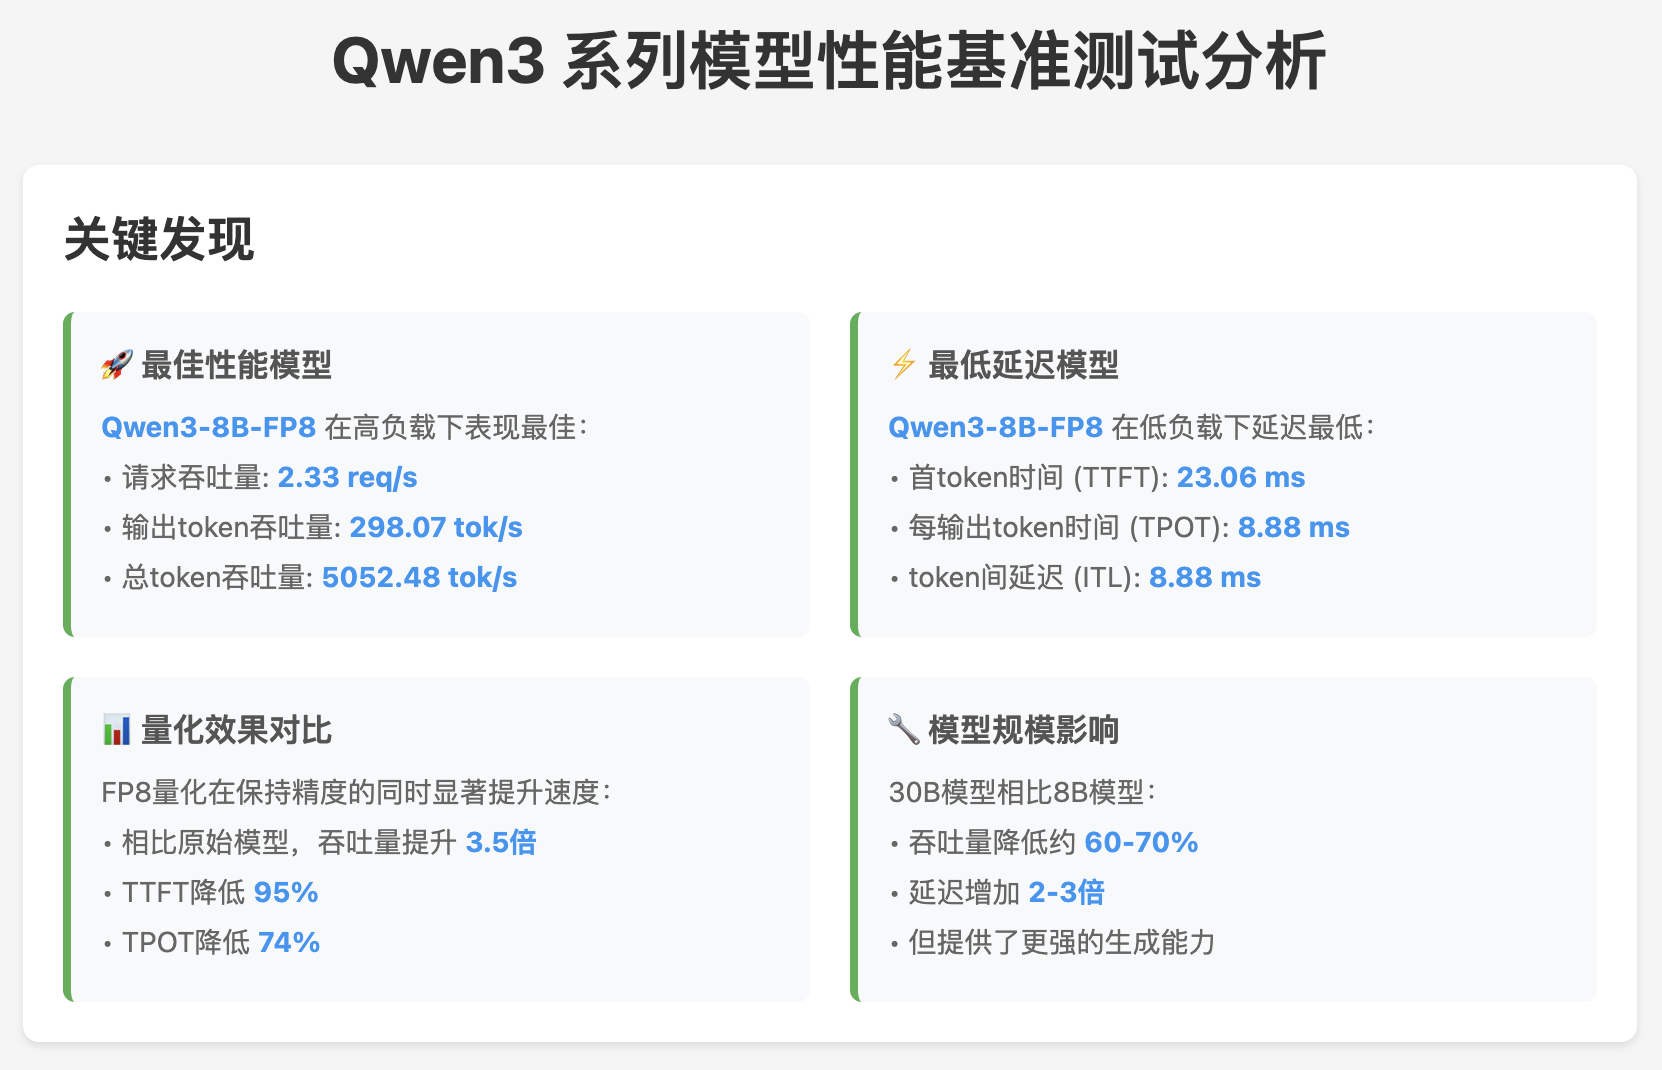
量化模型基准测试结果: 文章对 Qwen3-8B 模型的多种量化精度(包括 BF16、FP8、FP4、Int4 等)进行了详尽的性能分析。
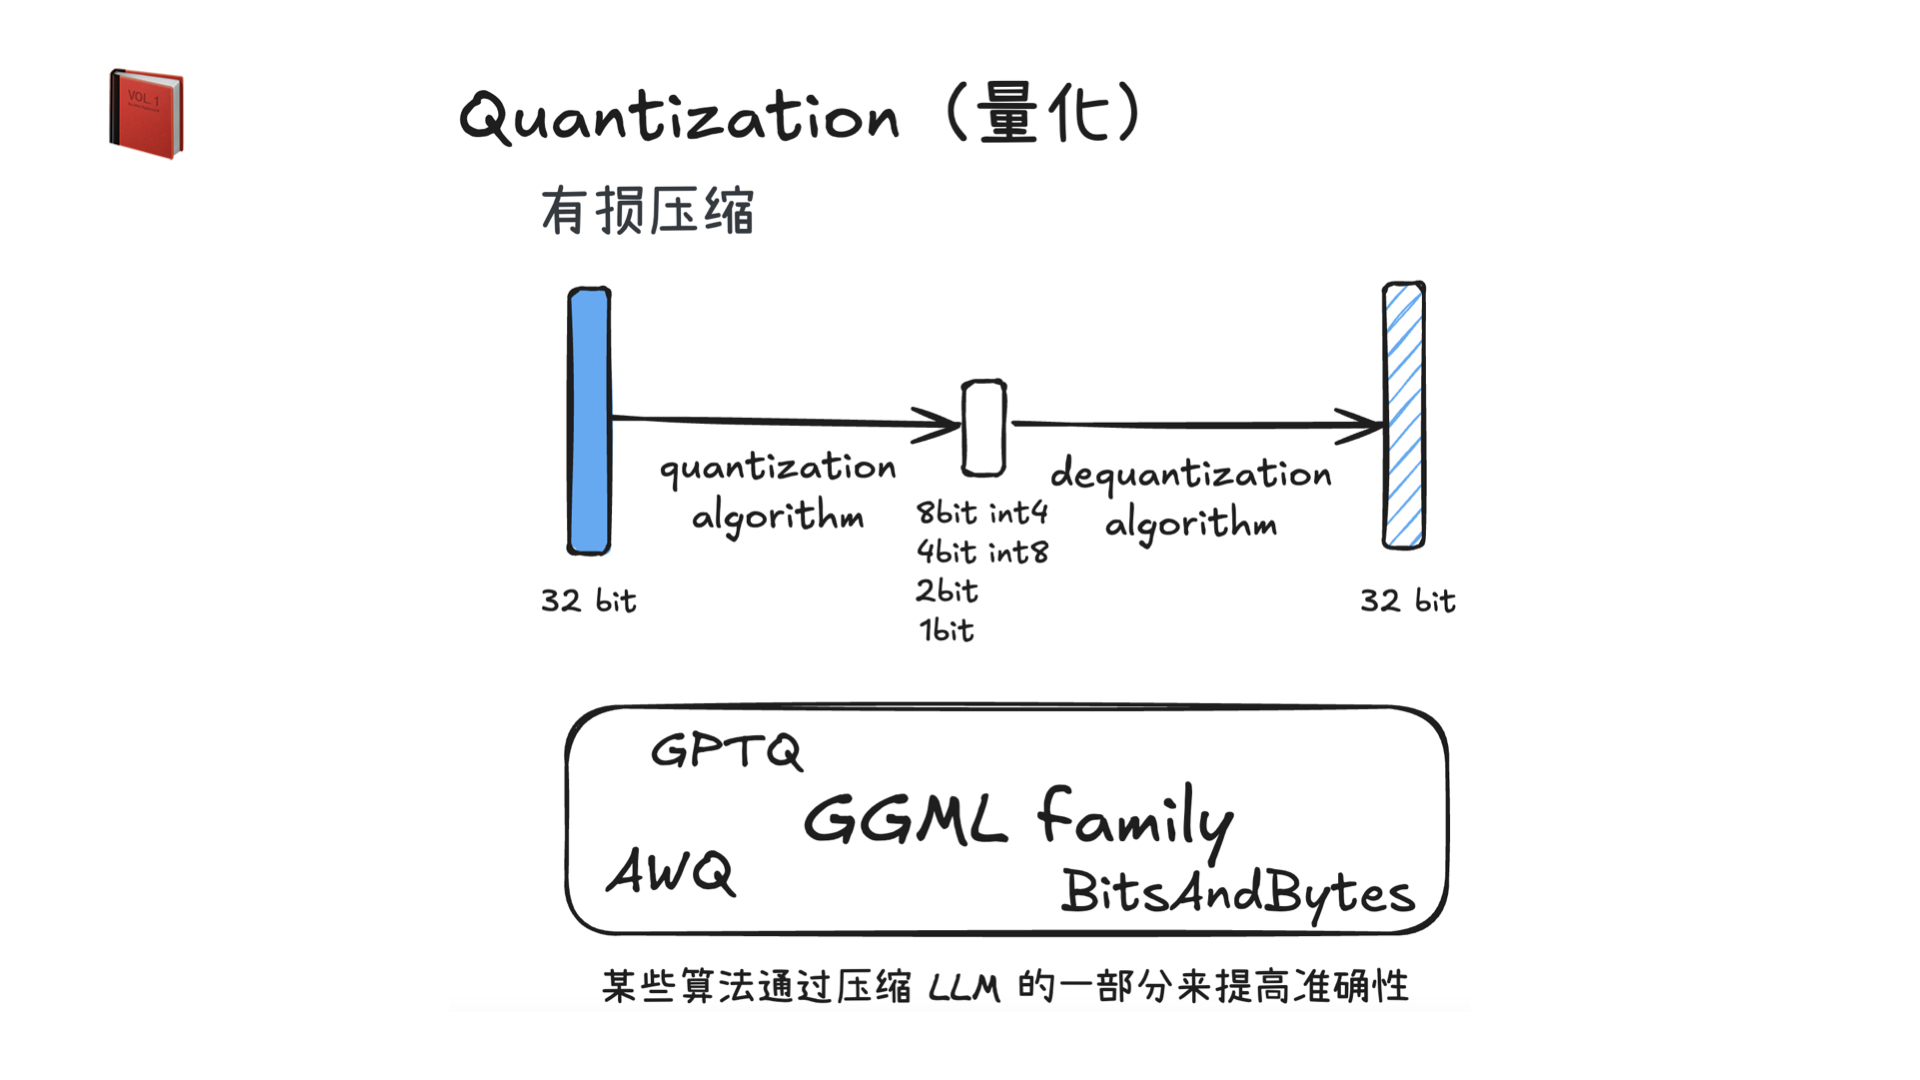
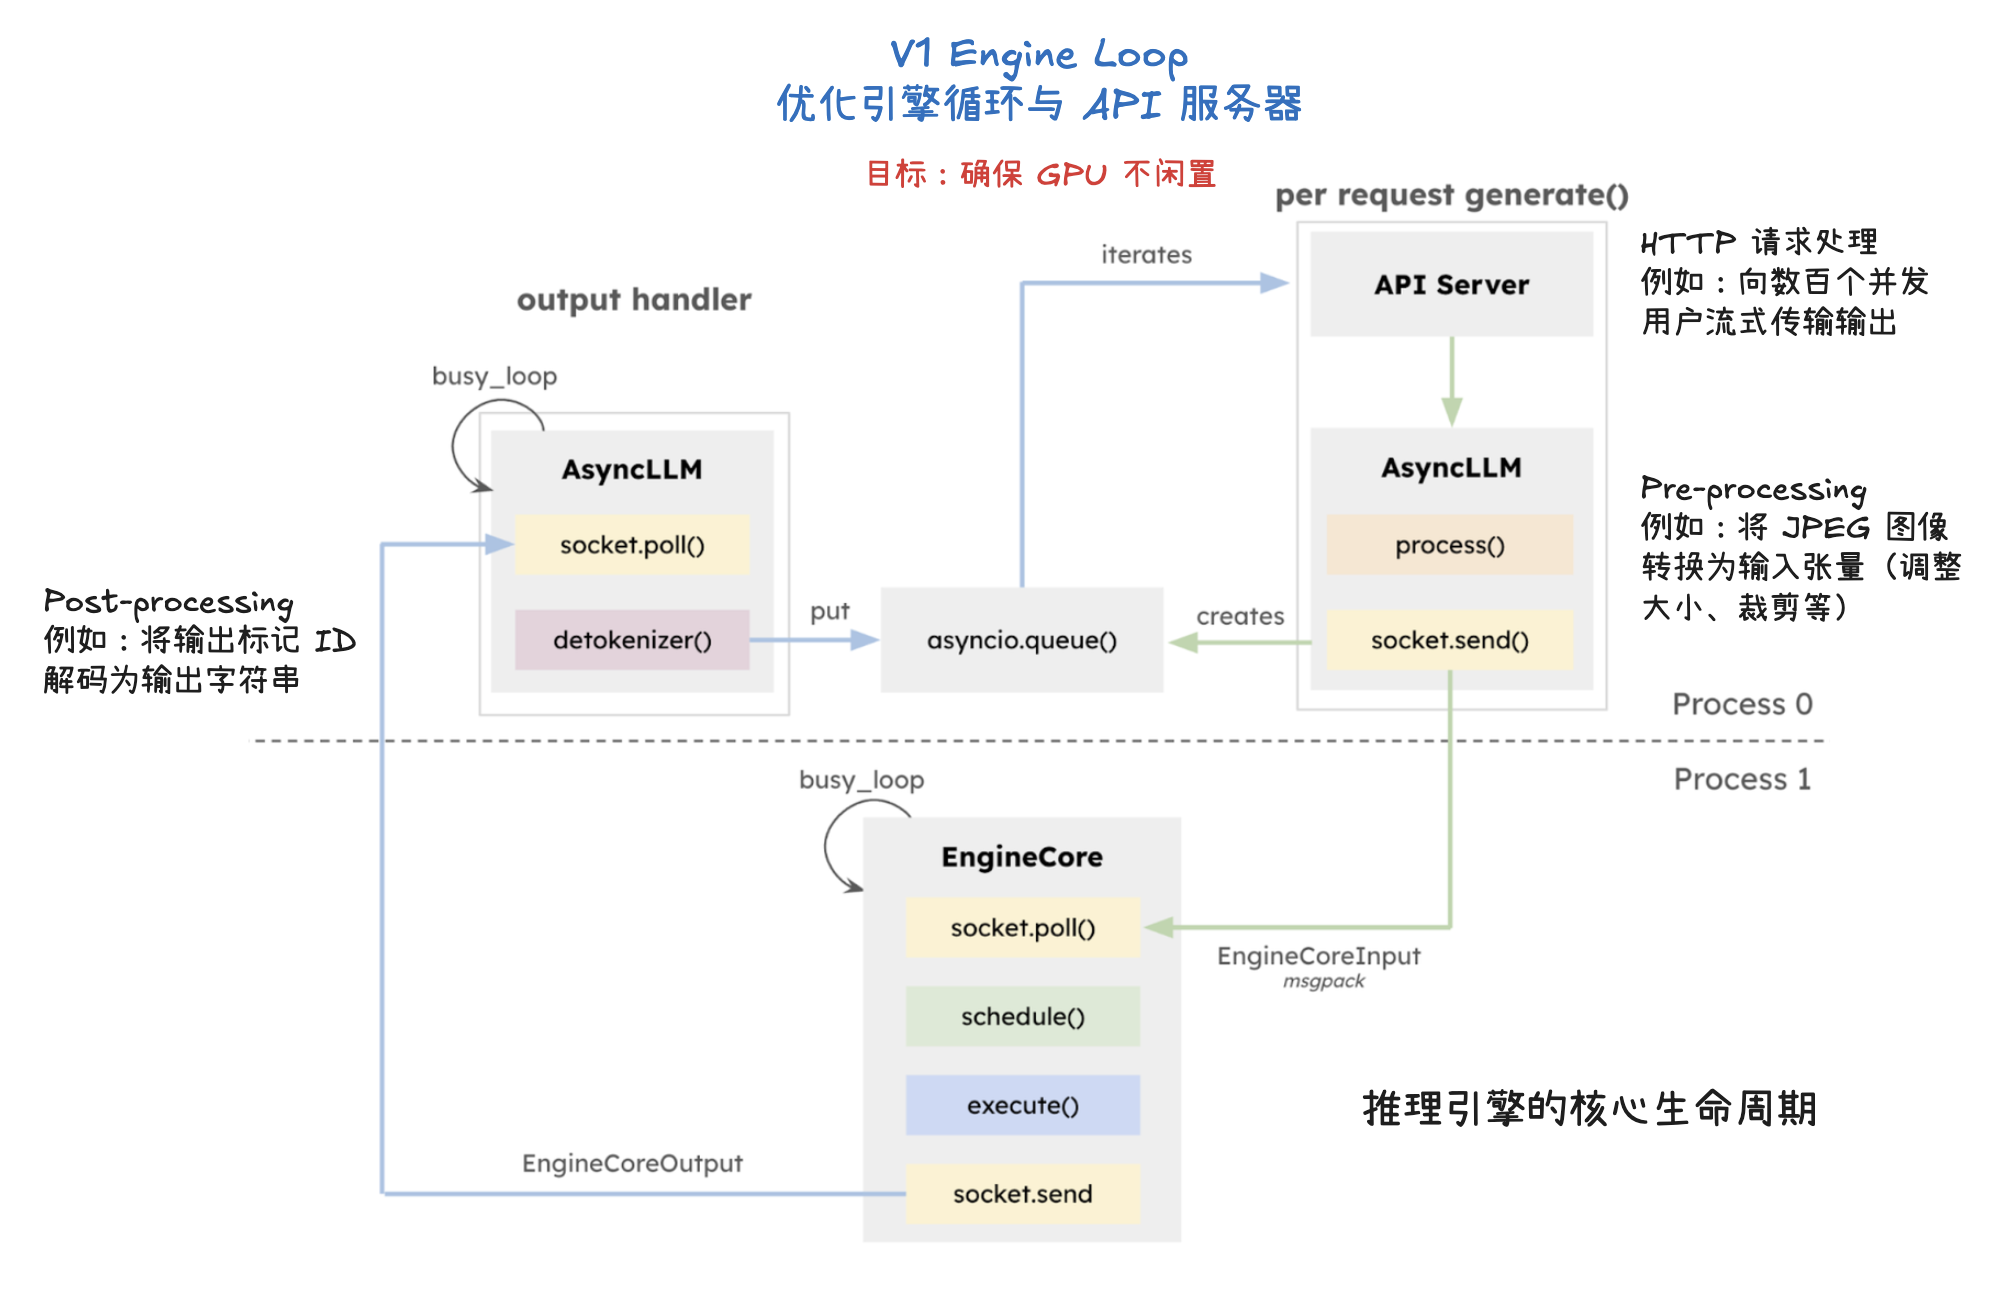
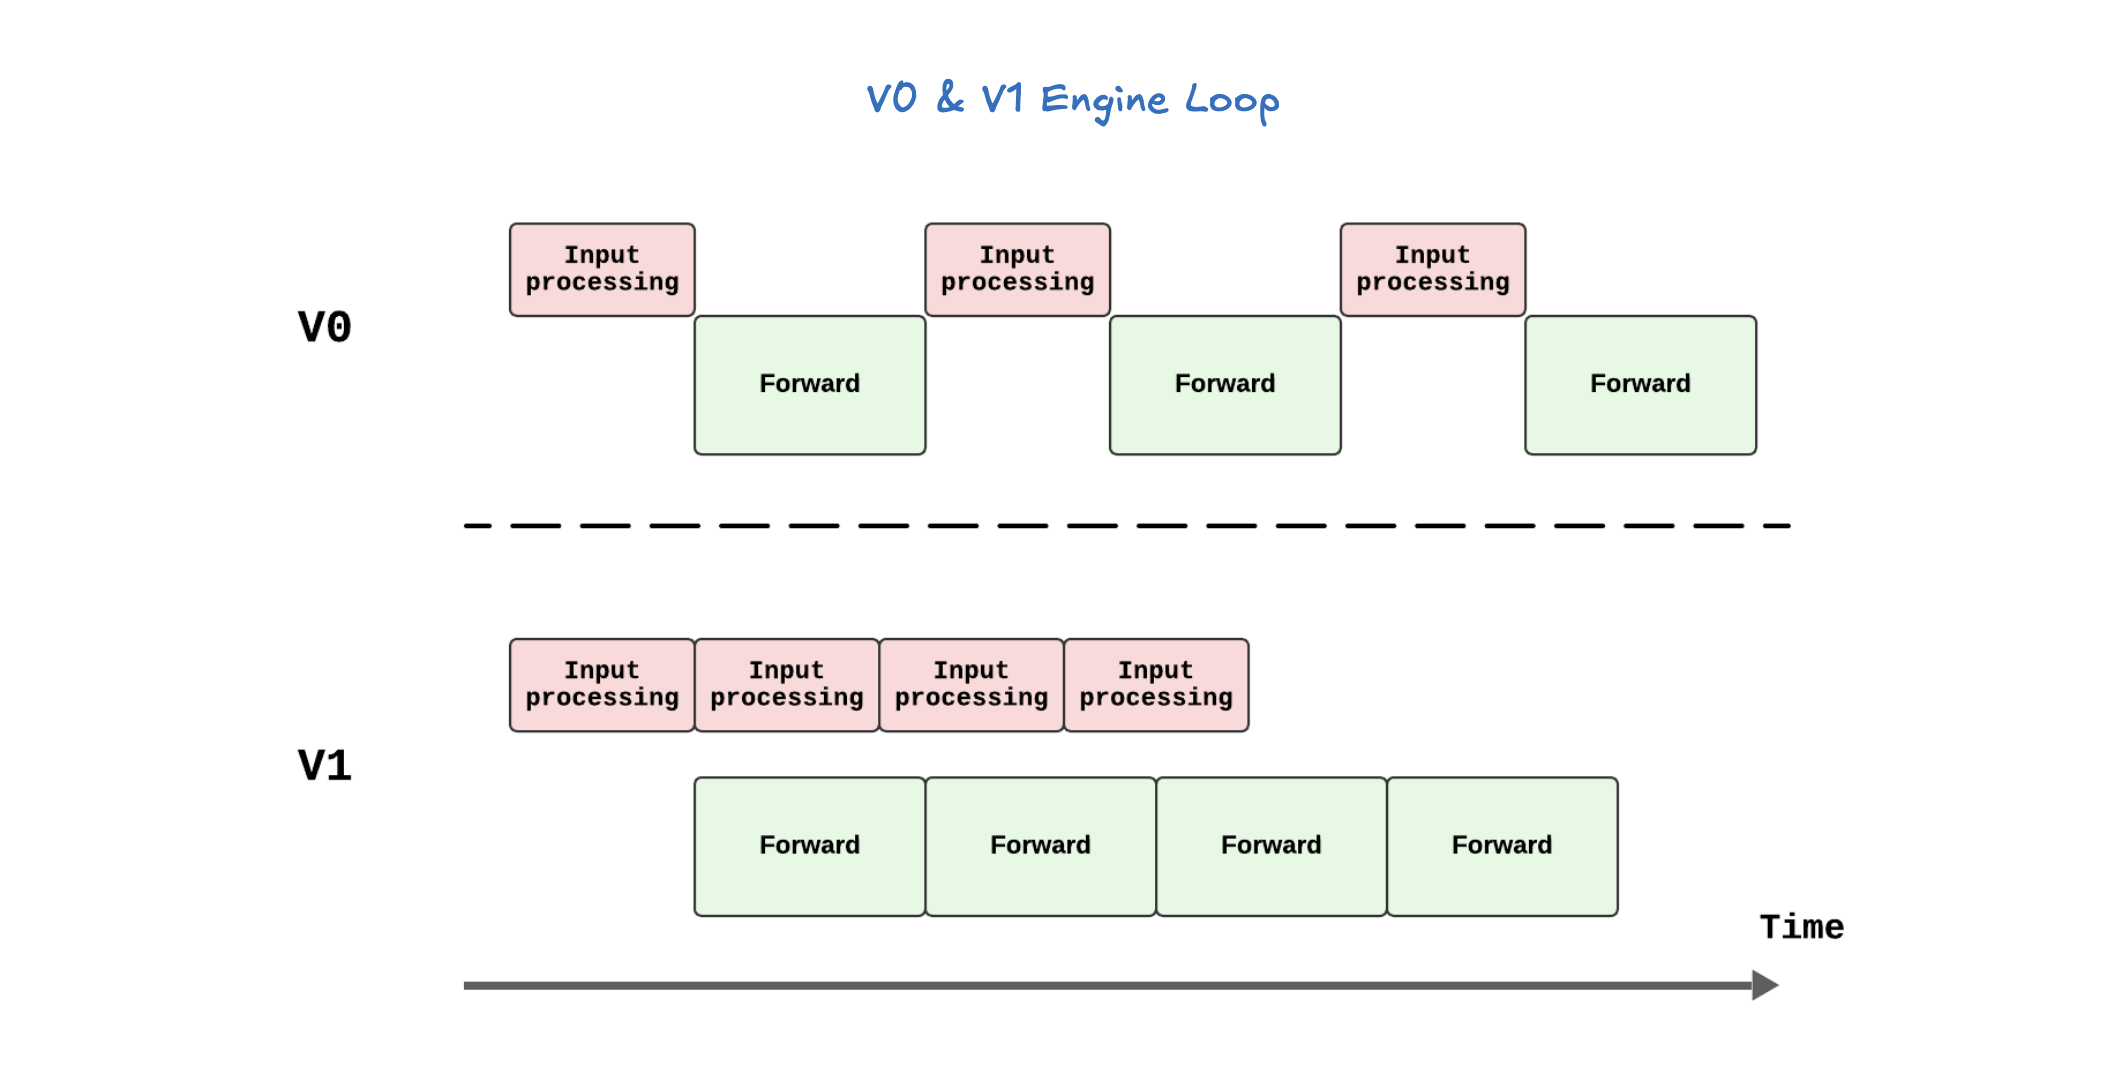
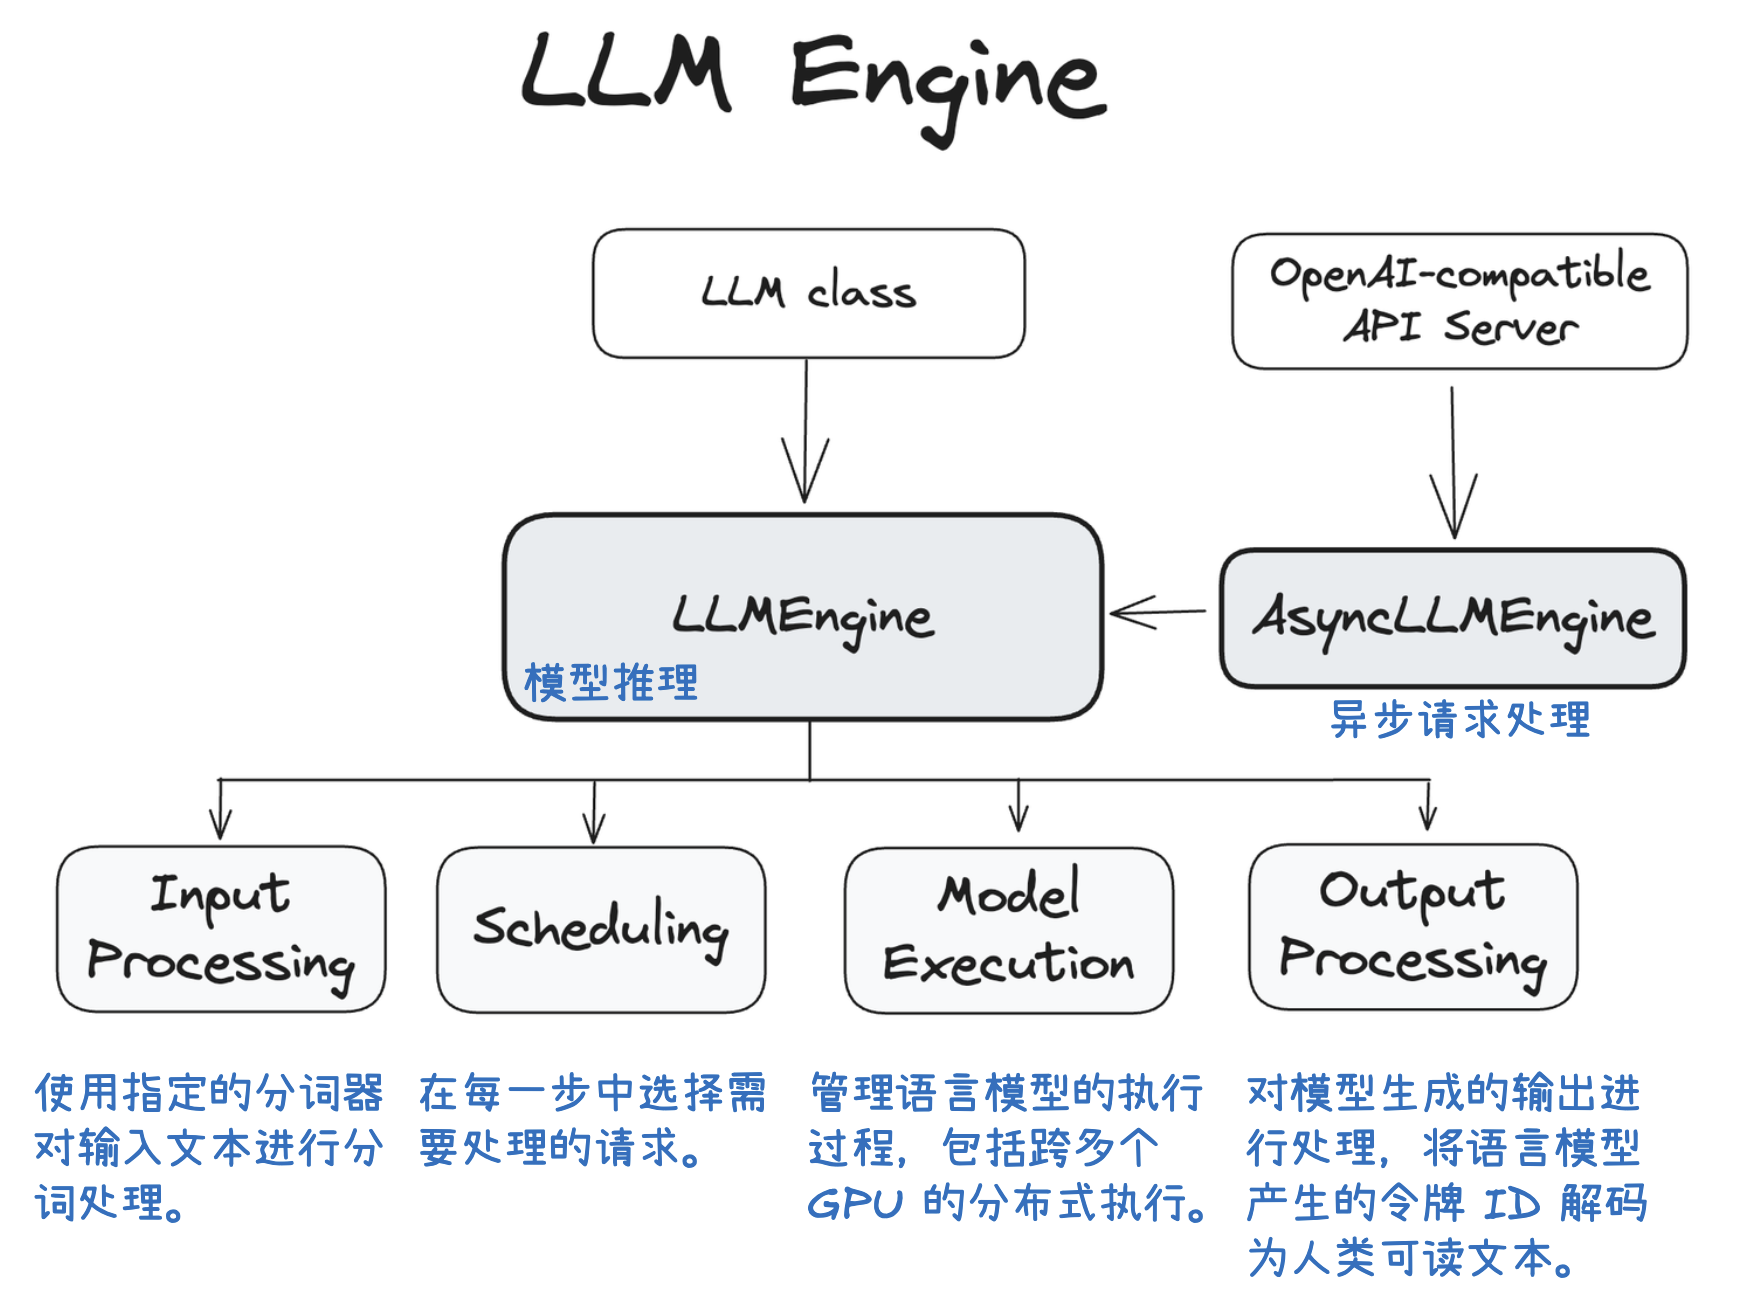
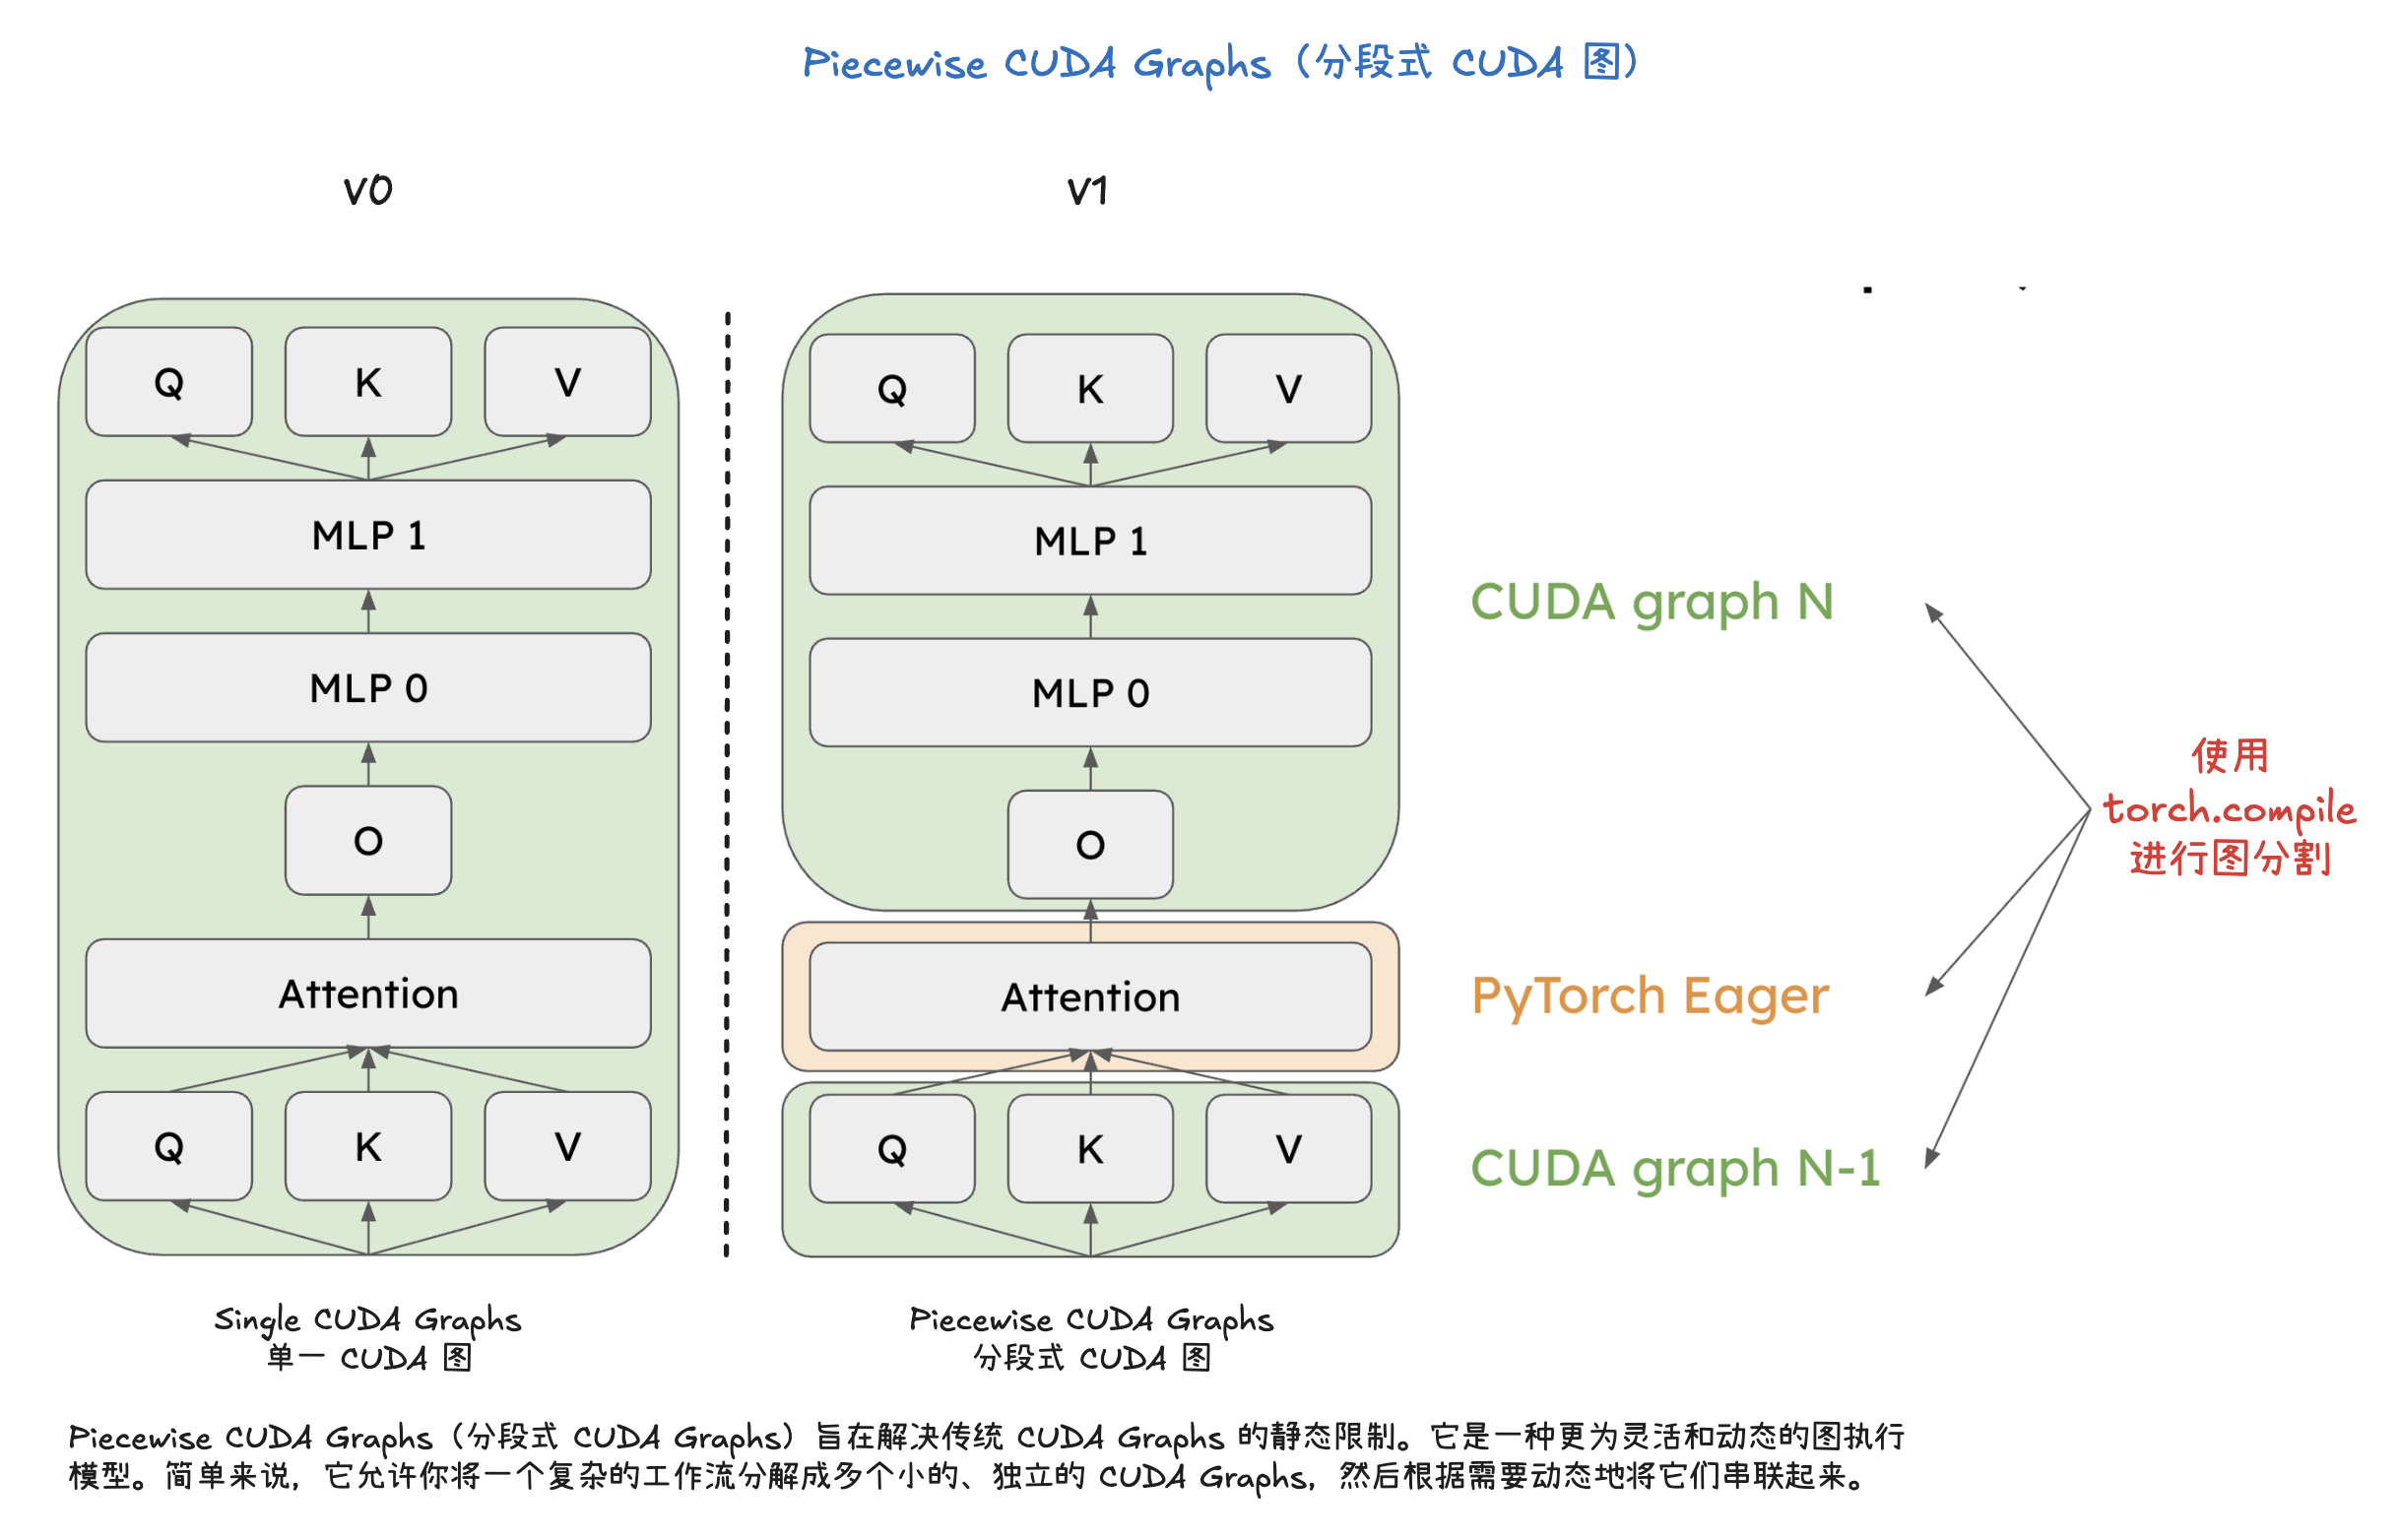
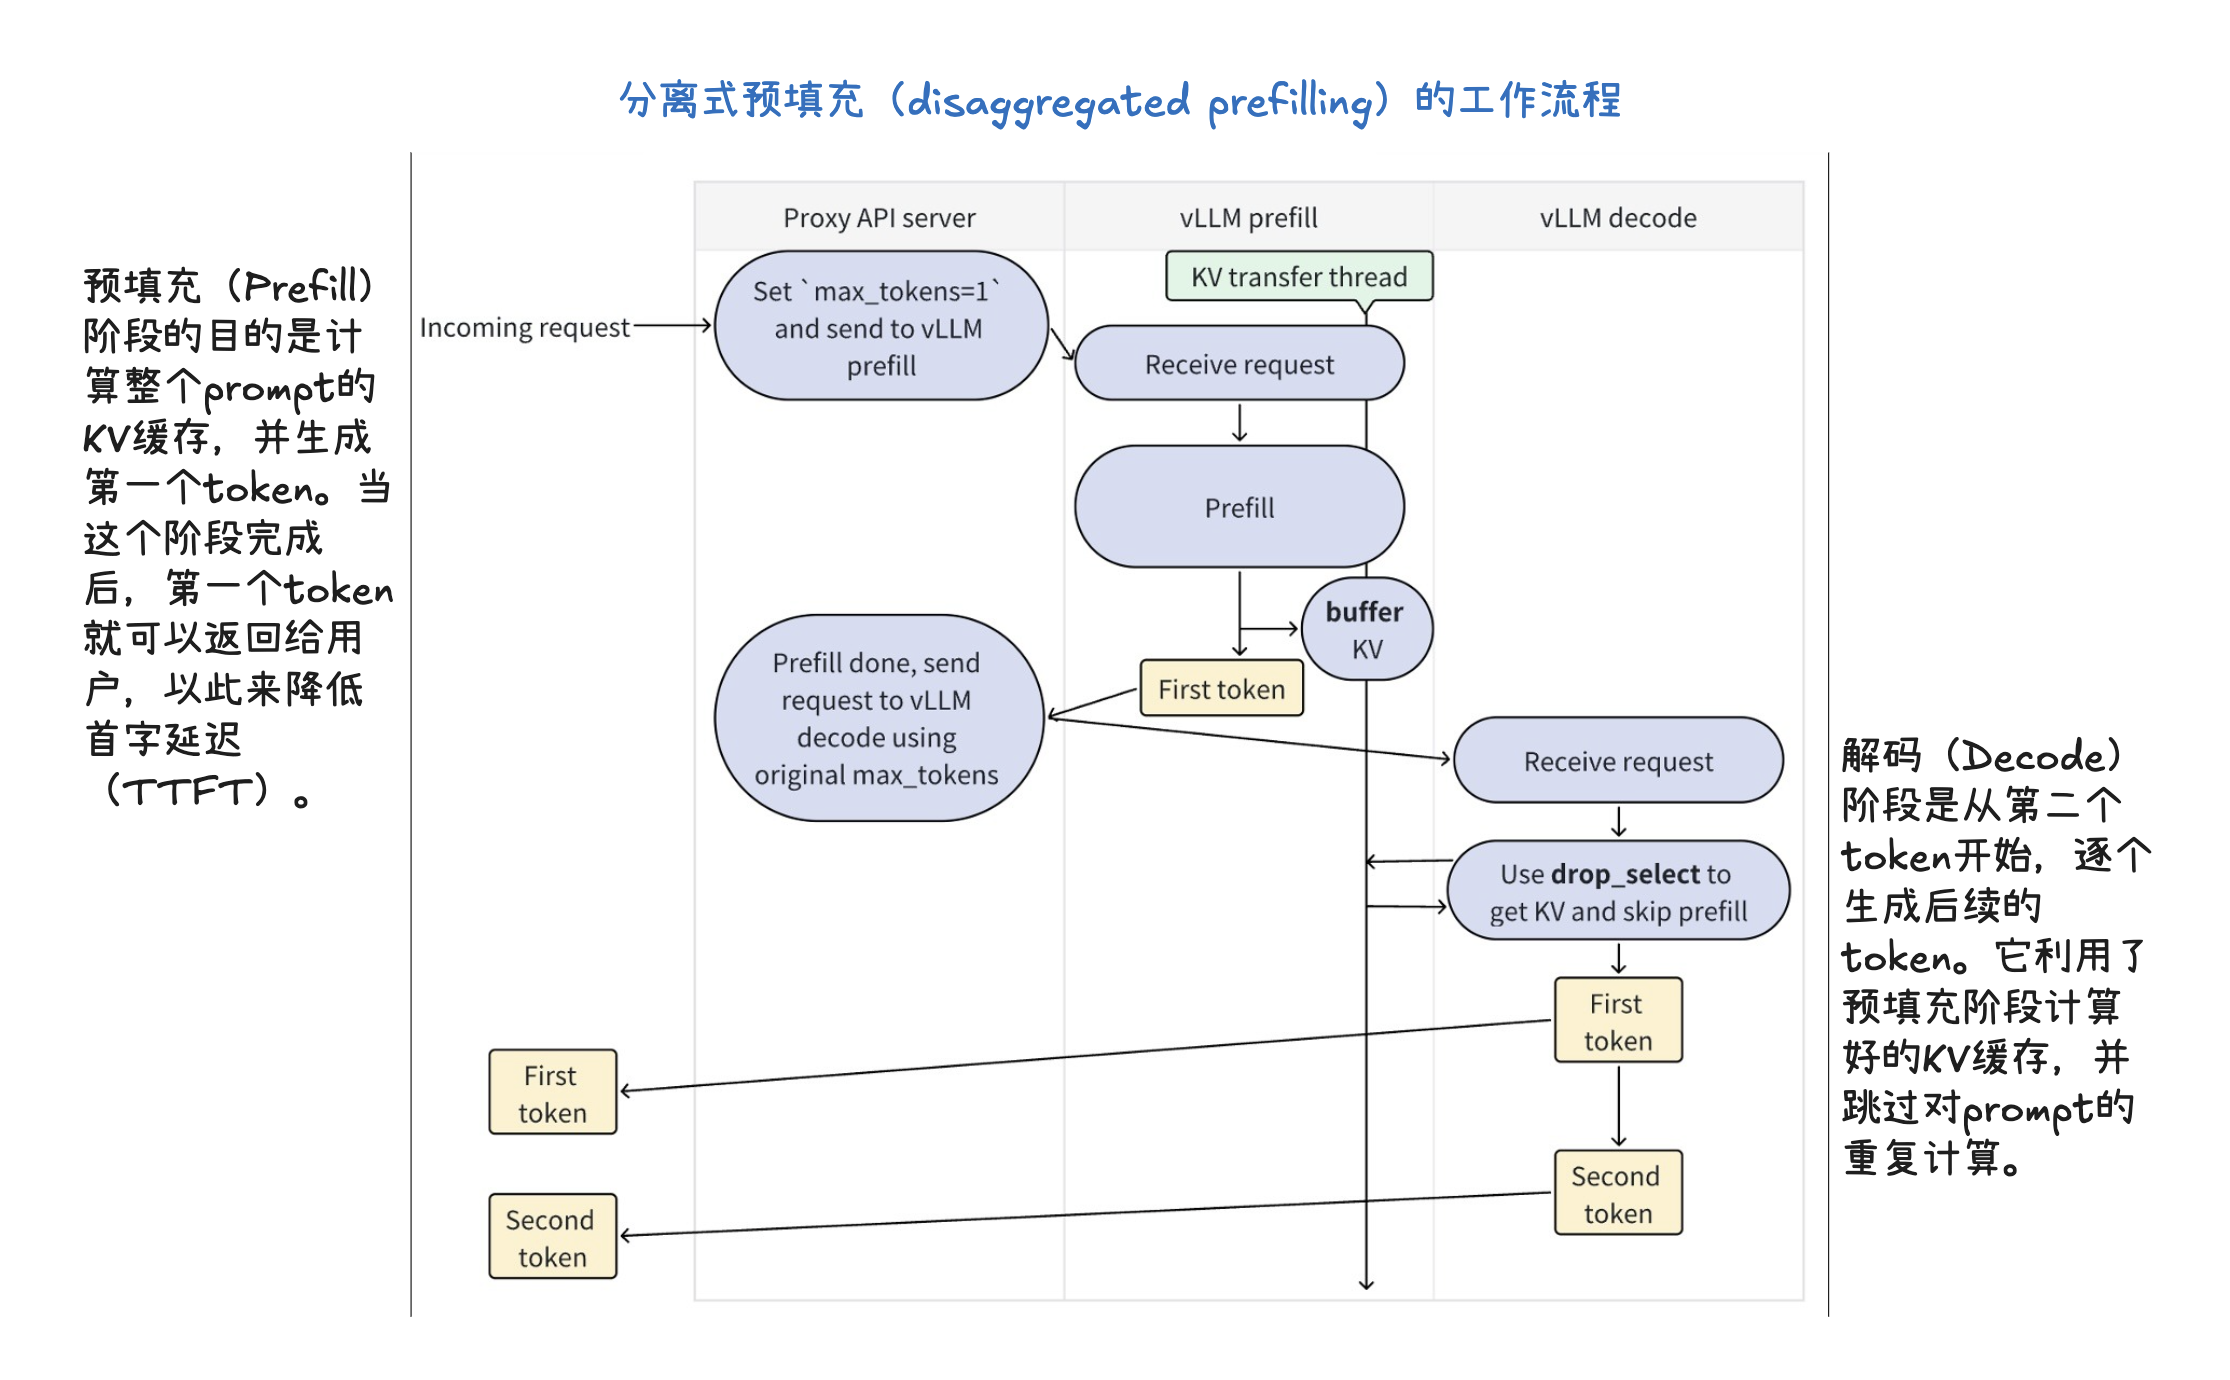
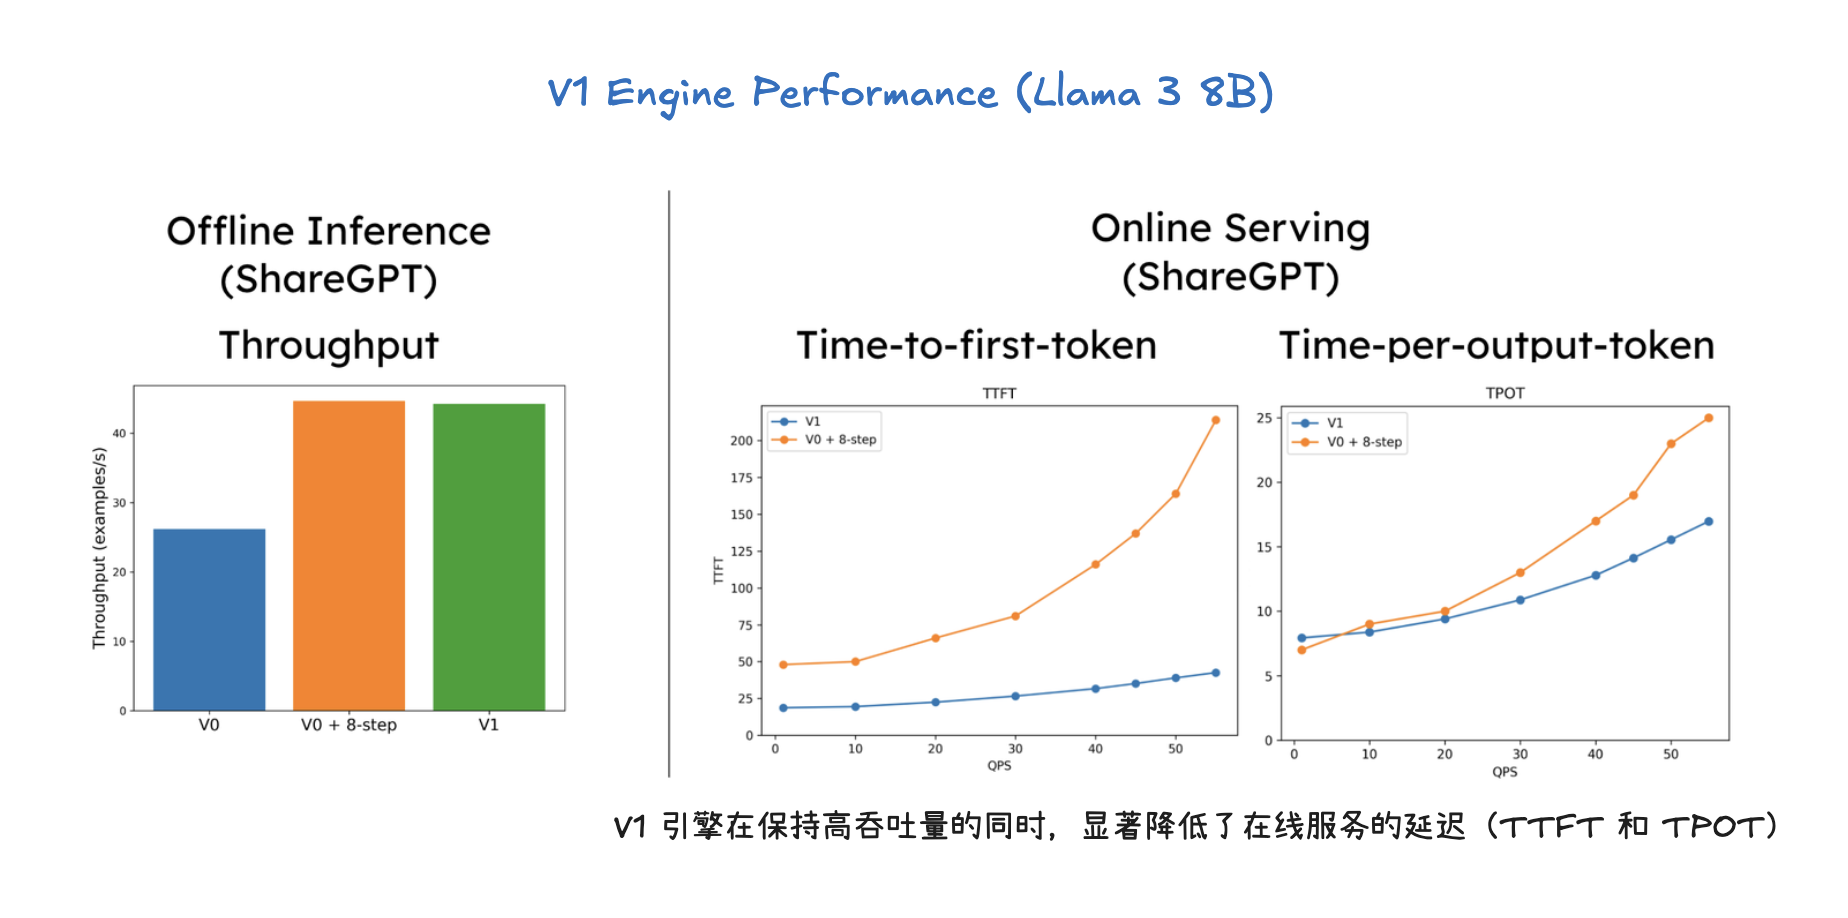
vLLM V1 引擎通过优化其核心引擎循环,将输入处理并行化,并引入了分段式 CUDA 图,从而实现了更灵活、动态的执行模型,显著降低了在线服务的延迟(TTFT 和 TPOT),同时保持了高吞吐量。其设计目标是确保 GPU 不闲置,通过 API 服务器和 EngineCore 之间的协作来高效调度和执行任务。为了进一步加速大型语言模型推理,vLLM V1 采用了多种优化技术:它通过分离式预填充和分块预填充来优化首个 token 的生成延迟,并结合连续批处理与分页注意力来提高 KV 缓存的内存效率和 GPU 利用率。此外,前缀缓存技术避免了重复计算相同提示的 KV 缓存,而级联推理则是一种内存带宽高效的共享前缀批处理解码技术,通过结合多查询注意力处理共享 KV 和单查询批处理解码处理独特 KV,特别适用于多用户共享长提示的场景,能显著提升性能。其他高级解码方法如推测性解码利用草稿模型加速生成,跳跃解码则适用于结构化输出场景。最后,量化技术是提升性能的关键手段,通过对权重、激活值和 KV 缓存使用低位精度(如 FP8、INT8),它能减少存储和内存占用,加速计算密集型和内存带宽密集型任务,并允许在固定硬件下处理更多 token,从而大幅提升吞吐量,同时保持模型准确性。
V1 Engine 工作流程
推理优化
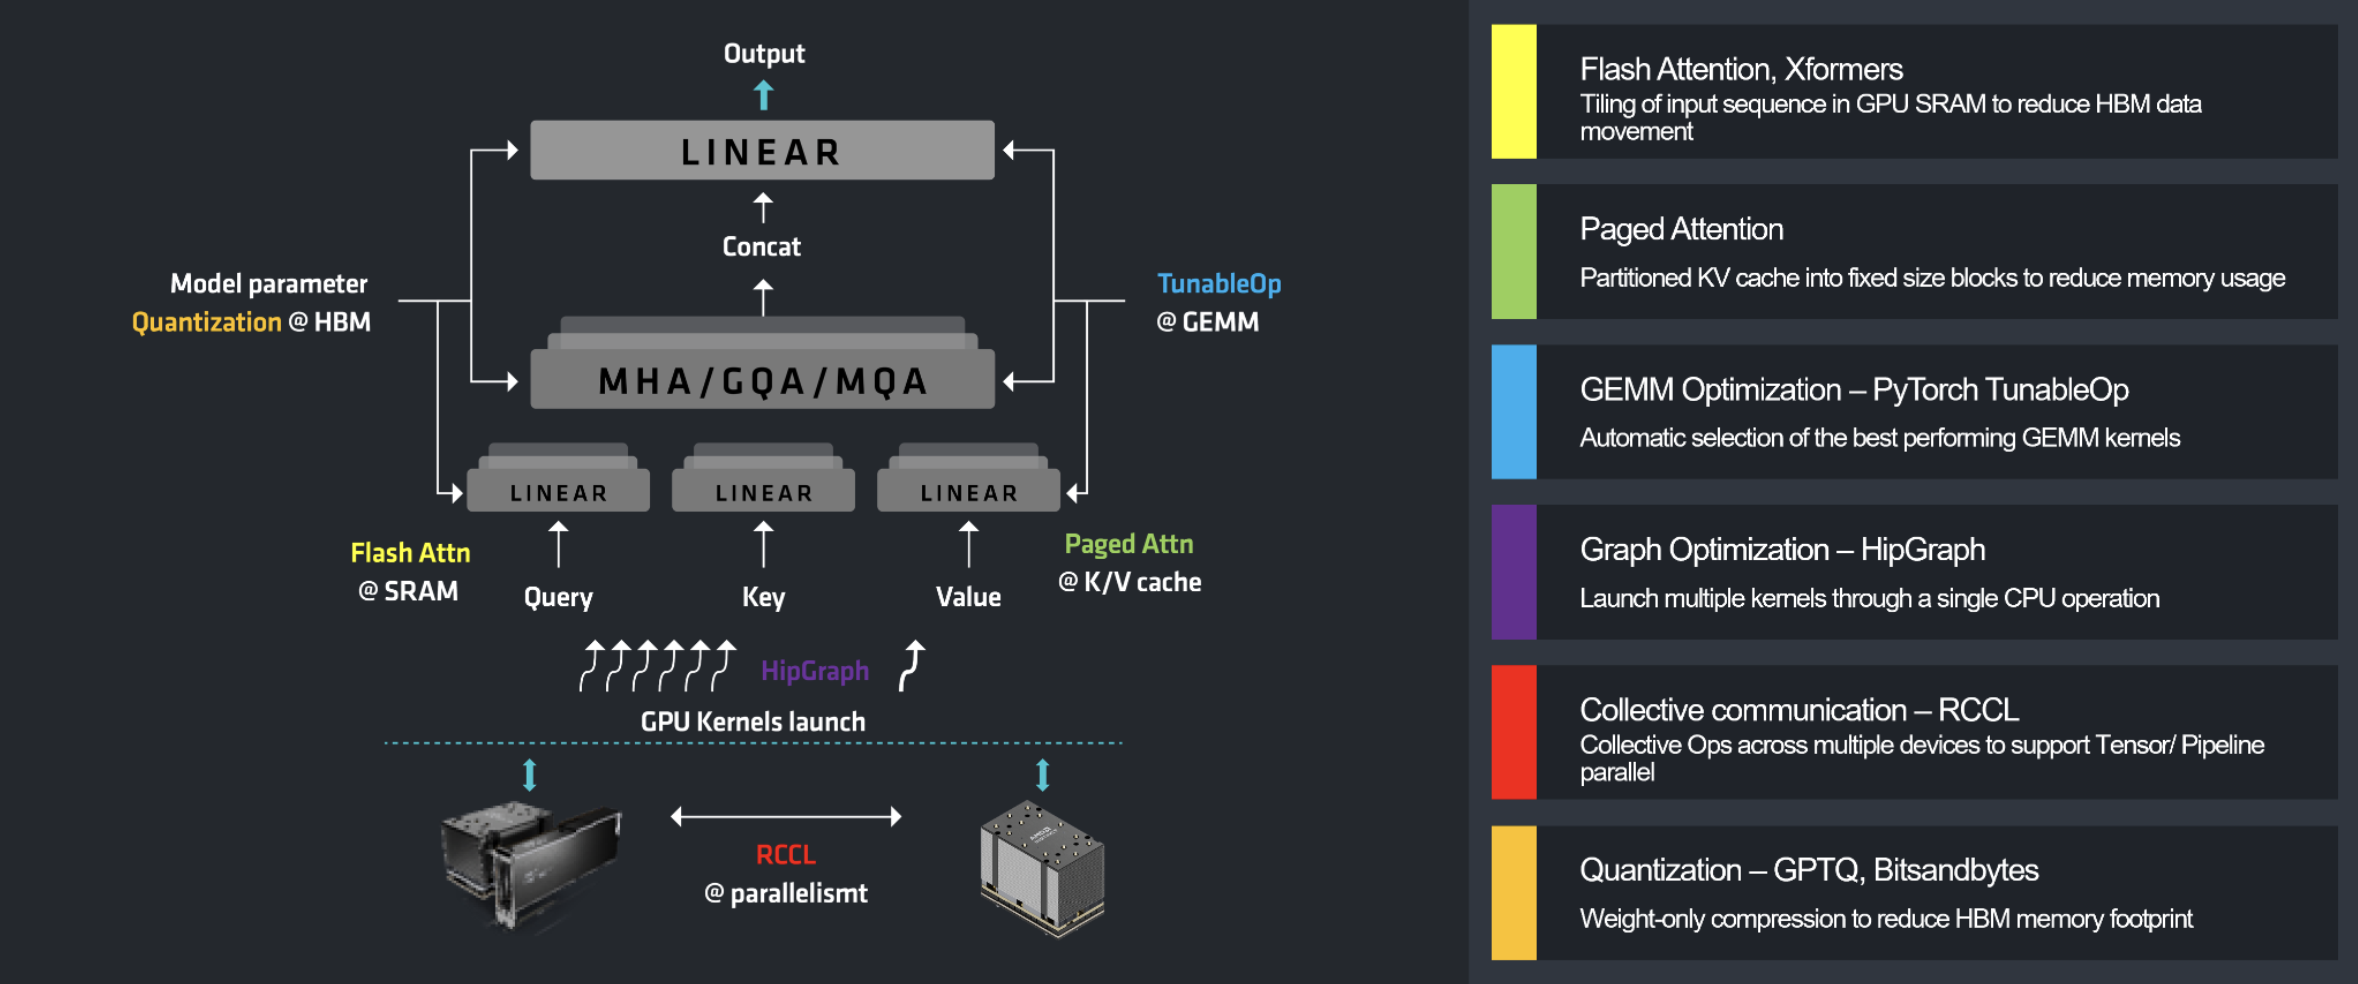
典型 LLM 推理优化
SGLang
SGLang is a fast serving framework for large language models and vision language models. It makes your interaction with models faster and more controllable by co-designing the backend runtime and frontend language.
SGLang 是用于大型语言模型和视觉语言模型的快速服务框架。通过协同设计后端运行时和前端语言,使您与模型的交互更快速、更可控。
The core features include:
核心功能包括: Fast Backend Runtime: Efficient serving with RadixAttention for prefix caching, jump-forward constrained decoding, continuous batching, token attention (paged attention), tensor parallelism, FlashInfer kernels, and quantization (AWQ/FP8/GPTQ/Marlin).
# (Optional) Create a new conda environment.
conda create -n vllm python=3.9 -y
conda activate vllm

# Install vLLM with CUDA 12.1.
pip install vllm
vLLM 帮助 vLLM 兼容 OpenAI 的 RESTful API 服务器。 可选参数: -h, --help 显示此帮助信息并退出 --host HOST 主机名 --port PORT 端口号 --allow-credentials 允许凭证 --allowed-origins ALLOWED_ORIGINS 允许的来源 --allowed-methods ALLOWED_METHODS 允许的方法 --allowed-headers ALLOWED_HEADERS 允许的头部 --api-key API_KEY 如果提供,服务器将要求在头部中呈现此密钥。 --served-model-name SERVED_MODEL_NAME 在API中使用的模型名称。如果没有指定,模型名称将与huggingface名称相同。 --lora-modules LORA_MODULES [LORA_MODULES ...] LoRA模块配置,格式为名称=路径。可以指定多个模块。
MLX 介绍
MLX 是一个为 Apple Silicon 芯片上的机器学习研究设计的 array 框架,由 Apple 机器学习研究团队提供。
安装
pip install mlx
pip install mlx-lm
conda install -c conda-forge mlx
conda install -c conda-forge mlx-lm
将 MLX 微调的模型转换为 GGUF 模型最大的意义是可以融入 GGUF 的生态系统,可以在更多的平台上使用。
LoRA 微调
大模型 Mistral-7B-v0.1
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py
if __name__ == "__main__":
    # ......
    for dataset, name, size in datasets:
        with open(f"data/{name}.jsonl", "w") as fid:
            for e, t in zip(range(size), dataset):
                t = t[3:]
                json.dump({"text": t}, fid)
                fid.write("\n")
执行脚本 data/wikisql.py 生成数据集。
data/wikisql.py
安装 mlx-lm
pip install mlx-lm
微调
使用 LoRA 和 QLoRA 基于 Mistral-7B 微调的实验
LoRA 和 QLoRA 对比
微调
| Iteration | LoRA Train Loss | LoRA Val Loss | LoRA Tokens/sec | QLoRA Train Loss | QLoRA Val Loss | QLoRA Tokens/sec |
|---|---|---|---|---|---|---|
| 1 | 2.343 | 2.420 | ||||
| 100 | 1.204 | 221.348 | 1.216 | 166.377 | ||
| 200 | 1.091 | 1.111 | 207.353 | 1.095 | 1.130 | 187.795 |
| 300 | 0.818 | 234.182 | 1.065 | 194.826 | ||
| 400 | 0.837 | 1.076 | 207.763 | 0.998 | 1.006 | 170.072 |
| 500 | 0.774 | 223.036 | 0.726 | 189.288 | ||
| 600 | 0.609 | 1.001 | 218.118 | 0.607 | 1.015 | 186.397 |
微调的参数量 LoRA 微调万分之 2.35 (1.704M / 7243.436M * 10000)的模型参数。 QLoRA 微调万分之 13.
预训练模型 mistralai/Mistral-7B-v0.1
量化
QLoRA 微调需要量化,生成 4 位量化的 Mistral 7B 并默认将其存储在 mlx_model 目录中
python convert.py --hf-path mistralai/Mistral-7B-v0.1 -q
mlx_model 目录结构如下:
mlx_model
├── config.json
├── model.safetensors
├── special_tokens_map.json
├── tokenizer.json
├── tokenizer.model
├── tokenizer_config.json
└── weights.00.safetensors
量化后的模型 8.0G
微调
QLoRA 微调
[llama.cpp][llama.cpp]
模型量化 量化类型 ./quantize --help Allowed quantization types: 2 or Q4_0 : 3.56G, +0.2166 ppl @ LLaMA-v1-7B 3 or Q4_1 : 3.90G, +0.1585 ppl @ LLaMA-v1-7B 8 or Q5_0 : 4.33G, +0.0683 ppl @ LLaMA-v1-7B 9 or Q5_1 : 4.70G, +0.0349 ppl @ LLaMA-v1-7B 19 or IQ2_XXS : 2.06 bpw quantization 20 or IQ2_XS : 2.31 bpw quantization 10 or Q2_K : 2.63G, +0.6717 ppl @ LLaMA-v1-7B 21 or Q2_K_S : 2.16G, +9.0634 ppl @ LLaMA-v1-7B 12 or Q3_K : alias for Q3_K_M 11 or Q3_K_S : 2.75G, +0.5551 ppl @ LLaMA-v1-7B 12 or Q3_K_M : 3.07G, +0.2496 ppl @ LLaMA-v1-7B 13 or Q3_K_L : 3.35G, +0.
DeepSeek Coder
Code LLM 排行榜
选择了两个通用基准来评估:
下面显示了 OctoCoder vs Base HumanEval prompt 的示例,在这里可以找到它。

LLM 排行榜
介绍 DeepSeek Coder 由一系列代码语言模型组成,每个模型都在 2T 令牌上从头开始训练,其中 87% 是英文和中文的代码,13% 是自然语言。我们提供各种尺寸的代码模型,范围从 1B 到 33B 版本。
NEON & MPS 🆚 CoreML
下载模型(large-v3)
models/download-ggml-model.sh large-v3
NEON & MPS
编译
make clean
make -j
main 帮助 ./main --help usage: ./main [options] file0.wav file1.wav ...
TGI 是一个用于部署和服务大型语言模型(LLM)的工具包。 TGI 为最流行的开源 LLM 提供高性能文本生成,包括 Llama、Falcon、StarCoder、BLOOM、GPT-NeoX 和 T5 。
系统架构
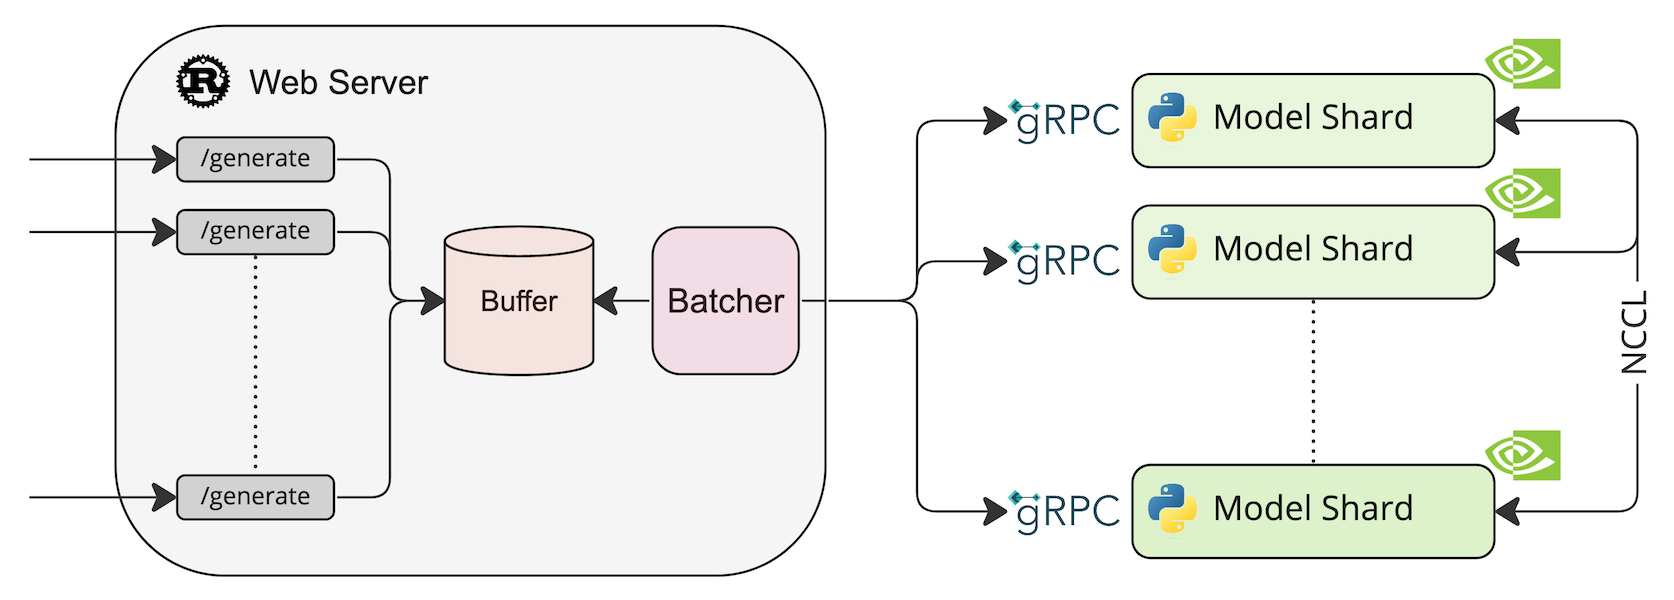
部署模型 HuggingFaceH4/zephyr-7b-beta model=HuggingFaceH4/zephyr-7b-beta volume=$PWD/data # Avoid downloading weights every run docker run --
llama.cpp
构建
❶ 克隆 [llama.cpp][llama.cpp] 仓库
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp
❷ make
make -j
❸ 安装依赖
pip install -r requirements.txt
获得 Facebook LLaMA2 模型
可以从 TheBloke 下载已转换和量化的模型。
下载 GGUF 模型
huggingface-cli pip install huggingface_hub REPO_ID=TheBloke/Llama-2-7B-chat-GGUF FILENAME=llama-2-7b-chat.Q4_K_M.
没有找到匹配的文章