文心 Unlimited OCR 2 深度研究 · 从长视野到无限视野HTML
百度 Unlimited OCR 2 深度拆解:SR-SWA 把每步视野钉在 640 token,分块解码让成本与页数解耦;逐项核对架构、评测分数、八个该打的折扣与部署配方,回答它到底是更强的 OCR,还是智能体的读档层。
百度 Unlimited OCR 2 深度拆解:SR-SWA 把每步视野钉在 640 token,分块解码让成本与页数解耦;逐项核对架构、评测分数、八个该打的折扣与部署配方,回答它到底是更强的 OCR,还是智能体的读档层。
把 30B 的混元同传模型塞进 M2 Max 笔记本:绕开官方 CUDA 封装,给 llama-mtmd-cli 加 --stream 改流式,自建音频链路与账本,做到 255 ms 字幕、1150 ms 配音,并完整复盘五轮静默失败排查。
一、研究背景
大型语言模型(LLM)的发展一直沿着两条轴线推进:
近年来,OpenAI的o系列、Anthropic的扩展思维模型、DeepSeek-R1和Kimi K1.5等工作,让"测试时扩展"成为前沿研究的核心焦点。然而,开源社区在第二条轴上进展迅速,但在第一条轴上却明显滞后——大多数开源模型仍停留在1T参数规模左右。随着越来越复杂的推理和智能体方法被应用于规模相近的预训练模型上,开源进展面临趋同风险,而与最强大专有系统(Claude、GPT系列)的差距可能持续扩大。
与此同时,真实世界的智能体任务需要处理超长上下文(如软件工程仓库、数万页文档、多天跨度的对话),要求模型同时具备大参数规模、长上下文窗口和原生多模态理解能力。Kimi K3正是在这一背景下诞生的:同时推进两条扩展轴,将预训练基础扩展到前所未有的3T类参数规模,同时在1M上下文长度上扩展强化学习、推理努力和长周期交互。
二、要解决什么问题
Kimi K3要解决的核心问题可以概括为以下
DeepSeek-V4
简介
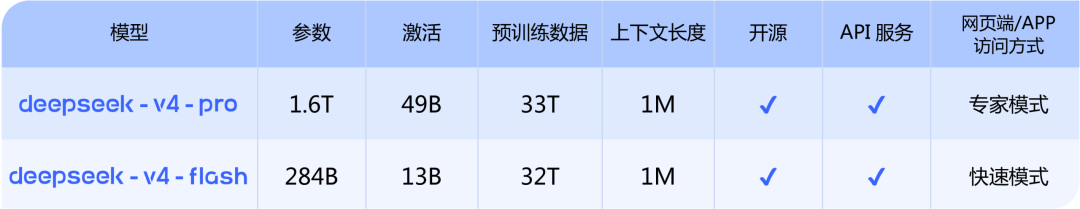
我们在此发布 DeepSeek-V4 系列的预览版本,包括两个强大的混合专家(MoE)语言模型 —— 总参数量 1.6T(激活 49B)的 DeepSeek-V4-Pro,以及总参数量 284B(激活 13B)的 DeepSeek-V4-Flash,两者均支持长达 一百万 token 的上下文。
DeepSeek-V4 系列在架构与优化方面引入了多项关键升级:
两款模型均在大于 32T 的多样化高质量 token 上进行了预训练,并随后执行了全面的后训练流程。后训练采用两阶段范式:首先独立培养领域专属专家(通过 SFT 与基于 GRPO 的强化学习),随后通过 on-policy 蒸馏将不同领域的专长整合至单一模型中。
DeepSeek-V4-Pro-Max 作
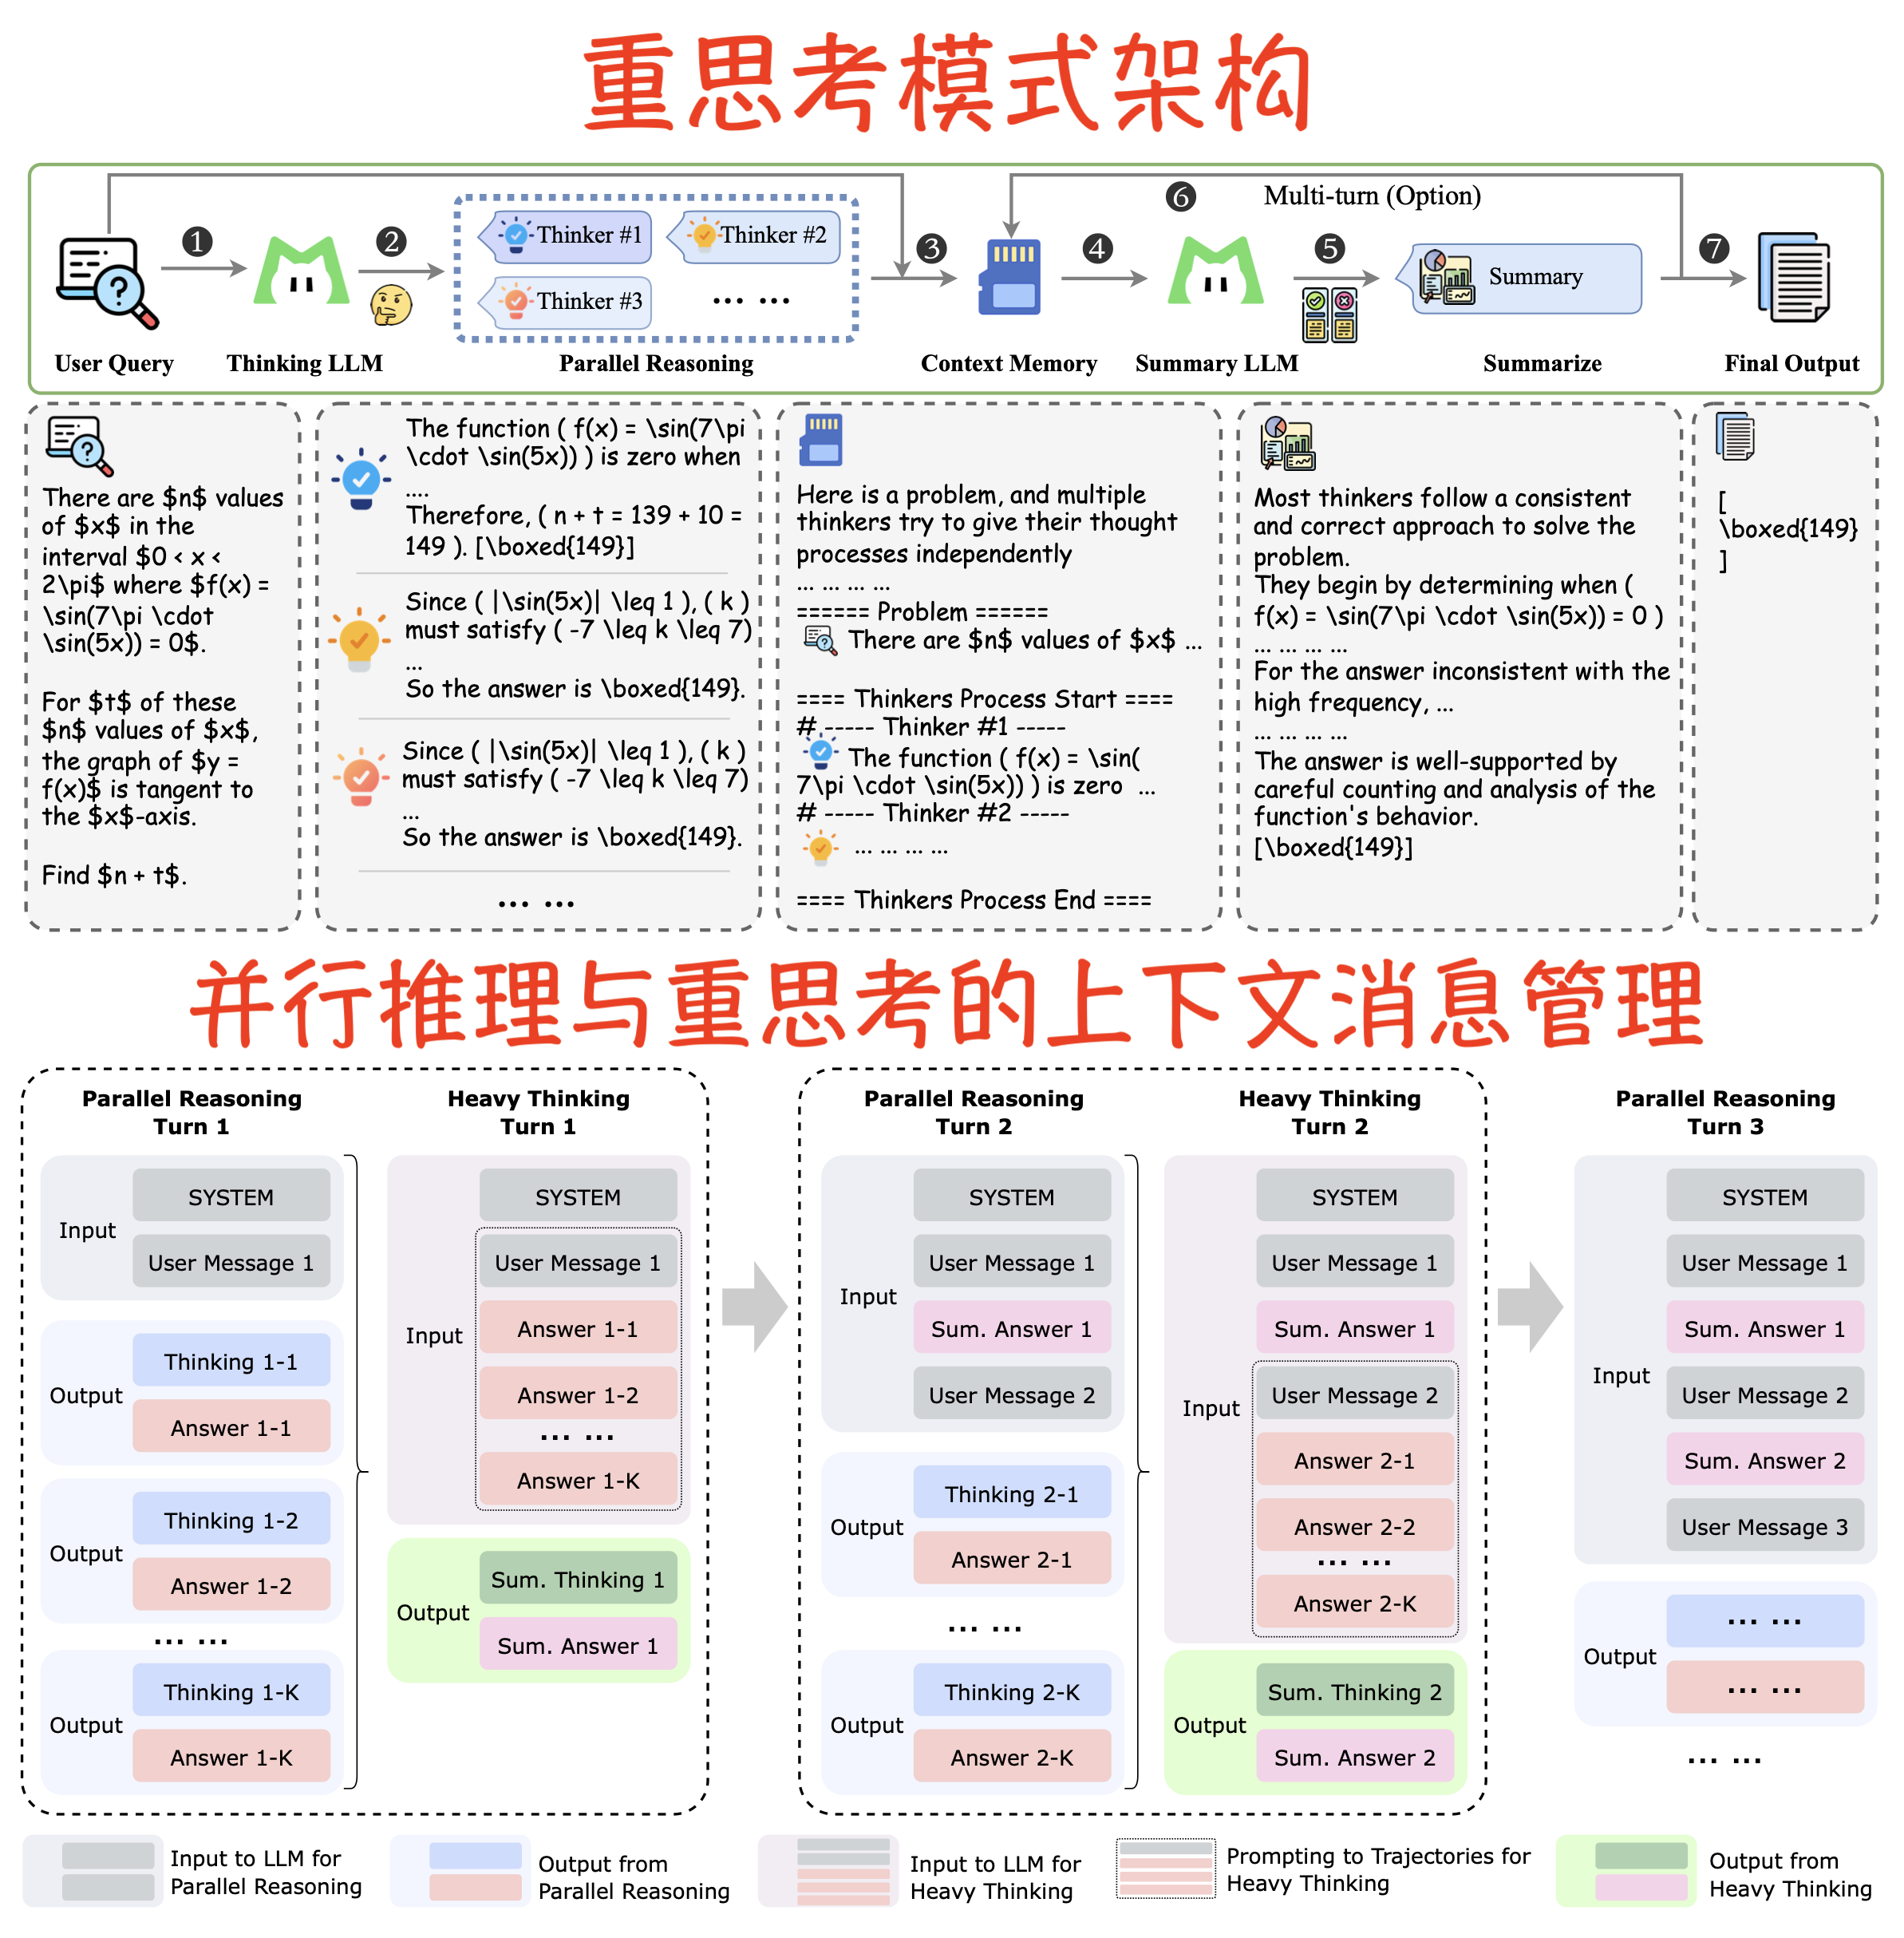
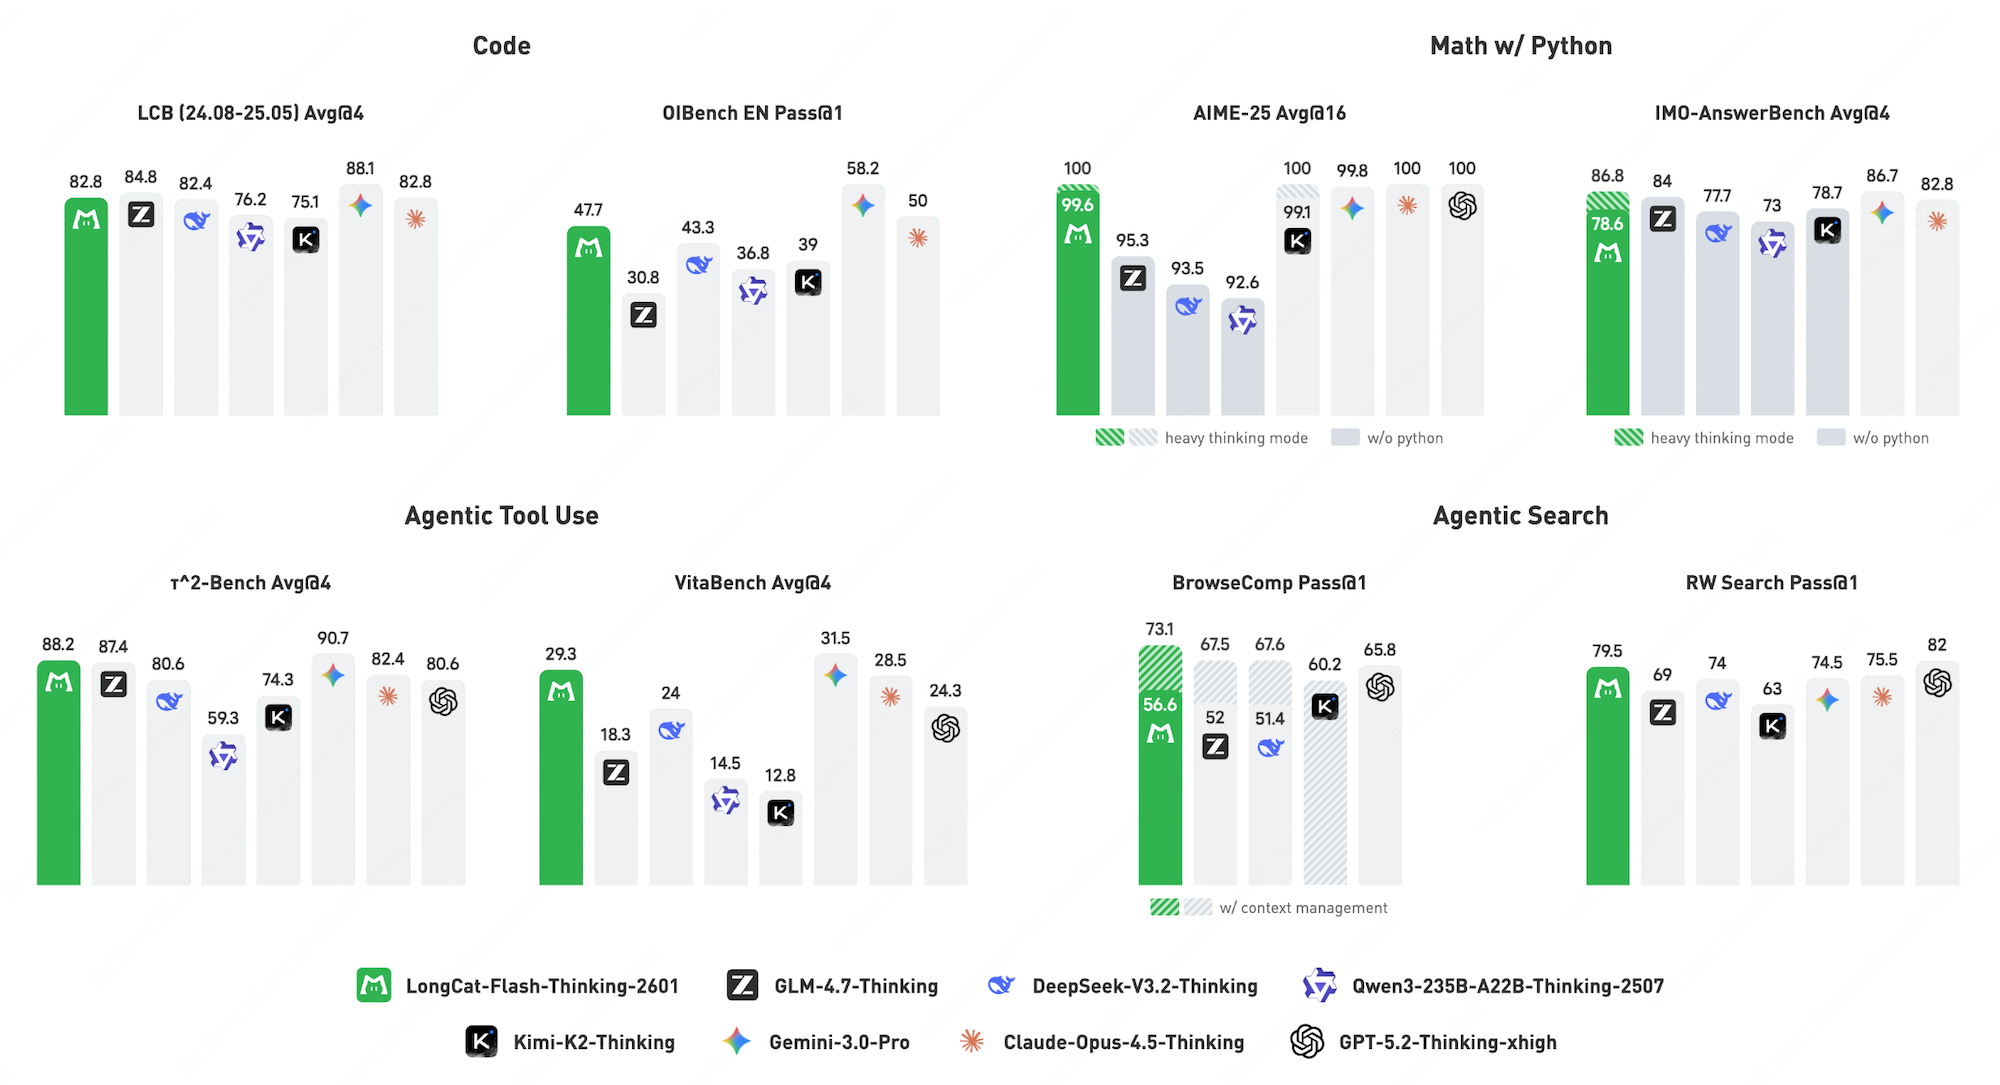
LongCat-Flash-Thinking-2601 创新性地开启了全栈式的智能体推理(Agentic Reasoning)训练体系与架构优化。首先,提出了自动化的环境扩展流水线,构建了覆盖 20 多个领域的高质量、可执行且可验证的智能体环境,有效解决了真实世界中复杂智能体交互数据匮乏的难题。其次,针对现实任务的不确定性,创新性地引入了鲁棒性智能体训练流程,通过系统性分析现实噪声模式并采用课程强化学习(Curriculum RL)将噪声整合进训练,显著增强了模型在非理想环境下的泛化与生存能力。在底层支撑上,扩展了异步强化学习框架 DORA 以支持高达 32,000 个环境的大规模并发训练,并引入了 Heavy Thinking(深思考)模式,通过在推理阶段同时扩展思考的深度与广度(Test-time Scaling),进一步突破了复杂任务的性能边界。此外,还设计了 Zigzag Attention 稀疏注意力机制,使模型能以极低开销实现高达 100 万 token 的长上下文扩展,为长程智能体任务提供了坚实的架构基础。
重思考模式架构
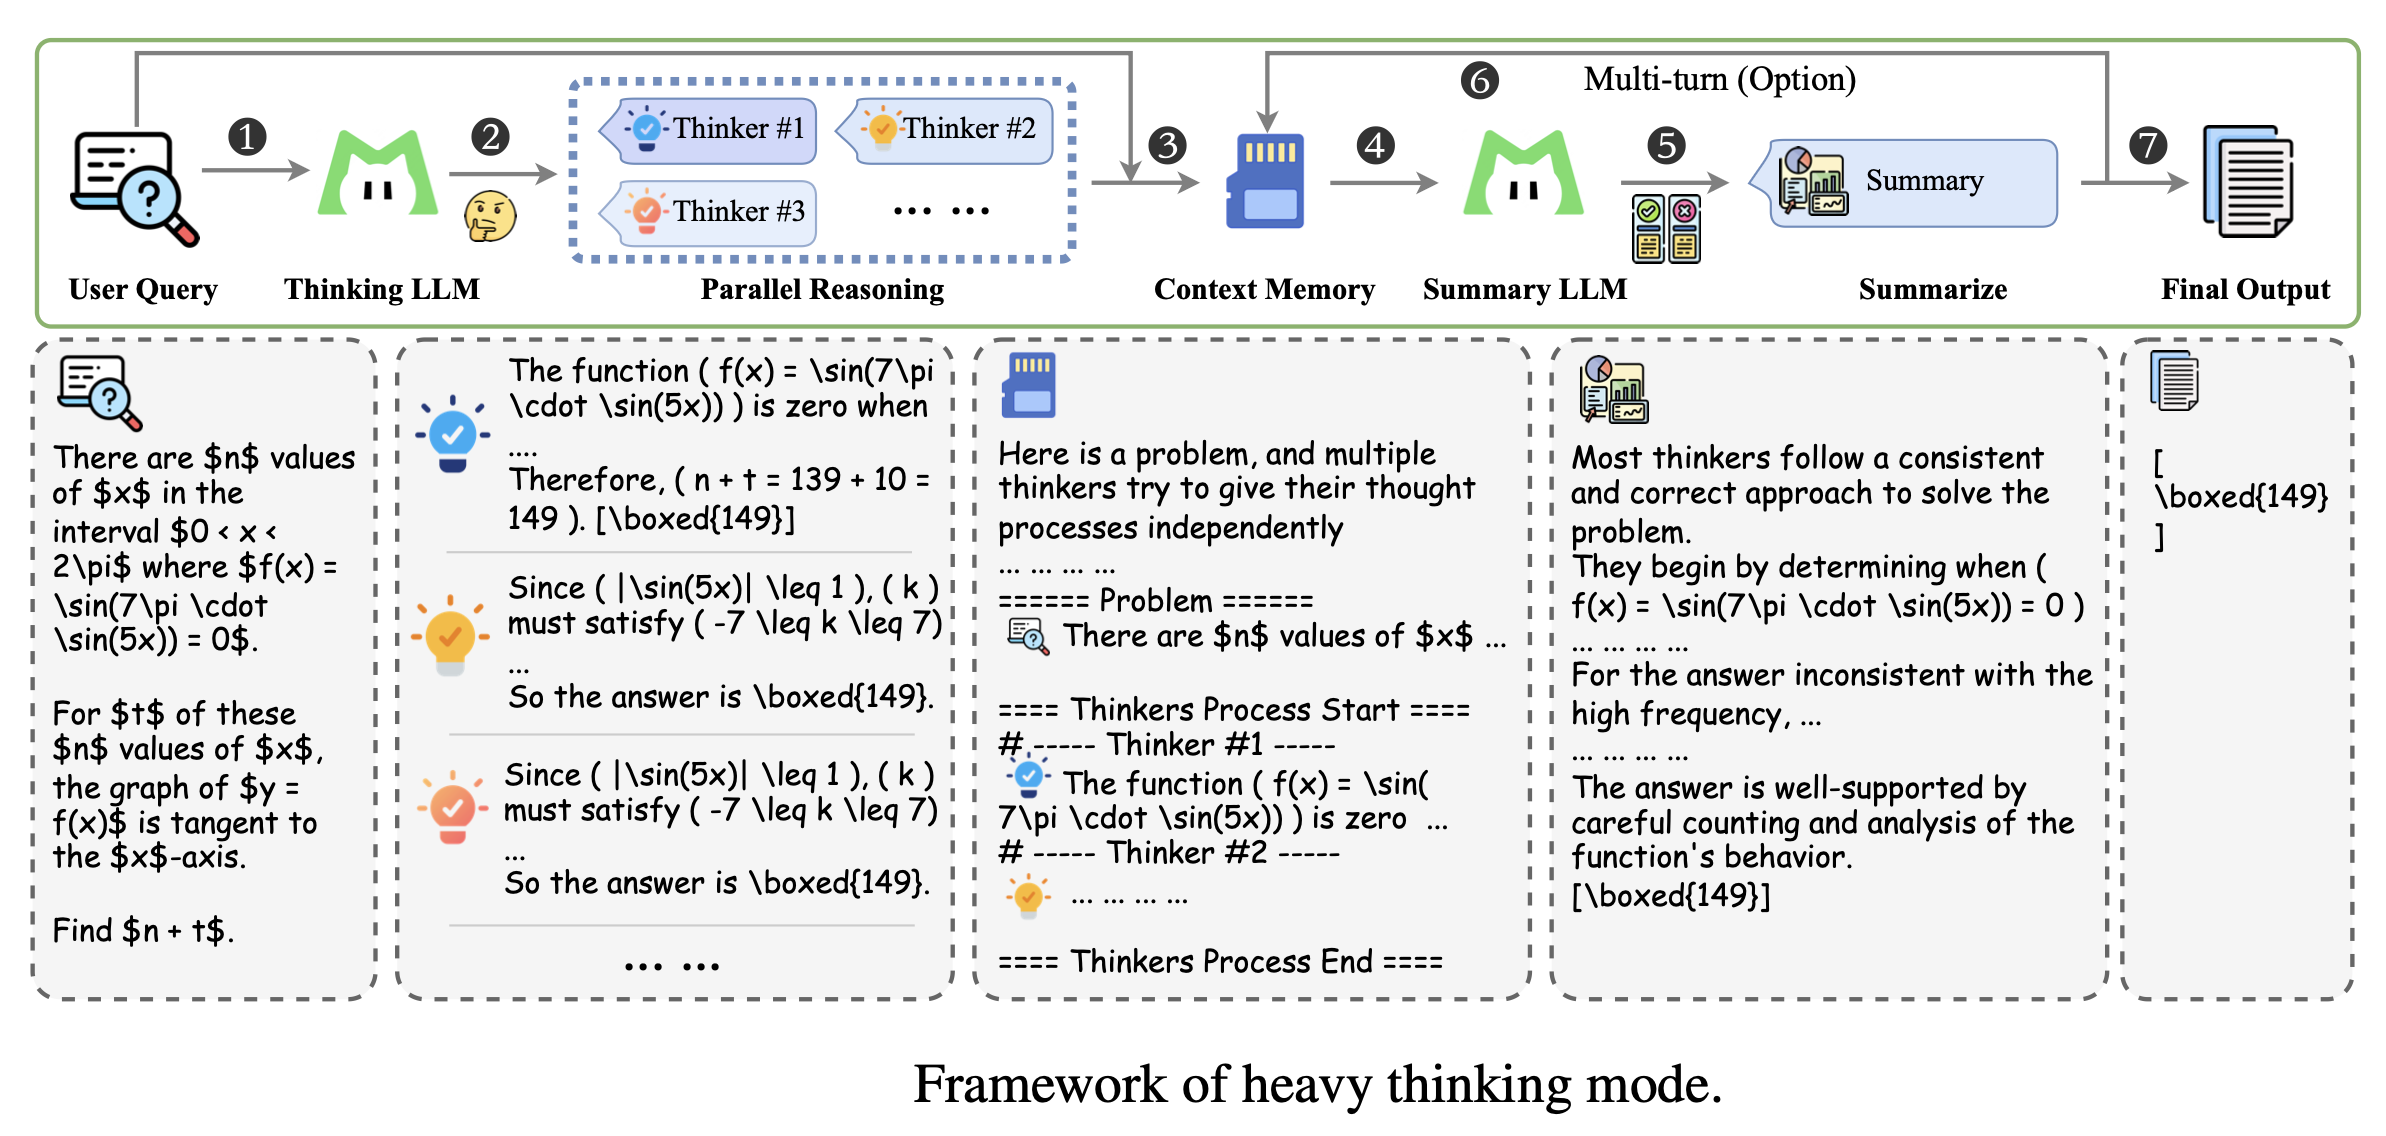
“重思考模式”(Heavy Thinking Mode)是 LongCat-Flash-Thinking-2601 模型为了突破现有推理能力极限而引入的一种推理时扩展(Test-Time Scaling)架构。
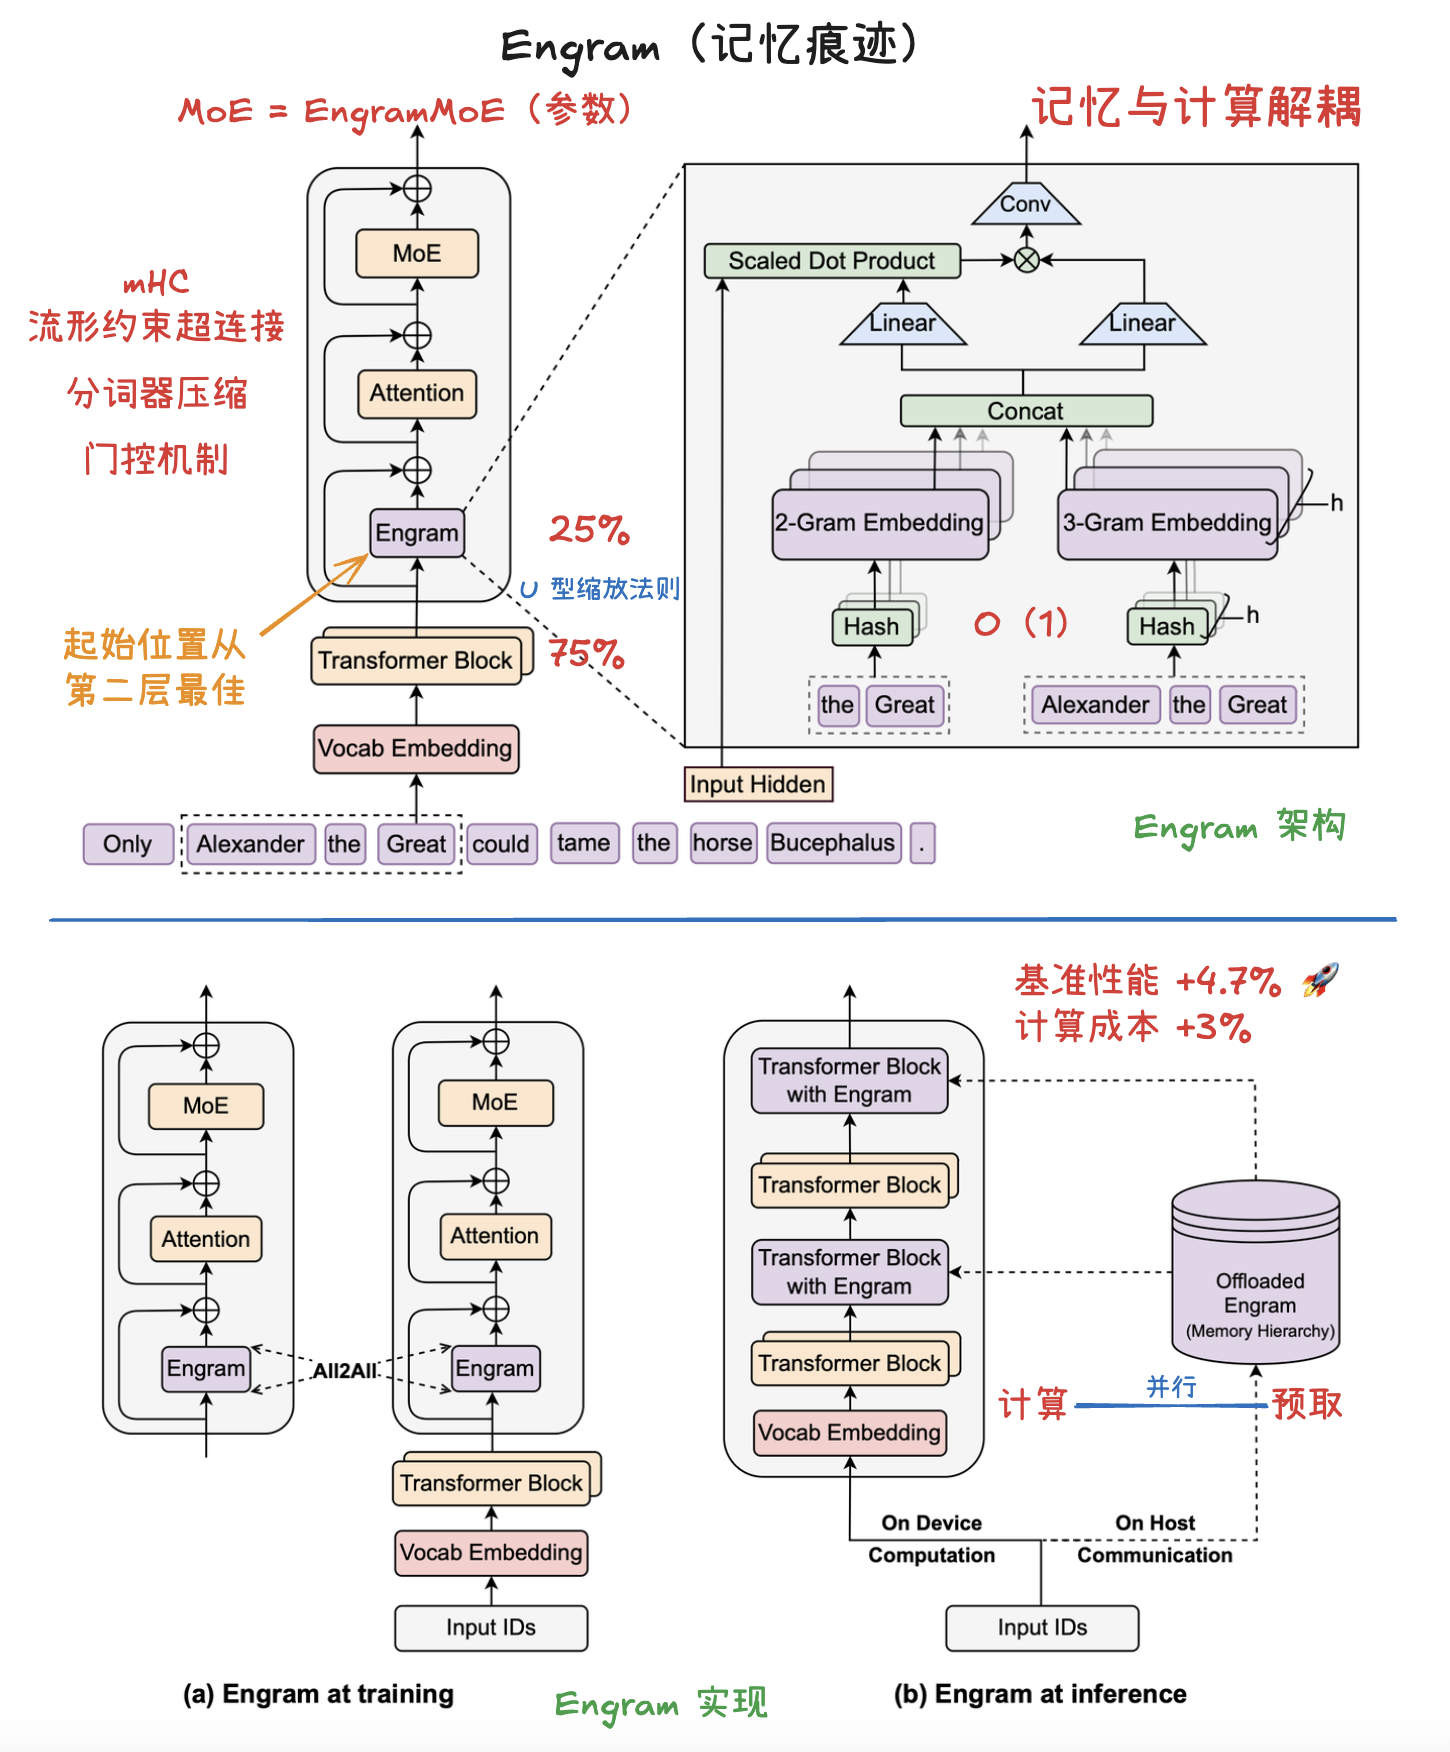
Engram 是一种旨在增强大语言模型性能的条件记忆(Conditional Memory)模块。传统的 Transformer 架构在处理静态知识检索时效率较低,往往需要通过复杂的计算来模拟记忆,而 Engram 通过现代化的 N-gram 哈希查找实现了常数级时间复杂度 O(1) 的知识获取。研究者揭示了一种 U 型缩放法则,证明在固定参数预算下,平衡条件计算(MoE)与静态内存(Engram) 能显著提升模型在推理、代码及数学任务中的表现。实验分析表明,Engram 能减轻模型底层对基础模式的重复构建,从而释放更多算力用于处理全球上下文和深度推理。此外,Engram 的确定性寻址特性支持从主机内存预取数据,使其能在不增加硬件负担的情况下实现大规模参数扩张。最终,该技术为构建更高效、具备长文本处理能力的新一代稀疏模型提供了核心原语。
Engram 架构
记忆内存的参数就像是图书馆书架上的一本本百科全书,记录着世界上的事实;而 Engram 模块的参数就像是一位经验丰富的图书管理员。管理员通过训练(学习),能够根据你当前提出的研究课题(隐藏状态),迅速判断哪些百科全书的条目是有用的,哪些是由于名字相似而找错的(哈希冲突),并帮你把这些知识翻译成你研究报告能用的语言(投影整合)。
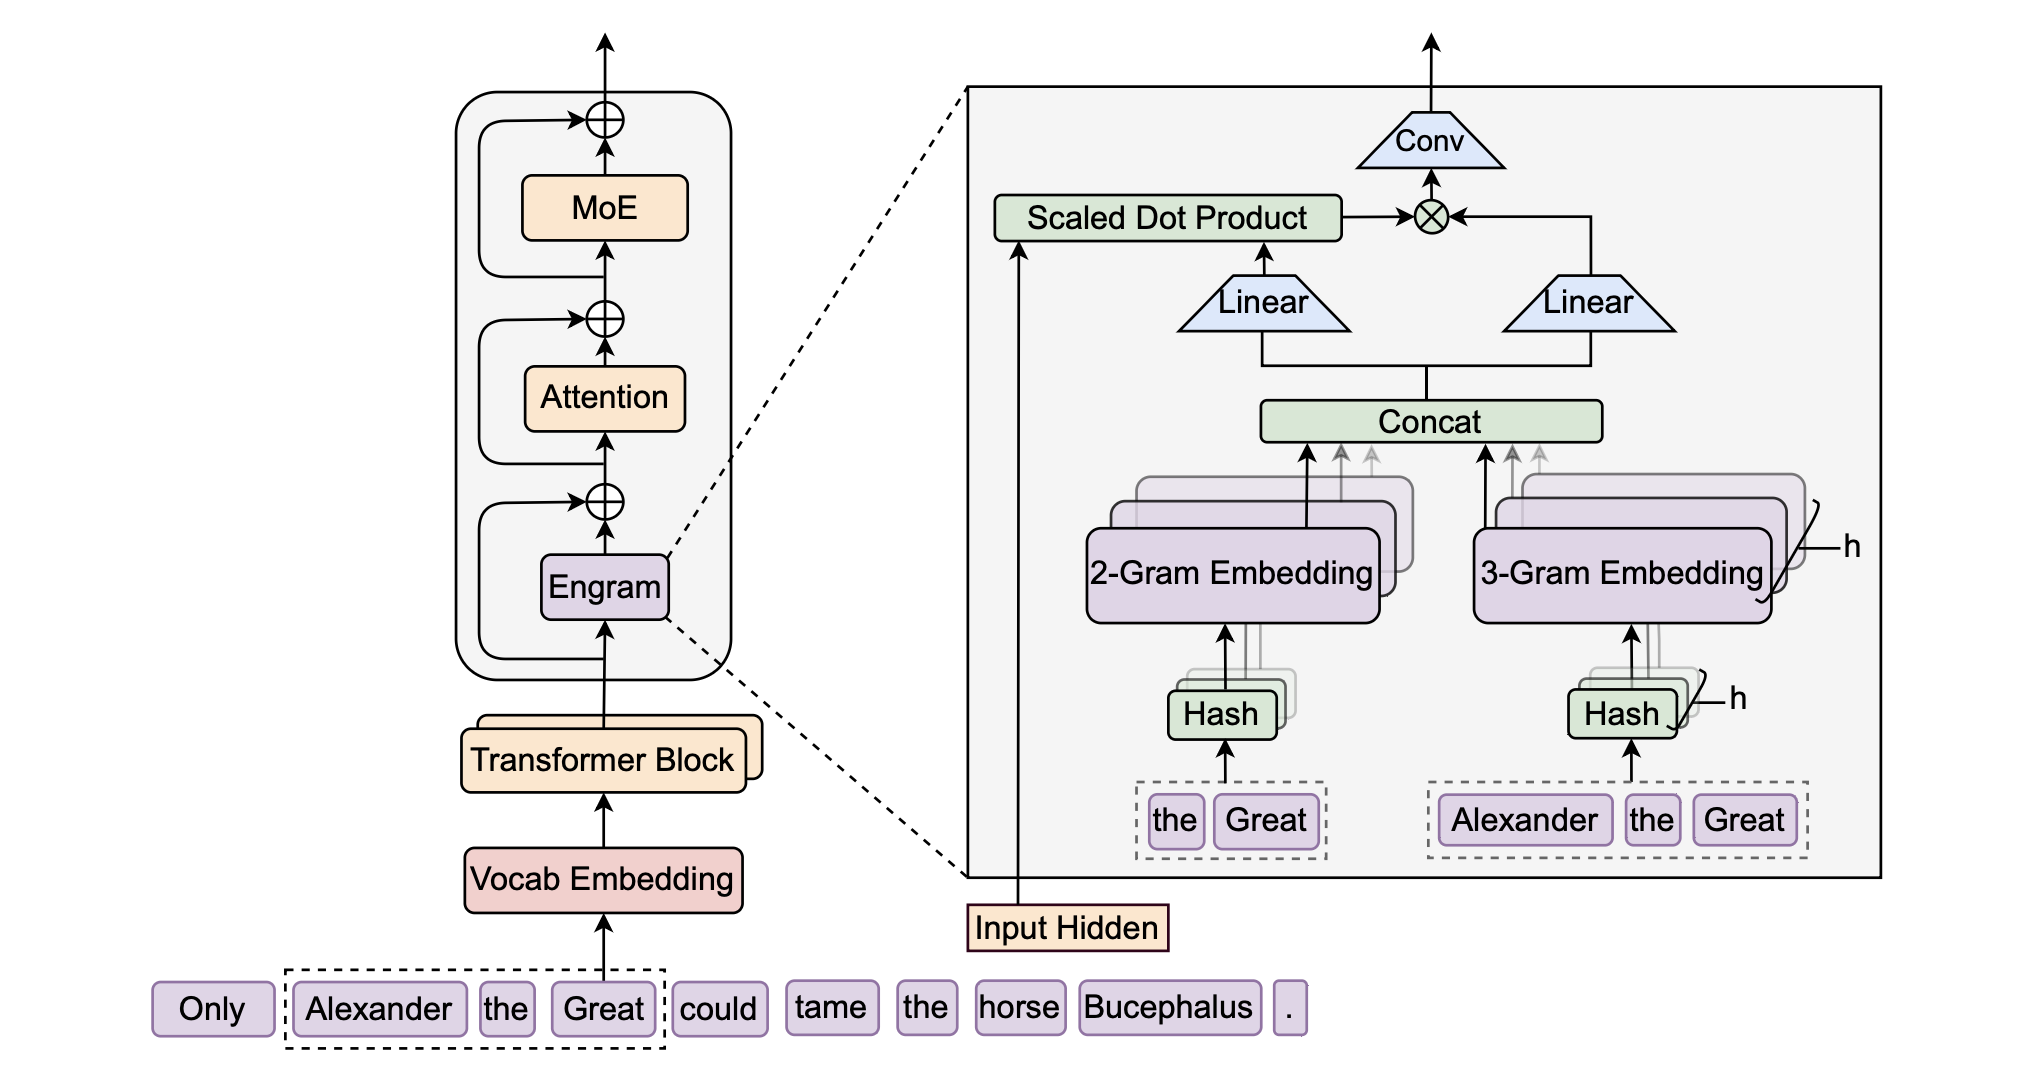
该模块通过检索静态 N-gram 记忆,并利用上下文感知门控(context-aware gating)将其
Abstract(摘要)
We present DeepSeek-V3, a strong Mixture-of-Experts (MoE) language model with 671B total parameters with 37B activated for each token. To achieve efficient inference and cost-effective training, DeepSeek-V3 adopts Multi-head Latent Attention (MLA) and DeepSeekMoE architec- tures, which were thoroughly validated in DeepSeek-V2. Furthermore, DeepSeek-V3 pioneers an auxiliary-loss-free strategy for load balancing and sets a multi-token prediction training objective for stronger performance. We pre-train DeepSeek-V3 on 14.
Abstract(摘要)
This report introduces the Qwen2 series, the latest addition to our large language models and large multimodal models. We release a comprehensive suite of foundational and instruction-tuned language models, encompassing a parameter range from 0.5 to 72 billion, featuring dense models and a Mixture-of-Experts model. Qwen2 surpasses most prior open-weight models, including its predecessor Qwen1.
没有找到匹配的文章