Unlimited OCR 2 上手指南 · 是什么、怎么跑、什么时候用HTML
面向工程师的 Unlimited OCR 2 上手指南:先按三条路线选型,再给出 Transformers 直跑与 SGLang 服务化的完整命令、参数速查表和症状排错表,最后用六类适用场景、五个别用场景与一天验收清单,帮你判断整本文档要不要上这套方案。
面向工程师的 Unlimited OCR 2 上手指南:先按三条路线选型,再给出 Transformers 直跑与 SGLang 服务化的完整命令、参数速查表和症状排错表,最后用六类适用场景、五个别用场景与一天验收清单,帮你判断整本文档要不要上这套方案。
DeepSeek-OCR:上下文光学压缩
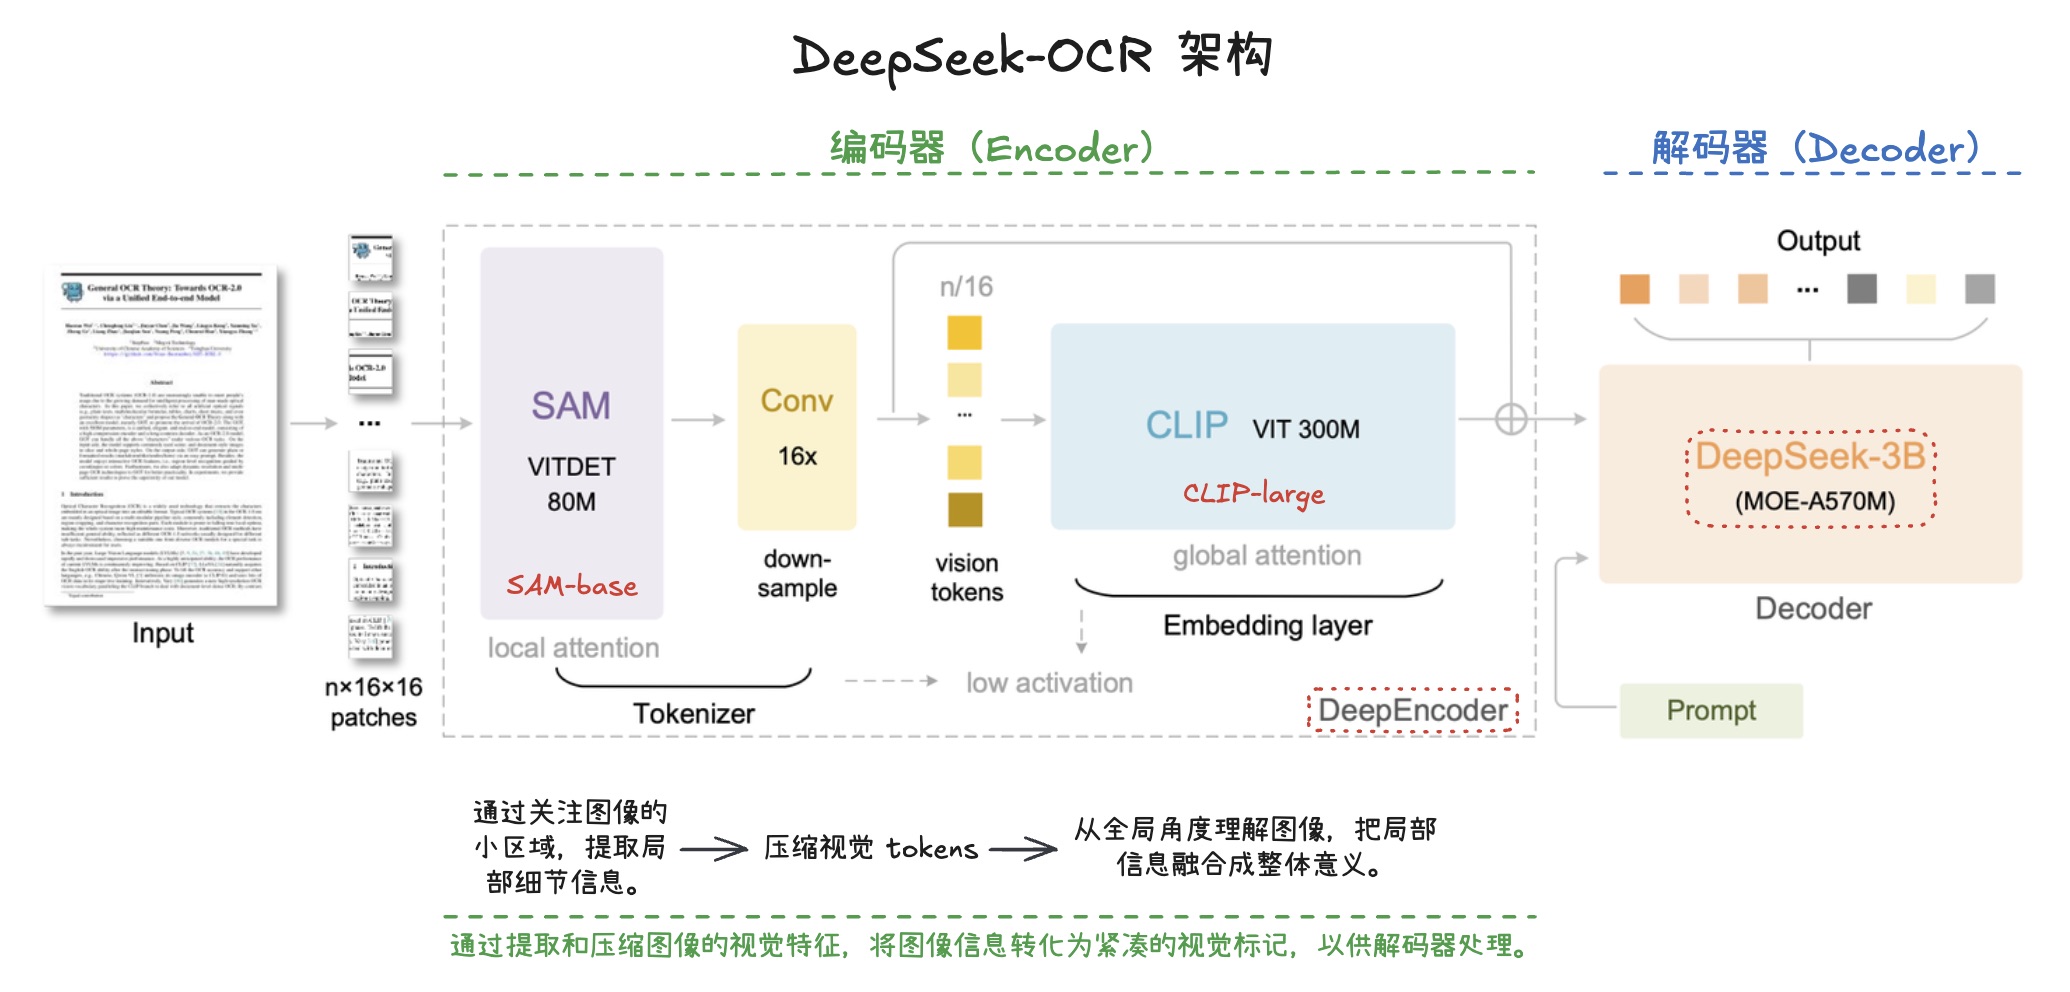
DeepSeek-OCR 架构
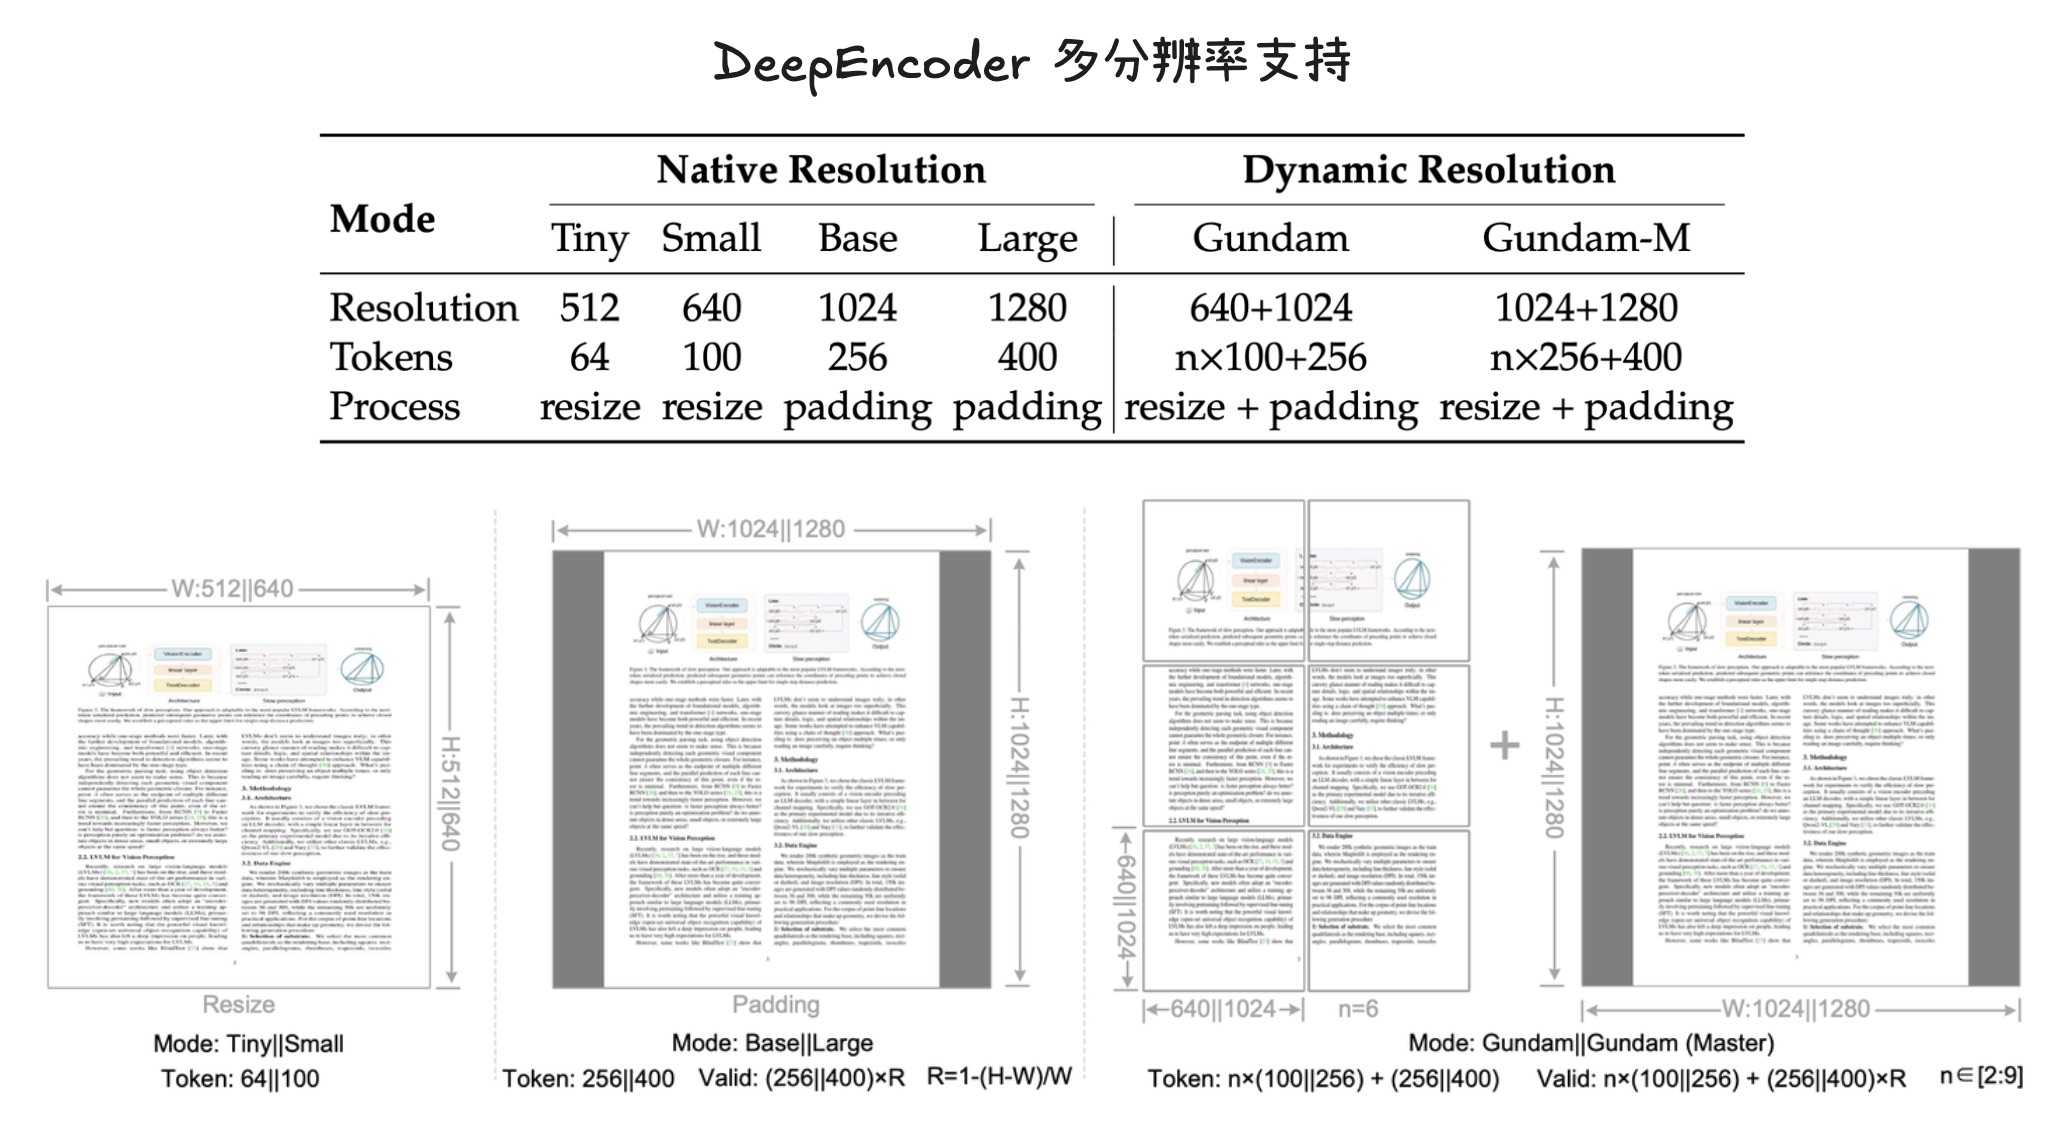
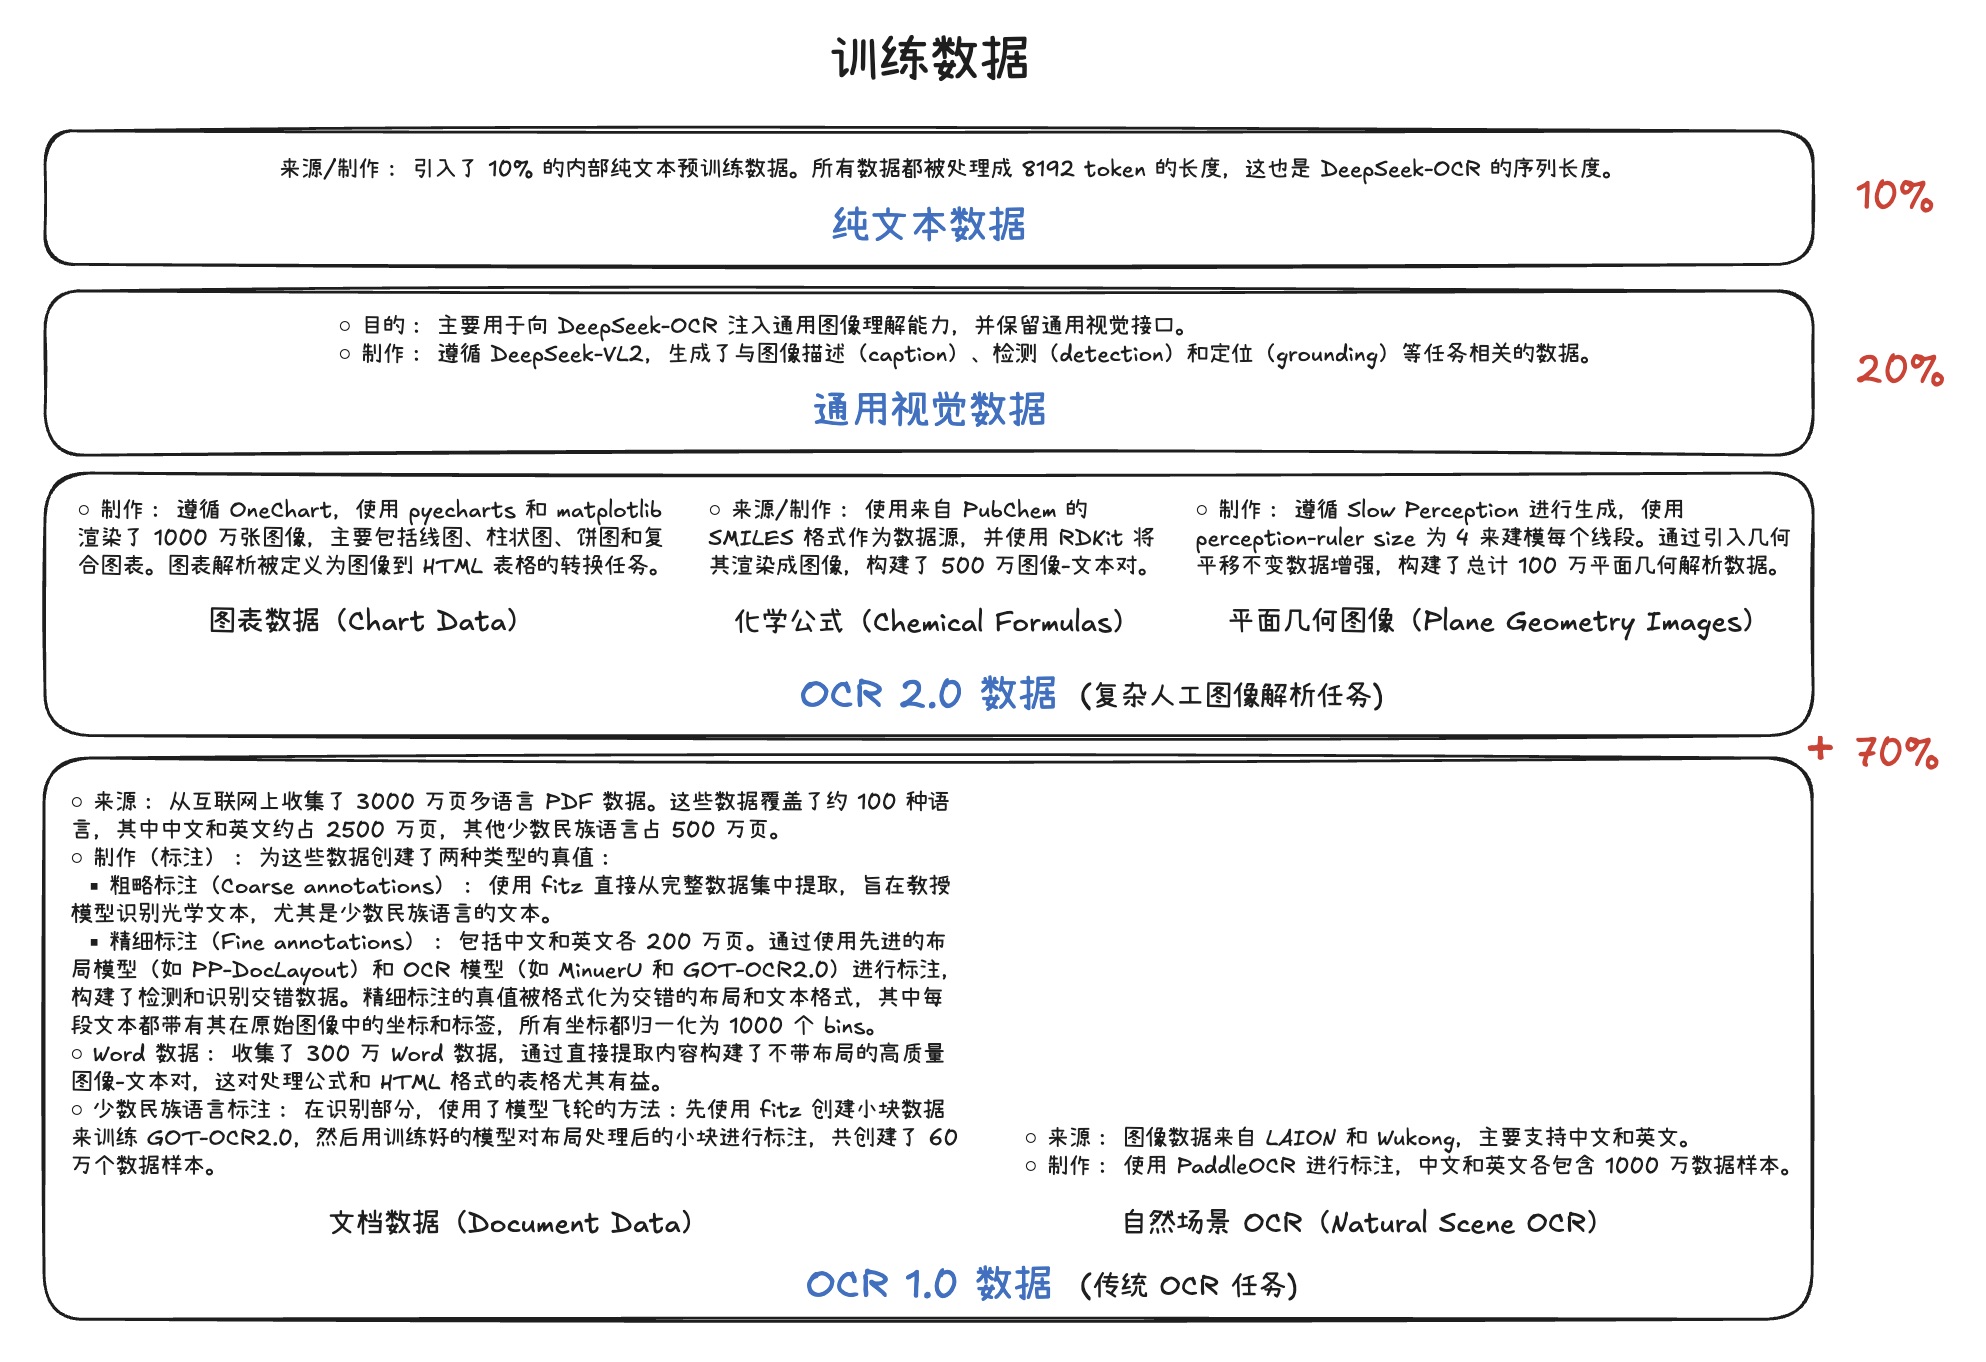
训练数据
数据组成
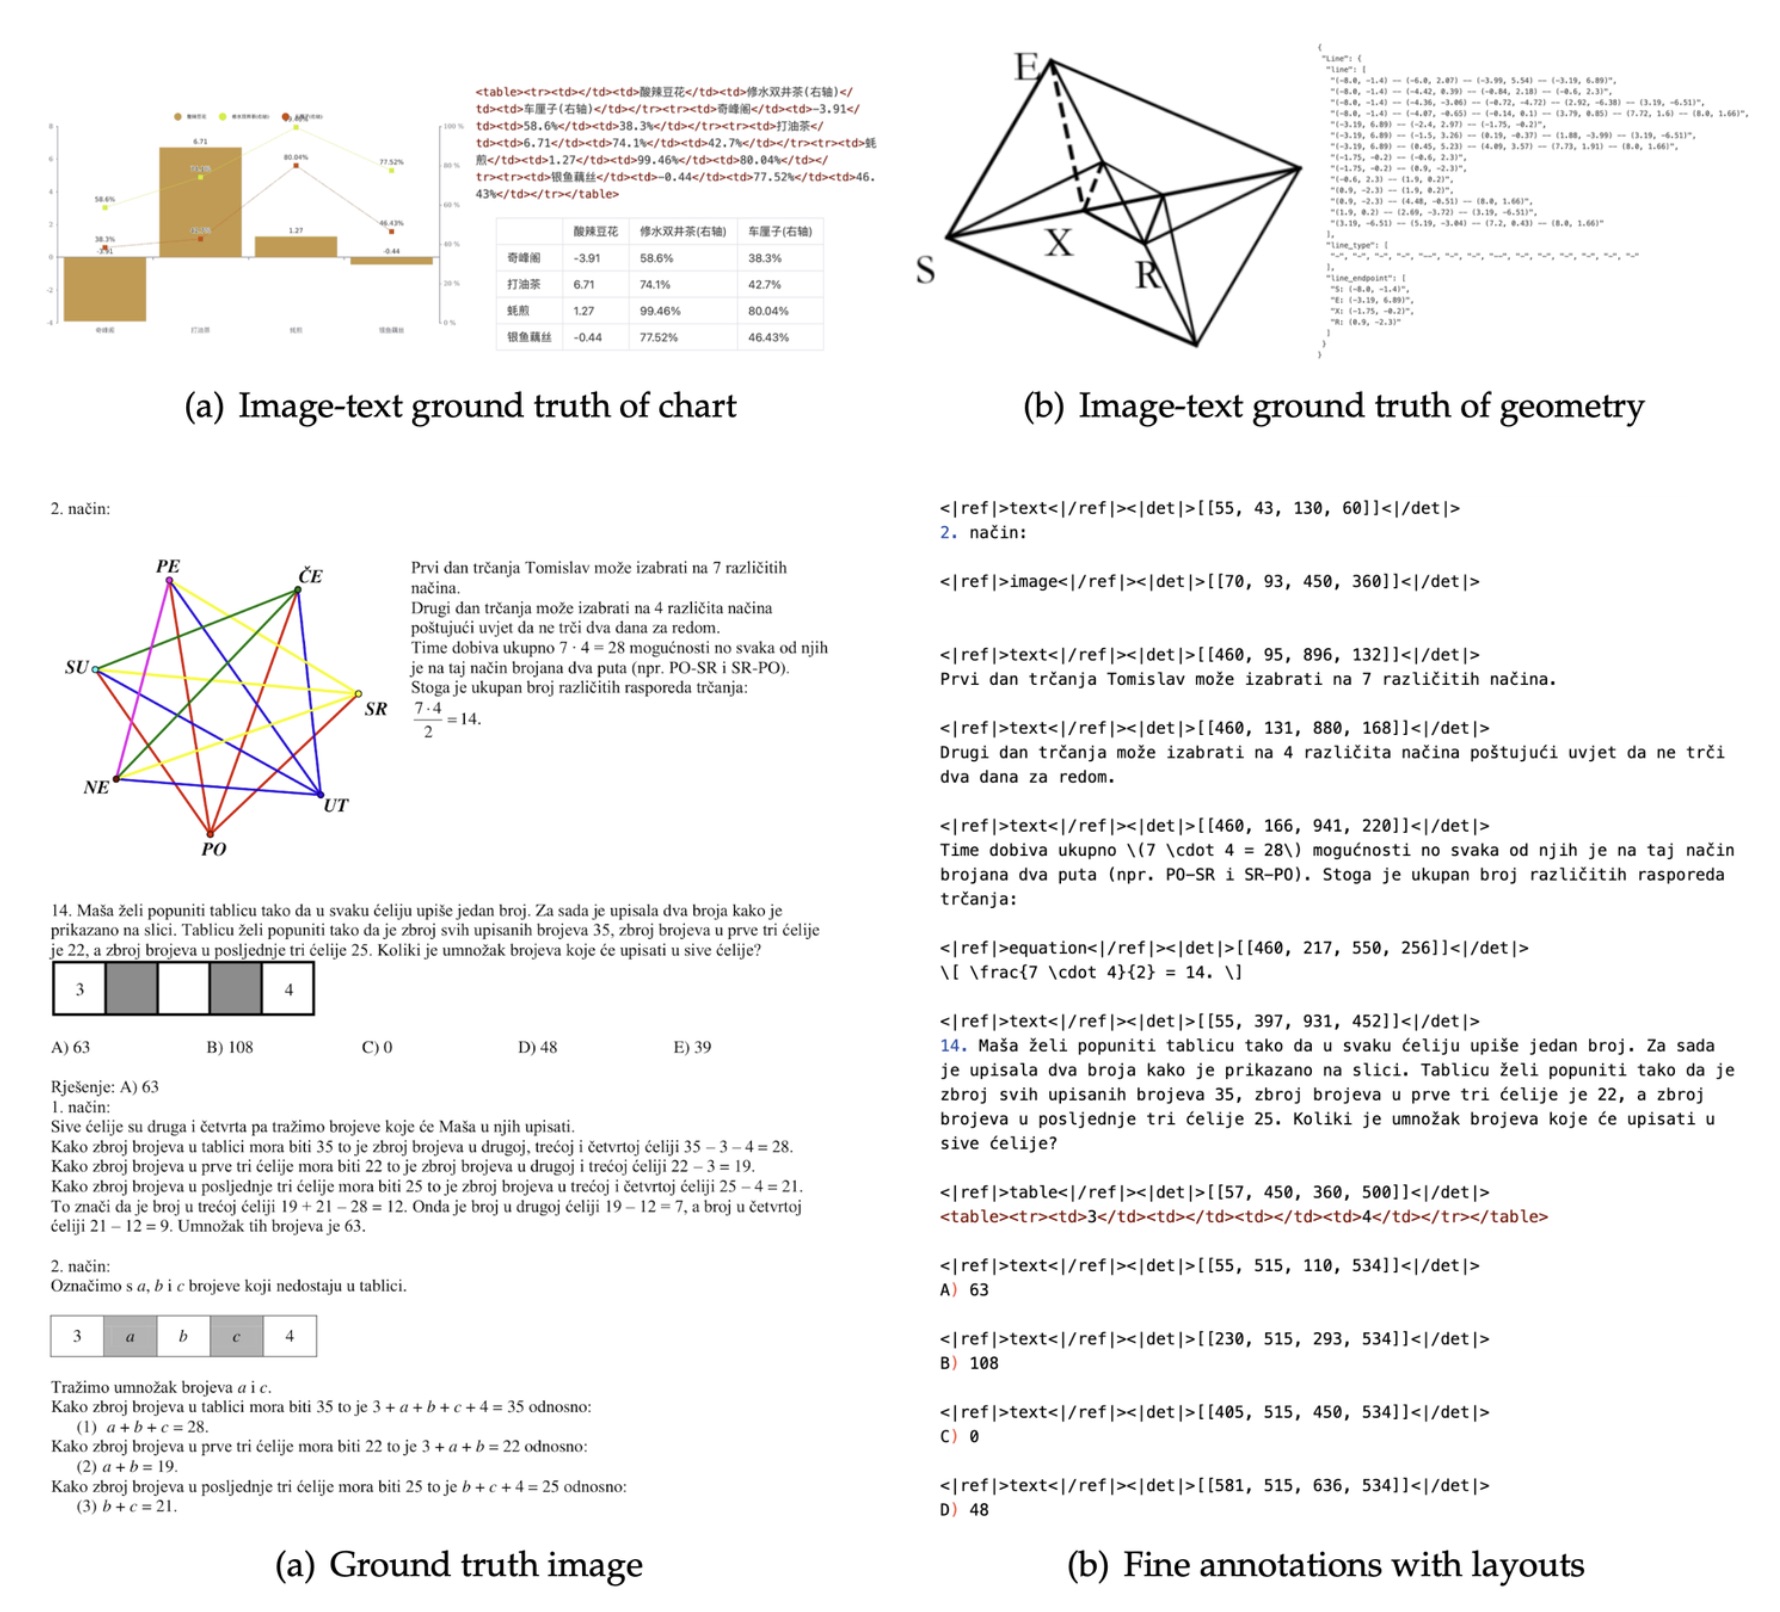
数据标注
训练流程
训练 DeepEncoder
Vary,使用紧凑语言模型和下一词元预测(next token prediction)框架进行训练。OCR 1.0 和 OCR 2.0 数据,以及从 LAION 数据集中采样的 1 亿(100M)通用数据。2 个 epoch,批次大小为 1280,使用 AdamW 优化器,配合余弦退火(cosine annealing)调度器,学习率为 5e-5。训练序列长度为 4096。训练 DeepSeek-OCR
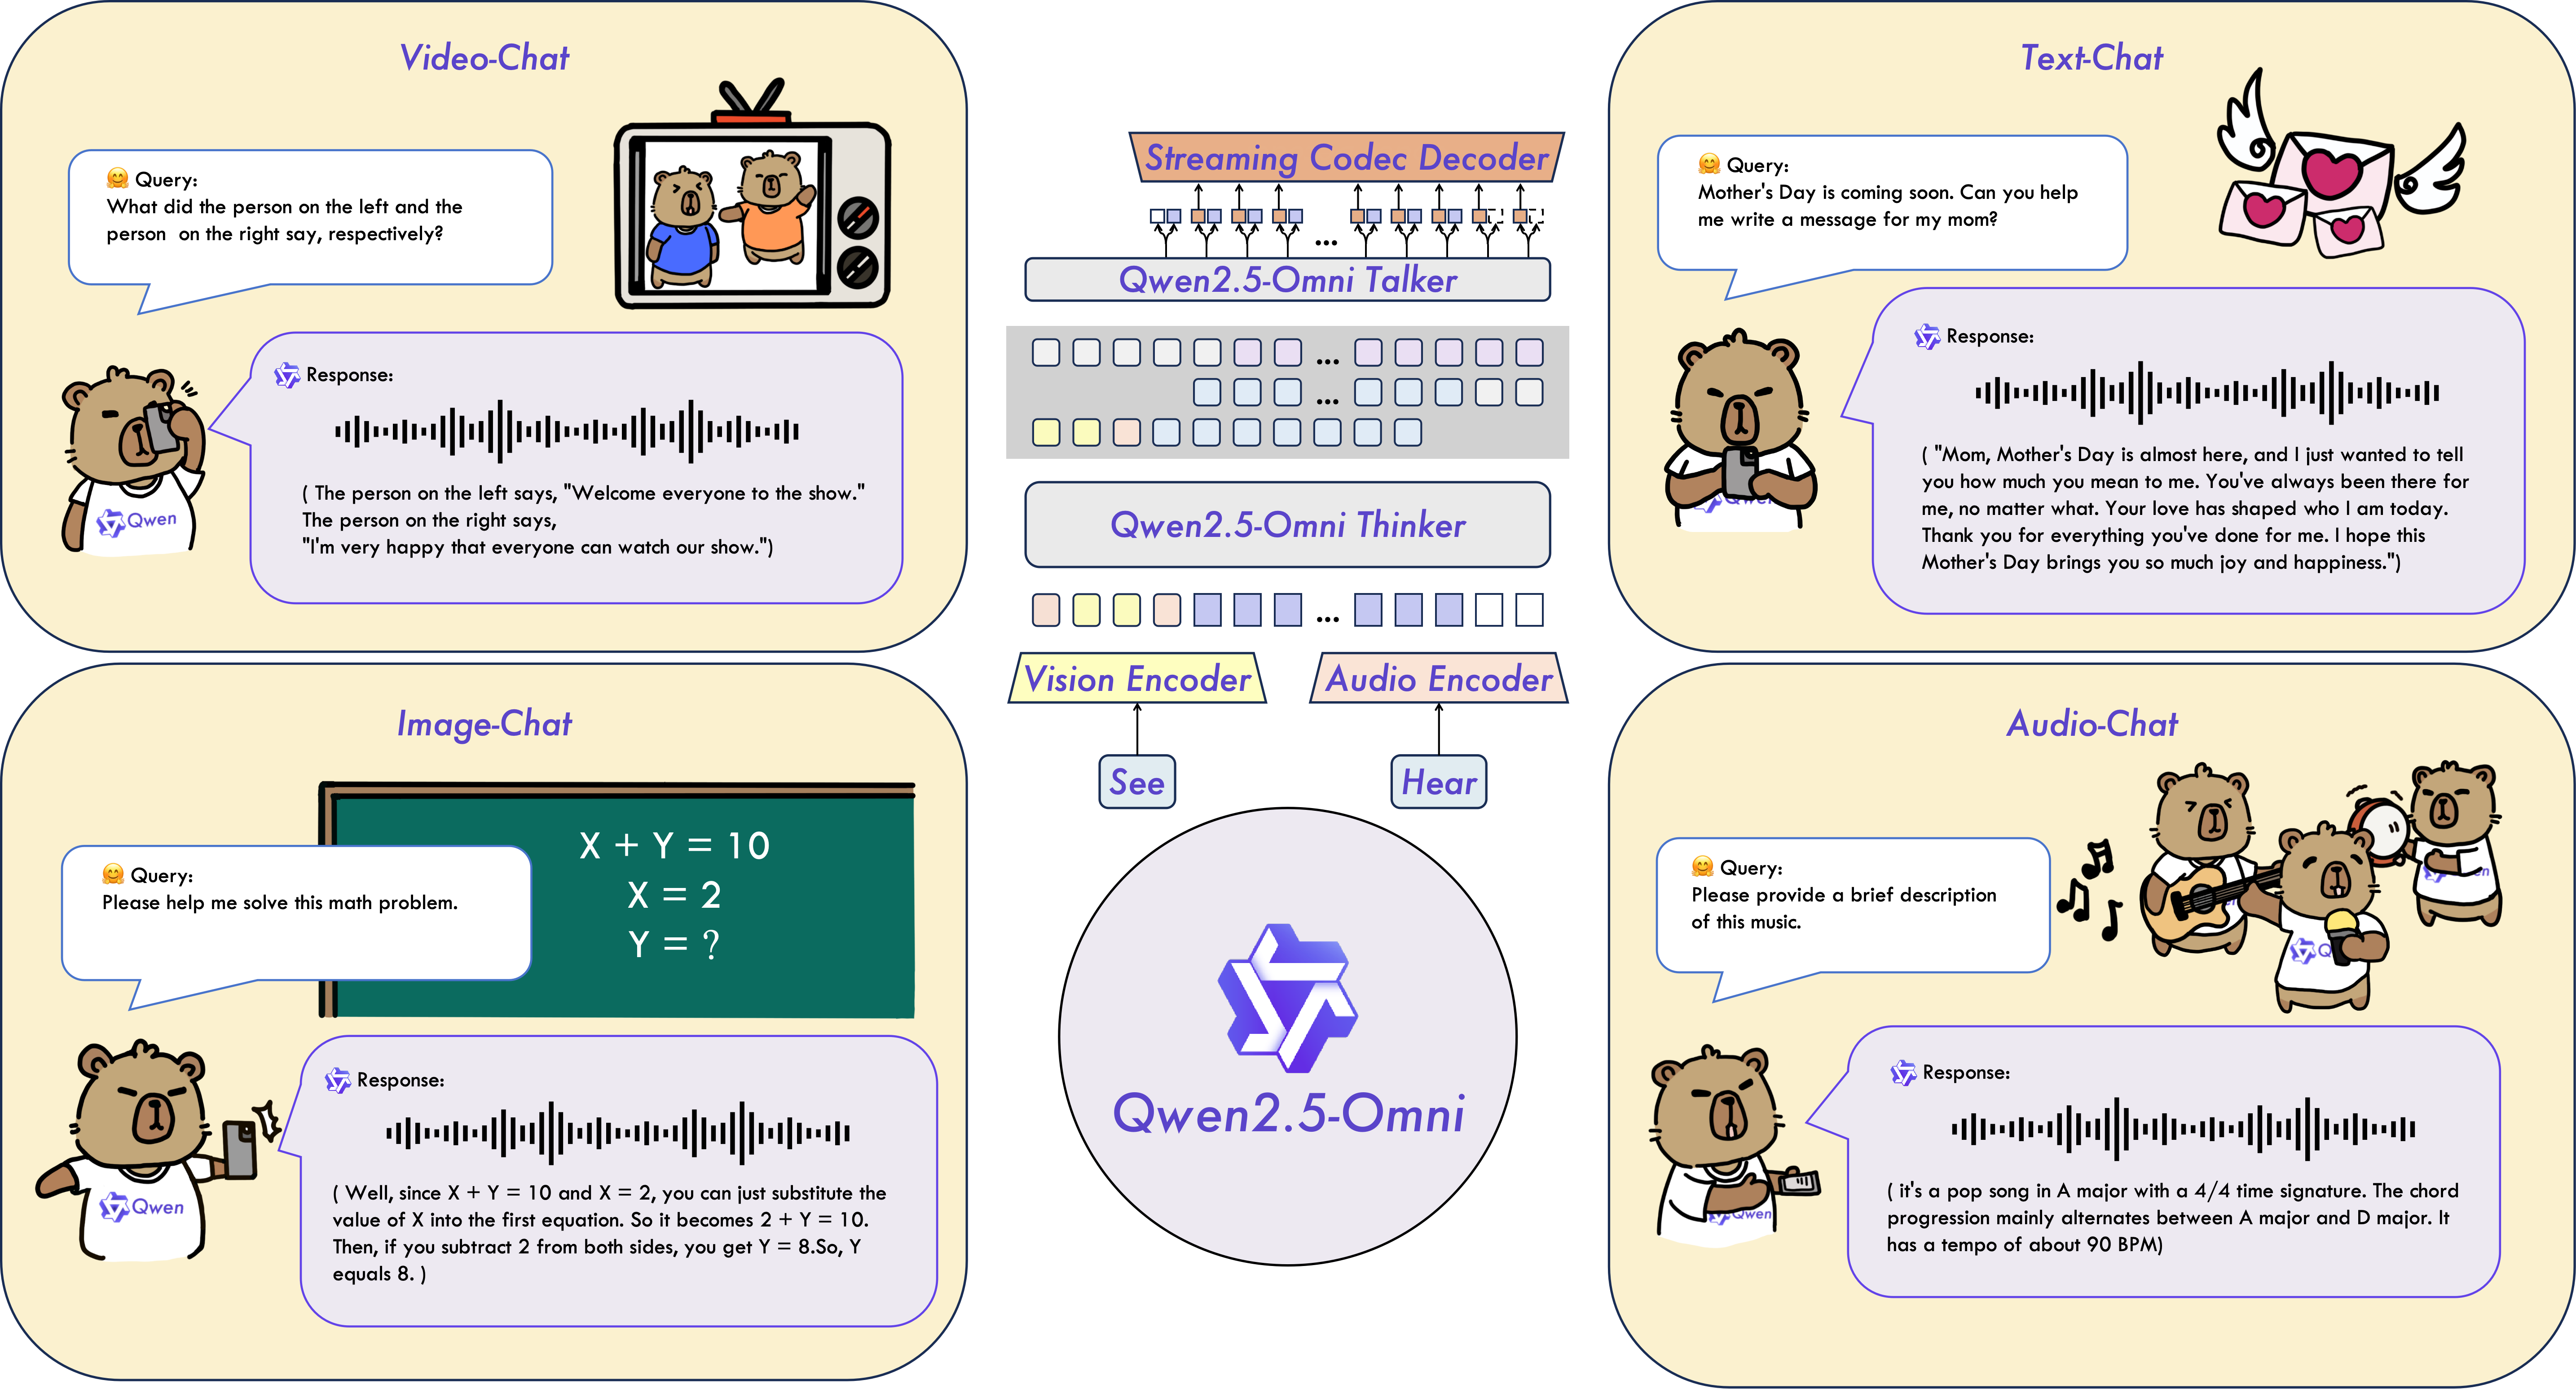
流水线并行(PP),模型被分为 4 部分:SAM 和压缩器(作为视觉词元分析器),参数冻结。CLIP 部分(作为输入嵌入层),权重不冻结,参与训练。640。AdamW 优化器,配合基于步数的调度器(step-based scheduler),初始学习率为 3e-5。Qwen2.5-Omni是Qwen系列中全新的旗舰级端到端多模态大模型,专为全面的多模式感知设计,无缝处理包括文本、图像、音频和视频在内的各种输入,同时支持流式的文本生成和自然语音合成输出。
点击下方视频了解更多信息吧 😃
概览
简介
Qwen 2.5-Omni是一个端到端的多模态大语言模型,旨在感知包括文本、图像、音频和视频在内的多种模态,同时以流式的方式生成文本和自然语音响应。
主要特点
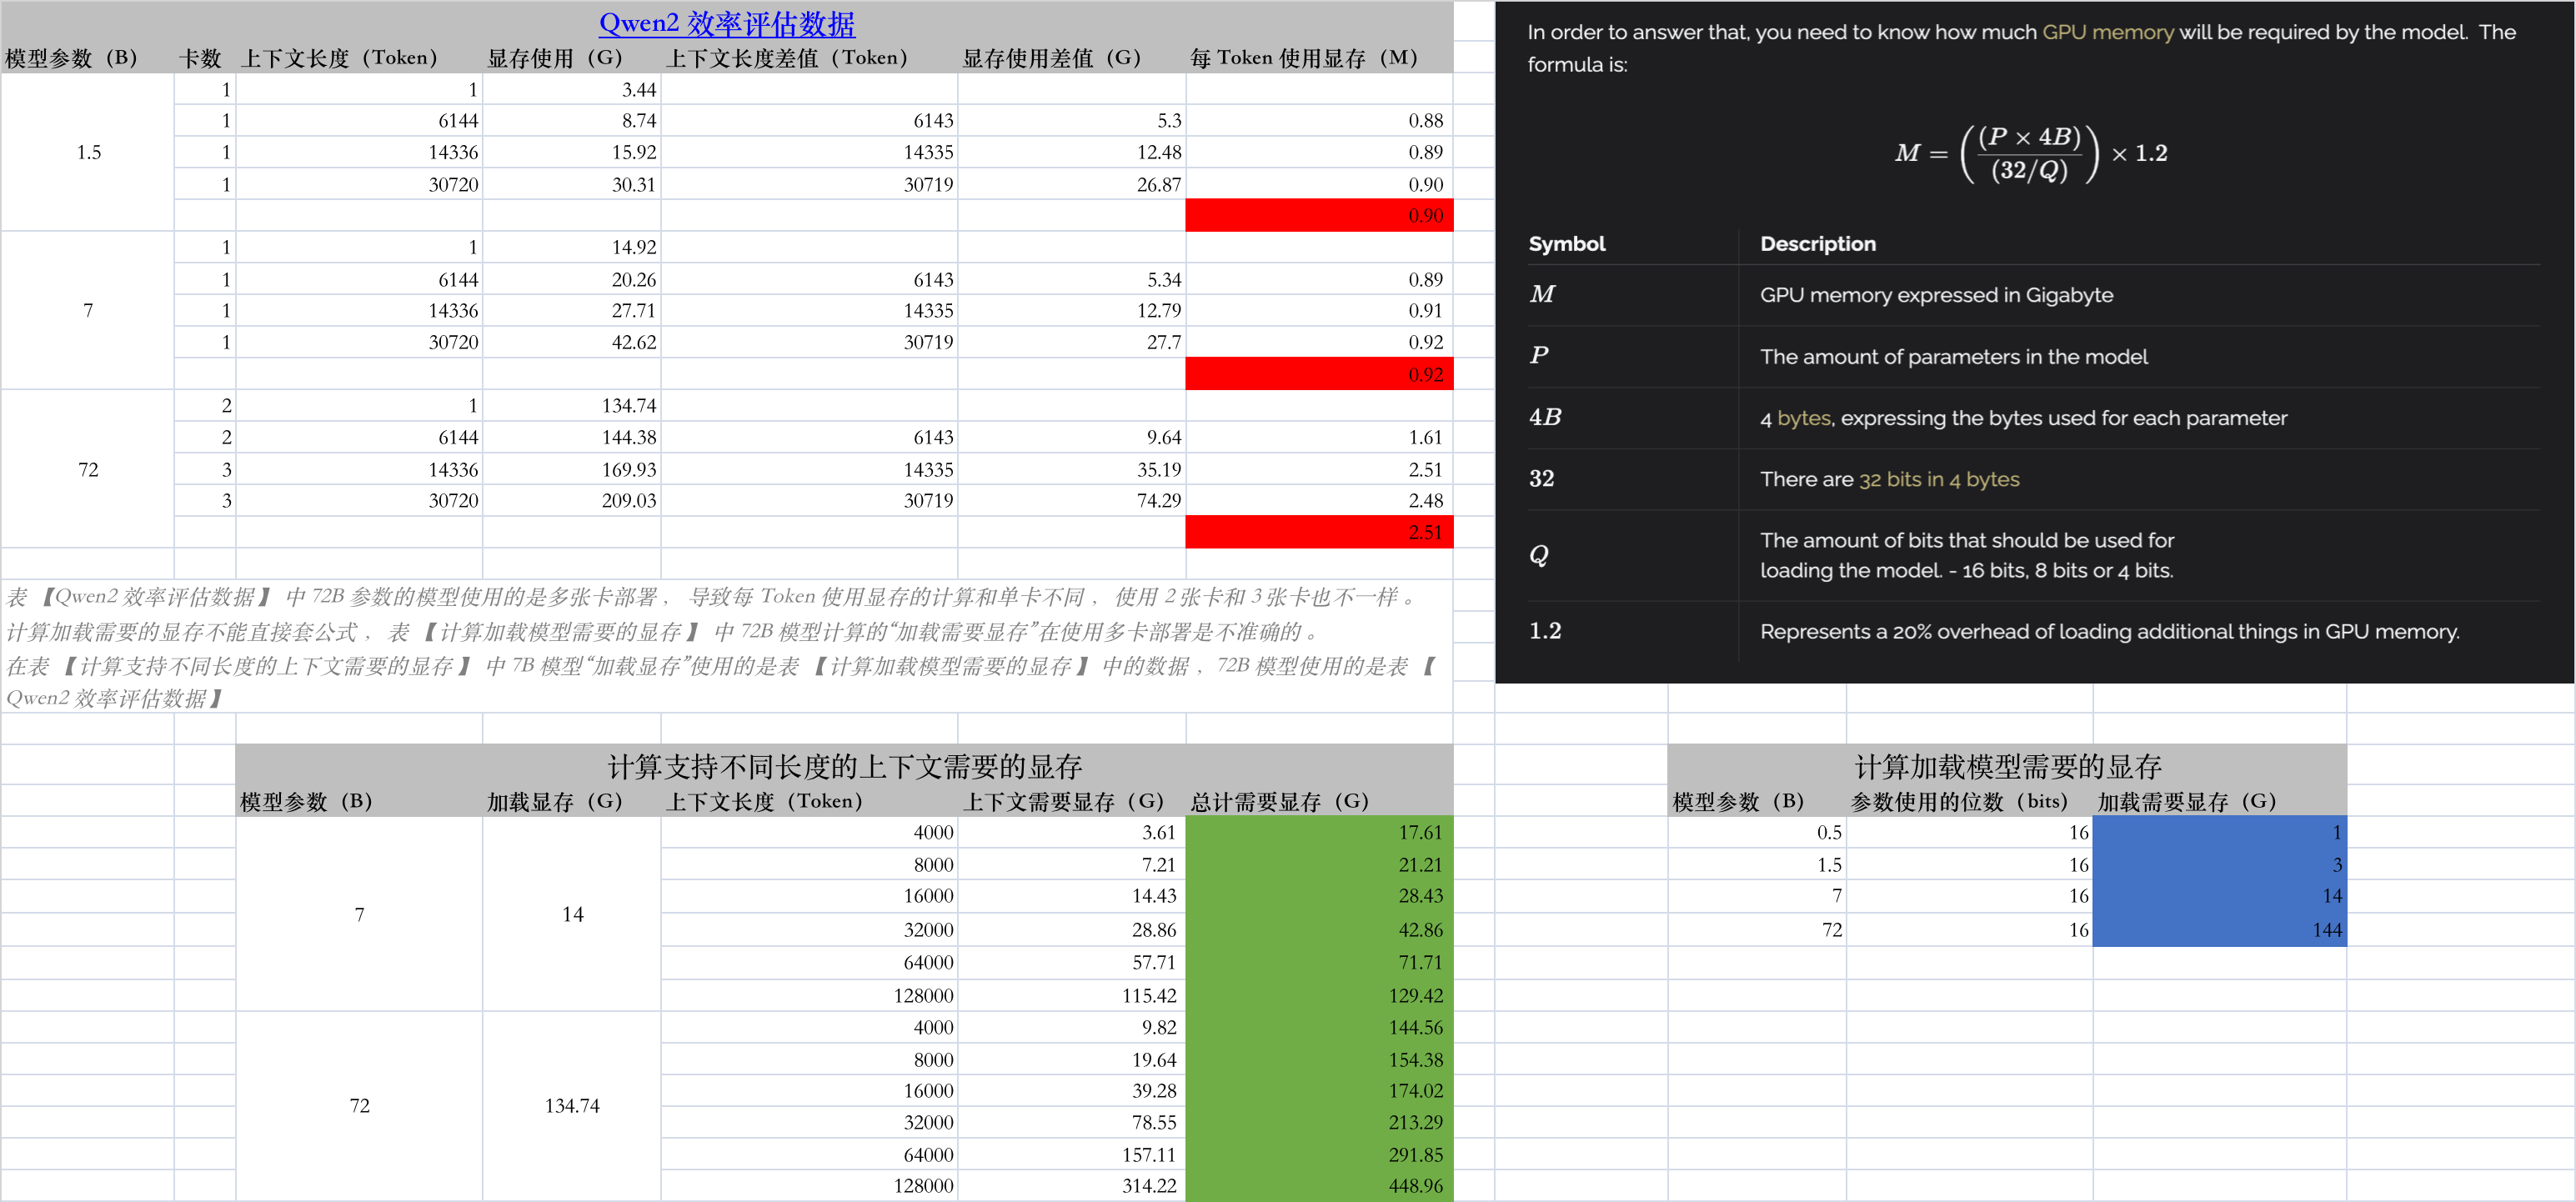
transformers 库进行推理,对于 vLLM,由于 GPU 显存预分配,实际显存使用难以评估。计算加载模型需要的显存
| 模型参数(B) | 参数使用的位数(bits) | 加载需要显存(G) |
|---|---|---|
| 0.5 | 16 | 1 |
| 1.5 | 16 | 3 |
| 7 | 16 | 14 |
| 9 | 16 | 18 |
| 22 | 16 | 44 |
| 72 | 16 | 144 |
计算支持不同长度的上下文需要的显存
Llama3
模型
下载
数据集
No Robots 是由熟练的人类注释者创建的包含 10,000 条指令和演示的高质量数据集。该数据可用于监督微调(SFT),使语言模型更好地遵循指令。 No Robots 是根据 OpenAI 的 InstructGPT 论文中描述的指令数据集进行建模的。
介绍 Llama 3 最大的变化是采用了新的 Tokenizer,将词汇表大
Natural Language Processing (NLP)
安装依赖库
pip install transformers
Conversational
1. TRANSFORMER 模型
自然语言处理
NLP 是语言学和机器学习交叉领域,专注于理解与人类语言相关的一切。 NLP 任务的目标不仅是单独理解单个单词,而且是能够理解这些单词的上下文。
以下是常见 NLP 任务的列表:
Transformers 能做什么?
Transformers 库中最基本的对象是 pipeline() 函数。它将模型与其必要的预处理和后处理步骤连接起来,使我们能够通过直接输入任何文本并获得最终的答案:
DeepSeek Coder
Code LLM 排行榜
选择了两个通用基准来评估:
下面显示了 OctoCoder vs Base HumanEval prompt 的示例,在这里可以找到它。

LLM 排行榜
介绍 DeepSeek Coder 由一系列代码语言模型组成,每个模型都在 2T 令牌上从头开始训练,其中 87% 是英文和中文的代码,13% 是自然语言。我们提供各种尺寸的代码模型,范围从 1B 到 33B 版本。
Phi-2: The surprising power of small language models
创建虚拟环境
conda create -n huggingface python==3.10.9
conda activate huggingface
安装依赖包
conda install pytorch torchvision -c pytorch
pip install transformers
pip install einops
下载模型
huggingface-cli download microsoft/phi-2 --local-dir microsoft/phi-2 --local-dir-use-symlinks False
代码 import torch from transformers import AutoModelForCausalLM, AutoTokenizer torch.set_default_device("mps") model = AutoModelForCausalLM.
使用 Transformers 的 Pipeline 进行推理
安装依赖包
pip install datasets evaluate transformers[sentencepiece]
英文情感分类
from transformers import pipeline

classifier = pipeline("sentiment-analysis")
classifier(
    [
        "I've been waiting for a HuggingFace course my whole life.",
        "I hate this so much!",
    ]
)
模型
Taiyi-CLIP-Roberta-102M-Chinese 中文CLIP模型
使用电网的图片测试了一下,效果不理想。
HuggingFace 下载
Qwen-7B
chat(..., stream=True)
ChatGLM2-6B 是开源中英双语对话模型 ChatGLM-6B 的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,ChatGLM2-6B 引入了如下新特性:
Hugging Face 是所有机器学习任务的大本营。 您可以在这里找到开始一项任务所需的内容:演示、用例、模型、数据集等等!
创建和托管很棒的机器学习演示
Solutions
Expert Acceleration Program(专家加速计划)- 加速您的 ML 路线图
从我们屡获殊荣的机器学习专家那里获得指导。我们组建了一个世界一流的团队,帮助客户更快地构建更好的 ML 解决方案。
机器学习的成功取决于为用例找到最佳架构、微调模型并将它们部署到生产环境中。 所有这些都需要经验和技能的正确结合。 我们的专家加速计划提供必要的技术专长,以实施最先进的技术、做出更好的决策并更快地进入市场。
Electrical Safety Work Procedures (电力安全工作规程) 数据
ChatGLM-6B 是一个开源的、支持中英双语的对话语言模型,基于 General Language Model (GLM) 架构,具有 62 亿参数。
下载
克隆
https://github.com/THUDM/ChatGLM-6B.git
cd ChatGLM-6B
下载模型
git clone https://huggingface.co/THUDM/chatglm-6b THUDM/chatglm-6b
没有找到匹配的文章