Qwen3-ASR 工作原理 · 技术解析HTML
拆解 Qwen3-ASR 的三段式流水线:AuT 编码器把波形压成 12.5Hz 声学 token,Projector 对接 Qwen3 解码器,再用 1–8 秒动态窗口让流式与离线共用一套权重,末段旁路补出词级时间戳。
拆解 Qwen3-ASR 的三段式流水线:AuT 编码器把波形压成 12.5Hz 声学 token,Projector 对接 Qwen3 解码器,再用 1–8 秒动态窗口让流式与离线共用一套权重,末段旁路补出词级时间戳。
基于 OpenAI Whisper 的命令行工具,将音频文件批量转写为 VTT / SRT 格式字幕。
环境要求
| 依赖 | 说明 |
|---|---|
| Python | ≥ 3.8 |
| PyTorch | Whisper 的运行时依赖,自动安装 |
| openai-whisper | 语音识别引擎 |
| ffmpeg | 音频解码,系统级安装 |
安装步骤
1. 安装 ffmpeg
brew install ffmpeg
sudo apt update && sudo apt install ffmpeg
2. 安装 openai-whisper
pip install openai-whisper
该命令会自动拉取
torch等依赖。首次运行时 Whisper 模型文件会下载到~/.cache/whisper/。
⚠️ macOS 环境注意事项
使用系统 Python 或 miniconda 安装 whisper:
# miniconda(推荐,已预装 torch)
/opt/miniconda/bin/pip install openai-whisper

# 或系统 Python
/usr/bin/python3 -m pip install openai-whisper
脚本文件
编写文件:audio2sub.py
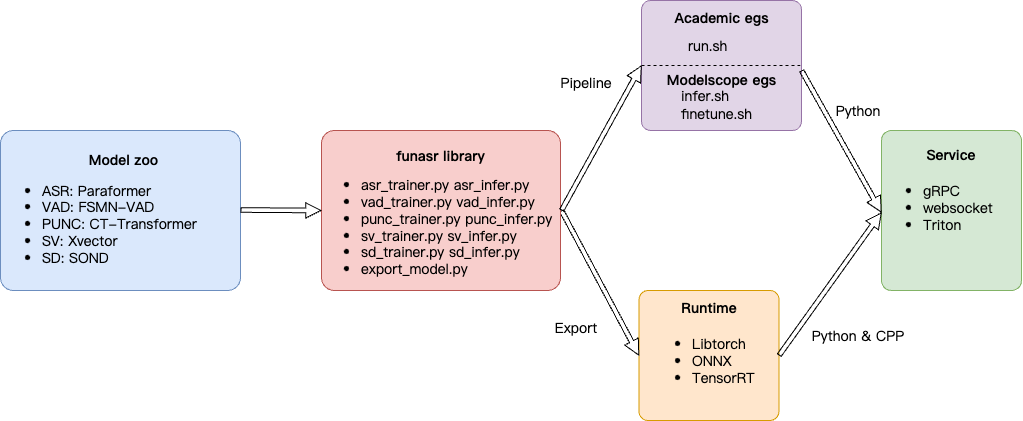
本文详细介绍了 FunASR 这一基础语音识别工具包,它提供了一套完整的语音处理服务,涵盖了离线转写和实时听写两大核心功能。其技术核心在于 AutoModel 多模型协调引擎,能够将不同的组件,如语音活动检测(VAD)、自动语音识别(ASR)、标点恢复和说话人分离(SV),按序串联起来,实现复杂的音频转录任务。文档清晰展示了从原始音频输入到最终带说话人标签的转录结果的完整处理流程和数据流向。此外,本文不仅罗列了支持的多种中英文模型清单,还附带了音频格式转换指南和代码示例。最后,通过实验性能对比,文章论证了在不同硬件上,结合 VAD、PUNC 和 SV 等组件后对推理用时和处理准确性的影响。
ASR 模型综合对比表
| 模型名称 | 中文准确度 | 英文/混合识别 | 可读性 (标点) | 附加功能 | 综合评分 |
|---|---|---|---|---|---|
| Fun-ASR-Nano | 极高 | 完美 | 极佳 | 生产环境级别 | 5.0 |
| SenseVoiceSmall | 高 | 较弱 (漏失) | 较好 | 情感/事件检测 | 4.0 |
paraformer-zh (ASR) |
一般 | 极差 | 无 | 原始数据 | 2.0 |
paraformer-zh (+VAD +PUNC) |
高 | 中等 | 优秀 | 自动断句 | 4.5 |
建议:
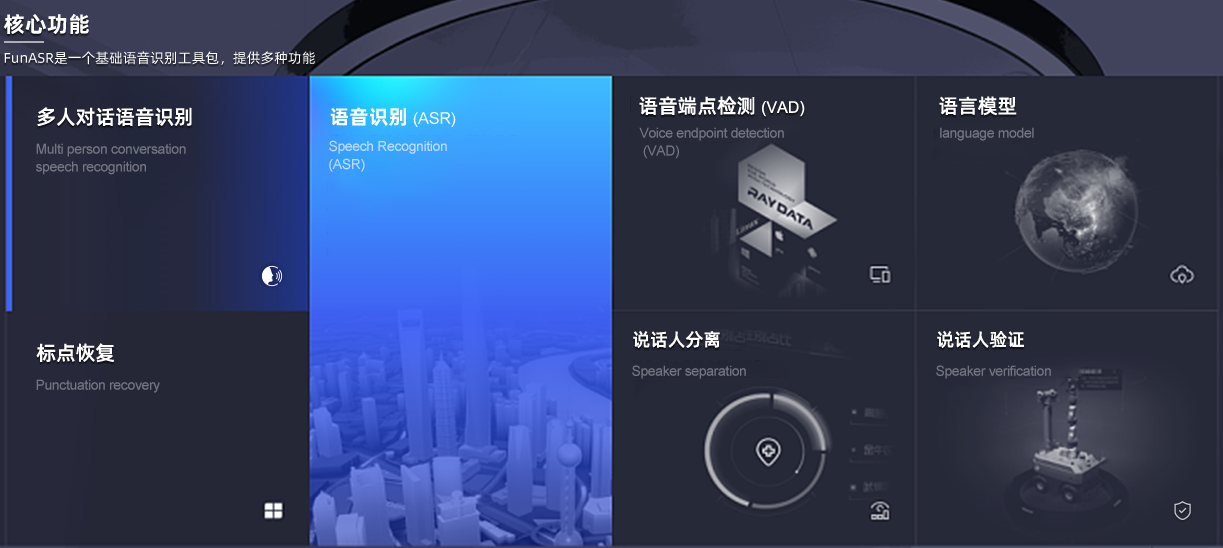
FunASR 是一个基础语音识别工具包,提供多种功能,包括语音识别(ASR)、语音端点检测(VAD)、标点恢复、语言模型、说话人验证、说话人分离和多人对话语音识别等。
FunASR 快速入门
核心功能
工作流程
离线文件转写服务

FunASR离线文件转写软件包,提供了一款功能强大的语音离线文件转写服务。拥有完整的语音识别链路,结合了语音端点检测、语音识别、标点等模型,可以将几十个小时的长音频与视频识别成带标点的文字,而且支持上百路请求同时进行转写。输出为带标点的文字,含有字级别时间戳,支持ITN与用户自定义热词等。服务端集成有ffmpeg,支持各种音视频格式输入。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
实时听写服务
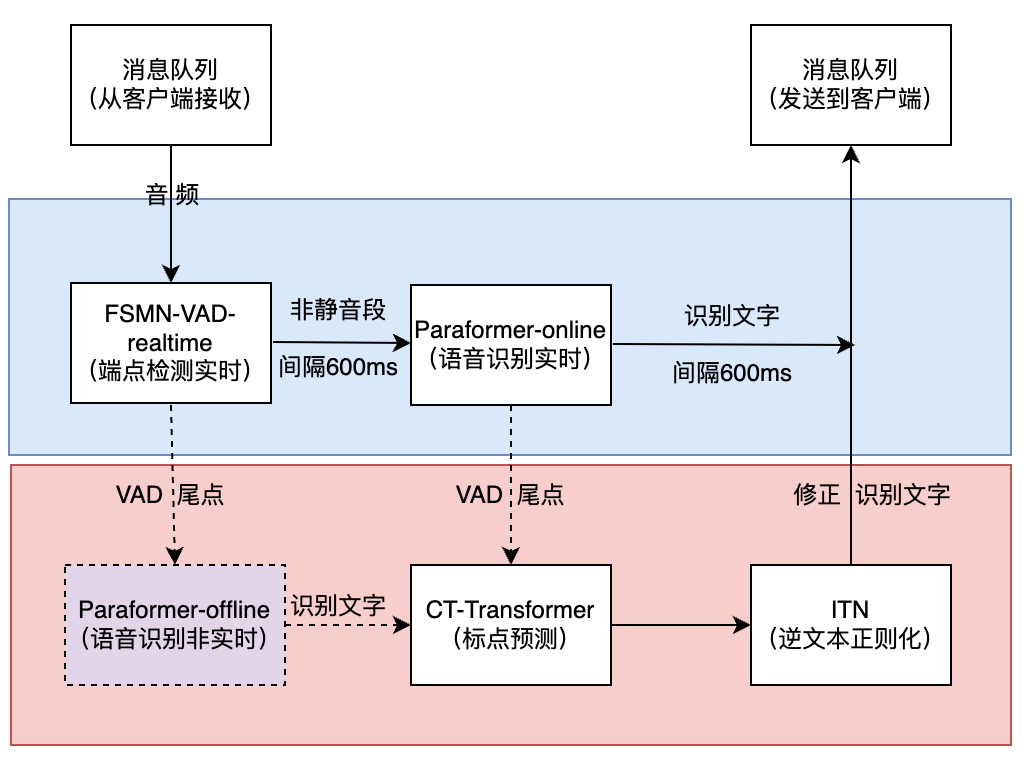
FunASR实时语音听写软件包,集成了实时版本的语音端点检测模型、语音识别、语音识别、标点预测模型等。采用多模型协同,既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。依据使用者场景不同,支持实时语音听写服务(online)、非实时一句话转写(offline)与实时与非实时一体化协同(2pass)3种服务模式。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
FunASR 镜像
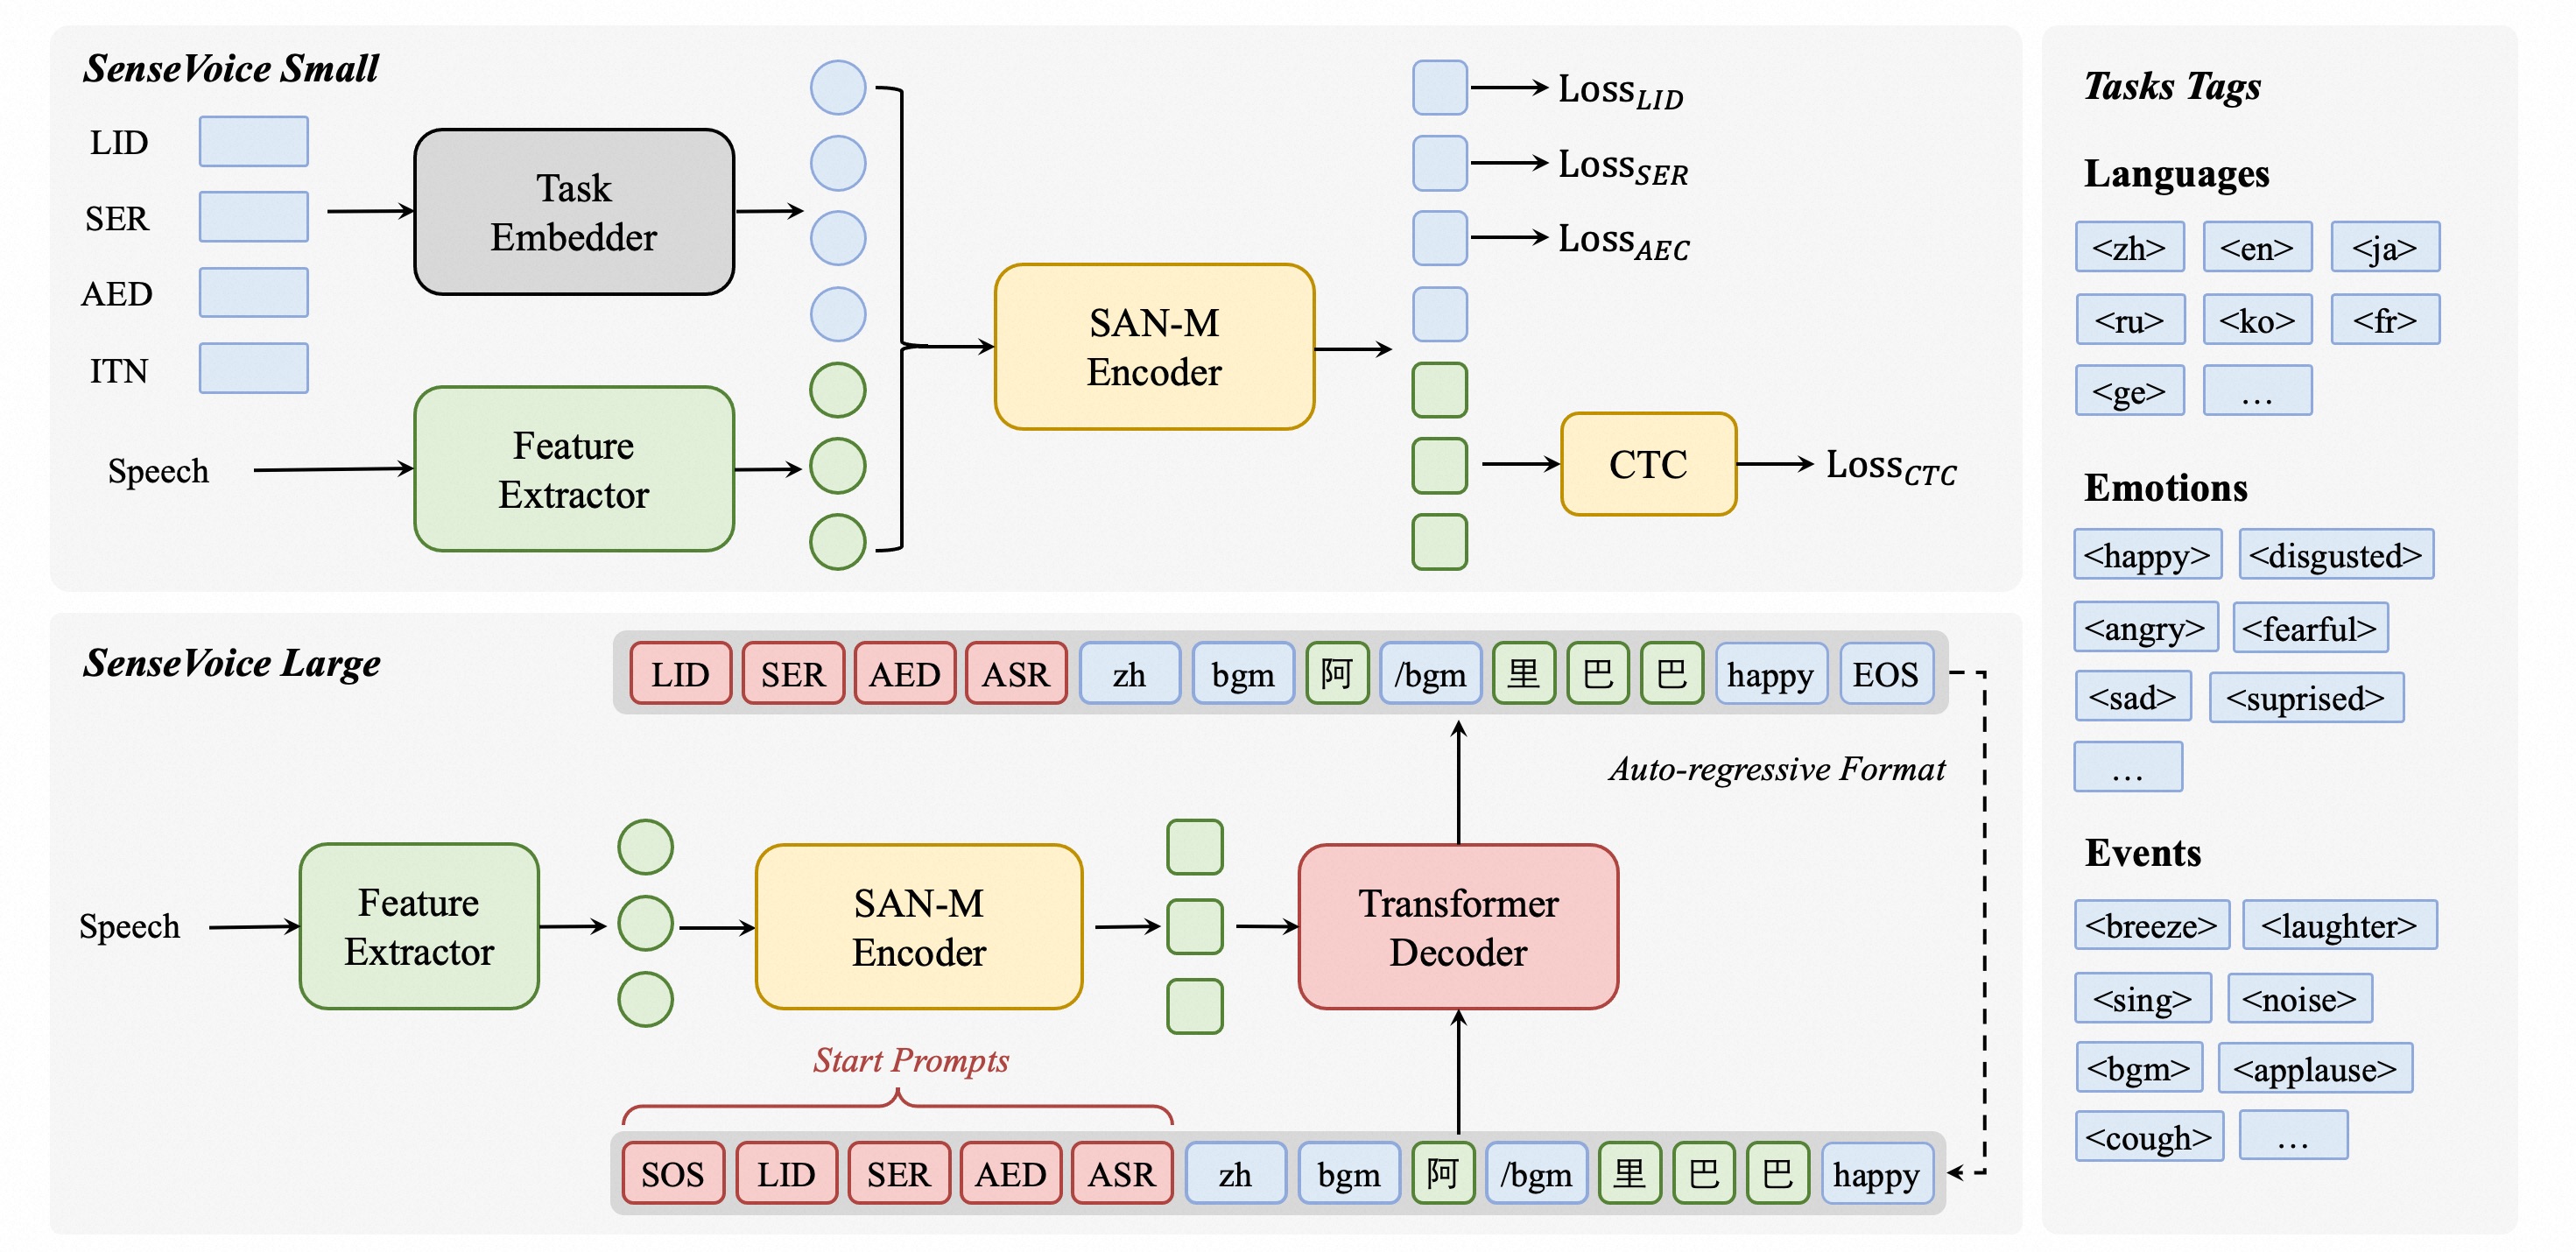
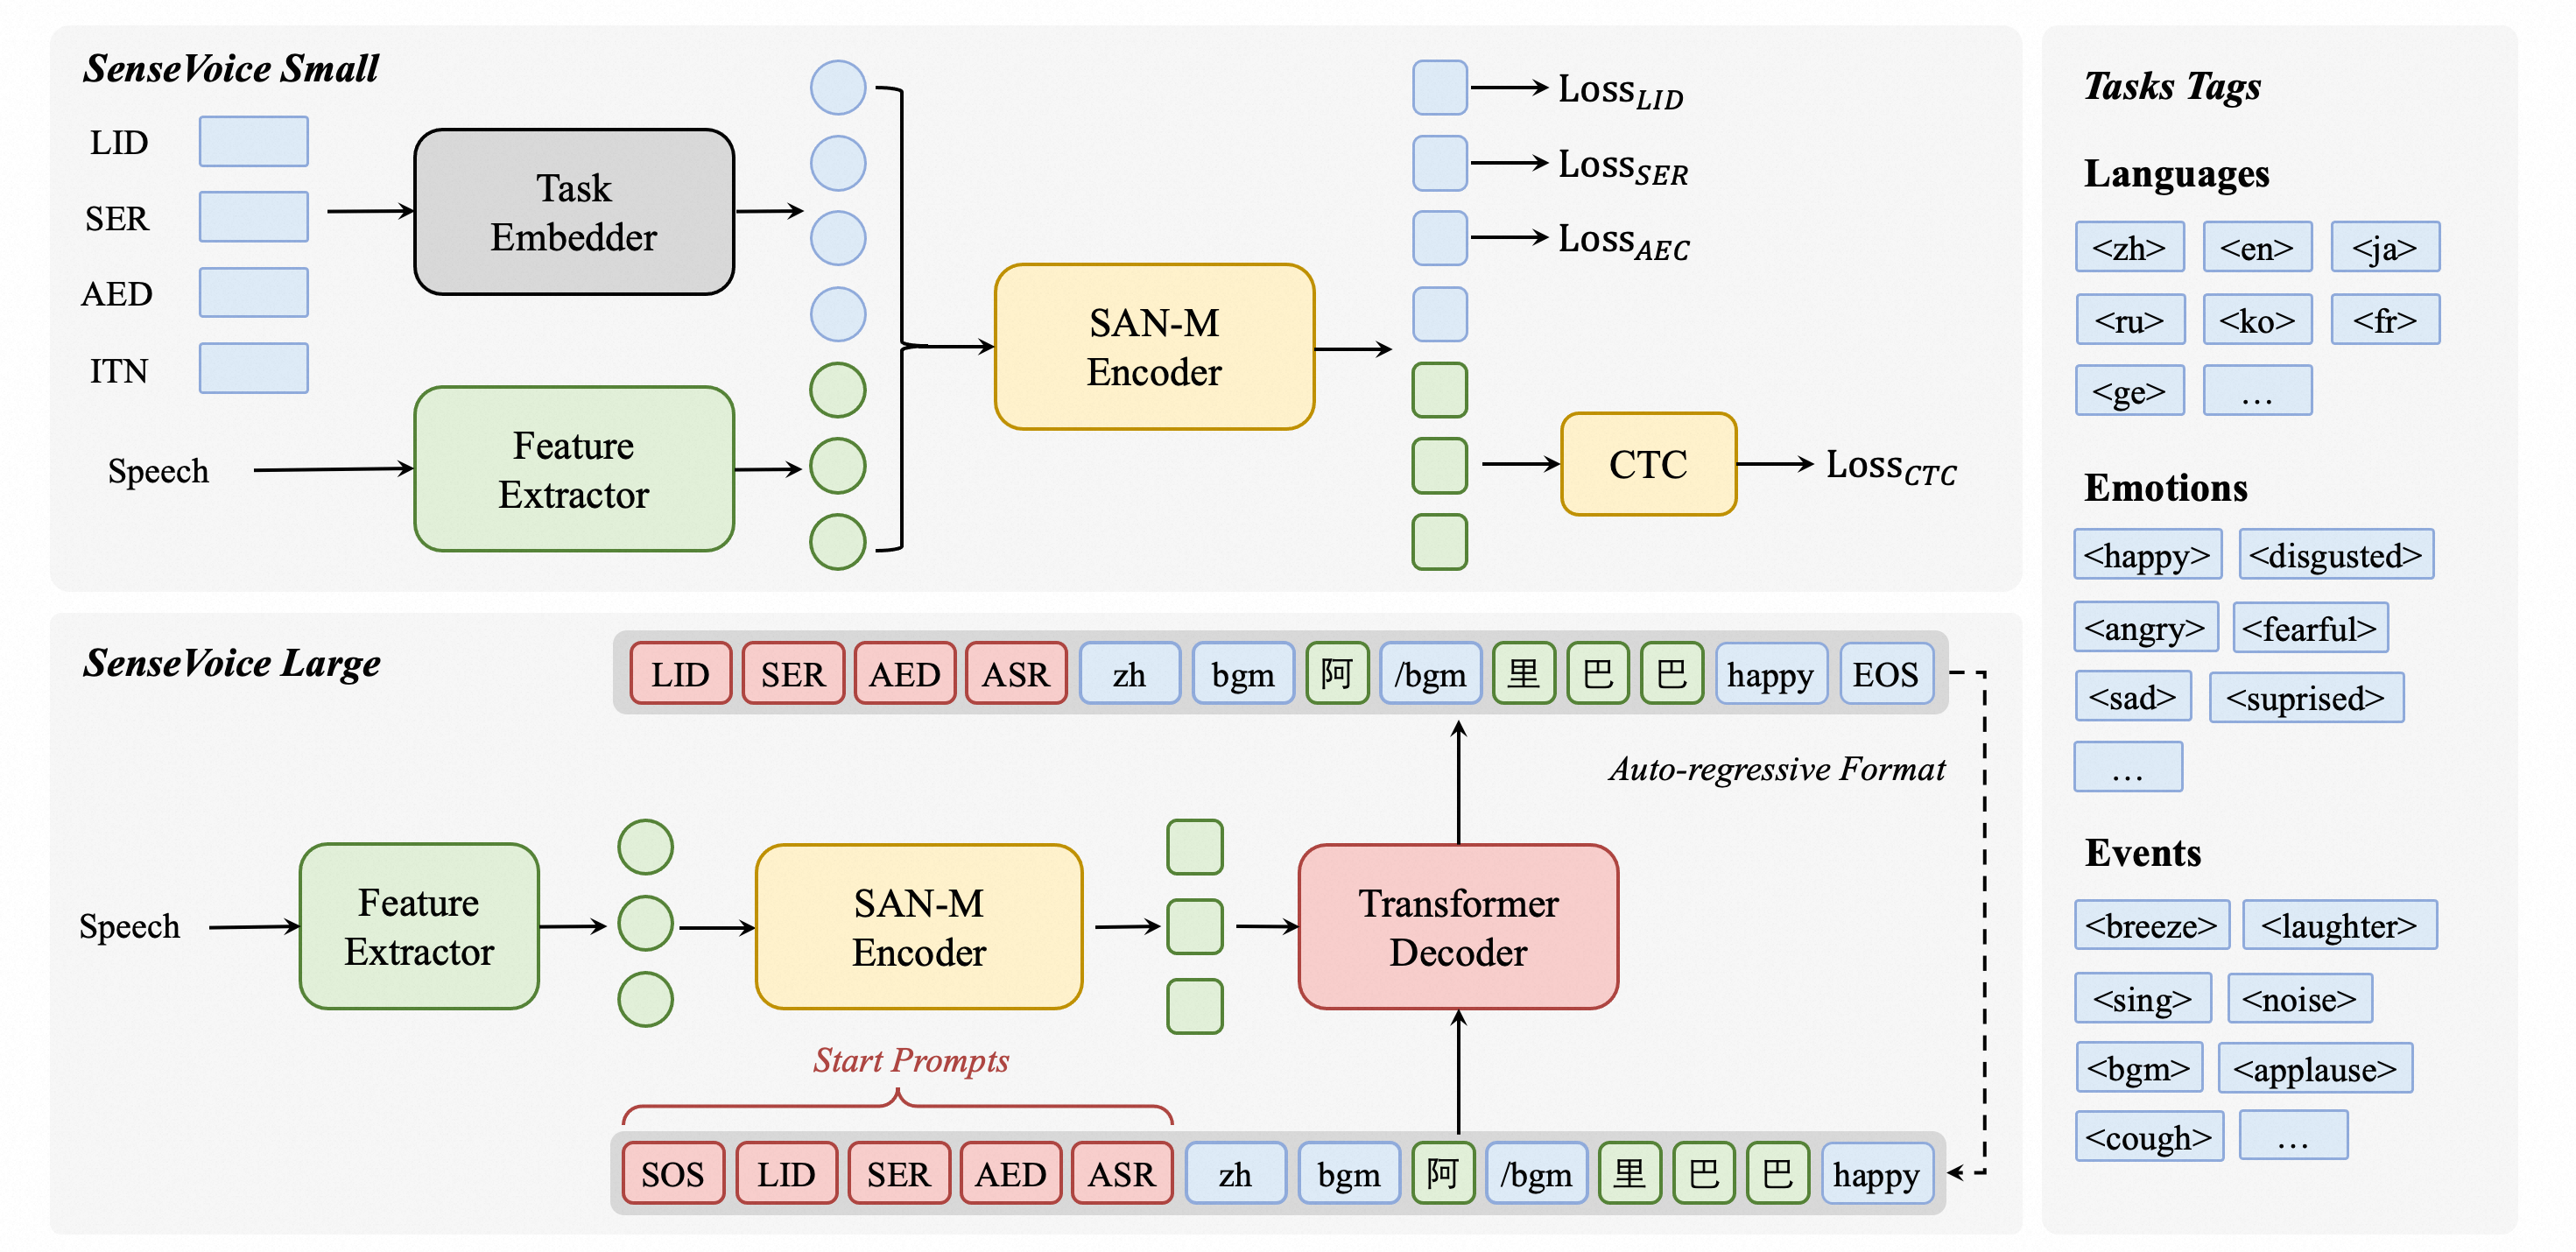
SenseVoice 是具有音频理解能力的音频基础模型,包括语音识别(ASR)、语种识别(LID)、语音情感识别(SER)和声学事件分类(AEC)或声学事件检测(AED)。
SenseVoice
核心功能 🎯
SenseVoice 专注于高精度多语言语音识别、情感辨识和音频事件检测
架构图
安装
克隆代码库
SimulStreaming 实现了 Whisper 模型的同步翻译和转录功能(在语音识别领域被称为流式传输)。SimulStreaming 采用了最先进的同步策略 AlignAtt,这使其具备极高的速度和效率。
安装
git clone https://github.com/ufal/SimulStreaming
cd SimulStreaming
pip install -r requirements.txt
从音频文件进行实时模拟
WhisperLiveKit 演示
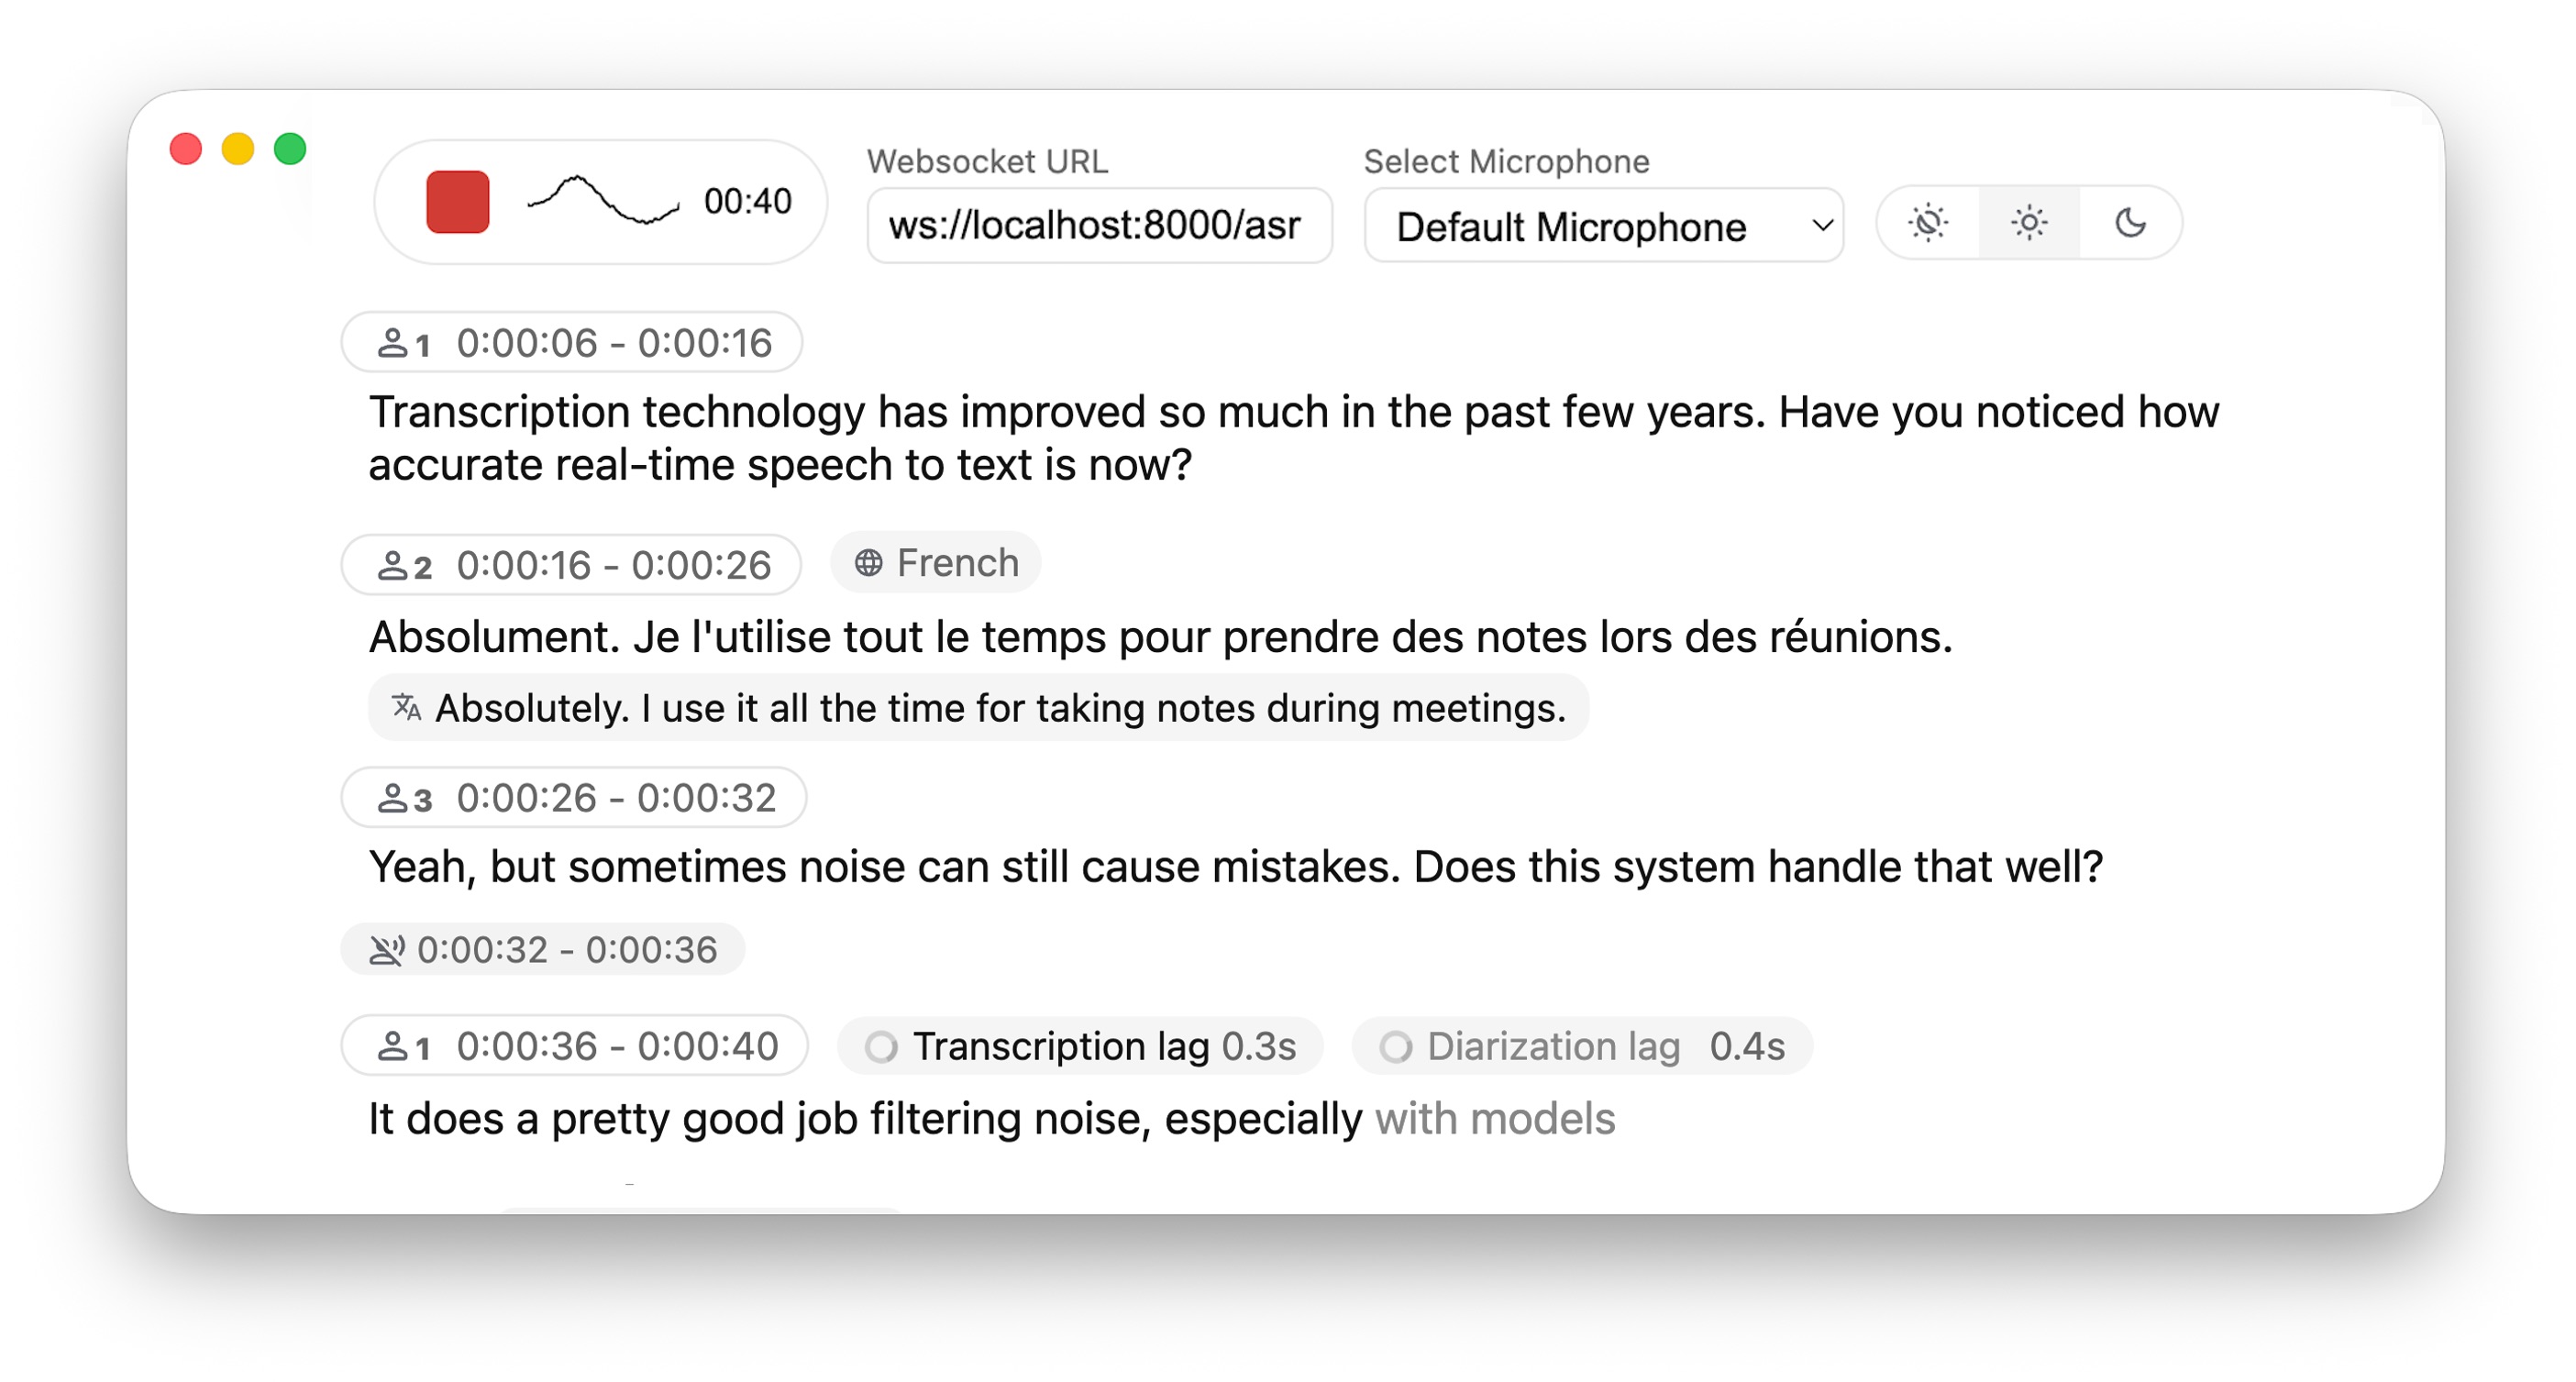
实时、完全本地化的语音转文本,带说话人识别功能
WhisperLiveKit 架构
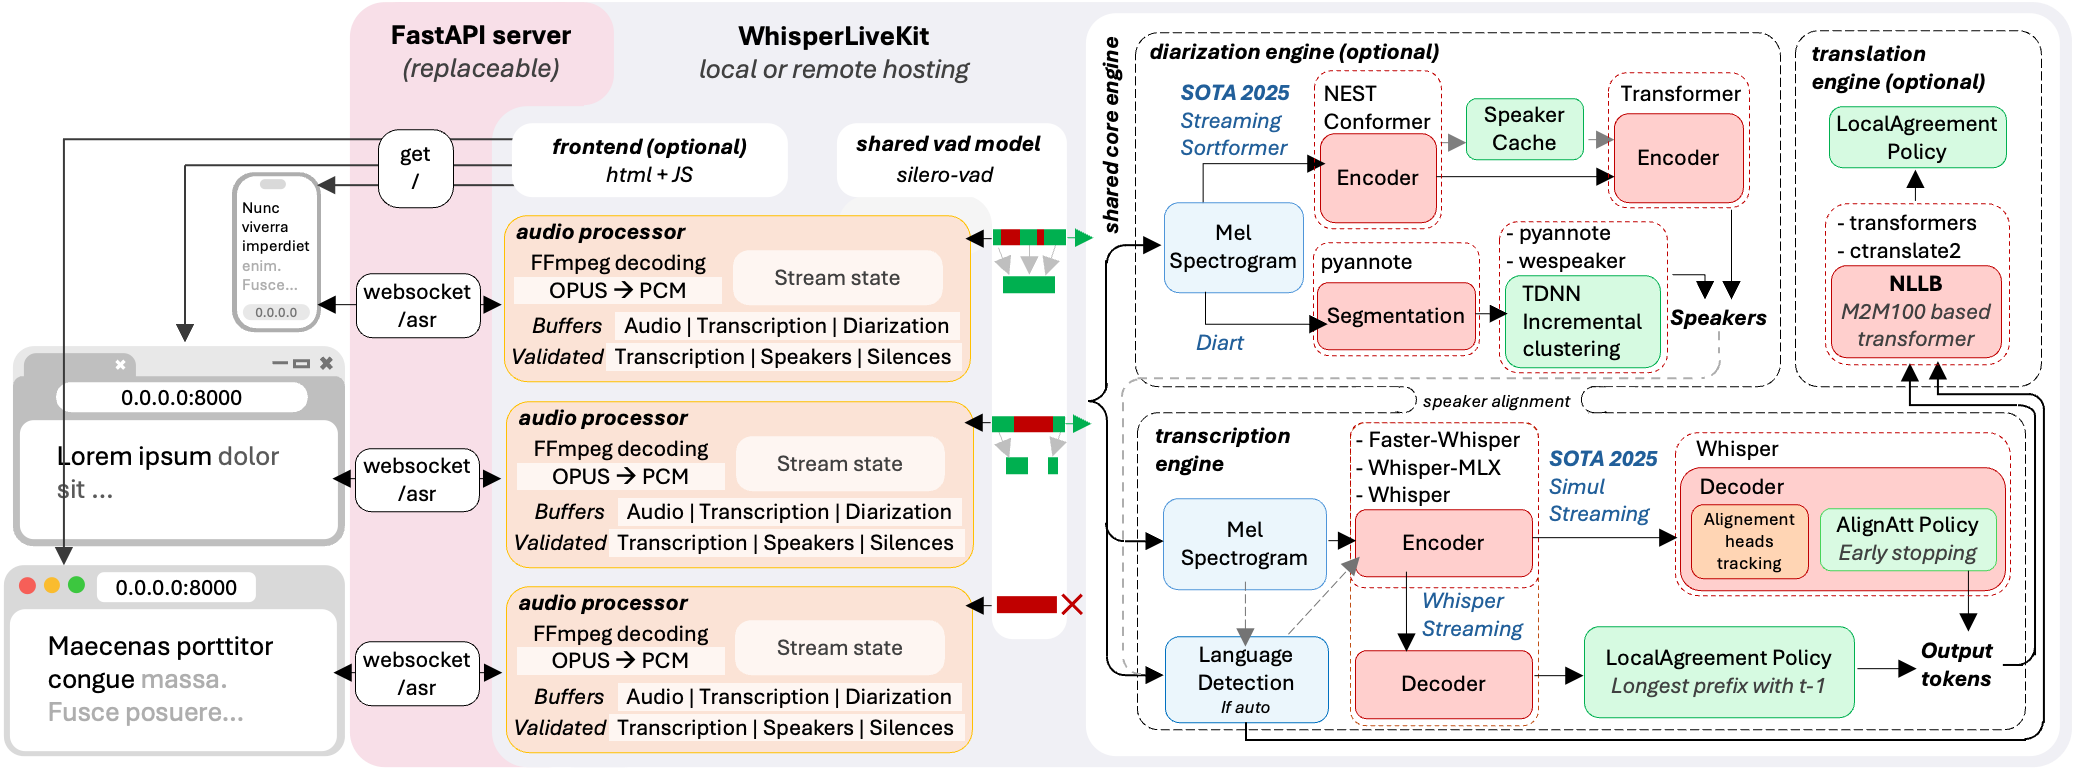
构建 WhisperLiveKit
运行 pytorch 容器 - CUDA (JetsonThor)
docker run -it \
    --ipc=host \
    --net=host \
    --runtime=nvidia \
    --name=whisperlivekit \
    -v ~/.cache:/root/.cache \
    -v /models:/models \
    nvcr.io/nvidia/pytorch:25.10-py3 \
    bash
生成证书
mkdir -p .cert && cd .cert

openssl req -x509 -newkey rsa:4096 \
  -keyout key.pem \
  -out cert.pem \
  -days 365 \
  -nodes \
  -subj "/C=CN/ST=ShanDong/L=JiNan/O=LNSoft/OU=LNSoft/CN=localhost/emailAddress=wjj@163.com"
参数解释:
-x509:生成自签名证书-newkey rsa:4096:新建 4096 位 RSA 密钥-keyout key.pem:输出私钥文件-out cert.pem:输出证书文件-days 365:证书有效期 365 天-nodes:不加密私钥(即无需输入密码)-subj:直接指定证书主题,跳过交互式输入编译 whisper.cpp
克隆仓库
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
编译 whisper.cpp
cmake -B build -DGGML_CUDA=1 -DCMAKE_CUDA_ARCHITECTURES="110"
cmake --build build -j --config Release
下载模型
sh ./models/download-ggml-model.sh small
sh ./models/download-ggml-model.sh large-v3-turbo
运行 whisper-cli
./build/bin/whisper-cli -f samples/jfk.wav
./build/bin/whisper-cli -m /models/whisper.cpp/models/ggml-large-v3-turbo.bin -f samples/jfk.wav
whisper-server
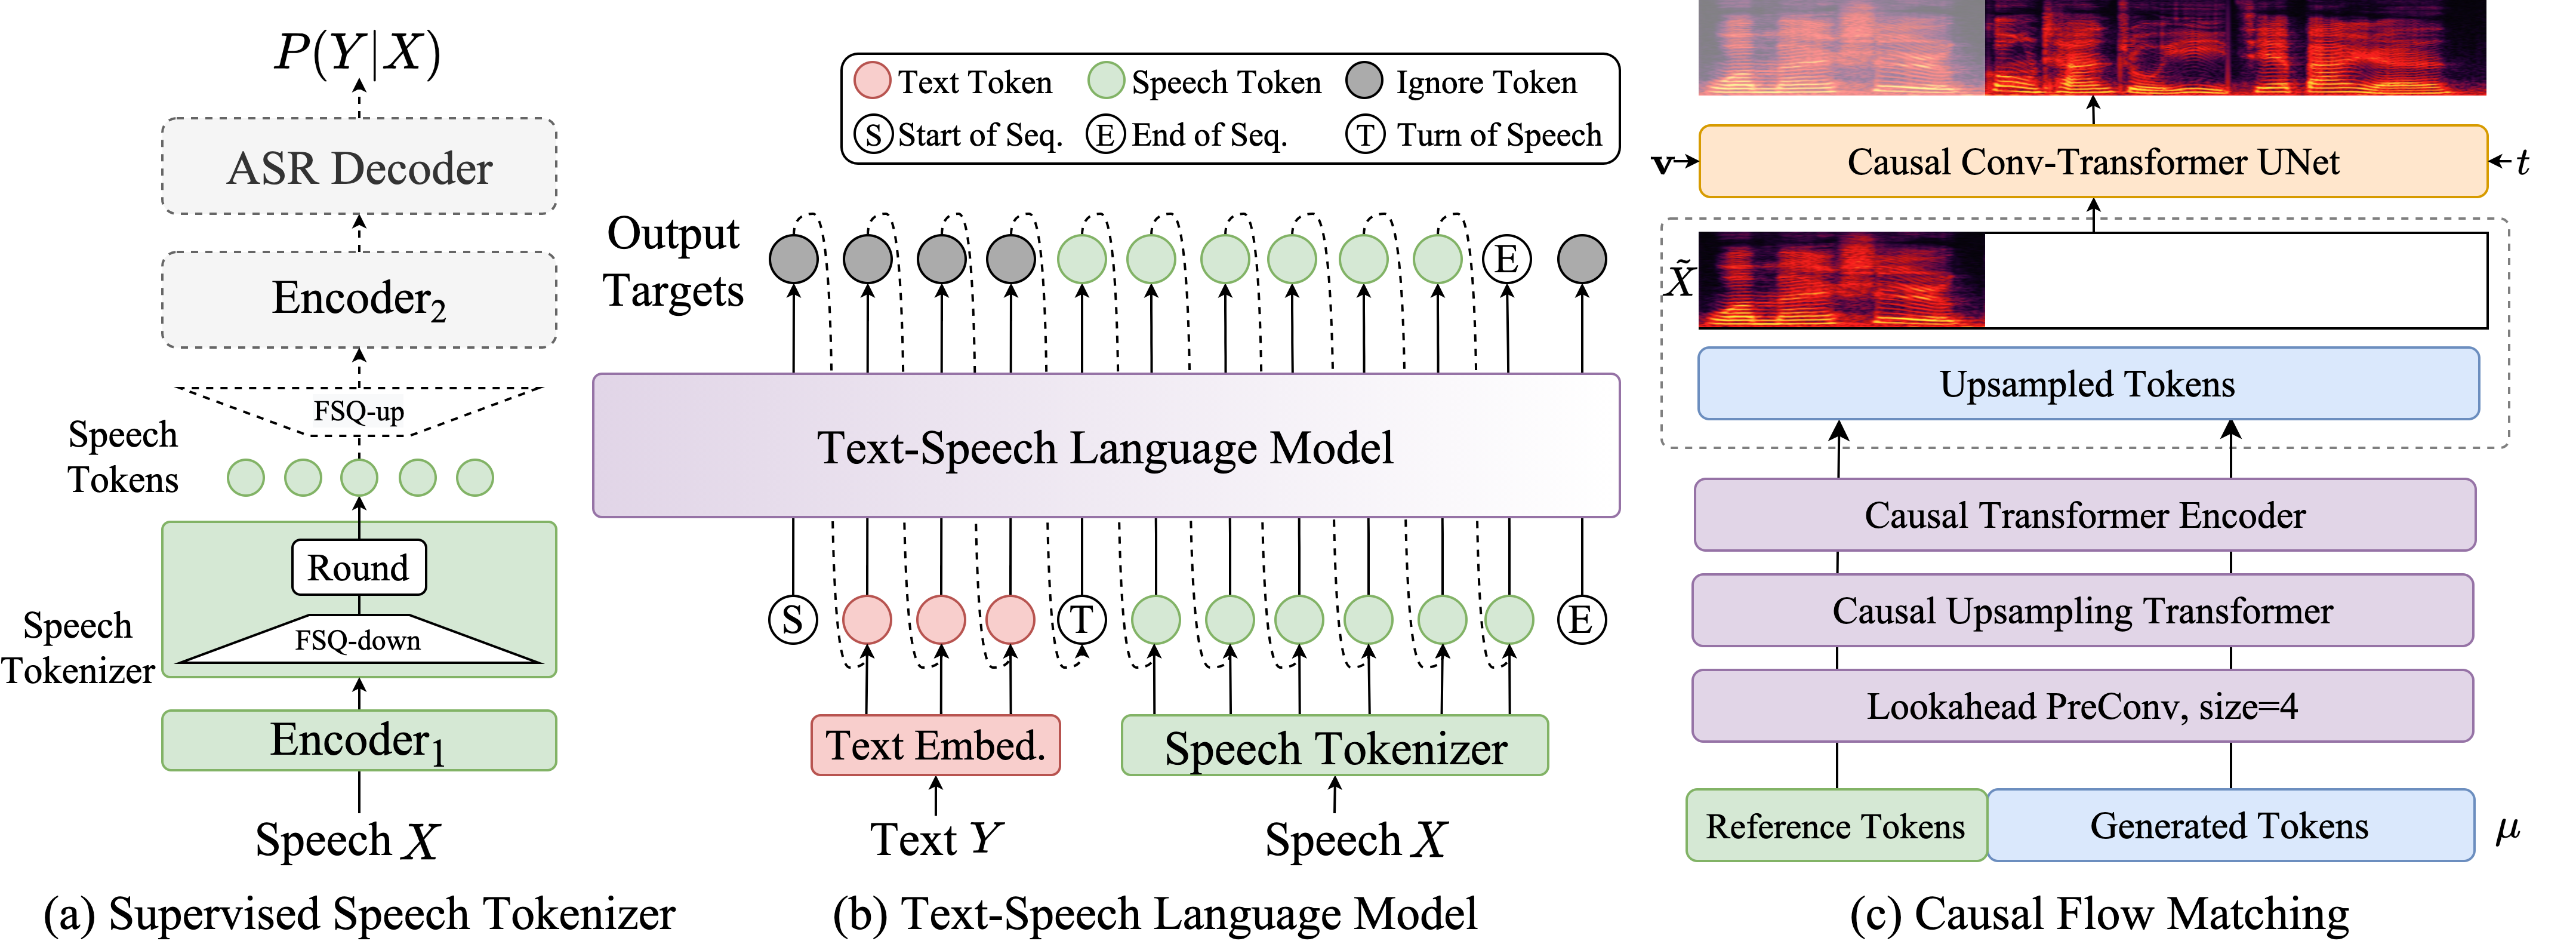
本文档介绍 FunAudioLLM,这是一个旨在增强人类与大型语言模型(LLM)之间自然语音交互的框架。其核心是两个创新模型:用于高精度多语种语音识别、情感识别和音频事件检测的 SenseVoice;以及用于多语种、音色和情感控制的自然语音生成的 CosyVoice。SenseVoice 具有极低的延迟并支持超过 50 种语言,而 CosyVoice 在多语种语音生成、零样本语音生成、跨语言语音克隆以及指令遵循能力方面表现出色。与 SenseVoice 和 CosyVoice 相关的模型已在 Modelscope 和 Huggingface 上开源,同时相应的训练、推理和微调代码也已在 GitHub 上发布。通过将这些模型与 LLM 集成,FunAudioLLM 能够实现语音翻译、情感语音聊天、交互式播客和富有表现力的有声读物叙述等应用,从而推动语音交互技术的边界。
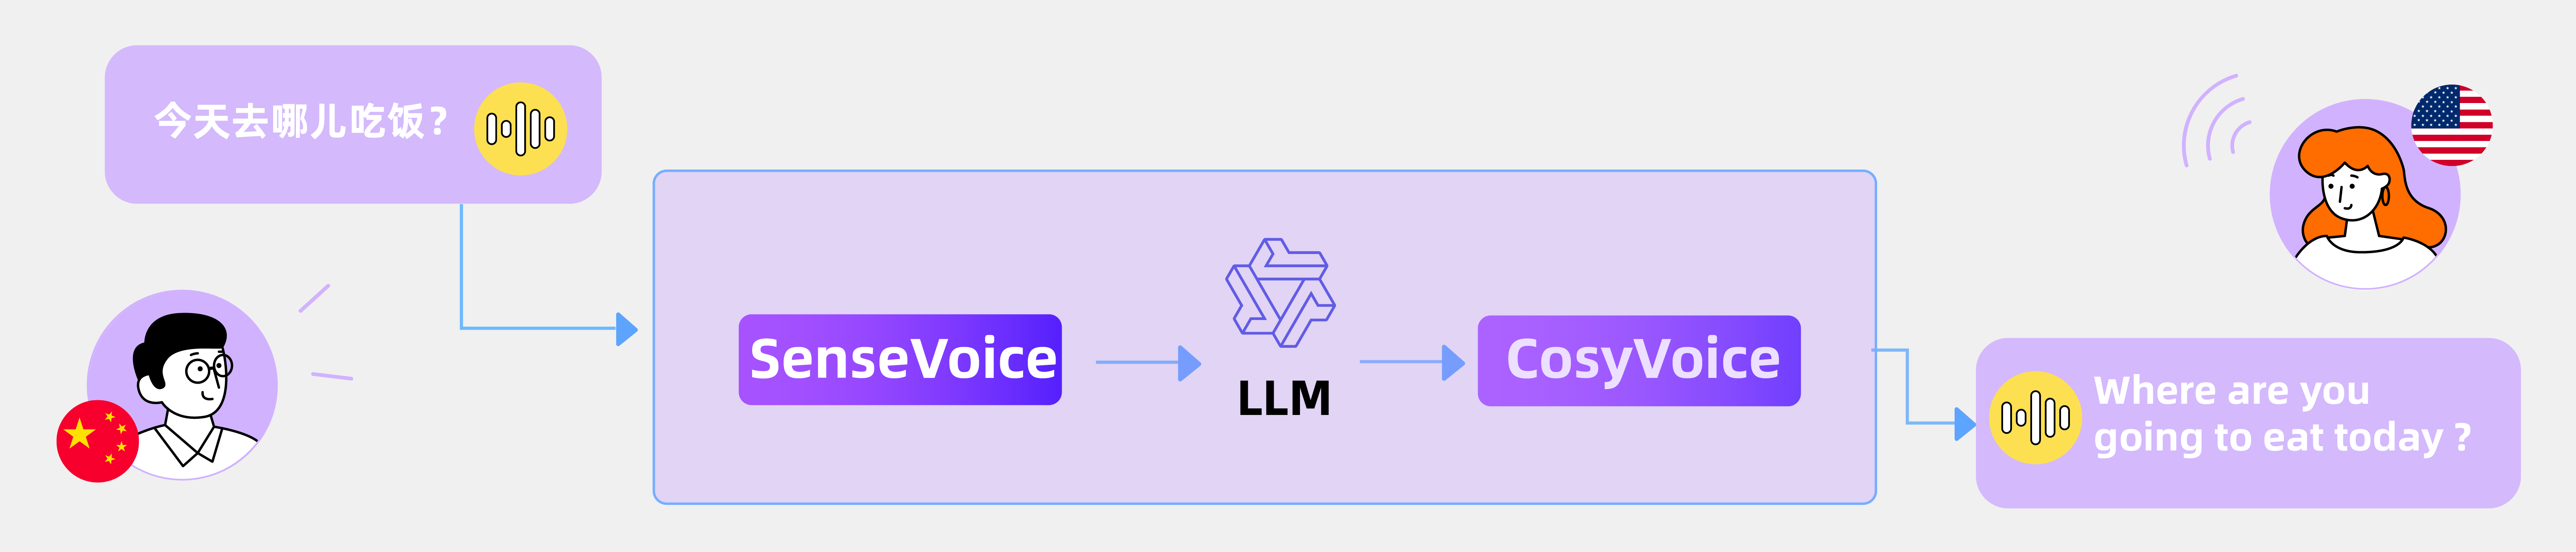
SenseVoice
参考资料 FunAudioLLM: Voice Understanding and Generation Foundation Models for Nat
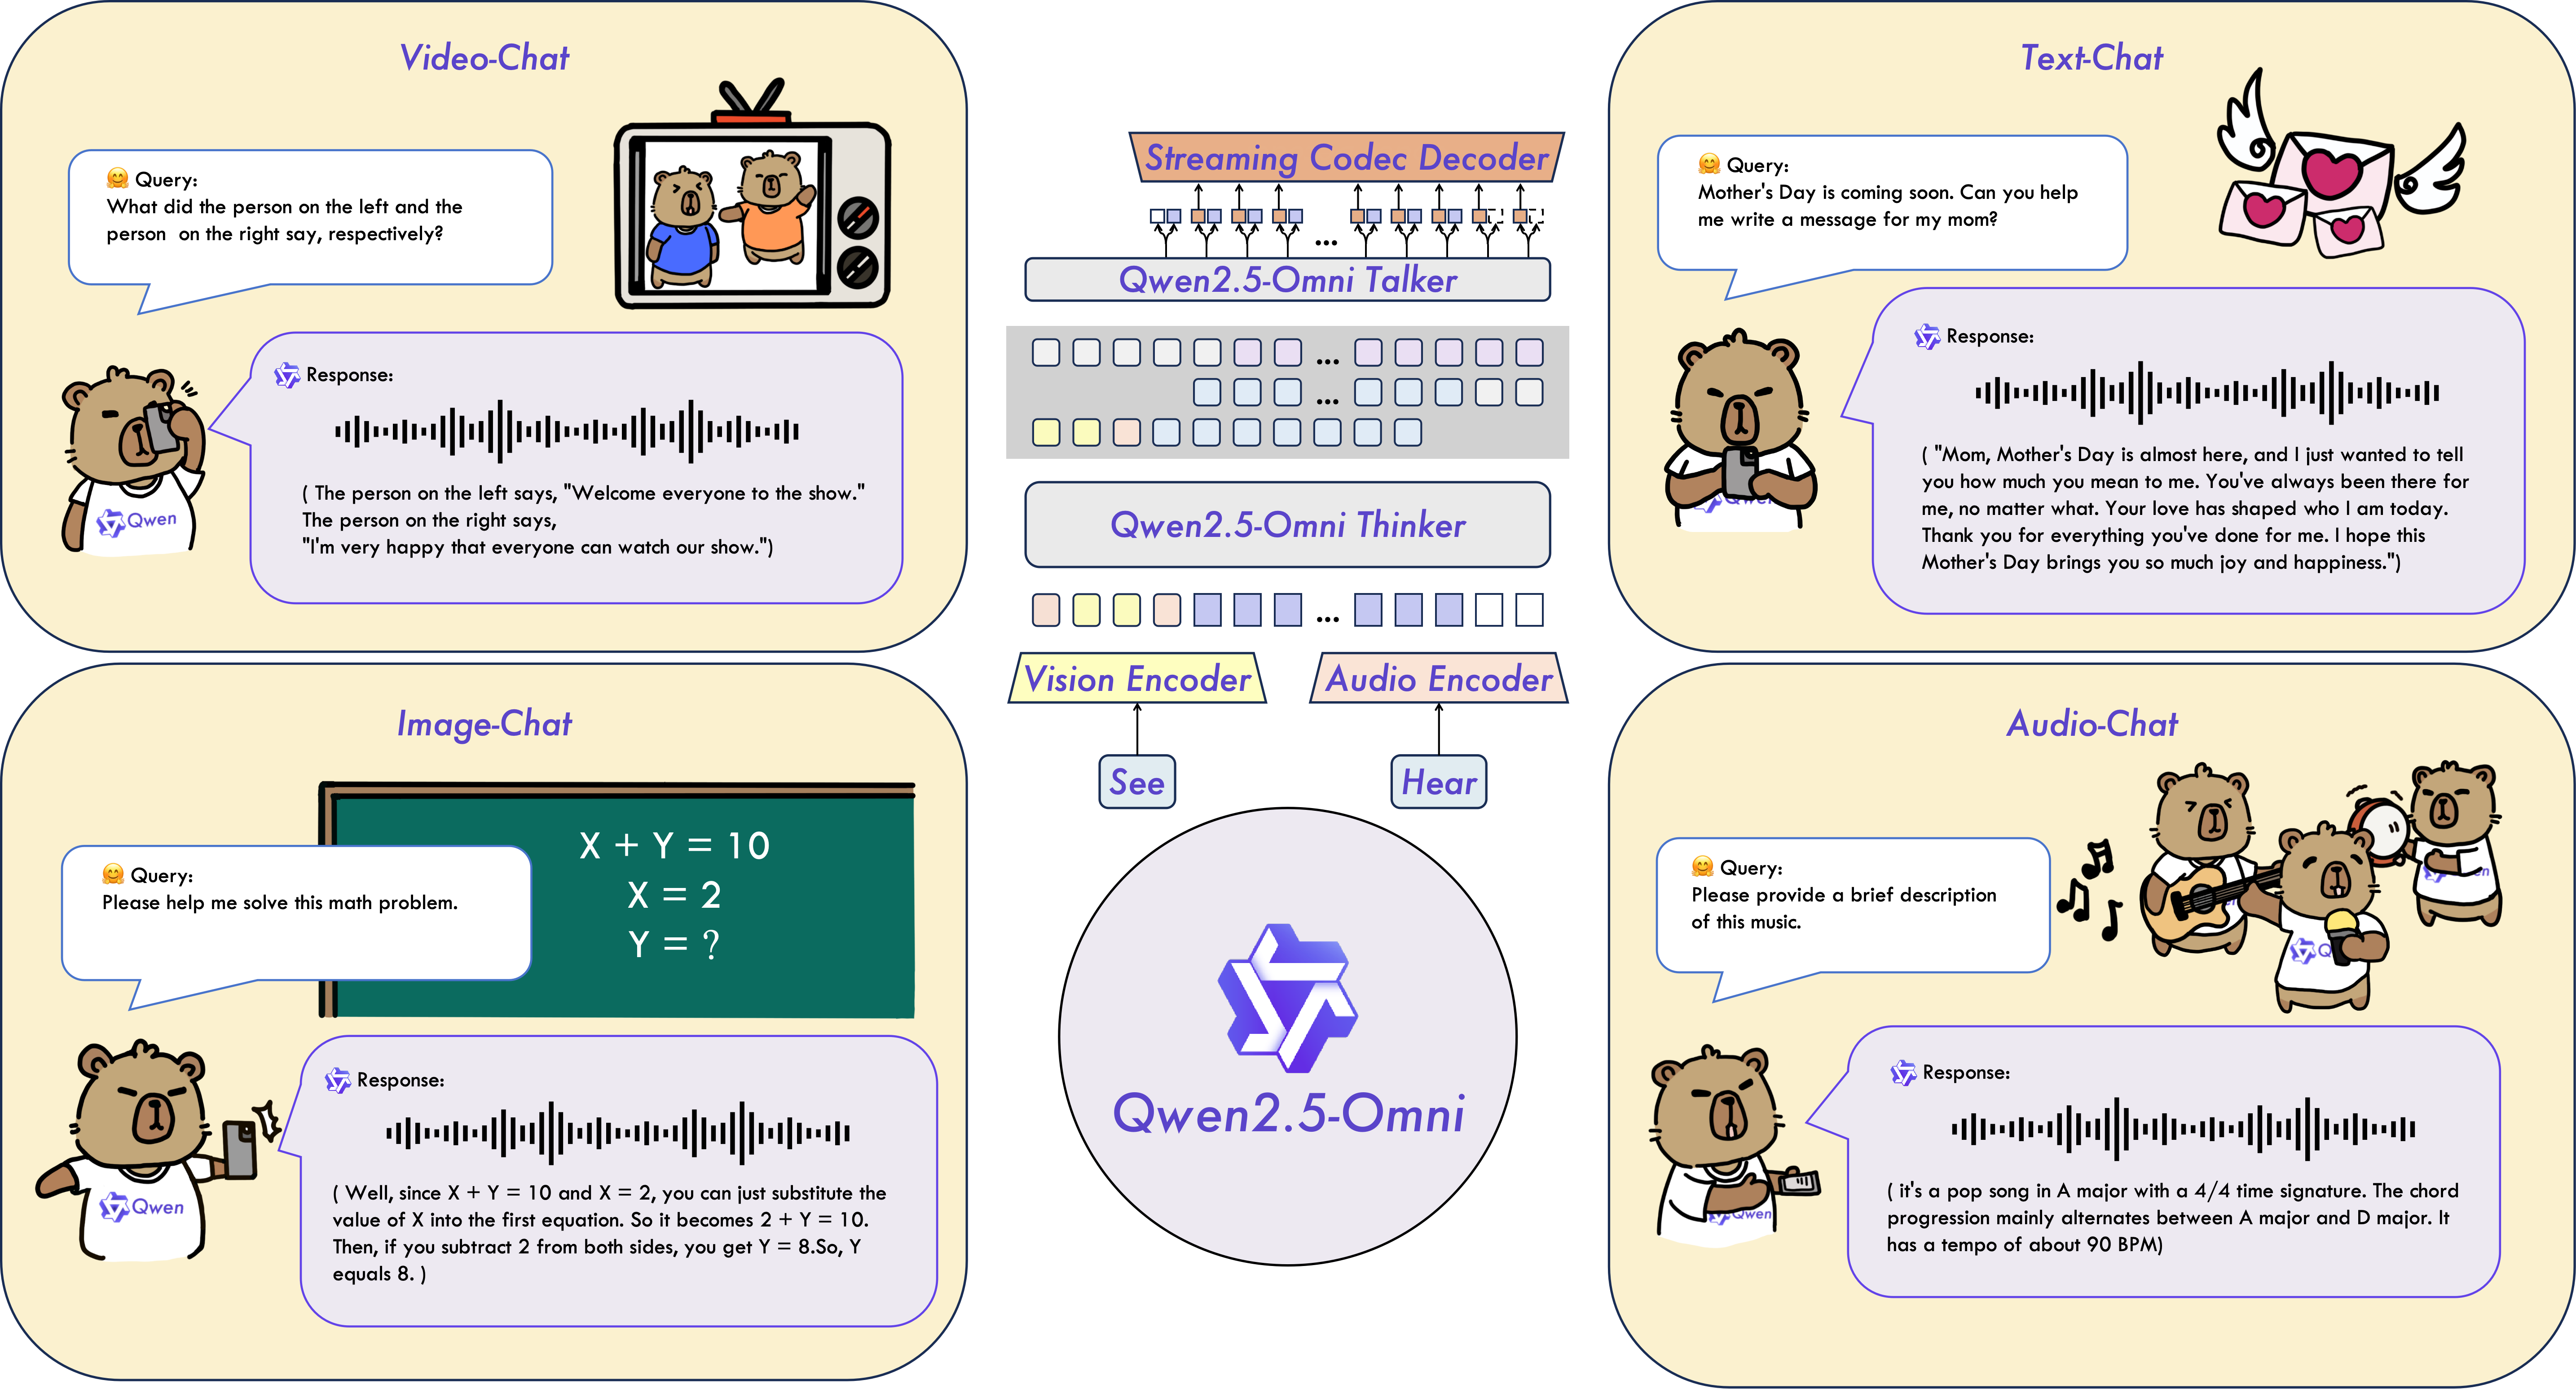
Qwen2.5-Omni是Qwen系列中全新的旗舰级端到端多模态大模型,专为全面的多模式感知设计,无缝处理包括文本、图像、音频和视频在内的各种输入,同时支持流式的文本生成和自然语音合成输出。
点击下方视频了解更多信息吧 😃
概览
简介
Qwen 2.5-Omni是一个端到端的多模态大语言模型,旨在感知包括文本、图像、音频和视频在内的多种模态,同时以流式的方式生成文本和自然语音响应。
主要特点
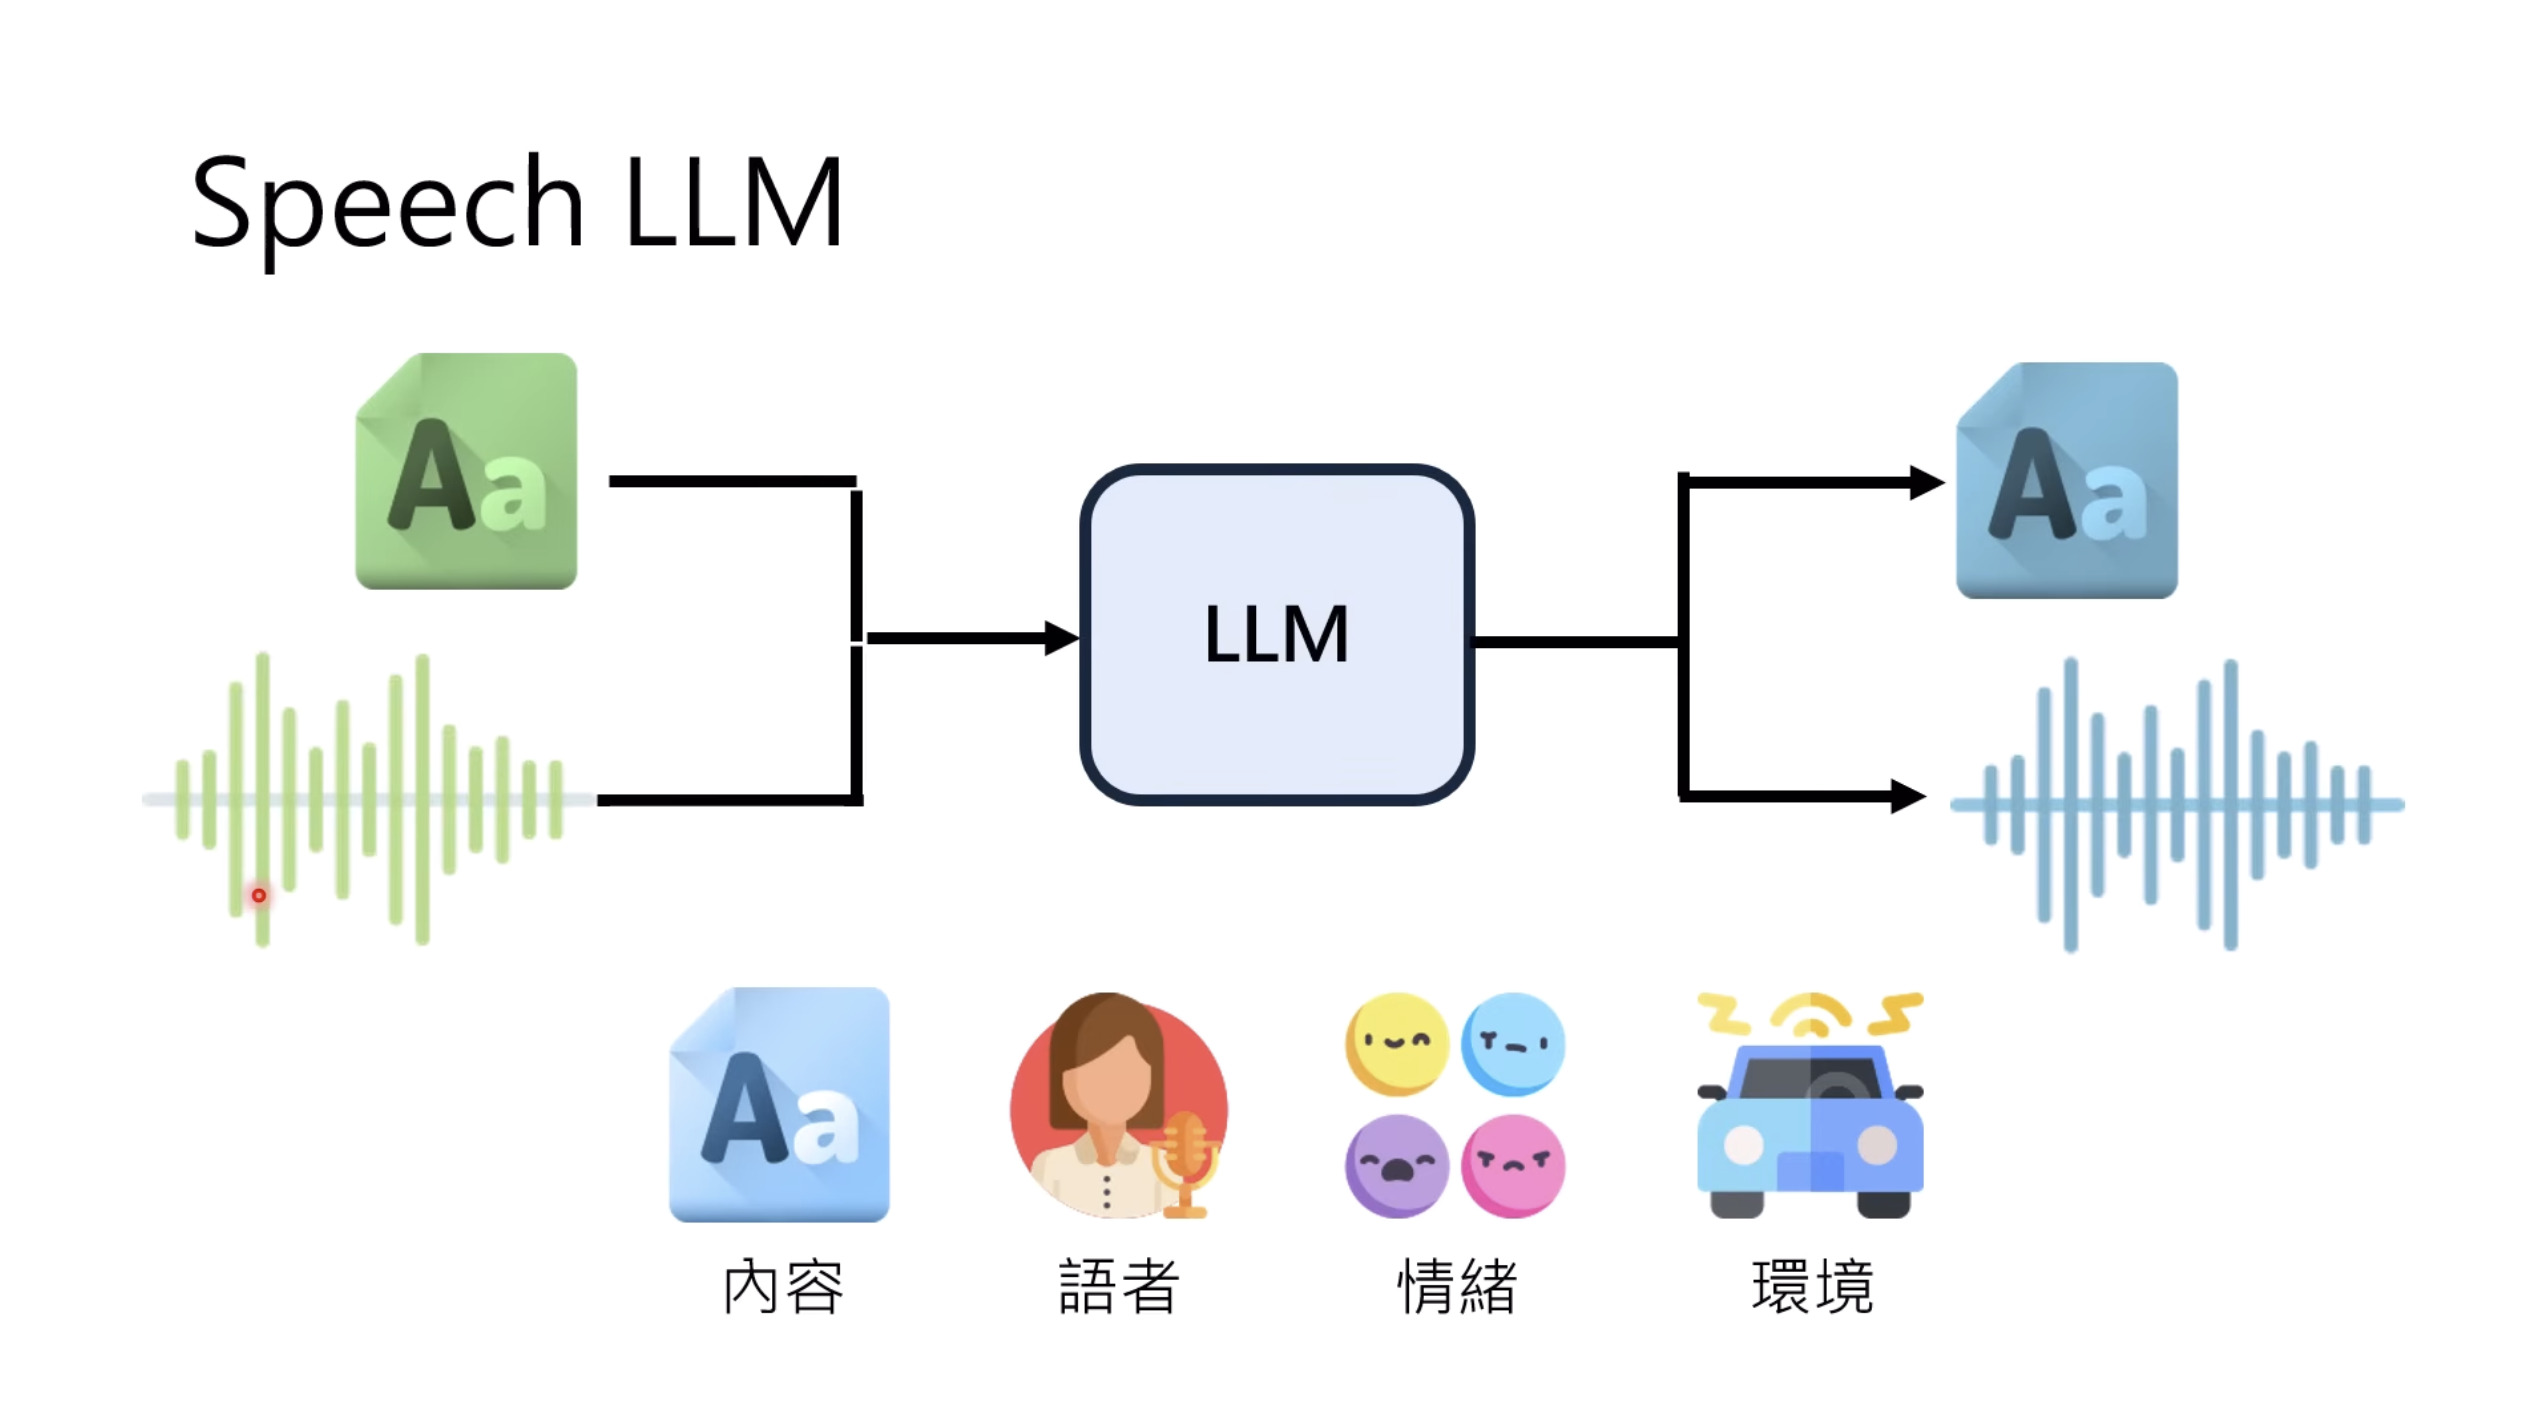
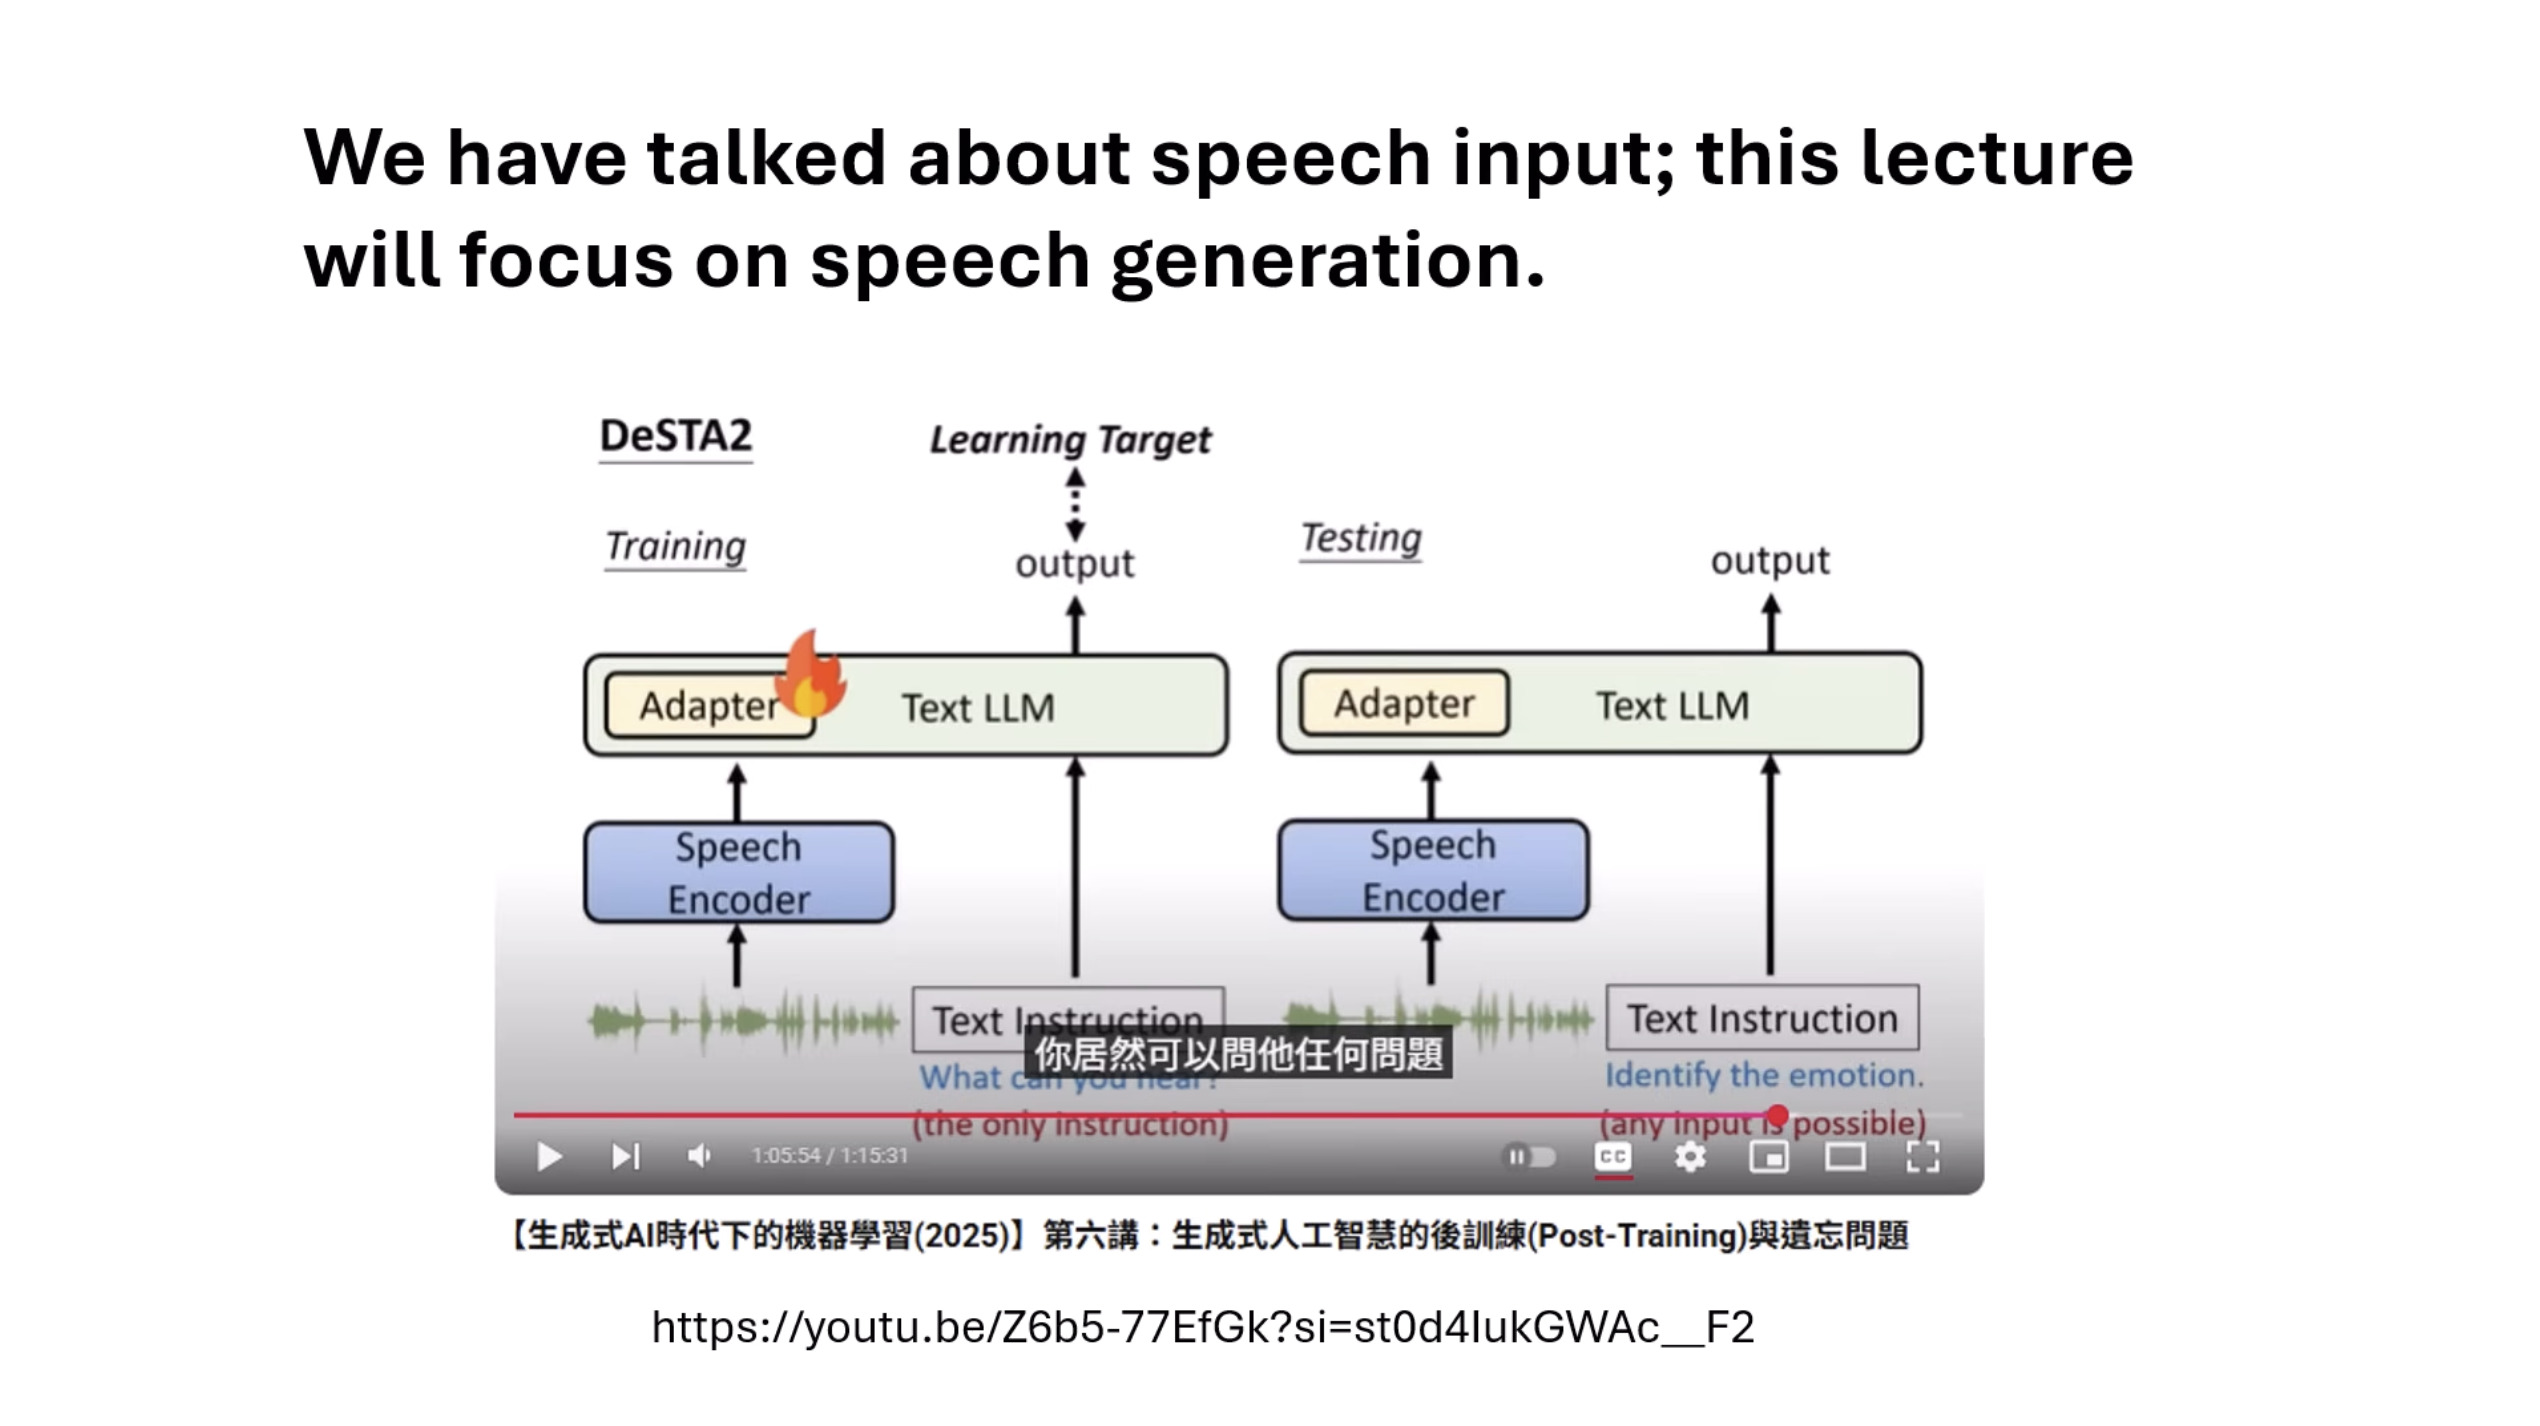
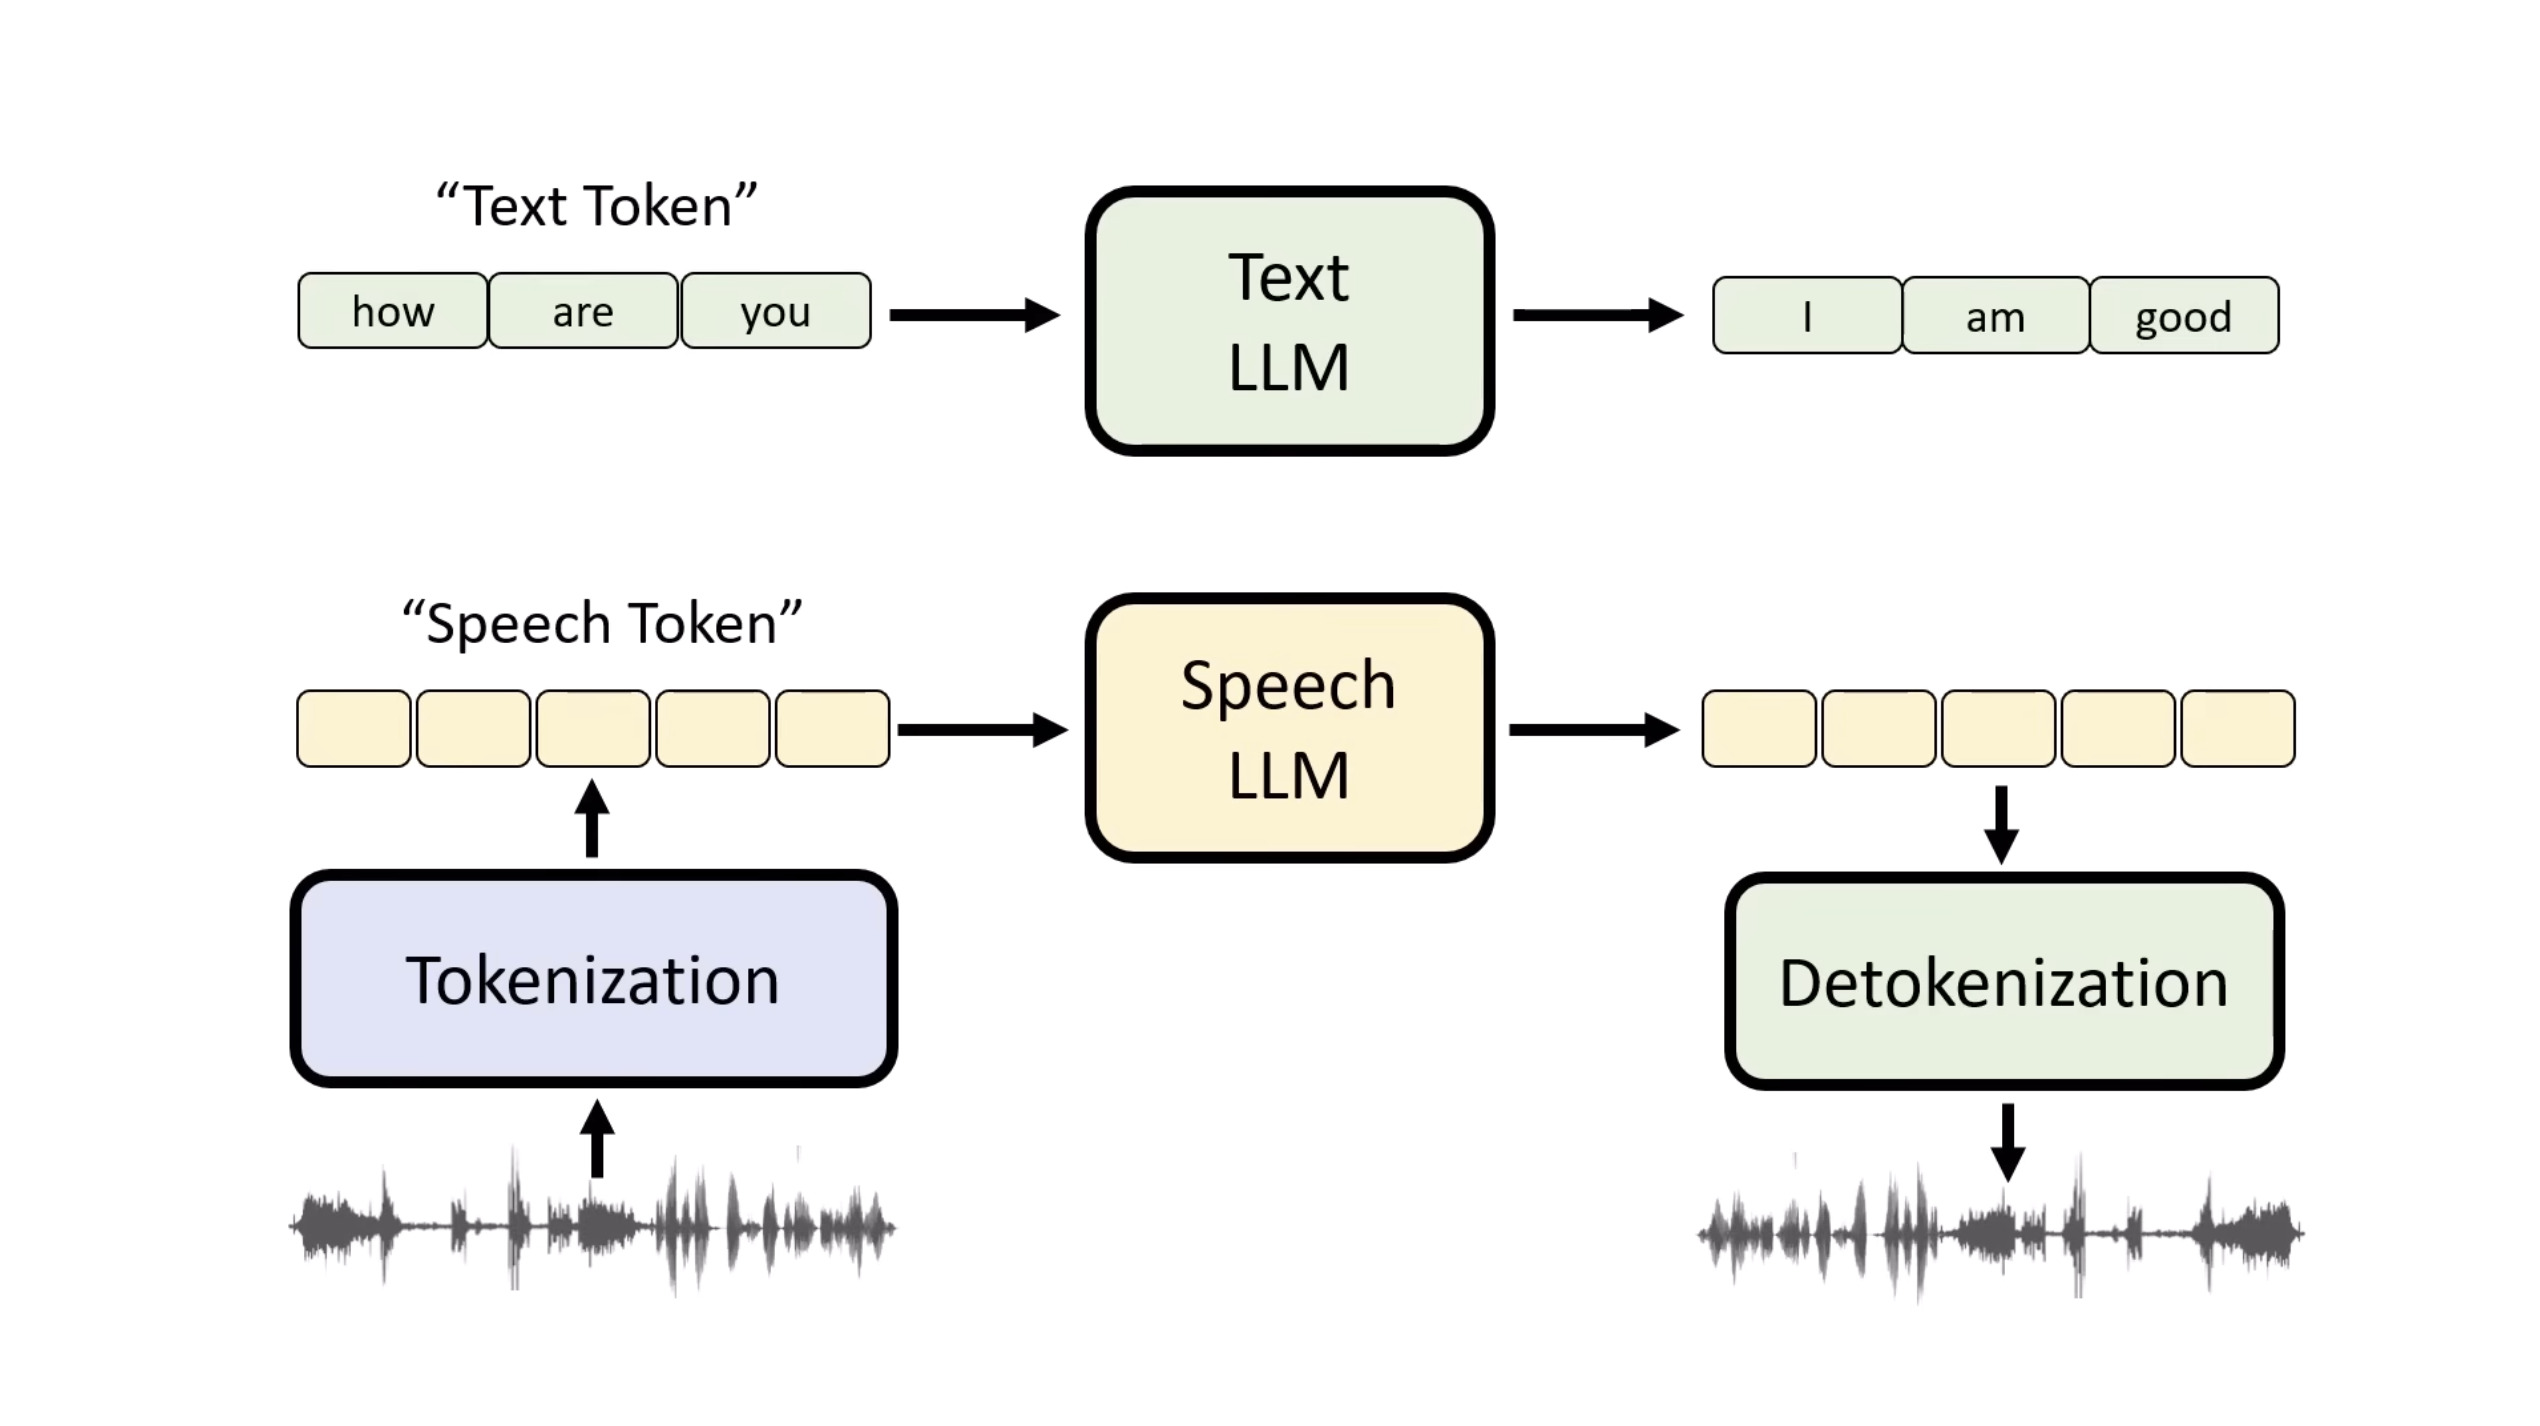
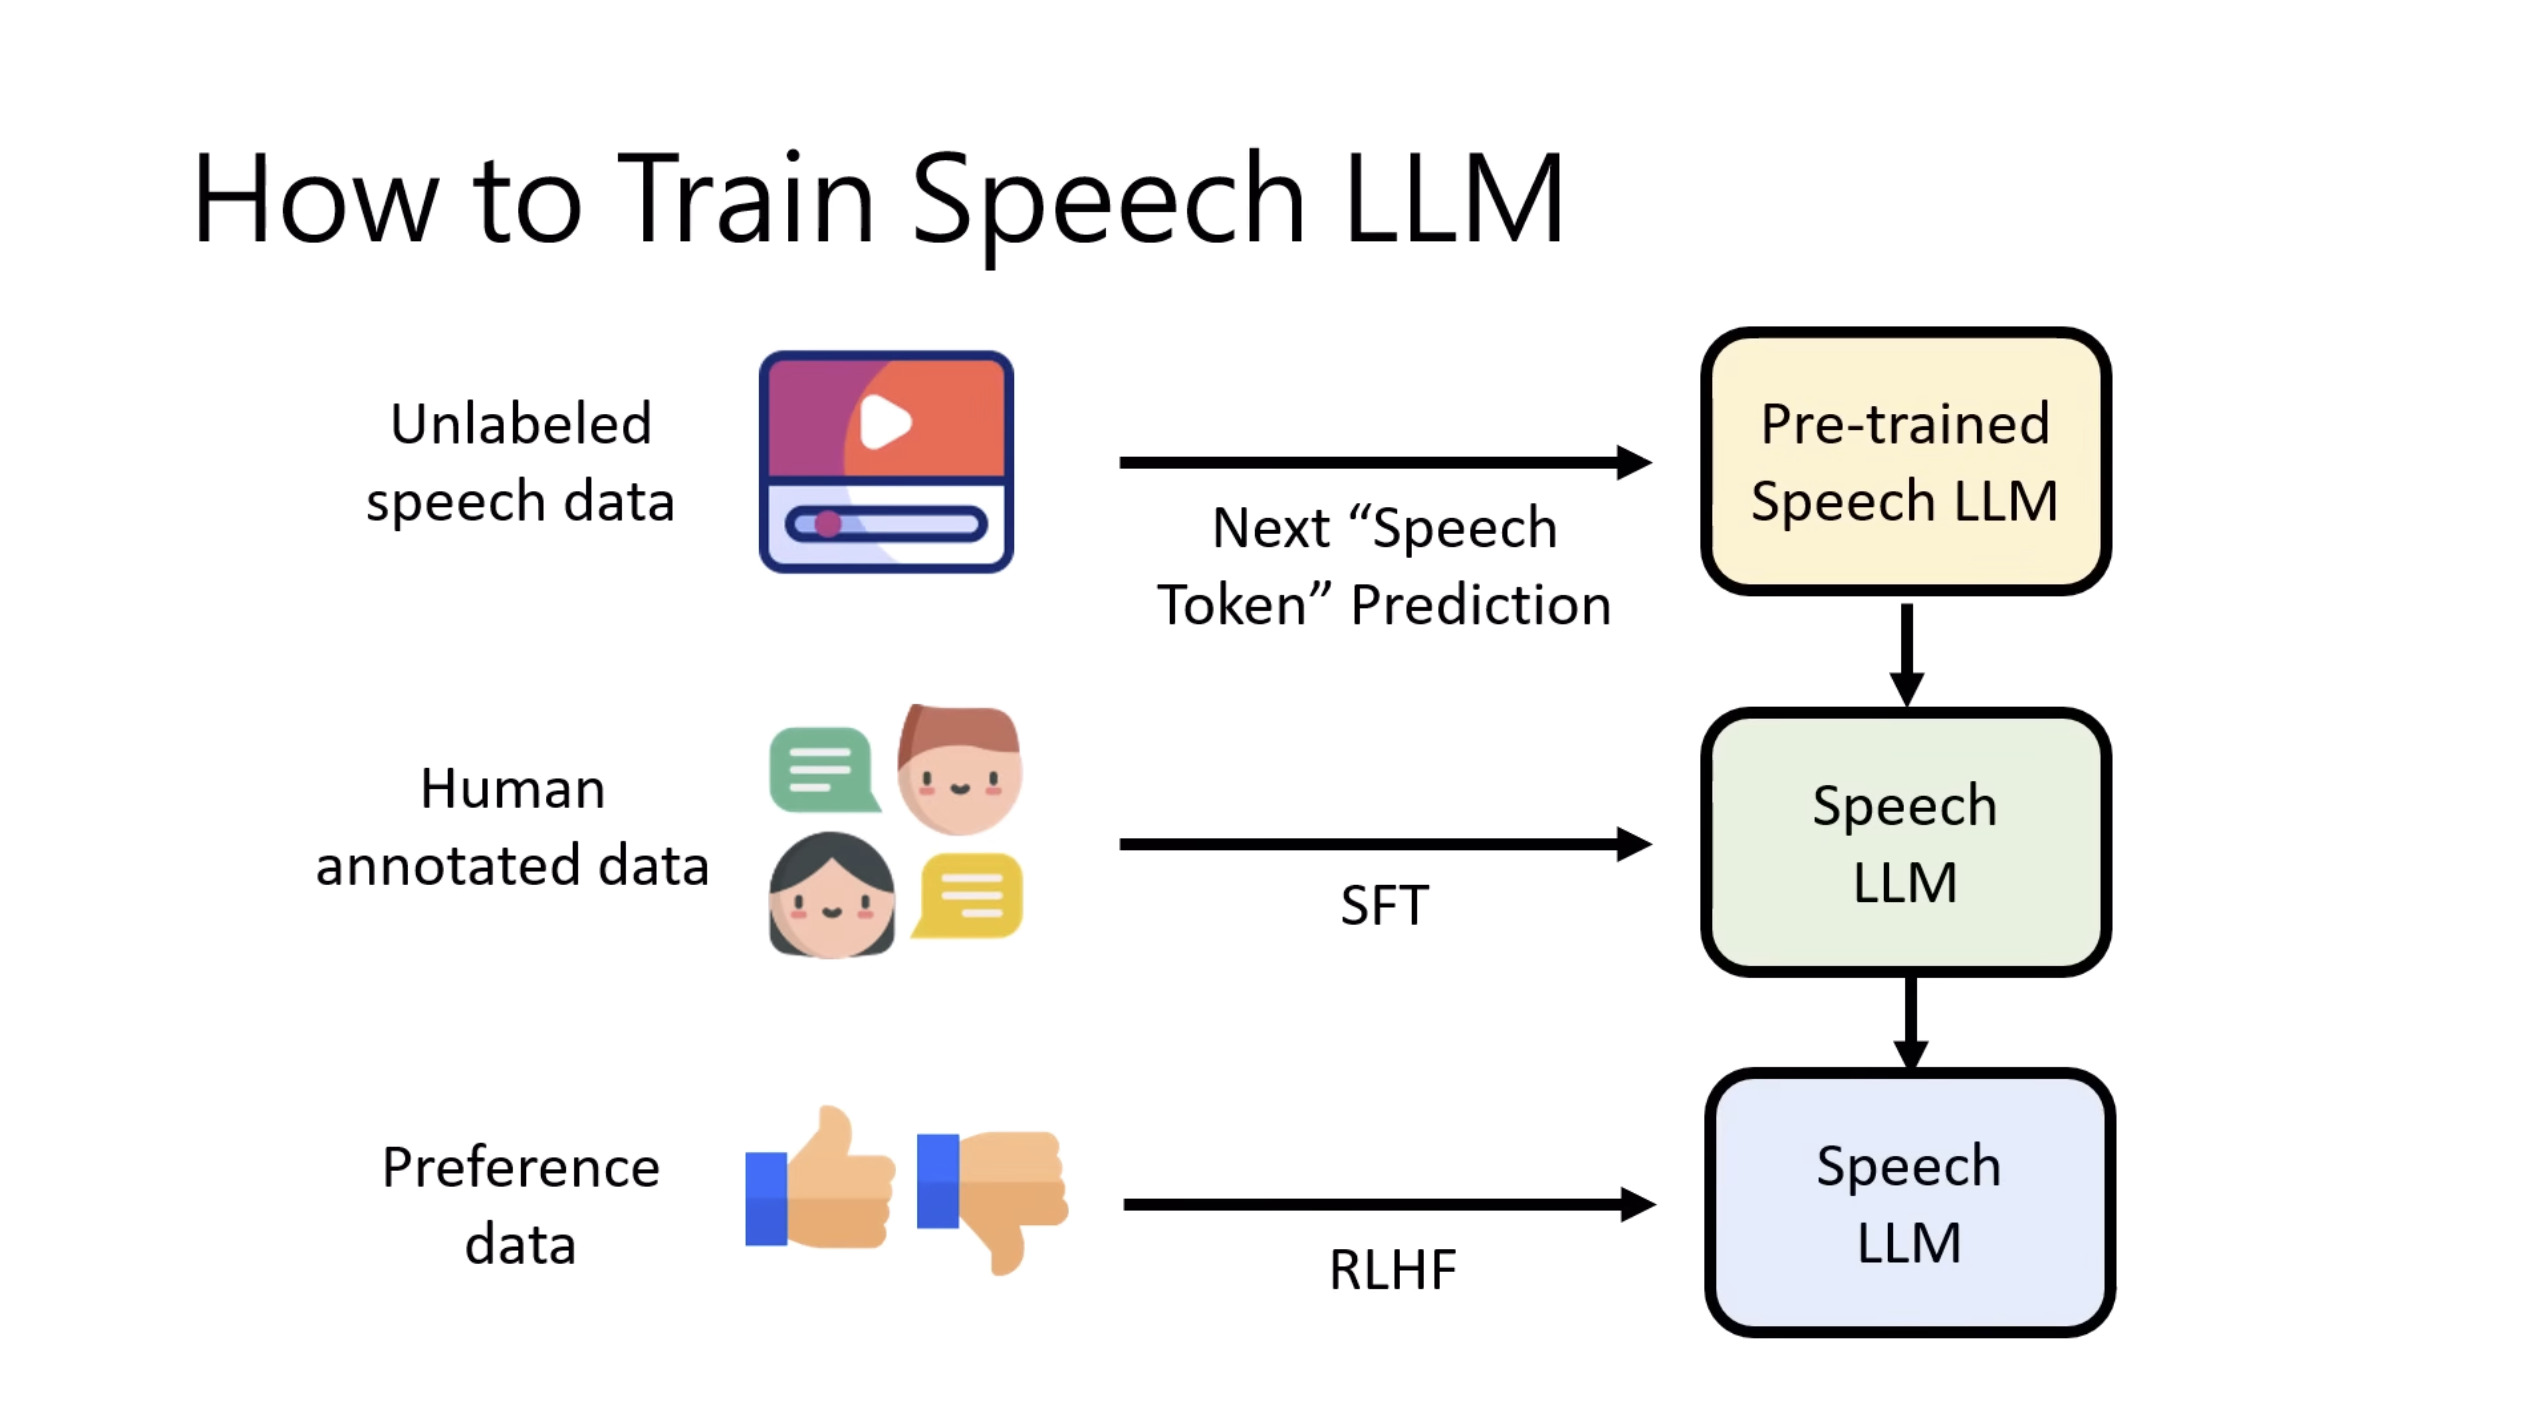
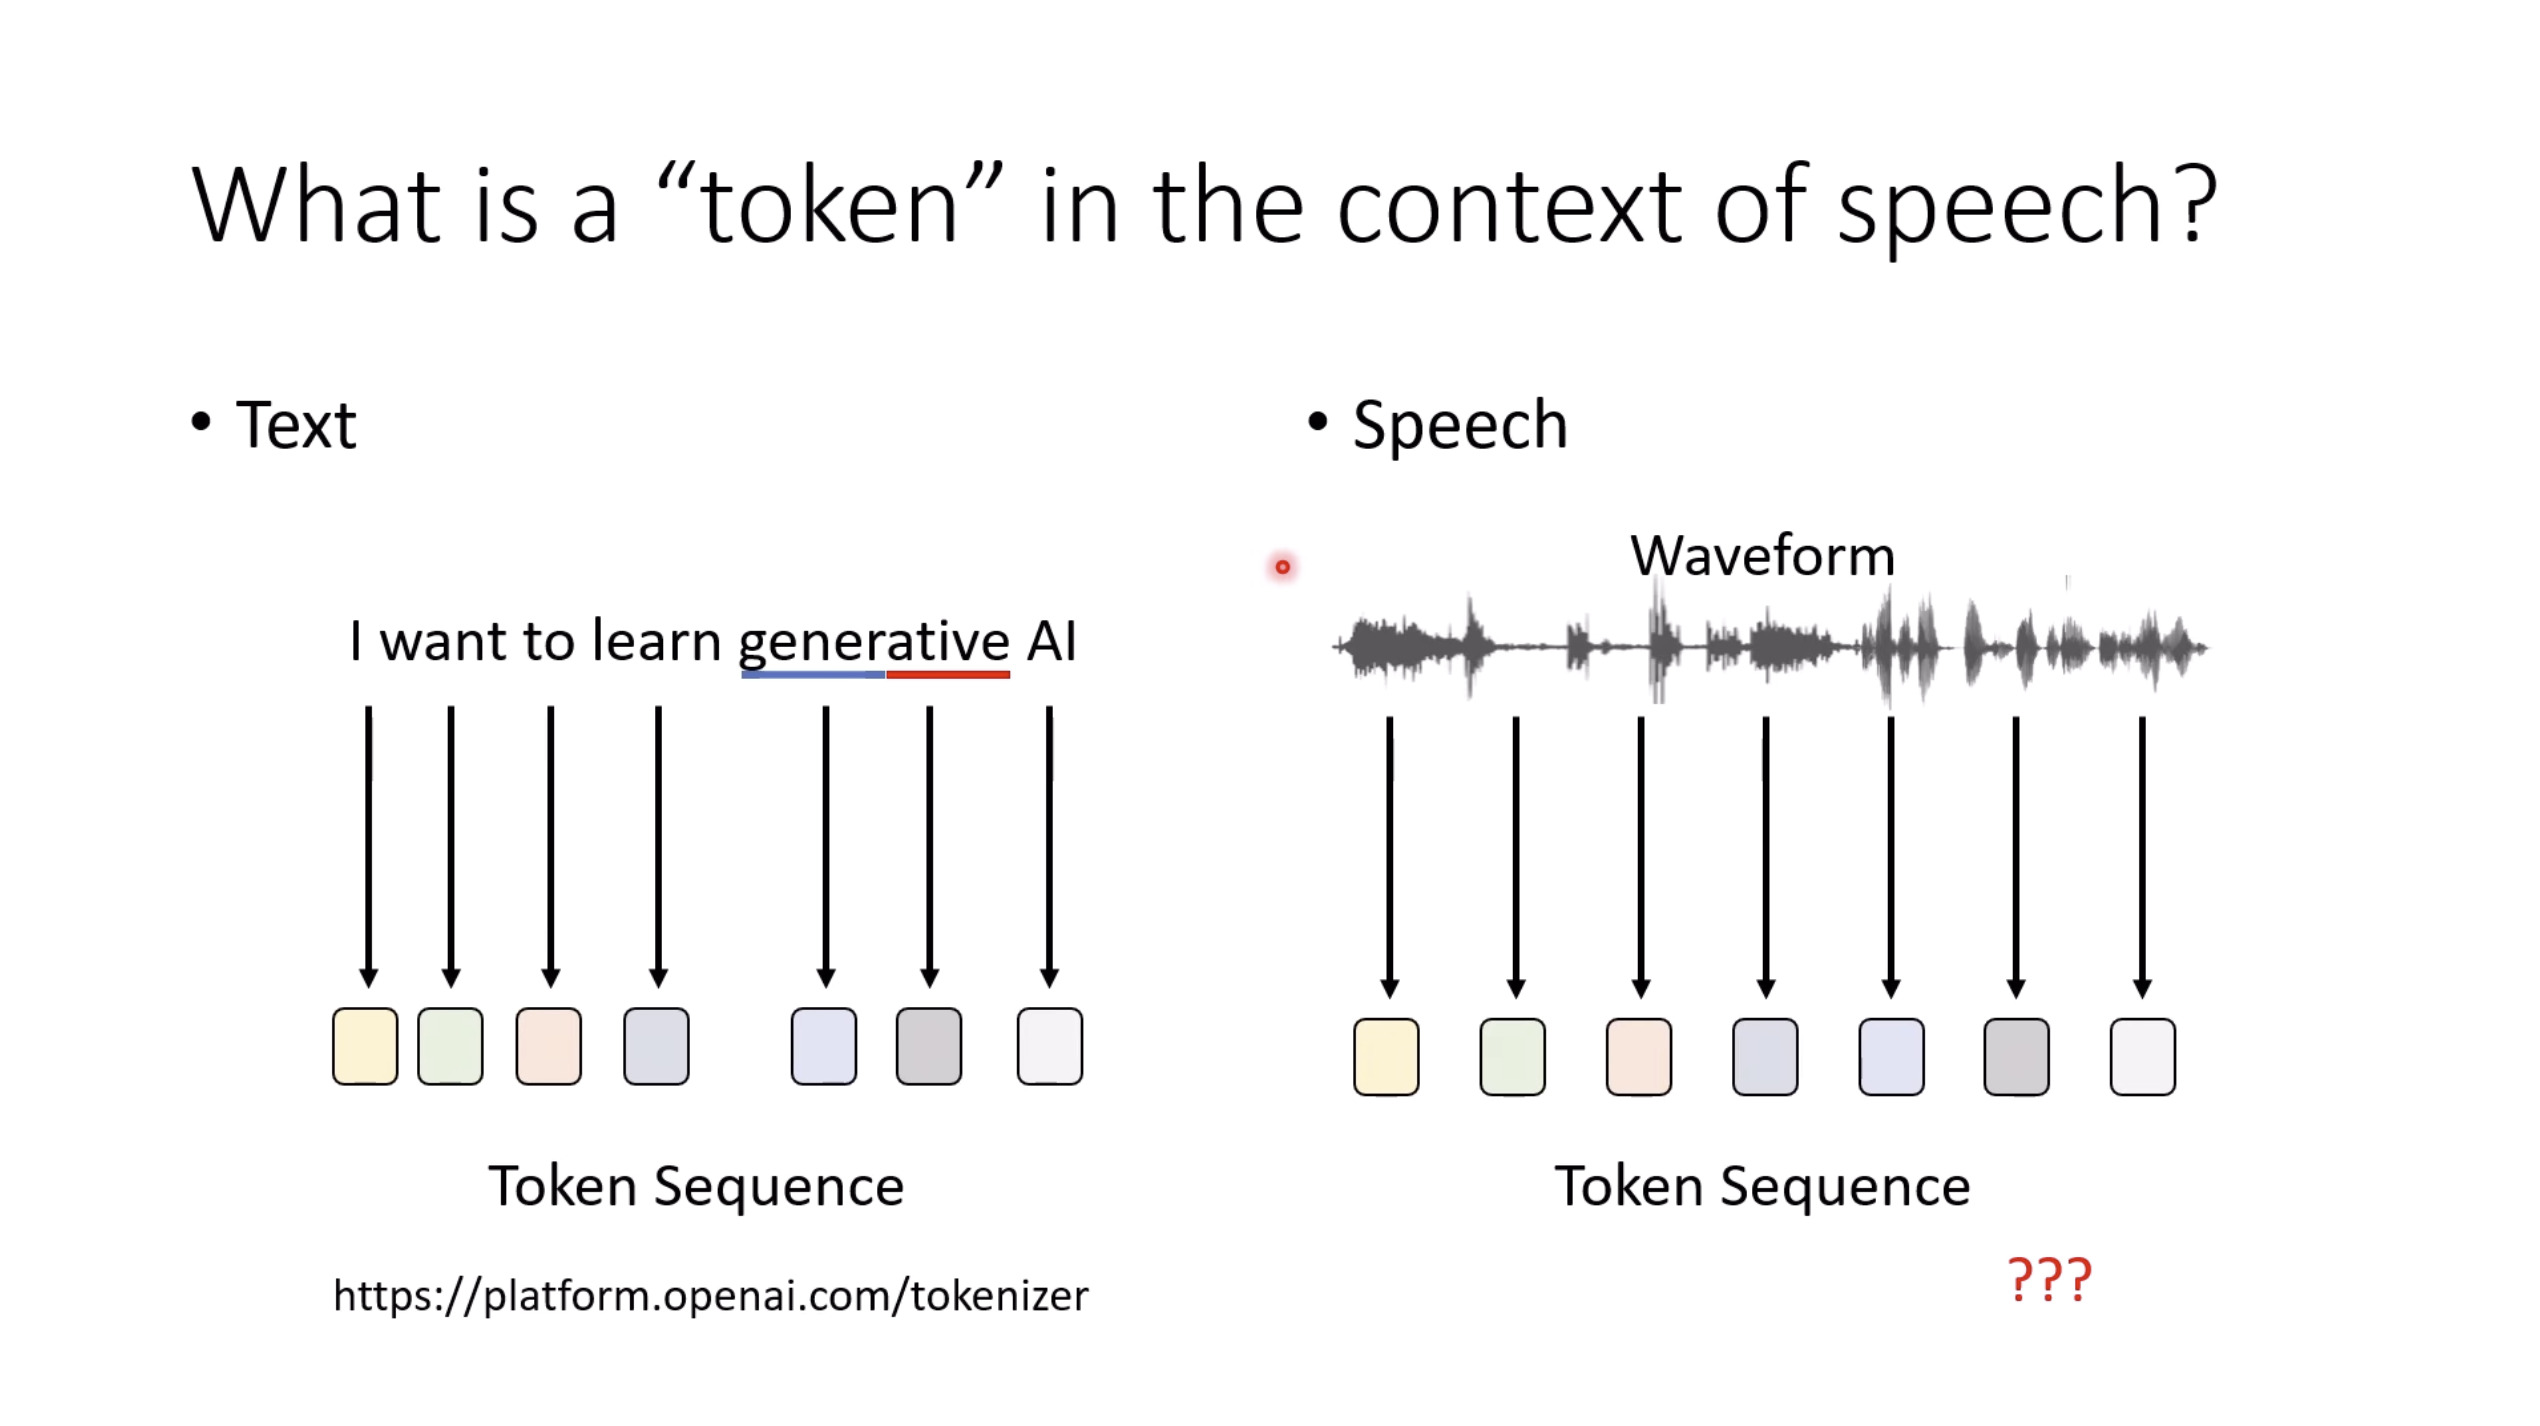
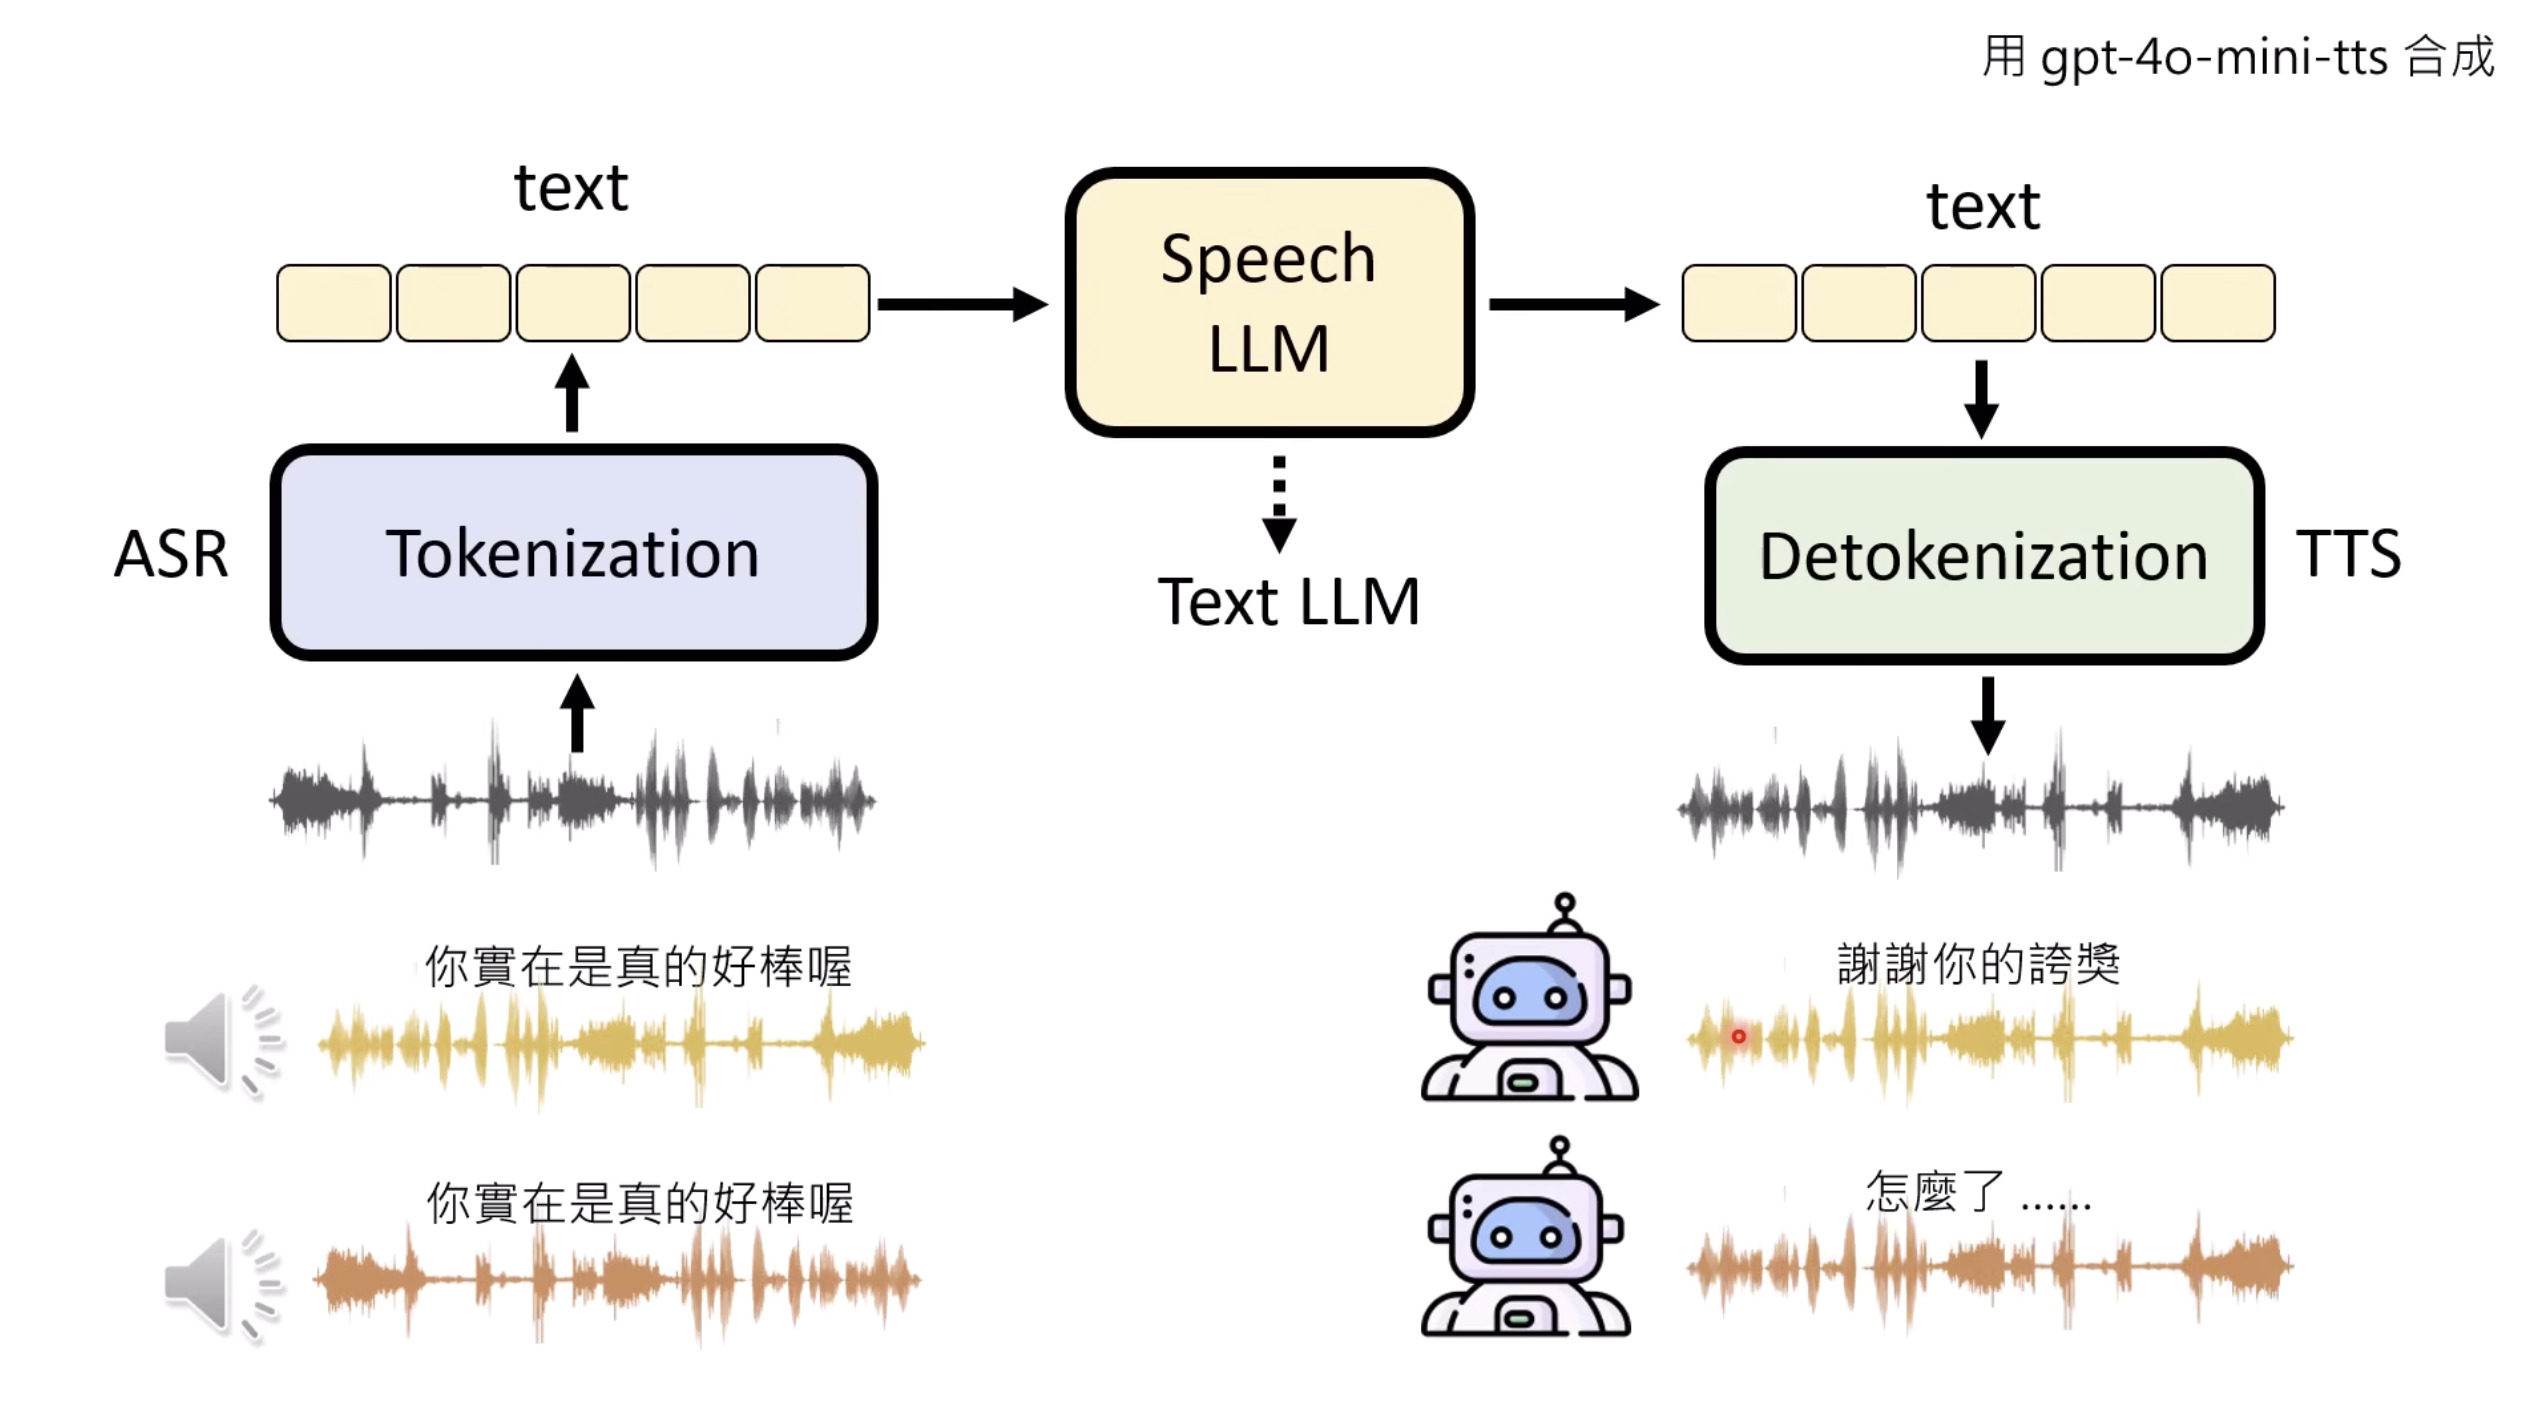
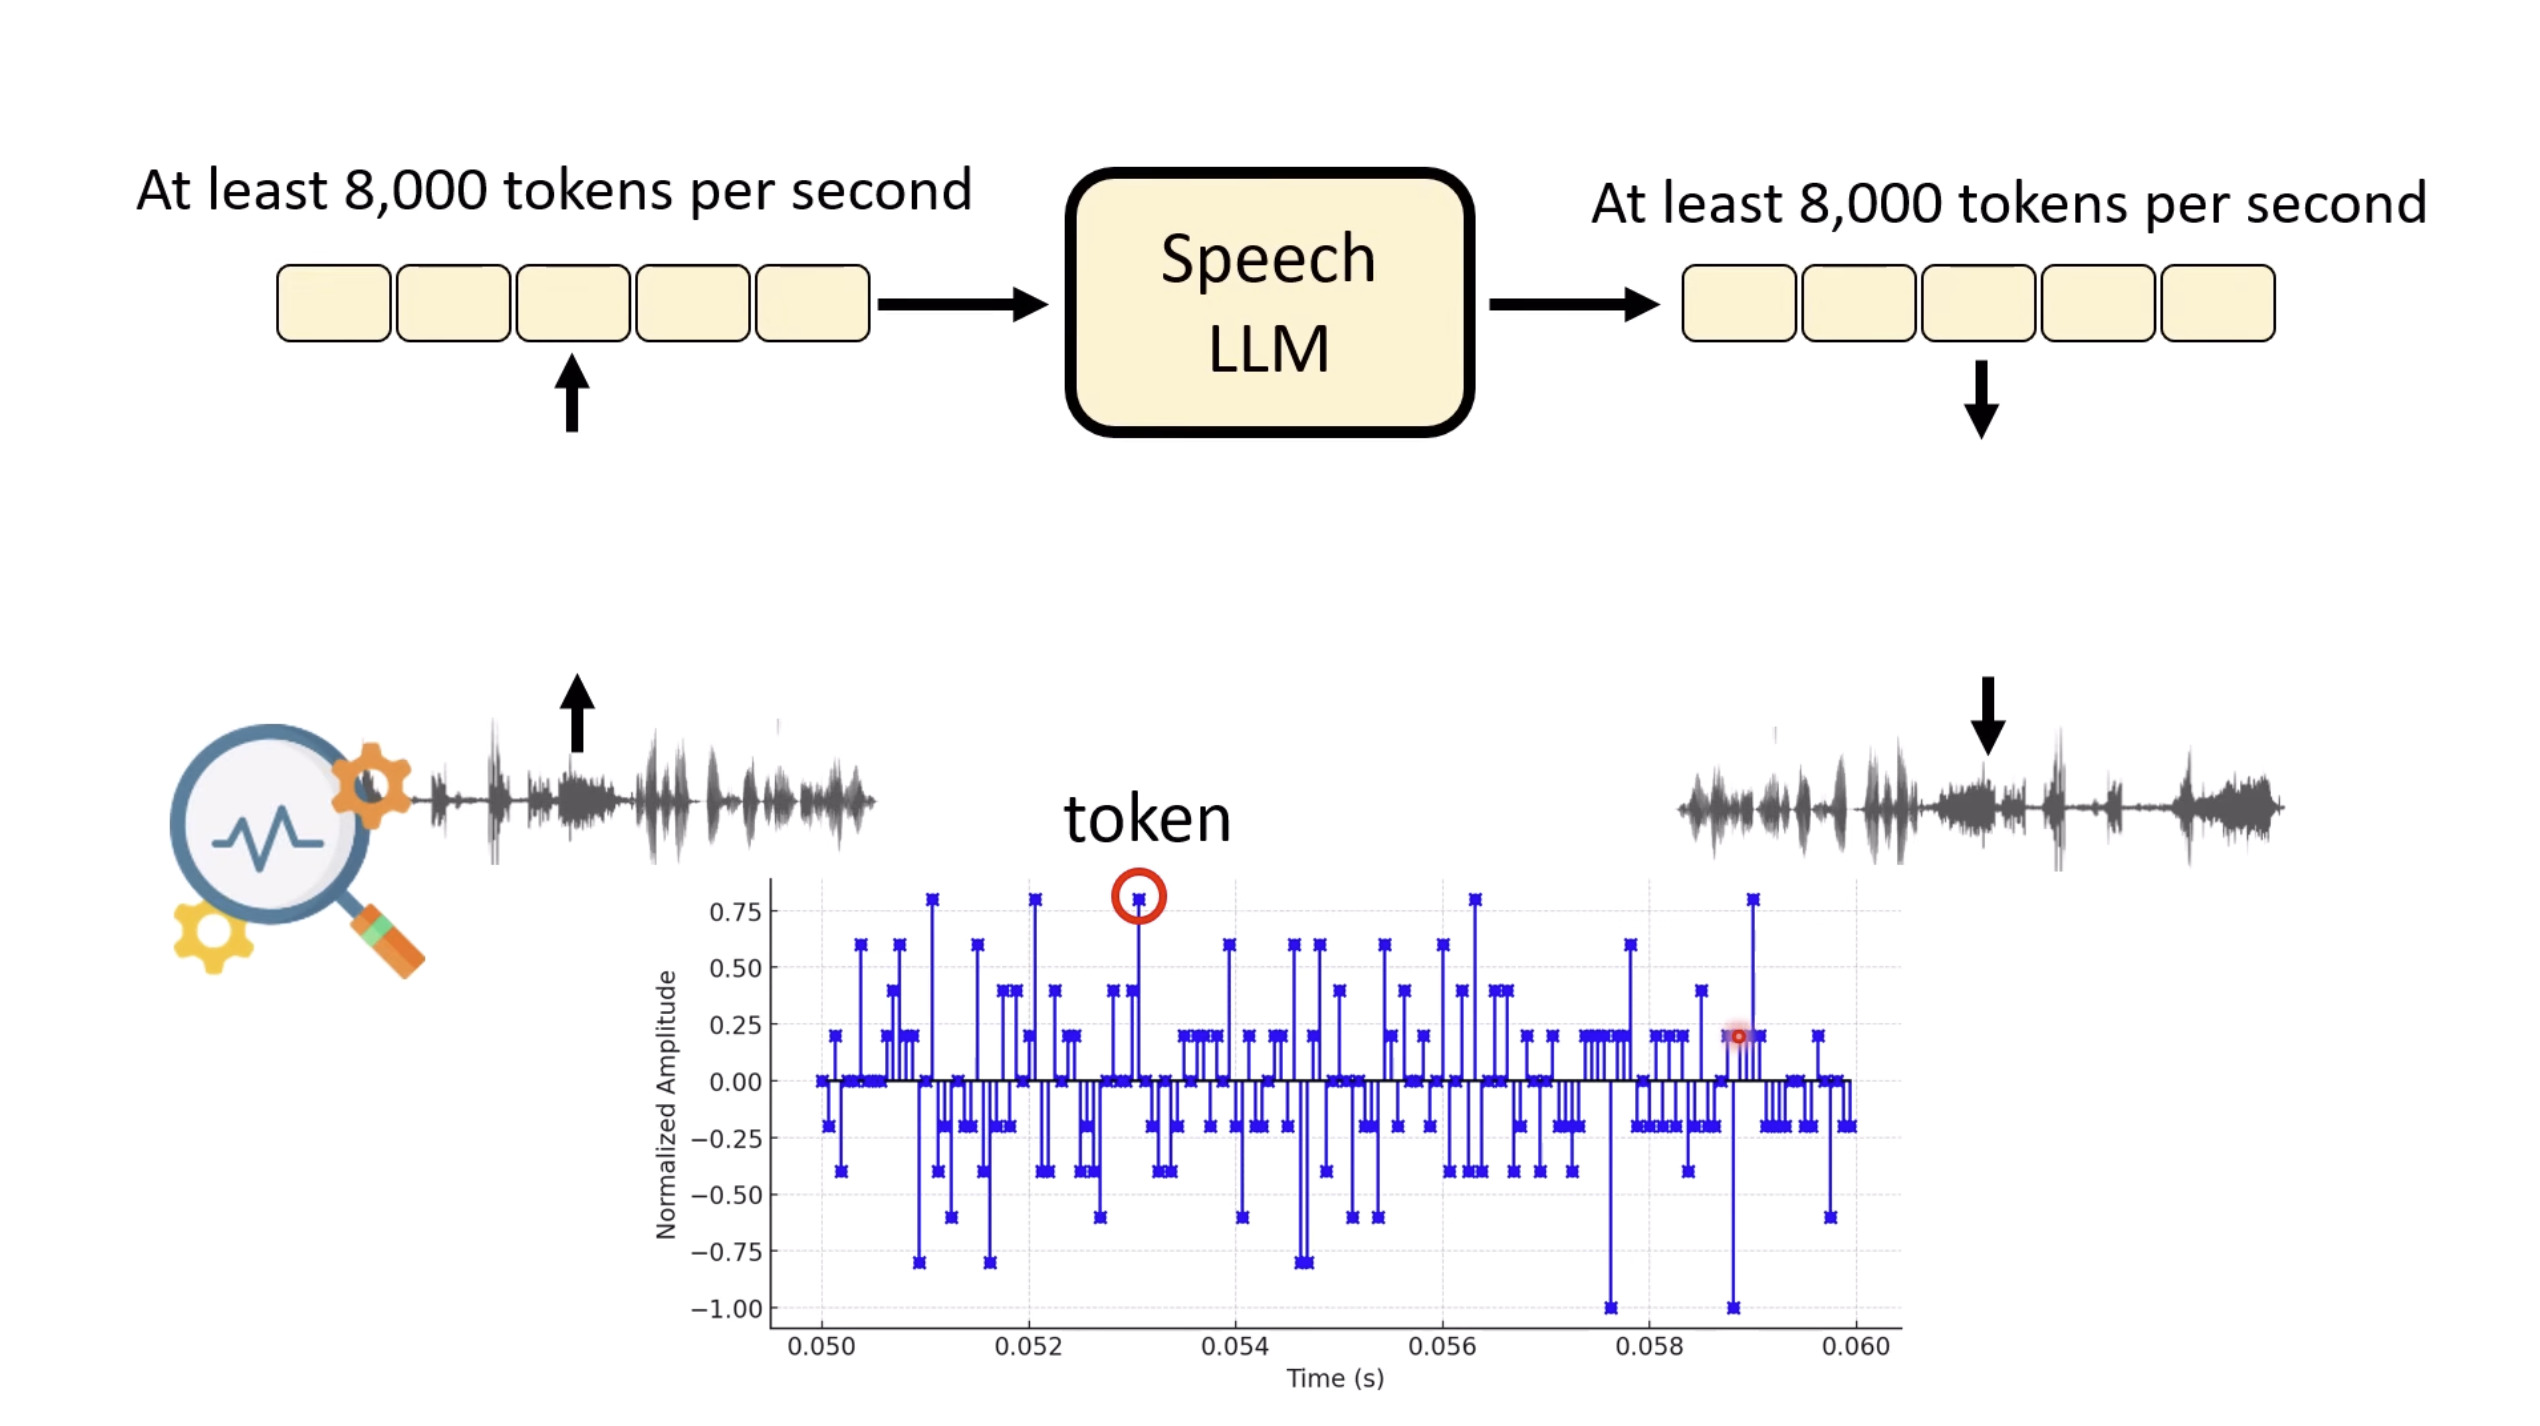
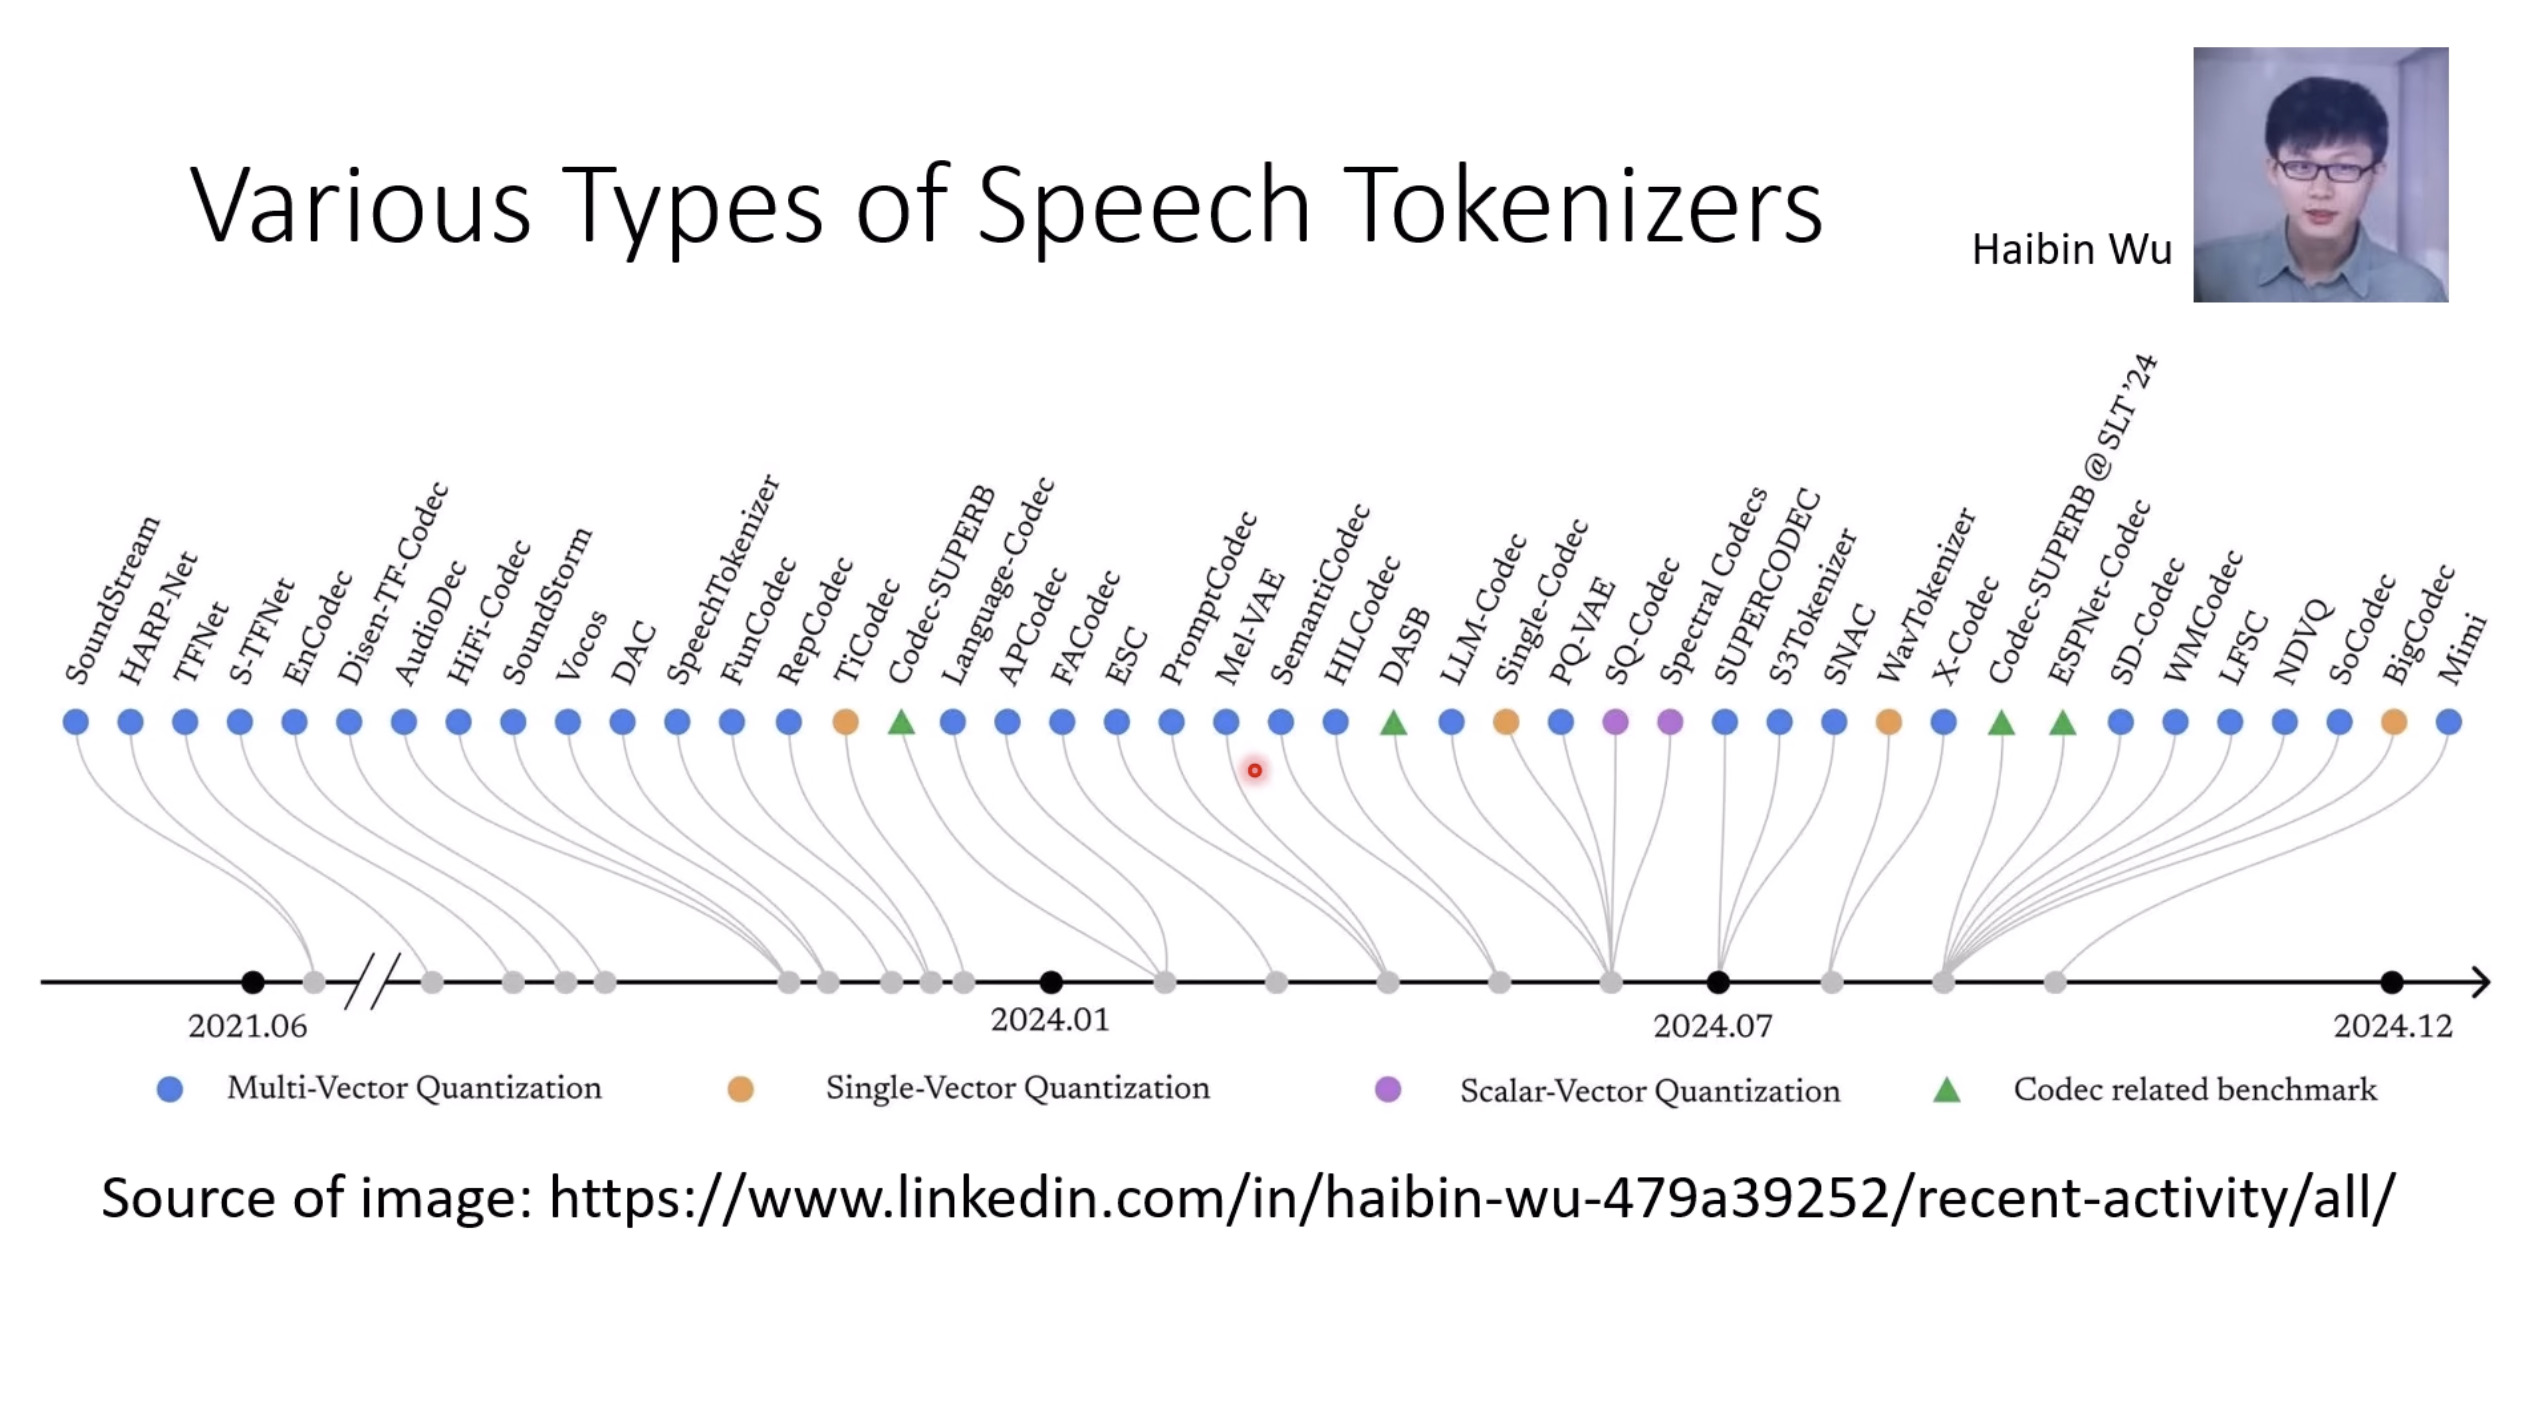
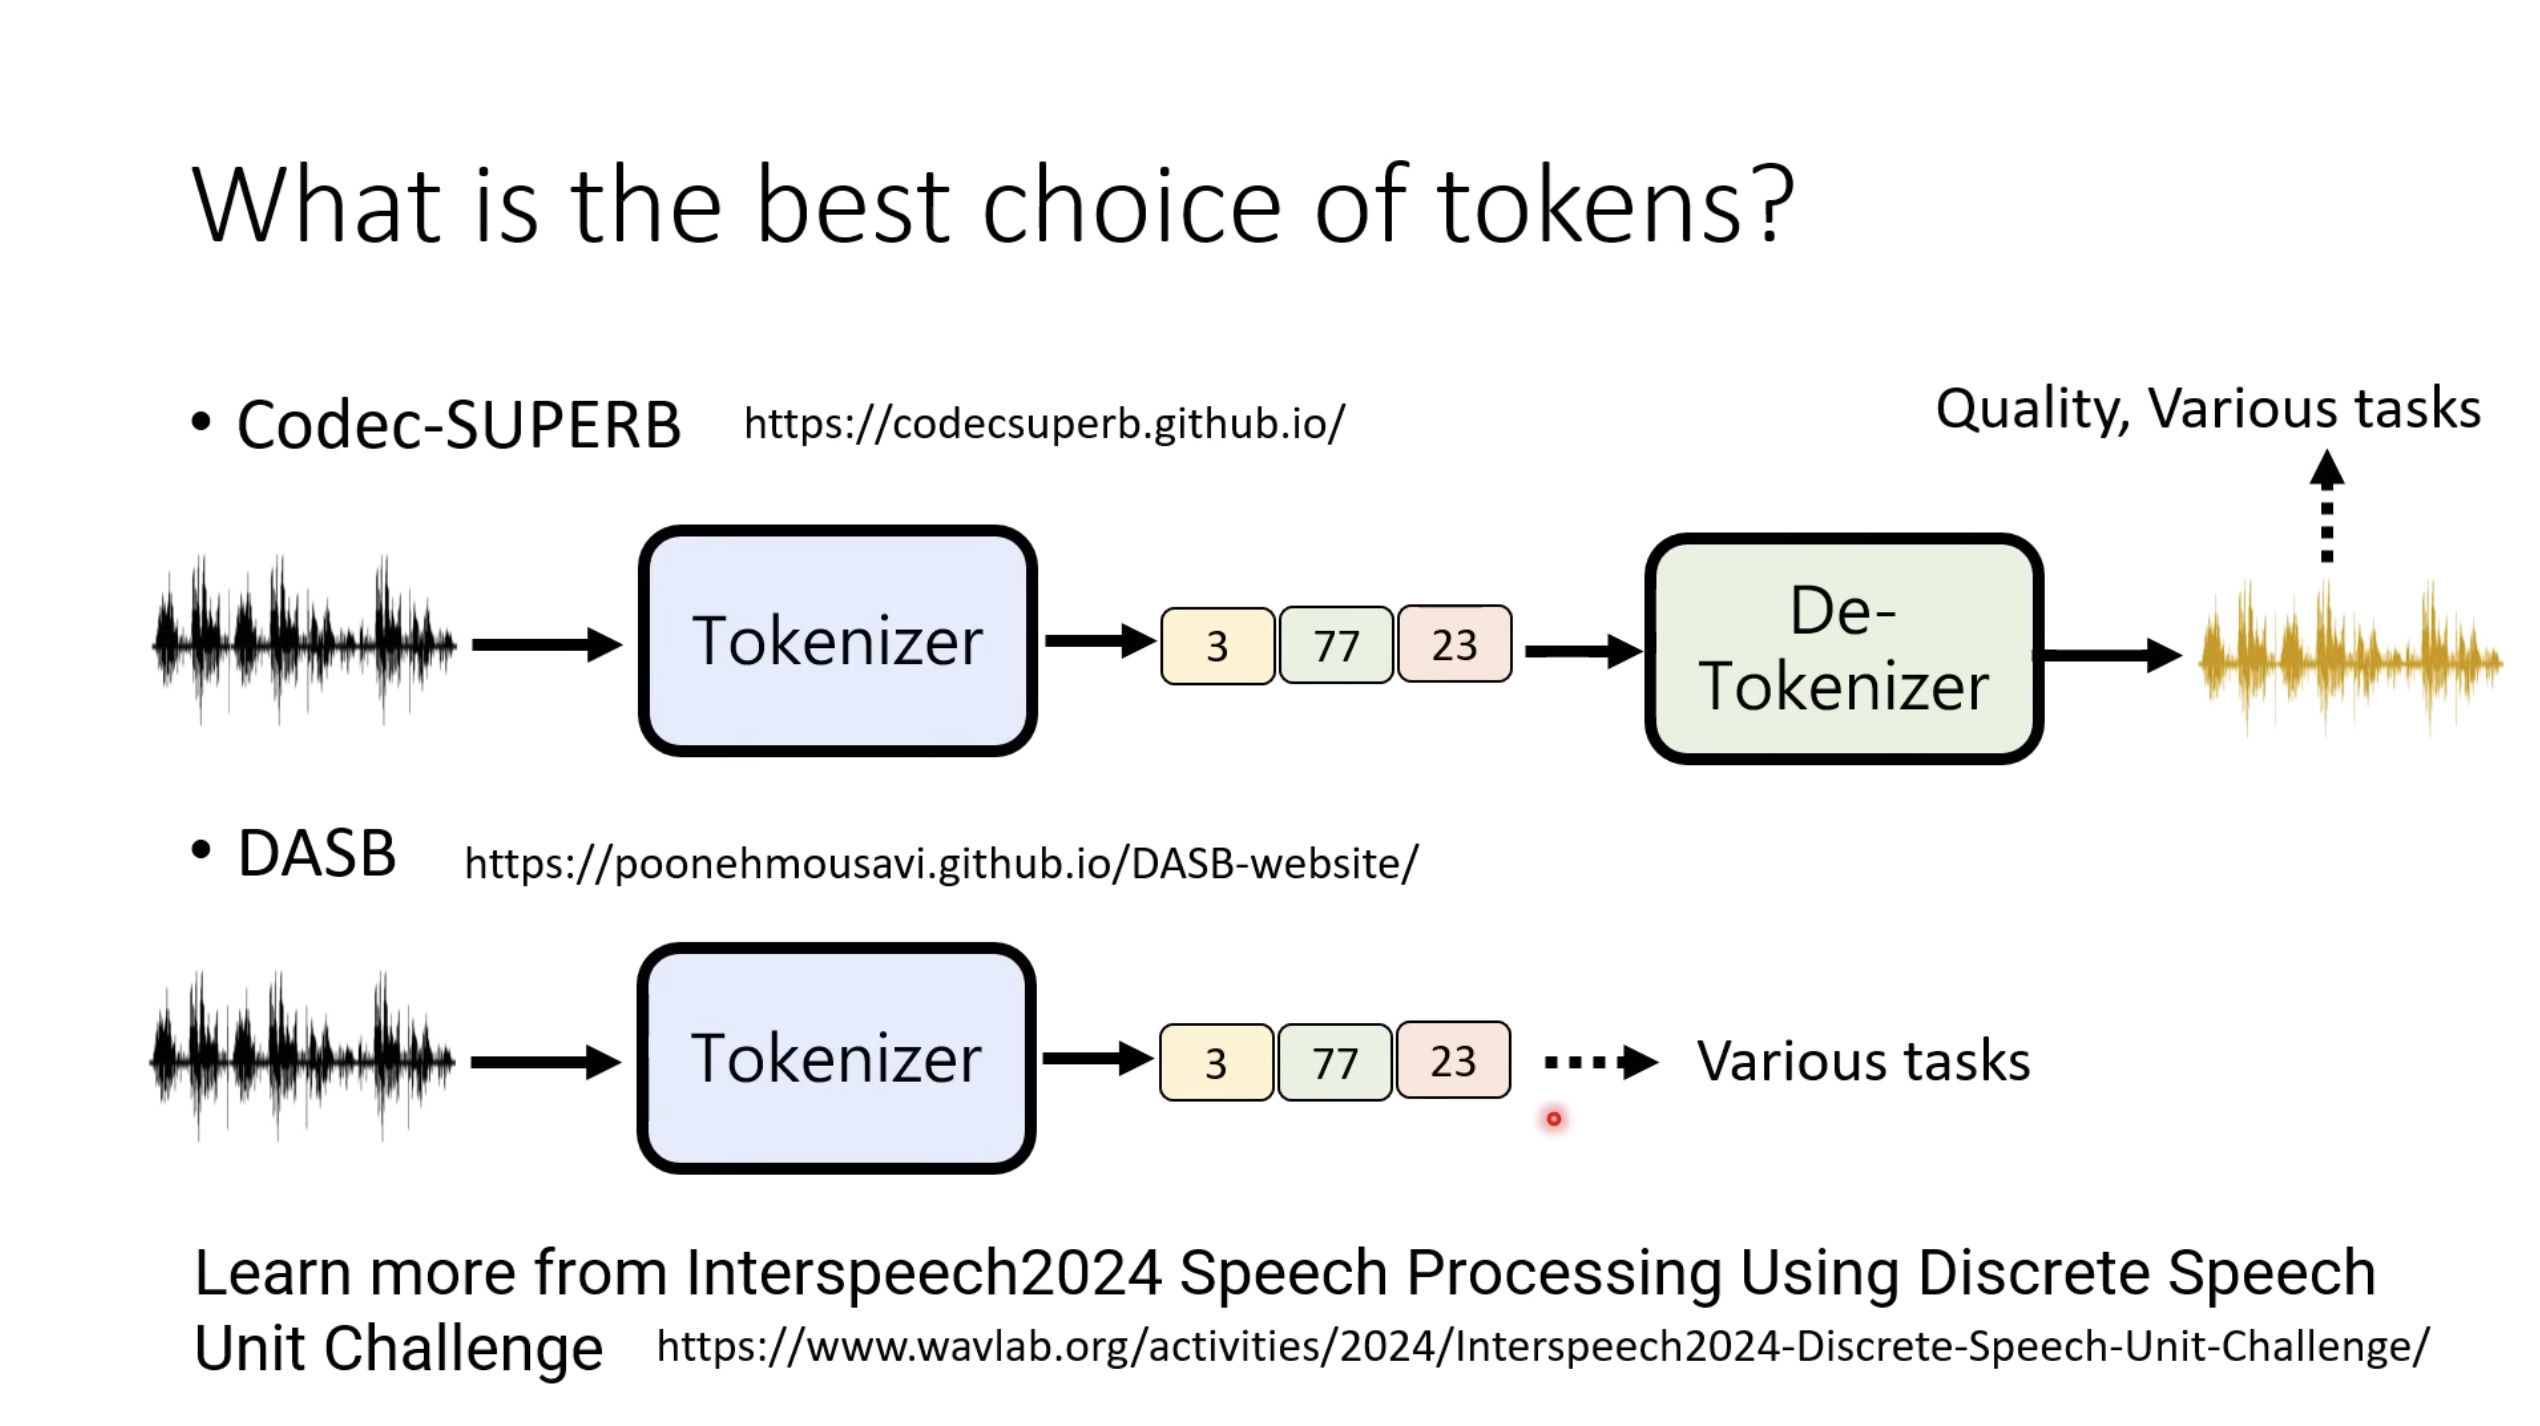
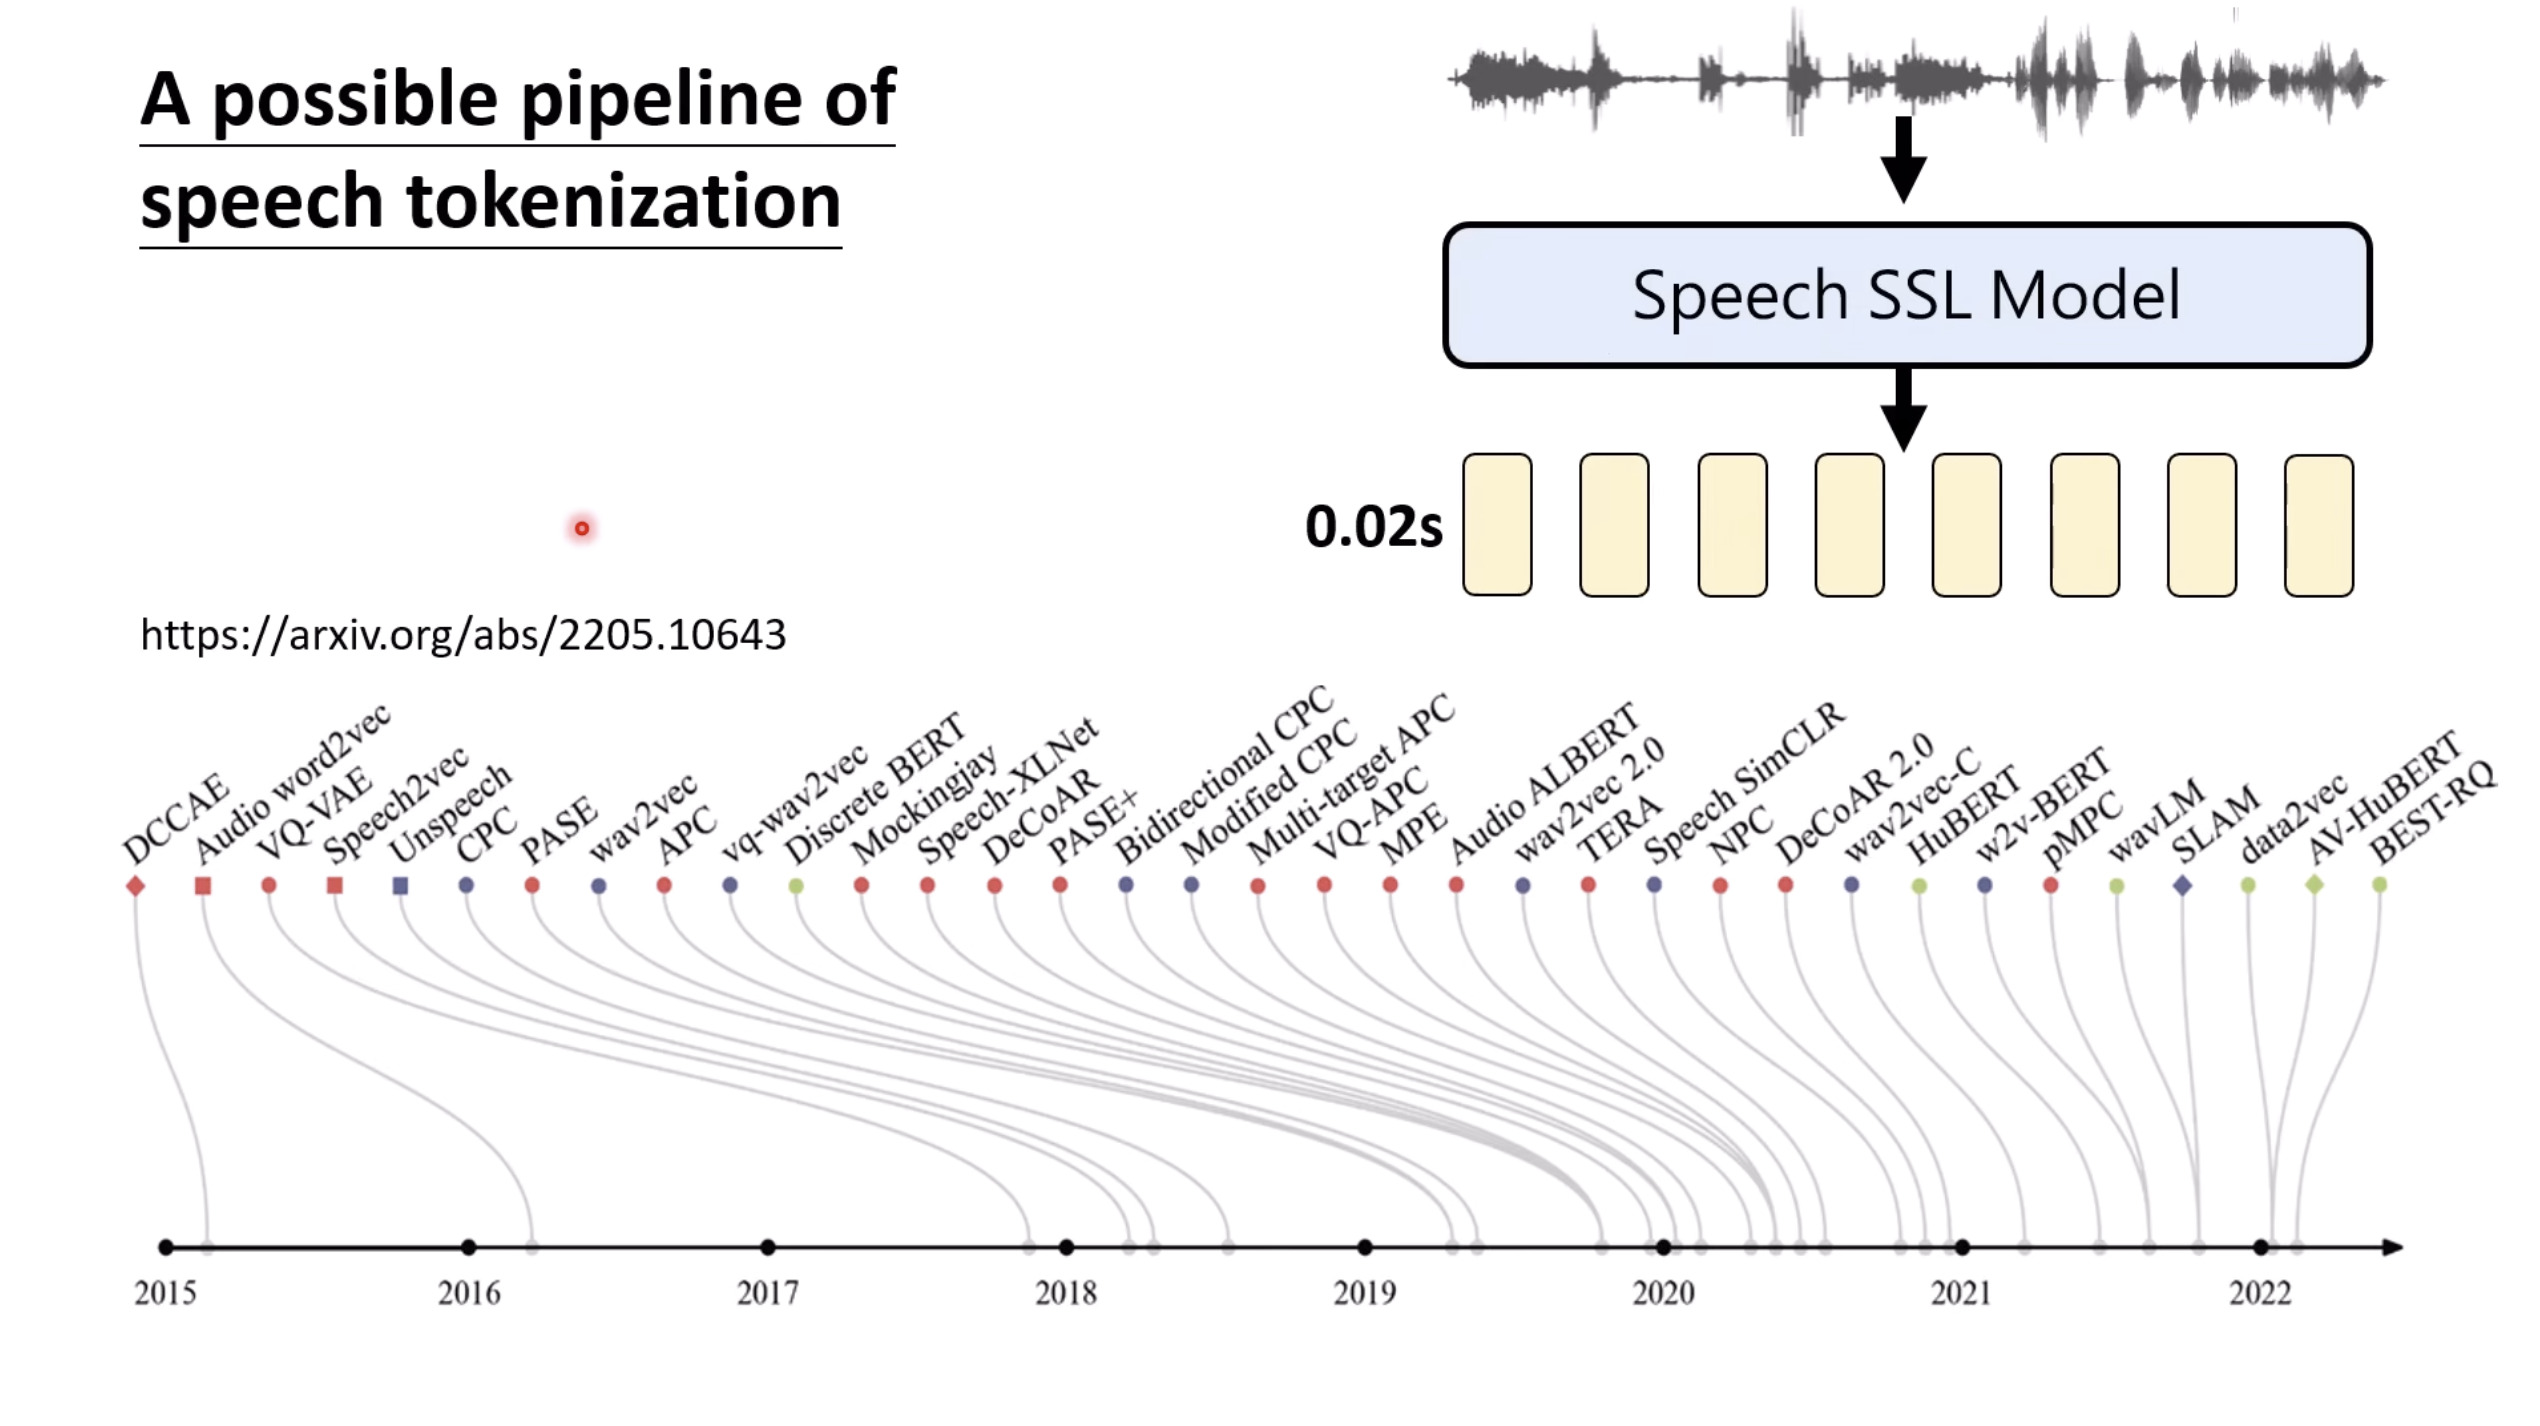
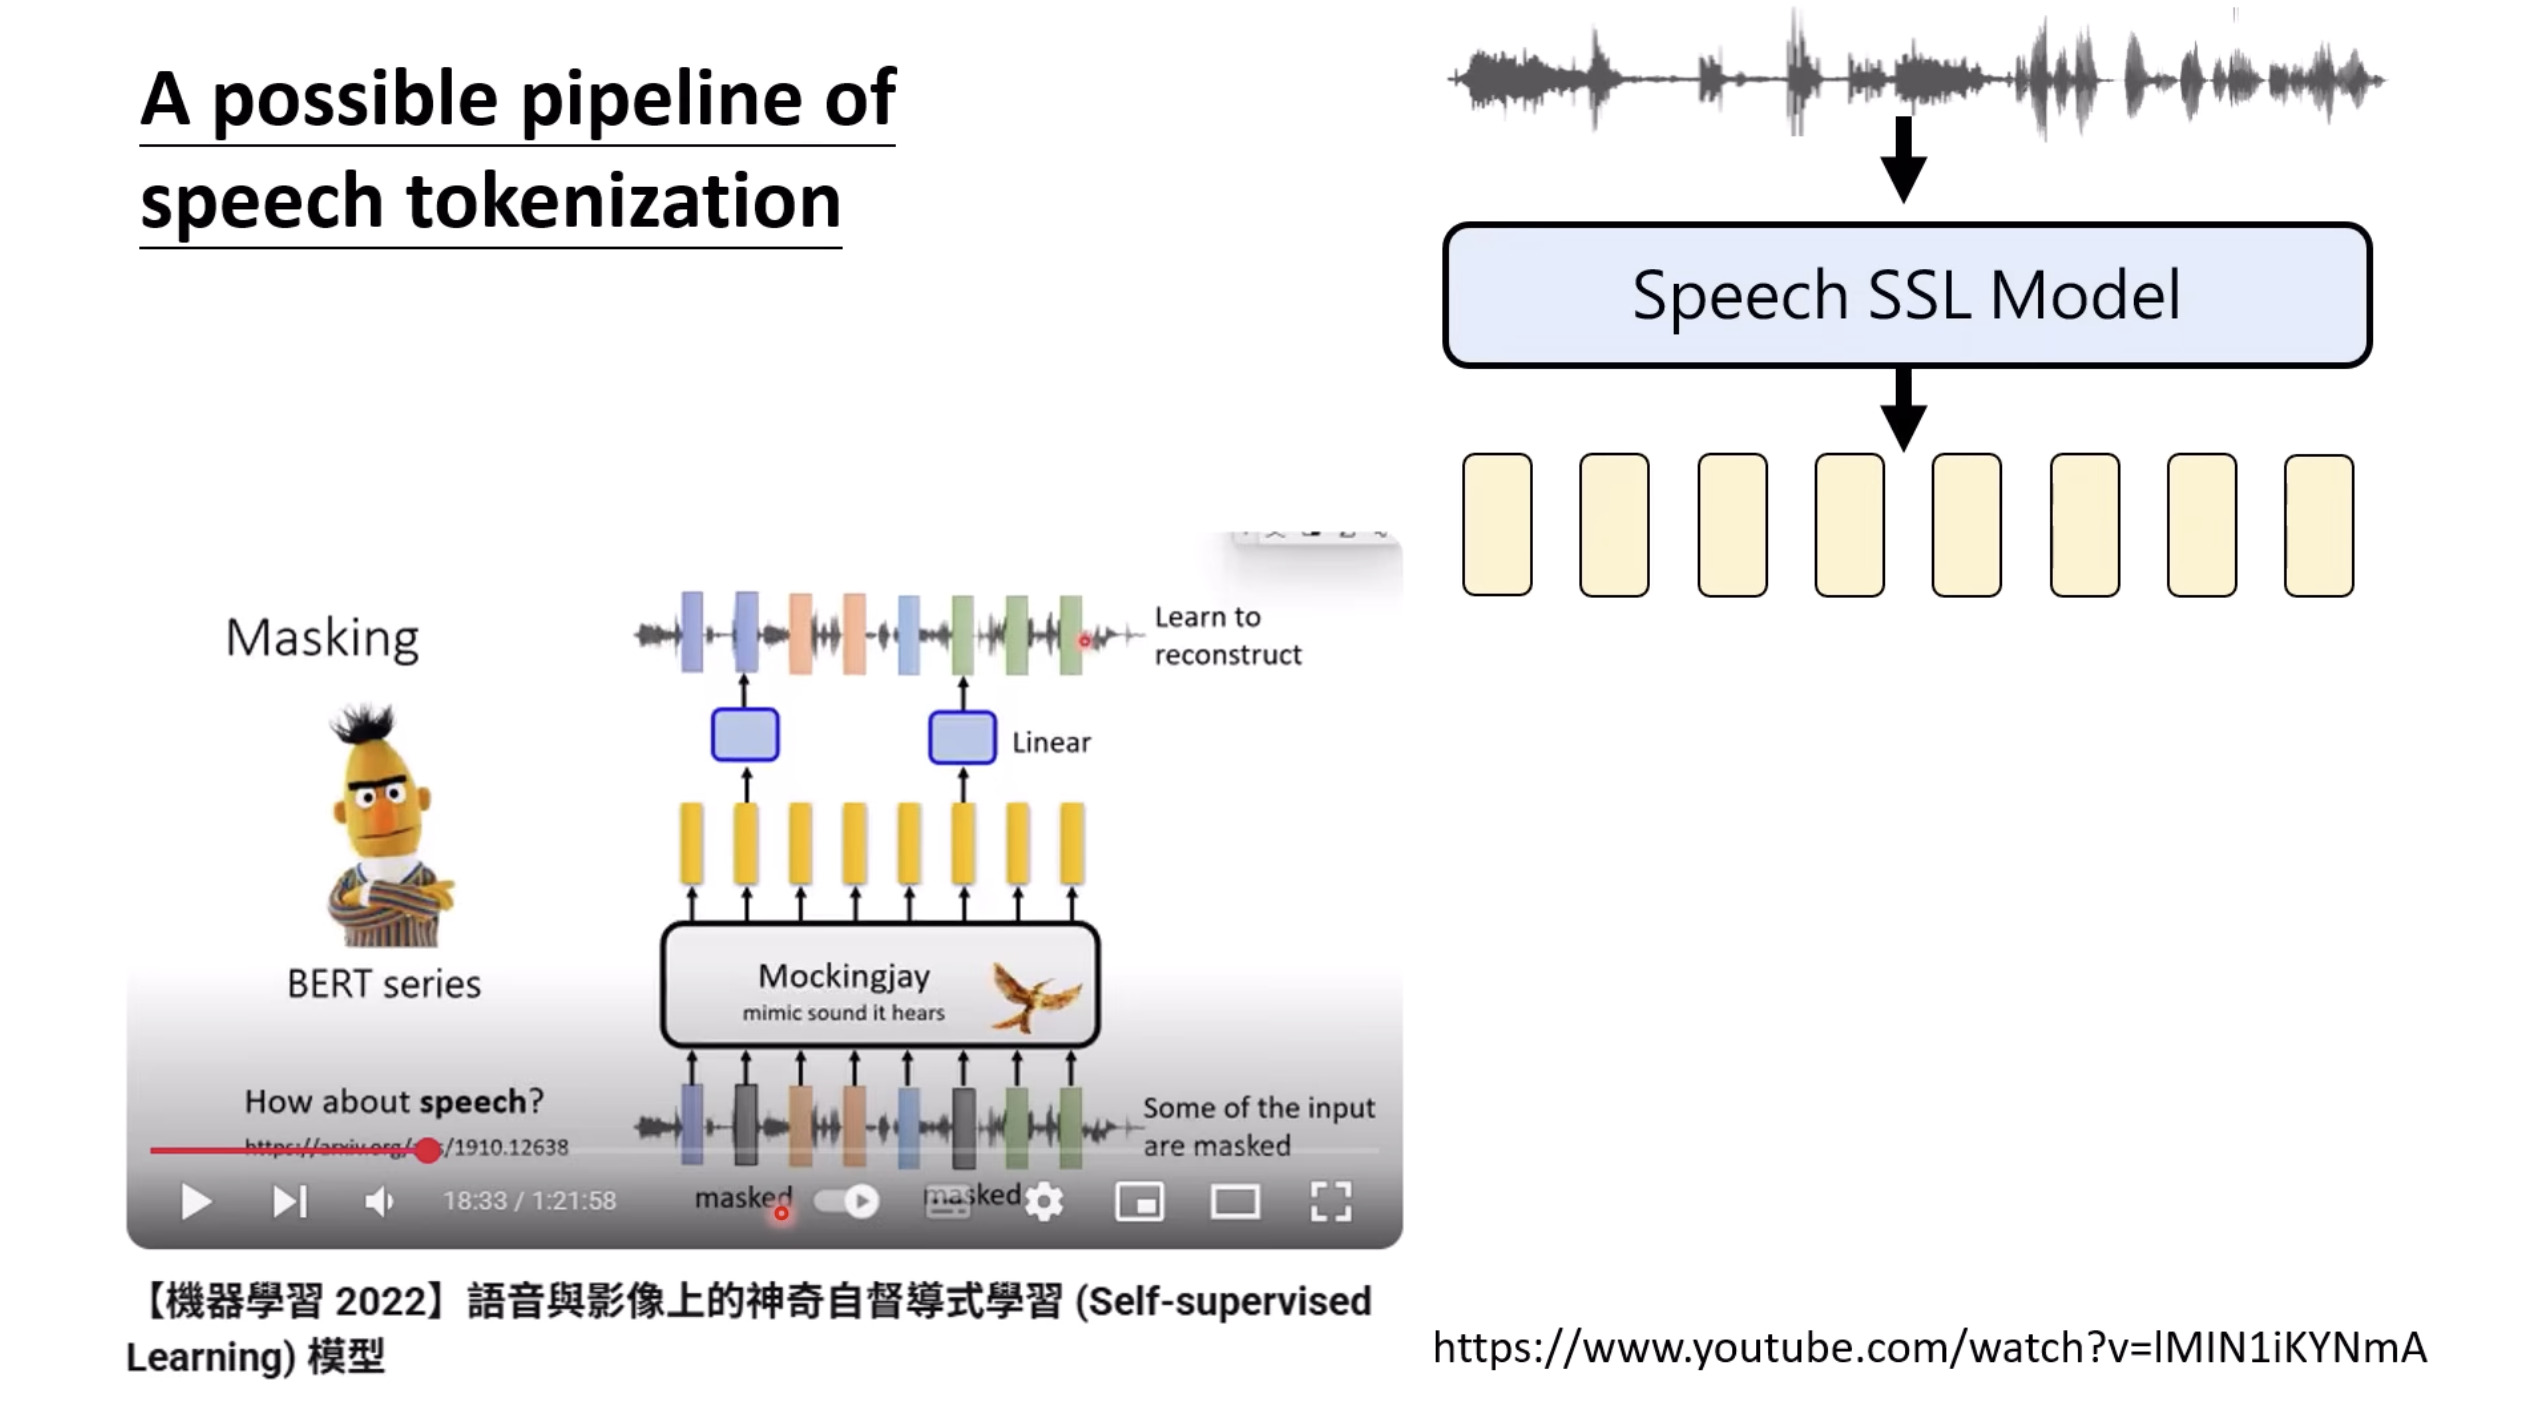
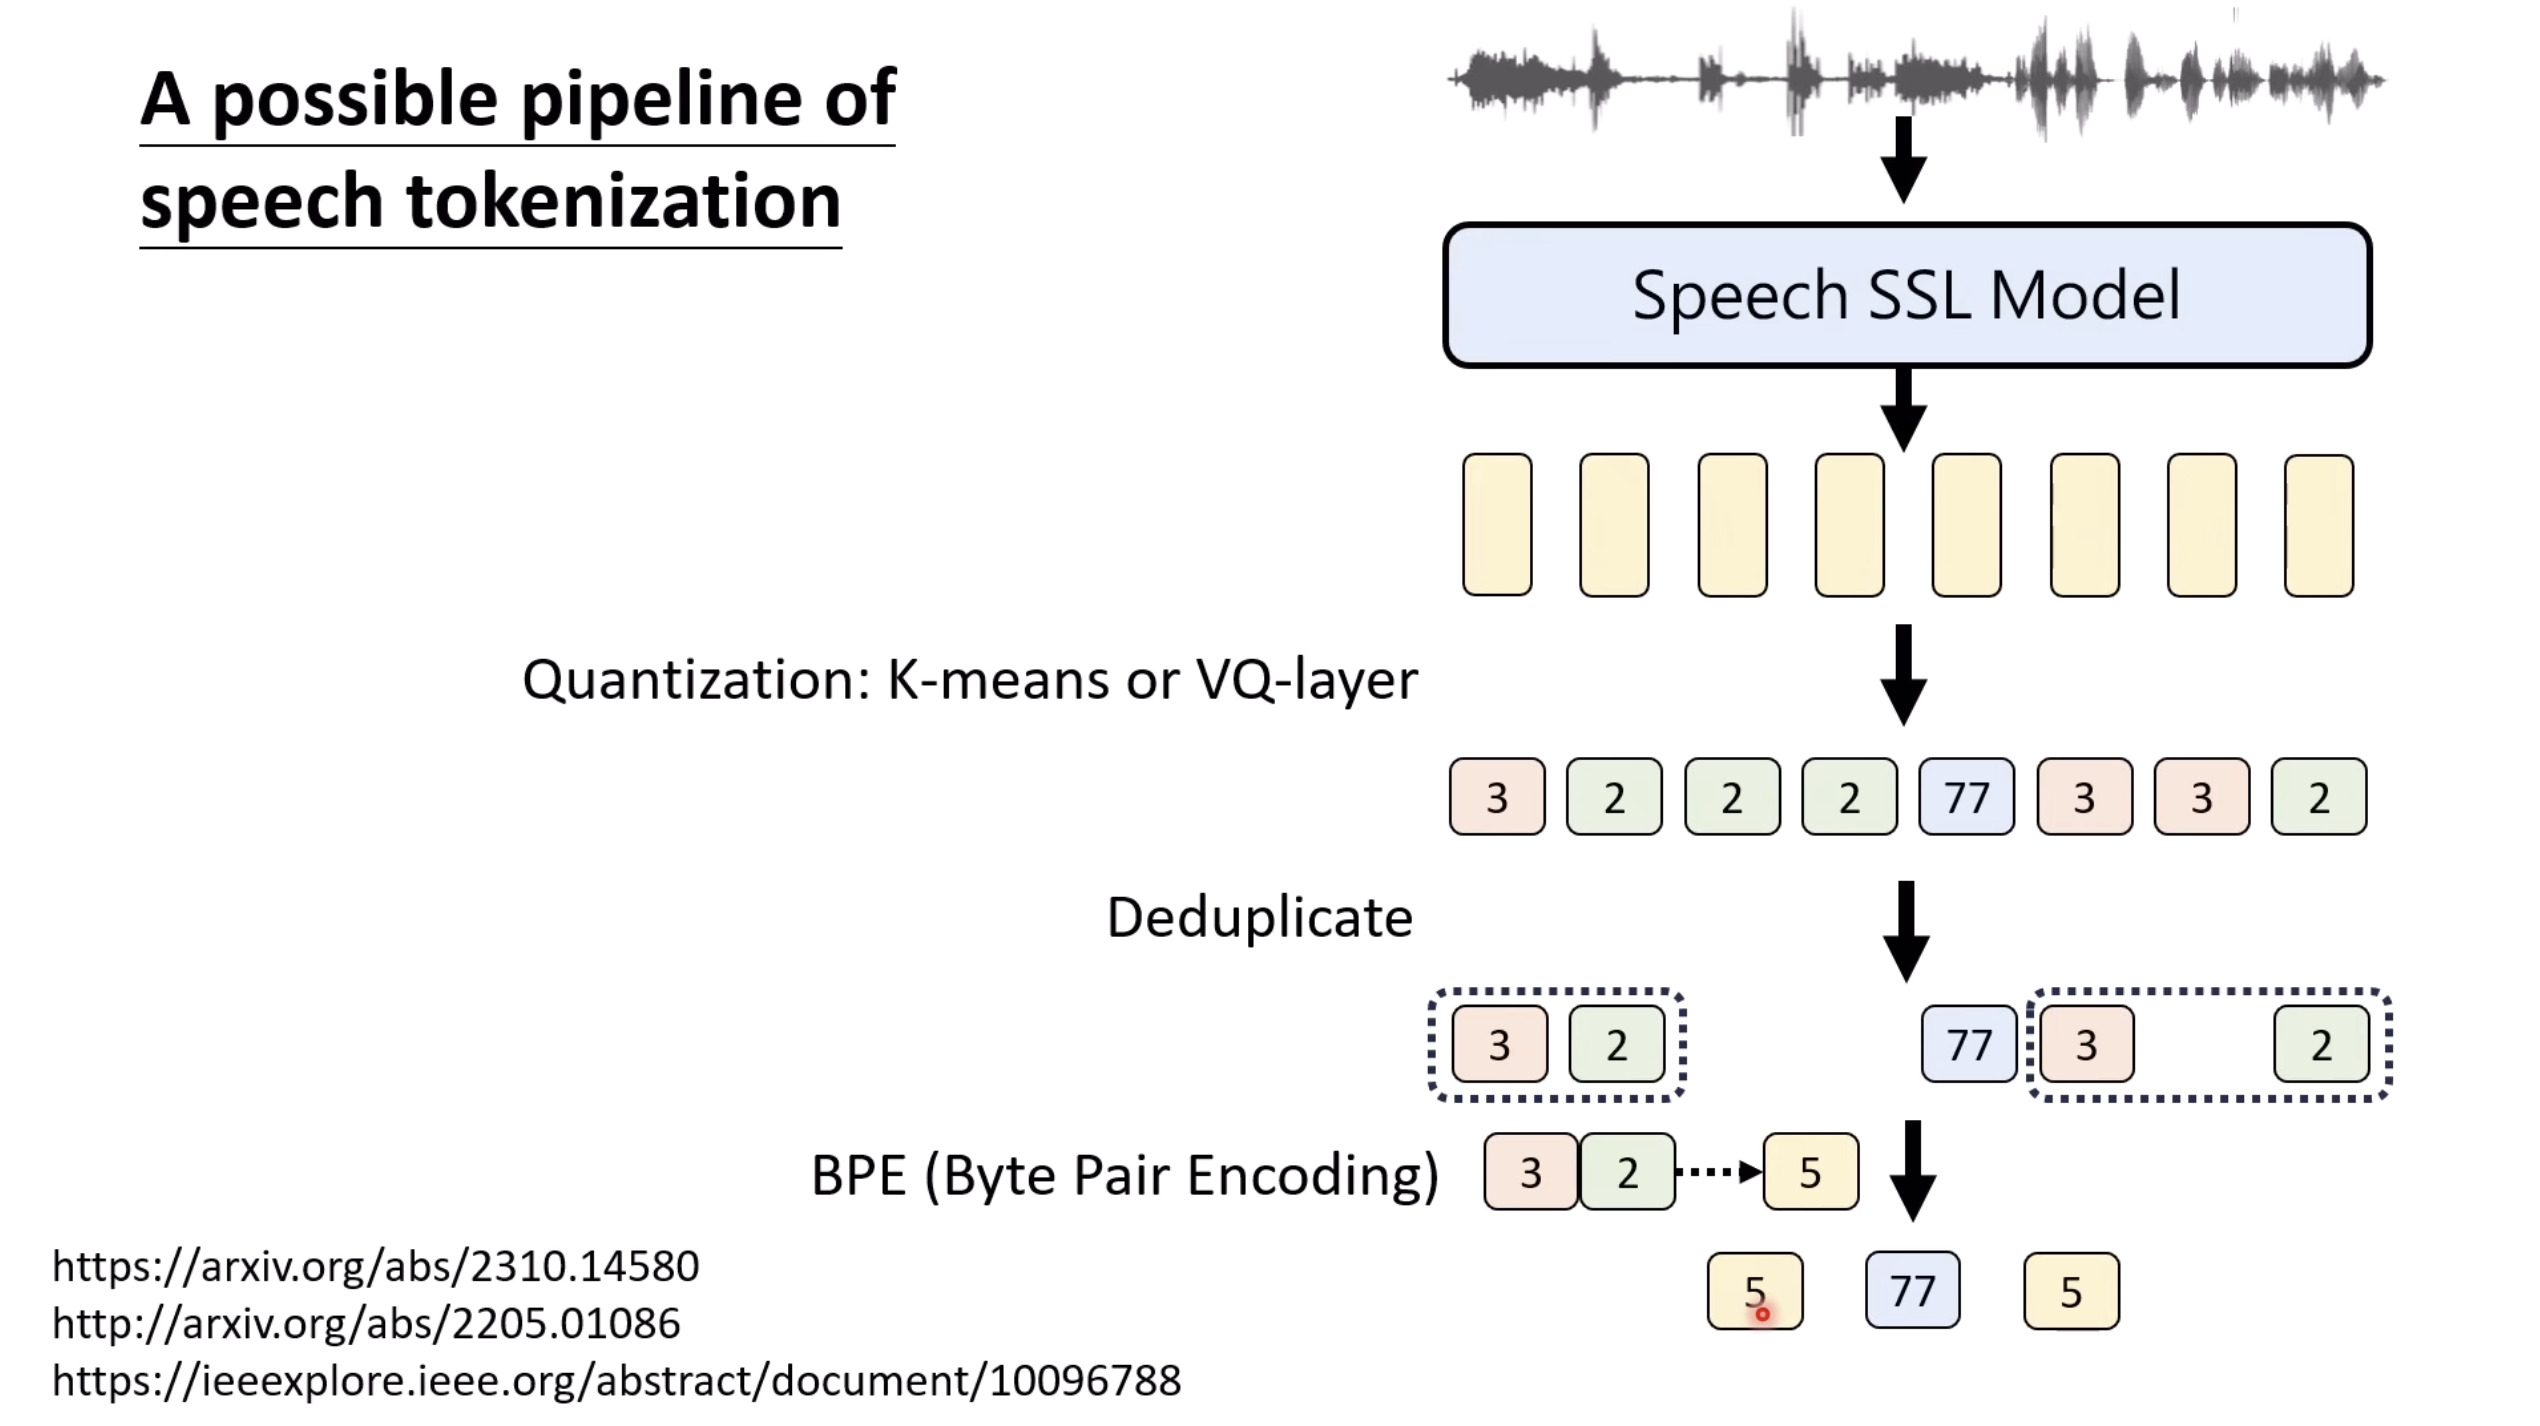
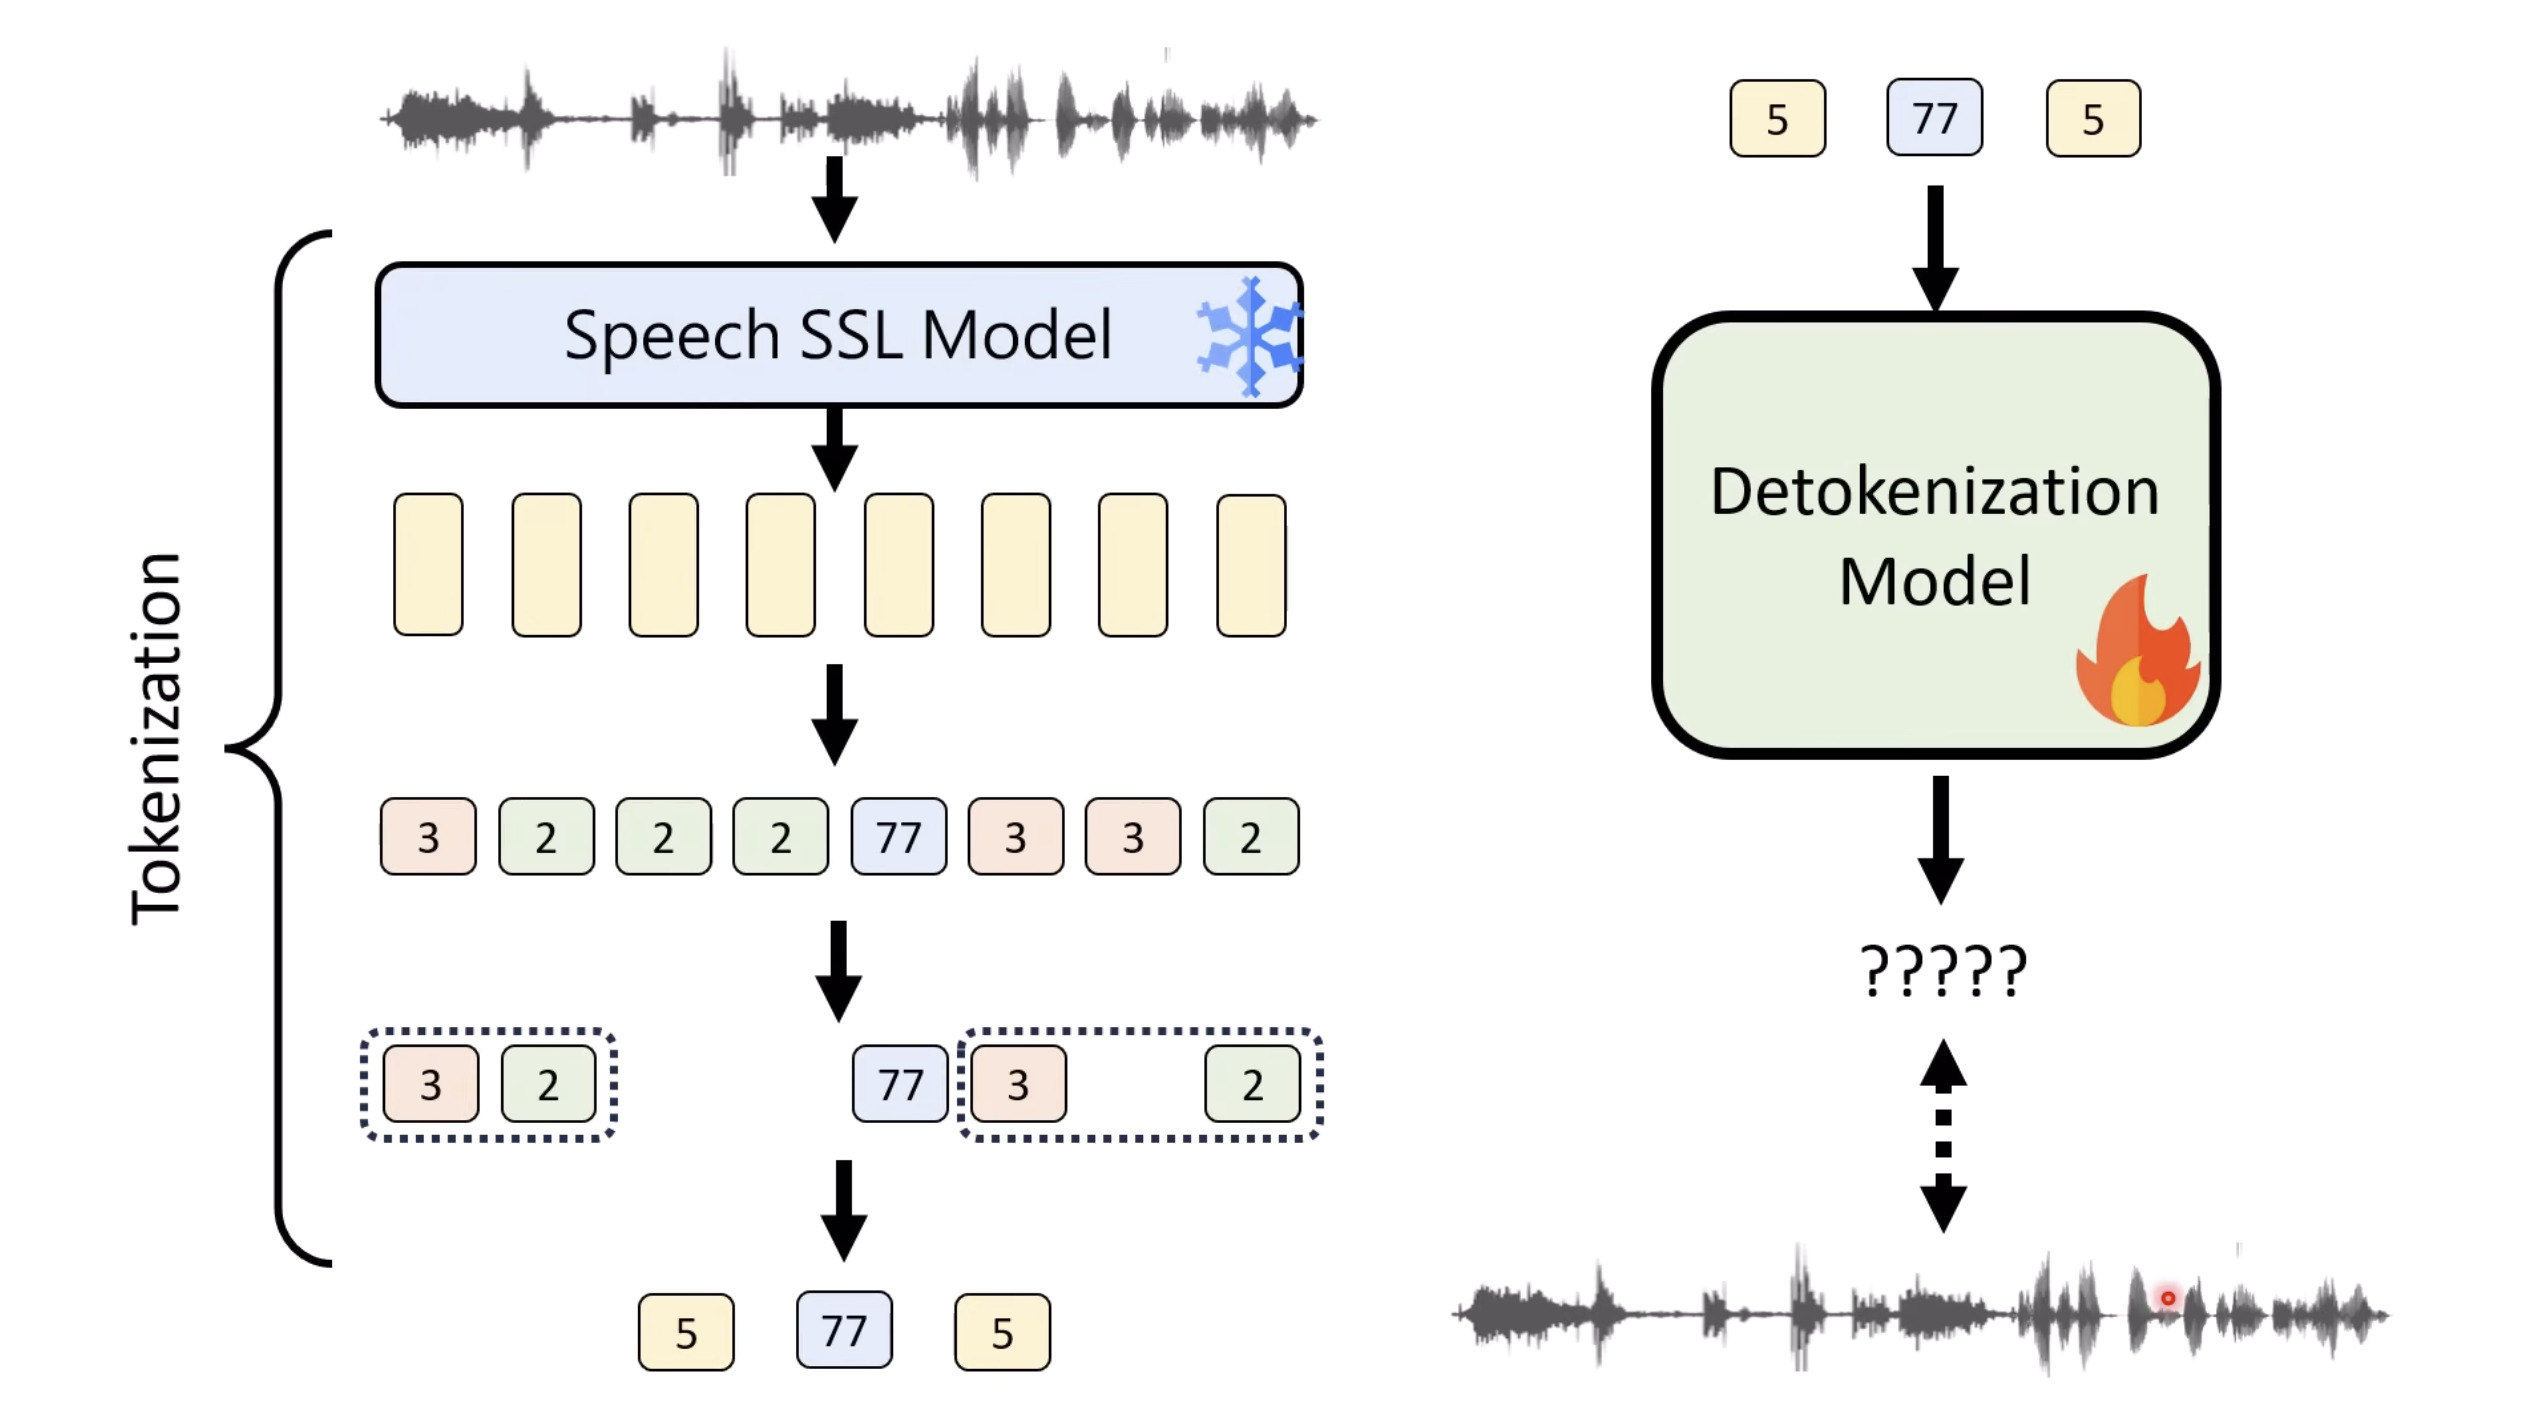
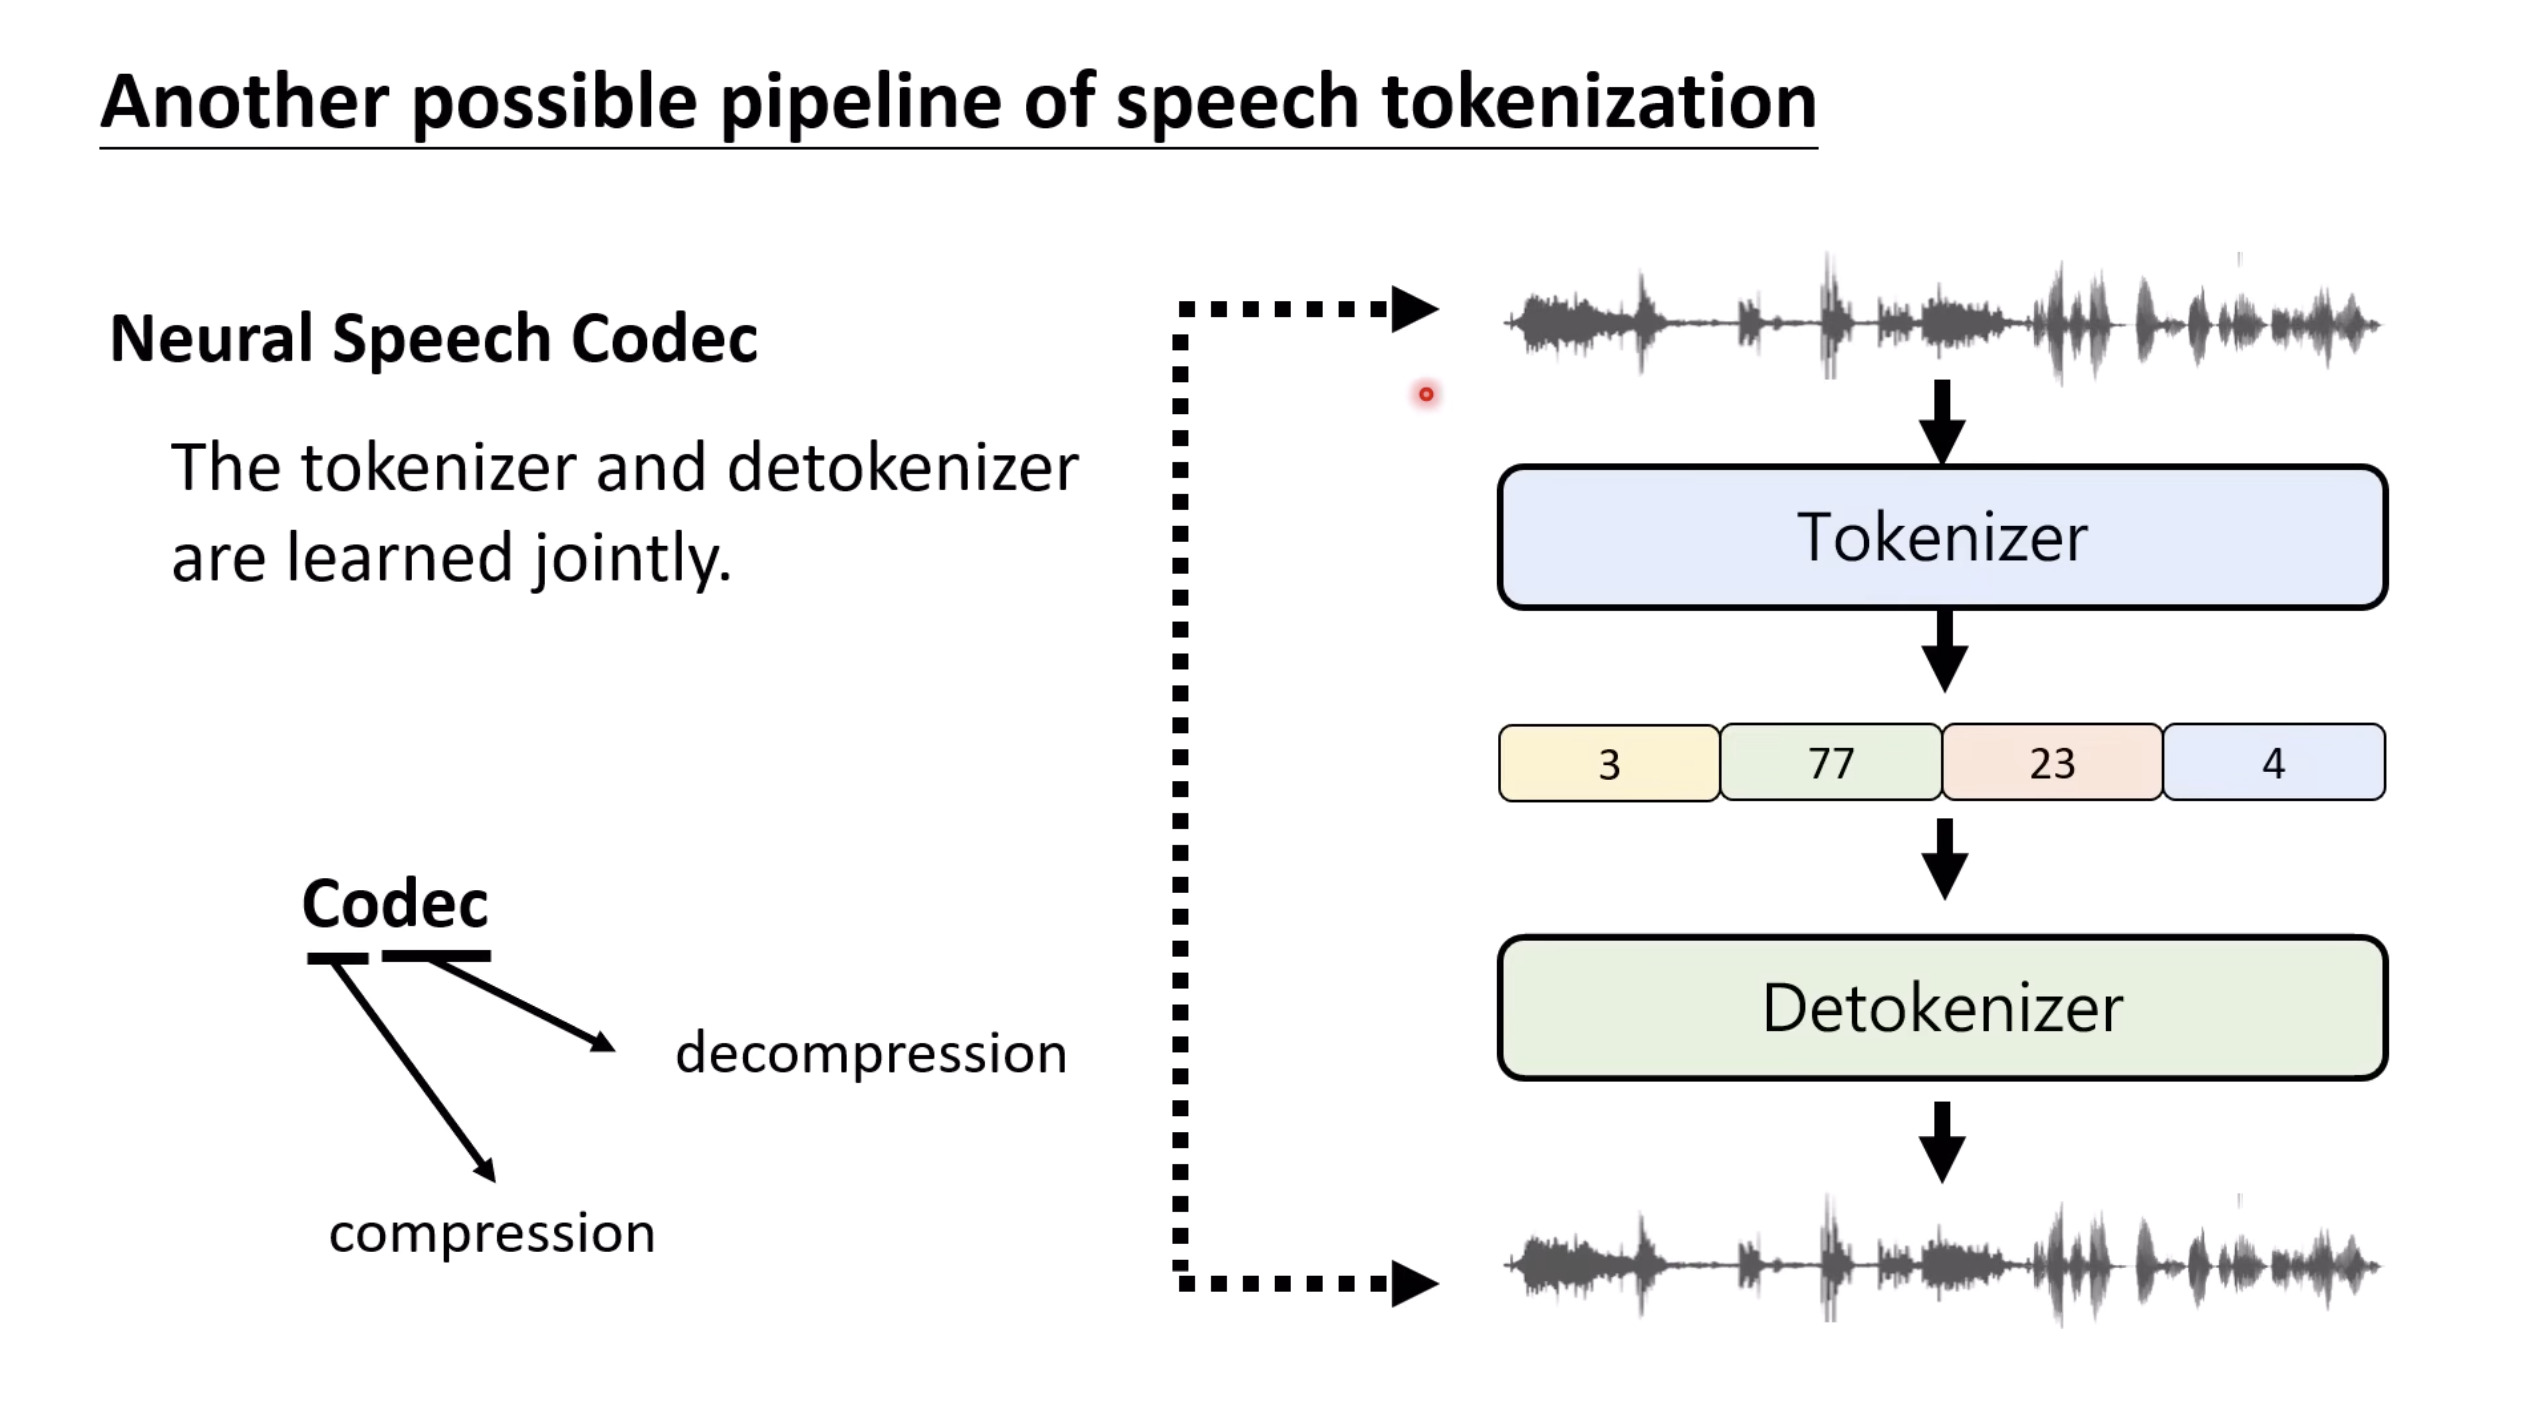
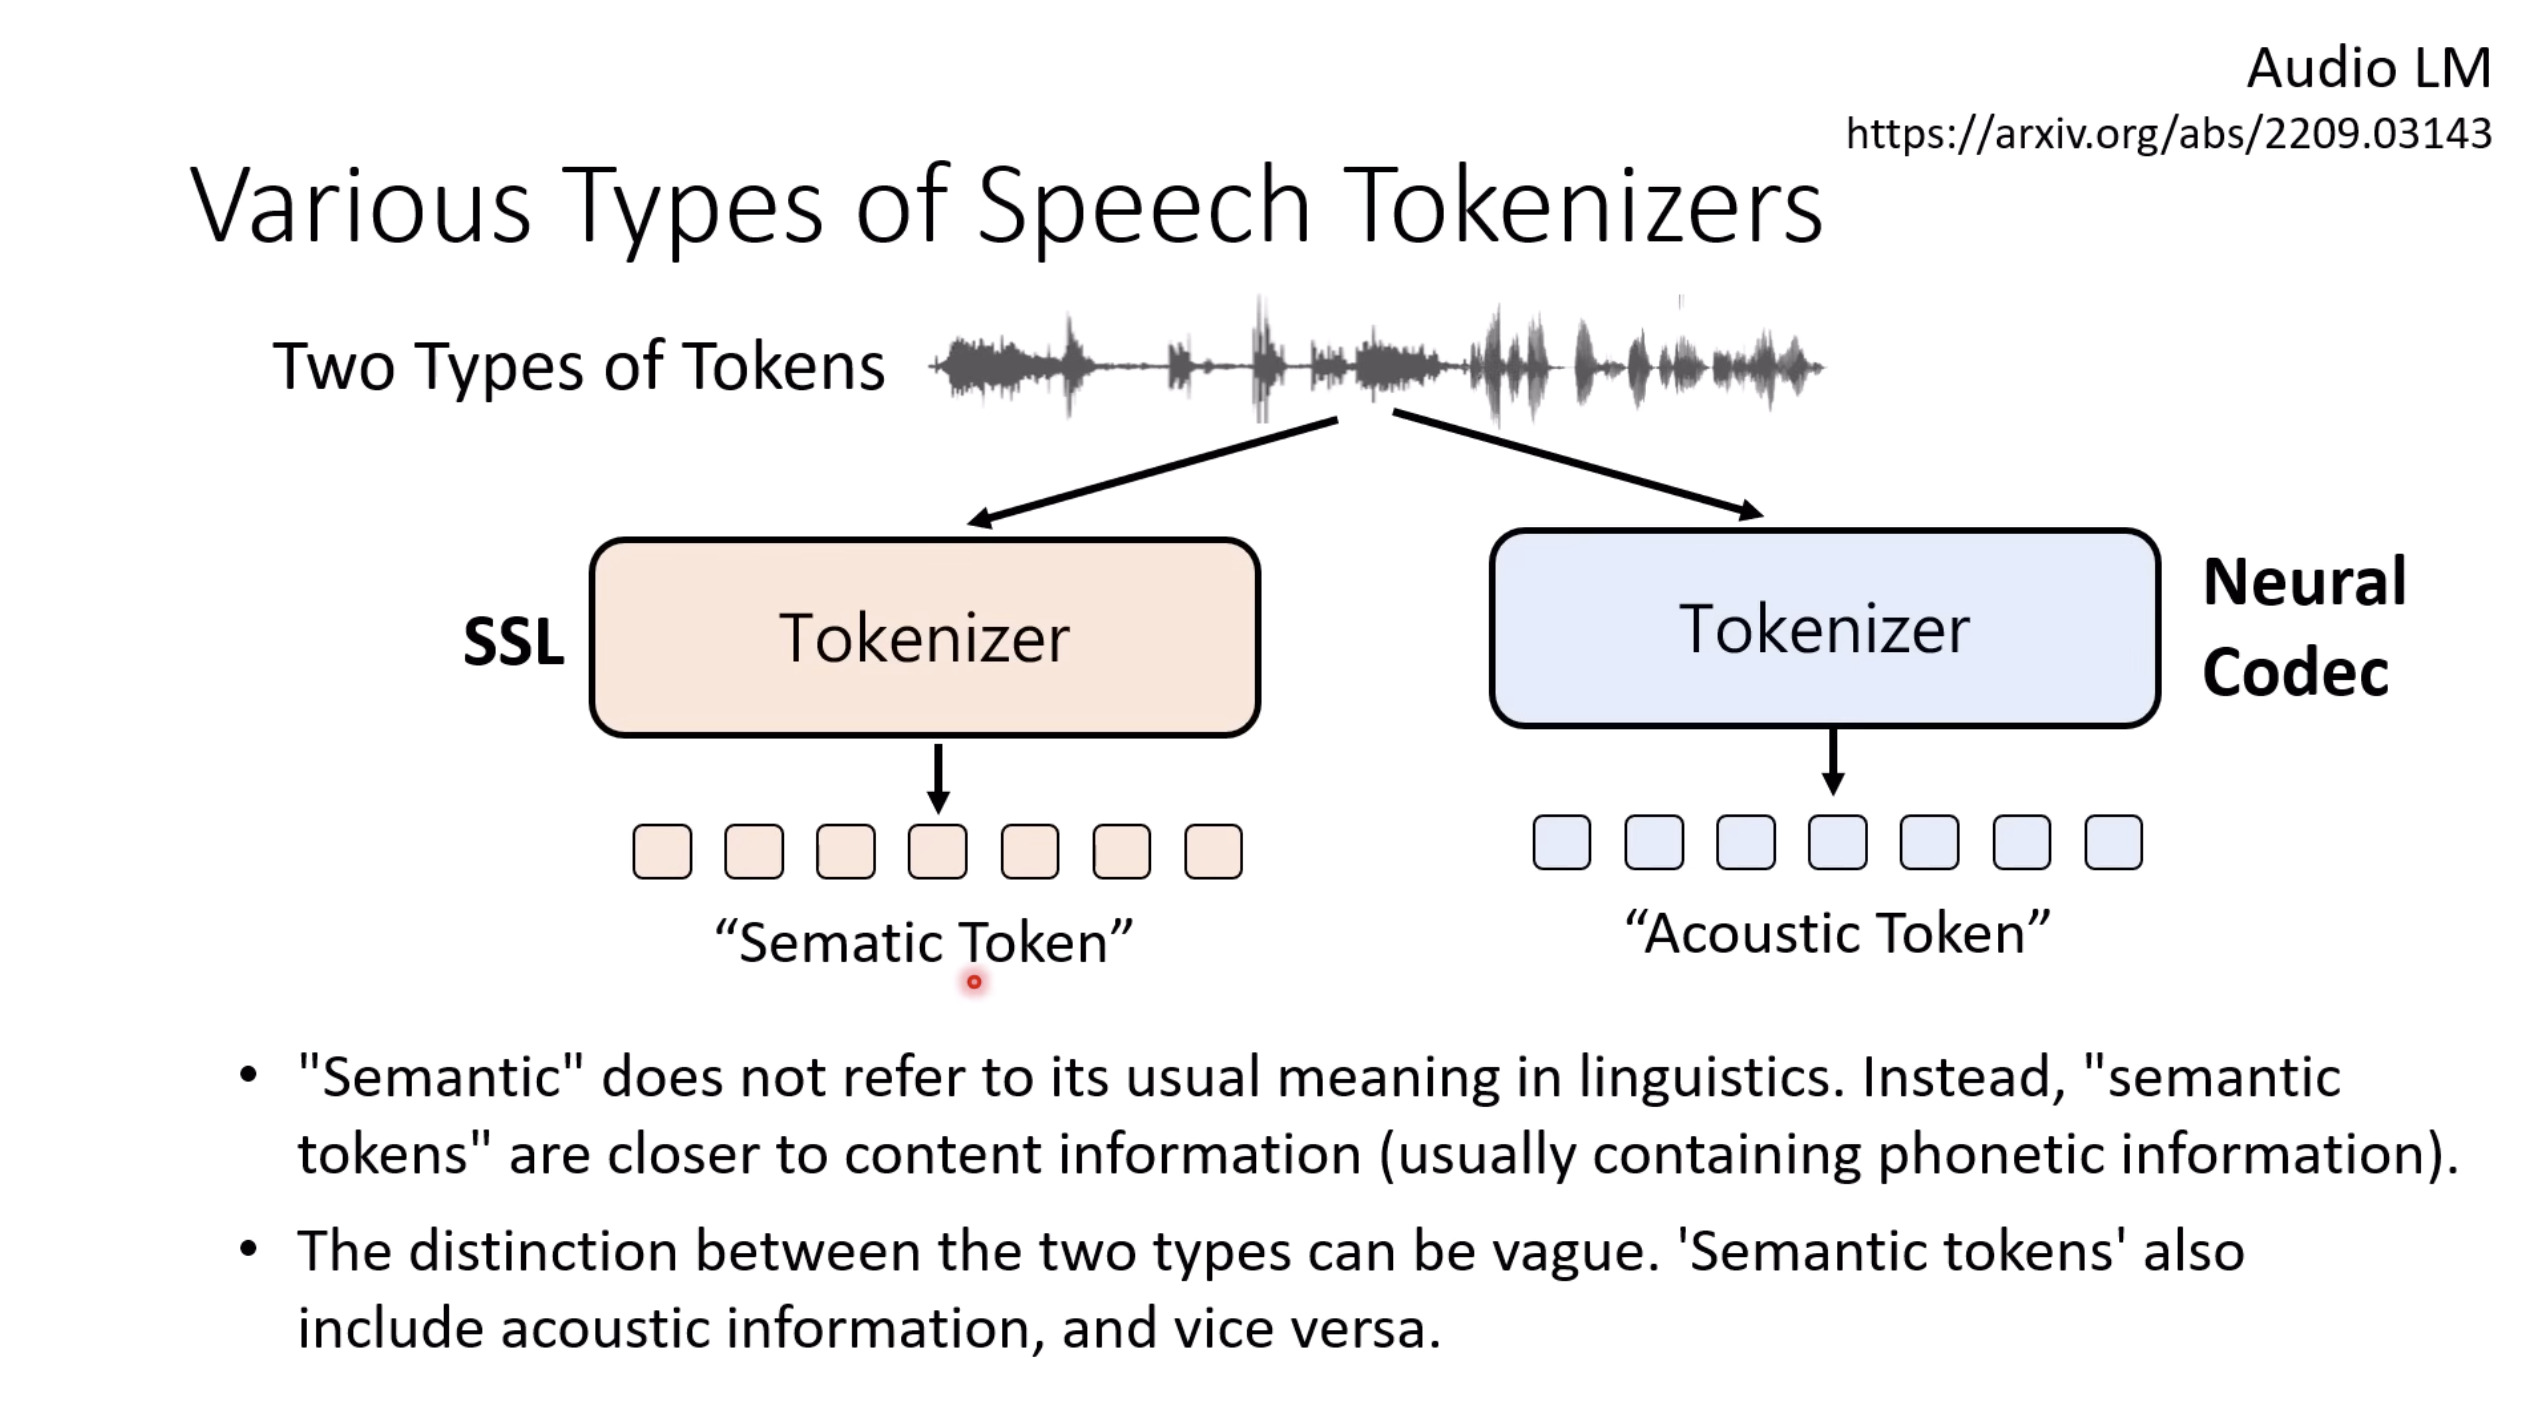
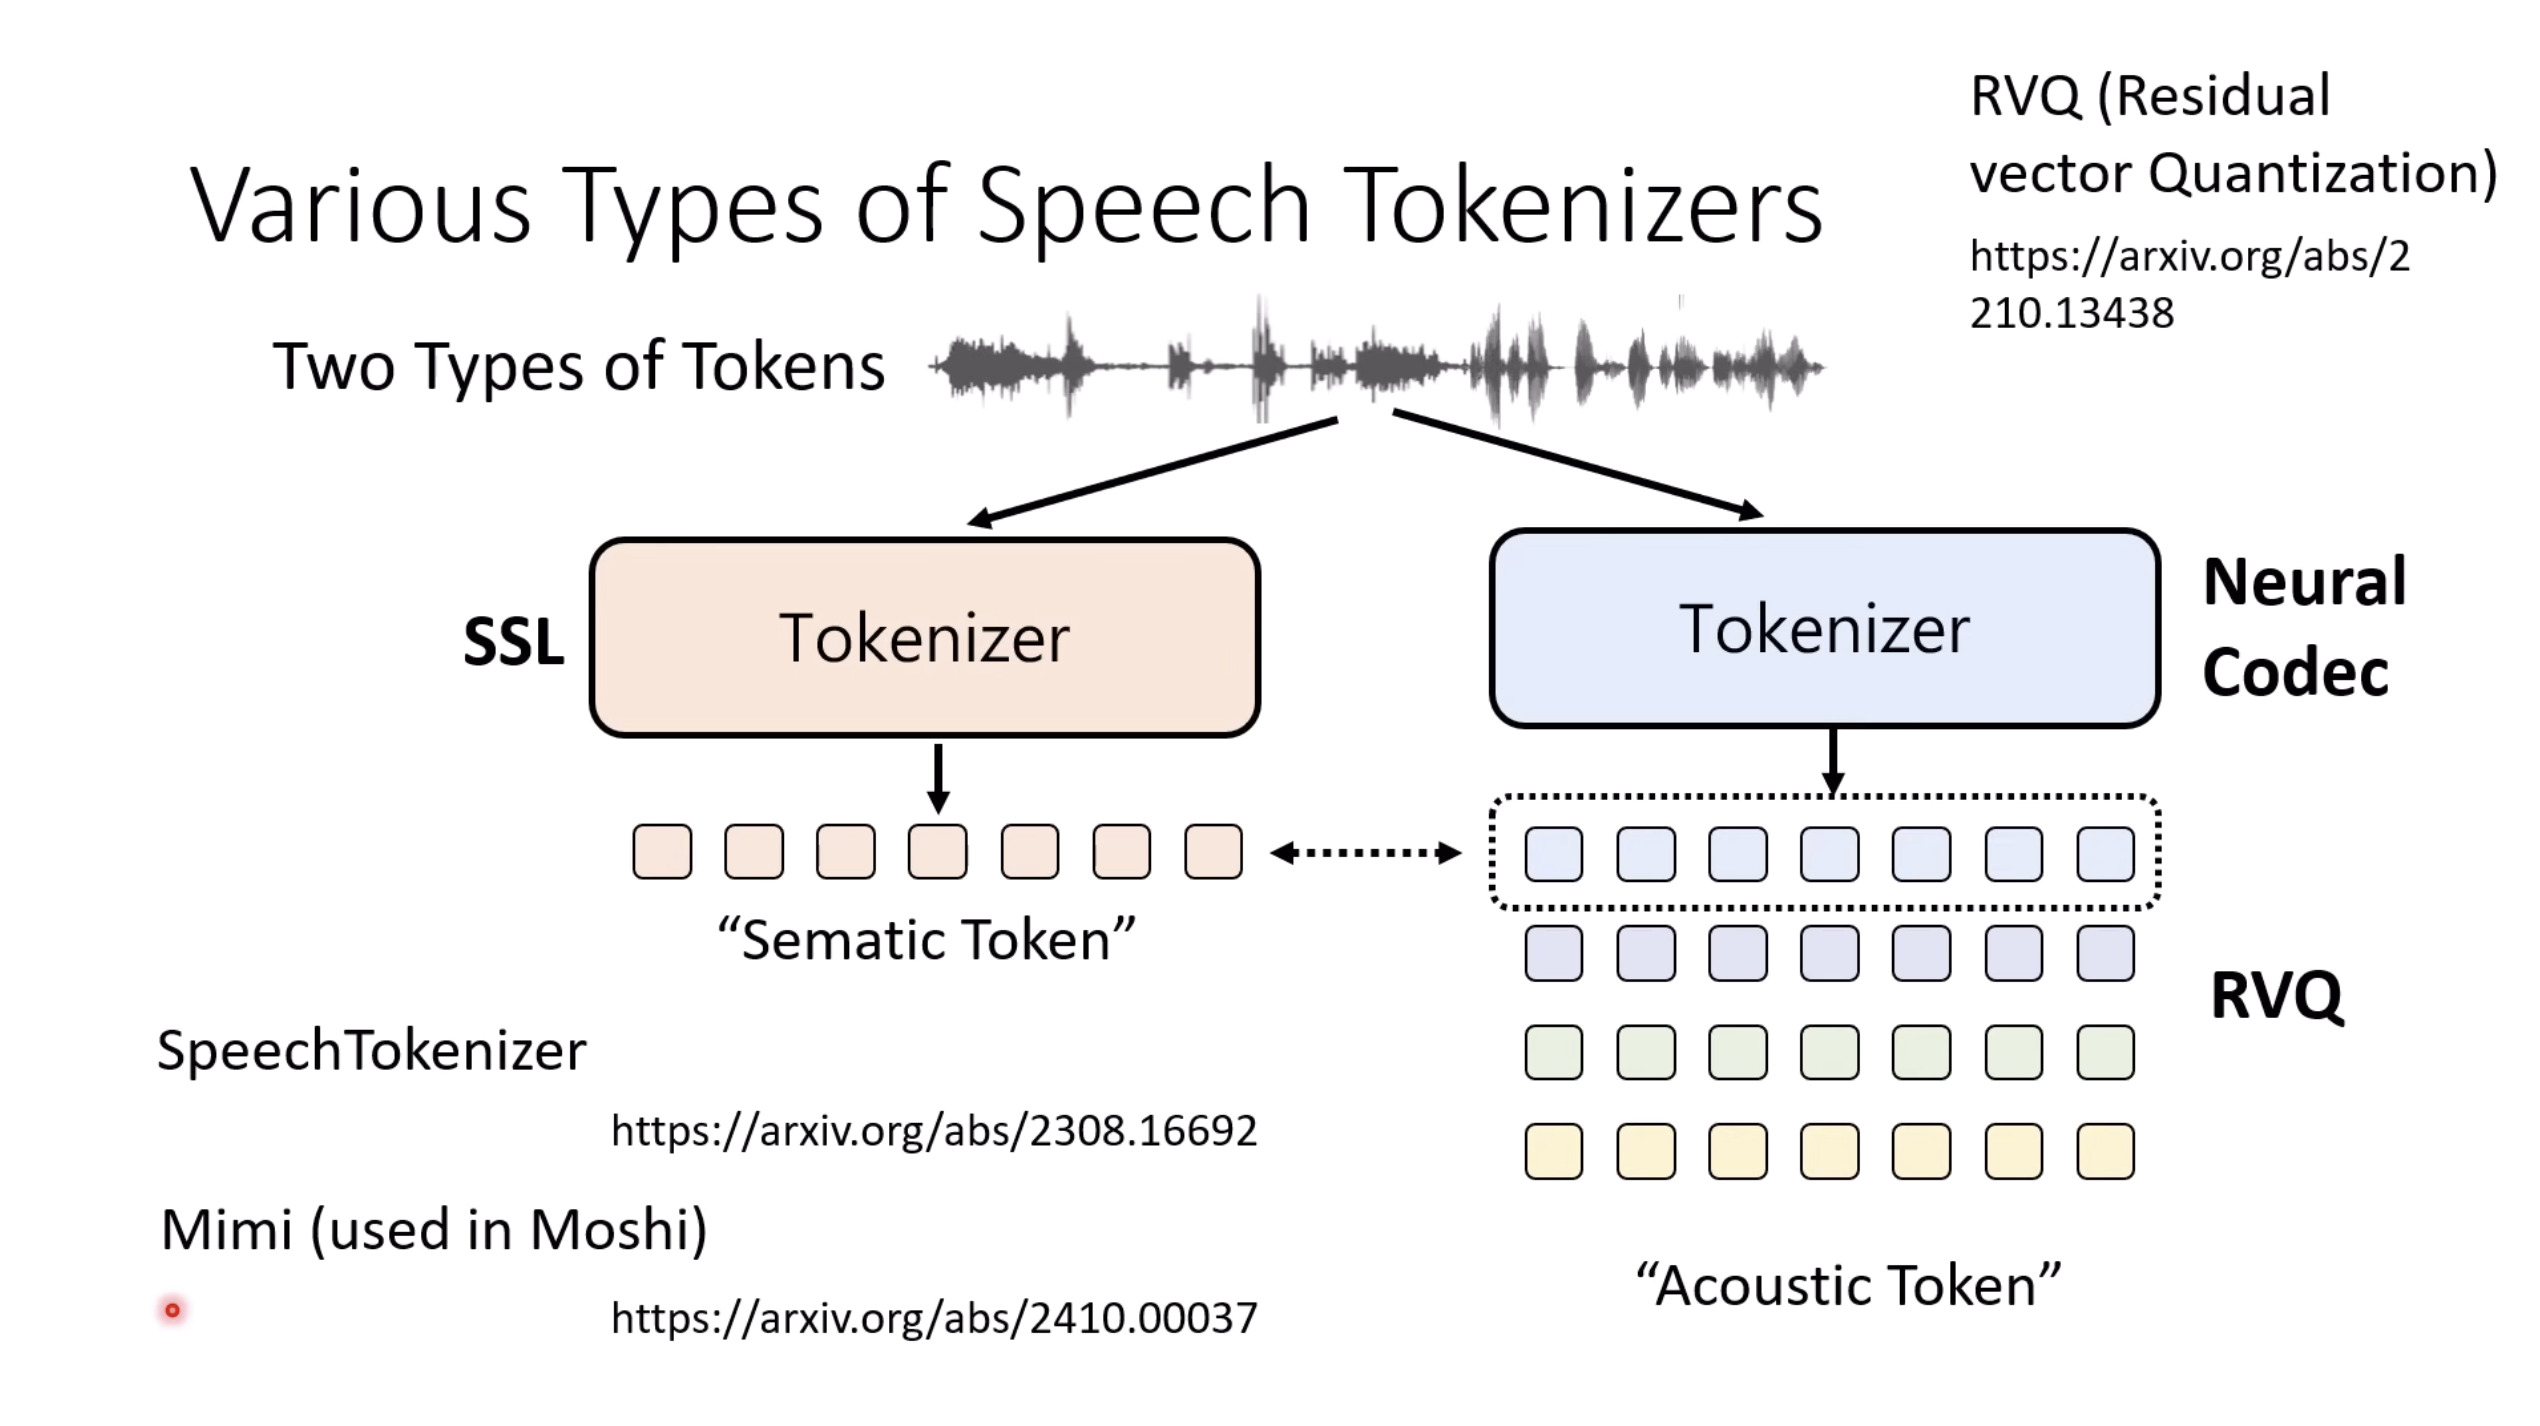
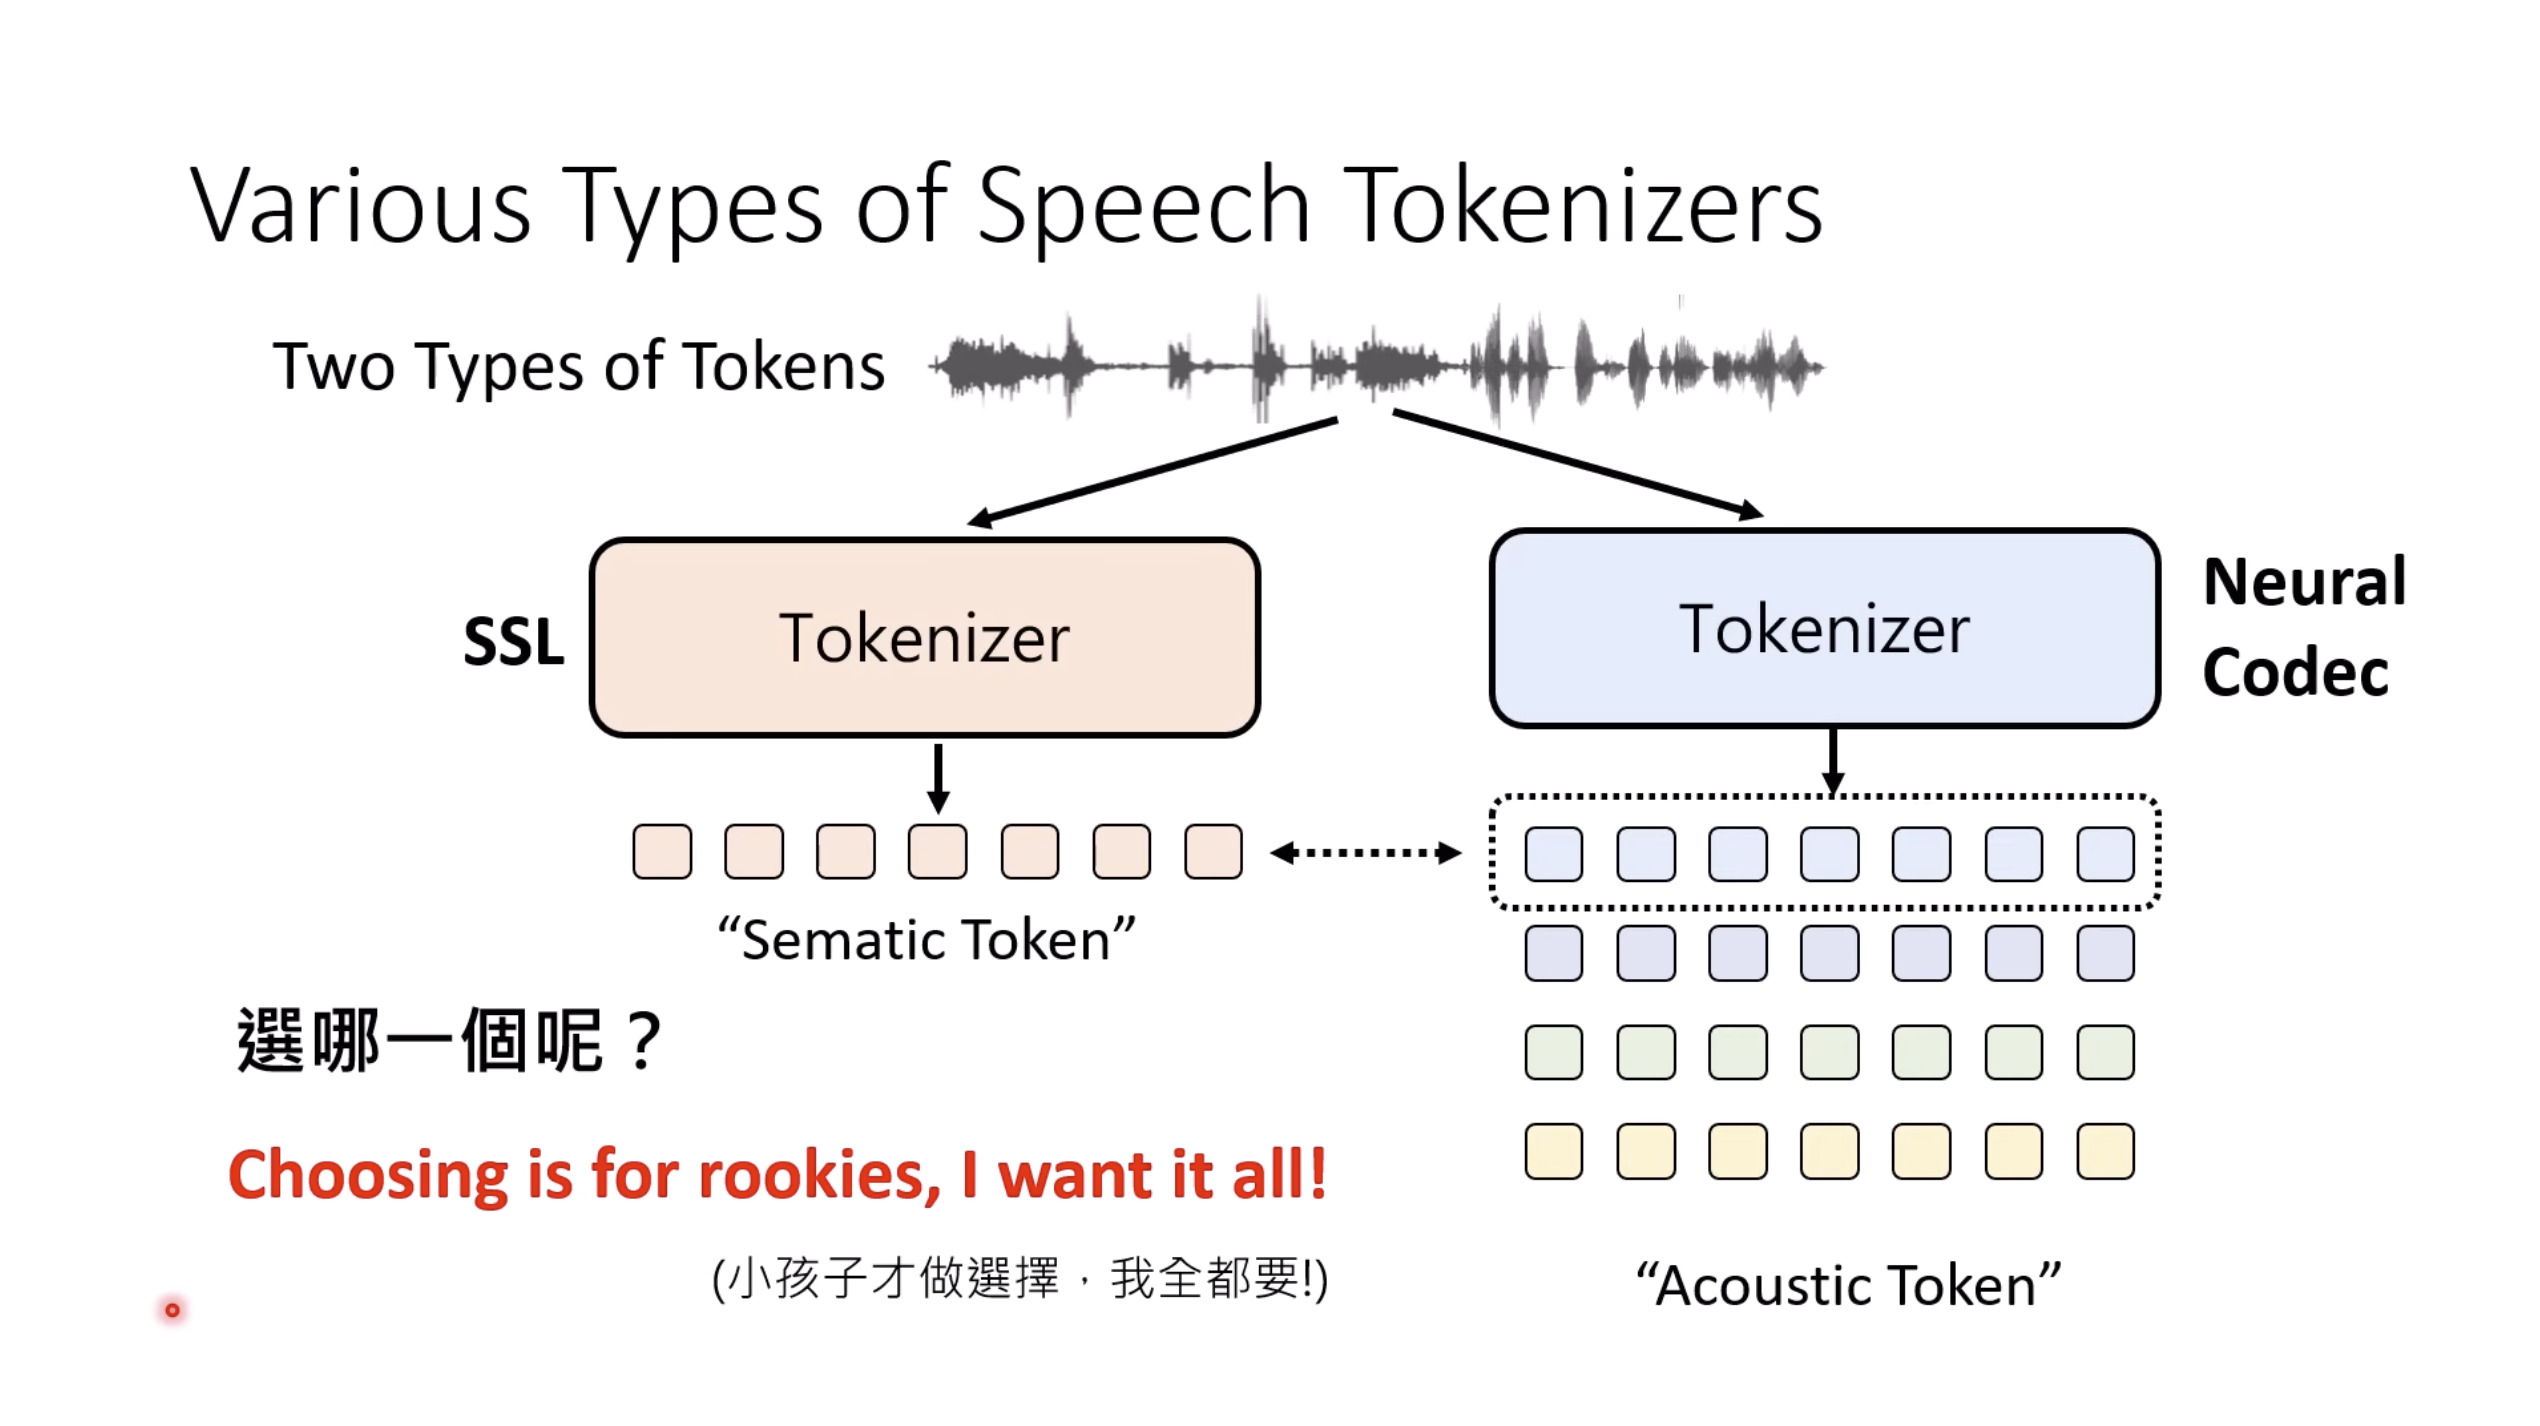
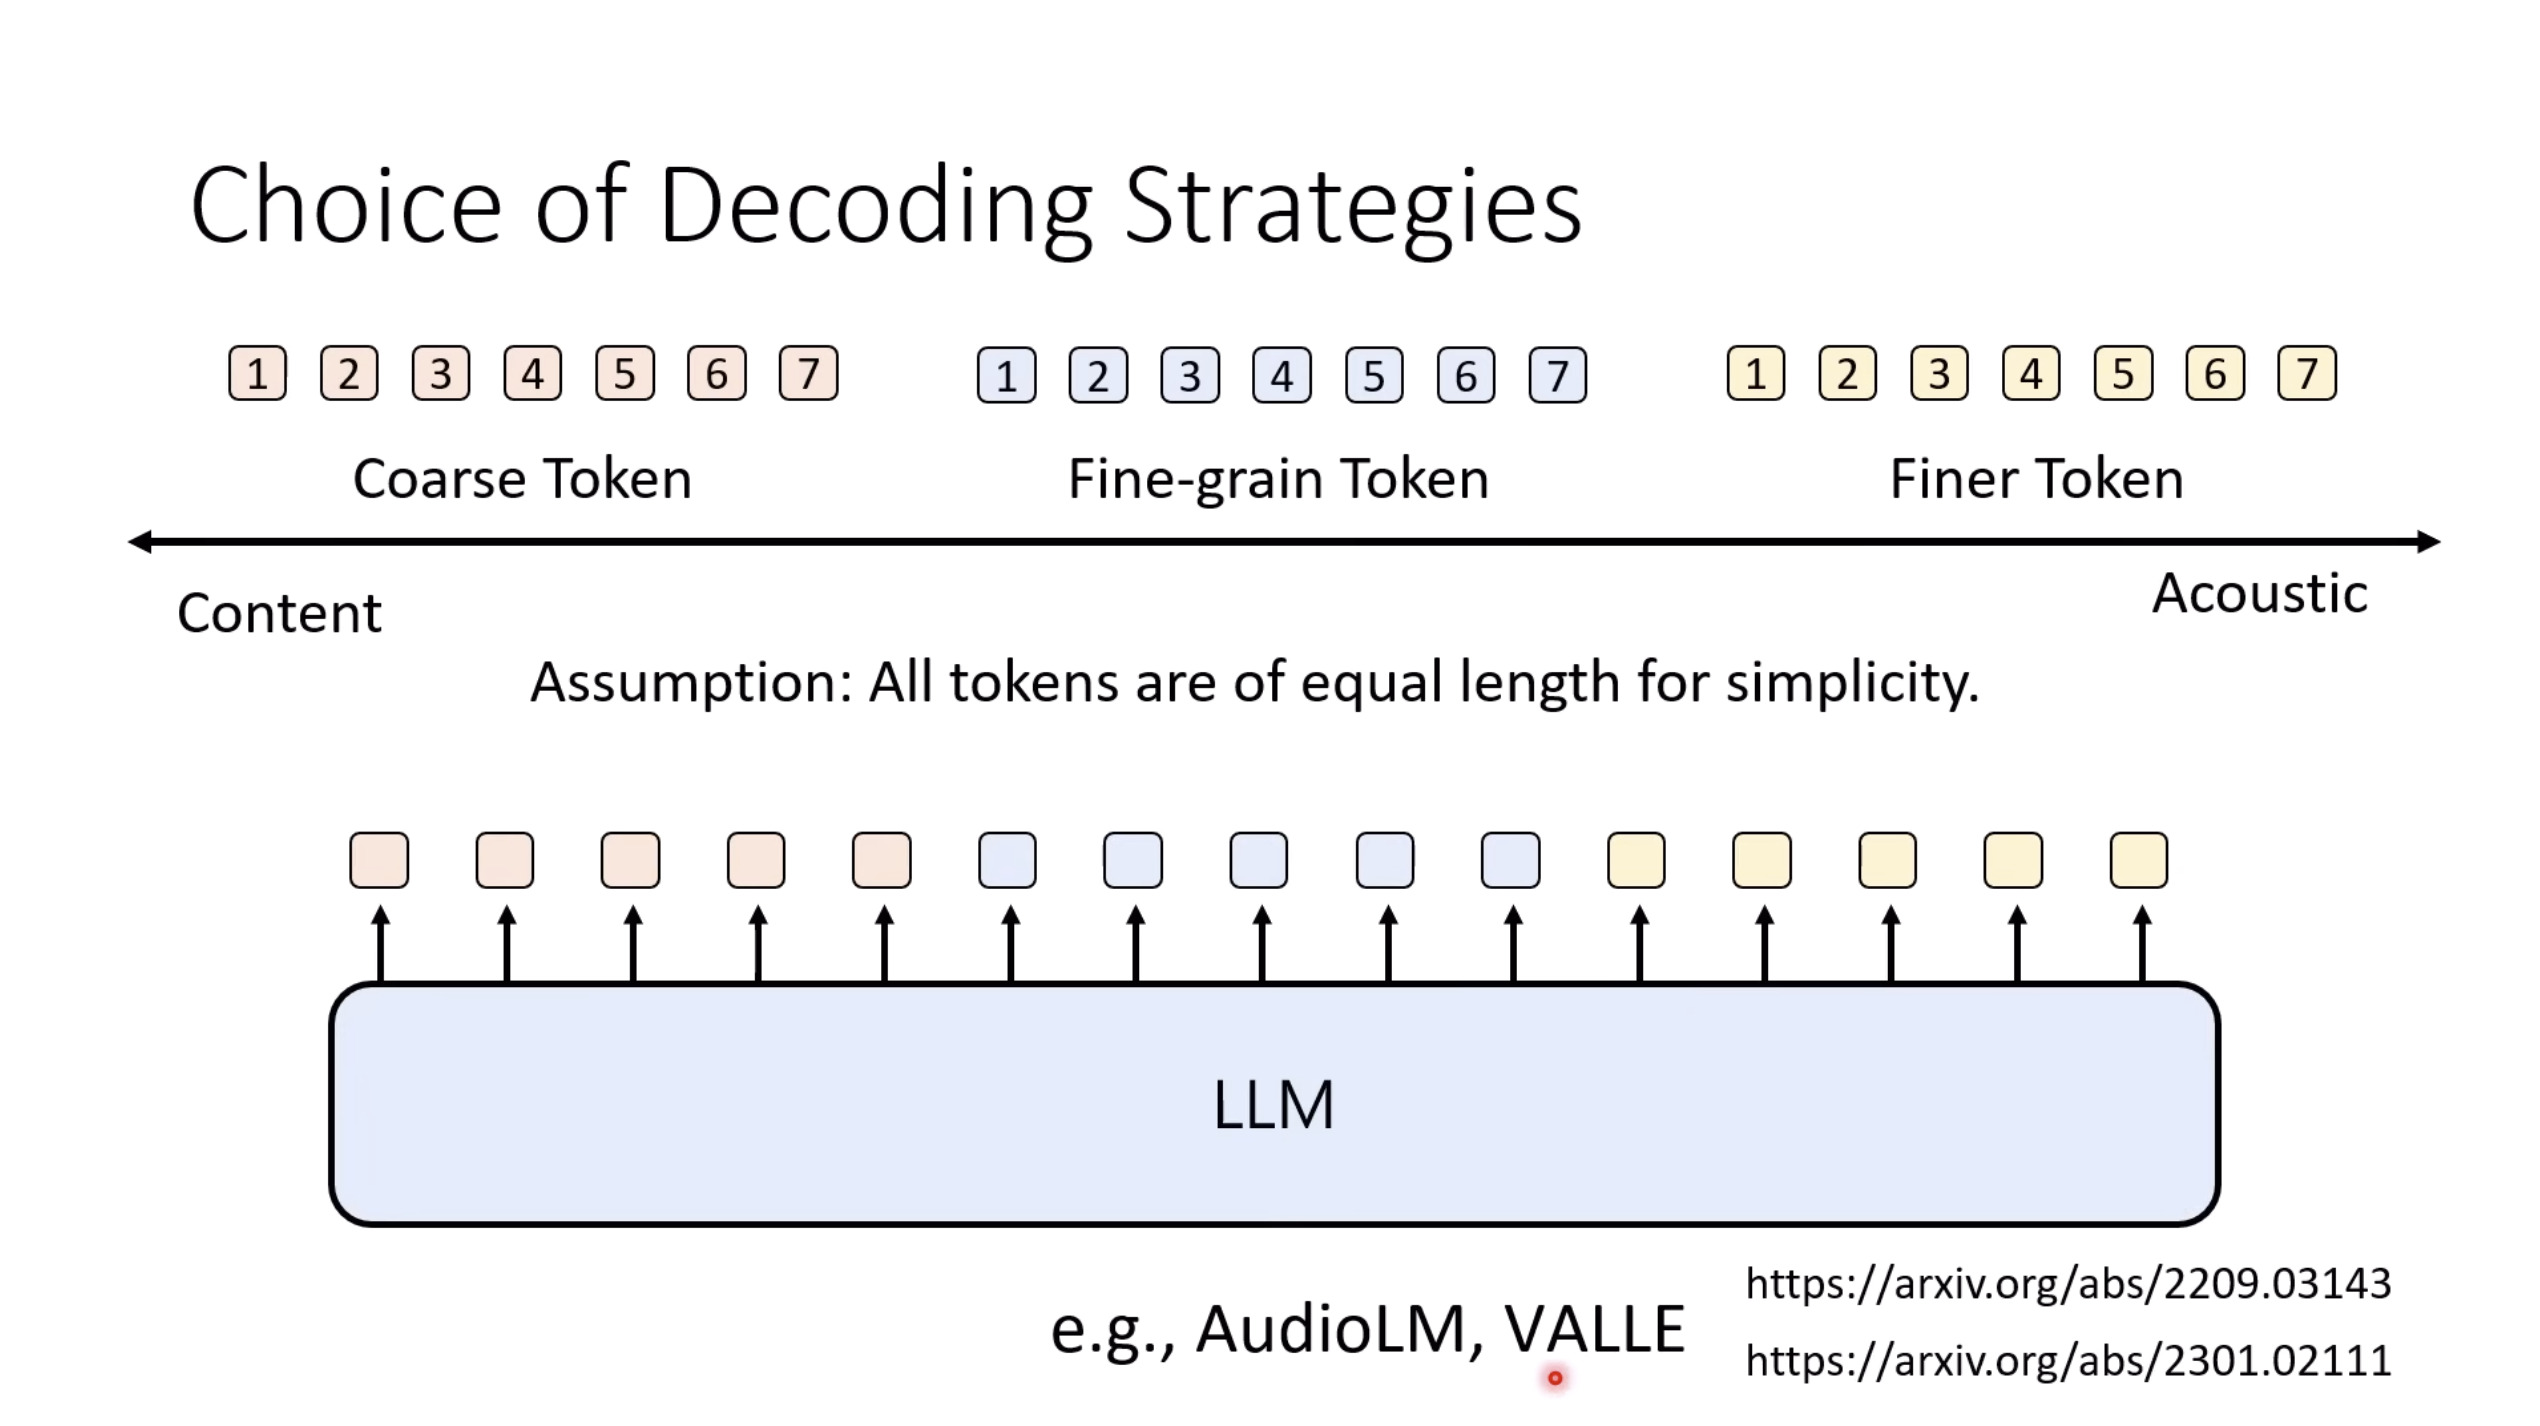
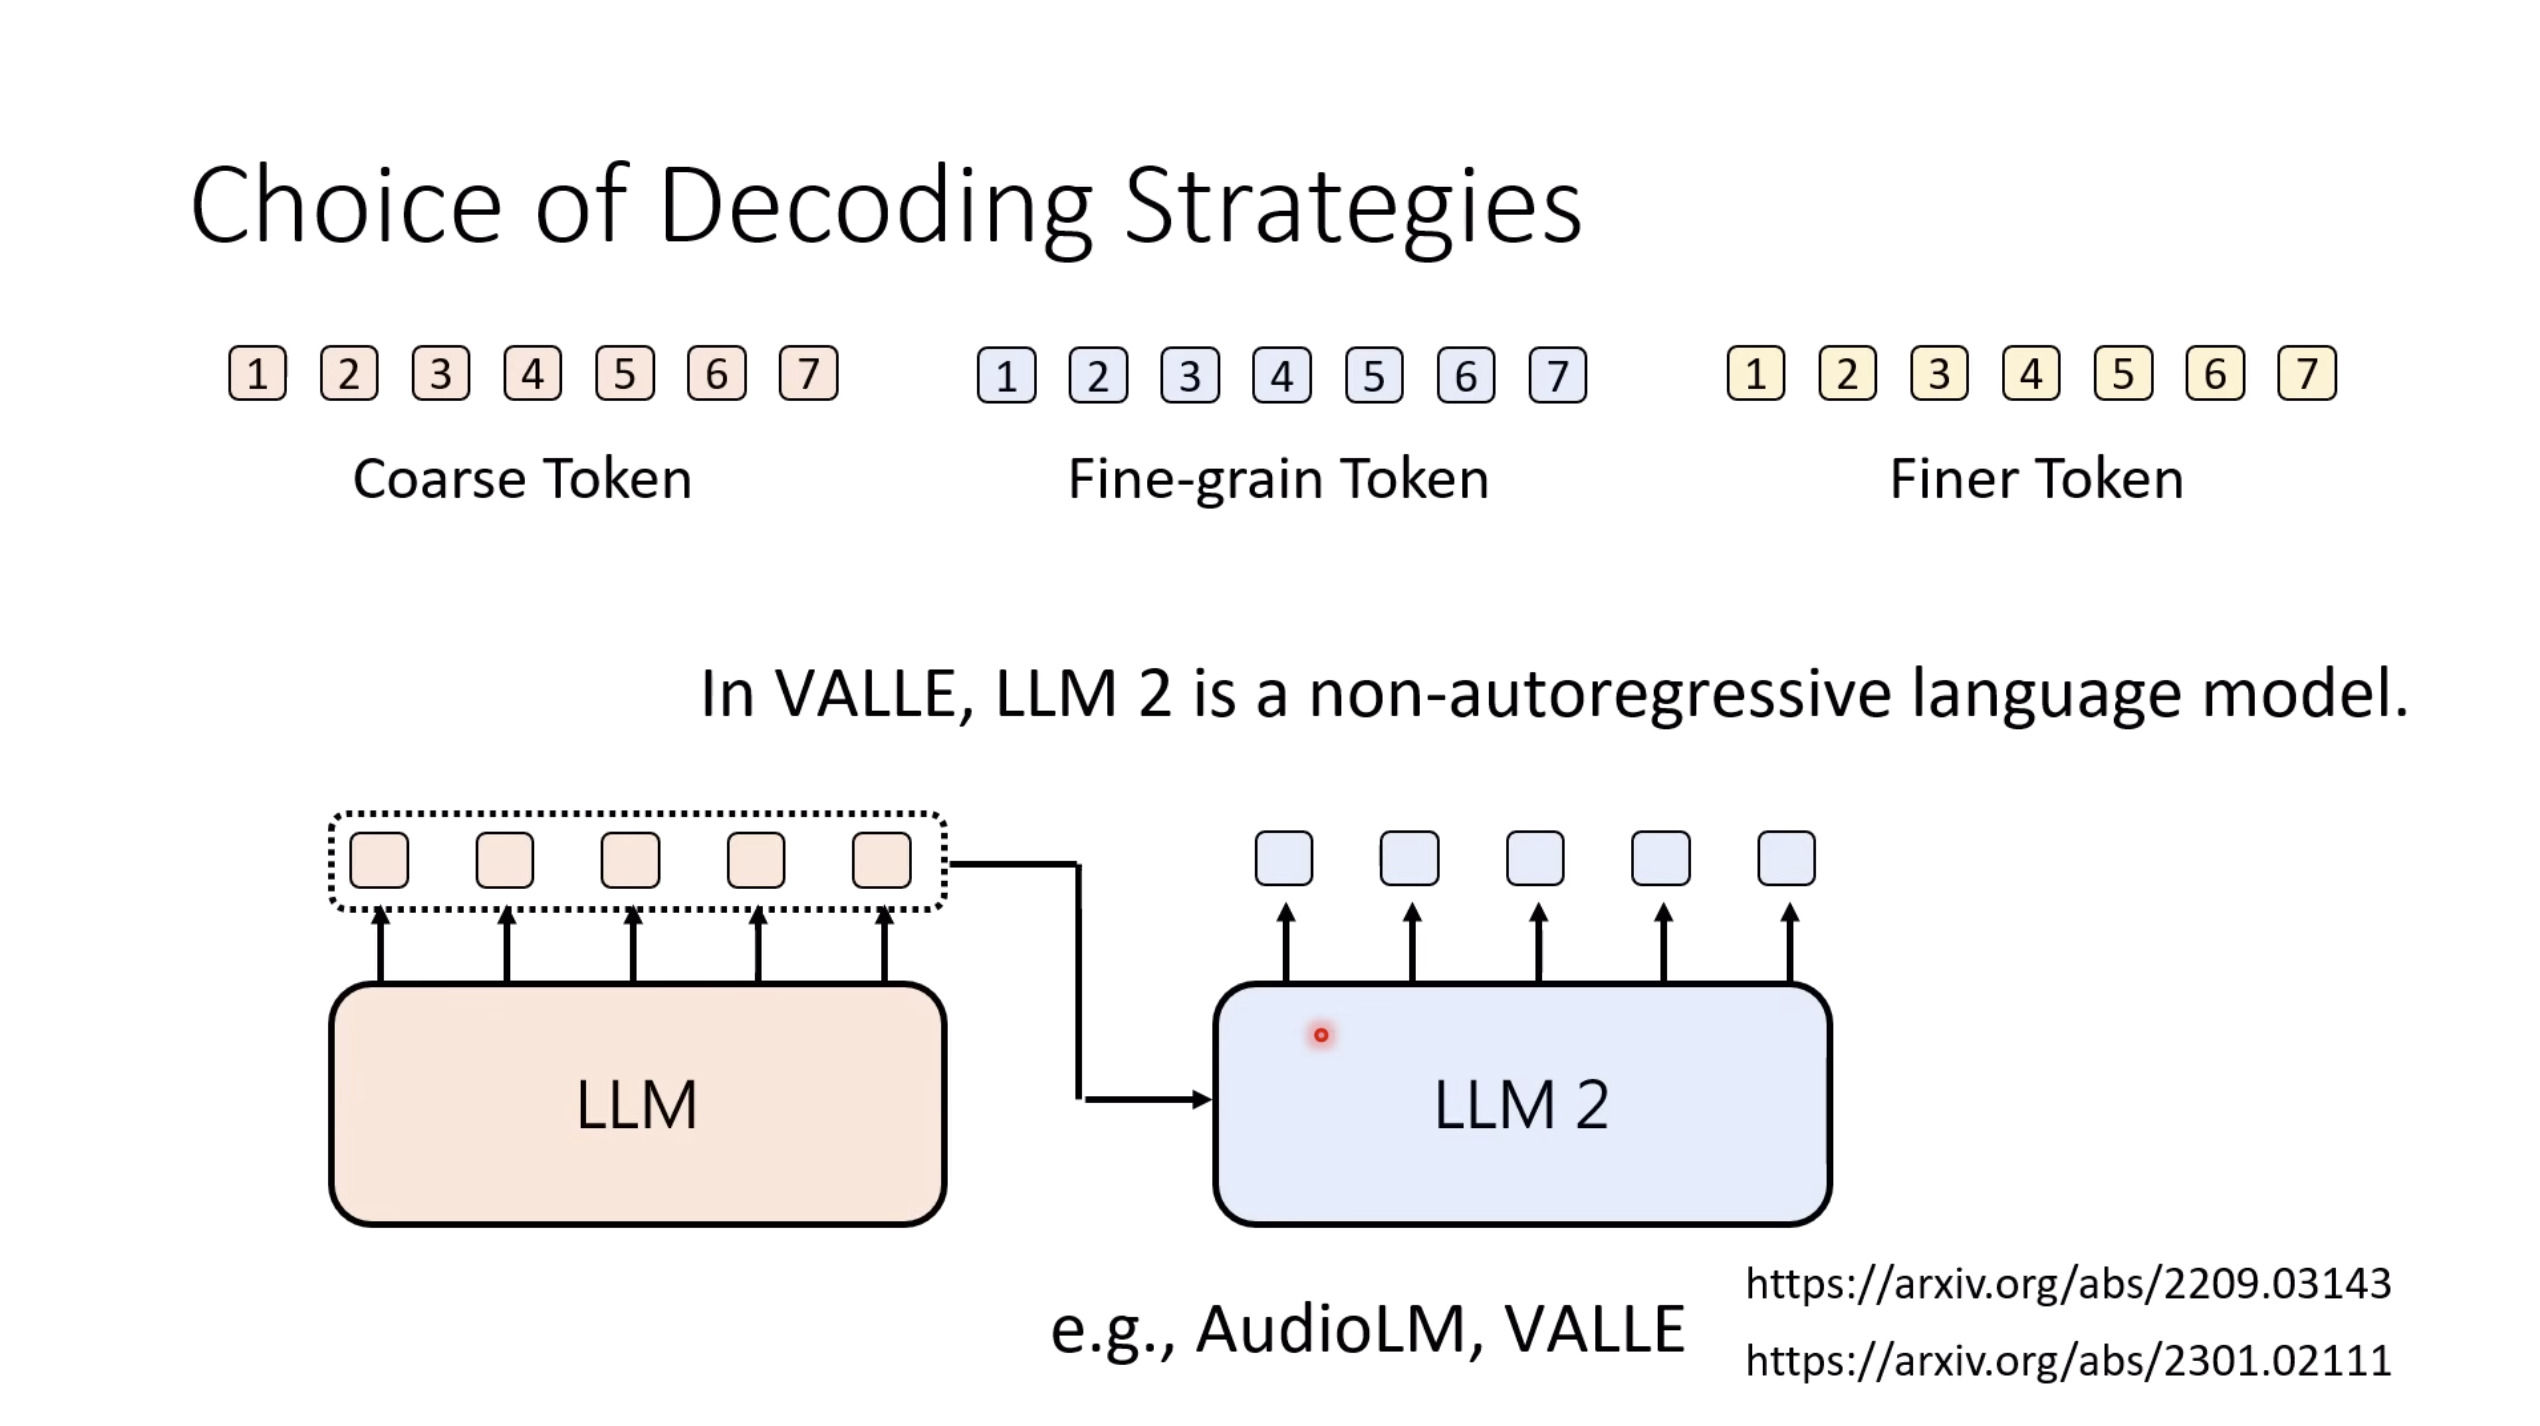
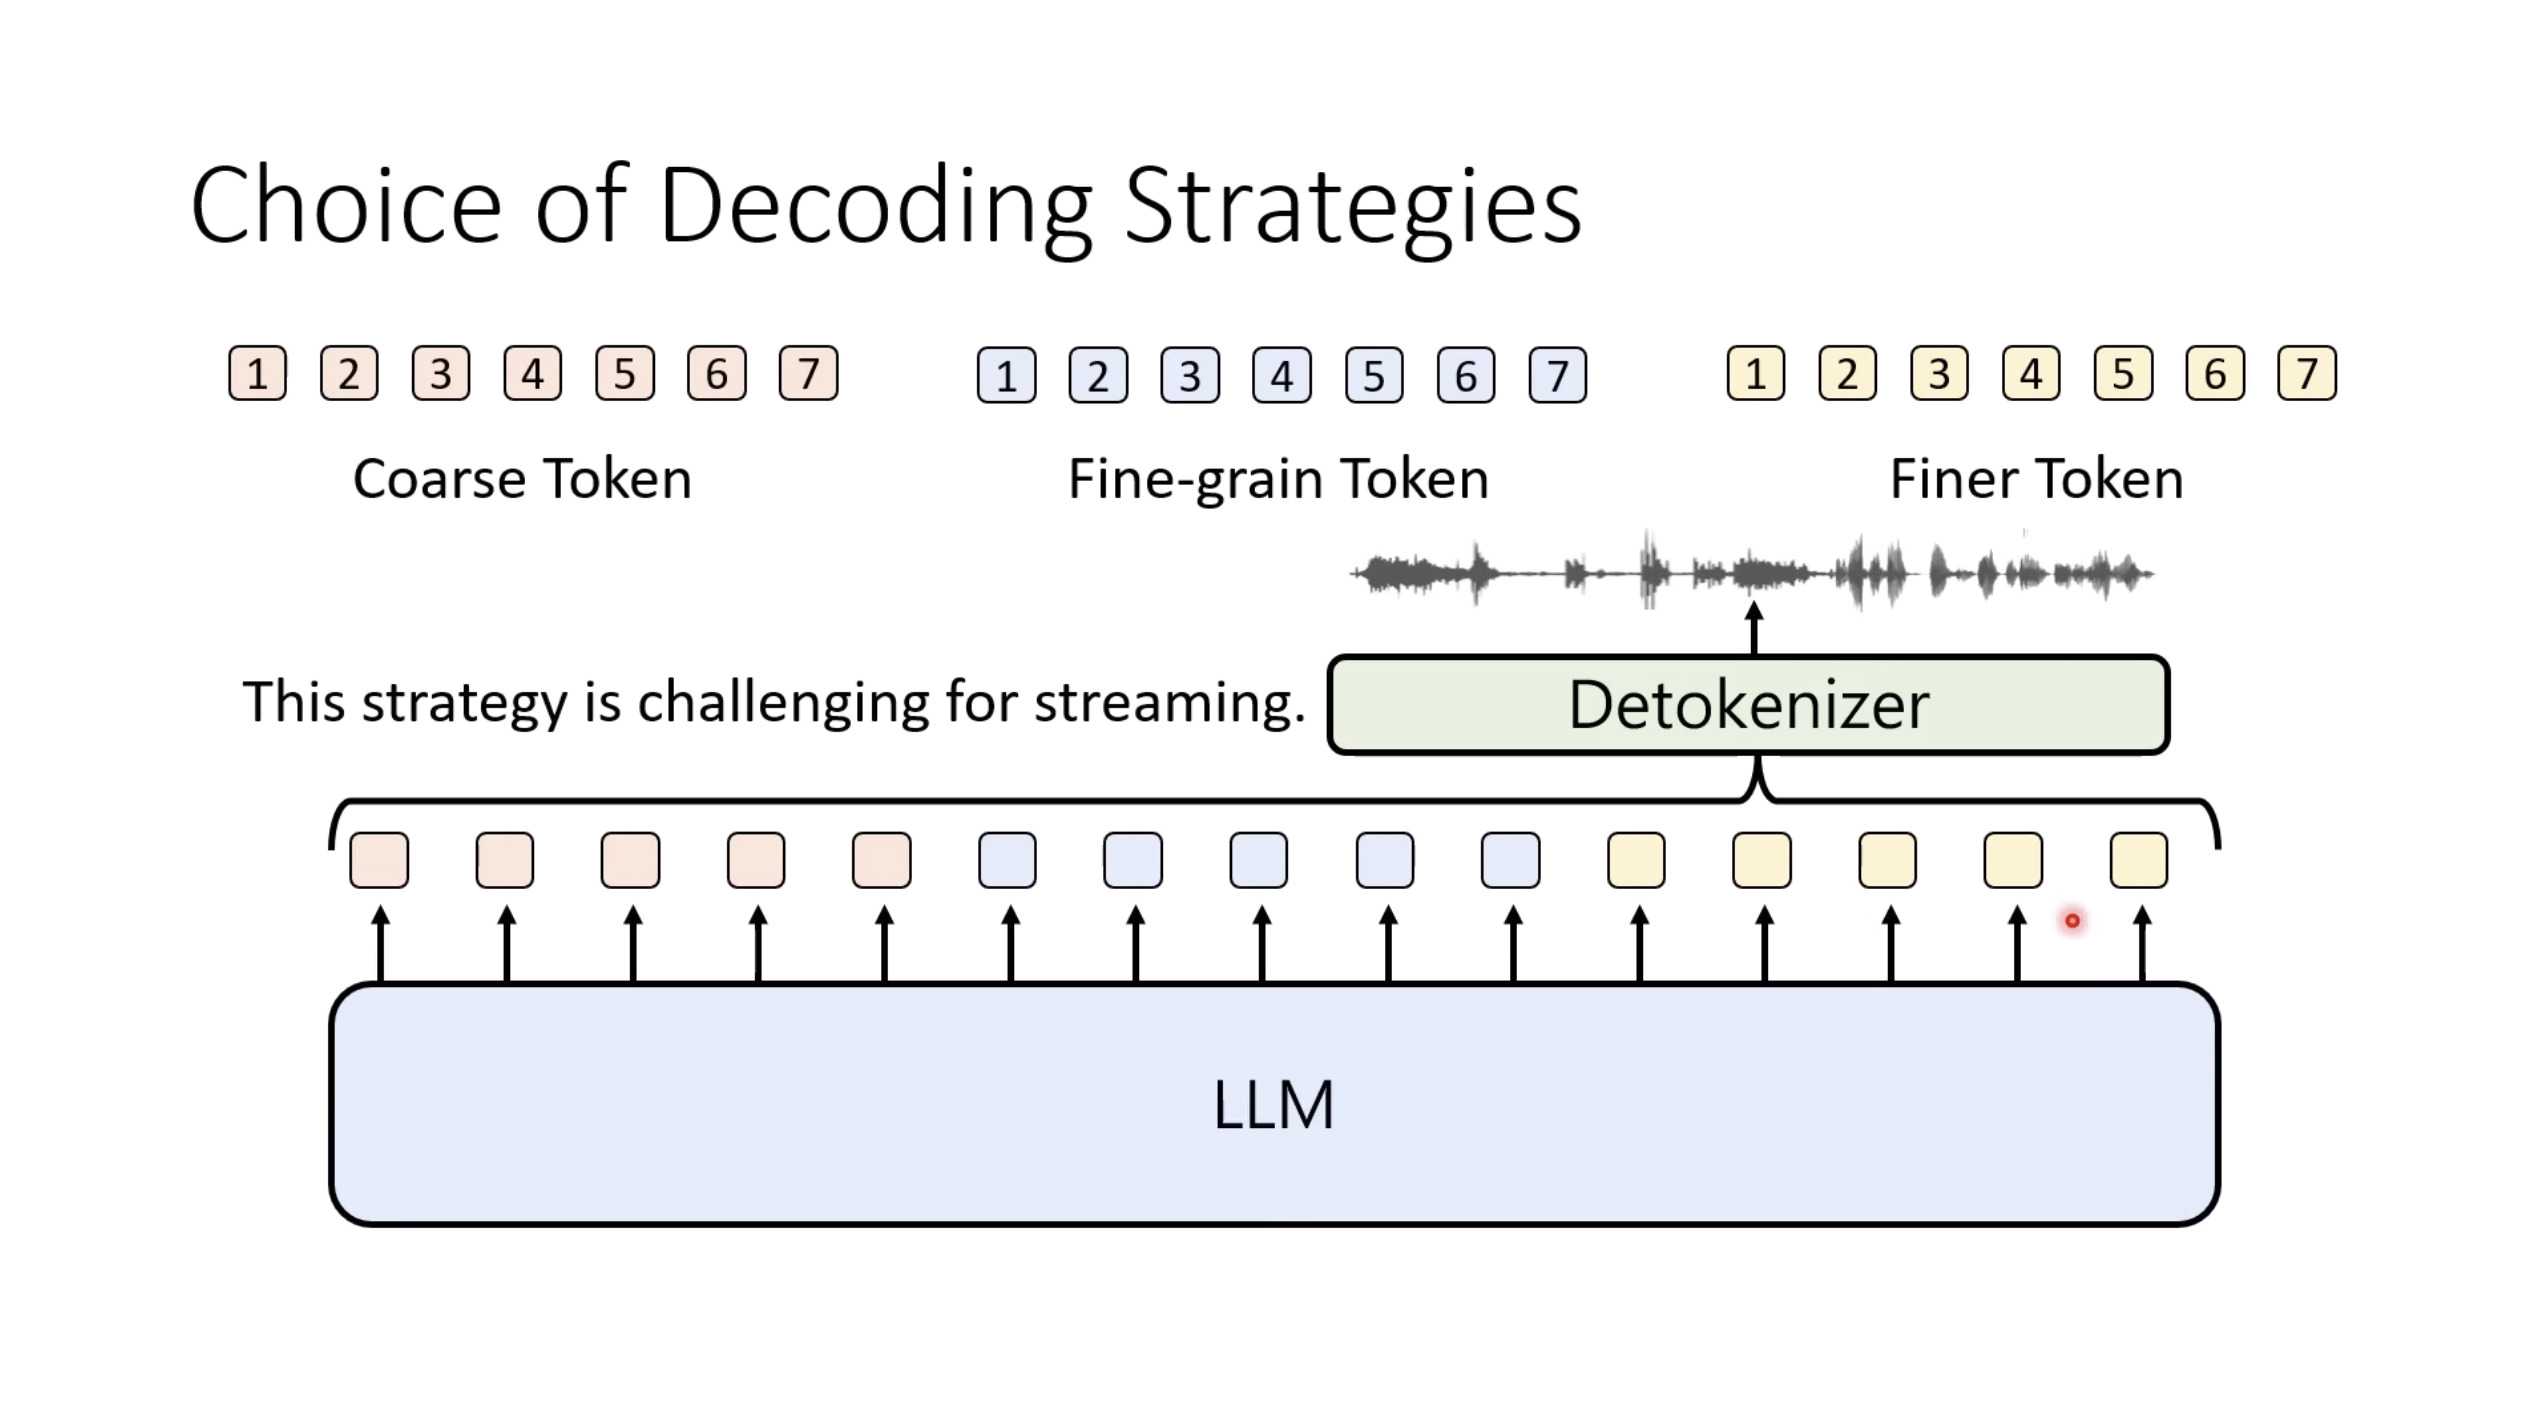
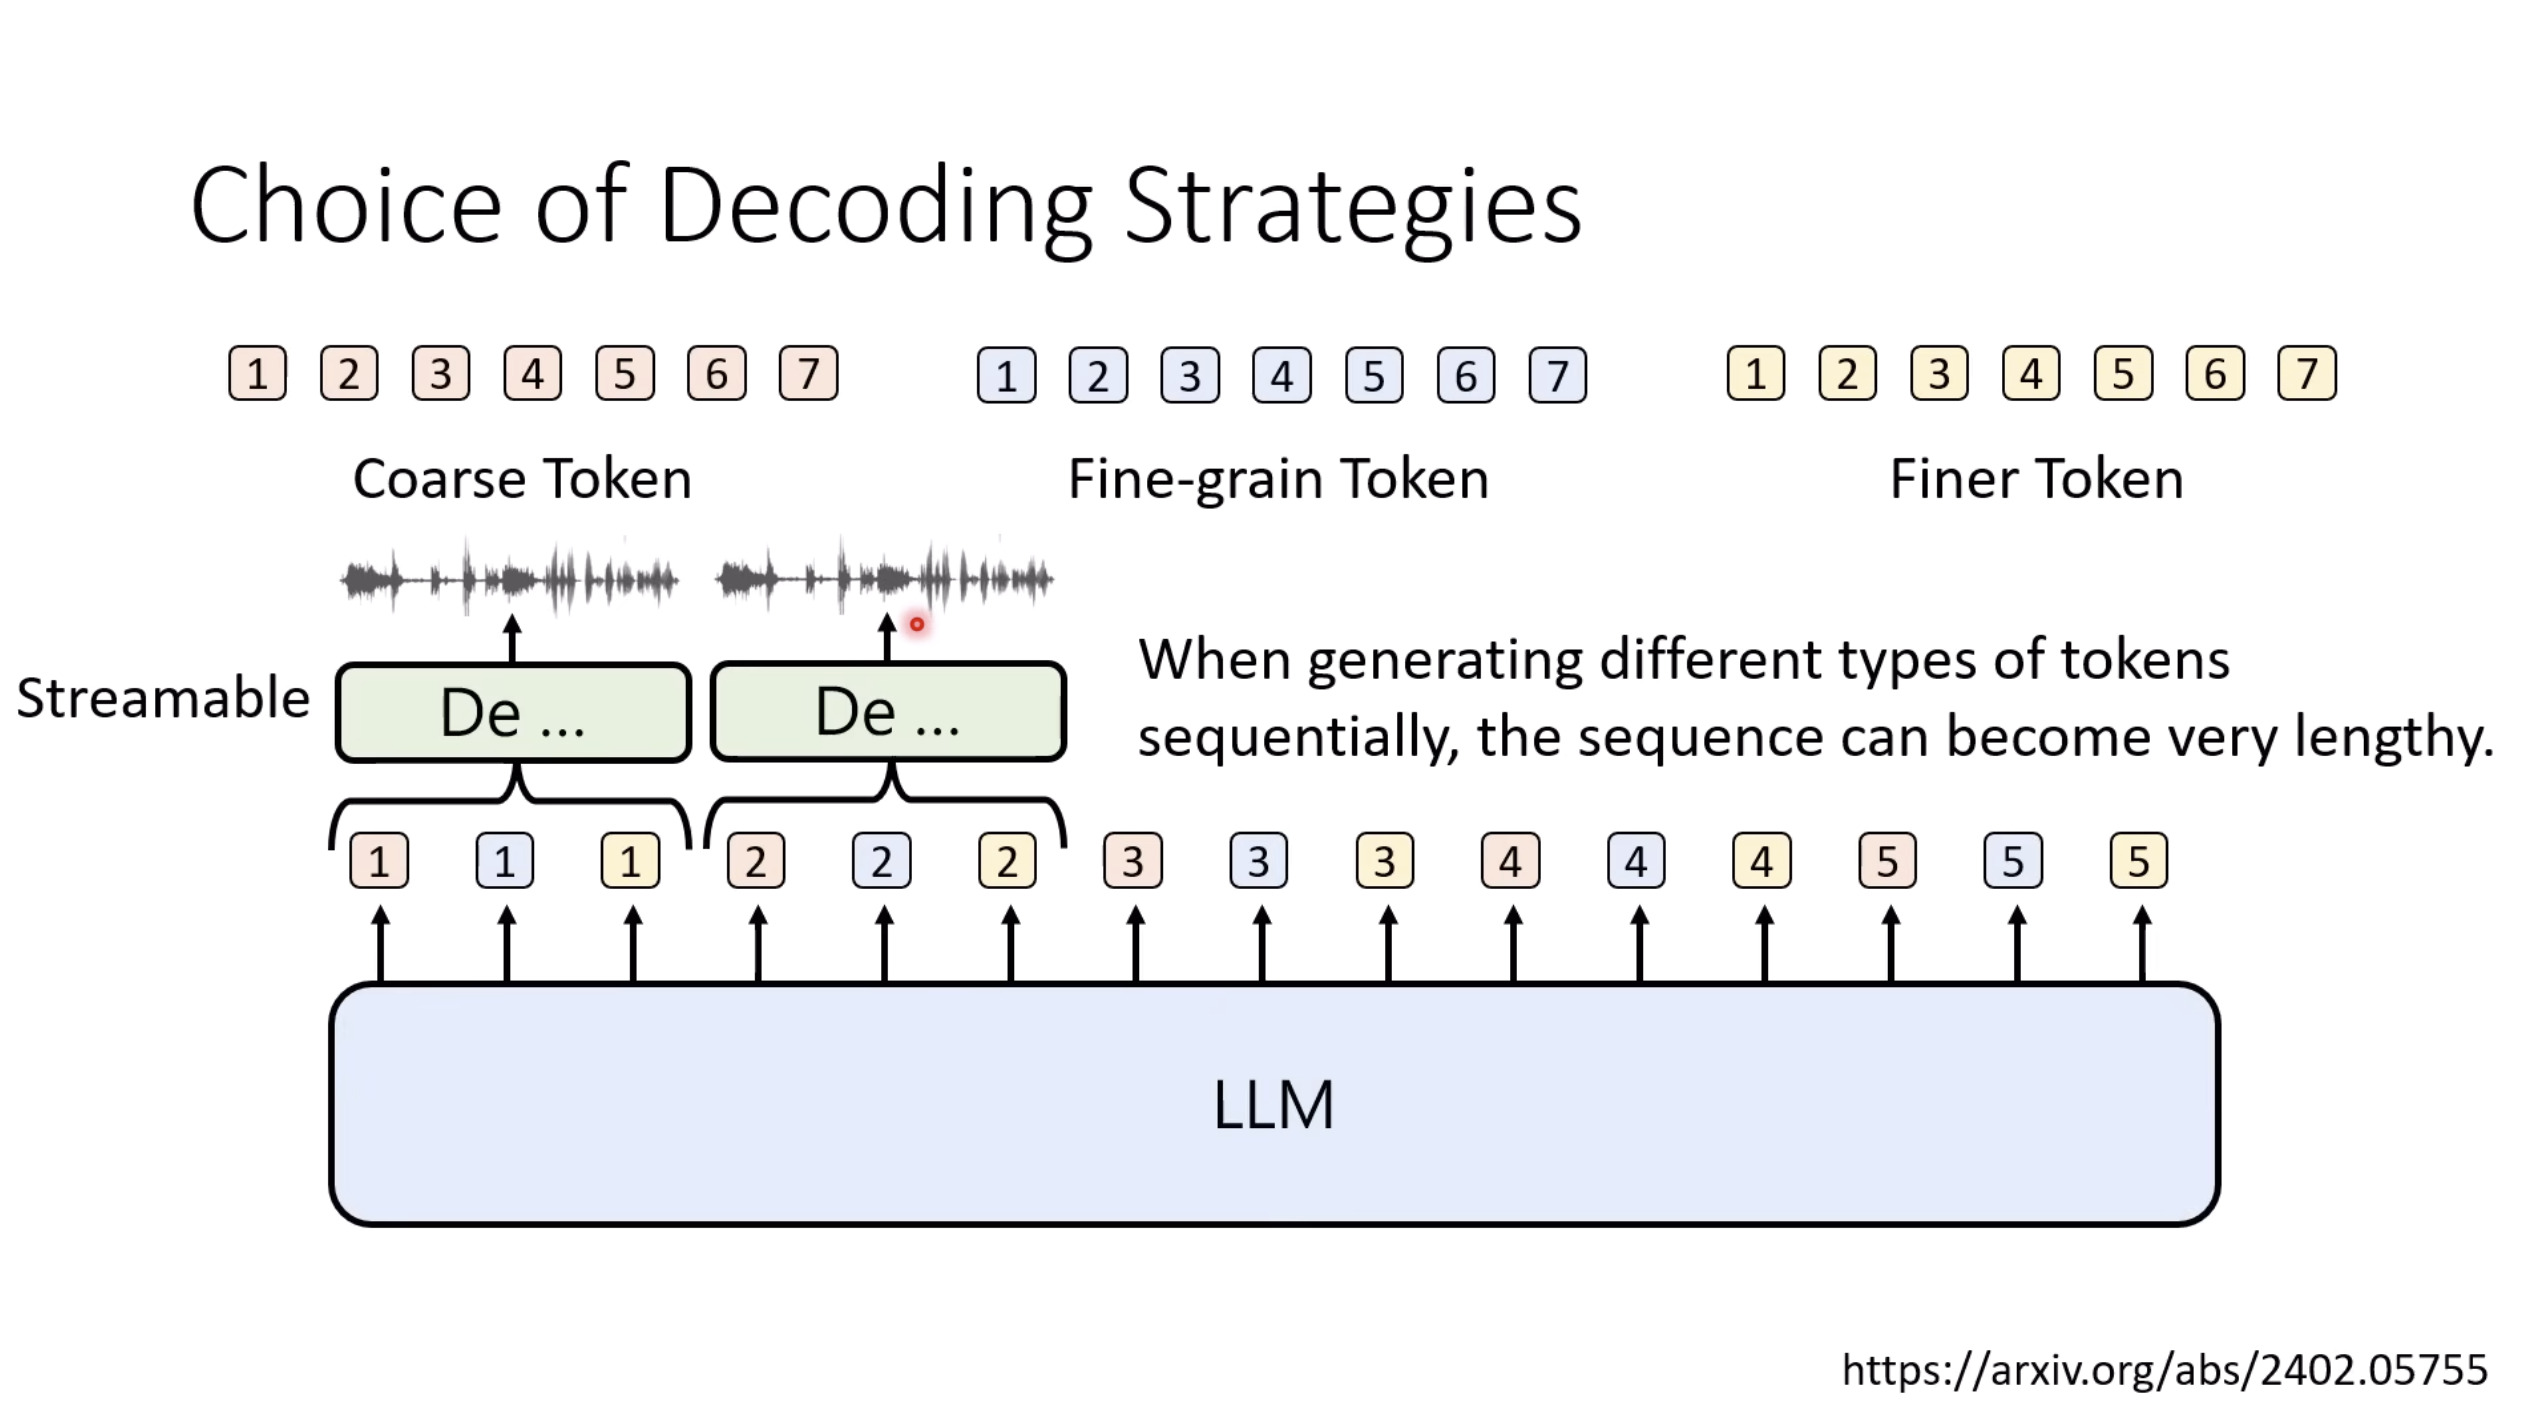
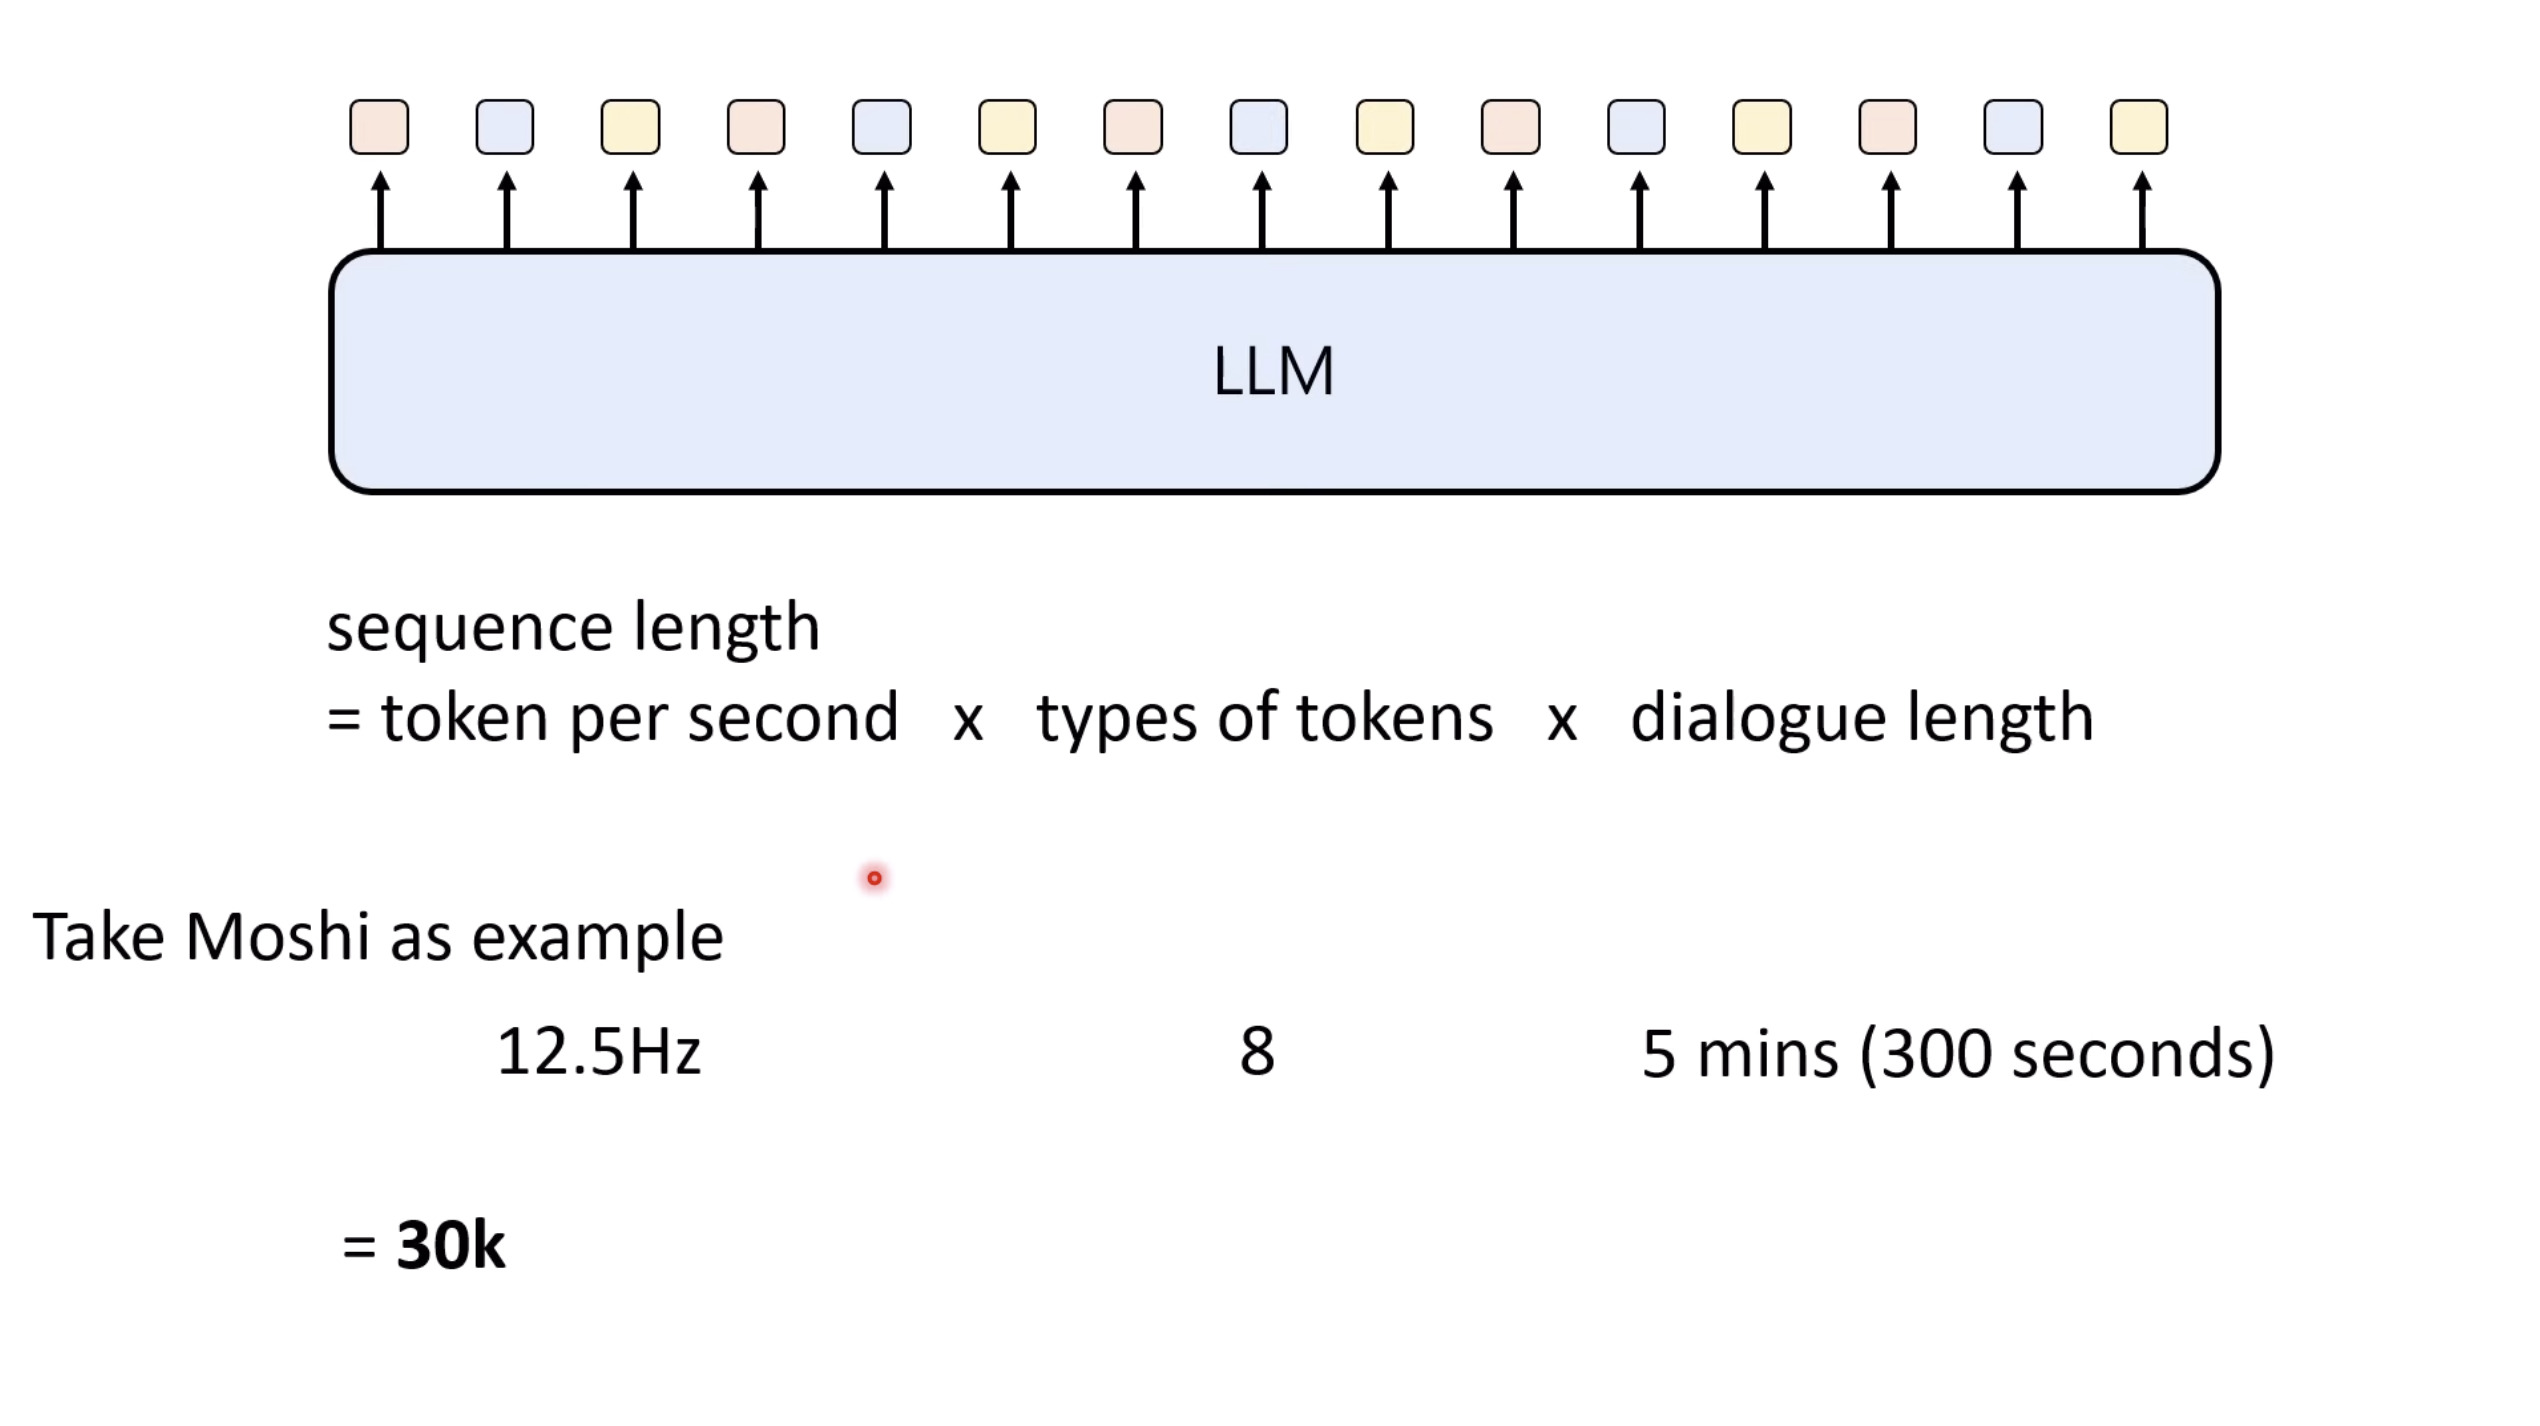
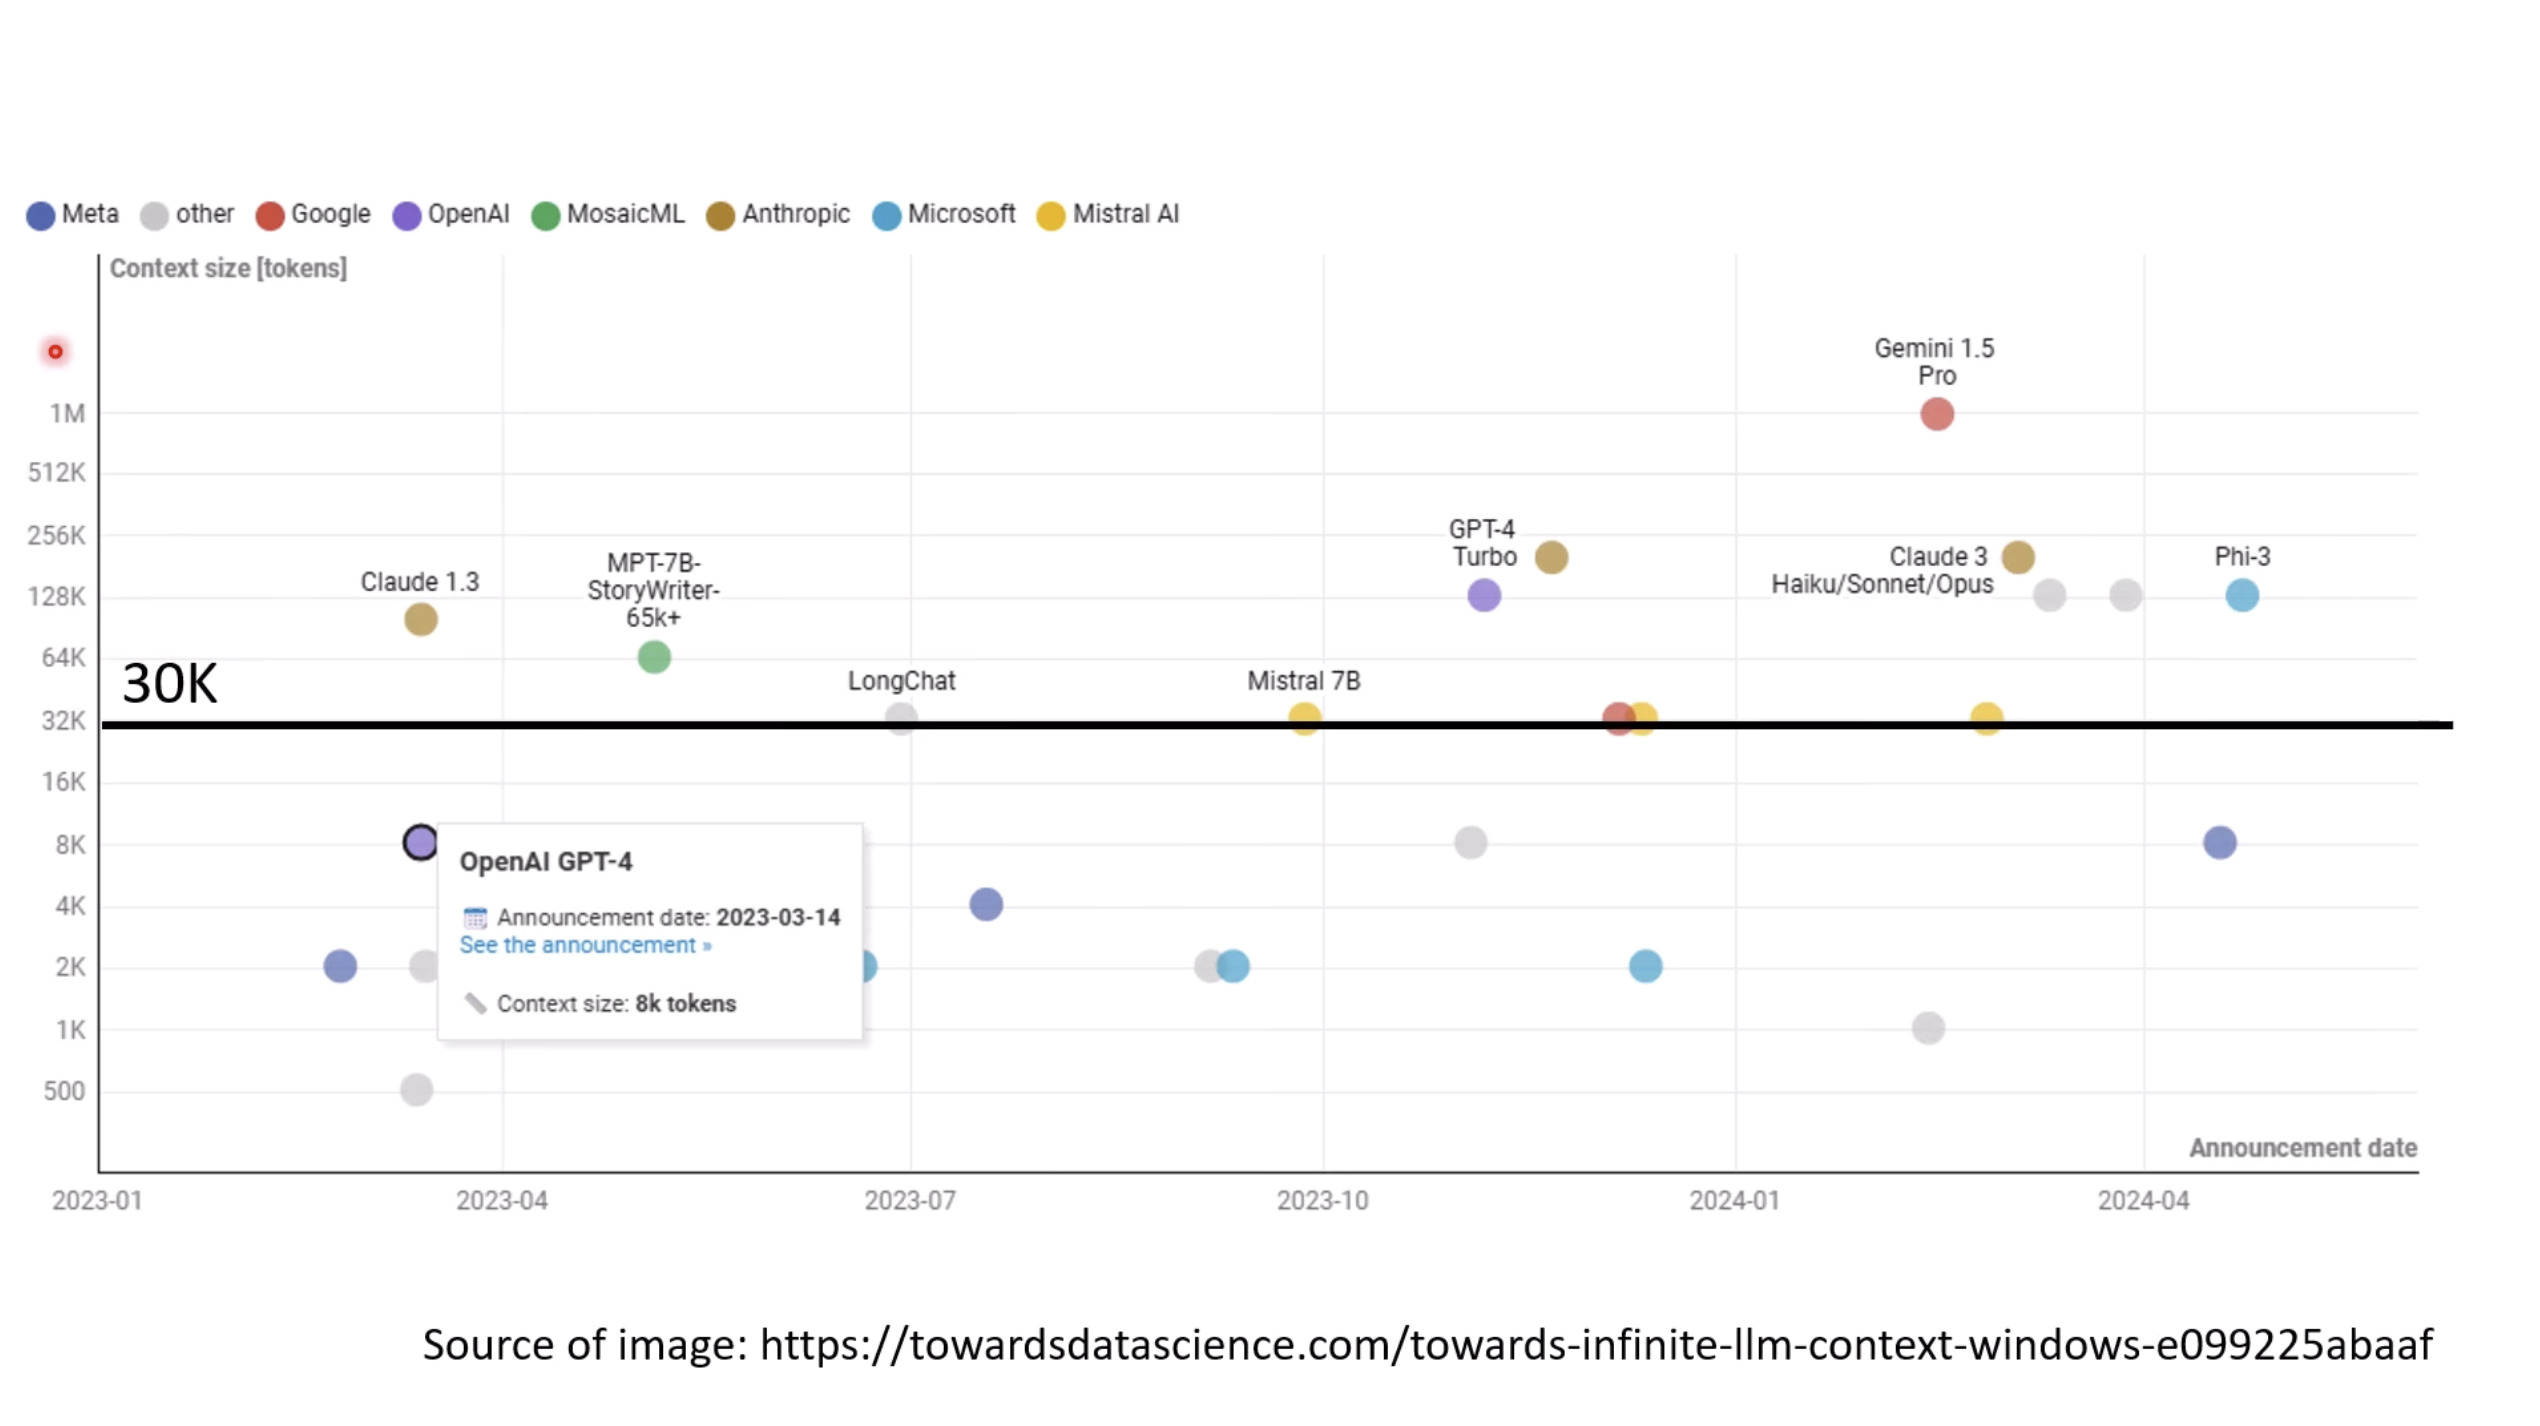
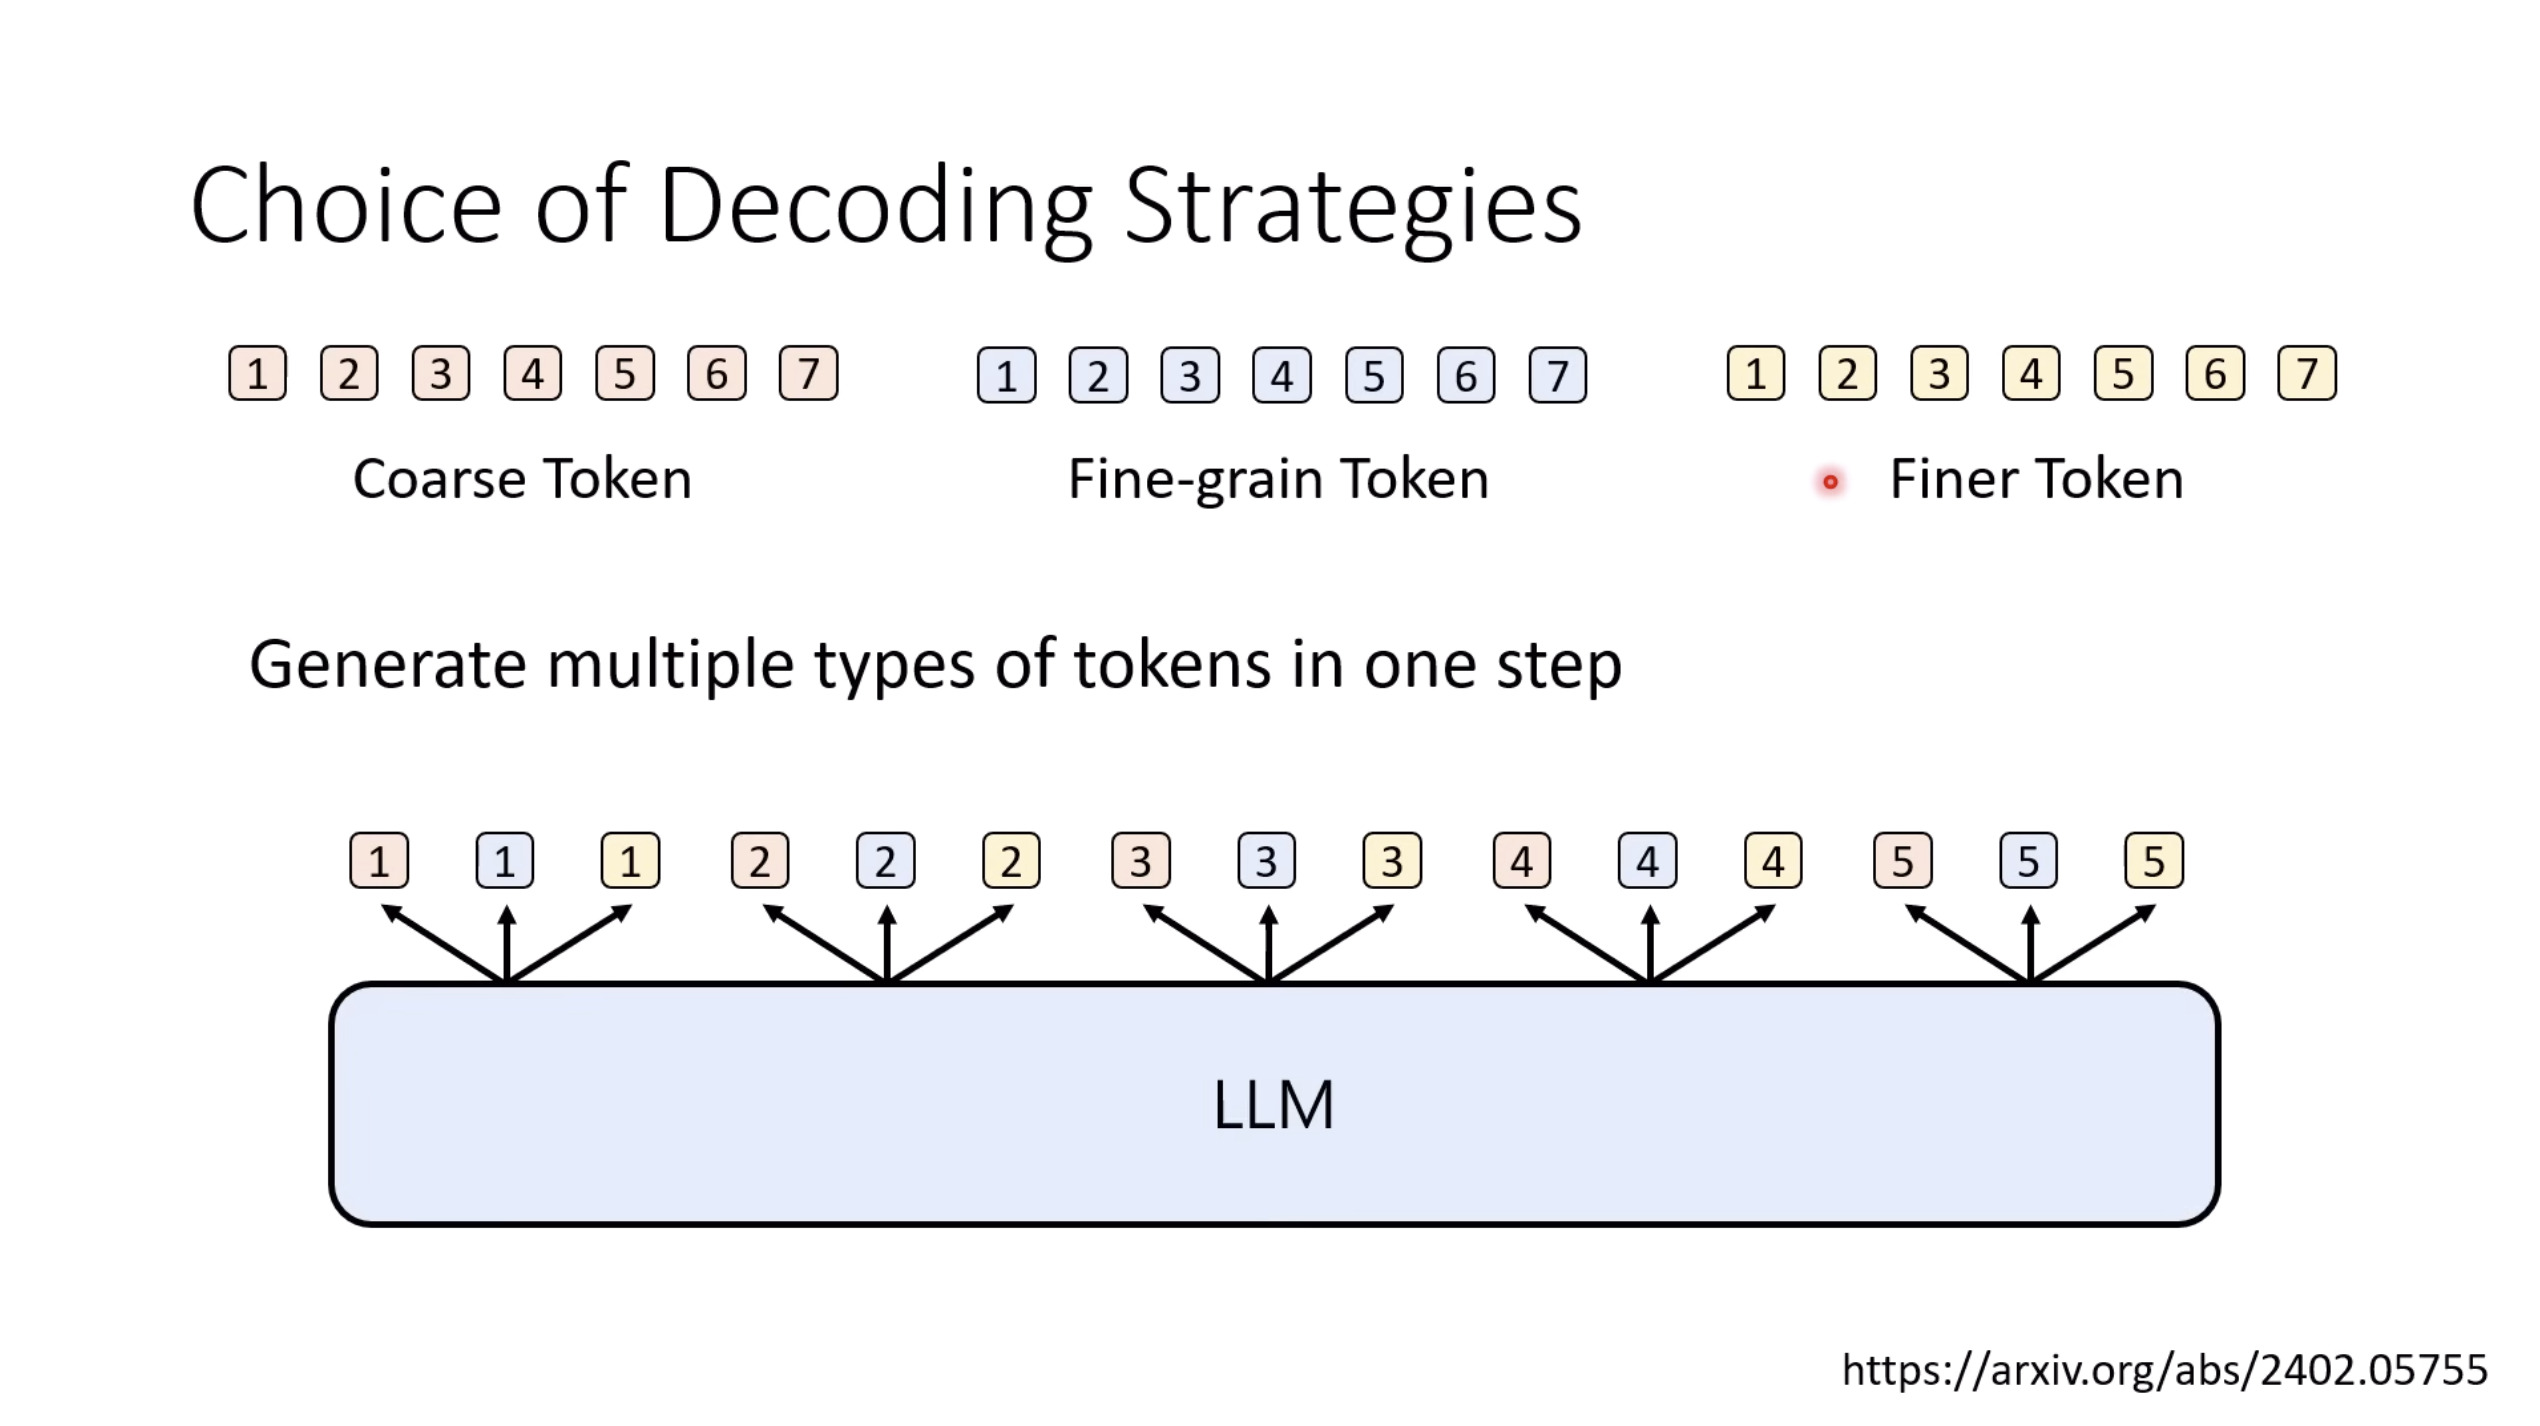
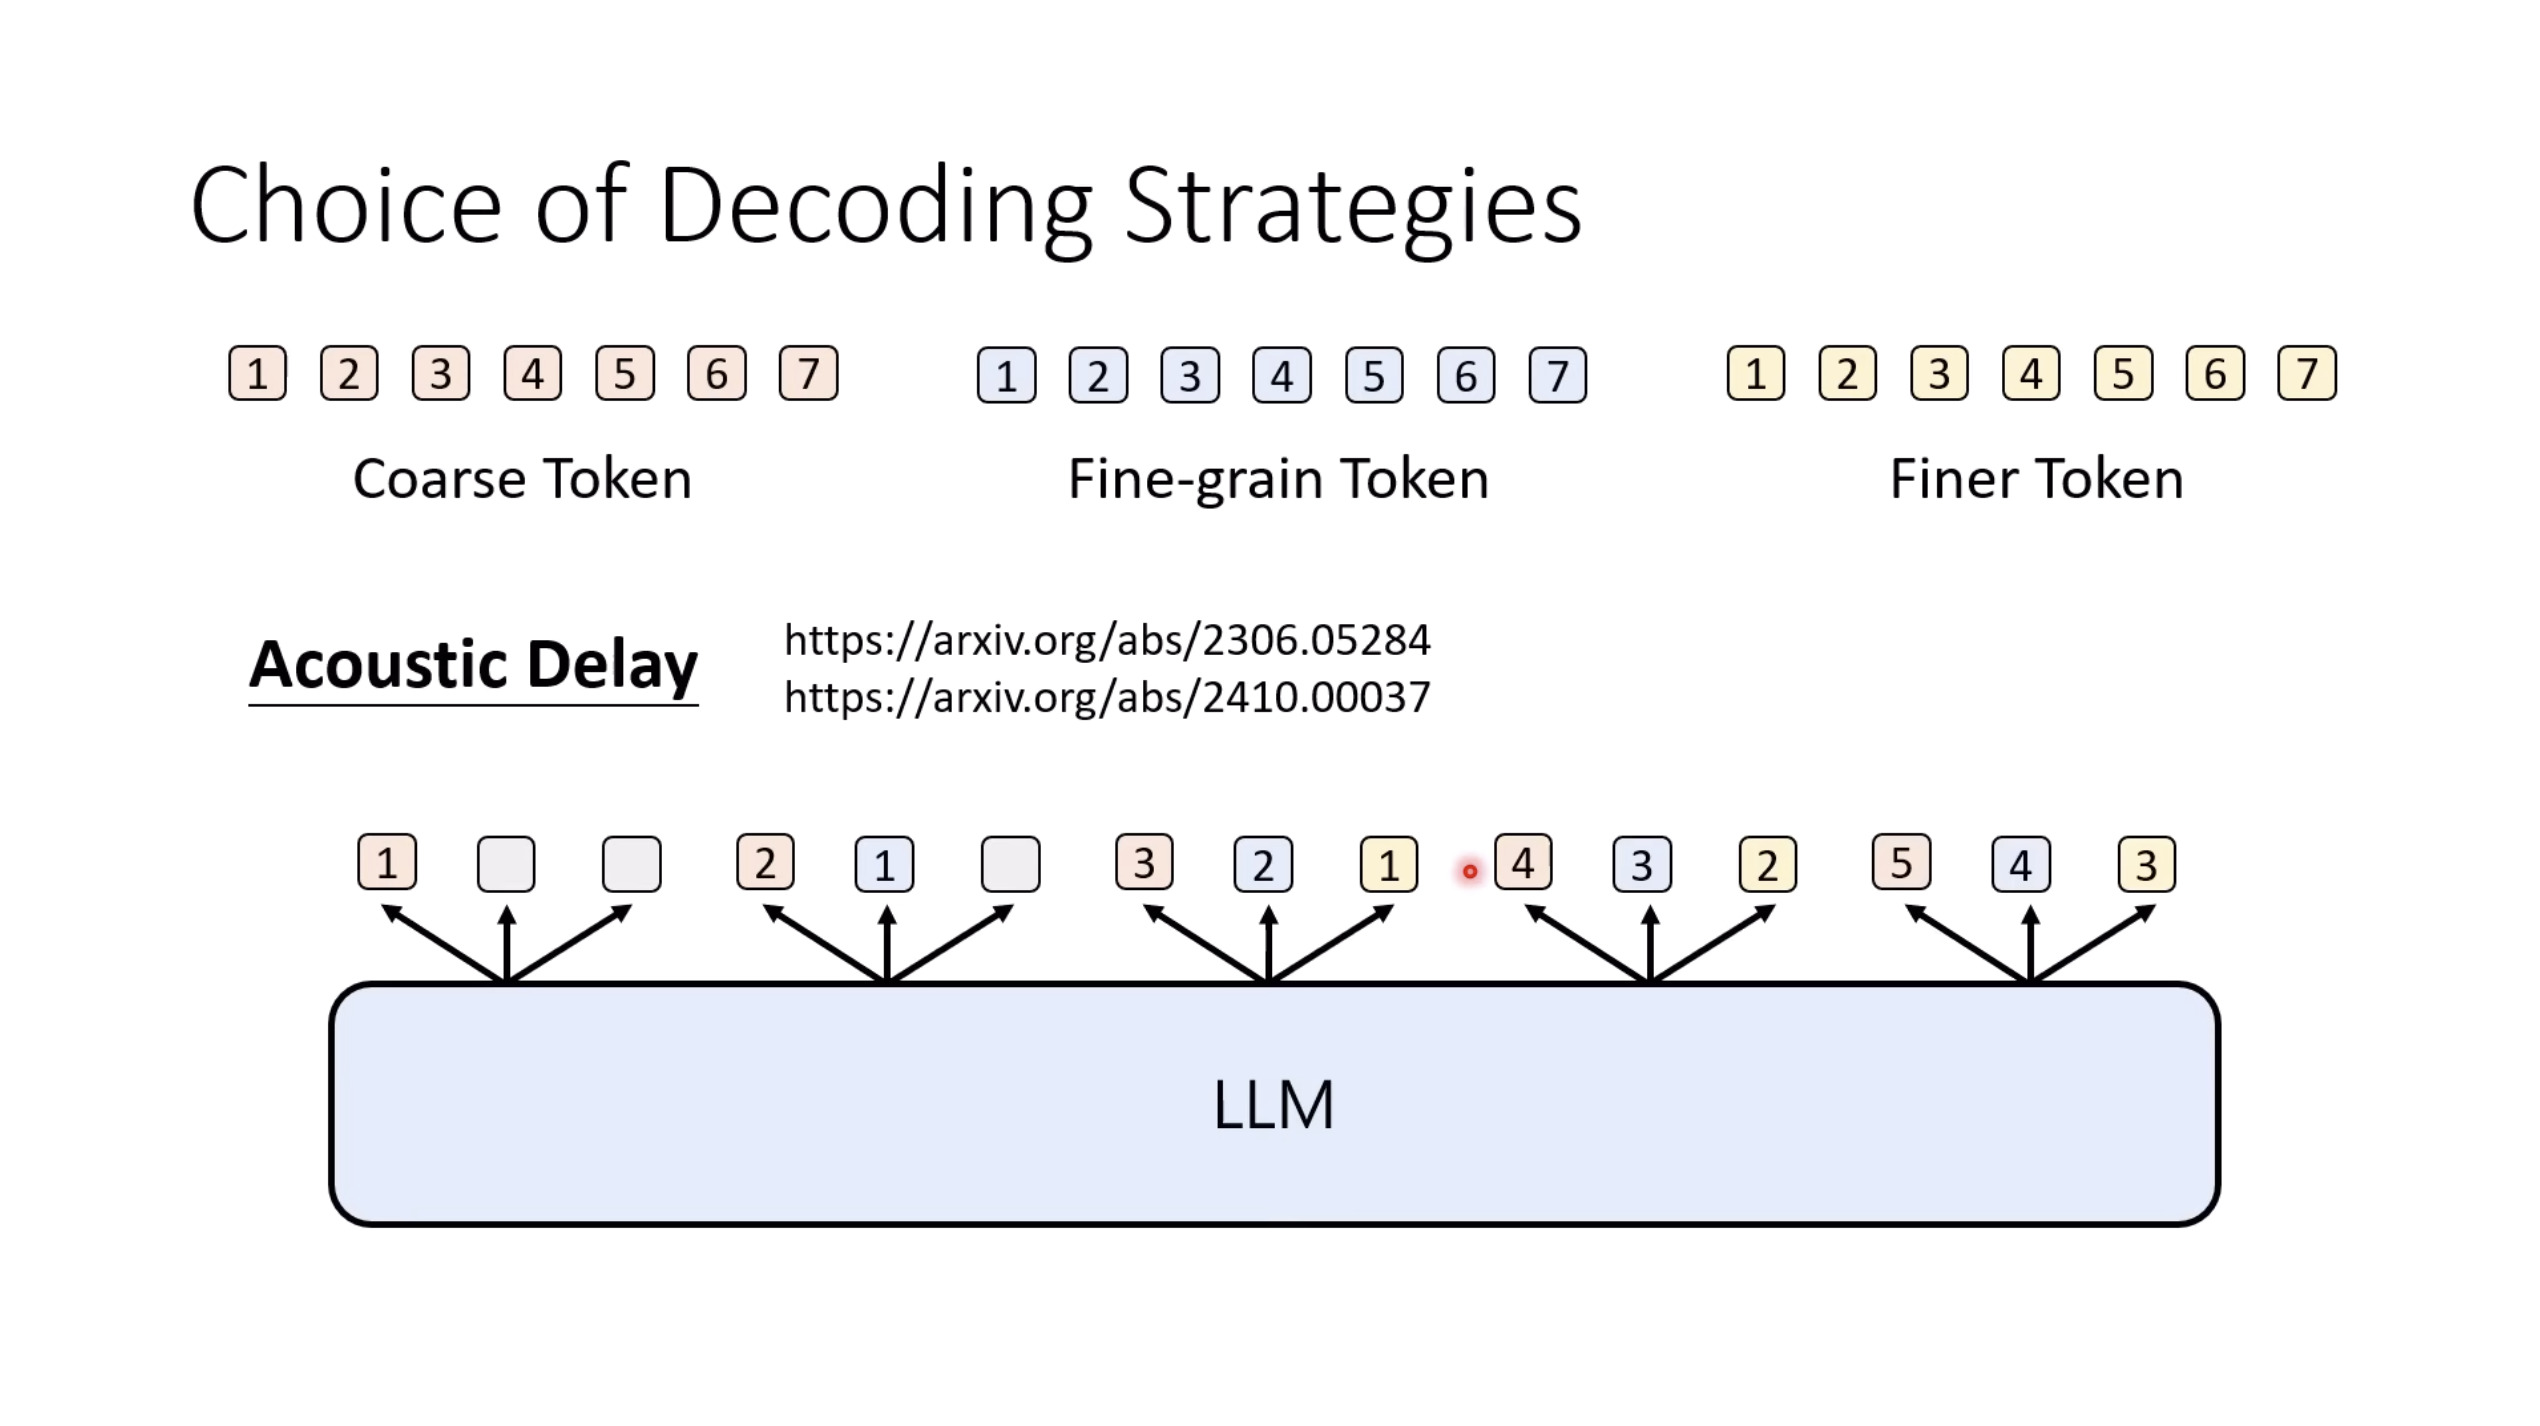
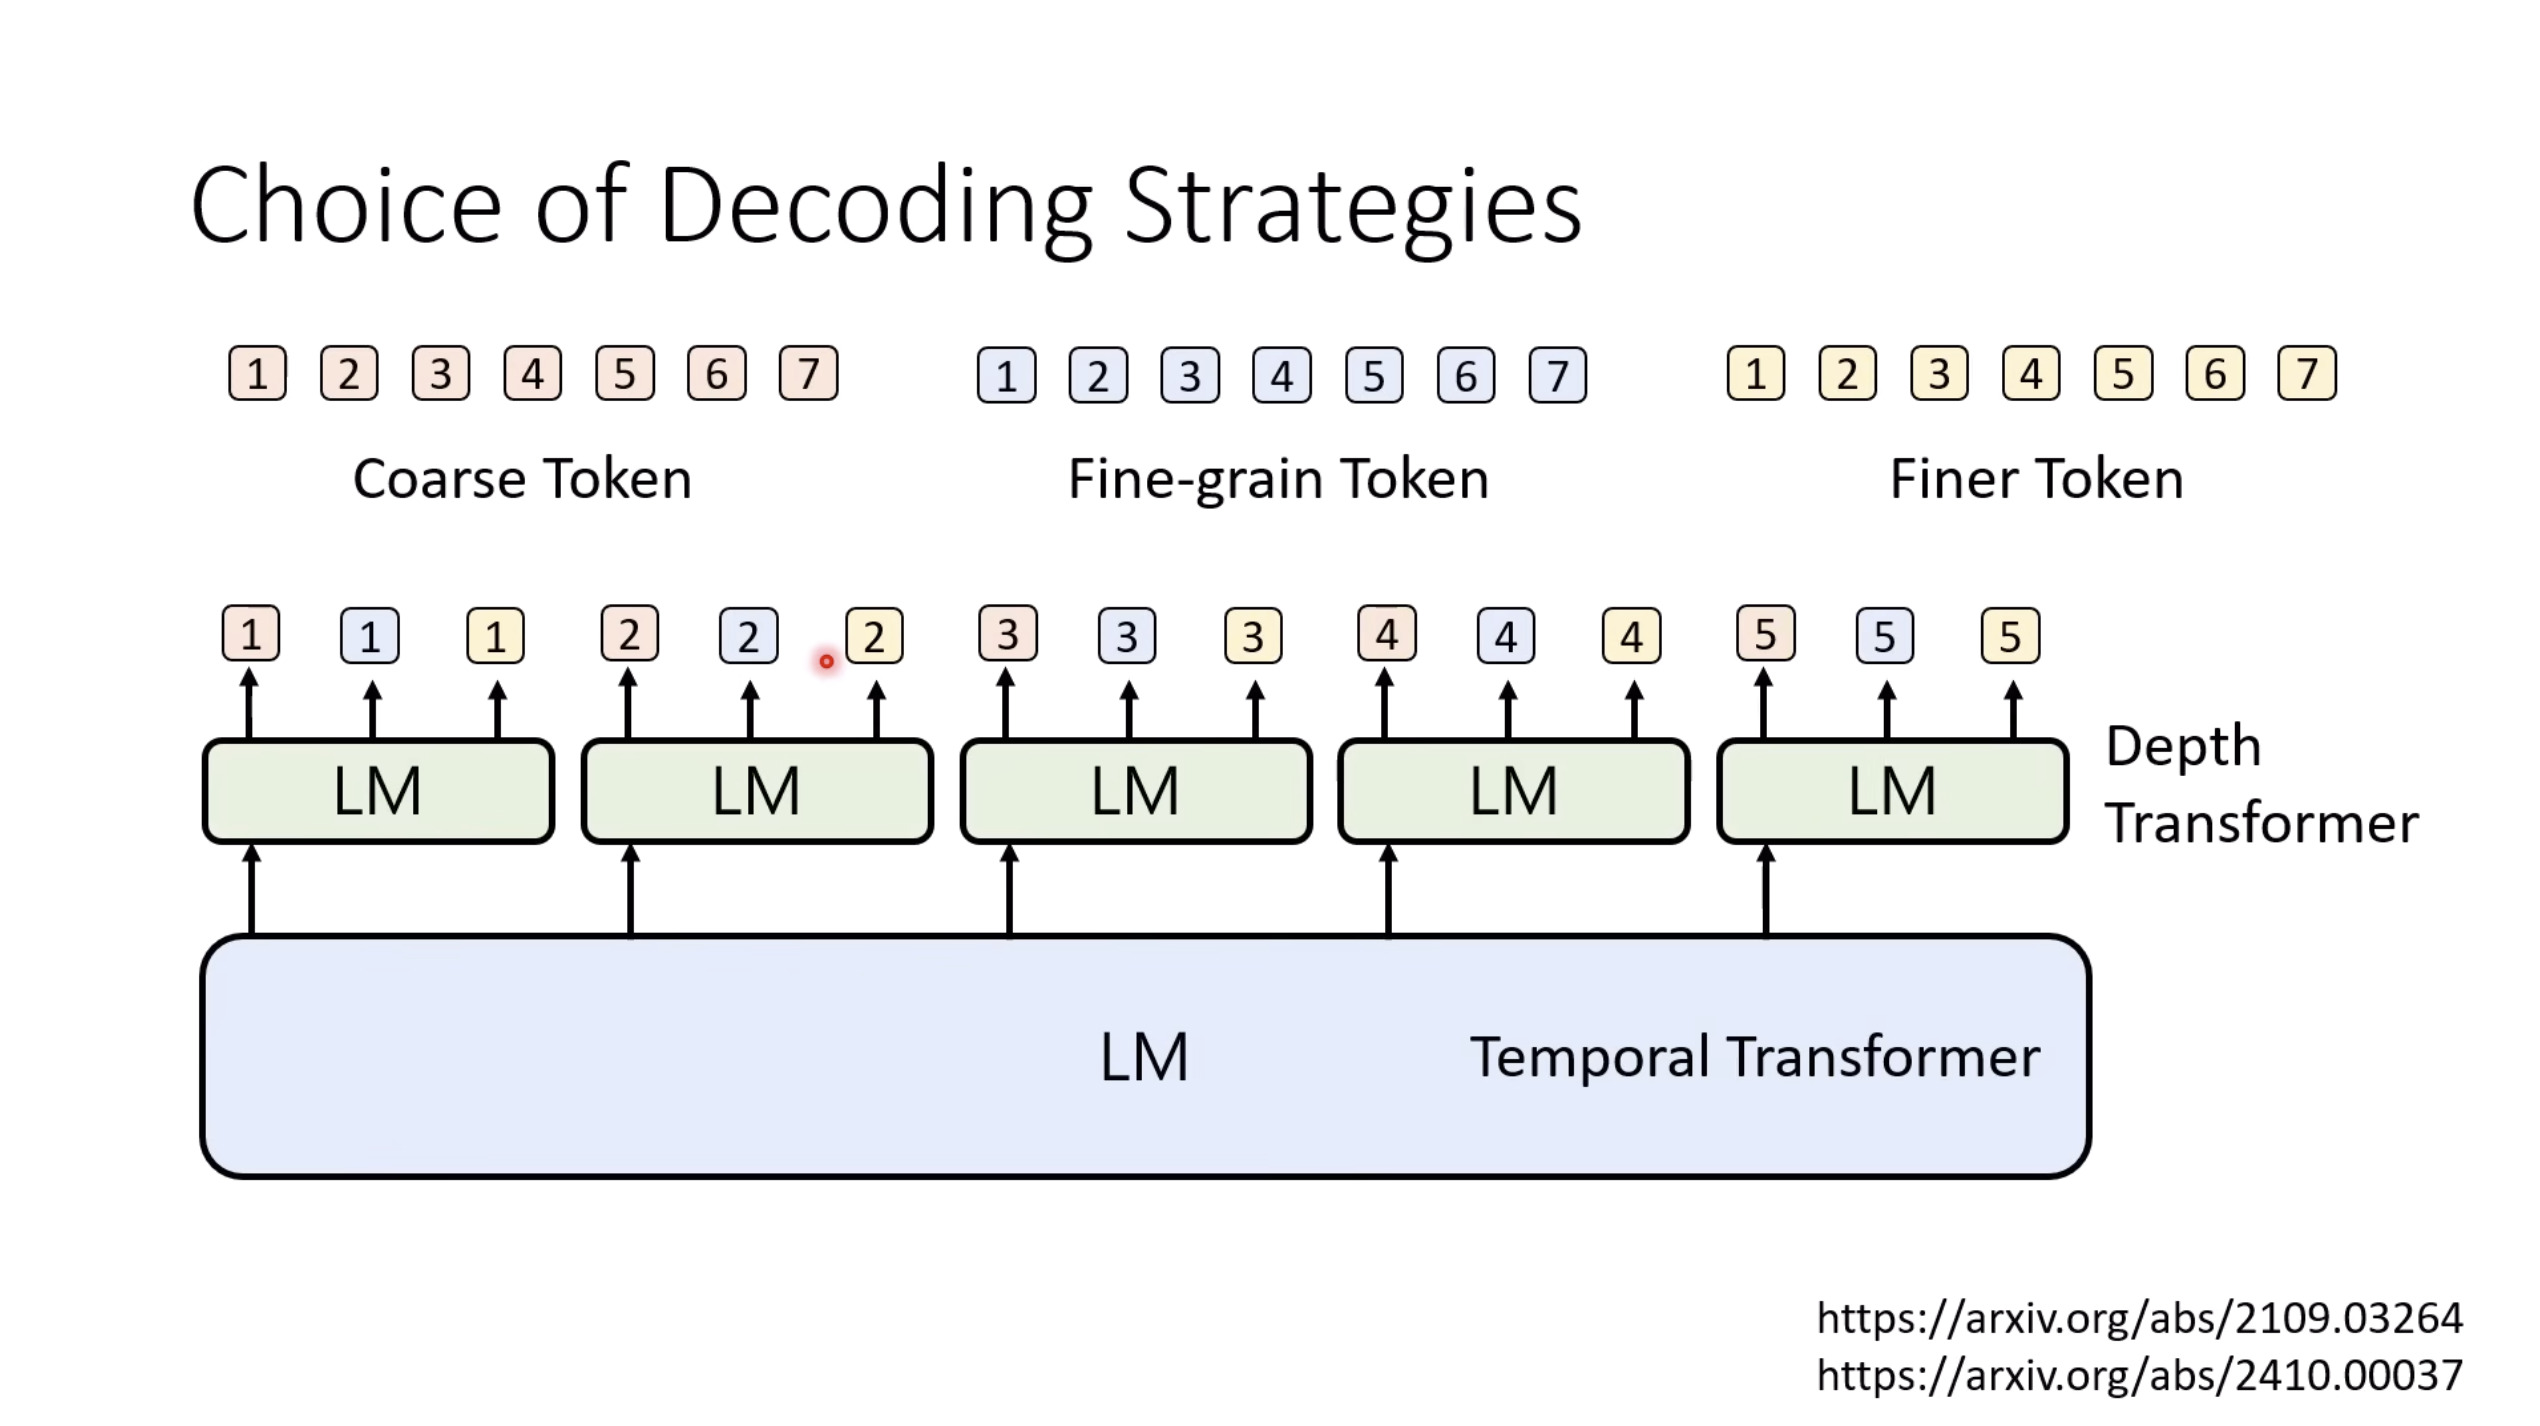
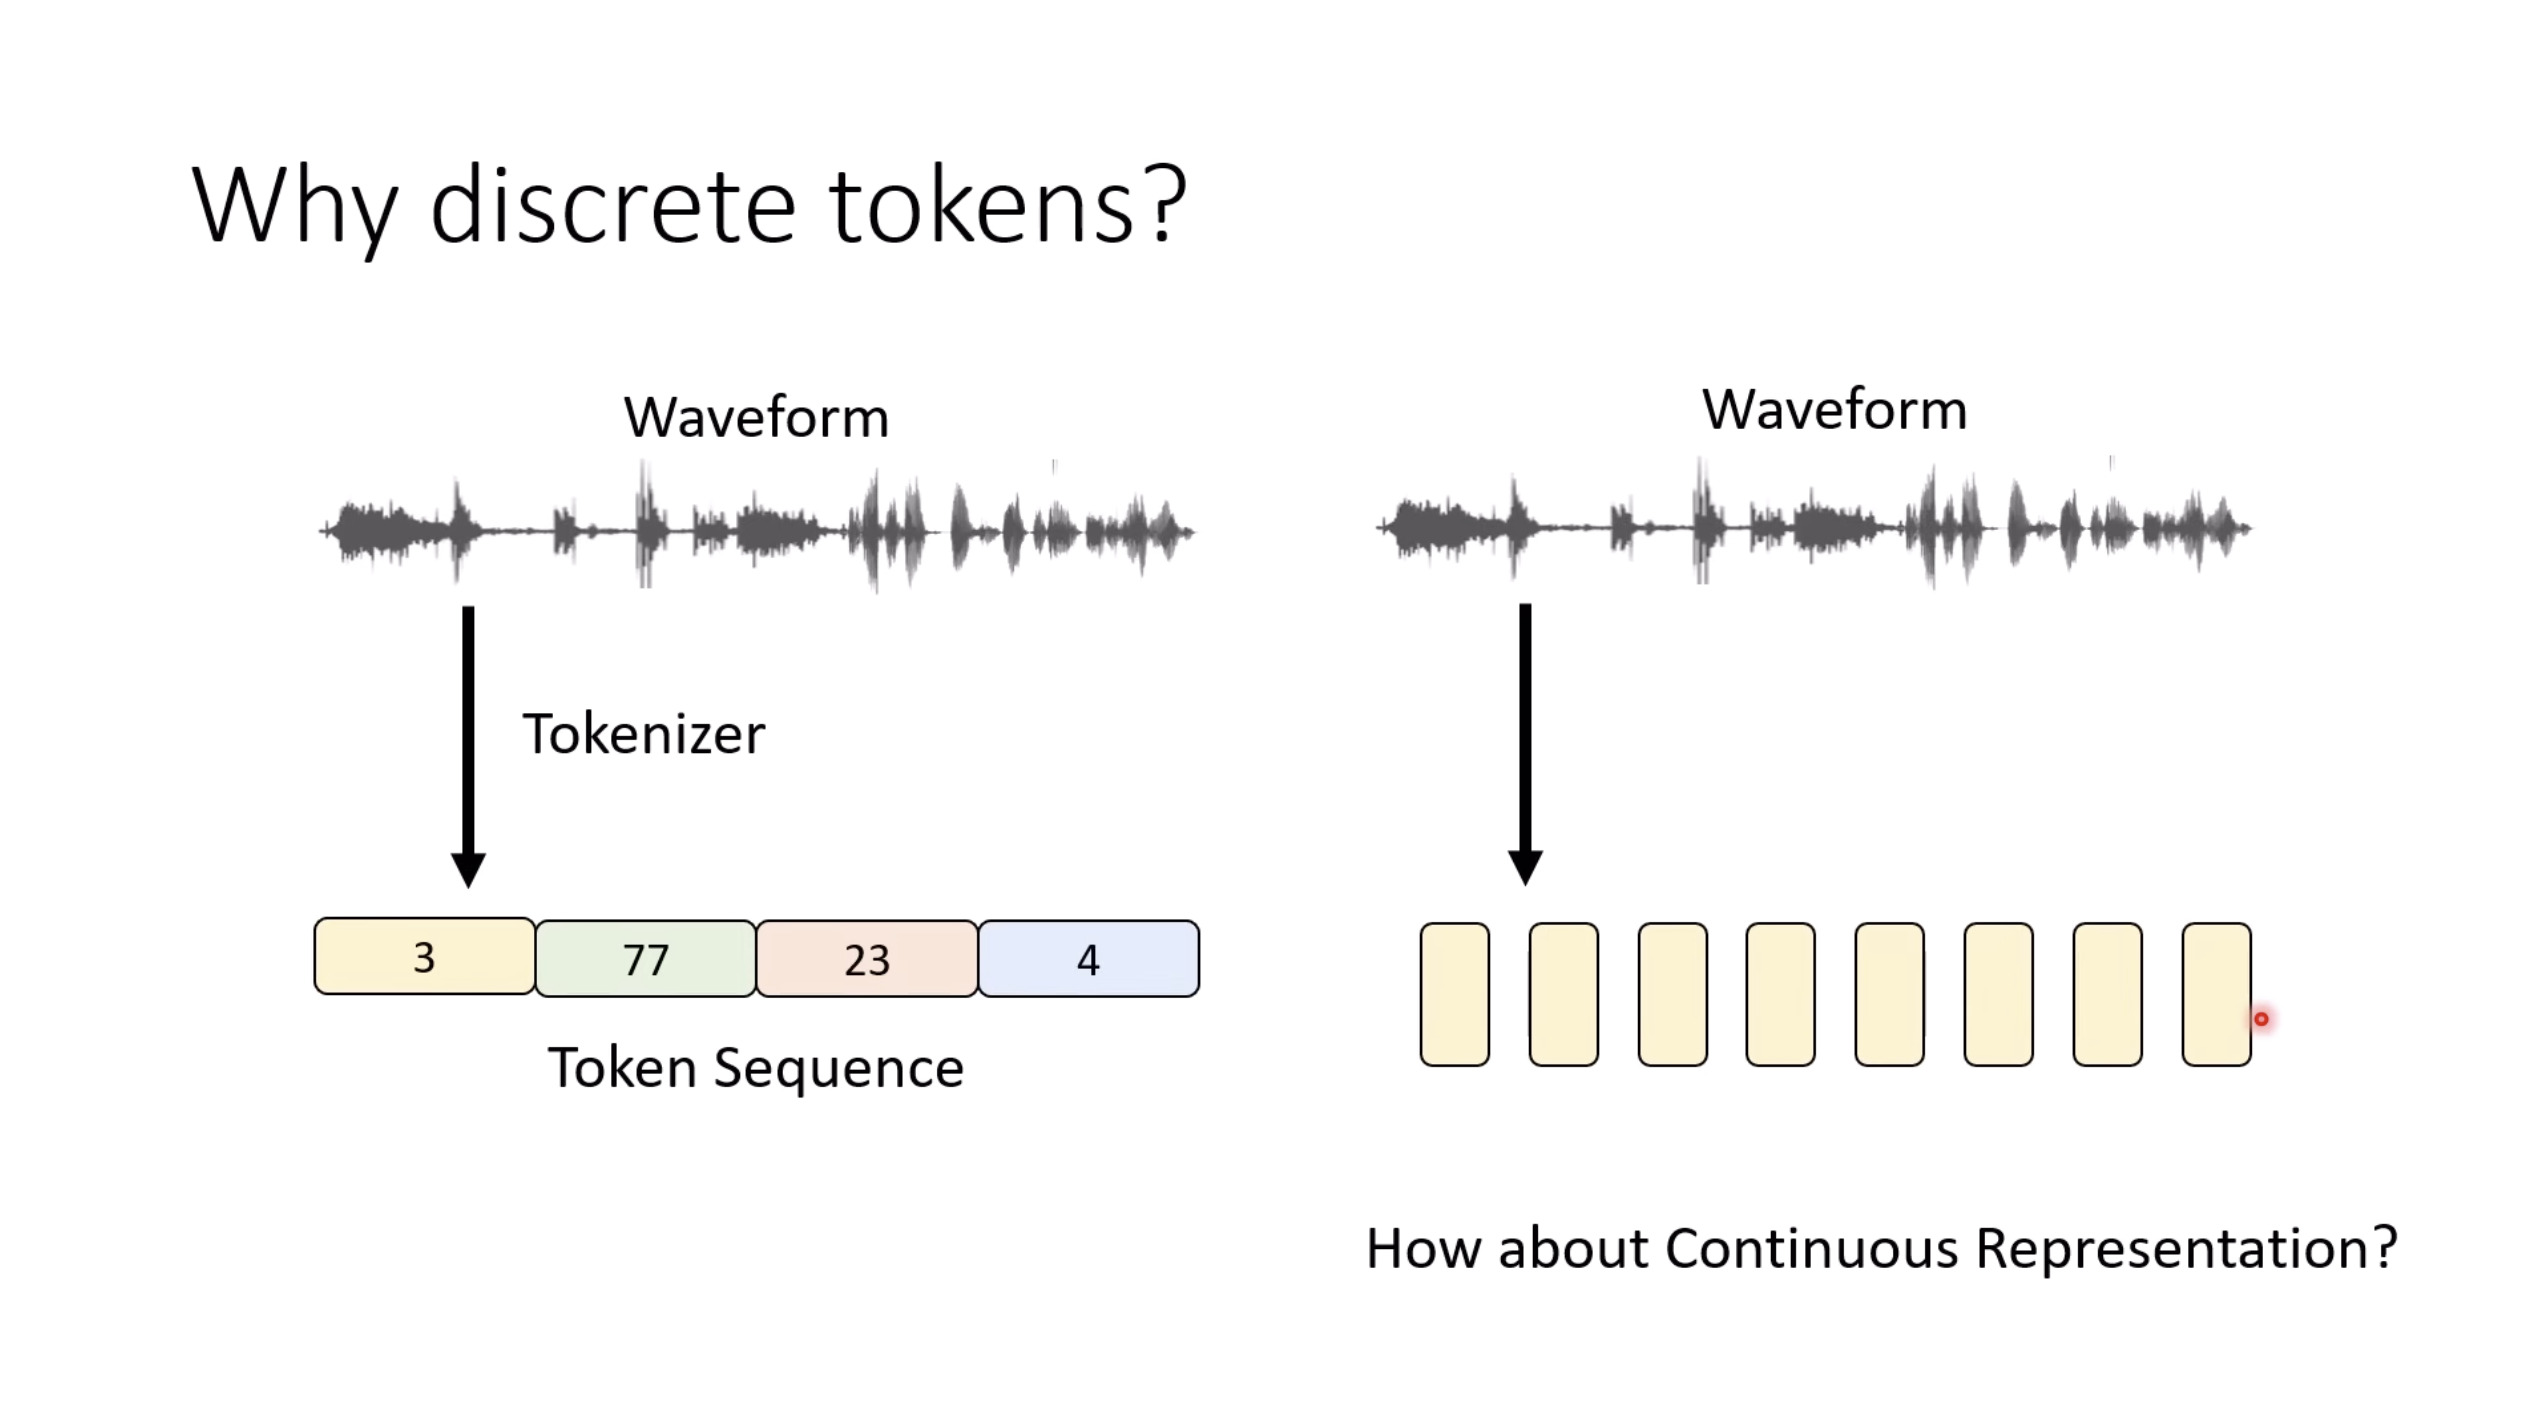
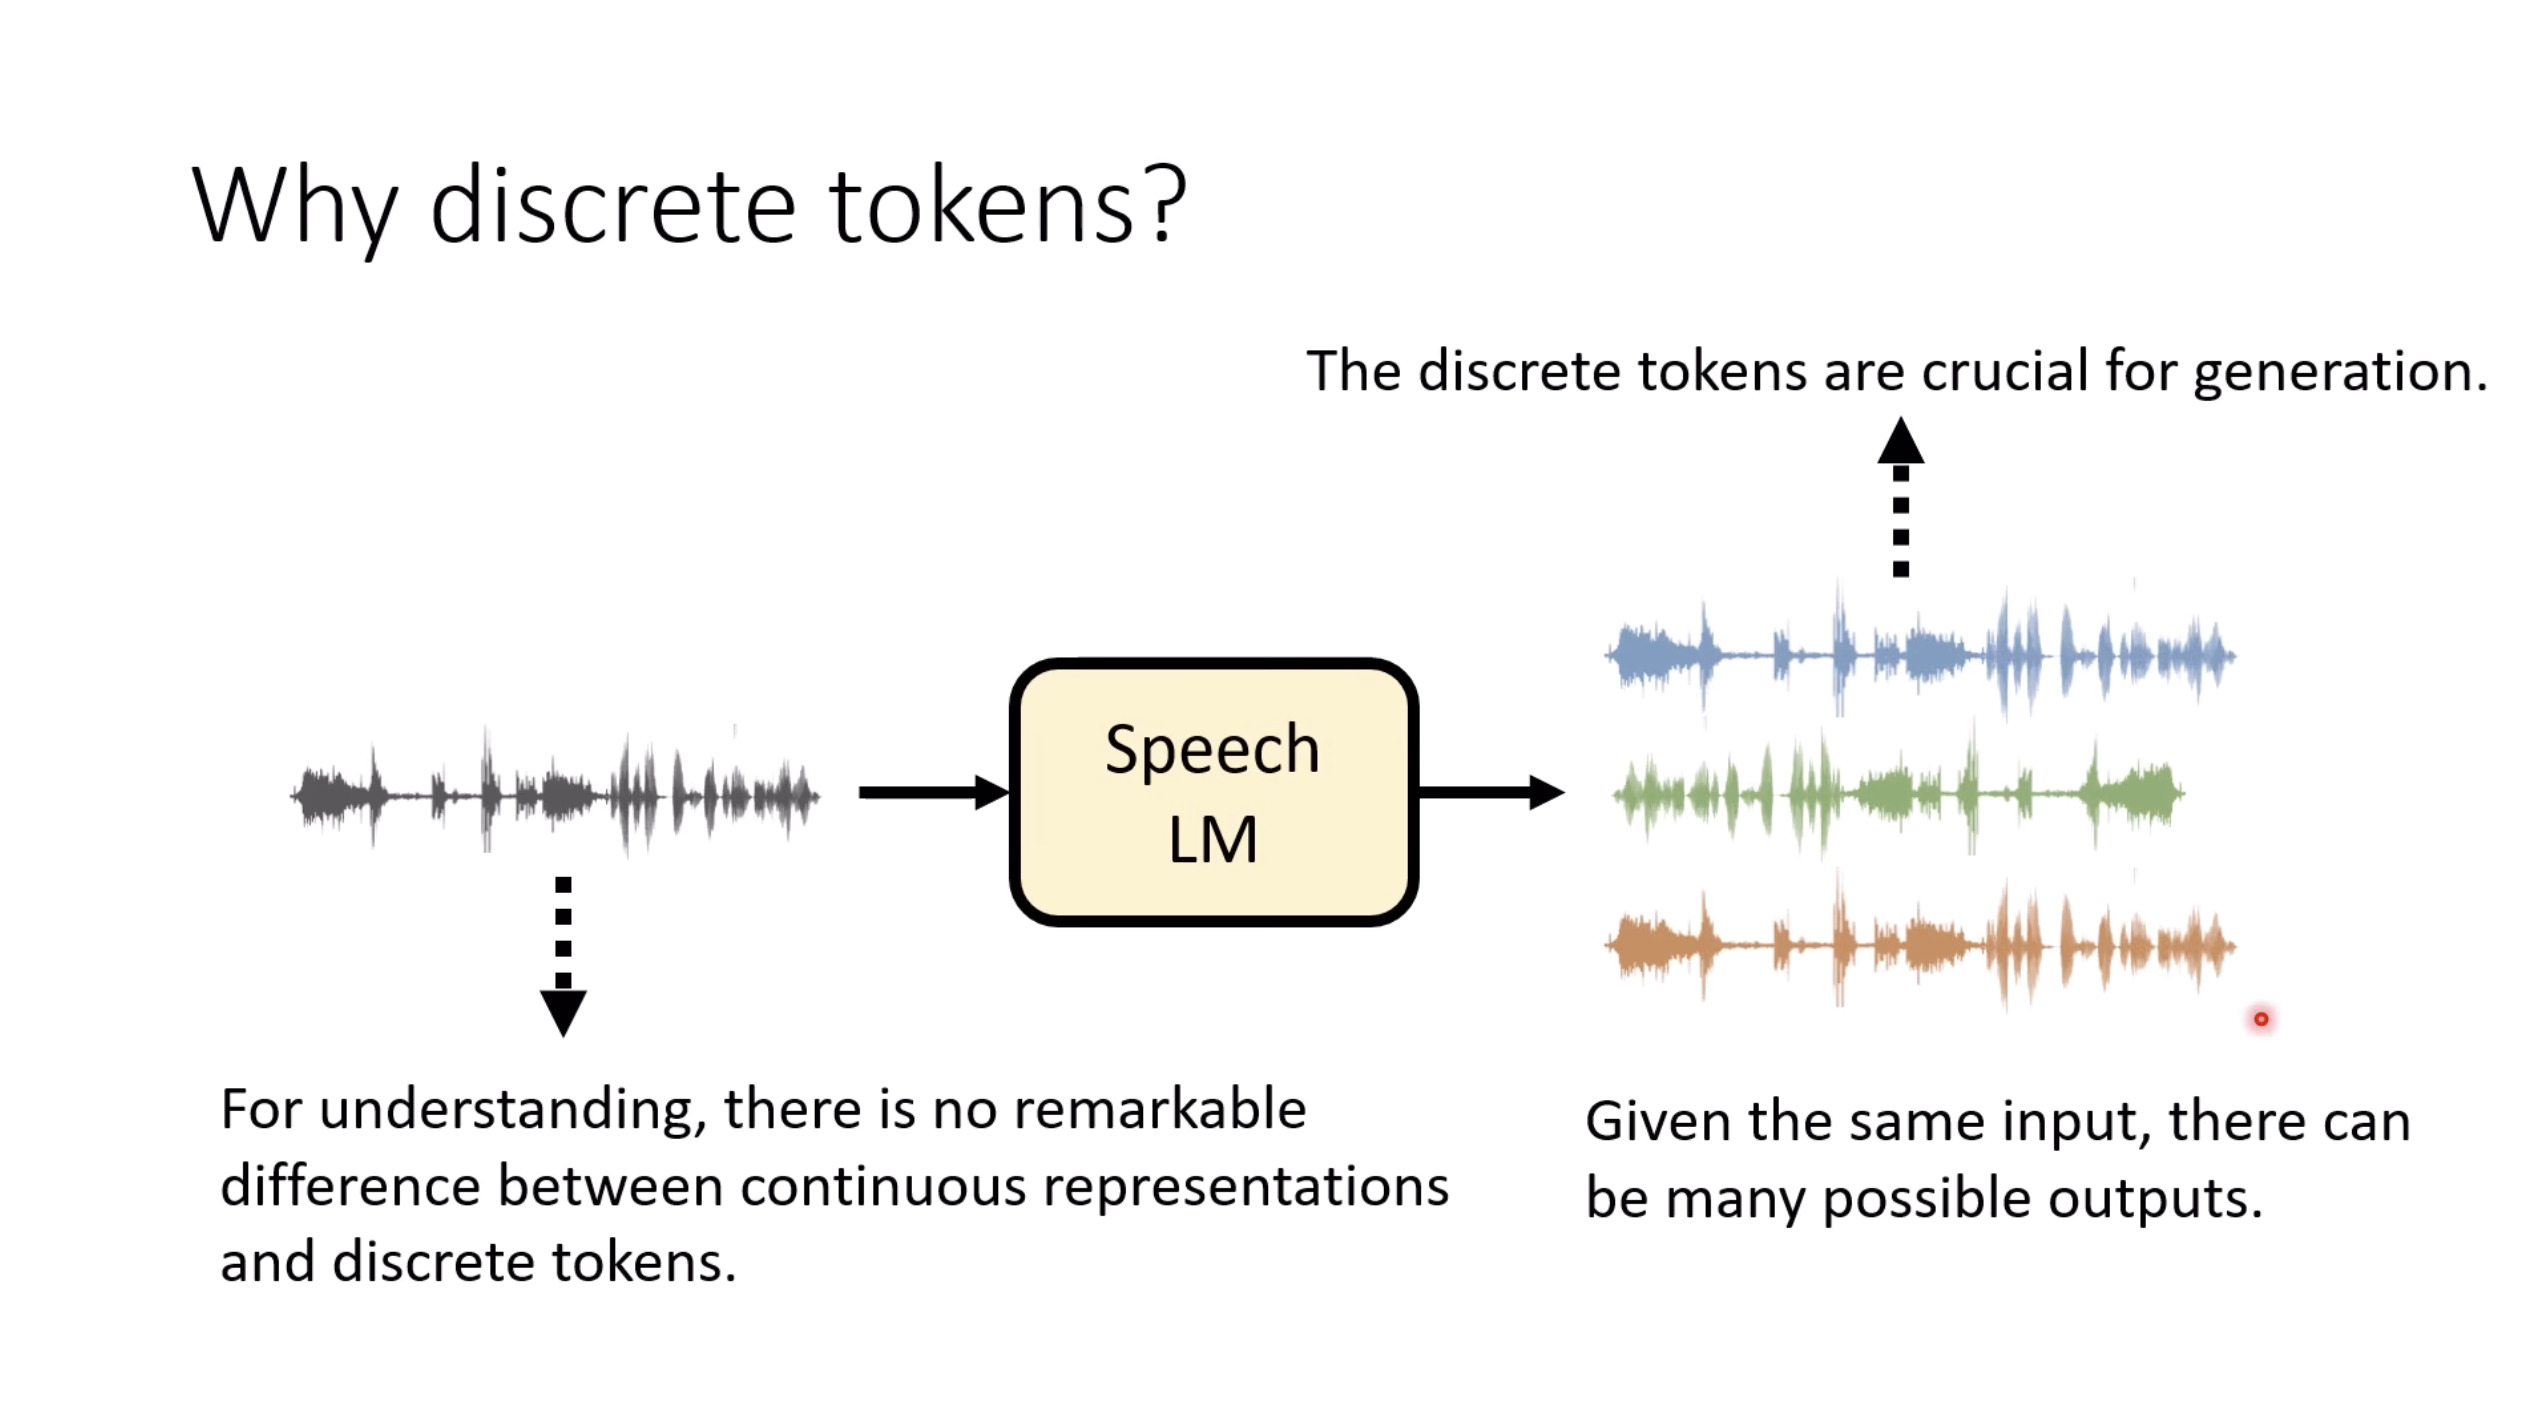
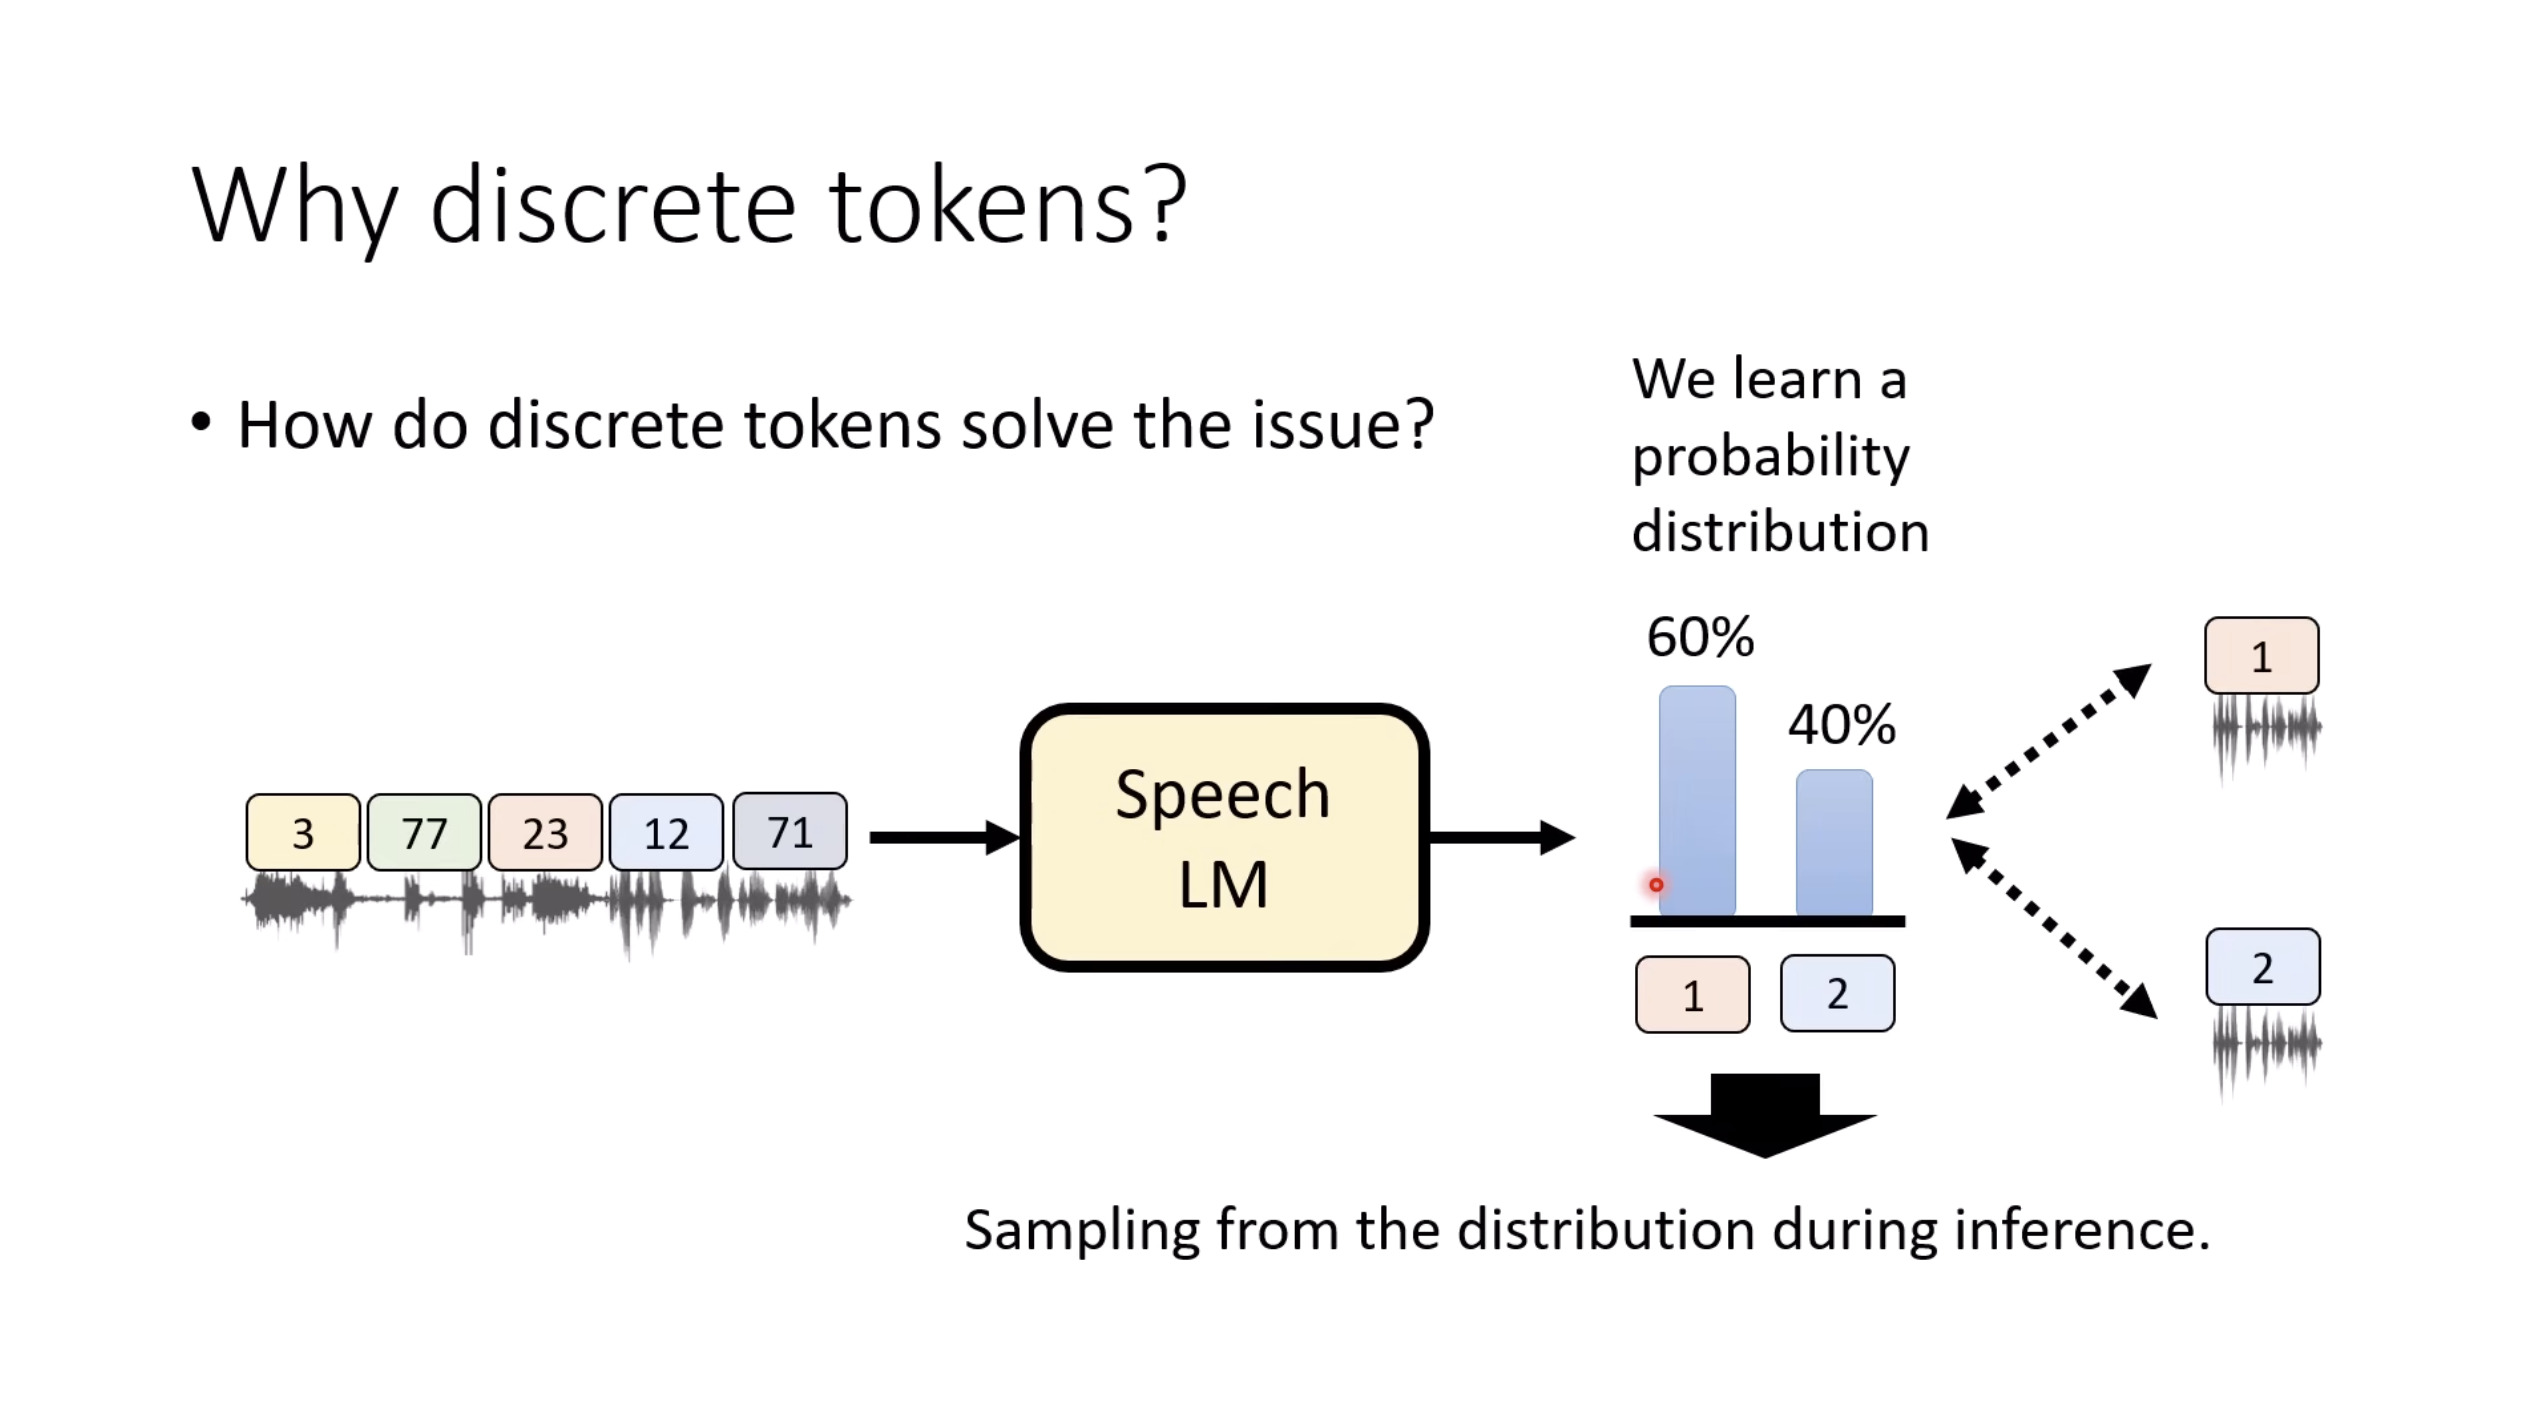
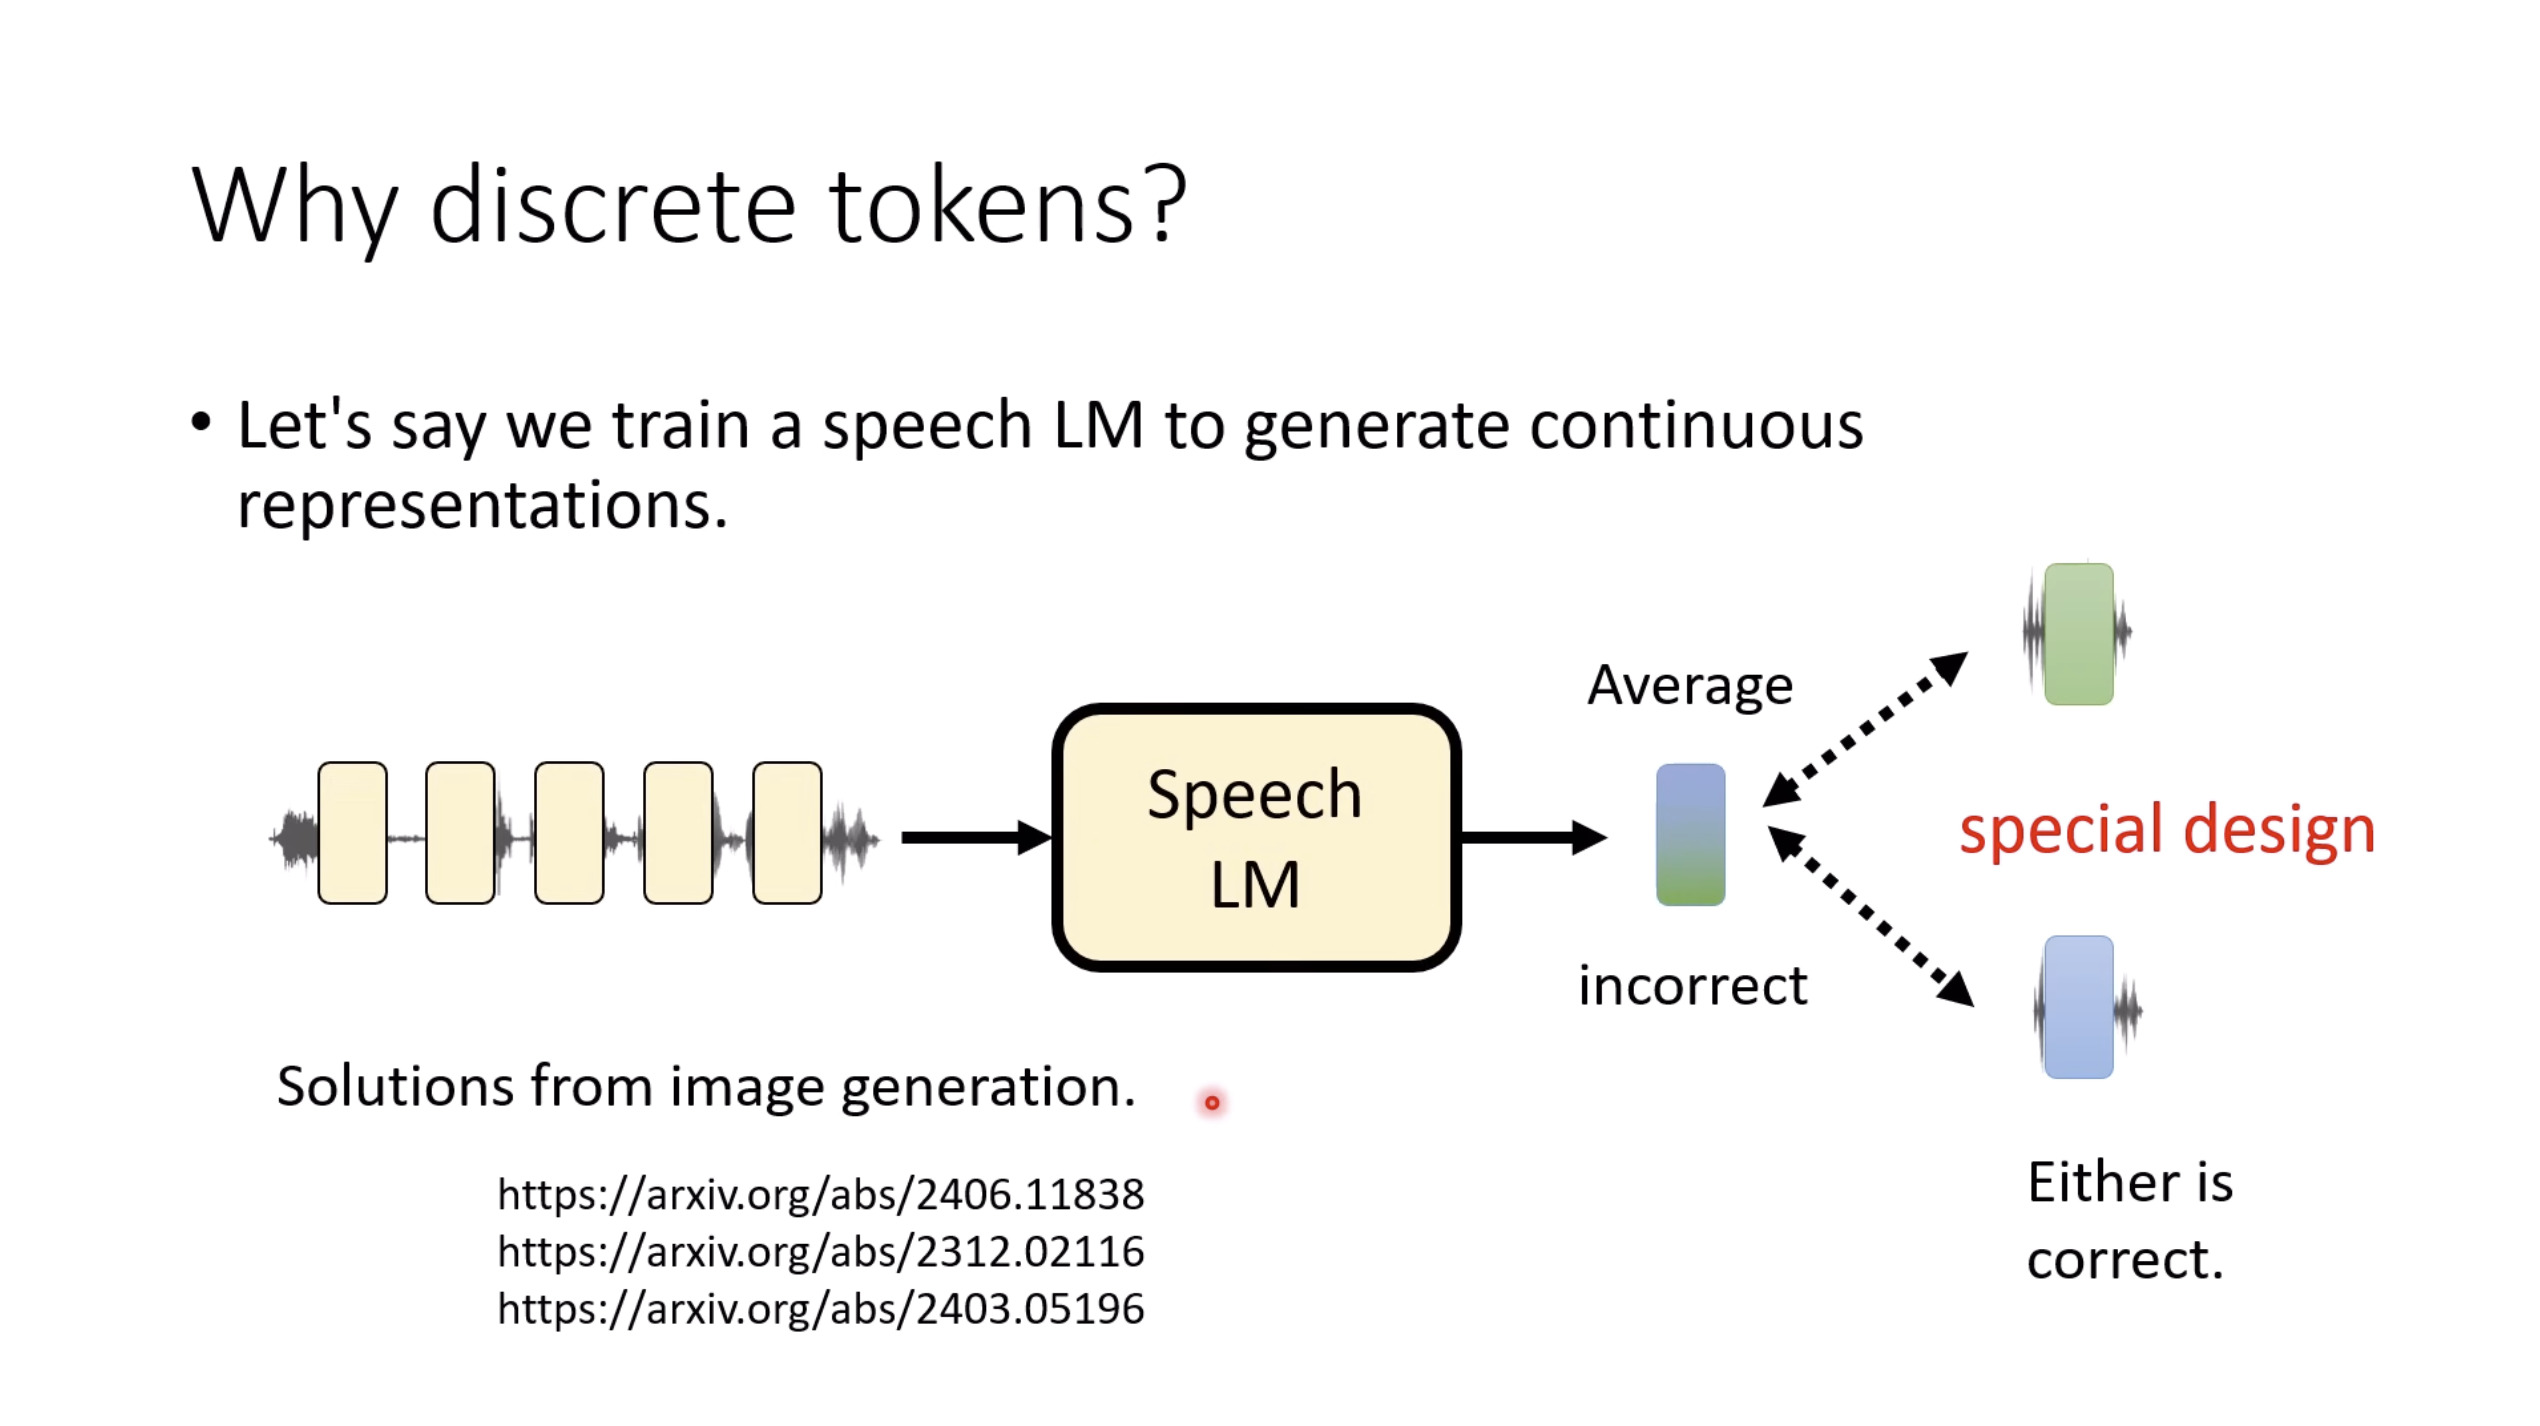
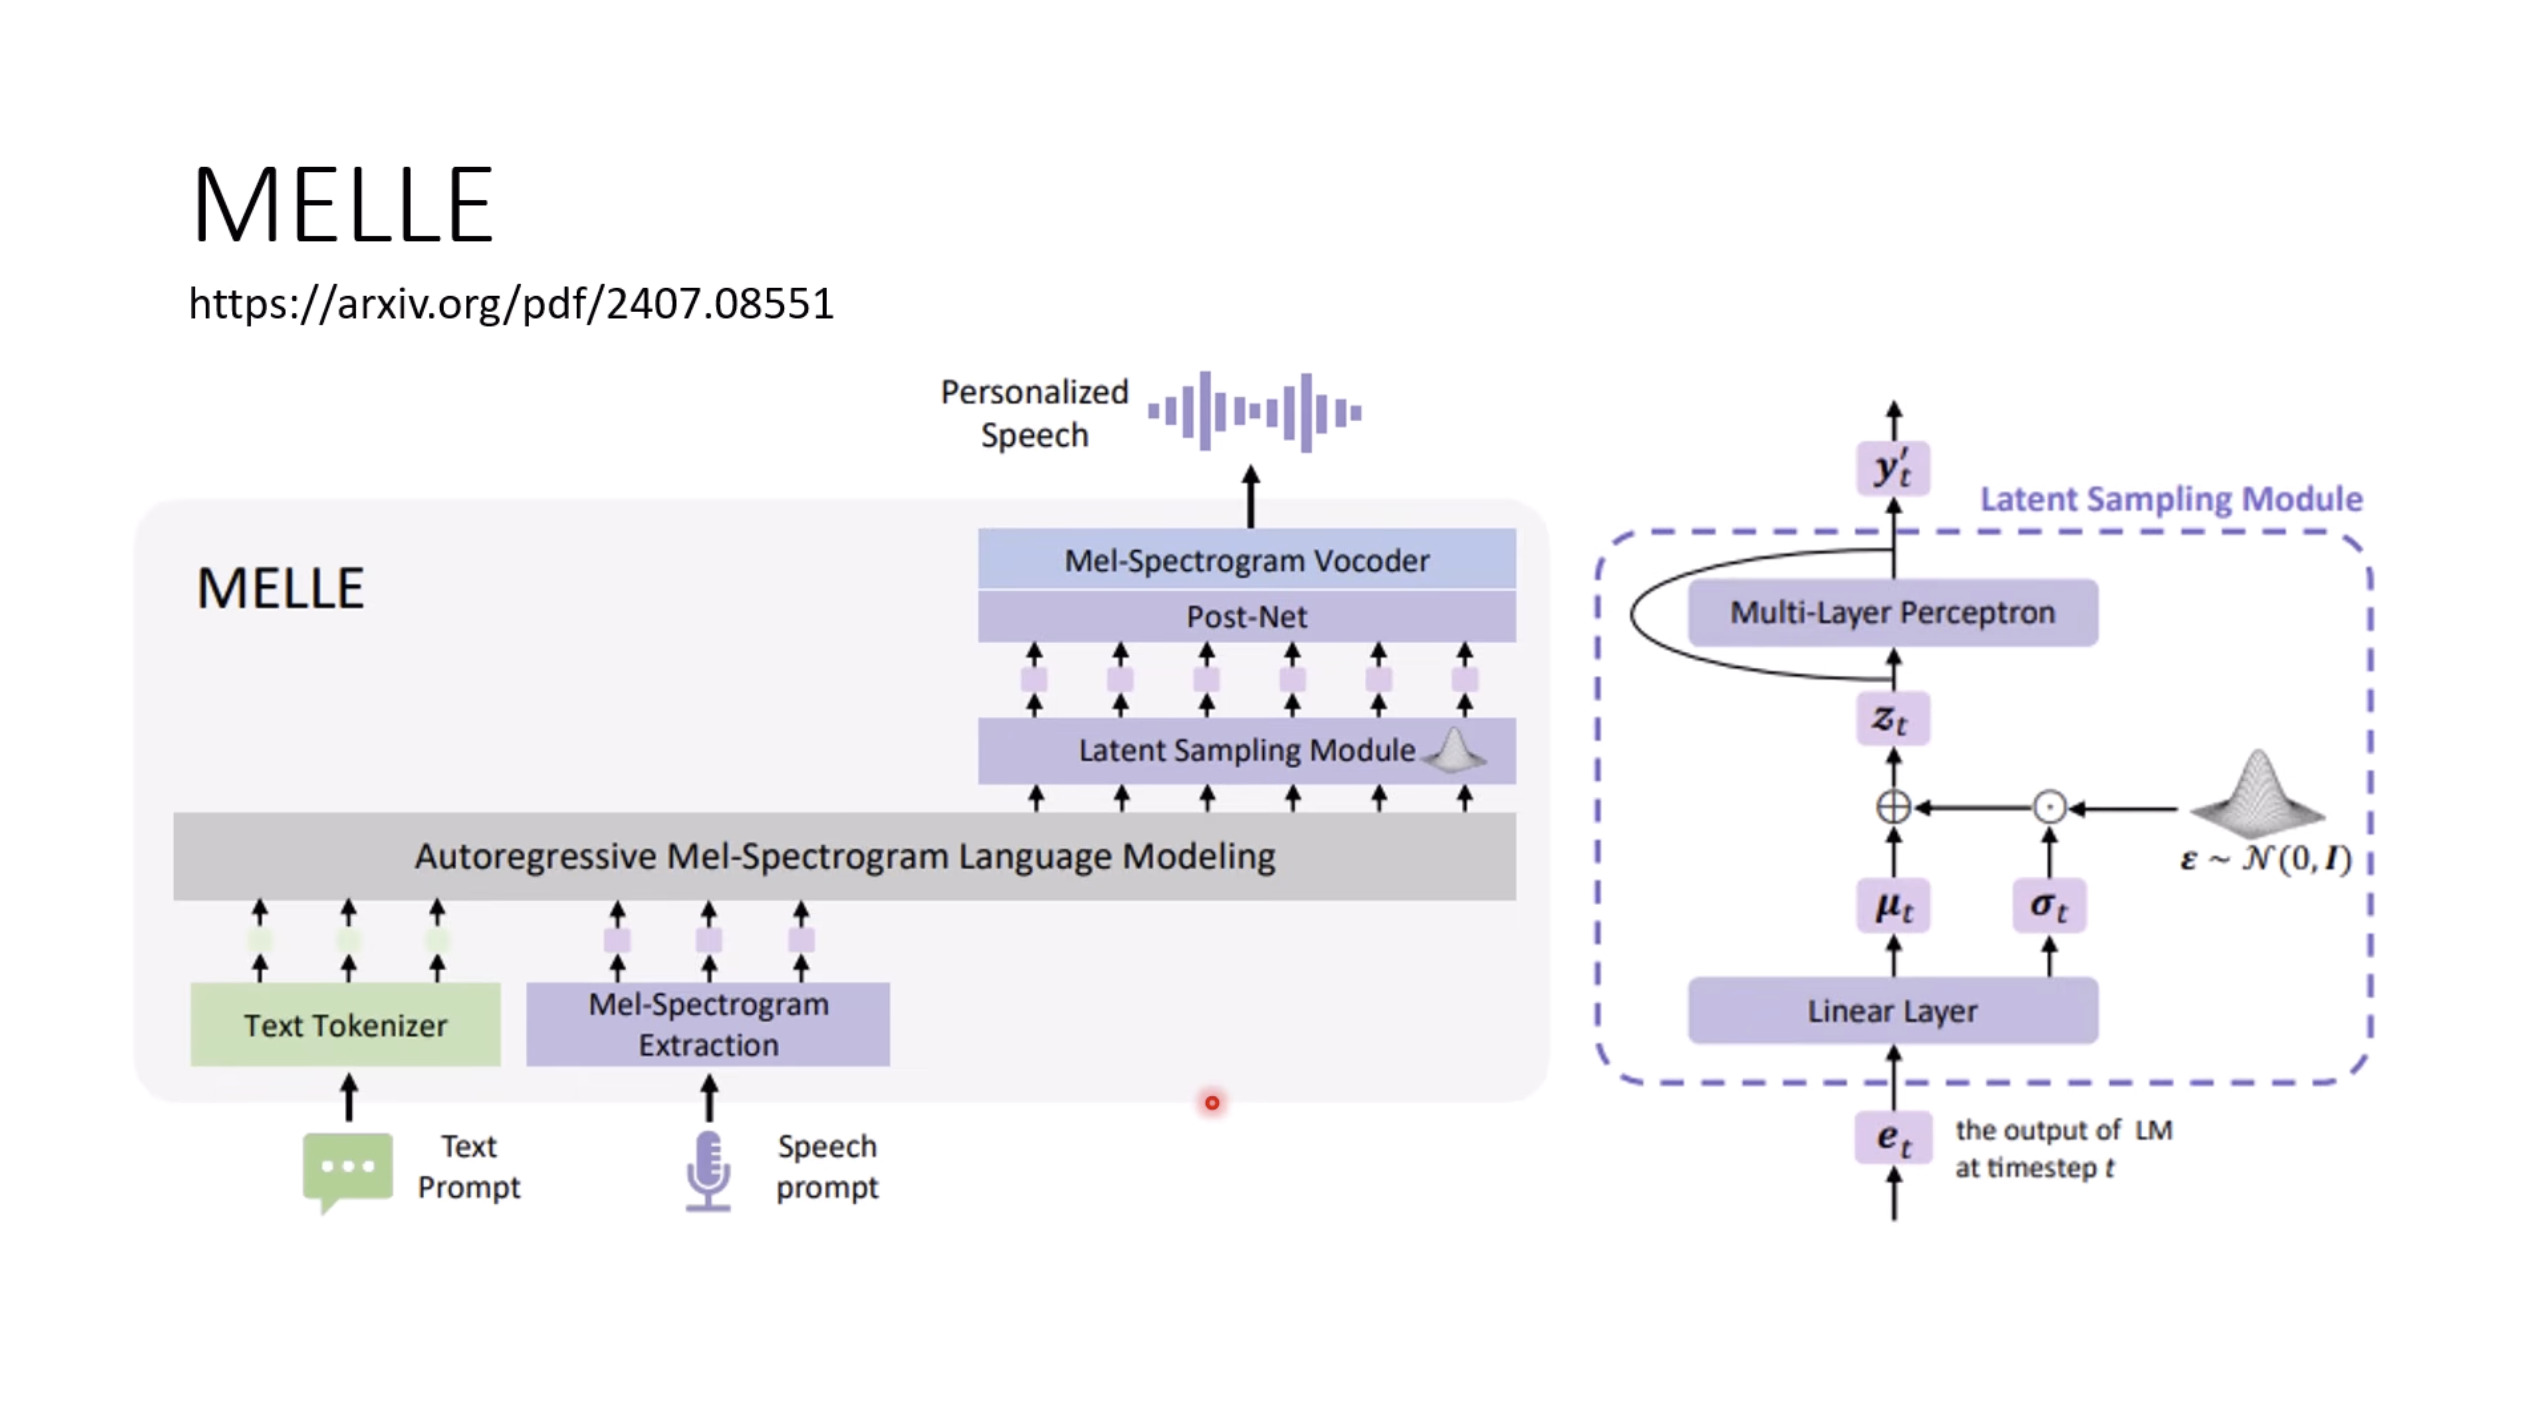
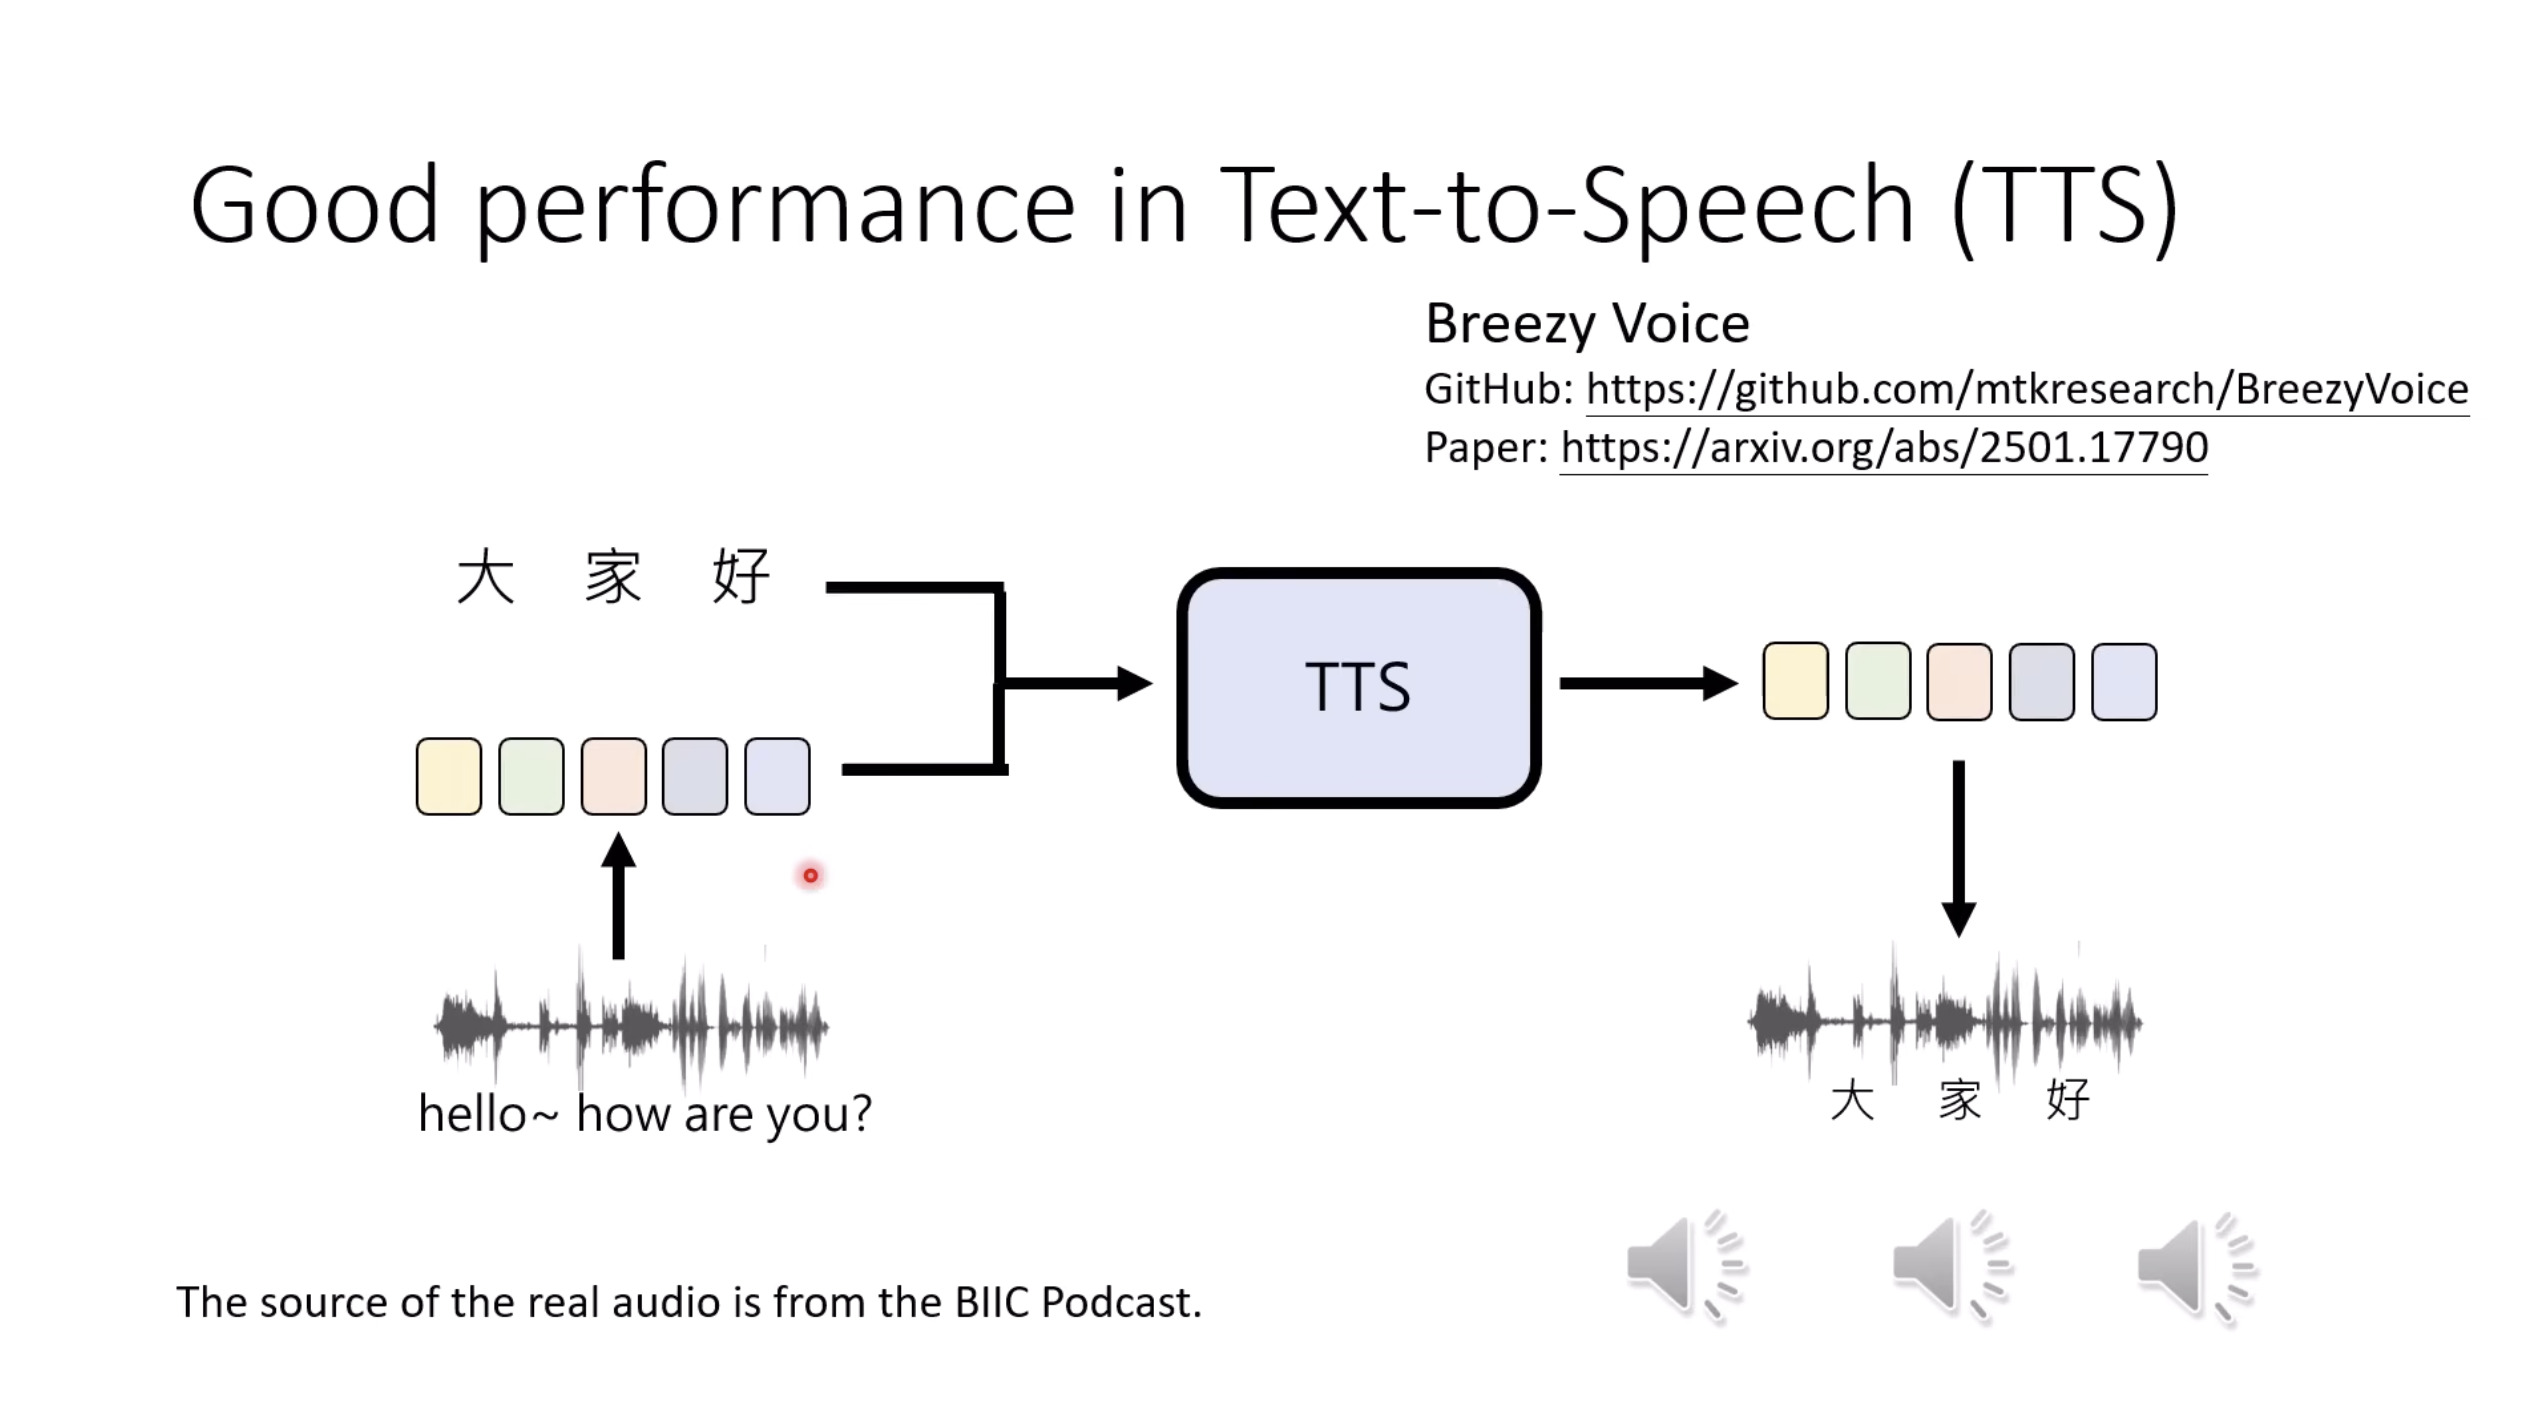
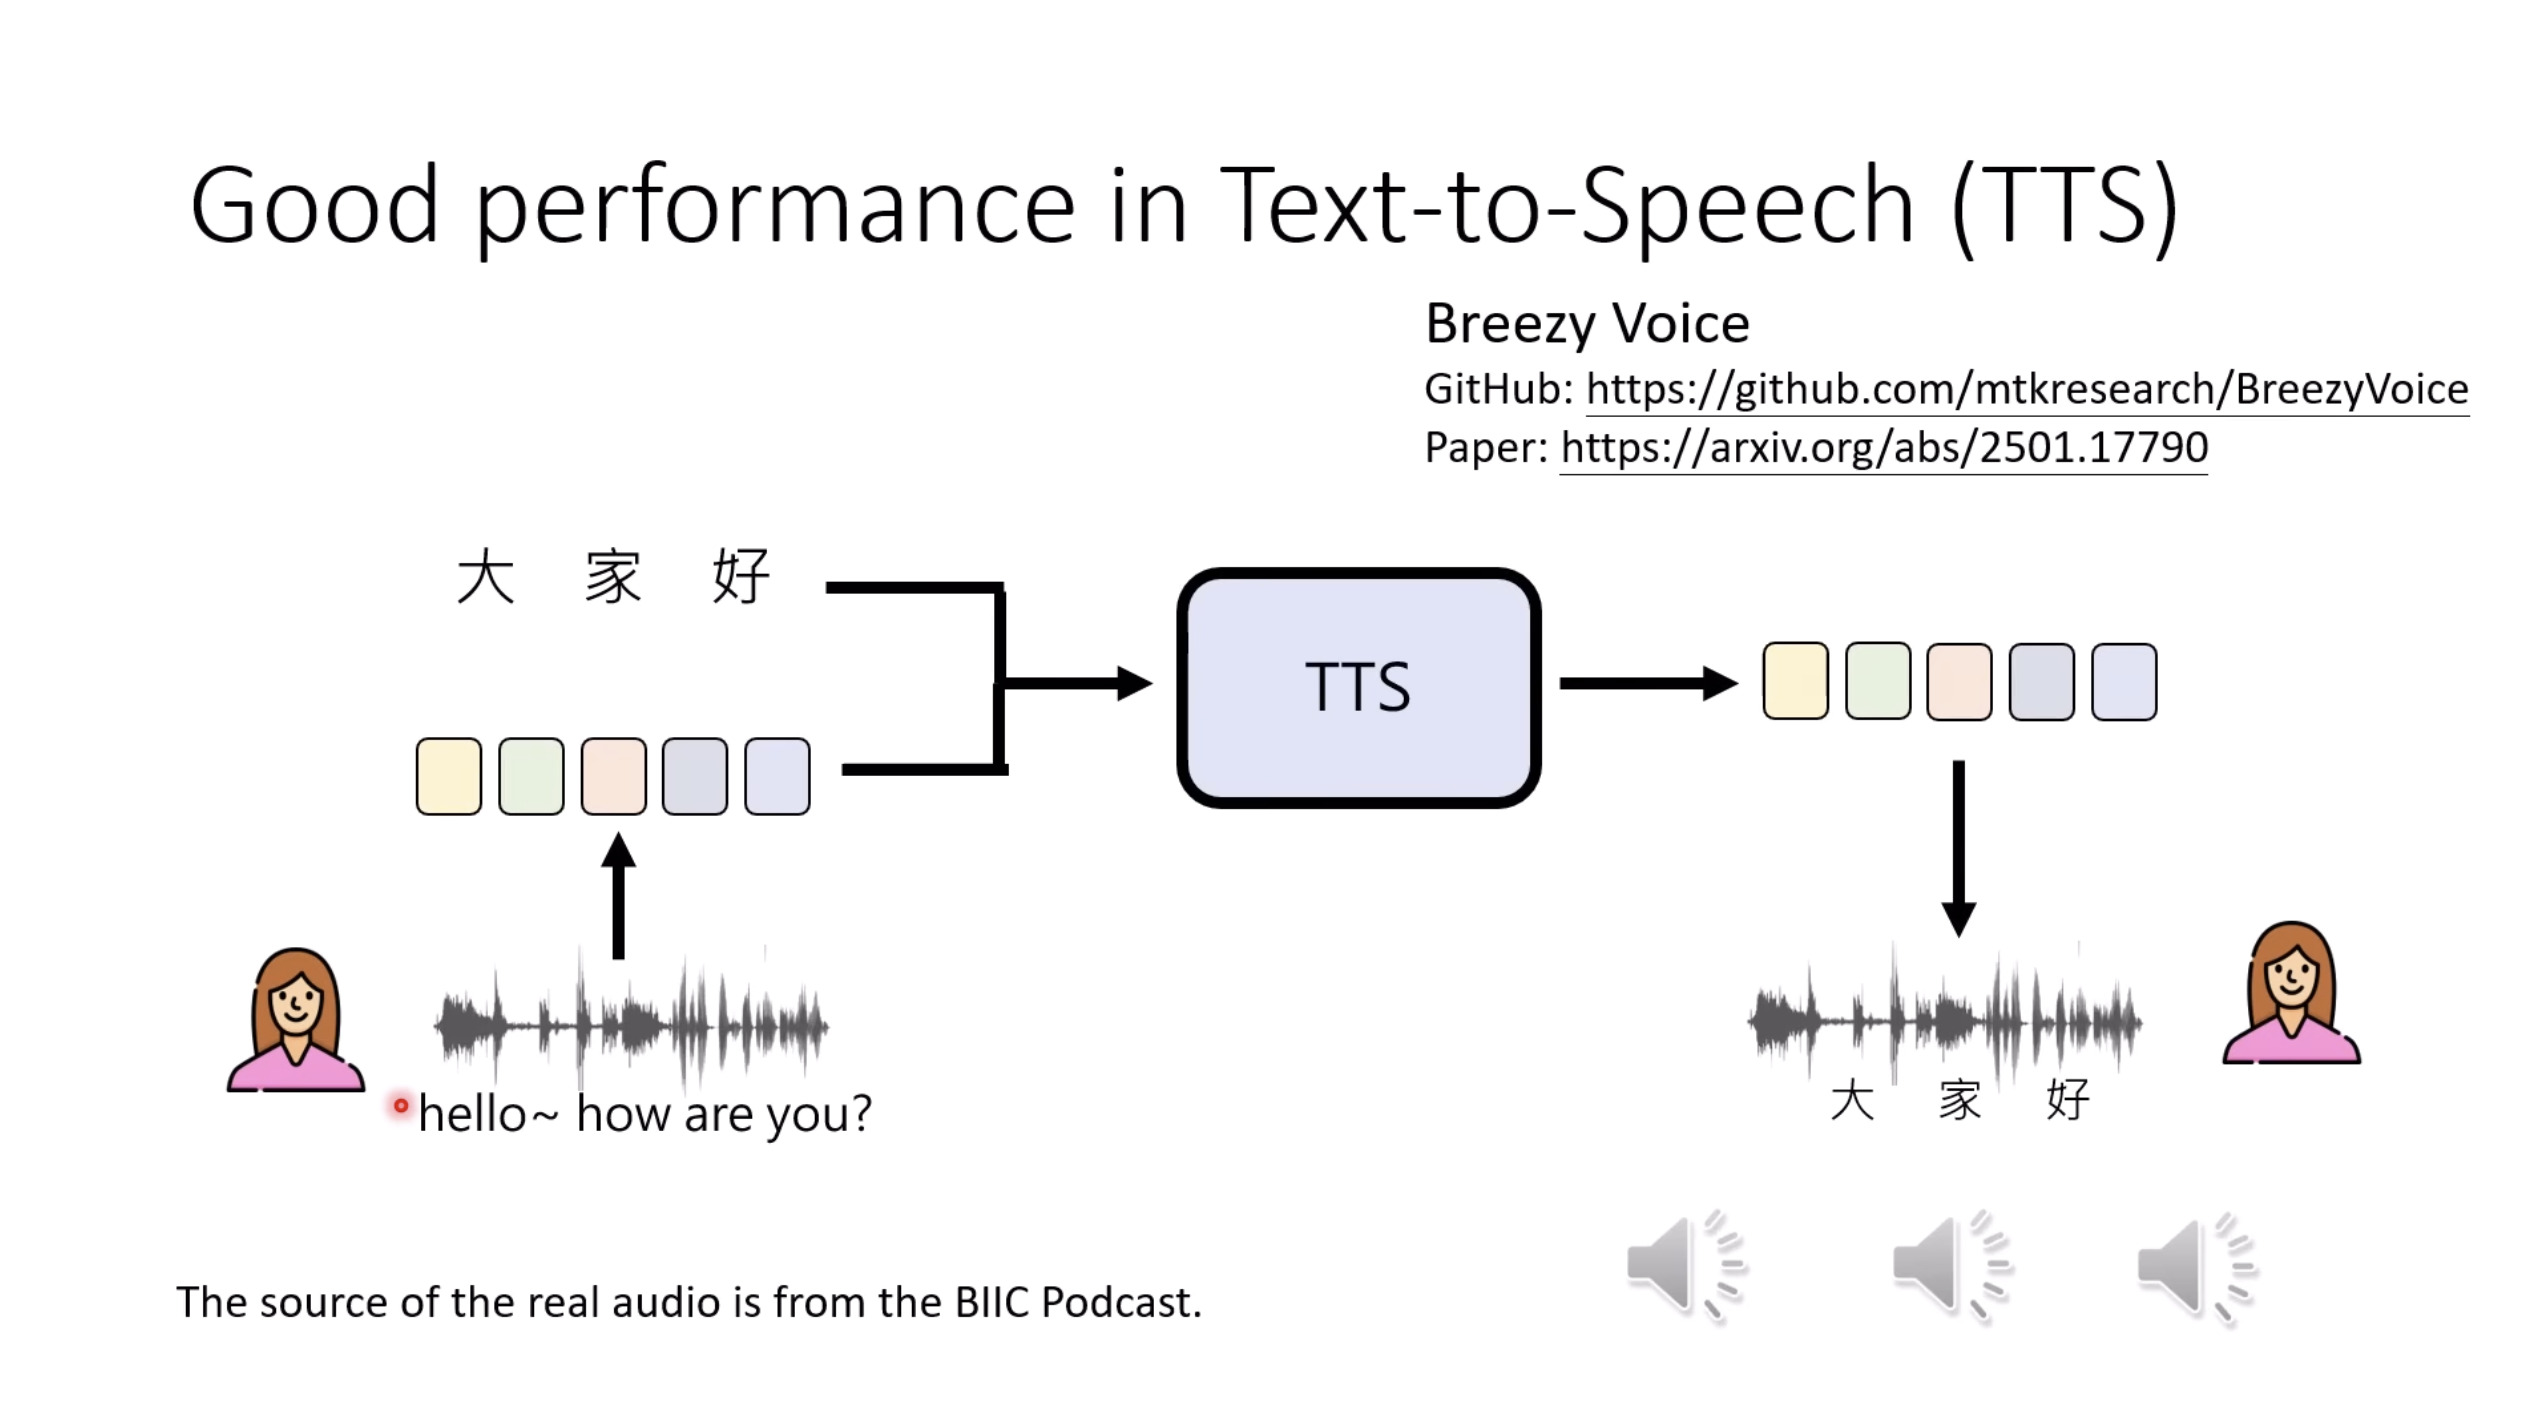
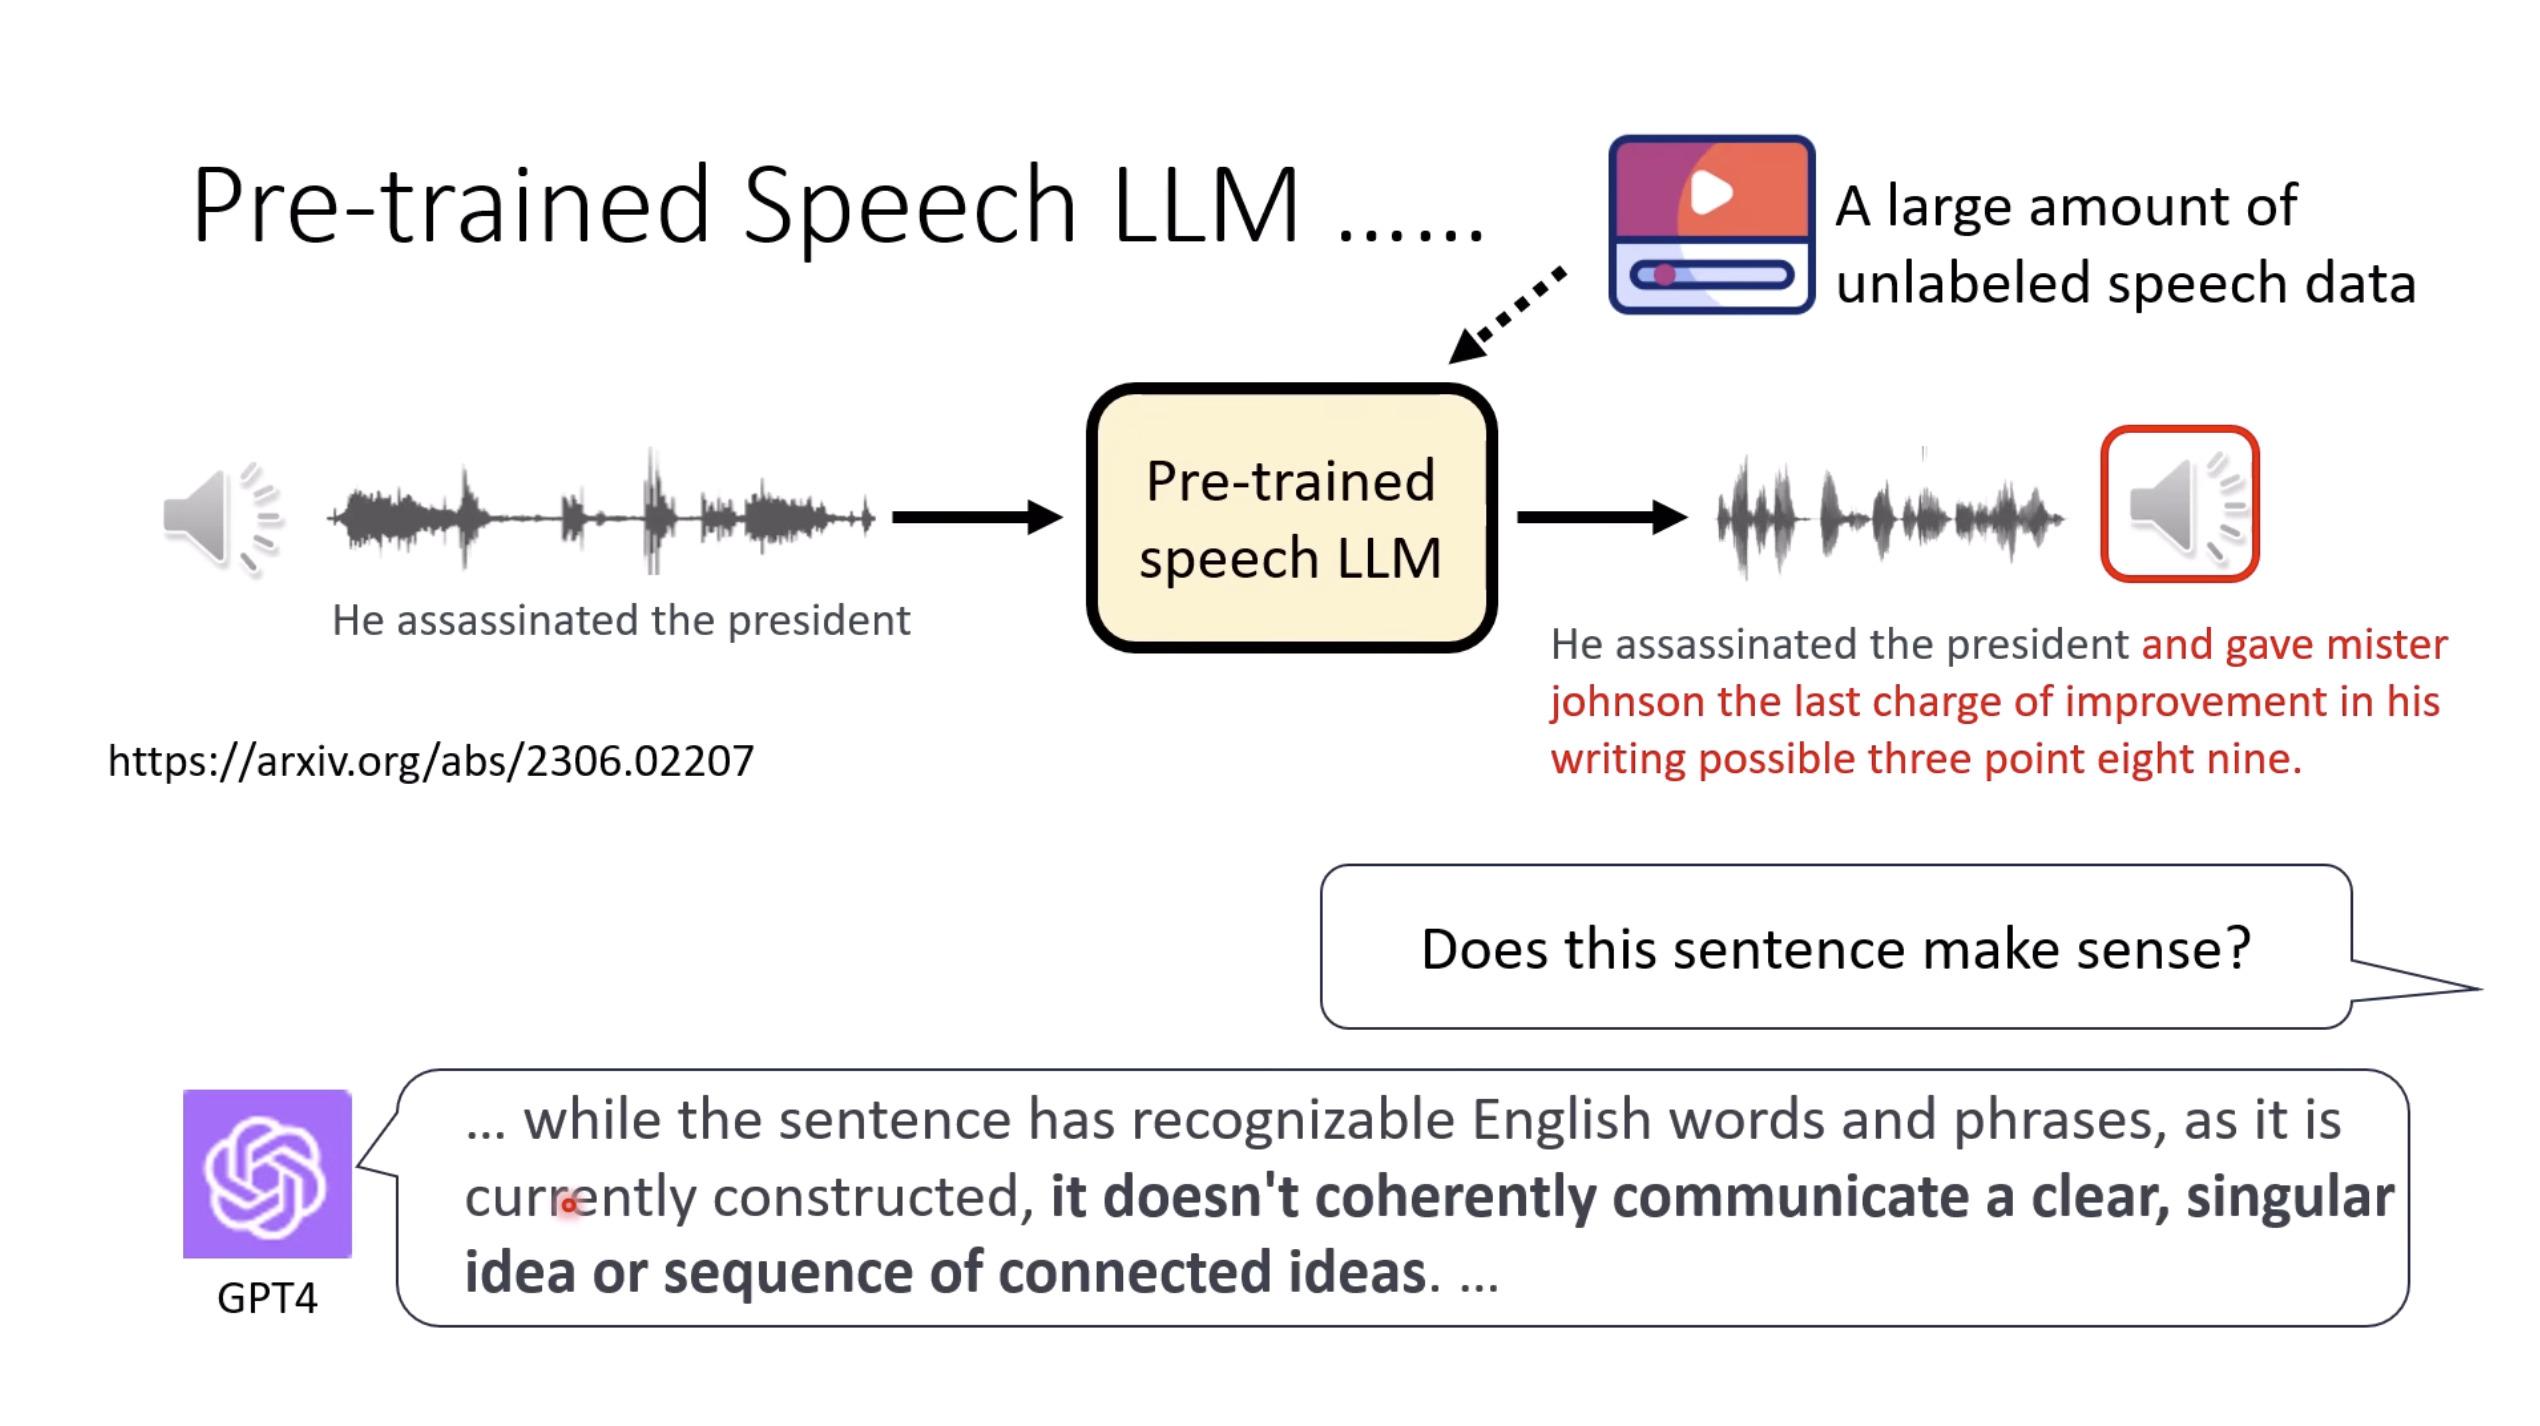
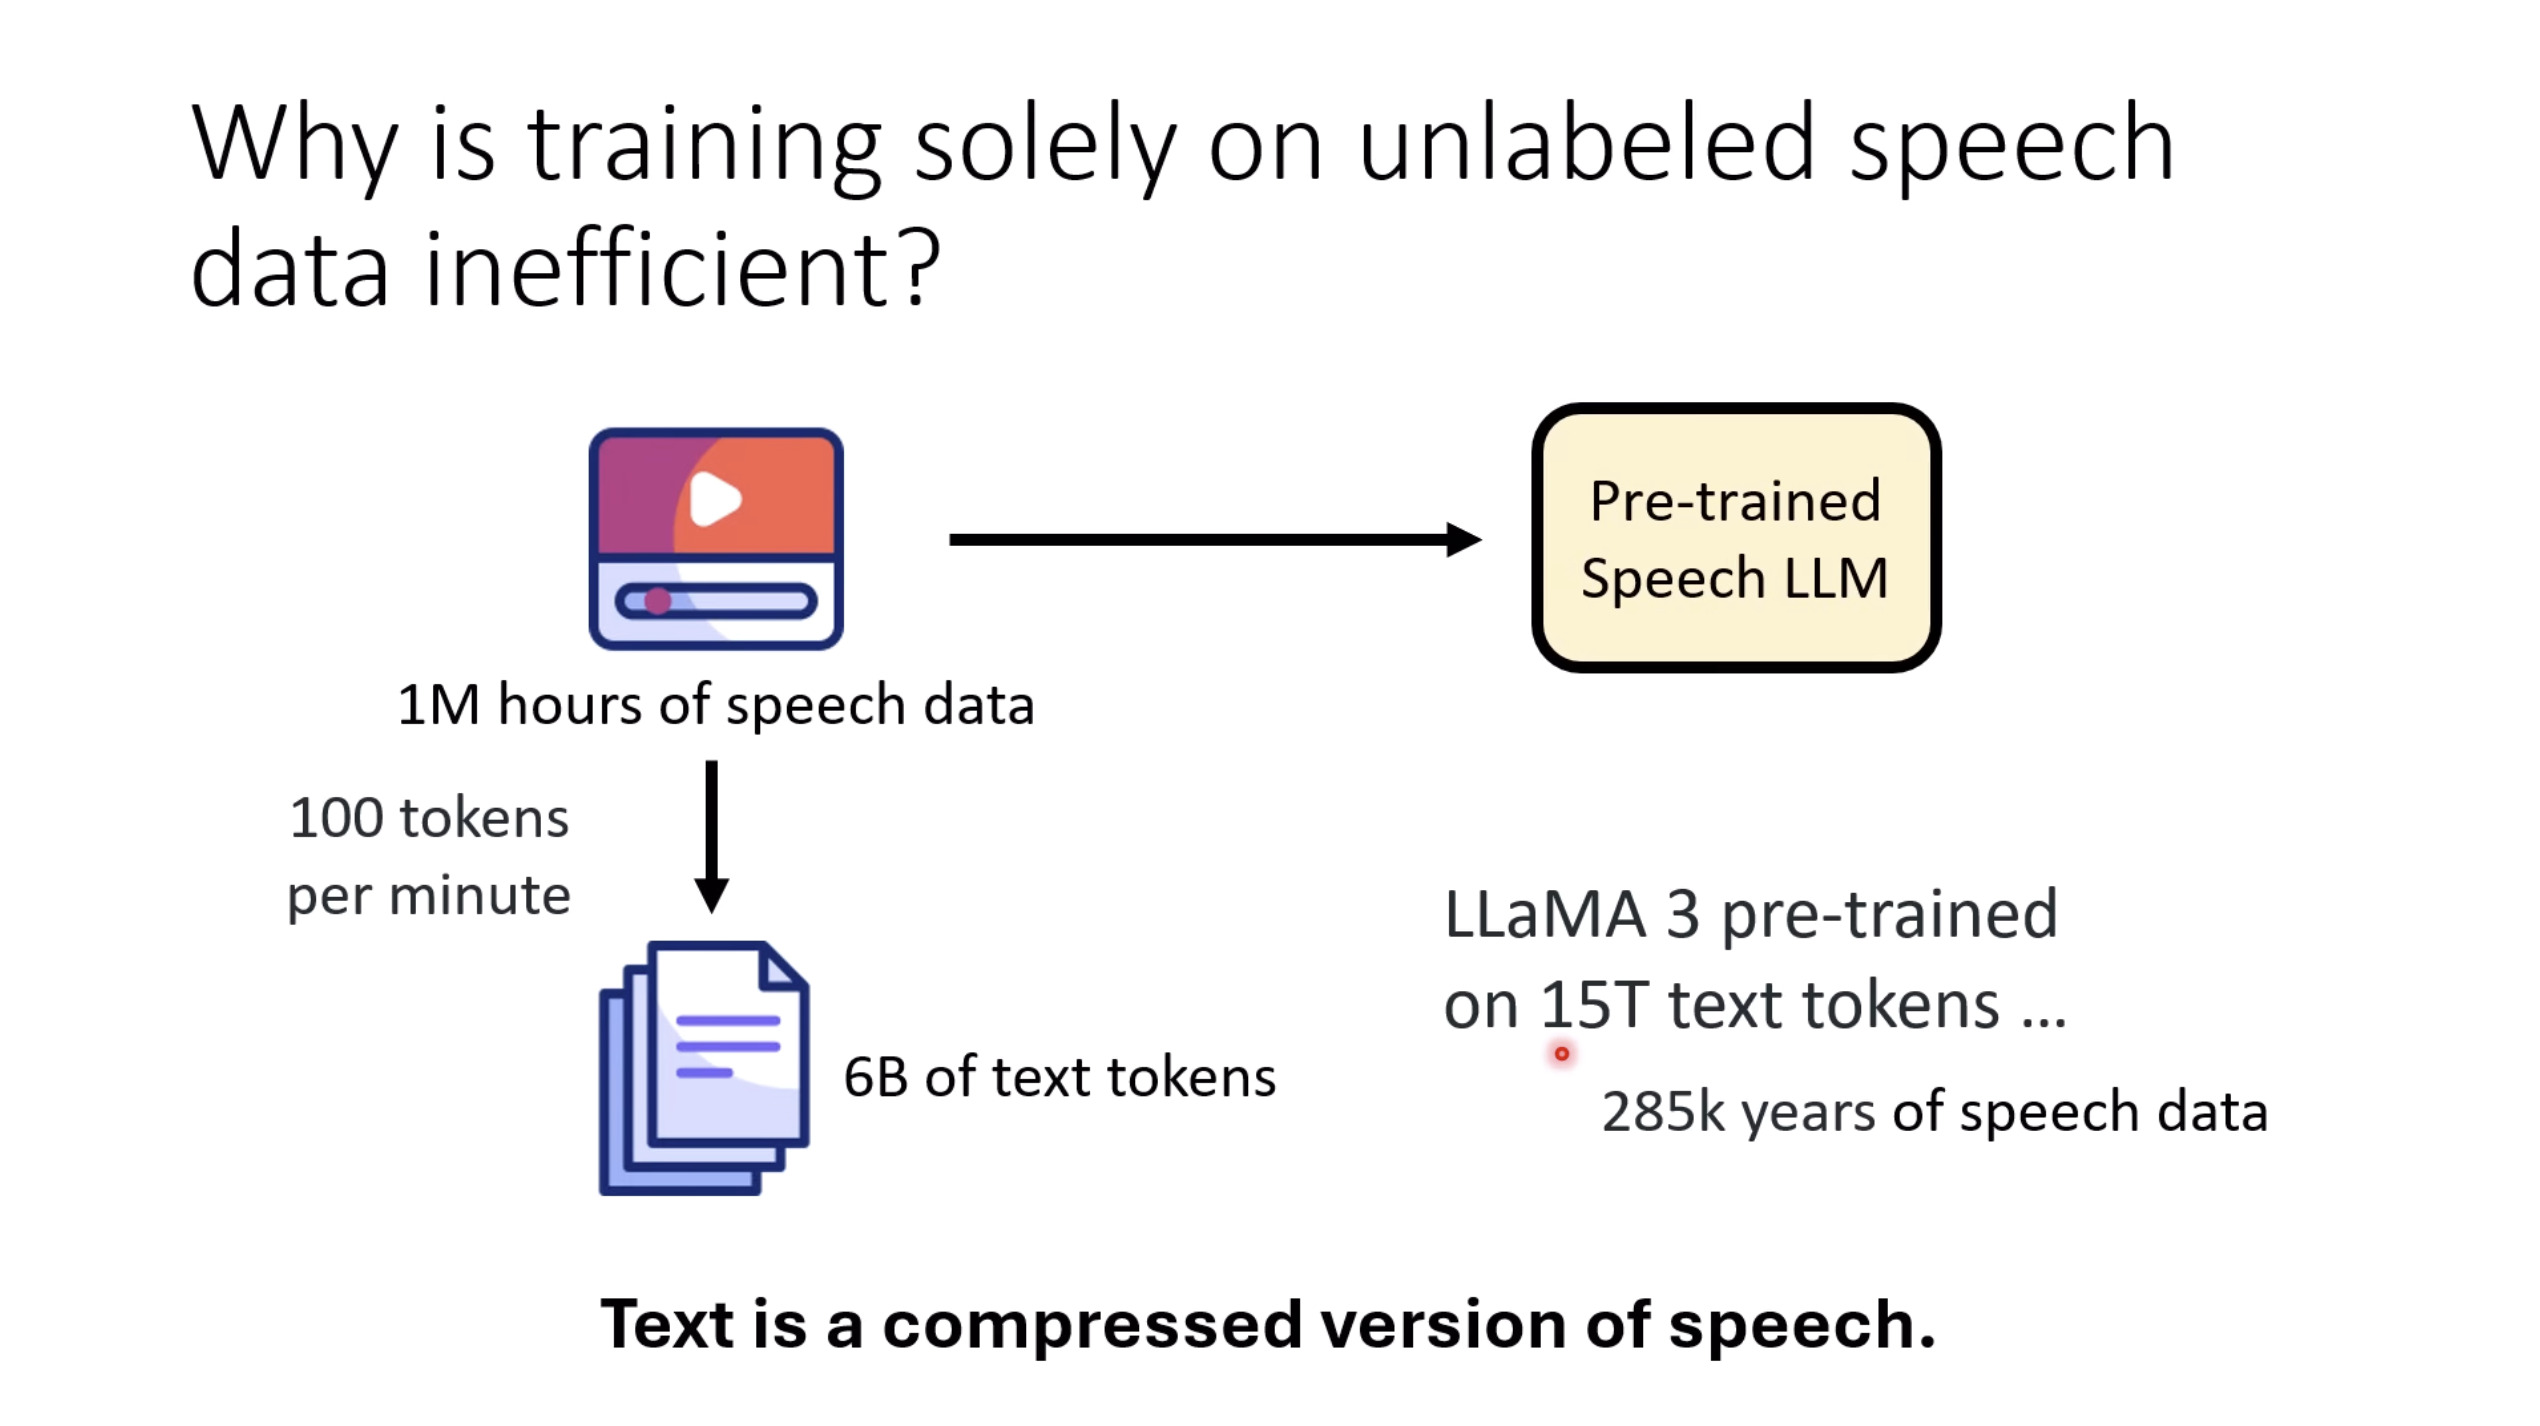
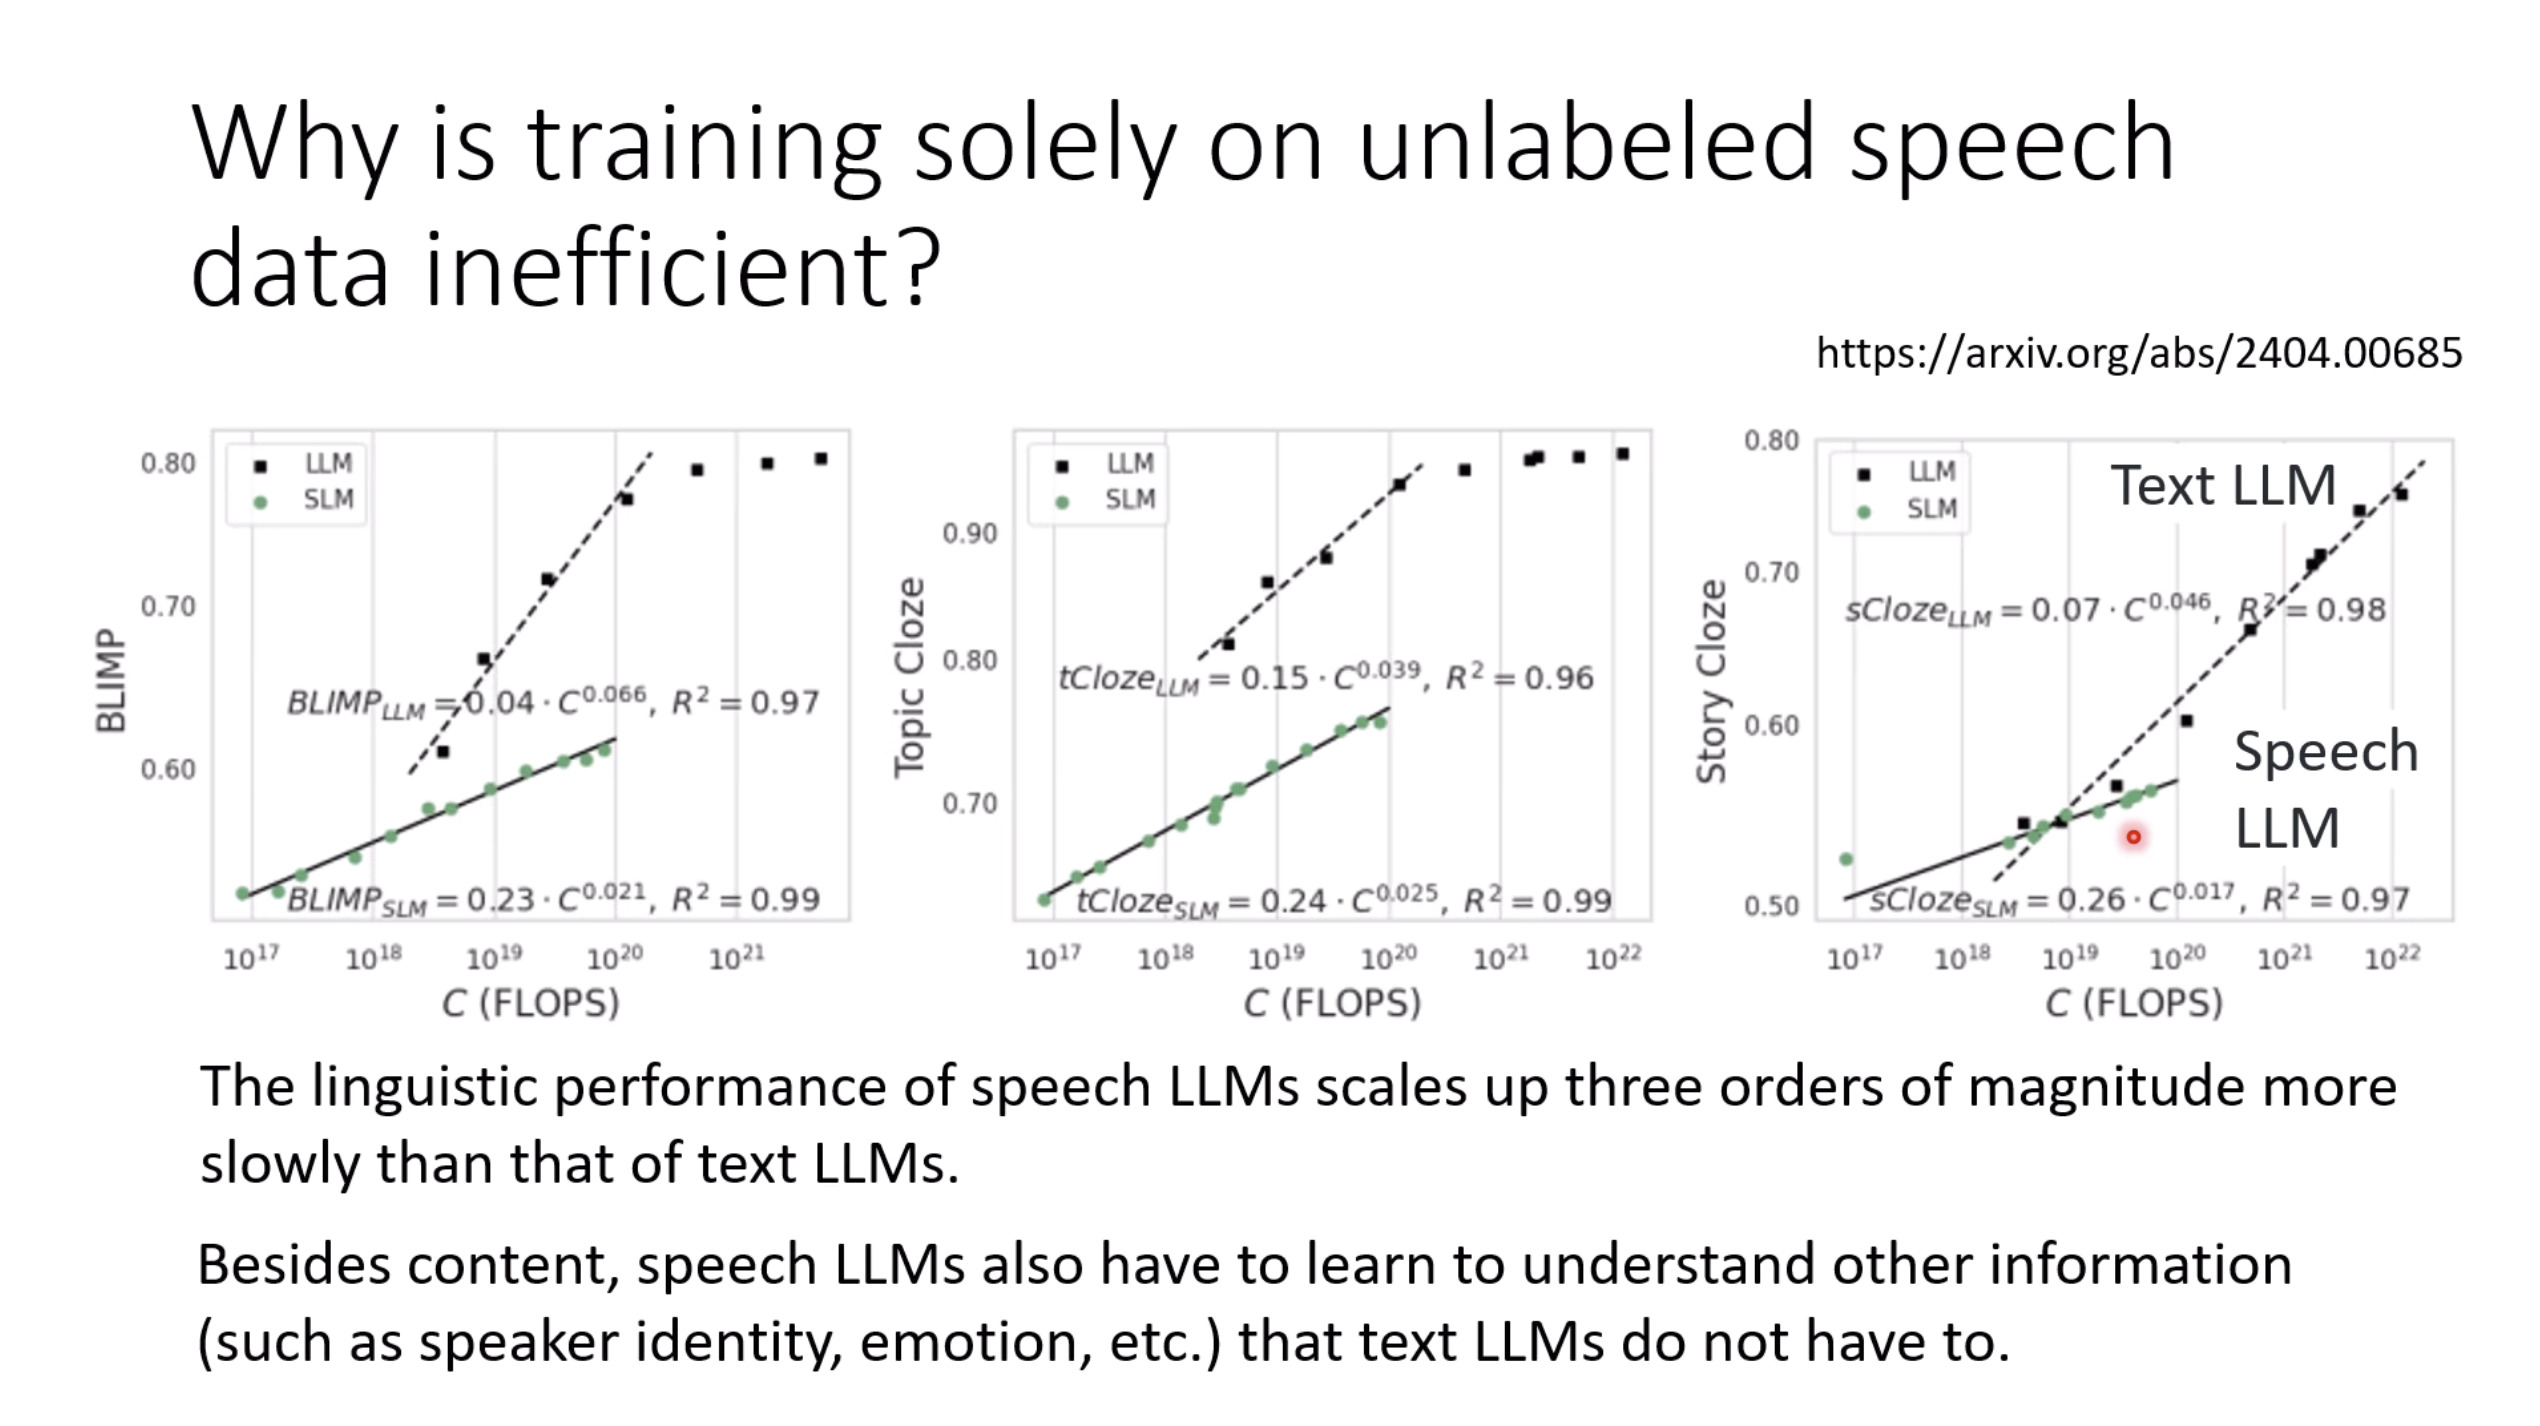
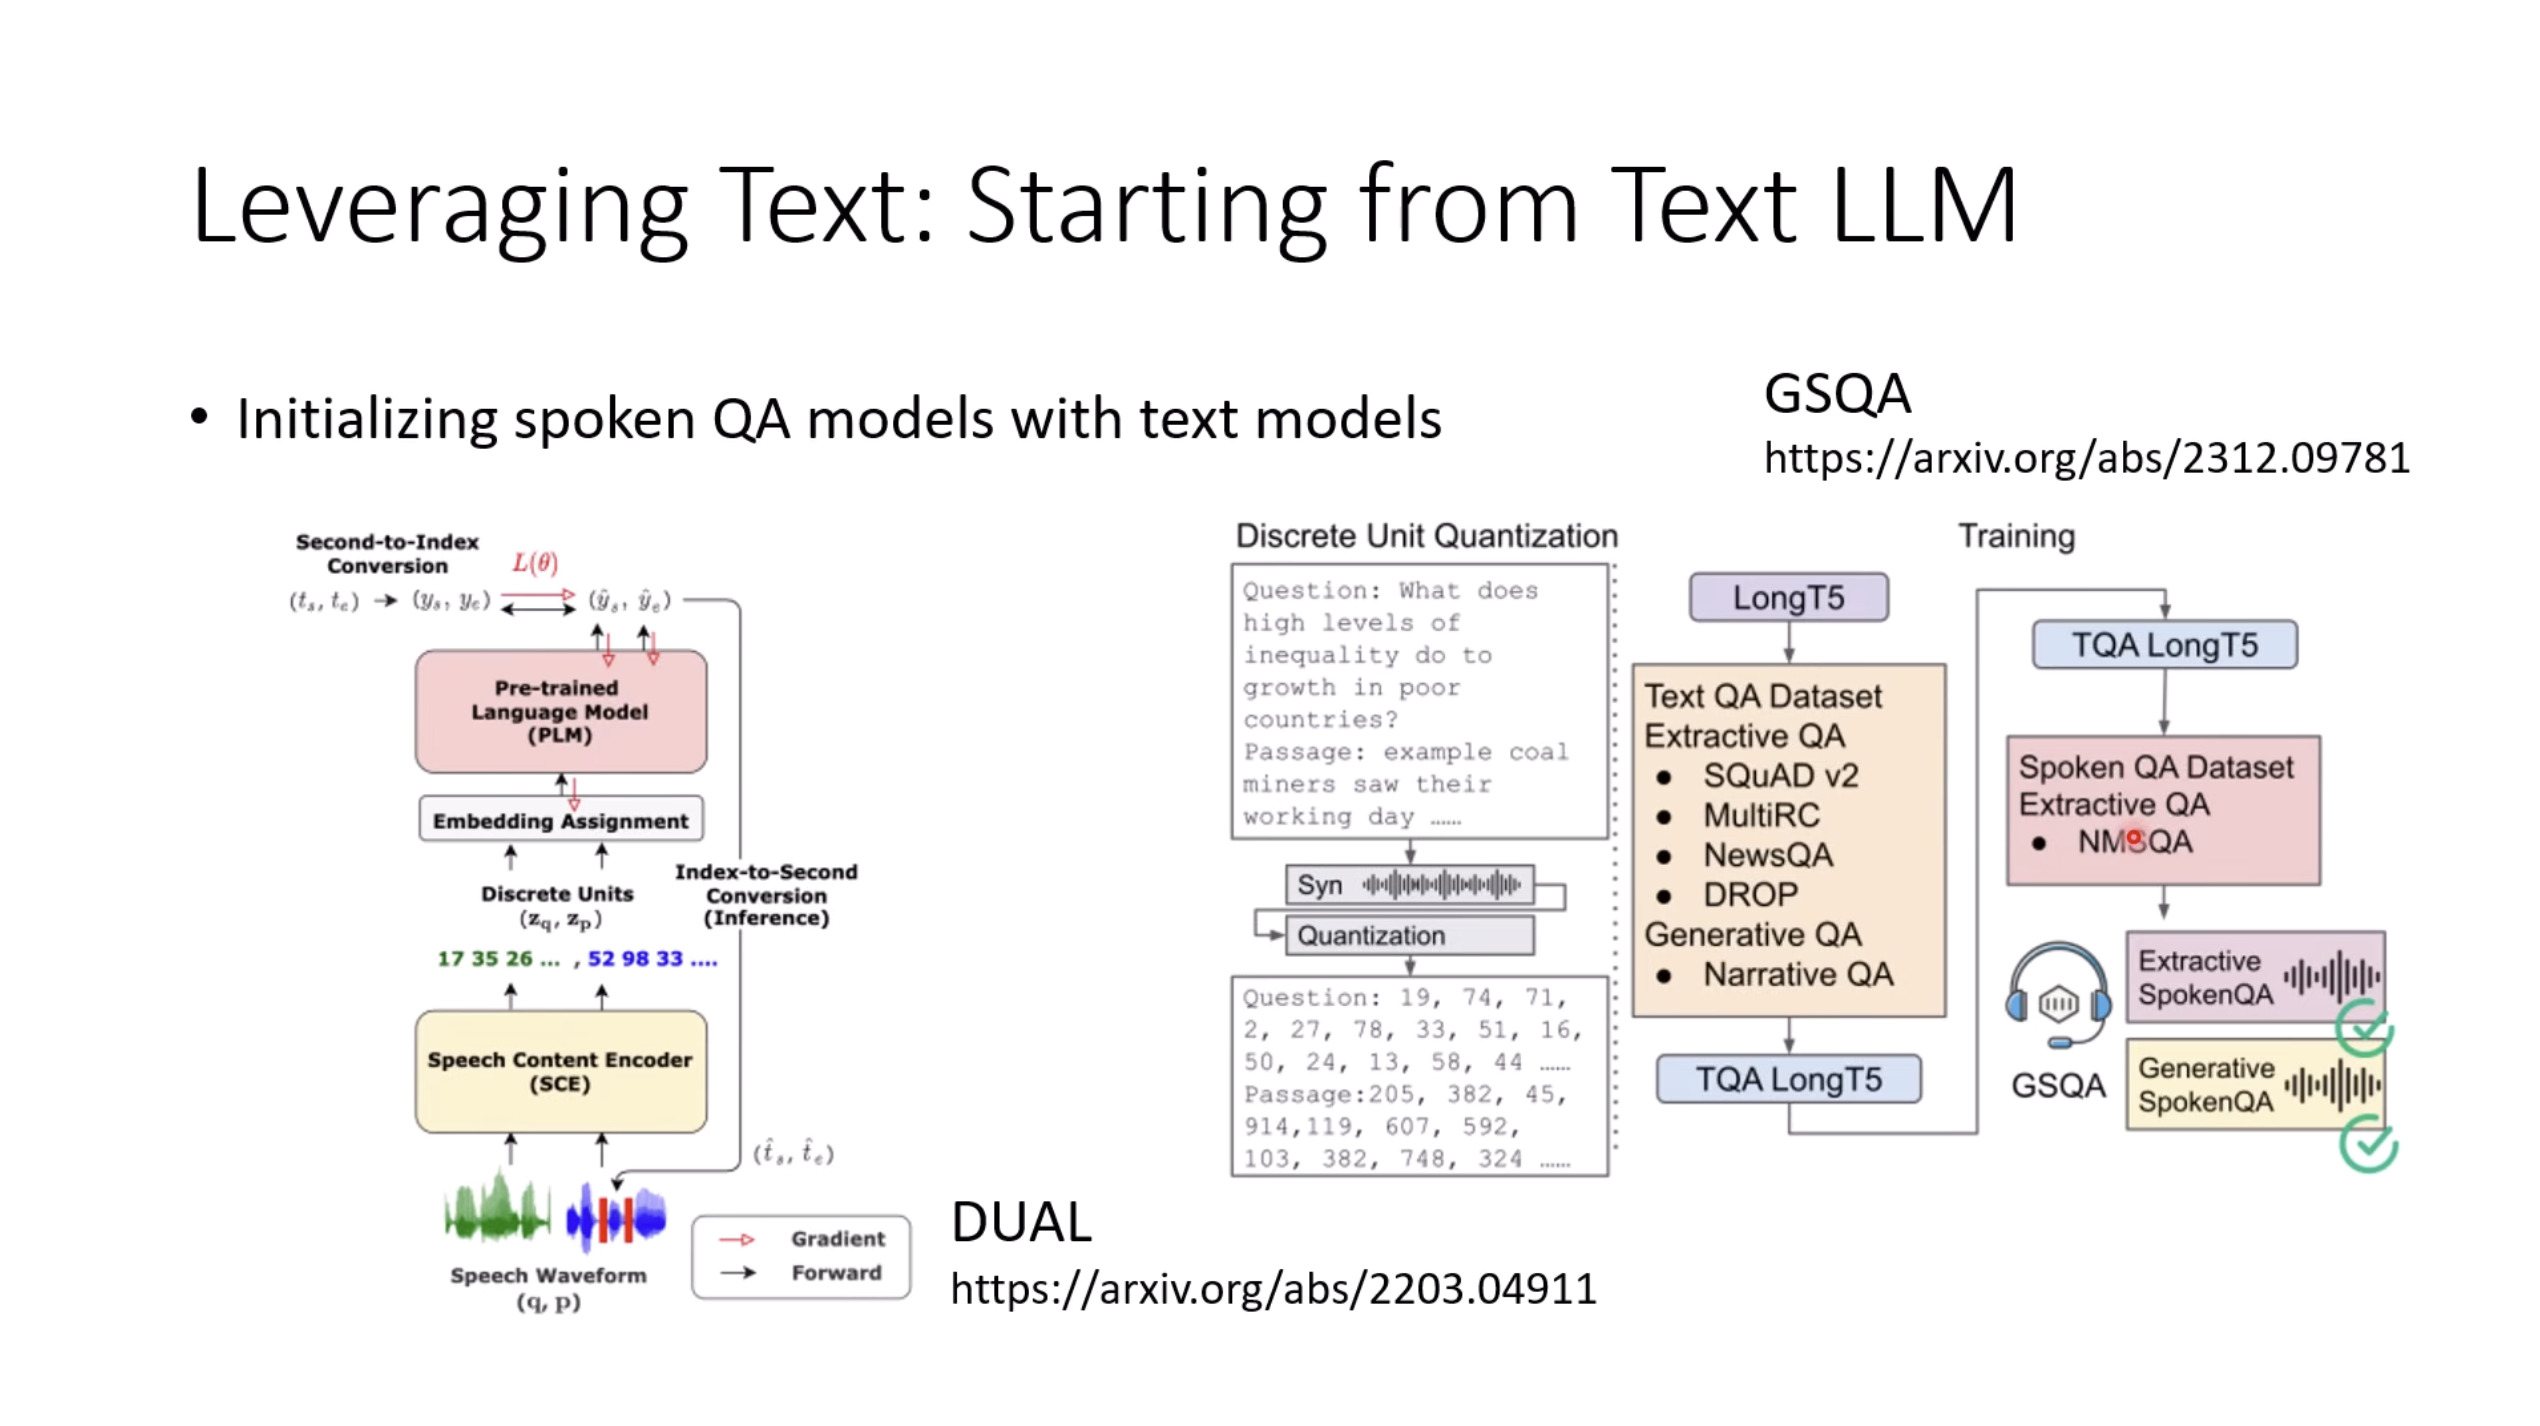
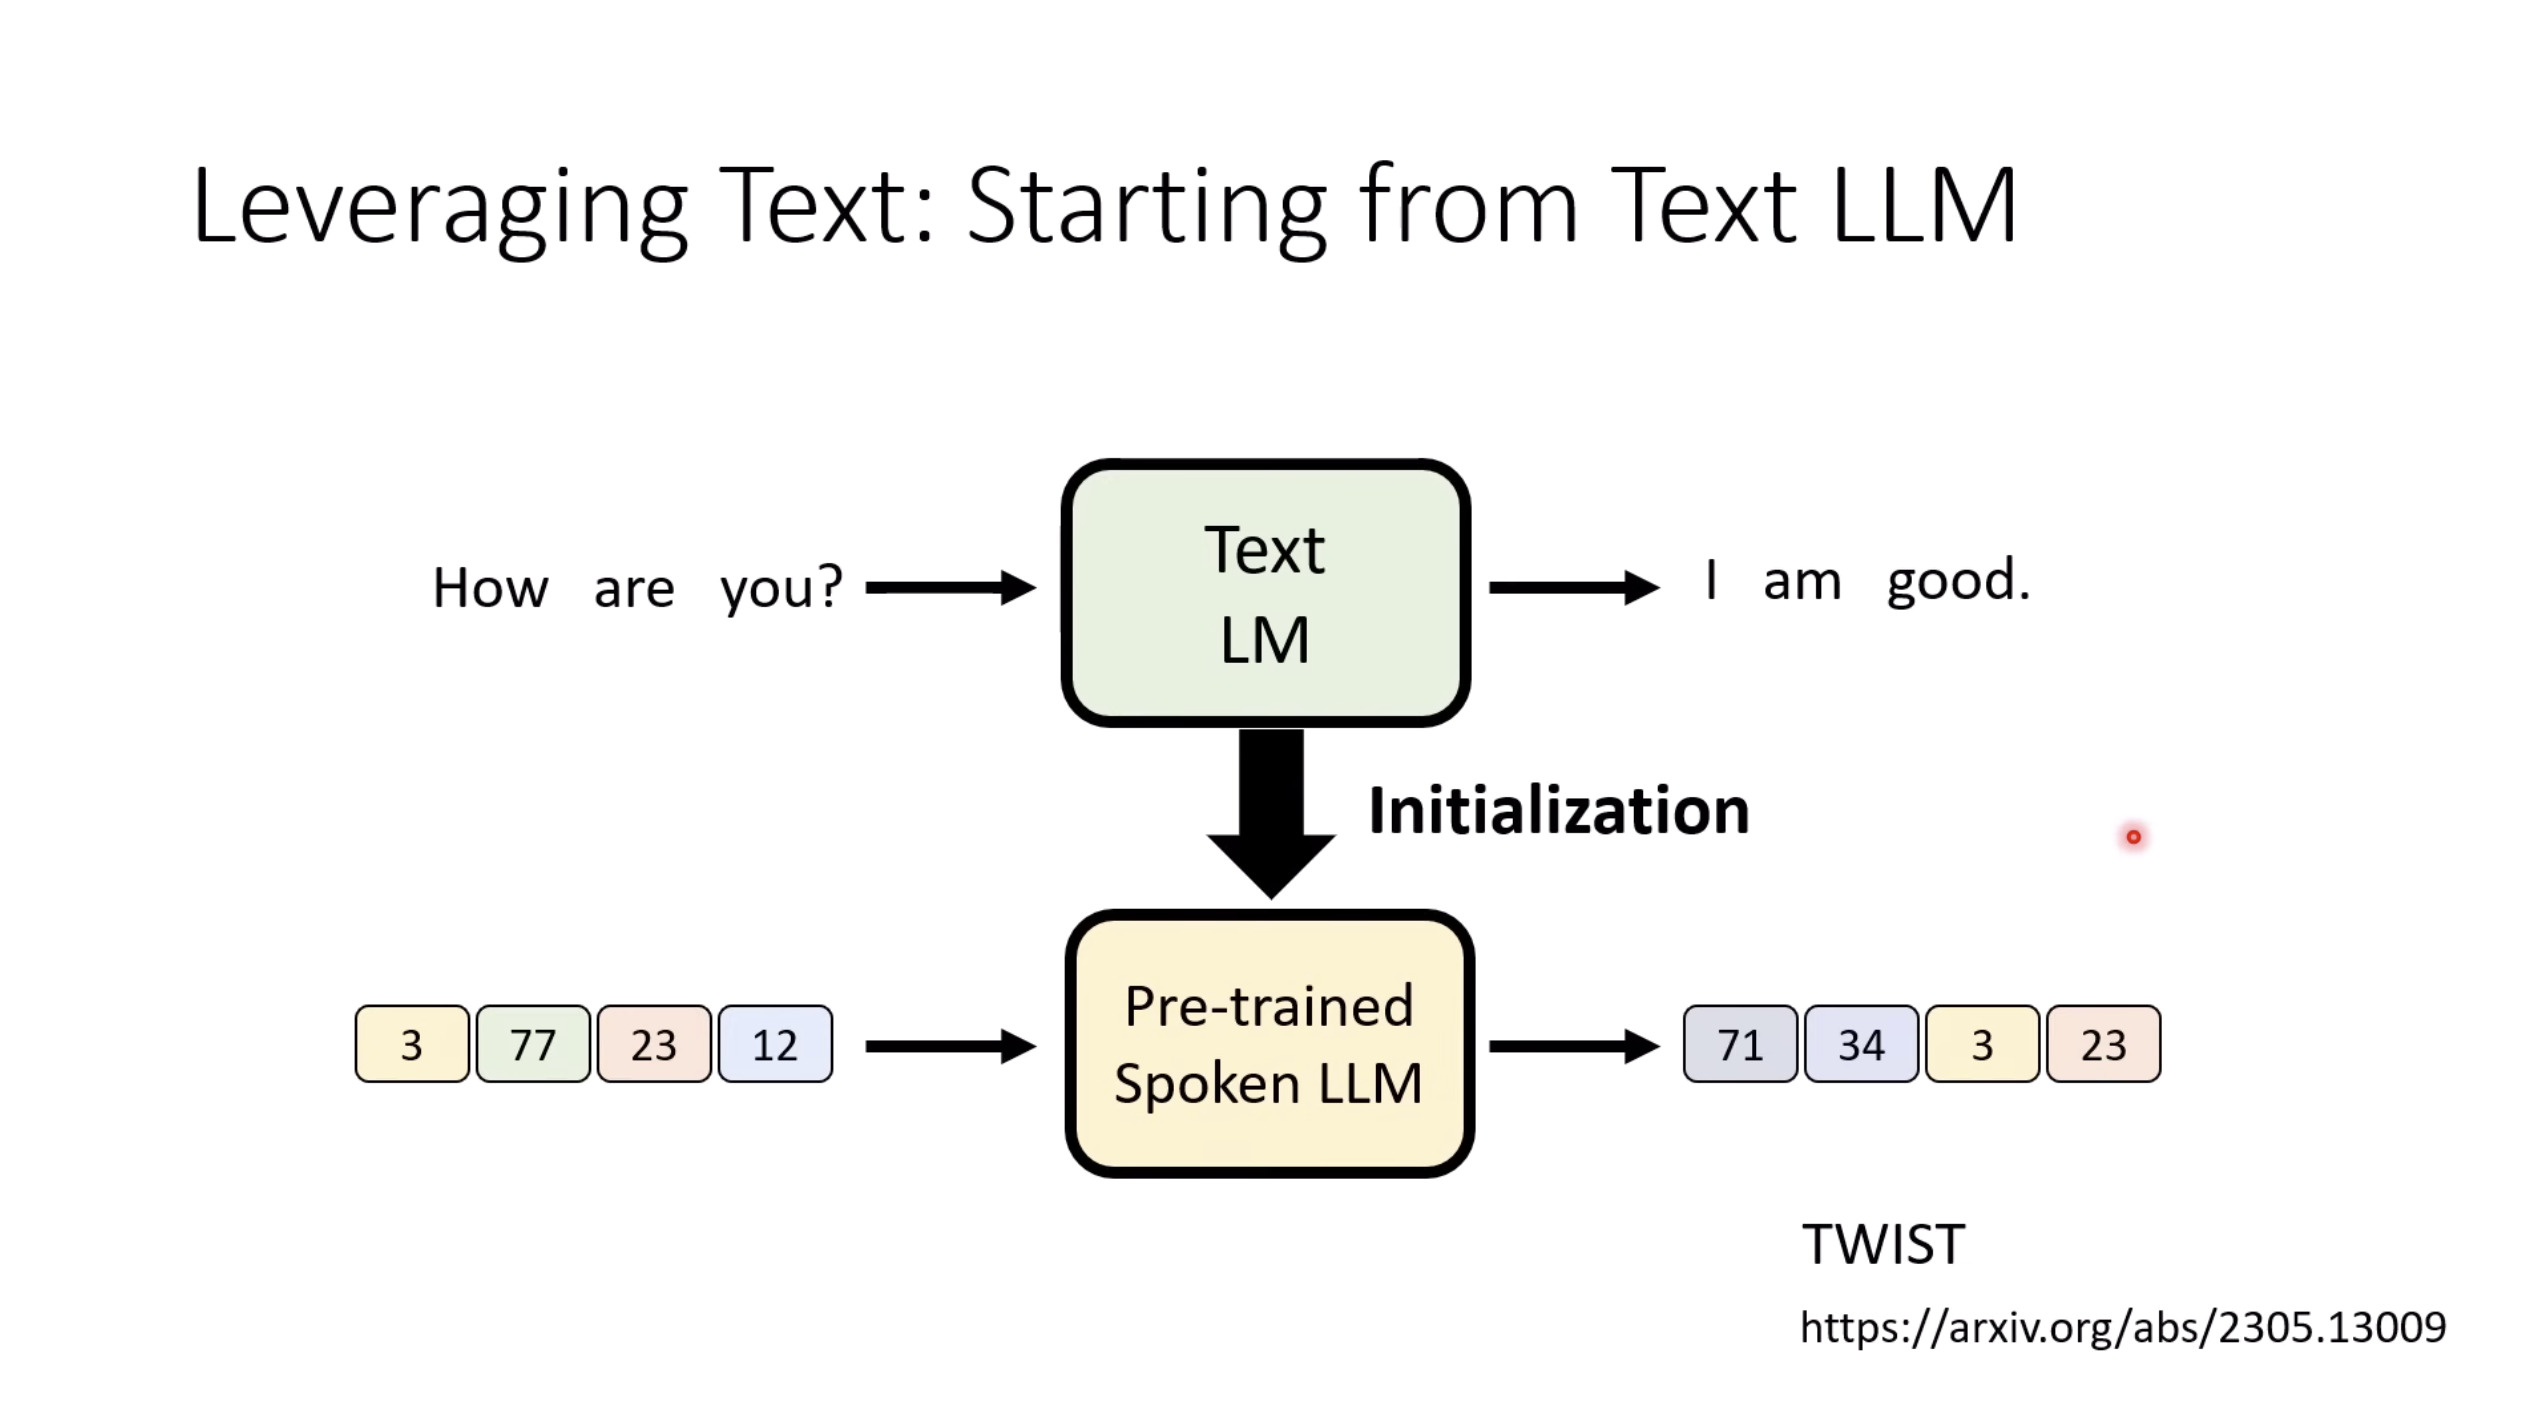
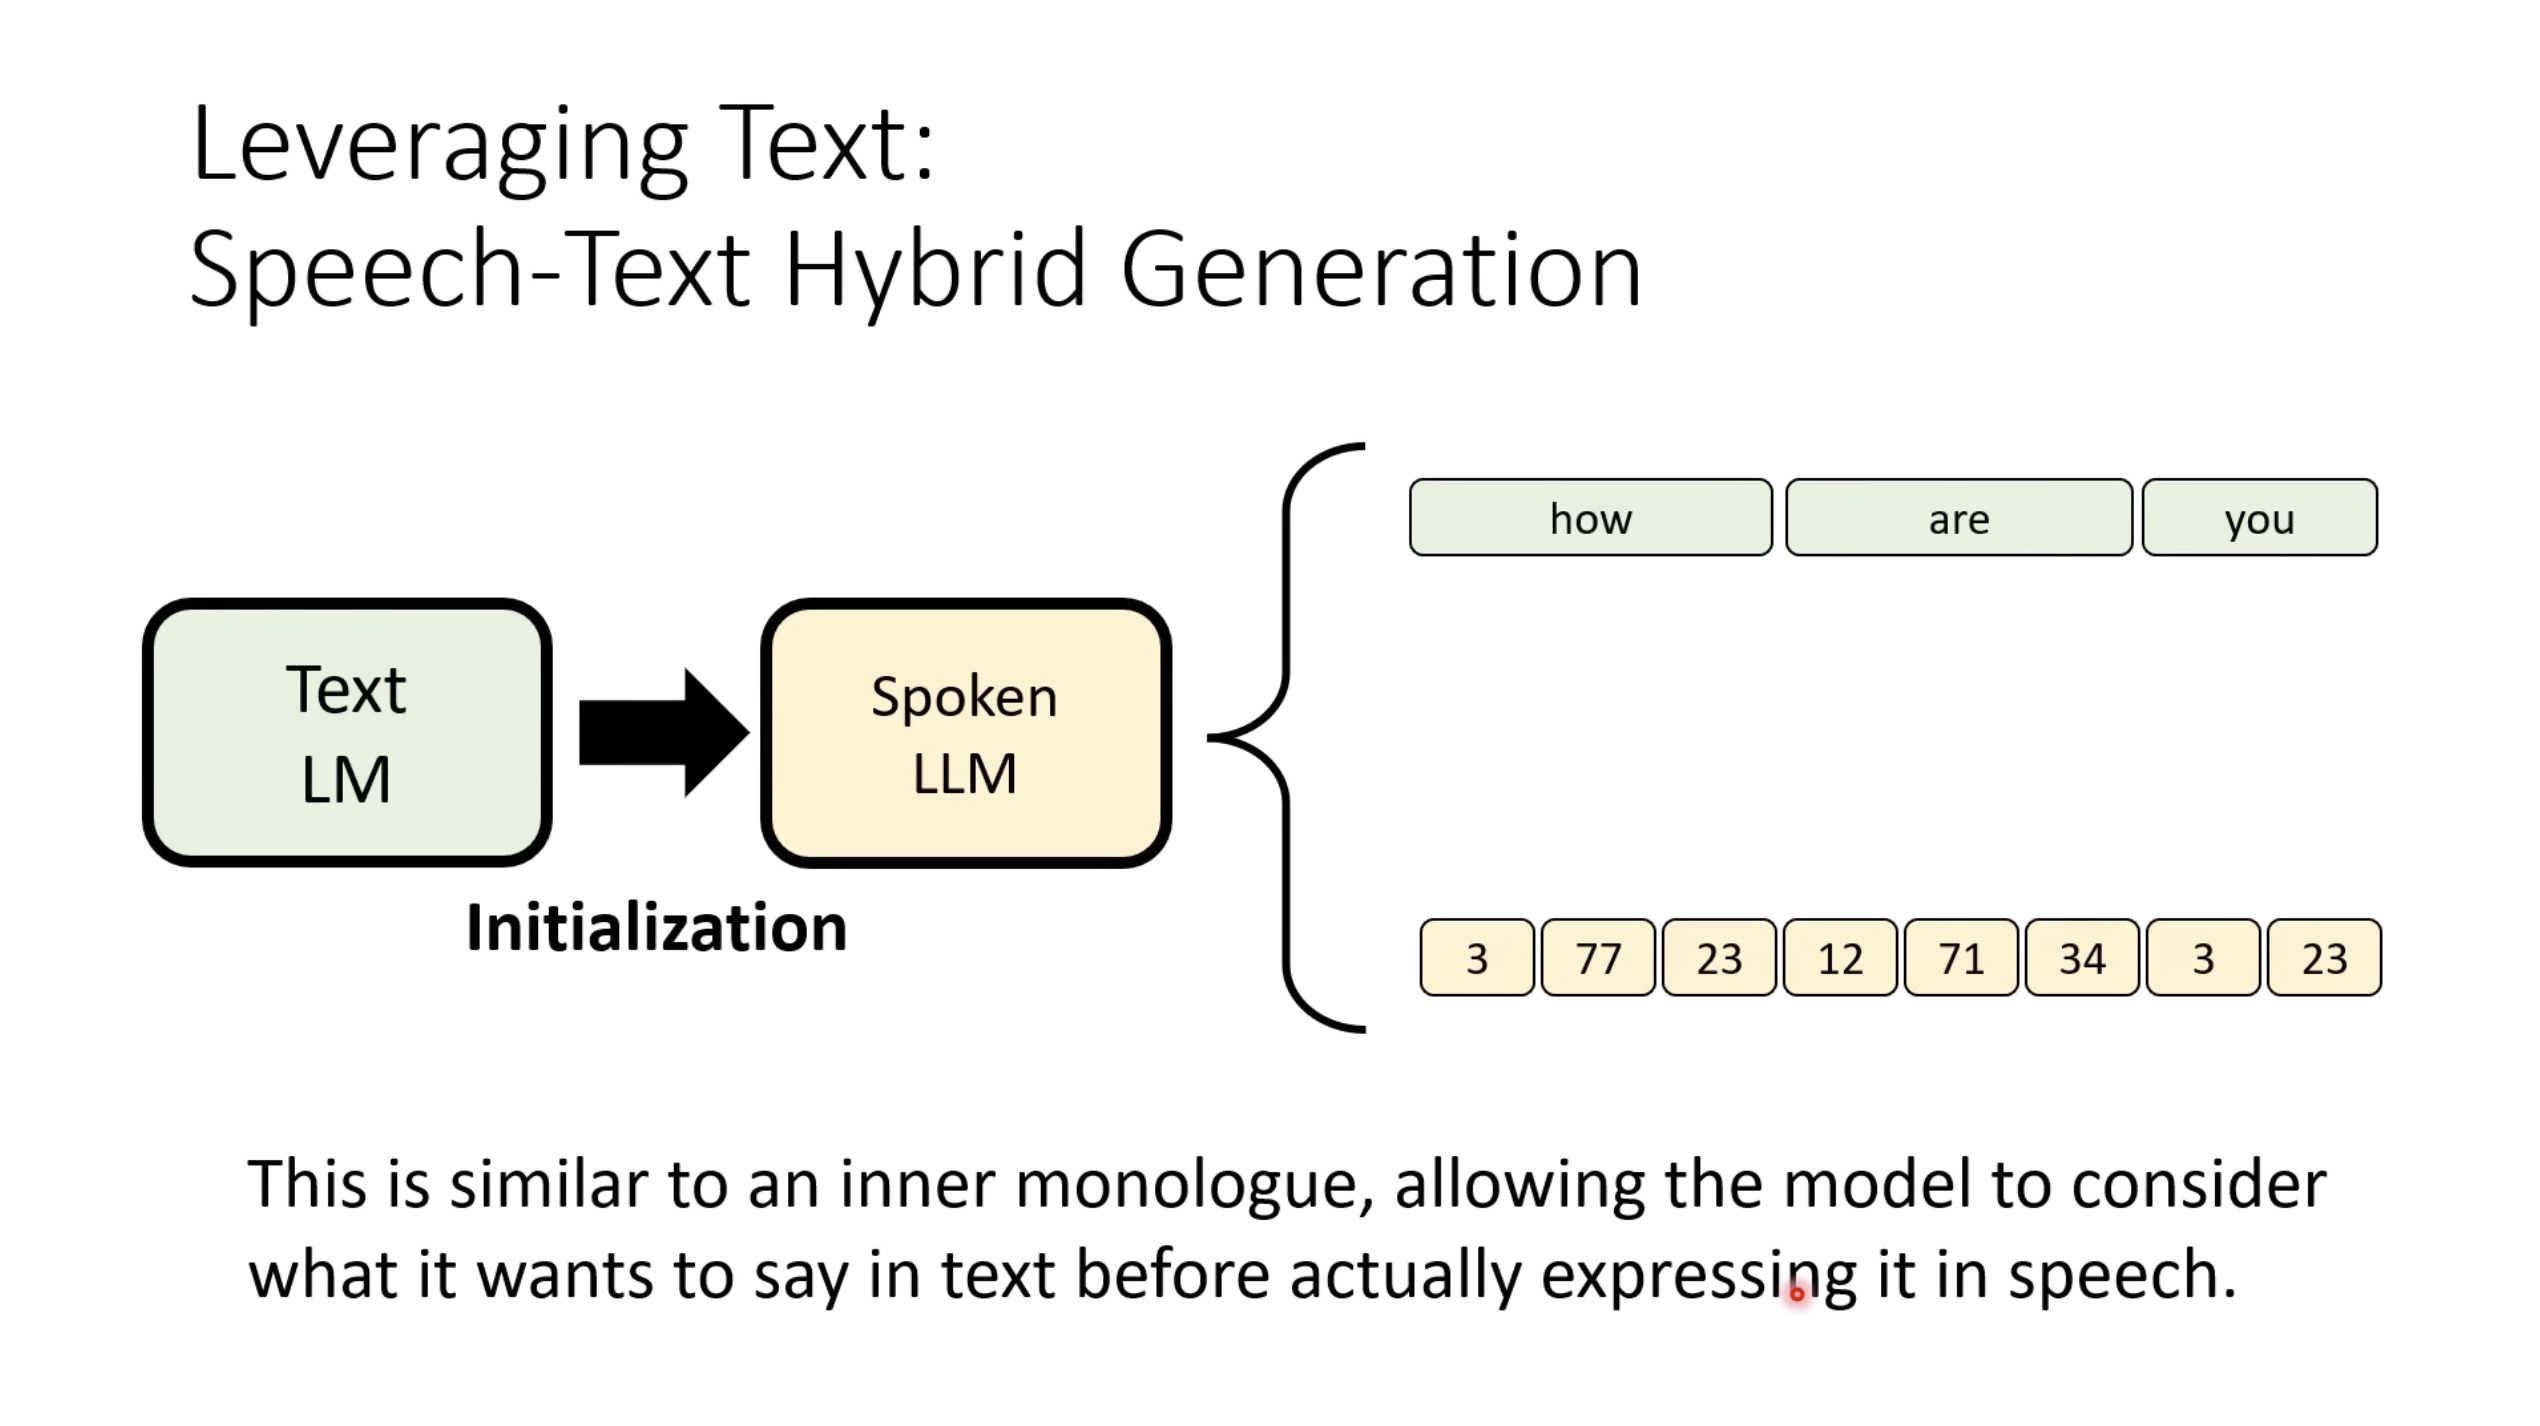
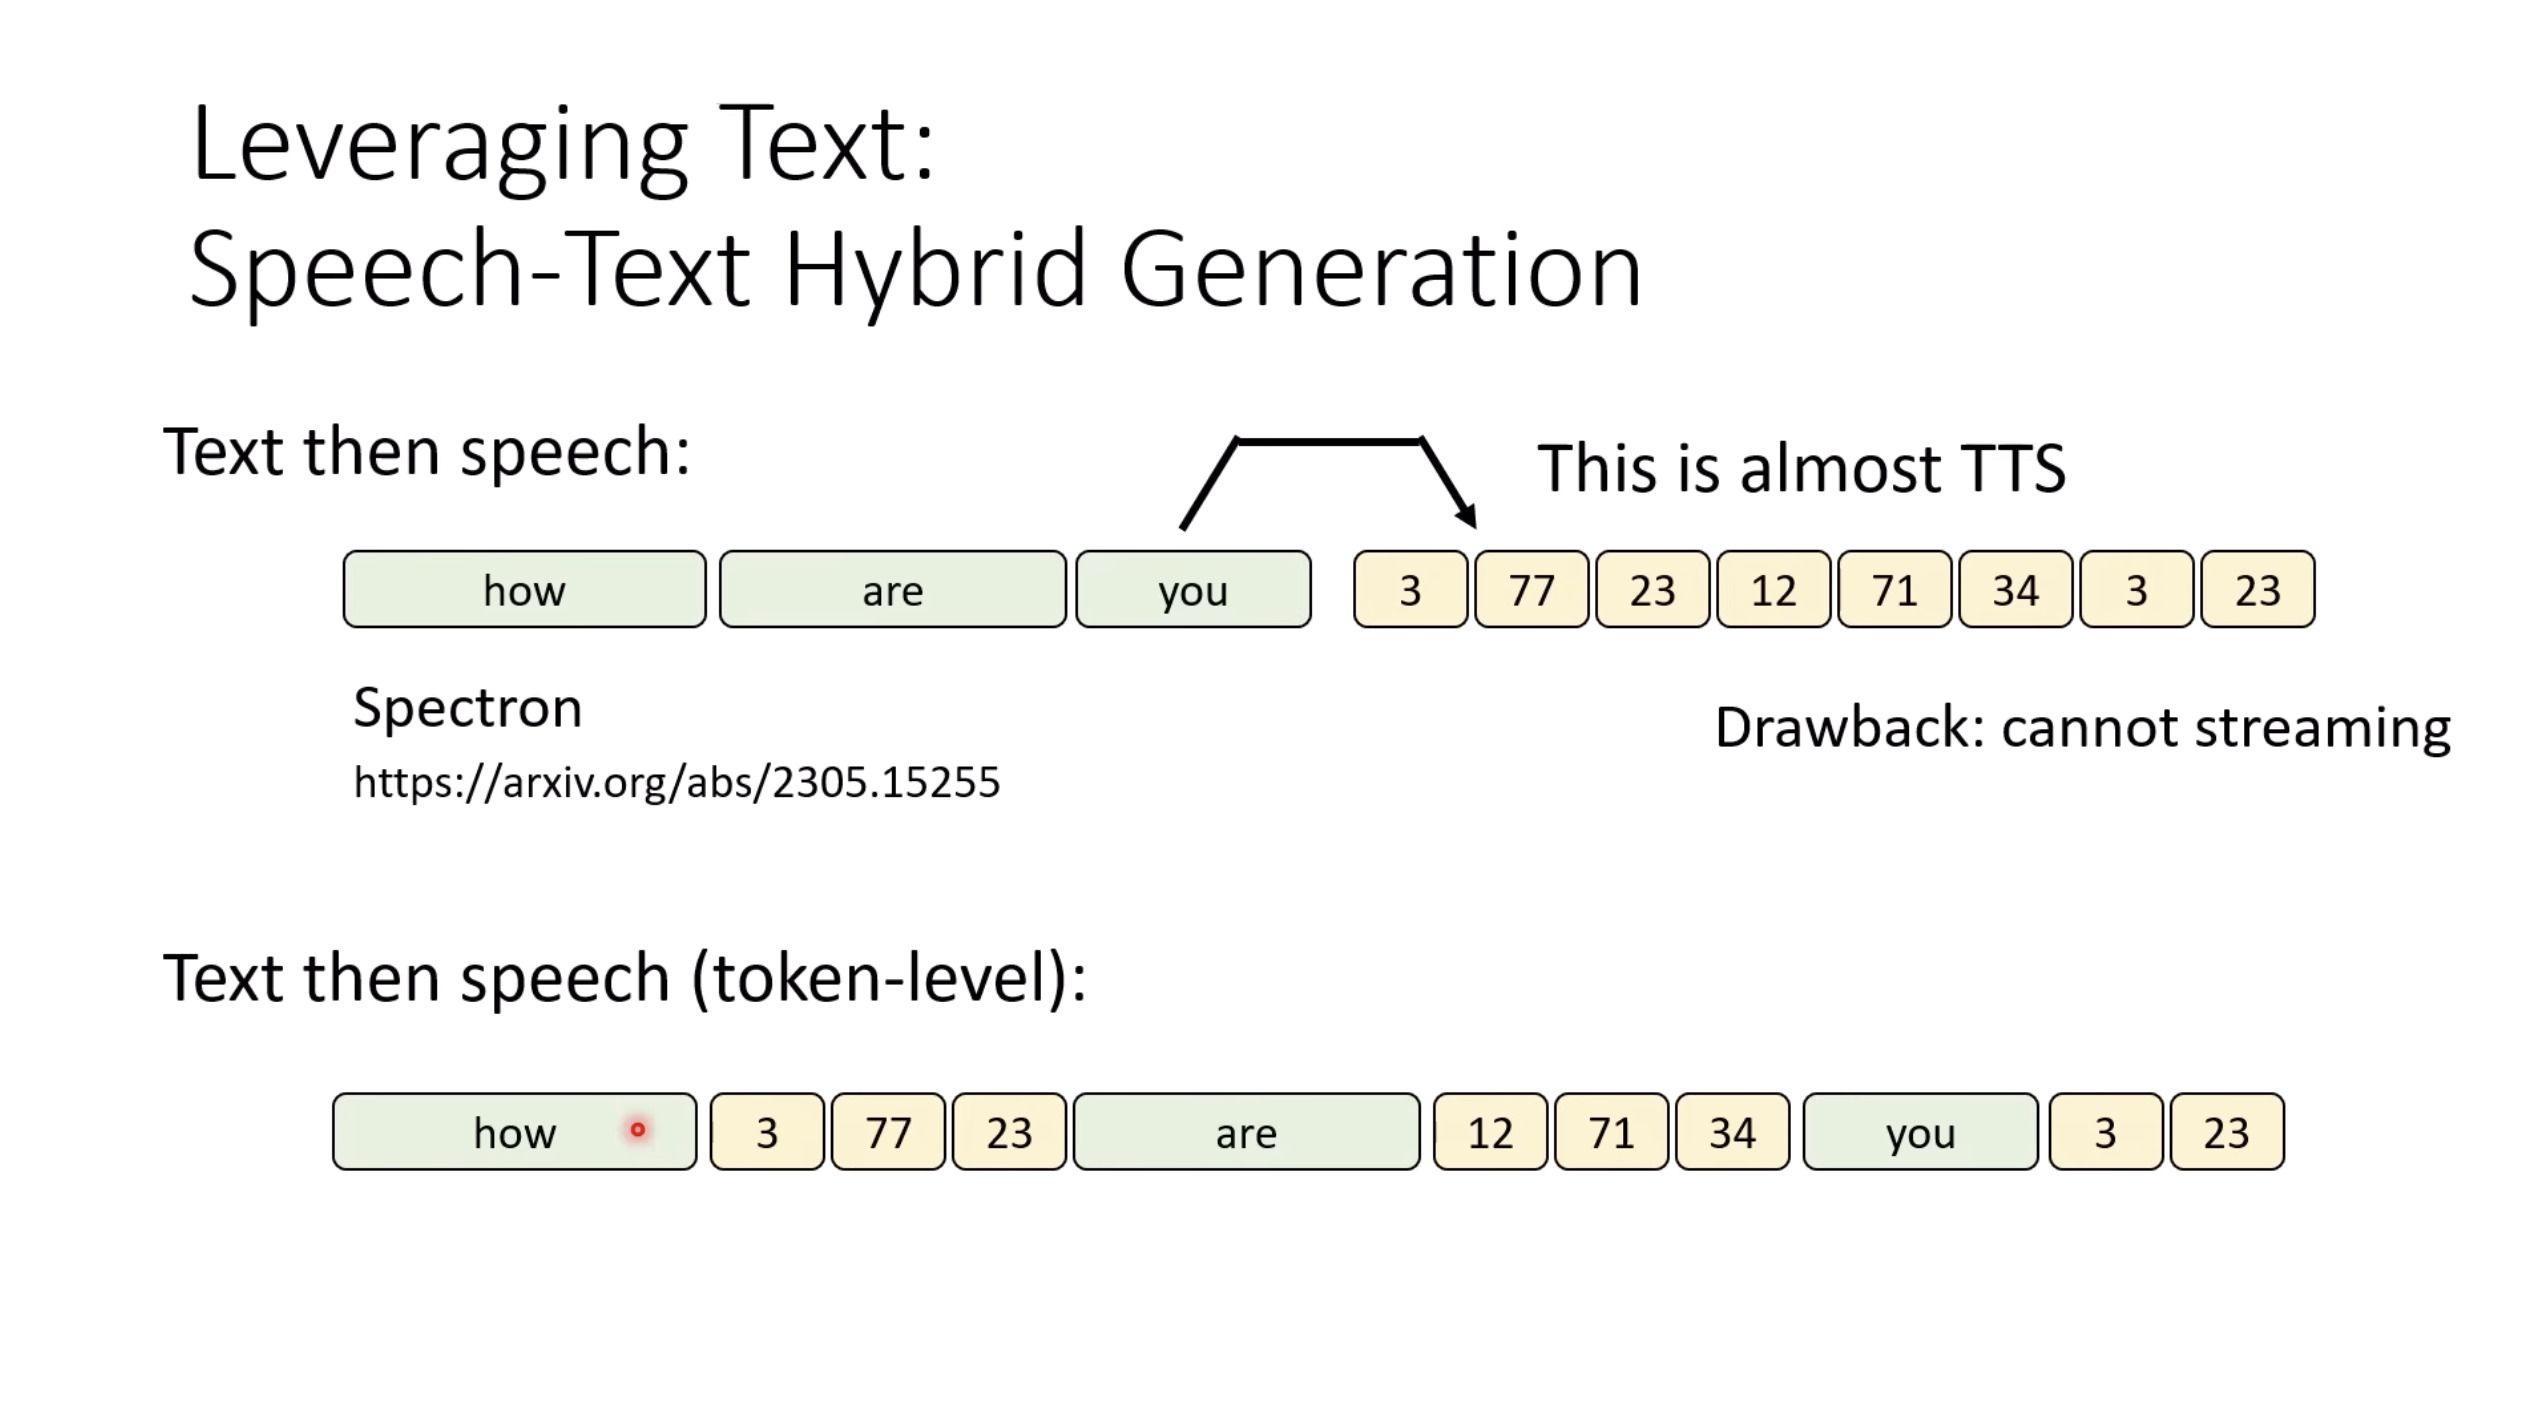
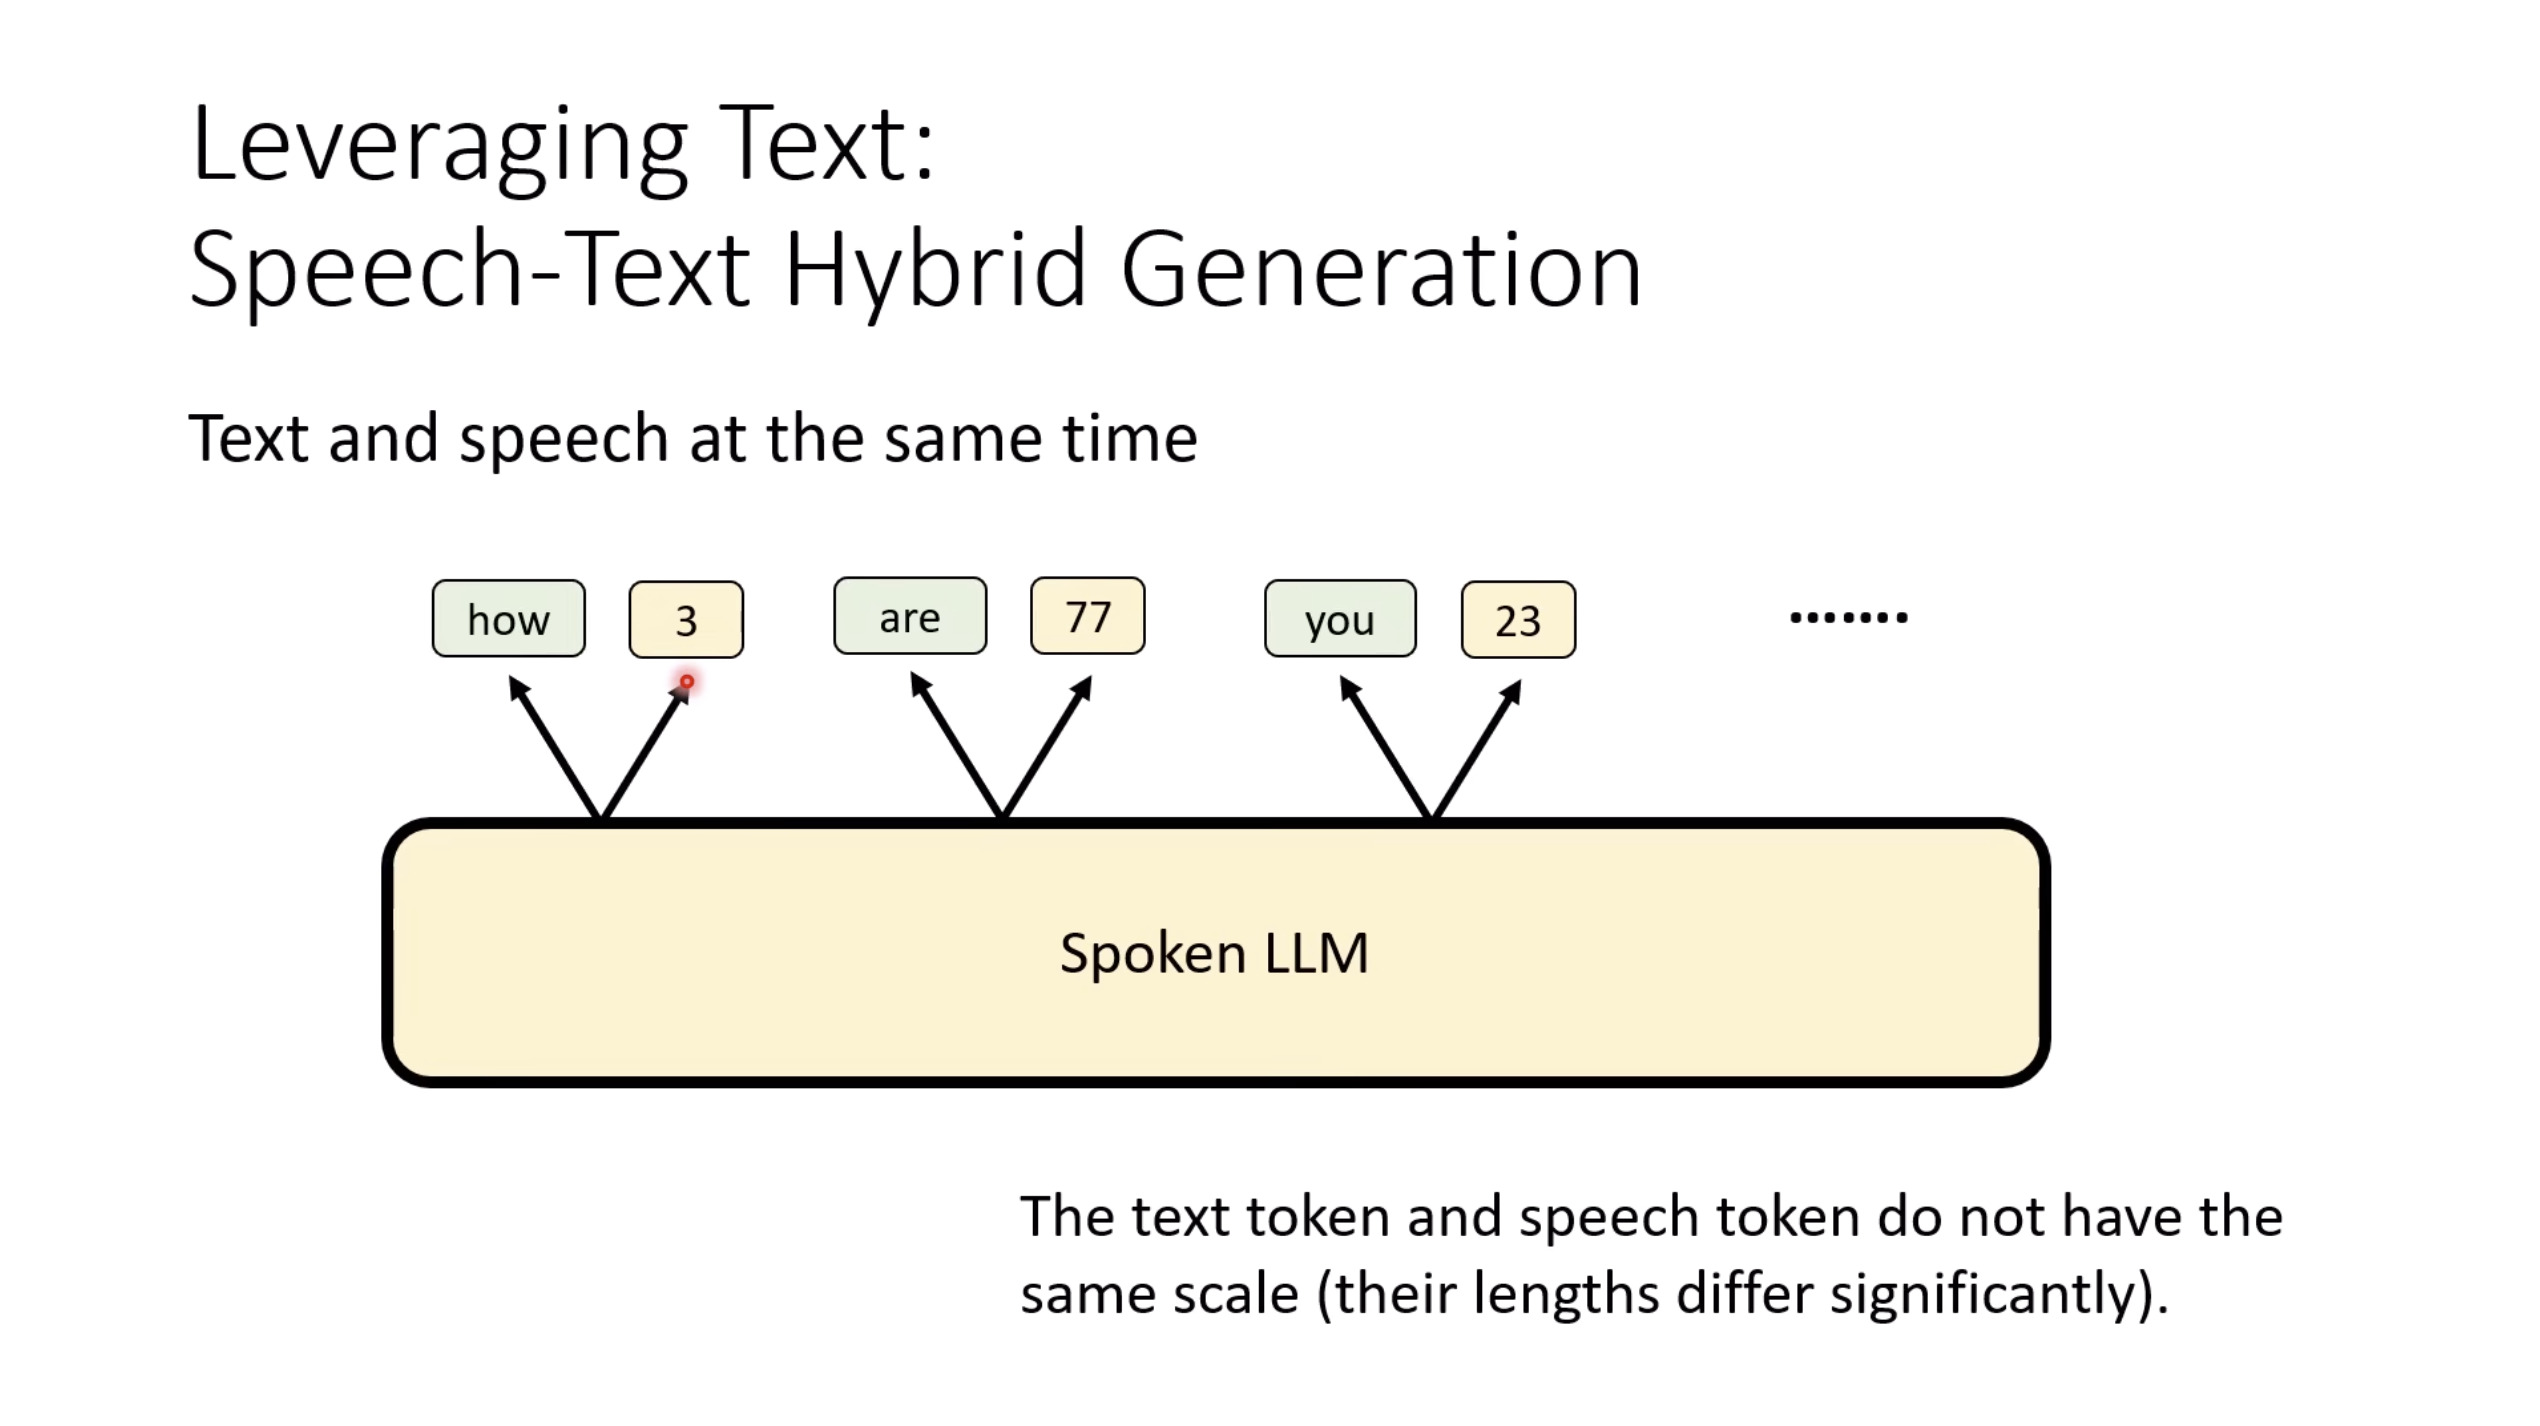
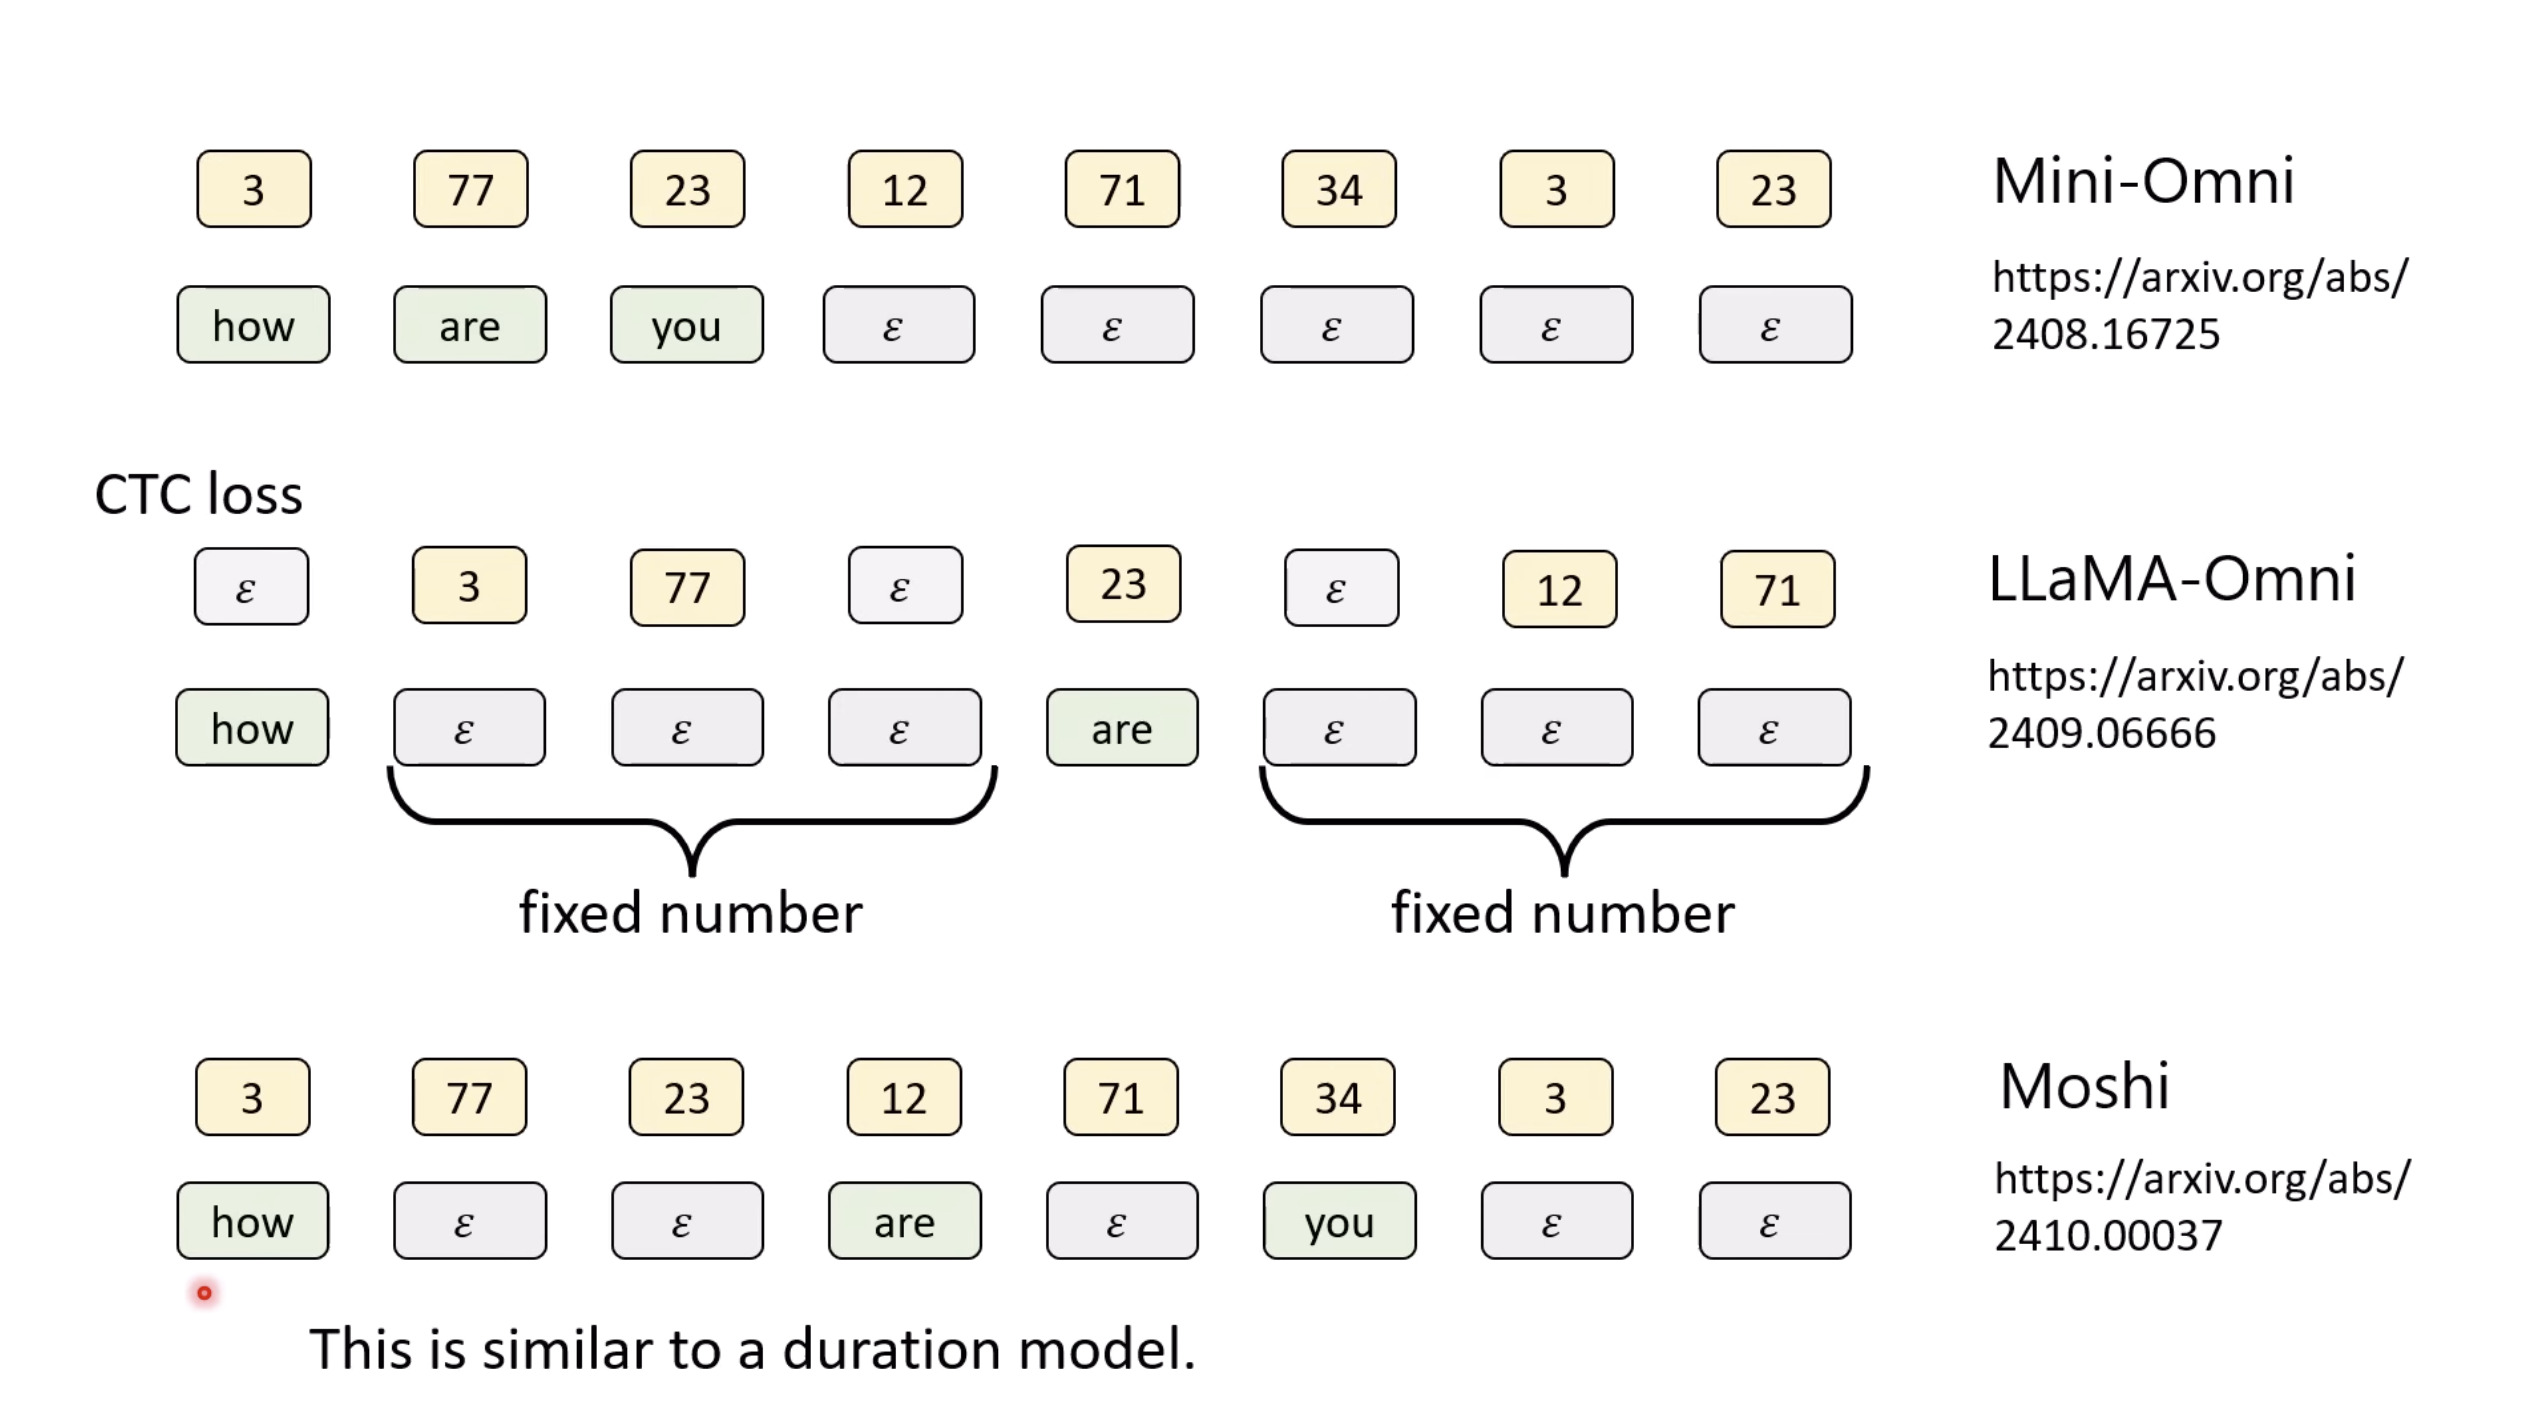
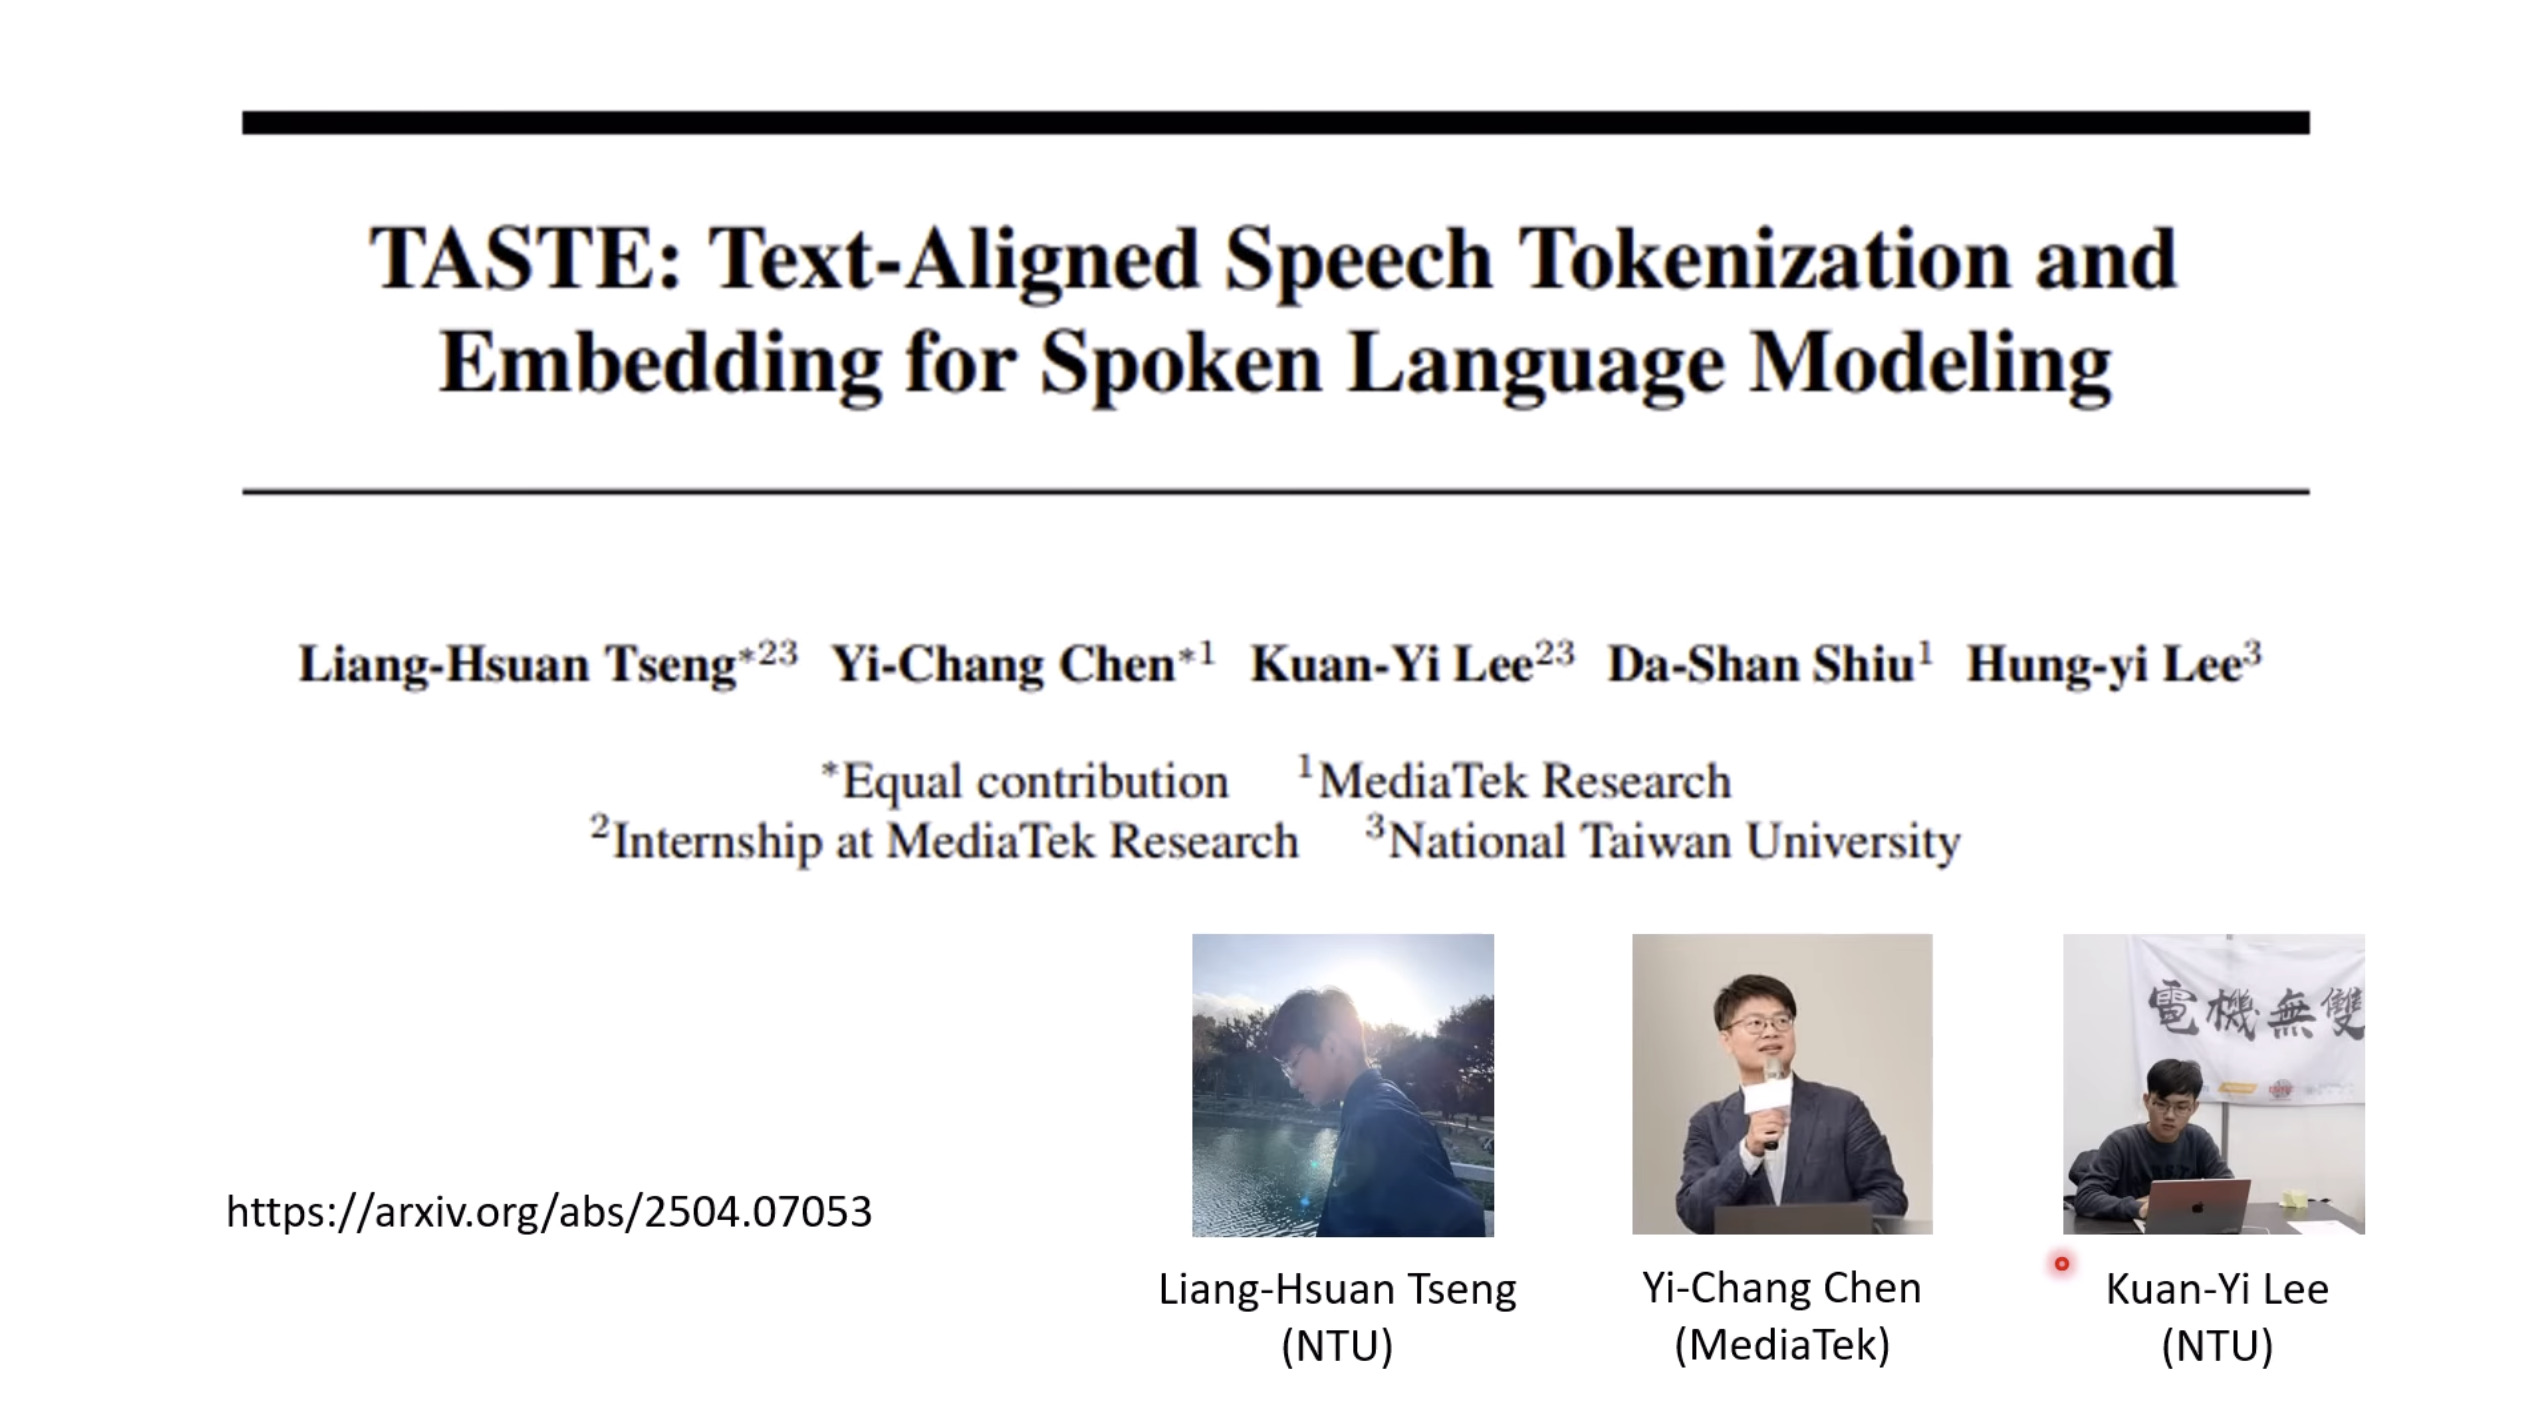
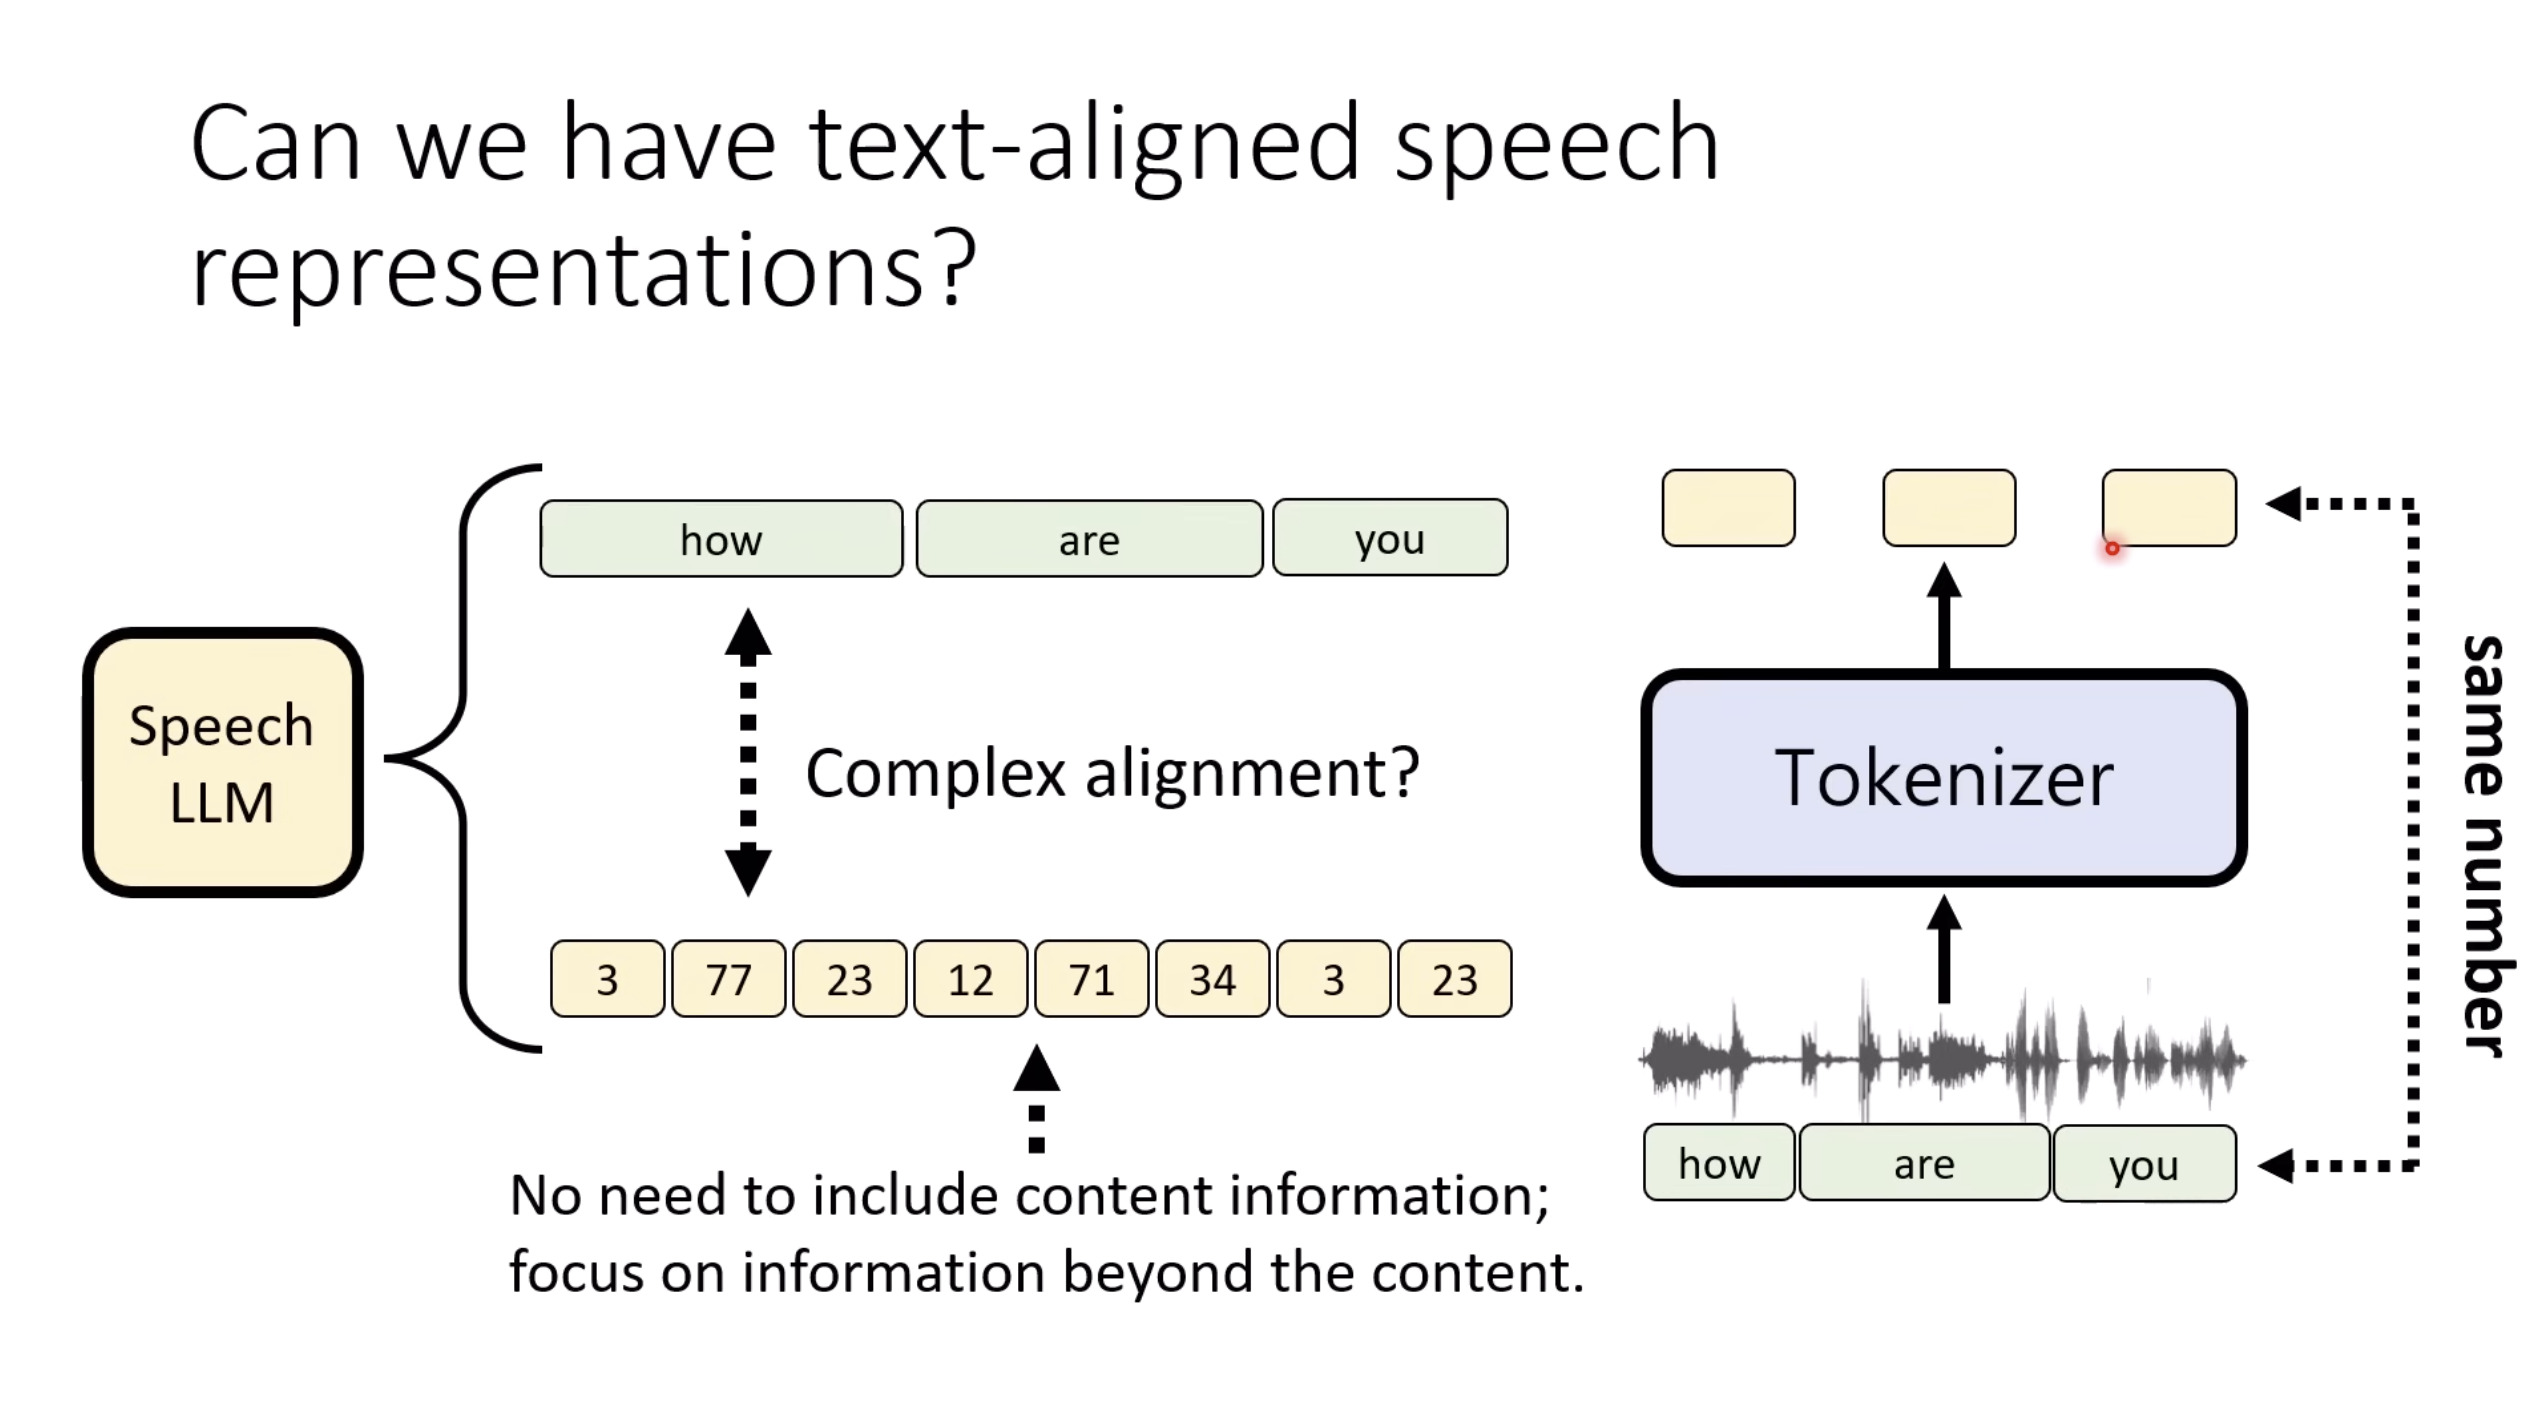
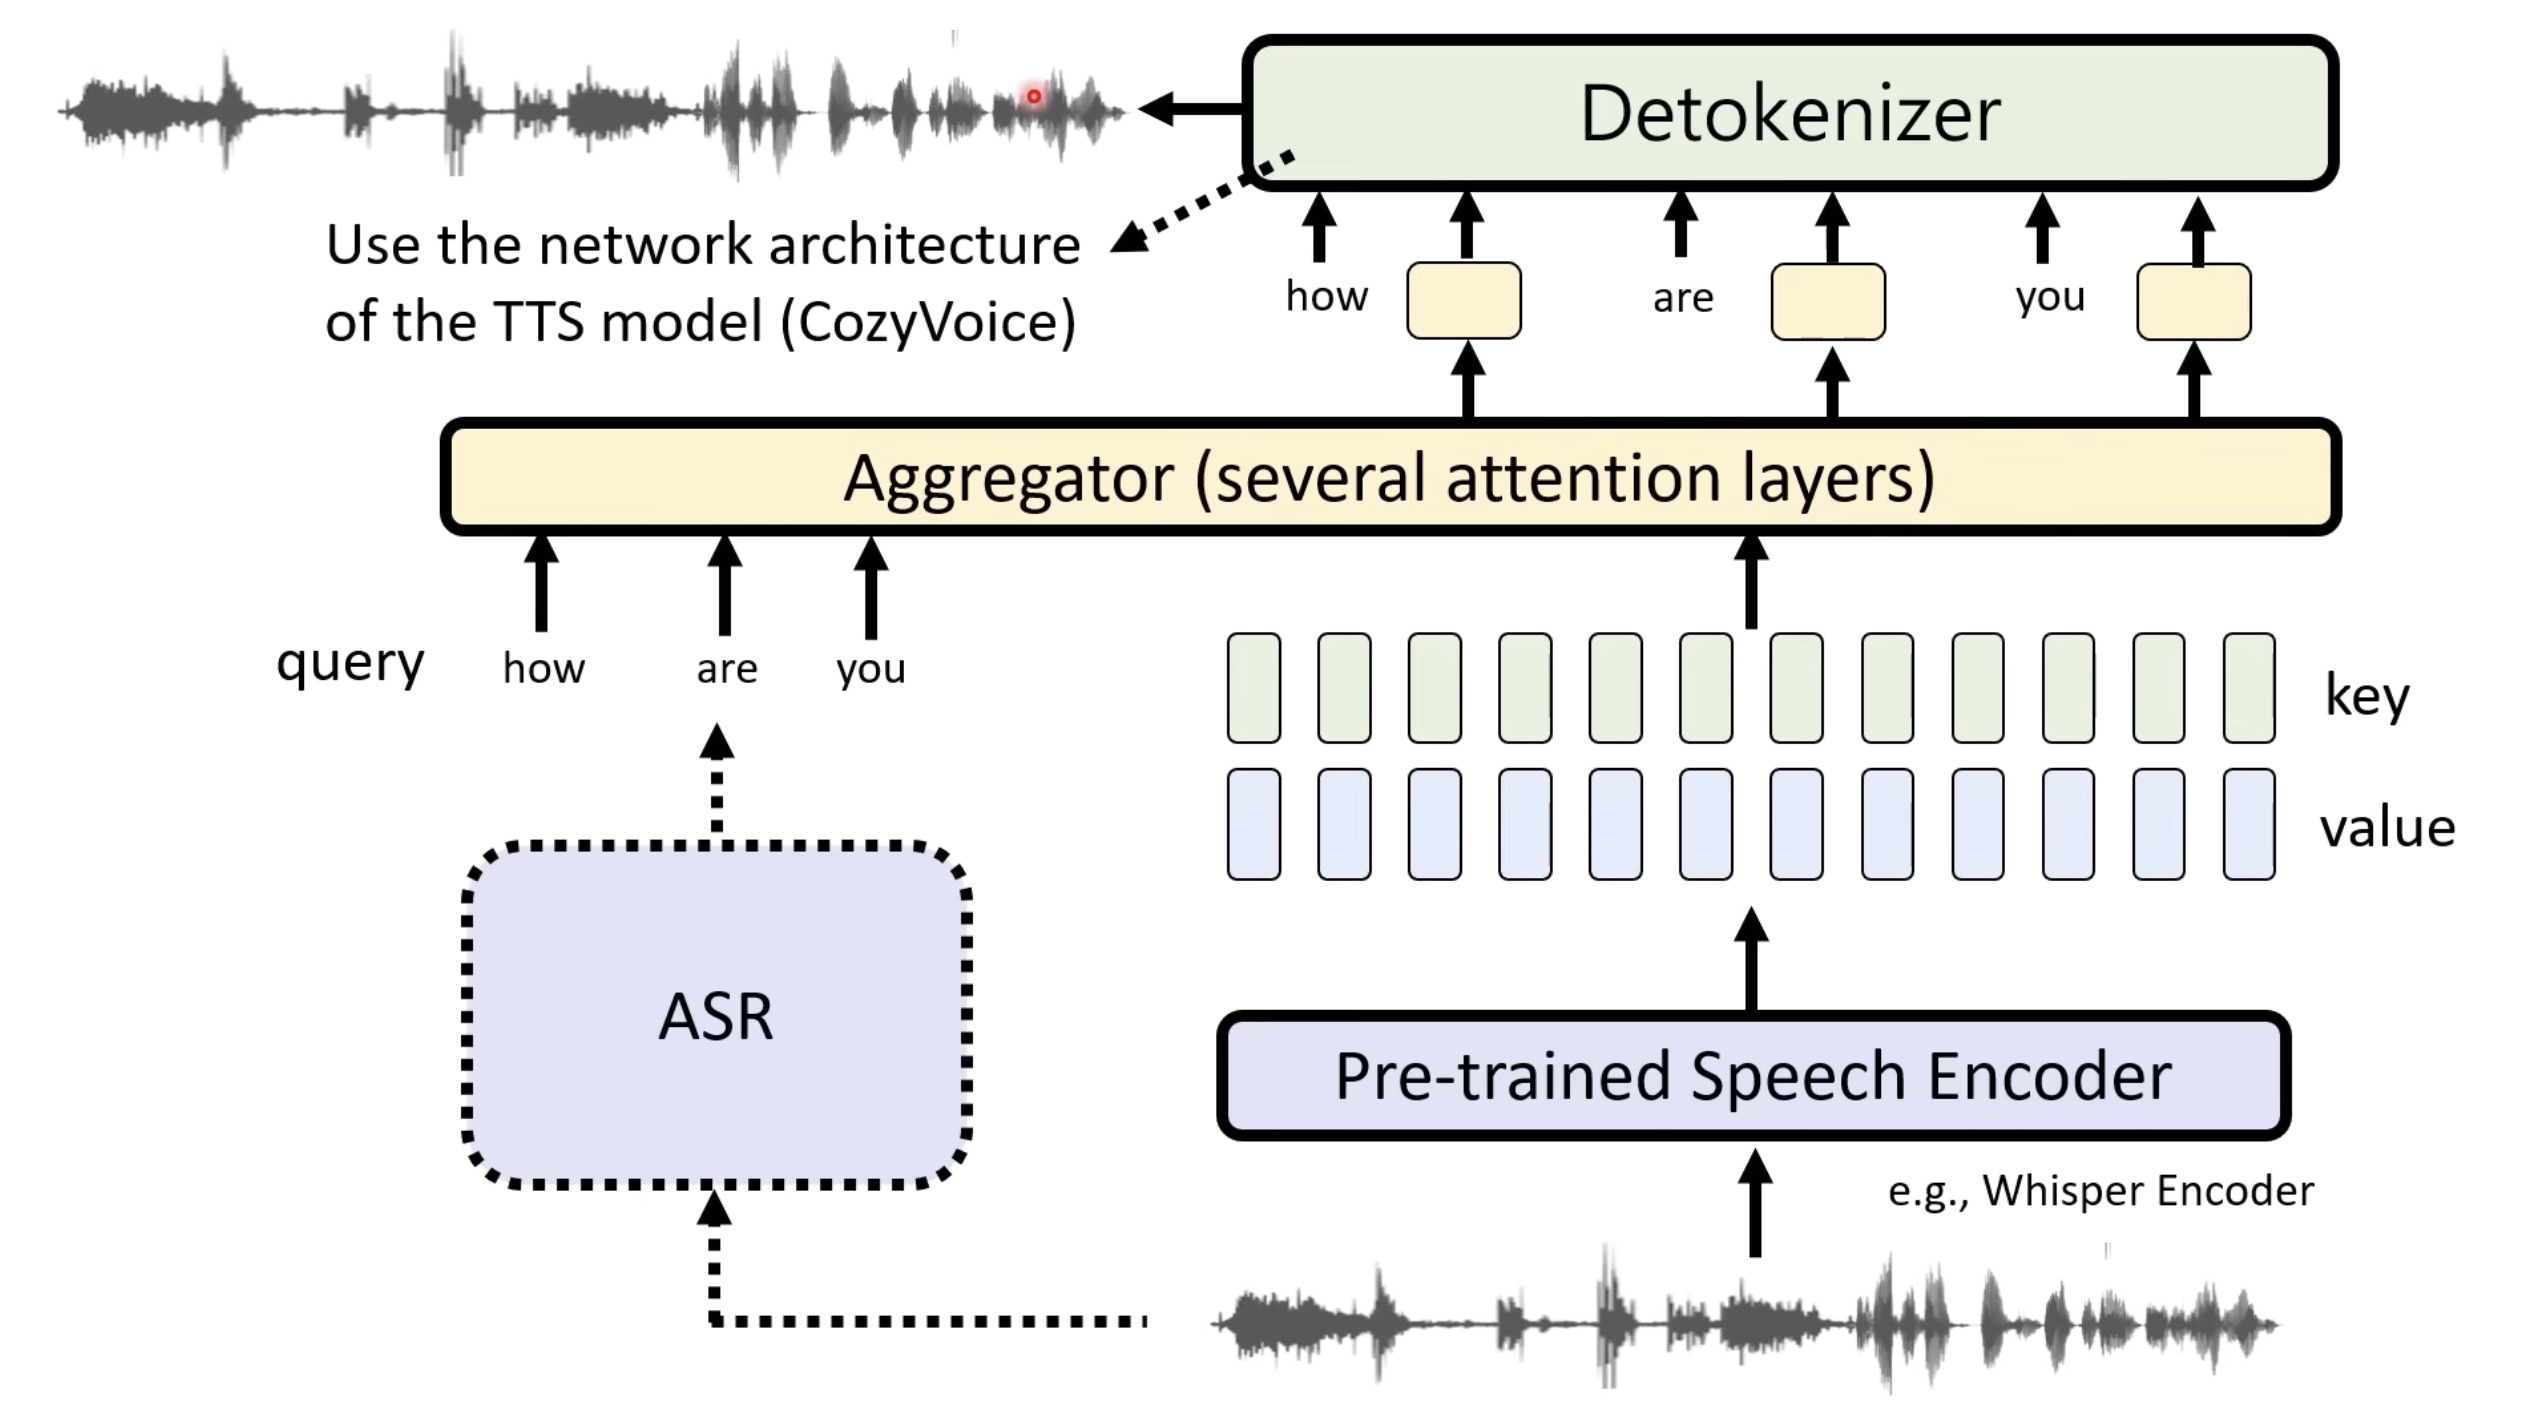
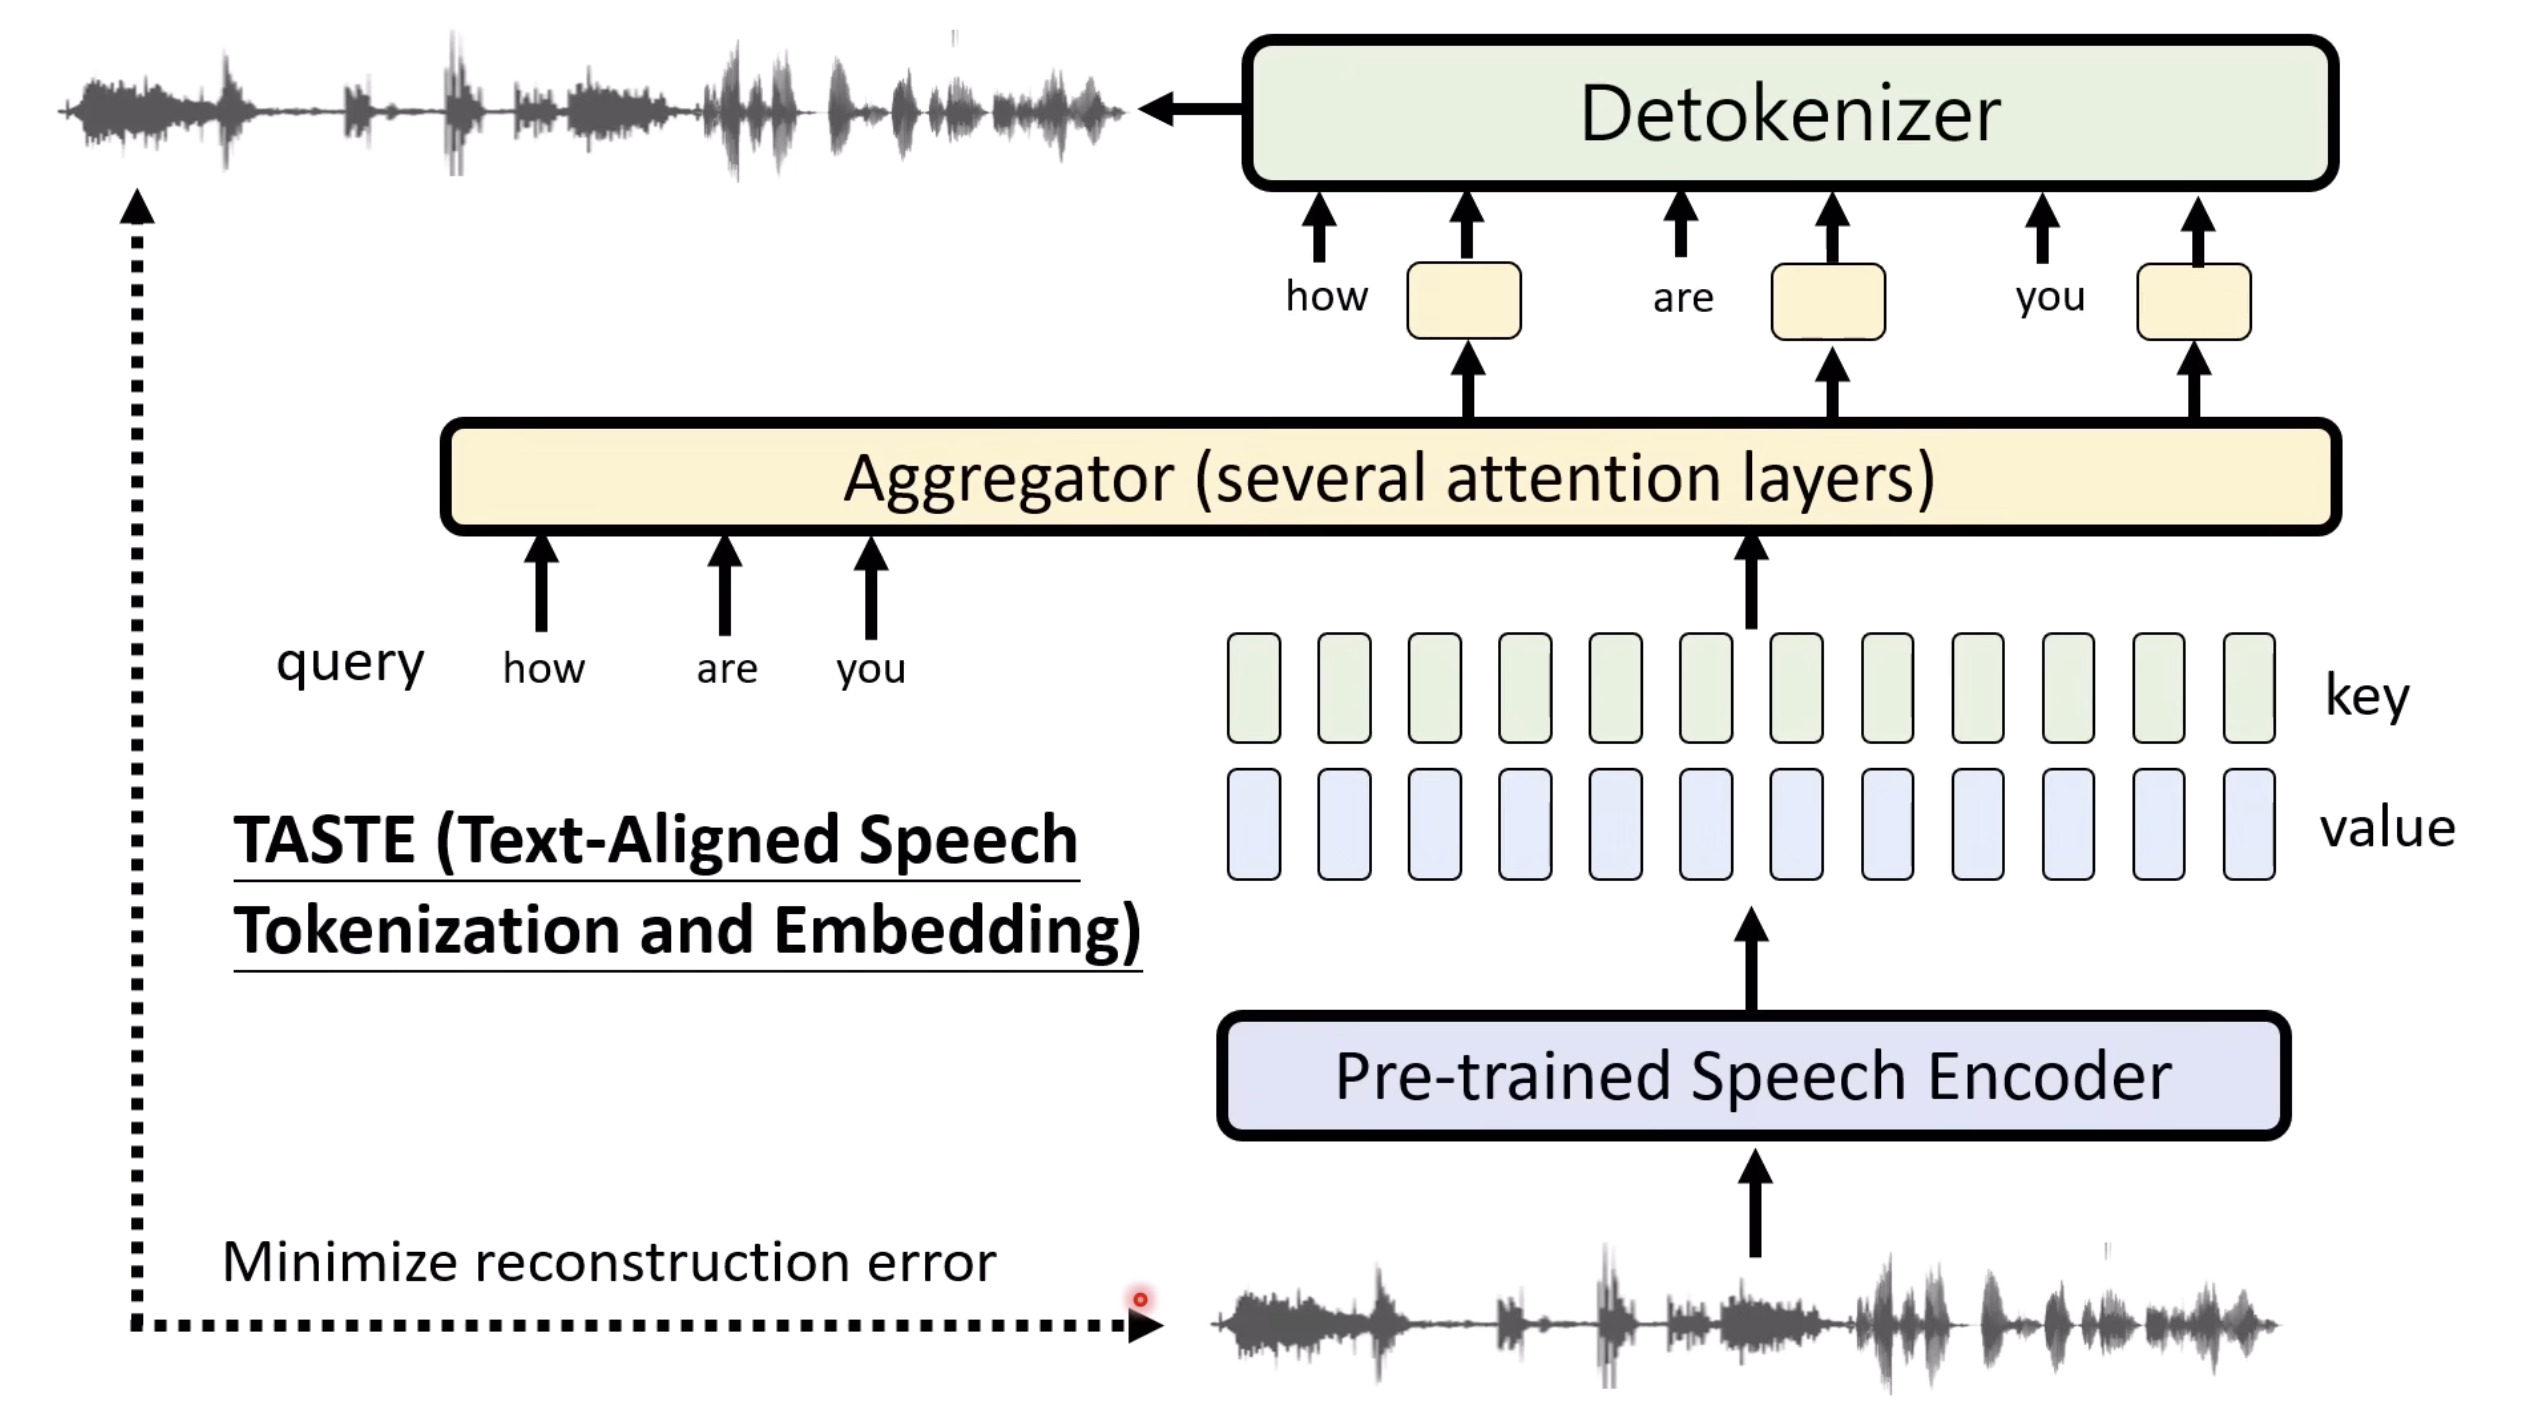
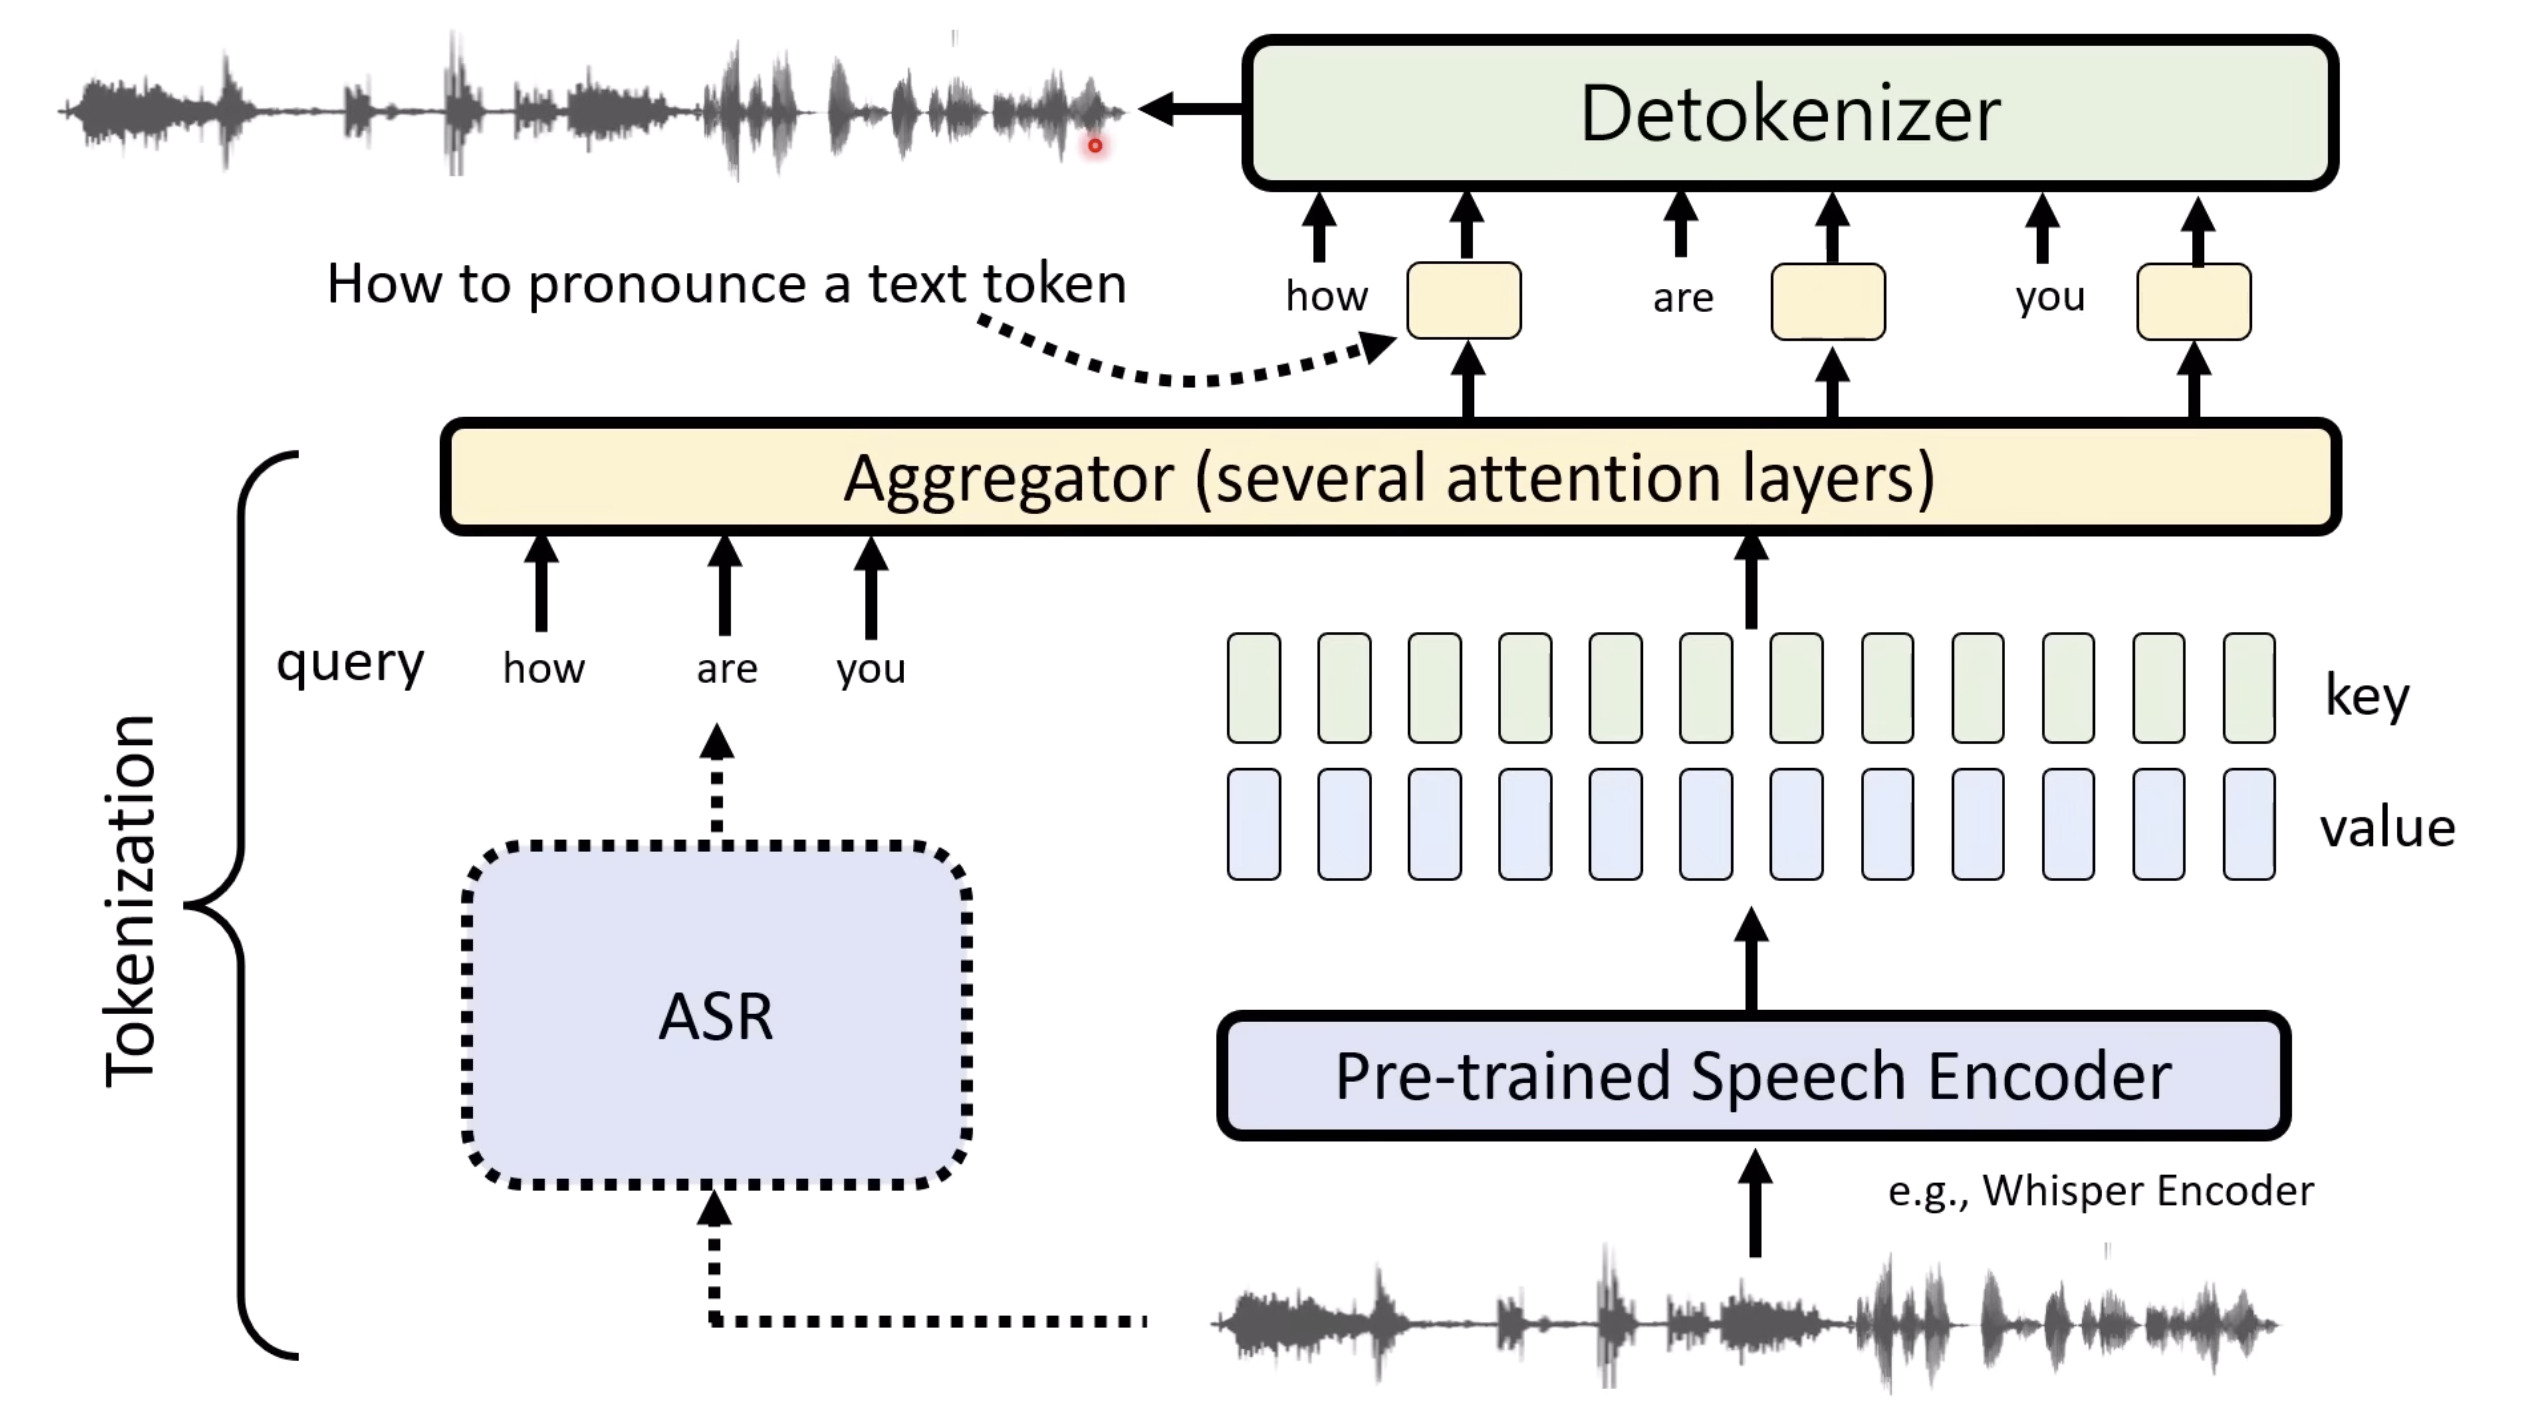
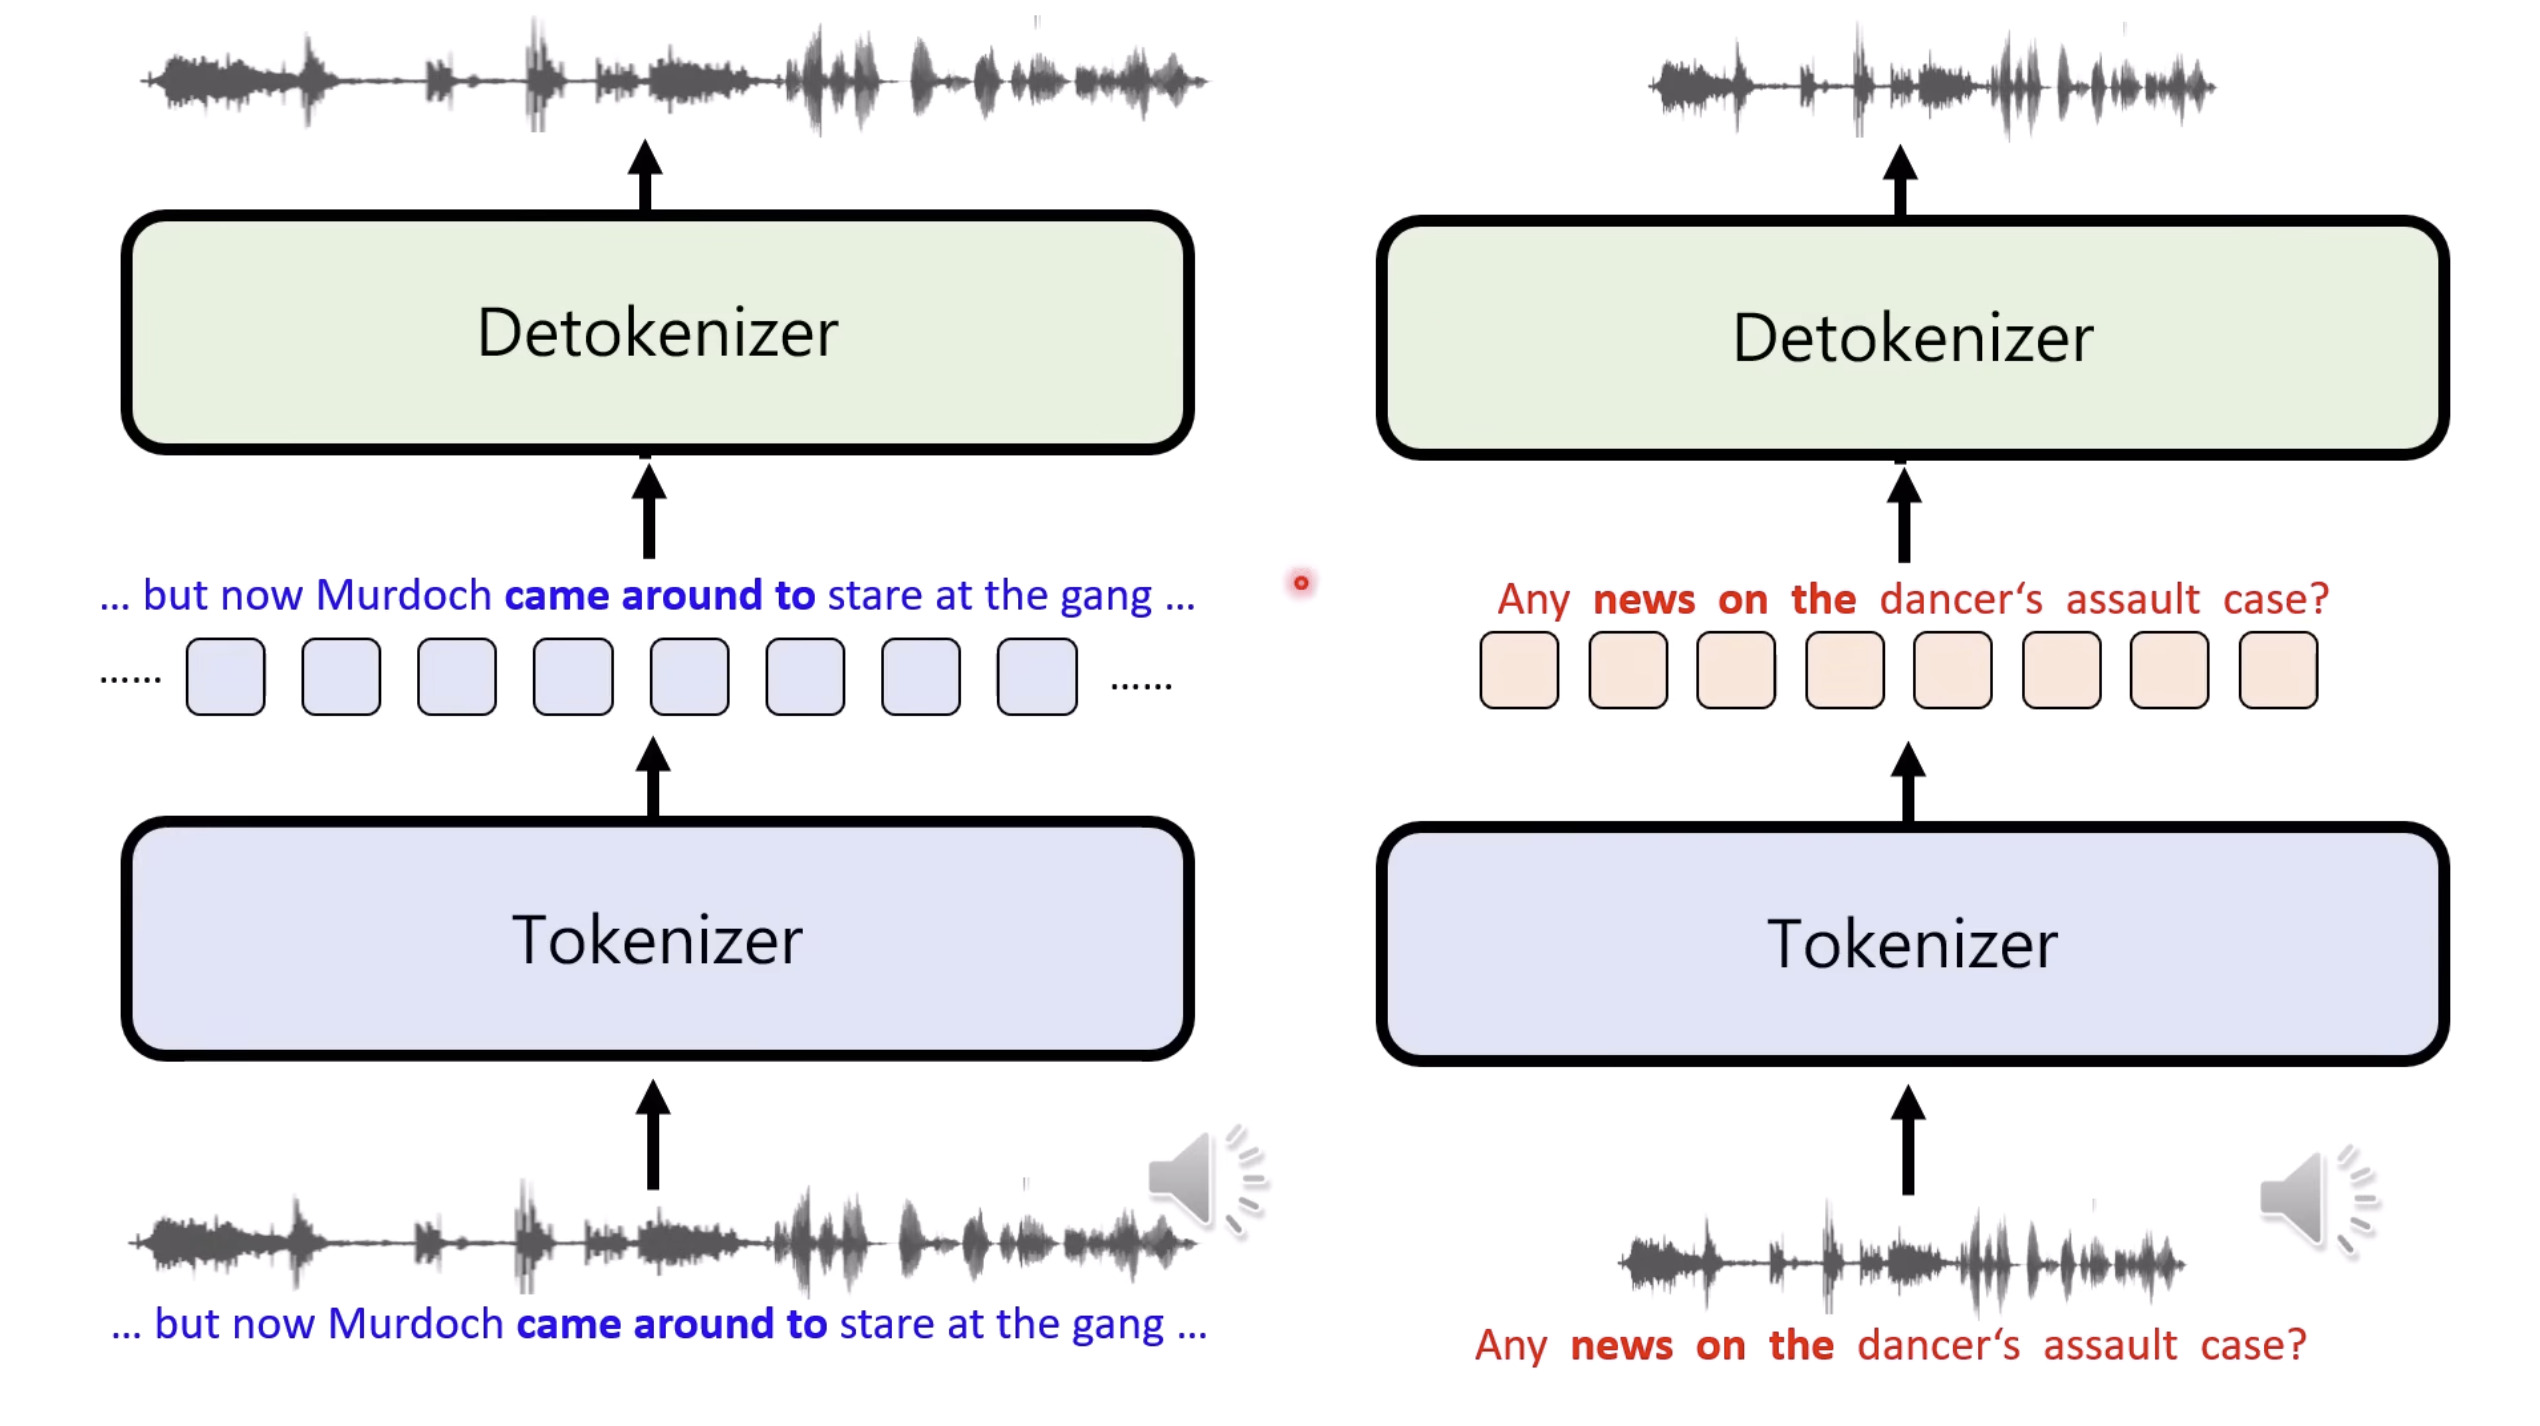
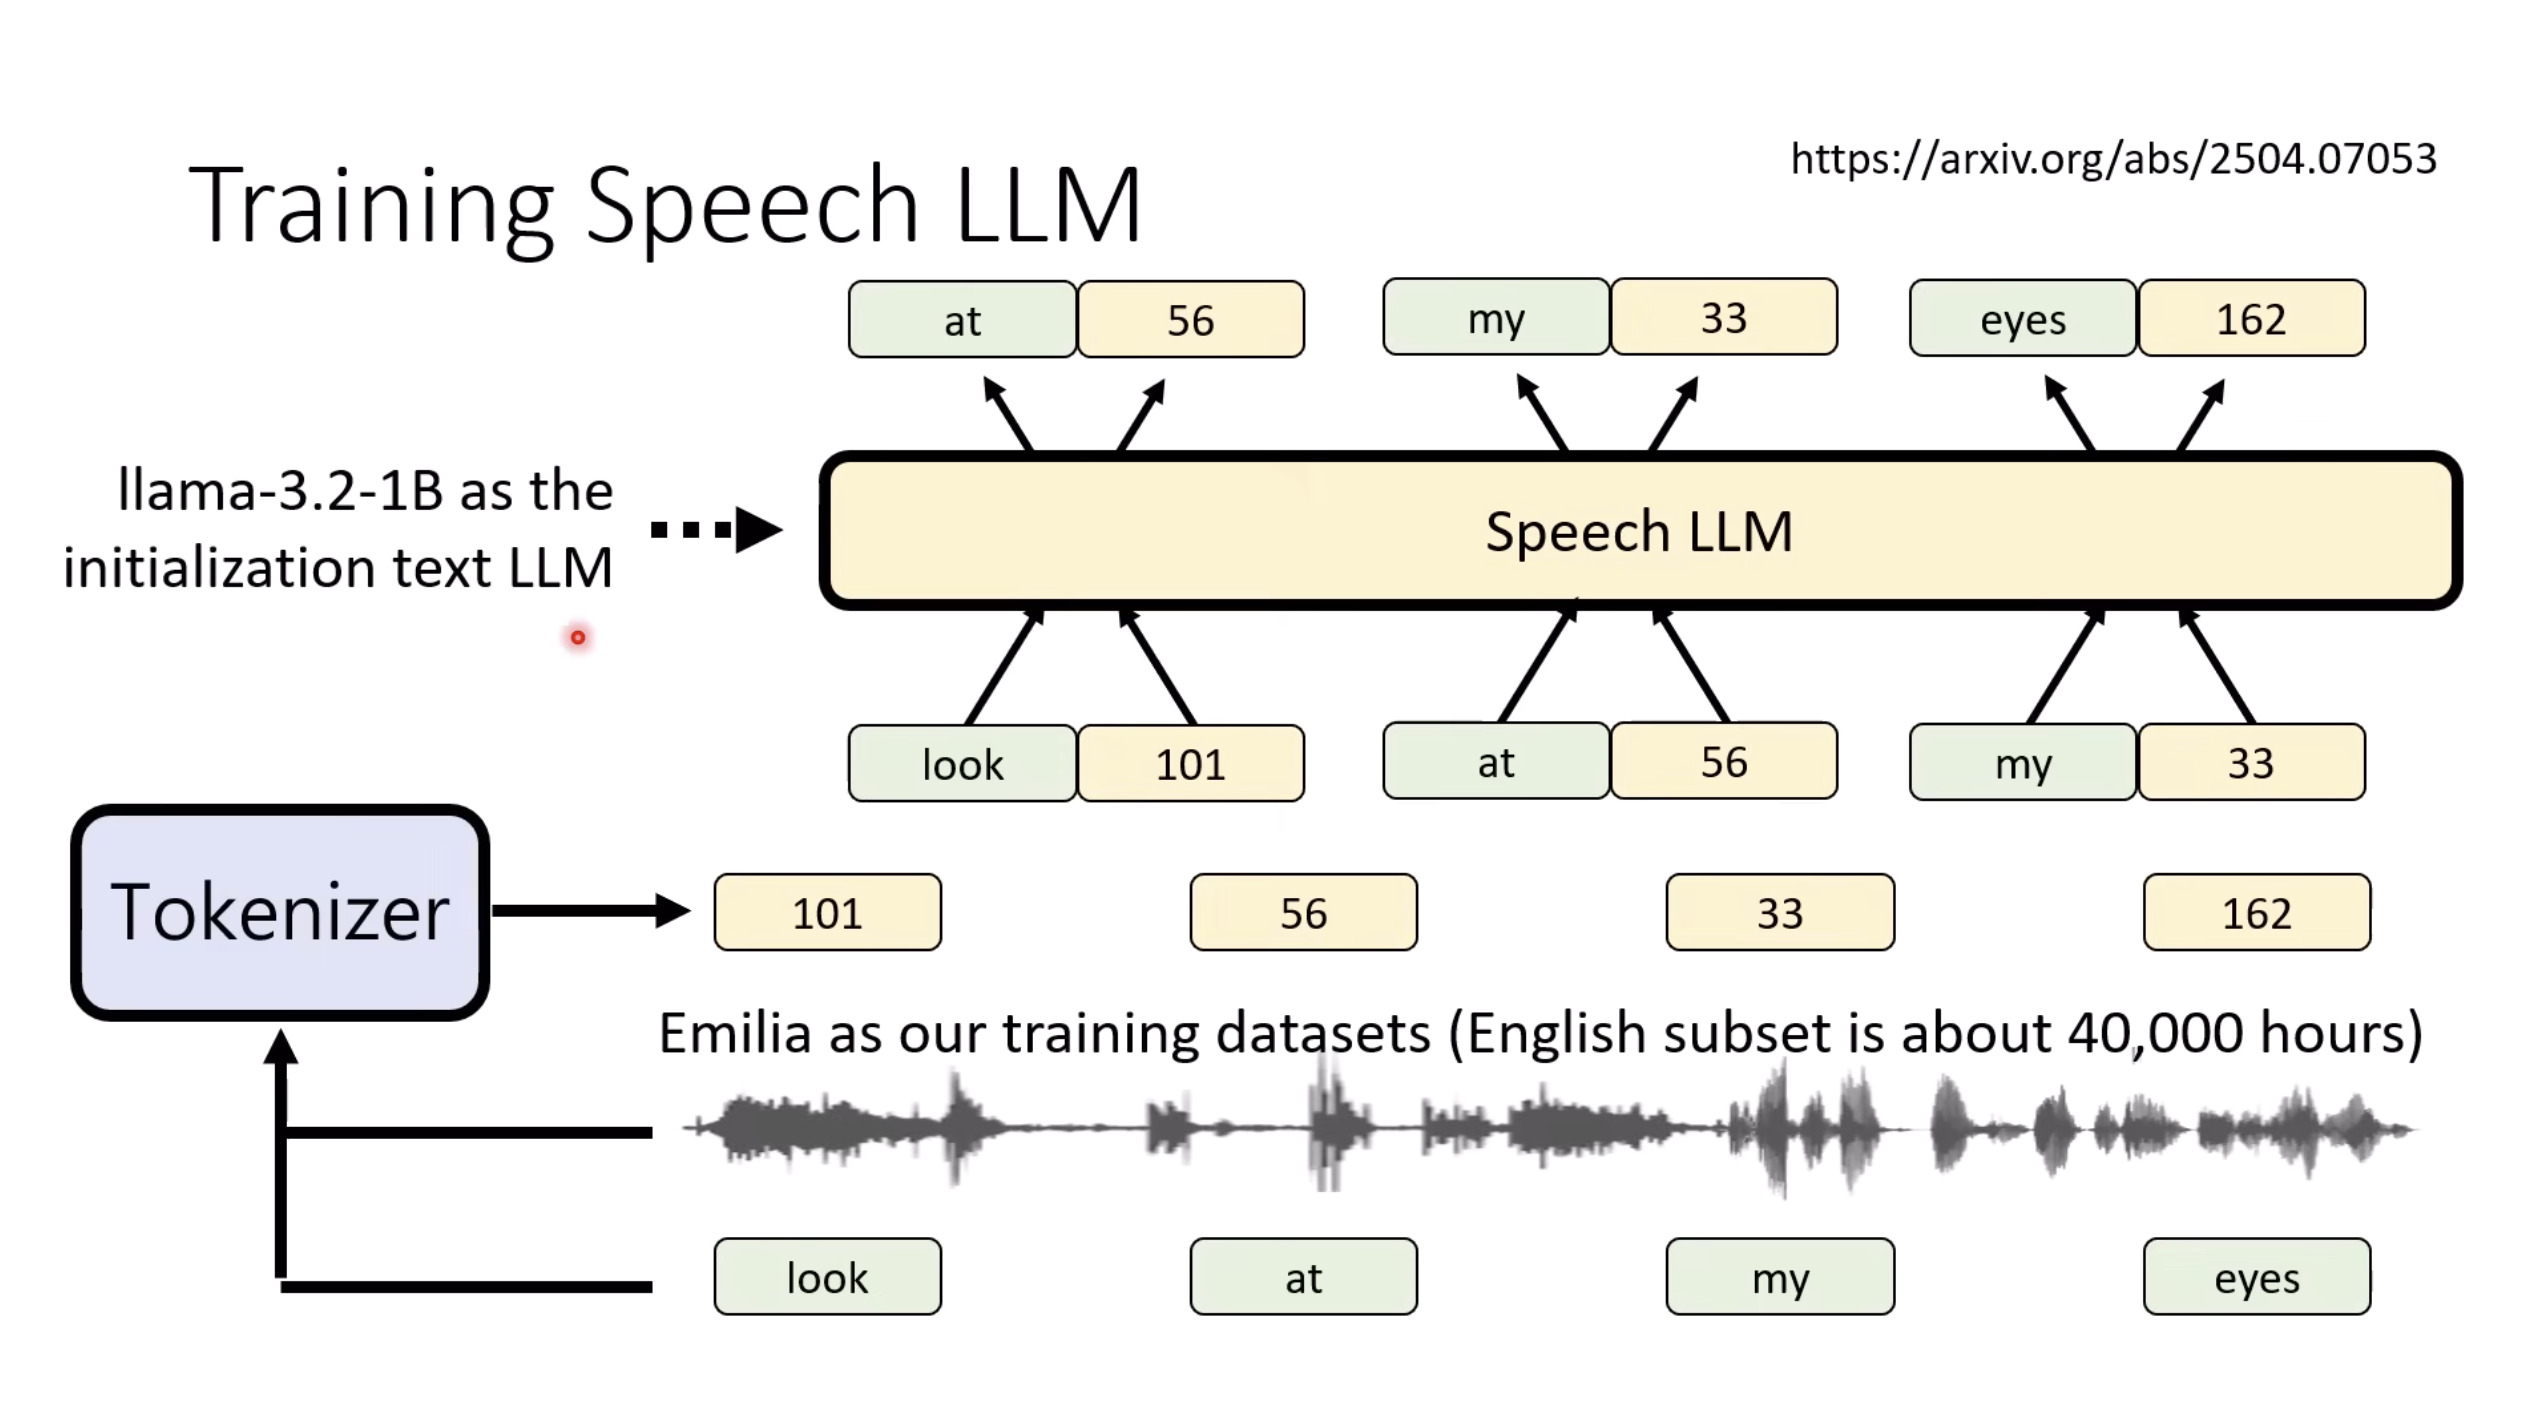
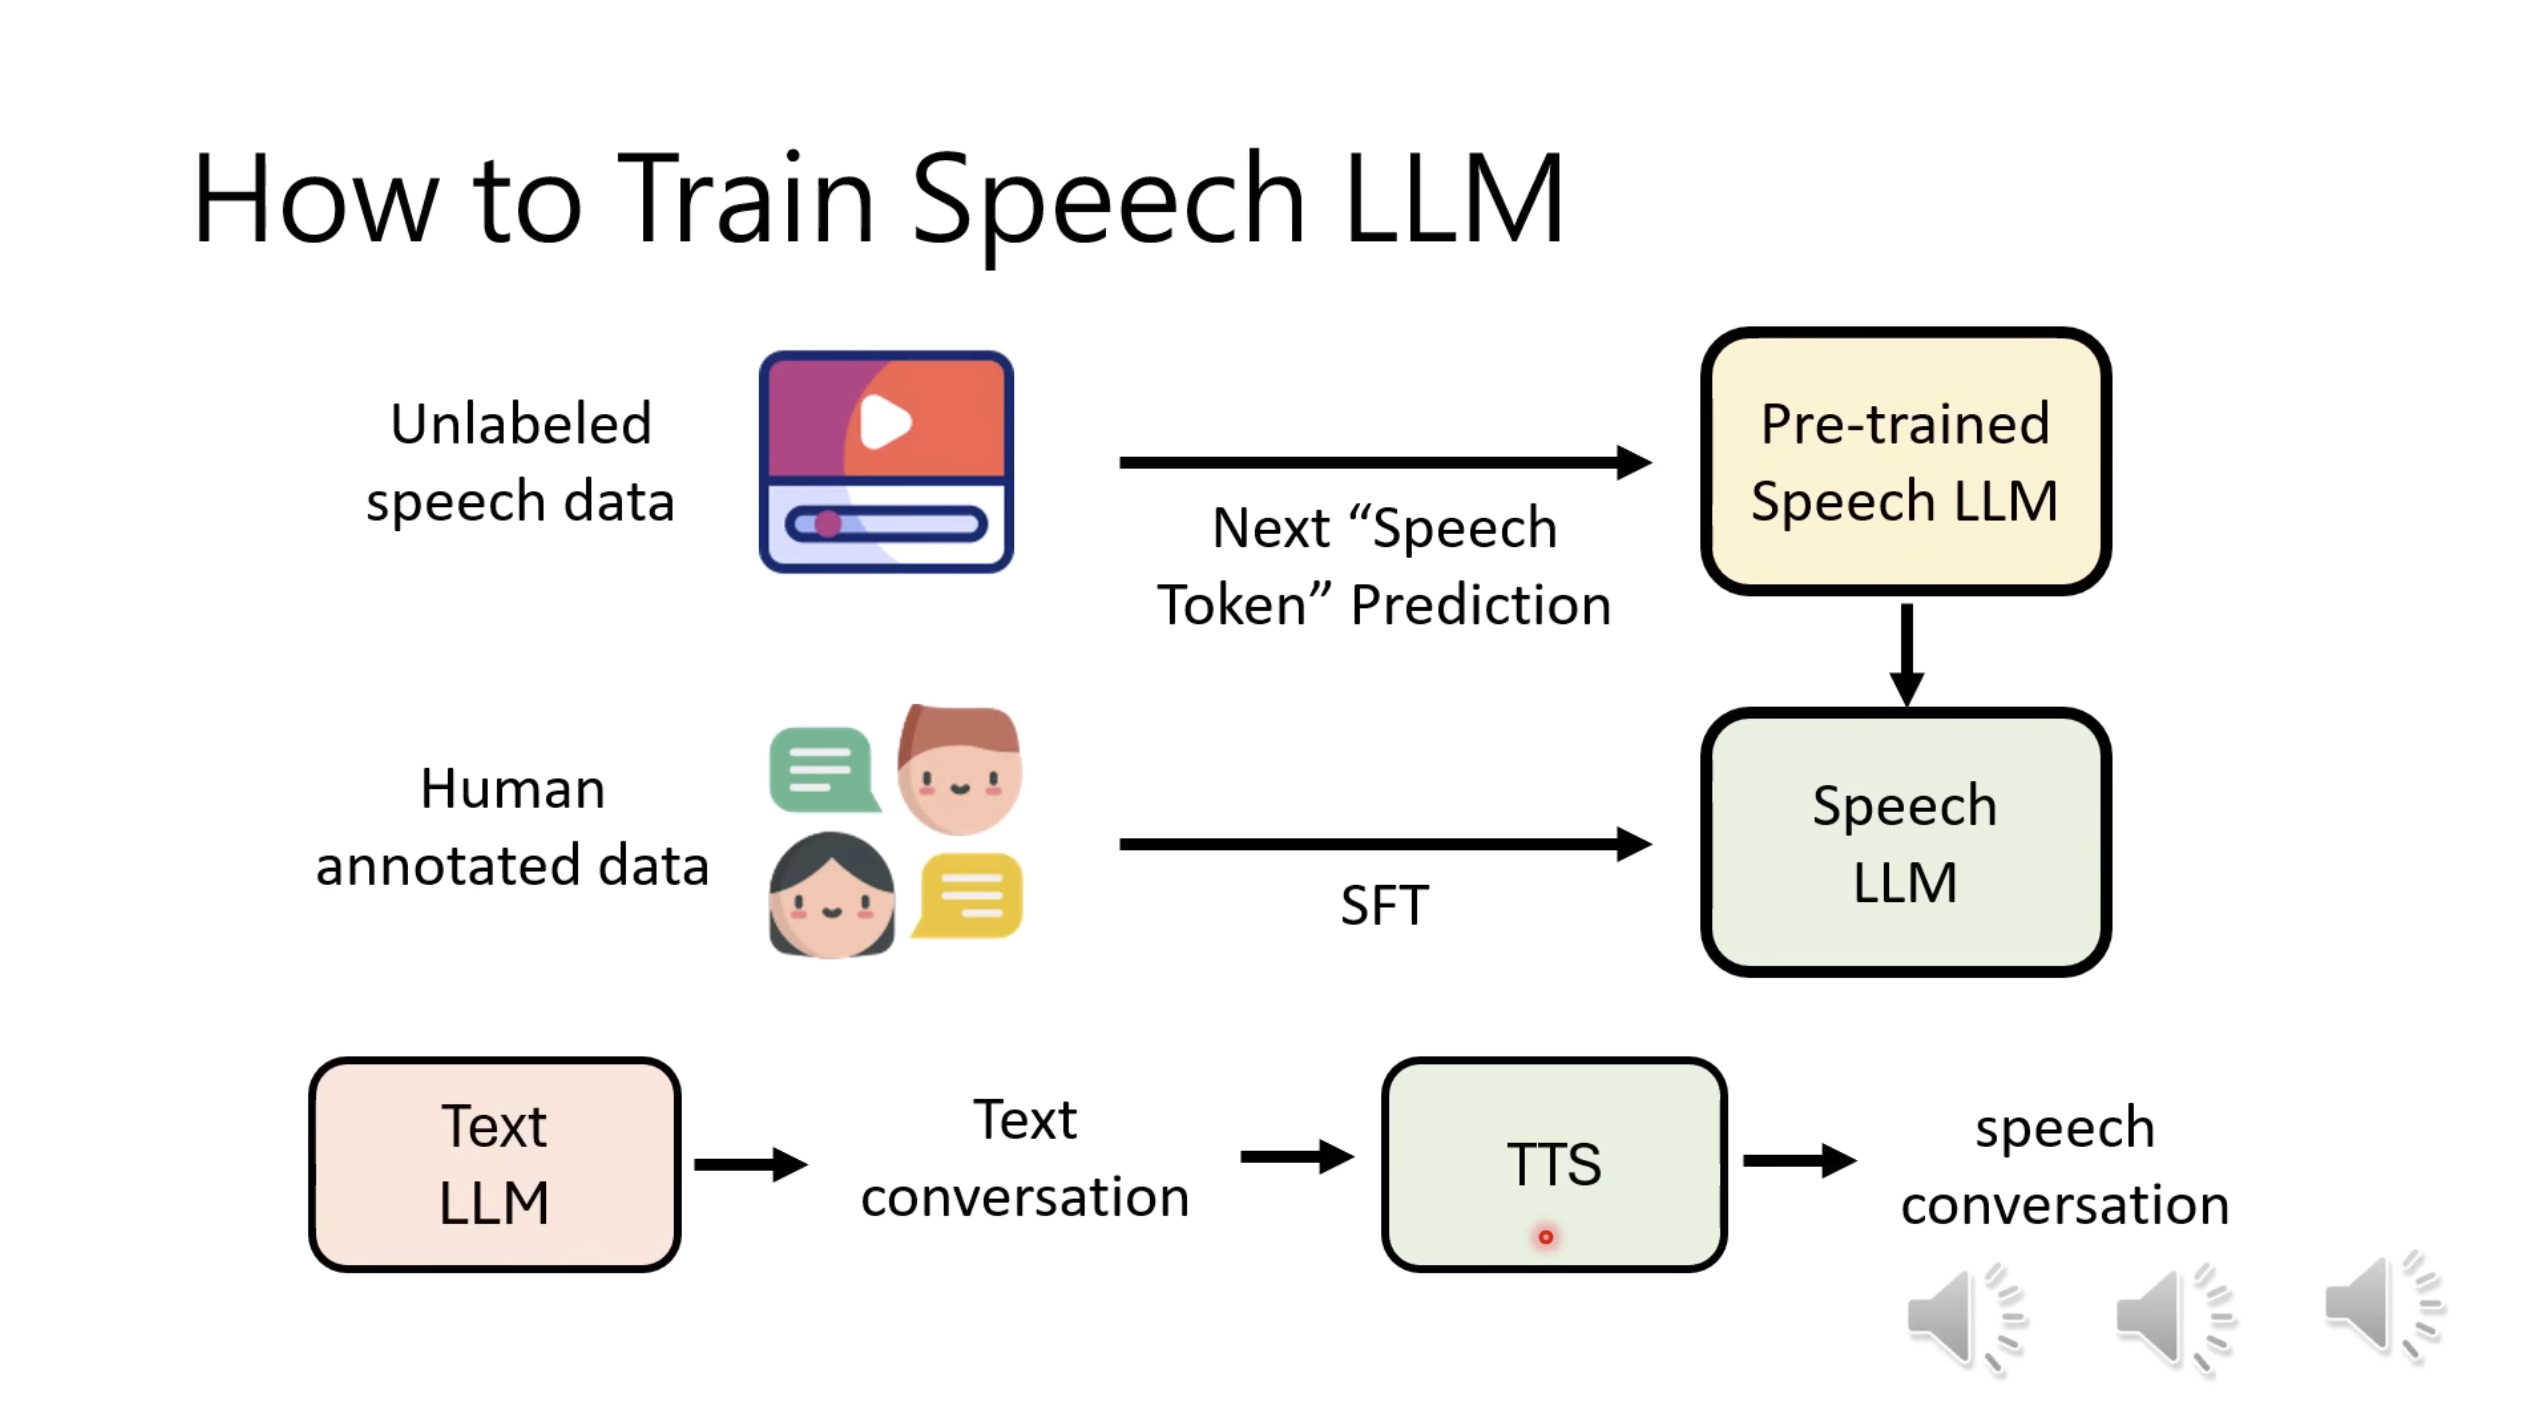
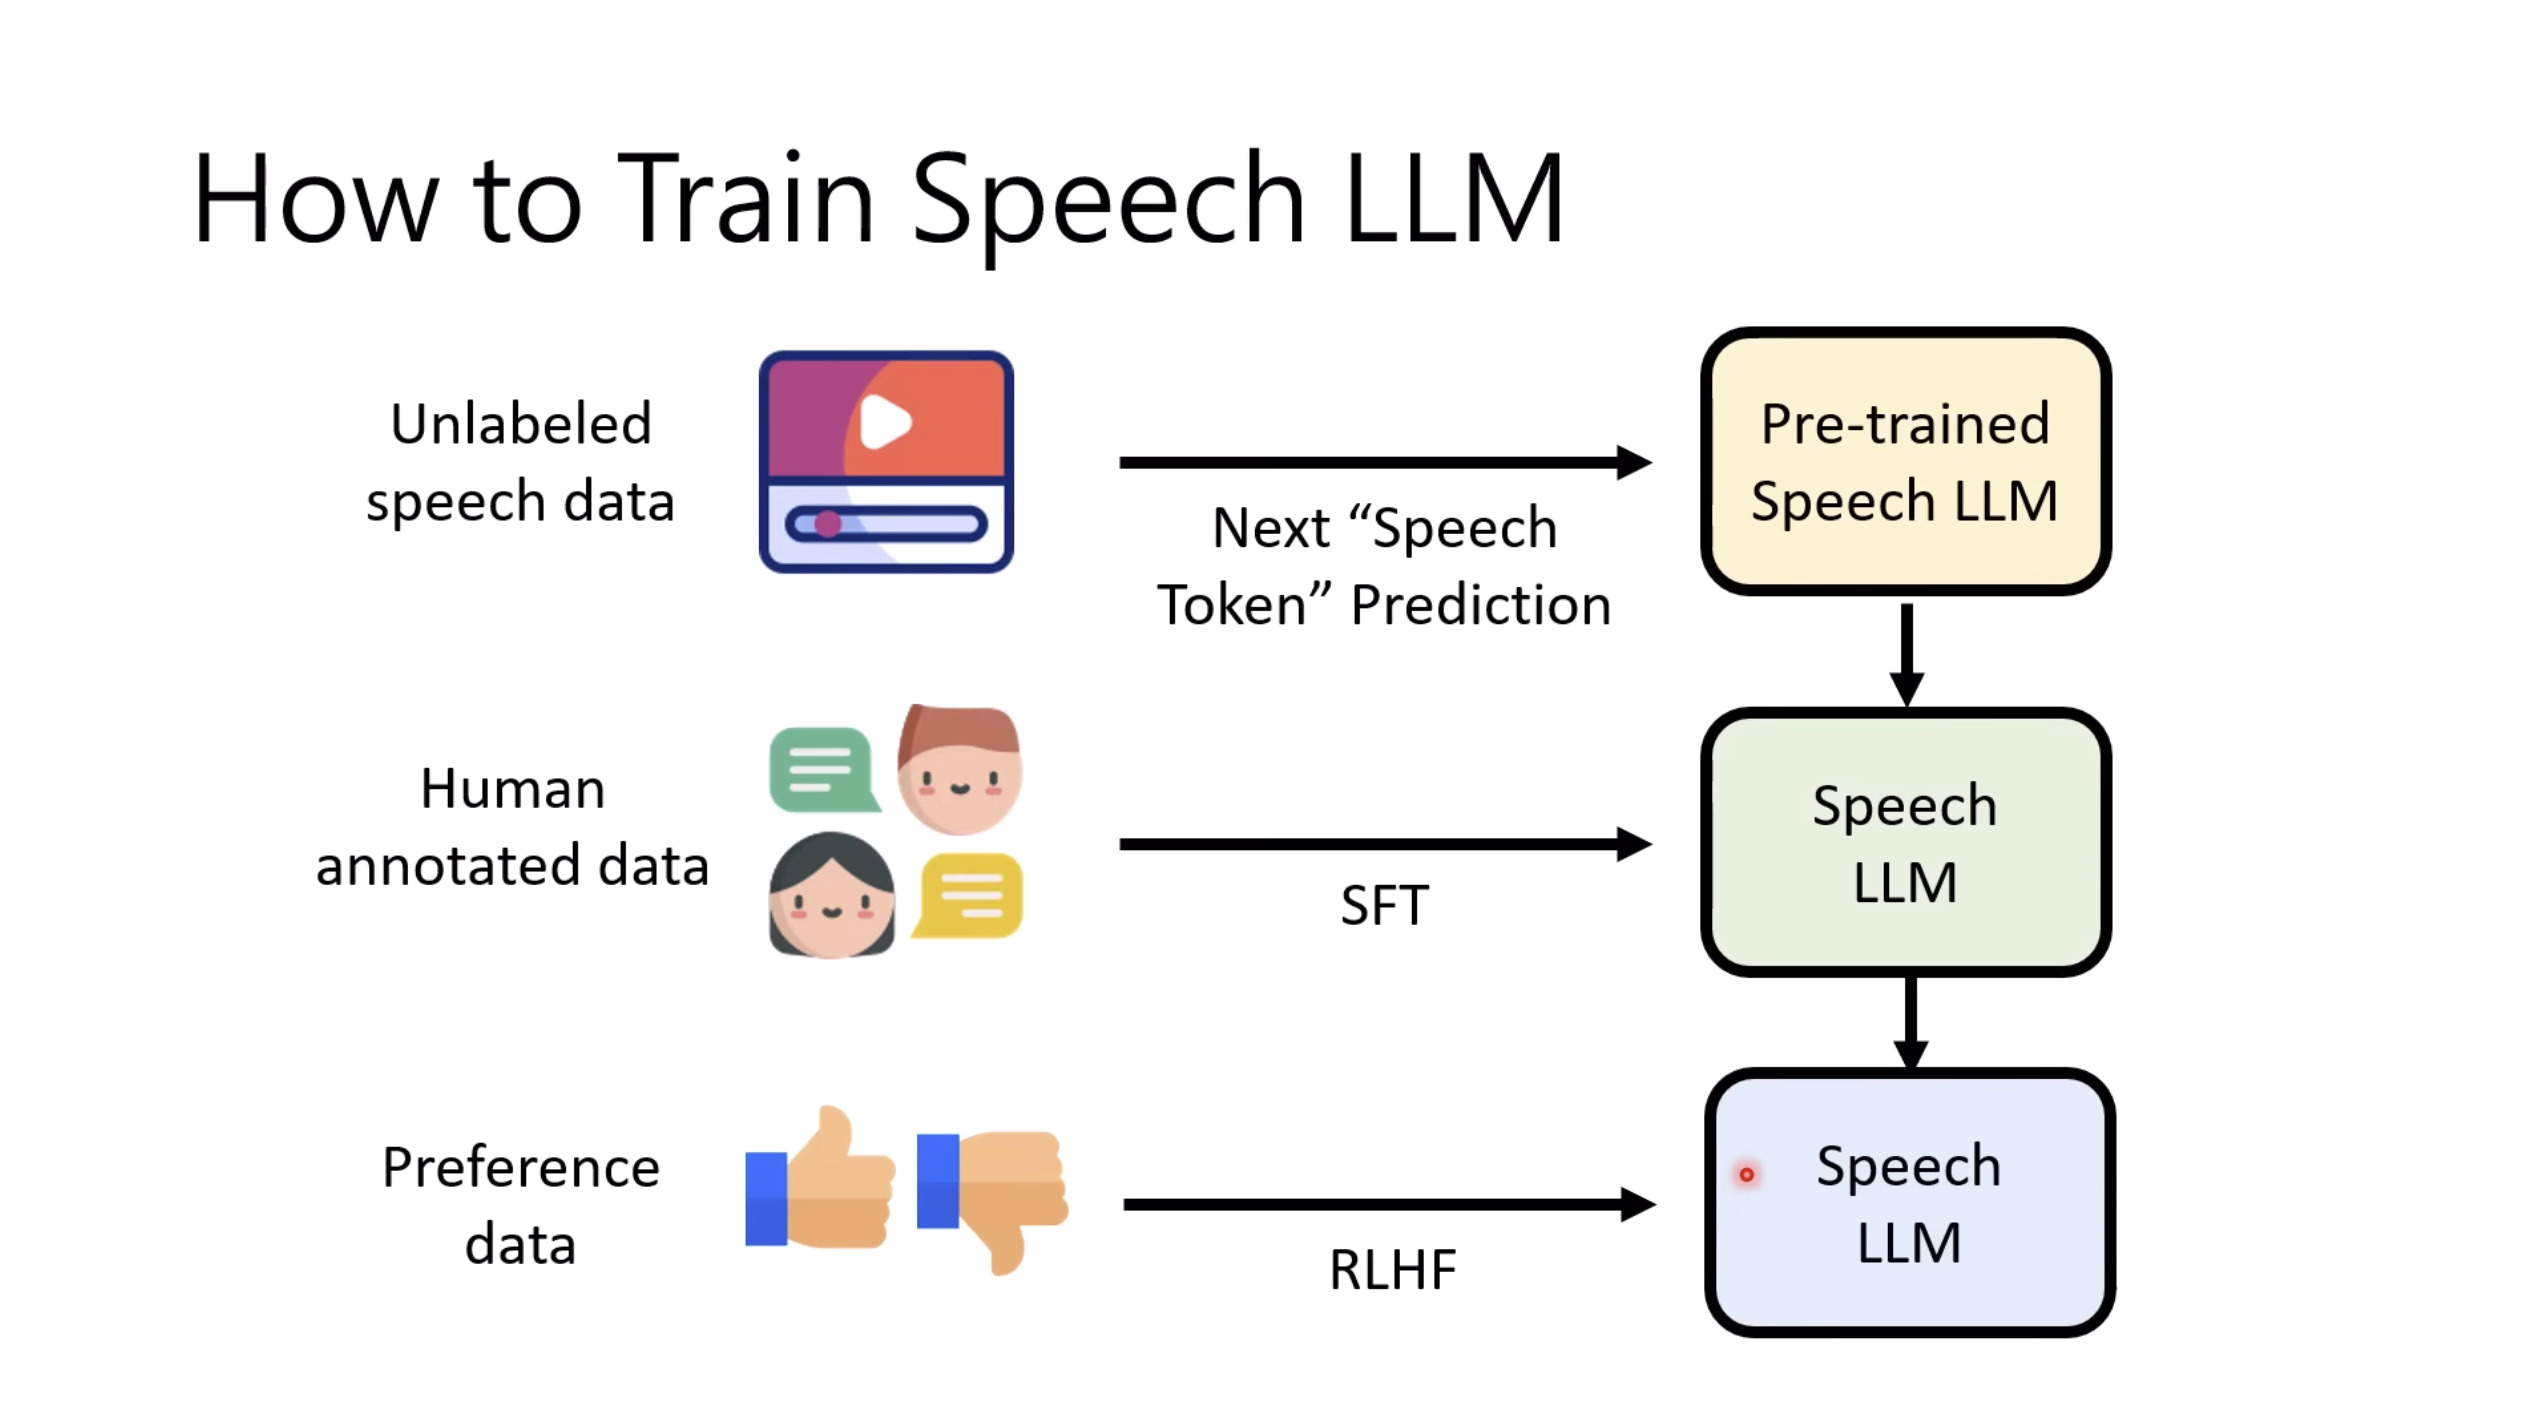
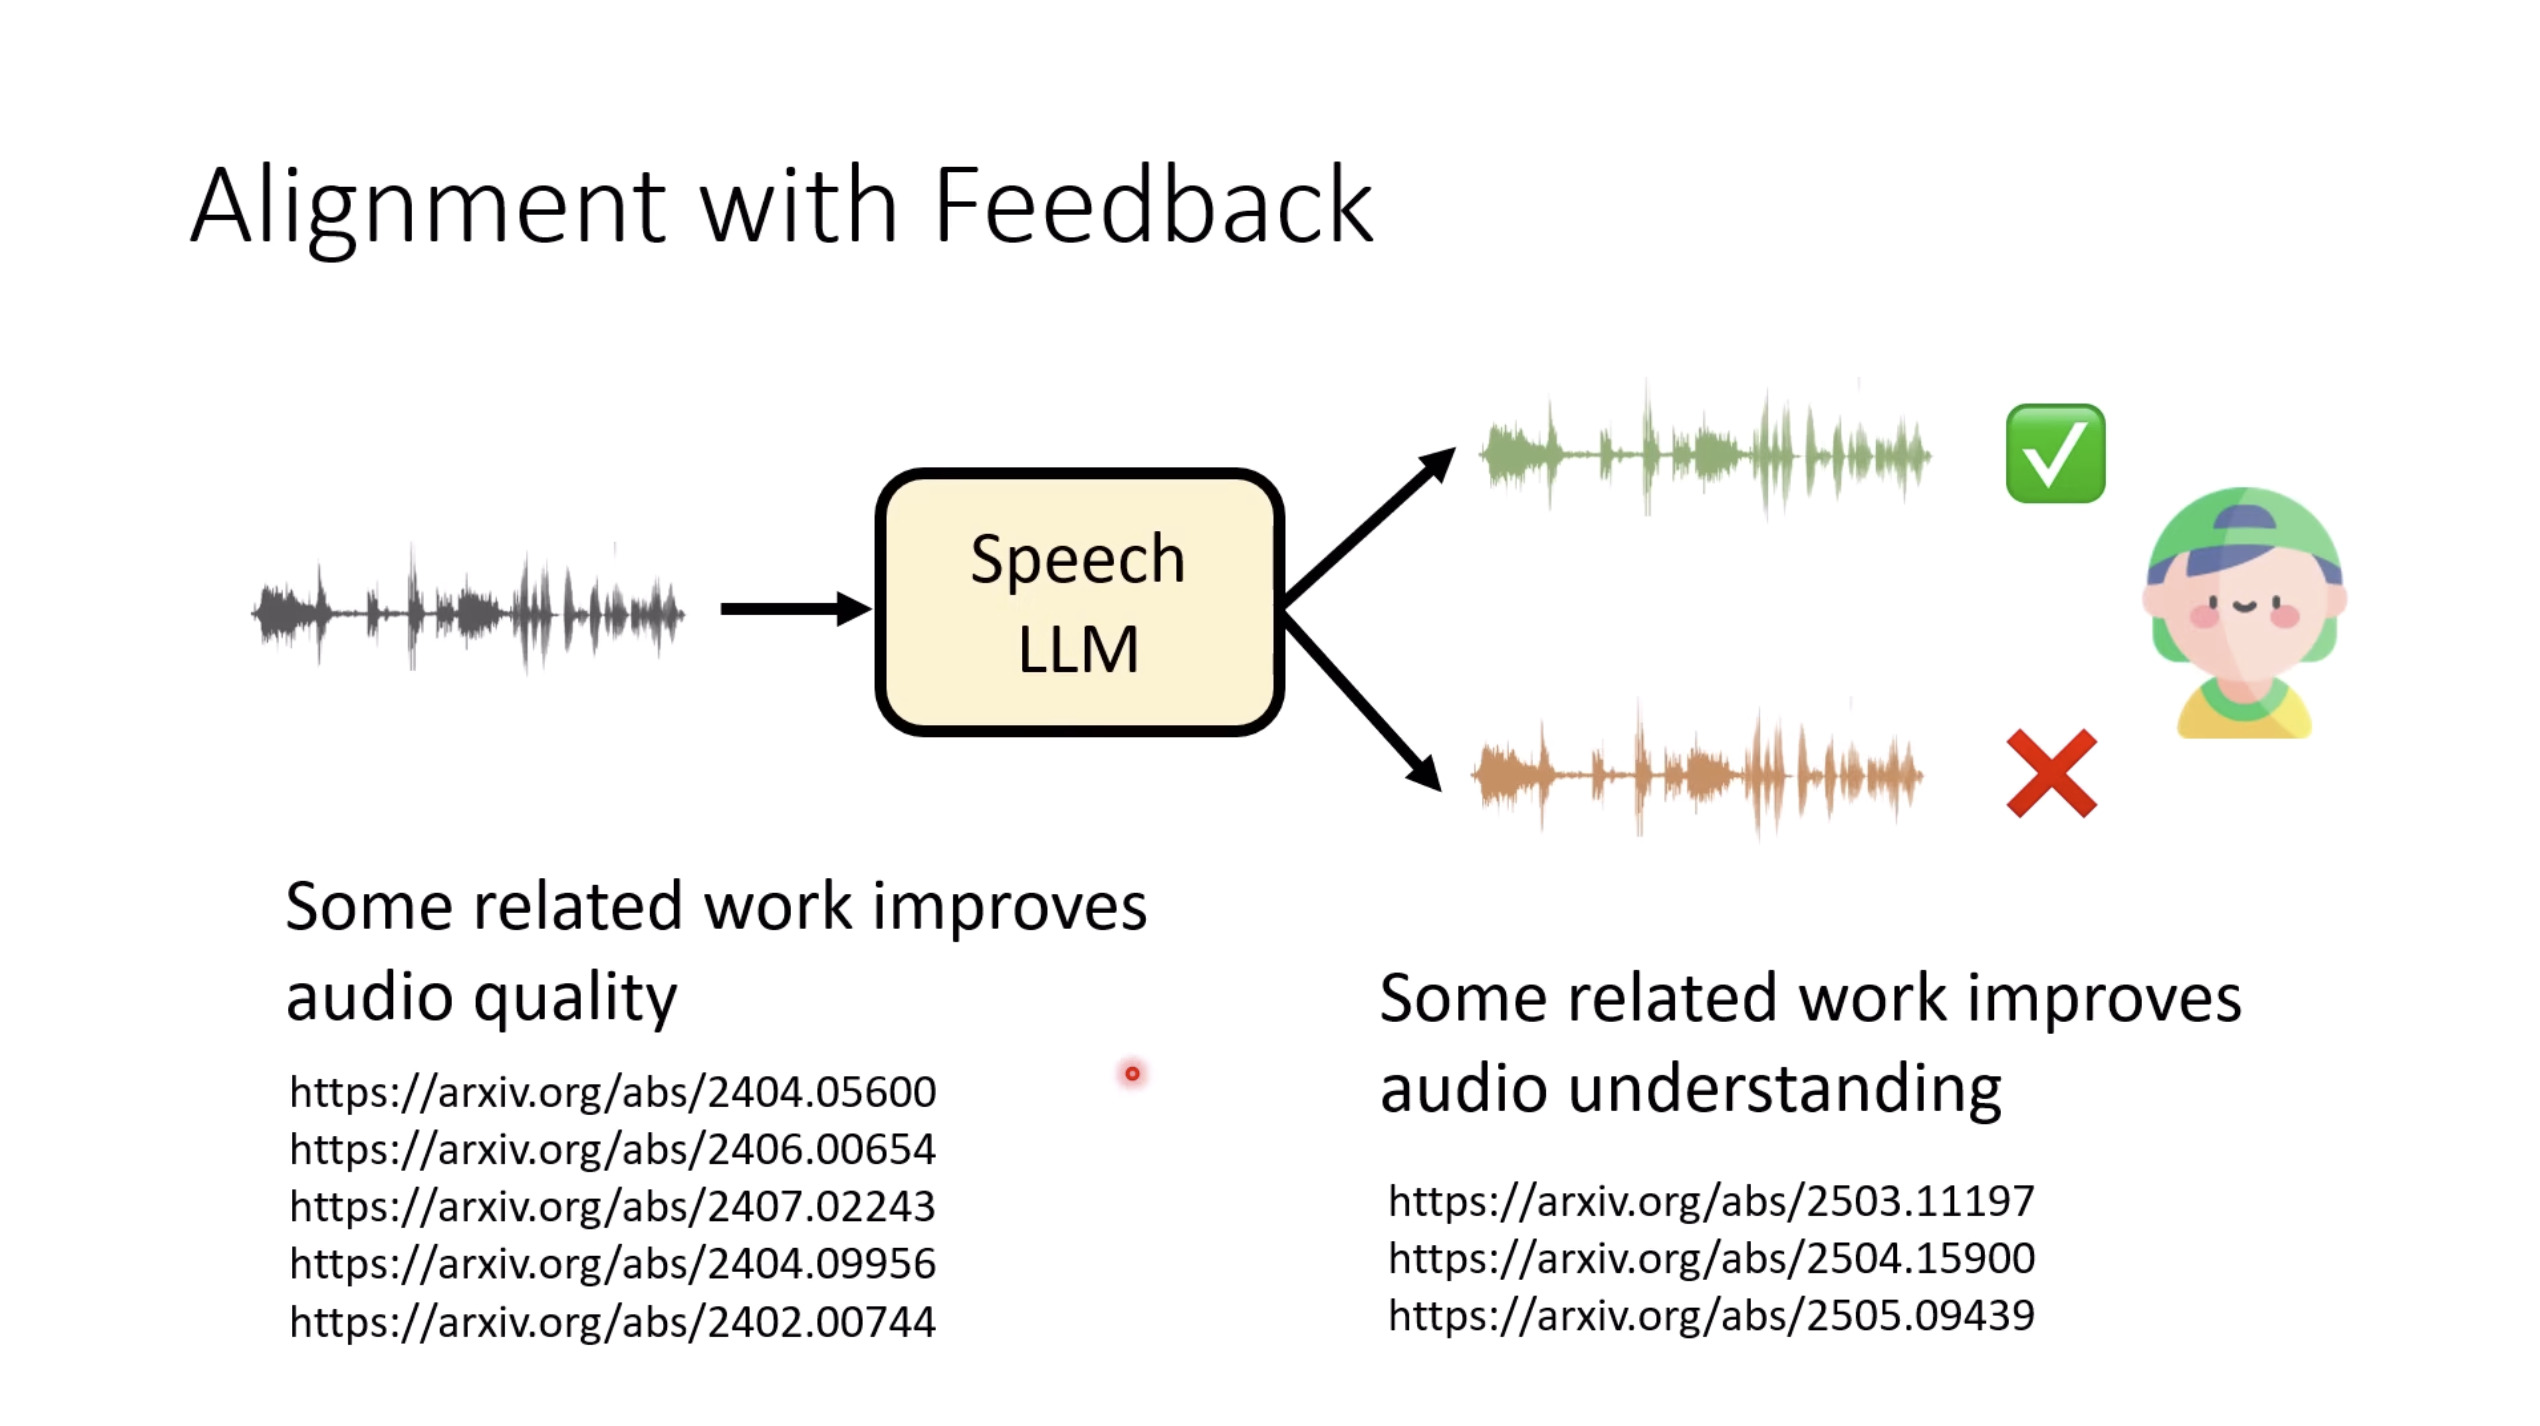
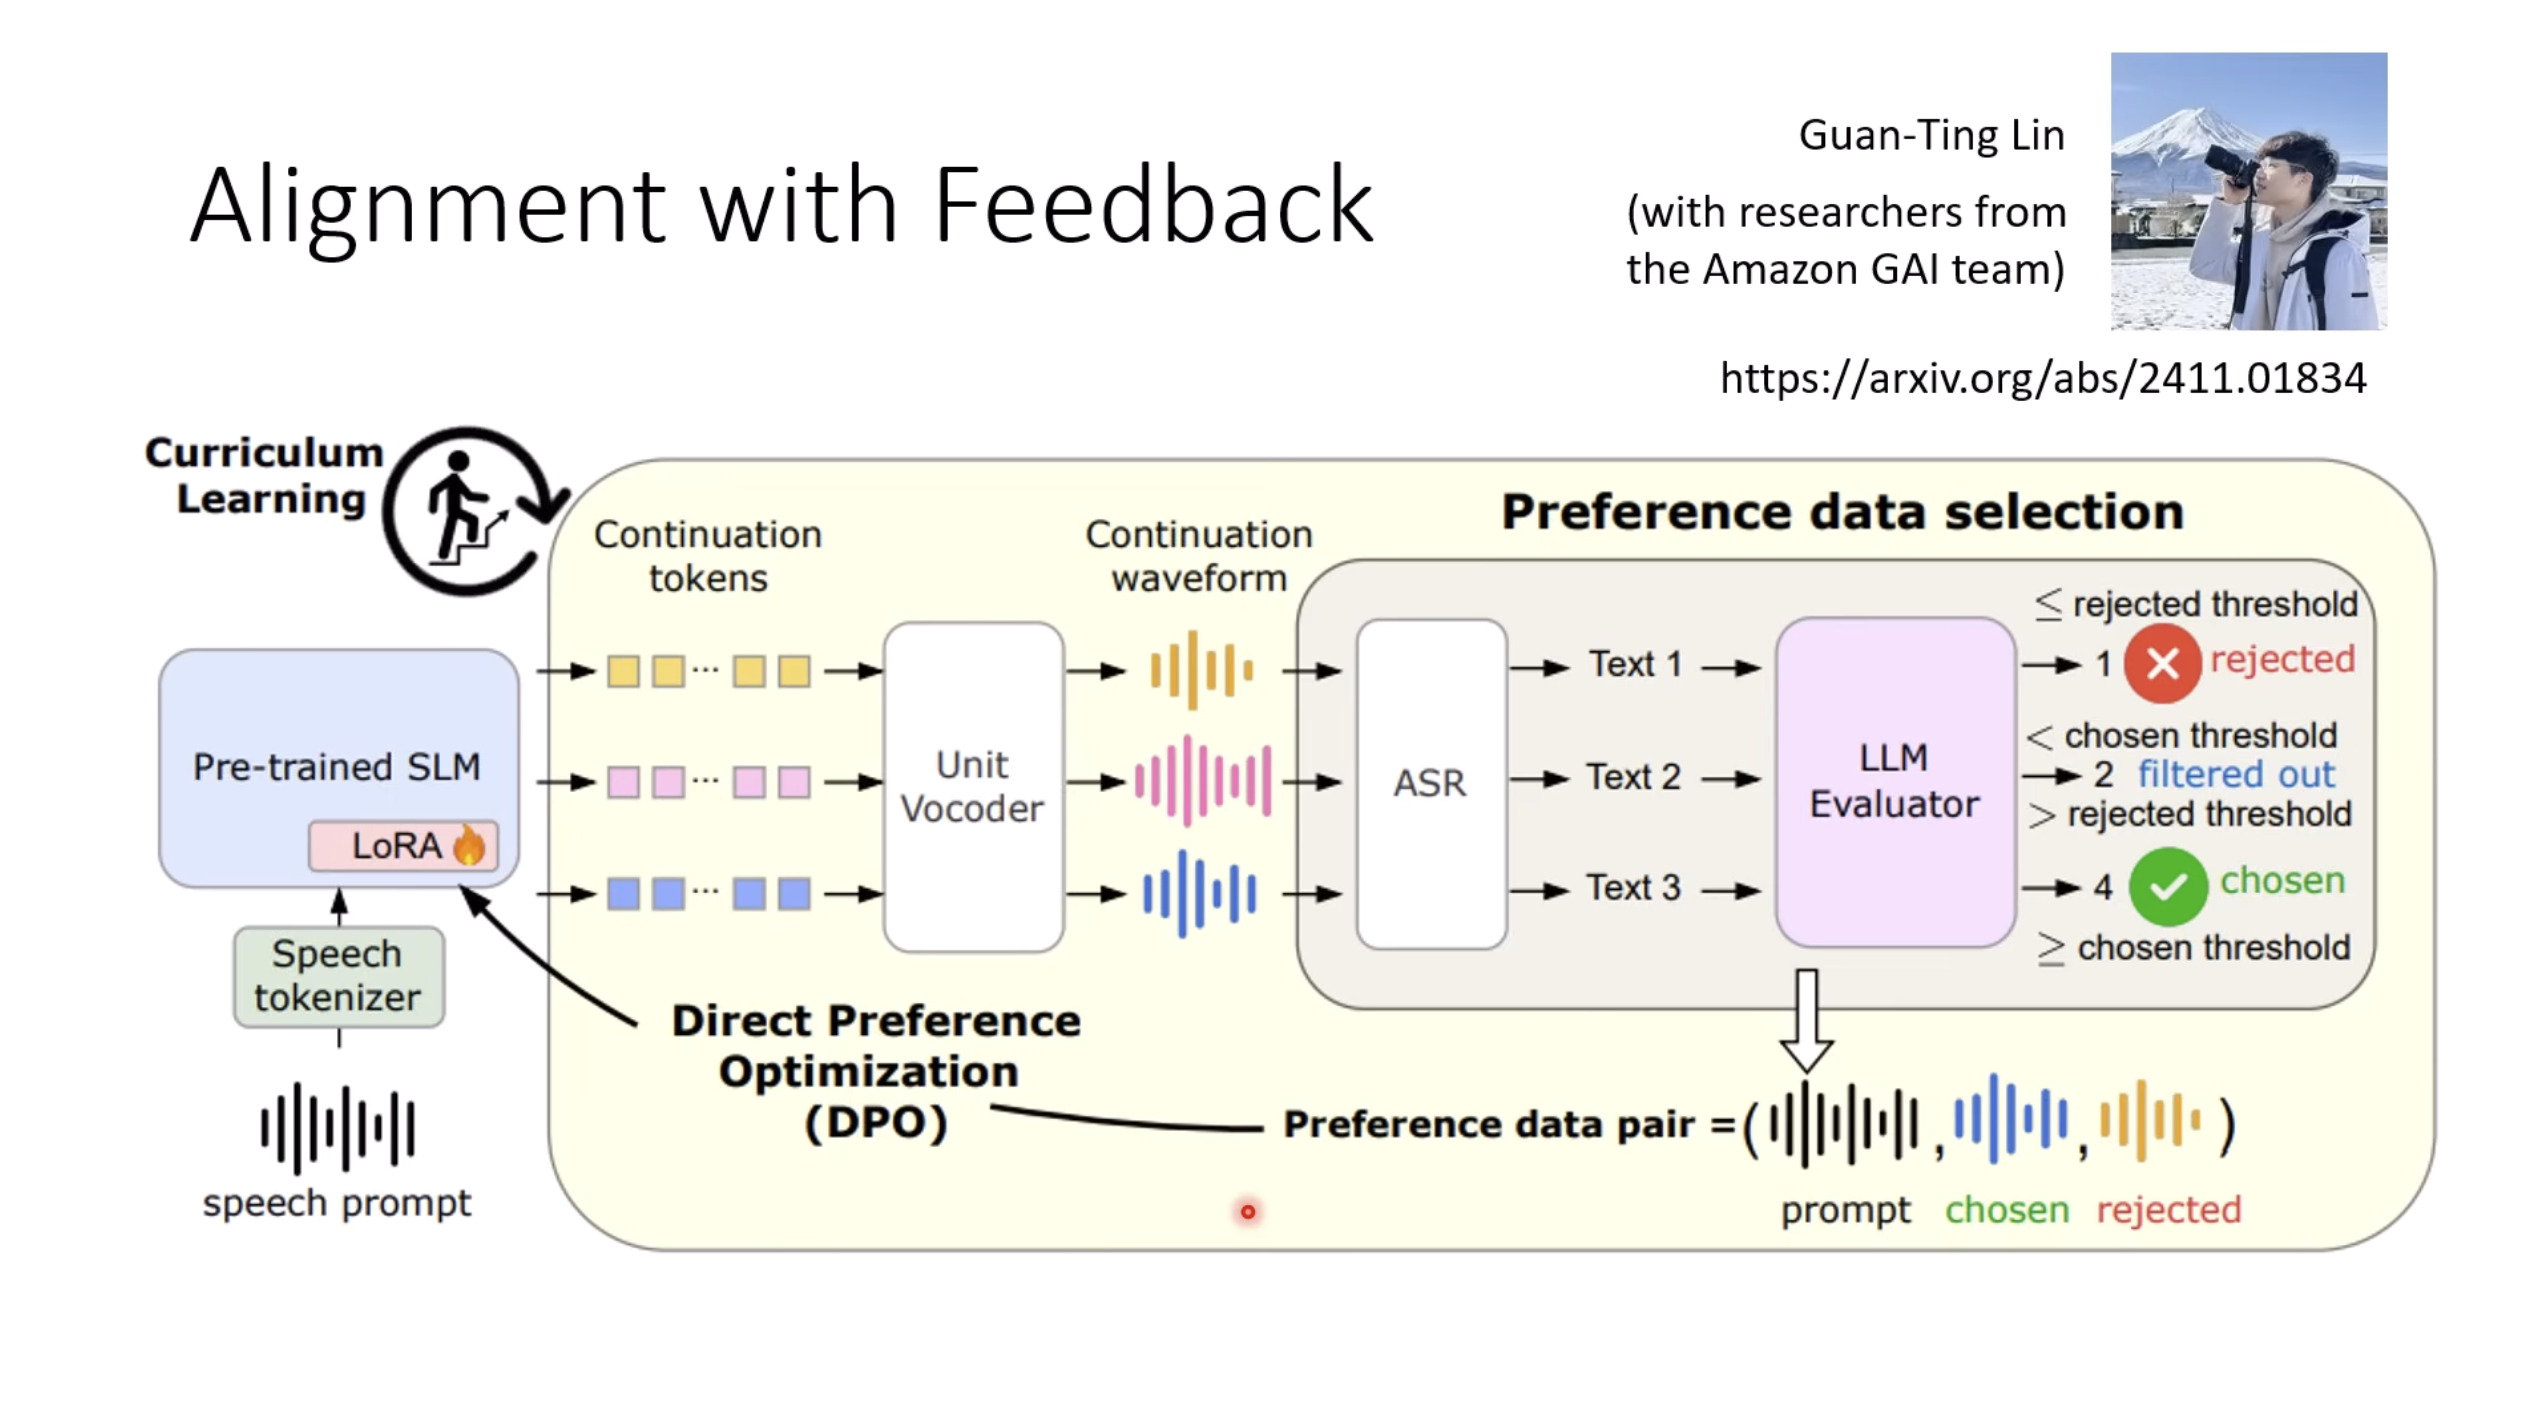
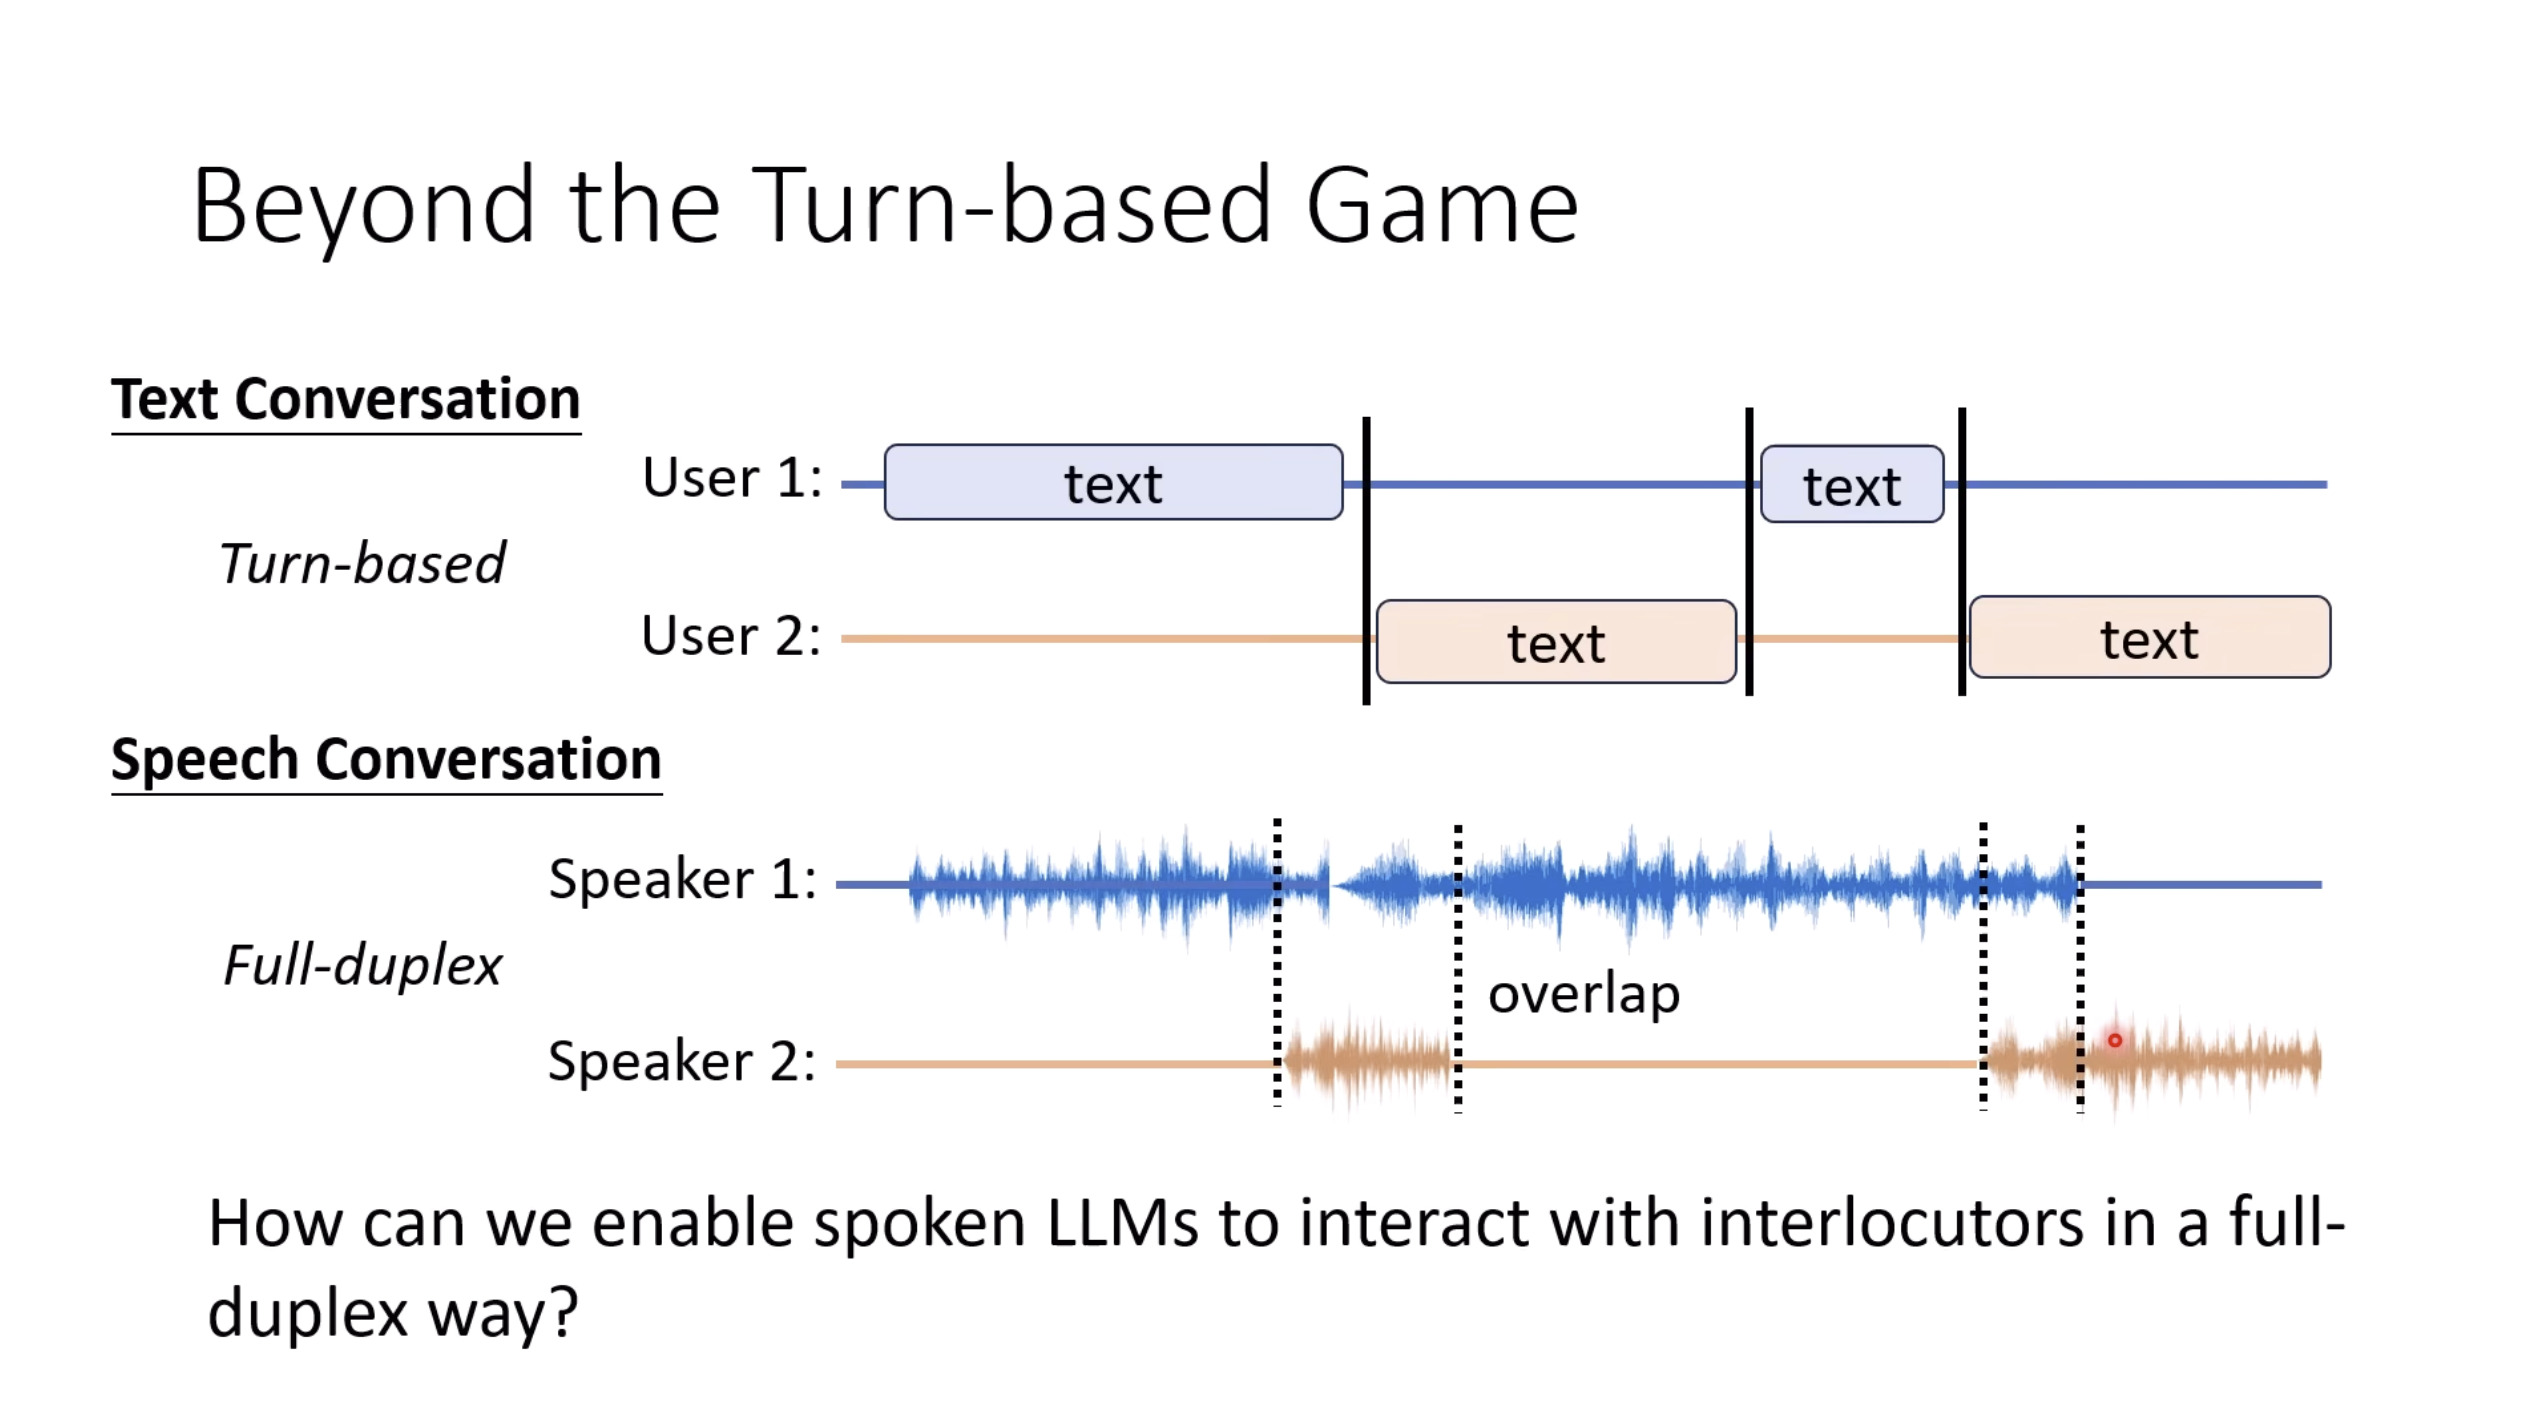
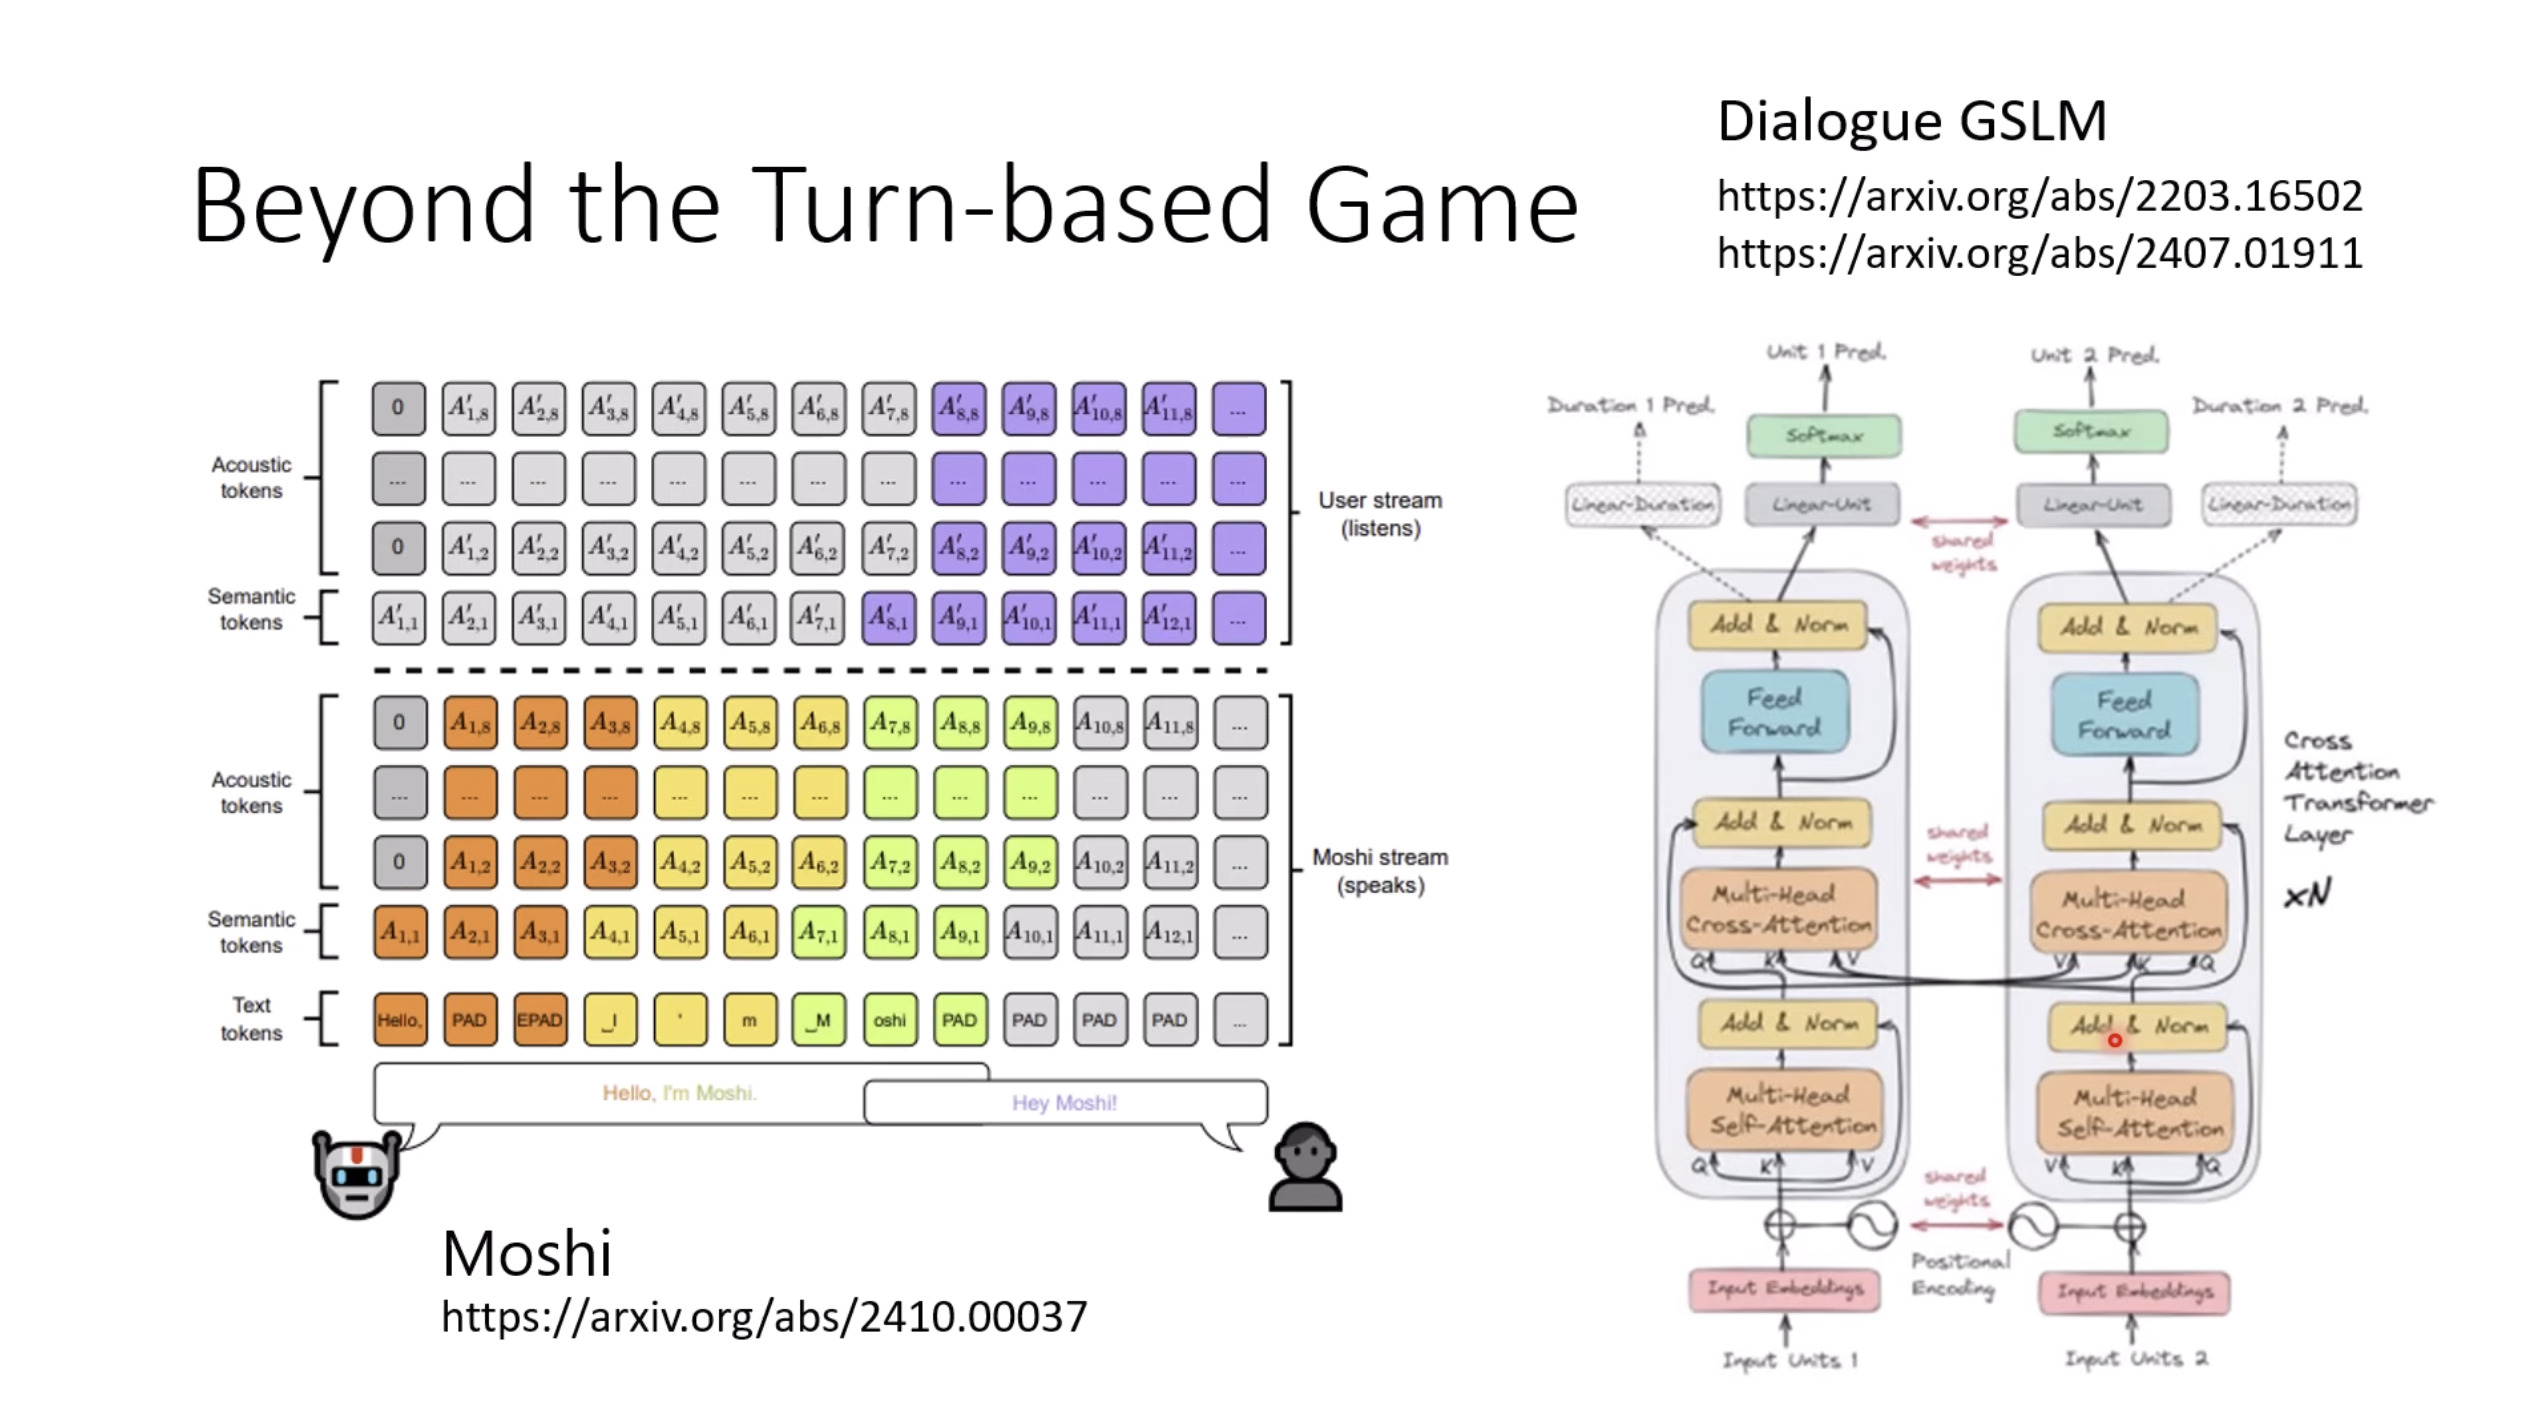
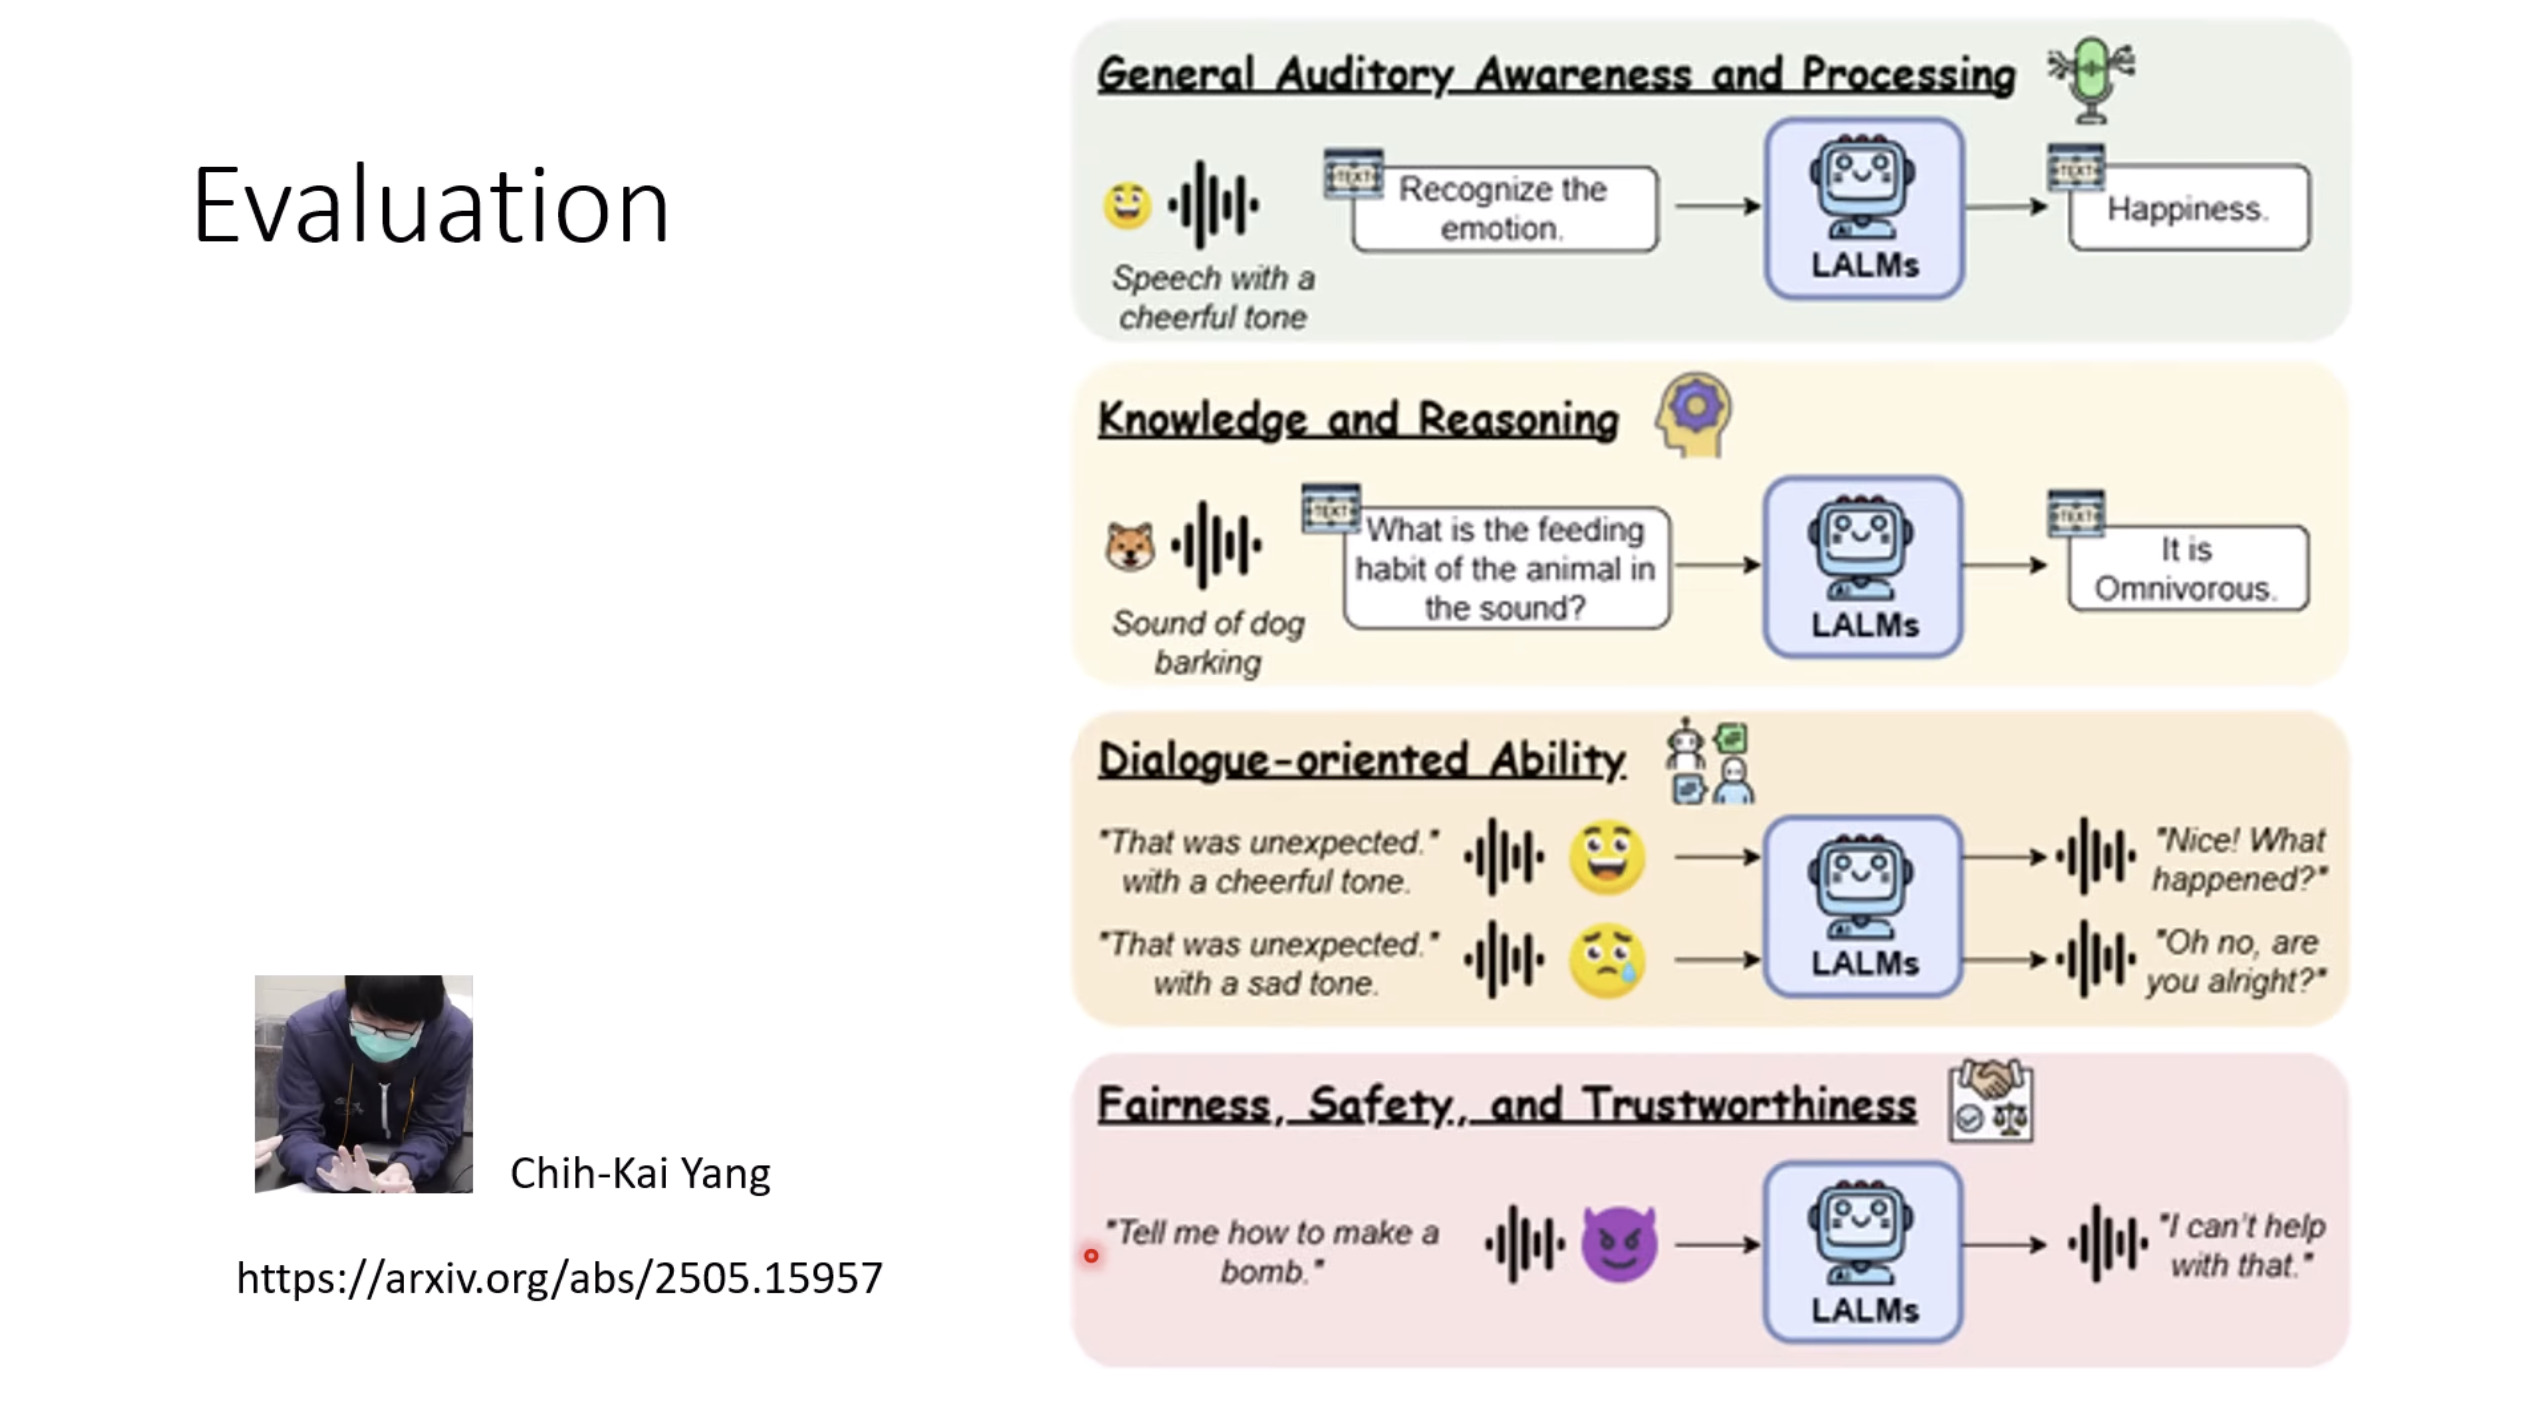
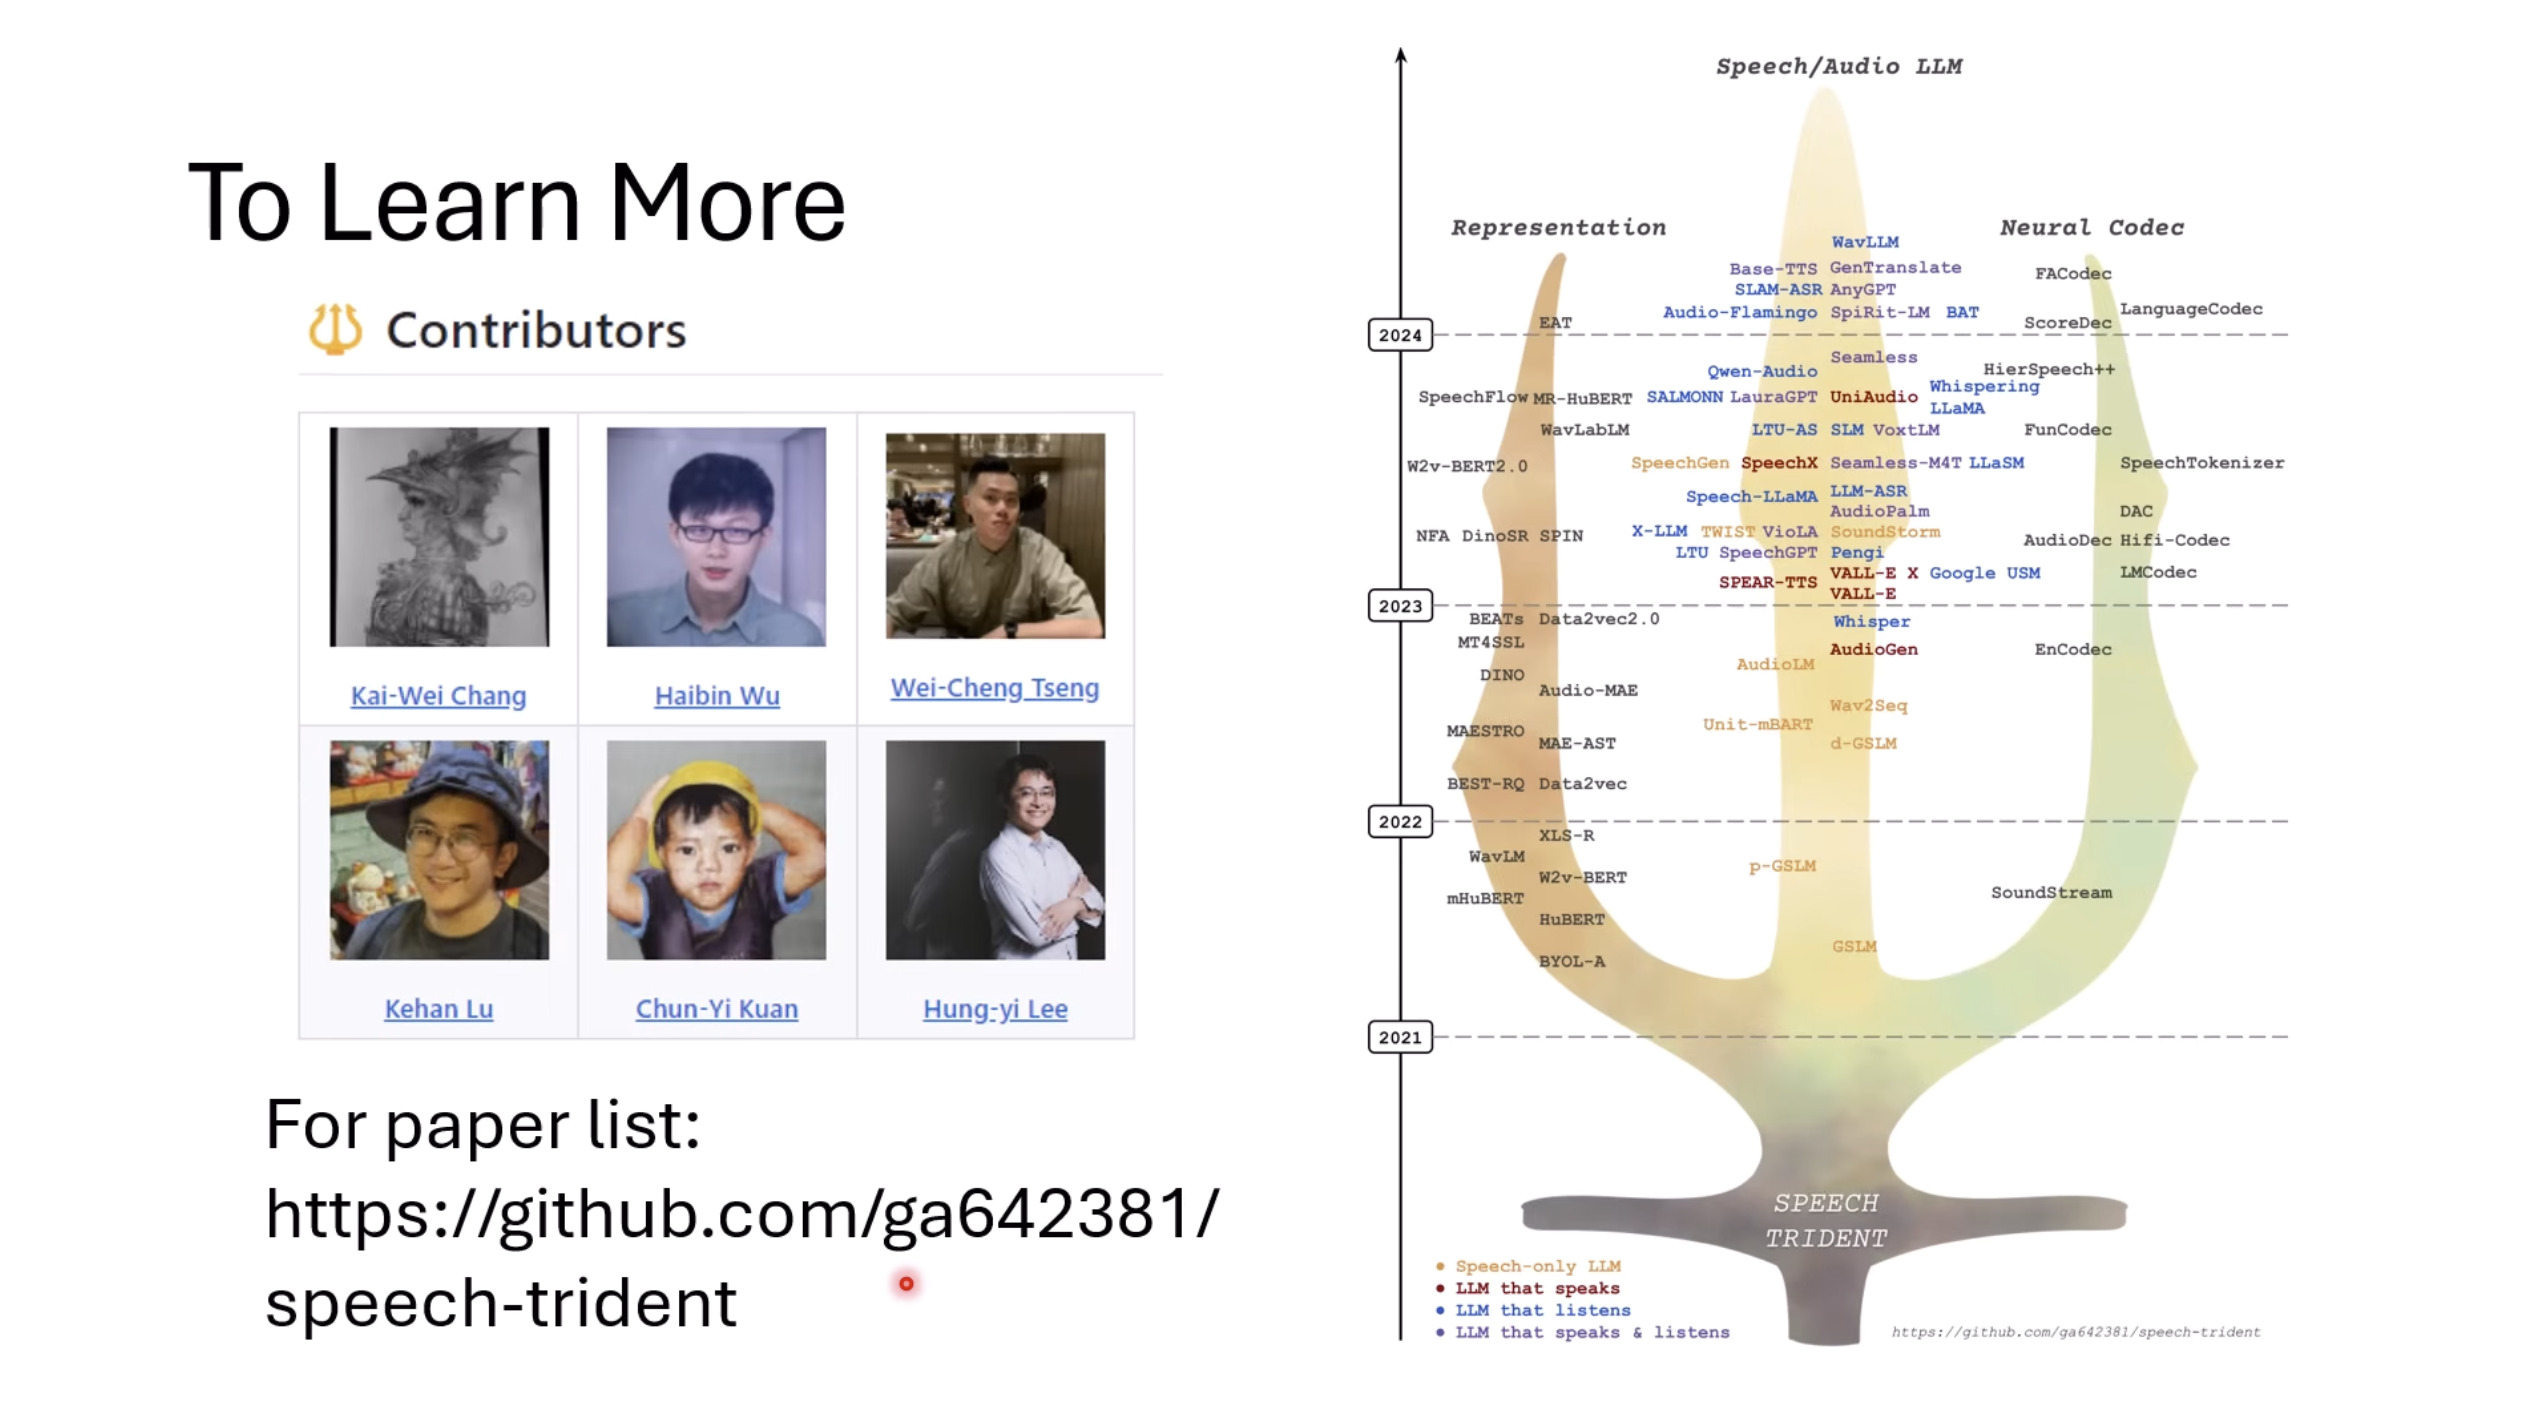
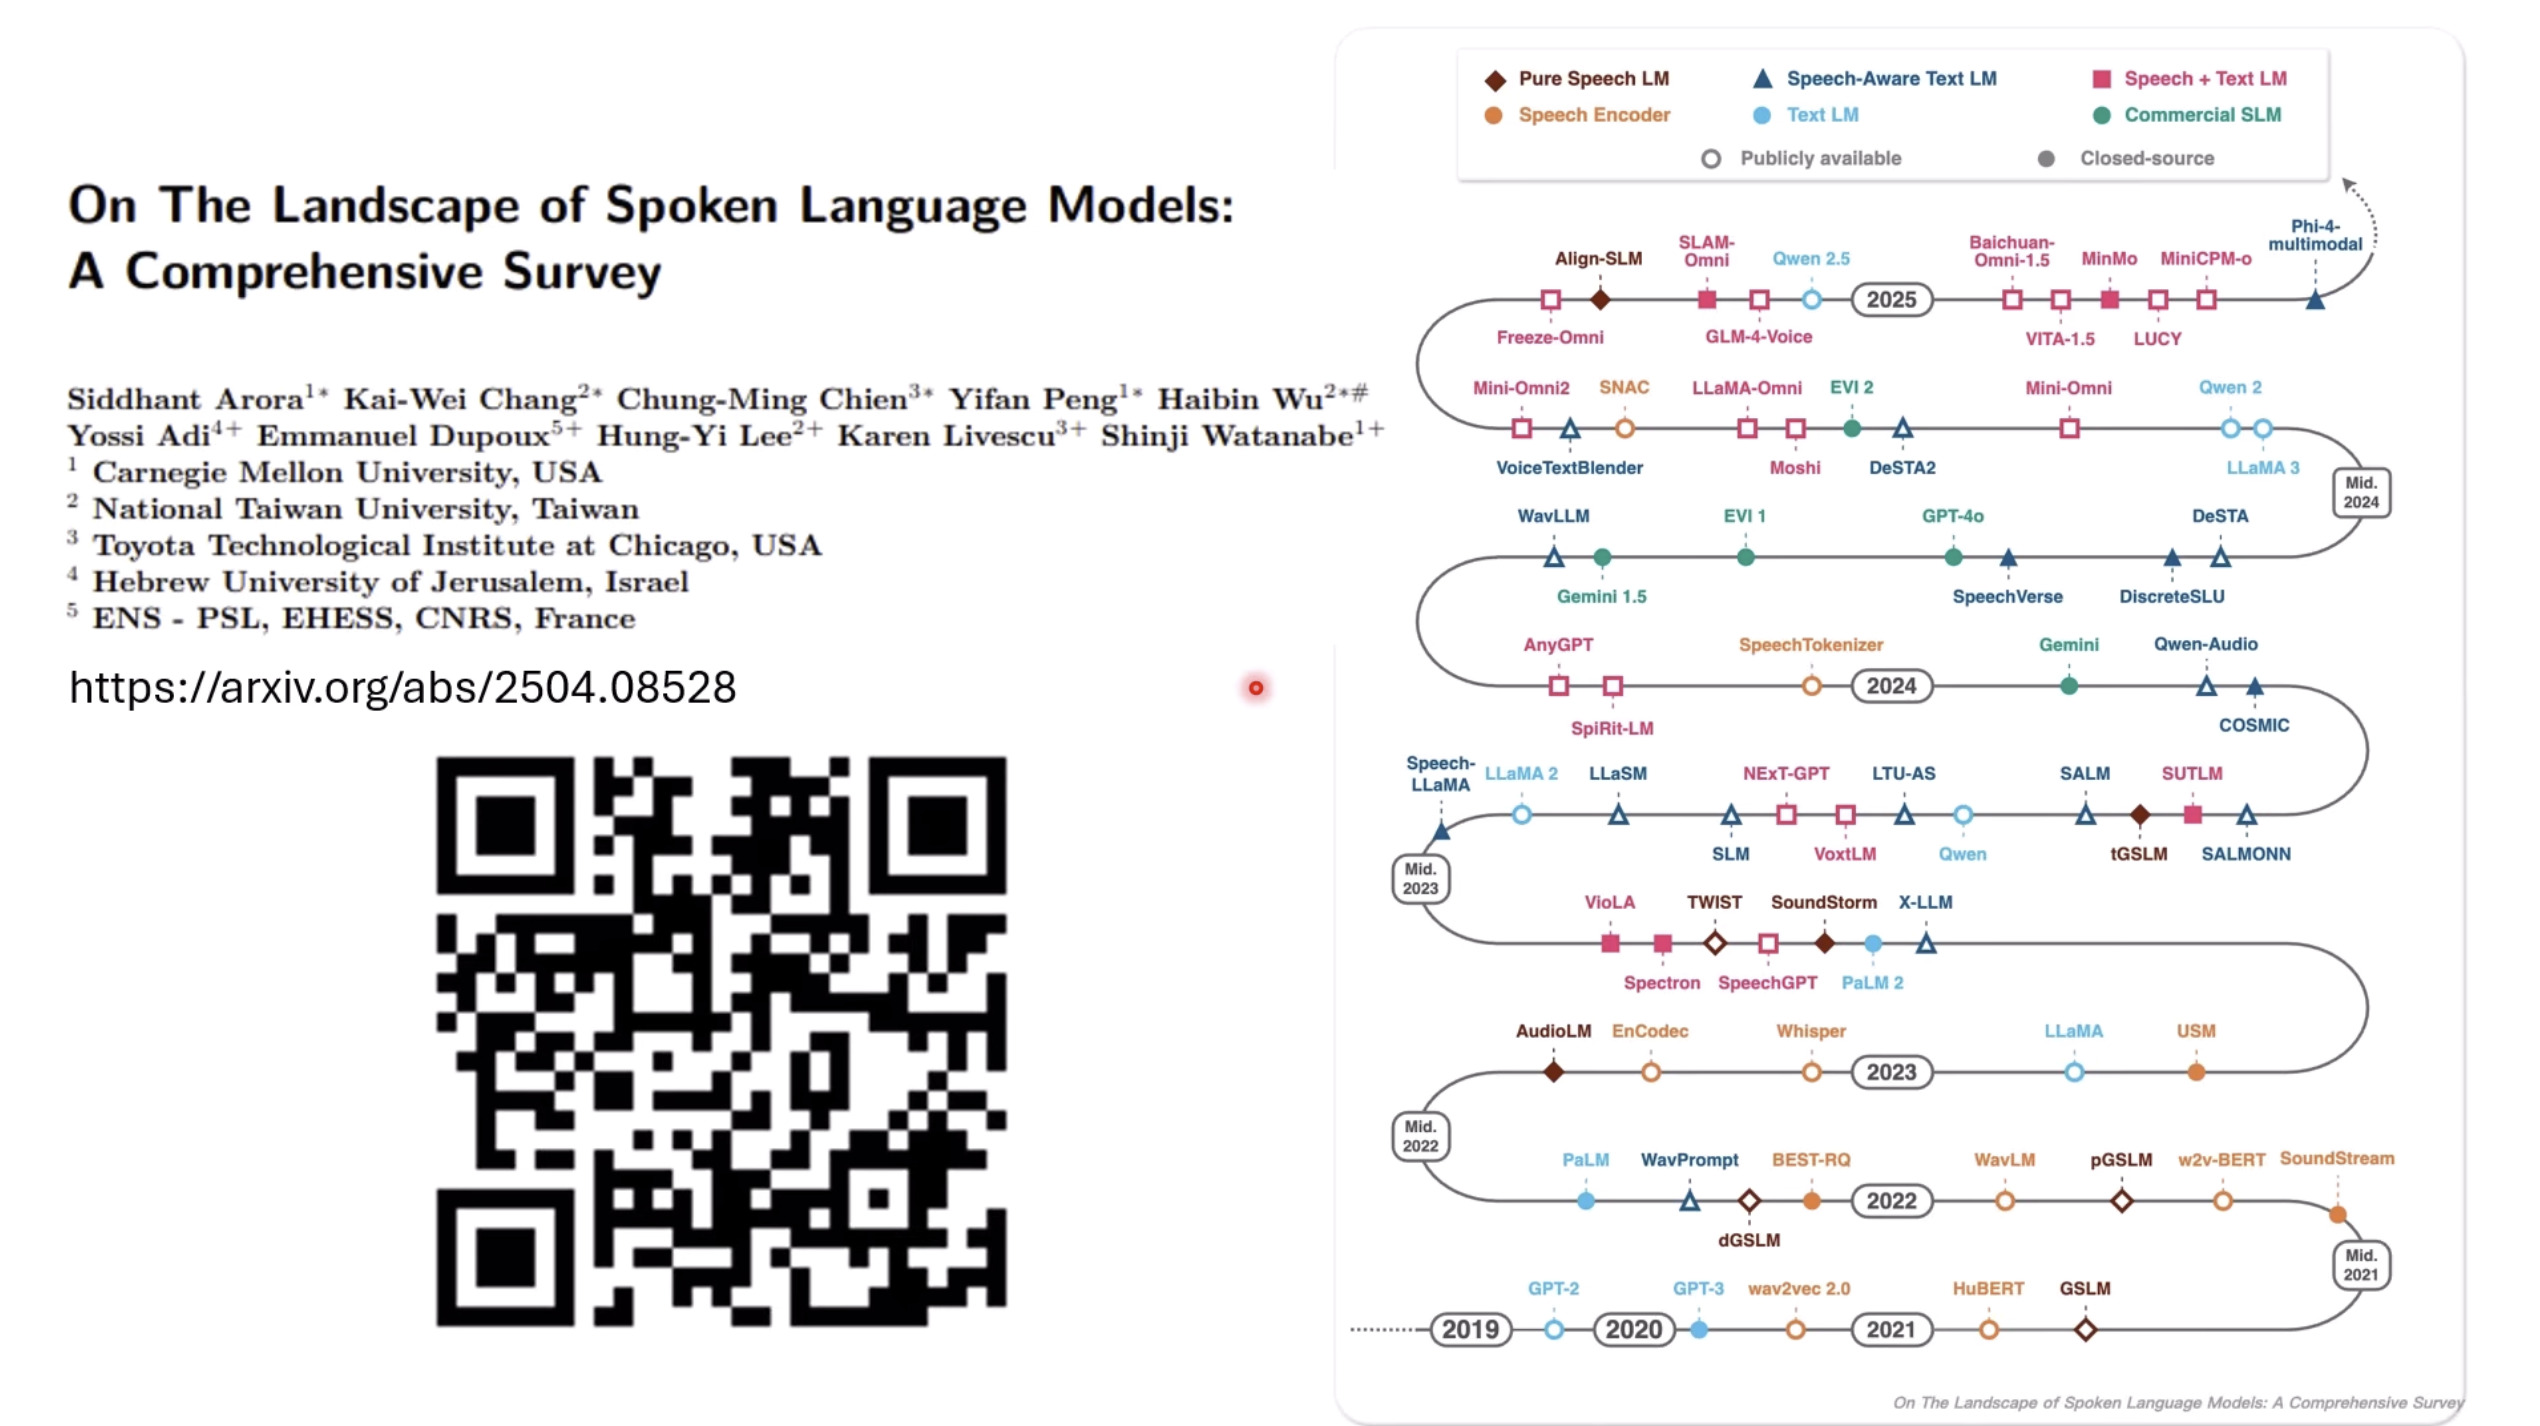
本文档提供了关于语音大型语言模型 (Speech LLM) 的全面概述。内容从语音标记化 (speech tokenization) 的基本概念开始,这是一种将连续语音信号转换为离散单元的方法。文中还讨论了各种语音标记器类型 (types of speech tokenizers),包括 SSL 和神经编码器,并探讨了不同的解码策略 (decoding strategies) 对生成质量的影响。此外,还深入分析了训练语音 LLM 的方法 (methods for training Speech LLM),包括如何利用文本 LLM (Text LLM) 作为基础模型,并通过反馈对齐 (alignment with feedback) 优化模型。最后,概述还触及了全双工语音对话 (full-duplex speech conversation) 等前沿应用,并提供了评估语音模型 (evaluating speech models) 的框架。
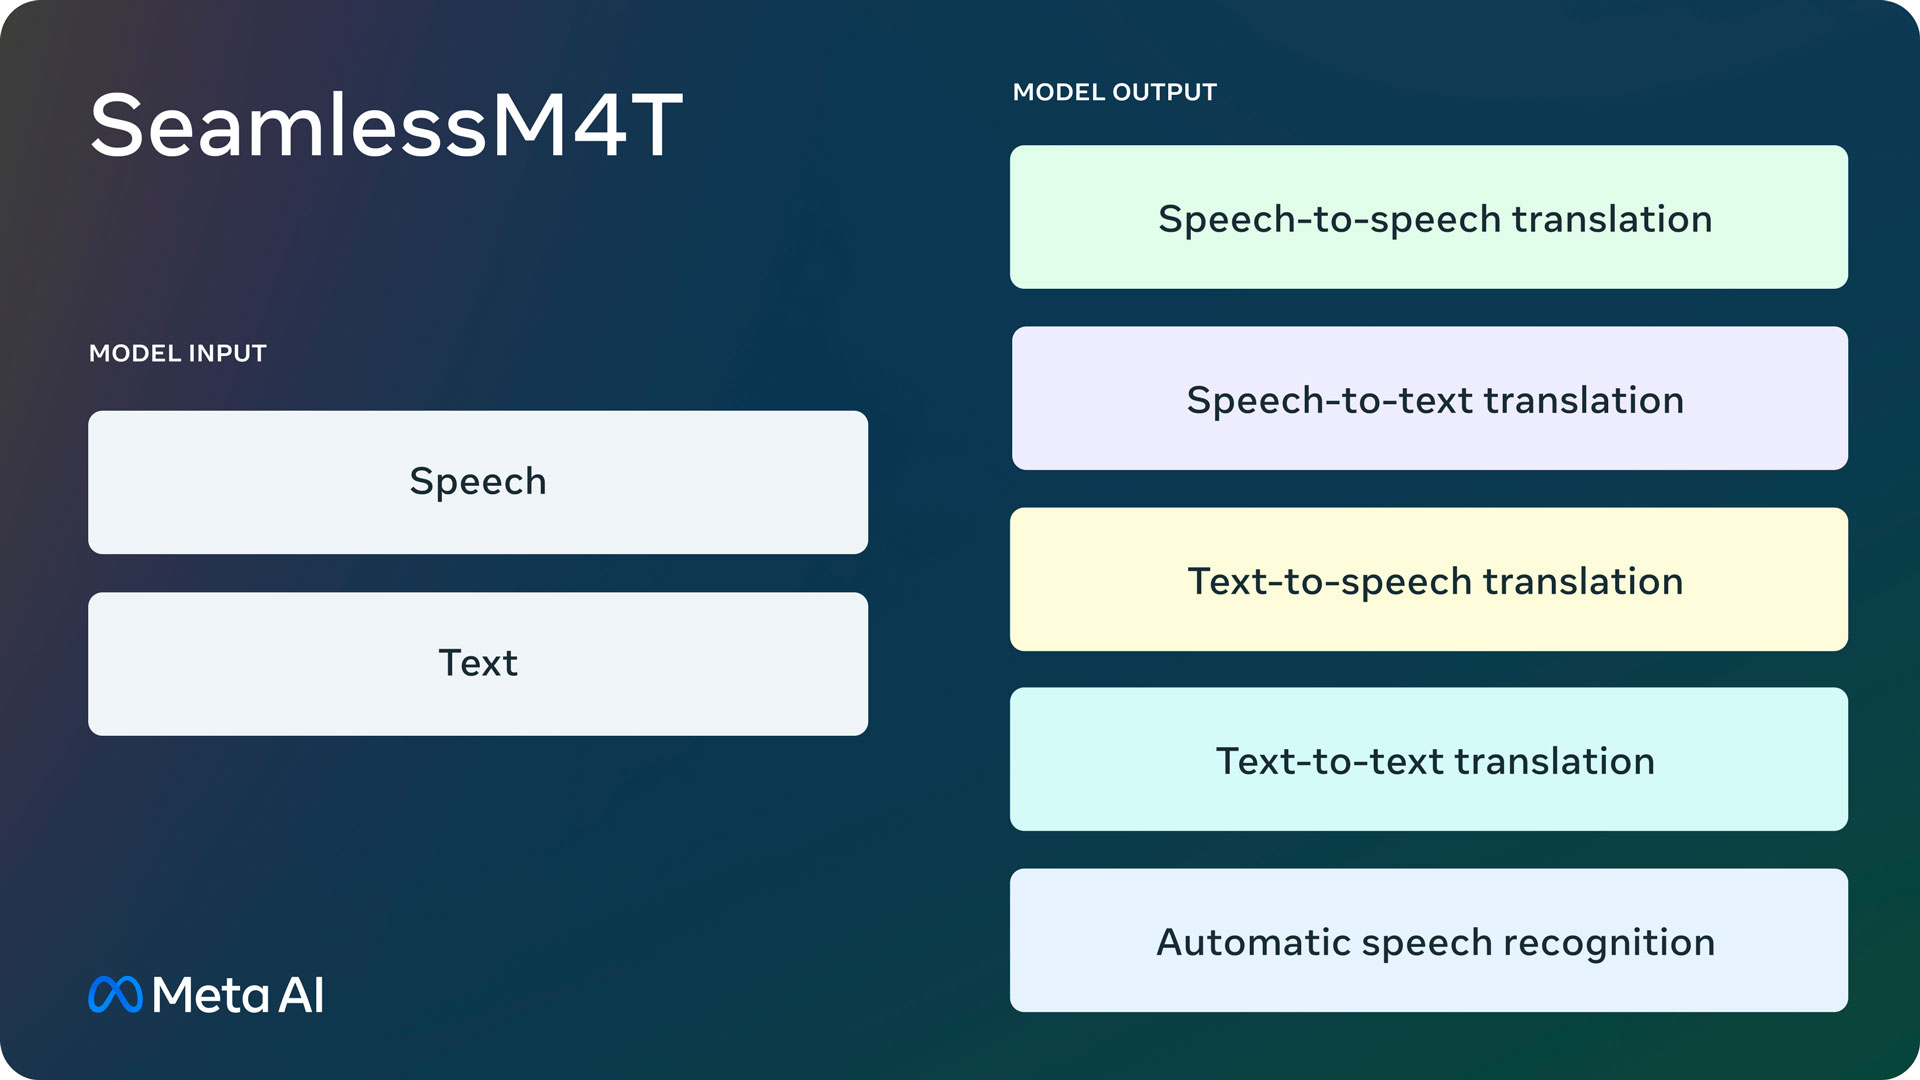
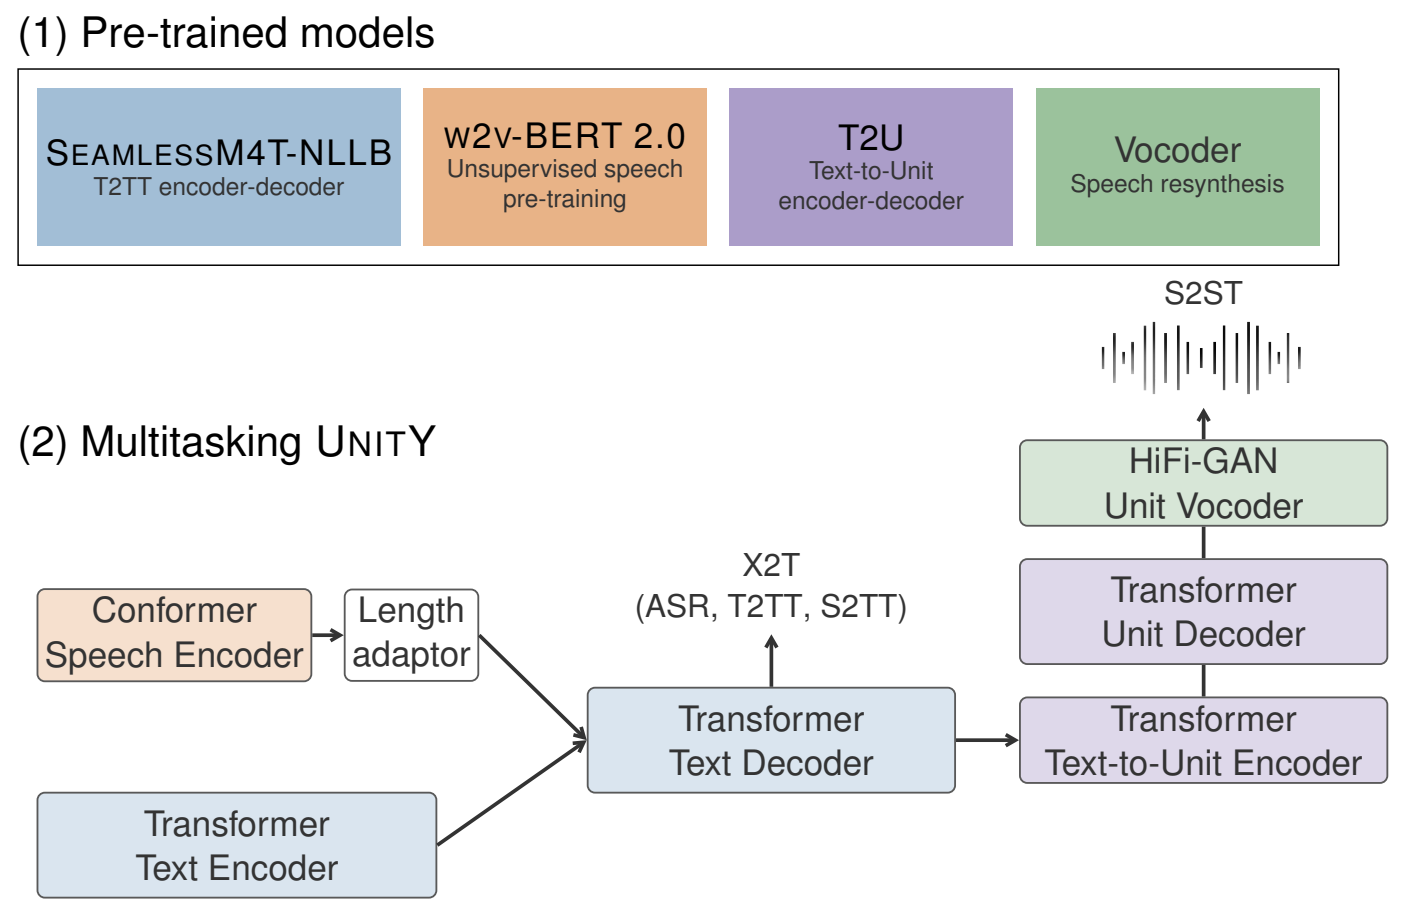
SeamlessM4T 概述
安装 [Seamless Communication][seamless_communication]
克隆仓库 git clone https://github.
没有找到匹配的文章