Hy-SimulMT 本地实时同传 · 技术实现原理解析HTML
拆解 30B 语音同传模型如何在本机跑成常驻流式服务:改 260 行 C++ 打通 --stream,用 800ms 分轮与 stdin 节拍,配音频账本、双 AudioContext 与六类故障分诊,字幕延迟压到 255ms,也坦白单向与轮换的边界。
拆解 30B 语音同传模型如何在本机跑成常驻流式服务:改 260 行 C++ 打通 --stream,用 800ms 分轮与 stdin 节拍,配音频账本、双 AudioContext 与六类故障分诊,字幕延迟压到 255ms,也坦白单向与轮换的边界。
朗读者是什么
朗读者(Long Reader)是一款基于 Web Speech API 的纯前端长文朗读工具。它采用左侧编辑设置、右侧沉浸阅读的布局,支持中英文长文本逐句朗读,无需上传、无需后端,所有文本处理与语音合成都在浏览器本地完成。
核心功能
.txt 文件,也内置中英文范文一键体验。Space 播放 / 暂停,← / → 切换上下句,Esc 停止。使用方式
浏览器原生语音合成(TTS)开发经验
最近先后在站点上线了两个纯前端的朗读工具:Read Aloud 和 智能朗读阅读器。两者都基于浏览器的 Web Speech API 实现,没有后端、没有上传、没有第三方语音服务。开发过程中踩了一些坑,也积累了一些可复用的经验,记录如下。
一、Web Speech API 基础
浏览器 TTS 的入口非常简洁:
const synth = window.speechSynthesis;
const utterance = new SpeechSynthesisUtterance(text);
synth.speak(utterance);
window.speechSynthesis 负责全局的语音队列,SpeechSynthesisUtterance 则是每一次发音的单元。在真正可用之前,建议先做兼容性判断:
if (!window.speechSynthesis) {
  alert('当前浏览器不支持 Web Speech API,无法使用朗读功能。');
  return;
}
目前 Safari、Chrome、Edge 等现代浏览器都支持该 API,但不同浏览器在语音质量、语音名、事件触发等方面差异明显,后面会详细说。
二、语音列表是异步加载的
第一次调用 speechSynthesis.getVoices() 时,返回的数组经常为空。
智能朗读阅读器是什么
智能朗读阅读器是一款基于 Web Speech API 的纯前端朗读工具。它采用左右分屏设计:左侧为阅读区,右侧为可折叠编辑区,适合朗读中文小说、英文范文、演讲稿等长文本。所有文本处理与语音合成都在浏览器本地完成,无需上传、无需后端。
核心功能
← / → 快速切换到上一句 / 下一句。Ctrl + Enter 加载文本,Esc 停止,← / → 切换句子。Read Aloud 是什么
Read Aloud 是一款纯前端、无需上传文本的浏览器朗读工具。它基于 Web Speech API 实现,全部文本处理与语音合成都在本地完成,适合朗读英文范文、中文小说、演讲稿、技术文档等长文本。
核心功能
使用方式
快捷键
Ctrl / ⌘ + Space:播放 / 暂停。Space:快速播放 / 暂停。Esc:关闭帮助窗口。浏览器兼容性
Read Aloud 依赖 Web Speech API,建议使用 Safari、Chrome、Edge 等
极简长文朗读器是什么
极简长文朗读器是一款基于浏览器 Web Speech API 的本地文本朗读工具。它采用左右分屏的极简设计:左侧输入文本,右侧实时生成可朗读的阅读视图,全部处理都在浏览器内完成,无需上传、无需后端。
核心功能
与 Read Aloud 的区别
| 特性 | 极简长文朗读器 | Read Aloud |
|---|---|---|
| 界面 | 左右分屏,实时同步 | 编辑/阅读视图切换 |
| 分句 | 按中英文标点实时切分 | 段落 + 句子双层切分 |
| 音调调节 | 无 | 支持 |
| 进度显示 | 无 | 句数 / 时间 |
| 设计 | 极简 Tailwind 风格 | 卡片式工具风格 |
可以根据个人喜好选择更适合自己的一款,两者都是纯浏览器本地运行。
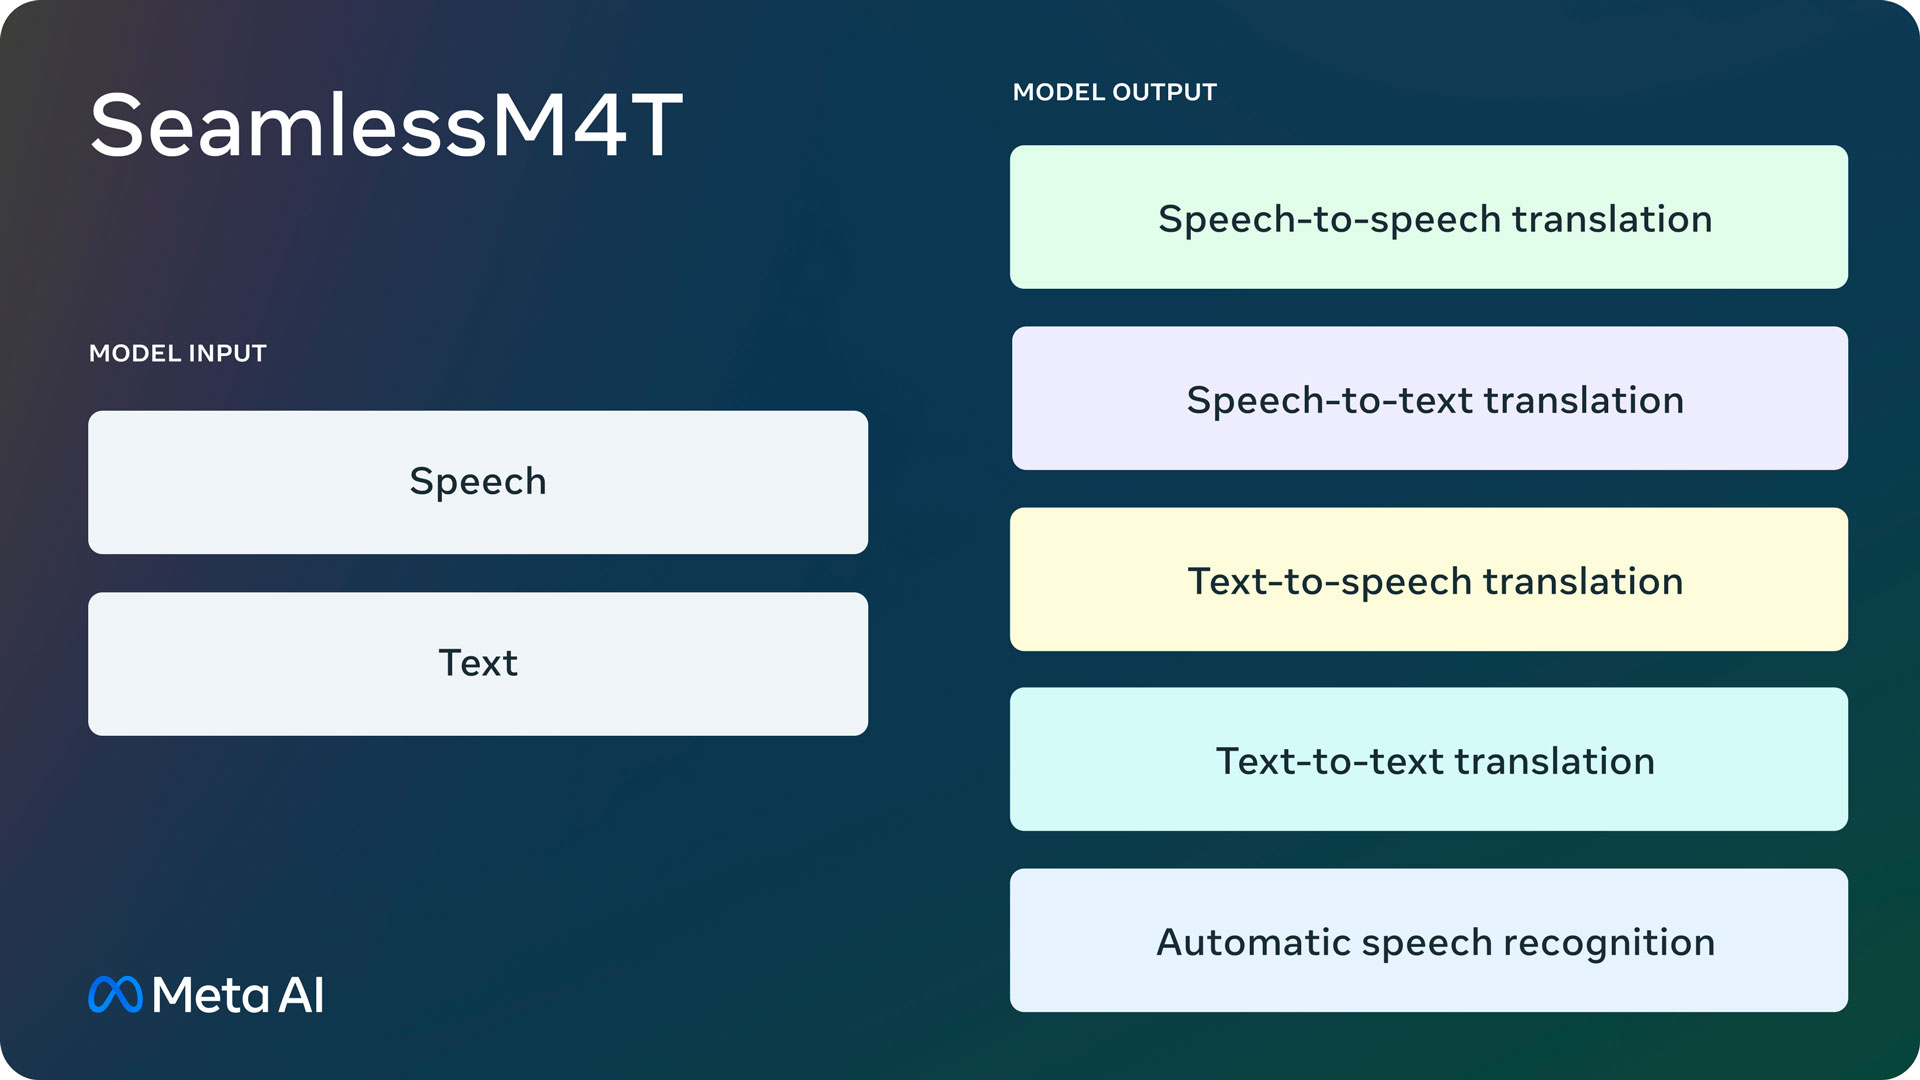
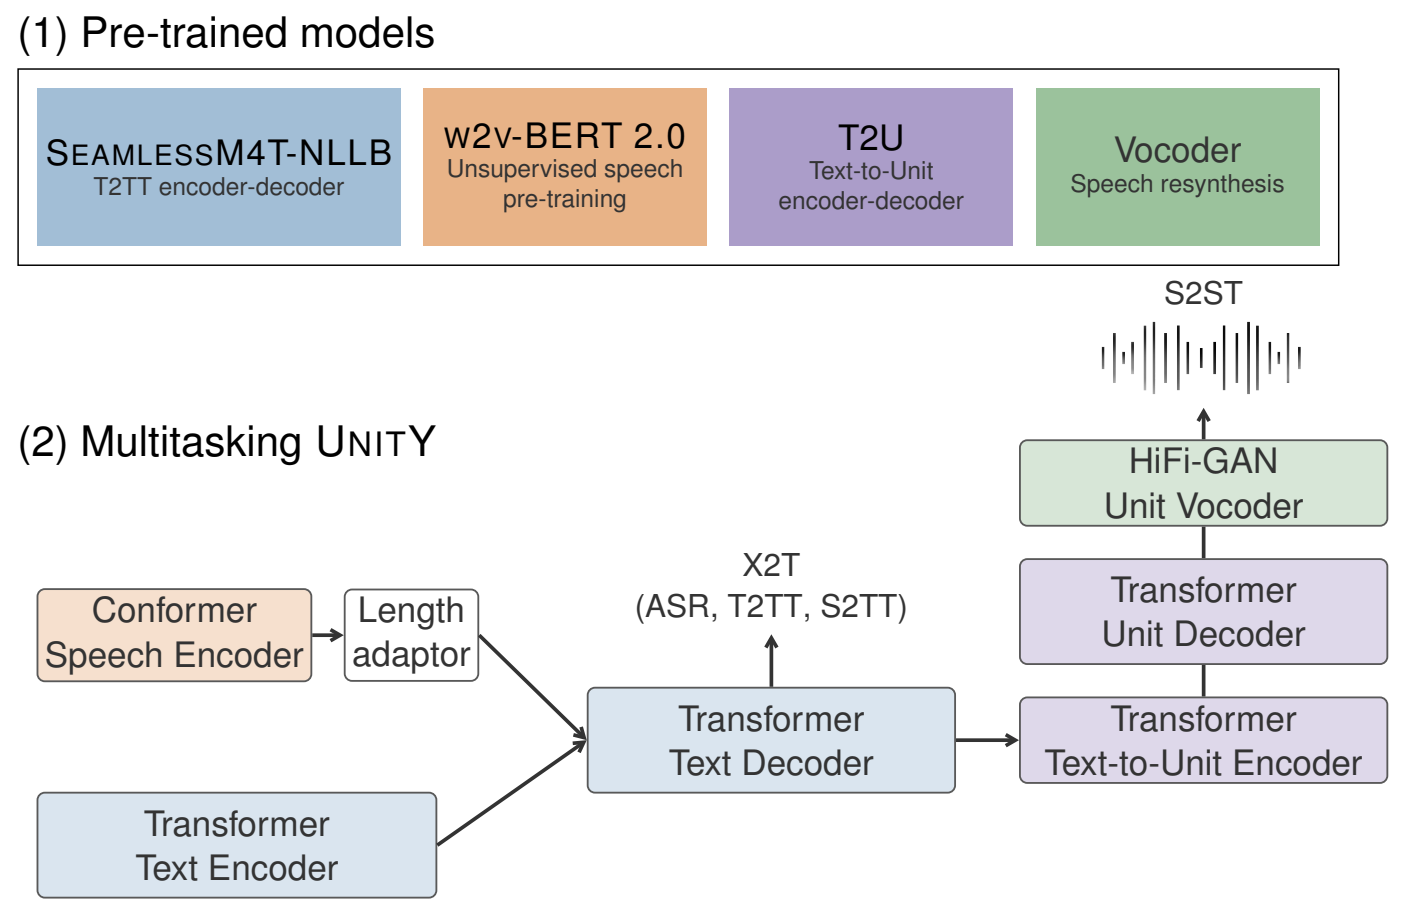
SeamlessM4T 概述
安装 [Seamless Communication][seamless_communication]
克隆仓库 git clone https://github.
该文档详细介绍了 2023年全国行业职业技能竞赛,涵盖了多个技术任务。任务一侧重于语音处理,通过Python代码展示了如何利用腾讯云API进行语音识别和语音合成,包括音频文件的Base64编码转换和请求参数配置,并输出了实际的识别结果。任务二则聚焦于语音模型,阐述了声学模型的初始化、加载预训练模型以及语音识别的整个流程,并提到了模型训练的配置。任务三涉及文本处理,通过requests库抓取网页内容,并利用re、BeautifulSoup和lxml.etree等工具进行网页内容解析和文本提取,同时展示了文本清洗、数据扩充以及使用Stanford CoreNLP进行中文分词、词性标注和命名实体识别。任务四是数据分析与可视化,展示了如何从Excel文件中读取急诊科就诊数据,并计算男女比例、每日就诊人数和各诊室就诊人数,最终通过matplotlib库生成饼状图、柱状图和折线图进行数据可视化。
2023年全国行业职业技能竞赛 第二届全国电子企业职业技能竞赛
任务一
任务1.1
任务1.2
介绍
PaddleSpeech 是基于飞桨 PaddlePaddle 的语音方向的开源模型库,用于语音和音频中的各种关键任务的开发,包含大量基于深度学习前沿和有影响力的模型。
功能
学习
安装
conda create -n paddlespeech python==3.10.9
conda activate paddlespeech

pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple
pip install pytest-runner paddlespeech

pip install "numpy<1.24"
测试数据下载
wget -c https://paddlespeech.bj.bcebos.com/PaddleAudio/zh.wav
wget -c https://paddlespeech.bj.bcebos.com/PaddleAudio/en.wav
FAQ paddlespeech asr --lang zh --input zh.
没有找到匹配的文章