Qwen3-ASR 本地语音识别 · 技术文档HTML
在 Apple Silicon Mac 上完全离线部署 Qwen3-ASR:双模型常驻、SRT/VTT 字幕对齐、VAD 按句切分与整段精修,并复盘三种可复现的精度损耗、内存回归与六个真实踩坑,附完整验证断言。
在 Apple Silicon Mac 上完全离线部署 Qwen3-ASR:双模型常驻、SRT/VTT 字幕对齐、VAD 按句切分与整段精修,并复盘三种可复现的精度损耗、内存回归与六个真实踩坑,附完整验证断言。
用八张图拆解 Hy-SimulMT 同声传译推理:1.6 秒切块、VAD 跳过静音、全量历史续写、1600 毫秒音频压成 11 个语音词元、模型自判说与不说、ST 补偿重译与上下文切断,并给出延迟来源、8 秒时序与代码地图。
方法
架构
本仓库实现了一个语音到语音的级联管道,包含以下部分:
模块化
该管道提供了一种完全开放且模块化的方法,重点是利用 Hugging Face Hub 上 Transformers 库提供的模型。代码设计易于修改,我们已经支持特定设备和外部库的实现:
VAD
STT
LLM
TTS ChatTTS Pocket TTS - Kyutai Labs 提供的支持语音克隆的流式 TTS Kokoro-
本文详细介绍了 FunASR 这一基础语音识别工具包,它提供了一套完整的语音处理服务,涵盖了离线转写和实时听写两大核心功能。其技术核心在于 AutoModel 多模型协调引擎,能够将不同的组件,如语音活动检测(VAD)、自动语音识别(ASR)、标点恢复和说话人分离(SV),按序串联起来,实现复杂的音频转录任务。文档清晰展示了从原始音频输入到最终带说话人标签的转录结果的完整处理流程和数据流向。此外,本文不仅罗列了支持的多种中英文模型清单,还附带了音频格式转换指南和代码示例。最后,通过实验性能对比,文章论证了在不同硬件上,结合 VAD、PUNC 和 SV 等组件后对推理用时和处理准确性的影响。
ASR 模型综合对比表
| 模型名称 | 中文准确度 | 英文/混合识别 | 可读性 (标点) | 附加功能 | 综合评分 |
|---|---|---|---|---|---|
| Fun-ASR-Nano | 极高 | 完美 | 极佳 | 生产环境级别 | 5.0 |
| SenseVoiceSmall | 高 | 较弱 (漏失) | 较好 | 情感/事件检测 | 4.0 |
paraformer-zh (ASR) |
一般 | 极差 | 无 | 原始数据 | 2.0 |
paraformer-zh (+VAD +PUNC) |
高 | 中等 | 优秀 | 自动断句 | 4.5 |
建议:
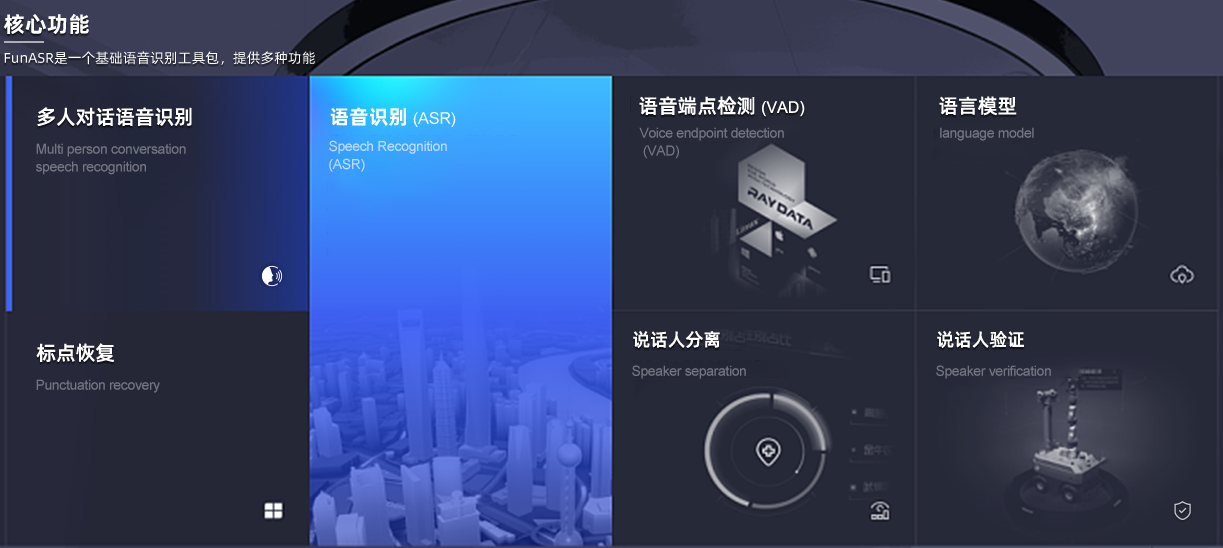
FunASR 是一个基础语音识别工具包,提供多种功能,包括语音识别(ASR)、语音端点检测(VAD)、标点恢复、语言模型、说话人验证、说话人分离和多人对话语音识别等。
FunASR 快速入门
核心功能
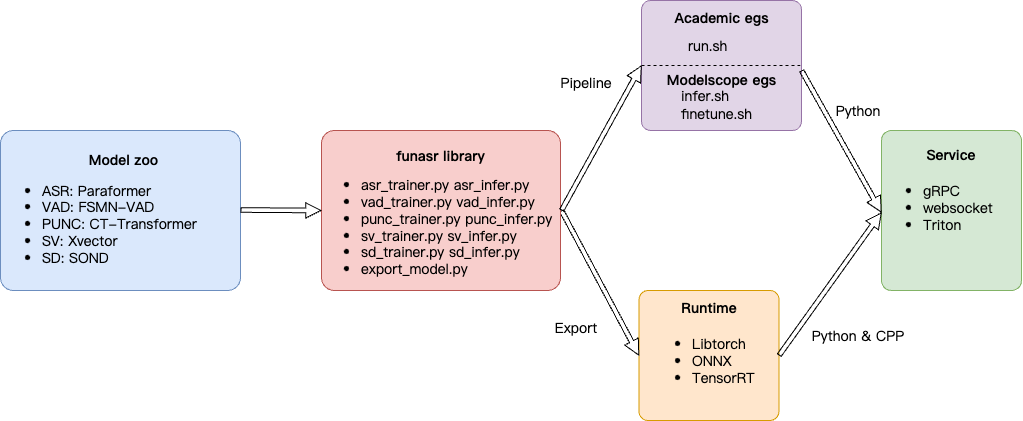
工作流程
离线文件转写服务

FunASR离线文件转写软件包,提供了一款功能强大的语音离线文件转写服务。拥有完整的语音识别链路,结合了语音端点检测、语音识别、标点等模型,可以将几十个小时的长音频与视频识别成带标点的文字,而且支持上百路请求同时进行转写。输出为带标点的文字,含有字级别时间戳,支持ITN与用户自定义热词等。服务端集成有ffmpeg,支持各种音视频格式输入。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
实时听写服务
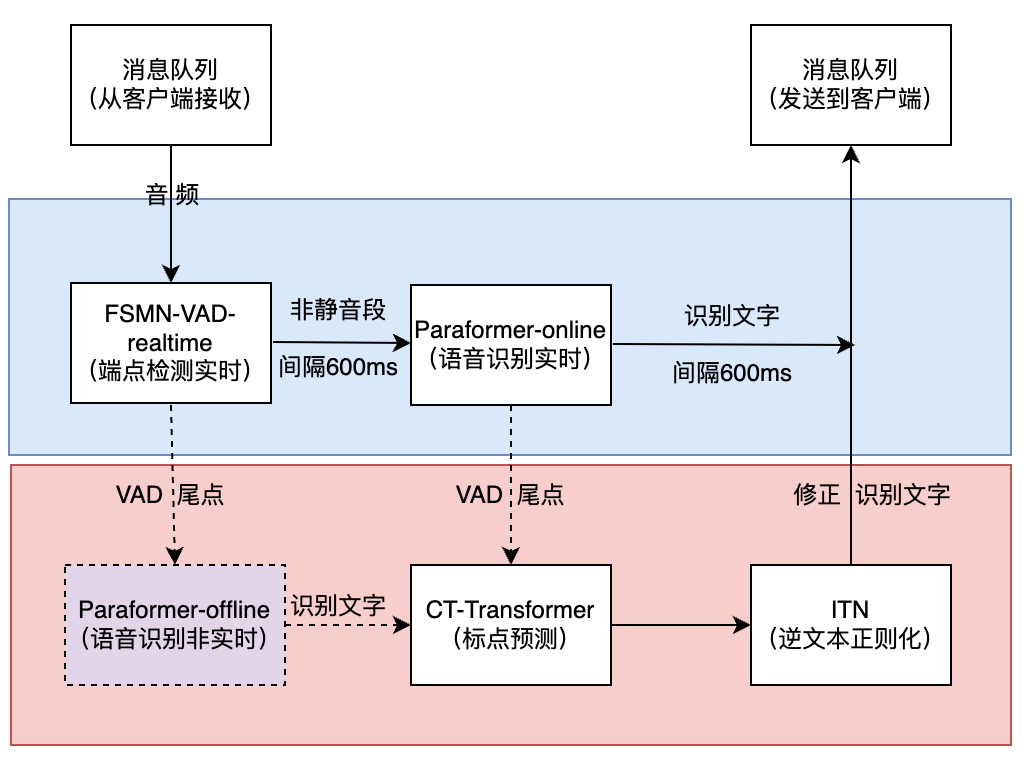
FunASR实时语音听写软件包,集成了实时版本的语音端点检测模型、语音识别、语音识别、标点预测模型等。采用多模型协同,既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。依据使用者场景不同,支持实时语音听写服务(online)、非实时一句话转写(offline)与实时与非实时一体化协同(2pass)3种服务模式。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
FunASR 镜像
没有找到匹配的文章