文心 Unlimited OCR 2 深度研究 · 从长视野到无限视野HTML
百度 Unlimited OCR 2 深度拆解:SR-SWA 把每步视野钉在 640 token,分块解码让成本与页数解耦;逐项核对架构、评测分数、八个该打的折扣与部署配方,回答它到底是更强的 OCR,还是智能体的读档层。
百度 Unlimited OCR 2 深度拆解:SR-SWA 把每步视野钉在 640 token,分块解码让成本与页数解耦;逐项核对架构、评测分数、八个该打的折扣与部署配方,回答它到底是更强的 OCR,还是智能体的读档层。
技能:
image-text-desensitization(别名"智能自动脱敏工具")v3.0.0 主类:SmartDesensitizer能力:覆盖文本 / JSON / 图像三类对象的隐私脱敏,全程本地运行,不联网 安全背书:经腾讯云安全cloudsec.tencent.com与腾讯内部tix.qq.com扫描,状态均为"安全无风险(benign)"
颜色图例(贯穿全文)
| 颜色 | 类型 |
|---|---|
| 🟣 紫 | 手机号 |
| 🟠 橙 | 身份证 |
| 🩵 青 | 邮箱 |
| 🟢 绿 | 银行卡 |
| 🔴 红 | IP 地址 |
① 能力总览
该技能是一个被动库——需要显式调用才生效,不会自动拦截对话。它提供三个入口方法:
| 入口 | 方法 | 说明 |
|---|---|---|
| 📝 文本脱敏 | desensitize_text(text) |
基于 5 条正则逐类替换。已验证可用,纯 Python 即可。 |
| 🧾 JSON 脱敏 | desensitize_json(json_str) |
按字段名命中 + 按值形态智能遮蔽。已验证可用。 |
| 🖼️ 图像脱敏 | desensitize_image_base64(b64) |
OCR 文字框 + 人脸检测后高斯模糊。需额外依赖(本地未装)。 |
② 文本脱敏规则 desensitize_text
源码写死 5 条正则,按固定顺序执行:手机 → 身份证 → 邮箱 → 银行卡 → IP。
MinerU 是 OpenDataLab 开源的一款高精度文档解析引擎,能把 PDF、DOCX、PPTX、XLSX、图片和网页转换成结构化的 Markdown 或 JSON,方便下游 LLM、RAG 和 Agent 工作流直接消费。
What|是什么
MinerU 的定位是“为 LLM 准备数据”的文档解析基础设施。它支持多种输入格式,输出则强调人类阅读顺序和语义结构:
mineru-router 等多种使用形态Why|为什么值得关注
MinerU 诞生于 InternLM 预训练过程中的实际需求,最初是为了解决科技文献中的符号转换问题。相比直接购买商业文档解析服务,它的几个亮点很突出:
pipeline 后端快且省资源,vlm-engine / hybrid-engine 后端精度更高,可按场景选择pipeline 后端在 OmniDocBench v1.6 上整体得分 86.47,hybrid 后端可达 95.39(high 模式)DeepSeek-OCR:上下文光学压缩
DeepSeek-OCR 架构
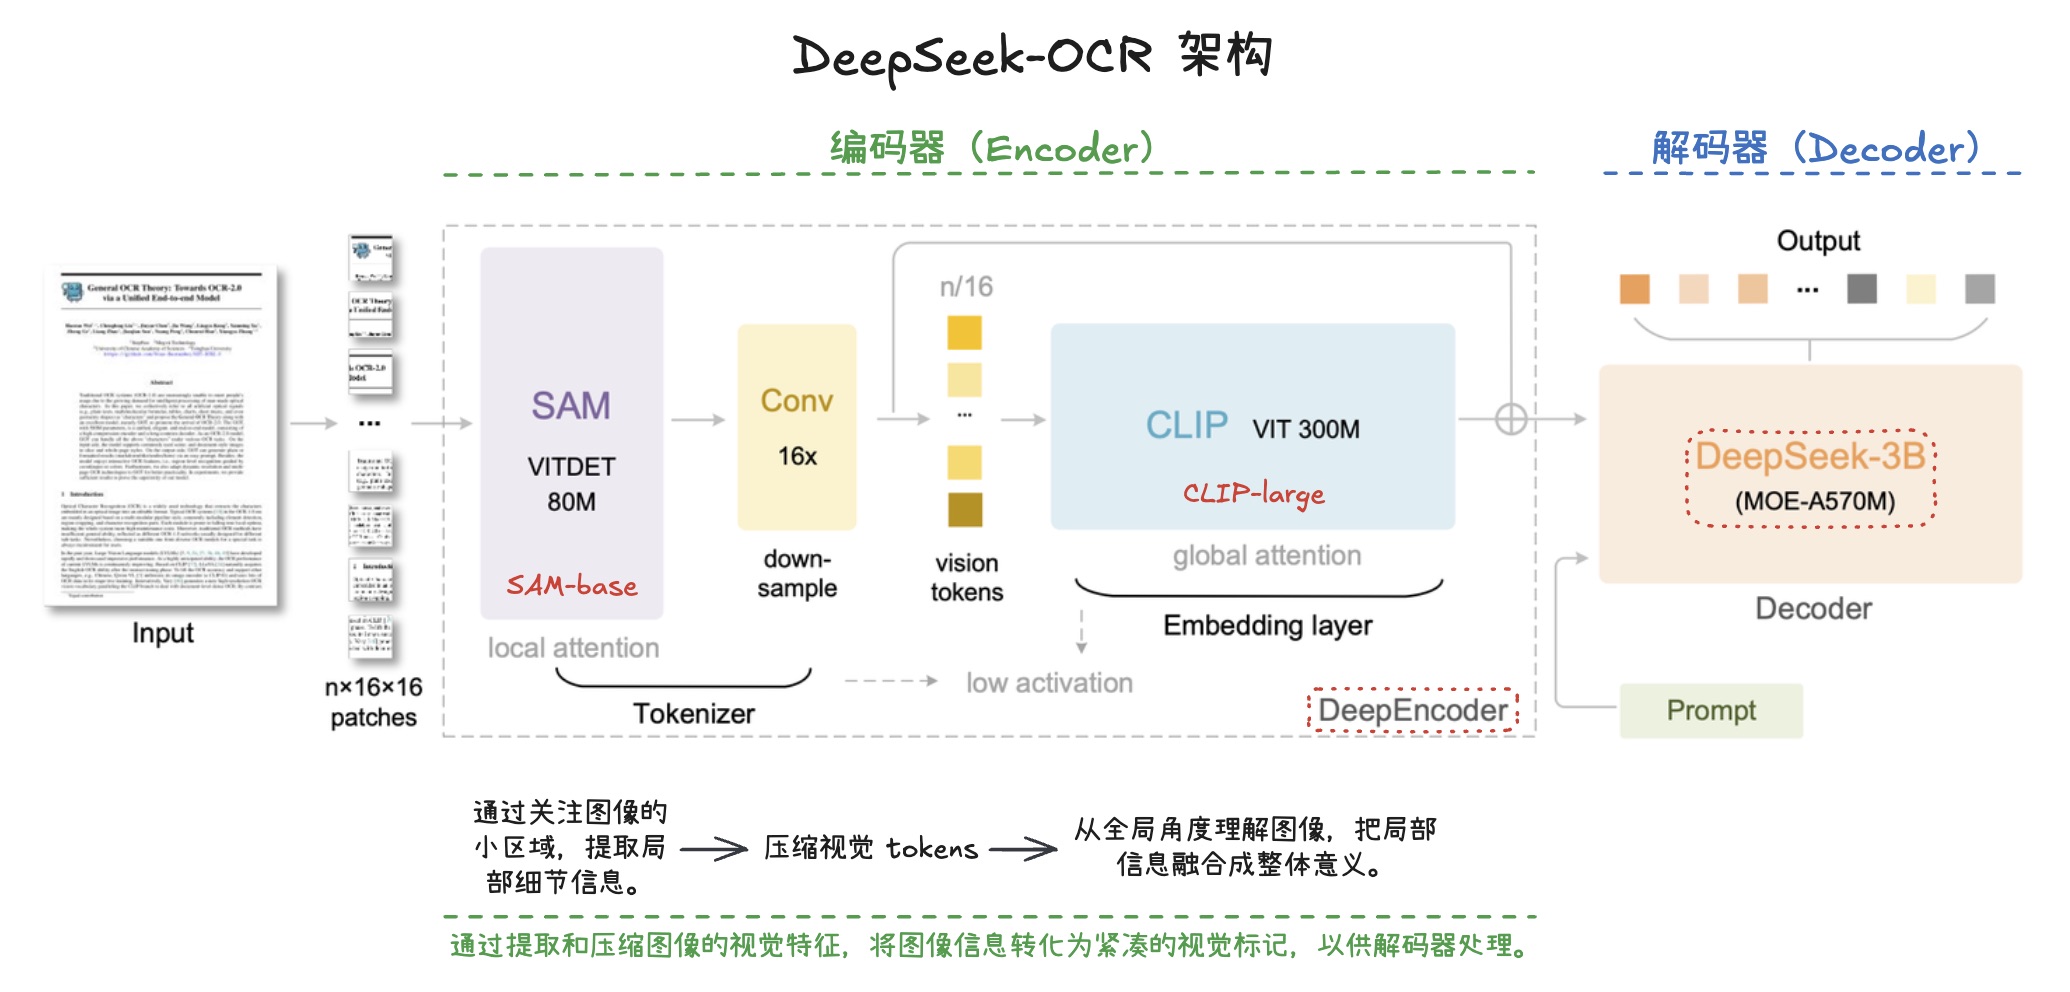
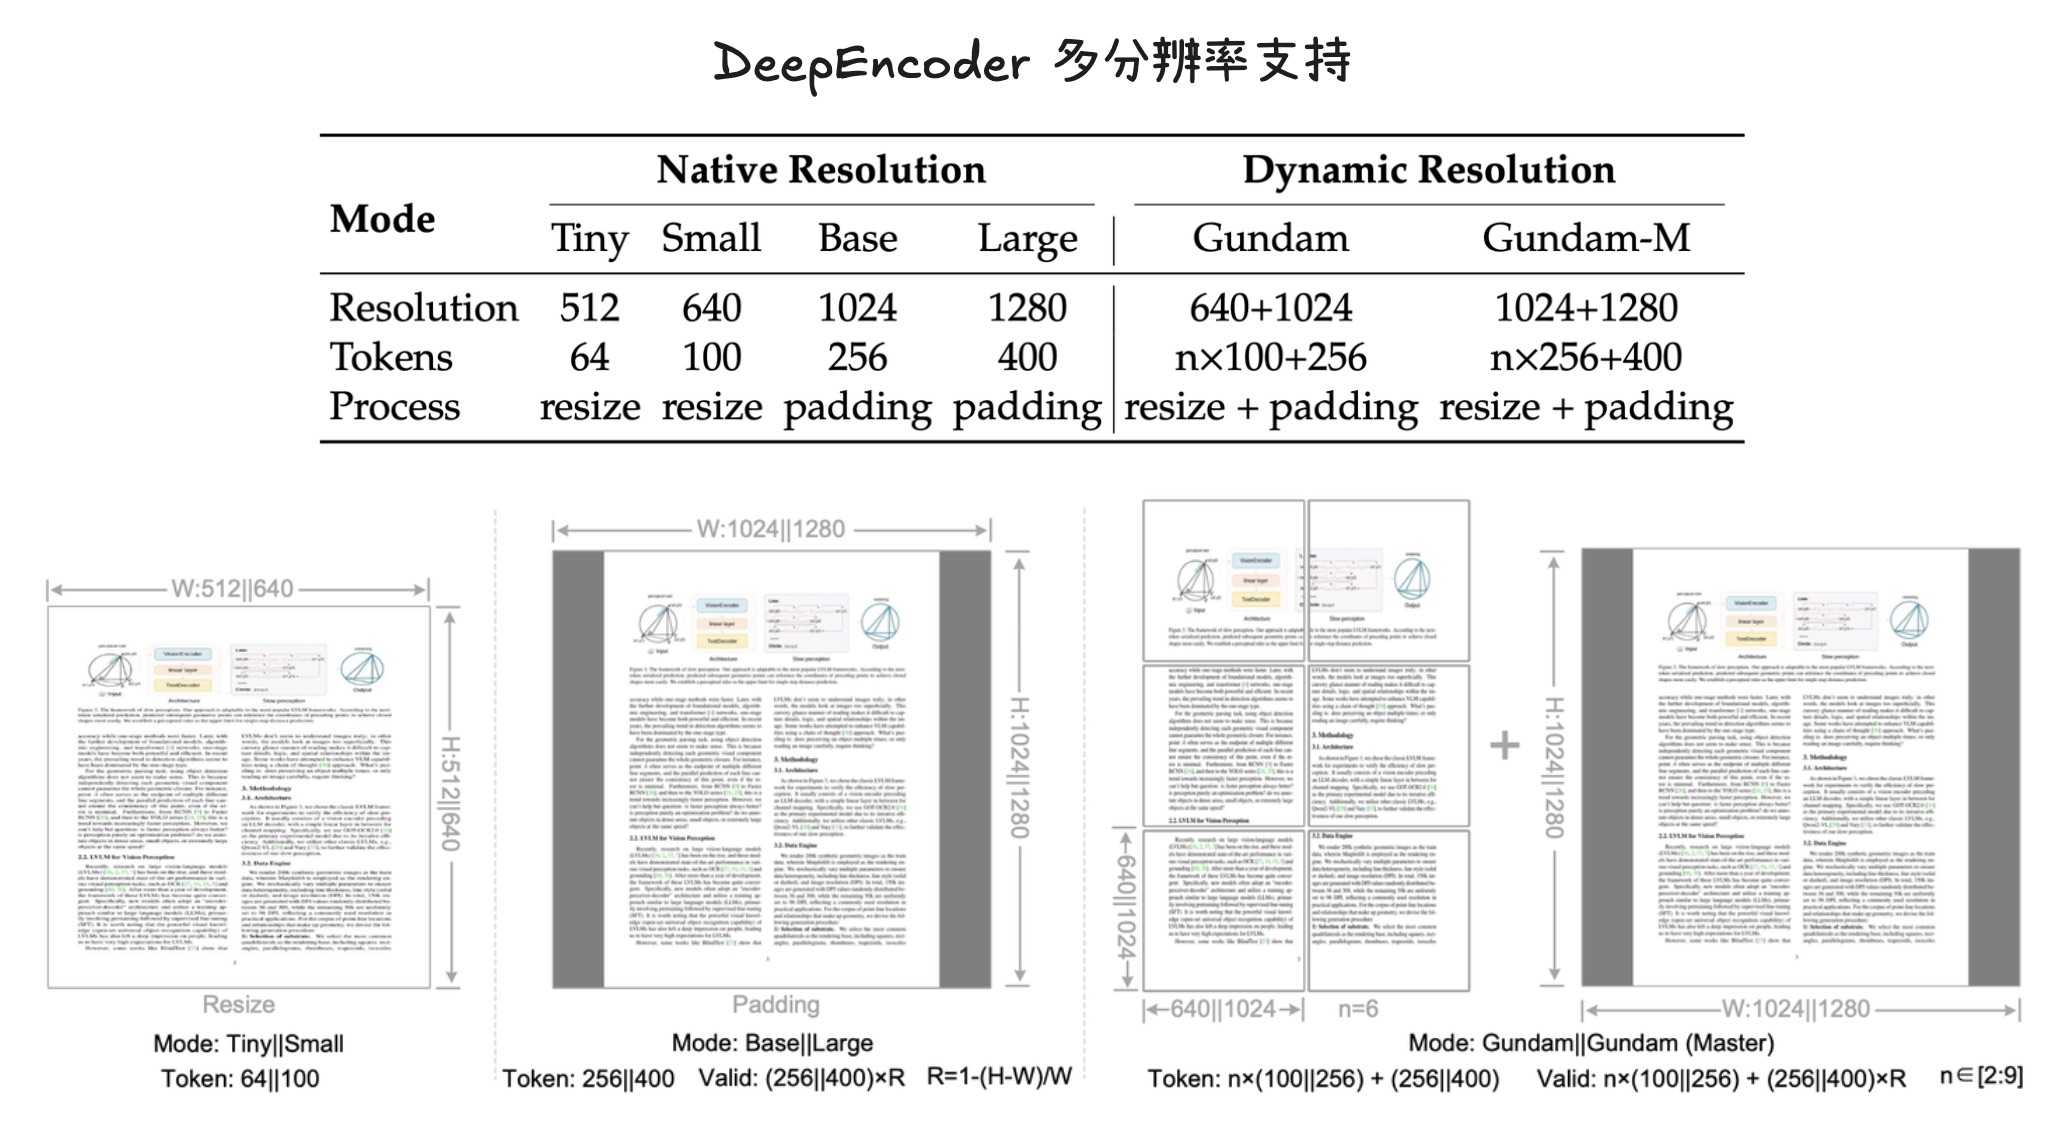
训练数据
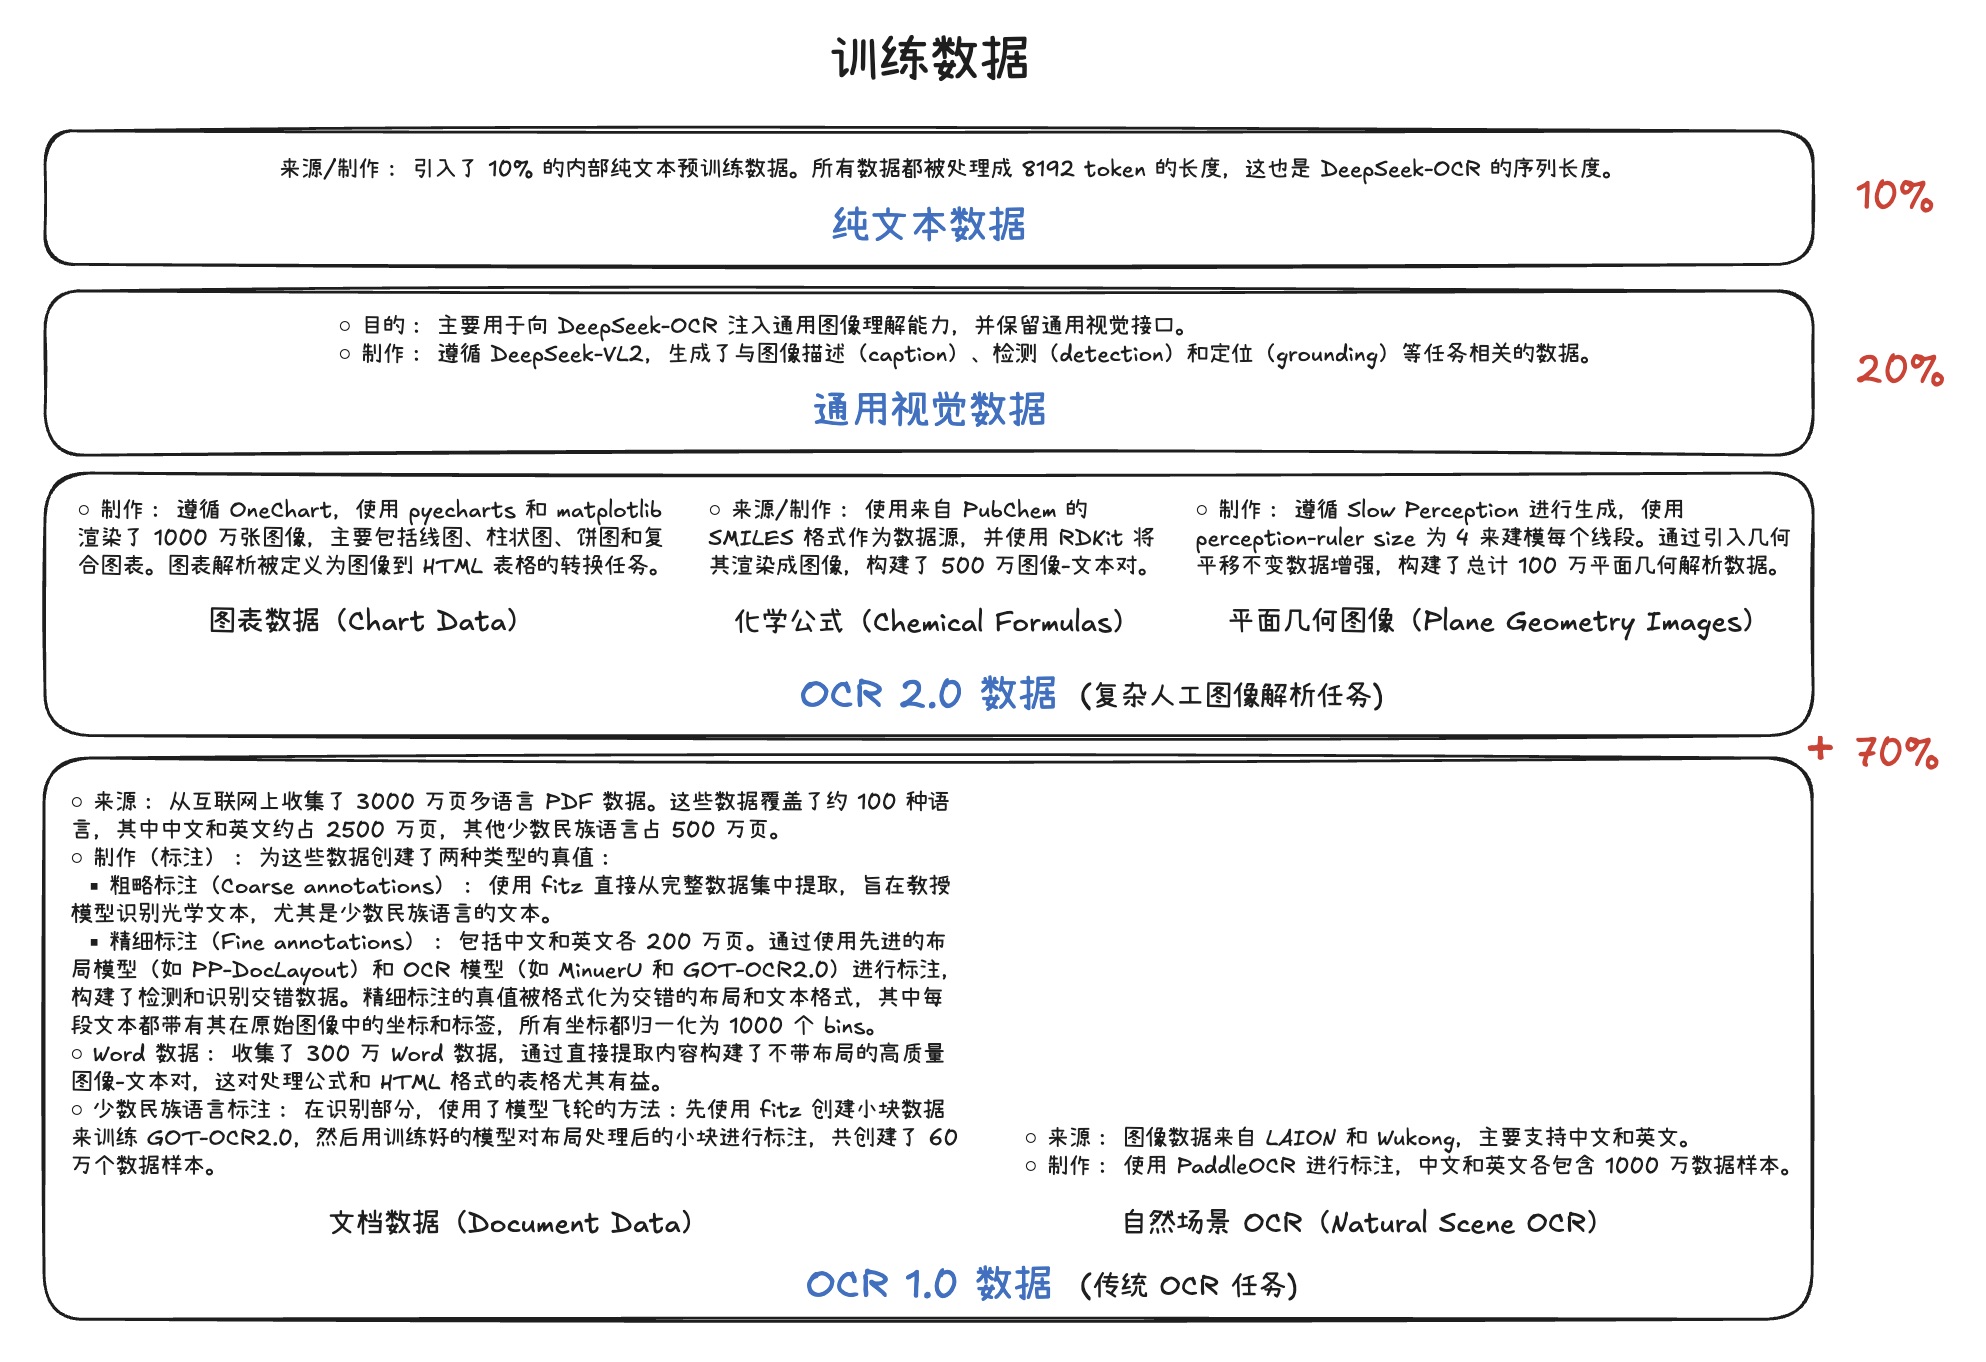
数据组成
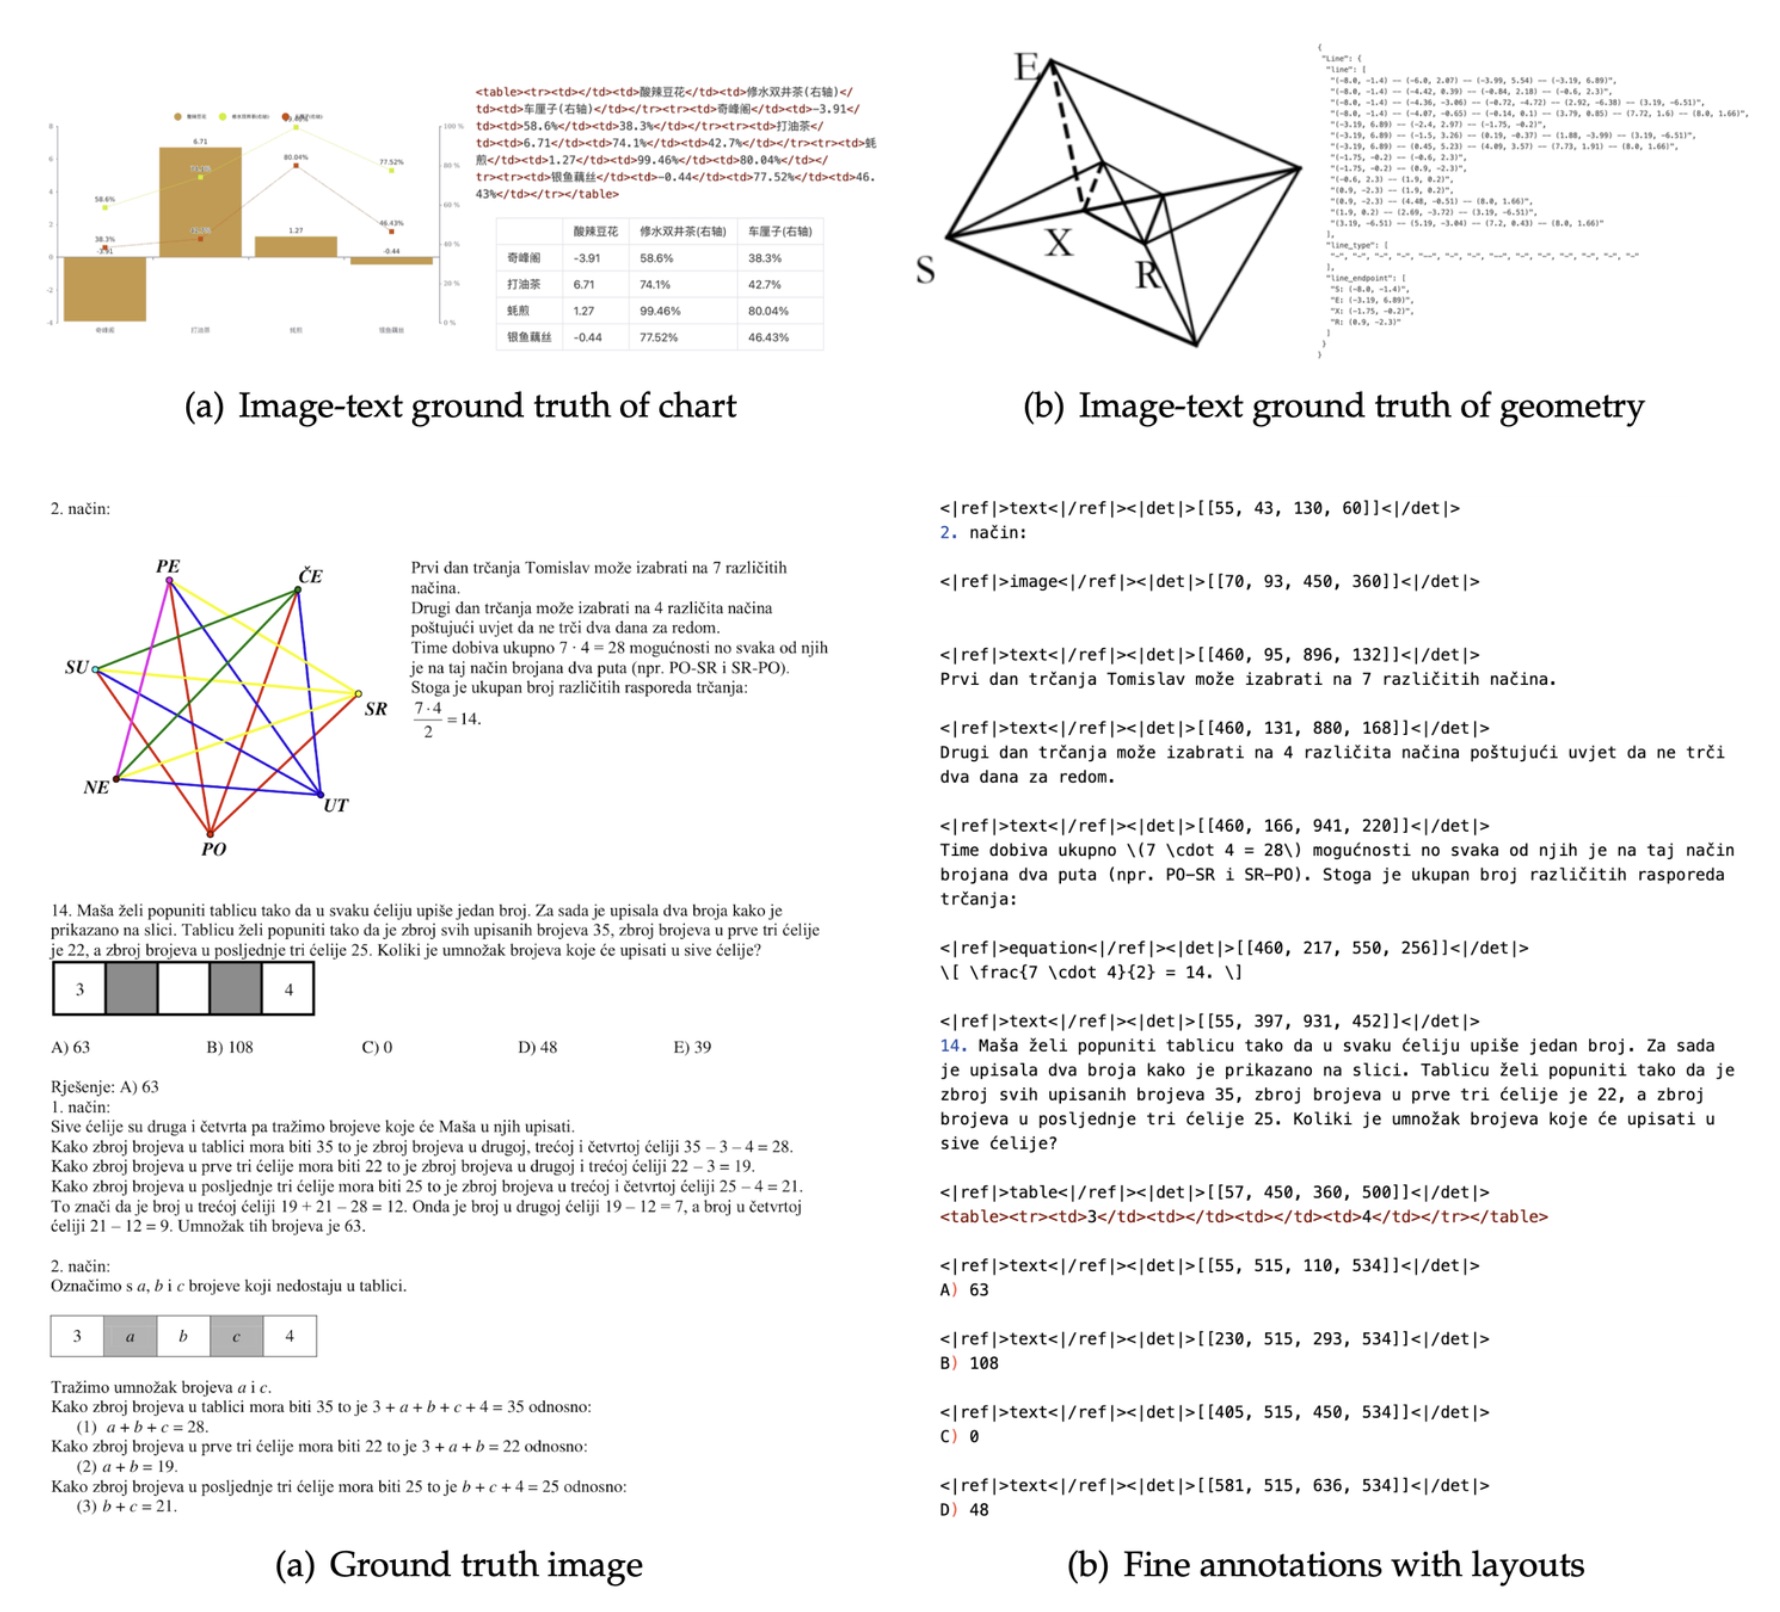
数据标注
训练流程
训练 DeepEncoder
Vary,使用紧凑语言模型和下一词元预测(next token prediction)框架进行训练。OCR 1.0 和 OCR 2.0 数据,以及从 LAION 数据集中采样的 1 亿(100M)通用数据。2 个 epoch,批次大小为 1280,使用 AdamW 优化器,配合余弦退火(cosine annealing)调度器,学习率为 5e-5。训练序列长度为 4096。训练 DeepSeek-OCR
流水线并行(PP),模型被分为 4 部分:SAM 和压缩器(作为视觉词元分析器),参数冻结。CLIP 部分(作为输入嵌入层),权重不冻结,参与训练。640。AdamW 优化器,配合基于步数的调度器(step-based scheduler),初始学习率为 3e-5。Abstract(摘要)
We introduce Qwen2.5-VL, the latest flagship model of Qwen vision-language series, which demonstrates significant advancements in both foundational capabilities and innovative functionalities. Qwen2.5-VL achieves a major leap forward in understanding and interacting with the world through enhanced visual recognition, precise object localization, robust document parsing, and long-video comprehension. A standout feature of Qwen2.5-VL is its ability to localize objects using bounding boxes or points accurately.
GLM-4V-9B
GLM-4V-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源多模态版本。 GLM-4V-9B 具备 1120 * 1120 高分辨率下的中英双语多轮对话能力,在中英文综合能力、感知推理、文字识别、图表理解等多方面多模态评测中均表现优异。
总结
相比 CogVLM2 能力还是不如。
文字识别
识别中文
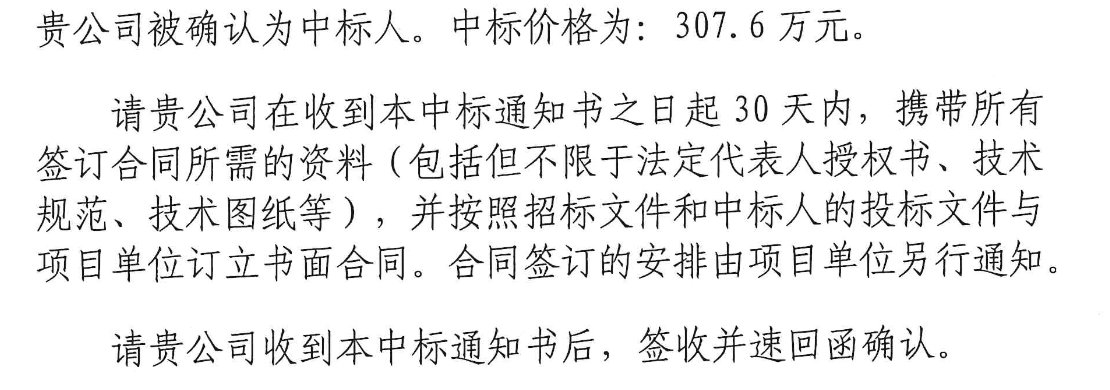
提示词:输出图像中的文字
贵公司被认为中标人。中标价格为:307.6万元。 请贵公司在收到本中标通知书之日起30天内,携带所有签订合同所需的资料(包括但不限于法定代表人授权书、技术规范、技术图纸等),并按照招标文件和中标人的投标文件与项目单位订立书面合同。合同签订的安排由项目单位另行通知。 请贵公司收到本中标通知书后,签收并速回函确认。
确() 识别成全角识别手写英文
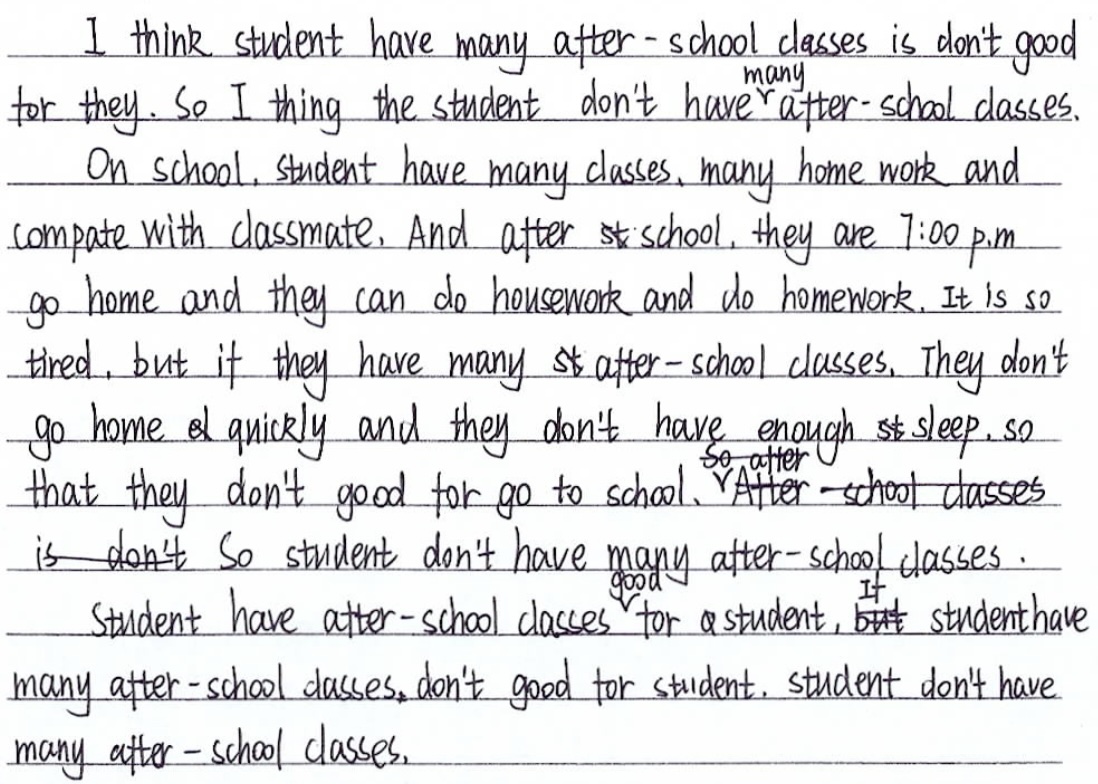
提示词:识别图像上的手写英文
I think student have many after-school classes is don't good for they. So I thing the student don't have after-school classes.
Phi-3 Vision 是一个轻量级、最先进的开放多模态模型,基于数据集构建,其中包括合成数据和经过过滤的公开网站,重点关注文本和视觉方面的高质量推理密集数据。该模型属于 Phi-3 模型系列,多模式版本可支持 128K 上下文长度(以 Token 为单位)。该模型经历了严格的增强过程,结合了监督微调和直接偏好优化,以确保精确的指令遵守和稳健的安全措施。
模型参数 4B。
预期用途
主要用例
该模型旨在广泛用于英语商业和研究用途。该模型为通用人工智能系统和应用程序提供了视觉和文本输入功能,这些系统和应用程序需要
我们的模型旨在加速对高效语言和多模态模型的研究,作为生成人工智能驱动功能的构建块。
用例注意事项
我们的模型并非针对所有下游目的而专门设计或评估。开发人员在选择用例时应考虑语言模型的常见限制,并在特定下游用例中使用之前评估和减轻准确性、安全性和公平性,特别是对于高风险场景。开发人员应了解并遵守与其用例相关的适用法律或法规(包括隐私、贸易合规法等)。
手写文字识别
提示词:对图像文字进行识别
这段文字是一个人的自己写作,表达了对学生在学校和家庭生活中的看法。
提示词:这张图片上写了什么?
MiniCPM-Llama3-V 2.5 是 MiniCPM-V 系列的最新版本模型,基于 SigLip-400M 和 Llama3-8B-Instruct 构建,共 8B 参数量,相较于 MiniCPM-V 2.0 性能取得较大幅度提升。MiniCPM-Llama3-V 2.5 值得关注的特点包括:
TextVQA, DocVQA。您可以在下表中看到 CogVLM2 系列开源模型的详细信息:
| 模型名称 | cogvlm2-llama3-chat-19B | cogvlm2-llama3-chinese-chat-19B |
|---|---|---|
| 基座模型 | Meta-Llama-3-8B-Instruct | Meta-Llama-3-8B-Instruct |
| 语言 | 英文 | 中文、英文 |
| 模型大小 | 19B | 19B |
| 任务 | 图像理解,对话模型 | 图像理解,对话模型 |
| 模型链接 | 🤗 Huggingface 🤖 ModelScope 💫 Wise Model | 🤗 Huggingface 🤖 ModelScope 💫 Wise Model |
| 体验链接 | 📙 Official Page | 📙 Official Page 🤖 ModelScope |
| Int4模型 | 暂未推出 | 暂未推出 |
| 文本长度 | 8K | 8K |
| 图片分辨率 | 1344 * 1344 | 1344 * 1344 |
总结 能力非常强大 👍 OCR 已经成为基础能力。包含印刷、手写、中文、英文。 图像描述。 基于图像问答。 信息提取。包含保单、车牌、火车票、手机充值。 表格识别。包含复杂表格。
OCR 引擎
EasyOCR 支持 80+ 语言。
Abaza = 'abq'
Adyghe = 'ady'
Afrikaans = 'af'
Angika = 'ang'
Arabic = 'ar'
Assamese = 'as'
Avar = 'ava'
Azerbaijani = 'az'
Belarusian = 'be'
Bulgarian = 'bg'
Bihari = 'bh'
Bhojpuri = 'bho'
Bengali = 'bn'
Bosnian = 'bs'
Simplified_Chinese = 'ch_sim'
// ...
安装
pip install torch==2.0.1 torchvision==0.15.2 -i https://download.pytorch.org/whl/cpu
pip install easyocr
代码示例 import easyocr languages = ['ch_sim', 'en'] model = easyocr.
安装
pip install paddleocr
测试
import cv2
import numpy as np

from paddleocr import PaddleOCR


ocr = PaddleOCR(use_angle_cls=True)
image_path = 'test.jpg'
img = cv2.imread(image_path)

img_gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
img_gray1 = img_gray[:,:, np.newaxis]
img_gray3 = np.concatenate([img_gray1, img_gray1, img_gray1], axis=-1)

texts = ocr.ocr(img_gray3)
for text in texts:
    """
    box   坐标1         坐标2
          坐标4         坐标3
    """
    box = text[0]
    t = text[1][0]
    score = text[1][1]
可视化(图像上画出文本和得分) import os import shutil import cv2 import numpy as np import uuid from PIL import ImageFo
没有找到匹配的文章