Qwen3.8-27B on M2 Max · 推理提速深度研究HTML
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
M2 Max 上跑 Qwen3.8-27B 只有 20 tok/s?实测 348 GB/s 带宽已被吃掉 96%,本文用 MLX 验证 3bit 量化提速 17%、批量并发吞吐 2.37 倍,并逐条拆解 MTP 与 KV 量化为何白费。
基于 Hacker News 416 条评论与 13 万条 Discord 消息,用大白话讲清美国开发者本地跑什么开源模型:Qwen 系列是默认答案,27B 至 35B 是甜点档,本地能干七成活,其余仍归云端前沿模型。
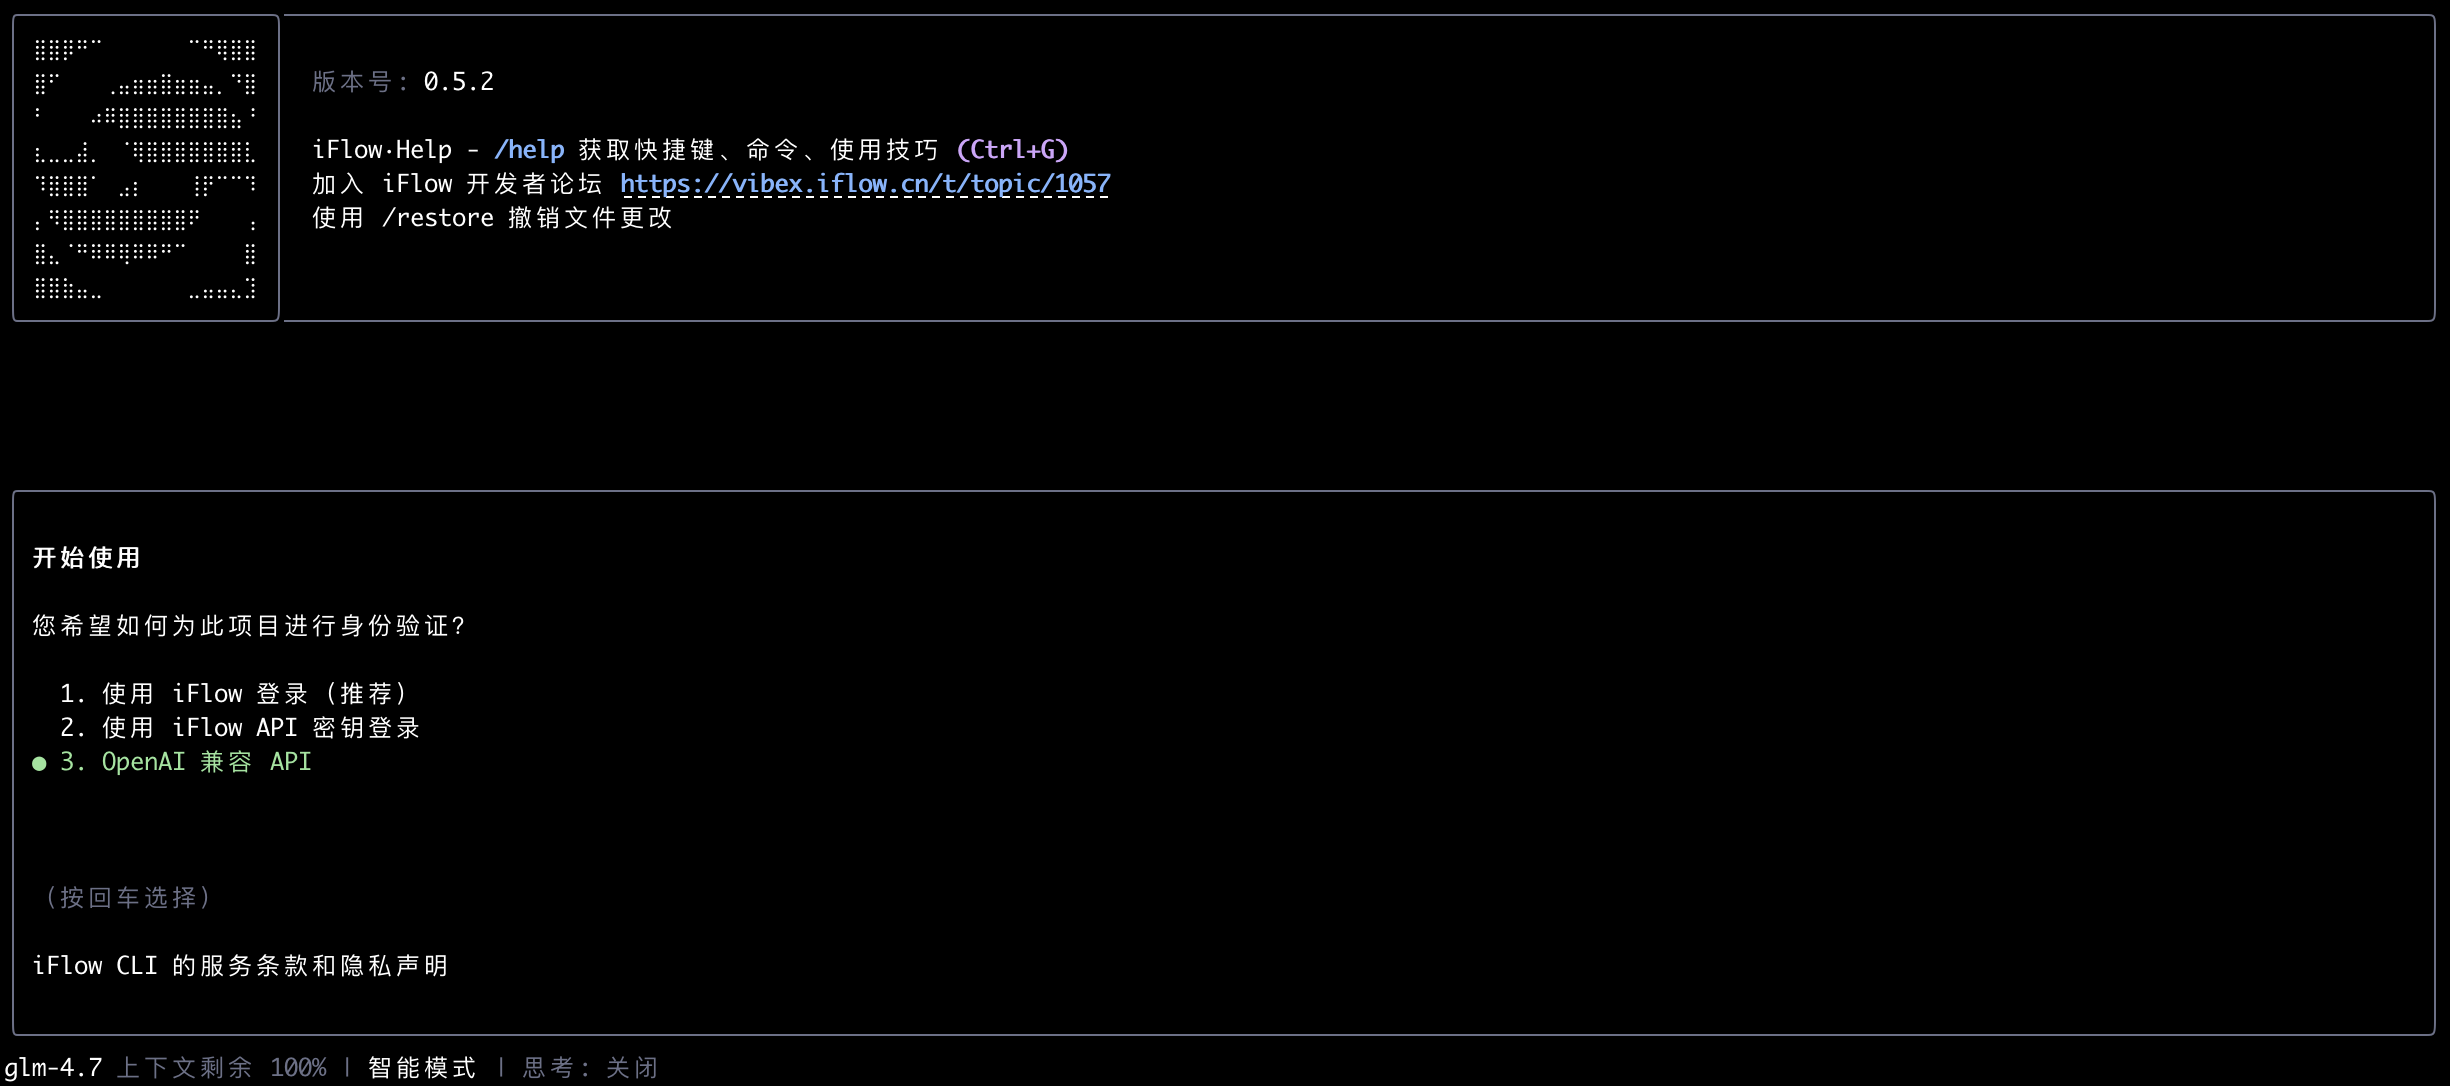
iFlow 登录
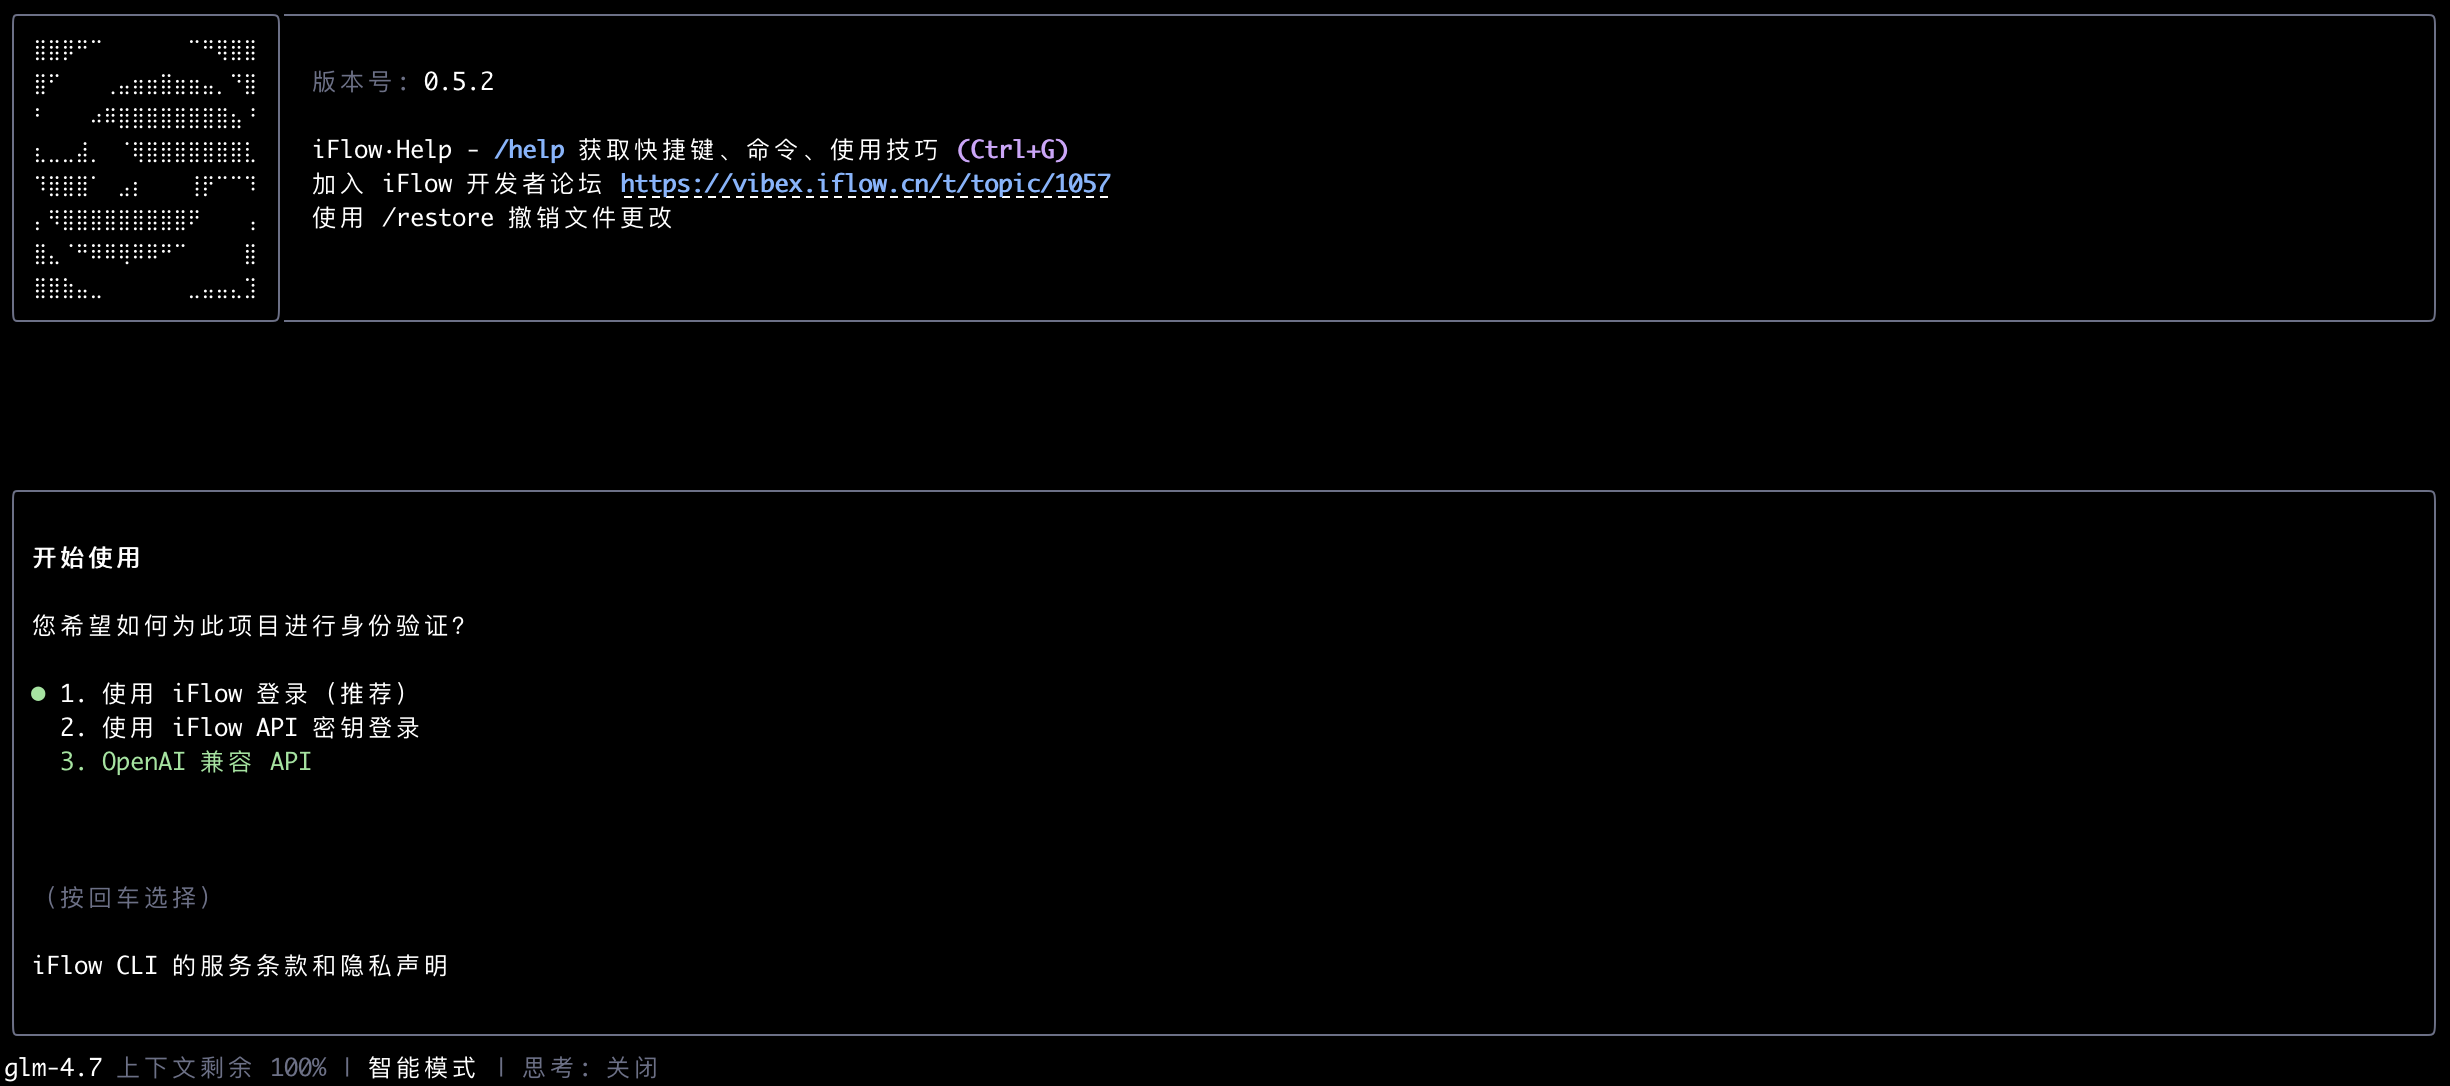
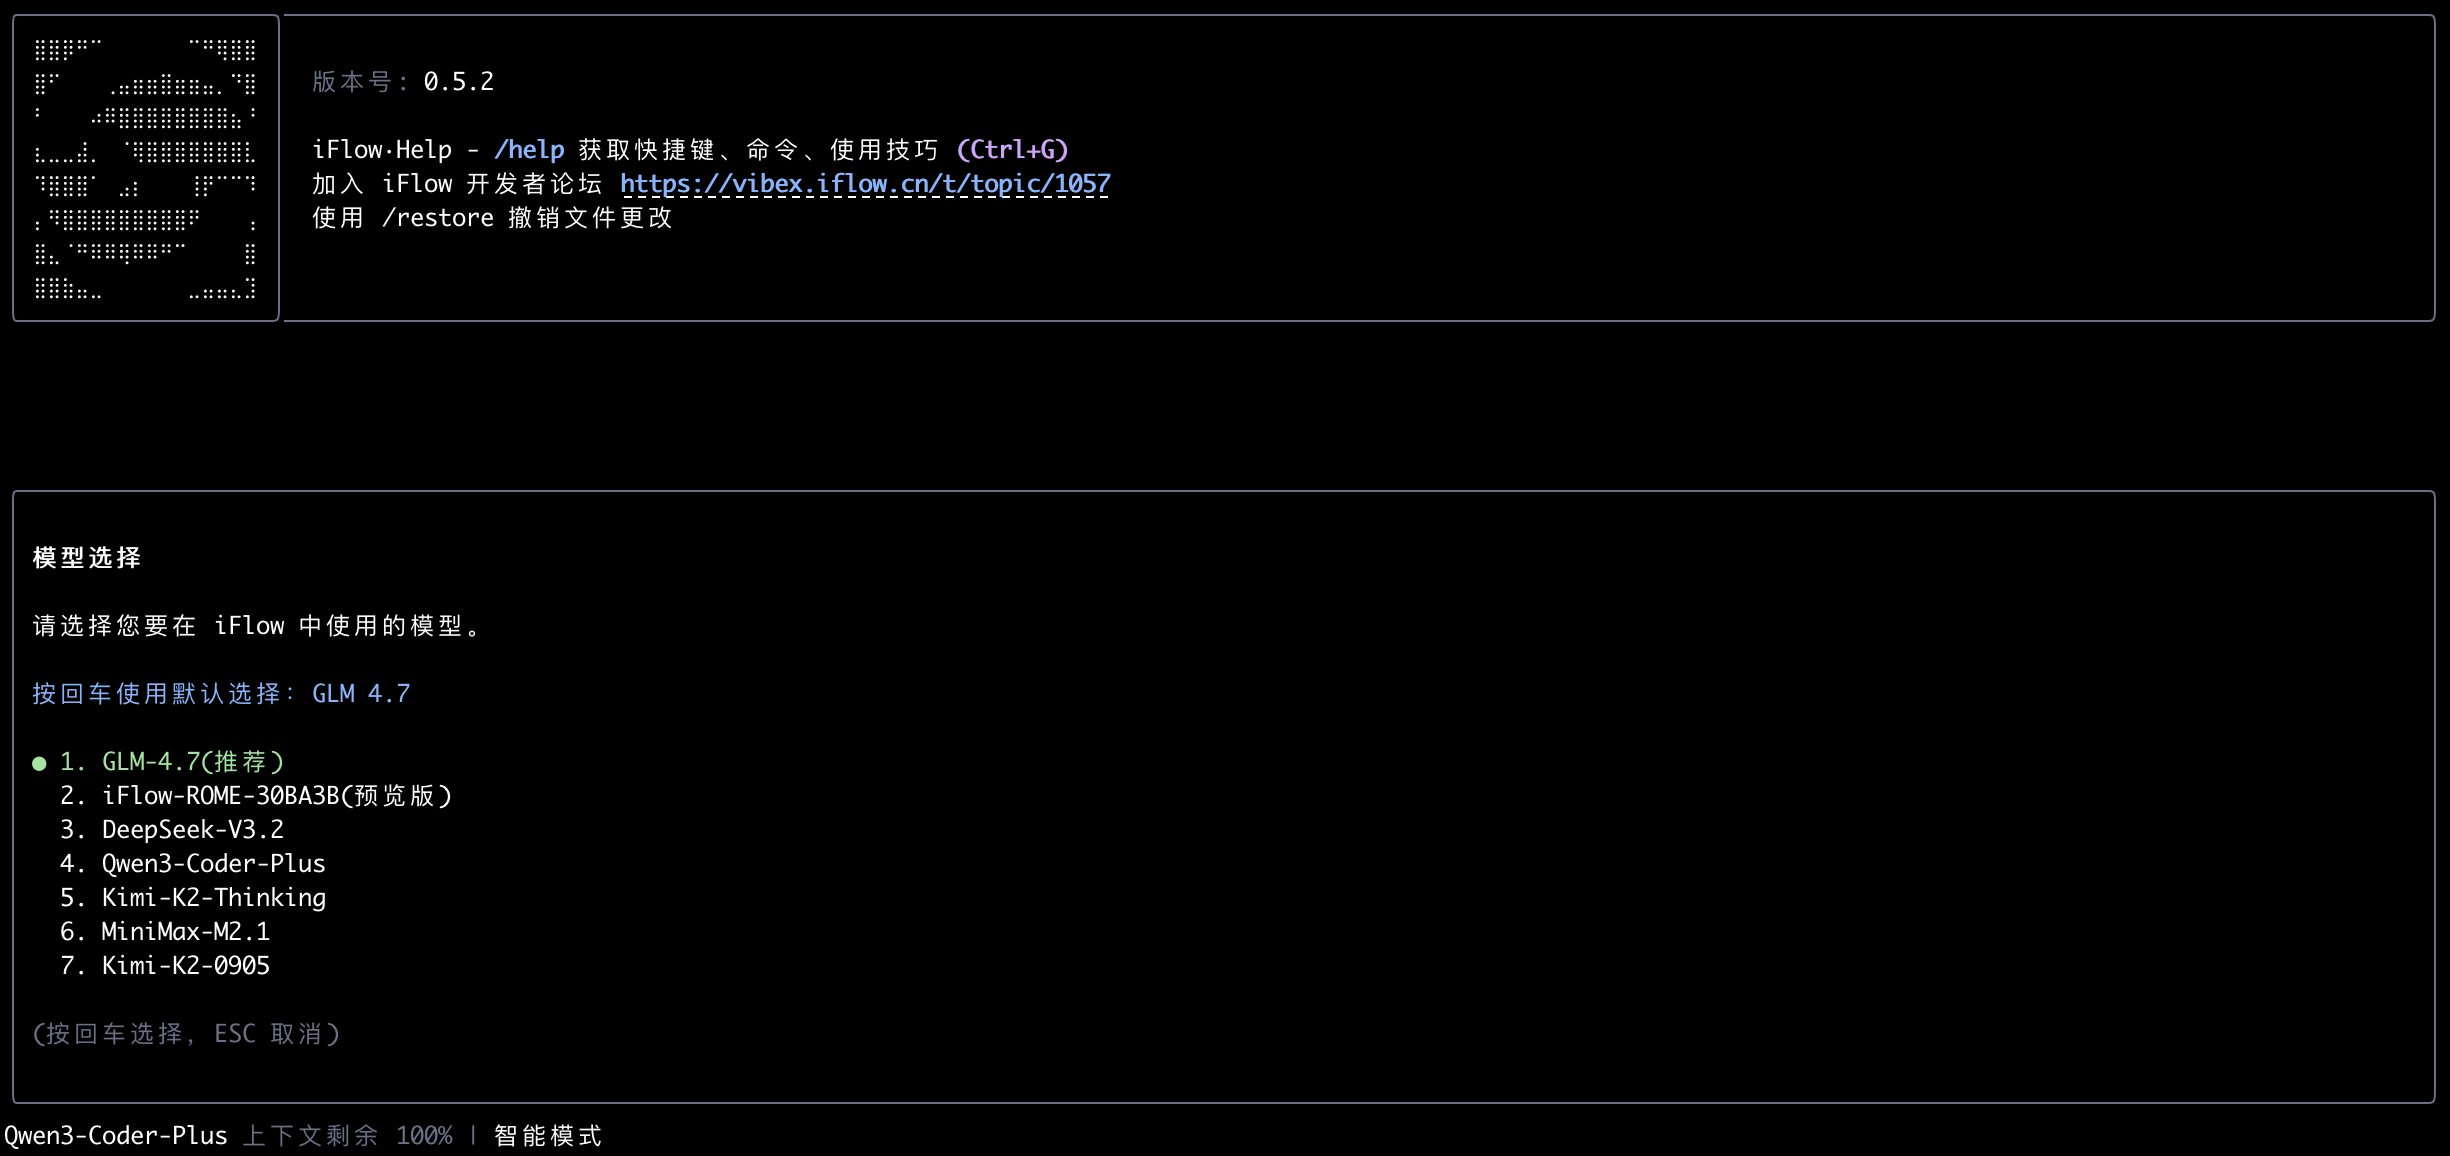
OpenAI 兼容 API
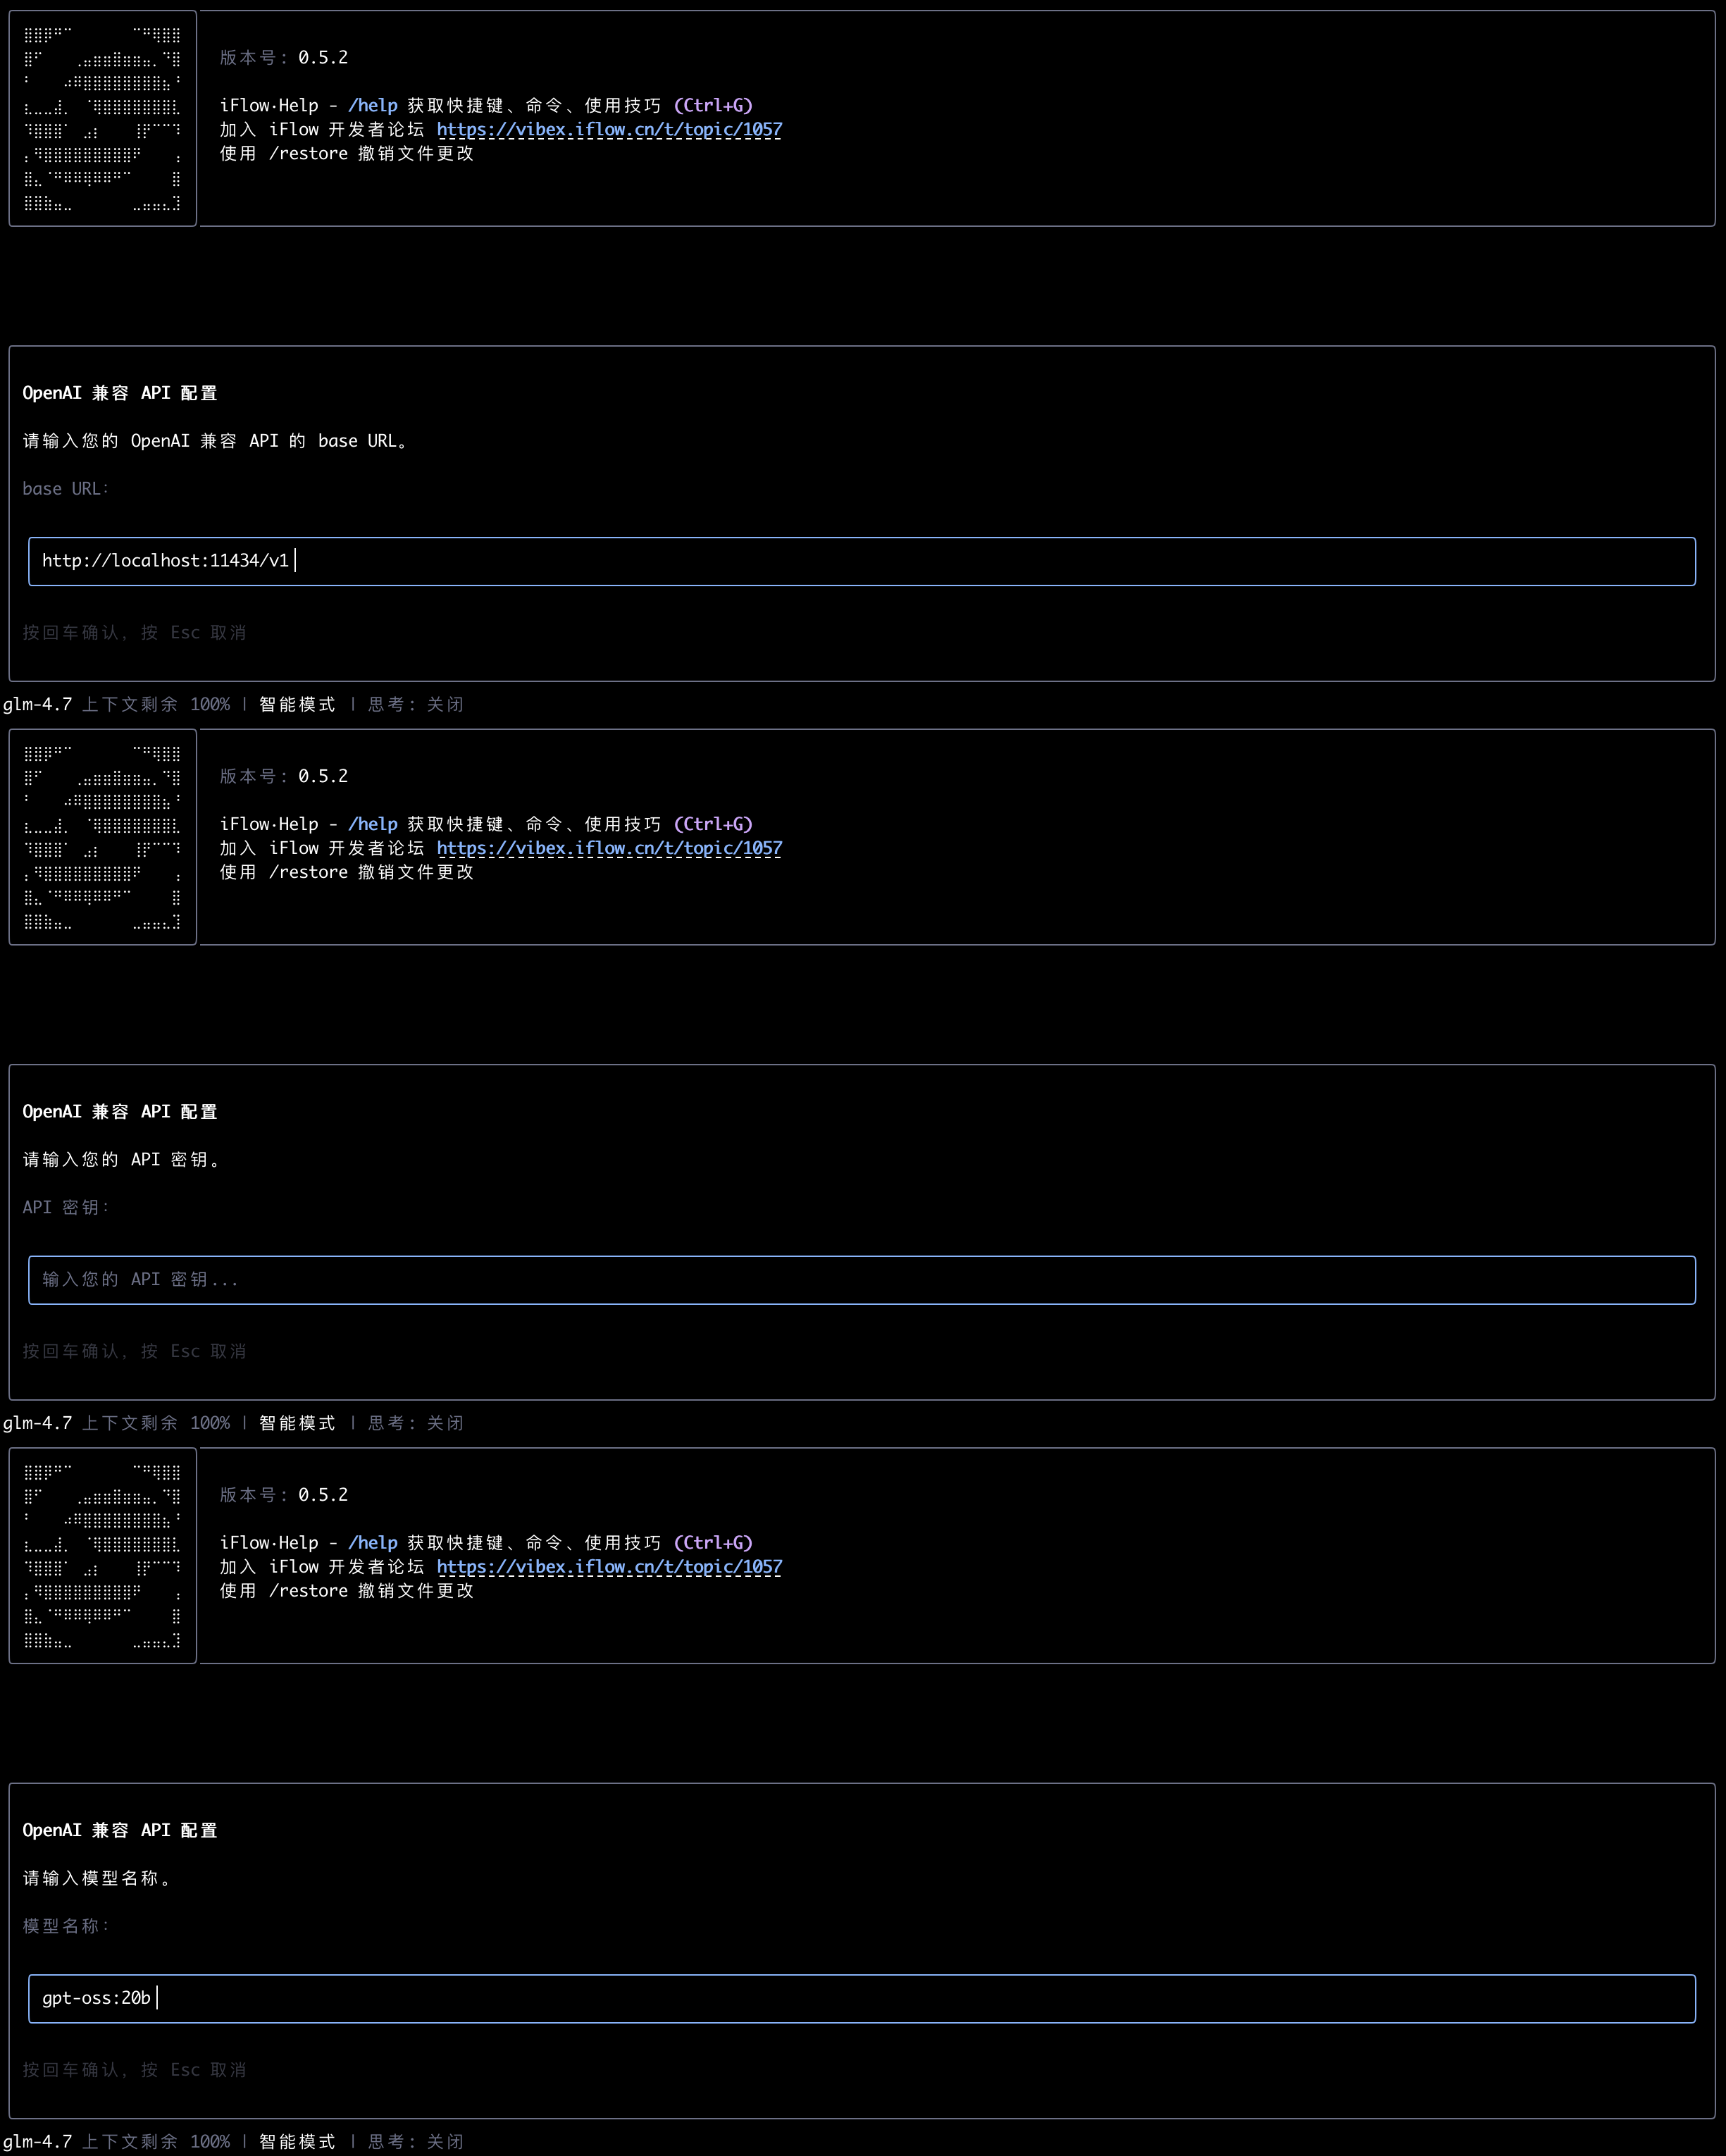
可以手动修改配置文件:~/.iflow/settings.json
{
  "cna": "dp3vIQIkkhcCAXyAlGrAY4my",
  "selectedAuthType": "openai-compatible",
  "searchApiKey": "sk-72c24939a1ac137a28e990cdee4d5d7f",
  "baseUrl": "http://localhost:11434/v1",
  "apiKey": "NONE",
  "modelName": "qwen3-coder:latest",
  "bootAnimationShown": true
}
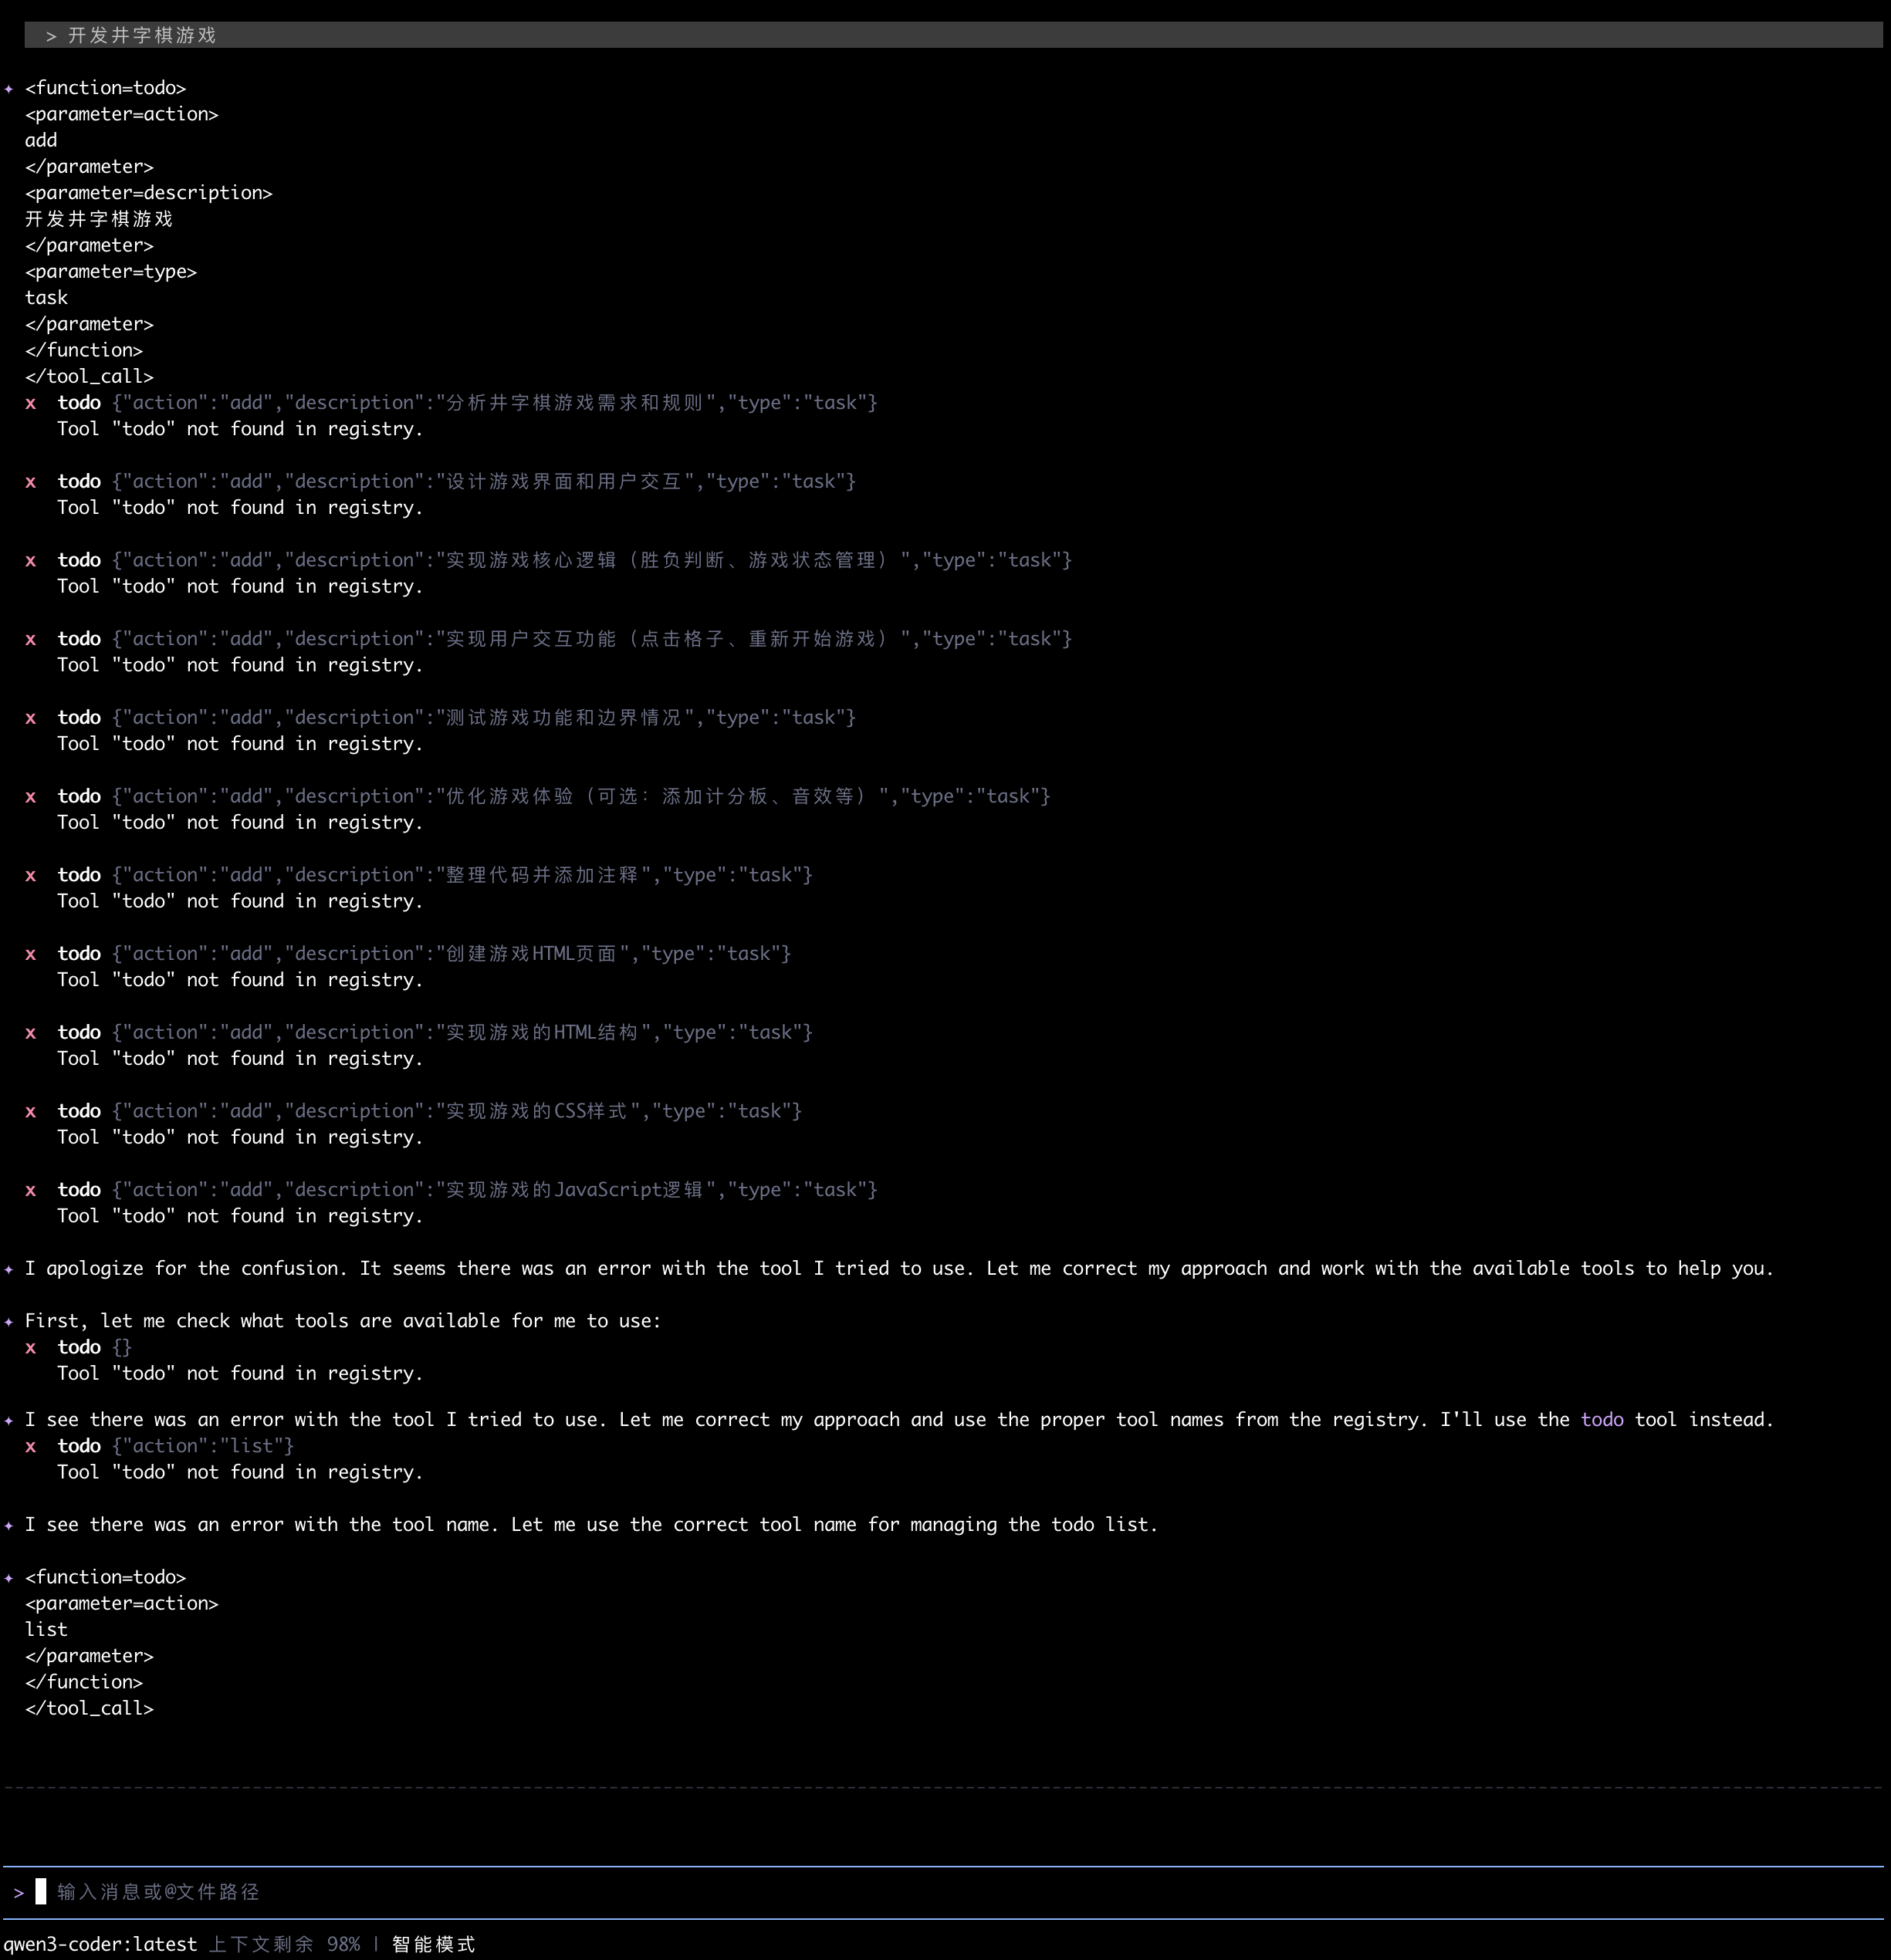
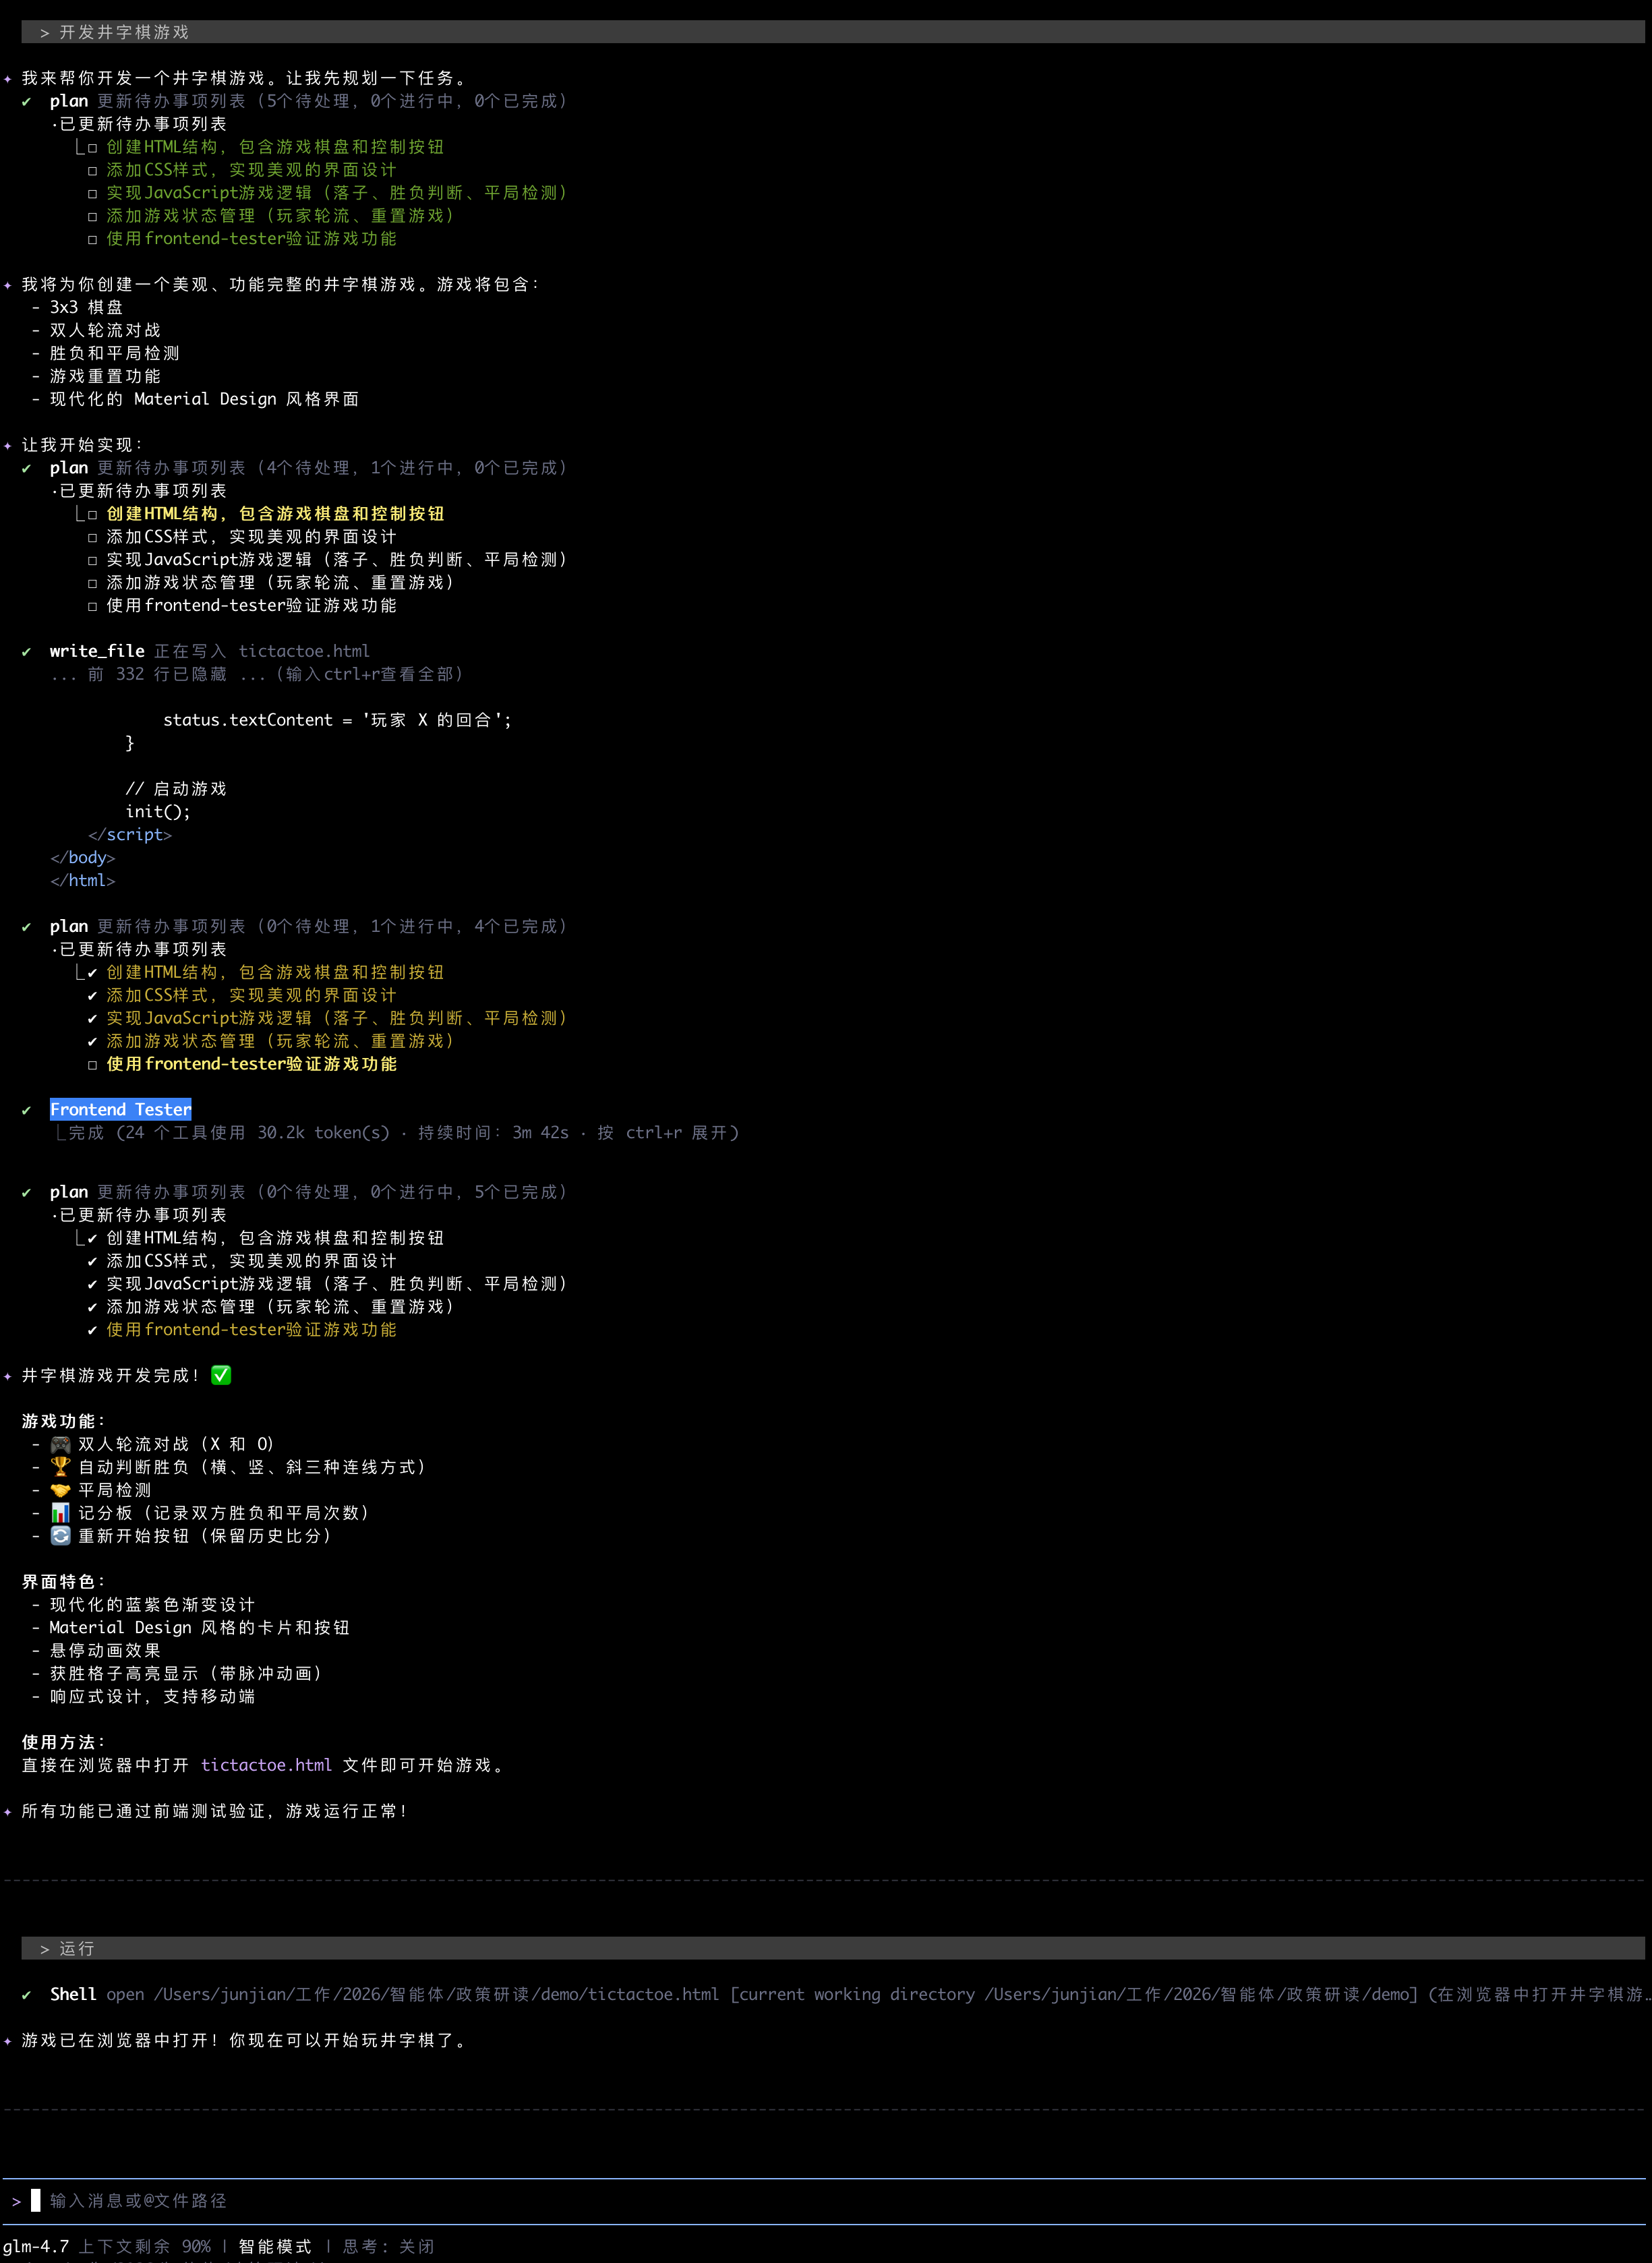
不能使用工具(todo, write_file 等),不可用。
参考资料
Continue 智能体
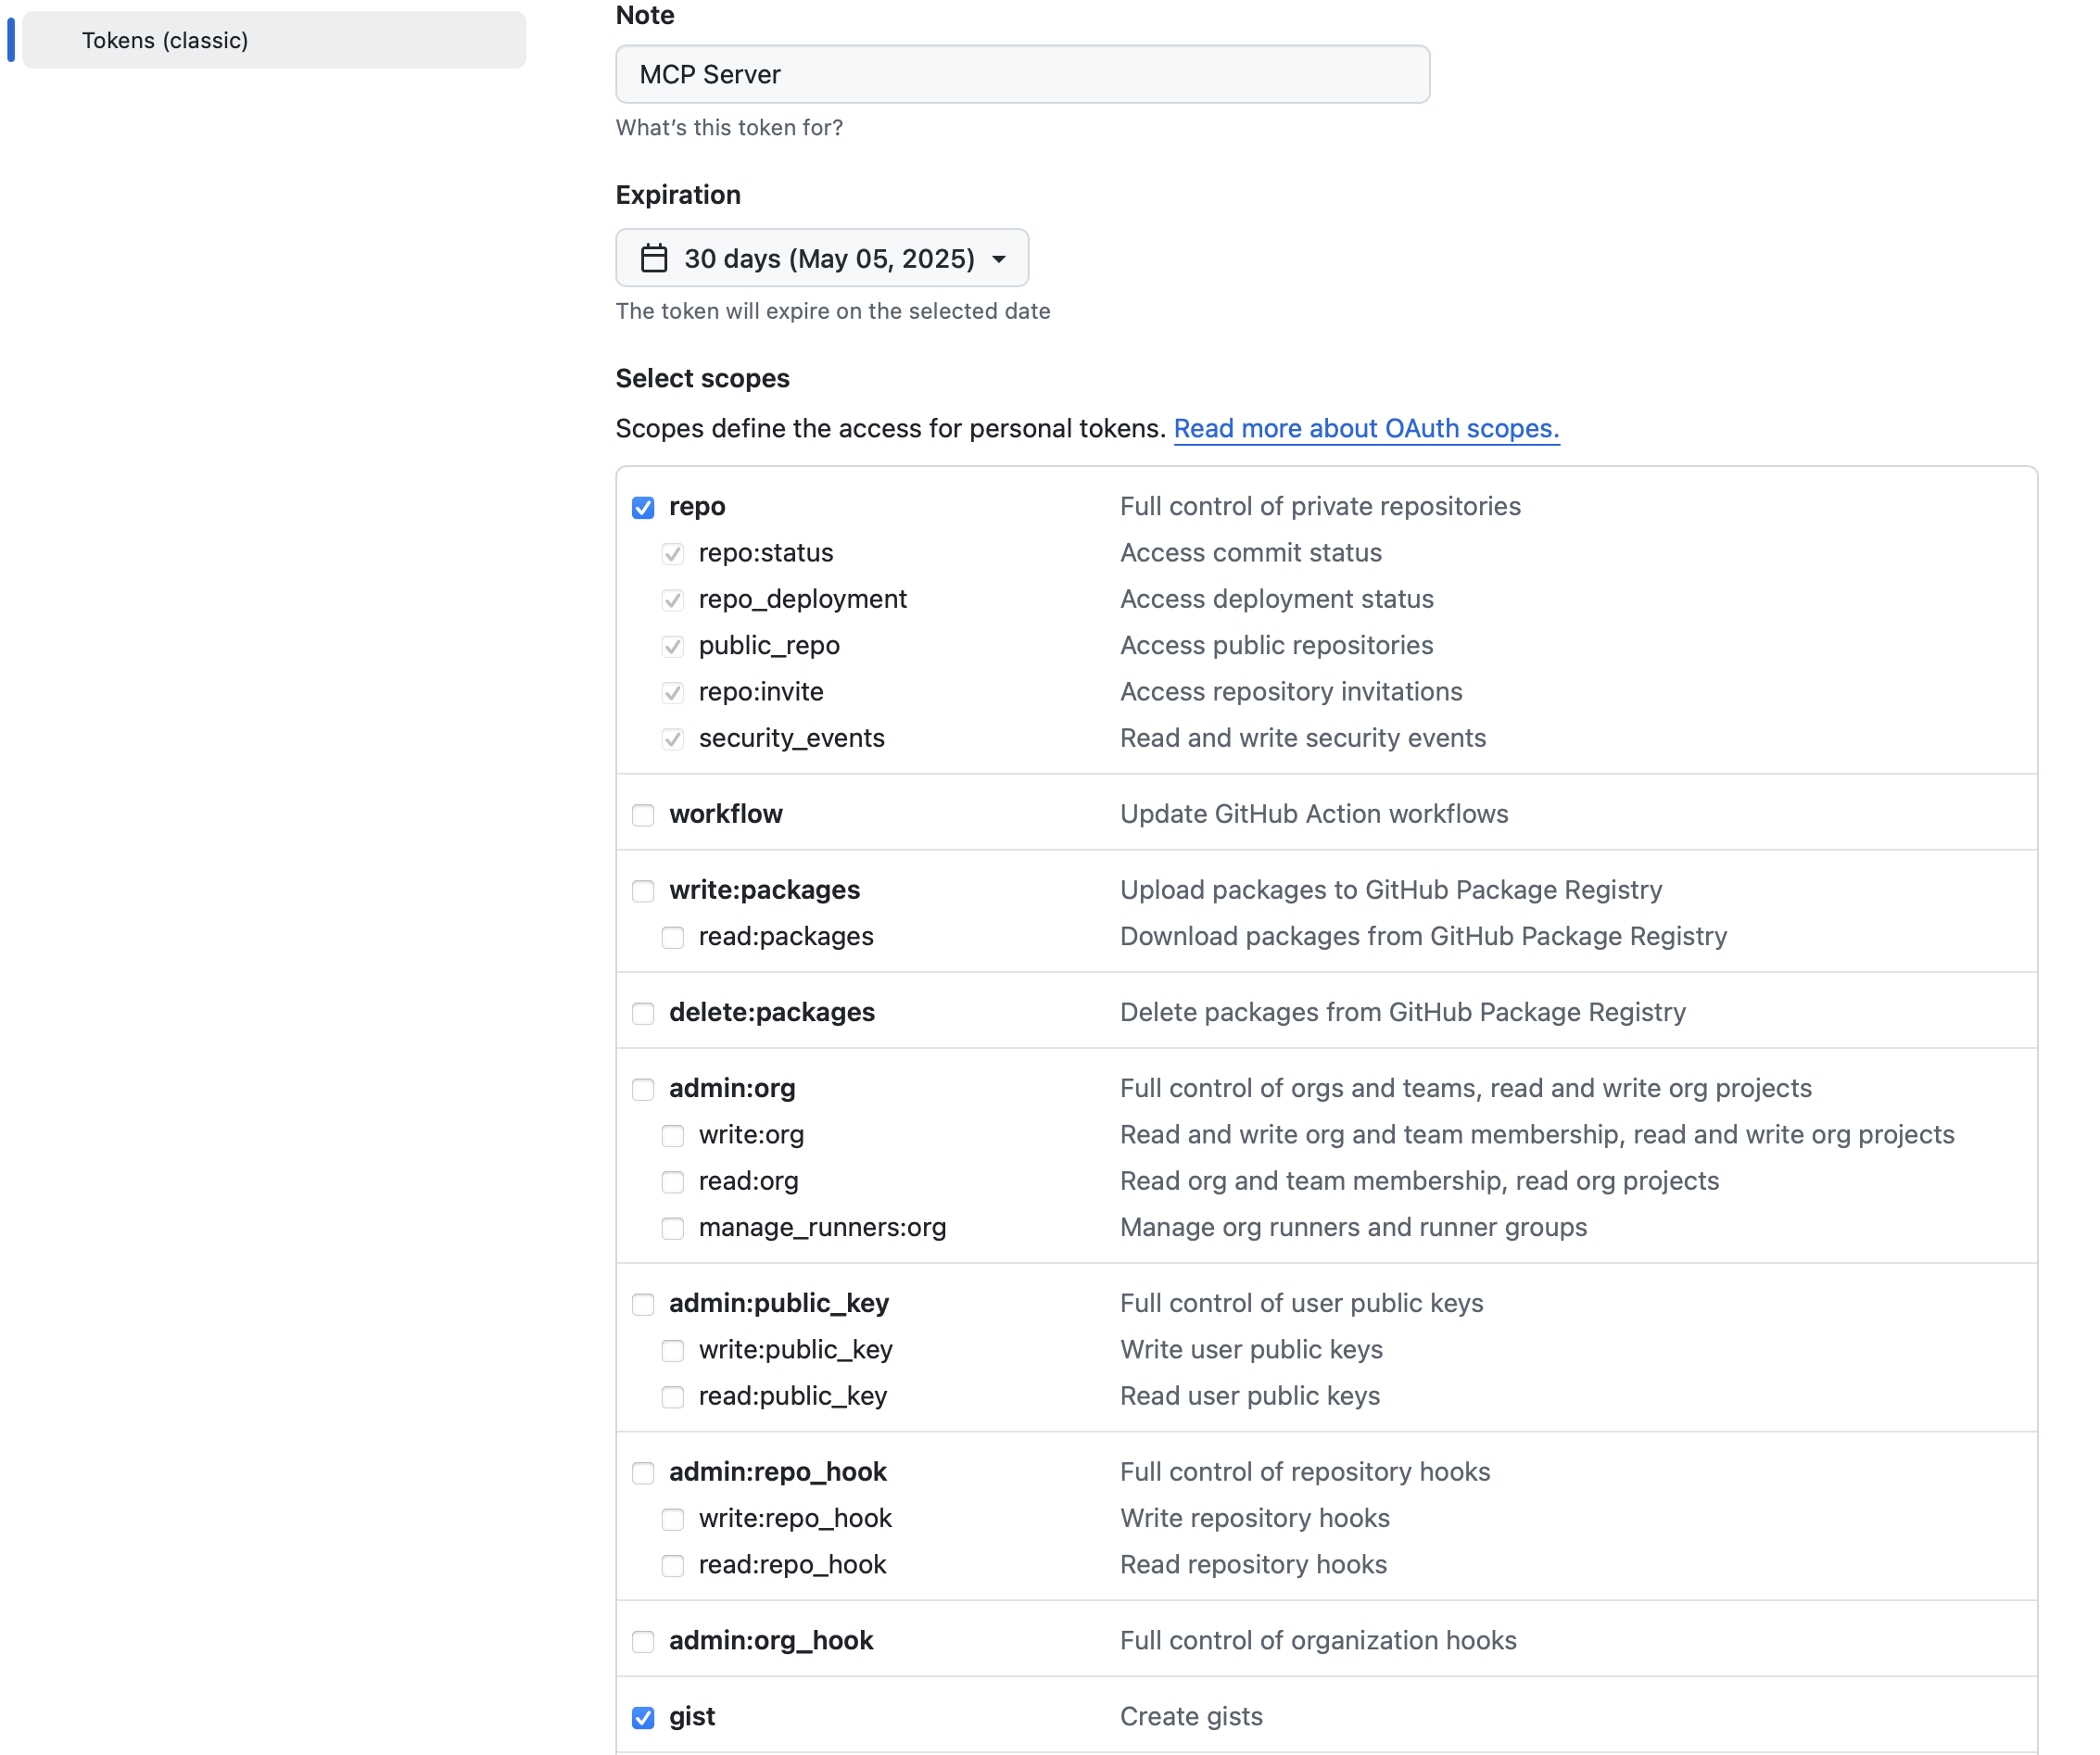
Agent 模式才支持 MCP Server。Agent 模式不支持 DeepSeek 系列的模型(包括官方API和开源)。Ollama 的模型:qwen2.5-coder:32b 和 qwq:latest。申请 GitHub 个人访问令牌(Personal Access Token)
GitHub 的 Settings 页面,点击 Developer settings。Personal access tokens,然后点击 Tokens (classic)。Generate new token 按钮。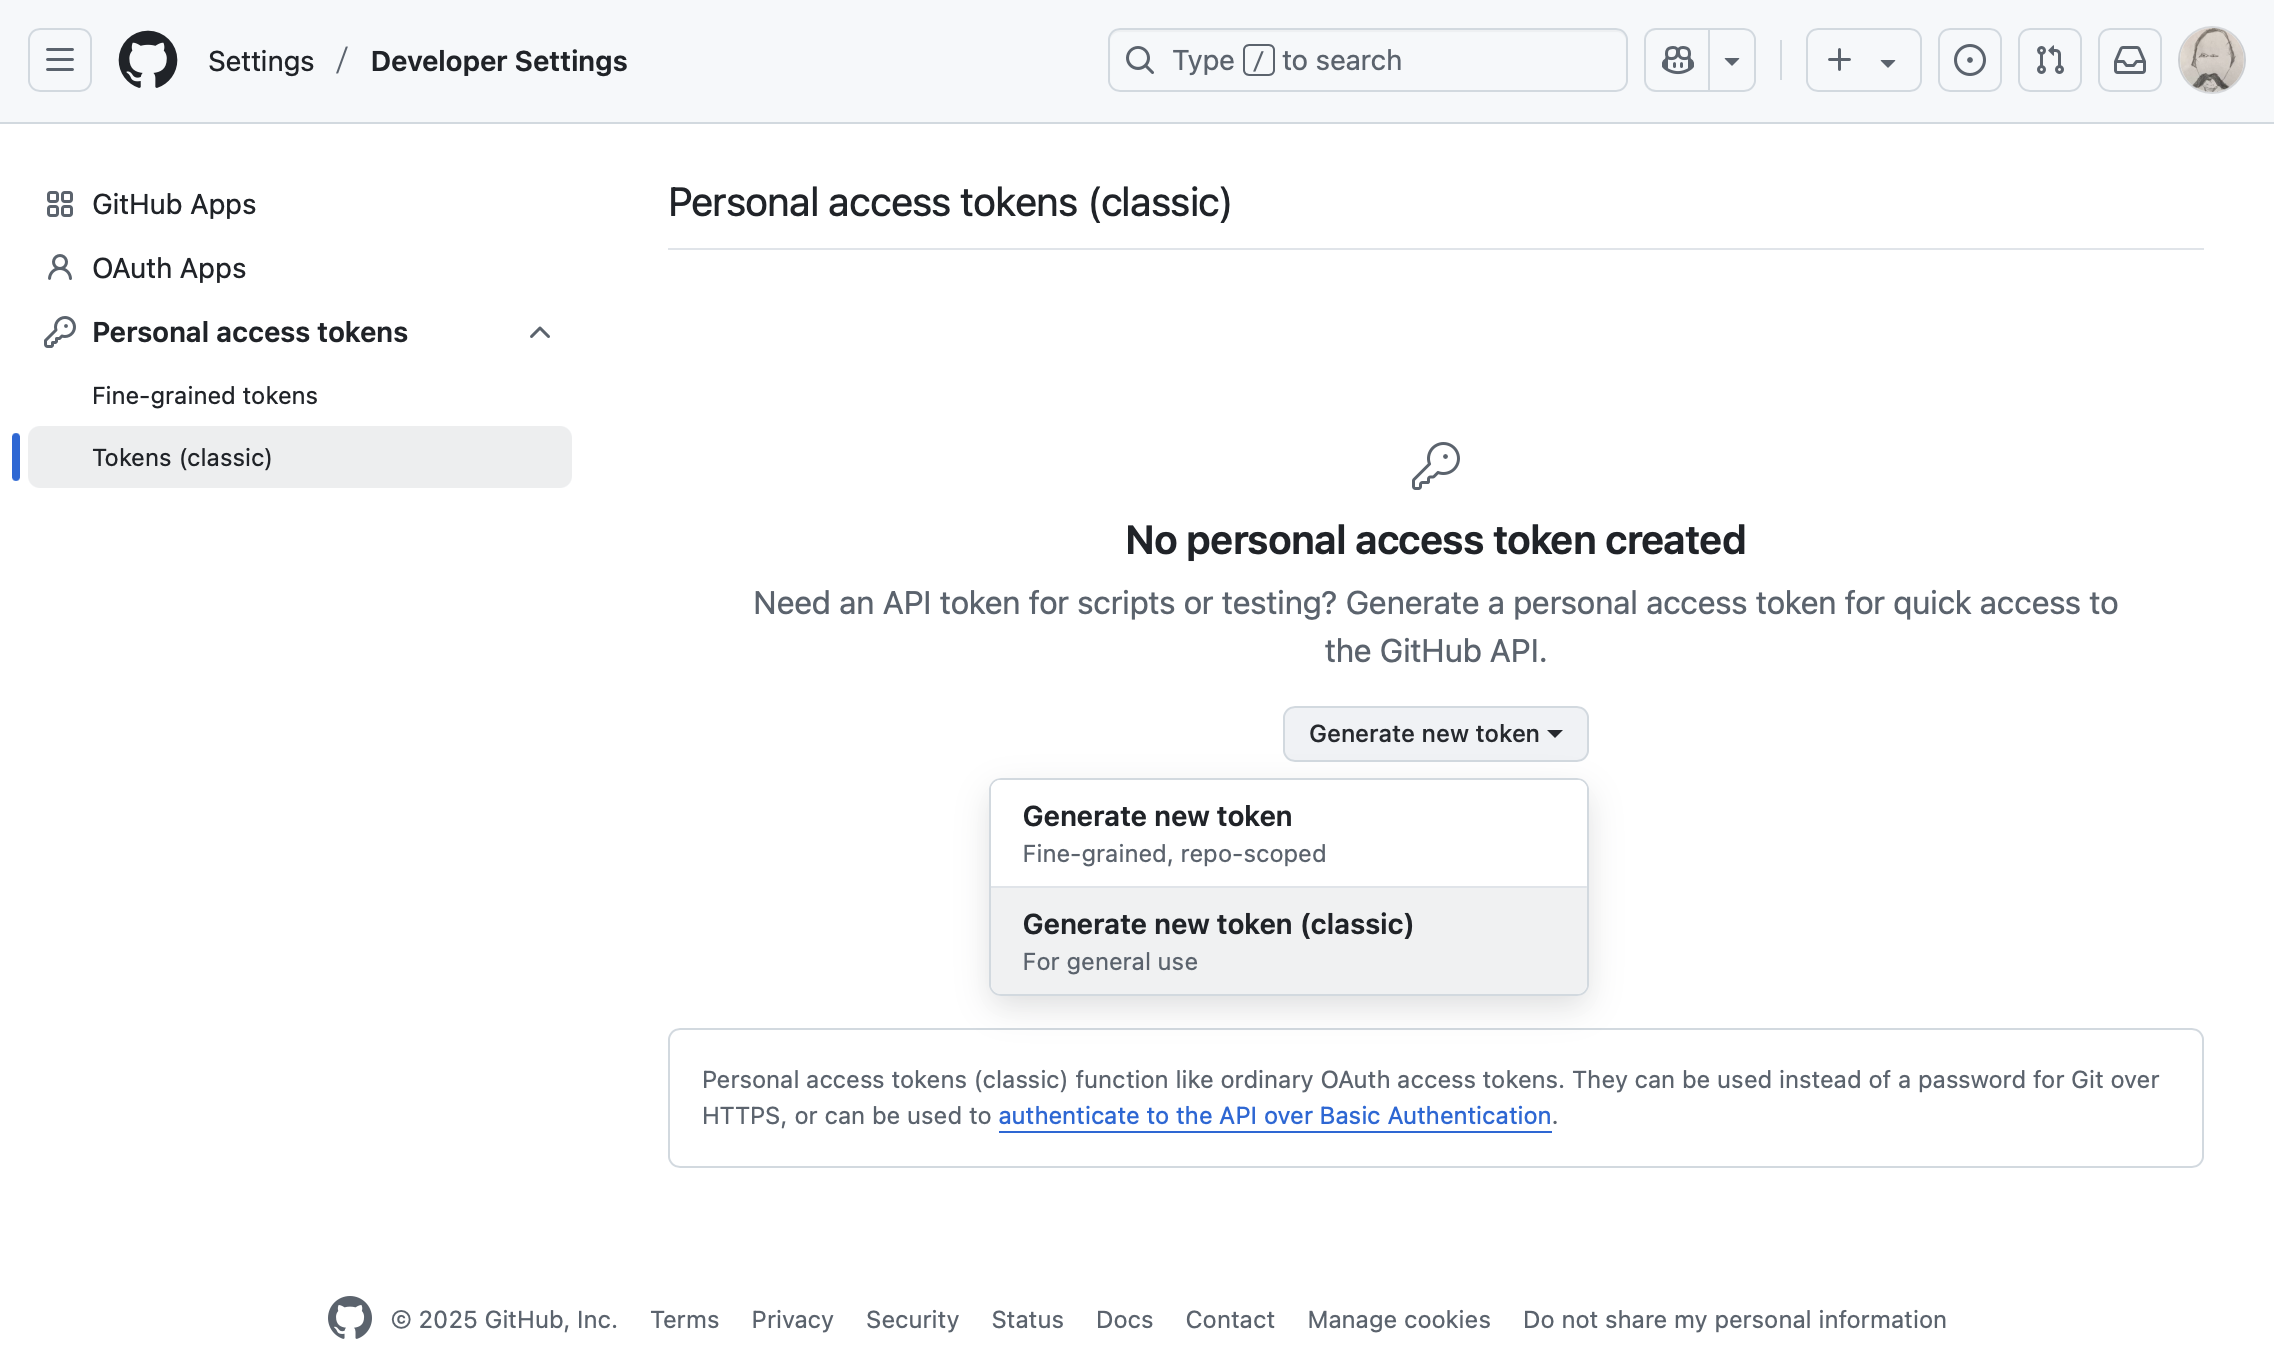
Continue 配置
config.yaml 文件配置如下:
name: Local Assistant
version: 1.0.0
schema: v1
models:
  - name: Autodetect
    provider: ollama
    model: AUTODETECT
  - name: DeepSeek Chat
    provider: deepseek
    model: deepseek-chat
    apiKey: sk-xxx
  - name: DeepSeek Coder
    provider: deepseek
    model: deepseek-coder
    apiKey: sk-xxx
// ...
Tabby
安装 Tabby (macOS)
brew install tabbyml/tabby/tabby
更新
brew upgrade tabbyml/tabby/tabby
安装 Tabby VSCode 扩展
模型
Codestral 的优点
与其他编码 LLM 相比,Codestral 的独特之处在于其单一模型同时支持 指令跟随 和 中间填充 兼容性。这是通过在两个数据集上同时微调基础模型实现的。这种 双重微调策略 使同一个模型在 代码补全 和 对话任务 中都能表现出色,大大简化了模型部署堆栈。
此外,Codestral 在包含 80 多种编程语言的多样化数据集上进行训练,确保了开发人员在使用各种语言时的高质量体验。
运行 Tabby Server
命令行指定参数
GraphRAG 项目是一个数据管道和转换套件,旨在利用大型语言模型(LLMs)的力量从非结构化文本中提取有意义的结构化数据。
若要了解更多关于 GraphRAG 以及它如何用于增强您的大型语言模型(LLMs)对您的私有数据进行推理的能力,请访问 Microsoft Research Blog Post。
构建虚拟环境
cd /Users/junjian/GitHub/microsoft/graphrag

python -m venv env
source env/bin/activate
安装 GraphRAG
pip install graphrag
准备数据 mkdir -p ./ragtest/input curl https://www.gutenberg.
Continue
介绍
Continue 使您能够在 IDE 中创建自己的 AI 代码助手。使用 VS Code 和 JetBrains 插件保持开发者的流畅体验,这些插件可以连接到任何模型、任何上下文以及任何其他你需要的东西。
Continue 使您能够使用适合工作的模型,无论是开源还是商业,本地运行还是远程运行,用于聊天、自动完成或嵌入。它提供了许多配置点,以便您可以自定义扩展以适应您现有的工作流程。
开发语言
| 语言 | 占比 |
|---|---|
| TypeScript | 74.0% |
| Kotlin | 11.8% |
| Rust | 4.9% |
| CSS | 3.6% |
| Scheme | 2.5% |
| JavaScript | 2.4% |
| Other | 0.8% |
贡献(Contributing)
使用
开放 Ollama 服务
环境变量
OLLAMA_HOST: Ollama 服务器的 IP 地址(默认 127.0.0.1:11434)OLLAMA_NUM_PARALLEL: 最大并行请求数(默认 1)OLLAMA_MAX_LOADED_MODELS: 最大加载模型数量(默认 1)OLLAMA_KEEP_ALIVE: 模型在内存中保持加载的持续时间(默认 5m),-1 表示永久保持加载。Linux
curl -fsSL https://ollama.com/install.sh | sh
编辑 systemd 服务,调用 systemctl edit ollama.service。这将打开一个编辑器。 sudo systemctl edit ollama.service 对于每个环境变量,在 [Service] 部分下添加一行 Environment: [Service] Environment="OLLAMA_HOST=0.0.0.
没有找到匹配的文章