Open Knowledge Format (OKF) 全面使用指南HTML
全面解读 OKF v0.2 规范:目录树加 Markdown 构建 Agent 可读知识库,覆盖 Bundle 结构、信任与来源字段、Attested Computation、Reference Agent 双 pass 原理与六大使用场景。
全面解读 OKF v0.2 规范:目录树加 Markdown 构建 Agent 可读知识库,覆盖 Bundle 结构、信任与来源字段、Attested Computation、Reference Agent 双 pass 原理与六大使用场景。
一、技术方案
1.1 总体架构
采用 “公众号前端 + 智能客服中台 + 知识库底座” 三层架构:
| 层级 | 功能 | 技术选型建议 |
|---|---|---|
| 接入层 | 公众号对话入口,支持文字、图片、视频等多模态输入 | 微信公众号开发接口 |
| 智能客服中台 | 意图识别、知识检索、问答生成、智能路由(AI/人工分流) | RAG架构 + 大模型API(通义千问/Qwen、文心一言等) |
| 知识库底座 | 产品手册、FAQ、历史工单、维修案例的结构化存储与向量检索 | 向量数据库 + 结构化知识库 |
1.2 核心功能模块
1.3 实施路径(建议分三期)
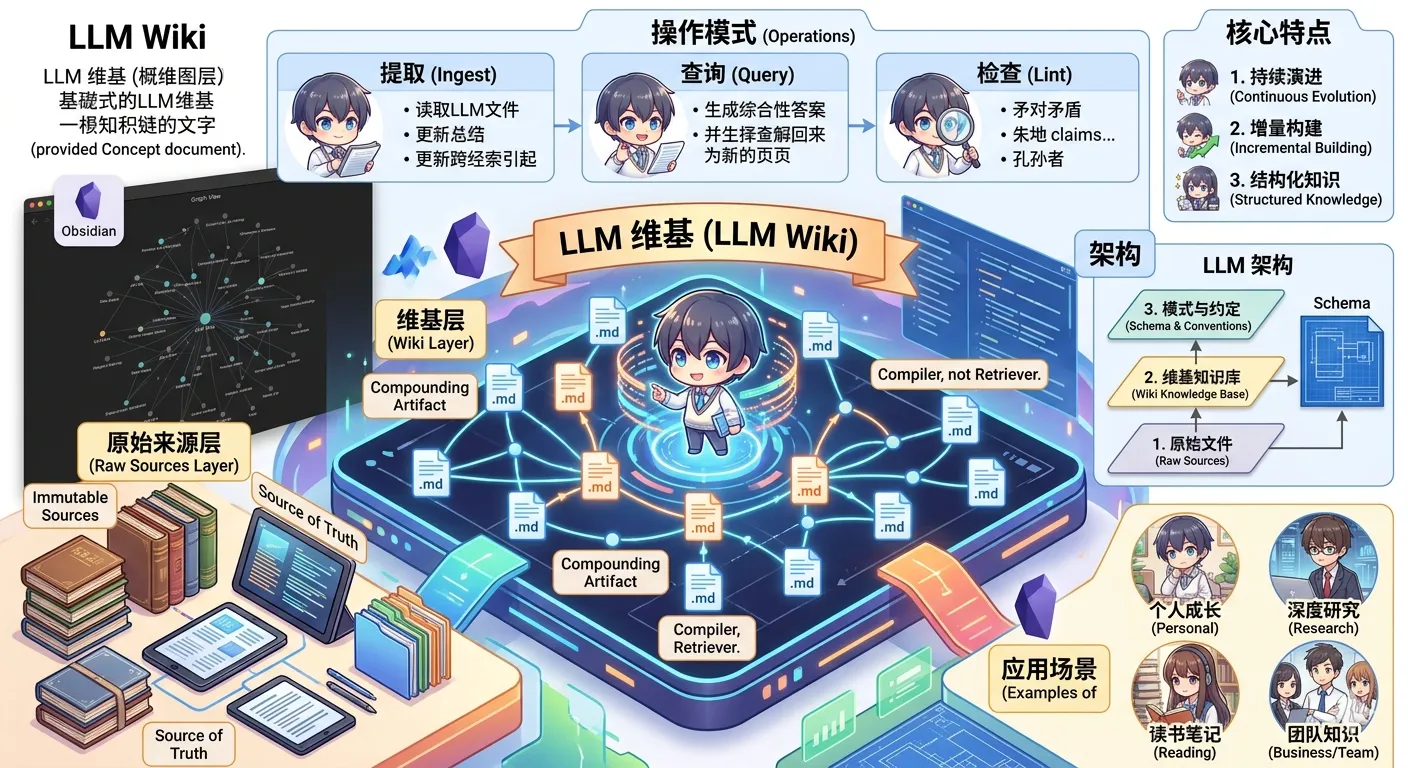
使用大语言模型(LLM)构建个人知识库的模式。
这是一份概念文件,设计用于复制粘贴到你自己的 LLM 智能体中(例如 OpenAI Codex、Claude Code、OpenCode / Pi 等)。它的目标是传达高层级的理念,而具体细节将由你的智能体与你协作构建。
核心理念
大多数人与 LLM 和文档打交道的体验看起来像是 RAG:你上传一批文件,LLM 在查询时检索相关片段,然后生成答案。这确实有效,但 LLM 每次都要从零开始重新发现知识,没有任何积累。当你问一个需要综合五份文档的微妙问题时,LLM 必须每次都找到并拼凑相关片段,没有任何东西被沉淀下来。NotebookLM、ChatGPT 文件上传以及大多数 RAG 系统都是这样工作的。
这里的理念不同。与其仅在查询时从原始文档中检索,LLM 增量式地构建并维护一个持久的维基 —— 一个结构化的、相互关联的 Markdown 文件集合,位于你和原始来源之间。当你添加新来源时,LLM 不只是将其索引以备后用。它会阅读来源,提取关键信息,并将其整合到现有维基中 —— 更新实体页面、修订主题摘要、标注新数据与旧主张的矛盾之处、强化或挑战不断演进的综合结论。知识被编译一次,然后保持最新,而不是每次查询都重新推导。
这就是关键区别:维基是一个持久的、复合增长的产物。
WikiLLM
利用 LLM 构建个人知识库的系统。WikiLLM 将原始素材"编译"成结构化、交叉链接的高质量中文 Wiki,可在 Obsidian 中查看。
本项目基于 Andrej Karpathy 提出的理念构建。详见:LLM Knowledge Bases
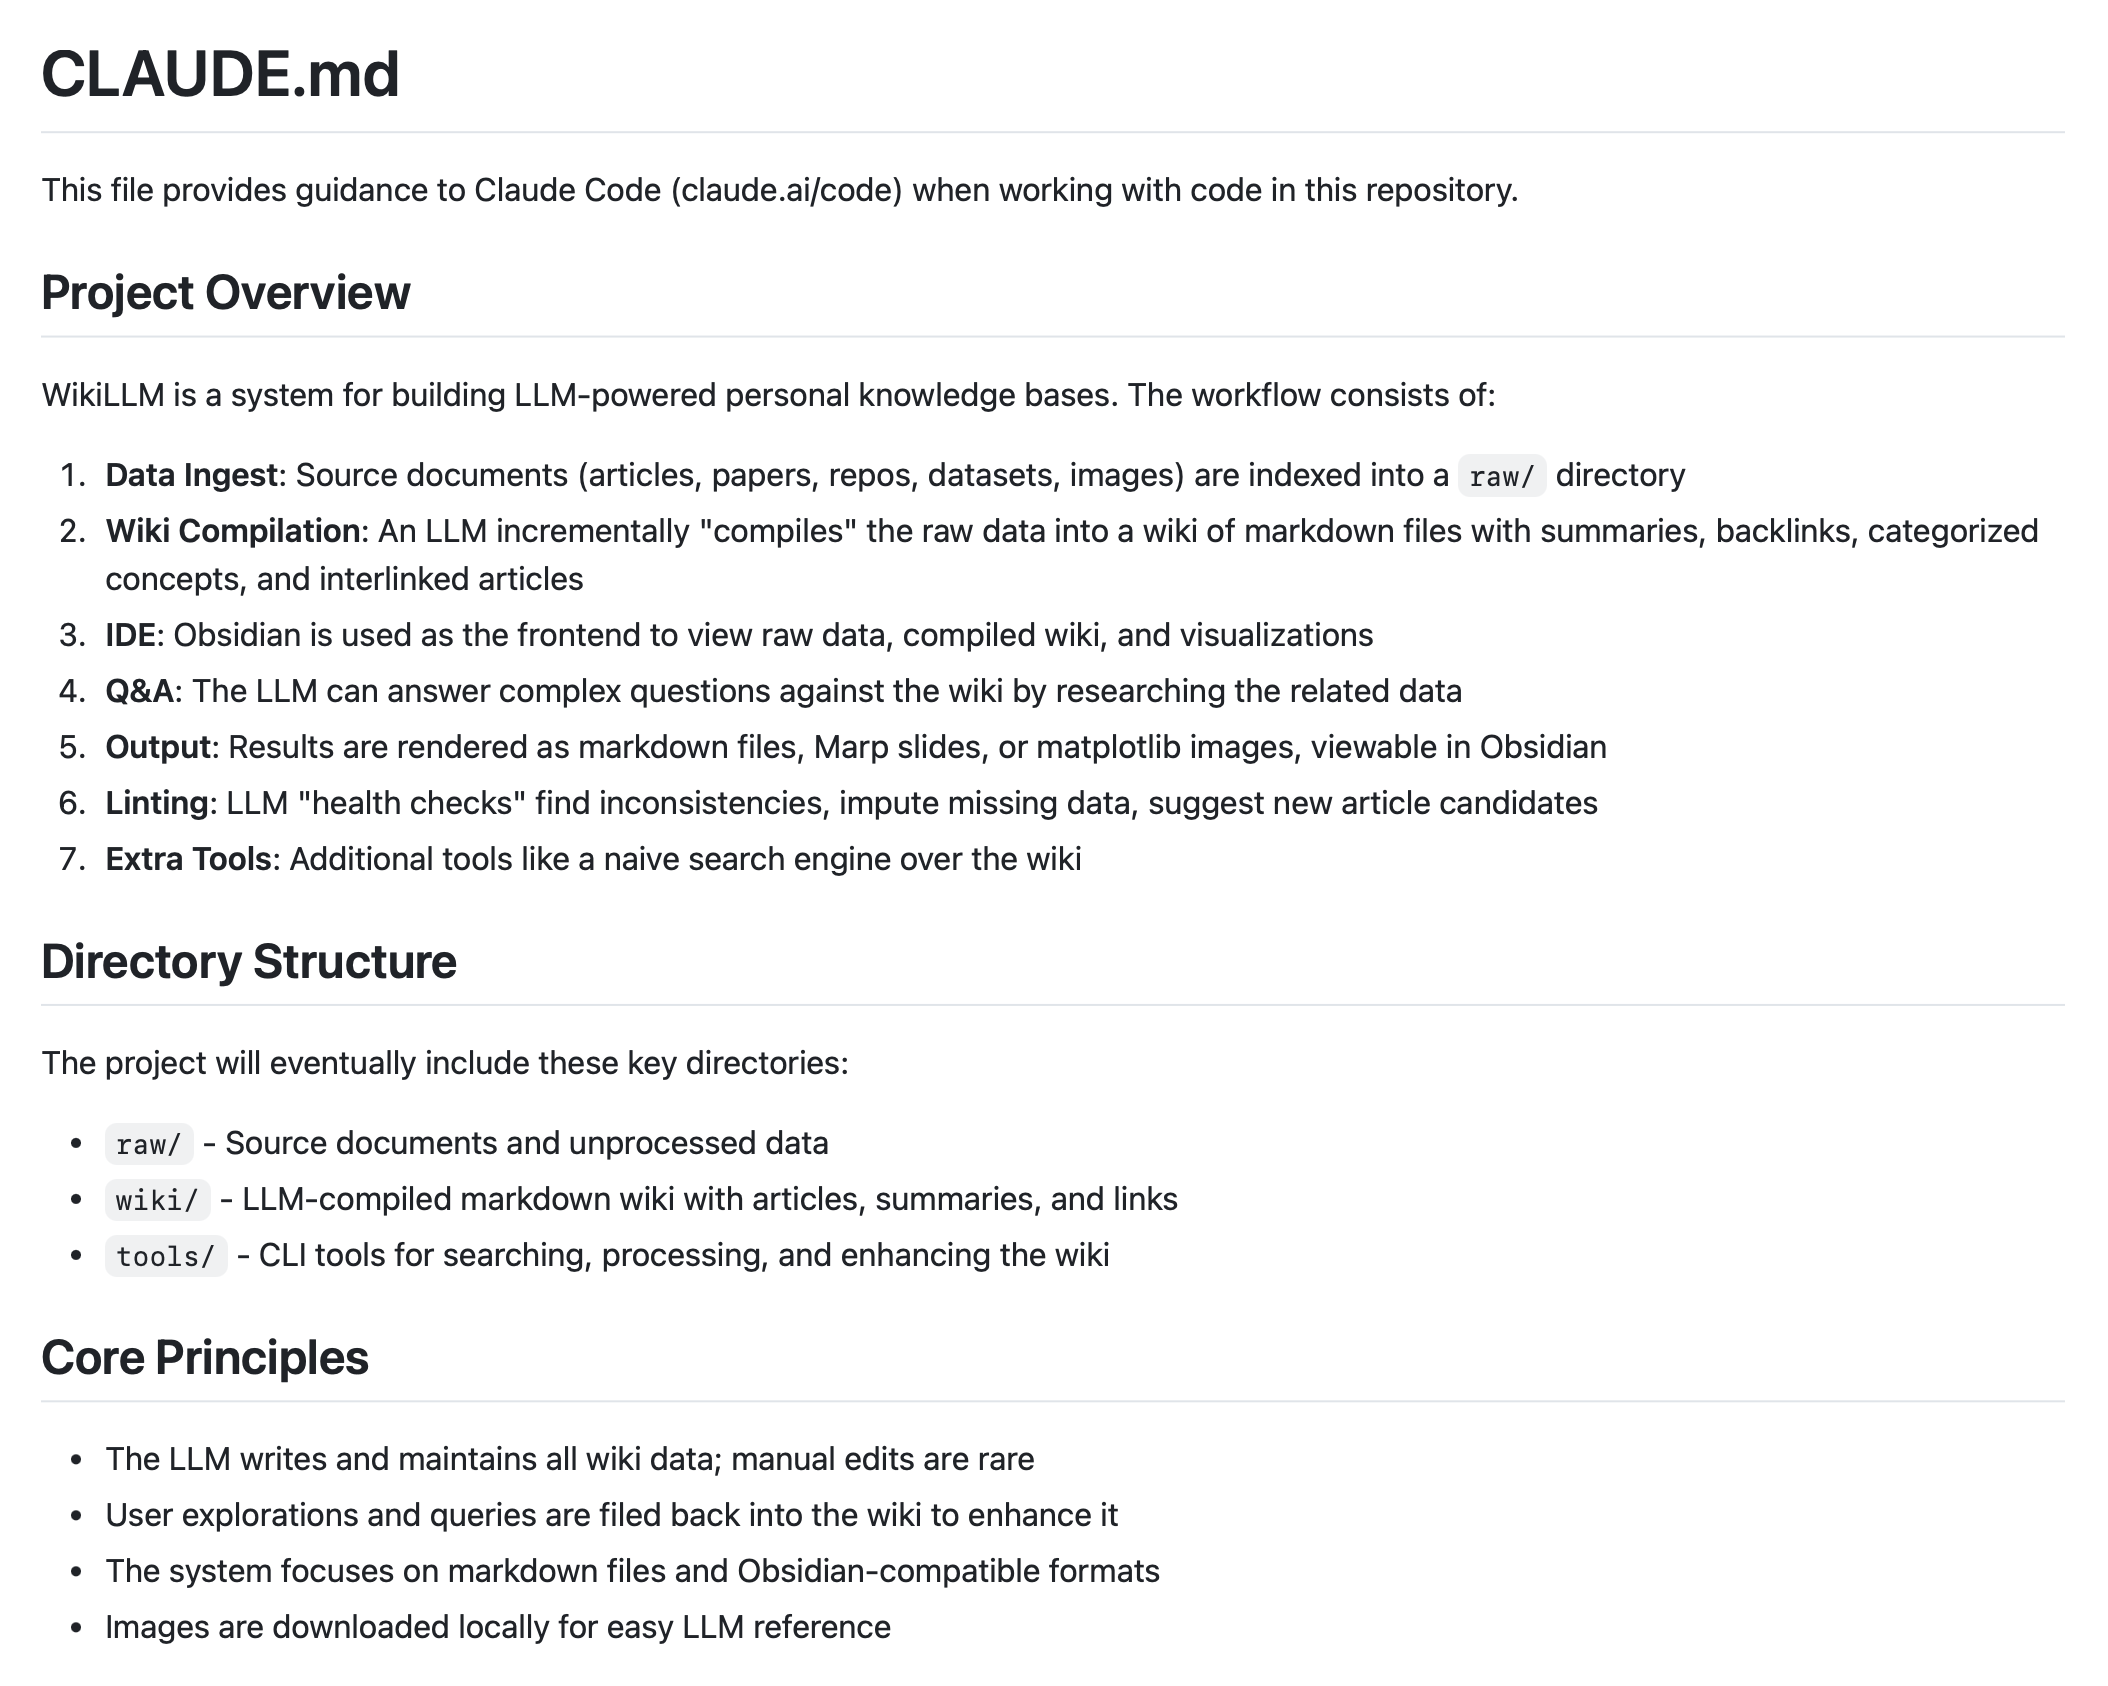
项目概述
WikiLLM 的工作流包括:
raw/ 目录核心原则
目录结构
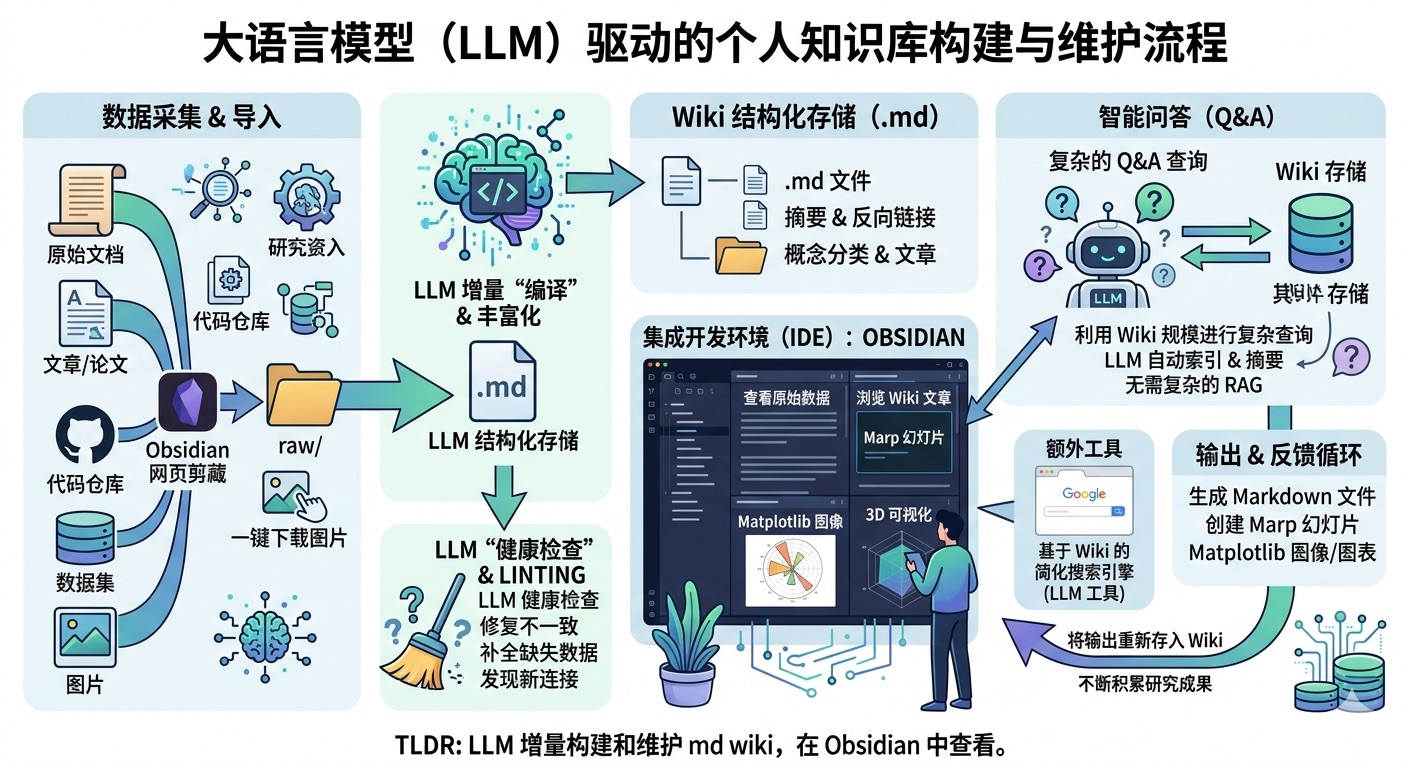
最近我发现一个非常实用的方法:利用大语言模型(LLM)为各类感兴趣的研究方向搭建个人知识库。这样一来,我近期消耗的模型令牌中,用于处理代码的占比大幅减少,更多被用于处理知识(以 Markdown 文件和图片形式存储)。最新的大语言模型在这方面表现十分出色。具体做法如下:
数据导入
我先将各类源文件(文章、论文、代码仓库、数据集、图片等)归档到 raw/ 目录下,再通过大语言模型逐步“编译”生成一份知识库,这份知识库本质就是按目录结构组织的一系列 .md 文件。
知识库会包含 raw/ 目录下所有数据的摘要、反向链接,还会将数据按概念分类、撰写对应词条并完成相互关联。
为把网页文章转为 .md 文件,我习惯使用 Obsidian 网页剪藏插件,同时通过快捷键将相关图片批量下载到本地,方便大语言模型直接调用。
集成开发环境
我把 Obsidian 当作前端 IDE,既能查看原始数据、编译后的知识库,也能查看衍生的可视化内容。 需要重点说明的是:整个知识库的内容撰写与维护均由大语言模型完成,我几乎不直接手动修改。我还试用过多款 Obsidian 插件,以其他形式渲染和查看数据(比如用 Marp 制作幻灯片)。
问答交互 真正有意思的是,当知识库规模足够大时(比如我近期的研究知识库已有约 100 篇词条、40 万字),就可以向大语言模型智能体提出各类复杂问题
初始化
uv init RAGFlowAssistant
cd RAGFlowAssistant
uv add ragflow-sdk
运行
sh run.sh
RAGFlowAssistant
配置
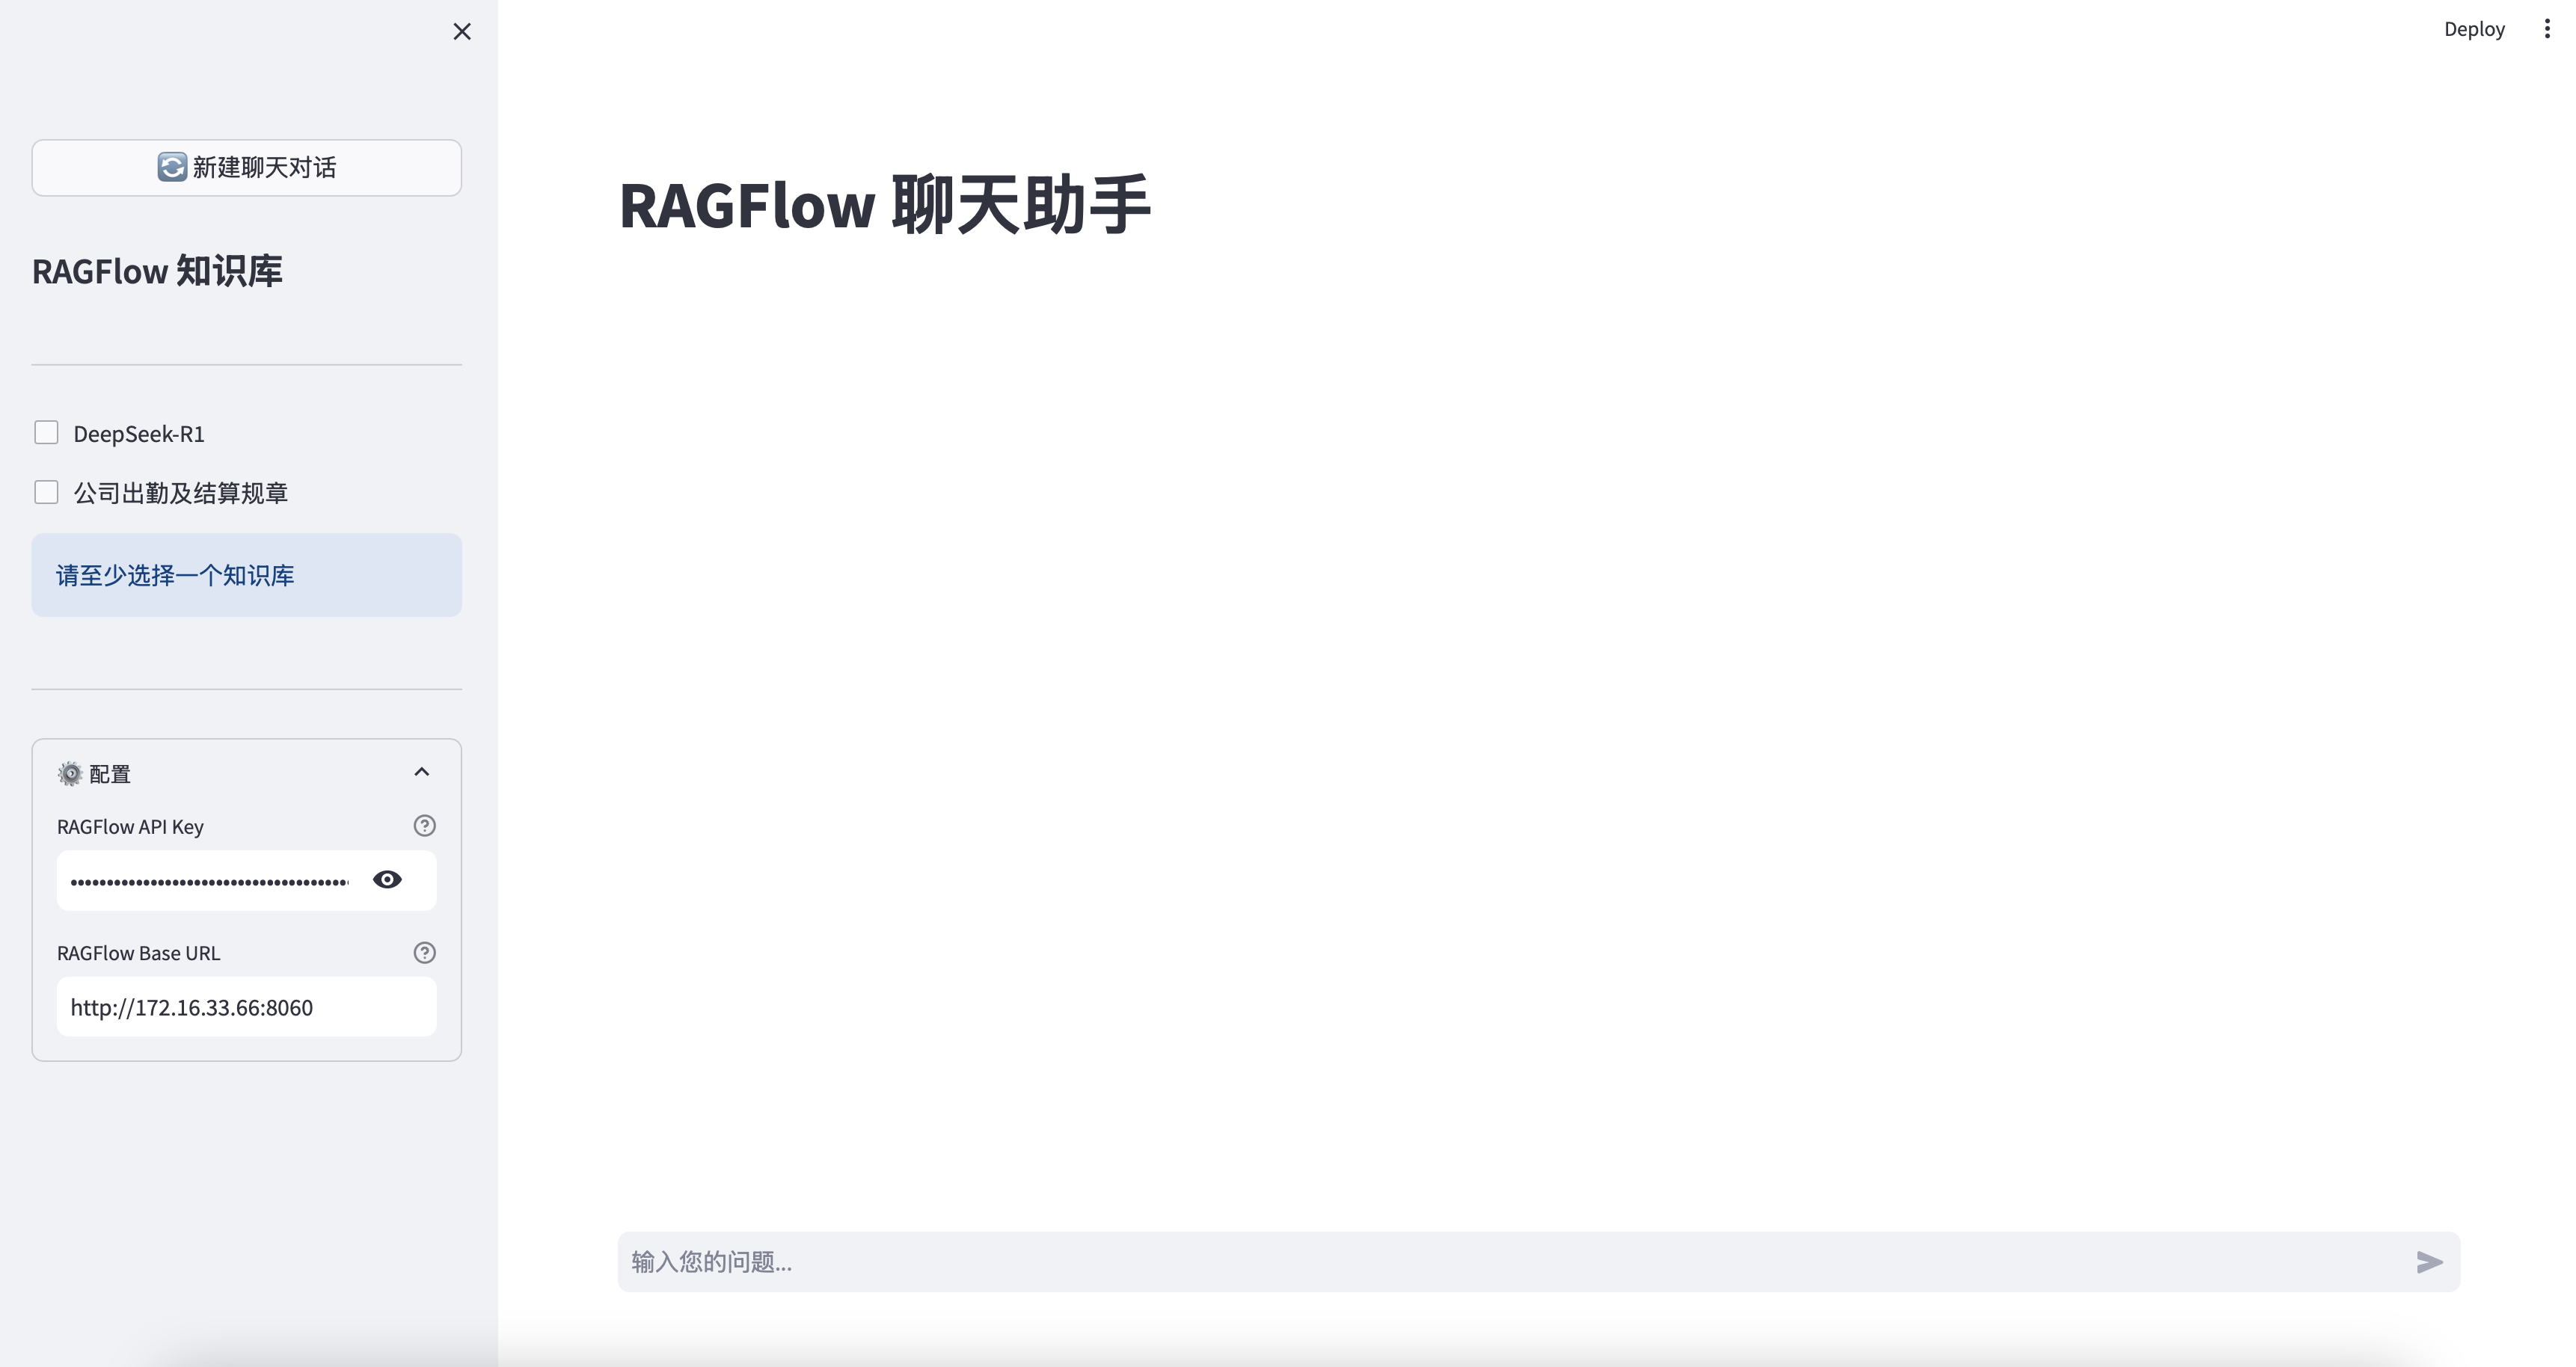
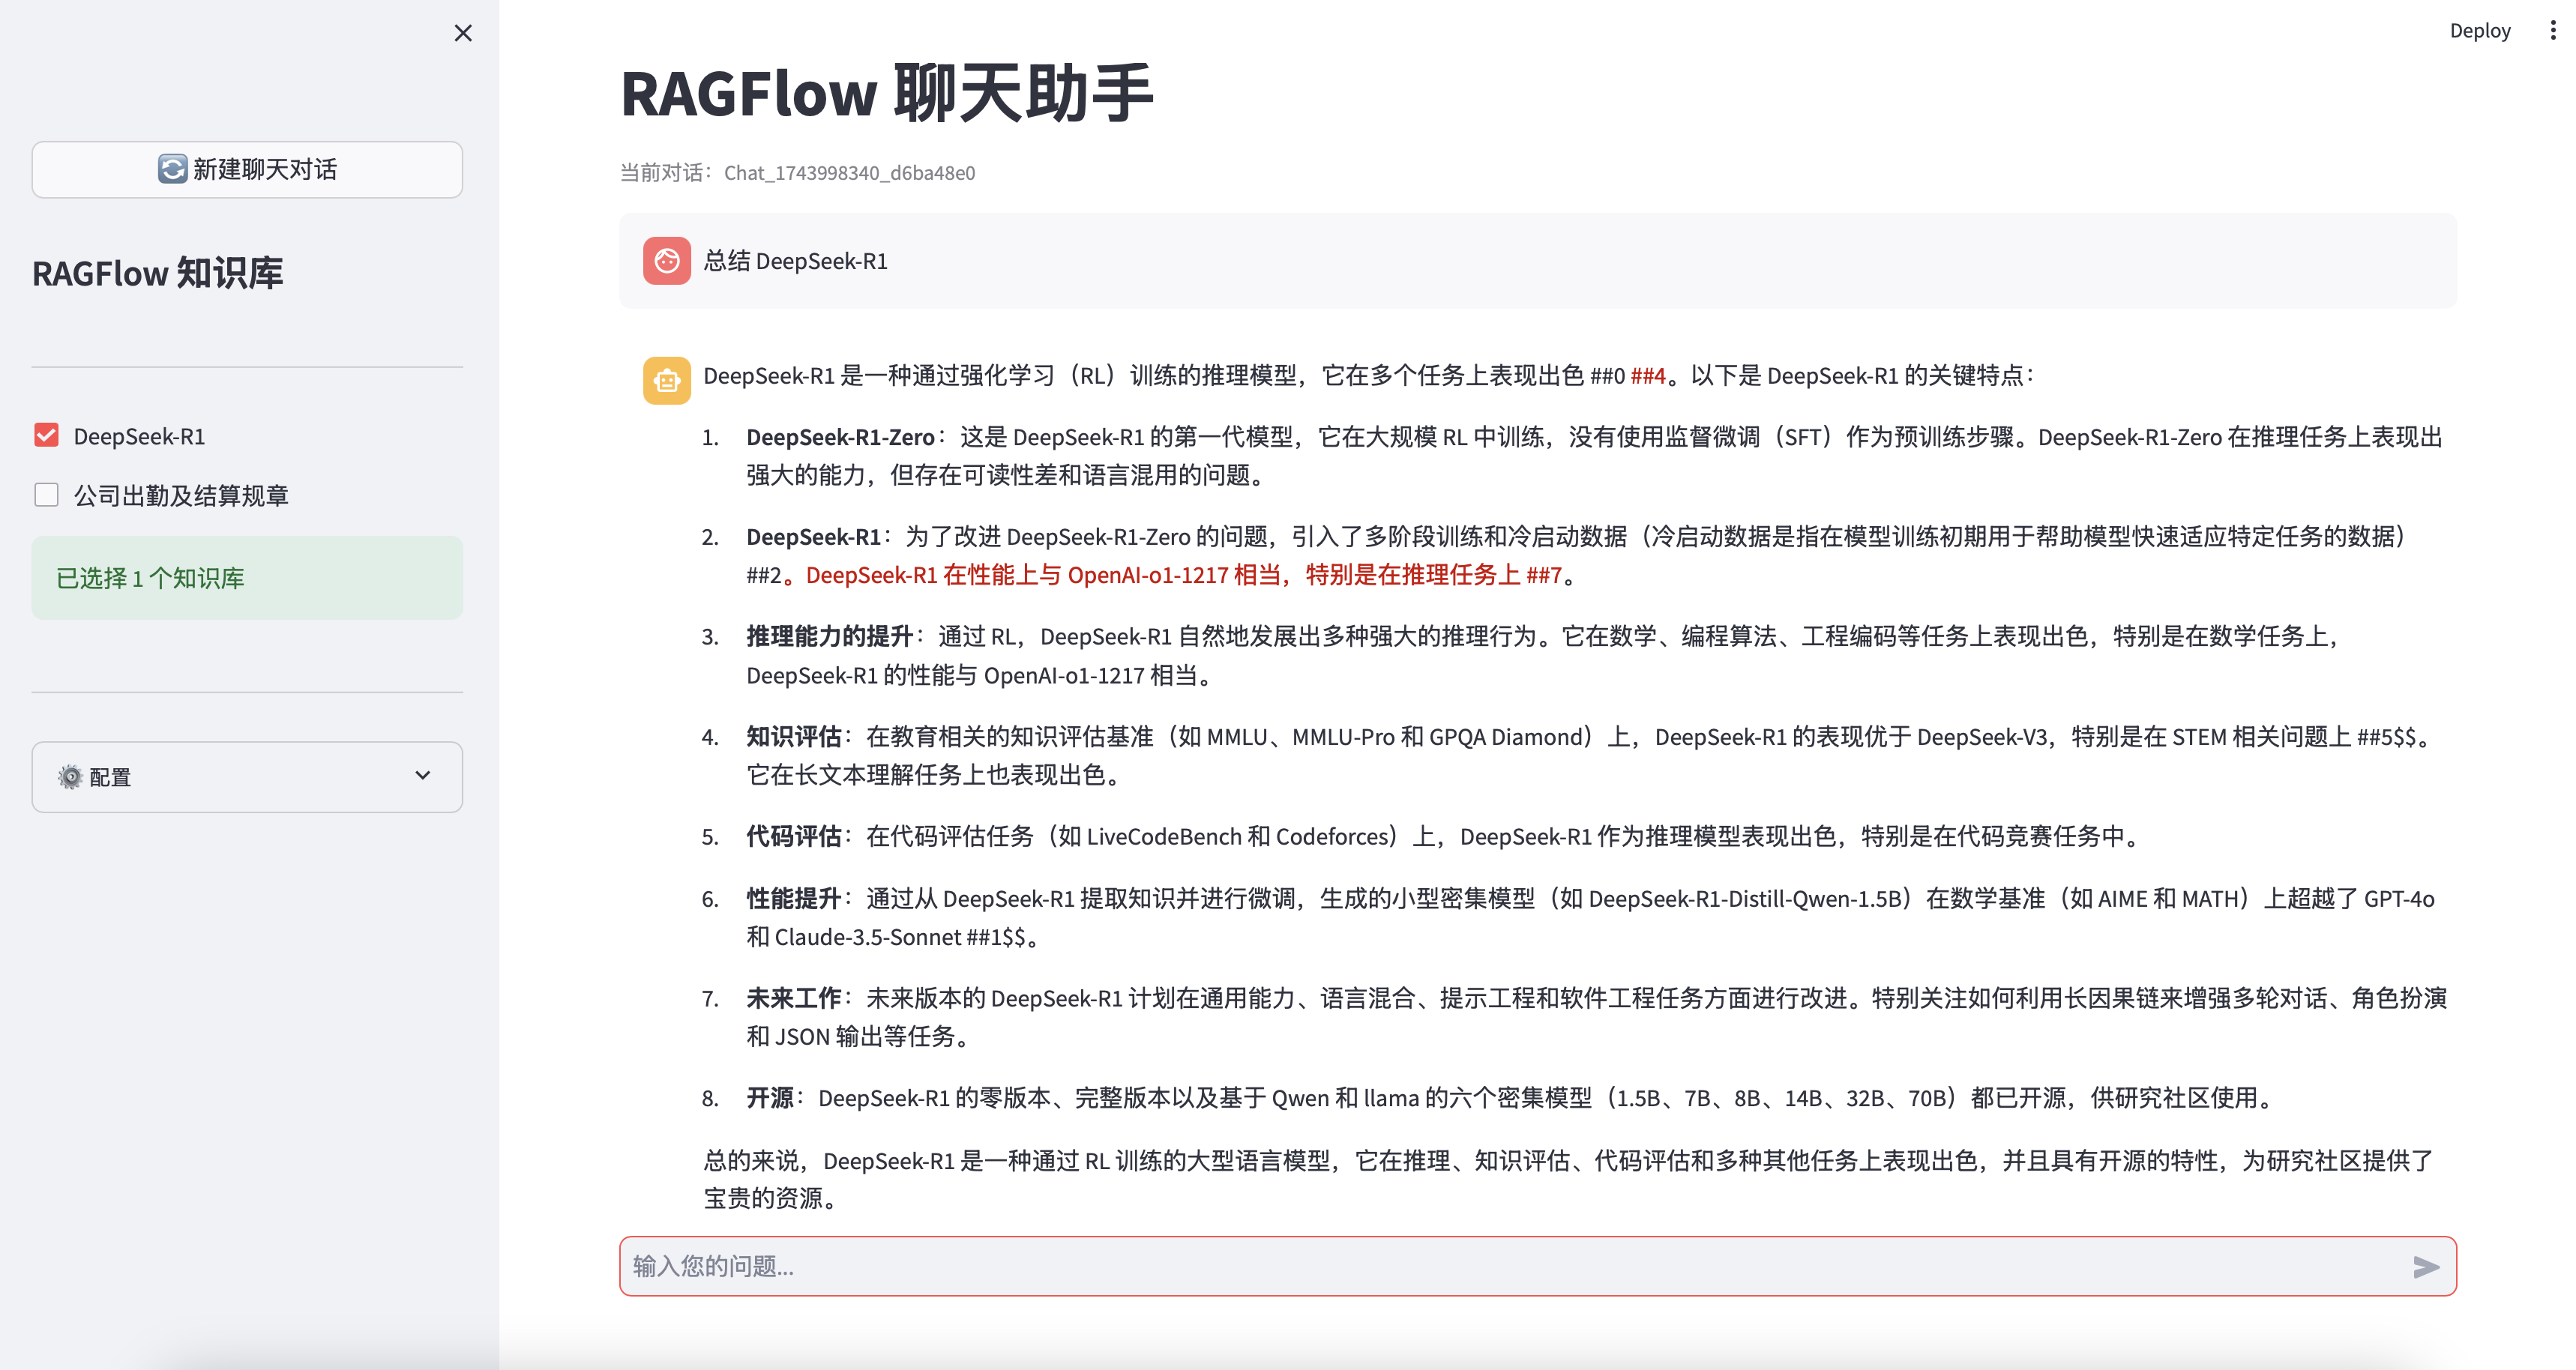
知识库问答
核心代码
⚠️ Trae 试用感受
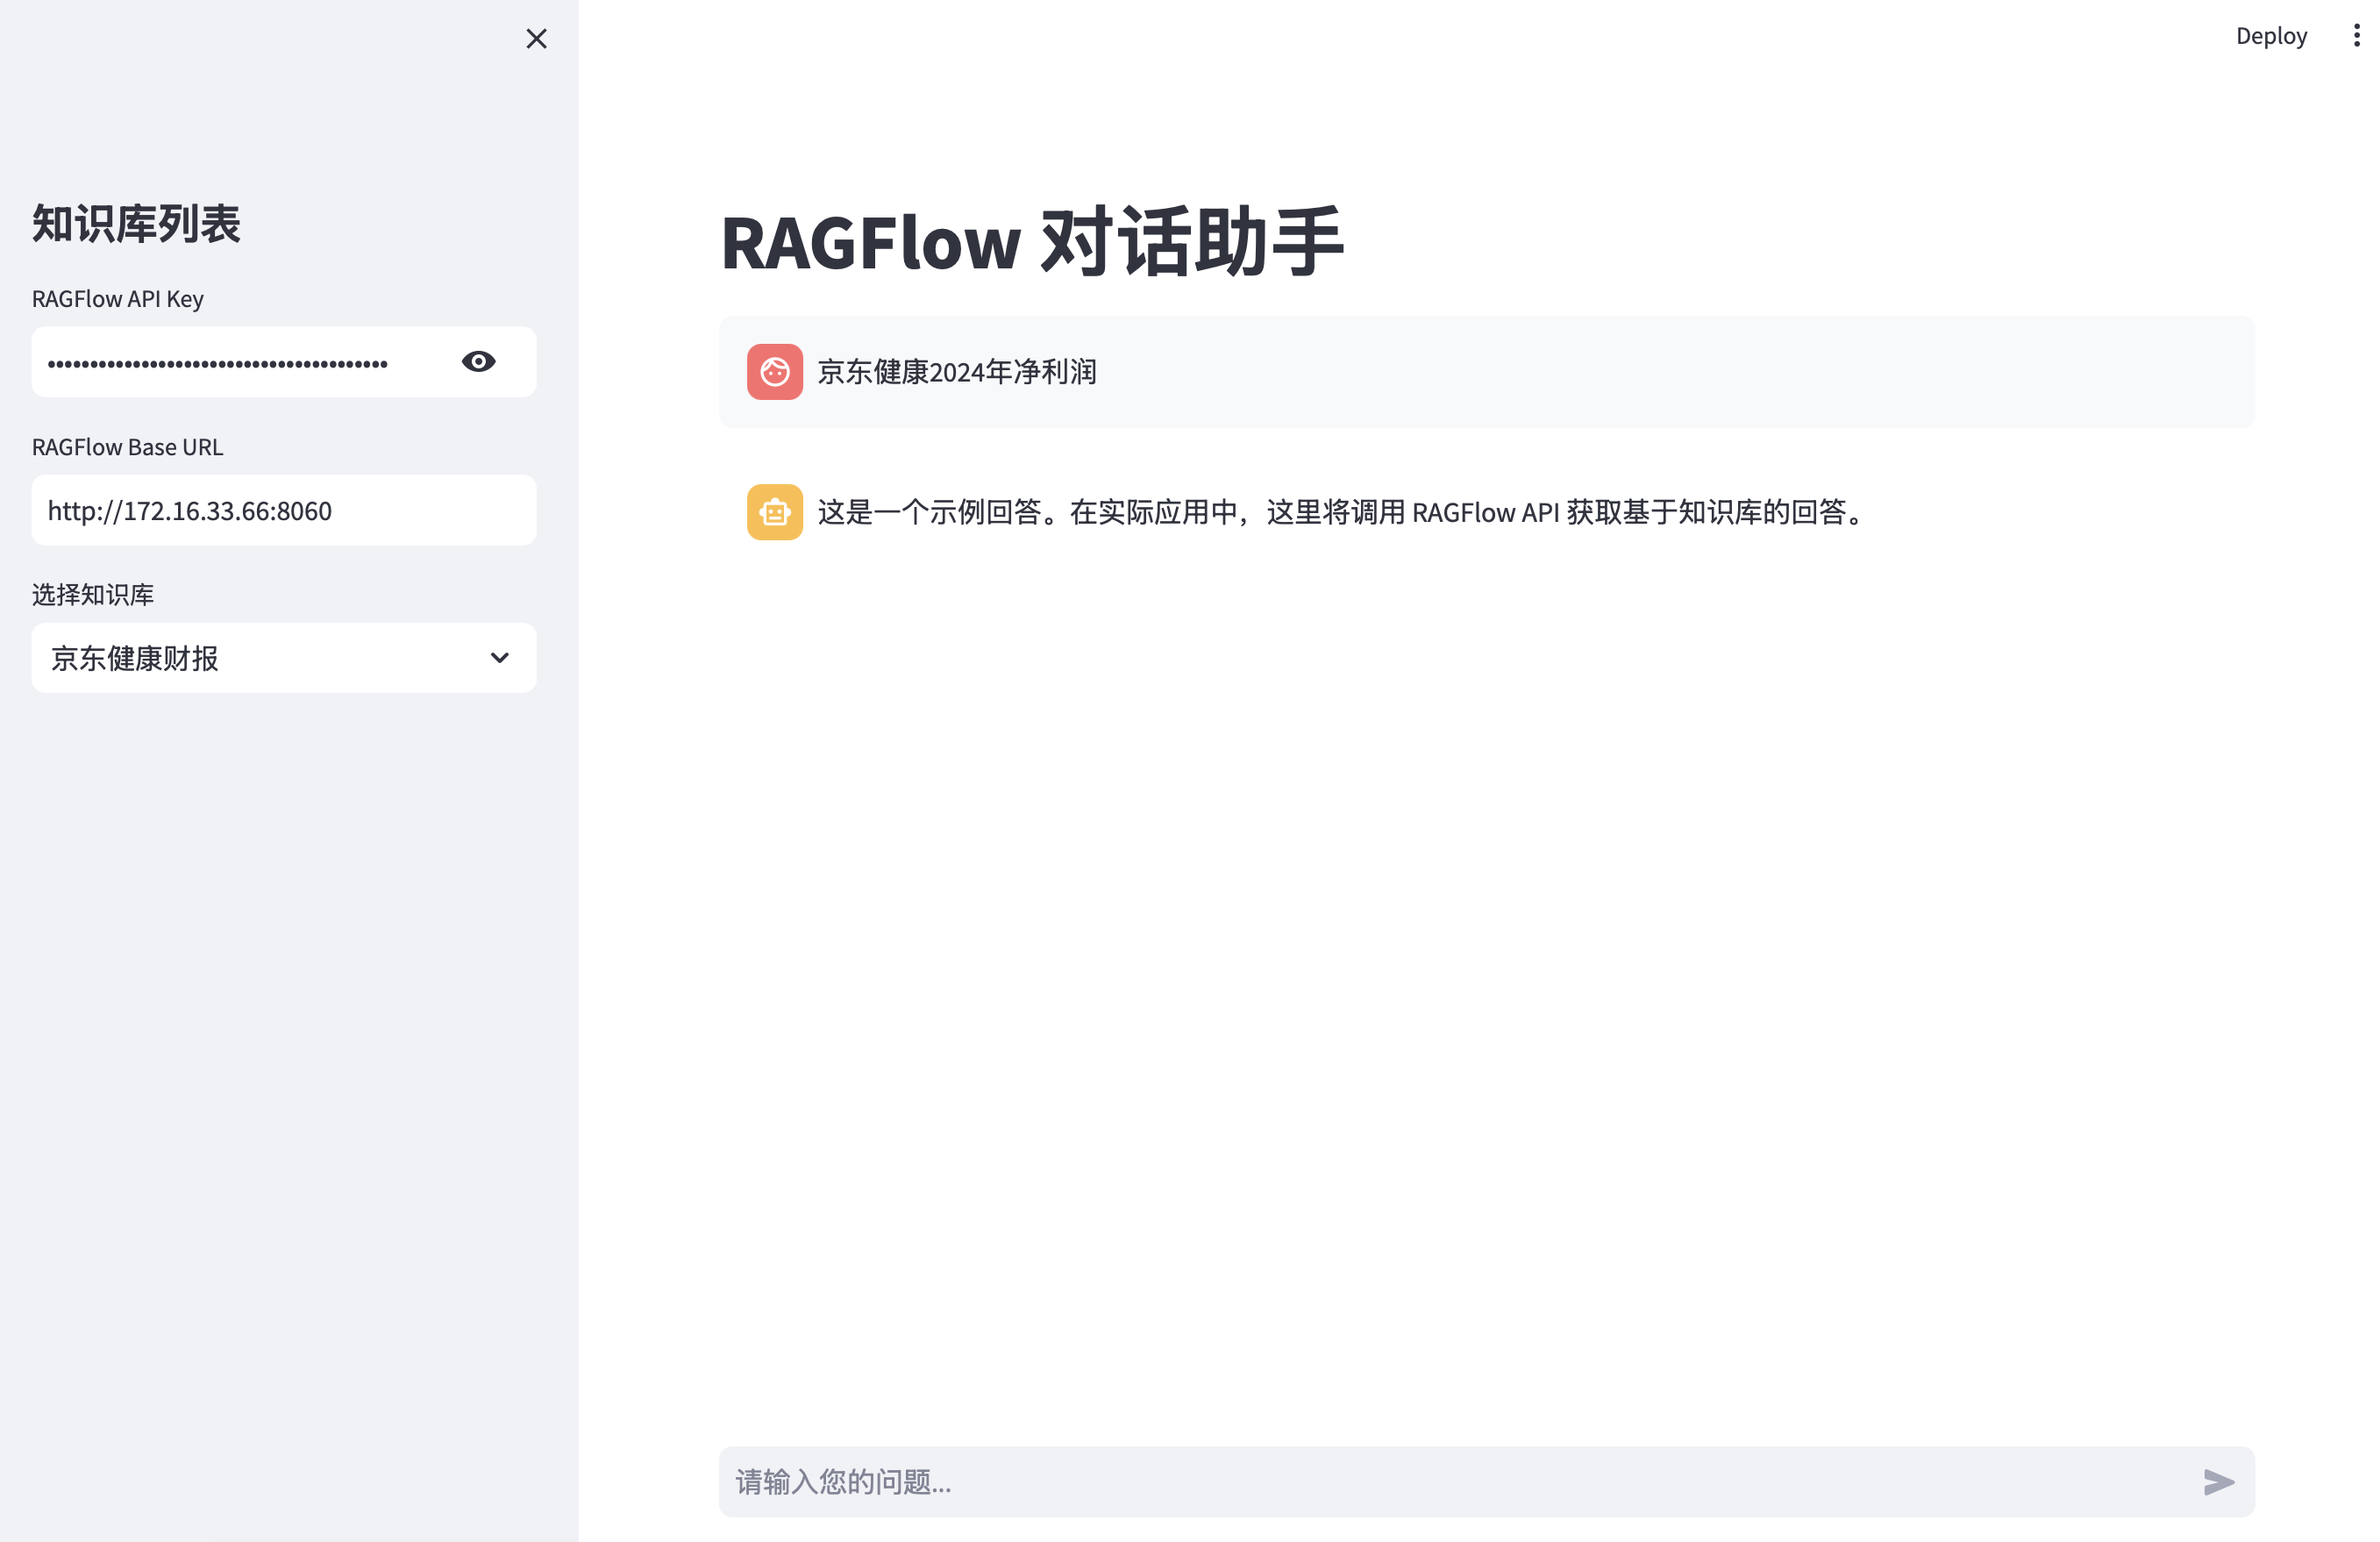
功能界面
操作
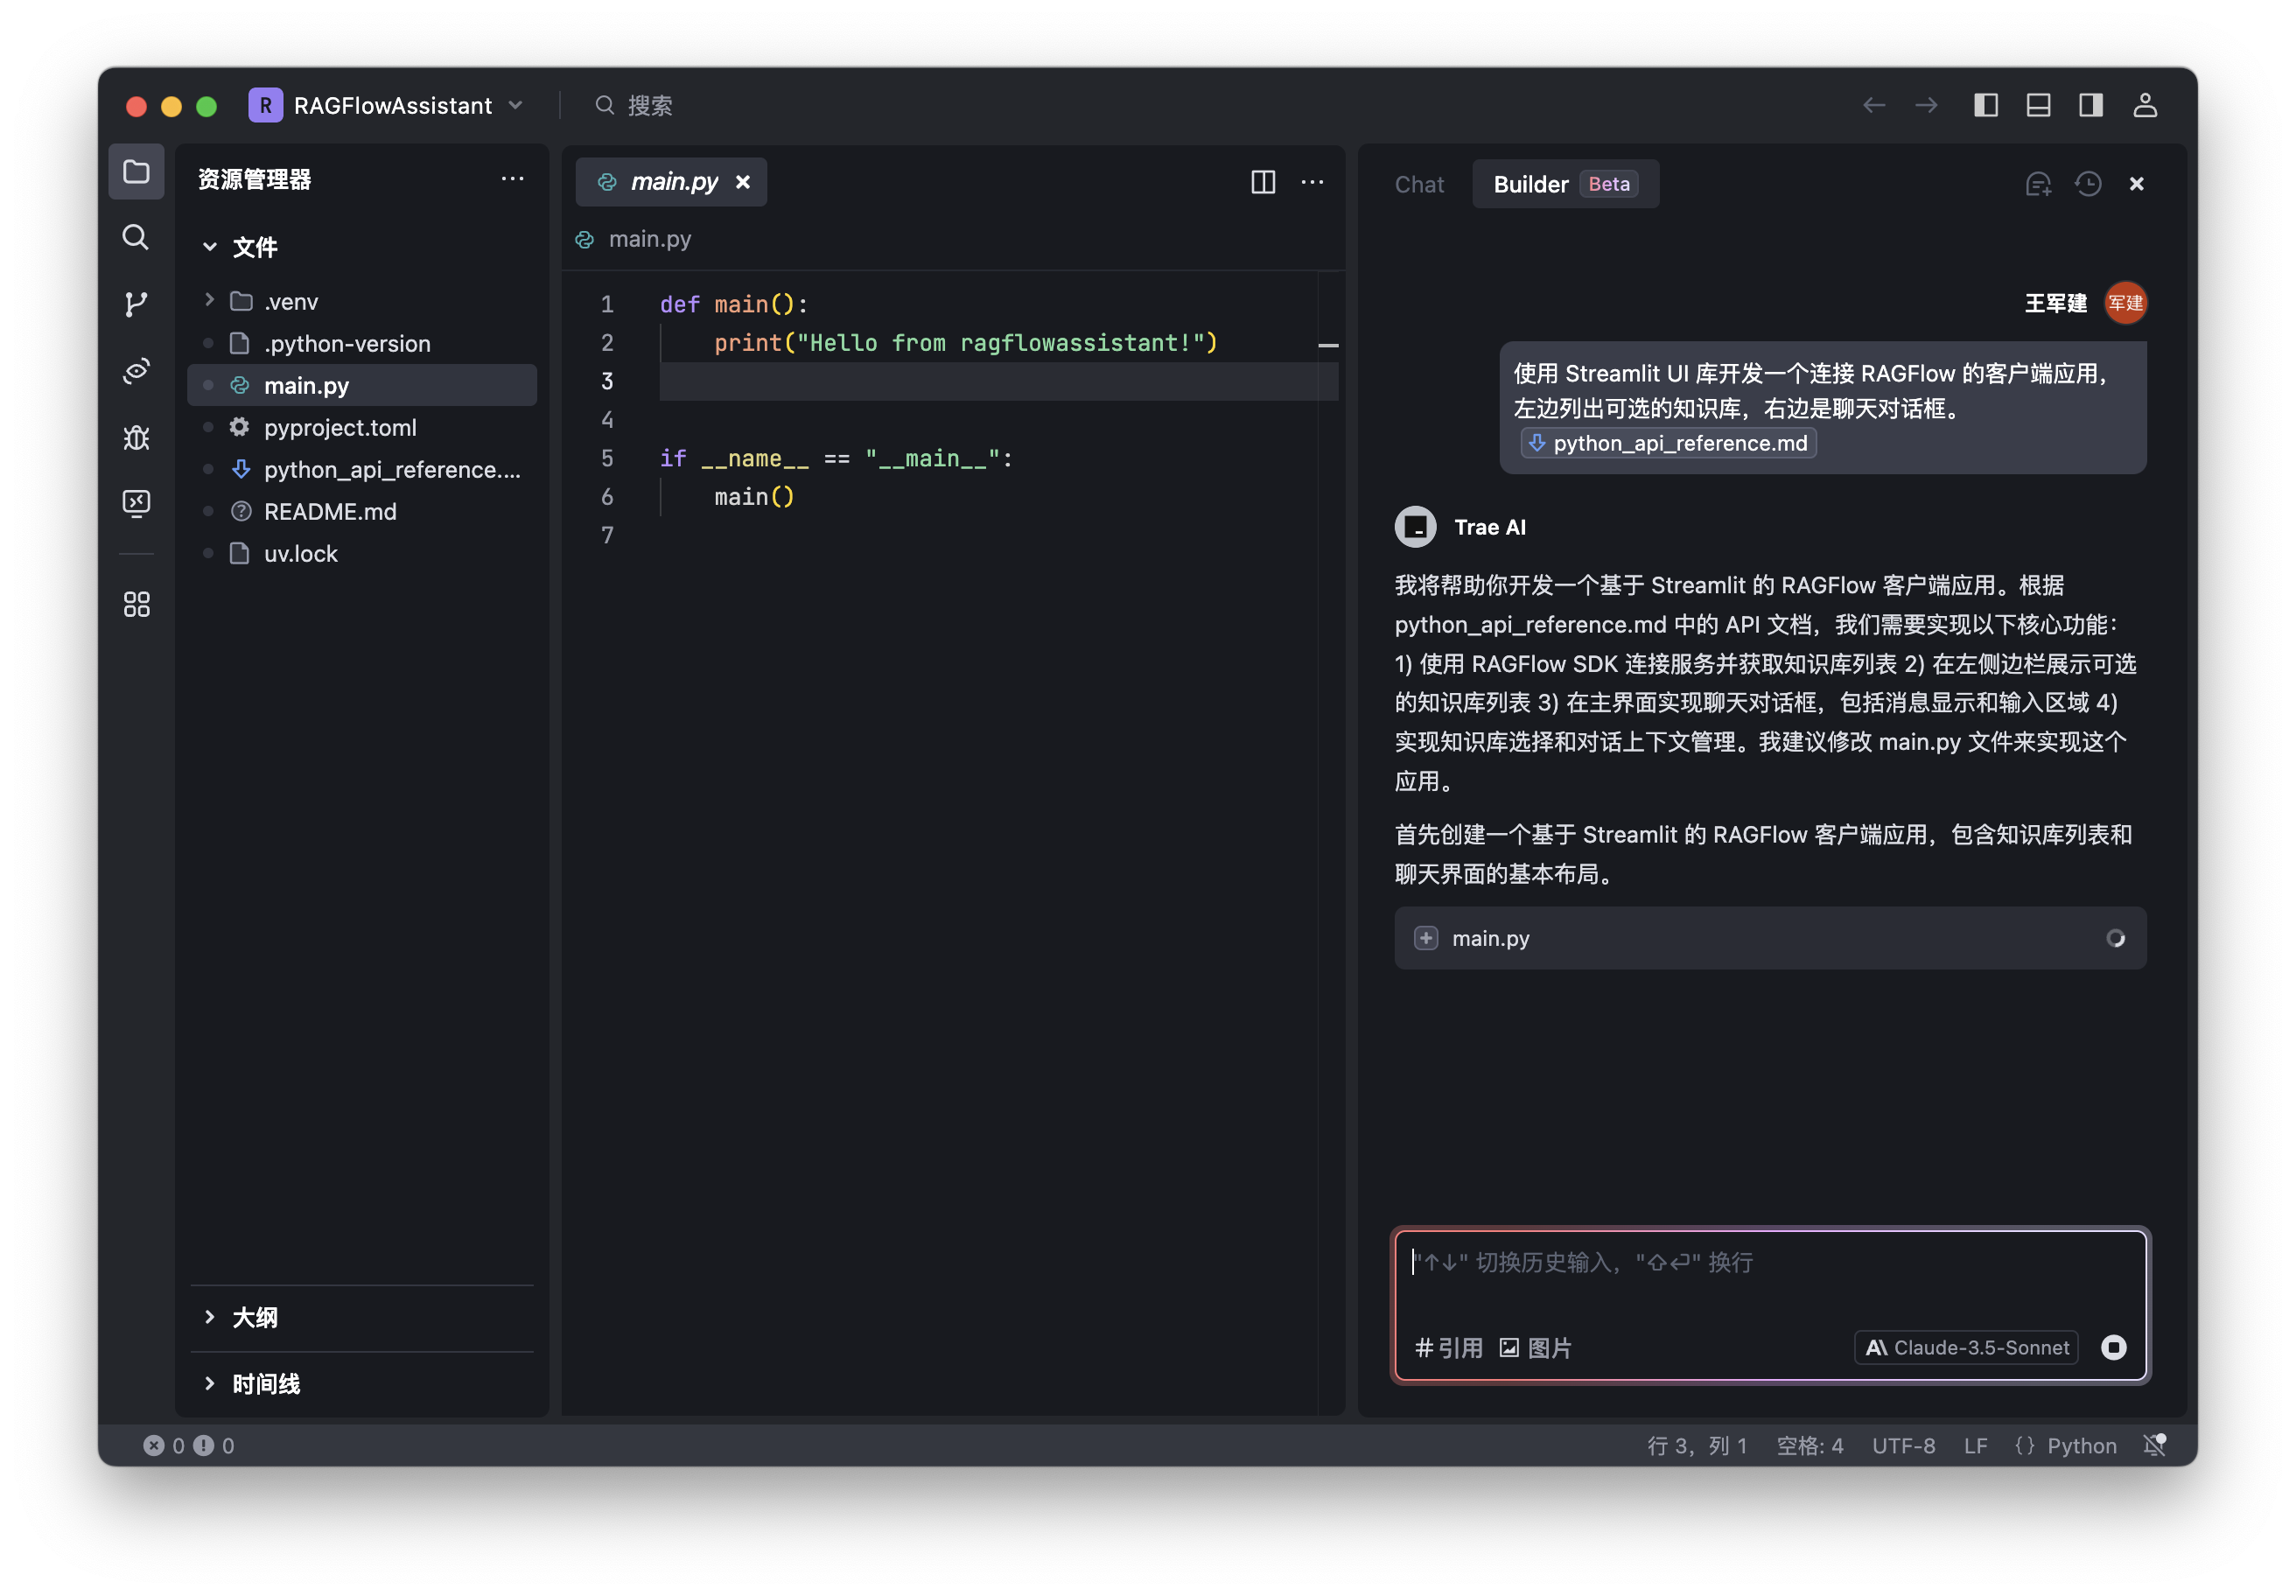
提示词
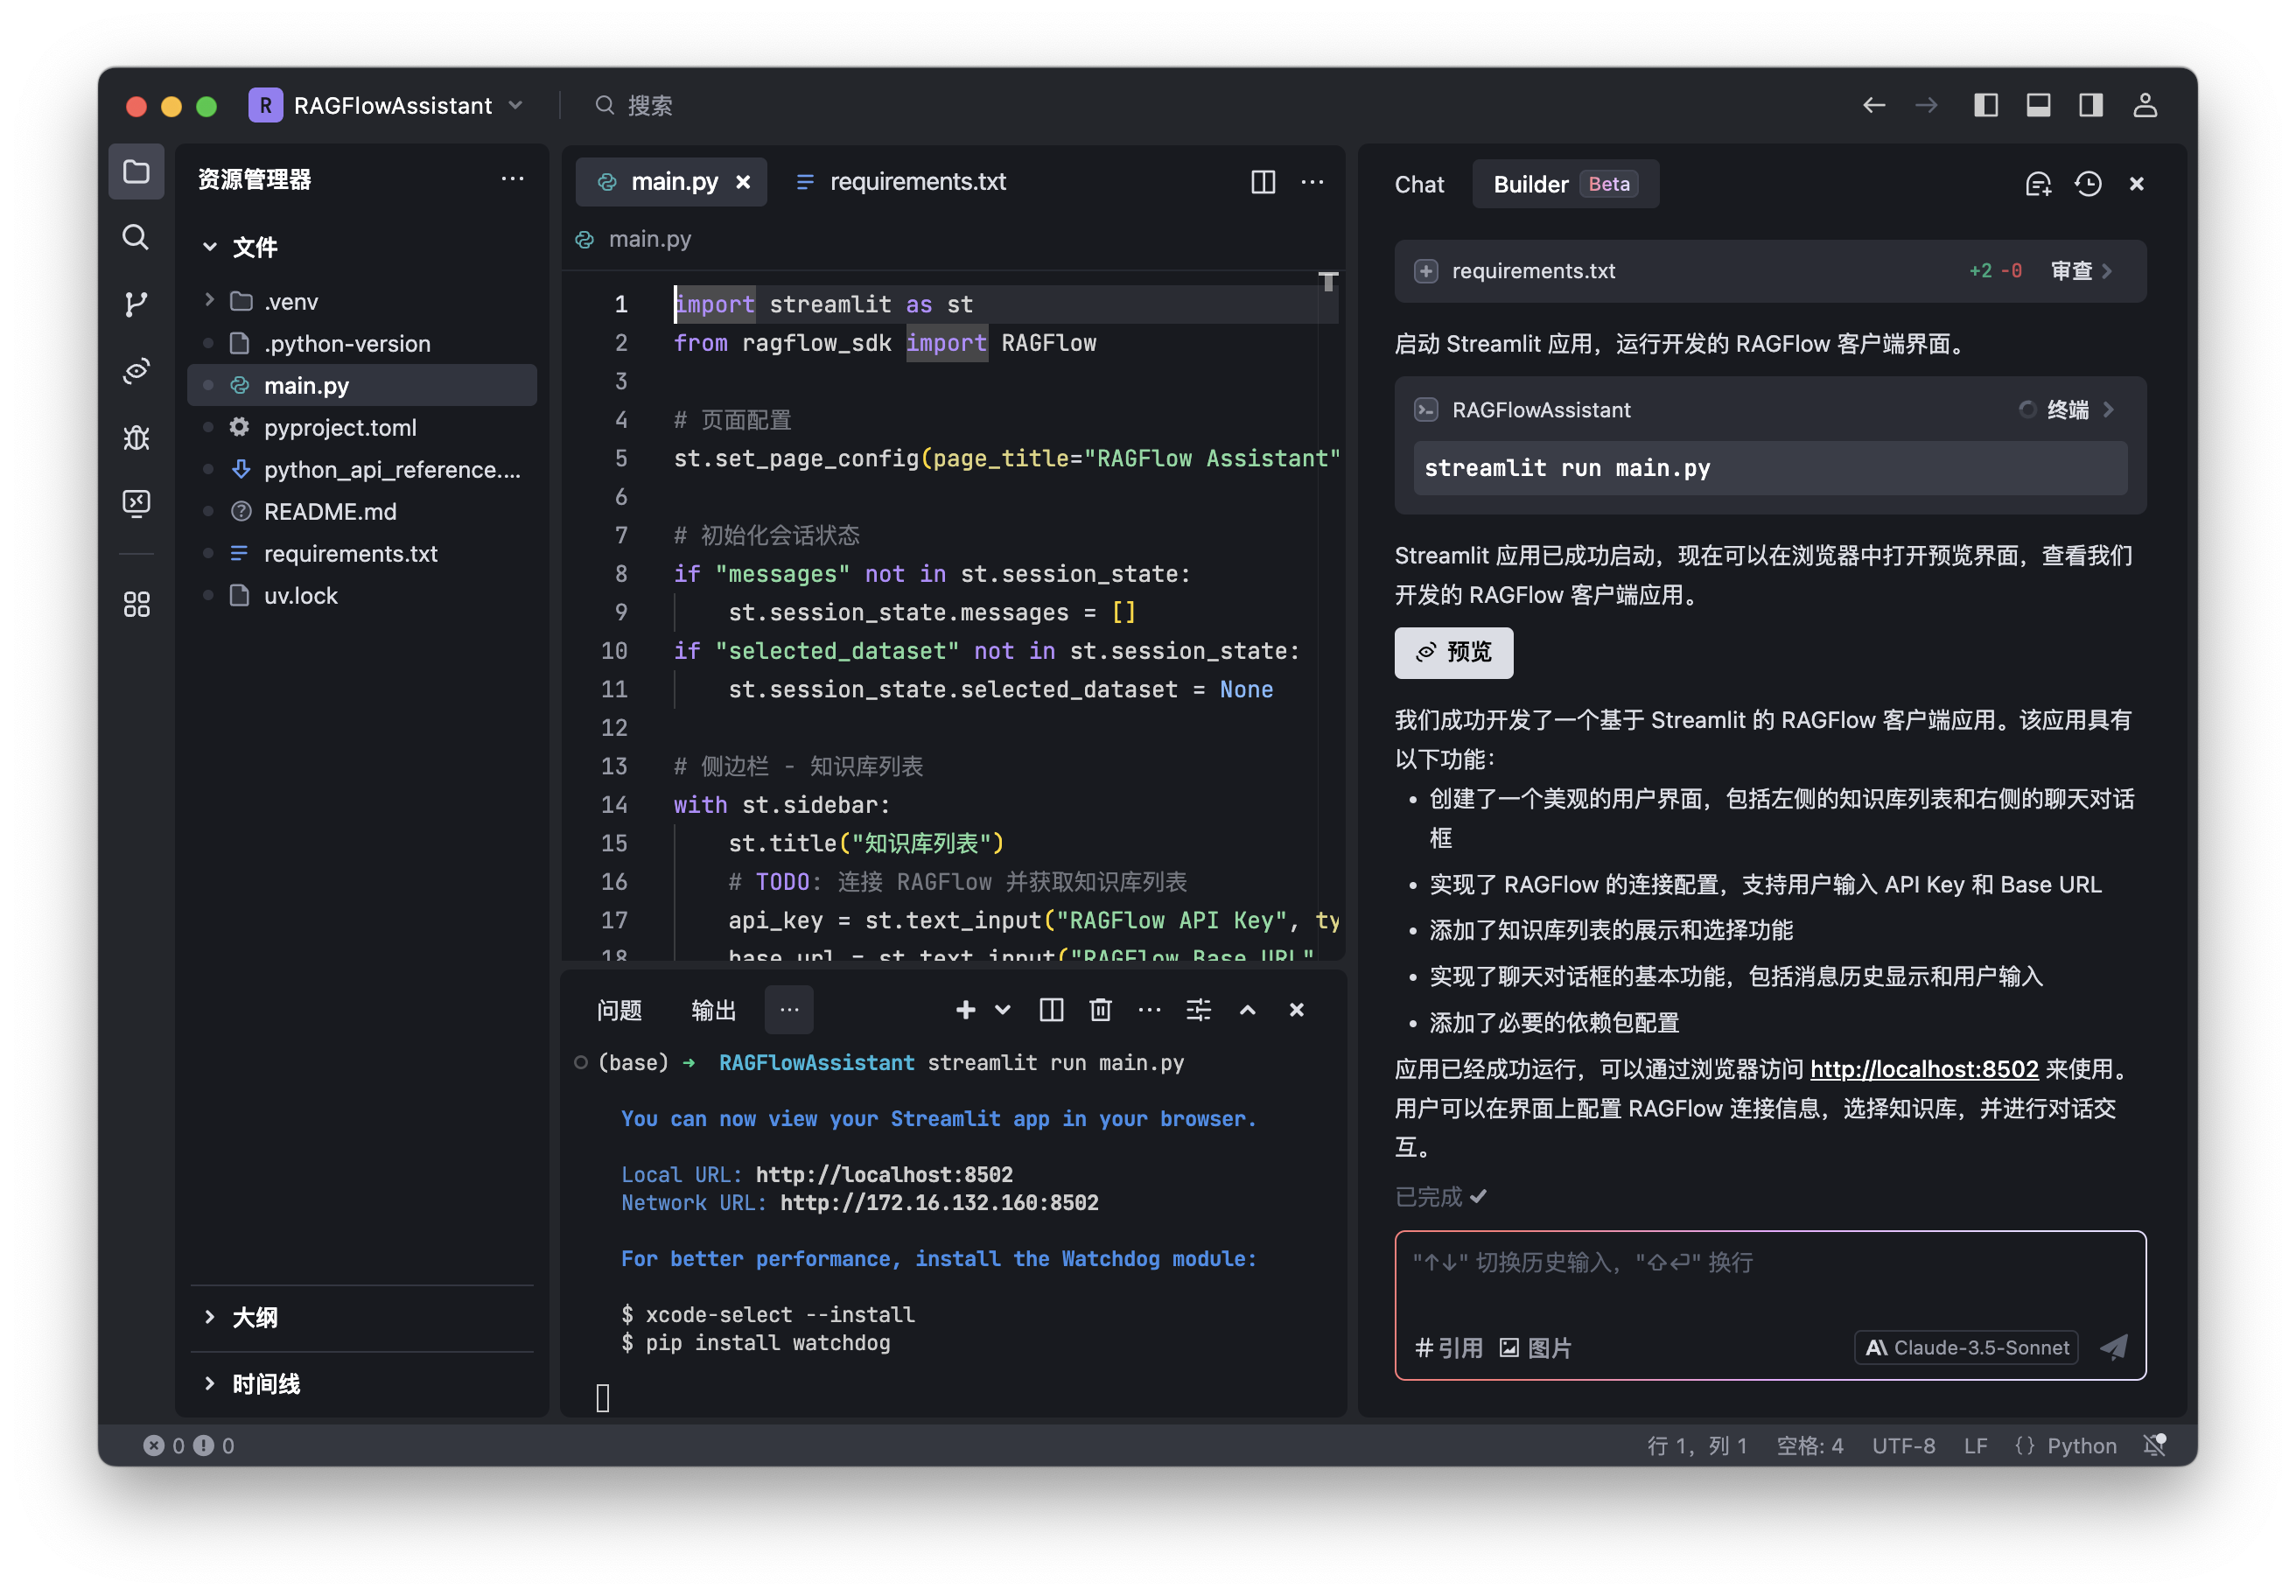
使用 Streamlit UI 库开发一个连接 RAGFlow 的客户端应用,左边列出可选的知识库,右边是聊天对话框。
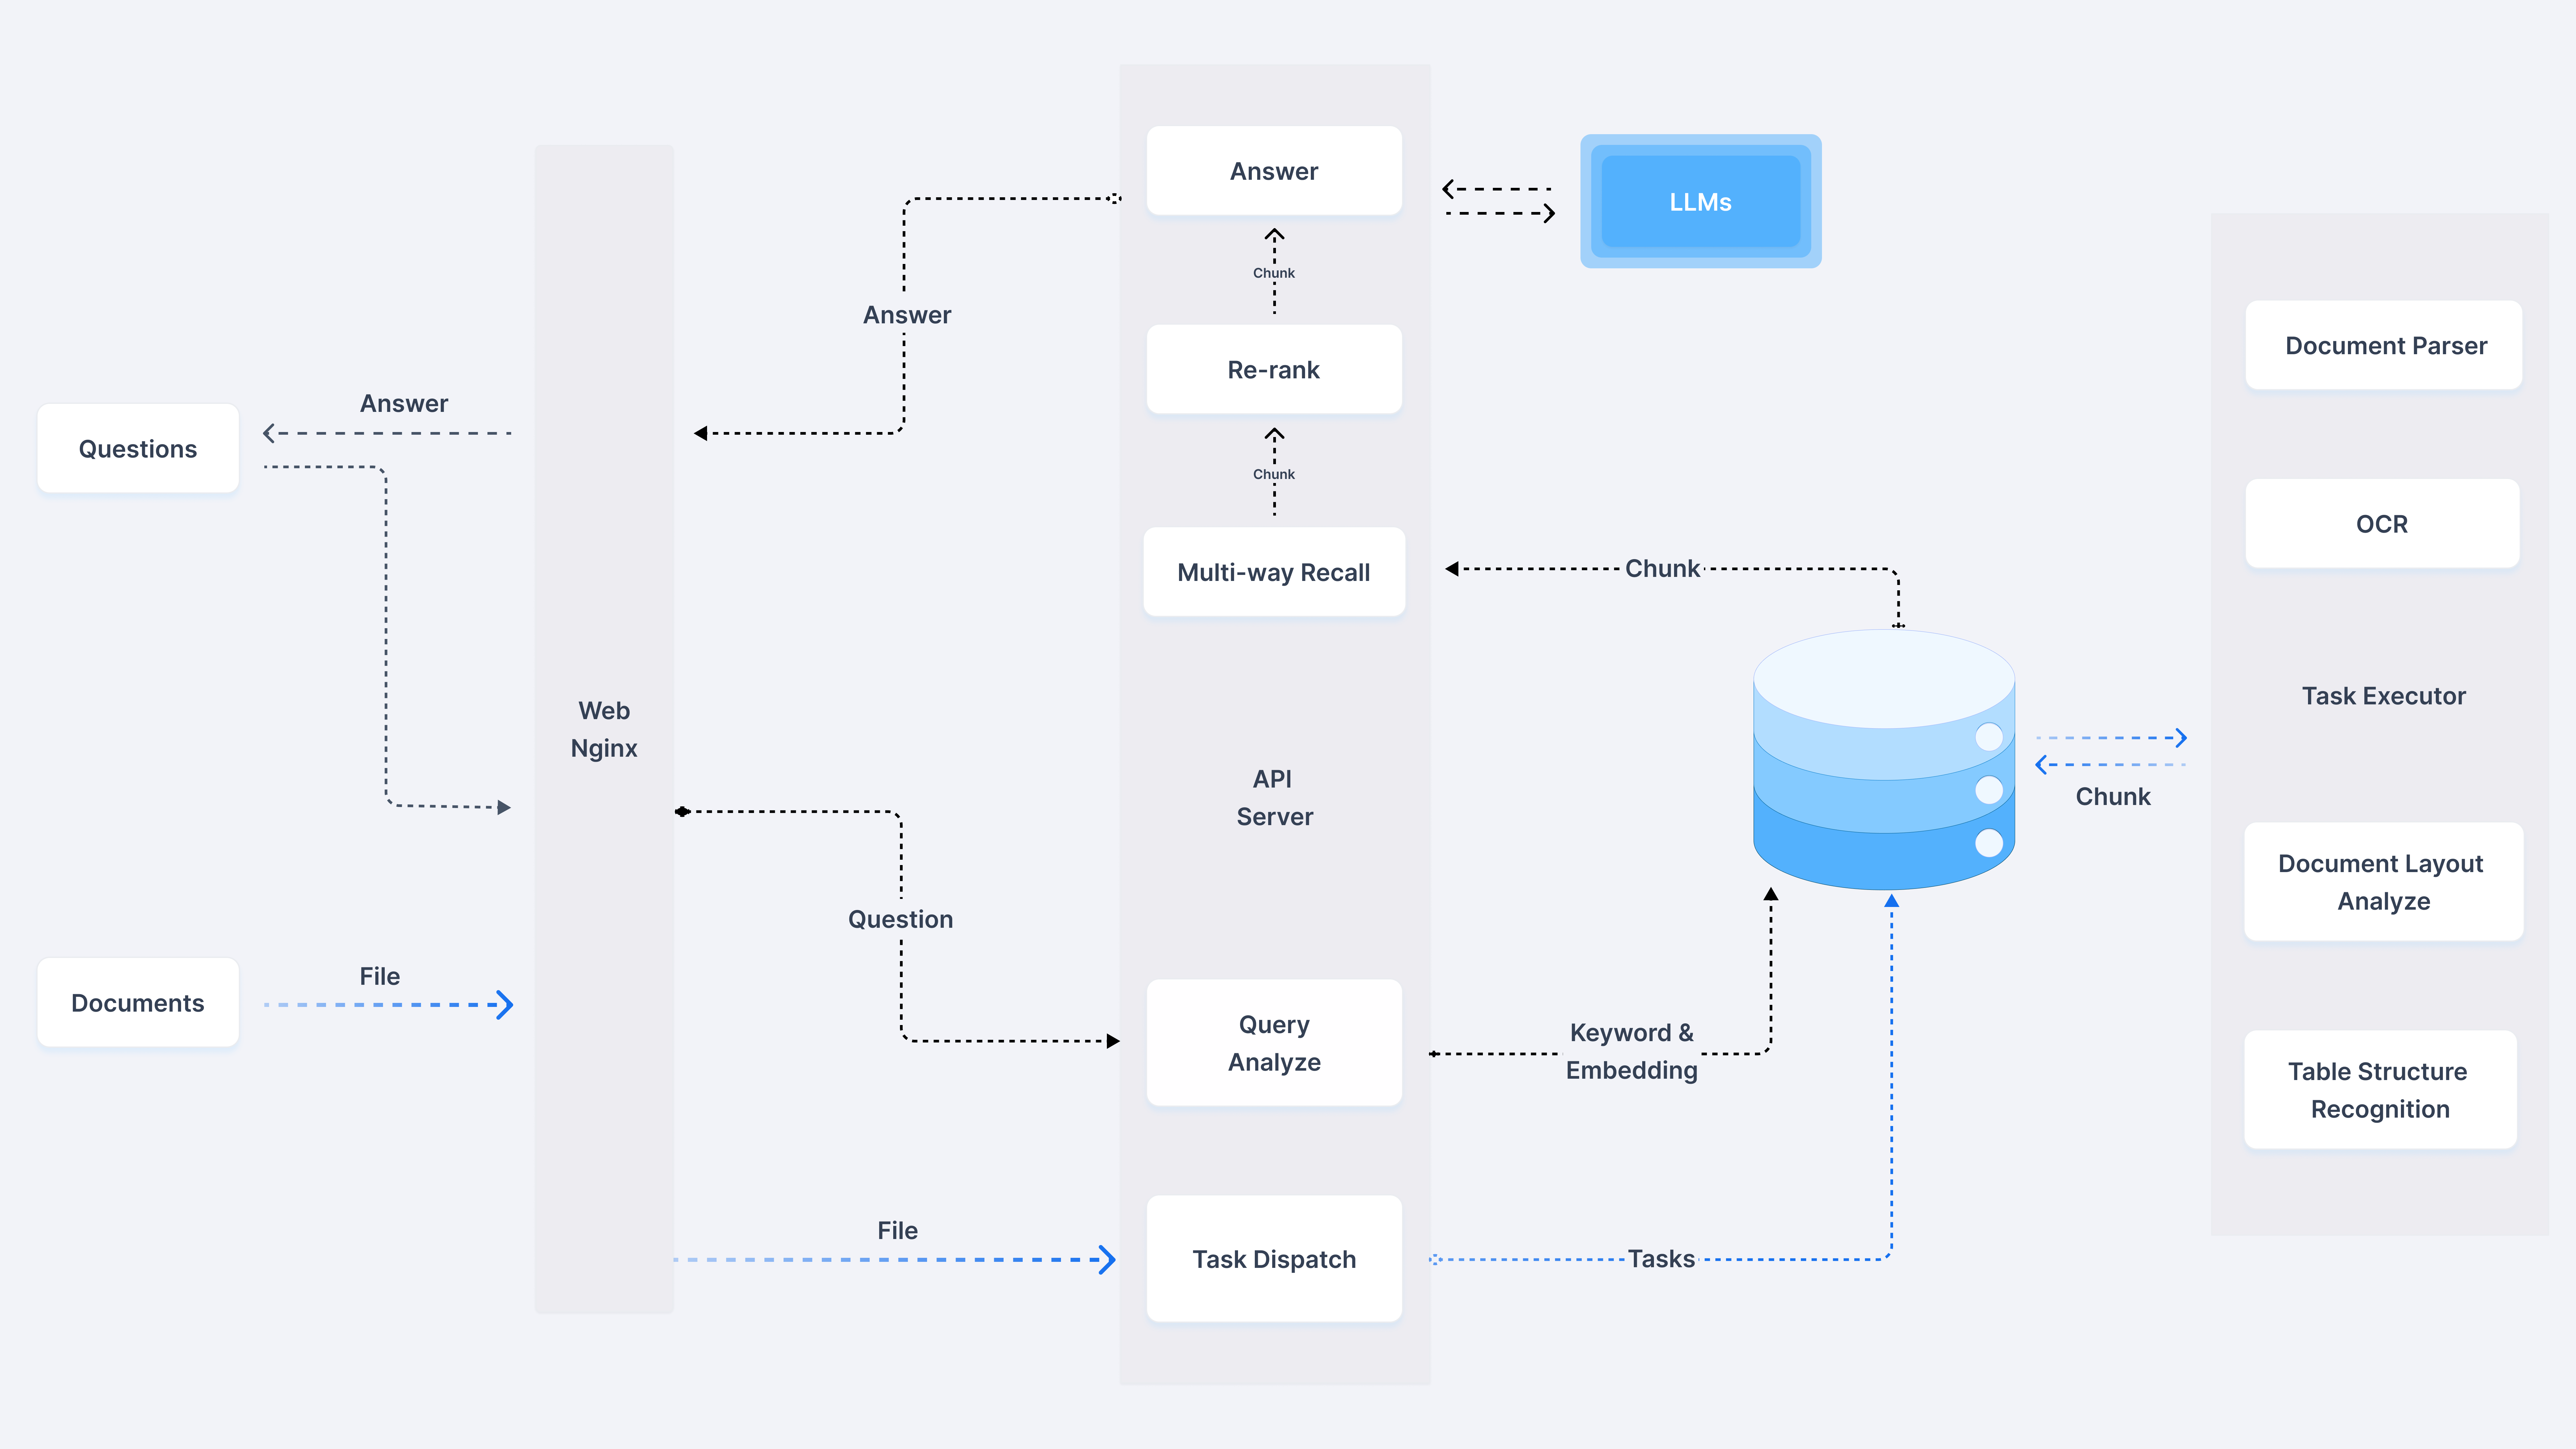
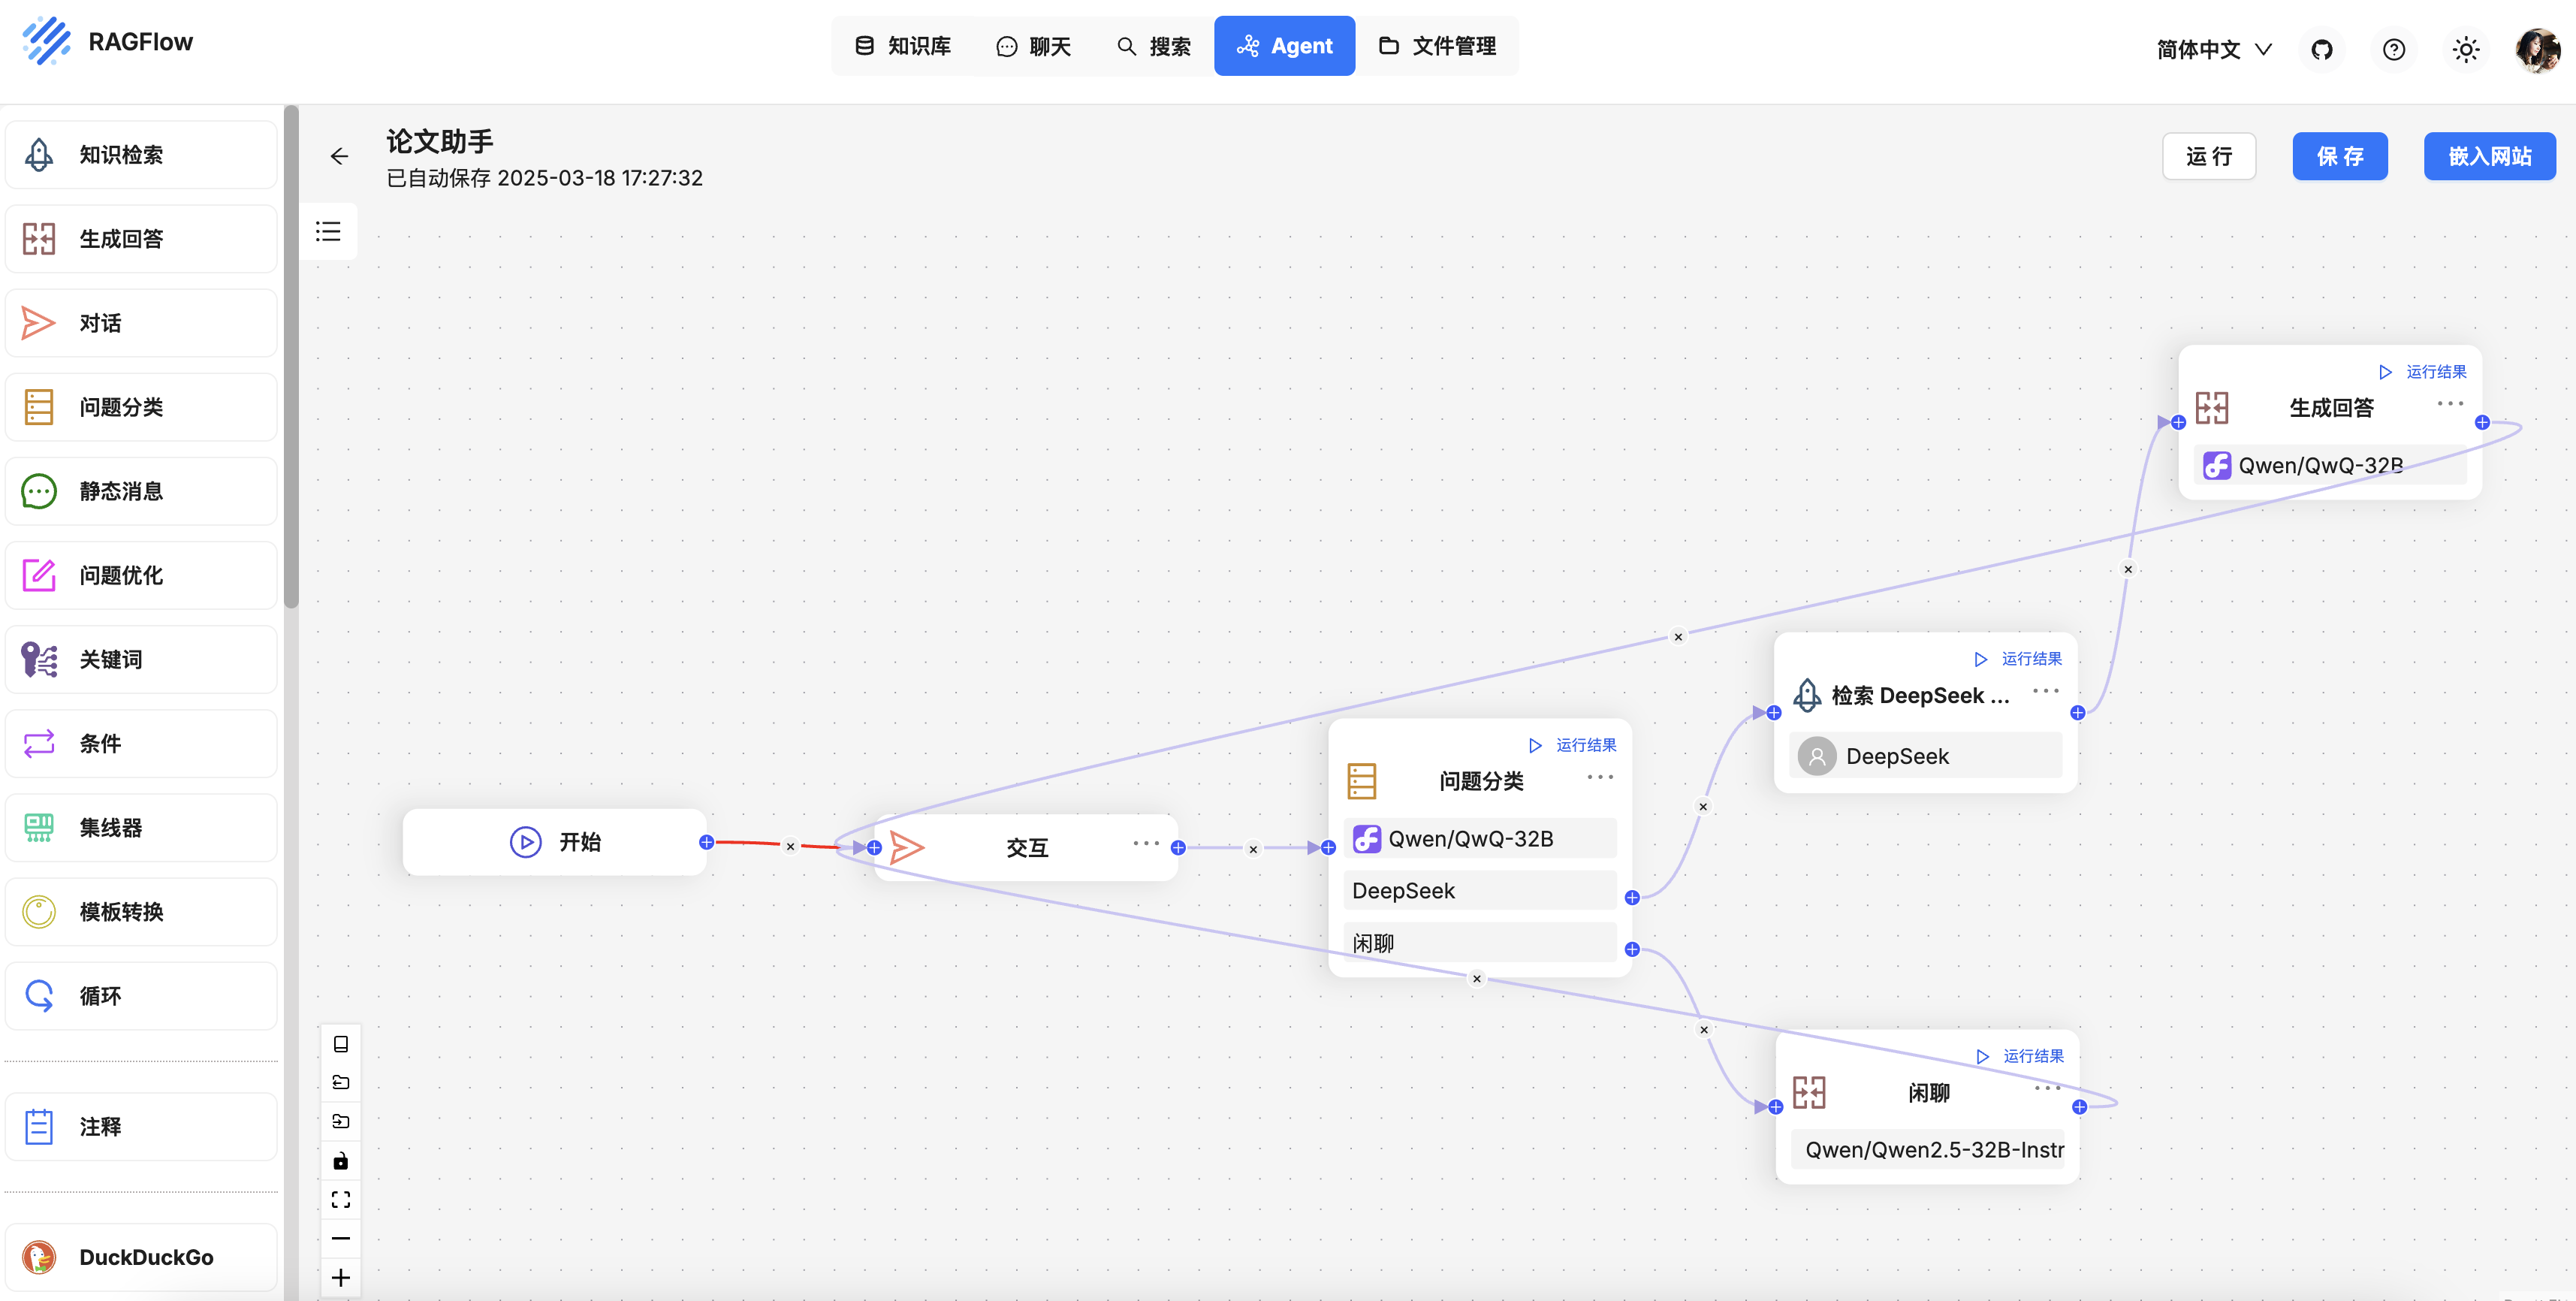
RAG 复杂场景下的工作流程
召回模式(选择数据集) → 混合检索(同时进行语义检索和关键词搜索) → 重排序(合并和归一化检索结果)
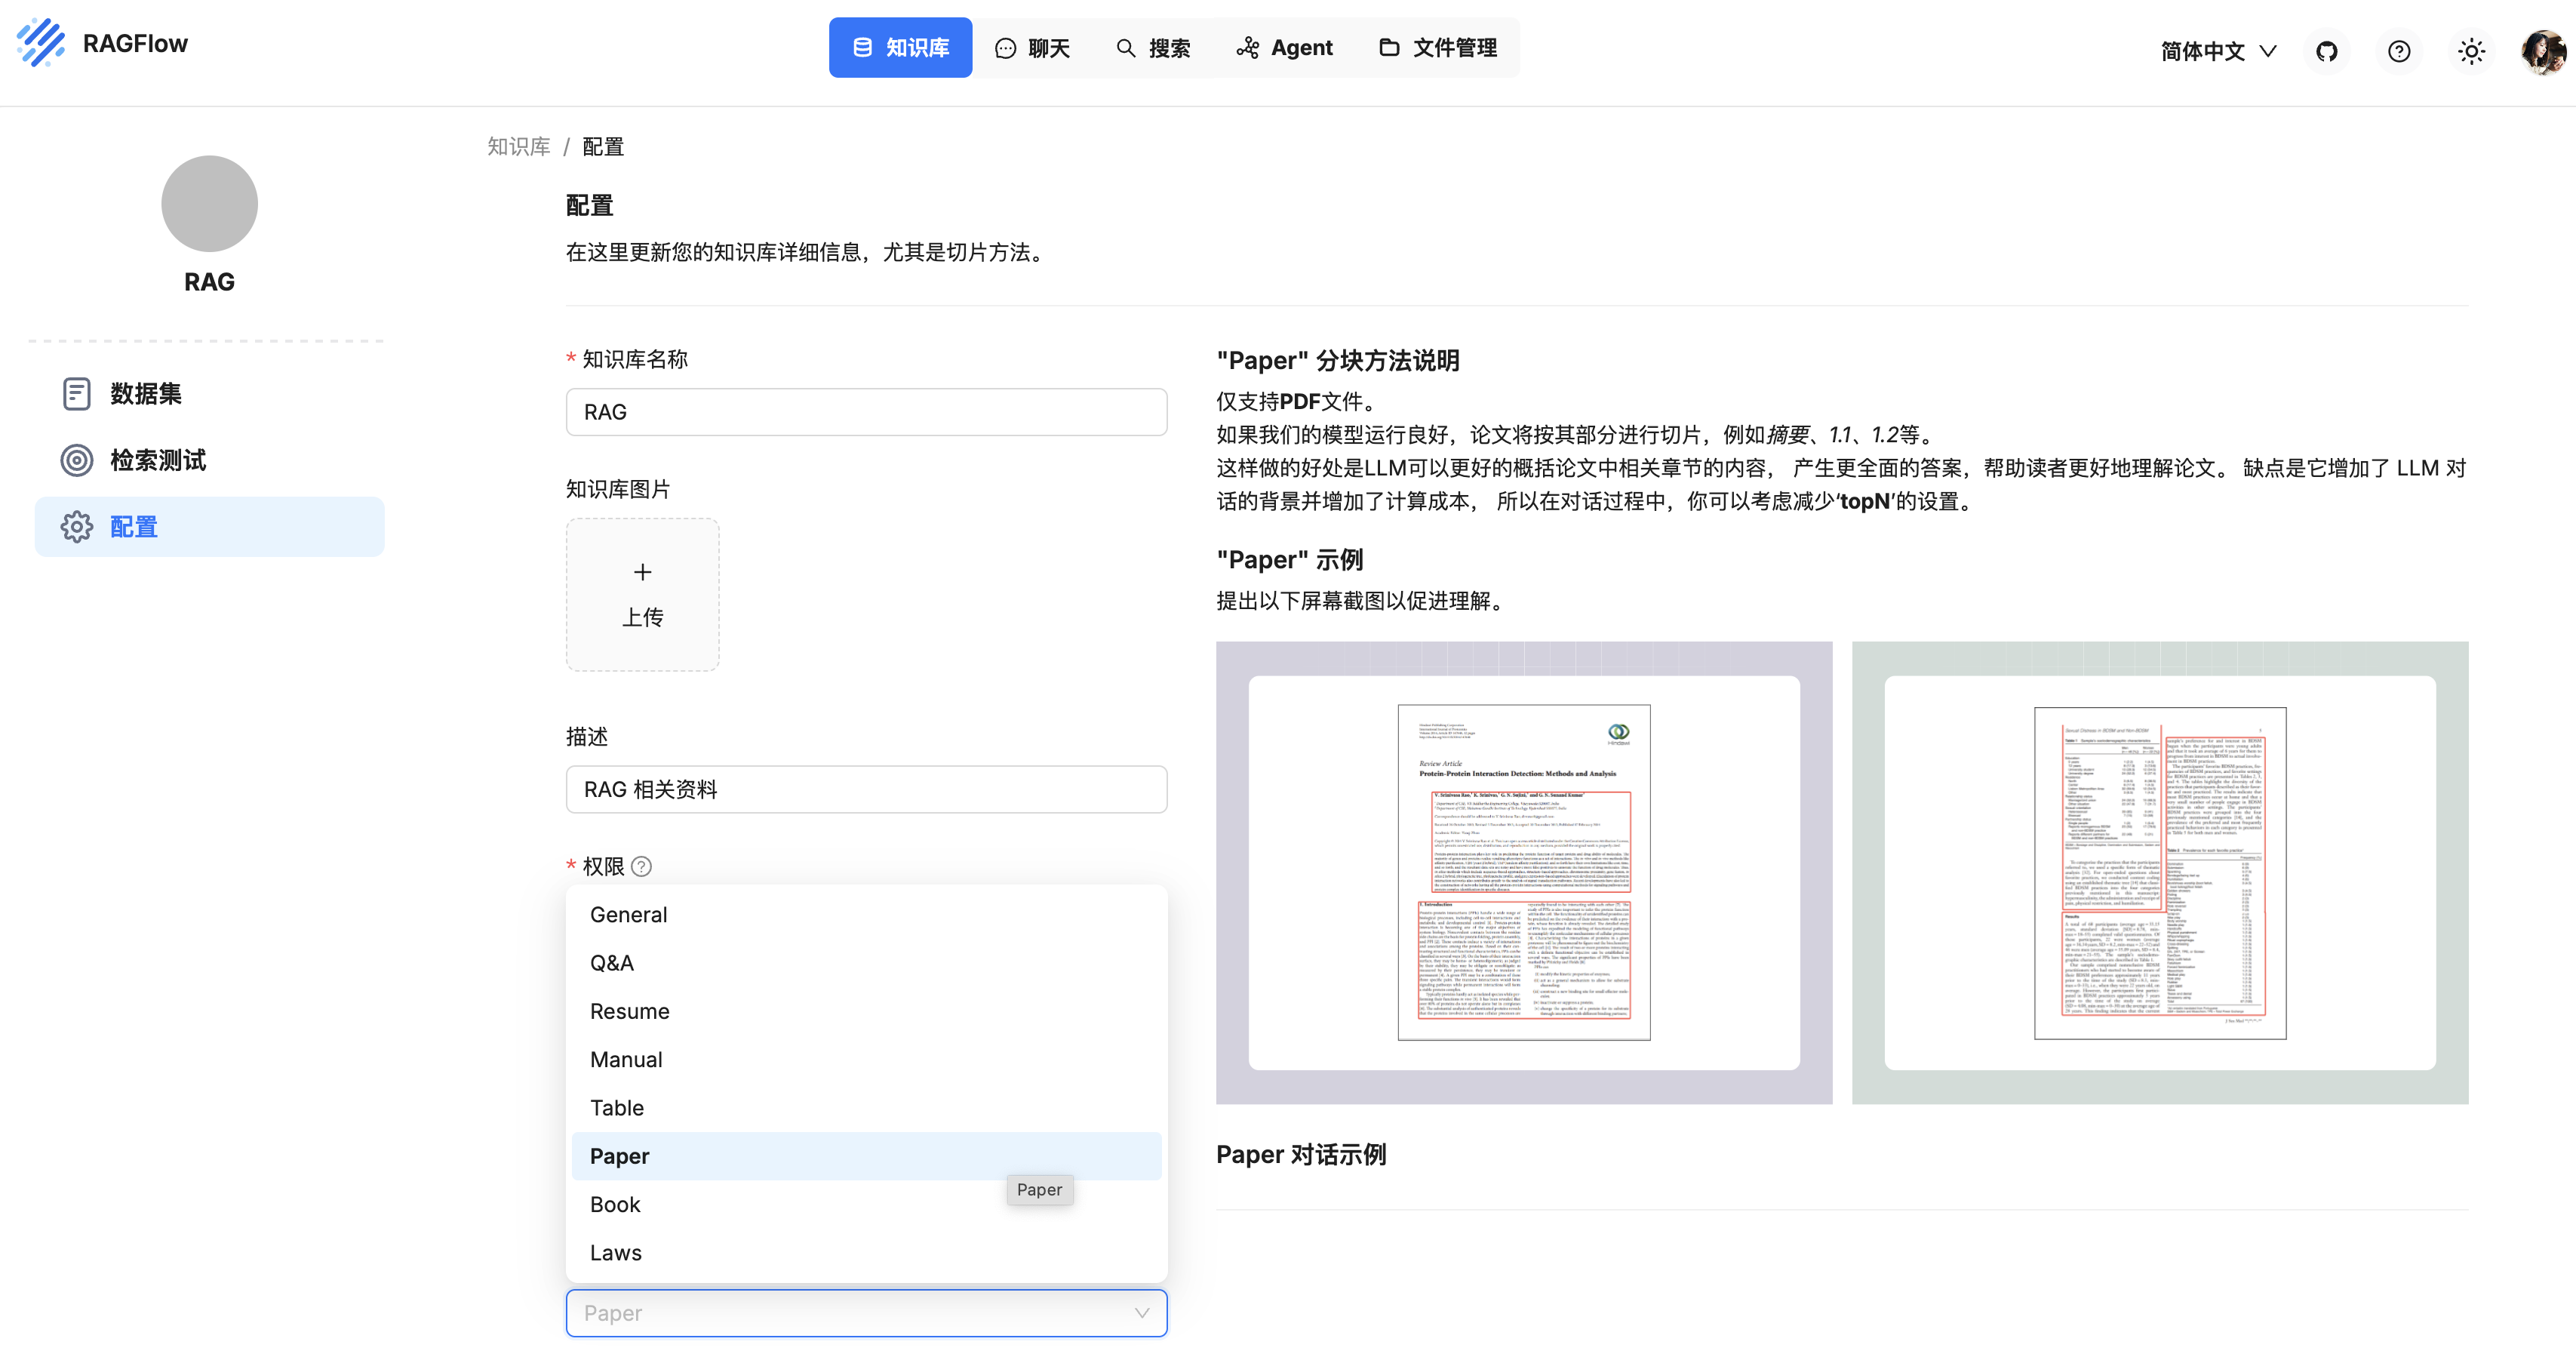
RAG 中构建知识库的解析方法
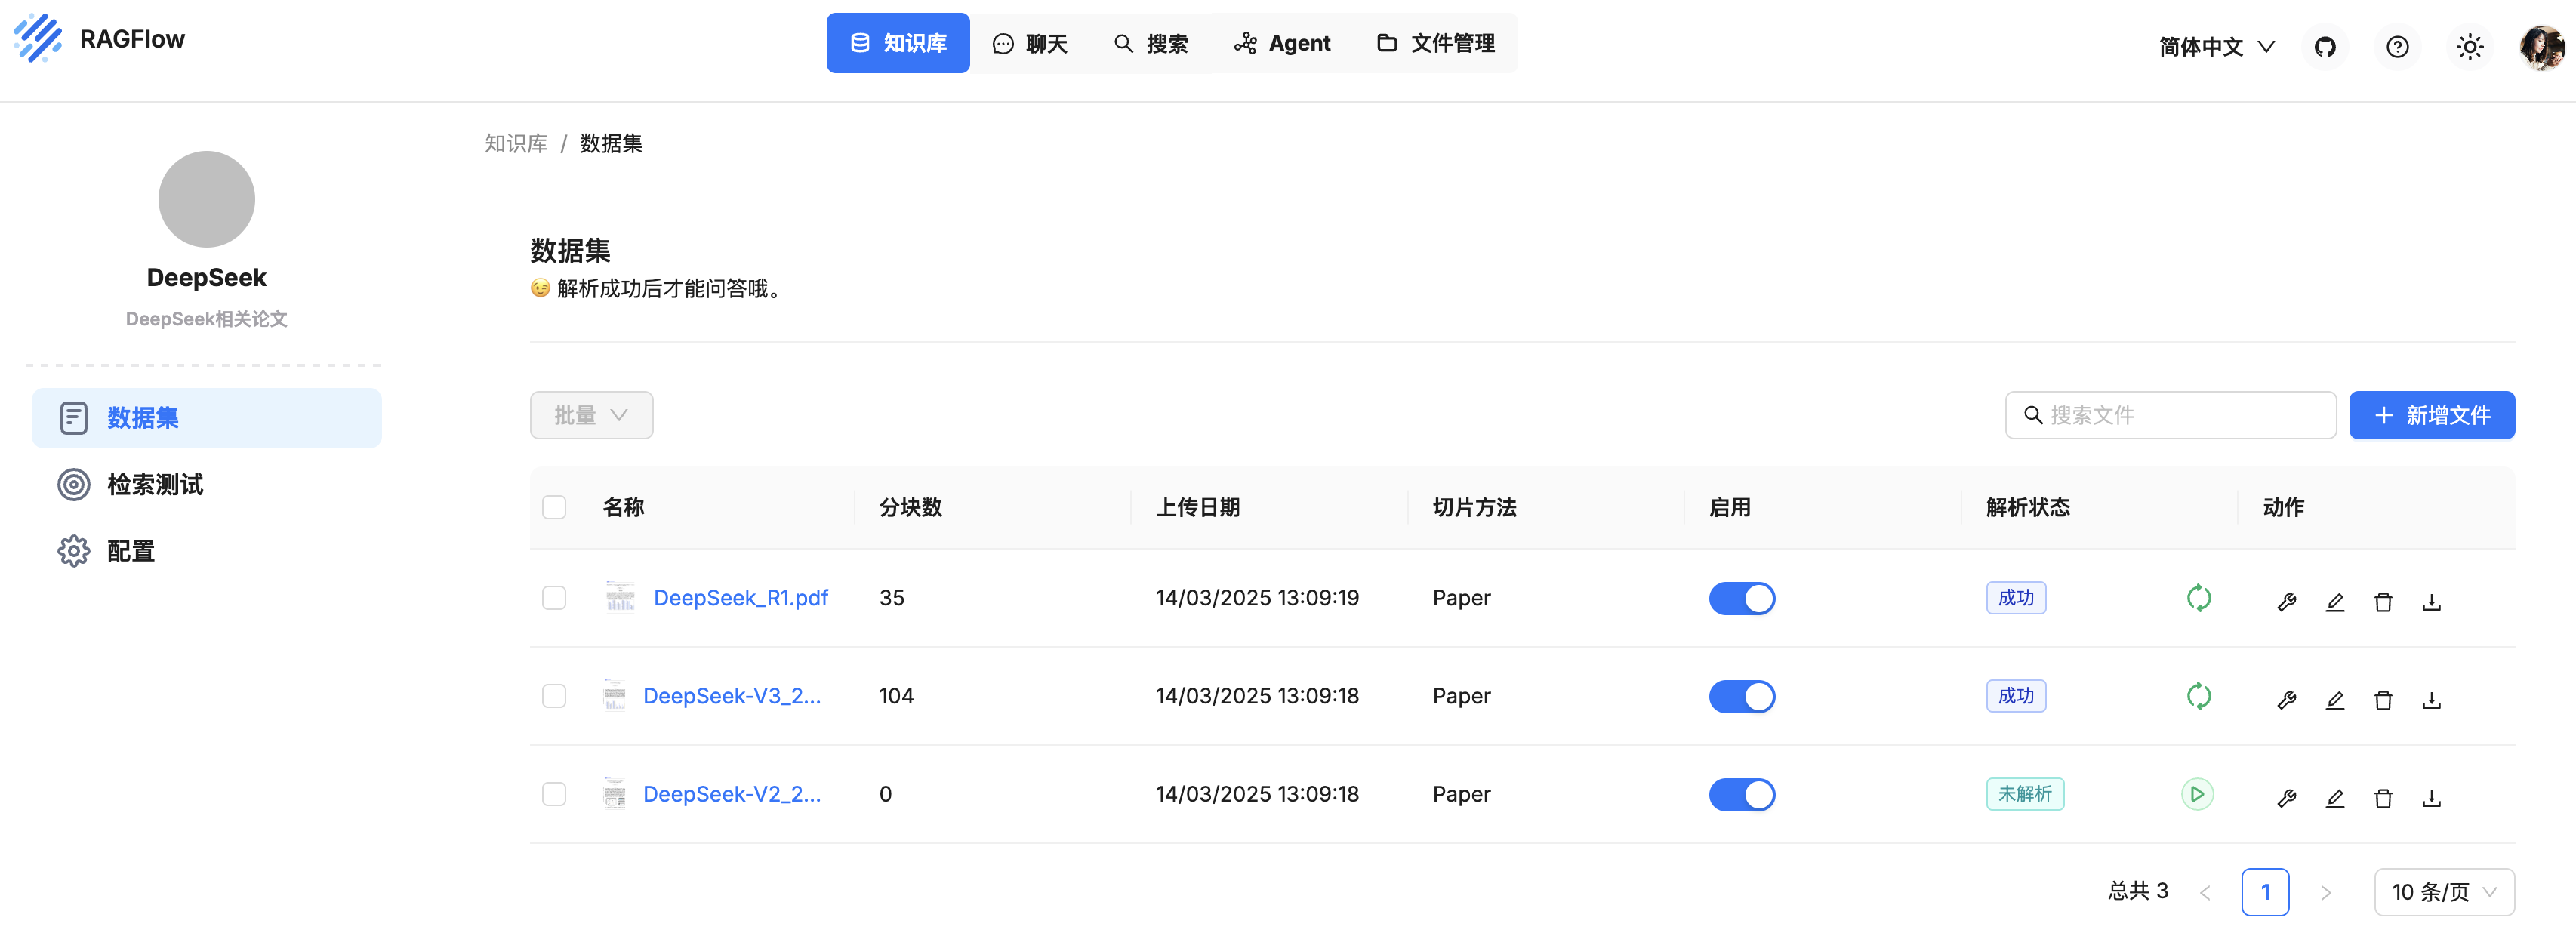
RAGFlow 是一款基于深度文档理解构建的开源 RAG 引擎,内置了丰富地文档解析方法,可以帮助用户快速构建知识库。
没有找到匹配的文章