Open Knowledge Format (OKF) 全面使用指南HTML
全面解读 OKF v0.2 规范:目录树加 Markdown 构建 Agent 可读知识库,覆盖 Bundle 结构、信任与来源字段、Attested Computation、Reference Agent 双 pass 原理与六大使用场景。
全面解读 OKF v0.2 规范:目录树加 Markdown 构建 Agent 可读知识库,覆盖 Bundle 结构、信任与来源字段、Attested Computation、Reference Agent 双 pass 原理与六大使用场景。
面向 LLM · RAG · Agent 的高精度文档解析引擎 | 实测版本
3.4.4| 含本地真实跑通经验与踩坑实录
一、介绍:MinerU 是什么
MinerU(opendatalab/MinerU)是一个面向 LLM · RAG · Agent 工作流 的高精度文档解析引擎。它把 PDF / 图片 / DOCX / PPTX / XLSX / 网页转换为机器可读的 Markdown / JSON,供下游检索、抽取与处理。它的起源是 InternLM 预训练过程中的科学文献符号(公式、表格)转换需求,因此对公式和表格的处理是强项。
一句话定位:把"人类看的文档"变成"模型能吃的干净结构化数据"——这是任何 RAG / 知识库 / 文档智能产品的第一道摄入层。
1.1 能力矩阵
基于本地实测(markitdown v0.1.6 · Python 3.13)编写,输出均为真实命令捕获,非示意。 项目:https://github.com/microsoft/markitdown | 许可证:MIT(可商用)| 维护:Microsoft AutoGen 团队
验证进度:9 种格式中,Excel / Word / HTML / ZIP / Image(EXIF) / Audio(容器元数据) 已在本地用真实文件跑通;PPT / PDF 表现与直觉有出入(已标注);YouTube 因本环境代理重置其 TLS 而未在本机跑通,命令与用法见第 5 节,可在能直连 YouTube 的机器上验证。
1. 它到底是什么
一句话:把任意文件(PDF / Office / 图片 / 音频 / 网页 / 压缩包…)转换成对 LLM 友好的 Markdown 的轻量 Python 工具。
本质定位:AI 应用链路里「模型前面的数据入口」——在喂给 RAG / 知识库 / 检索之前,先把杂乱格式洗干净。 设计哲学:不追求高保真排版还原,只保留对机器有用的结构(标题、列表、表格、链接),输出给文本分析工具消费。
⚠️ 它不是排版转换工具。如果你要的是「合同归档 / 视觉一致的 PDF 重排」,它不合适。
2. 30 秒上手
Markdown 渲染器是什么
Markdown 渲染器是一款纯前端的在线 Markdown 转 HTML 工具。它调用 GitHub Markdown API 进行渲染,支持 GitHub Flavored Markdown (GFM) 标准,输出干净的 HTML 代码和实时预览,无需安装任何软件,打开浏览器即可使用。
核心功能
使用方式
版本 0.1 — 草案
OKF 是一种开放、对人类和智能体友好的格式,用于表示知识——即围绕数据和系统的元数据、上下文和精心整理的洞察。它旨在由人类编写、由智能体生成、跨组织交换,并由两者共同消费。
该格式有意保持极简:一个由 Markdown 文件和 YAML 前置元数据组成的目录。没有 Schema 注册中心,没有中央权威机构,也不需要任何特定工具。如果你能 cat 一个文件,你就能读取 OKF;如果你能 git clone 一个仓库,你就能分发它。
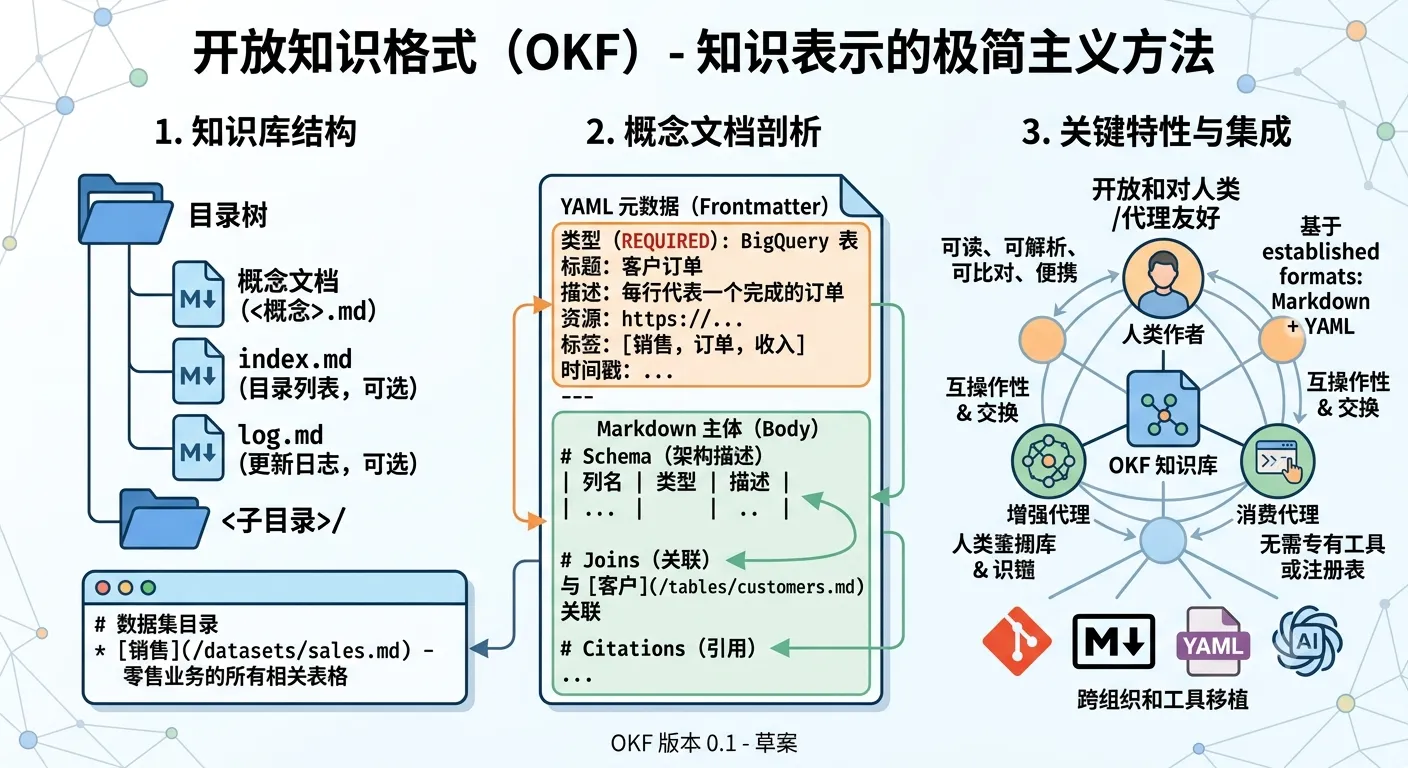
1. 动机
面向 AI 智能体的知识表示领域正在快速演进,许多互不兼容的约定正在涌现。OKF 的立场是,知识最好用常见、已建立的格式来表示,这些格式应具备以下特性:
该格式保持最低限度的主观性。它仅标准化一小套结构约定,使知识语料库能够自我描述——除此之外的一切留给生产者自行决定。
目标
非目标
Thariq: Using Claude Code: The Unreasonable Effectiveness of HTML
Markdown 已成为智能体(agent)与我们沟通时占主导地位的文件格式。它简单、可移植,具备一定的富文本能力,且易于编辑。Claude 甚至已经相当擅长在 Markdown 文件中使用 ASCII 绘制图表。
但随着智能体变得越来越强大,我感到 Markdown 已成为一种受限的格式。我发现自己很难阅读超过一百行的 Markdown 文件。我想要更丰富的可视化效果、色彩和图表,并且希望能轻松分享它们。
我也越来越不亲自编辑这些文件,而是将它们用作规格说明、参考文件、头脑风暴输出等。当我确实需要编辑时,我通常会让 Claude 来编辑,这就削弱了 Markdown 最大的一个优势。
我开始更偏爱 HTML 作为输出格式,而不是 Markdown,并且越来越多地看到 Claude Code 团队中的其他人也在使用它。以下就是原因。
(如果你想先看一些示例,可以在这里看到一大堆:https://thariqs.github.io/html-effectiveness ,不过记得回来看更多关于"为什么"的内容。)
为什么选择 HTML?
信息密度
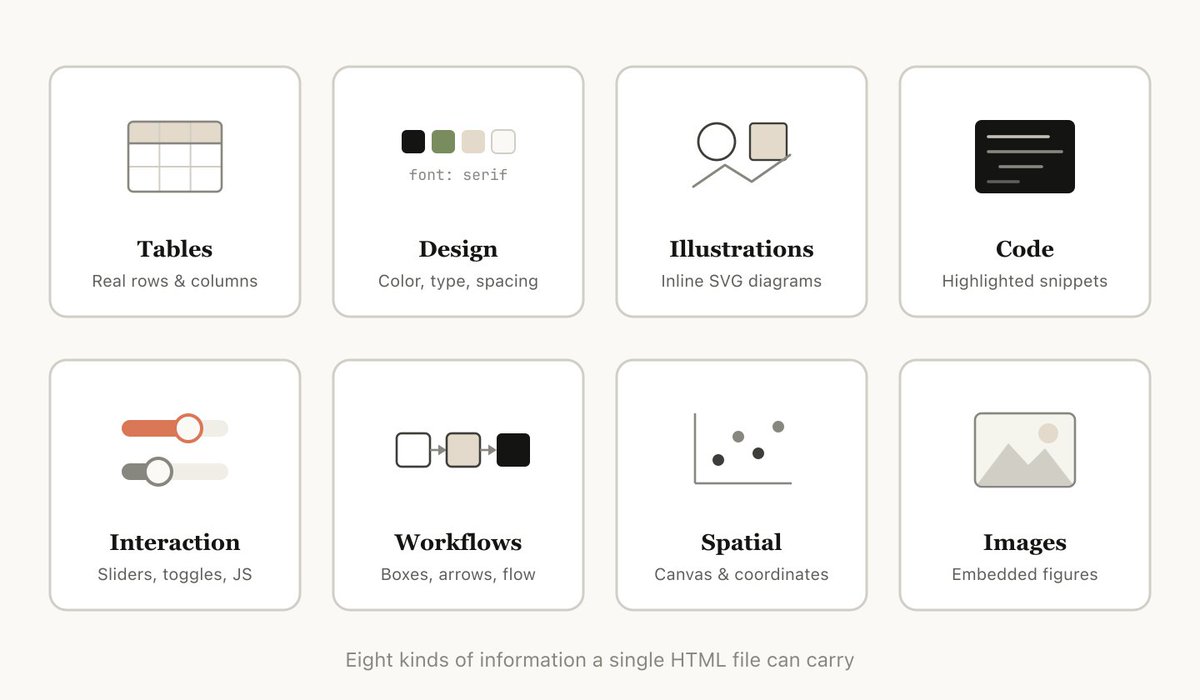
与 Markdown 相比,HTML 能够传达更丰富得多的信息。
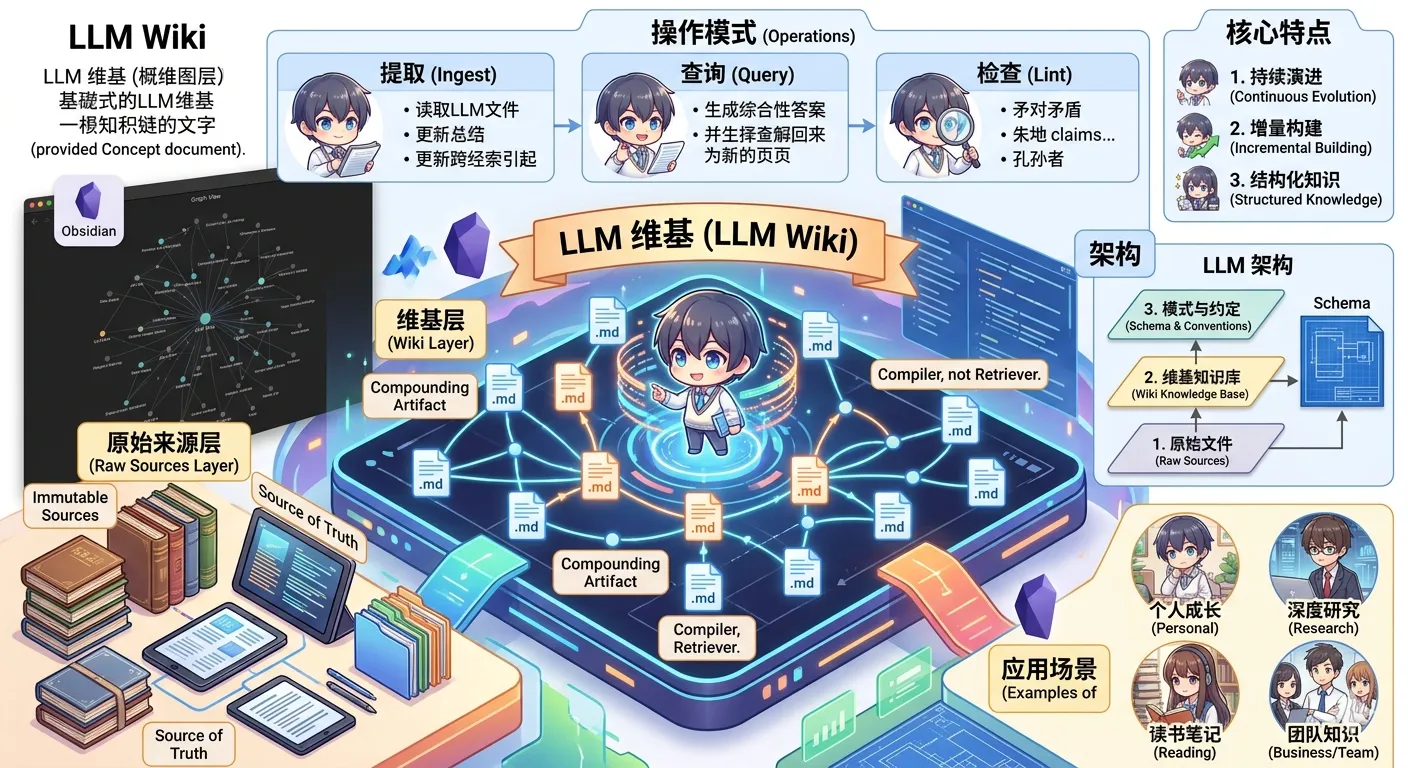
使用大语言模型(LLM)构建个人知识库的模式。
这是一份概念文件,设计用于复制粘贴到你自己的 LLM 智能体中(例如 OpenAI Codex、Claude Code、OpenCode / Pi 等)。它的目标是传达高层级的理念,而具体细节将由你的智能体与你协作构建。
核心理念
大多数人与 LLM 和文档打交道的体验看起来像是 RAG:你上传一批文件,LLM 在查询时检索相关片段,然后生成答案。这确实有效,但 LLM 每次都要从零开始重新发现知识,没有任何积累。当你问一个需要综合五份文档的微妙问题时,LLM 必须每次都找到并拼凑相关片段,没有任何东西被沉淀下来。NotebookLM、ChatGPT 文件上传以及大多数 RAG 系统都是这样工作的。
这里的理念不同。与其仅在查询时从原始文档中检索,LLM 增量式地构建并维护一个持久的维基 —— 一个结构化的、相互关联的 Markdown 文件集合,位于你和原始来源之间。当你添加新来源时,LLM 不只是将其索引以备后用。它会阅读来源,提取关键信息,并将其整合到现有维基中 —— 更新实体页面、修订主题摘要、标注新数据与旧主张的矛盾之处、强化或挑战不断演进的综合结论。知识被编译一次,然后保持最新,而不是每次查询都重新推导。
这就是关键区别:维基是一个持久的、复合增长的产物。
WikiLLM
利用 LLM 构建个人知识库的系统。WikiLLM 将原始素材"编译"成结构化、交叉链接的高质量中文 Wiki,可在 Obsidian 中查看。
本项目基于 Andrej Karpathy 提出的理念构建。详见:LLM Knowledge Bases
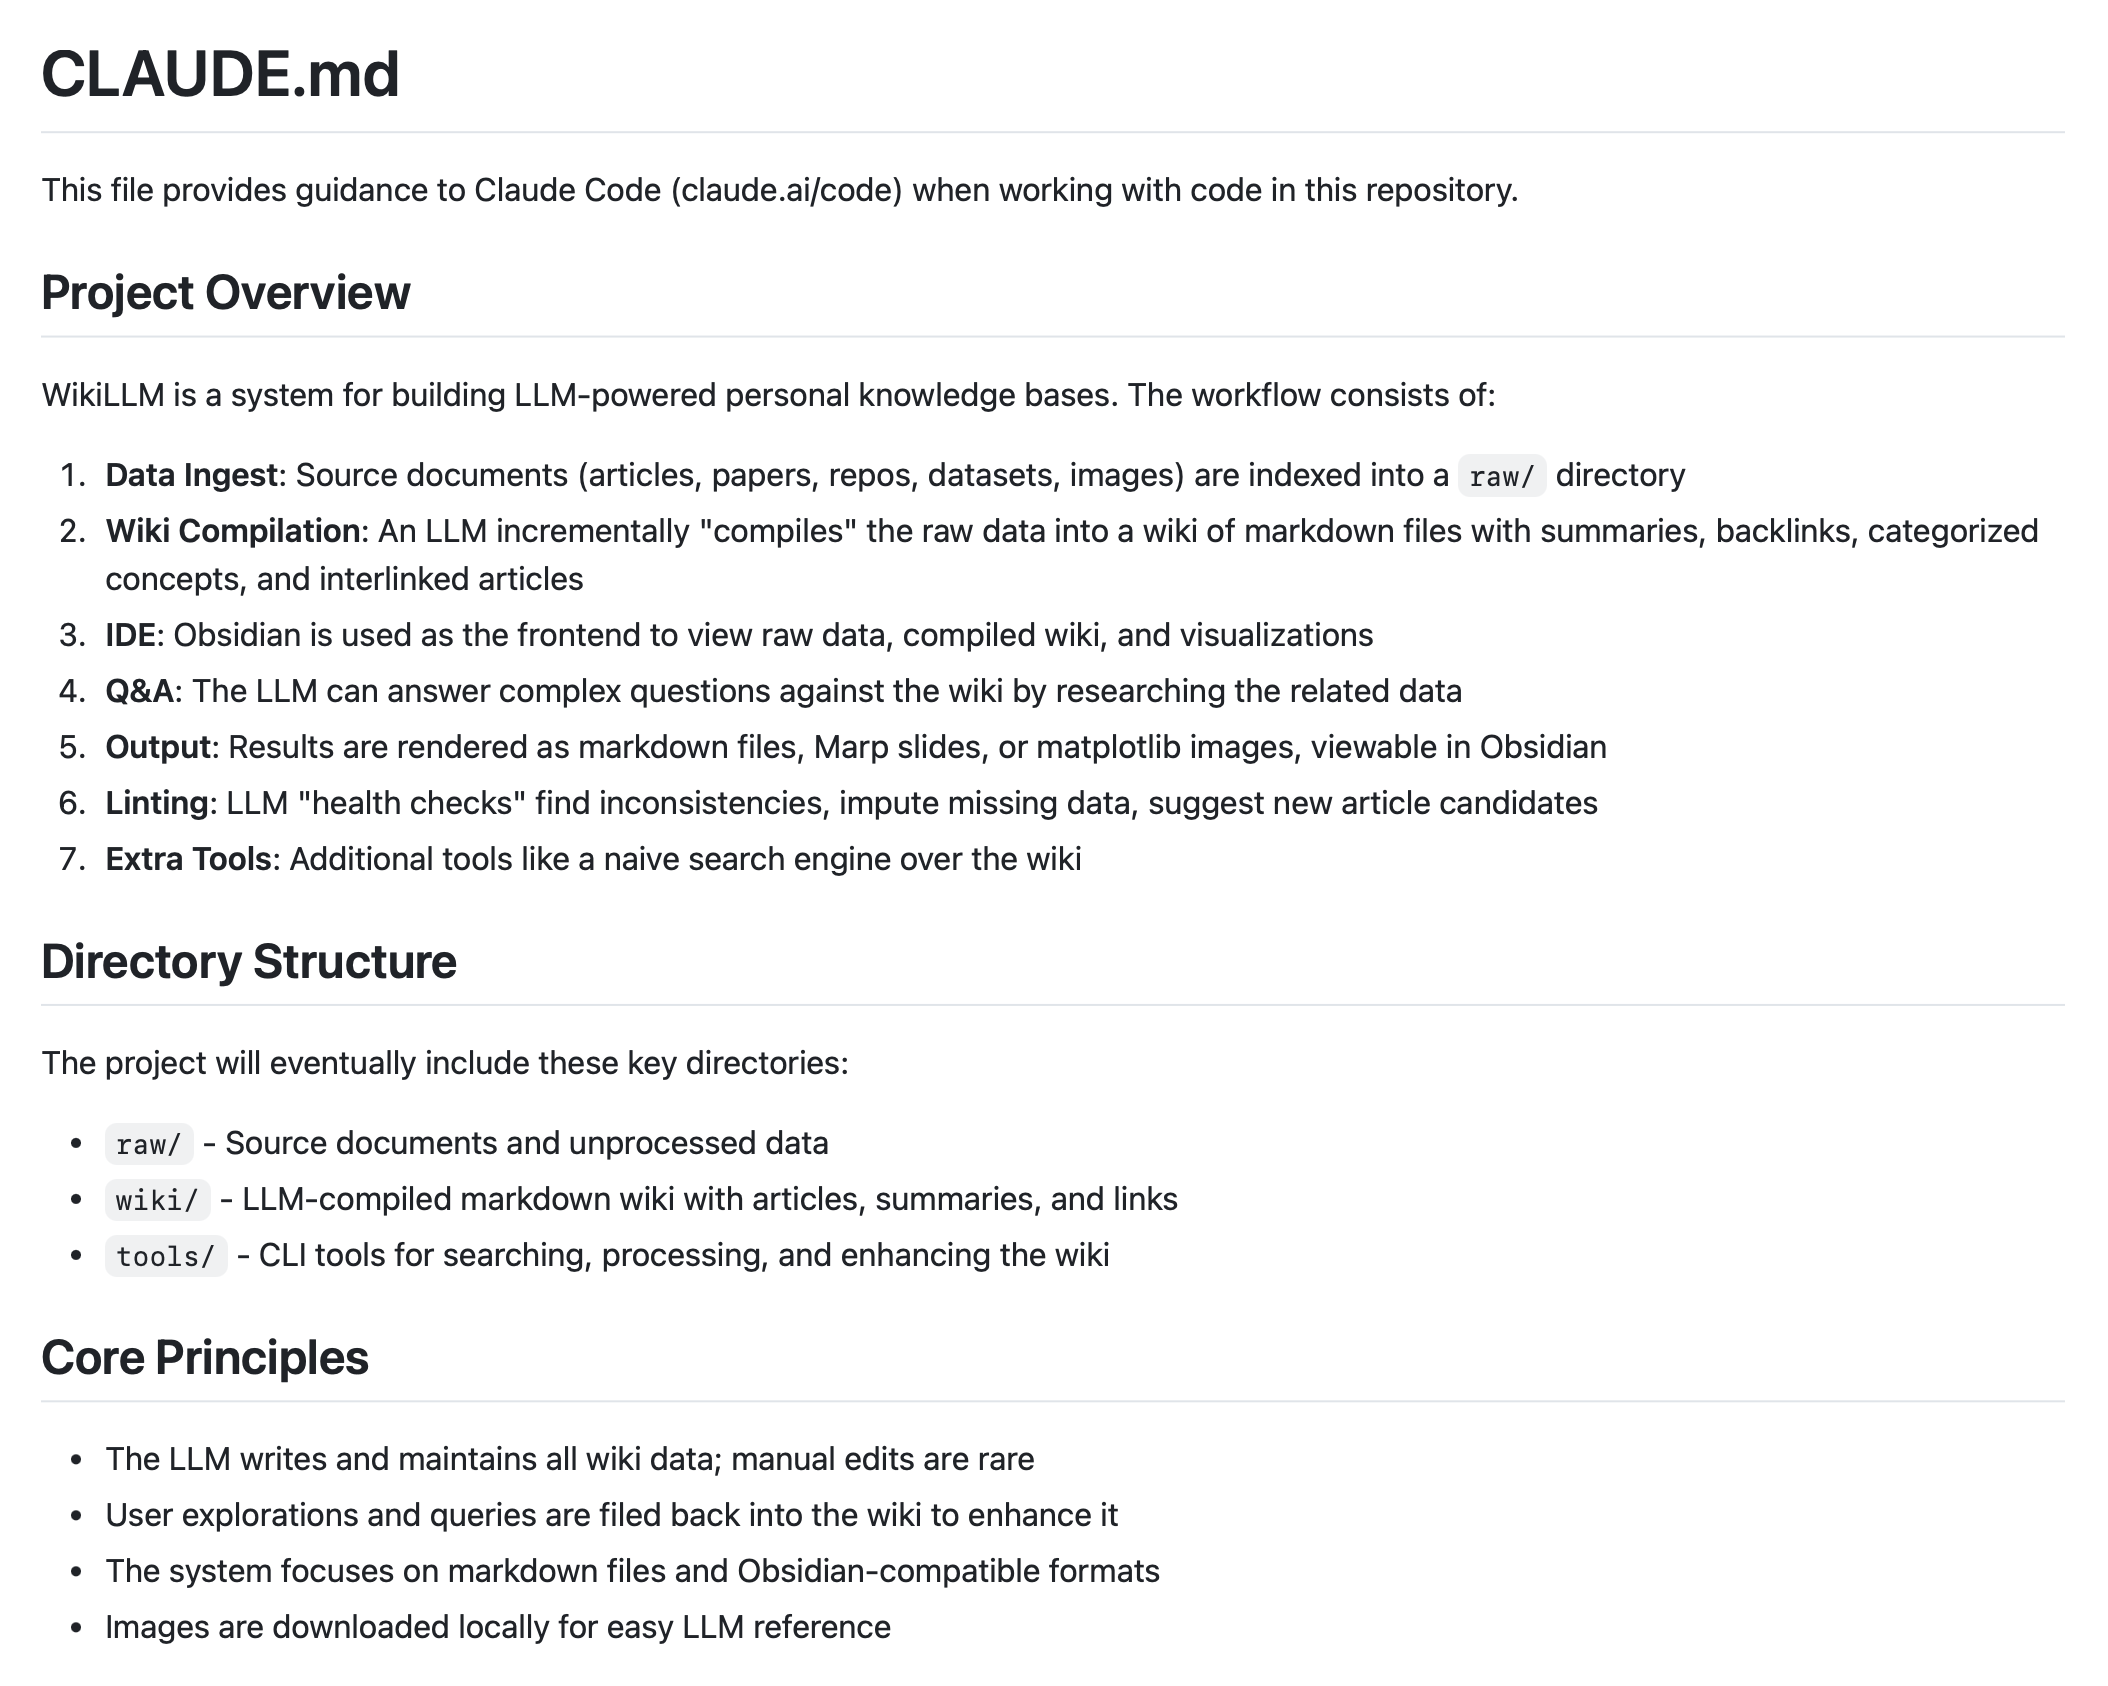
项目概述
WikiLLM 的工作流包括:
raw/ 目录核心原则
目录结构
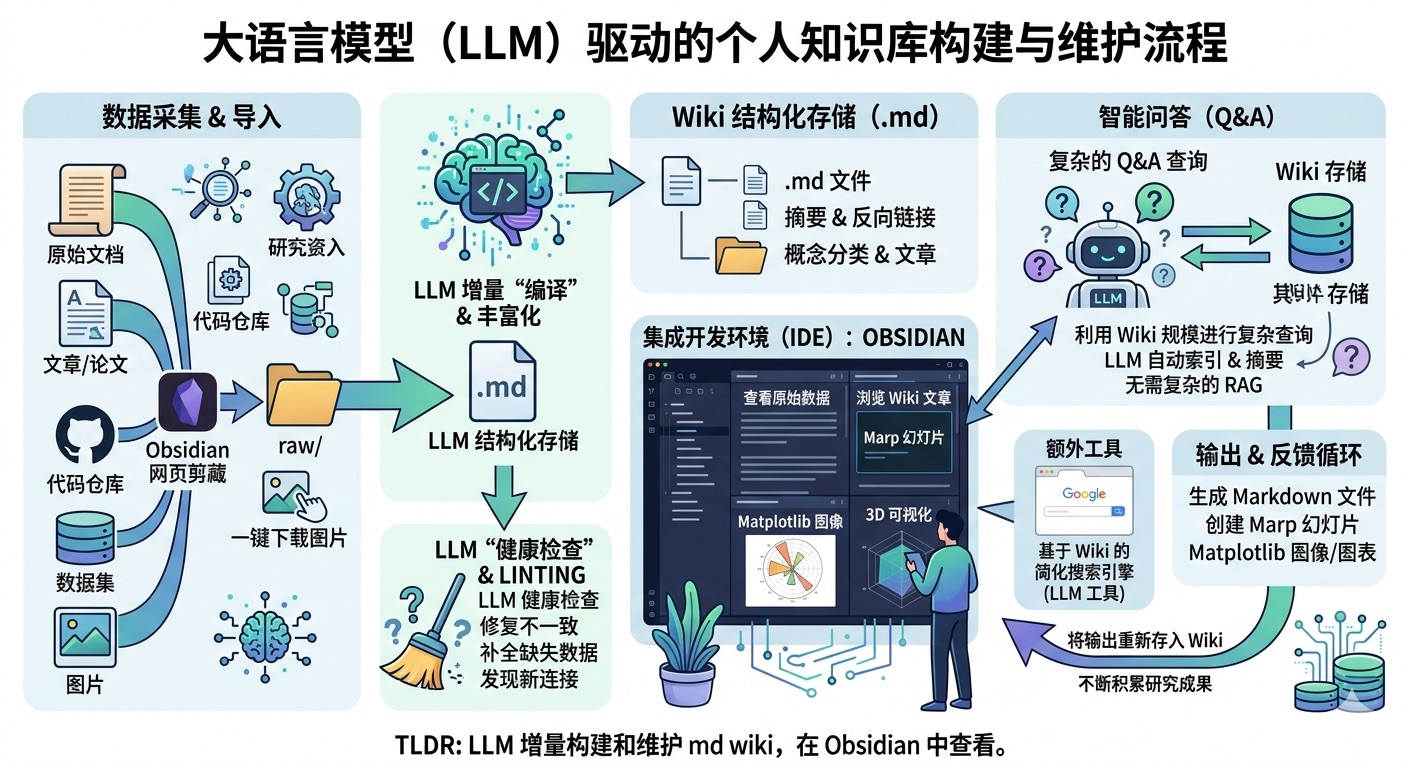
最近我发现一个非常实用的方法:利用大语言模型(LLM)为各类感兴趣的研究方向搭建个人知识库。这样一来,我近期消耗的模型令牌中,用于处理代码的占比大幅减少,更多被用于处理知识(以 Markdown 文件和图片形式存储)。最新的大语言模型在这方面表现十分出色。具体做法如下:
数据导入
我先将各类源文件(文章、论文、代码仓库、数据集、图片等)归档到 raw/ 目录下,再通过大语言模型逐步“编译”生成一份知识库,这份知识库本质就是按目录结构组织的一系列 .md 文件。
知识库会包含 raw/ 目录下所有数据的摘要、反向链接,还会将数据按概念分类、撰写对应词条并完成相互关联。
为把网页文章转为 .md 文件,我习惯使用 Obsidian 网页剪藏插件,同时通过快捷键将相关图片批量下载到本地,方便大语言模型直接调用。
集成开发环境
我把 Obsidian 当作前端 IDE,既能查看原始数据、编译后的知识库,也能查看衍生的可视化内容。 需要重点说明的是:整个知识库的内容撰写与维护均由大语言模型完成,我几乎不直接手动修改。我还试用过多款 Obsidian 插件,以其他形式渲染和查看数据(比如用 Marp 制作幻灯片)。
问答交互 真正有意思的是,当知识库规模足够大时(比如我近期的研究知识库已有约 100 篇词条、40 万字),就可以向大语言模型智能体提出各类复杂问题
关于标准化使用 /llms.txt 文件以提供信息,帮助大语言模型(LLM)在推理阶段使用网站内容的提案。
Jeremy Howard 2024-09-03
背景
大型语言模型(LLM)越来越依赖网站信息,但面临一个关键限制:上下文窗口(Context Windows)太小,无法处理大多数完整的网站内容。将包含导航、广告和 JavaScript 的复杂 HTML 页面转换为 LLM 友好的纯文本内容既困难又不精确。
虽然网站同时服务于人类读者和 LLM,但 LLM 受益于在单一可访问位置收集的更简洁、专业级别的信息。这在开发环境等用例中尤为重要,LLM 需要快速访问编程文档和 API。
提案
我们建议在网站上添加一个 /llms.txt Markdown 文件,以提供 LLM 友好的内容。该文件提供简要的背景信息、指导和指向详细 Markdown 文件的链接。
llms.txt Markdown 既可以被人类阅读,也可以被 LLM 读取,同时具有精确的格式,允许使用固定的处理方法(即经典的编程技术,如解析器和正则表达式)。
我们进一步建议,网站上可能对 LLM 有价值的信息页面应提供该页面的干净 Markdown 版本,URL 与原始页面相同,但附加 .md 扩展名。(没有文件名的 URL 应附加 index.html.md 代替。)
🦞 OpenClaw 是一个本地优先(Local-First)、高度自治、基于 Markdown 记忆管理的 AI Agent(智能体)系统。
它的核心亮点在于:
HEARTBEAT) 和分层记忆,试图构建一个有“长期记忆”和“自主行为”的 AI,而不仅仅是一个聊天机器人。架构系统
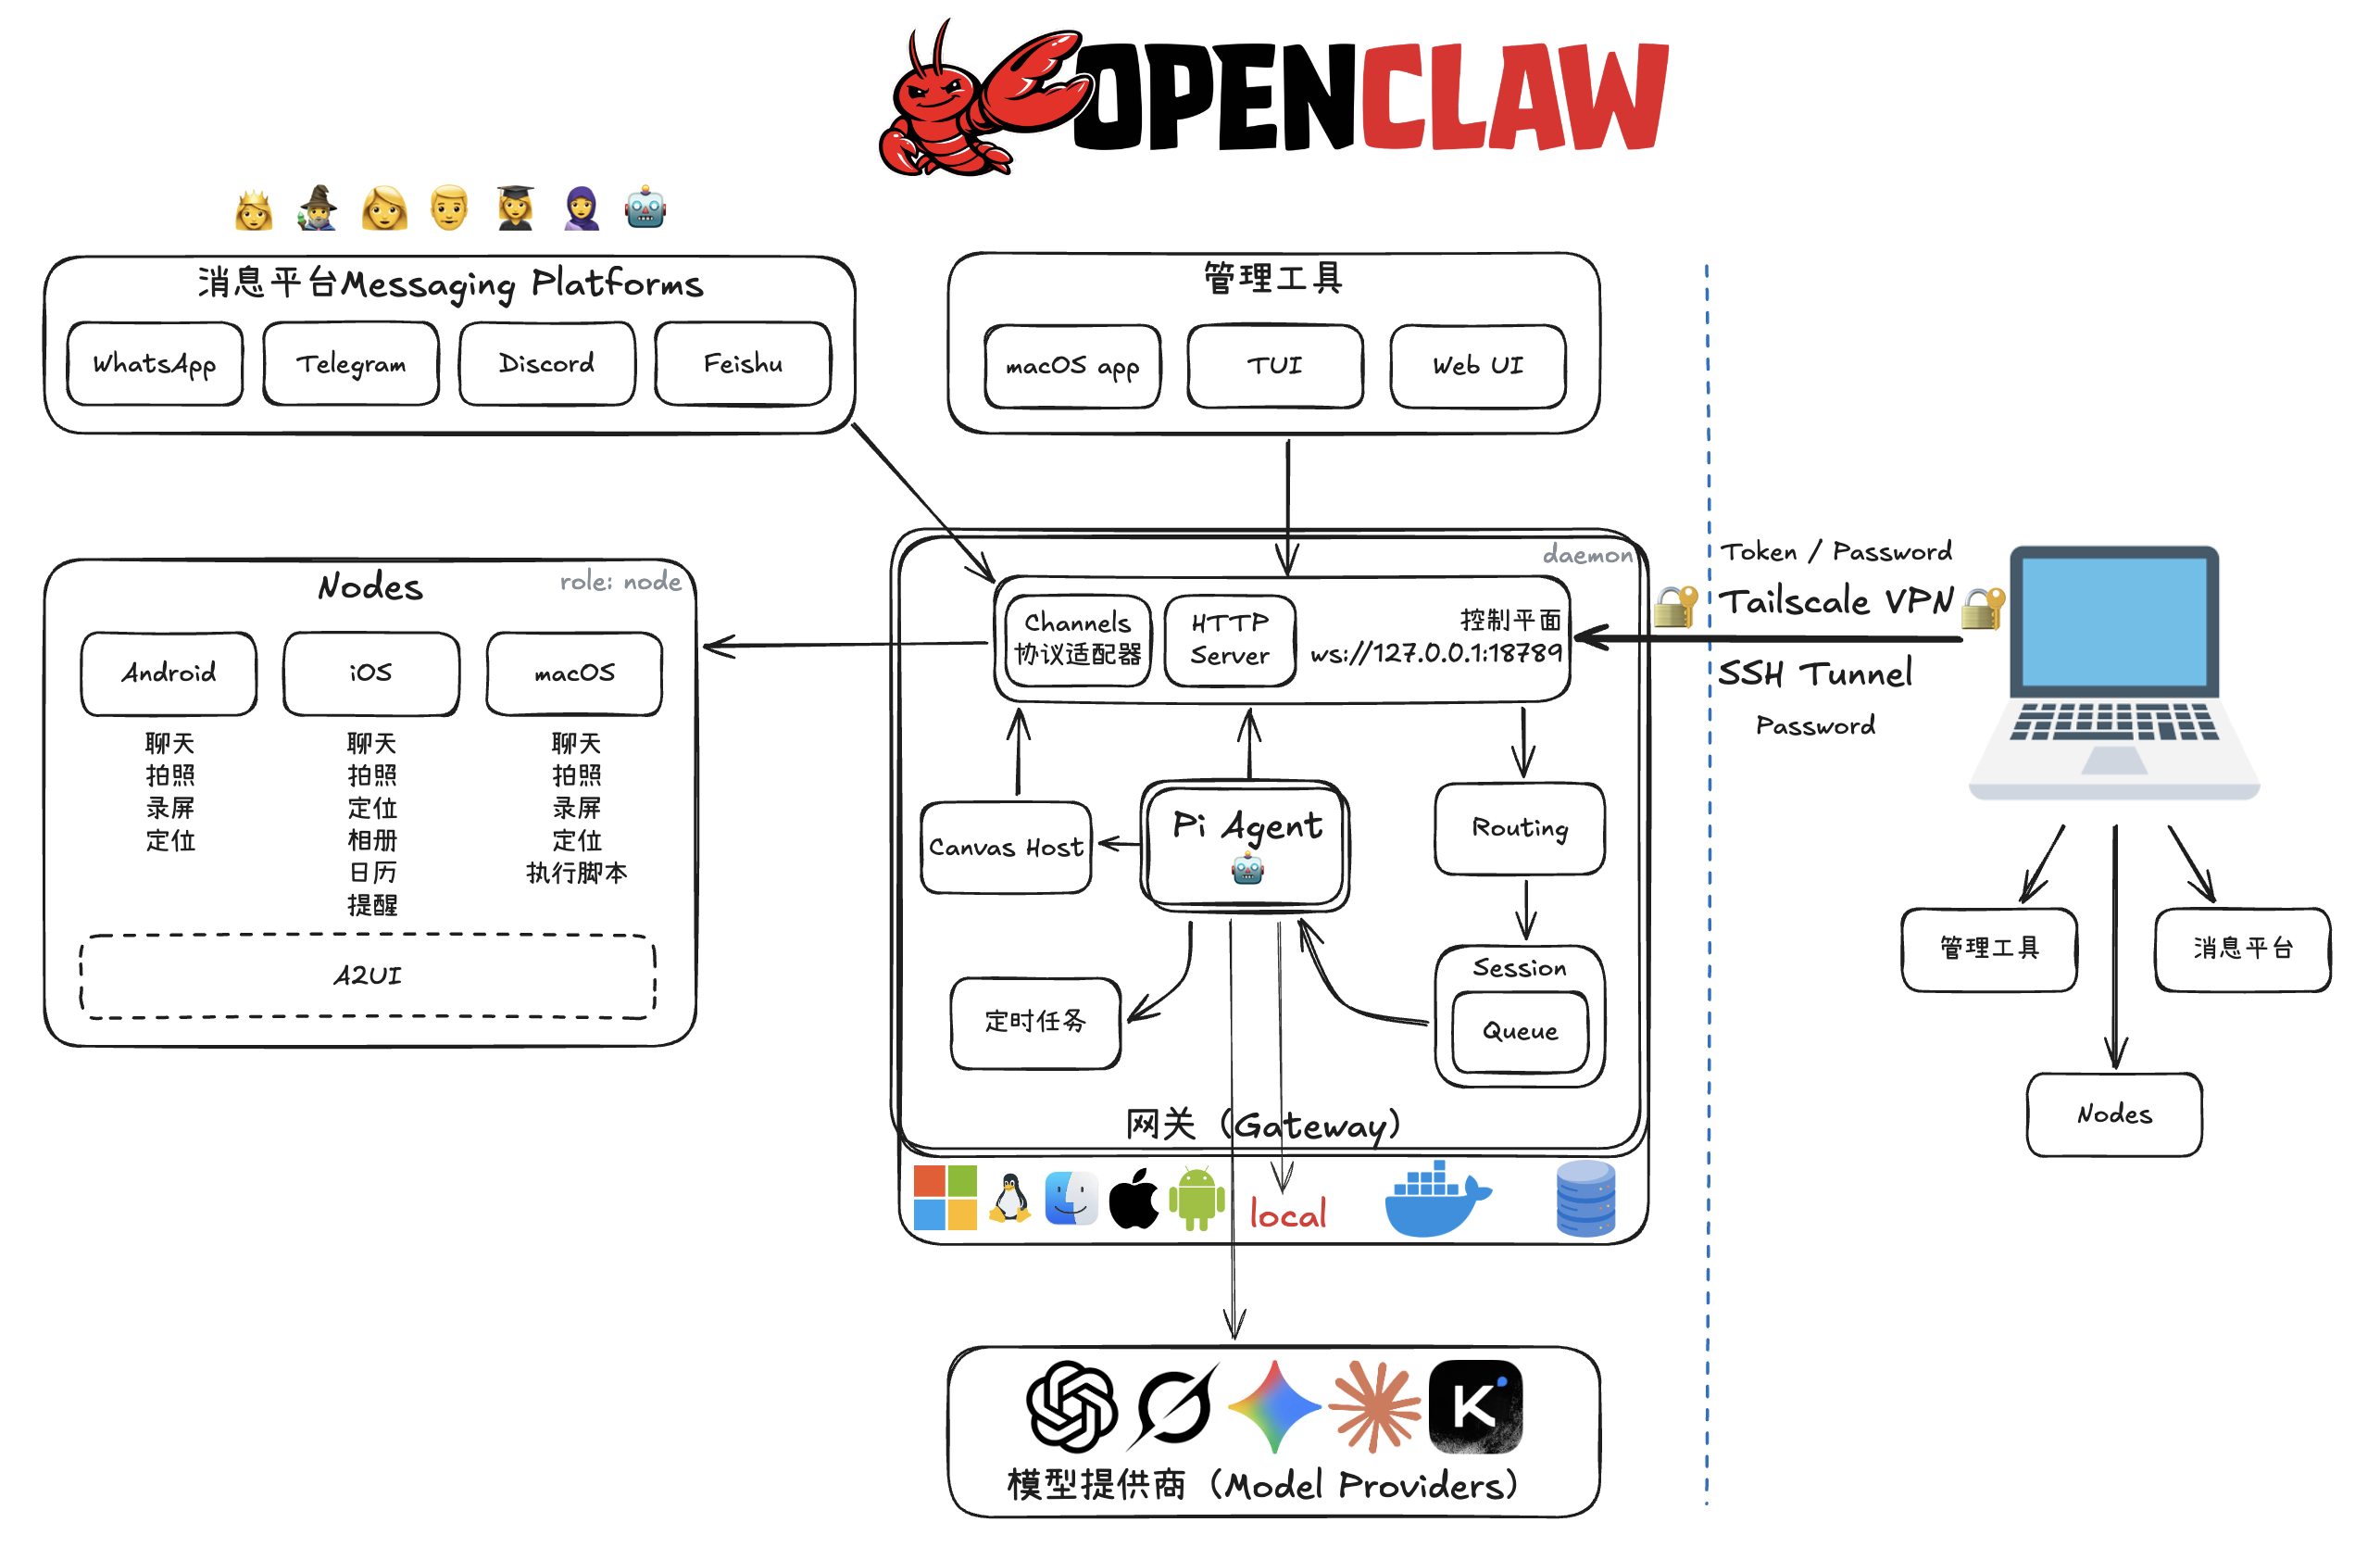
OpenClaw 智能体工作区,旨在构建一个具有独立人格、长期记忆和自治能力的 AI。
核心基于 Markdown 文件系统:
BOOTSTRAP, SOUL, IDENTITY):确立 AI 的自我认知、名字与核心行为守则。MEMORY, AGENTS):通过“每日日志”与“长期记忆”实现跨会话的知识积累,而非每次新鲜唤醒。USER, TOOLS):记录人类偏好与本地环境配置,实现个性化与外部协作。HEARTBEAT):在无指令时主动执行维护与状态检查。总体而言,这套架构通过将记忆转化为持久化、可编辑的 Markdown 文件,实现了自主反思与知识沉淀的自治目标。
首页
重定向到 Swagger UI
@app.get("/", include_in_schema=False)
async def index():
    return RedirectResponse('/docs', status_code=303)
使用 route 的 docstring 作为首页内容
@app.get("/", response_class=HTMLResponse, include_in_schema=False)
async def index():
    # 需要过滤的路由
    filted_routes = [
        "/openapi.json",
        "/docs",
        "/docs/oauth2-redirect",
        "/redoc",
        "/static",
        "/"
    ]

    routes = []
    for route in app.routes:
        if route.path not in filted_routes:
// ...
Markdown to HTML
安装
pip install markdown
使用
浏览Markdown
sudo apt install lynx
sudo apt install pandoc

pandoc README.md | lynx -stdin
sudo pip install grip
sudo apt install lynx

grip -b README.md
lynx http://localhost:6419/
sudo apt install pandoc
pandoc README.md -t plain | less
浏览HTML
sudo apt install w3m

w3m index.html
sudo apt install lynx
sudo apt install pandoc

pandoc index.html | lynx -stdin
sudo pip install grip

grip -b index.html
参考资料
You’ll find this post in your _posts directory. Go ahead and edit it and re-build the site to see your changes. You can rebuild the site in many different ways, but the most common way is to run jekyll serve, which launches a web server and auto-regenerates your site when a file is updated.
Jekyll requires blog post files to be named according to the following format:
YEAR-MONTH-DAY-title.MARKUP
Where YEAR is a four-digit number, MONTH and DAY are both two-digit numbers, and MARKUP is the file extension representing the format used in the file. After that, include the necessary front matter.
没有找到匹配的文章