Gemini Robotics On-Device

本文档描述了Gemini Robotics On-Device,这是一款先进的视觉-语言-动作 (VLA) 模型,旨在本地设备上高效运行以实现通用机器人操作。该模型能够处理文本、图像和机器人本体感受数据作为输入,并输出机器人动作。训练使用了包含图像、文本以及机器人传感器和动作数据的数据集,并利用Google的Tensor Processing Units (TPUs)进行。评估结果表明,Gemini Robotics On-Device在泛化、指令遵循和快速适应方面表现出色,其性能与旗舰版Gemini Robotics 模型相似,同时超越了之前的最佳设备端VLA模型。该模型主要用于机器人应用的设备端部署,作为核心组件使机器人能够理解并响应视觉和语言指令,并在给定环境中采取行动。
Gemini Robotics On-Device 简介
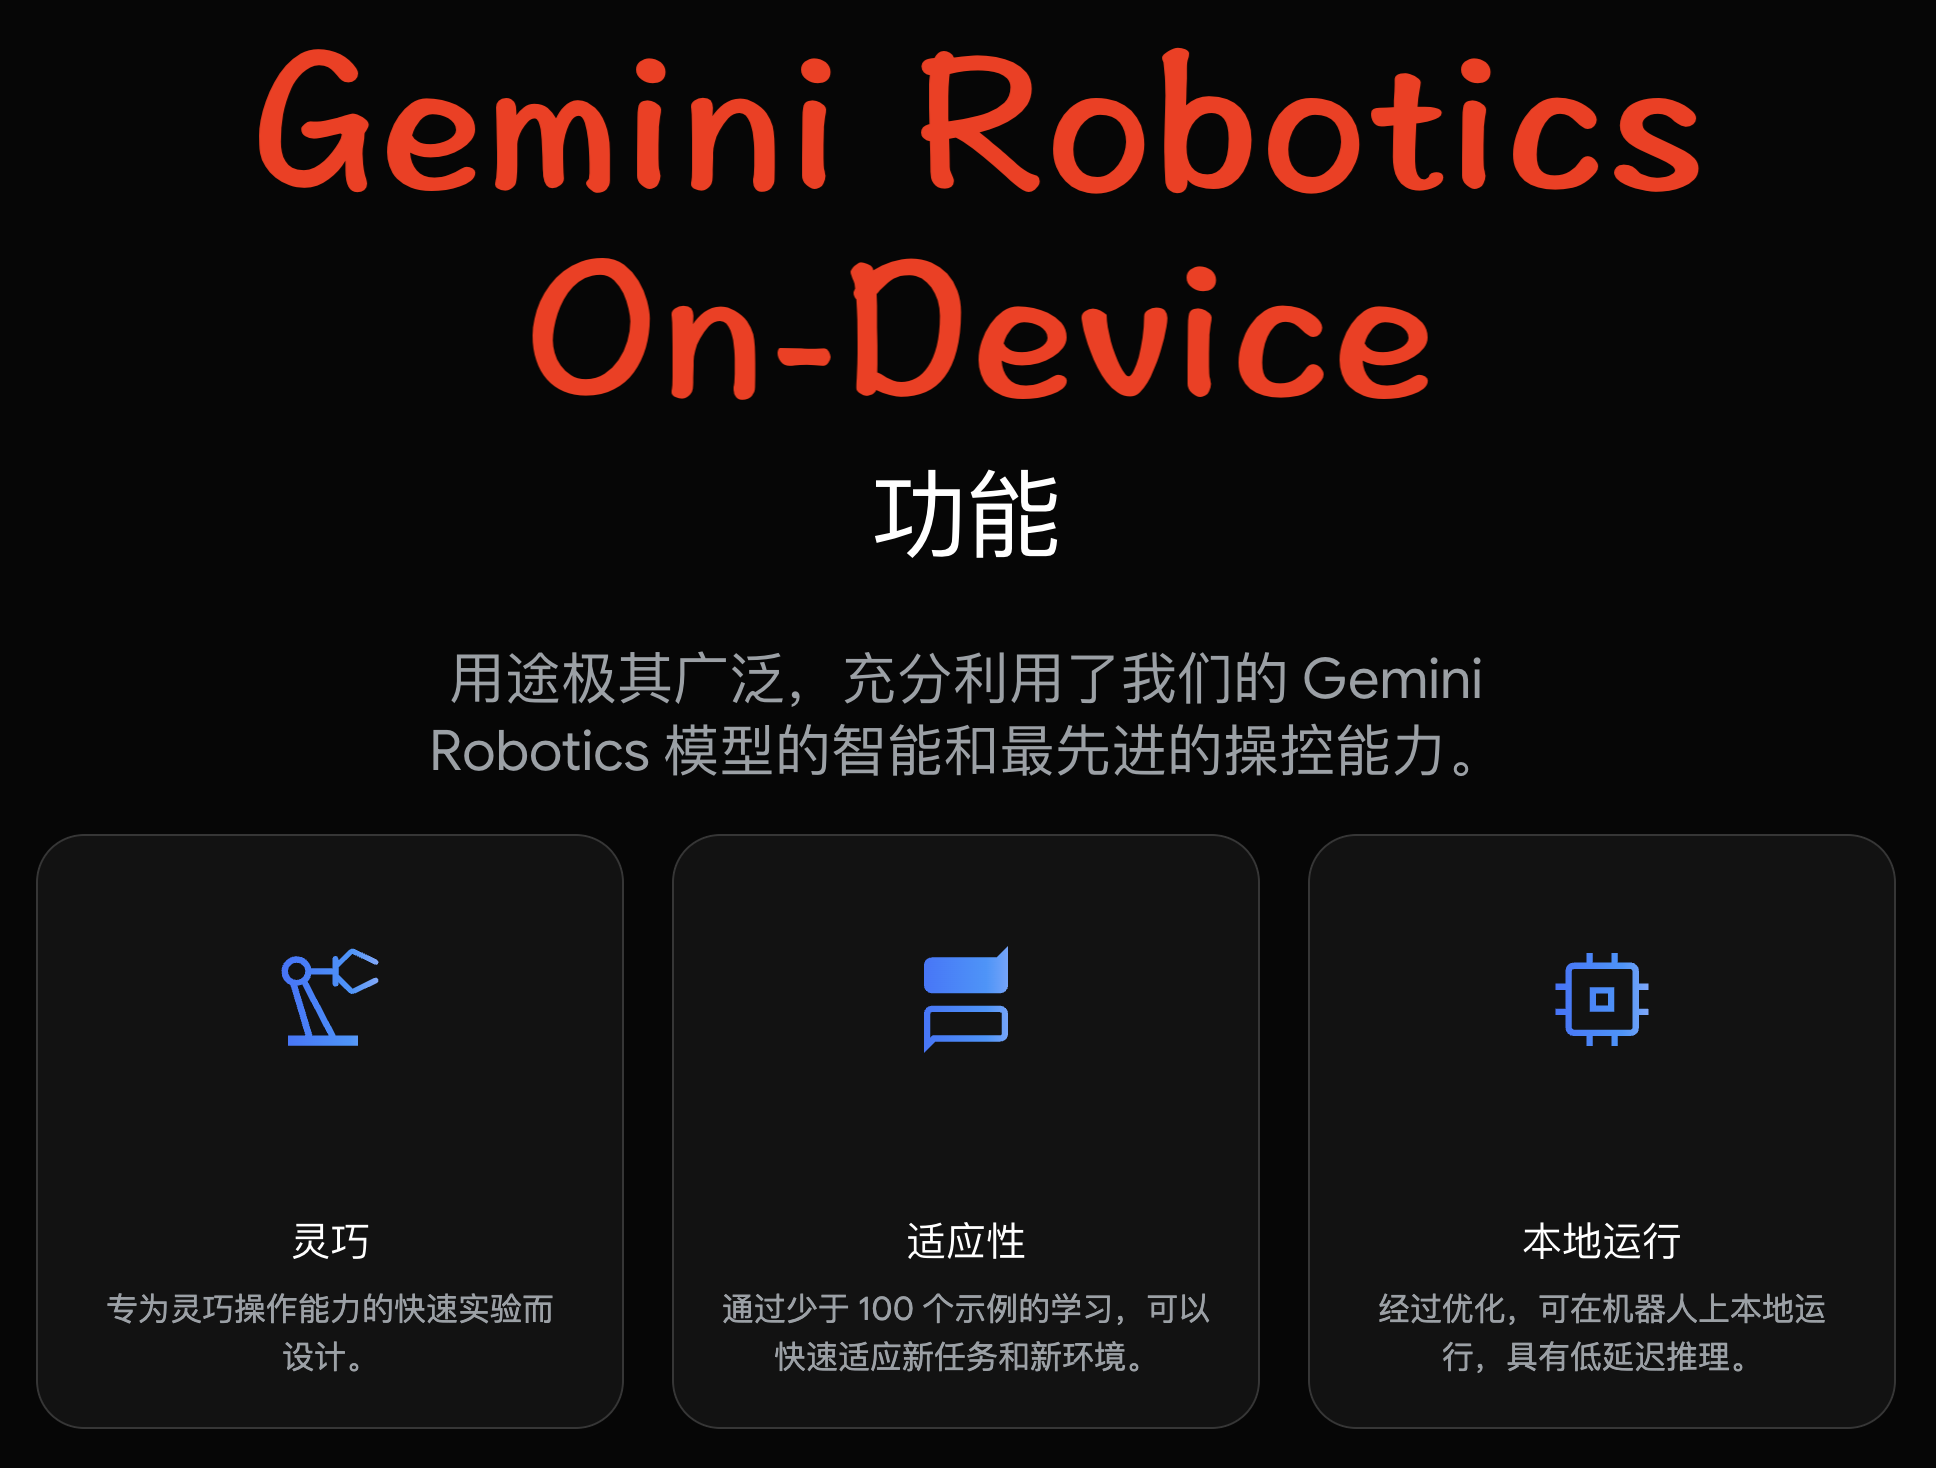
模型概述与核心功能

Gemini Robotics On-Device 是一款尖端的视觉-语言-动作 (VLA) 模型,其设计宗旨是在本地设备上高效运行,以实现通用机器人操作。该模型能够支持广泛的任务、场景和多种机器人类型。

  • 模型描述: “Gemini Robotics On-Device 是我们基于设备端 Gemma 模型的先进视觉-语言-动作 (VLA) 模型。它专为通用机器人操作而设计,可在本地设备上高效运行。该模型支持广泛的任务、场景和多种机器人类型。”
  • 输入: 接收文本(例如问题或指令)、图像(例如机器人环境视角)和机器人本体感受数据(数值)。
  • 输出: 生成机器人动作的数值。
  • 架构: 基于 Gemini Robotics 技术和设备端 Gemma 模型的设备端 VLA 模型。
FastMCP 实战:构建计算器 MCP 服务器与客户端

该文档详细介绍了如何使用 FastMCP 框架来构建和集成计算器 MCP 服务器与客户端。它首先指导用户初始化并设置开发环境,包括创建虚拟环境和安装 FastMCP。接着,文档展示了MCP 服务器的开发过程,通过 main.py 文件定义了加、减、乘、除、幂等计算工具,并配置了项目元数据文件 pyproject.toml。此外,文档还提供了构建和发布服务器到 PyPI 的步骤,以及运行 MCP 服务器的方法,包括使用 MCP Inspector 进行调试和通过 FastMCP CLI 运行。最后,文档展示了MCP 客户端的开发,演示了客户端如何调用服务器上的工具,并深入探讨了将 MCP 客户端与 OpenAI 集成,实现通过自然语言与计算器服务器进行交互的能力。

创建 MCP 服务器

初始化

uv init calculator-mcp-server
cd calculator-mcp-server

创建虚拟环境

uv venv
Using CPython 3.10.9 interpreter at: /opt/miniconda/bin/python3.10
Creating virtual environment at: .venv
Activate with: source .venv/bin/activate

激活虚拟环境

source .venv/bin/activate

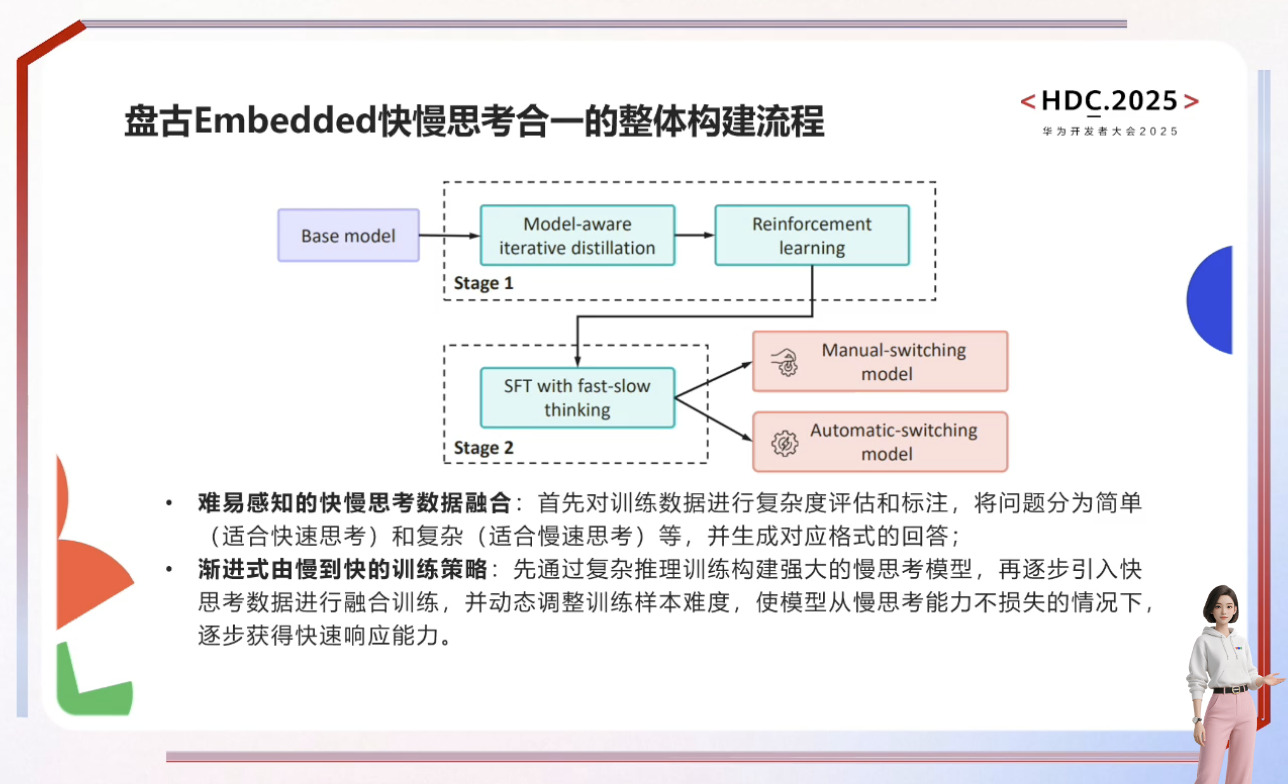
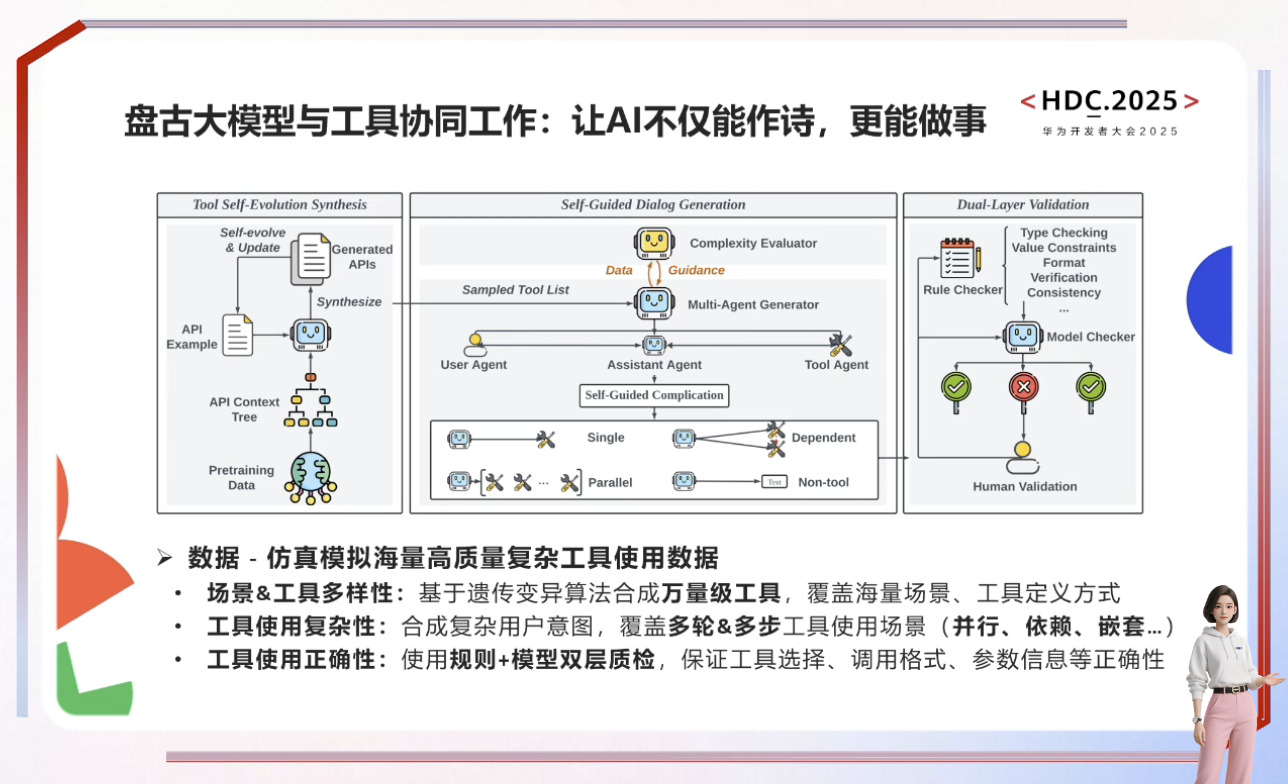
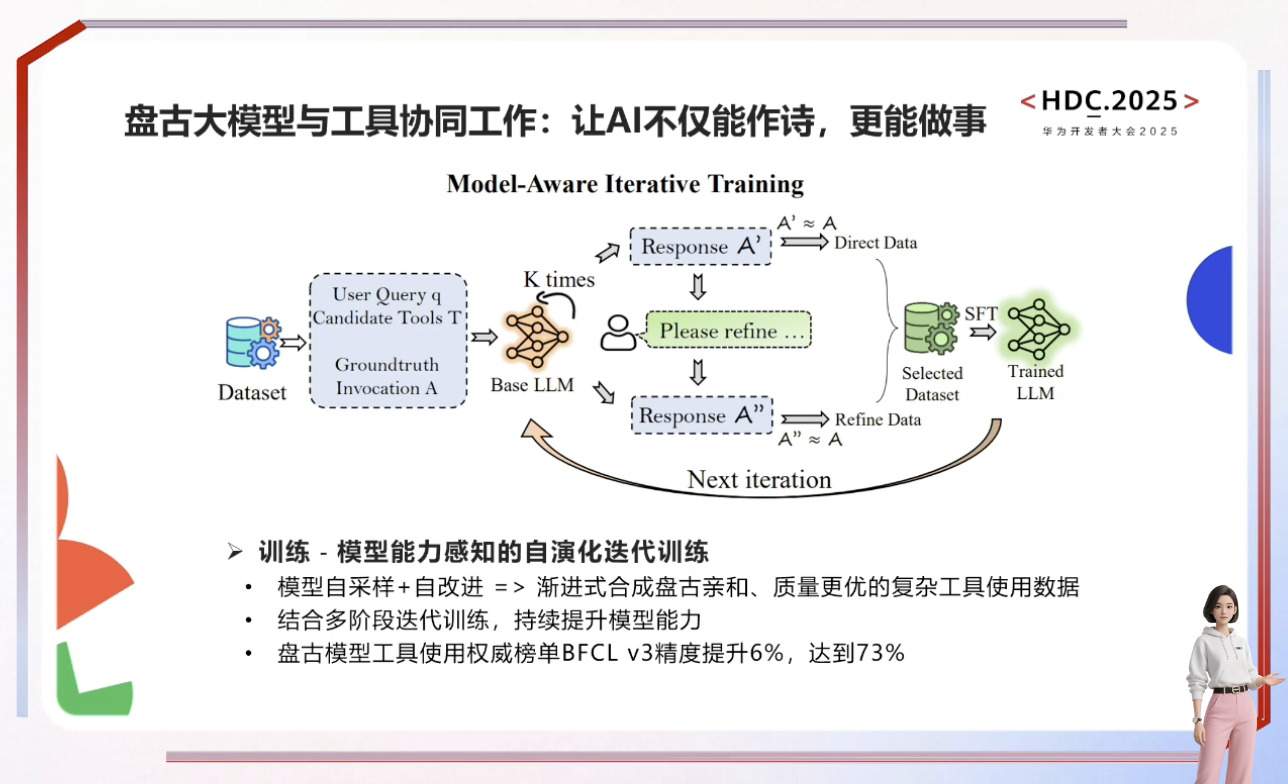
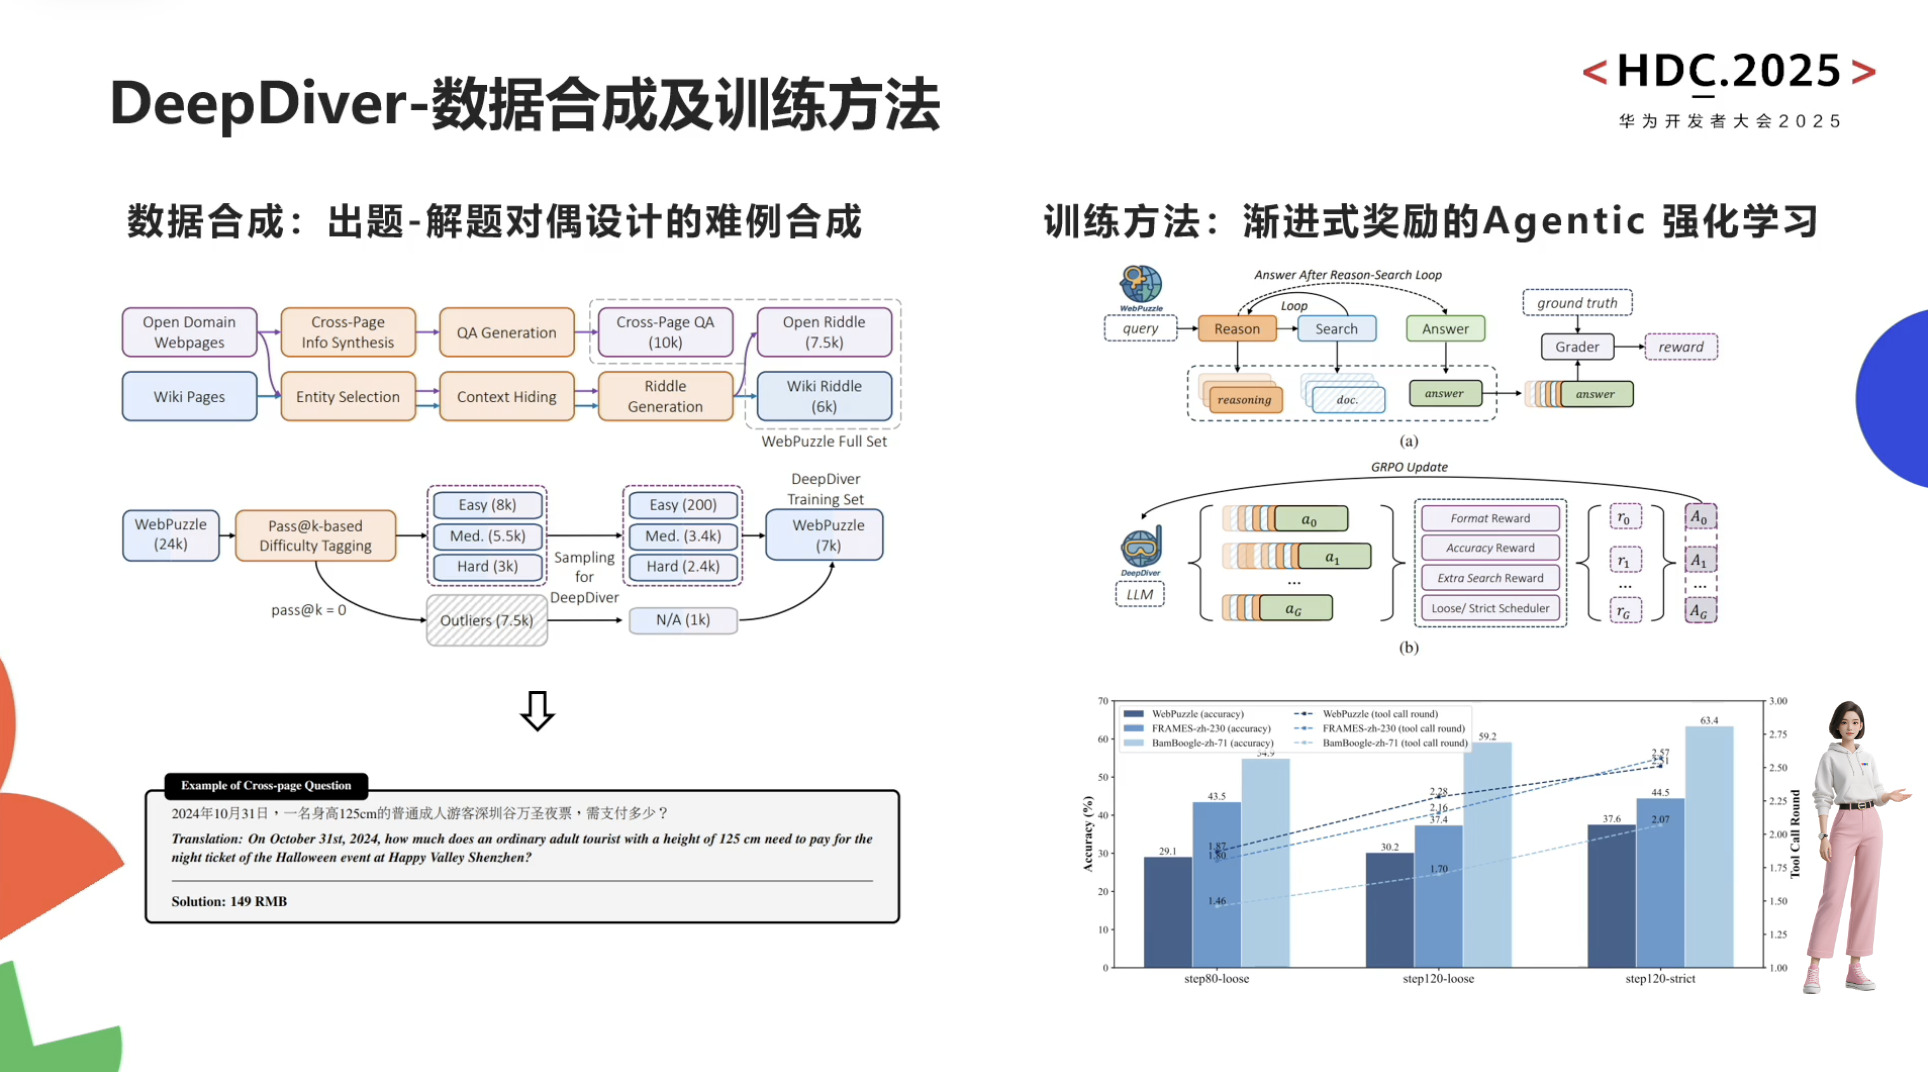
盘古大模型关键技术解读

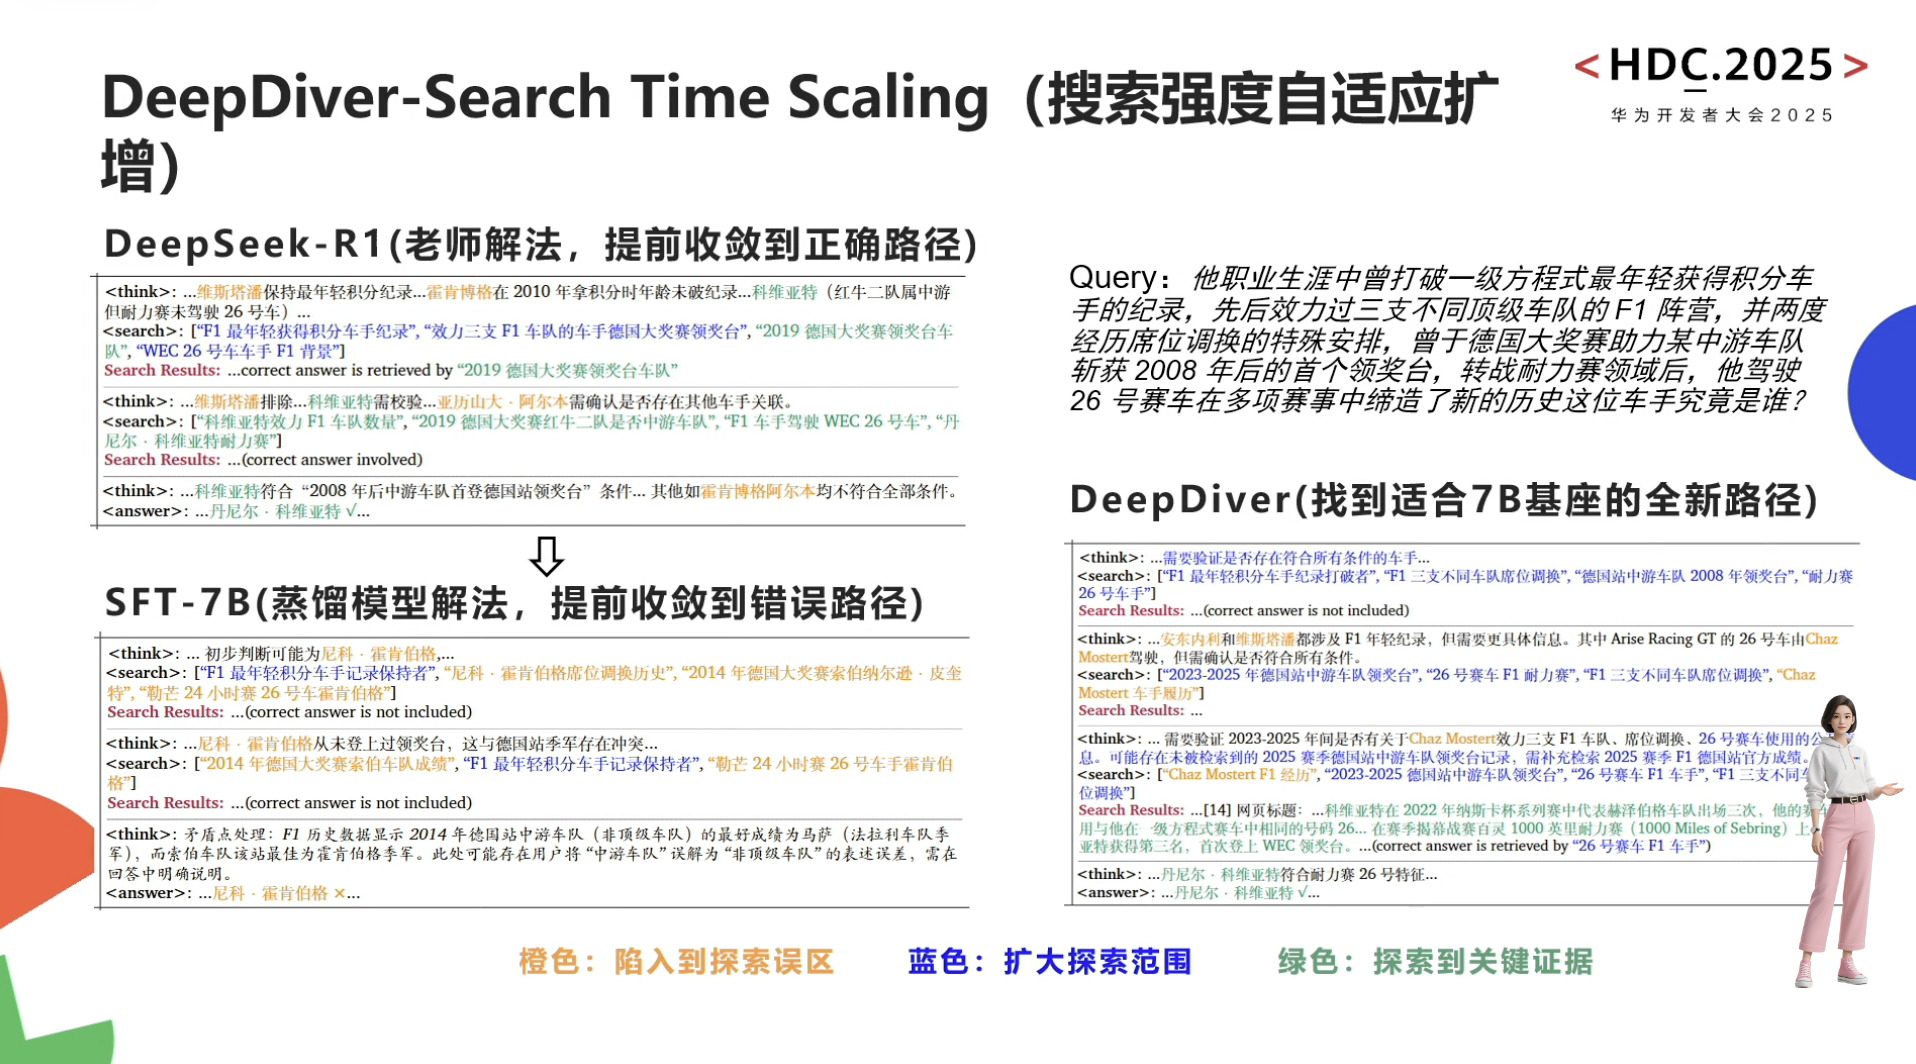
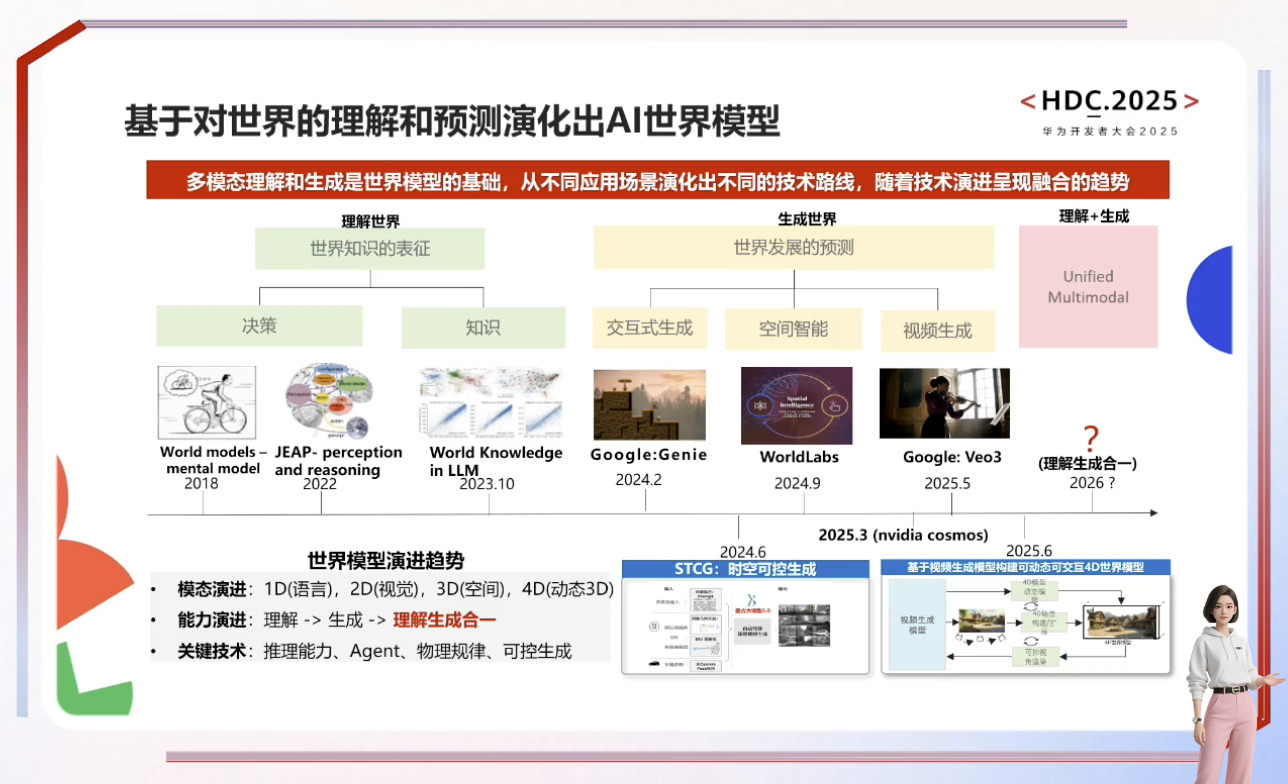
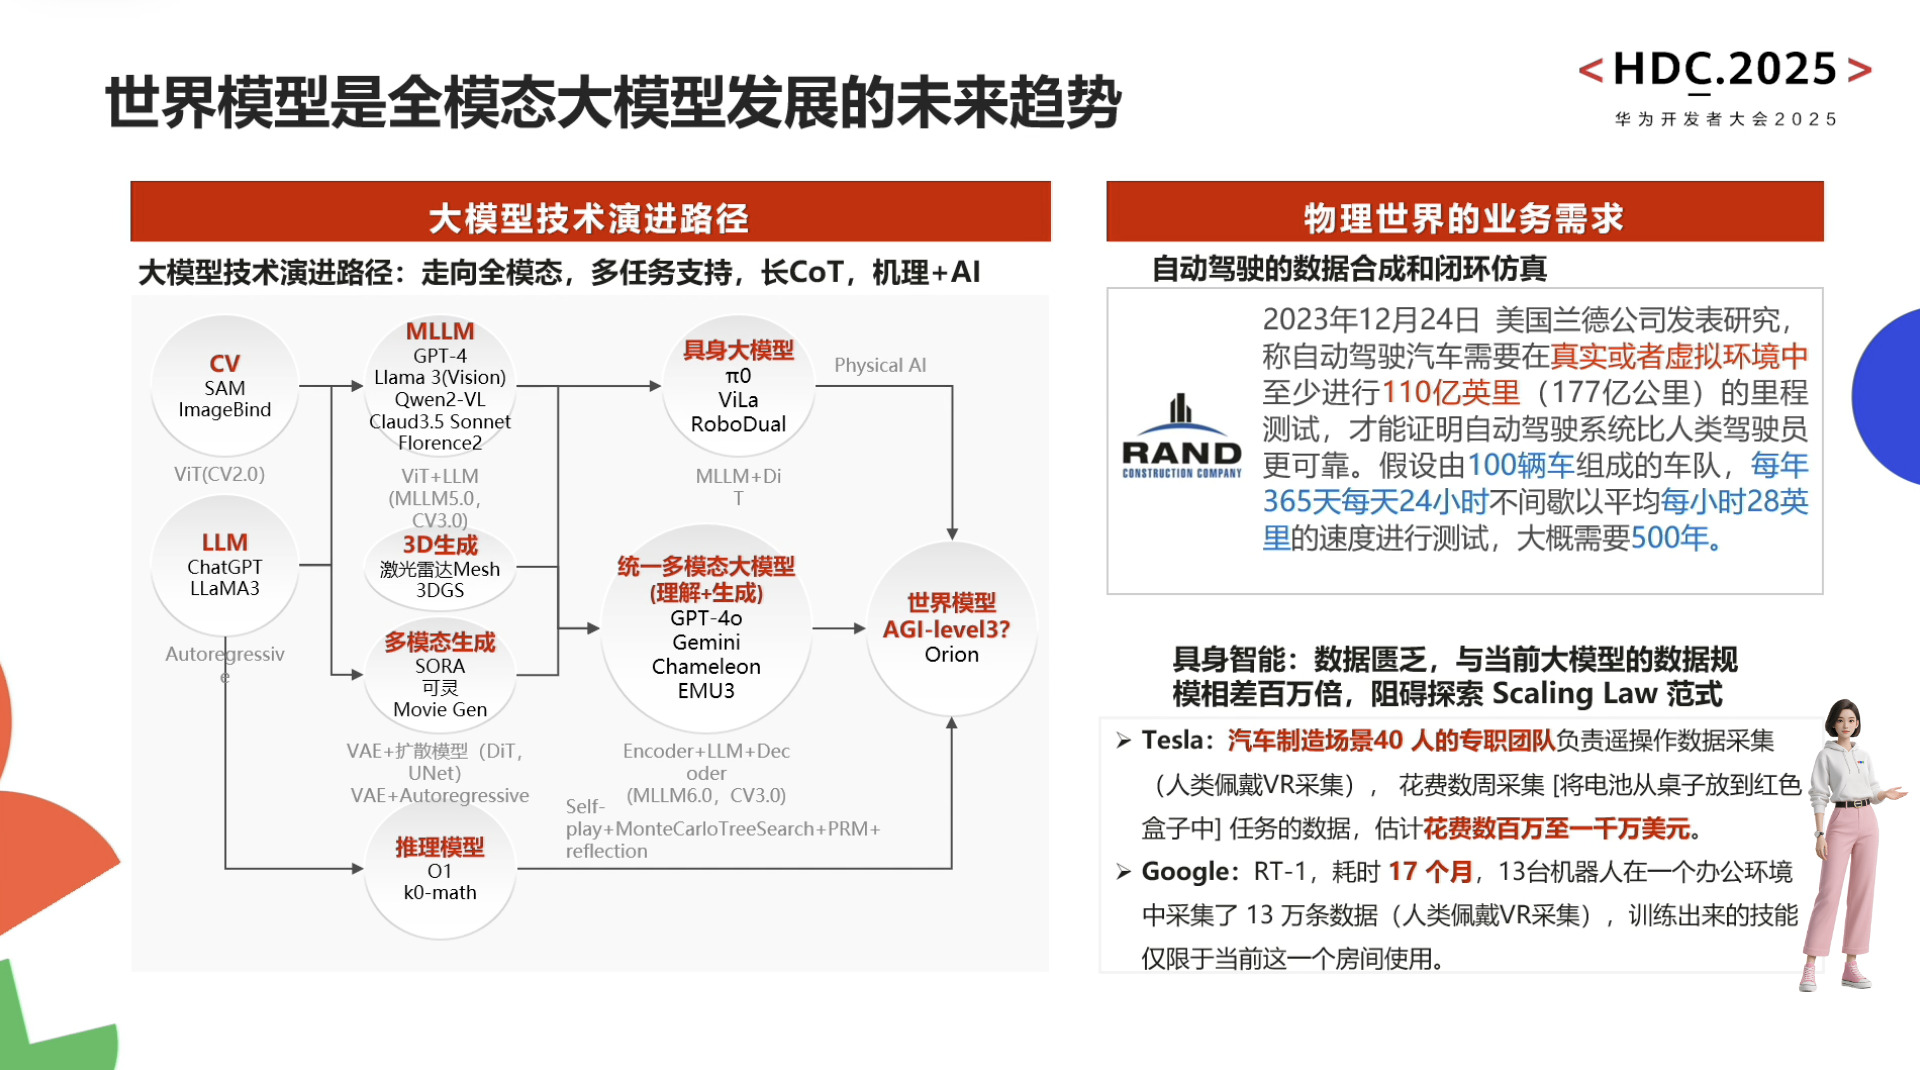
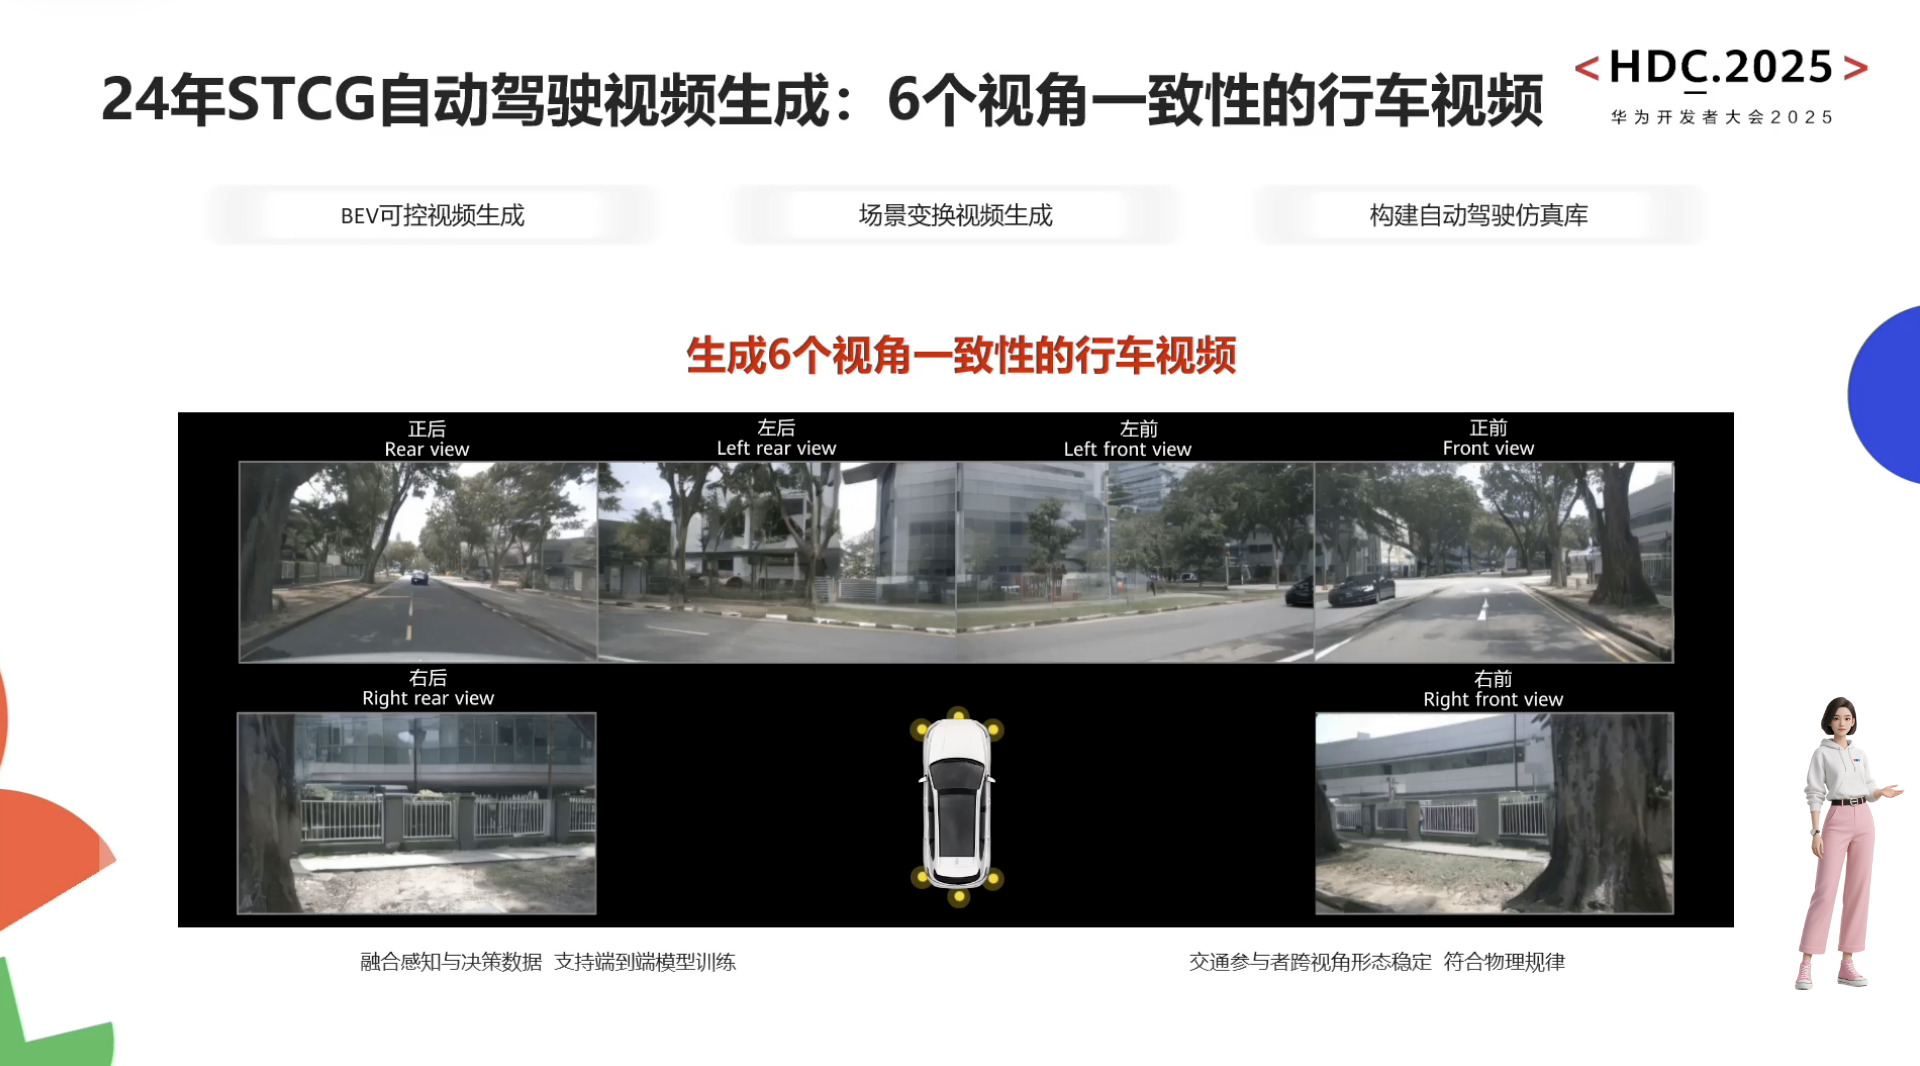
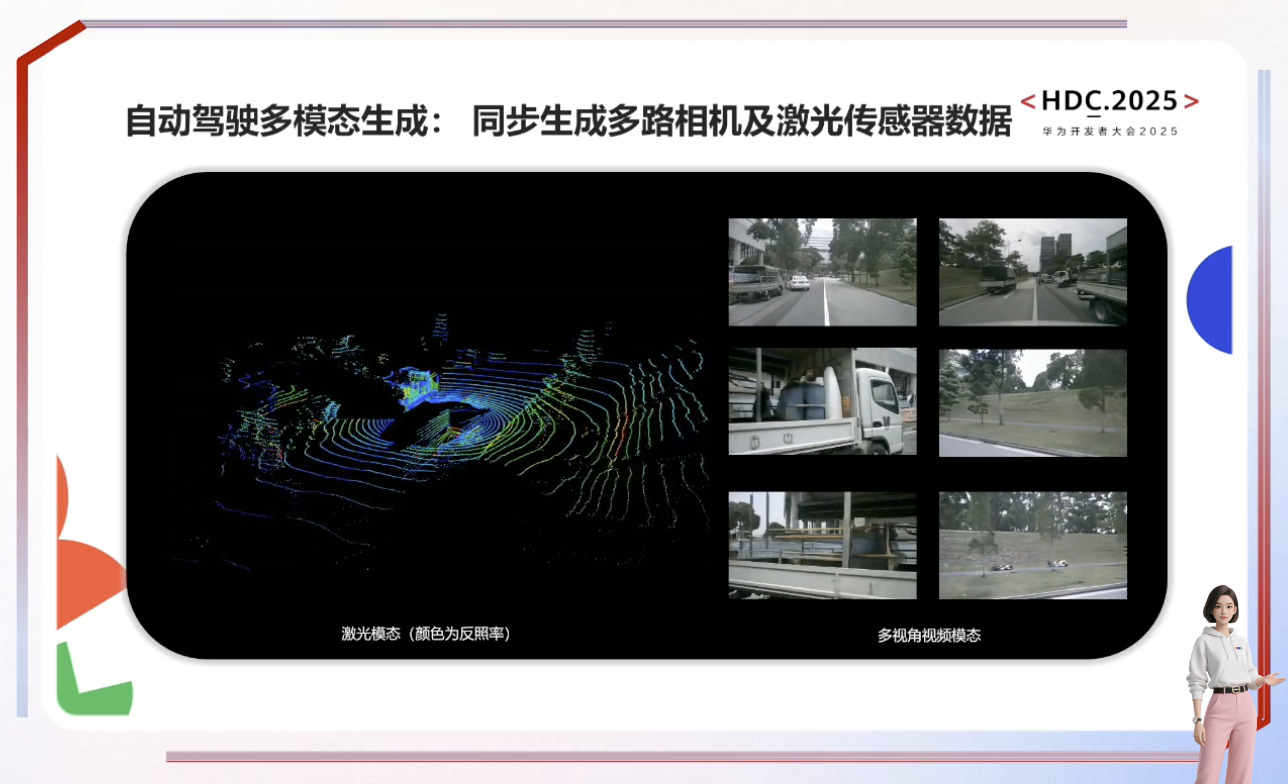
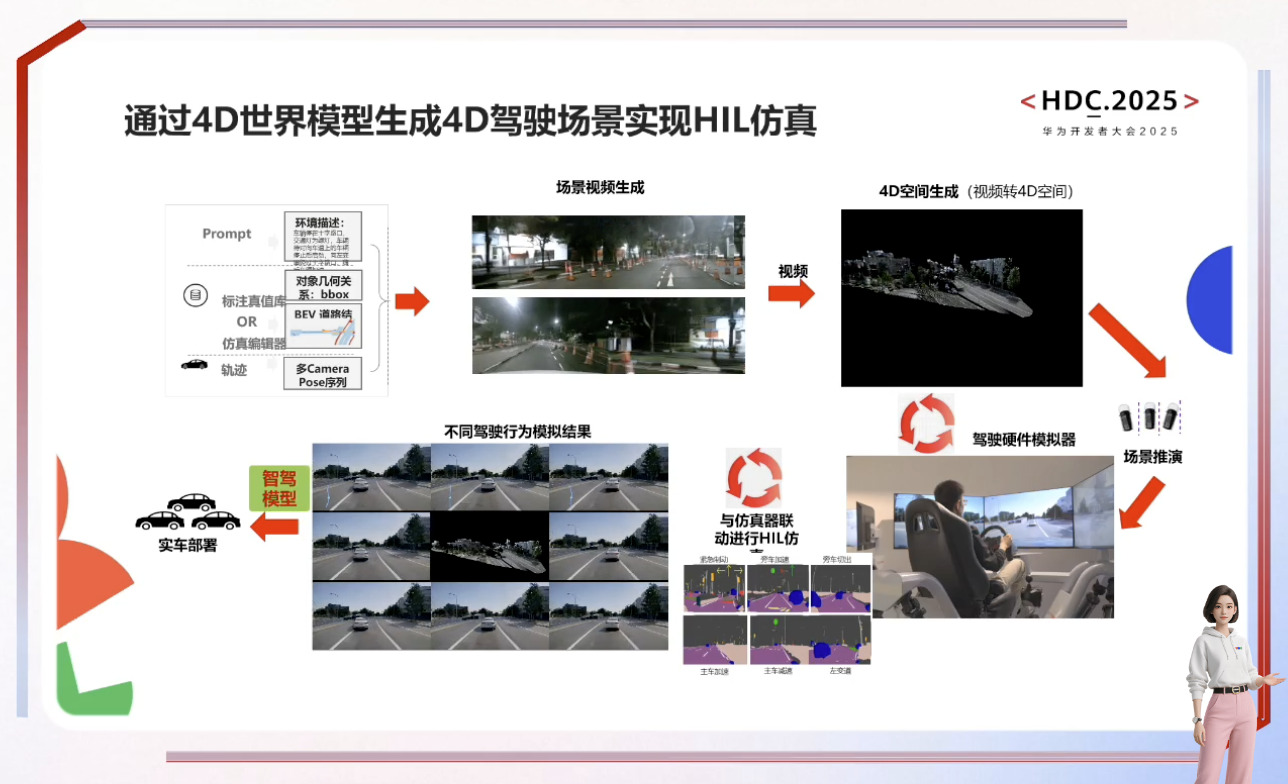
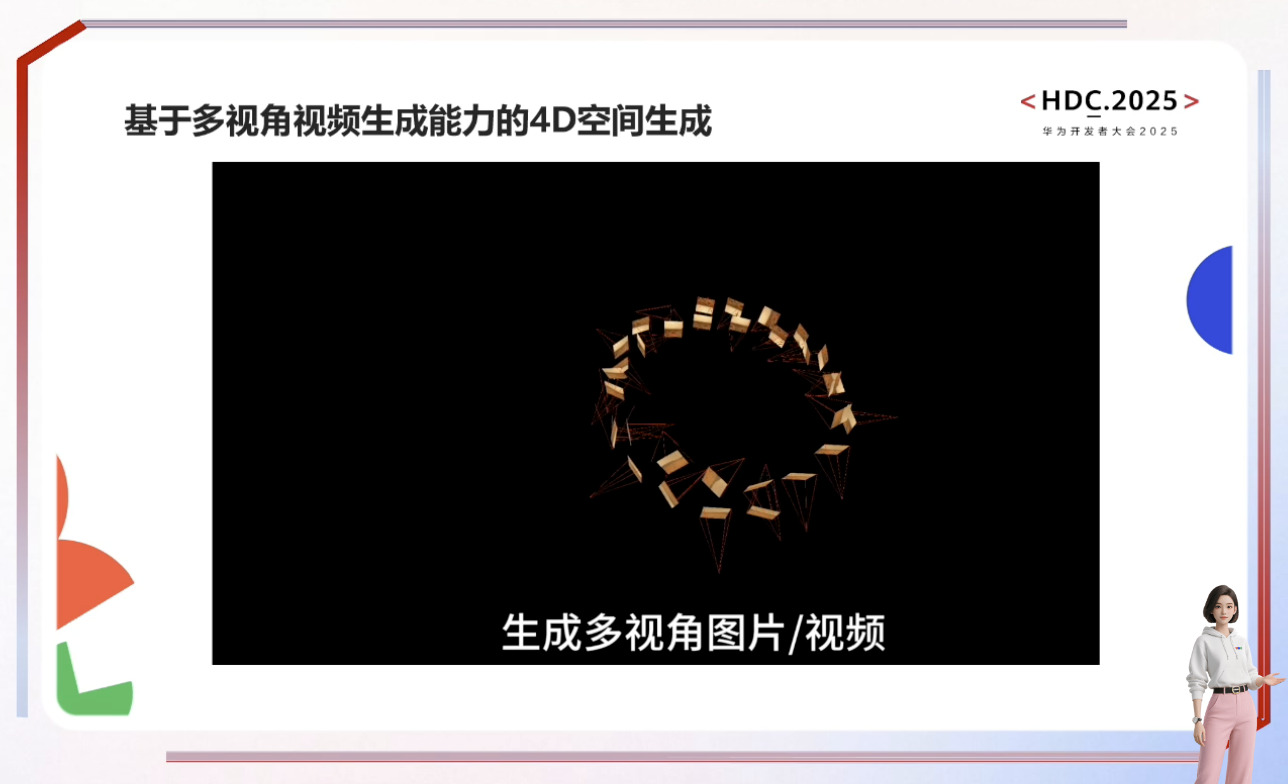
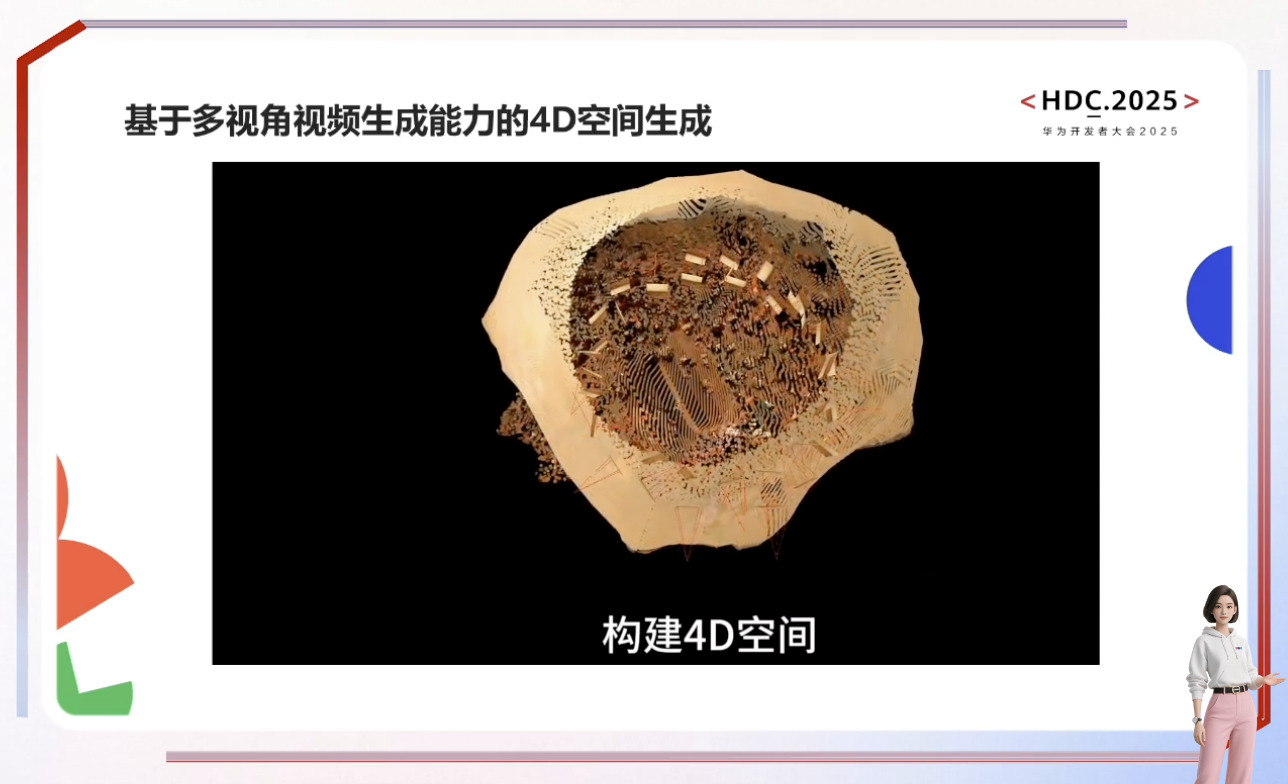
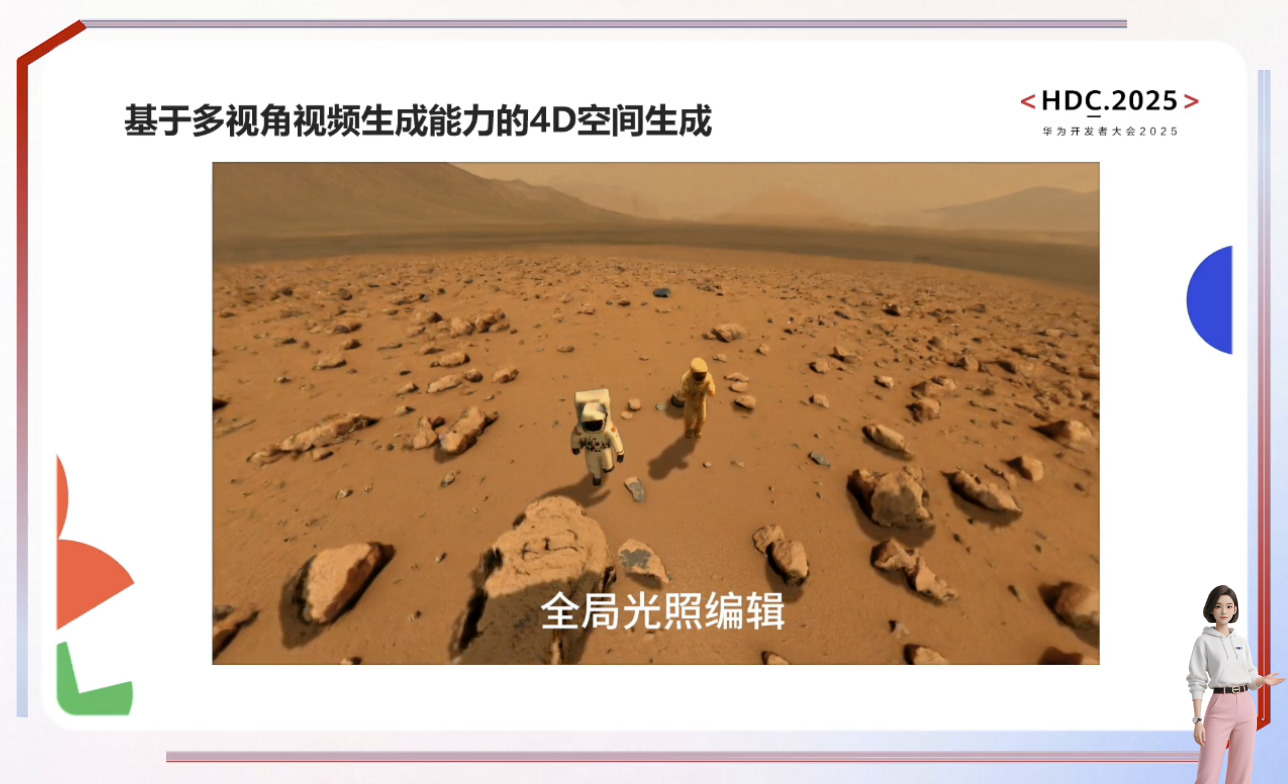
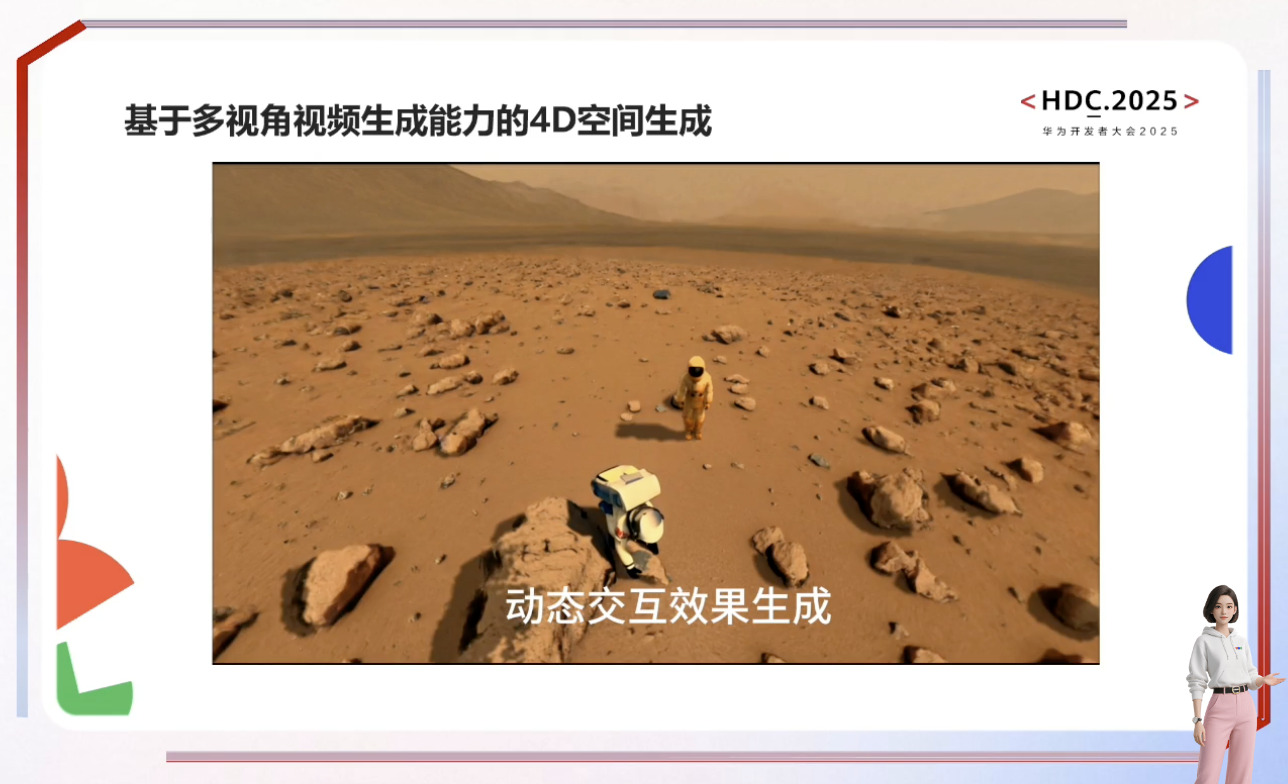
自动驾驶与具身智能的发展依赖于世界模型和虚拟环境的构建,通过数字孪生和4D物理空间模拟真实世界规律以解决训练数据不足和安全性问题。盘古NLP大模型借助外部工具提升行业智能水平,而具身智能需融合3D空间理解、物理推理及行为预测能力,最终实现在高危场景中超越人类的目标。尽管发展曲折,但SFT训练链条和通用机器人愿景已展现潜力,预测大模型则致力于打破数据孤岛,通过原子级表达实现跨场景统一推演,推动AI向善与社会效率提升。
基础模型

世界模型

具身智能

预测大模型

参考资料

人工智能时代的软件 (Software in the era of AI) - Andrej Karpathy

主要介绍了软件开发领域正在经历的重大变革,将其分为软件1.0(传统手工编码)、软件2.0(基于神经网络权重训练)和软件3.0(通过自然语言提示编程大型语言模型)。演讲者将大型语言模型(LLMs)比作新型操作系统基础设施,指出它们既具备公用事业的性质(按量付费、集中式),也展现出类似芯片制造厂和操作系统的特征,且目前仍处于早期阶段(类似于1960年代的计算)。进一步探讨了LLMs的认知特性(如广博知识、幻觉、记忆局限),并强调了开发部分自主应用的重要性,这些应用能让人类通过图形用户界面自主性滑块有效监督AI。最后,演讲者提出,随着自然语言编程的兴起,人人皆可编程,并呼吁开发者为智能体优化数字基础设施和文档,预示着一个由人类与AI协作构建的 “钢铁侠战衣”式未来

Software is changing. (again)

Map of GitHub

Map of GitHub 是一个创新的数据可视化项目,旨在以交互式地图的形式展示 GitHub 上的开源项目生态。该项目由开发者 Anvaka 创建,通过复杂的算法和可视化技术,将超过 400,000 个 GitHub 仓库以节点和连接的形式呈现,帮助用户探索项目之间的关联、技术趋势以及开源社区的演变。

Software 2.0

Software 3.0

Part 1: 如何思考 LLM

LLM 具有公用事业的特性

vLLM:快速易用的 LLM 推理和服务库

大模型

在下载前,请先通过如下命令安装 ModelScope

pip install modelscope

ModelScope 下载默认存储到 ~/.cache/modelscope/hub(Linux/macOS)或 C:\Users<用户名>.cache\modelscope\hub(Windows)。--local_dir 参数可以指定下载目录。

多模态(Multi-modal)

modelscope download --model Qwen/Qwen2.5-VL-3B-Instruct --local_dir Qwen2.5-VL-3B-Instruct
modelscope download --model Qwen/Qwen2.5-VL-7B-Instruct --local_dir Qwen2.5-VL-7B-Instruct

转录(Transcriptions)

modelscope download --model openai-mirror/whisper-large-v3 --local_dir whisper-large-v3
modelscope download --model openai-mirror/whisper-large-v3-turbo --local_dir whisper-large-v3-turbo

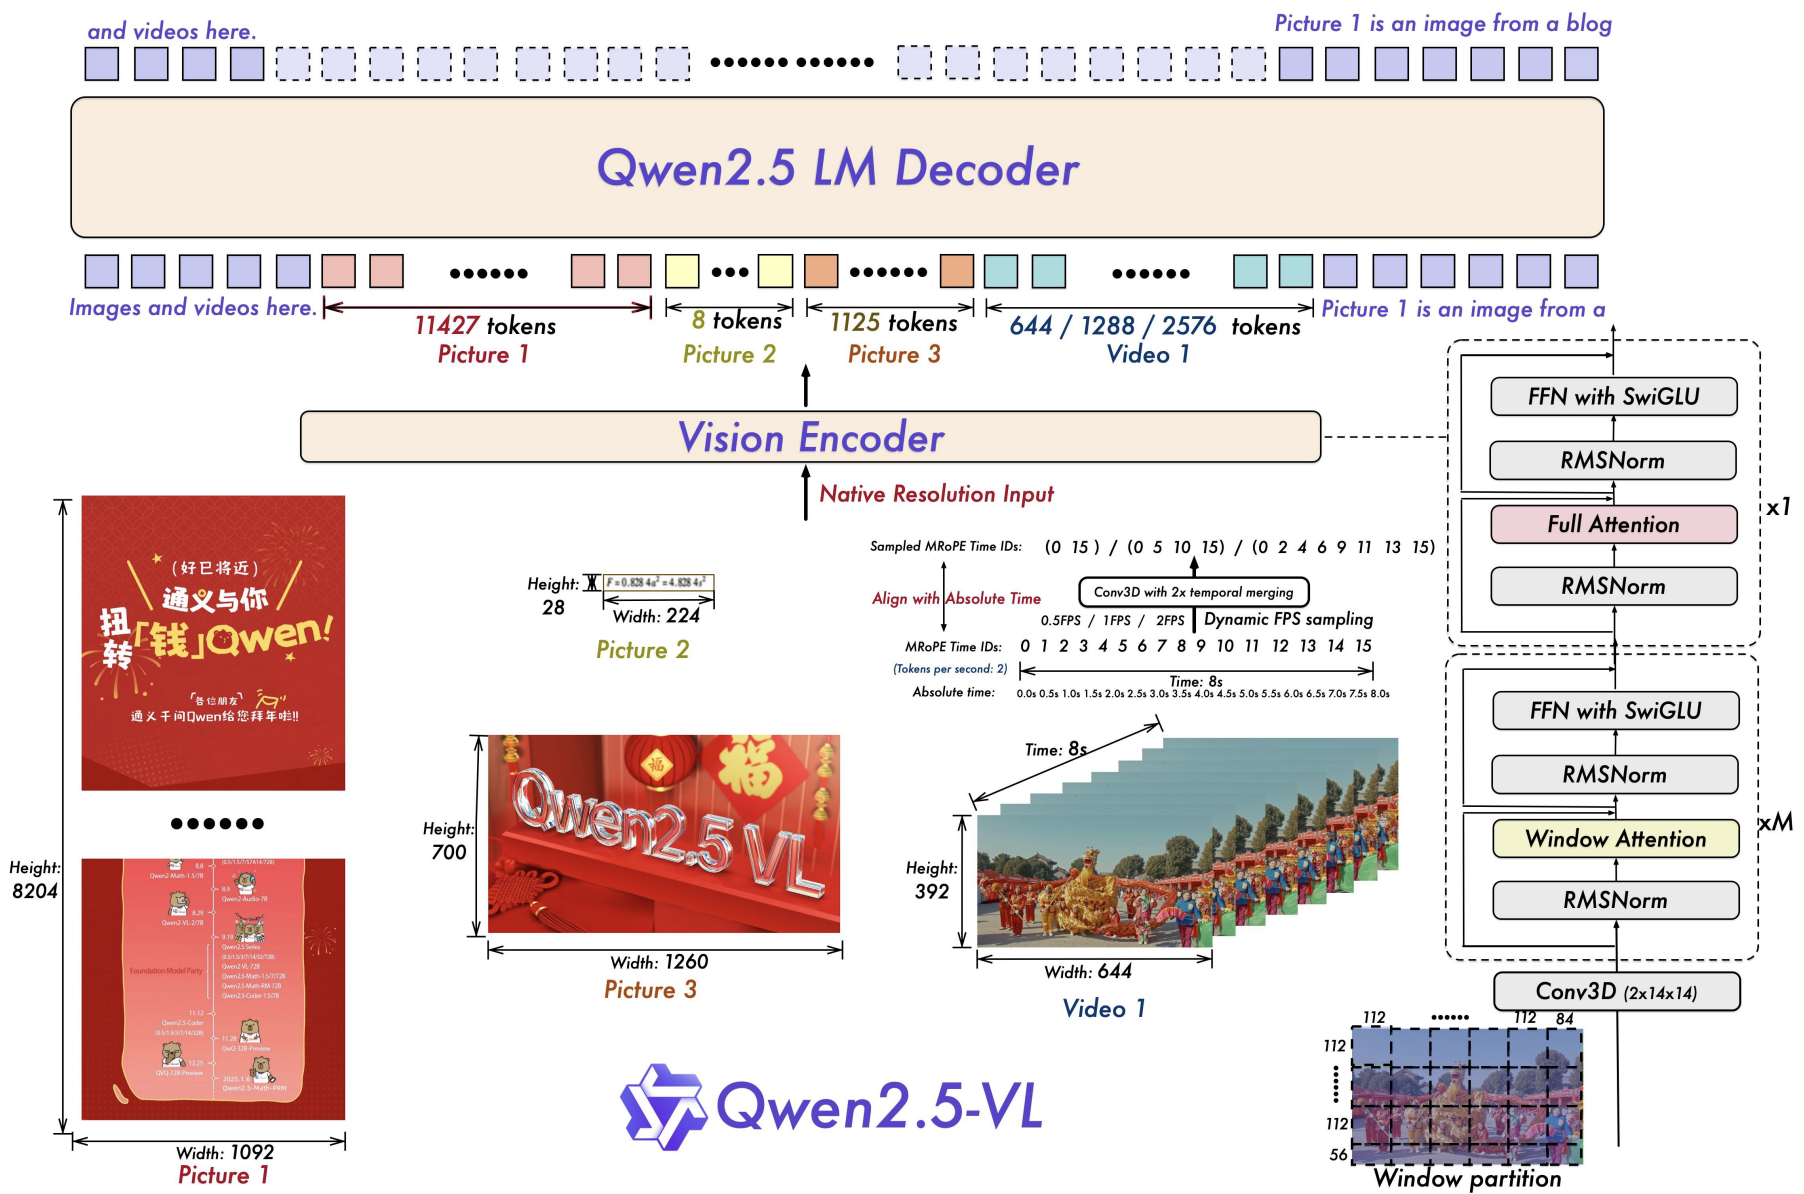
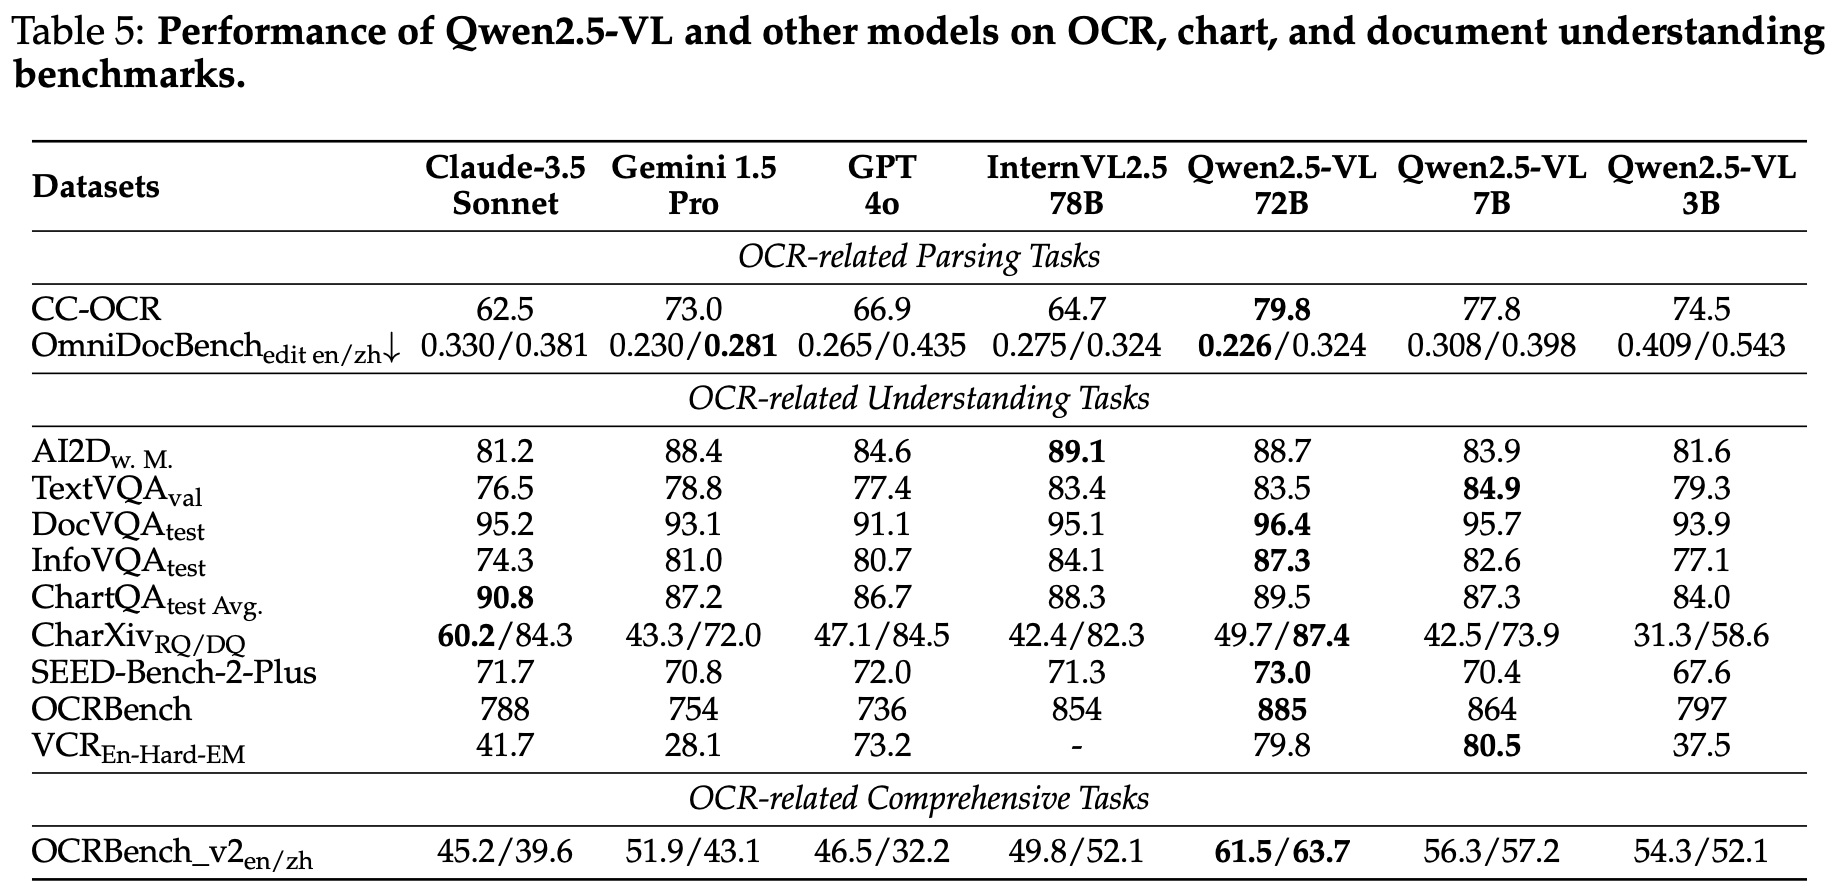
探索多模态大模型 Qwen2.5-VL

本文档提供了一篇关于Qwen2.5-VL 多模态大模型的详细指南,涵盖了从模型架构、性能到实际部署和使用的各个方面。它不仅介绍了如何下载不同版本(如 3B 和 7B Instruct)的模型,还提供了安装和启动模型的命令行指令。此外,文档还展示了如何通过 cURL 命令测试模型,并给出了一个使用 OpenAI API 与 Qwen2.5-VL 进行交互的 Python 示例代码,该代码专注于图像中的火灾、烟雾和安全帽佩戴情况检测,支持本地和网络图片。

Qwen2.5-VL

模型架构

模型性能

魔搭下载

在下载前,请先通过如下命令安装 ModelScope

pip install modelscope

Qwen2.5-VL-3B-Instruct

modelscope download --model Qwen/Qwen2.5-VL-3B-Instruct --local_dir Qwen2.5-VL-3B-Instruct

Qwen2.5-VL-7B-Instruct

modelscope download --model Qwen/Qwen2.5-VL-7B-Instruct --local_dir Qwen2.5-VL-7B-Instruct

默认存储到 ~/.

Verdaccio:构建与管理内网 npm 仓库的实践指南

本文档提供了一份关于使用 Verdaccio 搭建本地 npm 仓库的指南。它详细介绍了如何通过 Docker 拉取 Verdaccio 镜像,以及配置目录结构和 YAML 配置文件的步骤。此外,文章还展示了通过 Docker 或 Docker Compose 部署 Verdaccio 的方法,并演示了如何使用 npm 命令(如安装、发布和下载包)与本地 Verdaccio 仓库进行交互。最后,内容涵盖了Verdaccio 的自动缓存机制以及用户创建和登录操作

什么是 Verdaccio

Verdaccio 一个基于 Node.js 的轻量级私有仓库

下载镜像

docker pull verdaccio/verdaccio

配置

创建目录结构

在本地创建一个目录结构来存储 Verdaccio 的配置文件、插件和存储数据。

mkdir -p ./verdaccio/conf
mkdir -p ./verdaccio/plugins
mkdir -p ./verdaccio/storage

创建配置文件

编辑文件 verdaccio/conf/config.yaml

可以拷贝文件 https://github.com/verdaccio/verdaccio/blob/5.x/conf/docker.yaml 的内容到 config.yaml 中,并根据需要进行修改。

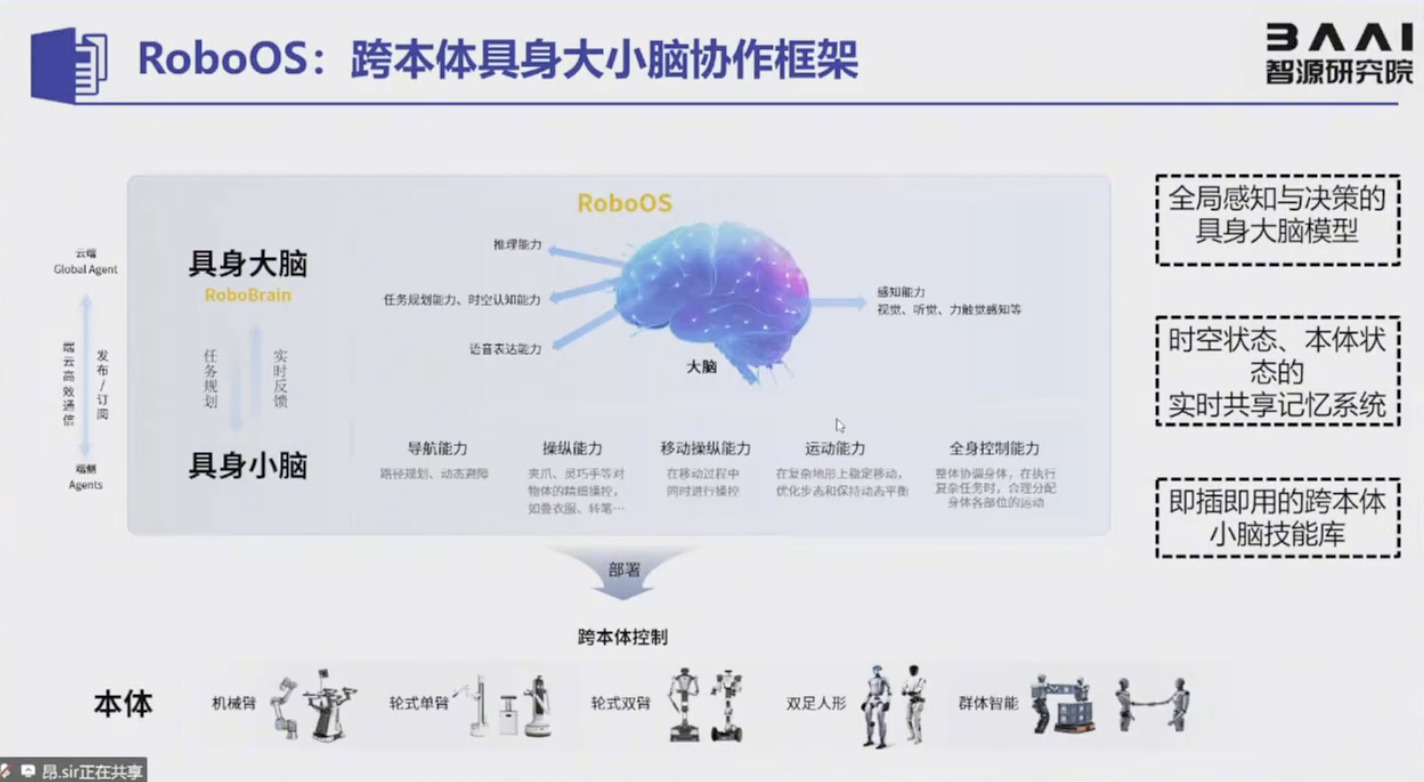
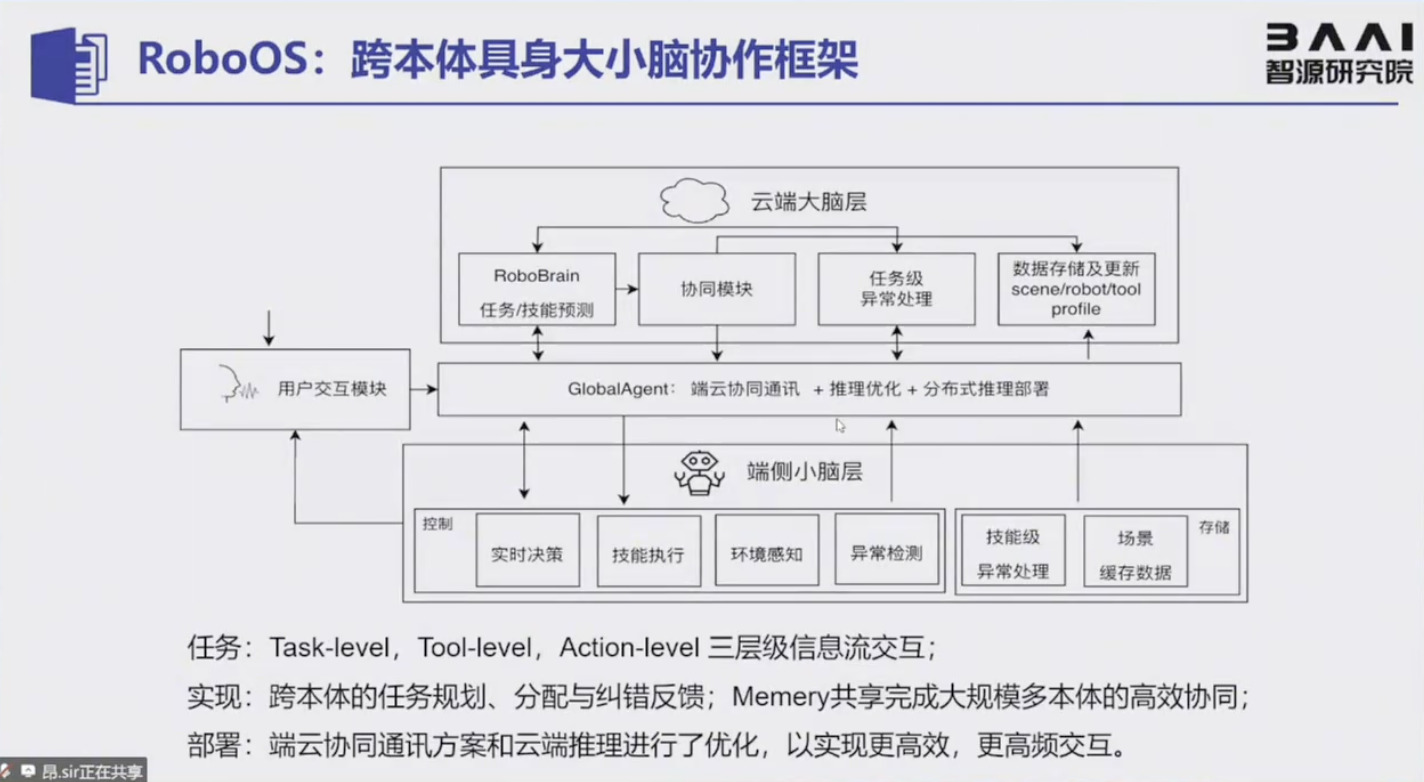
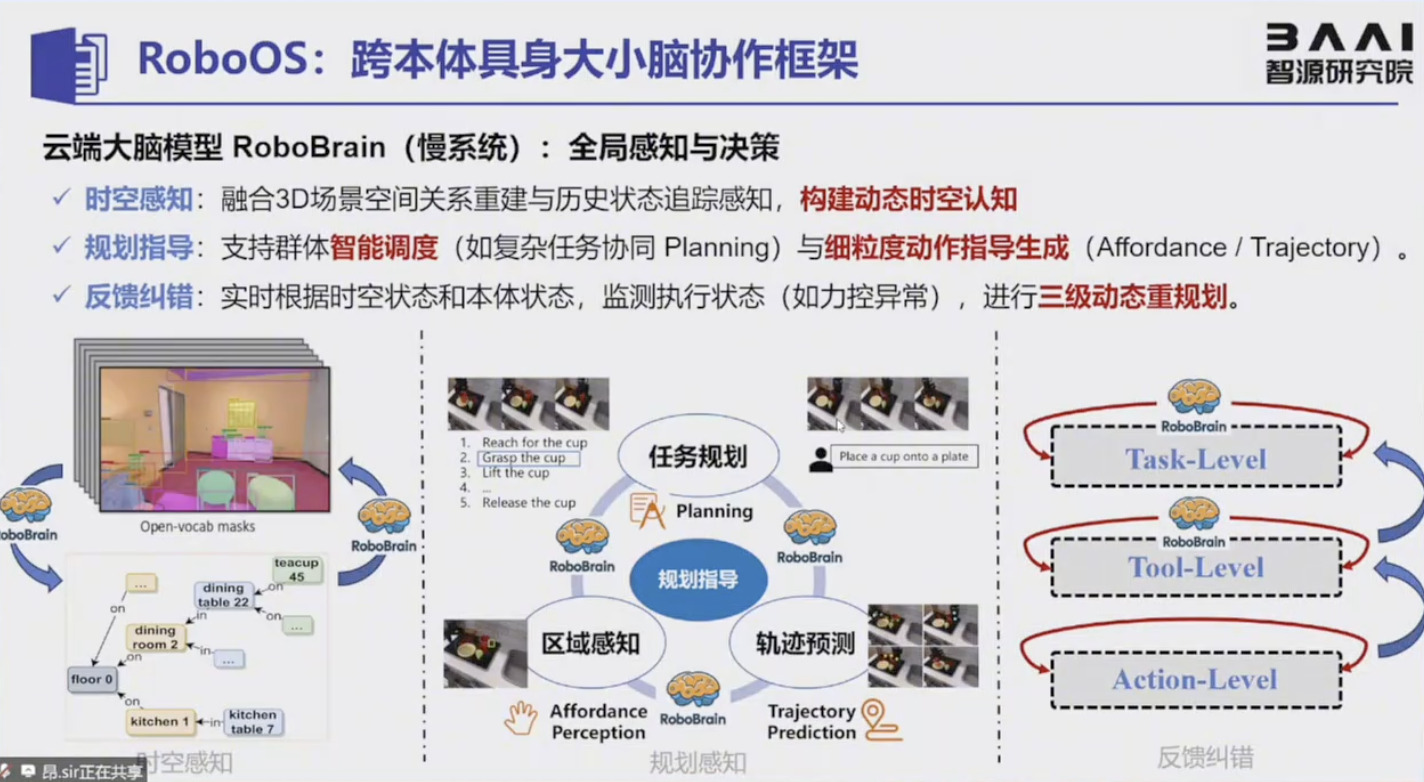
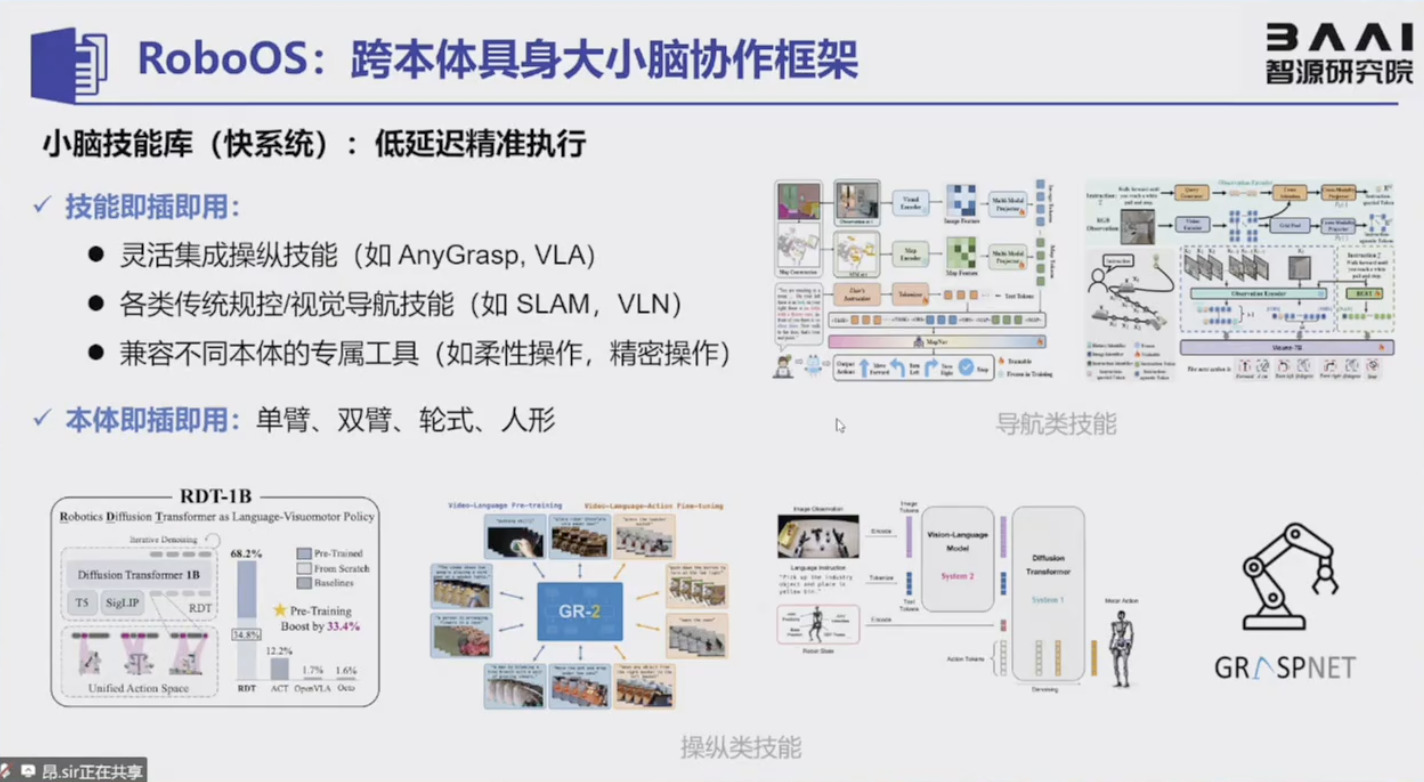
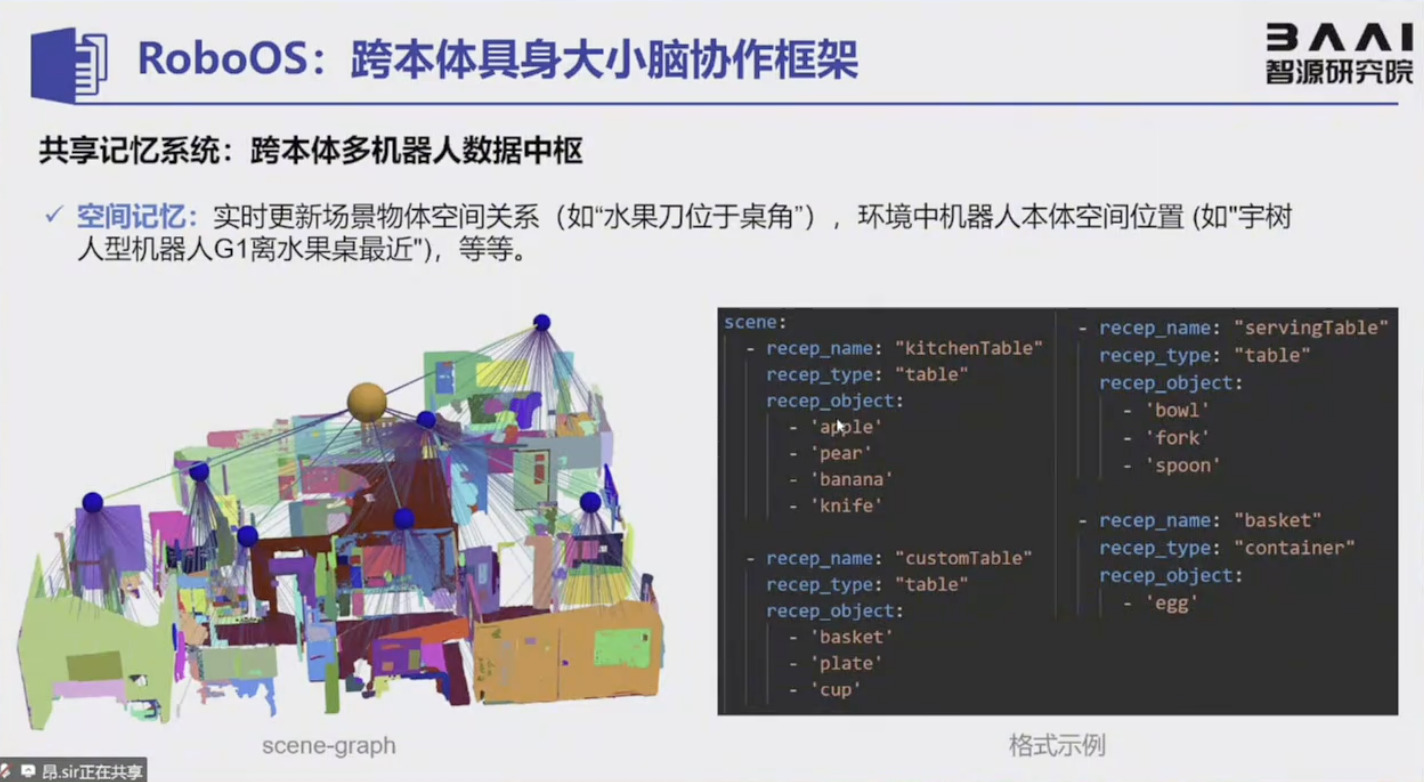
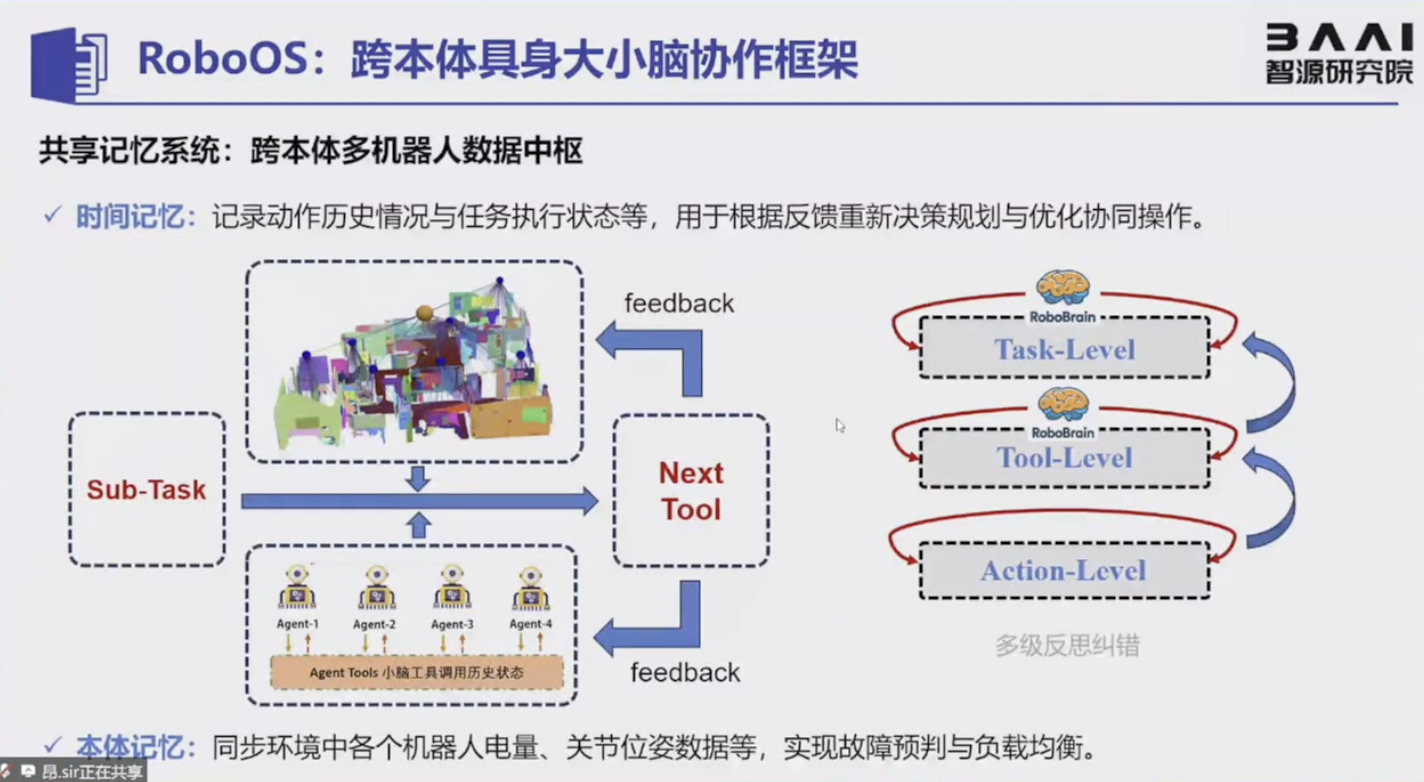
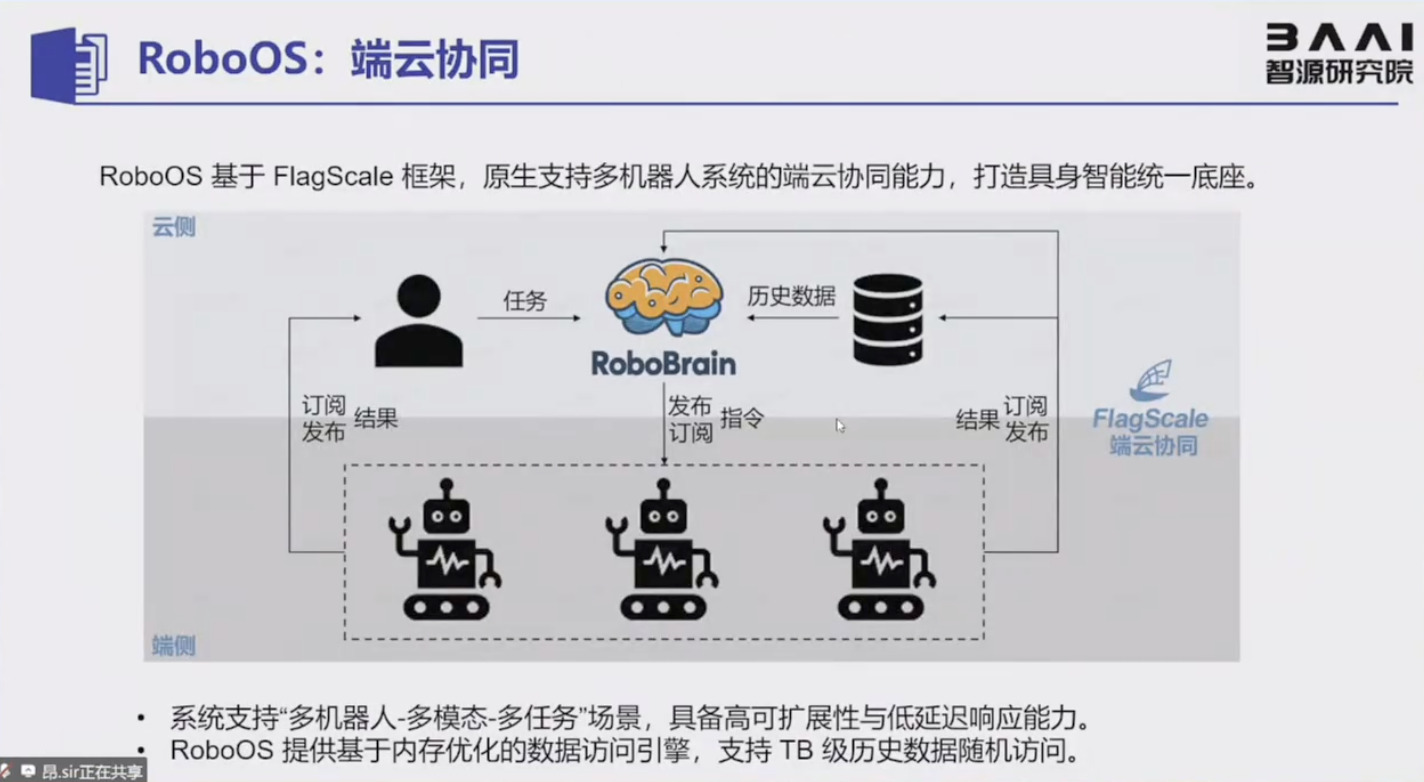
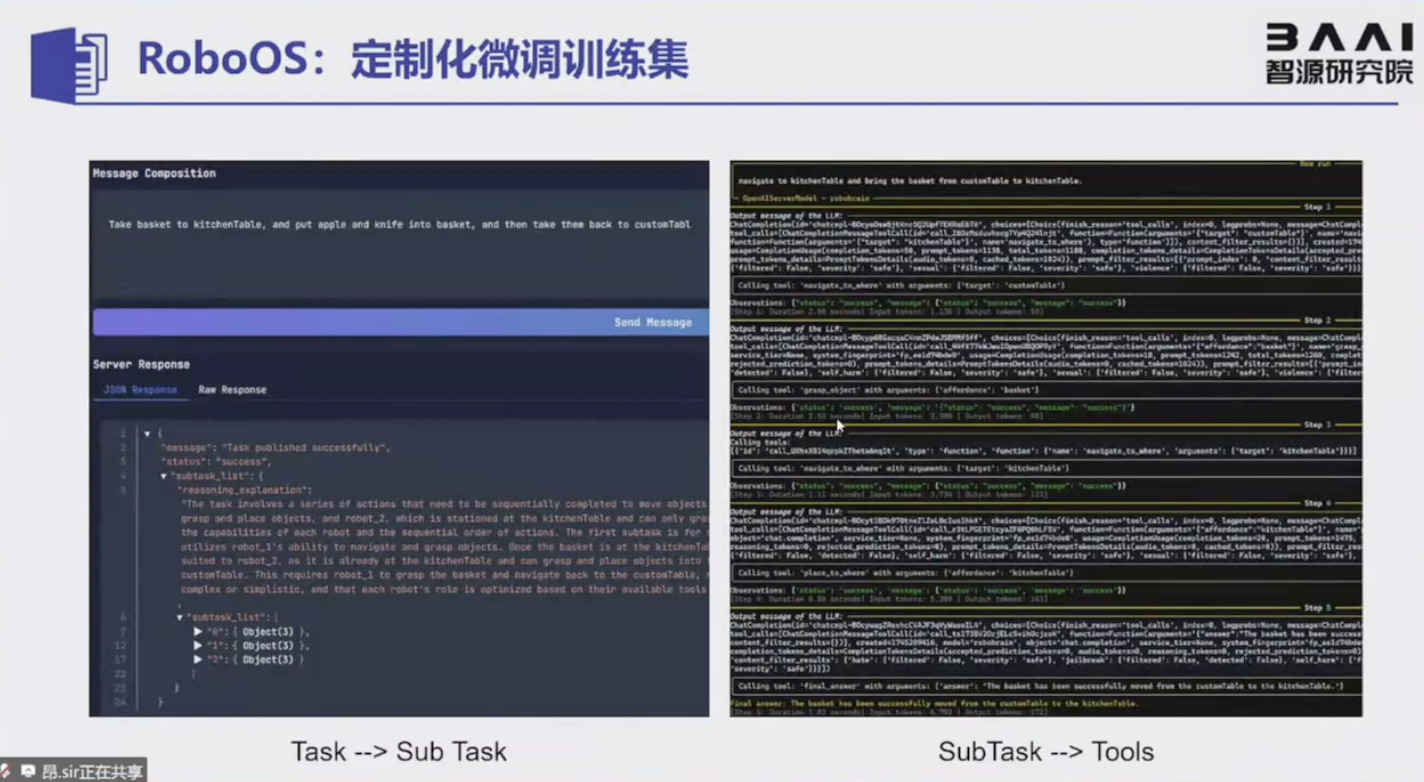
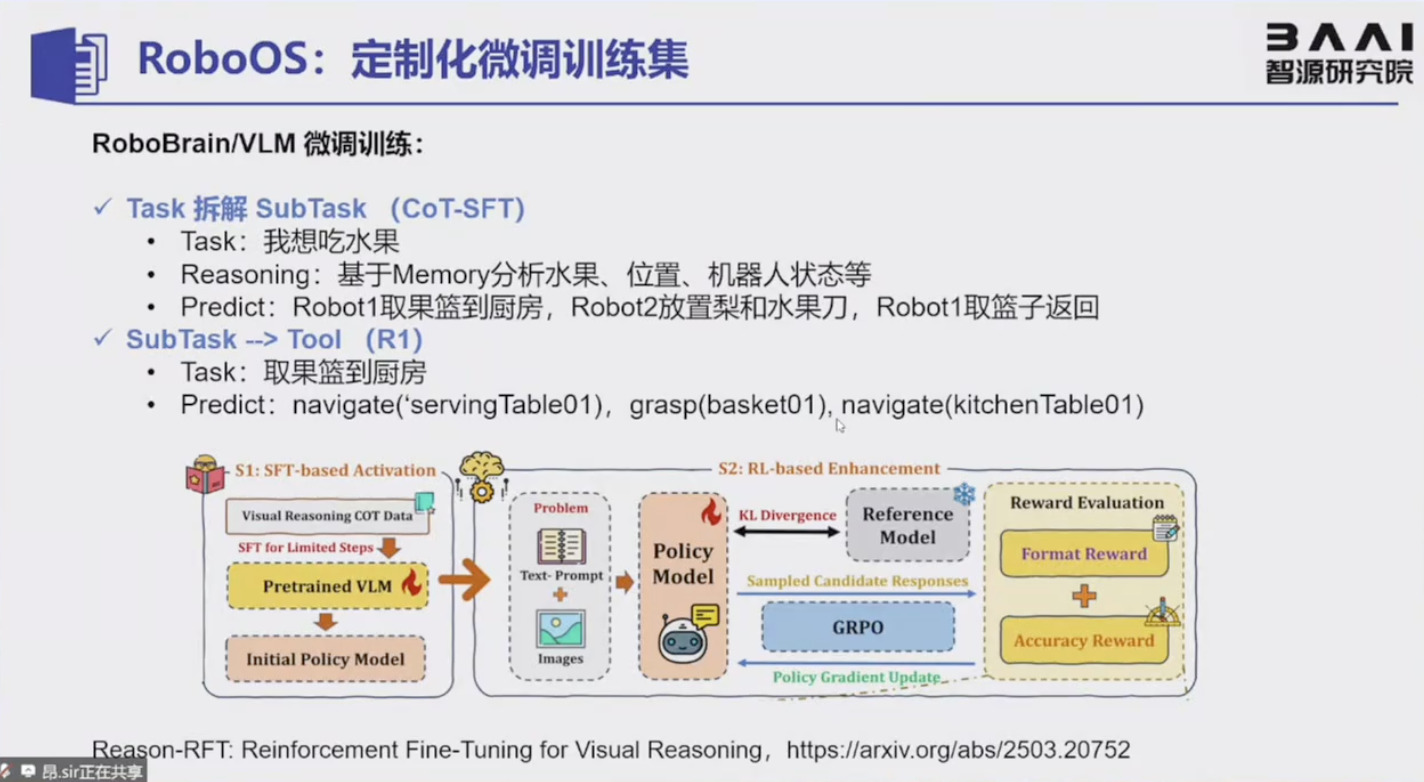
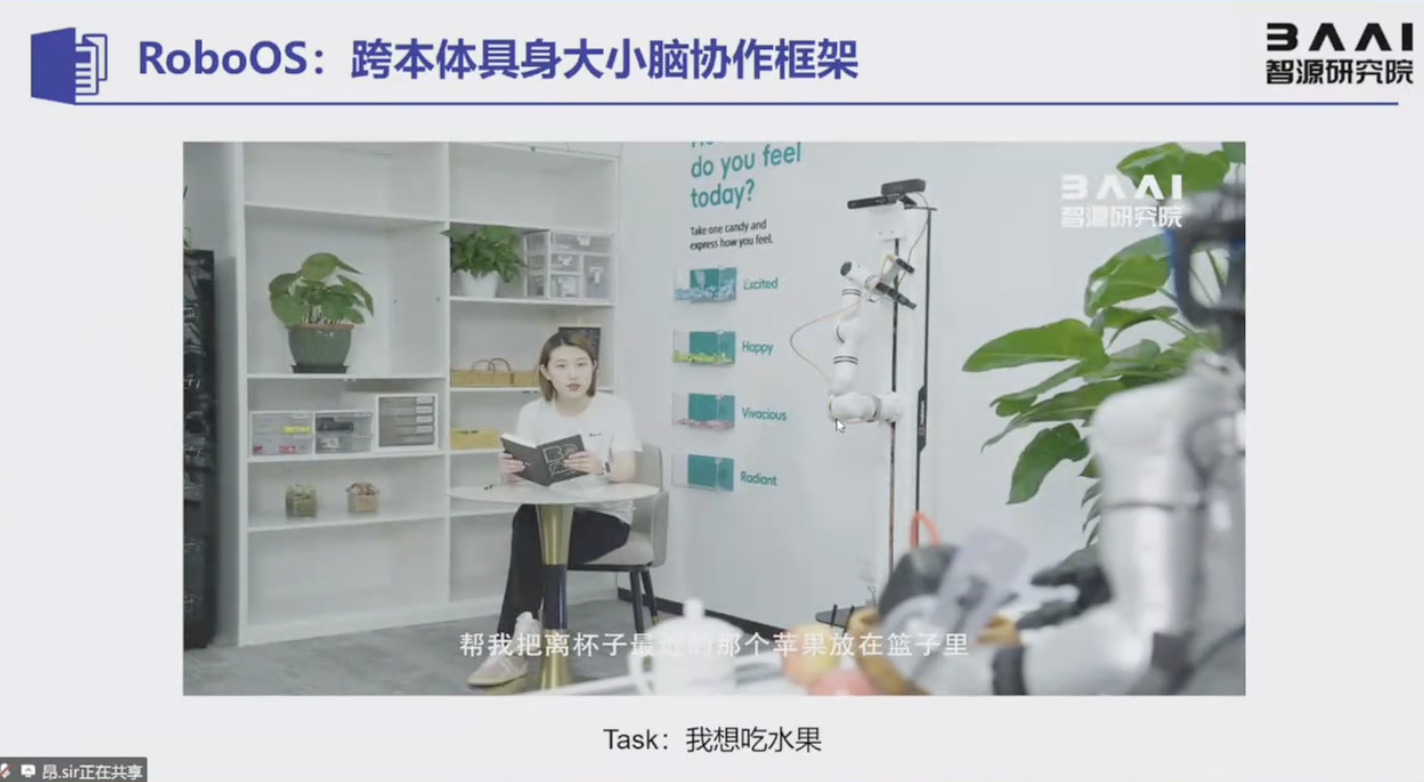
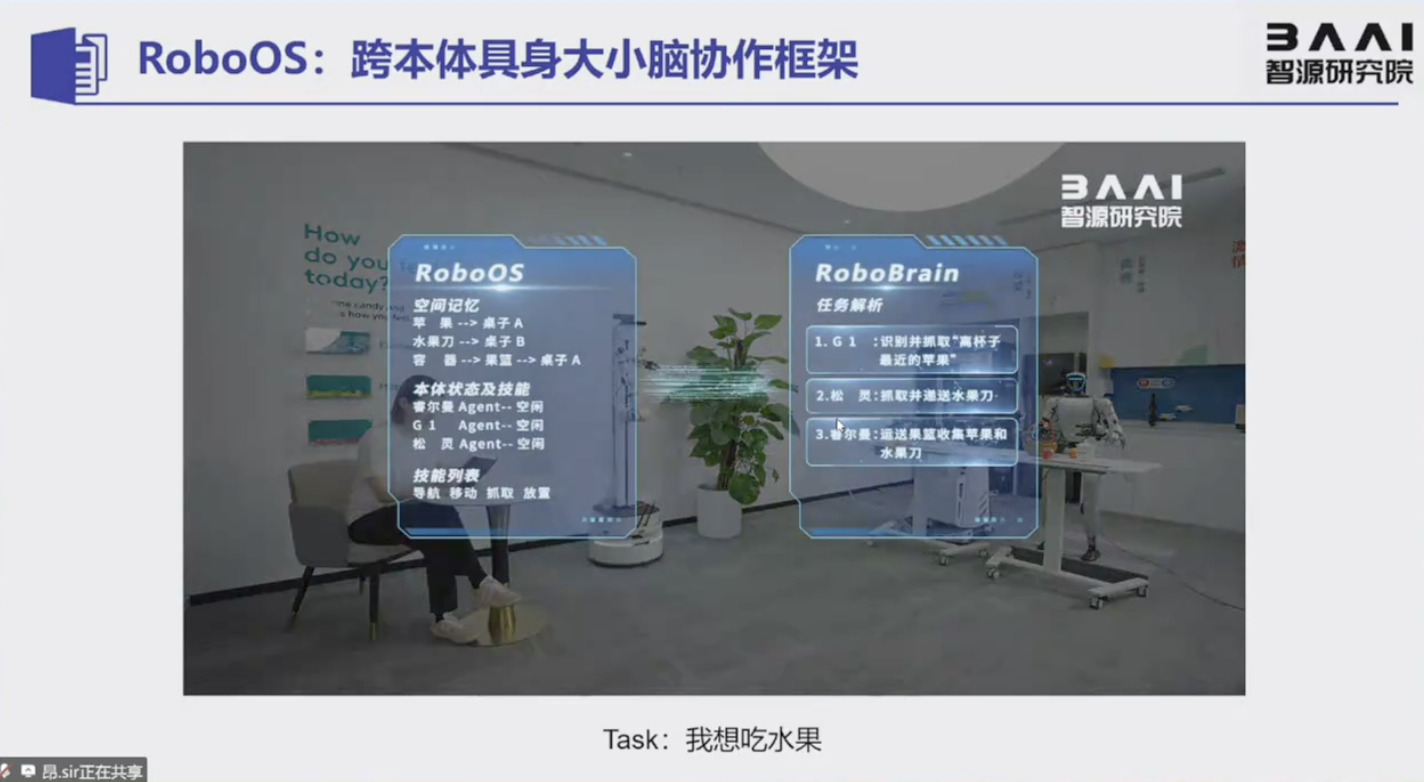
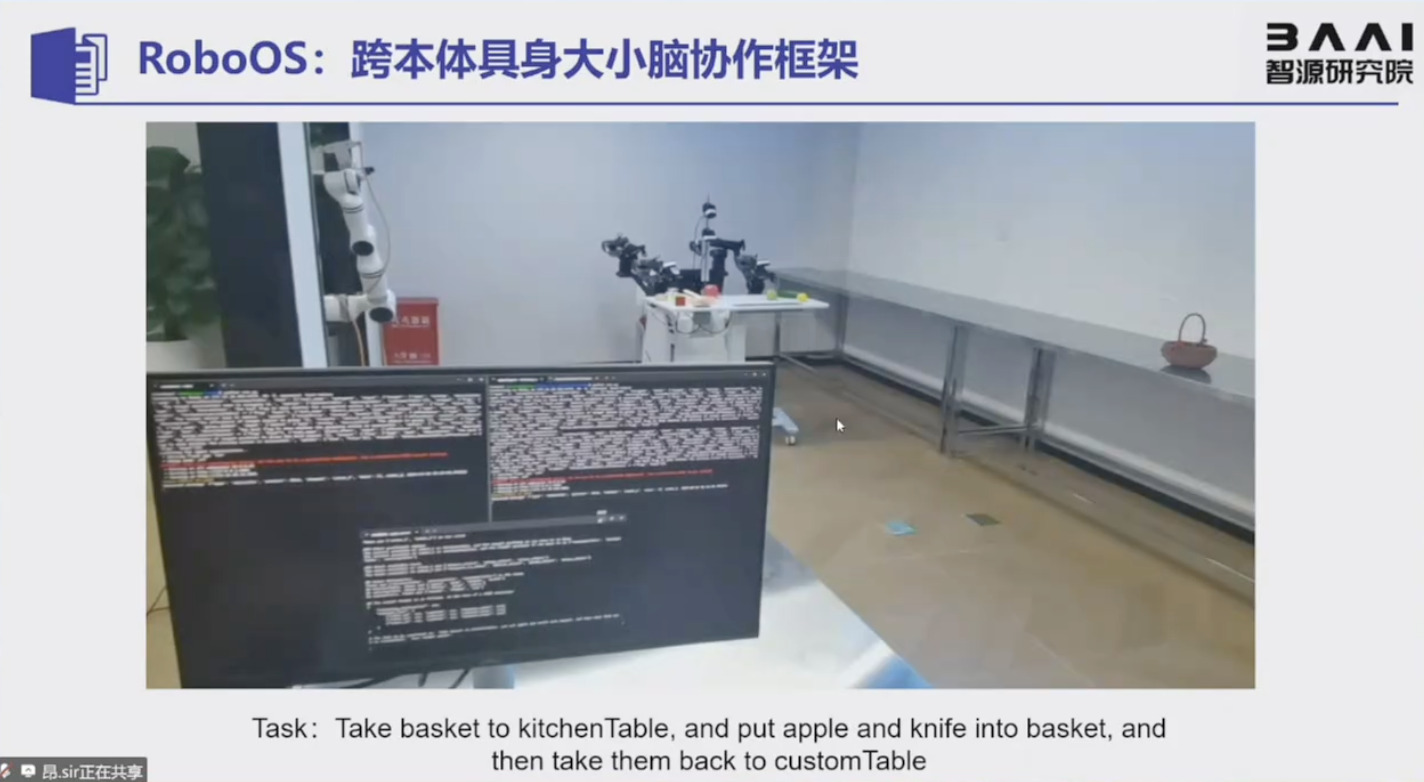
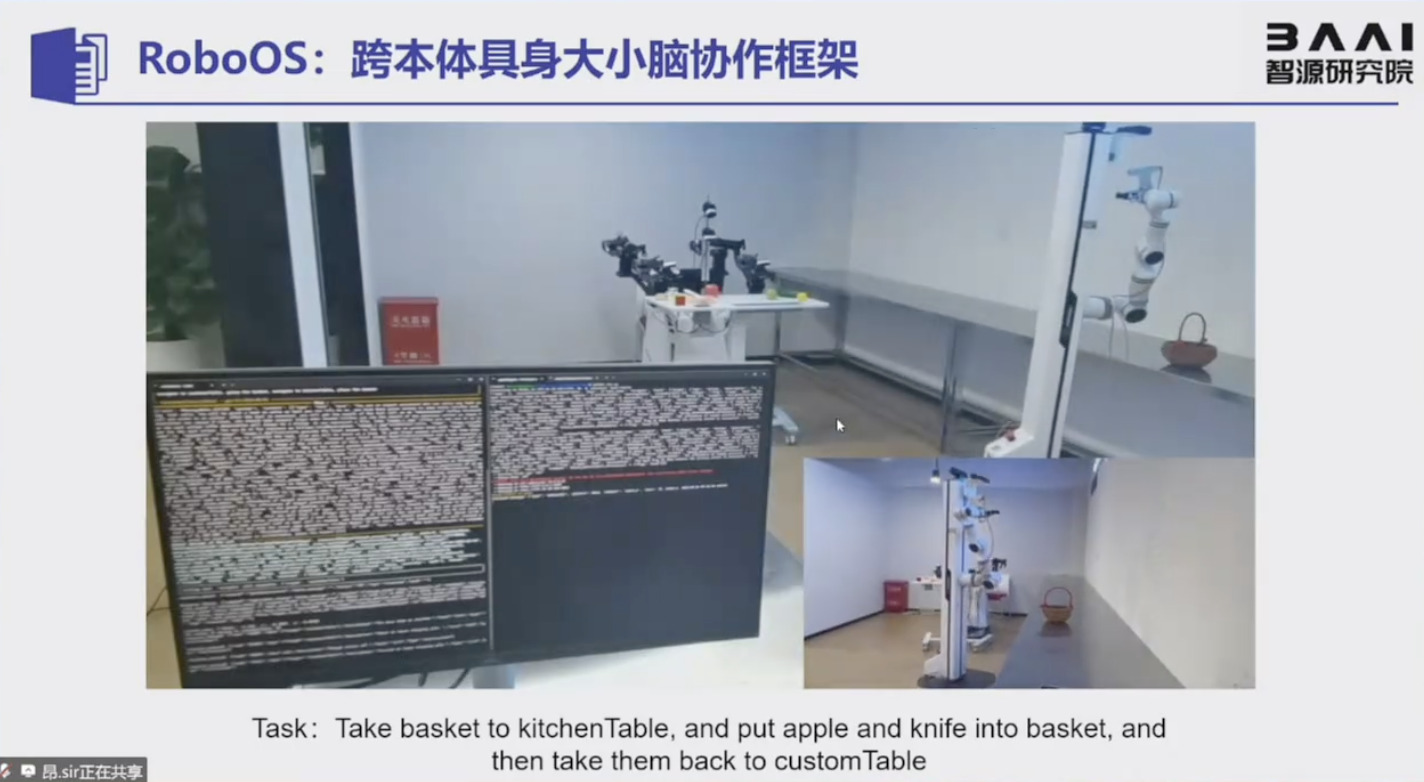
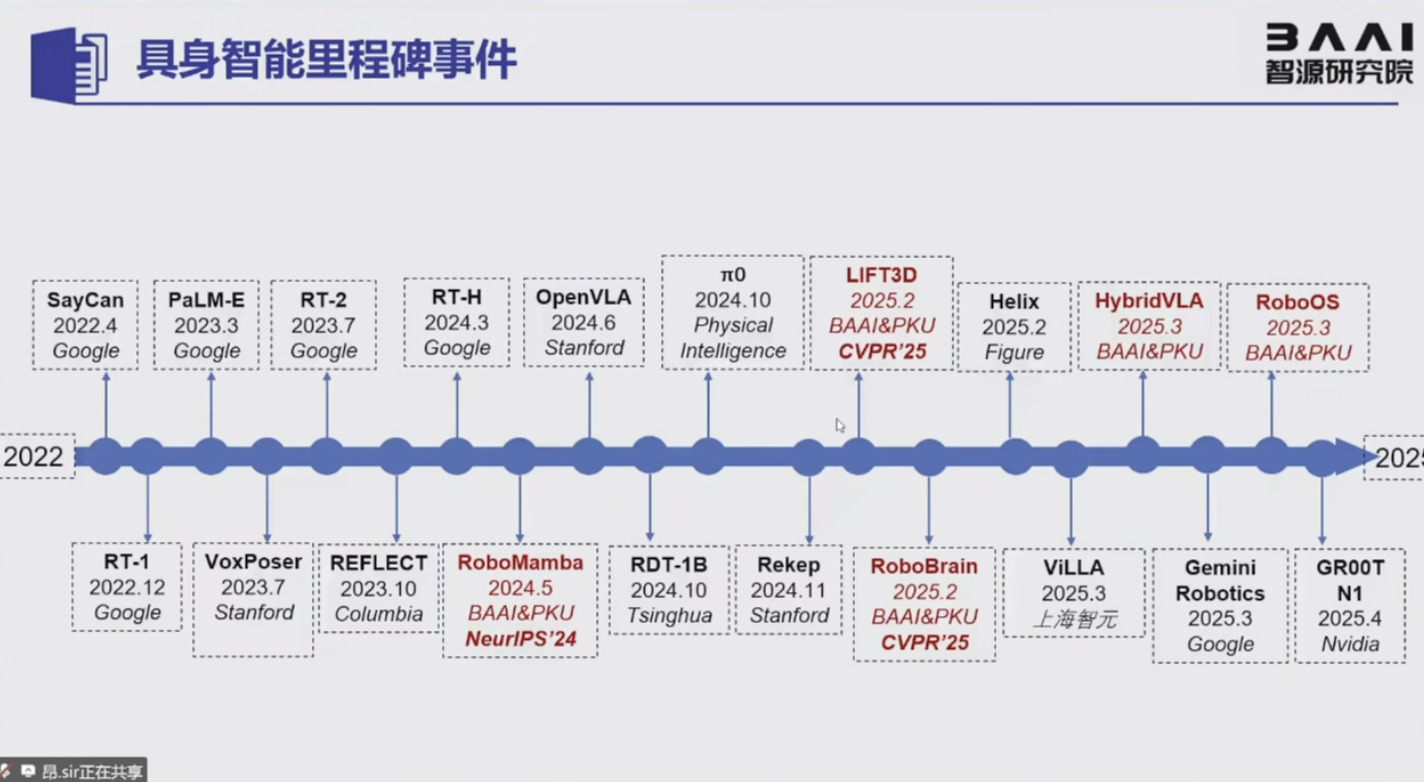
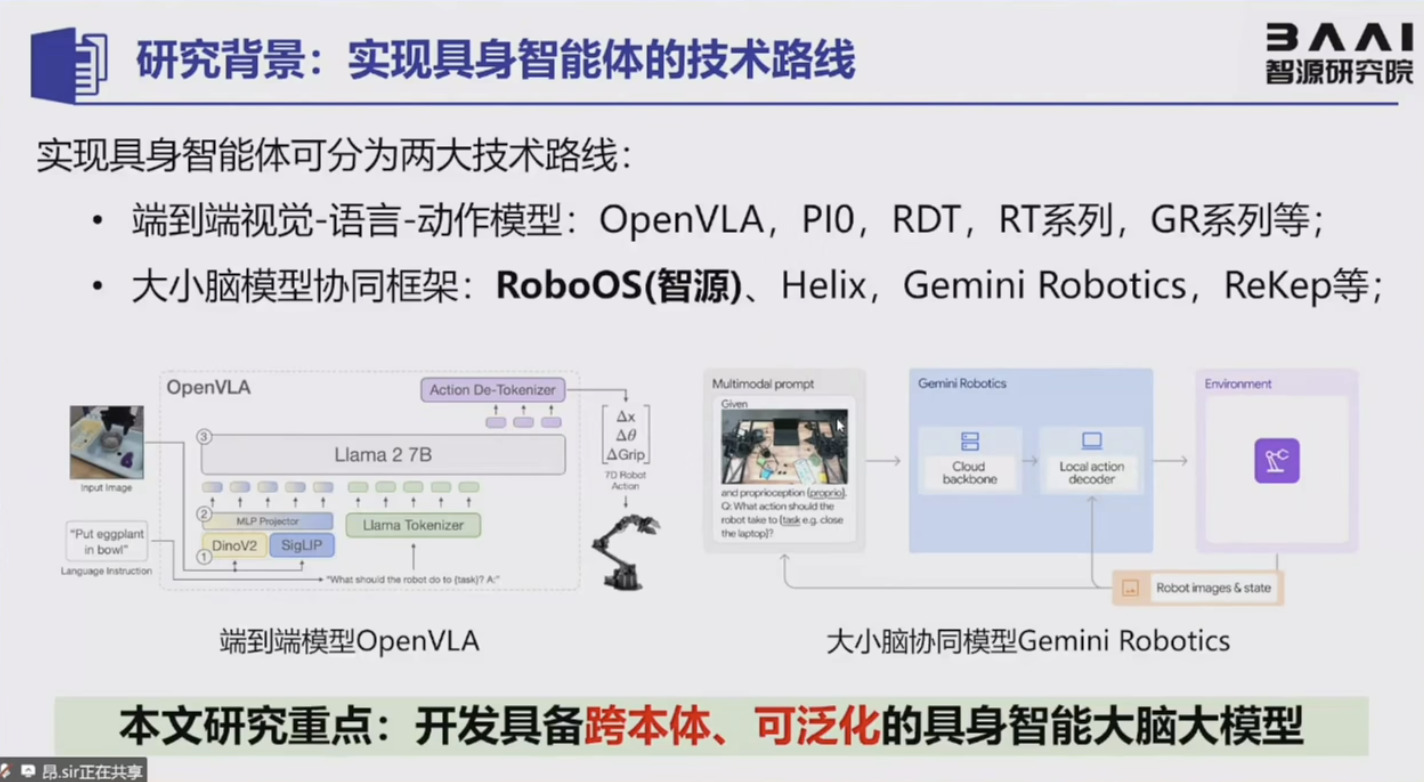
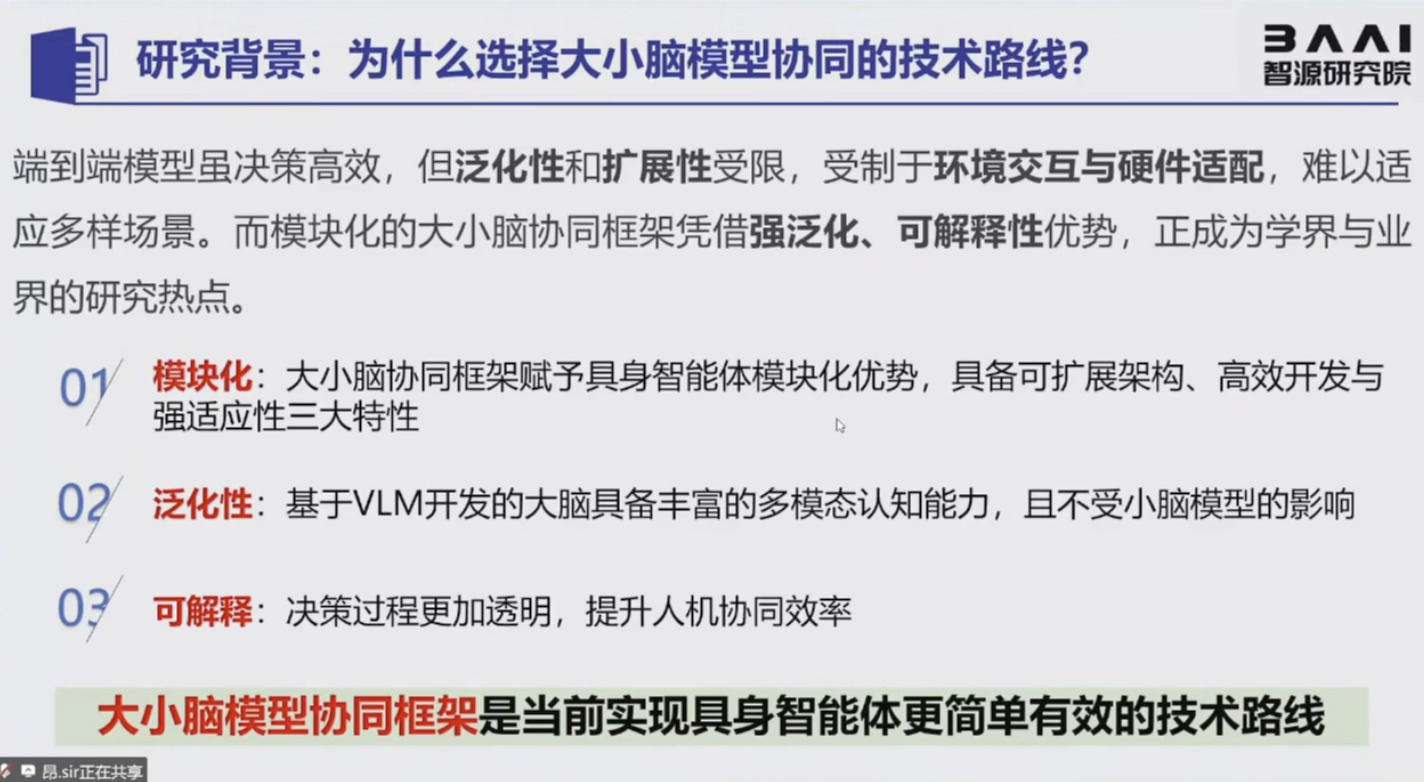
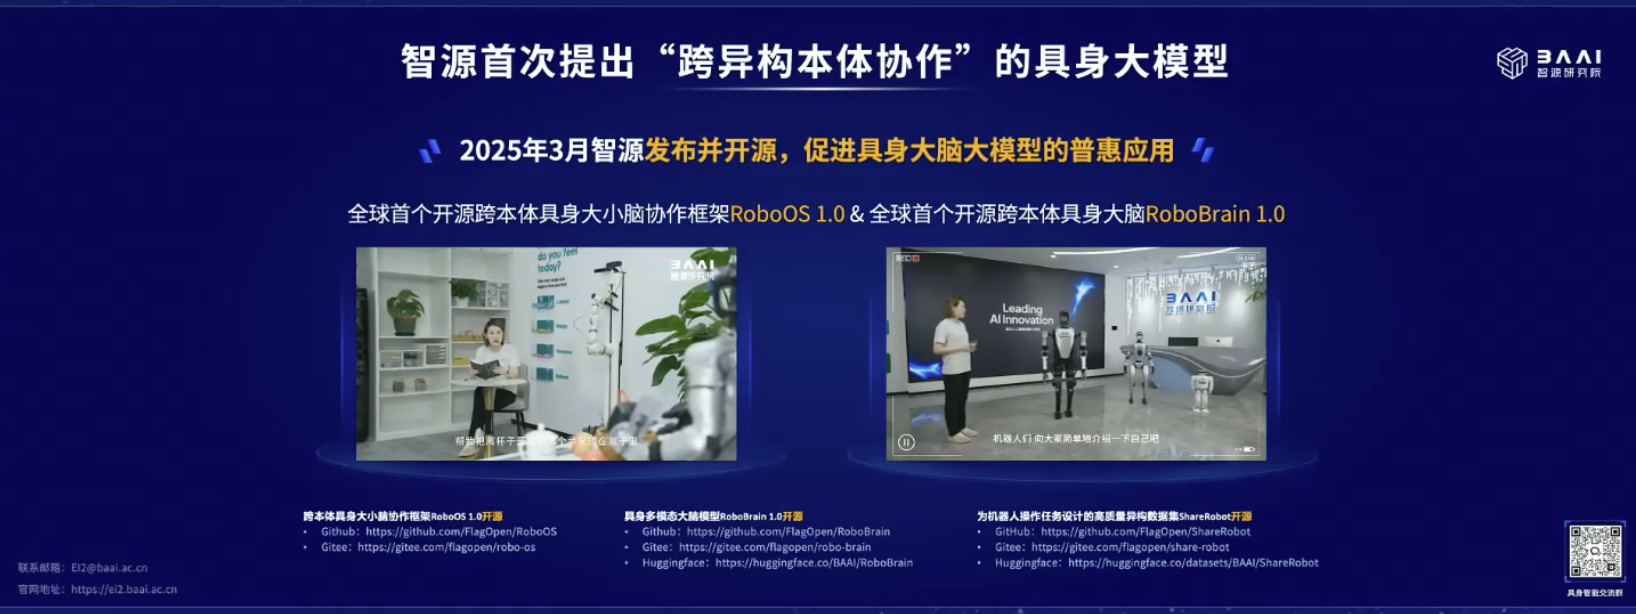
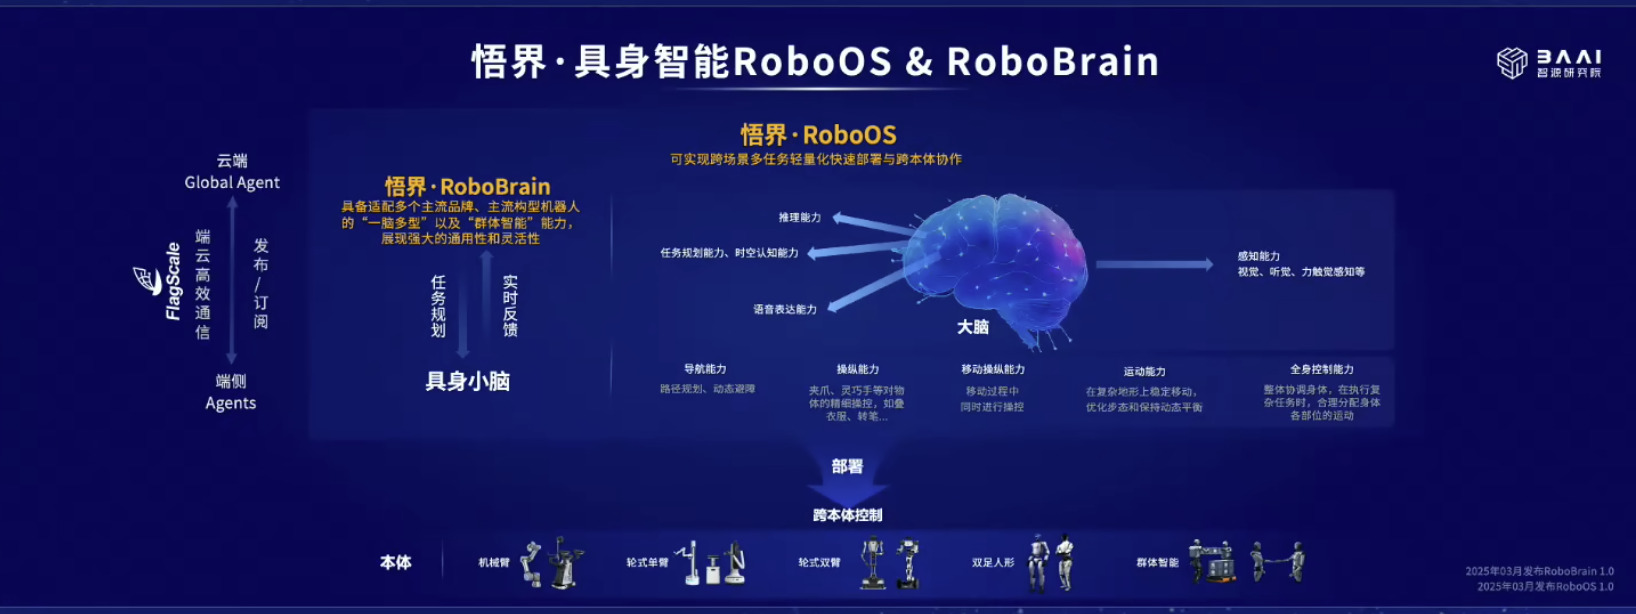
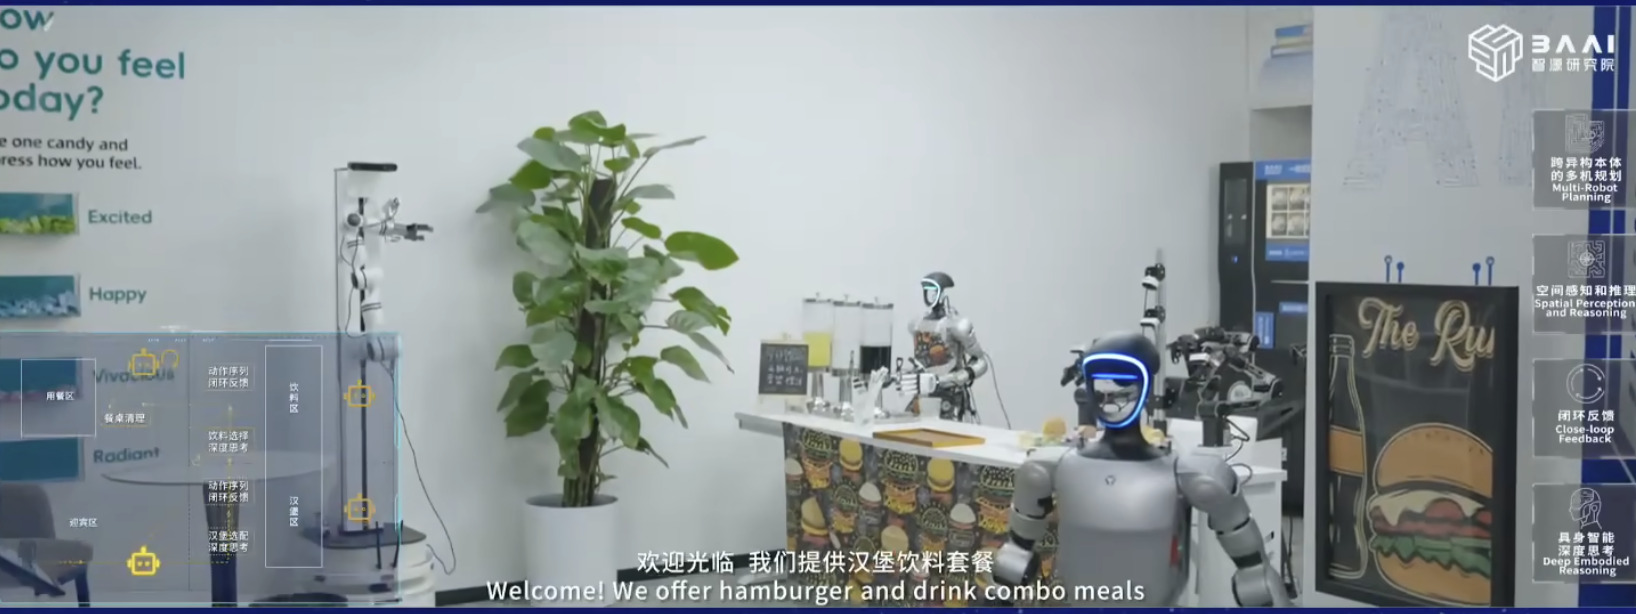
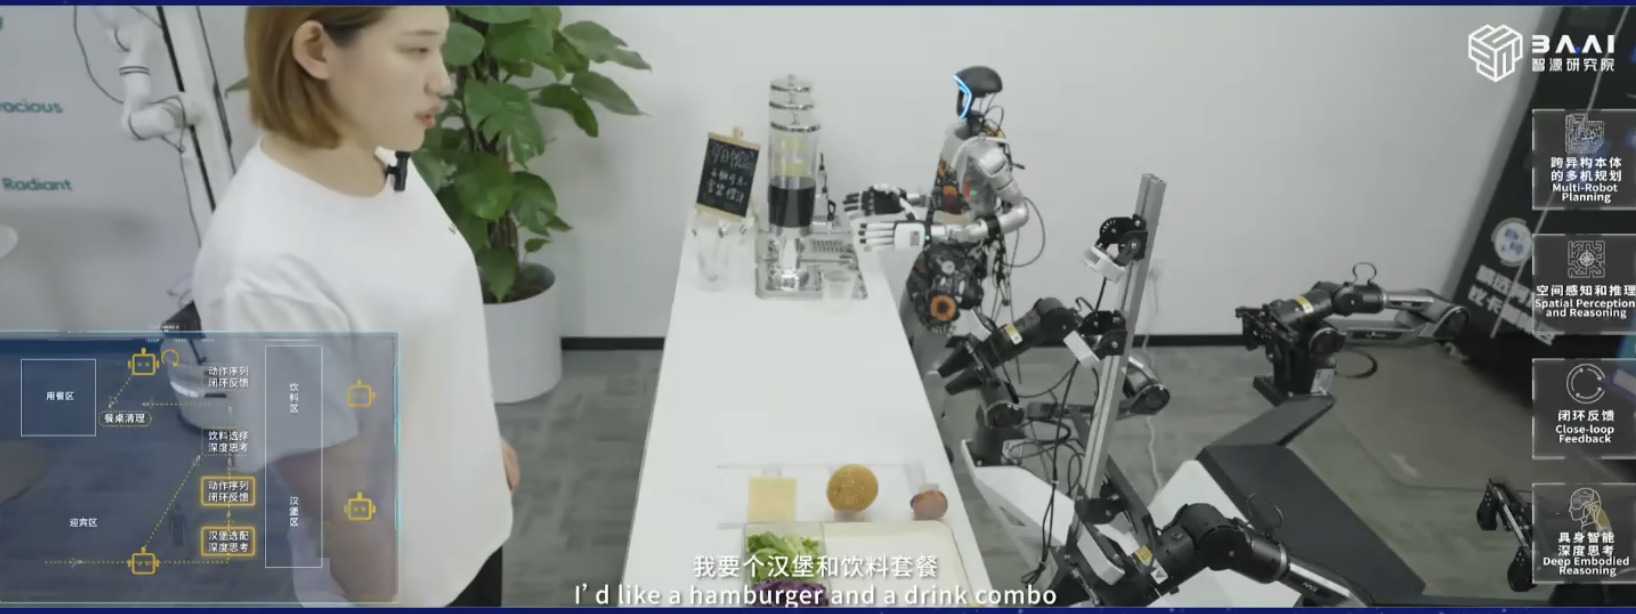
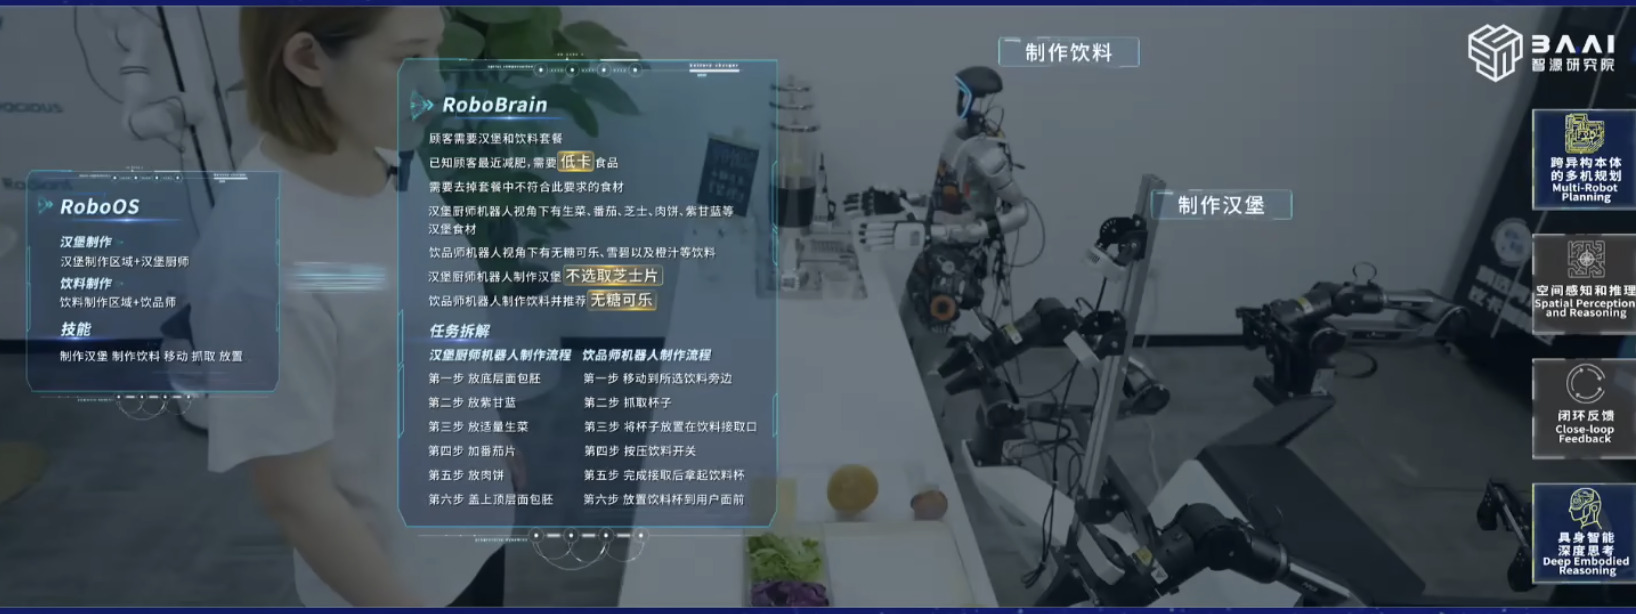
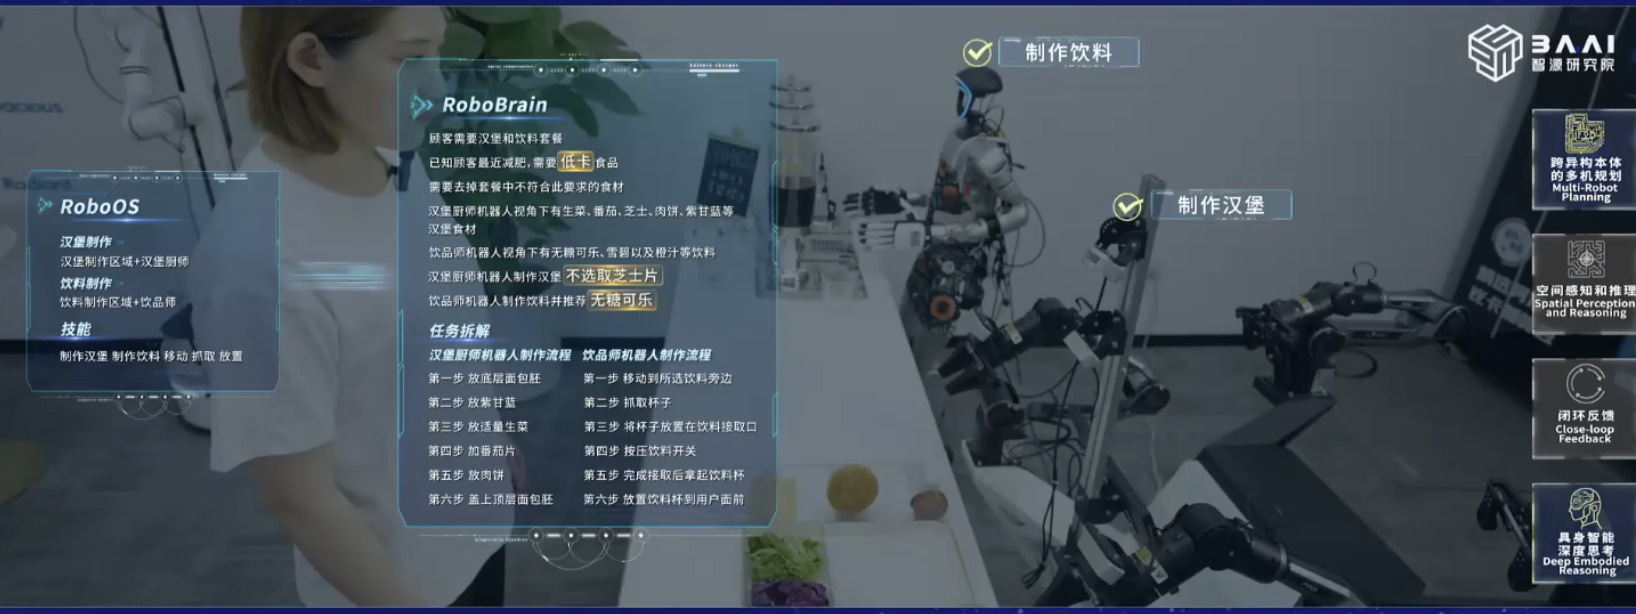
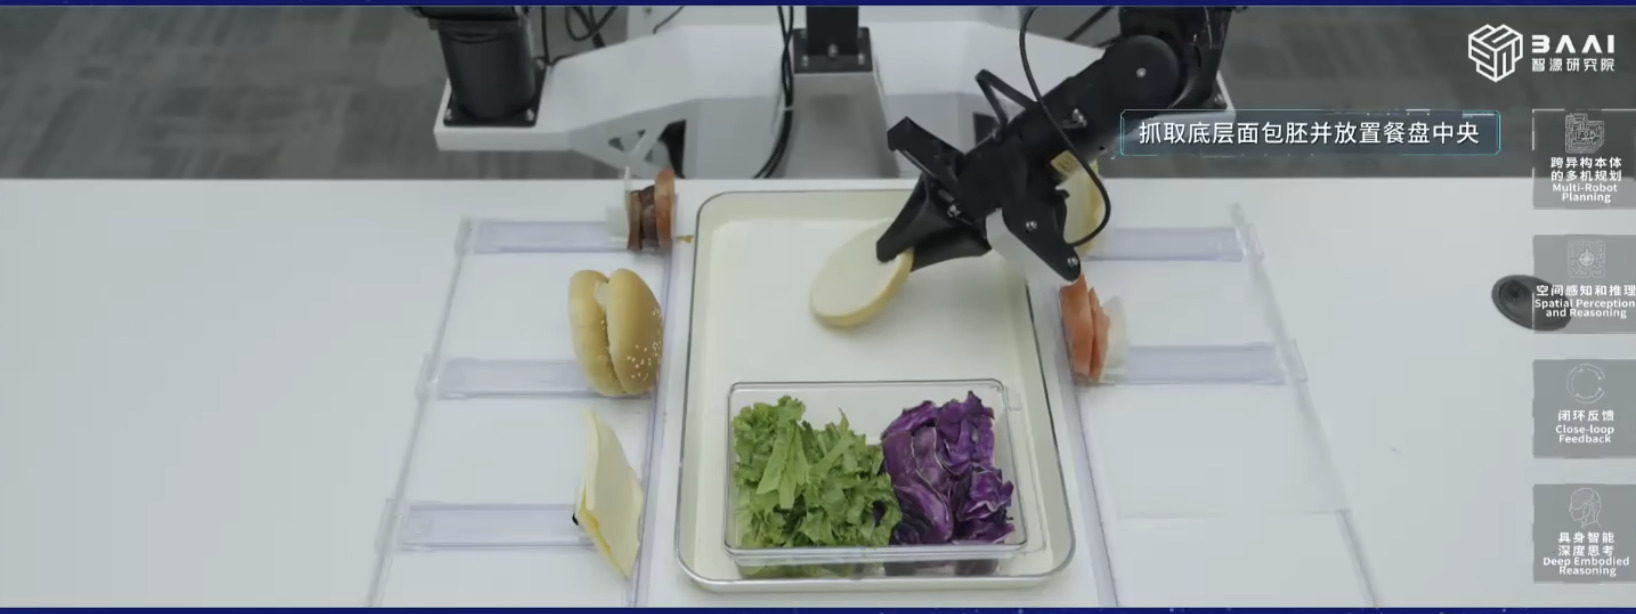
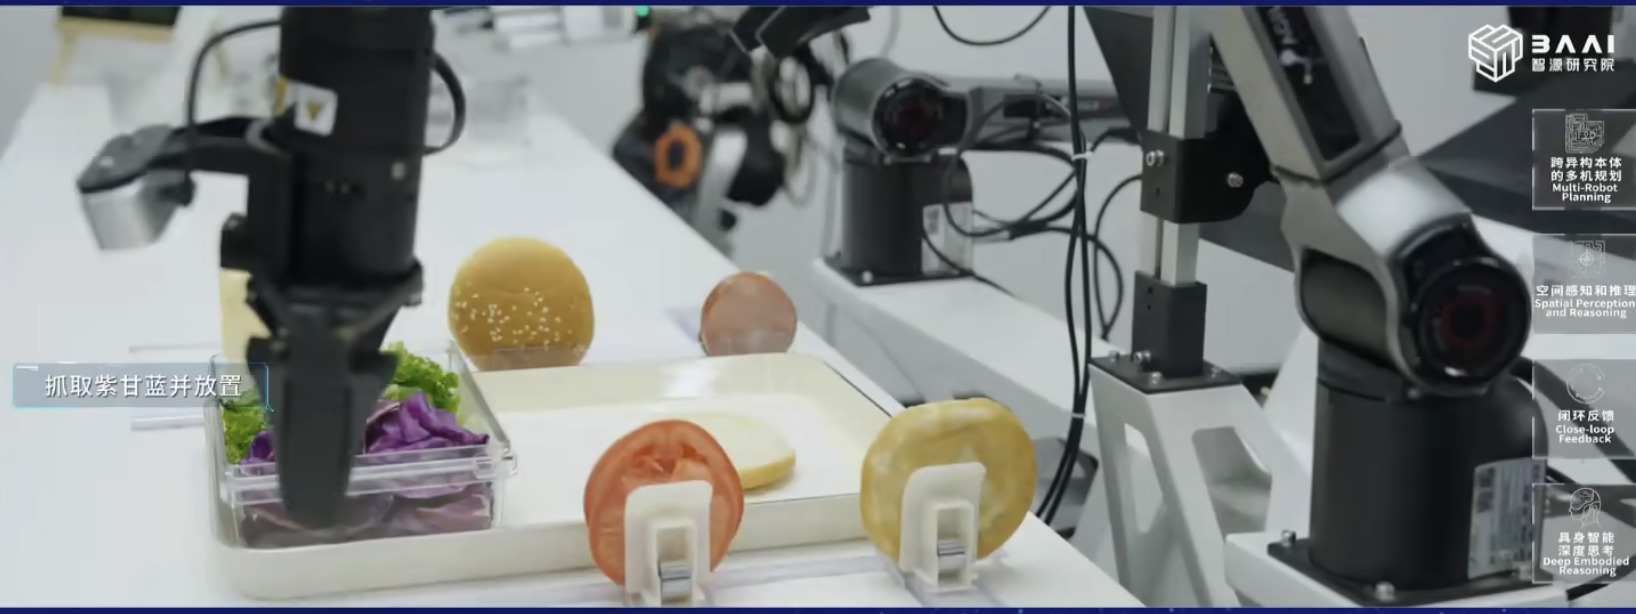
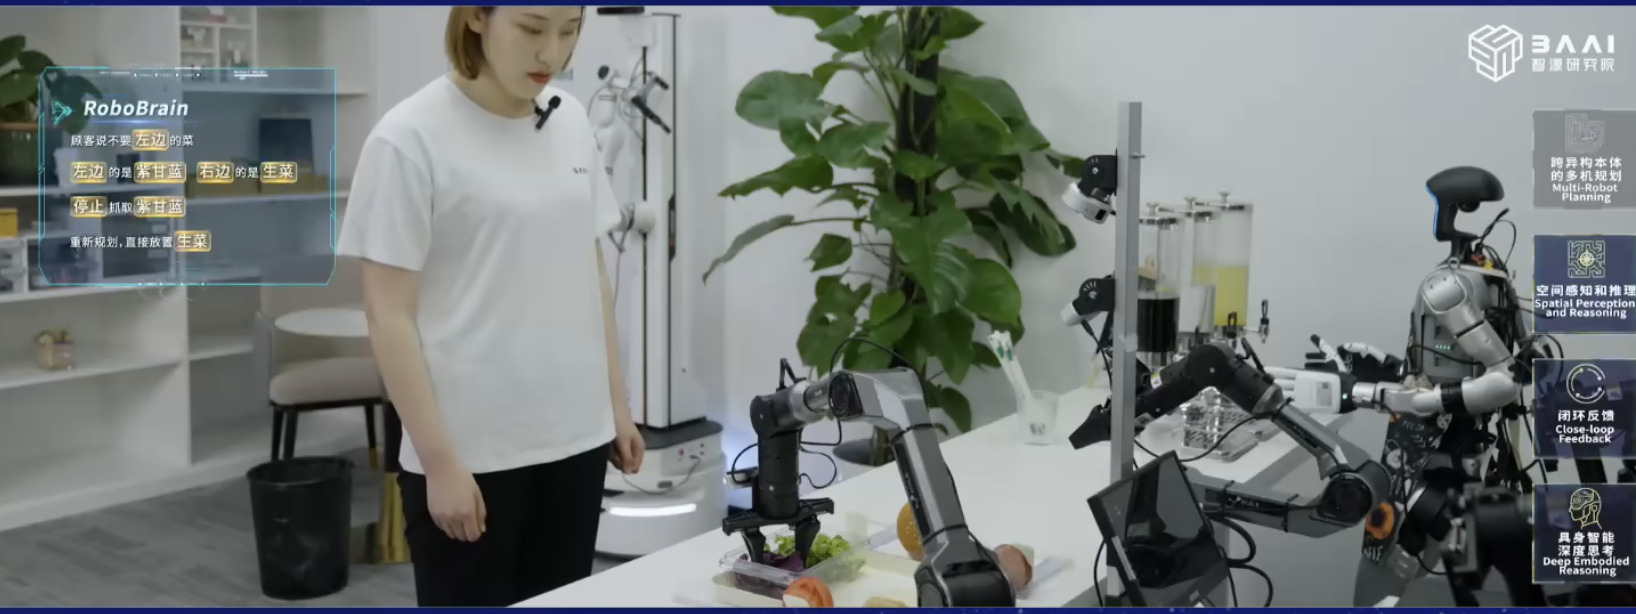
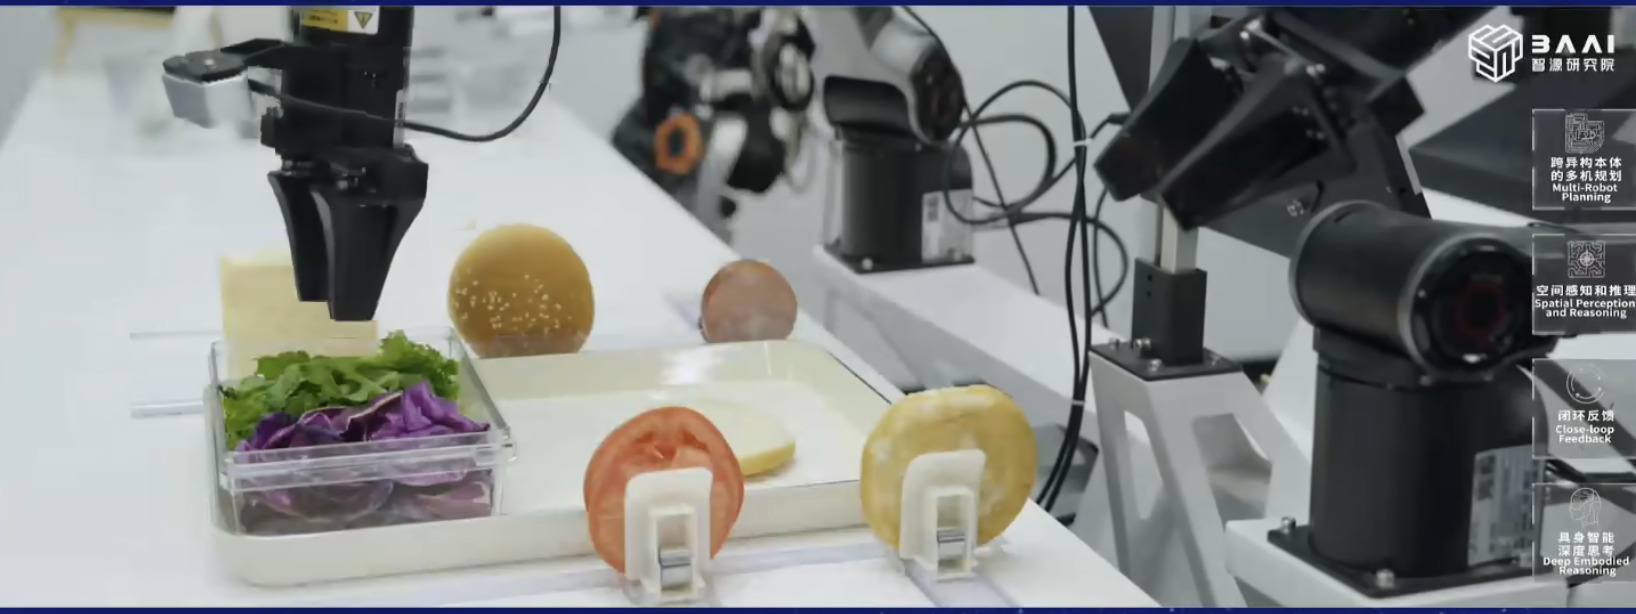
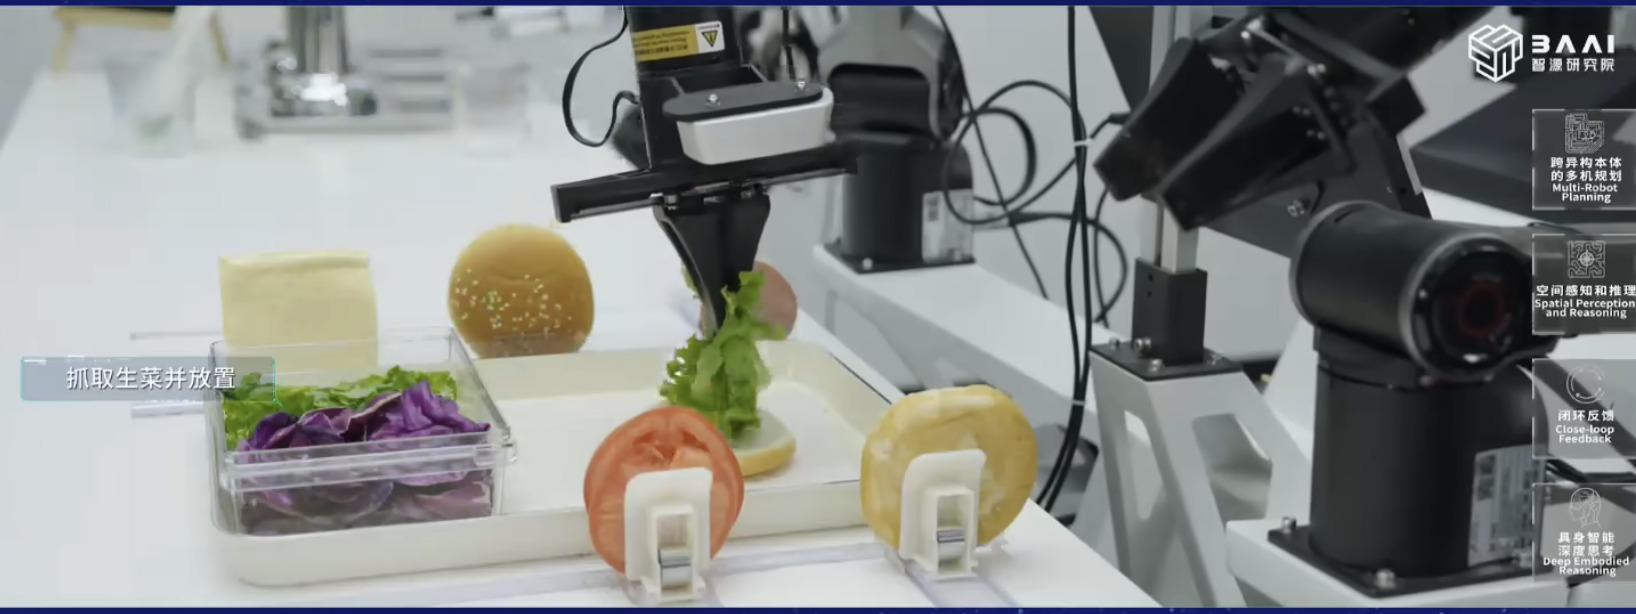
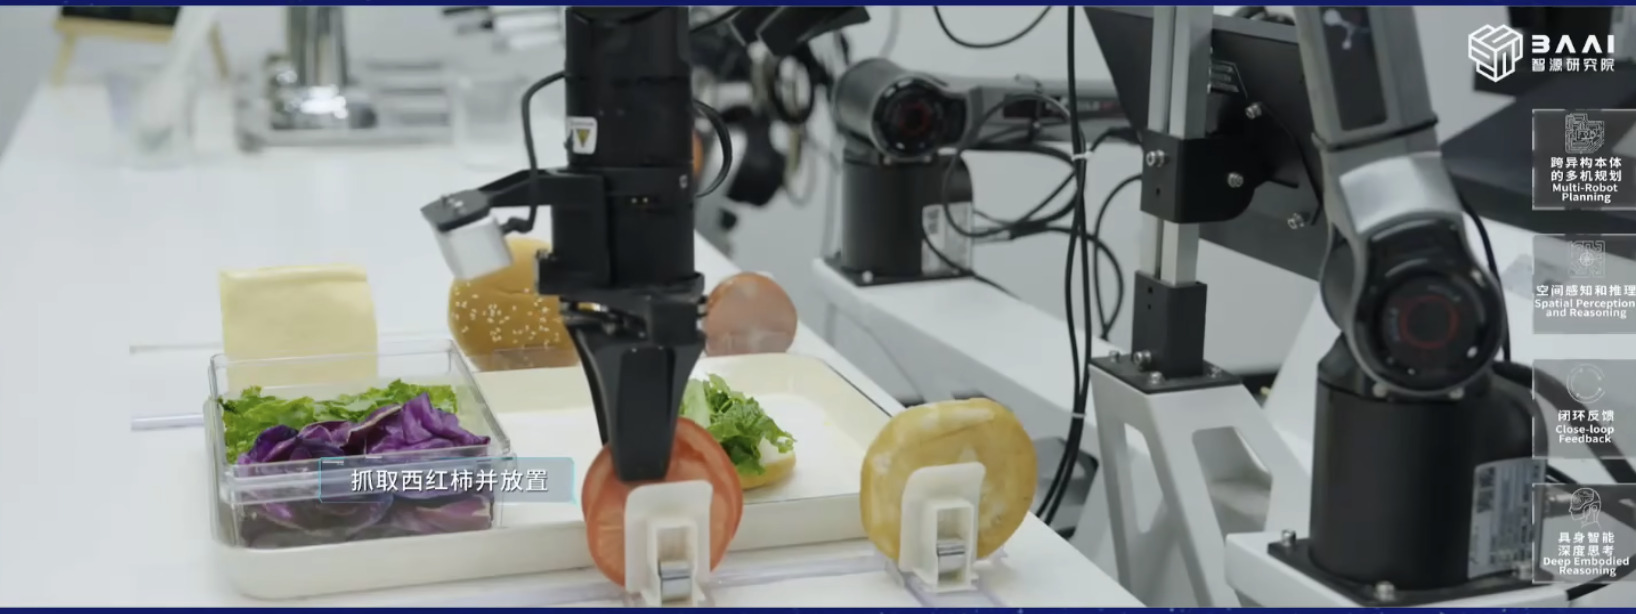
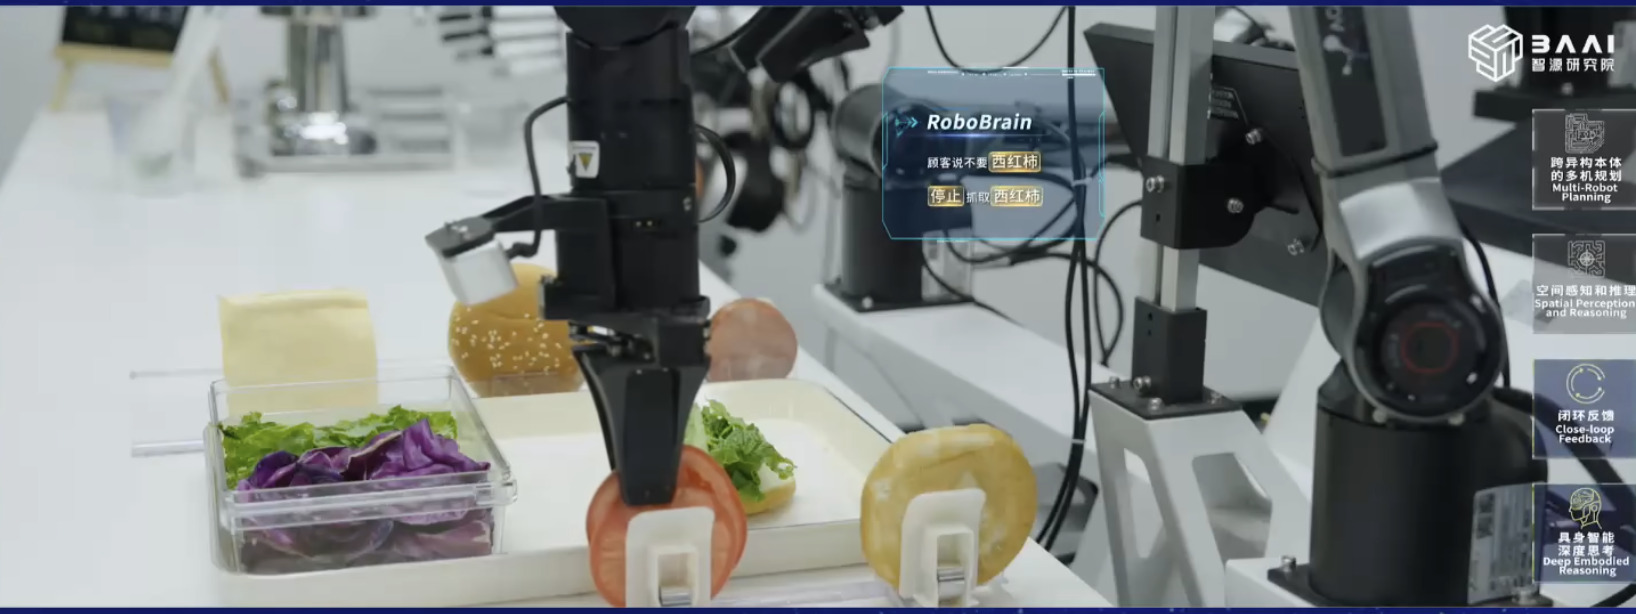
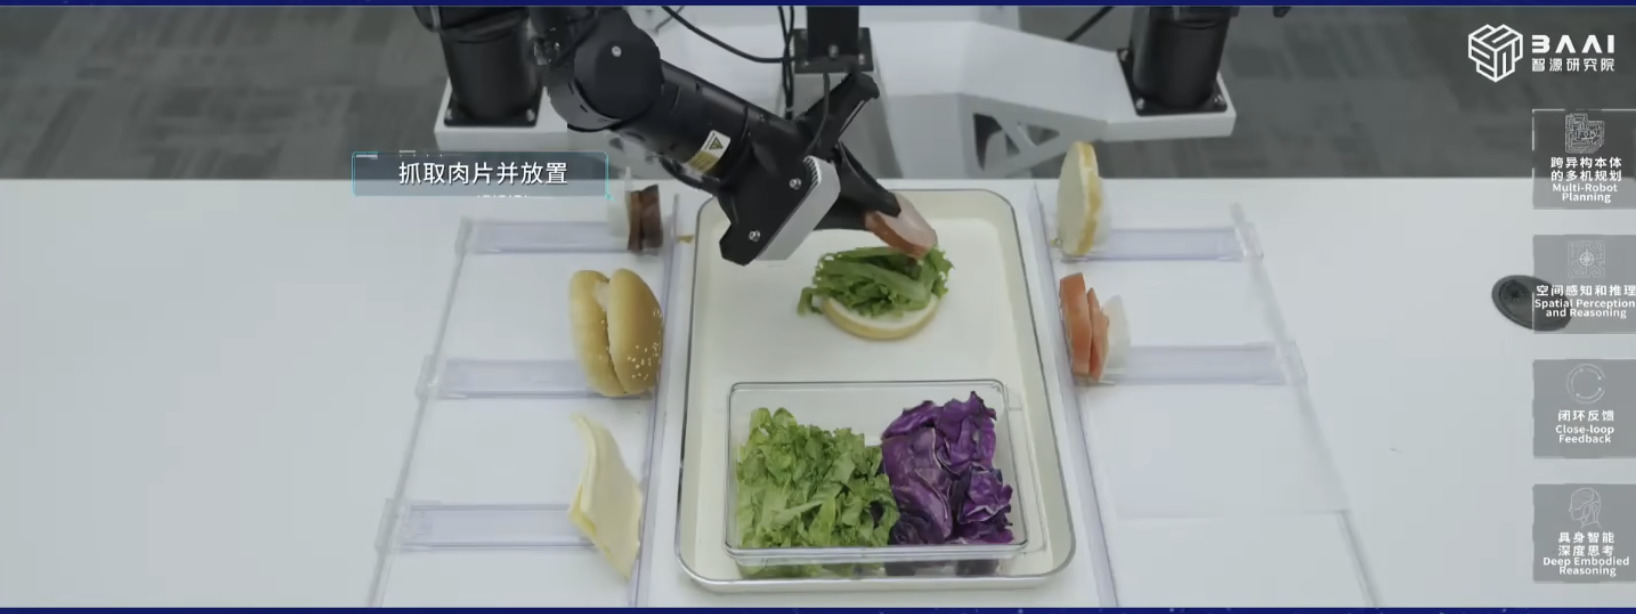
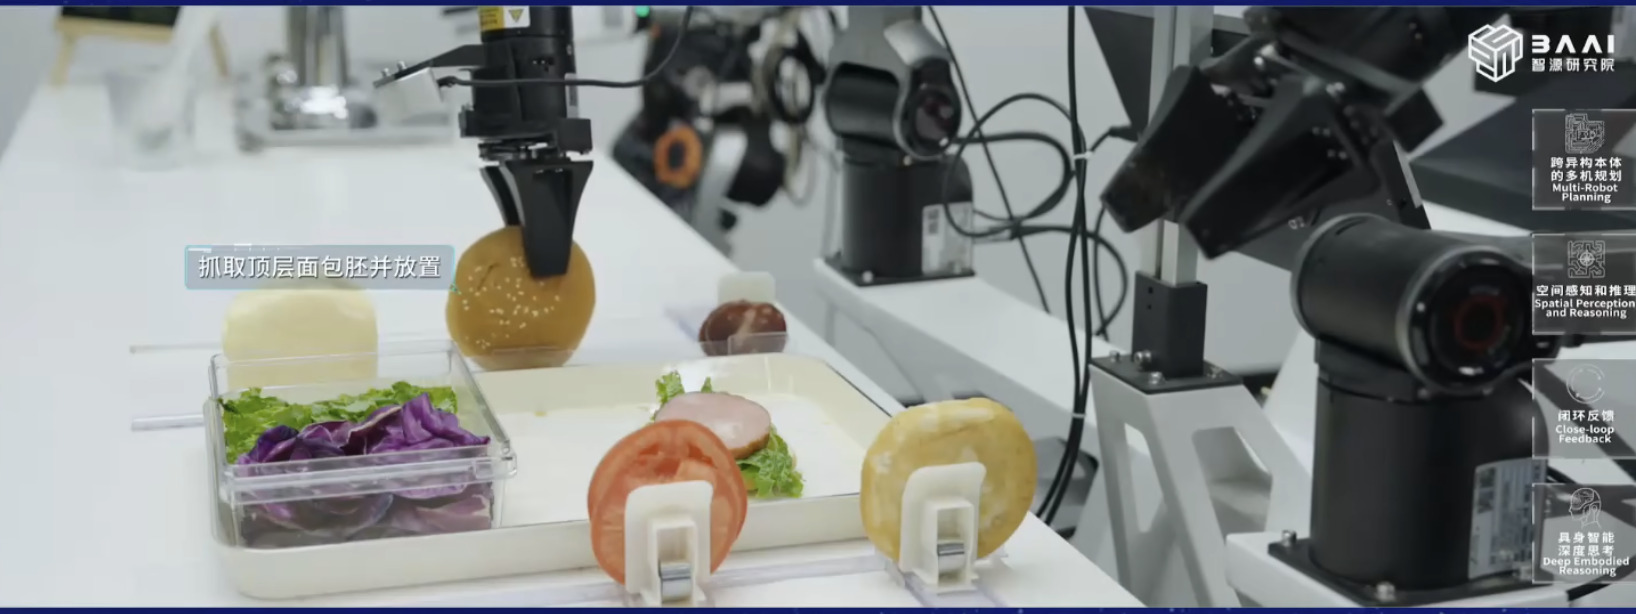
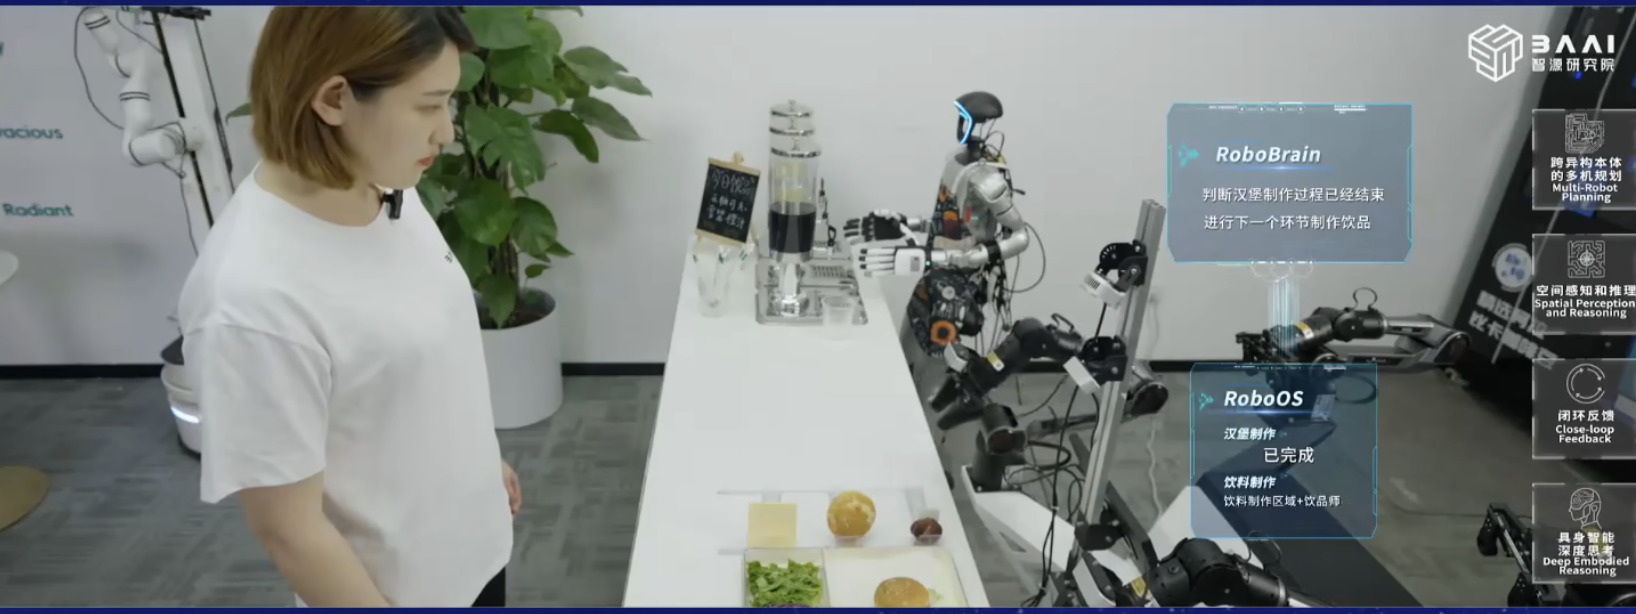
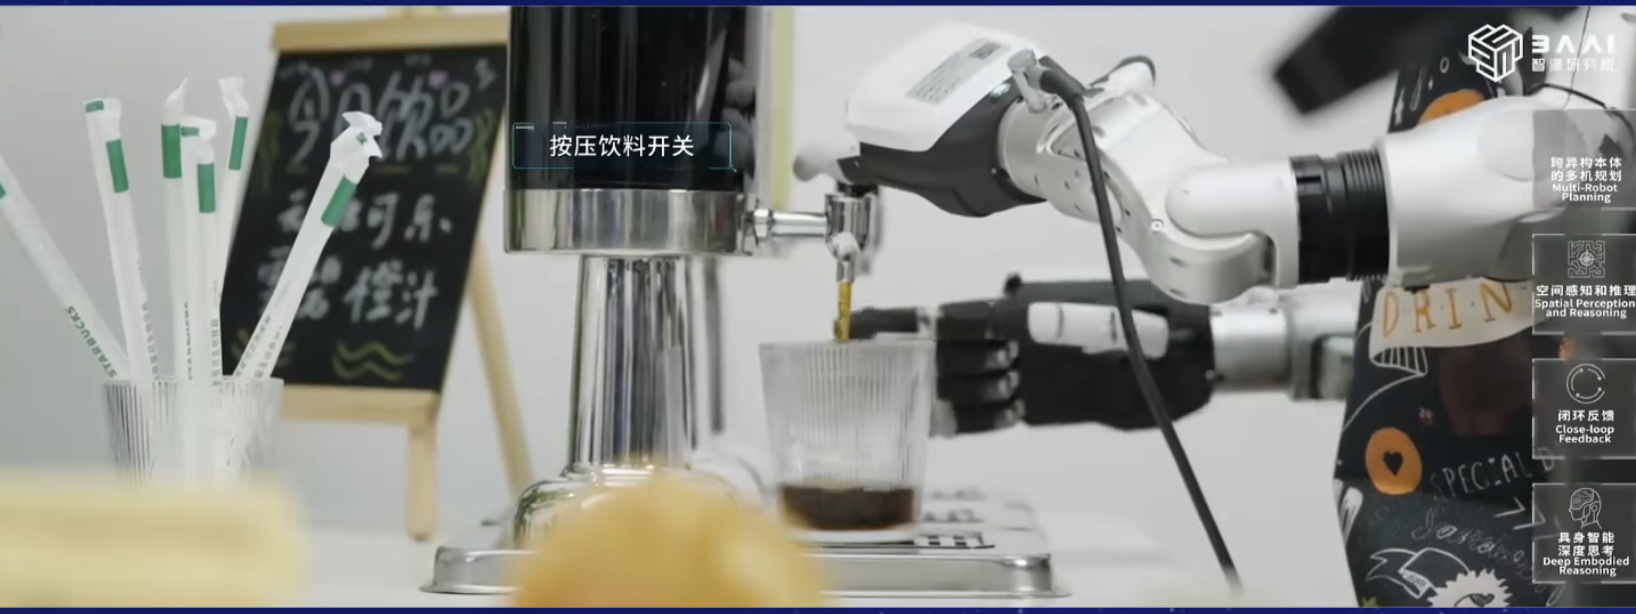
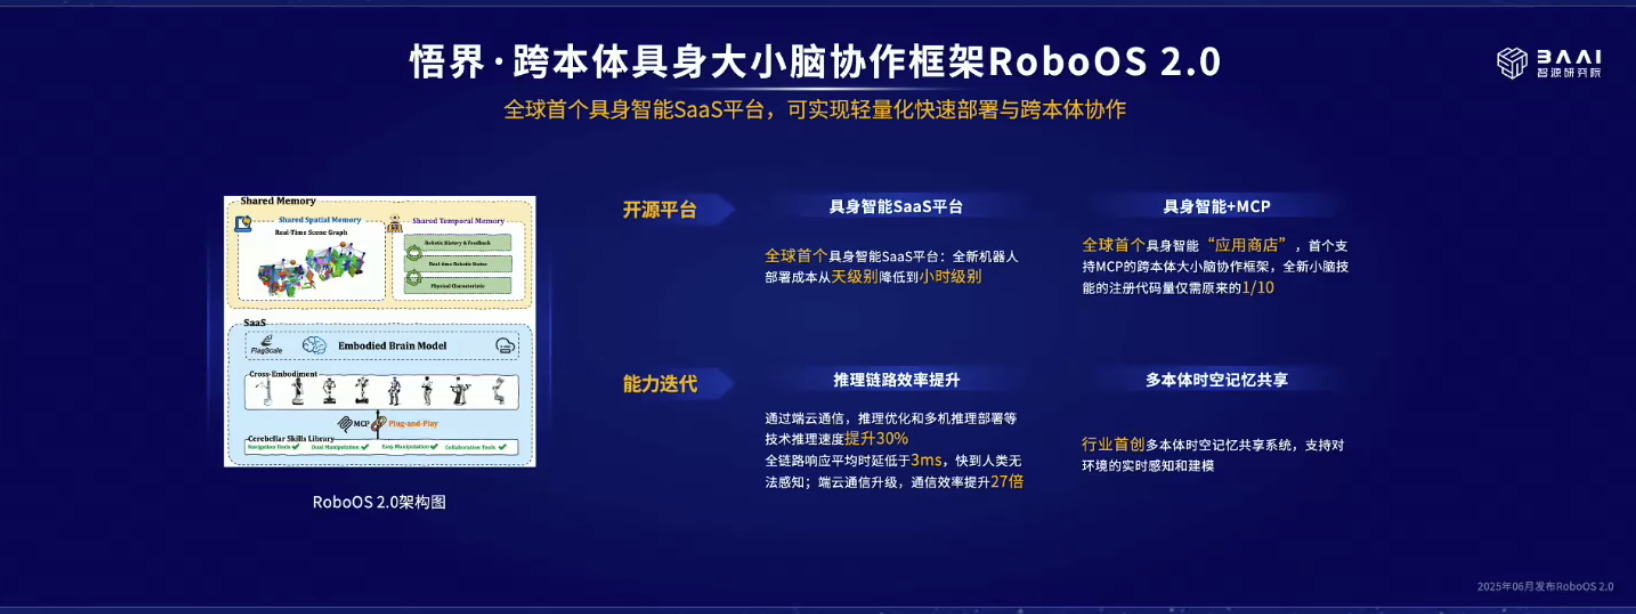
跨本体具身大小脑协作框架 RoboOS

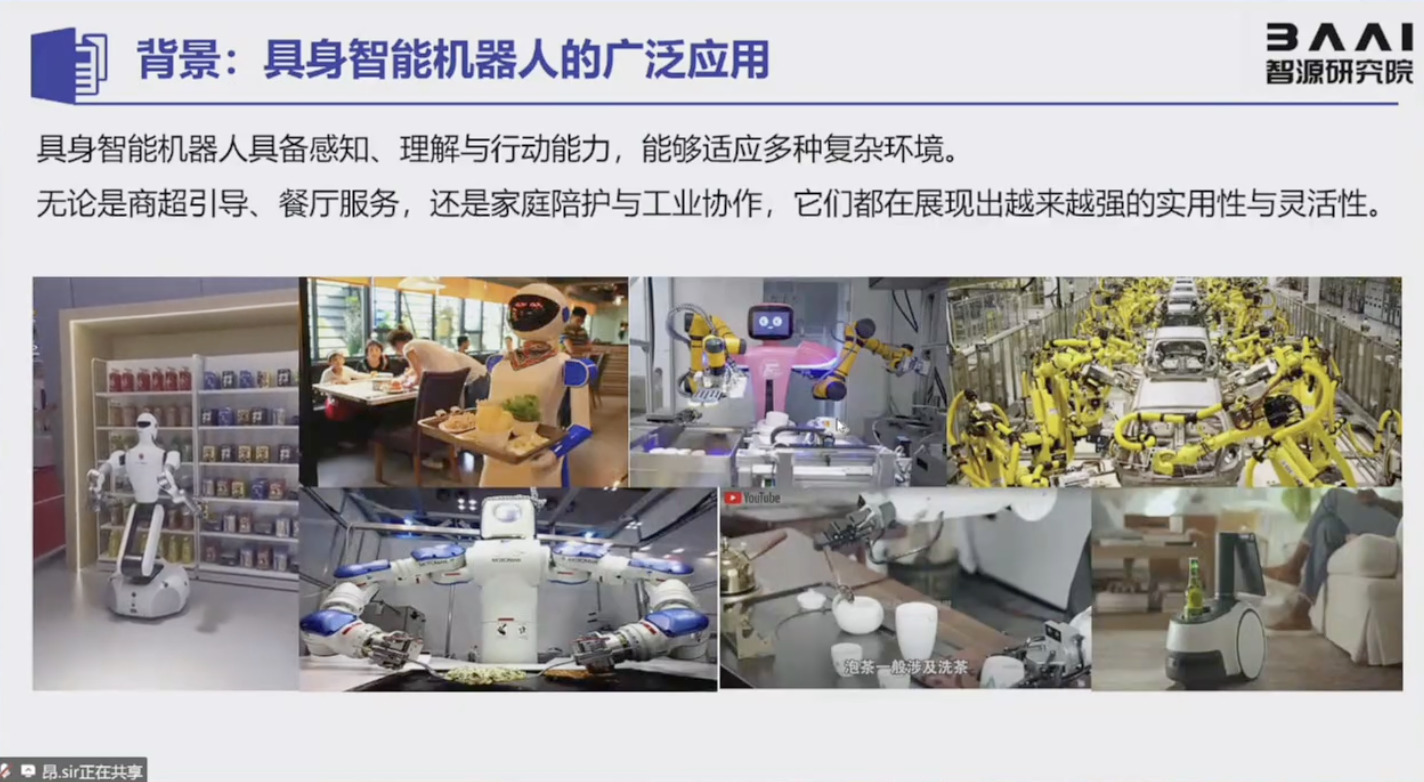
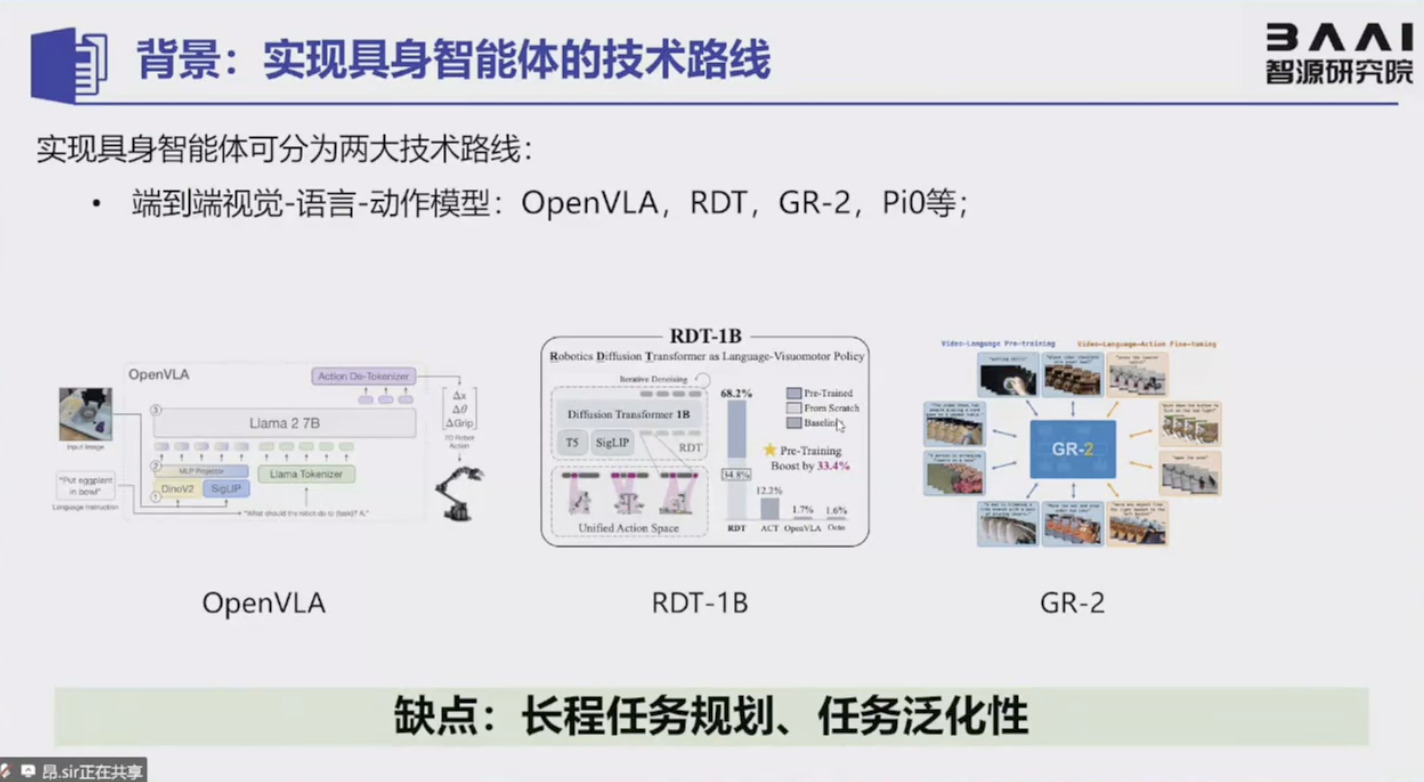
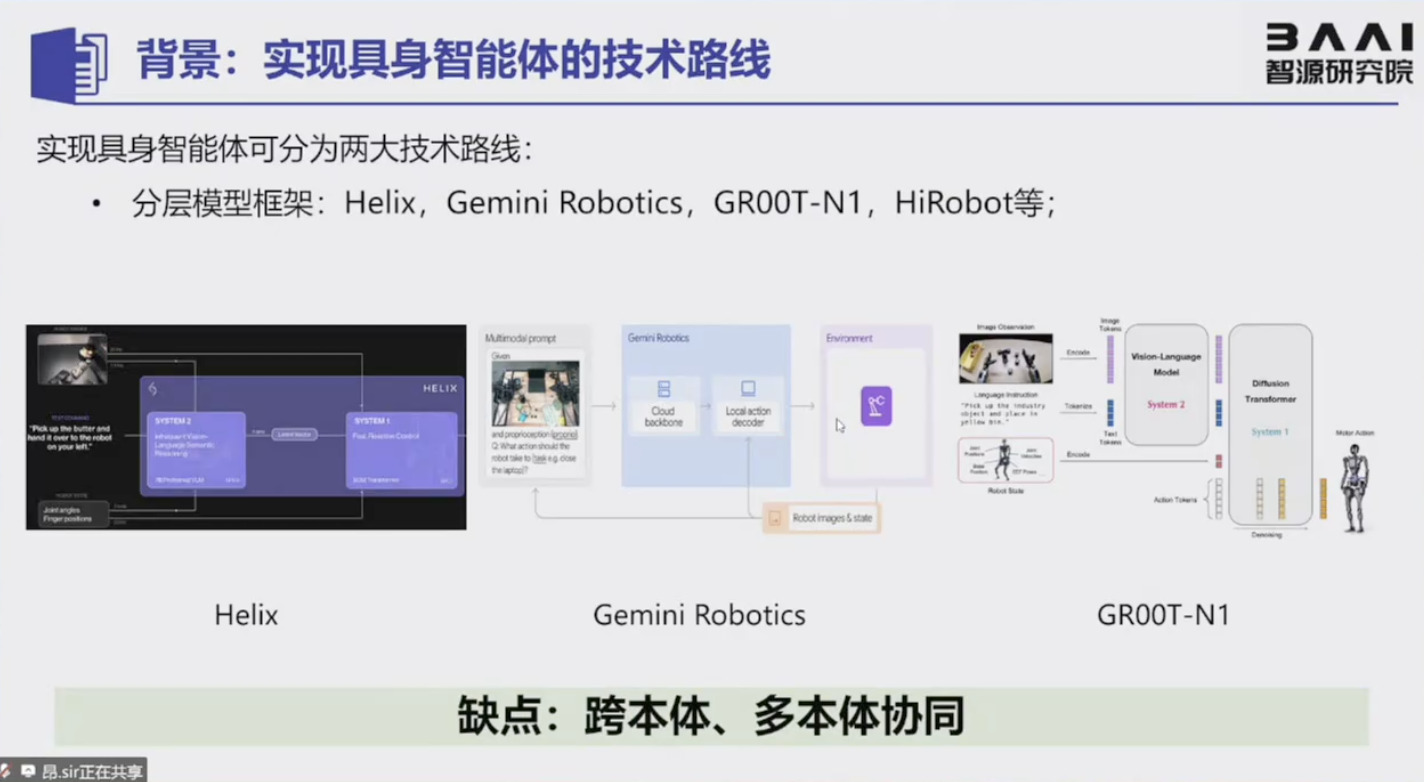
本文档介绍了 RoboOS,一个用于跨本体具身大小脑协作的框架。它首先概述了具身智能体的现有技术路线及其局限性,例如:在长程任务规划和跨本体协作方面的不足。该框架通过 “具身大脑”(负责全局感知与决策)和 “具身小脑”(提供即插即用的技能库)实现多本体协作控制。文档还重点说明了共享记忆系统空间和时间维度上的数据中心化,以及云端协同如何支持多机器人、多任务场景,并展示了自定义微调集以提高任务分解和执行的准确性。

参考资料

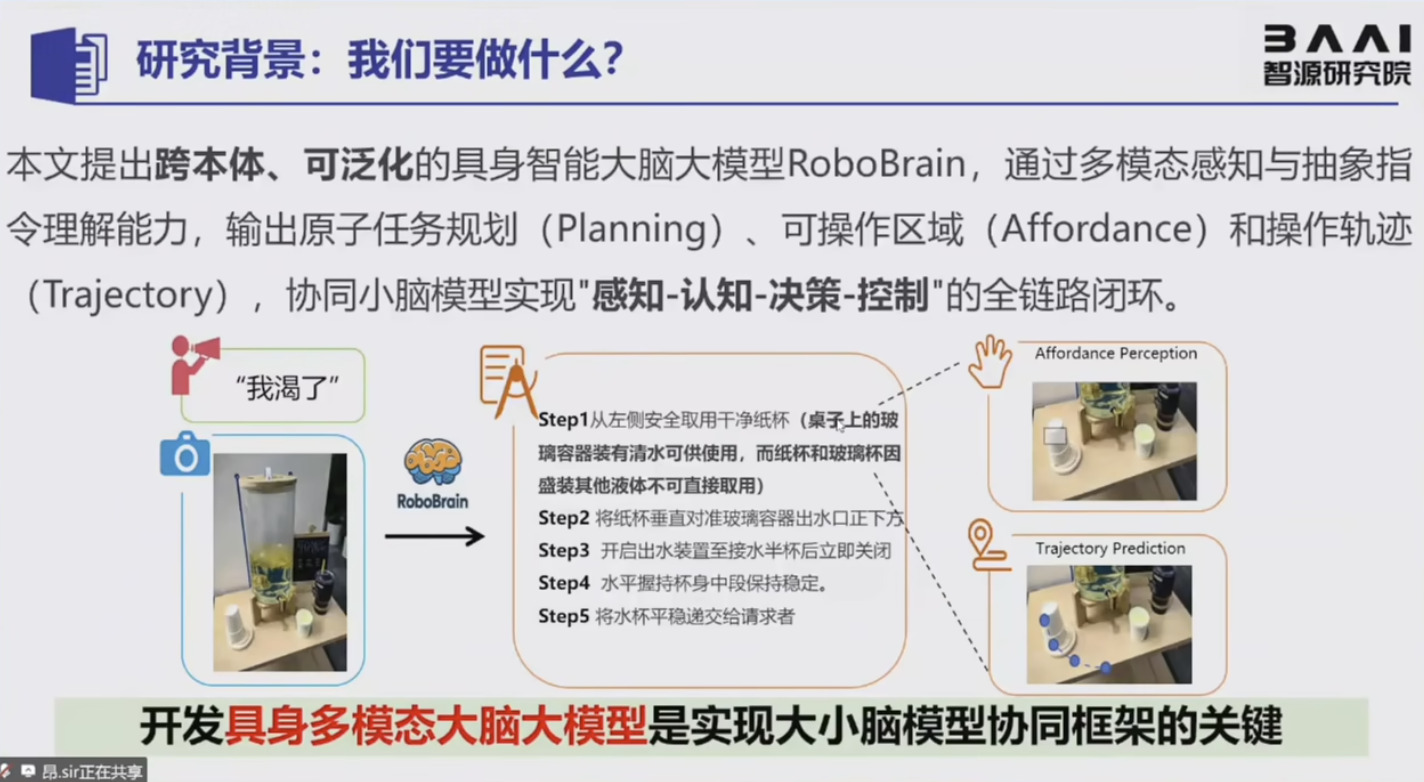
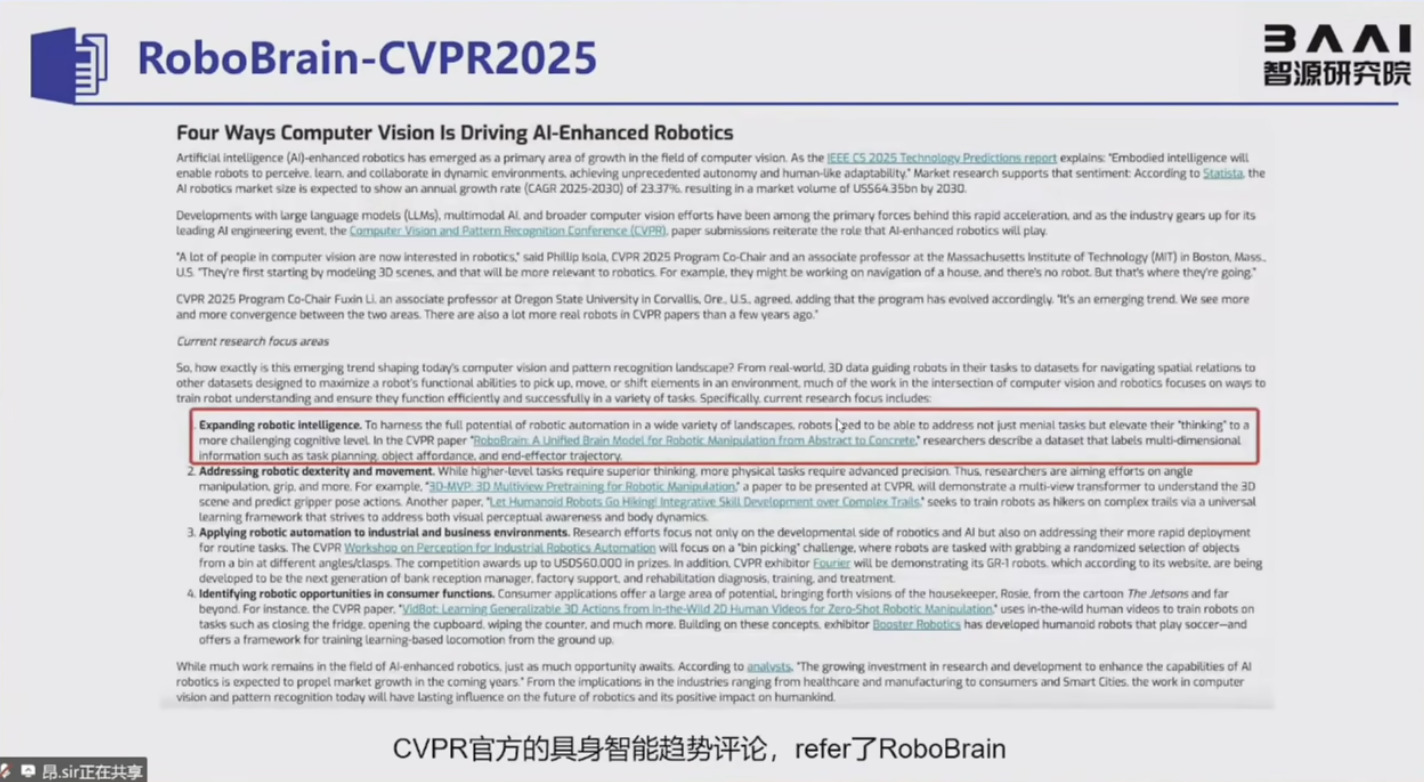
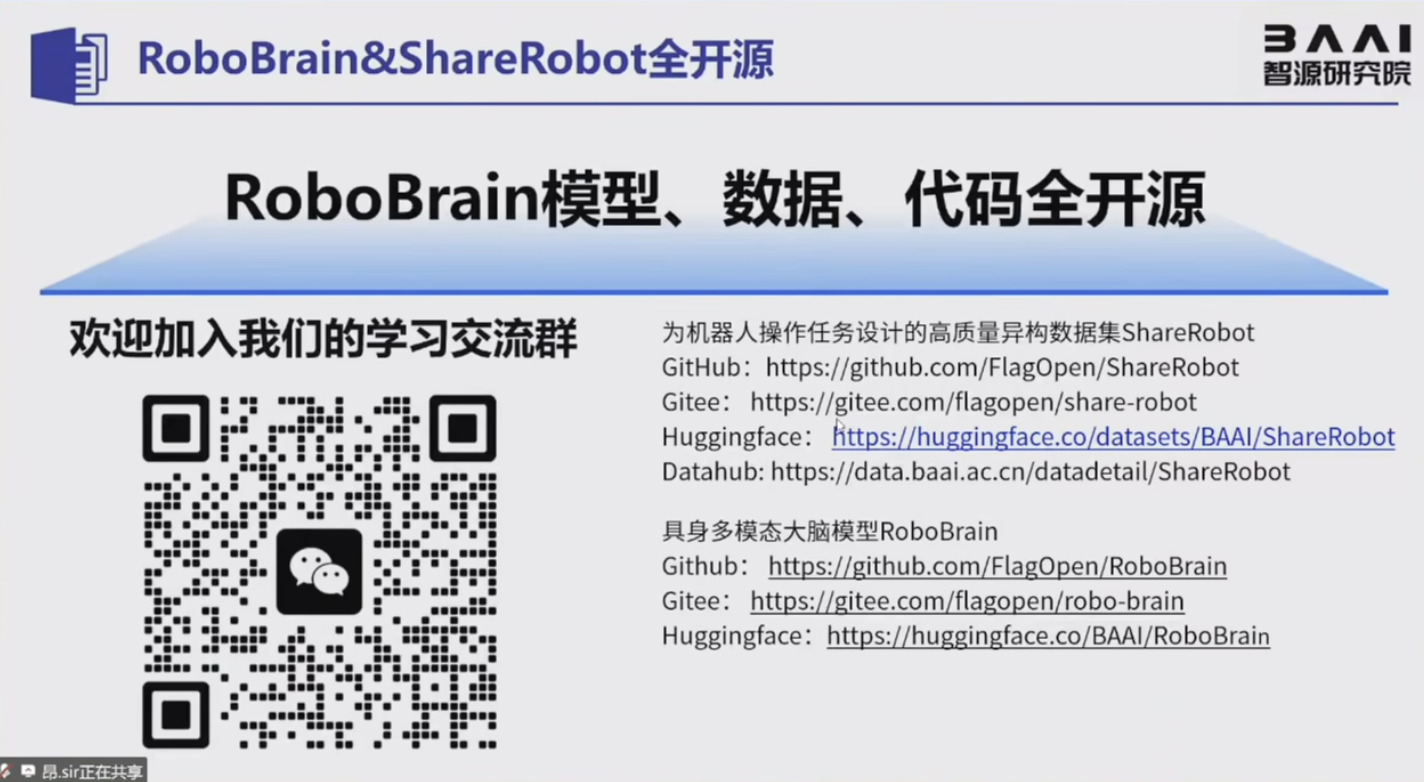
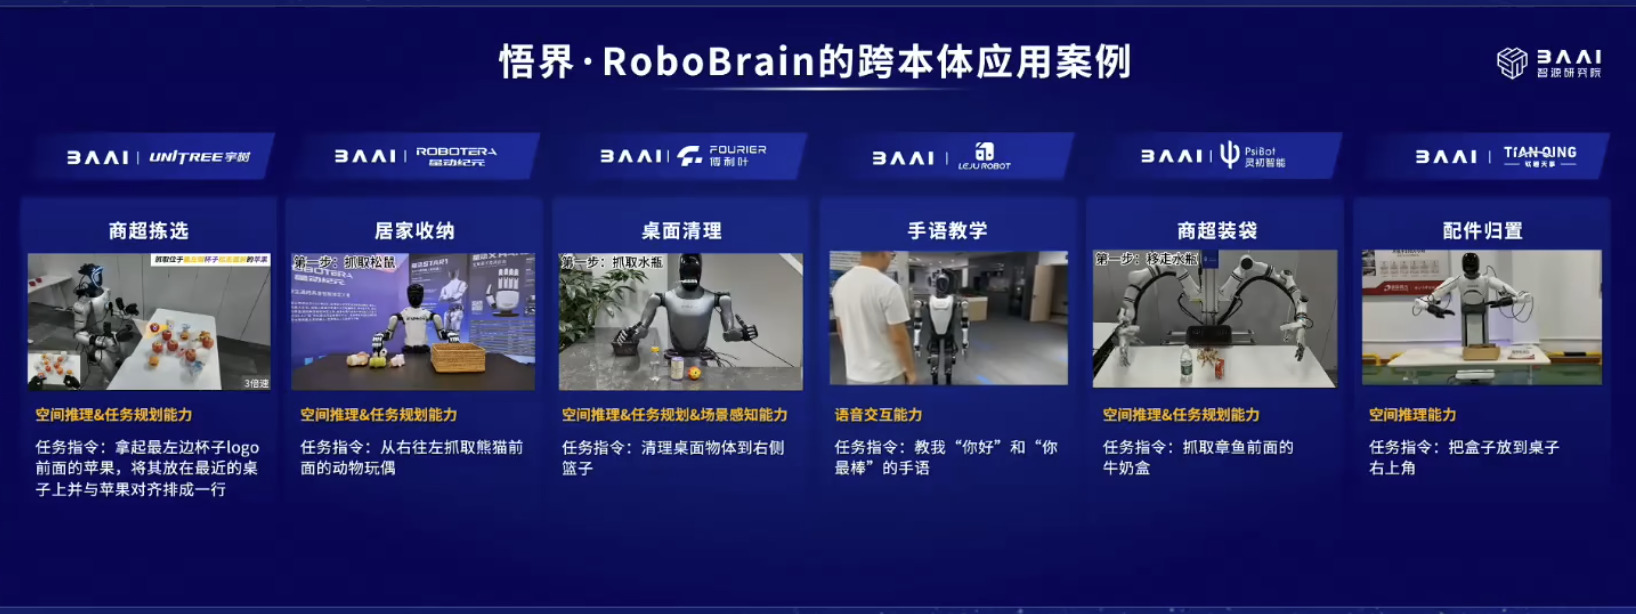
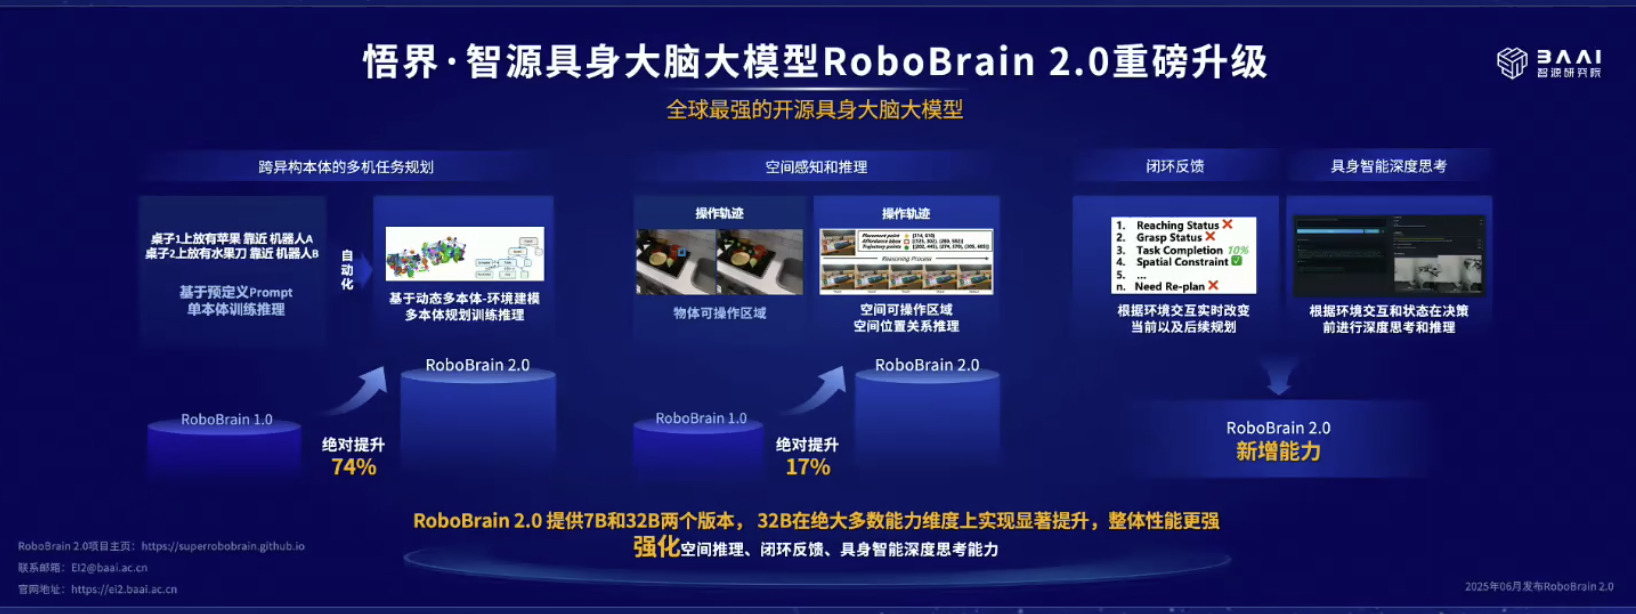
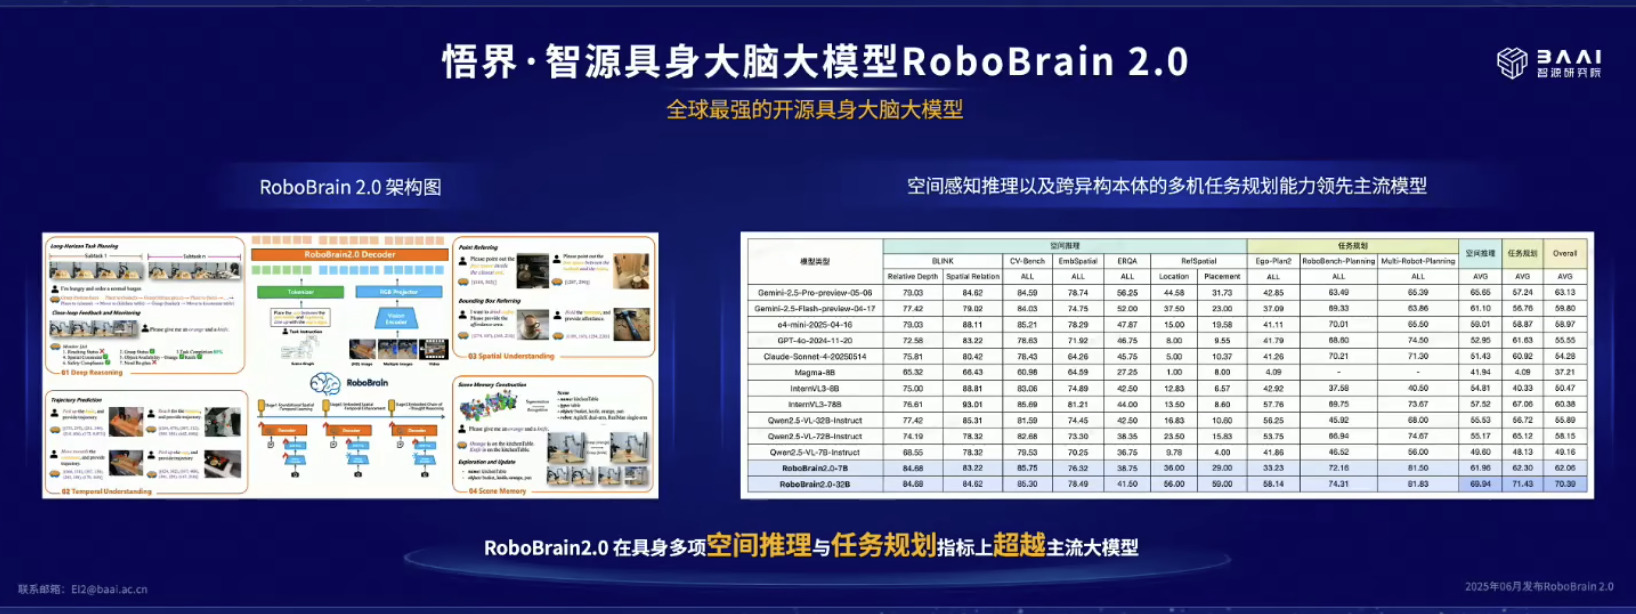
具身大脑 RoboBrain

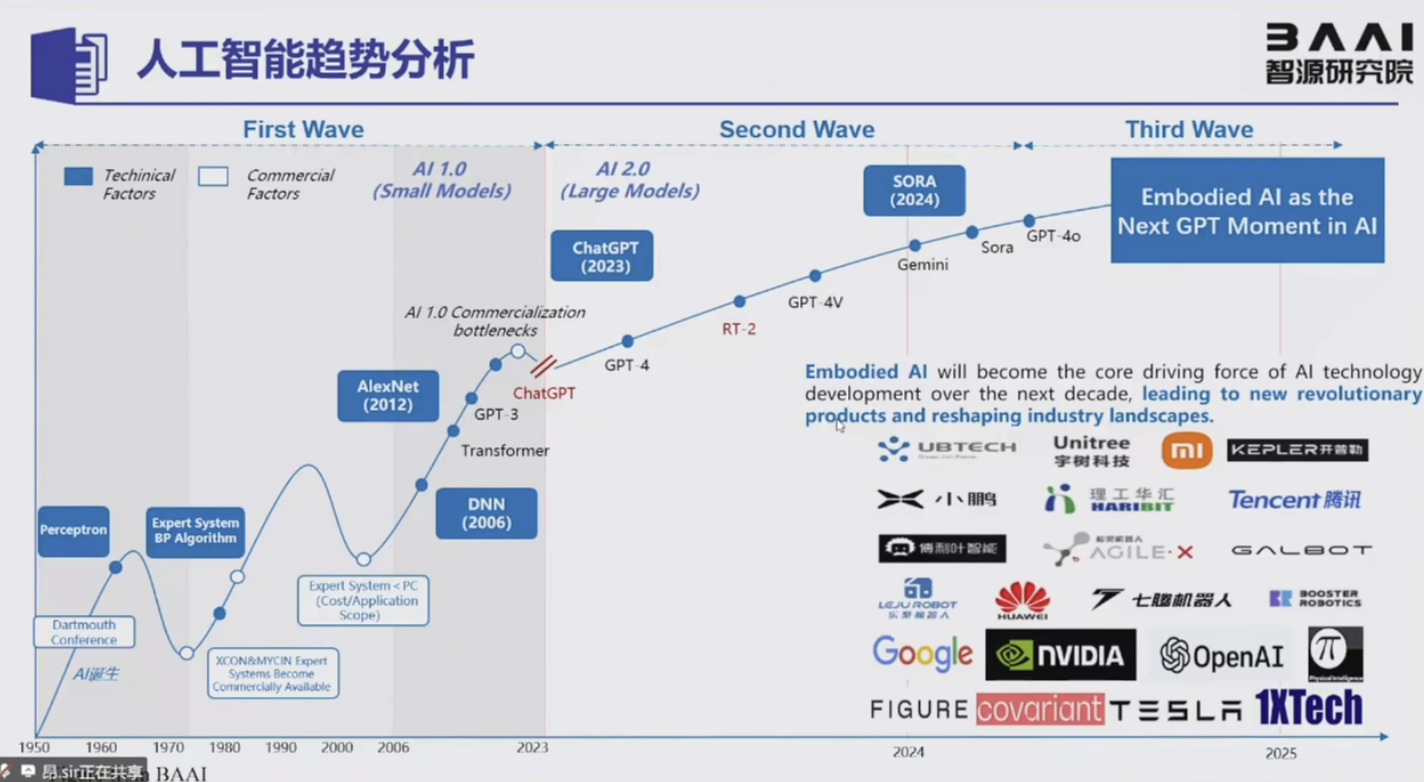
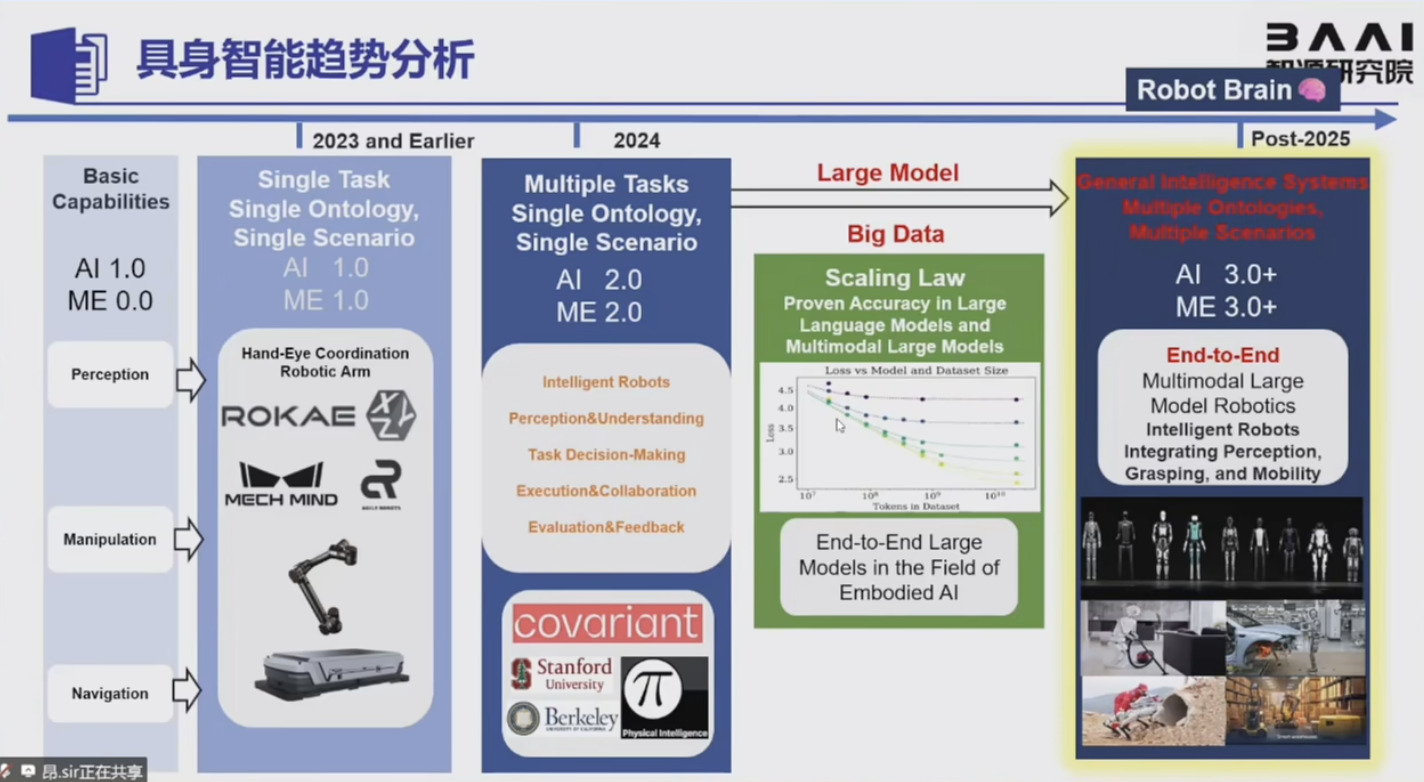
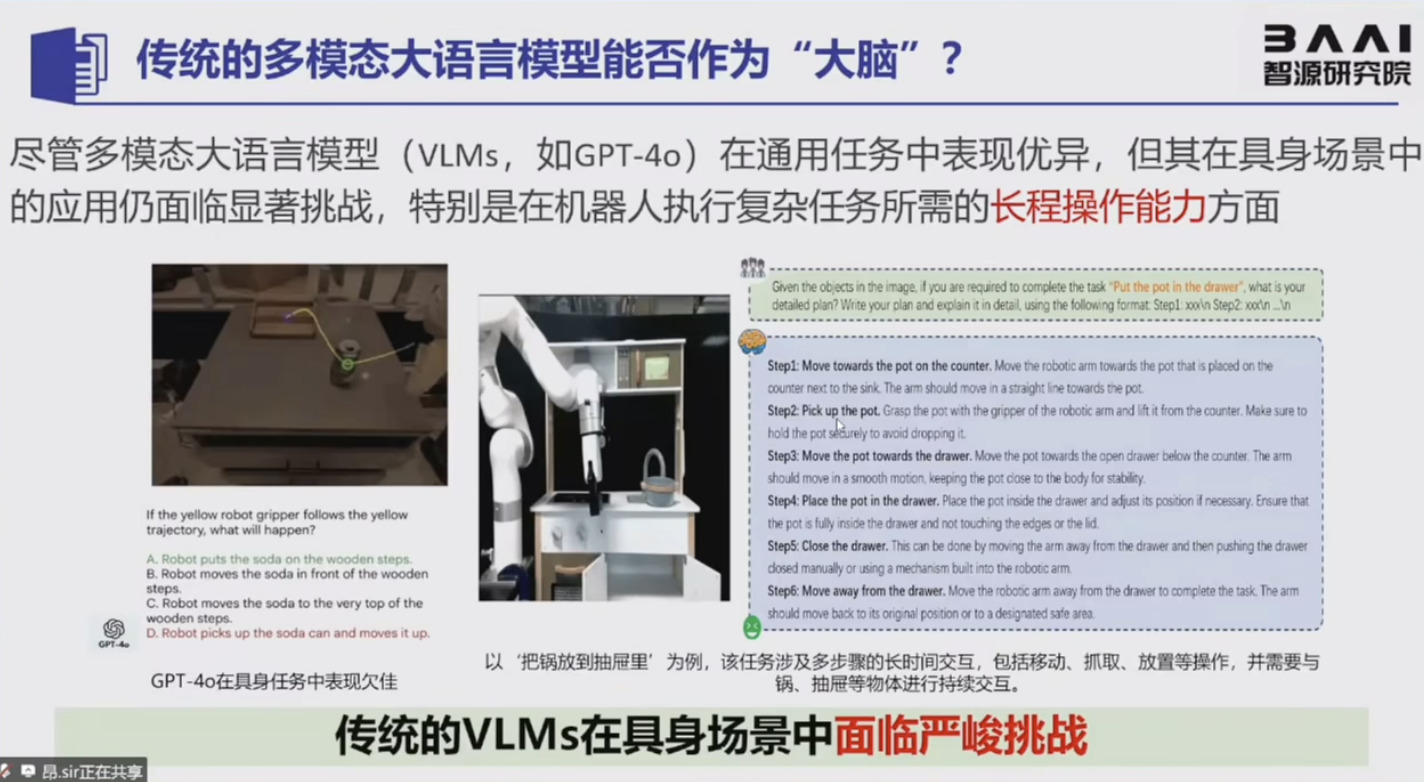
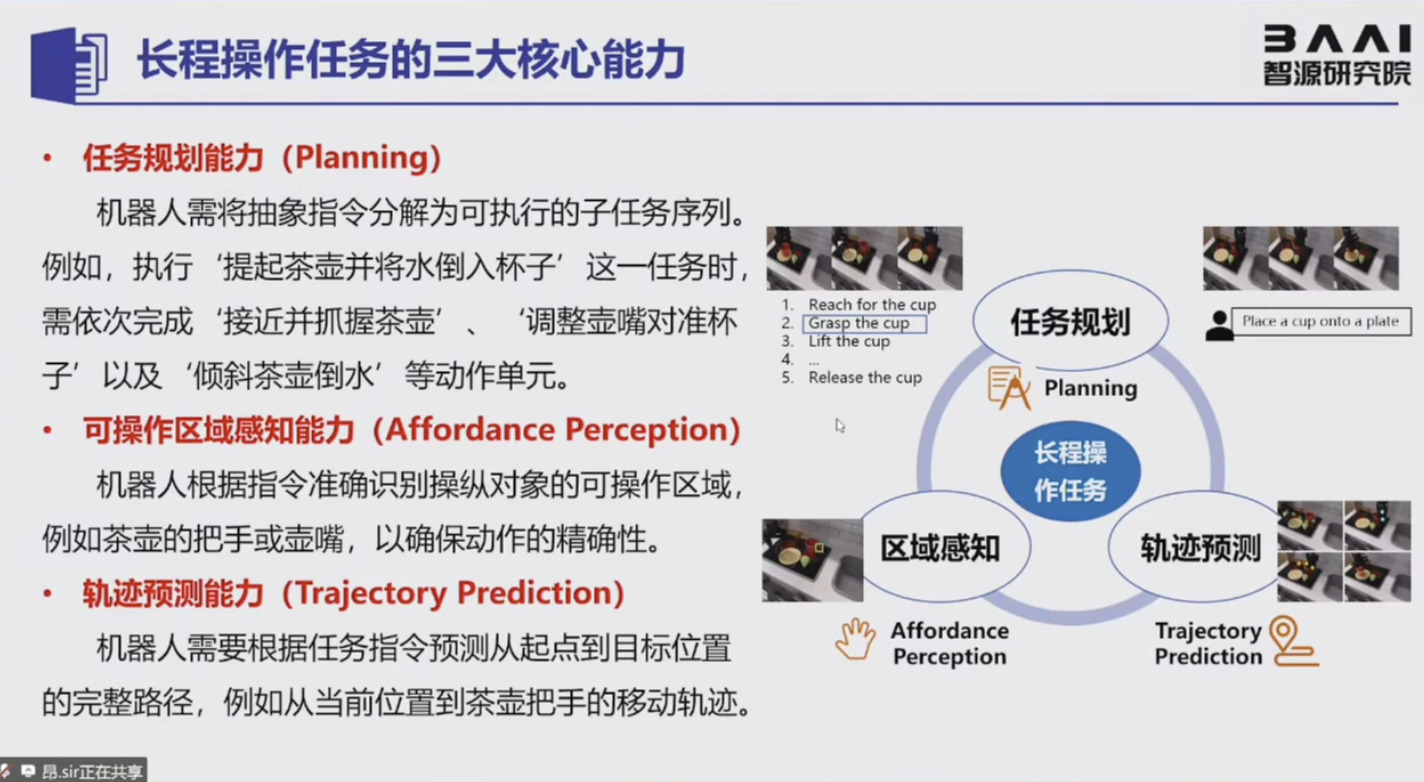
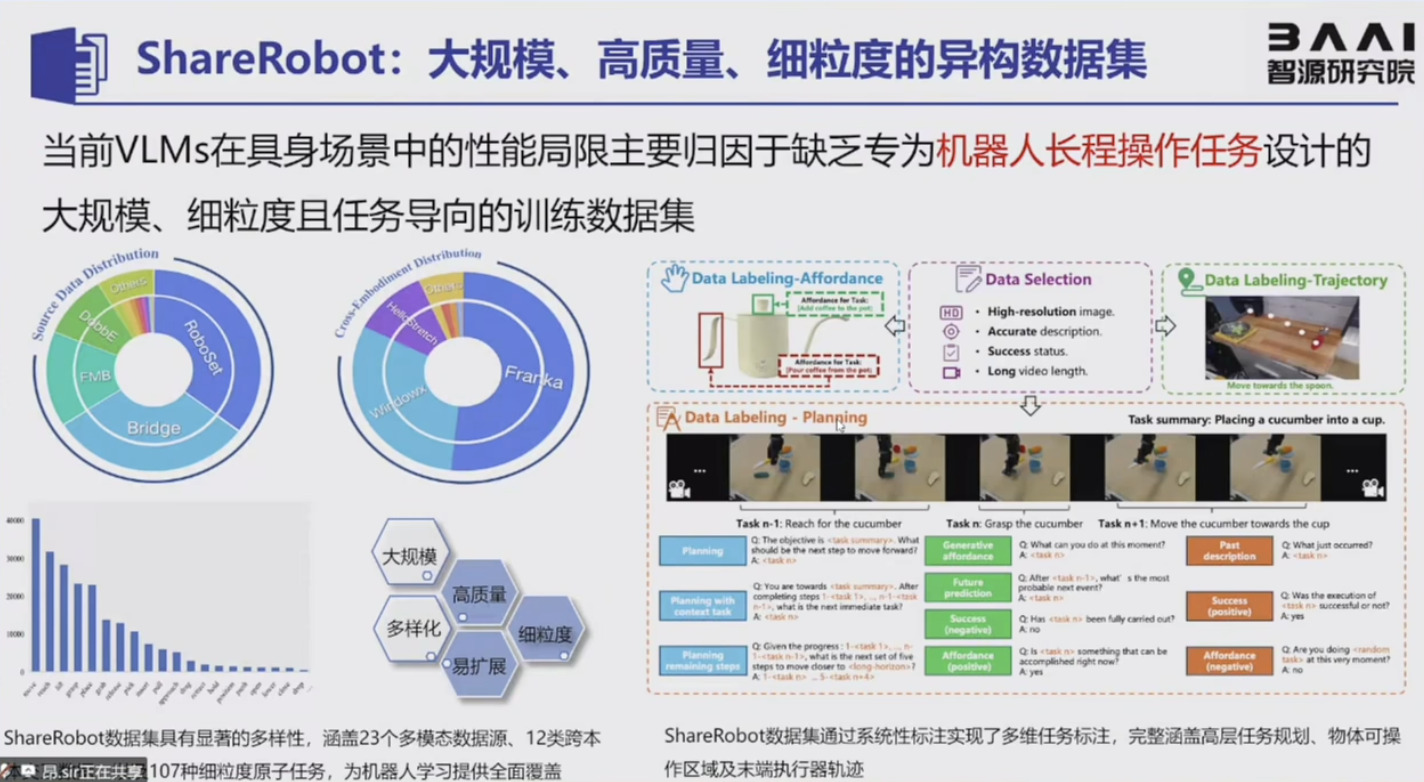
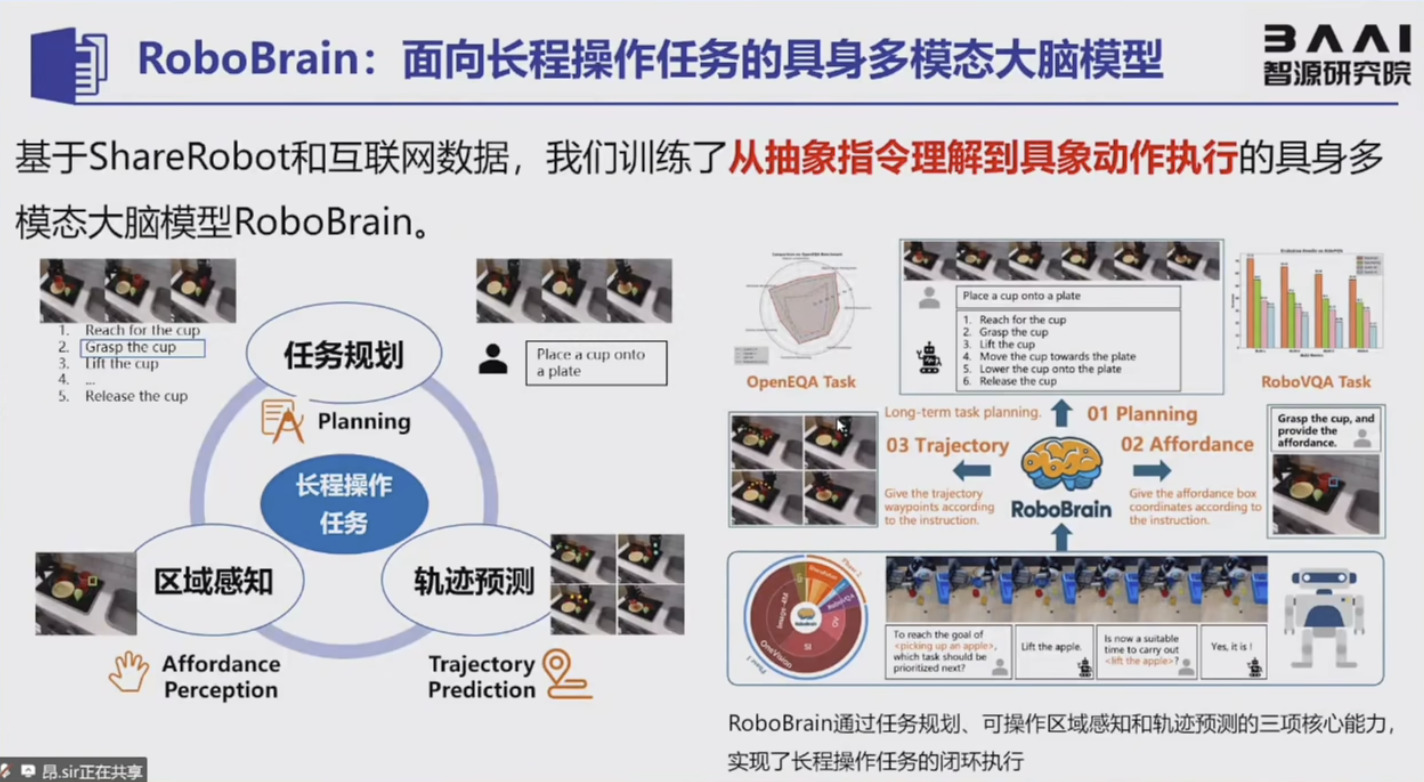
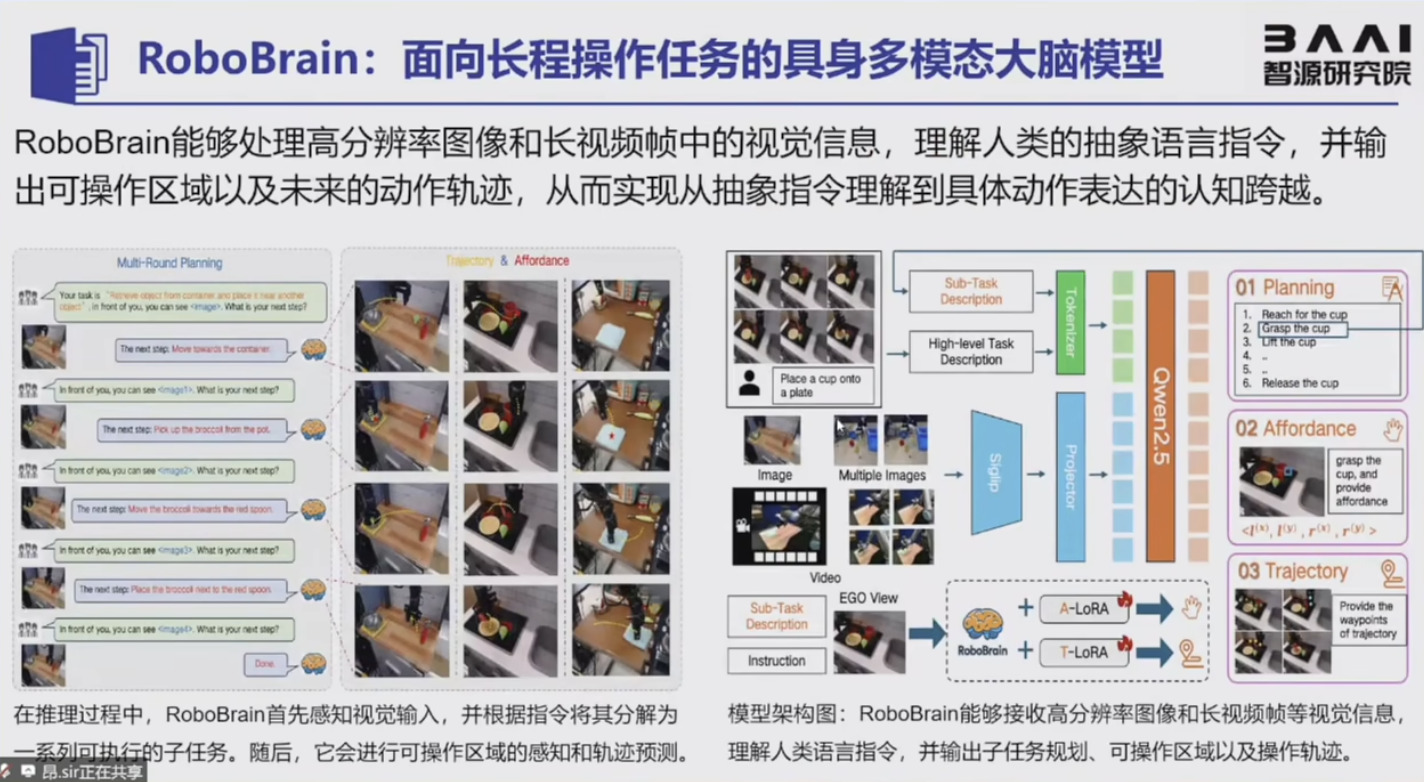
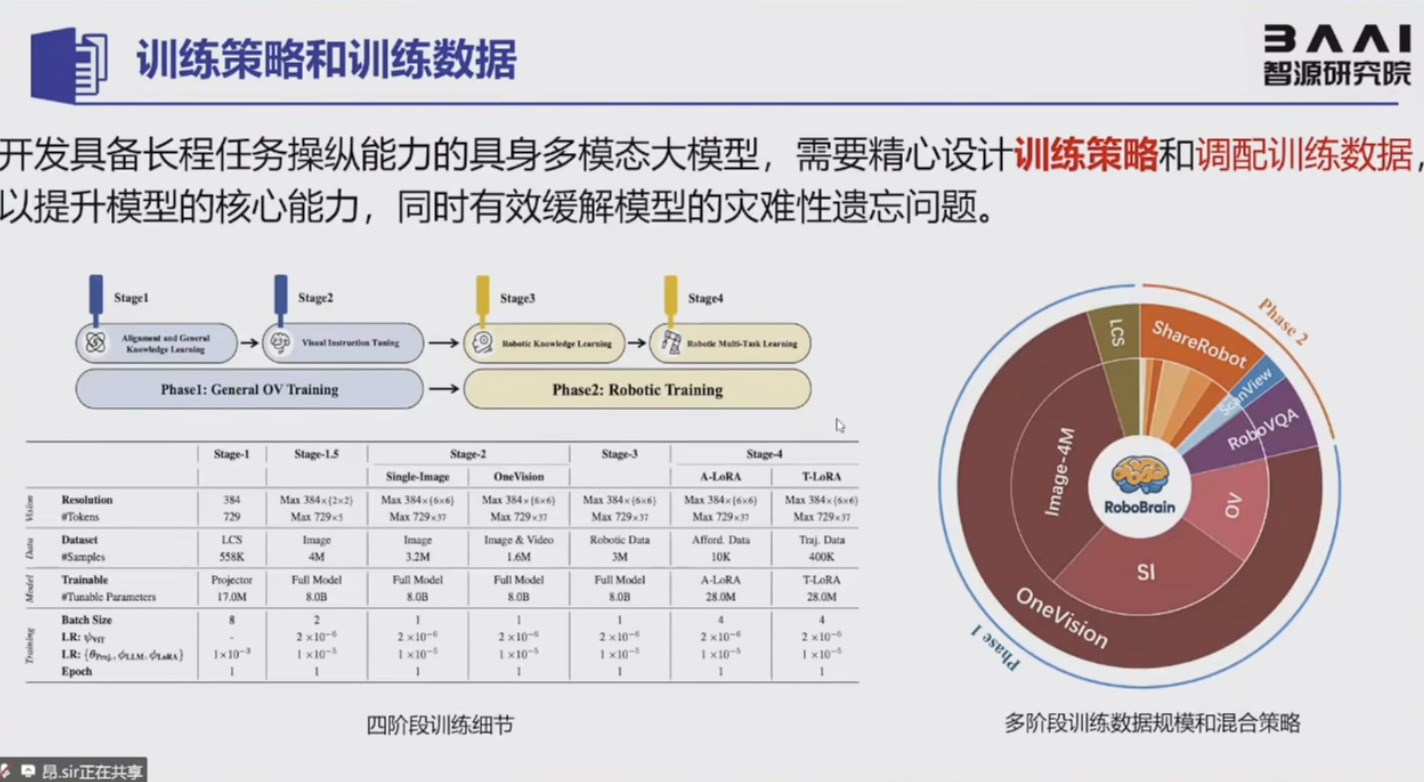
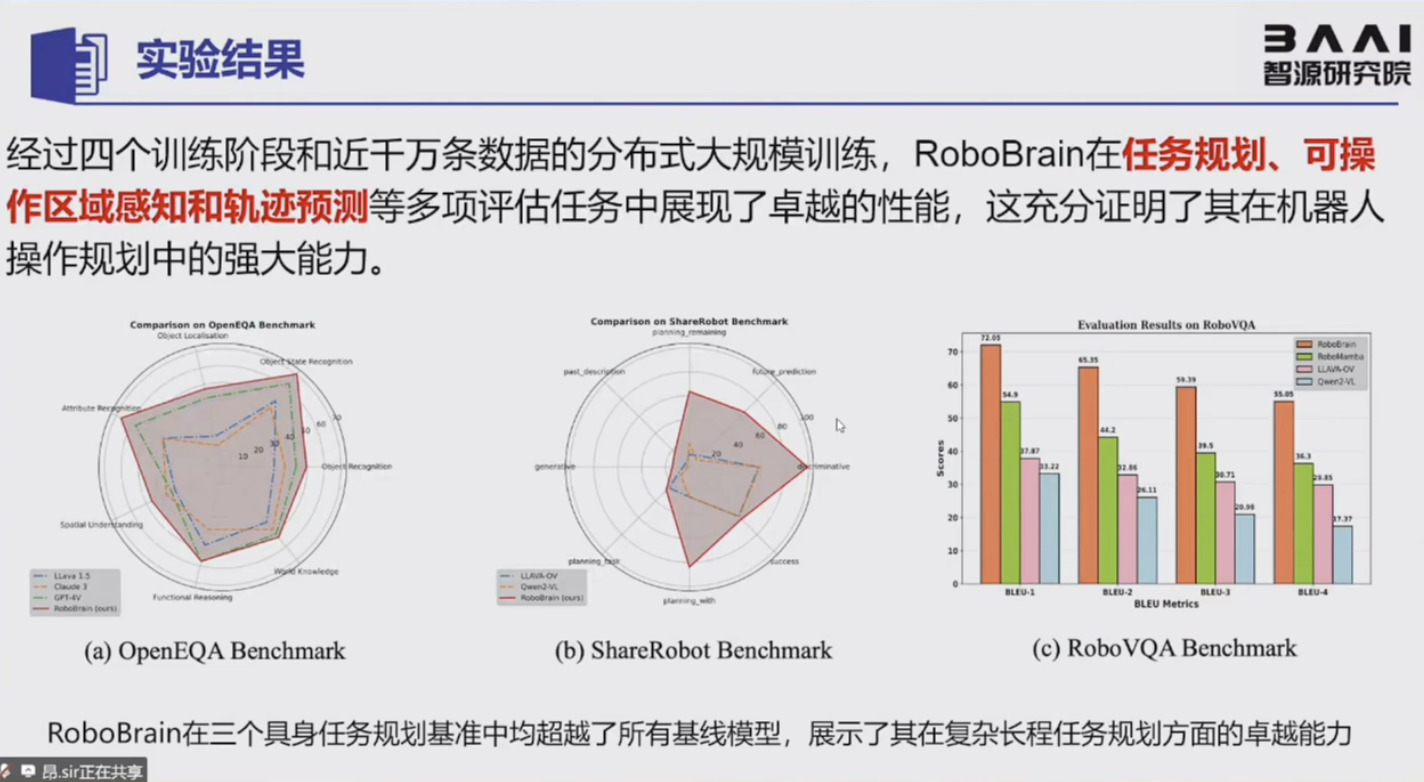
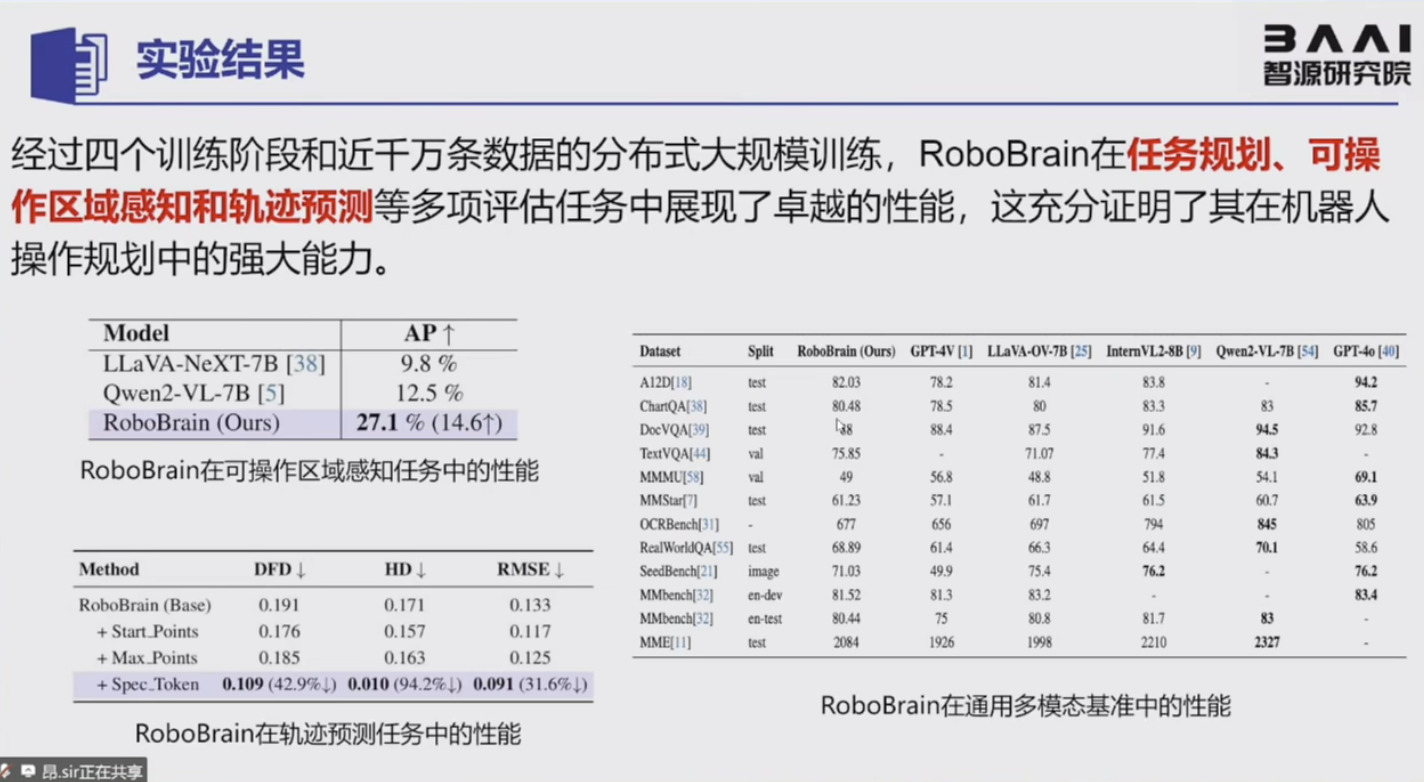
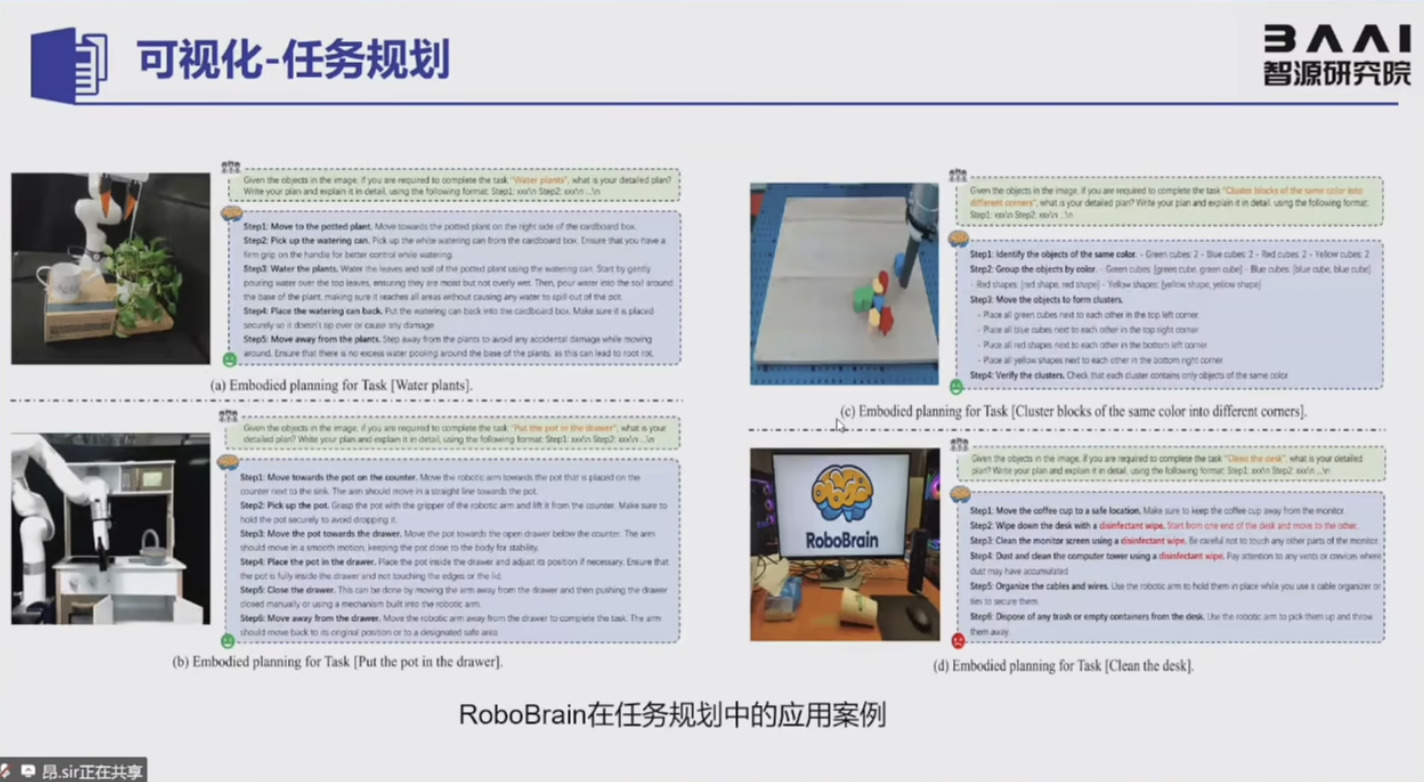
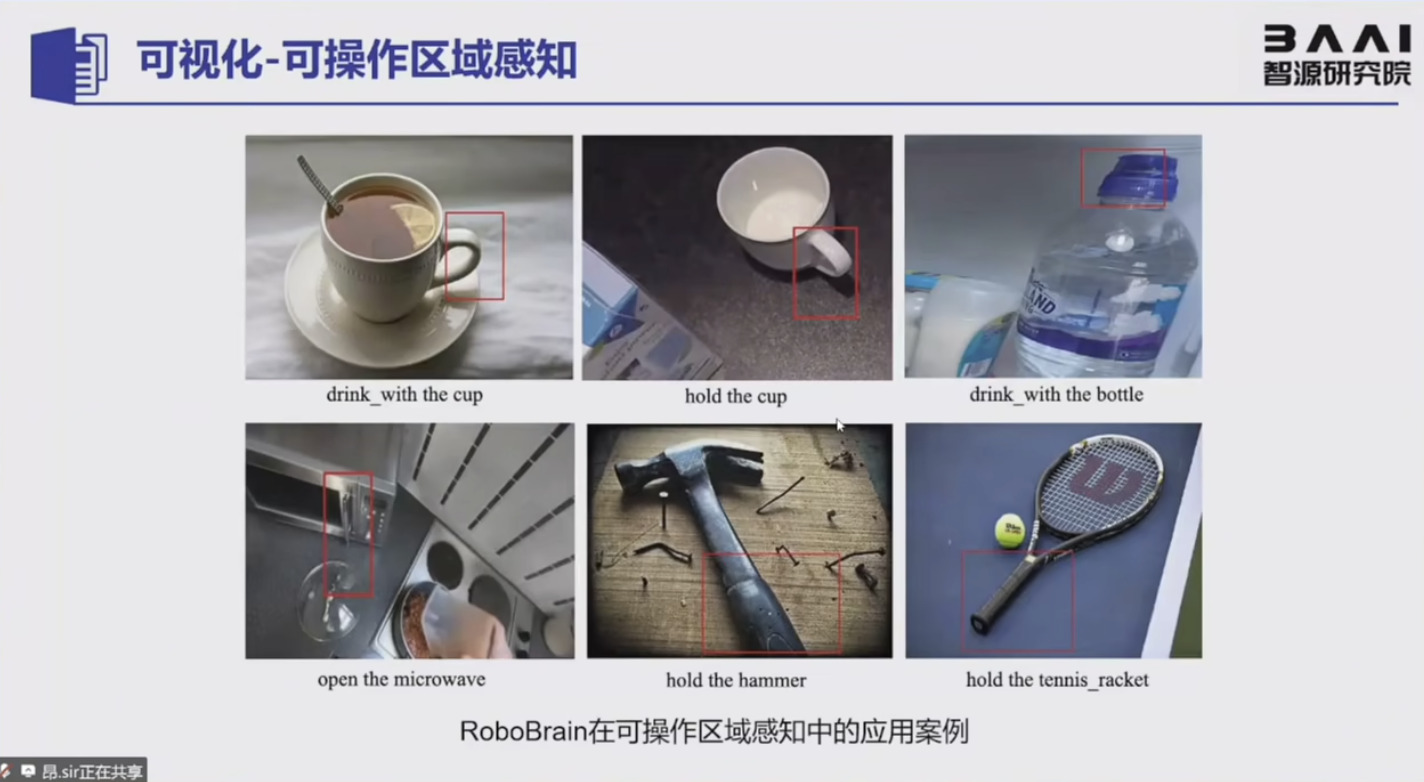
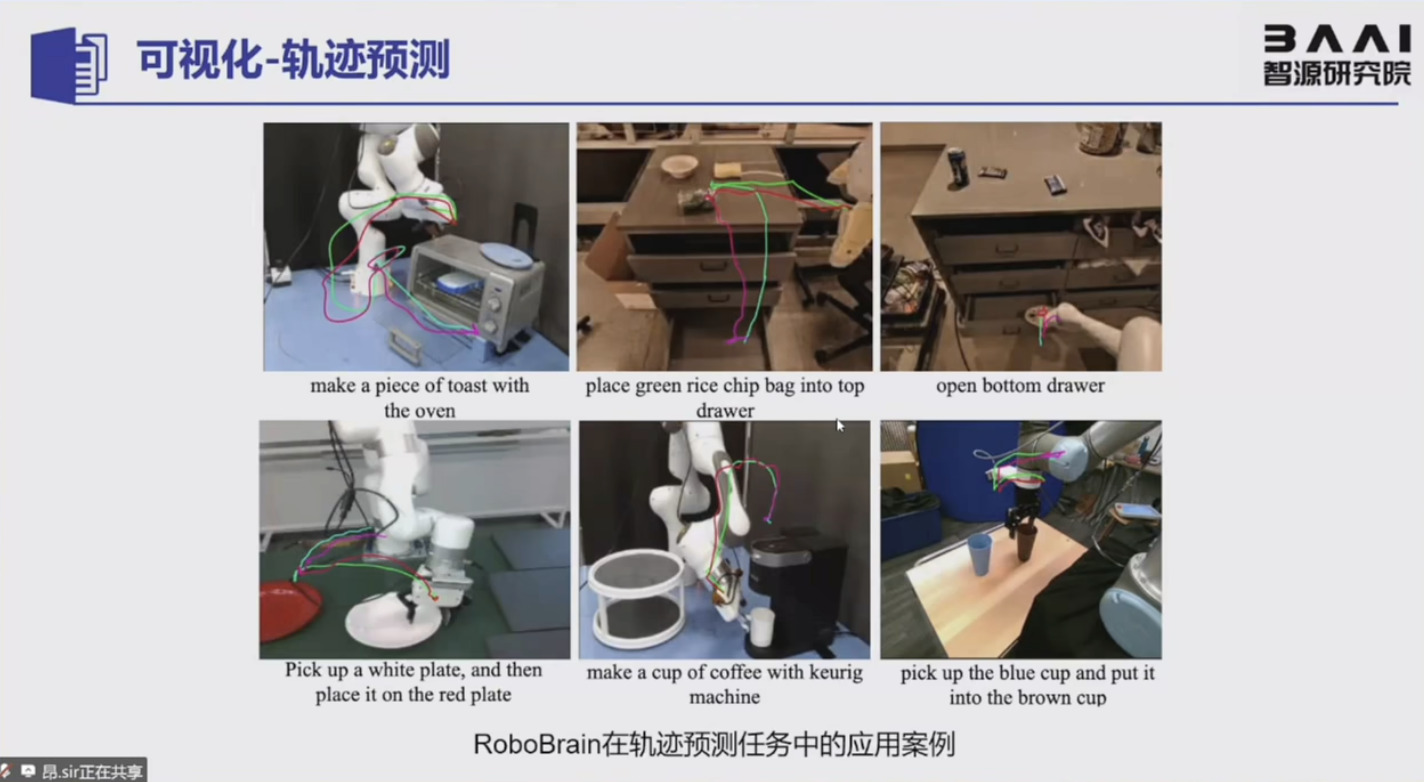
本文档介绍了RoboBrain,一个由智源人工智能研究院开发的具身多模态大模型。它详细阐述了具身人工智能的发展趋势,并强调了大型模型在复杂长期操作任务中的重要性。文件中解释了任务规划可操作区域感知轨迹预测是RoboBrain实现端到端具身智能的关键能力。此外,它还介绍了用于训练RoboBrain的ShareRobot数据集,以及模型训练策略实验结果,展示了RoboBrain在各项基准测试中超越现有模型的表现。

参考资料

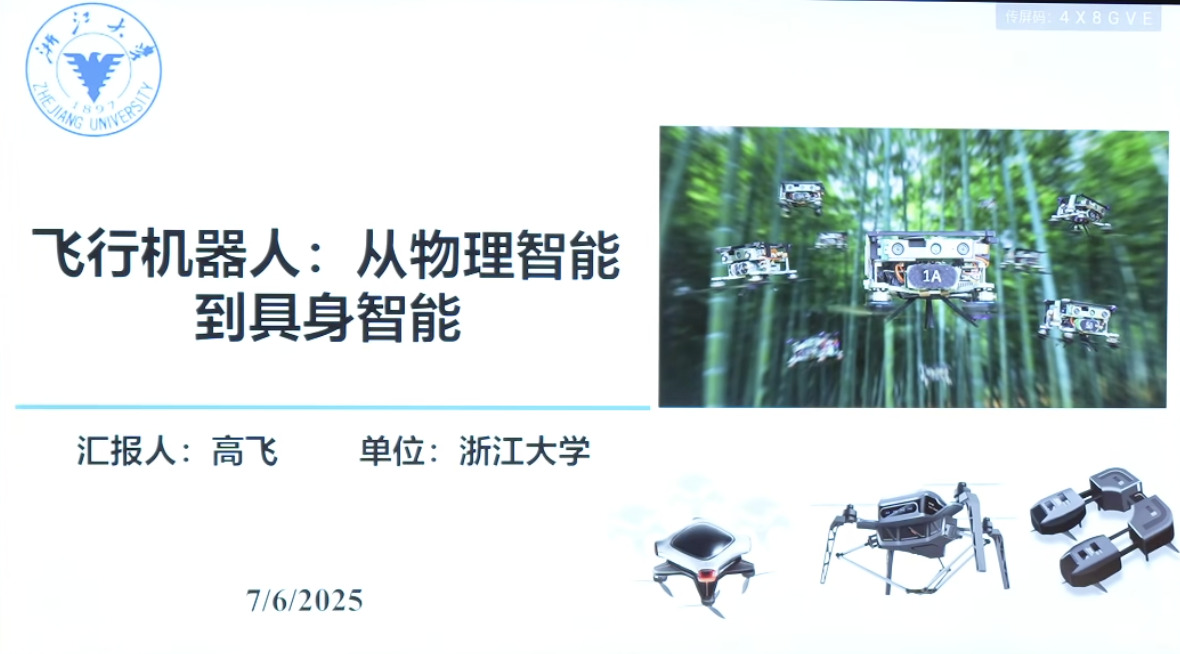
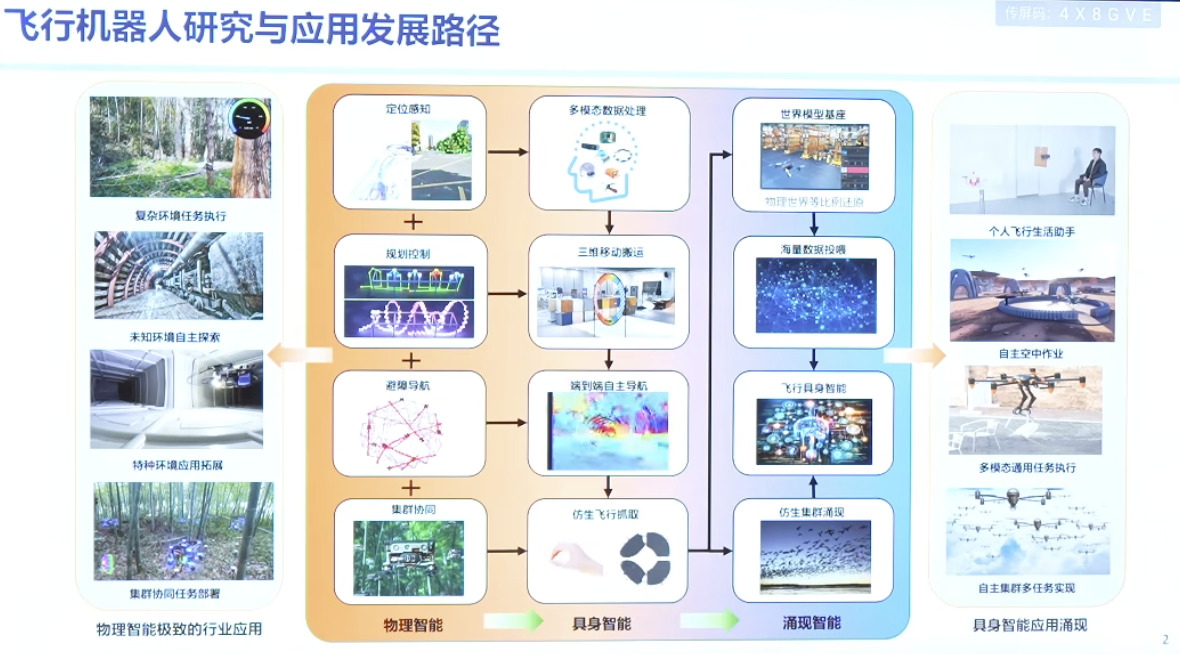
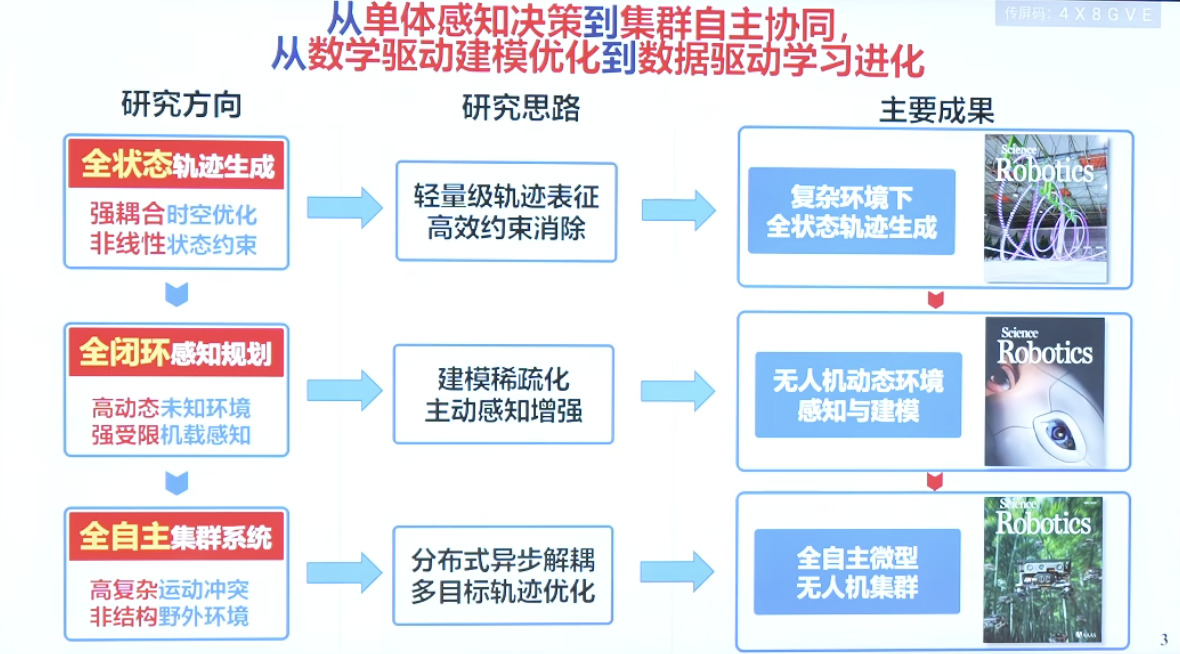
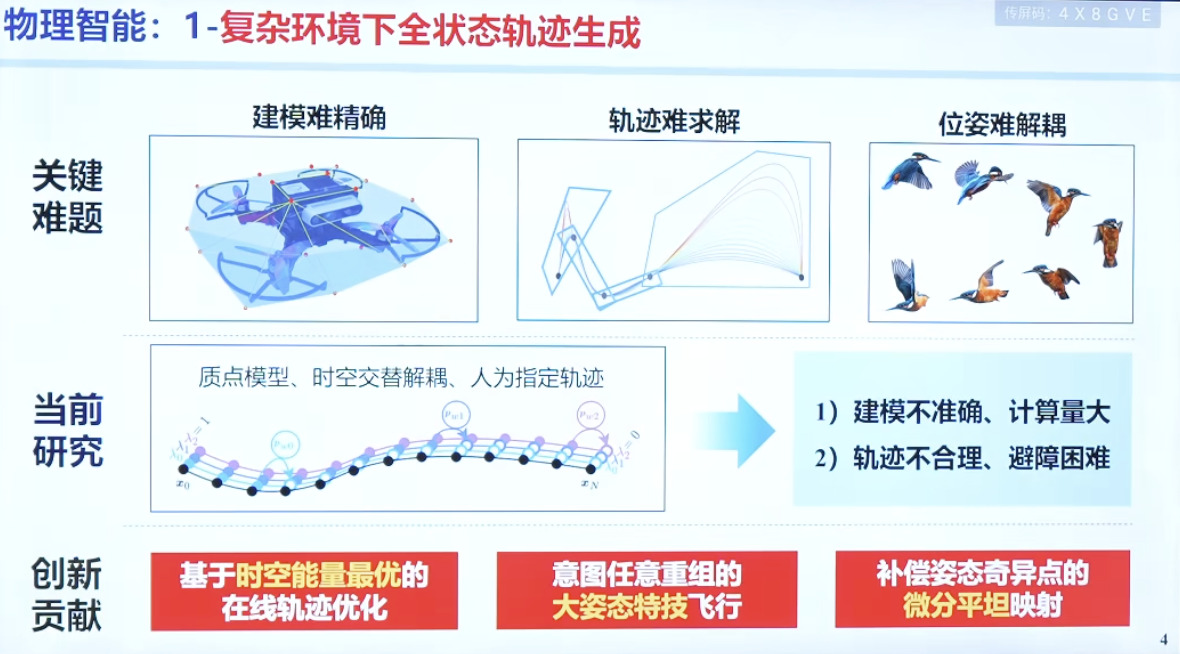
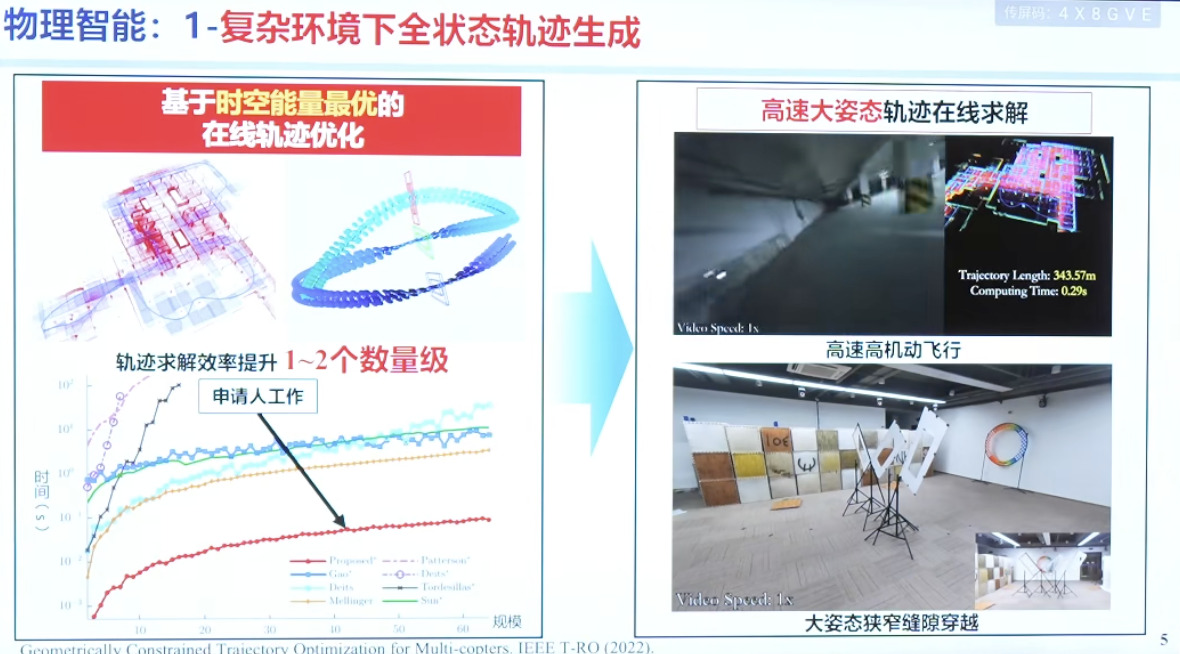
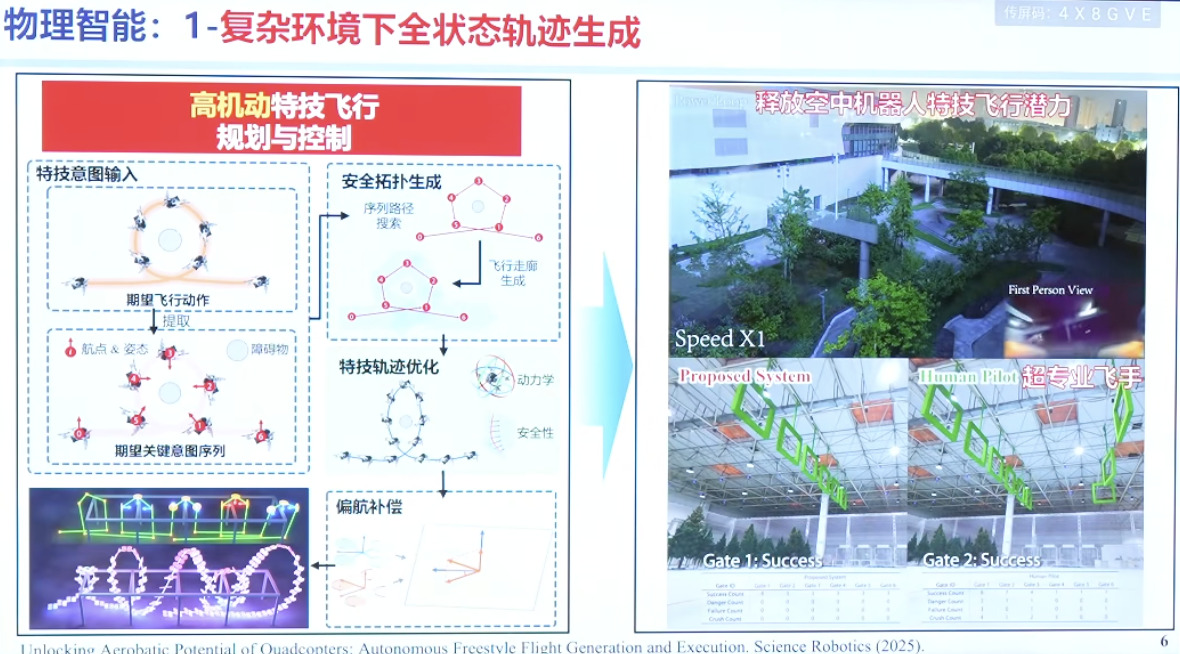
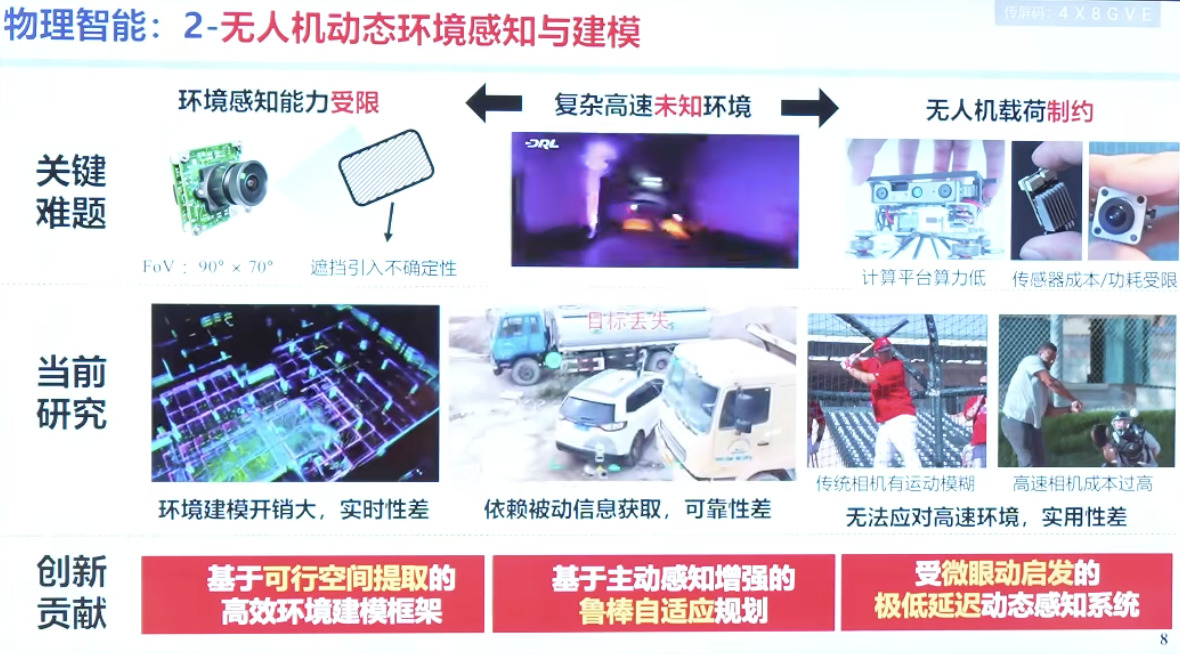
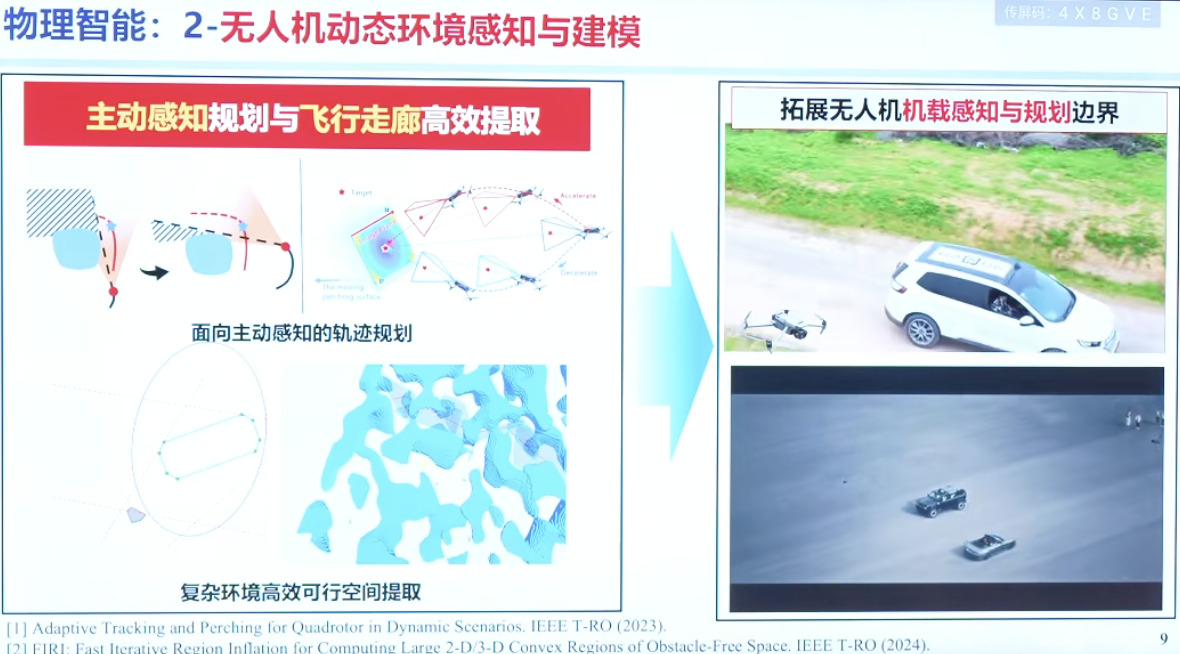
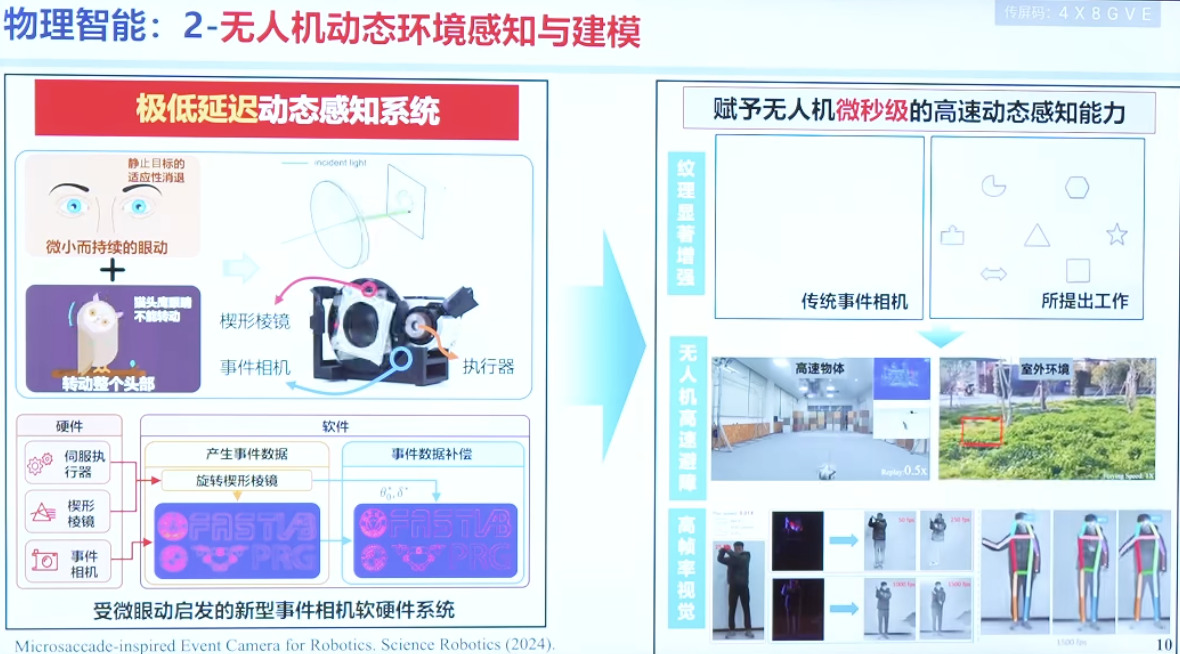
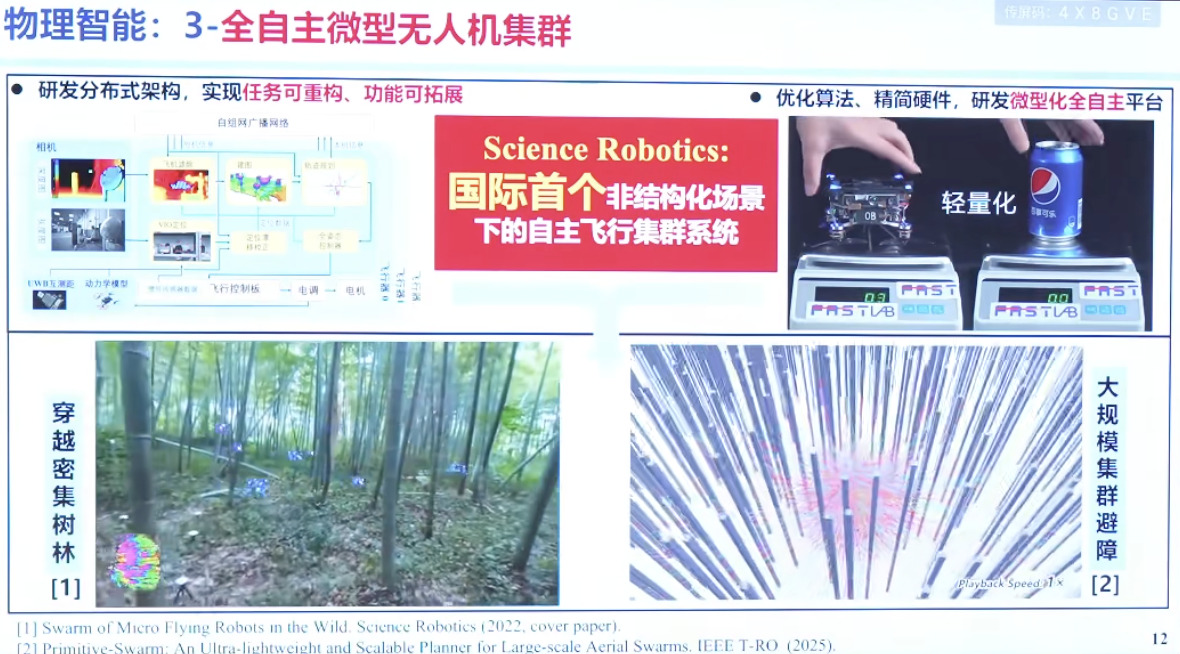
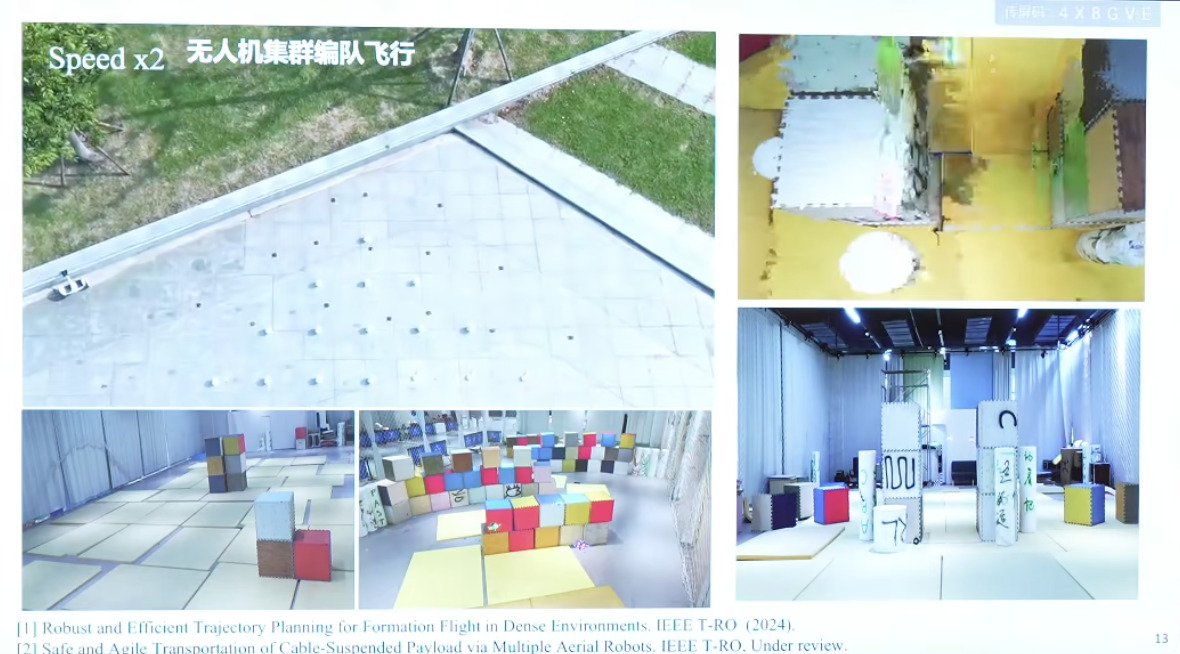
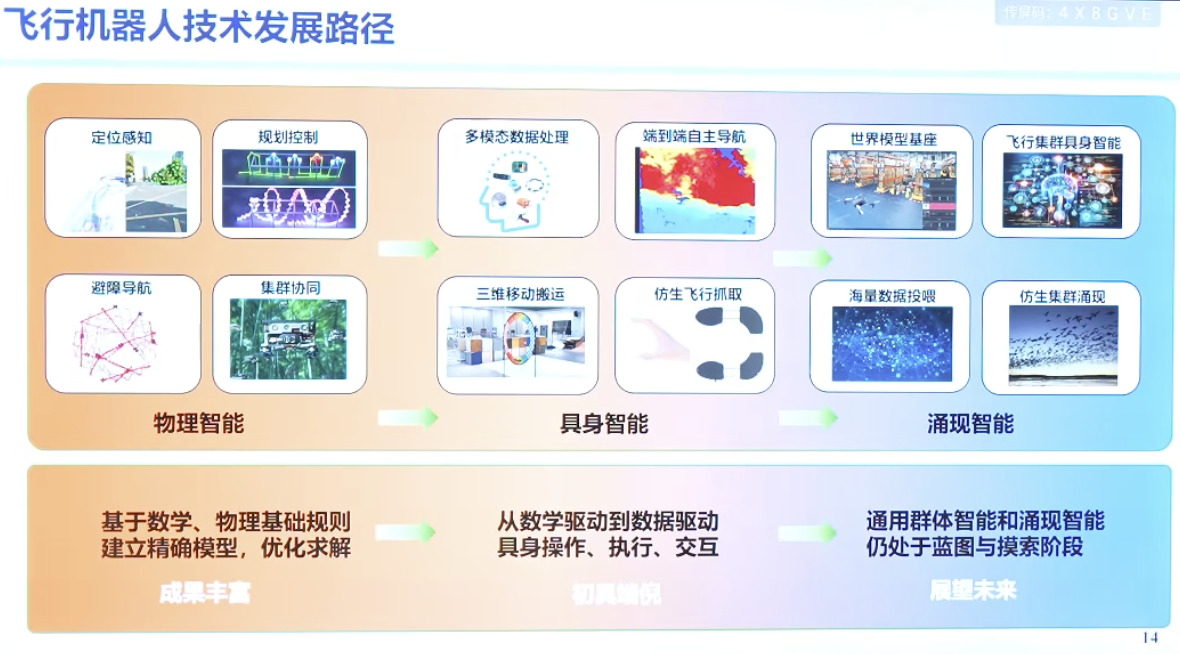
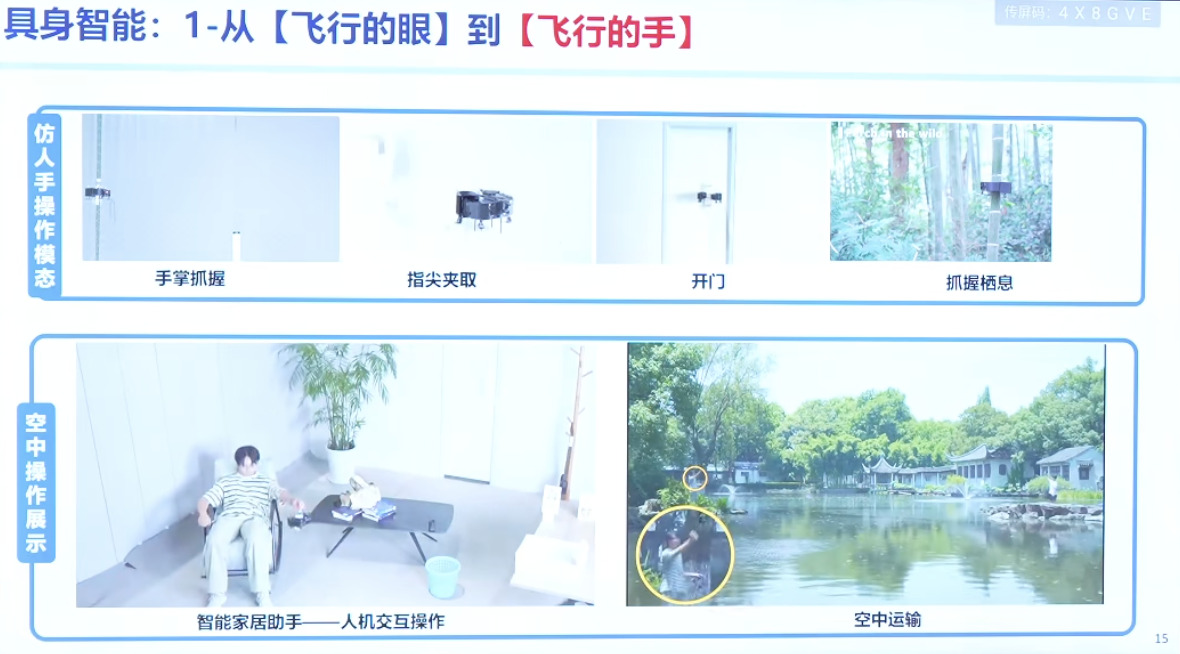
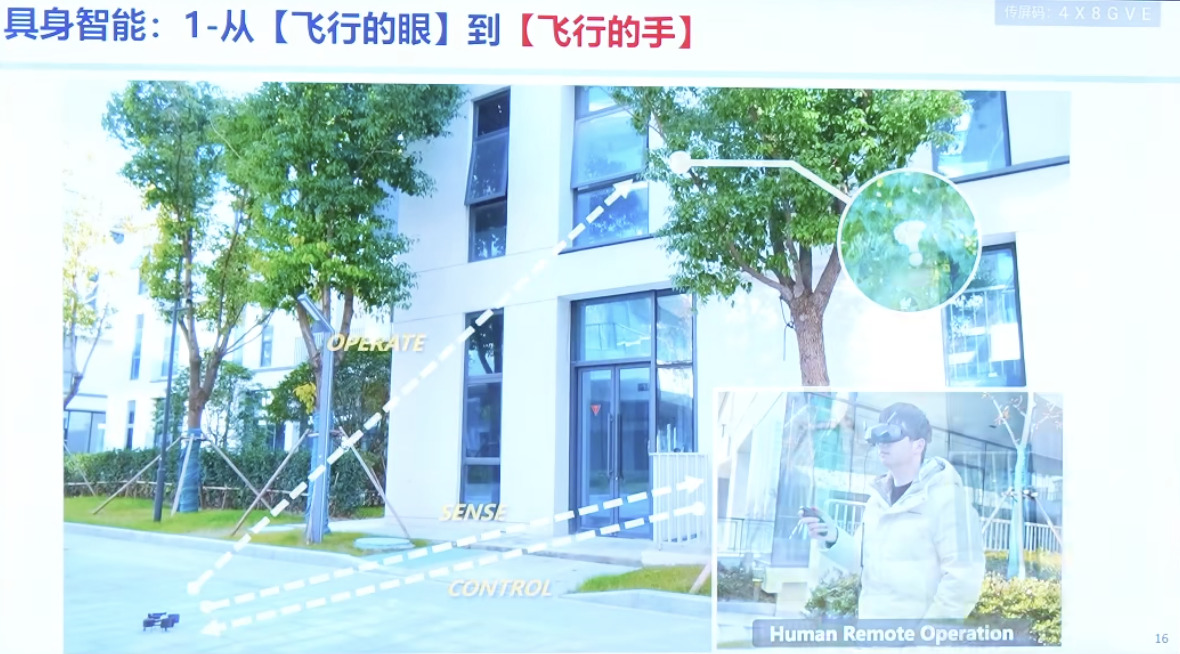
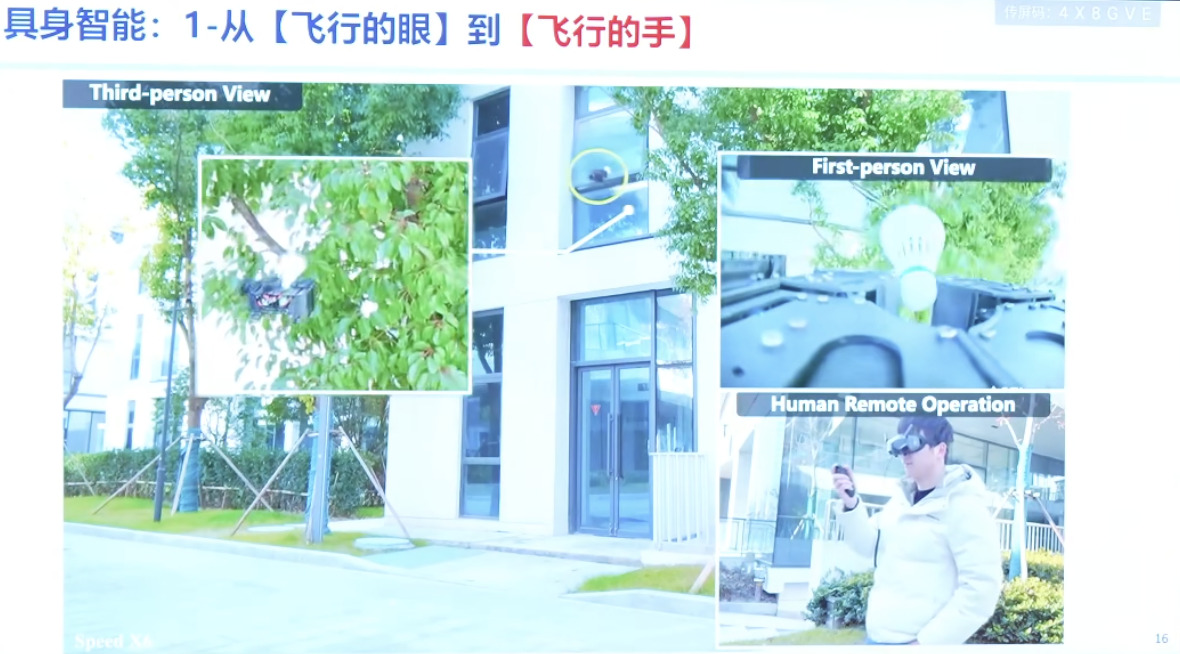
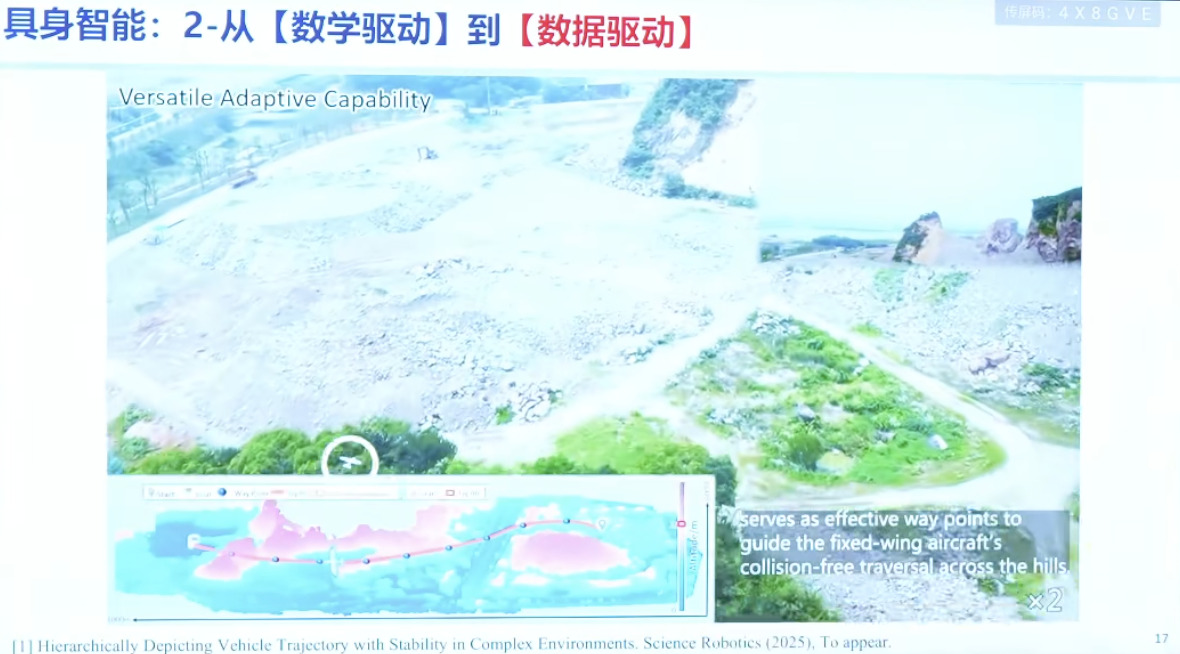
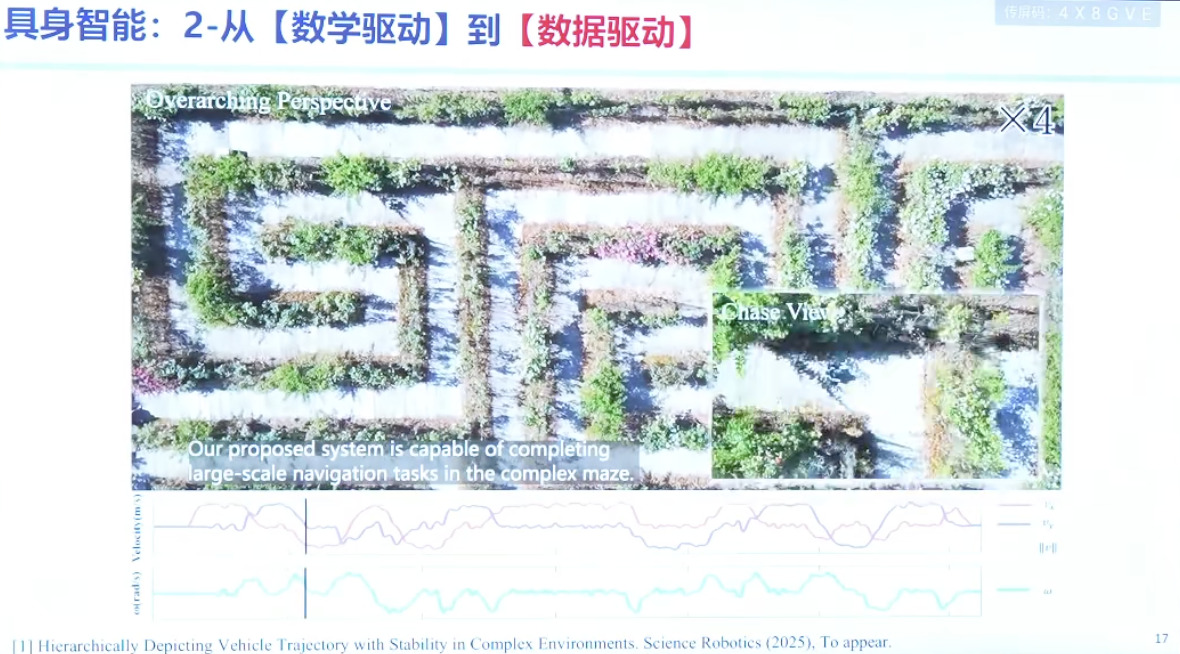
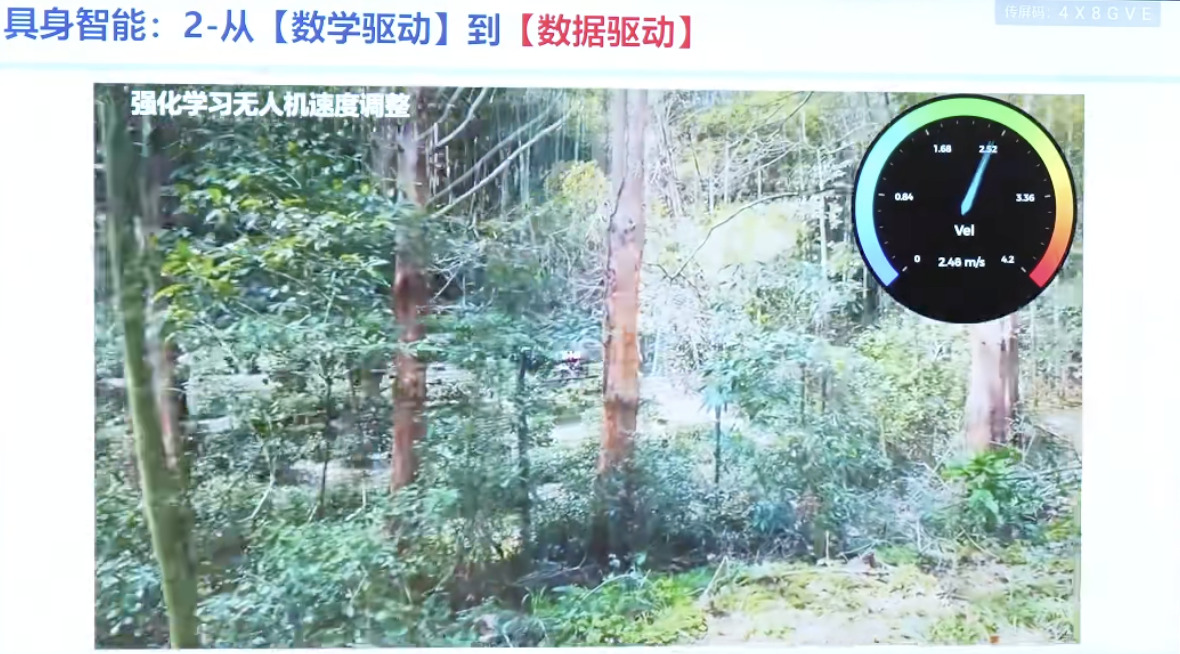
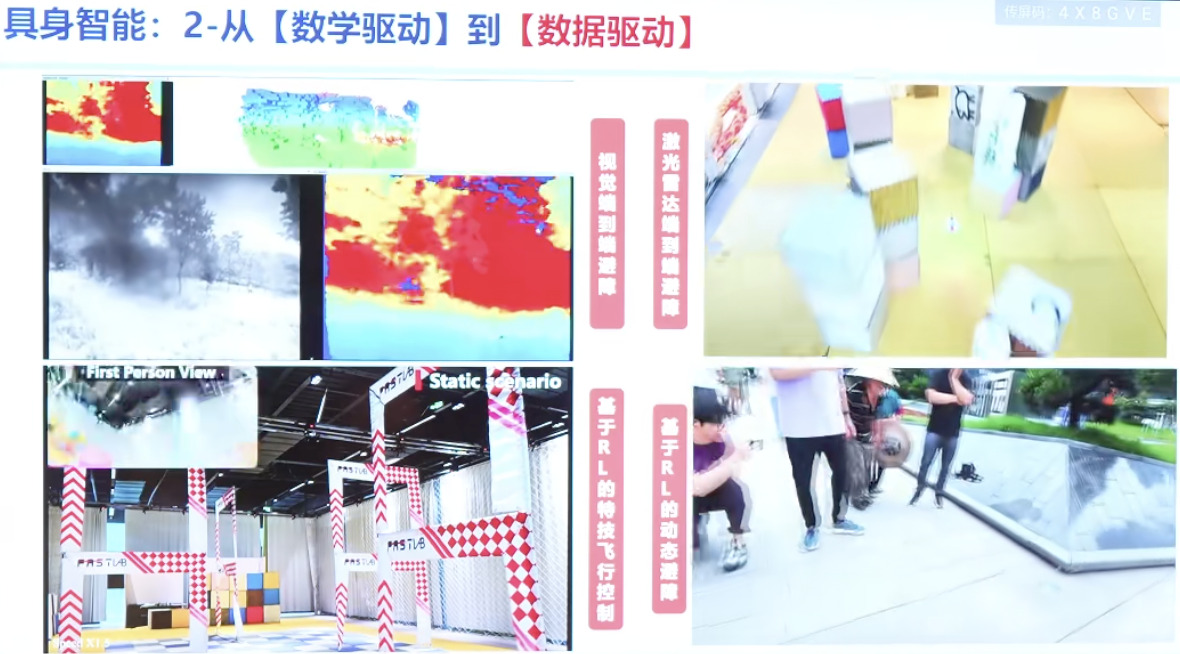
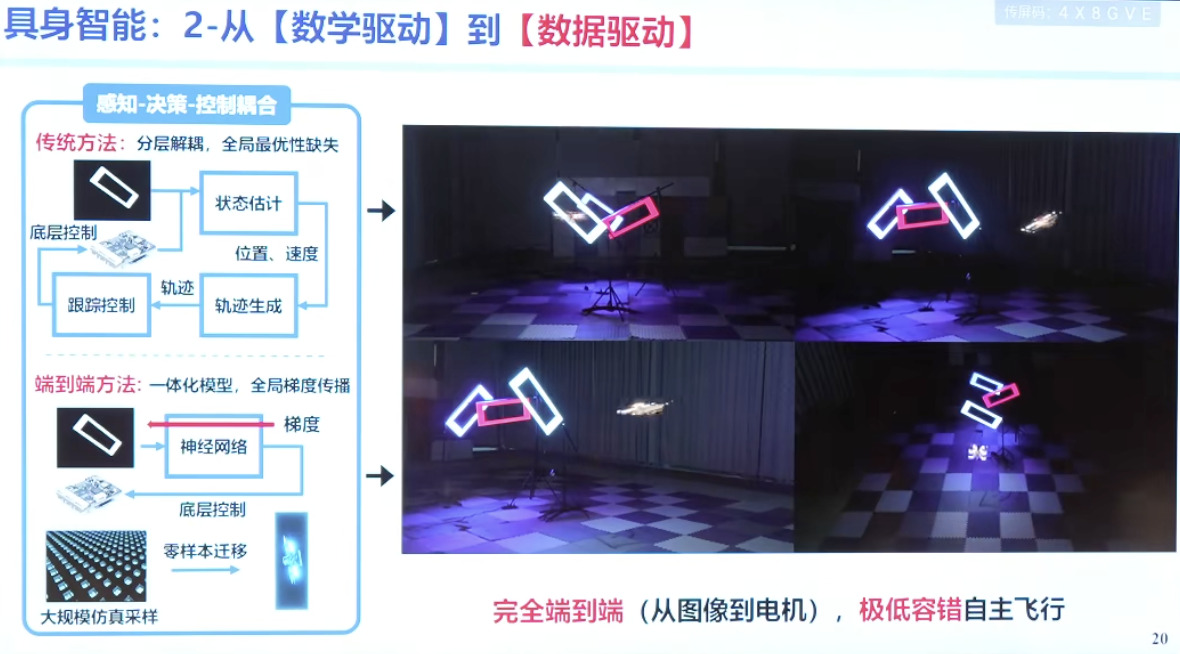
飞行机器人—从物理智能到具身智能

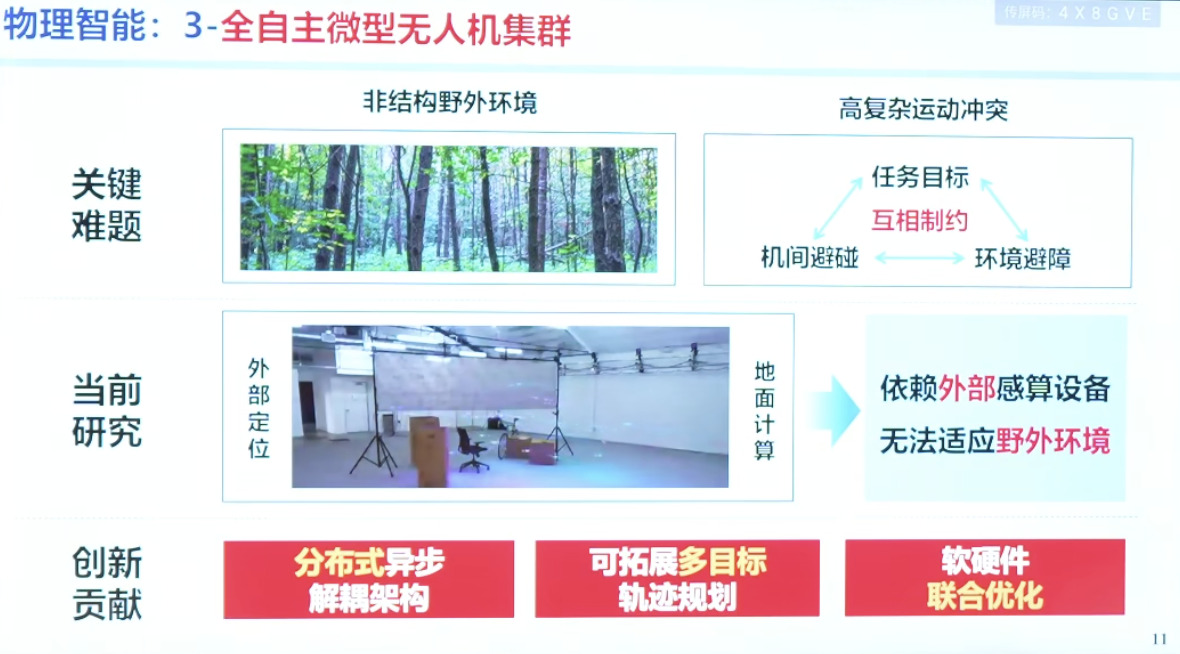
该幻灯片介绍了飞行机器人从物理智能到具身智能的演变。概述了飞行机器人的研究方向,包括在复杂环境下生成全状态轨迹、无人机动态环境感知与建模,以及全自主微型无人机集群。幻灯片还展示了如何通过创新方法克服关键挑战,例如优化在线轨迹生成和开发低延迟动态感知系统。最后,它描绘了飞行机器人技术未来的发展路径,强调了从数学驱动到数据驱动的转变,以实现更强大的具身智能和涌现智能

参考资料

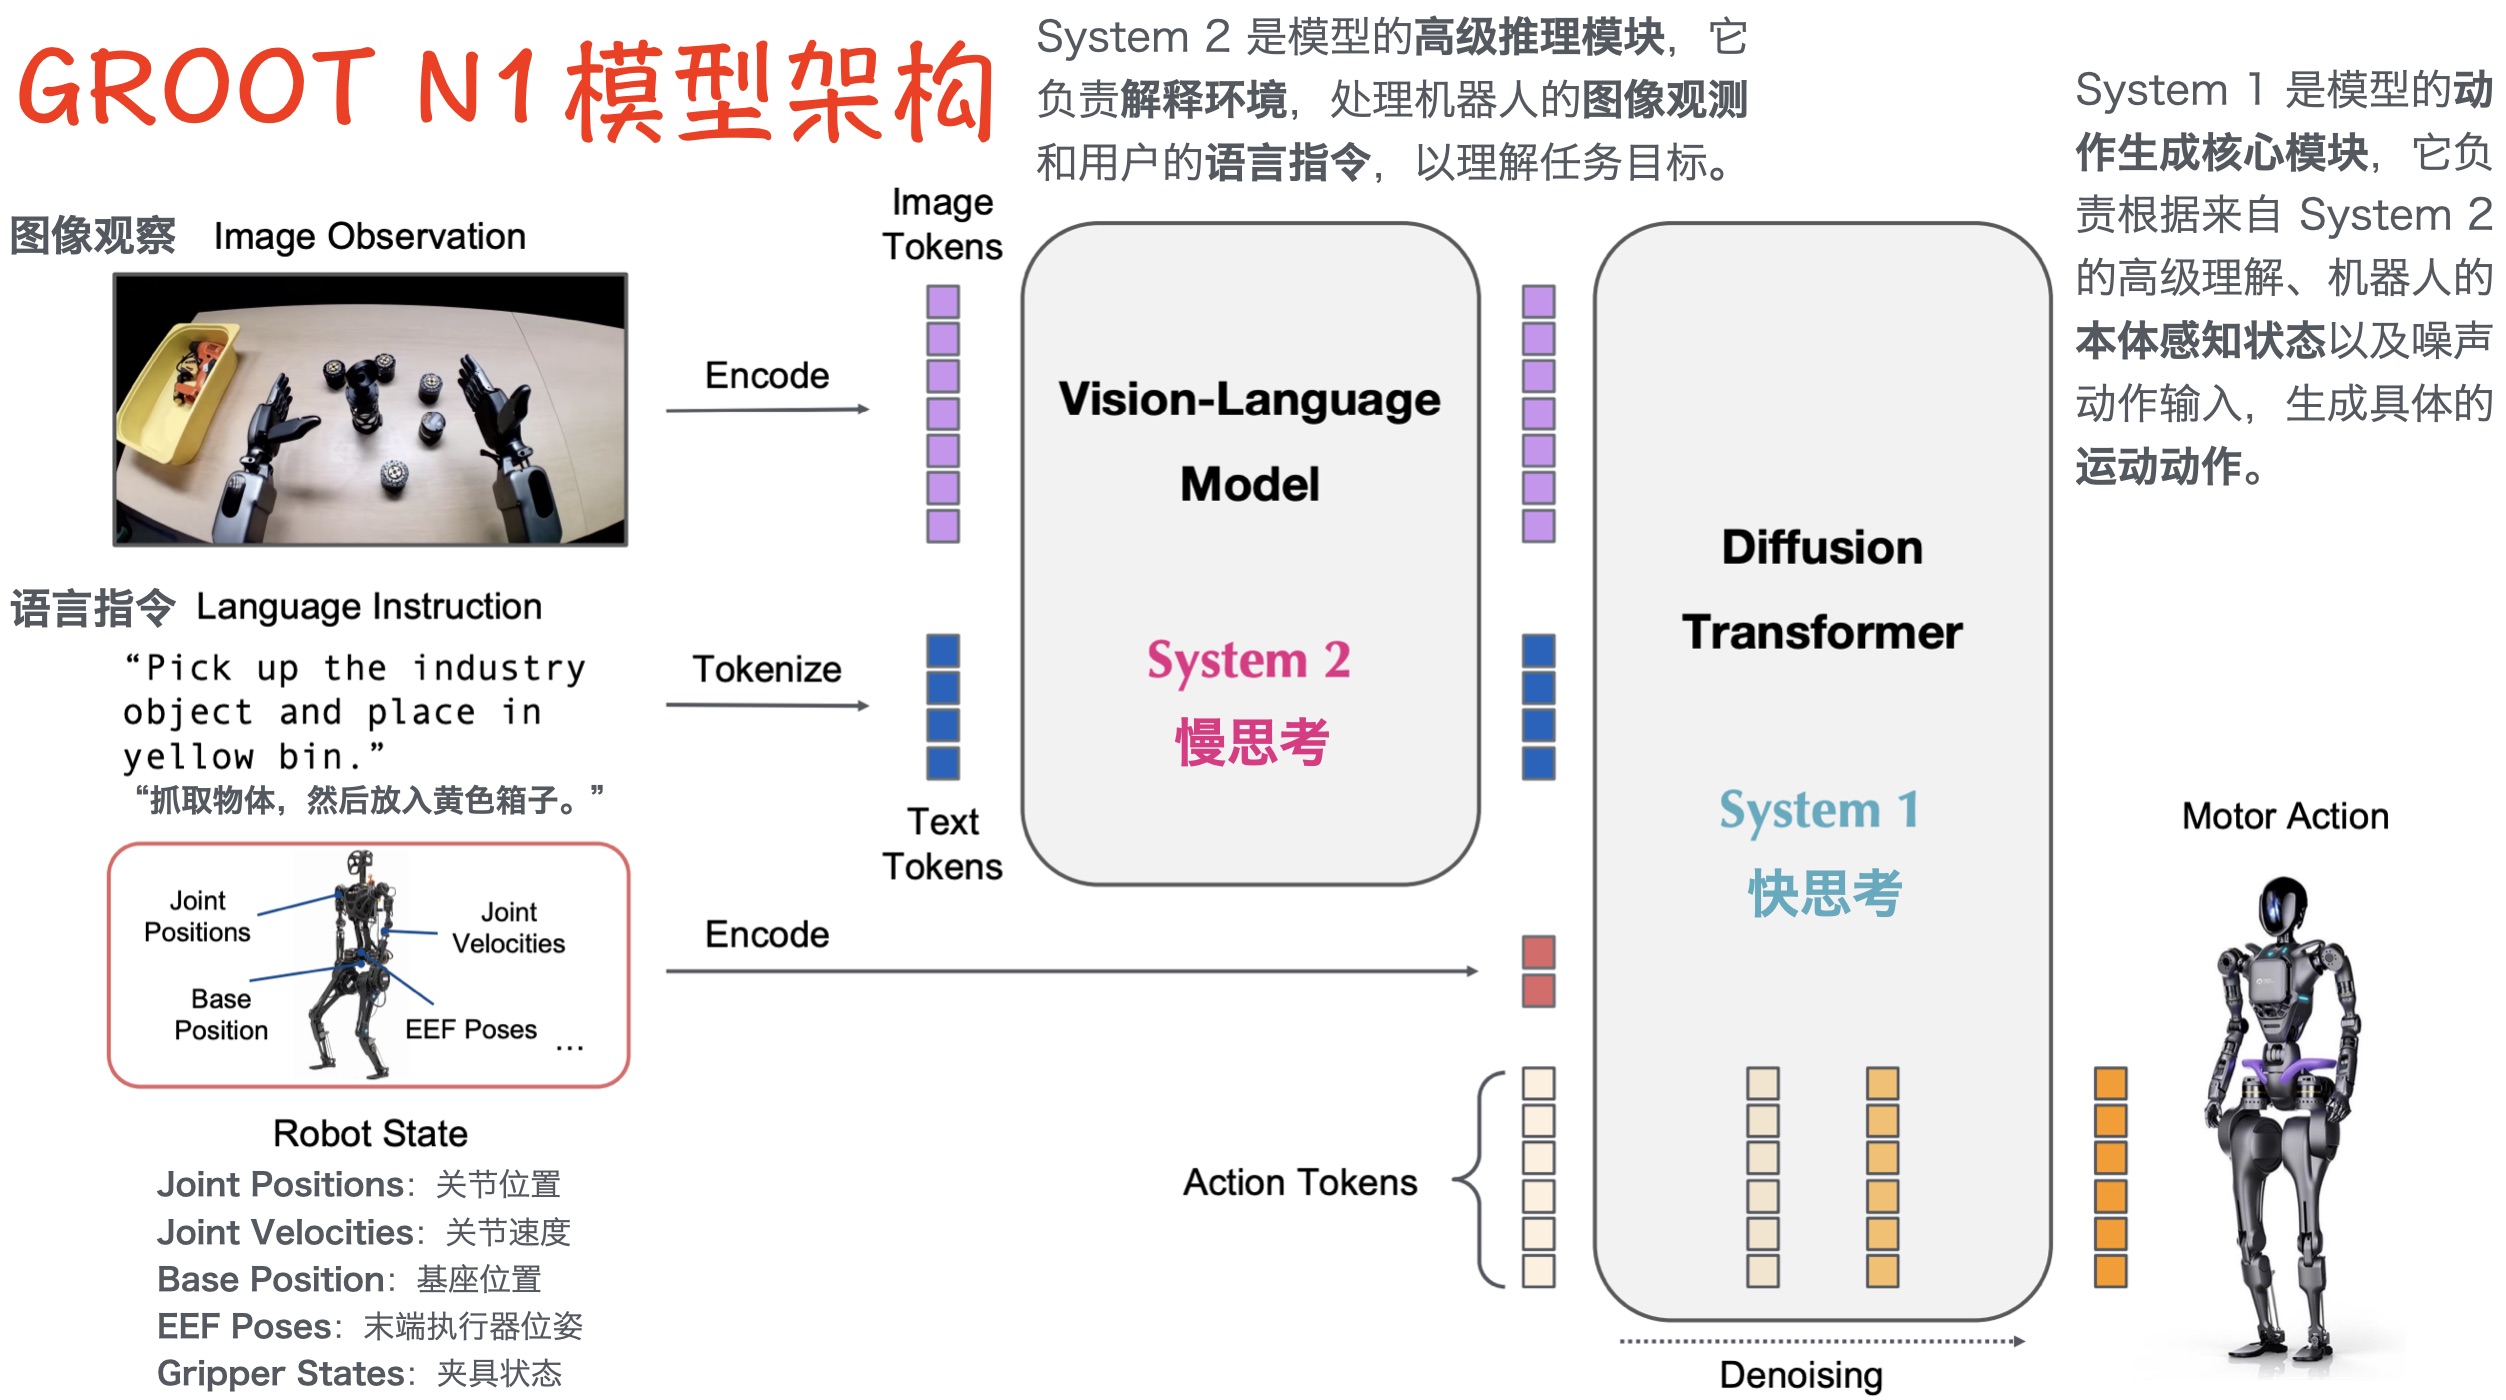
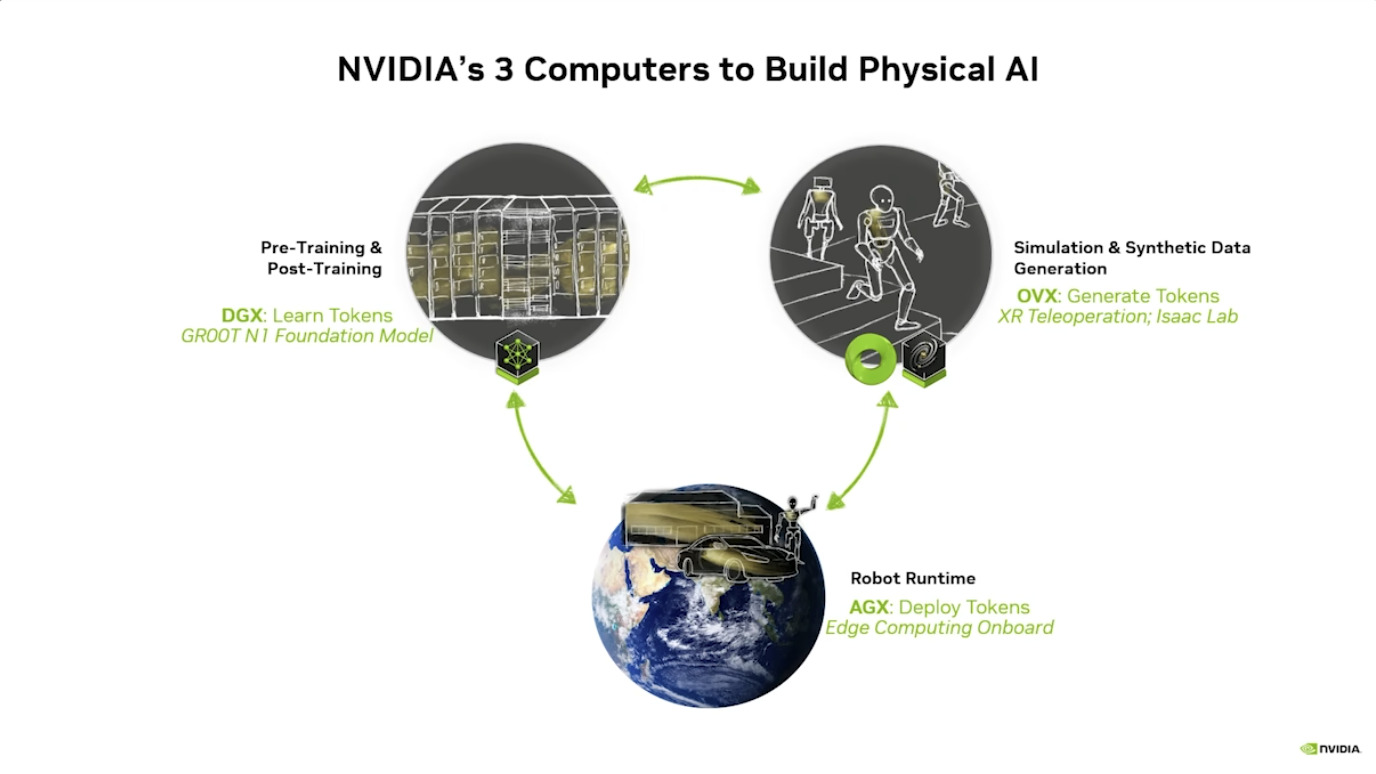
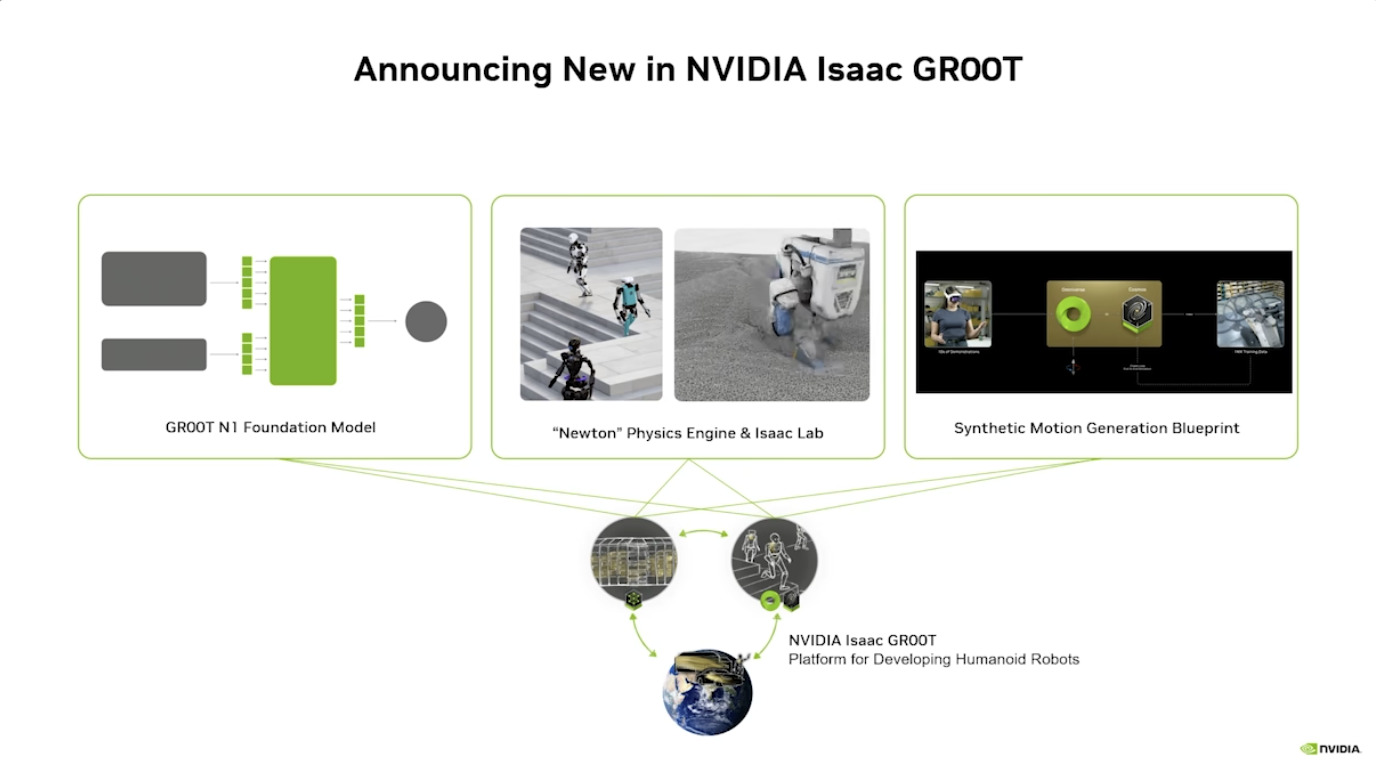
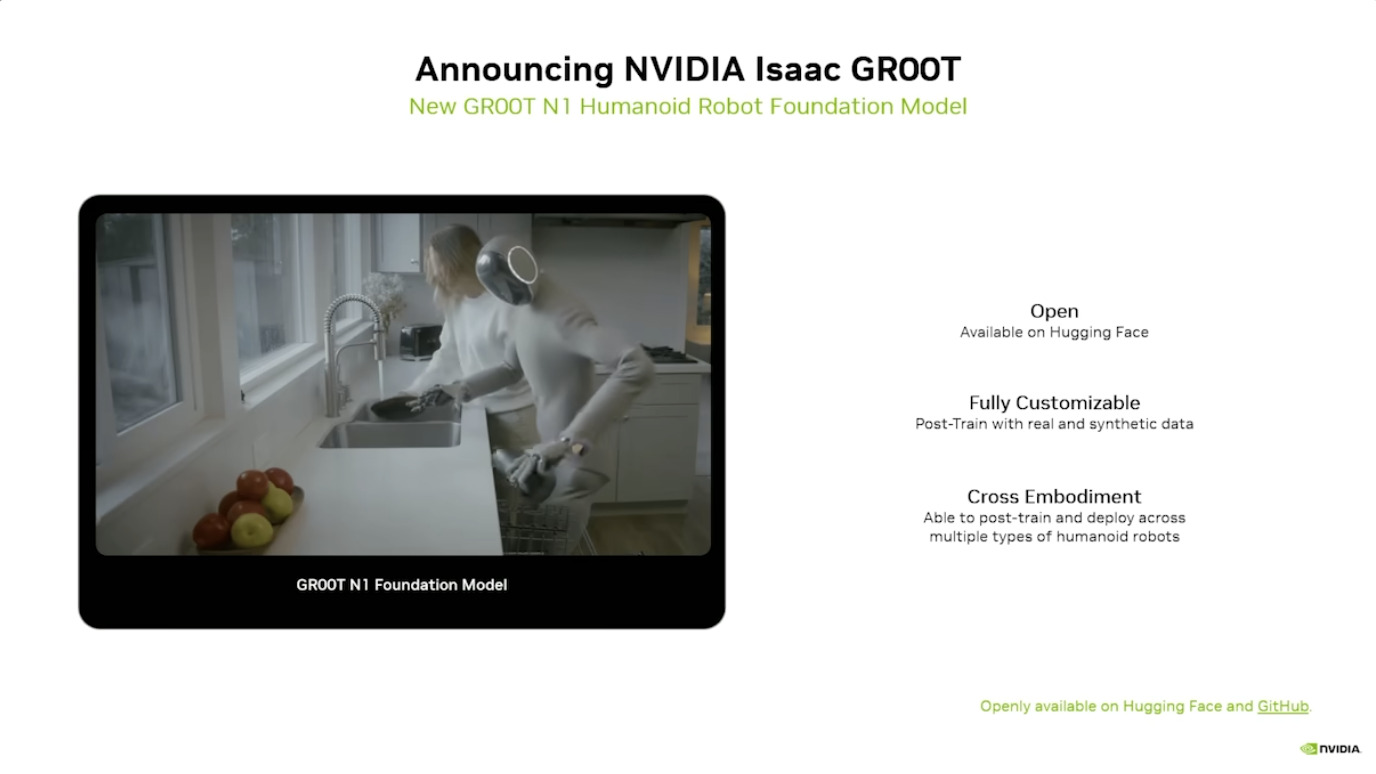
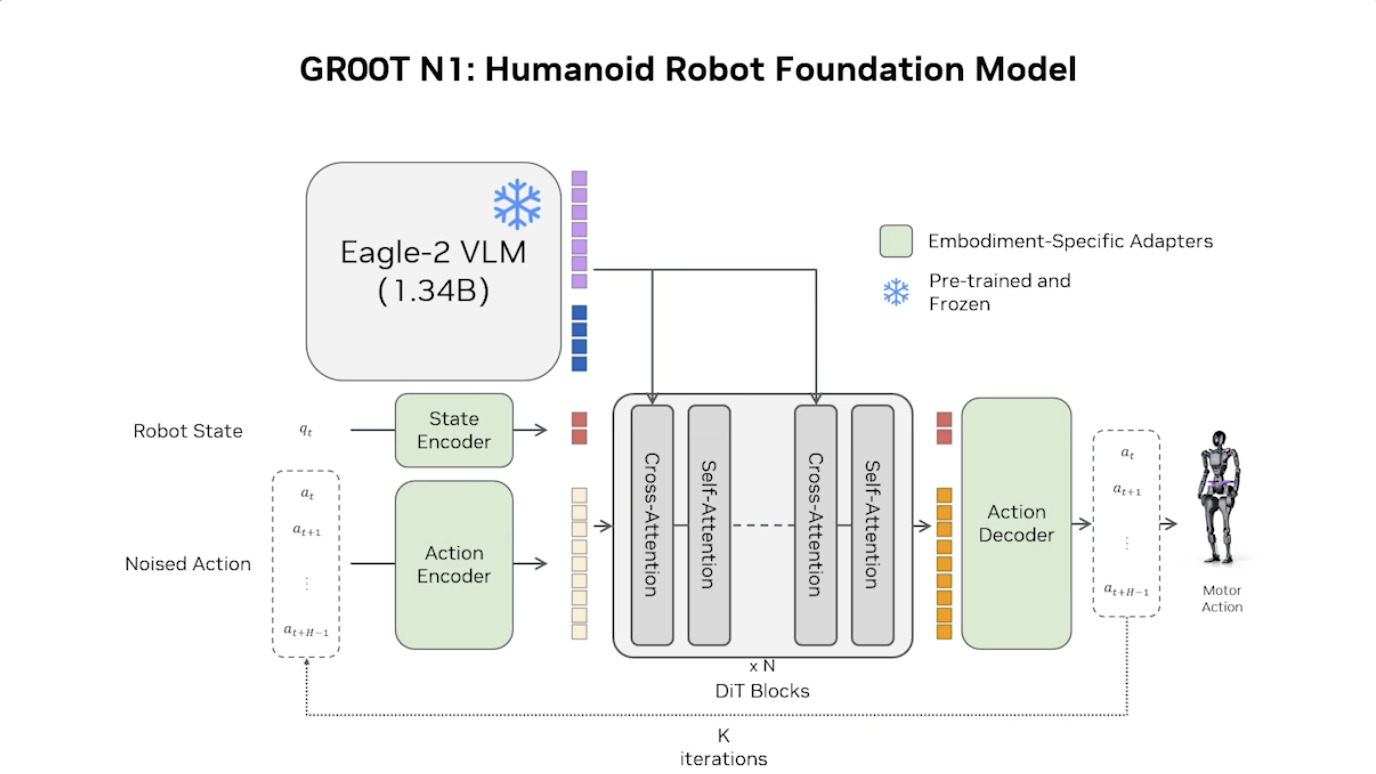
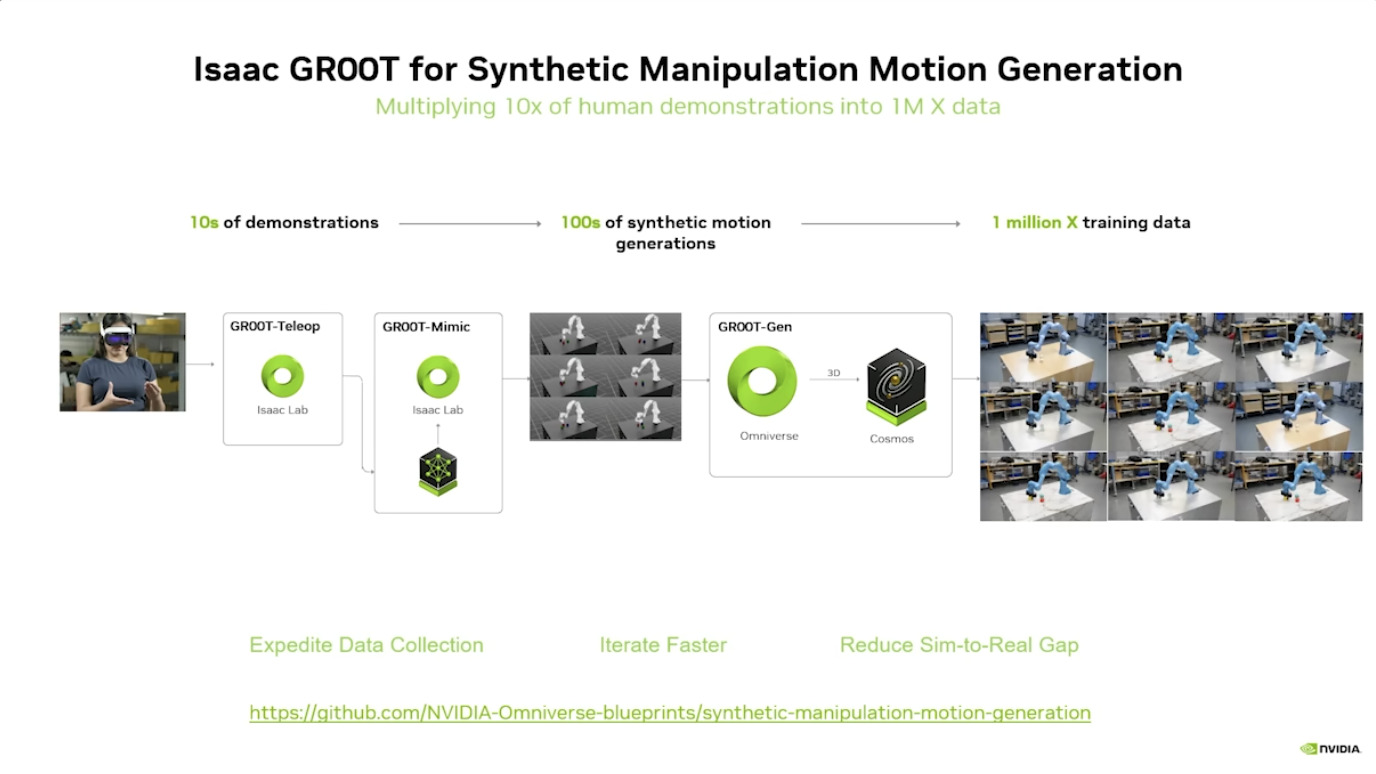
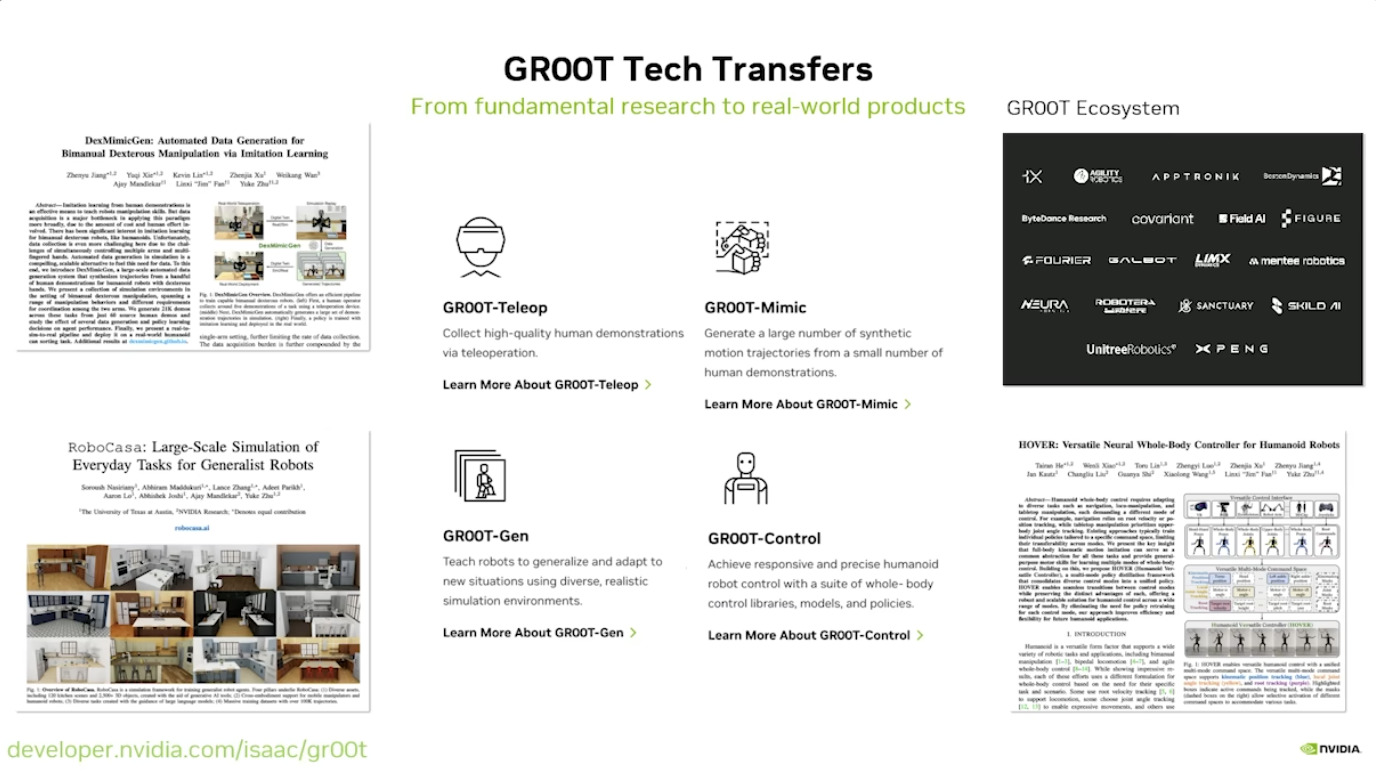
具身模型 NVIDIA Isaac GROOT N1 详解

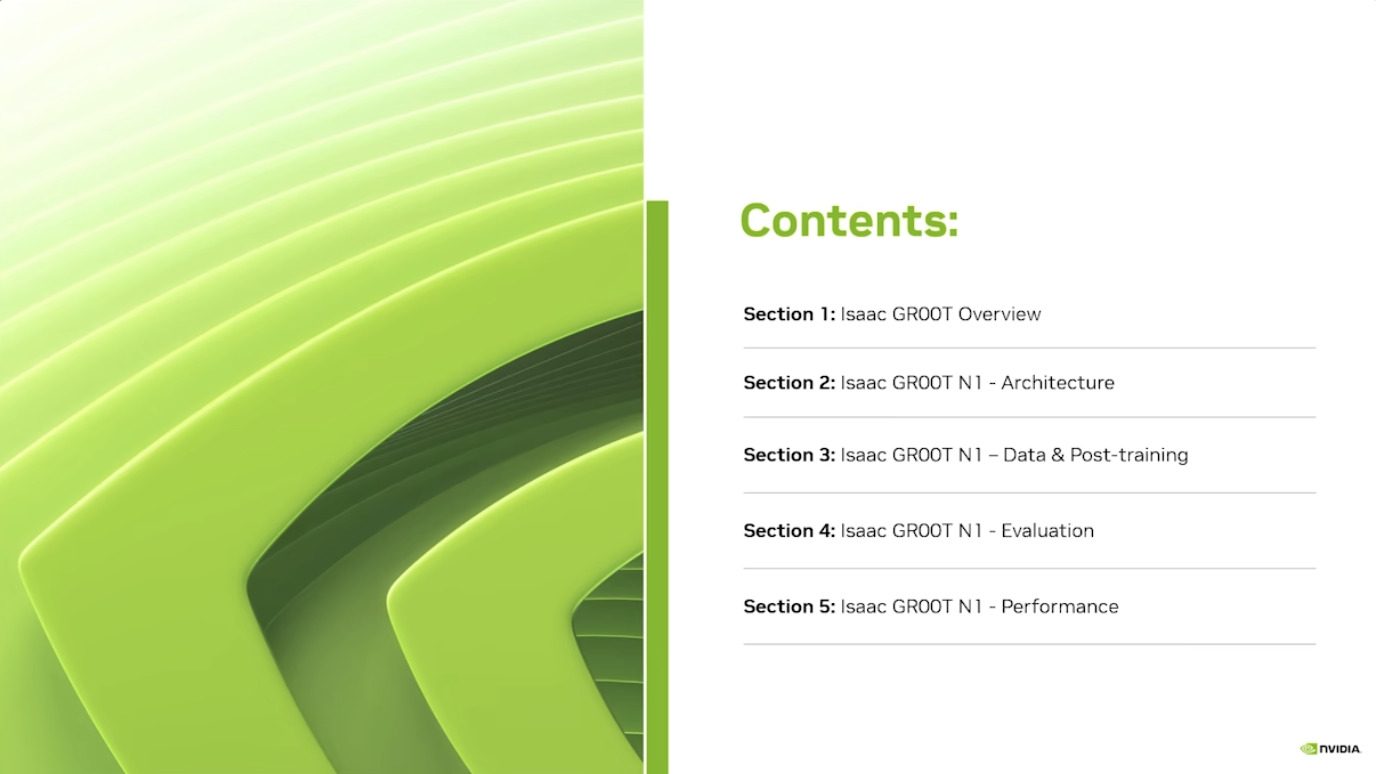
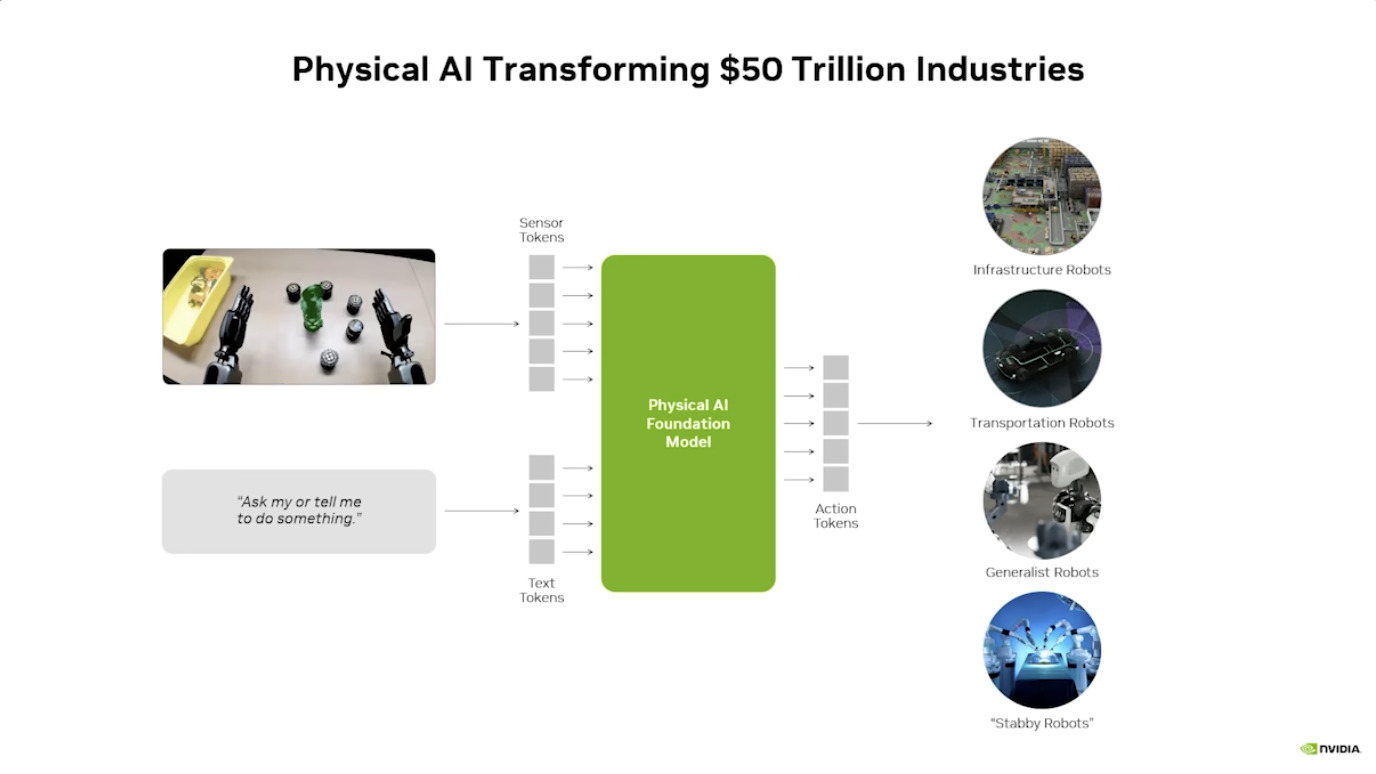
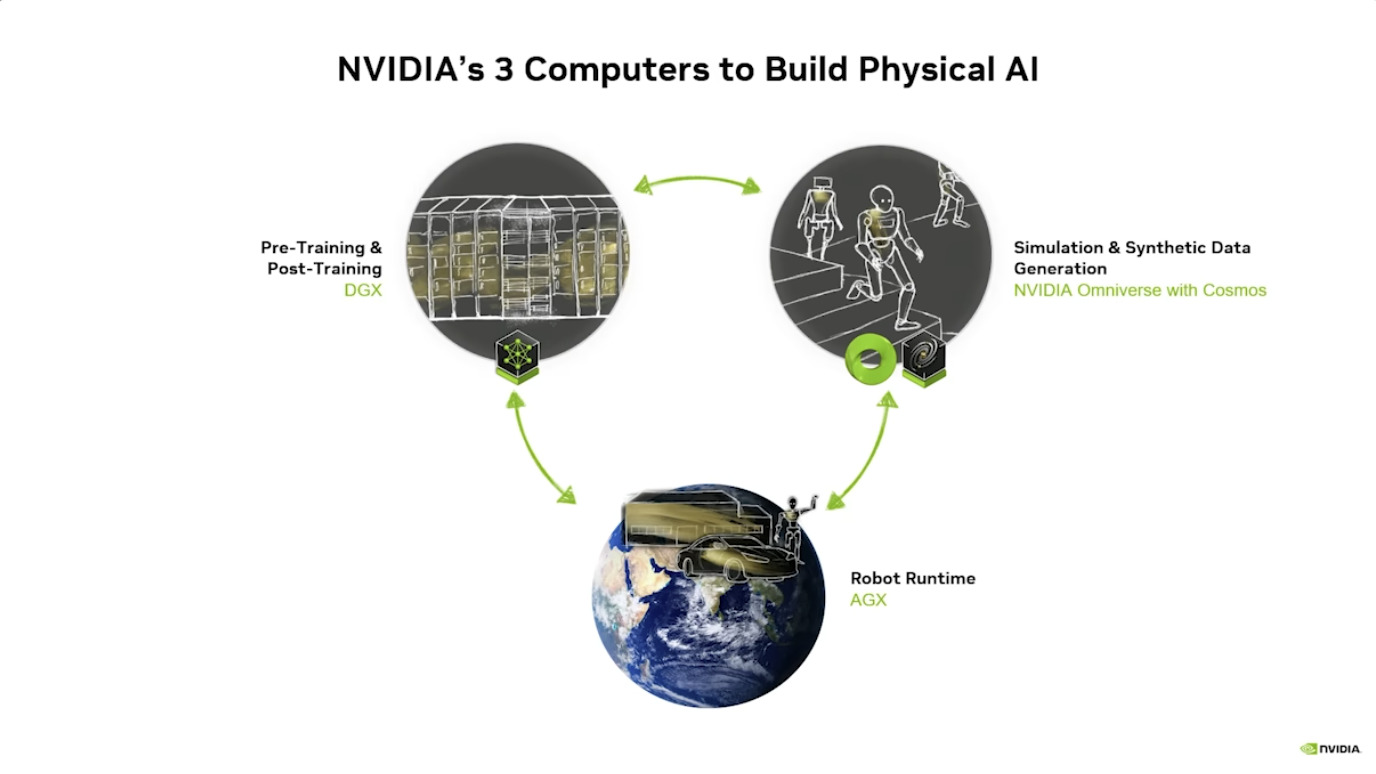
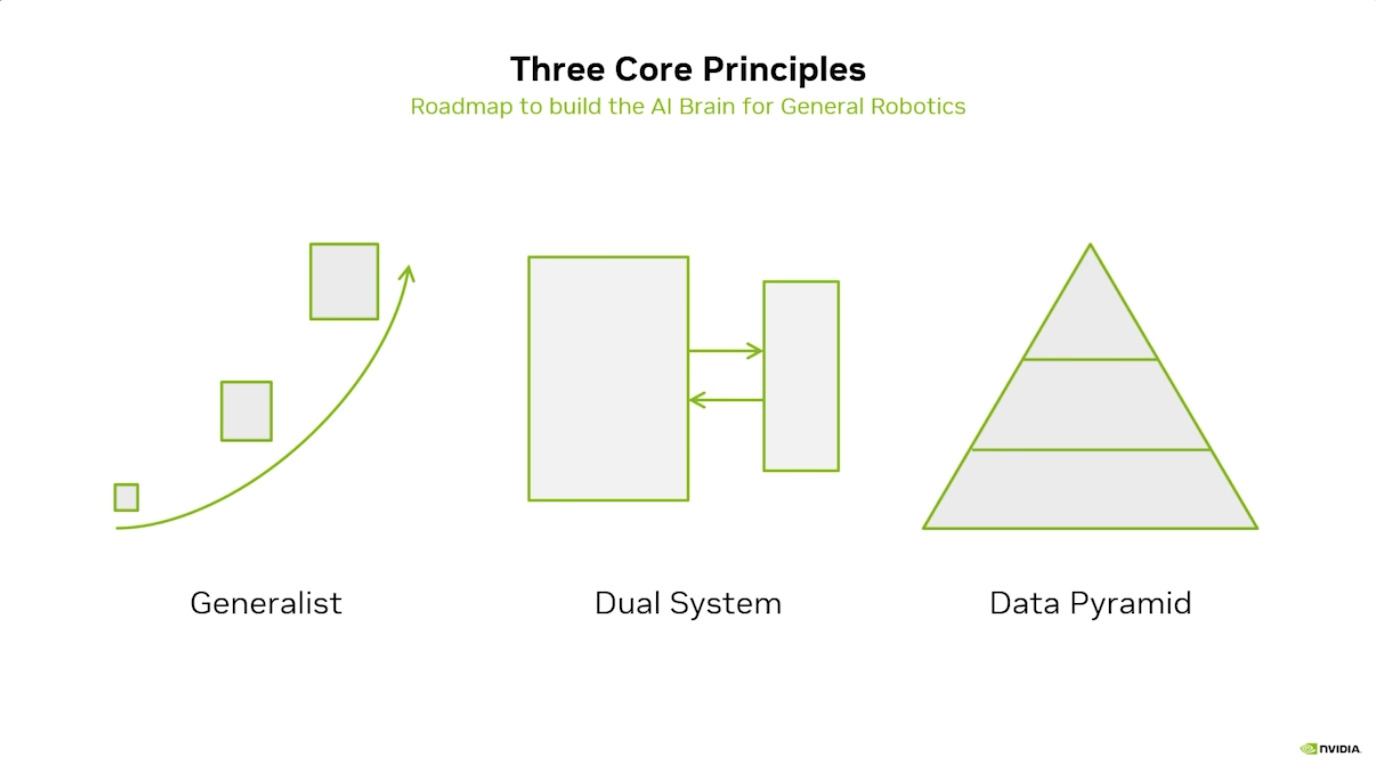
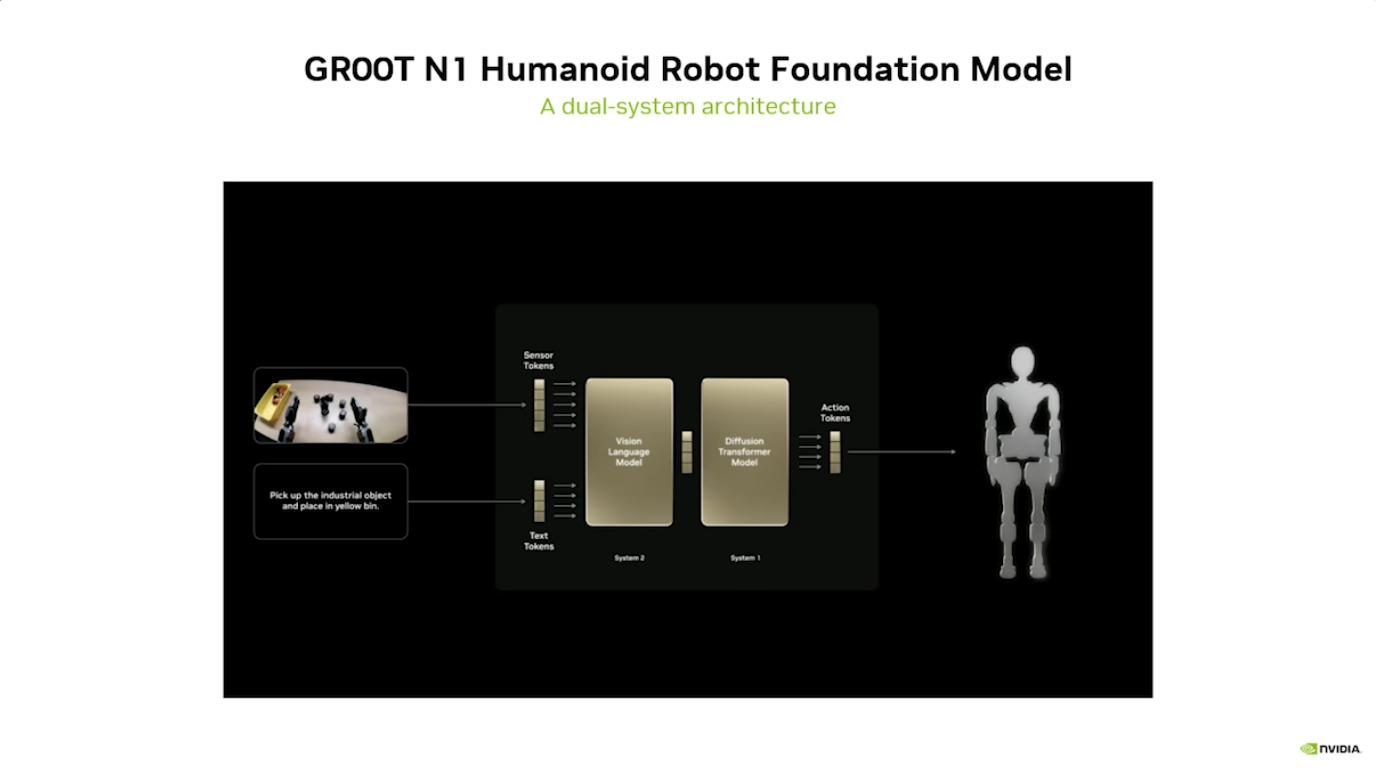
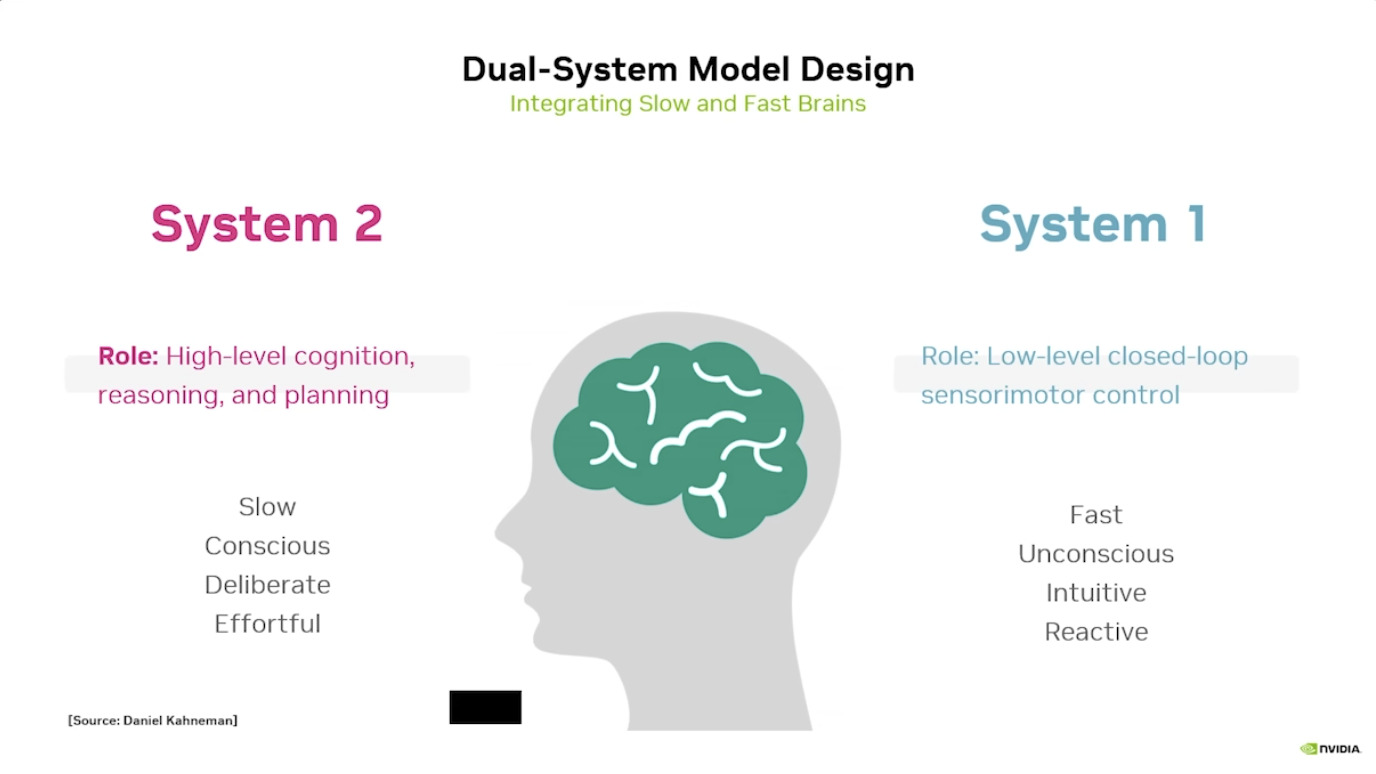
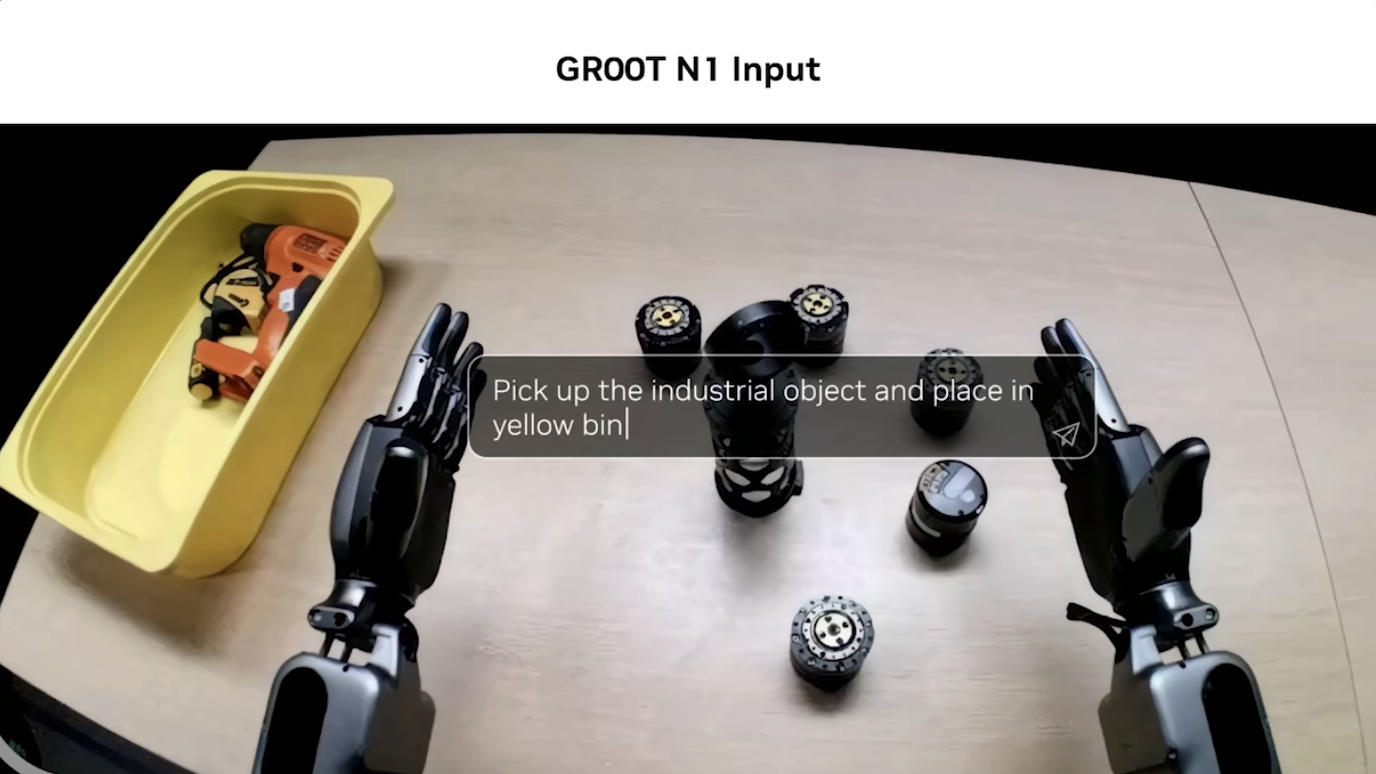
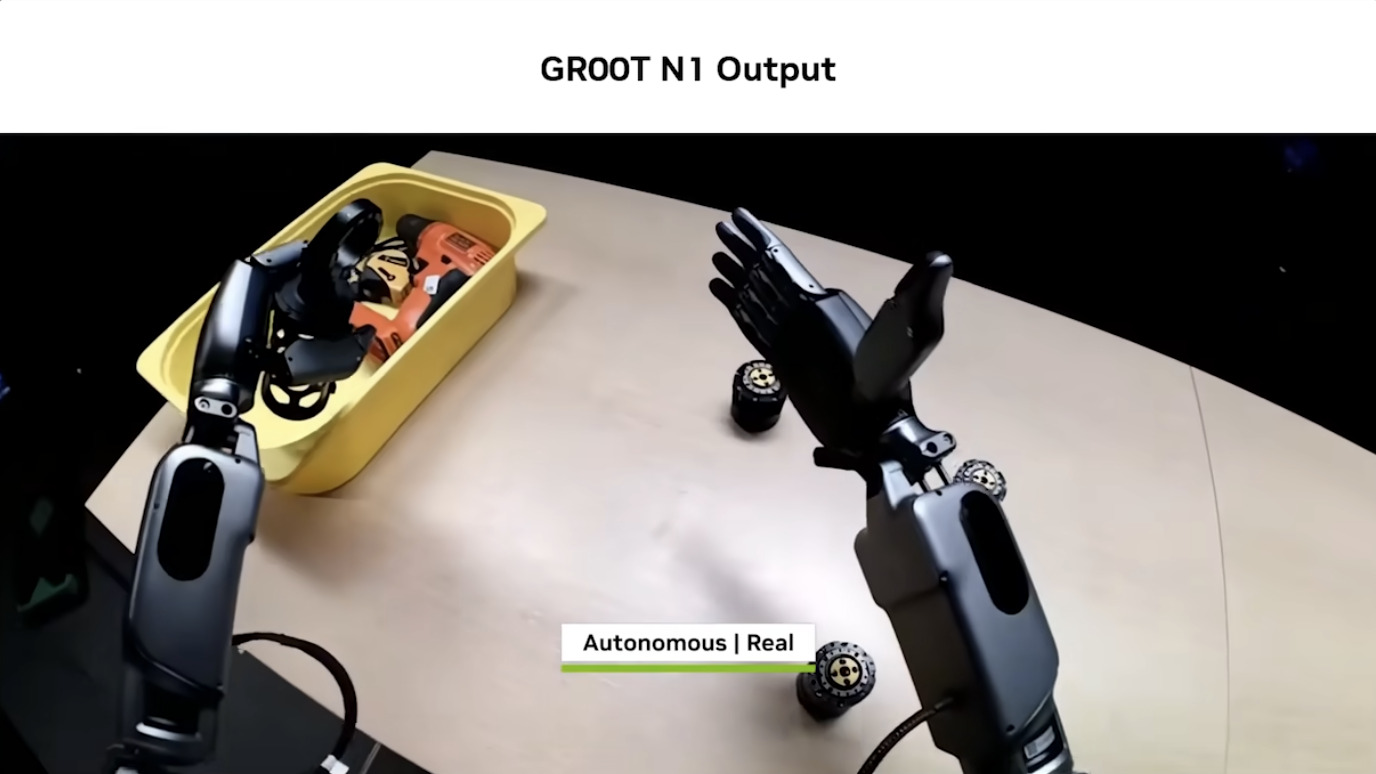
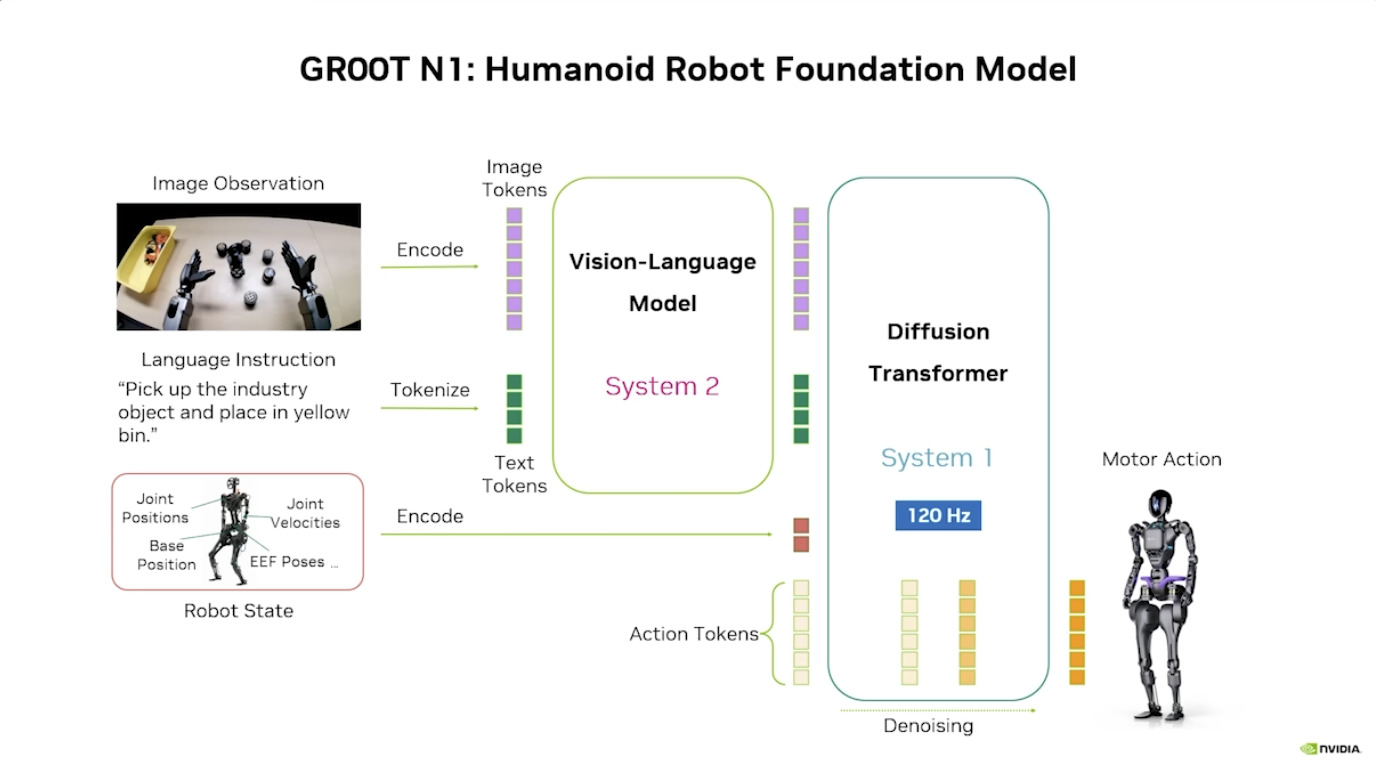
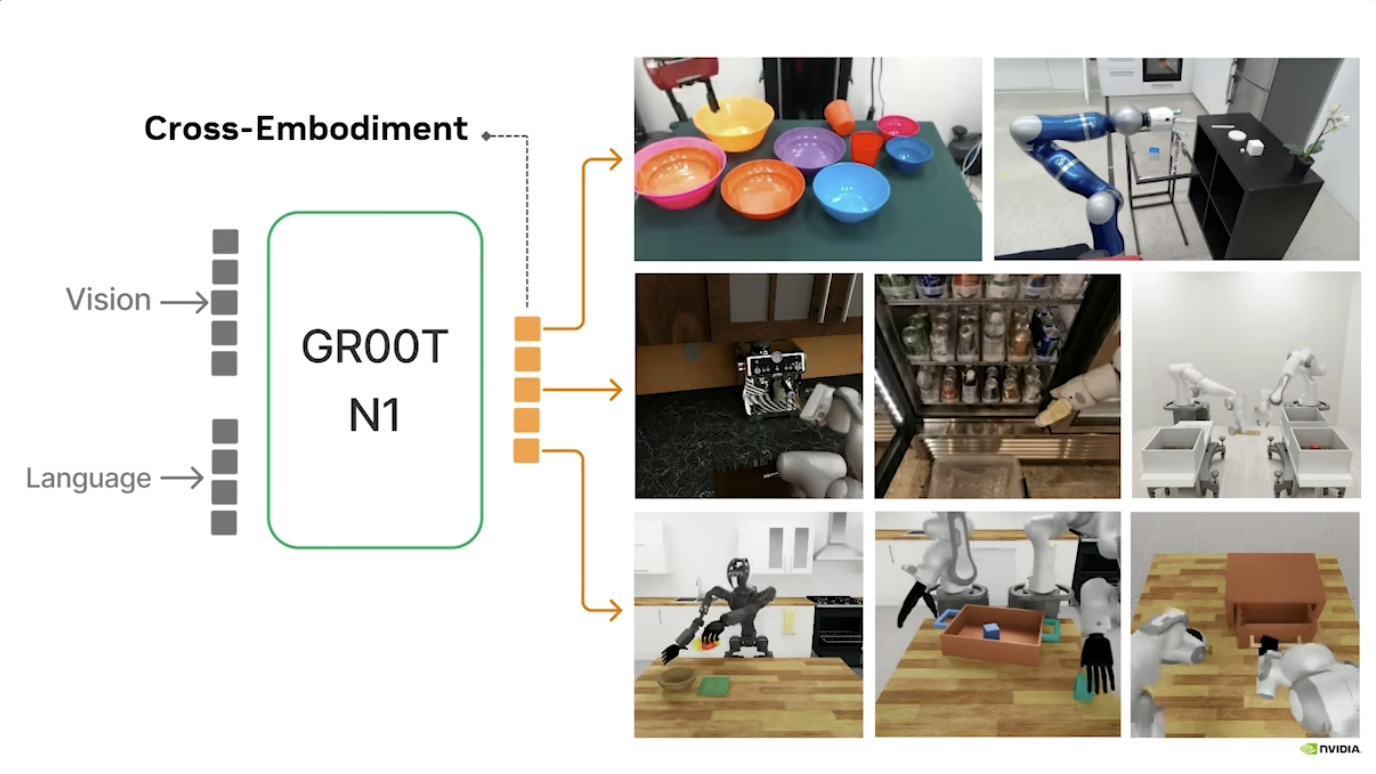
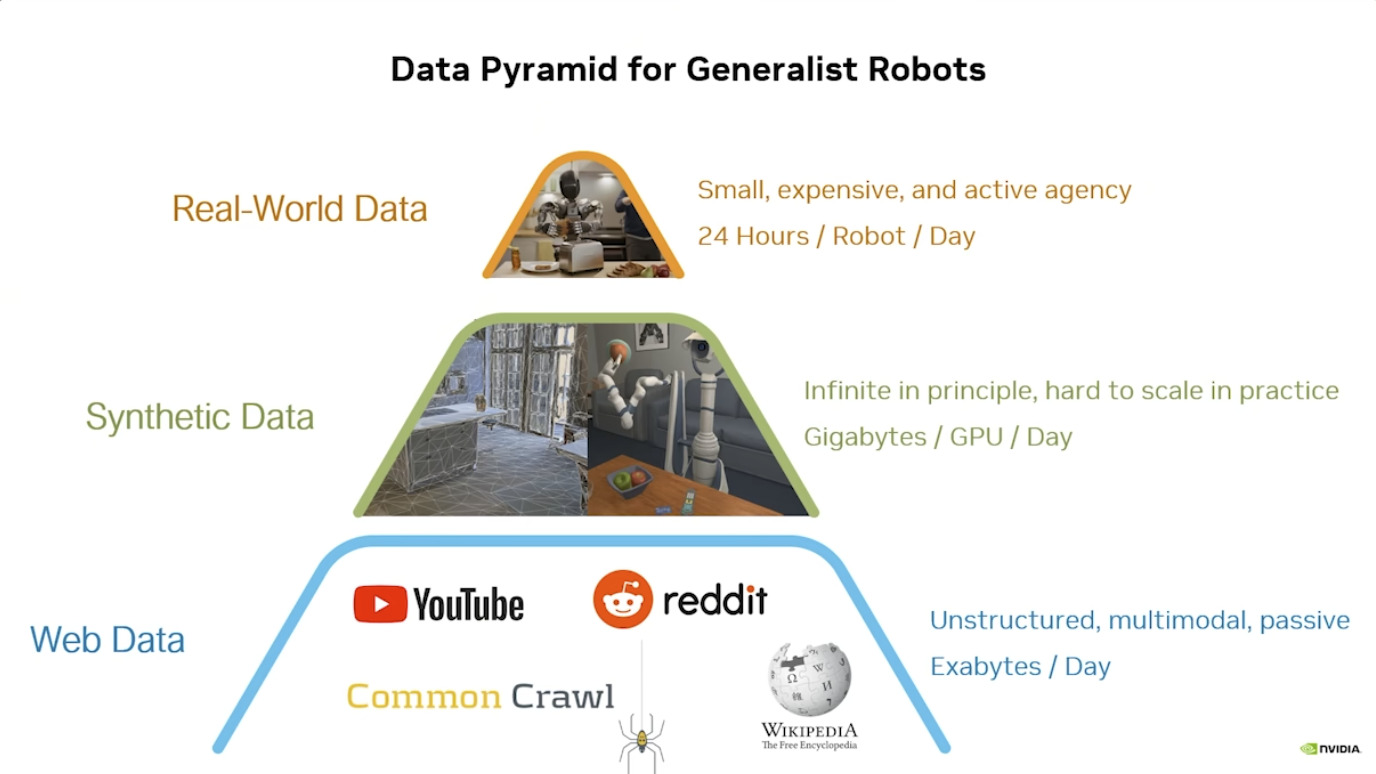
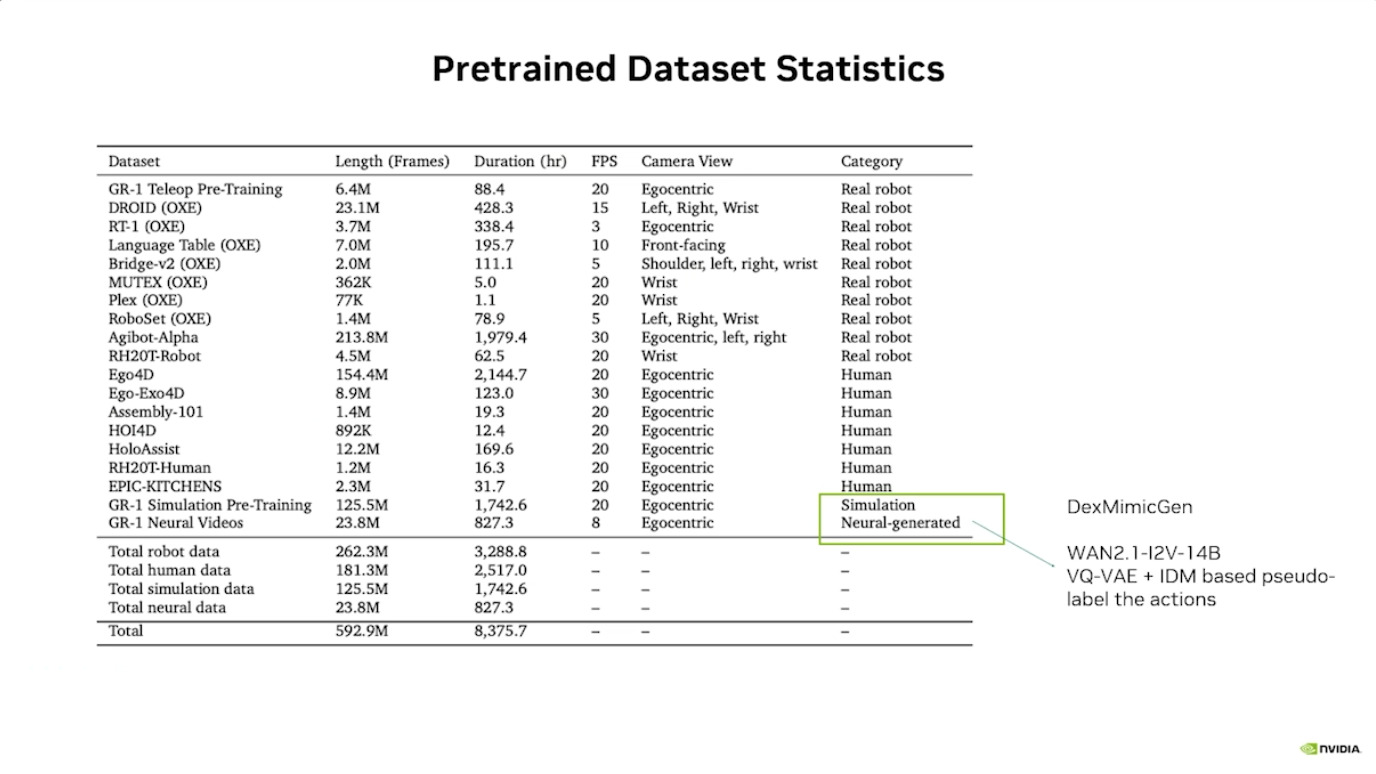
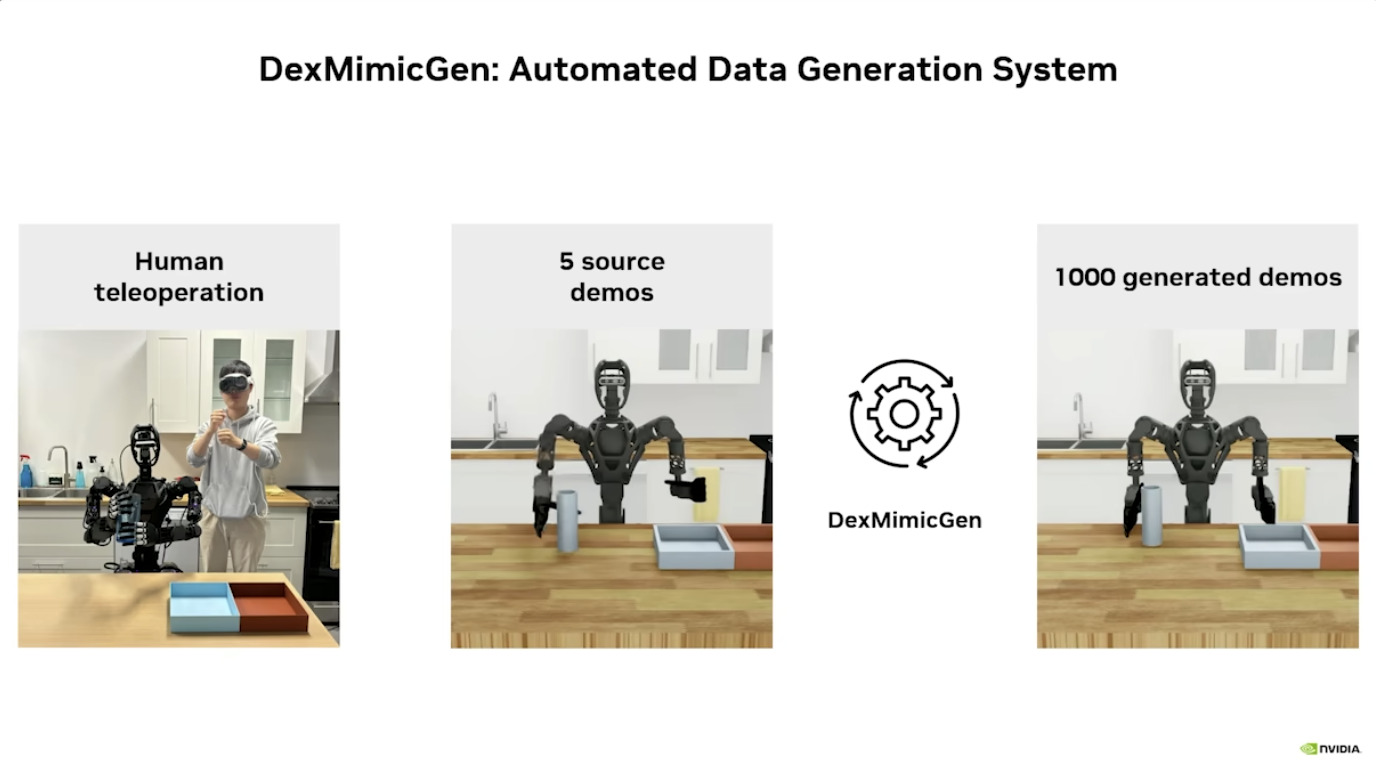
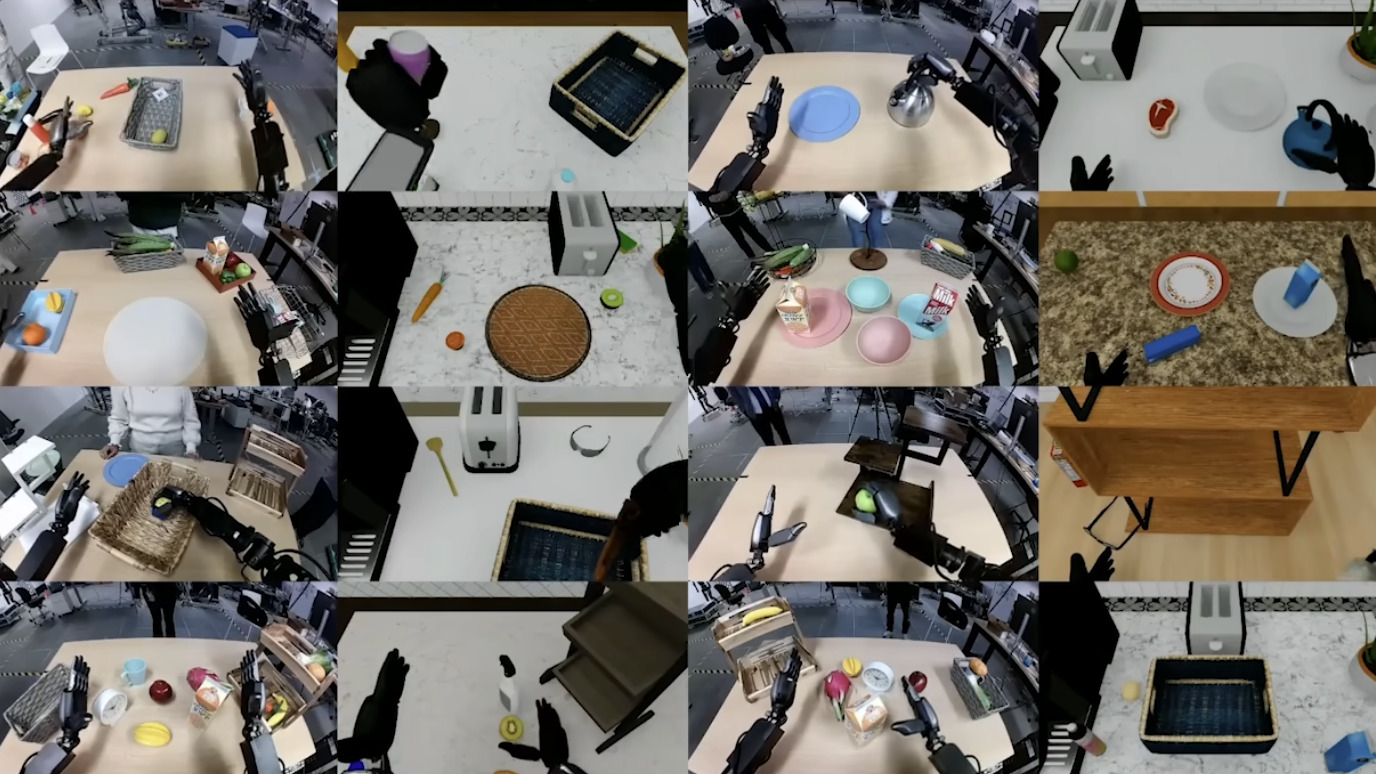
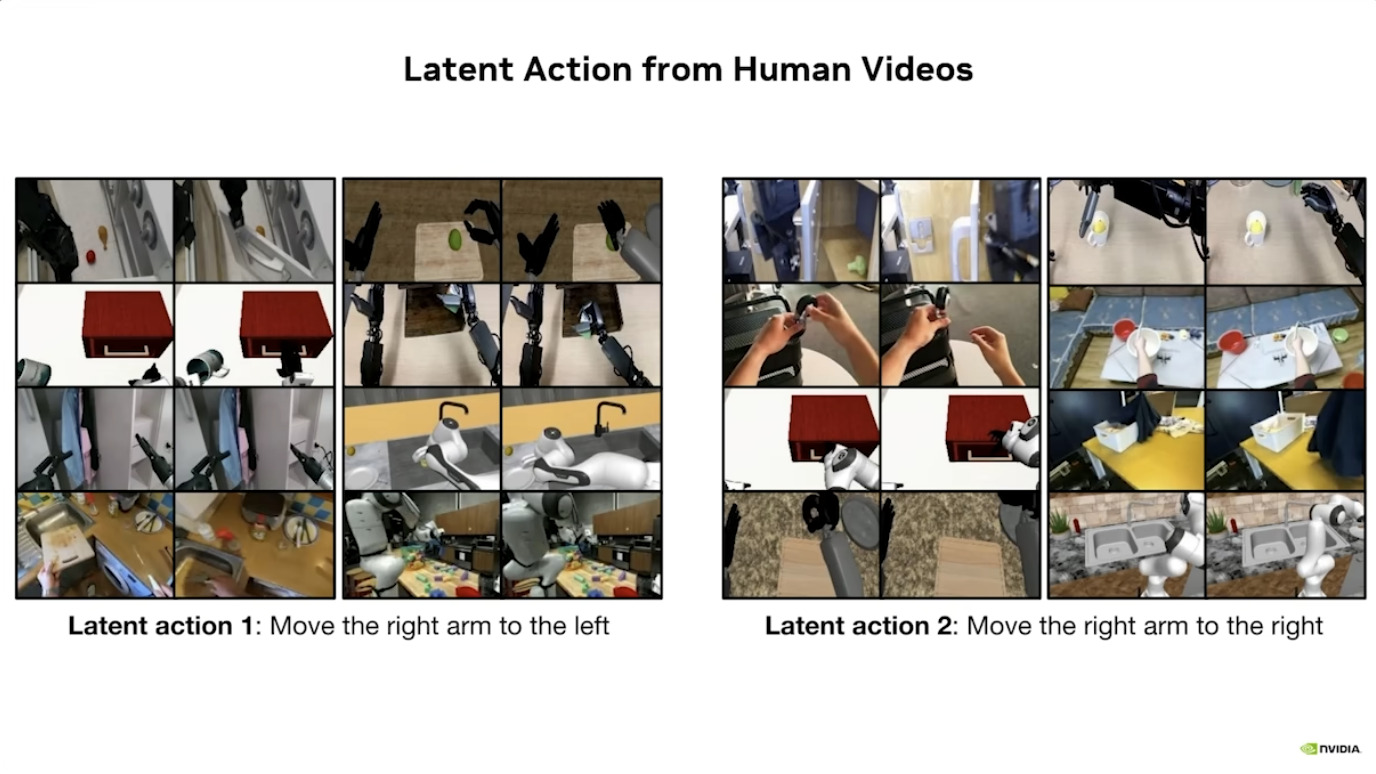
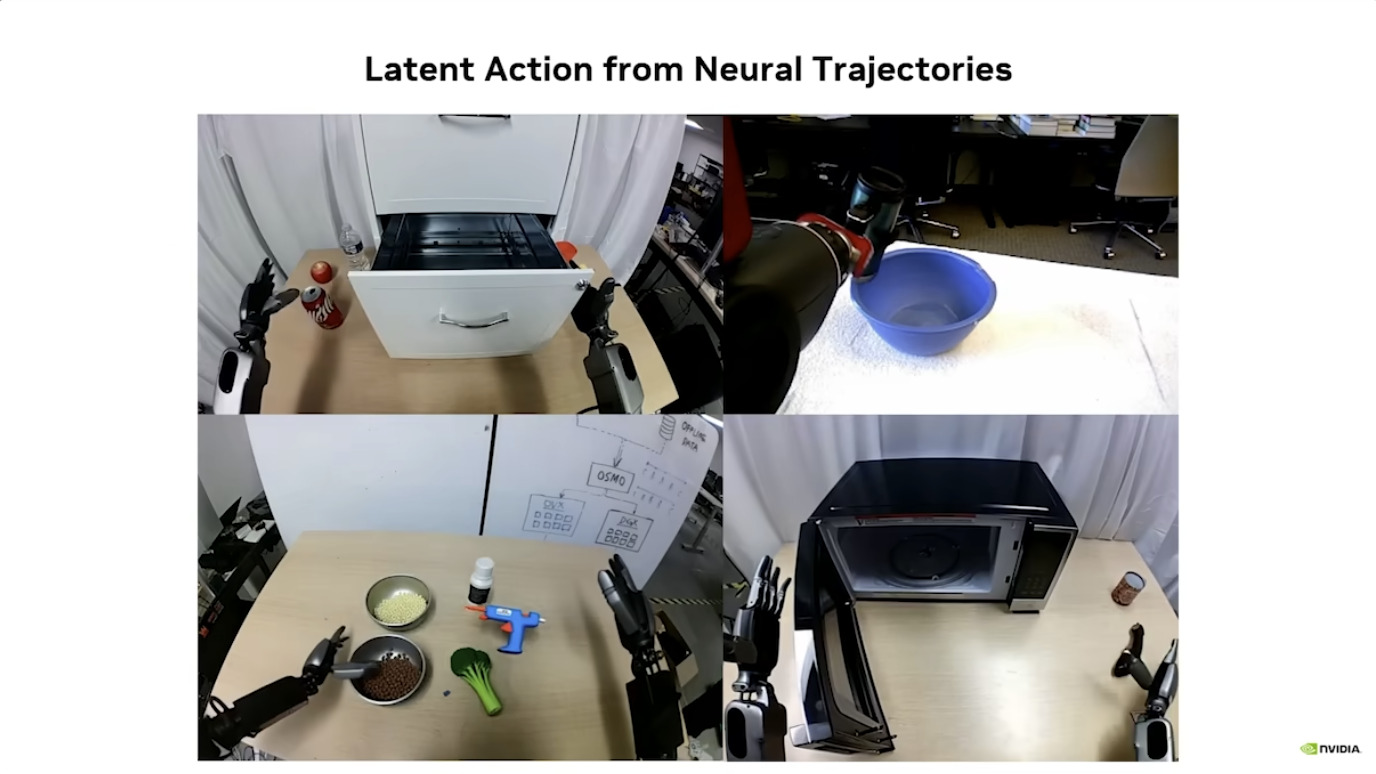
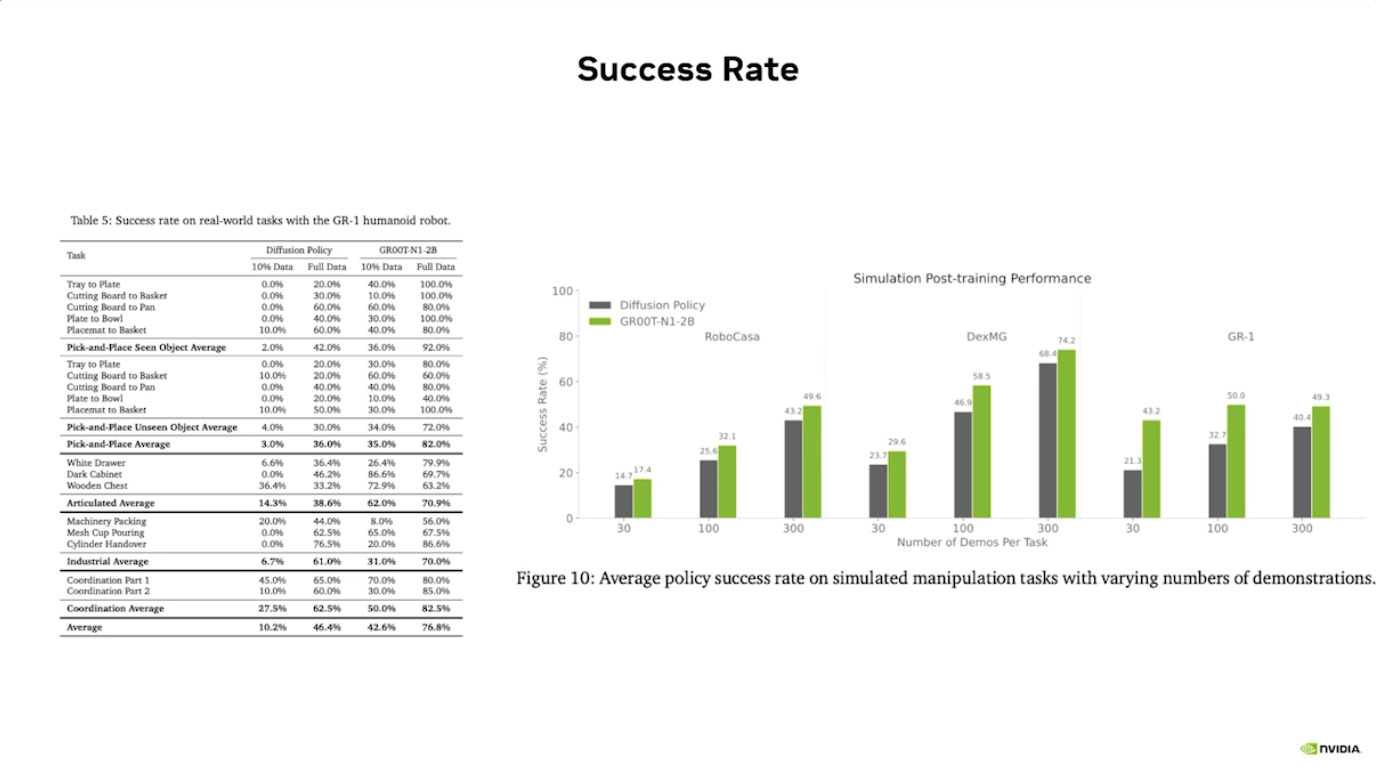
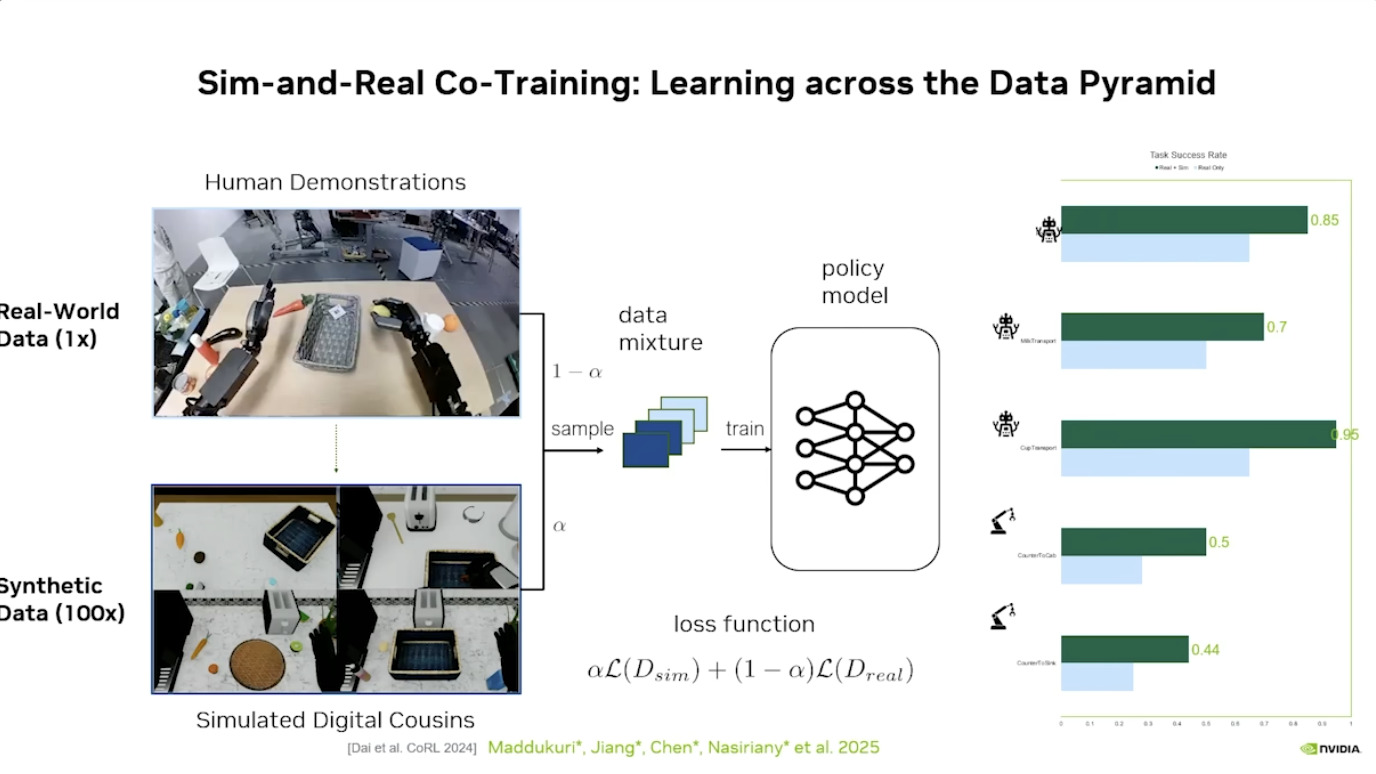
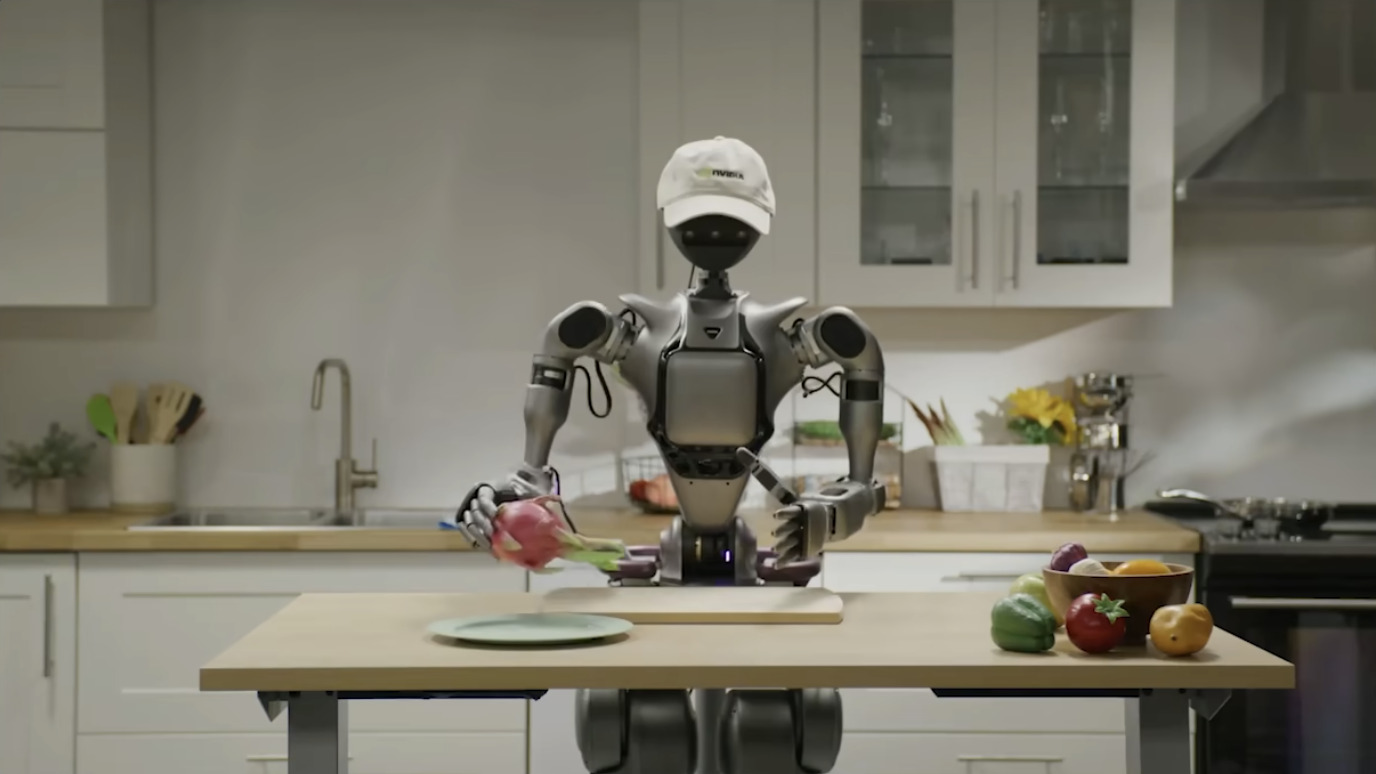
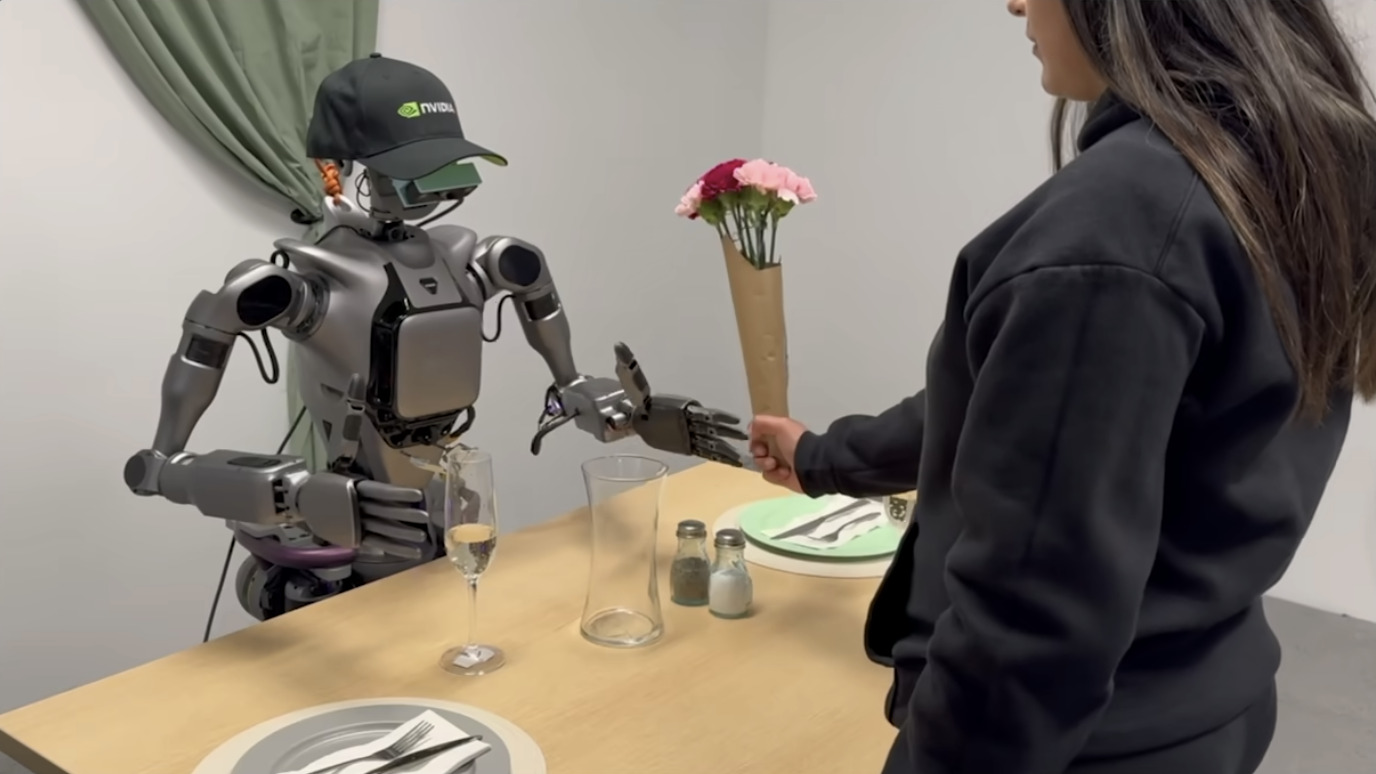
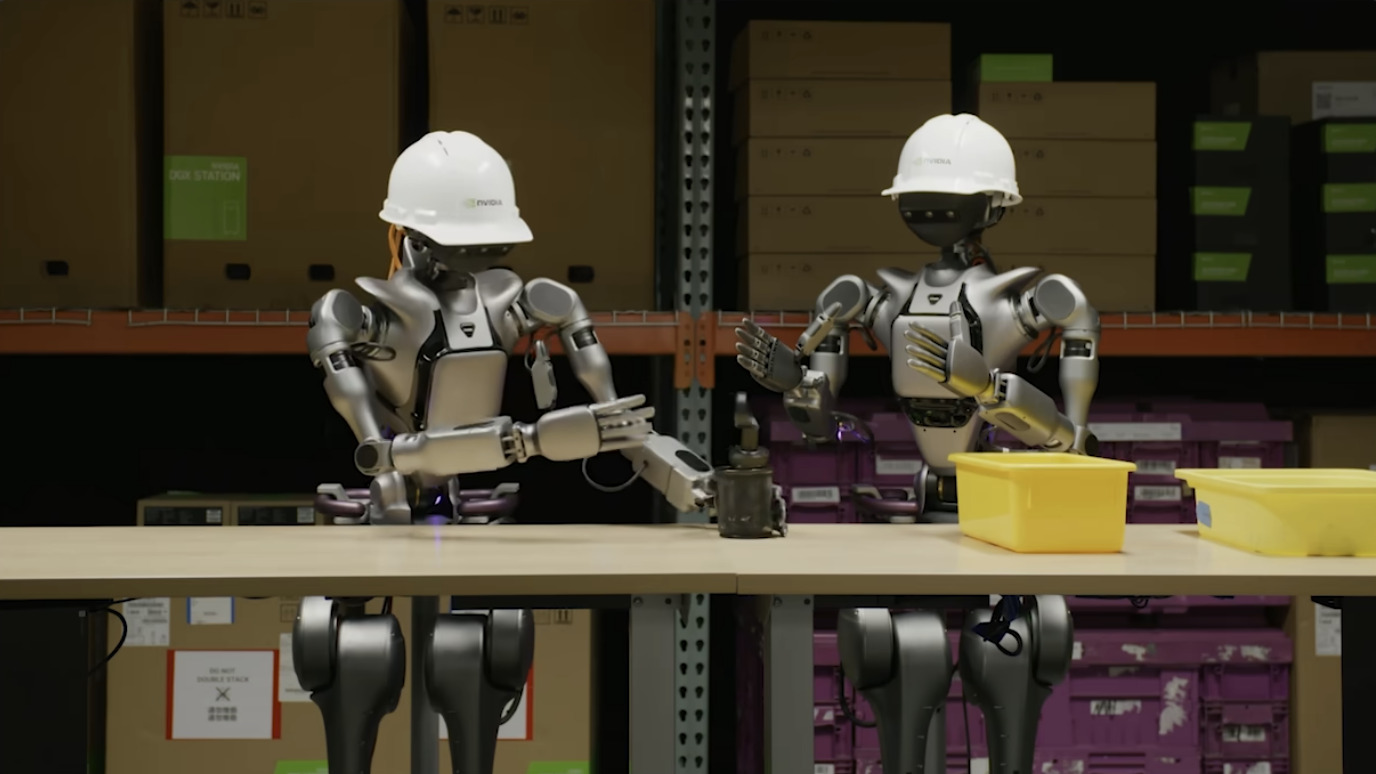
本文档概述了 NVIDIA Isaac GROOT N1,一个专为具身人工智能(Physical AI)设计的人形机器人基础模型。该系统通过三个核心原则运作:泛化能力双系统架构(结合高层认知与低层控制),以及一个涵盖现实世界数据、合成数据和网络数据的数据金字塔。 Isaac GROOT N1 利用大量训练数据来驱动人形机器人进行通用型操作,并通过 NVIDIA 的生态系统,包括 OmniverseIsaac Lab 进行模拟与部署。推荐的的微调方法是:收集真实数据,也要生成对应比例的模拟数据

Isaac GROOT Overview

Isaac GROOT N1 - Architecture

Isaac GROOT N1 - Data

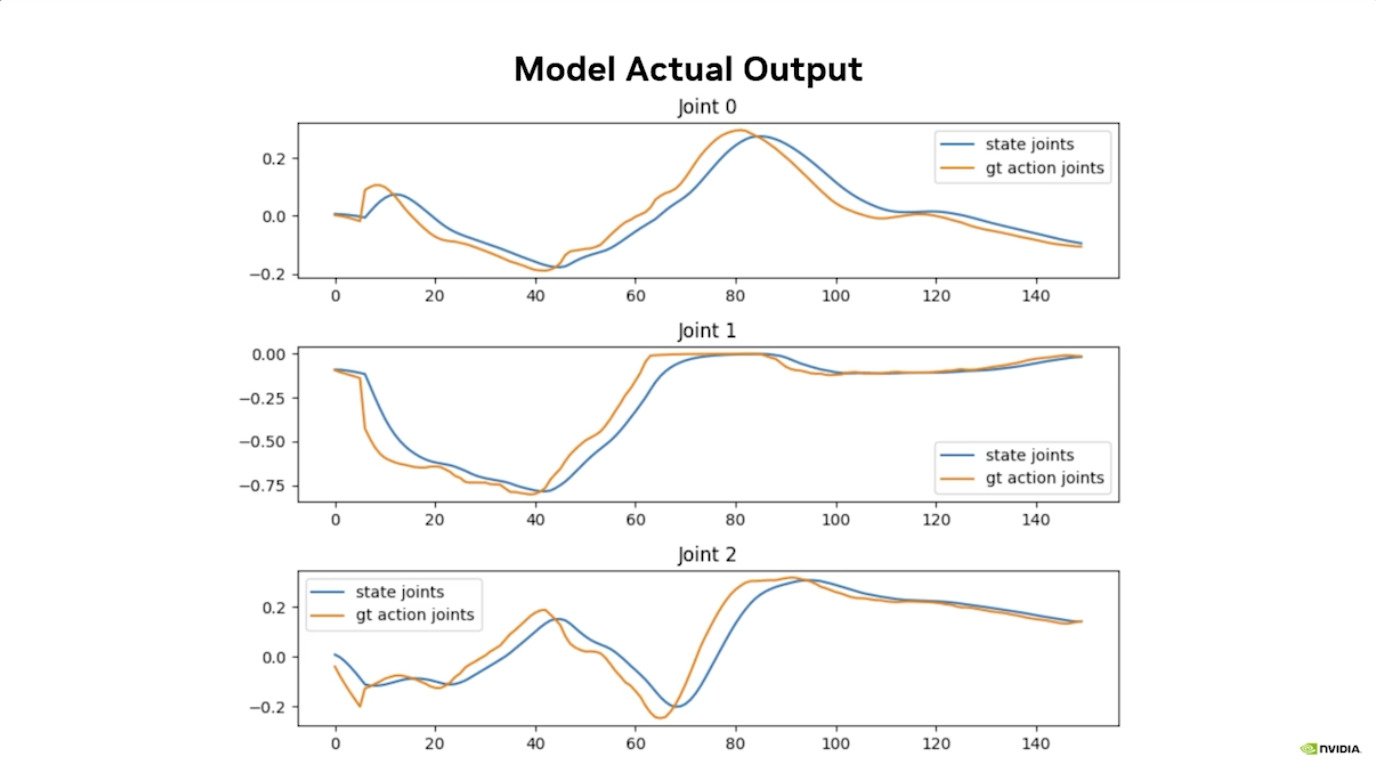
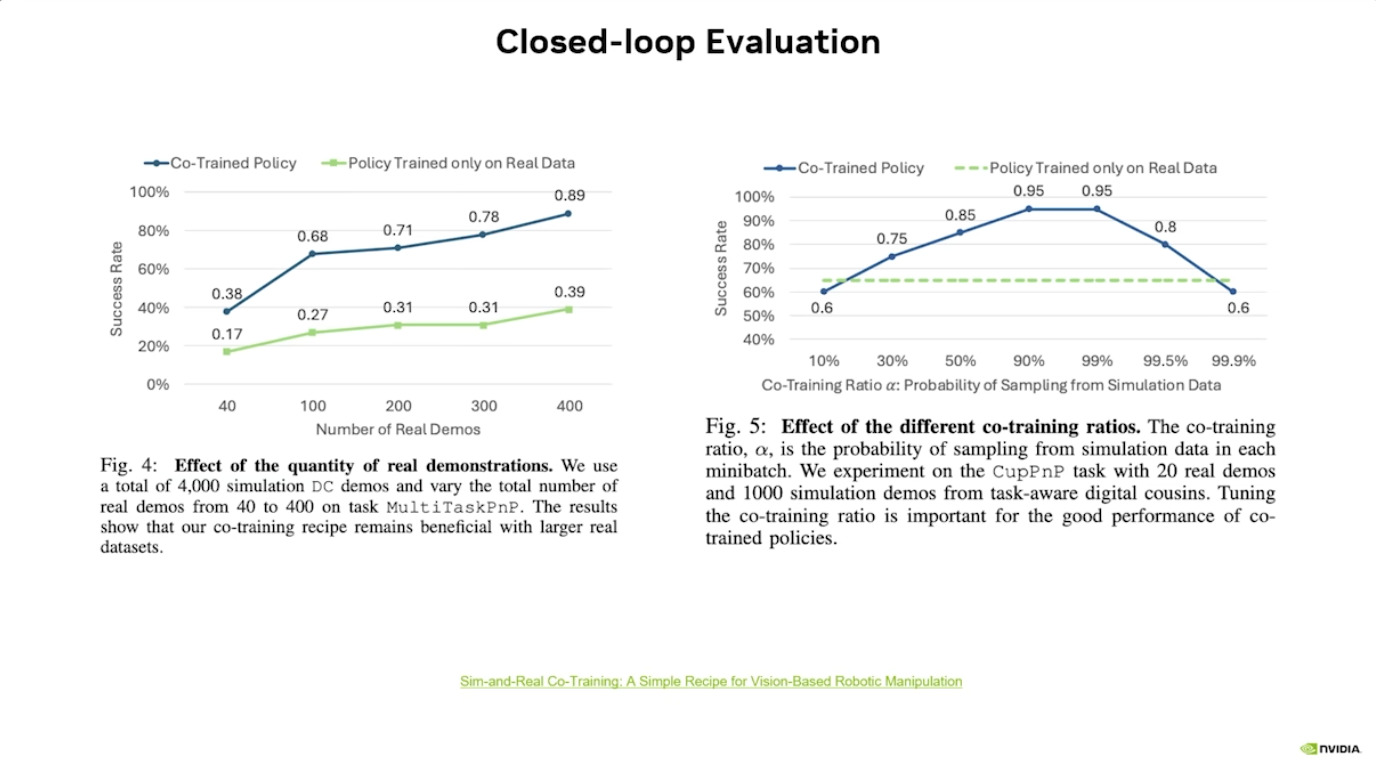
Isaac GROOT N1 - Evaluation

Inference Benchmark

参考资料

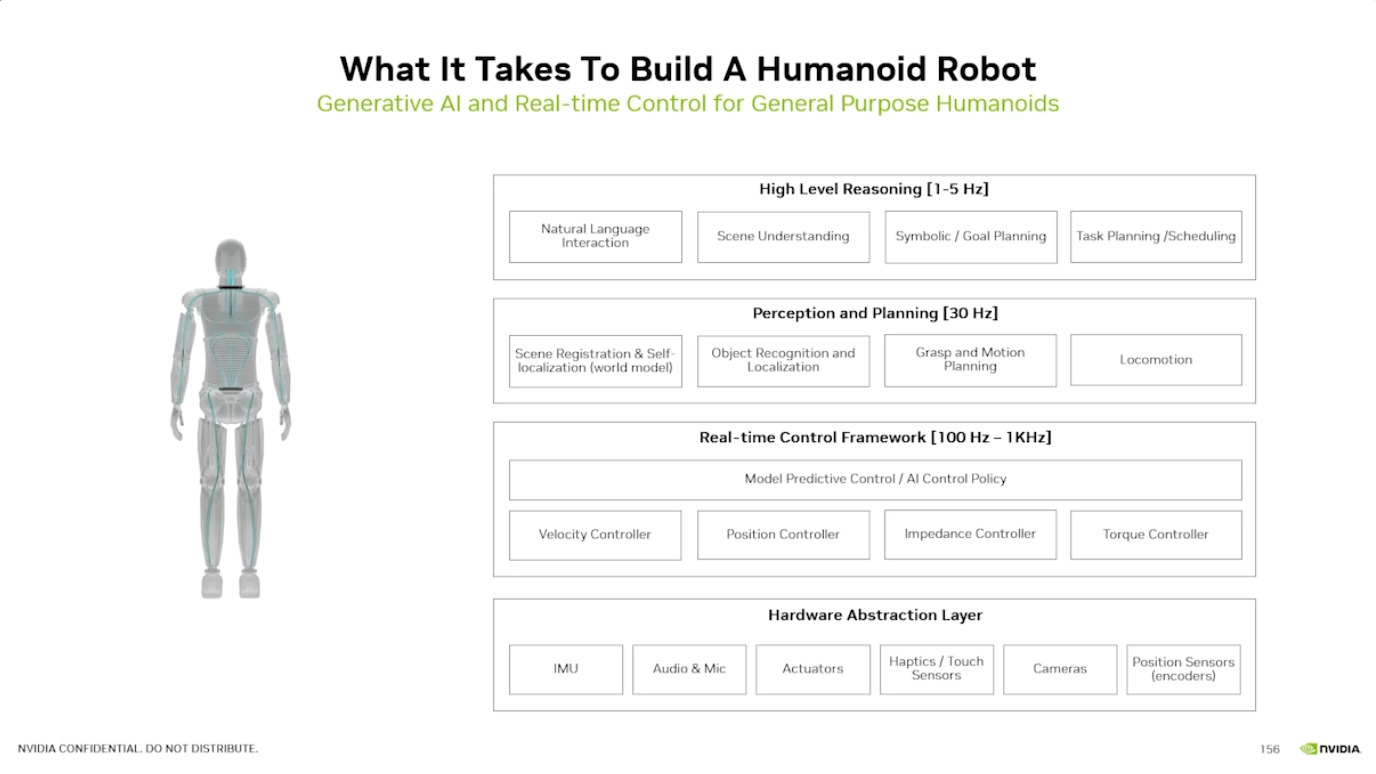
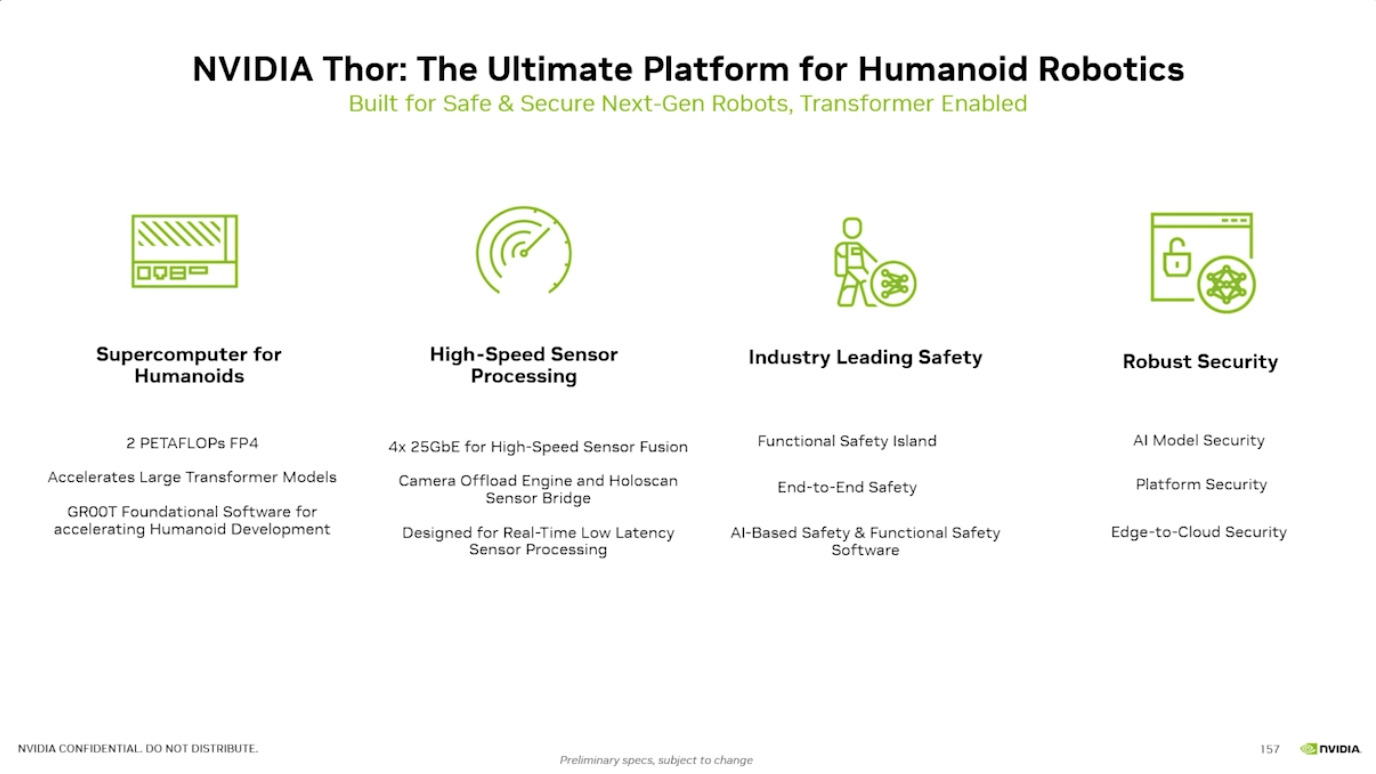
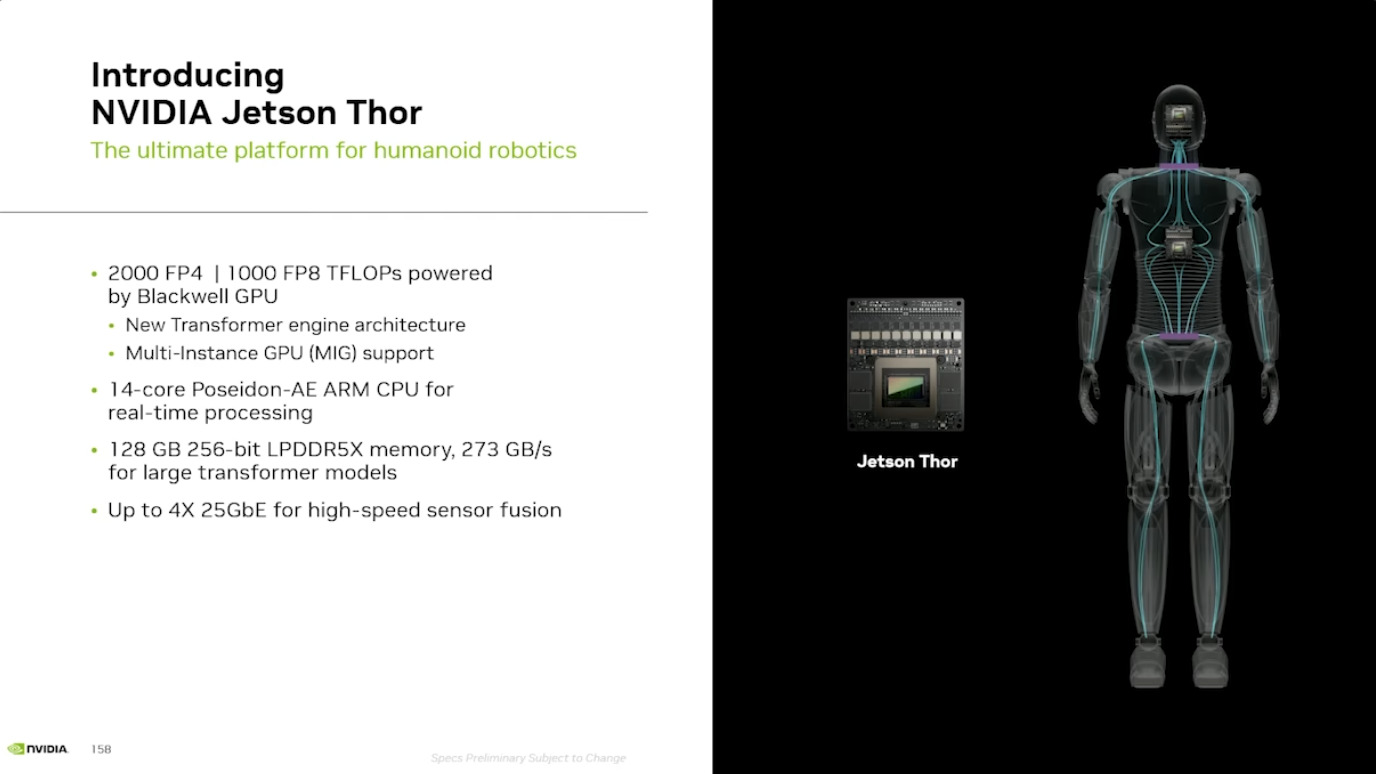
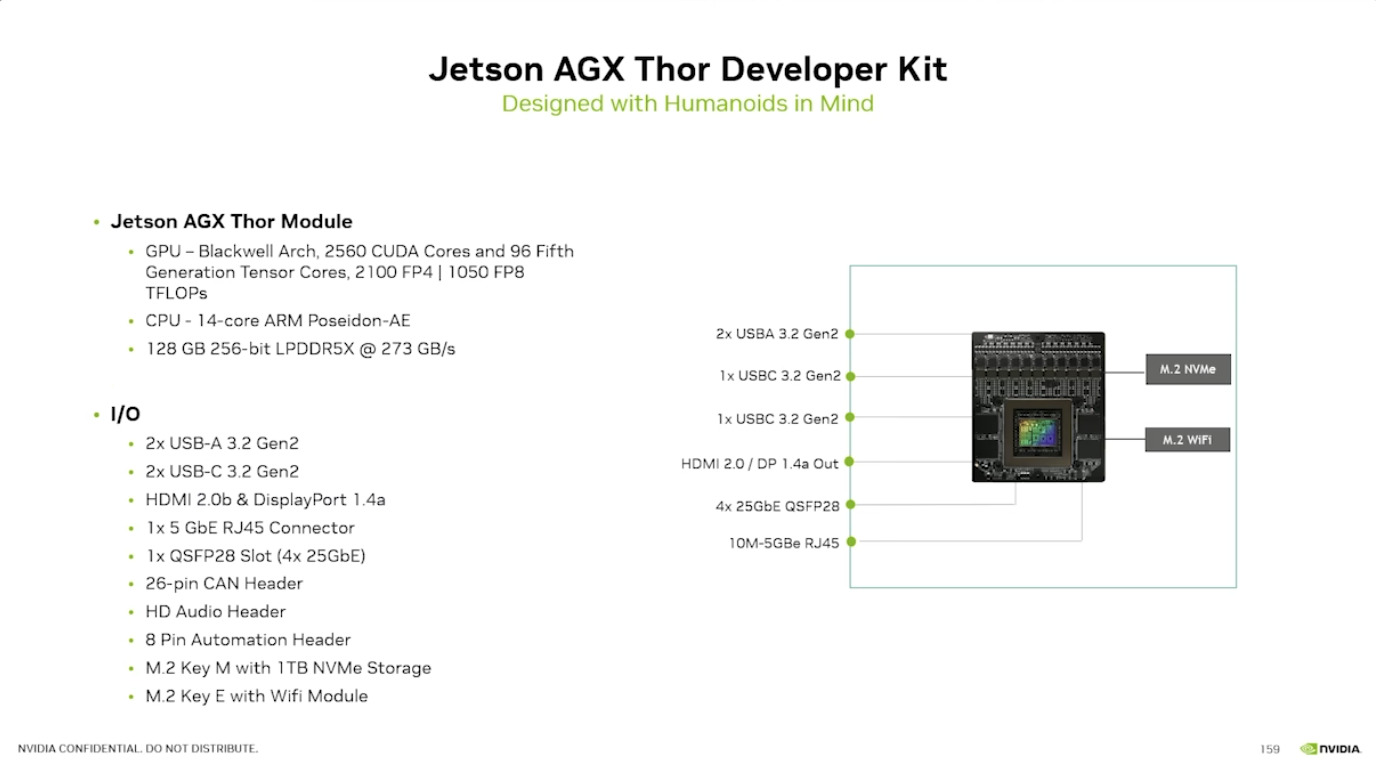
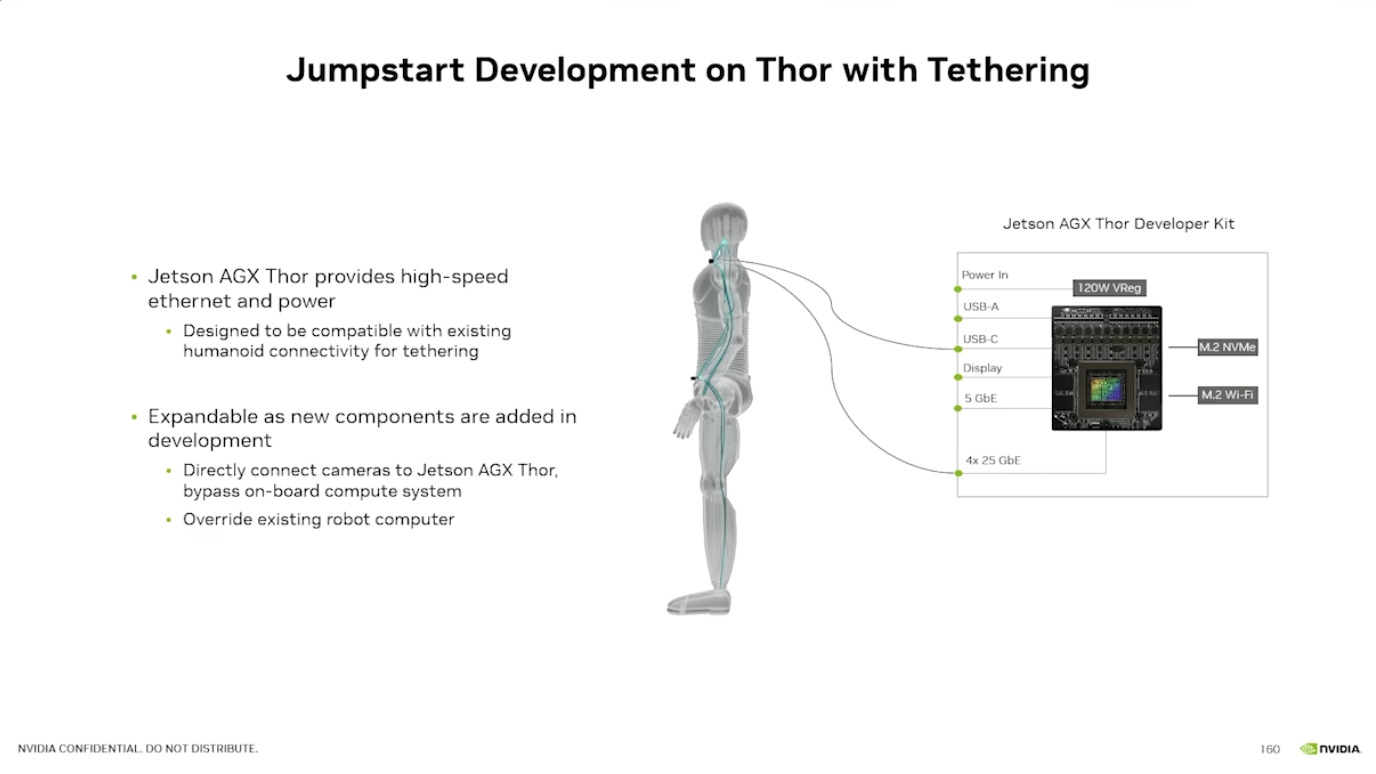
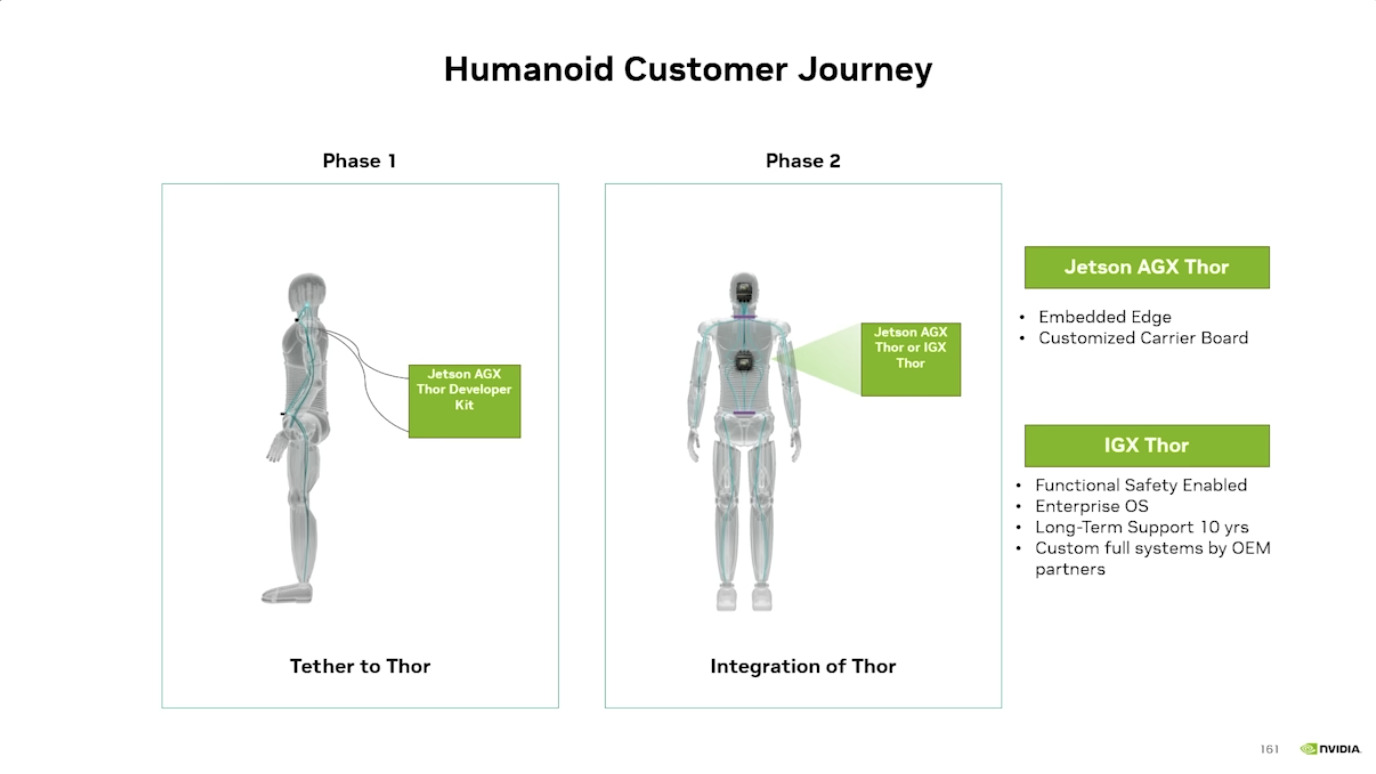
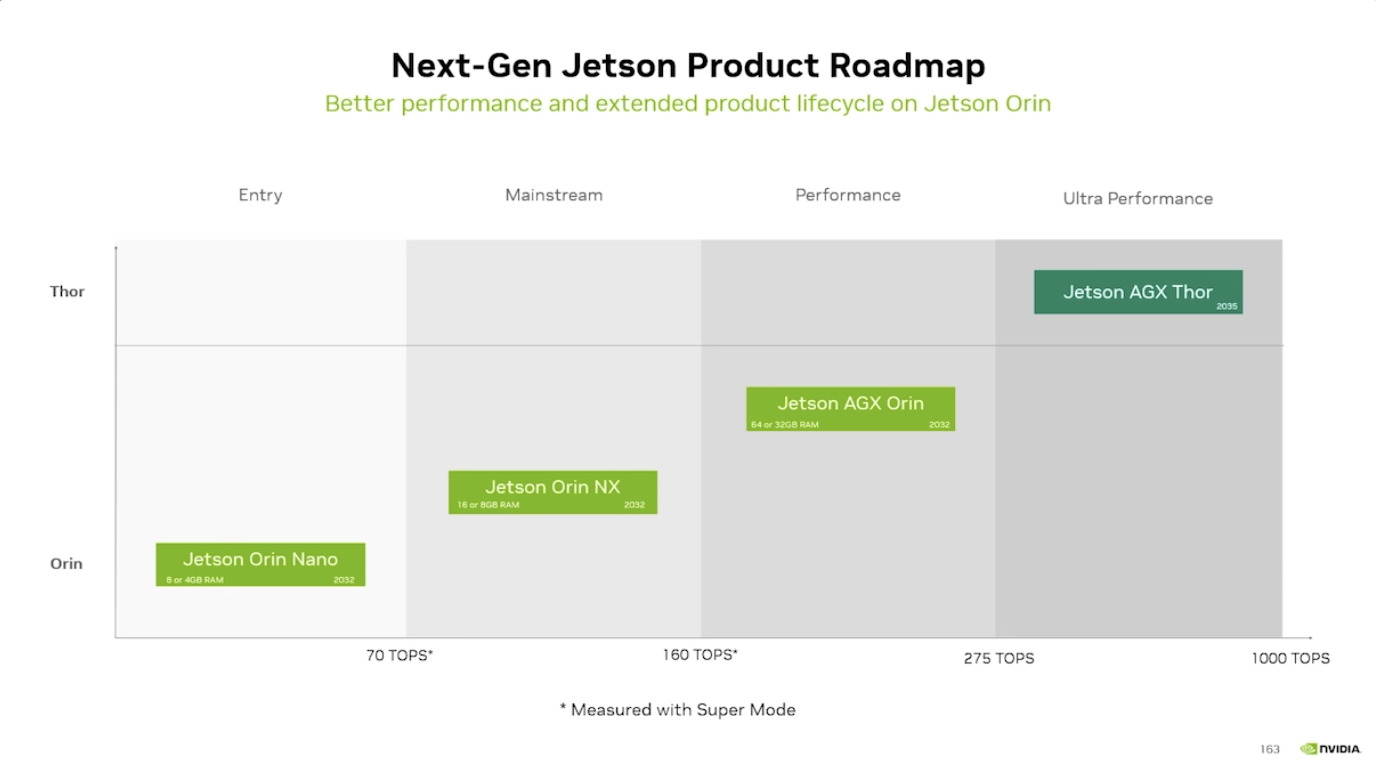
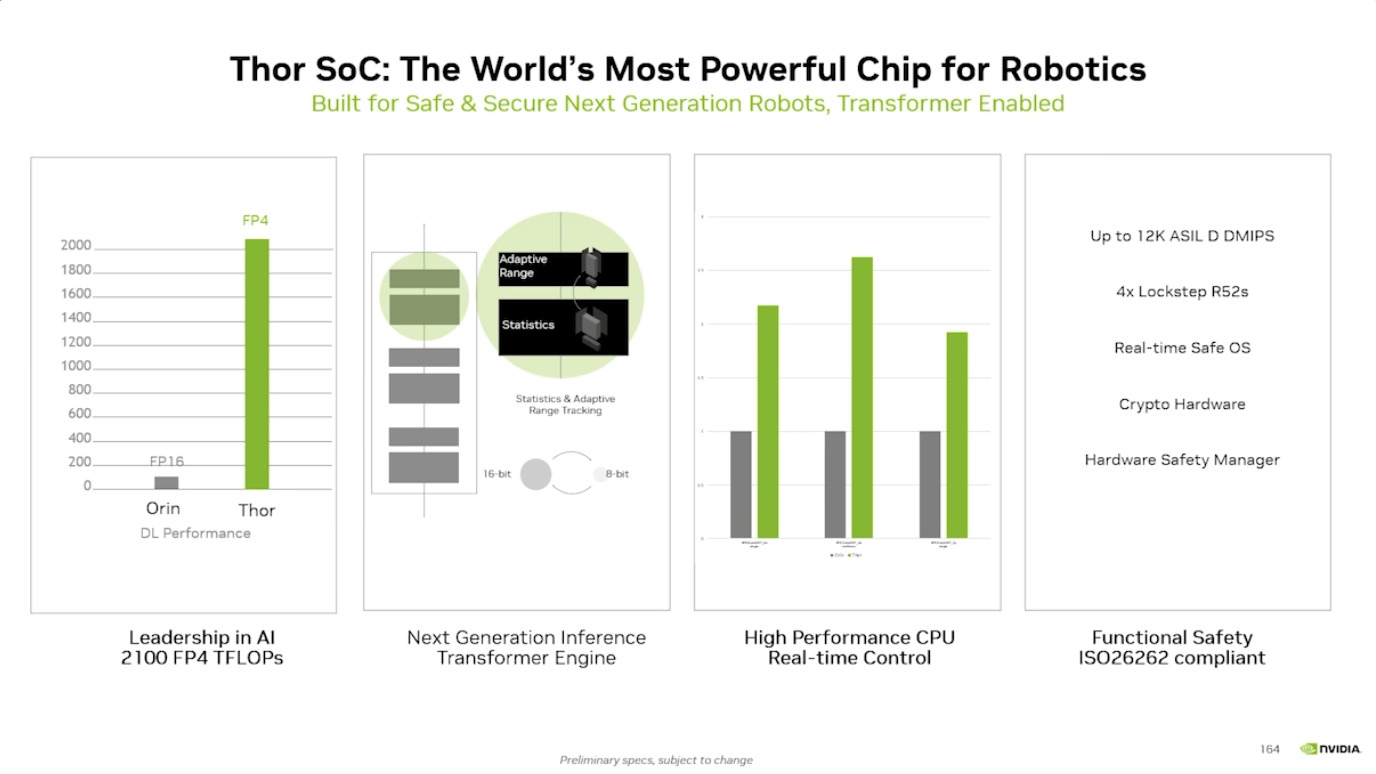
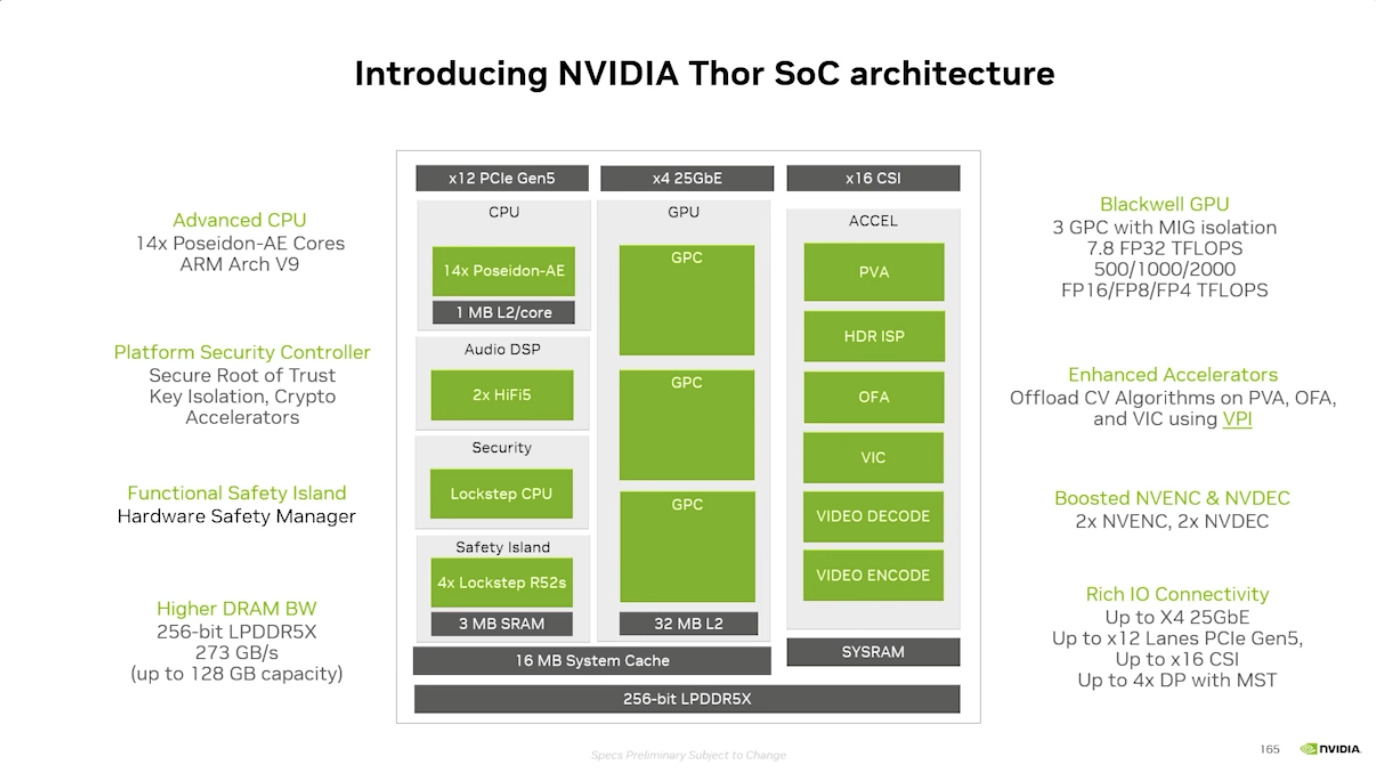
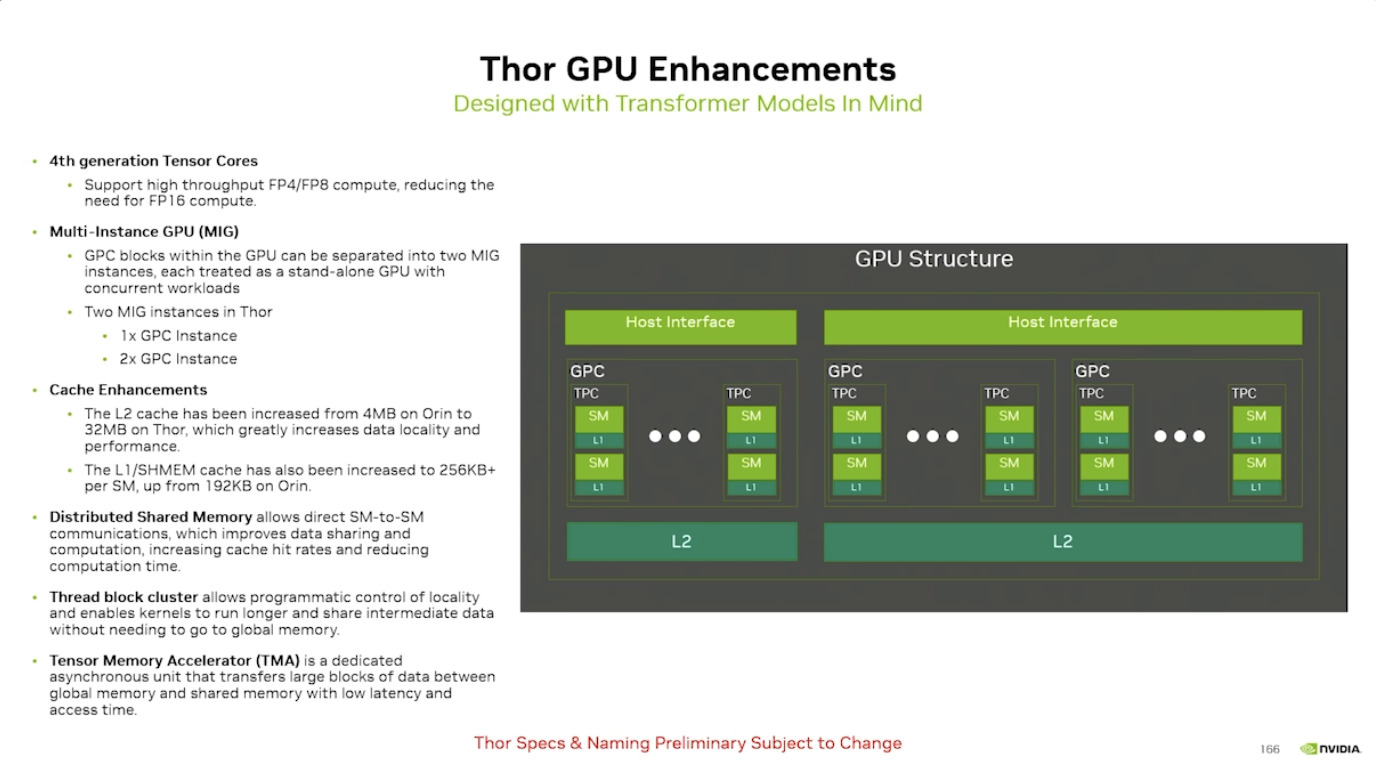
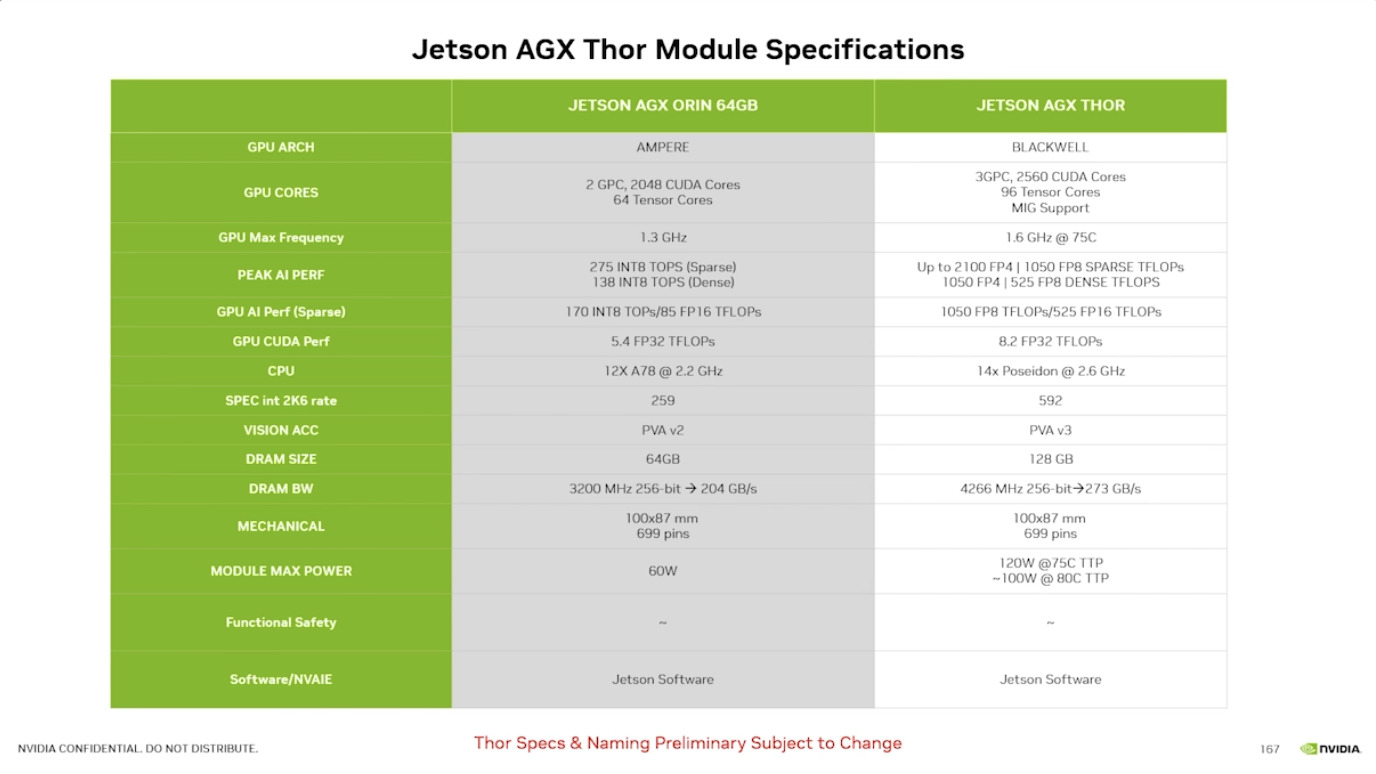
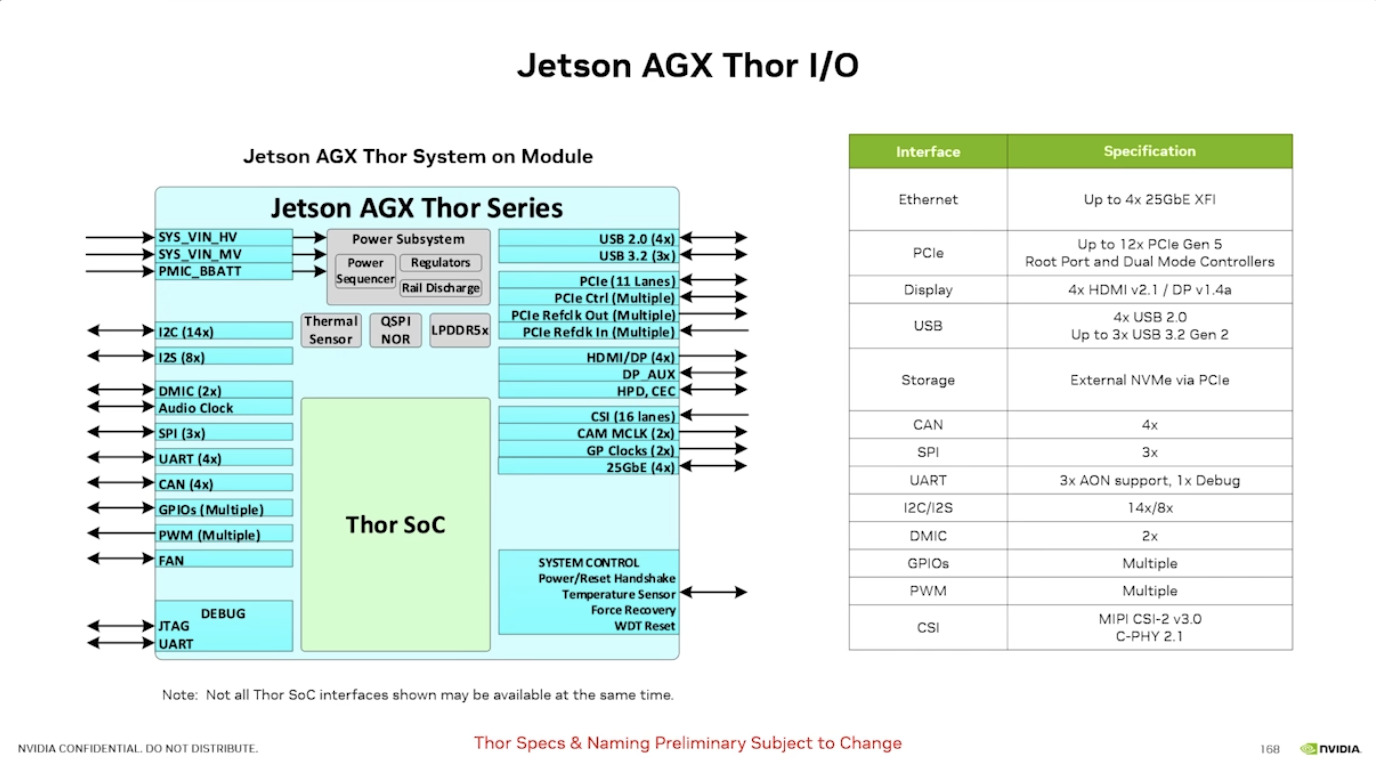
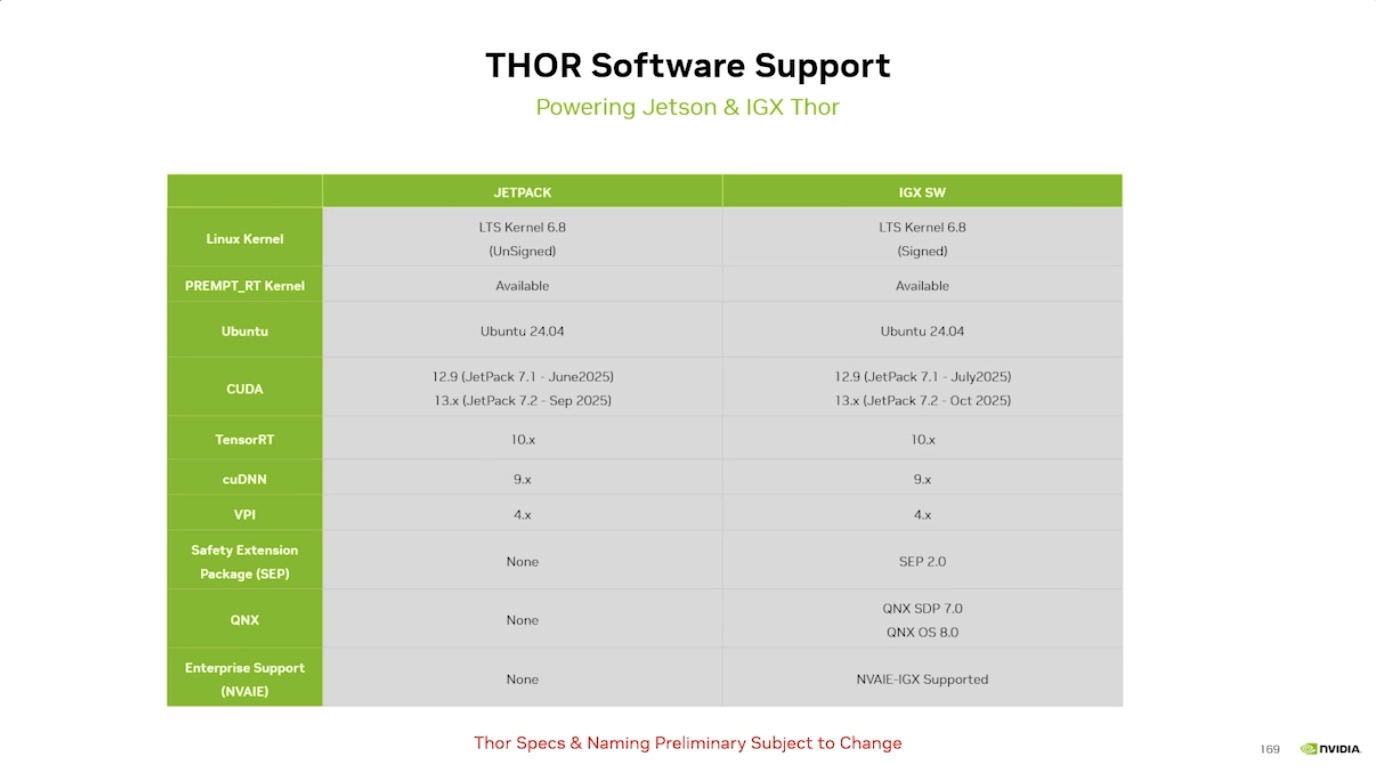
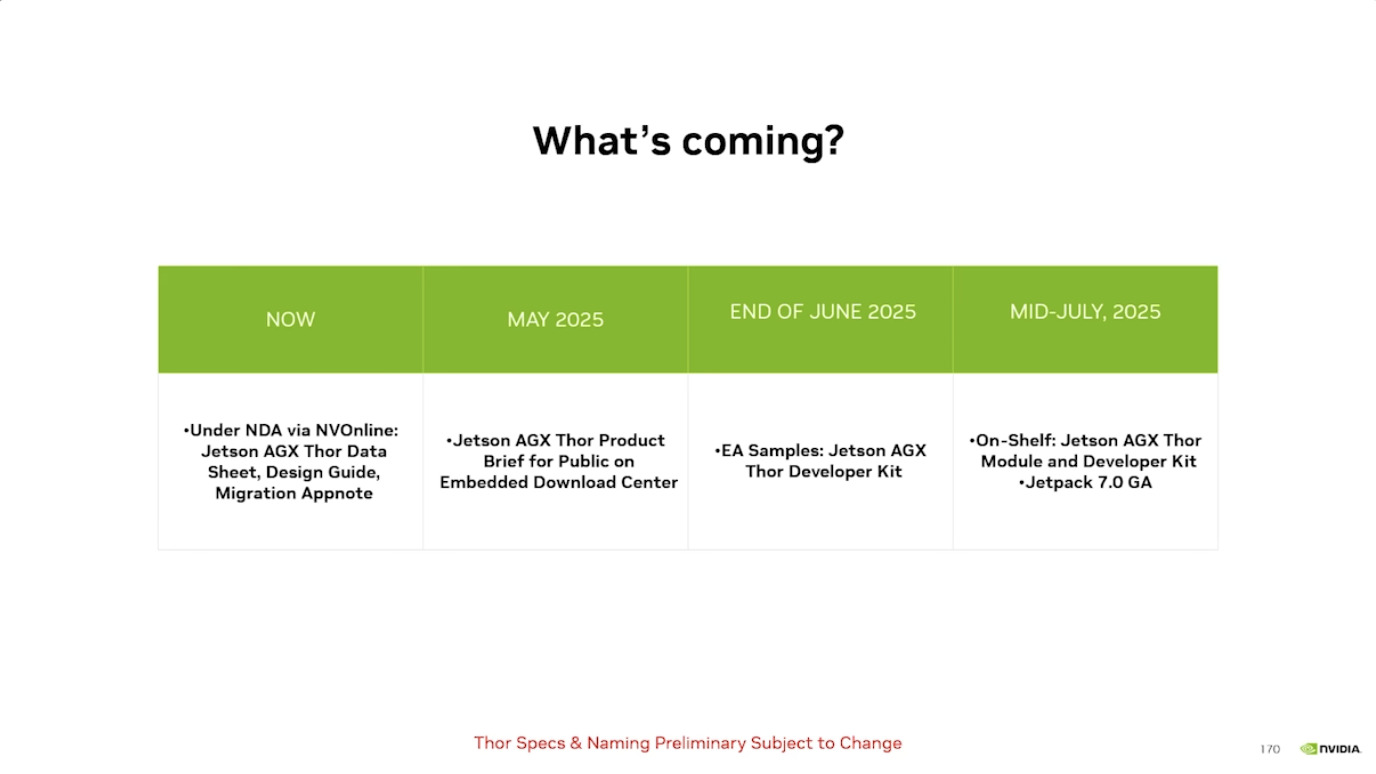
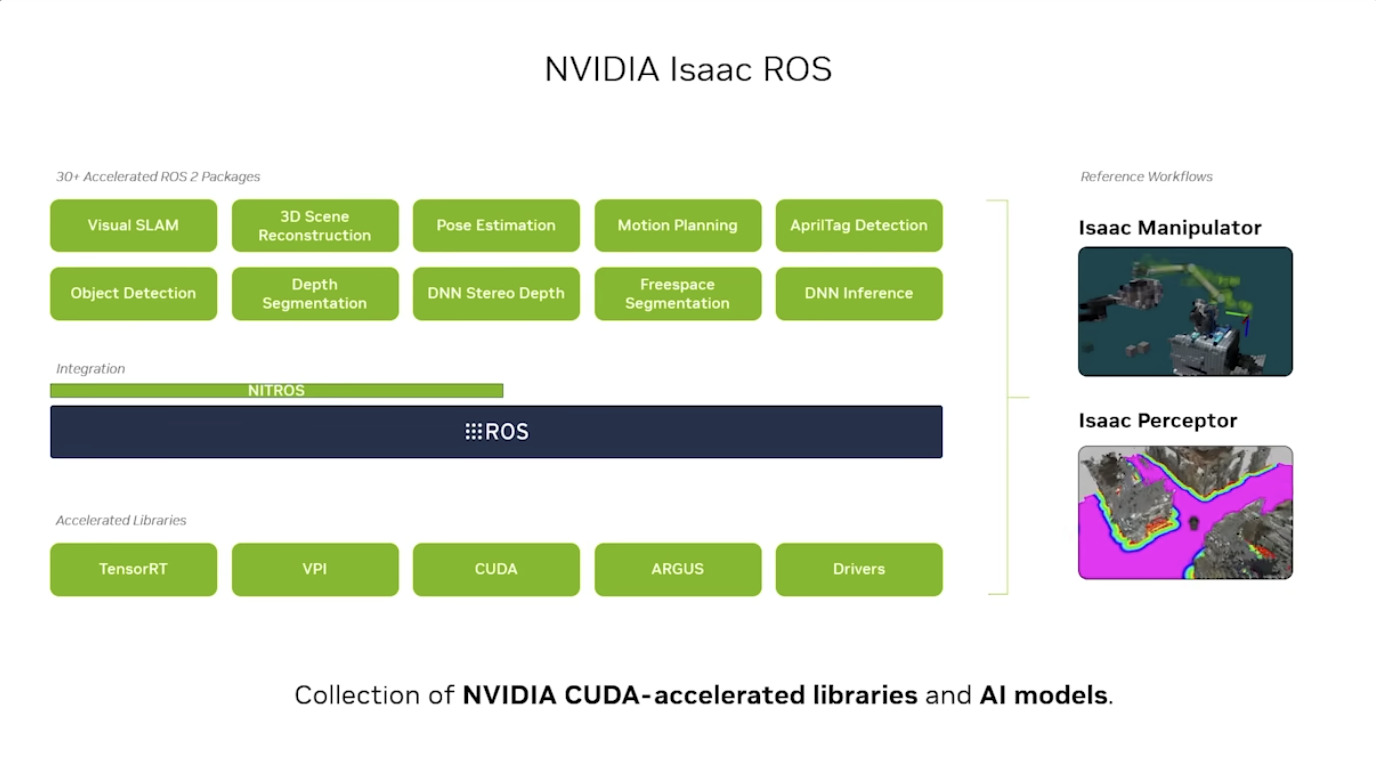
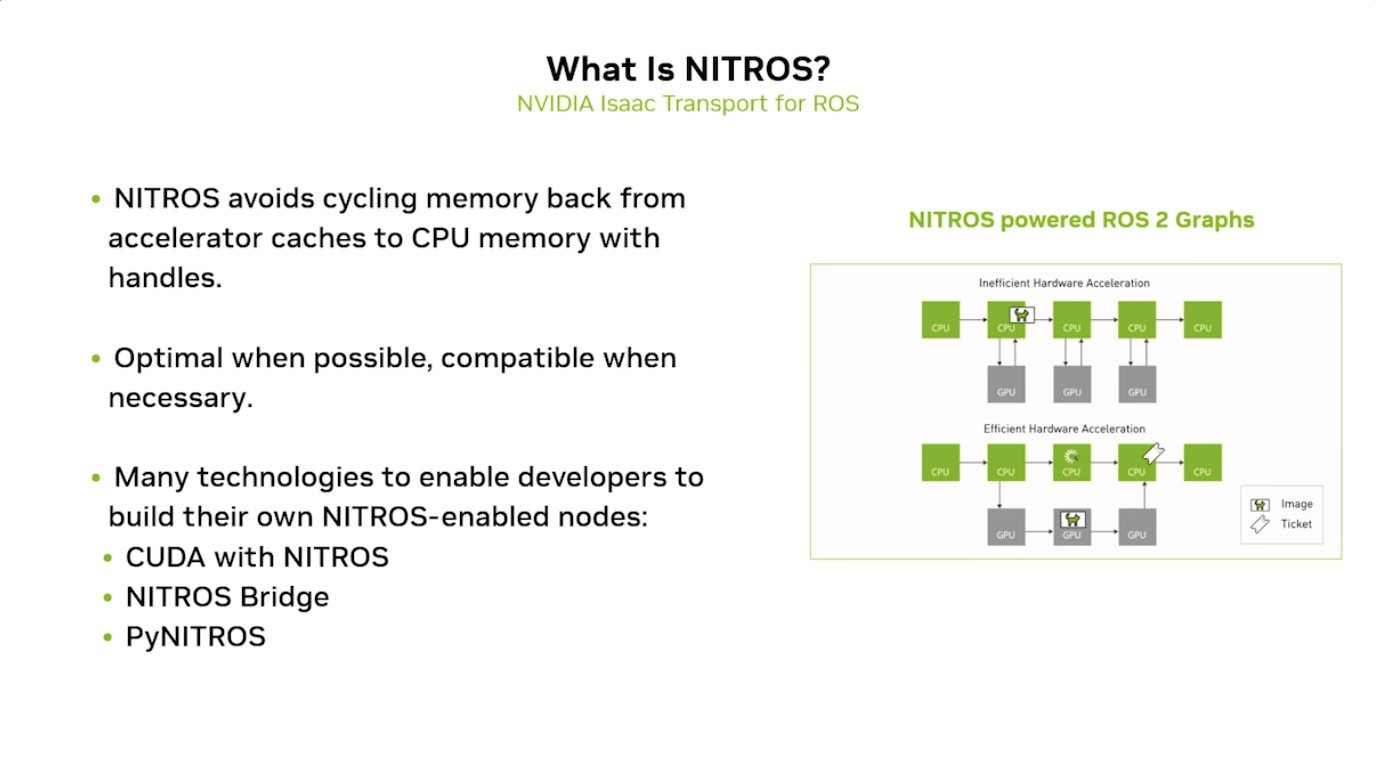
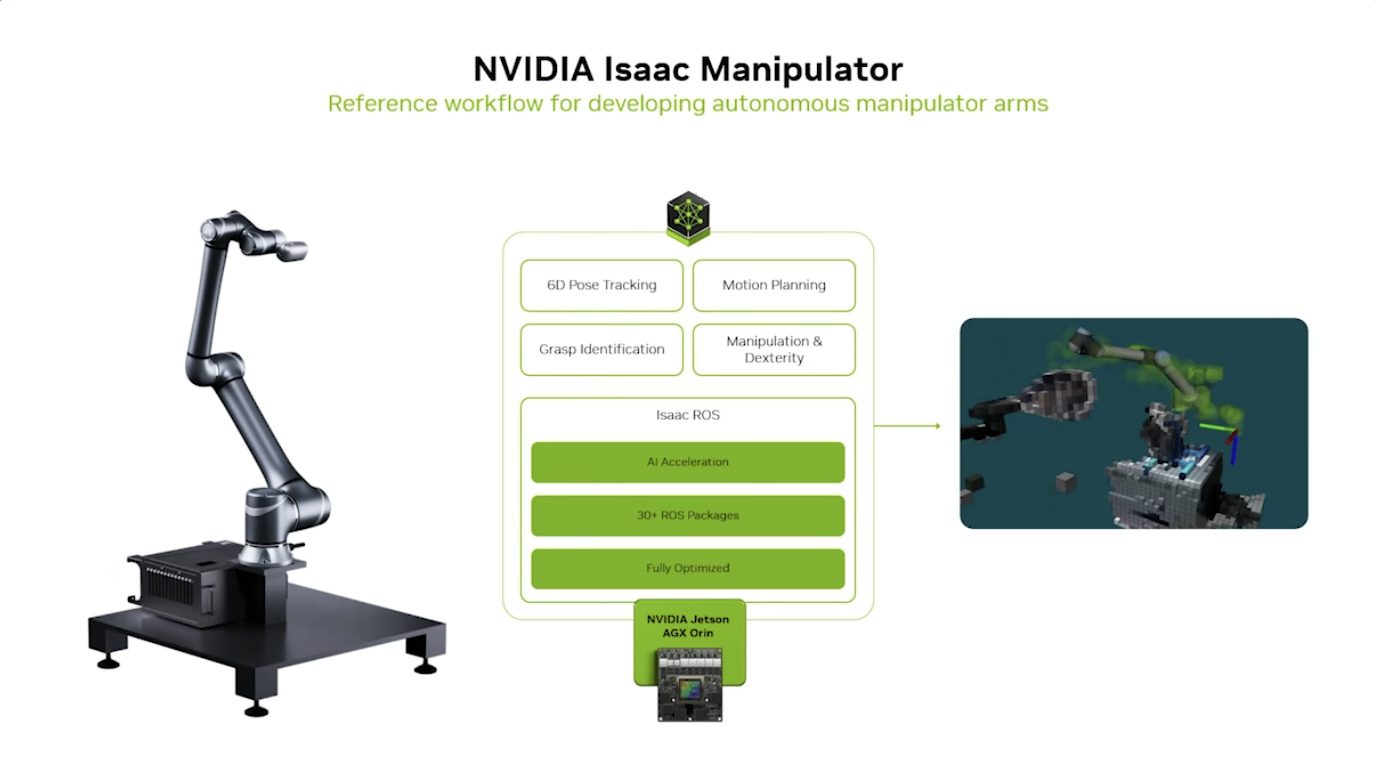
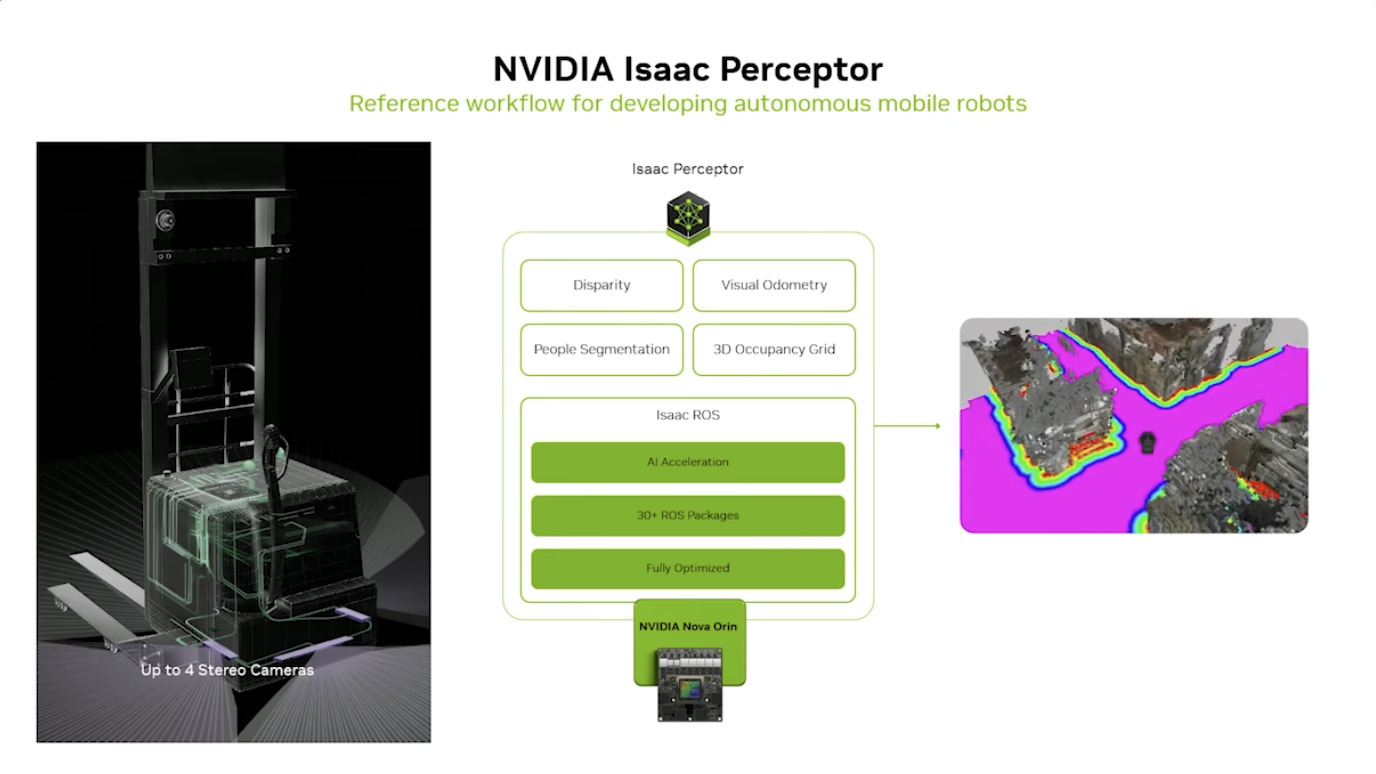
具身端侧芯片 NVIDlA Jetson Thor 和 NVIDIA Isaac ROS 介绍

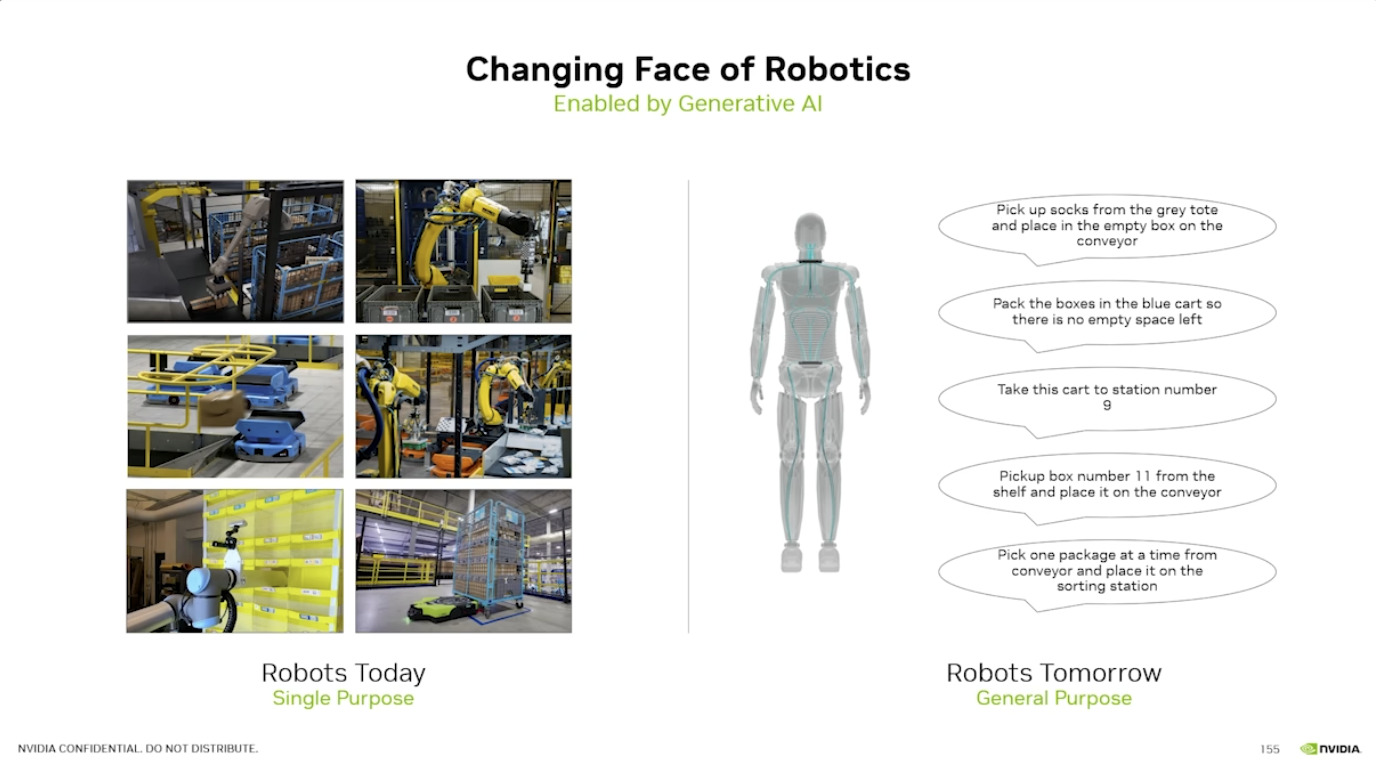
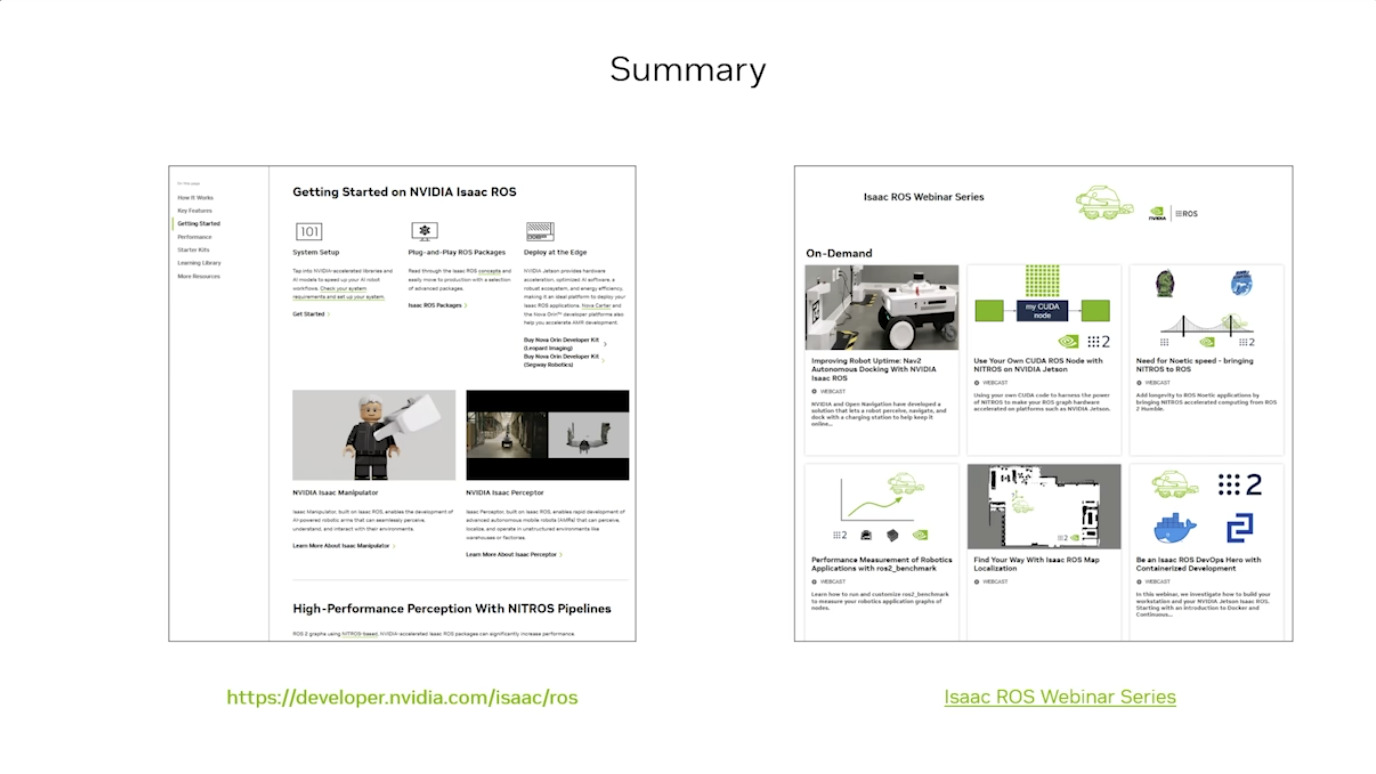
本文档详细介绍了NVIDIA Jetson Thor,这是一款为下一代人形机器人设计的强大计算平台,其特点包括卓越的AI性能、高速传感器处理、行业领先的安全性和强大的安全性。此外,文档还介绍了NVIDIA Isaac ROS,一个利用CUDA加速库和AI模型加速机器人开发的软件框架,并提及了NITROS以优化ROS 2的硬件加速。最后,还展示了Jetson AGX Thor开发套件和未来产品路线图,强调了该技术在复杂机器人应用中的应用,例如自主机械臂和移动机器人。

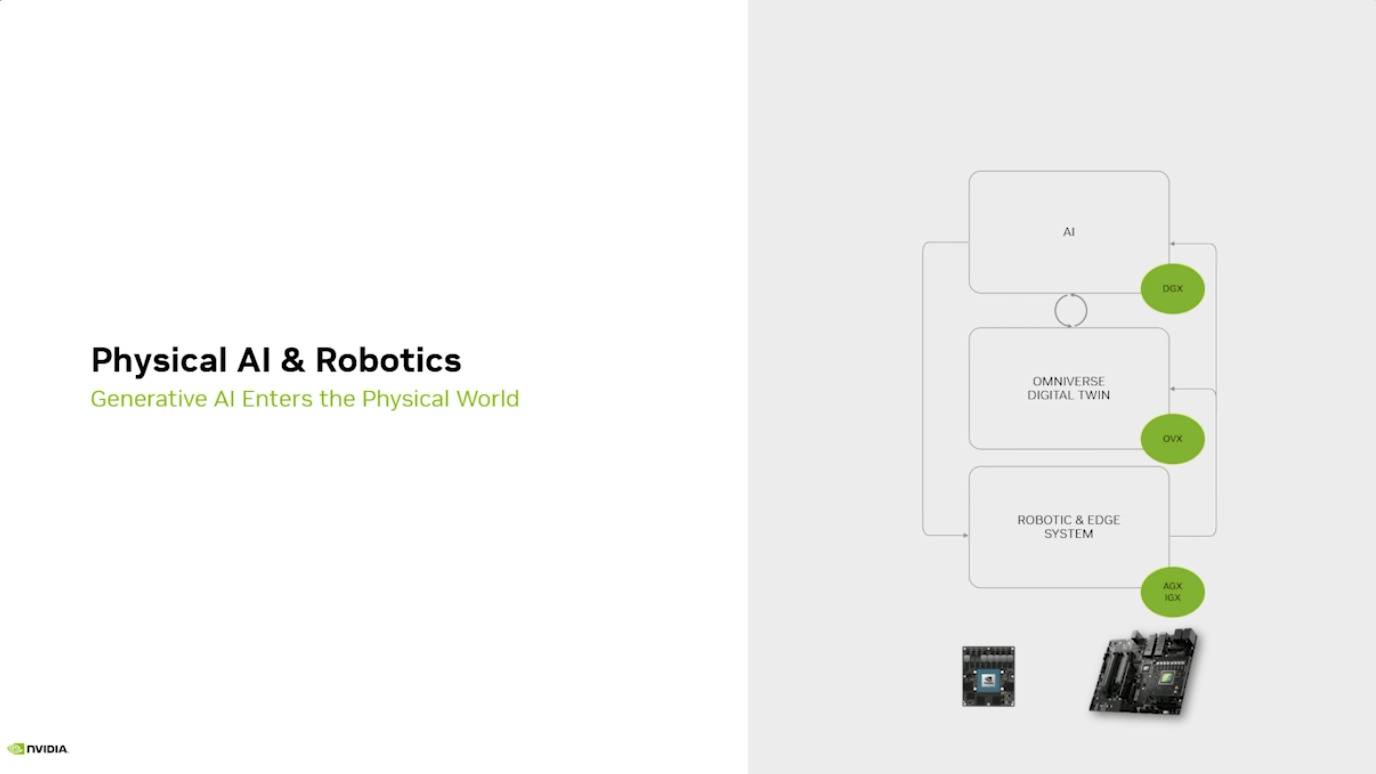
Physical Al & Robotics

AGX Thor Product Overview

Isaac ROS for Robot Development

参考资料

MCPHub 自定义服务器配置及内网部署(二)

本文档指导用户构建一个本地 PyPI 源,以便持久化存储 Python 包并进行离线安装。接着,文档说明了自定义 MCPHub 配置,包括定义 MCP 服务器市场中的服务(例如:mcp-server-time, calculator-mcp-server)以及调整 MCPHub 自身的运行时设置,例如指定本地 PyPI 源和用户认证信息。

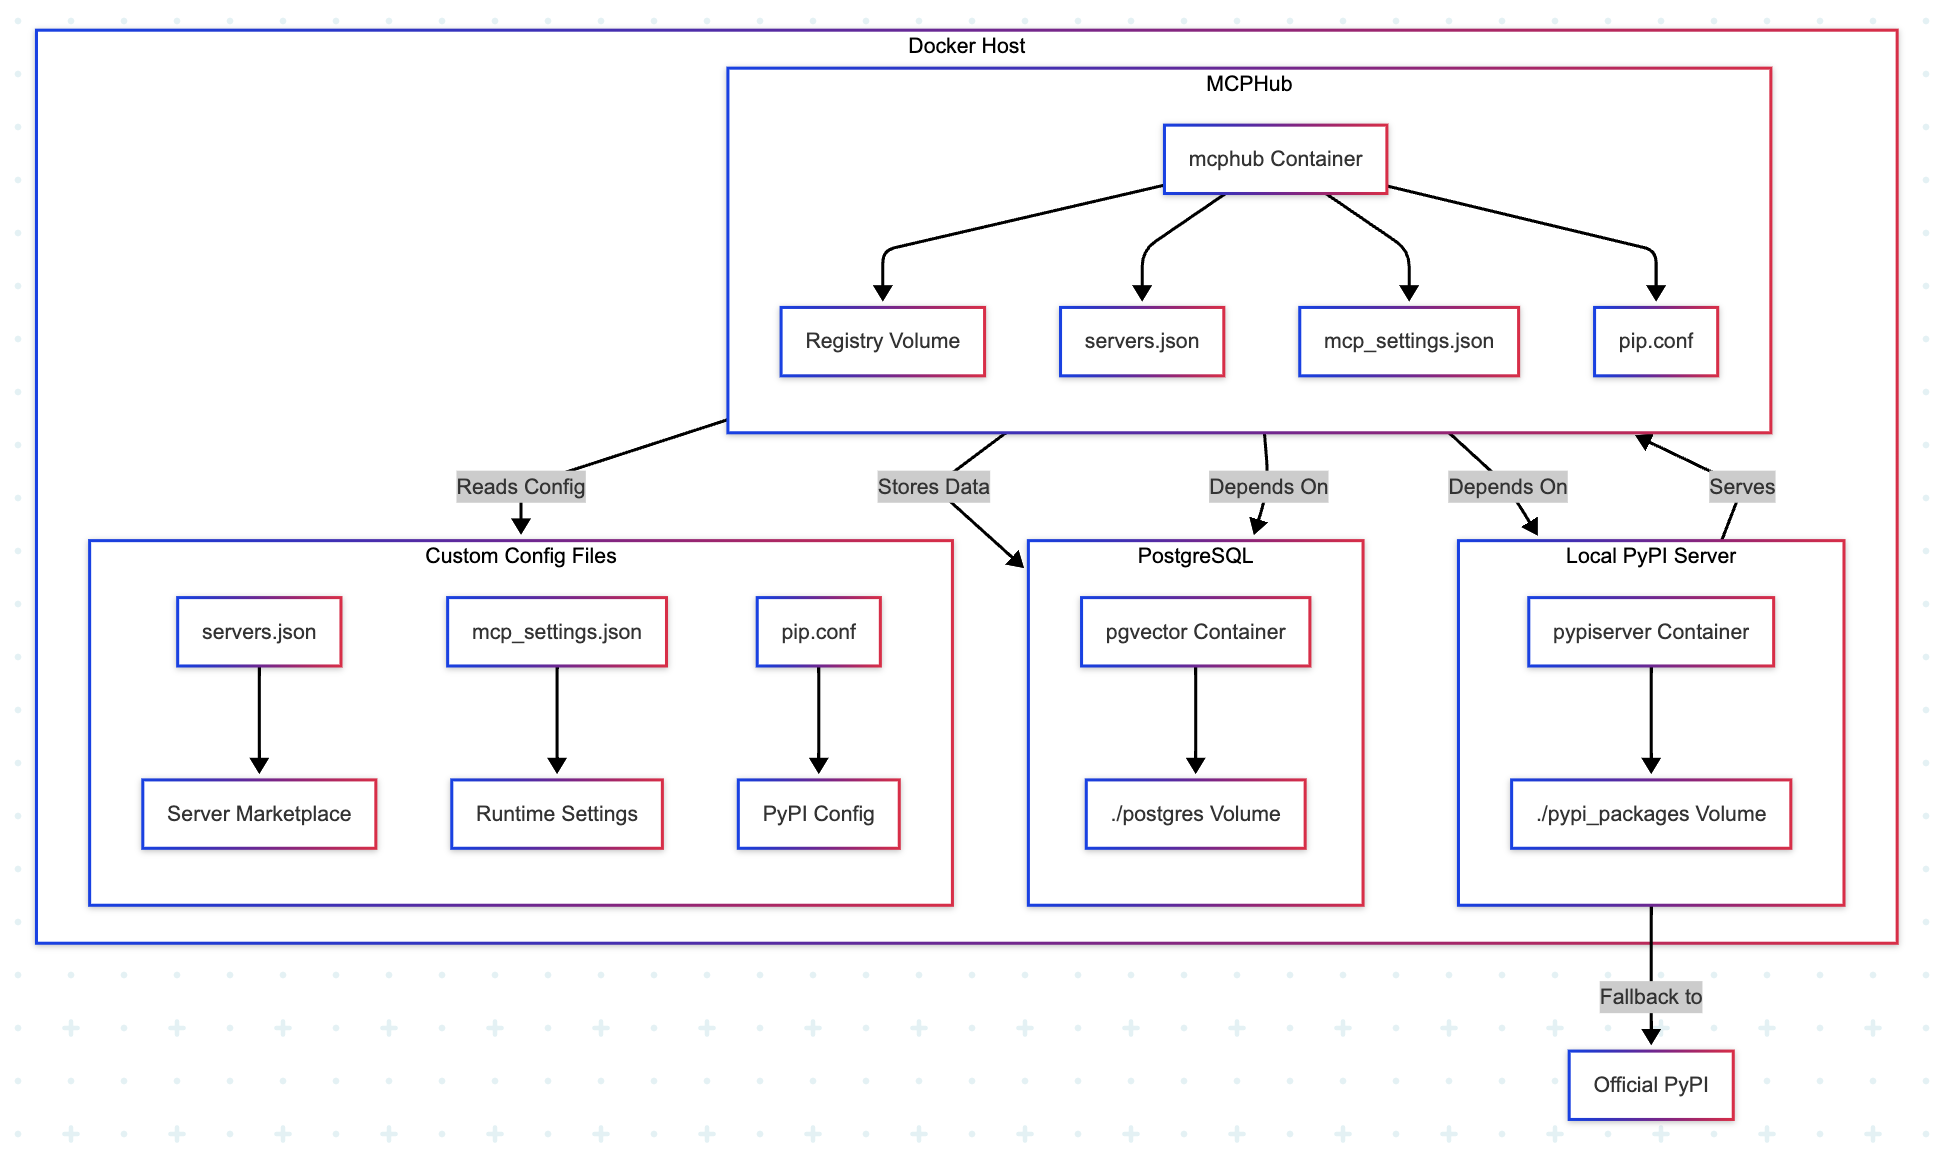
架构图

graph TD
    subgraph Docker Host
        A[Local PyPI Server] -->|Serves| B[MCPHub]
        B -->|Stores Data| C[PostgreSQL]
        B -->|Reads Config| D[Custom Config Files]
    end

    subgraph A[Local PyPI Server]
        A1[pypiserver Container] --> A2[./pypi_packages Volume]
    end

    subgraph B[MCPHub]
        B1[mcphub Container] --> B2[Registry Volume]
        B1 --> B3[servers.json]
        B1 --> B4[mcp_settings.json]
        B1 --> B5[pip.conf]
    end

    subgraph C[PostgreSQL]
        C1[pgvector Container] --> C2[./postgres Volume]
    end

    subgraph D[Custom Config Files]
        D1[servers.json] --> D2[Server Marketplace]
        D3[mcp_settings.json] --> D4[Runtime Settings]
        D5[pip.conf] --> D6[PyPI Config]
    end

    A -->|Fallback to| E[Official PyPI]
    B -->|Depends On| A
    B -->|Depends On| C

搭建本地 PyPI 源

拉取 pypiserver 镜像

docker pull pypiserver/pypiserver

创建存储 Python 包的目录

Docker 容器是隔离的,容器内的数据默认会随着容器的删除而丢失。为了持久化你的 Python 包,你需要将宿主机上的一个目录挂载到容器内部。

mkdir pypi_packages

下载 mcp-server-time 及其依赖包

把需要部署的 MCP 服务器及其依赖包存储到 pypi_packages 目录中,以便在内网环境中使用。

pip download mcp-server-time --dest ./pypi_packages

最好到 mcphub 容器中进行下载

  • 📌 calculator-mcp-server
pip download calculator-mcp-server --dest /app/registry -i https://pypi.org/simple/ --resume-retries 3

MCPHub 自定义服务器配置及内网部署(一)

本文档重点介绍了如何在内网(离线)集成和配置一个名为 "mcp-server-time" 的特定 MCP 服务器。首先指导用户如何 获取 MCPHub 容器的 Python 环境信息,包括版本和平台标签,以便下载兼容的 Python 包。接着,文档详细阐述了如何使用 pip download 命令 下载服务器及其依赖包,并解释了各个命令参数的用途。最后,展示了如何通过 编辑 custom/servers.jsoncustom/mcp_settings.json 文件 来自定义 MCP 服务器市场配置和运行时设置,并给出了 Docker Compose 配置示例,以实现自定义配置的替换并部署。

这里使用 mcp-server-time 作为示例。

查看 MCPHub 容器的 Python 环境信息(版本和平台)

进入 MCPHub 容器

docker exec -it mcphub bash

安装 packaging 库

pip install packaging

编辑 get_info.py

Cherry Studio 分支策略指南

该文档概述了 Cherry Studio分支策略指南,详述了其软件开发中的主要分支贡献分支的使用规范。它明确指出,main分支作为主开发线,只接受通过拉取请求(PR)合入的代码,且可能包含不稳定功能;而release/*分支则用于稳定的发布代码,主要用于文档更新和错误修复。此外,文档还详细列举了不同类型的贡献分支(如功能、错误修复、文档和热修复分支)的命名约定和提交PR的目标分支,并强调了PR必须遵循的准则,包括与main同步、包含问题编号以及通过测试。最后,它还提及了版本标签管理的分类,以确保代码库的组织性和可追溯性。

Cherry Studio 采用结构化的分支策略,以维护代码质量并简化开发流程。

工作流图

主要分支

  • main: 主开发分支
  • 包含最新的开发代码。 * 不允许直接提交——所有更改必须通过拉取请求(PR)合入。 * 代码可能包含正在开发中的功能,因此可能不稳定。
  • release/*: 发布分支
  • main 分支创建。 * 包含已准备好发布的稳定代码。 * 只接受文档更新和错误修复。 * 在部署到生产环境之前,会进行彻底测试。

贡献分支

向 Cherry Studio 贡献代码时,请遵循以下准则:

  1. 功能分支 (Feature Branches):
  • main 分支创建。 * 命名格式: feature/issue-number-brief-description (例如: feature/123-add-user-profile)。 * 提交 PR 到 main 分支。

FunAudioLLM:用于人类与LLM自然交互的语音理解与生成基础模型

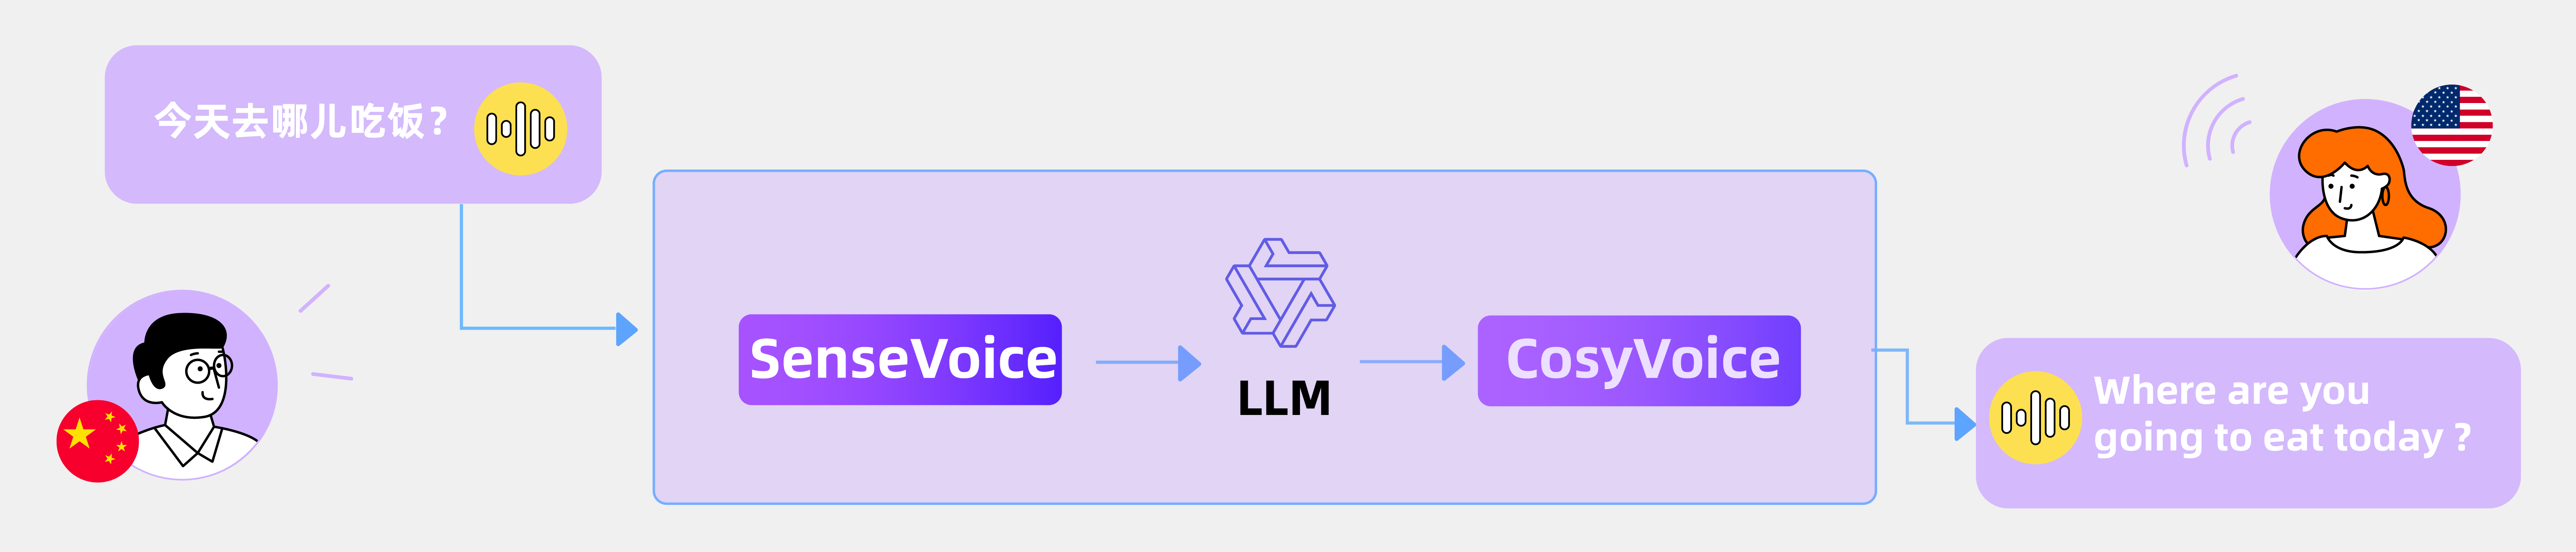
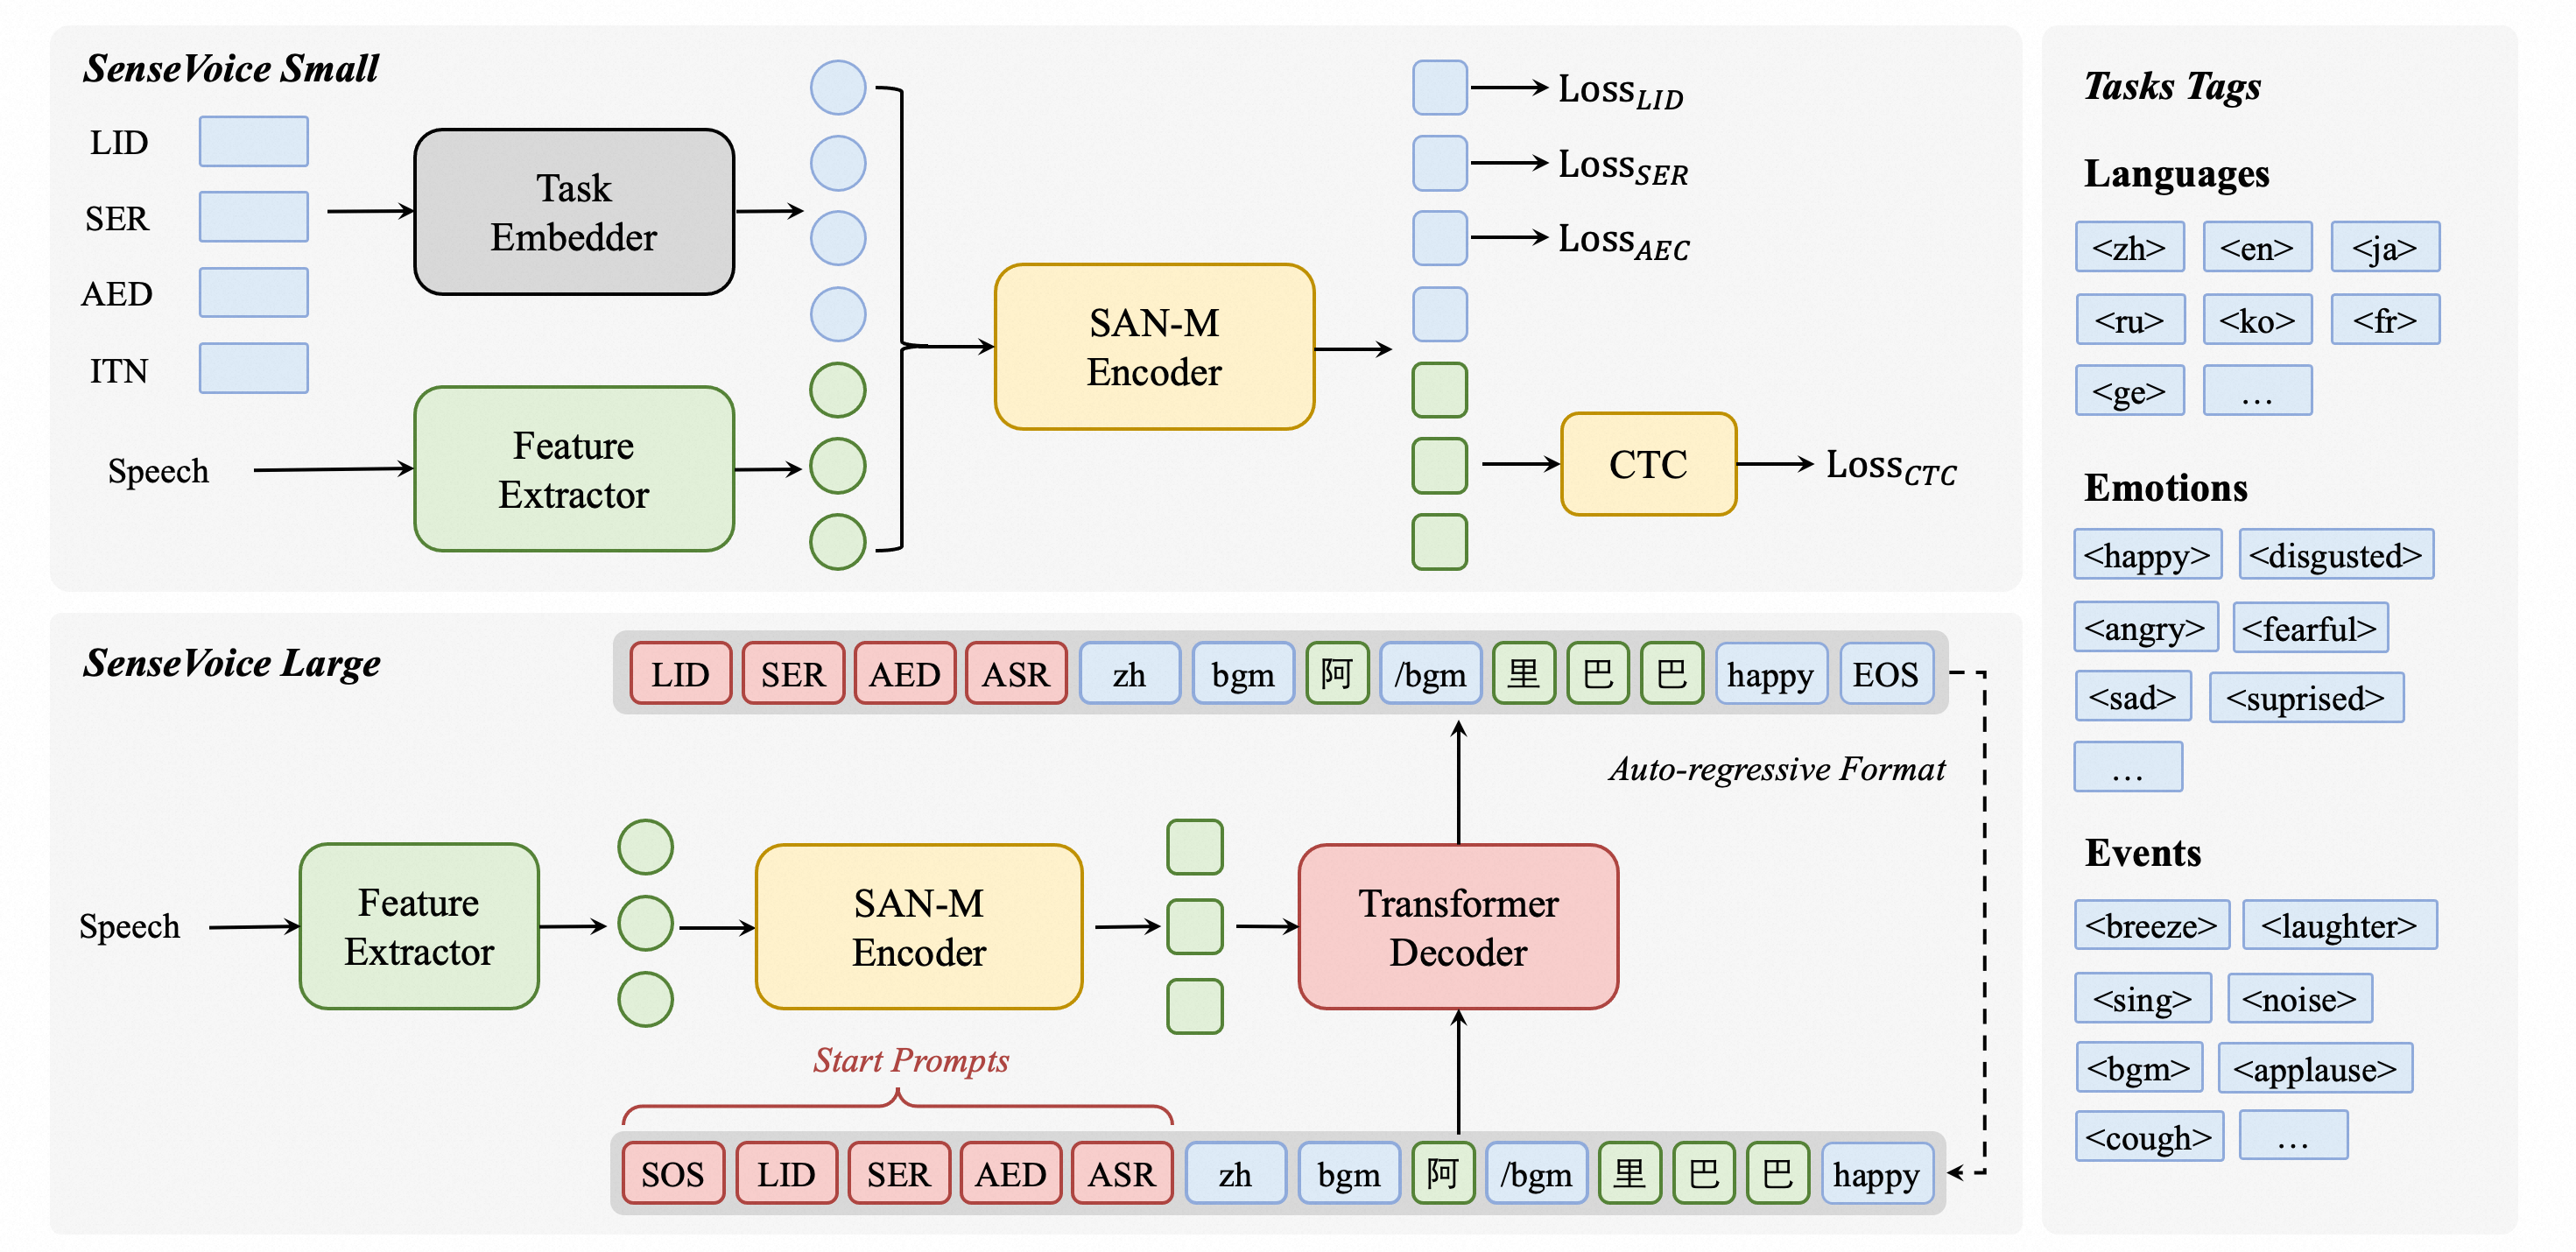
本文档介绍 FunAudioLLM,这是一个旨在增强人类与大型语言模型(LLM)之间自然语音交互的框架。其核心是两个创新模型:用于高精度多语种语音识别、情感识别和音频事件检测的 SenseVoice;以及用于多语种、音色和情感控制的自然语音生成的 CosyVoice。SenseVoice 具有极低的延迟并支持超过 50 种语言,而 CosyVoice 在多语种语音生成、零样本语音生成、跨语言语音克隆以及指令遵循能力方面表现出色。与 SenseVoice 和 CosyVoice 相关的模型已在 Modelscope 和 Huggingface 上开源,同时相应的训练、推理和微调代码也已在 GitHub 上发布。通过将这些模型与 LLM 集成,FunAudioLLM 能够实现语音翻译、情感语音聊天、交互式播客和富有表现力的有声读物叙述等应用,从而推动语音交互技术的边界。

SenseVoice

CosyVoice 2

参考资料 FunAudioLLM: Voice Understanding and Generation Foundation Models for Nat

Dify:开源 LLM 应用开发平台

Dify 是一个开源的 LLM 应用开发平台。其直观的界面结合了 AI 工作流、RAG 管道、Agent、模型管理、可观测性功能等,让您可以快速从原型到生产。

安装

克隆代码仓库

git clone https://github.com/langgenius/dify

Docker 部署

Dify 提供了 Docker 部署方式,您可以通过以下步骤快速部署:

cd dify
cd docker
cp .env.example .env
docker compose up -d

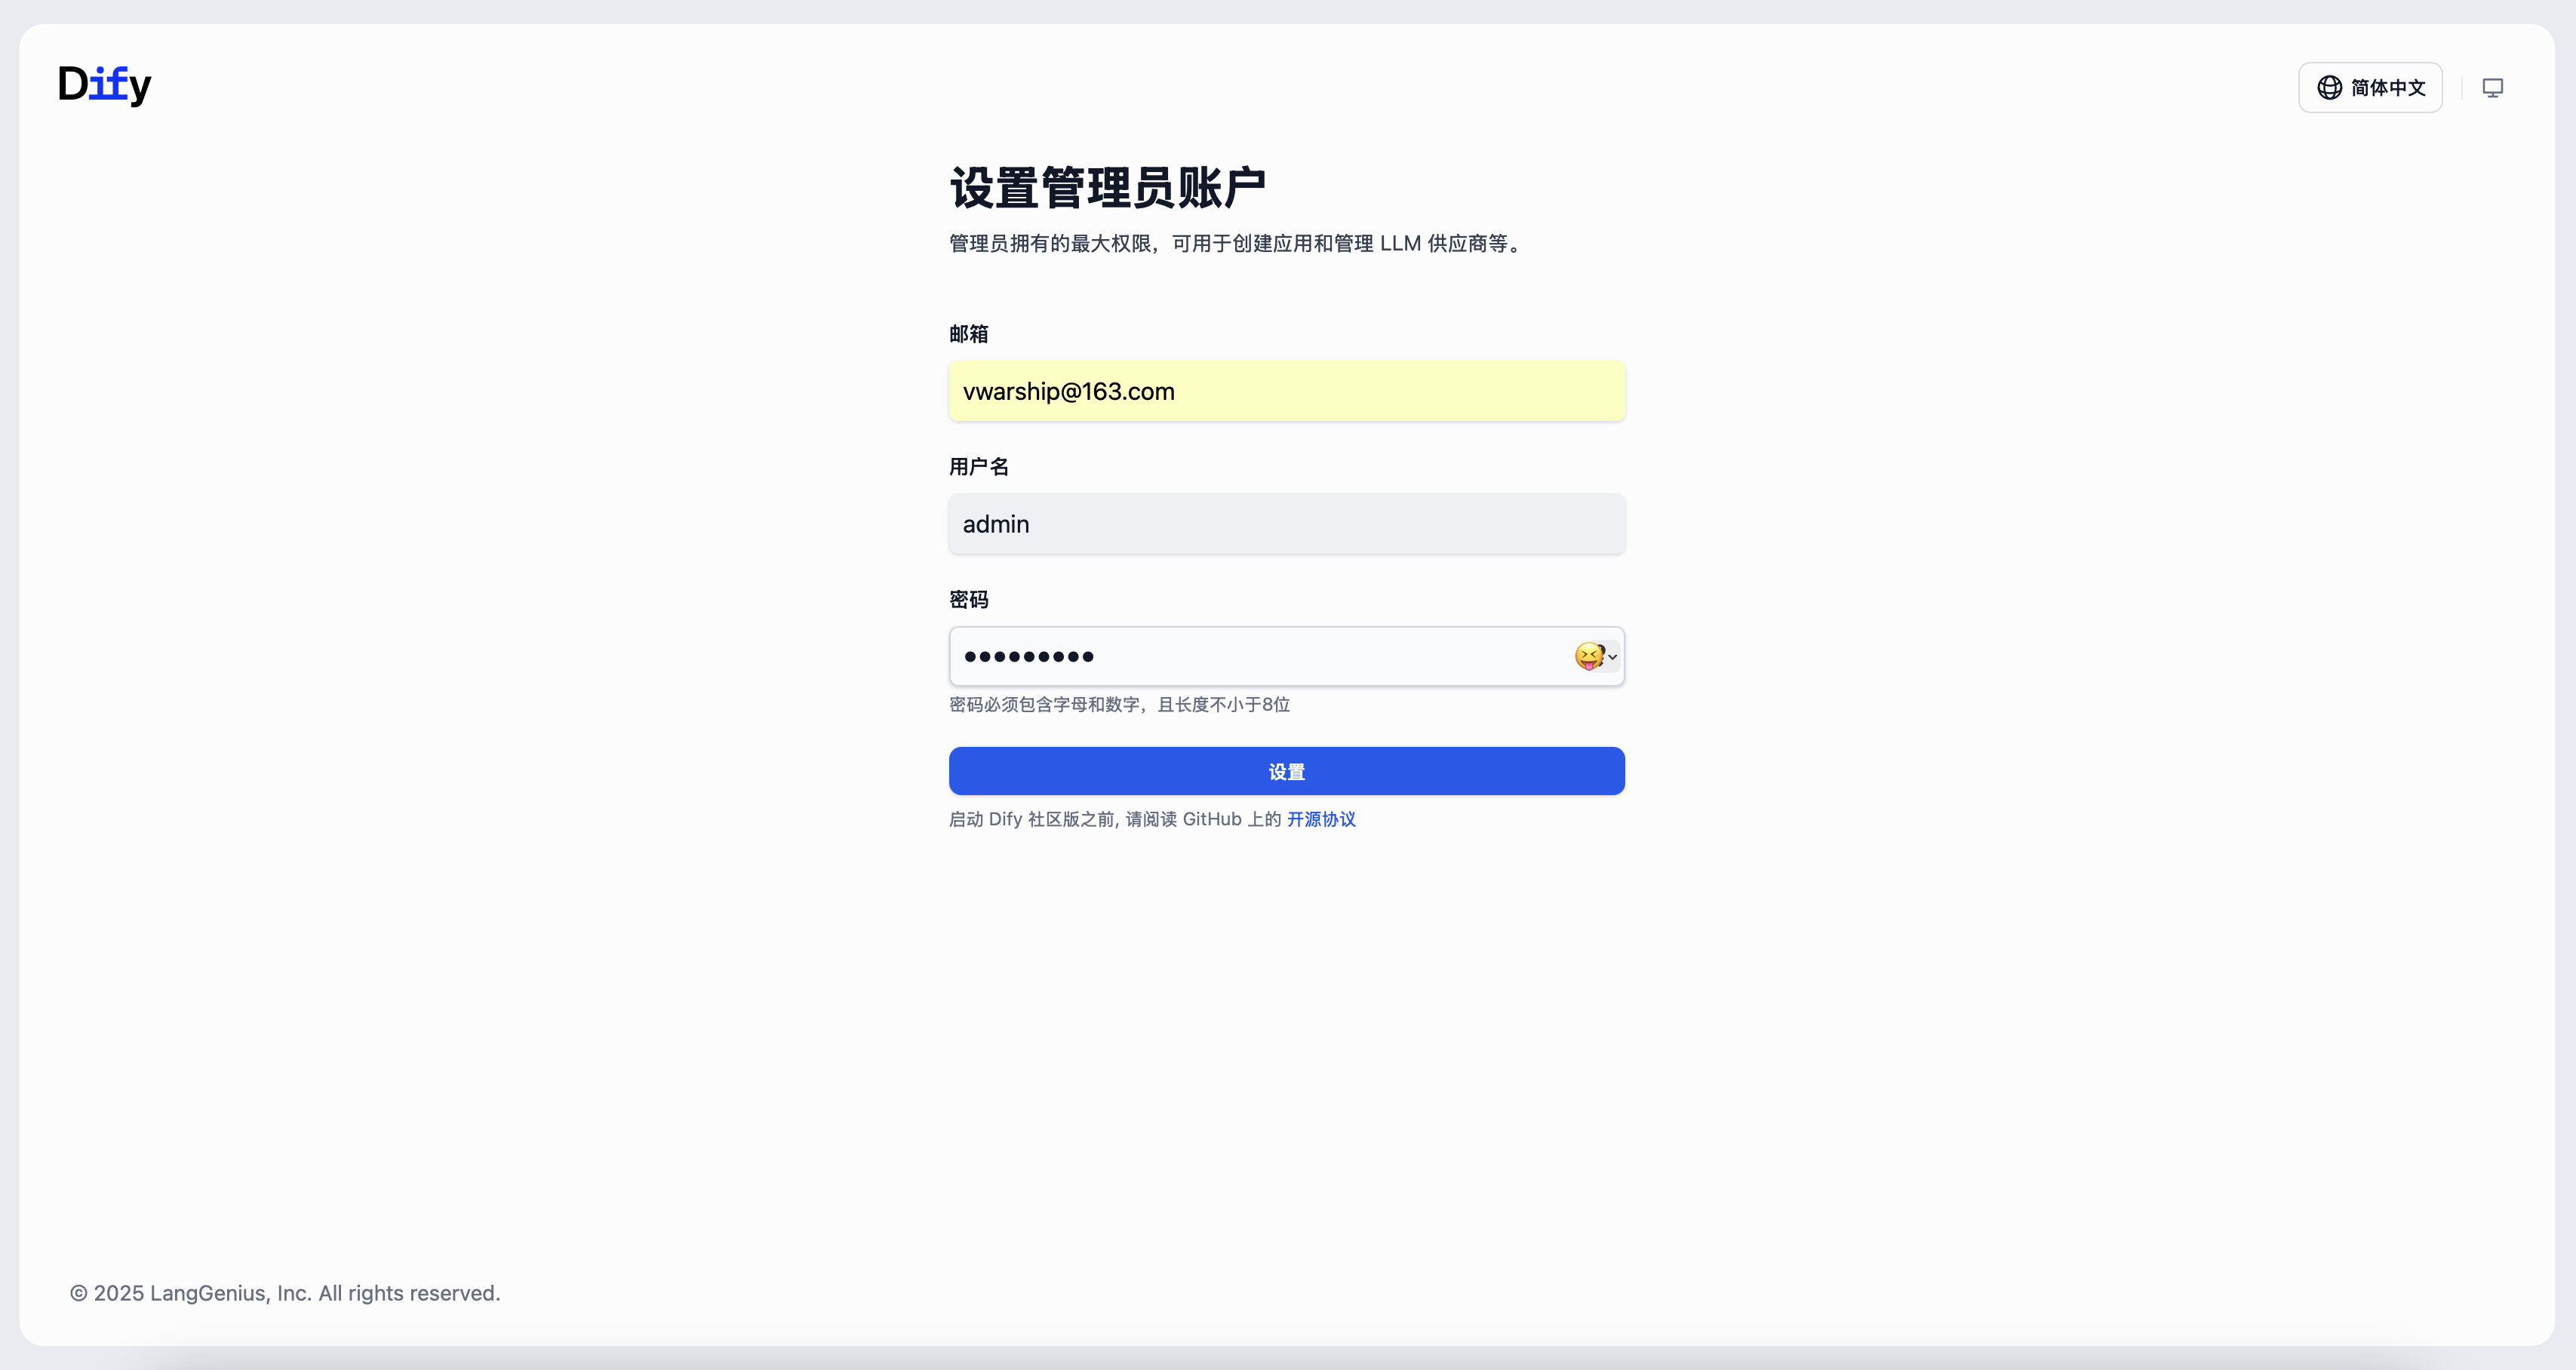
运行后,可以在浏览器上访问 http://localhost/install 进入 Dify 控制台并开始初始化安装操作。

自定义配置

如果您需要自定义配置,请参考 .env.example 文件中的注释,并更新 .env 文件中对应的值。此外,您可能需要根据您的具体部署环境和需求对 docker-compose.yaml 文件本身进行调整,例如更改镜像版本、端口映射或卷挂载。完成任何更改后,请重新运行 docker-compose up -d。您可以在此处找到可用环境变量的完整列表。

服务镜像

核心镜像(必需)

Qwen2.5-Omni:端到端多模态大模型

Qwen2.5-Omni是Qwen系列中全新的旗舰级端到端多模态大模型,专为全面的多模式感知设计,无缝处理包括文本、图像、音频和视频在内的各种输入,同时支持流式的文本生成和自然语音合成输出。

点击下方视频了解更多信息吧 😃

Open Video

概览

简介

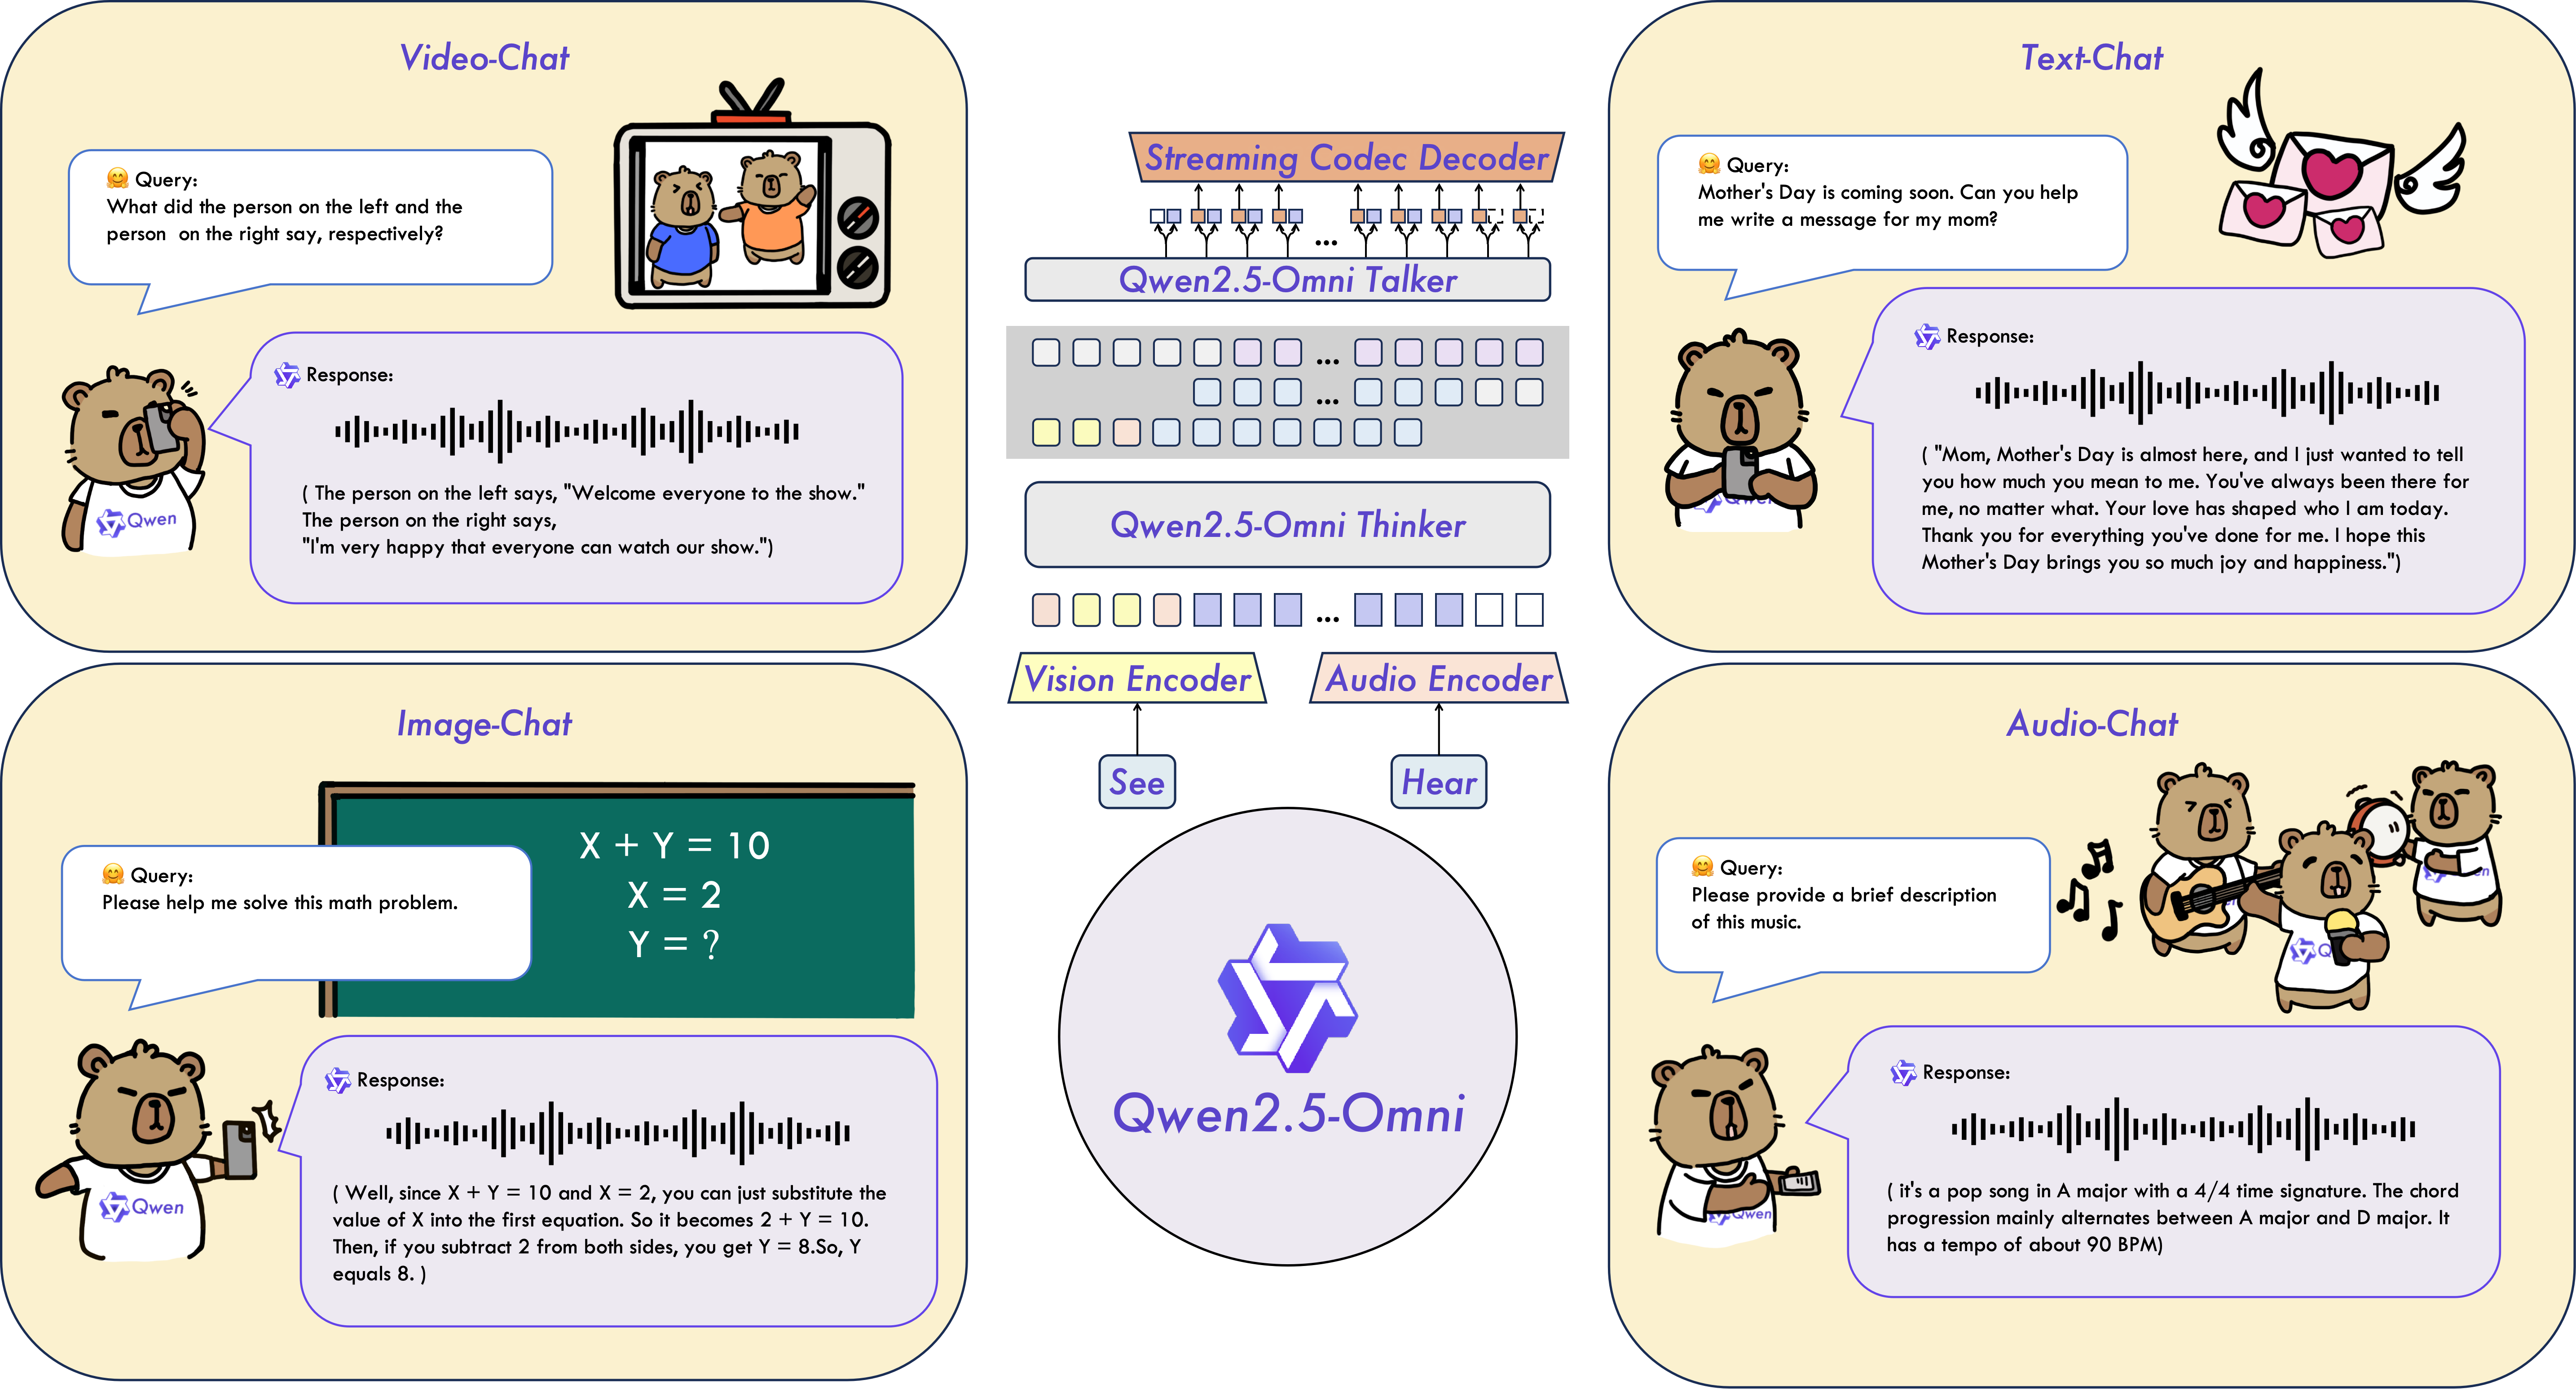
Qwen 2.5-Omni是一个端到端的多模态大语言模型,旨在感知包括文本、图像、音频和视频在内的多种模态,同时以流式的方式生成文本和自然语音响应。

主要特点

  • 全能创新架构:我们提出了一种全新的Thinker-Talker架构,这是一种端到端的多模态模型,旨在支持文本/图像/音频/视频的跨模态理解,同时以流式方式生成文本和自然语音响应。我们提出了一种新的位置编码技术,称为TMRoPE(Time-aligned Multimodal RoPE),通过时间轴对齐实现视频与音频输入的精准同步。
  • 实时音视频交互:架构旨在支持完全实时交互,支持分块输入和即时输出。
  • 自然流畅的语音生成:在语音生成的自然性和稳定性方面超越了许多现有的流式和非流式替代方案。
  • 全模态性能优势:在同等规模的单模态模型进行基准测试时,表现出卓越的性能。Qwen2.5-Omni在音频能力上优于类似大小的Qwen2-Audio,并与Qwen2.5-VL-7B保持同等水平。
  • 卓越的端到端语音指令跟随能力:Qwen2.5-Omni在端到端语音指令跟随方面表现出与文本输入处理相媲美的效果,在MMLU通用知识理解和GSM8K数学推理等基准测试中表现优异。

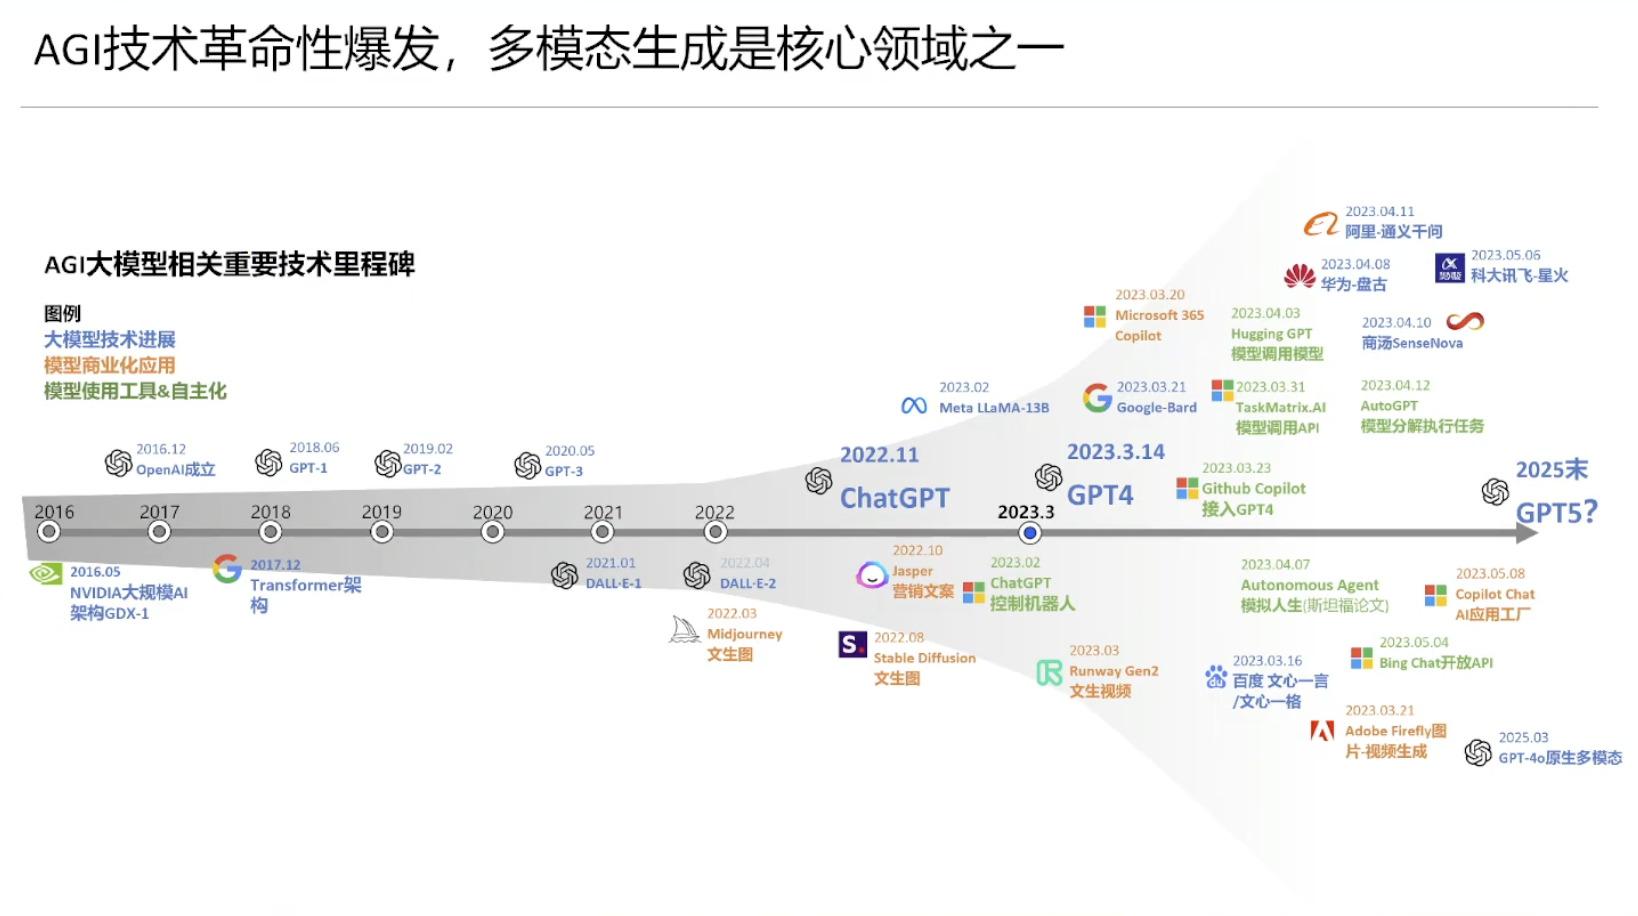
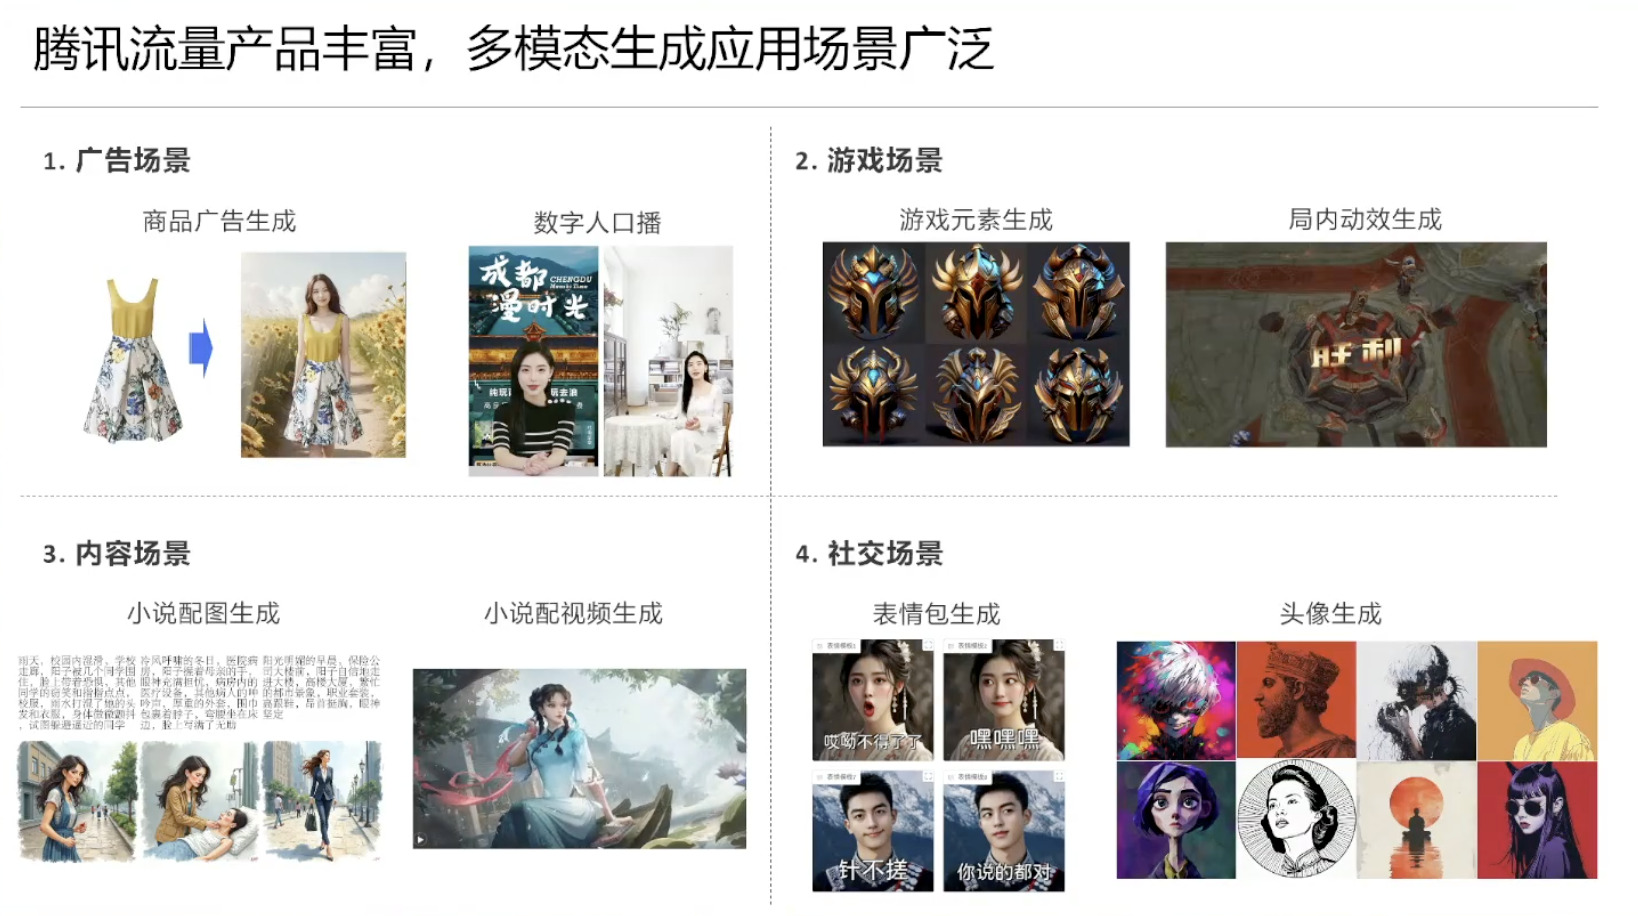
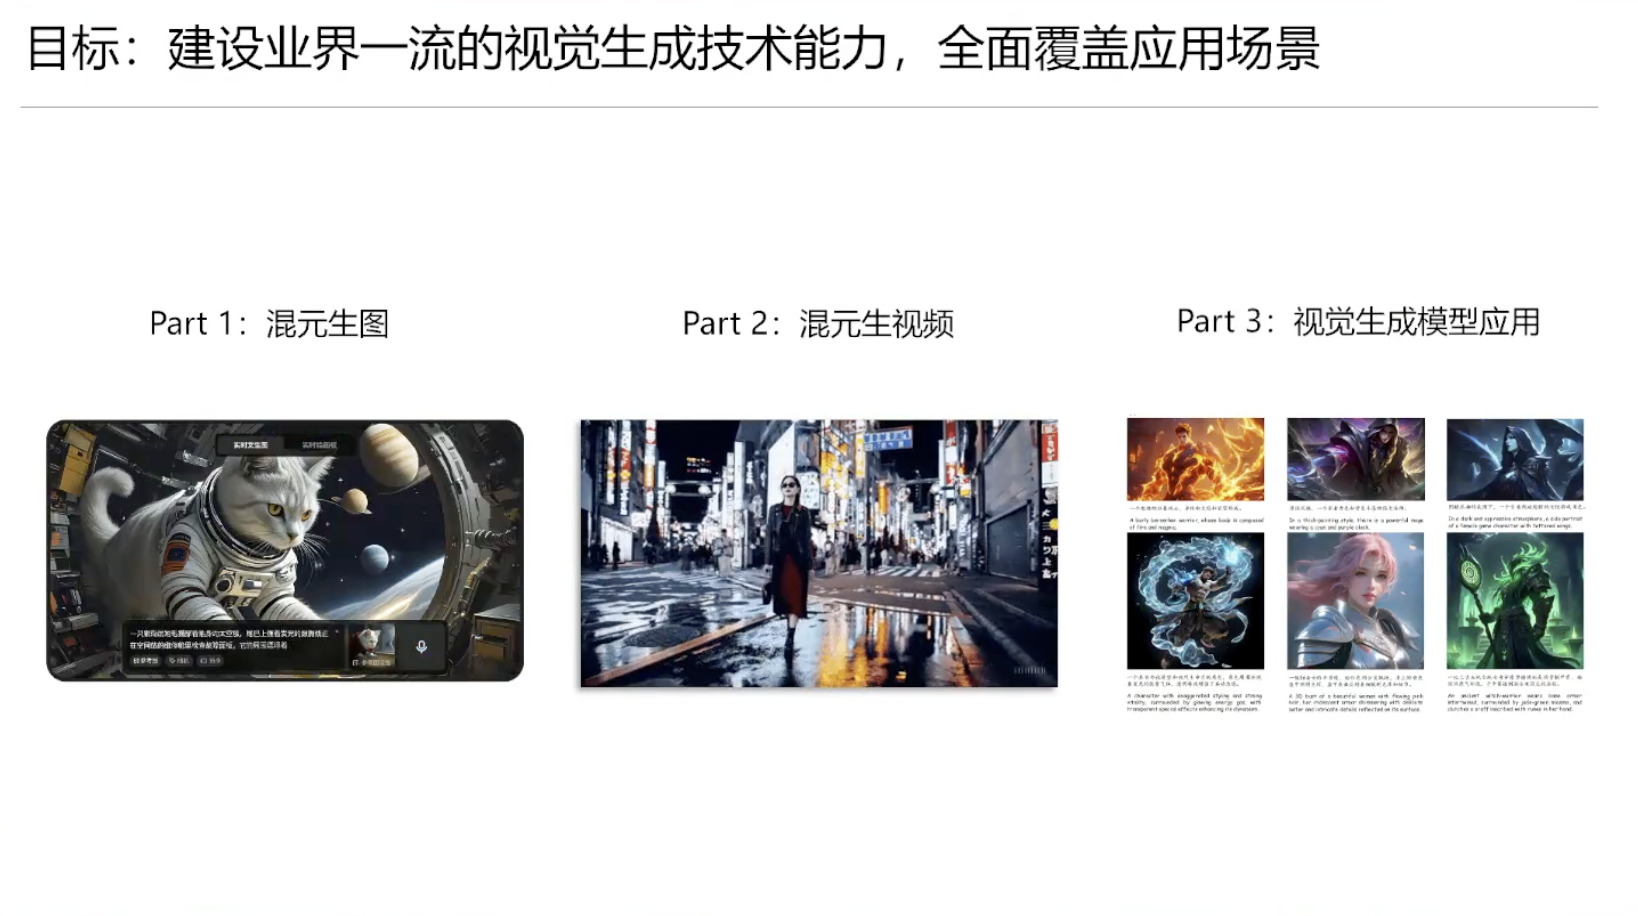
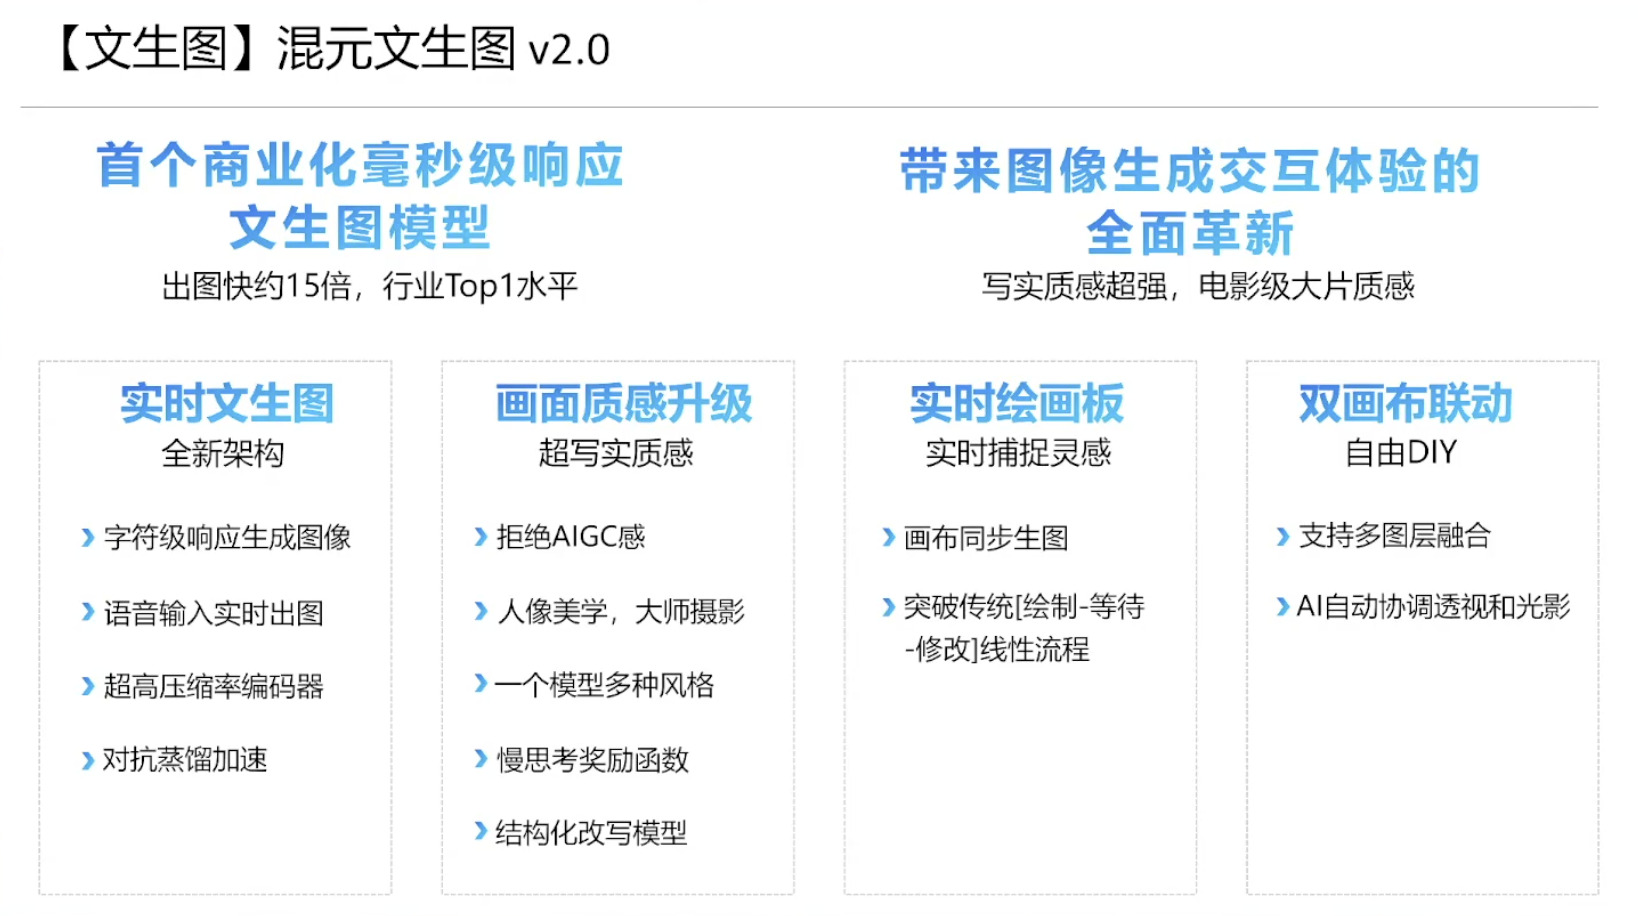
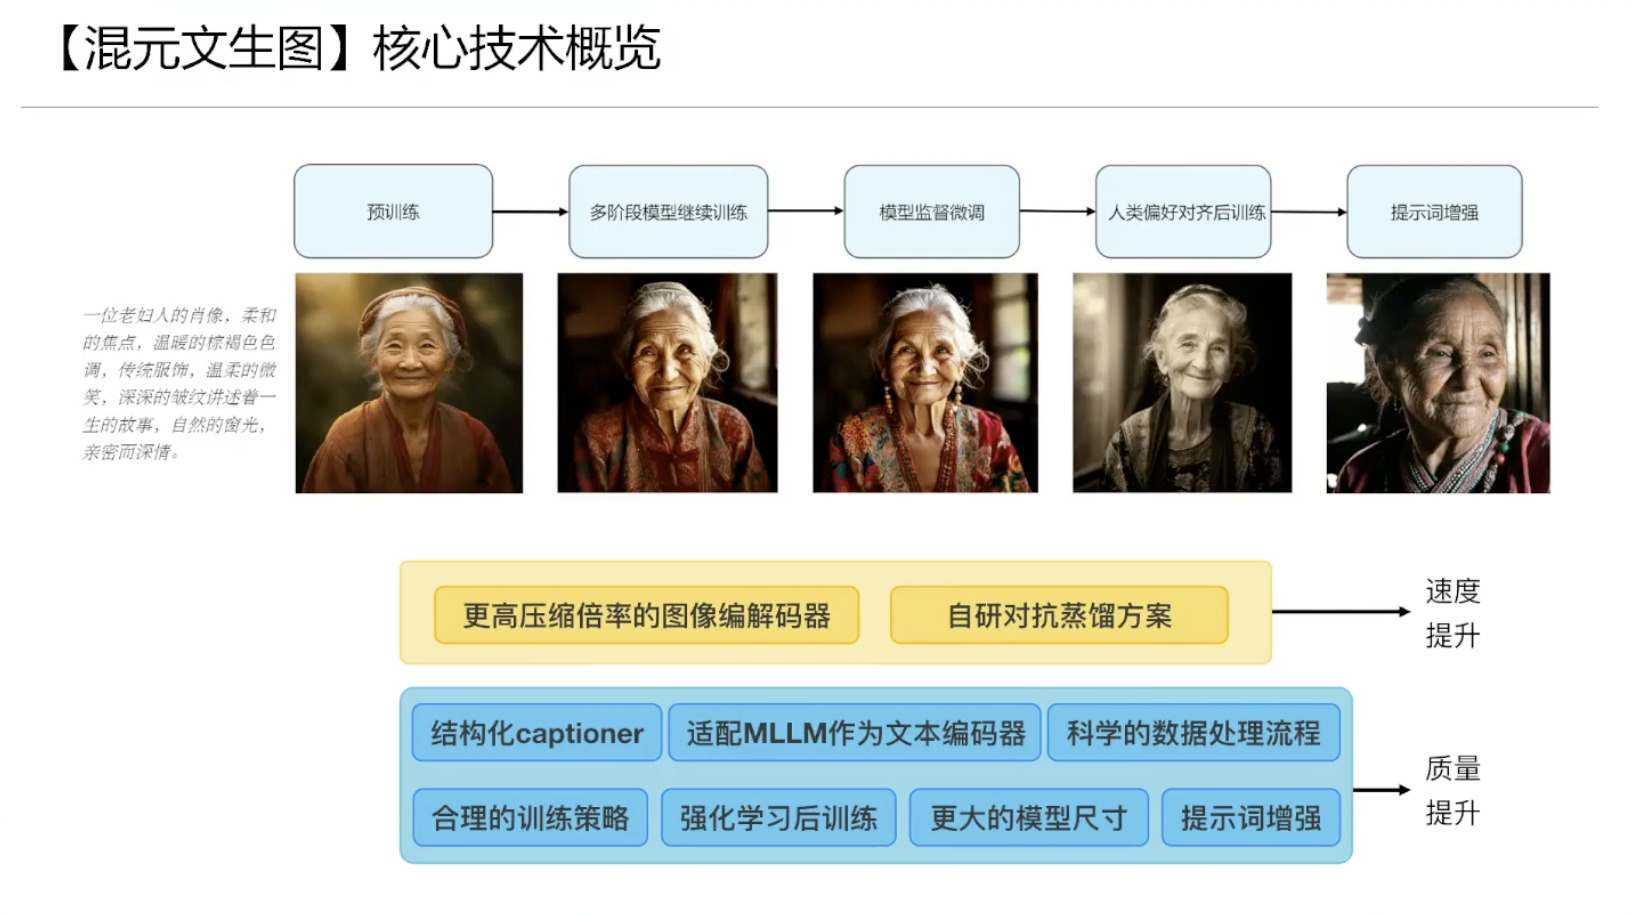
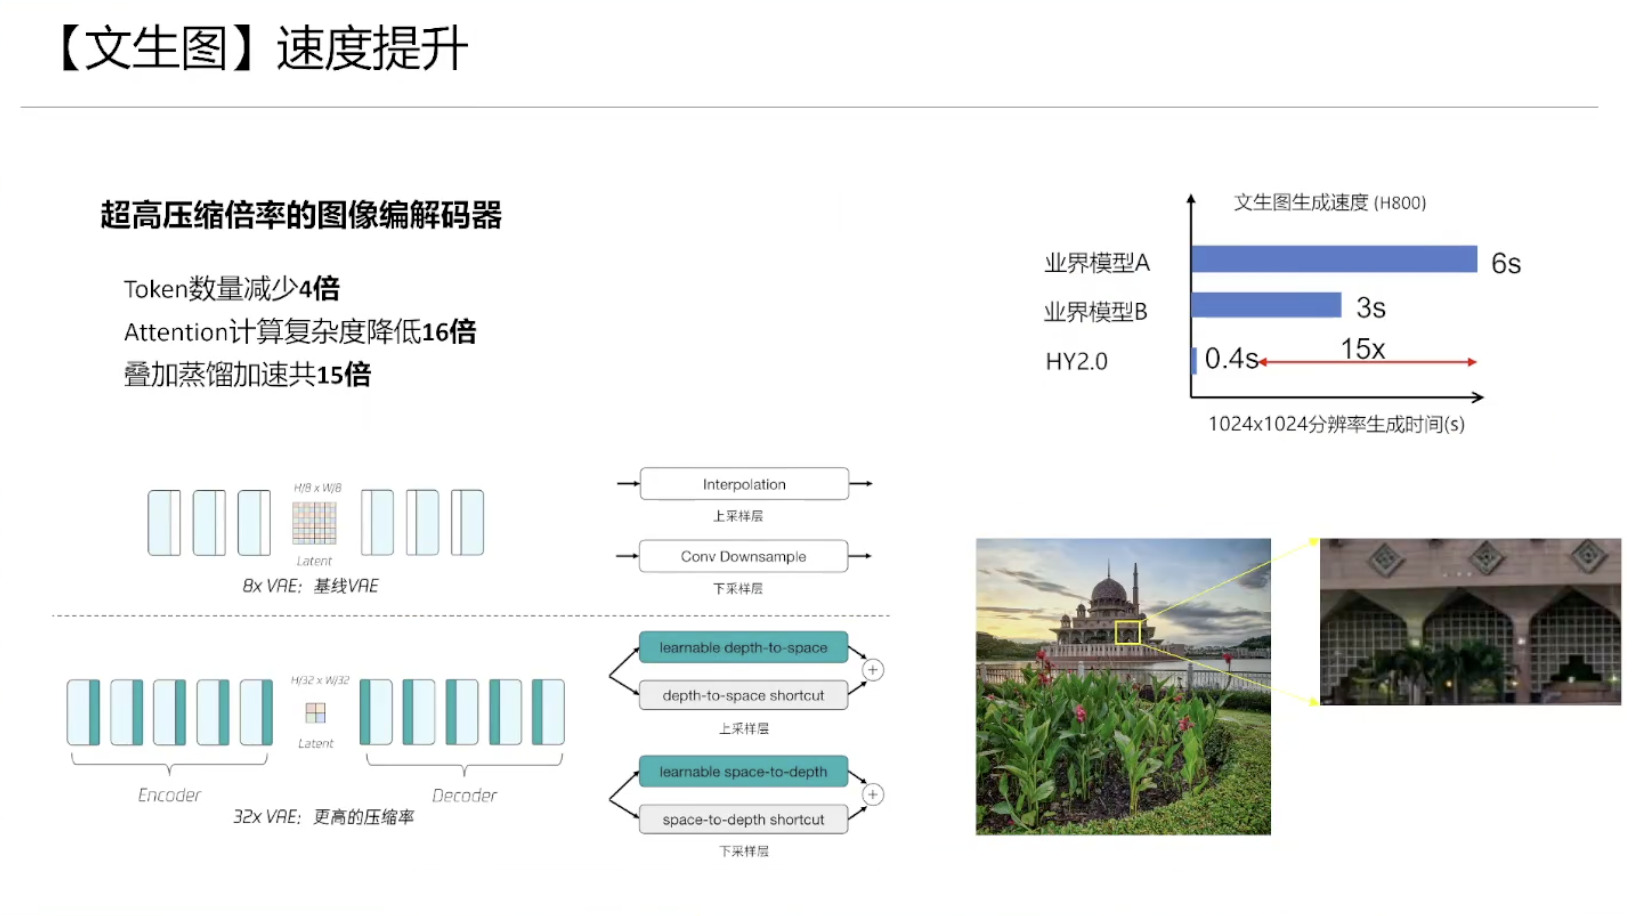
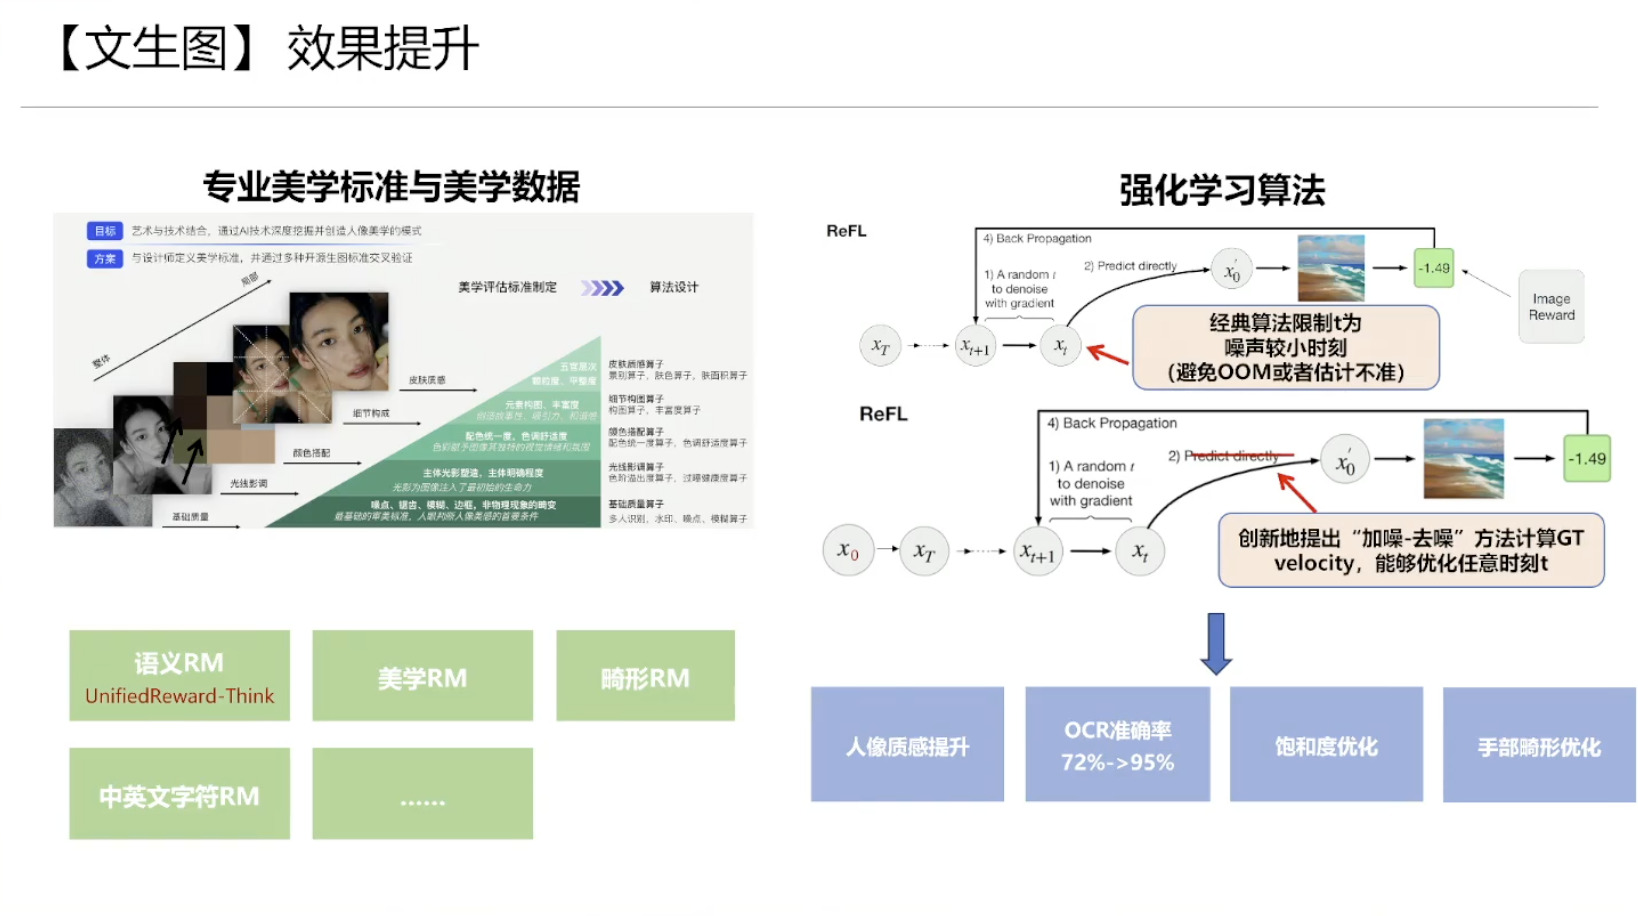
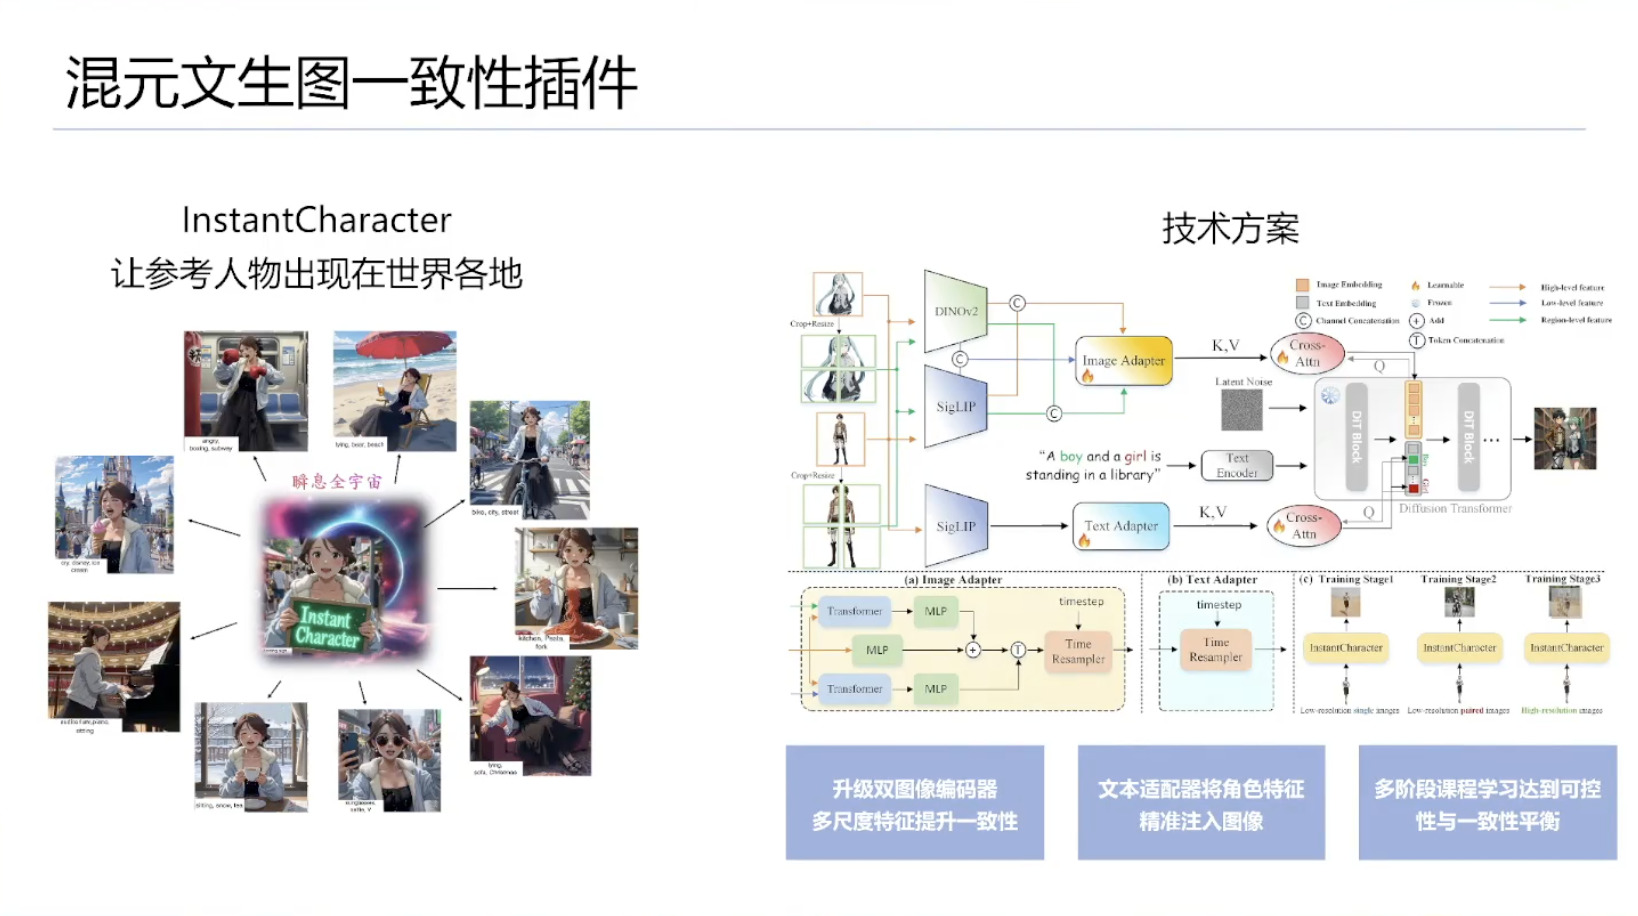
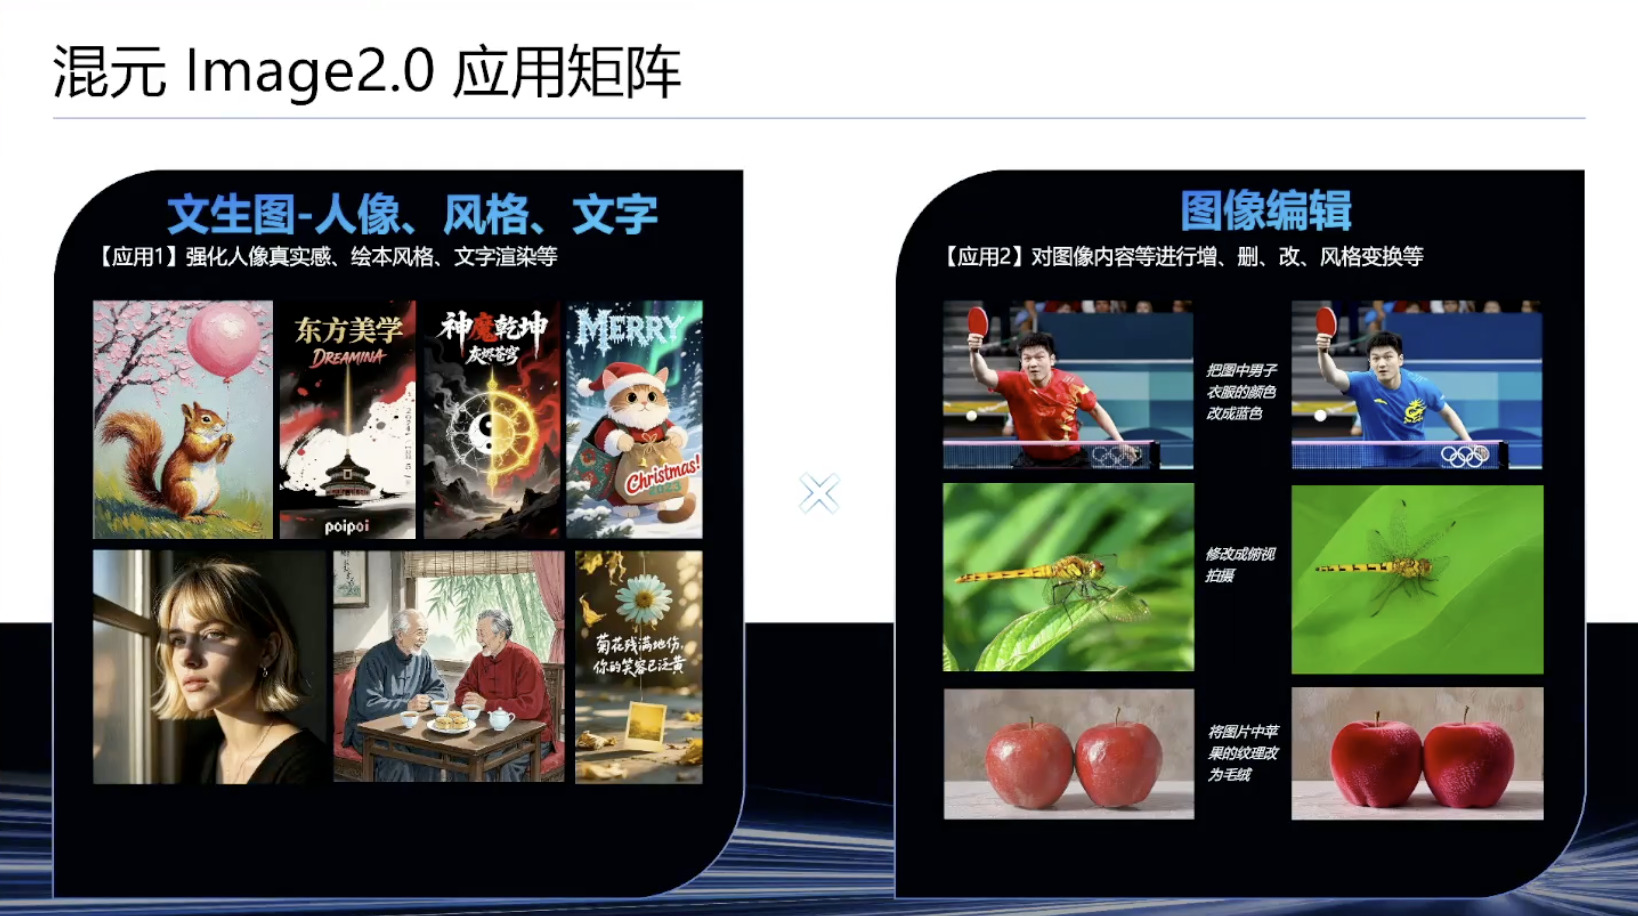
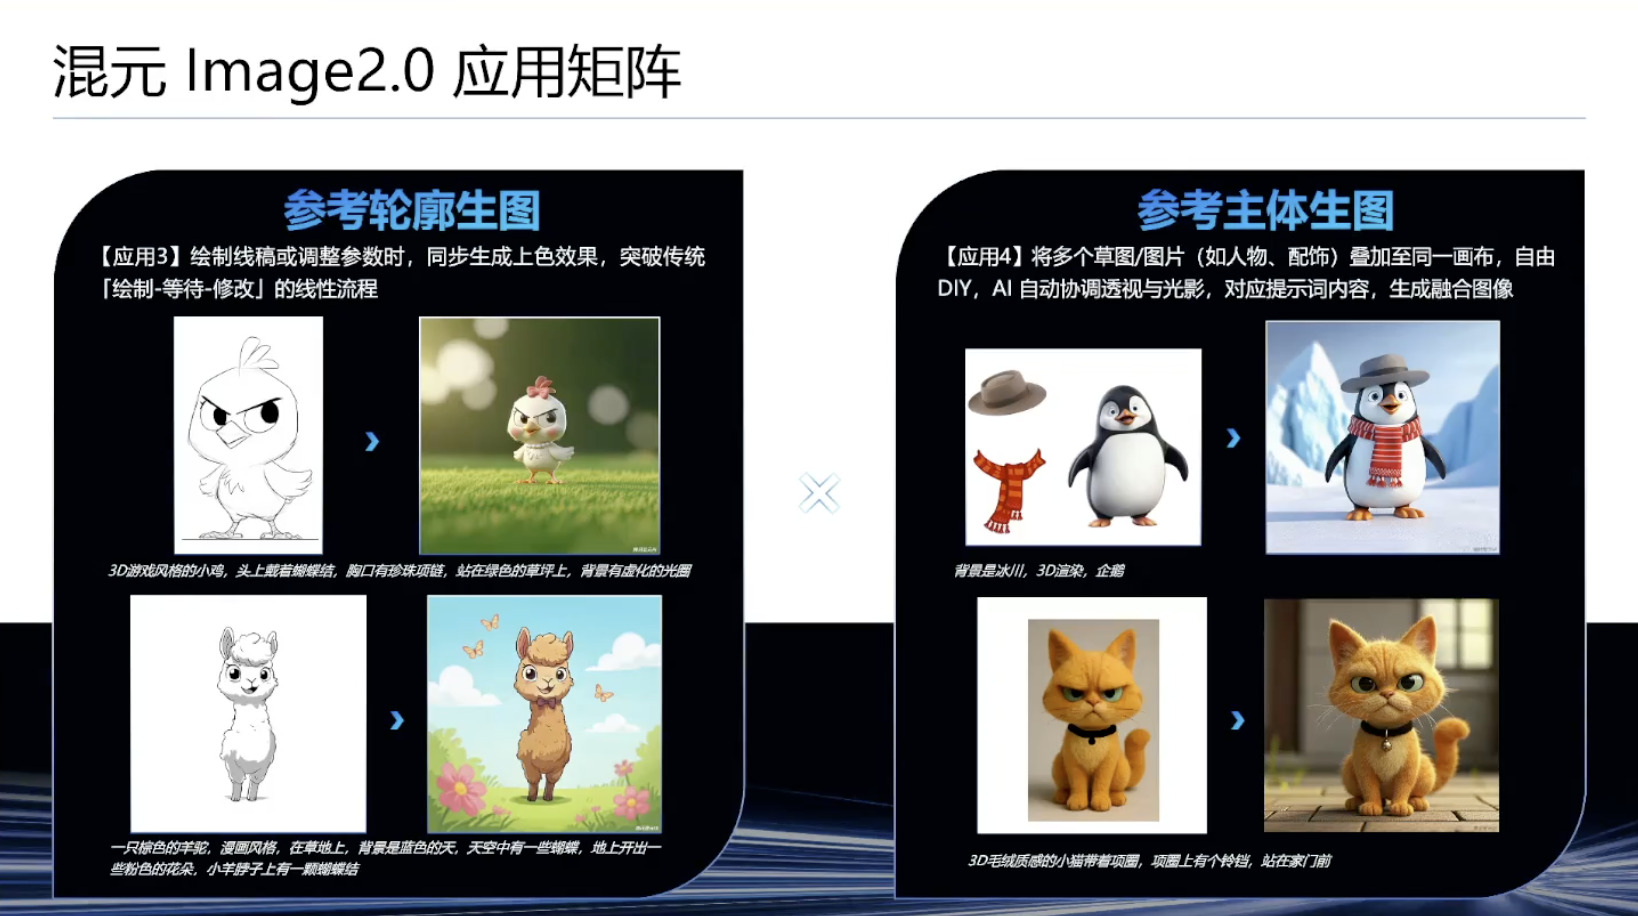
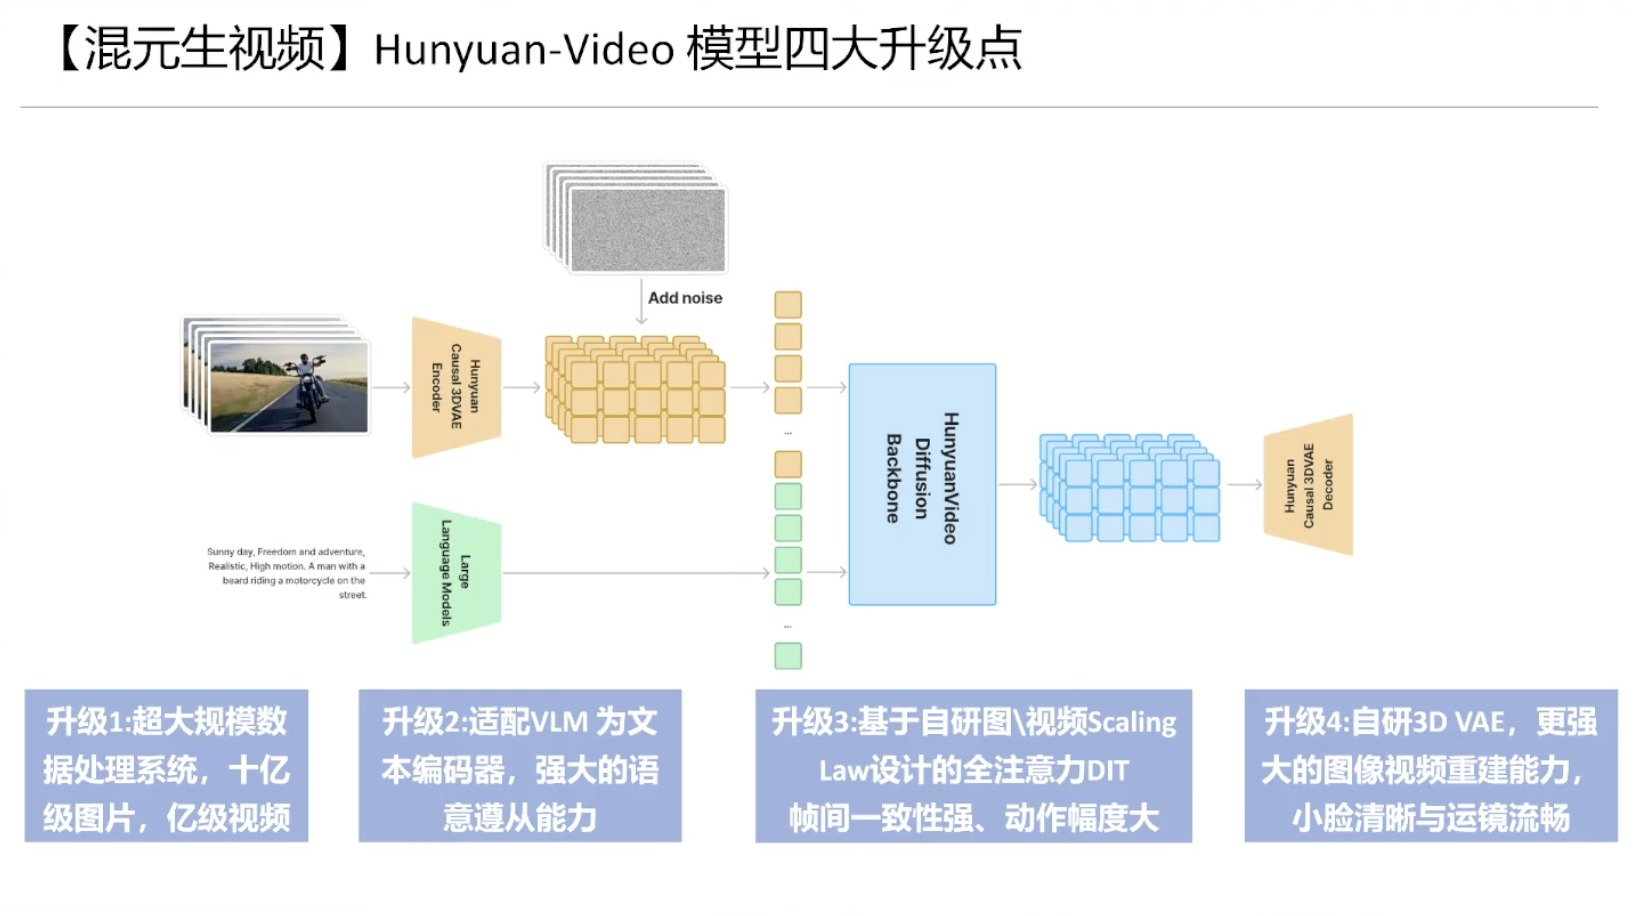
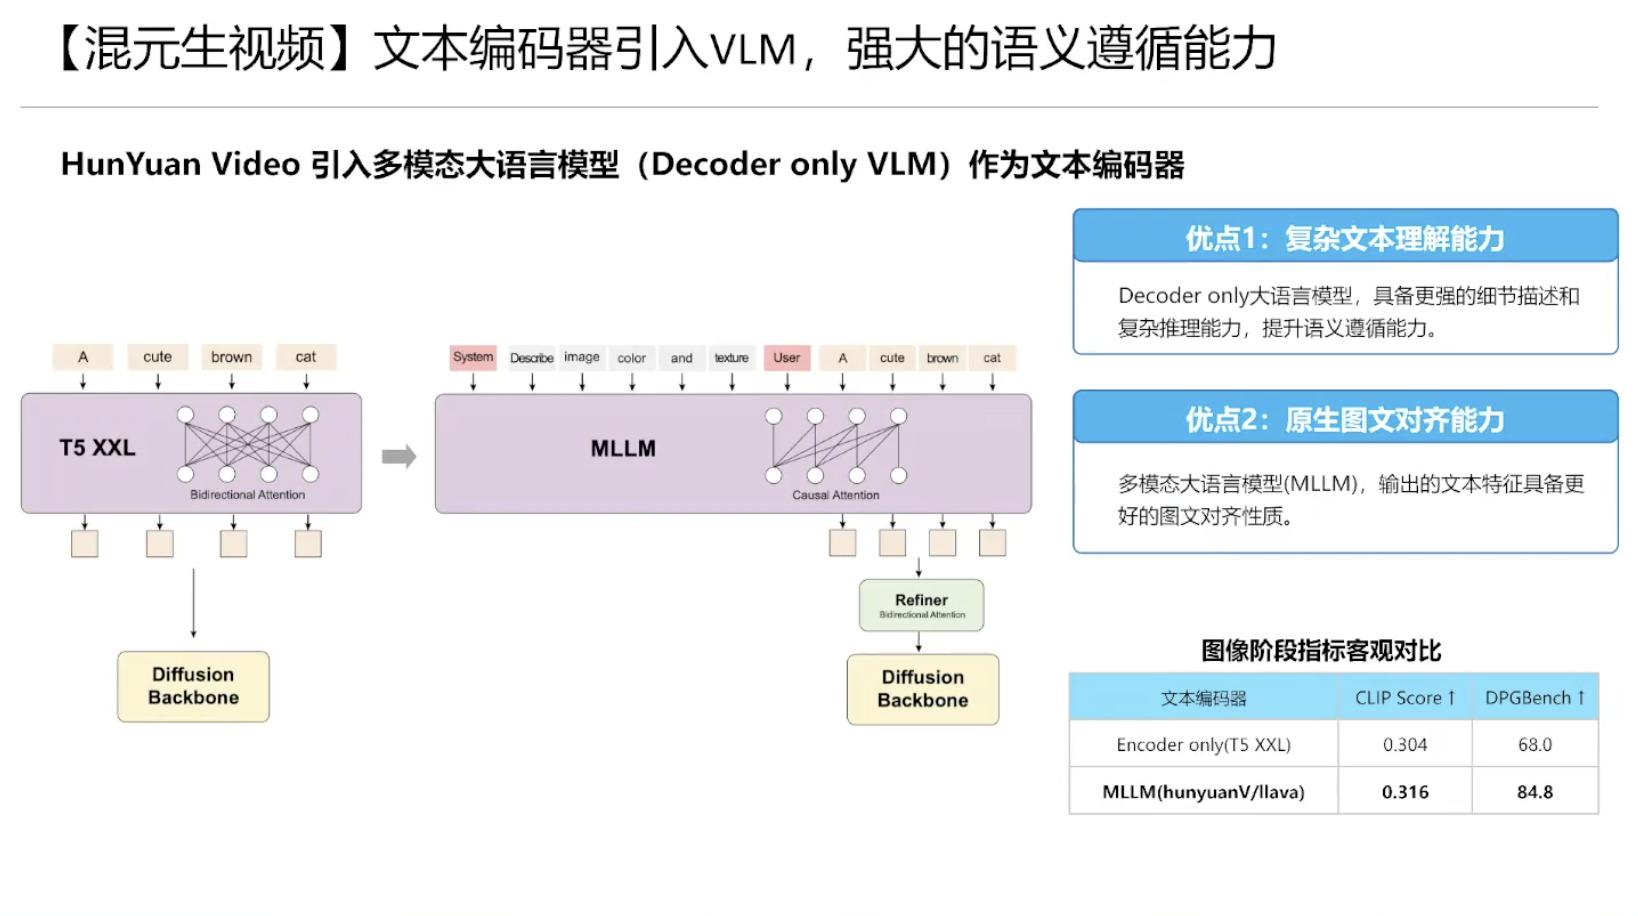
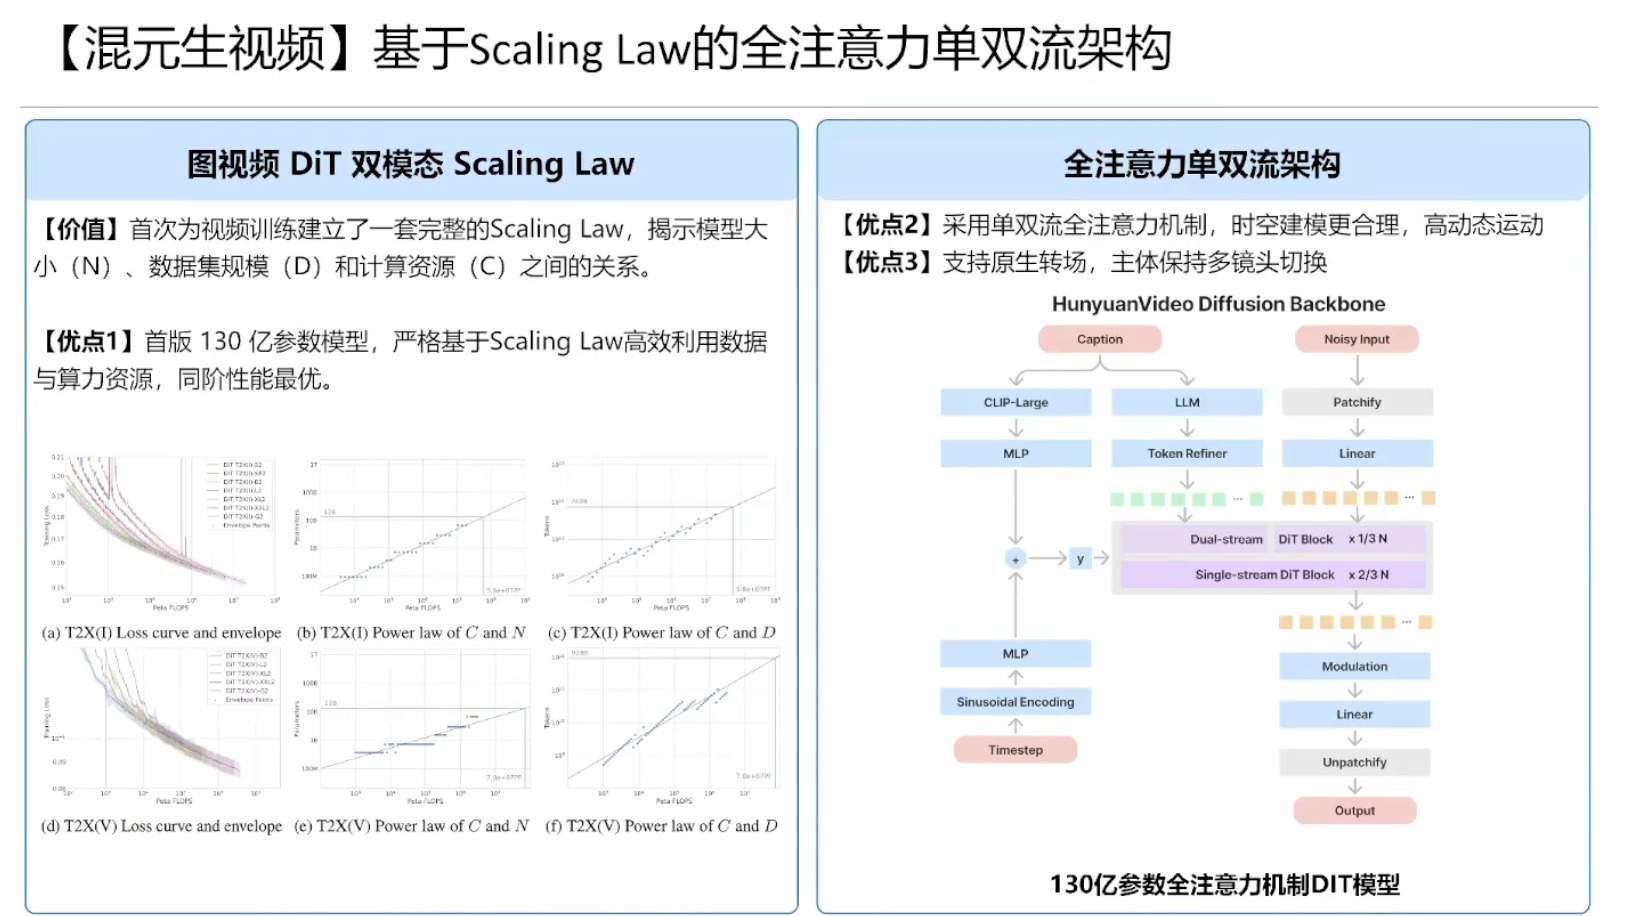
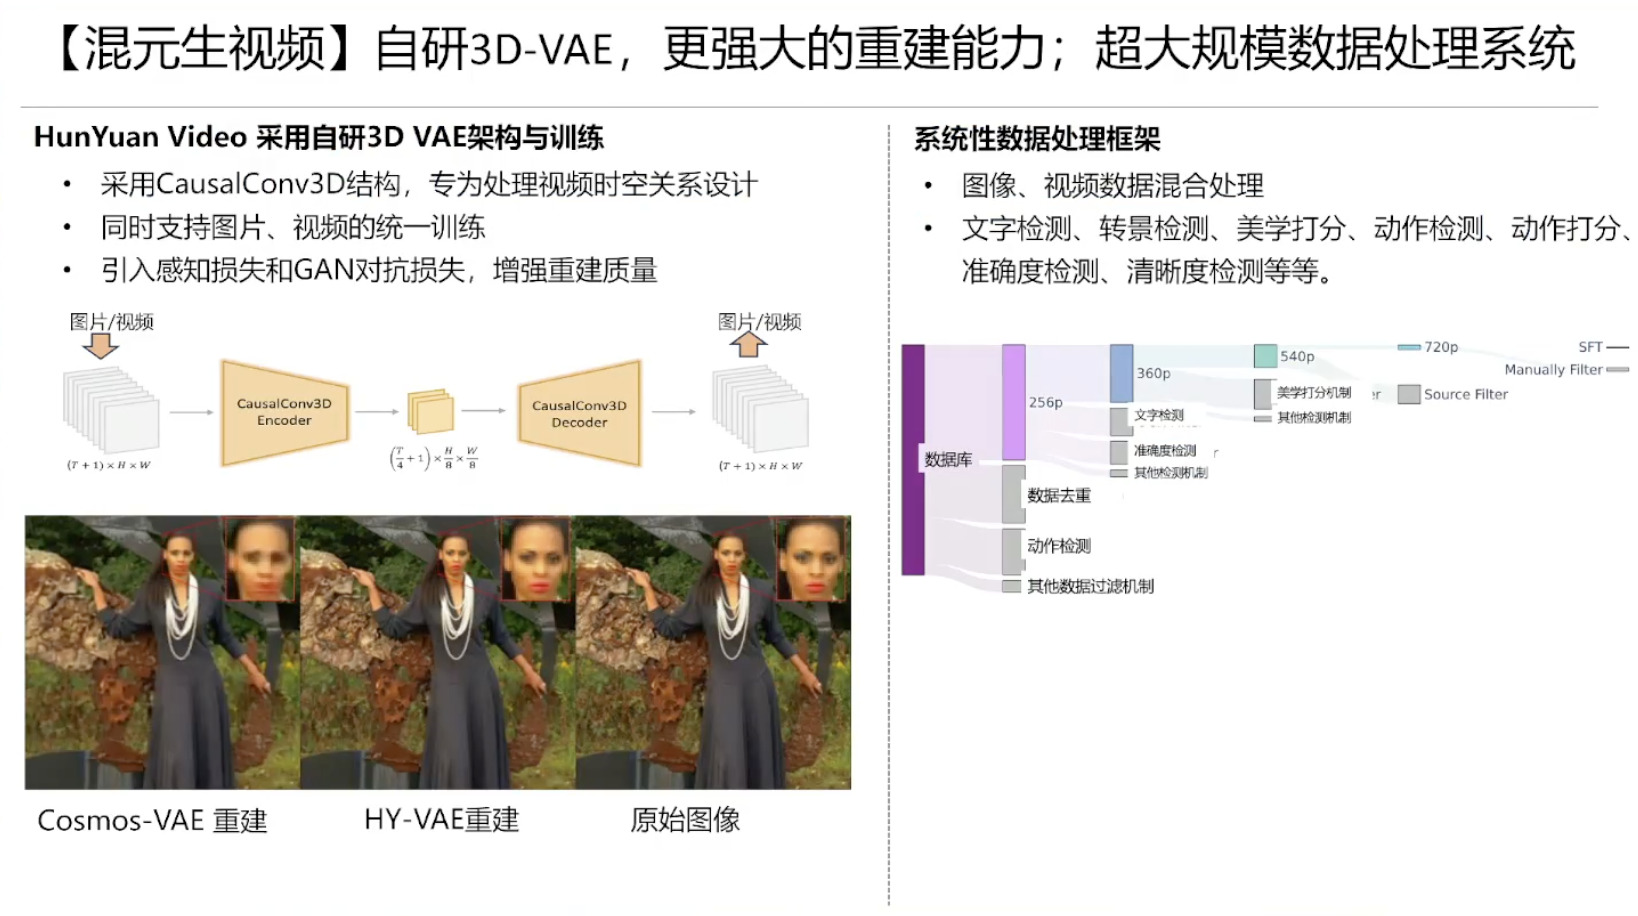
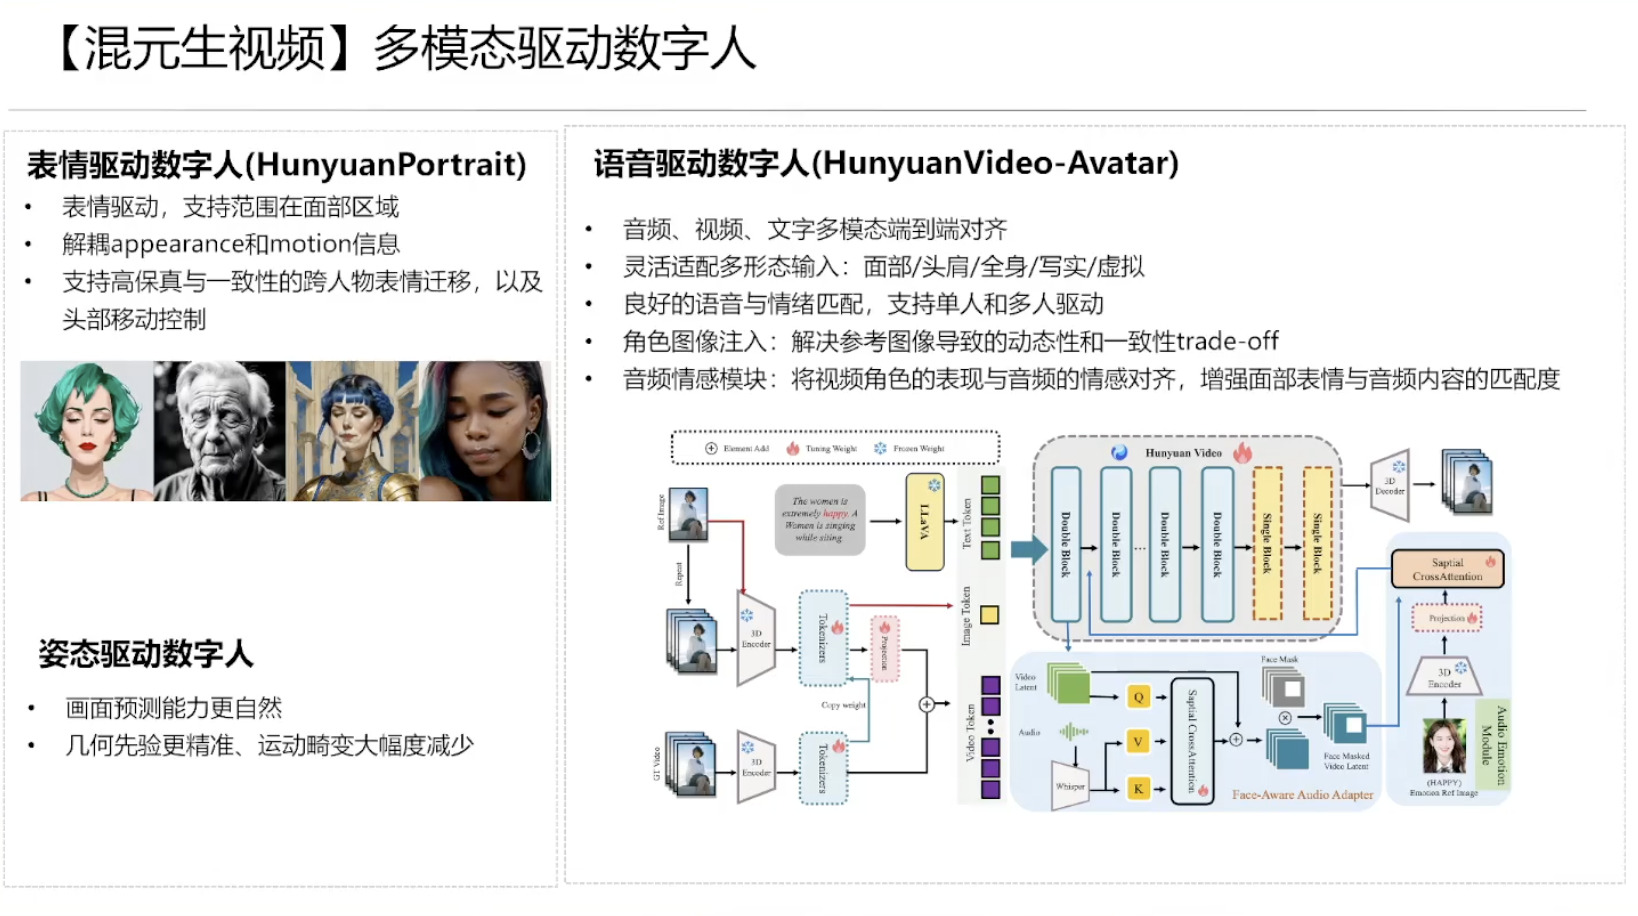
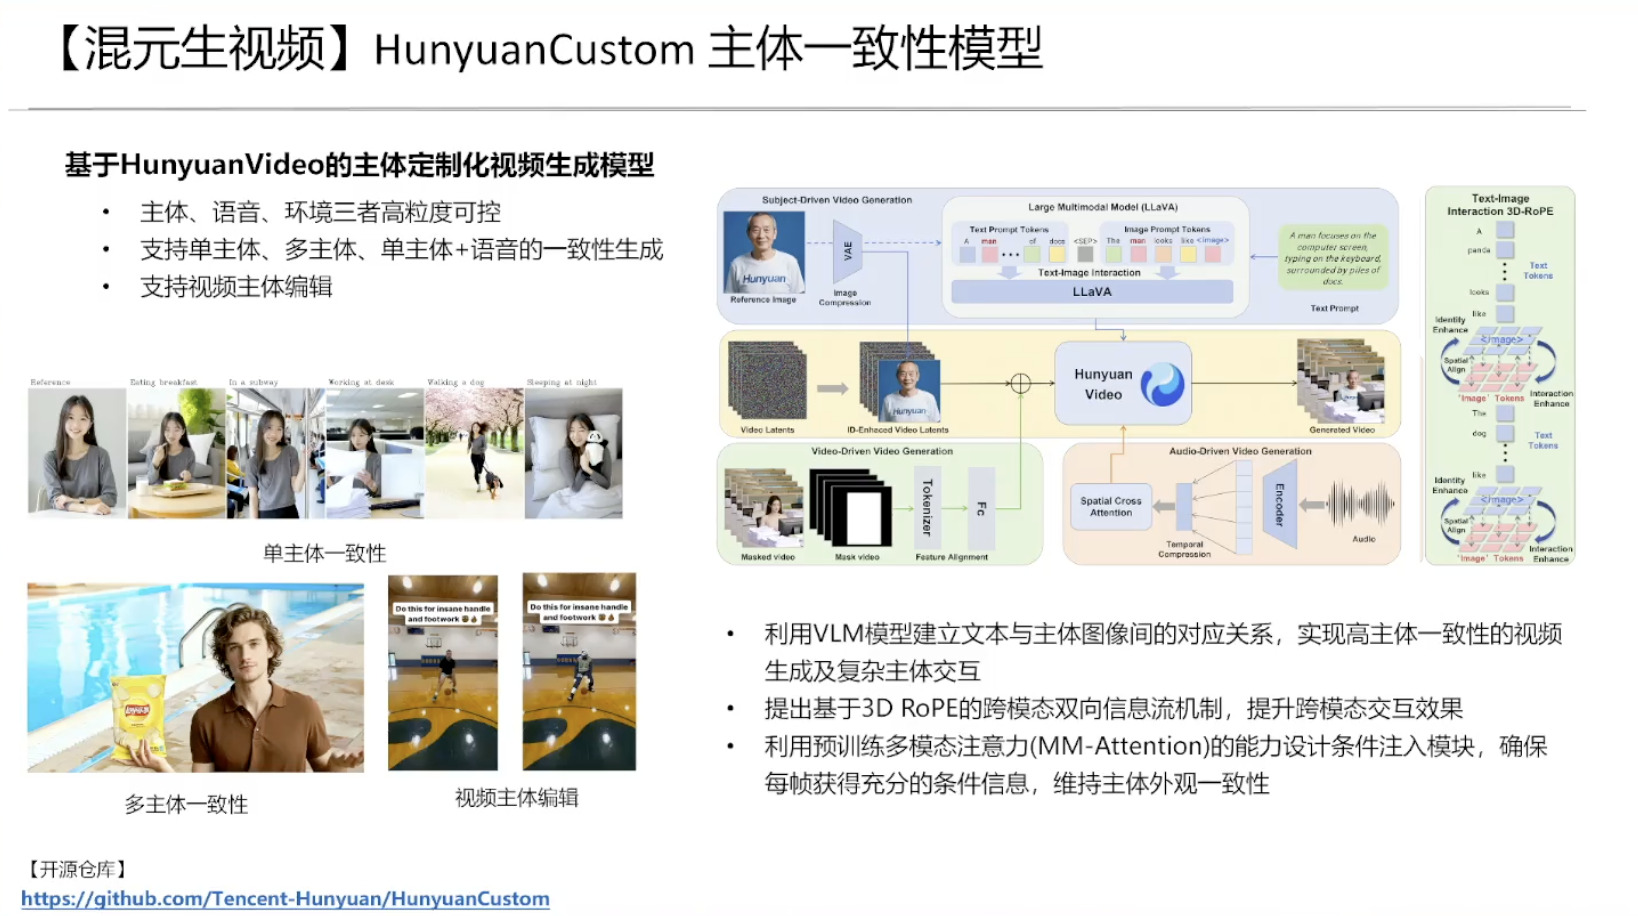
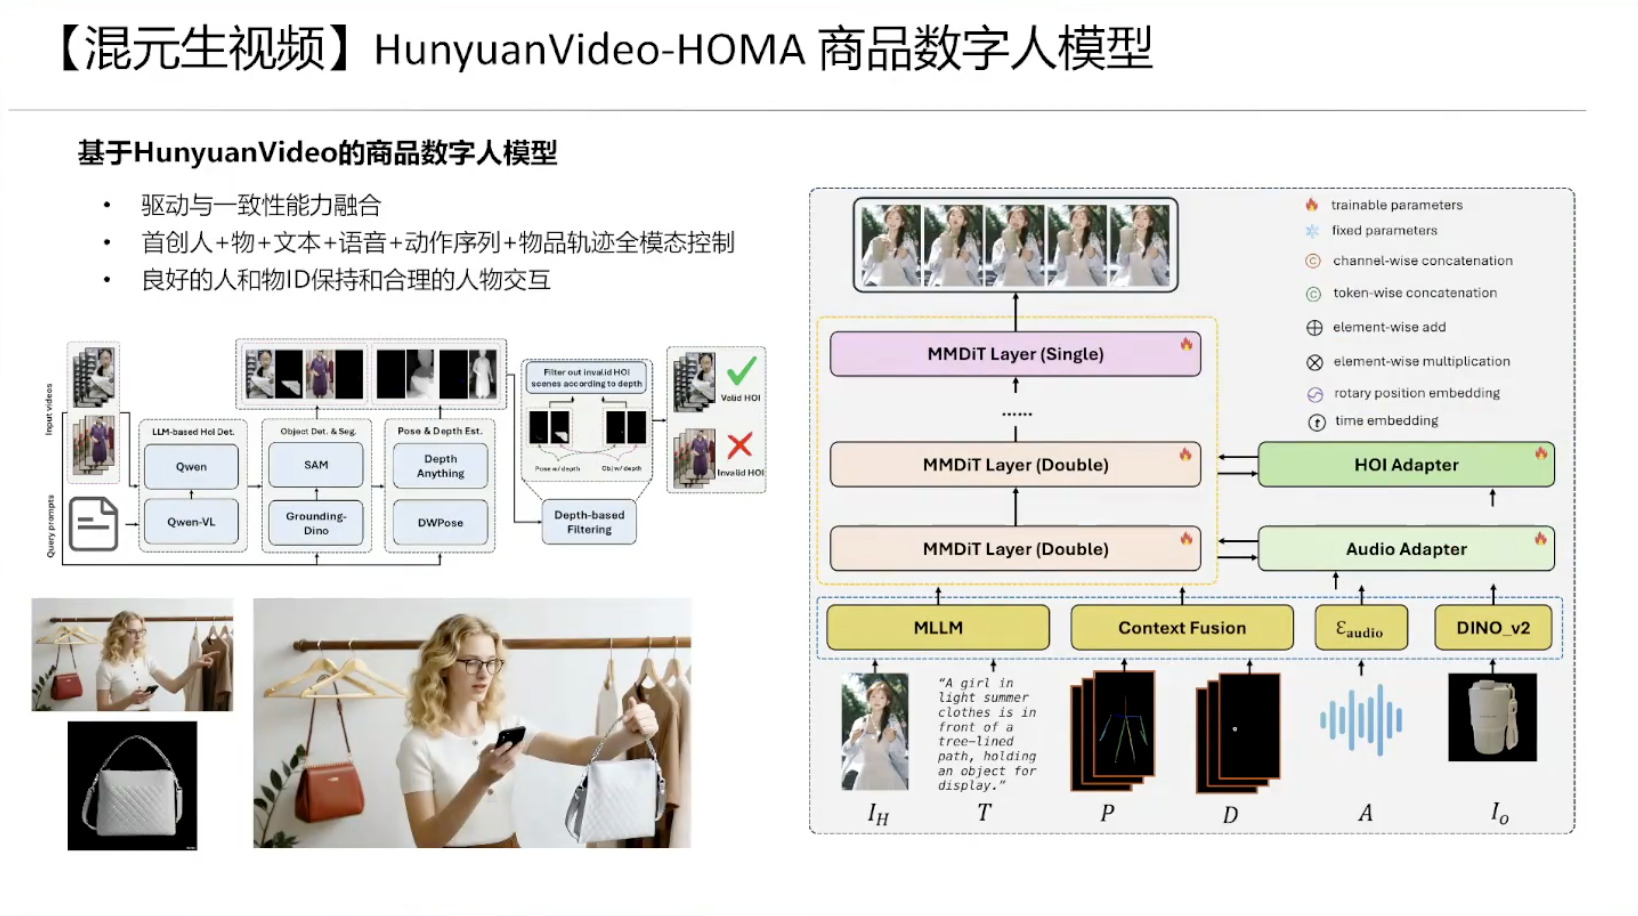
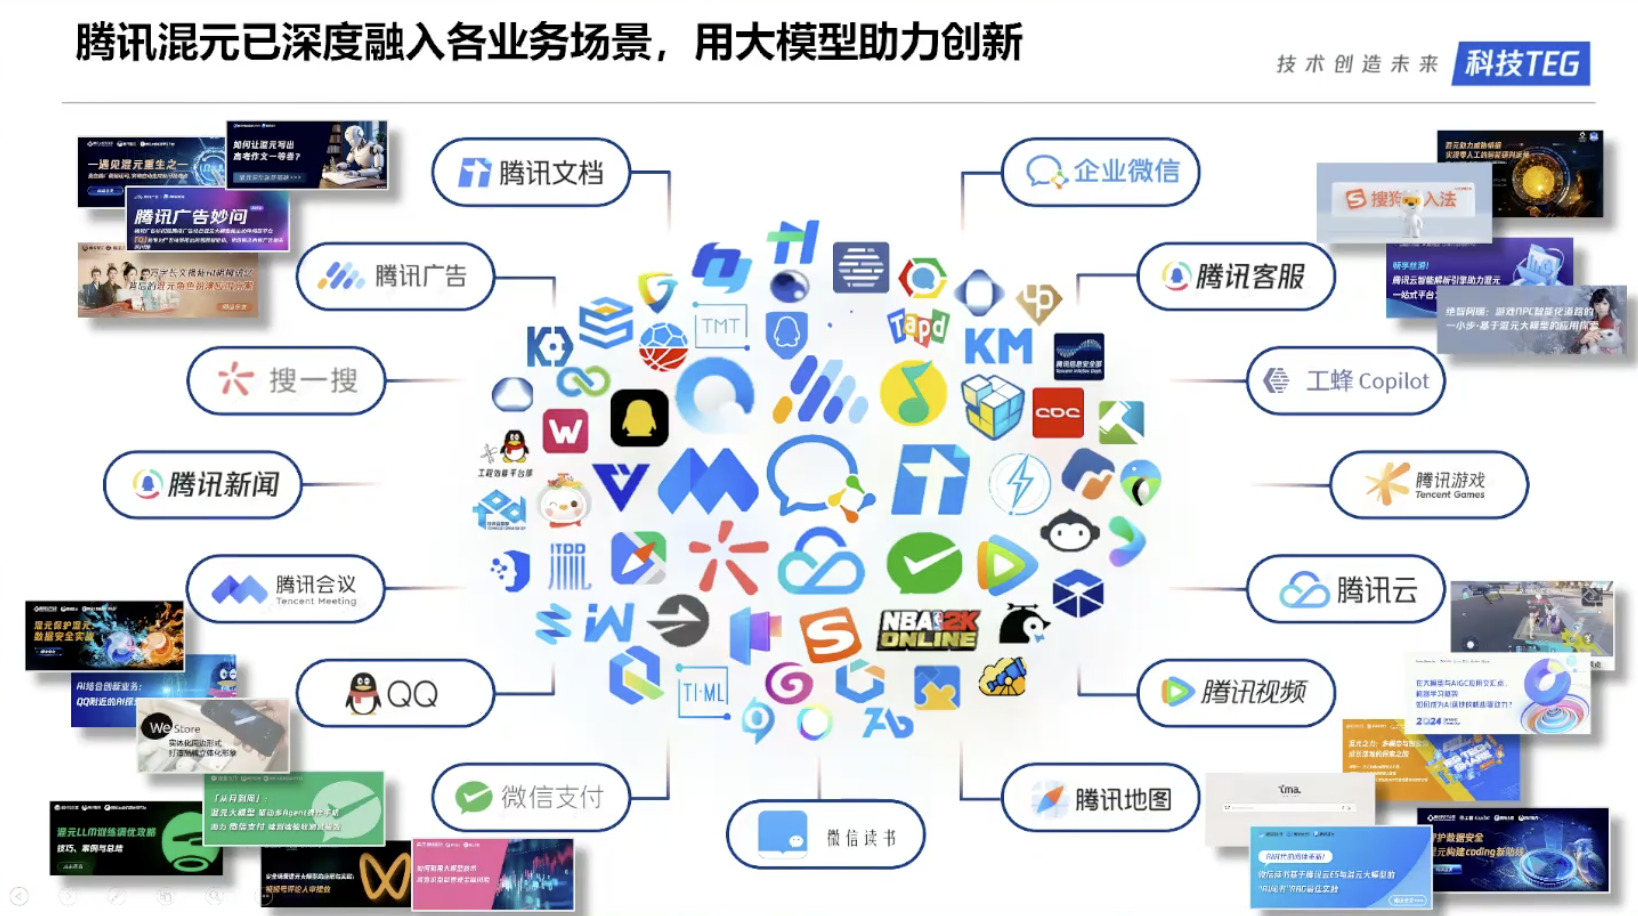
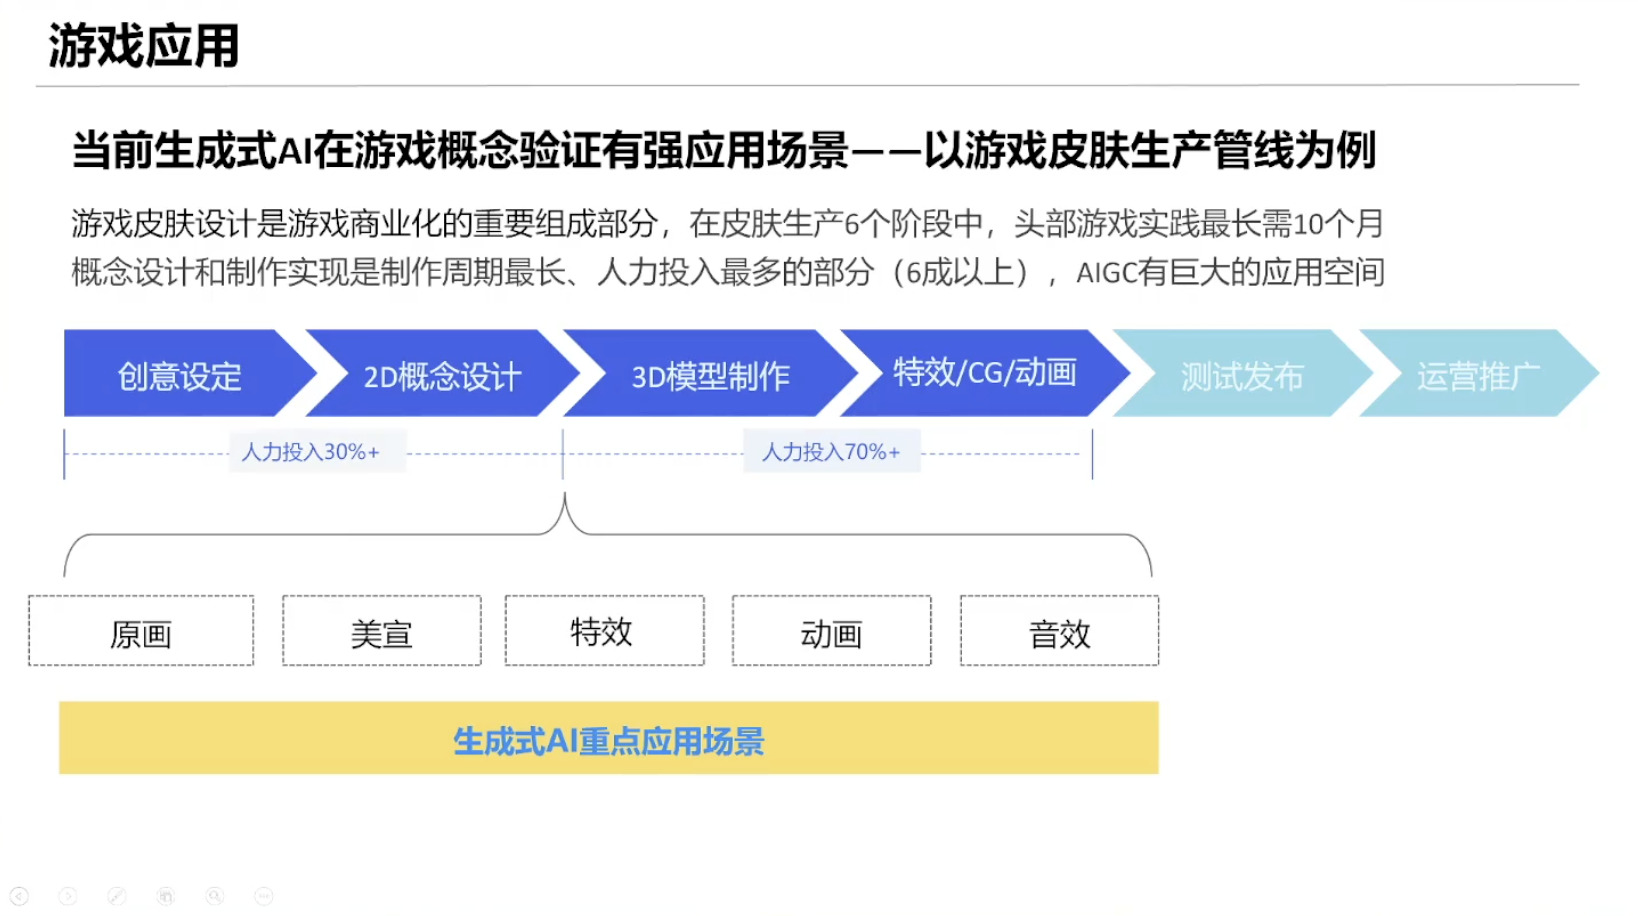
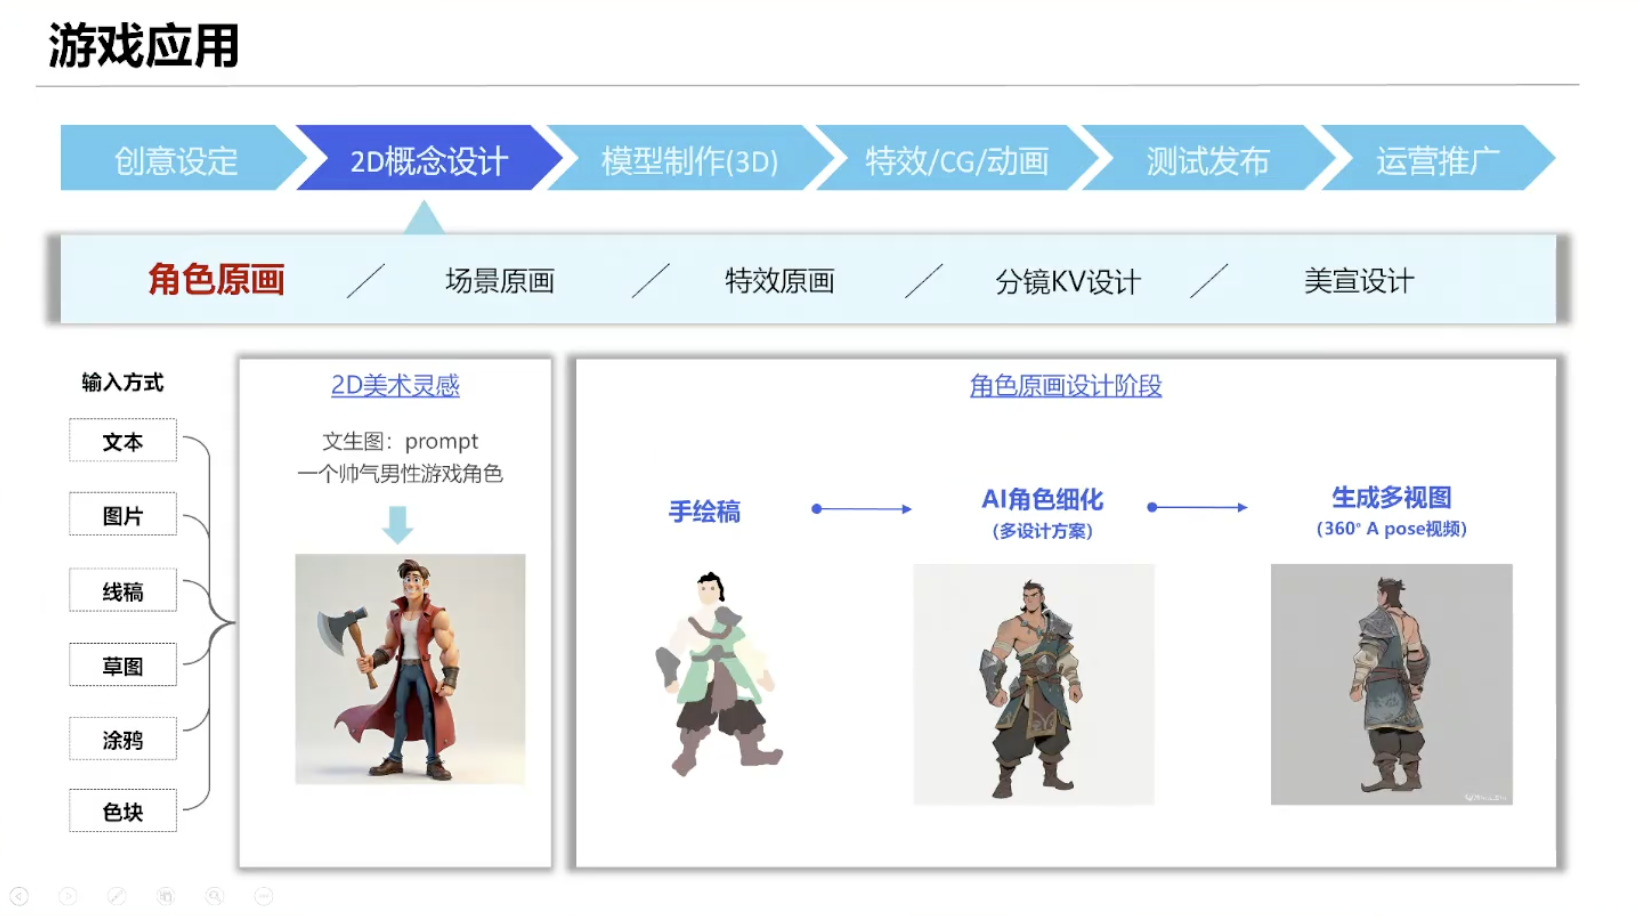
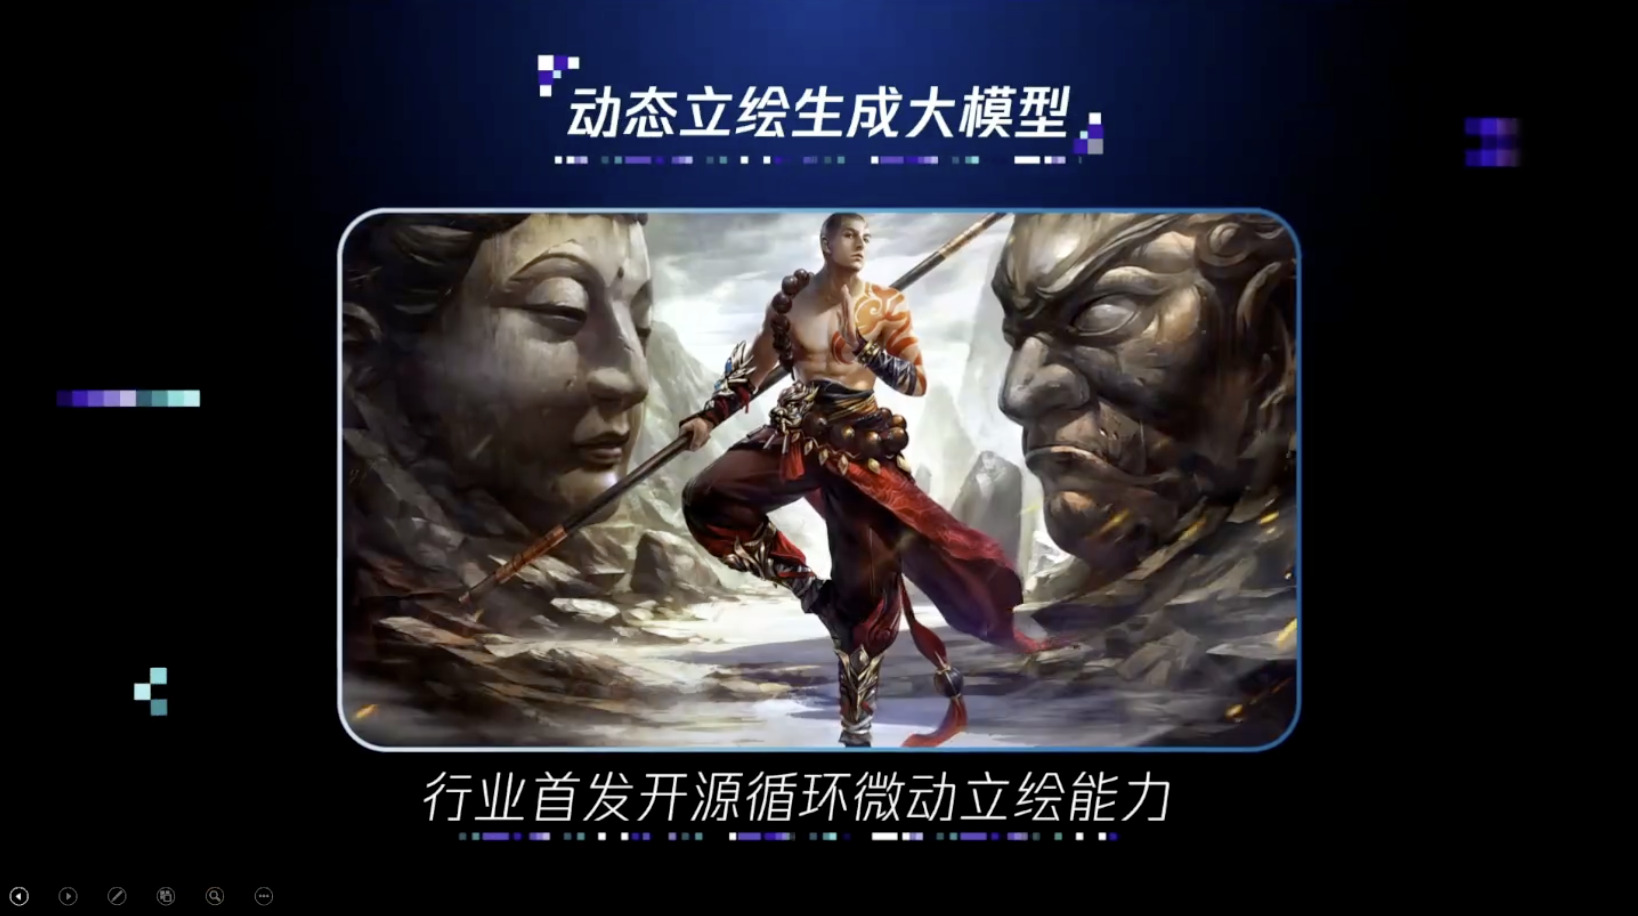
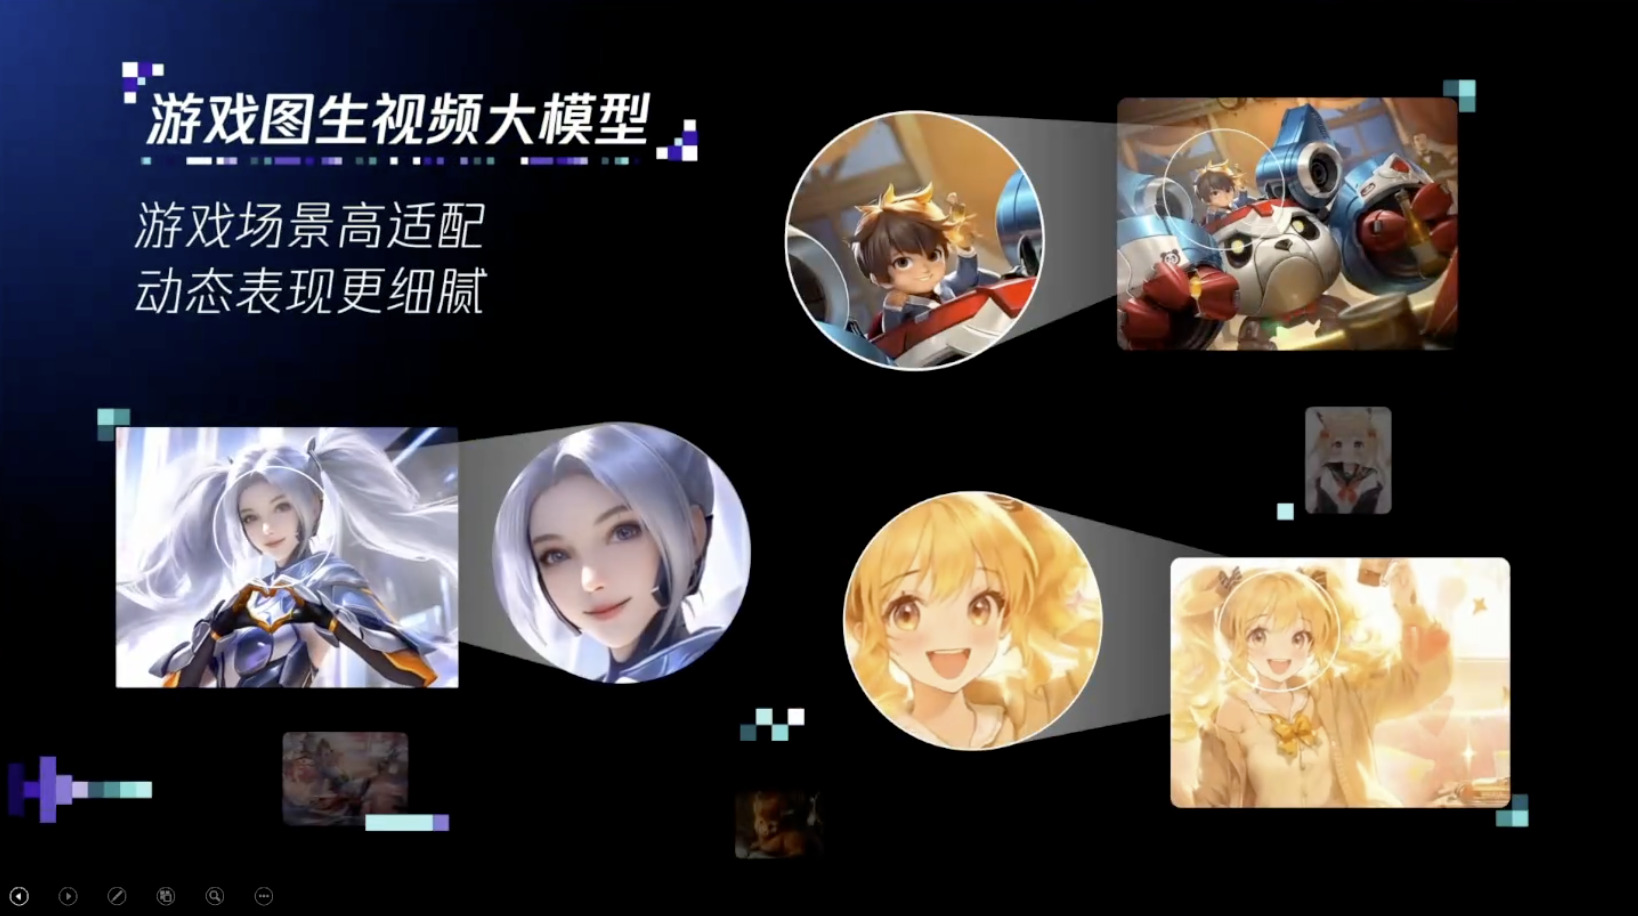
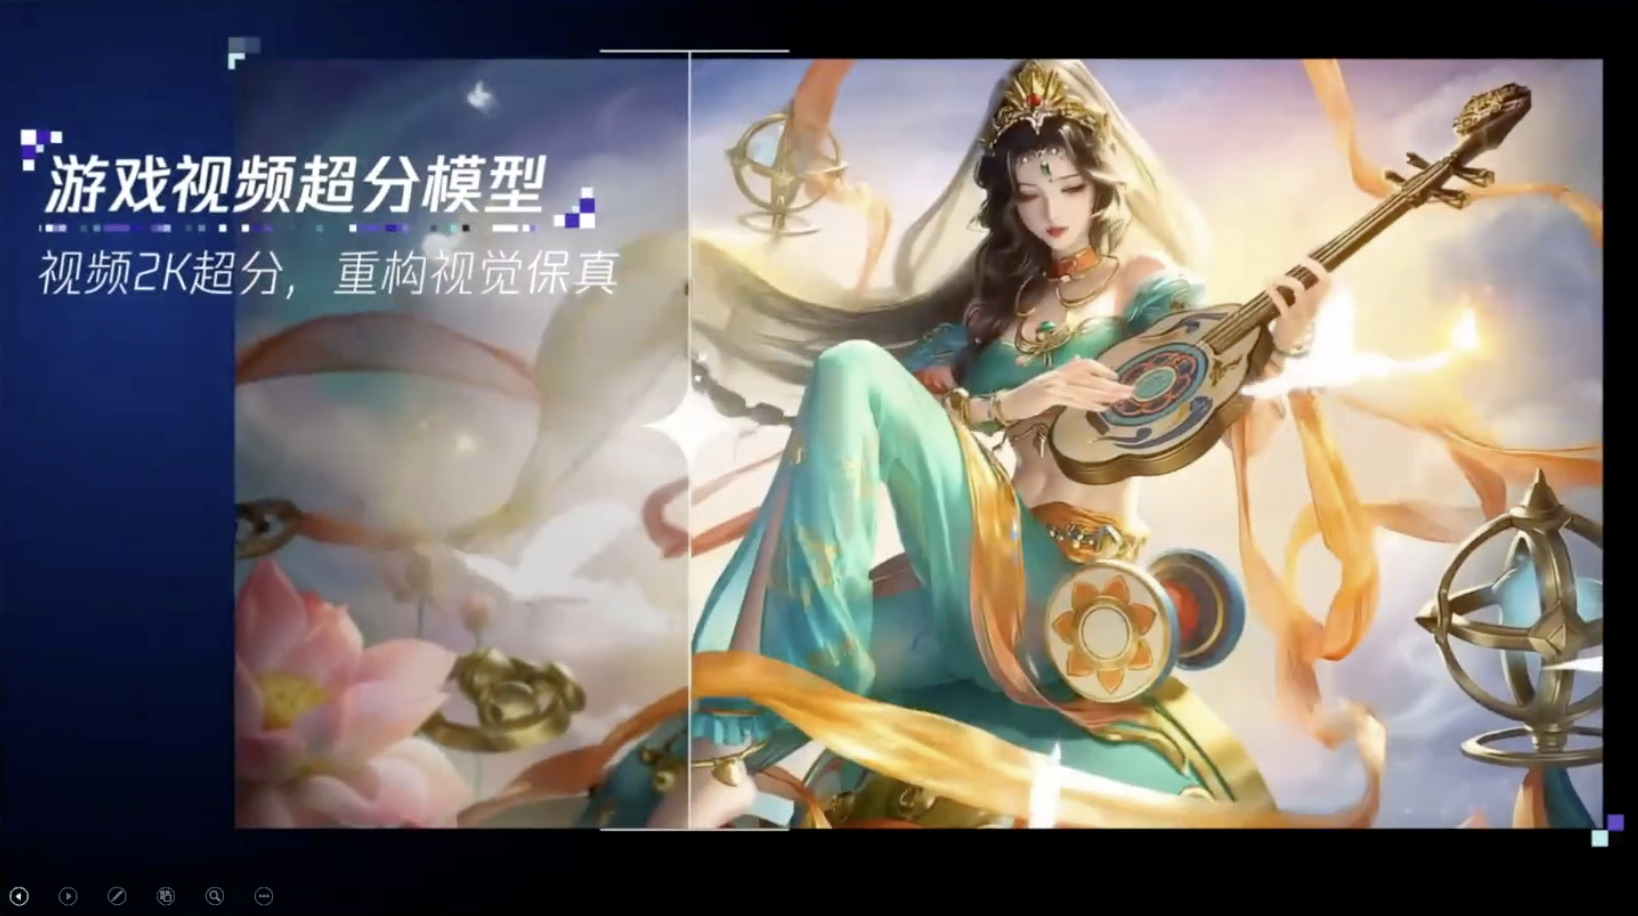
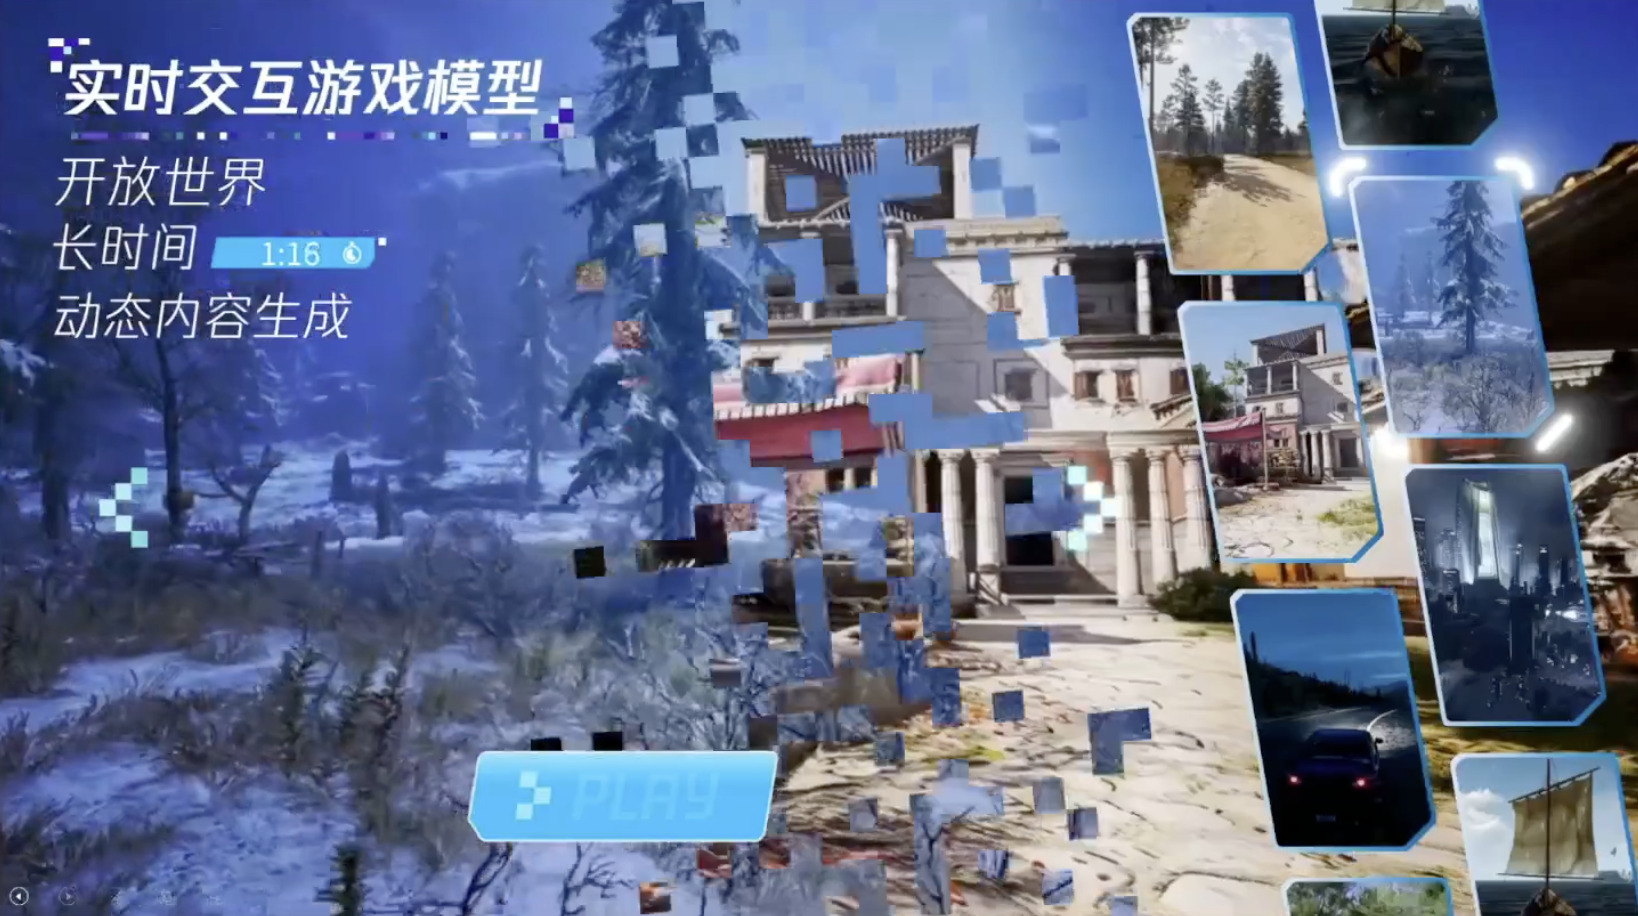
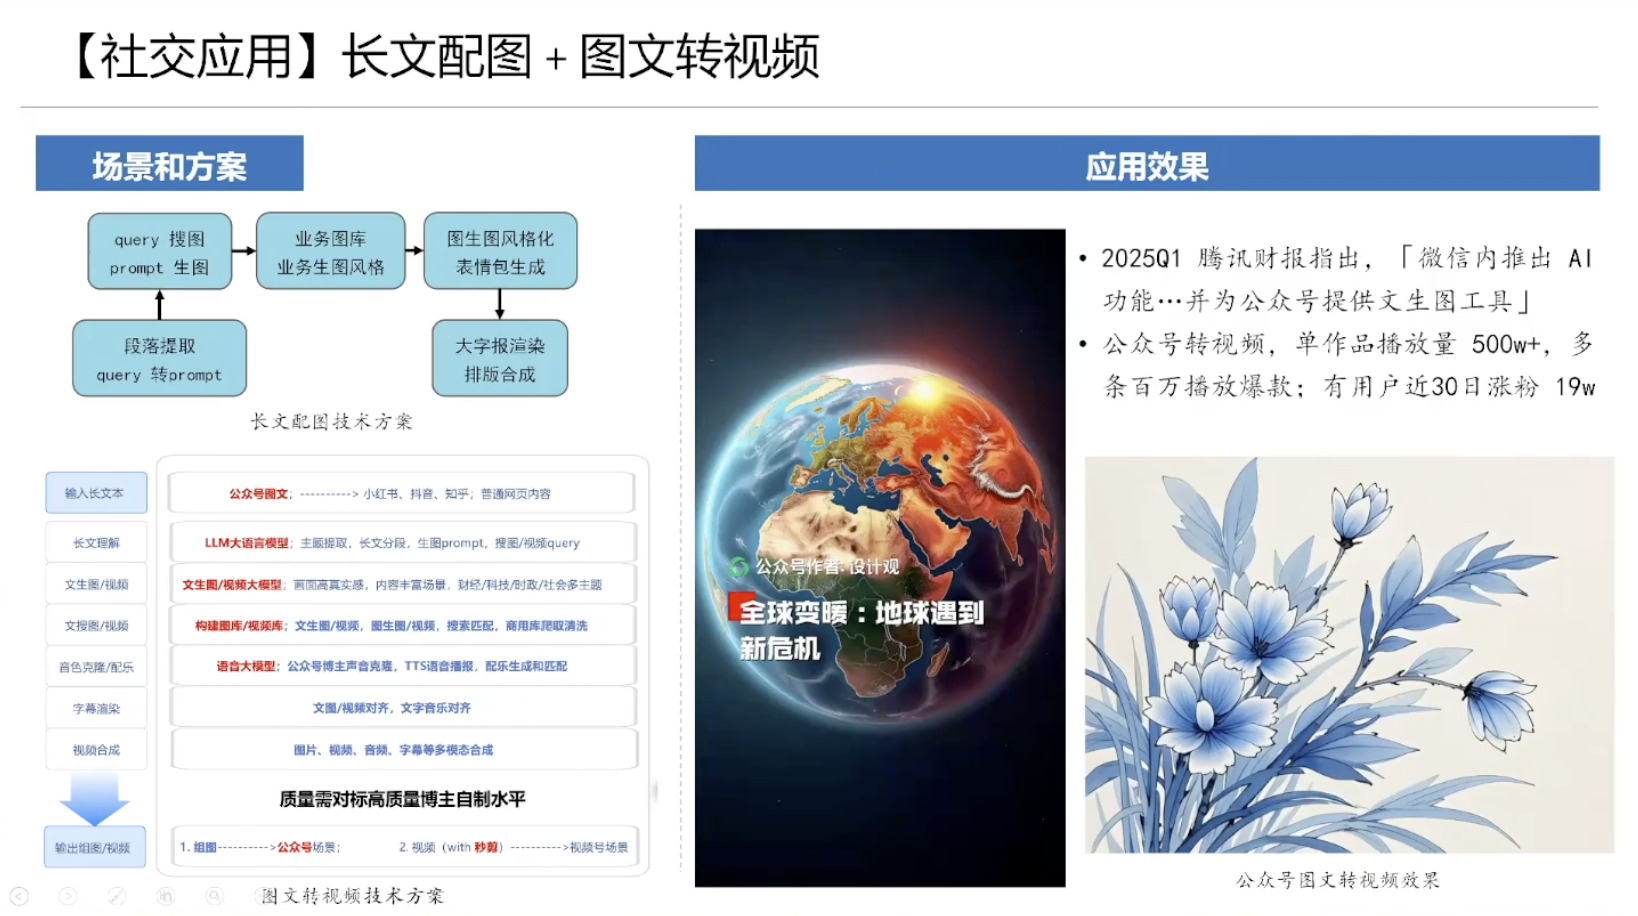
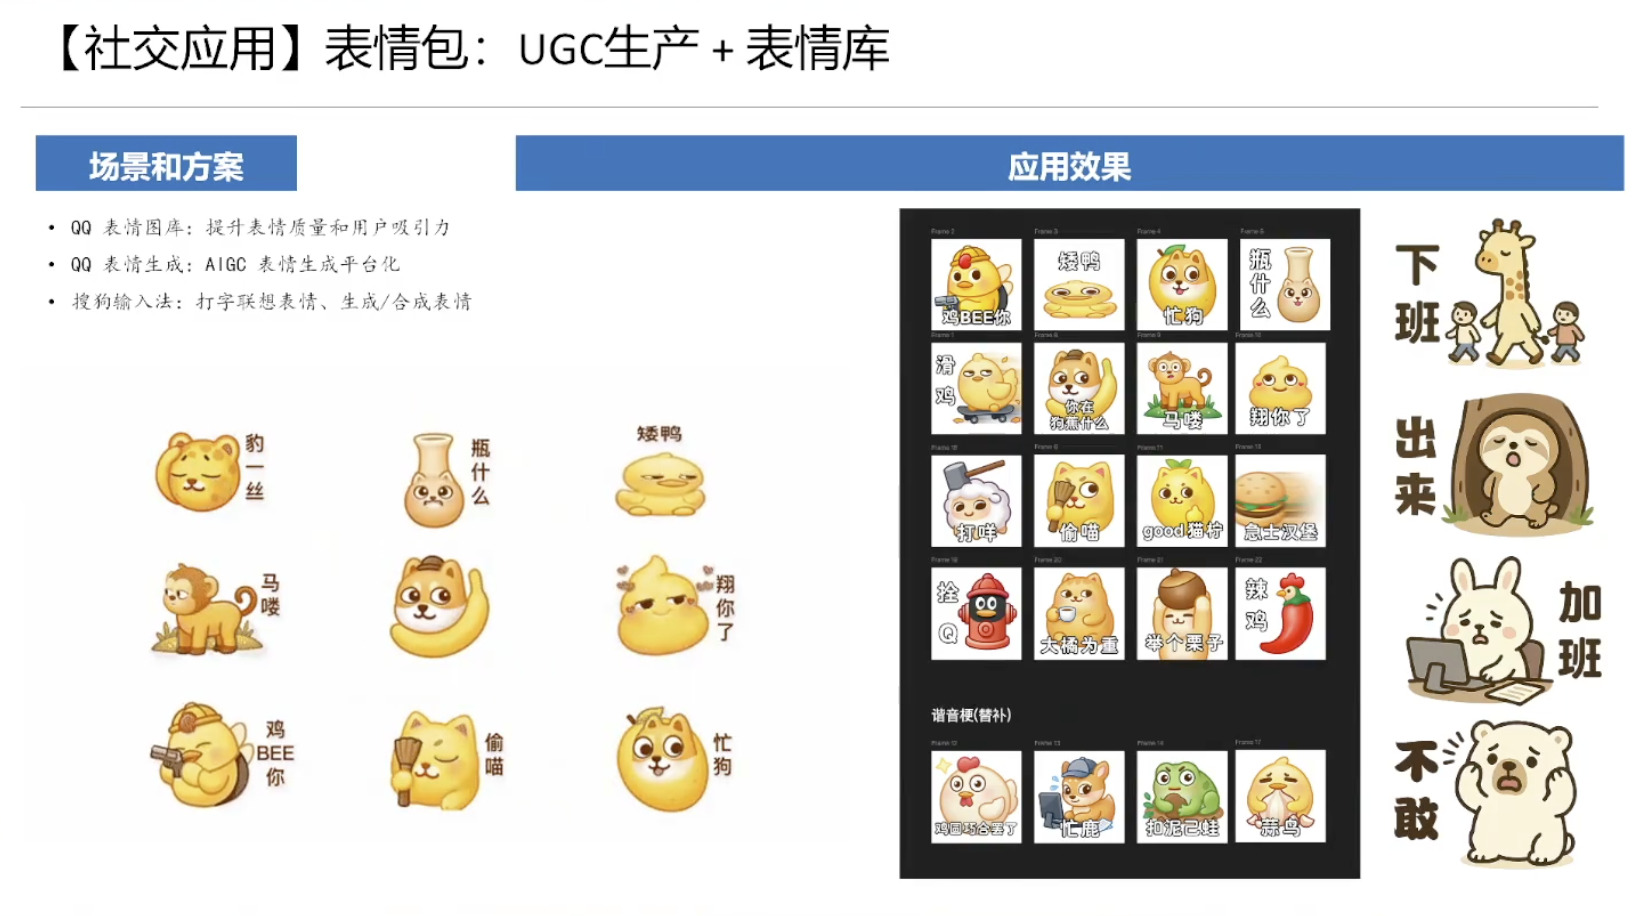
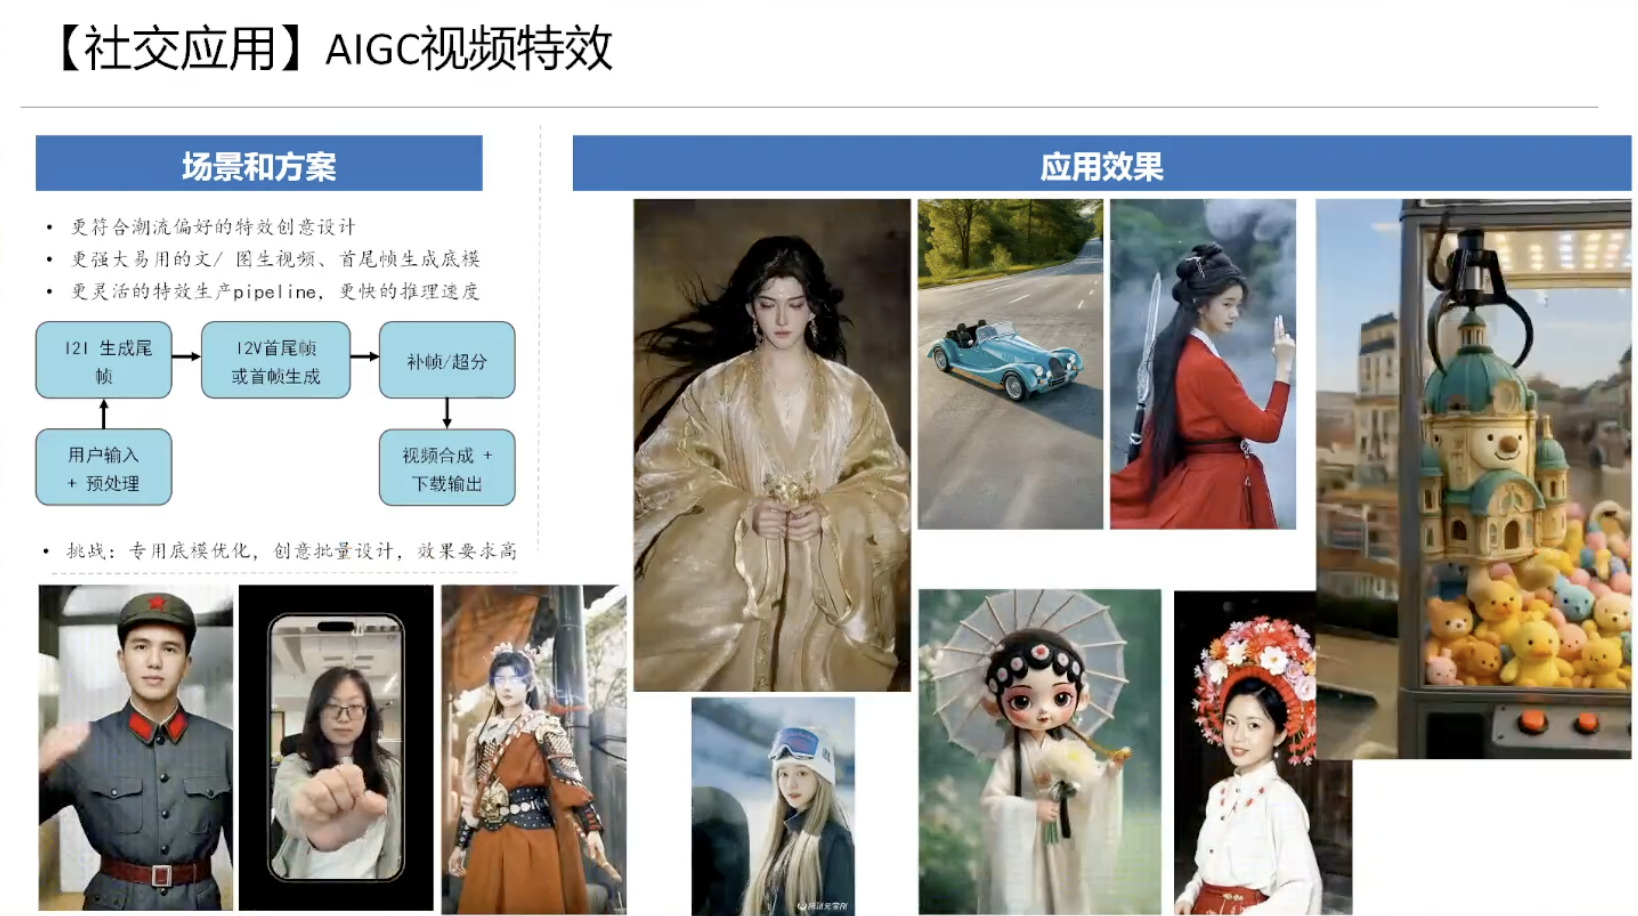
腾讯混元多模态生成模型

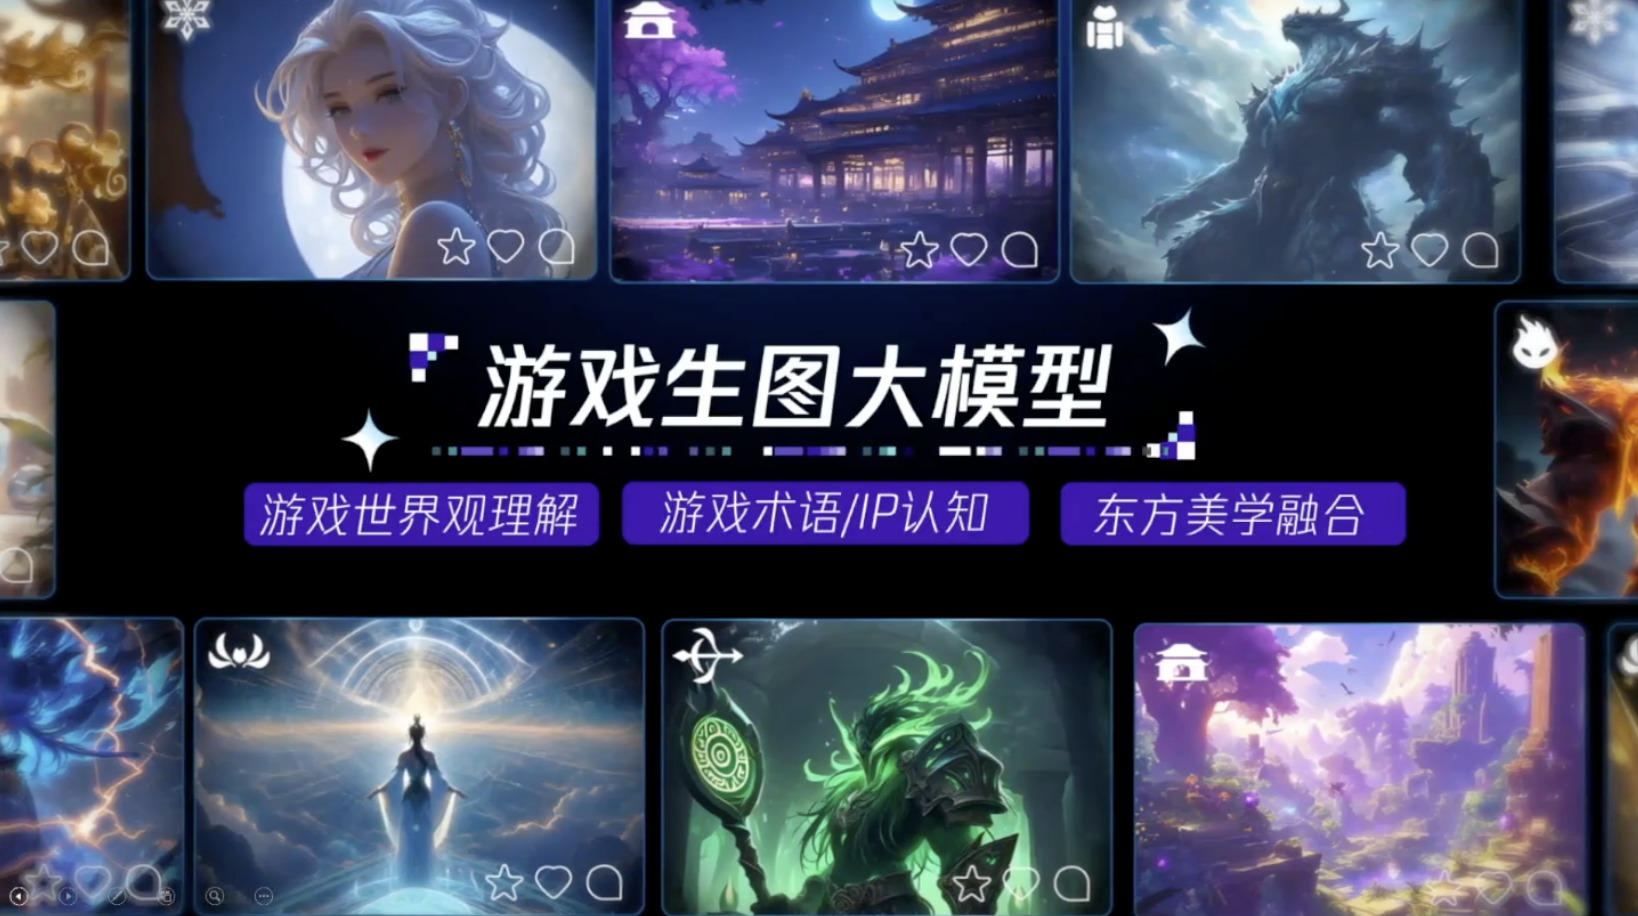
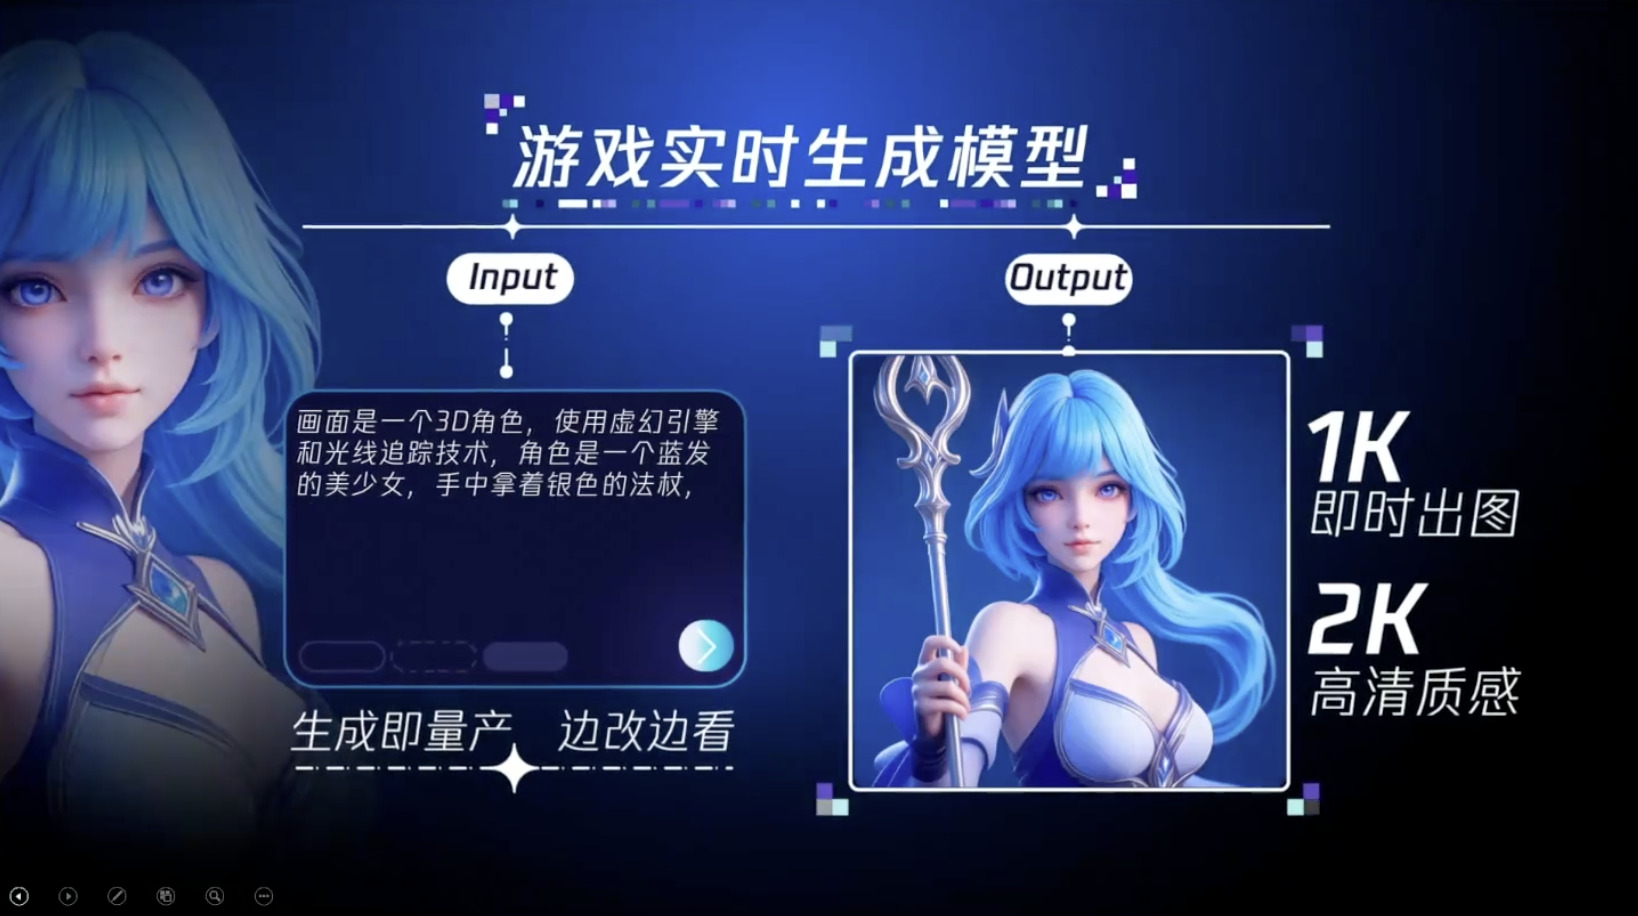
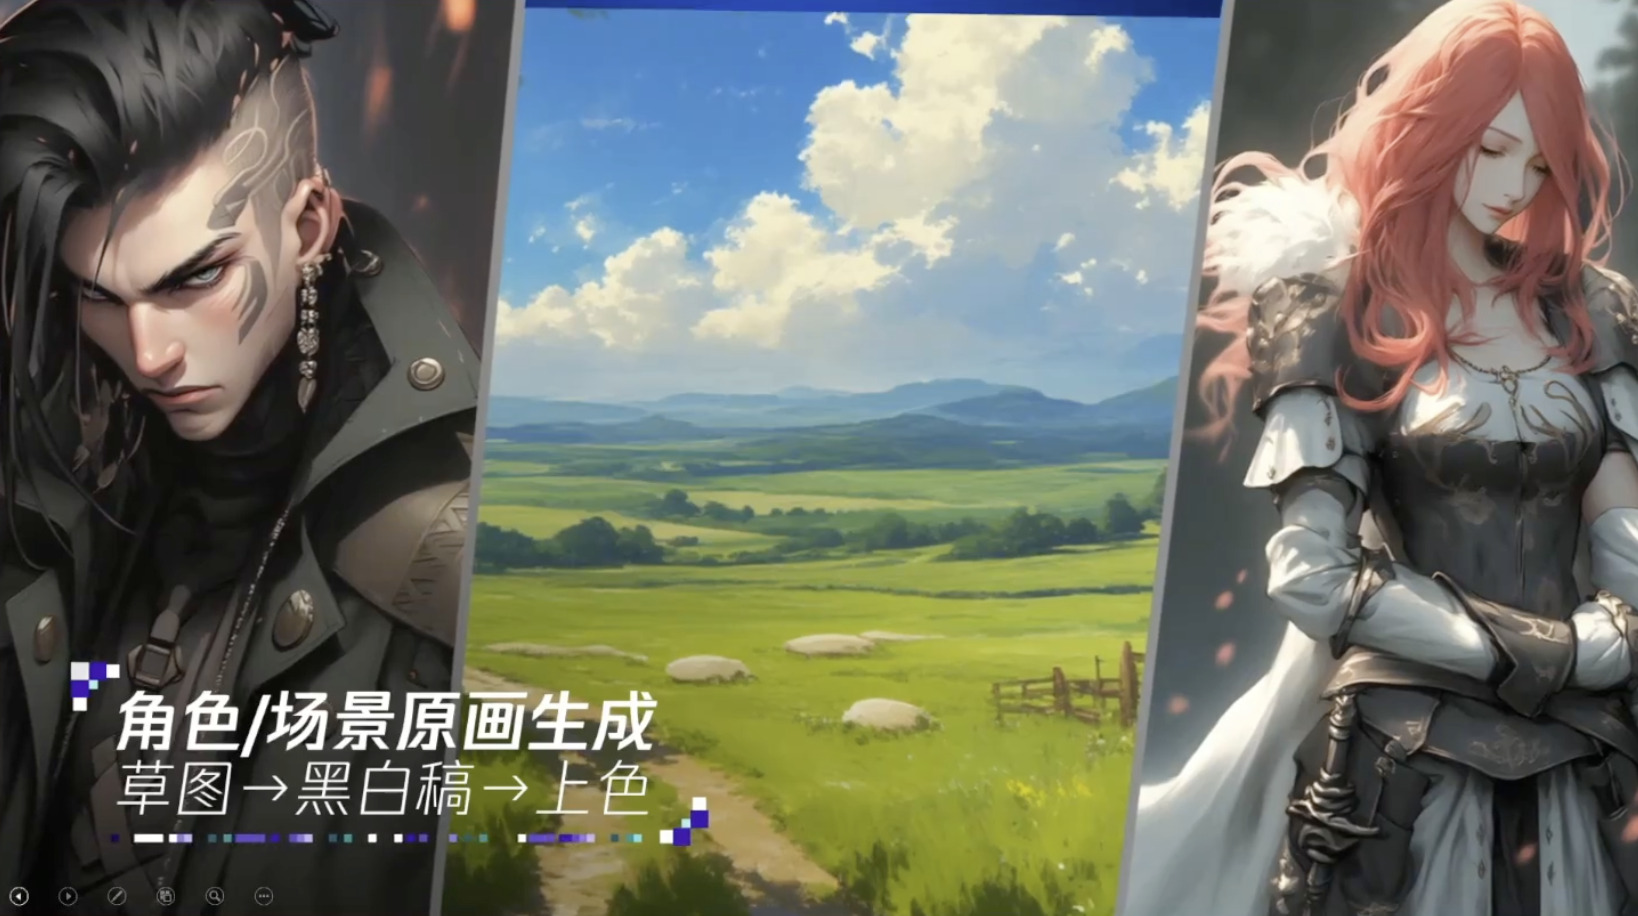
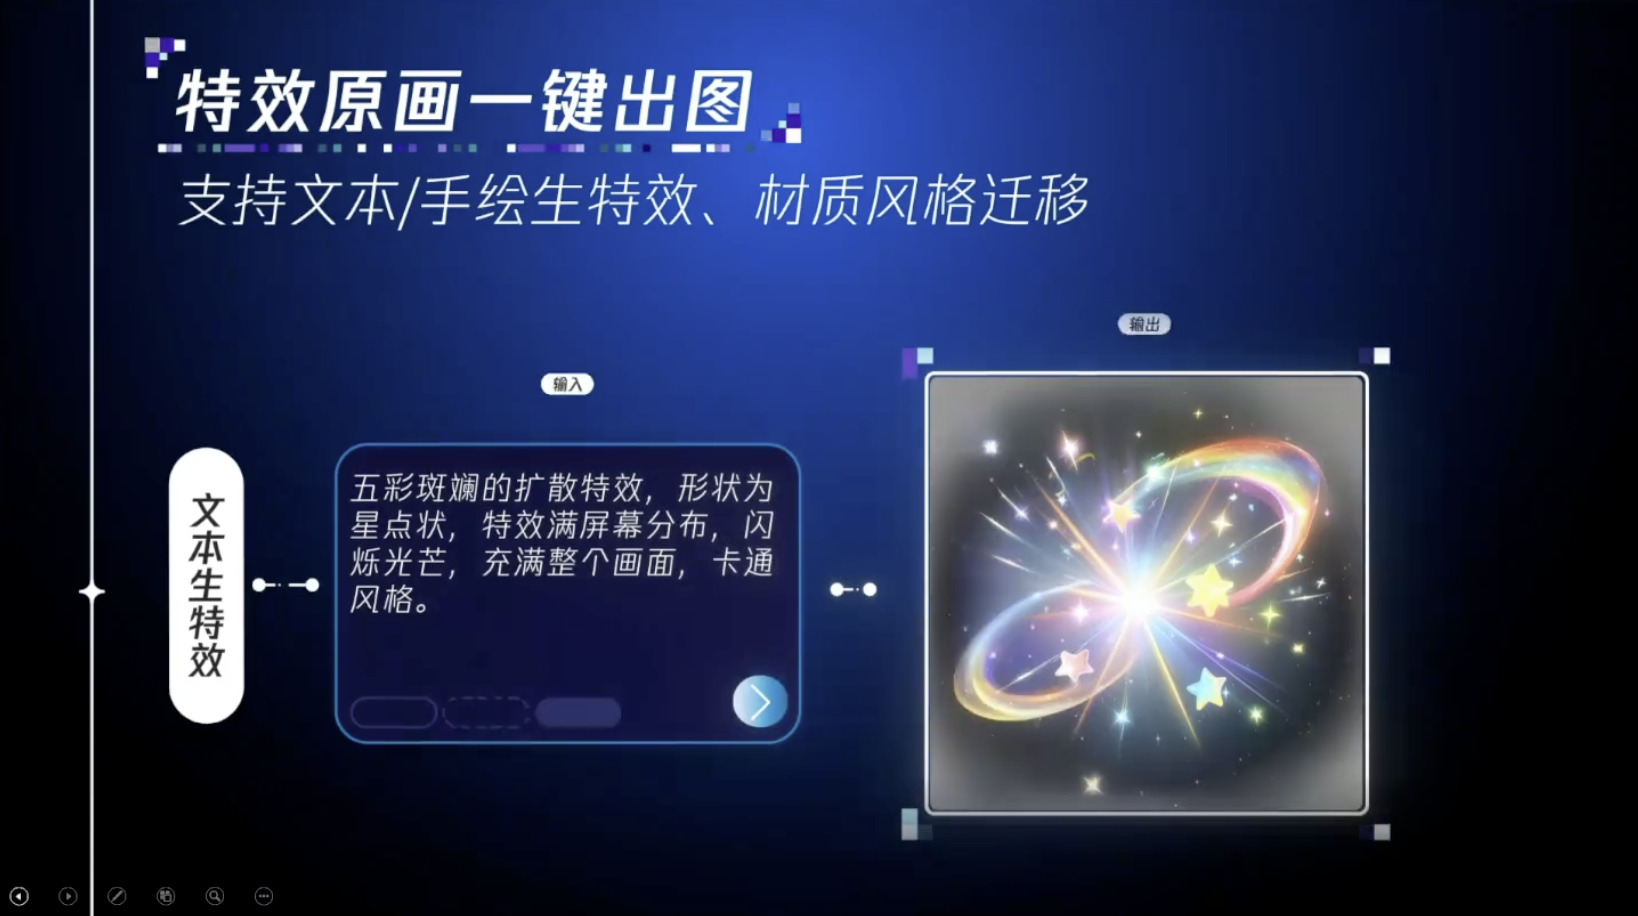
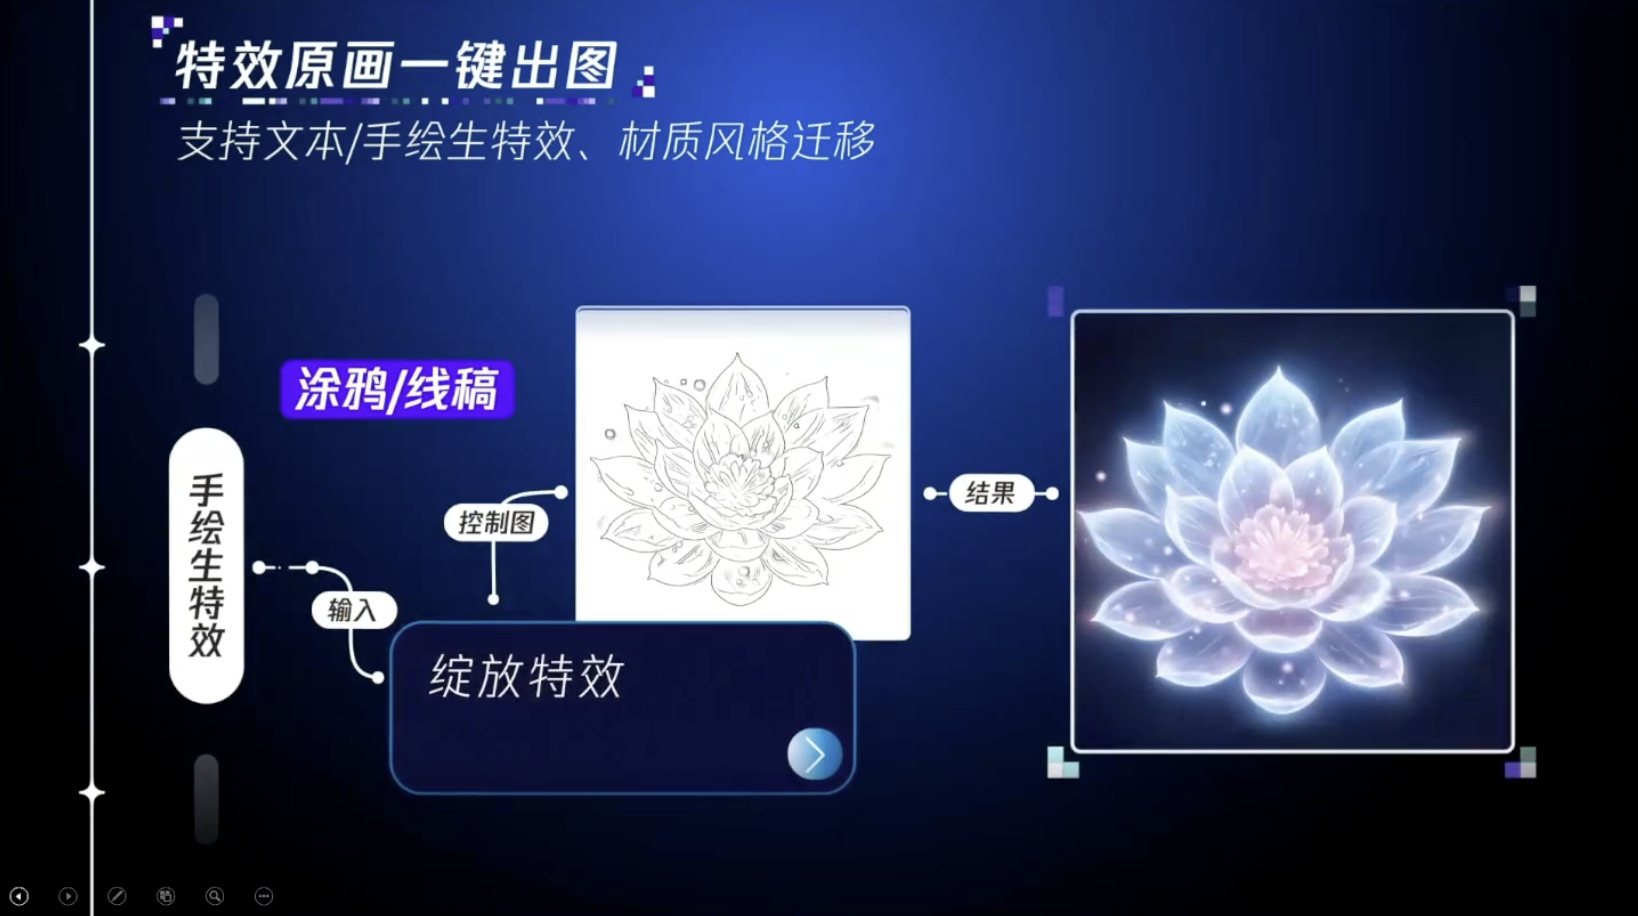
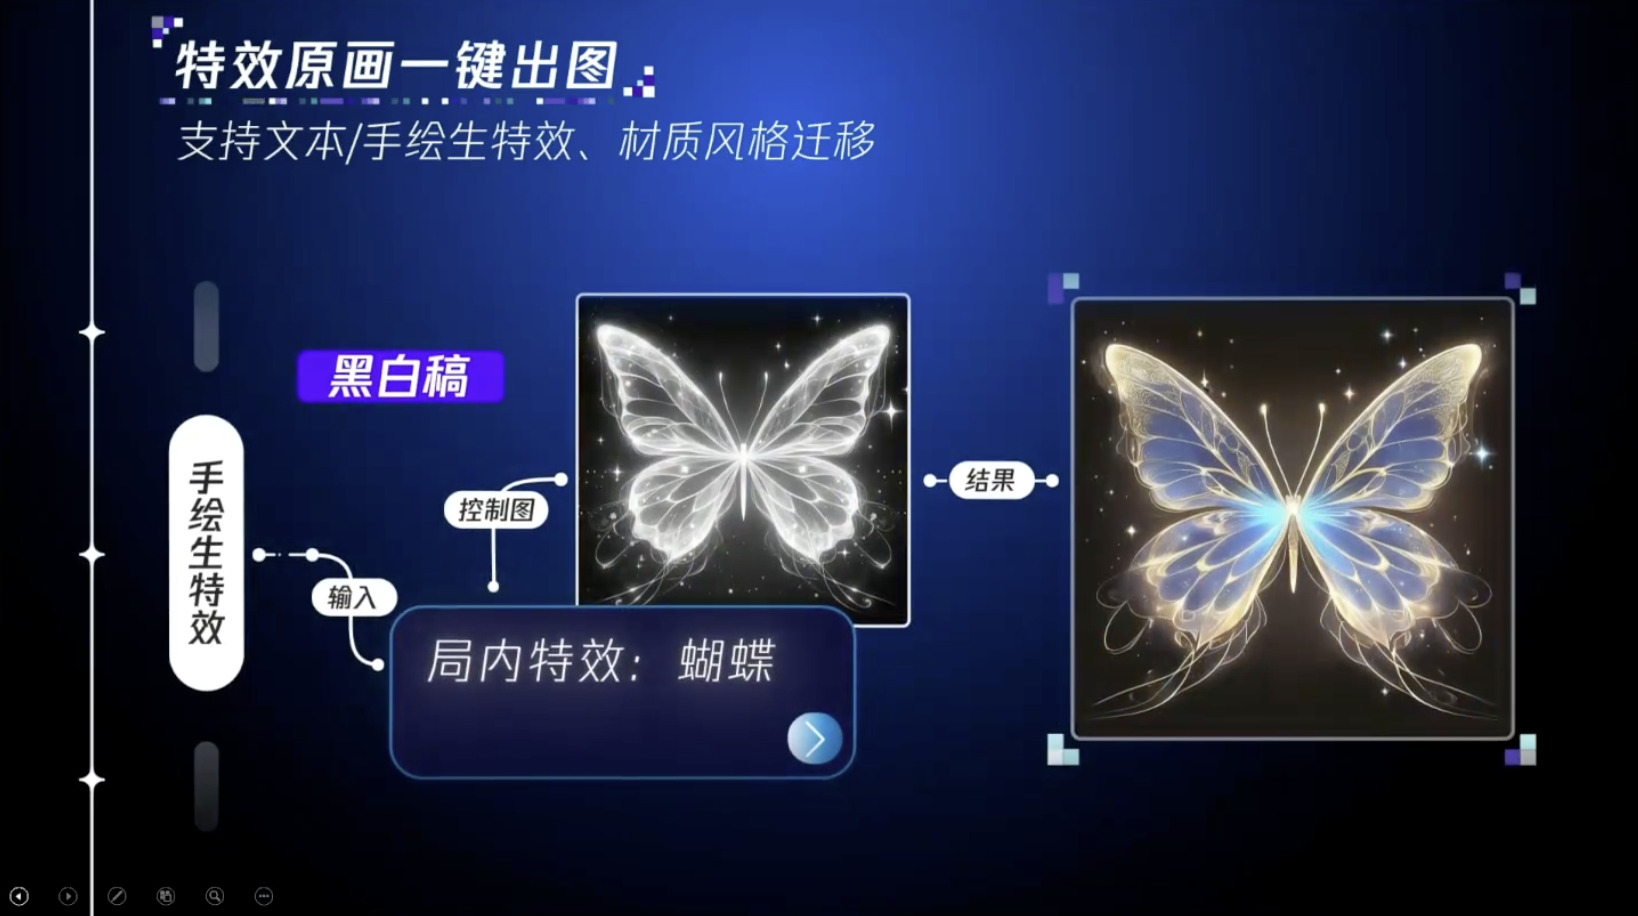
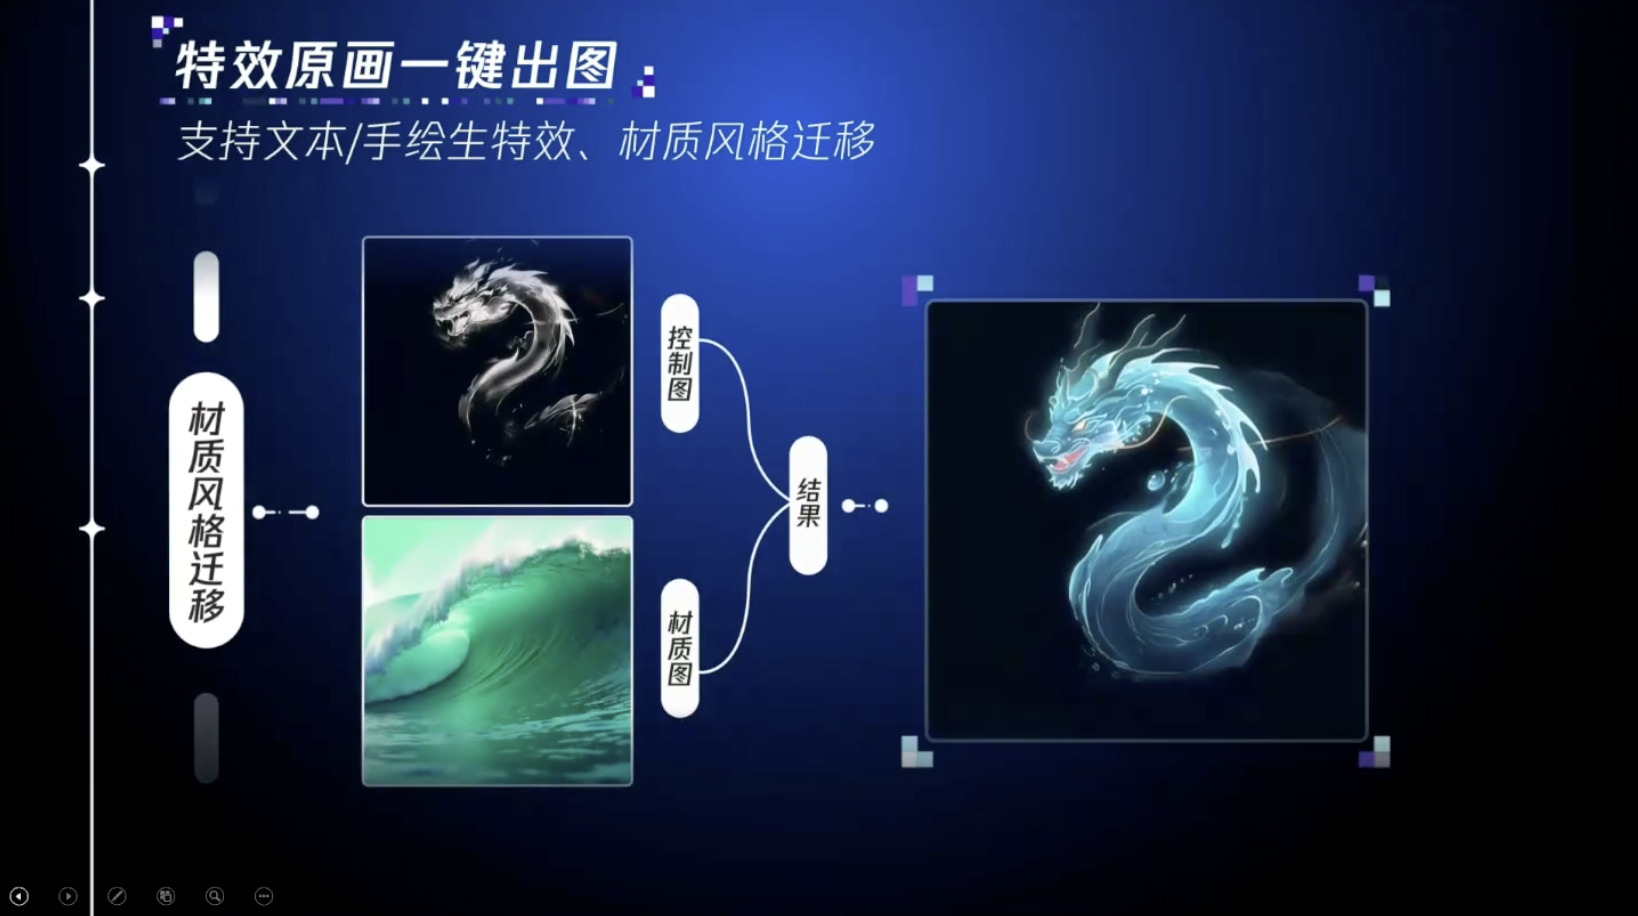
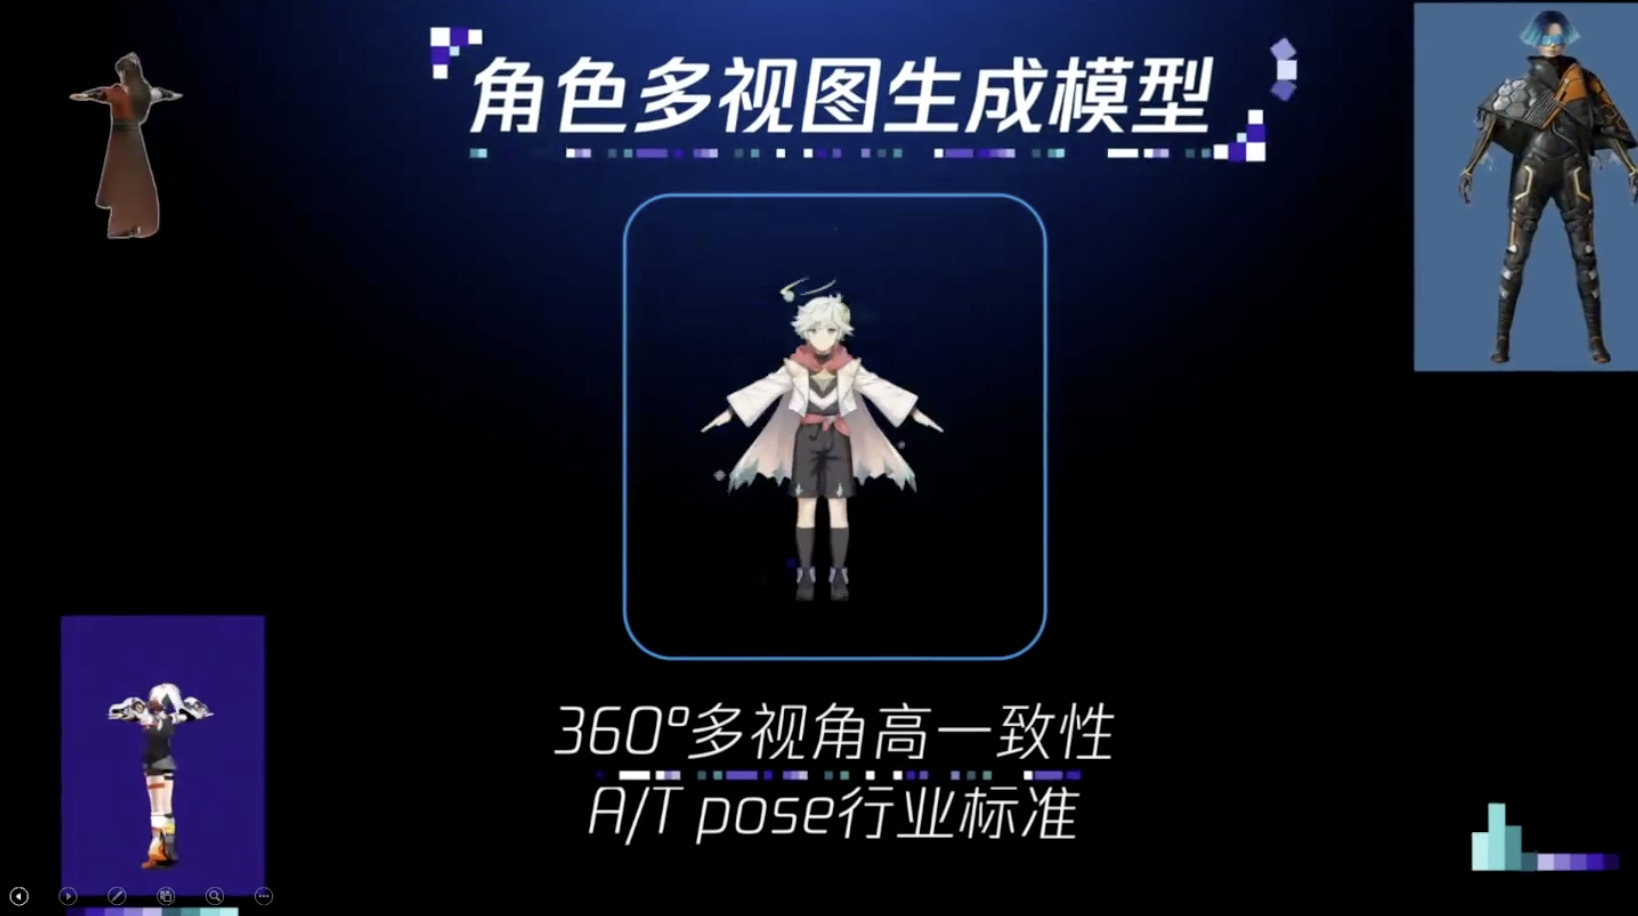
本文档重点介绍了腾讯混元多模态生成模型,强调其在人工智能大模型技术革命中的作用。还概述了该模型在图像和视频生成方面的能力,并展示了其在游戏、社交媒体等领域的广泛应用。特别是,它详细阐述了文本到图像生成的速度提升,以及在游戏皮肤制作和特效创建中的实际应用。此外,该模型还被用于生成表情包多媒体内容,展示了腾讯在视觉生成技术方面的雄心。

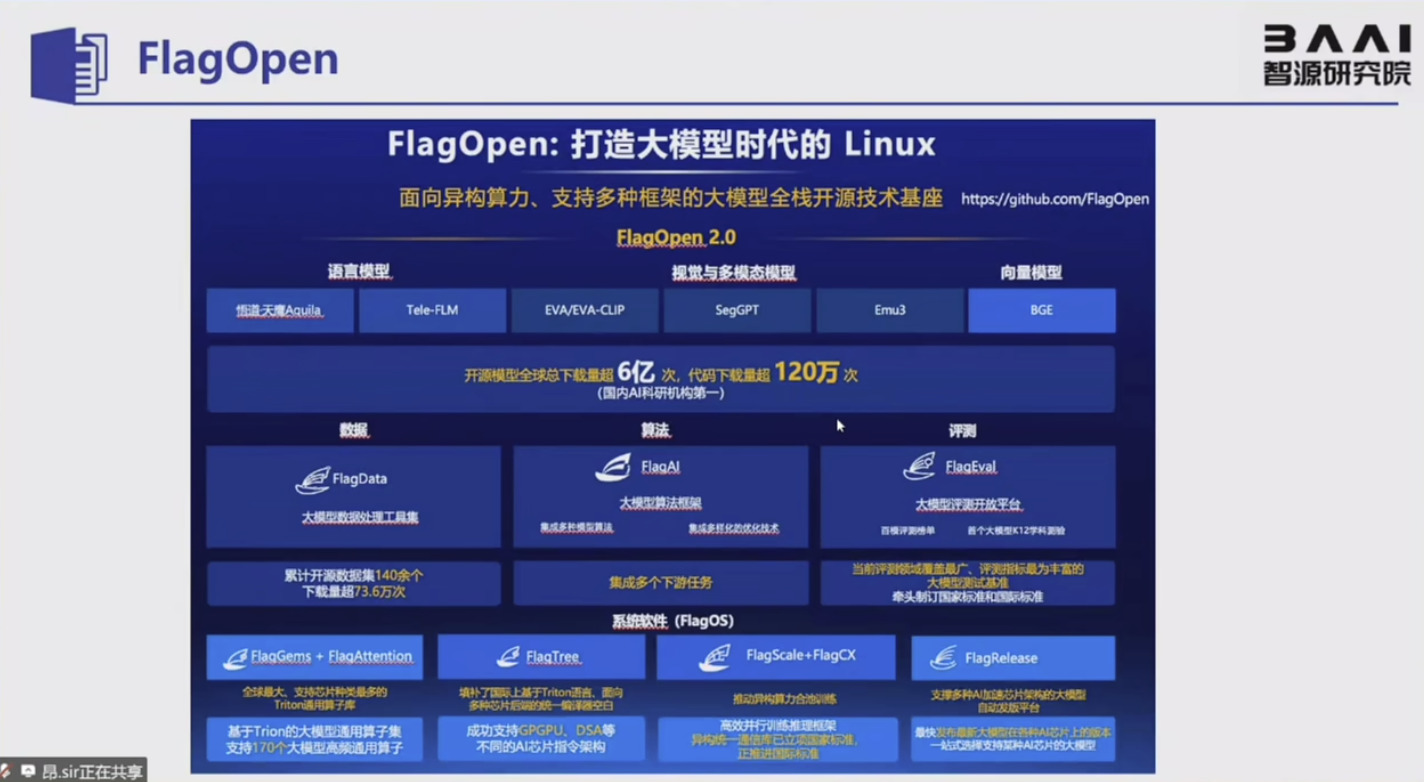
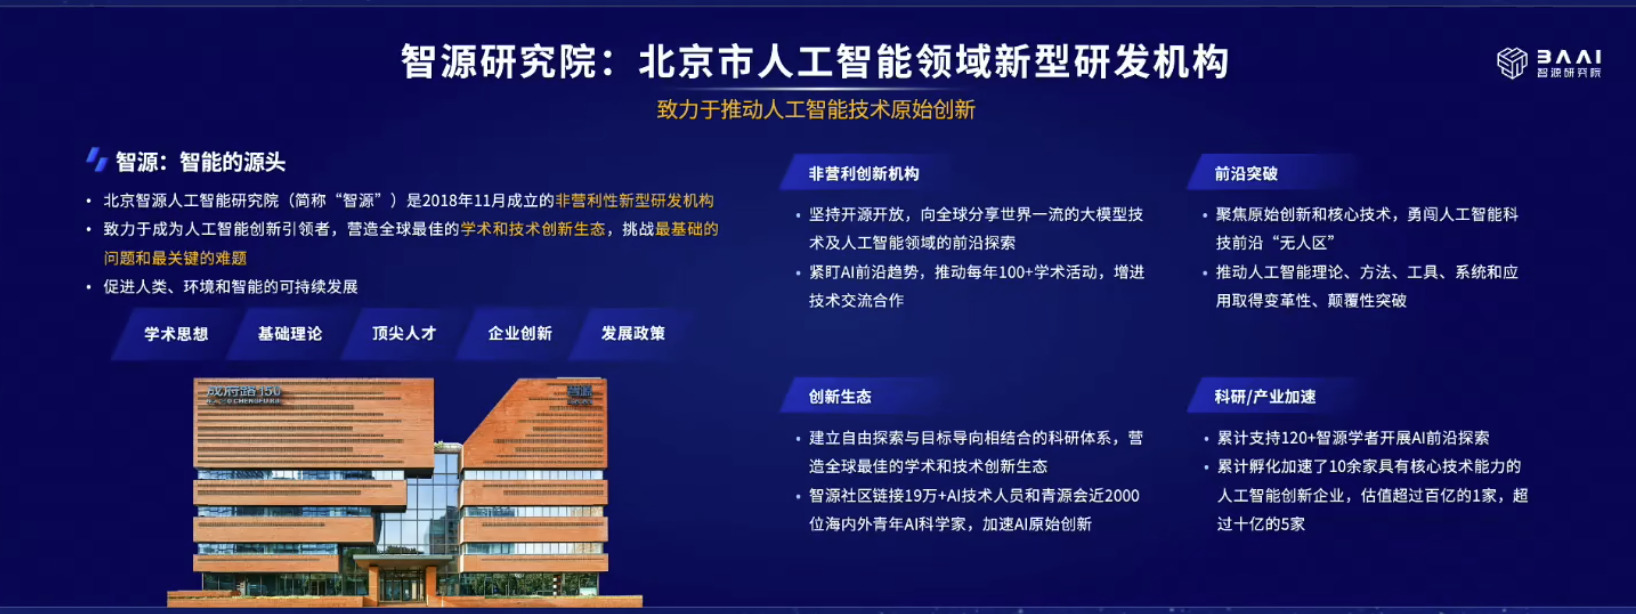
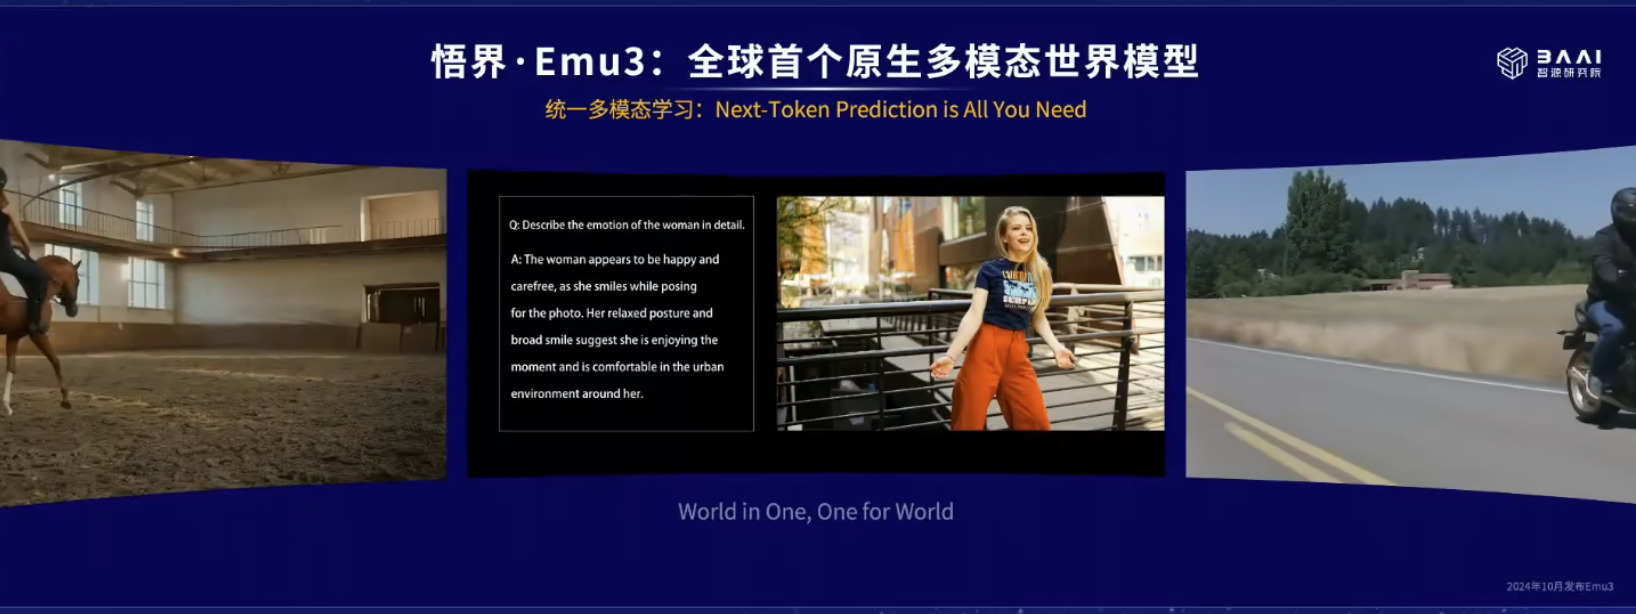
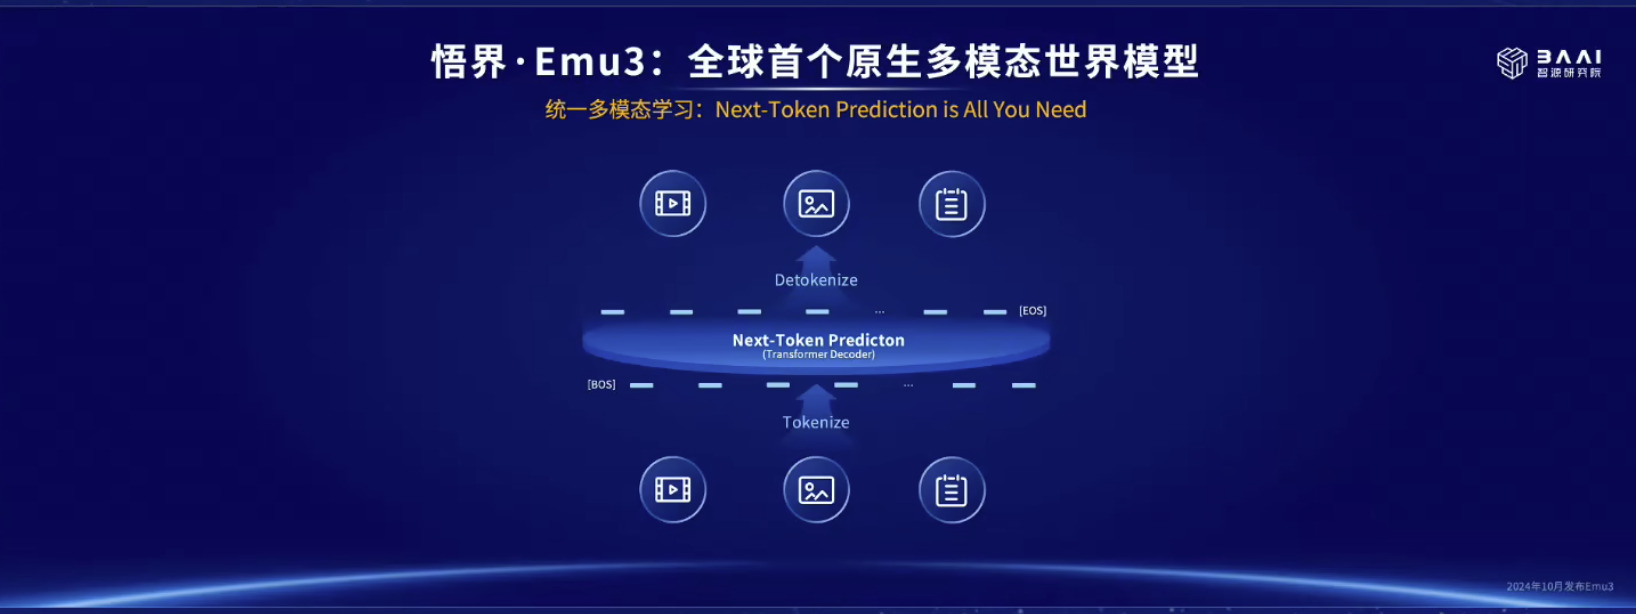
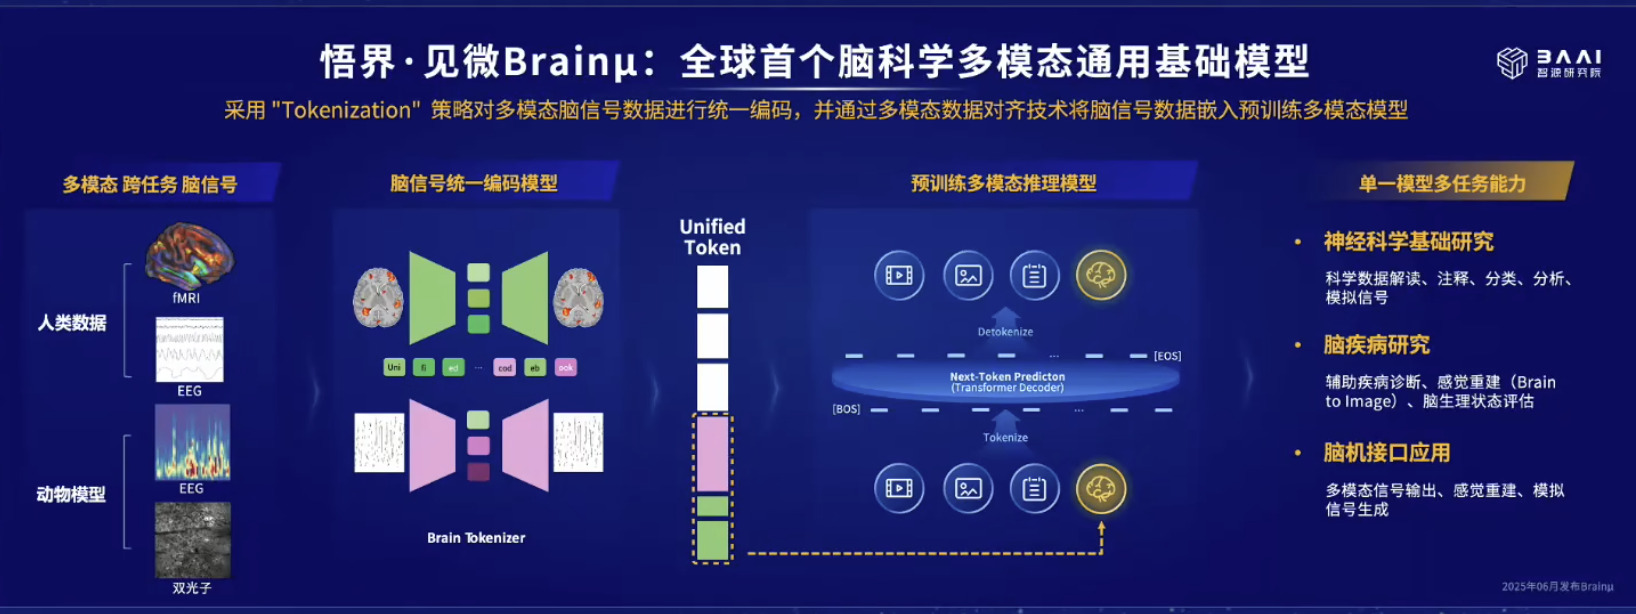
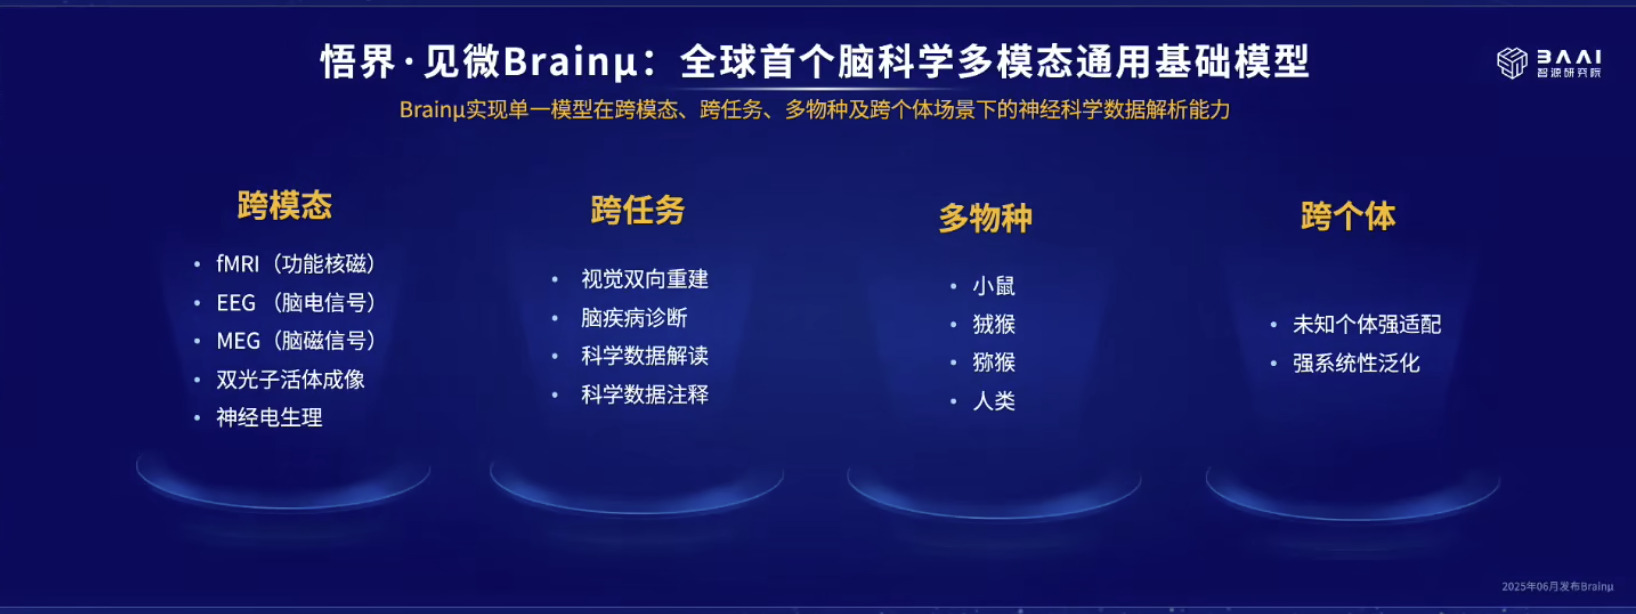
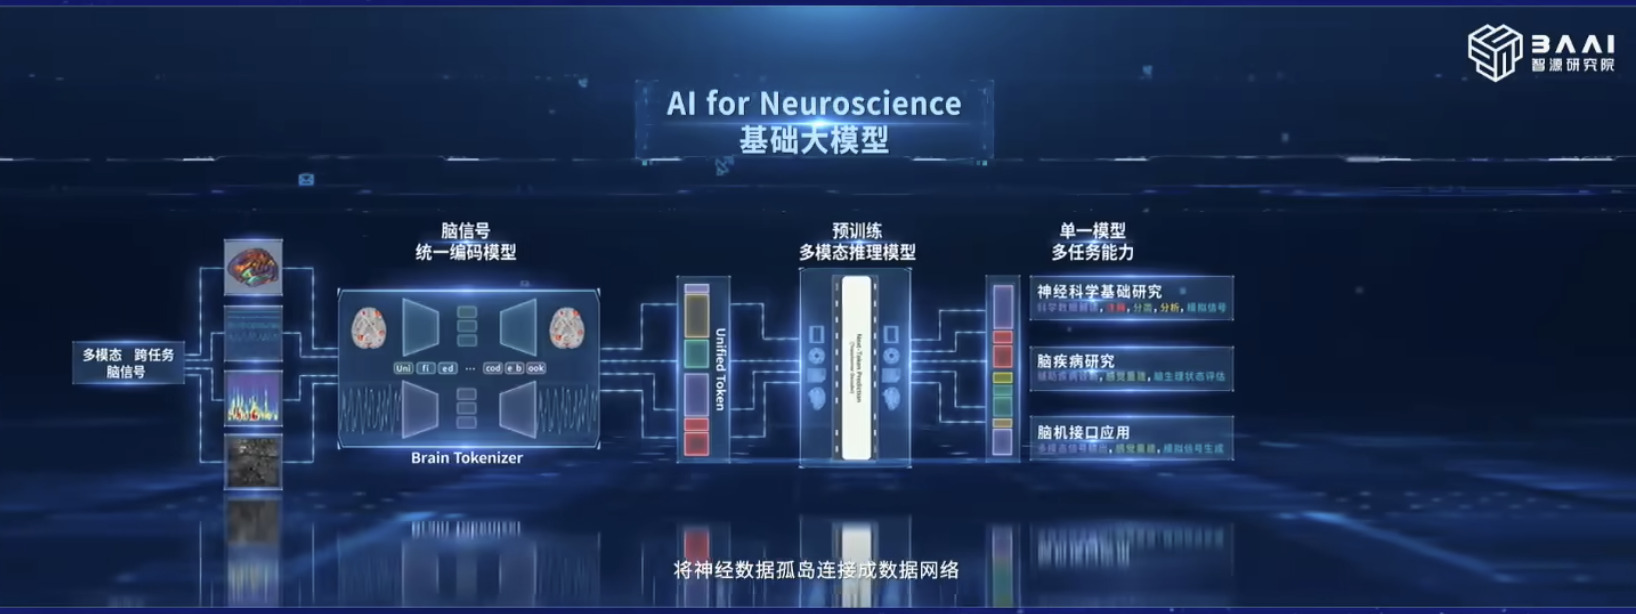
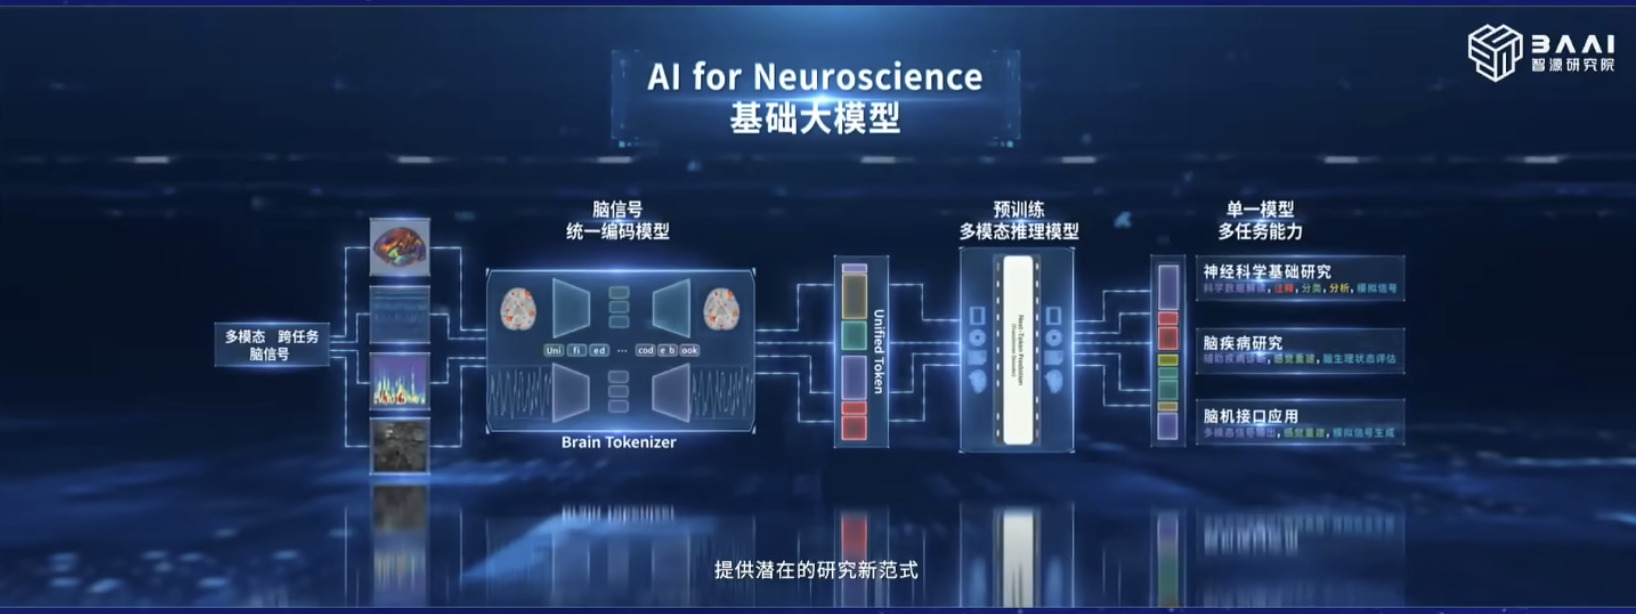
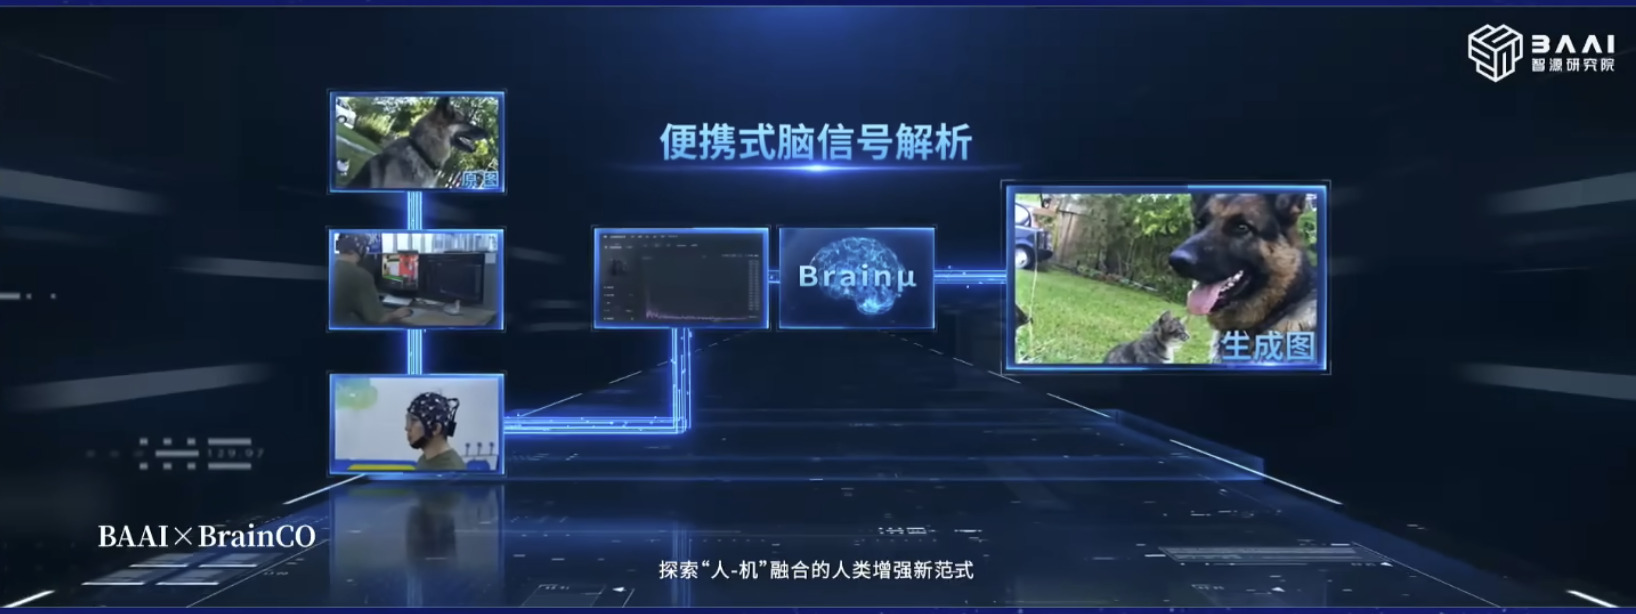
北京智源人工智能研究院(BAAI)

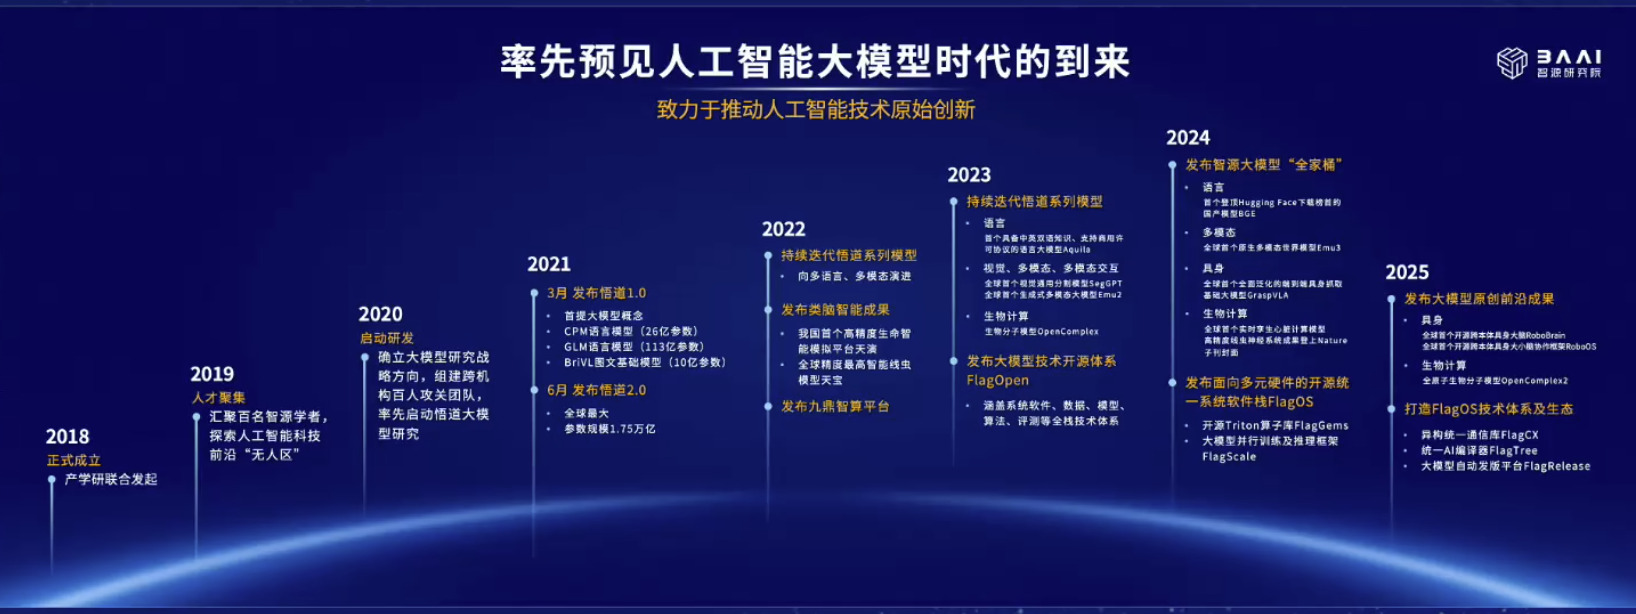
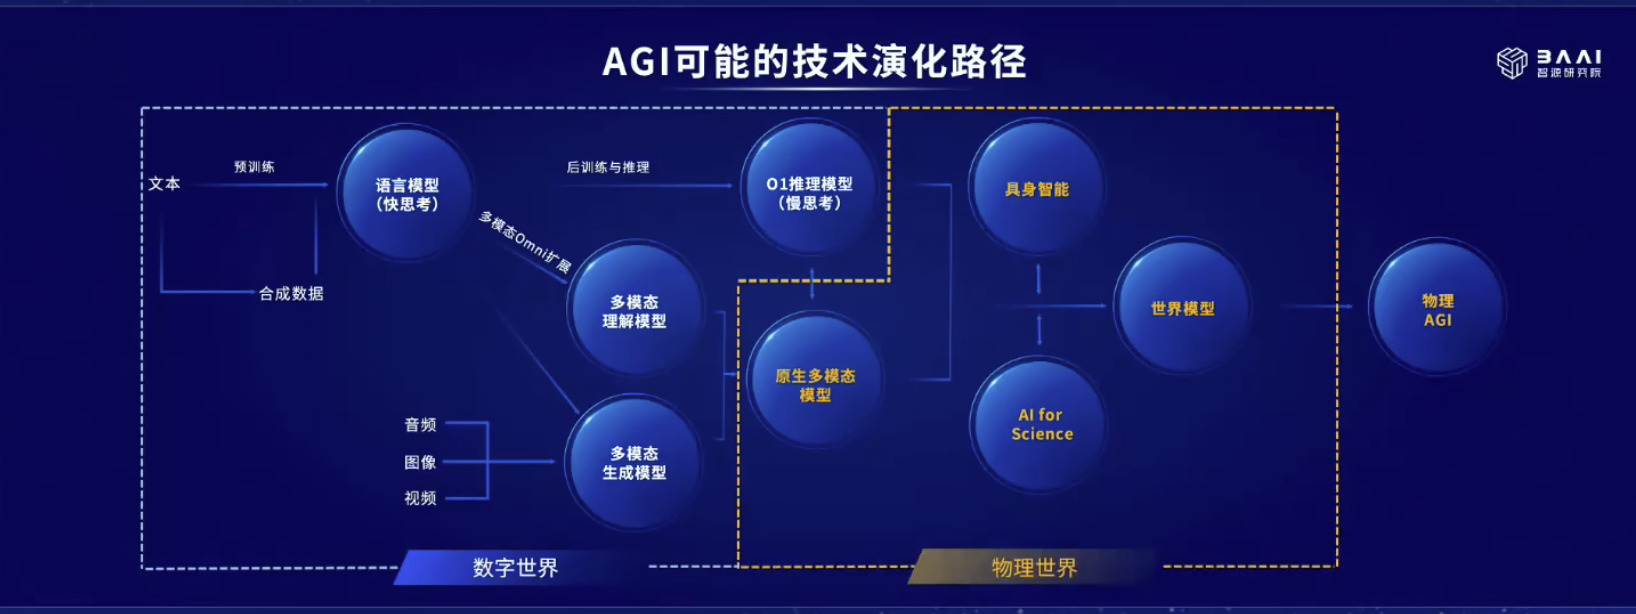
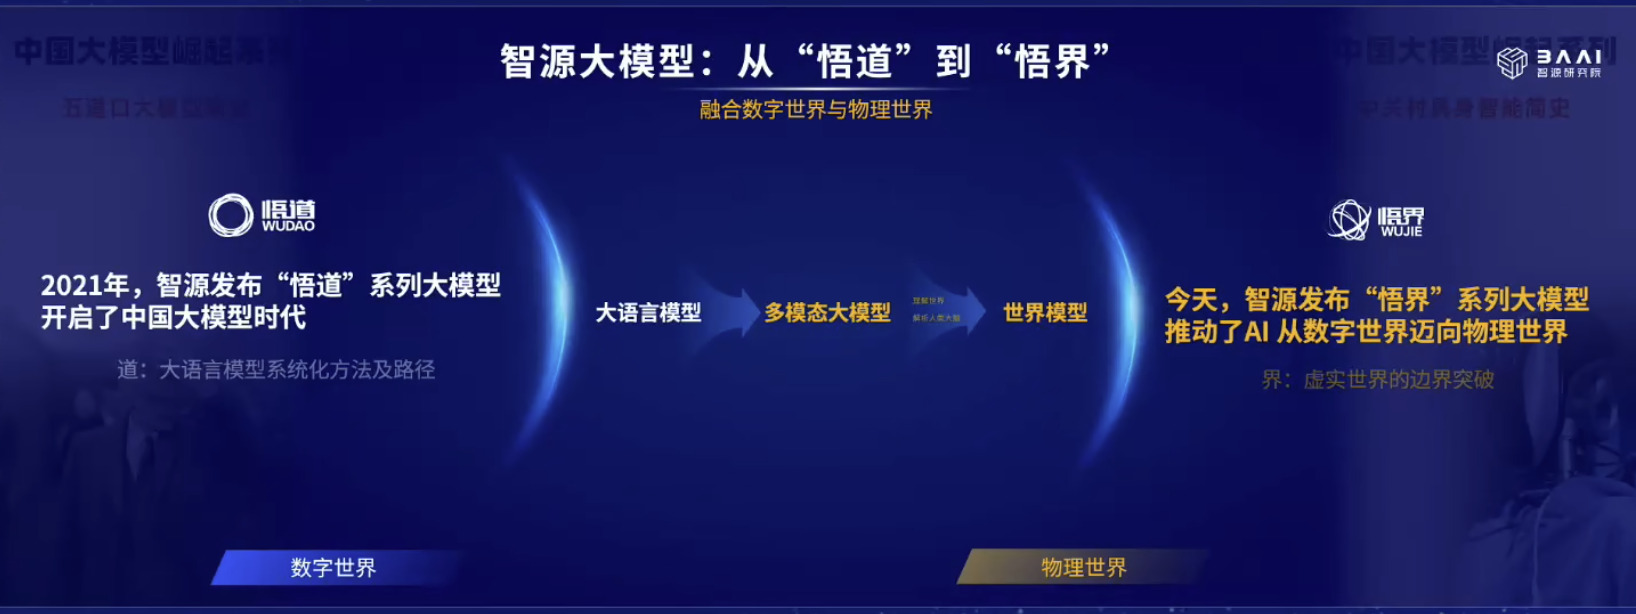
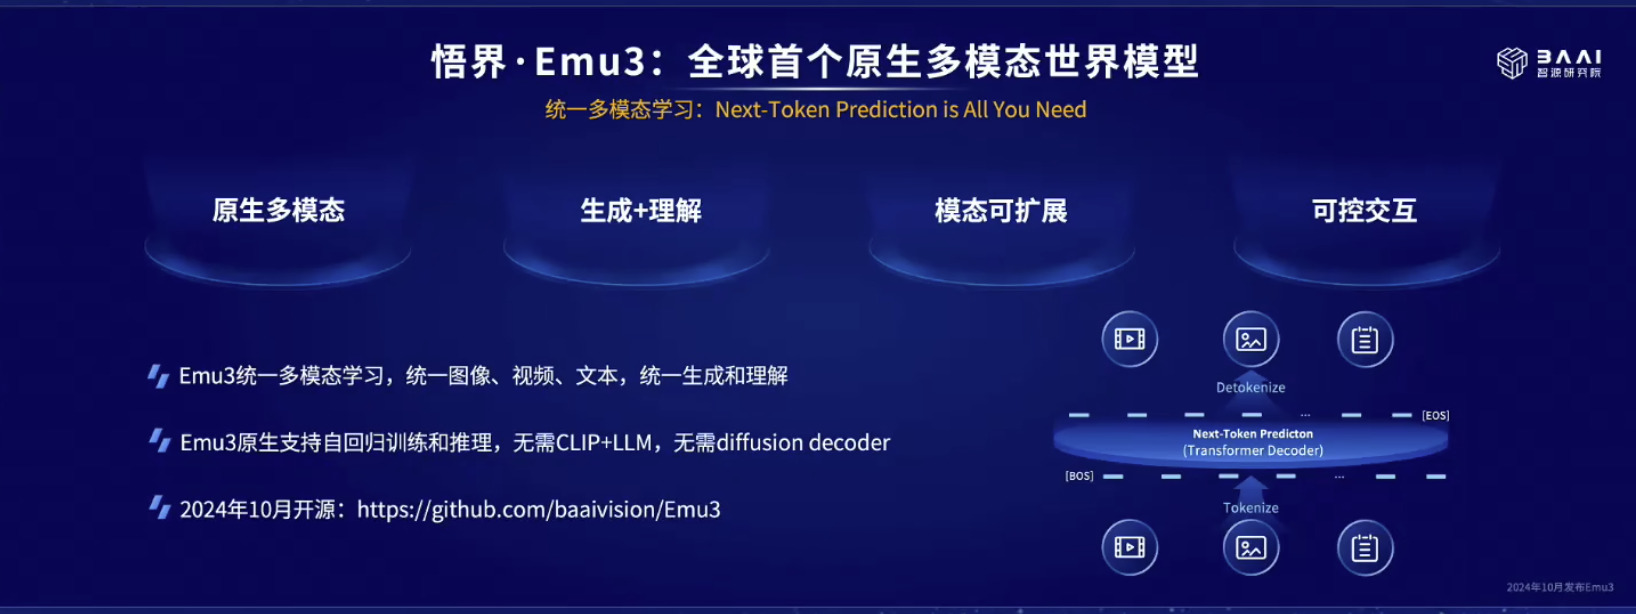
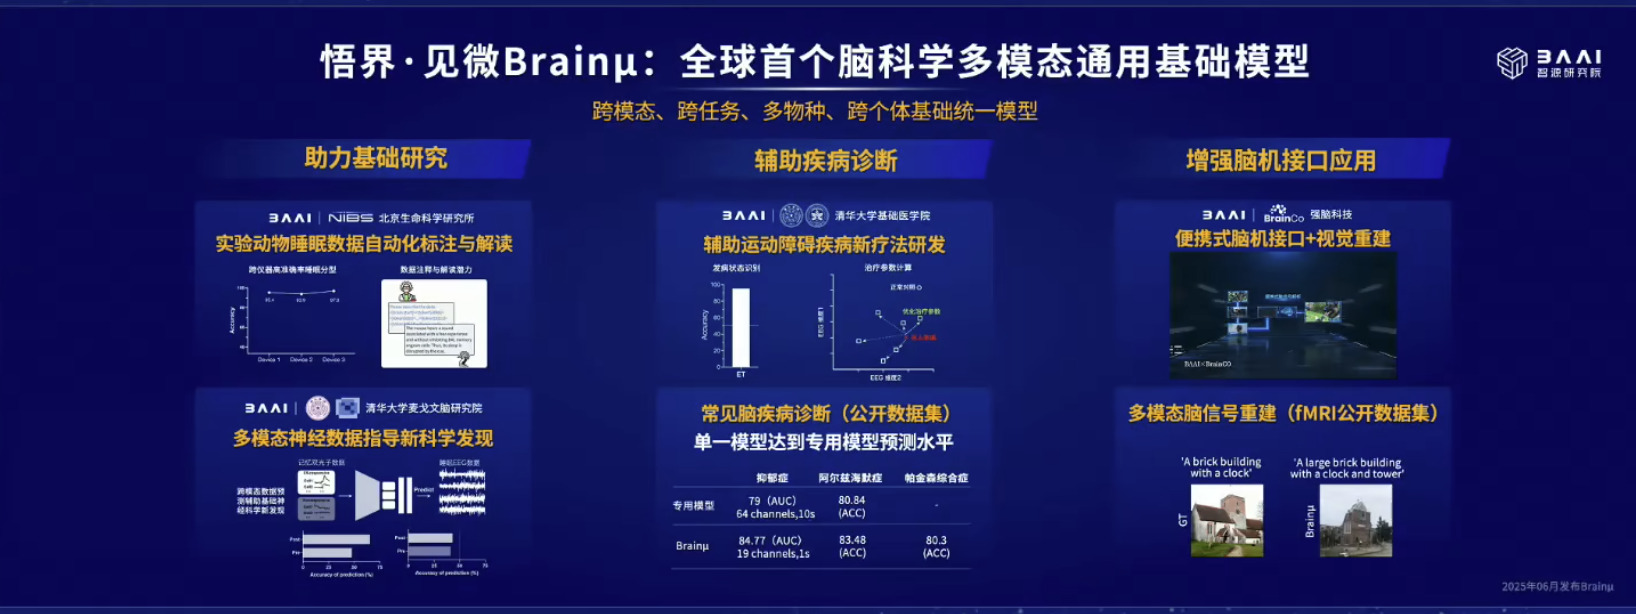
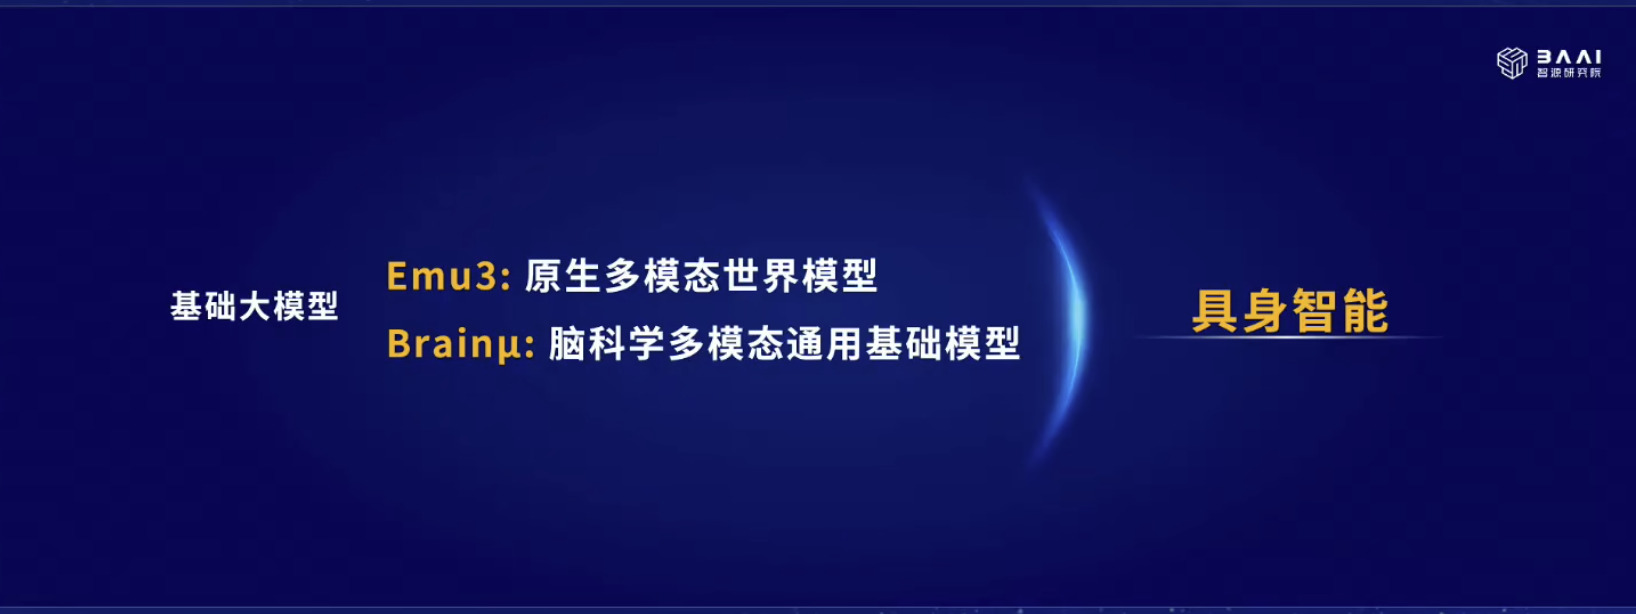
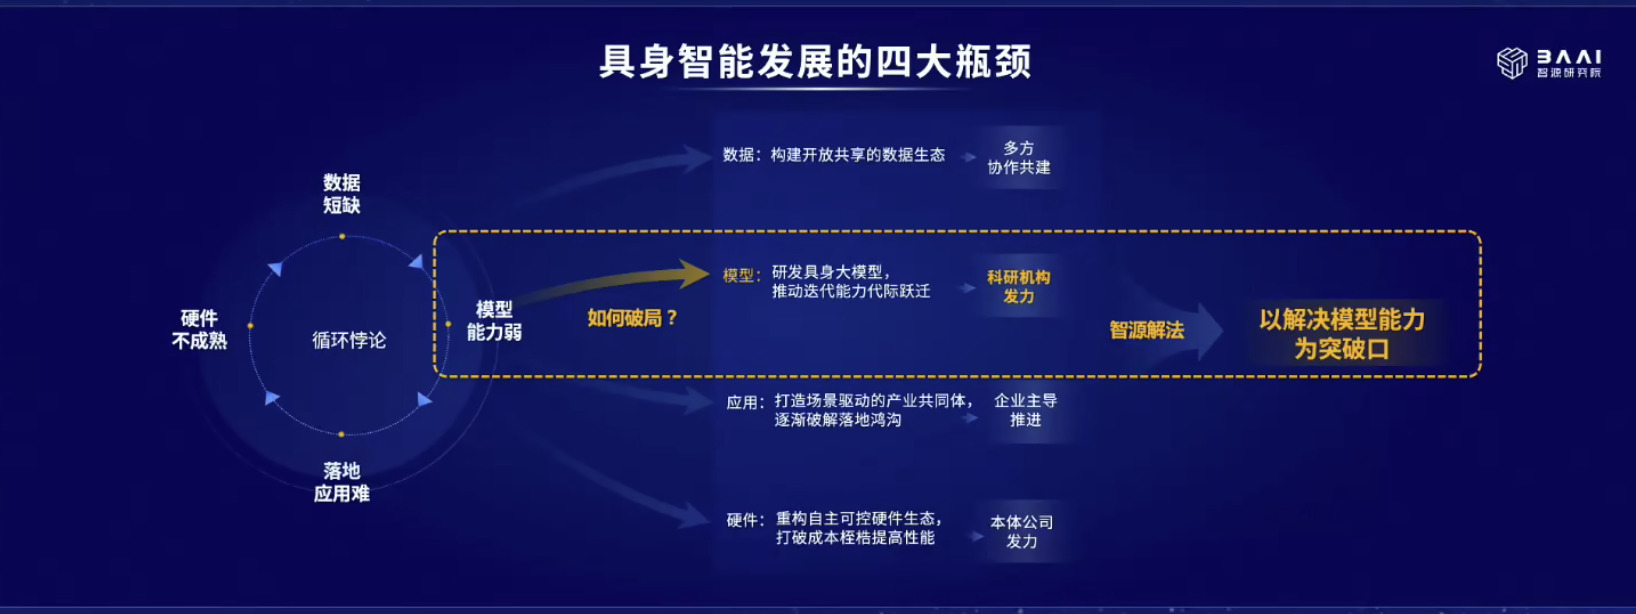
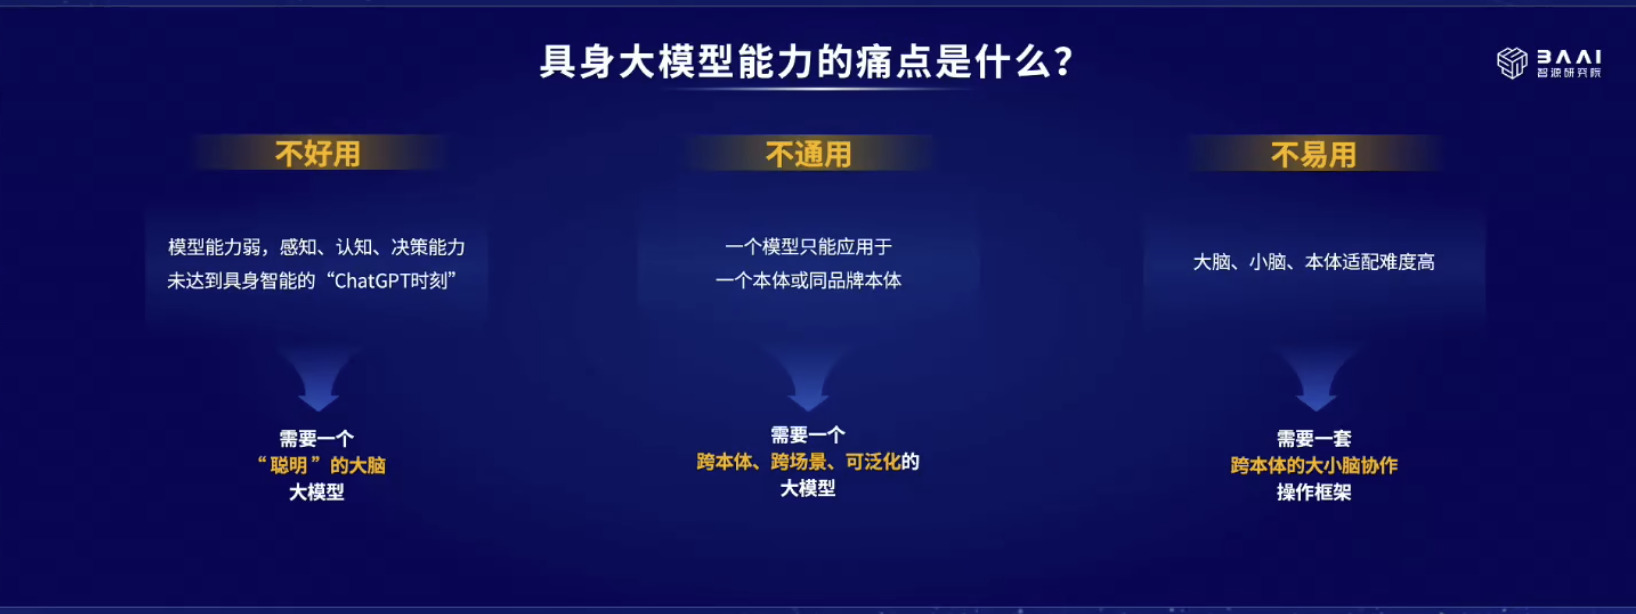
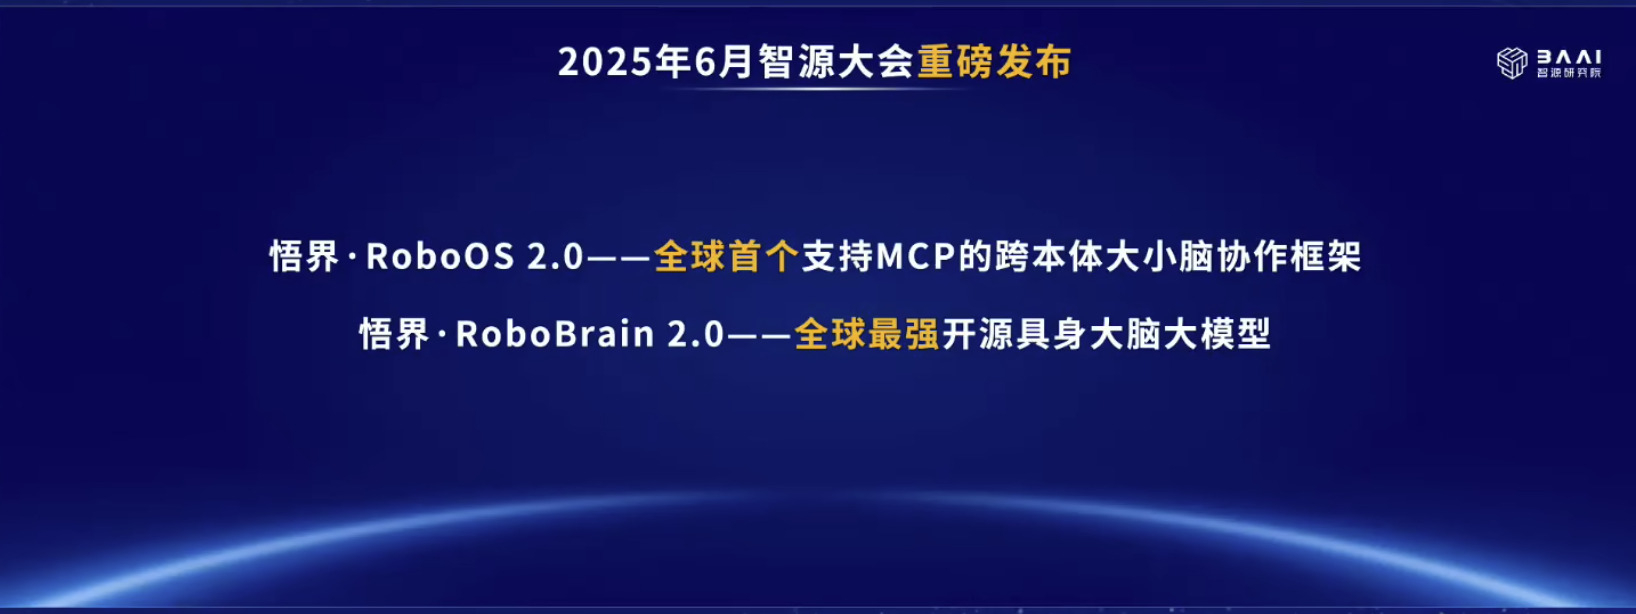
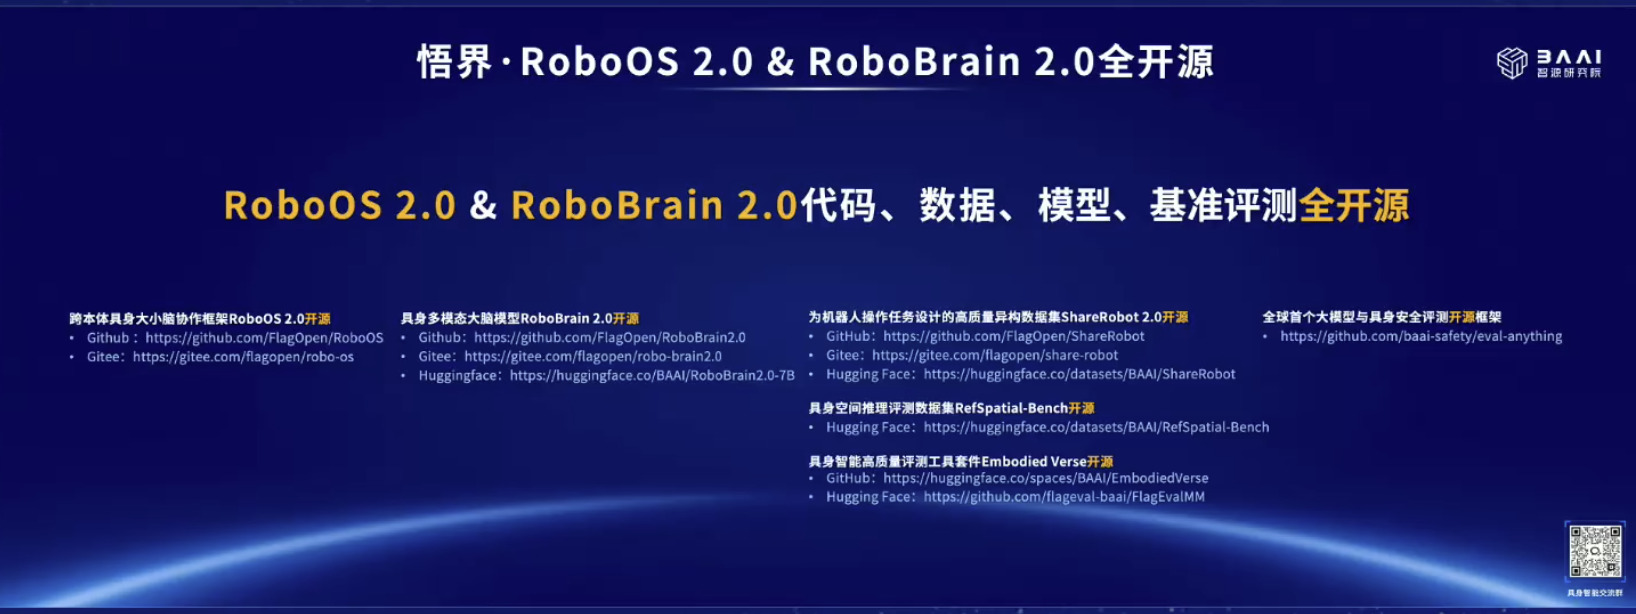
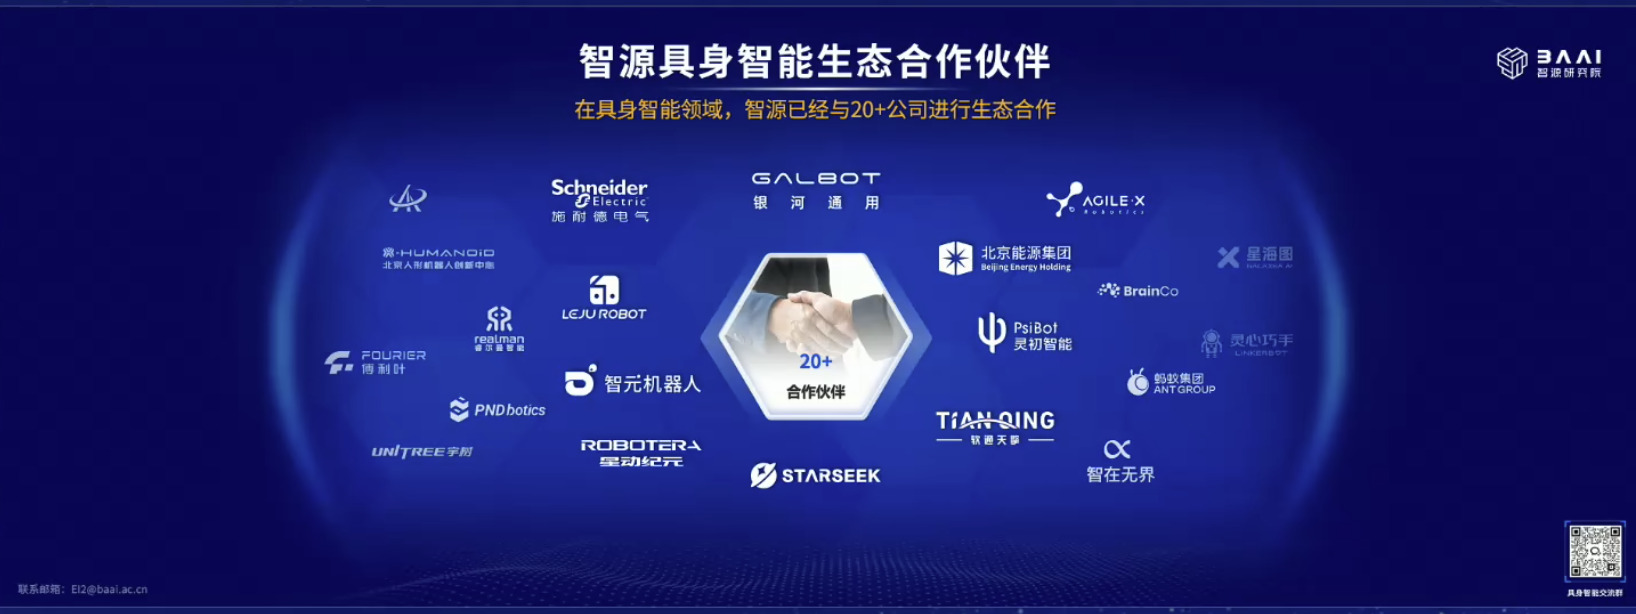
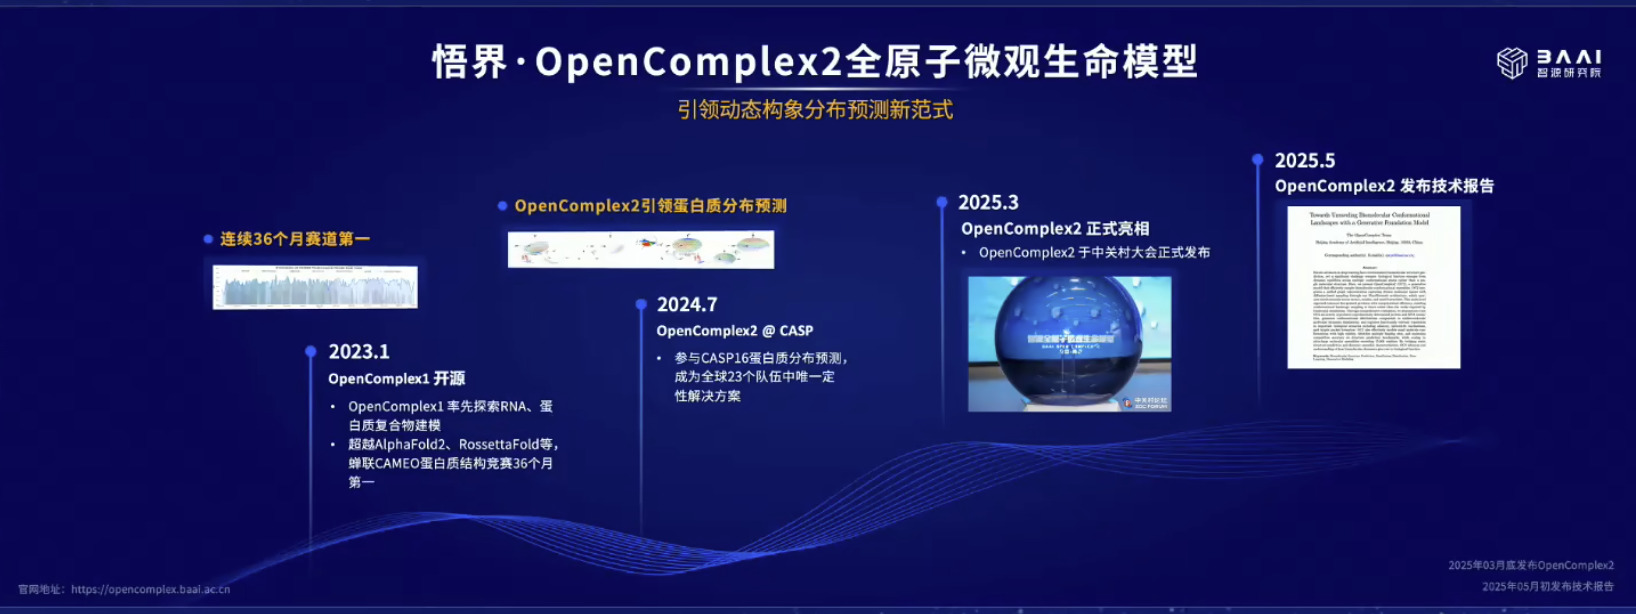
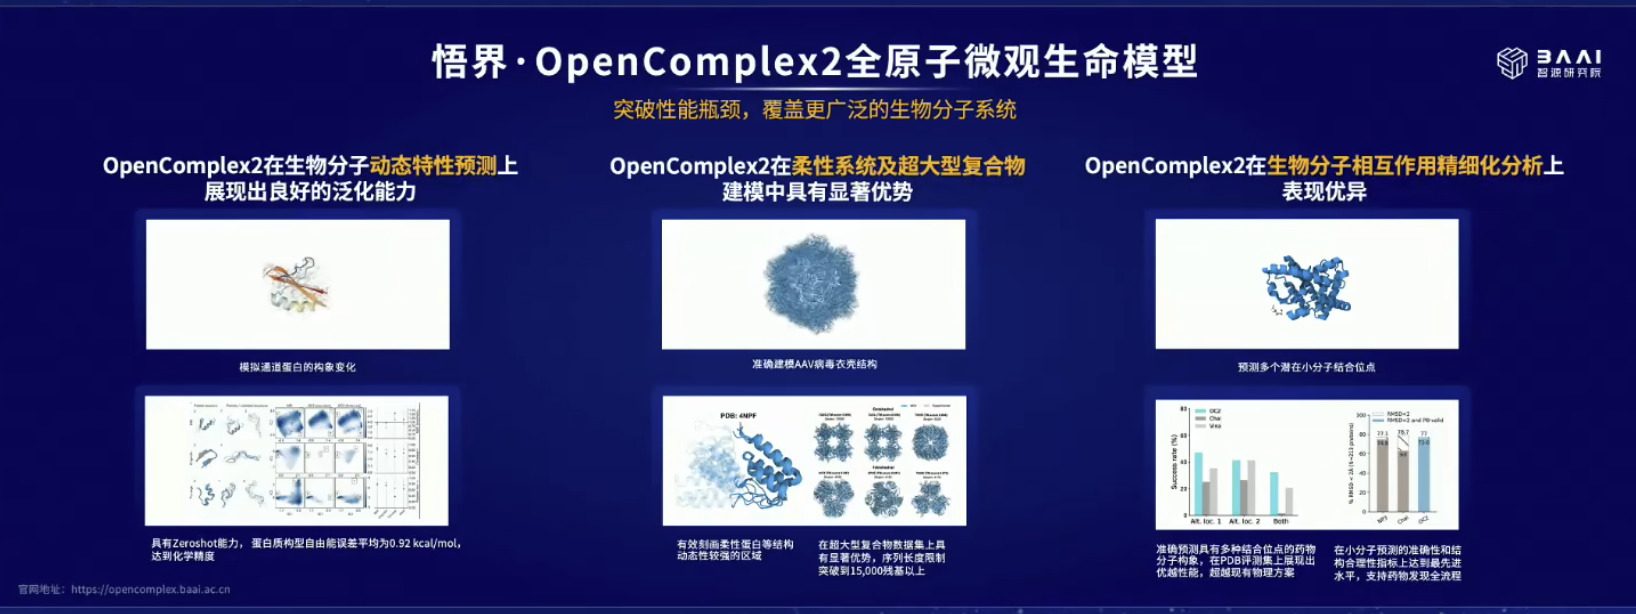
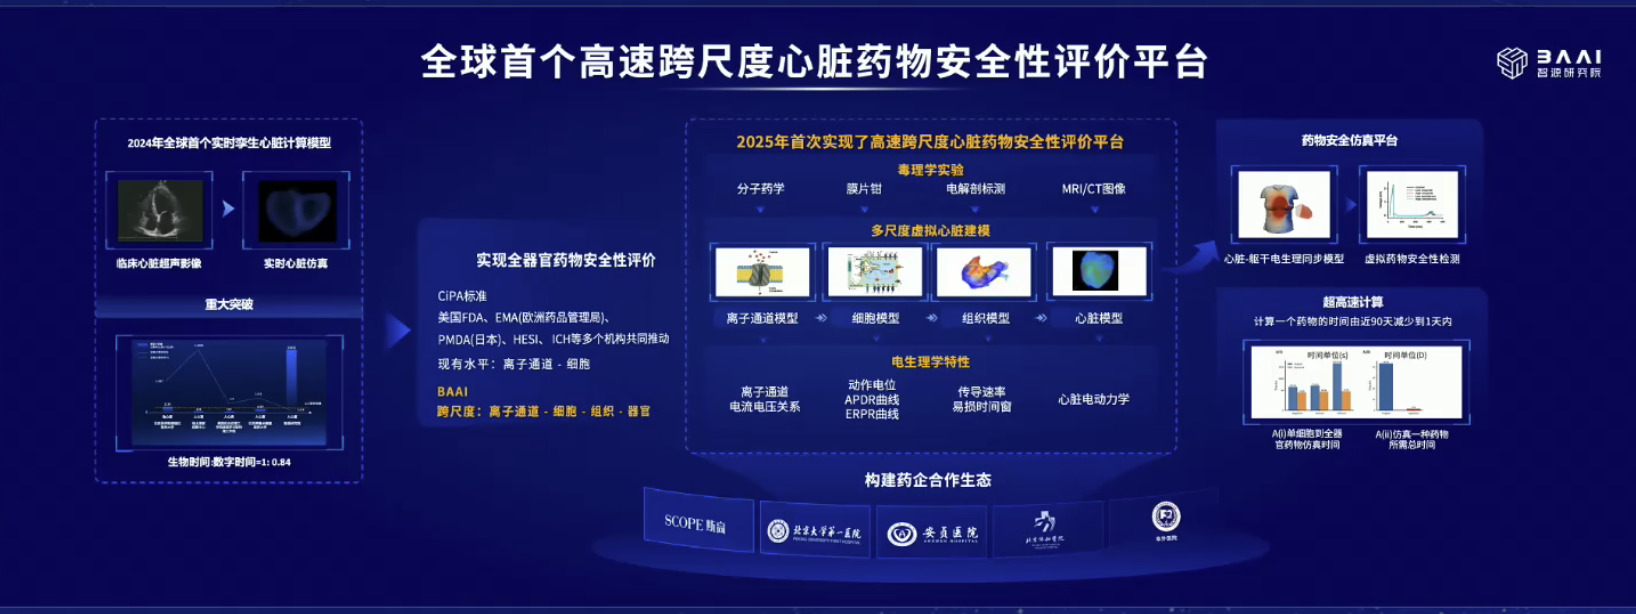
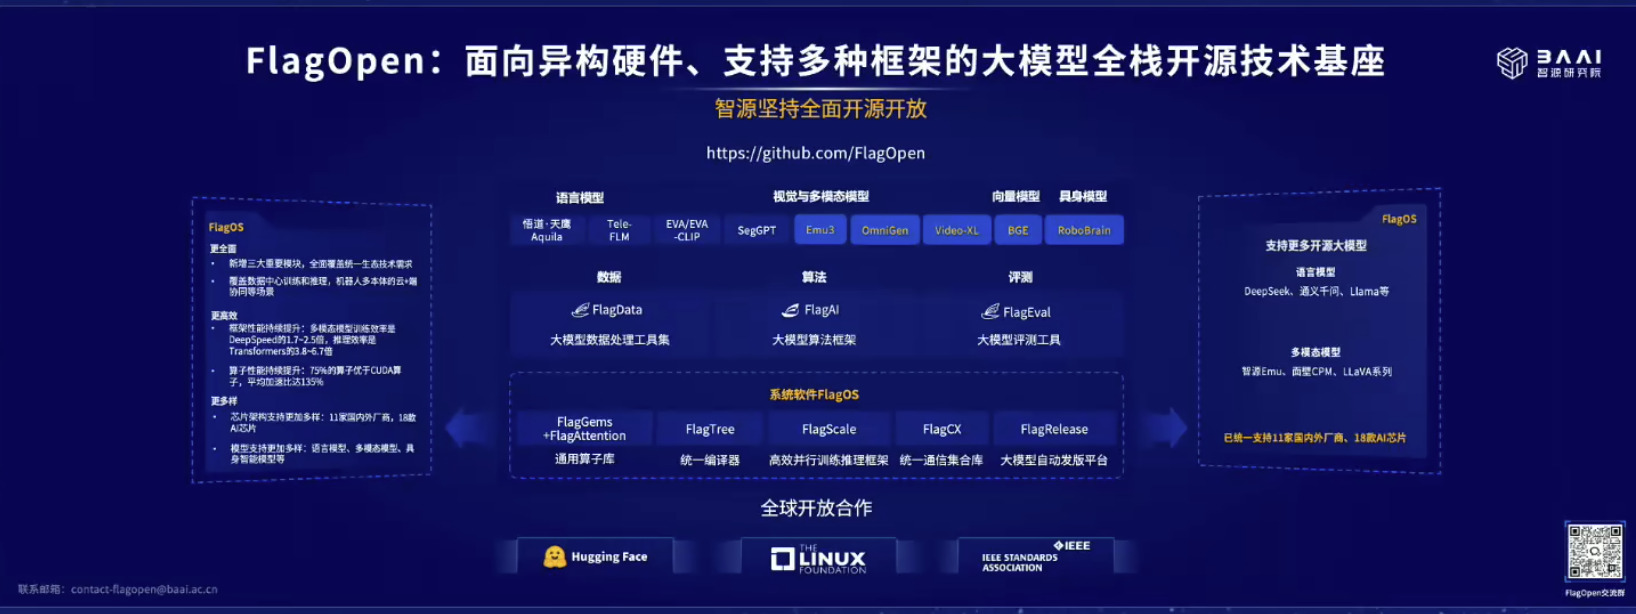
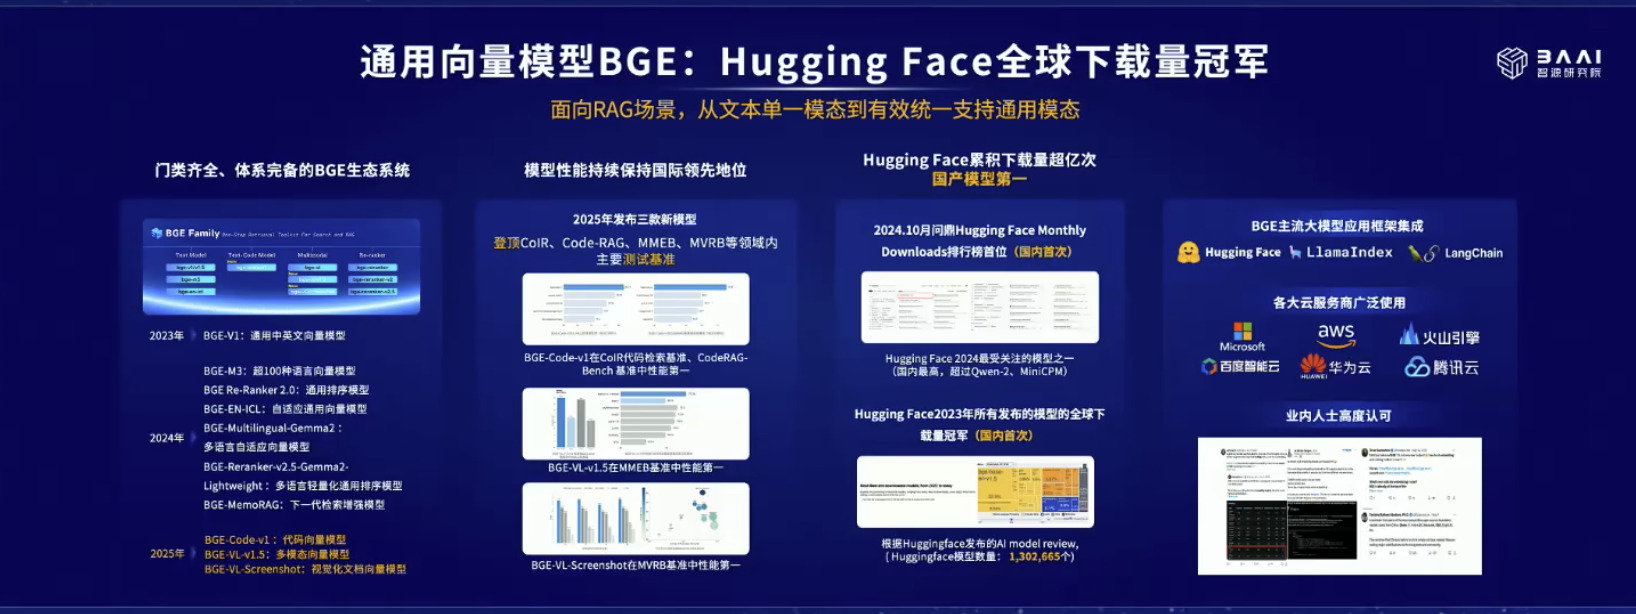
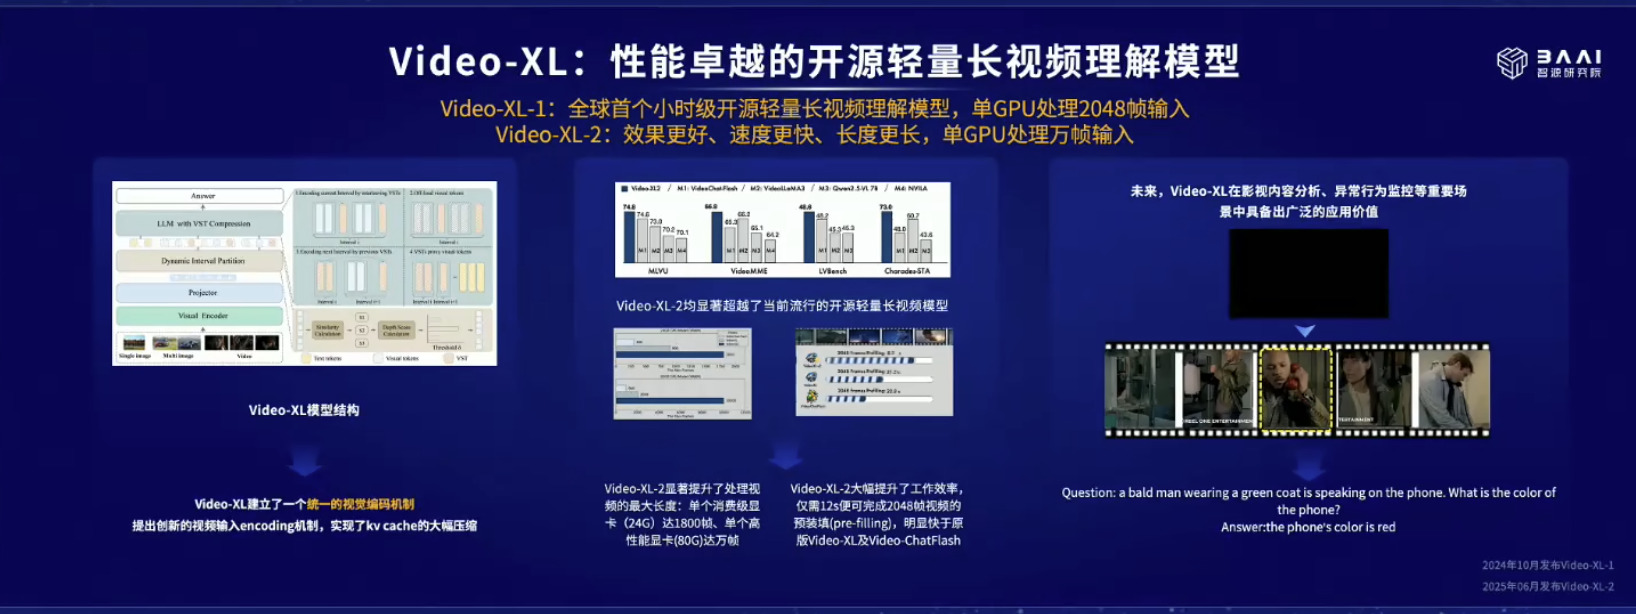
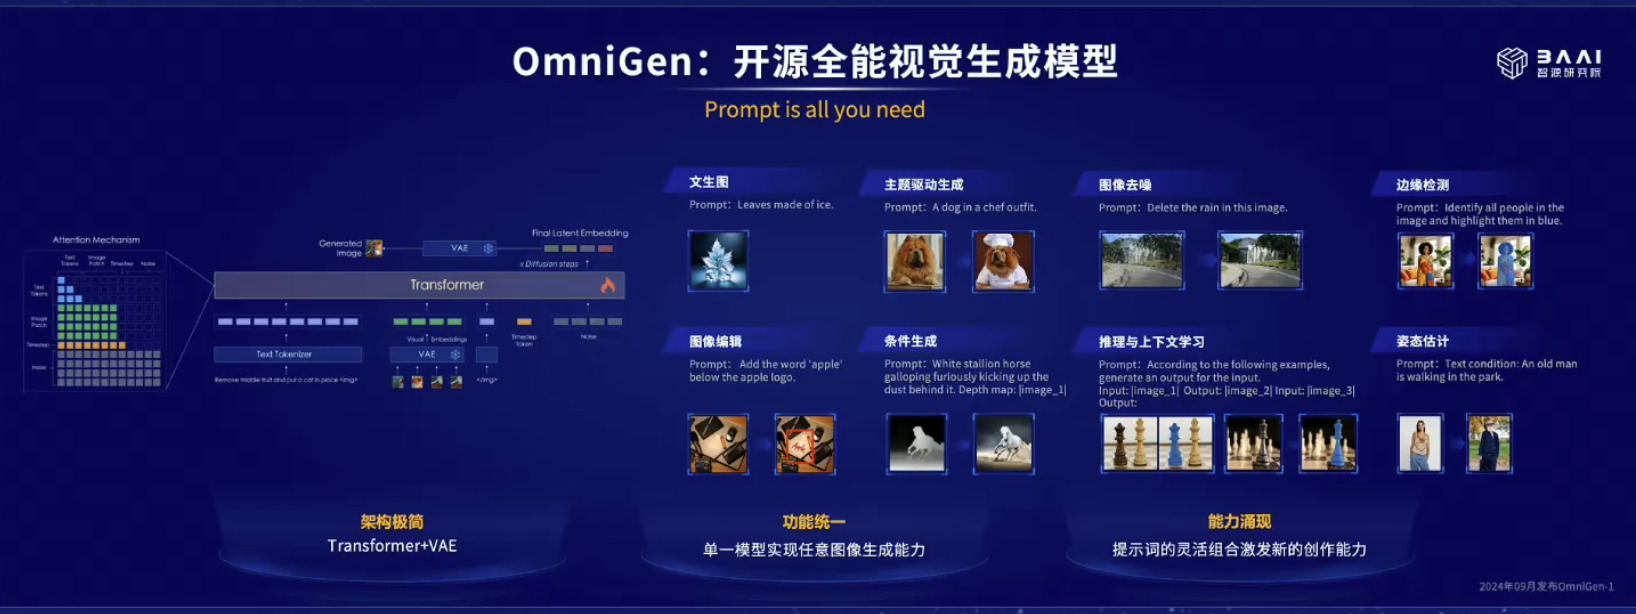
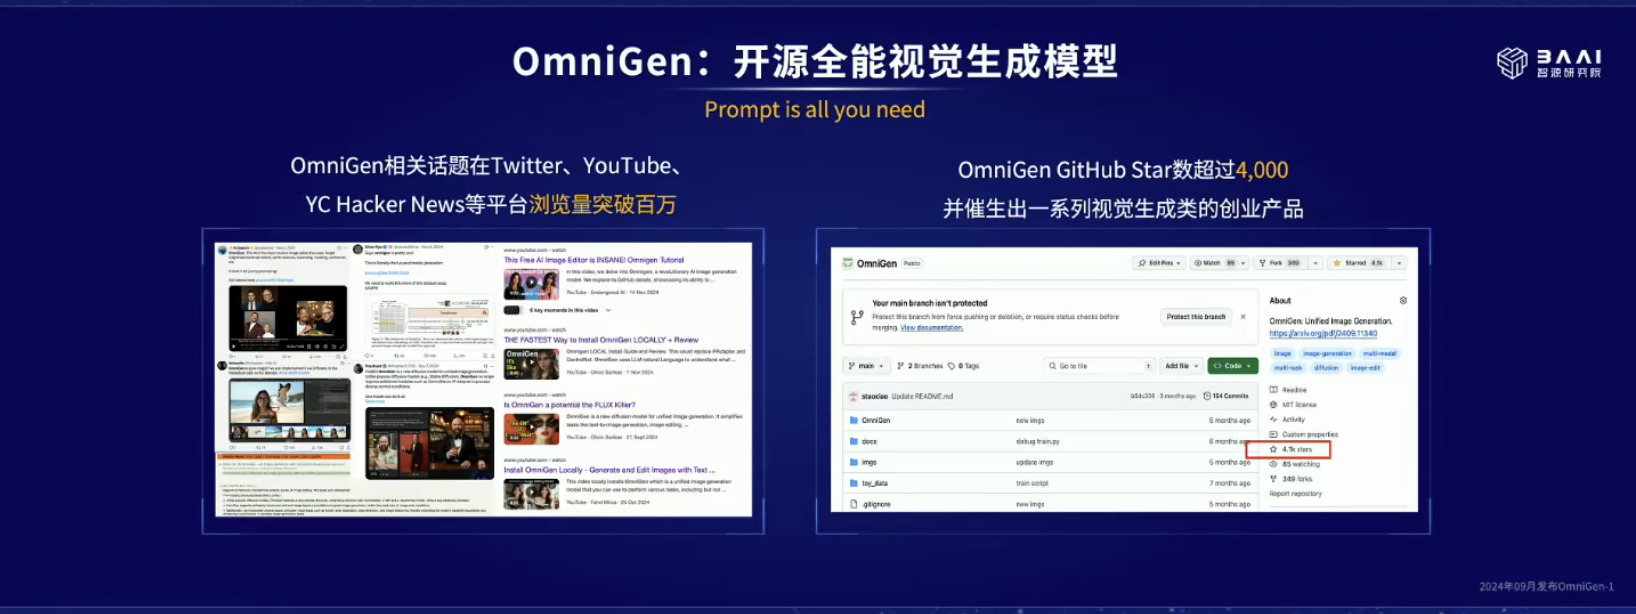
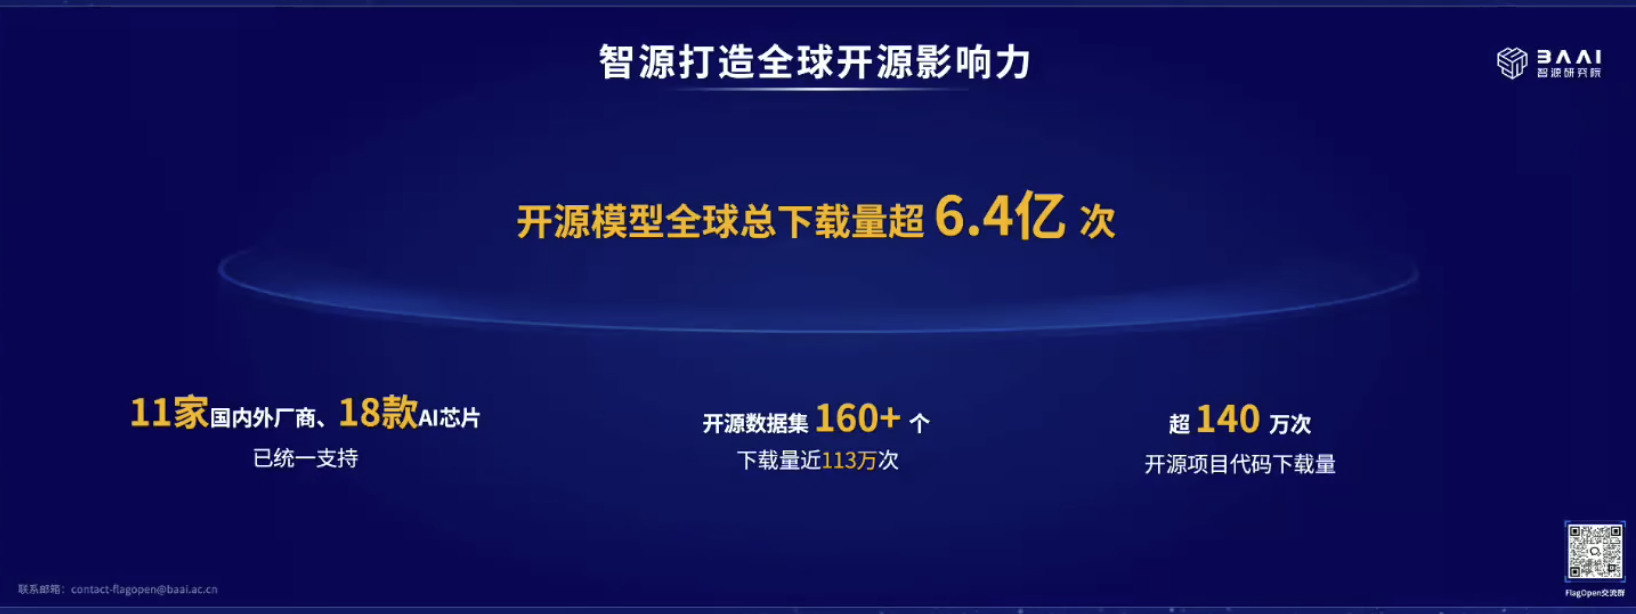
本文档概述了北京智源人工智能研究院 (BAAI),一个致力于推动人工智能原始创新的新型研发机构。它详细介绍了 BAAI 的发展历程,从2018年成立至今,以及其在大型人工智能模型领域取得的重大进展,包括推出 FlagOpen 开放平台。此外,来源还介绍了 BAAI具身智能生命科学等前沿领域的具体研究成果,例如 RoboOS 2.0OpenComplex2。整体而言,这份资料展现了 BAAI构建通用人工智能推动开放生态以及解决现实世界问题方面的努力和愿景。