部署 LLM
测试结果
模型 & 精度 & 显存 & 速度
测试结果
模型 & 精度 & 显存 & 速度
LLM
Embedding 模型
Massive Text Embedding Benchmark (MTEB) Leaderboard
piccolo是一个通用embedding模型(中文), 由来自商汤科技的通用模型组完成训练。piccolo借鉴了E5以及GTE的训练流程,采用了两阶段的训练方式。 在第一阶段中,我们搜集和爬取了4亿的中文文本对(可视为弱监督文本对数据),并采用二元组的softmax对比学习损失来优化模型。 在第二阶段中,我们搜集整理了2000万人工标注的中文文本对(精标数据),并采用带有难负样本的三元组的softmax对比学习损失来帮助模型更好地优化。
FlagEmbedding 将任意文本映射为低维稠密向量,以用于检索、分类、聚类或语义匹配等任务,并可支持为大模型调用外部知识。
不同的任务
参考资料
模型
Taiyi-CLIP-Roberta-102M-Chinese 中文CLIP模型
使用电网的图片测试了一下,效果不理想。
HuggingFace 下载
Qwen-7B
chat(..., stream=True)
DirectPV
安装 DirectPV plugin
Krew
kubectl krew update
kubectl krew install directpv
Release 二进制
release=$(curl -sfL "https://api.github.com/repos/minio/directpv/releases/latest" | awk '/tag_name/ { print substr($2, 3, length($2)-4) }')
curl -fLo kubectl-directpv https://github.com/minio/directpv/releases/download/v${release}/kubectl-directpv_${release}_linux_amd64
sudo chmod a+x kubectl-directpv
sudo mv kubectl-directpv /usr/local/bin/
安装 DirectPV CSI driver kubectl directpv install ███████████████████████████████████████████████████████████████████████████ 100% ┌───────────────
🔥 大模型
🔥 Andrej Karpathy
🔥 李沐 论文精读 如何读论文 AlexNet ResNet 零基础多图详解图神经网络(GNN/GCN) GAN Transformer BERT Pre-training ViT 卷积神经网络的两个归纳偏置:1、locality(相同区域有相同的特征);2、translation equivariance(平移等变性) local neighborhoods MAE Autoencoder 对比学习论文综述 数据增强:Crop 和 Color 的组合最有效 MoCo CLIP How to Train Really Large Models on Many GPUs?
Velero 是一款开源工具,用于安全备份和恢复、执行灾难恢复以及迁移 Kubernetes 集群资源和持久卷。
功能
与其他直接访问 Kubernetes etcd 数据库来执行备份和恢复的工具不同,Velero 使用 Kubernetes API 来捕获集群资源的状态并在必要时恢复它们。这种 API 驱动的方法具有许多关键优势:
此外,Velero 使您能够使用存储平台的本机快照功能或称为 Restic 的集成文件级备份工具来备份和恢复应用程序的持久数据及其 配置。
参考资料 Velero Kubernetes 備份,災難復原之 Velero 篇 使用
ChatGLM2-6B 是开源中英双语对话模型 ChatGLM-6B 的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,ChatGLM2-6B 引入了如下新特性:
部署单实例 MySQL
创建 PVC(NFS)
mysql-pvc.yaml
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: mysql-pv-claim
spec:
  storageClassName: nfs-client
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi
创建 Deployment mysql-deployment.yaml apiVersion: apps/v1 kind: Deployment metadata: name: mysql spec: selector: matchLabels: app: mysql strategy: type: Recreate template: metadata: labels: app: mysql spec: containers: - image: mysql:5.
监控组件
Prometheus 是一个开源系统监控和警报工具包。
架构图
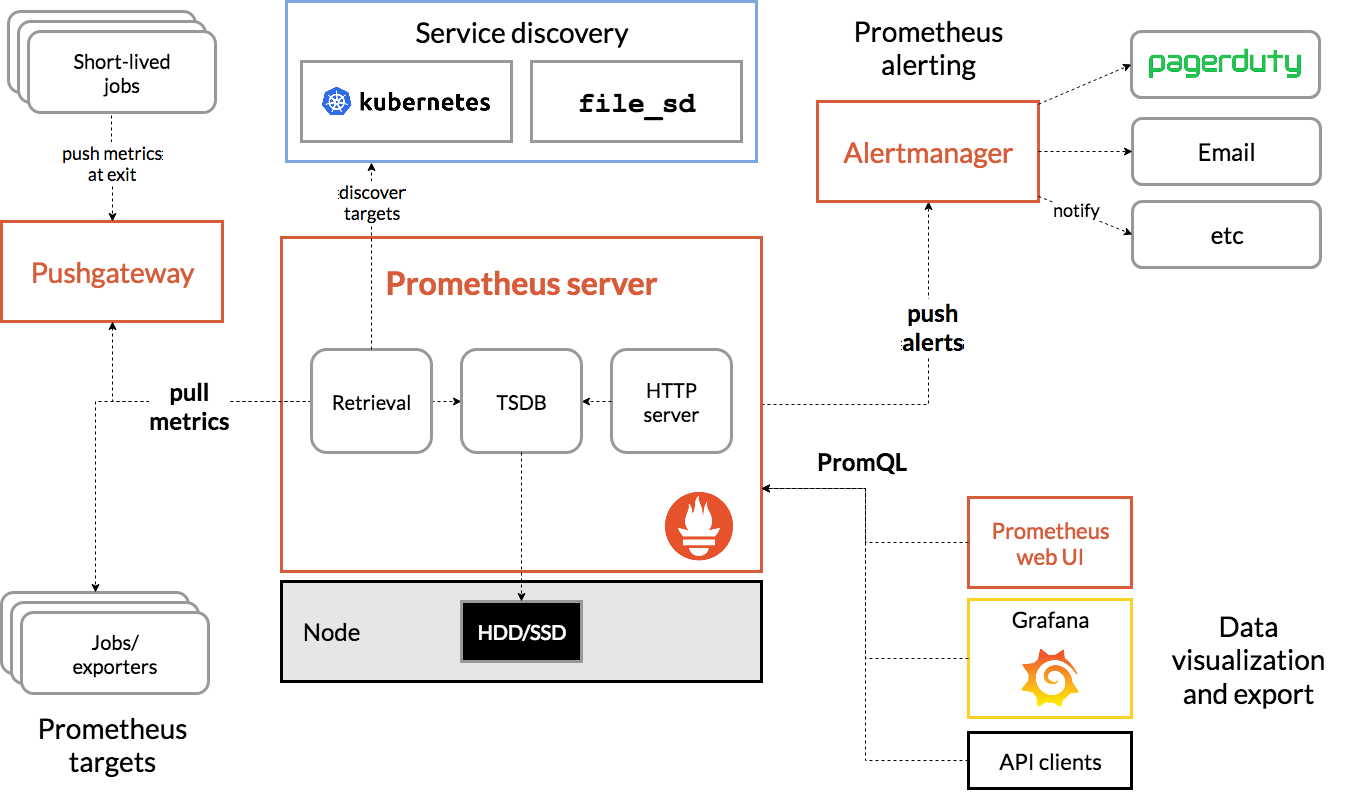
Grafana 用于对收集并存储在 Prometheus 数据库中的指标进行分析和交互式可视化。 您可以以 Prometheus 作为数据源,为 Kubernetes 集群创建自定义图表、图形和警报。
概述
Prometheus Operator 提供 Prometheus 及相关监控组件的 Kubernetes 原生部署和管理。 该项目的目的是简化和自动化 Kubernetes 集群基于 Prometheus 的监控堆栈的配置。
架构图
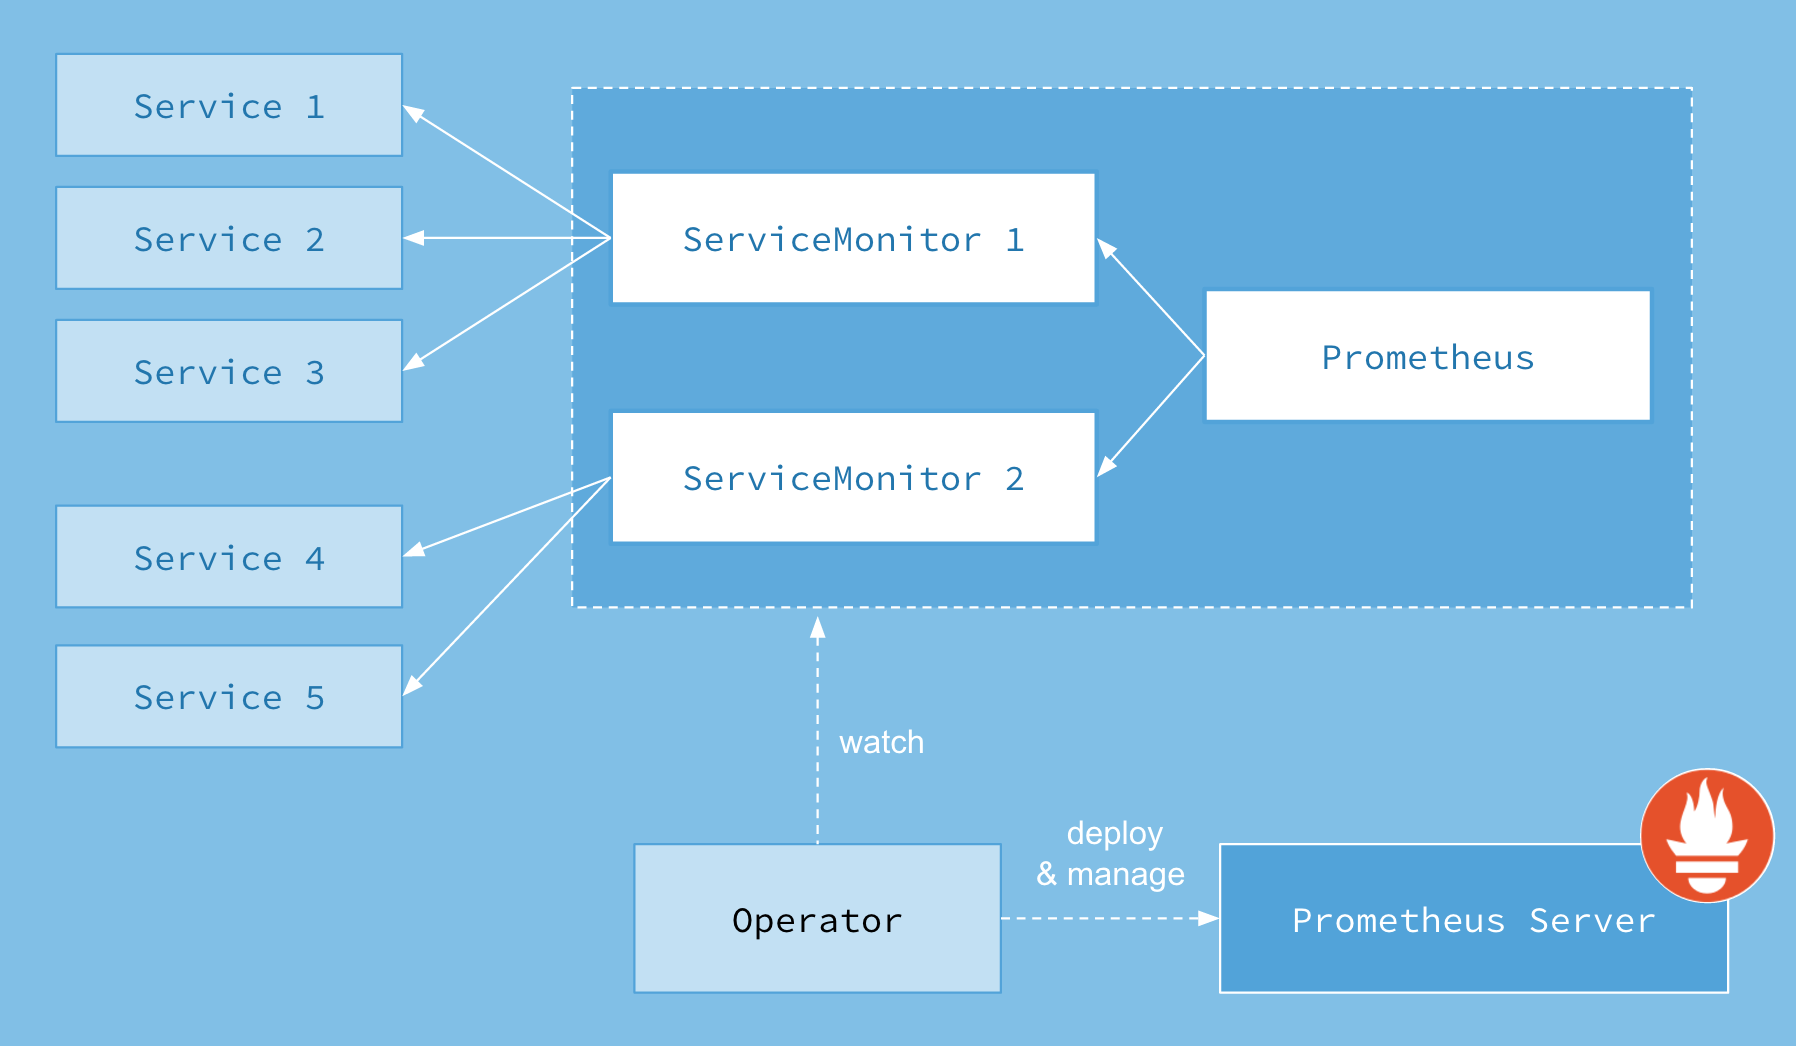
部署 Prometheus 和 Grafana Monitoring Stack
克隆 kube-prometheus 项目
git clone https://github.com/prometheus-operator/kube-prometheus.git
cd kube-prometheus/
创建 monitoring namespace, CustomResourceDefinitions 和 operator pod
创建 namespace 和 CustomResourceDefinitions
在 Kubernetes 集群中部署 ECK(Elastic Cloud Kubernetes)
安装自定义资源定义(Custom Resource Definition, CRD)
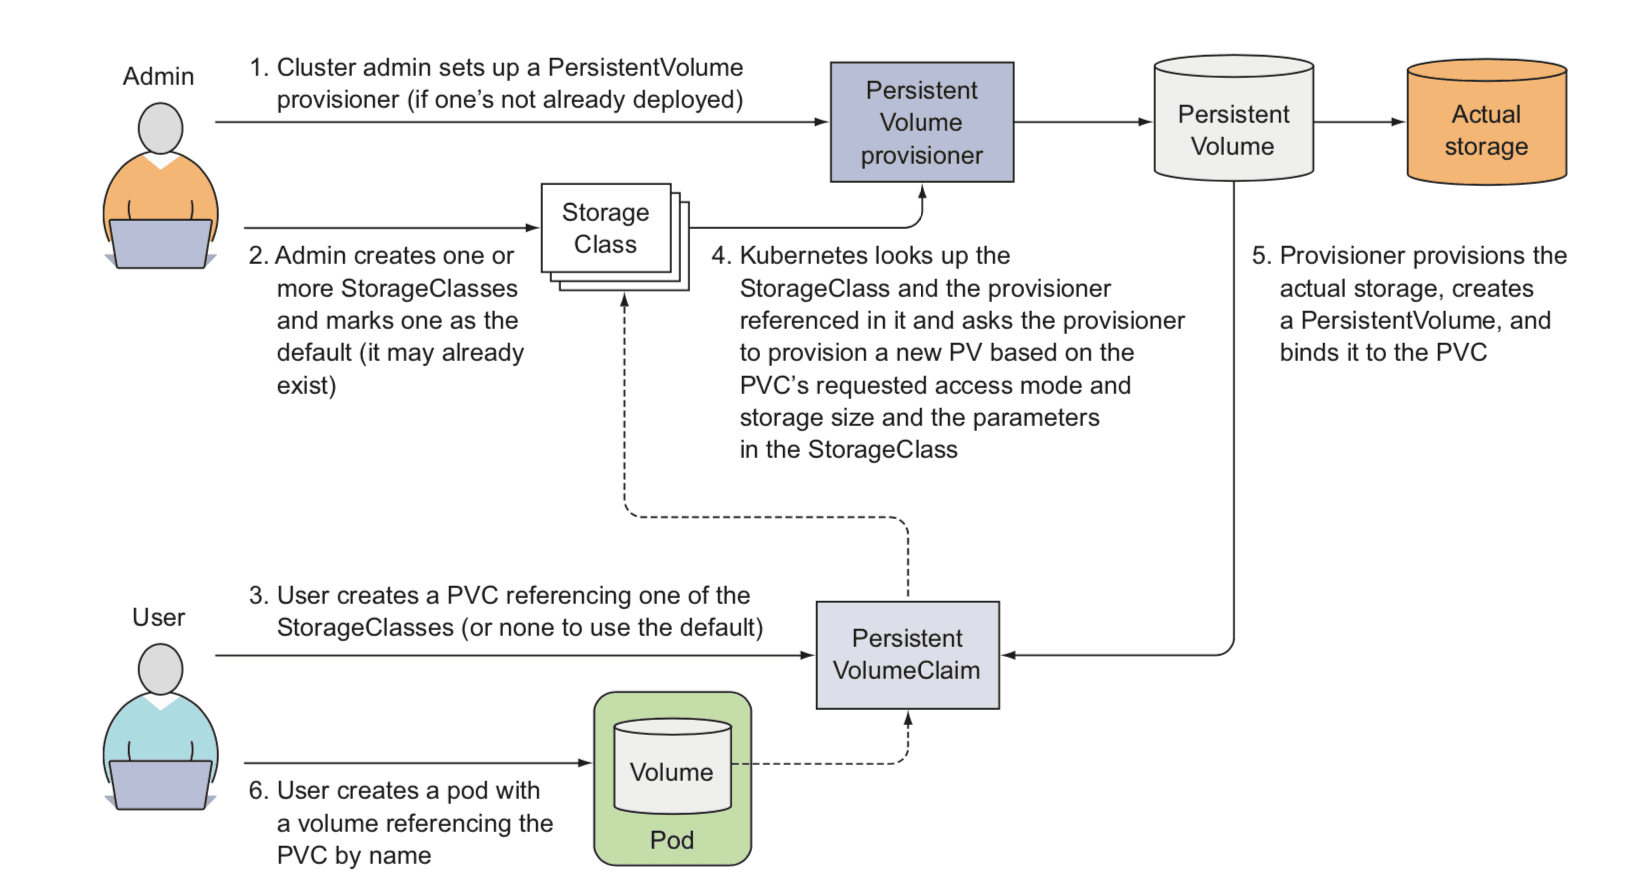
PVC 操作流程
卷的核心是一个目录,其中可能存有数据,Pod 中的容器可以访问该目录中的数据。 所采用的特定的卷类型将决定该目录如何形成的、使用何种介质保存数据以及目录中存放的内容。
使用卷时, 在 .spec.volumes 字段中设置为 Pod 提供的卷,并在 .spec.containers[*].volumeMounts 字段中声明卷在容器中的挂载位置。
emptyDir 卷的存储介质(例如磁盘、SSD 等)是由保存 kubelet 数据的根目录(通常是 /var/lib/kubelet)的文件系统的介质确定。 Kubernetes 对 emptyDir 卷或者 hostPath 卷可以消耗的空间没有限制,容器之间或 Pod 之间也没有隔离。
持久卷(PersistentVolume,PV) 是集群中的一块存储,可以由管理员事先创建, 或者使用存储类(Storage Class)来动态创建。 持久卷是集群资源,就像节点也是集群资源一样。PV 持久卷和普通的 Volume 一样, 也是使用卷插件来实现的,只是它们拥有独立于任何使用 PV 的 Pod 的生命周期。
PV 对象是由运维人员事先创建在 Kubernetes 集群里待用的。
PersistentVolumeClaim 持久卷声明(PersistentVolumeClaim,PVC
Intuition(直觉)
Making images useful to a neural network(使图像对神经网络有用)
噪声处理:添加不同的噪声级别到训练数据中。
灵感来源于物理学,你可以想像一滴墨水滴入一杯水中,最初你确切地知道它落在哪里,但随着时间的推移,你看到到扩散到水中,直到消失。
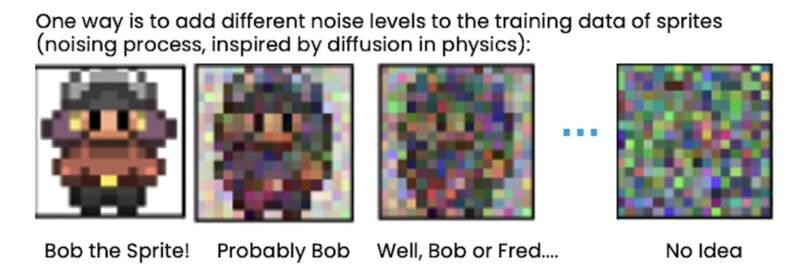
神经网络真正应该思考的是在每个噪声级别,当你逐渐向图像添加噪声时:
Training a neural network to make sprites(训练神经网络制作精灵)
神经网络学习不同的噪声图像并将它们变回精灵。
它学会消除您添加的噪声。
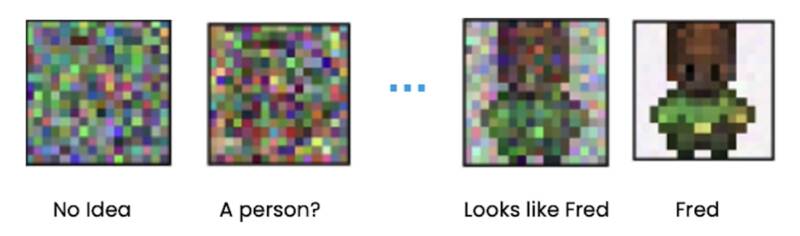
"No Idea" 的噪声级别很重要,因为它是正态分布的,每一个像素的采样都来自于正态分布。
Building Systems with the ChatGPT API
Language Models, the Chat Format and Tokens(语言模型、聊天格式和 Tokens)
Load OpenAI API key
import os
import openai
import tiktoken
from dotenv import load_dotenv, find_dotenv
_ = load_dotenv(find_dotenv()) # read local .env file

openai.api_key  = os.environ['OPENAI_API_KEY']
LangChain for LLM Application Development
LangChain 是用于构建 LLM 应用程序的开源框架
LangChain: Models, Prompts and Output Parsers
安装依赖包
pip install python-dotenv
pip install openai
ChatCompletion import os import openai from dotenv import load_dotenv, find_dotenv _ = load_dotenv(find_dotenv()) # read local .env file openai.api_key = os.environ['OPENAI_API_KEY'] def get_completion(prompt, model="gpt-3.5-turbo"): messages = [{"role": "user", "content": prompt}] response = openai.ChatCompletion.
介绍
Learn about the training pipeline of GPT assistants like ChatGPT, from tokenization to pretraining, supervised finetuning, and Reinforcement Learning from Human Feedback (RLHF). Dive deeper into practical techniques and mental models for the effective use of these models, including prompting strategies, finetuning, the rapidly growing ecosystem of tools, and their future extensions.
了解 ChatGPT 等 GPT 助手的训练管道,从标记化到预训练、监督微调和人类反馈强化学习 (RLHF)。 深入研究有效使用这些模型的实用技术和心智模型,包括提示策略、微调、快速增长的工具生态系统及其未来的扩展。
ChatGPT Prompt Engineering for Developers 由Isa Fulford(OpenAI)和Andrew Ng(DeepLearning.AI)教授的课程将描述 LLM 的工作原理,提供快速工程的最佳实践,并展示 LLM API 如何用于各种任务的应用程序。
Instroduction(介绍)
Guidelines(准则)
帮助函数 import openai import os openai.api_key = os.getenv('OPENAI_API_KEY') def get_completion(prompt, model="gpt-3.5-turbo"): messages = [{"role": "user", "content": prompt}] response = openai.ChatCompletion.create( model=model, messages=messages, temperature=0, # this is the degree of randomness of the model's output ) return response.choices[0].
Whisper
功能
文件上传目前限制为 25 MB,并且支持以下输入文件类型:mp3, mp4, mpeg, mpga, m4a, wav, webm.
语音内容
Mira Murati 是一位对人工智能技术充满热情的科技领袖,她的理念和影响对人工智能技术的发展和应用产生了深远的影响。
她认为人工智能技术应该是以人为本的,强调人工智能技术应该是一种能够服务于人类的工具,而不是取代人类的工具。
她指出,人工智能技术的最终目的是为人类服务,因此人工智能技术应该以人类的利益和需求为中心,以解决人类面临的实际问题。人工智能技术的应用需要深入了解人类社会的需要和价值,将其应用到真正有意义的领域中。
OpenAI Whisper
安装 OpenAI
!pip install -U openai
测试
语音识别
import openai
audio_file= open("data/audios/test.m4a", "rb")
transcript = openai.Audio.transcribe("whisper-1", audio_file)
print(transcript["text"])
Miramurati是一位对人工智能技术充满热情的科技领袖 他的
Stable Diffusion
数据集 LAION-5B
一个由 58.5 亿个 CLIP 过滤的图像-文本对组成的数据集
工作原理是将文本查询转换为 CLIP 嵌入,然后使用该嵌入来查询剪辑图像嵌入的 knn 索引,在搜索演示中搜索数据集。
Stable Diffusion GUI
🤗 Diffusers 是最先进的预训练扩散模型的首选库,用于生成图像、音频,甚至分子的 3D 结构。无论您是在寻找简单的推理解决方案,还是想训练自己的扩散模型,🤗 Diffusers 都是一个支持两者的模块化工具箱。
知识扩展
Latent Representation
数据中的潜在特征表示,这些特征可能不易直接观察到,但对于模型的学习和预测等任务具有重要意义。例如,在图像识别中,一张图片的颜色、形状、纹理等特征可以被视为潜在特征表示。
Latent Space
由模型自动生成的潜在特征空间,其中每个点都表示一种可能的特征组合。在深度学习和人工智能领域,常常使用自编码器等技术来学习并探索数据的潜在特征空间,以期获得更深入的理解和更好的应用效果。
参考资料 AutoFaiss Multimodal search
多平台构建器
当前构建器实例是驱动程序 docker-container,可以同时指定多个平台。在这种情况下,它会构建一个清单列表,其中包含所有指定架构的镜像。在构建的时候可以并行构建多个架构的镜像。
docker run 当您在使用此镜像时 docker service,Docker 会根据节点的平台选择正确的镜像。
有个缺点:必须发布到 Docker Hub 或者私有仓库,因为 Docker 不支持多架构的本地镜像。
查看构建器 docker buildx ls NAME/NODE DRIVER/ENDPOINT STATUS BUILDKIT PLATFORMS default docker default default running v0.11.6+616c3f613b54 linux/arm64, linux/riscv64, linux/ppc64le, linux/s390x, linux/386, linux/mips64, linux/arm/v7, linux/arm/v6, linux/amd64, linux/amd64/v2 desktop-linux * docker desktop-linux desktop-linux running v0.11.
没有找到匹配的文章