分析基于边端电力设备的人工智能应用

基于边端电力设备的报文需要使用人工智能

这是一个非常前沿且具有实际意义的问题。简单直接的回答是:是的,在边端电力设备中引入人工智能(AI)处理报文,正在从“锦上添花”转变为“行业刚需”。

传统的电力报文处理主要依赖预设规则阈值报警,但在复杂的现代电网环境下,这种方式已显露疲态。

以下是为什么边端电力设备报文需要 AI 的核心原因及应用场景:

1. 毫秒级的实时响应需求

电力系统的故障处理通常要求在 到 内做出反应。

  • 传统痛点: 如果将海量报文上传到云端处理,网络延迟和带宽压力会导致响应滞后。
  • AI 优势: 在边缘侧部署轻量化 AI 模型(如卷积神经网络 CNN 或长短期记忆网络 LSTM),可以直接在设备端实时解析 GOOSE、SV 等协议报文,瞬间识别出瞬时故障并触发保护机制。

2. 网络安全与入侵检测

电力报文(如 IEC 61850、DNP3)往往缺乏复杂的加密,容易受到恶意篡改或重放攻击。

  • AI 应用: AI 可以学习正常报文的“行为基准”(流量特征、时间间隔、序列逻辑)。一旦黑客尝试通过异常报文操纵开关,AI 能基于异常检测算法识别出这种不符合常规逻辑的行为并阻断,这是静态规则防火墙难以做到的。

3. 故障预测与健康管理 (PHM)

报文不仅是指令,还包含丰富的设备状态数据。

  • 应用场景: 通过对变压器、断路器上报的采样值(SV)报文进行深度挖掘,AI 可以捕捉到波形中极其细微的畸变或局部放电特征。
  • 价值: 在设备真正坏掉之前,AI 就能发现其性能衰减的趋势,从而实现**从“事后维修”到“预测性维护”**的转变。
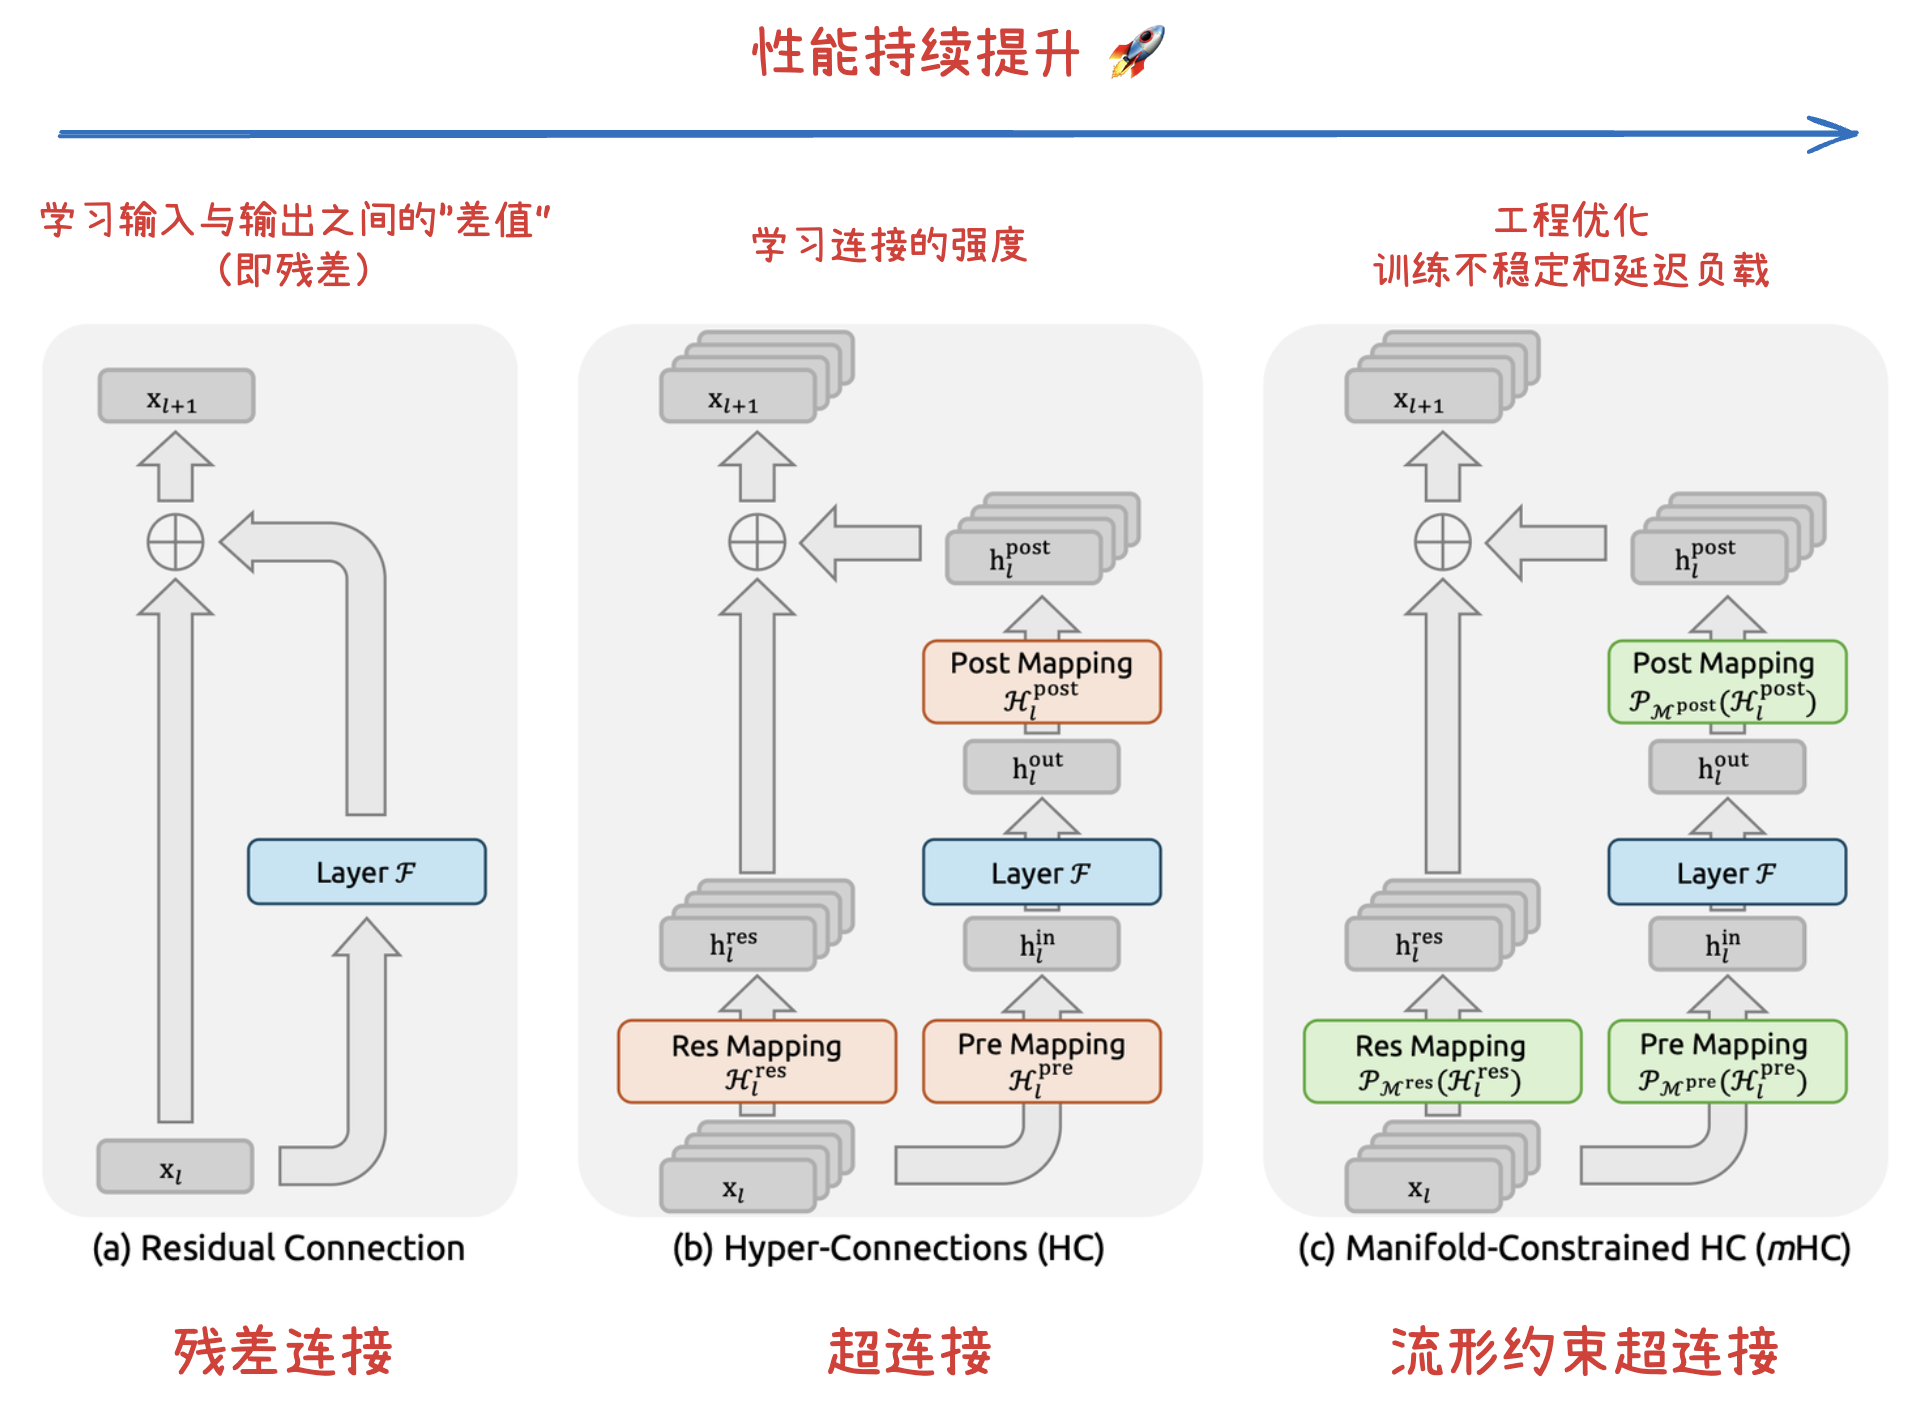
深度网络连接范式演进:残差连接 → 超连接 (HC) → 流形约束超连接 (mHC)

深度神经网络架构的演进,本质上是在寻找梯度稳定性特征表达力的最优解:残差连接 通过恒等映射初步破解了深层网络的退化难题,但在缓解梯度消失与防止表征坍缩之间仍存在“跷跷板效应”;超连接(HC) 在此基础上打破了固定连接的束缚,通过引入可学习的深度连接与宽度连接,允许网络“自主学习最优连接强度”,显著提升了大模型训练的性能;流形约束超连接(mHC) 则通过将 HC 的连接矩阵投影至双随机流形,利用数学上的凸组合约束恢复了恒等映射的数值稳定性,并辅以算子融合、选择性重算和 DualPipe 通信重叠等工程优化,最终在大模型训练中实现了训练稳定性和显著降低延迟负载。

深度神经网络

梯度消失与梯度爆炸

在深度学习中,梯度消失(Vanishing Gradient)梯度爆炸(Exploding Gradient) 是训练深层神经网络时经常遇到的两个核心障碍。

它们本质上是由于神经网络在反向传播过程中,梯度通过多层链式法则累积相乘导致的数值稳定性问题。

数学根源:链式法则的连乘效应

在反向传播时,我们需要计算损失函数对某一层权重的偏导数。根据链式法则,对于每一层,其梯度贡献项通常与激活函数的导数以及权重的数值有关。

  • 梯度消失: 如果每一层的梯度项都小于 1(例如使用 Sigmoid 激活函数,其导数最大值仅为 0.25),经过 层连乘后,梯度会呈指数级衰减。当层数很多时,靠近输入层的梯度会变得接近于 0,导致权重无法更新,网络停止学习。
  • 梯度爆炸: 如果每一层的权重较大(例如 ),且激活函数的导数也大于 1,梯度会随着层数的增加呈指数级增长。这会导致权重更新步长过大,数值溢出(出现 NaN),模型剧烈震荡甚至崩溃。

2026 年飞马图像生成

提示词(DeepSeek)

2026年新年来了,生成一张红色的飞马图像。以这个为基础写个生成图像的提示词

一只雄伟的飞马(天马)在绚烂的夜空中展翅翱翔,周围环绕着金色与橙红色的新年烟火,鬃毛与翅膀边缘散发柔和光芒,背景为深红色星空与闪烁的星光,风格融合奇幻艺术与节日喜庆,色彩以红色、金色为主,充满动态与希望感,4K高清,细节精致,史诗光影。

生成结果

ChatGPT

豆包

Gemini

Grok

可灵 2.1

龙猫

MiniMax

千问

元宝

美团核心能力与护城河分析

美团历年财报2018年至2025年上半年)来看,其核心能力已从早期的 “Food + Platform” 演进为 “零售+科技” 战略。在2025年上半年对“美团优选”进行战略转型并撤出亏损区域后,美团的护城河更加聚焦于高效率的即时履约网络和强大的零售生态体系。

以下是基于财报的美团核心能力与护城河分析:

1. 核心能力:全球领先的即时配送基础设施

  • 规模经济与履约效率: 美团建立了全球规模最大、订单密度最高的即时配送网络,通过人工智能调度系统优化,单均配送人工成本持续改善。
  • 物流网络韧性: 配送网络已成为本地生活的关键基础设施,在疫情等特殊时期保障了民生供应。目前,该网络不仅支撑餐饮外卖,还成功扩展至美团闪购、小象超市等即时零售品类,实现了 “万物到家” 的愿景。
  • 技术领先优势: 美团持续投入无人机配送自动配送车等前沿科技,进一步提升了长期的履约效率和创新运营能力。

2. 核心能力:高频带动低频的超级平台生态

  • 强大的双向网络效应: 美团连接了8亿交易用户和超过1450万活跃商家。这种规模效应形成了良性循环:更多的用户吸引更多商家,更丰富的供给又进一步提升了用户黏性。
  • 交叉销售与会员体系: 美团利用餐饮外卖等高频业务获取用户流量,并成功将其转化为到店、酒店及旅游等高利润业务的客户。神会员体系的升级有效实现了不同业务间的用户转化。

2025 年大模型实践总结

具身智能

Scaling Laws

全链路解决方案

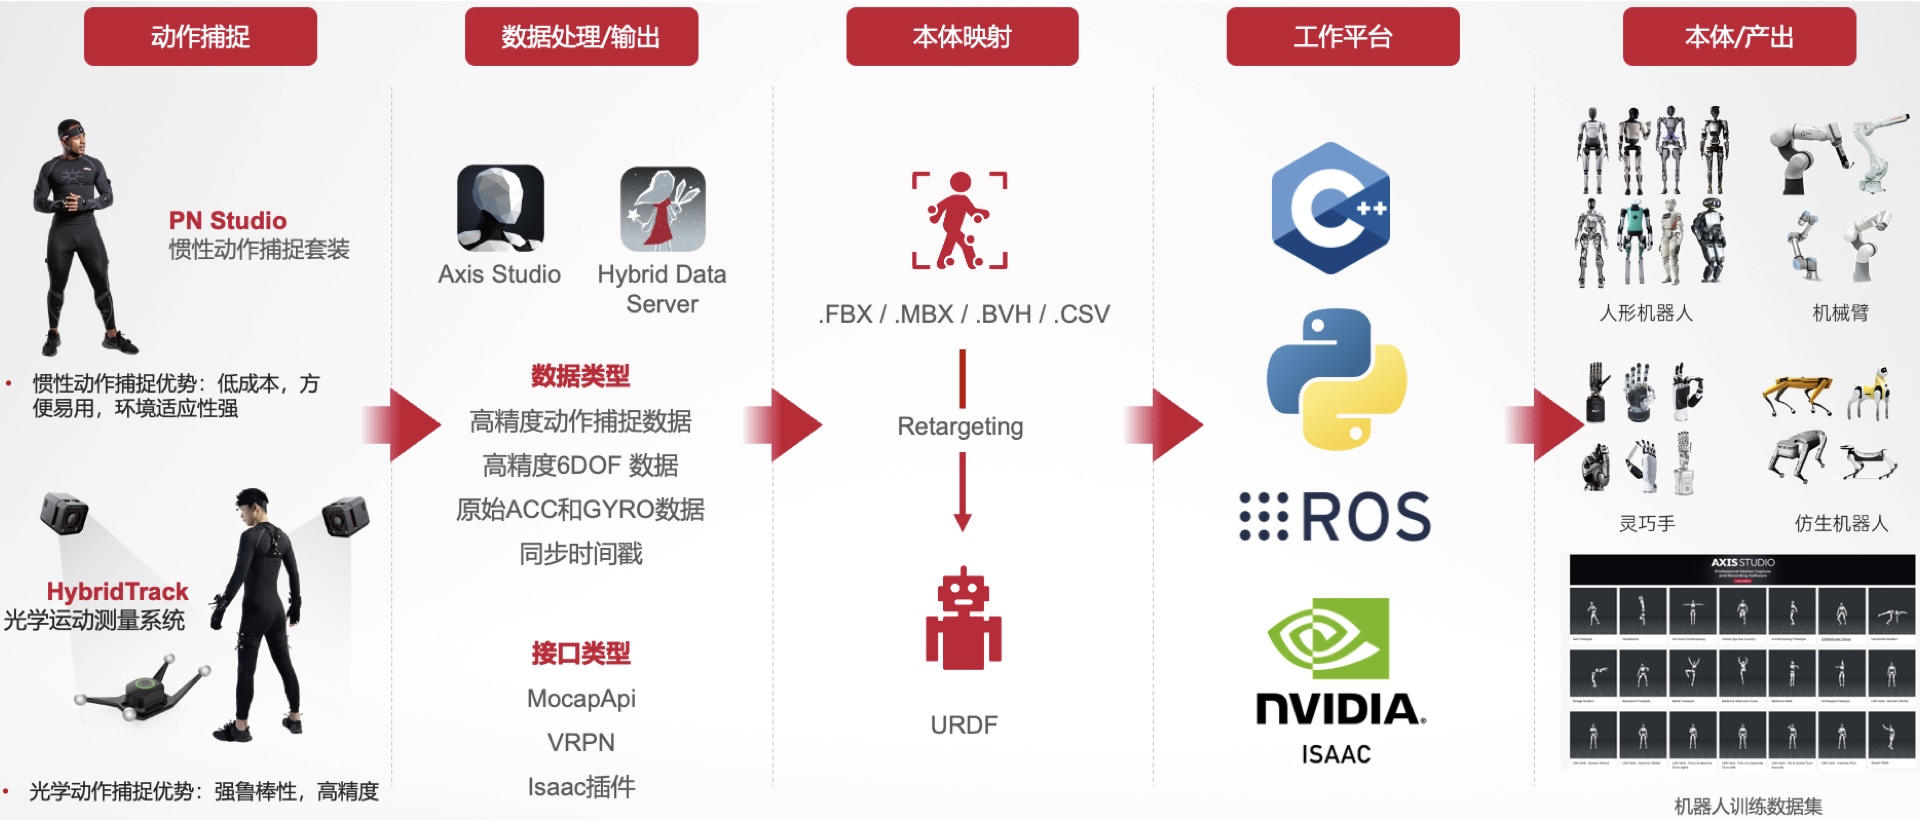
1. 动作捕捉

这一阶段负责采集人类的原始动作数据。图中列出了两种主要技术:

  • PN Studio (惯性动捕): 利用惯性传感器套件。优点是成本低、易用、环境适应性强。
  • HybridTrack (光学动捕): 利用摄像头和标记点。优点是鲁棒性强、精度极高。

2. 数据处理/输出

捕捉到的信号通过 Axis StudioHybrid Data Server 进行初步处理。

  • 数据类型: 包括高精度动捕数据、6DOF(六自由度)数据、原始加速度(ACC)和陀螺仪(GYRO)数据,以及同步时间戳。
  • 接口类型: 支持 MocapApi、VRPN 以及专门的 Isaac 插件。

3. 本体映射

这是将人类动作转化为机器人动作的关键步骤。

  • 输入格式: 常见的 3D 动画格式,如 .FBX.MBX.BVH 和数据格式 .CSV
  • 重定向 (Retargeting): 通过算法将人类的骨架运动映射到机器人的 URDF(统一机器人描述格式)模型上,确保动作符合机器人的物理结构约束。

4. 工作平台

展示了开发和仿真所使用的核心软件生态:

  • 编程语言: C++ 和 Python。
  • 中间件: ROS (Robot Operating System),用于机器人控制。
  • 仿真环境: NVIDIA ISAAC,一个强大的机器人仿真和人工智能训练平台。

5. 本体/产出

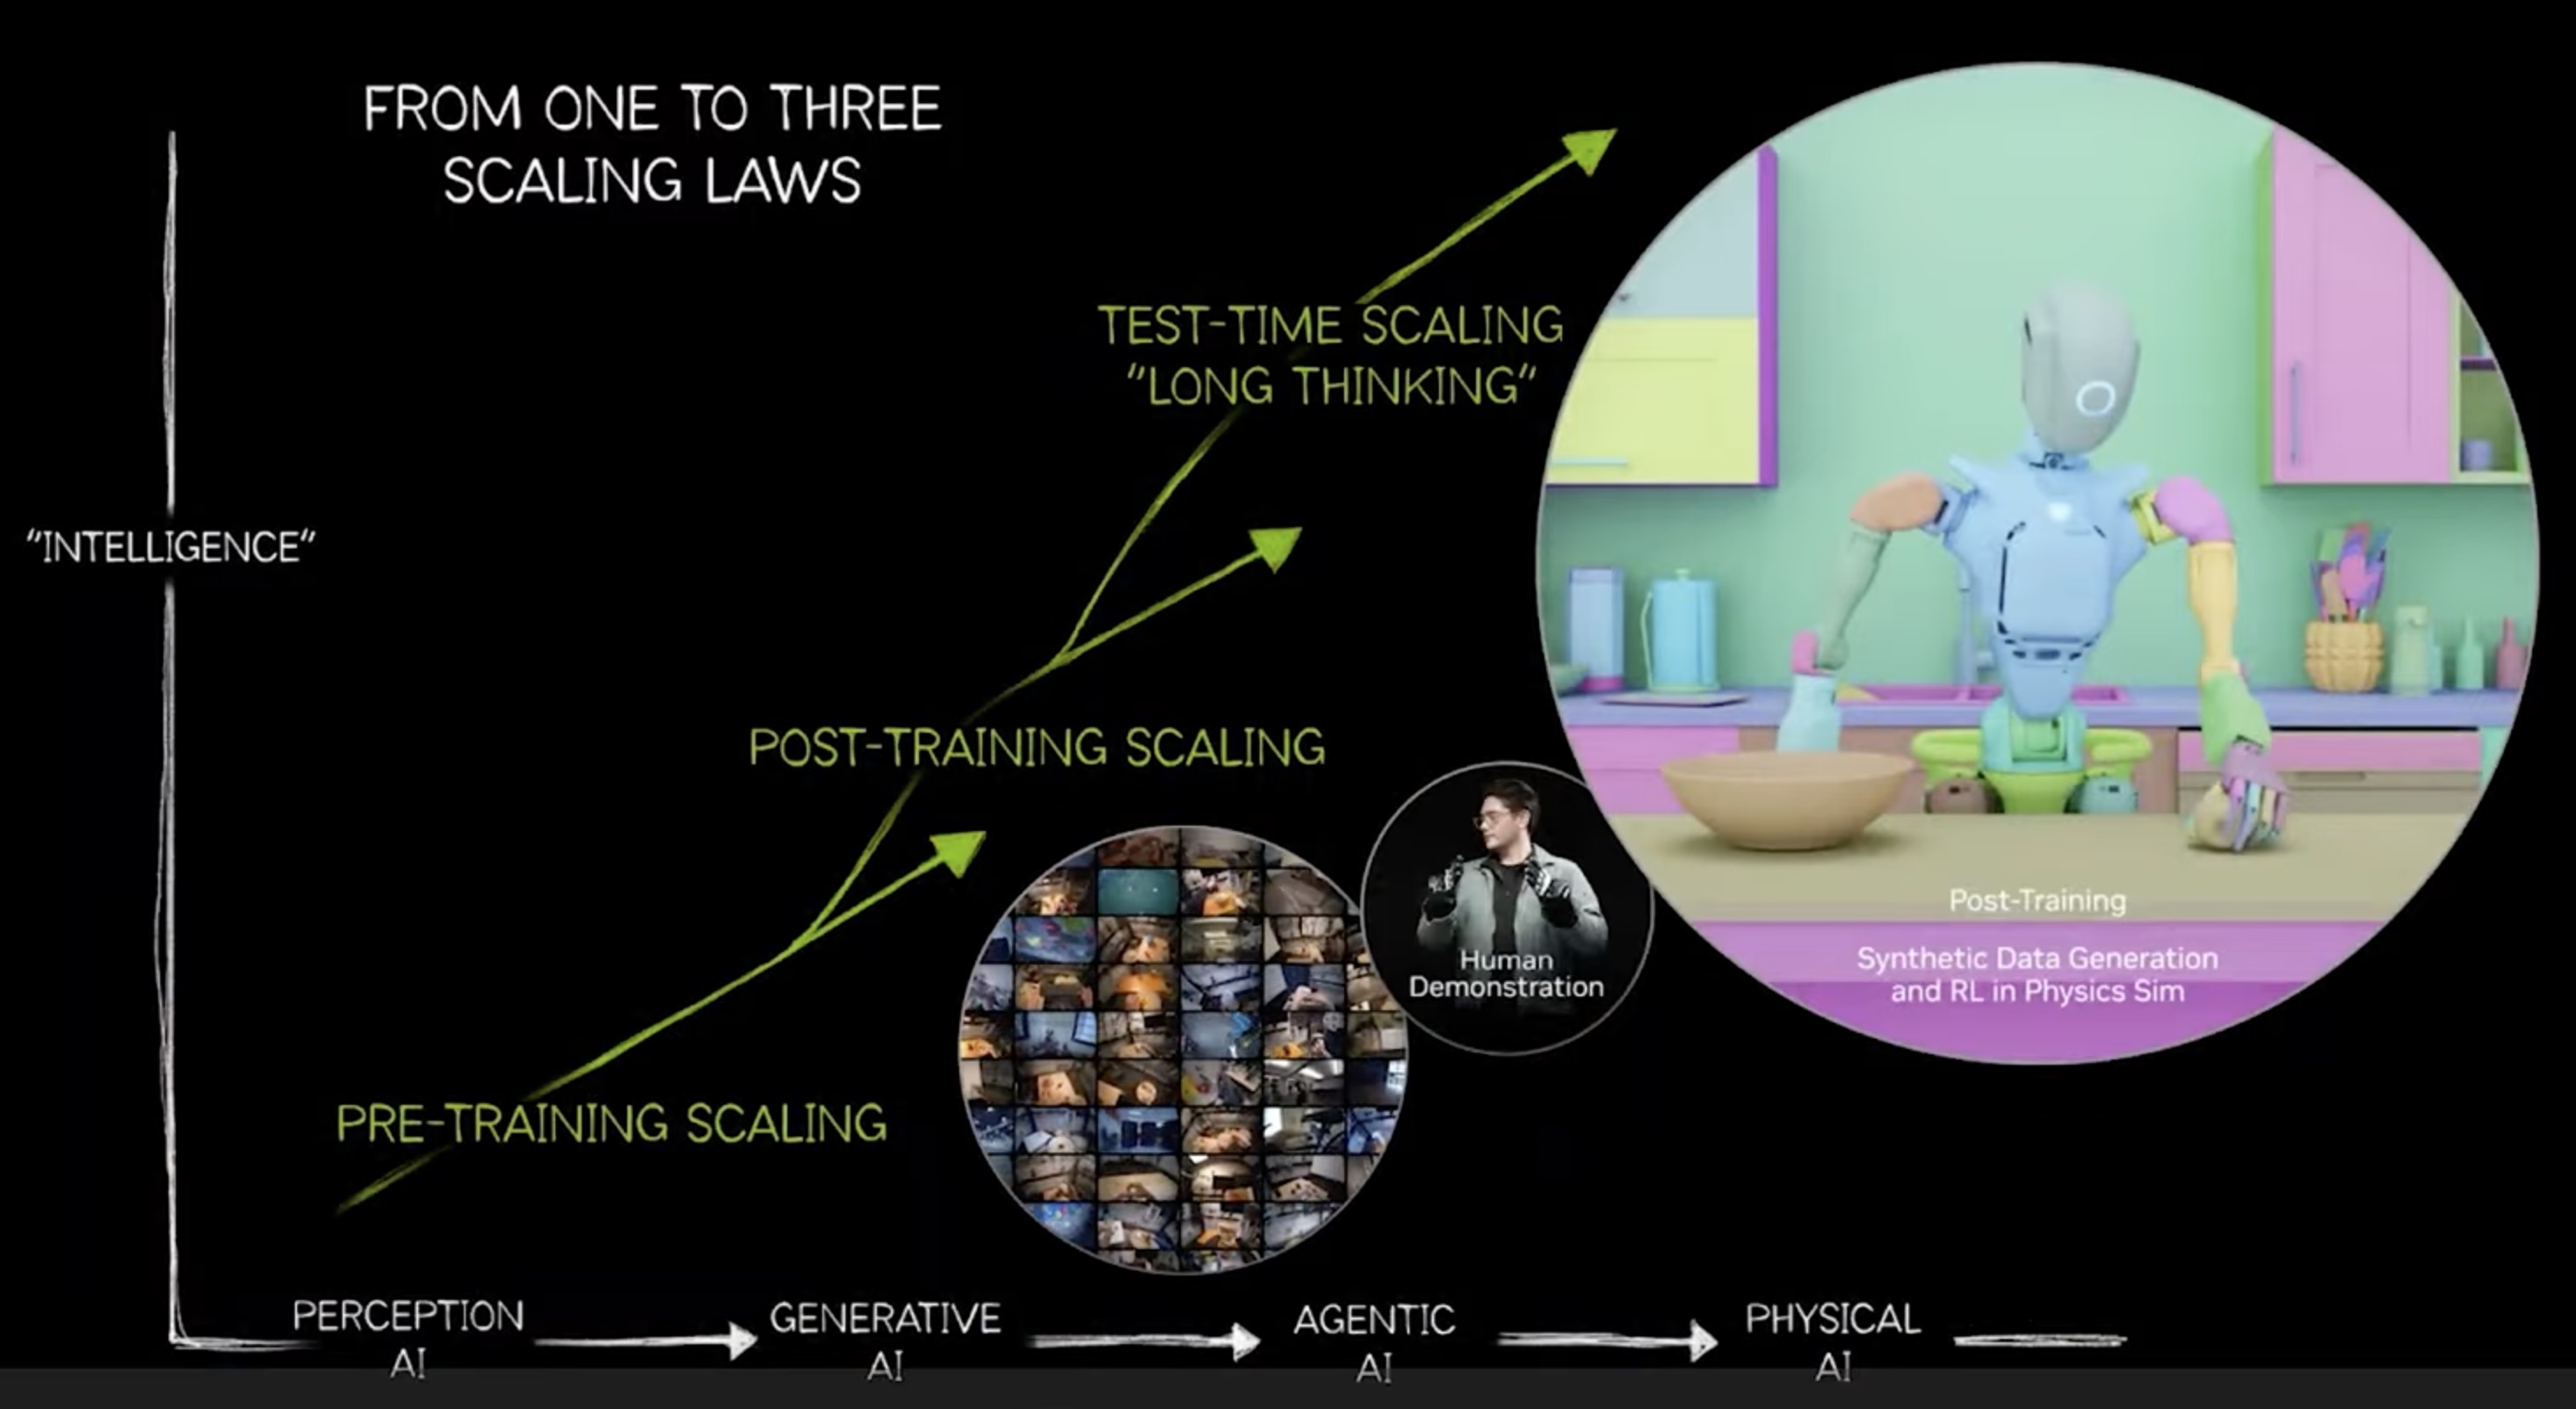
2025 年,基于可验证奖励的强化学习(RLVR)脱颖而出,成为这一时期事实上的新重要阶段。通过在多个环境中利用自动可验证的奖励来训练大语言模型(例如数学/代码谜题),大语言模型会自发地发展出对人类来说看起来像「推理」的策略——它们学会将问题解决分解为中间计算,并学会多种来回探索的策略以弄清楚事物(参见 DeepSeek R1 论文中的例子)。来源: Simon Willison 的网络日志

Andrej Karpathy

FunASR:多模型协同推理与语音处理全链路实践 (ASR, VAD, PUNC, SV)

本文详细介绍了 FunASR 这一基础语音识别工具包,它提供了一套完整的语音处理服务,涵盖了离线转写和实时听写两大核心功能。其技术核心在于 AutoModel 多模型协调引擎,能够将不同的组件,如语音活动检测(VAD)、自动语音识别(ASR)、标点恢复和说话人分离(SV),按序串联起来,实现复杂的音频转录任务。文档清晰展示了从原始音频输入到最终带说话人标签的转录结果的完整处理流程和数据流向。此外,本文不仅罗列了支持的多种中英文模型清单,还附带了音频格式转换指南和代码示例。最后,通过实验性能对比,文章论证了在不同硬件上,结合 VAD、PUNC 和 SV 等组件后对推理用时和处理准确性的影响。

ASR 模型综合对比表

模型名称 中文准确度 英文/混合识别 可读性 (标点) 附加功能 综合评分
Fun-ASR-Nano 极高 完美 极佳 生产环境级别 5.0
SenseVoiceSmall 较弱 (漏失) 较好 情感/事件检测 4.0
paraformer-zh (ASR) 一般 极差 原始数据 2.0
paraformer-zh (+VAD +PUNC) 中等 优秀 自动断句 4.5

建议

  • 如果你的场景需要极致的准确率和排版,首选 Fun-ASR-Nano
  • 如果你的场景需要分析说话人的情绪SenseVoiceSmall 是唯一的选择。
  • 对于普通的长音频转写,带标点补全的 paraformer-zh 性价比最高。

PowerShell 脚本示例

# 核心参数配置(无需修改,已按你的需求设定)
$targetMinDate = Get-Date "2024-06-01"  # 目标日期区间:开始
$targetMaxDate = Get-Date "2024-12-31"  # 目标日期区间:结束
$hourMin = 8                            # 限制最小小时(8点)
$hourMax = 21                           # 限制最大小时(21点,因22点不包含,实际最晚21:59:59)
$folderPath = "D:\test"                 # 要遍历的目录
$skipExtension = ".eml"                 # 需跳过的文件后缀
$logFilePath = "D:\log.txt"  # 日志文件路径(与脚本同目录)

# 生成目标区间内随机时间(限制8:00-22:00)的函数
function Get-RandomTargetDateTime {
    param(
        [datetime]$DateMin = $targetMinDate,
        [datetime]$DateMax = $targetMaxDate,
        [int]$HourMin = $hourMin,
// ...

该PowerShell脚本的核心功能是 批量筛选并修改指定目录下文件的修改时间,同时跳过特定类型文件、记录操作日

未来 5 年公司智算需求预测

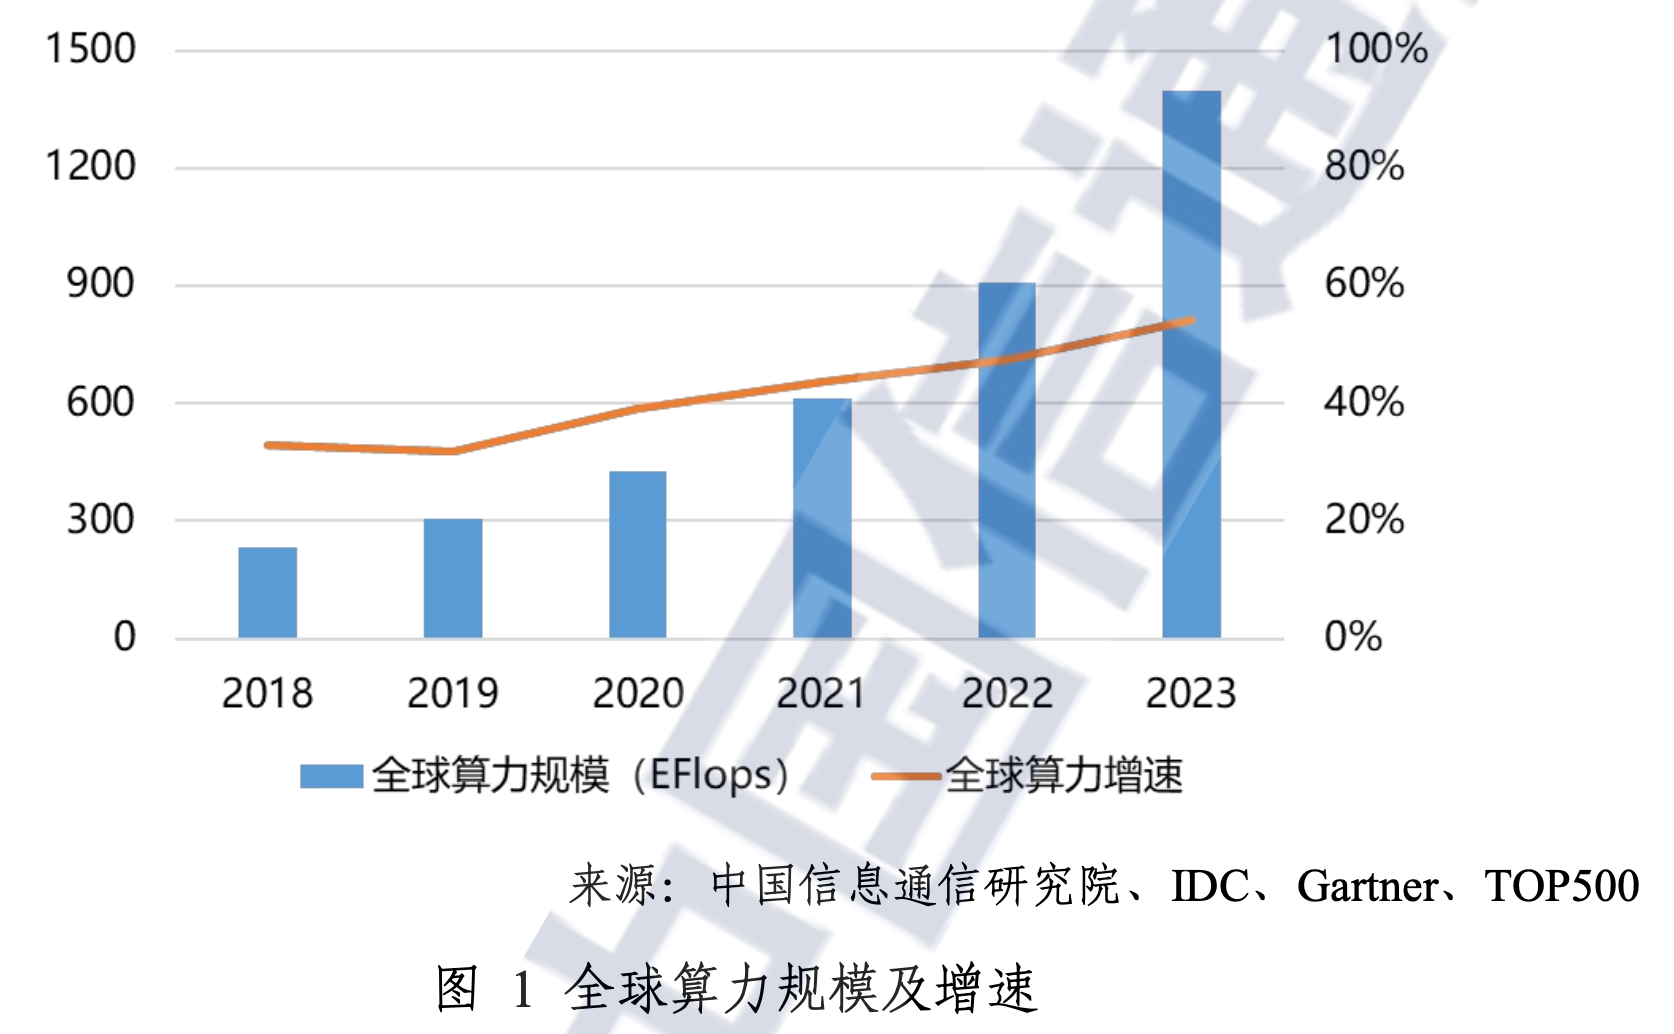
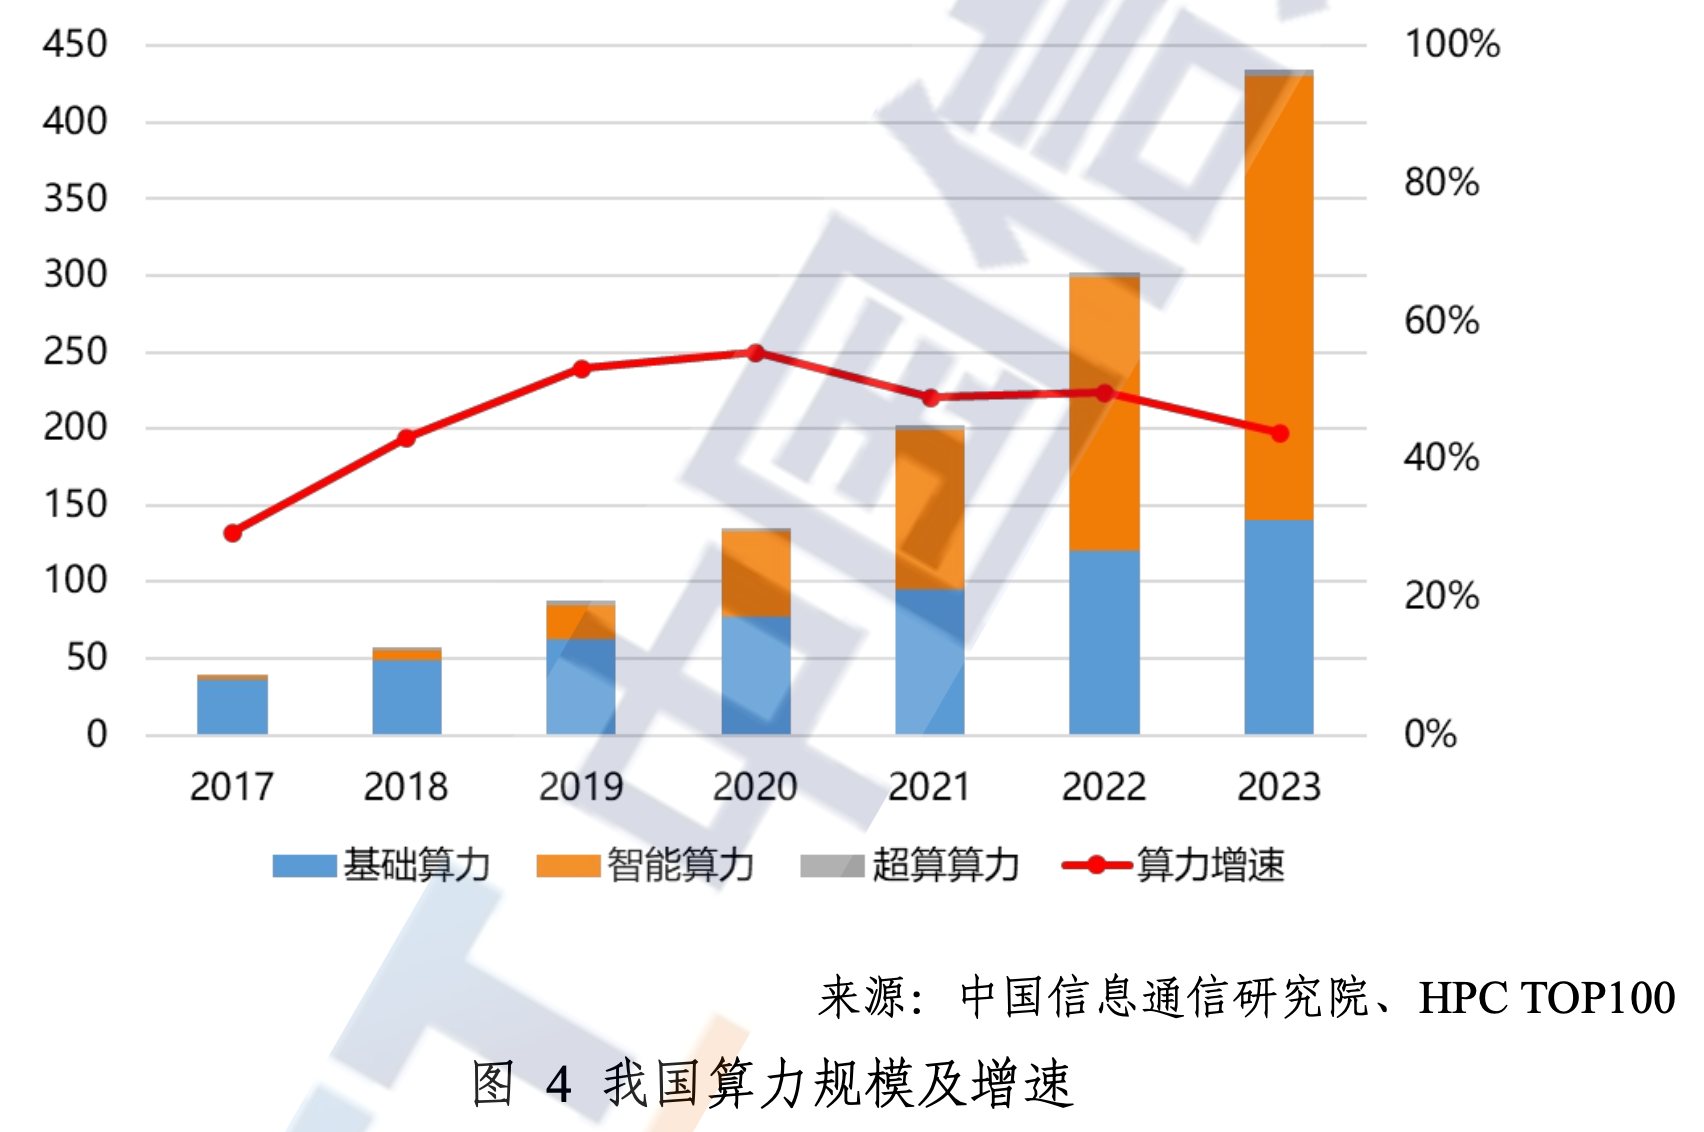
用半精度浮点数(FP16)计算能力评估服务器的智能计算能力,服务器算力=处理器芯片数x每时钟周期执行单精度浮点运算次数x处理器主频x处理器核数。

全球算力概览

中国算力概览

截至 2025 年 3 月底,我国智算规模达 748EFLOPS(FP16),近五年平均增速达 49%

公司算力概览

昇腾 910B4 (32GB) 算力概览

配置级别 硬件描述 FP16 峰值算力 备注
单卡 昇腾 910B4 (32GB) 280 TFLOPS 单卡 FP16 算力峰值
单机 Atlas 800I A2 服务器 (8 x 910B4) 2240 TFLOPS (2.24 PFLOPS2.24 \text{ PFLOPS}) 服务器搭载 8 张 910B4 卡
集群 5 台 Atlas 800I A2 服务器 11.2 PFLOPS 由 5 台服务器组成的集群

NVIDIA T4 (16GB) 算力概览

配置级别 硬件描述 FP16 峰值算力 备注
单卡 NVIDIA T4 65 TFLOPS 使用混合精度 Tensor Cores
单机 4 卡服务器 260 TFLOPS 服务器搭载 4 张 T4 卡
集群 4 台 4 卡服务器 1.04 PFLOPS 由 4 台服务器组成的集群

总算力

智能会议系统 Jetson Thor 上部署模型服务指南

内网IP27.41.19.62

服务 说明 端口 模型 备注
whisperlivekit 实时语音识别服务 8000 Whisper
small (默认)
large-v3-turbo
说话人分离
FunASR 实时语音识别服务 8000 语音识别paraformer-zh
实时语音识别paraformer-zh-streaming
实时语音端点检测fsmn-vad
标点恢复ct-punc
文本逆规范化fst_itn_zh
实时与非实时一体化协同(2pass)服务模式
llama-server GGUF 模型推理服务 8080 Qwen3
Qwen3-8B-Q5_K_M.gguf
模型名:qwen3
上下文长度:32K
不思考

系统设置

系统优化

最大功率模式(一次性设置)

sudo nvpmodel -m 0

启动最高频率(每次重启后设置)

sudo jetson_clocks

清理内存

sync && echo 3 | sudo tee /proc/sys/vm/drop_caches

WhisperLiveKit

部署服务

tmux new -s wlk

默认容器内应用(标点识别有时会失灵 ⚠️)

FunASR - 基础语音识别工具包

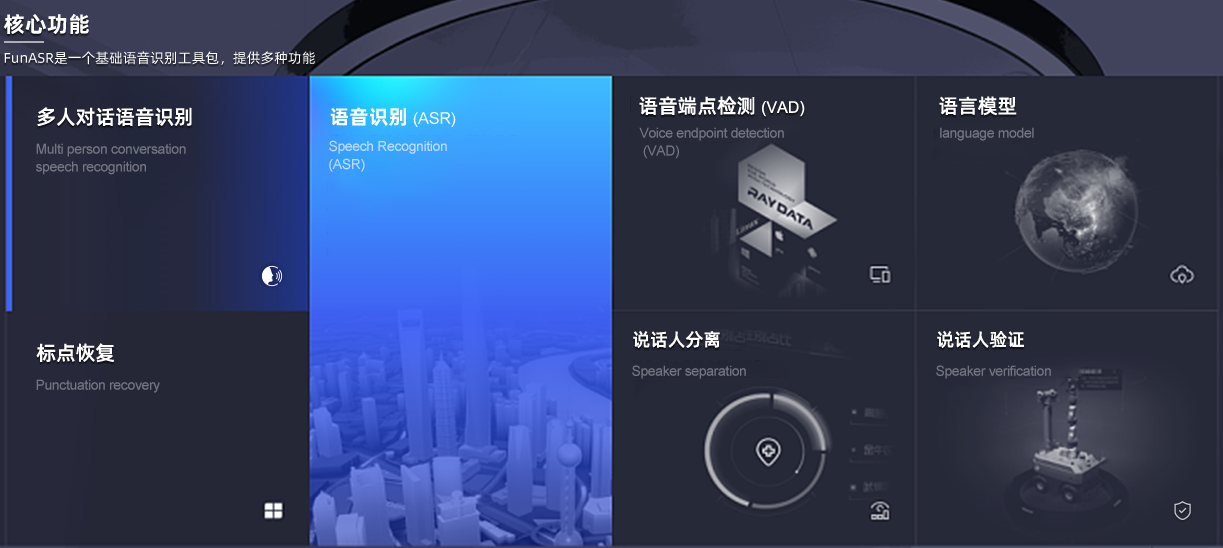
FunASR 是一个基础语音识别工具包,提供多种功能,包括语音识别(ASR)、语音端点检测(VAD)、标点恢复、语言模型、说话人验证、说话人分离和多人对话语音识别等。

FunASR 快速入门

核心功能

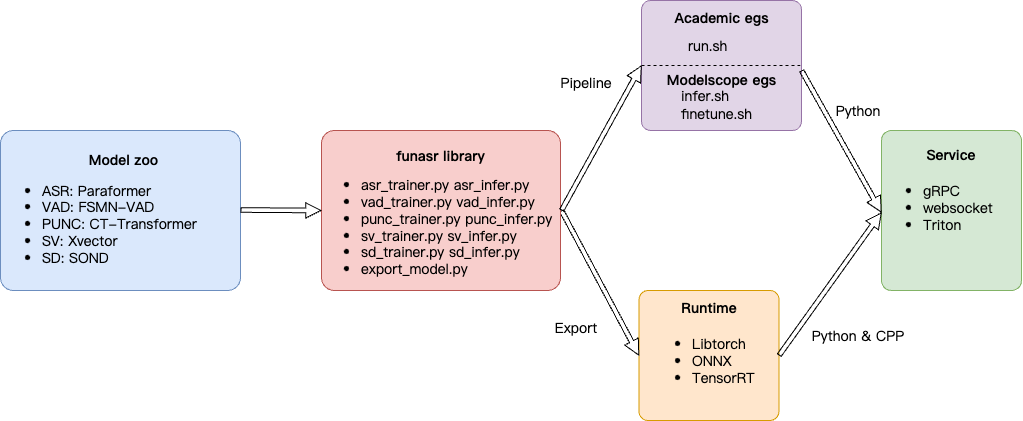
工作流程

离线文件转写服务

FunASR离线文件转写软件包,提供了一款功能强大的语音离线文件转写服务。拥有完整的语音识别链路,结合了语音端点检测、语音识别、标点等模型,可以将几十个小时的长音频与视频识别成带标点的文字,而且支持上百路请求同时进行转写。输出为带标点的文字,含有字级别时间戳,支持ITN与用户自定义热词等。服务端集成有ffmpeg,支持各种音视频格式输入。软件包提供有html、python、c++、java与c#等多种编程语言客户端。

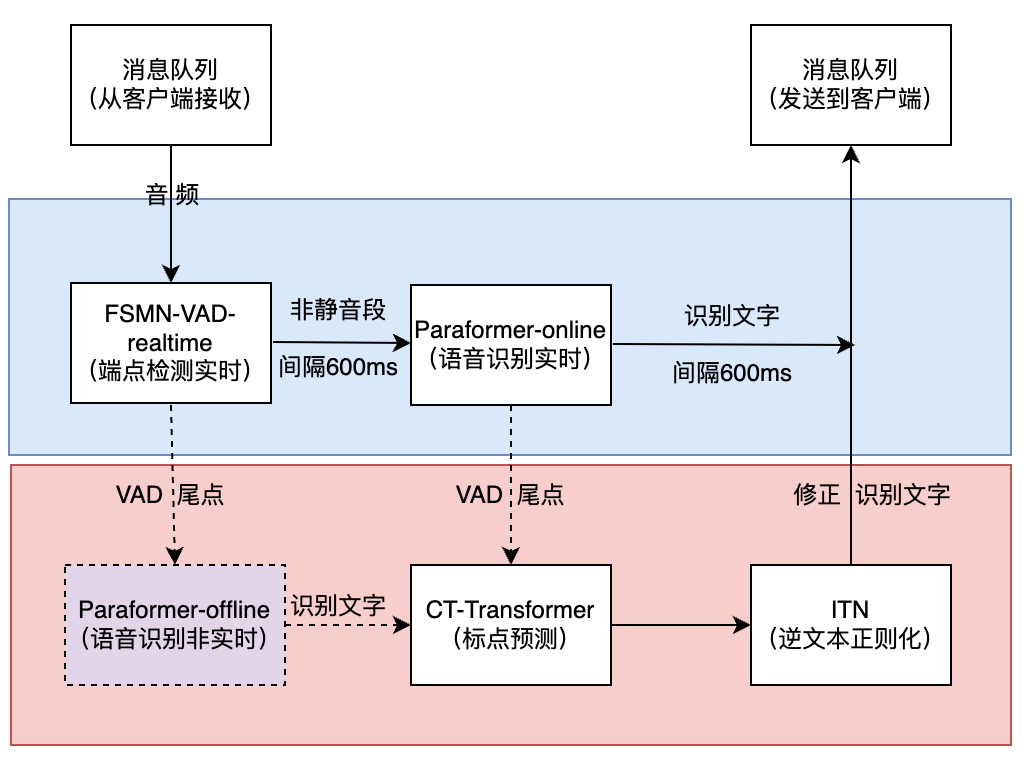
实时听写服务

FunASR实时语音听写软件包,集成了实时版本的语音端点检测模型、语音识别、语音识别、标点预测模型等。采用多模型协同,既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。依据使用者场景不同,支持实时语音听写服务(online)、非实时一句话转写(offline)与实时与非实时一体化协同(2pass)3种服务模式。软件包提供有html、python、c++、java与c#等多种编程语言客户端。

FunASR 镜像

  • 在线 CPU 版本

SenseVoice

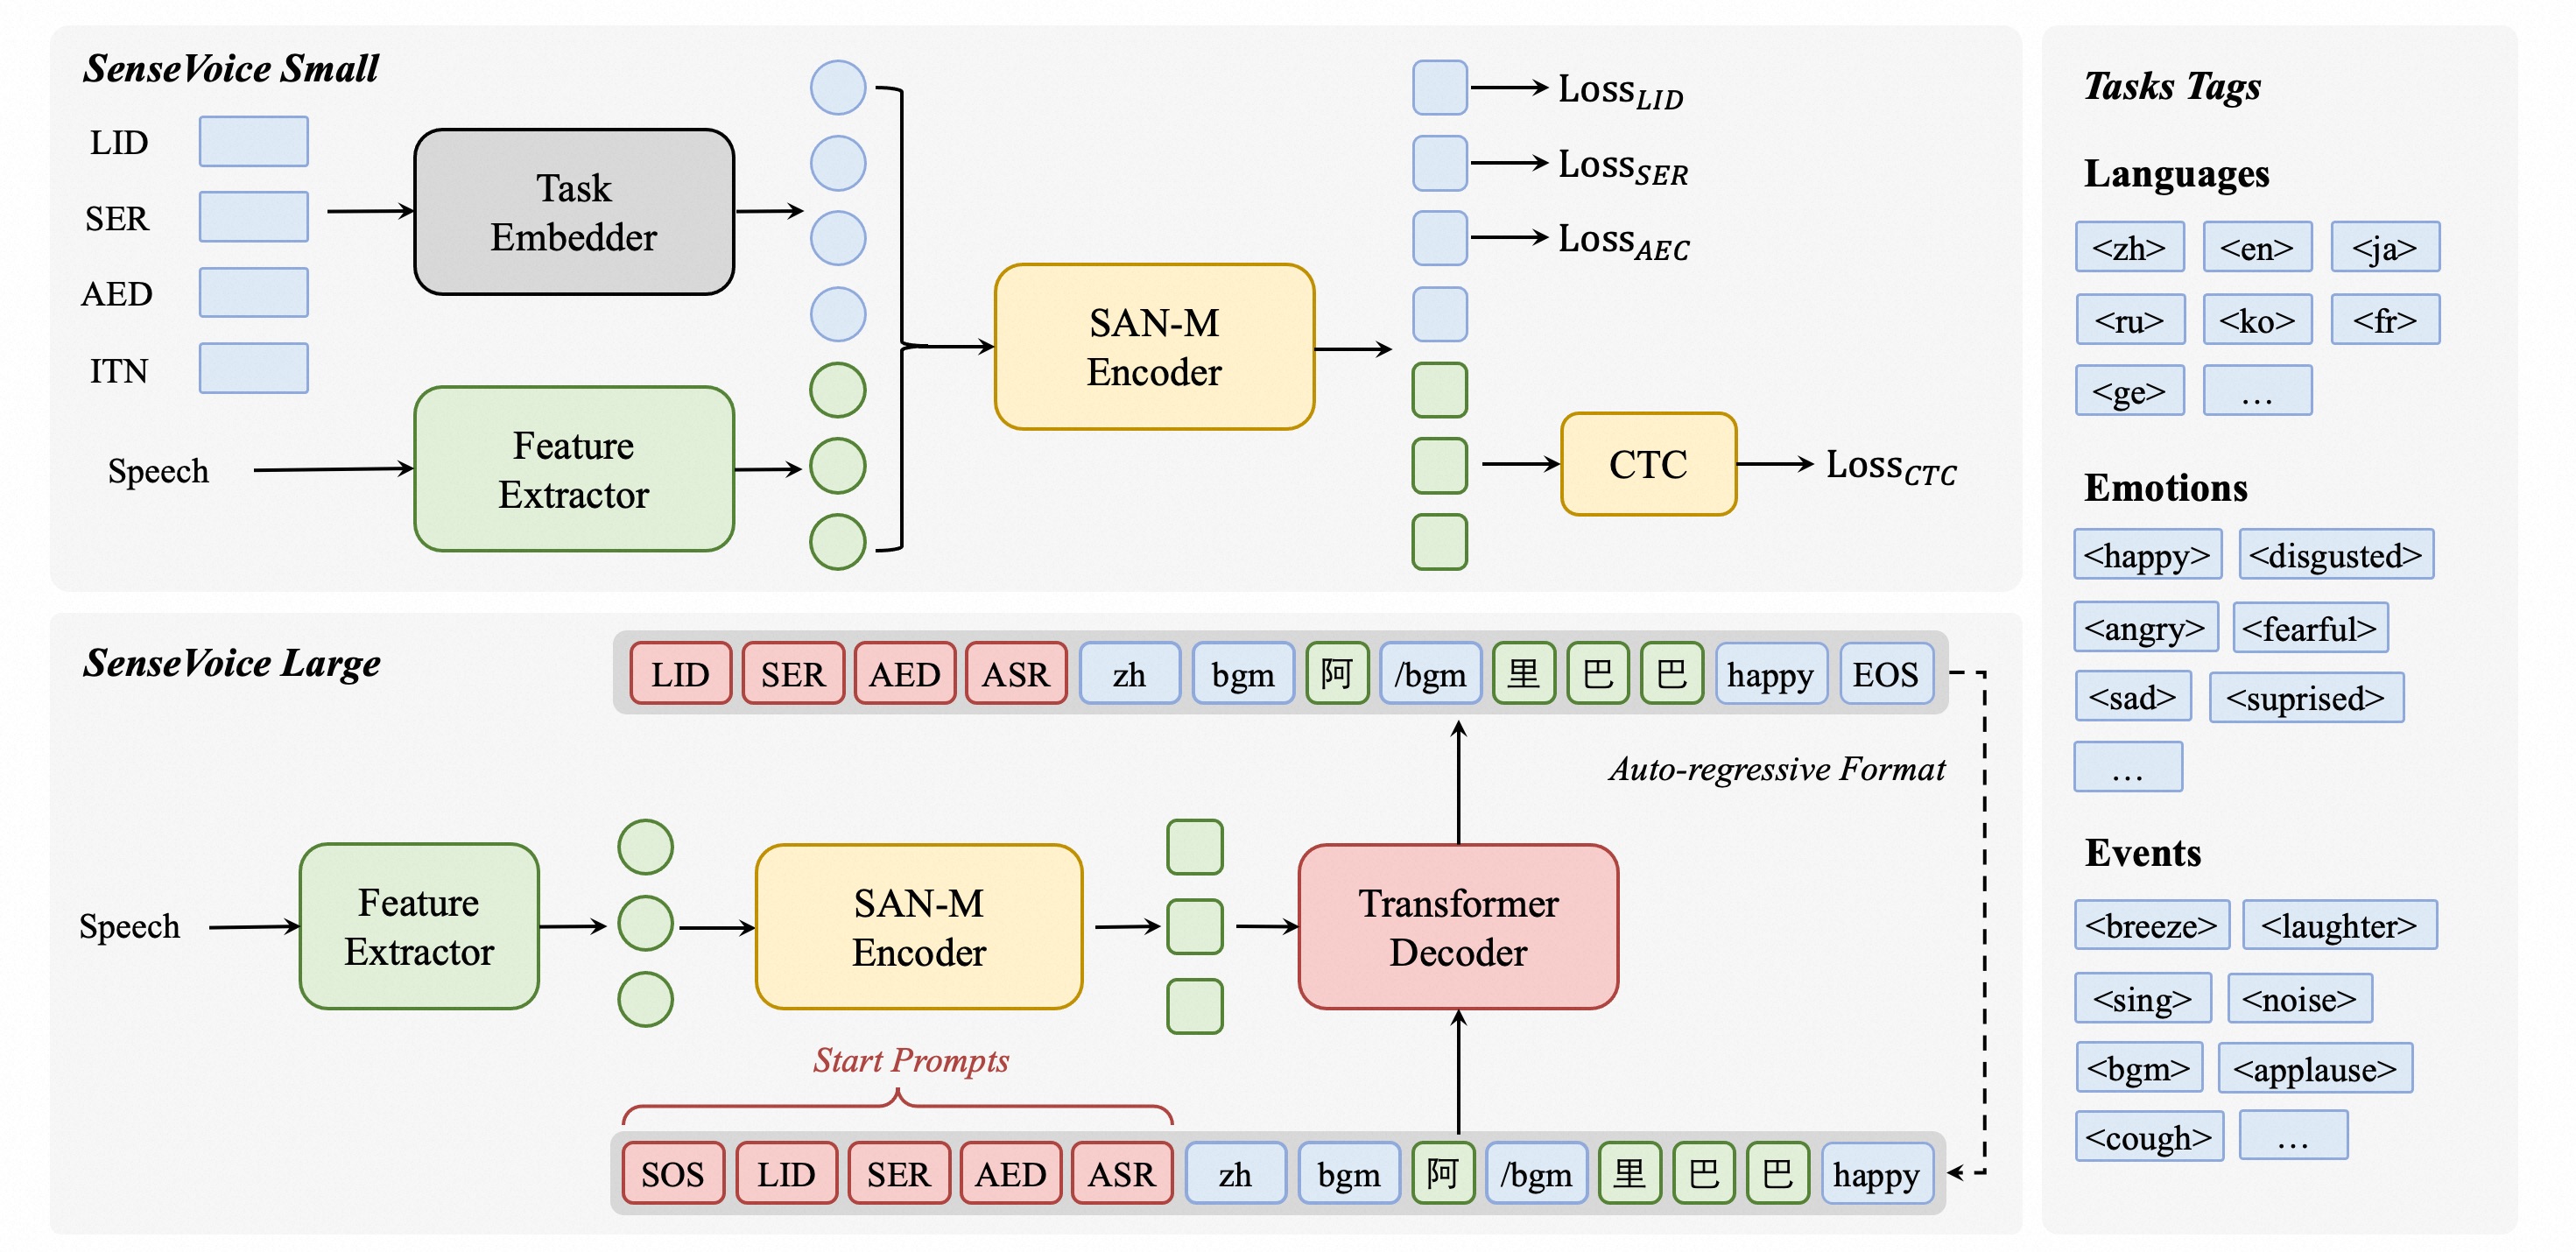
SenseVoice 是具有音频理解能力的音频基础模型,包括语音识别(ASR)、语种识别(LID)、语音情感识别(SER)和声学事件分类(AEC)或声学事件检测(AED)。

SenseVoice

核心功能 🎯

SenseVoice 专注于高精度多语言语音识别、情感辨识和音频事件检测

  • 多语言识别: 采用超过 40 万小时数据训练,支持超过 50 种语言,识别效果上优于 Whisper 模型。
  • 富文本识别:
    • 具备优秀的情感识别,能够在测试数据上达到和超过目前最佳情感识别模型的效果。
    • 支持声音事件检测能力,支持音乐、掌声、笑声、哭声、咳嗽、喷嚏等多种常见人机交互事件进行检测。
  • 高效推理: SenseVoice-Small 模型采用非自回归端到端框架,推理延迟极低,10s 音频推理仅耗时 70ms,15 倍优于 Whisper-Large。
  • 微调定制: 具备便捷的微调脚本与策略,方便用户根据业务场景修复长尾样本问题。
  • 服务部署: 具有完整的服务部署链路,支持多并发请求,支持客户端语言有,python、c++、html、java 与 c# 等。

架构图

  • 语音识别(ASR)
  • 语言识别(LID)
  • 语音情感识别(SER)
  • 音频事件检测(AED,比如笑声、掌声、背景音乐、咳嗽等)
  • 逆文本归一化(ITN)

安装

克隆代码库

SimulStreaming — 实时流式语音识别工具包

SimulStreaming 实现了 Whisper 模型的同步翻译和转录功能(在语音识别领域被称为流式传输)。SimulStreaming 采用了最先进的同步策略 AlignAtt,这使其具备极高的速度和效率。

安装

git clone https://github.com/ufal/SimulStreaming
cd SimulStreaming
pip install -r requirements.txt

从音频文件进行实时模拟

凭借现在的人工智能,我们能够编写以前根本无法手工编写的新程序。我们通过指定目标(例如分类准确率、奖励函数)来做到这一点,并通过梯度下降搜索程序空间,以找到在该目标上表现良好的神经网络。

Karpathy 引用了他的「Software 2.0」博客文章。他指出,「可验证性」是人工智能优化中最具预测性的特征——如果一项任务是可验证的,那么它就可以直接或通过强化学习进行优化。而人工智能「练习」的环境必须满足三个要求:可重置、高效、可奖励。 来源: Simon Willison 的网络日志

Andrej Karpathy

WhisperLiveKit - 实时语音识别

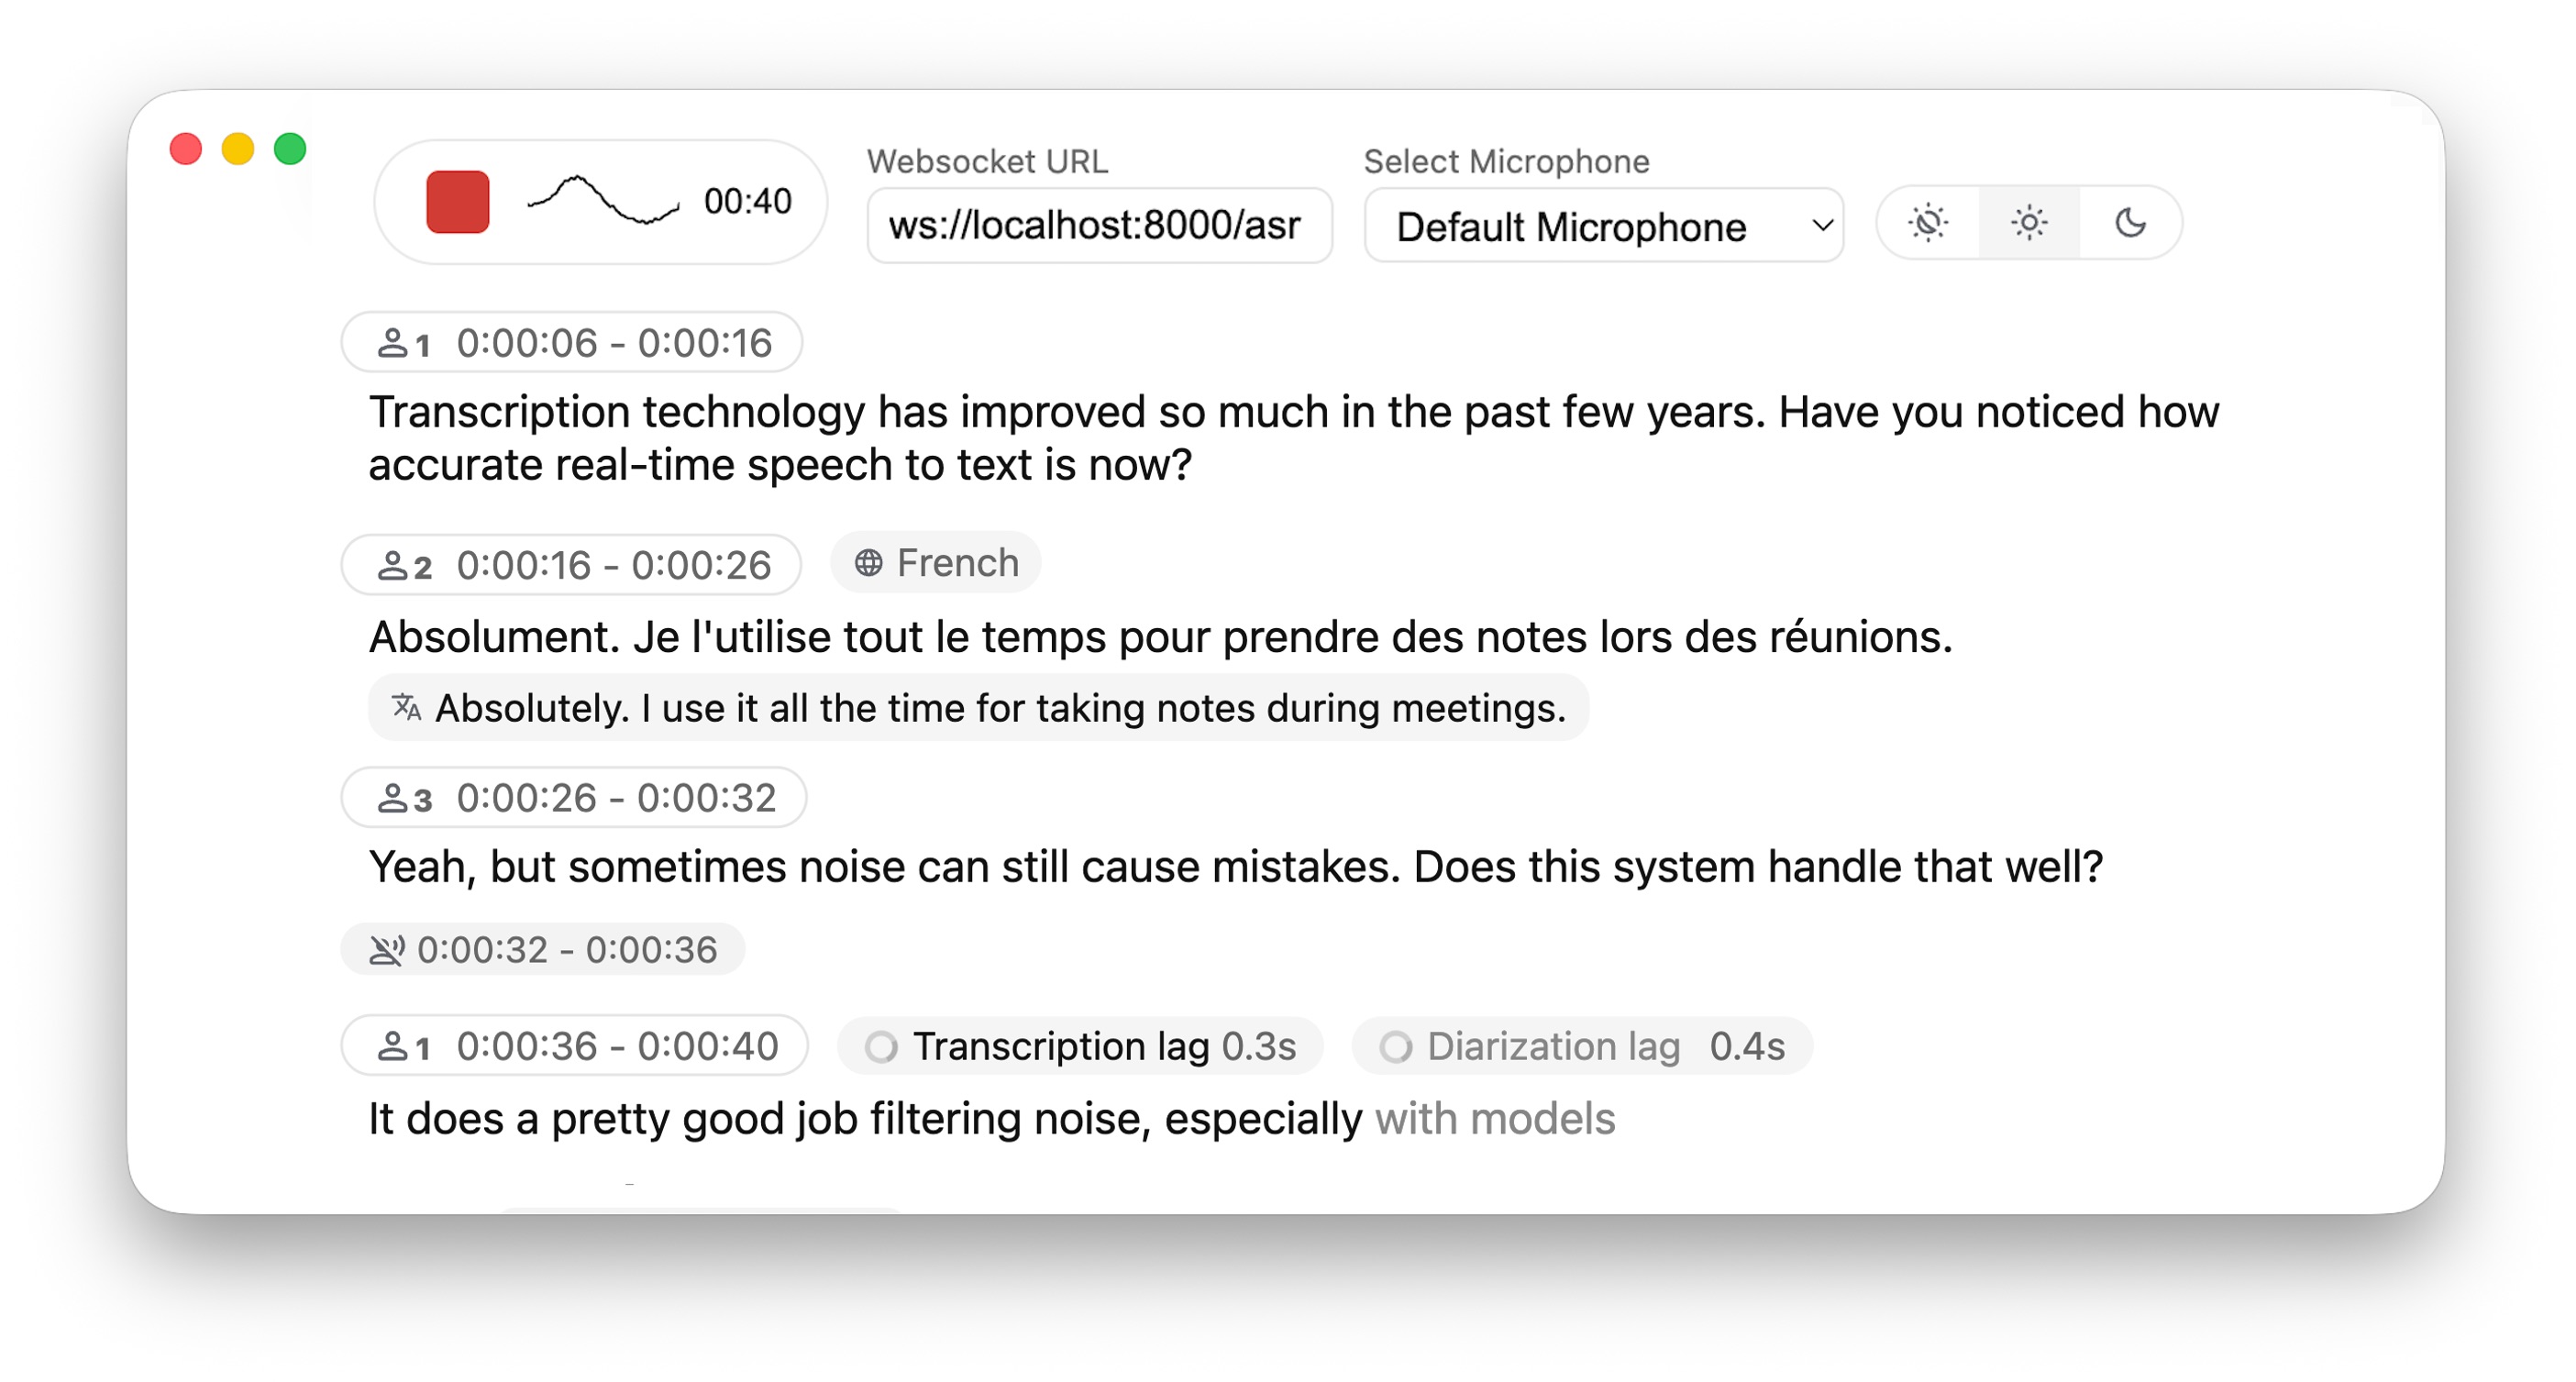
WhisperLiveKit 演示

实时、完全本地化的语音转文本,带说话人识别功能

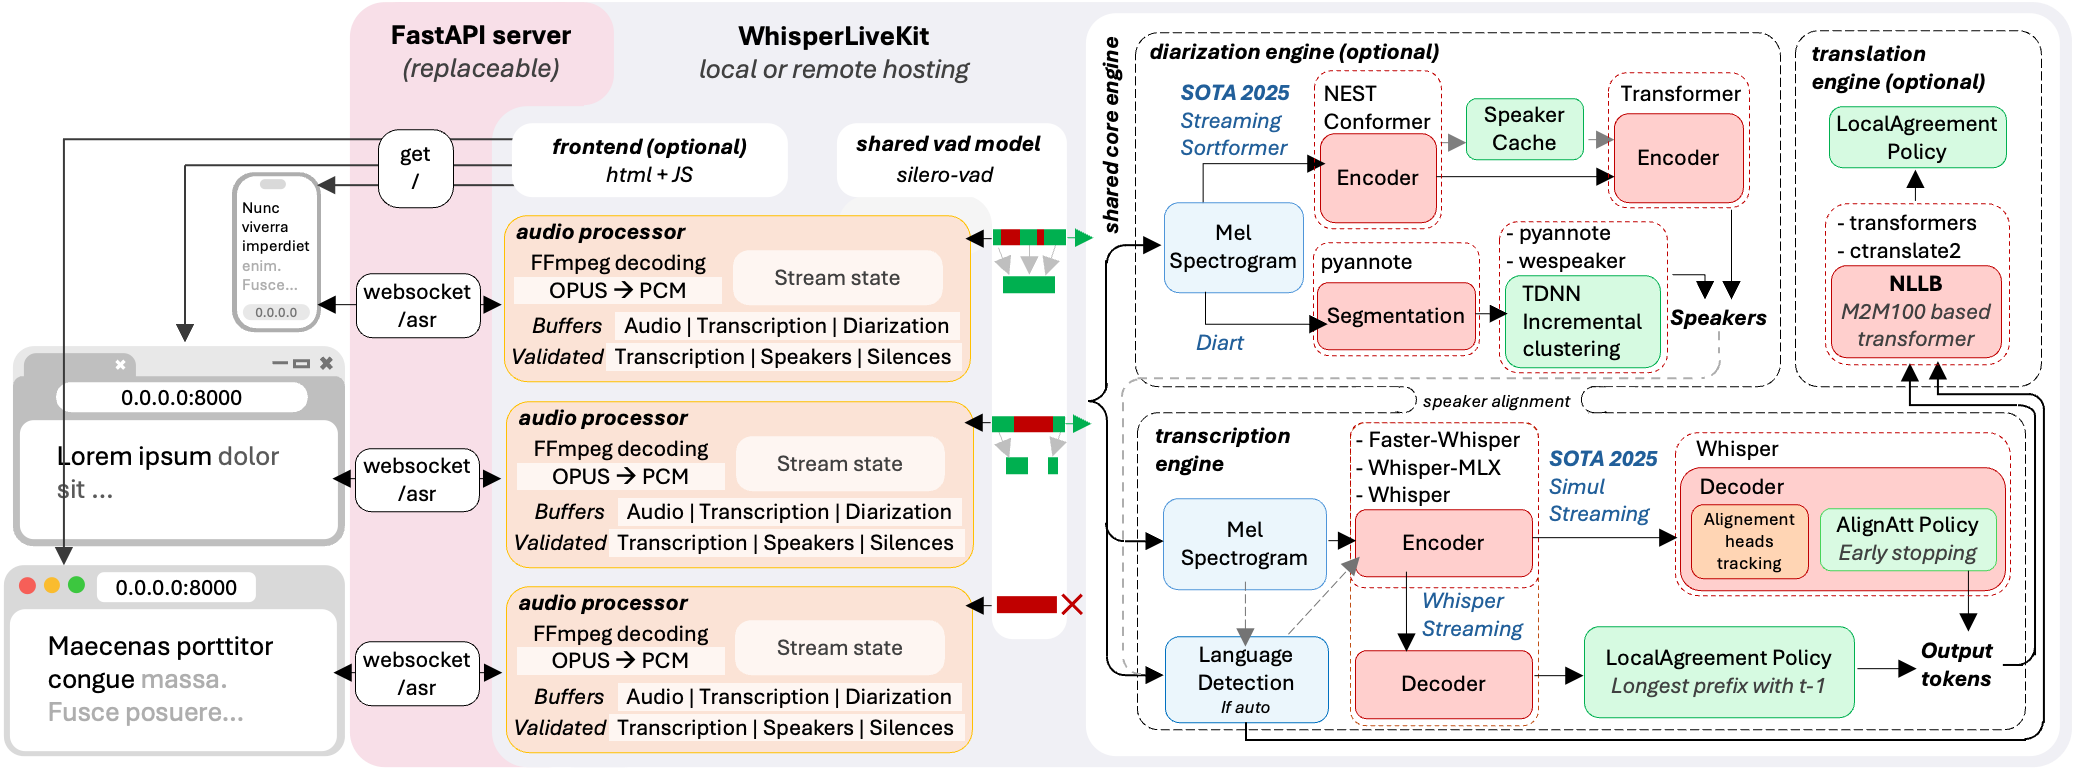
WhisperLiveKit 架构

构建 WhisperLiveKit

运行 pytorch 容器 - CUDA (JetsonThor)

docker run -it \
    --ipc=host \
    --net=host \
    --runtime=nvidia \
    --name=whisperlivekit \
    -v ~/.cache:/root/.cache \
    -v /models:/models \
    nvcr.io/nvidia/pytorch:25.10-py3 \
    bash

生成证书

mkdir -p .cert && cd .cert

openssl req -x509 -newkey rsa:4096 \
  -keyout key.pem \
  -out cert.pem \
  -days 365 \
  -nodes \
  -subj "/C=CN/ST=ShanDong/L=JiNan/O=LNSoft/OU=LNSoft/CN=localhost/emailAddress=wjj@163.com"

参数解释:

  • -x509:生成自签名证书
  • -newkey rsa:4096:新建 4096 位 RSA 密钥
  • -keyout key.pem:输出私钥文件
  • -out cert.pem:输出证书文件
  • -days 365:证书有效期 365 天
  • -nodes:不加密私钥(即无需输入密码)
  • -subj:直接指定证书主题,跳过交互式输入

大模型(语言、视觉语言、语音)推理服务部署与测试

推理服务

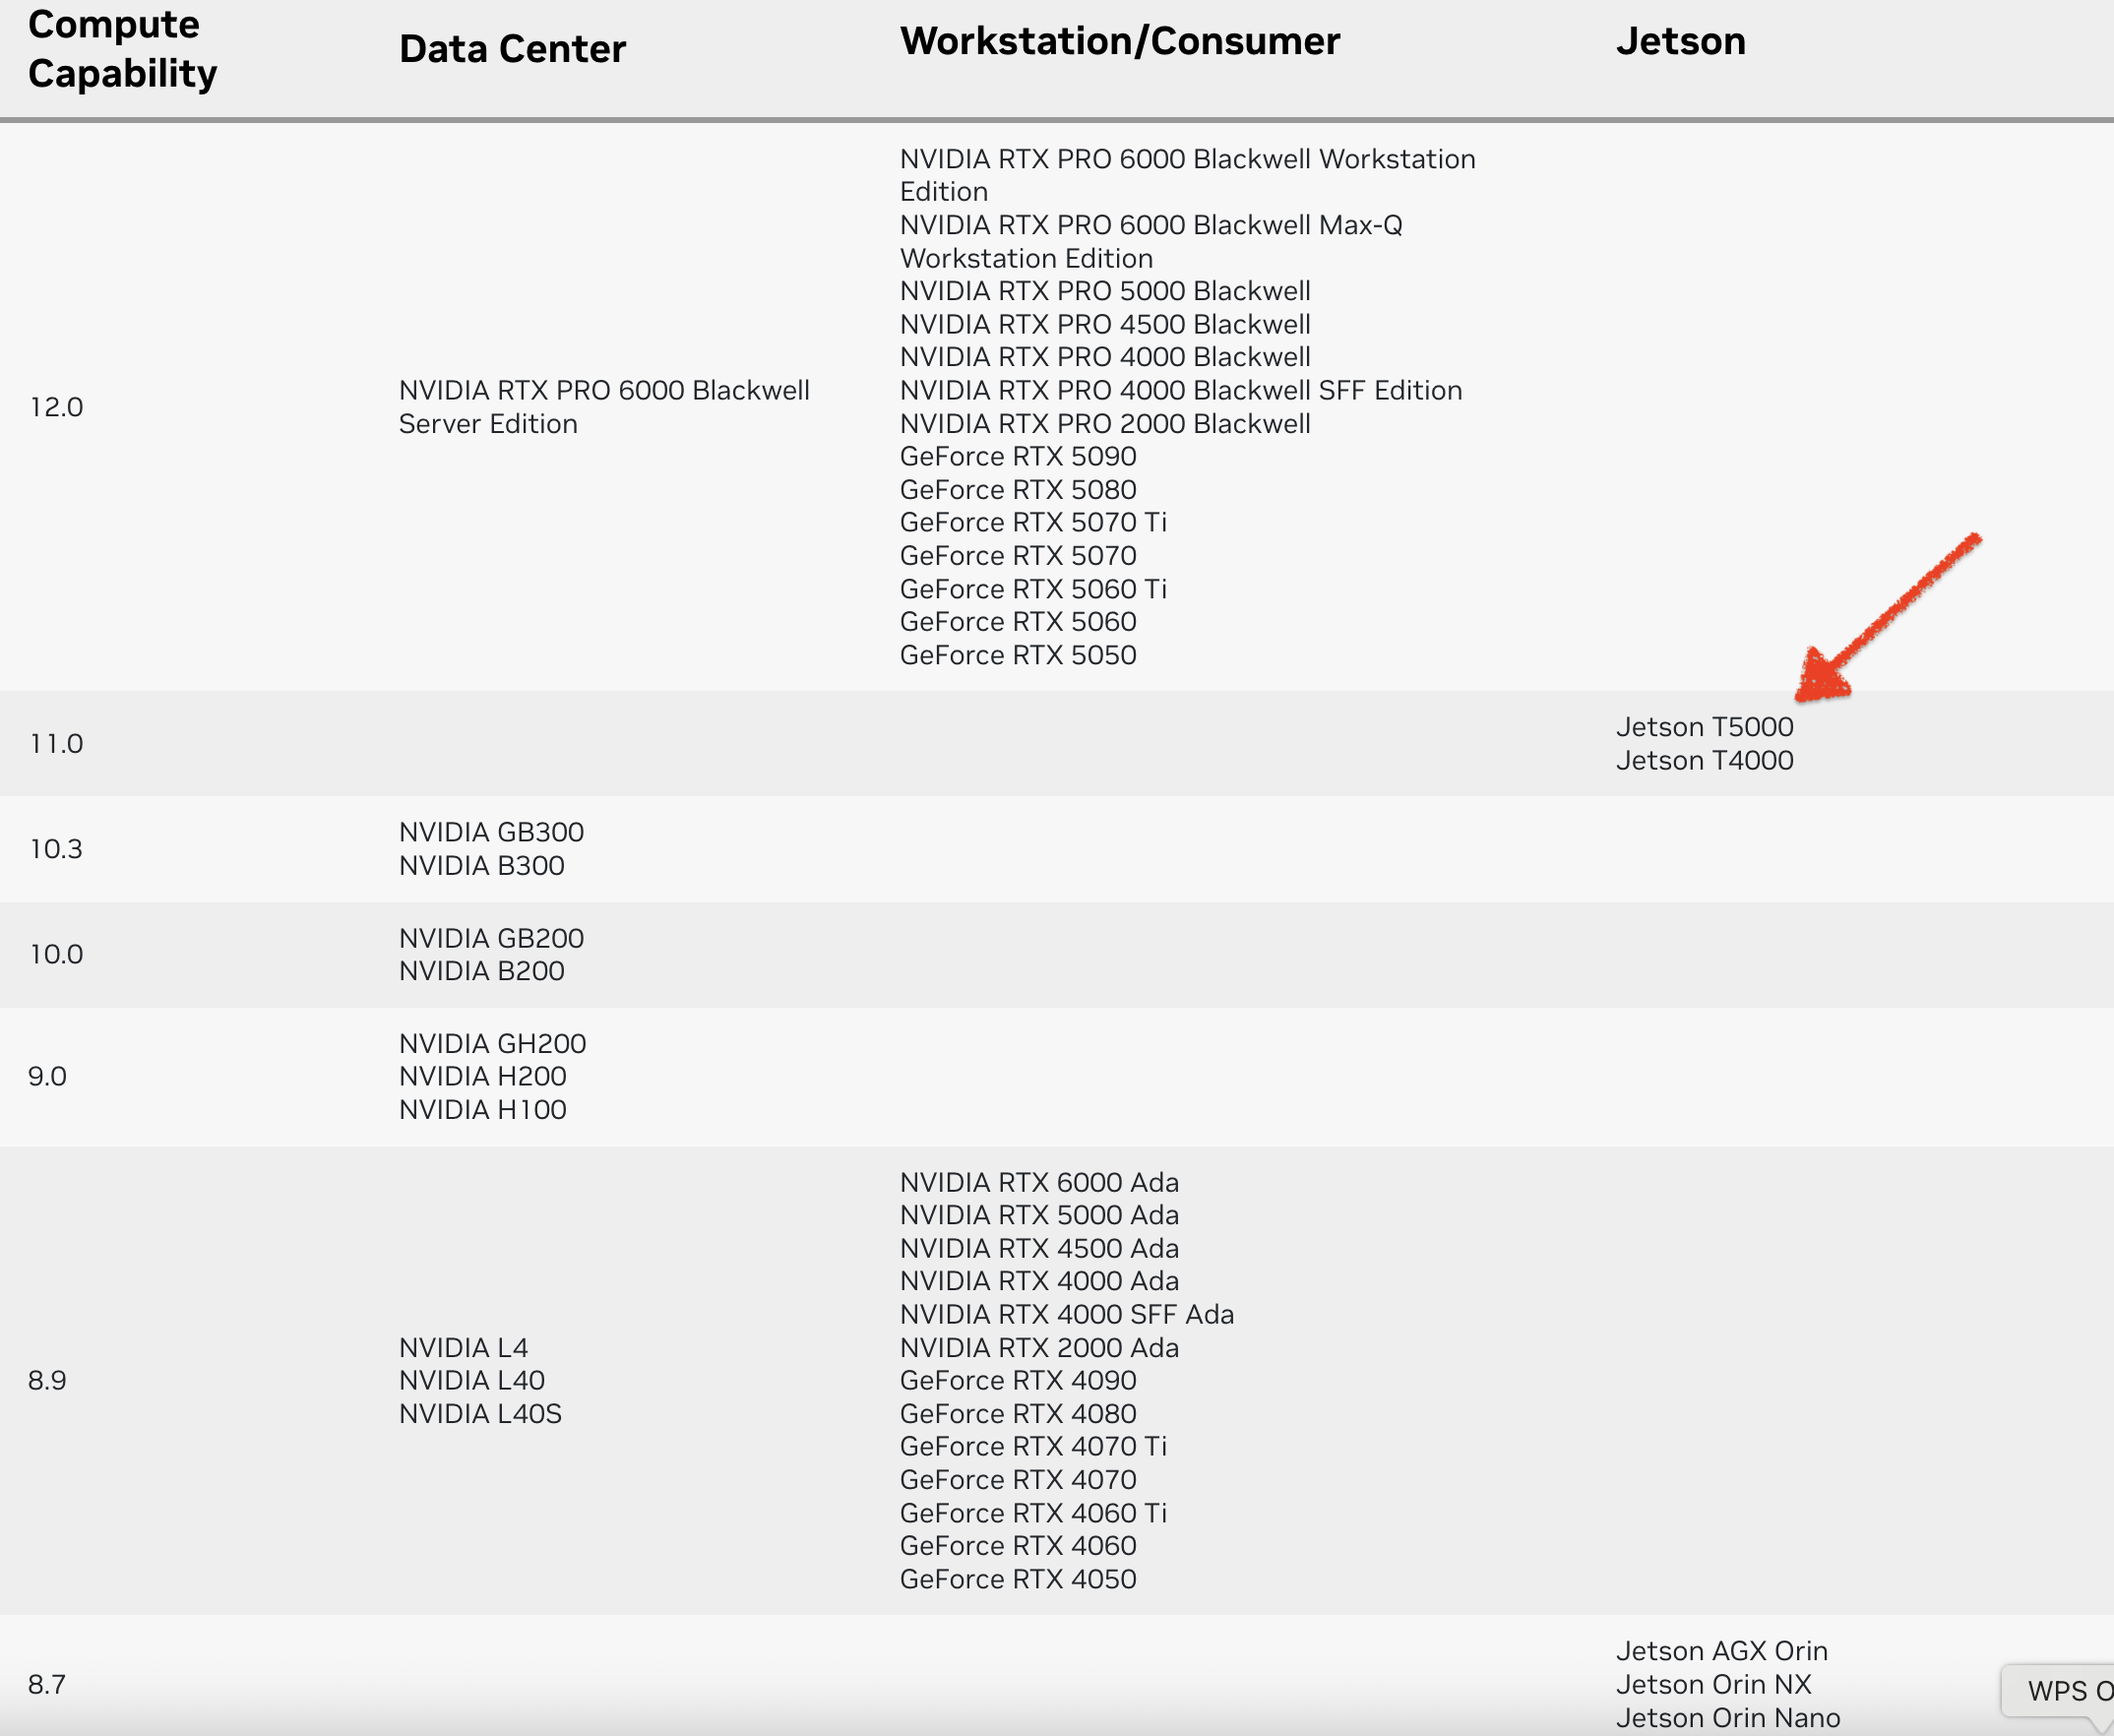
CUDA GPU Compute Capability(计算能力)

计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性支持的指令。在下表中查找您的GPU的计算能力。

vLLM

docker run -it --rm \
  --ipc=host \
  --net=host \
  --runtime=nvidia \
  --name=vllm-test \
  -v /models:/models \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -v ~/.cache/modelscope:/root/.cache/modelscope \
  nvcr.io/nvidia/vllm:25.10-py3 \
  bash

默认情况下,如果模型未指向有效的本地目录,它将从 Hugging Face Hub 下载模型文件。要从 ModelScope 下载模型,请在运行命令之前进行如下设置:

export VLLM_USE_MODELSCOPE=true
vllm serve /models/Qwen/Qwen3-8B \
  --served-model-name qwen3 \
  --chat-template /models/Qwen/Qwen3-8B/qwen3_nonthinking.jinja

SGLang

DeepSeek-OCR 研究与实测

DeepSeek-OCR:上下文光学压缩

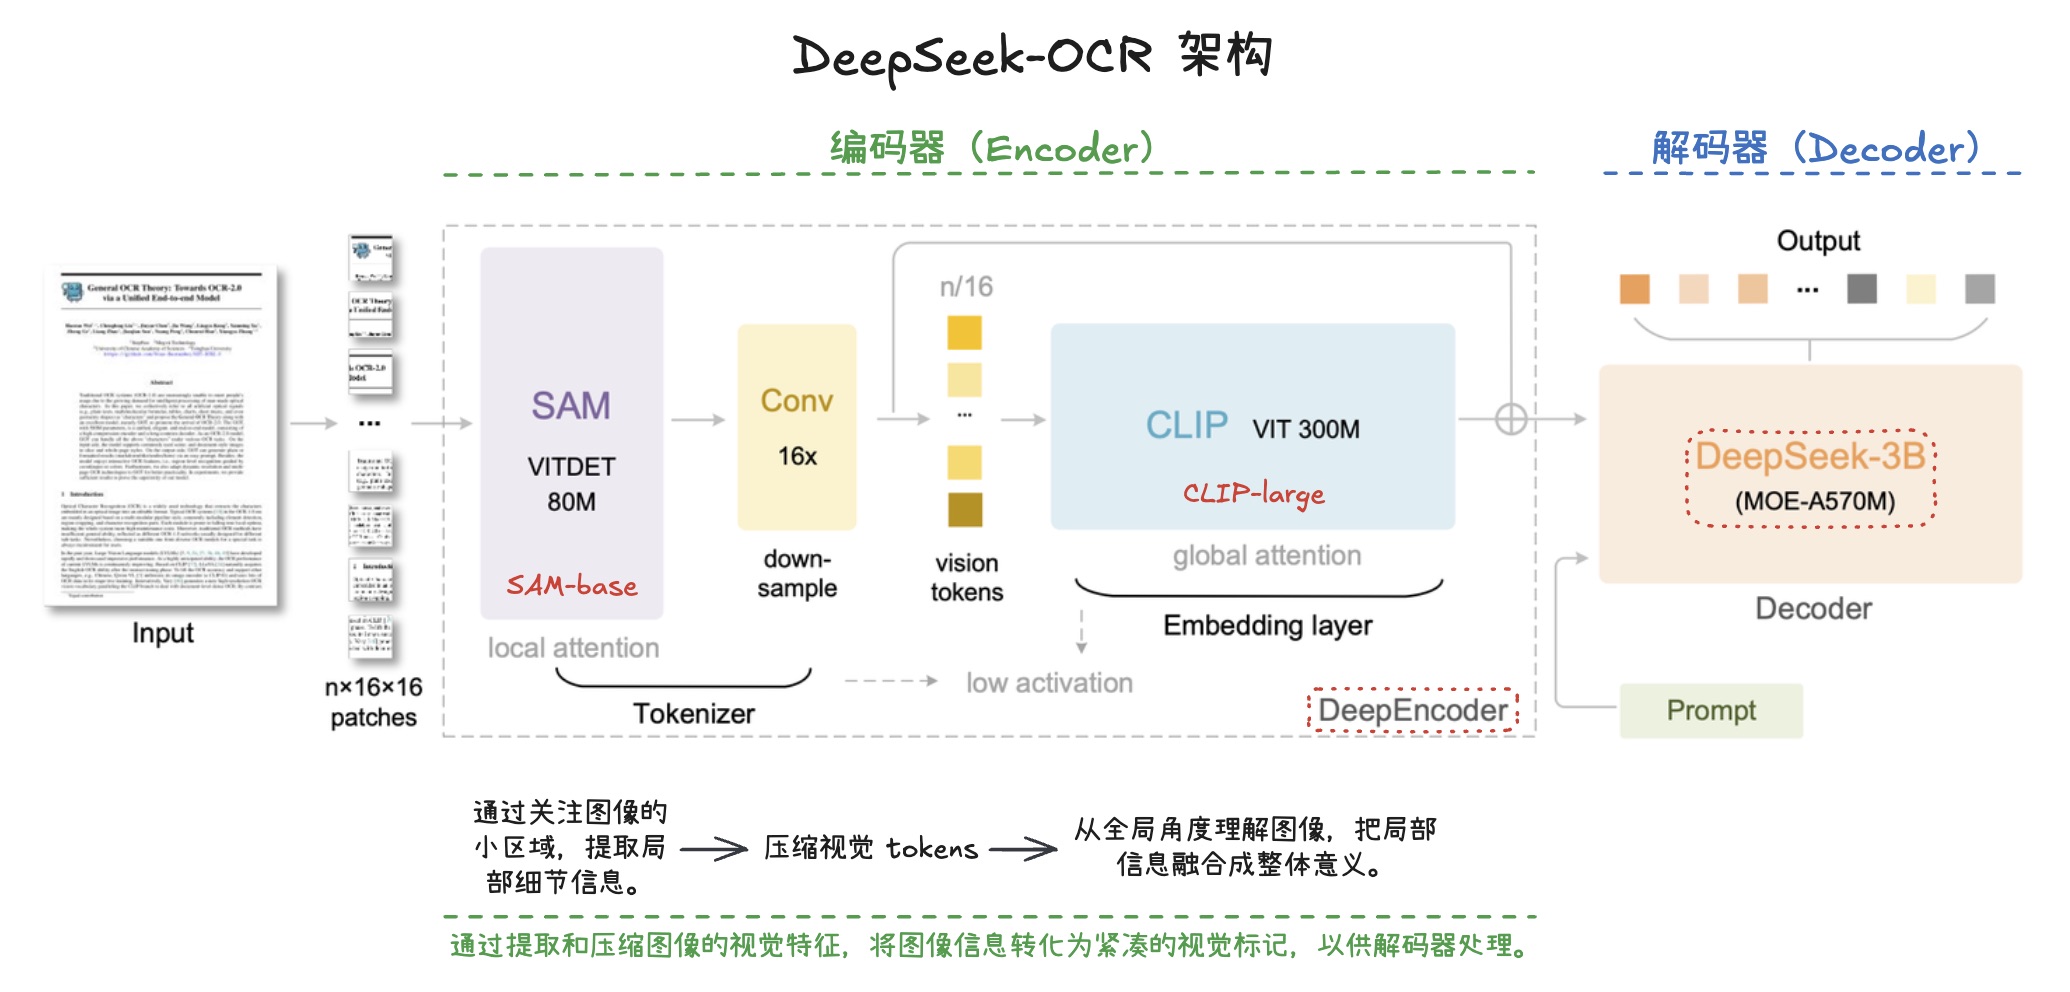
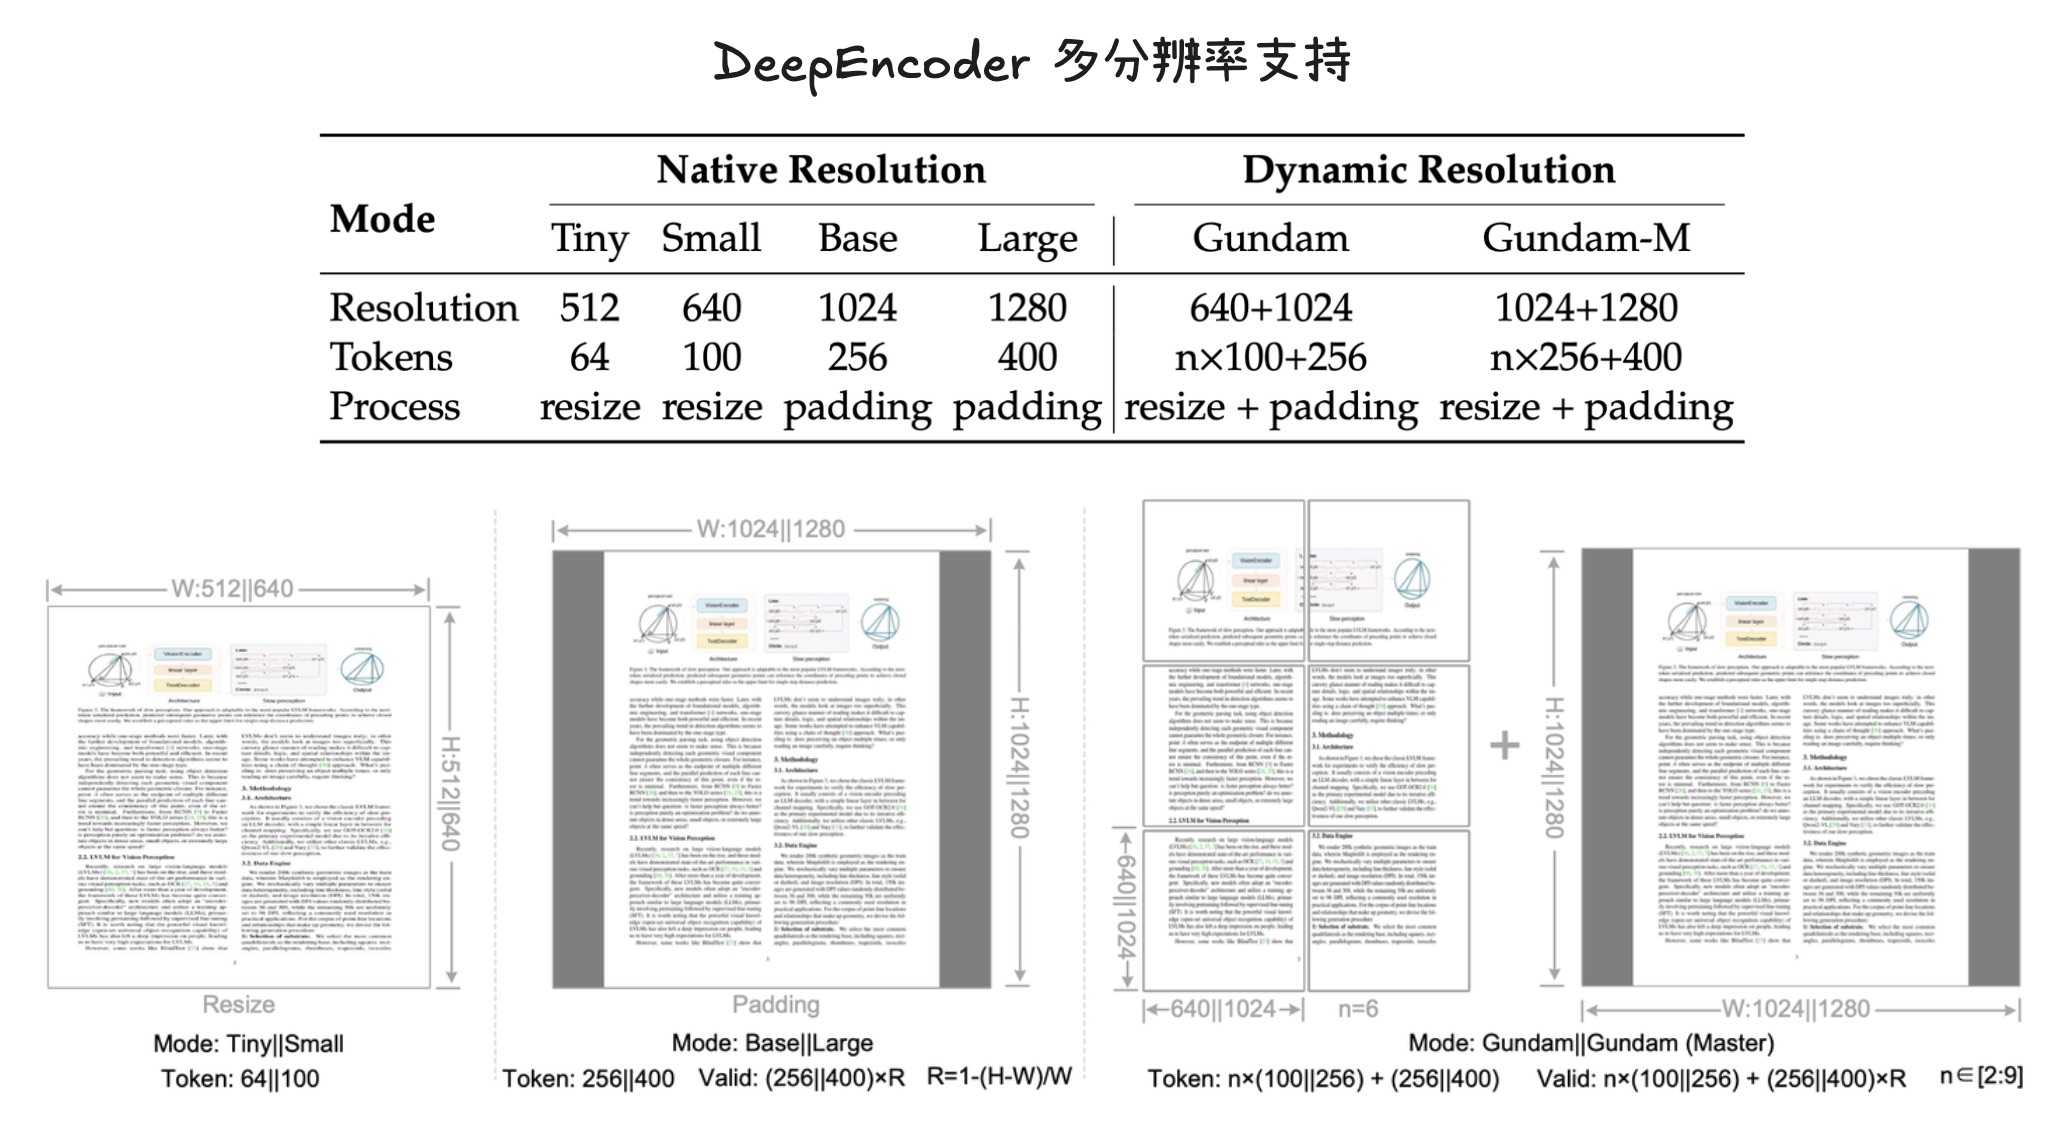
DeepSeek-OCR 架构

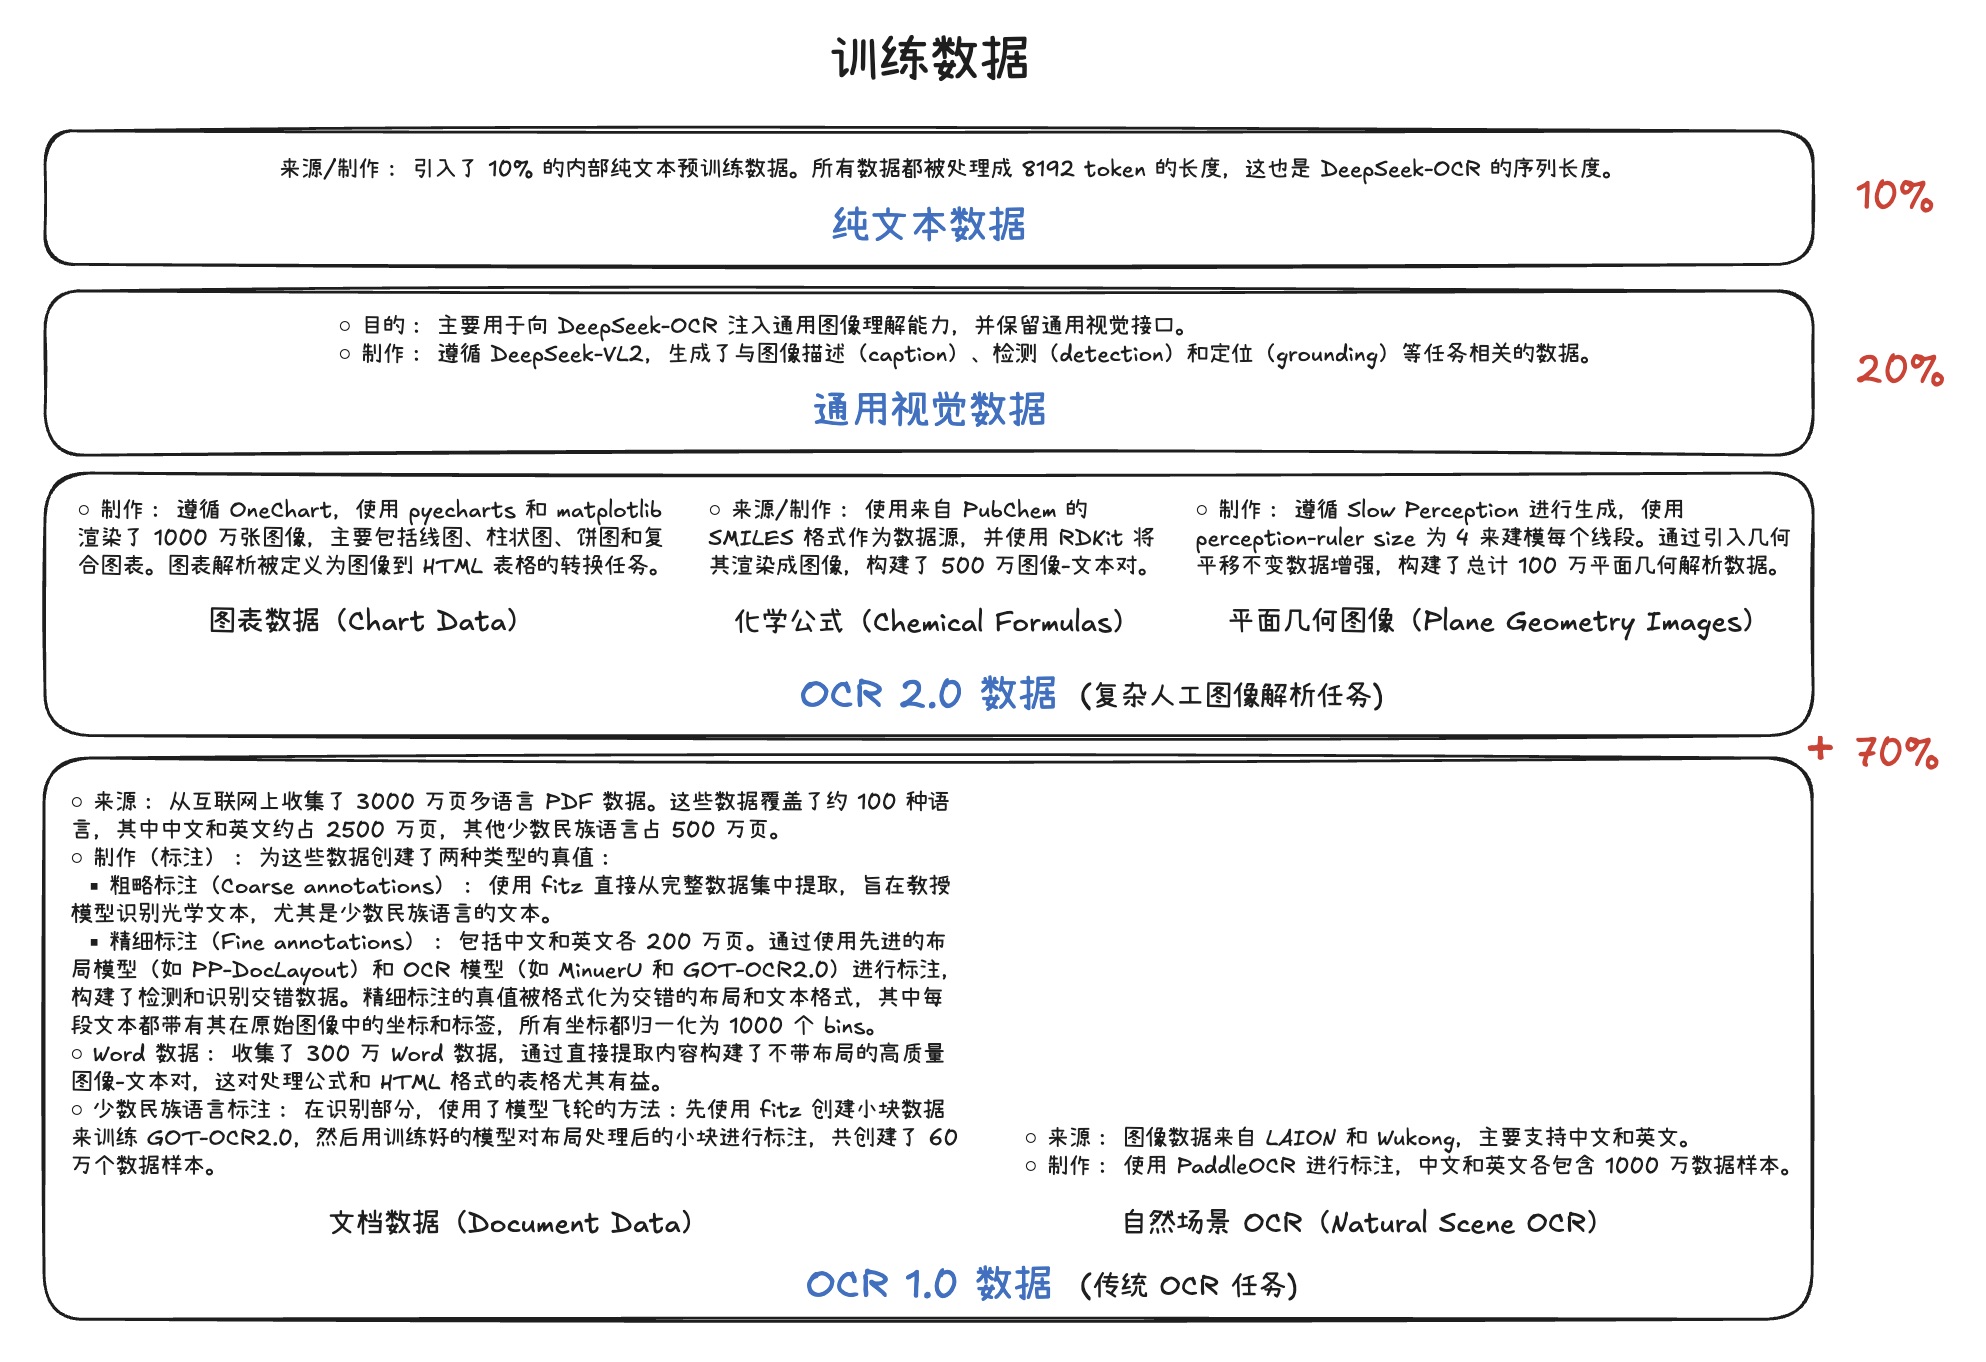
训练数据

数据组成

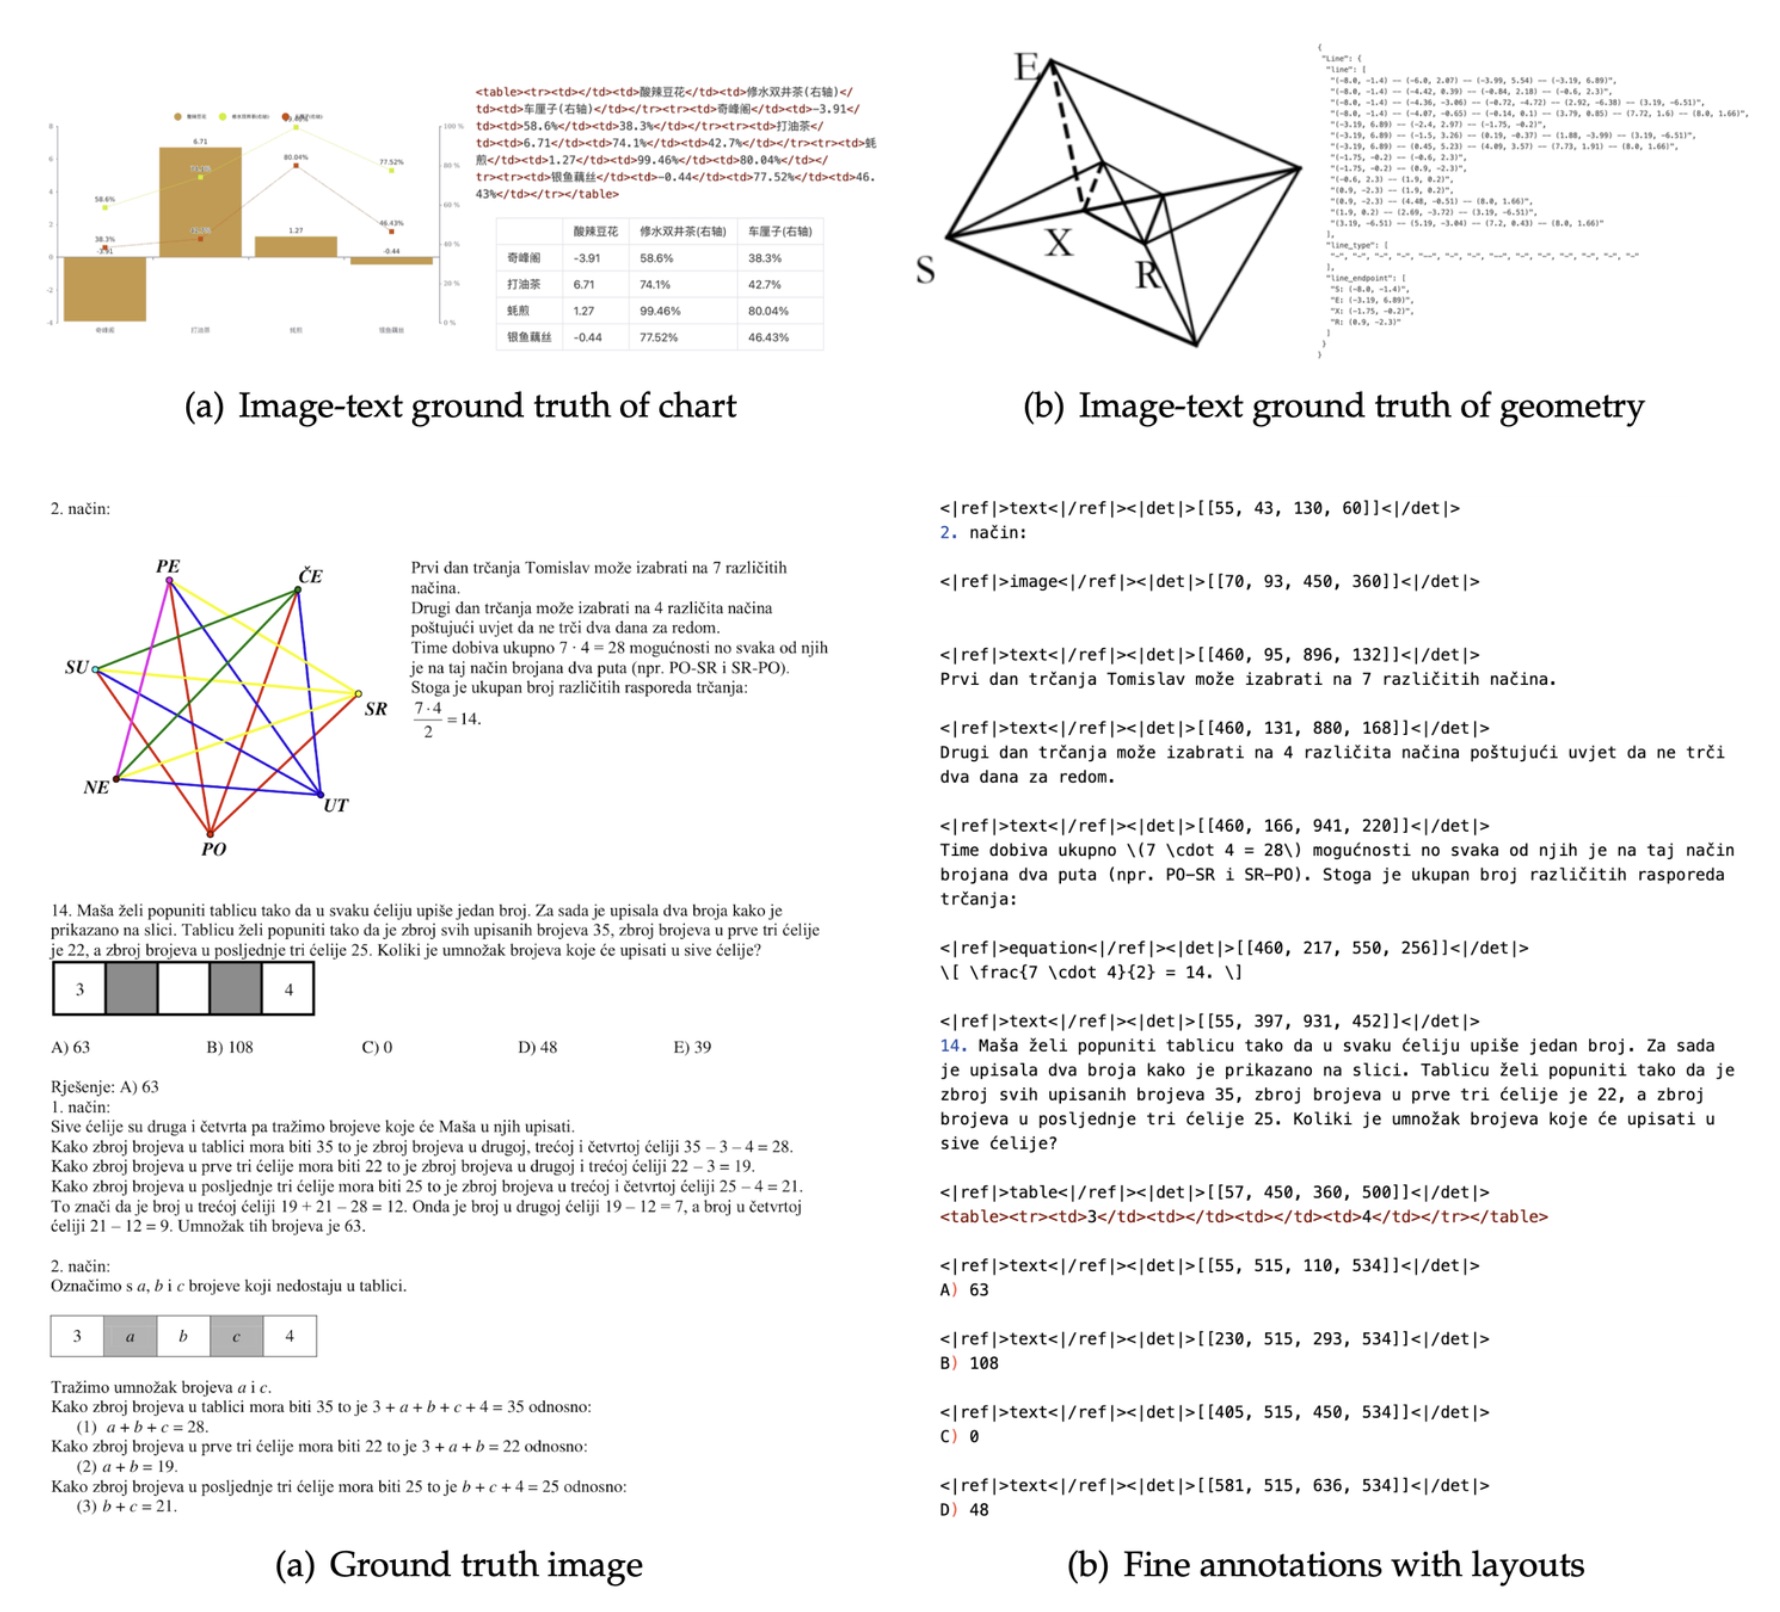
数据标注

训练流程

训练 DeepEncoder

  • 方法: 遵循 Vary,使用紧凑语言模型和下一词元预测(next token prediction)框架进行训练。
  • 数据: 使用所有 OCR 1.0OCR 2.0 数据,以及从 LAION 数据集中采样的 1 亿(100M)通用数据。
  • 训练细节: 训练 2 个 epoch,批次大小为 1280,使用 AdamW 优化器,配合余弦退火(cosine annealing)调度器,学习率为 5e-5。训练序列长度为 4096

训练 DeepSeek-OCR

  • 时机: DeepEncoder 准备好后进行。
  • 数据: 使用训练数据。
  • 并行策略: 采用流水线并行(PP),模型被分为 4 部分:
    • DeepEncoder (PP0, PP1)
      • PP0: 包含 SAM 和压缩器(作为视觉词元分析器),参数冻结
      • PP1: 包含 CLIP 部分(作为输入嵌入层),权重不冻结,参与训练。
    • 语言模型 (PP2, PP3): DeepSeek3B-MoE 共有 12 层,PP2 和 PP3 各放置 6 层。
  • 硬件与批次: 使用 20 个节点(每个节点配备 8 块 A100-40G GPU)进行训练,数据并行(DP)为 40,全局批次大小为 640
  • 优化器: 使用 AdamW 优化器,配合基于步数的调度器(step-based scheduler),初始学习率为 3e-5
  • 训练速度: 纯文本数据:900 亿词元/天(90B tokens/day);多模态数据:700 亿词元/天(70B tokens/day)。

whisper.cpp 实战指南(Jetson Thor 平台)

编译 whisper.cpp

克隆仓库

git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp

编译 whisper.cpp

cmake -B build -DGGML_CUDA=1 -DCMAKE_CUDA_ARCHITECTURES="110"
cmake --build build -j --config Release

下载模型

sh ./models/download-ggml-model.sh small
sh ./models/download-ggml-model.sh large-v3-turbo
  • tiny.en
  • tiny
  • base.en
  • base
  • small.en
  • small
  • medium.en
  • medium
  • large-v1
  • large-v2
  • large-v3
  • large-v3-turbo

运行 whisper-cli

./build/bin/whisper-cli -f samples/jfk.wav
./build/bin/whisper-cli -m /models/whisper.cpp/models/ggml-large-v3-turbo.bin -f samples/jfk.wav

whisper-server