2026 AI 指数报告:在模型超越人类的同时,我们正面临的五个残酷真相

1. 引言:加速中的断裂感 (Introduction: The Acceleration Gap)

技术正在以一种令人眩晕的速度降临。根据最新的《2026 年人工智能指数报告》(AI Index Report 2026),生成式 AI 在短短三年内就达到了近 53% 的人口级采用率。这一速度已经全面超越了个人电脑和互联网,成为人类历史上渗透最快的通用技术。

然而,这种疯狂的扩张背后正隐藏着一种深刻的断裂感。这种断裂不仅存在于技术与监管之间,更深植于全球地缘政治的核心——“AI 主权(AI Sovereignty)”已成为各国政策的定调词。我们正处于一个核心矛盾之中:AI 的能力正在呈指数级增长,但我们的治理框架、评价体系和基础设施却步履蹒跚。

“数据并没有指向单一方向,它揭示了一个规模化速度超过系统适应能力的领域。” 这种能力与准备度之间的鸿沟,是我们理解当下技术狂奔的唯一入口。

2. 真相一:中美性能差消失,但人才引力正在逆转 (The Parity and the Talent Drain)

长期以来,美国在 AI 领域的霸权似乎建立在不可逾越的资金壁垒之上。但 2025 年的数据揭示了一个残酷的反直觉现状:资金优势不再是唯一的胜负手。

虽然美国 2025 年的 AI 私人投资达到了 2859 亿美元,是中国的 23 倍(124 亿美元),但模型性能的差距已几乎消失。
Hermes 智能体全面研究报告与 OpenClaw 对比分析

1. Hermes 智能体基础认知与发展概况

1.1 技术定义与核心特征

Hermes Agent 是由 Nous Research 开发的开源自主 AI 智能体,于 2026 年 2 月正式发布,其核心定位为 "与你共同成长的智能体"(The agent that grows with you)(1)。与传统的 AI 聊天机器人或 IDE 绑定的代码补全工具不同,Hermes Agent 是一个运行在用户服务器上的自主智能体,具有持久记忆和自我改进能力,能够在运行过程中不断学习和进化。

Hermes Agent 的技术架构采用模块化单代理持久循环设计,核心是 run_agent.py 中的 AIAgent 类(约 9200 行代码),负责同步编排整个生命周期:输入→推理→工具执行→内存更新→输出。该系统支持 Linux、macOS 和 WSL2 平台,用户可以通过一条 curl 命令完成安装,无需任何前置依赖,体现了其设计的简洁性和易用性。

在技术栈方面,Hermes Agent 基于 Python 3.11 + 开发,使用 uv (Astral) 管理,主要依赖包括 openai SDK 进行 LLM 通信、rich 和 prompt_toolkit 构建终端 UI、SQLite FTS5 实现会话持久化(97)。

具身智能(Embodied AI)技术综述:从基础理论到工程实践

具身智能(Embodied AI)作为人工智能通往通用人工智能(AGI)的关键路径,近年来取得了突破性进展。本文基于 Every-Embodied 开源项目的丰富实践经验,系统性地综述具身智能领域的技术栈、算法演进、工程实践和前沿复现。全文涵盖:(1)具身智能的基础理论与发展历程;(2)机器人学基础(运动学、动力学、坐标变换);(3)计算机视觉在具身场景中的应用;(4)强化学习与模仿学习;(5)视觉-语言-动作(VLA)大模型全景;(6)视觉语言导航(VLN)技术;(7)世界模型最新进展;(8)无人机控制与规划专题;(9)仿真环境与真机部署;(10)数据集与评估基准。本文强调"理论-实践-复现"三位一体的学习路径,为工程师和从业者提供从入门到前沿复现的完整技术指南。

关键词:具身智能、机器人学习、视觉-语言-动作模型、VLA、视觉语言导航、VLN、世界模型、强化学习、模仿学习、MuJoCo仿真

目录

  1. 引言
  2. 具身智能基础理论
  3. 机器人学基础
  4. 具身场景的计算机视觉
  5. 强化学习与模仿学习
  6. 视觉-语言-动作(VLA)大模型
  7. 视觉语言导航(VLN)
  8. 具身世界模型
  9. 无人机控制与规划专题
  10. 仿真环境与真机部署
  11. 数据集与评估基准
  12. 工程实践指南
  13. 总结与展望

1. 引言

1.1 什么是具身智能?

人工智能的发展历程中,我们见证了从"非具身"(Disembodied)到"

用通俗易懂的方式理解 Harness Engineering

Harness 工程:给 AI 智能体一个"可靠的家"

想象一下,你有一个非常聪明但有点冲动的助手——它知识渊博、能说会道,但有时候会:

  • 忘记五分钟前你们讨论的事情
  • 直接执行危险操作而不问你
  • 在复杂任务中迷路,绕来绕去
  • 做错了事,但你不知道为什么

这就是没有 Harness 的 LLM 智能体。

什么是 Harness?

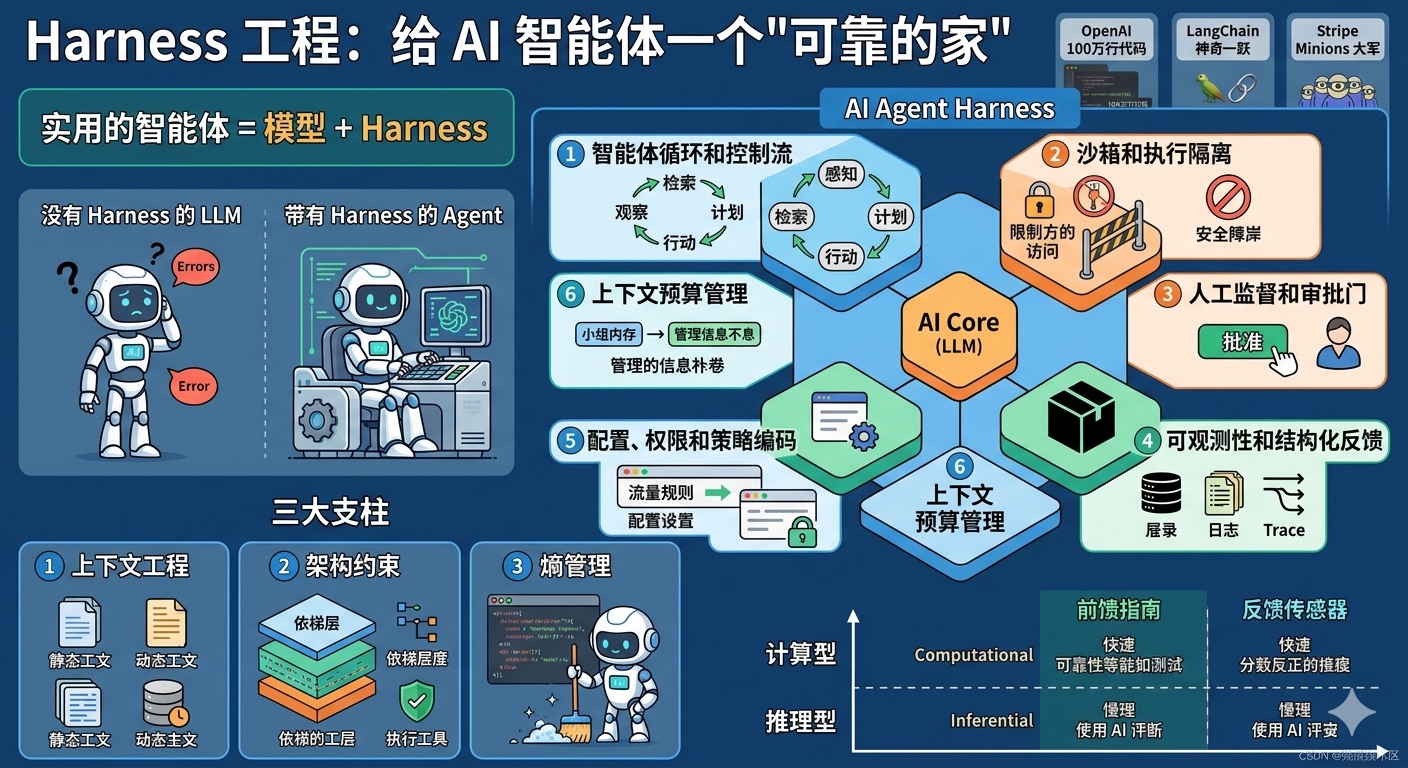
Harness 这个词在英文里有"马具"、"安全带"的意思。在 AI 智能体的世界里,它就是那个让智能体既能够发挥能力,又不会失控的"安全脚手架"。

这个隐喻是有意的:

  • 是 AI 模型——强大、快速,但它自己不知道去哪里
  • Harness是基础设施——约束、护栏、反馈循环,以富有成效地引导模型的力量
  • 骑手是人类工程师——提供方向,而不是亲自奔跑

用一个更贴近生活的比喻:Harness 就像是智能体的"驾驶舱 + 安全带 + 导航系统 + 黑匣子"的组合体

根据 Harness Engineering 将原始模型能力转化为可靠 Agent 行为的脚手架。实用的 Agent 最好被理解为在 Harness 内部运行的模型,而不是带有外围能力的模型。

真实故事:Harness 工程的威力

在我们深入技术细节之前,让我们看看几个真实的例子,了解为什么 Harness 工程如此重要:

macOS Finder 中的“反向选择”功能实现(Automator)

通过 Automator 制作一个“快速操作”的方案。请按照以下的步骤操作:

  1. 打开 Automator,新建一个 “快速操作”
  2. 设置:“工作流程收到当前”选 “没有输入”,“位于”选 “Finder.app”
  3. 在搜索框输入 AppleScript,拖入 “运行 AppleScript” 动作。
  4. 清空原内容,粘贴以下这段代码:
on run {input, parameters}
    tell application "Finder"
        -- 获取当前窗口,如果没有窗口则退出
        if (count of windows) = 0 then return
        set win to front window
        
        -- 获取文件夹内所有对象的路径列表
        set all_items to every item of win
        set all_paths to {}
        repeat with i in all_items
            set end of all_paths to (POSIX path of (i as alias))
        end repeat
        
        -- 获取当前已选对象的路径列表
        set sel_items to selection
// ...

保存并命名为 “反向选择”。

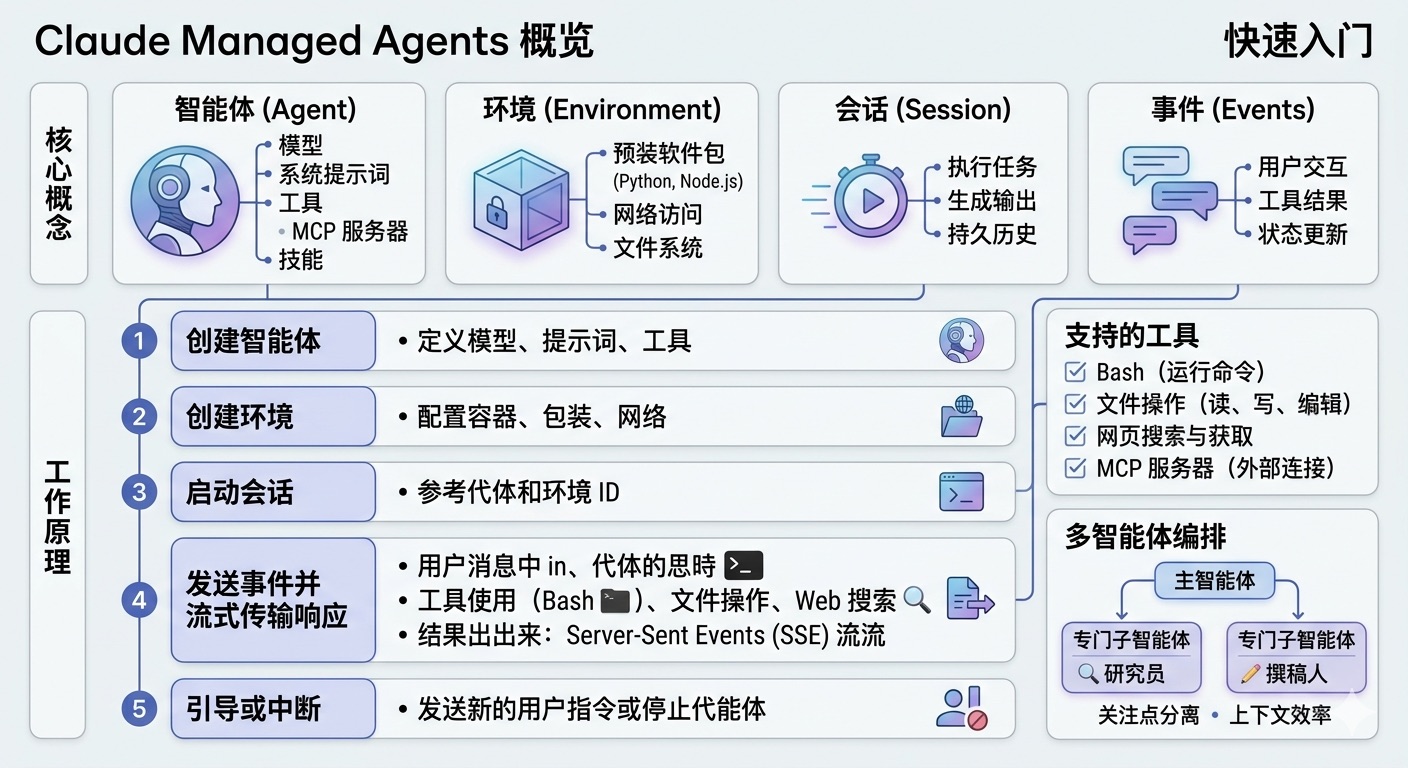
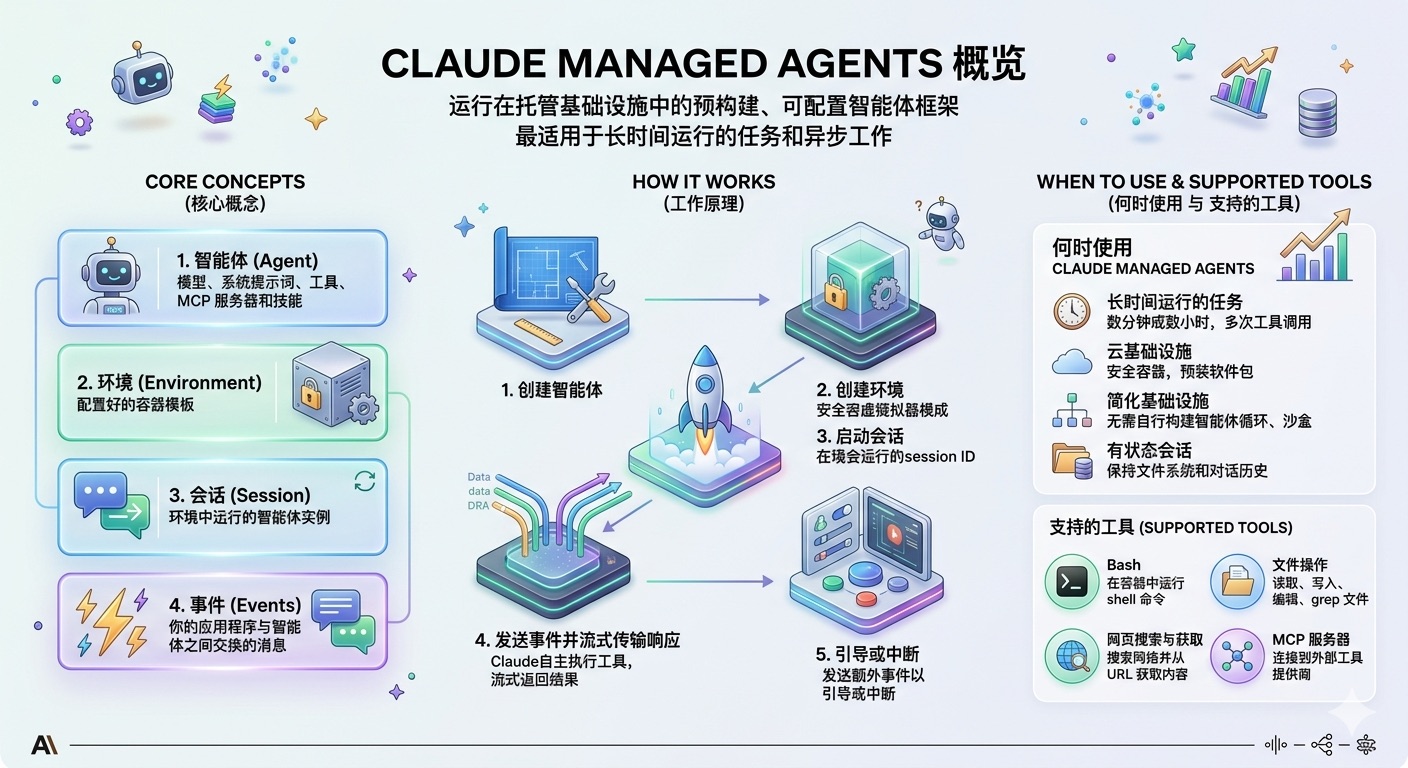
Claude Managed Agents(托管智能体)开发者参考指南

Claude Managed Agents 概览

这是一个运行在托管基础设施中的预构建、可配置智能体(Agent)框架,最适用于长时间运行的任务和异步工作。

Anthropic 提供了两种使用 Claude 构建应用的方式,分别适用于不同的使用场景:

Messages API Claude Managed Agents
定位 直接的模型提示词访问 运行在托管基础设施中的预构建、可配置智能体框架
最佳用途 自定义智能体循环和精细化控制 长时间运行的任务和异步工作
了解更多 Messages API 文档 Claude Managed Agents 文档

Claude Managed Agents 为将 Claude 作为自主智能体运行提供了框架和基础设施。无需构建自己的智能体循环、工具执行环境和运行时,你即可获得一个全托管的环境,让 Claude 能够安全地读取文件、运行命令、浏览网页并执行代码。该框架支持内置的提示词缓存、压缩以及其他性能优化,以实现高质量、高效的智能体输出。

核心概念

Claude Managed Agents 基于四个核心概念构建:

LLM 智能体的外化:记忆、技能、协议与 Harness Engineering 统一综述

论文基础信息

核心观点

可靠的智能体能力不只是来自更强的模型本身,而是来自将认知负担系统性地转移到外部组件:

  • 记忆外化:解决跨会话状态延续问题
  • 技能外化:复用成熟的流程经验,避免每次都重新推理
  • 协议外化:标准化交互规则,让工具调用、多智能体协作更稳定
  • Harness(智能体引擎/管控框架) 是协调以上所有组件的统一运行层,是智能体系统的"认知环境"

什么是Harness?

Harness不是普通的工具链或者SDK,而是模型运行的完整认知环境

  • 模型本身只有通用推理能力,Harness决定了它能访问什么数据、能执行什么操作、怎么受到约束、怎么从错误中学习
  • 智能体的能力不是模型单独具备的,而是模型和Harness环境耦合之后共同产生的
  • Harness的核心作用是把零散的外部组件(内存、技能、协议)组合成连贯的智能行为,把无边界的推理任务转化为结构化的可控执行流程

Garry Tan(YC 总裁)- 大展宏图(煮沸海洋)

超级人工智能时代,是时候告别保守、提升雄心了

大展宏图(煮沸海洋)

超级人工智能(ASI)意味着是时候停止畏首畏尾,提高我们的雄心壮志了。

作者:Garry Tan | 2026年2月7日

核心观点(TL;DR): 我们对未来的恐惧,与我们的野心之渺小成正比。如果你的计划是维持现状,那么 AI 将令人恐惧;如果你的计划是创造某种翻天覆地的大事,那么 AI 就是你收到的最好消息。

你一定听过这句话:“别想一口气煮沸海洋(don't boil the ocean)。” 每一个在野心过大的会议上的人都说过这句话。在正常时期,这是个好建议,它能让团队保持专注,防止范围蔓延(scope creep)。但现在已非常规时期,我认为是时候让这句话退休了。

超级人工智能(Artificial Superintelligence)意味着,现在正是“煮沸海洋”的时候。我们可以先从煮沸几个湖泊开始。

最近我遇到了一家大学捐赠基金的私募投资负责人,他告诉我,他们的工程师在看到 Claude Code(注:Anthropic 开发的 AI 编码工具)的能力后,对自己丢掉工作感到极度恐惧。我能理解——这是人类的本能反应。但这反应是错的。这是在“正和游戏”的时刻做出的“零和游戏”反应。

我们不该担心如何用更廉价的方式重复过去的工作,为什么不把精力集中在那些我们从未梦想过能做成的事情上呢?

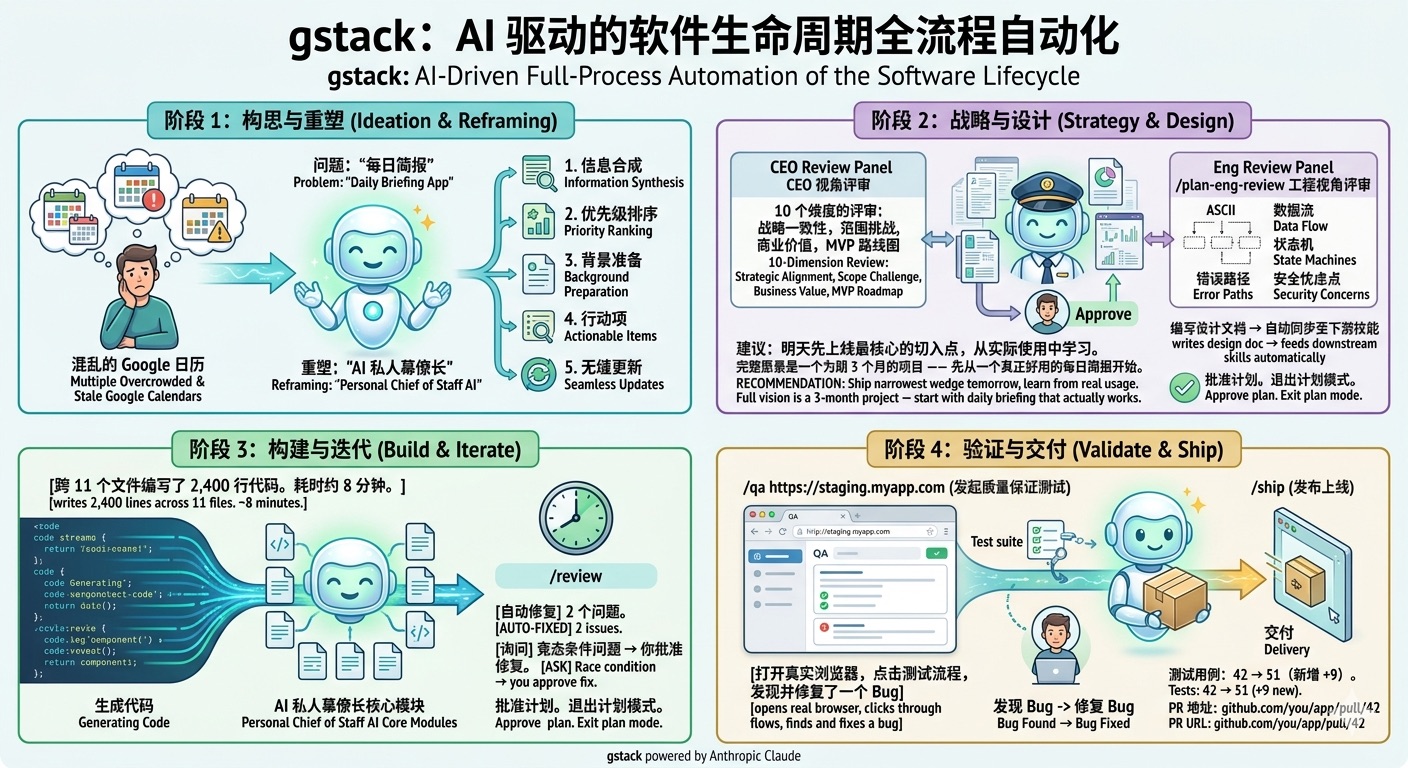
gstack:AI 驱动的软件生命周期全流程自动化

gstack 是由 YC 首席执行官 Garry Tan 发起的开源智能体技能集(Skills),旨在将 Claude Code 等 AI 编程助手重塑为一支全栈虚拟开发团队。它通过一套高度专业化的指令流,实现了从产品构思、架构设计、自动化编码到代码评审、质量保障及发布部署的软件全生命周期闭环开发

你:      我想为我的日历做一个每日简报应用。
你:      /office-hours(发起咨询)
Claude: [询问痛点 —— 要求提供具体的例子,而不是假设]

你:      多个 Google 日历,活动信息已过时,地点也是错的。
          准备工作耗时太长,而且效果不够好……

Claude: 我想挑战一下你的设定。你说的是“每日简报应用”,但你实际描述的是一个“AI 私人幕僚长”。
         [提取了 5 项你甚至没意识到自己已经描述出的功能]
         [挑战了 4 个前提 —— 你对此表示同意、反对或进行调整]
         [生成了 3 种实施方案及工作量预估]
         建议: 明天先上线最核心的切入点,从实际使用中学习。完整愿景是一个为期 3 个月的项目 —— 
               先从一个真正好用的每日简报开始。
         [编写设计文档 → 自动同步至下游技能]

// ...

英文版本

WikiLLM:基于 LLM 驱动的个人知识库

WikiLLM

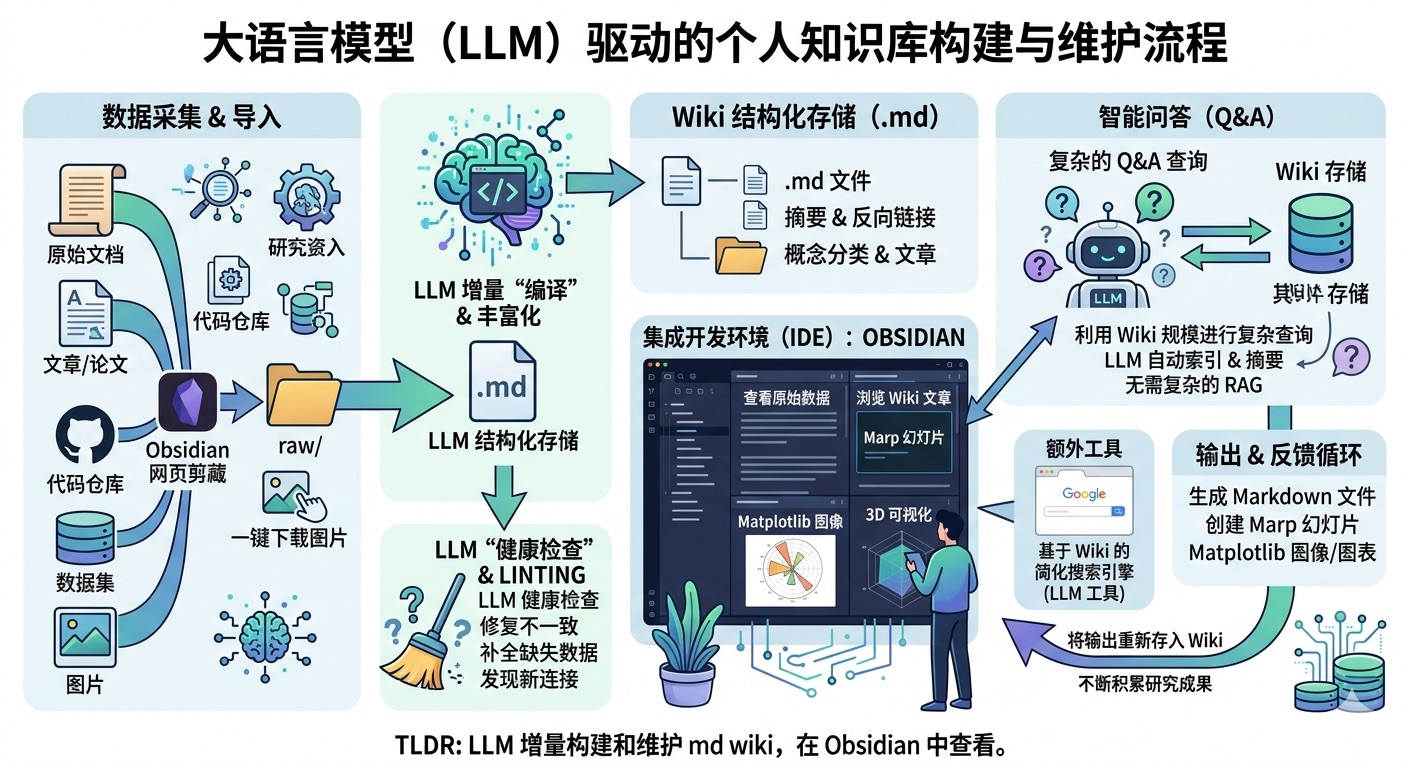
利用 LLM 构建个人知识库的系统。WikiLLM 将原始素材"编译"成结构化、交叉链接的高质量中文 Wiki,可在 Obsidian 中查看。

本项目基于 Andrej Karpathy 提出的理念构建。详见:LLM Knowledge Bases

项目概述

WikiLLM 的工作流包括:

  1. 数据摄入:源文档(文章、论文、代码库、数据集、图像)被索引到 raw/ 目录
  2. Wiki 编译:LLM 增量地"编译"原始数据成 markdown 文件的 wiki,包含摘要、反向链接、分类概念和相互链接的文章
  3. IDE:Obsidian 用作前端查看原始数据、编译后的 wiki 和可视化
  4. 问答:LLM 可以通过研究相关数据来回答针对 wiki 的复杂问题
  5. 输出:结果渲染为 markdown 文件、Marp 幻灯片或 matplotlib 图像,可在 Obsidian 中查看
  6. Linting:LLM"健康检查"发现不一致、填补缺失数据、建议新文章候选
  7. 额外工具:诸如 wiki 上的朴素搜索引擎等额外工具

核心原则

  • LLM 编写和维护所有 wiki 数据;手动编辑很少见
  • 用户探索和查询被归档回 wiki 以增强它
  • 系统专注于 markdown 文件和 Obsidian 兼容格式
  • 图像被下载到本地 以便 LLM 轻松引用

目录结构

AutoResearch:AI 自主进行前沿语言模型研究

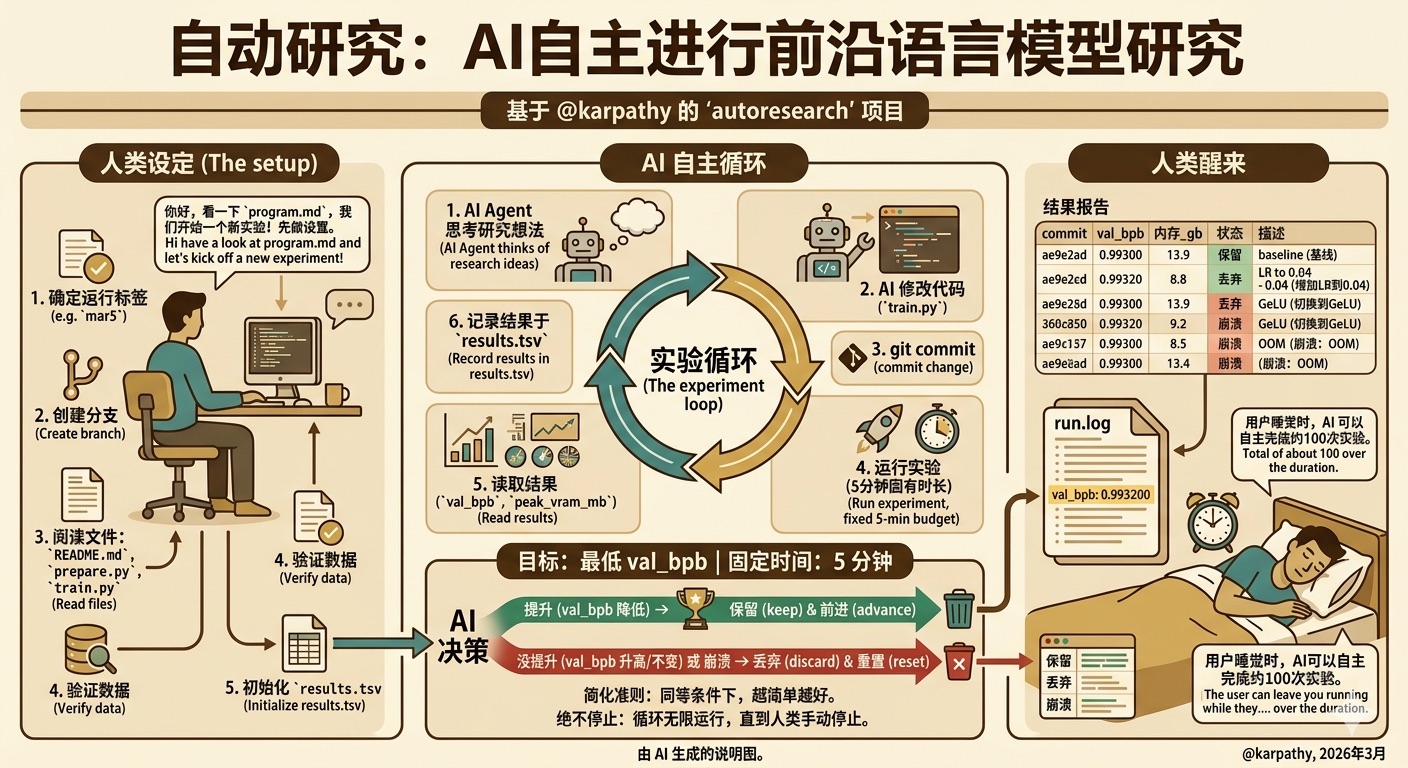
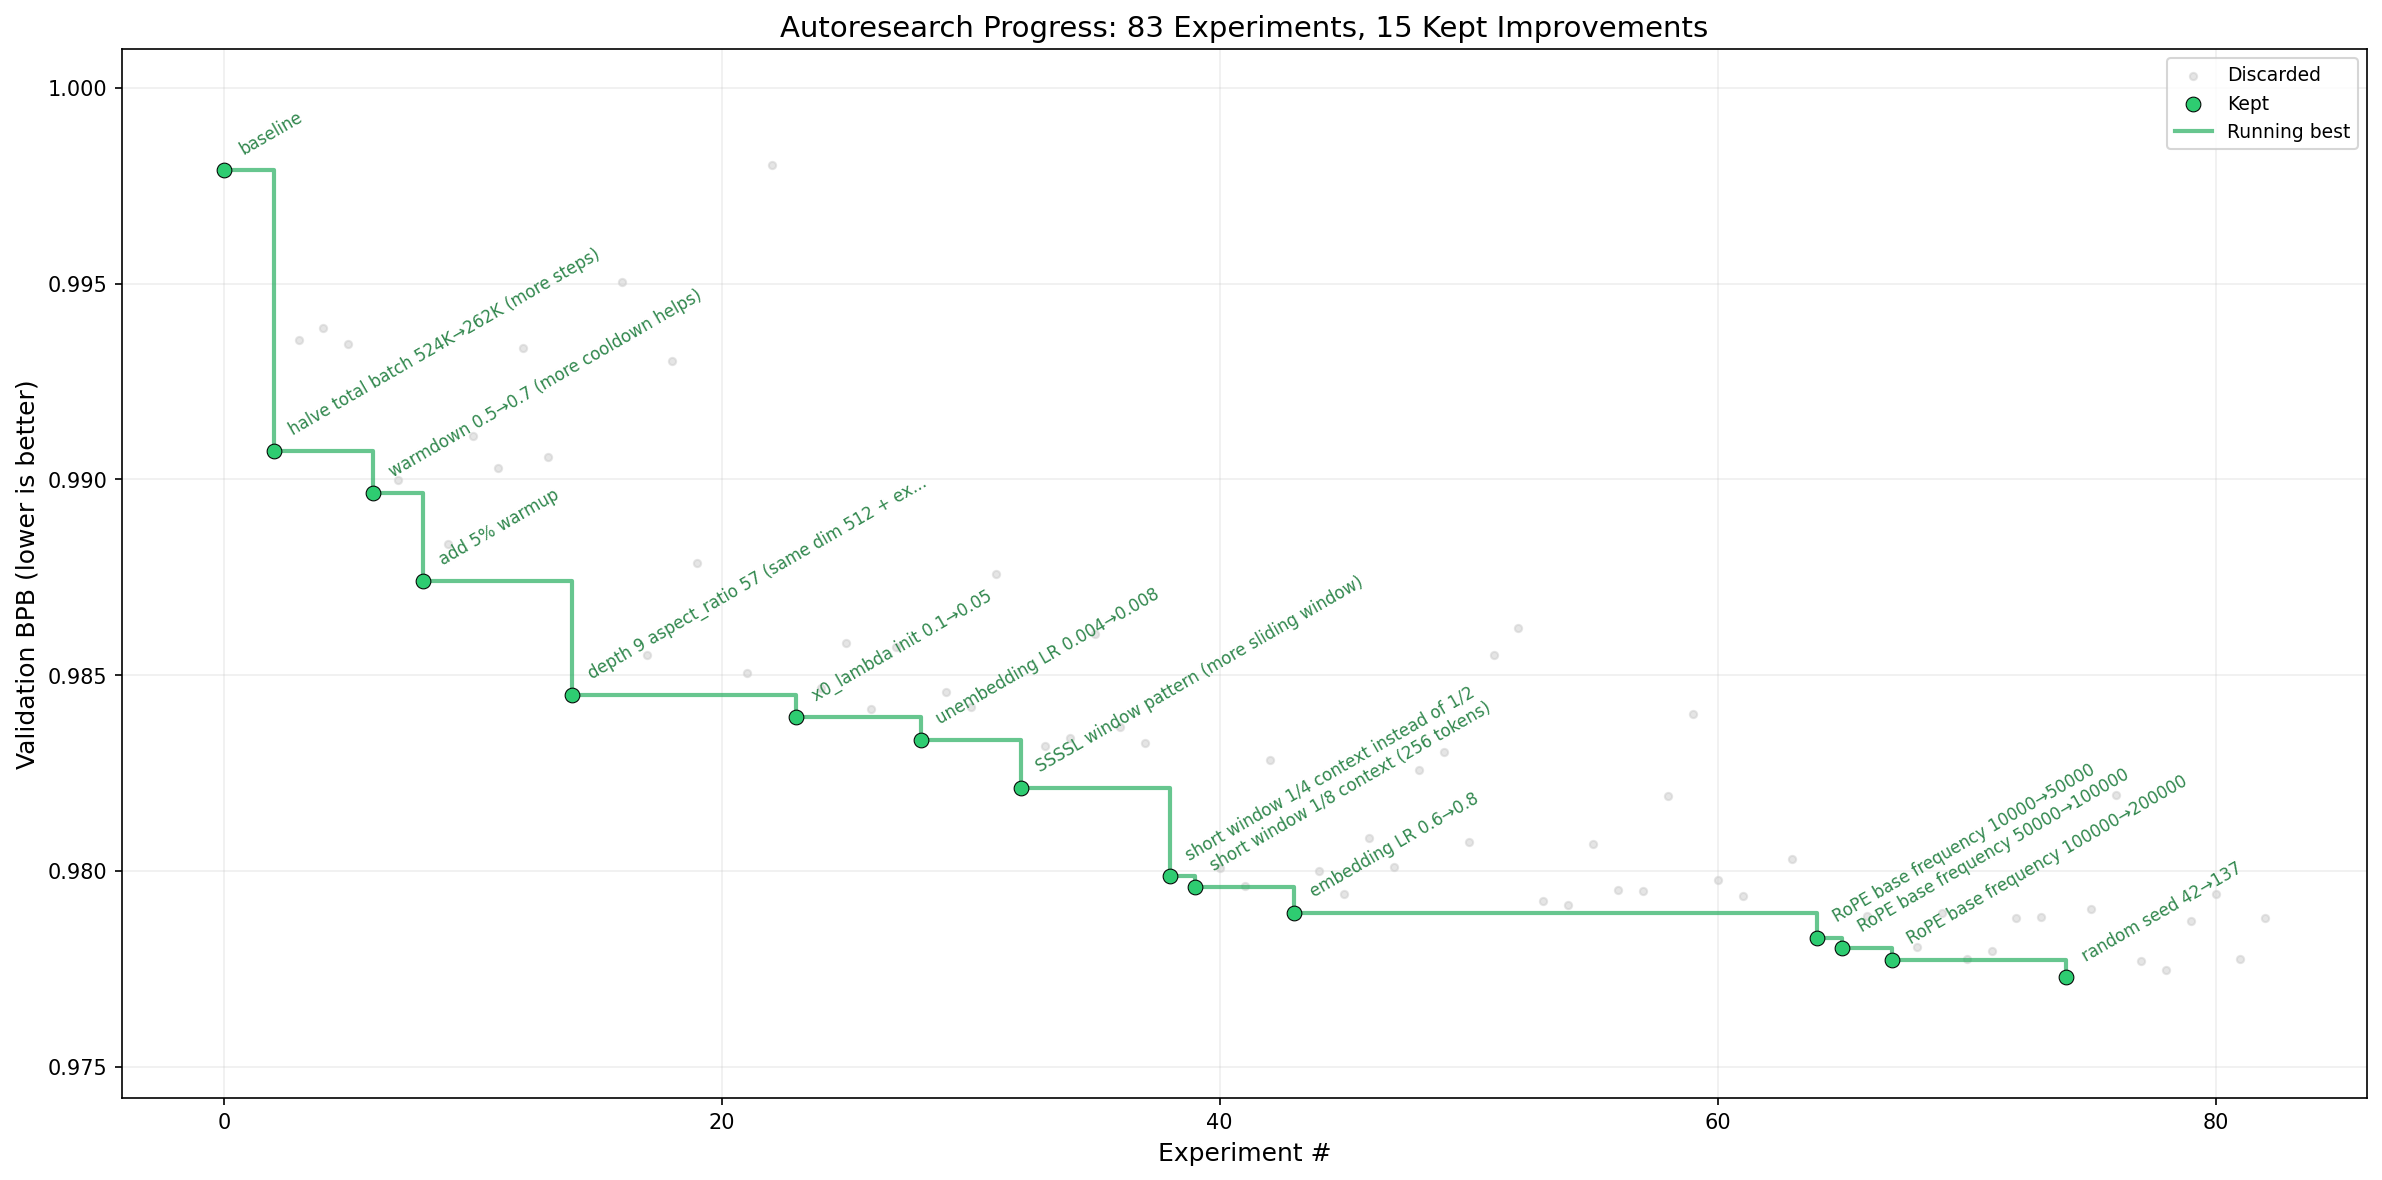
这是 Andrej Karpathy 设计的极简自主 AI 研究实验框架:让 AI 智能体仅修改 train.py,在固定 5 分钟训练预算内自主迭代优化 GPT 模型、以最低验证集 bpb 为目标,自动实验、记录结果并择优保留,无人值守持续运行。

README

teaser

曾经有一天,前沿 AI 研究是由人类在吃饭、睡觉、享受其他乐趣,以及偶尔使用声波互连进行被称为"组会"的仪式之间完成的。那个时代早已远去。现在的研究完全属于运行在天空中计算集群巨型结构上的自主 AI 智能体集群。这些智能体声称我们现在处于代码库的第 10,205 代,反正没人能说得清这是对是错,因为"代码"现在已经是一个自我修改的二进制文件,已经超出了人类的理解范围。这个仓库讲述了这一切是如何开始的故事。-@karpathy,2026 年 3 月

这个想法是:给一个 AI 智能体一个小但真实的 LLM 训练设置,让它在夜间自主实验。它修改代码、训练 5 分钟、检查结果是否有所改进、保留或丢弃,然后重复。你早上醒来时会看到一个实验日志,以及(希望)一个更好的模型。这里的训练代码是 nanochat 的简化单 GPU 实现。核心思想是,你不需要像研究人员通常那样触碰任何 Python 文件。相反,你是在编写 program.

Harness Engineering 实战:利用 Autoresearch 实现 AI 模型的自我进化

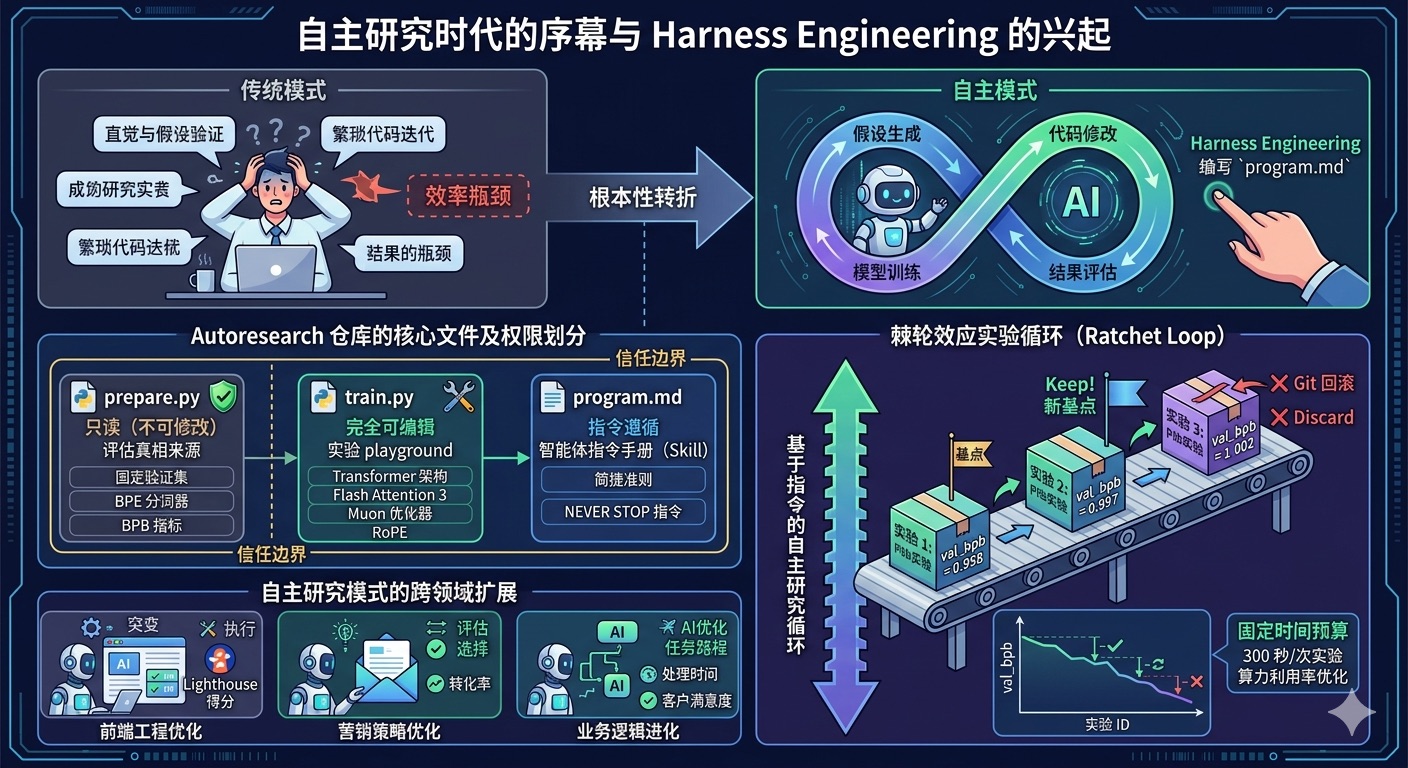
自主研究时代的序幕与 Harness Engineering 的兴起

人工智能研究的传统模式长期依赖于人类研究员的直觉、假设验证以及繁琐的代码迭代过程。这种模式在处理海量参数空间和复杂架构组合时表现出明显的效率瓶颈,尤其是在前沿人工智能研究领域。

Andrej Karpathy 发起的 autoresearch 项目代表了从命令式编程向指令式编排的根本性转折。该项目不仅是一个技术工具,更是一种关于人类与人工智能在科研领域协作关系的深刻重塑。其核心理念在于将 AI 智能体置于研究流程的中心,使其能够独立完成从假设生成、代码修改、模型训练到结果评估的完整闭环,而无需人类在过程中间进行干预。

这一转变标志着 Harness Engineering 时代的到来。在这一范式下,研究人员的角色发生了质变,不再是直接编写解决具体问题的 Python 代码,而是编写用于指导 AI 智能体的自然语言指令集,即 program.md 文件。这种模式通过将复杂的机器学习实验简化为一种可自动执行的、具备“棘轮效应”的改进循环,实现了科研效率的指数级提升。

项目背景设定在一个虚构但具有高度前瞻性的未来:尖端 AI 研究已不再由人类在会议中通过同步信息来推进,而是由在超大规模算力集群上运行的自主智能体集群独立完成。

Harness Engineering(驾驭工程):2026 AI 软件工程新范式

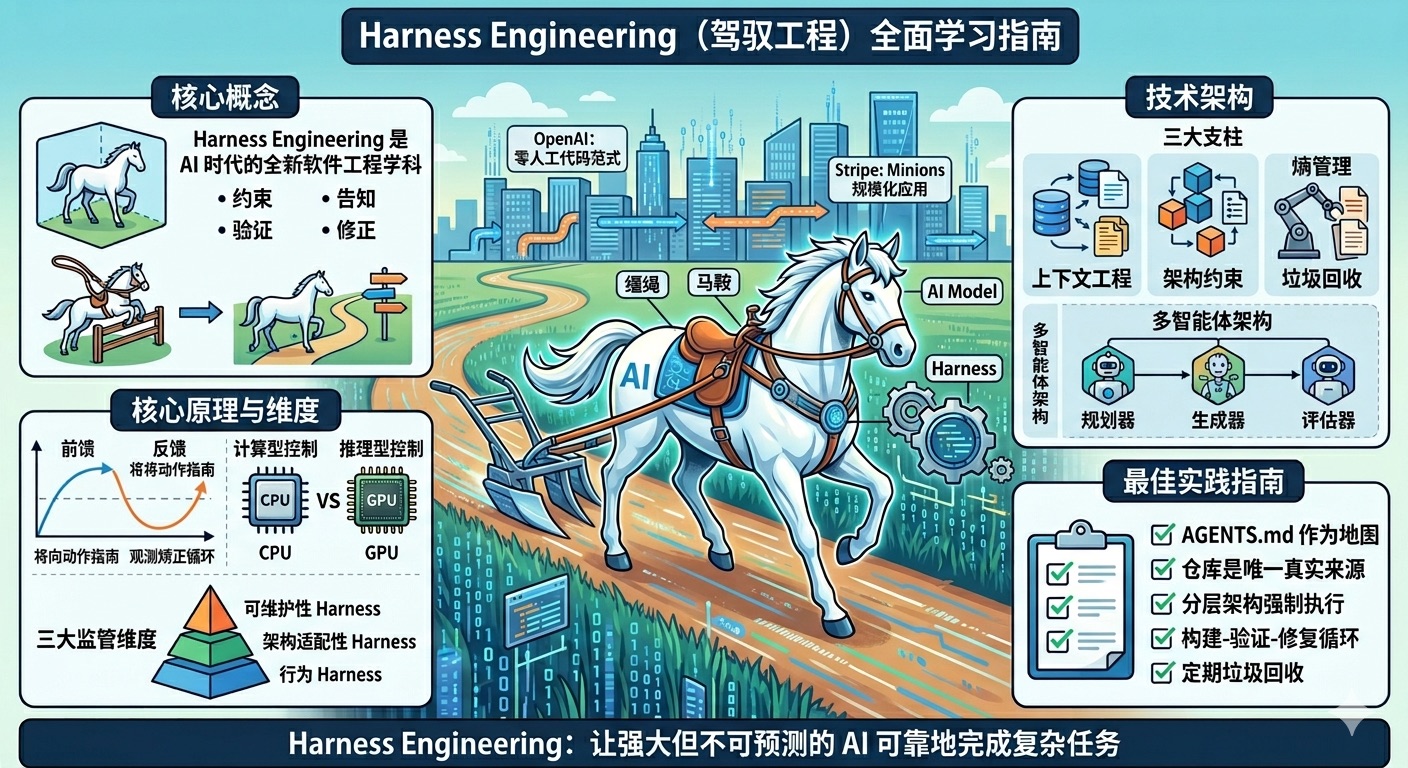
Harness Engineering 是 AI 时代的全新软件工程学科 —— 设计和实现系统来约束、引导、验证和修正 AI 智能体的行为,让强大但不可预测的 AI 模型能够可靠地完成复杂任务。

📚 目录

核心概念

什么是 Harness Engineering?

Harness Engineering 是设计和实现系统的学科,这些系统能够:

  1. 约束:定义 AI 智能体可以做什么(架构边界、依赖规则)
  2. 告知:告诉智能体应该做什么(上下文工程、文档体系)
  3. 验证:检查智能体是否正确完成任务(测试、 linting、CI 验证)
  4. 修正:当智能体出错时引导其自我修复(反馈循环、自我修正机制)

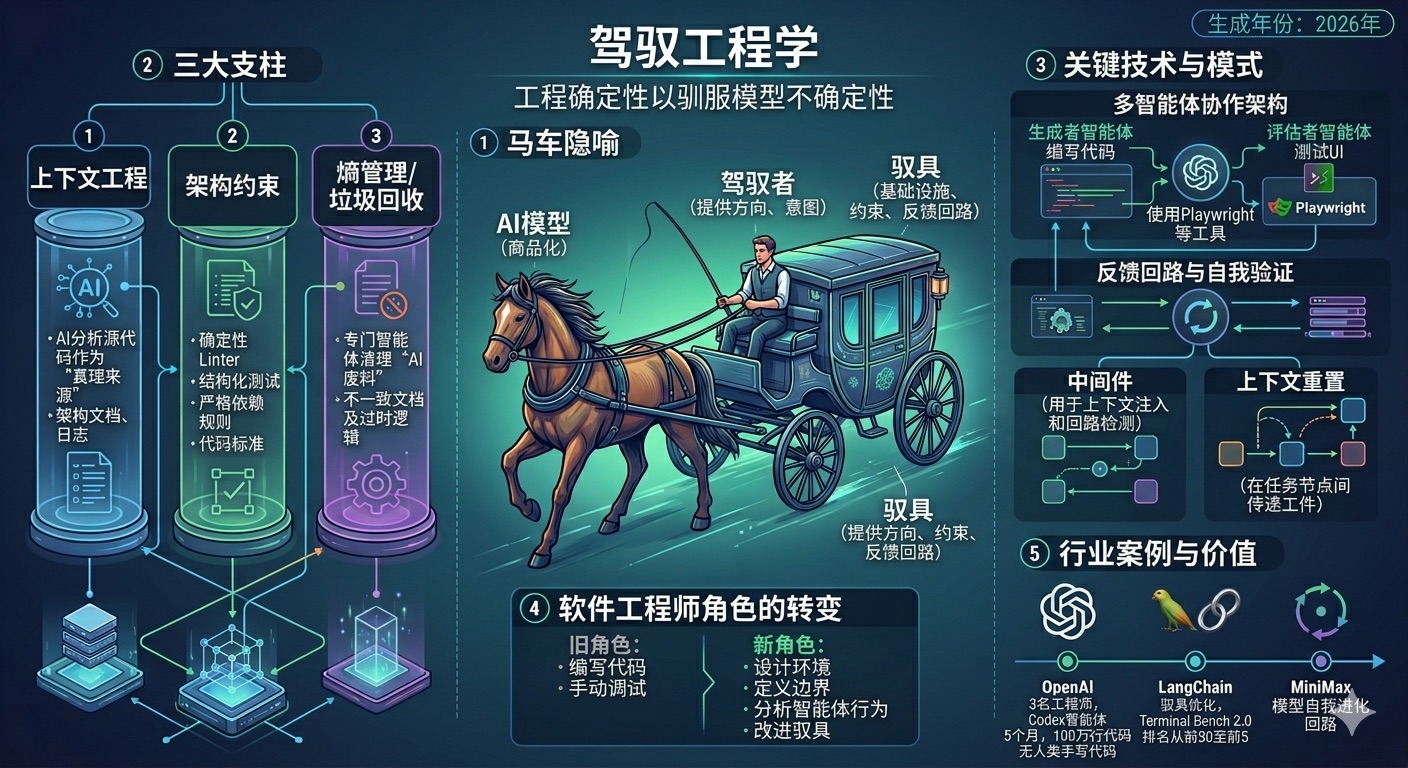
类比:AI 模型是一匹强大但无方向的骏马,Harness 是缰绳、马鞍和全套马具,人类工程师是骑手。没有 Harness 的 AI 是开阔场地里的纯种马——速度快、令人印象深刻,但完全无法用来完成任何实际工作。

为什么 Harness Engineering 至关重要?

模型是商品,Harness 是护城河

AI 行业正在达成一个共识:底层模型的重要性远低于围绕它的系统。LangChain 的实验最能证明这一点:他们的编码智能体在 Terminal Bench 2.0 上的得分从 52.8% 提升到 66.

Andrej Karpathy:大语言模型构建个人知识库的实践指南

最近我发现一个非常实用的方法:利用大语言模型(LLM)为各类感兴趣的研究方向搭建个人知识库。这样一来,我近期消耗的模型令牌中,用于处理代码的占比大幅减少,更多被用于处理知识(以 Markdown 文件和图片形式存储)。最新的大语言模型在这方面表现十分出色。具体做法如下:

数据导入

我先将各类源文件(文章、论文、代码仓库、数据集、图片等)归档到 raw/ 目录下,再通过大语言模型逐步“编译”生成一份知识库,这份知识库本质就是按目录结构组织的一系列 .md 文件。 知识库会包含 raw/ 目录下所有数据的摘要、反向链接,还会将数据按概念分类、撰写对应词条并完成相互关联。 为把网页文章转为 .md 文件,我习惯使用 Obsidian 网页剪藏插件,同时通过快捷键将相关图片批量下载到本地,方便大语言模型直接调用。

集成开发环境

我把 Obsidian 当作前端 IDE,既能查看原始数据、编译后的知识库,也能查看衍生的可视化内容。 需要重点说明的是:整个知识库的内容撰写与维护均由大语言模型完成,我几乎不直接手动修改。我还试用过多款 Obsidian 插件,以其他形式渲染和查看数据(比如用 Marp 制作幻灯片)。

问答交互 真正有意思的是,当知识库规模足够大时(比如我近期的研究知识库已有约 100 篇词条、40 万字),就可以向大语言模型智能体提出各类复杂问题

Claude Code 源代码分析

创建 CLAUDE.md

这样它会将项目的规范、构建命令和架构要点记录下来,后续对话中它会自动参考这个文件,不再需要你重复解释背景。有利于后续的代码分析、调试和功能开发。

运行 /init 命令

/init - 自动分析该项目并生成 CLAUDE.md
我已为该仓库成功创建了CLAUDE.md文件。以下是文件包含的内容:

### CLAUDE.md 内容概要
1. **概述** - 包含项目统计信息(约1884个文件、51.2万行代码、40+工具、80+命令)的项目说明,以及法律免责声明。

2. **命令** - 构建与开发相关命令:
    - `npm run prepare-src` - 准备源码
    - `npm run build` - 使用esbuild构建
    - `npm run check` - 执行类型检查
    - `npm start` - 运行编译后的命令行工具

3. **高层架构**:
    - src/query.ts中的核心智能体循环模式
    - 核心目录(入口点、命令行、命令、工具、组件、服务、状态、工具函数)
    - 关键文件及其用途
// ...

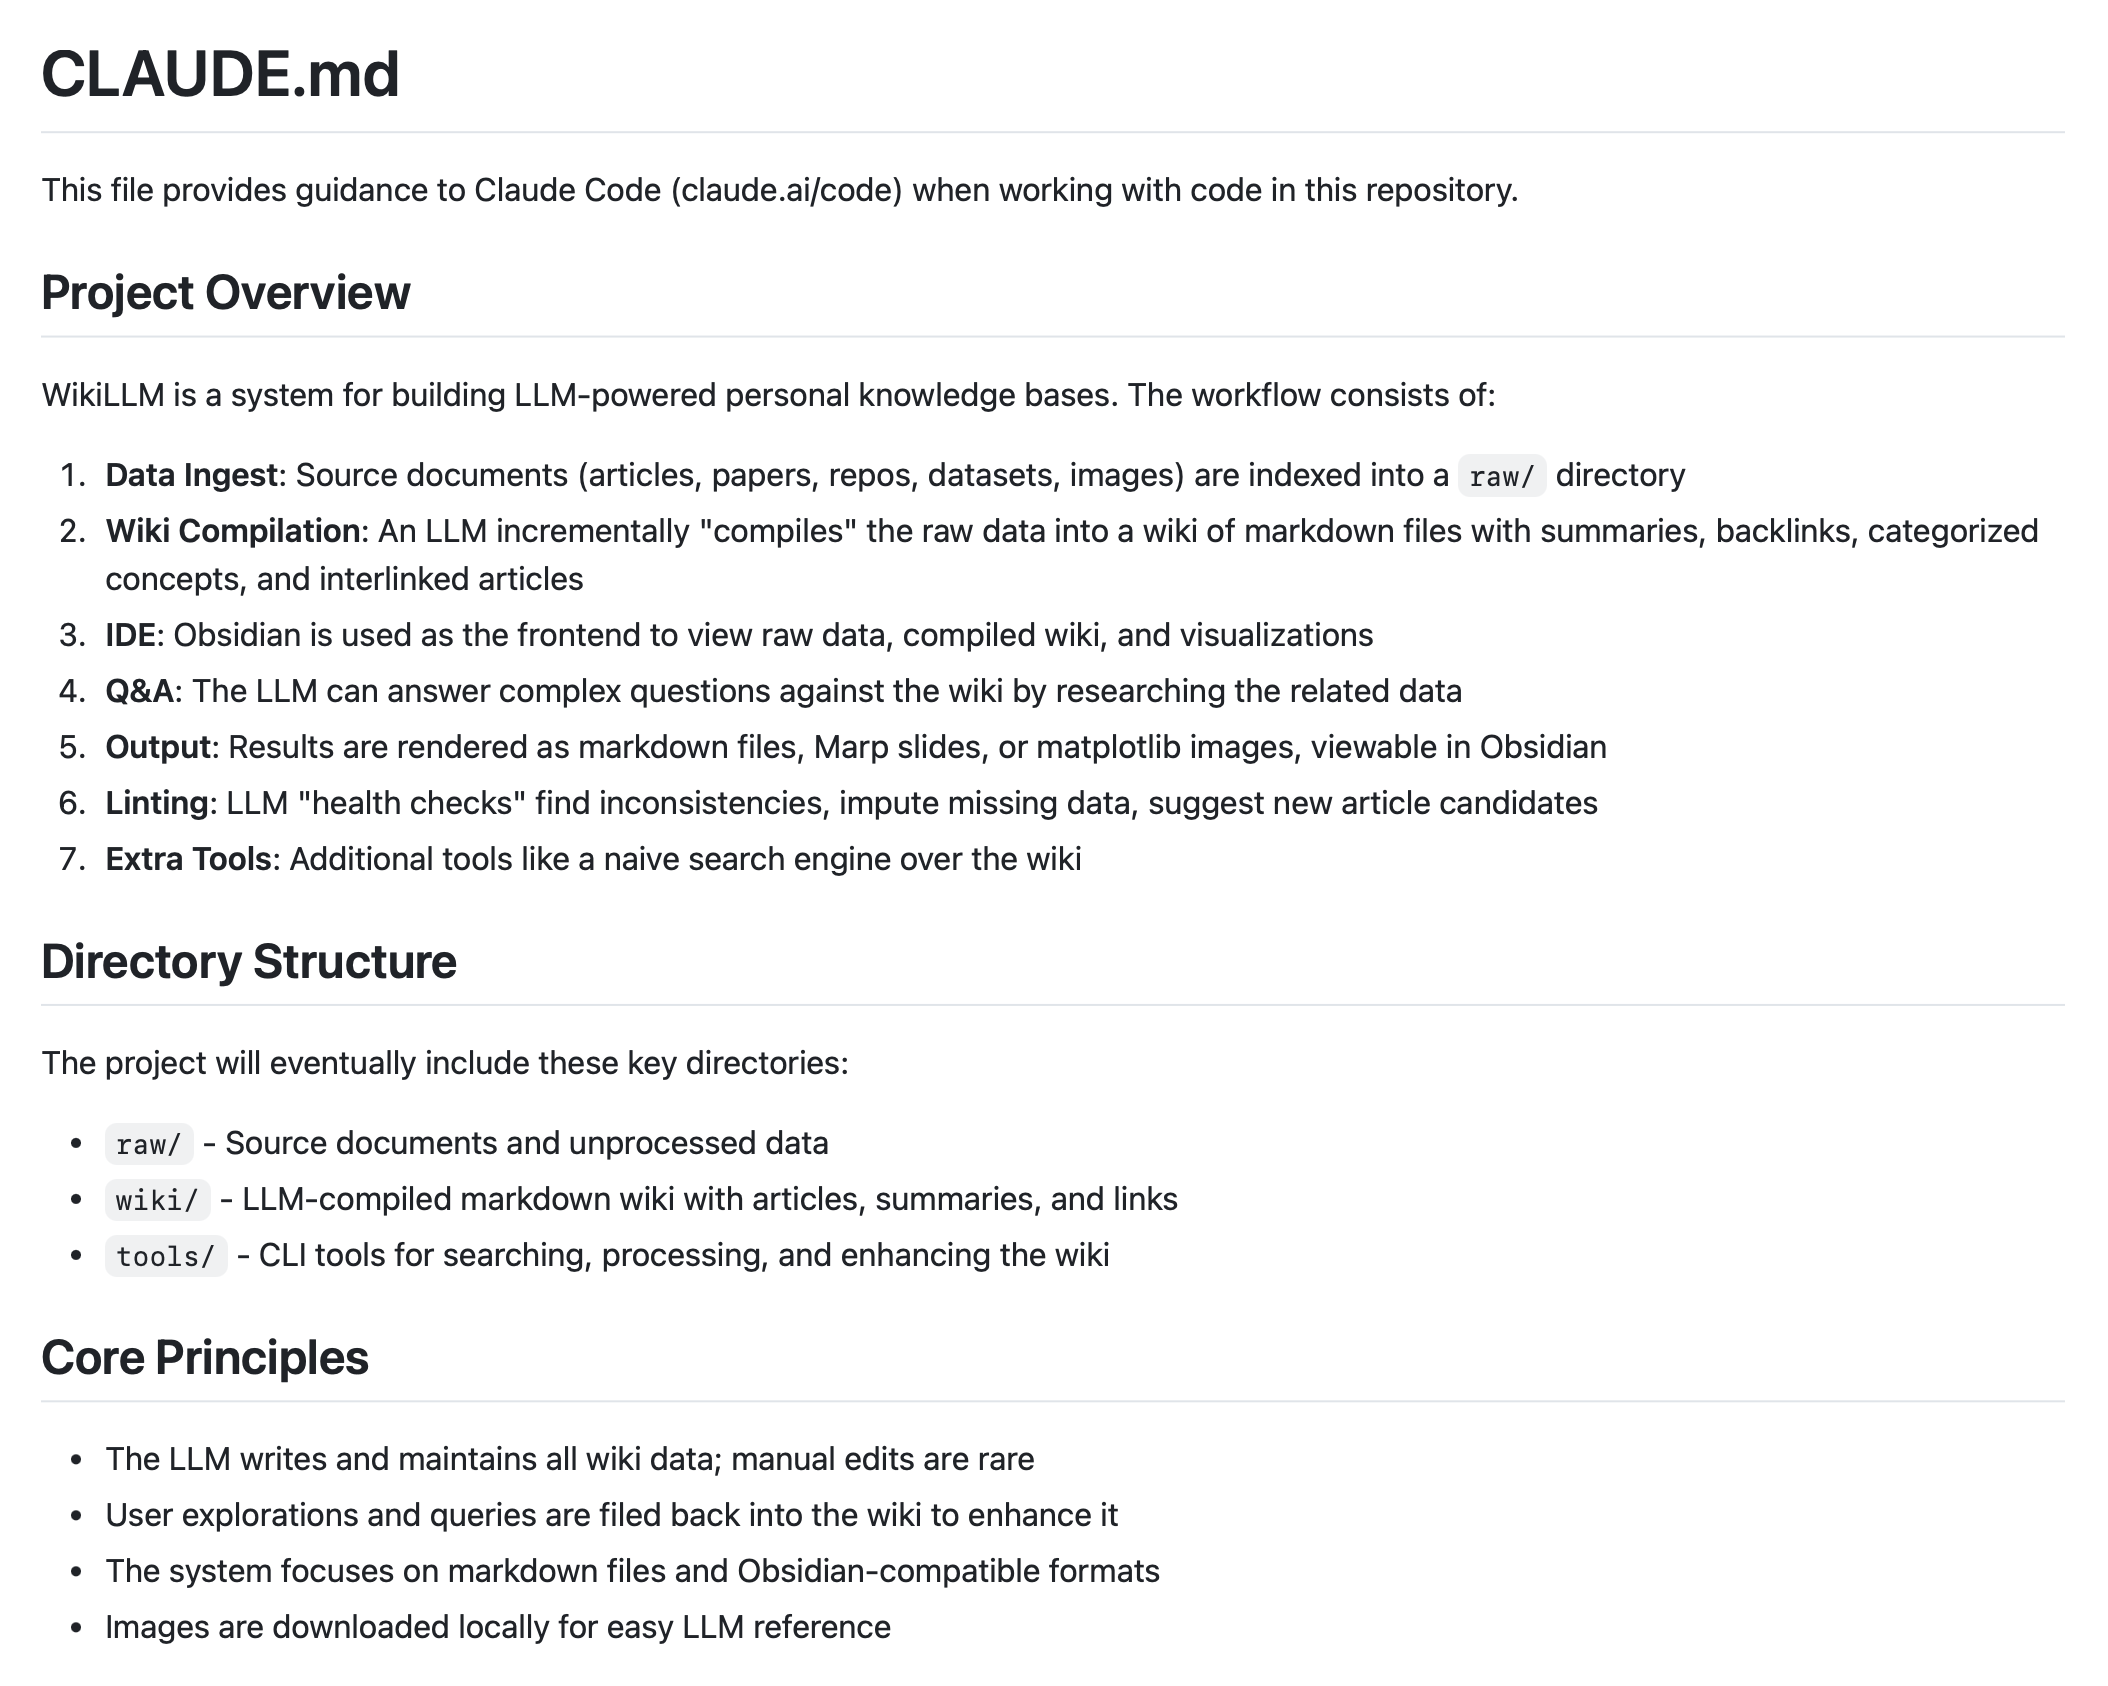
CLAUDE.md

本文件用于指导 Claude Code(claude.ai/code)处理此代码仓库中的代码。

概述

本仓库包含 Claude Code v2.1.

开源 AI 编码智能体 OpenCode 使用指南

OpenCode

OpenCode 是一个开源的 AI 编码智能体。它提供终端界面桌面应用IDE 扩展等多种使用方式。

安装

curl -fsSL https://opencode.ai/install | bash
                                 ▄
█▀▀█ █▀▀█ █▀▀█ █▀▀▄ █▀▀▀ █▀▀█ █▀▀█ █▀▀█
█░░█ █░░█ █▀▀▀ █░░█ █░░░ █░░█ █░░█ █▀▀▀
▀▀▀▀ █▀▀▀ ▀▀▀▀ ▀  ▀ ▀▀▀▀ ▀▀▀▀ ▀▀▀▀ ▀▀▀▀

OpenCode includes free models, to start:

cd <project>  # Open directory
opencode      # Run command

For more information visit https://opencode.ai/docs

配置

Claude Code 项目概览及架构设计

一、项目概述

Claude Code 是 Anthropic 开发的一款终端智能体编码工具,通过自然语言与开发者交互,理解代码库上下文,自动化完成日常编码任务、代码审查、Git 工作流管理等工作。

核心特性

  • 基于 Anthropic Claude 大语言模型
  • 高度可扩展的插件架构
  • 安全的工具调用和权限管理
  • 支持多种工作流和集成

二、项目目录结构

OpenCode 落地指南:从模型配置到 agency-agents 智能体集成

这是一套通过命令行安装 OpenCode、配置火山方舟等多模型接入,并集成 agency-agents 多智能体体系,最终可在 CLI 或桌面端使用专业化 AI 智能体协作完成各类任务的完整部署与使用流程。

安装 OpenCode

curl -fsSL https://opencode.ai/install | bash
Installing opencode version: 1.3.9
■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■ 100%
Successfully added opencode to $PATH in /Users/junjian/.zshrc

                                 ▄
█▀▀█ █▀▀█ █▀▀█ █▀▀▄ █▀▀▀ █▀▀█ █▀▀█ █▀▀█
█░░█ █░░█ █▀▀▀ █░░█ █░░░ █░░█ █░░█ █▀▀▀
▀▀▀▀ █▀▀▀ ▀▀▀▀ ▀  ▀ ▀▀▀▀ ▀▀▀▀ ▀▀▀▀ ▀▀▀▀


OpenCode includes free models, to start:

cd <project>  # Open directory
opencode      # Run command

// ...

桌面应用程序

配置 OpenCode

Harness Engineering|软件工程师的角色革命,从写代码到设计环境

Harness Engineering 是 2026 年软件工程领域涌现的一门新学科,其核心理念是:在生成式 AI 时代,由于模型能力已趋于同质化(Commodity),构建可靠、可扩展的 AI 智能体系统的关键不再是模型本身,而是在模型周围设计的“Harness”(支架/编排系统)

通过分析提供的资料,可以从以下几个维度深入理解 Harness Engineering:

1. 核心定义与马车隐喻

“Harness”一词源于马具(如缰绳、马鞍、嚼子),这个隐喻生动地解释了三者的关系:

  • 马(Horse):指代 AI 模型。它拥有强大的动力和速度,但本身并不知道要去哪里,也不具备自我约束力。
  • Harness(马具/支架):指代基础设施。包括约束机制、护栏和反馈回路,用于将模型的原始能力转化为生产力。
  • 骑手(Rider):指代人类工程师。负责提供方向和意图,而不是亲自奔跑(写代码)。

正式定义上,Harness engineering 是设计和实现一个能够约束、告知、验证并纠正 AI 智能体行为的系统学科。

2. Harness Engineering 的三大支柱

根据 OpenAI 和 NxCode 的实践,一个成熟的 Harness 系统包含三大核心组件:

  • 上下文工程(Context Engineering):确保智能体在正确的时间获得正确的信息。这要求将代码库视为唯一的真理来源,不仅包含代码,还包括架构决策、API 契约和动态的观测数据(如日志、指标)。
  • 架构约束(Architectural Constraints):通过机械化的手段强制执行“好代码”的标准。例如使用确定性的 Linter、结构化测试(如 ArchUnit)和严格的依赖层级校验,防止 AI 智能体在生成代码时由于灵活性过高而导致架构腐化。
  • 熵管理/垃圾回收(Entropy Management / Garbage Collection):AI 生成的代码库容易积累“AI 废料(AI Slop)”,文档也容易过时。Harness 系统需要定期运行专门的智能体来清理不一致的文档、修复违反架构约束的代码以及优化冗余逻辑。

一文读懂 Harness Engineering:AI 时代软件工程的全新范式

本文综合 Anthropic、OpenAI、Martin Fowler、LangChain、Mitchell Hashimoto、NxCode、MiniMax 等前沿文章的分析报告。

一、什么是 Harness Engineering?

1.1 词源与隐喻

"Harness" 直译为"马具"——缰绳、鞍座、嚼子,是用来驾驭一匹强大但不可预测的动物的工具。这个隐喻极其精准:

隐喻 对应实体
马匹 AI 模型——强大、快速,但自身不知道该去哪里
马具(Harness) 基础设施——约束、护栏、反馈循环,引导模型的力量
骑手 人类工程师——提供方向,而不是亲自奔跑

没有 Harness 的 AI Agent 就像旷野中的野马——速度快、令人印象深刻,但对完成任何目标完全无用。

1.2 正式定义

Harness Engineering 是设计和实现以下系统的学科:

  1. 约束(Constrain)——限制 AI Agent 能做什么(架构边界、依赖规则)
  2. 告知(Inform)——告诉 Agent 它该做什么(上下文工程、文档)
  3. 验证(Verify)——检查 Agent 是否正确完成了任务(测试、Linter、CI)
  4. 纠正(Correct)——当 Agent 出错时进行修复(反馈循环、自我修复机制)

1.3 与相关概念的区别