在 Hugging Face 上搭建 ChatGPT 聊天机器人

Hugging Face 上创建 ChatGPT Space
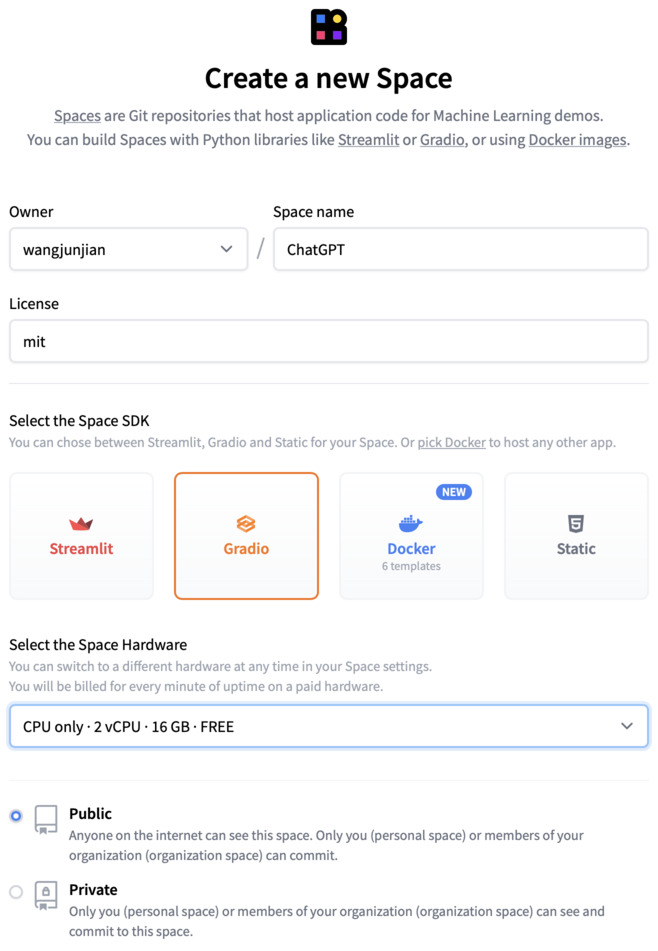
克隆

git clone https://huggingface.co/spaces/wangjunjian/ChatGPT
cd ChatGPT

创建应用(聊天机器人)

chat.py

这里的 Conversation 记录了所有的对话消息,在提问前,会检查是否超过最大 token 数量,如果超过,会删除第一条与用户的对话消息,然后再提问。

import openai
import tiktoken


class Conversation:
    def __init__(self, prompt, model="gpt-3.5-turbo", temperature=0.8, max_tokens=250):
        self.prompt = prompt
        self.model = model
        self.temperature = temperature
        self.max_tokens = max_tokens

        self._init_messages()

    def _init_messages(self):
        self.messages = [{"role": "system", "content": self.prompt}]
// ...
OpenAI API Documentation Chat Completion

Chat Completion

模型

  • gpt-3.5-turbo
  • gpt-4

可以做很多事情

  • 起草电子邮件或其他书面文件
  • 编写 Python 代码
  • 回答有关一组文件的问题
  • 创建会话代理
  • 为您的软件提供自然语言界面
  • 一系列科目的导师
  • 翻译语言
  • 模拟视频游戏中的角色等等

API 调用 例子 import os import openai openai.api_key = os.getenv("OPENAI_API_KEY") response = openai.ChatCompletion.create( model="gpt-3.5-turbo", messages=[ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": "Who won the world series in 2020?

OpenAI API Documentation Embeddings

什么是 Embedding?

文本嵌入用于衡量文本字符串的相关性。嵌入通常用于:

  • 搜索(结果按与查询字符串的相关性排序)
  • 聚类(其中文本字符串按相似性分组)
  • 推荐(推荐具有相关文本字符串的项目)
  • 异常检测(识别出相关性很小的异常值)
  • 多样性测量(分析相似性分布)
  • 分类(其中文本字符串按其最相似的标签分类)

嵌入是浮点数的向量(列表)。两个向量之间的距离衡量它们的相关性。小距离表示高相关性,大距离表示低相关性。

如何获得 Embedding?

Embedding API

请求格式

{
  "input": "A string to be embedded",
  "model": "text-embedding-ada-002"
}

响应格式 { "data": [ { "embedding": [ -0.02181987278163433, ... -0.

OpenAI API Documentation 快速入门

工具

Examples

Playground

了解标记和概率

分词器工具

GPT 比较工具

介绍

概述

OpenAI API 几乎可以应用于任何涉及理解或生成自然语言、代码或图像的任务。提供一系列具有不同功率级别的模型,适用于不同的任务,并且能够微调您自己的自定义模型。这些模型可用于从内容生成到语义搜索和分类的所有领域。

关键概念

Prompts

设计提示本质上是您“编程”模型的方式,通常是通过提供一些说明或一些示例。通过 completions 和 chat completions 端点可用于几乎任何任务,包括内容或代码生成、摘要、扩展、对话、创意写作、风格转换等。

Tokens

模型通过将文本分解为标记来理解和处理文本。标记可以是单词或只是字符块。例如,单词“hamburger”被分解为标记“ham”、“bur”和“ger”,而像“pear”这样的短而常见的单词是一个标记。许多标记以空格开头,例如“ hello”和“ bye”。

在给定的 API 请求中处理的令牌数量取决于输入和输出的长度。根据粗略的经验法则,对于英文文本,1 个标记大约为 4 个字符或 0.75 个单词。要记住的一个限制是,您的文本提示和生成的完成组合不能超过模型的最大上下文长度(对于大多数模型,这是 2048 个标记,或大约 1500 个单词)。

Playground 了解标记和概率 我们的模型通过将文本分

文心一言测试

文心一言

👎分类

❓ 电脑:3C;手机:3C;铅笔:
💬 非常抱歉,我之前的回答有误。
* 电脑是一种3C产品。
* 手机也是一种3C产品。
* 铅笔不是一种3C产品。
如您还有其他问题,欢迎继续向我提问。

👎情感分类

❓ “这个手机的功能不好用”这是好评还是差评?
💬 这是一个主观的评价,可以根据个人的使用体验和需求来进行判断。如果这个手机的功能符合个人的需求,那么这个评价可以是好评;如果这个手机的功能不符合个人的需求,那么这个评价可以是差评。

👍英语语法更正

❓ Correct this to standard English:

She no went to the market.
💬 She did not go to the market.

ChatGPT 还会解释语法的问题

翻译

英译中

❓ What rooms do you have available? 翻译成中文
💬 您好,您想要预订哪些房型呢?

中译英

❓ 您好,您想要预订哪些房型呢?翻译成英文
💬 Hello, which rooms are available for booking?

👎阅读理解 ❓ 北京市卫生健康委副主任、新闻发言人李昂通报:4月18日下午,长峰医院突发火情,市卫生健康委即刻启动应急预案,迅速调集29辆救护车300余人次急救力量,及时赶赴现场,全力开展医疗救援和转运工作。

AutoGPT

下载

git clone https://github.com/Torantulino/Auto-GPT.git
cd Auto-GPT

安装

conda create --name autogpt python=3.9
conda activate autogpt
pip install -r requirements.txt

配置

cp .env.template .env
vim .env

OPENAI_API_KEY

打开 OpenAI 的 API Keys,通过 Create new secret key 获取 Secret Key。

OPENAI_API_KEY=your-openai-api-key

GOOGLE_API_KEY

打开 可编程搜索引擎控制台,通过 创建项目 获取 API Key。

GOOGLE_API_KEY=your-google-api-key

CUSTOM_SEARCH_ENGINE_ID

打开 Custom Search JSON API,通过 创建项目 获取 Custom Search Engine ID。

CUSTOM_SEARCH_ENGINE_ID=your-custom-search-engine-id

Custom Search JSON API 每天免费提供 100 次搜索查询。

PINECONE_API_KEY & PI

在 MacBook Pro M2 Max 上测试 ChatGLM-6B

ChatGLM-6B 是一个开源的、支持中英双语的对话语言模型,基于 General Language Model (GLM) 架构,具有 62 亿参数。

聊天 ChatGLM-6B

下载

克隆

https://github.com/THUDM/ChatGLM-6B.git
cd ChatGLM-6B

下载模型

git clone https://huggingface.co/THUDM/chatglm-6b THUDM/chatglm-6b
  • 在国内为了加快下载速度,模型文件可以单独从 清华云 下载。

命令 alias

zsh 中使用单引号('),不对特殊符号进行解析,使用双引号(")会对特殊符号进行解析,如:$

docker rmi none

alias docker.rmi.none='docker rmi --force $(docker images -q --filter "dangling=true")'

在终端通过 Safari 打开网址

alias open.chatgpt='open -a Safari https://platform.openai.com/playground\?mode\=chat'

基于 FastAPI 开发 Ultralytics Serving

Ultralytics Serving

Inference service based on Ultralytics

创建虚拟环境

python -m venv venv source venv/bin/activate

安装依赖包

创建 requirements.txt

fastapi
python-multipart
aiofiles
onnxruntime
ultralytics
uvicorn[standard]
gunicorn
pytest
httpx

安装

pip install -r requirements.txt

调试

创建 launch.json 文件,用于调试 FastAPI 应用。

.vscode/launch.json { "version": "0.2.0", "configurations": [ { "name": "Python: FastAPI", "type": "python", "request": "launch", "module": "uvicorn", "args": [ "app.

人工智能服务 REST API 响应的 JSON 格式

什么是 REST API?

REST API 也称为 RESTful API,是遵循 REST 架构规范的应用编程接口(API 或 Web API),支持与 RESTful Web 服务进行交互。REST 是表述性状态传递的英文缩写,由计算机科学家 Roy Fielding 创建。

如何实现 RESTful API?

API 要被视为 RESTful API,必须遵循以下标准:

  • 客户端-服务器架构由客户端、服务器和资源组成,并且通过 HTTP 管理请求。
  • 无状态客户端-服务器通信,即 get 请求间隔期间,不会存储任何客户端信息,并且每个请求都是独立的,互不关联。
  • 可缓存性数据:可简化客户端-服务器交互。
  • 组件间的统一接口:使信息以标准形式传输。这要求:
    • 所请求的资源可识别并与发送给客户端的表述分离开。
    • 客户端可通过接收的表述操作资源,因为表述包含操作所需的充足信息。
    • 返回给客户端的自描述消息包含充足的信息,能够指明客户端应该如何处理所收到的信息。
    • 超文本/超媒体可用,是指在访问资源后,客户端应能够使用超链接查找其当前可采取的所有其他操作。
  • 组织各种类型服务器(负责安全性、负载平衡等的服务器)的分层系统会参与将请求的信息检索到对客户端不可见的层次结构中。
  • 按需编码(可选):能够根据请求将可执行代码从服务器发送到客户端,从而扩展客户端功能。

虽然 REST API 需要遵循这些标准,但是

Python in Visual Studio Code

开发文档

扩展

选择 Python 解释器

  1. 通过 Shift + Command + P 快捷键,打开命令面板。
  2. 输入 Python: Select Interpreter ,回车。
  3. 选择您想使用的环境。

在状态栏上可以单击进行切换不同的环境

测试

我选择了 pytest 测试框架,这个写起来更自然且简单。

GitHub Copilot - Your AI pair programmer

注册

打开 GitHub Copilot - Your AI pair programmer,可以选择 Copilot for Individuals(Copilot个人版) 进行免费 2 个月的试用,每年 $100 ,可以使用 PayPal 进行支付。

IDE 集成

VS Code

GitHub Copilot 扩展

GitHub Copilot Labs 扩展

Neovim

安装 Neovim

brew install neovim
brew install node

安装 GitHub Copilot 扩展

  • 使用 Neovim 的内置插件管理器安装 GitHub Copilot。
git clone https://github.com/github/copilot.vim \
   ~/.config/nvim/pack/github/start/copilot.vim
  • 若要配置 GitHub Copilot,请打开 Neovim 并输入以下命令。
:Copilot setup
  • 在 Neovim 配置中或使用 Neovim 命令启用 GitHub Copilot。
:Copilot enable

Ultralytics Hub 快速入门

准备数据集

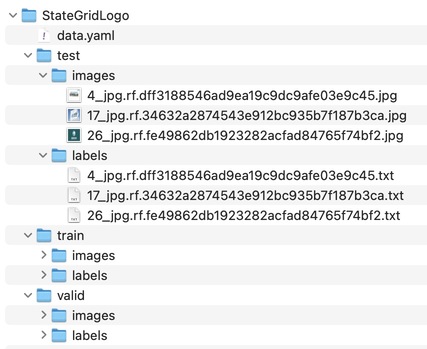
目录结构

data.yaml

train: ../train/images
val: ../valid/images
test: ../test/images

nc: 1
names: ['logo']

压缩成 zip 文件

登录 Ultralytics Hub

Projects

创建项目

Datasets

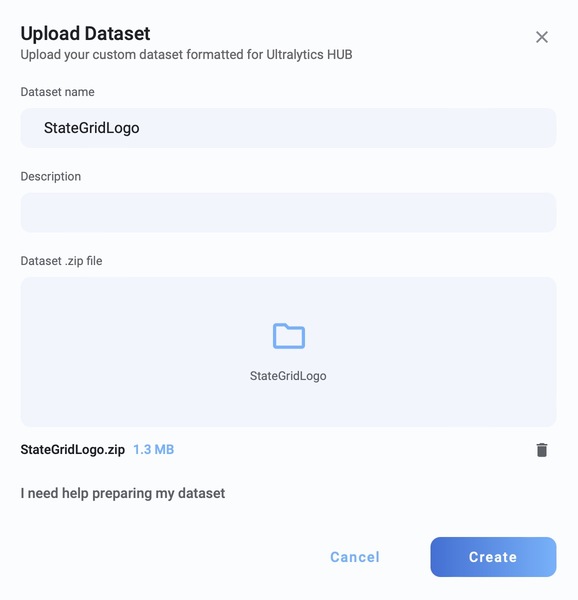
上传数据集

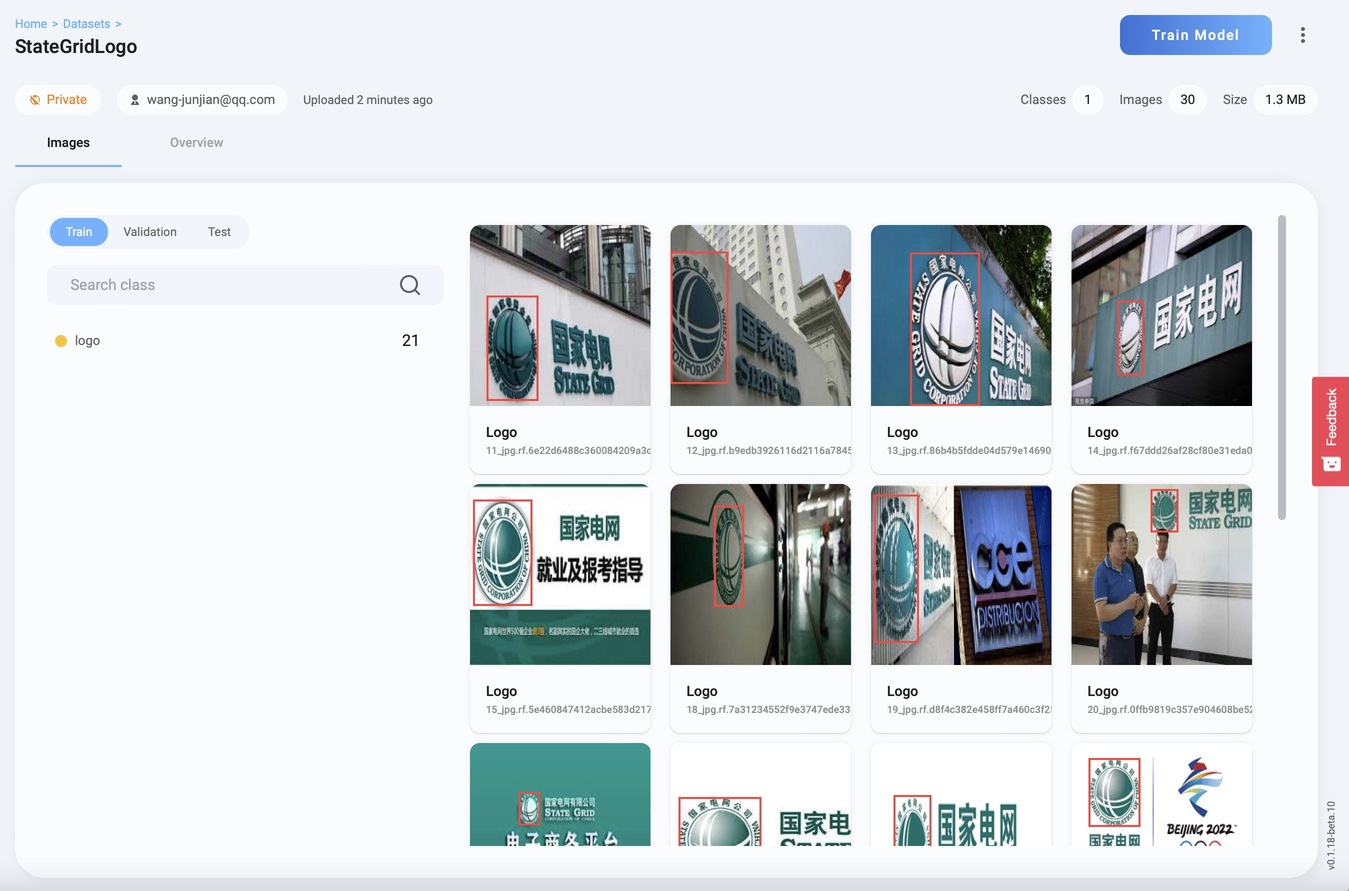
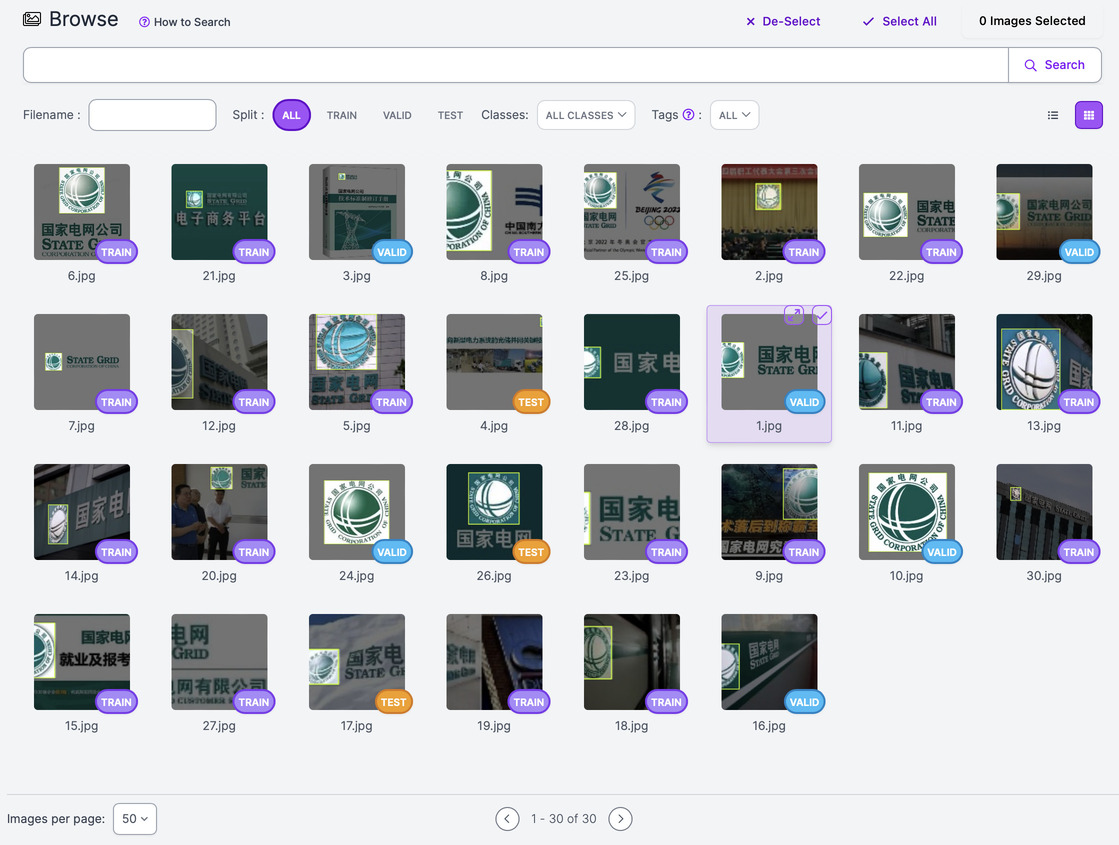
数据集图像

数据集概貌

Train

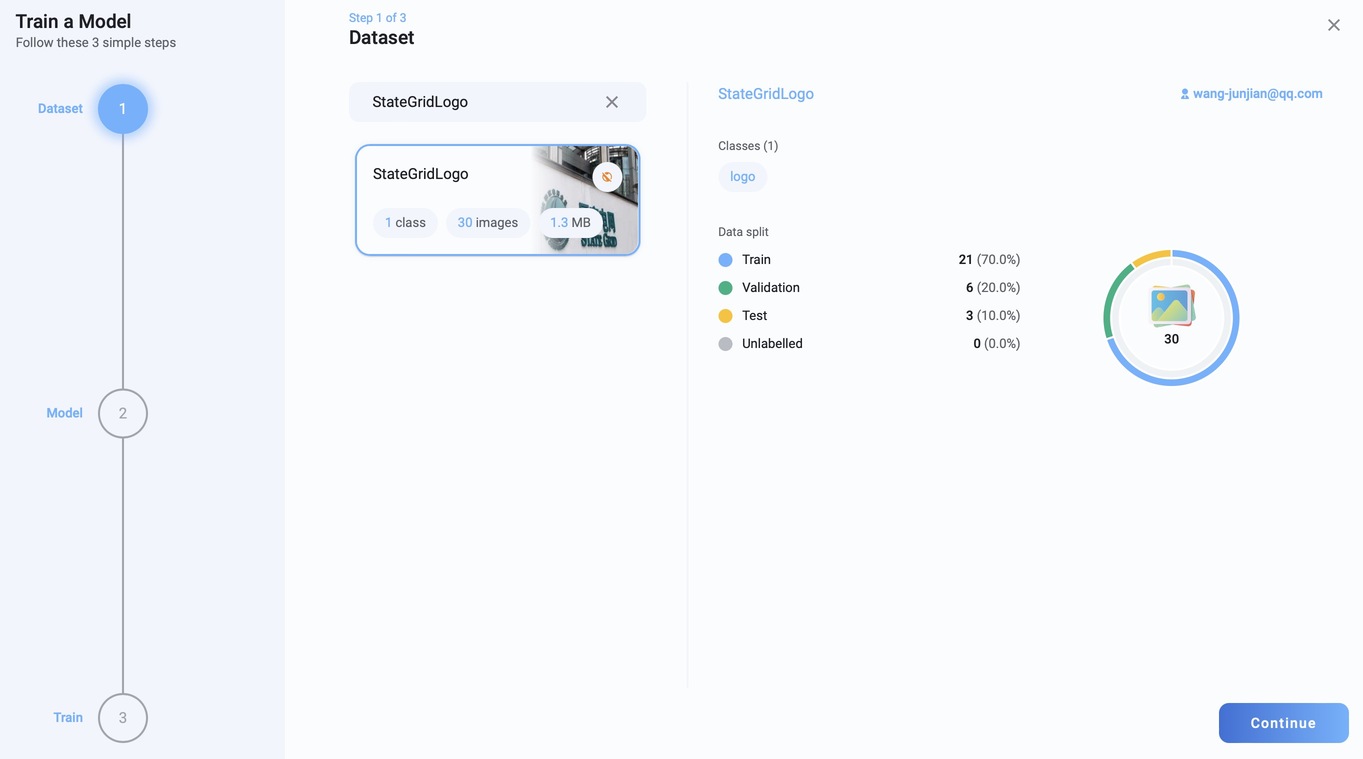
选择数据集

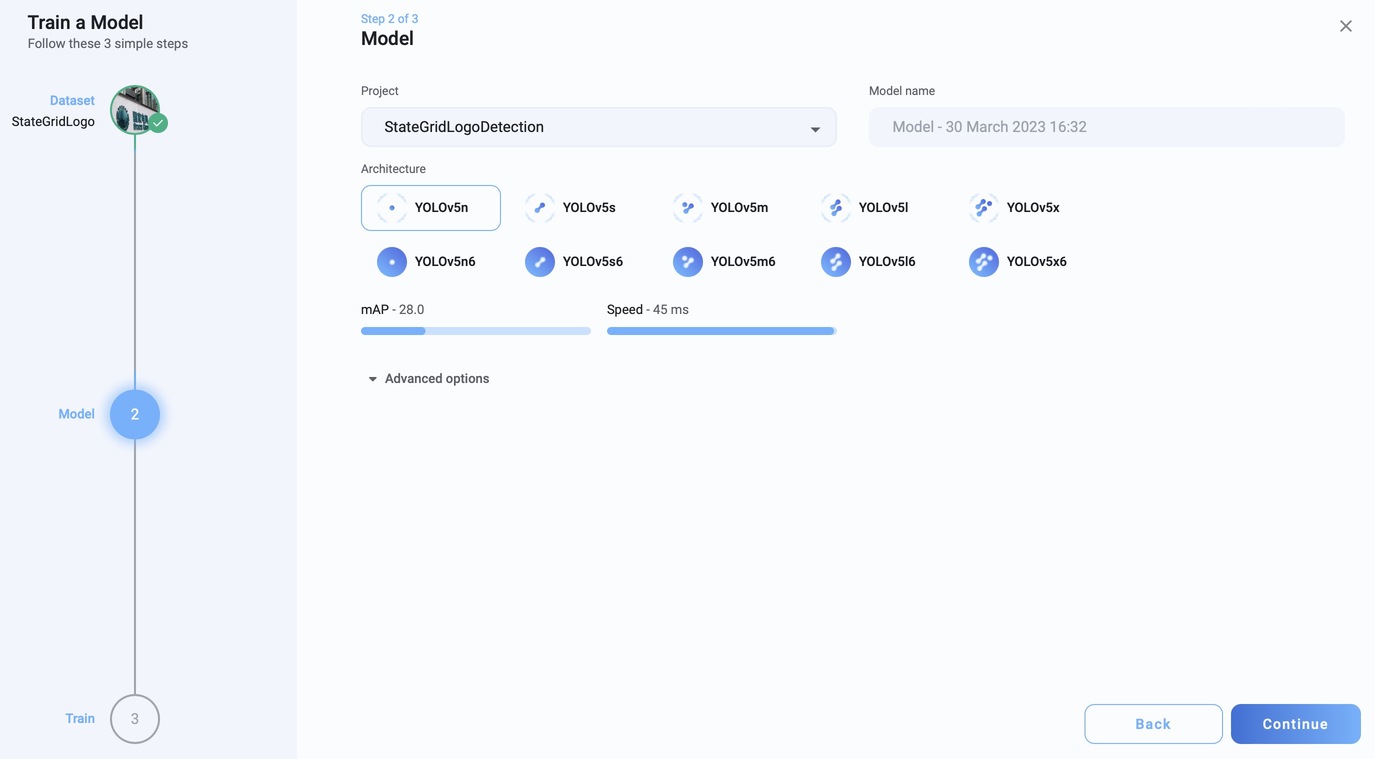
选择模型

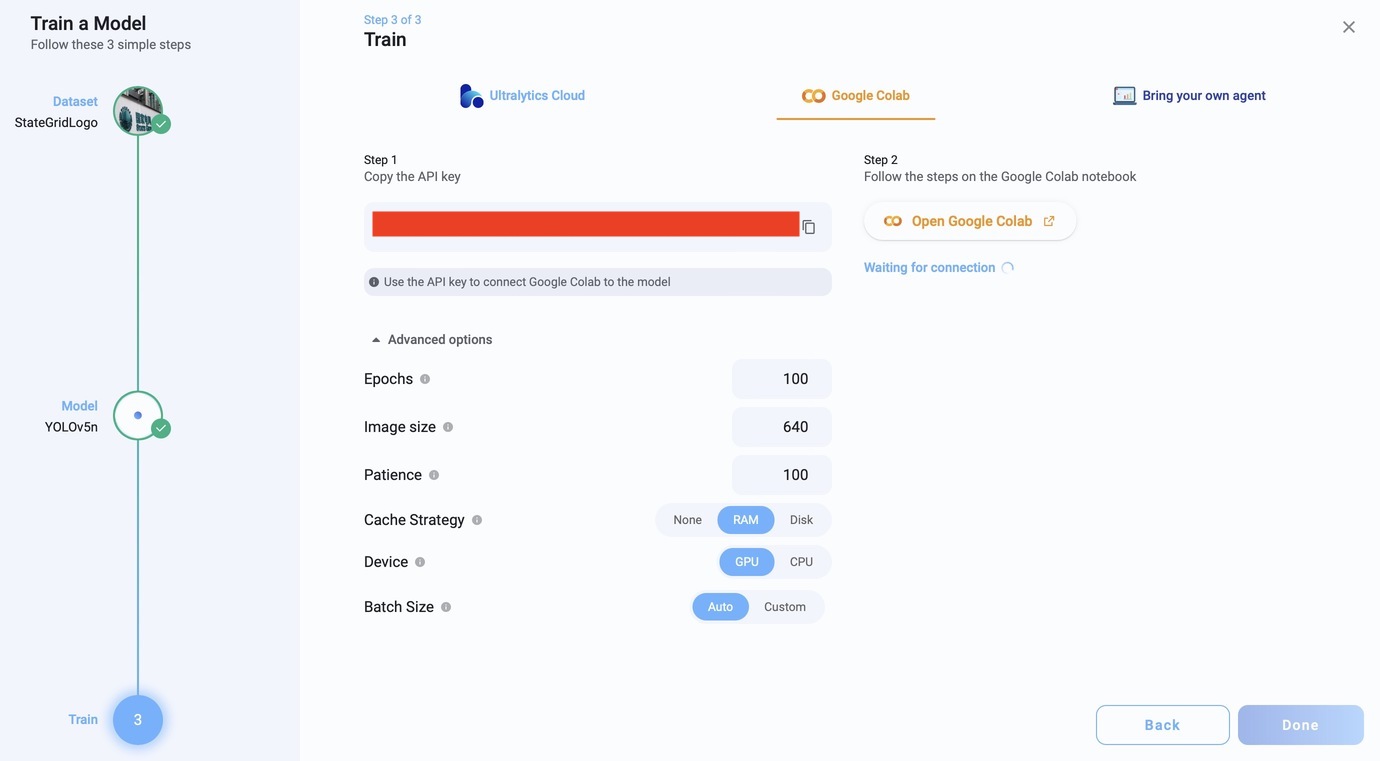
选择训练参数

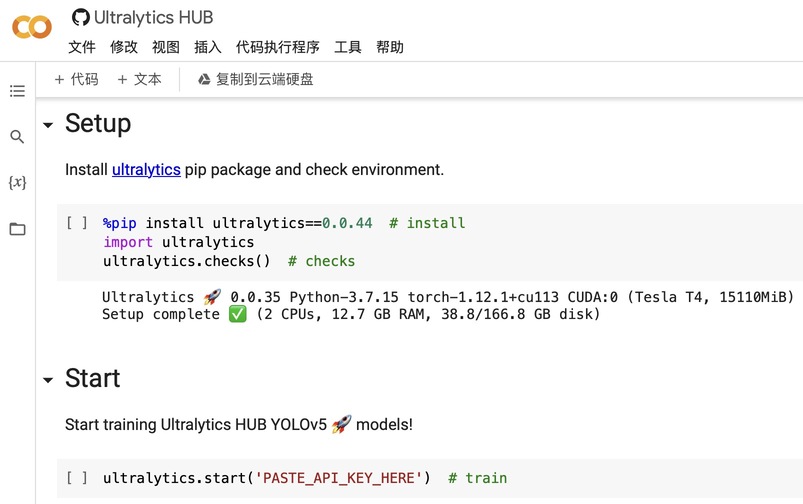
Google Colab 训练模型

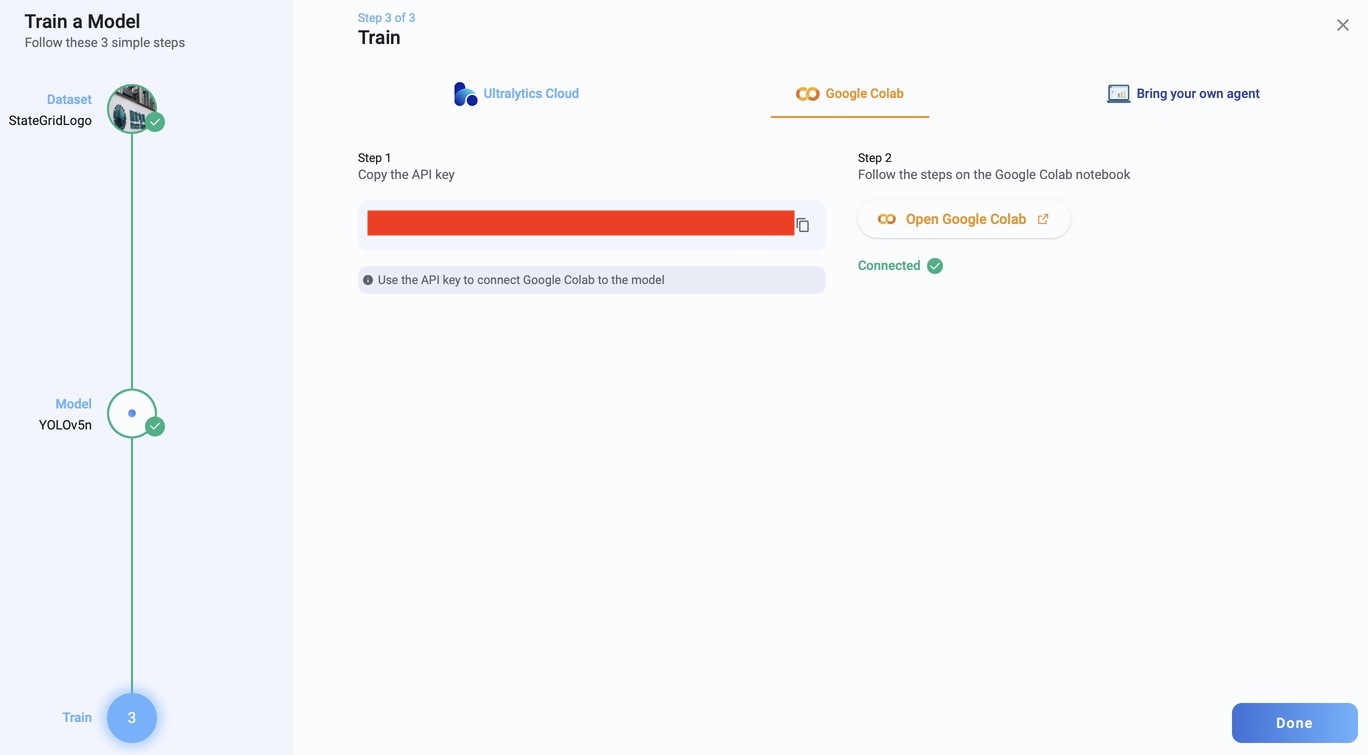
使用上图的 API key 替换 PASTE_API_KEY_HERE

Done

Models

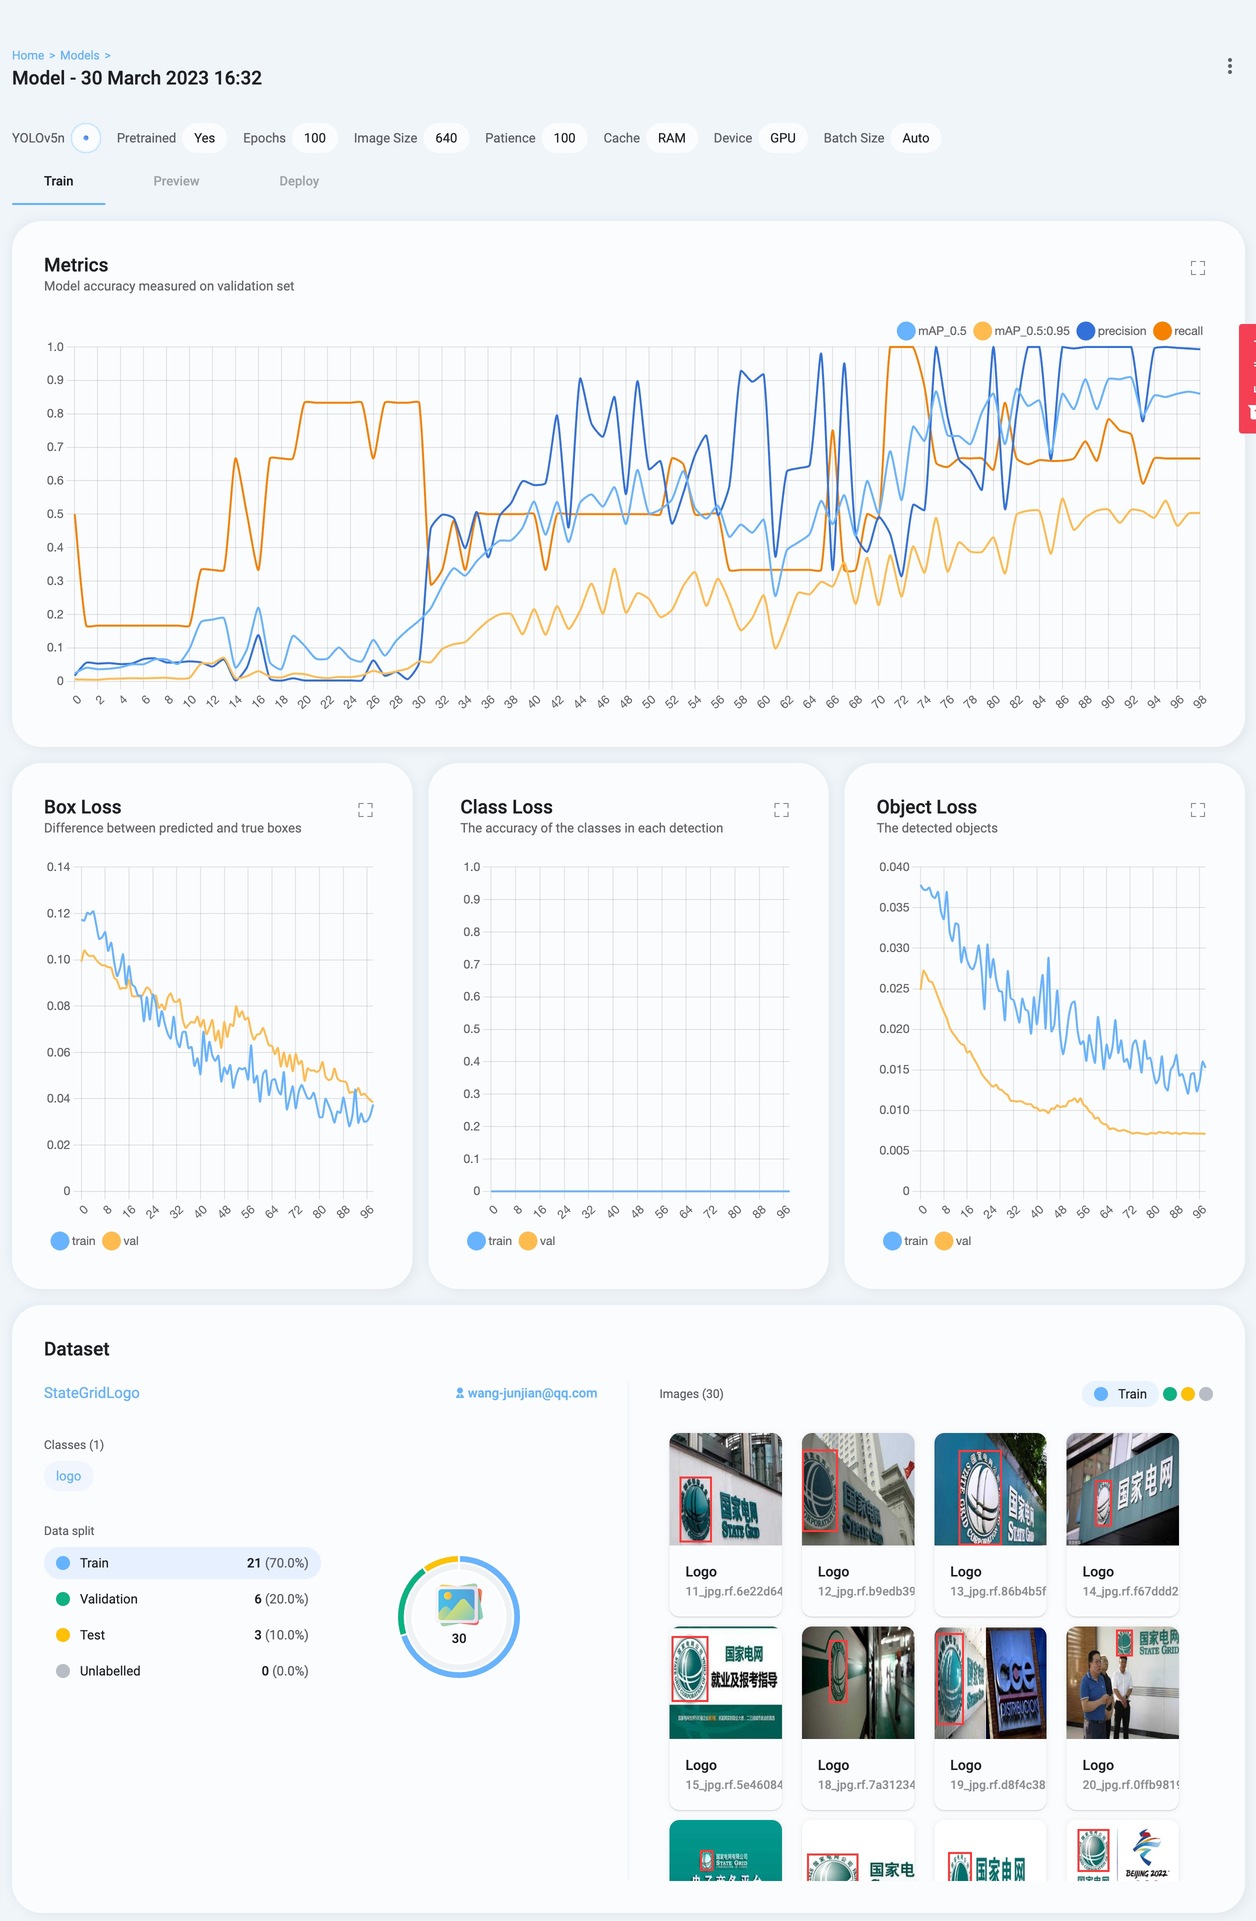
模型训练的性能指标

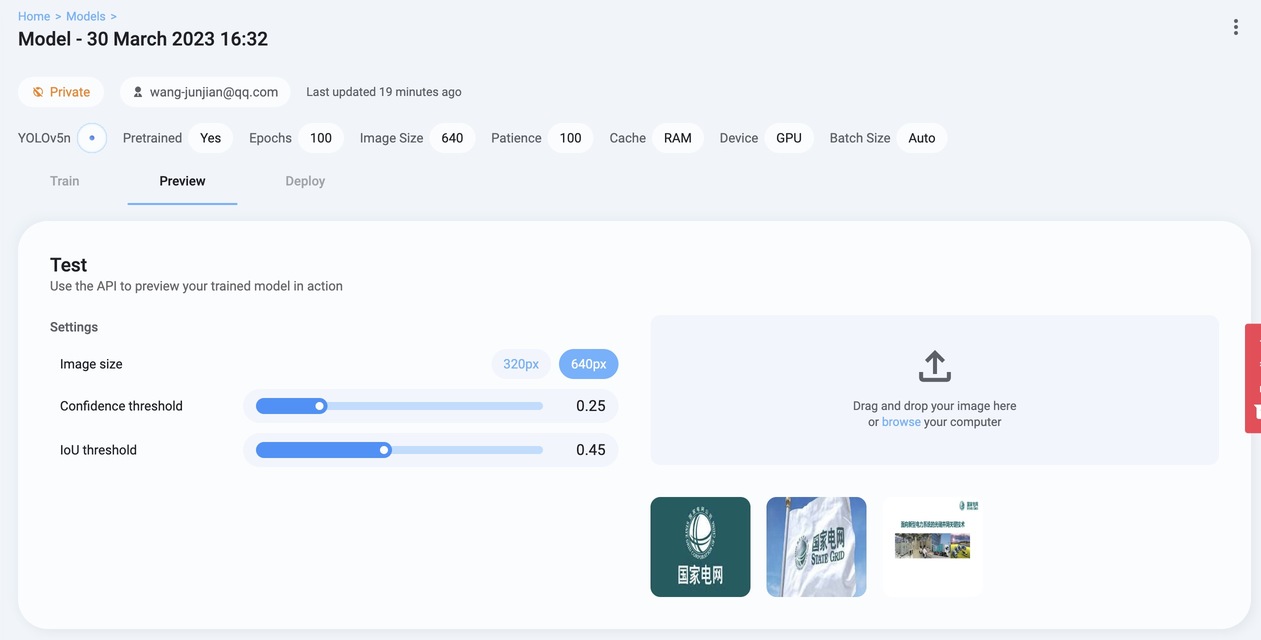
模型测试

模型部署

参考资料

Roboflow 快速入门

创建工作区

在 Workspaces 侧边栏单击 ”Add Workspace“。

工作区是团队可以协作创建、管理和标记数据集以及训练和部署模型的地方。

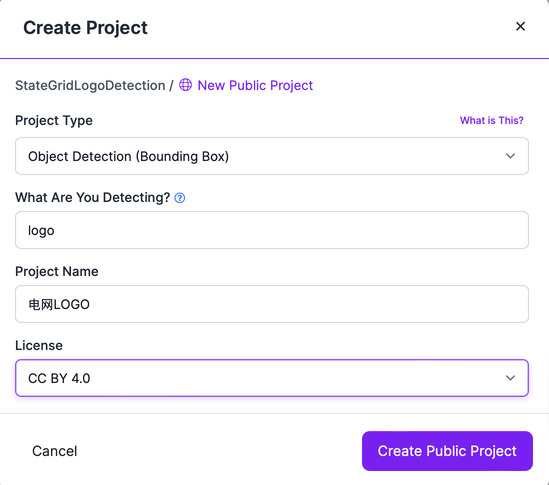
创建项目

单击 “Create New Project”

项目的菜单项

Upload(上传数据集)

支持直接上传标注好的数据集。

Annotate(标注)

Dataset(数据集)

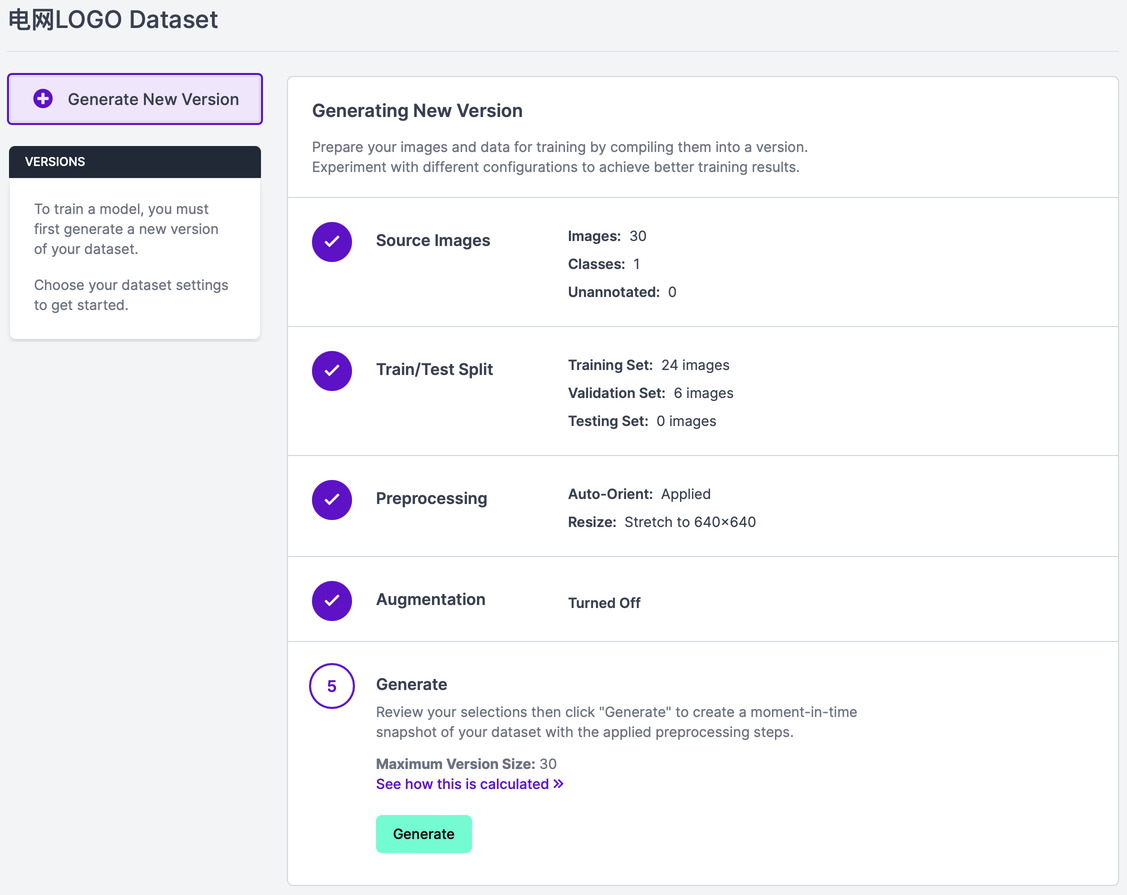
Generate(生成新版本数据集)

1️⃣ Source Images

2️⃣ Train/Test Split

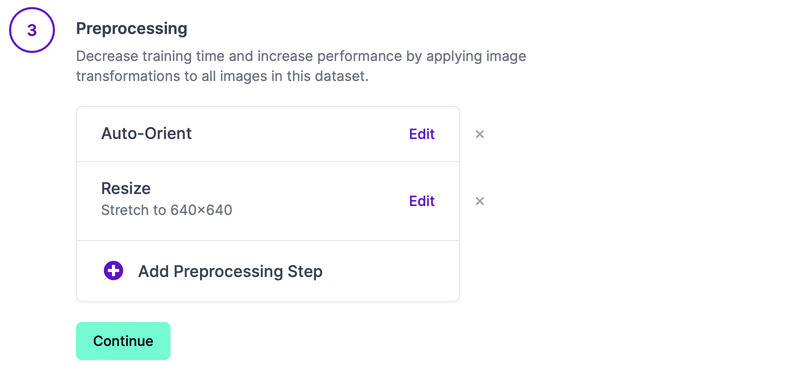
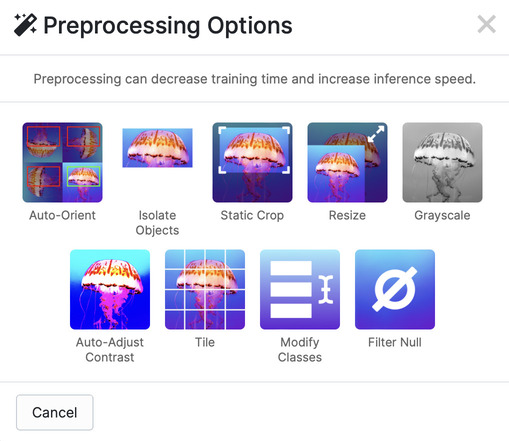
3️⃣ Preprocessing

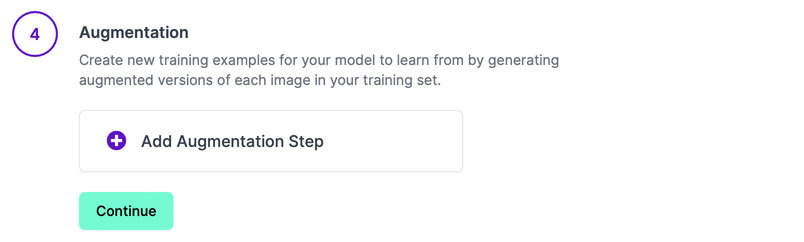
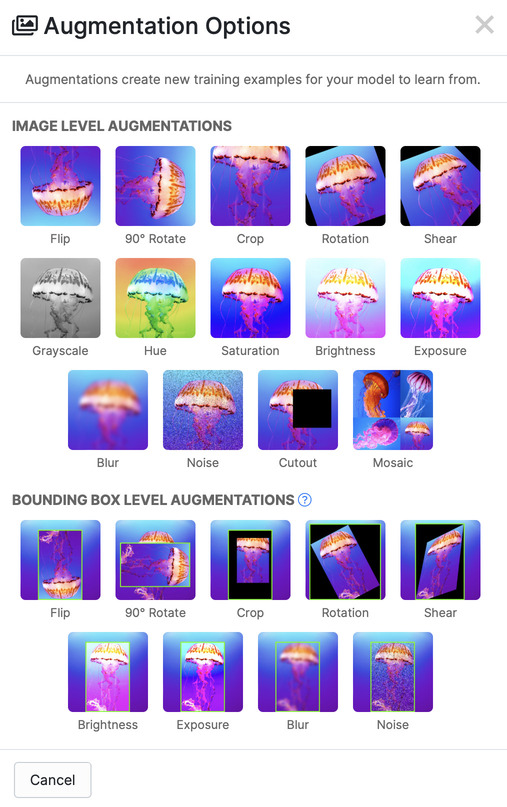
4️⃣ Augmentation

5️⃣ Generate

Versions(数据集版本)

单击“Export”,可以导出不同格式的数据集。

单击“Start Training”,可以进行训练,能够进行3次免费训练。

Deploy(预测或部署)

基于 Python 的推理示例

pip install roboflow

Ultralytics YOLOv8

Ultralytics

构建环境

Ultralytics 镜像

  • GPU
docker pull ultralytics/ultralytics:latest
  • CPU
docker pull ultralytics/ultralytics:latest-cpu
  • Apple Silicon
docker pull ultralytics/ultralytics:latest-arm64

本地安装

pip install ultralytics

基于 COCO128 数据集的目标检测范例

运行容器

git clone https://github.com/ultralytics/ultralytics.git
docker run --runtime=nvidia -it --name ultralytics -v `pwd`/ultralytics:/usr/src/ultralytics ultralytics/ultralytics:latest

yolo 命令的使用参数

yolo TASK MODE ARGS

训练模型

yolo train data=coco128.yaml model=yolov8n.pt

训练可视化(Comet) pip install comet_ml export

在 MacBook Pro M2 Max 上测试 LLaMA

LLaMA

LLaMA-13B 在大多数基准上的表现优于 GPT-3(175B),LLaMA-65B 与最好的型号 Chinchilla-70B 和 PaLM-540B 具有竞争力。

克隆

git clone https://github.com/facebookresearch/llama
cd llama

下载模型

修改 download.sh,配置下载模型的 地址(PRESIGNED_URL) 和 下载目录(TARGET_FOLDER)。

vim download.sh
PRESIGNED_URL="https://agi.gpt4.org/llama/LLaMA/*"             # replace with presigned url from email
TARGET_FOLDER="./"             # where all files should end up
bash download.sh

llama.cpp

构建

git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make

拷贝 LLaMA 模型到当前目录 ls .

在 MacBook Pro M2 Max 上测试 Whisper

准备音频文件

macOS 上打开 QuickTimePlayer

  1. [文件] -> [新建音频录制]
  2. 录制
  3. 朗读:荷兰发布了一份主题为“宣布即将对先进半导体制造设备采取的出口管制措施”的公告表示,鉴于技术的发展和地缘政治的背景,政府已经得出结论,有必要扩大现有的特定半导体制造设备的出口管制。
  4. 停止
  5. 保存(test.m4a)

m4a 转换 wav

ffmpeg -i test.m4a -ar 16000 -ac 1 -c:a pcm_s16le test.wav

OpenAI Whisper

创建虚拟环境

conda create --name whisper python
conda activate whisper

安装

pip install --upgrade --no-deps --force-reinstall git+https://github.com/openai/whisper.git

wget https://raw.githubusercontent.com/openai/whisper/main/requirements.txt
pip install -r requirements.txt

测试 模型默认保存在 ~/.cache/whisper ls ~/.cache/whisper base.pt large-v2.

在 CentOS 上安装 EPEL 软件仓库

EPEL(Extra Packages for Enterprise Linux)是为企业级Linux操作系统(如CentOS、Red Hat Enterprise Linux等)提供的一个高质量、稳定的软件仓库,包含了许多不包含在标准软件仓库中的软件包。

安装 EPEL 软件仓库

yum -y install epel-release

FAQ

不能安装软件

No match for argument: htop
Error: Unable to find a match: htop

参考资料