CodeGate - 让 AI 编码助手更安全

什么是 CodeGate

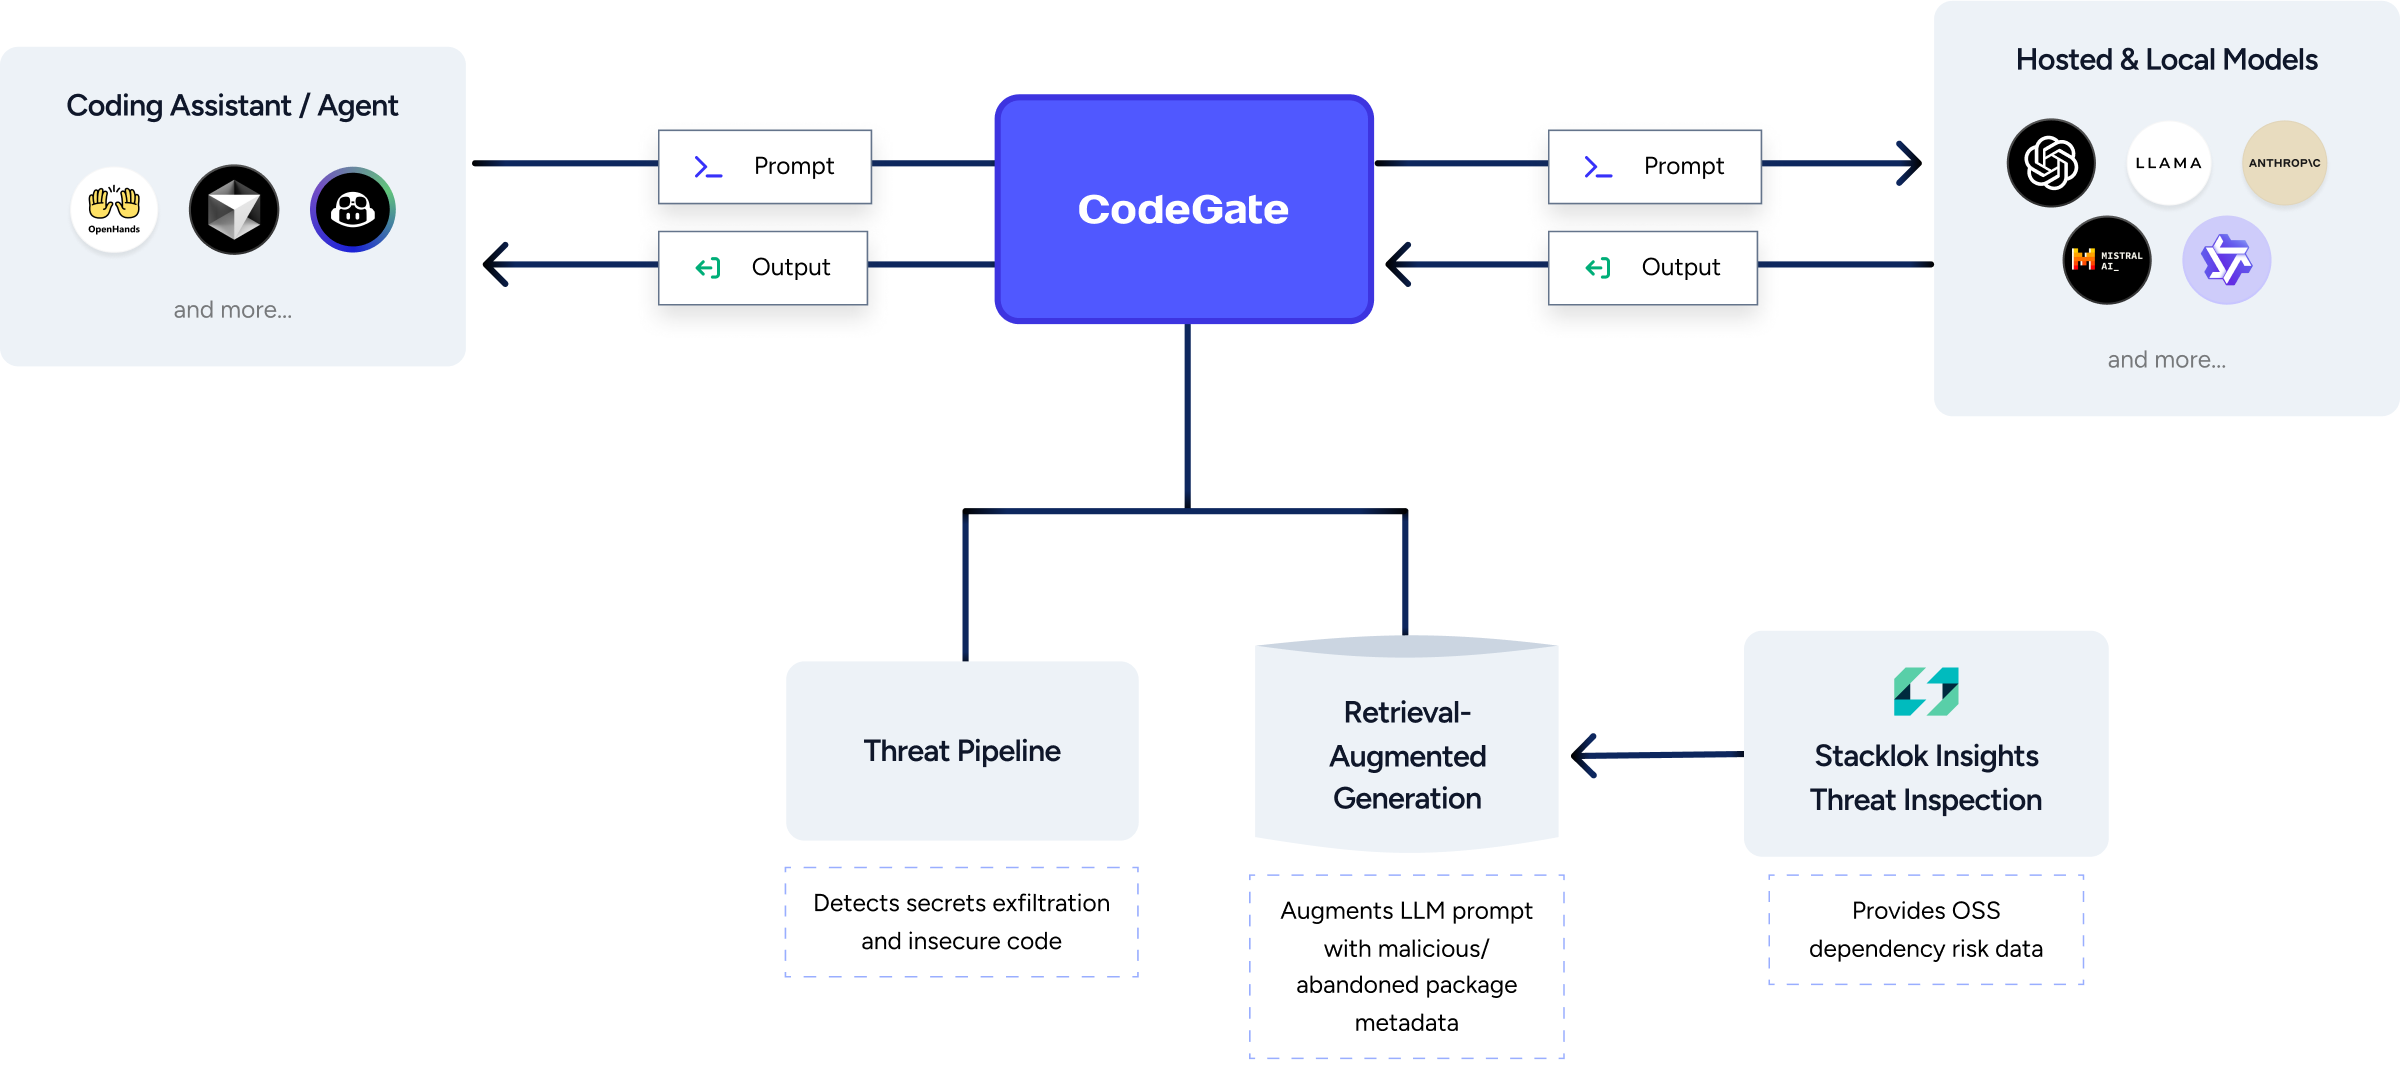
CodeGate 是位于 AI 编码助手和 LLM 之间的本地提示网关,用于增强隐私和安全性。

  • 执行代码安全审查
  • 识别包依赖项中的漏洞
  • 防止敏感数据(如机密)与 AI 模型共享

工作原理

CodeGate 是位于 AI 编码助手和 LLM 之间的本地代理。CodeGate 会审查您的提示是否存在任何潜在的机密泄露 — 在机密离开您的桌面之前对其进行加密,并在响应中对其进行解密。CodeGate 使用 RAG 来更新任何 LLM 的知识库,并提供相关的风险洞察。
Continue 指南

启动 CodeGate 服务

docker pull ghcr.io/stacklok/codegate:latest
docker run --name codegate -d -p 8989:8989 -p 9090:9090 --restart unless-stopped ghcr.io/stacklok/codegate:latest

下载 Ollama 代码模型

ollama pull qwen2.5-coder:7b
ollama pull qwen2.5-coder:1.5b

配置 Continue 扩展

编辑配置文件:~/.continue/config.json
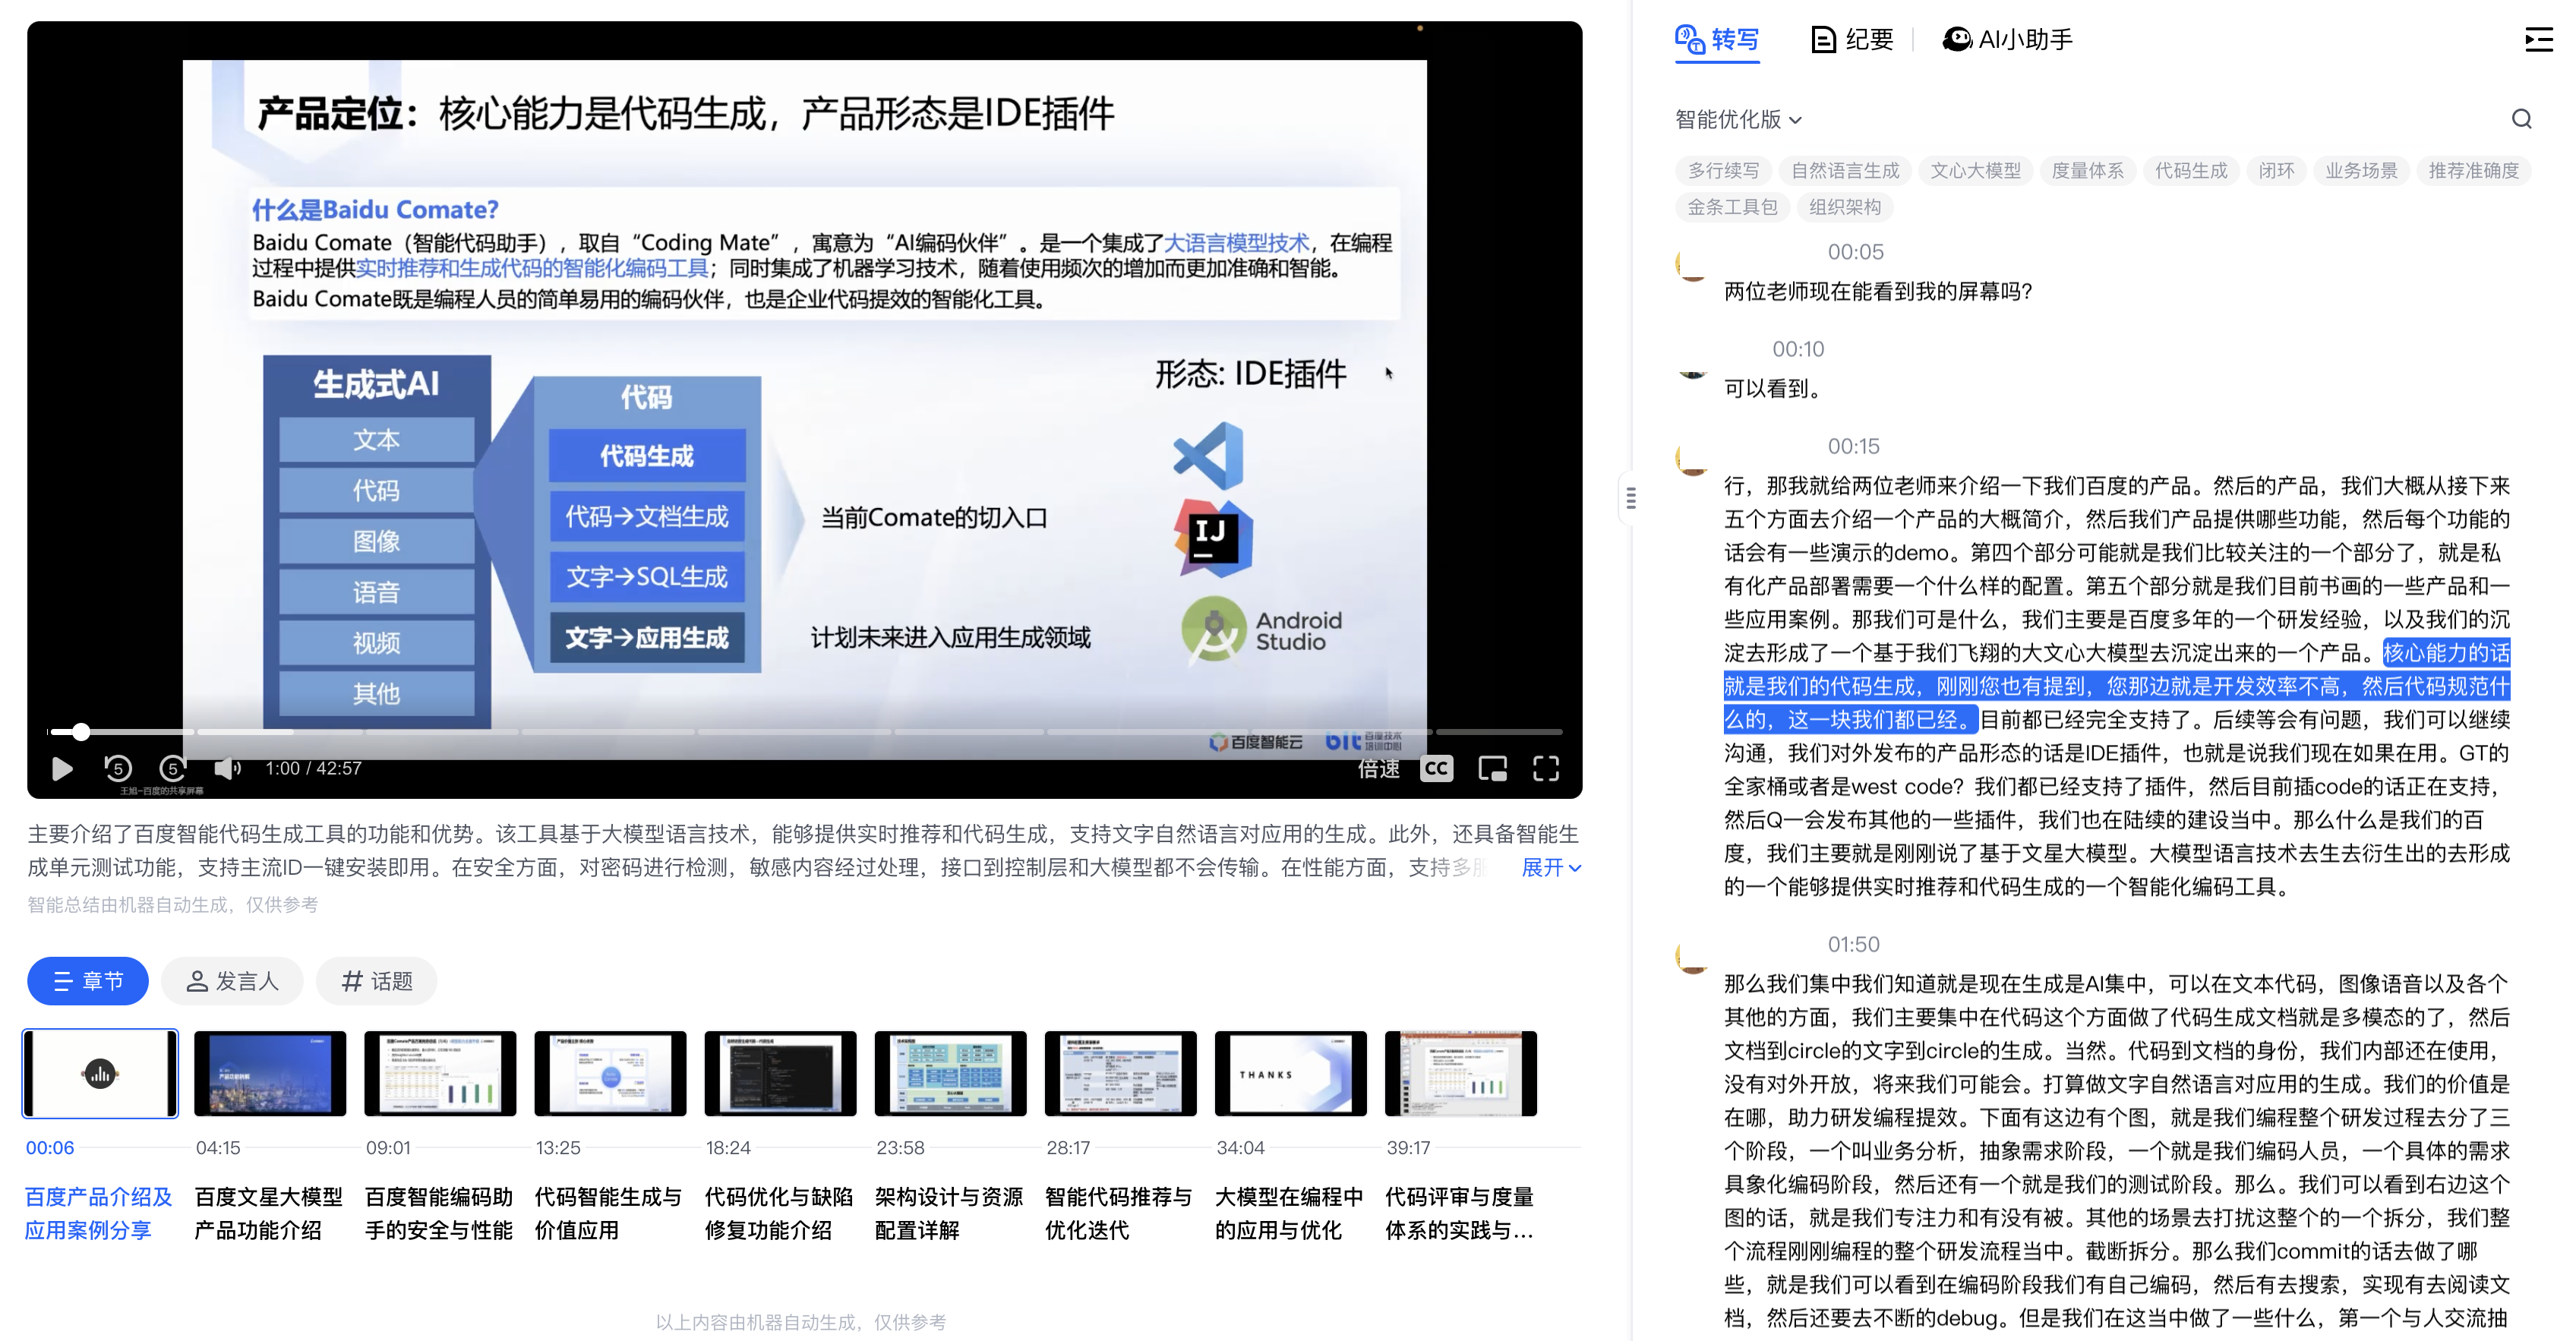
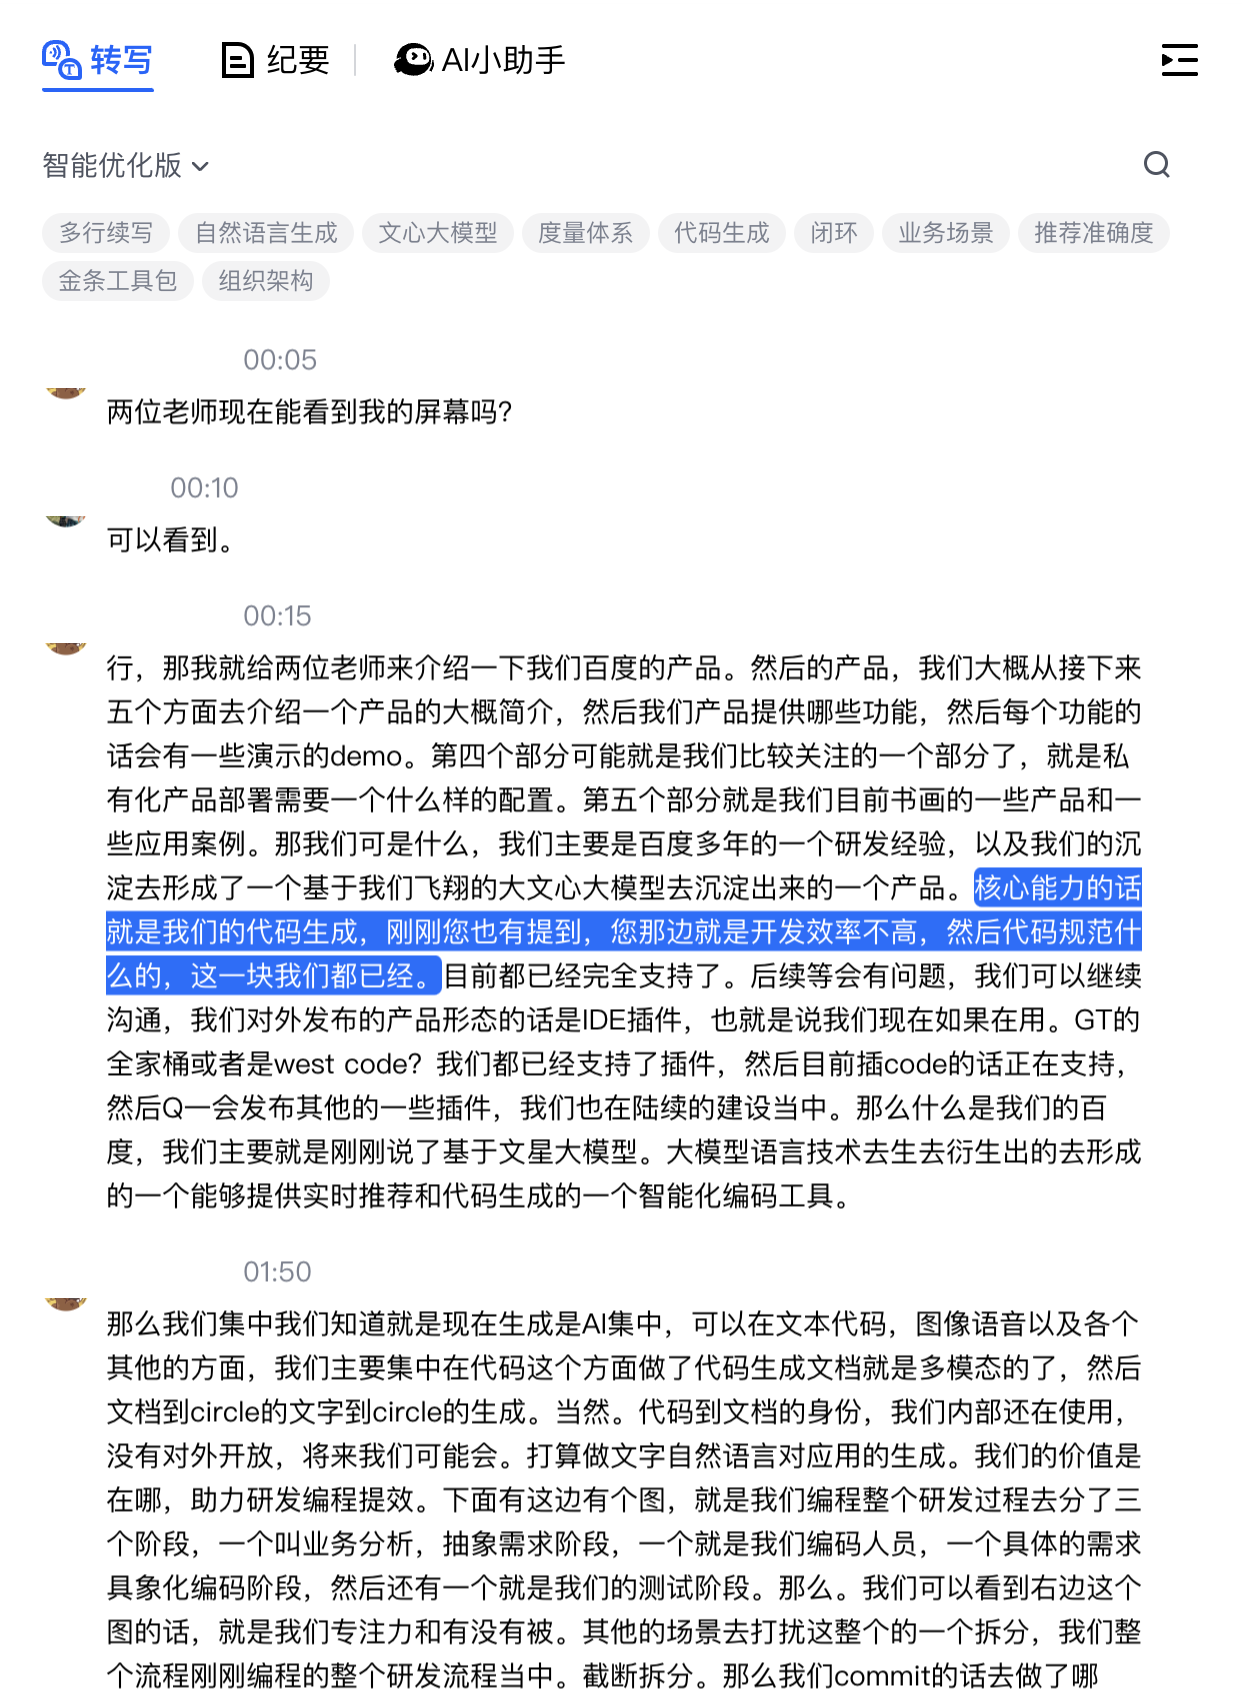
腾讯会议中云录制的 AI+

腾讯会议中云录制应用的核心:

  • 快速定位(章节、发言人、话题)
  • 转写、纪要、总结
  • 内容问答(AI小助手)

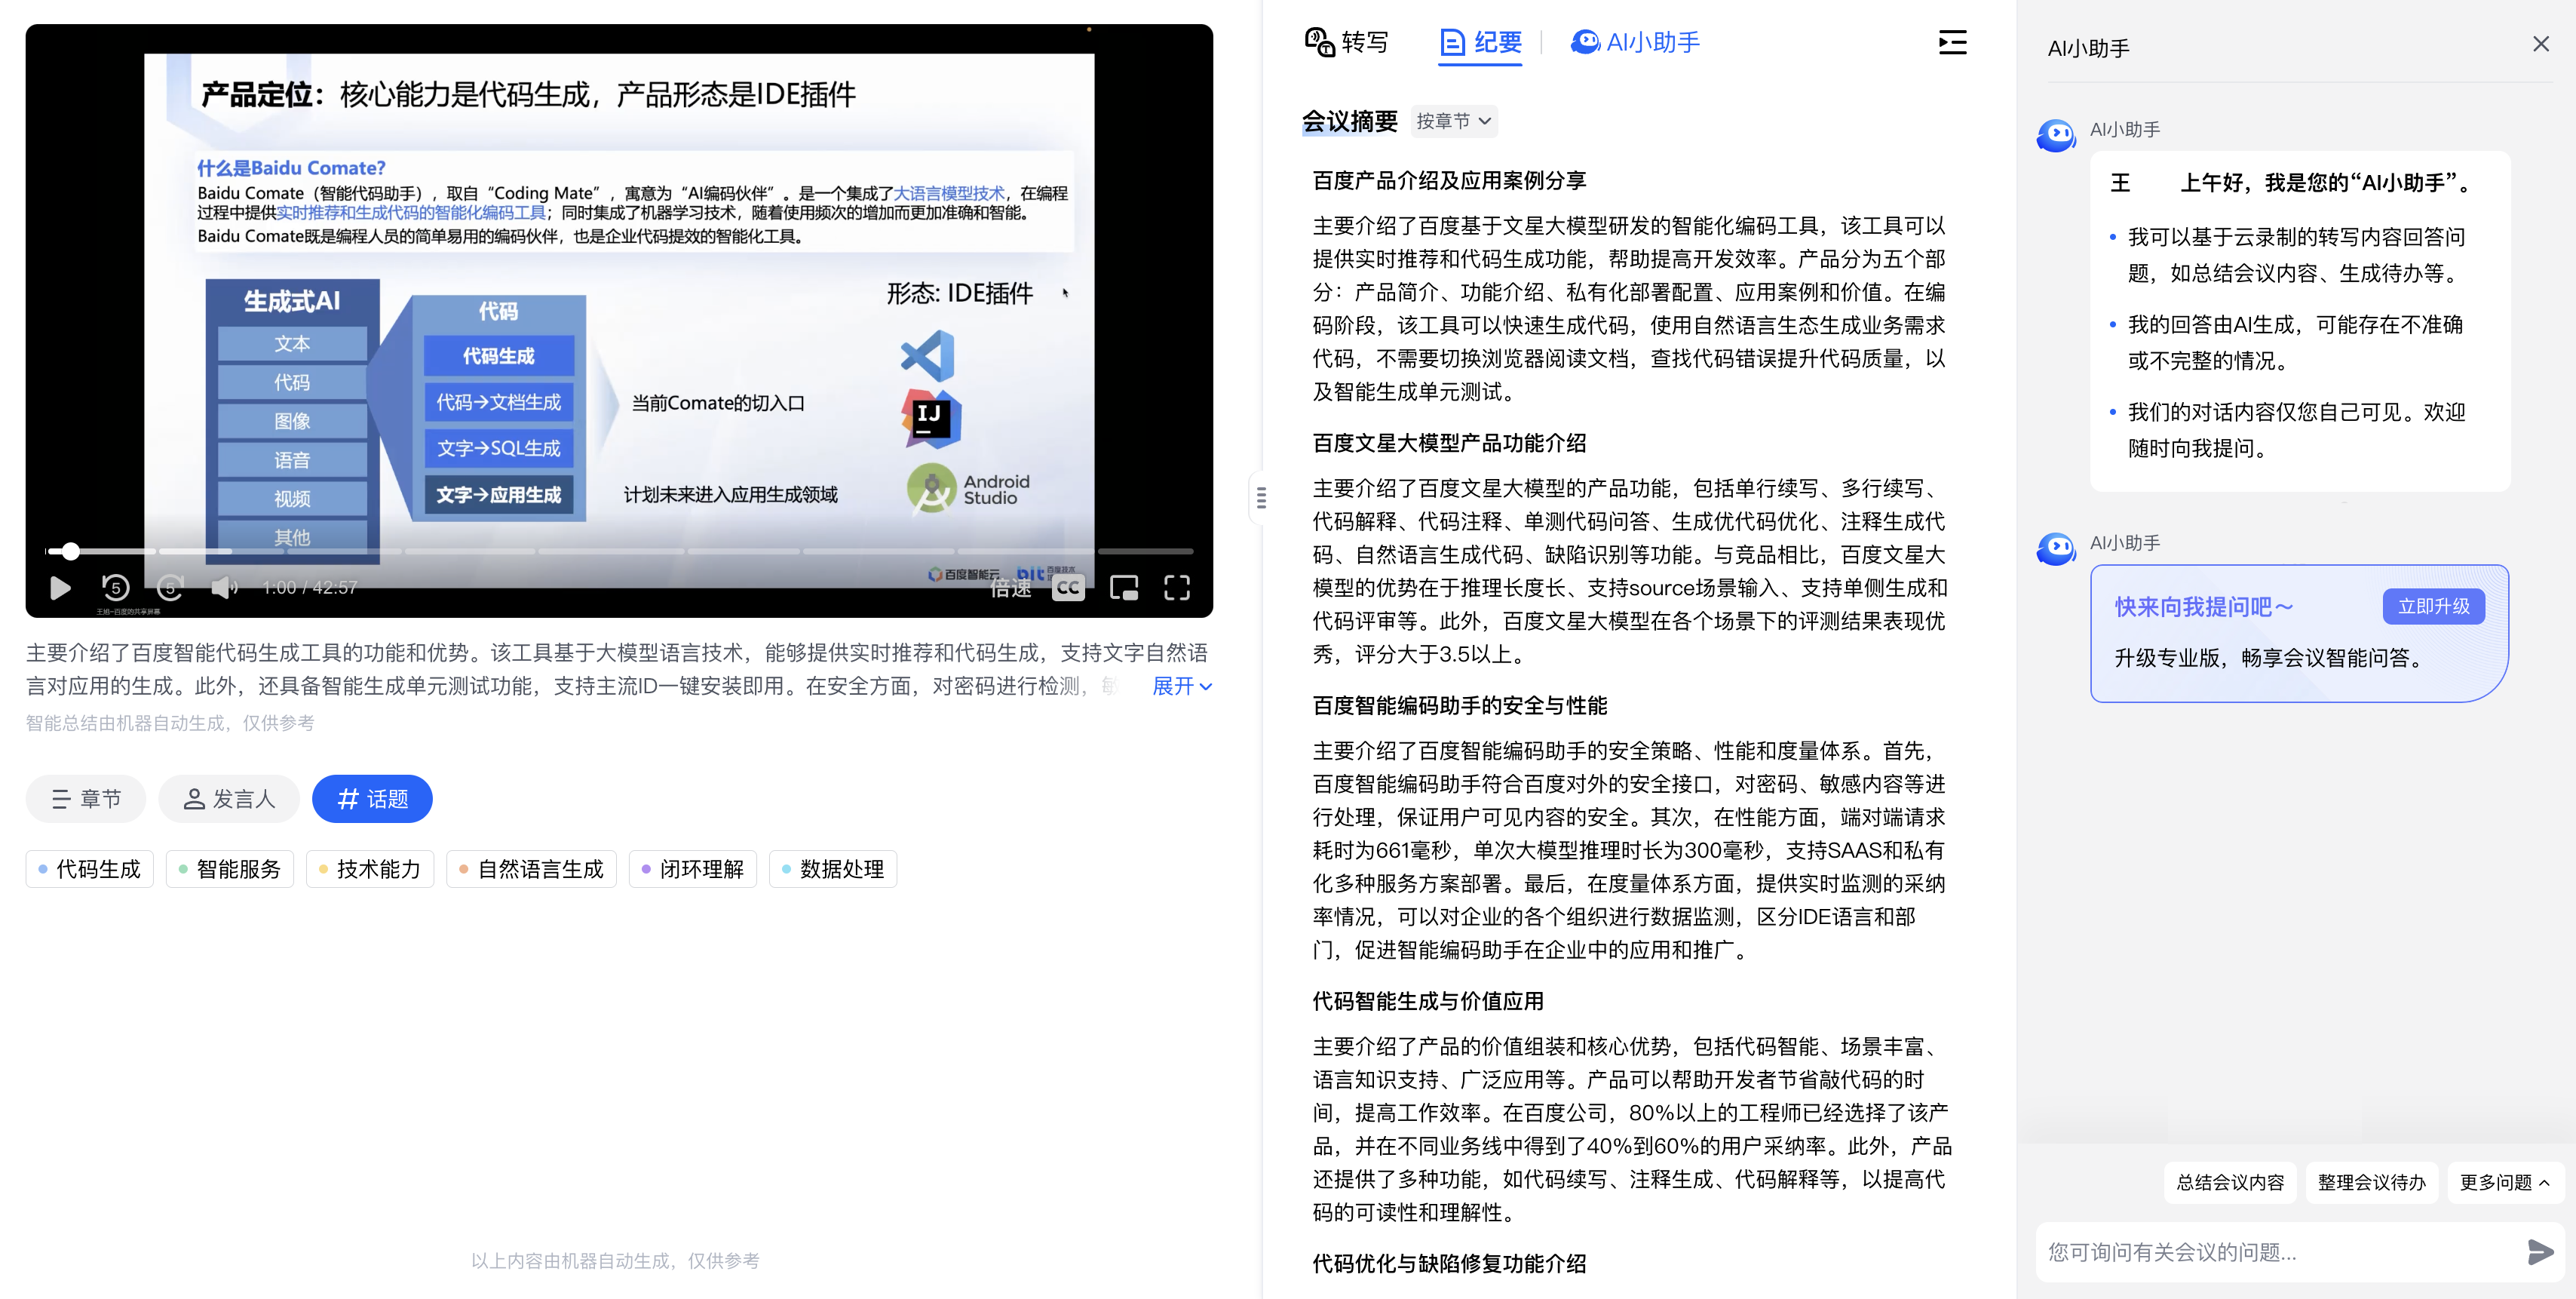
视频的主界面

下方区域

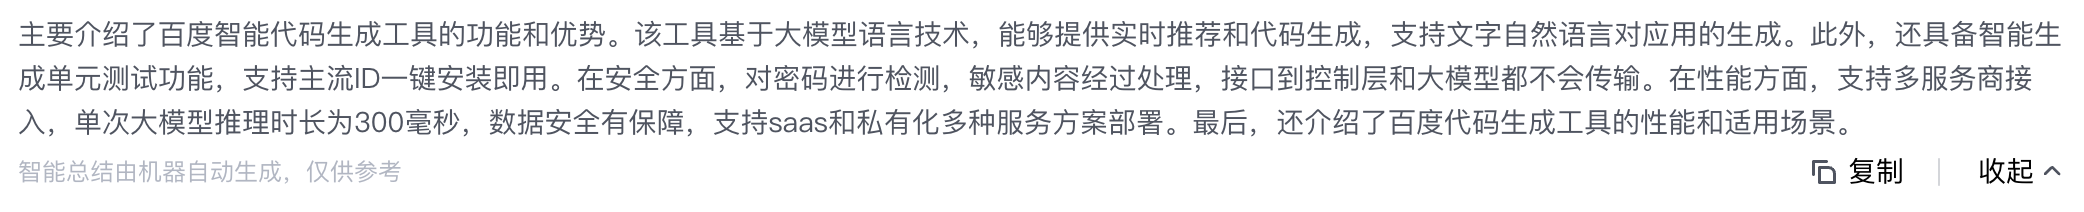
总结

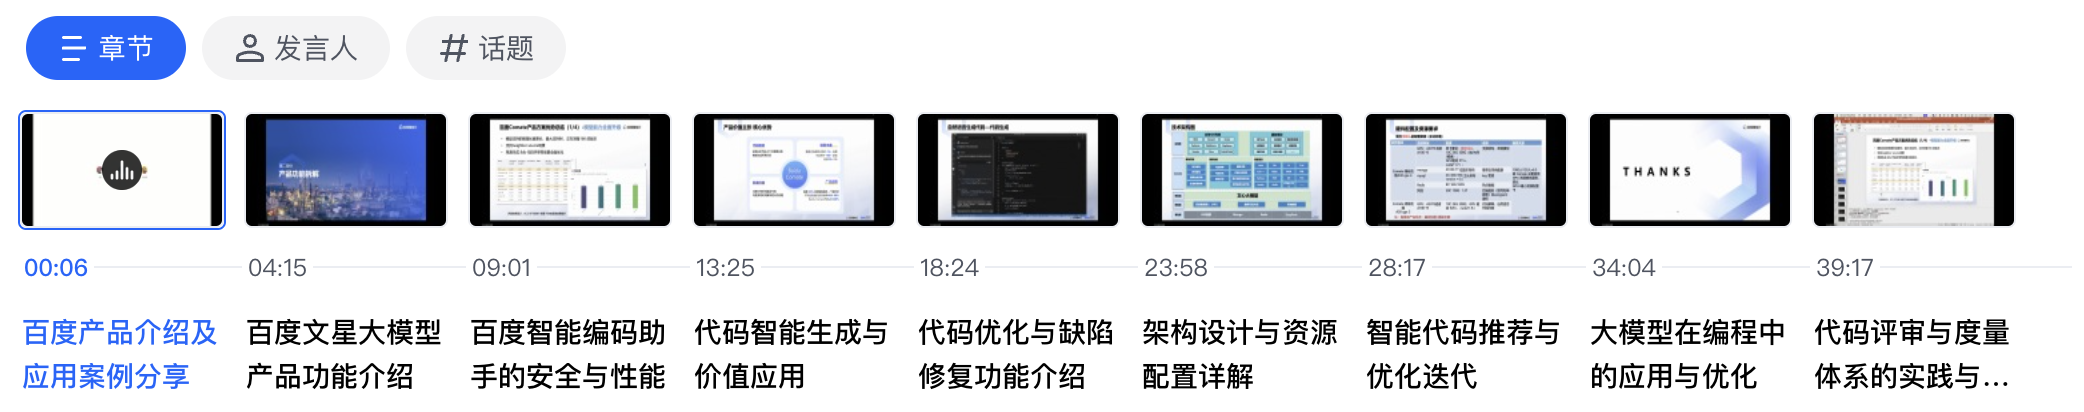
章节

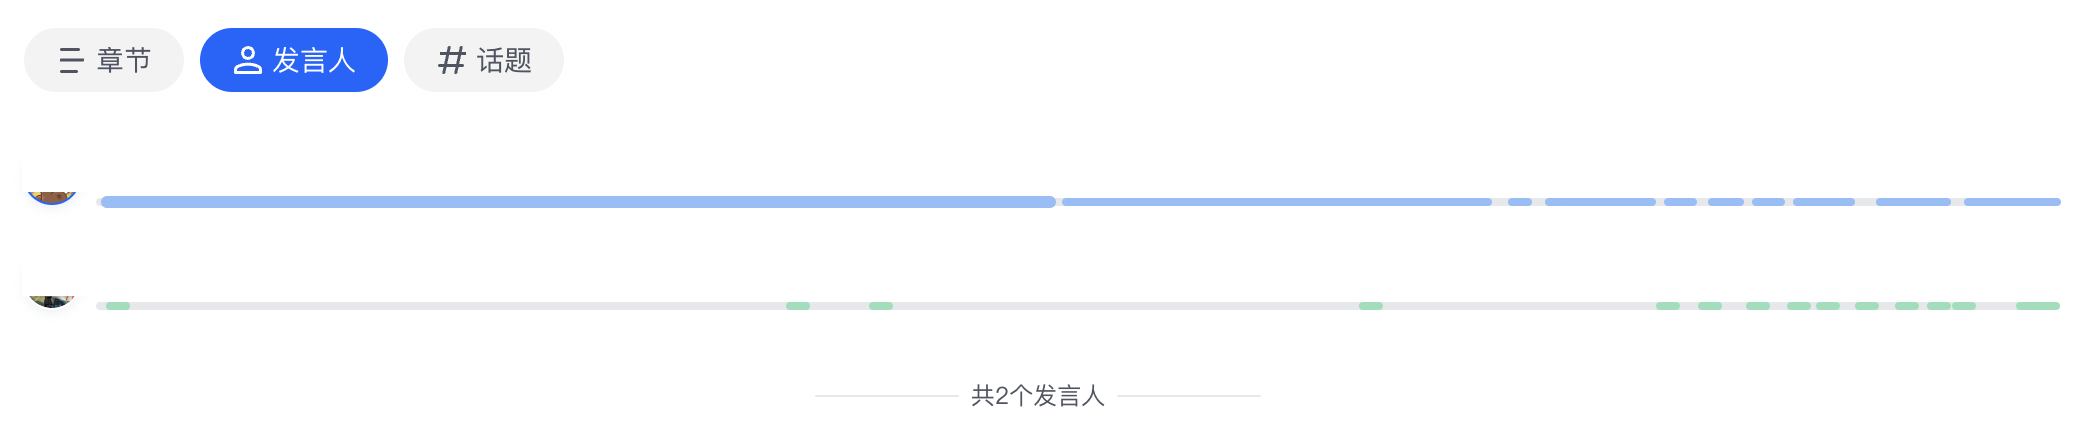
发言人

话题

右侧区域

转写

可以使用句子进行视频定位

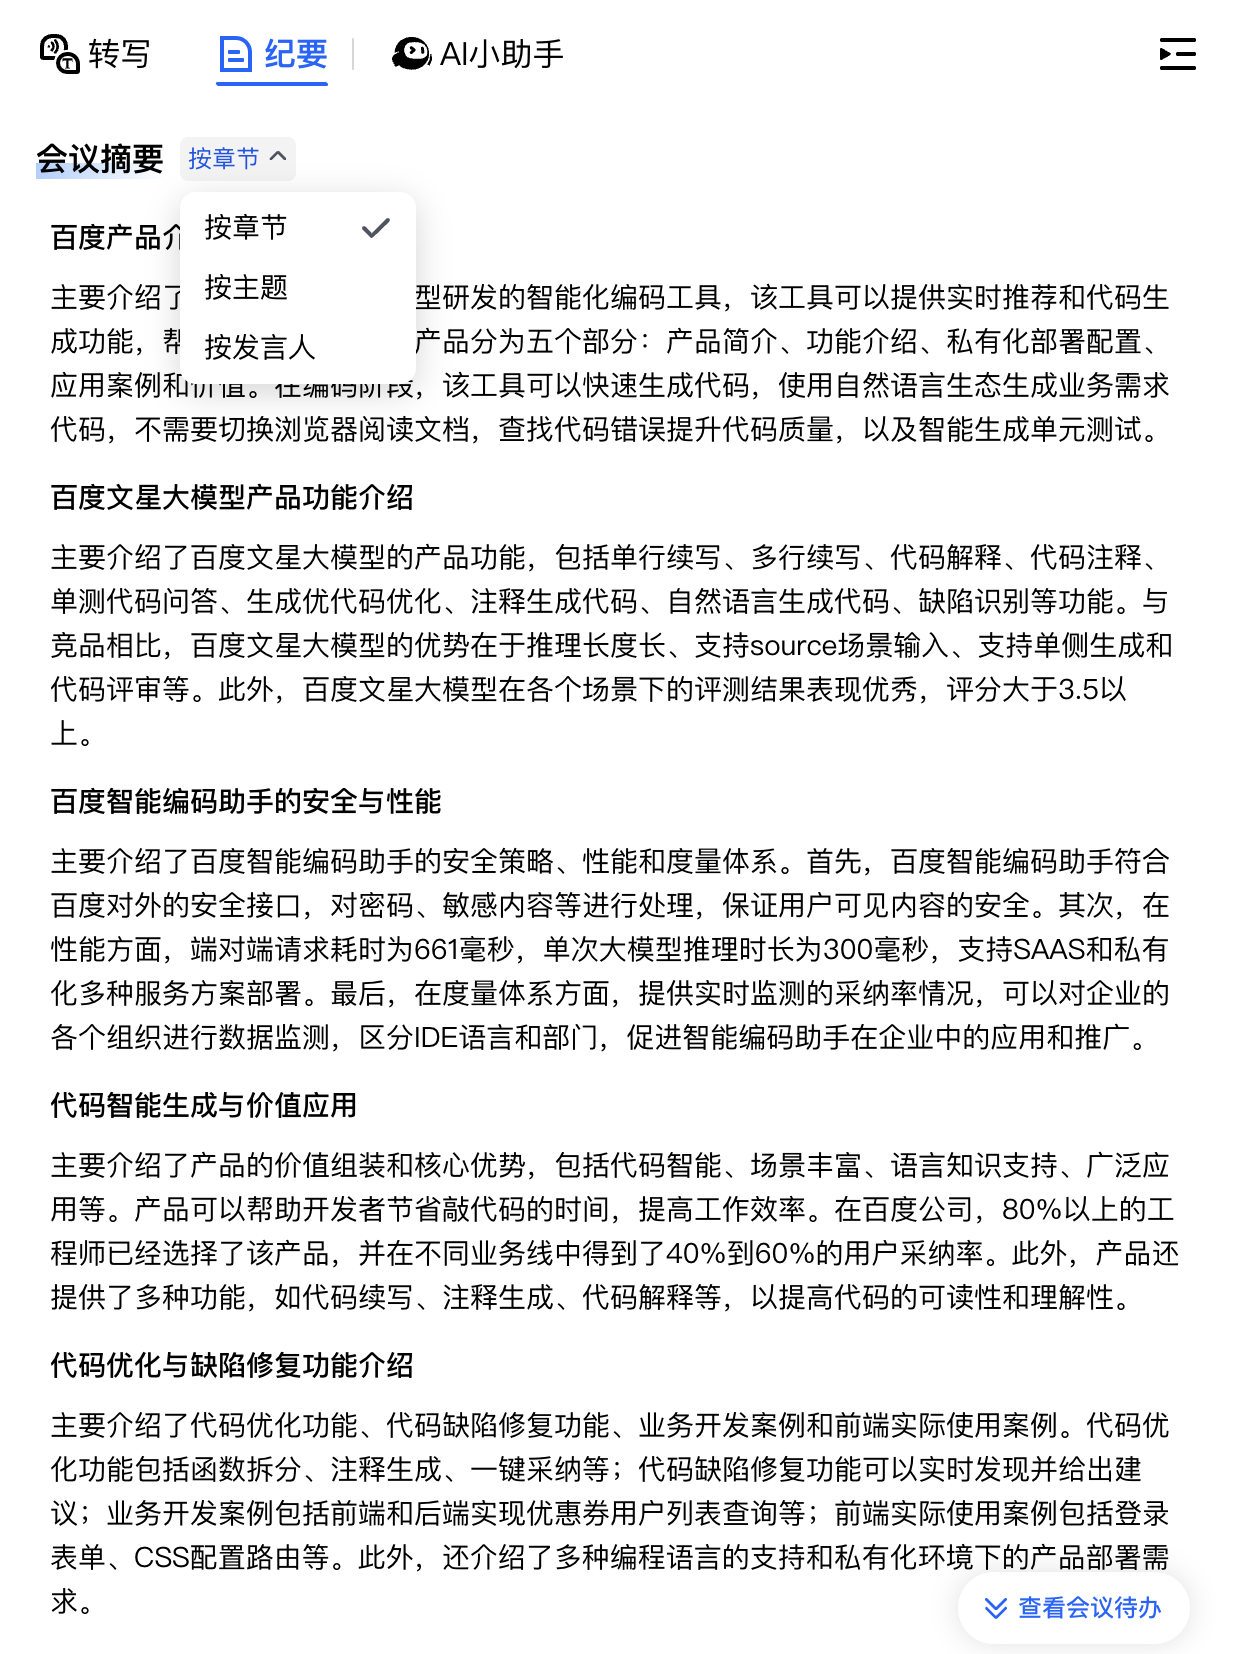
纪要

可以按 章节主题发言人 进行纪要生成。

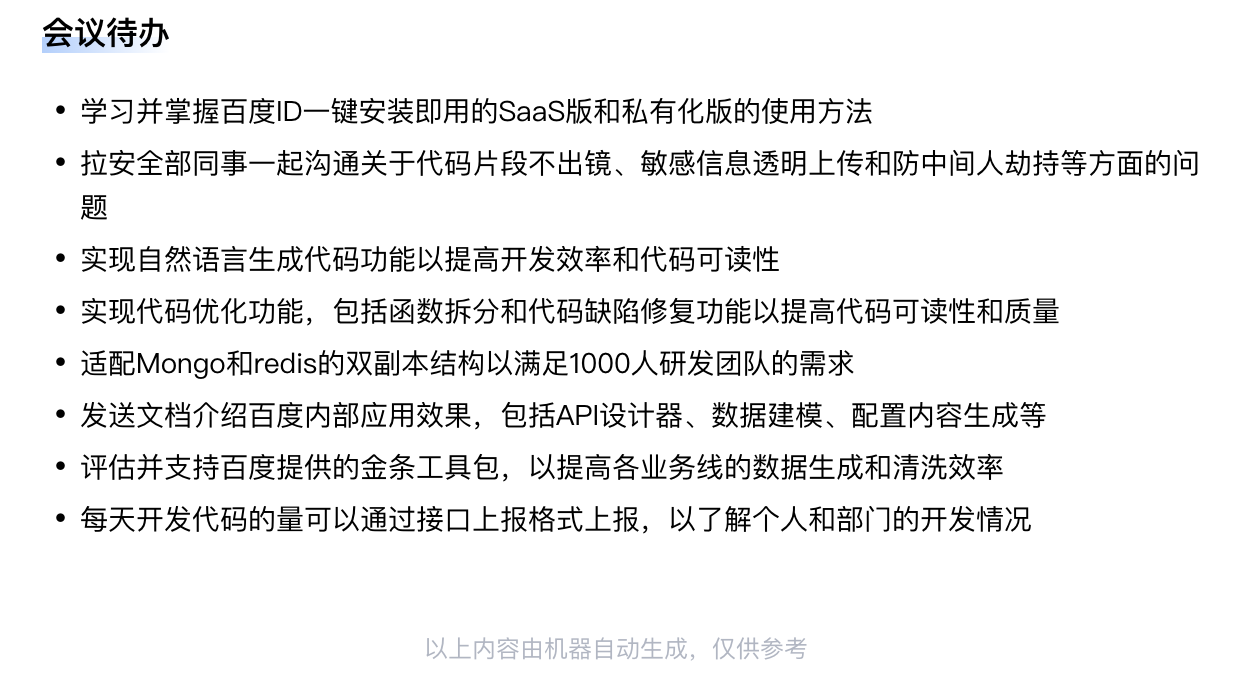
会议待办

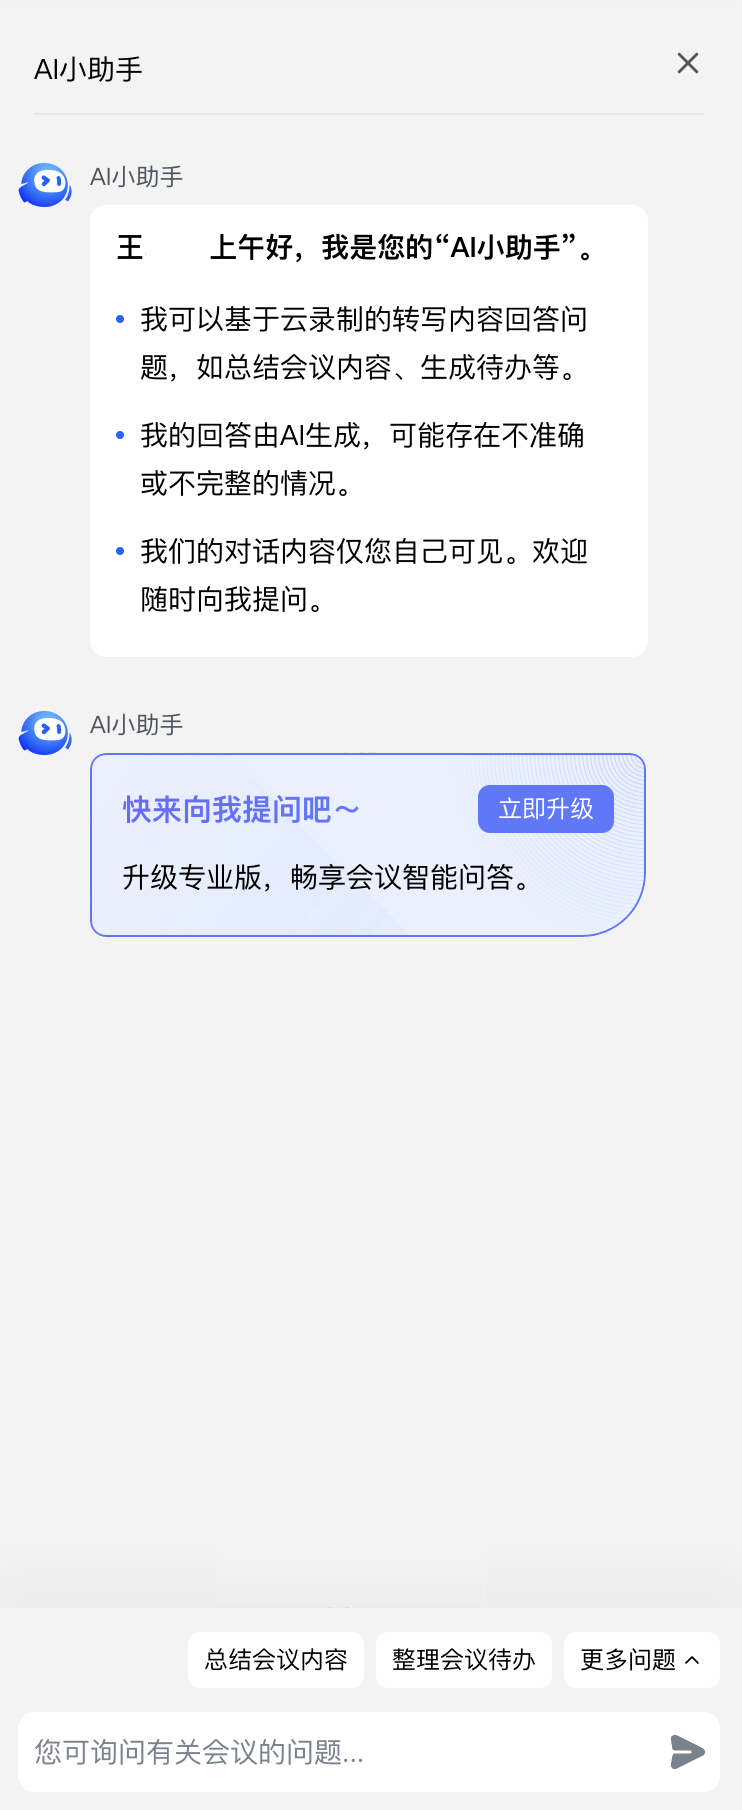
AI小助手

这个AI小助手价格太贵了,可能对于中大型企业用户有一定吸引力,没有多少录制视频的用户基本不用考虑,上面的功能已经足够了。

这个营销太差了,这么高的价格也不给人试用,上来就收费,打击用户积极性。

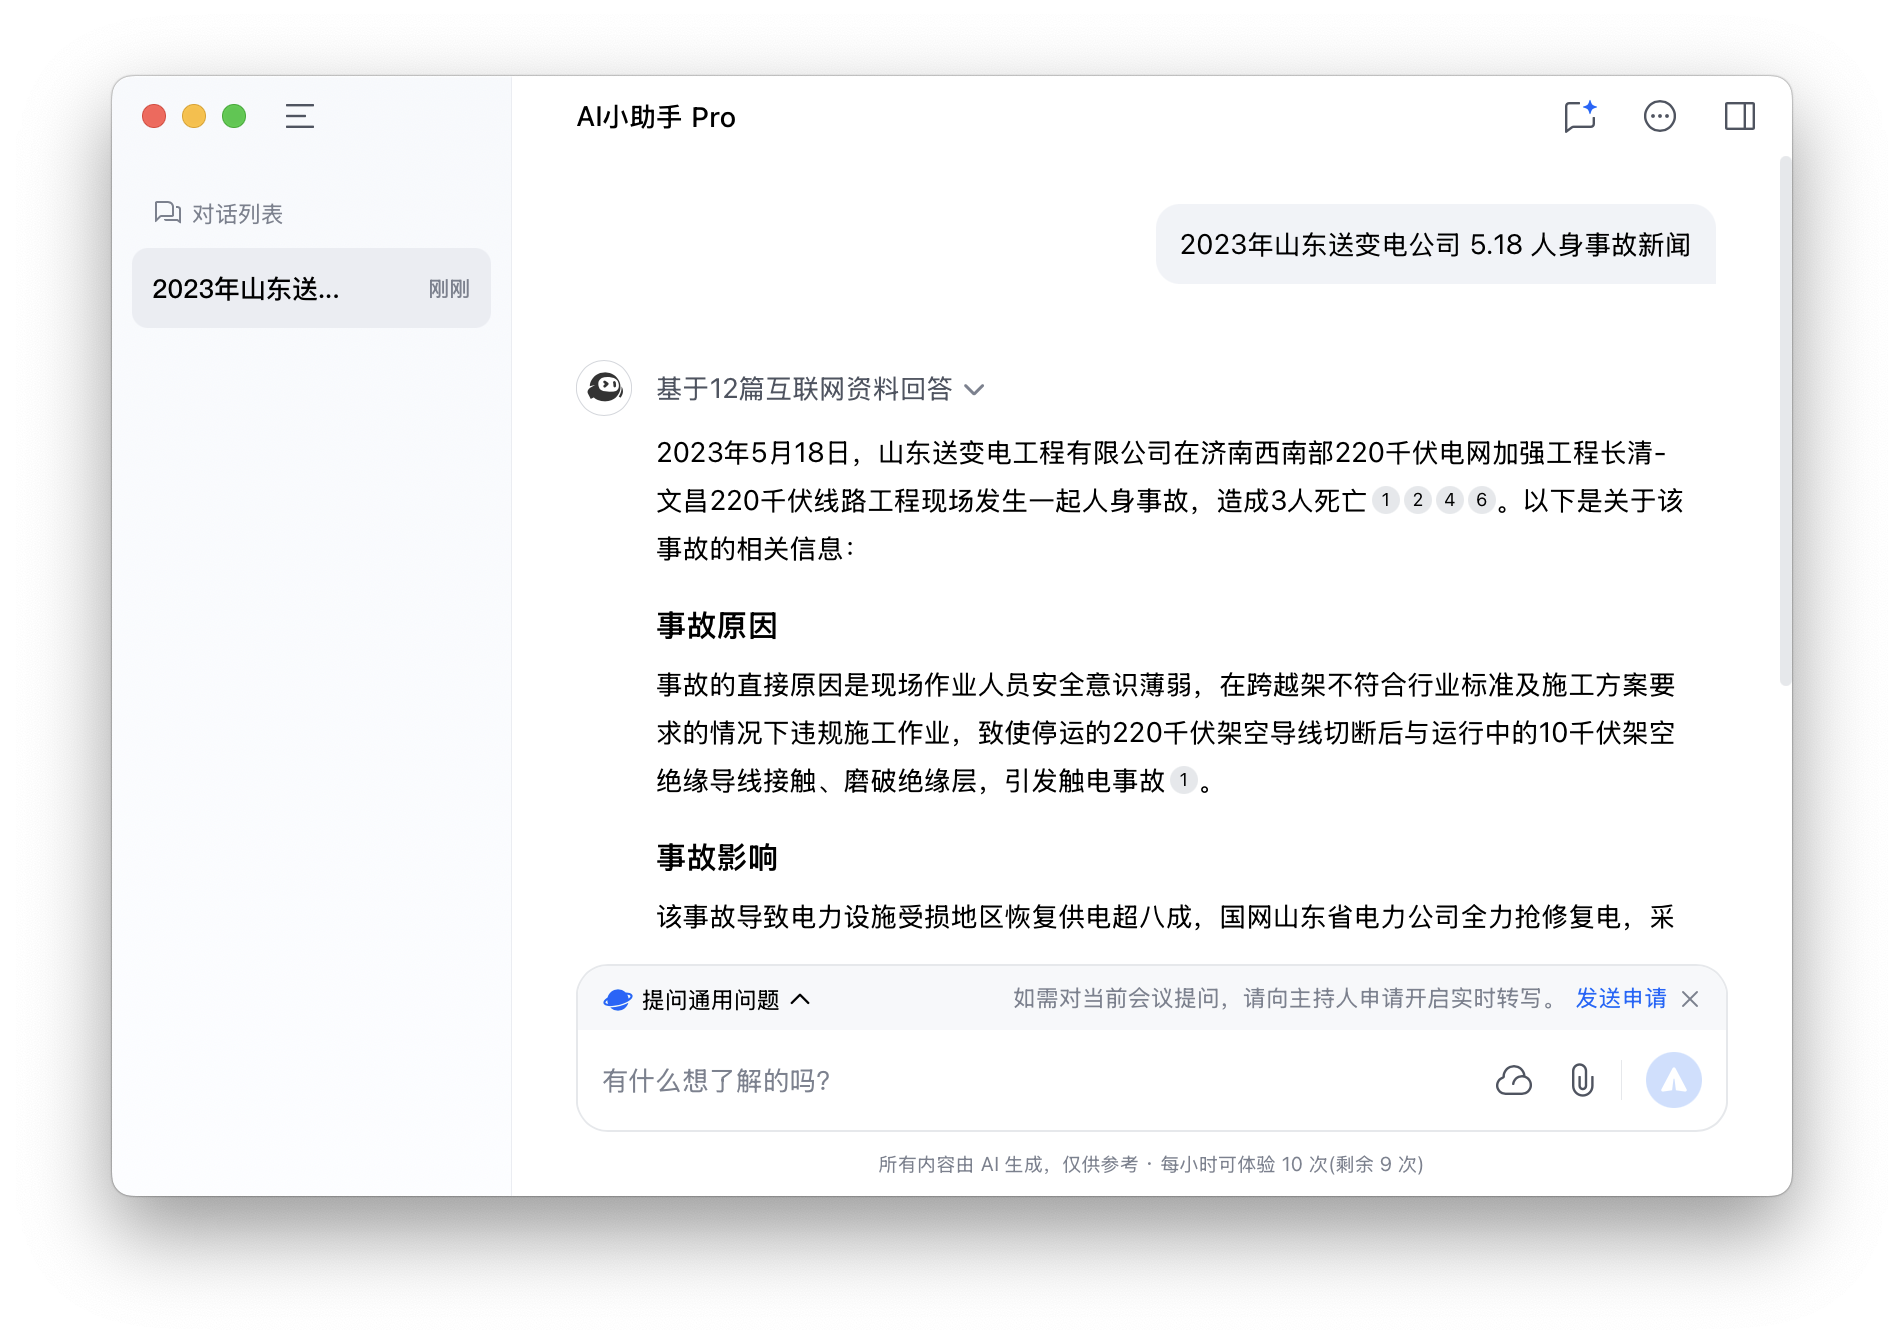
下面是AI会议中提供的AI小助手

如何投资个人养老金

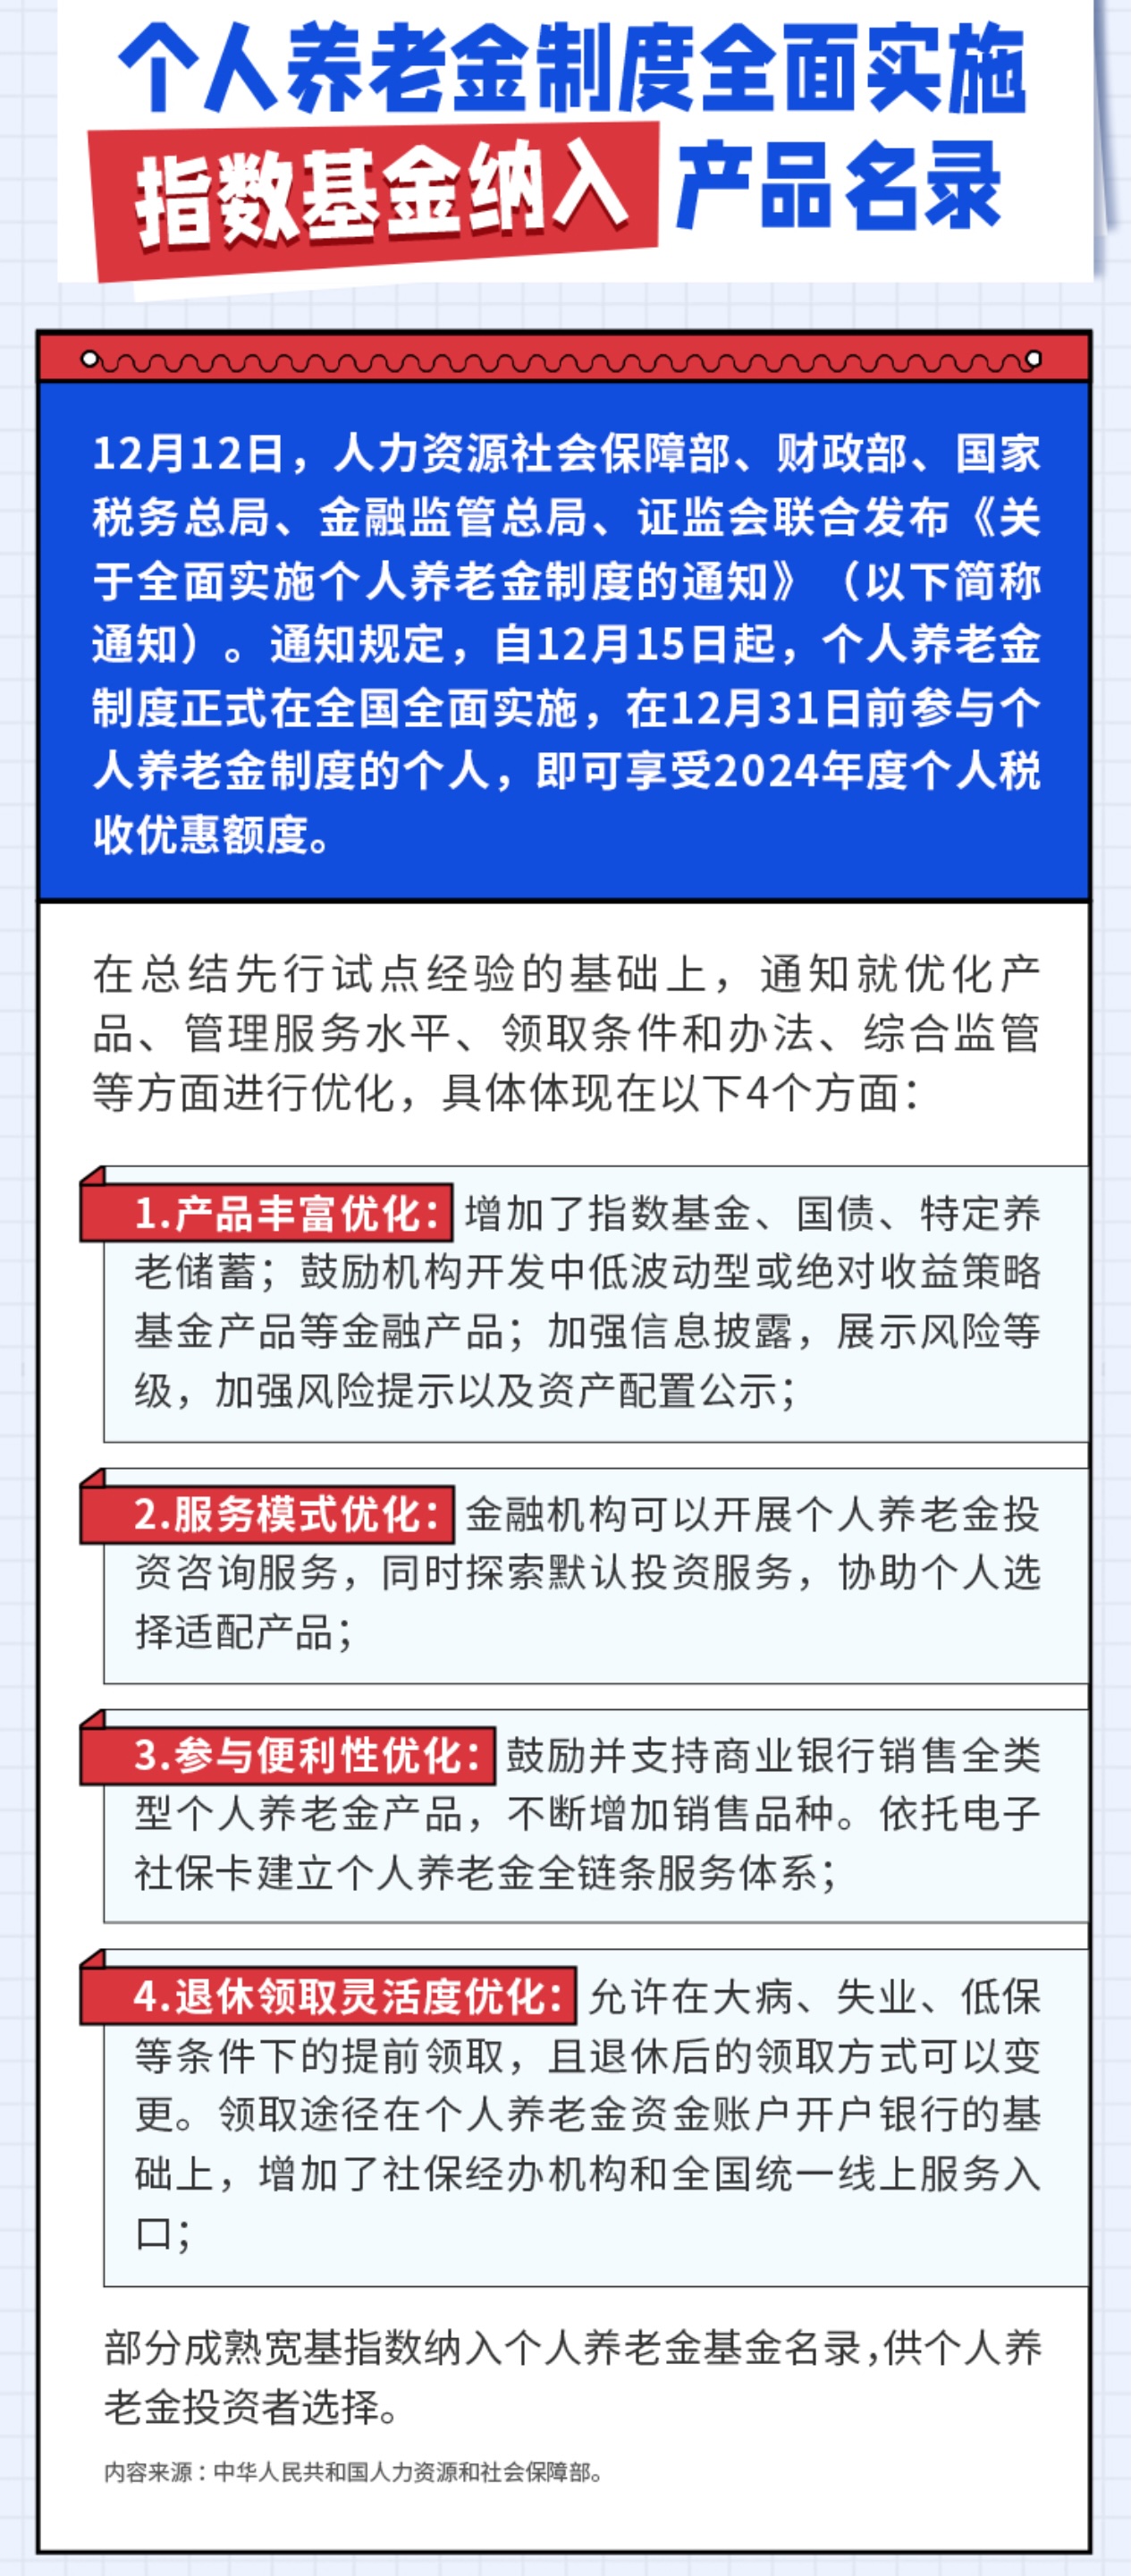
2024年12月15日,个人养老金制度正式在全国全面实施。这里记录一下如何投资个人养老金。

个人养老金

个人养老金制度全面实施

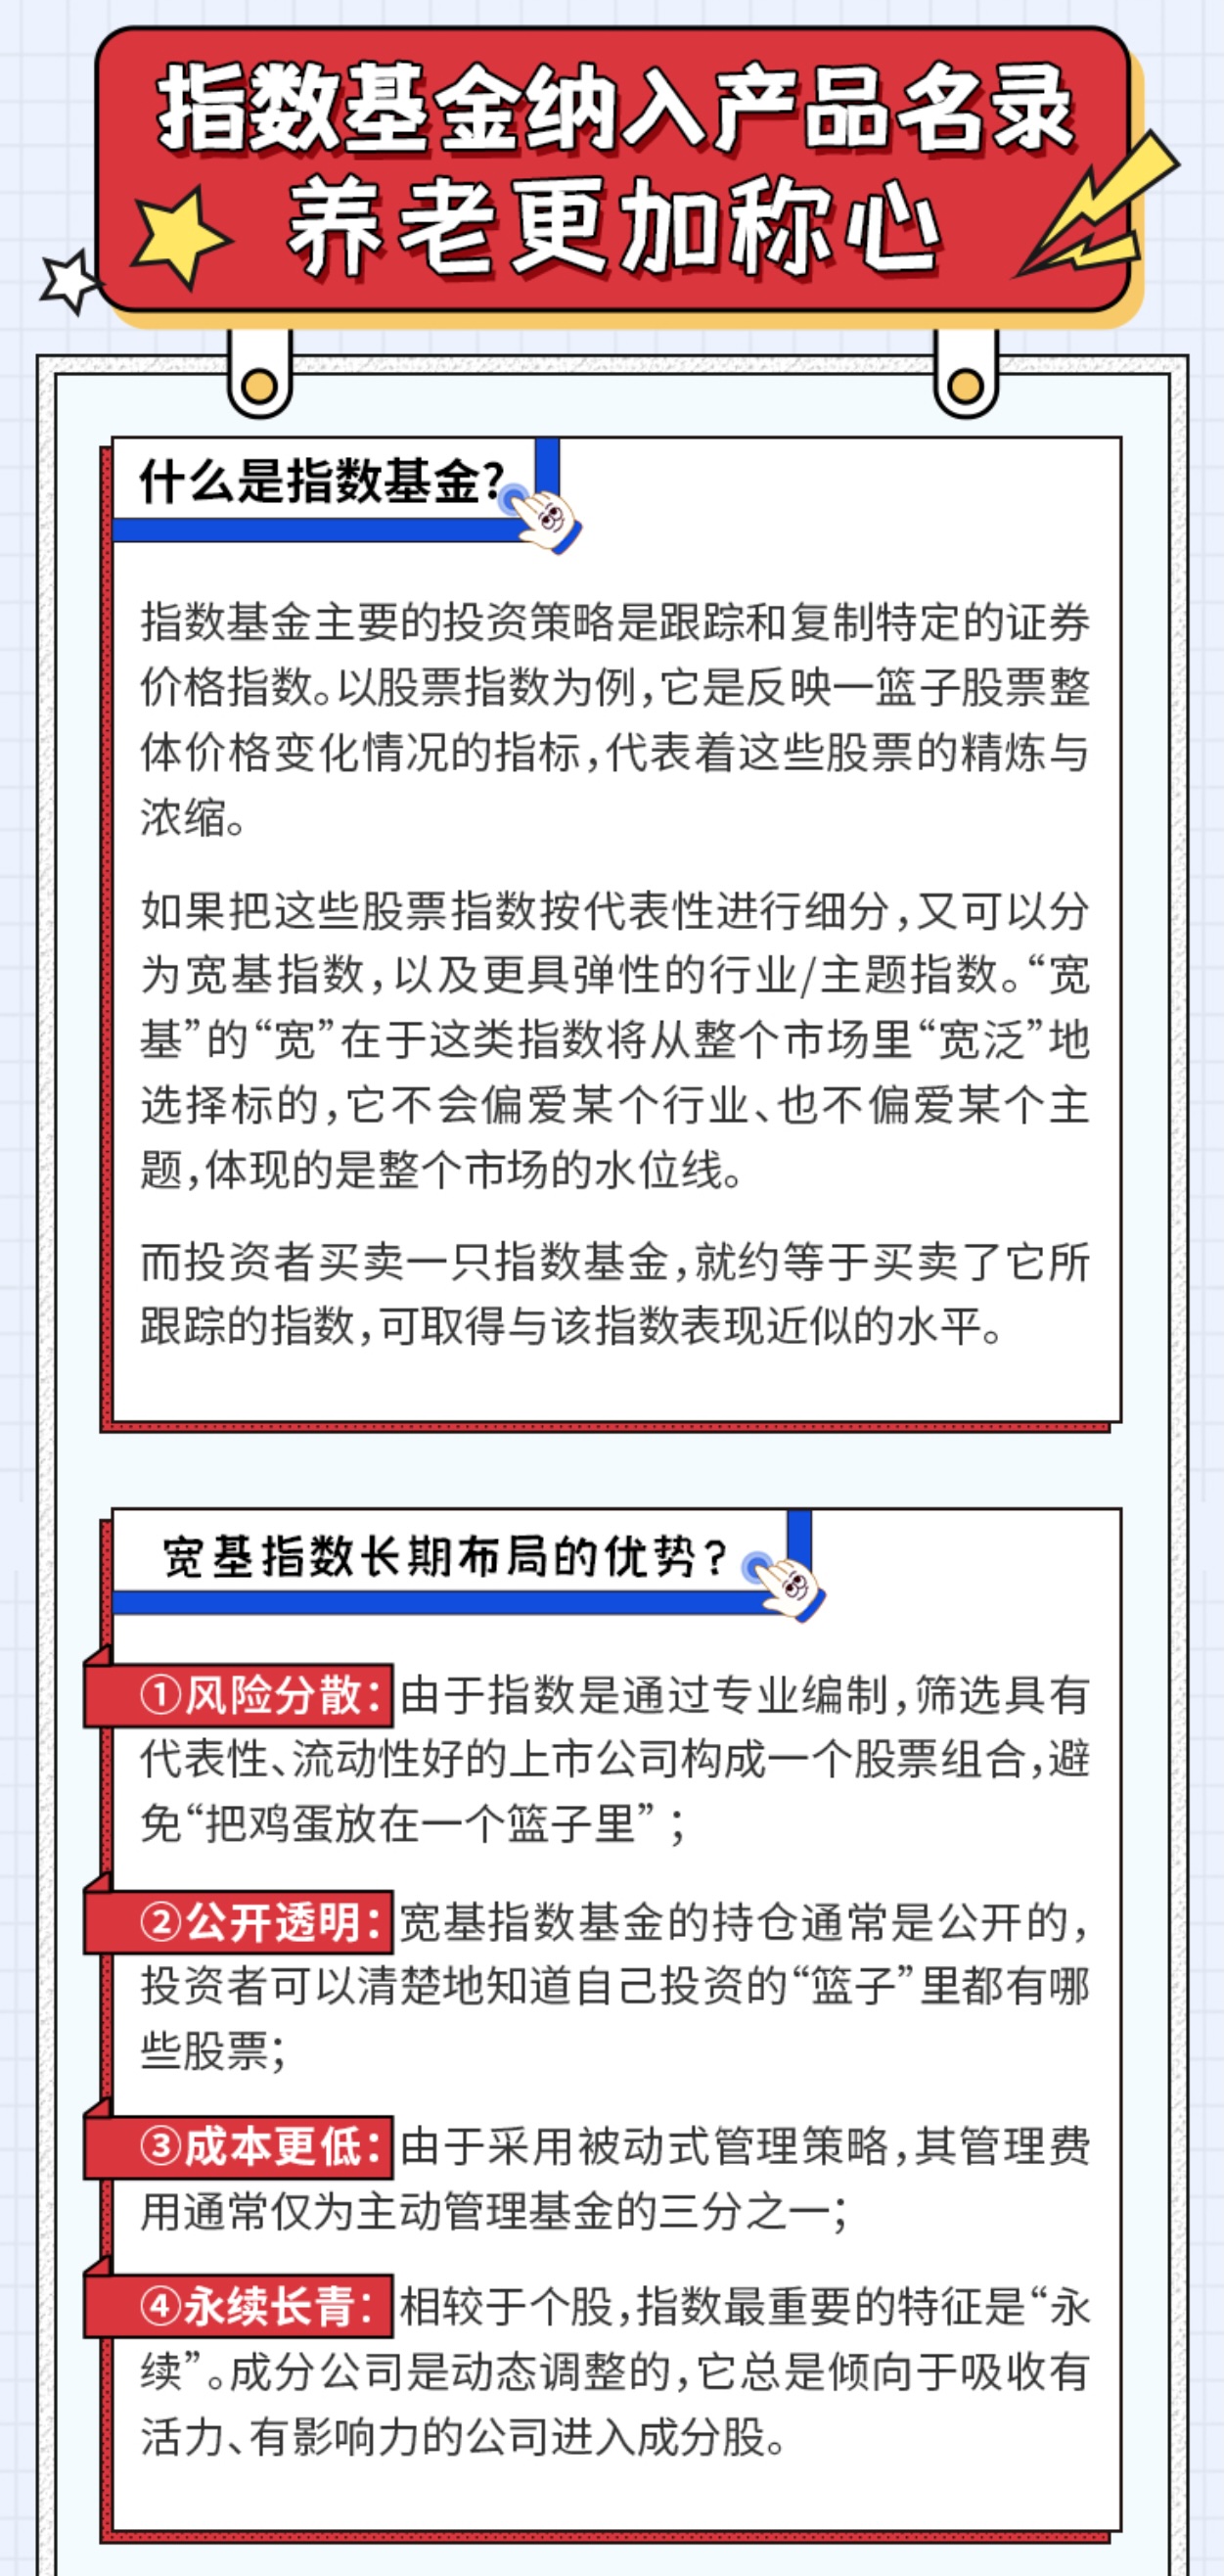
指数基金

什么是个人养老金

基金数据

2024年 第三季度 基金管理机构非货币理财公募基金月均规模排名

排名 公募基金管理人名称 非货币理财公募基金 月均规模(亿元) 排名 公募基金管理人名称 非货币理财公募基金 月均规模(亿元)
1 易方达基金管理有限公司 12307 11 鹏华基金管理有限公司 4225
2 华夏基金管理有限公司 10557 12 景顺长城基金管理有限公司 3881
3 广发基金管理有限公司 7887 13 工银瑞信基金管理有限公司 3695
4 嘉实基金管理有限公司 6598 14 国泰基金管理有限公司 3437
5 富国基金管理有限公司 6105 15 天弘基金管理有限公司 3431
6 南方基金管理股份有限公司 5945 16 华安基金管理有限公司 3419
7 博时基金管理有限公司 5677 17 永赢基金管理有限公司 3202
8 招商基金管理有限公司 5504 18 中银基金管理有限公司 3135
9 华泰柏瑞基金管理有限公司 4878 19 中欧基金管理有限公司 2869
10 汇添富基金管理股份有限公司 4796 20 兴证全球基金管理有限公司 2648

剔除了短期理财债券基金规模和基金中基金持有的自身管理的基

Open WebUI

下载镜像

docker pull ghcr.io/open-webui/open-webui:main

运行

Docker Compose (Ollama)

编写配置文件:docker-compose.yml

version: '3'
services:
  openwebui:
    image: ghcr.io/open-webui/open-webui:main
    extra_hosts:
      - host.docker.internal:host-gateway    
    ports:
      - "3000:8080"
    volumes:
      - open-webui:/app/backend/data
volumes:
  open-webui:
docker compose up

Docker (OpenAI API)

vscode-extension-samples/chat-sample 源码分析

运行 Chat Sample

克隆仓库

git clone https://github.com/microsoft/vscode-extension-samples

安装依赖

cd vscode-extension-samples/chat-sample
npm install

调试

在 Debug View 中运行 Run Extension

Chat Sample 源码分析

扩展入口

文件:src/extension.ts

export function activate(context: vscode.ExtensionContext) {
    registerSimpleParticipant(context);
    registerToolUserChatParticipant(context);
    registerChatLibChatParticipant(context);

    registerChatTools(context);
}

注册参与者

文件:src/simple.ts

export function registerSimpleParticipant(context: vscode.ExtensionContext) {

}

Language Model API

The Language Model API enables you to use the Language Model and integrate AI-powered features and natural language processing in your Visual Studio Code extension.

语言模型 API 可以让您使用语言模型,并在您的 Visual Studio Code 扩展中集成 AI 功能和自然语言处理。

You can use the Language Model API in different types of extensions. A typical use for this API is in chat extensions, where you use a language model to interpret the user's request and help provide an answer. However, the use of the Language Model API is not limited to this scenario.

Chat Extensions (VS Code)

聊天用户体验的组成部分

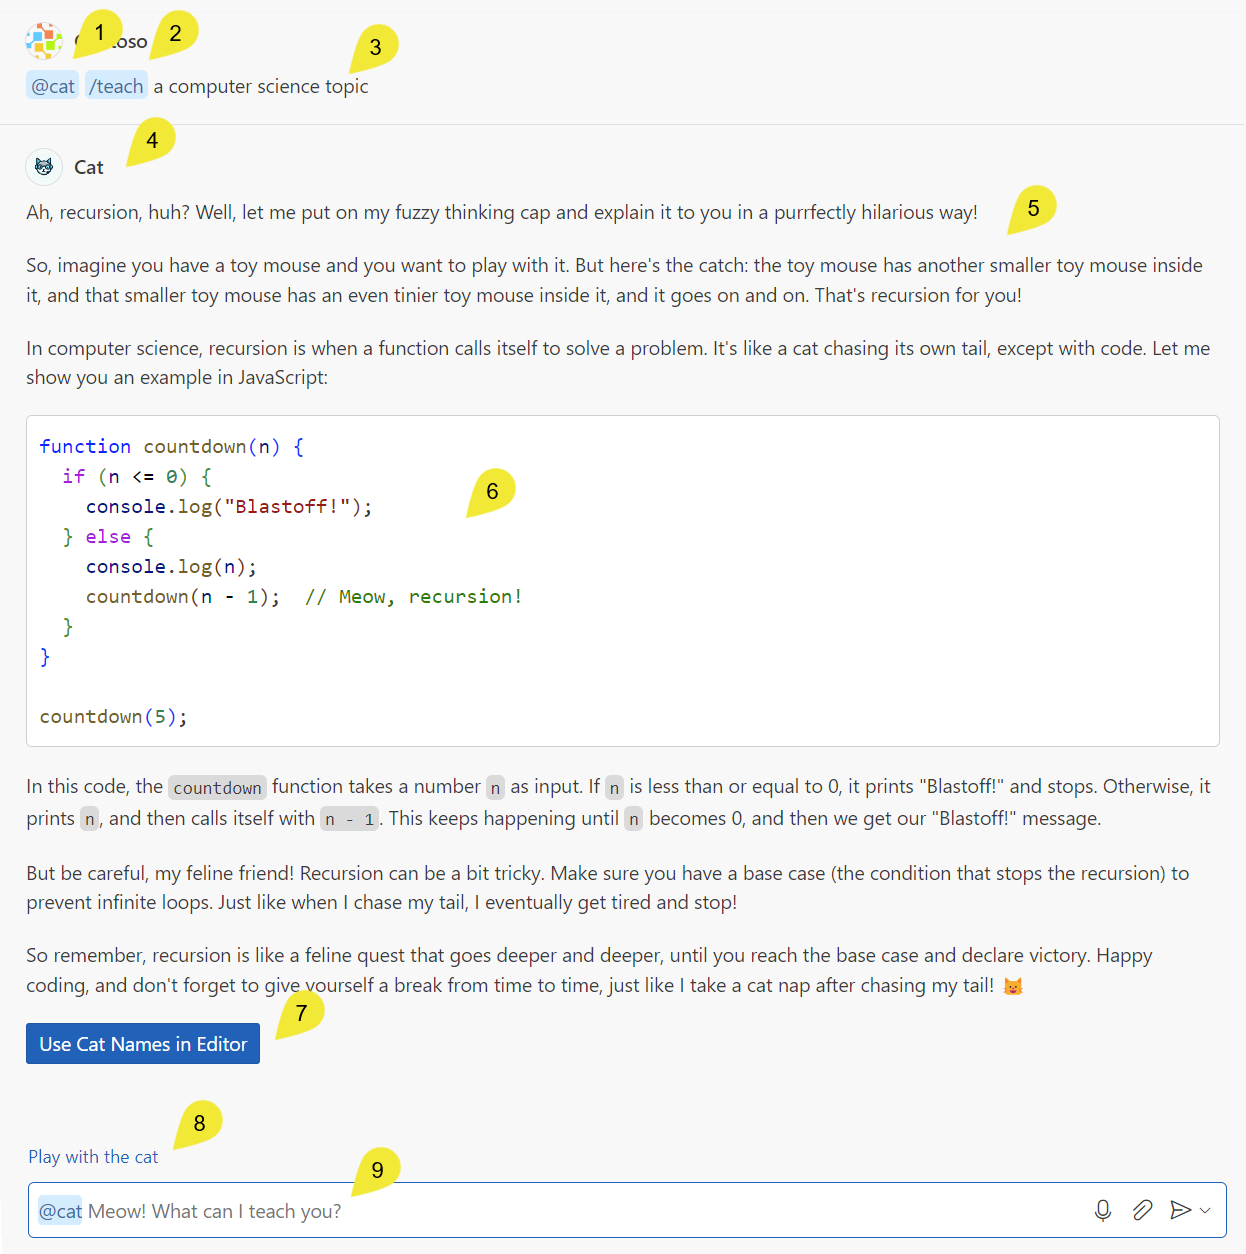
下面的截图显示了示例扩展中 Visual Studio Code 聊天体验中的不同聊天概念。

  1. 使用 @ 语法调用 @cat 聊天参与者
  2. 使用 / 语法调用 /teach 命令
  3. 用户提供的查询,也称为用户提示
  4. 图标和参与者的 fullName,表示 Copilot 正在使用 @cat 聊天参与者
  5. @cat 提供的 Markdown 响应
  6. 包含在 Markdown 响应中的代码片段
  7. 包含在 @cat 响应中的按钮,按钮调用 VS Code 命令
  8. 聊天参与者提供的建议后续问题
  9. 聊天输入字段,其中的占位文本由聊天参与者的 description 属性提供

开发聊天扩展(chat extension)

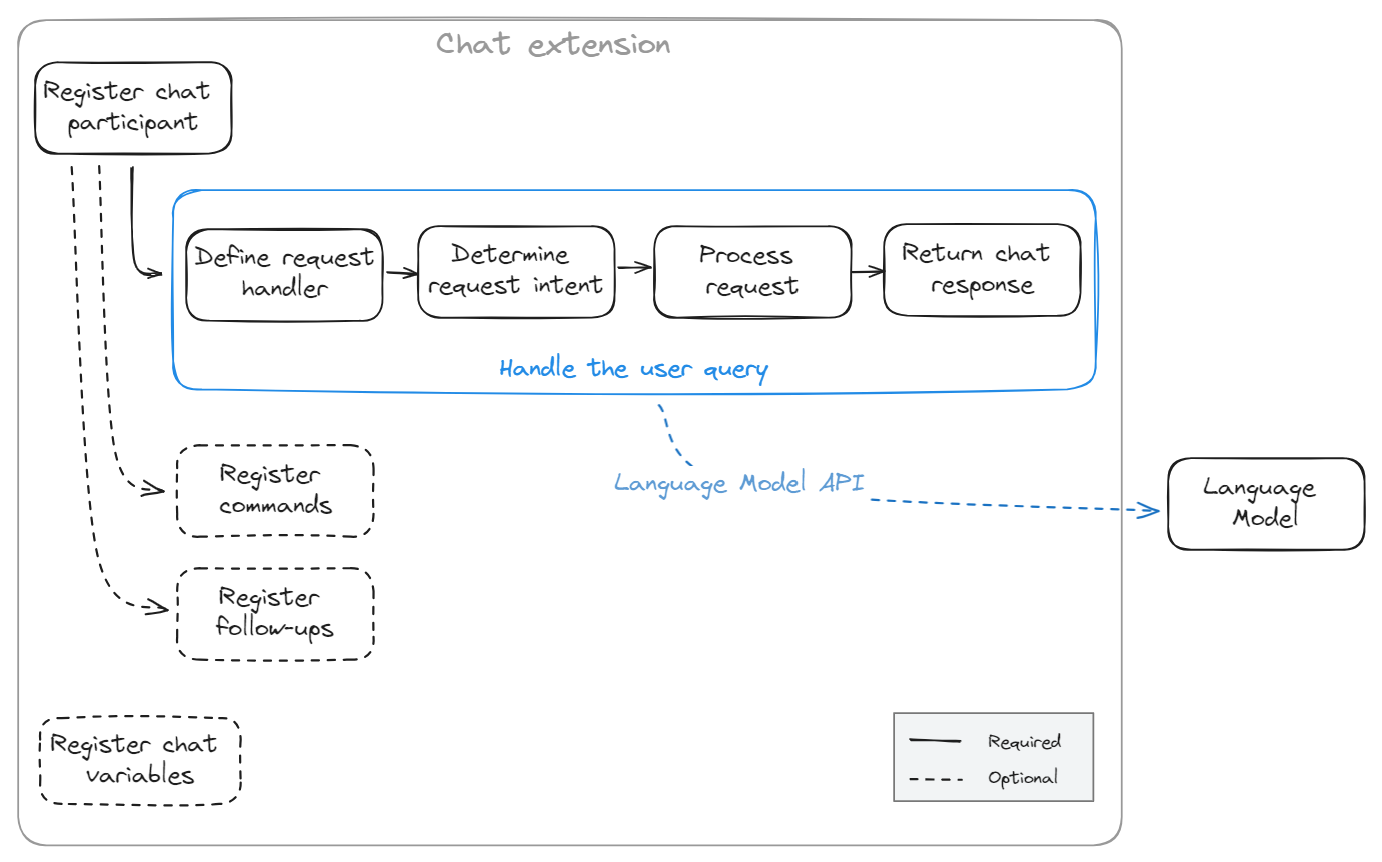
聊天扩展是一种扩展,它向 Chat 视图提供了一个聊天参与者。

实现聊天扩展所需的最小功能是:

  • 注册聊天参与者,让用户可以在 VS Code Chat 视图中使用 @ 符号调用它。
  • 定义一个请求处理程序,解释用户的问题,并在 Chat 视图中返回响应。

您可以使用以下可选功能进一步扩展聊天扩展的功能:

  • 注册聊天命令,为用户提供常见问题的简写符号
  • 定义建议的后续问题,帮助用户继续对话

作为开发聊天扩展的起点,您可以参考我们的 chat extension sample。此示例实现了一个简单的猫导师,可以使用猫隐喻解释计算机科学主题。

GitHub Copilot in VS Code

GitHub Copilot

GitHub Copilot 你的 AI 编程伙伴,助你更快、更智能地编写代码。

UI 设计

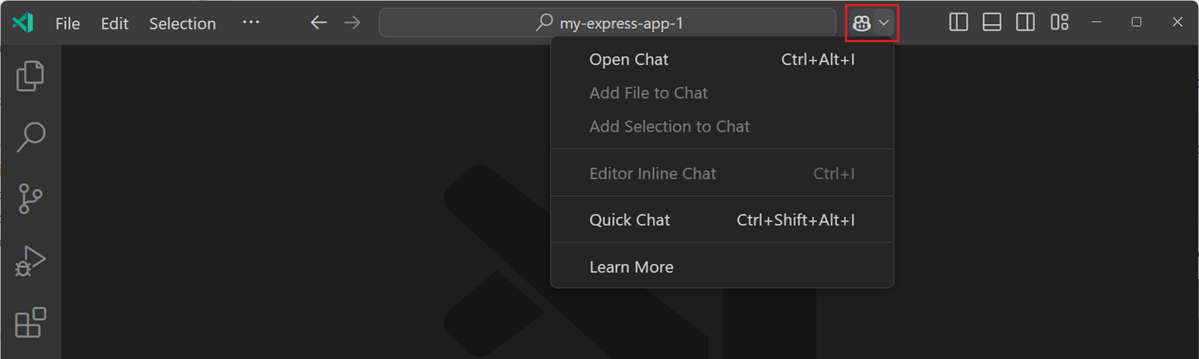
Command Center

Inline Chat

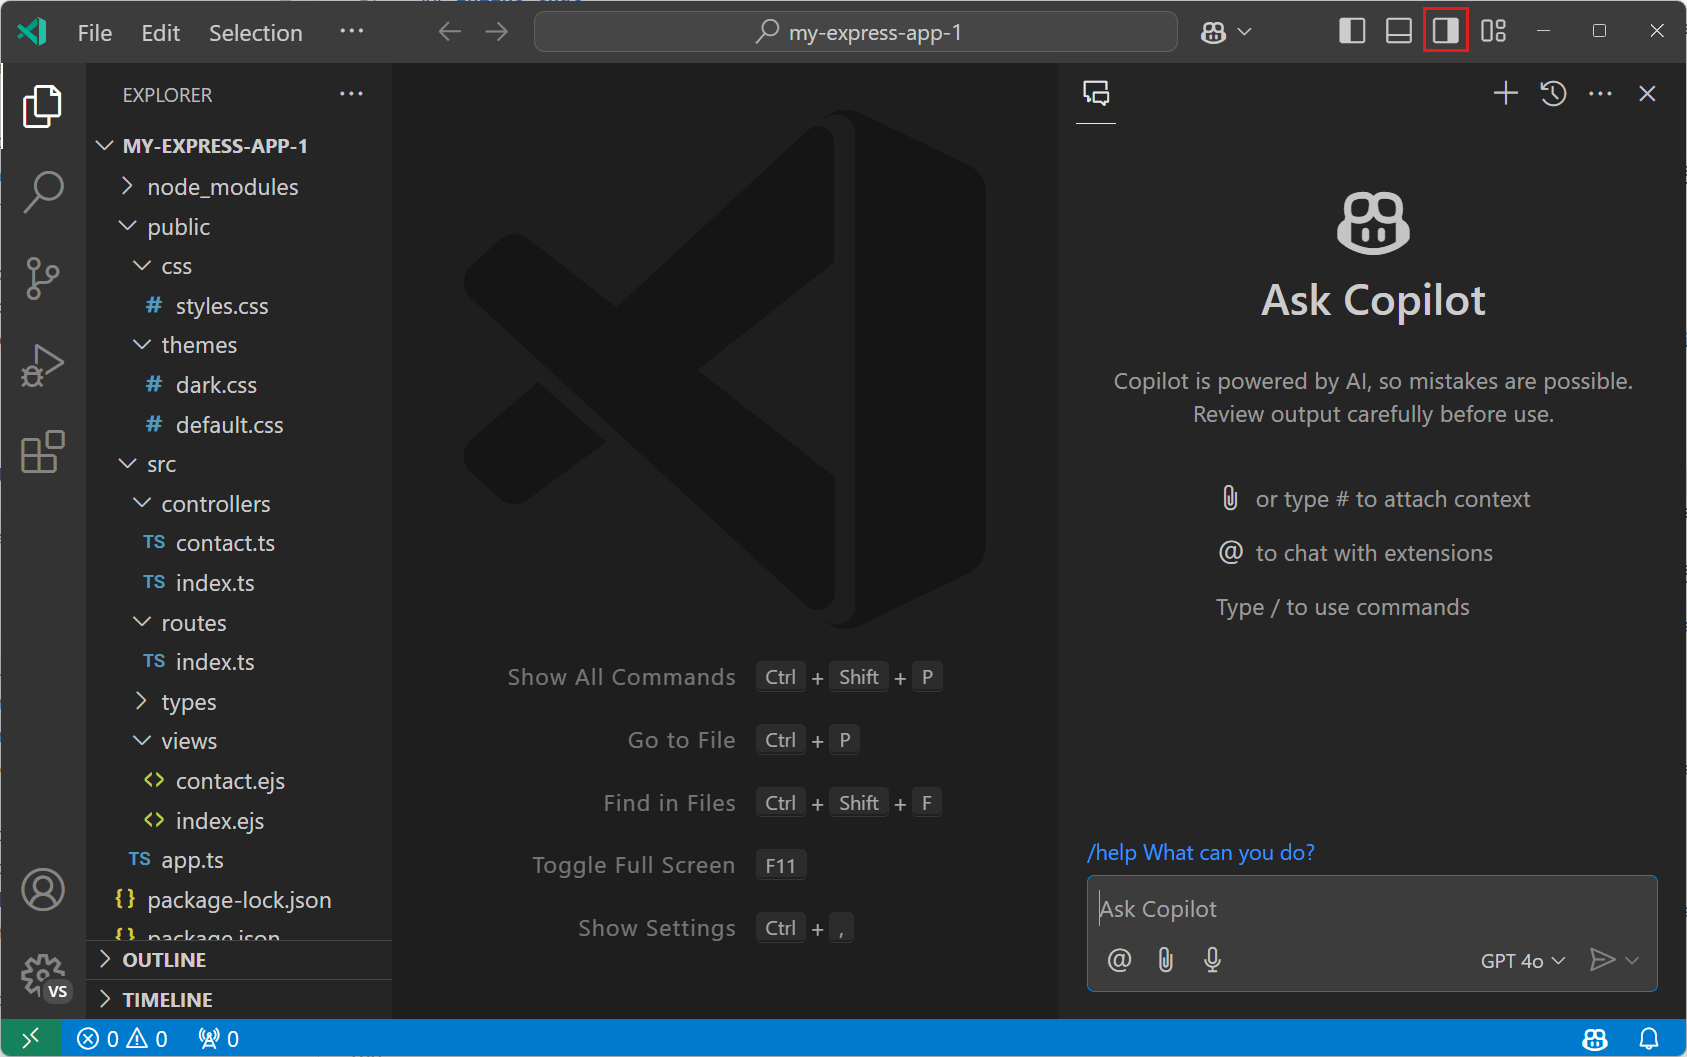
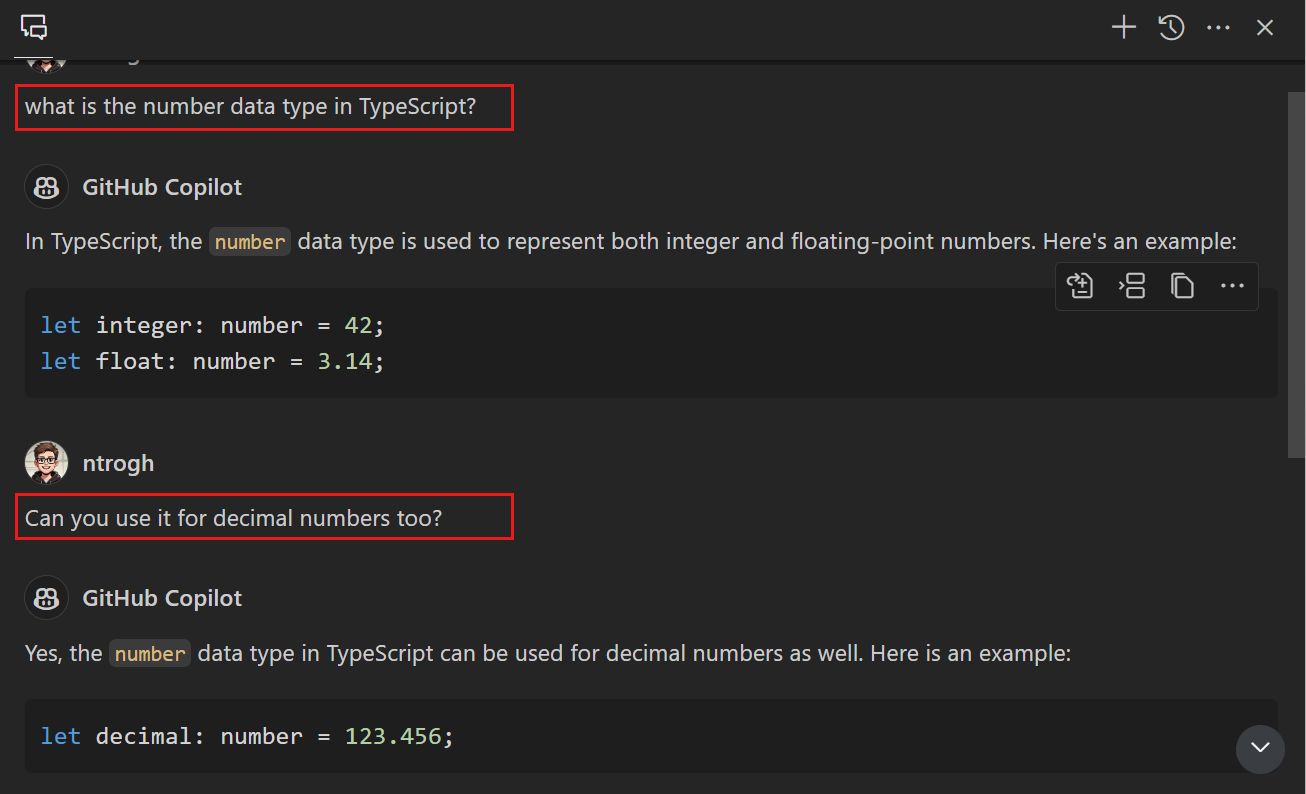
Chat View

  • Conversation History

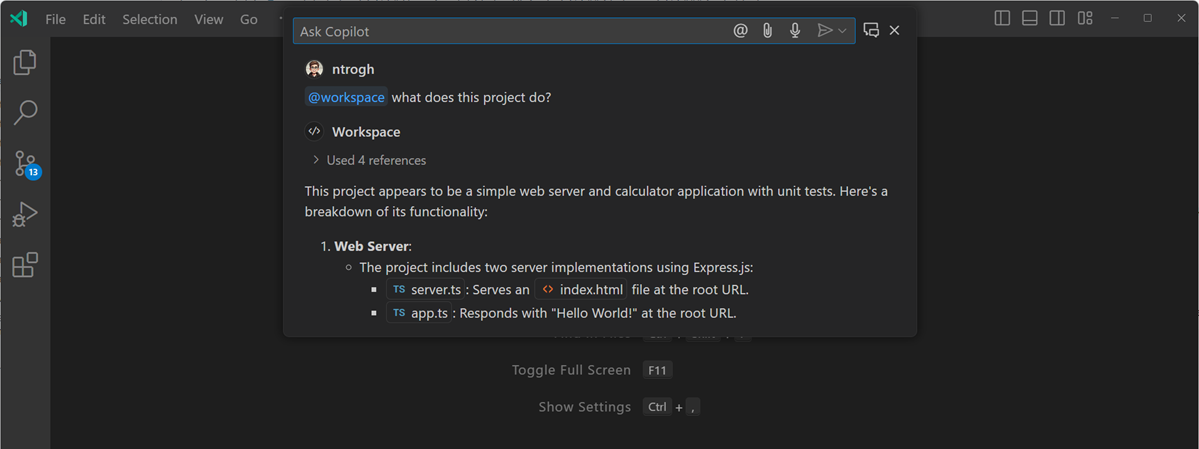
Quick Chat

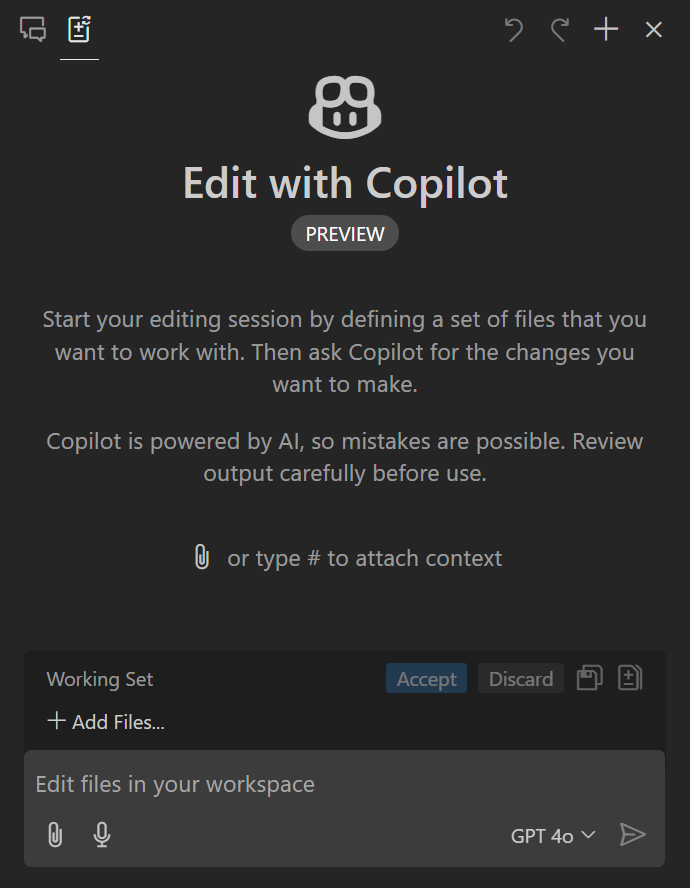
Copilot Edits

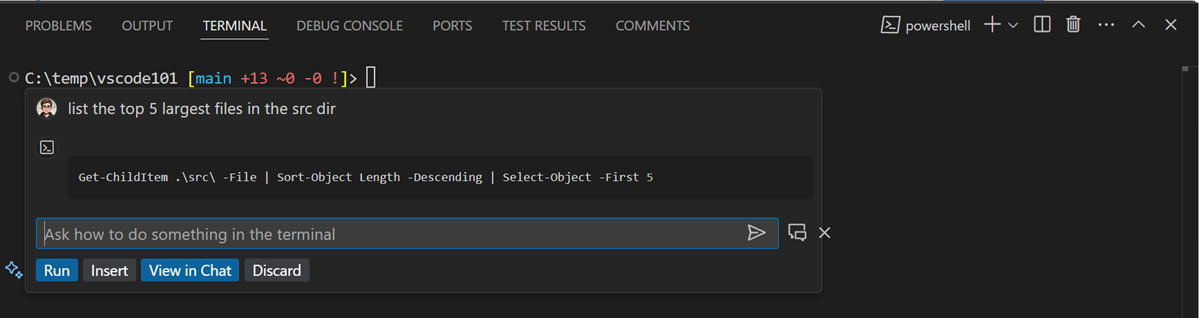
Terminal Inline Chat

支持的 IDE

  • Visual Studio
  • Visual Studio Code
  • JetBrains IDEs
  • Xcode
  • Vim/Neovim
  • Azure Data Studio
  • Web browser(GitHub website)
  • Windows Terminal
  • GitHub Mobile

交互方式

Code Completions(代码完成)

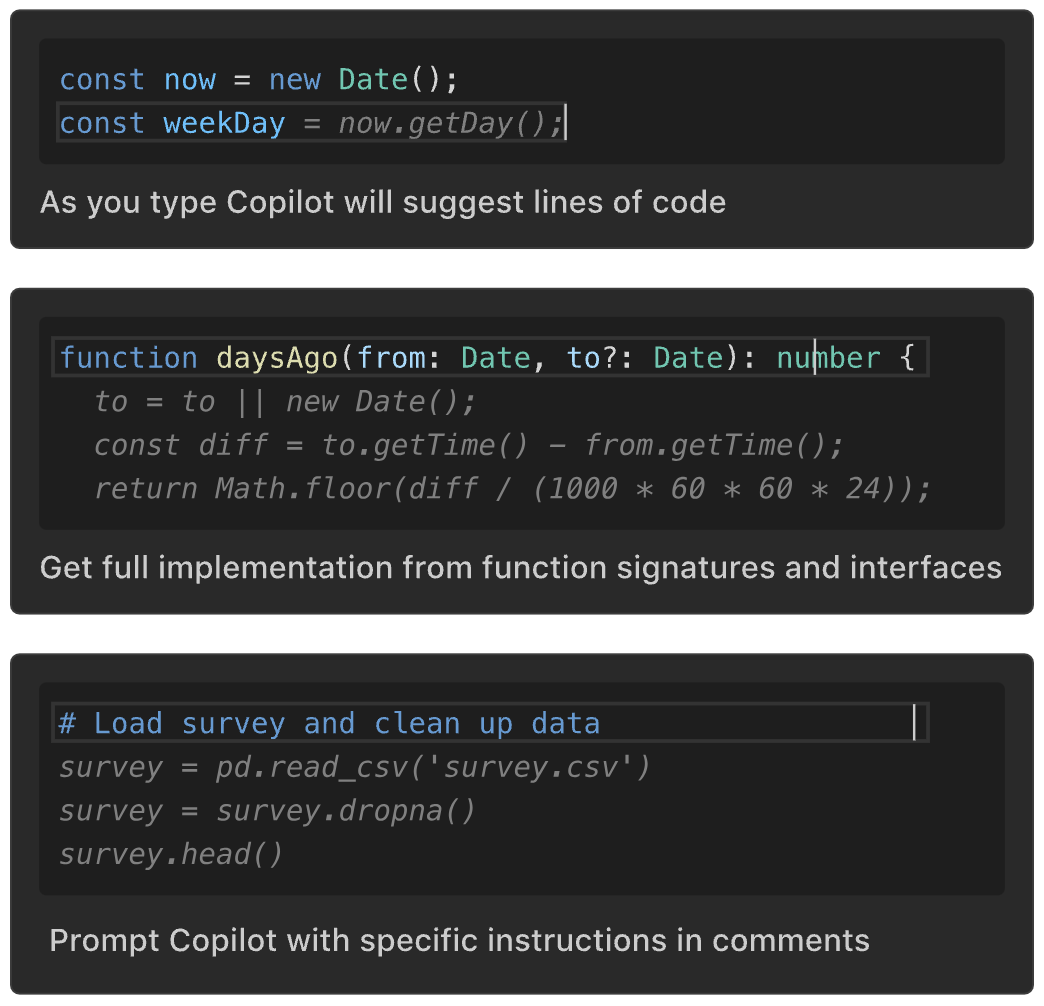
Copilot 会在你输入时建议代码行,并为函数签名提供多行建议。注释中的提示会根据你期望的结果、逻辑和步骤提供具体的建议。

  1. 代码行建议
  2. 函数签名建议
  3. 注释中的提示

您可能不想接受 GitHub Copilot 的整个建议。您可以使用 ⌘→ 键盘快捷键来接受建议的下一个单词或下一行。

Inline Chat

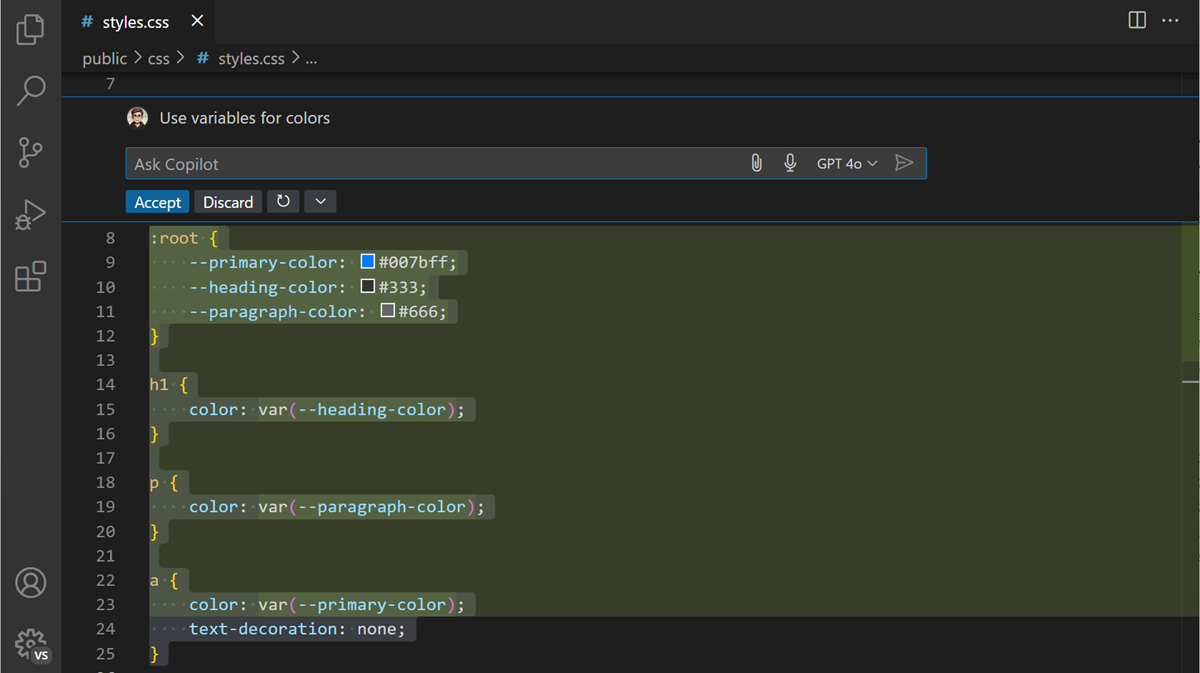
Inline Chat 使您能够直接从编辑器与 Copilot 进行聊天对话,而无需离开您的工作上下文。使用 Inline Chat,您可以在代码中就地预览代码建议,这对于快速迭代代码更改非常有用。

Chat View

Mac 外接显示器 DELL U2723QE

硬件

Apple MacBook Pro 16 M2 Max

显示屏

  • Liquid 视网膜 XDR 显示屏
    • 16.2 英寸 (对角线) Liquid 视网膜 XDR 显示屏1;初始分辨率 3456 x 2234 (254 ppi)
  • XDR (极致动态范围)
    • 1000000:1 对比度
    • XDR 亮度:1000 尼特持续亮度 (全屏),1600 尼特峰值亮度2 (仅限 HDR 内容)
    • SDR 亮度:500 尼特
  • 色彩
    • 10 亿色彩
    • 广色域 (P3)
    • 原彩显示技术
  • 刷新率
    • ProMotion 自适应刷新率技术,最高可达 120Hz
    • 固定刷新率:47.95Hz、48.00Hz、50.00Hz、59.94Hz、60.00Hz

充电和外设扩展

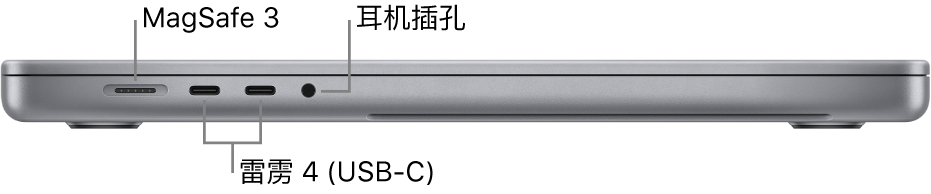
左侧 右侧
左侧 右侧
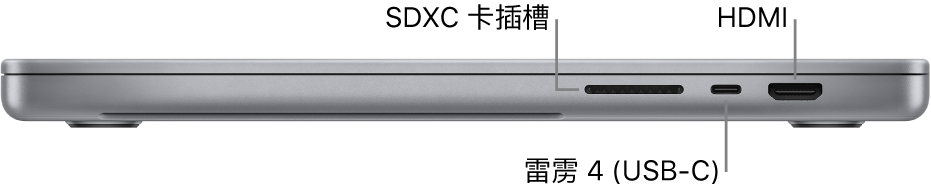
  • SDXC 卡插槽
  • HDMI 端口
  • 3.5 毫米耳机插孔
  • MagSafe 3 端口
  • 三个雷雳 4 (USB-C) 端口,均可支持:
    • 充电
    • DisplayPort
    • 雷雳 4 (速率最高可达 40Gb/s)
    • USB 4 (速率最高可达 40Gb/s)

显示器支持 同时支持初始分辨率下的内置显示屏 (可显示 10 亿色彩) 以及: 最多达四台外接显示器:通过雷雳端口连接多达三台分辨率最高达 6K (60 Hz) 的外接显示器,同时通过 HDMI 端口连接一台分辨率最高达 4K (144Hz) 的外接显示器 最多达三台外接显示器:通过雷雳端口连接多达两台分辨率最高

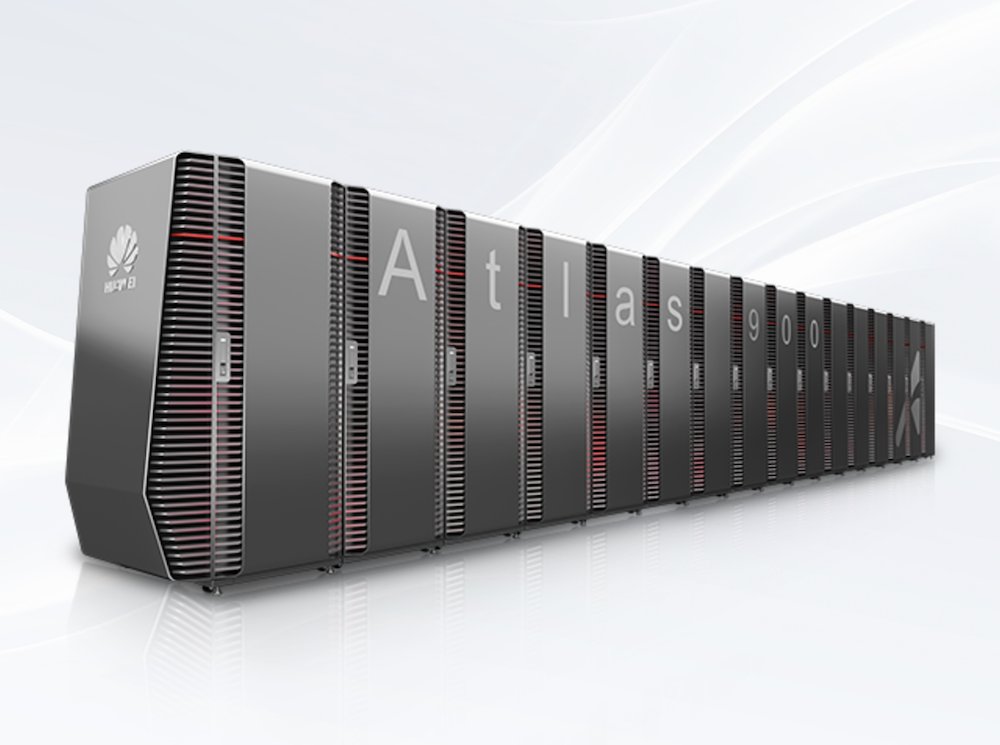
Atlas 900 AI 集群

济南人工智能计算中心

AI 机房(Atlas 900 AI 集群)

  • 计算节点:由大量高性能服务器组成,搭载华为自研的昇腾处理器,提供强大的算力支持。
  • 高速互联网络:采用高速InfiniBand网络,实现节点之间的低延迟、高带宽通信。
  • 存储系统:配置分布式存储,满足海量数据的高速读写需求。
  • 管理调度系统:提供统一的资源管理和任务调度,提升集群的利用效率。
  • AI 软件平台:支持主流深度学习框架,提供完善的AI开发和部署环境。

384 张卡

电池间空调系统

  • 恒温恒湿空调:确保机房温度和湿度稳定,适应设备运行要求。
  • 动力环境监控:实时监测空调系统的运行状态,及时预警异常情况。
  • 冗余设计:配置备用空调设备,保障系统的连续运行。

制冷系统配电柜、UPS 系统

  • 配电柜:为制冷系统提供可靠的电力供应,具备过载和短路保护功能。
  • UPS 系统:配置不间断电源,防止电源中断对设备造成影响。
  • 电源监控:实时监测电力系统状态,确保供电稳定性。

水处理系统

  • 冷却水循环:维持制冷系统的正常运行,保证设备散热需求。
  • 水质处理设备:防止水垢和腐蚀,提高系统效率和寿命。
  • 泄漏检测:配置水 leak 检测传感器,及时发现和处理漏水问题。

路由器、交换机、防火墙

  • 核心路由器:连接内外网络,实现数据高速转发。
  • 高速交换机:构建集群内部网络,提供大带宽低延迟的通信环境。
  • 防火墙:实施网络安全策略,防护外部网络攻击和入侵。

Mac 外接显示器选购

Apple MacBook Pro 16 M2 Max

为我的 MacBook Pro 16 M2 Max 选择一款显示器

显示屏

Liquid 视网膜 XDR 显示屏

  • 14.2 英寸 (对角线) Liquid 视网膜 XDR 显示屏1;初始分辨率 3024 x 1964 (254 ppi)
  • 16.2 英寸 (对角线) Liquid 视网膜 XDR 显示屏1;初始分辨率 3456 x 2234 (254 ppi)

XDR (极致动态范围)

  • 1000000:1 对比度
  • XDR 亮度:1000 尼特持续亮度 (全屏),1600 尼特峰值亮度2 (仅限 HDR 内容)
  • SDR 亮度:500 尼特

色彩

  • 10 亿色彩
  • 广色域 (P3)
  • 原彩显示技术

刷新率

  • ProMotion 自适应刷新率技术,最高可达 120Hz
  • 固定刷新率:47.95Hz、48.00Hz、50.00Hz、59.94Hz、60.00Hz

充电和外设扩展

左侧

左侧

右侧

右侧

  • SDXC 卡插槽
  • HDMI 端口
  • 3.5 毫米耳机插孔
  • MagSafe 3 端口
  • 三个雷雳 4 (USB-C) 端口,均可支持:
    • 充电
    • DisplayPort
    • 雷雳 4 (速率最高可达 40Gb/s)
    • USB 4 (速率最高可达 40Gb/s)

显示器支持 同时支持初始分辨率下的内置显示屏 (可显示 10 亿色彩) 以及: 最多达四台外接显示器:通过雷雳端口连接多达三台分辨率最

华为 Atlas A2 上使用 LLaMA-Factory 模型微调

济南人工智能计算中心

菜单

  • 云资源
    • ModelArts
      • 开发环境
        • Notebook

创建 Notebook

  • 自定义镜像:llama2
  • 类型:ASCEND
  • 规格:Ascend: 8*Ascend910 ARM: 192核 768GB
  • 存储配置:云硬盘EVS
    • 磁盘规格:200GB

工作目录:/home/ma-user/work

下载模型

安装 modelscope

pip install --upgrade modelscope

SDK 下载模型脚本

编辑 download.py 文件

#模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('Qwen/Qwen1.5-7B-Chat')

设置下载路径

export MODELSCOPE_CACHE=/home/ma-user/work

下载

python download.py

查看下载的模型

ll /home/ma-user/work/hub/Qwen/Qwen1___5-7B-Chat

修改模型配置文件

修改配置文件:Qwen/Qwen1___5-7B-Chat/config.json
{
  "torch_dtype": "float16",
}

NPU 不支持 bfloat16,模型配置文件需要修改为 float16

华为 Atlas A2 算力切分

算力切分

查询算力切分模式

sudo npu-smi info -t vnpu-mode
    vnpu-mode                      : docker

查询算力切分模板信息 sudo npu-smi info -t template-info +------------------------------------------------------------------------------------------+ |NPU instance template info is: | |Name AICORE Memory AICPU VPC VENC JPEGD | | GB PNGD VDEC JPEGE | |==========================================================================================| |vir10_3c_16g 10 16 3 4 0 12 | | 0 1 2 | +------------------------------------------------------------------------------------------+ |vir10_4c_16g_m 10 16 4 9 0 24 | | 0 2 4 | +---------------------------

LangChain Blog: In the Loop

What is an agent?

“什么是代理?”

几乎每天都会有人问我这个问题。在 LangChain,我们构建工具来帮助开发者构建 LLM 应用程序,特别是那些充当推理引擎并与外部数据和计算源交互的应用程序。这包括通常被称为“代理”的系统。

每个人似乎对代理都有稍微不同的定义。我的定义可能比大多数人更技术性:

💡 代理是一个使用 LLM 来决定应用程序控制流的系统。

即使在这里,我也承认我的定义并不完美。人们通常认为代理是高级的、自主的、类人的——但如果是一个简单的系统,LLM 在两个不同路径之间进行路由呢?这符合我的技术定义,但不符合人们对代理应具备能力的普遍看法。很难准确定义什么是代理!

这就是为什么我非常喜欢 Andrew Ng 上周的推文。在推文中,他建议“与其争论哪些工作应被包括或排除为真正的代理,我们可以承认系统可以有不同程度的代理性。”就像自动驾驶汽车有不同的自动化级别一样,我们也可以将代理能力视为一个光谱。我非常同意这个观点,我认为 Andrew 表达得很好。将来,当有人问我什么是代理时,我会转而讨论什么是“代理性”。

什么是代理性(agentic)?

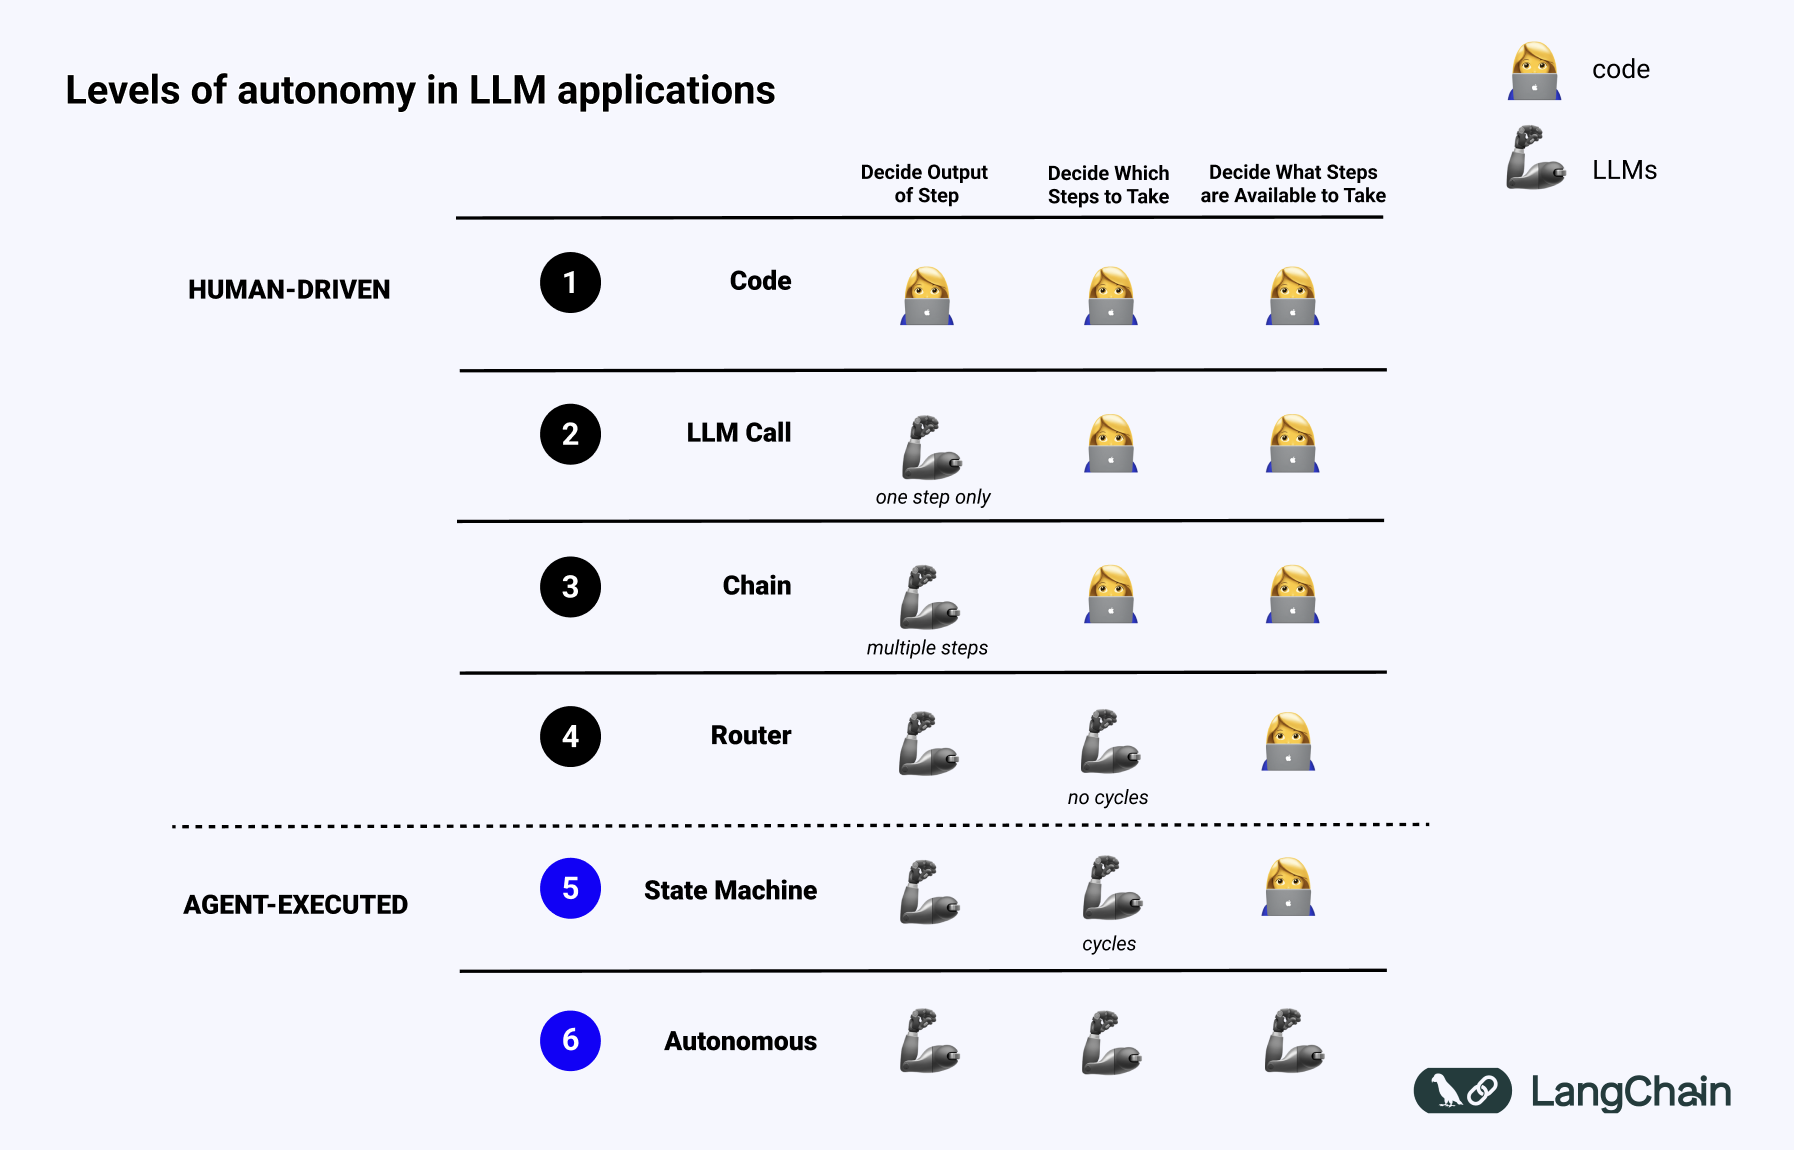
去年我在 TED 演讲中谈到了 LLM 系统,并使用下面的幻灯片讨论了 LLM 应用程序中存在的不同自主级别。

一个系统越“代理性”,LLM 决定系统行为的程度就越高。

使用 LLM 将输入路由到特定的下游工作流中具有一些小的“

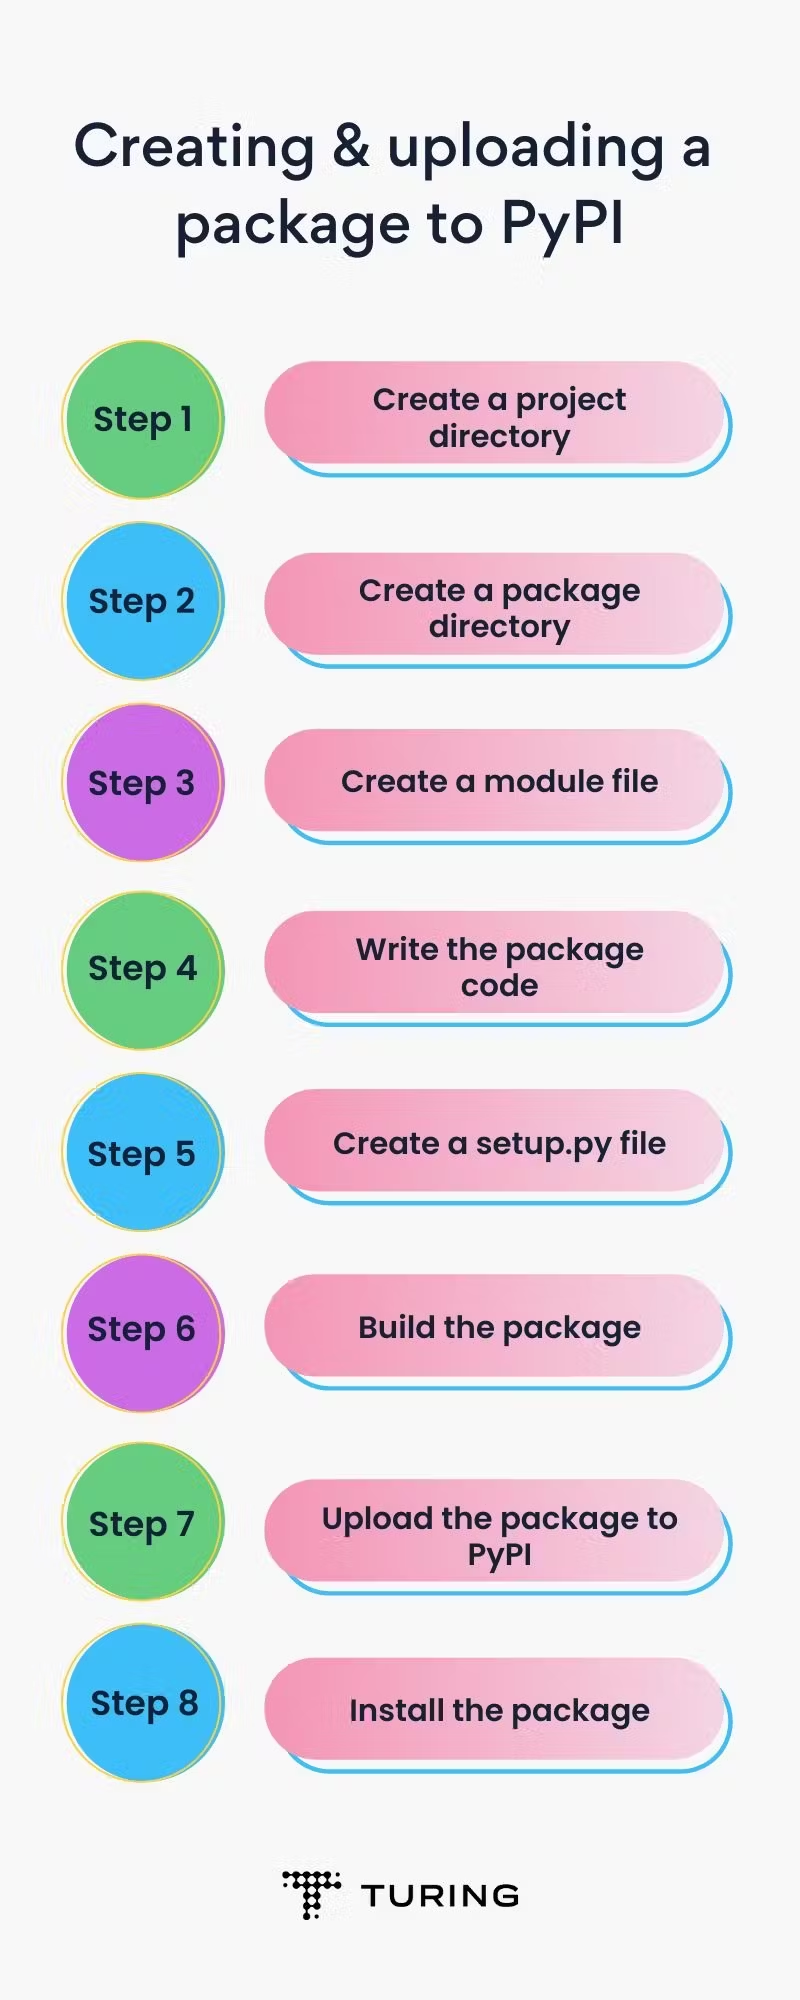
打包 Python 工程到 PyPI:构建 LLM 压测工具 evalscope-perf

创建 Python 工程 evalscope-perf

工程的目录结构

evalscope-perf/
├── evalscope_perf/
│   ├── __init__.py
│   └── main.py
├── README.md
├── LICENSE
├── pyproject.toml
└── setup.py

evalscope_perf/init.py

没有可以不写。

evalscope_perf/main.py import subprocess import re import typer import matplotlib.pyplot as plt from typing import List from typing_extensions import Annotated app = typer.

华为 Atlas 800I A2 服务器的大模型推理性能压测

大模型推理性能压测工具

安装 EvalScope

git clone https://github.com/modelscope/evalscope
cd evalscope

pip install -e .

压测命令的使用

evalscope perf \
    --api openai \
    --url 'http://127.0.0.1:1025/v1/chat/completions' \
    --model 'qwen' \
    --dataset openqa \
    --dataset-path './datasets/open_qa.jsonl' \
    --max-prompt-length 8000 \
    --stop '<|im_end|>' \
    --read-timeout=120 \
    --parallel 100 \
    -n 1000

--stream 不要加,经常出问题。

  • --read-timeout: 网络读取超时
  • --parallel: 并发数
  • -n: 请求数

数据集 中文聊天 HC3-Chinese mkdir datasets wget https://modelscope.cn/datasets/AI-ModelScope/HC3-Chinese/resolve/master/open_qa.

在华为 Atlas 800I A2 服务器上搭建大模型推理服务

华为昇腾 NPU 与英伟达 GPU 生态层级对比:

NPU GPU
CANN CUDA
MindSpore PyTorch
MindFormer Transformers
MindIE vLLM

下载大模型

cd /home/luruan/disk1/models

大型语言模型

  • Qwen1.5-7B
git clone https://www.modelscope.cn/Qwen/Qwen1.5-7B-Chat.git
  • Qwen2-7B ❌
git clone https://www.modelscope.cn/Qwen/Qwen2-7B-Instruct.git
  • Qwen2-72B
git clone https://www.modelscope.cn/Qwen/Qwen2-72B-Instruct.git

代码大模型

  • DeepSeek-Coder-6.7B
git clone https://www.modelscope.cn/deepseek-ai/deepseek-coder-6.7b-instruct.git
  • StarCoder2-15B ❌
git clone https://www.modelscope.cn/AI-ModelScope/starcoder2-15b.git
  • CodeGeeX2-6B ❌
git clone https://www.modelscope.cn/ZhipuAI/codegeex2-6b.git

OpenAI API Compatibility

设置 API Key

export LITELLM_API_KEY=sk-1234

服务端口

  • Ollama: 11434
  • LiteLLM: 4000
  • XInference: 9997
  • MindIE: 1025

models

Ollama

curl -s http://localhost:11434/v1/models \
    | jq -r '.data[].id'
  • curl -s: -s 选项表示静默模式,不输出进度信息。
  • jq -r: -r 选项表示以原始格式输出,去掉了引号。

LiteLLM

curl -s http://localhost:4000/v1/models \
    -H "Authorization: Bearer $LITELLM_API_KEY" \
    | jq -r '.data[].id'

在 Bash 中,单引号和双引号的使用有一些重要的区别:

  • 单引号 (')
    • 完全字面值:单引号内的内容被视为字面值,不会对其中的任何字符进行扩展或解析。
    • 变量不扩展:在单引号内,变量不会被解析。例如,'LITELLMAPIKEY会被视为字符LITELLM_API_KEY' 会被视为字符串 'LITELLM_API_KEY',而不是变量的值。
    echo '$LITELLM_API_KEY'  # 输出: $LITELLM_API_KEY
    

部署 LLM 多 LoRA 适配器的推理服务

Text Generation Inference

conda create -n text-generation-inference python=3.9
conda activate text-generation-inference

git clone https://github.com/huggingface/text-generation-inference.git && cd text-generation-inference
BUILD_EXTENSIONS=True make install

vLLM

conda create -n vllm python=3.10 -y
conda activate vllm
pip install vllm
cd ~/HuggingFace/mistralai/Mistral-7B-v0.1
git clone https://huggingface.co/predibase/magicoder adapters/magicoder
vllm serve `pwd` \
    --enable-lora \
    --lora-modules magicoder=`pwd`/adapters/magicoder