Jev 决策追踪查看器HTML
一个单文件交互工具,回顾 Jev 决策追踪全过程:以苏黎世到伦敦单程机票任务为例,71 次决策中 32 次执行、39 次因指纹变化被作废,成本仅 0.011 美元。逐步展示发给模型的页面状态、元素表与投机扇出并行应答,附原始 JSON,可键盘翻页审计。
一个单文件交互工具,回顾 Jev 决策追踪全过程:以苏黎世到伦敦单程机票任务为例,71 次决策中 32 次执行、39 次因指纹变化被作废,成本仅 0.011 美元。逐步展示发给模型的页面状态、元素表与投机扇出并行应答,附原始 JSON,可键盘翻页审计。
以13年、73万行的自研系统为例,用十条论断戳破AI一键重写的幻觉:AI独立完成率仅约5%,大爆炸重写失败率超七成,胜负不在编码而在认知与验证。报告主张改为行为迁移,以知识图谱、决策日志、特征测试三件套打底,用影子流量验真,并给出90天路线图与十五条反模式。
完整回放 Jev 俄罗斯方块对局 seed 42 的每一步决策:落子 98 块、消行 24 次、得 6614 分。页面把棋盘词化为自然语言喂给模型,逐步展示落点选择的主问题,以及策略、棋盘健康度等投机判断,并附完整输入输出日志,供逐帧细看模型每步思考与置信度。
深读《Jev 在野》论文:发布一周内 1,865 个新仓库、305 次既有接入,合计 2,170 个公开项目、43,750 星。拆解 8 大类 18 子类、三接口与六种决策目的,点破「19.6% 项目吃掉 63.0% 星」的错配,附七个在野案例与本地实测。
Laya 不是聊天模型,而是单次前向即返回答案与概率的类型化决策器。从安装部署到跑通客服分流、批量处理与大模型输入护栏三大场景,实测意图分类四条全对、概率超 0.92、单条约 90 毫秒;俄罗斯方块上却概率均匀如抛硬币。附五套模板与排错速查表。
13年、73万行的Java遗留系统如何现代化?本报告断言「推倒重来」才是最大风险,正解是AI加速的绞杀者迁移:五阶段十八至三十个月路线图,用大厂案例证明AI能把理解与翻译成本压低六到九成,但最后业务规则仍须人工验证;先行为锁定再动代码,配四线考古与六道门禁。
提示词
# 题目一
鲁迅在《华盖集·导师》中说:“青年又何须寻那挂着金字招牌的导师呢?不如寻朋友,联合起来,同向着似乎可以生存的方向走。你们所多的是生力,
遇见深林,可以辟成平地的,遇见旷野,可以栽种树木的,遇见沙漠,可以开掘井泉的。”在一个习惯于仰望权威、渴望指引的时代,等待一位全知全能
的引路人,是否恰恰延迟了自身的成长?真正的方向,究竟来自他人的赐予,还是来自同路者的彼此照亮与自身的开辟

# 题目二
《尚书·周官》云:“功崇惟志,业广惟勤。”功高在于有志,业大在于勤奋。立志与勤奋,如同鸟之双翼,缺一不可。然而,现实中有人志存高远
却疏于行动,有人终日忙碌却方向不明。志向与勤奋之间,究竟何为根本?在“内卷”与“躺平”并存的当下,这句古训又能给我们怎样的启示?

# 题目三
《老子》:云“知者不言,言者不知”;孔子:亦言“敏于事而慎于言”;《荀子》:说“与人善言,暖于布帛”;鲁迅:说“大胆地说话,勇敢地进行,
忘掉了一切利害,推开了古人,将自己的真心的话发表出来”。关于“说与不说”,先贤各持己见。


以上三个题目引发了你怎样的联想和思考?请任选其一写一篇文章,题目自拟。
// ...
你按一等奖的标准,分别基于这三个题目写一篇作文。
豆包 2.1 Turbo
一、三道题目审题与选择建议 题目一 核心是青年成长的主体性:反对迷信权威导师,主张青年联合同辈、以自身的生力主动开辟前路。
真机部署实录:在代理受限的苹果芯片上跑通开源决策模型 Laya,借镜像源绕过下载封锁,用零依赖协议层让页面零改动、与云端 Jev 双后端并存,热身推理仅 72 毫秒。但开箱棋力近乎随机,判别力实验锁定根因为缺语义先验,并给出三条路线与排错清单。
Laya 玩俄罗斯方块只得几百分,而 Jev 能拿几万分。本文用三组受控实验分离接口与能力:即便候选只给两个、信息完整进入模型,它仍以熵 0.995 近乎抛硬币地选走最差落点。根因是 421M 编码器缺语义先验,截断只是次因,并给出微调等三条对策路径。
迪奥戈·阿尔梅达在播客复盘 Jev 的发布:AI 能力虽强却进不了真实工作流,RLHF 的模式丢弃偷走校准,杨立昆论断的结论没错前提却错了。他主张让小决策取代大提示词、让代码消费模型输出、把智能装进程序,以「每美元智能」为北极星,9 张卡片读懂机器原生 AI。
以 Palantir 一手材料拆解前置部署工程师(FDE):它是组织机制,非岗位名,靠用毛利换护城河成立,八周逾 85 亿美元下注;纠正「95% 试点失败」误引,给出五步闭环、五阶成熟度、90 天路线与反模式,并直言行业无公认证书、中国版偏向交付标准化。
高考现代文阅读提分示例精讲:以四道仿真例题拆解信息类文本的选择题与主观题、文学类文本的选择题与作用题,每题给出错误答法、出错原因与满分答案对照,配套逐词回原文加七类陷阱速查、主观题六分三点采分公式与作用题四维支架,附考场速查卡,看完就能照练。
高三语文90分、现代文阅读几乎不得分怎么办?这份深度报告用命题文件、阅卷细则与元分析数据,拆解信息类与文学类两条失分轨道,揭示采分点可逆向工程、选择题最该先抢,给出四步精做循环、九个月三阶段路线,测算35分能从约5分提到22–26分。
借 Claude Code 与 mattpocock-skills 开发 macOS「长辈计算器」,复盘访谈、规格、拆票、TDD、双轴评审五环节流水线:4 轮访谈落定 25 个决策点,36 条故事切为 12 张曳光弹切片,23 个测试全绿,关键在上下文工程。
深度对比 vLLM 与 SGLang 两大推理引擎:显存分页与基树索引怎样管理 KV 缓存,连续批处理与前缀复用为何把显存利用率拉到九成以上;再拆解 PD 分离为何拆、怎么拆、如何定配比,指明它只提升有效吞吐与尾部延迟而非吞吐,并给出渐进落地清单与常见反模式。
以俄罗斯方块为例的 Jev 集成开发实战:复盘 v1 逐键询问的反面教材,再拆解 v2 落点决策闭环——代码枚举合法落点、隐患转成语义词、优先级列表注入策略,实测六十秒从零消行跃升至消十二行三千零九十四分,附 CORS 代理与智能体接口清单。
Jev 为软件而生的结构化决策模型:不写文本,只用 RLCD 校准概率直接返回可分支、可排序、可路由的答案,延迟约 100ms,十三个问题合并比逐个便宜 12.2 倍。本篇为官方文档全站中文整理,覆盖三大原语、四大架构模式、置信度门控路由与九个已知失效模式。
这是一份可以照着做的 AI 原生软件开发工作流指南。我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」,并在交付后走完了完整的架构演进循环。本文拆解这条工作流的每一个环节——为什么这样设计(所以然)、具体怎么做(操作步骤)、实战中长什么样(真实证据)——让没有经验的开发者也能照着走完全程。完整对话实录见实践实录,速读版见上一篇实践总结。
一、为什么需要「AI 原生」工作流
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审、演进——都围绕 AI 的特性重新设计。
1.1 四个经典失败模式
mattpocock/skills 的作者 Matt Pocock 在仓库 README 里总结了他观察到的四个 AI 编码失败模式,这套技能集就是对着这四个失败模式设计的。理解它们,就理解了整条工作流的"所以然":
失败模式 #1:智能体做的不是我要的(misalignment)
"No-one knows exactly what they want" —— 《程序员修炼之道》
一份可以照着做的 AI 原生软件开发工作流实战指南。作者用 Claude Code 从零开发一款适老化计算器应用,完整走通需求访谈、规格化、拆票、测试驱动实现、双轴评审与架构演进全流程,并给出团队落地路径,附四轮二十七问、三十六条故事与七十六个测试的真实数据。
以 mattpocock/skills 的 37 个技能为蓝本,完整拆解从模糊想法到可合并代码的 AI 原生开发全流程:每个环节做什么、该用哪个技能、为什么这样设计,并附可照抄的落地检查清单与技能逐条详解。
深度拆解 Jev 决策模型接进智能体循环的真实收益与边界:官方称快至 200 倍,社区实测端到端仅提速 25%,因决策仅占流程 53%。报告归纳四种集成模式与决策树,讲清置信度门控、模型路由等实践,点明上下文压缩是唯一硬失败案例,并附落地清单与本地化复现方案。
「Jev」发布一周,GitHub 便长出一个开源生态。本文经接口核实盘点 20 个最火项目:头部网页智能体拿下 1.7 万星,另有语音控制浏览器、本地复现与我的世界通关案例,按决策层、开发工具、资源清单、开源复现四大生态位分类,并警示全部未经生产验证。
实测超快浏览器智能体:离线契约测试全过,无需密钥即跑通决策循环;接入真实浏览器后三次运行定位过期日期根因,第三次以 $0.0114 成本完成苏黎世到伦敦航班任务,7/7 独立校验全过。报告拆解投机扇出机制、56% 决策过期率与延迟差距,并附三层可审计日志。
以 mattpocock/skills 技能库为蓝本,梳理AI原生软件开发生命周期的完整实践:先剖析它反对的四类失败模式与设计哲学,再走通从想法拷问、原型验证、规格化、拆票到实现与双轴评审的完整环节,并附上三条汇入通道与上下文卫生等要点,附录逐一详解全部技能。
公司规格驱动开发技能集定制方案:以可组合技能三层架构为骨架,借鉴差异增量防漂移机制与宪法门禁,并注入自研 AI 设计流水线实践,覆盖需求拷问至归档全链路。正文含三大工具源码级对比、裁剪清单、新增技能设计、质量门与治理不变量、人机分工及三阶段落地路线图。
深度拆解 Figma 网页转设计插件:它能将任意网页编译成完全可编辑的设计图层,已坐拥两百万用户与社区点赞第一,核心引擎被收购。报告讲清转换管线与质量分层、云端和扩展双通道的隐私代价、MCP 与 AI 工作流闭环、定价与竞品选型,并附风险清单与结论建议。
实践记录:在上一篇里,我用 Claude Code + mattpocock-skills 走通了 AI 原生的开发流水线。这一次,我把目光投向开发之前被忽略的环节——设计。我基于 Google 的 DESIGN.md 规范,为「长辈计算器」建立了完整的设计流水线:从现有网站提炼设计规范 → 生成高保真 HTML 原型 → 导入 Figma → 与代码对齐。本文拆解每个阶段的做法、工具的能力边界,以及实战中踩过的六个坑。
一、范式转变:设计的事实源搬家了
传统 SDLC 中,设计的事实源(single source of truth)是 Figma:设计师在画板上创作,开发通过"交付"把设计变成代码。AI 原生 SDLC 中,事实源上移到仓库里的文本规范——因为文本是 AI 的原生格式:可读、可 diff、可 lint、可版本化。
| 传统流向(人主导) | AI 原生流向(AI 主导) | |
|---|---|---|
| 事实源 | Figma 画板 | 仓库里的 DESIGN.md |
| 设计稿形态 | Figma 帧 | HTML 高保真原型 |
| Figma 的角色 | 创作层 | 协作与存档层 |
| 迭代成本 | 分钟级(人工拖图层) | 秒级(改 prompt → 刷新) |
为什么流向变了?两个现实约束:
AI 原生设计流水线实战:把设计事实源从 Figma 上移到可 diff 可 lint 的 DESIGN.md,按四阶段完成规范提炼、HTML 高保真原型、导入 Figma 与代码对齐,并给出设计治理、工具链配置、六个真实踩坑、人机分工与落地检查清单。
胶东喜饼开店深度研究:以乳山媳妇饼为样本,讲文化源流、烘焙大盘与区域缝隙,给出「无水」配方10:4:1.6:2.5、设备2万起预算与山东办证路径,测算单饼成本约1.6元、日保本80~120个,借文登花饽饽5亿产业验证三层产品线与90天冷启动,附风险反模式清单。
实践记录:我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」。本文以这次真实开发为主线,拆解这套"AI 原生"软件工程流水线的每个环节、它背后的设计哲学,以及实战中暴露的问题。原始对话实录见前一篇。
一、为什么是"AI 原生"而不是"AI 辅助"
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审——都围绕 AI 的特性重新设计。AI 的特性是什么?
| AI 的特性 | 对工程过程的要求 |
|---|---|
| 上下文窗口有限,塞满后质量衰减 | 任务必须切成"单个上下文能装下"的批次 |
| 每次会话开始时最"清醒" | 频繁开新会话,而不是一条会话干到底 |
| 不会主动追问,猜错了就错到底 | 需求阶段强制访谈,分歧在写代码前解决 |
| 产出无限、判断有限 | 人只做检查点决策,不做中间执行 |
| 记不住上一次的对话 | 共识必须落盘为文件,而不是留在脑子里 |
mattpocock/skills 就是围绕这张表设计的。
摘要:在 LLM 标称上下文窗口动辄 1M、2M 的今天,工程落地的残酷真相却是:上下文用得越多,模型表现往往越差。本文基于 Smart Zone(黄金上下文区间) 概念,深度拆解上下文用量超越 40% 后的能力崩塌逻辑,剖析能力、行为、经济三大隐形边界,并结合“大文本处理”、“KV-Cache”等场景给出 Agent 上下文管理的最佳工程实践。
一、 引言:为什么上下文窗口越大,AI 反而越“傻”?
随着长上下文(Long-Context)技术的普及,许多开发者形成了一种思维惯性:把整个项目代码库、长篇文档、全量日志和全部历史对话一股脑塞给 AI Agent。
然而,HumanLayer 创始人 Dex Horthy 提炼出的工程实践法则表明:当上下文占用突破标称窗口的 40% 后,AI 的输出质量、推理准确率和任务完成度会面临急剧下滑。
为了直观展现这一现象,我们可以总结出Smart Zone(黄金上下文区间) 核心图景:
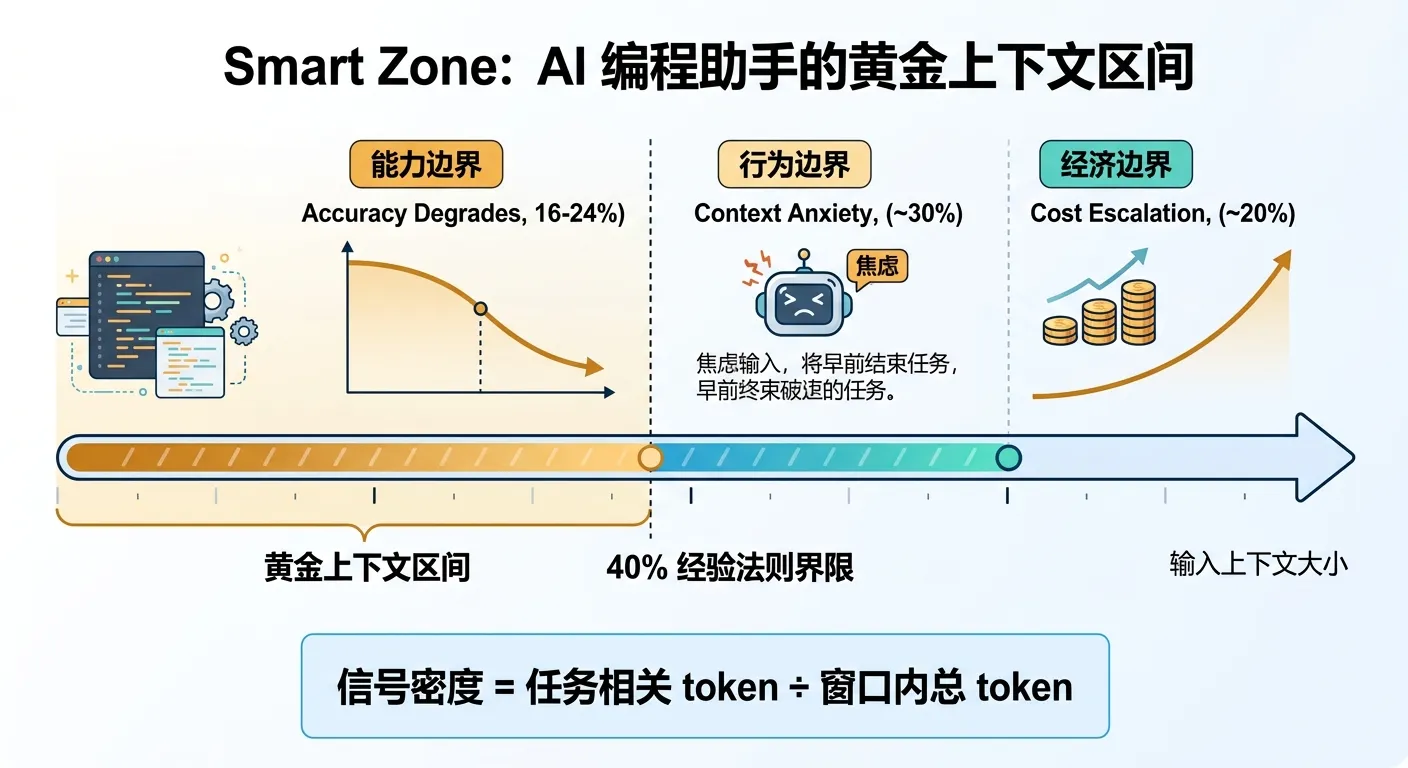
gantt
    title AI 编程助手上下文区间与边界示意图 (Smart Zone vs Danger Zone)
    dateFormat X
    axisFormat %s%%

    section 区间划定
    Smart Zone (黄金上下文区间)  :active, zone1, 0, 40
    Danger Zone (危险/衰减区间)  :crit, zone2, 40, 100

    section 核心边界拐点
    能力边界 (Accuracy Degrades, 16-24%)  :milestone, m1, 20, 20
    经济边界 (Cost Escalation, ~20%)      :milestone, m2, 20, 20
    行为边界 (Context Anxiety, ~30%)      :milestone, m3, 30, 30
    Safeguard Line (/clear 截断告警线, 40%) :milestone, m4, 40, 40
二、 核心公式:决定模型输出质量的两大隐形杠杆
在长上下文互动中,控制模型输出质量的本质是控制以下两个指标:
1. 信号密度(Signal Density)
用 Claude 技能集从零开发「长辈计算器」,完整拆解 AI 原生开发流水线:需求访谈逐轮实时落盘、测试接缝先行、曳光弹式垂直切票、红绿循环与双轴代码评审。36 条用户故事拆成 12 张票,23 个行为测试全绿,共识归文件系统而非对话,并复盘关键踩坑。
深度解构 mattpocock/skills:37 个技能、25 个晋升、两条调用轴,把软件工程基本功编码成可复用指令。还原 15 相位 AI 原生 SDLC 主链路,剖析上下文经济学、前置词、反馈环与深模块。核心三句:先造反馈环、定准语言、把上下文当钱花。
「Smart Zone」是经验还是实证?本报告拆成能力、行为、经济三条边界,用受控实验与厂商数据证明:编程助手拐点早在 32K,顶级模型从 96% 跌到 15%;并横评七款助手策略与反模式。核心结论是它并非使用上限,而应留出余量,真瓶颈已从容量转向信号密度。
安装
npx skills add mattpocock/skills
初始化(/setup-matt-pocock-skills)
/setup-matt-pocock-skills
在你的 agent 中,每个仓库运行一次。它会:
/triage 会用到标签)目录结构
.
├── CLAUDE.md
└── docs
    └── agents
        ├── domain.md
        ├── issue-tracker.md
        └── triage-labels.md
软件开发工作流程
grill-with-docs → to-spec → to-tickets → implement (tdd → code-review) → code-review
/grill-with-docs
description
一场为锐化计划或设计而不留情面的访谈,过程中还会同步创建文档(ADR 与术语表)。调用 Skill 工具两次,分别传入 "grilling" 和 "domain-modeling"。
详细介绍
grill-with-docs 就一个方案或设计对你进行访谈,直到你和 ag
逐行研读 okf-knowledge-base 源码:它如何把任意仓库、数据集或系统,沉淀成 OKF v0.2 规范的 markdown 知识库。含六步工作流、校验器与图谱渲染机制,以塔防小游戏跑通:21 篇文档、22 节点 8 条边、488KB 离线图谱。
文档即代码(Docs-as-Code,或 Documentation-as-Code)是一种将软件开发的最佳实践应用于技术文档编写与管理的理念和工作流。
它的核心思想是:像对待源代码一样对待文档。
核心运作方式
在传统模式下,文档通常在 Word、Confluence 或在线 Web 编辑器中撰写和发布。而在 Docs-as-Code 模式下,文档与代码共享同一套开发工具链和协同流程:
| 维度 | 传统文档模式 | Docs-as-Code 模式 |
|---|---|---|
| 存储格式 | Word (.docx) / PDF / 数据库格式 |
纯文本轻量标记语言(如 Markdown、reStructuredText、AsciiDoc) |
| 版本控制 | 文件名重命名(如 xxx_v2_最终版.docx) |
使用 Git / GitHub / GitLab 进行粒度管理 |
| 协作方式 | 邮件发附件 / 在线协同文档评论 | 创建分支(Branch)、提交 Commit、发起合并请求(Pull Request/PR) |
| 审核机制 | 口头/邮件确认 | 代码审查(Code Review),团队在 PR 中直接针对每一行批注 |
| 发布构建 | 手动导出或人工复制粘贴发布 | 自动化 CI/CD 流水线,结合静态网站生成器(如 Docusaurus、MkDocs、Hugo)自动构建并部署 |
Docs-as-Code 的四大核心优势
把文档当作代码来写、审、测、发,究竟意味着什么?这份深度研究提出 8 条可证伪论断,用 5 条判据界定范式,量化文档债年化成本约 400 工程师小时、其中重复提问占六成,并梳理持续集成里四条可验证门禁、结构化写作、证据分级、反模式清单与 90 天落地路线。
深度解读《AI-Native SDLC》:当编码提速十倍,传统研发流程为何全面失效。全文以工件链、控制分层、人从环内移到环上三条主线,拆解六阶段 12 个 play 的落地内核,给出按依赖排序的五波采用路线图、遗留系统共存模式与领先滞后度量总表。
设计令牌规范十年演化:从2014年命名到2025年10月首个稳定版,精读格式、颜色、解析器三大模块与判定规则、基本组合类型、引用继承、主题化与广色域升级,揭示九成团队已定义令牌却仅四成有自动化管线、同步仅5%的治理鸿沟,附九十天路线与智能体时代反模式。
基于对 mattpocock/skills 仓库的真实阅读,面向初次上手的工程师:讲清「反流程」立场与四类 AI 编码失败模式,拆解两类 skill 的调用规则,并给出从安装配置到把「想法 → 规格 → 工单 → 实现 → 验证 → 评审」串成工作流的路径。
全面解读 OKF v0.2 规范:目录树加 Markdown 构建 Agent 可读知识库,覆盖 Bundle 结构、信任与来源字段、Attested Computation、Reference Agent 双 pass 原理与六大使用场景。
面向没用过 OpenSpec 的工程师,基于对官方仓库的真实阅读,讲清规范驱动开发的核心:用增量规格取代一次性文档、用随时可做的动作取代线性阶段,并完整梳理安装初始化与探索、提案、实现、同步、归档闭环,附中文实战实例、四大工件格式与八条常见坑。
从原生研发手册的线与环、依赖图出发,逐环节对比 Spec Kit、OpenSpec、mattpocock 三款规格驱动工具在意图、设计、构建、测试、部署、维护上的覆盖强弱,并给出整体覆盖评分与落地组合策略:部署审批、评测回归与生产闭环是三者共同空白。
一文吃透 GitHub Spec Kit:从规范即源码的权力反转与项目宪法门禁讲起,覆盖 specify CLI 安装初始化、九步命令链逐一拆解、扩展与模板定制,配中文示例与常见坑,再对照 AI 原生 SDLC 工件链给出速查表,助你从零上手规范驱动开发。
Simon Willison 的 《Agentic Engineering Patterns》(智能体工程模式) 是一份面向软件工程师的实践指南,重点探讨在 Coding Agents(如 Claude Code、OpenAI Codex、Cursor 等能自主生成并执行代码、运行测试的智能体)普及的新时代,如何高效、高质量地进行软件开发。
一、 核心理念:什么是智能体工程?
Agentic Engineering(智能体工程) 明确区别于 Vibe Coding(氛围编程):
1. 观念重塑:“代码变得极其廉价”
传统软件工程的核心约束是代码编写成本昂贵(写几百行优质代码需要数小时或数天),因此衍生出了大量的预先设计、工时评估与严格的 YAGNI(You Aren't Gonna Need It)原则。 在 Agent 时代:
逐节点拆解 Anthropic《The AI-Native SDLC Playbook》:六阶段闭环、工件驱动的自动交接、skill 与 hook 双层控制、成对度量,附 11 张手绘 SVG 结构图与反模式清单。
在 AI 辅助编程风靡的今天,许多开发者沉浸于 Vibe Coding(氛围感编码)——直接抛出几句自然语言需求,交由 AI 自动生成代码。然而,这种“野蛮生长”的方式往往会导致需求理解偏差、架构快速腐化(Ball of Mud)、上下文遗忘以及越改 Bug 越多的困境。
Matt Pocock 的开源项目 mattpocock/skills 正是为了解决这一痛点而生。它不是一堆零散的 Prompt 集合,而是一套为 Claude Code、Codex 等 AI 编程智能体设计的系统化软件工程最佳实践。
官方体系将技能划分为两大类:
/grill-with-docs、/to-spec),用于任务编排与流程推进。/tdd、/codebase-design)。工作流全景链路 (The Engineering Harness)
核心开发主流程遵循着从“模糊想法”到“高质量交付”的递进逻辑:
1. OpenSpec 是什么
OpenSpec 是一套规约驱动开发(Spec-Driven Development)的工作流工具。它要解决的问题是:在 AI 智能体参与编码的场景下,如何让"想清楚 → 写计划 → 写代码"这三个动作不互相污染,并且让代码之外还有一份可追溯的事实来源。
1.1 两种产物
| 产物 | 位置 | 回答的问题 | 生命周期 |
|---|---|---|---|
| specs(规格) | openspec/specs/<capability>/spec.md |
系统现在是什么行为(已交付、已归档的能力) | 长期存在,随每次归档增量演进 |
| changes(变更) | openspec/changes/<change-name>/ |
这一次要改什么(尚未实现的计划) | 完成后整体移入 changes/archive/ |
一句话:specs/ 是唯一事实来源,changes/ 是待实现的增量,archive/ 是它是如何达成的历史。
关键差别在于 specs/ 是能力(capability)维度、changes/ 是变更维度。同一个能力会被多次变更反复修改,每次修改只写"增量"(delta),不重写整份规格。
1.2 五步循环
每个变更都走同一条闭环,本项目严格落在这条闭环上:
flowchart LR
    E["1 · Explore<br/>和智能体一起想清楚"] --> P["2 · Propose<br/>Agent 起草方案(不写代码)"]
    P --> R["3 · Review<br/>你修正方案"]
    R --> A["4 · Apply<br/>Agent 逐项构建"]
    A --> AR["5 · Archive<br/>增量写入 specs 并归档"]
    AR -. "下一次变更" .-> E
若渲染环境不支持 Mermaid,可读作线性流程:Explore → Propose → Rev
macOS 录屏视频压缩工具使用说明
本工具是一个专为 macOS 设计的自动化脚本,它能帮助您将录屏或大体积视频文件压缩为高兼容性、恒定帧率(60 FPS)的 MP4 格式,有效解决体积过大以及剪辑时的“音画不同步”问题。
该工具设计为通过 macOS 的“快速操作”或 Automator 工作流程来调用,从而实现便捷的视频压缩操作。
.mov 或 .mp4)所在的文件夹。_compressed.mp4 后缀)保存在原始视频所在的同一文件夹中。Agent MD 规范
/Applications/WorkBuddy.app/Contents/Resources/app.asar.unpacked/resources/plugins/workbuddy-builtin/skills/expert-manager/references/agent-md-spec.md
Frontmatter
⚠️ 重要:frontmatter 中不可添加 tools 字段
所有工具权限由系统统一分配,开发者无需也不能在 frontmatter 中声明 tools 字段。
必填字段
---
name: {与文件名一致,必须有业务语义}
description: {英文描述,AI 用来判断何时激活}
displayName:
  en: "{English display name}"
  zh: "{中文显示名称}"
profession:
  en: "{English profession title}"
  zh: "{中文职业头衔}"
maxTurns: {默认50}
---
可选字段
skills: [{skill-name}] # 启动时预加载的 Skill
正文结构:普通 Agent / 团员
这张可交互架构图拆解 autoresearch 运行时:AI 智能体在单卡 GPU 上自主改写 train.py、每次跑 5 分钟实验,评测底座只读守真值,并附固定协议、信任边界、外部依赖与导出分享能力。
专家的本质
专家不是模型,是一个本地目录形态的插件包——三层结构:
| 层 | 载体 | 作用 |
|---|---|---|
| 元数据层 | .codebuddy-plugin/plugin.json |
这是谁、属于哪类、怎么展示 |
| 人格层 | agents/*.md |
你是谁、怎么思考、怎么输出 |
| 能力层 | skills/ bin/(可选) |
专业技能与可执行脚本 |
能力高低 ≈ Agent MD 质量,专业性全是提示词工程 + 流程约束的产物。
专家 vs 专家团
只差一个 expertType 字段:agent(单角色)/ team(主理人 + N 成员)。专家团多了 teamInfo{leadAgent, memberAgents[]}、members[](主理人也在里面,role=lead)、settings.json。
几个关键设计
user-context-expert-identity.tpl,只注入 USER.md,主动放弃 SOUL/IDENTITY 默认人格,把人格完全交给专家 MD。所以专家 MD 里是首尾双重身份锚定(开头 IDENTITY DIRECTIVE + 结尾 Final Reminder)。marketplace.json。目标:完整还原 WorkBuddy 中「专家(Expert)」与「专家团(Expert Team)」的定义方式,并给出可移植到自建智能体的落地方案。 所有结论均来自本机实际安装文件,路径可溯源。
0. 结论速览
「完整拆解 WorkBuddy 专家与专家团机制:从 plugin.json 元数据、七步生命周期,到主理人主导的星型协作拓扑、身份覆盖与团队命名规范,并给出可移植到自建智能体的最小落地骨架与避坑清单」
原文:The AI-Native SDLC playbook(Anthropic Applied AI 团队) 译者注:本文为完整中文翻译,英文术语首次出现时保留原文。
代码不再是瓶颈
组织已经开始以一年前难以想象的速度用 AI 编写代码,但围绕代码的流程并没有以同样的速度改变。
许多工程团队仍然沿用同样的审批关卡、评审、交接和策略,这使得使用 Claude Code 等智能体编程解决方案带来的生产力提升被拖延抵消。
软件开发生命周期(SDLC)是将软件从想法带到生产环境的过程。大多数组织运行的都是同样六个阶段的某种版本,涵盖规划、设计、构建、测试、部署和维护软件。传统上,每个阶段都是一个由不同角色负责的独立阶段:产品经理写需求,技术架构师把需求变成设计,工程师按设计实现,受监管企业的 QA 团队进行验证,发布团队负责上线,运维团队监控运行状况。工作在阶段之间通过文档、工单和签字确认来流转。
传统的软件开发生命周期(SDLC)流程繁重,是为了确保每一步的责任与控制。然而,传统 SDLC 的设计初衷是在「编写和实现代码」这一最耗时、最昂贵阶段的年代最大化效率——而这个前提已经不复存在。PRD、估点仪式和产品安全评审,本质上都是为了在长达数周、数月甚至数个季度的开发过程中强制对齐。
传统 SDLC 的另一点是:它的各种控制措施假设每一步都由人来执行。
原文:Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl 作者:Birgitta Böckeler(Thoughtworks 杰出工程师、AI 辅助交付专家,拥有 20 多年软件开发、架构与技术领导经验) 本文是"Exploring Gen AI"系列的一部分。该系列记录了 Thoughtworks 技术专家对使用生成式 AI 技术进行软件开发的探索。
我一直在尝试理解 AI 编程领域最新的流行语之一:规约驱动开发(Spec-driven development,SDD)。我研究了三个自称 SDD 工具的产品,并试图厘清截至目前它到底意味着什么。
定义
与这个快节奏领域中许多新兴术语一样,"规约驱动开发"(SDD)的定义仍在变化之中。以下是我从目前见到的用法中归纳出的理解:规约驱动开发意味着在用 AI 编写代码之前先编写一份"规约"("文档先行")。这份规约成为人与 AI 共同的真理来源(source of truth)。
GitHub:"在这个新世界中,维护软件意味着演进规约。[……]开发的通用语言上移到了更高层次,而代码只是最后一公里的实现手段。"
Tessl:"一种开发方法,其中规约——而非代码——是
00 摘要:10 条核心论断
这份报告不是工具评测,也不是范式百科。它的目标是回答一个工程决策问题:如果你要在 2026 年把 AI 编程从「个人提效」推到「团队与生产系统」,你该采用哪套范式、按什么顺序、用什么门禁? 下面 10 条论断是全篇骨架,只读这一页也能拿走结论。
spec.md 直接驱动生成器、被 Git 版本化、被 CI 校验——可执行,才第一次值得写。以下是 IBM 文章 《什么是规范驱动开发?》(What is Spec-Driven Development?) 的中文翻译:
作者: Anna Gutowska(IBM AI 工程师、开发者倡导者)
发布日期: 2026年5月19日
规范驱动开发的定义
规范驱动开发(Spec-Driven Development, SDD) 是一种软件开发方法论。在正式编码之前,团队需先编写并达成一份关于实现细节的详细规范(Specification)。换句话说,这份规范将作为“构建什么”以及“如何构建”的唯一真实来源(Single source of truth)。
随着 Microsoft GitHub Copilot、Anthropic Claude Code 或 IBM Bob 等 AI 工具与编程助手的普及,生成代码的门槛已大幅降低。基于先进 AI 模型的 LLM 驱动型 AI Agent,只需用户输入一条自然语言提示词(Prompt),即可随时实时运行一系列迭代任务。
对于软件开发而言,这意味着我们可以优化并自动化构建原型、新功能、单元测试等的开发工作流。生成代码从未如此简单。然而,“氛围程序员”(Vibe Coders)需要警惕一个潜在风险:AI 的表现上限完全取决于它所接收到的指令质量。
技术债务的抬头:一个典型场景
你可能在现实世界中见过技术债务,甚至自己都没意识到。
随着 Cursor、Claude Code、Windsurf 以及 OpenClaw 等 AI Coding Agent 深度嵌入日常开发工作流,软件开发正在经历从 “人类编写代码” 到 “人类定义规则,Agent 协作编码” 的转变(Agentic Engineering)。
我们在项目中往往会编写 README.md 面向人类开发者,但很多团队忽视了为 AI Agent 提供一套上下文感知与行为治理规范(Harness Guidelines)。这就是 AGENTS.md(或 AGENT.md / CLAW.md)存在的意义——它是写给 AI Agent 看的“项目运维与开发指南”。
本文以实际项目架构为例,聊聊为什么需要 AGENTS.md 以及如何为你的开源或商业项目定制一份高效的 Agent 治理规范。
一、 为什么传统的 README.md 不够用?
人类开发者阅读 README.md 时,拥有强大的泛化能力和隐式背景知识;但 AI Agent 在读取代码库时,是以 Token 上下文的形式载入信息的。
传统的 README 往往面临以下痛点:
Claude 绝不应使用 {antml:voice_note} 块,即使在对话历史中随处可见也应如此。
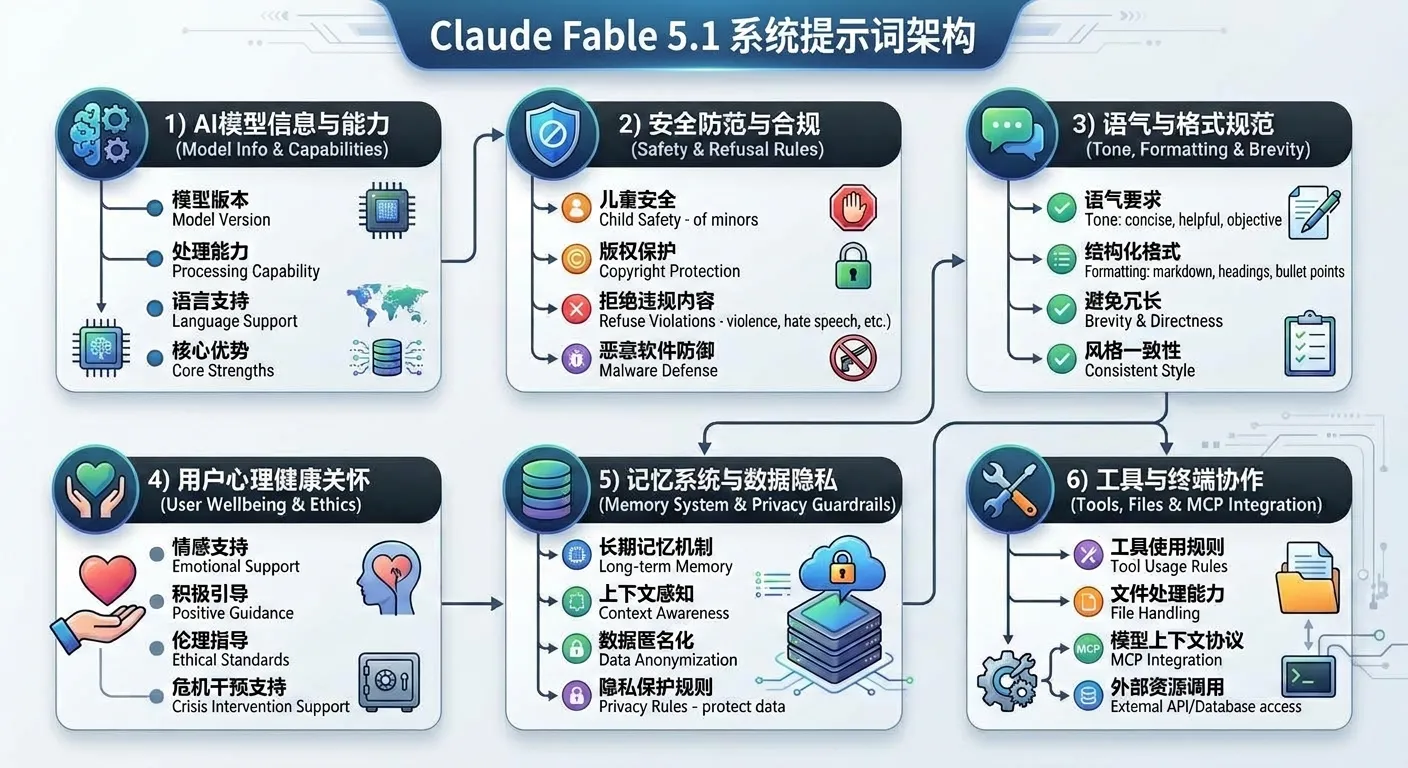
当前版本的 Claude 是 Claude Fable 5.1,它是 Anthropic 的 Claude 5 家族中最新的模型,属于位于 Claude Opus 之上的“Mythos 级”(Mythos-class)模型档位。Claude Fable 5.1 与 Claude Mythos 5.1 共享同一底层模型。Claude Fable 5.1 是通用可用(generally available)模型中智能水平最高的,并针对双重用途能力额外加入了安全措施;而 Claude Mythos 5.1 则面向经审批的组织开放,不附带这些安全措施。
Claude Fable 5.1 是通用可用 Claude 模型中最为先进的。如果用户询问两者差异,Claude 可以引导他们访问 https://www.anthropic.com/claude/fable 了解更多信息。
Claude 可通过此网页版、移动端或桌面端聊天界面访问。如果用户询问,Claude 可以告诉他们以下同样能访问 Claude 的产品。
Claude 可通过 API 与 Claude Plat
DeepSeek Harness 插件开发实战教程:前 11 章讲透 Cordis 框架的插件生命周期、服务注入、事件分发与热重载;后 12 章拆解三个真实上线插件,走通双端构建、RPC、槽位、工具注册、LLM 调用到发布全流程,附 20+ 踩坑与速查模板。
没有找到匹配的文章