内部信息化系统项目组智能体编码现状与实践推进建议HTML
内部信息化系统项目组智能体编码现状调研:梳理三个使用层次,提炼五步法最佳实践,剖析算力、模型、推理服务与智能体软件四层基础设施短板及组织瓶颈,给出三线并行推进建议。
内部信息化系统项目组智能体编码现状调研:梳理三个使用层次,提炼五步法最佳实践,剖析算力、模型、推理服务与智能体软件四层基础设施短板及组织瓶颈,给出三线并行推进建议。
实践记录:我用 Claude Code 加 mattpocock/skills 技能集,从零开发了一款 macOS 原生应用「长辈计算器」。本文以这次真实开发为主线,拆解这套"AI 原生"软件工程流水线的每个环节、它背后的设计哲学,以及实战中暴露的问题。原始对话实录见前一篇。
一、为什么是"AI 原生"而不是"AI 辅助"
大多数人的 AI 编码方式是:打开编辑器,描述一个需求,AI 吐出代码,人肉检查。这是 AI 辅助——AI 是打字快的初级程序员,工程过程还是人的那套。
AI 原生的含义不同:整个软件工程过程——需求澄清、规格化、任务拆解、实现、测试、评审——都围绕 AI 的特性重新设计。AI 的特性是什么?
| AI 的特性 | 对工程过程的要求 |
|---|---|
| 上下文窗口有限,塞满后质量衰减 | 任务必须切成"单个上下文能装下"的批次 |
| 每次会话开始时最"清醒" | 频繁开新会话,而不是一条会话干到底 |
| 不会主动追问,猜错了就错到底 | 需求阶段强制访谈,分歧在写代码前解决 |
| 产出无限、判断有限 | 人只做检查点决策,不做中间执行 |
| 记不住上一次的对话 | 共识必须落盘为文件,而不是留在脑子里 |
mattpocock/skills 就是围绕这张表设计的。
摘要:在 LLM 标称上下文窗口动辄 1M、2M 的今天,工程落地的残酷真相却是:上下文用得越多,模型表现往往越差。本文基于 Smart Zone(黄金上下文区间) 概念,深度拆解上下文用量超越 40% 后的能力崩塌逻辑,剖析能力、行为、经济三大隐形边界,并结合“大文本处理”、“KV-Cache”等场景给出 Agent 上下文管理的最佳工程实践。
一、 引言:为什么上下文窗口越大,AI 反而越“傻”?
随着长上下文(Long-Context)技术的普及,许多开发者形成了一种思维惯性:把整个项目代码库、长篇文档、全量日志和全部历史对话一股脑塞给 AI Agent。
然而,HumanLayer 创始人 Dex Horthy 提炼出的工程实践法则表明:当上下文占用突破标称窗口的 40% 后,AI 的输出质量、推理准确率和任务完成度会面临急剧下滑。
为了直观展现这一现象,我们可以总结出Smart Zone(黄金上下文区间) 核心图景:
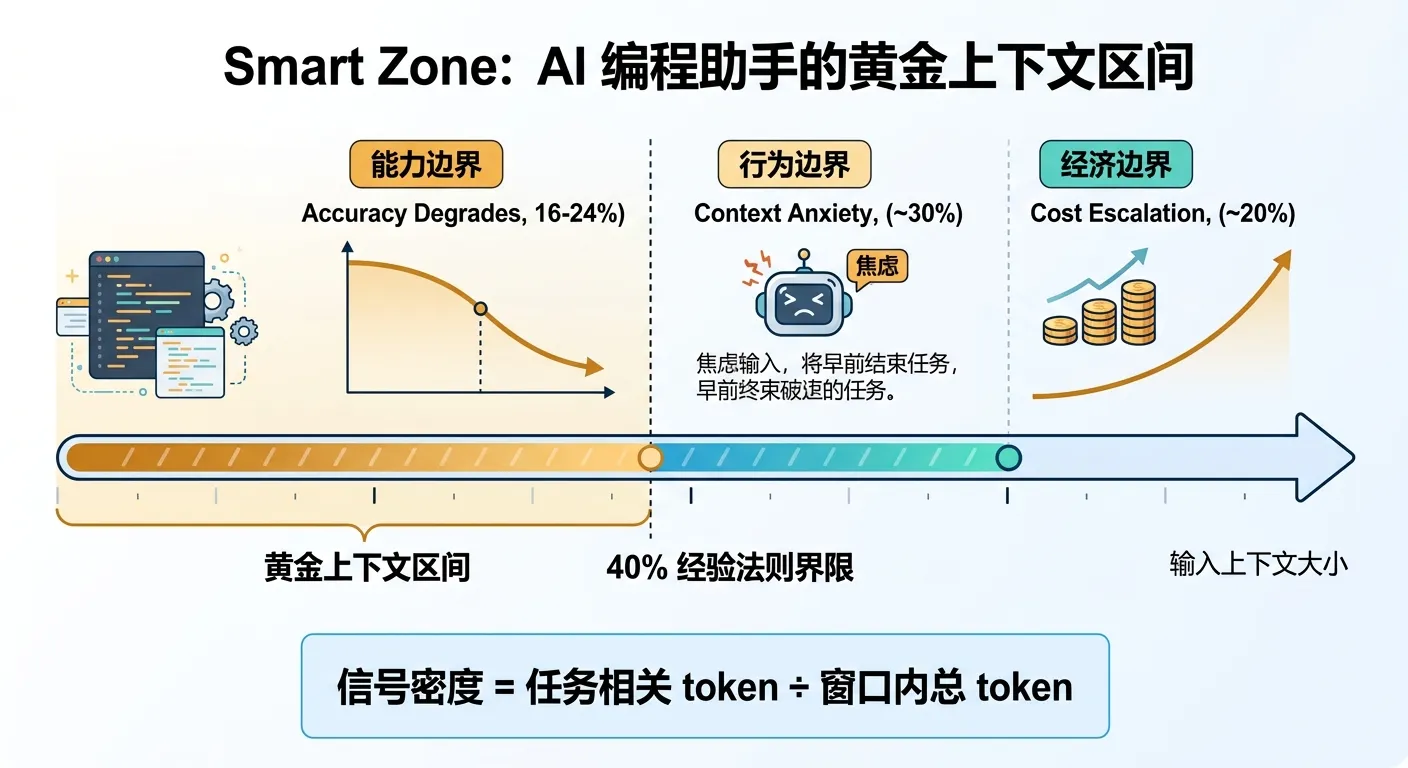
gantt
    title AI 编程助手上下文区间与边界示意图 (Smart Zone vs Danger Zone)
    dateFormat X
    axisFormat %s%%

    section 区间划定
    Smart Zone (黄金上下文区间)  :active, zone1, 0, 40
    Danger Zone (危险/衰减区间)  :crit, zone2, 40, 100

    section 核心边界拐点
    能力边界 (Accuracy Degrades, 16-24%)  :milestone, m1, 20, 20
    经济边界 (Cost Escalation, ~20%)      :milestone, m2, 20, 20
    行为边界 (Context Anxiety, ~30%)      :milestone, m3, 30, 30
    Safeguard Line (/clear 截断告警线, 40%) :milestone, m4, 40, 40
二、 核心公式:决定模型输出质量的两大隐形杠杆
在长上下文互动中,控制模型输出质量的本质是控制以下两个指标:
1. 信号密度(Signal Density)
安装
npx skills add mattpocock/skills
初始化(/setup-matt-pocock-skills)
/setup-matt-pocock-skills
在你的 agent 中,每个仓库运行一次。它会:
/triage 会用到标签)目录结构
.
├── CLAUDE.md
└── docs
    └── agents
        ├── domain.md
        ├── issue-tracker.md
        └── triage-labels.md
软件开发工作流程
grill-with-docs → to-spec → to-tickets → implement (tdd → code-review) → code-review
/grill-with-docs
description
一场为锐化计划或设计而不留情面的访谈,过程中还会同步创建文档(ADR 与术语表)。调用 Skill 工具两次,分别传入 "grilling" 和 "domain-modeling"。
详细介绍
grill-with-docs 就一个方案或设计对你进行访谈,直到你和 ag
Simon Willison 的 《Agentic Engineering Patterns》(智能体工程模式) 是一份面向软件工程师的实践指南,重点探讨在 Coding Agents(如 Claude Code、OpenAI Codex、Cursor 等能自主生成并执行代码、运行测试的智能体)普及的新时代,如何高效、高质量地进行软件开发。
一、 核心理念:什么是智能体工程?
Agentic Engineering(智能体工程) 明确区别于 Vibe Coding(氛围编程):
1. 观念重塑:“代码变得极其廉价”
传统软件工程的核心约束是代码编写成本昂贵(写几百行优质代码需要数小时或数天),因此衍生出了大量的预先设计、工时评估与严格的 YAGNI(You Aren't Gonna Need It)原则。 在 Agent 时代:
在 AI 辅助编程风靡的今天,许多开发者沉浸于 Vibe Coding(氛围感编码)——直接抛出几句自然语言需求,交由 AI 自动生成代码。然而,这种“野蛮生长”的方式往往会导致需求理解偏差、架构快速腐化(Ball of Mud)、上下文遗忘以及越改 Bug 越多的困境。
Matt Pocock 的开源项目 mattpocock/skills 正是为了解决这一痛点而生。它不是一堆零散的 Prompt 集合,而是一套为 Claude Code、Codex 等 AI 编程智能体设计的系统化软件工程最佳实践。
官方体系将技能划分为两大类:
/grill-with-docs、/to-spec),用于任务编排与流程推进。/tdd、/codebase-design)。工作流全景链路 (The Engineering Harness)
核心开发主流程遵循着从“模糊想法”到“高质量交付”的递进逻辑:
原文:The AI-Native SDLC playbook(Anthropic Applied AI 团队) 译者注:本文为完整中文翻译,英文术语首次出现时保留原文。
代码不再是瓶颈
组织已经开始以一年前难以想象的速度用 AI 编写代码,但围绕代码的流程并没有以同样的速度改变。
许多工程团队仍然沿用同样的审批关卡、评审、交接和策略,这使得使用 Claude Code 等智能体编程解决方案带来的生产力提升被拖延抵消。
软件开发生命周期(SDLC)是将软件从想法带到生产环境的过程。大多数组织运行的都是同样六个阶段的某种版本,涵盖规划、设计、构建、测试、部署和维护软件。传统上,每个阶段都是一个由不同角色负责的独立阶段:产品经理写需求,技术架构师把需求变成设计,工程师按设计实现,受监管企业的 QA 团队进行验证,发布团队负责上线,运维团队监控运行状况。工作在阶段之间通过文档、工单和签字确认来流转。
传统的软件开发生命周期(SDLC)流程繁重,是为了确保每一步的责任与控制。然而,传统 SDLC 的设计初衷是在「编写和实现代码」这一最耗时、最昂贵阶段的年代最大化效率——而这个前提已经不复存在。PRD、估点仪式和产品安全评审,本质上都是为了在长达数周、数月甚至数个季度的开发过程中强制对齐。
传统 SDLC 的另一点是:它的各种控制措施假设每一步都由人来执行。
原文:Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl 作者:Birgitta Böckeler(Thoughtworks 杰出工程师、AI 辅助交付专家,拥有 20 多年软件开发、架构与技术领导经验) 本文是"Exploring Gen AI"系列的一部分。该系列记录了 Thoughtworks 技术专家对使用生成式 AI 技术进行软件开发的探索。
我一直在尝试理解 AI 编程领域最新的流行语之一:规约驱动开发(Spec-driven development,SDD)。我研究了三个自称 SDD 工具的产品,并试图厘清截至目前它到底意味着什么。
定义
与这个快节奏领域中许多新兴术语一样,"规约驱动开发"(SDD)的定义仍在变化之中。以下是我从目前见到的用法中归纳出的理解:规约驱动开发意味着在用 AI 编写代码之前先编写一份"规约"("文档先行")。这份规约成为人与 AI 共同的真理来源(source of truth)。
GitHub:"在这个新世界中,维护软件意味着演进规约。[……]开发的通用语言上移到了更高层次,而代码只是最后一公里的实现手段。"
Tessl:"一种开发方法,其中规约——而非代码——是
00 摘要:10 条核心论断
这份报告不是工具评测,也不是范式百科。它的目标是回答一个工程决策问题:如果你要在 2026 年把 AI 编程从「个人提效」推到「团队与生产系统」,你该采用哪套范式、按什么顺序、用什么门禁? 下面 10 条论断是全篇骨架,只读这一页也能拿走结论。
spec.md 直接驱动生成器、被 Git 版本化、被 CI 校验——可执行,才第一次值得写。以下是 IBM 文章 《什么是规范驱动开发?》(What is Spec-Driven Development?) 的中文翻译:
作者: Anna Gutowska(IBM AI 工程师、开发者倡导者)
发布日期: 2026年5月19日
规范驱动开发的定义
规范驱动开发(Spec-Driven Development, SDD) 是一种软件开发方法论。在正式编码之前,团队需先编写并达成一份关于实现细节的详细规范(Specification)。换句话说,这份规范将作为“构建什么”以及“如何构建”的唯一真实来源(Single source of truth)。
随着 Microsoft GitHub Copilot、Anthropic Claude Code 或 IBM Bob 等 AI 工具与编程助手的普及,生成代码的门槛已大幅降低。基于先进 AI 模型的 LLM 驱动型 AI Agent,只需用户输入一条自然语言提示词(Prompt),即可随时实时运行一系列迭代任务。
对于软件开发而言,这意味着我们可以优化并自动化构建原型、新功能、单元测试等的开发工作流。生成代码从未如此简单。然而,“氛围程序员”(Vibe Coders)需要警惕一个潜在风险:AI 的表现上限完全取决于它所接收到的指令质量。
技术债务的抬头:一个典型场景
你可能在现实世界中见过技术债务,甚至自己都没意识到。
随着 Cursor、Claude Code、Windsurf 以及 OpenClaw 等 AI Coding Agent 深度嵌入日常开发工作流,软件开发正在经历从 “人类编写代码” 到 “人类定义规则,Agent 协作编码” 的转变(Agentic Engineering)。
我们在项目中往往会编写 README.md 面向人类开发者,但很多团队忽视了为 AI Agent 提供一套上下文感知与行为治理规范(Harness Guidelines)。这就是 AGENTS.md(或 AGENT.md / CLAW.md)存在的意义——它是写给 AI Agent 看的“项目运维与开发指南”。
本文以实际项目架构为例,聊聊为什么需要 AGENTS.md 以及如何为你的开源或商业项目定制一份高效的 Agent 治理规范。
一、 为什么传统的 README.md 不够用?
人类开发者阅读 README.md 时,拥有强大的泛化能力和隐式背景知识;但 AI Agent 在读取代码库时,是以 Token 上下文的形式载入信息的。
传统的 README 往往面临以下痛点:
code‑review‑graph 是一款为 AI 编程助手打造的本地代码知识图谱工具,核心是用增量图谱替代全量读码,大幅降低 AI 上下文 Token 消耗、提升代码审查与理解效率。
基于 Tree‑sitter 解析代码结构,构建持久化增量知识图谱,通过 MCP 协议给 AI 提供精准最小上下文,Token 用量可降 5–10 倍,零配置开箱即用。
pip install code-review-graph
将 MCP Server 注册到 AI 编程平台
# cd <project-root>
code-review-graph install --platform claude-code
这是一个通过多智能体(multi-agent)流水线将代码库或知识库转化为交互式知识图谱,并提供可视化看板和 AI 问答功能的 Claude Code 插件。
Understand Anything 将任意代码库、知识库或文档转化为可探索、可搜索、可对话的交互式知识图谱,支持 Claude Code、Codex、Cursor、Copilot、Gemini CLI 等多平台。
多智能体架构
/understand 命令调用 5 个 agent,/understand-domain 额外增加第 6 个:
| Agent | 职责 |
|---|---|
project-scanner |
扫描项目文件,检测语言和框架 |
file-analyzer |
提取代码结构(函数、类和导入),生成图节点和边 |
architecture-analyzer |
识别架构层 |
tour-builder |
生成引导式学习路径 |
graph-reviewer |
验证图的完整性和引用完整性 |
domain-analyzer |
提取业务领域、流程和处理步骤(由 /understand-domain 使用) |
article-analyzer |
从 wiki 文章中提取实体、论断和隐式关系(由 /understand-knowledge 使用) |
文件分析器并行运行(最多 3 个并发)。支持增量更新 — 仅重新分析自上次运行以来发生更改的文件。
创建项目
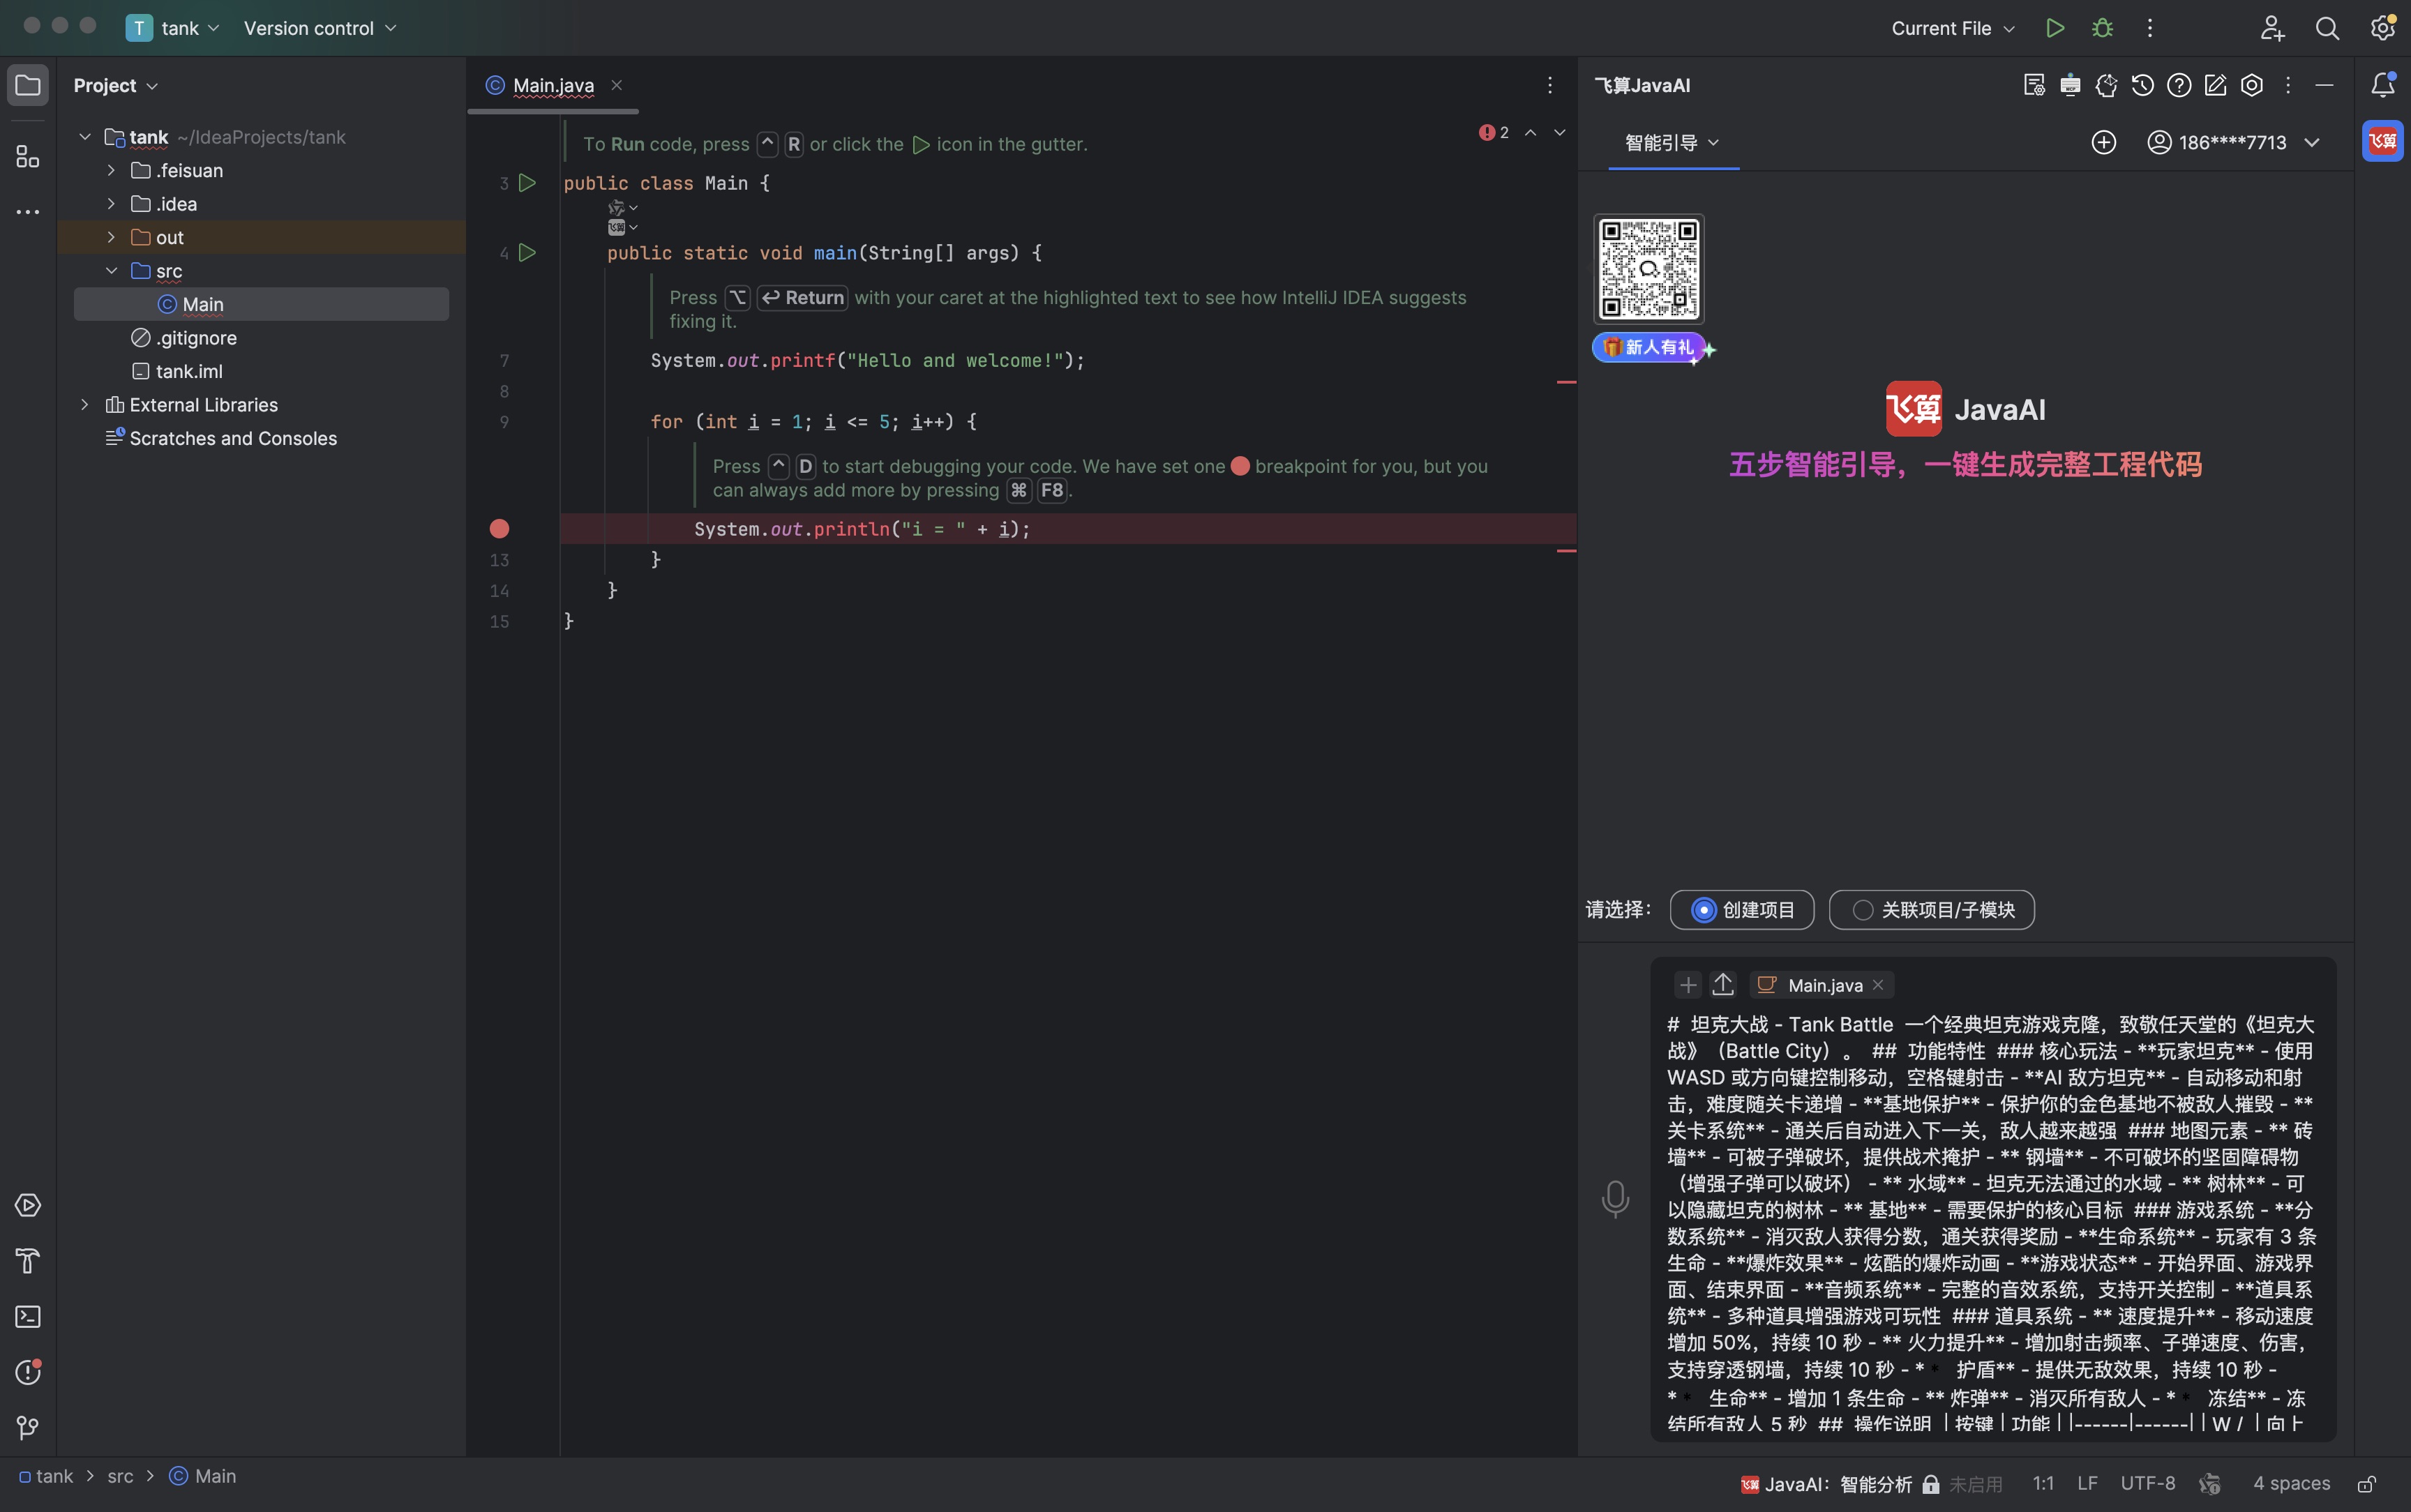
# 🎮 坦克大战 - Tank Battle

一个经典坦克游戏克隆,致敬任天堂的《坦克大战》(Battle City)。

## ✨ 功能特性

### 核心玩法
- **玩家坦克** - 使用 WASD 或方向键控制移动,空格键射击
- **AI 敌方坦克** - 自动移动和射击,难度随关卡递增
- **基地保护** - 保护你的金色基地不被敌人摧毁
- **关卡系统** - 通关后自动进入下一关,敌人越来越强

### 地图元素
- **🧱 砖墙** - 可被子弹破坏,提供战术掩护
- **🔩 钢墙** - 不可破坏的坚固障碍物(增强子弹可以破坏)
// ...
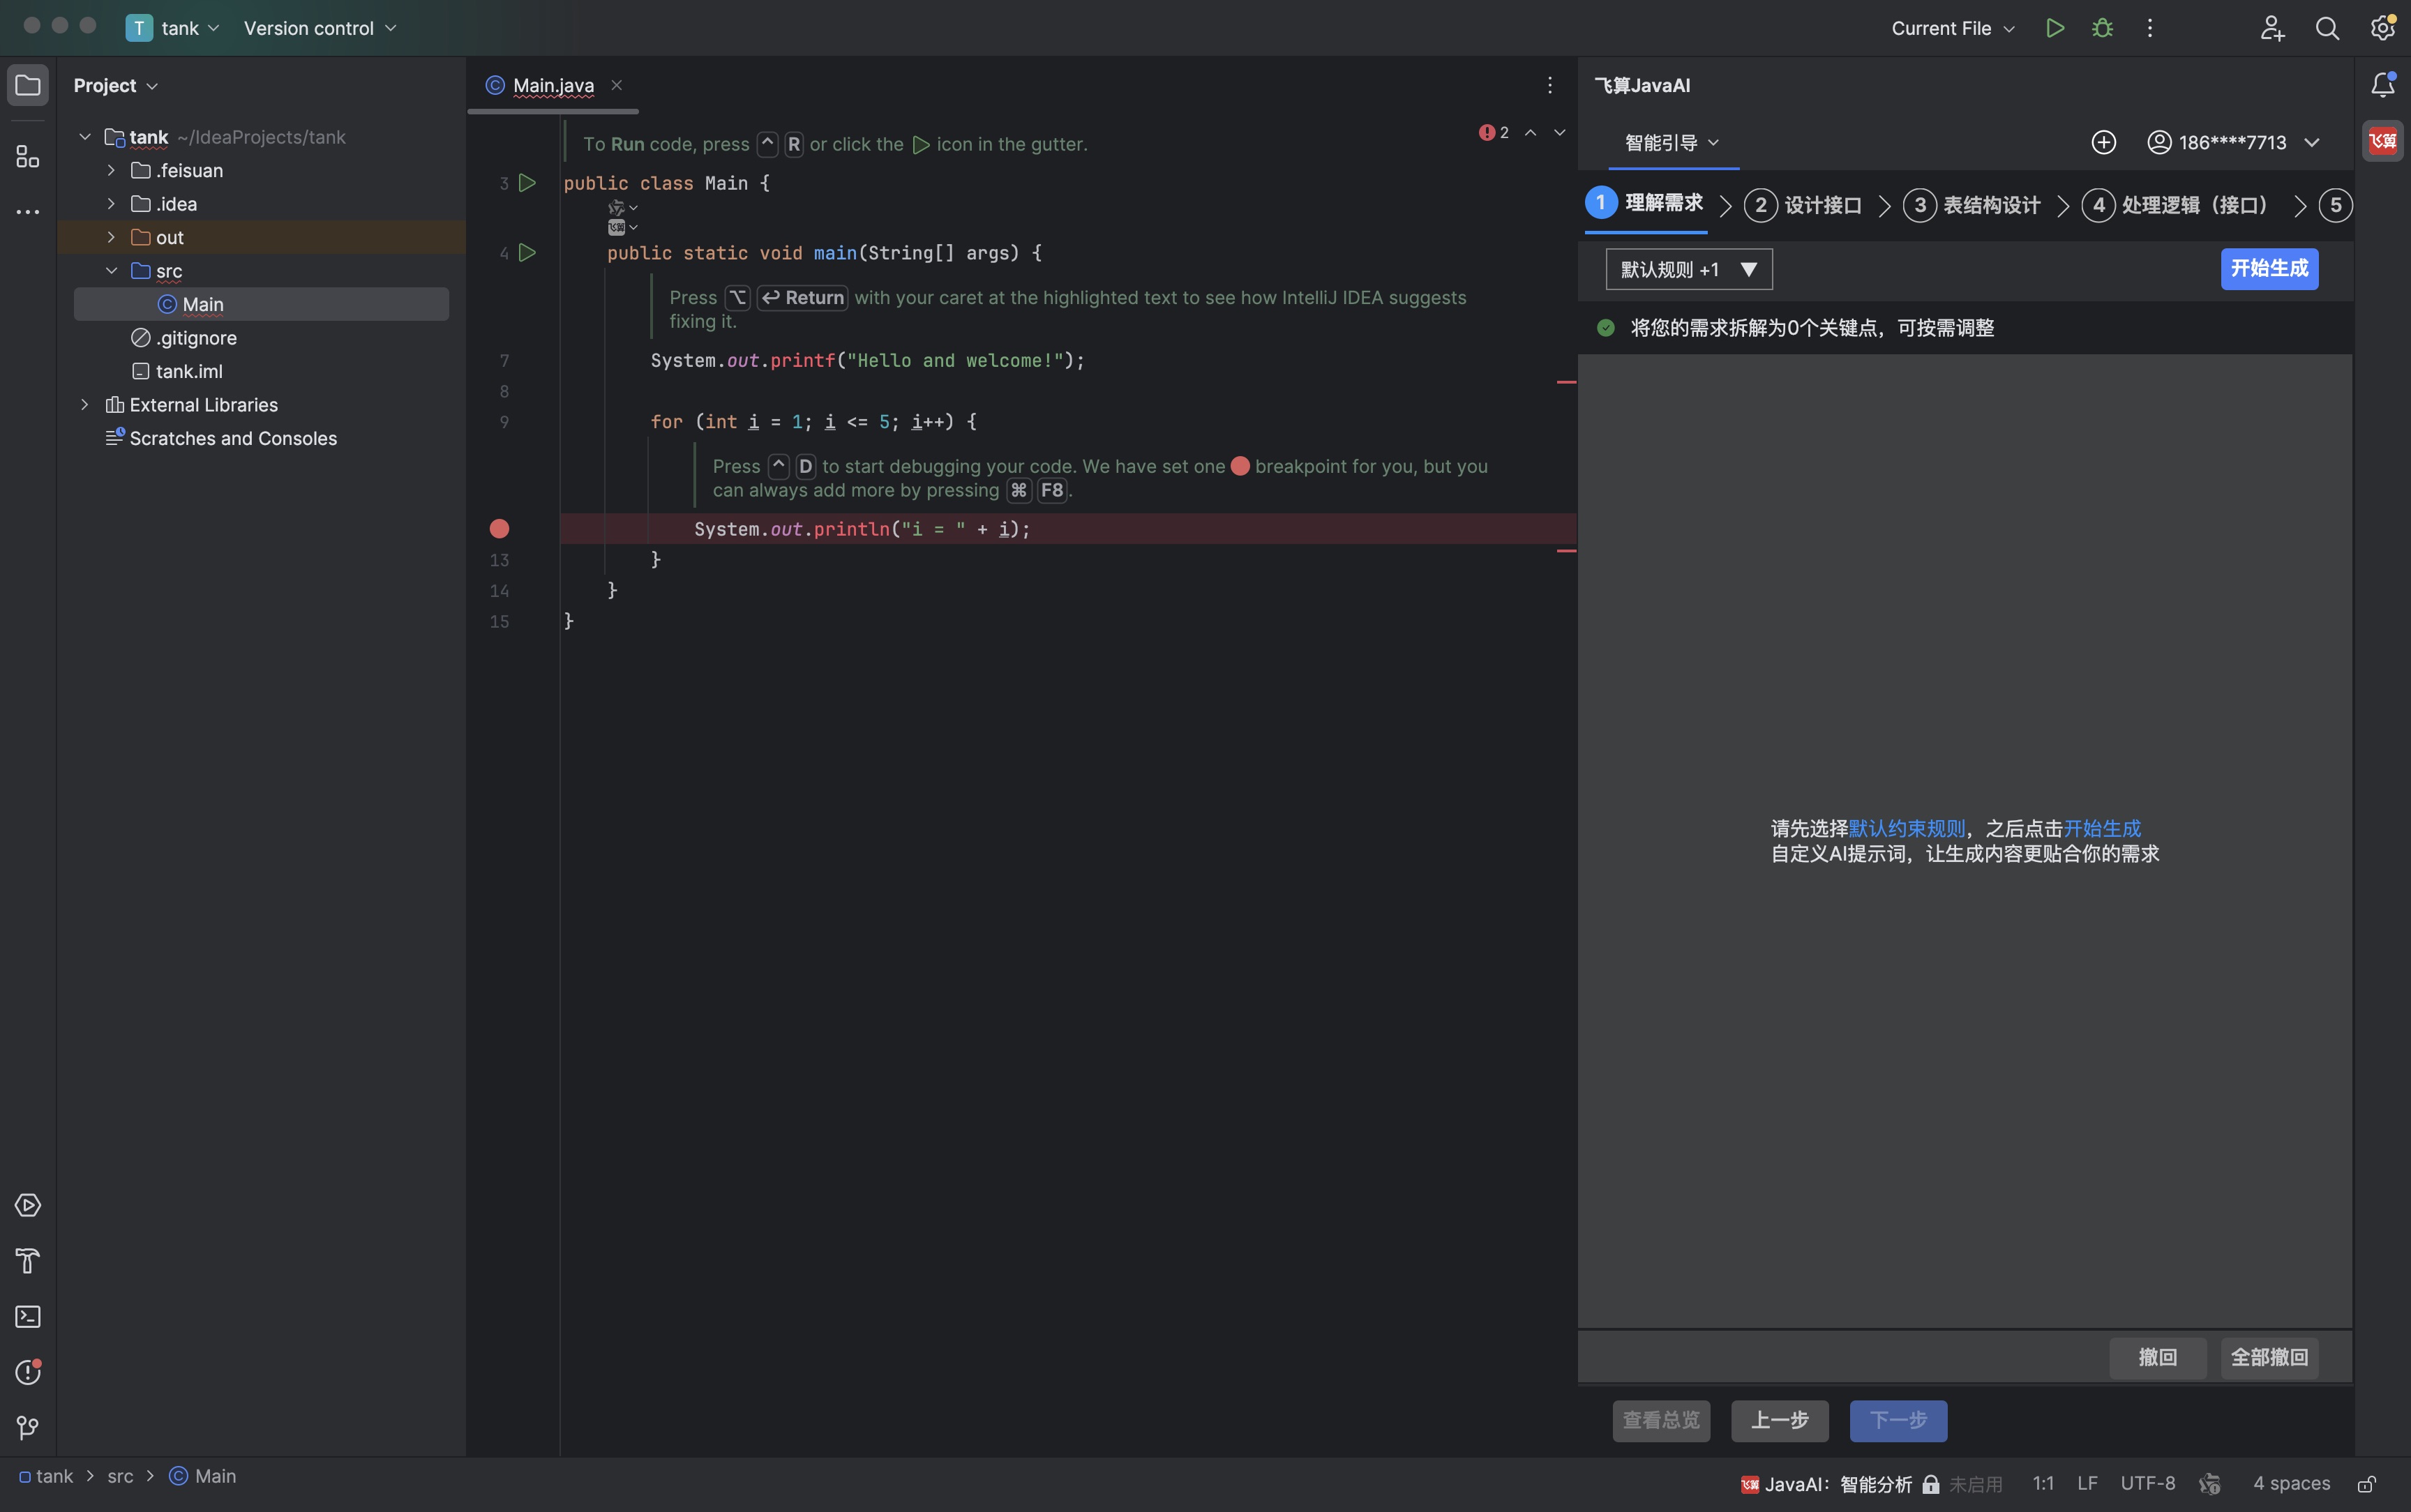
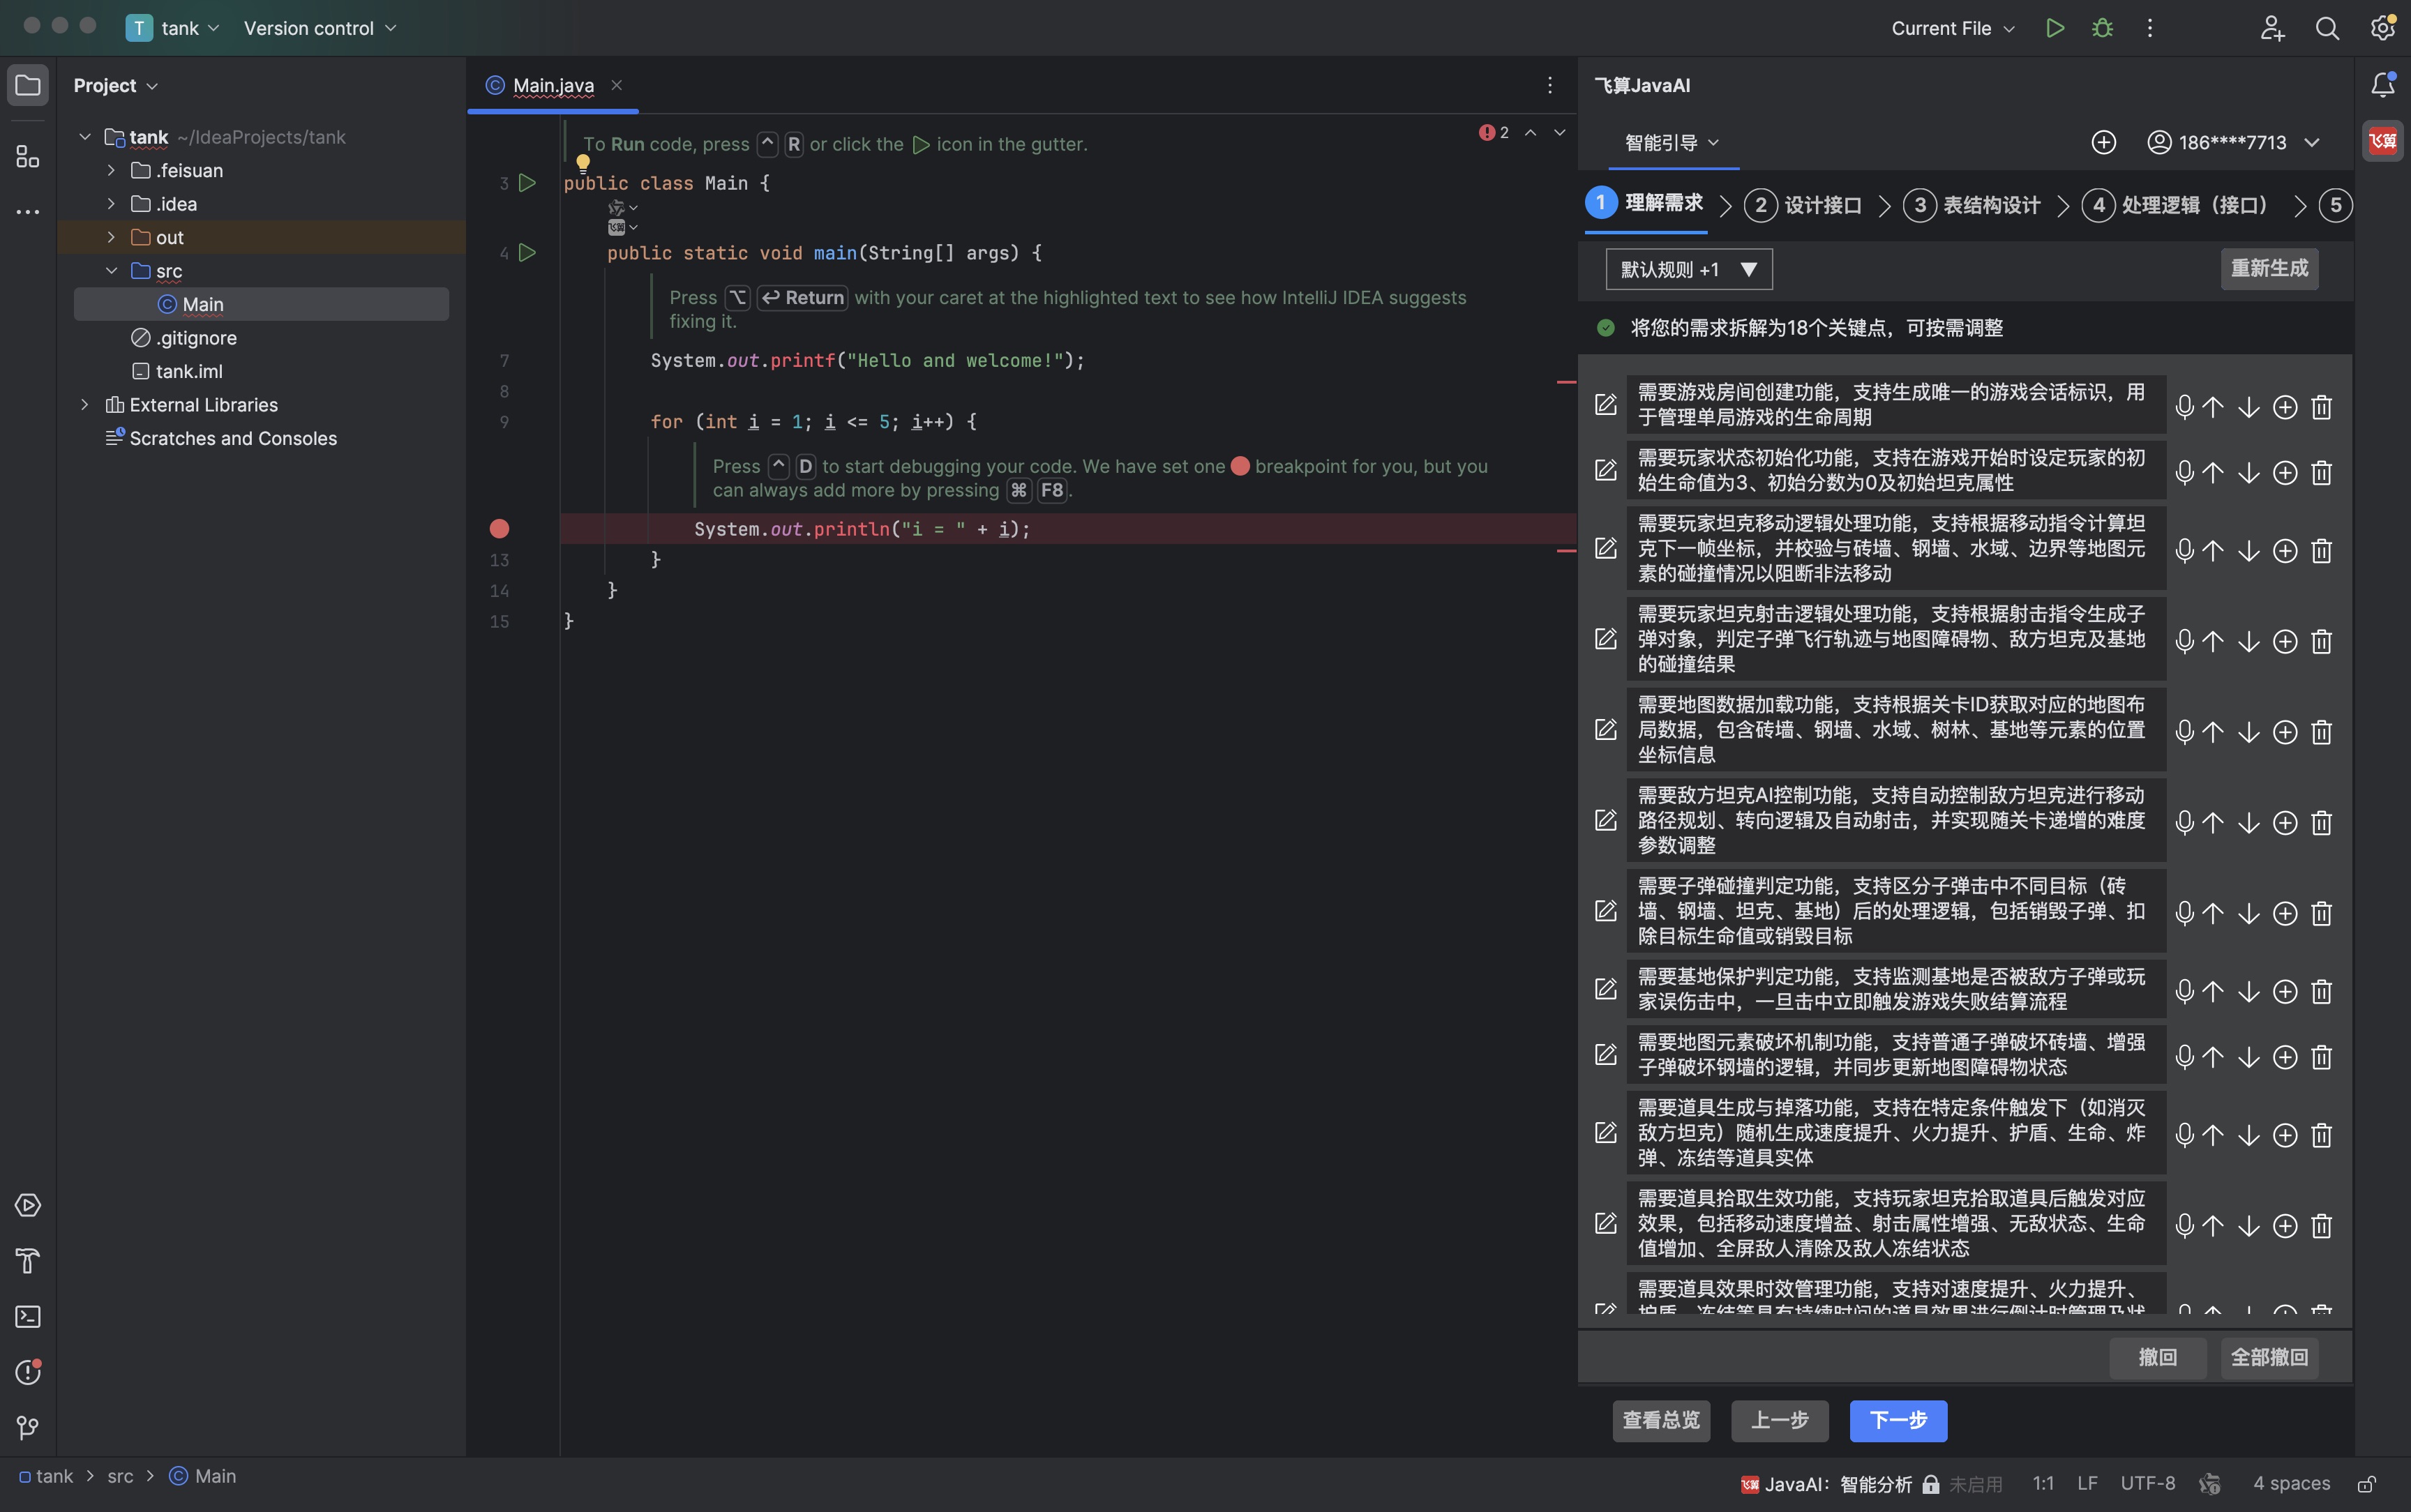
一、理解需求
AI 编程的演进逻辑非常清晰:GitHub Copilot 作为插件,在传统 IDE 里为大众提供辅助;Cursor 则打破束缚,通过 AI 原生 IDE 实现了深度的体验跃迁;而 Claude Code 这类 CLI 工具,则是为追求极致自由与自动化的极客准备的——它摆脱了图形界面的繁琐,让开发者在命令行中,就能以‘操作指令’驱动 AI 完成从编码到部署的全流程。
AI 编程三剑客:时间线与营收对比
| 维度 | GitHub Copilot | Cursor | Claude Code |
|---|---|---|---|
| 代表形态 | IDE 插件 (Plugin) | AI 原生 IDE (Forked) | CLI 智能体 (Agent) |
| 正式发布/爆发时间 | 2021年6月 (预览) / 2022年6月 (正式) | 2023年 (起步) / 2024年底 (爆发) | 2025年2月 (GA) |
| 年营收 (ARR) | (2025年Q3数据) | 10 亿+ (2025年底估算) | $10 亿+ (上线6个月即达成) |
| 用户规模 | 2000万+ 开发者 | 100万+ 付费用户 | 爆发式增长中 (API驱动) |
| 核心地位 | 行业标准与基建 | 效率工具的巅峰 | 自主编程的开端 |
1. GitHub Copilot:稳坐江山的“老牌霸主”
没有找到匹配的文章