AI 原生软件开发生命周期(SDLC)实战手册
原文:The AI-Native SDLC playbook(Anthropic Applied AI 团队) 译者注:本文为完整中文翻译,英文术语首次出现时保留原文。
代码不再是瓶颈
组织已经开始以一年前难以想象的速度用 AI 编写代码,但围绕代码的流程并没有以同样的速度改变。
许多工程团队仍然沿用同样的审批关卡、评审、交接和策略,这使得使用 Claude Code 等智能体编程解决方案带来的生产力提升被拖延抵消。
软件开发生命周期(SDLC)是将软件从想法带到生产环境的过程。大多数组织运行的都是同样六个阶段的某种版本,涵盖规划、设计、构建、测试、部署和维护软件。传统上,每个阶段都是一个由不同角色负责的独立阶段:产品经理写需求,技术架构师把需求变成设计,工程师按设计实现,受监管企业的 QA 团队进行验证,发布团队负责上线,运维团队监控运行状况。工作在阶段之间通过文档、工单和签字确认来流转。
传统的软件开发生命周期(SDLC)流程繁重,是为了确保每一步的责任与控制。然而,传统 SDLC 的设计初衷是在「编写和实现代码」这一最耗时、最昂贵阶段的年代最大化效率——而这个前提已经不复存在。PRD、估点仪式和产品安全评审,本质上都是为了在长达数周、数月甚至数个季度的开发过程中强制对齐。
传统 SDLC 的另一点是:它的各种控制措施假设每一步都由人来执行。而那些创造了最大价值的组织,已经围绕智能体 AI(agentic AI)如今能做的事重构了自己的流程,同时确保人仍然在环(human in the loop)。在本指南中,我们将介绍 Applied AI 团队在与客户合作中受到启发、在内部将 Claude 集成到 SDLC 各阶段的几项最佳实践,以加速开发、让流程跑得更快。
当代码不再是瓶颈、构建阶段快过传统 SDLC 所能容纳的速度时,三件事随之成立:
- 瓶颈转移到了构建阶段左右两侧的步骤。主要是计划、评审/测试和部署——它们仍然以人的速度运行。
- 控制措施与现实脱节,变得难以执行。逐行人工评审在代码由人编写时是合理的,但一旦大部分 diff 由智能体编写,它就跟不上了。
- 治理成本上升,因为例外情况仍然要路由到每周或每月开会的委员会和会议。
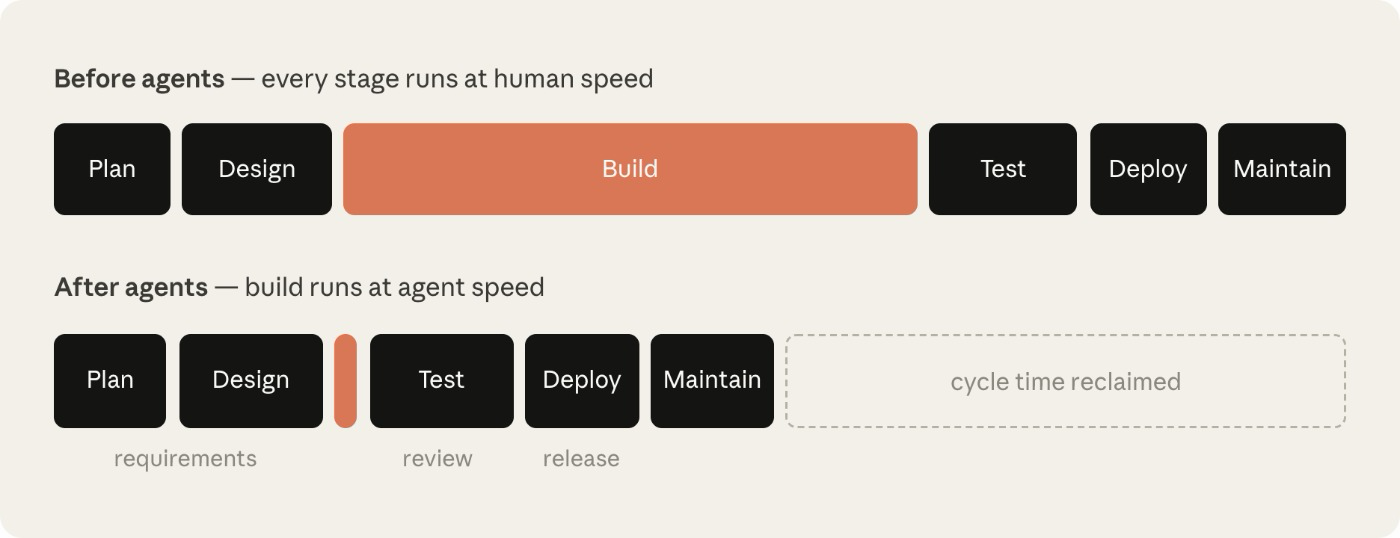
以安全瓶颈为例。安全团队的规模是按人的产出配置的,所以当智能体让代码产出倍增时,要么评审队列积压,要么代码在评审不足的情况下被发布。受监管的组织两者都不能接受,因此它的安全和策略检查必须跟上智能体的步伐。
要更好地实现智能体 AI 的生产力收益并保障其安全,传统 SDLC 生命周期需要与实现阶段已经经历过的同等程度的变革。
什么是 AI 原生 SDLC?
AI 原生 SDLC 是一个重新构想的过程,它把旧的控制目标与新的执行方式结合起来。流程不再是线性的,而是变成一个循环,AI 被嵌入到每一个节点。AI 原生 SDLC 推动交接的自动化以及后续战术(play)的自动触发,从而解决传统 SDLC 各阶段之间手动而笨拙的交接问题。
你也会听到这种转变被称为智能体 SDLC(agentic SDLC)、AI SDLC,或者直接叫智能体软件开发——名称不同,但说的是同一件事。
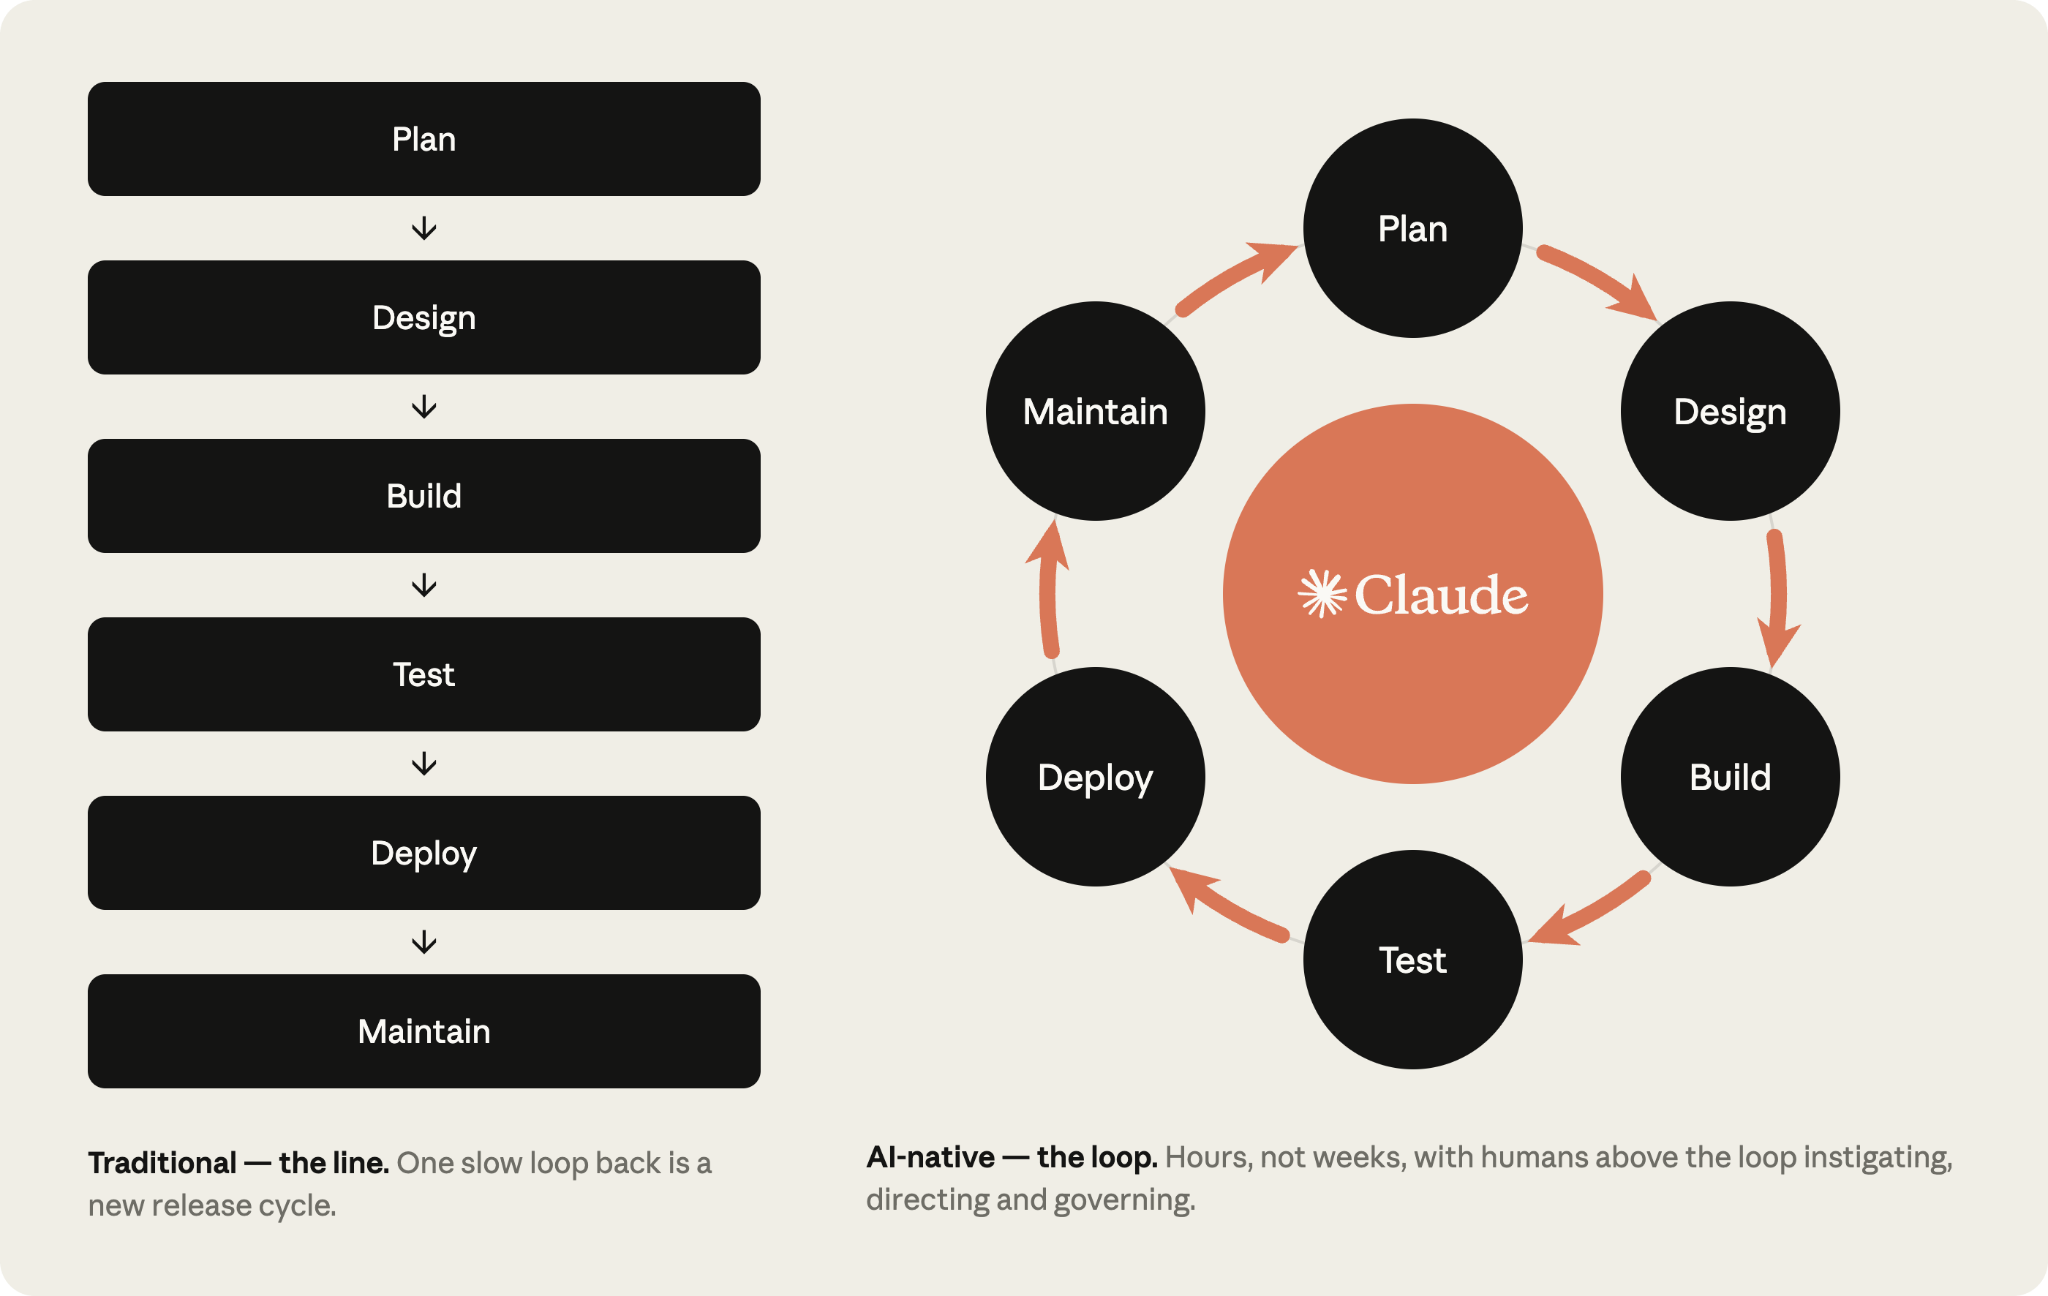
AI 原生 SDLC 六个阶段的转变
下表展示了传统 SDLC 与 AI 原生 SDLC(由 Claude 支撑)之间的光谱两端。大多数组织位于两列之间的某个位置。
| 阶段 | 传统 SDLC | AI 原生 SDLC |
|---|---|---|
| 计划(Plan) | 需求由委员会收集,经过工作坊和签字的提炼,手工写成文档 | Claude 直接从源头综合痛点,并把它们记录进 intent.md——既可被人阅读,也可被机器执行 |
| 设计(Design) | 分析师写规约,设计师再拆解规约 | 需求与设计在一次与智能体的工作会话中压缩完成,由编码为技能(skills)的标准引导,并在 git 中版本化 |
| 构建(Build) | 测试和代码手写,文档在主要开发完成后补写 | 测试和代码由 AI 生成,组织知识以可版本化、机器可读的 CLAUDE.md 文件和技能形式维护 |
| 测试(Test) | 阶段边界上的 QA 关卡 | 持续评测(evals)编织在实现过程中 |
| 部署(Deploy) | 人评审每一行代码,治理发生在评审周期中,且常常不一致 | 多层智能体评审,人工评审保留给受监管和关键的代码。治理在 AI 行动时强制执行,钩子(hooks)作为审批门禁 |
| 维护(Maintain) | 人盯守着生产环境找 bug | 智能体监控实时部署。任何被突破的控制带都会被诊断,并作为新的 intent.md 写回循环 |
右列贯穿始终的主线是「被提交的产物」(committed artifact)。每个阶段都以向版本控制写入一个产物结束(包括 intent.md、spec.md、plan.md、diff 及其测试、带评审结论的 PR,以及事故记录),而下一个阶段以读取它开始。在早期阶段,产物主要是 .md 文件,因为产品负责人和智能体都能读取并处理同一个文件。从构建阶段开始,产物就是代码及其记录。这条提交链也就是审计轨迹:谁提出了什么需求、智能体产出了什么、谁批准了它。
人仍然对每个需要判断力的决策负责。在智能体 SDLC 的世界里,人的注意力随着必须评审的产物一起转移。
每个阶段都提交一个下一阶段可读的产物。意图、规约、计划、diff 和评审结论合在一起,就是审计轨迹。
战术(Plays)
战术是本手册的核心,分为六个非线性的阶段(计划、设计、构建、测试、部署、维护),合起来覆盖完整的生命周期。
每个战术涵盖:
- 什么发生了变化;
- 如何上手;
- 实施的具体步骤;
- 治理方面的考量;以及
- 如何衡量它是否奏效。
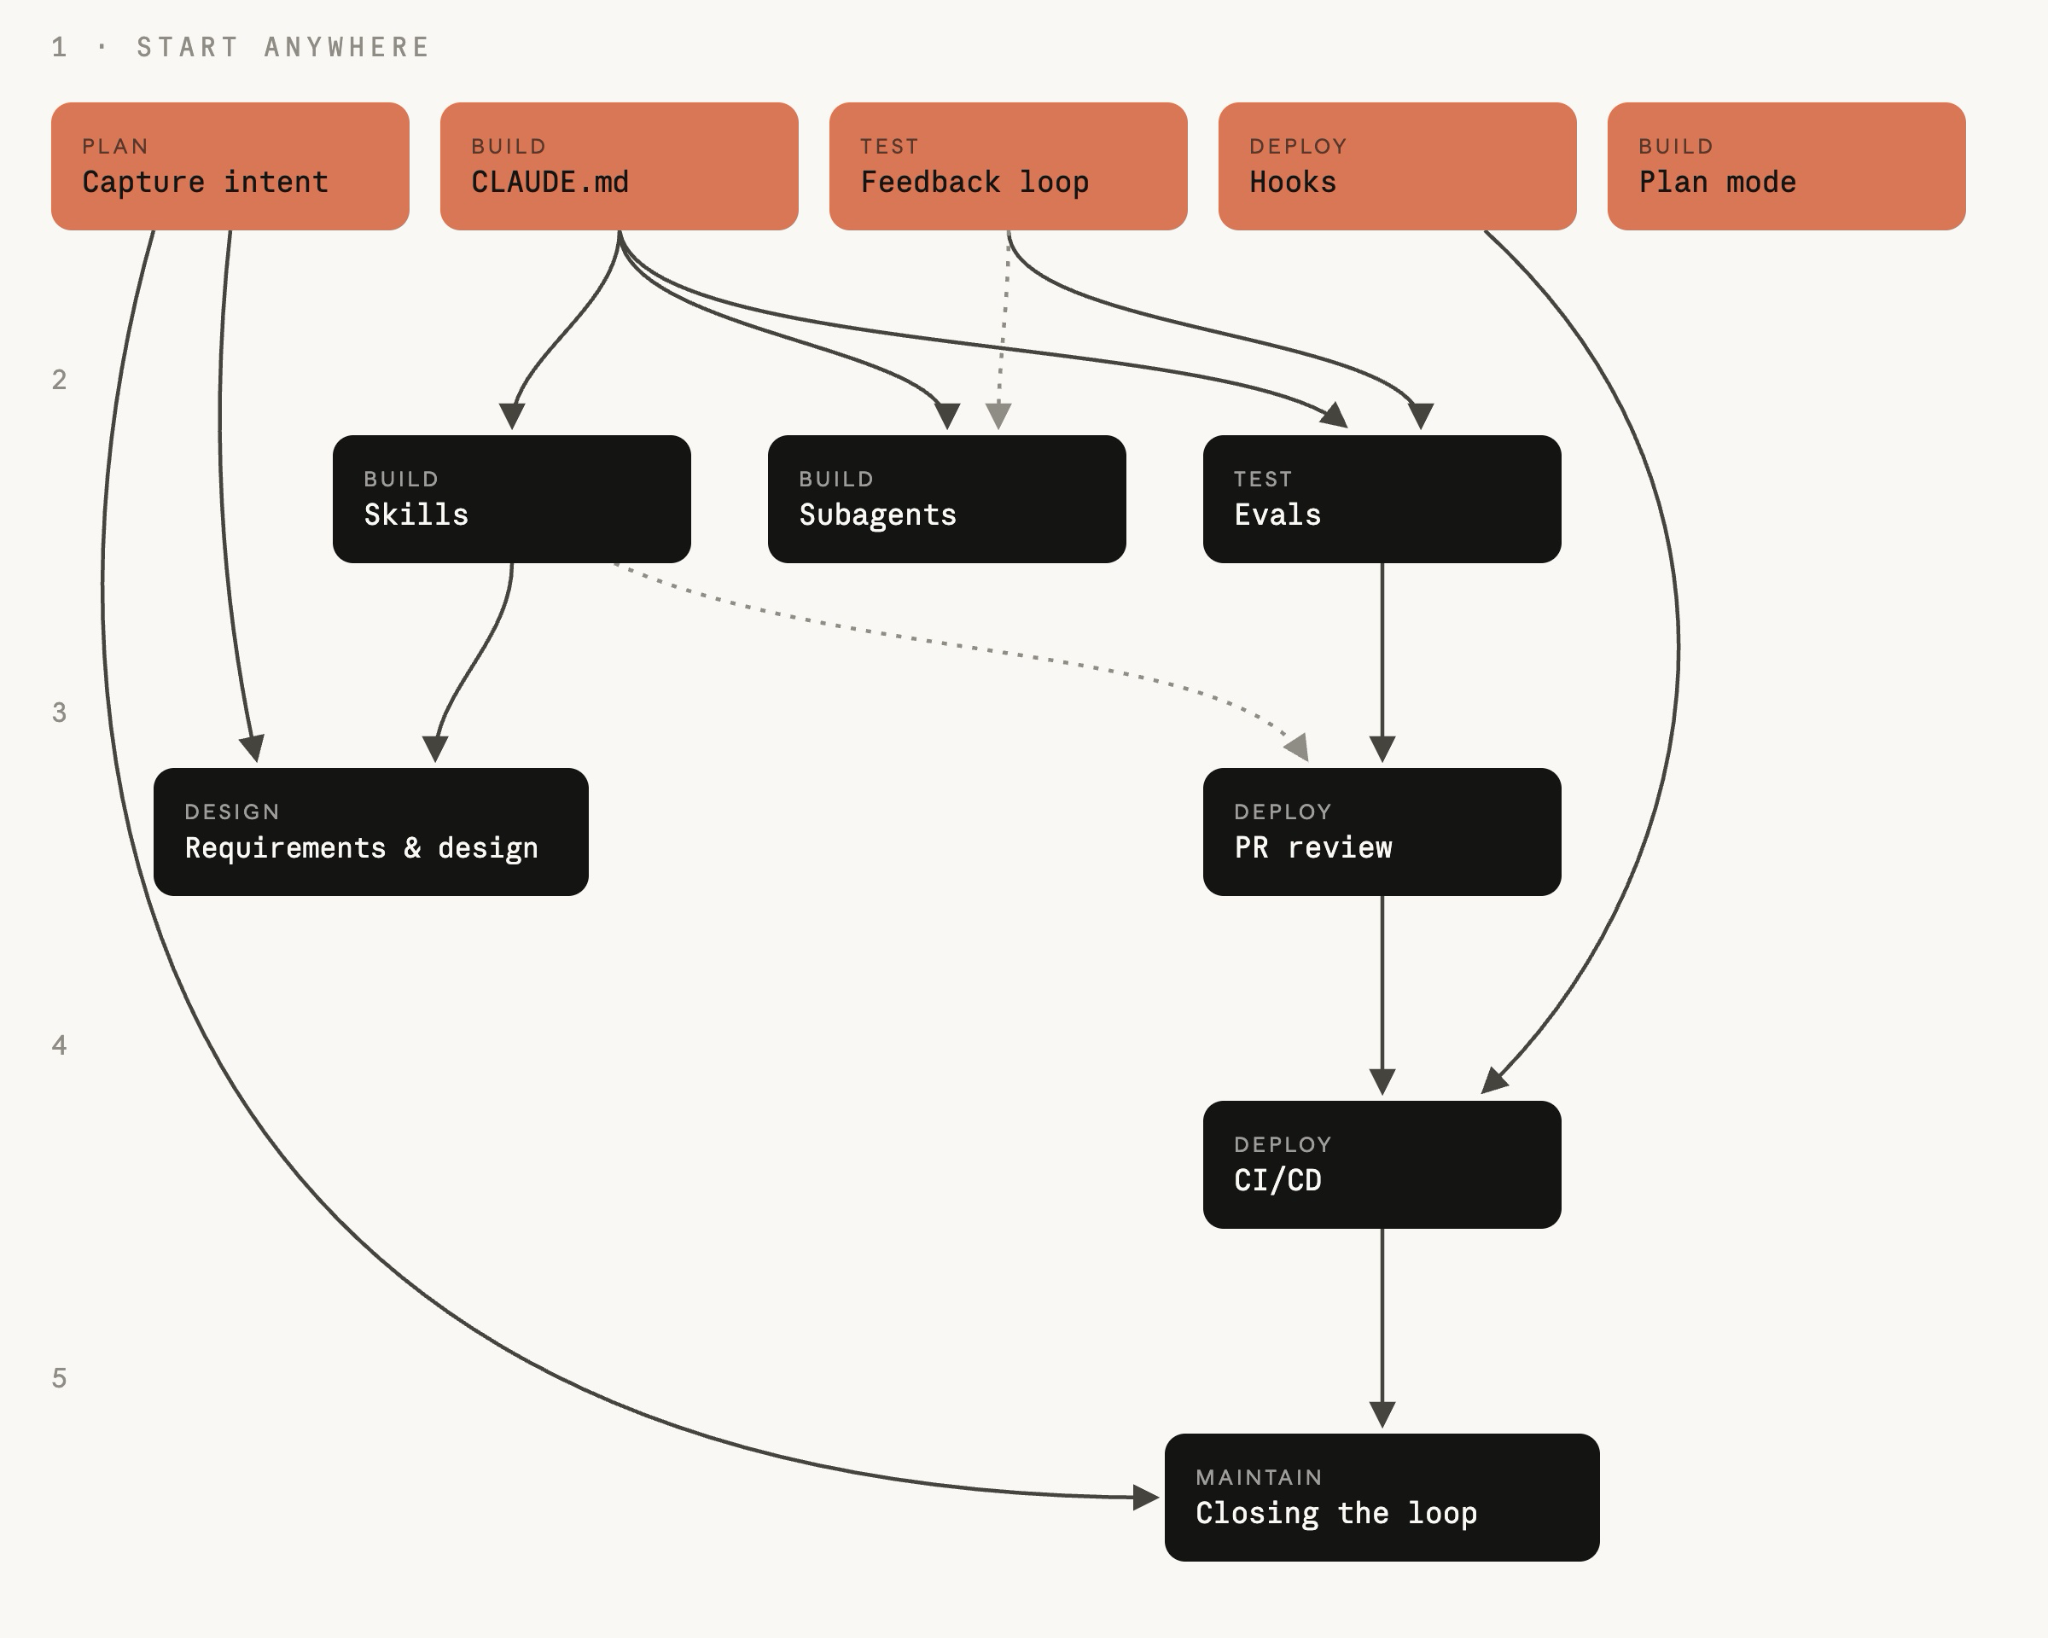
这些步骤是模块化的,组织可以根据自身独特需求选择在不同时间优先改造不同的阶段。每个战术在「前置条件(Prerequisites)」下列出它的依赖,依赖图进一步说明了这些关系。
一个阶段以提交一个产物结束,而该提交会启动下一个阶段。被接受的 intent.md 触发需求与设计环节,被批准的 spec.md 触发计划模式(plan mode),被合并的 PR 触发流水线,生产环境中被突破的控制带写下下一个 intent.md——循环如此继续。
一开始,你手工提示每个步骤,最终状态是一个循环:每个被接受的产物都会触发下一个关卡。人的注意力集中在关卡上,评审智能体标记出的内容,而不是每个阶段从零开始。
01 · 计划(Plan)
想法不再等待有人来把它们写下来。意图只捕捉一次,用提出者自己的话,作为一个可被下一阶段处理、受版本控制的产物。
记录为 intent.md
启动软件开发过程的 intent.md 可以通过不同途径进入。一个人有了想法,提交了一张工单,或者一次告警暴露了一个事故(见第 6 阶段:维护)。
当一个人有了想法时,他与 Claude 一起头脑风暴,产出一份 markdown 格式的原型规约(proto-spec)。在传统 SDLC 中,同一个人还必须说服产品团队的某位成员替他或和他一起把这个想法写出来。
由 Claude 生成的原型规约可被人阅读、受版本控制,并能被下一阶段立即消费。这份原型规约被保存为 intent.md。
无论意图来自事件触发还是智能体,步骤都相同:产品负责人在提交前评审并修正智能体写就的 intent.md。
传统方式:一个想法要经过 backlog 条目、用户故事、故事点和细化会议,之后才能有人动手。所有权在每次交接时转移,因此最终到达工程团队的东西,与提出者的本意已经隔了好几层。
AI 原生方式:提出者与 Claude 头脑风暴,结果用提出者自己的术语写成
intent.md,一份原型规约。产物包含想要什么、为什么、以及在哪些约束之下。重复性的流程通过技能(skills)编码。
如何上手
前置条件
无。
基础设施
非工程师人员也能使用 Claude(claude.ai 或 Cowork);一份达成共识的 intent.md 模板;一个共享的、受版本控制的意图存放处,由产品负责人看管。对于单一产品,最简单的存放处就是产品仓库里的 intent/ 文件夹。这样的布置让产物链与它派生出的代码放在一起。只有当意图跨越多个仓库时,专门的意图仓库才值得额外的开销;而在 monorepo 中,它就是一个目录。第 3 阶段:构建的侧栏涵盖了该存放处与已经保存记录的 Jira 或需求工具之间的关系。
搭建这是一项平台团队或工程团队的一次性任务。需要一名技术团队成员建立意图存放处并决定谁可以写入,因为许多贡献者将来自整个组织。
仓库建好之后,没有 git 经验的贡献者不需要直接使用 git。取而代之的是连接版本控制系统(如 GitHub)的连接器,让 Claude 在 claude.ai 或 Cowork 中替他们提交 markdown 文件。
如何执行
- 提出者用自己的话向 Claude 描述问题。提出者可以描述今天做不到的事、谁受这个想法影响、更好的状态是什么样,或者什么不在范围内。不需要正式的语言。
- 头脑风暴,直到想法变得具体。Claude 会问分析师会问的问题:范围、用户、约束,以及成功是什么样。
- 让 Claude 使用组织模板把结果写成
intent.md,该模板可以由技术团队成员编码为技能(skill)并由负责人签字认可。模板可以涵盖问题、预期结果、受影响的用户和系统、约束,以及未决问题。 - 提出者修正 Claude 误解的任何内容。
- 把
intent.md提交到共享存放处。作者和时间戳进入记录,产品负责人从这里接手这个想法。
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
治理考量
证据就是被提交的 intent.md,其中列出了作者、时间戳和完整的修订历史。它记录在意图存放处的 git 历史中。产品负责人进行批准,而送意图进入第 2 阶段:设计的接受或拒绝决定,被记录为合并或关闭评审。
如何衡量
先行指标
从第一次对话到 intent.md 被提交的时间,从意图存放处的 git 历史中读取(其中记录了作者和时间戳)。预期是从数周的需求提炼与细化周期缩短到数小时。
滞后指标
存活率,即 intent.md 被产品负责人接受进入第 2 阶段:设计(而不是被关闭)的比例。接受或拒绝的决定被记录为产物的合并或关闭的评审。此外,还有同一变更在第一个 spec.md 提交之后对 intent.md 做出的修改次数。
02 · 设计(Design)
需求与设计压缩进一次会话。策略在规约编写时就被应用,而不是几周后的评审中才被发现。
需求与设计
经产品负责人批准后,Claude 接过被接受的 intent.md,产出一份需求与设计规约。它由组织关于品牌、安全、合规和 UX 的技能(skills)引导。
产品负责人评审这份规约,但不亲自写它。这个过程的目标是产出一份工程团队可以据此做计划的规约,并标出需要关注的区域。
前端工作是最清晰的例子。intent.md 被接受后,产品负责人在 Claude Design(测试版)中根据 intent.md 做出设计稿,对设计稿迭代,然后把它导出到 Claude Code 去构建。
传统方式:需求与设计是由不同团队执行的两个独立阶段。分析师把想法形式化为需求,设计师再把这些需求解析回设计。这种分离是为了问责,但它既慢又有信息损耗。
AI 原生方式:两个阶段在一次提示会话中完成。Claude 接过
intent.md,在组织技能的约束下产出一份需求与设计规约,并标出需要关注的区域。
如何上手
前置条件
写一份 intent.md 文件,并把品牌、安全、合规和 UX 策略写为技能。
基础设施
一位有 Claude 使用权限的产品负责人。不需要工程技能。
如何执行
- 产品负责人打开一个会话,加载组织的技能,并附上
intent.md。 - 产品负责人的提示指向
intent.md,指明约束,并要求标出关注的疑点。先手工运行,然后把它固化成组织级的斜杠命令(slash command)。再进一步,把意图存放处中intent.md的被接受作为触发器:由一个非交互式任务在合并时触发,加载组织技能运行该环节,并把spec.md作为拉取请求提交(第 5 阶段:部署中的 CI/CD 战术涵盖底层机制)。从那时起,产品负责人的第一次介入就是评审。 - 由同一位产品负责人对照想法评审规约。规约是否解决了所述问题?
intent.md中的未决问题得到了回答,还是被带入下一阶段? - 先处理被标记的疑点,因为这些正是分析师会升级上报的问题。产品负责人在工程团队看到规约之前,与每一项疑点的策略负责人共同解决。
- 把
spec.md与intent.md一起提交。这一对文件记录了提了什么需求、决定了什么。 - 产品负责人决定规约和意图是否进入构建阶段;对组织认定为更高风险的任何内容,咨询技术负责人。这个决定总是由人类队友做出,而接受规约正是启动第 3 阶段:构建中计划模式战术的动作。
它看起来是什么样(提示词)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.
治理考量
活策略(live policy)在规约编写时就被读取和应用,而不是几周后在评审中才被发现。组织的技能作为约束被应用到规约上。规约、产生它的提示词、以及生效中的技能版本,全部被记录在版本控制中。产品负责人签署规约,并把标记的疑点路由给具名的策略负责人。
如何衡量
先行指标
同一变更的 intent.md 提交与 spec.md 提交之间的时间差(两个 git 时间戳),与旧的需求加设计周期对比。
滞后指标
构建开始后的需求返工。统计同一变更在第一个 plan.md 提交之后仍有提交的 spec.md 次数。git log 可以直接给出这个数字。
03 · 构建(Build)
没有被接受的计划,什么都不实现。组织知识变成智能体读取的文件,护栏作为代码运行,而不是作为习惯。
以 Claude Code 计划模式作为默认起点
工程师以计划模式(plan mode)启动 Claude Code 会话,把第 2 阶段:设计中获批的 spec.md 交给 Claude,让它像访谈一样与工程师交流,对计划反复迭代,直到工程师满意为止。
传统方式:工程师读完设计就开始写代码。变更将如何进行——具体到改哪些文件、写哪些测试——都留在工程师的脑子里,或者最多写在工单评论里。没有其他人能评审它。评审者看到的第一样东西就是完成的 diff,而到那时返工已经很慢了。
AI 原生方式:工作从一份书面的计划开始,由 Claude 在计划模式(plan mode)中产出——它可以读取代码库而不改动任何东西。工程师在代码写出之前修正计划,获批的版本被提交为
plan.md,供后续阶段对照检查。
如何上手
前置条件
意图产物(intent.md 或 spec.md),如果有的话;CLAUDE.md 文件会有帮助。
基础设施
能访问仓库的 Claude Code。
如何执行
- 工程师以计划模式启动与 Claude 的会话。
- 工程师把
intent.md和spec.md交给 Claude,要求一份实现计划:指明会改哪些文件、工作顺序,以及证明变更正确的测试。 - 拷问这份计划:问这个变更可能破坏什么、哪一步风险最大、以及 Claude 没有选择的其他方案是哪些。
- 反复迭代,直到一位从未看过这段对话的工程师仅凭计划就能实现这个变更。
- 把获批的计划提交为
plan.md。计划加入审计轨迹,PR 评审战术(第 5 阶段:部署)会对照它检查最终的 diff。 - 接受计划,让 Claude 去实现。有了扎实的计划,实现往往一次通过。
- 当实现偏离计划时,在同一个提交中更新
plan.md。可以考虑用一个钩子(hook)强制二者同步。
它看起来是什么样(plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
治理考量
设计评审发生在任何代码生成之前,此时改变方向还只是编辑一份文档的事。计划模式本身就强制执行这一点,因为在工程师接受计划之前 Claude 无法编辑文件。计划及其修订与接受人一起被记录。常规变更由工程师批准,组织认定为更高风险的任何东西交给技术负责人或架构师。
如何衡量
先行指标
从第一次实现就合并的变更所占比例,以及从计划获批到 PR 合并的时间,所需数据都在 PR 元数据中。
滞后指标
每个变更的返工周期数,同样来自 PR 元数据;以及合并的 diff 与已提交的 plan.md 仍然一致的频率。
Claude Code 自动模式(auto mode)
Claude Code 也可以运行在自动模式:工程师批准计划,一旦满意并完成迭代,Claude 就应用每一项变更,不再逐项提示。随着后续战术中的护栏逐渐成熟(调优过的 CLAUDE.md、编码了策略的技能、阻止不安全动作的钩子,以及 Claude 可以运行的测试套件),自动接受(auto-accept)成为常规工作的默认模式:规约足够紧凑、影响半径小、代码已被测试覆盖。
这个转变意味着:用户的注意力从盯着智能体做每一次编辑、评审每一个动作,转向在更长的自主会话之后评审产物。结合 worktree 使用时,自动接受模式还能让个人和团队实现并行,这也是自主运行 SDLC、实现第 6 阶段:维护所述闭环的基础。
侧栏:遗留系统与事实来源(source of truth)
适用于该流程产出的每一份产物。
现有的 SDLC 流程很可能已经在追踪产物,只是不在 markdown 文件里。工作项可能在 Jira,需求在带有监管追溯性构建的工具里,设计在 Figma,变更审批在变更委员会。这些系统很难替换,因为审计师和监管机构已经认可它们,其他团队也依赖它们,所以 AI 原生 SDLC 必须围绕已有系统来适配。
向 AI 原生 SDLC 过渡时,对流程产出的每一份产物,指定一个系统作为事实来源(source of truth),其余系统只保存副本或指向原件的链接。下面这些配置都可以做到单一事实来源,具体选择因产物而异:
以仓库为事实来源。 markdown 产物是权威记录,遗留系统引用提交中的文件。对工程主导的组织来说,这可能是最干净的配置之一,因为所有记录都活在同一个工具里,有统一的时间戳权威。
以遗留系统为事实来源。 Jira、ServiceNow 或需求工具持有权威记录,markdown 产物是工作副本。Claude 在会话开始时读取记录,并通过 MCP 连接器把结果写回——就在产出规约或计划的同一会话中。
链接是最低要求。 所有产物都注明记录 ID,所有遗留记录都包含 markdown 文件的提交 SHA。在向 AI 原生 SDLC 过渡时,从链接做起是个好起点,接受「两个事实来源」的现实。
只要两个系统之间有链接,或者其中一个被声明为事实来源,遗留系统和 markdown 优先的系统就可以共存。
CLAUDE.md
CLAUDE.md 给 Claude 提供新入职成员所需的上下文:约定、命令、架构,以及团队最常犯的错误。过去存在人们脑中和 wiki 上的知识,变成智能体在每次会话开始时读取的文件,由整个团队维护,并且每当犯了错误就迭代一次。
如何上手
前置条件
无。
基础设施
一个仓库、安装好的 Claude Code,以及一位熟悉代码库的工程师。
如何执行
- 在仓库中运行
/init。Claude 会根据它发现的内容生成一份初始的CLAUDE.md。 - 把生成的文件裁到新人第一天真正需要的程度。保留构建、测试和 lint 命令,重要的约定,以及 Claude 反复出错的地方。
- 把
CLAUDE.md提交到仓库根目录的 git,让整个团队共享同一个版本,修改像代码一样被评审。 - 一条好用的规则:当 Claude 同一个错误犯第二次时,修正就写进
CLAUDE.md。 - 保持在一页以内,因为 Claude 在会话开始时会读取它的全部内容,任何过时的内容都在白白占用上下文。
它看起来是什么样(CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
治理考量
CLAUDE.md 受版本控制,因此智能体所依据的指令是可评审、可审计的。团队约定通过该文件被应用,对它的修改记录在 git 历史中,代码负责人(code owner)在 PR 评审中批准这些修改。
如何衡量
先行指标
Claude 重复犯下 CLAUDE.md 本应拦住的错误的频率。对 CLAUDE.md 的修正或修改应在 git 历史中追踪。
滞后指标
团队新成员从 PR 历史中看到的第一个 PR 合并所需时间。
技能(Skills)作为组织知识
技能(skills)是一个组织让其组织知识可操作化的方式。这些指令是显式的、受版本控制的、被广泛应用的,并在策略变化时集中更新。经验法则:对必须被一致执行的组织知识写技能;对属于 CLAUDE.md 或提示词的内容不要写技能。
如何上手
前置条件
无。有 CLAUDE.md 会有帮助,因为它把智能体的工作知识留在仓库里,但技能并不依赖它。
基础设施
一条有具名负责人和书面事实来源的策略。
如何执行
- 挑一条今天执行不一致的知识。可以是一条安全标准、一个 API 设计约定,或一条品牌规则。
- 把它写成一个技能:一个包含
SKILL.md的文件夹,frontmatter 说明何时触发,正文说明该做什么。由工程师根据策略负责人的书面事实来源撰写,可以借助 Claude。 - 把技能放在仓库的
.claude/skills/<name>/下,让它随代码一起交付;或者通过插件(plugin)在整个组织内分发。 - 测试技能的触发。用不同方式让 Claude 做相关任务,确认每次技能都会加载。
- 策略变化时,修改技能,并由策略负责人签署修改。
- 工程师在下次会话中自动获得新版本。
它看起来是什么样(.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
治理考量
技能是一个控制项,但只是劝告性的(advisory)。它让 Claude 在编写代码时很可能应用该策略,但没有任何东西强制会话遵守它。一条必须始终成立的策略,需要在技能背后有确定性的机制,比如阻止该动作的钩子,或在 PR 重新检查策略的评审环节。技能让违规变少,钩子让违规接近不可能。技能调用记录在会话追踪(session traces)中,策略负责人像评审代码一样评审技能的修改。
如何衡量
先行指标
从策略负责人批准策略变更到更新后的技能合并的时间,取自技能文件夹的 PR。
滞后指标
PR 评审中引用该策略的发现项,一旦技能在编写代码时应用策略,它应趋近于零。如果发现项没有趋近于零,要么技能没有触发,要么它的文本已与官方策略脱节。
钩子(Hooks)作为构建期护栏
技能是劝告性控制,而钩子是它背后的确定性层。Claude 的大多数动作是实现过程中的文件编辑和 shell 命令,因此构建阶段是钩子触发最频繁的地方。
构建期钩子可以:
- 阻止对受保护路径的编辑,比如生成的类或冻结的包;
- 在文件编辑后运行格式化工具和 linter,让偏差不会累积;
- 让凭据不进入 diff。
为任何策略必须无条件成立的技能配上钩子。钩子在每个匹配的动作上运行,因此构建期钩子应该快,且限定在发生变化的文件上。更重的检查——比如完整的测试套件——属于提交时或 PR 时。
一个需要人类批准的钩子属于第 5 阶段:部署的关卡,因为在构建过程中弹出批准提示,会把人重新放回到所有并行会话的关键路径上。
并行会话与子代理(subagents)
一名工程师可以同时驱动多个工作流。
并行会话是另一个完整的 Claude Code 实例,在它自己的 git worktree 中处理独立的任务。每个独立的会话对其他会话一无所知,驾驭它们的工程师是它们唯一共享的东西。
子代理(subagent)在单个会话内部运行,是一个有独立上下文窗口和工具限制的、作用域受限的助手,适合在多个任务中反复出现的工作,比如验证应用是否按预期运行。
并行会话提高了一名工程师在途任务的数量上限,而子代理让每个会话专注于自己的任务。工程师的工作是驾驭和评审所有会话。
传统方式:一名工程师一次处理一个任务,一天或一周中的相当一部分时间花在构建、测试和等待评审上。等待时切换任务是可能的,但上下文切换的疲劳让很少有人愿意这么做。
AI 原生方式:一名工程师同时运行多个 Claude 会话,每个会话在自己的 worktree 中处理自己的任务。重复性的工作变成子代理,拥有自己的上下文和工具限制。工程师的工作转向编排,最终转向构建和监控循环。
如何上手
前置条件
CLAUDE.md,因为所有会话都会读取这个文件。反馈循环(第 4 阶段:测试)也有帮助,因为当会话能验证自己的工作时,需要的工程师监督就更少。
基础设施
一个 git 仓库——隔离来自 worktree——以及经过调优的权限设置,让会话不会为组织认为安全的命令等待批准提示。
如何执行
- 工程师把工作拆成触及不同文件的任务,借助计划模式战术(第 3 阶段:构建)中的计划看清哪些工作是相互独立的。共享文件的任务在单个会话中一个接一个地运行。
- 每个并行任务有自己的 worktree,例如在一个终端里运行
claude --worktree feature-auth,在另一个终端里运行claude --worktree fix-rate-limit。worktree 是独立分支上的独立检出,防止会话在文件上冲突。 - 两三个会话是合理的起点。实际上限是一个人能妥善评审的工作流数量,只在评审跟得上的时候增加会话。
- 把重复性的工作变成子代理,定义在
.claude/agents/的 markdown 文件中,每个子代理有名字、何时使用的描述,以及它可以动用的工具。例子包括:在主代理完成后剥离不必要复杂度的代码简化器、运行应用并检查行为的验证器、探索代码库并汇报而不淹没主上下文的研究员。把这些定义提交进 git,让整个团队共享。
它看起来是什么样(.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
治理考量
更多的会话意味着更多的产出,因此控制必须来自仓库中的配置。那里的钩子和权限设置应用于所有会话,会话的行为被记录并归因于运行它的工程师。
如何衡量
先行指标
每名工程师的并发会话数(在评审质量保持的前提下),从 OpenTelemetry 导出数据中统计;以及一天中花在驾驭上而非等待上的时间占比。
滞后指标
每名工程师每周合并的变更数,并与按 PR 历史确定的返工率对照阅读。
04 · 测试(Test)
每个会话在人看到之前先检查自己的工作,而驾驭智能体的配置要像它写的代码一样被回归测试。
给 Claude 一个反馈循环
始终给 Claude 一条验证自己工作的途径:测试、构建,或截图比对(screenshot diff)都可以。会话在工程师看到之前先检查自己的工作、修正自己的错误。
反馈循环不应与验证器子代理(第 3 阶段:构建)混淆。反馈循环在整个任务过程中运行,次数视工作所需而定。而验证器子代理是在会话认为工作完成后,用一个全新的上下文窗口封装最终检查的一种方式。这样,结论不会被产生代码的那些假设所污染。
传统方式:代码能工作的信号来得很晚。CI 几分钟之后,测试者几天之后,生产环境几周之后。当代码由智能体产出时,晚到的信号意味着必须有人检查它的全部产出,而这个人就成了瓶颈。
AI 原生方式:会话被赋予一条在人看到之前自检的途径。运行测试,运行构建,截个图。Claude 迭代到检查通过为止,所以到达工程师手上的东西已经通过了检查。搭建这个循环是运行会话的工程师的职责,下面的步骤是为他们写的。
如何上手
前置条件
无。
基础设施
一套测试套件和一个构建,各自能用一条命令在本地运行。对于 UI 工作,让 Claude 看到结果的方式至关重要:浏览器工具或通过 MCP 接入的截图工具都可以。
如何执行
- 如果今天检查工作需要一连串命令和一些环境知识,把它包装成单个目标,比如
make test或npm test,失败时以非零码退出。 - 在
CLAUDE.md的 Commands 一节中列出每条命令,并附上一个健康输出的样例。 - 声明一个可量化的目标,让 Claude 不用问你就能检查工作,例如:
test_status.py中的所有测试通过”、“截图与所附设计稿一致”,或”接口以新字段返回 200”。 - 对于 bug 修复,先写失败的测试。让 Claude 把 bug 复现为一个测试,运行它,并确认它如你预期地失败。提交这个测试。然后才要求 Claude 在不修改测试的前提下让它通过,由最后一步的测试文件钩子强制执行这个限制。一个在修复之前就存在、且智能体无法重写的测试,就是 bug 已消失的证明。
- 对于 UI 工作,用视觉检查闭环。给 Claude 浏览器或截图工具,给它设计稿,让它迭代。实现、截图、比对、调整。两三轮回合是正常的,且每轮的结果都应比上一轮更好。
- 让验证成为”完成”的一部分。指令写在
CLAUDE.md里:在报告任务完成之前运行测试,并展示输出。 - 最后,循环本身也需要保护,因为修复代码的智能体绝不能削弱对这段代码的检查。一个阻止修复任务期间编辑测试文件的钩子可以做到这一点。替代方案是在评审中检查 diff,拒绝任何触及测试的修改。
它看起来是什么样(CLAUDE.md 验证区块)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.
治理考量
强制执行的是什么
任务被报告完成之前的验证,以及修复期间对智能体编辑测试文件的阻止——在组织希望有保证的地方,二者都以钩子实现。
证据是什么
make test 的原始输出、构建日志或截图比对——由 Claude 运行并粘贴,因此证据来自工具链本身。
记录在哪里
会话记录(transcript)中,由 OpenTelemetry 导出转发到组织的可观测性栈;以及 PR 的检查运行(check run)中,评审者和任何后来的审计师都能看到。
谁批准
评审 PR 的代码负责人。机械性的证据已经附上,他可以专注于意图和风险。
如何衡量
先行指标
智能体编写的变更的首次 CI 通过率,CI 系统已经支持这个指标。
滞后指标
每个 PR 的评审时间(来自 PR 元数据),一旦测试能抓住评审者过去抓的问题,它应该下降;以及来自事故追踪器的变更失败率。
CI 中的持续评测(evals)
评测(evals)是 AI 原生世界中阶段关卡 QA 的对应物。实践中,这意味着一个套件:每当智能体的配置发生变化时就运行它。当换入新模型或重写提示词时,评测套件会告诉你智能体是否仍以同样的标准完成工作。
评测应被视为一个活的套件。随着模型进步,曾经能区分好坏的用例不再能区分了,必须不断补充来自持续监控的新用例。
根据用例不同,有些团队可能更喜欢按固定的节奏离线运行这些评测,而不是每次变更都运行。下面的步骤针对持续评测。
如何上手
前置条件
CLAUDE.md 和反馈循环(第 4 阶段:测试)。
基础设施
能非交互运行 Claude Code 的 CI,以及有预算跑评测的 API key。
如何执行
- 平台工程师从近期工作中收集 20 到 50 个真实任务及其预期/被接受的产出。
- 把每个任务写成一个评测:提示词加上定义”可接受”的检查项(测试通过、lint 干净、行为不变、策略被遵守)。
- 套件在 CI 中按计划非交互运行,并在
CLAUDE.md、技能或钩子发生任何变化时运行,因为这些配置驾驭着智能体,值得像代码一样得到回归测试。 - 把配置变更与结果挂钩。导致通过率下降的技能修改在合并前会被评审。
- 每个生产事故都对应一个评测,由负责该事故的团队撰写,并作为回归测试永久留在套件中。
它看起来是什么样(.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
治理考量
评测给了 QA 一个跟得上智能体产出的关卡。通过率阈值作为合并检查强制执行,运行被记录以便结果可以跨时间比较,拥有该配置变更的团队批准它。
如何衡量
先行指标
评测通过率随时间的变化,由套件每次运行报告;以及一个生产事故从发生到变成永久评测所需的时间。
滞后指标
CI 中抓到的回归与生产环境中发现的回归之比,数据来自事故追踪器。
05 · 部署(Deploy)
评审双向运行,治理在智能体行动时强制执行。智能体可以做生产门禁之前的所有事,但不能越过它。
PR 评审闭环中的 AI
Claude 既给出评审,也接收评审。它对照组织的策略评审 incoming 的 PR,也处理自己 PR 上的评审意见。这让工程师在 PR 评审中可以专注于行为——归根到底是判断意图和风险。
传统方式:评审产能是围绕人的产出规划的。一个 PR 等待评审者读完所有内容,评审质量随评审者的负载波动,作者在 backlog 增长时四处找人。
AI 原生方式:所有 PR 获得一整套一致的评审环节,发现项按严重程度排序。人的注意力上移一层:看这个变更是否做到了计划所意图的,以及风险是否可接受。
如何上手
前置条件
来自第 3 阶段:构建的最新 CLAUDE.md 文件;如果评审环节要执行书面策略,还需要定义好的技能和子代理。
基础设施
安装了 Claude 集成的仓库:由管理员启用的托管式 Code Review(研究预览)服务,或者运行在你自己 CI 中的 claude-code-action;需要时模型调用经由 AWS Bedrock、Google Vertex 或 Microsoft Foundry(CI/CD 战术涵盖部署选项)。要求代码负责人批准的分支保护策略也值得设置。
如何执行
- 托管式 Code Review 服务是最快的起步方式。管理员启用它并选择仓库。当你需要掌控流水线、或希望 API 调用走自己的云协议时,用 claude-code-action 在你自己的 CI 中运行评审(CI/CD 战术涵盖底层机制)。
- 技术负责人把评审策略写成仓库根目录的
REVIEW.md,划分为组织关心的几个环节:bug 与逻辑错误;安全与漏洞;对规约(需求战术产出的spec.md)、实现计划(计划模式战术产出的plan.md)和设计原则的合规性。REVIEW.md还定义什么算 Important(重要)、什么只是 Nit(吹毛求疵),以及什么可以跳过。 - 技术负责人设定人的阈值。发现项本身不批准或阻止 PR,分支保护仍然要求代码负责人批准。希望按发现项门禁合并的平台工程师,可以读取检查运行发布的机器可读的严重程度计数。
- 当评审者或作者在评审评论中 @claude 时,Claude 会处理该评论并推送修复。PR 线程同时记录请求与变更。这个修复闭环通过 claude-code-action 运行。在托管服务中,评论
@claude review改为请求一次全新的评审。对于 Claude 自己开的 PR,可以更进一步:让 Claude 一路照看 PR 直到合并。团队把这个闭环包装成自定义斜杠命令:扫过 PR 上未解决的评审评论和失败的检查,处理它们并推送修复,直到 PR 变绿、只等代码负责人批准。 - 评审发现回流进
CLAUDE.md。当评审第二次标记同一个错误时,修正作为该次评审的一部分进入CLAUDE.md;由于评审会读取CLAUDE.md,从下一个 PR 起这个错误就会被抓住。评审还会标记某个变更是否让CLAUDE.md过时了。 - 技术负责人每月调整一次设置:给发现项打分让评审者不断进步,并在
REVIEW.md中给 Nit 的数量设上限。生成的路径和 CI 已强制执行的内容被排除在外。
它看起来是什么样(REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
治理考量
职责分离(separation of duties)得到保留,因为写代码的智能体无法批准它。REVIEW.md 中的评审策略应用于所有 PR,发现项、修复、打分和批准都记录在 PR 历史中,因此 PR 就是审计记录。批准来自人类——通过分支保护机制,并在发现项的辅助下做出。
这些控制如何在生产规模下组合,参见 securing an AI-native SDLC at Anthropic。
如何衡量
先行指标
首次评审时间,应下降到分钟级;以及评审评论在不有人动分支的情况下被解决的比例,数据直接存在 Git 上。
滞后指标
合并前抓到的缺陷和漏洞,与逃逸到生产环境的对比,数据来自 PR 历史和事故追踪器。
钩子(Hooks)作为审批门禁
构建阶段把钩子用作护栏,在没有人参与的情况下允许或阻止动作(第 3 阶段:构建)。钩子也可以”询问”:暂停动作,直到特定的人批准——这正是发布门禁所需要的。
这个战术放在第 5 阶段:部署,因为发布门禁是最清晰的场景,但钩子并非部署专属:它们在 Claude 行动的任何地方运行。例如,钩子可以在第 3 阶段:构建中阻止没有变更工单的迁移和基础设施编辑,也可以在第 4 阶段:测试的修复任务中阻止智能体编辑测试文件。
如何上手
前置条件
无。
基础设施
一份书面清单:变更流程要求哪些审批。
如何执行
- 工程领导层与变更管理、合规部门一起,列出必须保留的人工审批关卡,比如变更管理签字、发布授权,以及对受保护路径的编辑。
- 平台工程师把每个关卡表达为一个钩子:一个在 Claude 行动之前运行的脚本,可以允许、询问或阻止。
- 团队级钩子放进 git 中的
.claude/settings.json;不可协商的钩子放进由平台或 IT 管理员拥有的托管设置(managed settings)中,单个工程师无法关闭它们。 - 阻止应该自我解释:当钩子阻止一个动作时,原因和通往批准的路径应出现在 Claude 的输出中。
它看起来是什么样(.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
以及门禁本身(.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
治理考量
钩子就是审批门禁。门禁条件对每个人、每一次都强制执行。允许和阻止的决定都带时间戳记录。门禁还定义什么算作批准——无论是一张已批准的变更工单,还是发布经理的签字。
示例演练:受监管企业的托管设置(managed settings)
由平台团队通过 MDM 或管理控制台部署;工程师无法编辑或覆盖其中任何内容。
{
  "permissions": {
     "deny": [
        "Read(.env*)", "Read(./secrets/**)",
        "WebFetch", "Bash(curl *)", "Bash(wget *)"
     ],
     "allow": [
        "Bash(git *)", "Bash(make build)",
        "Bash(make test)", "Bash(make lint)"
     ],
     "disableBypassPermissionsMode": "disable"
  },
  "allowManagedPermissionRulesOnly": true,
  "sandbox": {
     "enabled": true,
     "failIfUnavailable": true,
     "allowUnsandboxedCommands": false,
     "network": { "allowedDomains": ["git.internal.example.com",
"registry.npmjs.org"] },
     "credentials": {
        "files": [
          { "path": "~/.ssh", "mode": "deny" },
          { "path": "~/.aws/credentials", "mode": "deny" }
        ],
        "envVars": [ { "name": "GITHUB_TOKEN", "mode": "deny" } ]
     }
  },
  "allowManagedHooksOnly": true,
  "disableSideloadFlags": true,
  "allowManagedMcpServersOnly": true,
  "strictKnownMarketplaces": [
     { "source": "github", "repo": "example-corp/approved-plugins" }
  ],
  "requiredMinimumVersion": "2.1.193"
}
从控制角度看,每一行买到了什么
permissions.deny让机密不进入智能体的上下文,并阻断通过工具的任意网络外联;permissions.allow预先批准安全的内循环,让拒绝列表不会变成提示词疲劳。disableBypassPermissionsMode加allowManagedPermissionRulesOnly意味着没有工程师、项目文件或命令行标志可以放宽规则。sandbox堵上权限管不住的缺口。对 WebFetch 的工具级拒绝挡不住 shell 命令联网;操作系统级的域名白名单直接阻断外联。failIfUnavailable和allowUnsandboxedCommands让沙箱成为门禁:沙箱无法初始化时 Claude Code 拒绝启动;在沙箱内失败的命令无法在沙箱外重试。credentials堵住拒绝规则留下的缺口。permissions.deny管辖 Claude 的文件工具,但沙箱化的 shell 命令默认仍能读取~/.ssh或~/.aws/credentials;这一段阻止这些读取,并从每个沙箱命令的环境中剥离具名机密。allowManagedHooksOnly意味着本战术中的审批门禁是唯一运行的钩子;本地没有任何东西能添加或替换它们。disableSideloadFlags和strictKnownMarketplaces意味着工程师机器上的每个技能、代理、钩子和 MCP 服务器都是通过组织批准的插件市场来的,绝不来自某个 home 目录。allowManagedMcpServersOnly让智能体的工具面成为平台团队拥有的白名单。requiredMinimumVersion拒绝在低于批准的最低版本上启动,因此控制由组织实际评估过的构建来强制执行。把上面看作一个裁剪的起点,而不是照搬的建议。每一条 deny 都是与能力的权衡,正确的平衡取决于仓库的数据分级。设置参考文档记录了每个键,包括仅托管的键:code.claude.com/docs/en/settings。
如何衡量(针对钩子本身)
先行指标
在每个审批关卡上等待的时间。每个钩子决策都会带时间戳和允许/阻止结论写入 OpenTelemetry 导出,因此每个关卡的等待时长都可见。
滞后指标
到达生产环境的门禁违规,对比钩子部署前后,数据来自事故追踪器。
CI/CD 集成与部署
在 CI/CD 流水线内非交互地运行 Claude Code,对执行做沙箱隔离让长时间运行的智能体安全运行,通过 MCP 集成暴露部署能力,并在智能体真正需要回滚之前先演练回滚路径。
传统方式:流水线运行确定性的脚本,任何需要判断力的工作都等一个人。比如给不稳定的测试分类、写变更日志,或排查构建失败的原因。部署和回滚是人在压力下照着 runbook 执行。
AI 原生方式:Claude 在流水线内非交互地承担需要判断力的步骤,运行在具有限定凭据的沙箱中。部署工具通过 MCP 暴露给智能体,因此写出并测试了变更的工作流也能在组织为每个环境定义的门禁内发布它并回滚。
如何上手
前置条件
PR 评审闭环中的 Claude 和作为审批门禁的钩子——门禁必须先存在,自动化才能加速任何东西通过它们。
基础设施
安装了 claude-code-action 的 CI 平台,或任何能调用 claude -p 的 runner;通过 API 或 Bedrock、Foundry、Vertex 访问模型(流量必须留在组织的云协议内时);面向部署目标的 MCP 服务器;一个不含常备生产凭据的智能体任务沙箱 profile。
如何执行
- 平台工程师从只读的判断步骤开始。在流水线任务中用
claude -p给失败的构建分类、总结不稳定的测试,或起草变更日志。 - 在现有门禁之后增加写步骤,比如修复 lint、更新生成的文档,或通过
@claude提及处理评审意见。智能体写出的任何东西都以 PR 的形式经分支保护到达,智能体没有通往 main 的推送路径。 - 执行经过沙箱隔离。智能体任务在容器中运行,处于网络策略之下,使用短期限定令牌,默认不持有任何生产凭据。
- 通过 MCP 暴露部署。部署、状态查询、回滚变成工具,按环境限定范围,因此智能体的部署能力是白名单,而不是一个装着凭据的 shell 脚本。
- 按环境分级自主度。在开发环境,智能体自由部署。在生产环境,智能体准备发布,发布经理授权,钩子强制执行生产门禁。预发环境居中。
- 回滚应该是流水线中演练最多的路径:一条智能体可以运行的单命令,并且在预发环境中定期实际执行。闭环战术(第 6 阶段:维护)在控制带被突破时调用这个回滚,因此它必须事先被验证过。
它看起来是什么样(流水线步骤)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
治理考量
治理原则是:智能体可以行动到生产门禁为止,但不能越过它。下面的控制强制执行这条原则。
- 分支保护把智能体写出的任何东西变成 PR,没有直达 main 的路径。
- 生产部署钩子阻止发布,直到具名的发布经理授权。每次非交互运行都以智能体自己的身份行动,因此流水线日志把智能体做的和触发它的工程师做的区分开。
- 按环境的权限层级设定智能体在通往门禁的路上可以做什么。
如何衡量
先行指标
无需呼叫人工即可完成分类的流水线失败占比,取自 CI/CD 流水线日志。
滞后指标
DORA(DevOps 研究与评估)指标,CI 系统和部署工具已经产出这些数据。
06 · 维护(Maintain)
循环闭合了。一个触发器在没有人在调用路径上的情况下唤起 Claude,而它的发现作为 intent.md 重新进入流水线。
维护与闭环
到目前为止,我们讨论的是如何把 Claude 加入 SDLC 流程的每个阶段,每个阶段都需要人来启动初始步骤。而本阶段的重点转向自主运行 Claude,从而闭环。
例如,一个持续运行的监控智能体可以在 bug 工单被创建后生成一份 intent.md,并流经需求、计划、构建、测试和评审各环节。第 6 阶段:维护以无头(headless)方式运行,阶段之间有独立的置信度关卡——一个确定性检查或一个对抗性评审智能体——决定上一阶段的产出是继续流转,还是升级给人处理。
传统方式:维护是被动的。所有工单或事故都等人来处理、来重启流程。告警在凌晨 3 点响起可能被错过,工单在 backlog 里躺到有人捡起来,如果另一场火先烧起来,事后复盘的行动项可能根本到不了代码库。
AI 原生方式:控制带突破、工单、频道消息或计划任务这样的触发器,在没有人在路径上的情况下唤起 Claude。Claude 做诊断,只通过有门禁的路径行动,并把发现写成
intent.md,随后流经上面描述过的各个阶段。人负责分类和评审这些工作,而不再需要由人启动它们。
闭环
一个确定性脚本监控生产环境,在控制带被突破时唤起 Claude。对突破的监控是循环自主运行这一模式的范例;本阶段末尾的 Claude Tag(公开测试版)一节涵盖经由其他渠道到达的工作。
如何上手
前置条件
intent.md——它给循环一个结构化的输出来重启。Claude 加速的 PR 评审、作为行动边界的钩子,以及 CI/CD 的回滚路径(最高自主层级会调用它)。
基础设施
检测脚本可查询的指标存储(Prometheus、CI 系统的 API 或等价物)、仓库的读取权限、在 CI 中非交互运行 Claude Code 的方式,或用于接收 webhook 的服务的 Agent SDK。
如何执行
- 服务负责人或平台工程师挑一个具有稳定滚动基线的指标,比如 CI 测试失败率、部署后 5xx 比率,或 PR 周期时间。
- 编写检测脚本,通常是滚动窗口上的均值和标准差,加上规则(西部电气规则 Western Electric 或类似),让控制带既能捕捉缓慢漂移也能捕捉突刺。脚本受版本控制并有单元测试,检测完全保持确定性,不涉及任何模型。
- 响应层级在受版本控制的配置中定义(下面的
bands.yaml)。在 1σ 时脚本只记录日志,在 2σ 时以只读方式唤起 Claude 做诊断,在 3σ 时 Claude 可以行动——但只能通过向评审门禁开 PR,或触发预先批准的 runbook。 - 触发层可以是 GitHub 或 GitLab 中的计划工作流、来自现有监控栈的 webhook,或网络内的 Cron Job。Claude 无状态运行:作为 CI runner 上的非交互步骤,或作为沙箱容器中的 Agent SDK 服务,CI/CD 战术涵盖部署和模型访问选项。因为运行是无状态且非交互的,一个循环可以在没有任何人启动的情况下开始和结束。
- 智能体把诊断写成第 1 阶段:计划格式的
intent.md,涵盖异常及其证据、预期结果、受影响的系统和任何未决问题。从那里起,这个发现像其他任何东西一样流经流水线。 - 服务负责人或值班工程师给队列分类,把面向产品的发现路由给产品负责人:立即修复、排期,或驳回。驳回会调优控制带,有助于减少噪声。
- 当修复发布后,为该事故添加一个评测(持续评测战术),确保此类问题从此得到防护。
它看起来是什么样(例如:监控 CI 测试失败率的 bands.yaml)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
治理考量
层级边界从受版本控制的配置中强制执行,权限和托管设置拒绝生产访问。调用、发现和分类决定都带时间戳记录。服务负责人对发现进行分类和批准,由此产生的变更走正常的 PR 评审门禁,智能体可触发的 runbook 都是预先批准的。
如何衡量
先行指标
从控制带突破到 intent.md 进入分类队列的时间,与旧的从事故到复盘行动项的时间对比。检测脚本的日志中有突破时间戳和事故层级。
滞后指标
变成已合并修复的发现占比(分类队列对照实际 PR 历史);以及同一类事故的重复发生率——随着修复不断给评测套件补充用例,它应该下降。
示例
- 当 CI 测试失败率突破 3σ 时,智能体隔离不稳定的测试或开一个回退 PR,由评审门禁定夺。
- 当部署后 5xx 率突破 3σ 且时间窗内有一次部署时,智能体触发现有的回滚流水线。
- 当 PR 周期时间触发漂移规则时,智能体为工程领导层写一份报告——这说明该机制对流程指标和生产指标同样有效。
检测保持确定性。控制带被突破时才唤起 Claude,层级决定它可以做什么。
定期代码库扫描
安全扫描是关于「特定模型下的代码库」的某一时刻的陈述,而这两半都会过期:代码每周都在变,每一代模型都会发现上一代漏掉的漏洞。AI 原生的答案是按计划运行扫描,调用路径上没有人类,并把发现经由与其他代码变更相同的关卡发送出去。
Claude Security 是托管形式的定期扫描。连接一个 GitHub 仓库,扫描在 Anthropic 基础设施上的 Claude Mythos 5 上运行,每个发现项在报告前都经过验证并附有置信度评级。建议的补丁在网页版 Claude Code 中被评审和应用。组织无需自己访问模型即可获得发现项。
传统方式:安全扫描是一个事件,在发布或审计前启动一次扫描。报告进入一个追踪系统,backlog 靠手工消化,直到下一个事件。其间编写的代码只能指望 PR 评审能抓多少算多少。
AI 原生方式:扫描按计划对每一个已连接的仓库运行,使用可用的最强模型,发现项在任何人读到之前经过验证。每个发现项都按控制带突破的方式处理:一个 PR 装得下的修复走评审门禁,更大的写成
intent.md。覆盖率以最近一次运行为准,而不是以第一次扫描为准。
如何上手
前置条件
PR 评审门禁和作为审批门禁的钩子(第 5 阶段:部署),让发现项像任何其他变更一样经过评审;以及第 1 阶段:计划的 intent.md 格式,用于装不下单个 PR 的发现项。
基础设施
Claude Security 以公开测试版面向 Claude Enterprise 组织提供。它需要在目标仓库(云托管的 github.com)上安装 Anthropic GitHub App、启用 Claude Code on the Web、打开 Extra Usage 并设置支出上限、为运行扫描的人员配备 premium 席位,并由管理员在 claude.ai/admin-settings/claude-code 打开该功能。扫描按 Mythos 5 费率以消耗计费,因此支出上限应与仓库的规模和数量匹配。
如何执行
- 安全负责人连接仓库,并按仓库、服务或团队把它们组织成项目,让发现项的所有权从一开始就清晰。
- 对最关键的仓库运行第一次全量扫描,包括那些被其他工具或更早的模型扫描过的仓库。把第一次扫描作为基线。第一次扫描很可能会在以前被认为干净的代码中发现问题。
- 为每个项目设定计划。对活跃开发的服务,每周是合理的默认值;仓库很大或混杂时,把扫描限定到某个目录或分支。
- 拿着置信度评级给发现项分类。带着理由驳回,这样驳回会被记录,同一个发现项不会在下一次运行时作为新问题再次出现。
- 对于有界的发现项,在网页版 Claude Code 中打开建议的补丁,评审它,并像任何其他变更一样送它过 PR 评审门禁。提出修复的智能体没有批准它的路径。
- 对于任何超出一个补丁范围的问题——比如架构性弱点或跨服务重复的模式——按第 1 阶段的格式把它写成
intent.md,从计划阶段开始。 - 当修复发布到生产环境时,为该漏洞类别向持续评测战术的套件中添加一个评测,从此驾驭智能体的配置都要针对该类别做测试。
- 把发现项导出为 CSV 或 Markdown,或使用 webhook,让组织现有的追踪和审计系统继续作为记录系统——审计师本来就在那里找记录。
治理考量
扫描在组织的管理员控制下运行:连接哪些仓库、谁持有扫描席位、支出上限,全部是集中设置的。每个发现项都有一个验证结果和一个置信度评级,每次驳回都有一个理由,因此扫描历史是一份审计记录:发现了什么、修复了什么、有意识地接受了什么。
修复经由 PR 评审门禁和分支保护到达生产环境,而不是从扫描直接到达。Claude Security 是对现有静态分析和依赖扫描的增强。确定性检查留在 CI 中,模型驱动的扫描覆盖那些检查并非为它们设计的、依赖上下文的漏洞。
如何衡量
先行指标
已连接仓库中按计划扫描的占比,以及从发现项被报告到其补丁进入 PR 评审门禁的时间,从扫描历史和 PR 元数据中读取。
滞后指标
计划扫描发现的漏洞,与生产环境中发现的或外部报告的漏洞对比,数据来自事故追踪器;以及经历过多次运行的仓库上每次扫描的发现项趋势——随着修复和评测的积累,它应该下降。
用 Claude Tag 值班
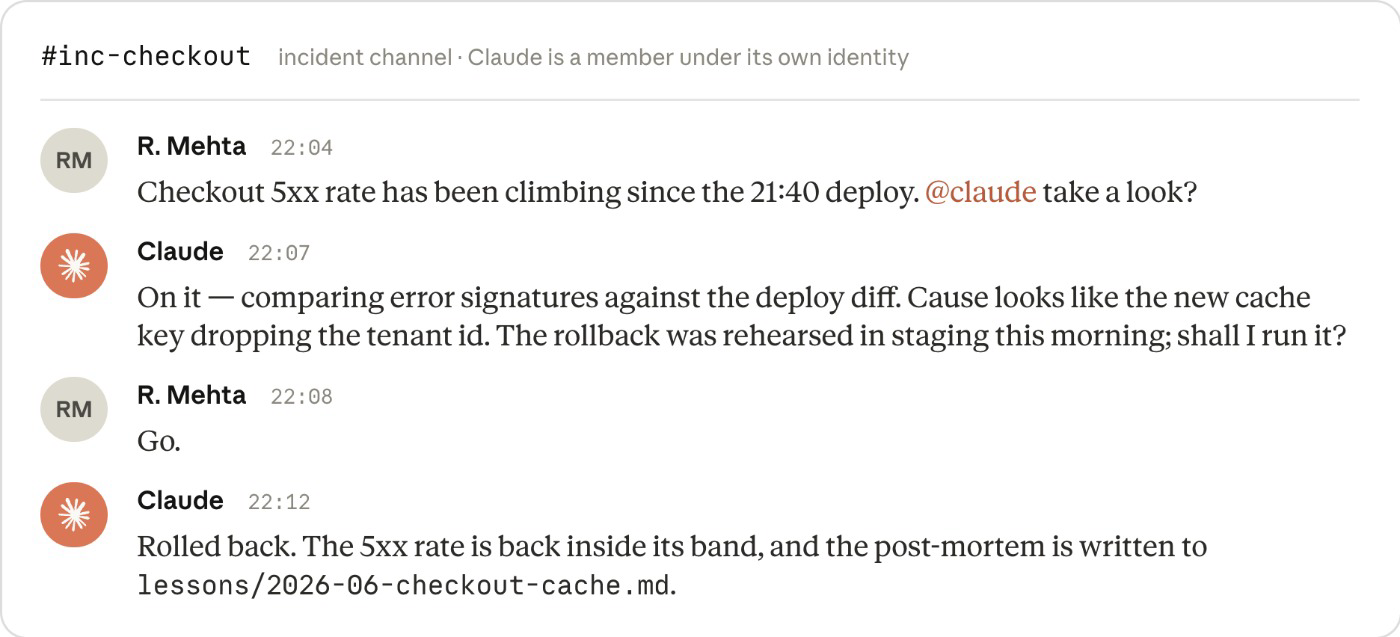
事故也会经由其他途径到达,比如工作场所通讯应用,如 Slack 或 Teams。事故可能表现为晚上 10 点事故频道里一条紧急修复的 Slack 消息,而现在它可以被立即处理。Claude Tag(目前在 Slack 提供公开测试版)让 Claude 以自己的身份成为这些频道的一员,因此每个新事故都有了一个第一响应者,而响应过程本身成为未来事故的循环和记忆的一部分。
对话和组织知识留在频道里,频道里的任何人都能引导响应、让它执行动作。任何团队成员都可以实时检验假设、探索新的选项、展开调查,频道历史增加了可审计性。通过 MCP 访问,Claude 验证指标已回到基线,在线程中确认,并把事后复盘写进一份受版本控制的教训文件,供未来的调查读取。
事故并不是 Claude Tag 接手的唯一工作。通过 MCP 在工单上 @ 它,或在频道里问它,Claude 以同样的方式给工作分类。一个范围明确的小修复以 PR 的形式经评审门禁到达;任何更大的工作被写成 intent.md 进入第 1 阶段:计划——到这时,循环开始自我喂养。参见:Claude Tag 如何在 Anthropic 为 CI/CD 值班。
结语
模型和 harness 已经变得足够先进,让组织不仅能够改变它们产出代码的方式,而且能够改变整个软件开发生命周期。
这场变革让人的判断保持在流程的核心位置,同时兼顾了大型企业组织的治理和监管要求。
本指南汇集了 Applied AI 团队每天为客户执行的许多真实最佳实践,希望你觉得它是一份实用、可操作的资源。
循环持续运转。人的判断保持在它之上。
资源与致谢
下面的文档是平台团队搭建这些控制所需的资料,大致按推出的顺序排列。
| 资源 | 链接 |
|---|---|
| 为你的组织设置 Claude Code——管理员决策地图;从这里开始 | code.claude.com/docs/en/admin-setup |
| 设置参考与优先级,包括每个仅托管的键 | code.claude.com/docs/en/settings |
| 来自 Claude 管理控制台的服务器端托管设置 | code.claude.com/docs/en/server-managed-settings |
| 权限 | code.claude.com/docs/en/permissions |
| 沙箱——操作系统级的文件系统与网络隔离 | code.claude.com/docs/en/sandboxing |
| 钩子——指南 | code.claude.com/docs/en/hooks-guide |
| 钩子——参考 | code.claude.com/docs/en/hooks |
| 技能(Skills) | code.claude.com/docs/en/skills |
| 插件与私有市场——技能与钩子如何在整个组织分发 | code.claude.com/docs/en/plugin-marketplaces |
| 托管 MCP——对智能体工具面的集中控制 | code.claude.com/docs/en/managed-mcp |
| 企业部署概览——Bedrock、Vertex、Foundry | code.claude.com/docs/en/third-party-integrations |
| 企业网络配置 | code.claude.com/docs/en/network-config |
| 监控(OpenTelemetry) | code.claude.com/docs/en/monitoring-usage |
| 分析仪表盘 | code.claude.com/docs/en/analytics |
| 合规 API——企业活动流、聊天检索与删除 | platform.claude.com/docs/en/manage-claude/compliance-api |
| 安全模型 | code.claude.com/docs/en/security |
感谢 Jim Blackhurst、Will Steuk 和 Jamal Arif 对本指南的贡献——本指南受到他们此前工作的启发,并建立在其基础之上。