Smart Zone:AI 编程助手黄金上下文区间
摘要:在 LLM 标称上下文窗口动辄 1M、2M 的今天,工程落地的残酷真相却是:上下文用得越多,模型表现往往越差。本文基于 Smart Zone(黄金上下文区间) 概念,深度拆解上下文用量超越 40% 后的能力崩塌逻辑,剖析能力、行为、经济三大隐形边界,并结合“大文本处理”、“KV-Cache”等场景给出 Agent 上下文管理的最佳工程实践。
一、 引言:为什么上下文窗口越大,AI 反而越“傻”?
随着长上下文(Long-Context)技术的普及,许多开发者形成了一种思维惯性:把整个项目代码库、长篇文档、全量日志和全部历史对话一股脑塞给 AI Agent。
然而,HumanLayer 创始人 Dex Horthy 提炼出的工程实践法则表明:当上下文占用突破标称窗口的 40% 后,AI 的输出质量、推理准确率和任务完成度会面临急剧下滑。
为了直观展现这一现象,我们可以总结出Smart Zone(黄金上下文区间) 核心图景:
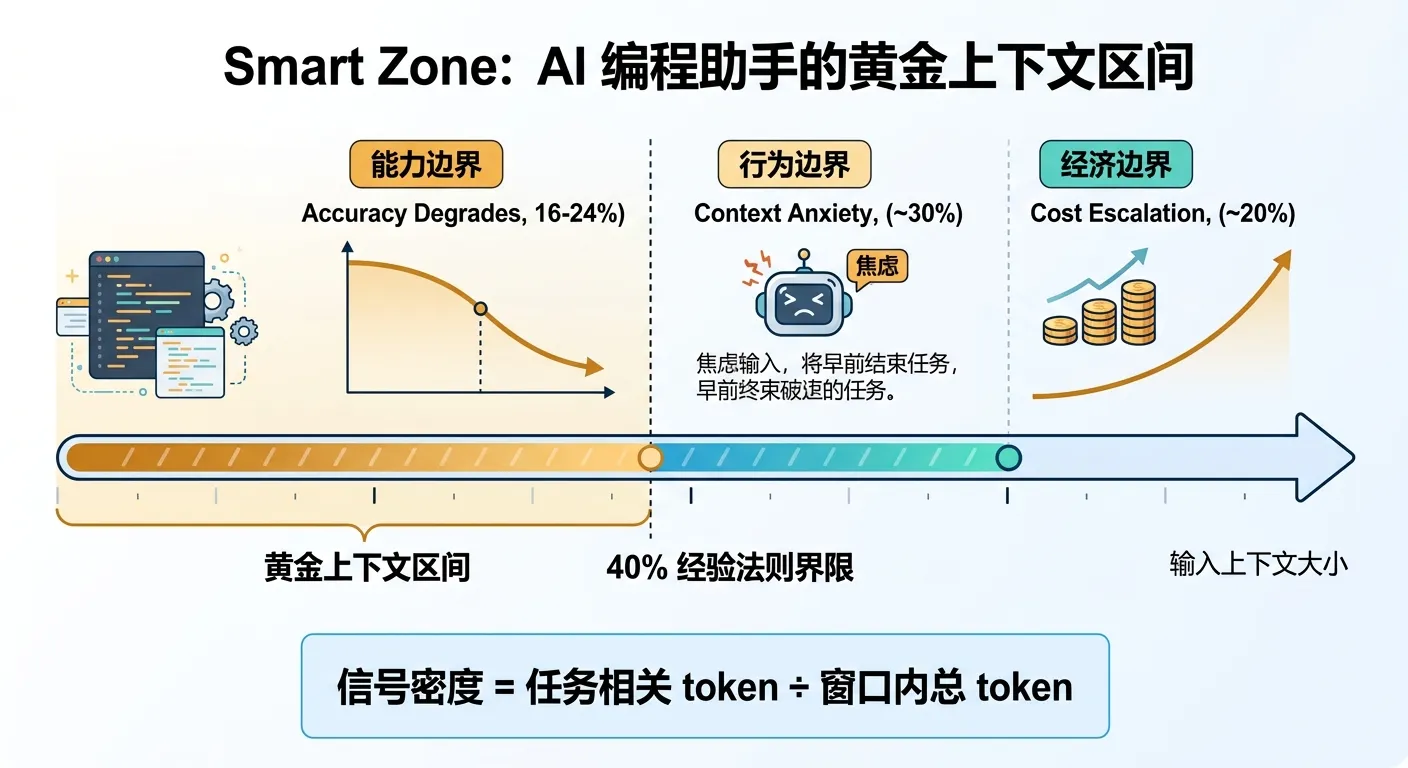
gantt
    title AI 编程助手上下文区间与边界示意图 (Smart Zone vs Danger Zone)
    dateFormat X
    axisFormat %s%%

    section 区间划定
    Smart Zone (黄金上下文区间)  :active, zone1, 0, 40
    Danger Zone (危险/衰减区间)  :crit, zone2, 40, 100

    section 核心边界拐点
    能力边界 (Accuracy Degrades, 16-24%)  :milestone, m1, 20, 20
    经济边界 (Cost Escalation, ~20%)      :milestone, m2, 20, 20
    行为边界 (Context Anxiety, ~30%)      :milestone, m3, 30, 30
    Safeguard Line (/clear 截断告警线, 40%) :milestone, m4, 40, 40
二、 核心公式:决定模型输出质量的两大隐形杠杆
在长上下文互动中,控制模型输出质量的本质是控制以下两个指标:
1. 信号密度(Signal Density)