LLaMA-Factory 微调 Text2SQL
git clone https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory

python -m venv env
source env/bin/activate

pip install -e .[metrics]
下载模型
git clone https://www.modelscope.cn/qwen/Qwen1.5-4B-Chat.git
自定义数据集
data/text2sql.json [ { "instruction": "You are an SQLite database expert. Help users write SQL statements based on the following table schema.
ChatTongyi
LangChain ChatTongyi
Stream
Gradio DataFrame
Gradio DataFrame
import pandas as pd
import gradio as gr

def read_csv_from_text2sql(file_path="data/text2sql.csv"):
    try:
        df = pd.read_csv(file_path)
        return df
    except Exception as e:
        return pd.DataFrame([{"error": f"❌ {e}"}])

def selected_text2sql_dataframe(selected_index: gr.SelectData, df: gr.DataFrame):
    selected_row = df.iloc[selected_index.index[0]]
    text = selected_row.get('Text', '')
    sql = selected_row.get('SQL', '')
    return text, sql

with gr.Blocks() as demo:
    # UI
    upload_button = gr.UploadButton(label="上传 Text2SQL CSV 文件",
                                    file_types = ['.csv'],
                                    file_count = "single")
    df_text2sql = gr.Dataframe(headers=["Text", "SQL"],
                                type="pandas",
                                col_count=2,
                                value=read_csv_from_text2sql,
                                interactive=False)
    with gr.Row():
        textbox_text = gr.Textbox(label="Text", lines=4)
        textbox_sql = gr.Textbox(label="SQL", lines=4)

    # Event
    upload_button.upload(fn=read_csv_from_text2sql,
                            inputs=upload_button,
                            outputs=df_text2sql)
    df_text2sql.select(fn=selected_text2sql_dataframe,
                        inputs=df_text2sql,
                        outputs=[textbox_text, textbox_sql])

demo.queue(api_open=False)
demo.launch(max_threads=30)
Gradio Chatbot
Gradio Chatbot
DashScope
import os
import pandas as pd
import gradio as gr
from http import HTTPStatus
from dashscope import Generation
from dashscope.api_entities.dashscope_response import Role
from typing import List, Optional, Tuple, Dict, Generator
from urllib.error import HTTPError


DEFAULT_SYSTEM = '您是一个有用的助手。'

History = List[Tuple[str, str]]
Messages = List[Dict[str, str]]

// ...
LangChain ChatTongyi
Meta Llama 3
Llama3
模型
- Meta-Llama-3-8b: 8B 基础模型
- Meta-Llama-3-8b-instruct: 8B 基础模型的指令调优版
- Meta-Llama-3-70b: 70B 基础模型
- Meta-Llama-3-70b-instruct: 70B 基础模型的指令调优版
- Llama Guard 2: Llama Guard 2 是基于 Llama 3 8B 微调的,为生产环境设计的,能够对大语言模型的输入(即提示)和响应进行分类,以便识别潜在的不安全内容。
下载
数据集
No Robots 是由熟练的人类注释者创建的包含 10,000 条指令和演示的高质量数据集。该数据可用于监督微调(SFT),使语言模型更好地遵循指令。 No Robots 是根据 OpenAI 的 InstructGPT 论文中描述的指令数据集进行建模的。
介绍 Llama 3 最大的变化是采用了新的 Tokenizer,将词汇表大
Anthropic Claude
Claude 3 模型
| 模型 | 模型名称 | 价格(MTok) | 能力 |
|---|---|---|---|
| Opus | claude-3-opus-20240229 | Input: 75 | 处理复杂的分析、多步骤的长期任务,以及更高阶的数学和编码任务 |
| Sonnet | claude-3-sonnet-20240229 | Input: 15 | 适用于高效、高吞吐量的任务 |
| Haiku | claude-3-haiku-20240307 | Input: 1.25 | 执行轻量级操作,速度领先行业 |
MTok= million tokens.(百万 Token)- 所有
Claude 3模型都支持视觉和200,000个 Token 上下文窗口。
例子
LangChain : SQL Chain & SQL Agent
SQL Chain
from datetime import datetime
from operator import itemgetter

from langchain.chains import create_sql_query_chain

from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.runnables import RunnableLambda

from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_community.utilities import SQLDatabase
from langchain_community.tools.sql_database.tool import QuerySQLDataBaseTool


// ...
LangChain : Tagging and Extraction Using OpenAI functions
Extraction
from enum import Enum
from typing import Optional, Type
from langchain.pydantic_v1 import BaseModel, Field


class ProvinceEnum(str, Enum):
    """省、直辖市、自治区"""
    山东省 = "山东省"

class CityEnum(str, Enum):
    """山东省地级市"""
    济南 = "济南"
    青岛 = "青岛"
    淄博 = "淄博"
    枣庄 = "枣庄"
// ...
OpenAI
from langchain_openai import ChatOpenAI

model = ChatOpenAI(temperature=0).bind(
    functions=functions,
    function_call={"name": PowerSupplyStationLocation.__name__}
)

response = model.invoke(prompt)
print(response)
LangChain Chat Models Function & Tool Calling
Chat Models Functions & Tools
| Model | Function Calling | Tool Calling | Python Package |
|---|---|---|---|
| ChatOpenAI | ✅ | ✅ | langchain-openai |
| ChatTongyi | ❌ | ✅ | langchain-community |
| ChatOllama | ❌ | ❌ | langchain-community |
| OllamaFunctions | ✅ | ❌ | langchain-experimental |
自定义工具
在构建自己的代理时,您需要为其提供一个工具列表,供其使用。除了实际调用的函数之外,工具还包括几个组件:
- name (str):是必需的,并且在提供给代理的一组工具中必须是唯一的。
- description (str):可选,但建议提供,因为代理使用它来确定工具的使用。
- args_schema (Pydantic BaseModel):可选,但建议提供,可用于提供更多信息(例如,少量示例)或对预期参数进行验证。
定义 Function
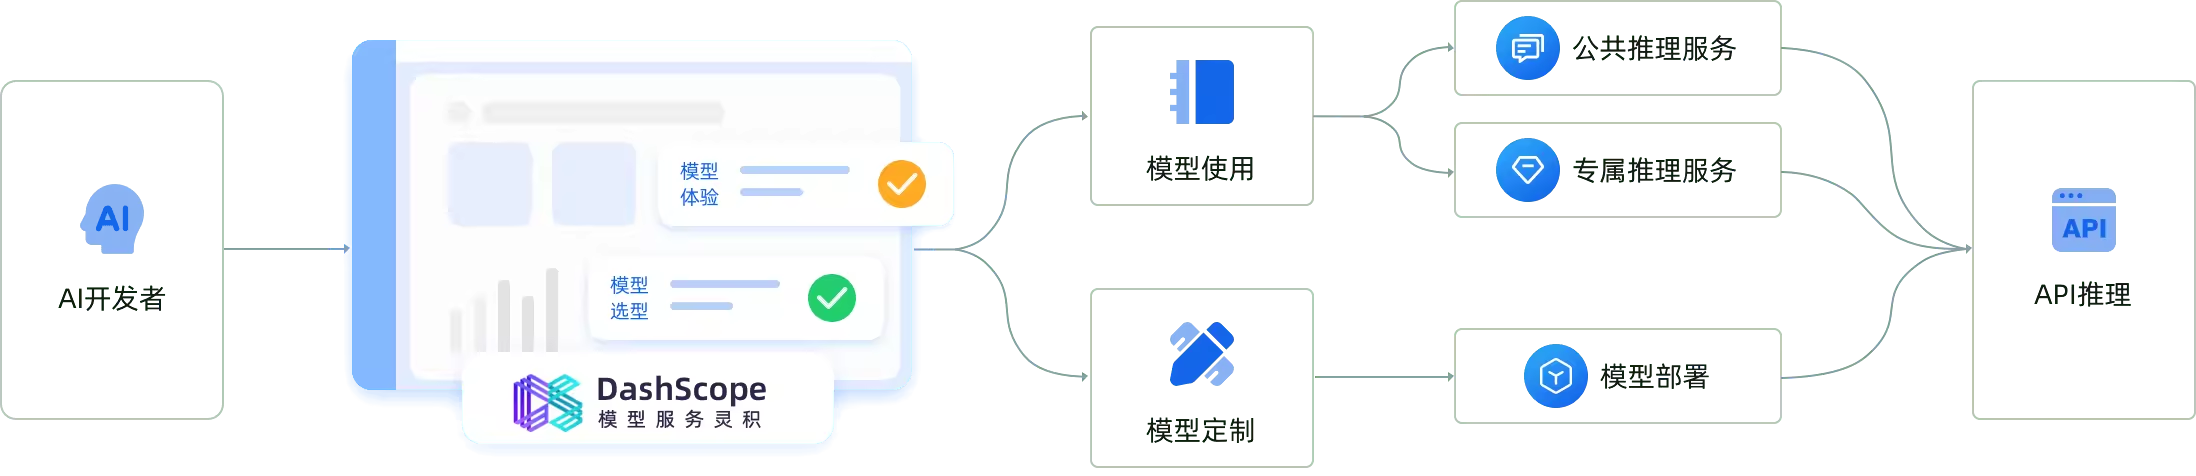
DashScope 模型服务灵积
让大模型能力触达每位开发者
灵积模型服务建立在“模型即服务”(Model-as-a-Service,MaaS)的理念基础之上。
灵积通过灵活、易用的模型API服务,让各种模态模型的能力,都能方便的为AI开发者所用。通过灵积API,开发者不仅可以直接集成大模型的强大能力,也可以对模型进行训练微调,实现模型定制化。
通义千问大型语言模型
| 模型 | 描述 | 上下文长度 | 计量单价 |
|---|---|---|---|
| qwen-turbo | 通义千问超大型语言模型,支持中文、英文等不同语言输入。 | 8k | 0.008元/1000 tokens |
| qwen-plus | 通义千问超大型语言模型增强版,支持中文、英文等不同语言输入。 | 32k | 0.02元/1000 tokens |
| qwen-max | 通义千问千亿级别超大型语言模型,支持中文、英文等不同语言输入。 | 8k | 0.12元/1000 tokens |
| qwen-max-longcontext | 通义千问千亿级别超大型语言模型,支持中文、英文等不同语言输入。 | 30k | 0.12元/1000 tokens |
| qwen-72b-chat | 通义千问开源 720 亿参数大型语言模型 | 8k | 0.02元/1000 tokens |
| qwen1.5-72b-chat | 通义千问开源 720 亿参数大型语言模型 | 32k |
LangChain 调用
LangChain Text2SQL Agent
OpenAI Function Call (Extraction)
这个方法只有 OpenAI 的模型支持。
from langchain.agents import tool
from langchain.chat_models import ChatOpenAI
from langchain.tools.render import format_tool_to_openai_function

from langchain.pydantic_v1 import BaseModel, Field
from enum import Enum


# 省份、直辖市
class ProvinceEnum(str, Enum):
    山东省 = "山东省"
    # 其它省份


# 山东省地级市
// ...
OpenAI gpt-3.
LangChain
介绍
LangChain 是一个用于开发由大型语言模型(LLM)支持的应用程序的框架。
LangChain 简化了 LLM 应用程序生命周期的每个阶段:
- 开发(Development):使用 LangChain 的开源构建块和组件构建您的应用程序。使用第三方集成和模板快速启动。
- 生产化(Productionization):使用 LangSmith 检查、监控和评估您的链,以便您可以持续优化并放心部署。
- 部署(Deployment):使用 LangServe 将任何链转换为 API。

具体来说,该框架由以下开源库组成:
- langchain-core: 基本抽象和 LangChain 表达语言(LangChain Expression Language)。
- langchain-community: 第三方集成。
- 合作伙伴包(例如 langchain-openai、langchain-anthropic 等):一些集成已进一步拆分为自己的轻量级包,这些包仅依赖于 langchain-core。
- langchain: 构成应用程序认知架构(Cognitive Architecture)的链(Chains)、代理(Agents)和检索策略(Retrieval Strategies)。
- langgraph: 通过将步骤建模为图中的边和节点,使用 LLM 构建强大且有状态的多参与者应用程序。
- langserve: 将 LangChain 链部署为 REST API。
Functions, Tools and Agents with LangChain
OpenAI Function Calling (OpenAI 函数调用)
import os
import openai
import json

from dotenv import load_dotenv, find_dotenv
_ = load_dotenv(find_dotenv()) # read local .env file
openai.api_key = os.environ['OPENAI_API_KEY']


# Example dummy function hard coded to return the same weather
# In production, this could be your backend API or an external API
def get_current_weather(location, unit="fahrenheit"):
    """Get the current weather in a given location"""
    weather_info = {
        "location": location,
        "temperature": "72",
        "unit": unit,
        "forecast": ["sunny", "windy"],
    }
    return json.dumps(weather_info)

# define a function
functions = [
    {
        "name": "get_current_weather",
        "description": "Get the current weather in a given location",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {
                    "type": "string",
                    "description": "The city and state, e.g. San Francisco, CA",
                },
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]},
            },
            "required": ["location"],
        },
    }
]

messages = [
    {
        "role": "user",
        "content": "What's the weather like in Boston?"
    }
]

response = openai.ChatCompletion.create(
    model="gpt-3.5-turbo",
    messages=messages,
    functions=functions
)
print(response)
{
  "id": "chatcmpl-9CK2or9rtxzcsVgbfwWmIvqi36wF0",
  "object": "chat.completion",
  "created": 1712724014,
  "model": "gpt-3.5-turbo-0125",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": null,
        "function_call": {
          "name": "get_current_weather",
          "arguments": "{\"location\":\"Boston\",\"unit\":\"celsius\"}"
        }
      },
      "logprobs": null,
      "finish_reason": "function_call"
    }
  ],
  "usage": {
    "prompt_tokens": 82,
    "completion_tokens": 20,
    "total_tokens": 102
  },
  "system_fingerprint": "fp_b28b39ffa8"
}
Continue - It’s time to collect data on how you build software
是时候收集关于你们如何构建软件的数据了。
Development data engine (开发数据引擎)
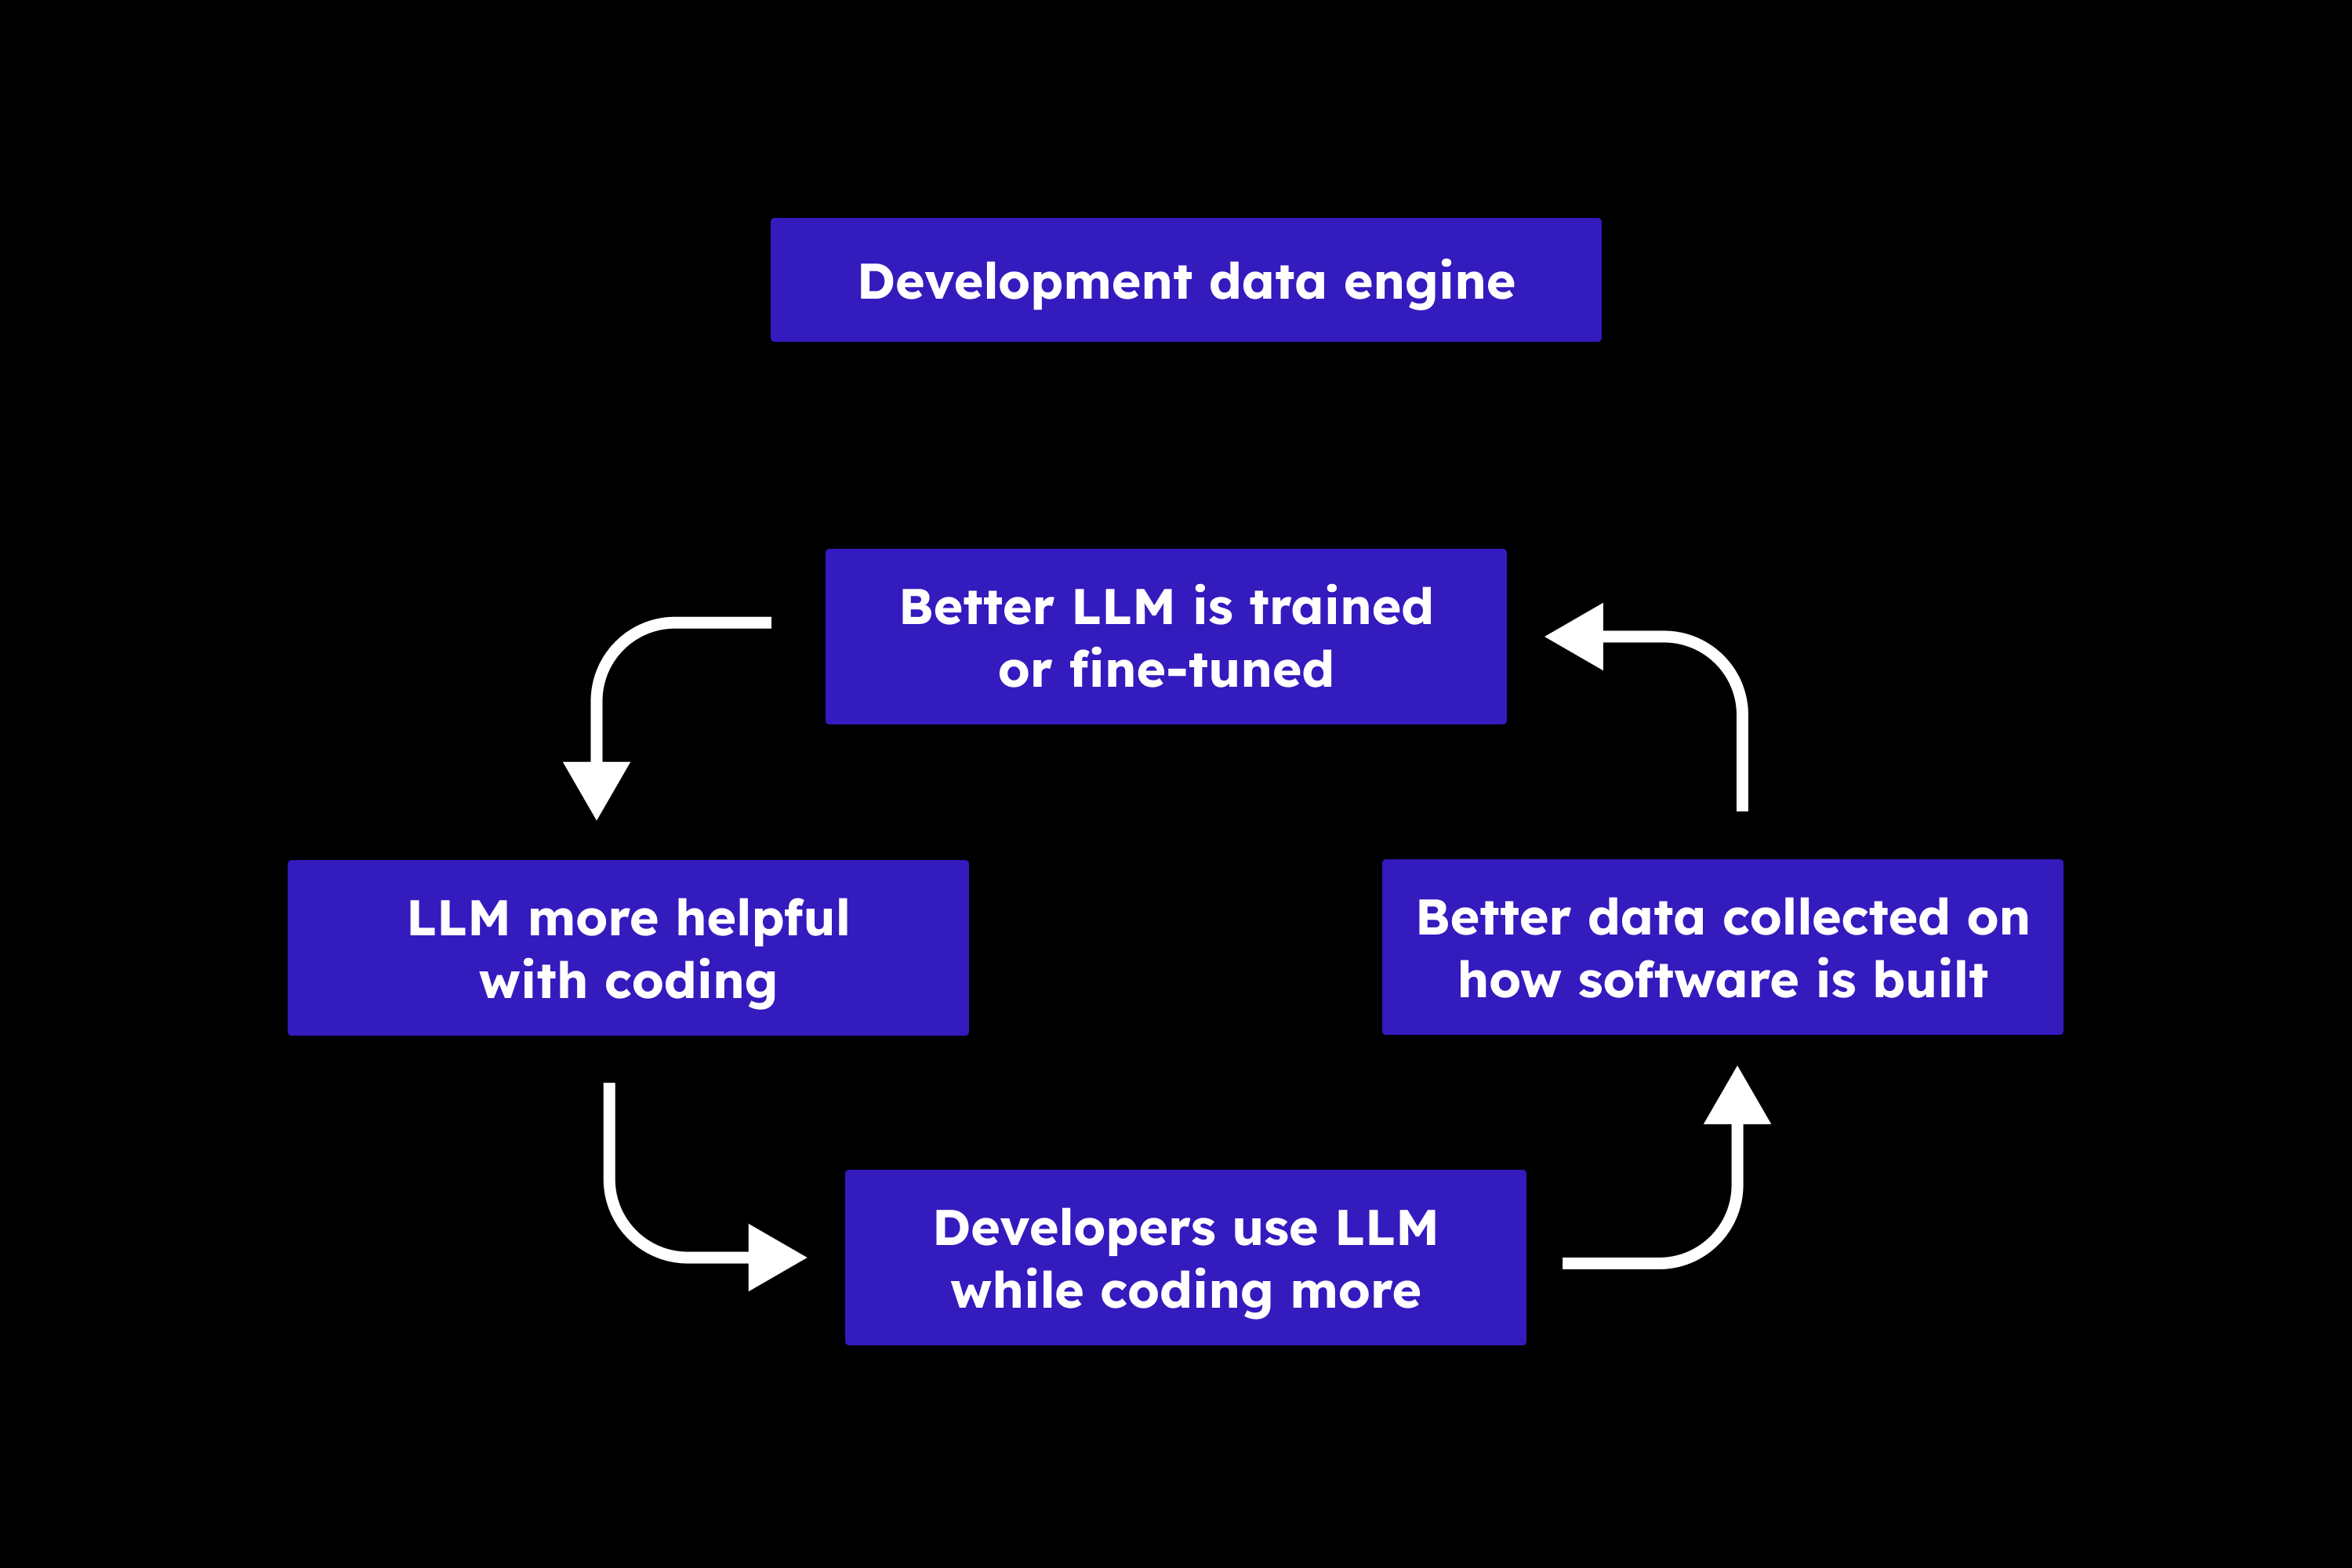
- LLM more helpful with coding (LLM在编码方面更有帮助)
- Developers use LLM while coding more (开发者在编码时更多地使用LLM)
- Better data collected on how software is built (收集到更好的关于软件构建方式的数据)
- Better LLM is trained or fine-tuned (训练或微调更好的LLM)
下一代开发者使用大型语言模型(LLMs)而不是谷歌搜索+ Stack Overflow。
随着时间的推移,开发者的偏好和使用的工具也在不断演进。当前一代的开发者正在用大型语言模型(LLMs)取代之前的Google和Stack Overflow,就像之前的一代人用Google和Stack Overflow取代了传统的参考手册一样。 在这个过渡期中,能够保留和吸引开发者的组织将会:
首先,理解他们的开发者如何使用LLMs,并通过收集开发数据——即他们组织构建软件的方式——来展示使用LLMs的投资回报率(ROI)。
Continue Code LLM Autopilot
Continue
注册 deepseek 的开发平台
OpenAI API
DeepSeek API 使用与 OpenAI 兼容的 API 格式,通过修改配置,您可以使用 OpenAI SDK 来访问 DeepSeek API,或使用与 OpenAI API 兼容的软件。
参数 值 base_url https://api.deepseek.com/v1 api_key 申请 api_key
| 参数 | 值 |
|---|---|
| base_url | https://api.deepseek.com/v1 |
| api_key | YOUR_API_KEY |
模型
| 模型 | 描述 | 上下文长度 |
|---|---|---|
| deepseek-coder | 擅长处理编程任务 | 16K |
| deepseek-chat | 擅长通用对话任务 | 16K |
安装 IntelliJ IDEA 插件 Continue
配置 deepseek-coder { "models": [ { "title": "deepseek api", "provider": "openai", "model": "
Together AI - The fastest cloud platform for building and running generative AI
用于构建和运行生成式人工智能的最快云平台
注册 Together AI 的开发平台
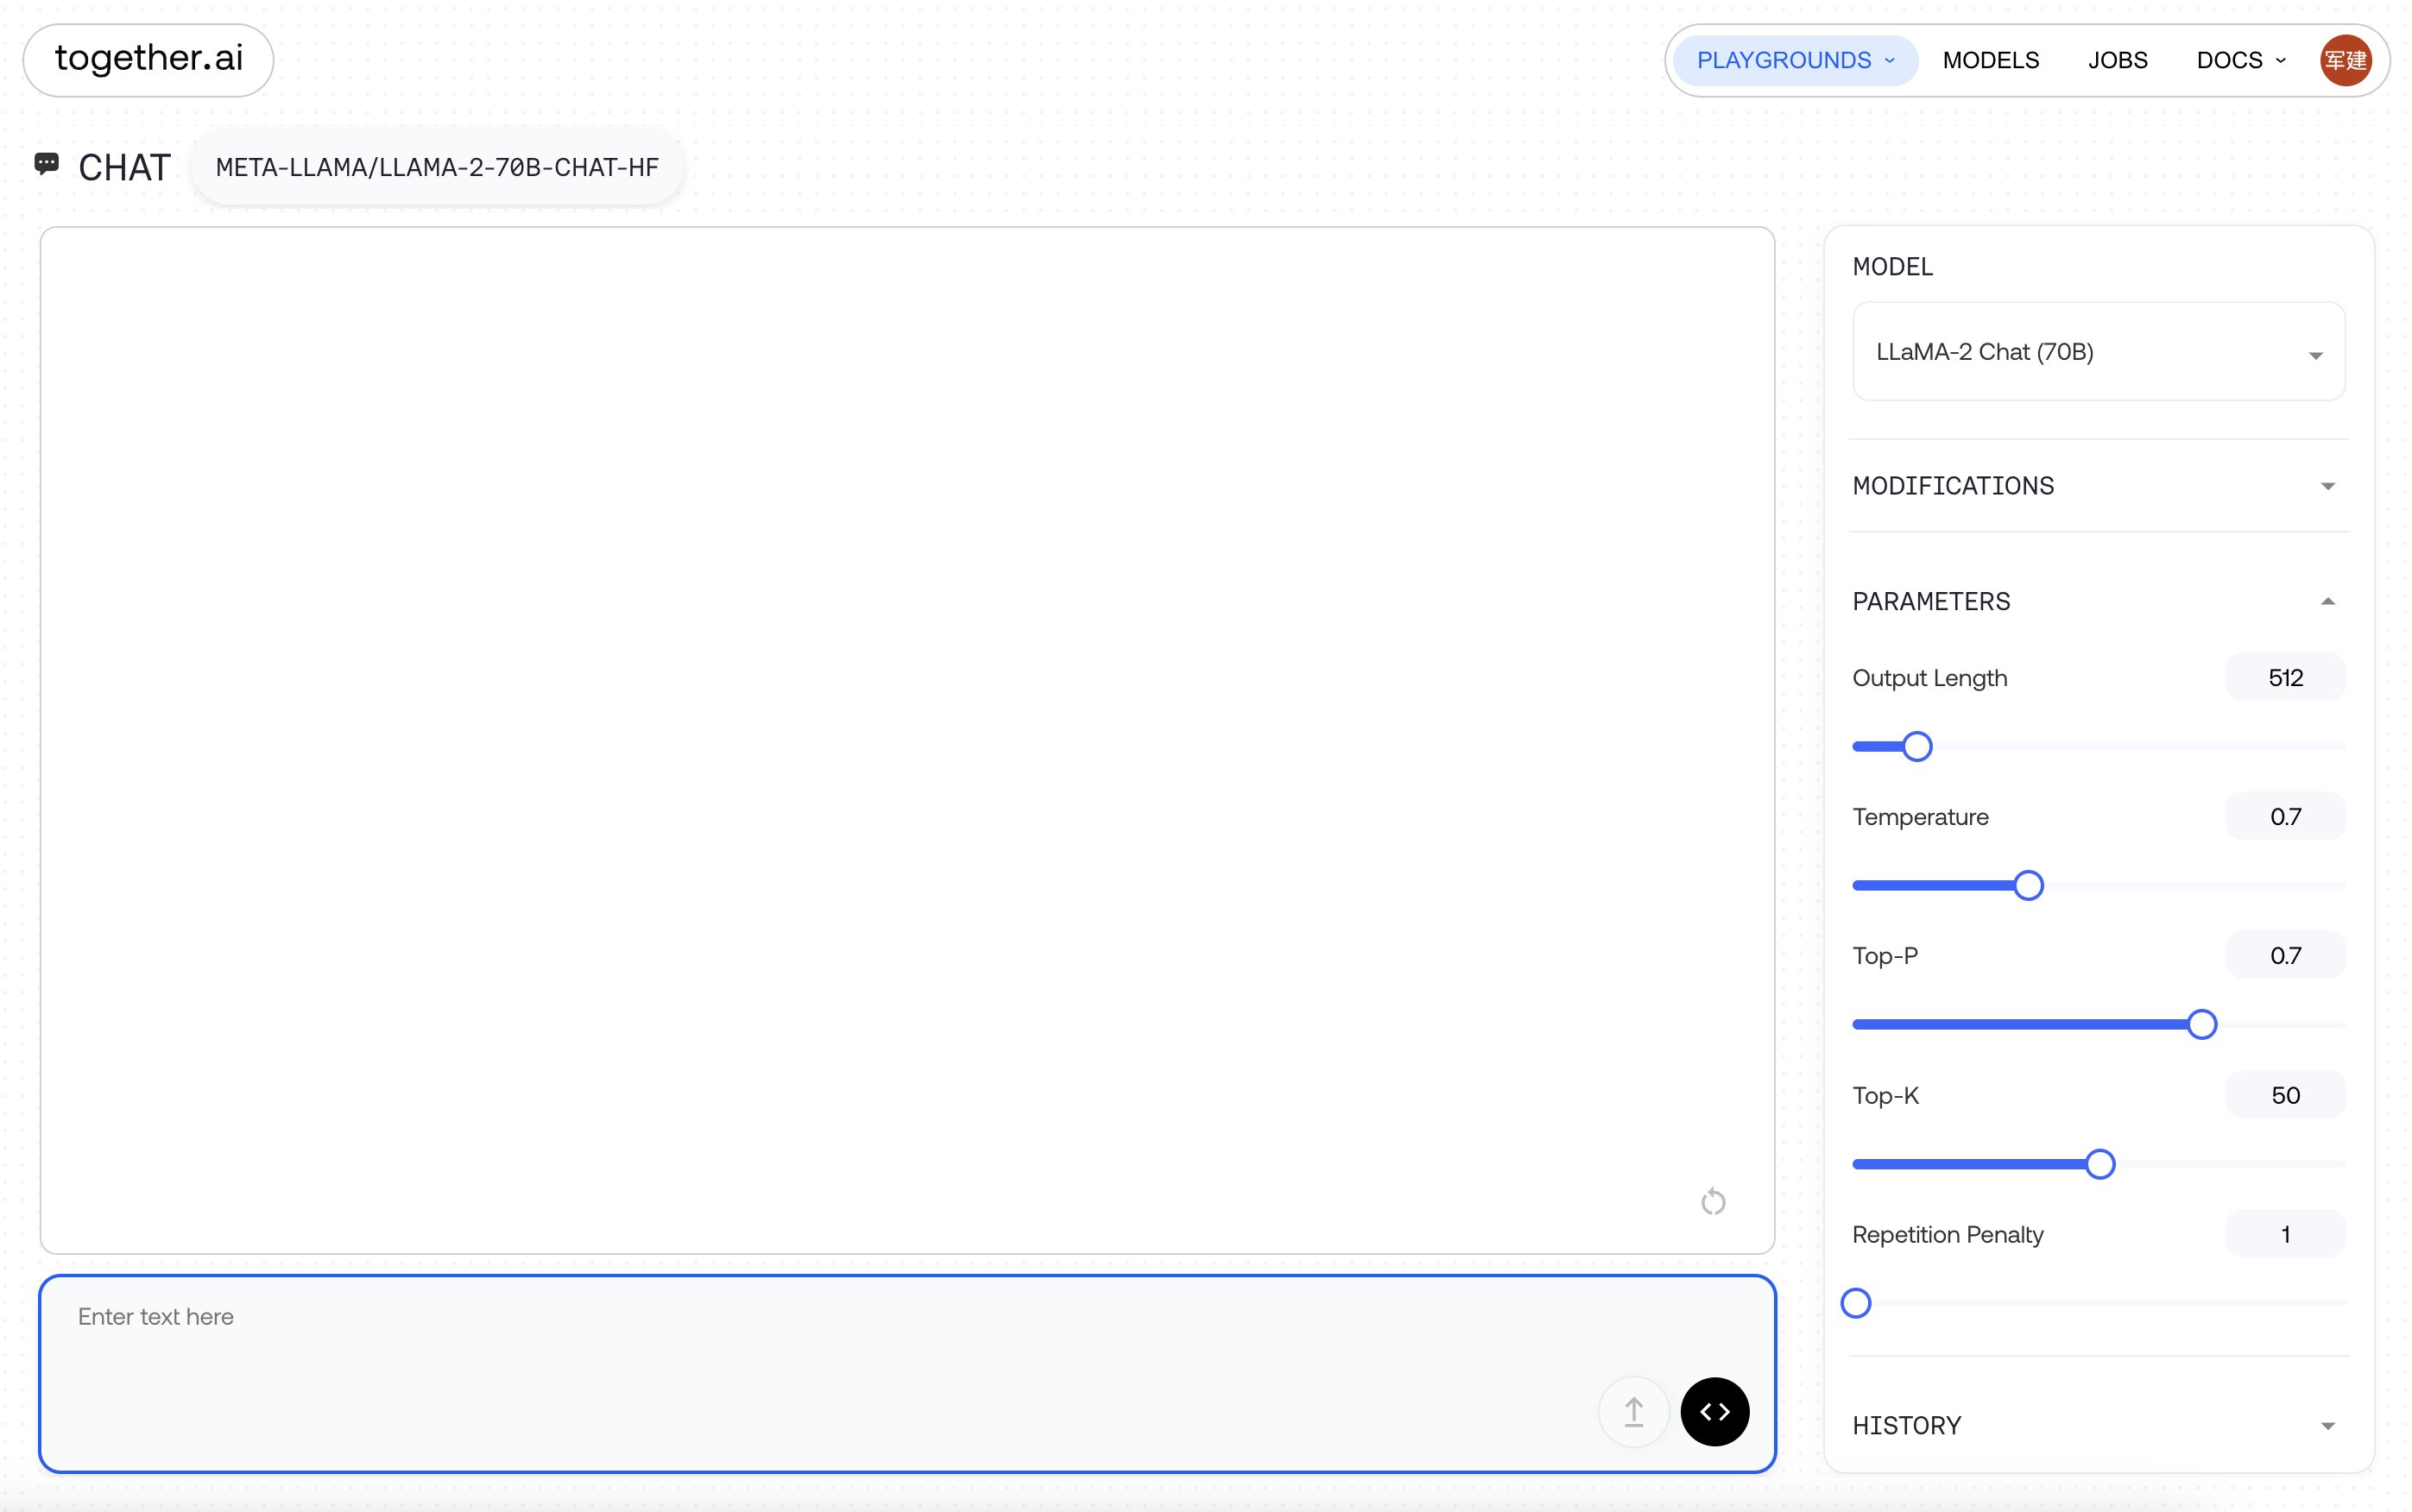
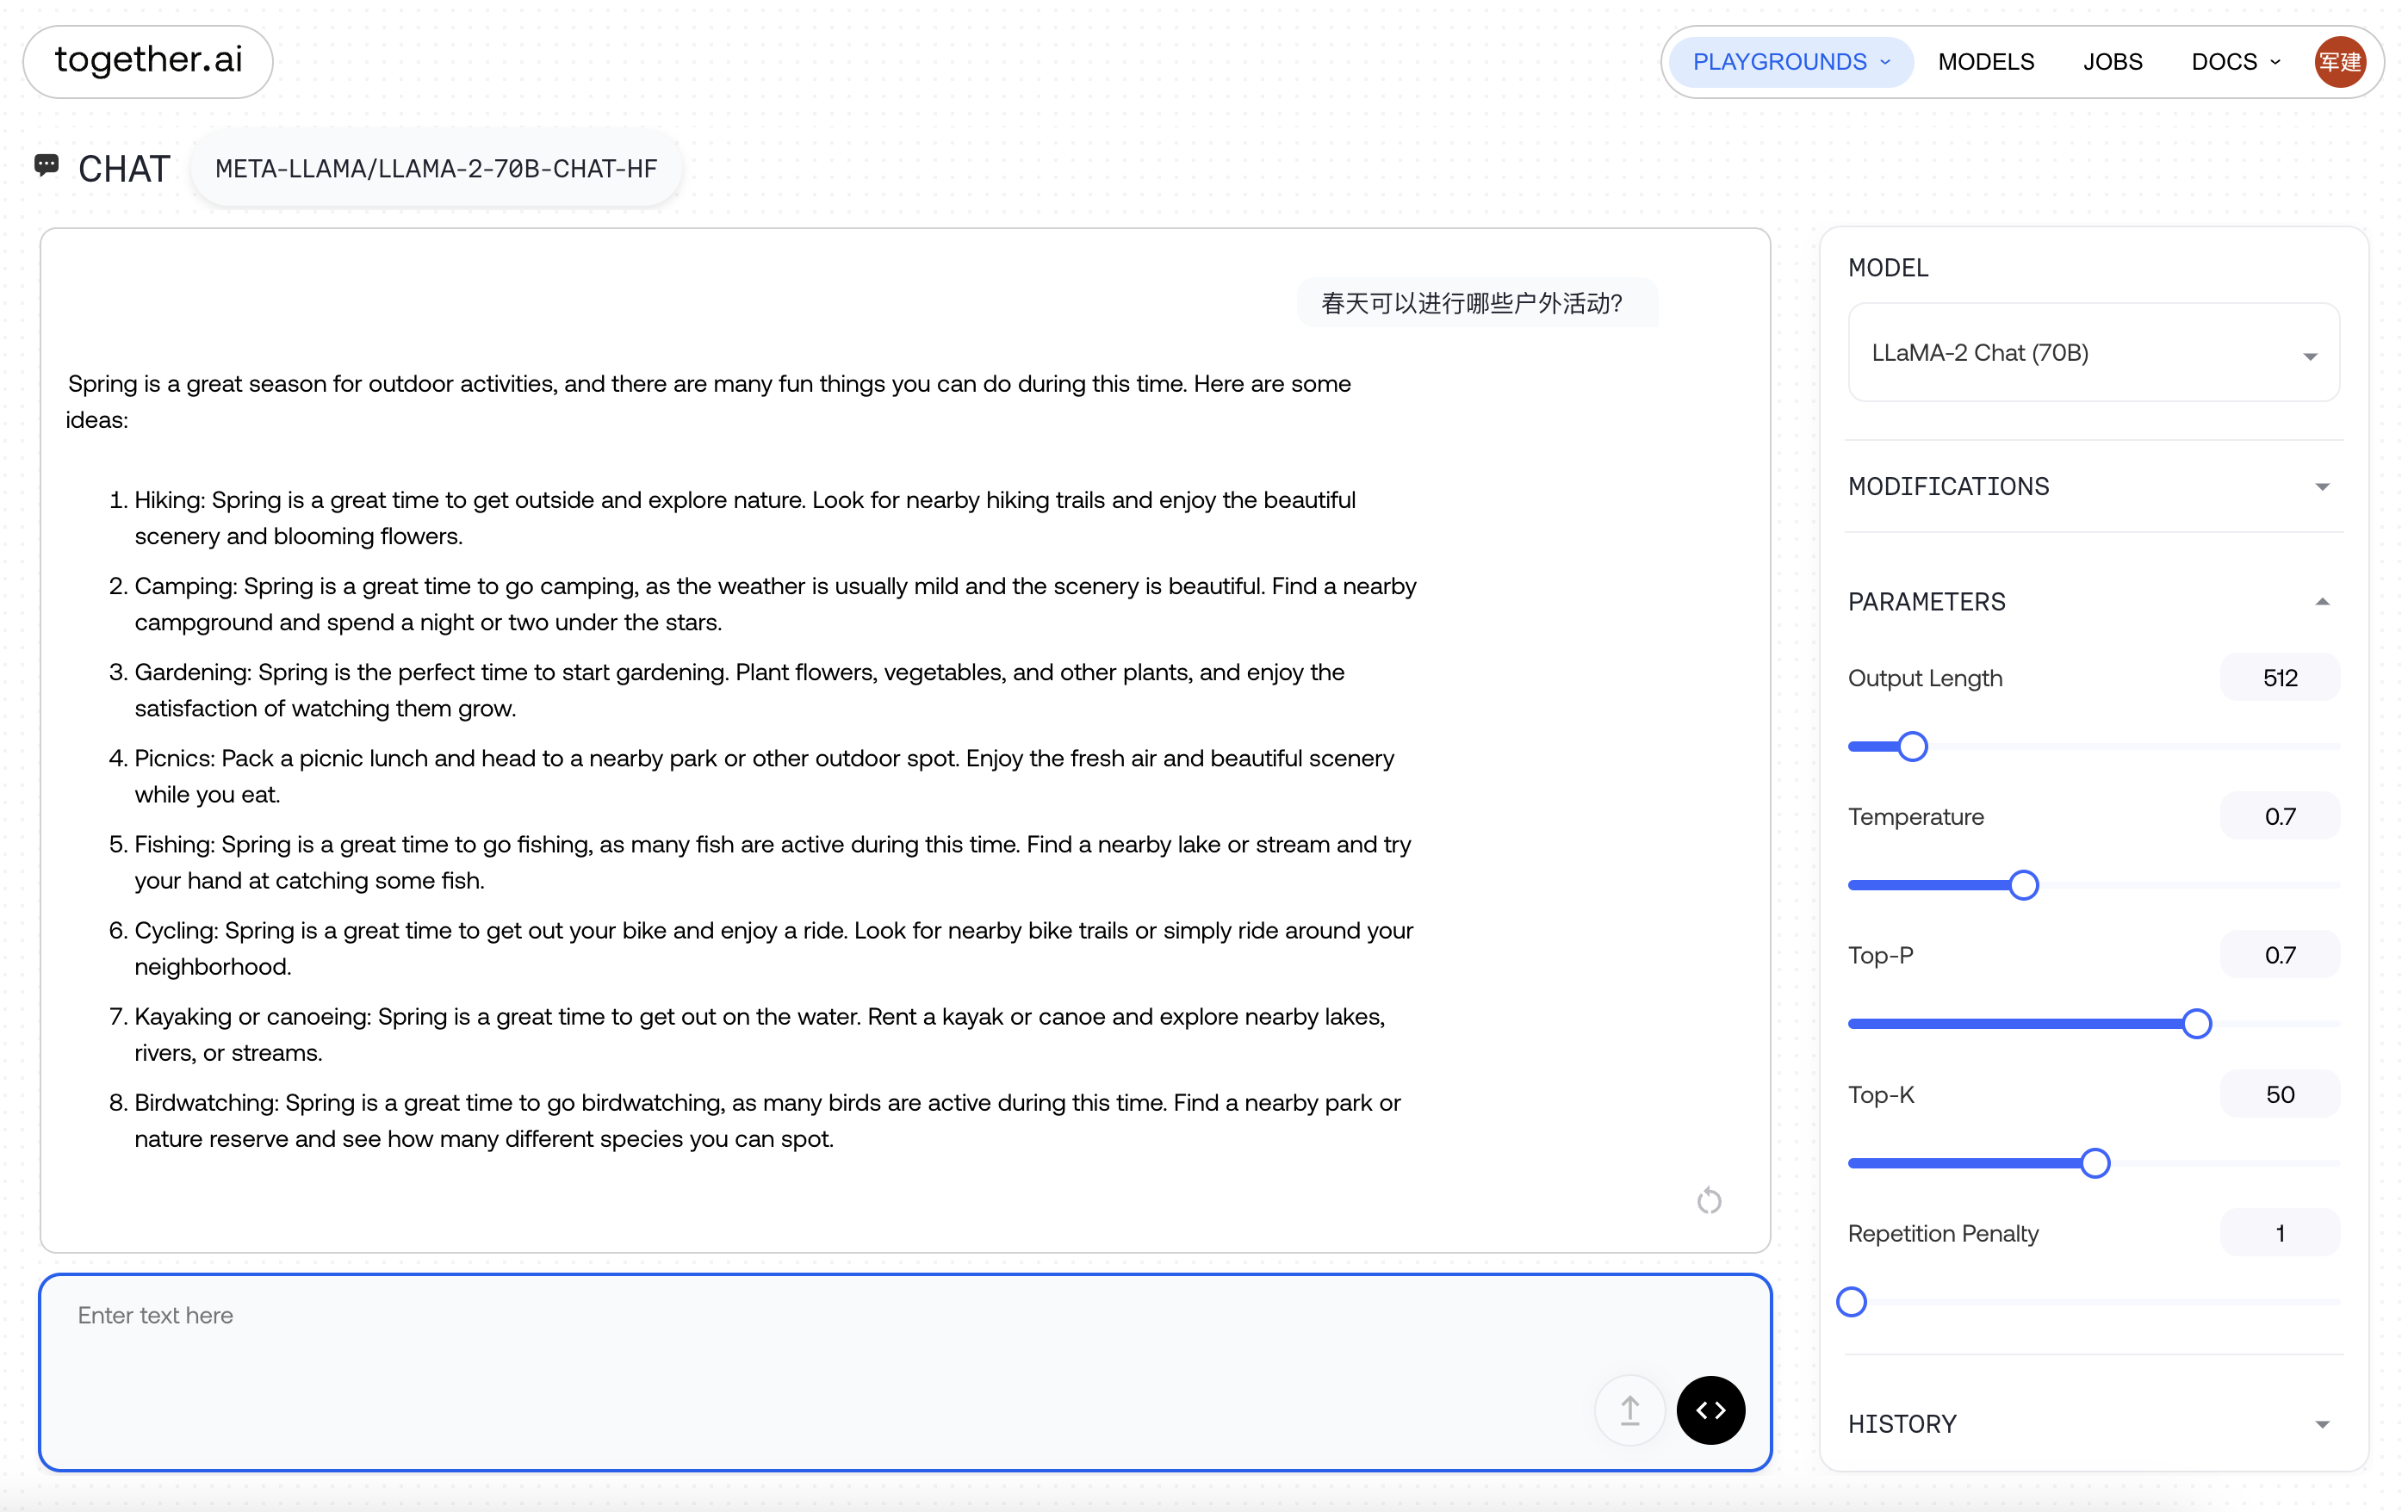

速度非常快
OpenAI API from openai import OpenAI import os TOGETHER_API_KEY = os.environ.get("TOGETHER_API_KEY") client = OpenAI( api_key=TOGETHER_API_KEY, base_url='https://api.together.xyz/v1', ) chat_completion = client.chat.completions.create( messages=[ { "role": "system", "content": "You are an expert travel guide.", }, { "role": "user", "content": "Tell me fun things to do in San Francisco.
LLaMA Factory: Easy and Efficient LLM Fine-Tuning
安装
- pip
git clone https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory

python -m venv env
source env/bin/activate

pip install -e .[metrics]
- conda
git clone https://github.com/hiyouga/LLaMA-Factory.git

conda create -n llama_factory python=3.10
conda activate llama_factory

cd LLaMA-Factory
pip install -r requirements.txt
使用 conda 第二次没有安装成功
使用
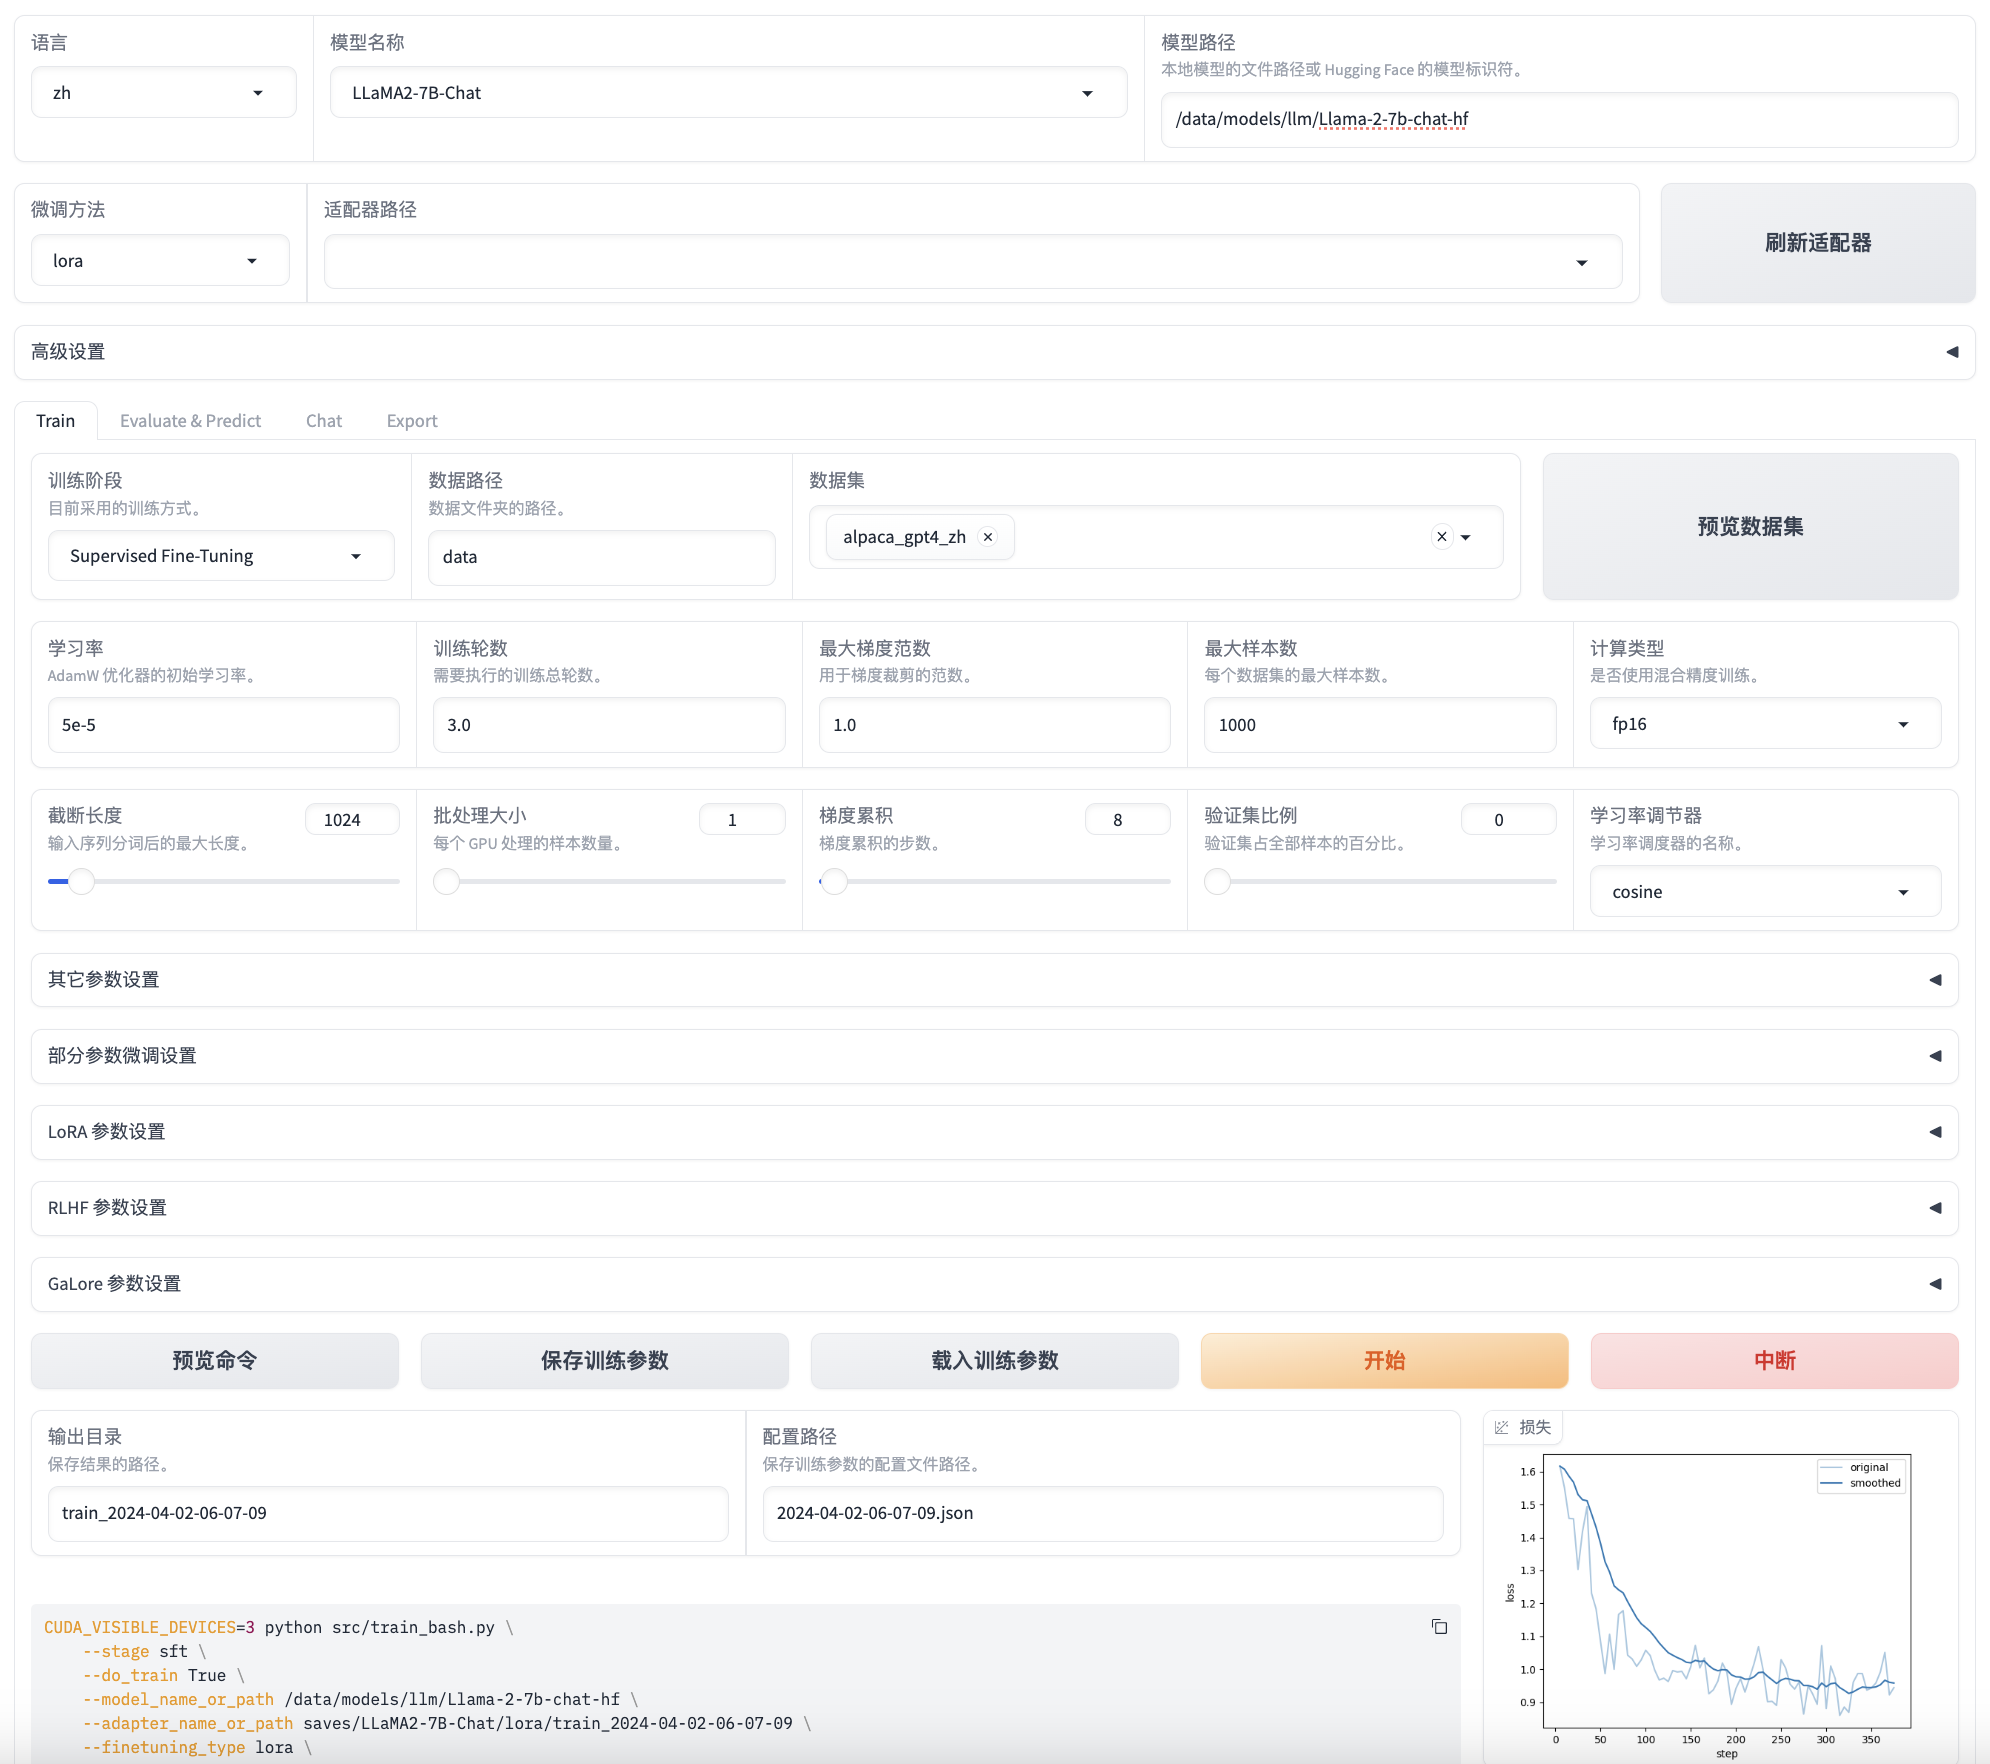
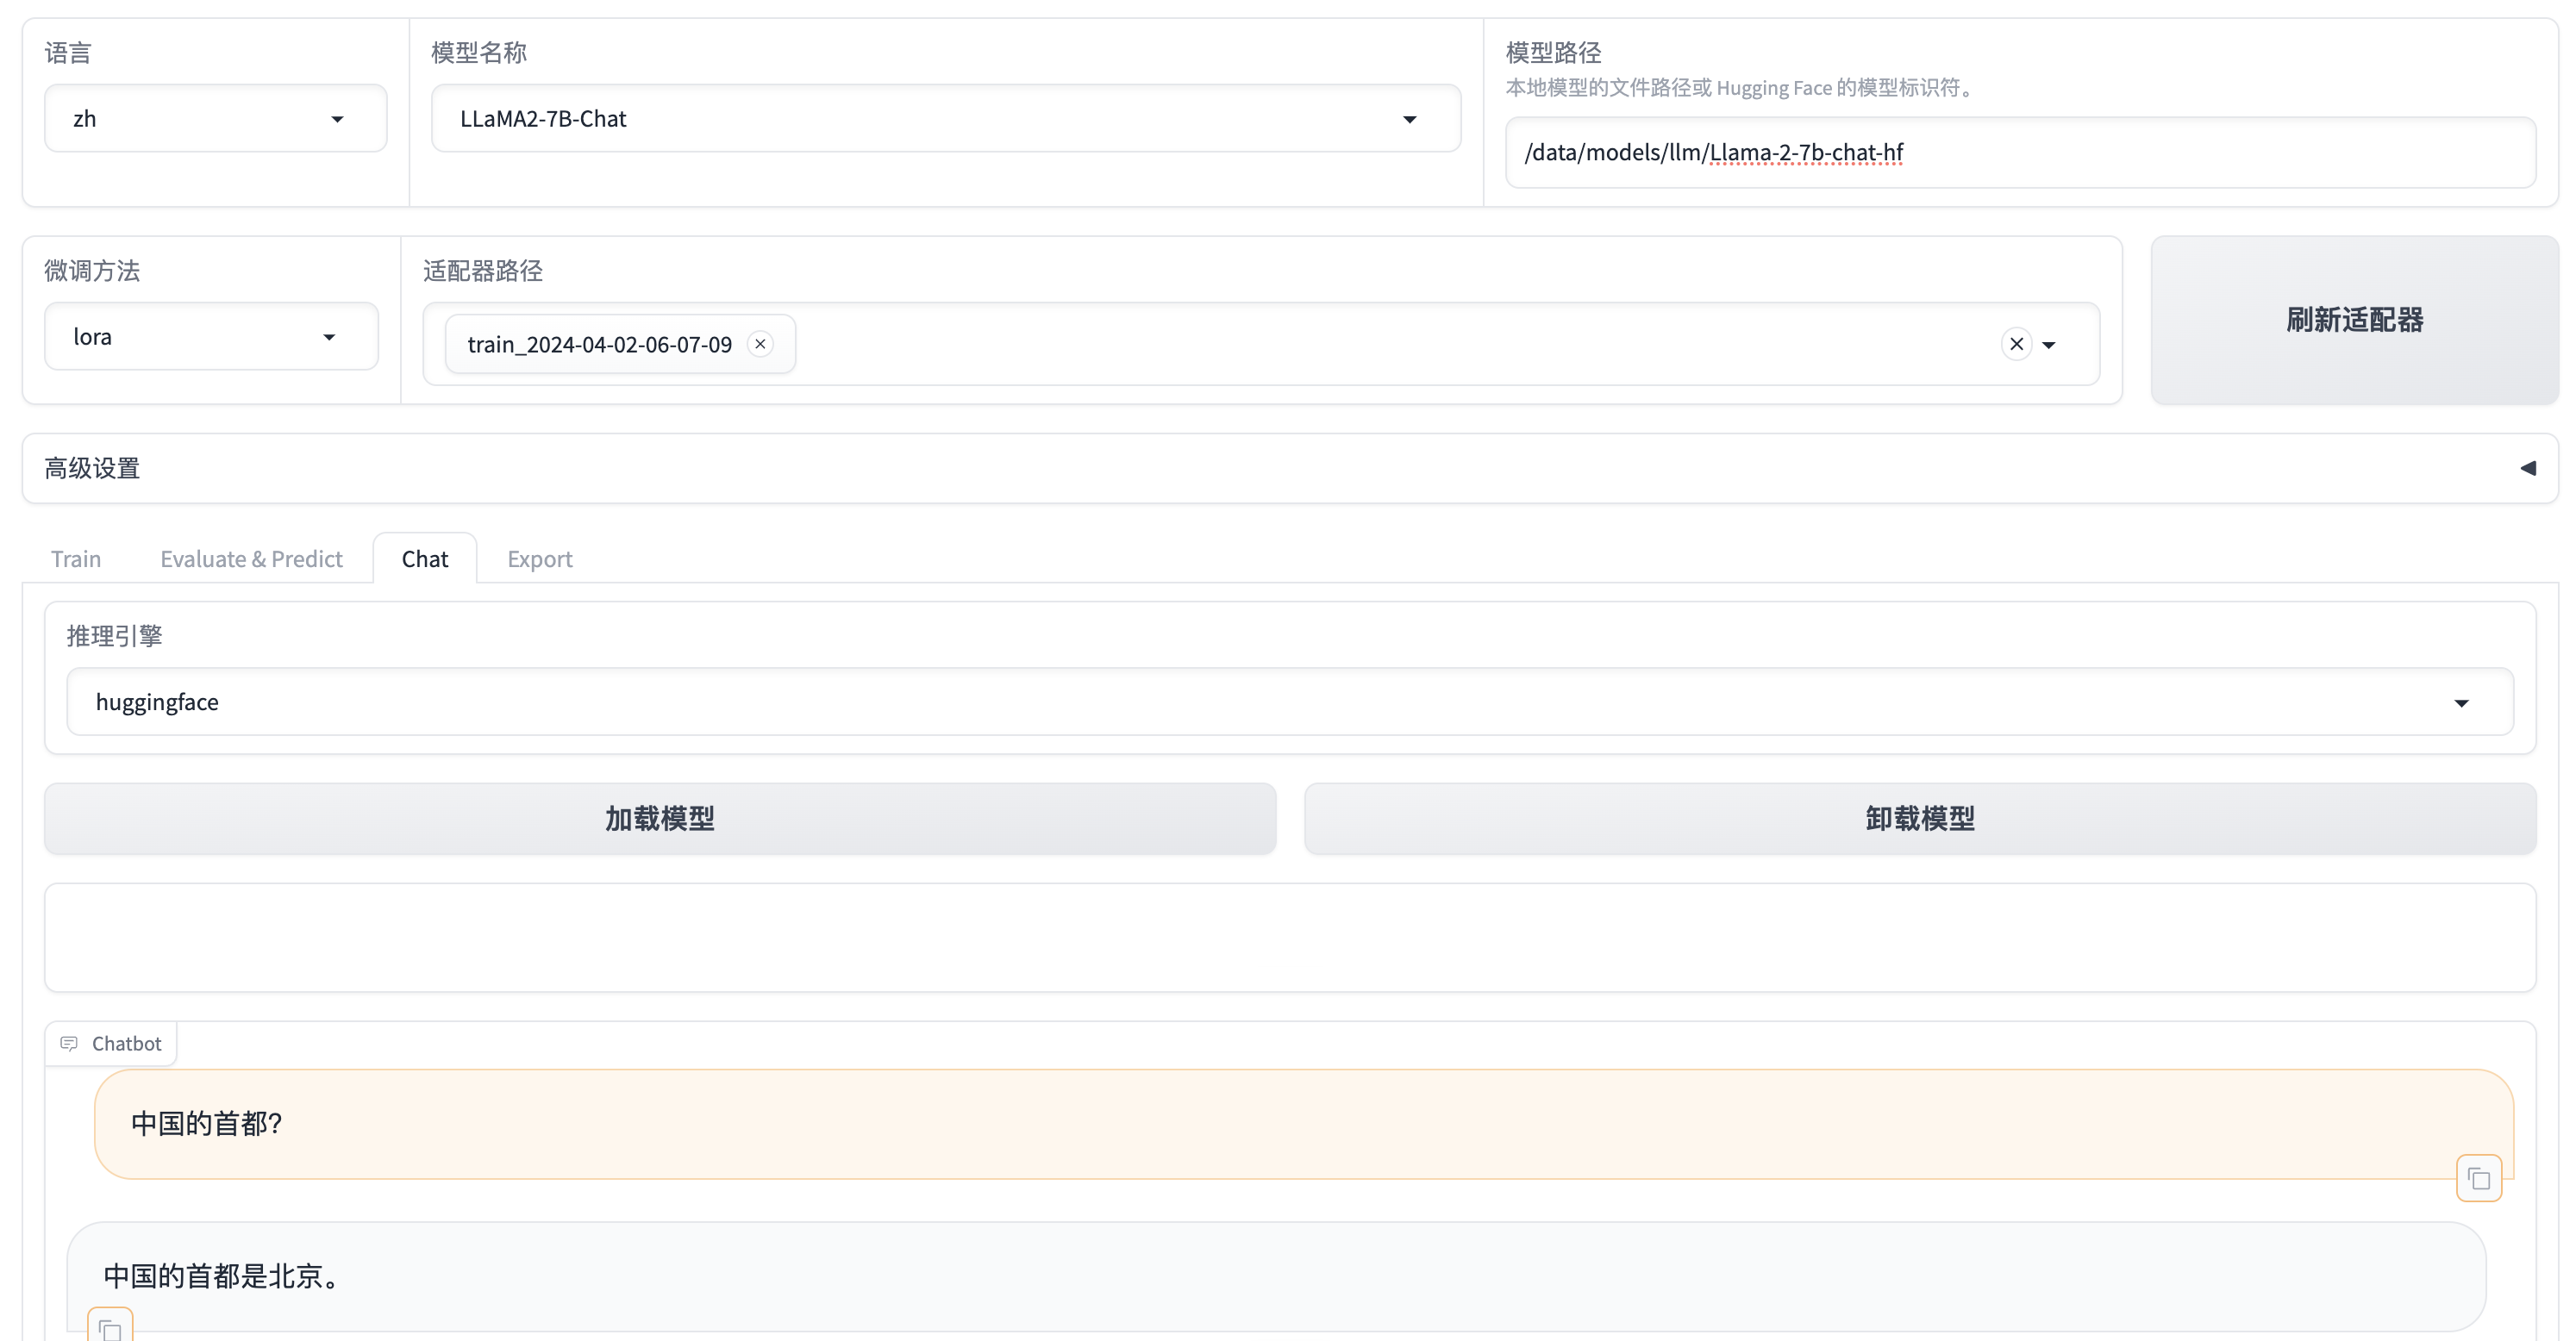
LLaMA Board
本地启动
CUDA_VISIBLE_DEVICES=0 USE_MODELSCOPE_HUB=1 python src/train_web.py
- CUDA_VISIBLE_DEVICES=0: 指定 GPU
- USE_MODELSCOPE_HUB=1: 使用魔搭社区的模型和数据集下载
浏览器访问
微调模型
聊天
没有找到匹配的文章