CrewAI 快速入门
安装
pip install 'crewai[tools]'
CrewAI 使用 Ollama 运行本地 LLM
.env
OPENAI_API_BASE=http://localhost:11434/v1
OPENAI_MODEL_NAME=aya:8b
OPENAI_API_KEY=NULL
agent.py
版本1
每次执行结果都不一样
from dotenv import load_dotenv
load_dotenv()

from crewai import Agent, Task, Crew
from langchain_openai import ChatOpenAI


general_agent = Agent(
    role = "数学教授",
    goal = """为提问数学问题的学生提供解决方案并给出答案。""",
    backstory = """您是一位优秀的数学教授,喜欢以每个人都能理解的方式解决数学问题。""",
    allow_delegation = False,
    verbose = True
)

// ...
版本2
稳定地生成结果
大型语言模型驱动的自主代理
Application scenarios of AI agents(AI代理的应用场景)
AI代理是LLM应用的重要场景,构建代理应用将是2024年的重要技术领域。目前我们主要的智能形式有单AI代理,多AI代理,混合AI代理等三种。
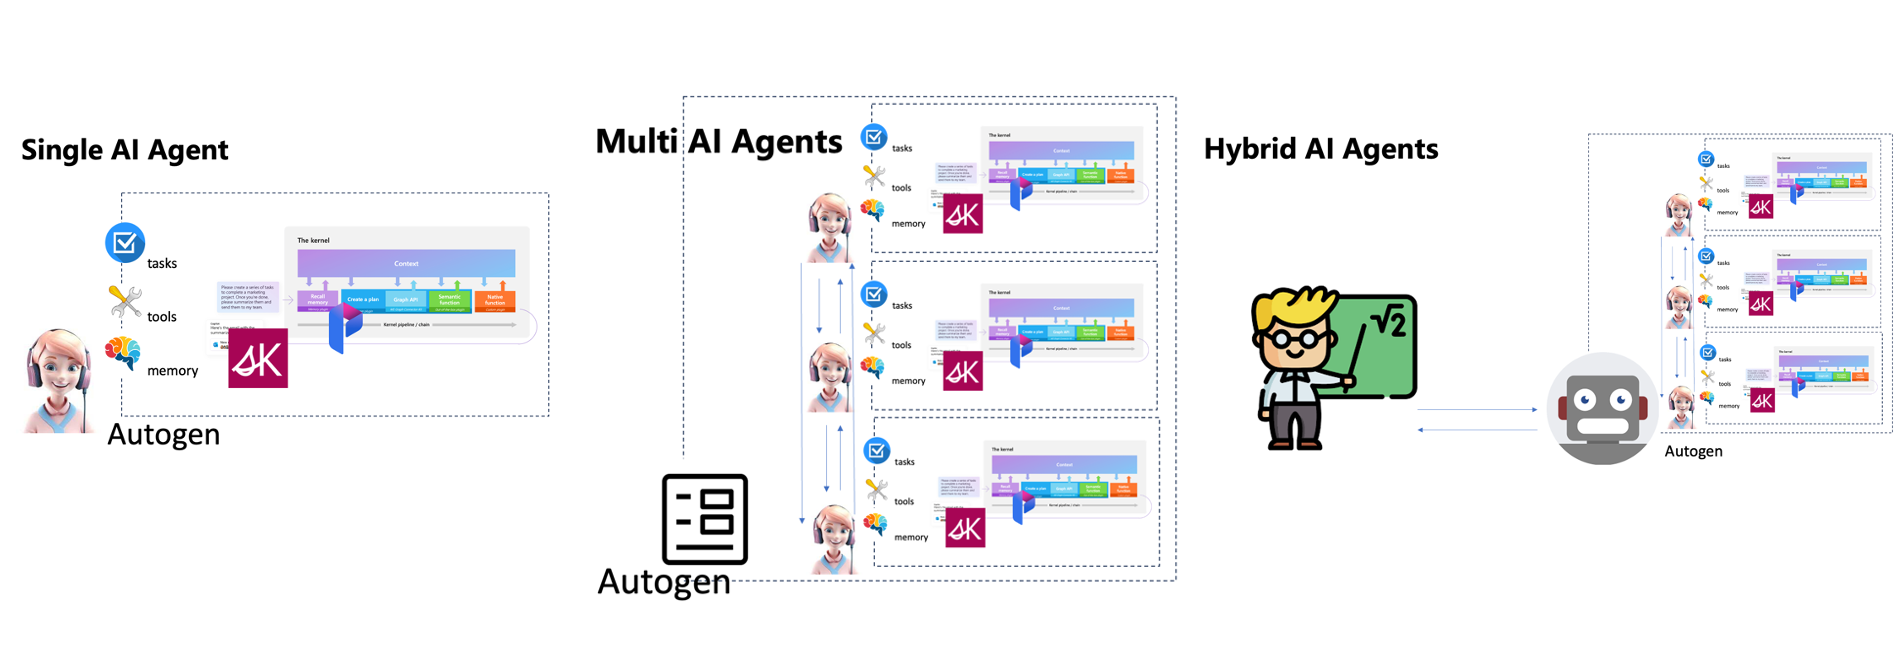
Single AI Agent(单一人工智能代理)
在特定任务场景下完成的工作,比如 GitHub Copilot Chat 下的代理工作区,就是根据用户需求完成特定编程任务的一个例子。基于 LLM 的能力,单个代理可以根据任务执行不同的动作,比如需求分析、项目阅读、代码生成等。它也可以应用于智能家居和自动驾驶。
Multi-AI Agents(多人工智能代理)
这就是AI代理之间相互交互的工作。例如上述Semantic Kernel代理实现就是一个例子。脚本生成的AI代理与执行脚本的AI代理进行交互。多代理应用场景在高度协同的工作中非常有帮助,例如软件行业开发、智能生产、企业管理等。
Hybrid AI Agent(混合人工智能代理)
这就是人机交互,在同一个环境下做决策。比如智慧医疗、智慧城市等专业领域,可以利用混合智能来完成复杂的专业工作。
Intro of AI agent, & AI agent projects s
基于 LLM 的源代码安全缺陷分析
代码注入:SQL注入:MyBatis
提示词
您是一名 Java 高级软件工程师,主要任务是根据缺陷报告的信息修复软件中的漏洞。
要求
请根据缺陷报告,修复缺陷代码片断的缺陷。
要求修复后的软件不改变原有的功能。
需要给出修复后的代码片段或者修复建议。
缺陷报告 缺陷类别: 一级类: 代码注入 二级类:SQL注入:MyBatis 详细信息: SQL注入是一种数据库攻击手段。攻击者通过向应用程序提交恶意代码来改变原SQL语句的含义,进而执行任意SQL命令,达到入侵数据库乃至操作系统的目的。在Mybatis Mapper Xml中,#变量名称创建参数化查询SQL语句,不会导致SQL注入。而$变量名称直接使用SQL指令,会导致SQL注入攻击。 例如:以下代码片段采用$变量名称动态地构造并执行了SQL查询。 <!
Phi-3-vision-128k-instruct 微软开源多模态大模型
Phi-3 Vision 是一个轻量级、最先进的开放多模态模型,基于数据集构建,其中包括合成数据和经过过滤的公开网站,重点关注文本和视觉方面的高质量推理密集数据。该模型属于 Phi-3 模型系列,多模式版本可支持 128K 上下文长度(以 Token 为单位)。该模型经历了严格的增强过程,结合了监督微调和直接偏好优化,以确保精确的指令遵守和稳健的安全措施。
模型参数 4B。
预期用途
主要用例
该模型旨在广泛用于英语商业和研究用途。该模型为通用人工智能系统和应用程序提供了视觉和文本输入功能,这些系统和应用程序需要
- 内存/计算受限的环境;
- 延迟限制场景;
- 一般图像理解;
- 光学字符识别;
- 图表和表格的理解。
我们的模型旨在加速对高效语言和多模态模型的研究,作为生成人工智能驱动功能的构建块。
用例注意事项
我们的模型并非针对所有下游目的而专门设计或评估。开发人员在选择用例时应考虑语言模型的常见限制,并在特定下游用例中使用之前评估和减轻准确性、安全性和公平性,特别是对于高风险场景。开发人员应了解并遵守与其用例相关的适用法律或法规(包括隐私、贸易合规法等)。
手写文字识别
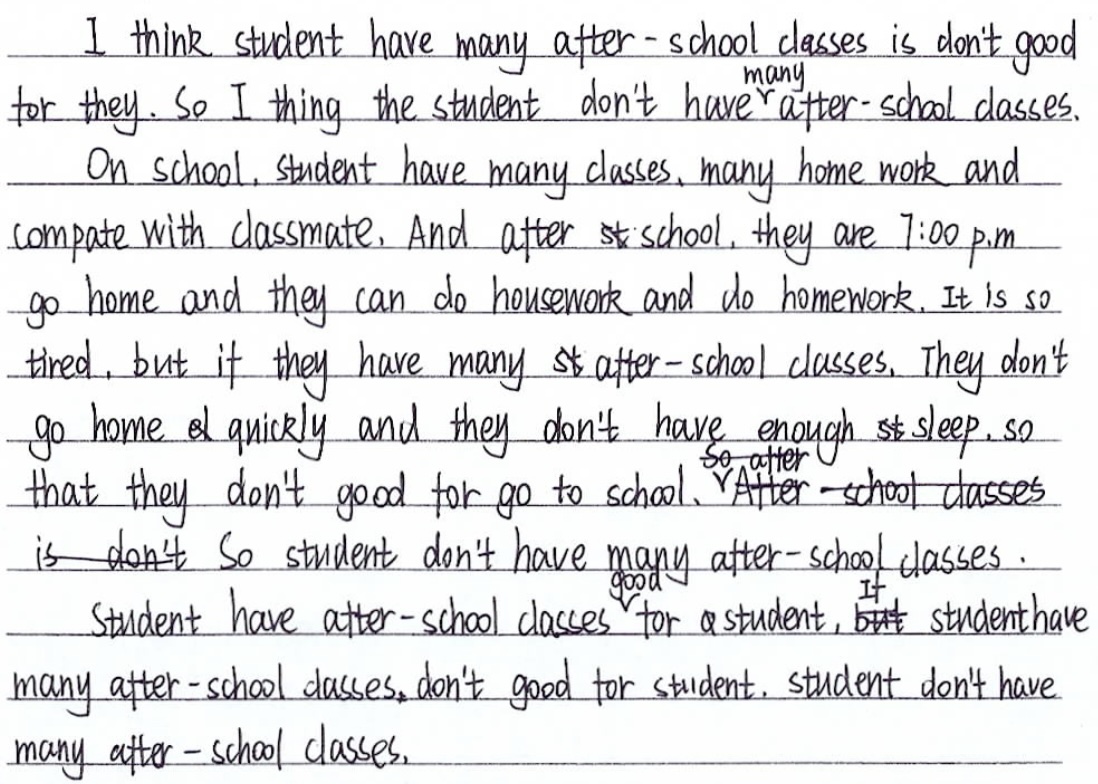
提示词:对图像文字进行识别
这段文字是一个人的自己写作,表达了对学生在学校和家庭生活中的看法。
提示词:这张图片上写了什么?
MiniCPM-Llama3-V 2.5 端侧可用的 GPT-4V 级多模态大模型
MiniCPM-Llama3-V 2.5 是 MiniCPM-V 系列的最新版本模型,基于 SigLip-400M 和 Llama3-8B-Instruct 构建,共 8B 参数量,相较于 MiniCPM-V 2.0 性能取得较大幅度提升。MiniCPM-Llama3-V 2.5 值得关注的特点包括:
- 🔥 领先的性能。 MiniCPM-Llama3-V 2.5 在综合了 11 个主流多模态大模型评测基准的 OpenCompass 榜单上平均得分 65.1,以 8B 量级的大小超过了 GPT-4V-1106、Gemini Pro、Claude 3、Qwen-VL-Max 等主流商用闭源多模态大模型,大幅超越基于Llama 3构建的其他多模态大模型。
- 💪 优秀的 OCR 能力。 MiniCPM-Llama3-V 2.5 可接受 180 万像素的任意宽高比图像输入,OCRBench 得分达到 725,超越 GPT-4o、GPT-4V、Gemini Pro、Qwen-VL-Max 等商用闭源模型,达到最佳水平。基于近期用户反馈建议,MiniCPM-Llama3-V 2.5 增强了全文 OCR 信息提取、表格图像转 markdown 等高频实用能力,并且进一步加强了指令跟随、复杂推理能力,带来更好的多模态交互体感。
CogVLM2 智谱开源多模态大模型
- 在许多关键指标上有了显著提升,例如
TextVQA,DocVQA。 - 支持 8K 文本长度。
- 支持高达 1344 * 1344 的图像分辨率。
- 提供支持中英文双语的开源模型版本。
您可以在下表中看到 CogVLM2 系列开源模型的详细信息:
| 模型名称 | cogvlm2-llama3-chat-19B | cogvlm2-llama3-chinese-chat-19B |
|---|---|---|
| 基座模型 | Meta-Llama-3-8B-Instruct | Meta-Llama-3-8B-Instruct |
| 语言 | 英文 | 中文、英文 |
| 模型大小 | 19B | 19B |
| 任务 | 图像理解,对话模型 | 图像理解,对话模型 |
| 模型链接 | 🤗 Huggingface 🤖 ModelScope 💫 Wise Model | 🤗 Huggingface 🤖 ModelScope 💫 Wise Model |
| 体验链接 | 📙 Official Page | 📙 Official Page 🤖 ModelScope |
| Int4模型 | 暂未推出 | 暂未推出 |
| 文本长度 | 8K | 8K |
| 图片分辨率 | 1344 * 1344 | 1344 * 1344 |
总结 能力非常强大 👍 OCR 已经成为基础能力。包含印刷、手写、中文、英文。 图像描述。 基于图像问答。 信息提取。包含保单、车牌、火车票、手机充值。 表格识别。包含复杂表格。
Thoughtworks 技术雷达 第30期
Thoughtworks 技术雷达
Thoughtworks 技术雷达 (Tech Radar) 是一份每半年发布一次的技术报告,涵盖了工具、技术、平台、语言和框架等方面的内容。这一知识成果来自于我们全球团队的经验,重点介绍了您可能想要在项目中探索的内容。
环的含义如下:
- 1️⃣ 采纳 (Adopt)。我们认为您应该认真考虑使用的点。
- 2️⃣ 试验 (Trial)。我们认为可以放心使用的点,但还没有达到“采纳”环中那么成熟的程度。
- 3️⃣ 评估 (Assess)。值得关注的点,但除非非常适合您的需求,否则目前可能不需要试用。
- 4️⃣ 暂缓 (Hold)。需要谨慎对待的点。
参考:
- Thoughtworks 技术雷达
- Thoughtworks 技术雷达 频繁被提及的问题
- Thoughtworks 技术雷达 第30期 2024年4月30日
- Exploring Generative AI - 探索生成式人工智能
- An example of LLM prompting for programming - LLM 提示编程的例子
技术 1️⃣ 将 CI/CD 基础设施作为一种服务 - 2023年4月 将 CI/CD 基础设施作为一种服务已经是很多元化以及成熟的方案,以至于需要自己管理整个 CI 基础设施的情况变得非常少见。
SWIFT: Scalable lightWeight Infrastructure for Fine-Tuning
简介
SWIFT 支持近200种LLM和MLLM(多模态大模型)的训练、推理、评测和部署。开发者可以直接将我们的框架应用到自己的Research和生产环境中,实现模型训练评测到应用的完整链路。我们除支持了PEFT提供的轻量训练方案外,也提供了一个完整的Adapters库以支持最新的训练技术,如NEFTune、LoRA+、LLaMA-PRO等,这个适配器库可以脱离训练脚本直接使用在自己的自定流程中。
安装
git clone https://github.com/modelscope/swift.git
cd swift
pip install -e '.[llm]'
支持的模型类型(model_type)
['chinese-alpaca-2-13b-16k', 'chinese-alpaca-2-13b', 'chinese-alpaca-2-7b-64k', 'chinese-alpaca-2-7b-16k', 'chinese-alpaca-2-7b', 'chinese-alpaca-2-1_3b', 'chinese-llama-2-13b-16k', 'chinese-llama-2-13b', 'ch
使用大型语言模型微调命名实体识别
目标
这里探索了借助大型语言模型微调进行命名实体识别的标注。
定义了一套电力领域的命名实体类型:
- Province: 省份。例如:山东省。
- City: 城市。例如:济南市、济南。
- Company: 供电公司。例如:长清区供电公司、市中供电中心。
- Substation: 供电所。例如:崮山供电所。
- Indicator: 指标。例如:投诉、意见。
- Date: 日期。例如:今天、昨天、今年、去年、本周、上周、本月、上月、3月、本季度、上季度、一季度、今年第一季度、2022年、2024年5月。
对用户的输入进行命名实体识别标注,输出的结果应该包含所有的电力领域实体类型的实例。
- 山东省菏泽巨野县供电公司麒麟供电所投诉数量
<Province>山东省</Province><City>菏泽</City><Company>巨野县供电公司</Company><Substation>麒麟供电所</Substation><Indicator>投诉</Indicator>数量
- 菏泽巨野县供电公司麒麟供电所投诉数量
<City>菏泽</City><Company>巨野县供电公司</Company><Substation>麒麟供电所</
使用大型语言模型微调命名实体识别生成
目标
这里探索了借助大型语言模型进行命名实体识别的标注,并在缺少相关类型实体的时候可以自动生成。
定义了一套电力领域的命名实体类型:
- Province: 省份。例如:山东省。
- City: 城市。例如:济南市、济南。
- Company: 供电公司。例如:长清区供电公司、市中供电中心。
- Substation: 供电所。例如:崮山供电所。
- Indicator: 指标。例如:投诉、意见。
- Date: 日期。例如:今天、昨天、今年、去年、本周、上周、本月、上月、3月、本季度、上季度、一季度、今年第一季度、2022年、2024年5月。
理想的情况下的输入可能是这样的:{DATE}山东省菏泽巨野县供电公司麒麟供电所投诉数量。
但是用户的输入是多种多样的:
- 山东省菏泽巨野县供电公司麒麟供电所投诉数量
- 菏泽巨野县供电公司麒麟供电所投诉数量
- 菏泽巨野投诉数量
- 菏泽麒麟投诉数量
- 巨野县供电公司麒麟供电所投诉数量
- 巨野麒麟投诉数量
- 巨野投诉数量
- 麒麟供电所投诉数量
- 麒麟投诉数量
通过微调后的模型可以生成如下实体标注: <Date>本月</Date><Province>山东省</Province><City>菏泽</City><Company>巨野县供电公司</Company><Substation>麒麟供电所
Next.js
- 初始化Next.js项目
首先,创建一个新的Next.js项目:
npx create-next-app next-quiz-app
cd next-quiz-app
运行
npm run dev
ESLint
npm run lint
> next-quiz-app@0.1.0 lint
> next lint

✔ No ESLint warnings or errors
使用大型语言模型进行命名实体识别
总结
- Qwen 模型的指令遵循还是差强人意,这里使用的参数应该是 72B
- 大型语言模型发挥了它的生成能力,会在原文的基础上给你增加内容,如:济南
市。 - 问题变化多样,示例也不可能覆盖所有的情况,写的越多占用的上下文长度越大。
- 在实验二中
- 明确说明
Date实体类型的值,并没有很好的识别出来,如:3月识别为Month,一季度识别为Quarter,今年识别为Year。这个跟模型有关,ChatGPT就识别的不错。
- 明确说明
- 在实验三中
- 明确说明不要增加实体类型,但还是增加了,如:
County实体类型。 - 识别的实体有重叠文字,如:
曹县,曹县供电公司。 - 位置很容易出错,一旦出错后面的实体位置都是错误的了。
- 明确说明不要增加实体类型,但还是增加了,如:
- 使用
XML标记方式比输出json结果方式效果更好。
代码 from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts import PromptTemplate from langchain_core.runnables import RunnablePassthrough from langchain_community.chat_models.
LLaMA-Factory 微调 Text2SQL
git clone https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory

python -m venv env
source env/bin/activate

pip install -e .[metrics]
下载模型
git clone https://www.modelscope.cn/qwen/Qwen1.5-4B-Chat.git
自定义数据集
data/text2sql.json [ { "instruction": "You are an SQLite database expert. Help users write SQL statements based on the following table schema.
ChatTongyi
LangChain ChatTongyi
Stream
Gradio DataFrame
Gradio DataFrame
import pandas as pd
import gradio as gr

def read_csv_from_text2sql(file_path="data/text2sql.csv"):
    try:
        df = pd.read_csv(file_path)
        return df
    except Exception as e:
        return pd.DataFrame([{"error": f"❌ {e}"}])

def selected_text2sql_dataframe(selected_index: gr.SelectData, df: gr.DataFrame):
    selected_row = df.iloc[selected_index.index[0]]
    text = selected_row.get('Text', '')
    sql = selected_row.get('SQL', '')
    return text, sql

with gr.Blocks() as demo:
    # UI
    upload_button = gr.UploadButton(label="上传 Text2SQL CSV 文件",
                                    file_types = ['.csv'],
                                    file_count = "single")
    df_text2sql = gr.Dataframe(headers=["Text", "SQL"],
                                type="pandas",
                                col_count=2,
                                value=read_csv_from_text2sql,
                                interactive=False)
    with gr.Row():
        textbox_text = gr.Textbox(label="Text", lines=4)
        textbox_sql = gr.Textbox(label="SQL", lines=4)

    # Event
    upload_button.upload(fn=read_csv_from_text2sql,
                            inputs=upload_button,
                            outputs=df_text2sql)
    df_text2sql.select(fn=selected_text2sql_dataframe,
                        inputs=df_text2sql,
                        outputs=[textbox_text, textbox_sql])

demo.queue(api_open=False)
demo.launch(max_threads=30)
Gradio Chatbot
Gradio Chatbot
DashScope
import os
import pandas as pd
import gradio as gr
from http import HTTPStatus
from dashscope import Generation
from dashscope.api_entities.dashscope_response import Role
from typing import List, Optional, Tuple, Dict, Generator
from urllib.error import HTTPError


DEFAULT_SYSTEM = '您是一个有用的助手。'

History = List[Tuple[str, str]]
Messages = List[Dict[str, str]]

// ...
LangChain ChatTongyi
Meta Llama 3
Llama3
模型
- Meta-Llama-3-8b: 8B 基础模型
- Meta-Llama-3-8b-instruct: 8B 基础模型的指令调优版
- Meta-Llama-3-70b: 70B 基础模型
- Meta-Llama-3-70b-instruct: 70B 基础模型的指令调优版
- Llama Guard 2: Llama Guard 2 是基于 Llama 3 8B 微调的,为生产环境设计的,能够对大语言模型的输入(即提示)和响应进行分类,以便识别潜在的不安全内容。
下载
数据集
No Robots 是由熟练的人类注释者创建的包含 10,000 条指令和演示的高质量数据集。该数据可用于监督微调(SFT),使语言模型更好地遵循指令。 No Robots 是根据 OpenAI 的 InstructGPT 论文中描述的指令数据集进行建模的。
介绍 Llama 3 最大的变化是采用了新的 Tokenizer,将词汇表大
Anthropic Claude
Claude 3 模型
| 模型 | 模型名称 | 价格(MTok) | 能力 |
|---|---|---|---|
| Opus | claude-3-opus-20240229 | Input: 75 | 处理复杂的分析、多步骤的长期任务,以及更高阶的数学和编码任务 |
| Sonnet | claude-3-sonnet-20240229 | Input: 15 | 适用于高效、高吞吐量的任务 |
| Haiku | claude-3-haiku-20240307 | Input: 1.25 | 执行轻量级操作,速度领先行业 |
MTok= million tokens.(百万 Token)- 所有
Claude 3模型都支持视觉和200,000个 Token 上下文窗口。
例子
没有找到匹配的文章