数据集
| 数据集 | 尺寸 (Tokens) |
|---|---|
| RefinedWeb | 500B |
| C4 | 172B |
| Dolma | 3T |
| The Pile | 340B |
| SlimPajama | 627B |
| RedPajama2 | 20T |
| FineWeb | 15T |
结合 TF/IDF 或者 BM25 算法改进代码检索的效果,提高代码检索的准确性。 采用 Jaccard 相似度算法,提高代码相似性检测的效果。 使用 TreeSitter 或者 AST 技术,进行语法分析,以构建更好的交互体验。
| 数据集 | 尺寸 (Tokens) |
|---|---|
| RefinedWeb | 500B |
| C4 | 172B |
| Dolma | 3T |
| The Pile | 340B |
| SlimPajama | 627B |
| RedPajama2 | 20T |
| FineWeb | 15T |
结合 TF/IDF 或者 BM25 算法改进代码检索的效果,提高代码检索的准确性。 采用 Jaccard 相似度算法,提高代码相似性检测的效果。 使用 TreeSitter 或者 AST 技术,进行语法分析,以构建更好的交互体验。
VS Code Extension
GraphRAG 项目是一个数据管道和转换套件,旨在利用大型语言模型(LLMs)的力量从非结构化文本中提取有意义的结构化数据。
若要了解更多关于 GraphRAG 以及它如何用于增强您的大型语言模型(LLMs)对您的私有数据进行推理的能力,请访问 Microsoft Research Blog Post。
构建虚拟环境
cd /Users/junjian/GitHub/microsoft/graphrag

python -m venv env
source env/bin/activate
安装 GraphRAG
pip install graphrag
准备数据 mkdir -p ./ragtest/input curl https://www.gutenberg.
TypeScript 安装
安装 tsc,它是 TypeScript 的编译器。
npm i -g typescript
查看版本
tsc -v
Version 5.5.3
安装 ts-node,它是 TypeScript 的运行时。
npm i -g ts-node
查看版本
ts-node -v
v10.9.2
Hello World
使用 tsc --init 命令快速创建一个 tsconfig.json 文件。
tsc --init

Created a new tsconfig.json with:
                                                                                                                     TS
  target: es2016
  module: commonjs
  strict: true
  esModuleInterop: true
  skipLibCheck: true
  forceConsistentCasingInFileNames: true


You can learn more at https://aka.ms/tsconfig
创建一个 hello.ts 文件。
function hello(name: string) {
  console.log(`Hello, ${name}!`);
}

hello("TypeScript");
使用 tsc 命令编译 hello.ts 文件。
tsc hello.ts
编译后生成一个 hello.js 文件。
Continue
VS Code Extension
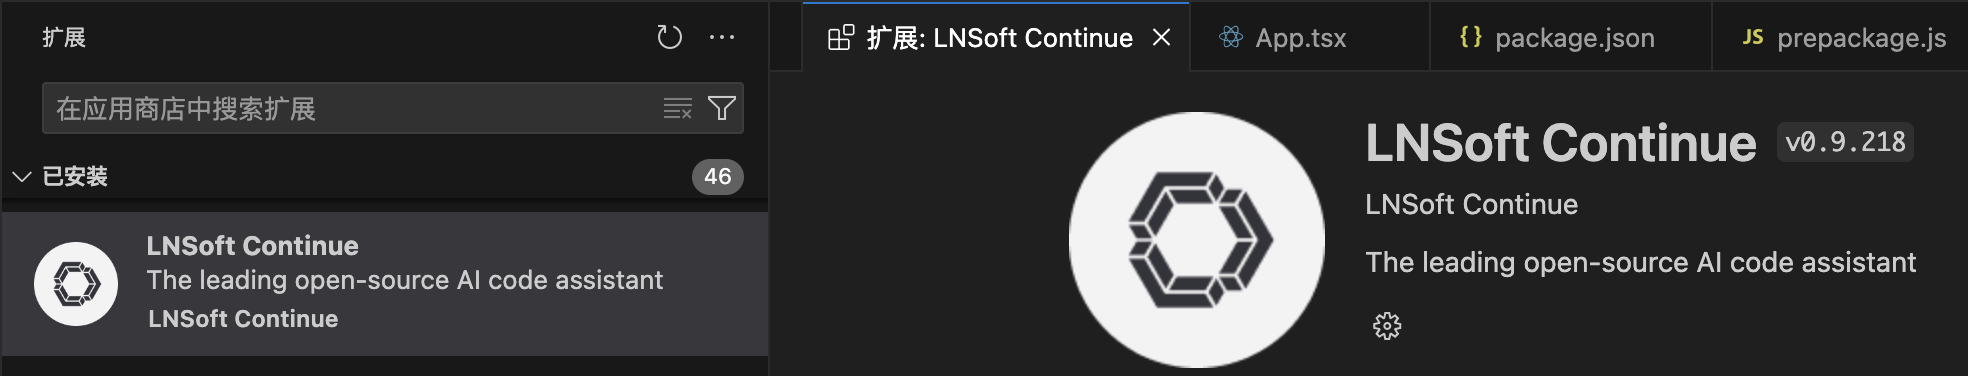
通过配置创建新的 Extension,用于区别于 Continue 。
{
  "name": "continue",
  "icon": "media/icon.png",
  "version": "0.9.218",
  "displayName": "LNSoft Continue",
  "description": "The leading open-source AI code assistant",
  "publisher": "LNSoft Continue"
}
入口
VS Code 扩展的起点是 activate.ts。activateExtension 这里的函数将注册所有命令,并将 Continue GUI 作为 webview 加载到 IDE 的侧边栏中。
配置
目录:extensions/vscode
package.json 由开发者手动创建和维护,主要用于定义项目的配置信息。
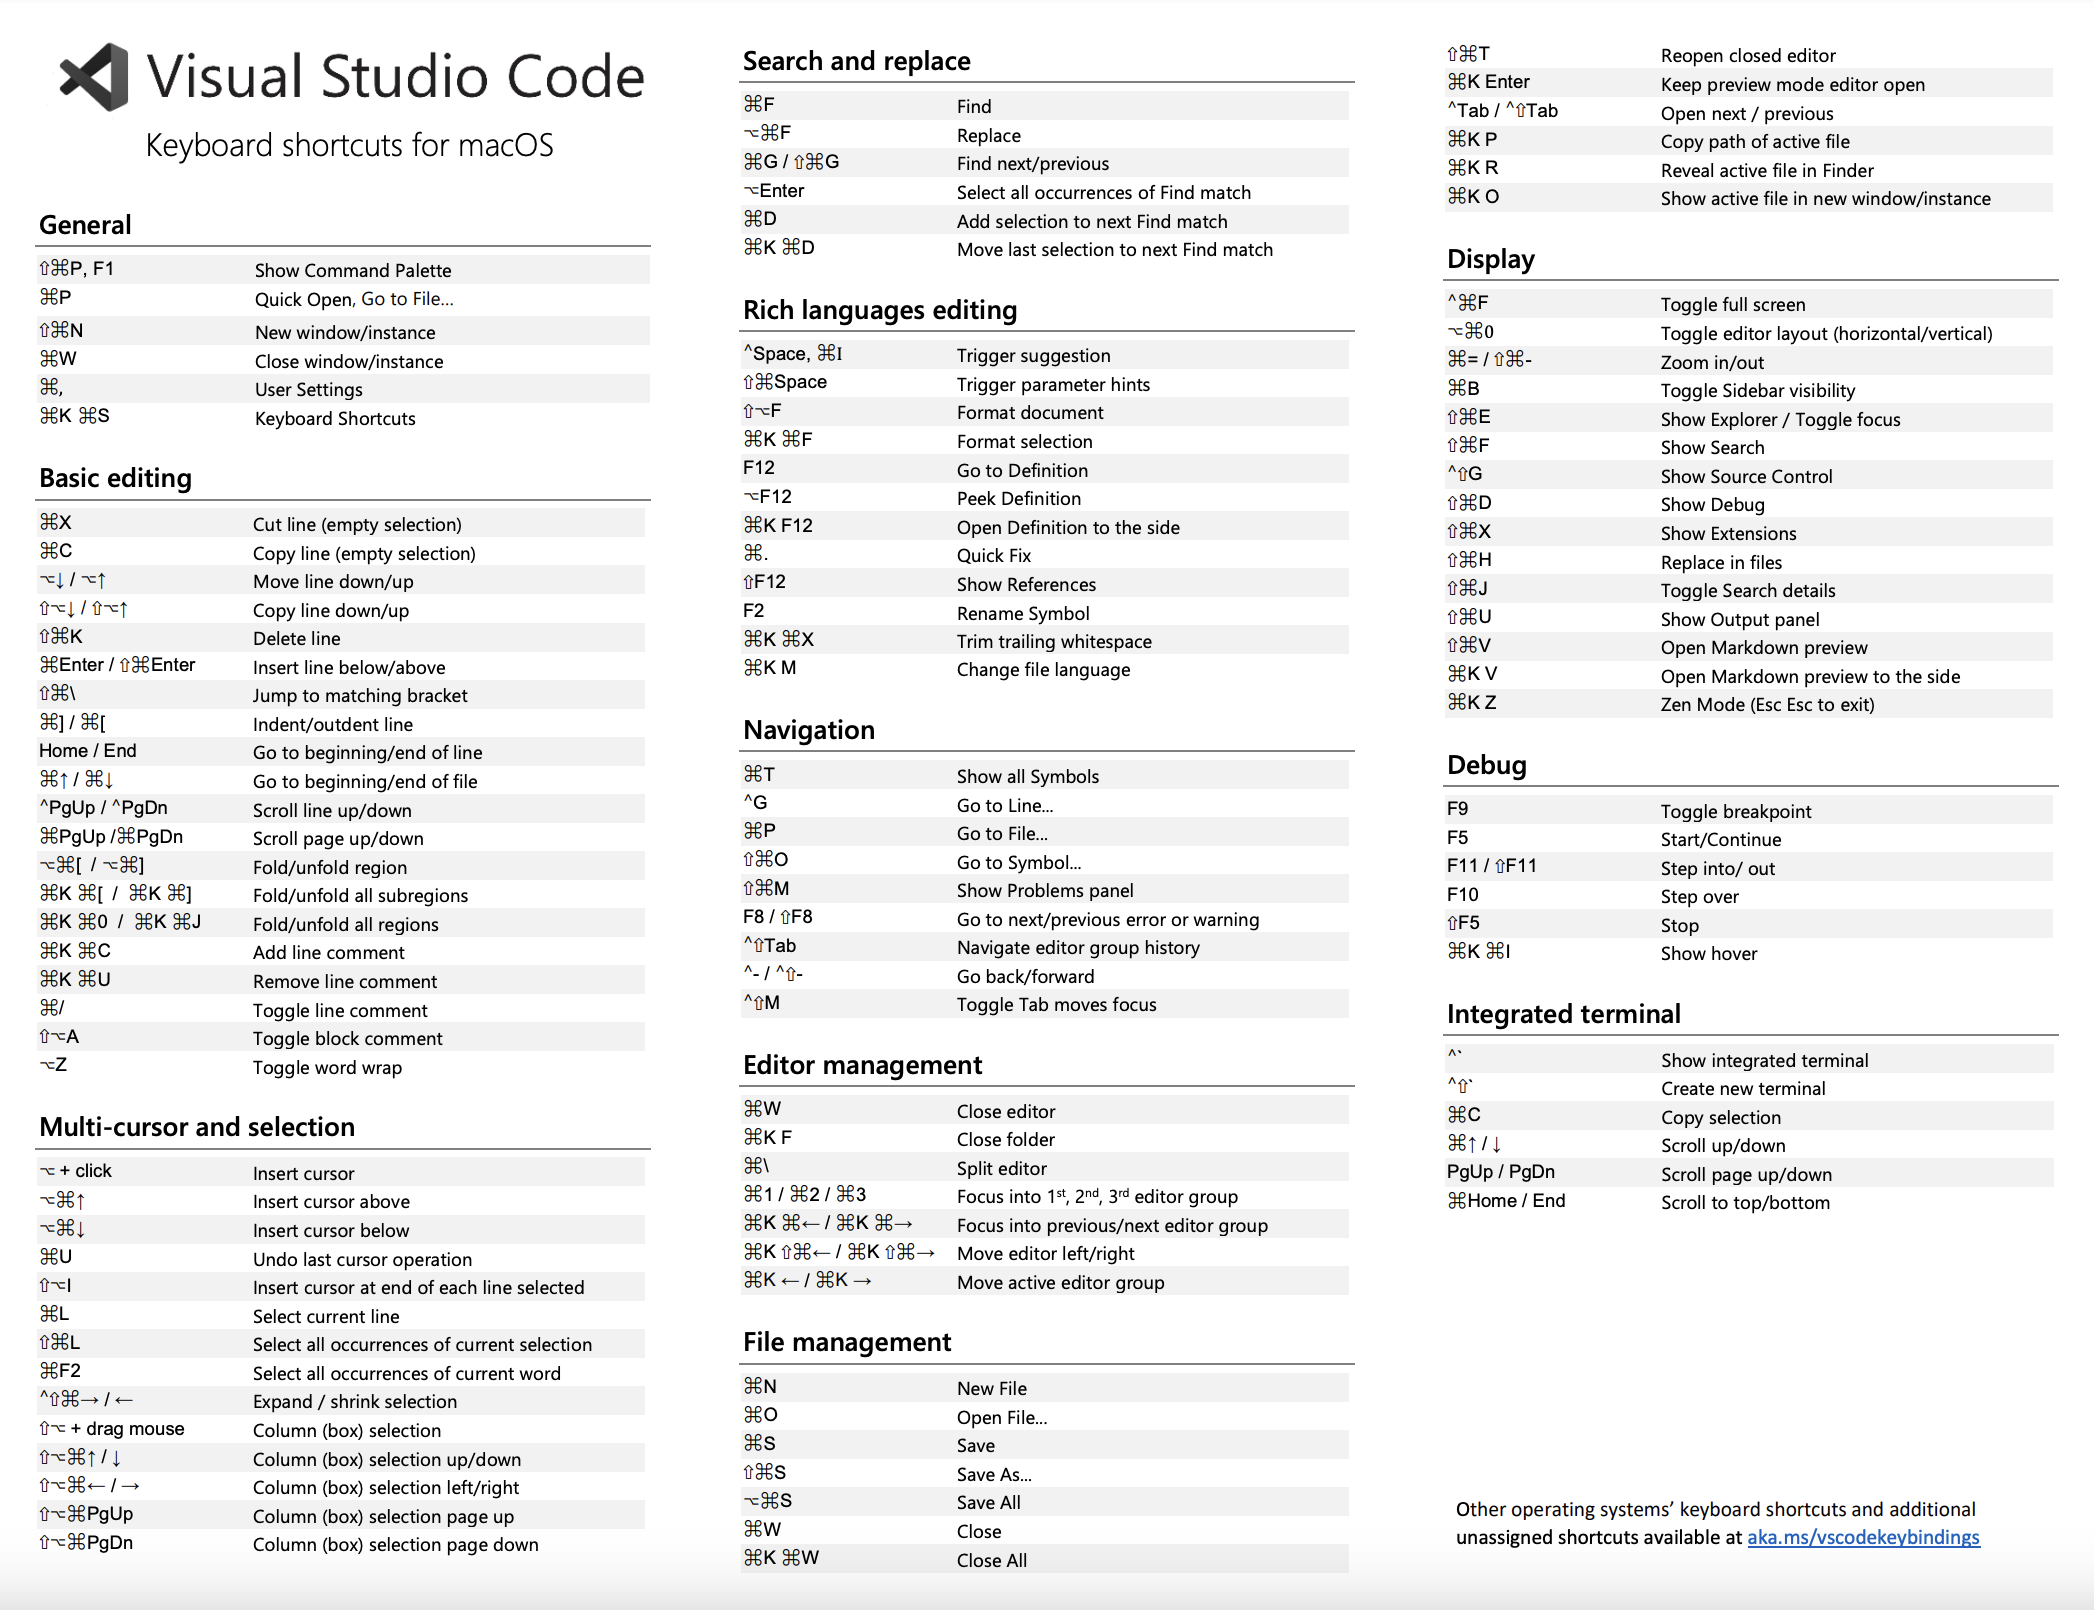
快捷键
| 常用 | |
|---|---|
| 显示所有命令 | F1, ⇧ ⌘ P |
| 全屏 | ⌃ ⌘ F |
| 设置 | ⌘ , |
| 键盘快捷方式 | ⌘ K ⌘ S |
| 导航 | |
|---|---|
| 转到文件 | ⌘ P |
| 转到工作区中的符号 | ⌘ T |
| 聚焦并选择痕迹导航 | ⇧ ⌘ . |
| 转到编辑器中的符号 | ⇧ ⌘ O |
| 转到行 | ⌃ G |
| 转到括号 | ⇧ ⌘ \ |
| 转到定义 | F12 |
| 转到引用 | ⇧ F12 |
| 后退 | ⌃ - |
| 前进 | ⌃ ⇧ - |
| 显示 | |
|---|---|
切换主侧栏可见性 |
⌘ B |
切换辅助侧栏可见性 |
⌥ ⌘ B |
切换面板可见性 |
⌘ J |
切换终端可见性 |
⌃ ` |
| 查看资源管理器 | ⇧ ⌘ E |
| 查看搜索 | ⇧ ⌘ F |
| 查看调试 | ⇧ ⌘ D |
| 查看 GitHub Copilot 聊天 | ⇧ ⌘ Space |
| 编辑器 | |
|---|---|
| 切分编辑器 | ⌘ \ |
| 关闭编辑器 | ⌘ W |
| 选择单词 | ⌘ D |
| 选择所有的查找匹配项 | ⇧ ⌘ L |
键盘参考表
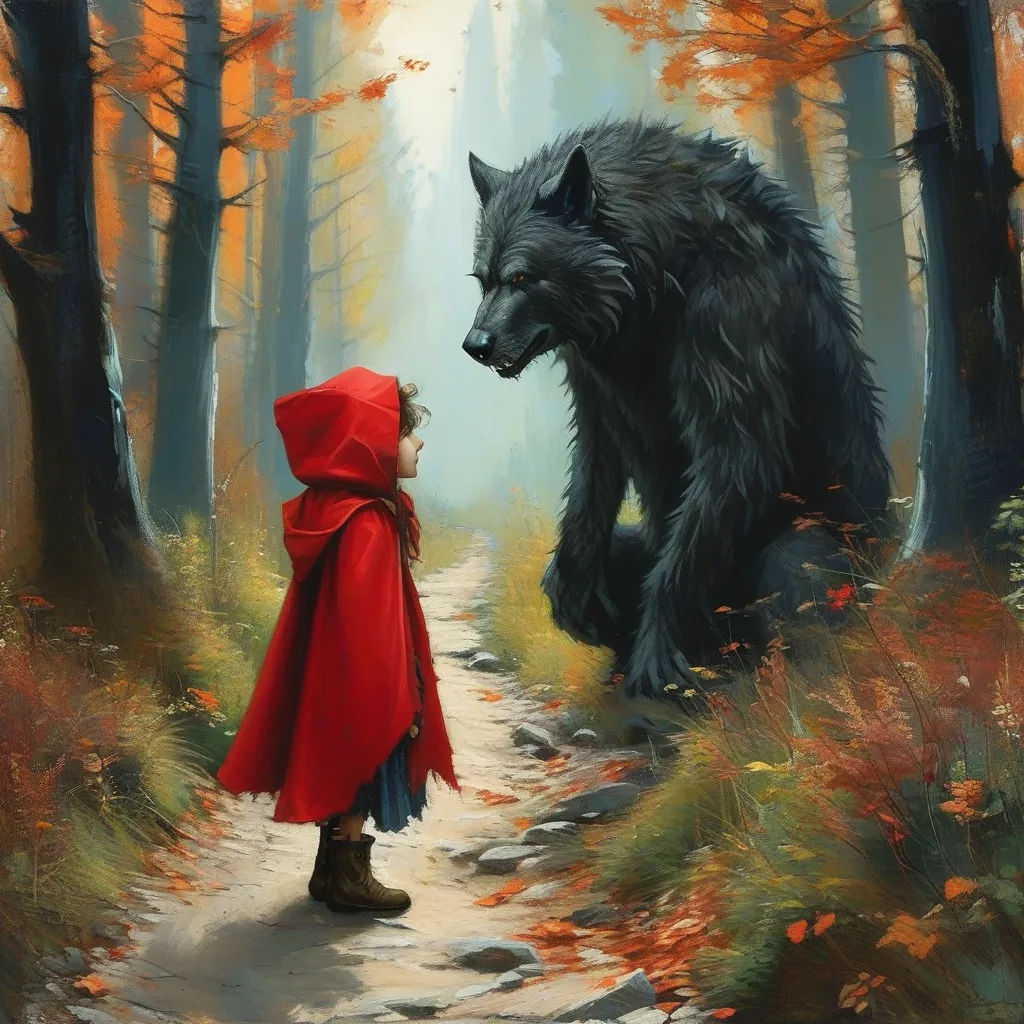
Kolors:用于真实感文本到图像合成的扩散模型的有效训练
例子
小红帽和大灰狼在森林的小路上相遇
用于下一代人工智能应用的向量搜索引擎
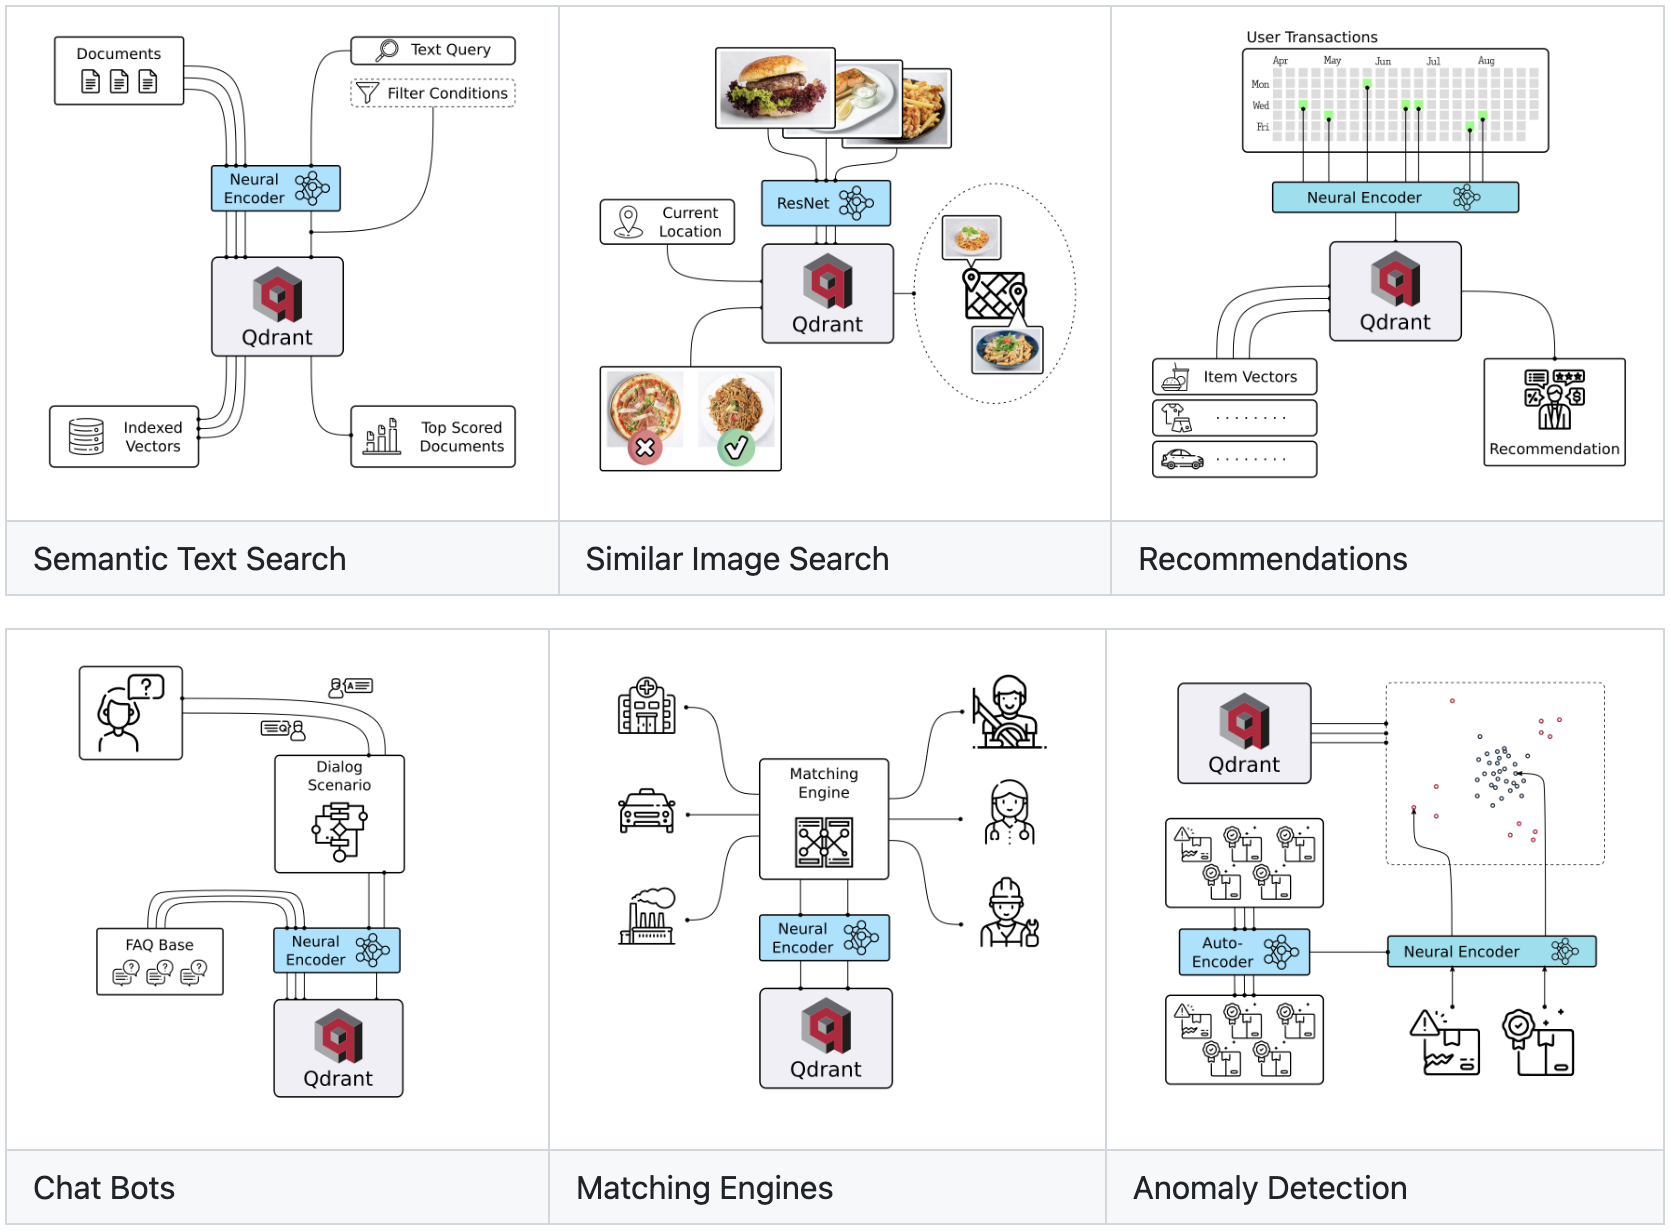
Qdrant(读作:quadrant)是一个向量相似性搜索引擎和向量数据库。它提供了一个生产就绪的服务,具有方便的 API 来存储、搜索和管理点 - 具有附加有效载荷的向量。Qdrant 专为扩展的过滤支持量身定制。它对所有类型的神经网络或基于语义的匹配、分面搜索和其他应用非常有用。
解决方案
运行
Qdrant 镜像
docker pull qdrant/qdrant
启动 Qdrant 服务
docker run -p 6333:6333 -p 6334:6334 \
    -v $(pwd)/qdrant_storage:/qdrant/storage:z \
    qdrant/qdrant
Qdrant 现在可访问:
安装 Qdrant Client
pip install qdrant-client
代码示例
FastEmbed 是一个轻量级、快速的 Python 库,专为嵌入生成而构建。
安装
pip install -Uqq fastembed
支持的嵌入模型
import pandas as pd

from fastembed import TextEmbedding


supported_models = (
    pd.DataFrame(TextEmbedding.list_supported_models())
    .sort_values("size_in_GB")
    .drop(columns=["sources", "model_file", "additional_files"])
    .reset_index(drop=True)
)

print(supported_models)
使用检索增强来帮助您使用 LLM 为数据库生成准确的 SQL 查询。
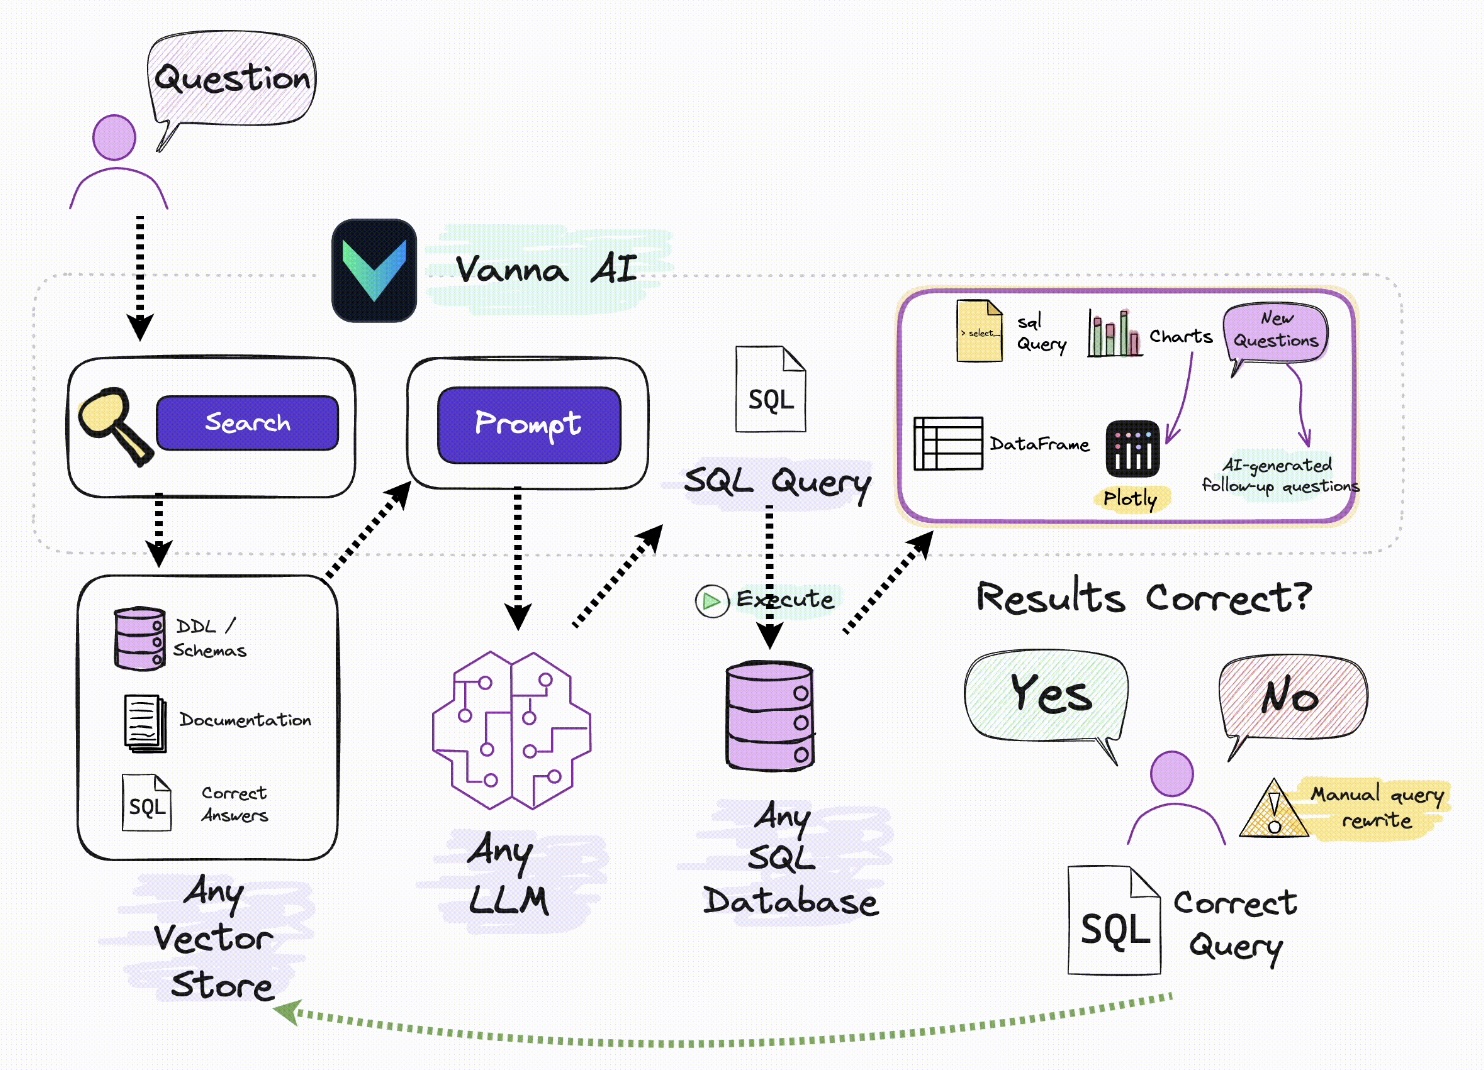
Vanna 的工作过程分为两个简单步骤 - 在您的数据上训练 RAG“模型”,然后提出问题,这些问题将返回 SQL 查询,这些查询可以设置为在您的数据库上自动运行。
在您的数据上训练 RAG“模型”。这些方法将添加到参考语料库。
问问题。这将使用参考语料库生成可以在您的数据库上运行的 SQL 查询。
例子
与您的 SQL 数据库聊天 📊。通过 RAG 使用 LLM 实现准确的文本到 SQL 生成 🔄。
ChromaDB & Ollama from vanna.ollama import Ollama from vanna.chromadb import ChromaDB_VectorStore class MyVanna(ChromaDB_VectorStore, Ollama): def init(self, config=None): ChromaDB_VectorStore.init(self, config=config) Ollama.init(self, config=config) vn = MyVanna(config={'model': 'qwen2:7b'}) vn.
RAG 复杂场景下的工作流程
召回模式(选择数据集) → 混合检索(同时进行语义检索和关键词搜索) → 重排序(合并和归一化检索结果)
RAG 中构建知识库的解析方法
RAGFlow 是一款基于深度文档理解构建的开源 RAG 引擎,内置了丰富地文档解析方法,可以帮助用户快速构建知识库。
概述
Elmo 是您的 AI 网络副驾驶,可创建摘要、洞察和扩展知识。
免费且无需 GPT/OpenAI 帐户和多语言支持。
功能亮点:
✅ 总结网站:将网络内容转换为快速、简短的摘要。
✅ 总结 YouTube:通过视频快速洞察和导航。
✅ 总结 Google Docs:高效创建 Google Docs 的简洁摘要。
✅ 与 PDF 聊天:简化对大型文档的理解。
✅ 回答问题:从网页获得即时答案。
✅ 关键字探索:在浏览过程中无缝提取相关信息。
✅ 翻译:轻松将文本翻译成不同的语言。
✅ 改写段落:简化和澄清复杂的句子。
如何使用?
🔹 单击“添加到 Chrome”按钮并将其固定到工具栏。
🔹 单击图标或按 Cmd/Ctrl + Shift + E 激活 Elmo Chat。
🔹 Elmo Chat 将为您总结当前网页。
安装 PostgreSQL
下载
安装
Installation Directory: /Library/PostgreSQL/16
Server Installation Directory: /Library/PostgreSQL/16
Data Directory: /Library/PostgreSQL/16/data
Database Port: 5432
Database Superuser: postgres
Operating System Account: postgres
Database Service: postgresql-16
Command Line Tools Installation Directory: /Library/PostgreSQL/16
pgAdmin4 Installation Directory: /Library/PostgreSQL/16/pgAdmin 4
Stack Builder Installation Directory: /Library/PostgreSQL/16
Installation Log: /tmp/install-postgresql.log
使用默认设置安装即可。
Locale 我选择了 zh_CN,在创建数据库的时候遇到了错误:The
GLM-4V-9B
GLM-4V-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源多模态版本。 GLM-4V-9B 具备 1120 * 1120 高分辨率下的中英双语多轮对话能力,在中英文综合能力、感知推理、文字识别、图表理解等多方面多模态评测中均表现优异。
总结
相比 CogVLM2 能力还是不如。
文字识别
识别中文
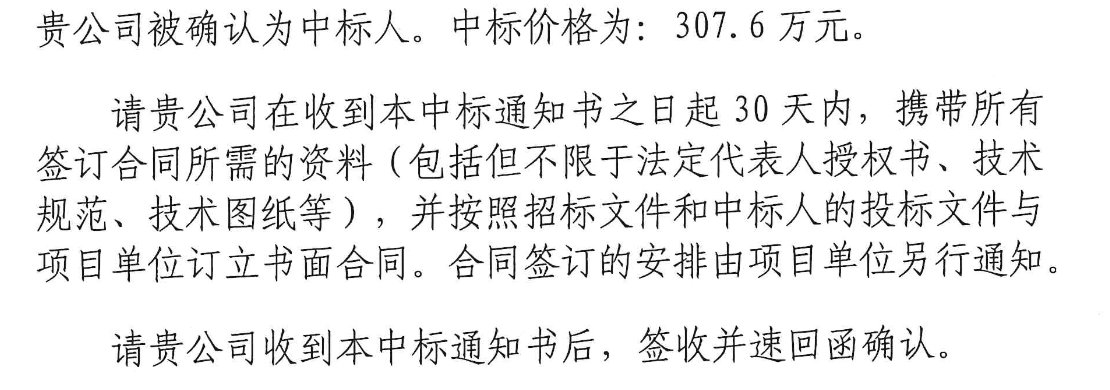
提示词:输出图像中的文字
贵公司被认为中标人。中标价格为:307.6万元。 请贵公司在收到本中标通知书之日起30天内,携带所有签订合同所需的资料(包括但不限于法定代表人授权书、技术规范、技术图纸等),并按照招标文件和中标人的投标文件与项目单位订立书面合同。合同签订的安排由项目单位另行通知。 请贵公司收到本中标通知书后,签收并速回函确认。
确() 识别成全角识别手写英文
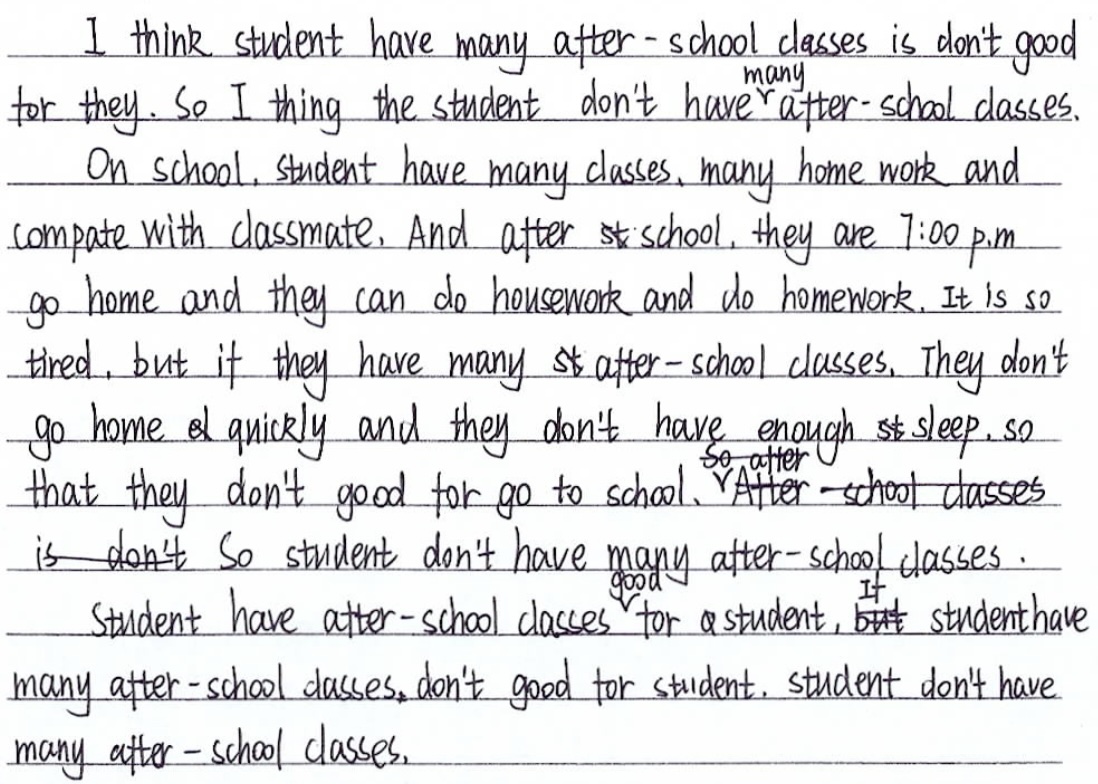
提示词:识别图像上的手写英文
I think student have many after-school classes is don't good for they. So I thing the student don't have after-school classes.
AutoGen
定义 Agent
from autogen import ConversableAgent

llm_config = {"model": "gpt-3.5-turbo"}

agent = ConversableAgent(
    name="chatbot",
    llm_config=llm_config,
    human_input_mode="NEVER",
)

reply = agent.generate_reply(
    messages=[{"content": "给我讲个笑话。", "role": "user"}]
)
print(reply)

// ...
为什么八卦杂志最爱讲床上故事?因为上面都有新闻!哈哈哈~
为什么兔子喜欢吃胡萝卜?因为胡萝卜有好处,营养丰富!
多智能体对话
双人笑话
Dify
介绍
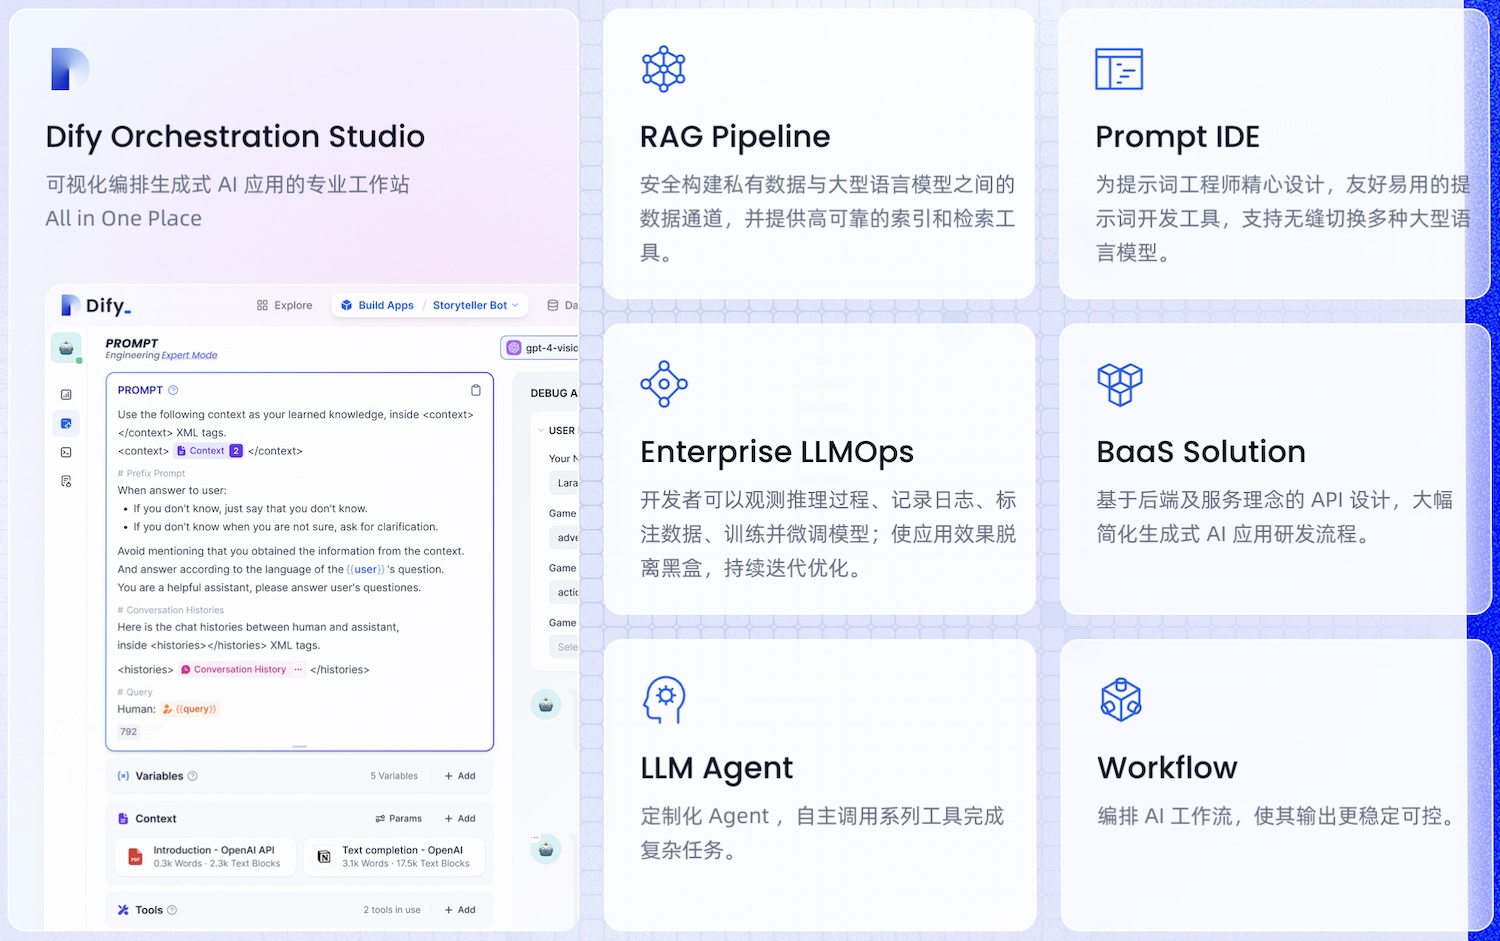
Dify 是一款开源的大语言模型(LLM) 应用开发平台。提供从 Agent 构建到 AI workflow 编排、RAG 检索、模型管理等能力,轻松构建和运营生成式 AI 原生应用。你可以基于任何模型自部署类似 Assistants API 和 GPTs 的能力,在灵活和安全的基础上,同时保持对数据的完全控制。
开发语言
| 语言 | 占比 |
|---|---|
| TypeScript | 49.9% |
| Python | 45.5% |
| MDX | 3.1% |
| CSS | 0.9% |
| JavaScript | 0.4% |
| SCSS | 0.2% |
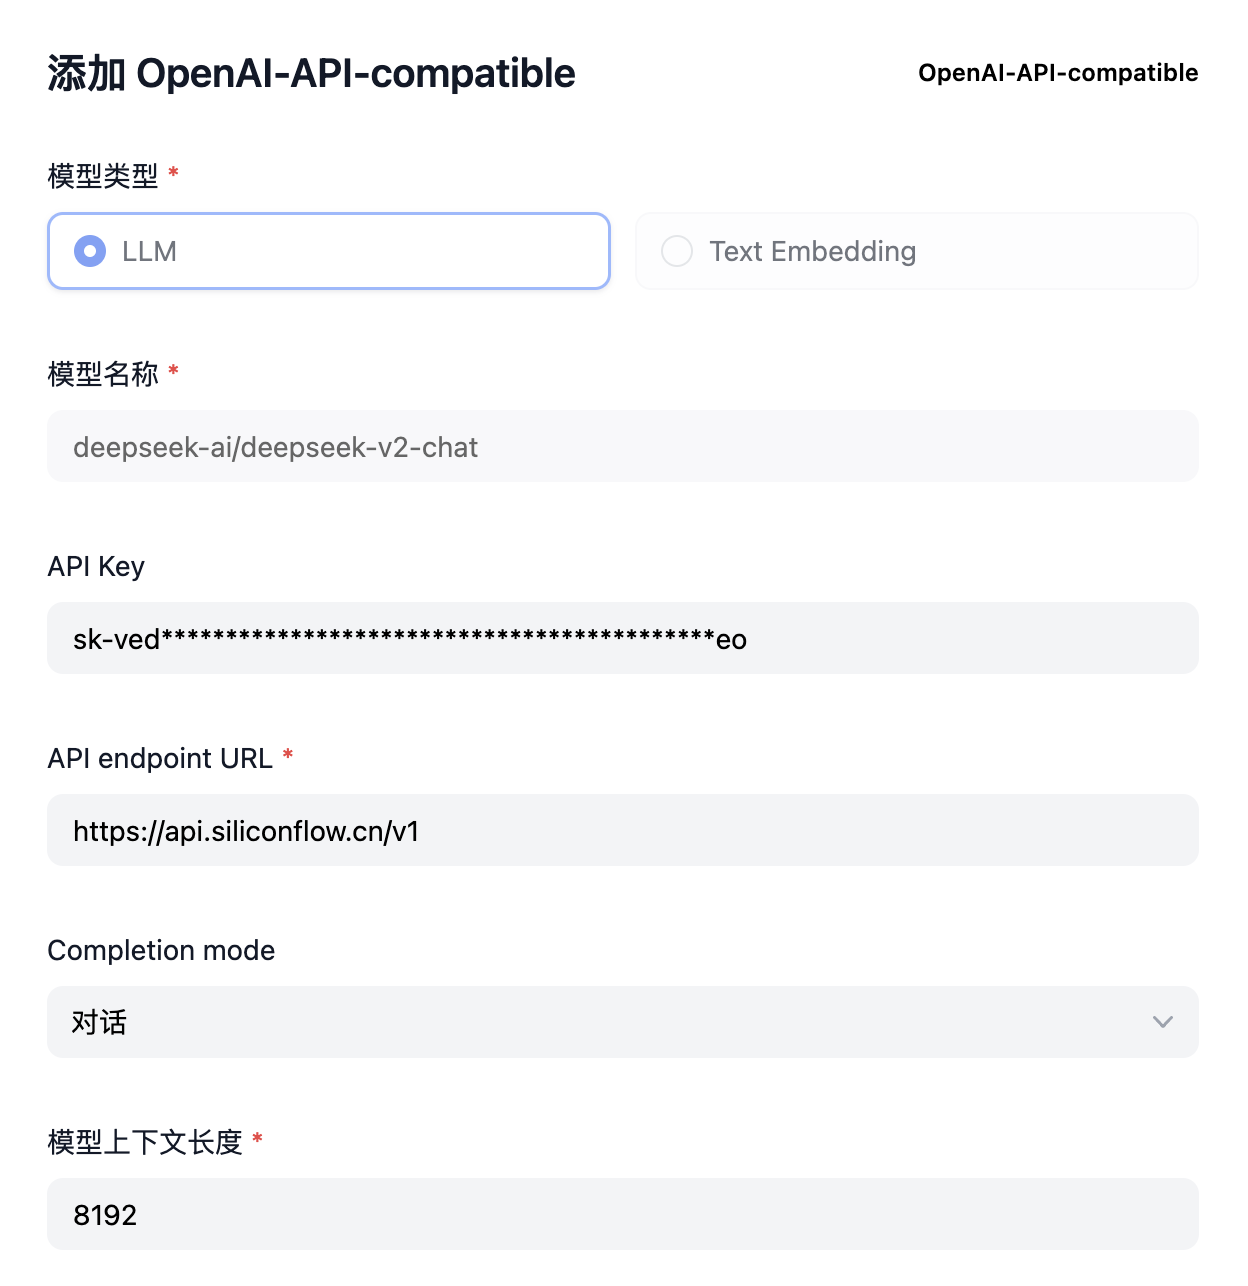
配置兼容 OpenAI API(SiliconFlow)
Continue
介绍
Continue 使您能够在 IDE 中创建自己的 AI 代码助手。使用 VS Code 和 JetBrains 插件保持开发者的流畅体验,这些插件可以连接到任何模型、任何上下文以及任何其他你需要的东西。
Continue 使您能够使用适合工作的模型,无论是开源还是商业,本地运行还是远程运行,用于聊天、自动完成或嵌入。它提供了许多配置点,以便您可以自定义扩展以适应您现有的工作流程。
开发语言
| 语言 | 占比 |
|---|---|
| TypeScript | 74.0% |
| Kotlin | 11.8% |
| Rust | 4.9% |
| CSS | 3.6% |
| Scheme | 2.5% |
| JavaScript | 2.4% |
| Other | 0.8% |
贡献(Contributing)
使用
开放 Ollama 服务
环境变量
OLLAMA_HOST: Ollama 服务器的 IP 地址(默认 127.0.0.1:11434)OLLAMA_NUM_PARALLEL: 最大并行请求数(默认 1)OLLAMA_MAX_LOADED_MODELS: 最大加载模型数量(默认 1)OLLAMA_KEEP_ALIVE: 模型在内存中保持加载的持续时间(默认 5m),-1 表示永久保持加载。Linux
curl -fsSL https://ollama.com/install.sh | sh
编辑 systemd 服务,调用 systemctl edit ollama.service。这将打开一个编辑器。 sudo systemctl edit ollama.service 对于每个环境变量,在 [Service] 部分下添加一行 Environment: [Service] Environment="OLLAMA_HOST=0.0.0.
框架
[SGLang][SGLang]
SGLang 是一种专为大型语言模型 (LLM) 设计的结构化生成语言。它通过共同设计前端语言和运行时系统,使您与 LLM 的交互更快、更可控。
平台
[Dify][Dify]
Dify 是一个 UI 驱动的用于开发大语言模型应用程序的平台,它使原型设计更加容易访问。它支持用户使用提示词模板开发聊天和文本生成应用。此外,Dify 支持使用导入数据集的检索增强生成(RAG),并且能够与多个模型协同工作。我们对这类应用很感兴趣。不过,从我们的使用经验来看,Dify 还没有完全准备好投入大范围使用,因为某些功能目前仍然存在缺陷或并不成熟。但目前,我们还没有发现更好的竞品。
工具
[Continue][Continue]
Continue 使您能够在 IDE 中创建自己的 AI 代码助手。使用 VS Code 和 JetBrains 插件保持开发者的流畅体验,这些插件可以连接到任何模型、任何上下文以及任何其他你需要的东西。Continue 使您能够使用适合工作的模型,无论是开源还是商业,本地运行还是远程运行,用于聊天、自动完成或嵌入。它提供了许多配置点,以便您可以自定义扩展以适应您现有的工作流程。
[Ollama][Ollama] Ollama 是一个在本机上运行并管理大语言模型的工具。
没有找到匹配的文章