WorkBuddy 提示词模板体系深度解析
一、目录总览
resources/templates/ 共包含 15 个模板文件,组织为 4 个功能层级 + 1 个风格库:
一、目录总览
resources/templates/ 共包含 15 个模板文件,组织为 4 个功能层级 + 1 个风格库:
一套面向 Agent 应用设计者的系统化设计原则、架构模式与实战指南。
基于对 WorkBuddy(CodeBuddy Code)工作空间源码、系统提示词、文档与架构的深度分析提炼而成。
目录
1. 概述:从 Chatbot 到 Agent 的范式跃迁
1.1 Chatbot 和 Agent 的本质区别
| 维度 | Chatbot | Agent |
|---|---|---|
| 核心能力 | 理解并回答 | 理解、计划、执行、验证 |
| 与环境的交互 | 被动接收文本 | 主动感知文件系统、网络、工具 |
| 输出的性质 | 文本回答 | 实际行动(文件变更、API 调用、部署) |
| 正确性保障 | 依赖训练数据 | 通过执行测试、编译、对比等方式自我验证 |
| 会话生命周期 | 一问一答,无持续性 | 跨多轮持久化,可中断恢复 |
| 用户角色 | 提问者 | 协作者/监督者 |
设计 Agent 系统,首先要完成这个认知跃迁:Agent 不是"更强的 Chatbot",而是一种全新的交互范式。
1.2 Agent 设计的核心张力
在设计 Agent 系统时,始终面临以下四对核心张力:
全场景智能体工作搭子
开启 AI Agent 办公新范式
AI 专家团 全场景办公
WorkBuddy 是全能 AI 工作台,一人指挥,全行业专家执行,从策略到交付一站搞定
免部署·安装即用 | 多专家·多模型协同 | 全平台·桌面 / 主流 IM / 小程序
100+ 领域专家组成你的虚拟团队,运营、设计、数据、开发等全角色场景覆盖
一句话指令自主规划并交付完整结果
多专家并行协作,一个人顶一支团队
MCP 生态 + 自定义 Skills,能力无限扩展
设计系统(Design System)
设计系统Deepseek-V4-Flash输入(宫崎骏的太空之城风格设计系统)
帮我建立一套完整的 Design System,包含颜色体系、字体层级、间距规则和基础组件规范文档,风格为宫崎骏的太空之城
输出
基于
/Applications/WorkBuddy.app/Contents/Resources/app.asar.unpacked逆向分析 WorkBuddy Desktop v5.2.5 + CodeBuddy CLI v2.106.4 | 腾讯出品
一、整体架构概览
graph TB
    subgraph "操作系统层"
        OS["macOS / Windows<br/>Darwin / Win32"]
        FSE["FSEvents API<br/>(macOS 文件监听)"]
        PTY["Pseudoterminal API<br/>(openpty / ConPTY)"]
        SQLITE["SQLite Engine<br/>(C++ 绑定)"]
    end

    subgraph "Electron 应用外壳 (WorkBuddy Desktop v5.2.5)"
        ELECTRON["Electron Main Process<br/>Node.js + Chromium"]
        RENDER["Renderer Process<br/>React/Vue UI + WebView"]
        DEVTOOLS["DevTools Panel<br/>Ghostty WASM Terminal"]
        PRELOAD["Preload Scripts<br/>IPC 安全桥接"]
    end

    subgraph "CLI 核心宿主 (CodeBuddy CLI v2.106.4)"
        CLI["cli/bin/codebuddy<br/>Node.js 启动器"]
        TUI["TUI Mode<br/>Ink + React 19<br/>~16MB Bundle"]
        DAEMON["Daemon Mode<br/>HTTP Server<br/>Port 51862+"]
        HEADLESS["Headless Mode<br/>-p / --print<br/>CI/CD 管道"]
        WEBUI["Web UI<br/>Workers / Logs / Metrics"]
    end

    subgraph "原生模块层 (app.asar.unpacked)"
        NATIVE_MOD["node_modules/"]
        BETTER_SQL["better-sqlite3<br/>v12.8.0 (MIT)"]
        NODE_PTY["node-pty<br/>v1.1.0 (Microsoft)"]
        LYDELL_PTY["@lydell/node-pty-darwin-arm64<br/>v1.2.0-beta.12"]
        DOCS_ENGINE["@tencent/docs-engine<br/>v0.0.1-beta.9"]
        FSE_MOD["fsevents<br/>(nunjucks 嵌套依赖)"]
    end

    subgraph "资源与扩展层 (resources/)"
        RES["resources/"]
        BUILT_PLUGINS["builtin-plugins/"]
        BUILT_SKILLS["builtin-skills/<br/>15 个内置技能"]
        BUILT_MCP["builtin-mcp-apps/"]
        TEMPLATES["templates/<br/>Nunjucks 提示词模板"]
        DEVTERM["devtools-terminal/<br/>Chrome Extension v3"]
        BRANDING["channel-branding/<br/>OEM 品牌资源"]
    end

    subgraph "AI 推理后端"
        BACKEND["copilot.tencent.com<br/>AI 推理集群"]
        MCP_PROXY["MCP Connector Proxy<br/>Port 61047"]
    end

    subgraph "用户数据层 (~/.workbuddy/)"
        USER_DATA["~/.workbuddy/"]
        DB["workbuddy.db<br/>(SQLite + WAL)"]
        SOUL["SOUL.md<br/>AI 灵魂"]
        IDENTITY["IDENTITY.md<br/>智能体身份"]
        MEMORY["memory/<br/>项目级记忆"]
        SESSIONS["sessions/<br/>会话 JSON"]
        TRACES["traces/<br/>运行追踪"]
    end

    OS --> ELECTRON
    ELECTRON --> RENDER
    ELECTRON --> PRELOAD
    RENDER --> DEVTOOLS

    ELECTRON -->|spawn| CLI
    CLI --> TUI
    CLI --> DAEMON
    CLI --> HEADLESS
    DAEMON --> WEBUI

    NATIVE_MOD --> BETTER_SQL
    NATIVE_MOD --> NODE_PTY
    NATIVE_MOD --> LYDELL_PTY
    NATIVE_MOD --> DOCS_ENGINE
    NATIVE_MOD --> FSE_MOD

    CLI --> NATIVE_MOD
    CLI --> RES

    RES --> BUILT_PLUGINS
    RES --> BUILT_SKILLS
    RES --> BUILT_MCP
    RES --> TEMPLATES
    RES --> DEVTERM
    RES --> BRANDING

    TUI -->|HTTP/WebSocket| BACKEND
    DAEMON -->|HTTP API| BACKEND
    HEADLESS -->|HTTP API| BACKEND
    BACKEND -->|MCP STDIO/SSE/HTTP| MCP_PROXY

    CLI -->|读写| USER_DATA
    DAEMON -->|读写| DB
    TUI -->|读取| SOUL
    TUI -->|读取| IDENTITY
    TUI -->|读取| MEMORY
    TUI -->|写入| SESSIONS
    TUI -->|写入| TRACES

    FSE -->|API 调用| FSE_MOD
    PTY -->|API 调用| NODE_PTY
    PTY -->|API 调用| LYDELL_PTY
    SQLITE -->|C++ 绑定| BETTER_SQL

    DOCS_ENGINE -->|"FFI 加载:libeditor_sdk_ffi.dylib (172 MB)"| EXT1
    DOCS_ENGINE -->|"HTTP Server:127.0.0.1:39099 本地文档预览"| EXT2
    DEVTERM -->|"WASM 执行:ghostty-vt.wasm 终端仿真"| EXT3
    EXT1 & EXT2 & EXT3:::dummy
    classDef dummy fill:none,stroke:none

    style ELECTRON fill:#e1f5fe
    style CLI fill:#fff3e0
    style BACKEND fill:#e8f5e9
    style USER_DATA fill:#fce4ec
    style NATIVE_MOD fill:#f3e5f5
    style RES fill:#e0f2f1
二、Electron 主进程与 CLI 双层架构
flowchart LR
    subgraph "Electron 主进程"
        direction TB
        EP1["app-instance.ts<br/>多实例检测"]
        EP2["auth.ts<br/>腾讯云 OAuth"]
        EP3["daemon-app-server-*.ts<br/>守护进程服务"]
        EP4["desktop-monitor-service.ts<br/>桌面监控"]
        EP5["helpers.ts<br/>工具函数集"]
        EP6["file-authentication-storage.ts<br/>文件认证存储"]
    end

    subgraph "CLI 进程 (Node.js 子进程)"
        direction TB
        C1["bin/codebuddy<br/>入口启动器"]
        C2["V8 Compile Cache<br/>~37% 启动加速"]
        C3["Node >= 18.20.8<br/>版本检查"]
        C4["Headless 路由<br/>--print / daemon / -p"]
        C5["TUI Bundle<br/>codebuddy.js<br/>Ink + React 19<br/>~16MB"]
        C6["Headless Bundle<br/>codebuddy-headless.js"]
    end

    subgraph "通信层"
        COM1["stdio<br/>标准输入输出"]
        COM2["HTTP<br/>Web UI / API"]
        COM3["WebSocket<br/>实时消息"]
        COM4["IPC<br/>Electron 内部"]
    end

    EP1 -->|"spawn('node', ['bin/codebuddy'])"| C1
    EP3 -->|HTTP 端口| COM2

    C1 --> C2
    C1 --> C3
    C1 --> C4
    C4 -->|TUI 模式| C5
    C4 -->|无头模式| C6

    C5 -->|stdio| COM1
    C5 -->|WebSocket| COM3
    C6 -->|HTTP| COM2
    EP1 -->|IPC| COM4
    RENDER["Renderer Process<br/>(UI 渲染)"] -->|IPC| COM4

    style EP1 fill:#e3f2fd
    style EP2 fill:#e3f2fd
    style EP3 fill:#e3f2fd
    style C1 fill:#fff8e1
    style C5 fill:#fff8e1
    style C6 fill:#fff8e1
关键设计决策:
v5.2.5 是 Electron 外壳,CodeBuddy CLI v2.106.4 是独立 Node.js 进程,两者版本独立演进ink + React 19 提供交互终端,Headless 模式剔除 UI 依赖,显著减小启动开销enableCompileCache() 将 ~16MB bundle 的加载时间从 ~400ms 降到 ~254ms三、原生模块与资源分层
graph LR
    subgraph "app.asar.unpacked 目录"
        direction TB
        subgraph "cli/ 目录"
            CLI_DIR["cli/"]
            CLI_BIN["bin/codebuddy<br/>入口脚本"]
            CLI_DIST["dist/<br/>codebuddy.js / codebuddy-headless.js"]
            CLI_WASM["dist/wasm/<br/>tree-sitter.wasm<br/>tree-sitter-bash.wasm"]
            CLI_WEBUI["dist/web-ui/<br/>docs/ (200+ 篇)"]
            CLI_VENDOR["vendor/<br/>sandbox / ripgrep / genie-trash"]
            CLI_PKG["package.json<br/>@genie/agent-cli"]
        end

        subgraph "node_modules/ 目录"
            NODE_DIR["node_modules/"]
            BETTER["better-sqlite3<br/>v12.8.0<br/>SQLite 数据库绑定"]
            NODE_PTY["node-pty<br/>v1.1.0<br/>Microsoft 伪终端"]
            LYDELL["@lydell/<br/>node-pty-darwin-arm64<br/>v1.2.0-beta.12"]
            TENCENT["@tencent/<br/>docs-engine<br/>v0.0.1-beta.9"]
            NJ["nunjucks<br/>+ fsevents<br/>模板引擎"]
        end

        subgraph "resources/ 目录"
            RES_DIR["resources/"]
            PLUGINS["builtin-plugins/<br/>weixinpay (MCP)"]
            SKILLS["builtin-skills/<br/>15 个技能"]
            MCP_APPS["builtin-mcp-apps/<br/>Ardot / Agently"]
            TEMPLATES["templates/<br/>8 模板 + 7 风格"]
            DEVT["devtools-terminal/<br/>Ghostty WASM"]
            BRAND["channel-branding/<br/>OEM 品牌"]
            PRELOADS["*-preload.js<br/>IPC 预加载脚本"]
        end
    end

    CLI_DIR --> CLI_BIN
    CLI_DIR --> CLI_DIST
    CLI_DIR --> CLI_WASM
    CLI_DIR --> CLI_WEBUI
    CLI_DIR --> CLI_VENDOR
    CLI_DIR --> CLI_PKG

    NODE_DIR --> BETTER
    NODE_DIR --> NODE_PTY
    NODE_DIR --> LYDELL
    NODE_DIR --> TENCENT
    NODE_DIR --> NJ

    RES_DIR --> PLUGINS
    RES_DIR --> SKILLS
    RES_DIR --> MCP_APPS
    RES_DIR --> TEMPLATES
    RES_DIR --> DEVT
    RES_DIR --> BRAND
    RES_DIR --> PRELOADS

    style BETTER fill:#ffebee
    style NODE_PTY fill:#ffebee
    style LYDELL fill:#ffebee
    style TENCENT fill:#ffebee
    style PLUGINS fill:#e8f5e9
    style SKILLS fill:#e8f5e9
    style MCP_APPS fill:#e8f5e9
为什么需要 app.asar.unpacked?
全场景智能体工作搭子
开启 AI Agent 办公新范式
AI 专家团 全场景办公
WorkBuddy 是全能 AI 工作台,一人指挥,全行业专家执行,从策略到交付一站搞定
免部署·安装即用 | 多专家·多模型协同 | 全平台·桌面 / 主流 IM / 小程序
100+ 领域专家组成你的虚拟团队,运营、设计、数据、开发等全角色场景覆盖
一句话指令自主规划并交付完整结果
多专家并行协作,一个人顶一支团队
MCP 生态 + 自定义 Skills,能力无限扩展
绘制架构图和流程图
输入
@file:open-ai-eco 研究这个项目,绘制架构图和流程图。
输出
全场景智能体工作搭子
开启 AI Agent 办公新范式
AI 专家团 全场景办公
WorkBuddy 是全能 AI 工作台,一人指挥,全行业专家执行,从策略到交付一站搞定
免部署·安装即用 | 多专家·多模型协同 | 全平台·桌面 / 主流 IM / 小程序
100+ 领域专家组成你的虚拟团队,运营、设计、数据、开发等全角色场景覆盖
一句话指令自主规划并交付完整结果
多专家并行协作,一个人顶一支团队
MCP 生态 + 自定义 Skills,能力无限扩展
截图重命名与分类
输入
把 截图 目录中的图像根据图像的内容进行重命名及文件夹分类。
输出
我先看看截图文件夹里有哪些图像,然后分析每张图的内容来重命名和分类。
截图文件夹有 11 张 PNG 图像。我需要逐一查看每张图的内容来判断如何命名和分类。我先读取这些图像。
我已经看完了全部 11 张截图,根据内容可以把它们分成三类。分类方案如下:
1. AI-概念图/
Claude-Code-上下文工程.png(Claude Code 的上下文工程结构图) RAG-检索增强生成.png(ChatGPT / RAG 流程图) Multi-Agent-ChatDev工作流.png(ChatDev 多智能体开发流程)mindmap
root((找到你的未知))
【是什么】
Anthropic 官方 agentic coding 指南
核心观点:减少并管理未知 = 核心技能
高手特征:未知少、懂代码库也懂模型
【给谁用】
用 Claude Code 的开发者
面对陌生代码库/新领域的人
想让 AI 协作更可控的人
【核心框架:未知四象限】
已知已知
写进提示词的需求
已知未知
知道自己还没搞懂
未知已知
太显然没写 看到才认出
未知未知
完全没想到的坑 最危险
【关键机制】
告知起点上下文
经验水平 思路进度 熟悉程度
指令粒度要平衡
太细→错过更优路径
太粗→模型乱假设
趁便宜先暴露未知
原型期改成本远低于实施后
【核心方法:按阶段】
实施前
盲点扫描:让 Claude 列出你的未知未知
头脑风暴+原型:快速看到多种方向
访谈:让 Claude 逐题问你澄清歧义
参考引用:给源码当参照 比截图好
实施计划:把易改决策放前面评审
实施中
实施笔记:记录偏离计划的决策
实施后
宣讲文档:加速评审者理解与批准
测验:通过测验才算真懂 才合并
【一句话精髓】
让 Claude 帮你找未知
在代价变大之前
原文:A field guide to Claude Fable 5: Finding your unknowns 作者:Thariq Shihipar(Anthropic 技术团队成员)
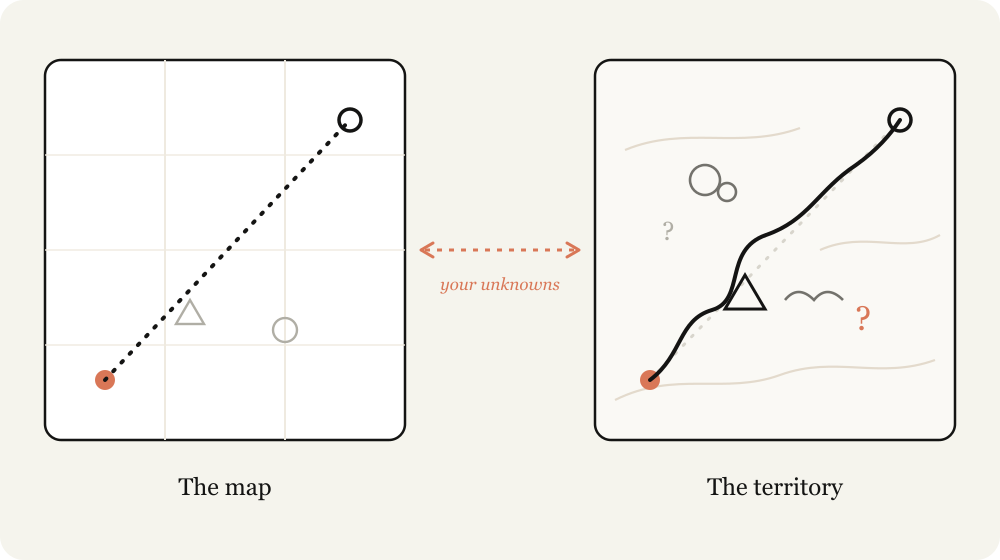
在使用 Claude Code 时,我常常想起地图与领土之间的区别。
地图,即待完成工作的表征,是我的提示词、技能和上下文——是我提供给 Claude 的东西。领土,则是工作需要实际发生的地方:代码库、现实世界、真实的约束条件。
地图与领土之间的差距,就是我所说的未知(unknowns)。当 Claude 遇到一个未知时,它需要根据对我意图的最佳猜测来做出决策。工作量越大,Claude 可能遇到的未知就越多。
Claude Fable 是我遇到的第一个模型,其工作质量的瓶颈在于我澄清未知的能力。
重要的是,仅仅提前规划并不总是足够的。你可能会在深入实现时发现未知,或者你的未知可能指向一个事实:你其实应该用完全不同的方式来解决问题。
我发现,使用 Fable 工作是一个迭代过程——在实现之前、之中和之后,不断发现自己的未知。
认识你的未知
你的未知是什么?当我带着问题来找 Claude 时,我倾向于将其分解为四种类型:
GitHub 仓库初始化
git init
git add .
git commit -m "first commit"
关联远程仓库并推送
git remote add origin https://github.com/wang-junjian/open-ai-eco.git
git branch -M main
git push -u origin main
视频没有使用 Git LFS
remote: warning: File public/videos/open-design-webprototype.mp4 is 84.20 MB; this is larger than GitHub's recommended maximum file size of 50.00 MB
remote: warning: GH001: Large files detected. You may want to try Git Large File Storage - https://git-lfs.github.com.
remote: warning: See https://gh.io/lfs for more information.
解决方案:
一、全局配置 public/videos/ 下所有文件走 Git LFS 1.
下面是 CLAUDE.md 文件的内容,用于改善 Claude Code 的行为,源自 Andrej Karpathy 的观察 关于 LLM 编码陷阱的总结。
CLAUDE.md
旨在减少大语言模型常见编码错误的行为准则。可根据项目特定说明按需合并。
权衡: 本准则偏向谨慎而非速度。对于琐碎任务,请自行判断。
1. 编码前先思考
不要假设。不要掩饰困惑。要呈现权衡。
实施之前:
2. 简单至上
用最少的代码解决问题。不添加任何推测性内容。
问问自己:“一位资深工程师会认为这过于复杂吗?” 如果会,就简化它。
3. 外科手术式的修改
只碰你必须改的。只清理你自己弄乱的。
编辑现有代码时:
当你的修改造成孤立代码时: 删除由你的修改导致的未使用的导入/变量/函数。
递归自我改进(recursive self-improvement, RSI) 的概念可以追溯到 I. J. Good (1965),他将"超智能机器"定义为一个能够在所有智力活动中超越人类、并设计出更好的机器来改进自身的系统。Yudkowsky (2008) 使用"递归自我改进"这一术语来描述一个特定的反馈循环:AI 利用其当前的智能来改进产生其智能的认知机制。
这种反馈循环在现代 AI 中可能意味着模型直接重写自身的权重,或者更广泛地说,模型改进了训练流水线和部署系统,从而催生出一个在经济价值任务上表现更优的继任模型。AI 研究发展的速度在前沿实验室中已被证明正在急剧加速(Anthropic;OpenAI)。
我特意提到 "部署系统",因为原始模型与真实世界环境之间的这一层,似乎与模型原始智能(即预训练后的评估)同等重要。Harness 是 AI 部署的重要组成部分,Claude Code 和 Codex 等成功的编码智能体产品已证明了这一点。Harness 是围绕基础模型的系统,负责编排执行、决定模型如何思考和规划、调用工具和执行动作、感知和管理上下文、存储产物以及评估结果。
本文将聚焦于 harness 工程相关的研究,以及它如何促进 RSI。
本周主线:Anthropic 双弹齐发 Sonnet 5 与 Claude Science,美团 LongCat-2.0 万亿参数模型亮剑国产算力,AI 独角兽 IPO 密集冲刺,优必选人形机器人订单破万——产业从实验室走向市场成为本周最强音。
本周看点
本周的六条主线——模型平权、智能体科研落地、编程工具体系化、机器人消费破冰、资本密集兑现、监管松绑——共同指向一个判断:AI 正从「能做什么」向「谁来做
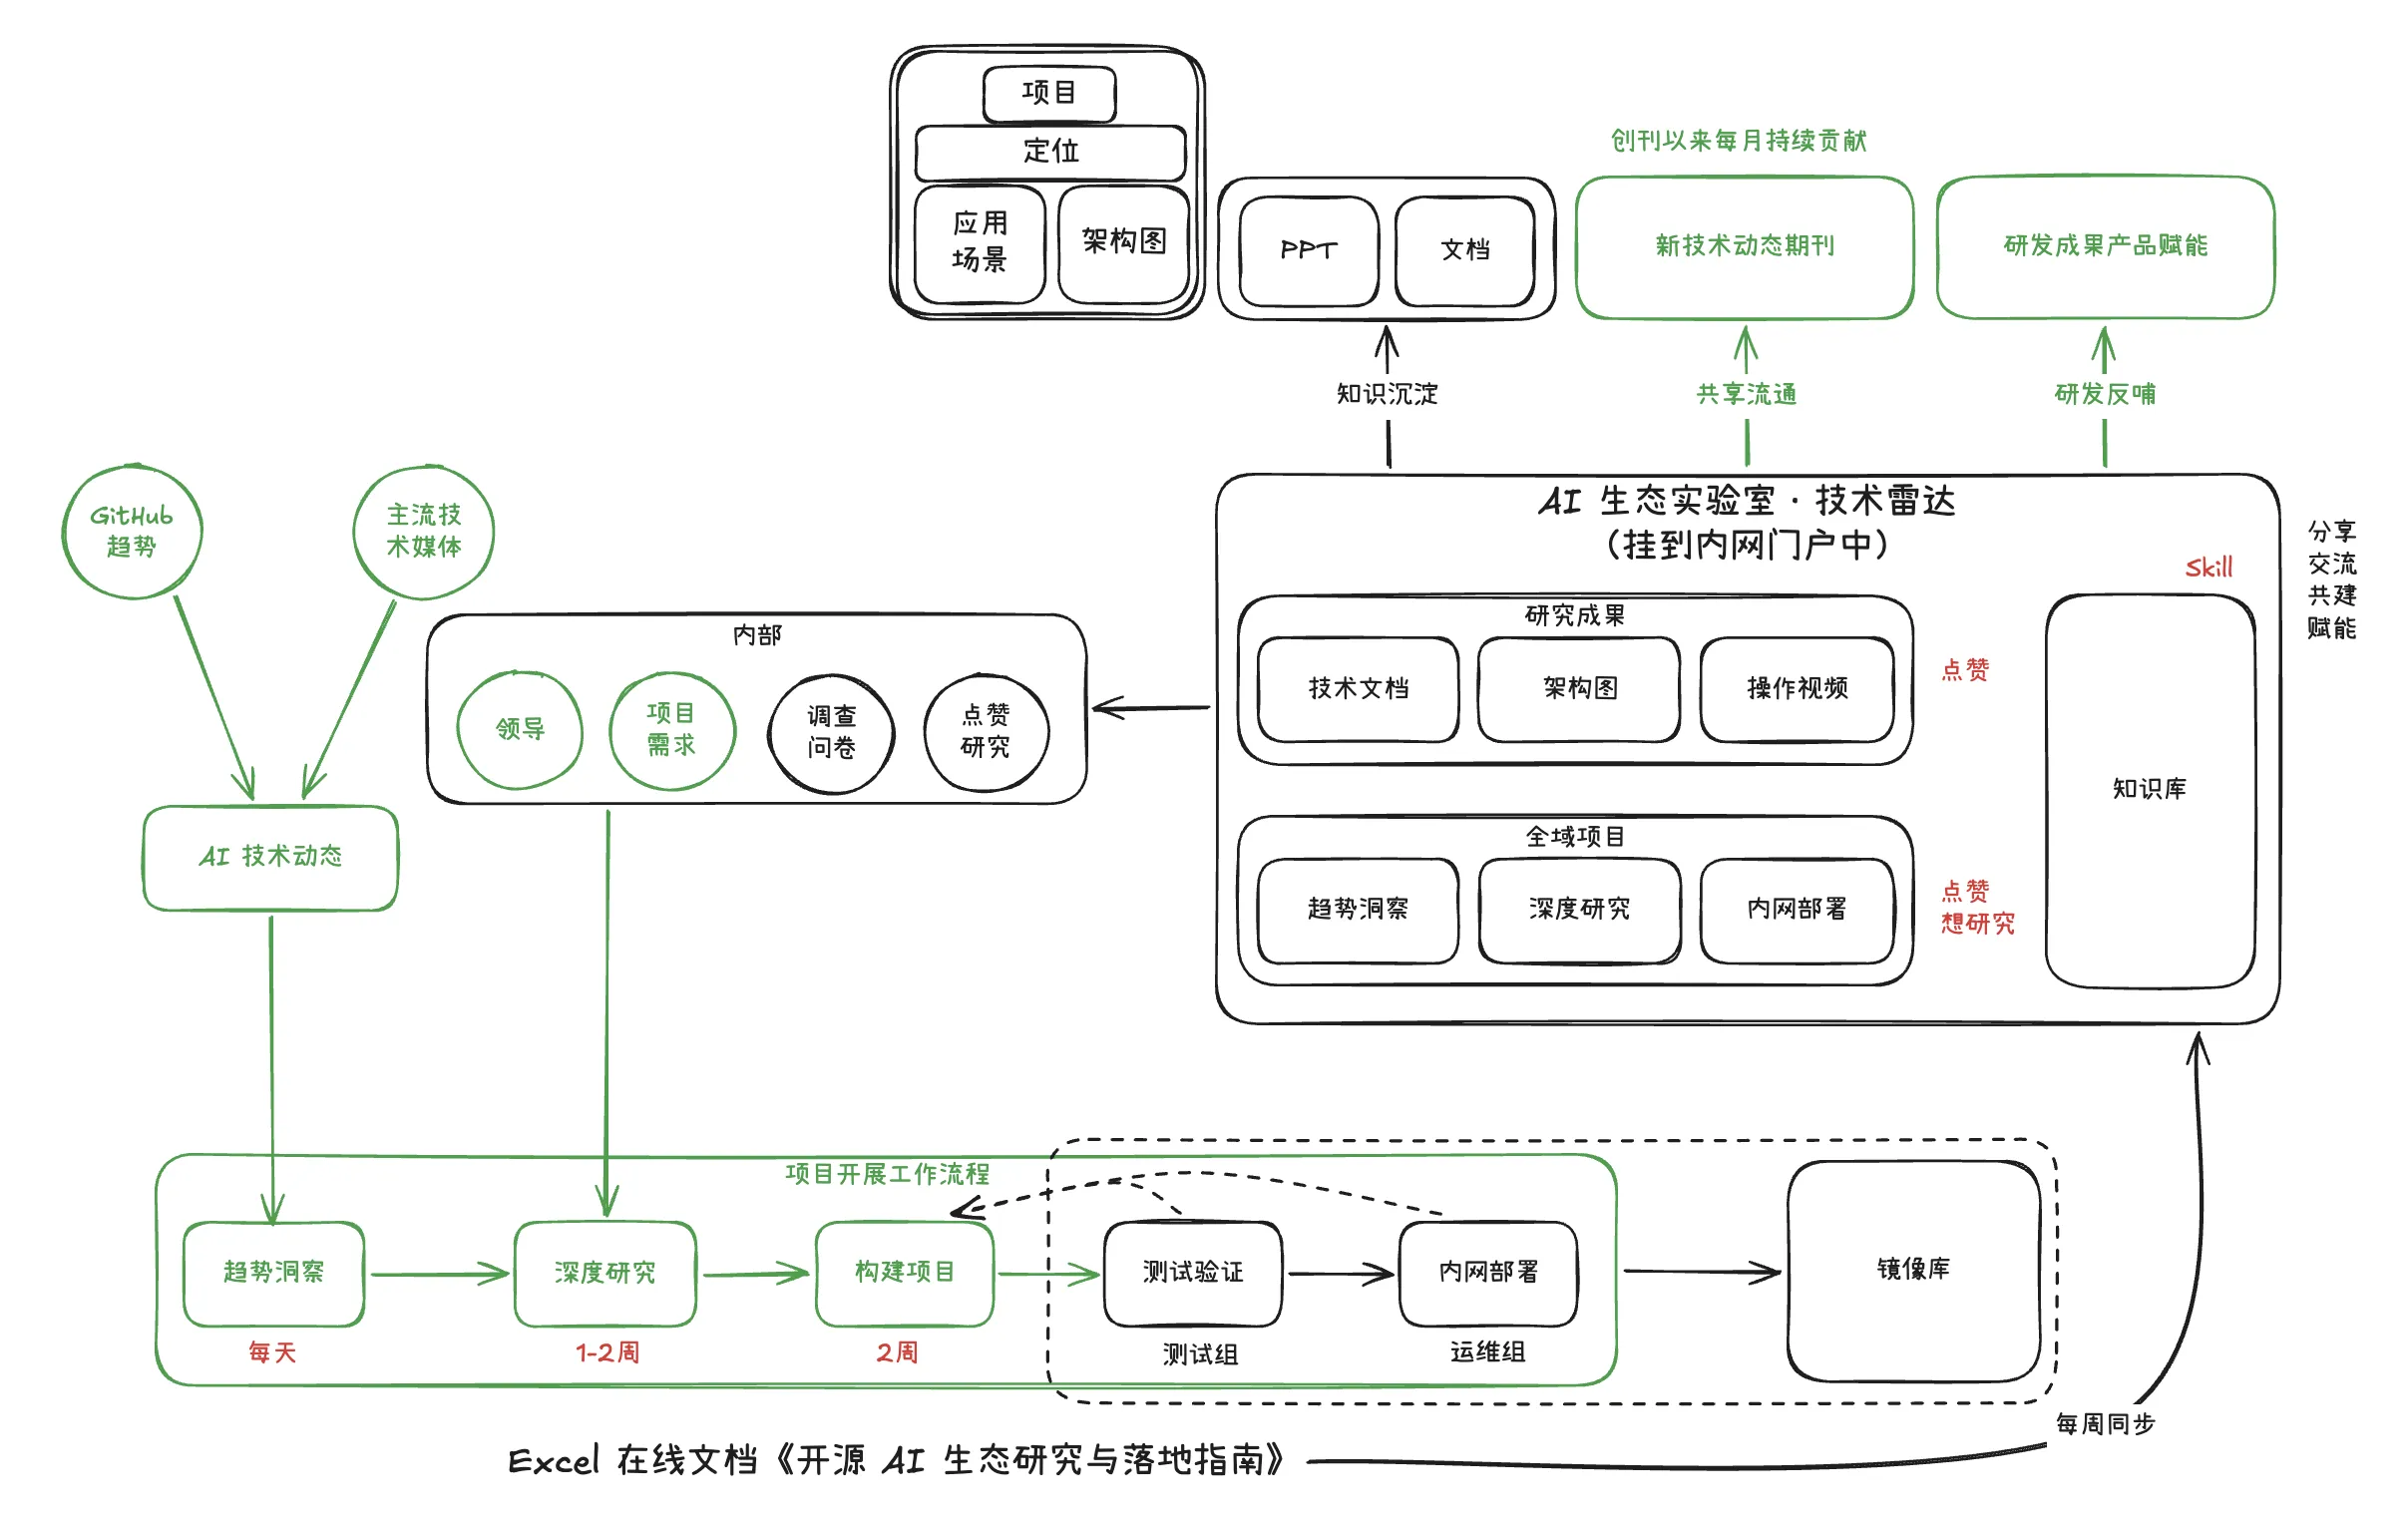
本文系统梳理了「AI 生态实验室 · 技术雷达」的完整工作流程,从信息输入、项目筛选、研究落地到成果分享,形成一套可执行、可度量的常态化研究机制。
一、为什么需要一套固化流程
开源技术每天都在产生新变量。如果研究工作是"想到哪做到哪",很容易陷入两个极端:要么因为信息过载而疲于奔命,要么因为缺乏目标感而长期停滞。我们需要的是一条从信息输入到技术落地的清晰链路,让每一天、每一周、每一个研究周期的产出都有明确的归属和节奏。
整个机制围绕三个核心问题展开:
下面这张图,就是我们对这三个问题的系统化回答。
二、全景架构:一张图看懂技术雷达
整个技术雷达的运转可以分为 三个层面 和 一条核心闭环。
三个层面
| 层面 | 角色 | 说明 |
|---|---|---|
| 信息输入层 | 外部信息源 + 内部需求 | 决定"看什么" |
| 核心引擎层 | AI 生态实验室 · 技术雷达 | 决定"怎么研" |
| 成果输出层 | 项目 PPT + 技术期刊 + 镜像库 + Skill | 决定"产出什么" |
一条核心闭环
项目开展工作流程:趋势洞察 → 深度研究 → 构建项目 → 测试验证 → 内网部署 → 镜像库。
这条链路从"每天的信息扫描"开始,到&q
一、技术方案
1.1 总体架构
采用 “公众号前端 + 智能客服中台 + 知识库底座” 三层架构:
| 层级 | 功能 | 技术选型建议 |
|---|---|---|
| 接入层 | 公众号对话入口,支持文字、图片、视频等多模态输入 | 微信公众号开发接口 |
| 智能客服中台 | 意图识别、知识检索、问答生成、智能路由(AI/人工分流) | RAG架构 + 大模型API(通义千问/Qwen、文心一言等) |
| 知识库底座 | 产品手册、FAQ、历史工单、维修案例的结构化存储与向量检索 | 向量数据库 + 结构化知识库 |
1.2 核心功能模块
1.3 实施路径(建议分三期)
上海交通大学
摘要
LLM 智能体越来越多地将技能(skill)作为可复用的组合单元。尽管技能在不同智能体平台间共享,但现有系统将其视为原始上下文处理,导致同一技能在不同智能体上表现不一致。这种脆弱性损害了技能的可移植性与执行效率。
为应对这一挑战,我们分析了 118,000 个技能,并从传统编译器设计中汲取灵感。我们将技能视为代码,将 LLM 视为异构处理器。为使可移植性成为现实,我们将技能的需求分解为一组原语能力(primitive capabilities),并衡量每个模型-执行框架(model-harness)组合对这些能力的支持程度。基于这些能力画像,我们提出了 SkVM——一个面向可移植且高效技能执行的编译与运行时系统。在编译期,SkVM 执行基于能力的编译、环境绑定与并发提取。在运行期,SkVM 应用 JIT 代码固化(code solidification)与自适应重编译以优化性能。
我们在 8 个不同规模的 LLM 和 3 个智能体执行框架上评估了 SkVM,覆盖 SkillsBench 及代表性技能任务。结果表明,SkVM 显著提升了不同模型与环境下的任务完成率,同时降低 Token 消耗高达 40%。在性能方面,SkVM 通过增强并行性实现最高 3.2× 加速,并通过代码固化实现 19–50× 的延迟降低。
1. 引言
在大语言模型(LLM)的生产落地中,自回归生成的 延迟始终是制约用户体验与系统吞吐的瓶颈。投机采样(Speculative Decoding)通过引入轻量级的“草稿模型(Draft Model)”先行生成候选 Token,再由大模型(Verification Model)进行并行校验,成为了当前最主流的加速方案。
本文将针对当前业界前沿的三种草稿模型方案——DFlash(纯并行)、DSpark(半自回归) 与 Eagle3(纯自回归) 进行深度架构剖析、技术指标对比及选型建议。
一、 核心架构与生成机制对比
三种方案的本质区别在于“生成速度(并行度)”与“草稿质量(接受率)”的权衡。以下图表直观展示了它们在计算模式上的根本差异:
graph TD
    %% 样式定义
    classDef flash fill:#d4edda,stroke:#28a745,stroke-width:2px;
    classDef spark fill:#fff3cd,stroke:#ffc107,stroke-width:2px;
    classDef eagle fill:#f8d7da,stroke:#dc3545,stroke-width:2px;

    subgraph DFlash ["DFlash: 纯并行 O(1)"]
        direction LR
        In1[输入 Token] -->|一次性前向传播| P1[Token 1] & P2[Token 2] & P3[Token 3] & P4[Token 4]
        note1[...]:::flash
    end

    subgraph DSpark [DSpark: 半自回归 - 带修正]
        direction LR
        In2[输入 Token] -->|马尔可夫并行生成| S1[候选池]
        S1 -->|置信度轻量筛选| S2[高概率 Token 块]
    end

    subgraph Eagle3 ["Eagle3: 纯自回归 O(N)"]
        direction TB
        In3[输入 Token] --> E1[草稿 Token 1]
        E1 -->|作为下一步输入| E2[草稿 Token 2]
        E2 -->|作为下一步输入| E3[草稿 Token 3]
    end

    class DFlash flash;
    class DSpark spark;
    class Eagle3 eagle;
1. DFlash (纯并行 / 无修正)
2. DSpark (半自回归 / 马尔可夫 + 置信度调度)
本文基于 DeepSpec 开源代码,以
Qwen3-4B+DSpark为具体实例,从算法思想、模型架构、训练数据流、推理流程四个维度,逐行拆解代码,帮助你完整理解 DSpark 草稿模型的训练与推理工作原理。
DeepSpec 核心工作原理
DeepSpec 训练草稿模型的本质是:在目标模型的 backbone 架构上,构建一个更小的 draft 网络,使用目标模型预计算的 hidden states 作为监督信号进行训练。
因此,适配新模型的核心工作量是让 draft 模型能够"理解"目标模型的内部表示——这包括:
一、DSpark 是什么:核心思想
DSpark 是一种面向推测解码(Speculative Decoding)的草稿模型训练方法。它的核心洞察可以总结为一句话:
"让草稿模型在训练时就学会——给定目标模型某几层的 hidden states,一次性猜出接下来的 N 个 token 是什么。"
传统训练语言模型是自回归的:输入 t0, t1, t2,预测 t3。
北京大学 DeepSeek-AI
摘要
推测解码(Speculative Decoding)通过将草稿生成与目标验证解耦来加速大语言模型(LLM)推理。尽管最近的并行 drafter 能够在单次前向传播中高效 Proposed 长令牌序列,但由于缺乏令牌间依赖关系,它们面临着接受率快速衰减的问题。此外,不加区分地验证这些扩展块会浪费关键的批次容量在具有高拒绝风险的令牌上,严重降低了高并发服务系统中的吞吐量。
我们提出了 DSpark,这是一个推测解码框架,统一了高吞吐量的并行生成与自适应的、负载感知的验证。为了保持草稿质量,DSpark 利用半自回归架构——将并行主干与轻量级顺序模块耦合——引入块内依赖建模并缓解后缀衰减。为了优化系统效率,DSpark 采用置信度调度验证,根据估计的前缀存活概率和引擎特定的吞吐量配置文件,动态地为每个请求定制验证长度。
在跨多个领域的离线基准测试中,DSpark 在已接受长度方面显著优于最先进的自回归和并行 drafter。当部署在 DeepSeek-V4 服务系统中并处理实时用户流量时,DSpark 成功缓解了验证浪费。与已确立的生产基线(MTP-1)相比,DSpark 在匹配的吞吐量水平上加速了每用户生成速度 60%–85%。
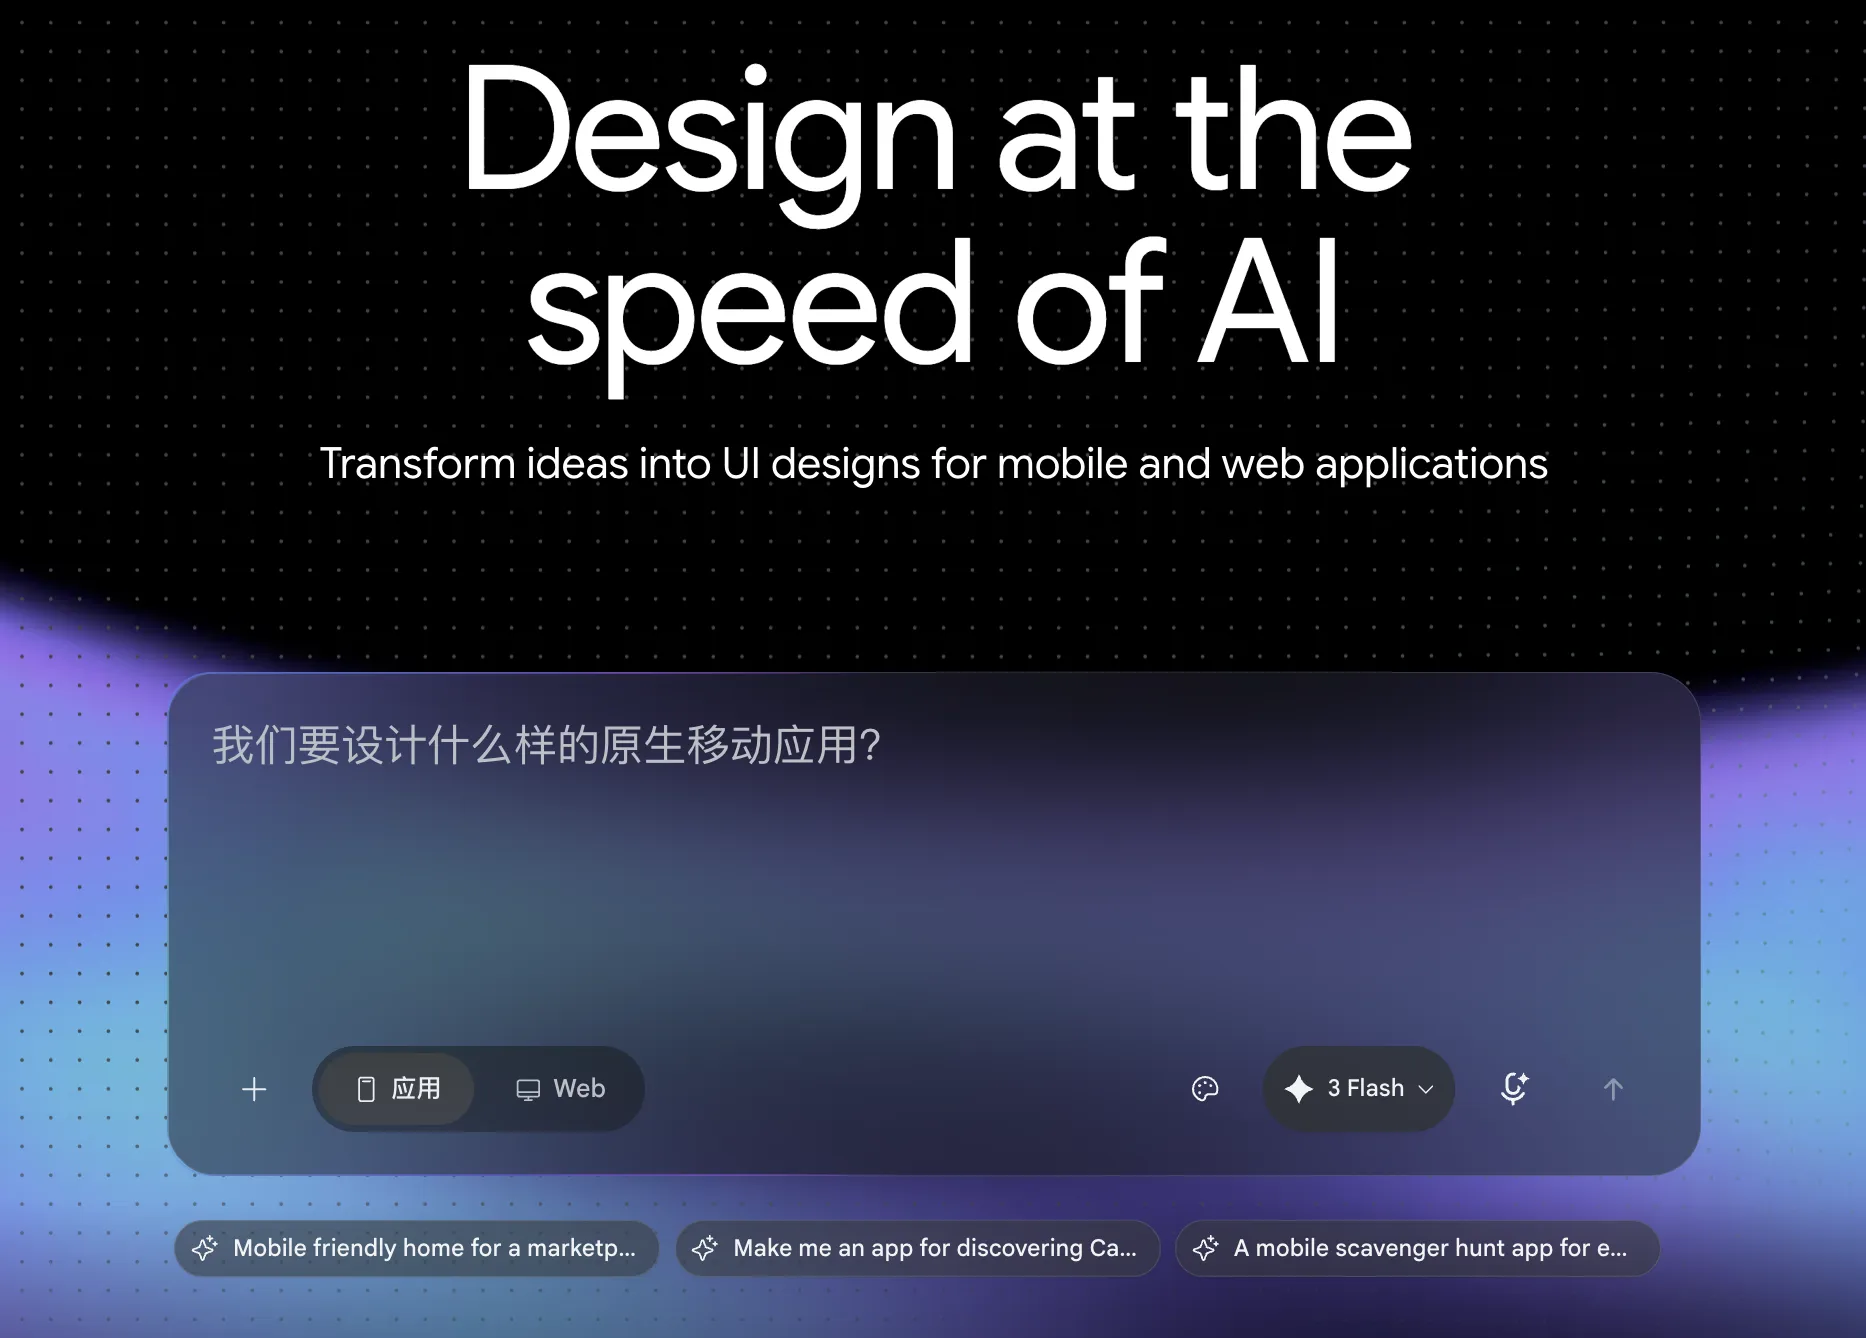
官网定位一句话:将文字、草图、截图、语音指令,一键生成 Web / 移动端高保真界面、可交互原型与可直接投入开发的前端代码,打通「灵感→设计→开发」完整工作流。
访问入口:stitch.withgoogle.com
🚀 Stitch:从想法到落地
Stitch 提倡“设计先行,边做边改”。告别面对空白页的焦虑,无需追求一步到位,通过不断迭代轻松产出优秀设计。
1. 极简起步:三步提示词公式
写下你的初始想法,无需死磕细节,给一个大概的“配方”即可生成:
2. 精准迭代:每次只改动一点
生成初稿后,构思才真正开始。
3. 验证与交付:从静态到上线
💡 核心寄语: 别想太多,先生成,再优化。持续构思,直到满意!
欢迎来到 Stitch。今天您将学习如何从设计切入并专注于概念构思。关键在于不要过度思考。
每个项目都有自己的视觉标识:颜色、字体、间距、组件样式。传统上,这些内容存储在 Figma 文件、品牌 PDF 或设计师的脑海中。AI 智能体无法读取这些格式。
DESIGN.md 改变了这一点。 它是一个纯文本设计系统文档,人类和智能体都可以阅读、编辑和执行。可以将其视为 AGENTS.md 的设计对应物:
| 文件 | 阅读者 | 定义内容 |
|---|---|---|
README.md |
人类 | 项目是什么 |
AGENTS.md |
编码智能体 | 如何构建项目 |
DESIGN.md |
设计智能体 | 项目应该长什么样、什么感觉 |
它能给你带来什么
当像 Stitch 这样的设计智能体读取你的 DESIGN.md 时,它生成的每个屏幕都遵循相同的视觉规则:你的调色板、你的排版、你的组件模式。没有它,每个屏幕都是孤立的;有了它,它们看起来属于同一个产品。
DESIGN.md 是一个活的产物,而不是静态配置文件。它随着你的设计演变而演变。智能体生成它,你完善它,并在迭代过程中重新应用到屏幕上。
在底层,每个 DESIGN.md 都有两层:YAML 前置元数据包含机器可读的设计令牌(精确的十六进制值、字体属性、间距尺度)和Markdown 正文提供人类可读的设计原理说明。令牌为智能体提供精确值。散文告诉它们为什么这些值存在。完整的格式请参阅规范。
设计理念
DESIGN.md 规范是一个基础,而非规定。
没有找到匹配的文章