AI 原生 SDLC 转型诊断与蓝图HTML
基于三份一线访谈,拆解 AI 接管九成编码后交付仍未提速的真相:三个开发者三种方法、四层瓶颈栈、三处等待,指出局部提效不等于整体提效,并给出规约驱动、测试自动化的九十天 AI 原生转型路径与北极星指标。
基于三份一线访谈,拆解 AI 接管九成编码后交付仍未提速的真相:三个开发者三种方法、四层瓶颈栈、三处等待,指出局部提效不等于整体提效,并给出规约驱动、测试自动化的九十天 AI 原生转型路径与北极星指标。
35 份来源按证据强度分六档:哈佛、NBER、DORA 证明 AI 的产出增益在下游被审查吃掉,Anthropic 与 OpenAI 的 Harness 和分级审查给出可抄制度,再落到 AGENTS.md、spec 与度量红线。
构建/测试 (Build/Test)
bun run --conditions=browser ./src/index.tsbun test(运行所有测试)或 bun test test/tool/tool.test.ts(运行单个测试)bun run typecheck(运行 tsgo --noEmit)导入别名 (Import Aliases)
@/* 映射到 ./src/*@tui/* 映射到 ./src/cli/cmd/tui/*核心模式 (Key Patterns)
命名空间模块 (Namespace modules) —— 代码以 TypeScript 命名空间(Namespace)的形式组织,而不是类(Class)。每个模块导出一个包含其 Zod schema、类型和函数的命名空间:
export namespace Session {
  export const Info = z.object({ ... })
  export type Info = z.infer<typeof Info>
  export const create = fn(z.object({ ... }), async (input) => { ... })
}
Instance.
Peter Steinberger (OpenClaw 的创造者) 分享了核心主张 “拒绝套路,直接对话”。他认为当前的 AI 智能体(尤其是 GPT-5-Codex)已足够强大,无需过度依赖 RAG、复杂的子智能体或繁琐的规格文档等“炒作”手段。
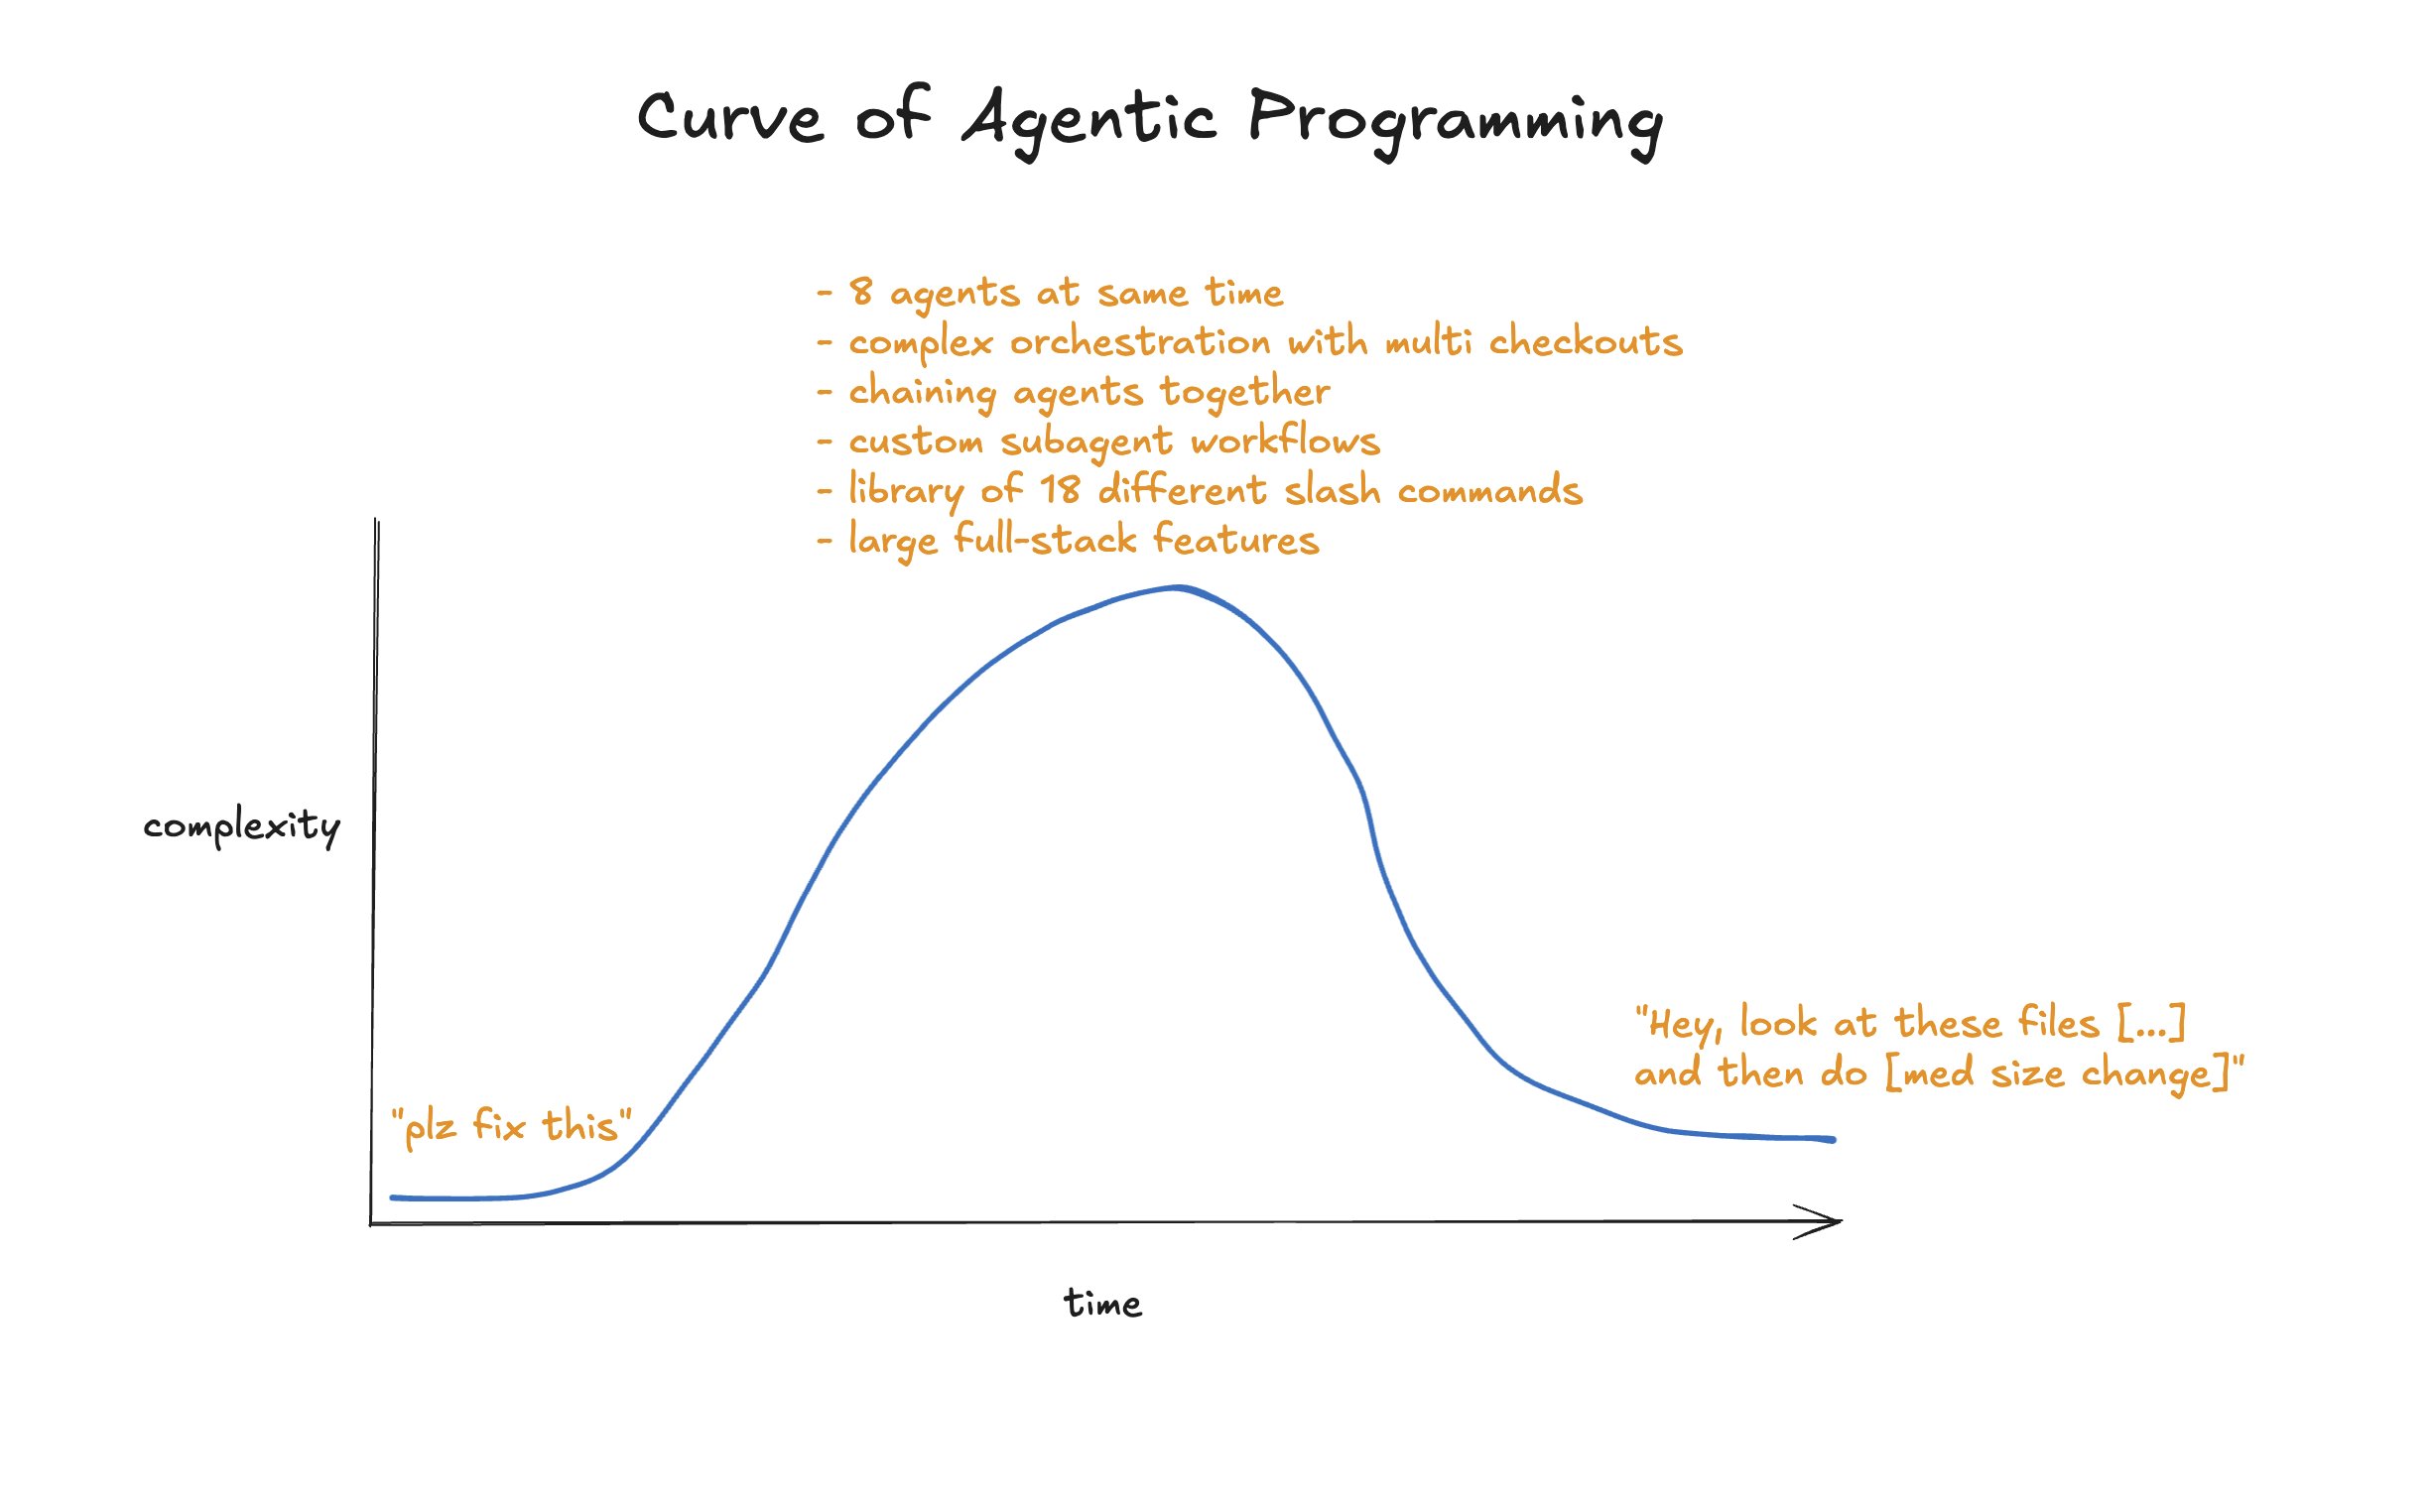
最近我在这里变得安静了许多,因为我正埋头于最新的项目。Agent 智能体工程(Agentic engineering)已经变得如此强大,以至于现在它几乎包揽了我 100% 的代码编写。然而,我看到仍有许多人在解决问题时,还在搞那些华而不实的复杂套路,而不是专注于把活干完(Getting sh*t done)。
这篇文章的灵感部分来自昨晚在伦敦参加的 Claude Code Anonymous 交流会,部分原因是从我上次更新工作流以来已经过了“AI 领域的一年”(实际才几个月,但变化巨大)。是时候同步一下进度了。
所有的基本理念仍然适用,所以我不会再提上下文管理等简单的事情。你可以阅读我的 《AI 开发最佳工作流》 作为入门。
背景与技术栈
我独立工作,当前项目是一个约 30 万行代码(LOC)的 TypeScript React 应用,包含 Chrome 扩展、CLI、基于 Tauri 的客户端以及基于 Expo 的移动端。我使用 Vercel 托管,一个 PR(拉取请求)大约在 2 分钟内就能交付新版本网页进行测试。
没有找到匹配的文章