LangChain HuggingFaceEmbeddings + FAISS

数据

weather_texts = [
    "😀 今天天气舒适,心情大好。",
    "😀 今天天气晴朗,阳光明媚。",
    "😀 今天天气宜人,适合出门游玩。",
    "😀 今天天气没有下雨,真是太好了。",
    "😀 今天天气比昨天好多了,真是令人欣喜。",
    "😀 今天天气晴空万里,蓝天白云,真是美不胜收。",
    "😀 今天天气温暖如春,空气清新,让人心旷神怡。",
    "😀 今天天气风和日丽,微风徐徐,让人心情舒畅。",
    "😀 今天天气万里无云,阳光灿烂,让人精神振奋。",
    "😀 今天天气秋高气爽,天朗气清,让人心胸开阔。",
    "🥶 今天天气很糟糕。",
    "🥶 今天天气阴沉沉的,让人心情烦躁。",
    "🥶 今天天气下雨了,真是让人沮丧。",
    "🥶 今天天气太热了,出门都觉得热得受不了。",
    "🥶 今天天气太冷了,出门都要穿上厚衣服。",
    "🥶 今天天气乌云密布,风雨欲来,真是让人提心吊胆。",
    "🥶 今天天气寒风刺骨,道路结冰,真是让人寸步难行。",
    "🥶 今天天气闷热潮湿,空气污浊,真是让人喘不过气来。",
    "🥶 今天天气灰蒙蒙的,看不到蓝天白云,真是让人心情沉重。",
    "🥶 今天天气狂风暴雨,树木倒伏,道路封闭,真是让人措手不及。"
]
Private GPT 中文 Embeddings 模型测试

文档

这里使用的文档是:合作方人员出勤及结算管理信息化支撑规则

一、出勤打卡
出勤打卡包括:正常出勤打卡、出差打卡、外出打卡、加班打卡。

1. 正常出勤打卡:指正常的出勤办公打卡。
(1)全天出勤打卡:上班打卡:8点30分之前打卡。下班打卡:17点30分之后打卡。
(2)半天出勤打卡。上午打卡时间段:8点30分之前、12点之后。下午时间段:13点之前,17点30分之后。
(3)打卡(考勤机或企业微信打卡)形式按部门要求为准,最小半天为统计单位。

2. 出差打卡:指出差地出勤办公或在途期间打卡。
(1)固定出差地打卡:打卡时间参照第1条正常出勤上下班打卡;无法定位有效范围的找部门管理员修改工作打卡位置。(具体按照各部门要求执行)
(2)出差在途打卡(使用手机外出打卡)。到车站坐车前打外出打卡一次,到达目的地后打外出打卡一次(往返同理)。下午出差的,上午需打正常出勤卡(上午正常出勤须闭环打卡);上午到达出差地的,下午需打一次外出打卡或上下班打卡。

3. 外出打卡:指外出办事打卡。提外出申请后,可以打外出卡,打外出卡时间需在申请时间内:
(1)半天外出:如外出时间在上午(12点前) 或者下午(12点后),则另外半天需正常出勤打卡。
(2)跨12点外出:如外出跨度期间包含12点,则12点前、12点后分别打外出卡即可记为合格出勤。
// ...

提示词模板 使用以下上下文来回答最后的问题。

将 API 密钥身份验证添加到 FastAPI 应用程序

API_KEY

方法一

from fastapi import Security, HTTPException, status
from fastapi.security.api_key import APIKeyHeader


API_KEY="123456"
API_KEY_NAME = "X-API-KEY"
api_key_header = APIKeyHeader(name=API_KEY_NAME, auto_error=True)

async def get_api_key(api_key: str = Security(api_key_header)):
    if api_key != API_KEY:
        raise HTTPException(
             status_code=status.HTTP_401_UNAUTHORIZED,
             detail="Invalid API Key"
        )


@app.get('/index', dependencies=[Security(get_api_key)])
async def index():
    return {"message": "Hello World"}

APIKeyHeader 的源码

Dockerfile 中 ARG 指令的作用范围

这里主要是了解 Dockerfile 中 ARG 指令的作用范围。

总结

  1. FROM 前定义的参数,只能在 FROM 指令中使用,且能够在多阶段中起作用。
ARG BASE_IMAGE=python:3.10.9
FROM ${BASE_IMAGE} AS builder
...

FROM ${BASE_IMAGE}
...
  1. FROM 后定义的参数,只能作用在本 Stage 阶段。
FROM python:3.10.9 AS builder
ARG APP_HOME=/WALL-E-AI
WORKDIR ${APP_HOME}

FROM python:3.10.9
ARG APP_HOME=/WALL-E-AI
WORKDIR ${APP_HOME}

实验

开源 OCR 引擎基准测试

OCR 引擎

EasyOCR

EasyOCR 支持 80+ 语言。

Abaza = 'abq'
Adyghe = 'ady'
Afrikaans = 'af'
Angika = 'ang'
Arabic = 'ar'
Assamese = 'as'
Avar = 'ava'
Azerbaijani = 'az'
Belarusian = 'be'
Bulgarian = 'bg'
Bihari = 'bh'
Bhojpuri = 'bho'
Bengali = 'bn'
Bosnian = 'bs'
Simplified_Chinese = 'ch_sim'
// ...

安装

pip install torch==2.0.1 torchvision==0.15.2 -i https://download.pytorch.org/whl/cpu
pip install easyocr

代码示例 import easyocr languages = ['ch_sim', 'en'] model = easyocr.

FastAPI 开发 RESTAPI 实践

首页

重定向到 Swagger UI

@app.get("/", include_in_schema=False)
async def index():
    return RedirectResponse('/docs', status_code=303)

使用 route 的 docstring 作为首页内容

@app.get("/", response_class=HTMLResponse, include_in_schema=False)
async def index():
    # 需要过滤的路由
    filted_routes = [
        "/openapi.json",
        "/docs",
        "/docs/oauth2-redirect",
        "/redoc",
        "/static",
        "/"
    ]
    
    routes = []
    for route in app.routes:
        if route.path not in filted_routes:
// ...

Markdown to HTML

安装

pip install markdown

使用

FastAPI : Request File and Form(BaseModel)

两种方法

(file: UploadFile = File(...), mask: Json = Form(default=None))

from pydantic import BaseModel, Json, ValidationError
from fastapi import APIRouter, File, UploadFile, HTTPException, Form, Depends

class Box(BaseModel):
    x: int
    y: int
    w: int
    h: int

router = APIRouter()

@router.post("/test")
async def test(file: UploadFile = File(...), 
               mask: Json = Form(default=None), 
               n: int = Form(default=0)) -> str:
// ...

(file: UploadFile = File(...), mask: Box = Depends(validate_json(Box)))

macOS 能连上 WiFi 但无法上网

问题描述

我的 MacBook Pro M2 Max 能够连接上 WiFi,但是无法上网,我进行了以下尝试:

  1. 路由器(没有问题);
  2. 重启电脑;
  3. 断开 WiFi 重新连接;

解决方案

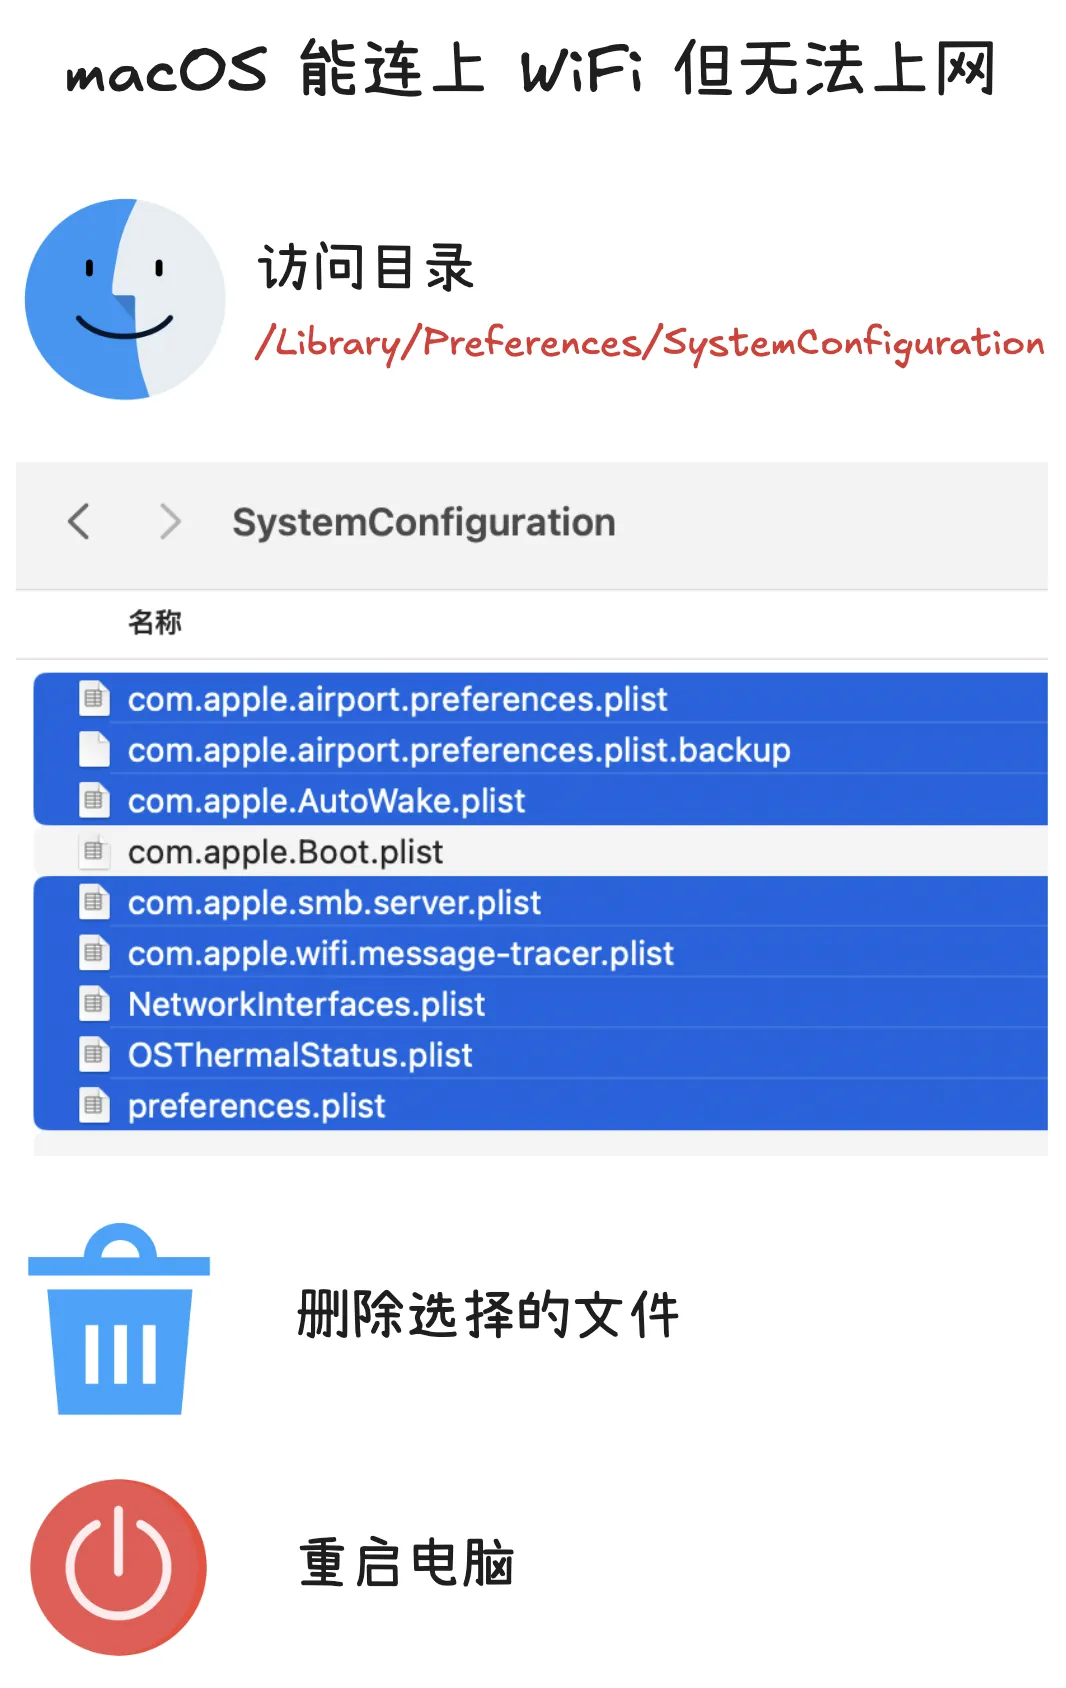
最后,我在抖音上看到了一个解决方案,我尝试了一下,果然解决了问题。

打开访达,按下Command + Shift + G,输入/Library/Preferences/SystemConfiguration/,除com.apple.Boot.plist文件外,删除其他所有文件,然后重启电脑。

LLM Leaderboard

Leaderboards

LLM

Open LLM Leaderboard

Qwen-7B

ChatGLM2-6B

Embedding 模型

Massive Text Embedding Benchmark (MTEB) Leaderboard

sensenova/piccolo-large-zh

piccolo是一个通用embedding模型(中文), 由来自商汤科技的通用模型组完成训练。piccolo借鉴了E5以及GTE的训练流程,采用了两阶段的训练方式。 在第一阶段中,我们搜集和爬取了4亿的中文文本对(可视为弱监督文本对数据),并采用二元组的softmax对比学习损失来优化模型。 在第二阶段中,我们搜集整理了2000万人工标注的中文文本对(精标数据),并采用带有难负样本的三元组的softmax对比学习损失来帮助模型更好地优化。

BAAI/bge-large-zh

FlagEmbedding 将任意文本映射为低维稠密向量,以用于检索、分类、聚类或语义匹配等任务,并可支持为大模型调用外部知识。

不同的任务

参考资料

MinIO for Kubernetes

DirectPV

安装 DirectPV plugin

Krew

kubectl krew update
kubectl krew install directpv

Release 二进制

release=$(curl -sfL "https://api.github.com/repos/minio/directpv/releases/latest" | awk '/tag_name/ { print substr($2, 3, length($2)-4) }')
curl -fLo kubectl-directpv https://github.com/minio/directpv/releases/download/v${release}/kubectl-directpv_${release}_linux_amd64
sudo chmod a+x kubectl-directpv
sudo mv kubectl-directpv /usr/local/bin/

安装 DirectPV CSI driver kubectl directpv install ███████████████████████████████████████████████████████████████████████████ 100% ┌───────────────

AI 大模型

🔥 大模型

ChatGPT

讯飞星火

活字通用大模型

🔥 Andrej Karpathy

State of GPT

🔥 李沐 论文精读 如何读论文 AlexNet ResNet 零基础多图详解图神经网络(GNN/GCN) GAN Transformer BERT Pre-training ViT 卷积神经网络的两个归纳偏置:1、locality(相同区域有相同的特征);2、translation equivariance(平移等变性) local neighborhoods MAE Autoencoder 对比学习论文综述 数据增强:Crop 和 Color 的组合最有效 MoCo CLIP How to Train Really Large Models on Many GPUs?

Velero: 备份和迁移 Kubernetes 资源和持久卷

介绍

Velero 是一款开源工具,用于安全备份和恢复、执行灾难恢复以及迁移 Kubernetes 集群资源和持久卷。

功能

  • 灾难恢复 减少基础设施丢失、数据损坏和/或服务中断时的恢复时间。
  • 数据迁移 通过轻松地将 Kubernetes 资源从一个集群迁移到另一个集群,实现集群可移植性。
  • 数据保护 提供关键数据保护功能,例如计划备份、保留计划以及用于自定义操作的备份前或备份后挂钩。

是什么让 Velero 脱颖而出?

与其他直接访问 Kubernetes etcd 数据库来执行备份和恢复的工具不同,Velero 使用 Kubernetes API 来捕获集群资源的状态并在必要时恢复它们。这种 API 驱动的方法具有许多关键优势:

  • 备份可以捕获集群资源的子集,按命名空间、资源类型和/或标签选择器进行过滤,从而为备份和恢复的内容提供高度的灵活性。
  • 托管 Kubernetes 产品的用户通常无权访问底层 etcd 数据库,因此无法直接备份/恢复它。
  • 通过聚合 API 服务器公开的资源可以轻松备份和恢复,即使它们存储在单独的 etcd 数据库中也是如此。

此外,Velero 使您能够使用存储平台的本机快照功能或称为 Restic 的集成文件级备份工具来备份和恢复应用程序的持久数据及其 配置。

Velero 的工作原理

参考资料 Velero Kubernetes 備份,災難復原之 Velero 篇 使用

在 MacBook Pro M2 Max 上测试 ChatGLM2-6B

ChatGLM2-6B

ChatGLM2-6B 是开源中英双语对话模型 ChatGLM-6B 的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,ChatGLM2-6B 引入了如下新特性:

  1. 更强大的性能:基于 ChatGLM 初代模型的开发经验,我们全面升级了 ChatGLM2-6B 的基座模型。ChatGLM2-6B 使用了 GLM 的混合目标函数,经过了 1.4T 中英标识符的预训练与人类偏好对齐训练,评测结果显示,相比于初代模型,ChatGLM2-6B 在 MMLU(+23%)、CEval(+33%)、GSM8K(+571%) 、BBH(+60%)等数据集上的性能取得了大幅度的提升,在同尺寸开源模型中具有较强的竞争力。
  2. 更长的上下文:基于 FlashAttention 技术,我们将基座模型的上下文长度(Context Length)由 ChatGLM-6B 的 2K 扩展到了 32K,并在对话阶段使用 8K 的上下文长度训练,允许更多轮次的对话。但当前版本的 ChatGLM2-6B 对单轮超长文档的理解能力有限,我们会在后续迭代升级中着重进行优化。
  3. 更高效的推理:基于 Multi-Query Attention 技术,ChatGLM2-6B 有更高效的推理速度和更低的显存占用:在官方的模型实现下,推理速度相比初代提升了 42%,INT4 量化下,6G 显存支持的对话长度由 1K 提升到了 8K。

在 Kubernetes 上部署 MySQL

部署单实例 MySQL

创建 PVC(NFS)

mysql-pvc.yaml

apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: mysql-pv-claim
spec:
  storageClassName: nfs-client
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi

创建 Deployment mysql-deployment.yaml apiVersion: apps/v1 kind: Deployment metadata: name: mysql spec: selector: matchLabels: app: mysql strategy: type: Recreate template: metadata: labels: app: mysql spec: containers: - image: mysql:5.

使用 Prometheus Operator 在 Kubernetes 上部署 Prometheus 和 Grafana

监控组件

Prometheus

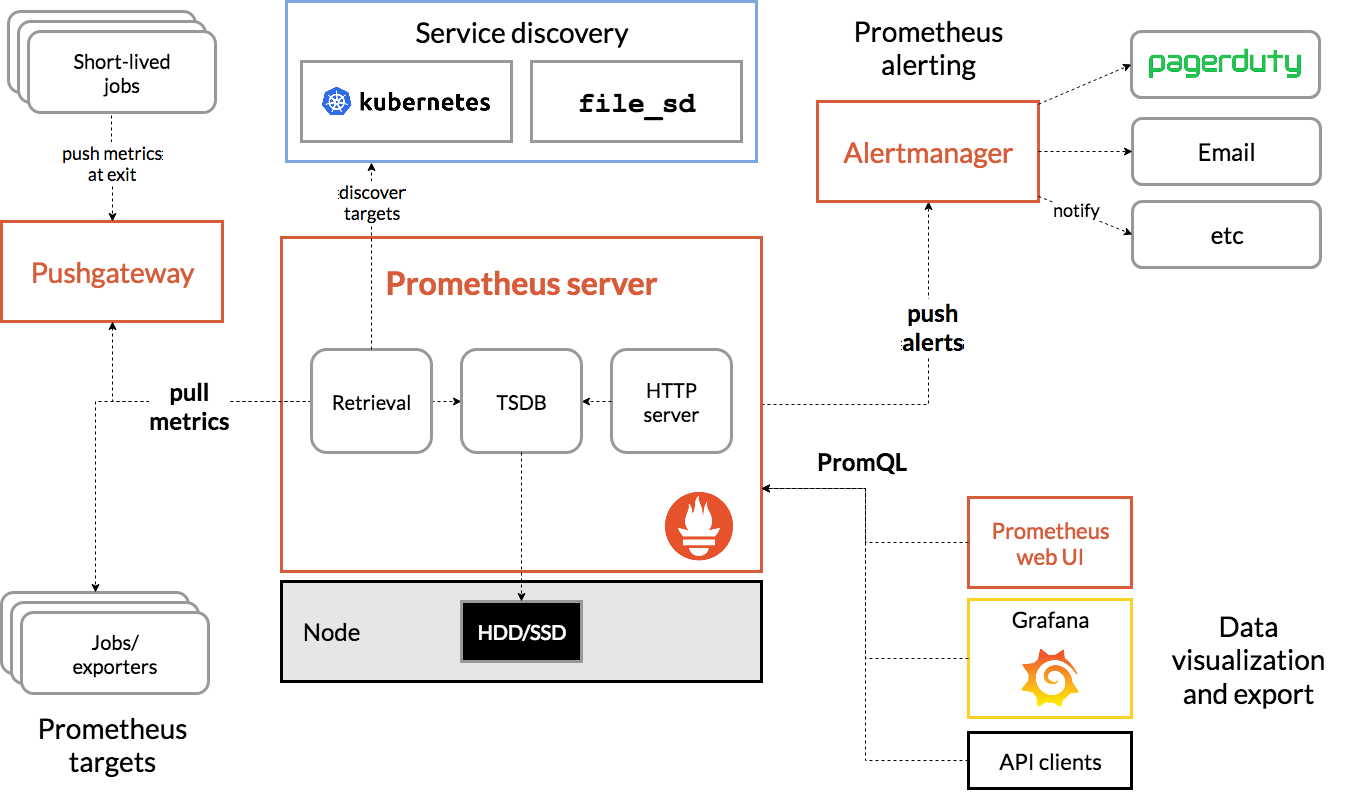
Prometheus 是一个开源系统监控和警报工具包。

架构图

Grafana

Grafana 用于对收集并存储在 Prometheus 数据库中的指标进行分析和交互式可视化。 您可以以 Prometheus 作为数据源,为 Kubernetes 集群创建自定义图表、图形和警报。

Prometheus Operator

概述

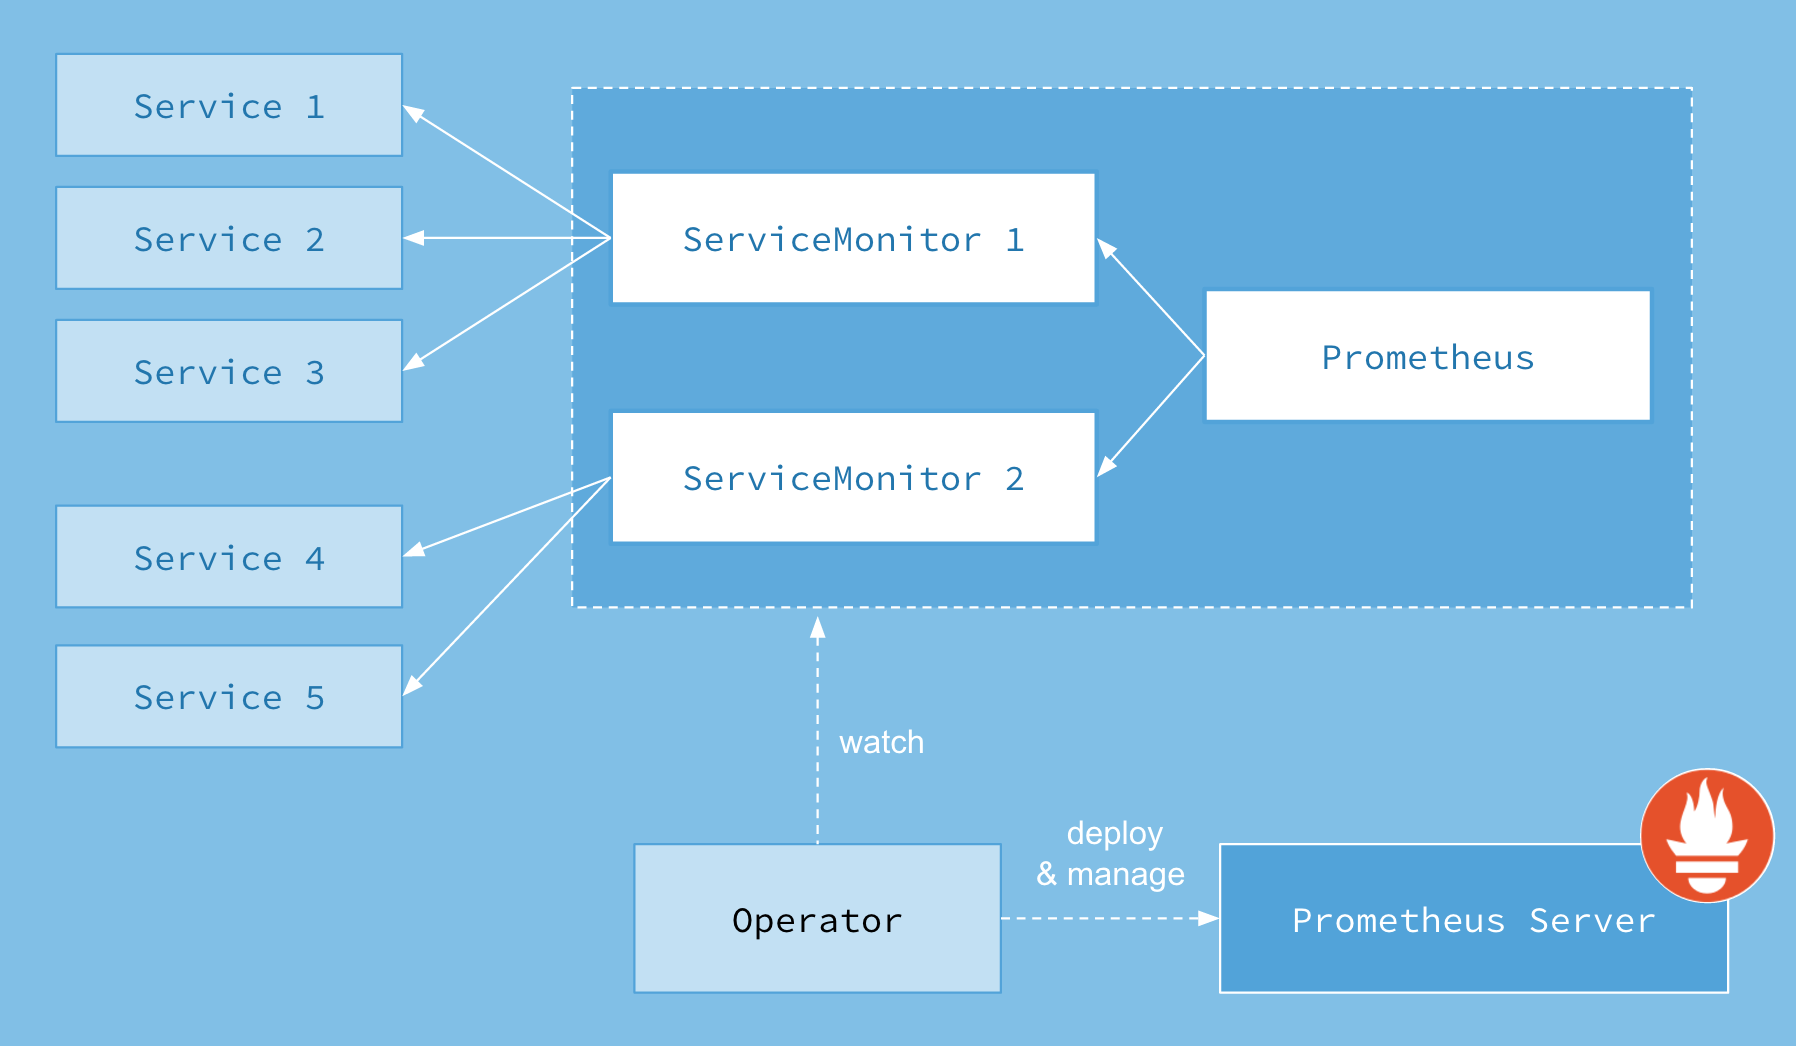
Prometheus Operator 提供 Prometheus 及相关监控组件的 Kubernetes 原生部署和管理。 该项目的目的是简化和自动化 Kubernetes 集群基于 Prometheus 的监控堆栈的配置。

架构图

部署 Prometheus 和 Grafana Monitoring Stack

克隆 kube-prometheus 项目

git clone https://github.com/prometheus-operator/kube-prometheus.git
cd kube-prometheus/

创建 monitoring namespace, CustomResourceDefinitions 和 operator pod

创建 namespace 和 CustomResourceDefinitions

使用 StorageClass 动态创建 NFS 持久卷

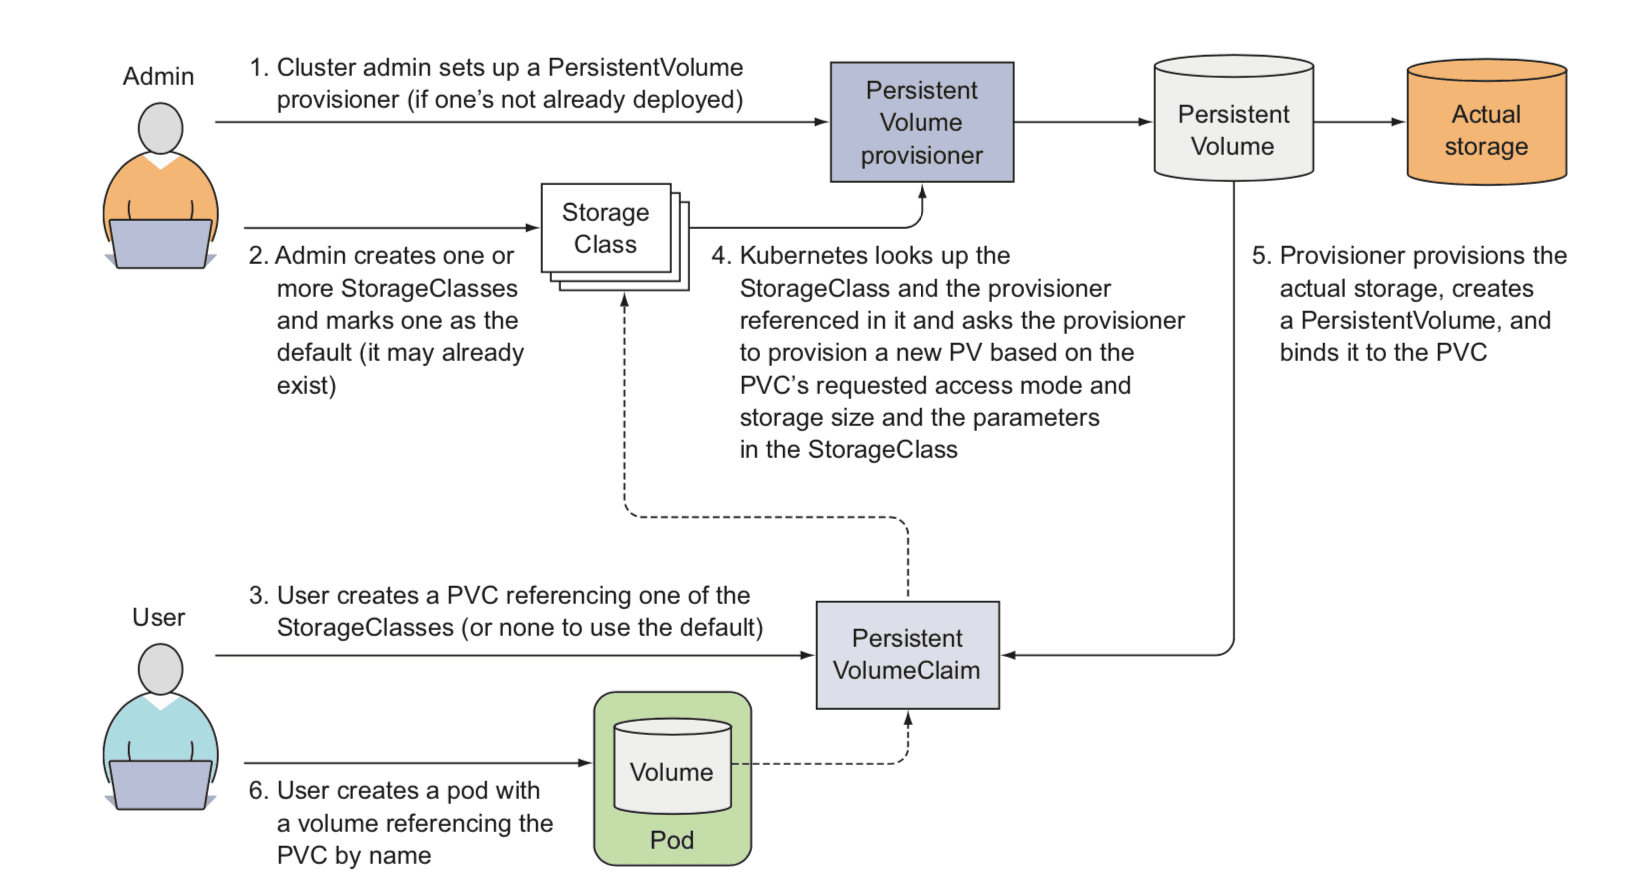
PVC 操作流程

Volume

卷的核心是一个目录,其中可能存有数据,Pod 中的容器可以访问该目录中的数据。 所采用的特定的卷类型将决定该目录如何形成的、使用何种介质保存数据以及目录中存放的内容。

使用卷时, 在 .spec.volumes 字段中设置为 Pod 提供的卷,并在 .spec.containers[*].volumeMounts 字段中声明卷在容器中的挂载位置。

emptyDir 卷的存储介质(例如磁盘、SSD 等)是由保存 kubelet 数据的根目录(通常是 /var/lib/kubelet)的文件系统的介质确定。 Kubernetes 对 emptyDir 卷或者 hostPath 卷可以消耗的空间没有限制,容器之间或 Pod 之间也没有隔离。

PersistentVolume

持久卷(PersistentVolume,PV) 是集群中的一块存储,可以由管理员事先创建, 或者使用存储类(Storage Class)来动态创建。 持久卷是集群资源,就像节点也是集群资源一样。PV 持久卷和普通的 Volume 一样, 也是使用卷插件来实现的,只是它们拥有独立于任何使用 PV 的 Pod 的生命周期。

PV 对象是由运维人员事先创建在 Kubernetes 集群里待用的。

PersistentVolumeClaim 持久卷声明(PersistentVolumeClaim,PVC

How Diffusion Models Work

How Diffusion Models Work

扩散模型如何工作

Intuition(直觉)

Making images useful to a neural network(使图像对神经网络有用)

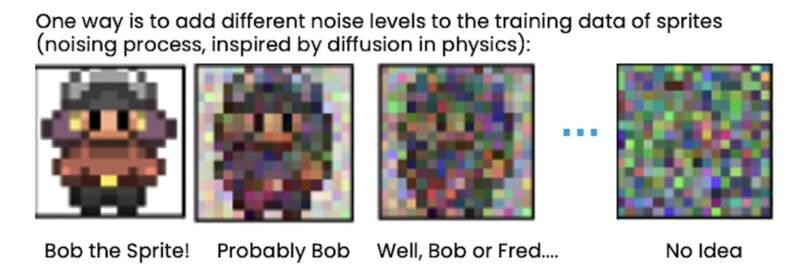
噪声处理:添加不同的噪声级别到训练数据中。

灵感来源于物理学,你可以想像一滴墨水滴入一杯水中,最初你确切地知道它落在哪里,但随着时间的推移,你看到到扩散到水中,直到消失。

神经网络真正应该思考的是在每个噪声级别,当你逐渐向图像添加噪声时:

  1. Bob the Sprite!: 如果是 Bob Sprite,你想让神经网络说那是 Bob Sprite,让 Bob 保持原样。
  2. Probable Bob: 如果可能是 Bob Sprite,你可能想让神经网络说你知道这里有些噪声,建议可能填写的详细信息,让它看起来就像 Bob Sprite。
  3. Well, Bob or Fred...: 如果它只是精灵的轮廓,你想建议可能的精灵的一般细节。
  4. No Idea: 如果看起来什么也不知道,建议提出什么是轮廓,让它看起来更像精灵。

Training a neural network to make sprites(训练神经网络制作精灵)

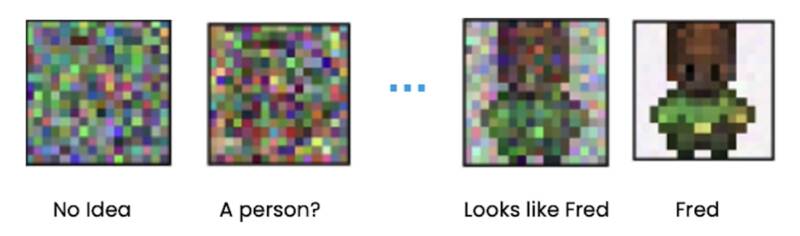
神经网络学习不同的噪声图像并将它们变回精灵。

它学会消除您添加的噪声。

"No Idea" 的噪声级别很重要,因为它是正态分布的,每一个像素的采样都来自于正态分布。