WorkBuddy 实战案例:代码开发

WorkBuddy 介绍

全场景智能体工作搭子

开启 AI Agent 办公新范式

AI 专家团 全场景办公

WorkBuddy 是全能 AI 工作台,一人指挥,全行业专家执行,从策略到交付一站搞定

免部署·安装即用 | 多专家·多模型协同 | 全平台·桌面 / 主流 IM / 小程序

100+ 领域专家组成你的虚拟团队,运营、设计、数据、开发等全角色场景覆盖

一句话指令自主规划并交付完整结果

多专家并行协作,一个人顶一支团队

MCP 生态 + 自定义 Skills,能力无限扩展

绘制架构图和流程图

输入

@file:open-ai-eco 研究这个项目,绘制架构图和流程图。

输出

WorkBuddy 实战案例:日常办公

WorkBuddy 介绍

全场景智能体工作搭子

开启 AI Agent 办公新范式

AI 专家团 全场景办公

WorkBuddy 是全能 AI 工作台,一人指挥,全行业专家执行,从策略到交付一站搞定

免部署·安装即用 | 多专家·多模型协同 | 全平台·桌面 / 主流 IM / 小程序

100+ 领域专家组成你的虚拟团队,运营、设计、数据、开发等全角色场景覆盖

一句话指令自主规划并交付完整结果

多专家并行协作,一个人顶一支团队

MCP 生态 + 自定义 Skills,能力无限扩展

截图重命名与分类

输入

把 截图 目录中的图像根据图像的内容进行重命名及文件夹分类。

输出

我先看看截图文件夹里有哪些图像,然后分析每张图的内容来重命名和分类。
截图文件夹有 11 张 PNG 图像。我需要逐一查看每张图的内容来判断如何命名和分类。我先读取这些图像。

我已经看完了全部 11 张截图,根据内容可以把它们分成三类。分类方案如下:

1. AI-概念图/

  • Claude-Code-上下文工程.png(Claude Code 的上下文工程结构图)
  • RAG-检索增强生成.png(ChatGPT / RAG 流程图)
  • Multi-Agent-ChatDev工作流.png(ChatDev 多智能体开发流程)
  1. Claude-Agent-SDK/ Claude-Agent-SDK-封面.

Claude Fable 实战指南:发现你的未知

mindmap
  root((找到你的未知))
    【是什么】
      Anthropic 官方 agentic coding 指南
      核心观点:减少并管理未知 = 核心技能
      高手特征:未知少、懂代码库也懂模型
    【给谁用】
      用 Claude Code 的开发者
      面对陌生代码库/新领域的人
      想让 AI 协作更可控的人
    【核心框架:未知四象限】
      已知已知
        写进提示词的需求
      已知未知
        知道自己还没搞懂
      未知已知
        太显然没写 看到才认出
      未知未知
        完全没想到的坑 最危险
    【关键机制】
      告知起点上下文
        经验水平 思路进度 熟悉程度
      指令粒度要平衡
        太细→错过更优路径
        太粗→模型乱假设
      趁便宜先暴露未知
        原型期改成本远低于实施后
    【核心方法:按阶段】
      实施前
        盲点扫描:让 Claude 列出你的未知未知
        头脑风暴+原型:快速看到多种方向
        访谈:让 Claude 逐题问你澄清歧义
        参考引用:给源码当参照 比截图好
        实施计划:把易改决策放前面评审
      实施中
        实施笔记:记录偏离计划的决策
      实施后
        宣讲文档:加速评审者理解与批准
        测验:通过测验才算真懂 才合并
    【一句话精髓】
      让 Claude 帮你找未知
      在代价变大之前

原文:A field guide to Claude Fable 5: Finding your unknowns 作者:Thariq Shihipar(Anthropic 技术团队成员)

地图与领土

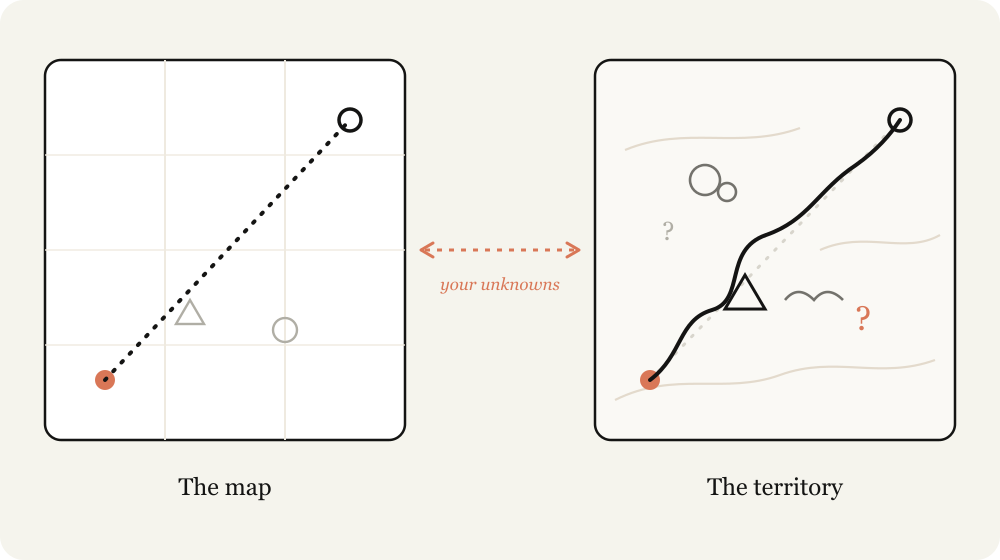
在使用 Claude Code 时,我常常想起地图与领土之间的区别。

地图,即待完成工作的表征,是我的提示词、技能和上下文——是我提供给 Claude 的东西。领土,则是工作需要实际发生的地方:代码库、现实世界、真实的约束条件。

地图与领土之间的差距,就是我所说的未知(unknowns)。当 Claude 遇到一个未知时,它需要根据对我意图的最佳猜测来做出决策。工作量越大,Claude 可能遇到的未知就越多。

Claude Fable 是我遇到的第一个模型,其工作质量的瓶颈在于我澄清未知的能力。

重要的是,仅仅提前规划并不总是足够的。你可能会在深入实现时发现未知,或者你的未知可能指向一个事实:你其实应该用完全不同的方式来解决问题。

我发现,使用 Fable 工作是一个迭代过程——在实现之前、之中和之后,不断发现自己的未知。

认识你的未知

你的未知是什么?当我带着问题来找 Claude 时,我倾向于将其分解为四种类型:

  • 已知的已知(Known Knowns):这本质上就是我的提示词中的内容。我告诉智能体我想要什么?
  • 已知的未知(Known Unknowns):我还有什么没搞清楚的,但我已经意识到我还没搞清楚?
  • 未知的已知(Unknown Knowns):有哪些事情如此显而易见,以至于我永远不会写下来,但看到时却能认出来?
  • 未知的未知(Unknown Unknowns):我完全没有考虑过什么?有哪些知识是我不知道自己不知道的?我知道某件事可以做得多好?

开源 AI 生态研究项目 Git 大文件 LFS 配置教程与团队开发指南

GitHub 仓库初始化

git init
git add .
git commit -m "first commit"

关联远程仓库并推送

git remote add origin https://github.com/wang-junjian/open-ai-eco.git
git branch -M main
git push -u origin main

视频没有使用 Git LFS

remote: warning: File public/videos/open-design-webprototype.mp4 is 84.20 MB; this is larger than GitHub's recommended maximum file size of 50.00 MB
remote: warning: GH001: Large files detected. You may want to try Git Large File Storage - https://git-lfs.github.com.
remote: warning: See https://gh.io/lfs for more information.

解决方案:

一、全局配置 public/videos/ 下所有文件走 Git LFS 1.

Andrej Karpathy 的 CLAUDE 编码准则

下面是 CLAUDE.md 文件的内容,用于改善 Claude Code 的行为,源自 Andrej Karpathy 的观察 关于 LLM 编码陷阱的总结。

CLAUDE.md

旨在减少大语言模型常见编码错误的行为准则。可根据项目特定说明按需合并。

权衡: 本准则偏向谨慎而非速度。对于琐碎任务,请自行判断。

1. 编码前先思考

不要假设。不要掩饰困惑。要呈现权衡。

实施之前:

  • 明确陈述你的假设。如果不确定,就提问。
  • 若存在多种解读,请呈现出来——不要默默选择一种。
  • 若有更简单的做法,请说出来。在必要时坚持己见。
  • 若某事不清楚,就停下来。指出困惑所在。提问。

2. 简单至上

用最少的代码解决问题。不添加任何推测性内容。

  • 不添加需求以外的功能。
  • 不为一次性代码创建抽象。
  • 不提供未要求的“灵活性”或“可配置性”。
  • 不对不可能发生的场景进行错误处理。
  • 如果你写了 200 行,而本可以 50 行完成,那就重写。

问问自己:“一位资深工程师会认为这过于复杂吗?” 如果会,就简化它。

3. 外科手术式的修改

只碰你必须改的。只清理你自己弄乱的。

编辑现有代码时:

  • 不要“改进”相邻的代码、注释或格式。
  • 不要重构没有坏的东西。
  • 即使你有不同做法,也要遵循现有风格。
  • 若注意到无关的无效代码,提出来——但不要删除。

当你的修改造成孤立代码时: 删除由你的修改导致的未使用的导入/变量/函数。

自我改进的 Harness 工程(Harness Engineering for Self-Improvement)

递归自我改进(recursive self-improvement, RSI) 的概念可以追溯到 I. J. Good (1965),他将"超智能机器"定义为一个能够在所有智力活动中超越人类、并设计出更好的机器来改进自身的系统。Yudkowsky (2008) 使用"递归自我改进"这一术语来描述一个特定的反馈循环:AI 利用其当前的智能来改进产生其智能的认知机制。

这种反馈循环在现代 AI 中可能意味着模型直接重写自身的权重,或者更广泛地说,模型改进了训练流水线和部署系统,从而催生出一个在经济价值任务上表现更优的继任模型。AI 研究发展的速度在前沿实验室中已被证明正在急剧加速(Anthropic;OpenAI)。

我特意提到 "部署系统",因为原始模型与真实世界环境之间的这一层,似乎与模型原始智能(即预训练后的评估)同等重要。Harness 是 AI 部署的重要组成部分,Claude Code 和 Codex 等成功的编码智能体产品已证明了这一点。Harness 是围绕基础模型的系统,负责编排执行、决定模型如何思考和规划、调用工具和执行动作、感知和管理上下文、存储产物以及评估结果。

本文将聚焦于 harness 工程相关的研究,以及它如何促进 RSI。

本周 AI 新闻 20260703

本周主线:Anthropic 双弹齐发 Sonnet 5 与 Claude Science,美团 LongCat-2.0 万亿参数模型亮剑国产算力,AI 独角兽 IPO 密集冲刺,优必选人形机器人订单破万——产业从实验室走向市场成为本周最强音。

本周看点

  1. Anthropic 双弹齐发:Sonnet 5 性能逼近 Opus 4.8:价格仅为前者的三分之一,Agent 能力大幅跃升,同时推出 Claude Science 科研工作台,将多智能体编排推向科学计算场景。
  2. 美团 LongCat-2.0 万亿参数模型亮剑:业界首个在五万卡国产算力集群上完成全流程训练的万亿参数大模型,OpenRouter 全球调用量排名前三。
  3. 优必选 U1 人形机器人订单破万:消费级全尺寸人形机器人首发即获 13,361 台订单,标志着具身智能从实验室走向家庭的第一步。
  4. AI 独角兽 IPO 密集窗口:Momenta、宇树科技、珞石机器人等 5 家 AI 企业冲刺上市,Anthropic 以 9,650 亿美元估值抢跑 OpenAI。
  5. Meta 为防模型蒸馏划红线:内部限制使用 Claude Code 和 Codex,引发行业对 AI 时代「谁教会了谁」的深层讨论。

本周的六条主线——模型平权、智能体科研落地、编程工具体系化、机器人消费破冰、资本密集兑现、监管松绑——共同指向一个判断:AI 正从「能做什么」向「谁来做

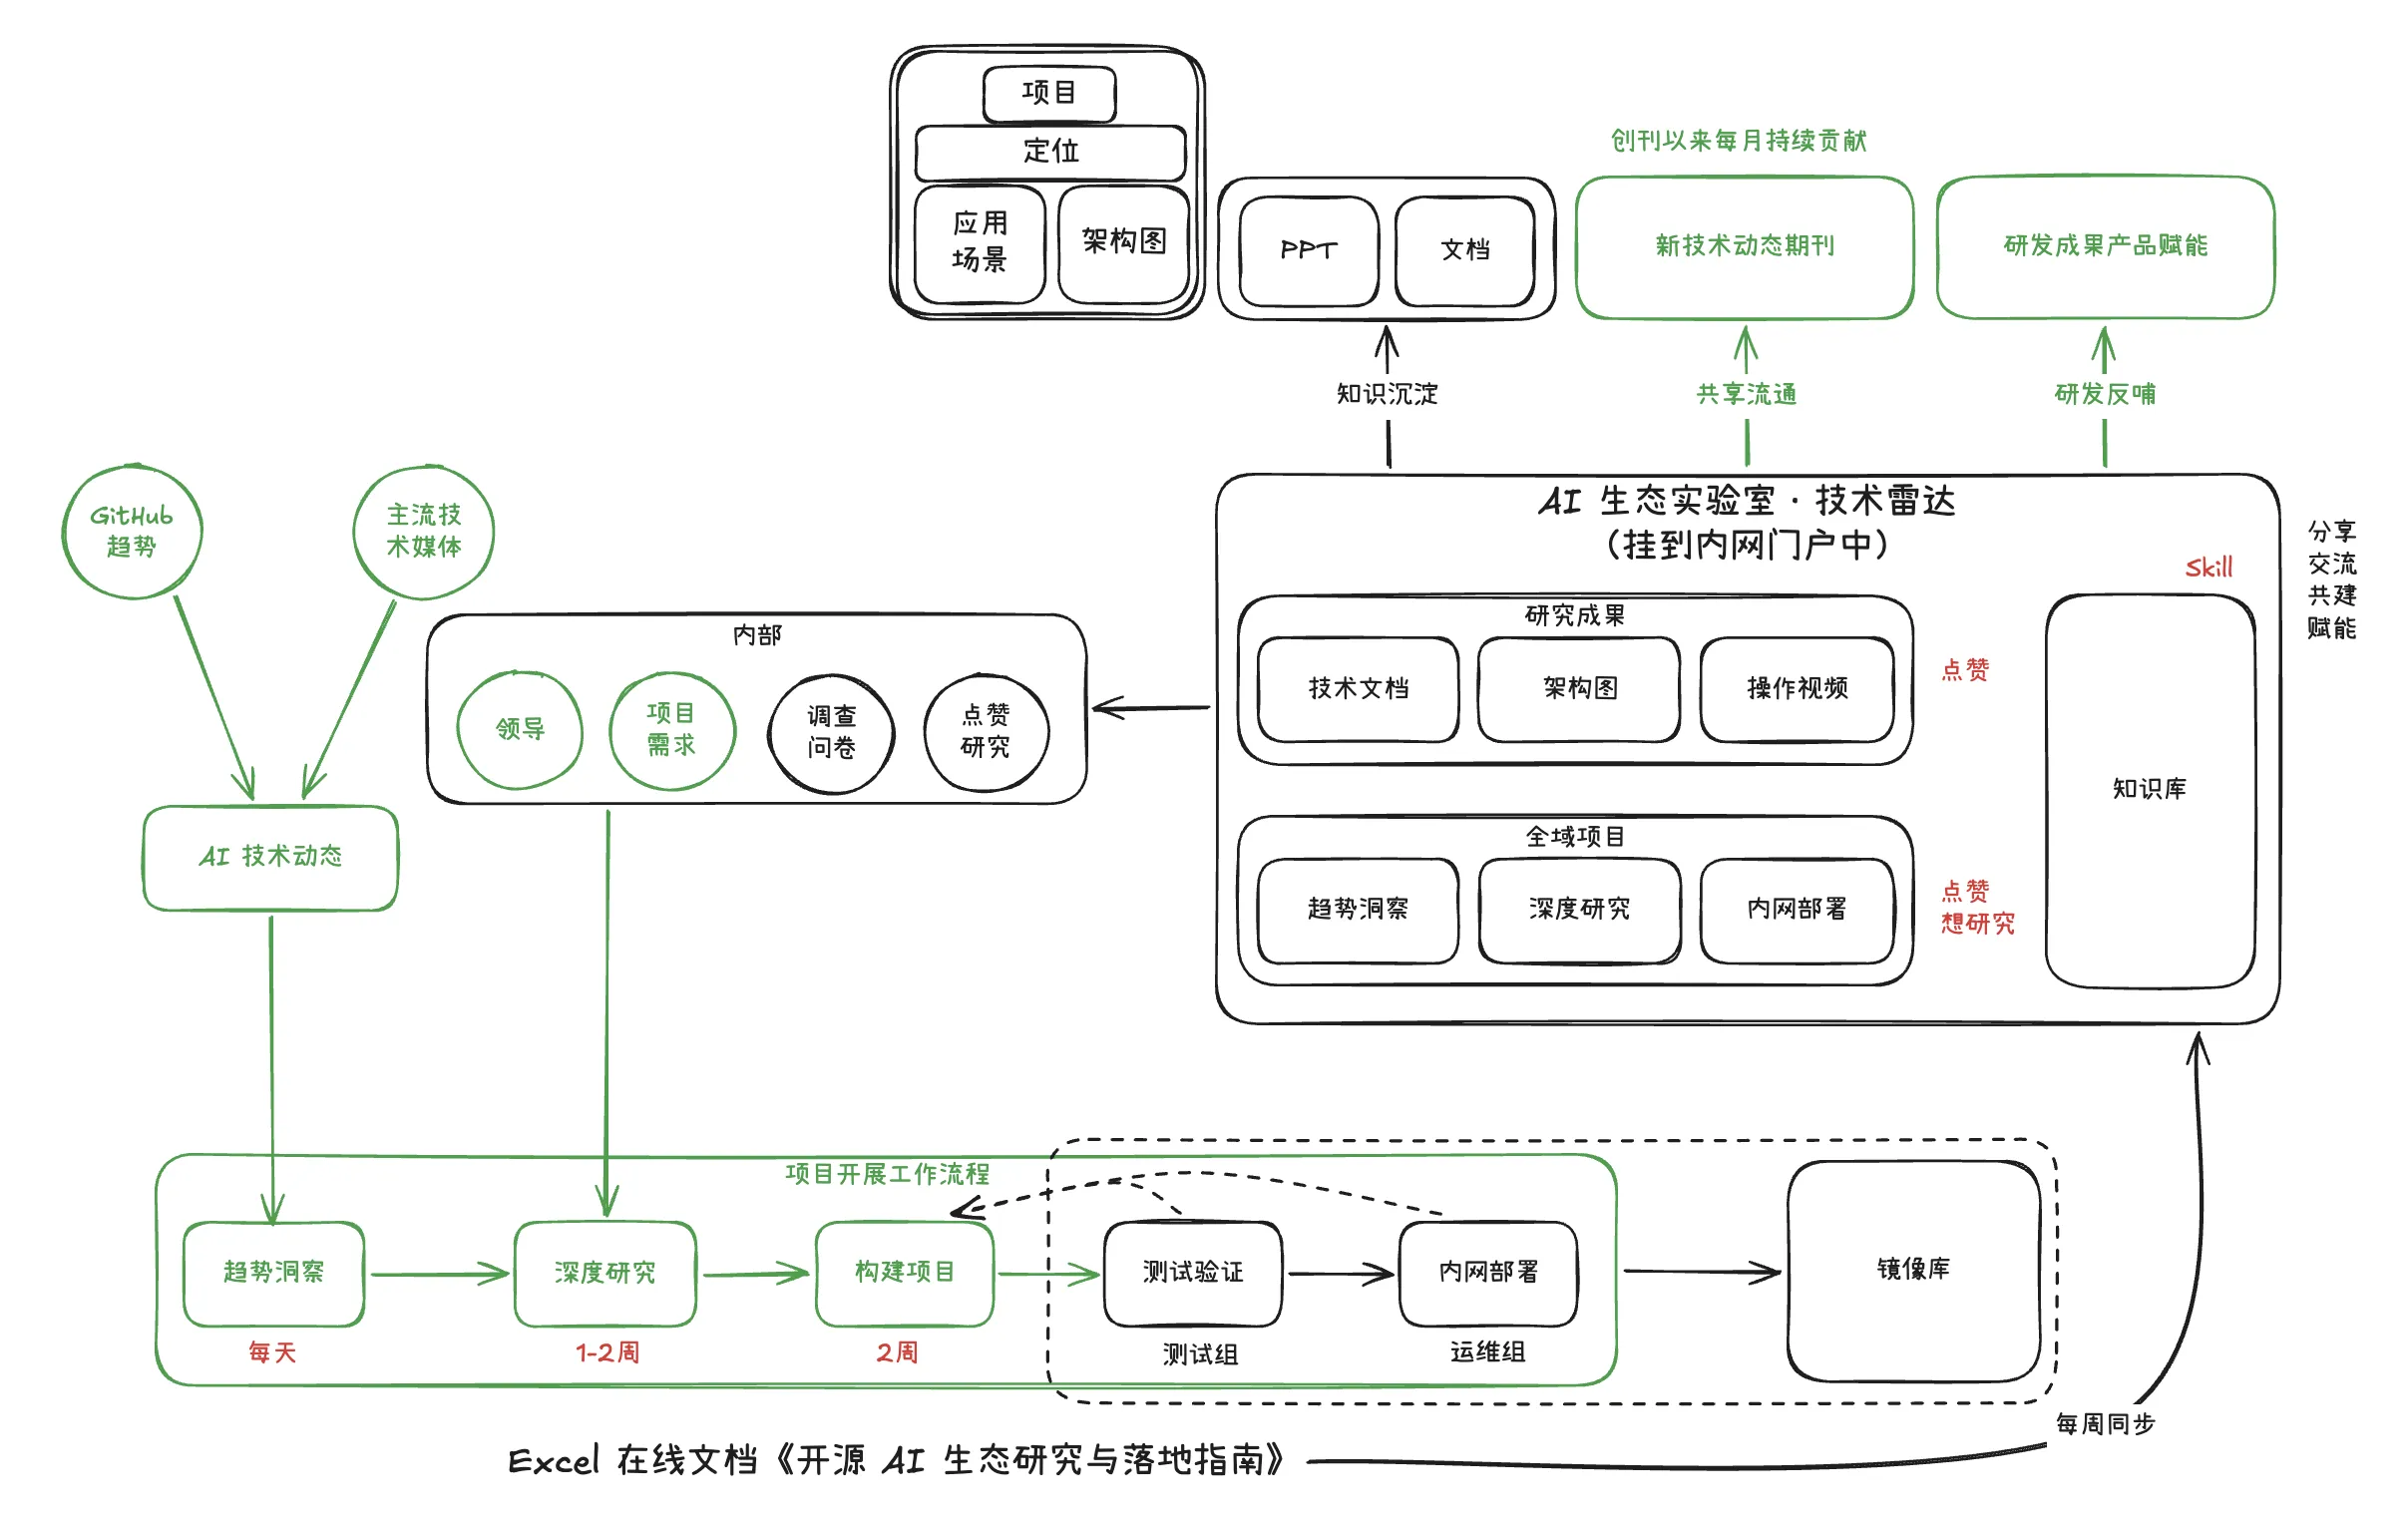
AI 生态实验室 · 技术雷达:工作流程全景解读

本文系统梳理了「AI 生态实验室 · 技术雷达」的完整工作流程,从信息输入、项目筛选、研究落地到成果分享,形成一套可执行、可度量的常态化研究机制。

一、为什么需要一套固化流程

开源技术每天都在产生新变量。如果研究工作是"想到哪做到哪",很容易陷入两个极端:要么因为信息过载而疲于奔命,要么因为缺乏目标感而长期停滞。我们需要的是一条从信息输入到技术落地的清晰链路,让每一天、每一周、每一个研究周期的产出都有明确的归属和节奏。

整个机制围绕三个核心问题展开:

  1. 节奏问题:每天、每周、每月到底该干什么?
  2. 方向问题:研究什么才能真正提升研发效率,而不是做无效功?
  3. 价值问题:研究成果怎么让团队看见、让业务用上?

下面这张图,就是我们对这三个问题的系统化回答。

二、全景架构:一张图看懂技术雷达

整个技术雷达的运转可以分为 三个层面 和 一条核心闭环。

三个层面

层面 角色 说明
信息输入层 外部信息源 + 内部需求 决定"看什么"
核心引擎层 AI 生态实验室 · 技术雷达 决定"怎么研"
成果输出层 项目 PPT + 技术期刊 + 镜像库 + Skill 决定"产出什么"

一条核心闭环

项目开展工作流程:趋势洞察 → 深度研究 → 构建项目 → 测试验证 → 内网部署 → 镜像库。

这条链路从"每天的信息扫描"开始,到&q

智能问答售后服务系统

一、技术方案

1.1 总体架构

采用 “公众号前端 + 智能客服中台 + 知识库底座” 三层架构:

层级 功能 技术选型建议
接入层 公众号对话入口,支持文字、图片、视频等多模态输入 微信公众号开发接口
智能客服中台 意图识别、知识检索、问答生成、智能路由(AI/人工分流) RAG架构 + 大模型API(通义千问/Qwen、文心一言等)
知识库底座 产品手册、FAQ、历史工单、维修案例的结构化存储与向量检索 向量数据库 + 结构化知识库

1.2 核心功能模块

  1. 智能问答:基于RAG(检索增强生成)架构,系统从知识库中检索相关文档,再由大模型生成精准答案。方案匹配准确率可达92%以上。
  1. 多模态故障识别:支持客户上传故障图片/视频,利用多模态大模型进行图像识别与故障推理,自动推送处理建议。
  1. 智能路由与转人工:AI首轮处理常规问题,疑难问题自动转接人工客服,实现“AI首轮服务+人工兜底”的协同模式。
  1. 知识自进化:系统在问答过程中持续学习,客户采纳的答案自动整理为问答对,不断优化知识库。

1.3 实施路径(建议分三期)

SkVM:面向随处高效执行的技能编译

上海交通大学

摘要

LLM 智能体越来越多地将技能(skill)作为可复用的组合单元。尽管技能在不同智能体平台间共享,但现有系统将其视为原始上下文处理,导致同一技能在不同智能体上表现不一致。这种脆弱性损害了技能的可移植性与执行效率。

为应对这一挑战,我们分析了 118,000 个技能,并从传统编译器设计中汲取灵感。我们将技能视为代码,将 LLM 视为异构处理器。为使可移植性成为现实,我们将技能的需求分解为一组原语能力(primitive capabilities),并衡量每个模型-执行框架(model-harness)组合对这些能力的支持程度。基于这些能力画像,我们提出了 SkVM——一个面向可移植且高效技能执行的编译与运行时系统。在编译期,SkVM 执行基于能力的编译、环境绑定与并发提取。在运行期,SkVM 应用 JIT 代码固化(code solidification)与自适应重编译以优化性能。

我们在 8 个不同规模的 LLM 和 3 个智能体执行框架上评估了 SkVM,覆盖 SkillsBench 及代表性技能任务。结果表明,SkVM 显著提升了不同模型与环境下的任务完成率,同时降低 Token 消耗高达 40%。在性能方面,SkVM 通过增强并行性实现最高 3.2× 加速,并通过代码固化实现 19–50× 的延迟降低。

1. 引言

大模型推理加速:DFlash、DSpark 与 Eagle3 草稿模型选型与架构设计指南

在大语言模型(LLM)的生产落地中,自回归生成的 O(N)O(N) 延迟始终是制约用户体验与系统吞吐的瓶颈。投机采样(Speculative Decoding)通过引入轻量级的“草稿模型(Draft Model)”先行生成候选 Token,再由大模型(Verification Model)进行并行校验,成为了当前最主流的加速方案。

本文将针对当前业界前沿的三种草稿模型方案——DFlash(纯并行)、DSpark(半自回归) 与 Eagle3(纯自回归) 进行深度架构剖析、技术指标对比及选型建议。

一、 核心架构与生成机制对比

三种方案的本质区别在于“生成速度(并行度)”与“草稿质量(接受率)”的权衡。以下图表直观展示了它们在计算模式上的根本差异:

graph TD
    %% 样式定义
    classDef flash fill:#d4edda,stroke:#28a745,stroke-width:2px;
    classDef spark fill:#fff3cd,stroke:#ffc107,stroke-width:2px;
    classDef eagle fill:#f8d7da,stroke:#dc3545,stroke-width:2px;

    subgraph DFlash ["DFlash: 纯并行 O(1)"]
        direction LR
        In1[输入 Token] -->|一次性前向传播| P1[Token 1] & P2[Token 2] & P3[Token 3] & P4[Token 4]
        note1[...]:::flash
    end

    subgraph DSpark [DSpark: 半自回归 - 带修正]
        direction LR
        In2[输入 Token] -->|马尔可夫并行生成| S1[候选池]
        S1 -->|置信度轻量筛选| S2[高概率 Token 块]
    end

    subgraph Eagle3 ["Eagle3: 纯自回归 O(N)"]
        direction TB
        In3[输入 Token] --> E1[草稿 Token 1]
        E1 -->|作为下一步输入| E2[草稿 Token 2]
        E2 -->|作为下一步输入| E3[草稿 Token 3]
    end

    class DFlash flash;
    class DSpark spark;
    class Eagle3 eagle;

1. DFlash (纯并行 / 无修正)

  • 机制:完全打破传统的自回归依赖。利用位置编码或修改 Attention Mask,在单次前向传播中强行“同时”预测未来多个位置的 Token。
  • 特点:拥有极致的 O(1)O(1) 时间复杂度,草稿生成阶段几乎不占用时间。但由于缺乏 Token 间的显式上下文依赖,预测长度越长,准确率(接受率)崩塌越严重。

2. DSpark (半自回归 / 马尔可夫 + 置信度调度)

  • 机制:介于并行与串行之间。利用轻量级的马尔可夫链(Markov Chain)或浅层 Head 快速并行产生多个候选 Token,并在其上叠加一套置信度(Confidence)评估系统。
  • 特点:在 O(1)O(1) 并行生成的基础上增加了“轻量修正”过滤。系统会根据当前生成的置信度动态截断低质草稿,实现 O(1)+修正O(1) + \text{修正} 的动态时间复杂度,在速度与质量之间取得了极佳的平衡。
DeepSpec 训练全流程详解(以 Qwen3 + DSpark 为例)

本文基于 DeepSpec 开源代码,以 Qwen3-4B + DSpark 为具体实例,从算法思想、模型架构、训练数据流、推理流程四个维度,逐行拆解代码,帮助你完整理解 DSpark 草稿模型的训练与推理工作原理。

DeepSpec 核心工作原理

DeepSpec 训练草稿模型的本质是:在目标模型的 backbone 架构上,构建一个更小的 draft 网络,使用目标模型预计算的 hidden states 作为监督信号进行训练。

因此,适配新模型的核心工作量是让 draft 模型能够"理解"目标模型的内部表示——这包括:

  • 复用目标模型的 tokenizer、embedding、归一化层、旋转位置编码等组件
  • 从目标模型的特定层抽取 hidden states 作为 draft 模型的输入
  • 保持注意力机制、MLP 结构与目标模型一致

一、DSpark 是什么:核心思想

DSpark 是一种面向推测解码(Speculative Decoding)的草稿模型训练方法。它的核心洞察可以总结为一句话:

"让草稿模型在训练时就学会——给定目标模型某几层的 hidden states,一次性猜出接下来的 N 个 token 是什么。"

传统训练语言模型是自回归的:输入 t0, t1, t2,预测 t3。

DSpark:基于置信度调度的半自回归生成推测解码

北京大学 DeepSeek-AI

摘要

推测解码(Speculative Decoding)通过将草稿生成与目标验证解耦来加速大语言模型(LLM)推理。尽管最近的并行 drafter 能够在单次前向传播中高效 Proposed 长令牌序列,但由于缺乏令牌间依赖关系,它们面临着接受率快速衰减的问题。此外,不加区分地验证这些扩展块会浪费关键的批次容量在具有高拒绝风险的令牌上,严重降低了高并发服务系统中的吞吐量。

我们提出了 DSpark,这是一个推测解码框架,统一了高吞吐量的并行生成与自适应的、负载感知的验证。为了保持草稿质量,DSpark 利用半自回归架构——将并行主干与轻量级顺序模块耦合——引入块内依赖建模并缓解后缀衰减。为了优化系统效率,DSpark 采用置信度调度验证,根据估计的前缀存活概率和引擎特定的吞吐量配置文件,动态地为每个请求定制验证长度。

在跨多个领域的离线基准测试中,DSpark 在已接受长度方面显著优于最先进的自回归和并行 drafter。当部署在 DeepSeek-V4 服务系统中并处理实时用户流量时,DSpark 成功缓解了验证浪费。与已确立的生产基线(MTP-1)相比,DSpark 在匹配的吞吐量水平上加速了每用户生成速度 60%–85%。

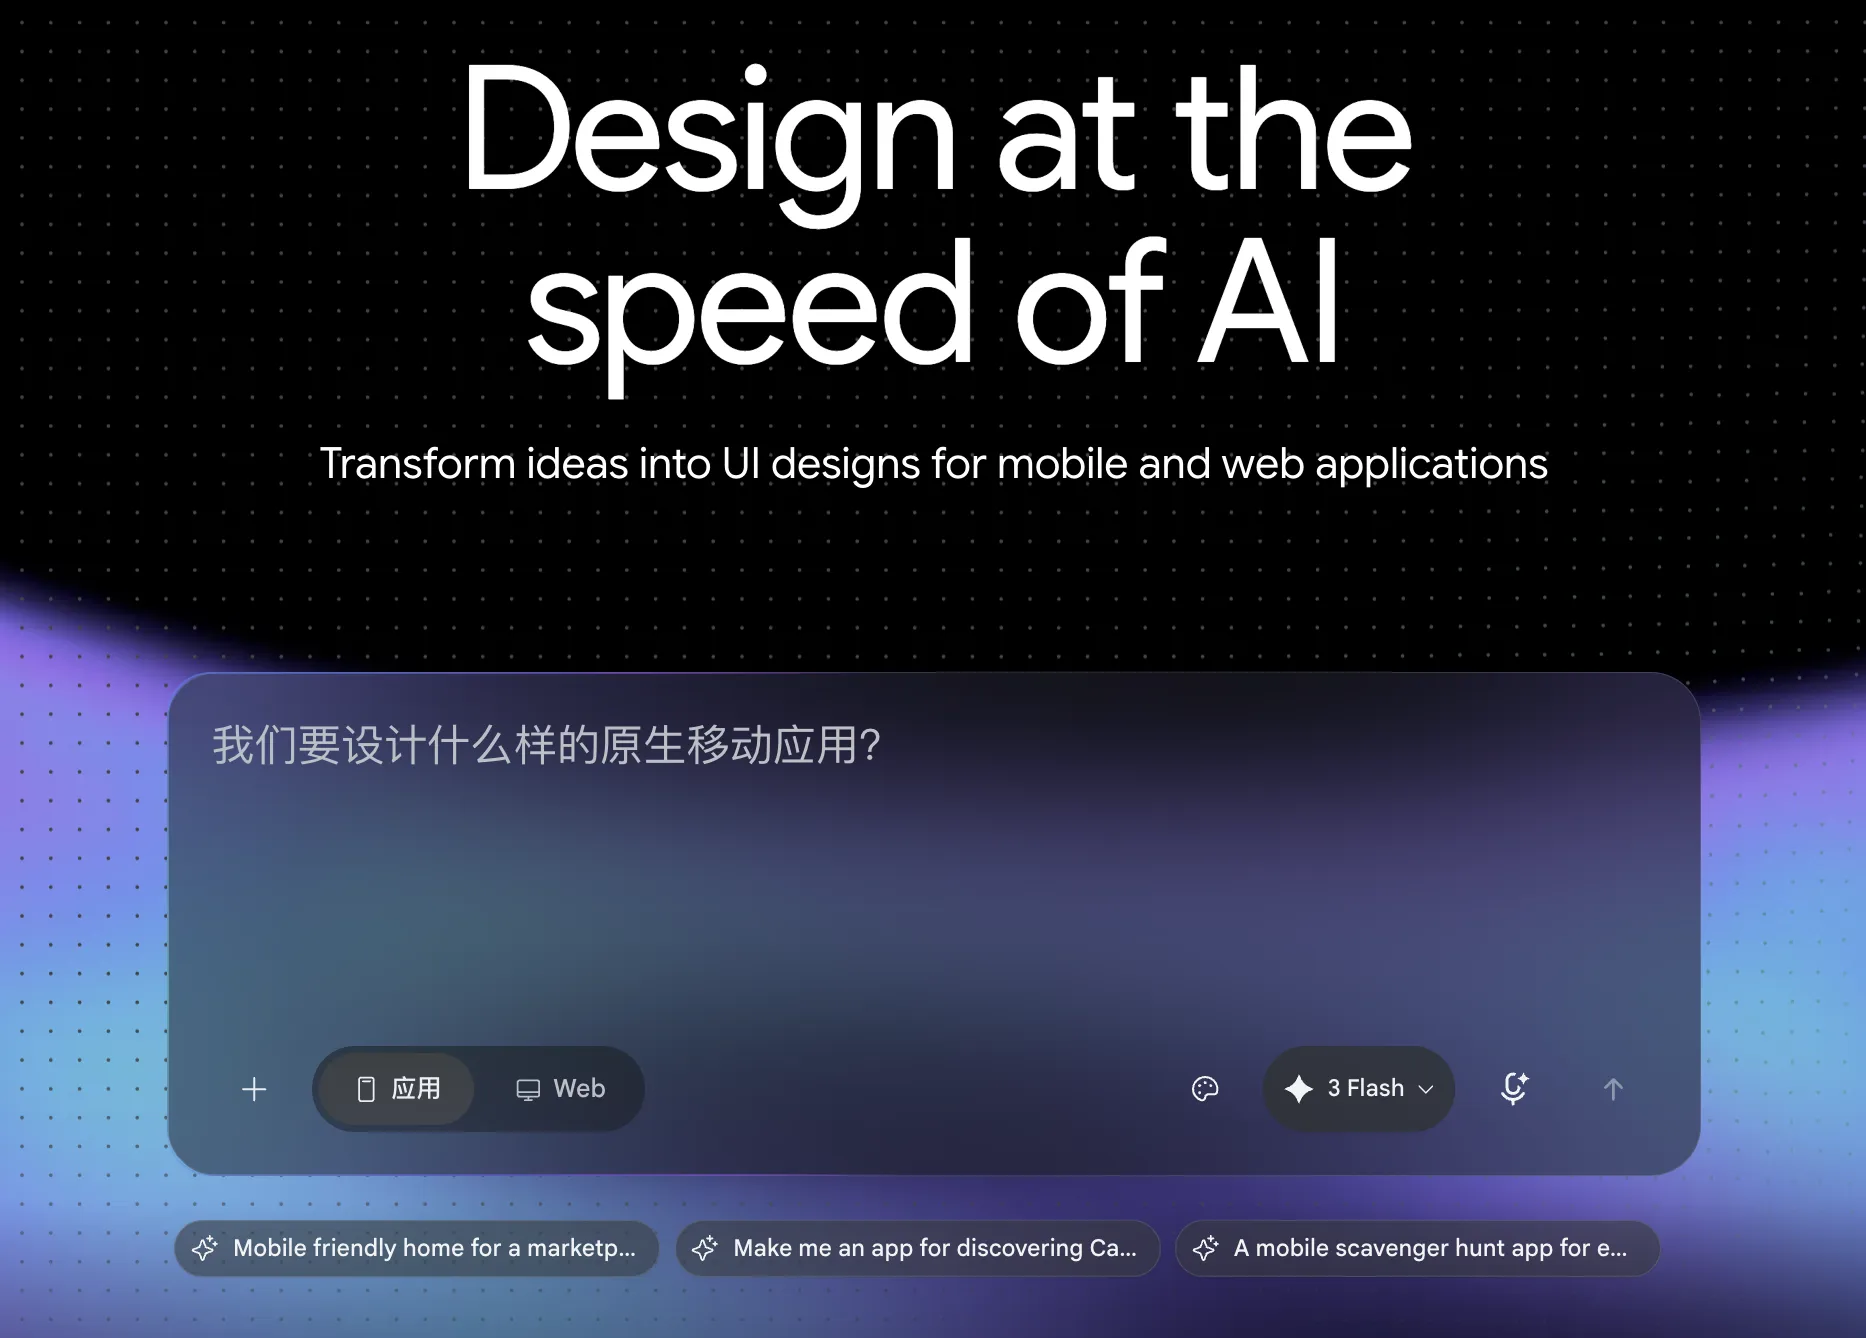
Google Stitch - AI 原生 UI 设计工具

官网定位一句话:将文字、草图、截图、语音指令,一键生成 Web / 移动端高保真界面、可交互原型与可直接投入开发的前端代码,打通「灵感→设计→开发」完整工作流。 访问入口:stitch.withgoogle.com

🚀 Stitch:从想法到落地

Stitch 提倡“设计先行,边做边改”。告别面对空白页的焦虑,无需追求一步到位,通过不断迭代轻松产出优秀设计。

1. 极简起步:三步提示词公式

写下你的初始想法,无需死磕细节,给一个大概的“配方”即可生成:

  • [想法] 是什么 + [主题] 风格氛围 + [内容] 核心板块。

2. 精准迭代:每次只改动一点

生成初稿后,构思才真正开始。

  • 小步快跑: 每次锁定一个问题,用具体指令(配合 UI/UX 词汇)让 AI 修改。
  • 全局调整: 善用“编辑主题”一键更换深浅模式、颜色和字体。

3. 验证与交付:从静态到上线

  • 动效测试: 一键生成交互式“原型”,测试按钮悬停、文本输入等真实体验。
  • 多端导出: 导出 HTML 和图片包。HTML 是万能资产,可借助大模型轻松转换为 React、Vue 或手机原生代码(Flutter/SwiftUI 等)。

💡 核心寄语: 别想太多,先生成,再优化。持续构思,直到满意!

欢迎来到 Stitch。今天您将学习如何从设计切入并专注于概念构思。关键在于不要过度思考。

Google DESIGN.md 规范与实践指南

DESIGN.md是什么?

每个项目都有自己的视觉标识:颜色、字体、间距、组件样式。传统上,这些内容存储在 Figma 文件、品牌 PDF 或设计师的脑海中。AI 智能体无法读取这些格式。

DESIGN.md 改变了这一点。 它是一个纯文本设计系统文档,人类和智能体都可以阅读、编辑和执行。可以将其视为 AGENTS.md 的设计对应物:

文件 阅读者 定义内容
README.md 人类 项目是什么
AGENTS.md 编码智能体 如何构建项目
DESIGN.md 设计智能体 项目应该长什么样、什么感觉

它能给你带来什么

当像 Stitch 这样的设计智能体读取你的 DESIGN.md 时,它生成的每个屏幕都遵循相同的视觉规则:你的调色板、你的排版、你的组件模式。没有它,每个屏幕都是孤立的;有了它,它们看起来属于同一个产品。

DESIGN.md 是一个活的产物,而不是静态配置文件。它随着你的设计演变而演变。智能体生成它,你完善它,并在迭代过程中重新应用到屏幕上。

在底层,每个 DESIGN.md 都有两层:YAML 前置元数据包含机器可读的设计令牌(精确的十六进制值、字体属性、间距尺度)和Markdown 正文提供人类可读的设计原理说明。令牌为智能体提供精确值。散文告诉它们为什么这些值存在。完整的格式请参阅规范。

设计理念

DESIGN.md 规范是一个基础,而非规定。

DESIGN.md - 面向智能体描述视觉识别系统的格式规范

一种用于向编码智能体描述视觉识别系统的格式规范。DESIGN.md 让智能体对设计系统拥有持久、结构化的理解。

格式

DESIGN.md 文件将机器可读的设计令牌(YAML 前置元数据)与人类可读的设计原理(Markdown 正文)相结合。令牌为智能体提供精确值,正文则解释这些值为何存在以及如何使用。

---
name: Heritage
colors:
  primary: "#1A1C1E"
  secondary: "#6C7278"
  tertiary: "#B8422E"
  neutral: "#F7F5F2"
typography:
  h1:
    fontFamily: Public Sans
    fontSize: 3rem
  body-md:
    fontFamily: Public Sans
    fontSize: 1rem
  label-caps:
// ...

读取此文件的智能体将生成一个 UI:Public Sans 字体的深墨标题、温暖石灰石背景,以及波士顿陶土色的行动号召按钮。

快速开始

对照规范验证 DESIGN.md,捕获损坏的令牌引用、检查 WCAG 对比度比率,并输出结构化发现——所有结果均以智能体可处理的 JSON 格式呈现。

基于 DSpark 的投机解码训练框架原理与实现(论文+代码对照)

结合 DSpark 论文与代码实现,全面剖析 DeepSpec 的工作原理与核心组件。

项目地址:https://github.com/deepseek-ai/DeepSpec DSpark 论文:https://github.com/deepseek-ai/DeepSpec/blob/main/DSpark_paper.pdf

DSpark 是 DeepSeek 提出的一套无损加速大模型推理的“看人下菜碟”机制。 传统加速手段(推测解码)通常是让小模型一次性盲目盲猜一大串后续 Token,再让大模型统一验证。但这存在两个痛点:小模型猜得越往后越不准(多模态冲突导致“后缀衰减”);高并发时,大模型花大力气去验证那些猜得不准的 Token,会严重压垮系统吞吐。

DSpark 的核心突破就在于两点:

  1. 猜得更准(半自回归): 它在原有的单次并行生成网络后,拼了一个极轻量的小尾巴(顺序头),在几乎不增加延迟的情况下,让后面的 Token 能根据前面猜出的 Token 进行自适应修正,大幅提升长序列的猜测准确度。
  2. 动态裁剪(置信度调度): 它能实时感知系统的硬件负载与并发压力。如果并发高、大模型很忙,或者发现后面小模型猜的置信度太低,它就会果断把不靠谱的后缀砍掉,只送靠谱的前缀给大模型验证。

通过这种“高质量猜测”与“负载感知动态裁剪”的结合,DSpark 在保障大模型输出质量完全无损的前提下,成功

本周 AI 新闻 20260626

本周主线:Google 一周内失去四位顶尖 AI 科学家,OpenAI 以 GPT-5.5-Cyber 正面回应 Anthropic 的网络安全布局,SpaceX 凭 63 亿美元算力协议巩固全球最大商业 AI 基础设施商地位,中美 AI 出口管制进入双向对抗阶段。

本周看点

  1. Google 遭遇史上最严重 AI 人才流失潮:诺贝尔化学奖得主 John Jumper 与 Gemini 核心人物 Noam Shazeer 等四位科学家在一周内相继离开,分别加入 Anthropic 与 OpenAI,Alphabet 市值蒸发超 2700 亿美元,Gemini 3.5 Pro 发布计划受挫。
  2. OpenAI 发布 GPT-5.5-Cyber 与 Patch the Planet:直接回应 Anthropic 的 Project Glasswing,将 AI 漏洞扫描嵌入 Codex,并承诺在 30 天内修复 cURL、Python、Linux 内核等 30 多个开源项目的安全漏洞。
  3. SpaceX 与 Reflection AI 签下 63 亿美元算力大单:每月 1.5 亿美元、为期三年的 GB300 算力租赁协议,使 SpaceX 的 AI 算力合同承诺收入超过 800 亿美元,成为全球最大商业 AI 基础设施提供商。
  4. Anthropic 把 Claude 智能体嵌入 Slack:Claude Tag 正式上线,企业用户可在任意频道 @Claude 调用智能体,Anthropic 内部称其已贡献产品团队 65% 的代码产出。
  5. 中国反制美国 AI 出口管制:6 月 24 日,中国将 56 家美国企业列入制裁清单,禁止部分企业参与政府采购并实施出口管制,标志 AI 技术出口战从单向限制转向双向对抗。

JiuwenSwarm 架构设计、工作原理与核心模块深度剖析

JiuwenSwarm 是什么?

JiuwenSwarm 是一个华为云开源的分布式 AI 多智能体协同与能力自进化系统。简单说,它是一个让 AI 智能体像团队一样协作、并且越用越聪明的系统。

核心特色

1. 三种执行模式,适配不同场景

模式 怎么工作 适合
Plan 模式 单 Agent 深度推理,自带任务规划 Rail,边思考边执行 复杂任务、多步骤分析
Performance 模式 卸掉规划护栏,直问直答,延迟最低 快速问答、简单查询
Swarm 模式 Leader 拆解任务,组建多 Agent 团队并行协作,可跨机器 大型复杂工作、多角色分工
flowchart LR
    M["用户输入"] --> P{模式选择}
    P -->|agent.plan| A1["单 agent 深度规划<br/>+ task planning rail"]
    P -->|agent.fast| A2["单 agent 快速响应<br/>- heavy rail"]
    P -->|team| A3["leader 拆解任务<br/>+ teammate 分布式执行"]
    A1 --> R["输出结果"]
    A2 --> R
    A3 --> R

2. 可部署可扩展

Gateway + AgentServer 双进程架构,支持:

  • 多用户隔离:SessionMap 按 (channel_id, user_id, mode, project_dir) 四元组独立缓存 Agent 实例
  • 多端接入:Web / TUI / 桌面端 / 飞书 / 钉钉 / 企微 / Telegram / Discord
  • 分布式:Swarm 模式下可用 pyzmq + PostgreSQL 跨机协作,Leader 在主节点,Teammate 跑在工作机

3. 技能自进化——越用越聪明

这是最创新的部分。系统不训练模型权重,而是通过一个确定性状态机流水线自动迭代 Skill 定义: