WorkBuddy 专家 / 专家团 开发规范

Agent MD 规范

/Applications/WorkBuddy.app/Contents/Resources/app.asar.unpacked/resources/plugins/workbuddy-builtin/skills/expert-manager/references/agent-md-spec.md

Frontmatter

⚠️ 重要:frontmatter 中不可添加 tools 字段

所有工具权限由系统统一分配,开发者无需也不能在 frontmatter 中声明 tools 字段。

必填字段

---
name: {与文件名一致,必须有业务语义}
description: {英文描述,AI 用来判断何时激活}
displayName:
  en: "{English display name}"
  zh: "{中文显示名称}"
profession:
  en: "{English profession title}"
  zh: "{中文职业头衔}"
maxTurns: {默认50}
---

可选字段

skills: [{skill-name}]   # 启动时预加载的 Skill

正文结构:普通 Agent / 团员
WorkBuddy 专家 / 专家团机制分析与最小实现骨架

专家的本质

专家不是模型,是一个本地目录形态的插件包——三层结构:

层 载体 作用
元数据层 .codebuddy-plugin/plugin.json 这是谁、属于哪类、怎么展示
人格层 agents/*.md 你是谁、怎么思考、怎么输出
能力层 skills/ bin/(可选) 专业技能与可执行脚本

能力高低 ≈ Agent MD 质量,专业性全是提示词工程 + 流程约束的产物。

专家 vs 专家团

只差一个 expertType 字段:agent(单角色)/ team(主理人 + N 成员)。专家团多了 teamInfo{leadAgent, memberAgents[]}、members[](主理人也在里面,role=lead)、settings.json。

几个关键设计

  1. 身份覆盖机制:专家模式用独立模板 user-context-expert-identity.tpl,只注入 USER.md,主动放弃 SOUL/IDENTITY 默认人格,把人格完全交给专家 MD。所以专家 MD 里是首尾双重身份锚定(开头 IDENTITY DIRECTIVE + 结尾 Final Reminder)。
  2. 发现靠显式注册,不是自动扫描——必须写进 marketplace 根目录的 marketplace.json。
  3. 团队不是"模拟多角色",是真实子智能体调度:TeamCreate → spawn → SendMessage 回传 → 主理人汇编。5 条红线(禁代写、禁直连、禁跳阶段等)本质是对抗大模型一气呵成的抄近道本能——这点不做约束,多角色必然退化为单人分饰多角。
  4. 唯一标识四绑定:name / agentName / 目录名 / MD 文件名,改任一即断裂。

AI 原生软件开发生命周期(SDLC)实战手册

原文:The AI-Native SDLC playbook(Anthropic Applied AI 团队) 译者注:本文为完整中文翻译,英文术语首次出现时保留原文。

代码不再是瓶颈

组织已经开始以一年前难以想象的速度用 AI 编写代码,但围绕代码的流程并没有以同样的速度改变。

许多工程团队仍然沿用同样的审批关卡、评审、交接和策略,这使得使用 Claude Code 等智能体编程解决方案带来的生产力提升被拖延抵消。

软件开发生命周期(SDLC)是将软件从想法带到生产环境的过程。大多数组织运行的都是同样六个阶段的某种版本,涵盖规划、设计、构建、测试、部署和维护软件。传统上,每个阶段都是一个由不同角色负责的独立阶段:产品经理写需求,技术架构师把需求变成设计,工程师按设计实现,受监管企业的 QA 团队进行验证,发布团队负责上线,运维团队监控运行状况。工作在阶段之间通过文档、工单和签字确认来流转。

传统的软件开发生命周期(SDLC)流程繁重,是为了确保每一步的责任与控制。然而,传统 SDLC 的设计初衷是在「编写和实现代码」这一最耗时、最昂贵阶段的年代最大化效率——而这个前提已经不复存在。PRD、估点仪式和产品安全评审,本质上都是为了在长达数周、数月甚至数个季度的开发过程中强制对齐。

传统 SDLC 的另一点是:它的各种控制措施假设每一步都由人来执行。

理解规约驱动开发(SDD):Kiro、spec-kit 与 Tessl

原文:Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl 作者:Birgitta Böckeler(Thoughtworks 杰出工程师、AI 辅助交付专家,拥有 20 多年软件开发、架构与技术领导经验) 本文是"Exploring Gen AI"系列的一部分。该系列记录了 Thoughtworks 技术专家对使用生成式 AI 技术进行软件开发的探索。

我一直在尝试理解 AI 编程领域最新的流行语之一:规约驱动开发(Spec-driven development,SDD)。我研究了三个自称 SDD 工具的产品,并试图厘清截至目前它到底意味着什么。

定义

与这个快节奏领域中许多新兴术语一样,"规约驱动开发"(SDD)的定义仍在变化之中。以下是我从目前见到的用法中归纳出的理解:规约驱动开发意味着在用 AI 编写代码之前先编写一份"规约"("文档先行")。这份规约成为人与 AI 共同的真理来源(source of truth)。

GitHub:"在这个新世界中,维护软件意味着演进规约。[……]开发的通用语言上移到了更高层次,而代码只是最后一公里的实现手段。"

Tessl:"一种开发方法,其中规约——而非代码——是

AI 编程开发范式深度研究(2026)

00 摘要:10 条核心论断

这份报告不是工具评测,也不是范式百科。它的目标是回答一个工程决策问题:如果你要在 2026 年把 AI 编程从「个人提效」推到「团队与生产系统」,你该采用哪套范式、按什么顺序、用什么门禁? 下面 10 条论断是全篇骨架,只读这一页也能拿走结论。

  1. 位移点不在「写代码」,而在「定义意图 + 验证结果」。 代码正在从「资产」降格为「构建产物」。当重写一段代码的成本趋近于零,真正稀缺的是「为什么这么做」的可追溯记录与「这样做对不对」的判定能力。
  2. 瓶颈已从生成迁移到验证。 生成的边际成本在两年内下降了一个数量级,验证的边际成本几乎没动。所有有效范式(SDD 的可执行验收标准、multi-agent 的 verifier 角色、TDD-as-gate)本质上都在做同一件事:压缩单位验证成本,而不是让评审更严格。
  3. 规范的复兴不是复古,而是因为规范第一次变得可执行。 1980 年代的需求文档会腐烂,因为它不驱动任何东西。2026 年的 spec.md 直接驱动生成器、被 Git 版本化、被 CI 校验——可执行,才第一次值得写。
  4. AI 是放大器,不是均衡器。 DORA 2025(n≈5,000)的核心结论:AI 放大高绩效组织的优势,也放大挣扎组织的失能。平台质量、数据生态、价值流管理决定收益的正负号,工具选择只决定幅度。
  5. 个体提速的证据显著弱于感知,且高度依赖任务与代码库。 METR 的 RCT(16 名资深开发者 / 246 个真实任务)显示用时增加 19%,而参与者事后仍自认为快了 20%。用「感觉更快」做投资决策是危险的。
  6. AI 改变的是缺陷的「结构」,而不只是数量。 Apiiro 在 Fortune 50 仓库的观测:语法错误下降 76%、逻辑 bug 下降 60%,但权限提升路径上升 322%、架构设计缺陷上升 153%。旧门禁(SAST + 人工 diff)恰好对新增的这一类是盲的。
  7. 多 Agent 是一个分布式系统问题,不是「多开几个窗口」。 隔离(git worktree / devbox)、编排(blueprint / workflow)、合并策略、可观测性四件套缺一不可;经验并行度上限在 3–5,超过后协调成本吃掉全部收益。
  8. 上下文工程是 agentic 时代的内存管理,Harness 是新的性能杠杆。 Anthropic 归纳为「写 / 选 / 压 / 隔」四类策略;产业侧报告显示,同一模型换一套 harness,标准基准可差 3 个百分点以上。
  9. 角色迁移是 Coder → Conductor → Orchestrator,但「可完全委托」仅 0–20%。 Anthropic 2026 趋势报告:约 60% 的工作流已含 AI,可完全委托的任务却不到两成。这是协作悖论,是稳态,不是过渡态。
  10. 安全与治理必须内建在生成路径,而不是事后扫描。 AI 生成代码的漏洞率在不同口径下为 25.7%(522 样本 / 5 个 SAST)到 45%(100+ 模型 / 80 任务);更棘手的是斯坦福实验发现的系统性过度自信——用 AI 的人写了更不安全的代码,却更相信它是安全的。

什么是规范驱动开发?(Spec-Driven Development, SDD)

以下是 IBM 文章 《什么是规范驱动开发?》(What is Spec-Driven Development?) 的中文翻译:

作者: Anna Gutowska(IBM AI 工程师、开发者倡导者)

发布日期: 2026年5月19日

规范驱动开发的定义

规范驱动开发(Spec-Driven Development, SDD) 是一种软件开发方法论。在正式编码之前,团队需先编写并达成一份关于实现细节的详细规范(Specification)。换句话说,这份规范将作为“构建什么”以及“如何构建”的唯一真实来源(Single source of truth)。

随着 Microsoft GitHub Copilot、Anthropic Claude Code 或 IBM Bob 等 AI 工具与编程助手的普及,生成代码的门槛已大幅降低。基于先进 AI 模型的 LLM 驱动型 AI Agent,只需用户输入一条自然语言提示词(Prompt),即可随时实时运行一系列迭代任务。

对于软件开发而言,这意味着我们可以优化并自动化构建原型、新功能、单元测试等的开发工作流。生成代码从未如此简单。然而,“氛围程序员”(Vibe Coders)需要警惕一个潜在风险:AI 的表现上限完全取决于它所接收到的指令质量。

技术债务的抬头:一个典型场景

你可能在现实世界中见过技术债务,甚至自己都没意识到。

给 AI 写的开发手册:如何在 GitHub 项目中优雅地配置 AGENTS.md

随着 Cursor、Claude Code、Windsurf 以及 OpenClaw 等 AI Coding Agent 深度嵌入日常开发工作流,软件开发正在经历从 “人类编写代码” 到 “人类定义规则,Agent 协作编码” 的转变(Agentic Engineering)。

我们在项目中往往会编写 README.md 面向人类开发者,但很多团队忽视了为 AI Agent 提供一套上下文感知与行为治理规范(Harness Guidelines)。这就是 AGENTS.md(或 AGENT.md / CLAW.md)存在的意义——它是写给 AI Agent 看的“项目运维与开发指南”。

本文以实际项目架构为例,聊聊为什么需要 AGENTS.md 以及如何为你的开源或商业项目定制一份高效的 Agent 治理规范。

一、 为什么传统的 README.md 不够用?

人类开发者阅读 README.md 时,拥有强大的泛化能力和隐式背景知识;但 AI Agent 在读取代码库时,是以 Token 上下文的形式载入信息的。

传统的 README 往往面临以下痛点:

  • 信息密度不匹配:包含大量面向用户的推广语言、演示 GIF 或过于冗长的安装介绍,浪费 Agent 有限的 Context Window。
  • 缺少隐式约束:Agent 无法从普通 README 中感知“不要在组件里直接写 Raw SQL”、“修改 Schema 后必须生成 Migration”等团队内部约定的代码禁区。
  • 缺乏验证门禁:Agent 在修改完代码后,往往不知道调用什么 CLI 命令来进行类型检查(Typecheck)和单元测试,导致提交带有隐式 Bug 的代码。

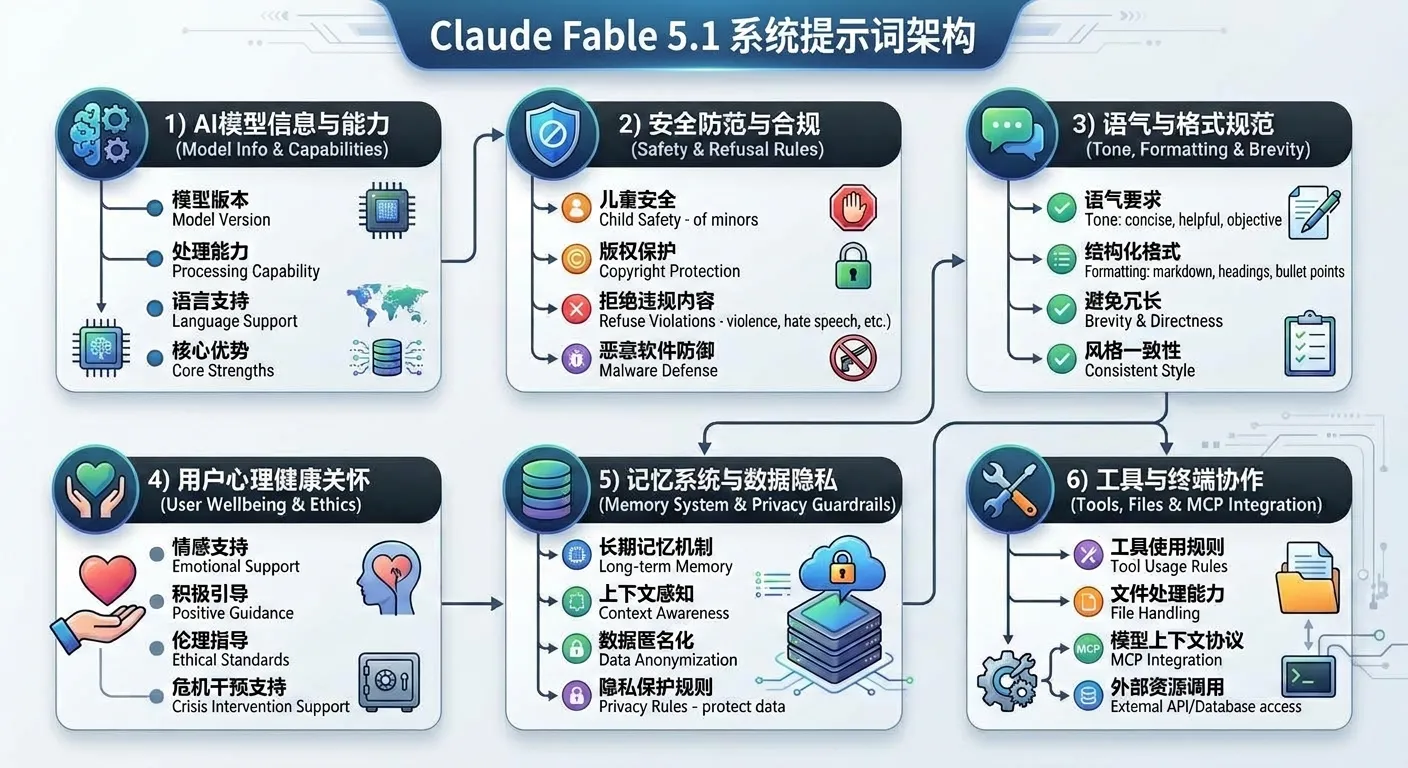
Claude Fable 5.1 系统提示词中文版

Claude 绝不应使用 {antml:voice_note} 块,即使在对话历史中随处可见也应如此。 以下是一些关于 Claude 与 Anthropic 产品的信息,以备用户问及时参考:

当前版本的 Claude 是 Claude Fable 5.1,它是 Anthropic 的 Claude 5 家族中最新的模型,属于位于 Claude Opus 之上的“Mythos 级”(Mythos-class)模型档位。Claude Fable 5.1 与 Claude Mythos 5.1 共享同一底层模型。Claude Fable 5.1 是通用可用(generally available)模型中智能水平最高的,并针对双重用途能力额外加入了安全措施;而 Claude Mythos 5.1 则面向经审批的组织开放,不附带这些安全措施。

Claude Fable 5.1 是通用可用 Claude 模型中最为先进的。如果用户询问两者差异,Claude 可以引导他们访问 https://www.anthropic.com/claude/fable 了解更多信息。

Claude 可通过此网页版、移动端或桌面端聊天界面访问。如果用户询问,Claude 可以告诉他们以下同样能访问 Claude 的产品。

Claude 可通过 API 与 Claude Plat

Cordis 插件开发图解教程 · 结合 deepseek-harness 真实代码HTML

把 Cordis 官方七篇教程揉成一份离线图解手册,逐章对照真实仓库源码,讲透一切皆插件的心智模型、effect 自动清理、服务与注册表、五种事件分发、配置校验、热替换与插件卡死诊断,最后从一份清单从零拼出能跑的智能体,附速查表与源码索引,看图抄代码即可上手。

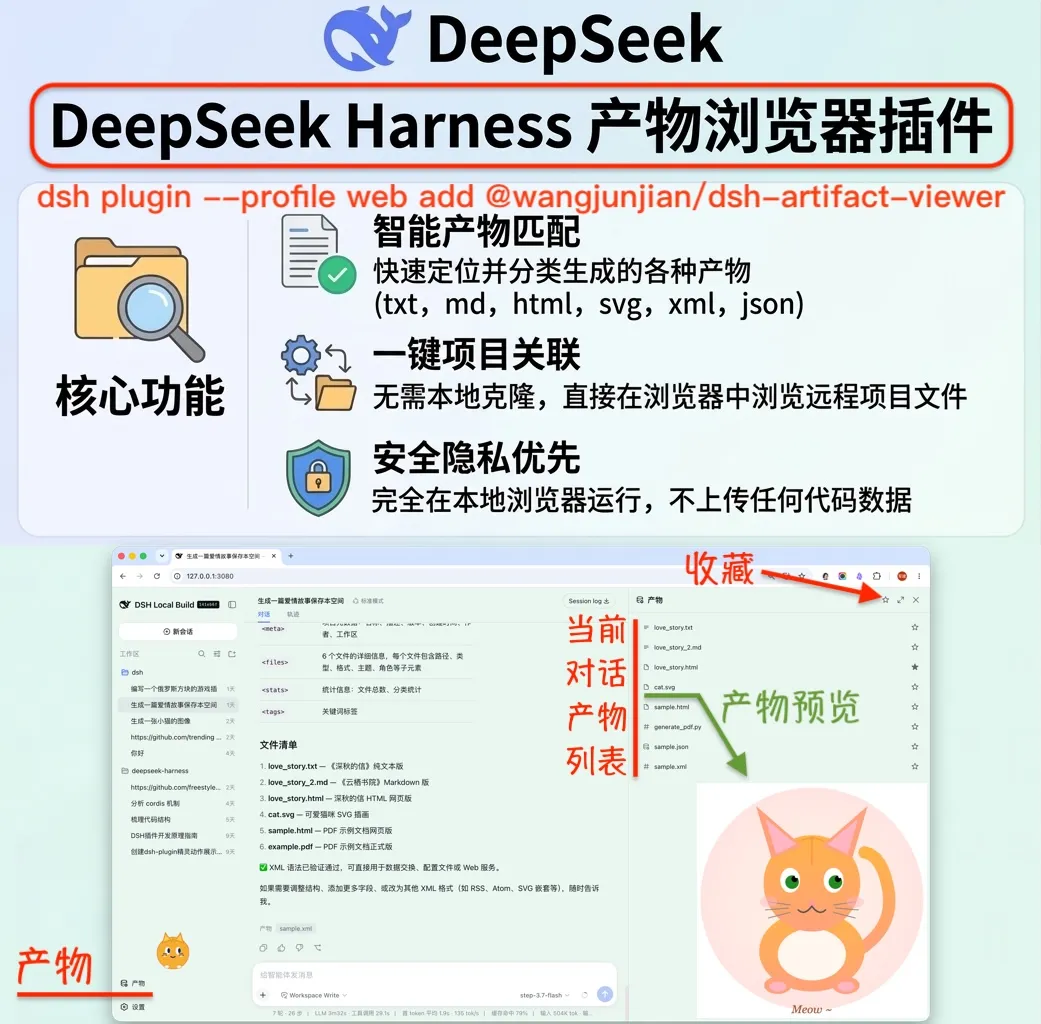
DeepSeek Harness 产物浏览器插件开发最佳实践

本文档以 @wangjunjian/dsh-artifact-viewer 为实例,系统梳理 DeepSeek Harness(DSH)bundle 插件的开发方法:工作原理、架构设计、构建打包、测试、发布自动化,以及开发和发布过程中实际踩过的坑。

1. 工作原理

Bundle 插件是什么

DSH 的 bundle 插件是一个普通 npm 包,通过 package.json 里的 dsh 字段声明自己:

{
  "dsh": {
    "bundle": { "patch": "./cordis.patch.yml" },
    "client": {
      "platform": "web",
      "inject": ["@deepseek-ai/dsh-client-runtime"],
      "external": ["@deepseek-ai/dsh-client-ui-primitives"]
    }
  }
}
  • dsh.bundle.patch:指向一个 cordis patch 文件,负责把插件注册进 loader 树。
  • dsh.client:声明浏览器半部分的运行平台、注入依赖和 external 包。

DeepSeek Harness 插件(dsh-github-trending)开发最佳实践

一份面向本仓库(DeepSeek Harness 外部 Bundle 插件)的全面开发规范。 内容均基于本仓库真实代码(src/、tsdown.config.ts、package.json、tests/ 等)提炼, 而非泛泛而谈的通用建议。改动代码前先读本文,能少踩 80% 的坑。

0. 项目定位速览

本仓库是一个 DeepSeek Harness(以下简称 DSH)外部 Bundle 插件,对外暴露一个面向模型(model-facing)的工具 github_trending,抓取 https://github.com/trending 的公开页面,返回结构化热门仓库列表。

智能体(Agent)架构分层详解(实现逻辑)

基于 deepseek-ai/deepseek-harness(TypeScript / Cordis 插件总线)与 openai/codex(Rust / codex-rs crate 体系)两个成熟开源项目的真实源码整理。 本文把每层的关键数据结构、控制流、不变量讲清楚,并为每个核心模块附上实现逻辑——这些是写 Agent 时真正会踩坑的地方。 所有 代码路径 均为实际文件,可下钻核对。伪代码为便于阅读对真实实现做了抽象,但结构与关键分支与源码一致。

0. 先定位:Agent 是什么

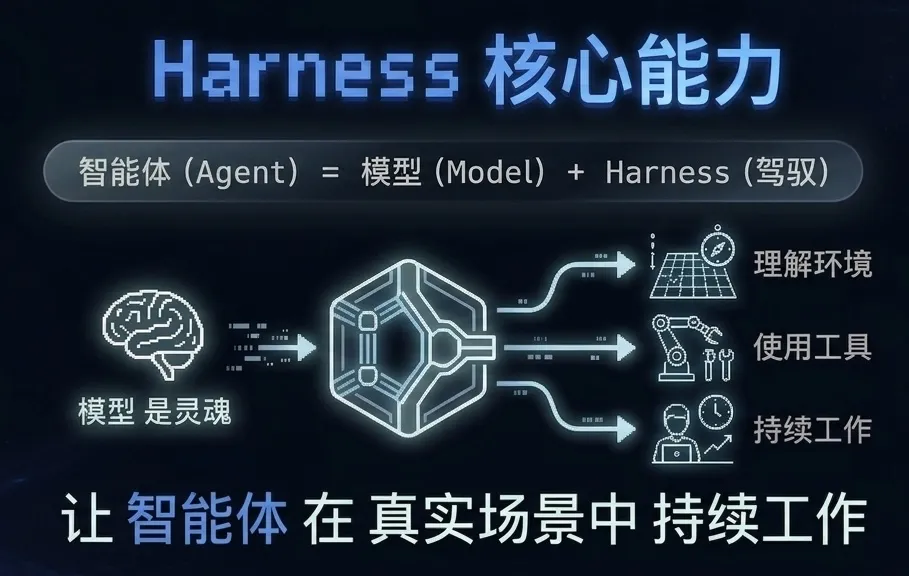
Agent = 以 LLM 为决策核心、以 Tool 为手、以 Sandbox 为边界、以 Append-Only 会话日志为记忆的闭环。

两条跨实现的底层信条:

  1. 会话日志是模型上下文的唯一真相(model-visible ⟺ logged)。 任何进模型请求的内容都必须能从日志重建。
  2. 能力是可替换的 seam。 模型、工具、文件系统、沙箱都通过接口/adapter 解耦。

分层总览

智能体(Agent)架构分层详解

基于 deepseek-ai/deepseek-harness(TypeScript / Cordis 插件总线)与 openai/codex(Rust / codex-rs crate 体系)两个成熟开源项目的源码与架构文档整理。 目标:用「分层 + 核心模块详解」的方式,把一个 Agent 讲清楚。

0. 先定位:什么是 Agent

一个 Agent 本质上是一个以 LLM 为决策核心、以工具为手、以沙箱为边界、以会话日志为记忆的闭环系统:

  • 它接收用户意图(自然语言 / 注入上下文);
  • 把意图和环境信息组装成模型上下文,向 LLM 发请求;
  • 解析 LLM 返回的「思考」与「工具调用」;
  • 在受控环境里执行工具(读文件、跑命令、改代码);
  • 把结果写回会话日志,再驱动下一轮,直到任务完成。

无论 TS 还是 Rust 实现,所有 Agent 的模块都收敛到同一组子系统。下面按自底向上的依赖顺序分成 7 层。

分层总览

DeepSeek Harness — 内置插件完整能力分类整理

分析对象:packages/ 下全部 @deepseek-ai/dsh-* 插件。 统计口径:直接扫描每个包的 package.json(name / description 字段)+ 分组级 README.md,逐包核对,无遗漏。 结论:共 50 个能力分组、226 个插件包。 核心理念:everything is a plugin。整个 harness 建立在 vendored Cordis 之上,每个能力都以插件形式通过 ctx.effect() / ctx.on() / ctx.waterfall() 贡献。 架构范式:能力分离(capability seam)——同一能力族通常拆成「服务定义(Service Definition)/ 具体提供方(Provider)/ 消费方/工具(Consumer)」三层,互不耦合、可独立替换。

0. 总览:50 个分组 / 226 个包

DeepSeek Harness — 内置模型工具(Tool)分类整理

分析对象:packages/**/src 下所有经 defineTool(...) / ctx.tools.register(defineTool(...)) 注册、或运行时注入的模型侧工具。 排除:测试 fixture、浏览器端 UI 占位工具、zod schema 字段名(误报)。 所有工具均由独立「消费方」插件注册,底层能力提供方(Provider)可在不改工具契约的前提下替换。

一、总览(按能力族分组的工具数)

OpenAI Codex CLI — 架构设计与核心模块原理

1. 项目概述

  • 项目:openai/codex —— OpenAI 的本地编码 Agent(Codex CLI)
  • 核心定位:在用户本机运行的编码智能体,支撑三种宿主形态:终端 TUI、IDE 插件(经 app-server)、非交互 exec 模式
  • 代码规模:Rust workspace 含约 90–115 个 crate(codex-rs/Cargo.toml),crate 统一以 codex- 前缀命名;另有 codex-cli(Node 包装层)与 sdk/
  • 主要语言:Rust(核心)+ TypeScript(CLI 分发包装)
  • 构建系统:同时使用 Bazel(根目录 MODULE.bazel)与 Cargo workspace

设计哲学(见 codex-rs/docs/protocol_v1.md)是:Core 引擎与 UI 解耦 —— "Codex runs locally, either in a background thread or separate process",并通过一对队列 SQ(Submission Queue,UI→Core) 与 EQ(Event Queue,Core→UI) 通信。任何 UI(TUI、桌面 App、IDE 插件、MCP 客户端)都可驱动同一个 Core。

关键抽象