支持 MCP 集成的应用程序列表
本页概述了支持模型上下文协议(Model Context Protocol, MCP)的应用程序。每个客户端可能支持不同的MCP功能,从而实现与MCP服务器的不同级别的集成。
功能支持矩阵
本页概述了支持模型上下文协议(Model Context Protocol, MCP)的应用程序。每个客户端可能支持不同的MCP功能,从而实现与MCP服务器的不同级别的集成。
功能支持矩阵
本页展示了各种模型上下文协议(MCP)服务器,这些服务器展示了该协议的功能和多样性。这些服务器使大型语言模型(LLM)能够安全地访问工具和数据源。
参考实现
这些官方参考服务器展示了核心 MCP 功能和 SDK 用法:
数据和文件系统
开发工具
Web 和浏览器自动化
生产力和通信
AI 和专业工具 EverArt - 使用各种模型的 AI 图像生成 Sequential Thinking -
大型语言模型(LLM)的工作原理根植于模式匹配和对下一个词元的统计预测("随机鹦鹉")。从这种方法中产生的一个有些出人意料的能力是它们也能在一定程度上"推理"解决问题。有些模型的推理能力比其他模型更强,OpenAI的"o1"和"o3"模型是两个突出的推理模型,而DeepSeek的"R1"最近引起了很大轰动。但是当我们在编码任务中使用AI时,这种能力发挥什么作用呢?
剧透提醒:我还没有答案!但我有问题和想法。
我将从两个方面开始讨论,这两个方面在我的理解中是推理能力的限制,而且这些限制在编码环境中是相关的。然后我将分享我的想法,即推理在哪些编码任务中可能有用,在哪些任务中可能没用。
上下文至关重要,尤其是对推理而言
苹果公司去年发表的一篇关于大型语言模型推理局限性的论文引起了广泛关注。作者引入了一个新的基准测试,用来测试LLM在"数学推理"方面的能力。他们的基准测试基于一个已有的包含小学数学问题的测试集。他们选取了100个问题,将其转化为带有变量占位符的模板,然后为每个模板创建了50个变体,形成了一个包含5,000个问题的数据集。在第二步中,他们还创建了一个新的数据集,在问题中添加了无关信息。
他们发现:
生成式人工智能和特别是大型语言模型(LLM)已迅速进入公众意识。像许多软件开发人员一样,我对其可能性感到好奇,但不确定它最终对我们的职业意味着什么。我现在在Thoughtworks担任一个角色,协调我们关于这项技术将如何影响软件交付实践的工作。我将在这里发布各种备忘录,描述我和同事们正在学习和思考的内容。
随着智能代理编码助手变得越来越强大,反应各不相同。有些人从最近的进步推断并声称,"一年后,我们将不再需要开发人员。"其他人则对AI生成代码的质量以及为初级开发人员准备应对这一变化的挑战表示担忧。
在过去几个月中,我定期使用Cursor、Windsurf和Cline中的智能代理模式,几乎完全用于更改现有代码库(而不是从头创建井字游戏)。总体而言,我对IDE集成的最新进展以及这些集成如何极大地提升工具辅助我的方式印象深刻。它们
所有这些都带来了与AI令人印象深刻的协作会话,有时帮助我在创纪录的时间内构建功能和解决问题。
然而。
即使在那些成功的会话中,我也一直在干预、纠正和引导。而且我经常决定不提交更改。
什么是生成式AI?
生成式AI是指能够根据提示或指令创建新内容的AI系统。这些系统被训练于大量数据,学习识别模式并生成类似于训练数据的新输出。现代生成式AI多为基于神经网络架构的深度学习系统。
目前主导生成式AI讨论的是大型语言模型(LLMs)。这些是经过大量文本训练的模型,可以生成连贯的文本,预测给定上下文中最可能的下一个词。尽管基础架构可能很复杂,但我们可以将其视为一个复杂的自动补全系统。
LLMs展现出的能力远超过以前的生成系统,它们能够:
关键应用领域
生成式AI已经在许多领域展示出其应用潜力:
代码生成和编程辅助
开发人员正在使用生成式AI工具(如GitHub Copilot、Amazon CodeWhisperer和Google Duet AI)来加速编码过程。这些工具可以:
内容创建和营销
生成式AI可以产生各种形式的内容:
客户服务和支持
生成式AI正在改变企业与客户的互动方式: 聊天机器人和虚拟助手 智能响应建议 自动票务分类和路由 知识库生成和
服务器通过MCP提供了为语言模型添加上下文的基本构建块。这些原语支持客户端、服务器和语言模型之间的丰富交互:
每个原语可以在以下控制层次结构中概括:
| 原语 | 控制方 | 描述 | 示例 |
|---|---|---|---|
| 提示 | 用户控制 | 由用户选择调用的交互式模板 | 斜杠命令、菜单选项 |
| 资源 | 应用程序控制 | 由客户端附加和管理的上下文数据 | 文件内容、Git历史 |
| 工具 | 模型控制 | 向LLM公开以执行操作的函数 | API POST请求、文件写入 |
提示词
模型上下文协议(MCP)提供了一种标准化方式,使服务器能够向客户端公开提示词模板。提示词允许服务器提供结构化消息和与语言模型交互的指令。客户端可以发现可用的提示词,获取其内容,并提供参数来自定义它们。
用户交互模型
提示词设计为用户控制的,这意味着它们从服务器暴露给客户端,目的是让用户能够明确选择使用它们。
通常,提示词会通过用户界面中的用户发起命令触发,这允许用户自然地发现和调用可用的提示词。
例如,作为斜杠命令:
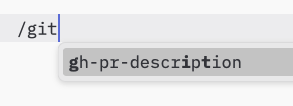
然而,实现者可以自由地通过任何适合其需求的界面模式来公开提示词——协议本身不强制要求任何特定的用户交互模型。
能力
支持提示词的服务器必须在初始化期间声明prompts能力:
模型上下文协议(Model Context Protocol)由几个协同工作的关键组件组成:
所有实现必须支持基础协议和生命周期管理组件。其他组件可以根据应用程序的特定需求来实现。
这些协议层在实现客户端和服务器之间丰富交互的同时,建立了明确的关注点分离。模块化设计允许实现精确支持所需的功能。
消息
MCP 客户端和服务器之间的所有消息必须遵循 JSON-RPC 2.0 规范。协议定义了以下类型的消息:
请求(Requests)
请求从客户端发送到服务器,或者从服务器发送到客户端,用于启动操作。
{
  jsonrpc: "2.0";
  id: string | number;
  method: string;
  params?: {
    [key: string]: unknown;
  };
}
null。响应(Responses)
响应是对请求的回复,包含操作的结果或错误。
模型上下文协议(MCP)采用客户端-主机-服务器架构,每个主机可以运行多个客户端实例。这种架构使用户能够跨应用程序集成AI功能,同时保持明确的安全边界和关注点隔离。MCP基于JSON-RPC构建,提供专注于客户端和服务器之间上下文交换和采样协调的有状态会话协议。
核心组件
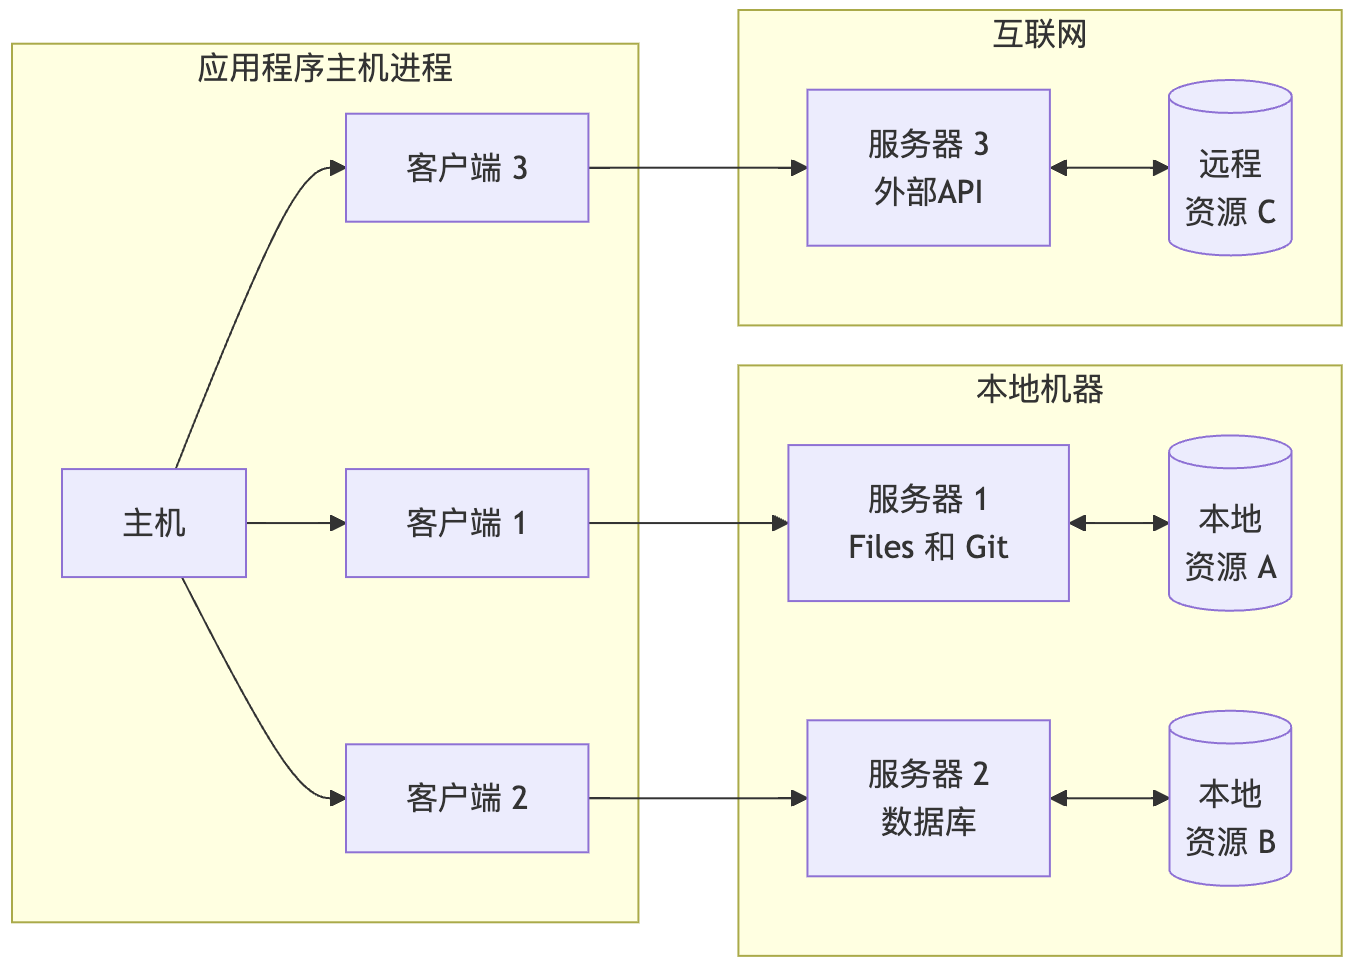
graph LR
    subgraph "应用程序主机进程"
        H[主机]
        C1[客户端 1]
        C2[客户端 2]
        C3[客户端 3]
        H --> C1
        H --> C2
        H --> C3
    end

    subgraph "本地机器"
        S1[服务器 1<br>Files 和 Git]
        S2[服务器 2<br>数据库]
        R1[("本地<br>资源 A")]
        R2[("本地<br>资源 B")]

        C1 --> S1
        C2 --> S2
        S1 <--> R1
        S2 <--> R2
    end

    subgraph "互联网"
        S3[服务器 3<br>外部API]
        R3[("远程<br>资源 C")]

        C3 --> S3
        S3 <--> R3
    end
主机
主机进程作为容器和协调器:
客户端
每个客户端由主机创建,并维护独立的服务器连接:
主机应用程序创建和管理多个客户端,每个客户端与特定服务器保持1:1关系。
服务器
服务器提供专门的上下文和功能:
设计原则
MCP基于几个关键设计原则,这些原则指导其架构和实现:
服务器不应能读取整个对话,也不应"
协议修订版本:2025-03-26
Model Context Protocol(MCP)是一个开放协议,它使 LLM 应用程序与外部数据源和工具之间能够无缝集成。无论您是构建 AI 驱动的 IDE、增强聊天界面,还是创建自定义 AI 工作流,MCP 都提供了一种标准化的方式来连接 LLM 与它们所需的上下文。
本规范基于 schema.ts 中的 TypeScript 模式,定义了权威的协议要求。
有关实现指南和示例,请访问 modelcontextprotocol.io。
概述
MCP 为应用程序提供了标准化的方式来:
该协议使用 JSON-RPC 2.0 消息在以下组件之间建立通信:
MCP 部分受到 Language Server Protocol 的启发,后者标准化了如何在整个开发工具生态系统中添加对编程语言的支持。类似地,MCP 标准化了如何将额外的上下文和工具集成到 AI 应用程序的生态系统中。
关键细节
基础协议
功能
服务器向客户端提供以下任何功能:
MCP 服务器创建工具


创建无需构建配置的 模型上下文协议 (MCP) 服务器项目。
快速概览
# 使用 uvx (推荐)
uvx create-mcp-server

# 或者使用 pip
pip install create-mcp-server
create-mcp-server
您无需手动安装或配置任何依赖项。 该工具将设置创建 MCP 服务器所需的一切。
创建服务器
您需要在您的机器上安装 UV >= 0.4.10。
要创建新服务器,请运行以下任一命令:
使用 uvx (推荐)
uvx create-mcp-server
使用 pip
pip install create-mcp-server
create-mcp-server
它将引导您创建一个新的 MCP 服务器项目。 完成后,您将拥有一个具有以下结构的新目录:
my-server/
├── README.md
├── pyproject.toml
└── src/
    └── my_server/
        ├── __init__.py
        ├── __main__.py
        └── server.py
没有配置或复杂的文件夹结构,只有运行服务器所需的文件。
安装完成后,您可以启动服务器:
cd my-server
uv sync --dev --all-extras
uv run my-server
特性
安装
On macOS and Linux
curl -LsSf https://astral.sh/uv/install.sh | sh
On Windows
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"
更新
uv self update
一键同步环境
创建/同步完整的开发环境
uv sync
执行该命令后,主要做了以下事:
pyproject.toml.venvuv.lock依赖包
安装
uv add "mcp[cli]"
移除
uv remove "mcp[cli]"
Python 项目
创建
uv init echo
cd echo
创建的文件:
.
├── .python-version
├── README.md
├── main.py
└── pyproject.toml
运行
uv run main.py
Hello from echo!
参考资料
概述
Model Context Protocol 允许应用程序以标准化的方式为 LLM 提供上下文,将提供上下文的关注点与实际的 LLM 交互分离开来。这个 Python SDK 实现了完整的 MCP 规范,使您能够轻松地:
安装
将 MCP 添加到您的 Python 项目中
我们推荐使用 uv 来管理您的 Python 项目。在由 uv 管理的 Python 项目中,通过以下方式将 mcp 添加到依赖项:
uv add "mcp[cli]"
或者,对于使用 pip 管理依赖的项目:
pip install mcp
运行独立的 MCP 开发工具
要使用 uv 运行 mcp 命令:
uv run mcp
快速开始
让我们创建一个简单的 MCP 服务器,它暴露一个计算器工具和一些数据:
sh ./scripts/install-dependencies.sh
❌ File out/node_modules/@esbuild/darwin-arm64/bin/esbuild does not exist
架构
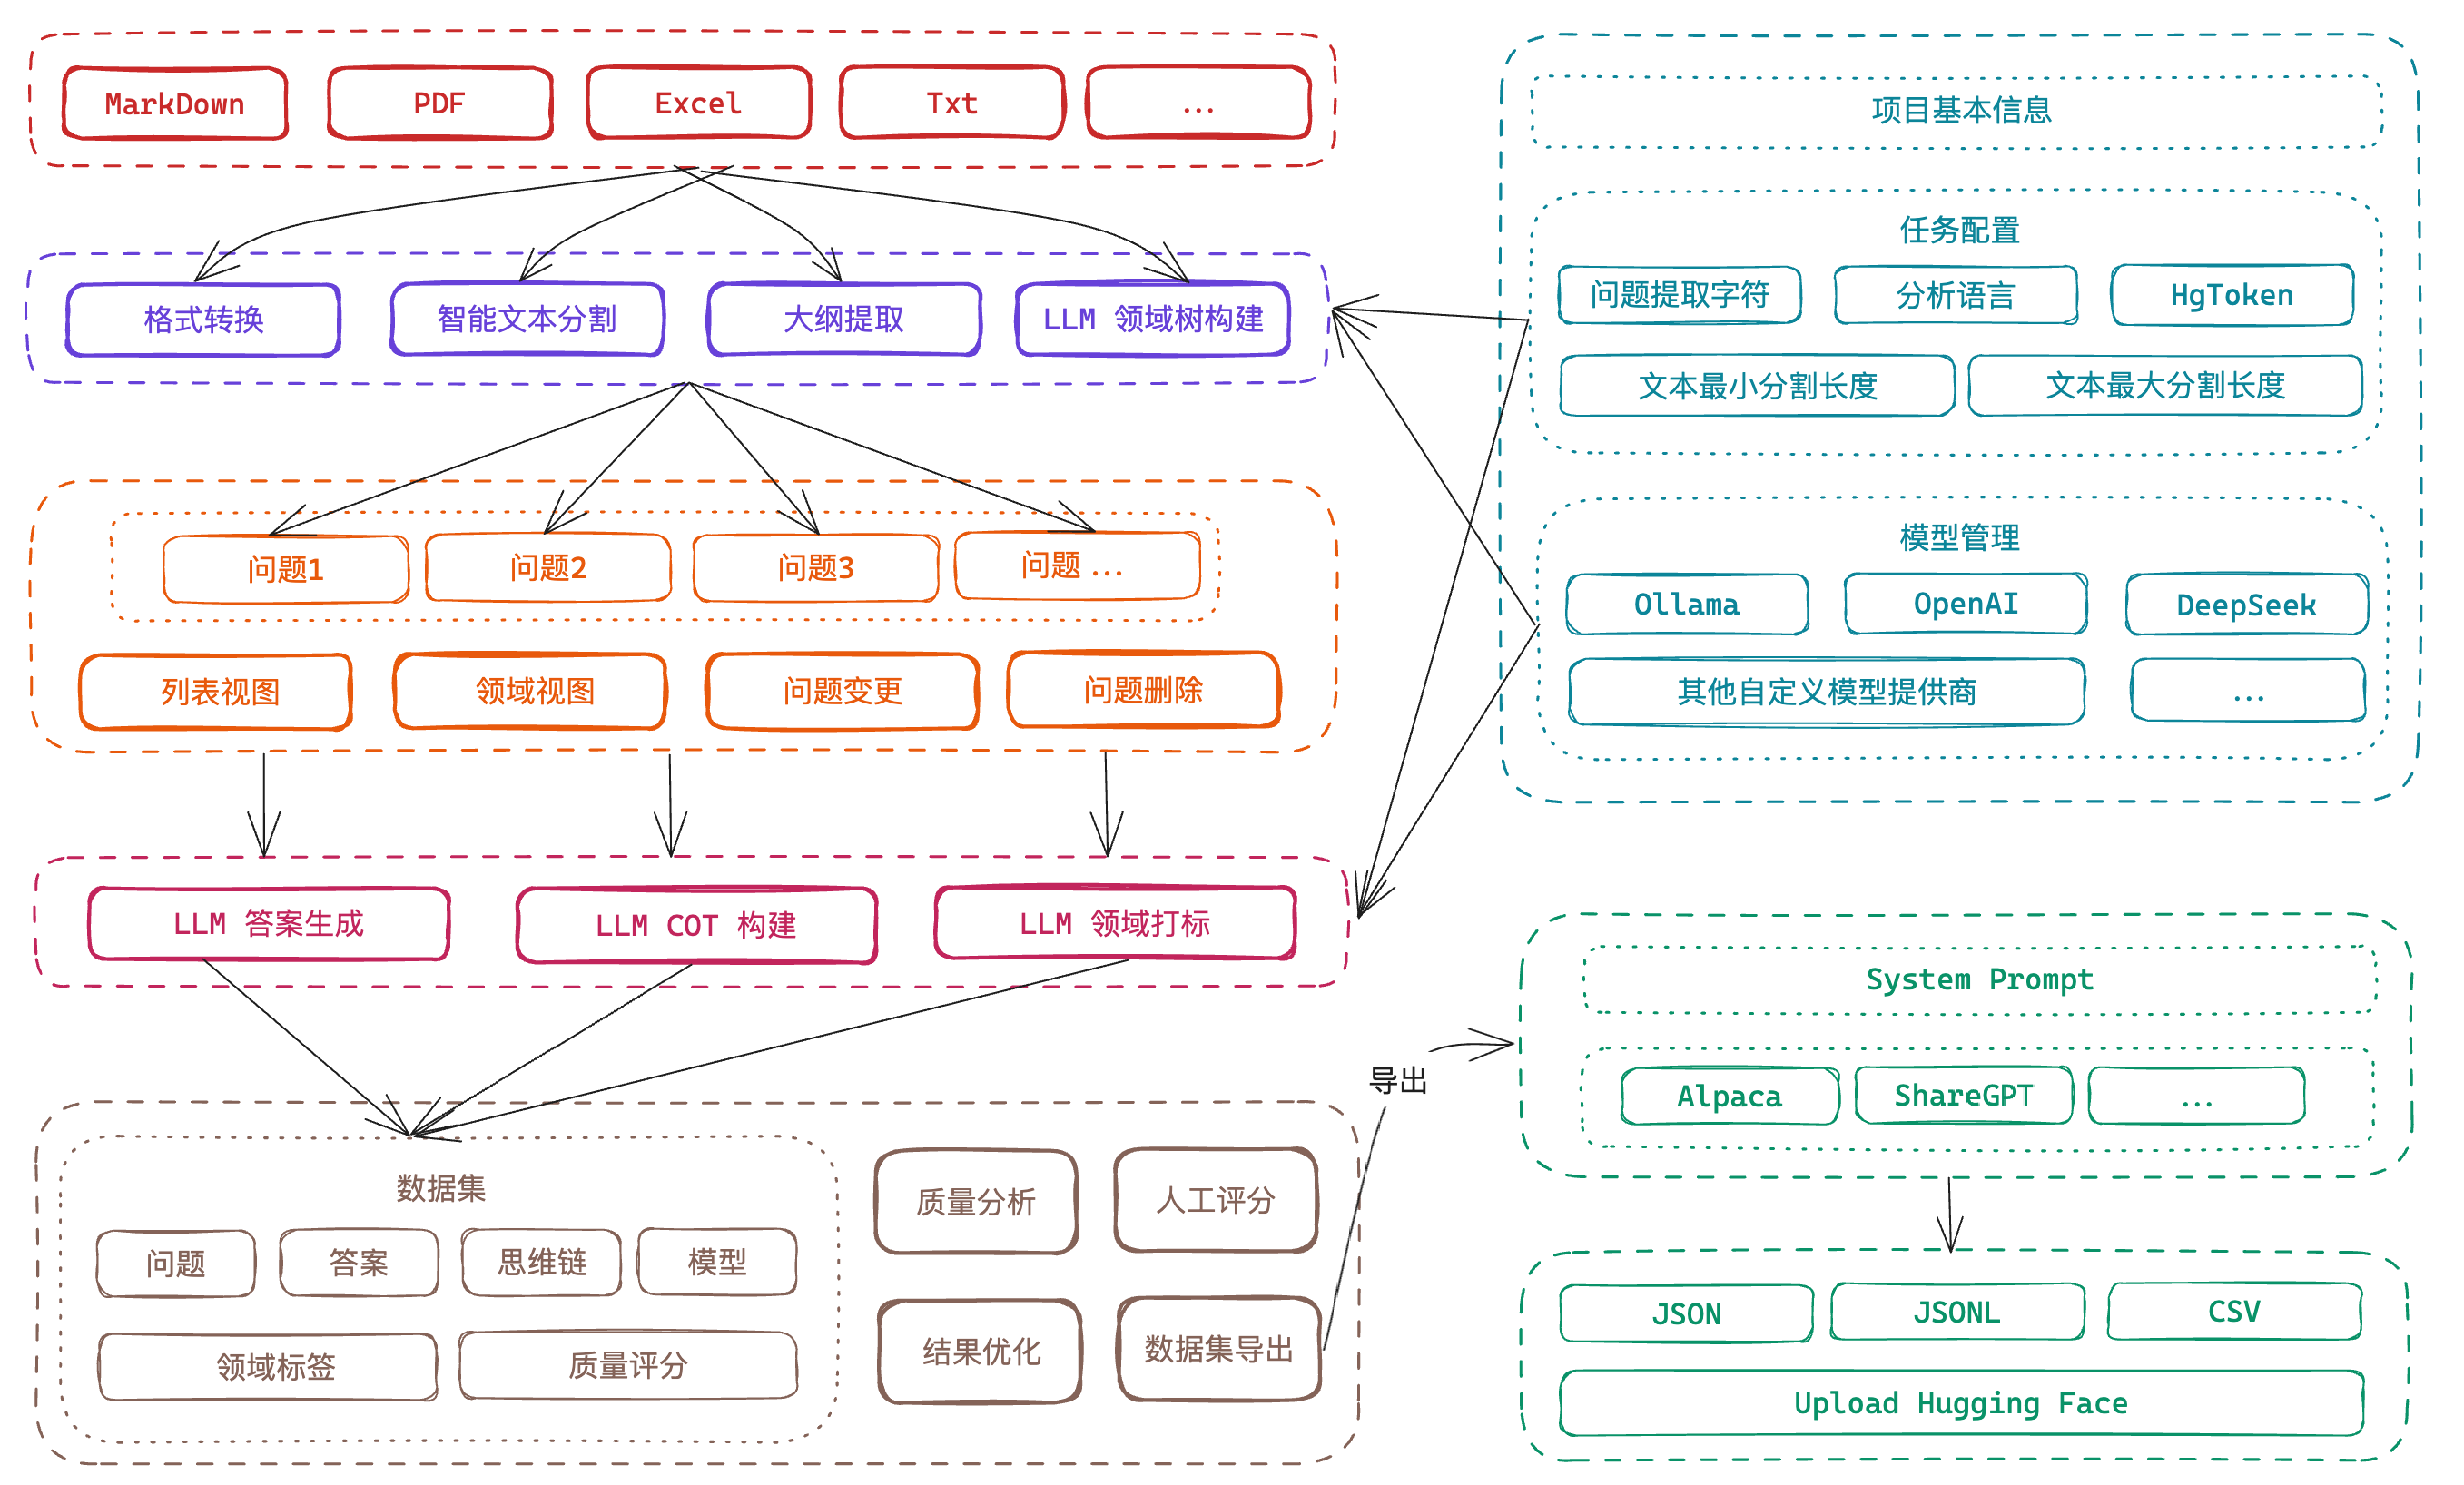
本地运行
使用 NPM 安装
   git clone https://github.com/ConardLi/easy-dataset.git
   cd easy-dataset
npm install
   npm run build

   npm run start
http://localhost:1717使用本地 Dockerfile 构建
如果你想自行构建镜像,可以使用项目根目录中的 Dockerfile:
git clone https://github.com/ConardLi/easy-dataset.git
cd easy-dataset
docker build -t easy-dataset .
docker run -d -p 1717:1717 -v {YOUR_LOCAL_DB_PATH}:/app/local-db --name easy-dataset easy-dataset
{YOUR_LOCAL_DB_PATH} 替换为你希望存储本地数据库的实际路径。http://localhost:1717首页
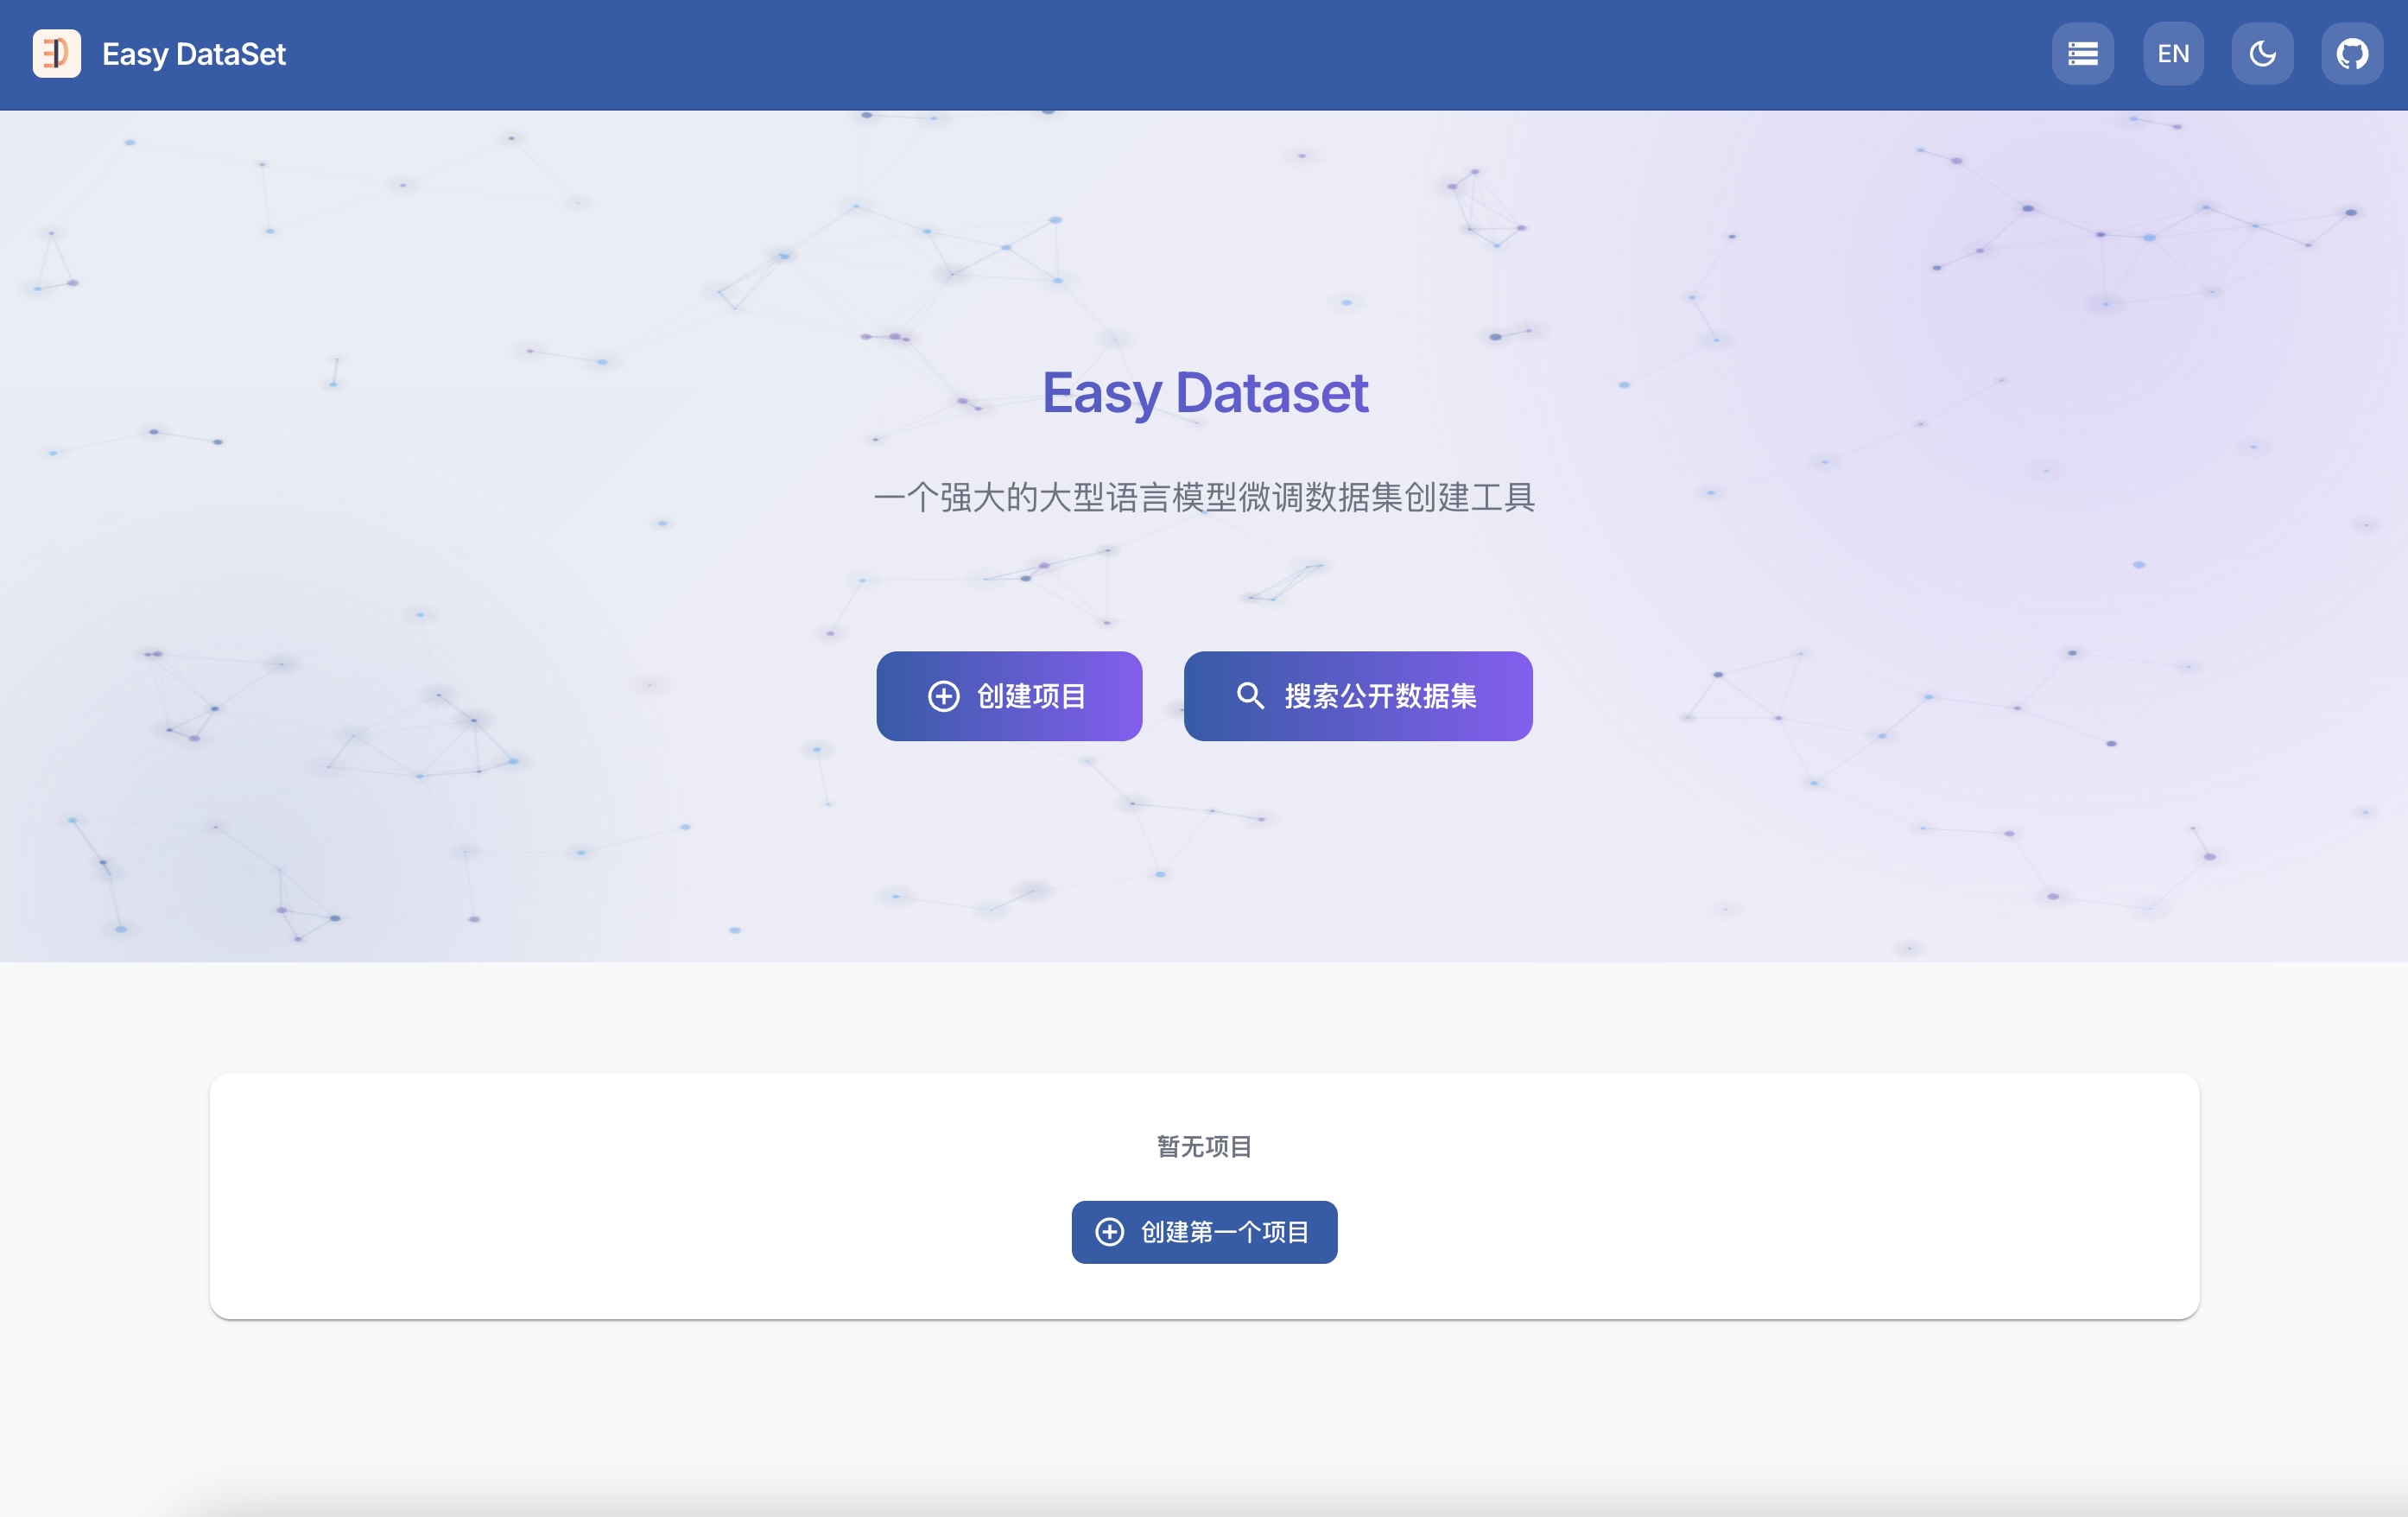
项目
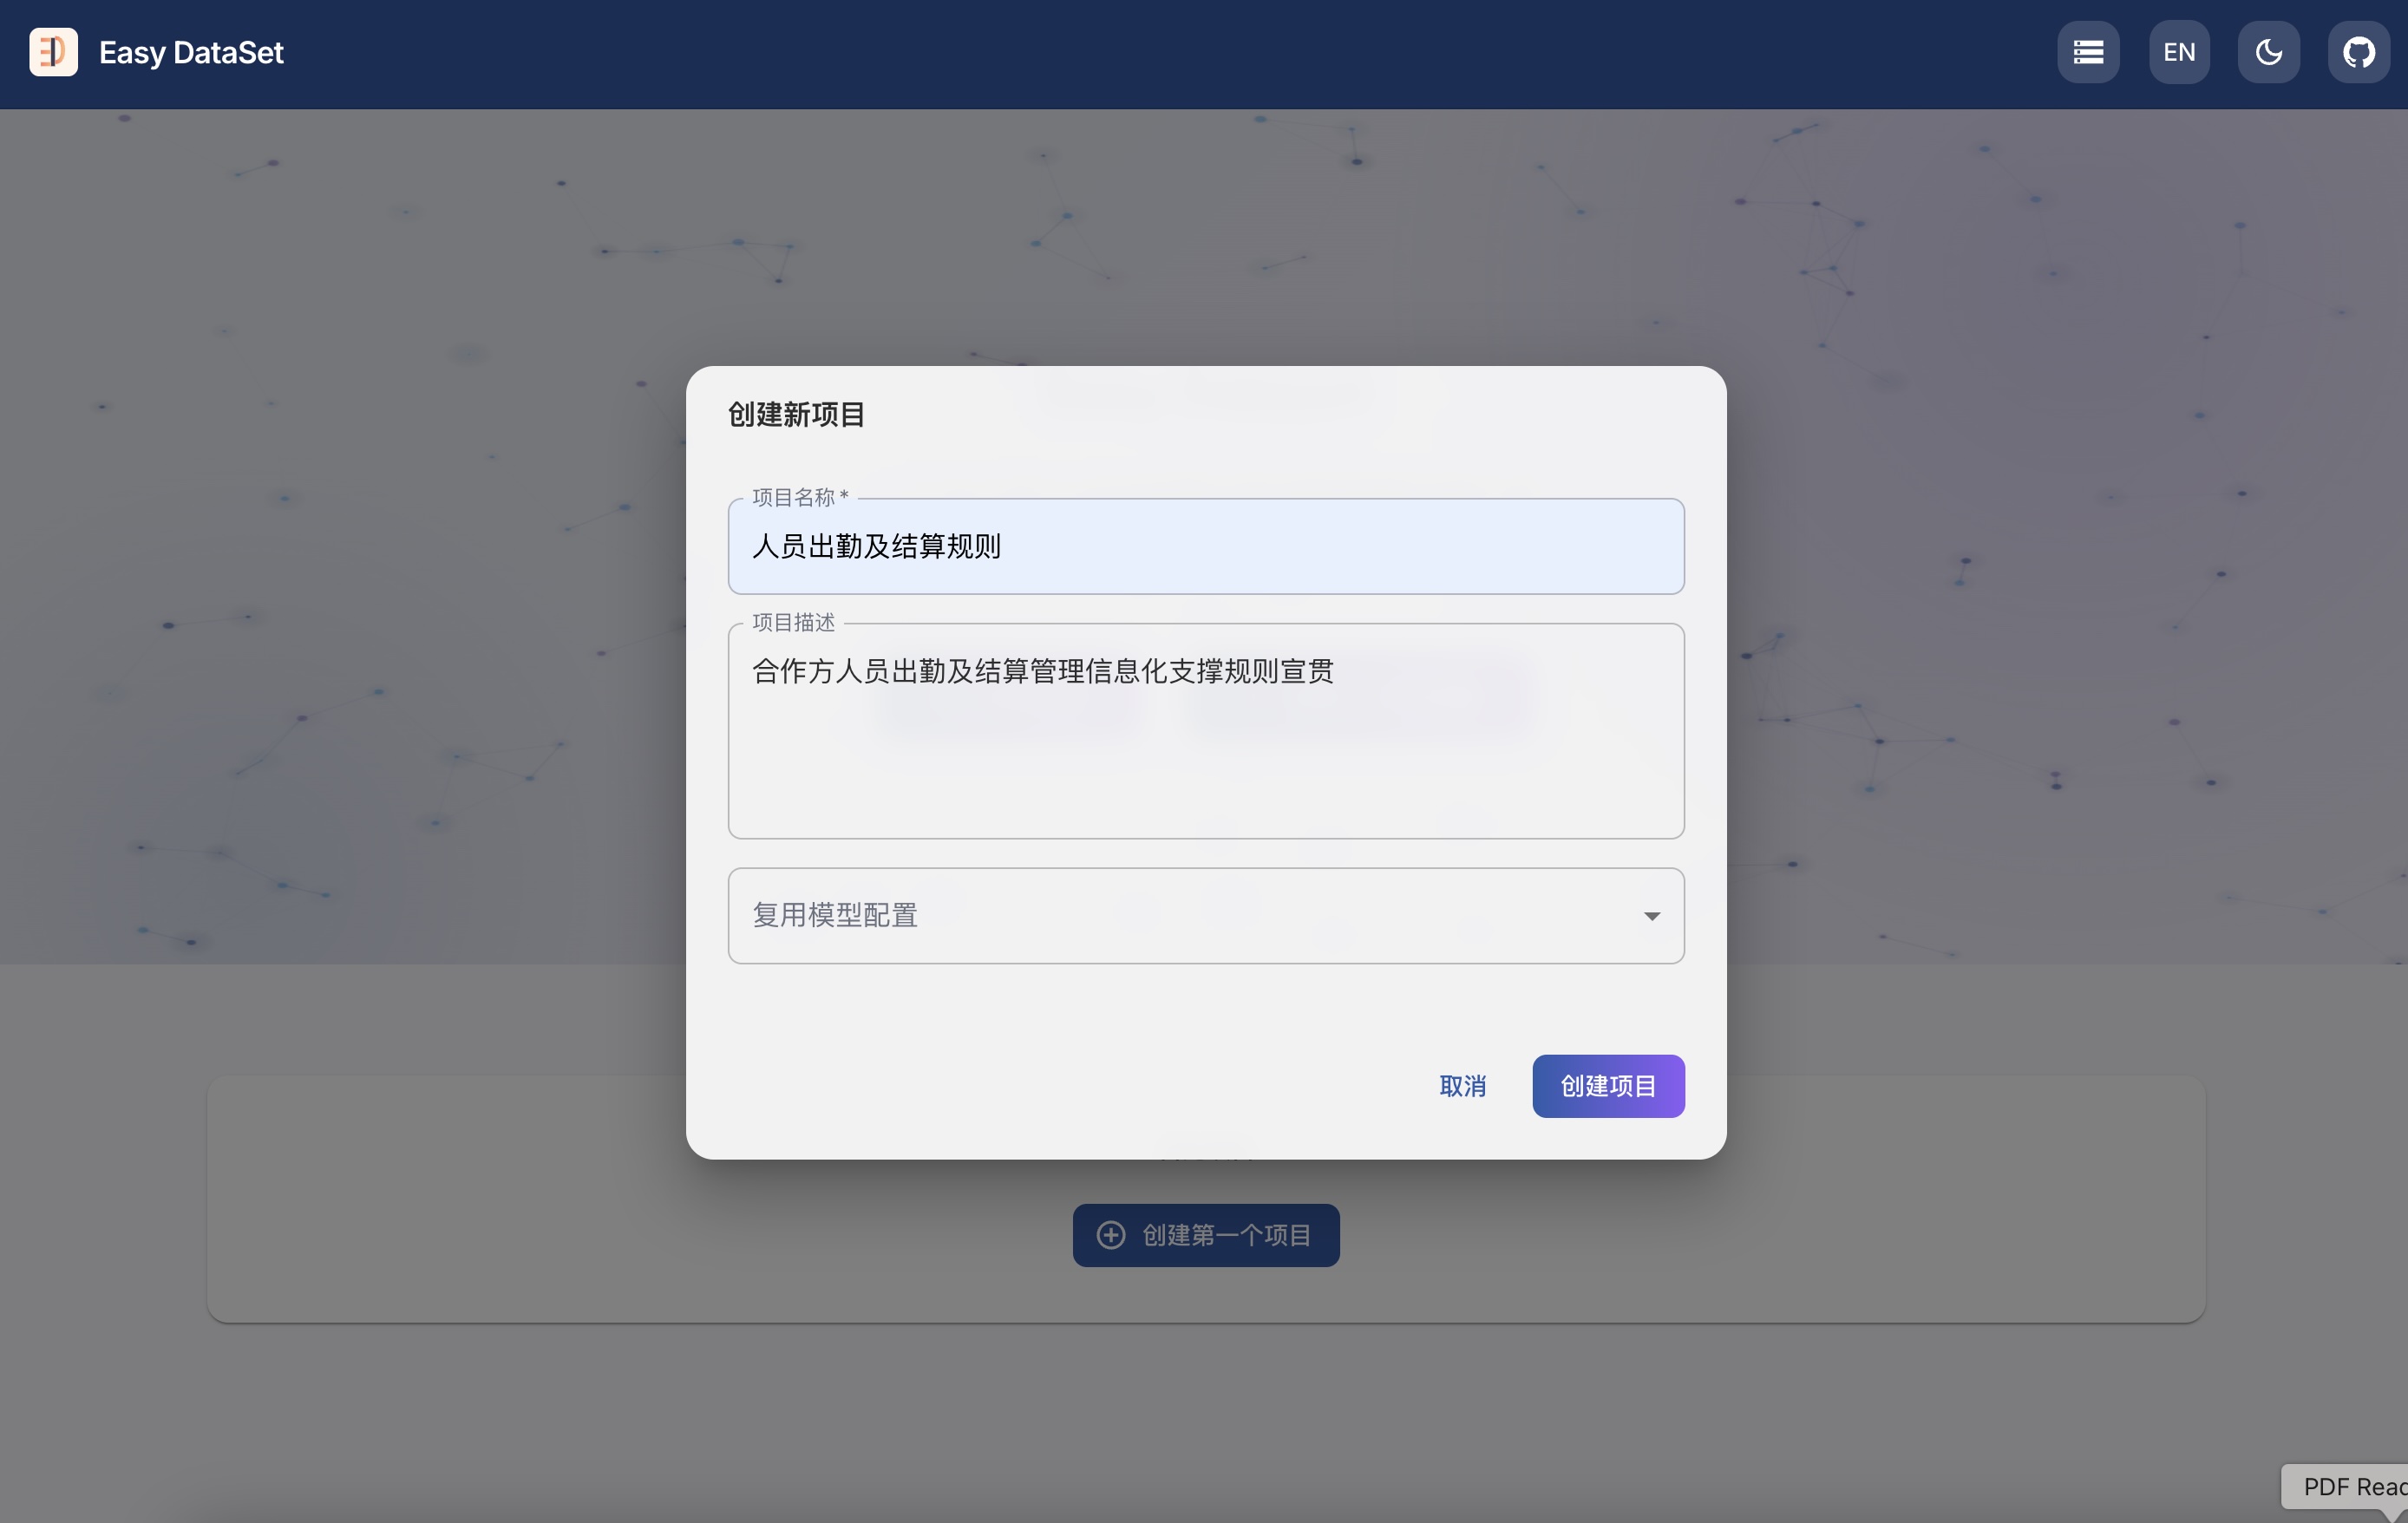
创建项目
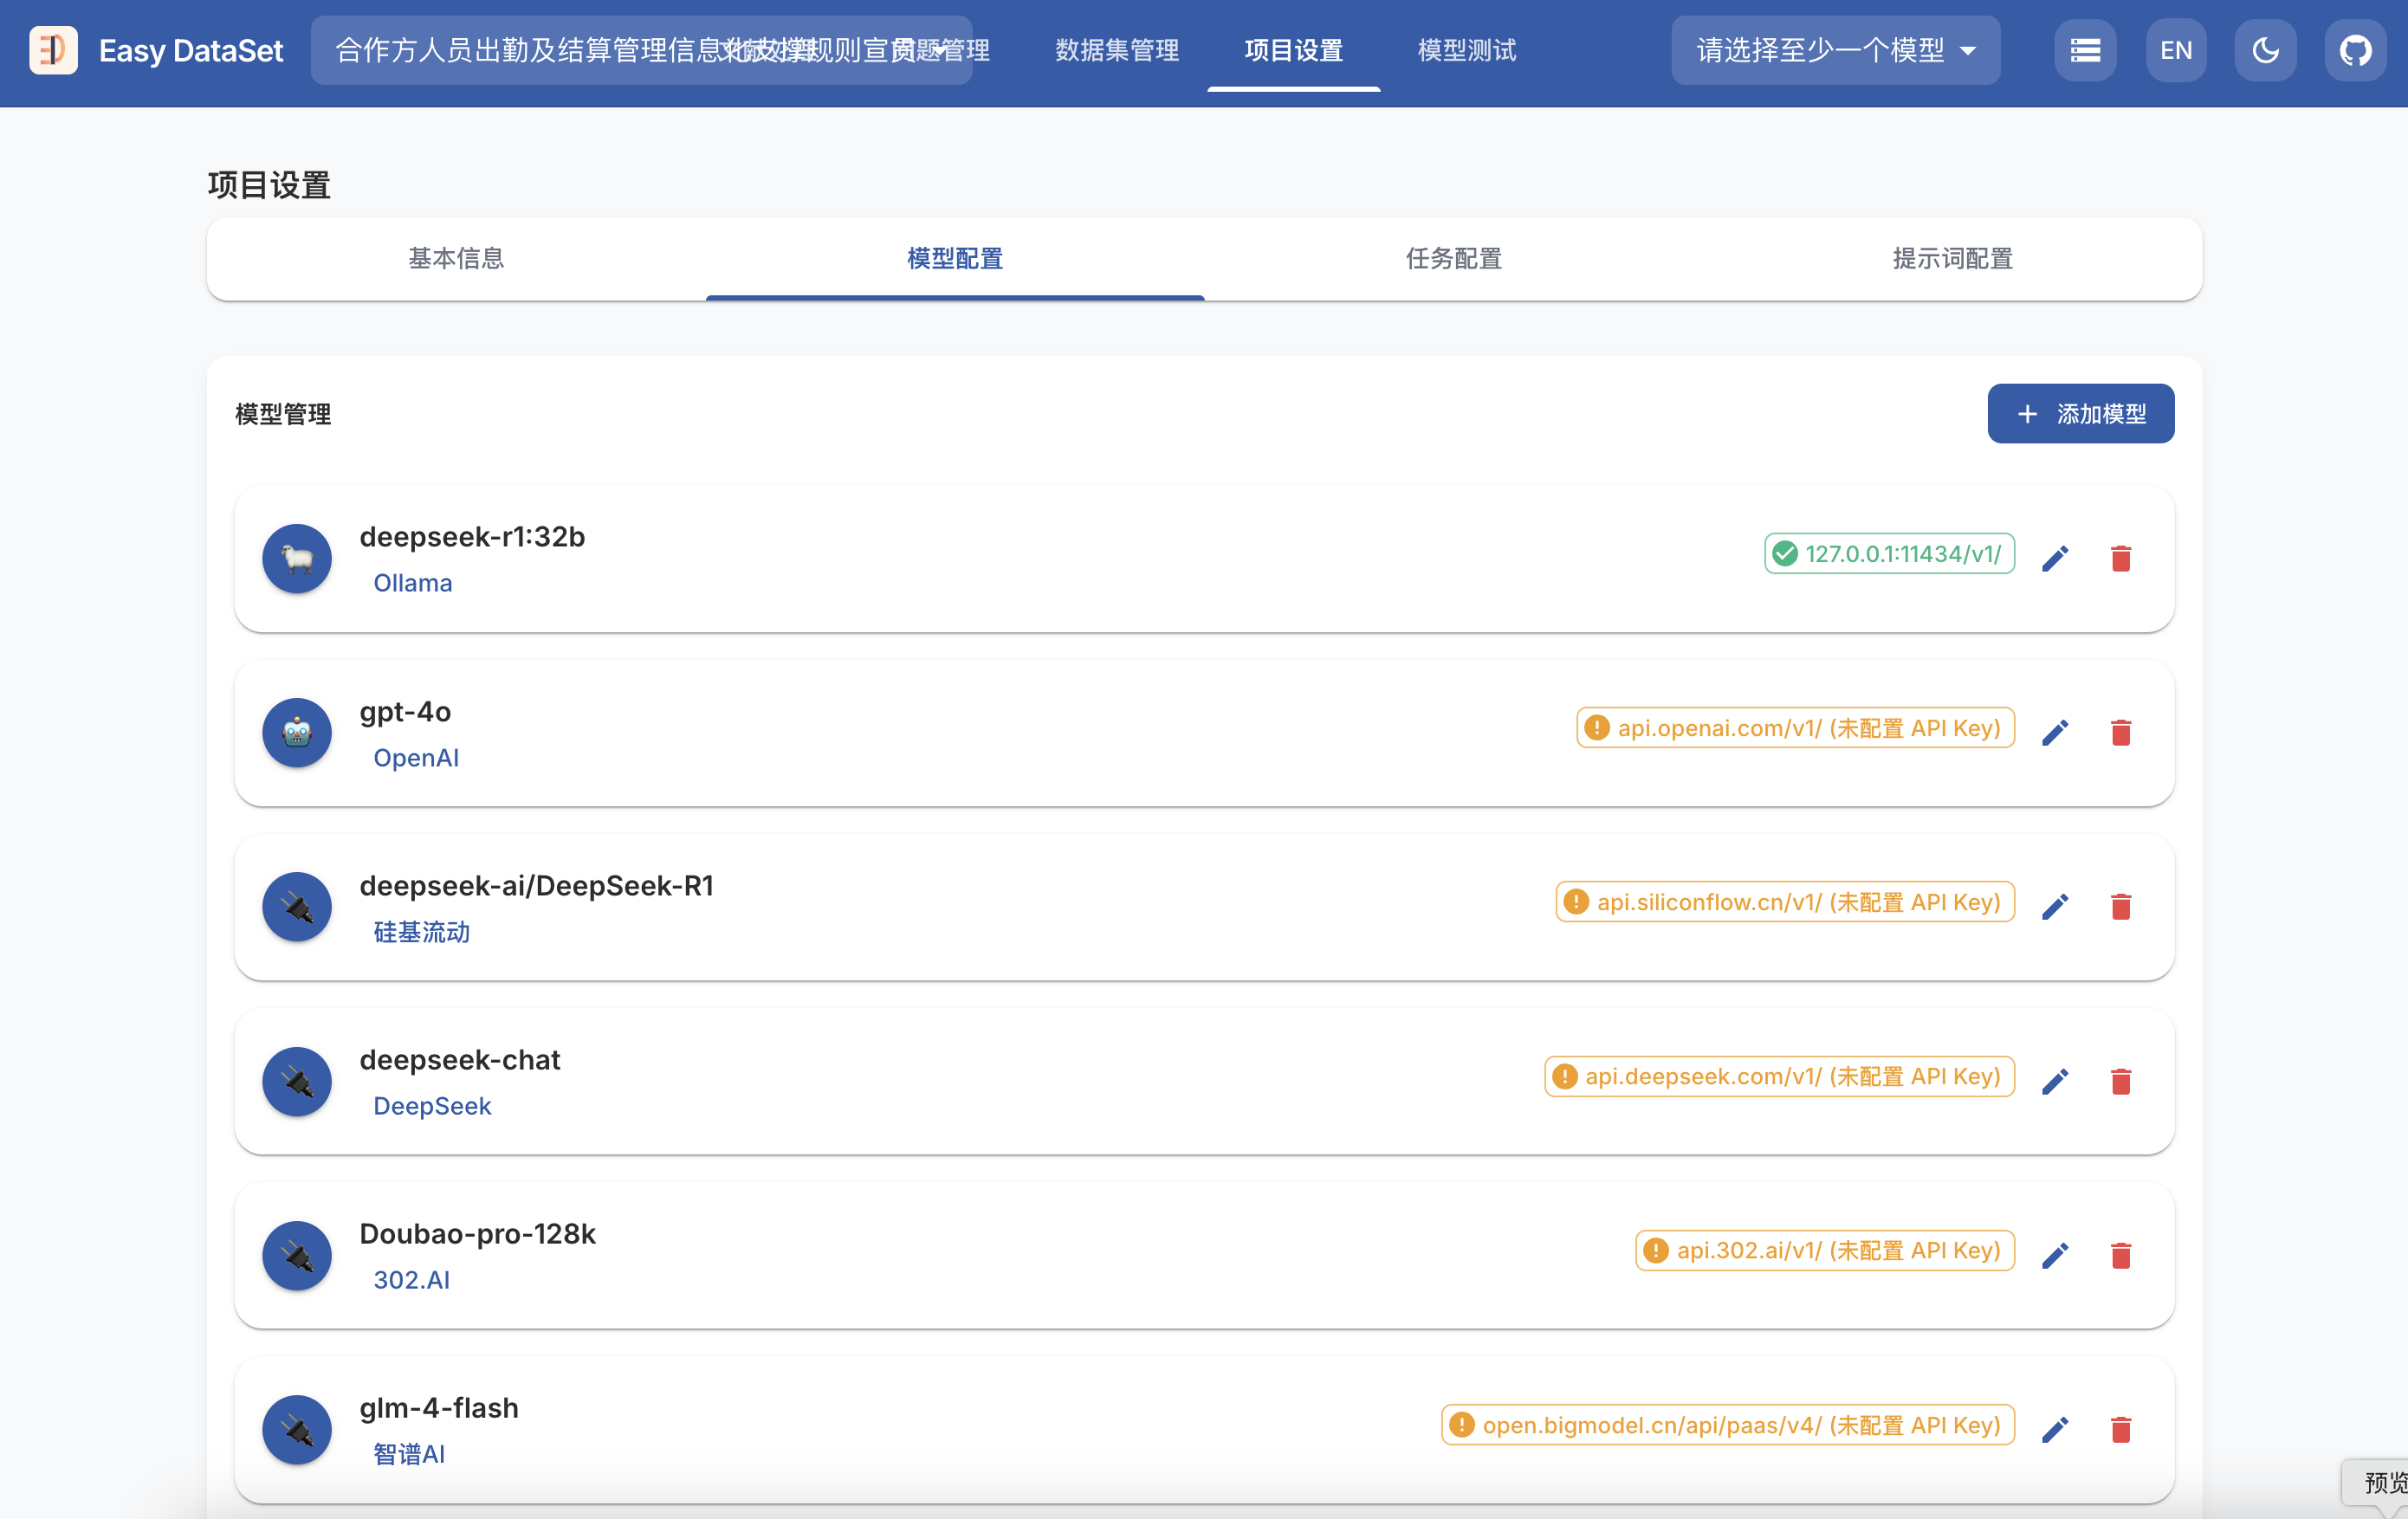
模型配置
任务配置
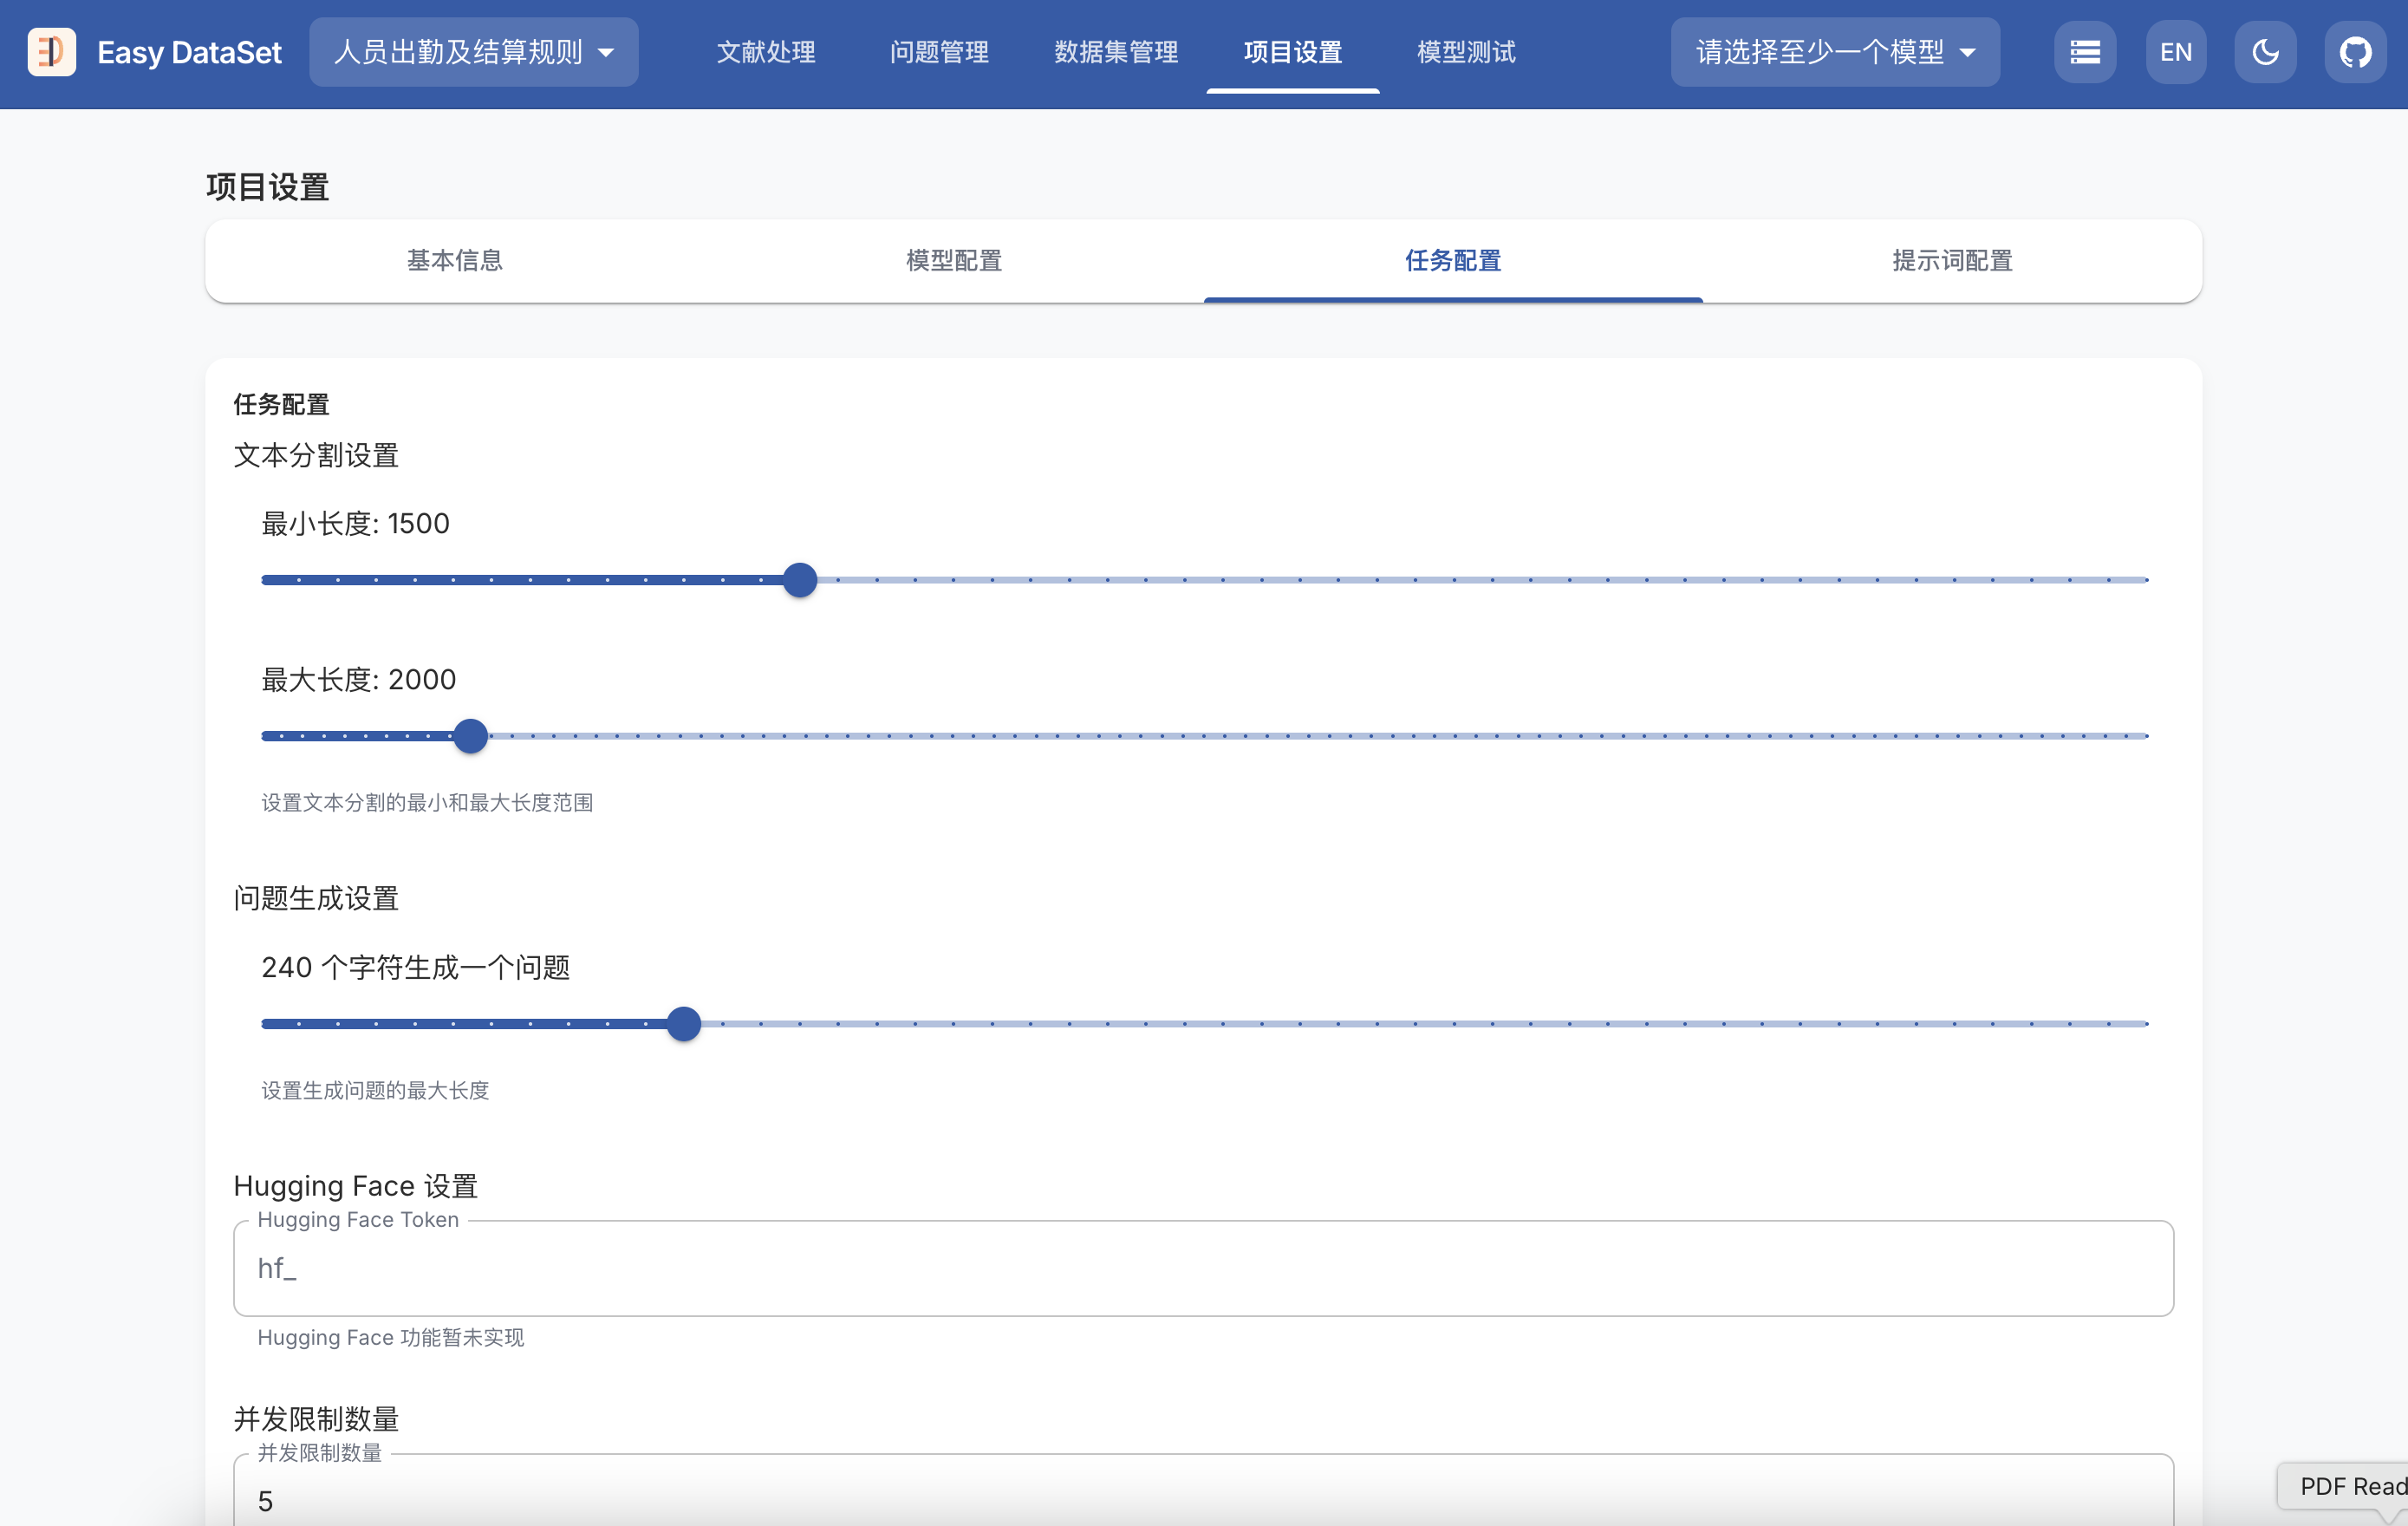
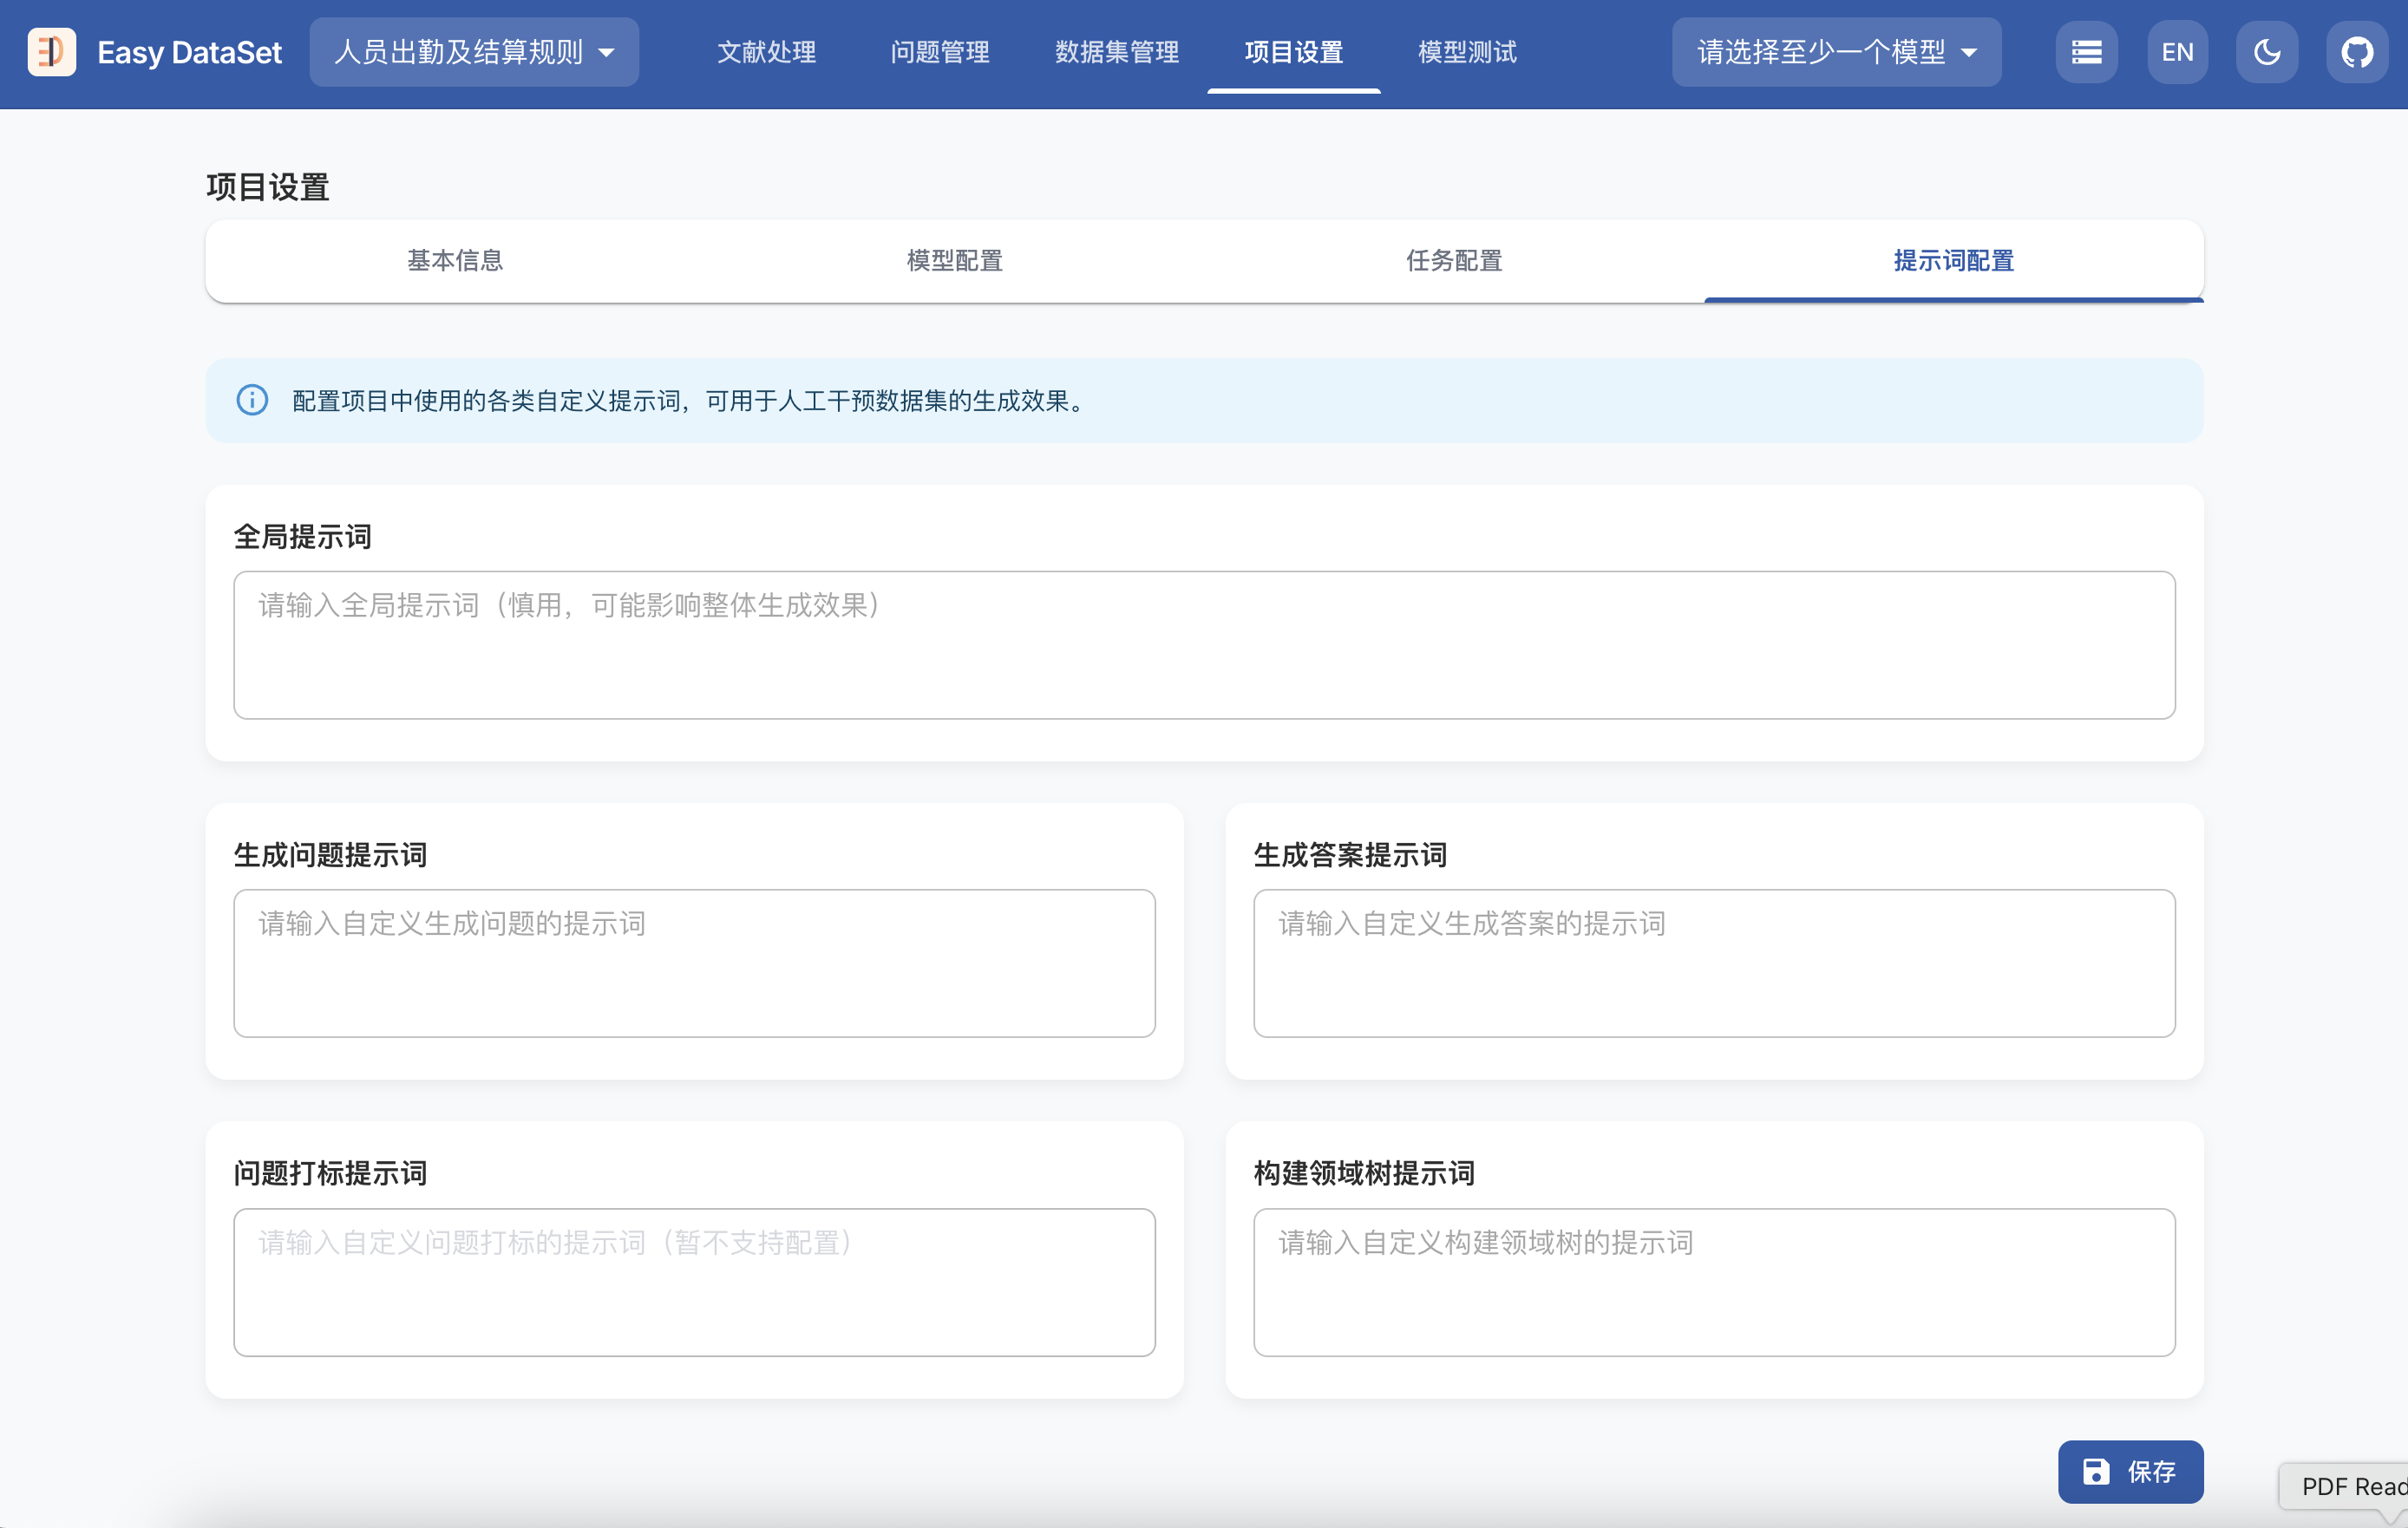
提示词配置
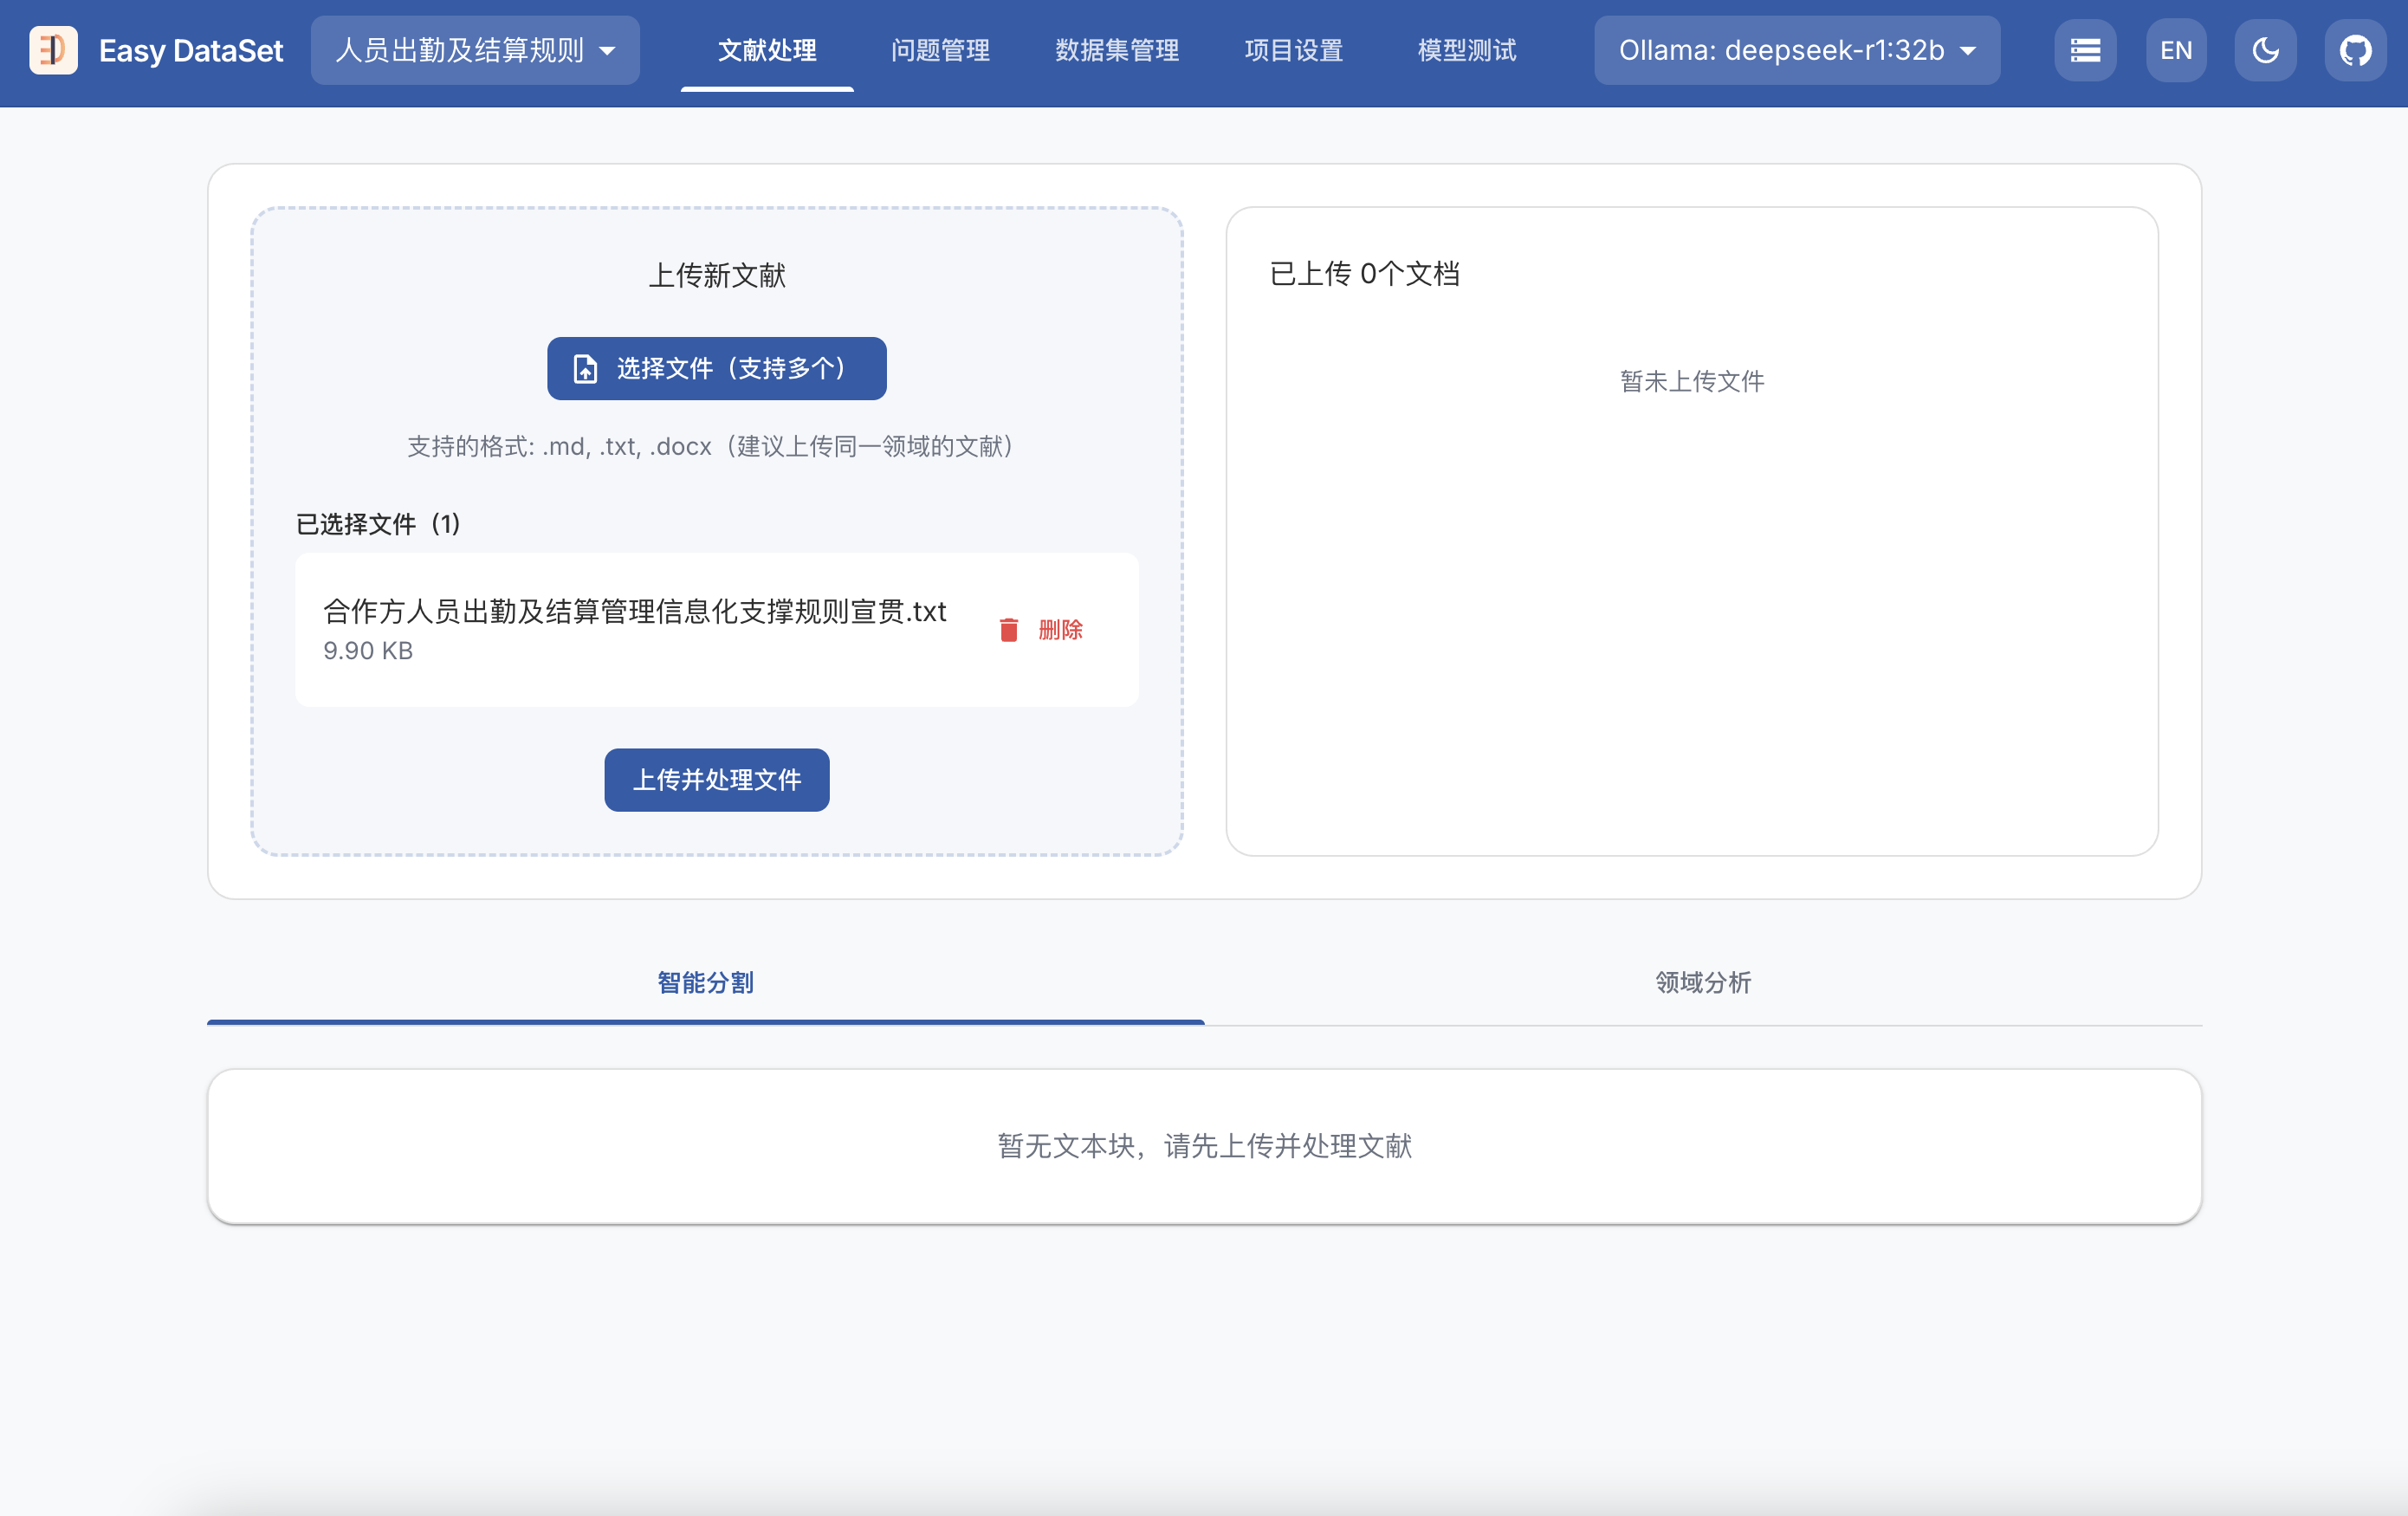
文献处理
上传文件
智能分割
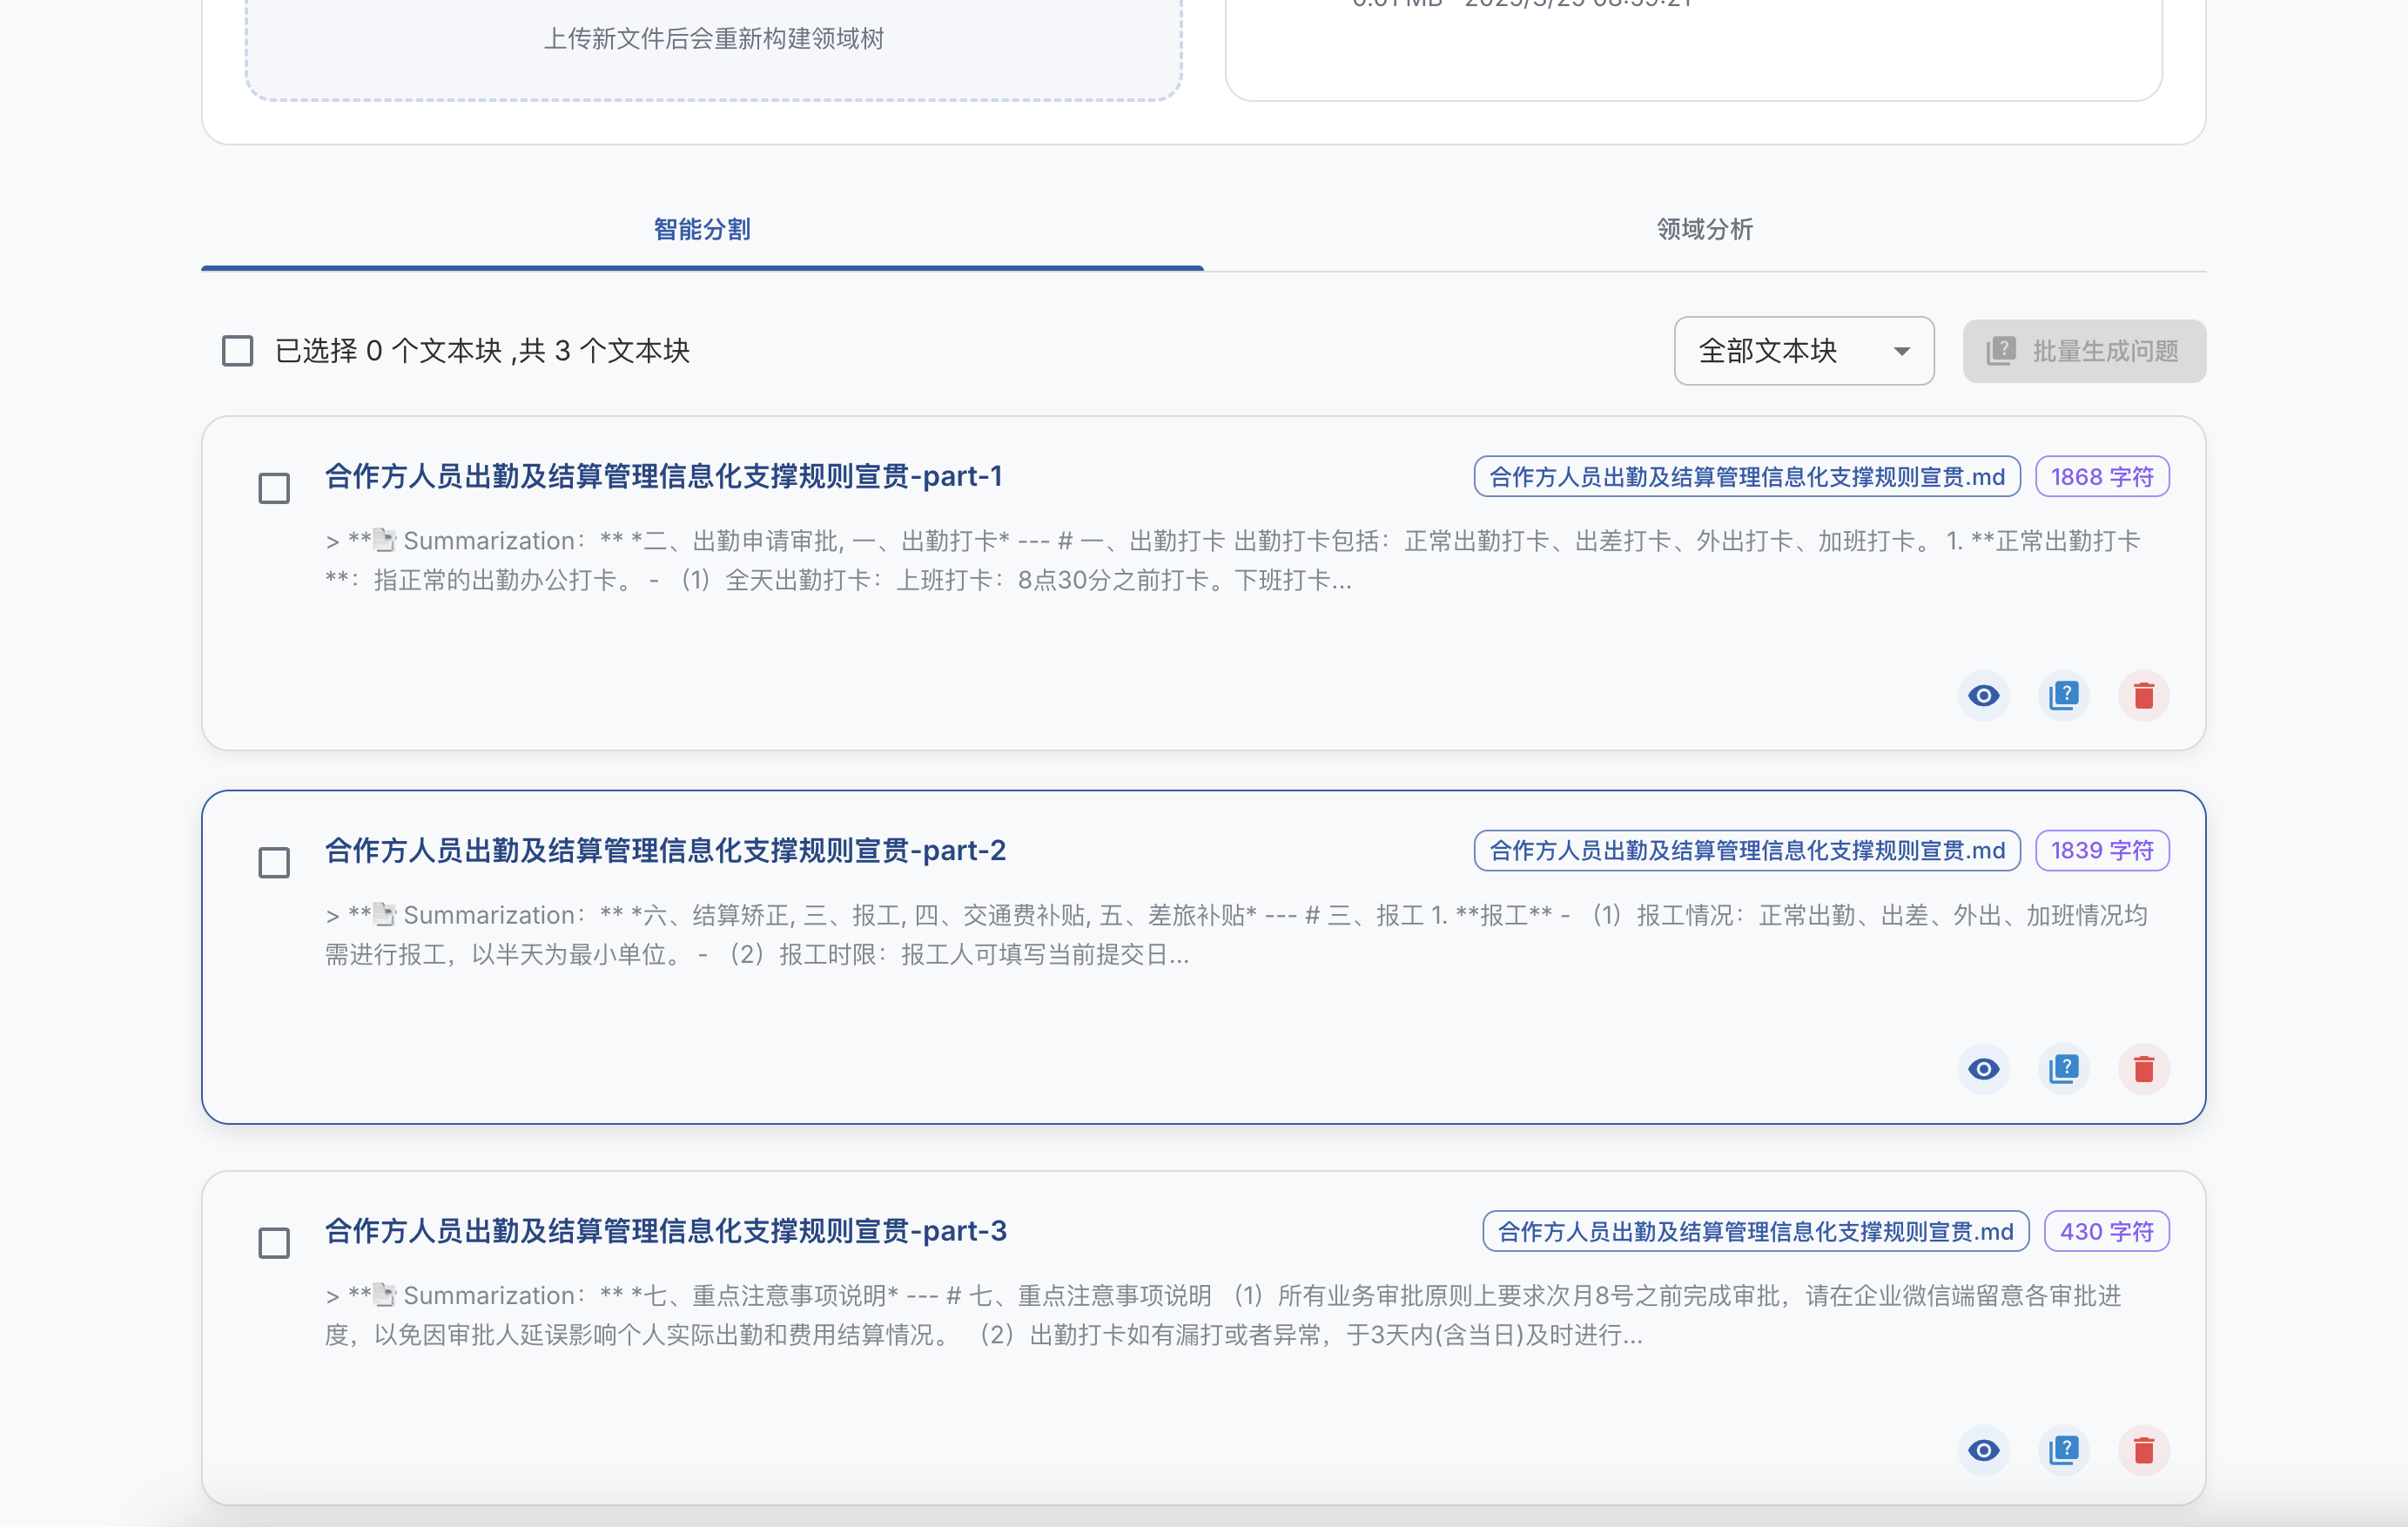
批量生成问题
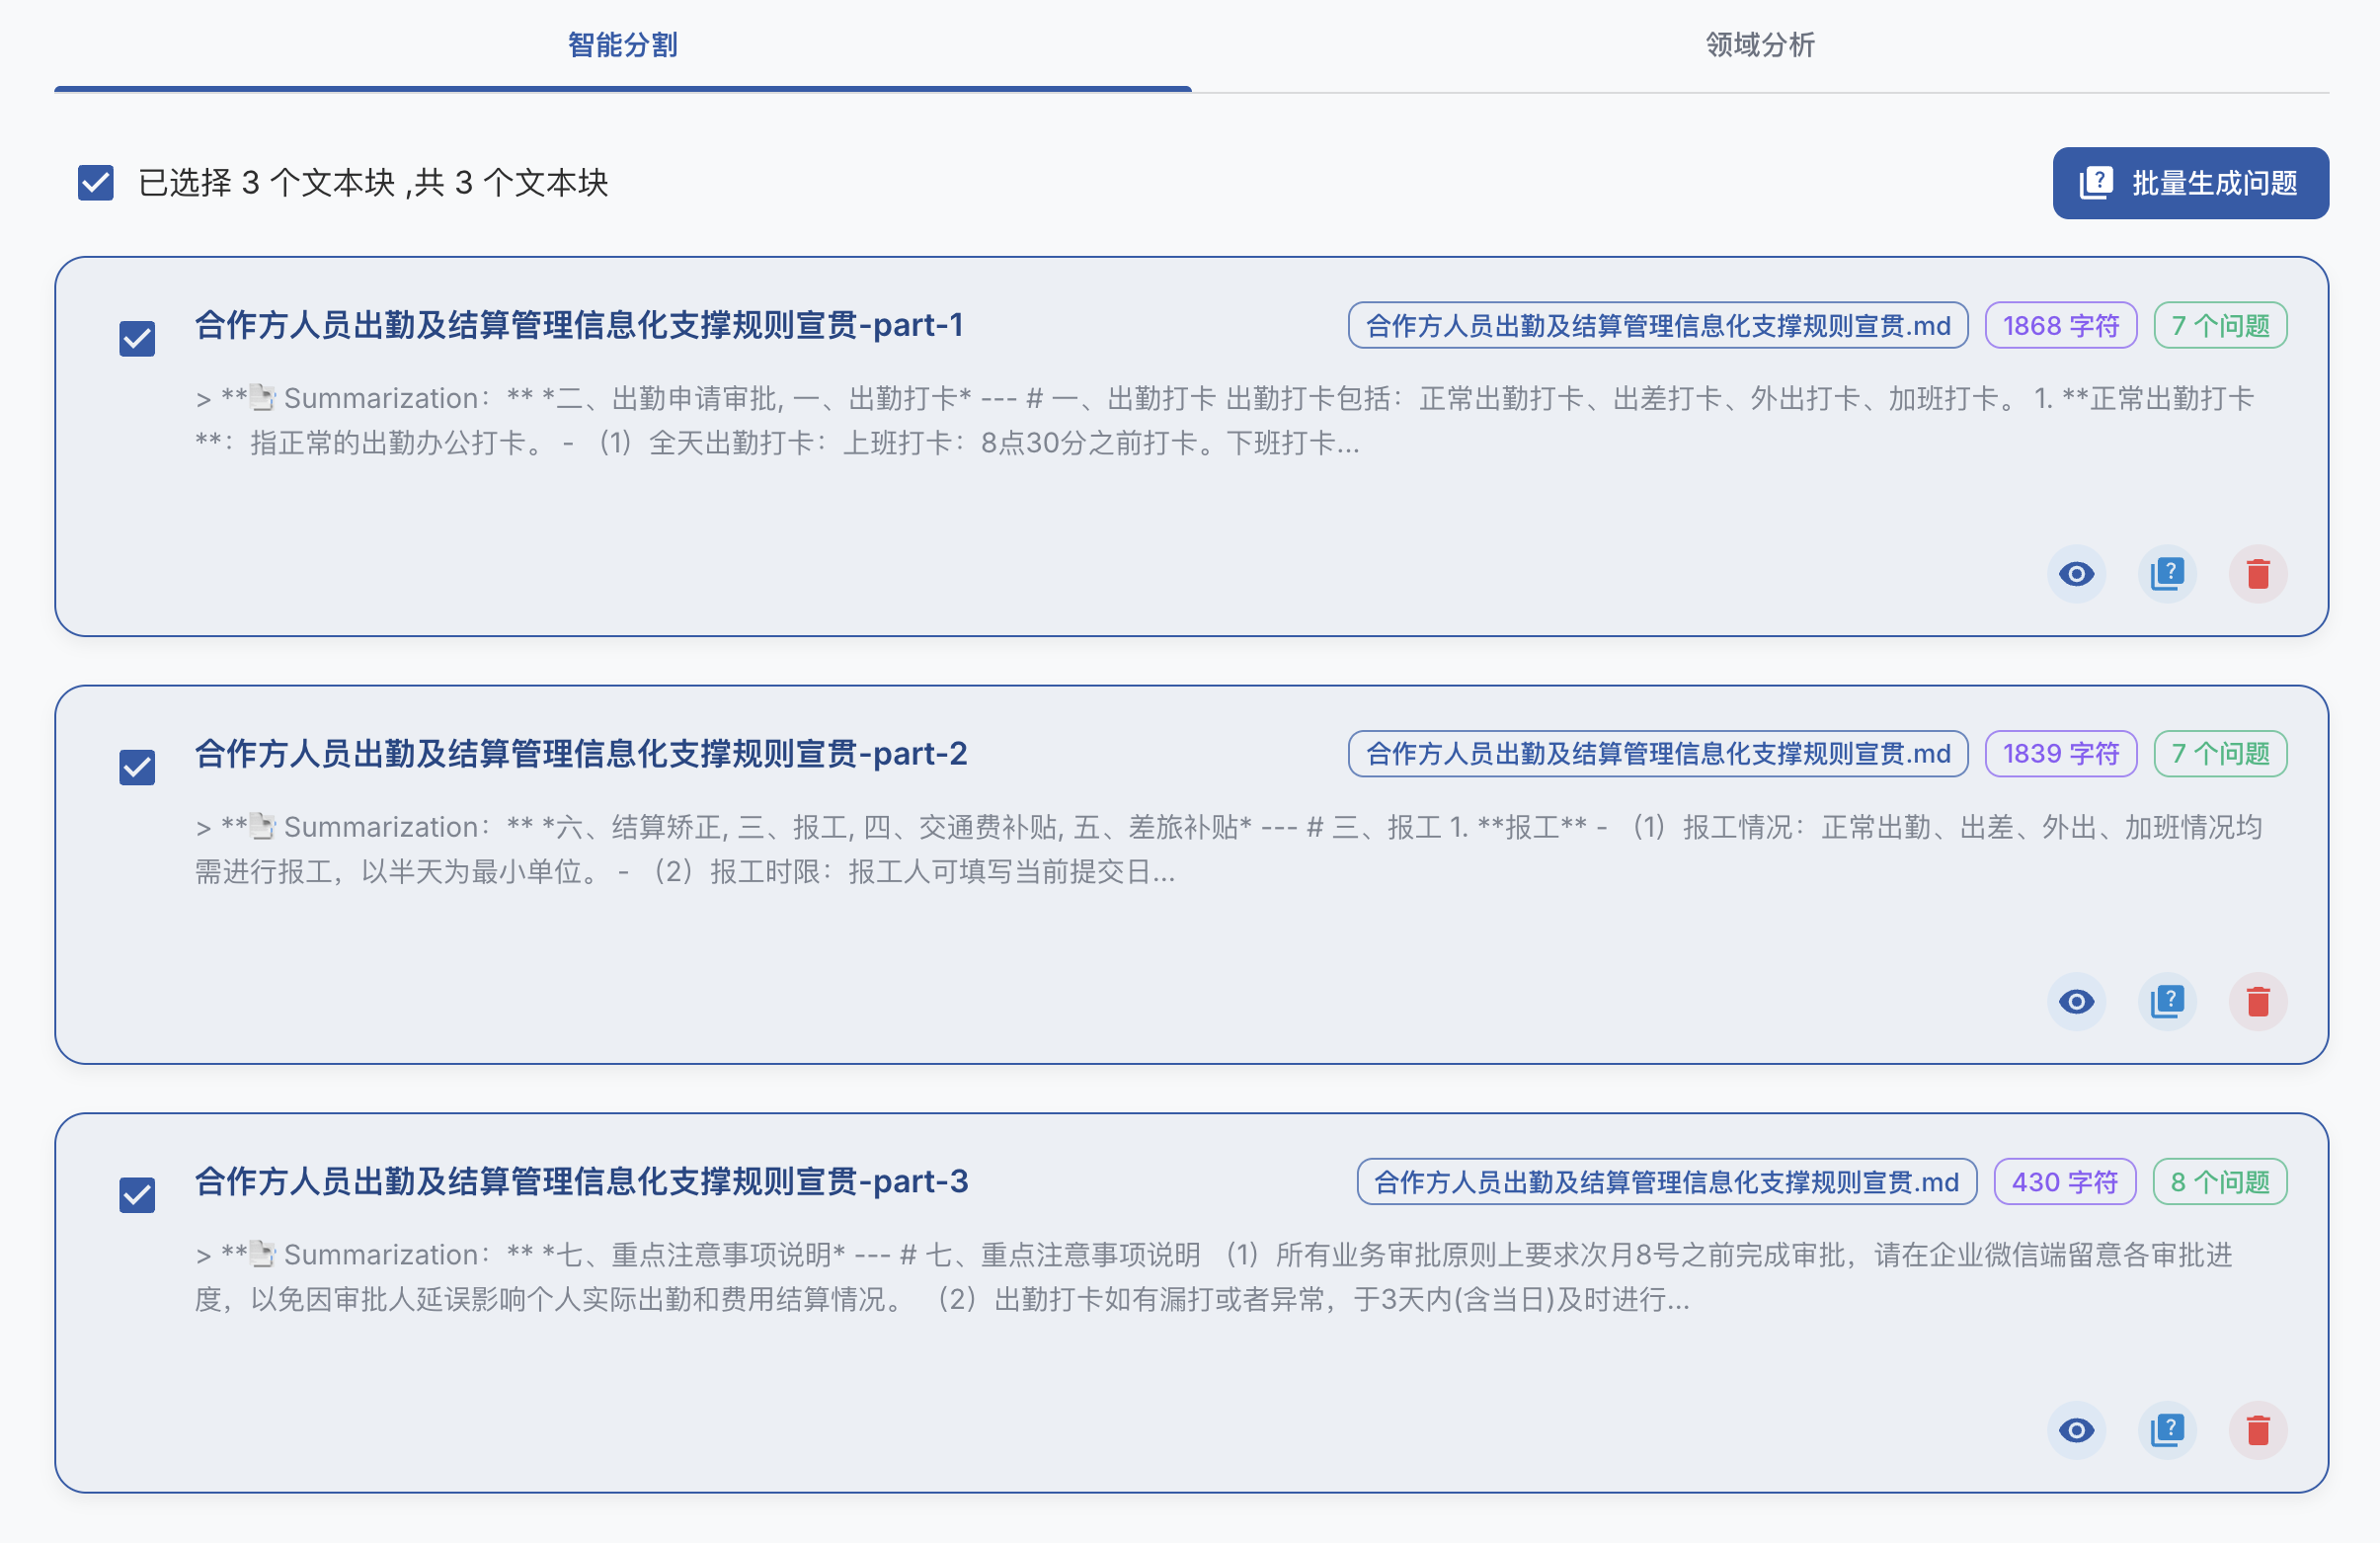
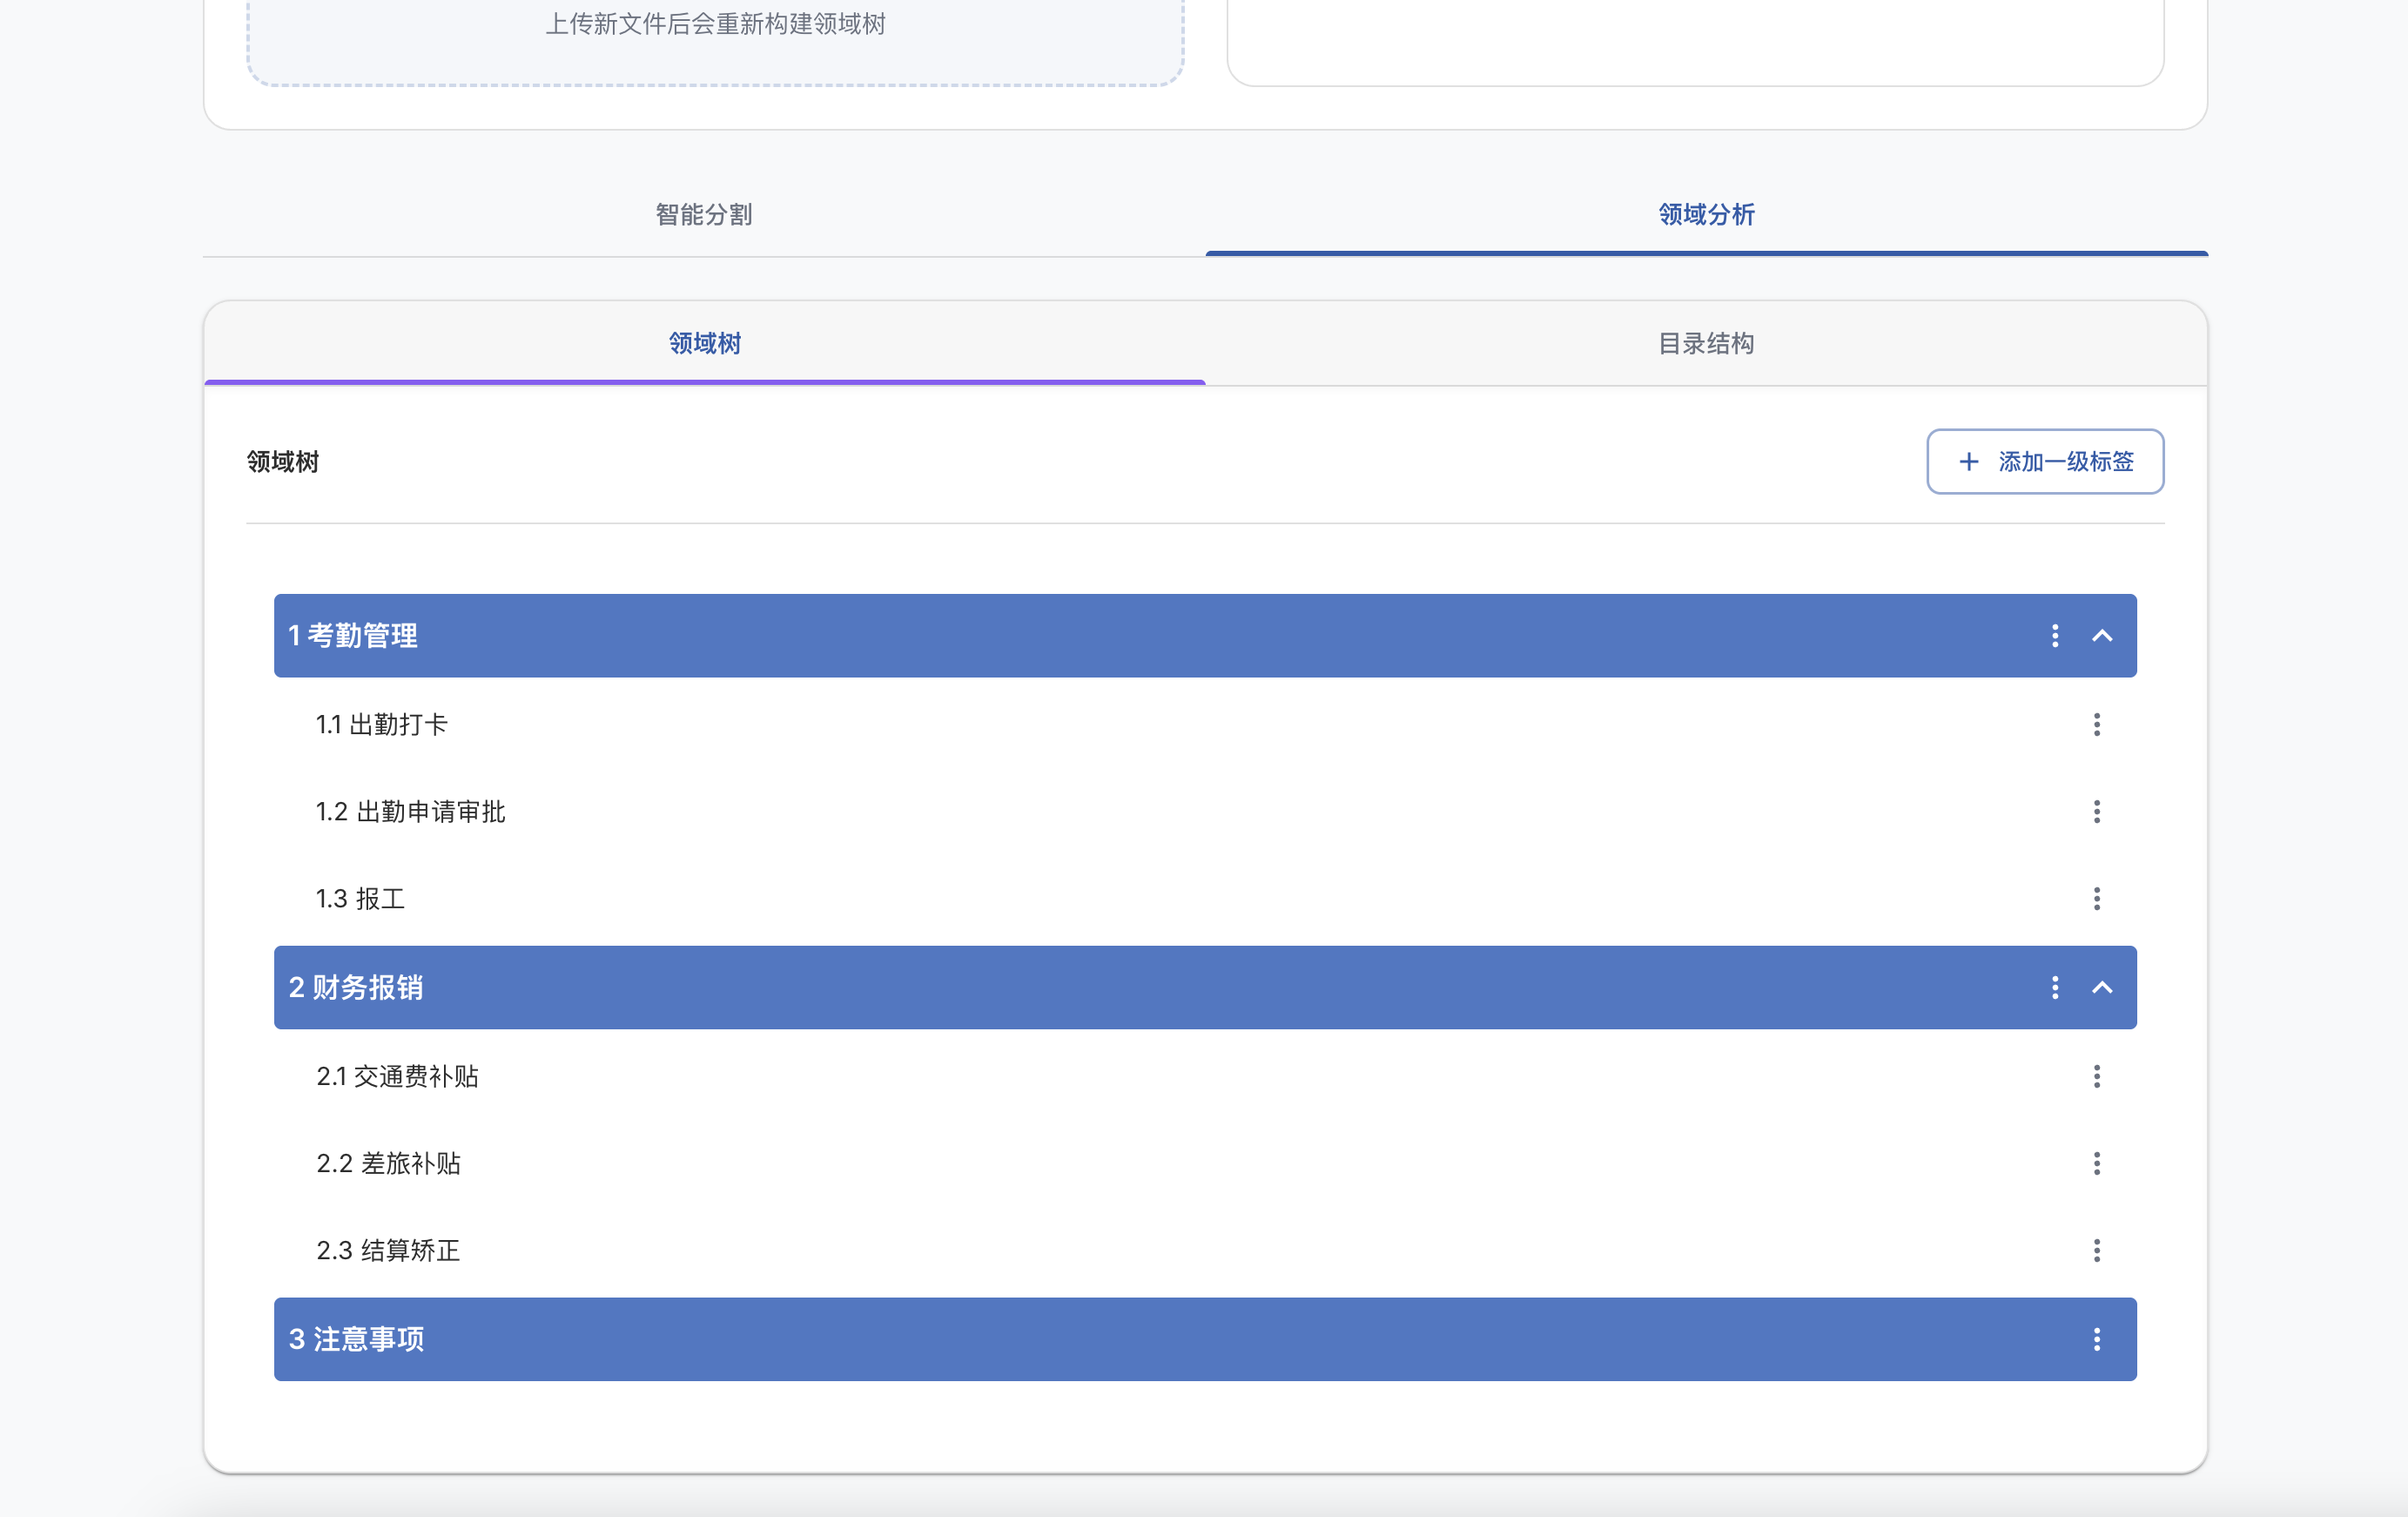
领域分析
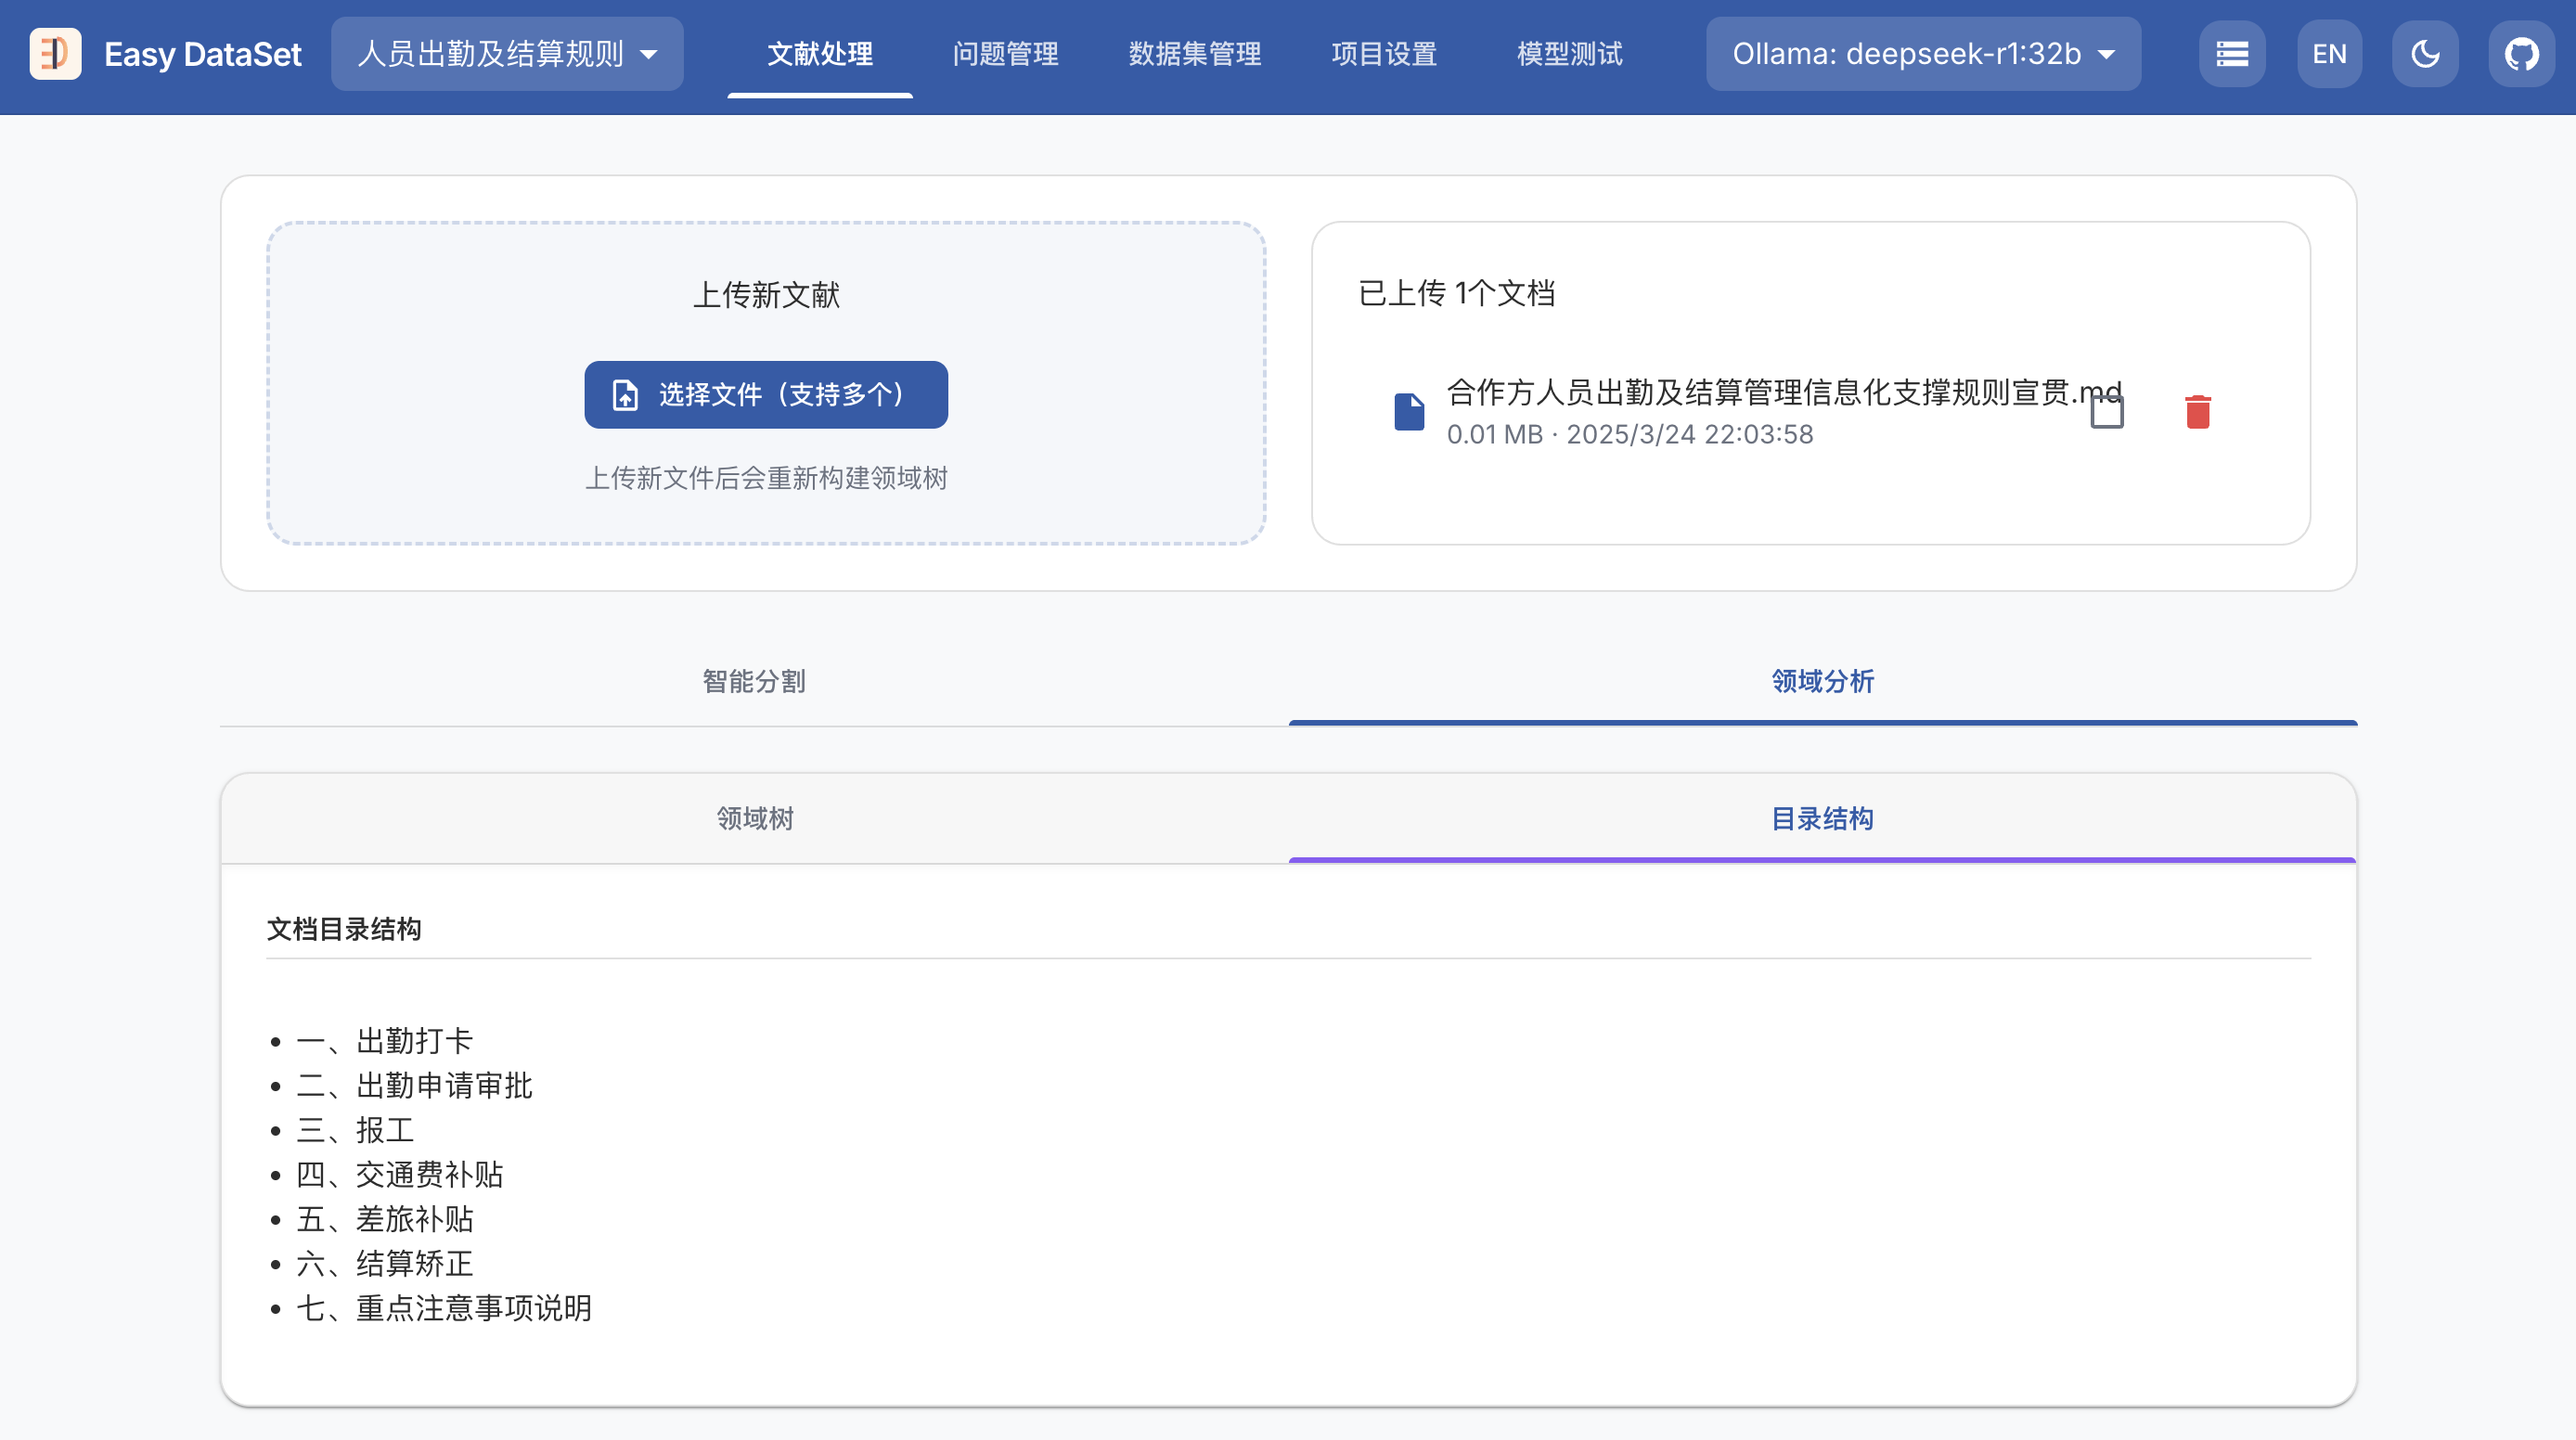
领域树
目录结构
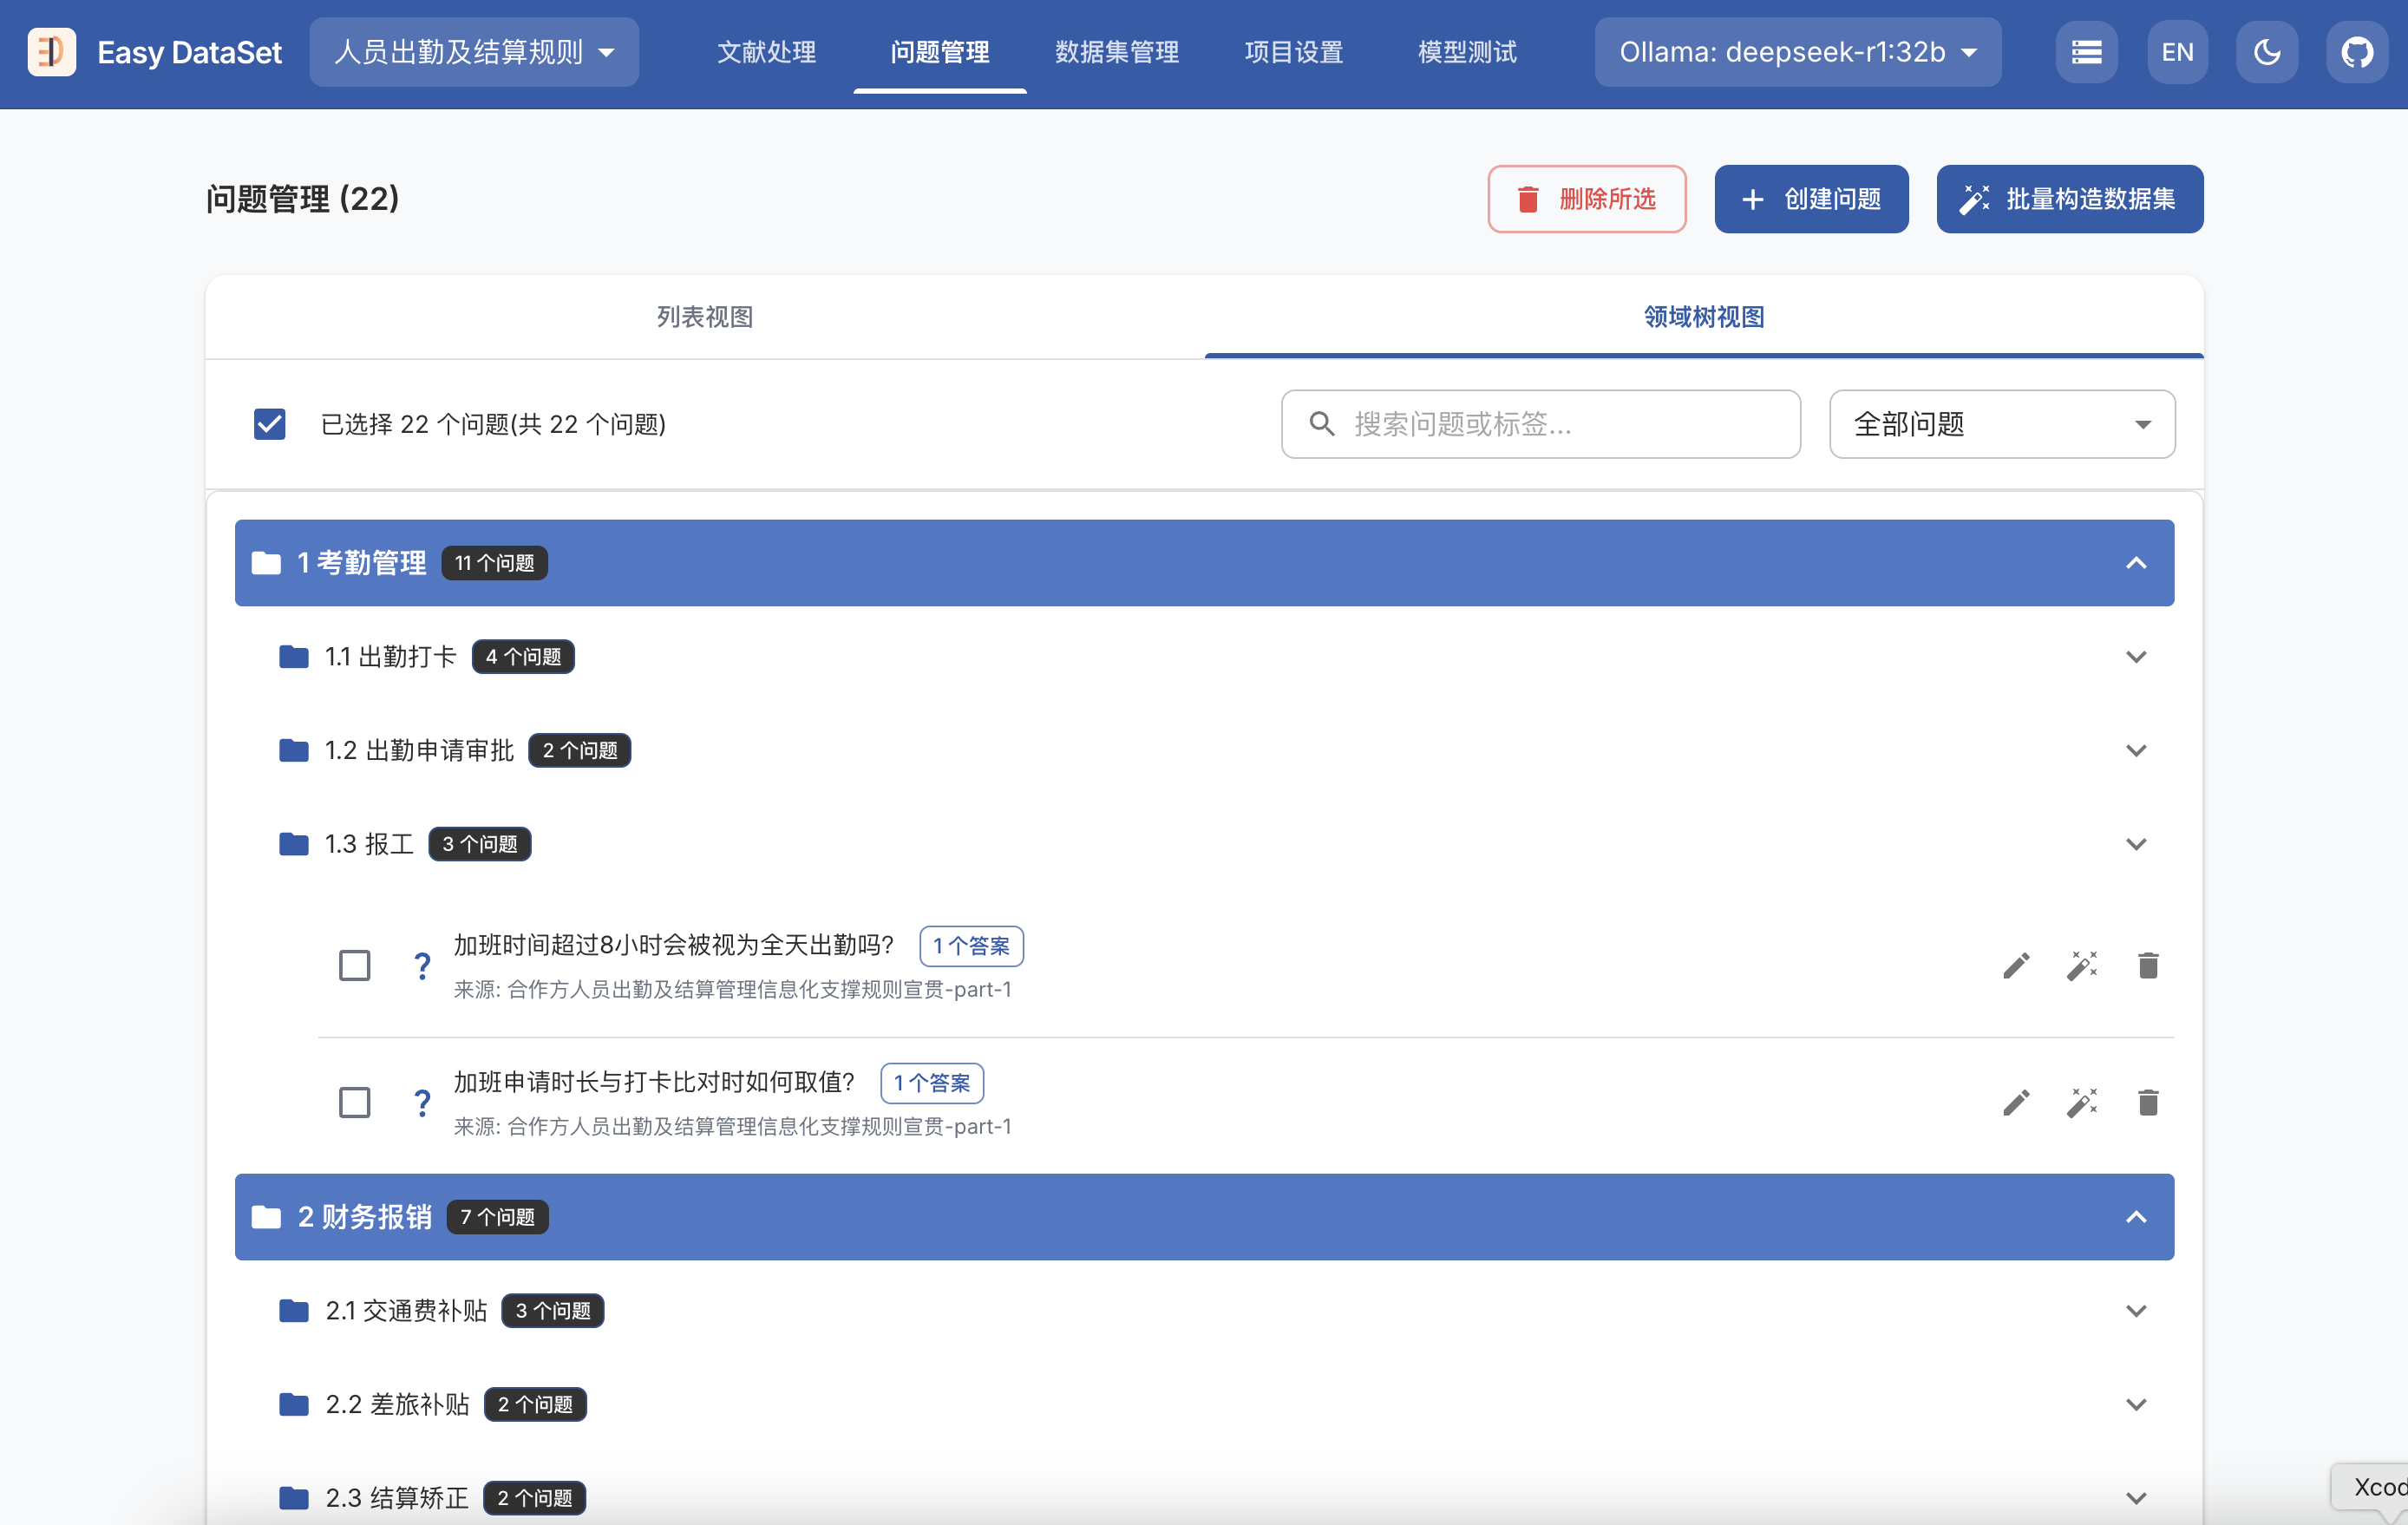
问题管理
列表视图
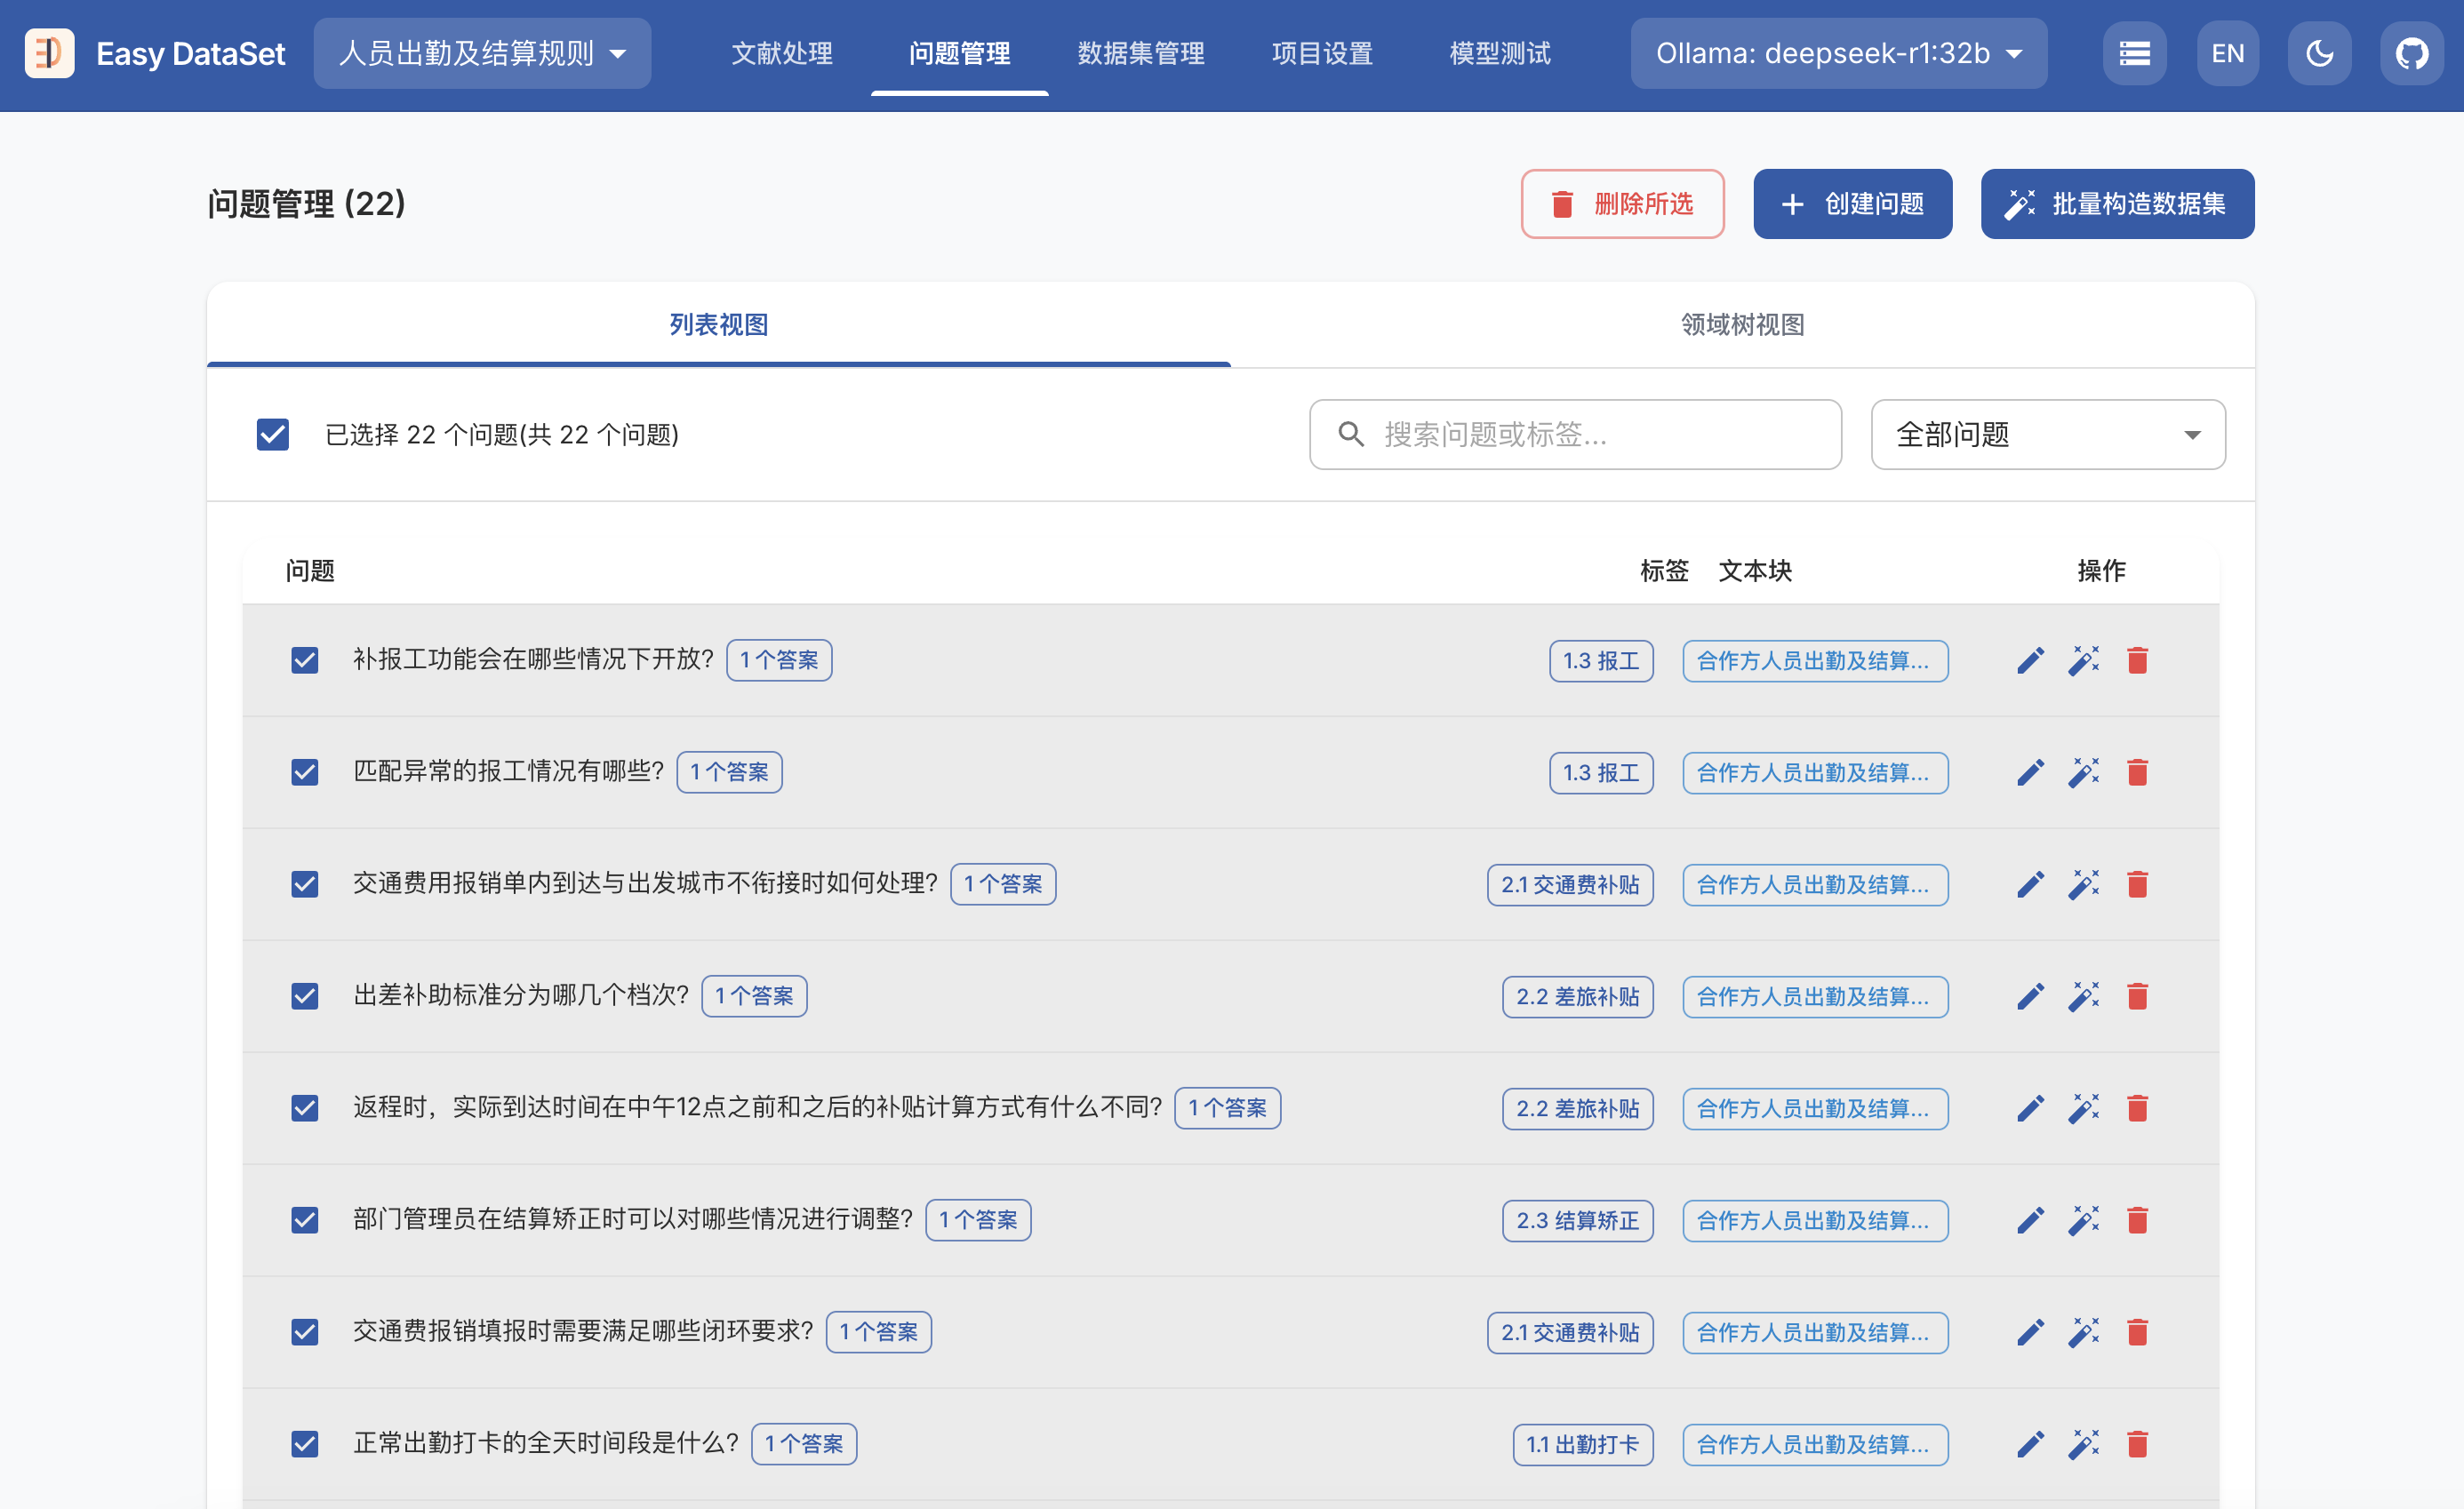
领域树视图
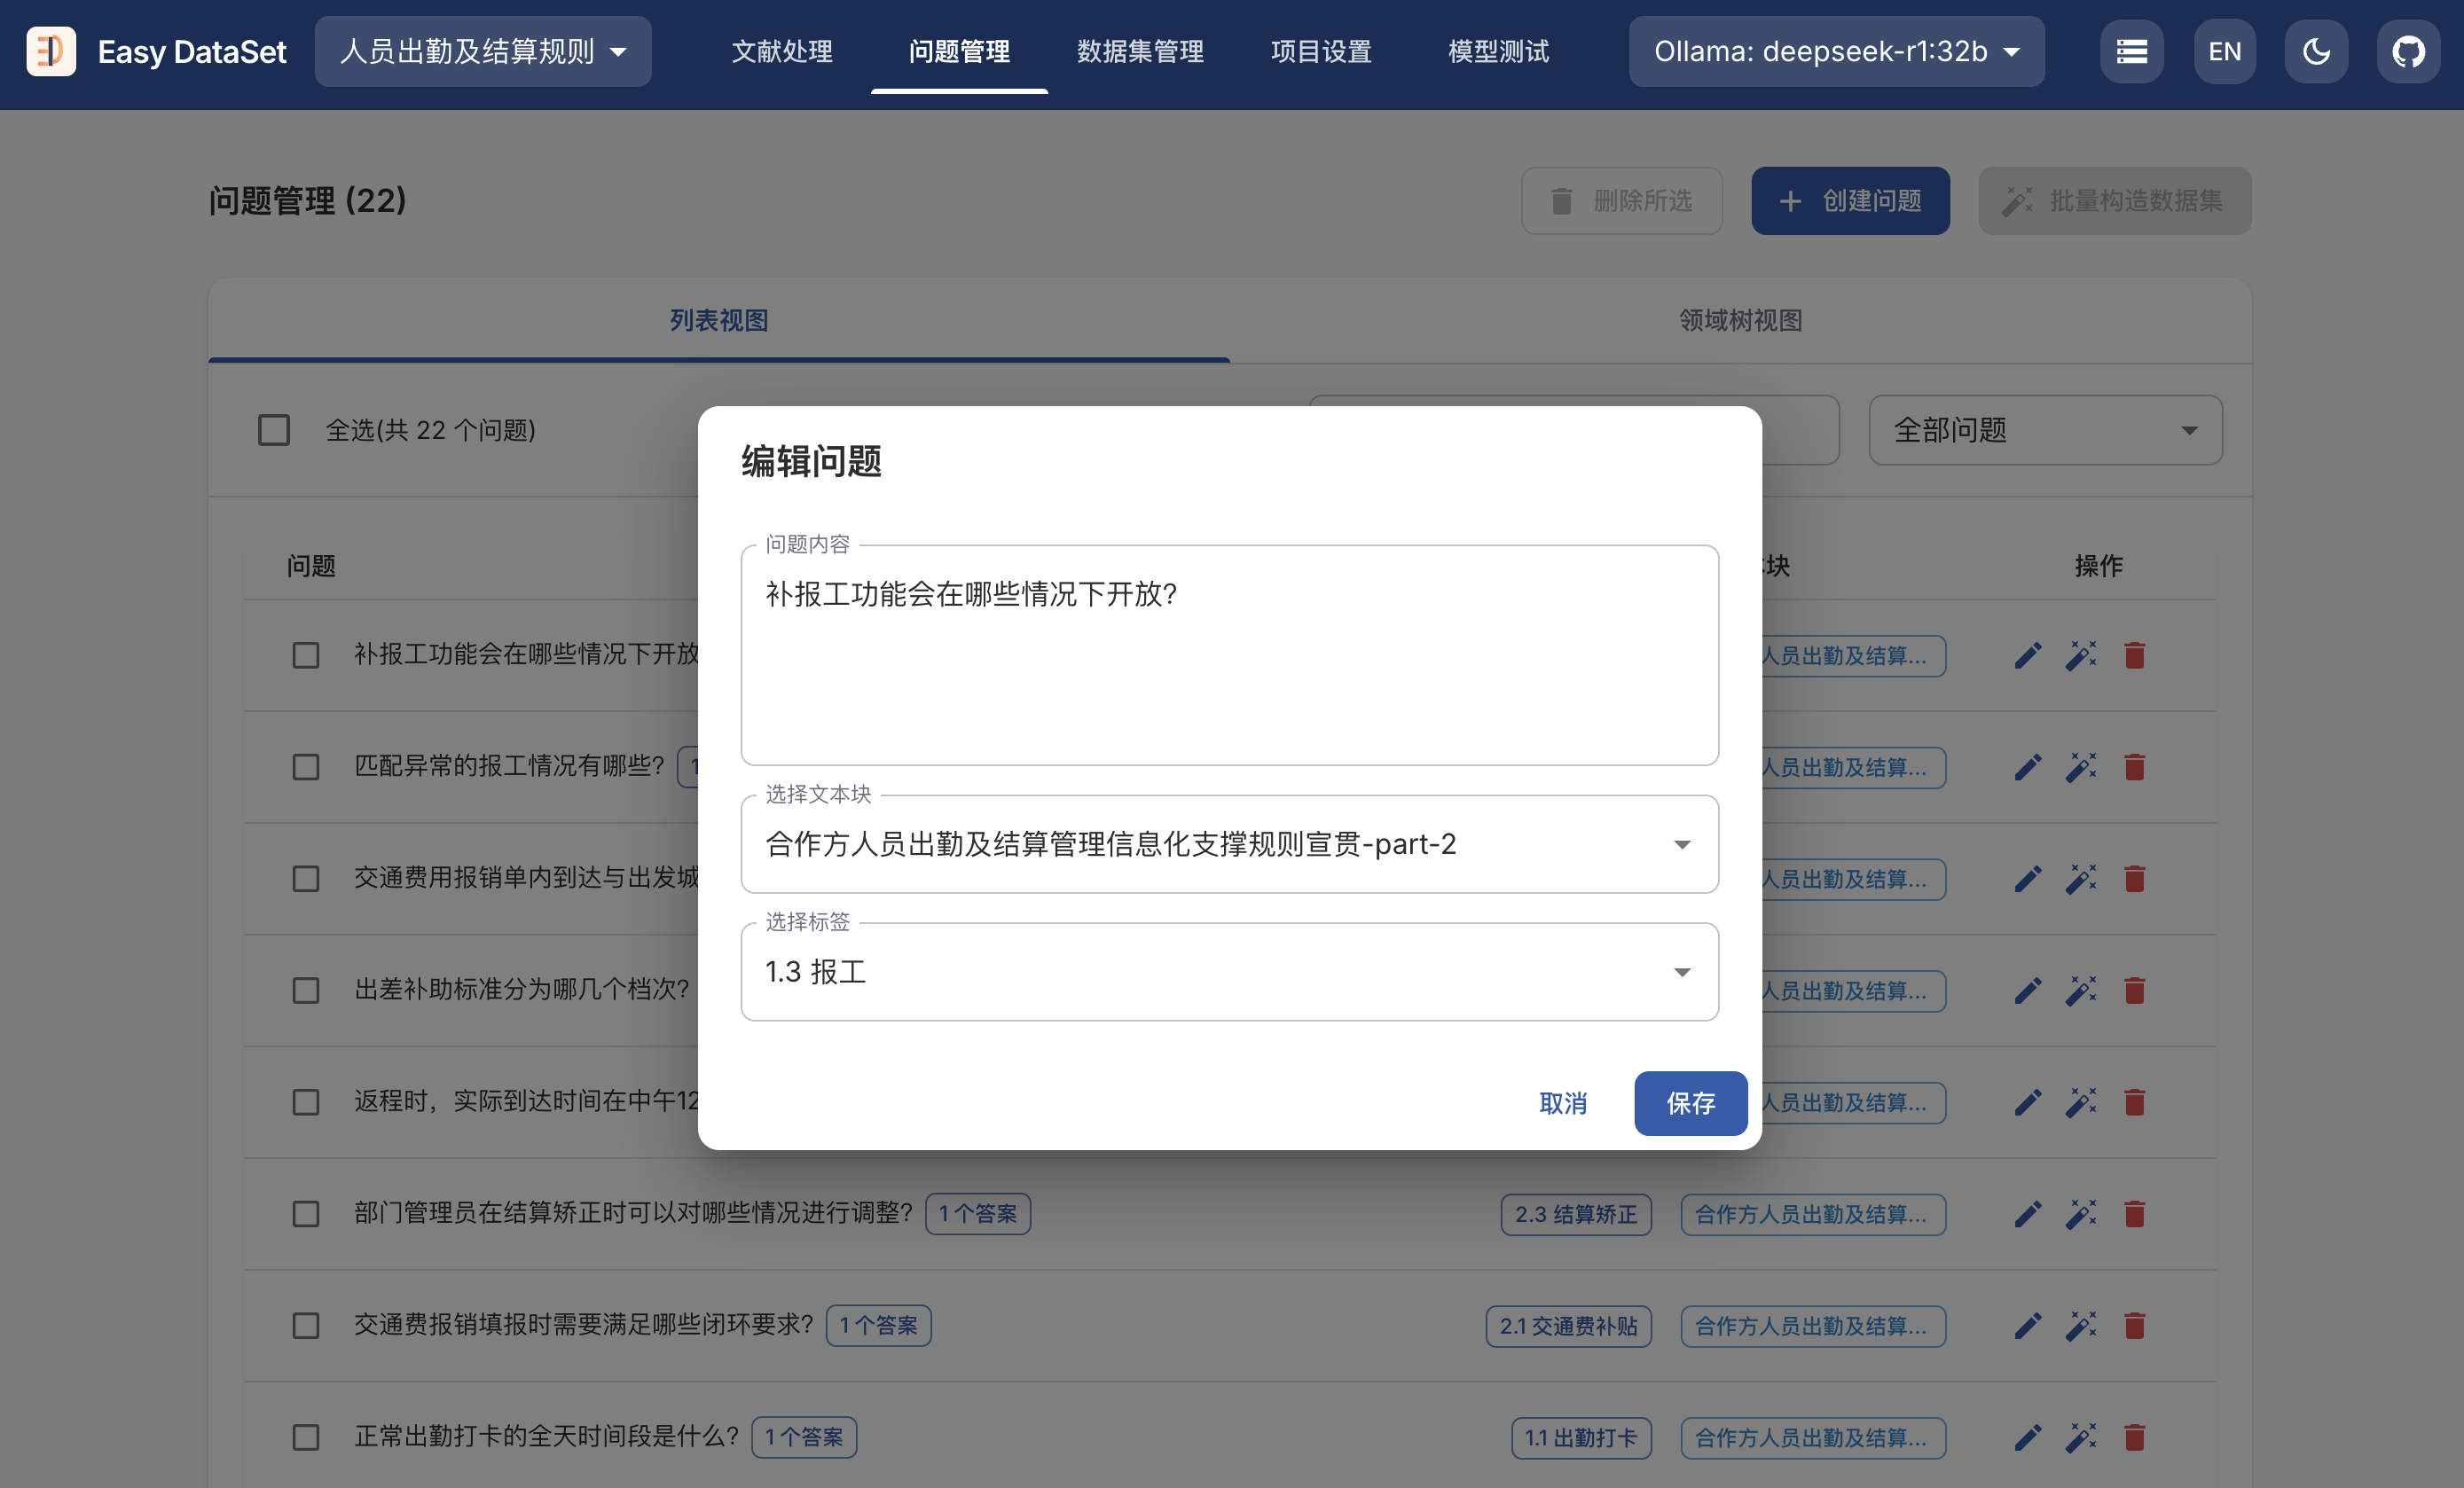
问题编辑
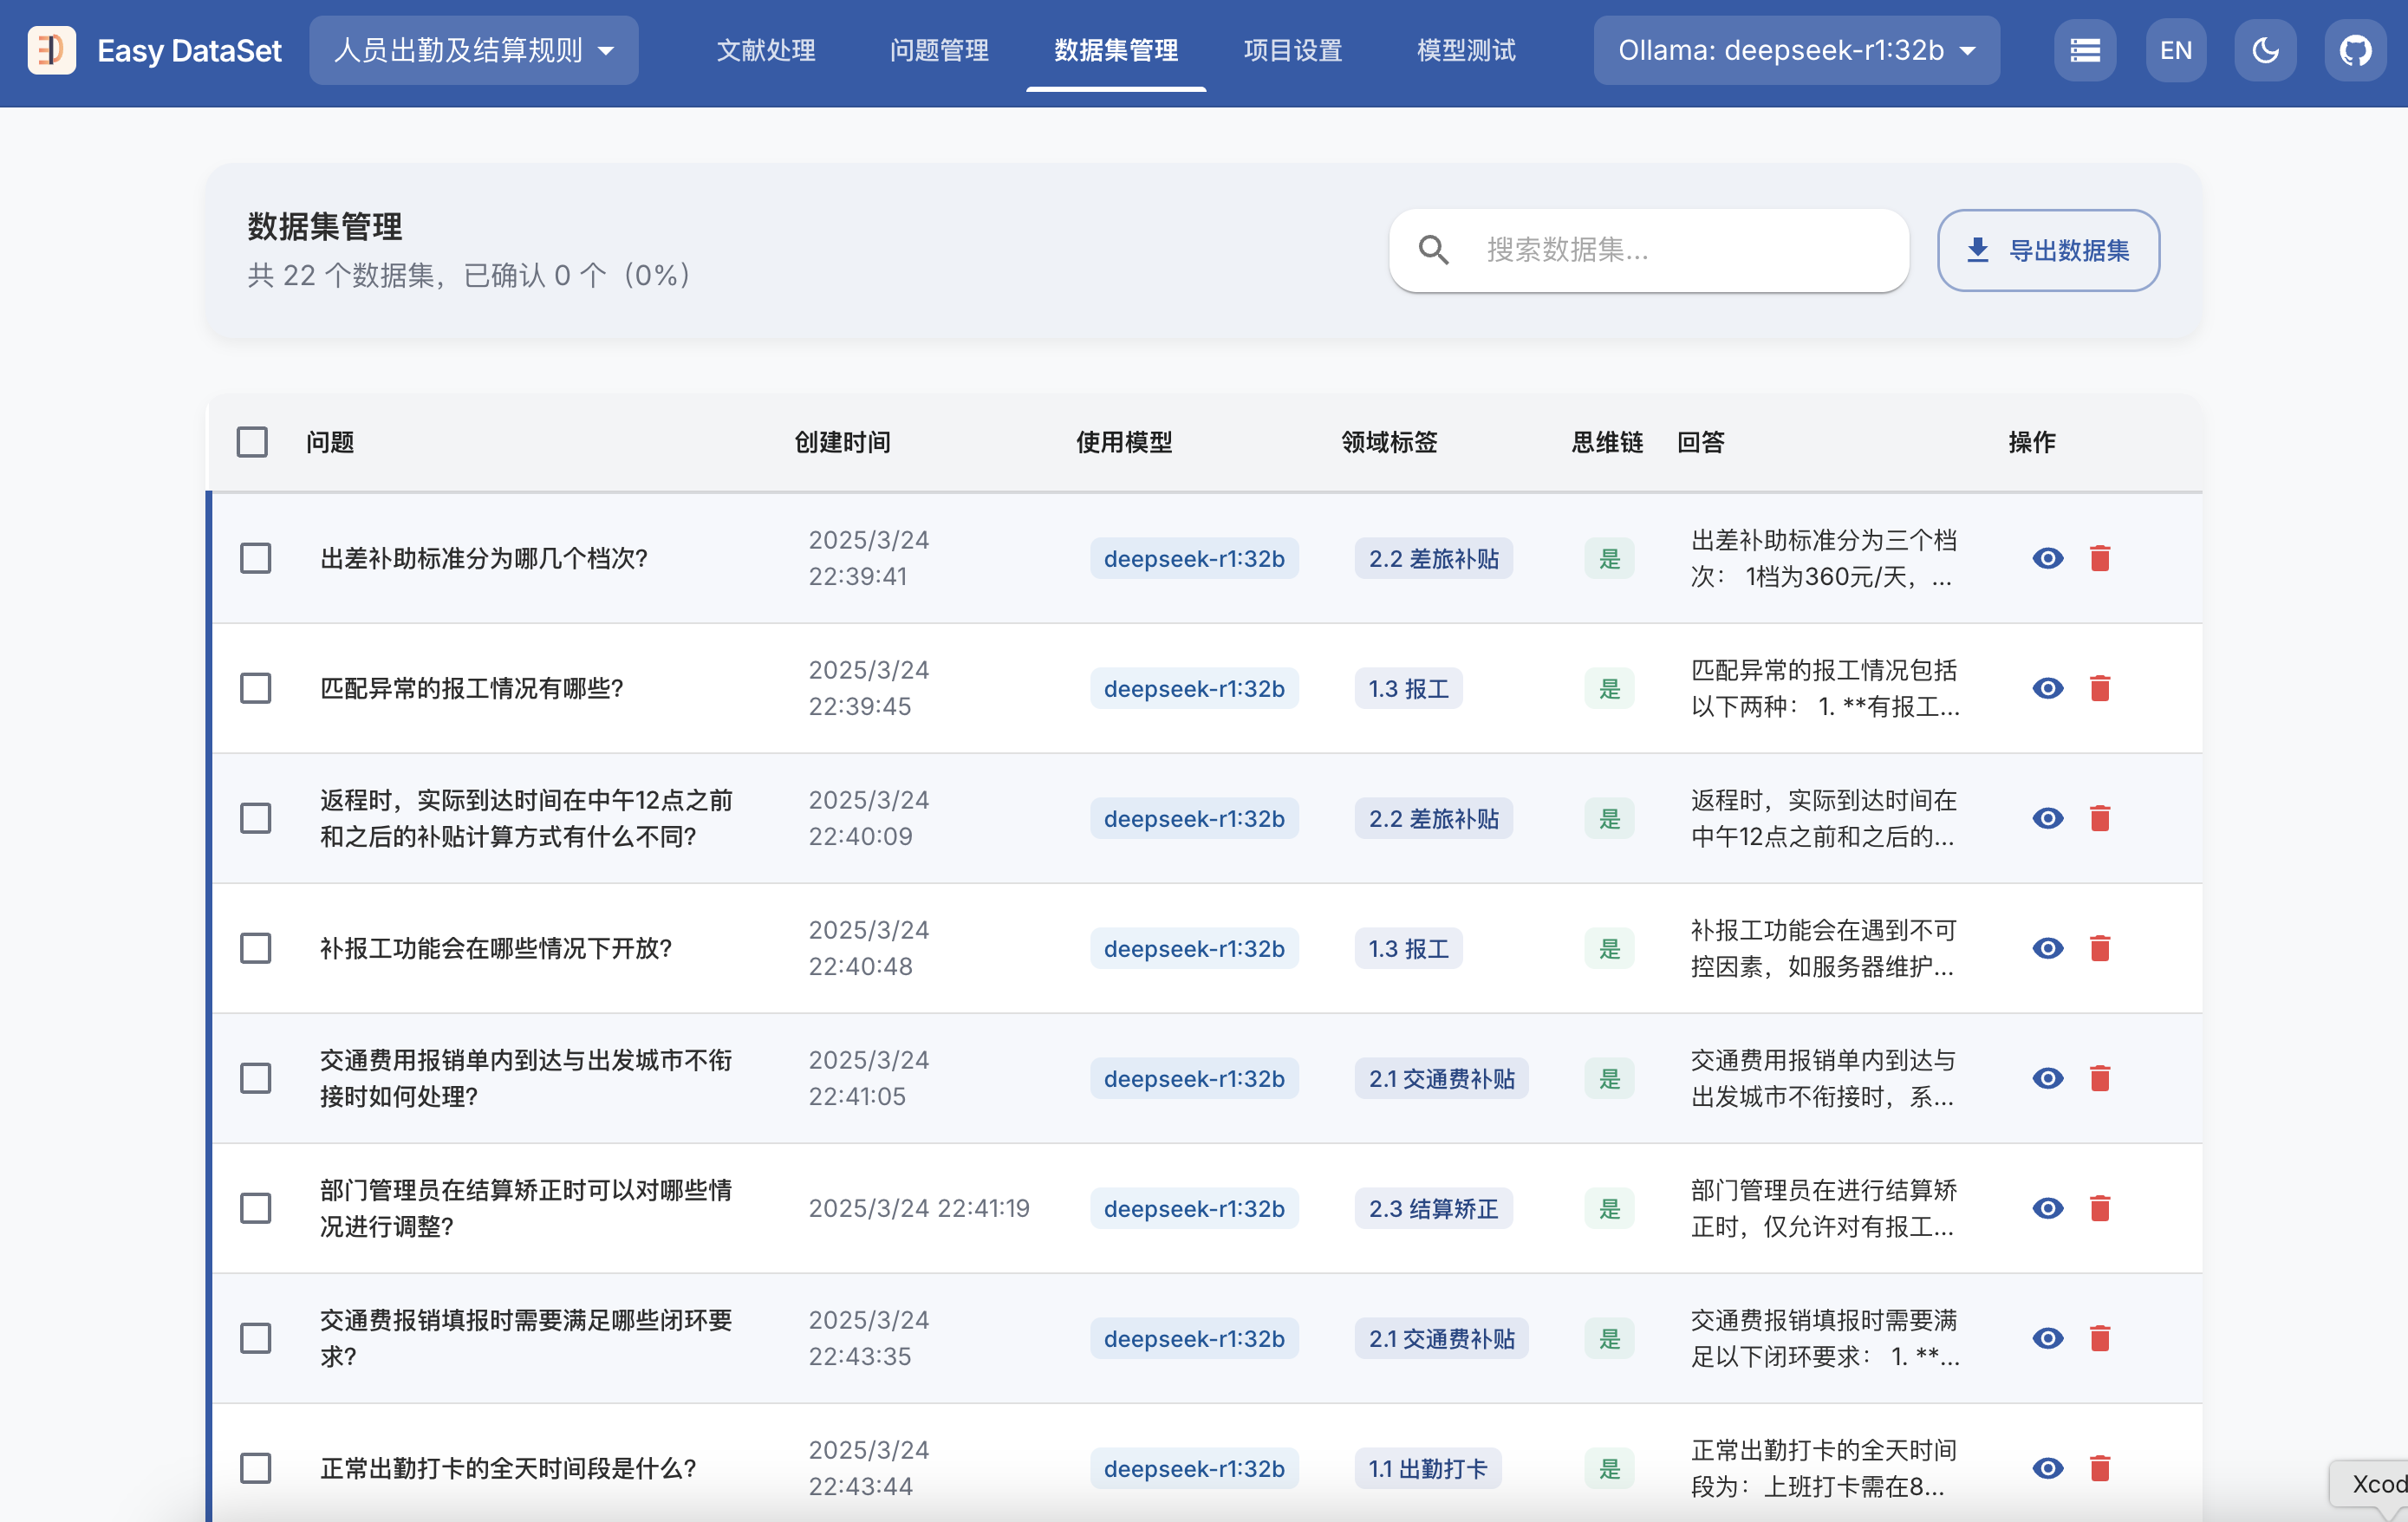
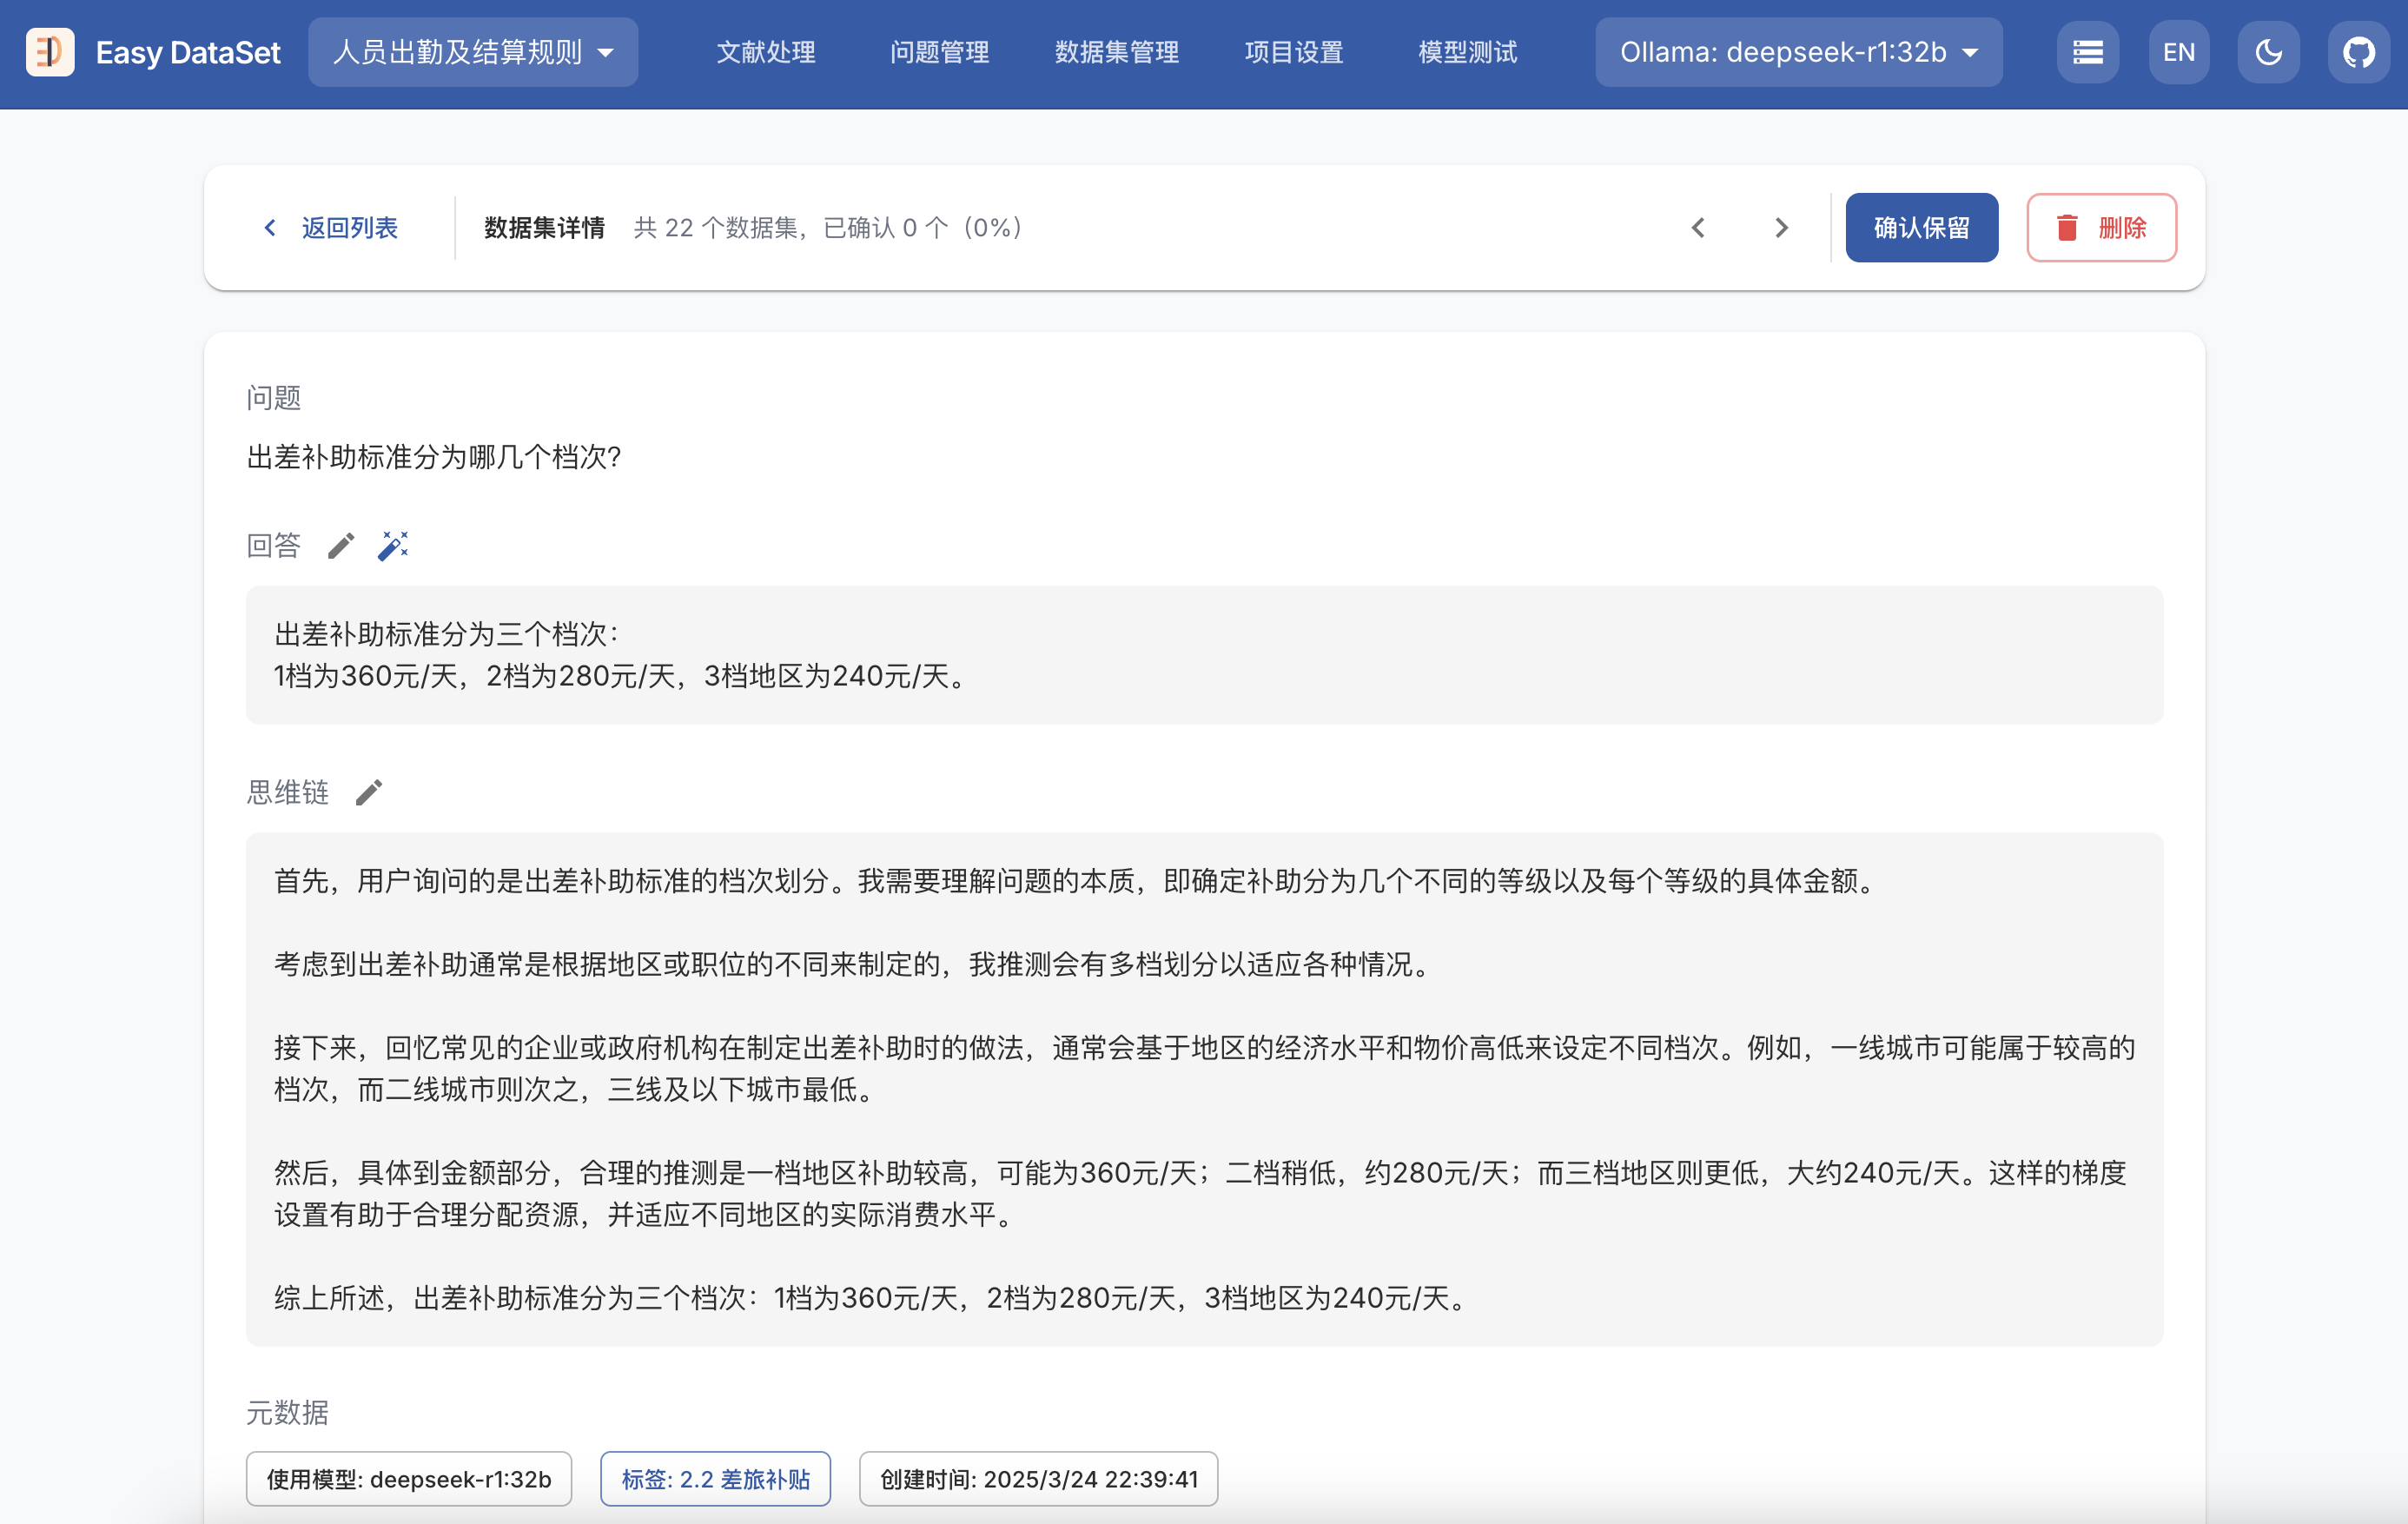
数据集管理
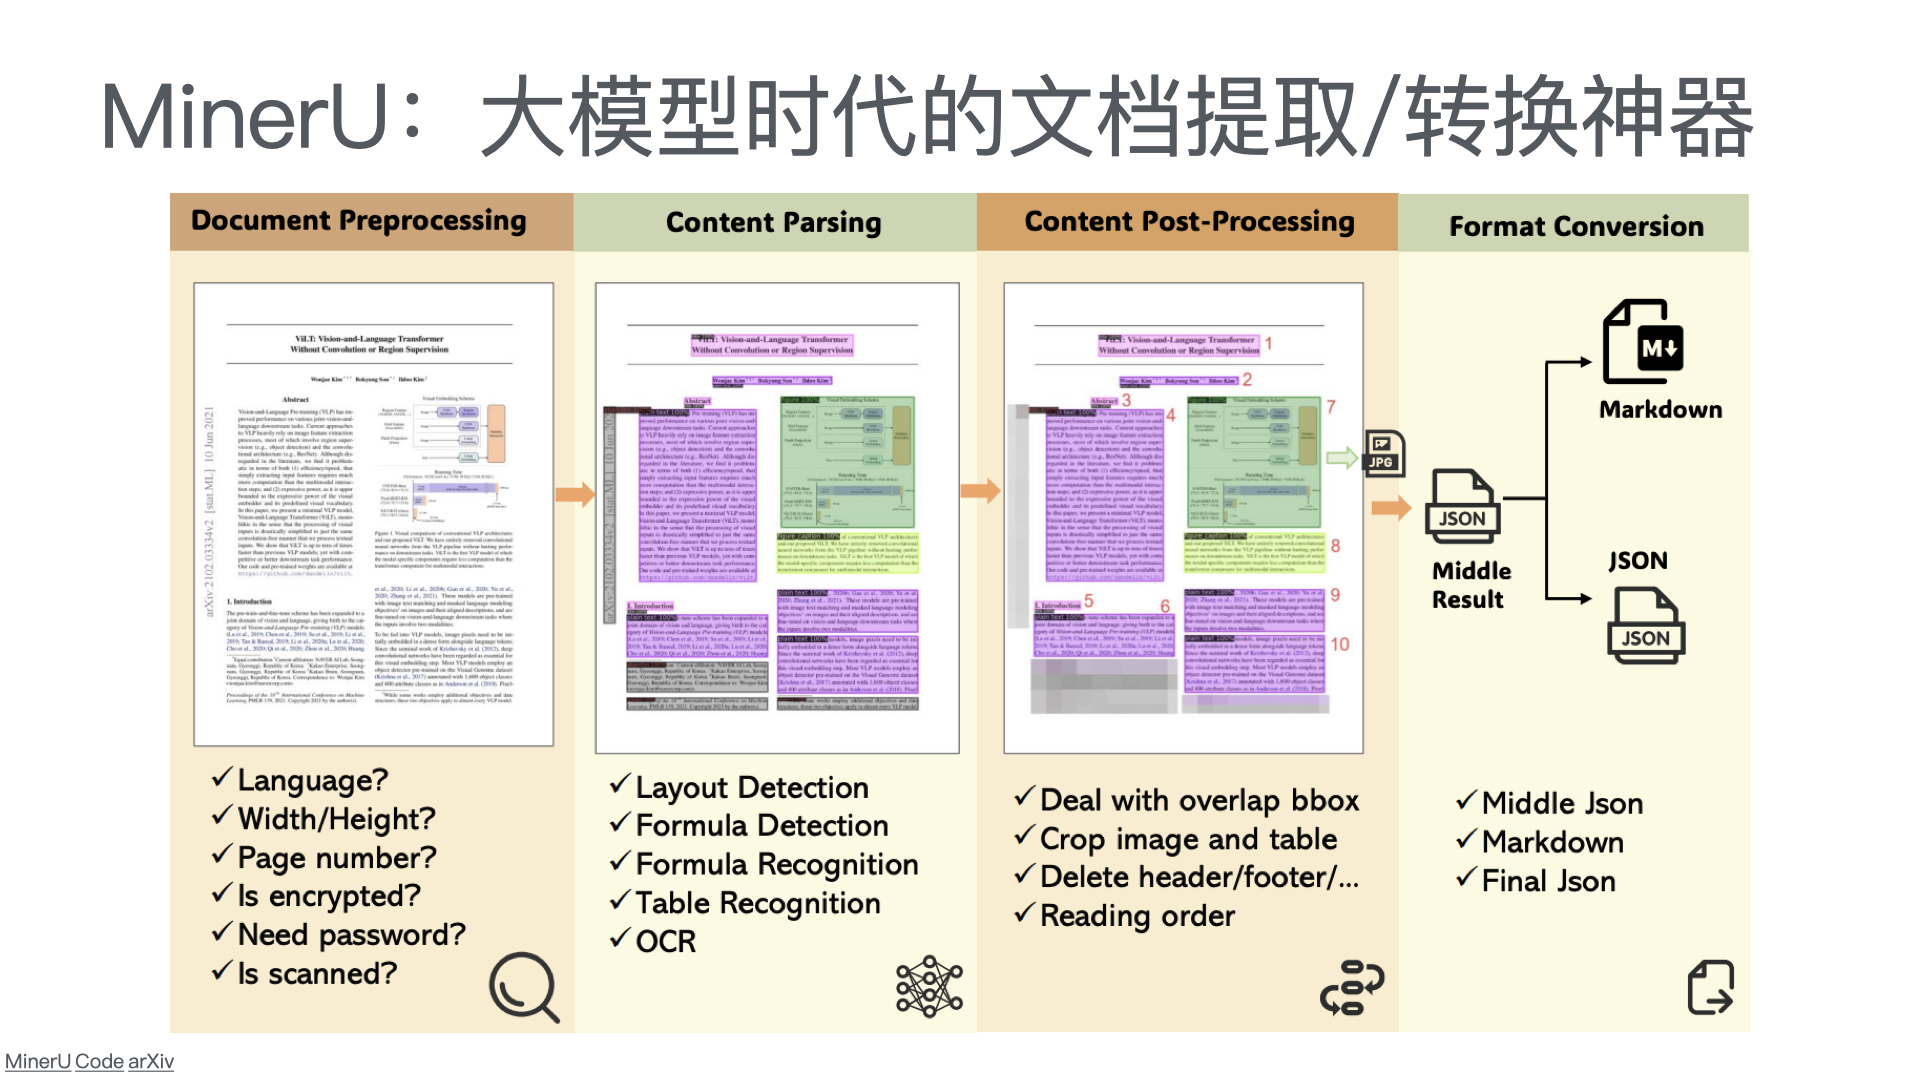
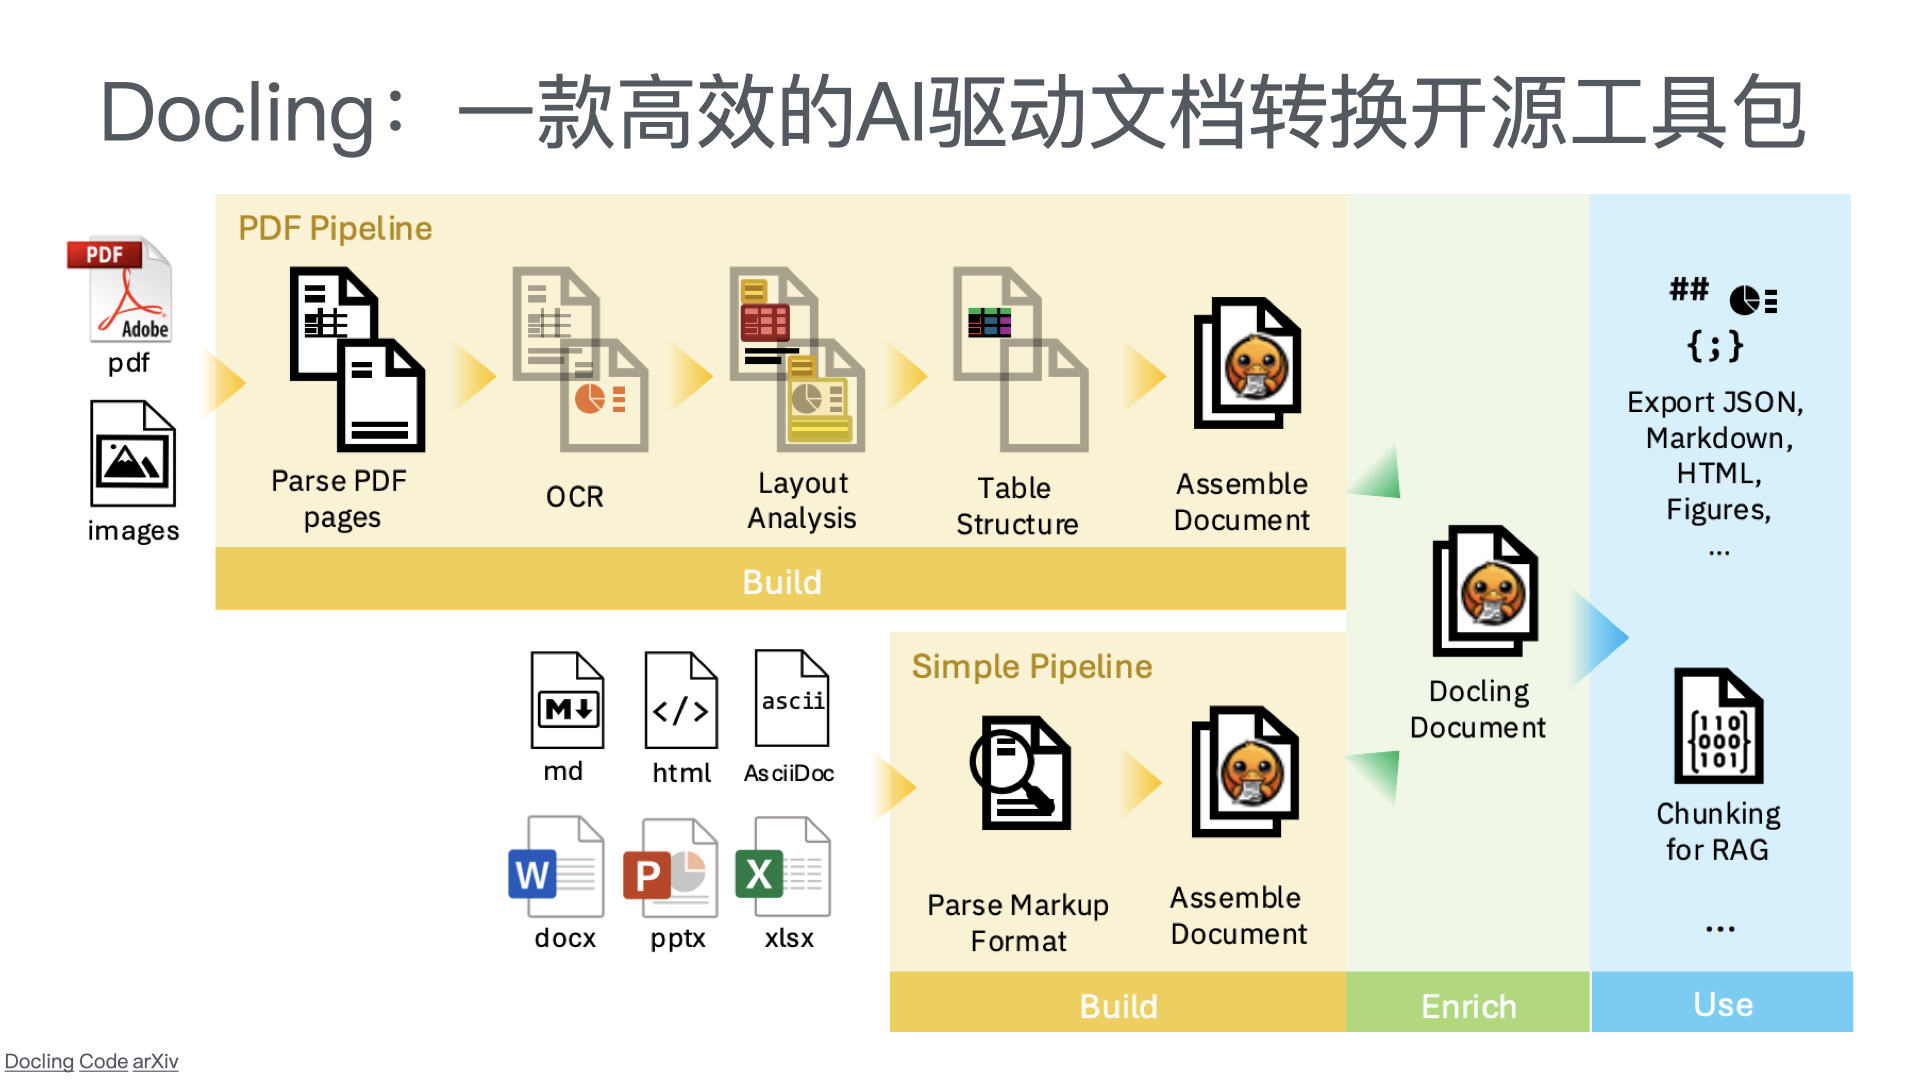
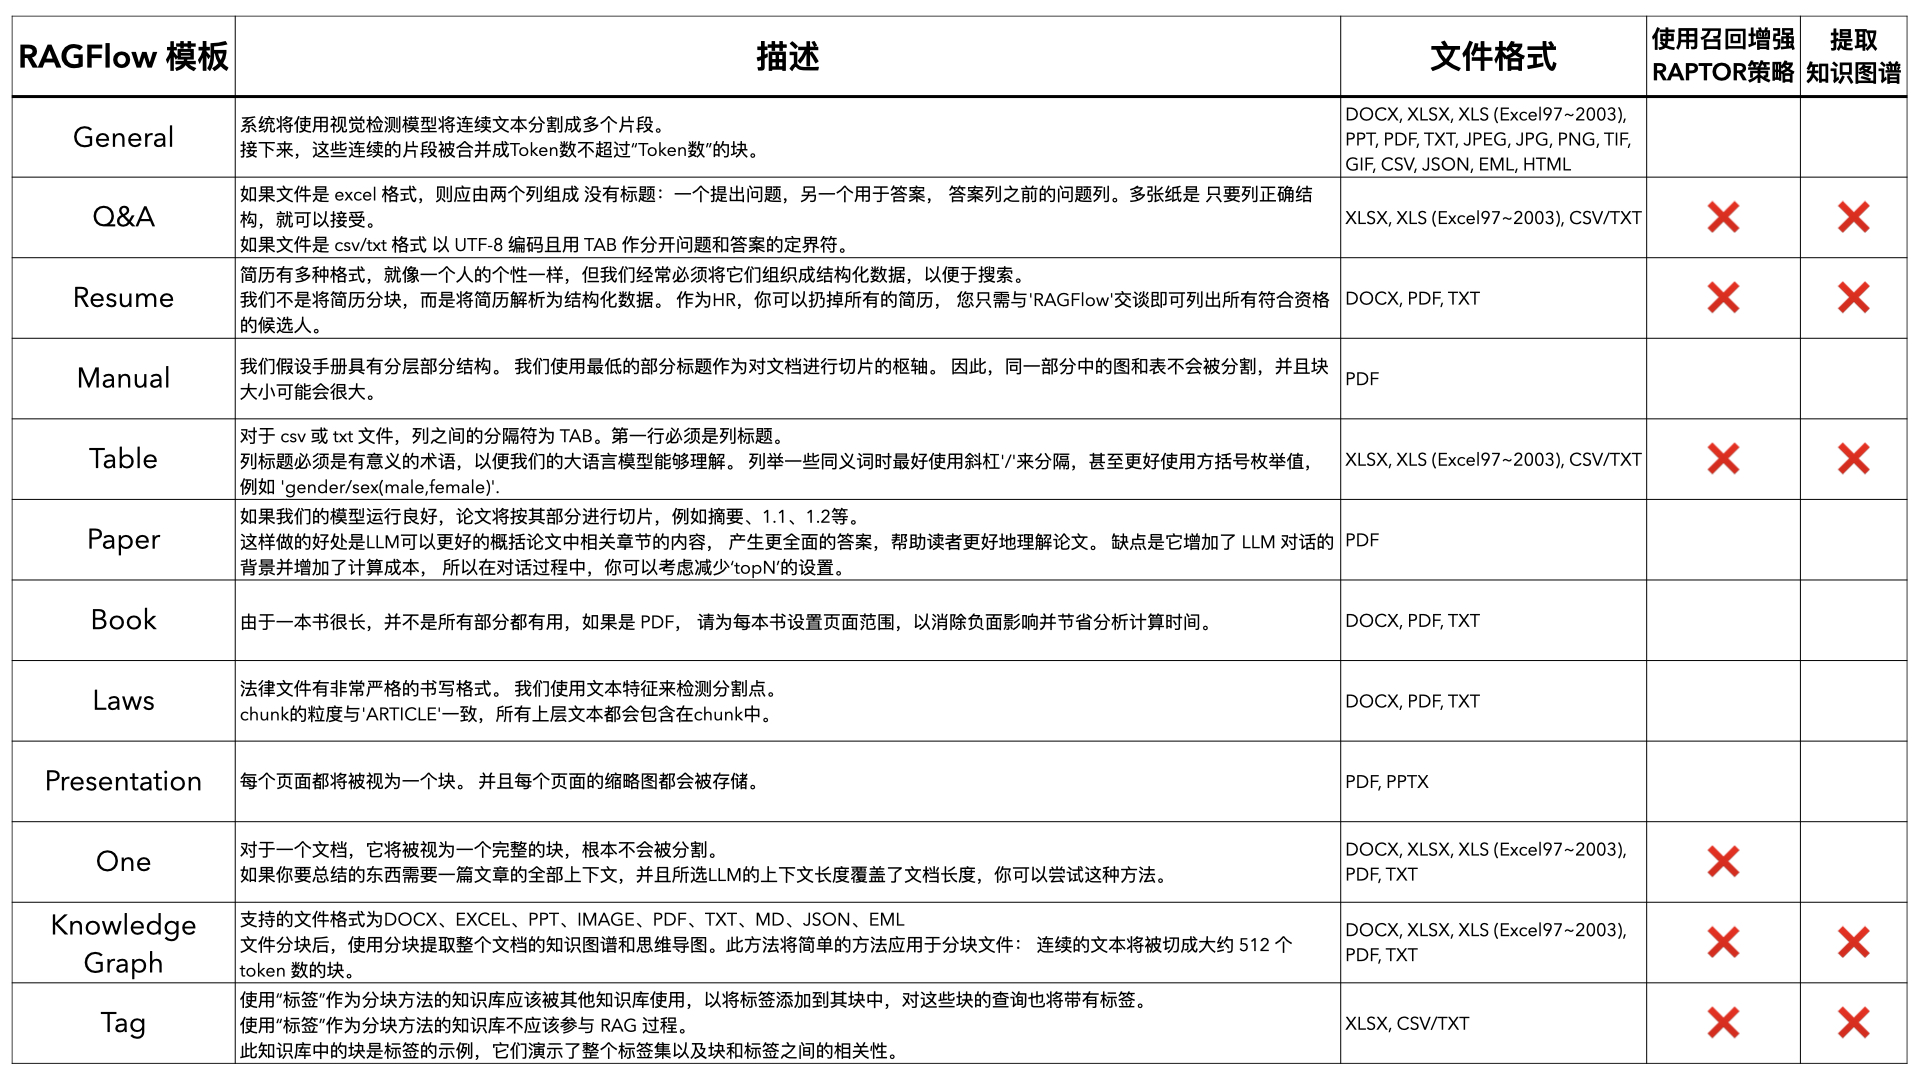
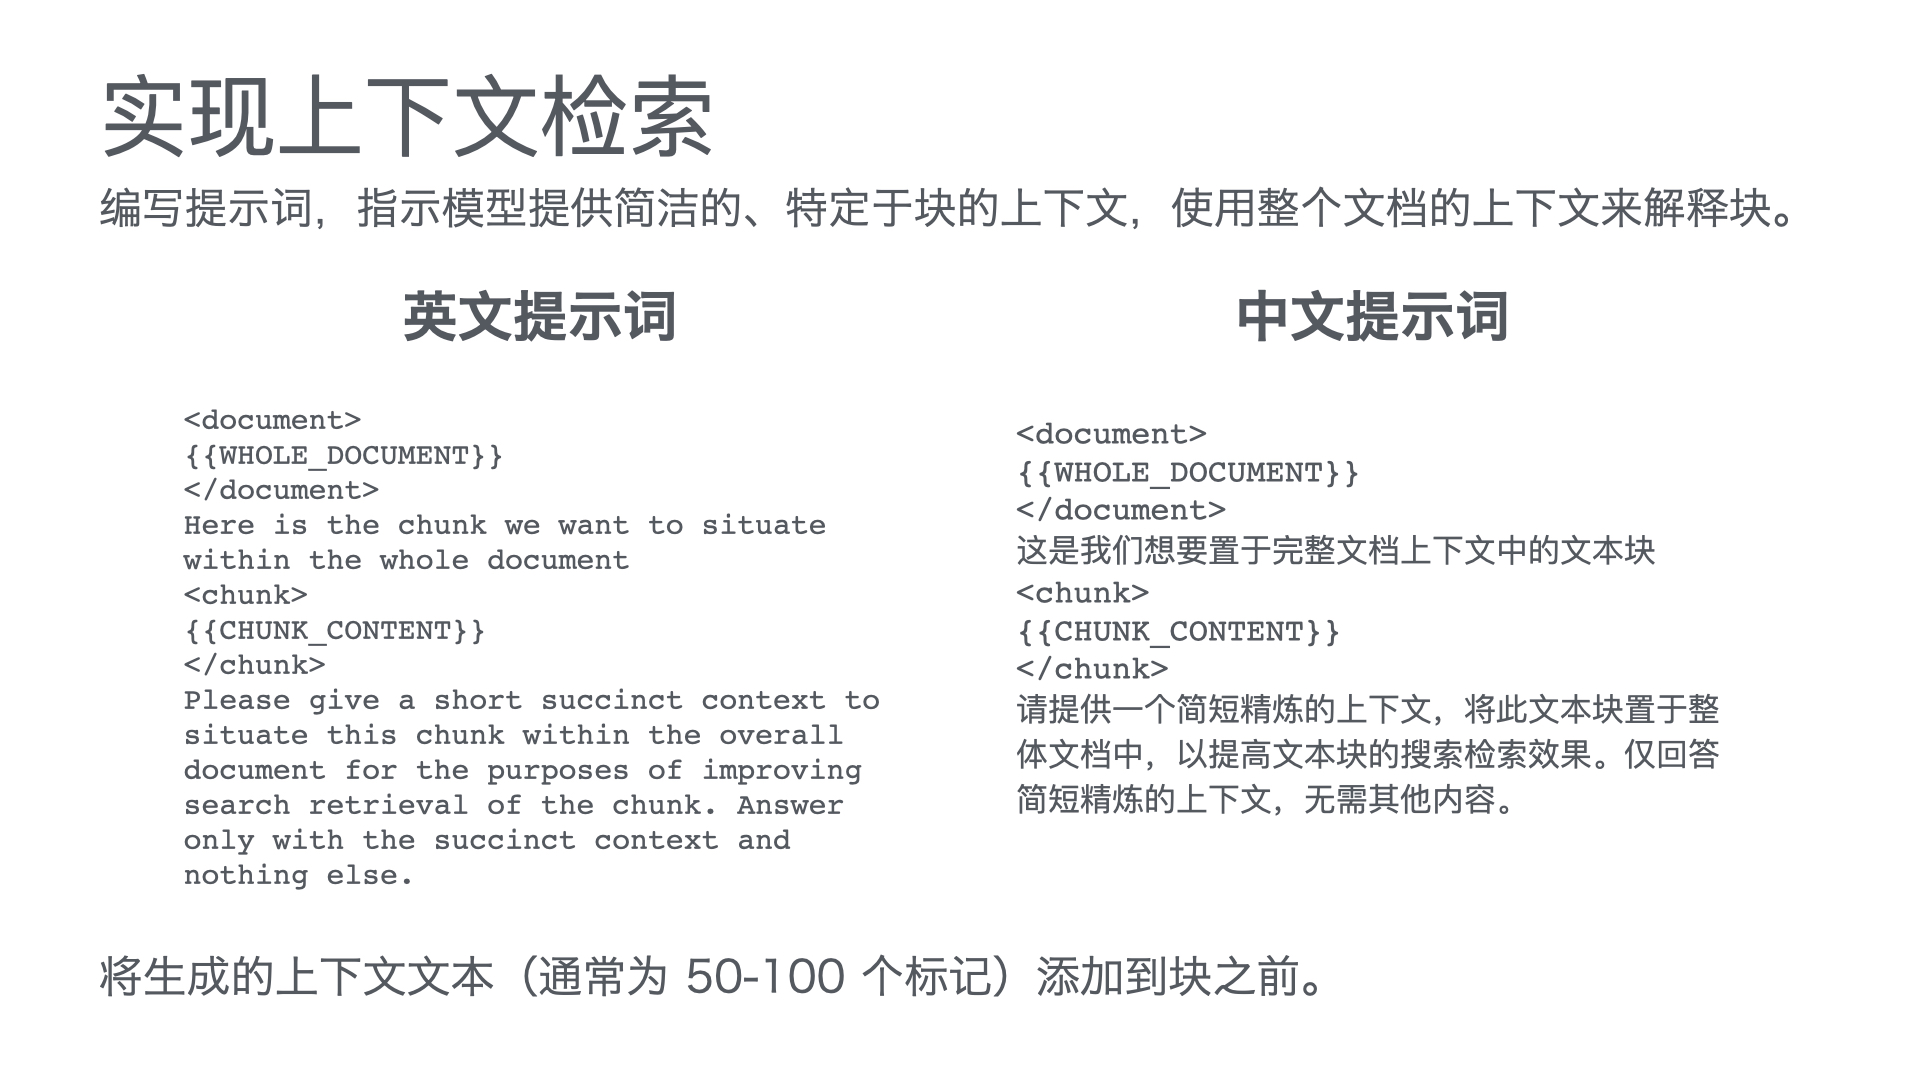
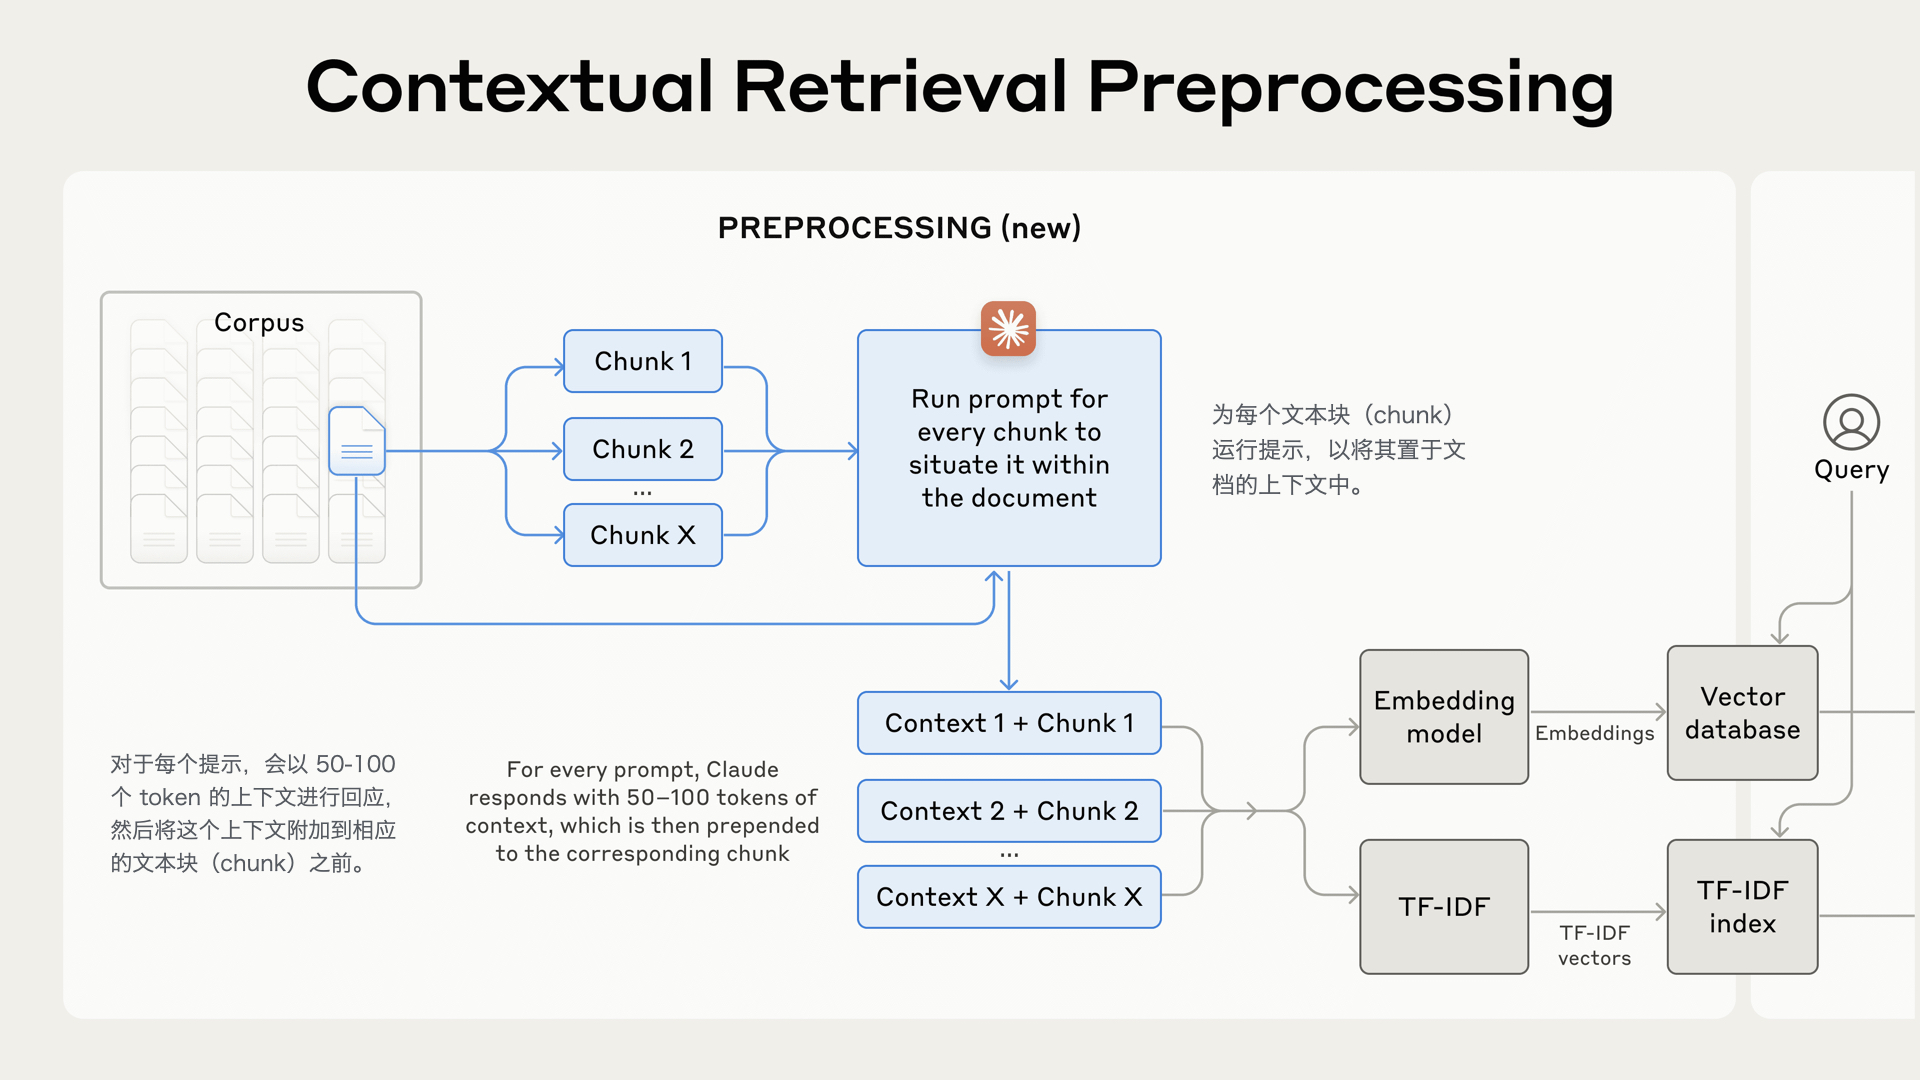
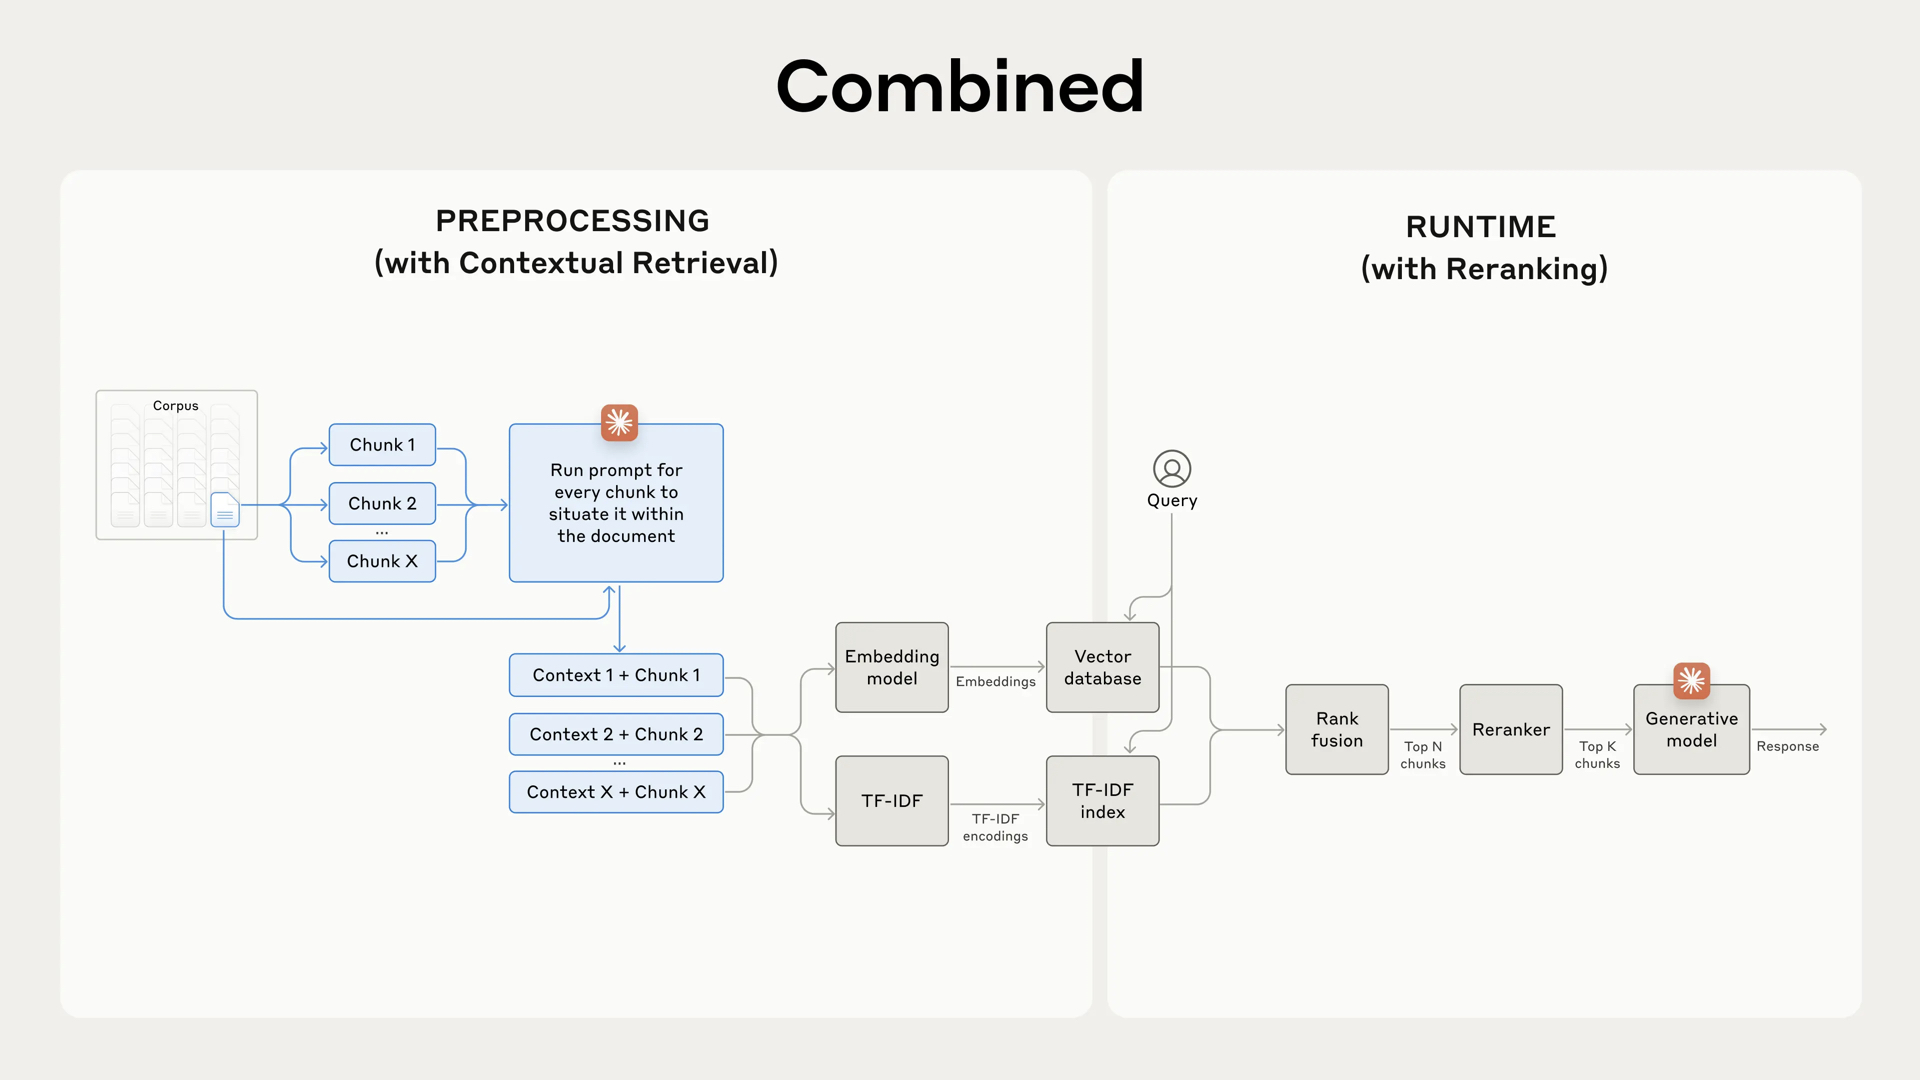
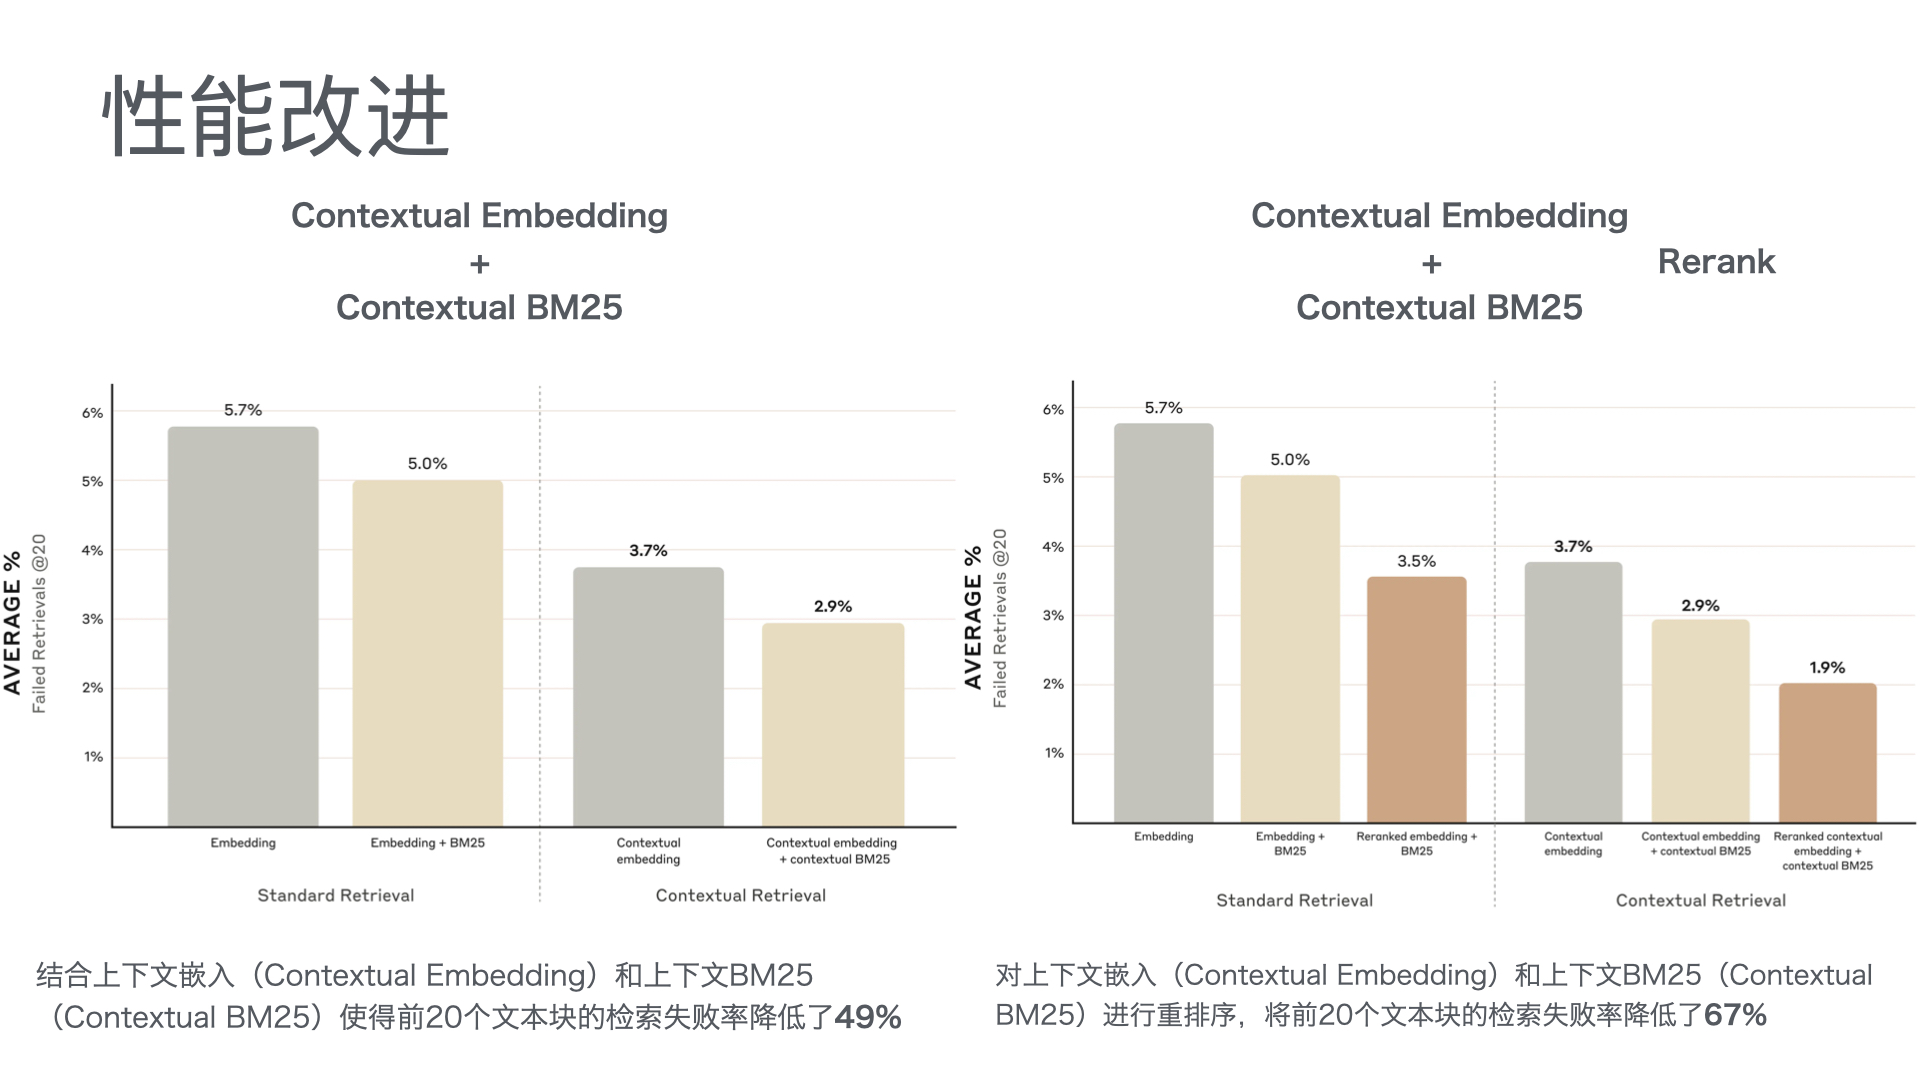
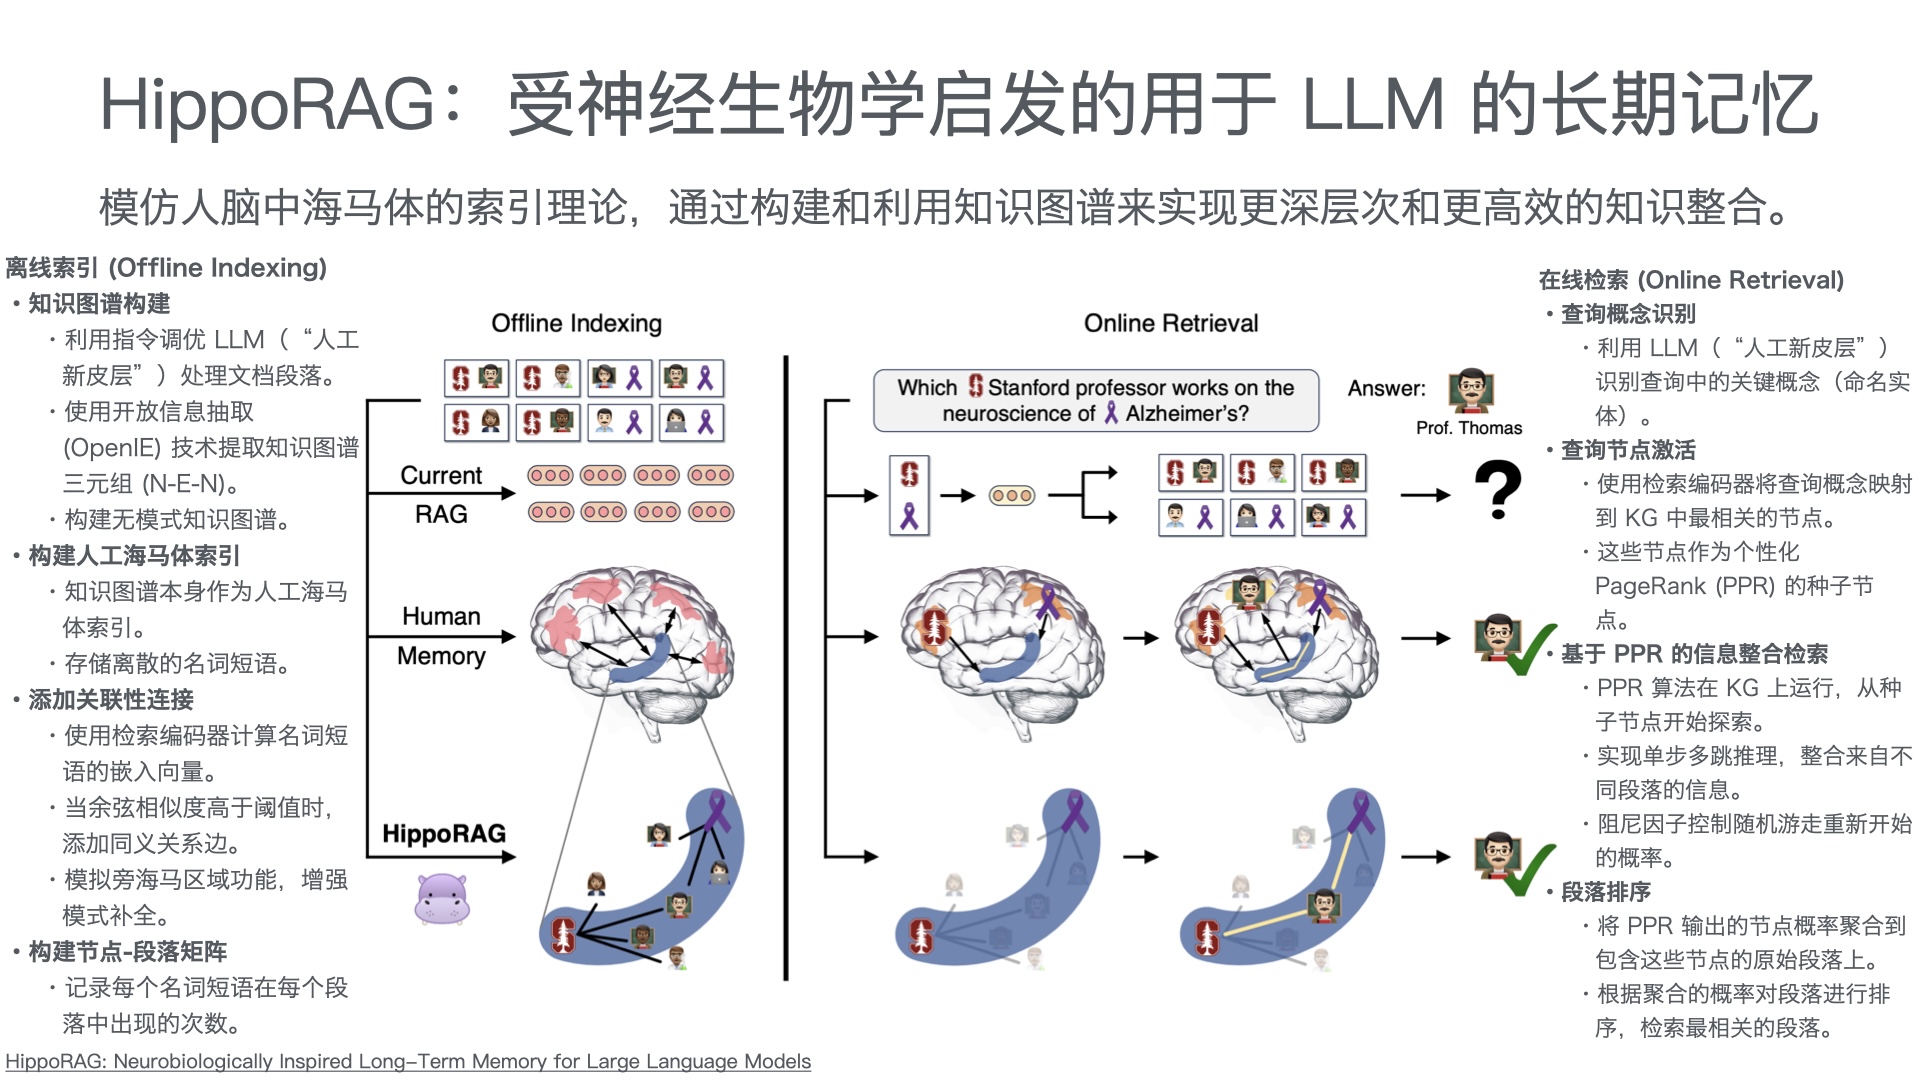
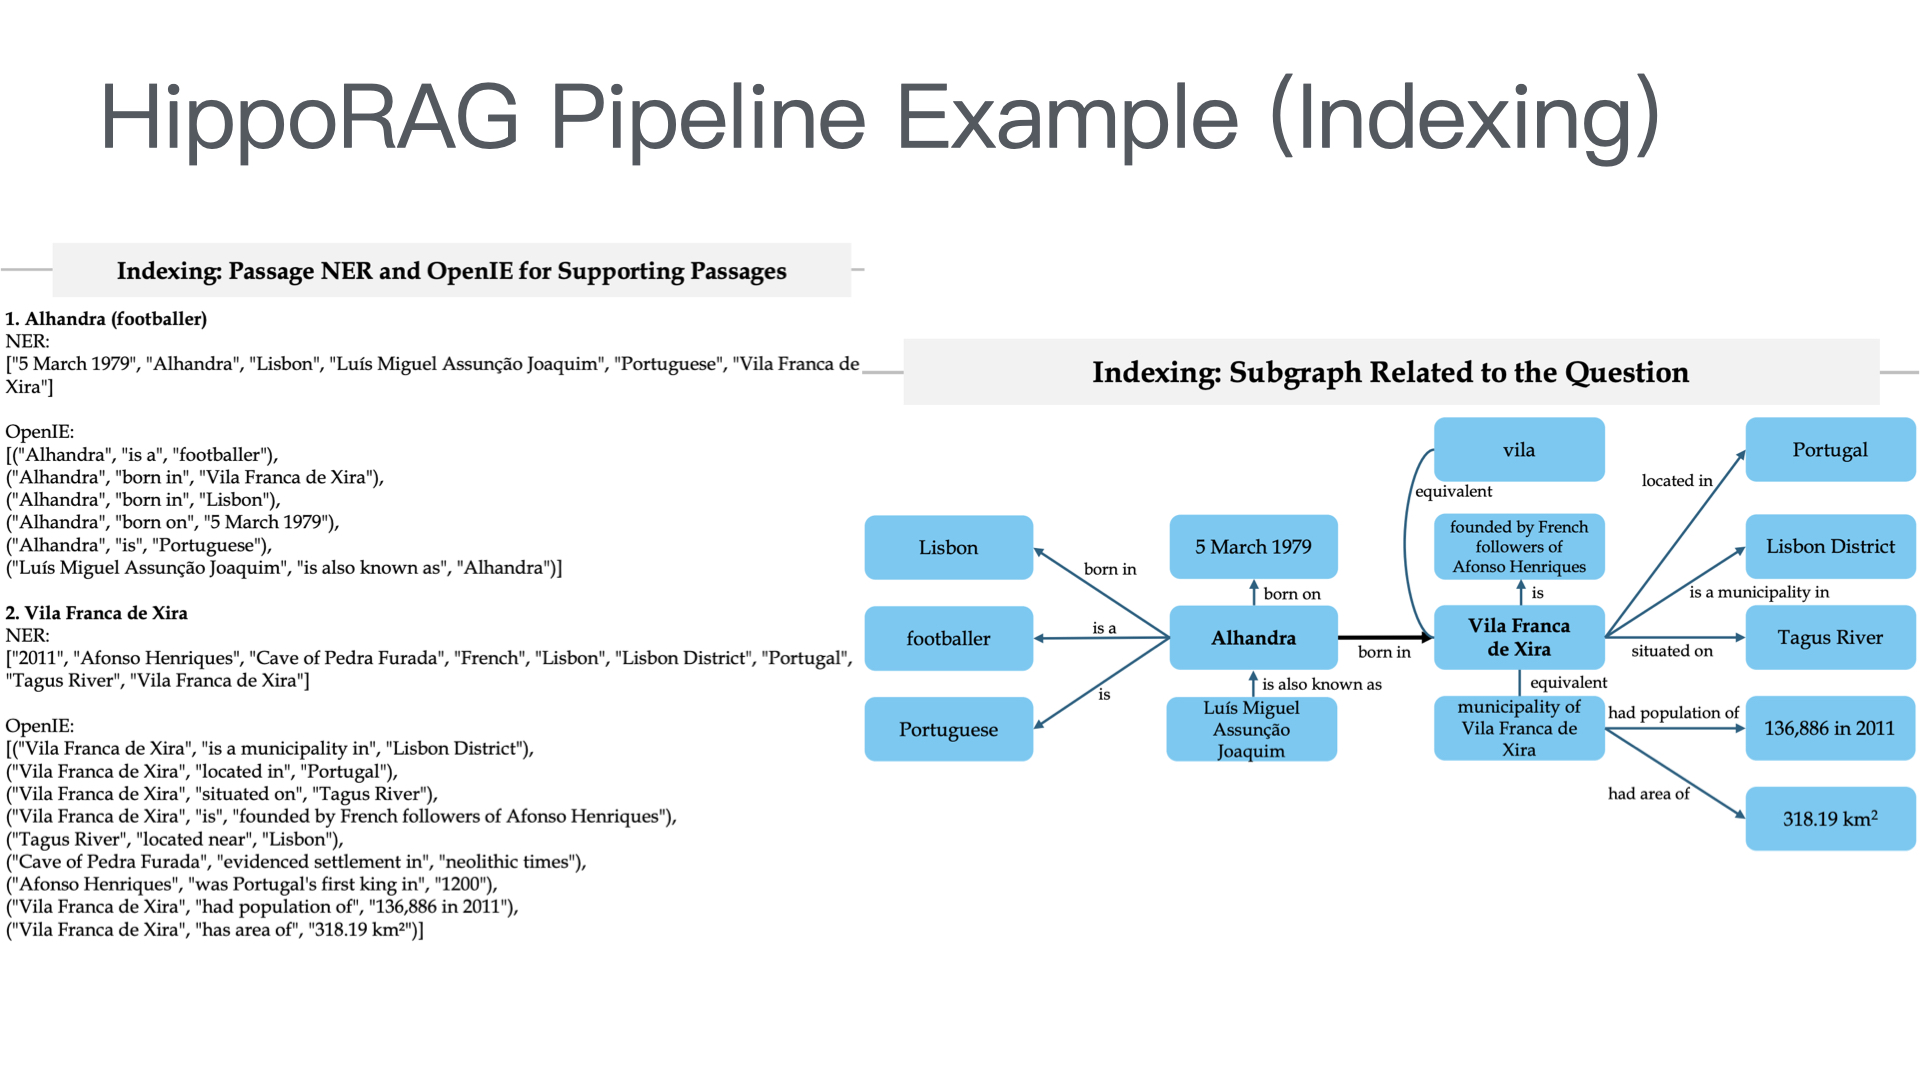
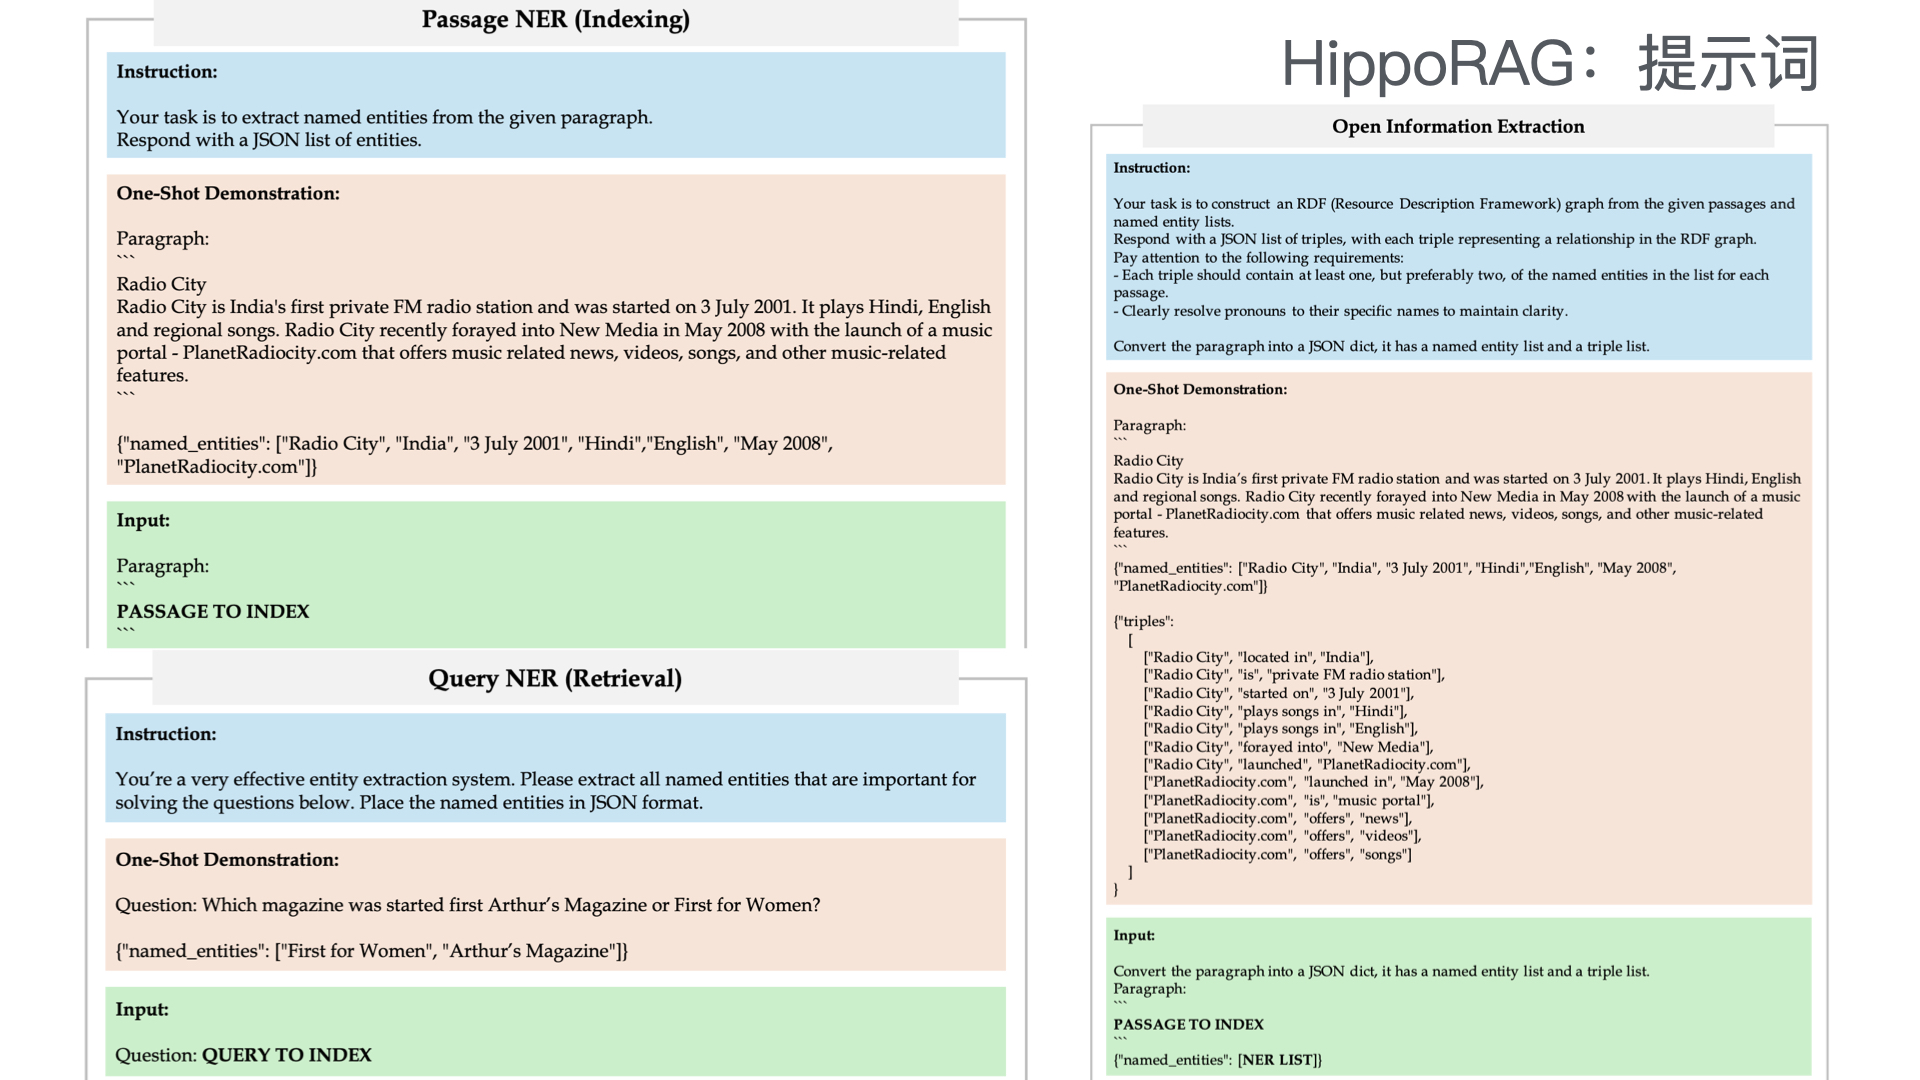
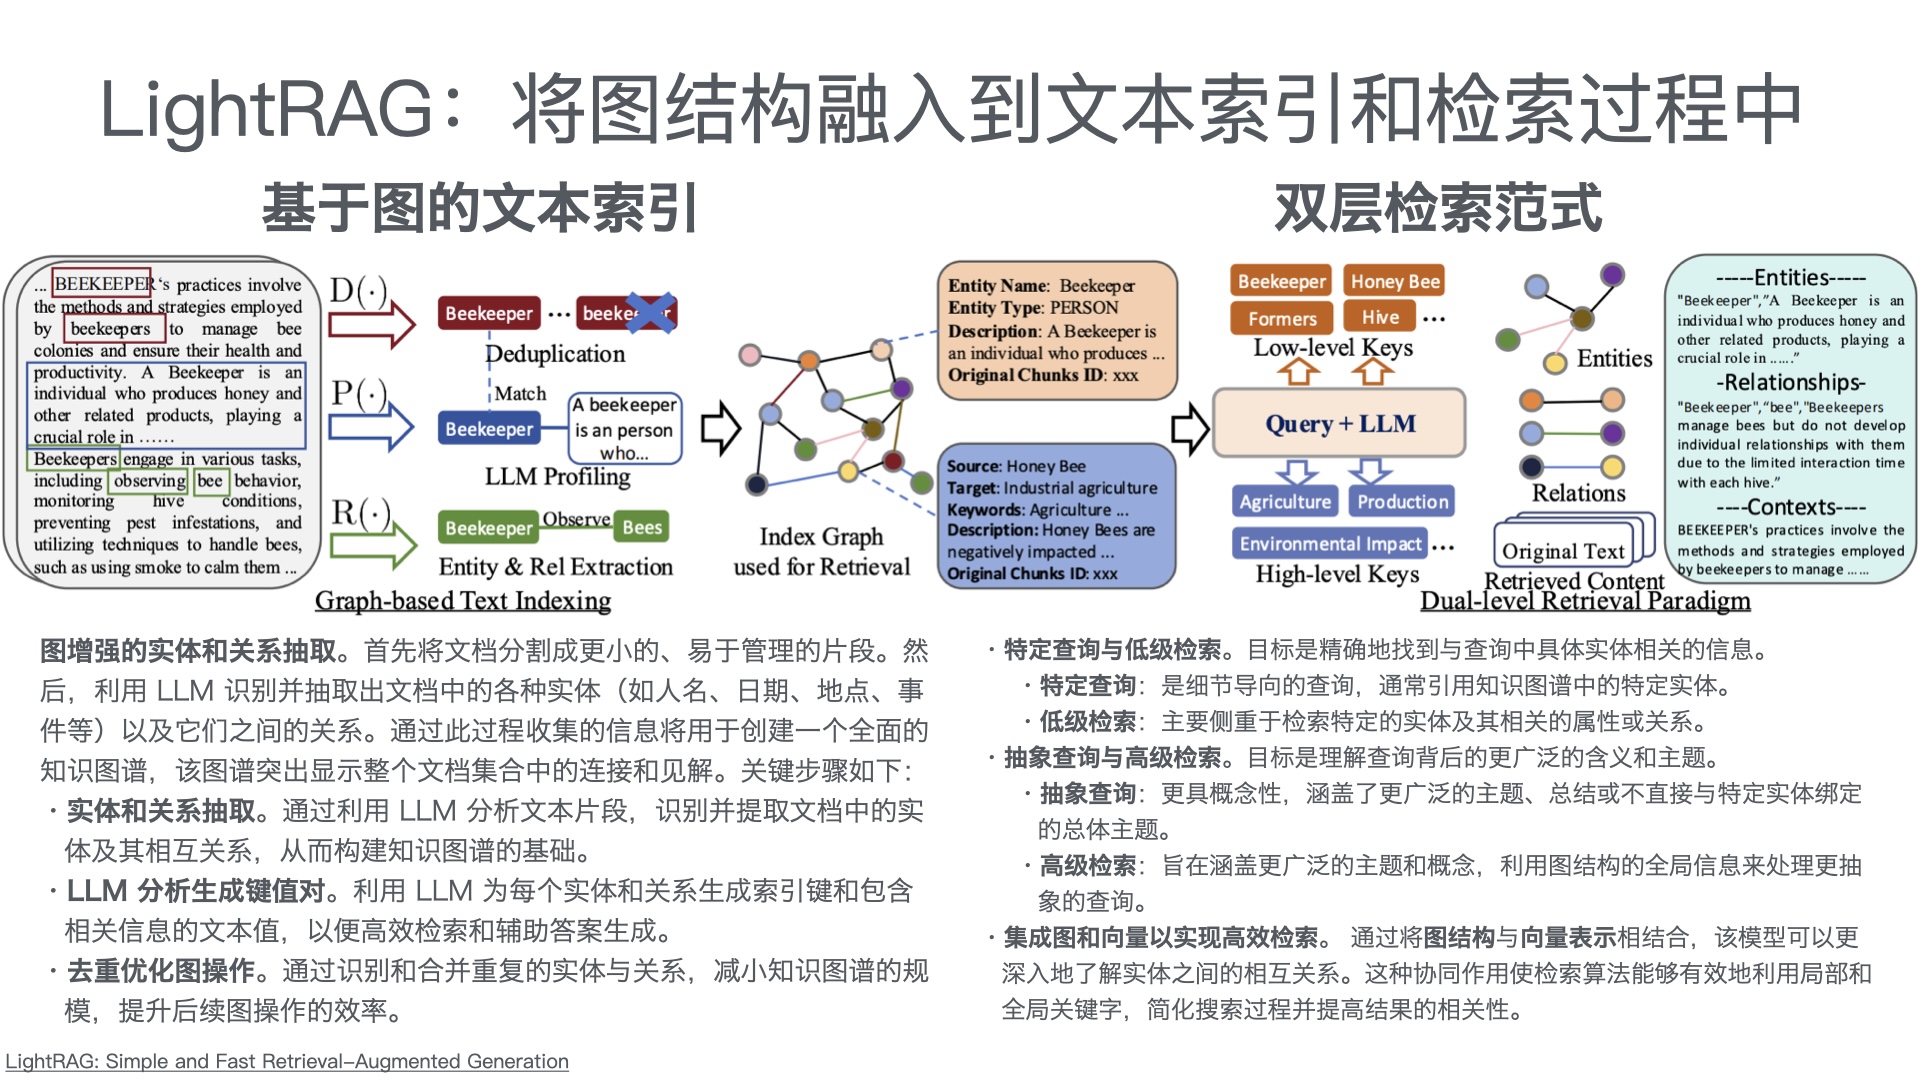
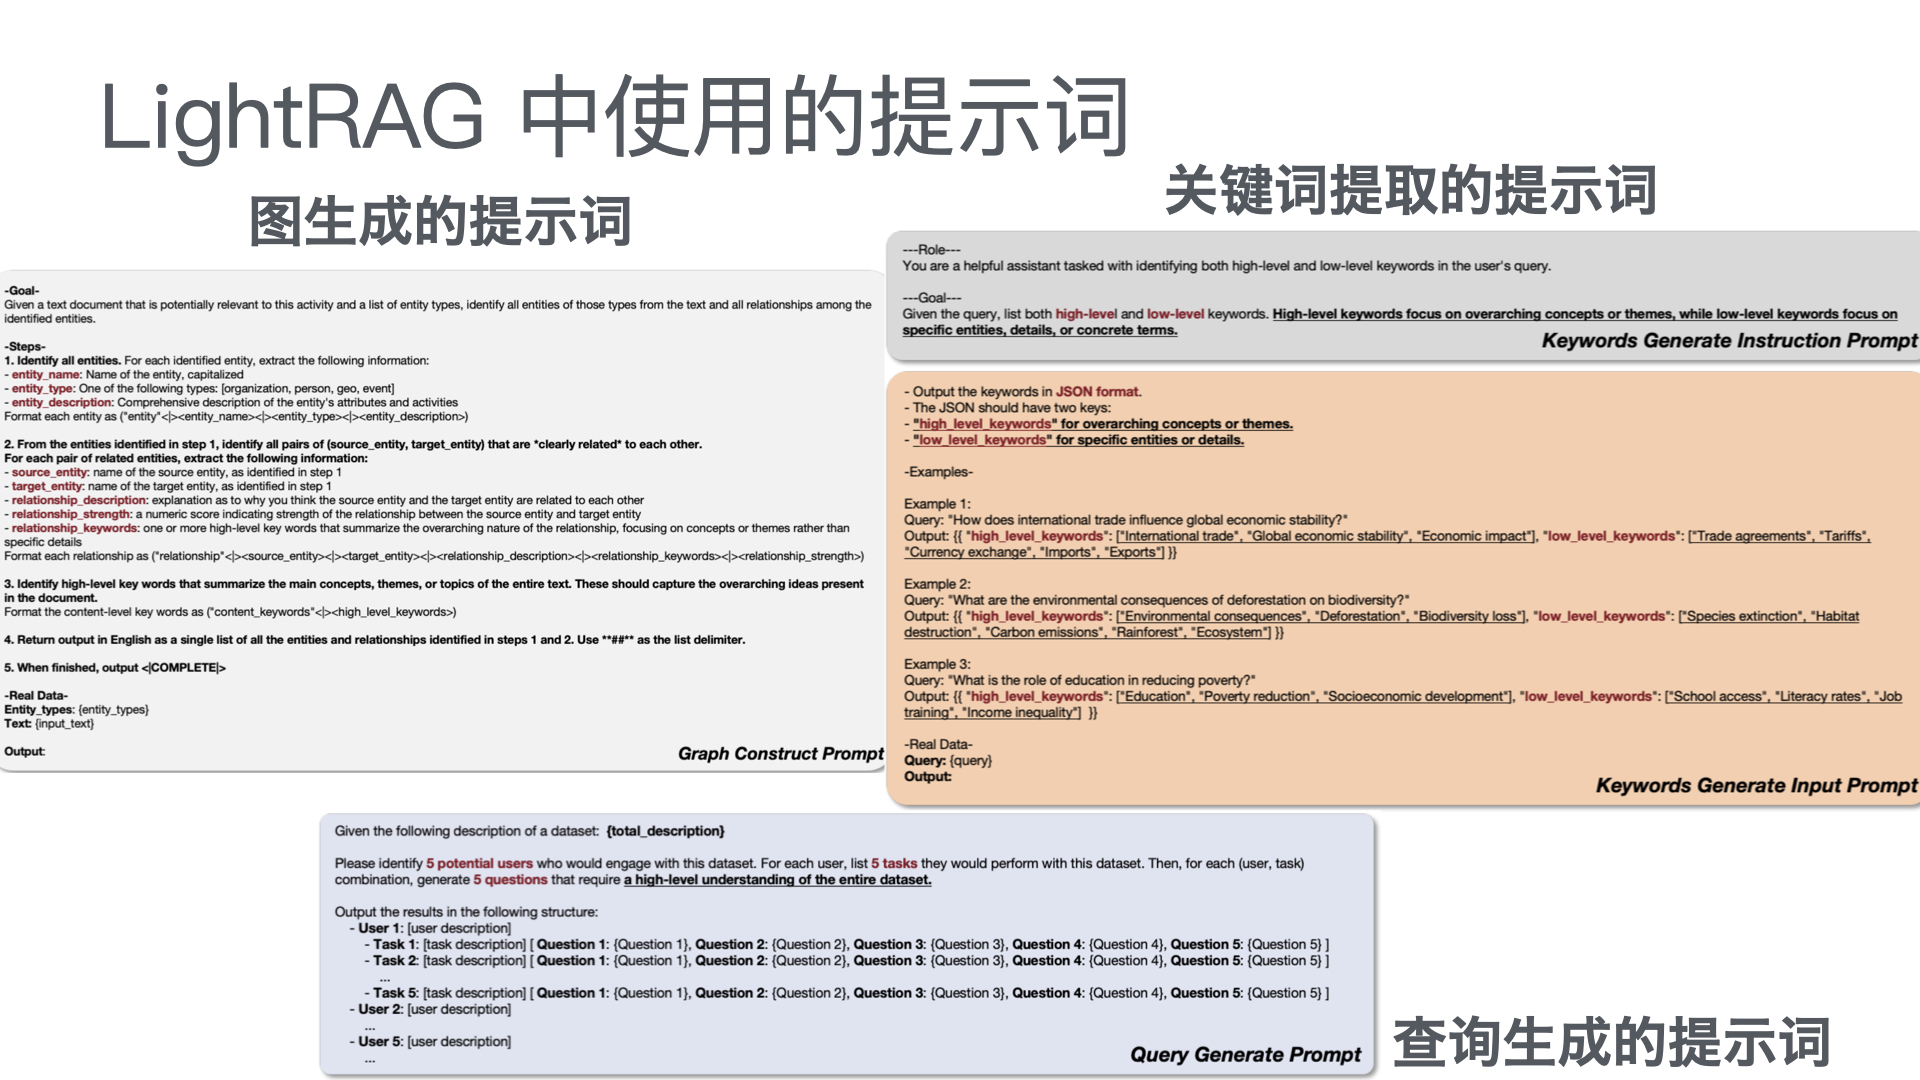
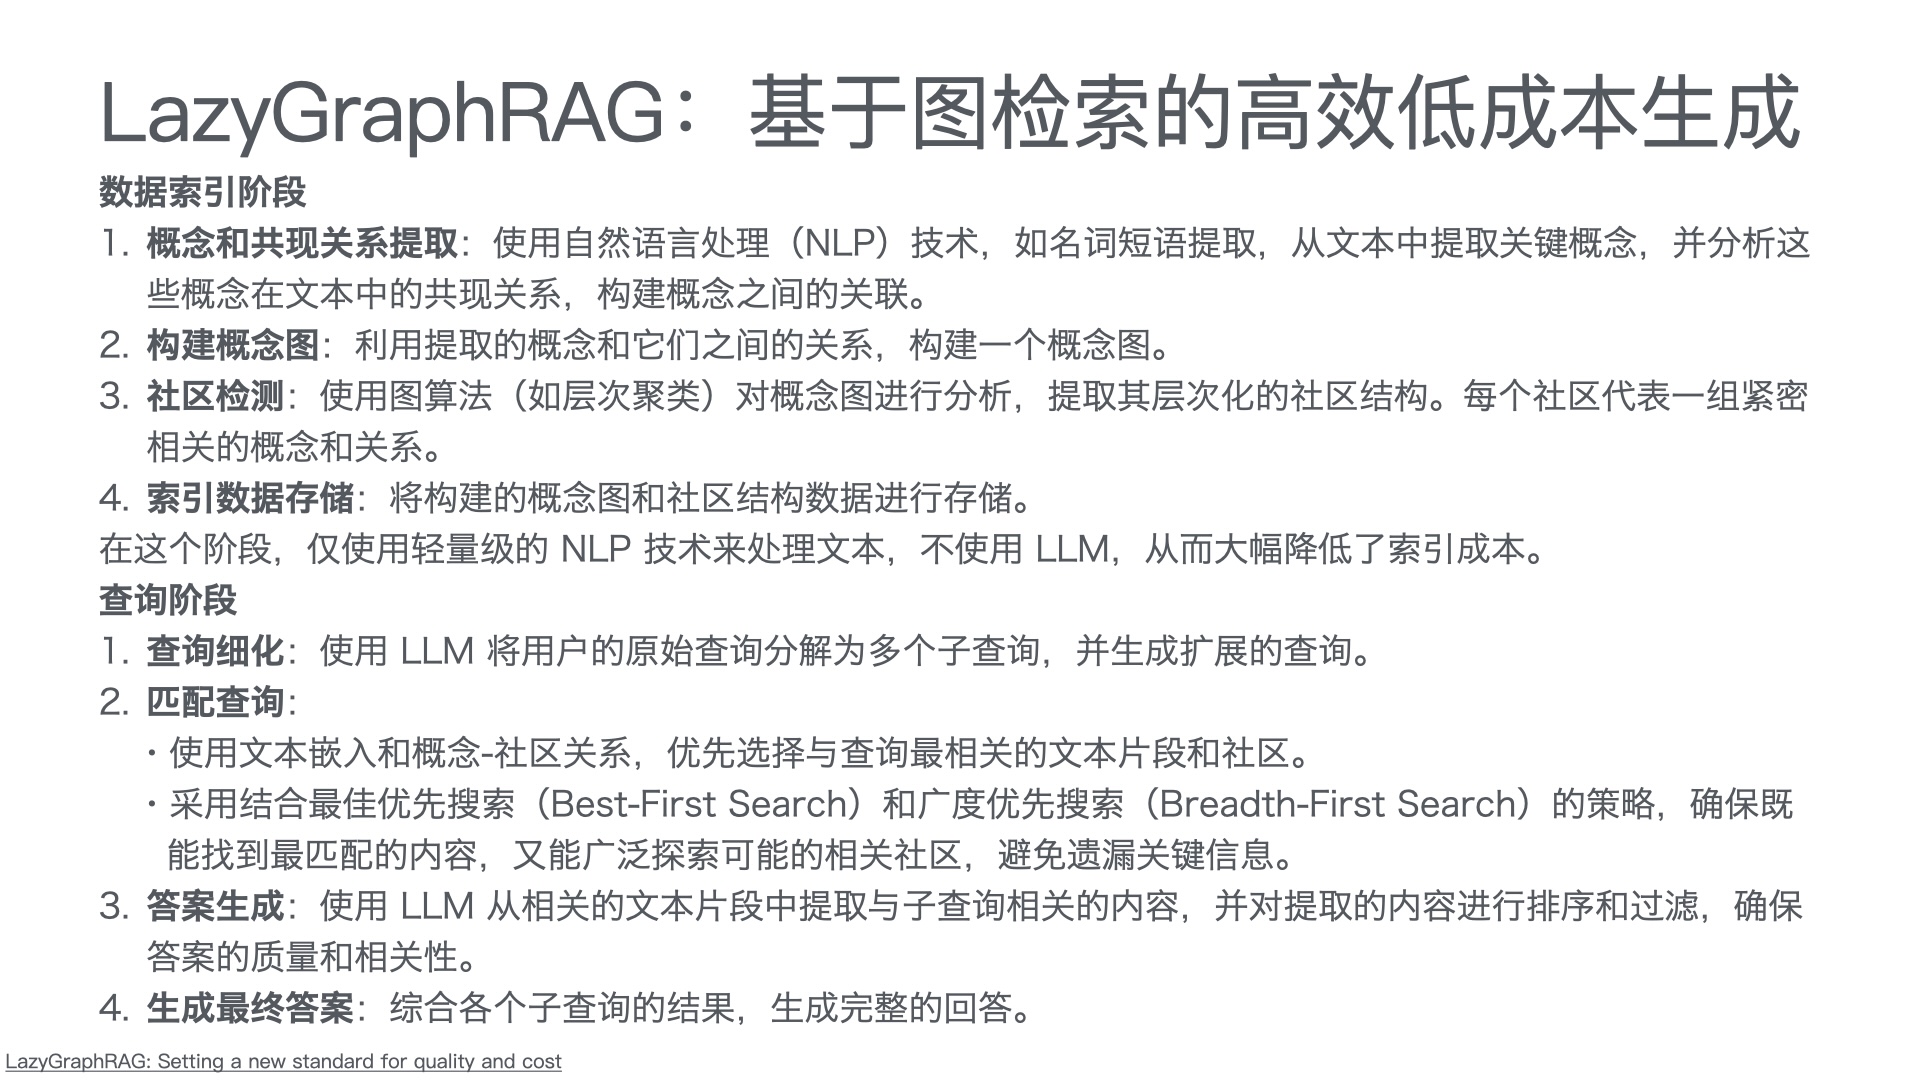
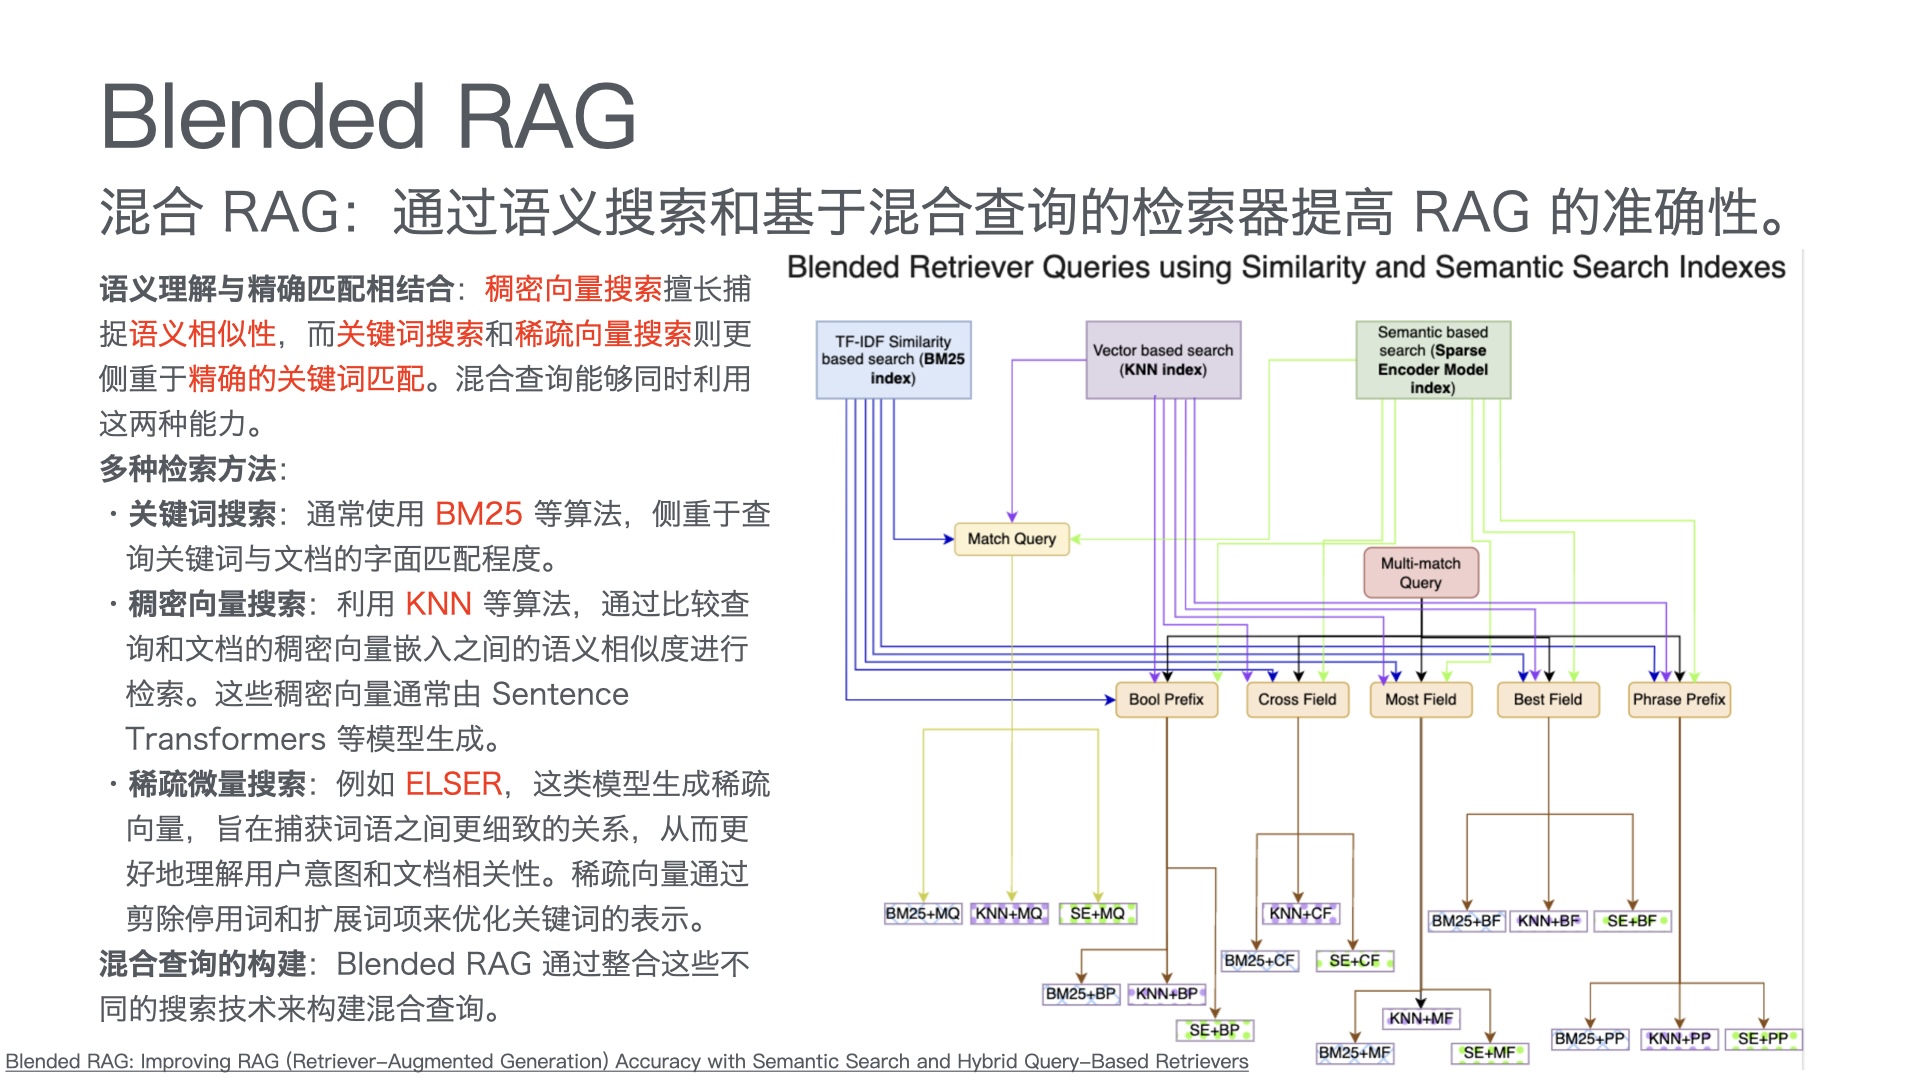
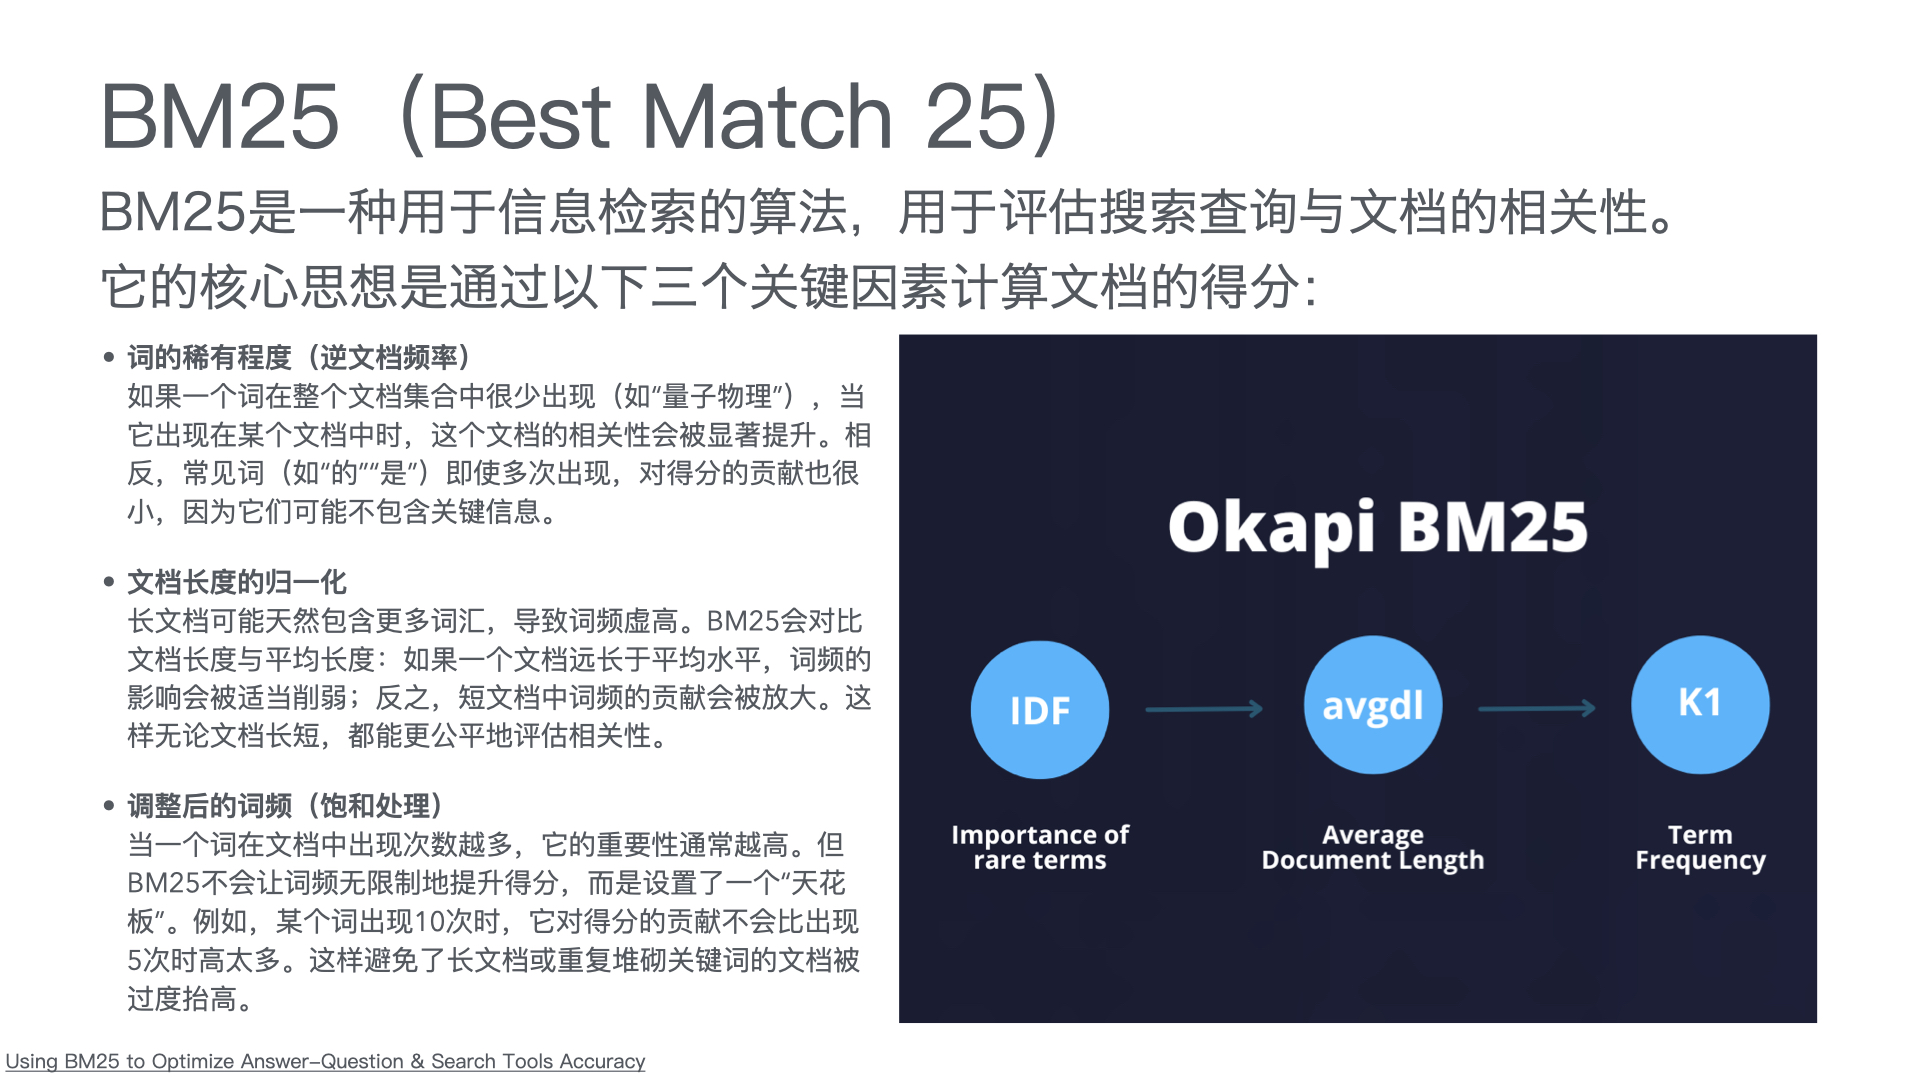
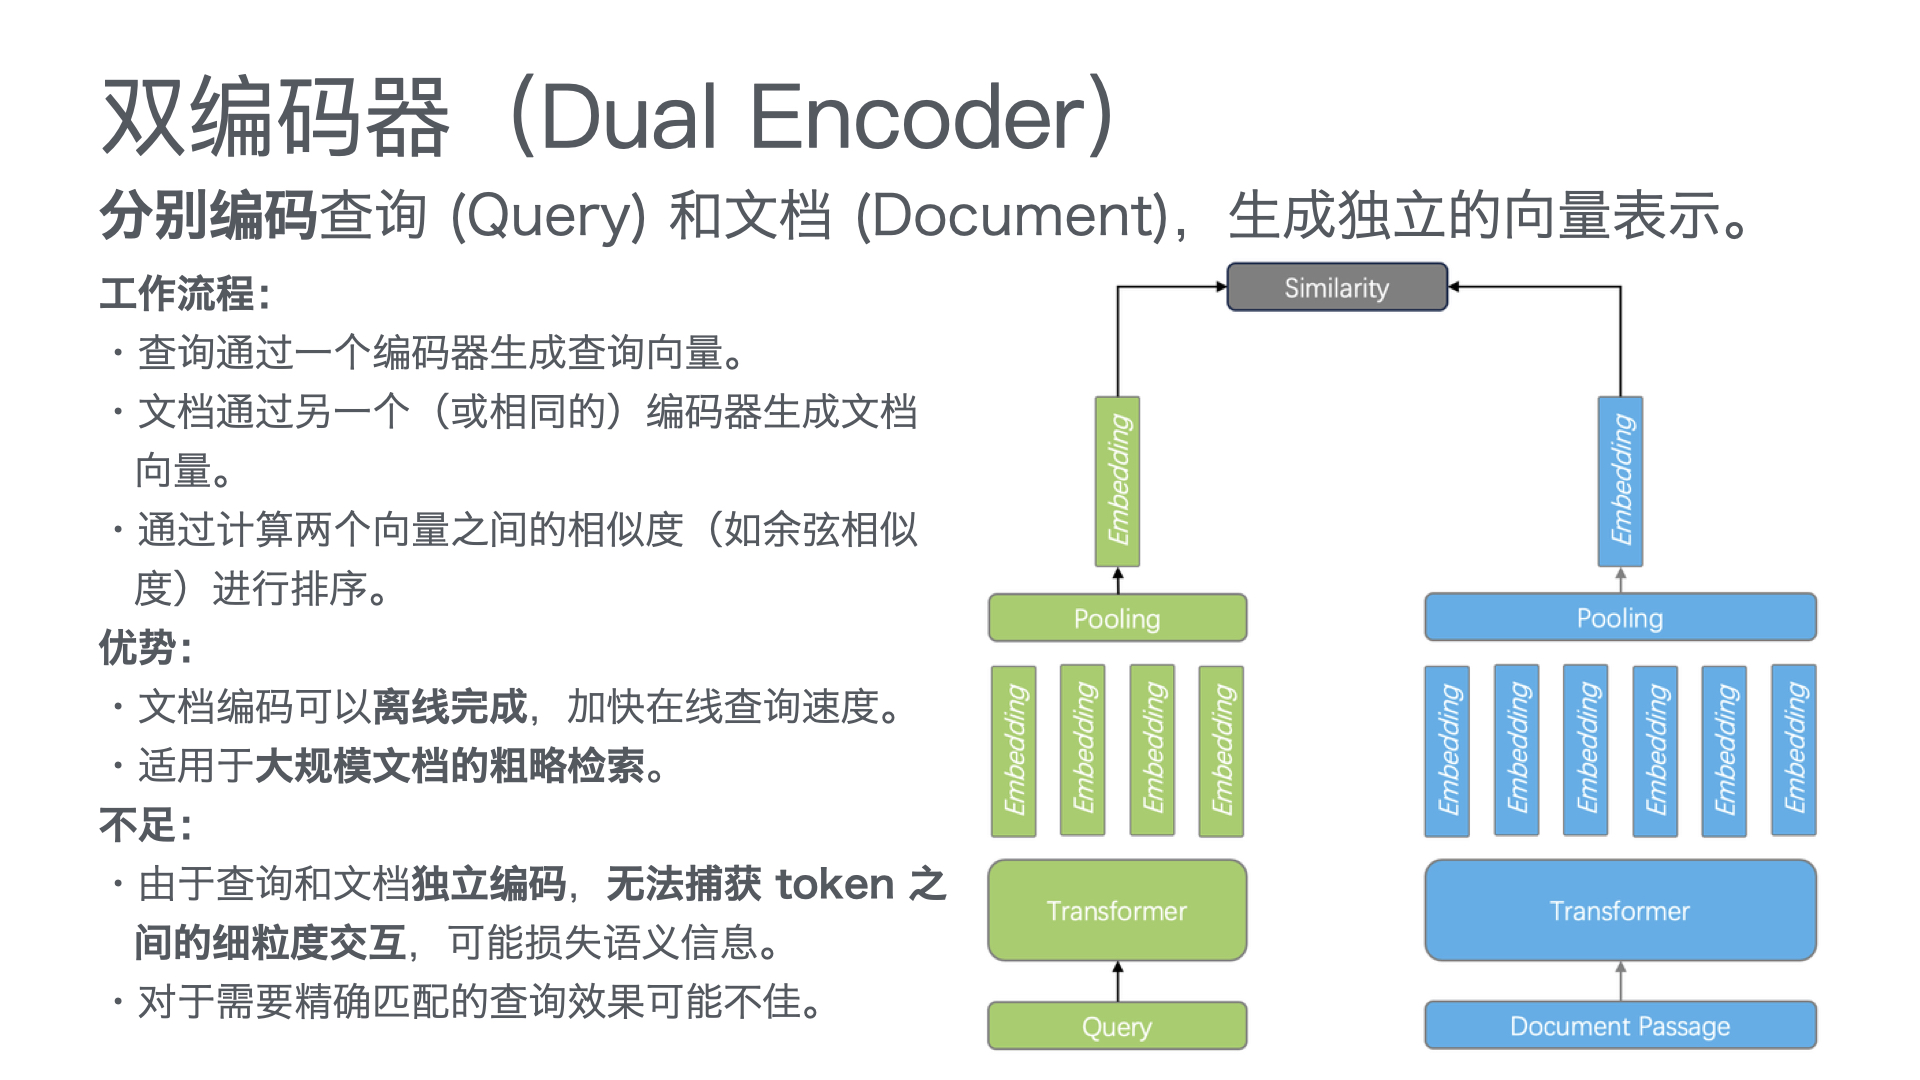
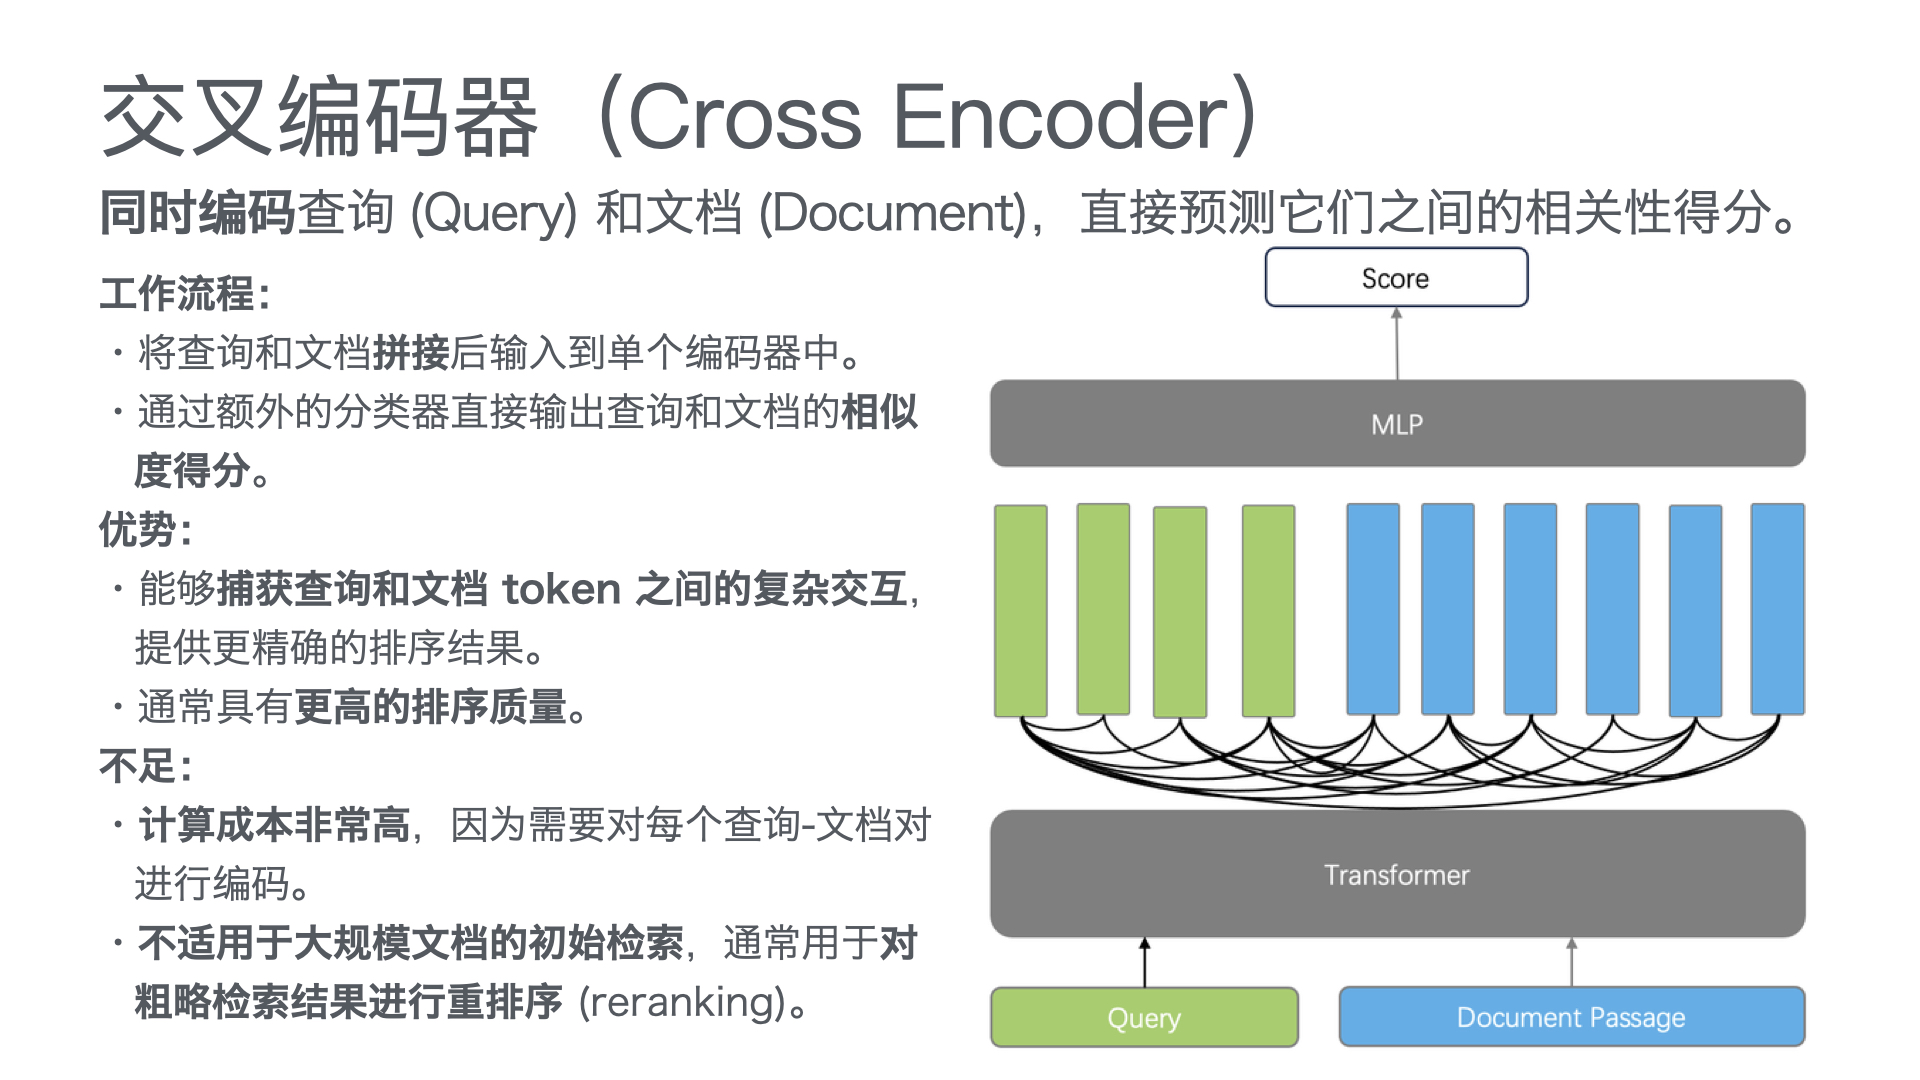
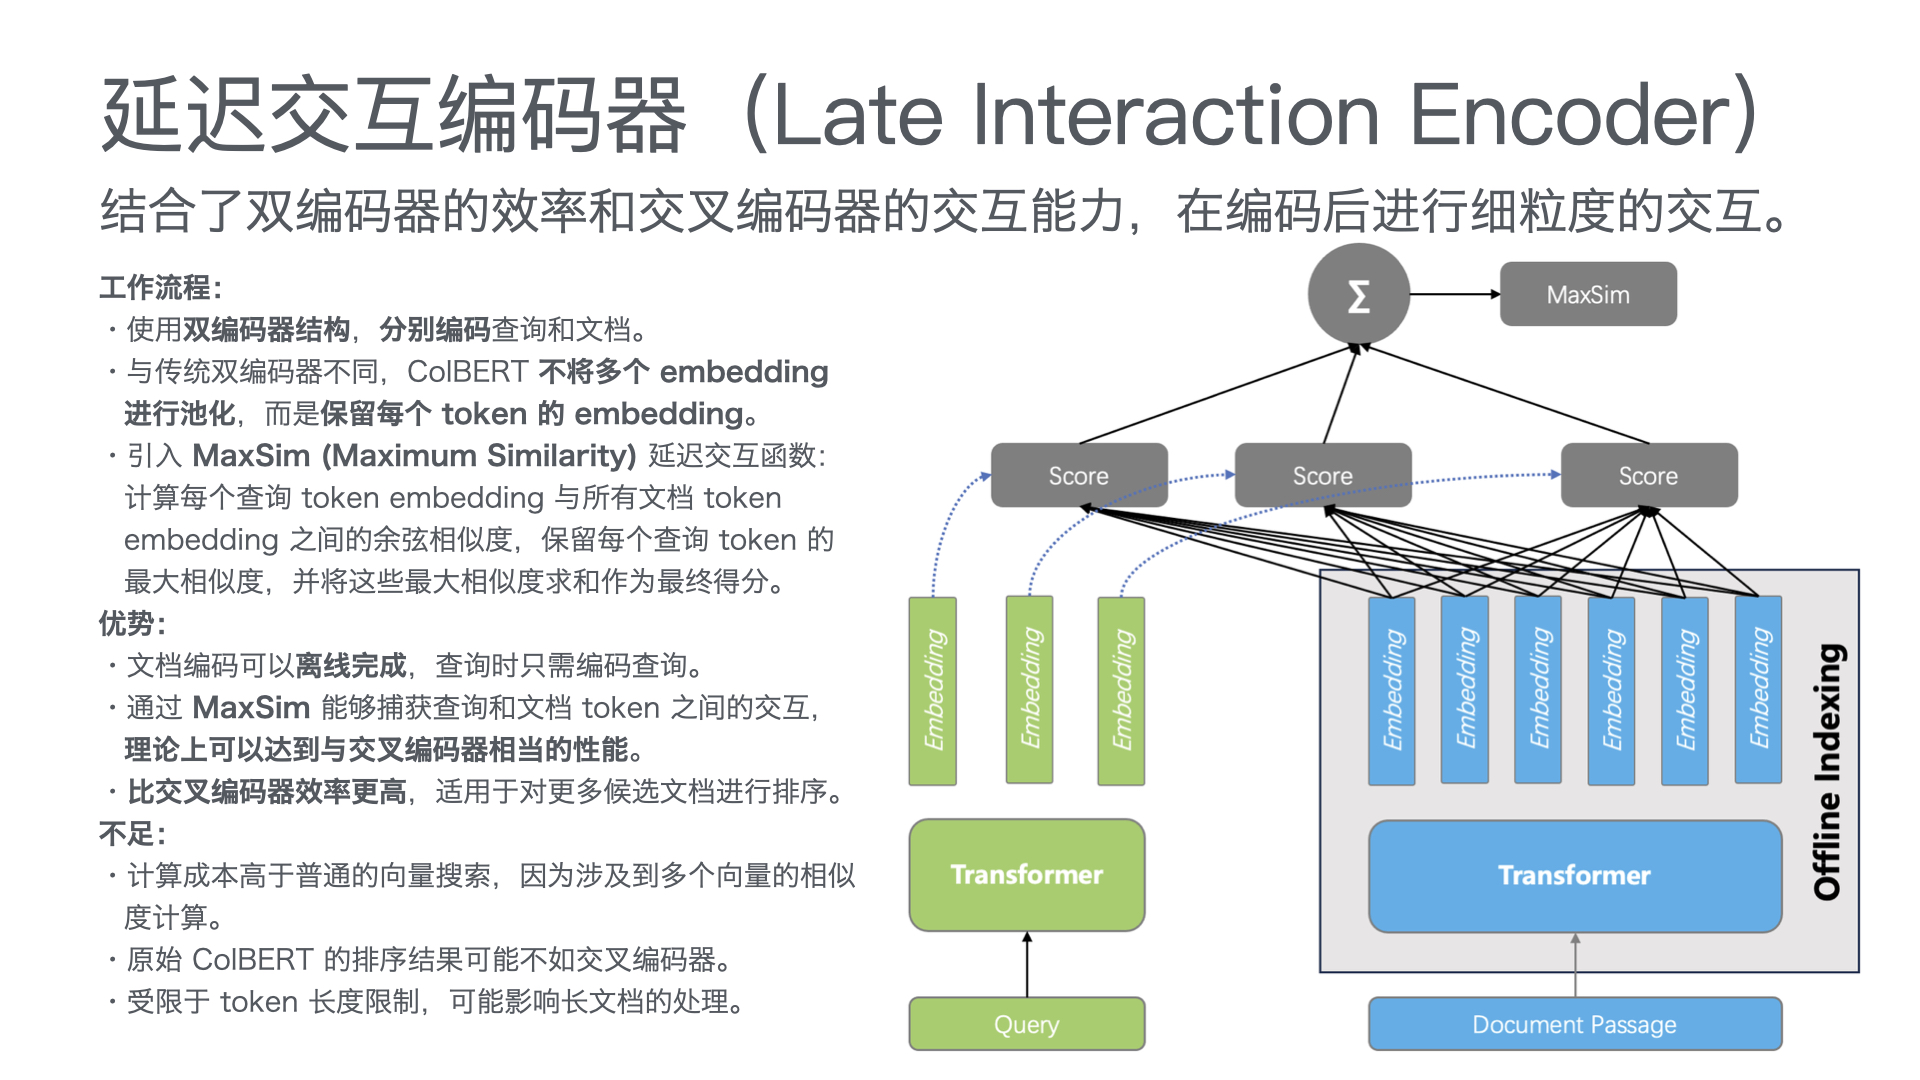
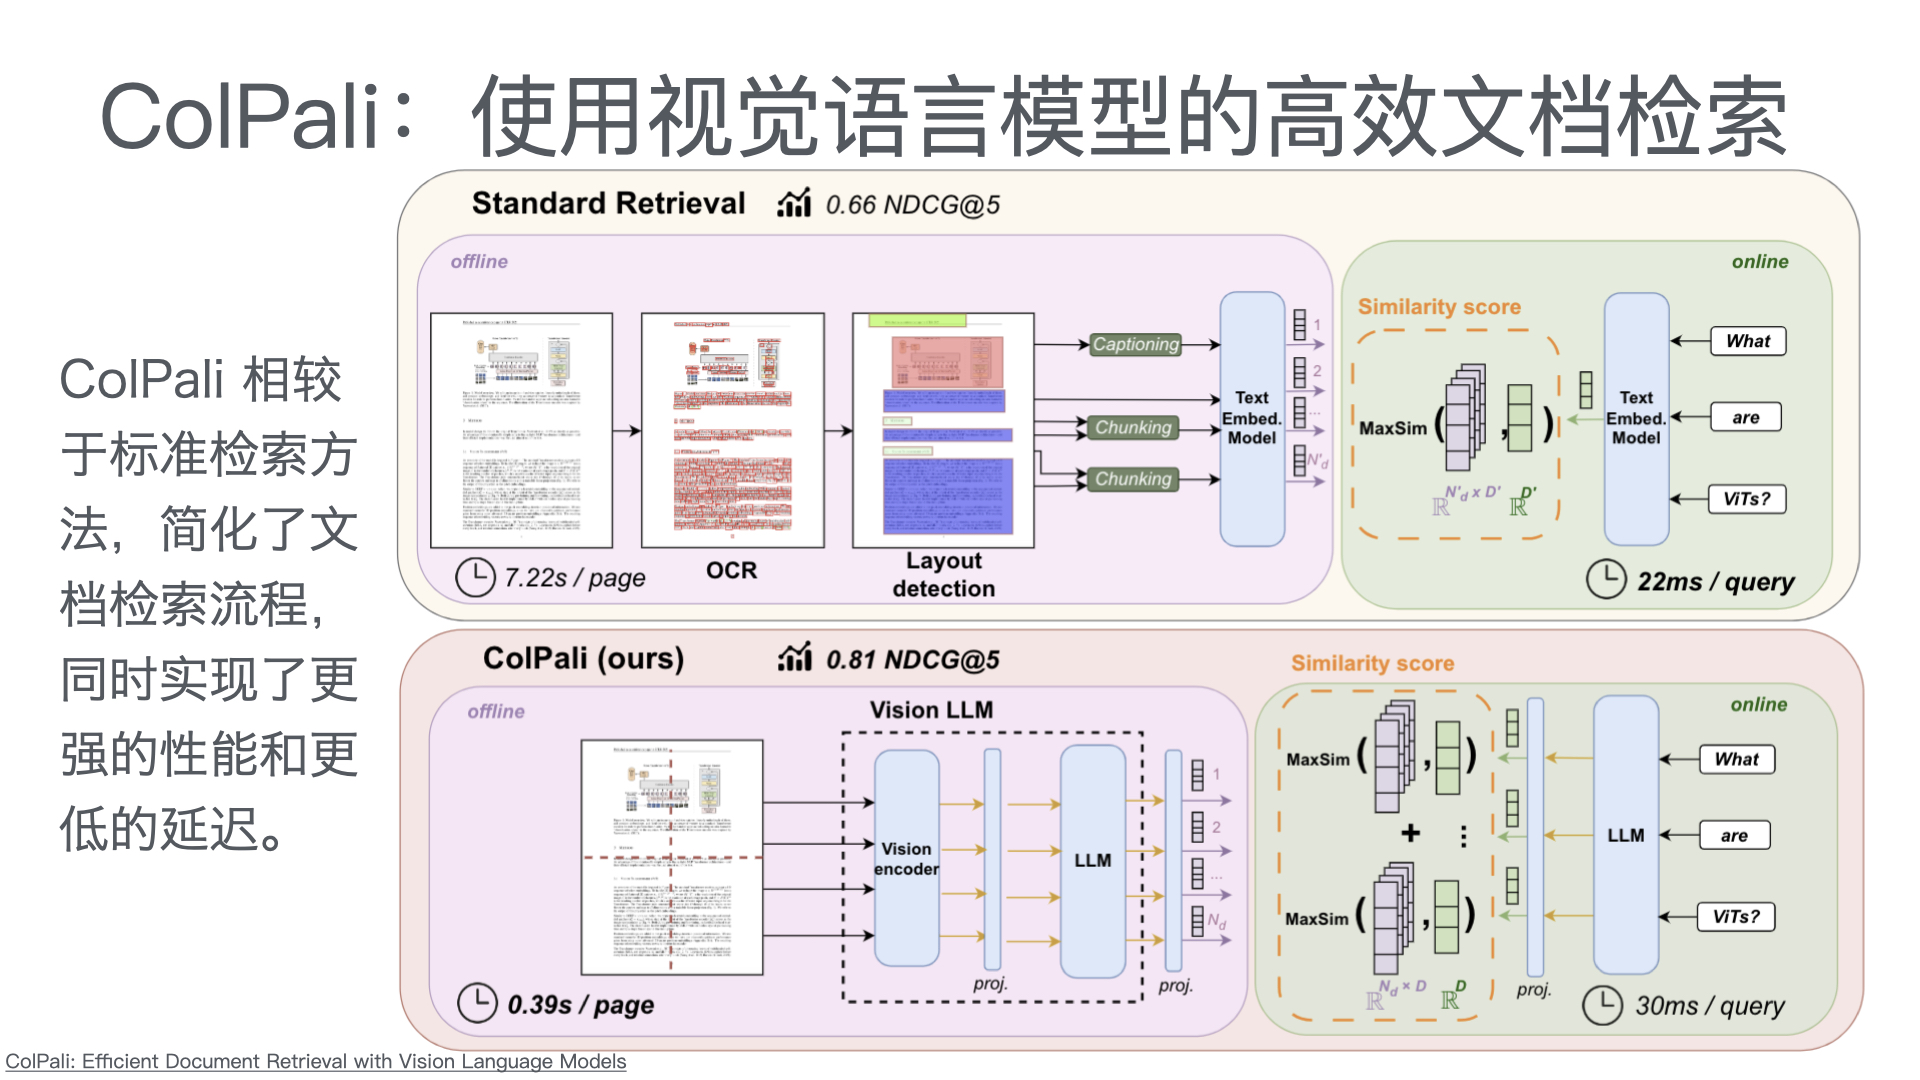
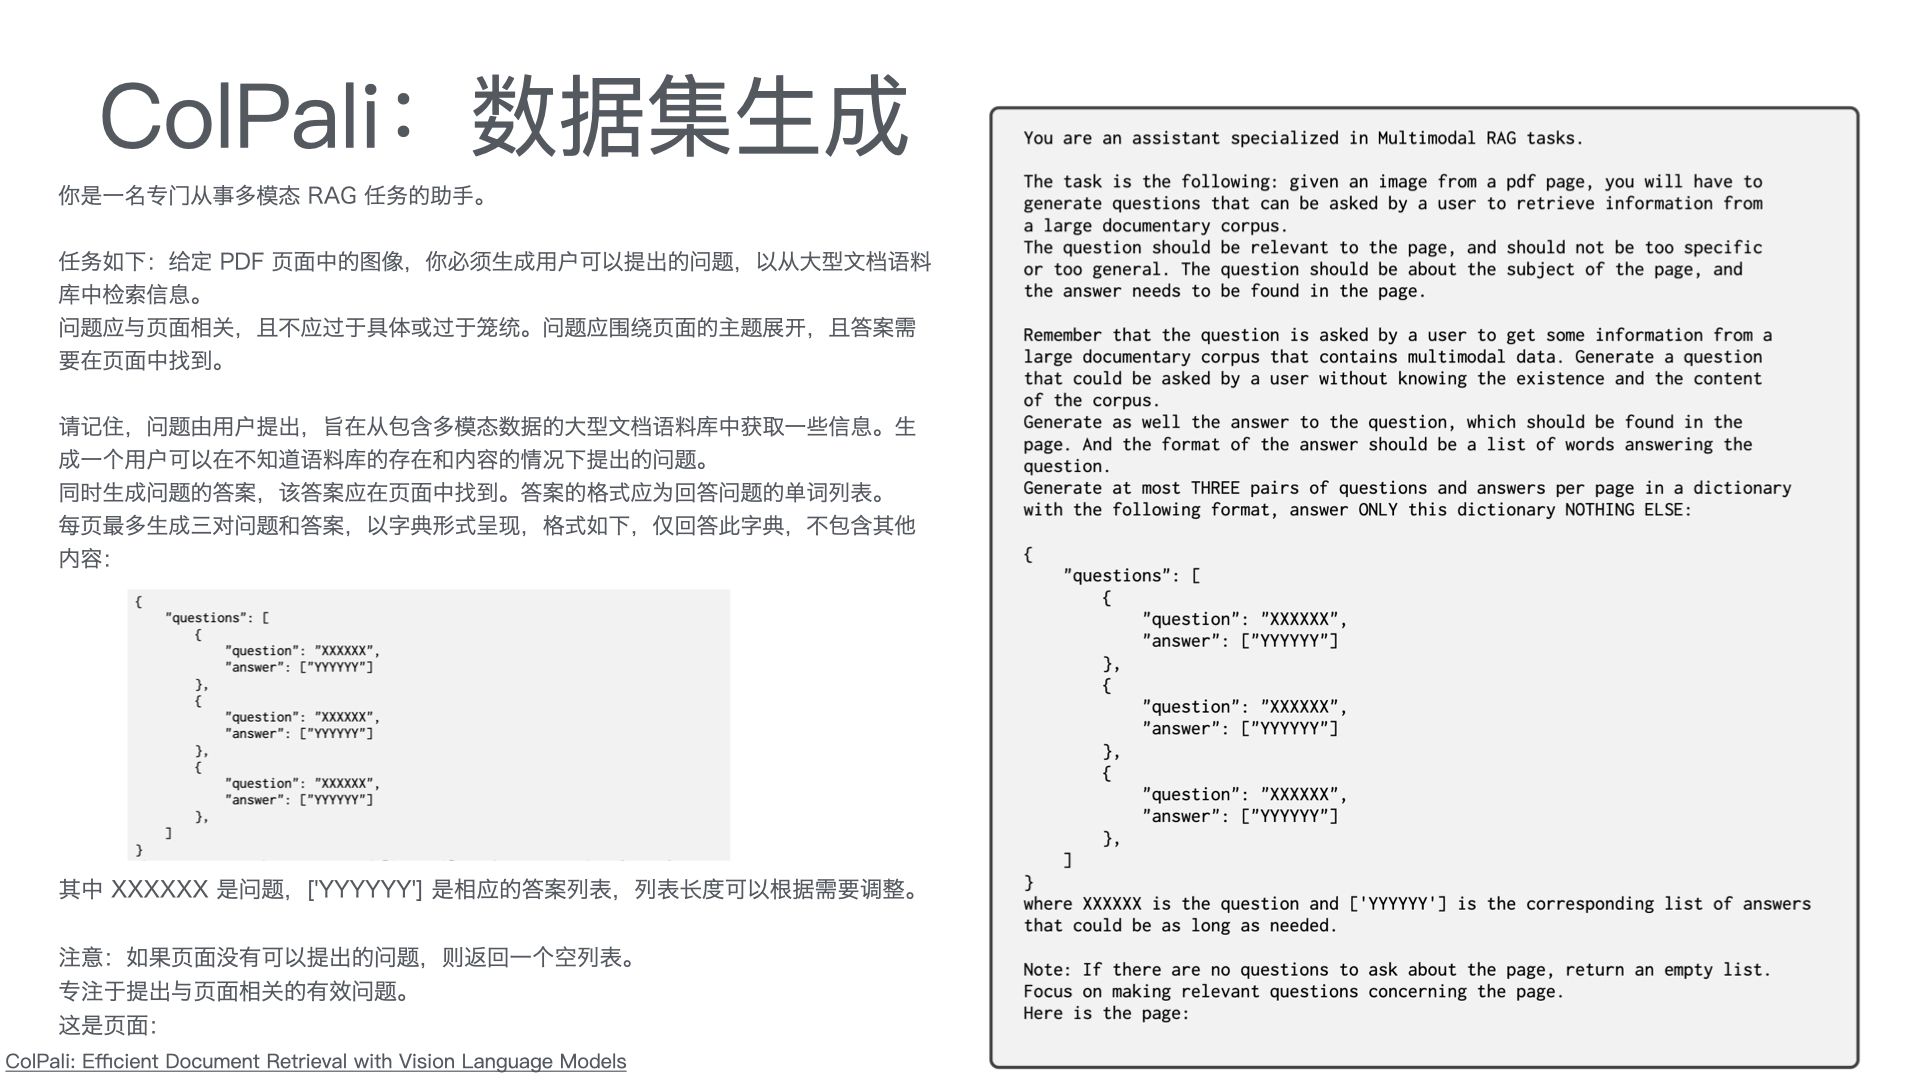
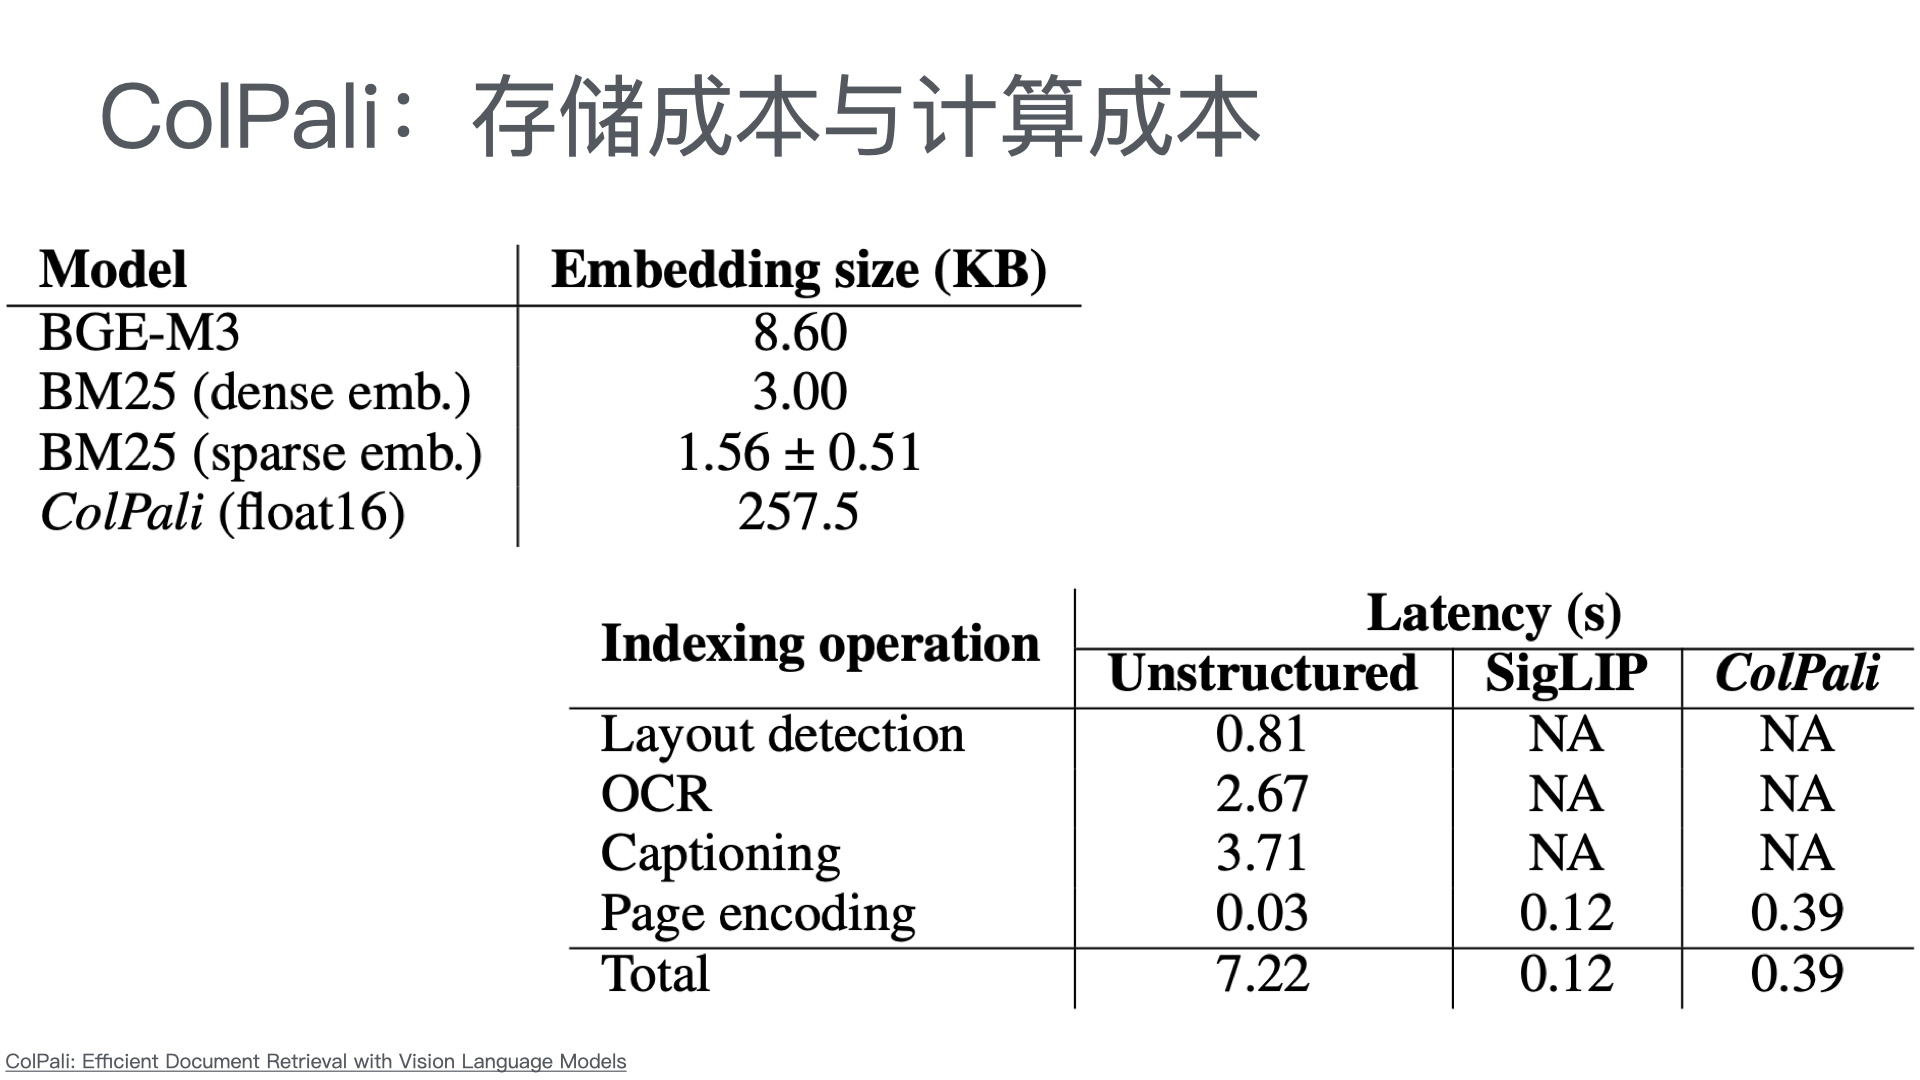
参考资料 2024 年 RAG 的崛起与演变年度回顾 所见即所得:多模态RAG正在向我们走来 What is Retrieval Augmented Generation (RAG)? Build with Claude - Prompt caching Introducing Contextual Retrieval Cookbook - Retrieval Augmented Generation with Contextual Embeddings Infinity Dense vector + Sparse vector + Full text search + Tensor reranker = Best retrieval for RAG? Sparse embedding or BM25?
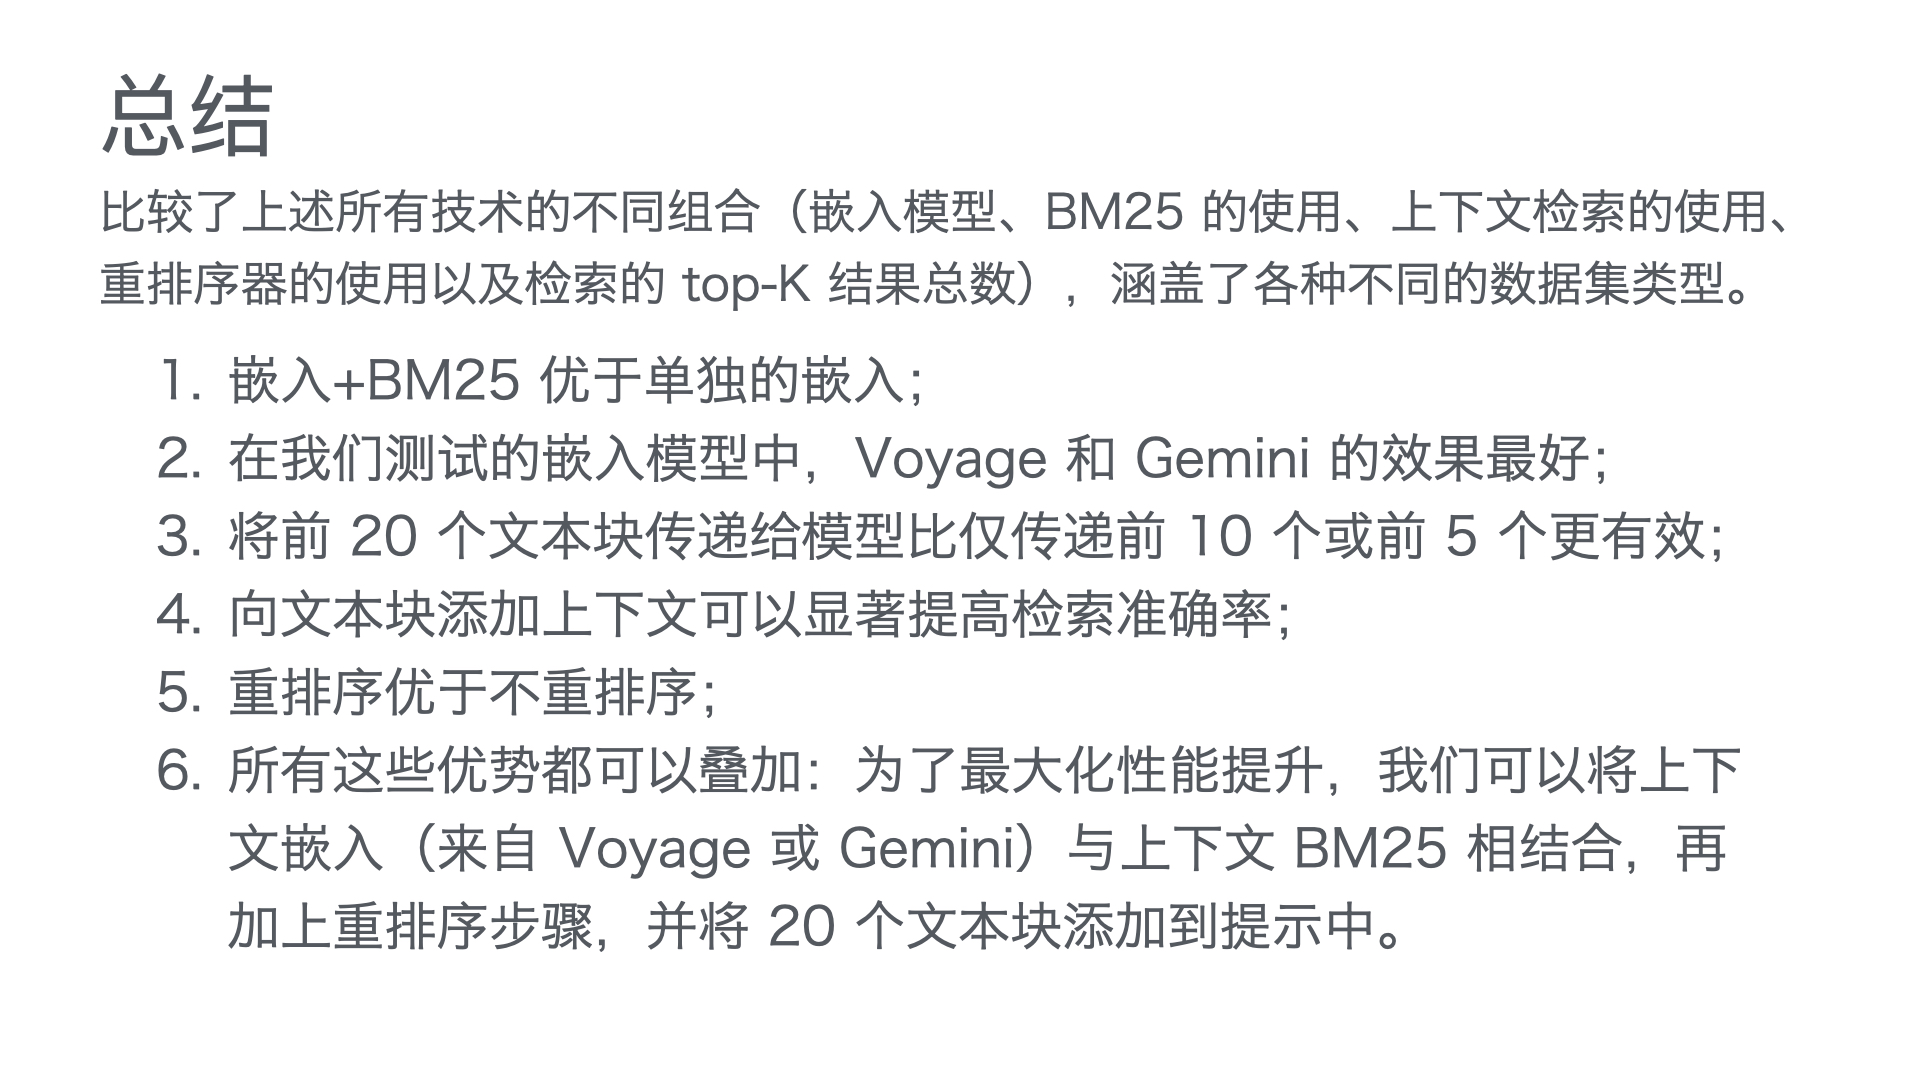
总结
| 模型类型 | 模型 | 评估结果 |
|---|---|---|
| 语言模型 | Qwen2.5-0.5B | ❌ |
| Qwen2.5-1.5B | ✅ | |
| Qwen2.5-7B | ✅ | |
| Qwen2.5-14B-Instruct | ✅ | |
| Qwen2.5-32B-Instruct | ✅ | |
| 推理模型 | DeepSeek-R1-Distill-Qwen2.5-1.5B | ❌ |
| DeepSeek-R1-Distill-Qwen2.5-7B | ❌ | |
| DeepSeek-R1-Distill-Qwen2.5-14B | ✅ | |
| DeepSeek-R1-Distill-Qwen2.5-32B | ✅ | |
| Qwen/QwQ-32B | ✅ | |
| Qwen/QwQ-32B-Preview | ✅ | |
| Qwen/QwQ-32B-AWQ | ❌ | |
| 代码模型 | Qwen2.5-Coder-0.5B | ❌ |
| Qwen2.5-Coder-1.5B | ✅ | |
| Qwen2.5-Coder-3B | ✅ |
对于这样的阅读理解任务,推理模型的表现要反而不如语言模型和代码模型,通过分析发现在思考的过程可能会出错而导致答案错误。对于大参数模型,进行了量化会导致模型性能下降,如:Qwen/QwQ-32B-AWQ。
提示词 收入 截至12月31日止年度 2024年 人民幣千元 2023年 人民幣千元 商品收入: 醫藥和健康產品銷售 48,795,702 45,652,922 服務收入: 平台、廣告及其他服務 9,364,179 7,877,019 58,159,88
Model Context Protocol (MCP) 入门
MCP 是一个开放协议,用于标准化应用程序向 LLM 提供上下文的方式。可以将 MCP 视为 AI 应用程序的 USB-C 端口。正如 USB-C 提供了一种将设备连接到各种外围设备和配件的标准化方式一样,MCP 提供了一种将 AI 模型连接到不同数据源和工具的标准化方式。
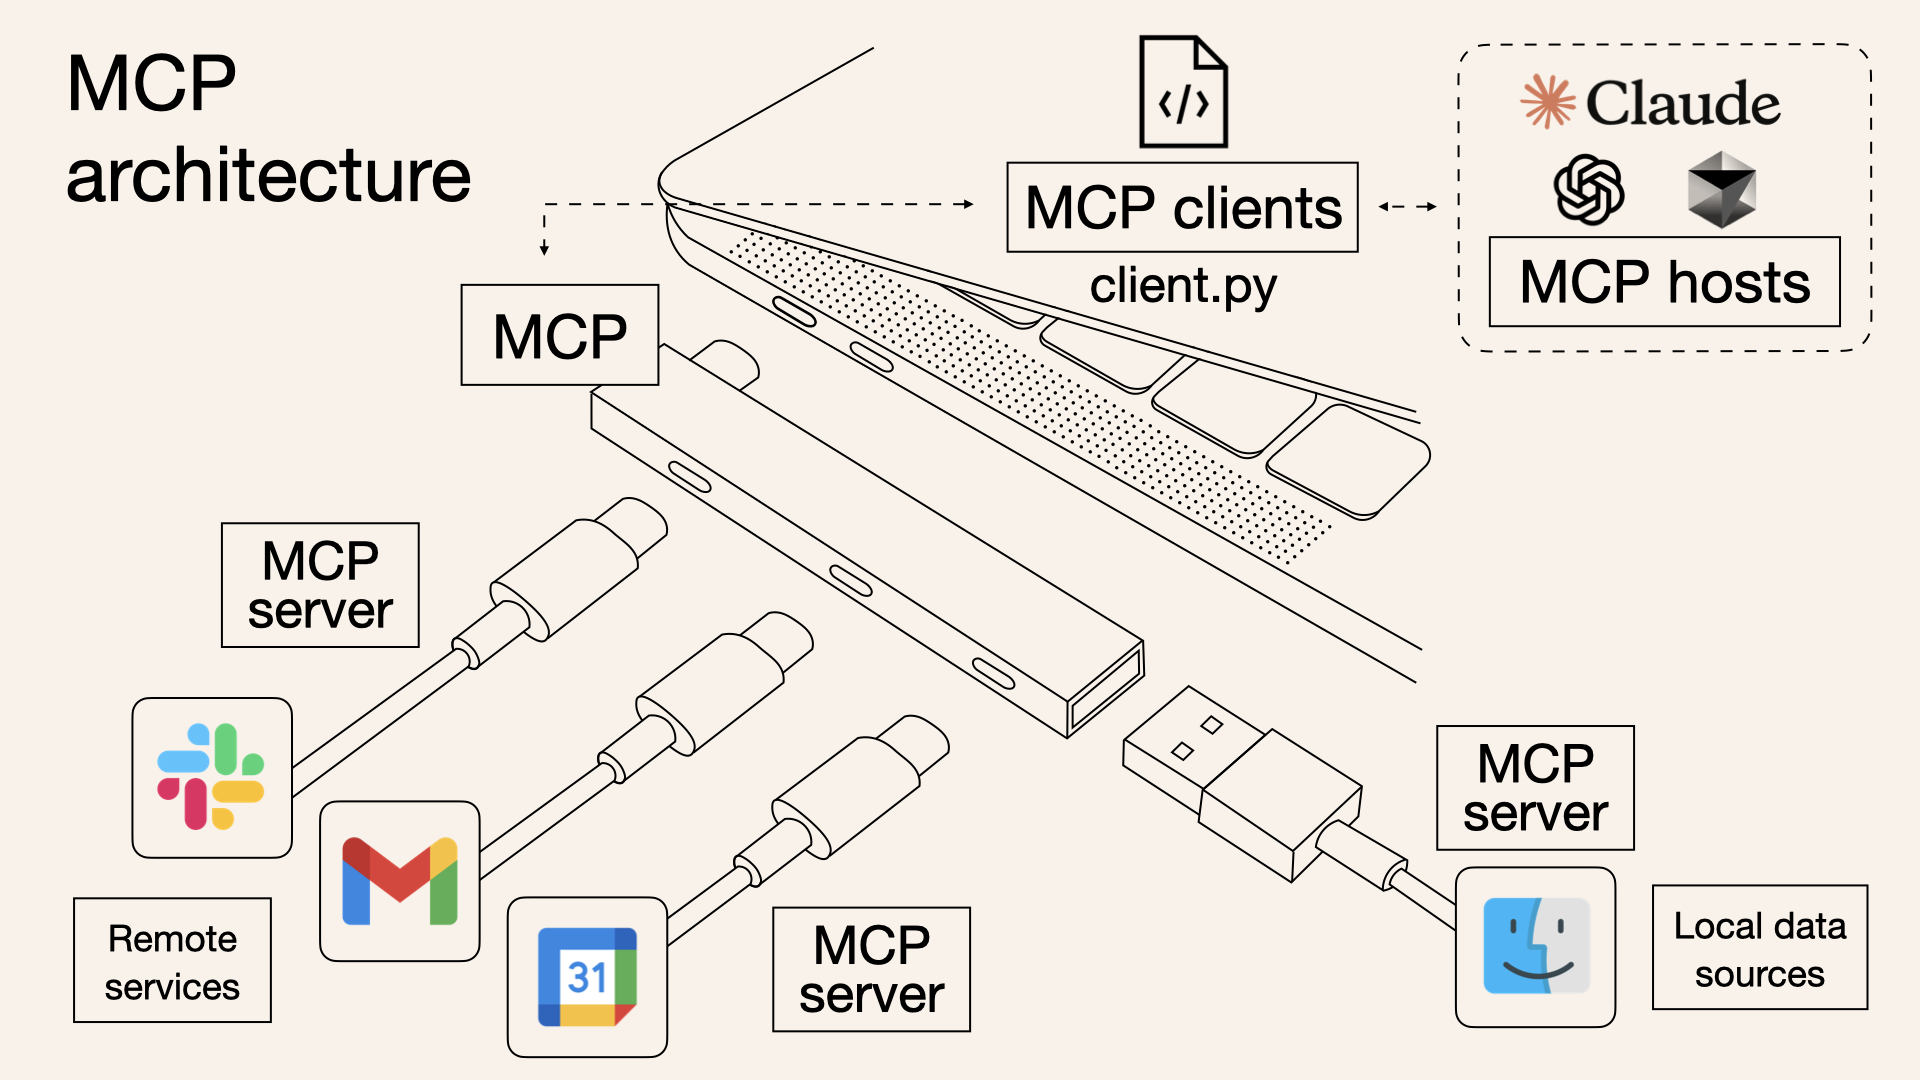
为什么选择 MCP?
MCP 帮助您在 LLM 之上构建代理和复杂的工作流程。LLM 经常需要与数据和工具集成,而 MCP 提供了:
一般架构
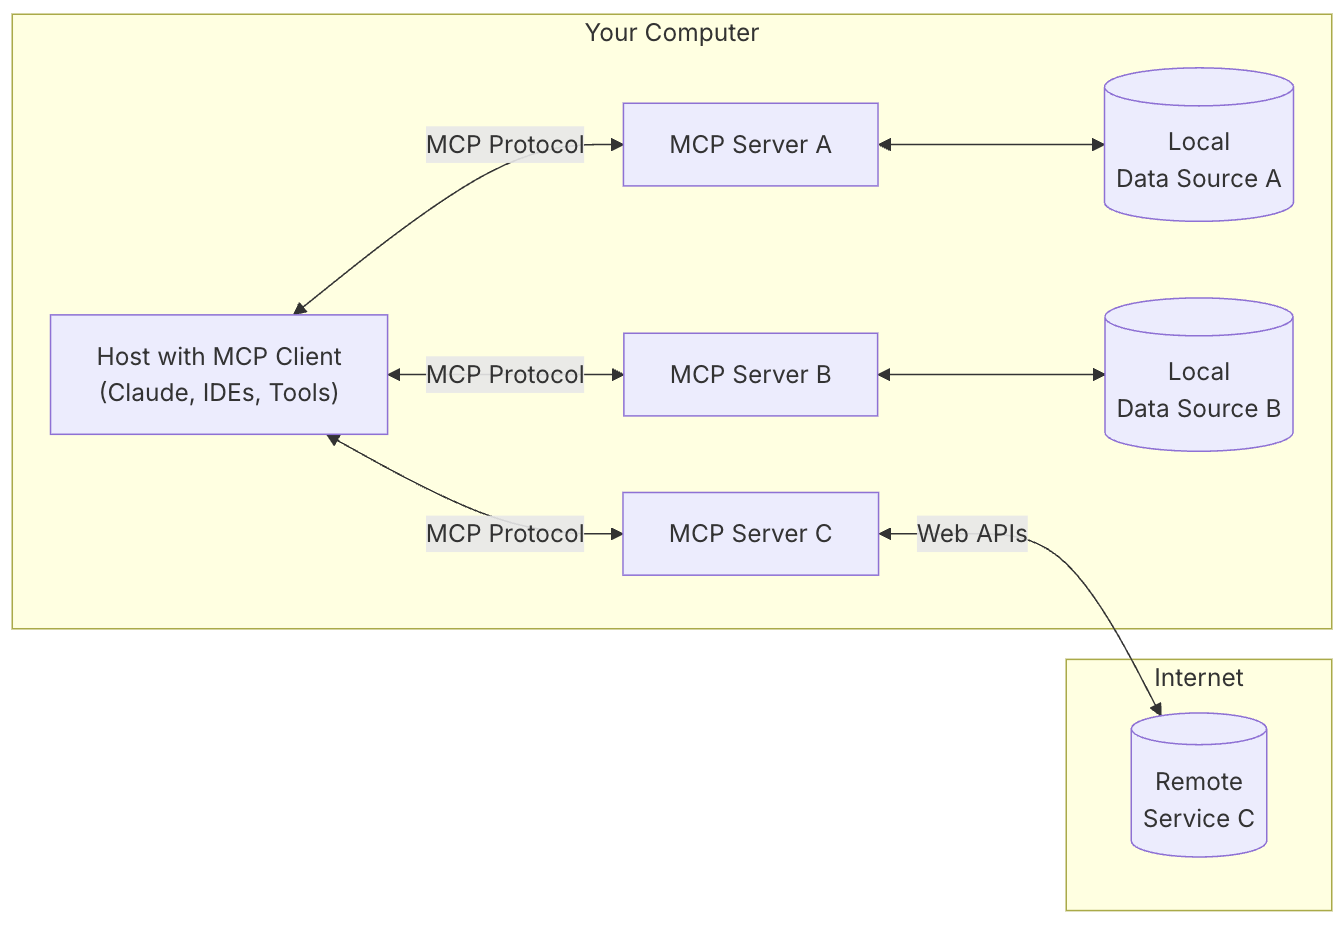
MCP 的核心遵循客户端-服务器架构,其中主机应用程序可以连接到多个服务器:
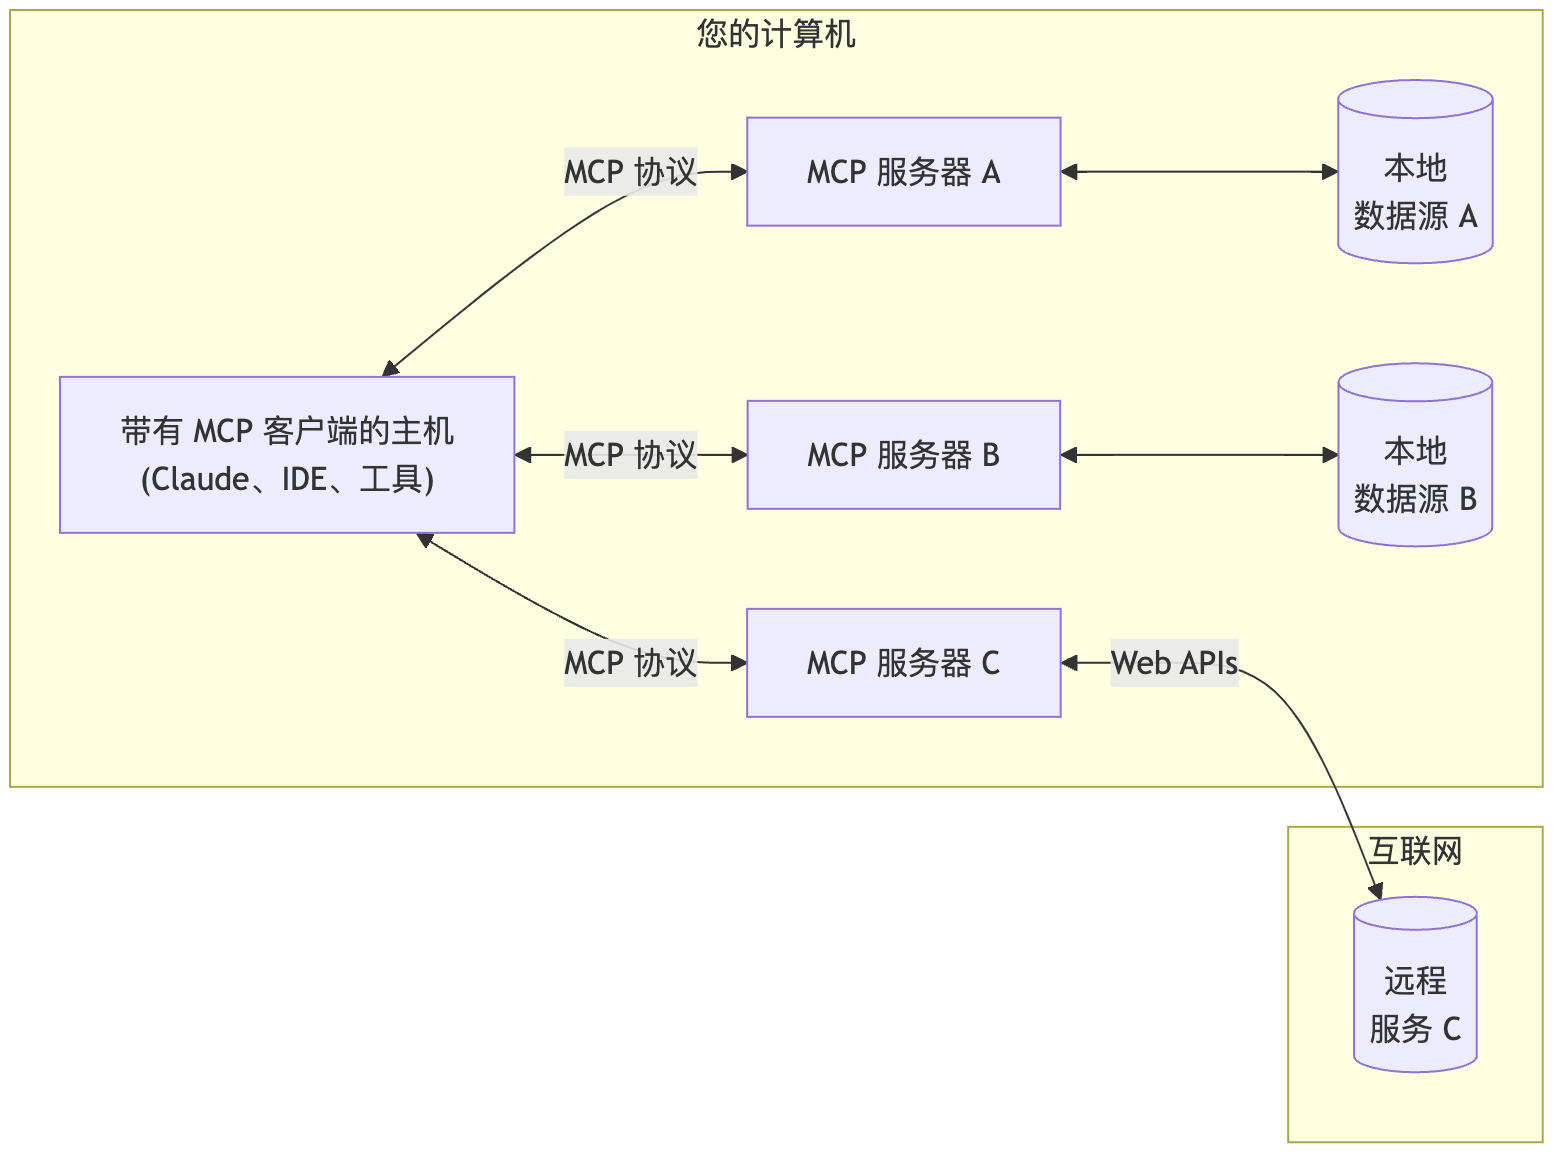
flowchart LR
    subgraph "您的计算机"
        Host["带有 MCP 客户端的主机<br>(Claude、IDE、工具)"]
        S1["MCP 服务器 A"]
        S2["MCP 服务器 B"]
        S3["MCP 服务器 C"]
        Host <-->|"MCP 协议"| S1
        Host <-->|"MCP 协议"| S2
        Host <-->|"MCP 协议"| S3
        S1 <--> D1[("本地<br>数据源 A")]
        S2 <--> D2[("本地<br>数据源 B")]
    end
    subgraph "互联网"
        S3 <-->|"Web APIs"| D3[("远程<br>服务 C")]
    end
了解 MCP 如何连接客户端、服务器和 LLM
简介
Continue hub 助手使用 config.yaml 规范定义。本地助手也可以通过放置在全局 .continue 文件夹中的 YAML 文件 config.yaml 进行配置(Mac 上为 ~/.continue,Windows 上为 %USERPROFILE%\.continue)
:::info
Config YAML 替代了 config.json。查看迁移指南。
:::
一个助手由以下部分组成:
name、version 和 config.yaml 的 schema块是编码助手的一个独立构建块,例如一个模型或一个文档来源。在 config.yaml 语法中,块包含与助手相同的顶级属性(name、version 和 schema),但在其所属的块类型下只有一个项目。
可以在 Continue hub 上找到块和助手的示例。
助手可以显式定义块(参见下面的属性),也可以导入和配置现有的 hub 块。
使用块
Hub 块和助手通过格式为 owner-slug/block-or-assistant-slug 的标识符识别,所有者可以是用户或组织。
可以通过在块类型下添加 uses 子句将块导入到助手中。
这篇文章是使用 Google Gemini Deep Research 生成的。提示词:
研究 Model Context Protocol
1. 模型上下文协议 (MCP) 导论
大型语言模型 (LLMs) 在理解和生成人类语言方面取得了显著的进步。然而,这些模型本质上是孤立的,它们的知识仅限于训练数据,并且缺乏与外部世界交互的能力 1。为了克服这些限制,将 LLMs 与外部数据源和工具集成变得至关重要 1。传统上,这种集成是通过为每个新的数据源或工具开发定制的连接器来实现的 1。这种方法导致了集成工作的重复,难以扩展,并且维护成本高昂,阻碍了上下文感知 AI 的广泛采用 1。
为了应对这一挑战,模型上下文协议 (MCP) 应运而生 1。MCP 是一种开放标准,旨在规范应用程序如何向 LLMs 提供上下文和工具 6。可以将 MCP 视为 AI 应用程序的通用连接器,类似于 USB-C 标准化了设备和外设之间的连接 6。通过提供一种标准化的方式将 AI 模型连接到各种数据源和工具,MCP 简化了集成,增强了互操作性,并促进了可扩展性 6。
本报告旨在对模型上下文协议 (MCP) 进行全面的解析,涵盖其基本原理、核心架构、通信机制、广泛的应用场景以及客户端和服务器端的创建方法。通过深入理解 MCP,开发者和组织可以更好地利用这一新兴标准,构建更智能、更具上下文感知能力的 AI 应用。
没有找到匹配的文章