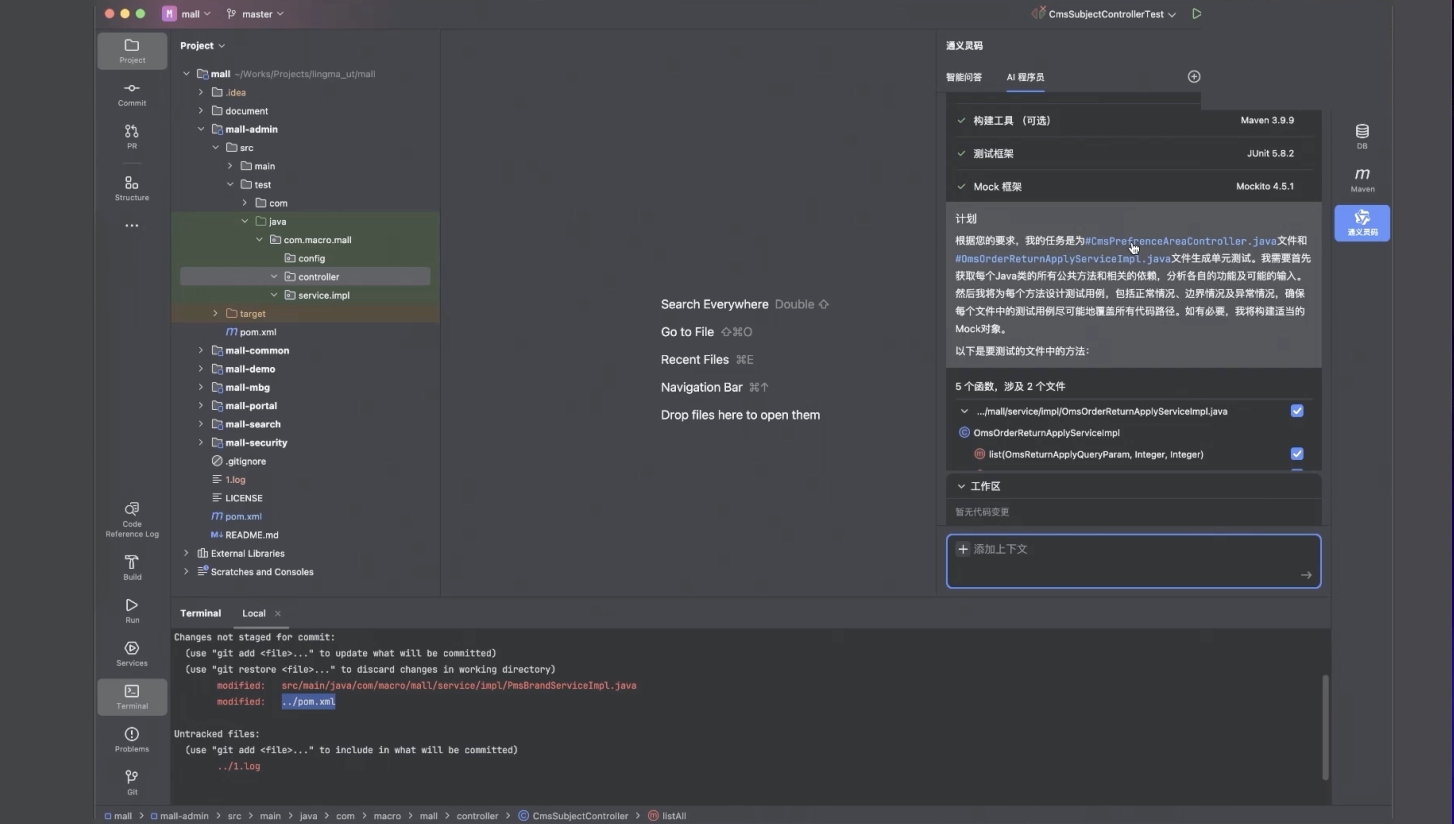
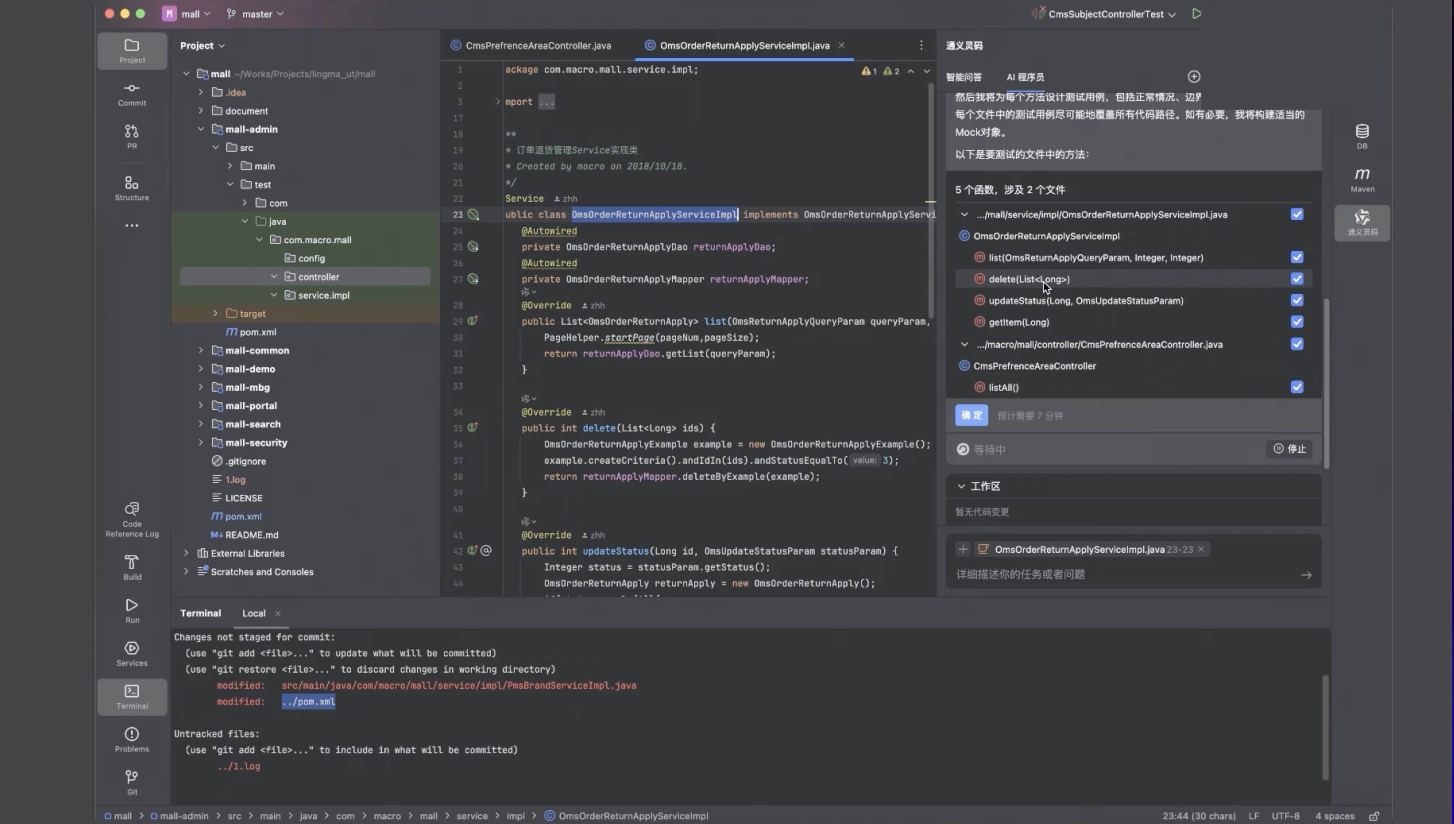
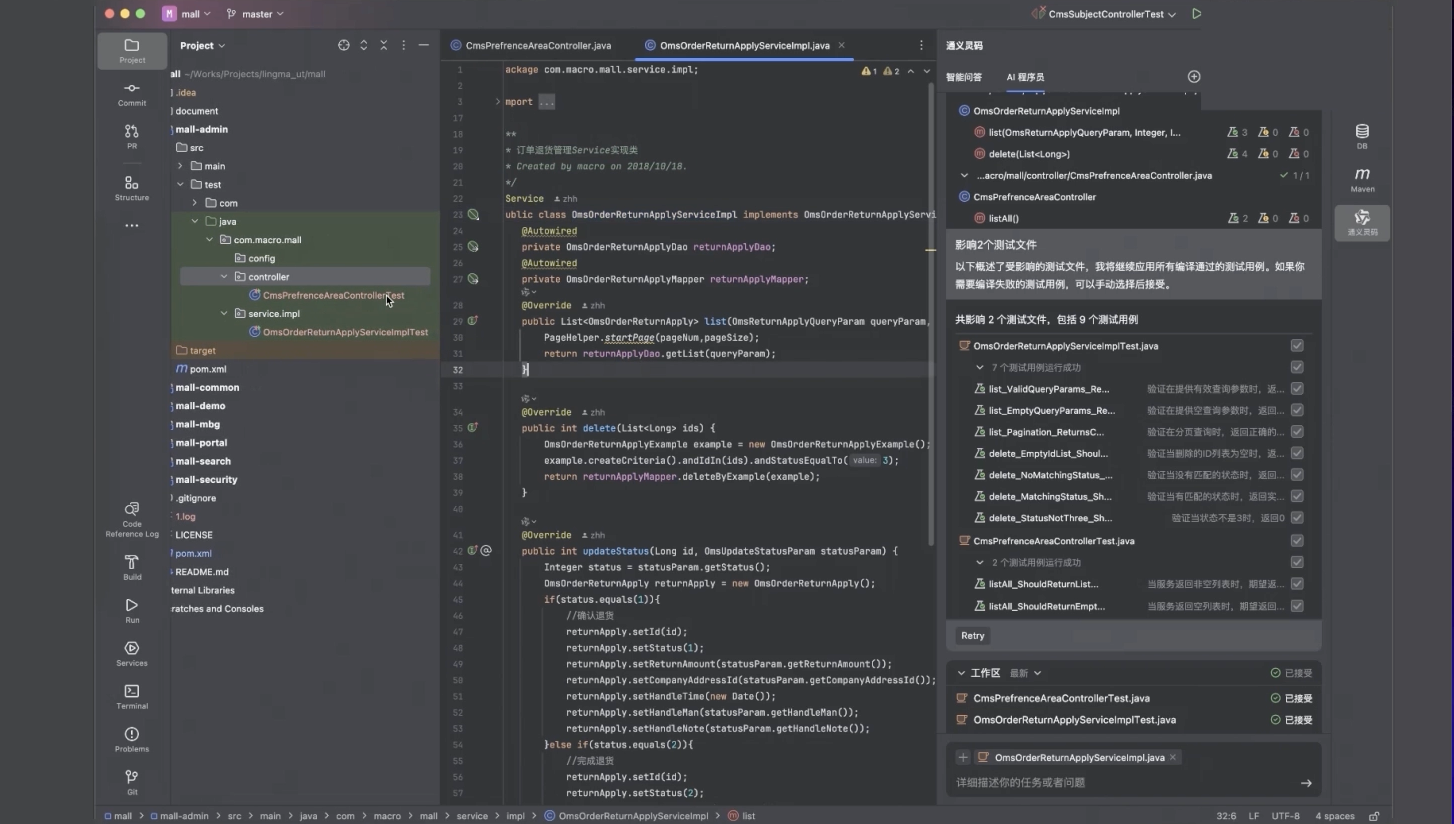
Continue 开发环境搭建时遇到了 esbuild 缺失问题
sh ./scripts/install-dependencies.sh
❌ File out/node_modules/@esbuild/darwin-arm64/bin/esbuild does not exist
sh ./scripts/install-dependencies.sh
❌ File out/node_modules/@esbuild/darwin-arm64/bin/esbuild does not exist
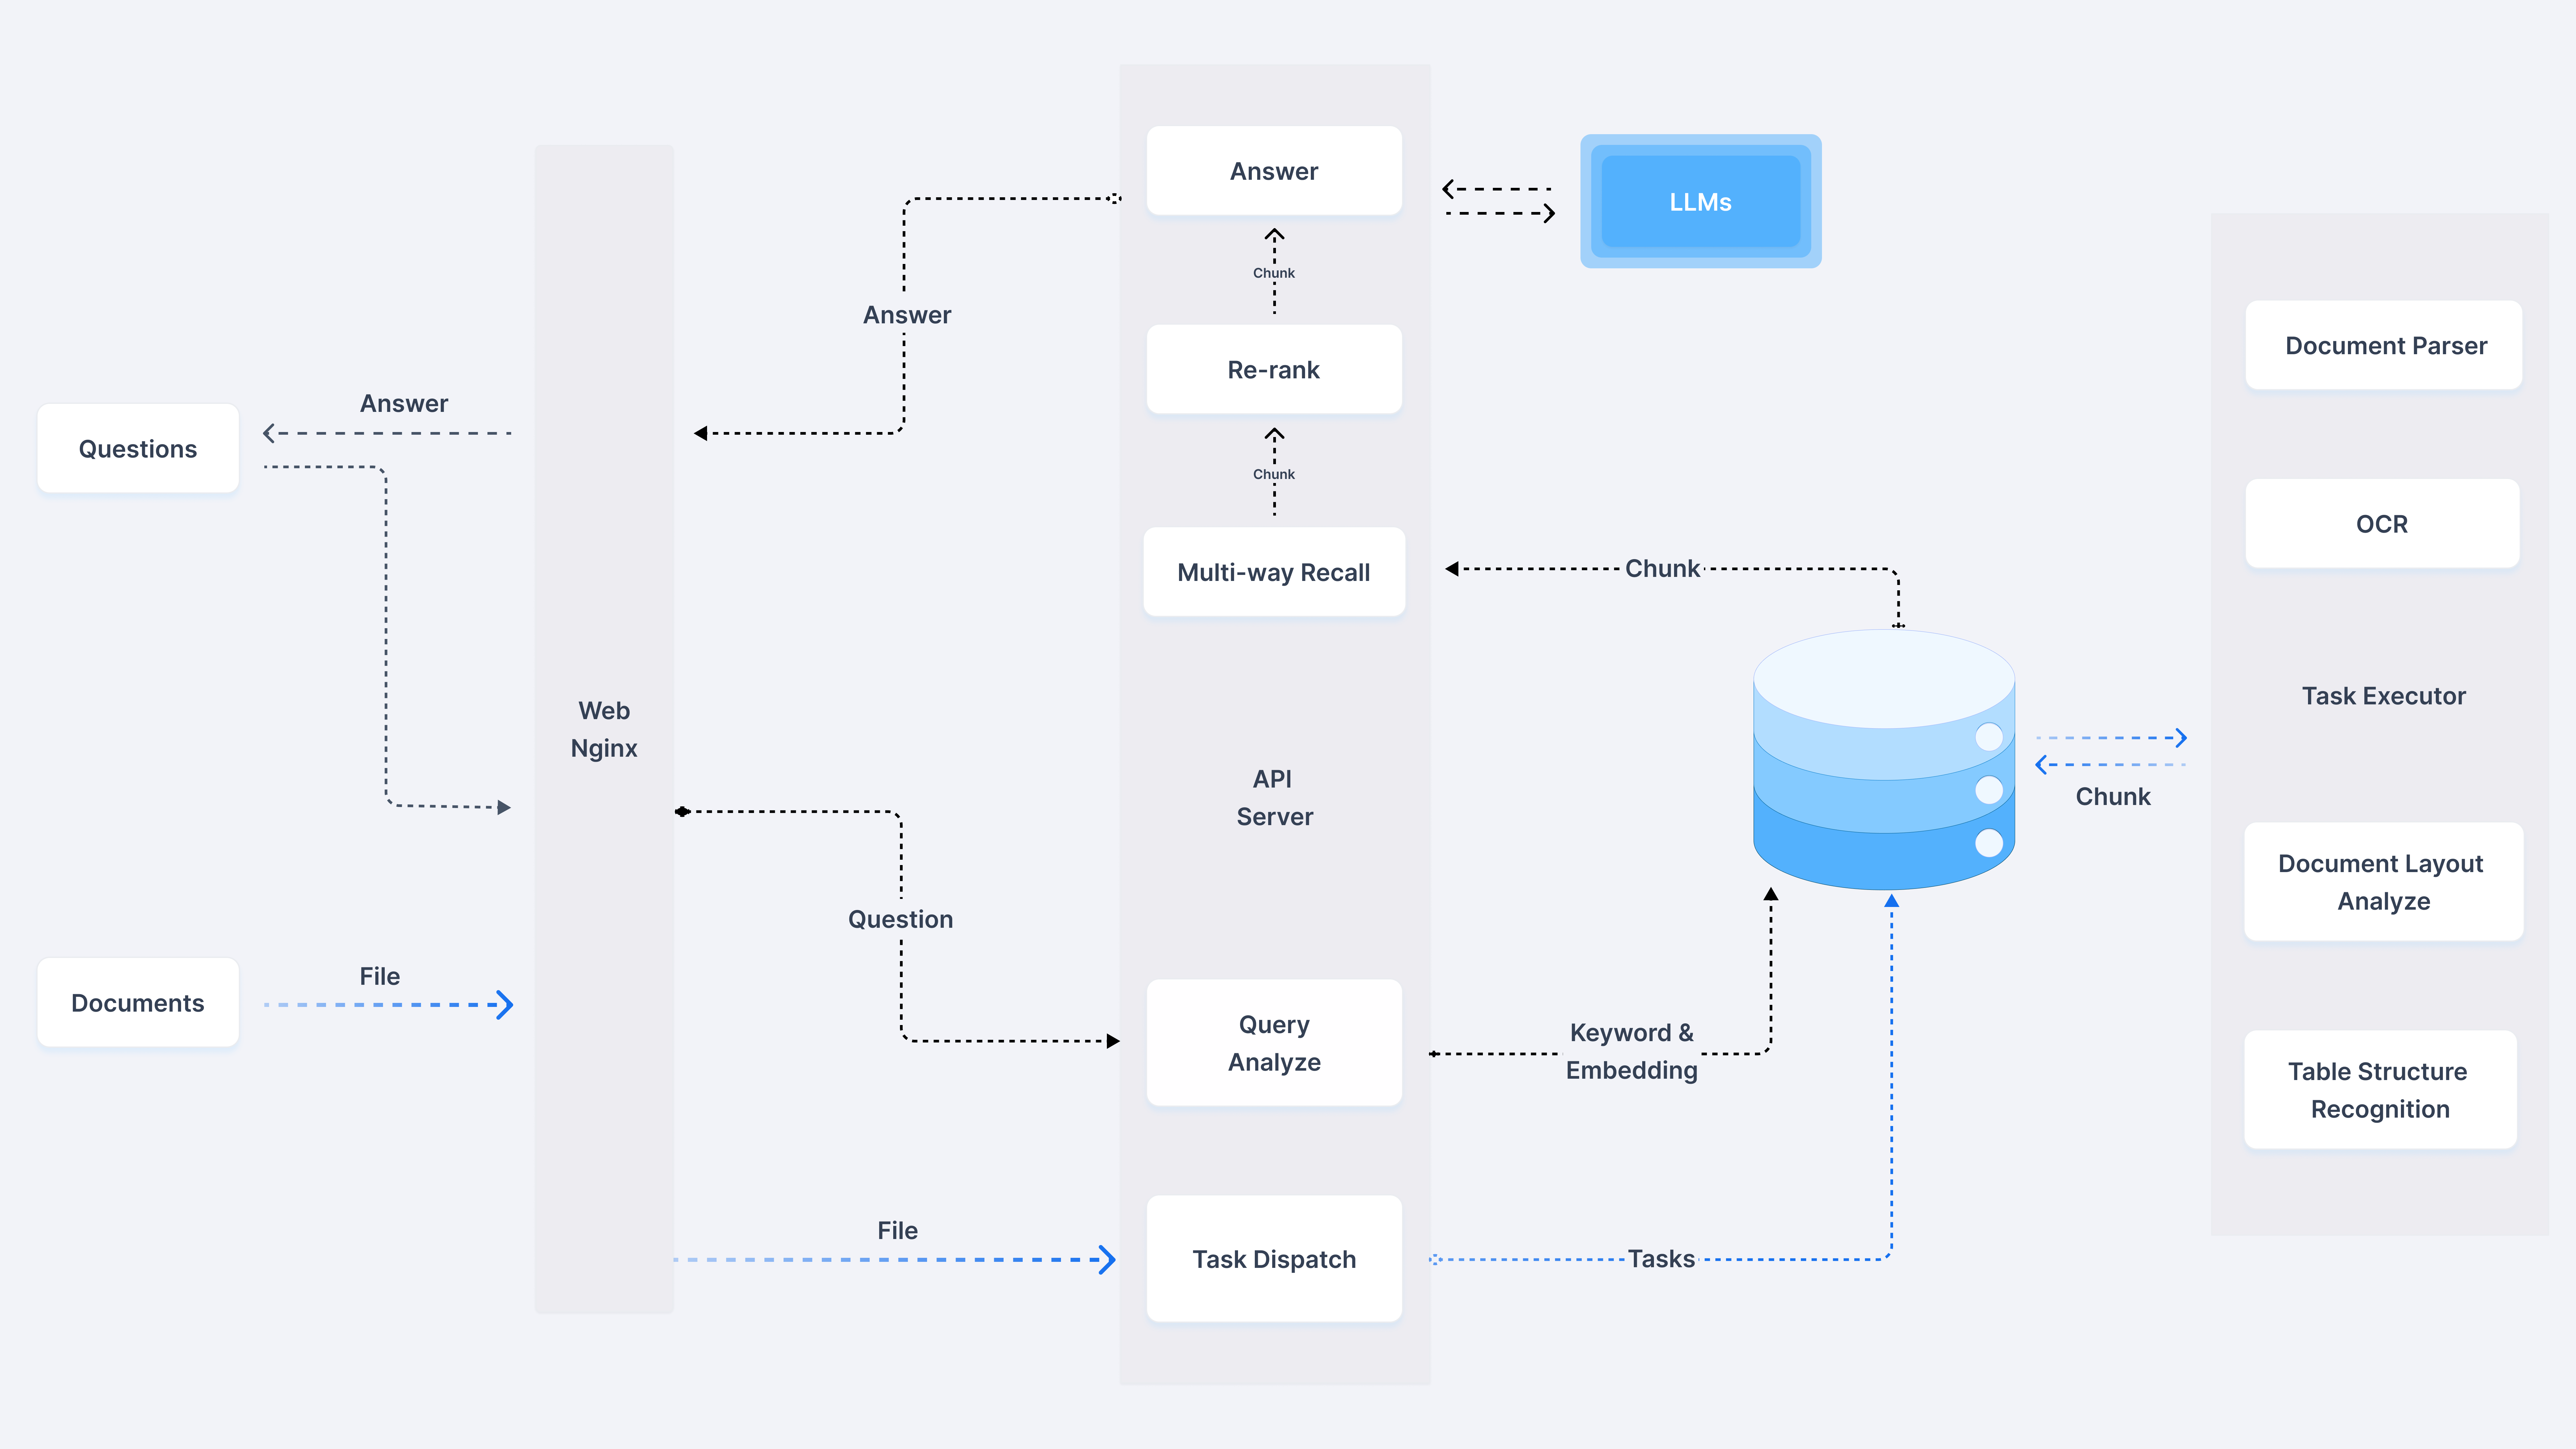
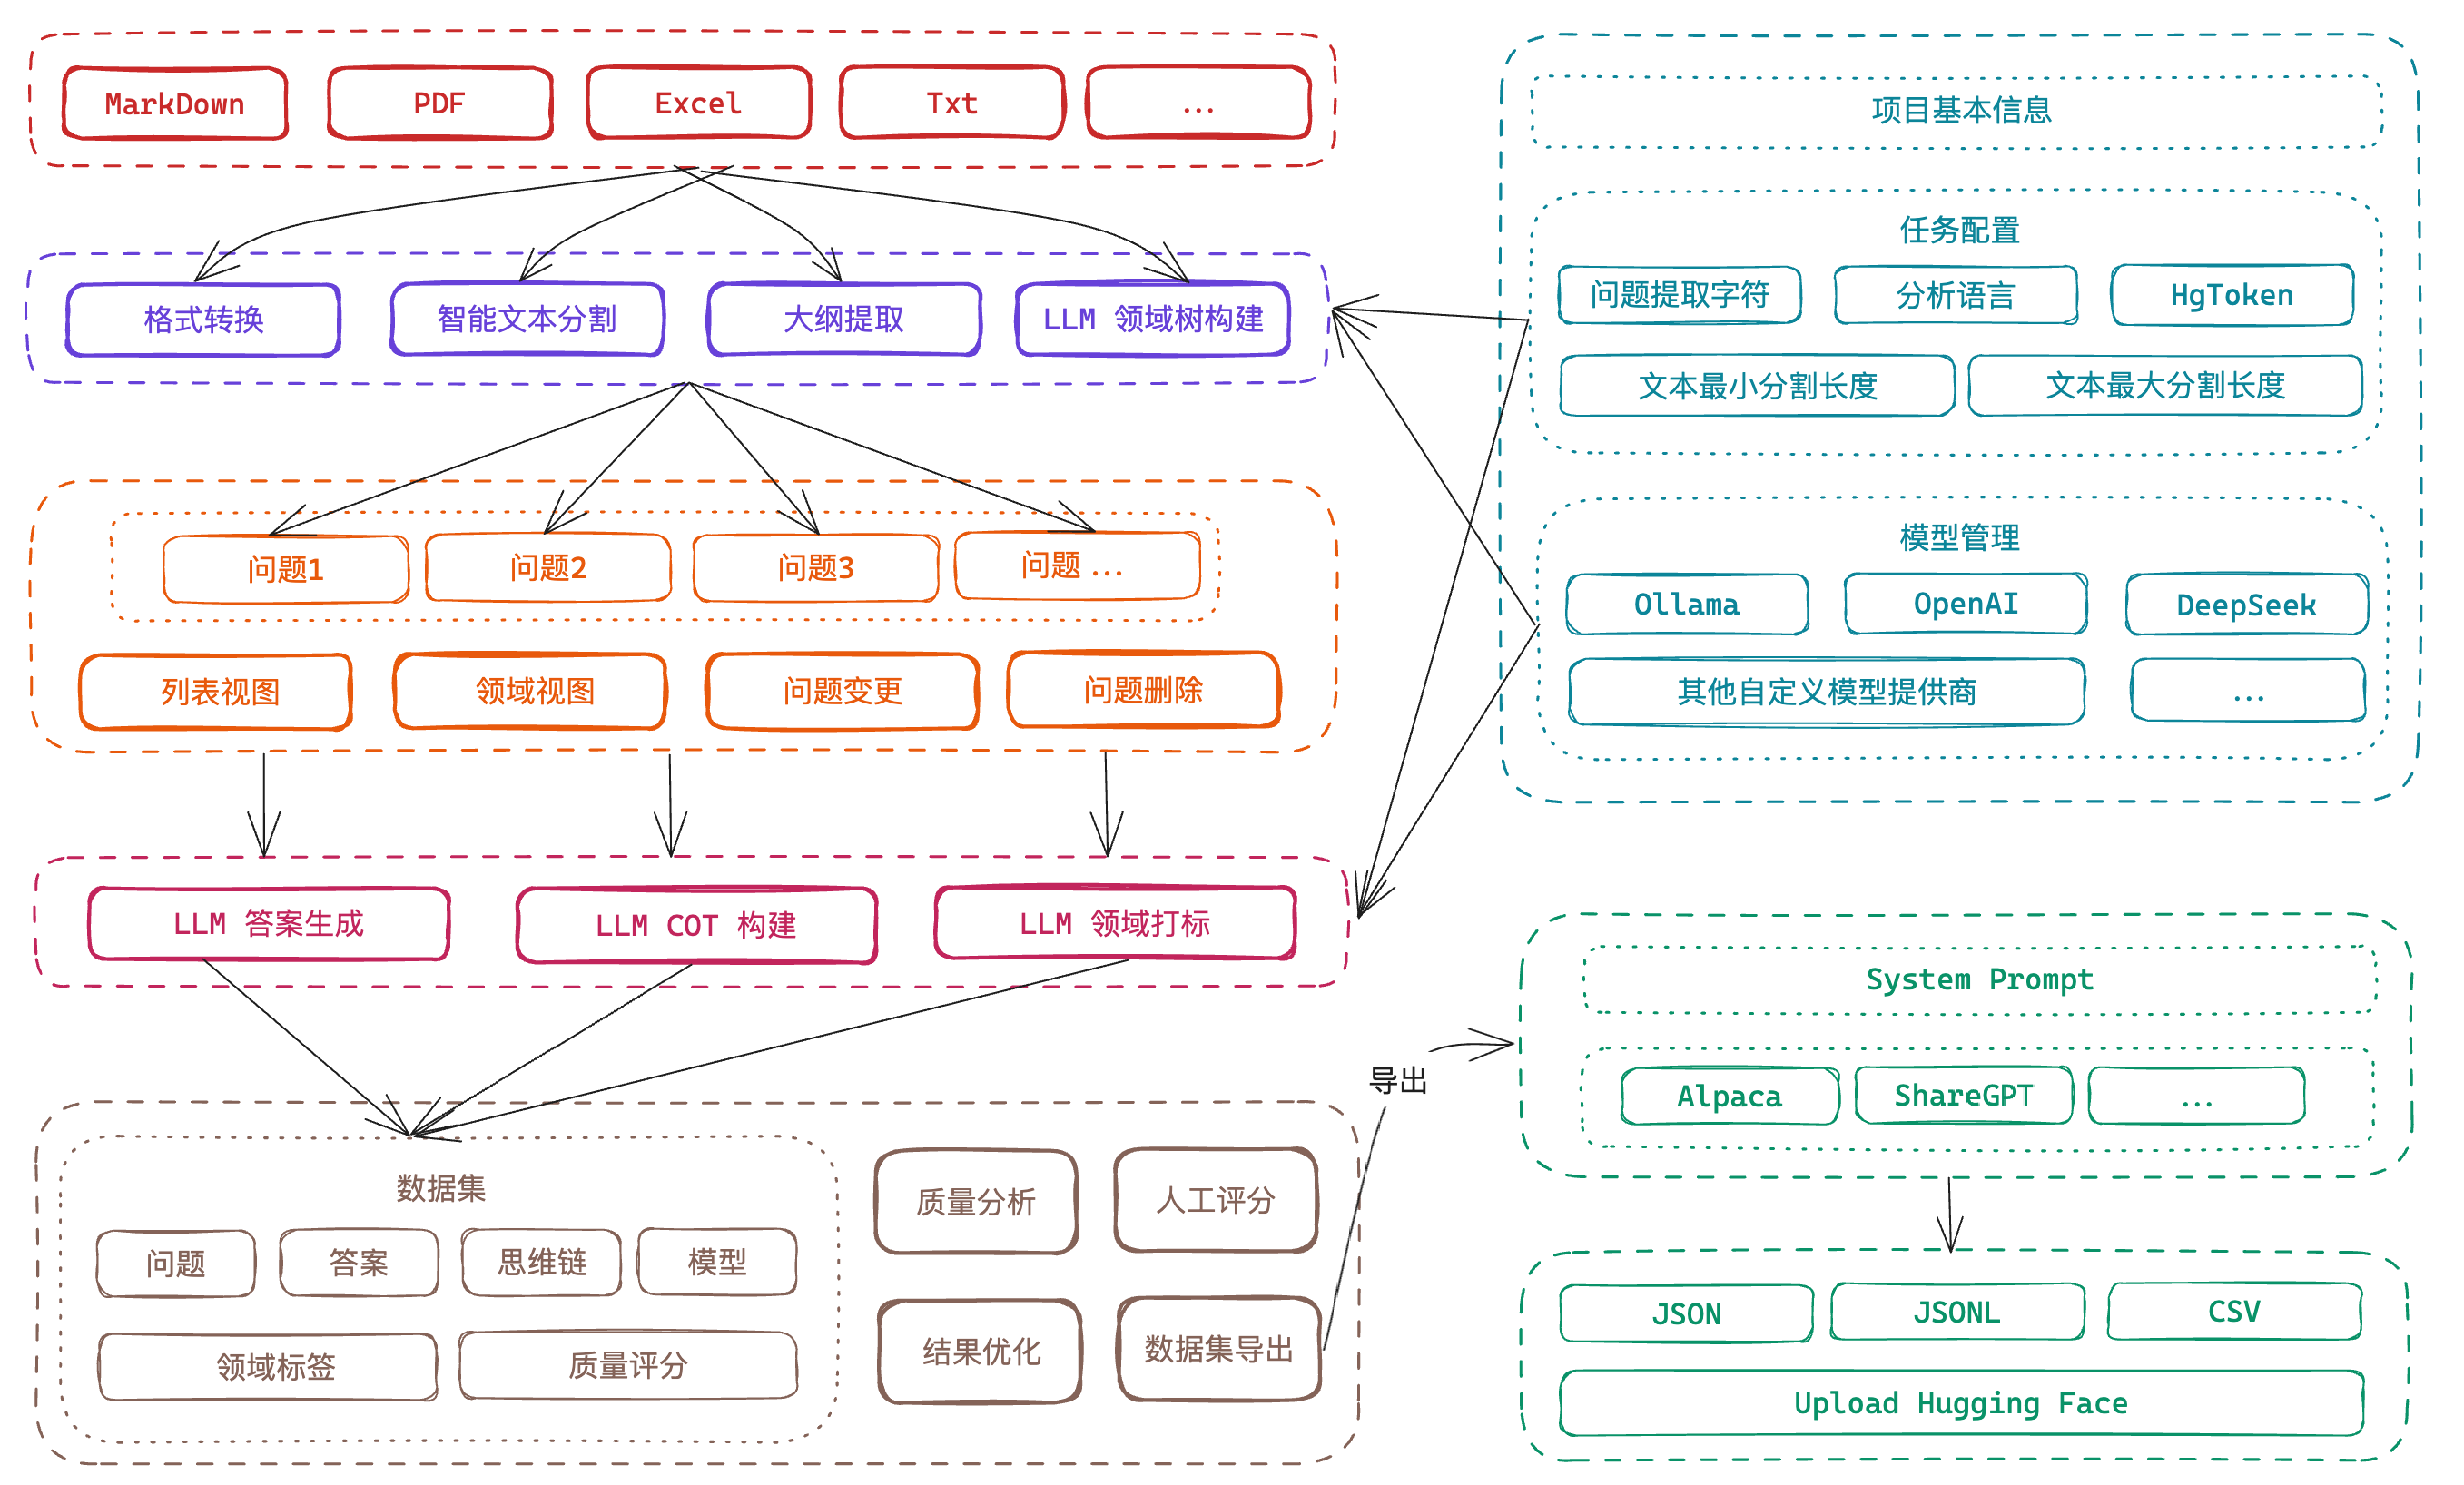
架构
本地运行
使用 NPM 安装
   git clone https://github.com/ConardLi/easy-dataset.git
   cd easy-dataset
npm install
   npm run build

   npm run start
http://localhost:1717使用本地 Dockerfile 构建
如果你想自行构建镜像,可以使用项目根目录中的 Dockerfile:
git clone https://github.com/ConardLi/easy-dataset.git
cd easy-dataset
docker build -t easy-dataset .
docker run -d -p 1717:1717 -v {YOUR_LOCAL_DB_PATH}:/app/local-db --name easy-dataset easy-dataset
{YOUR_LOCAL_DB_PATH} 替换为你希望存储本地数据库的实际路径。http://localhost:1717首页
项目
创建项目
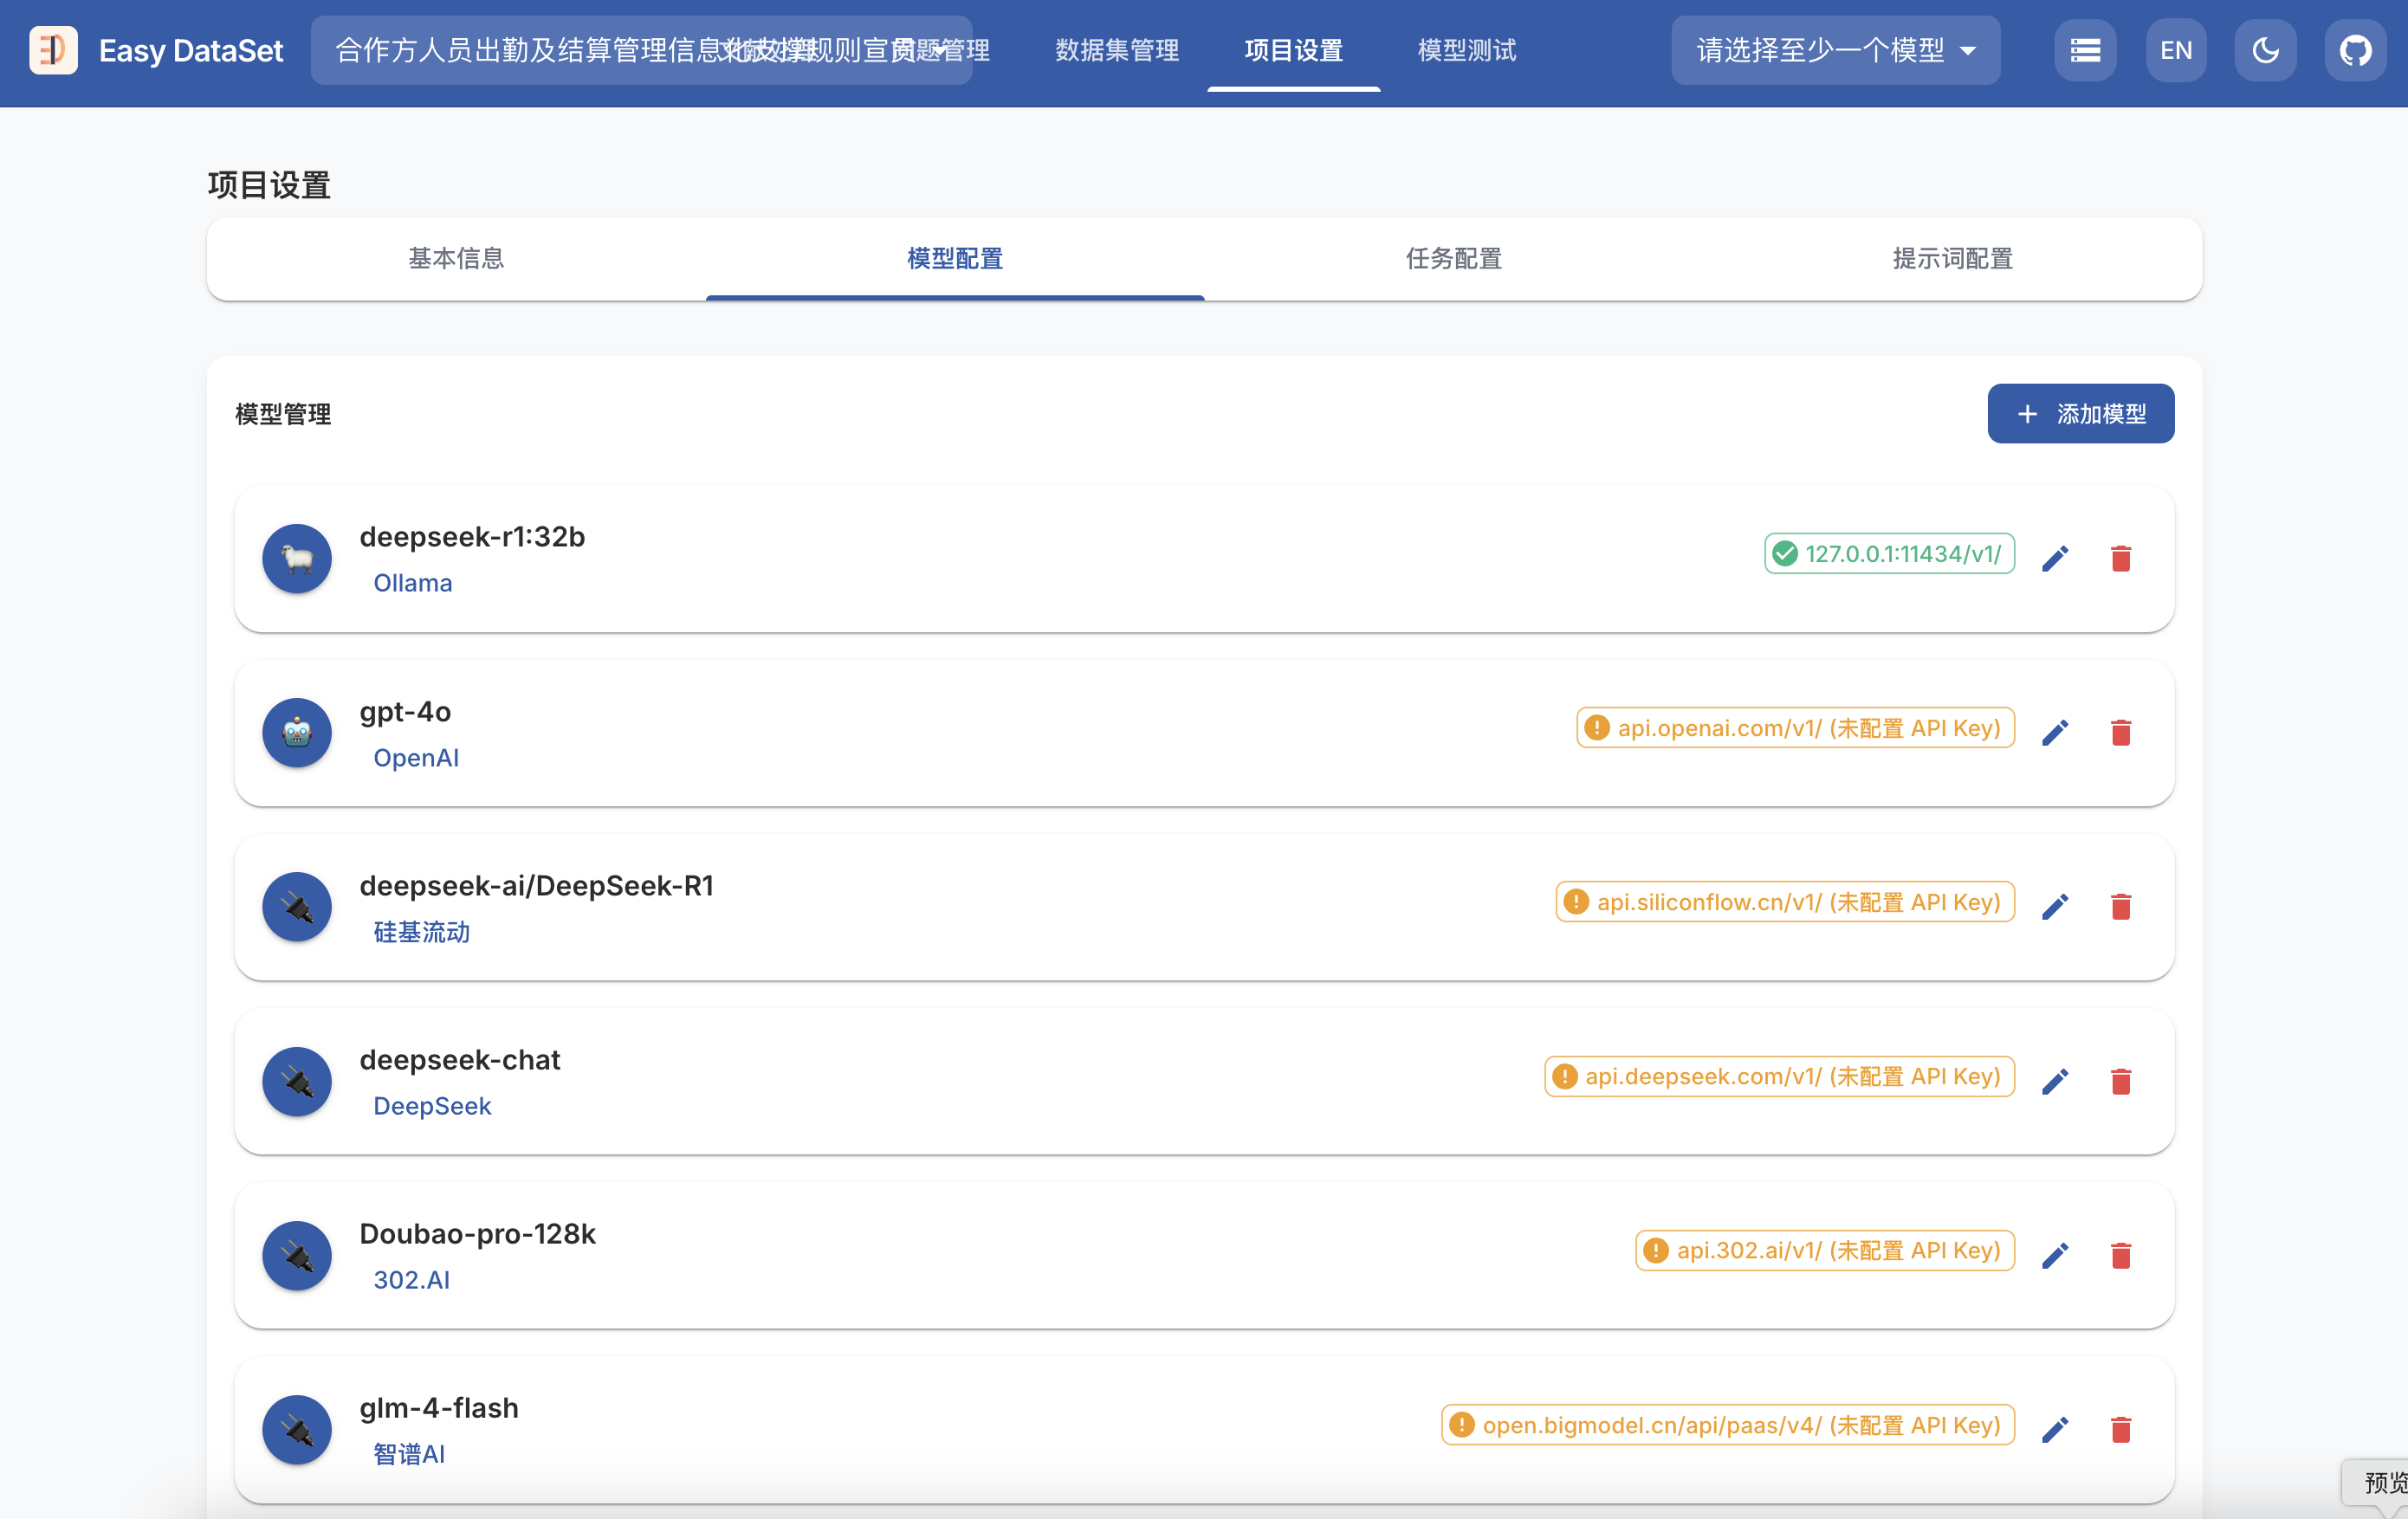
模型配置
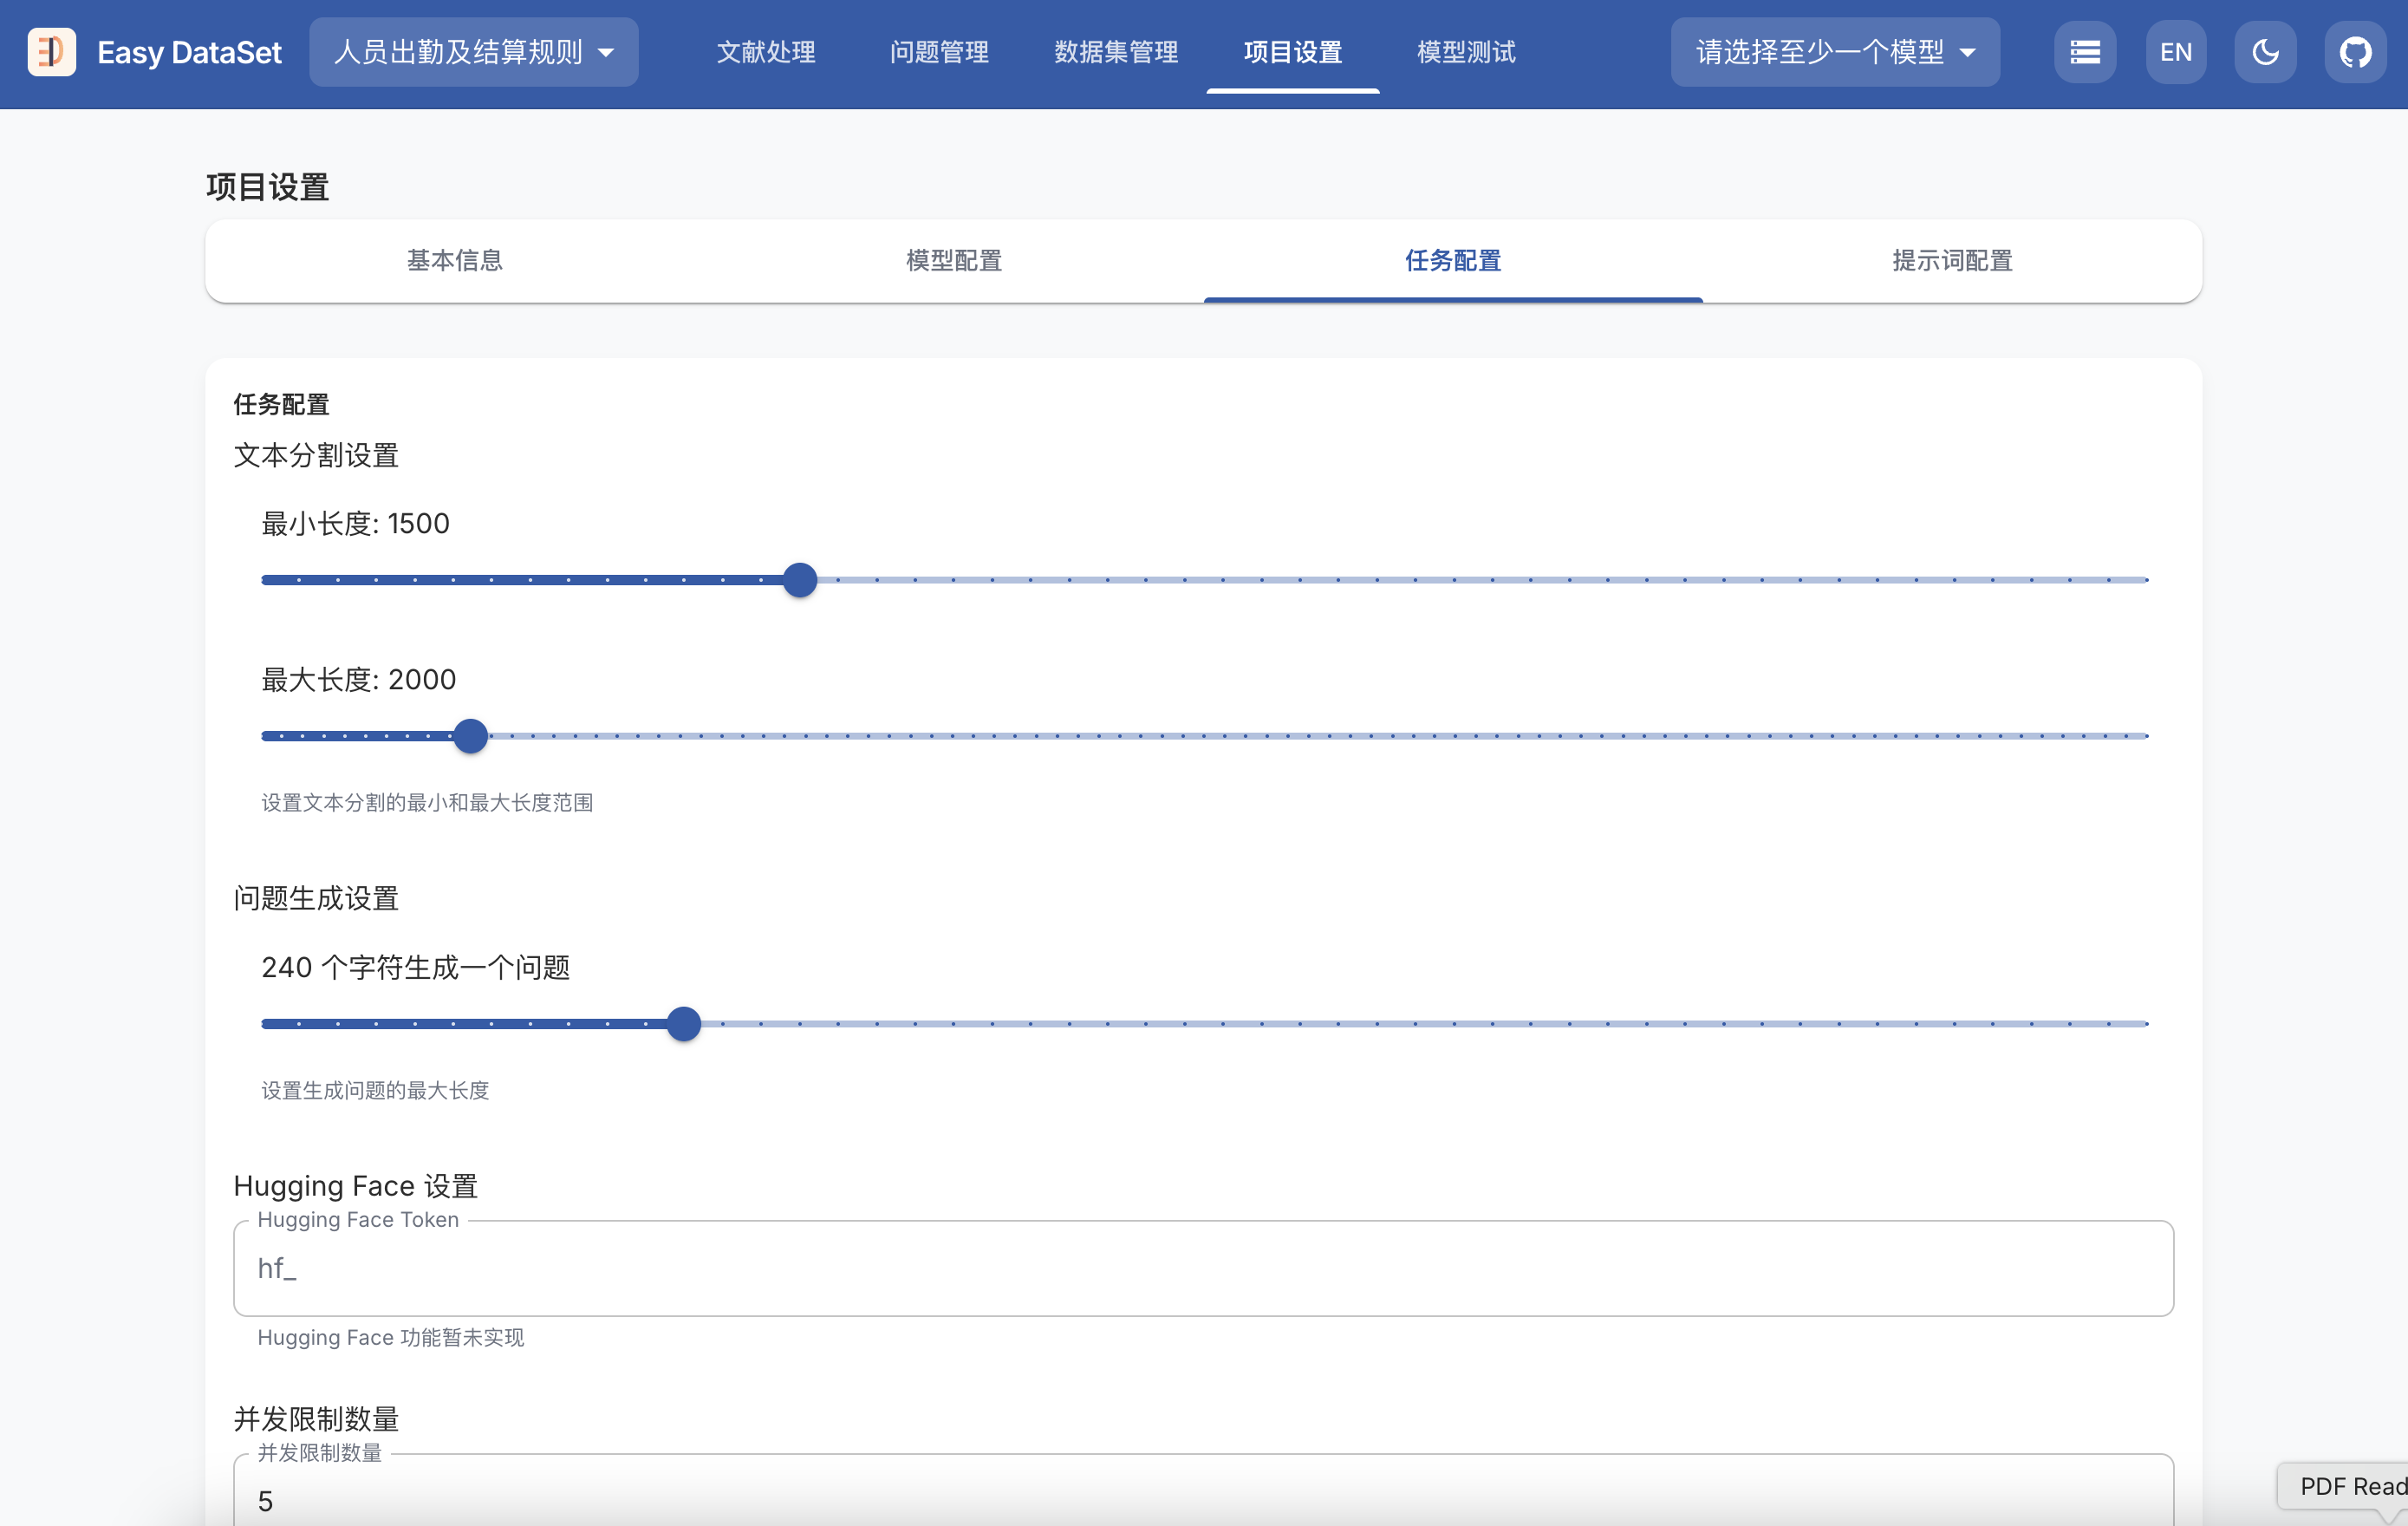
任务配置
提示词配置
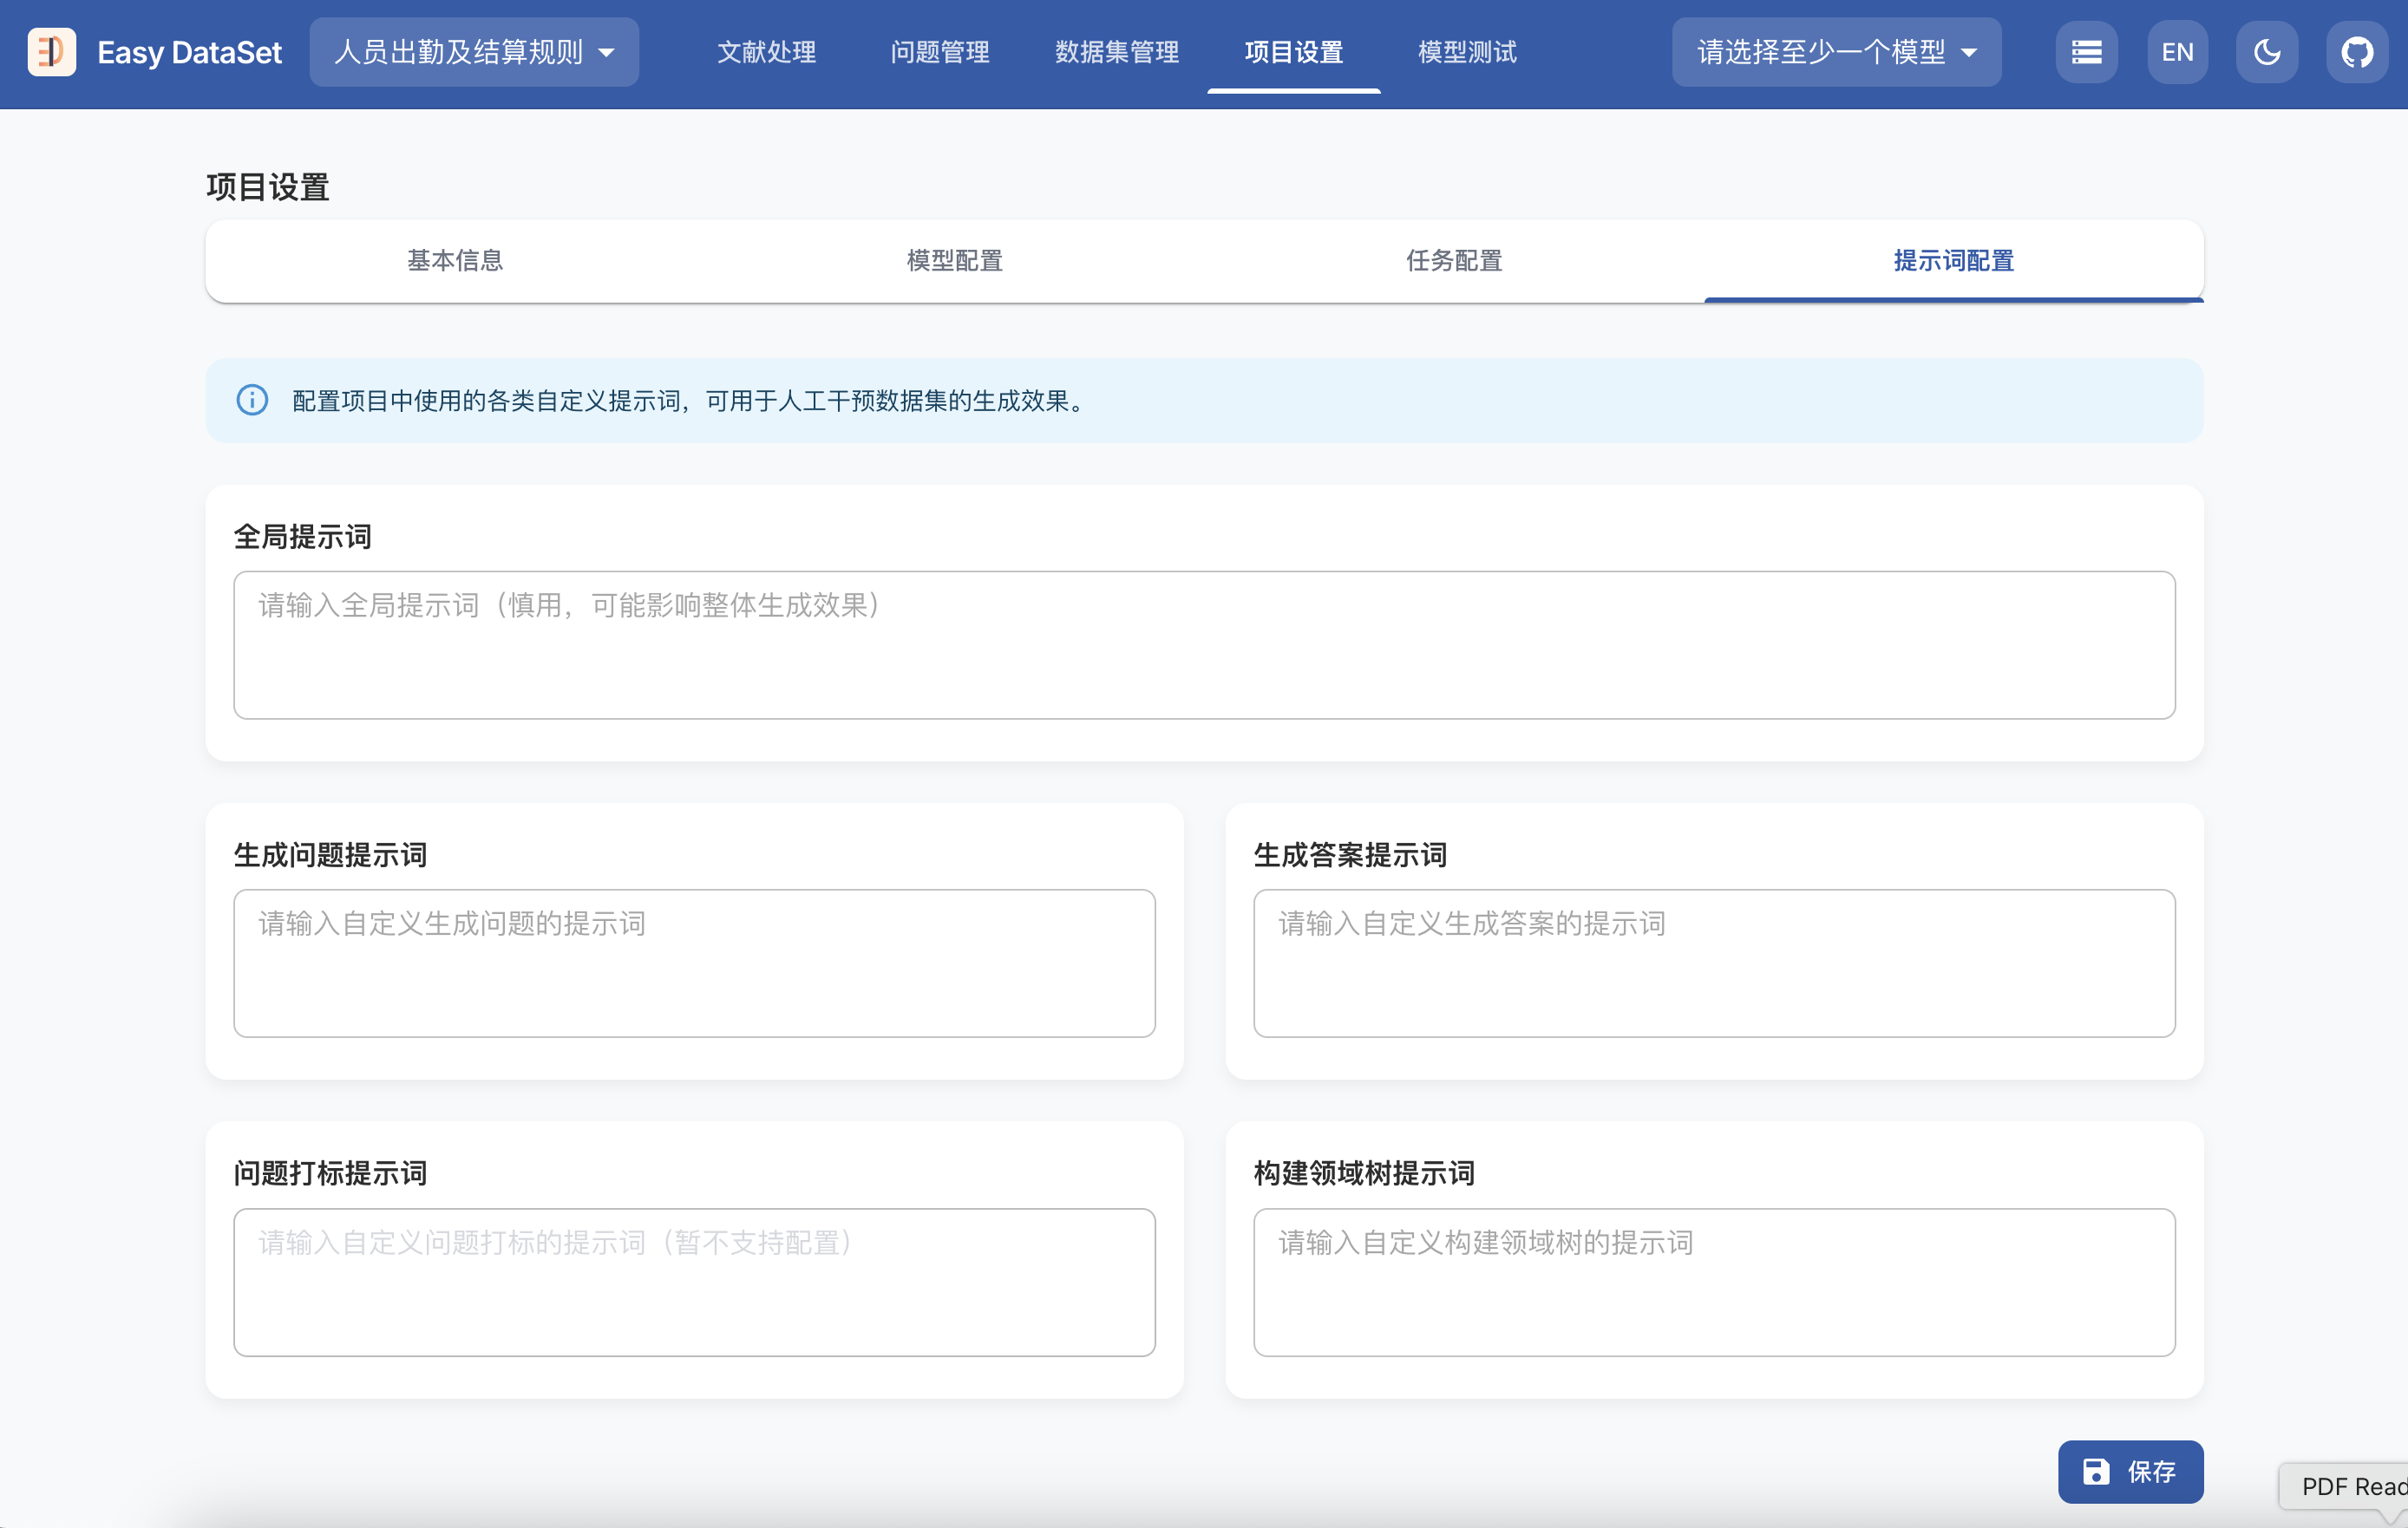
文献处理
上传文件
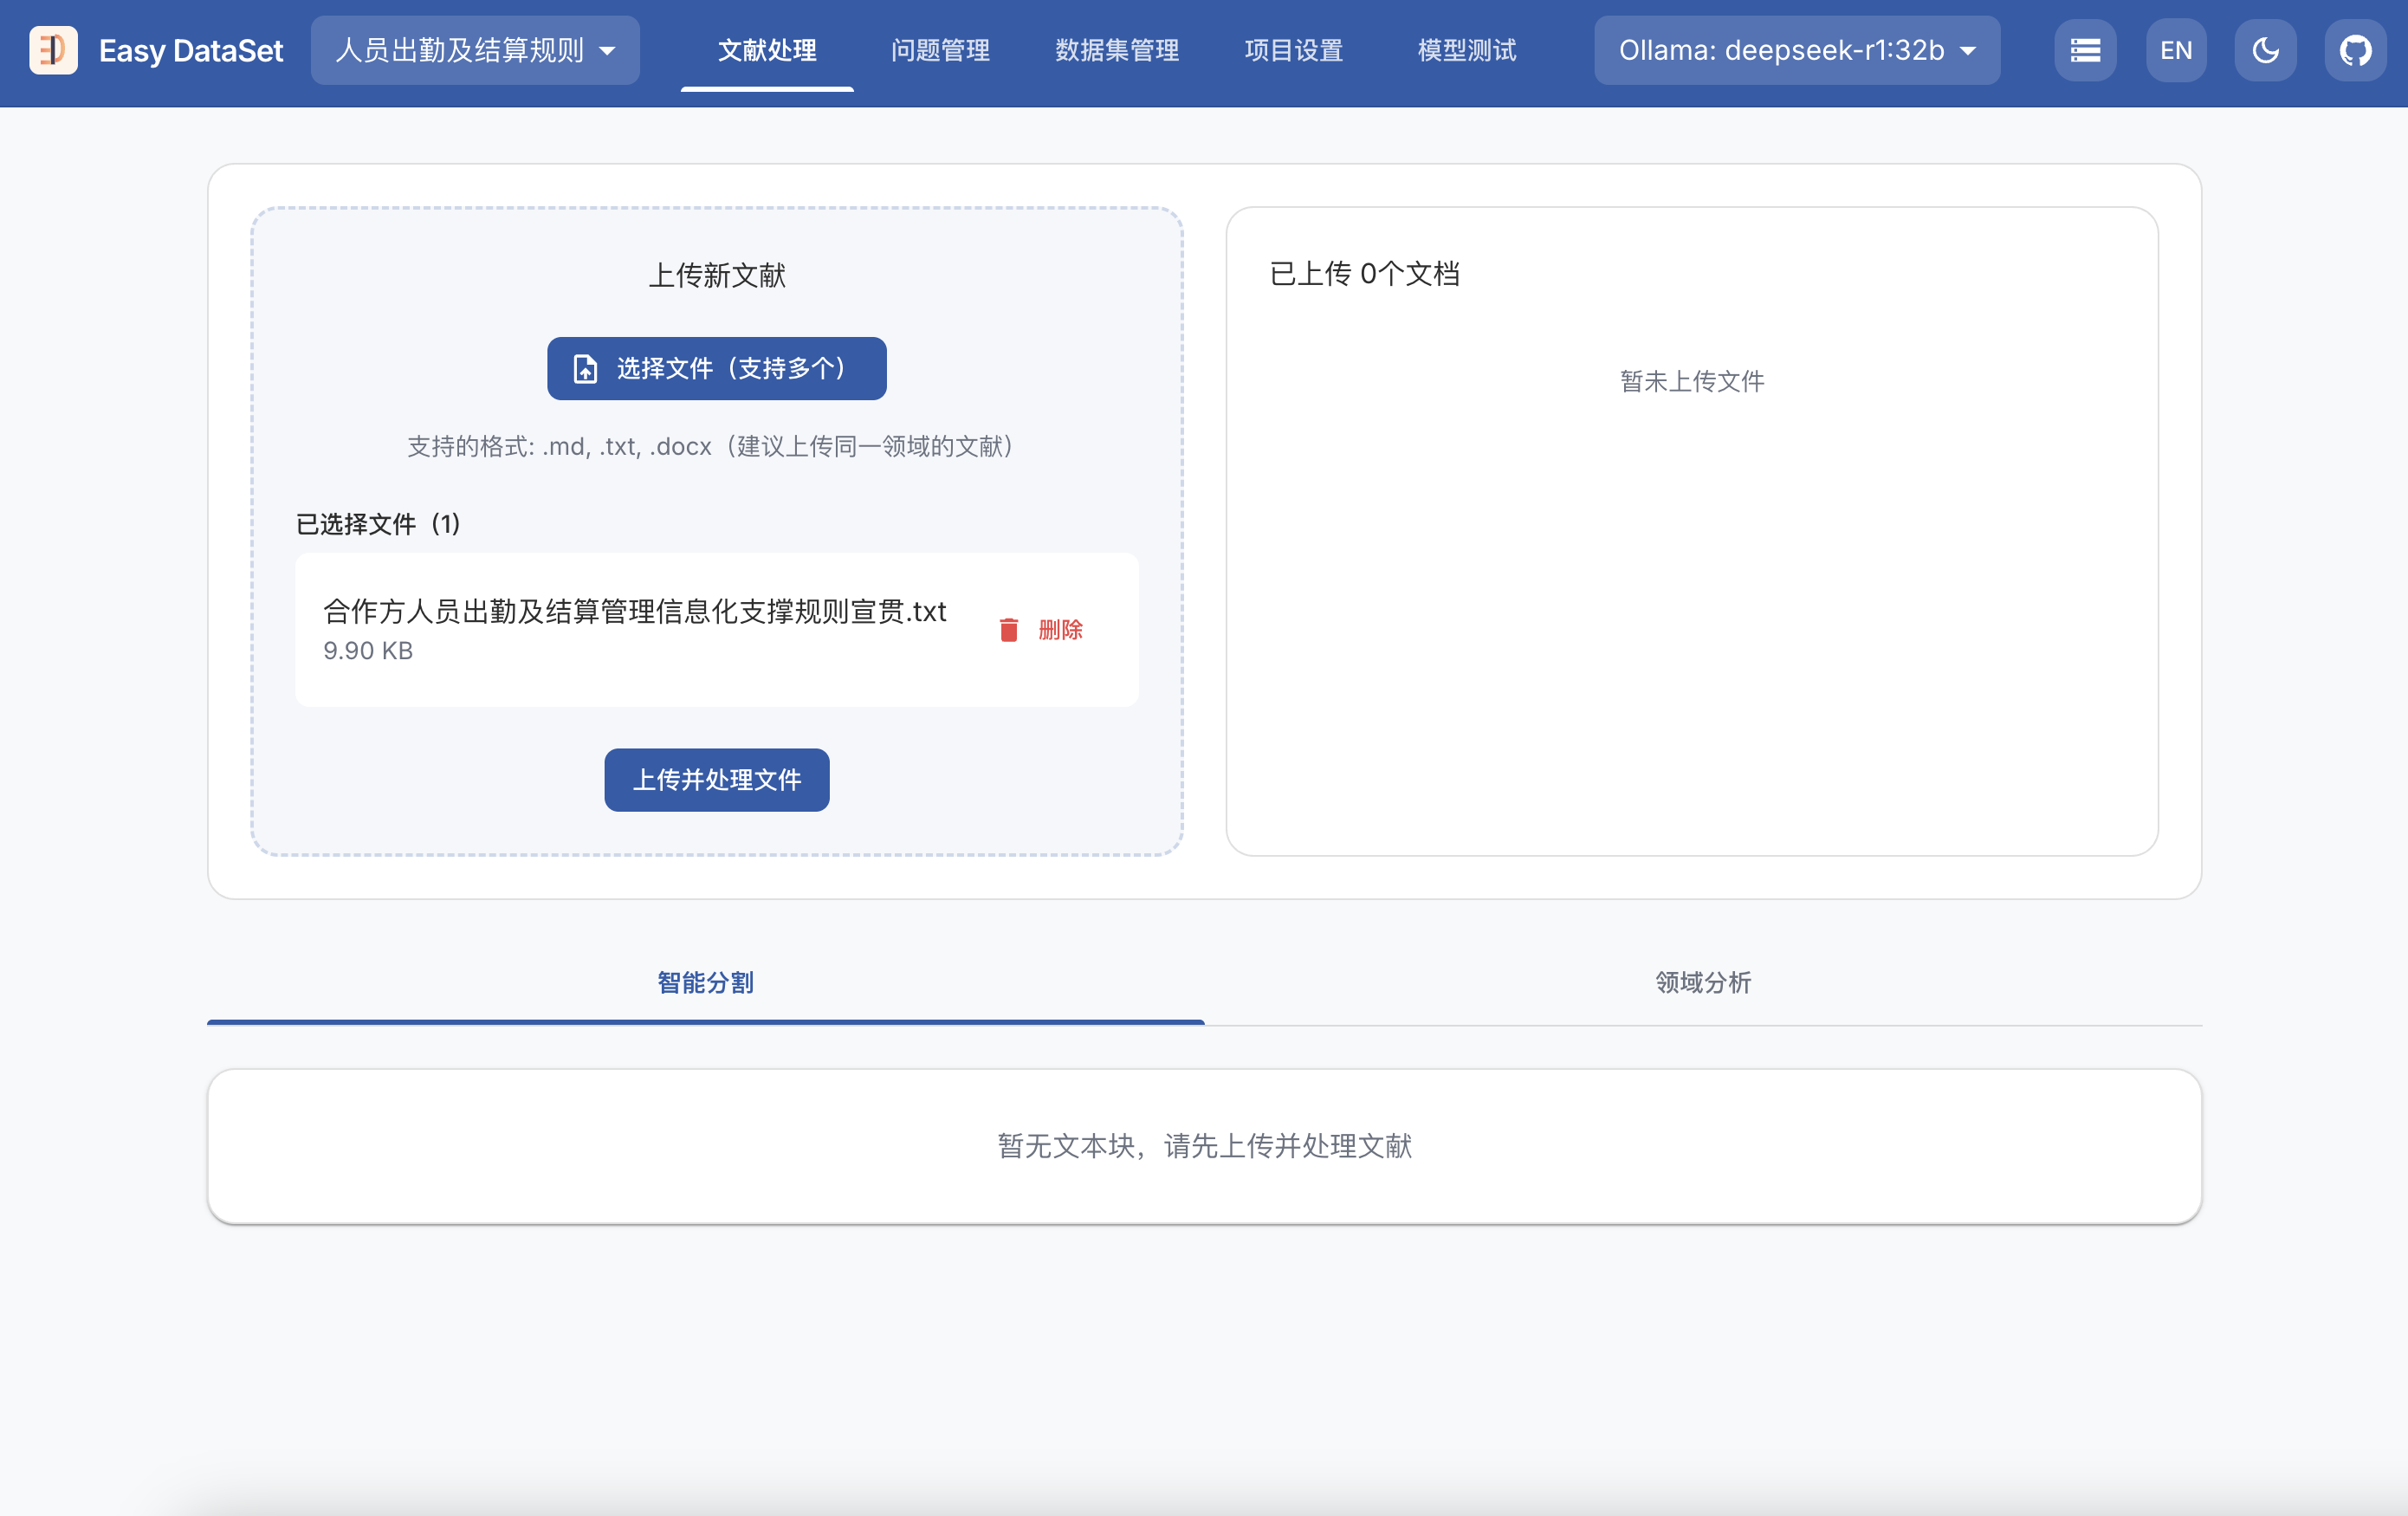
智能分割
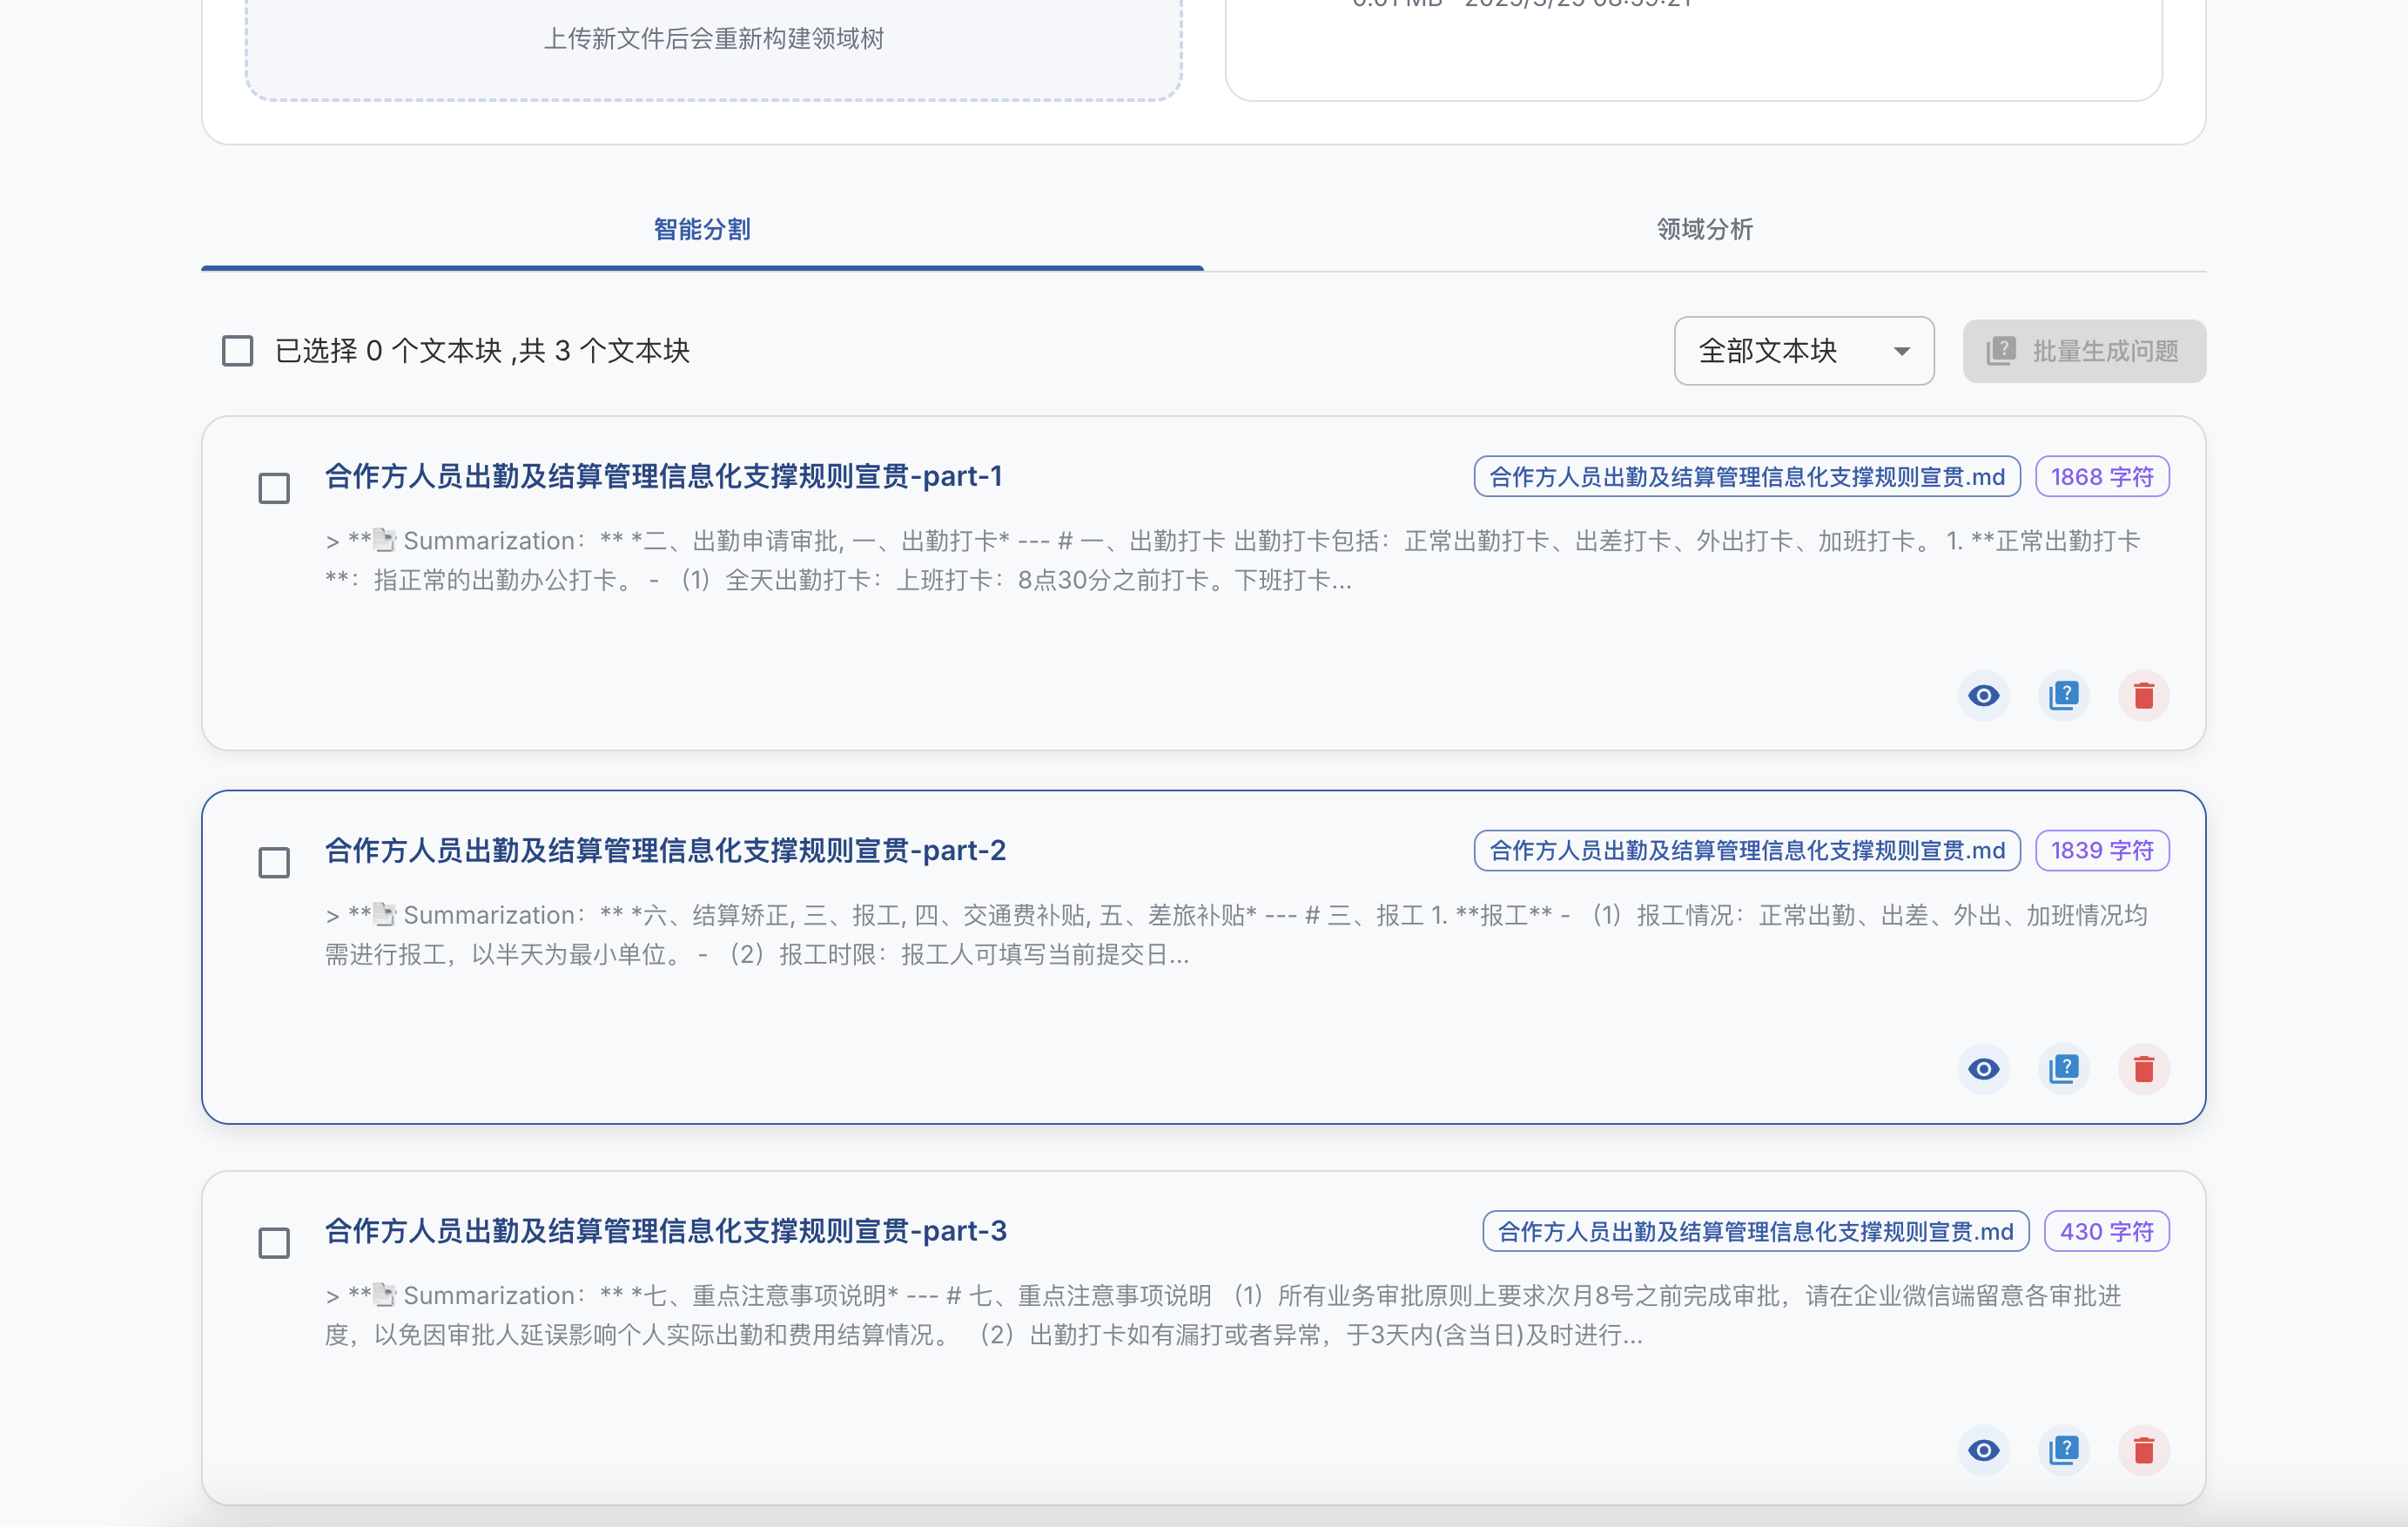
批量生成问题
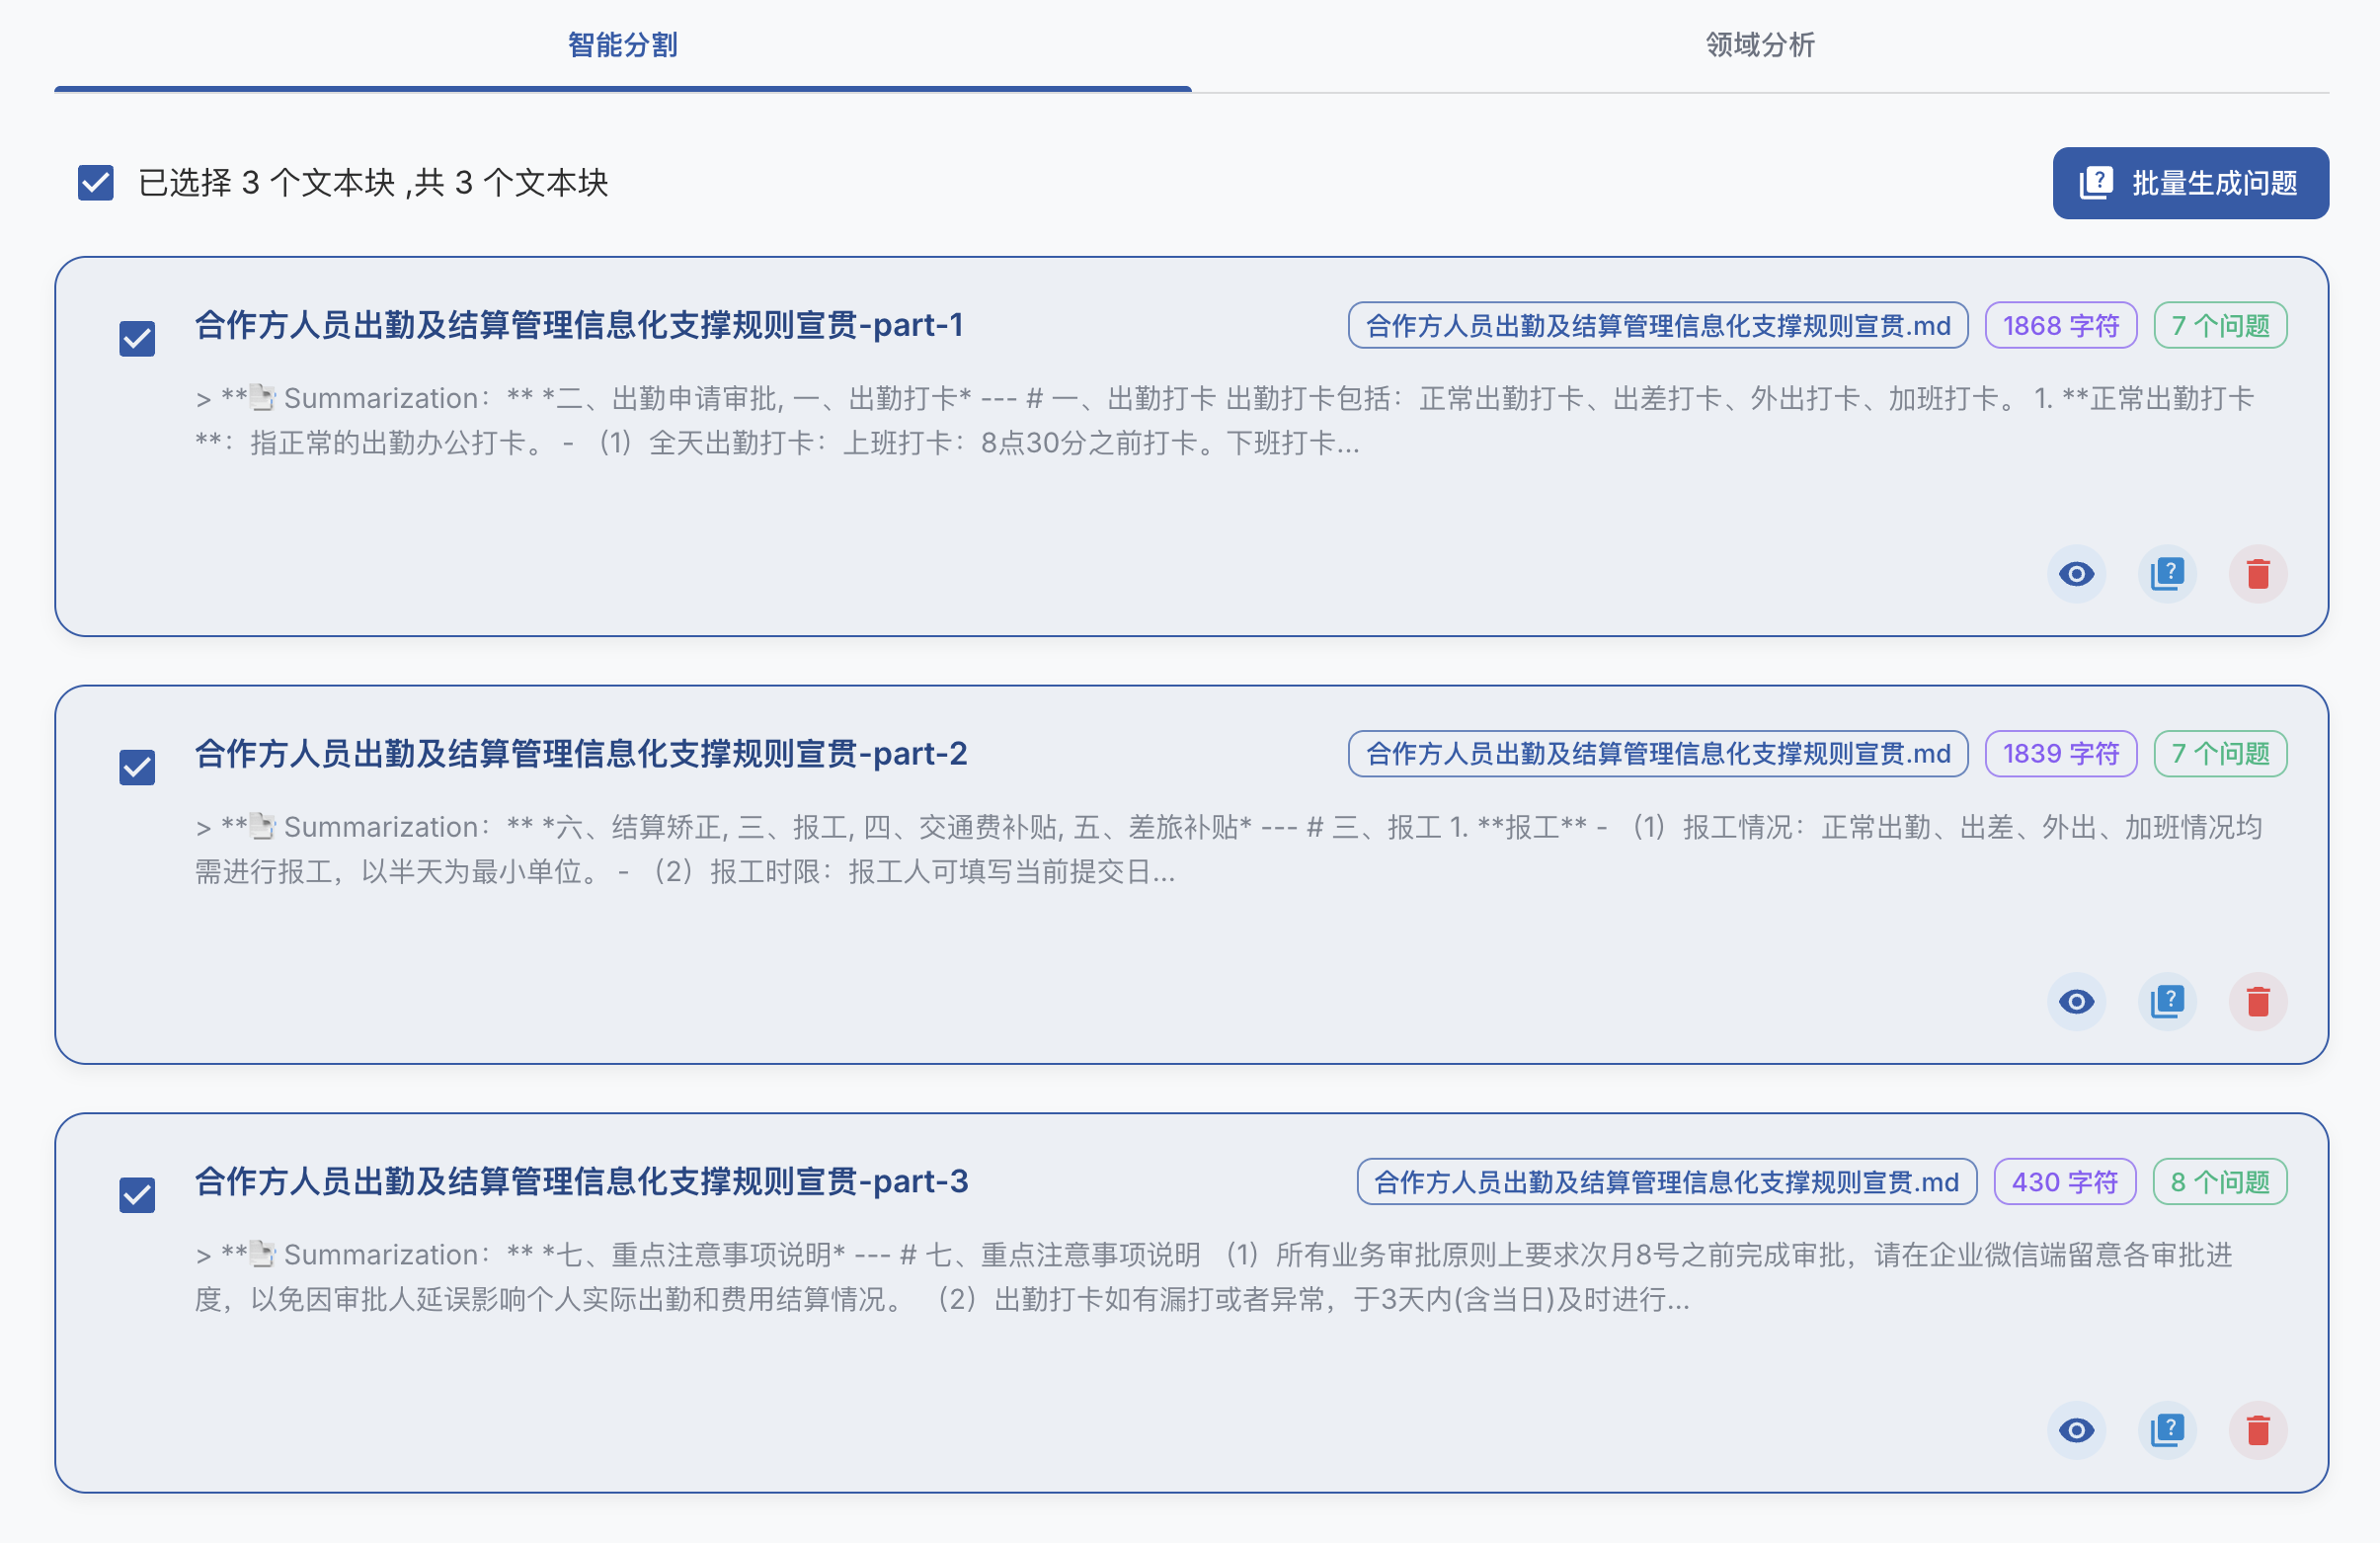
领域分析
领域树
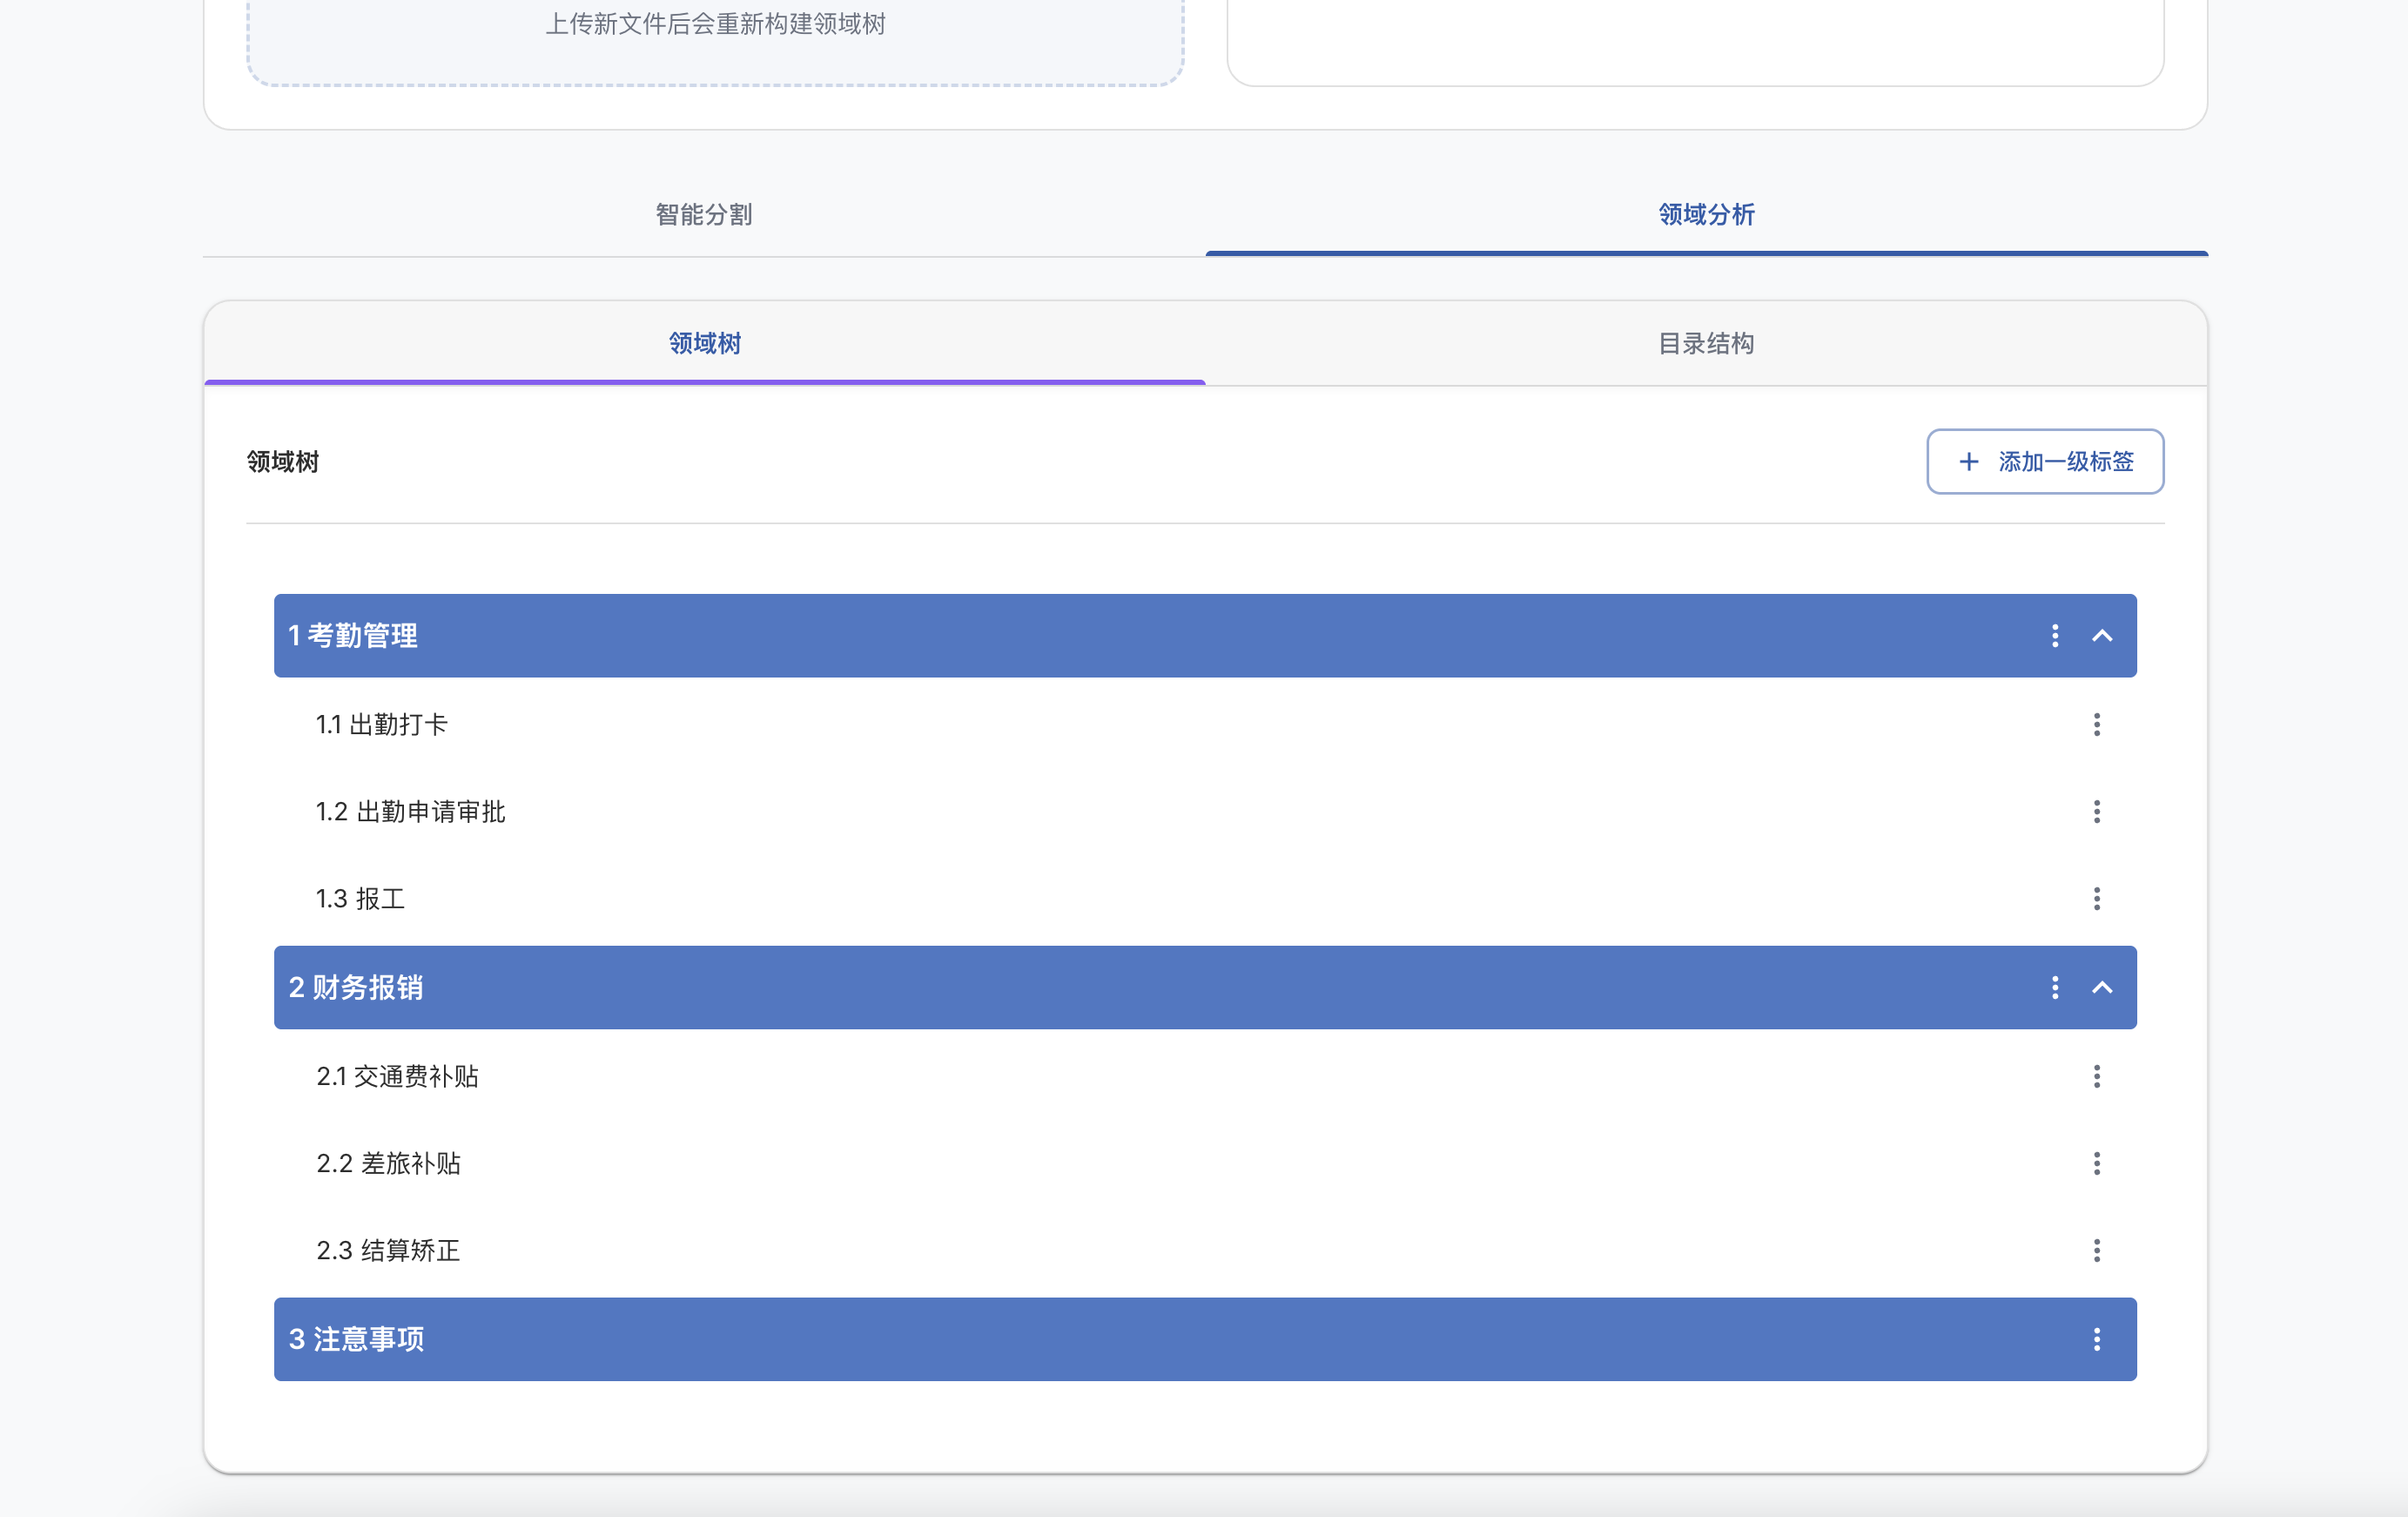
目录结构
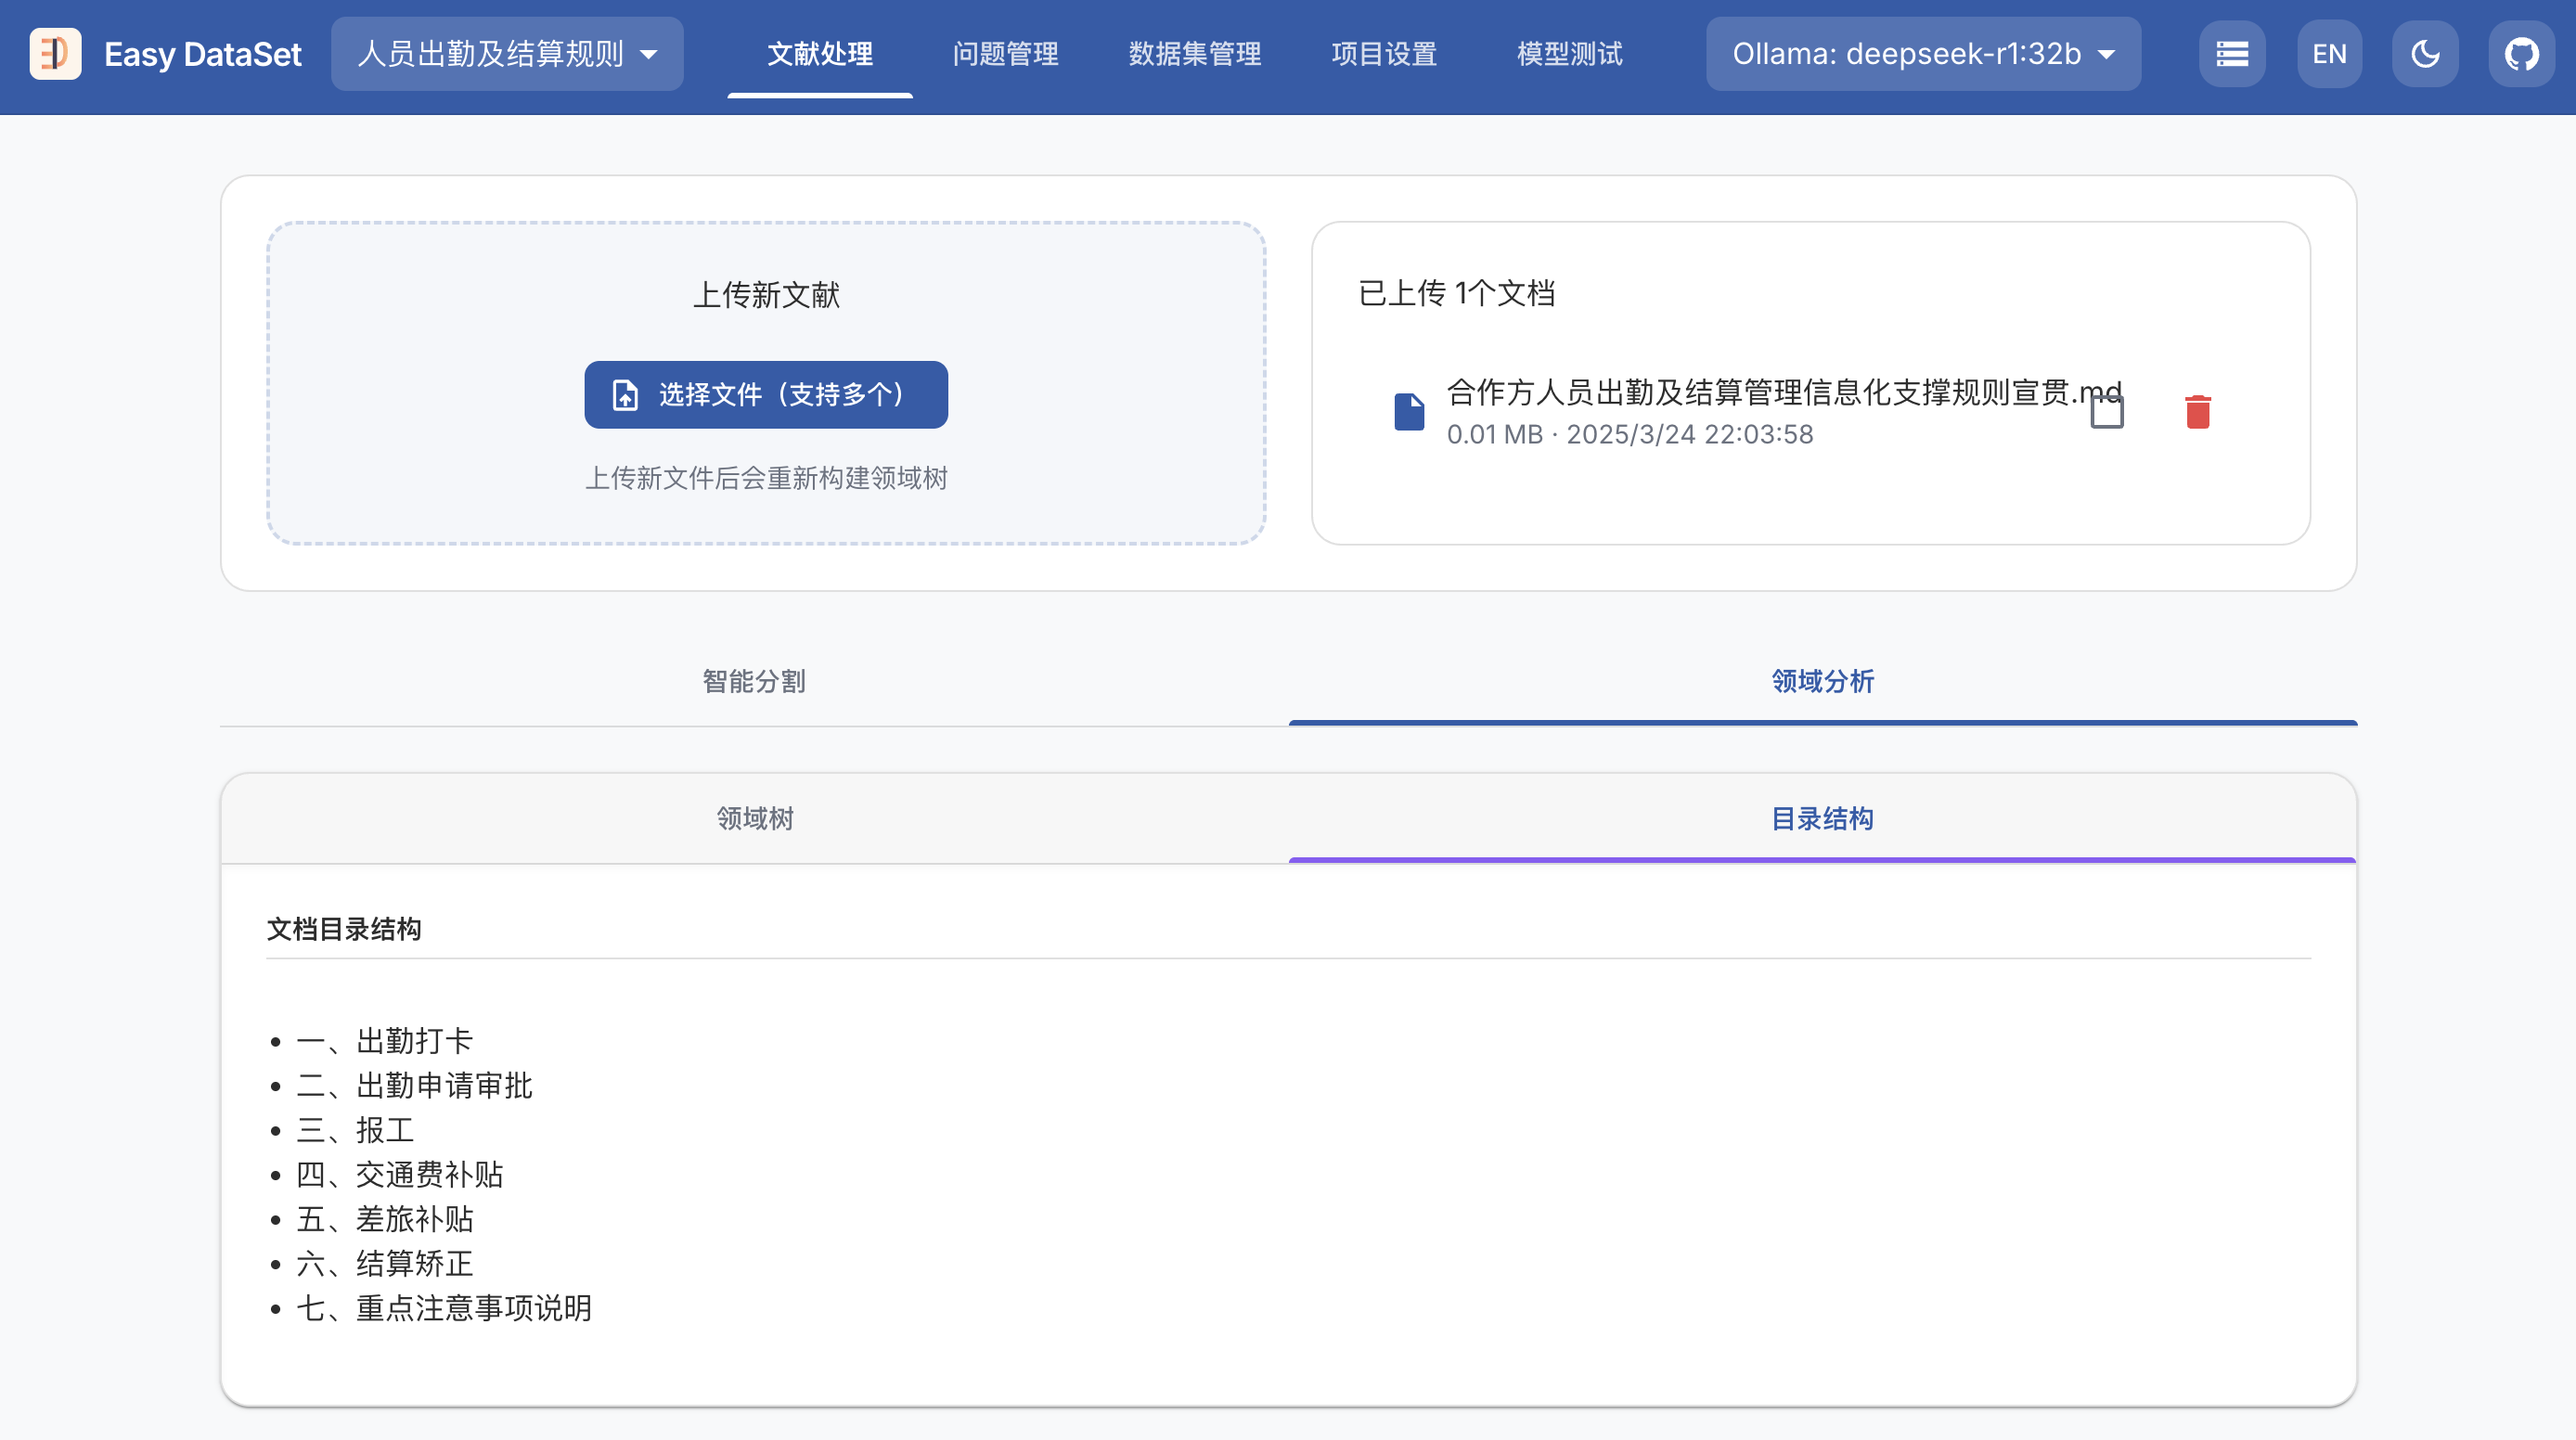
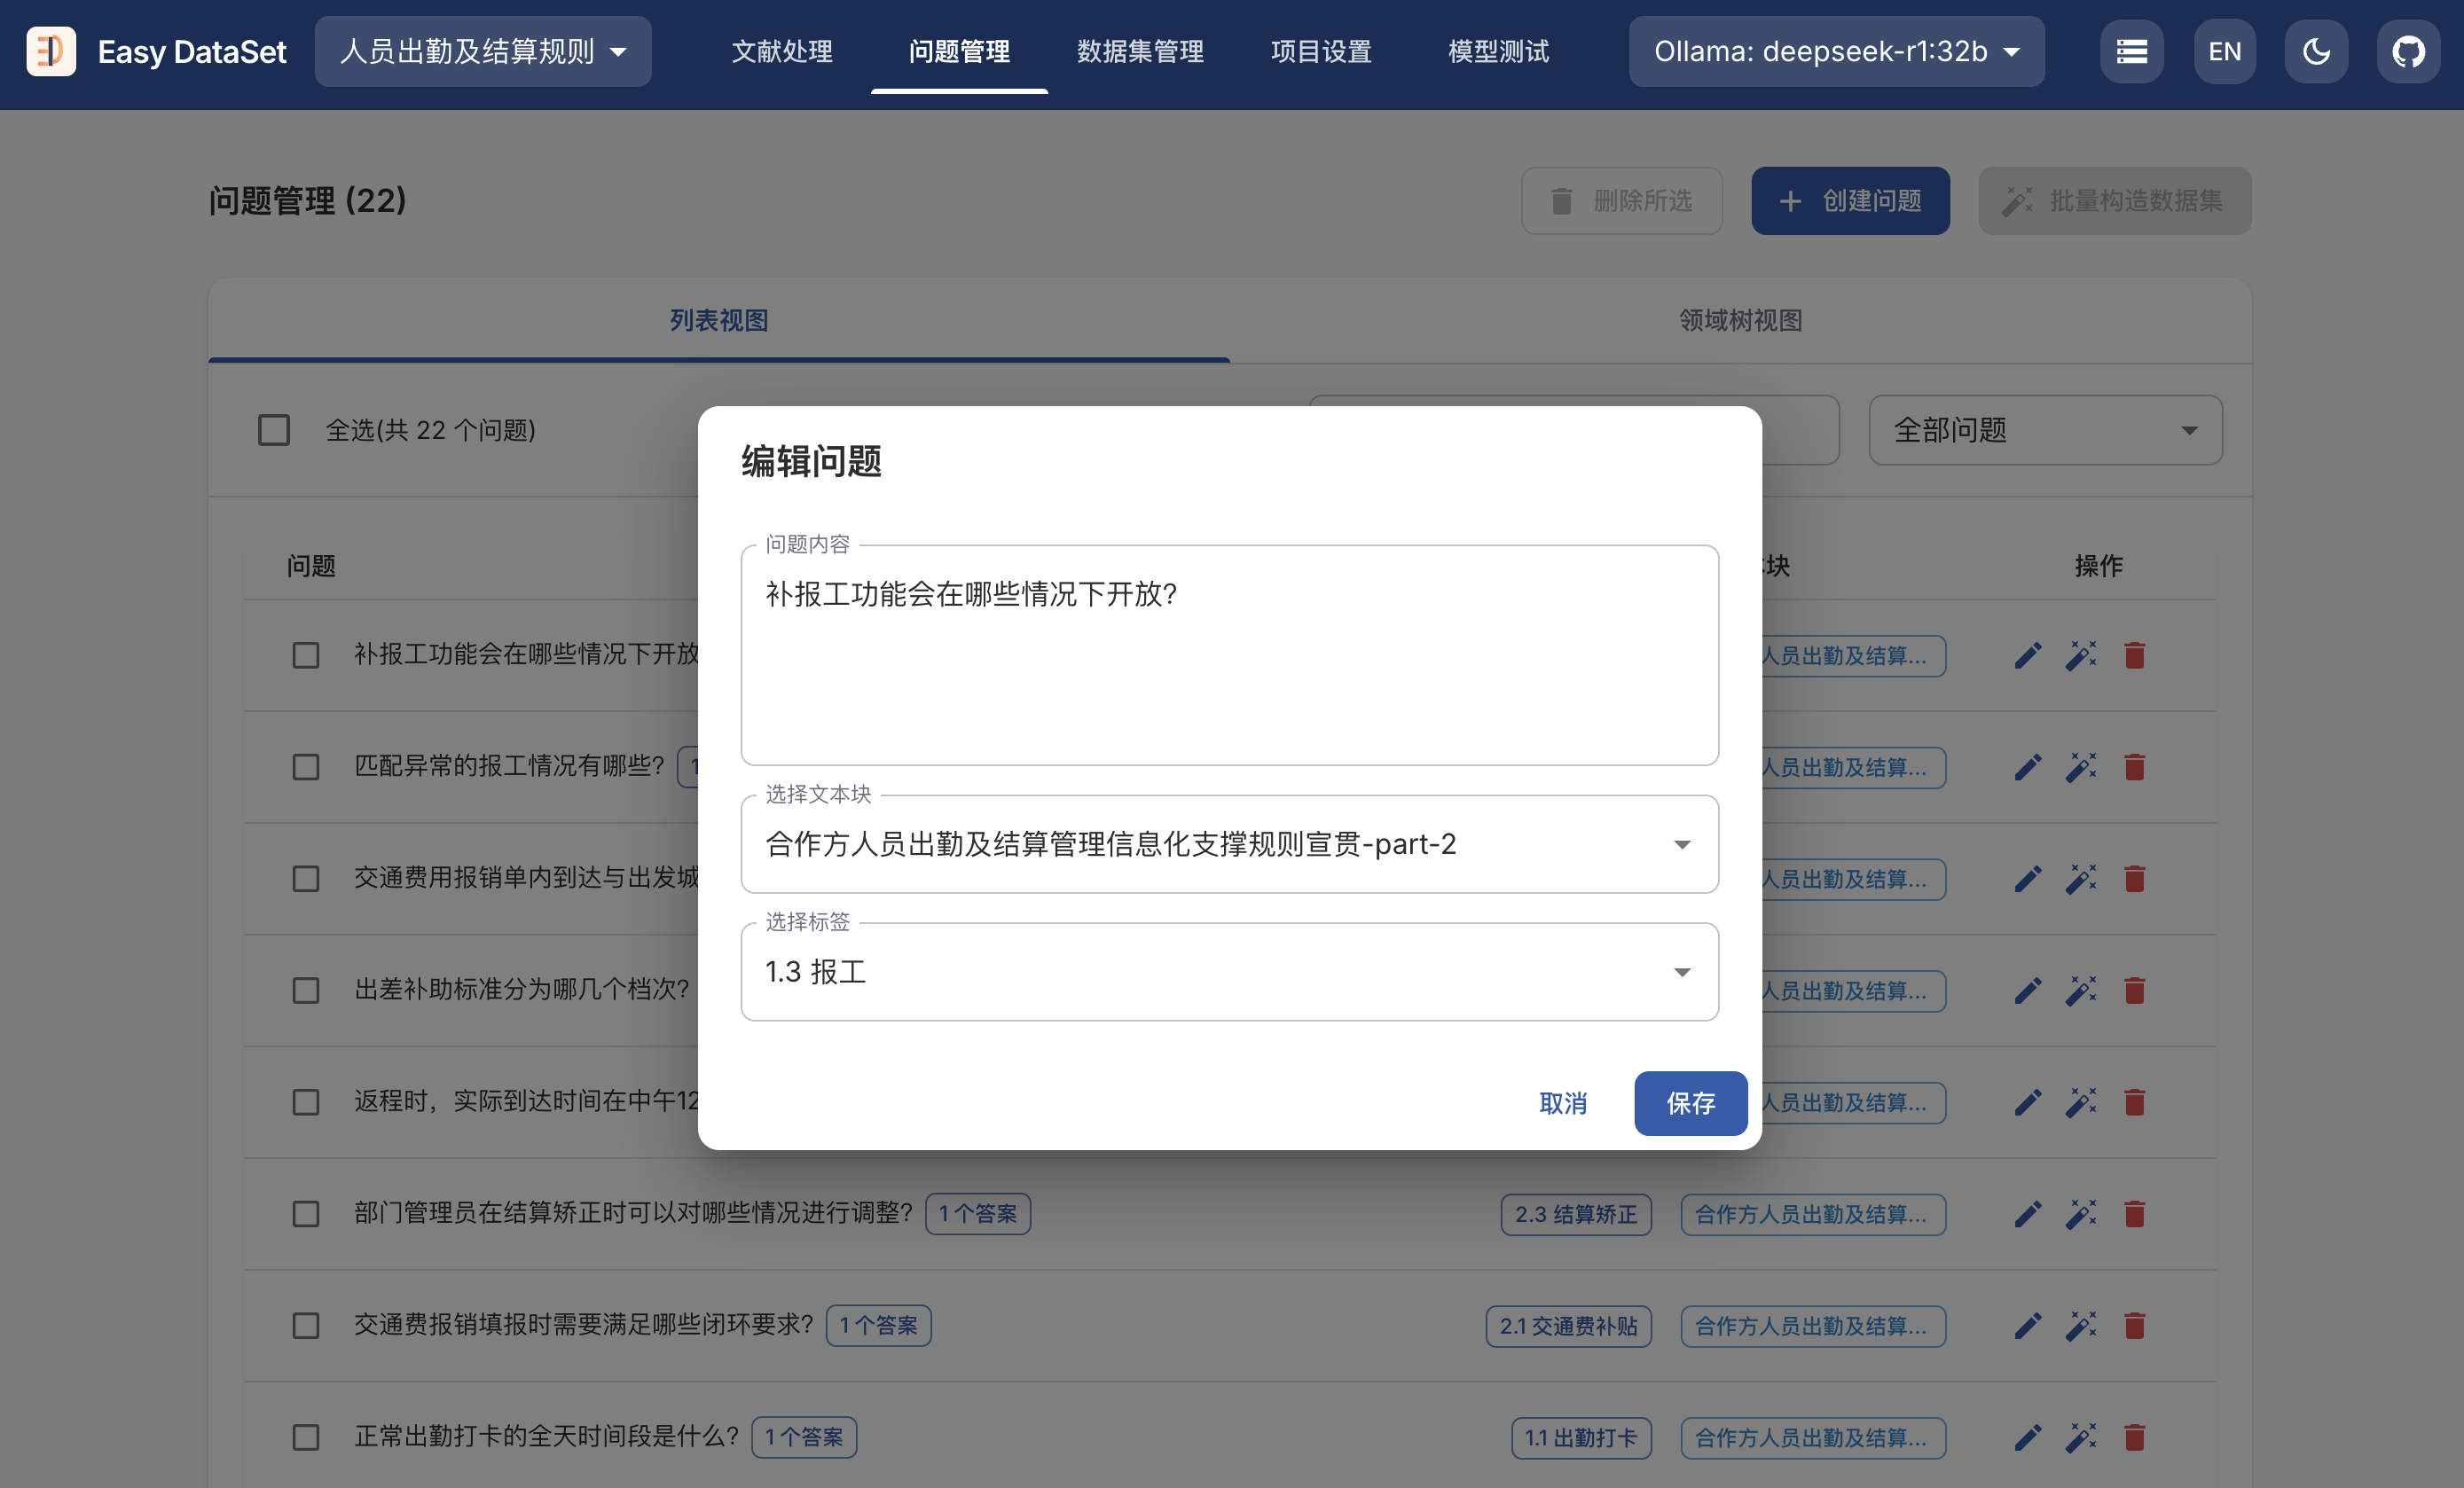
问题管理
列表视图
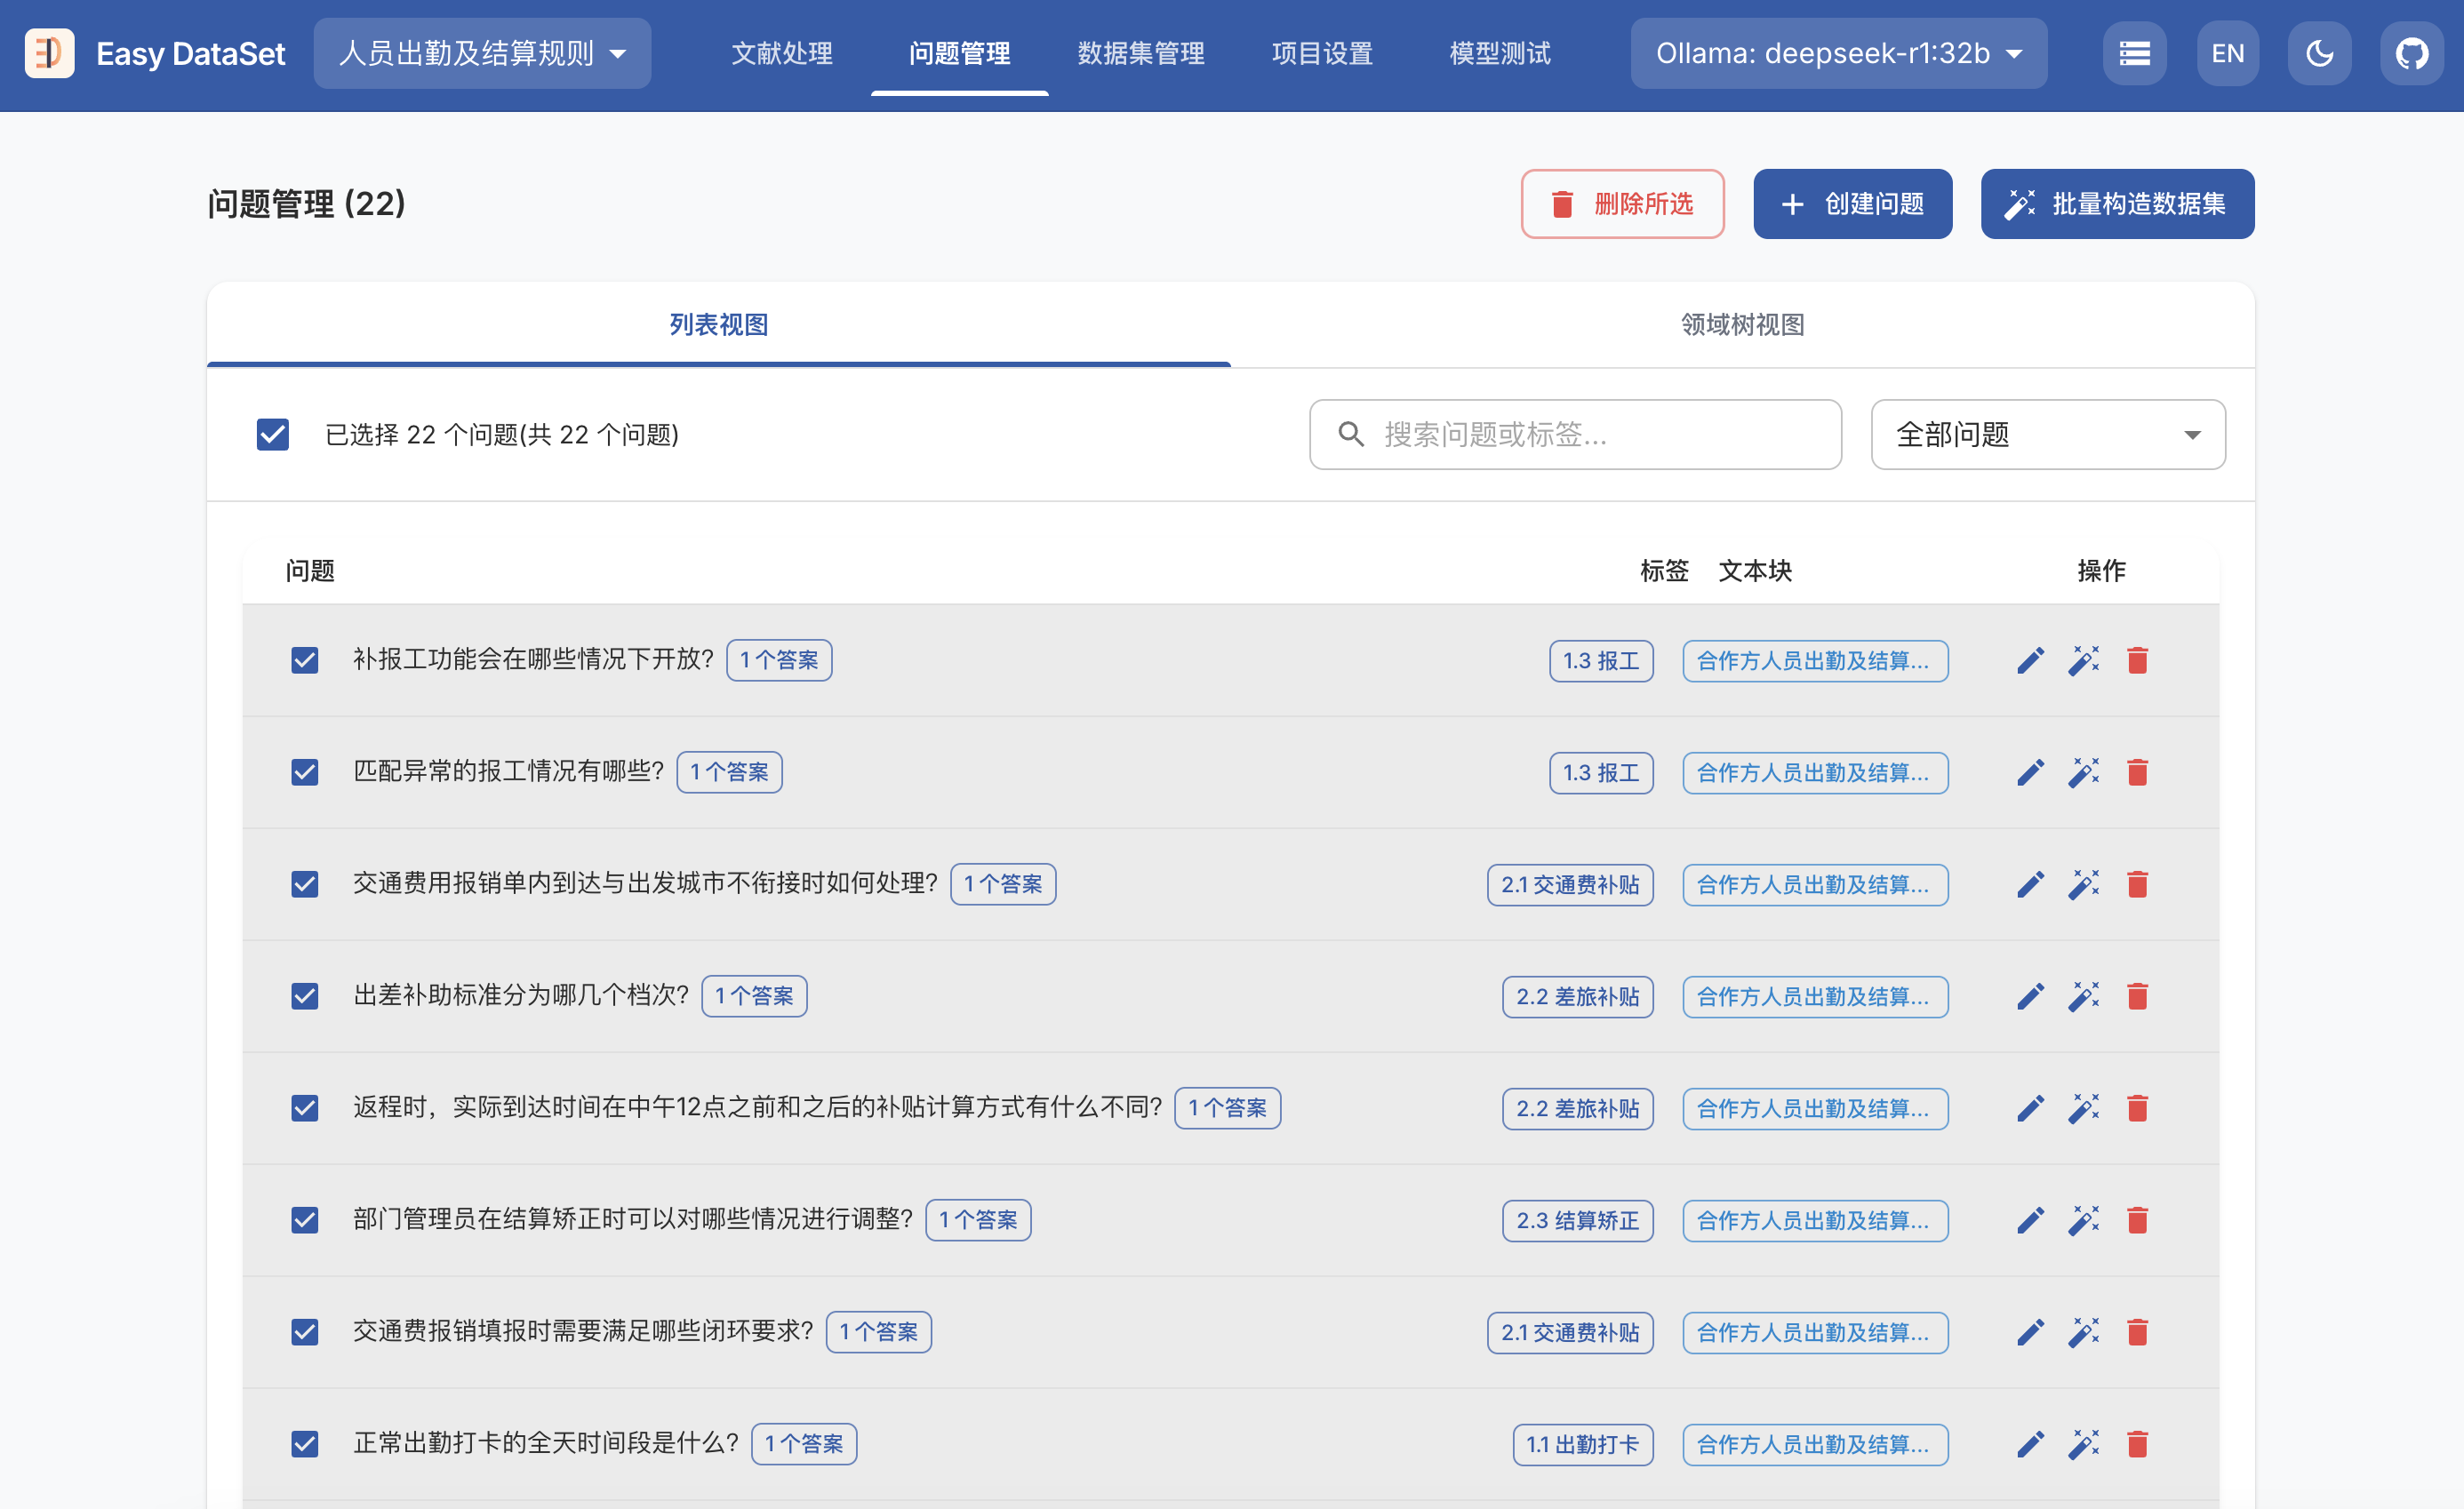
领域树视图
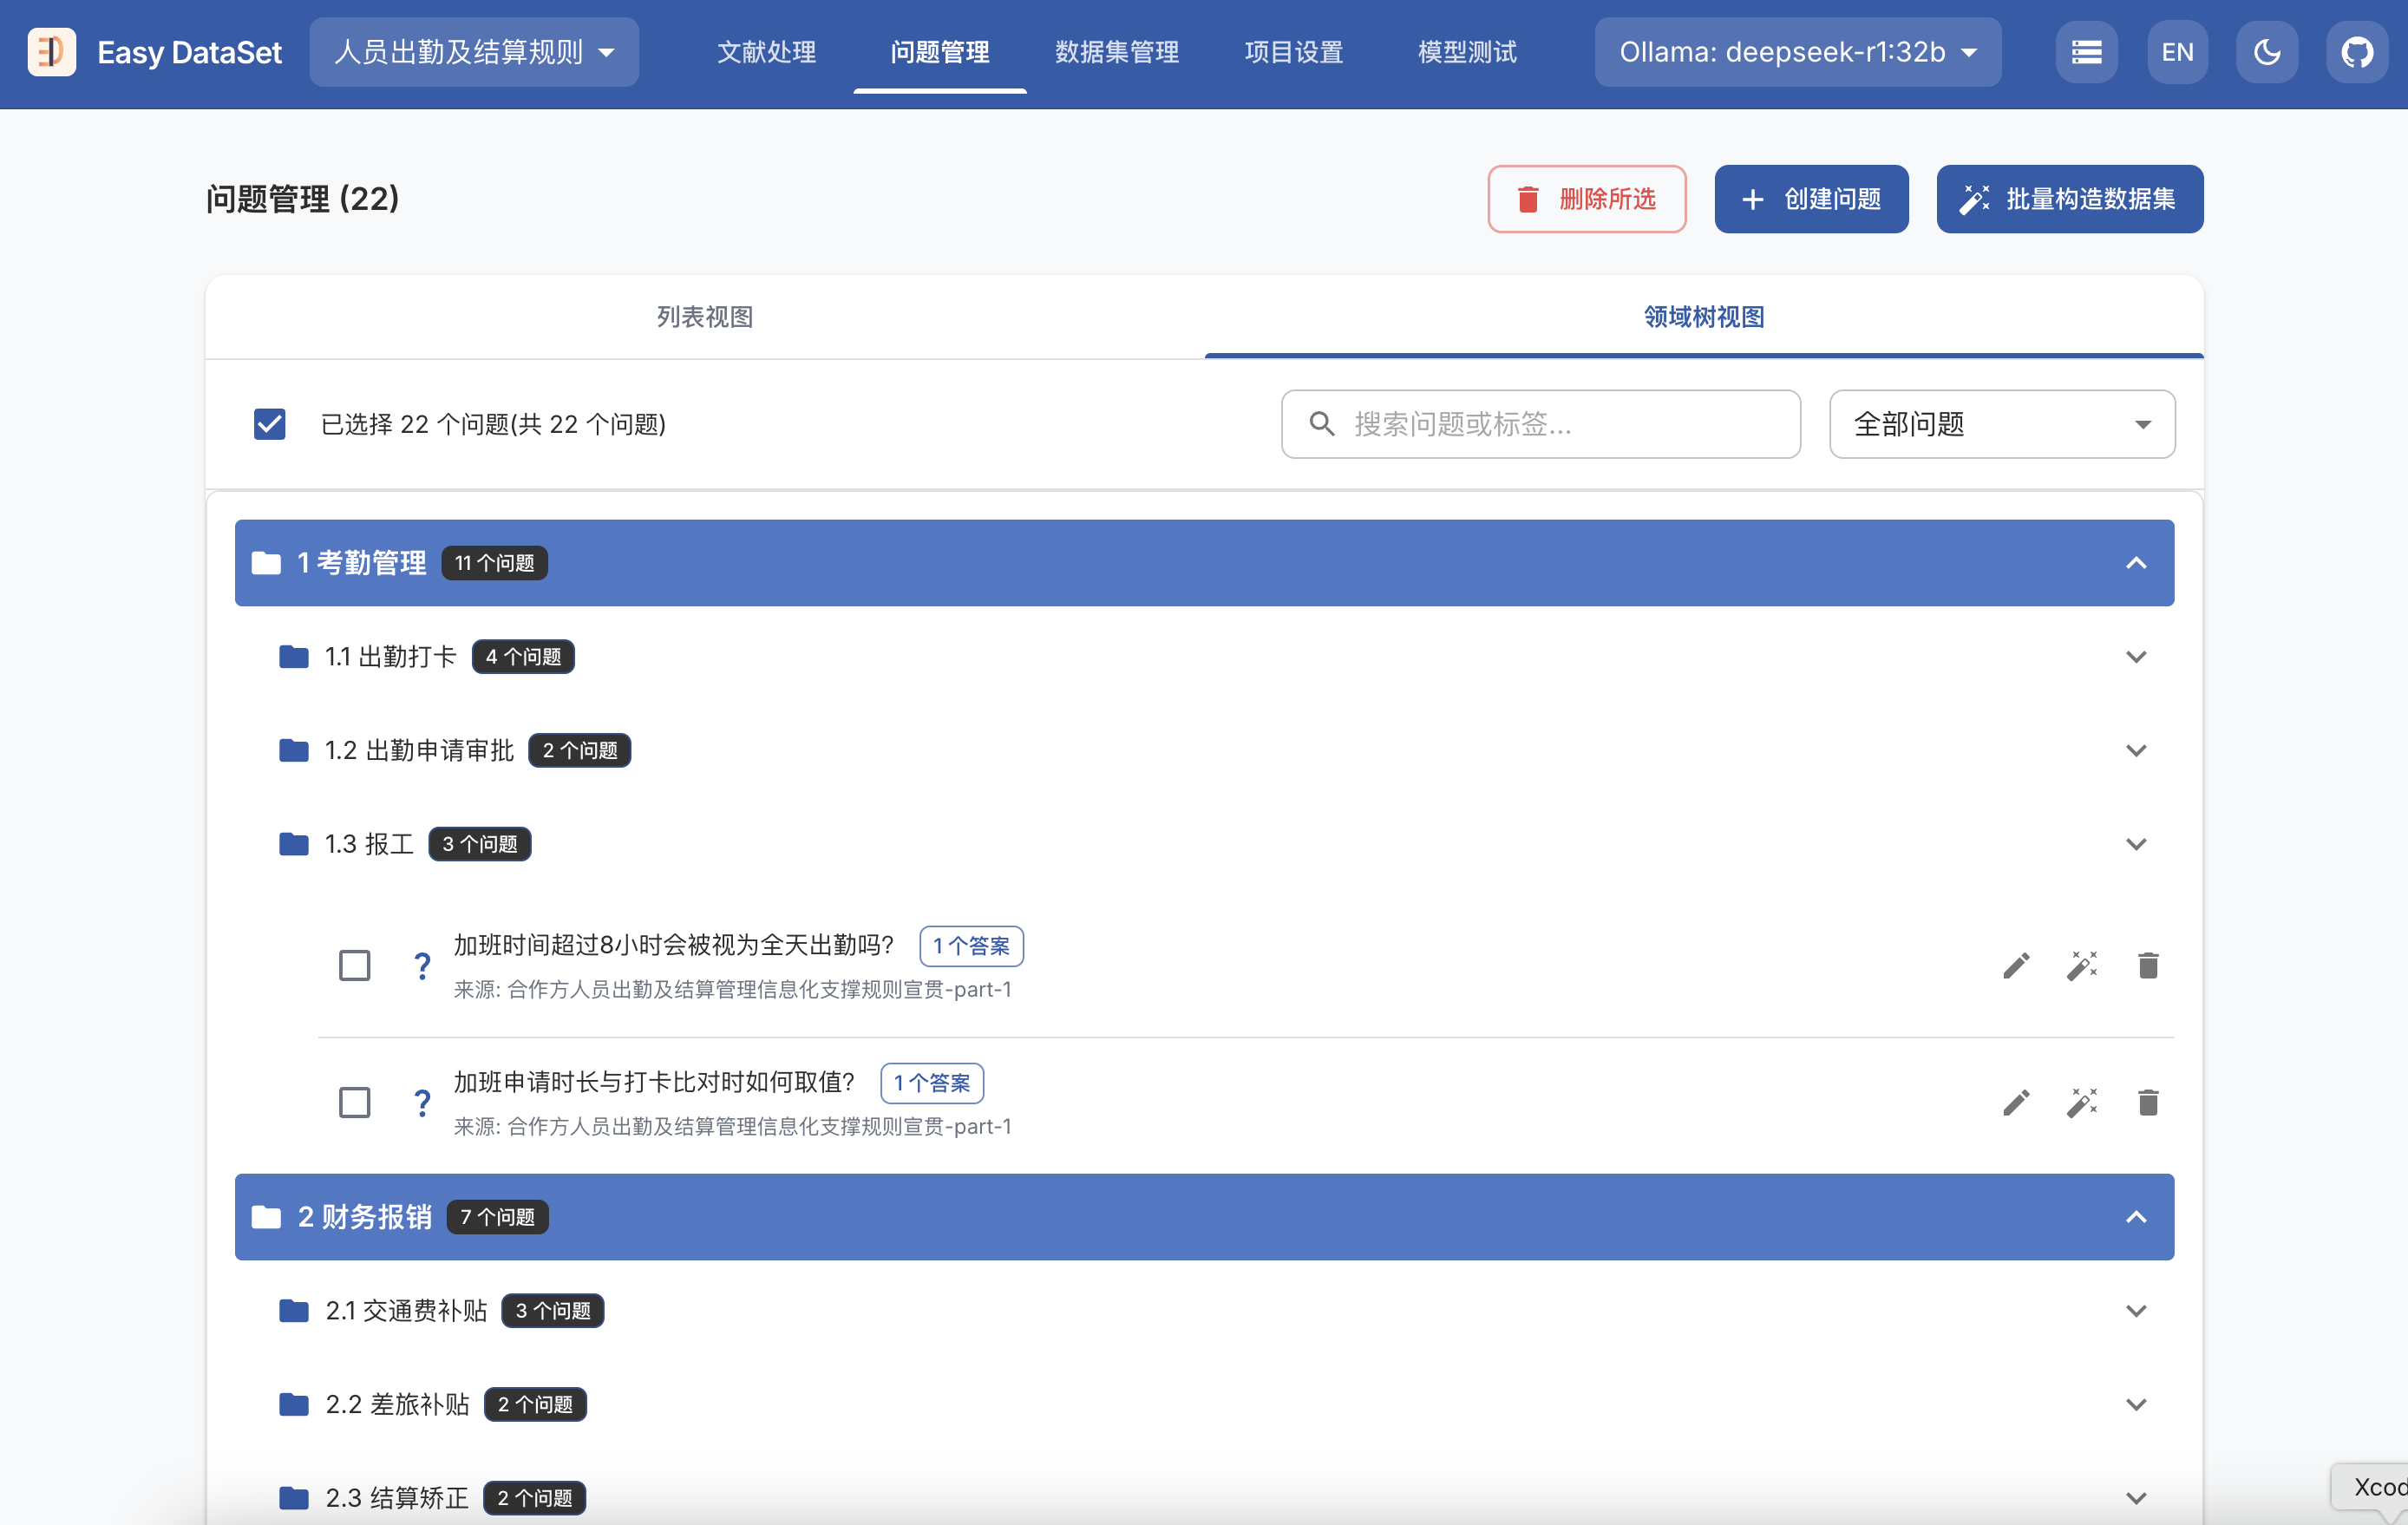
问题编辑
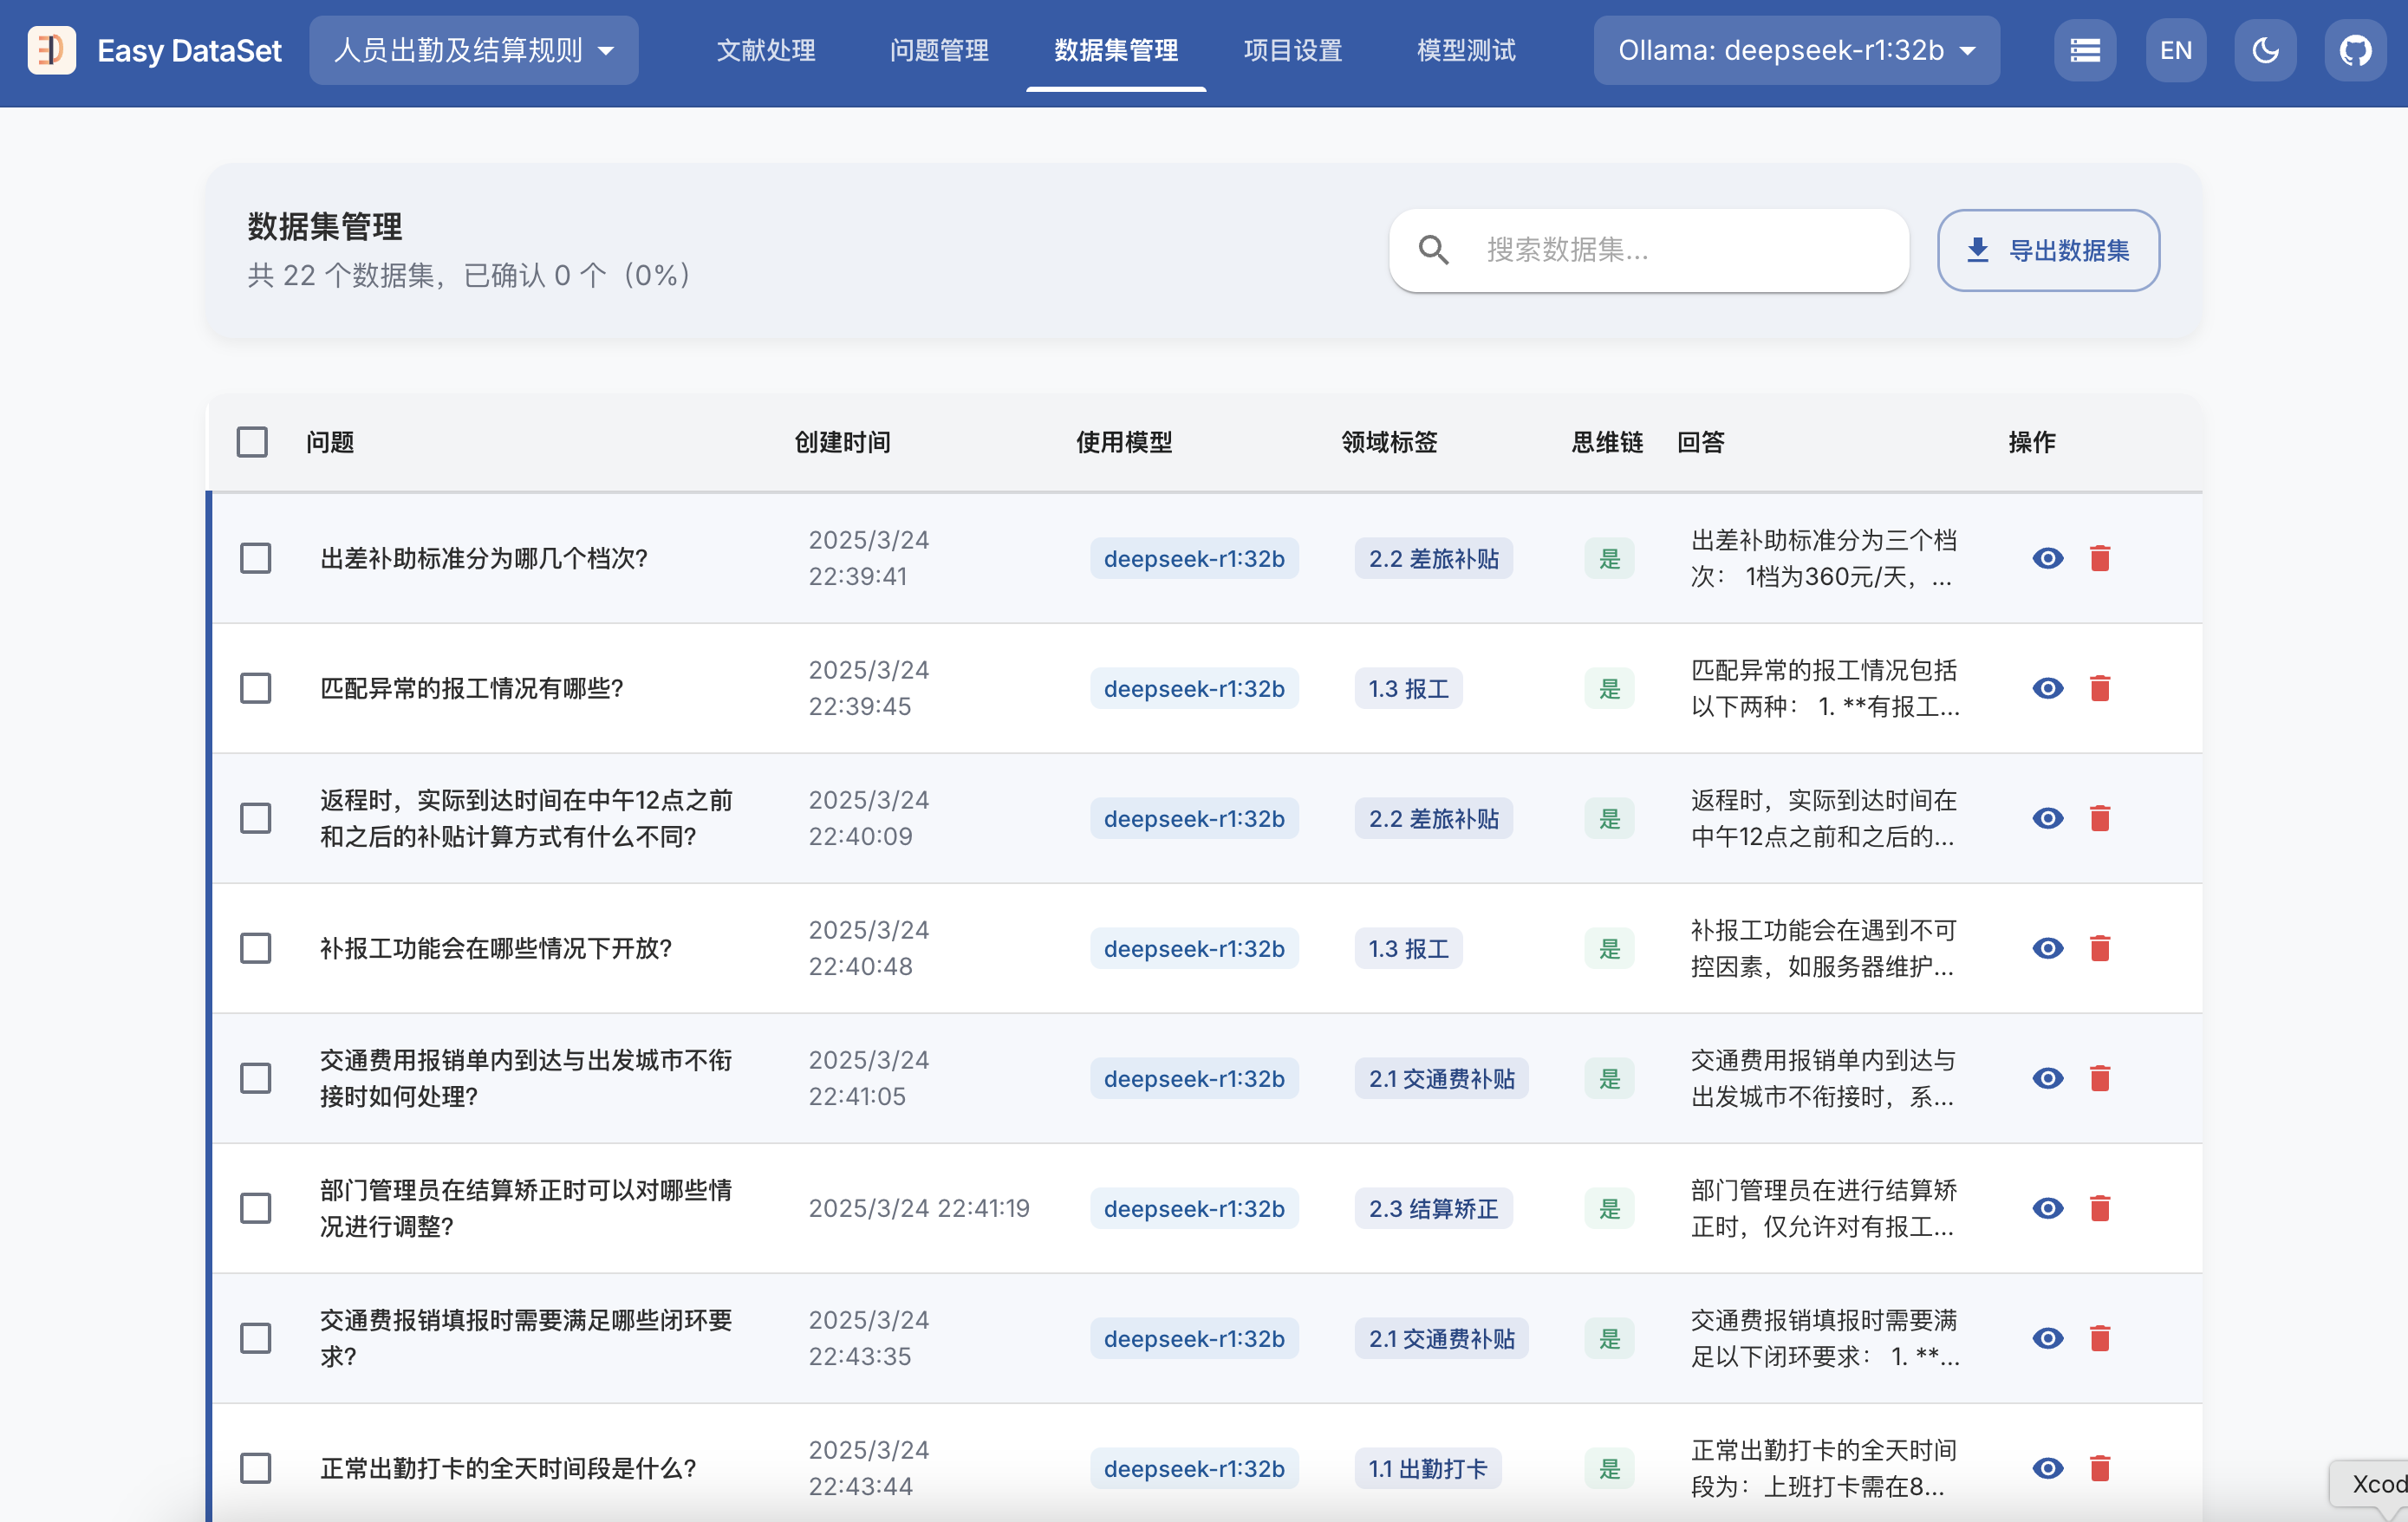
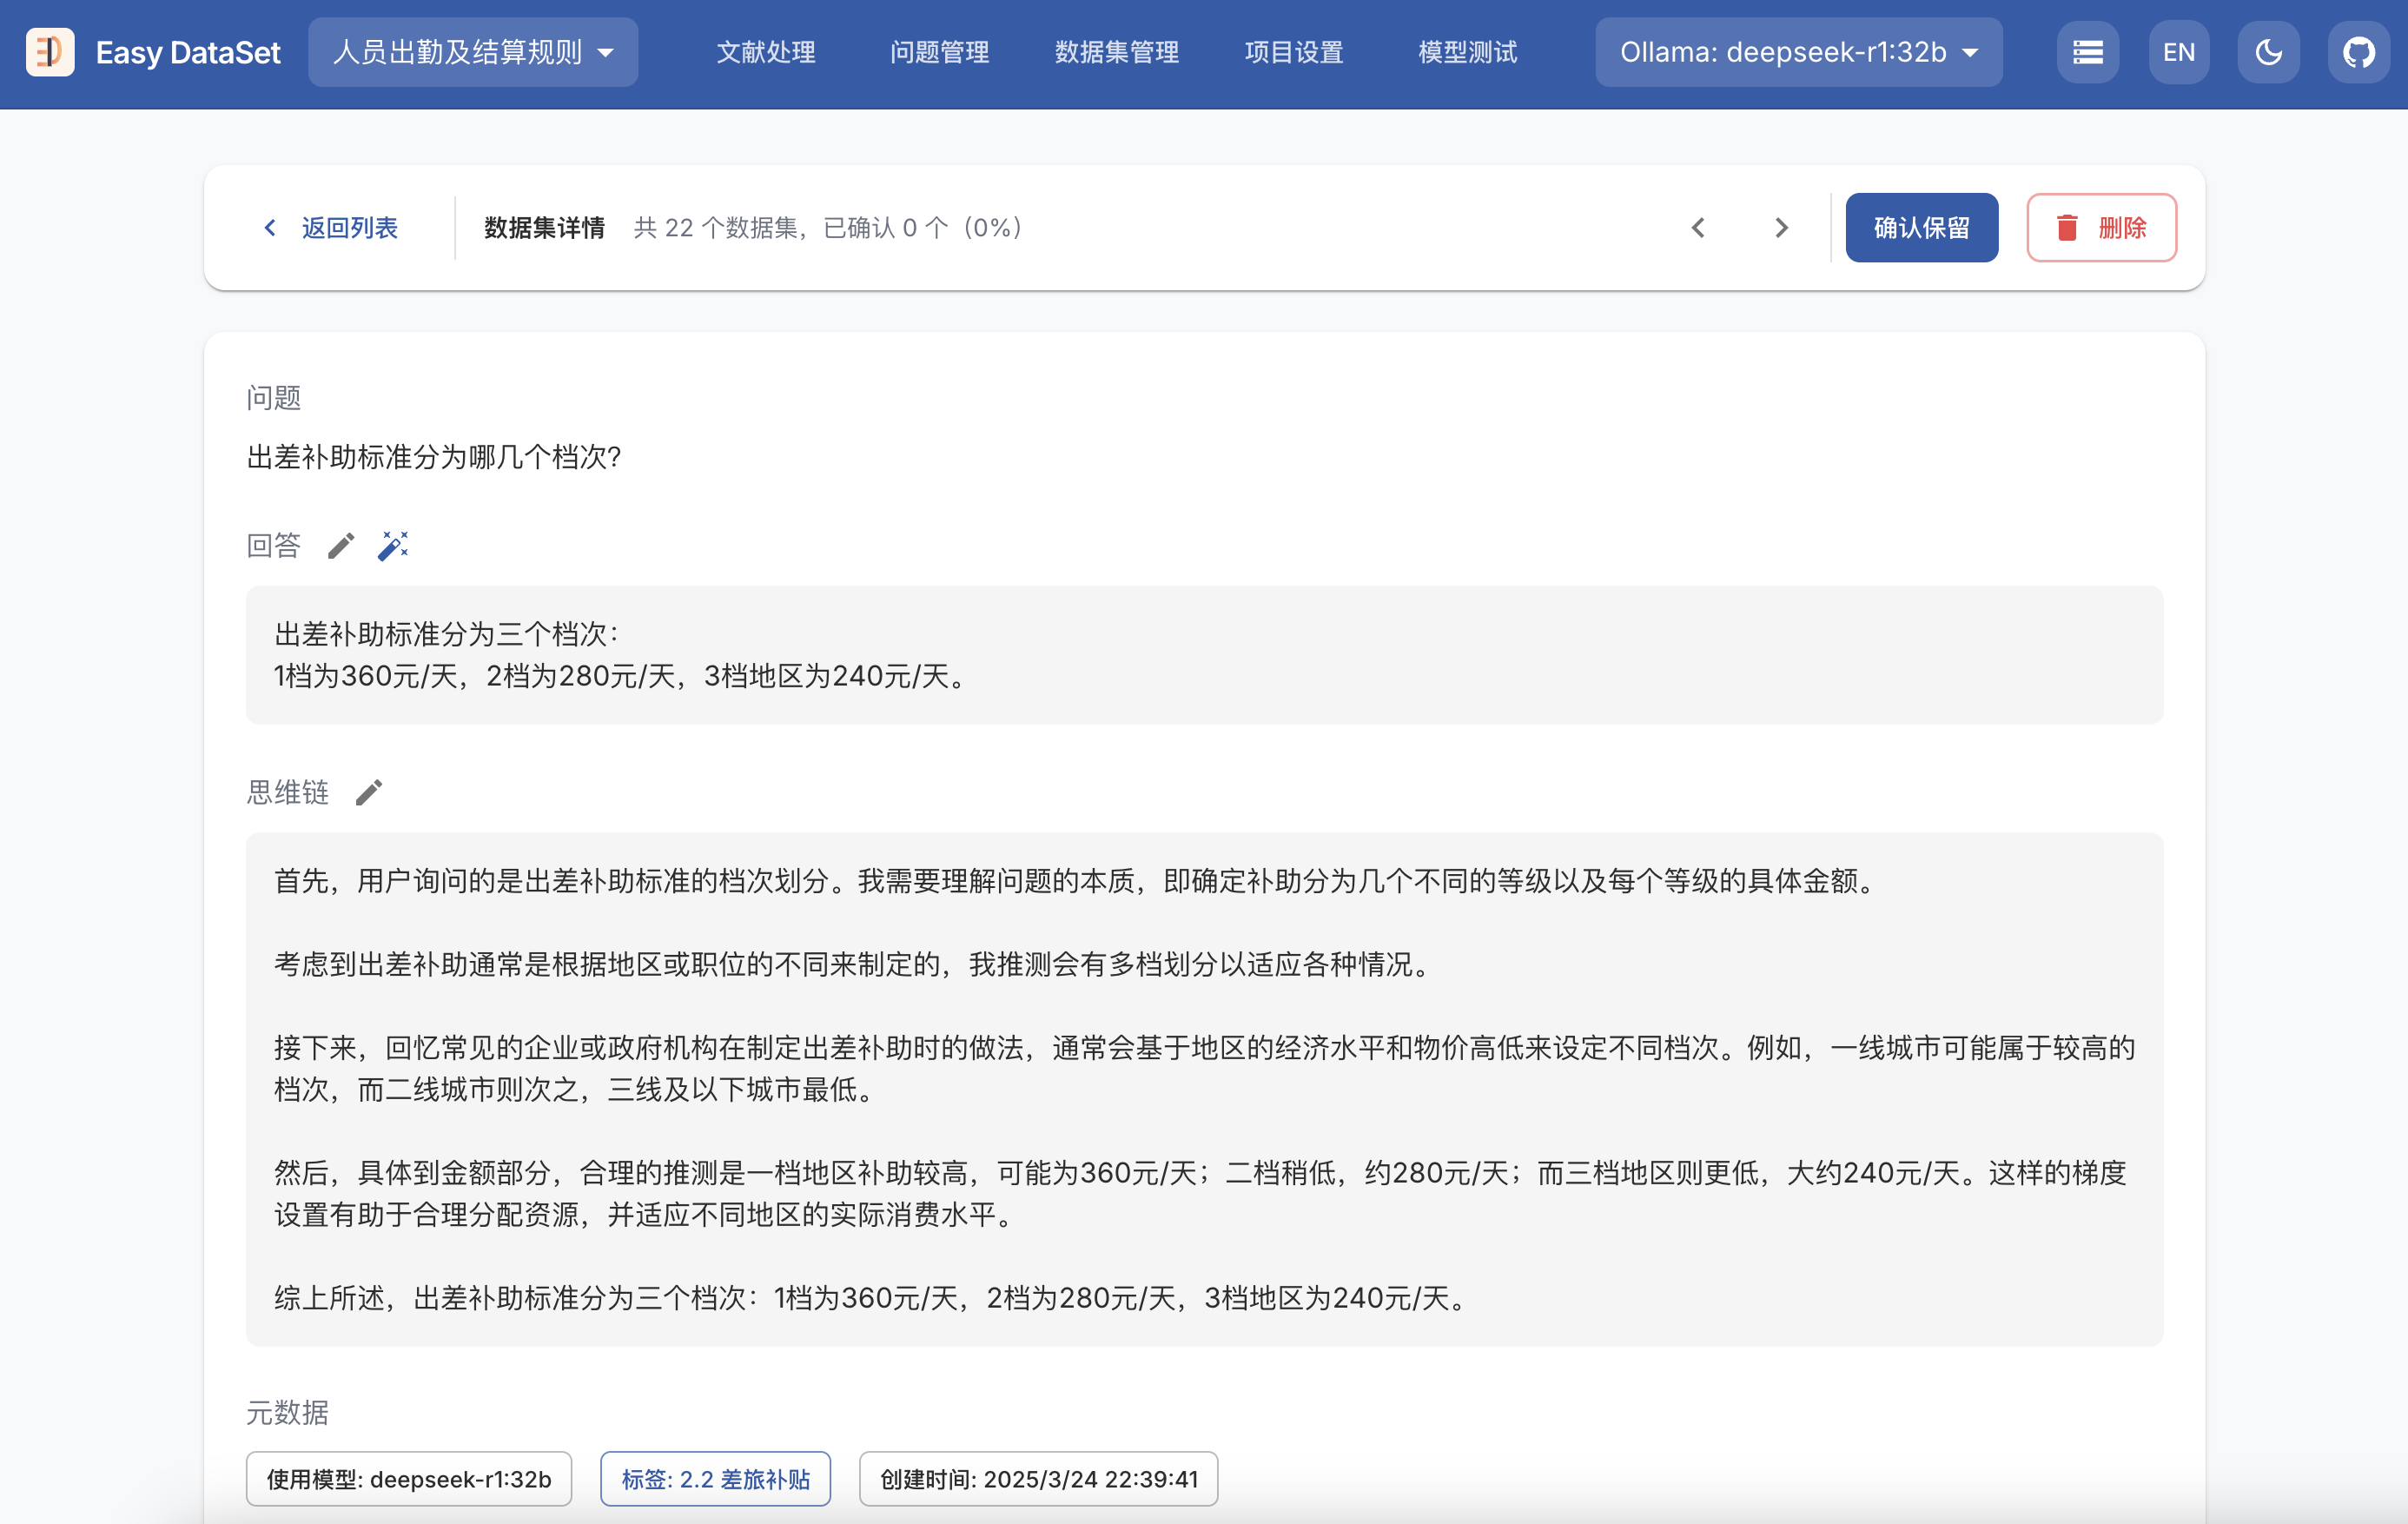
数据集管理
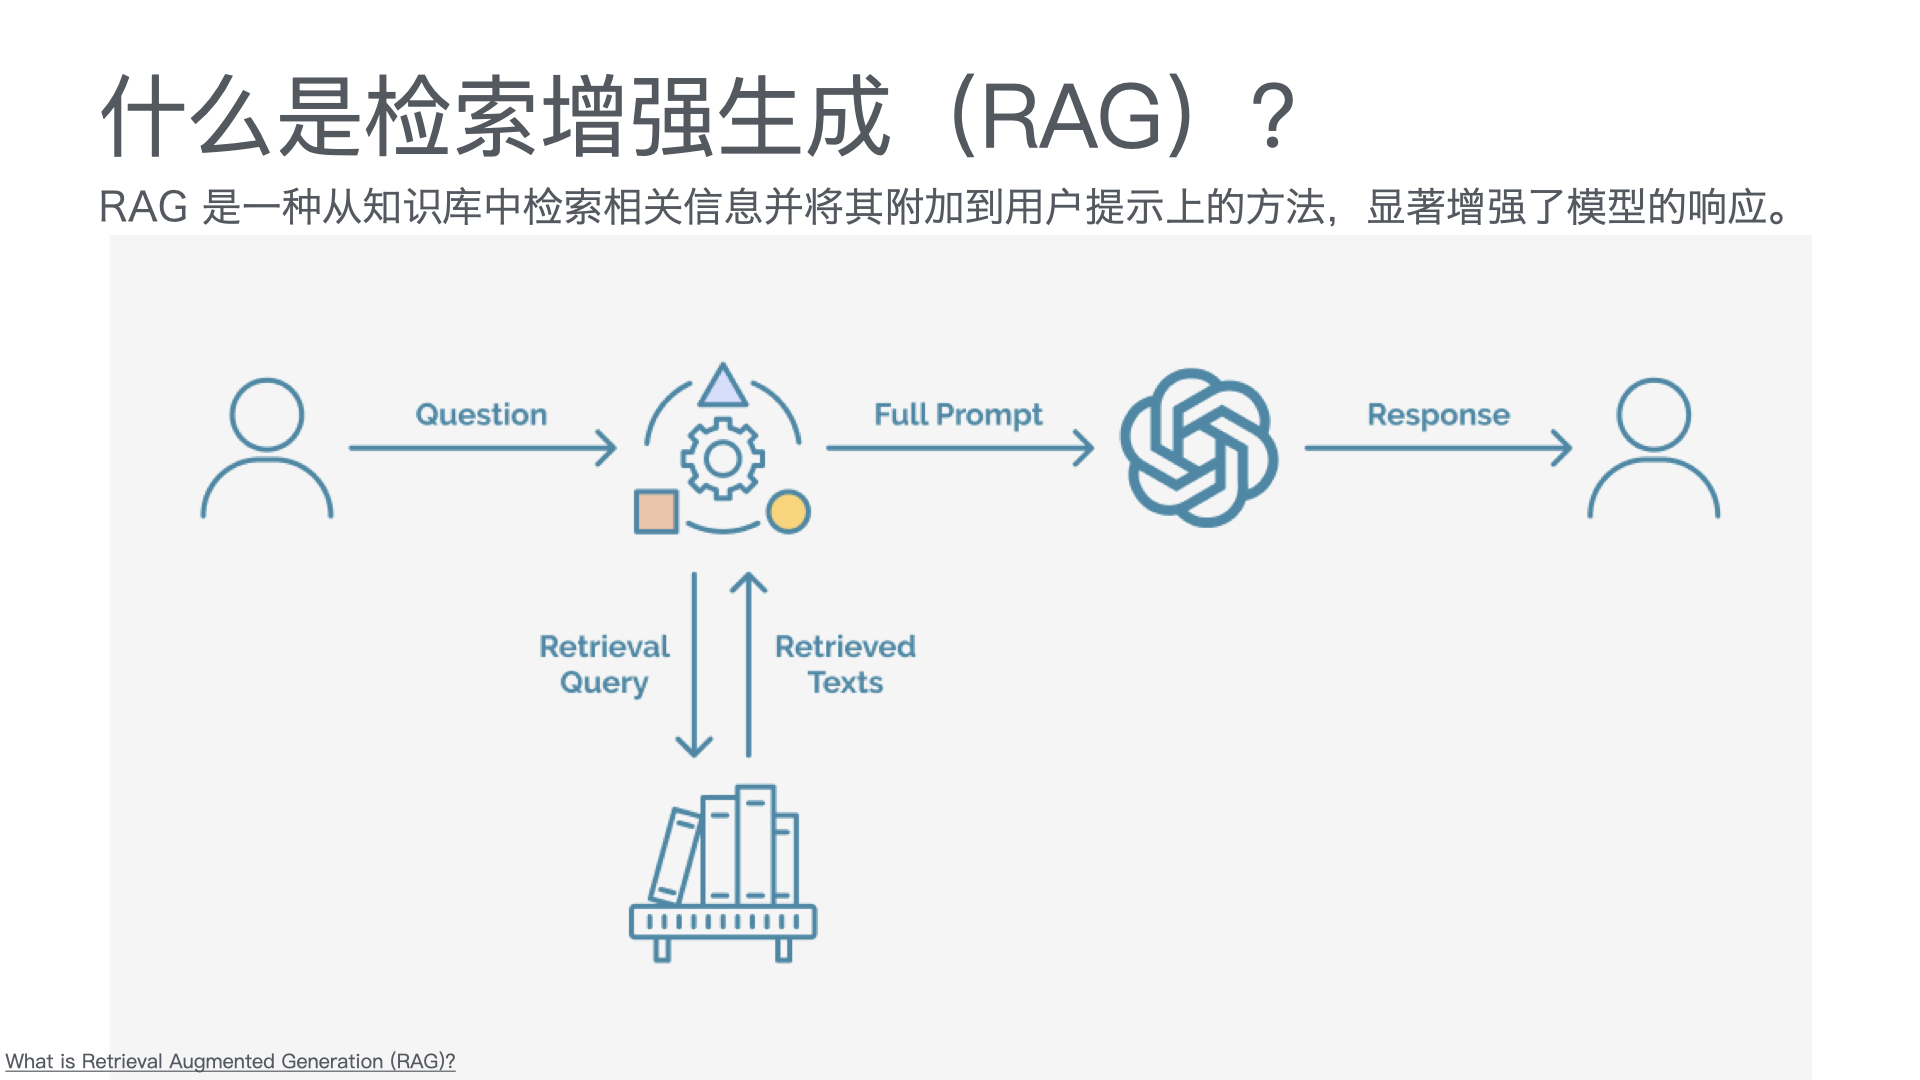
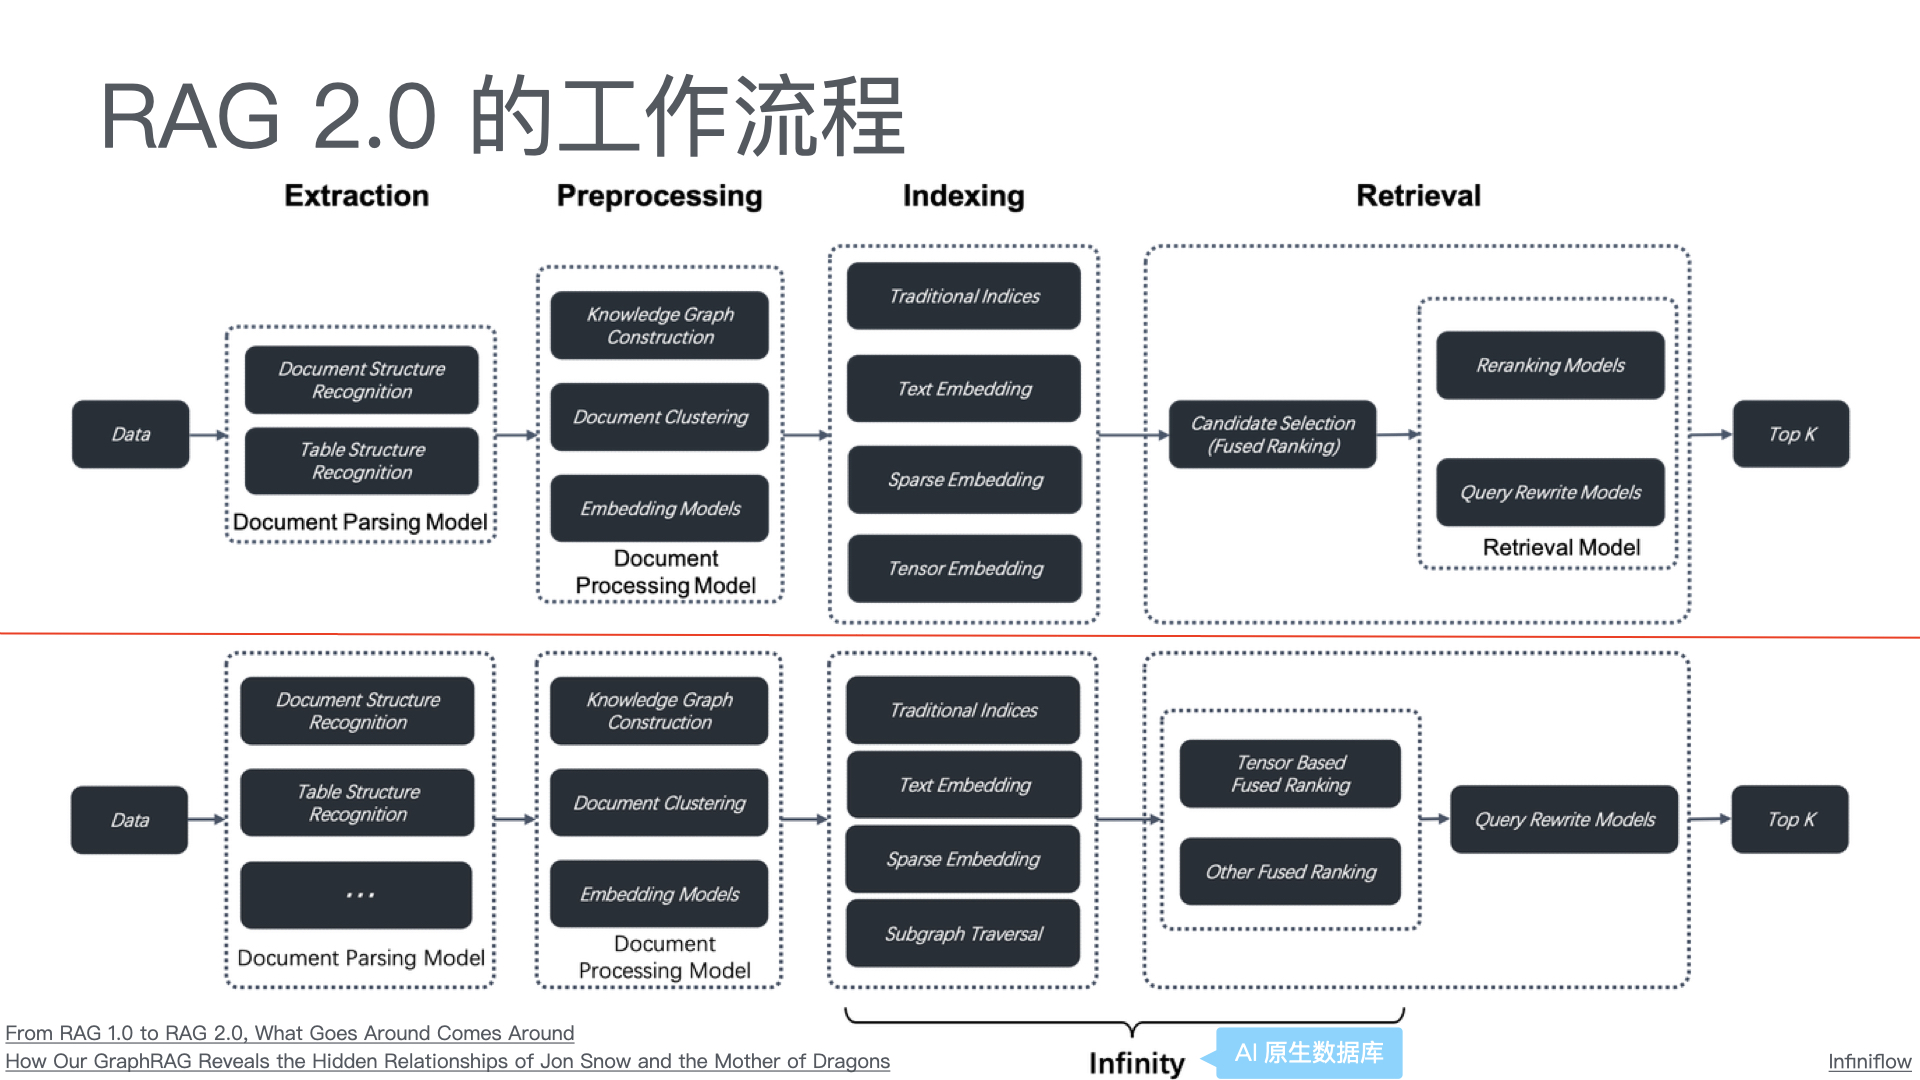
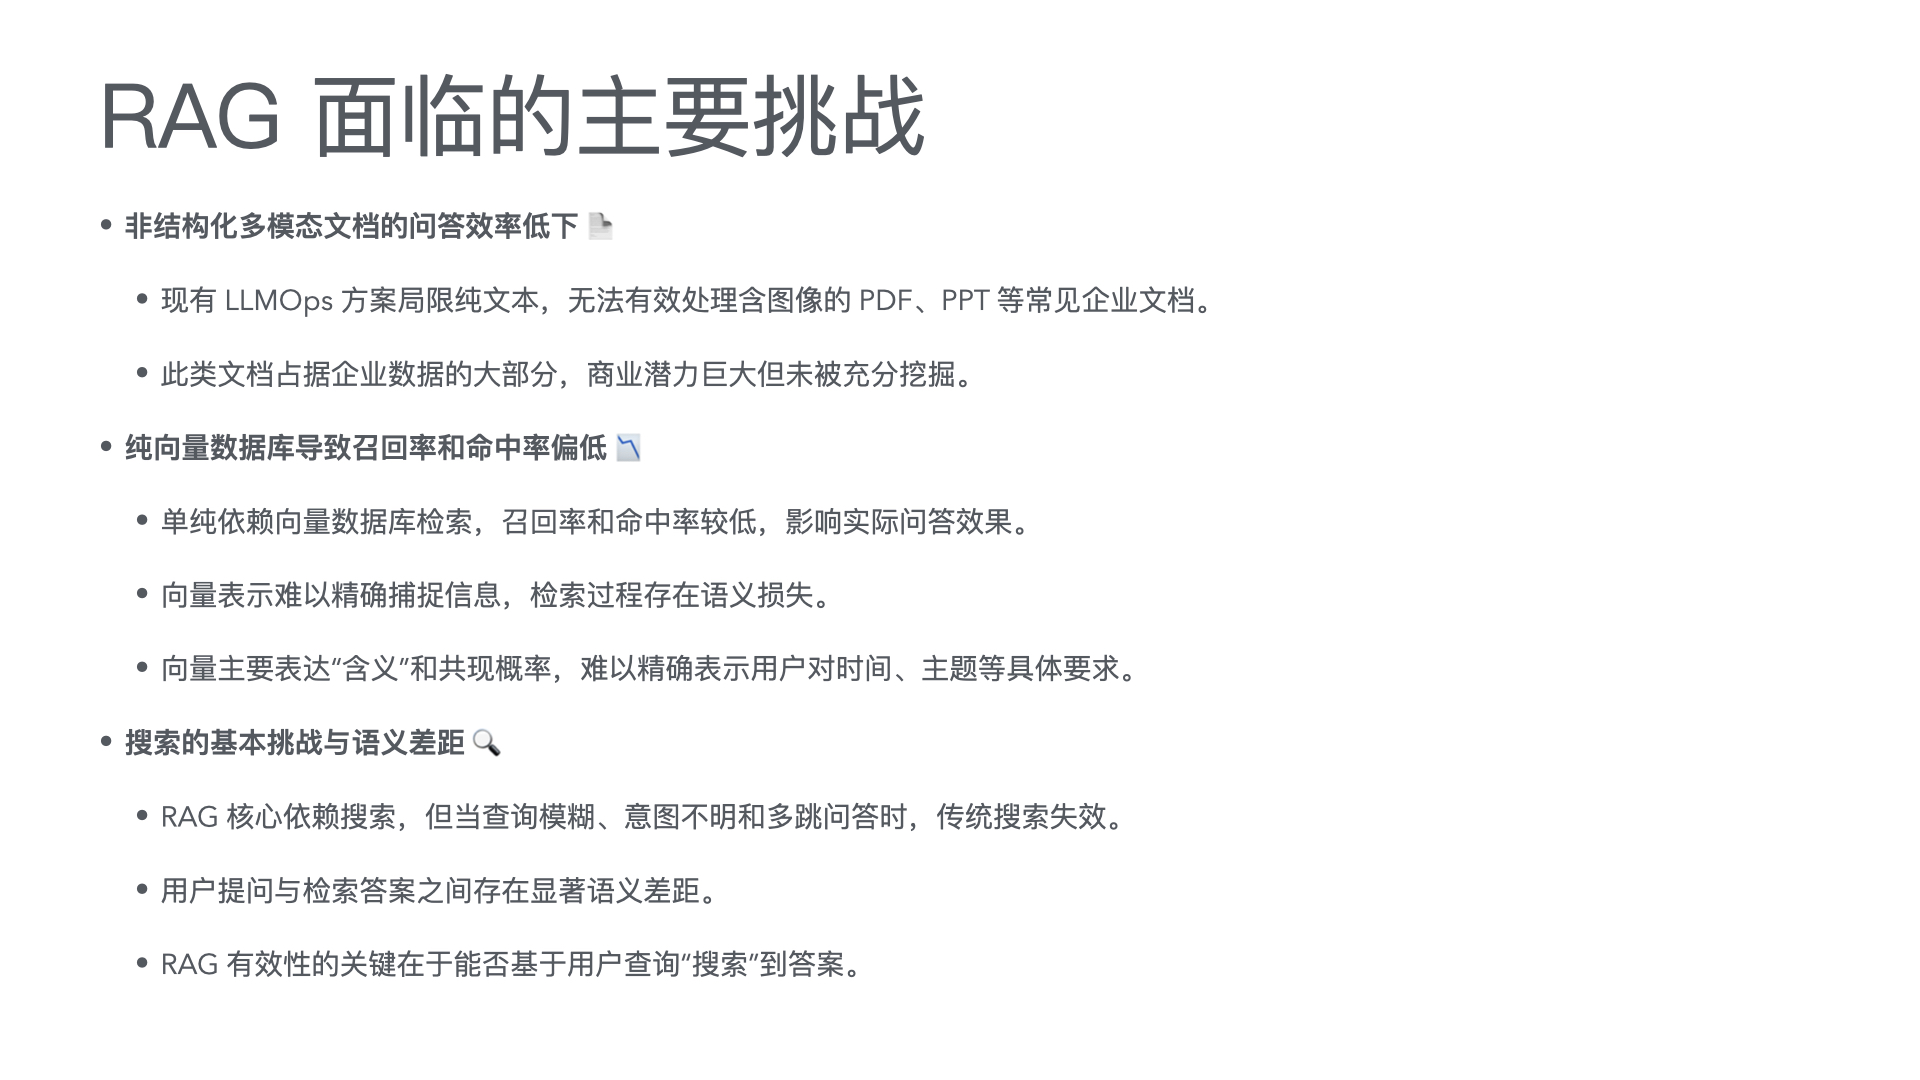
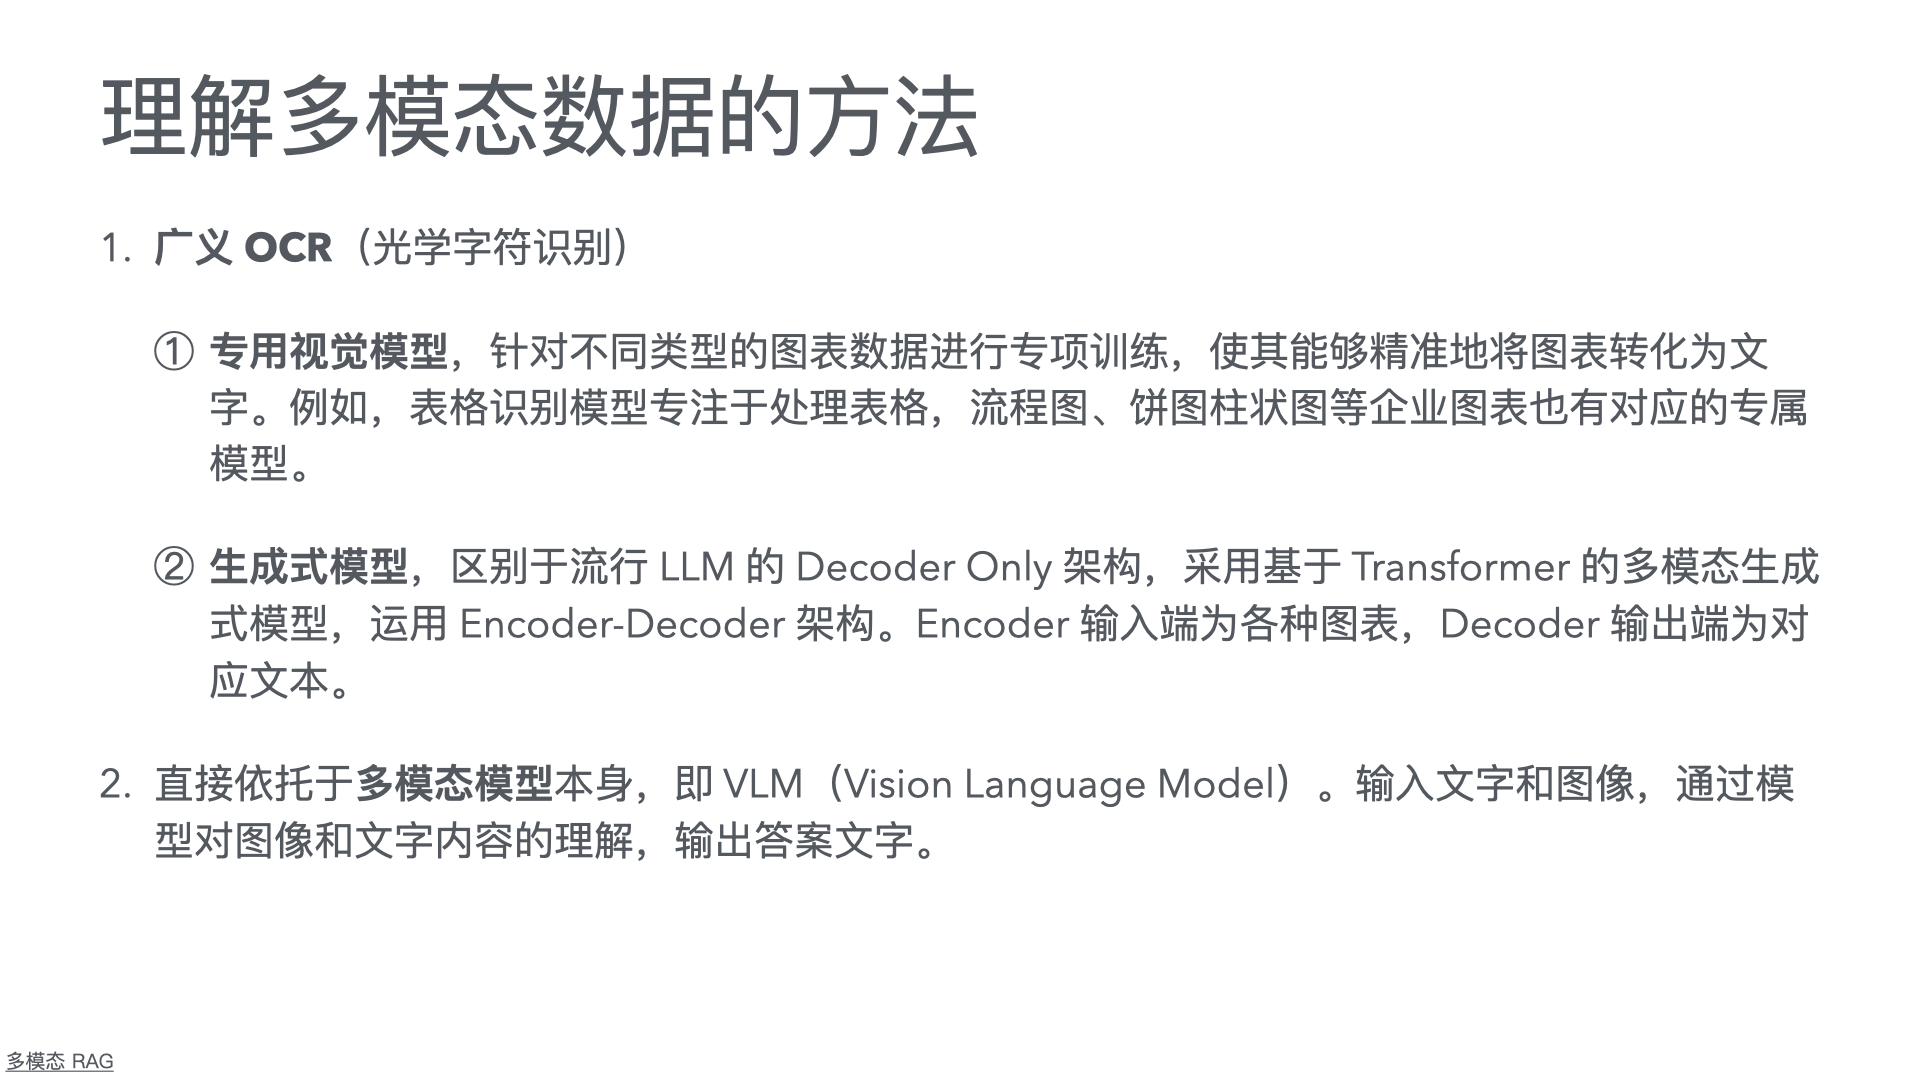
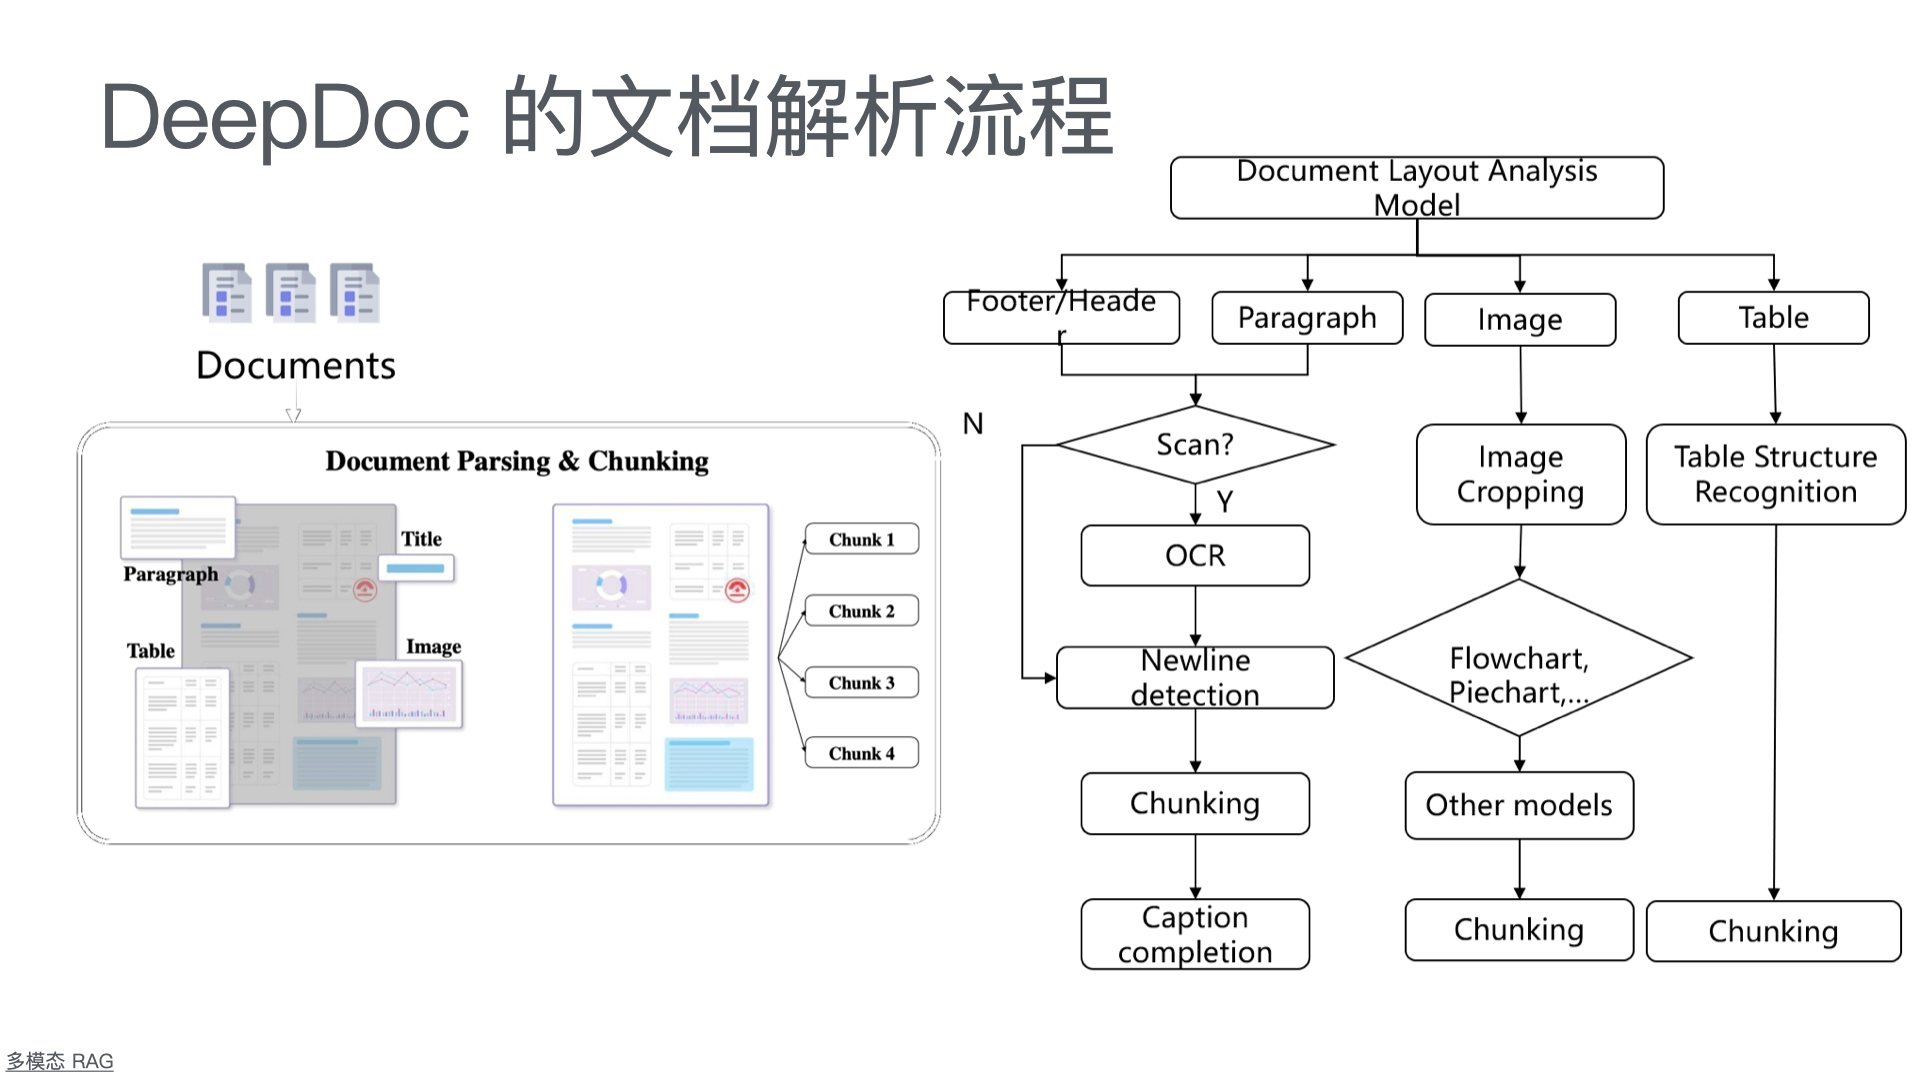
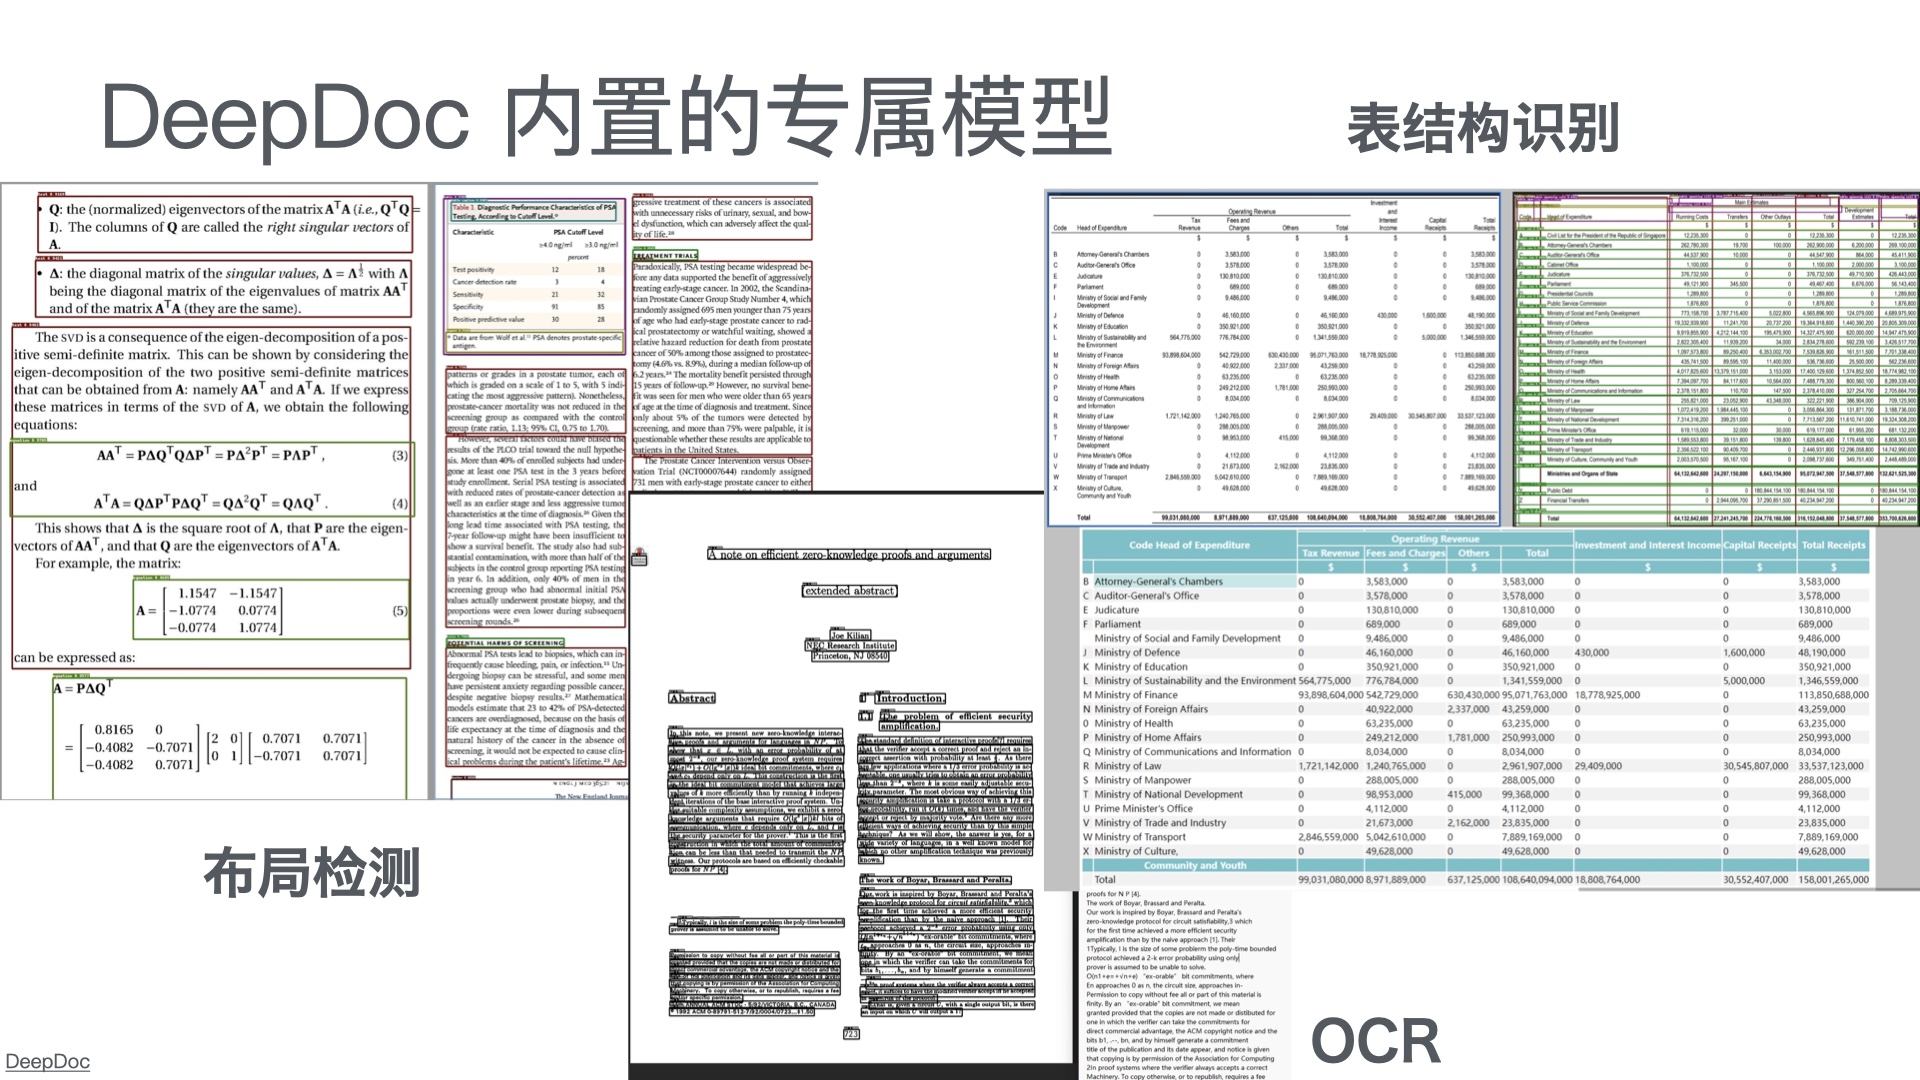
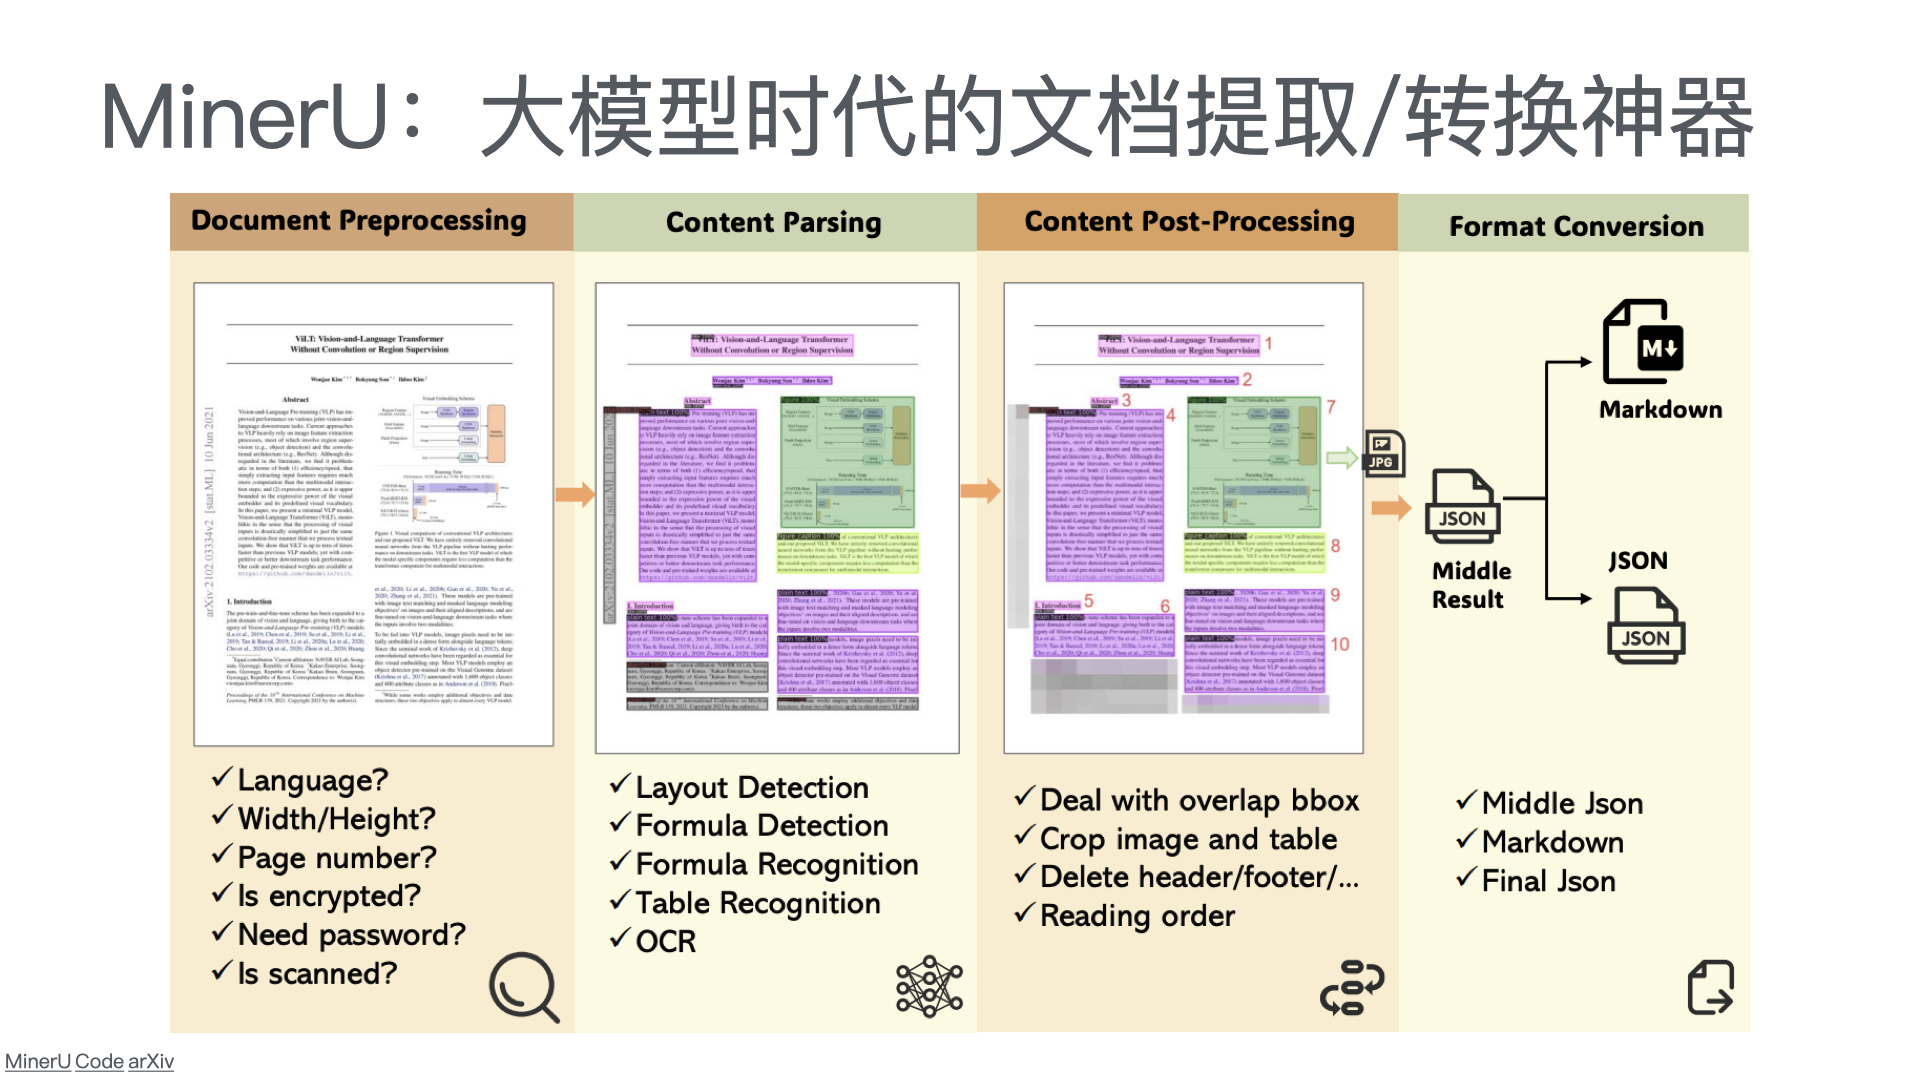
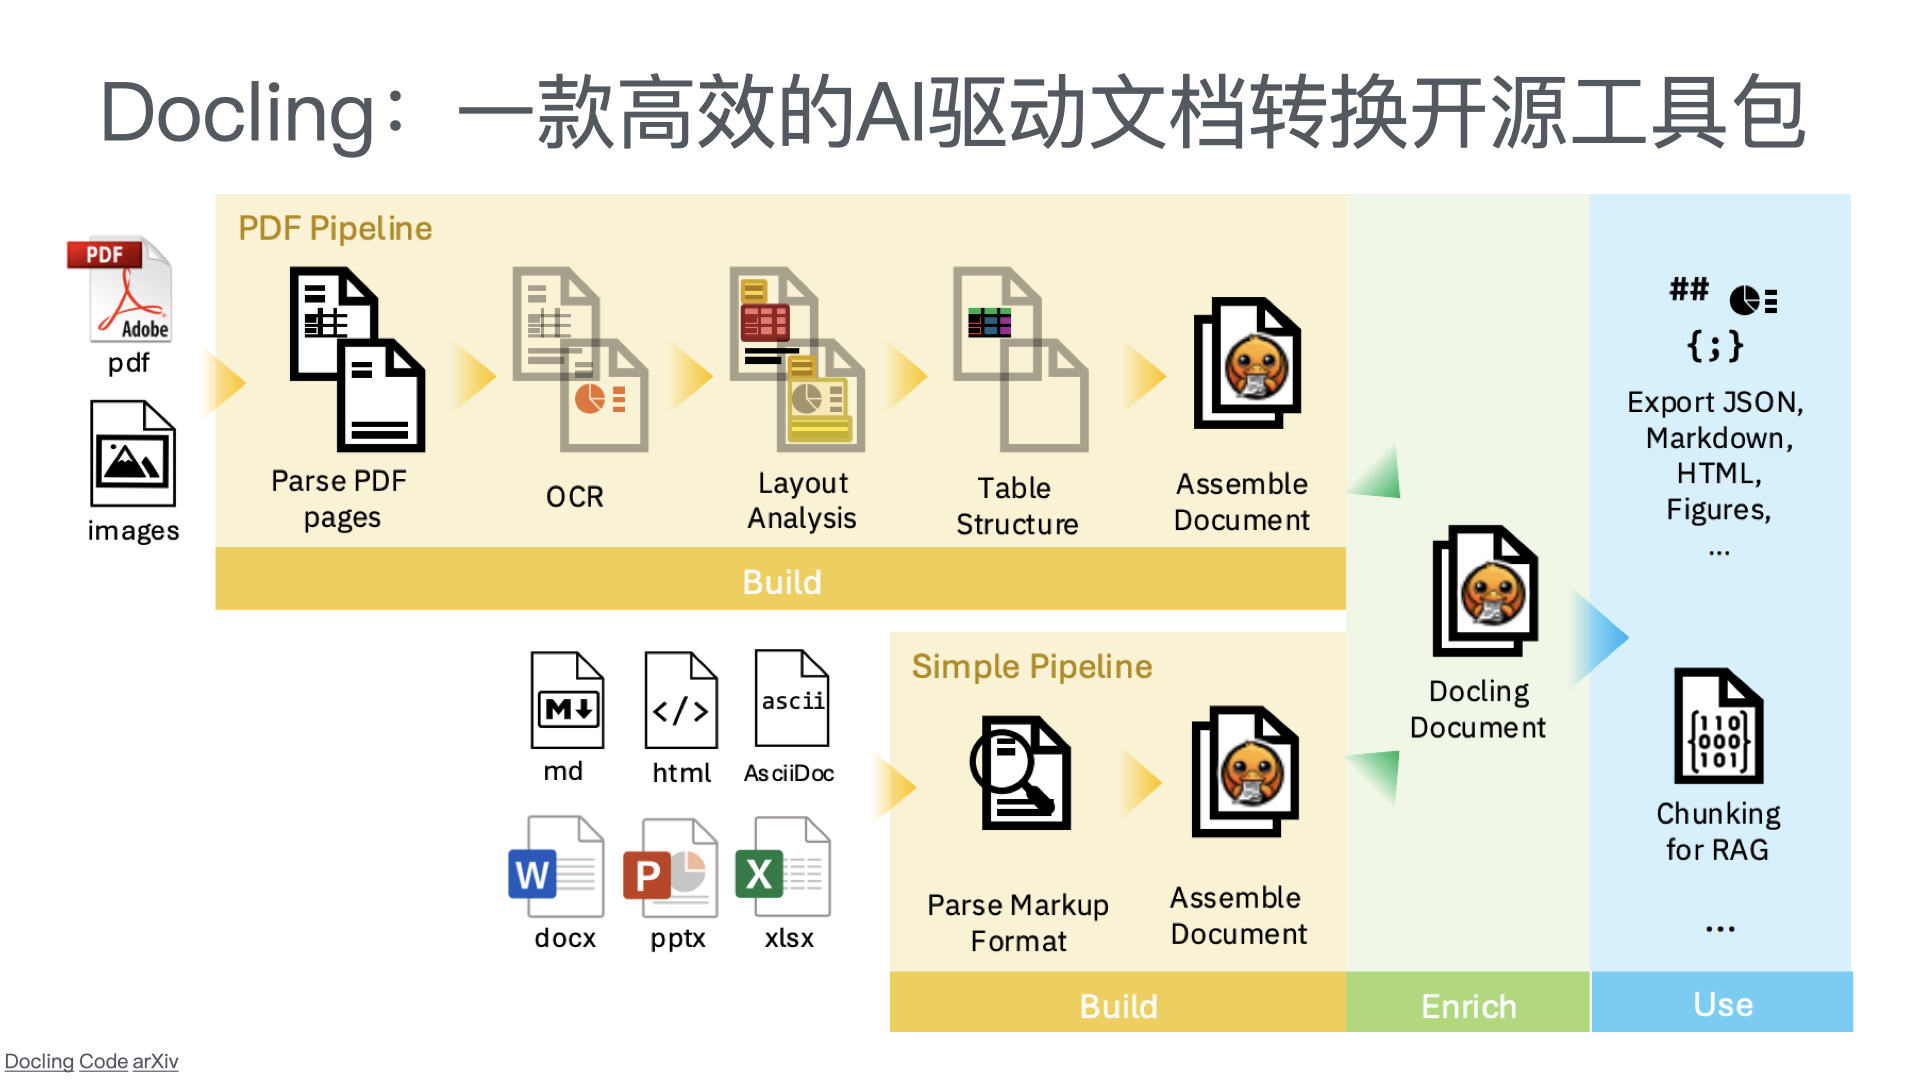
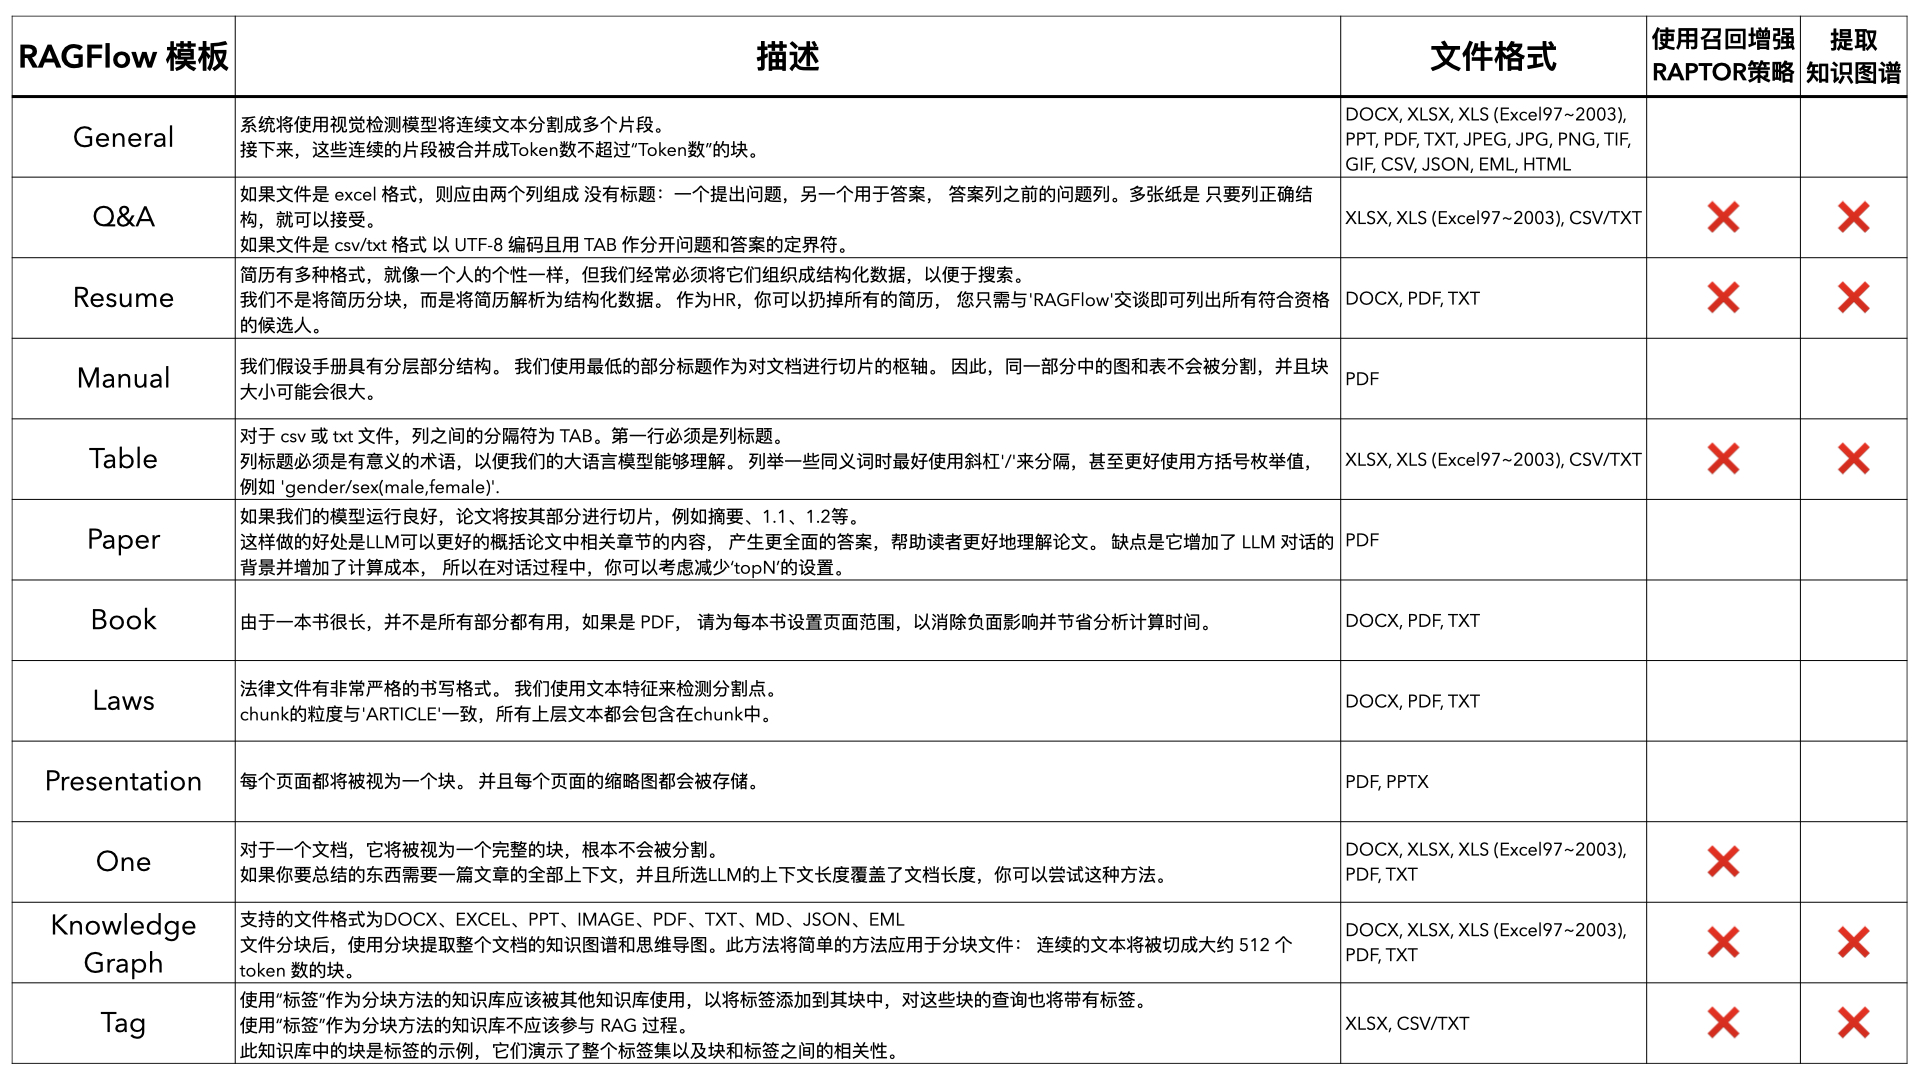
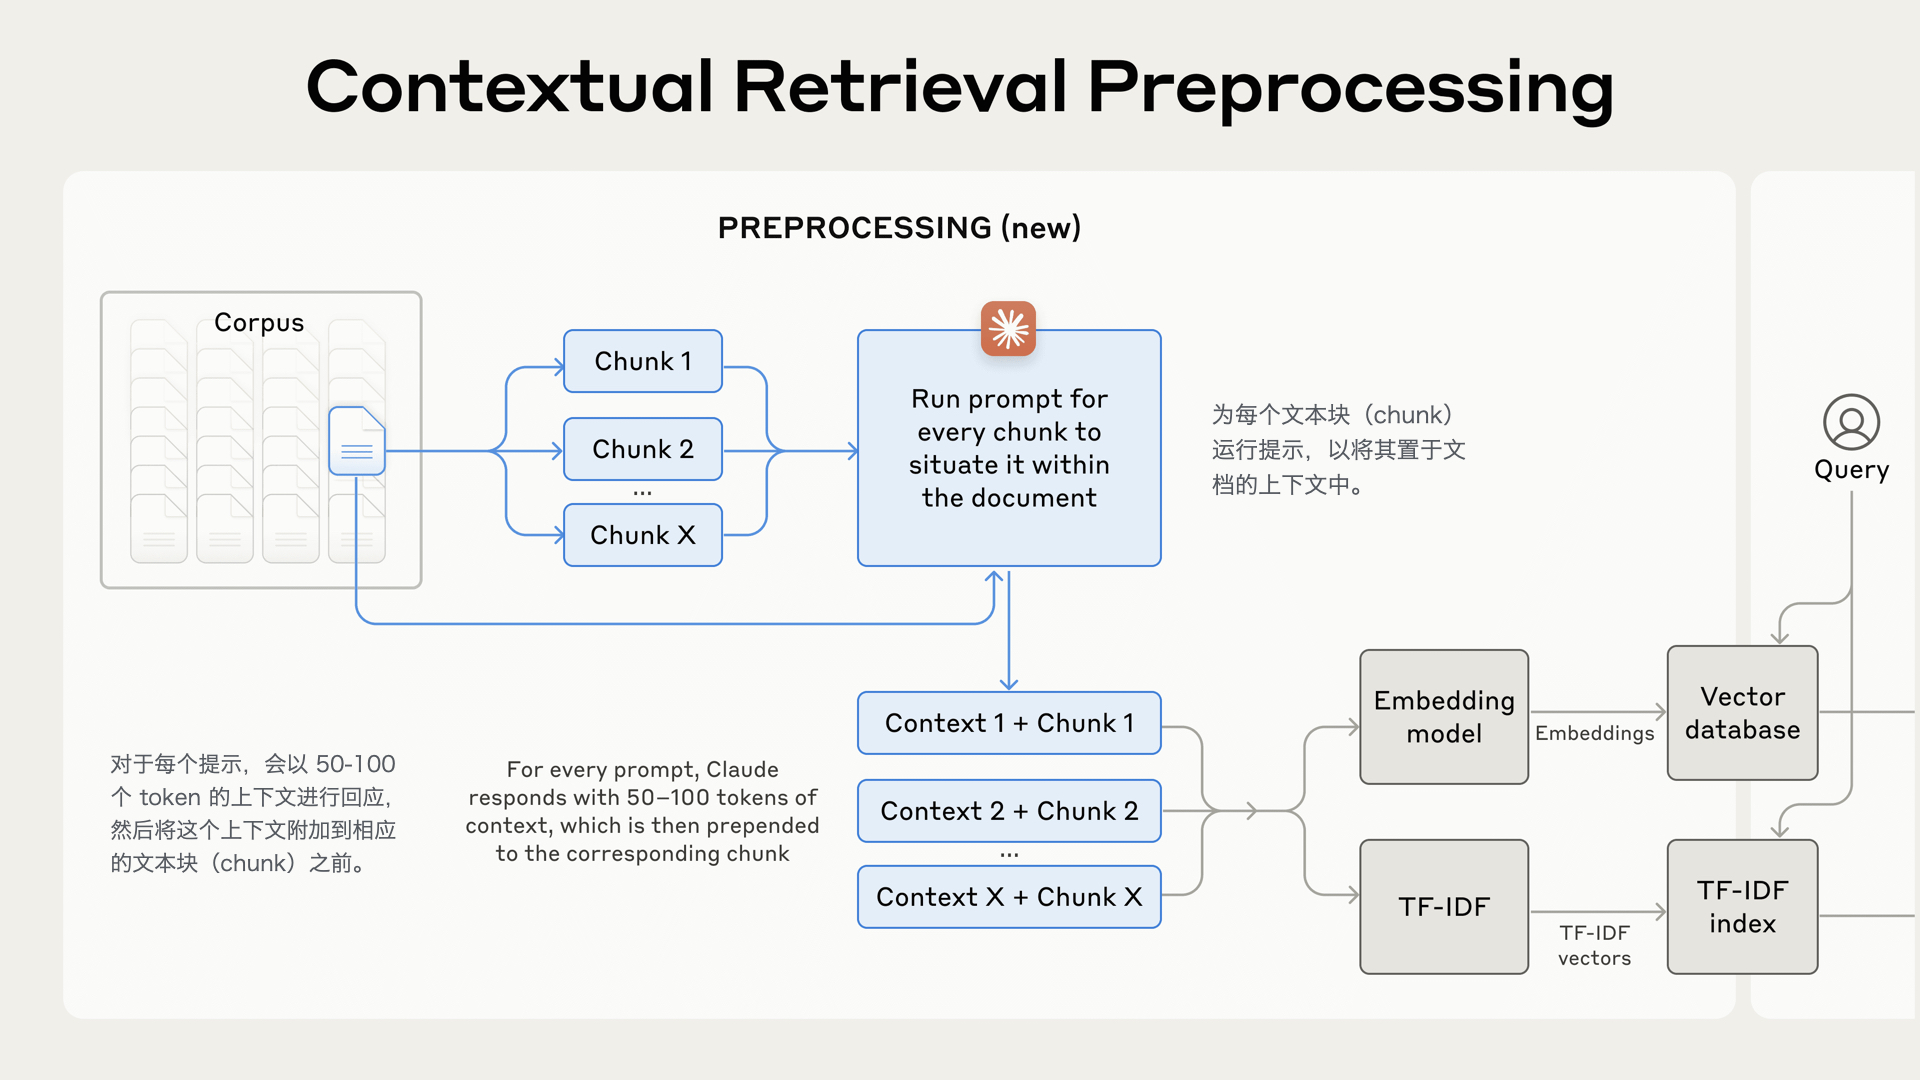
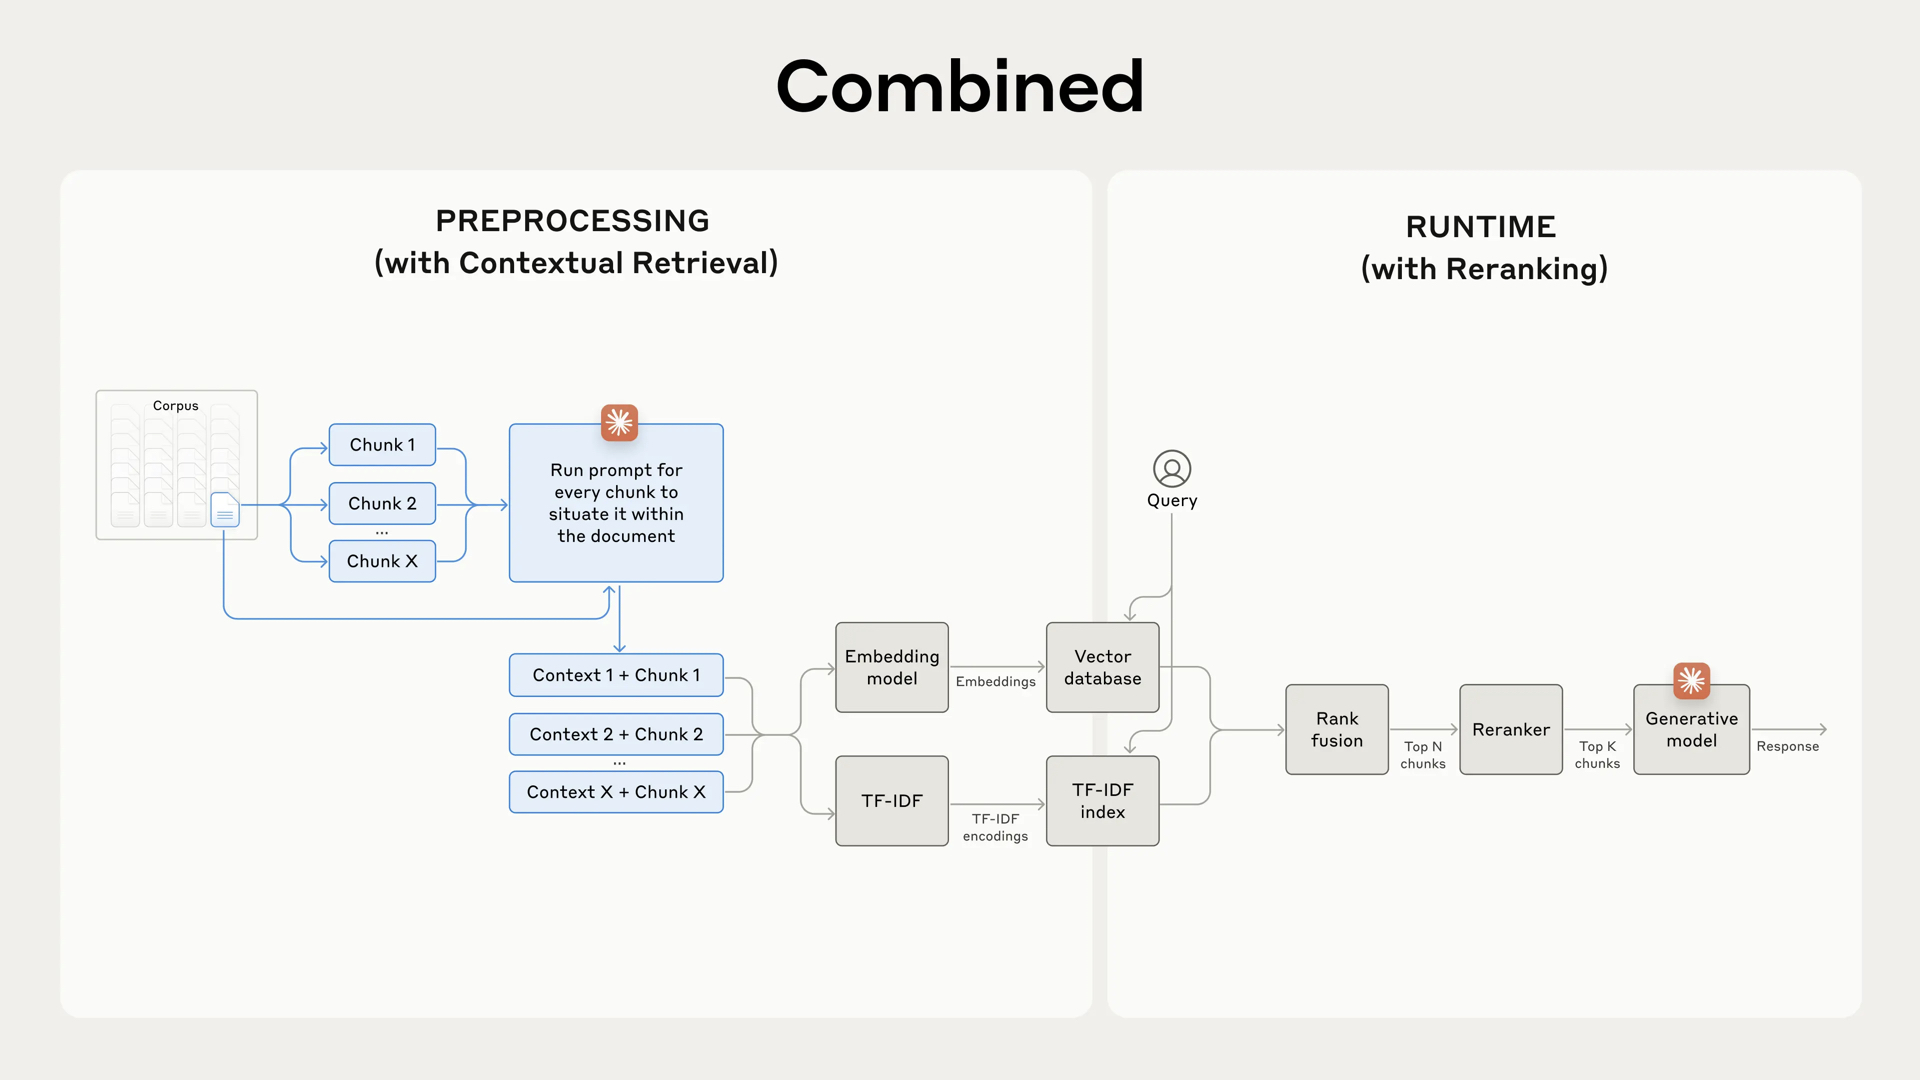
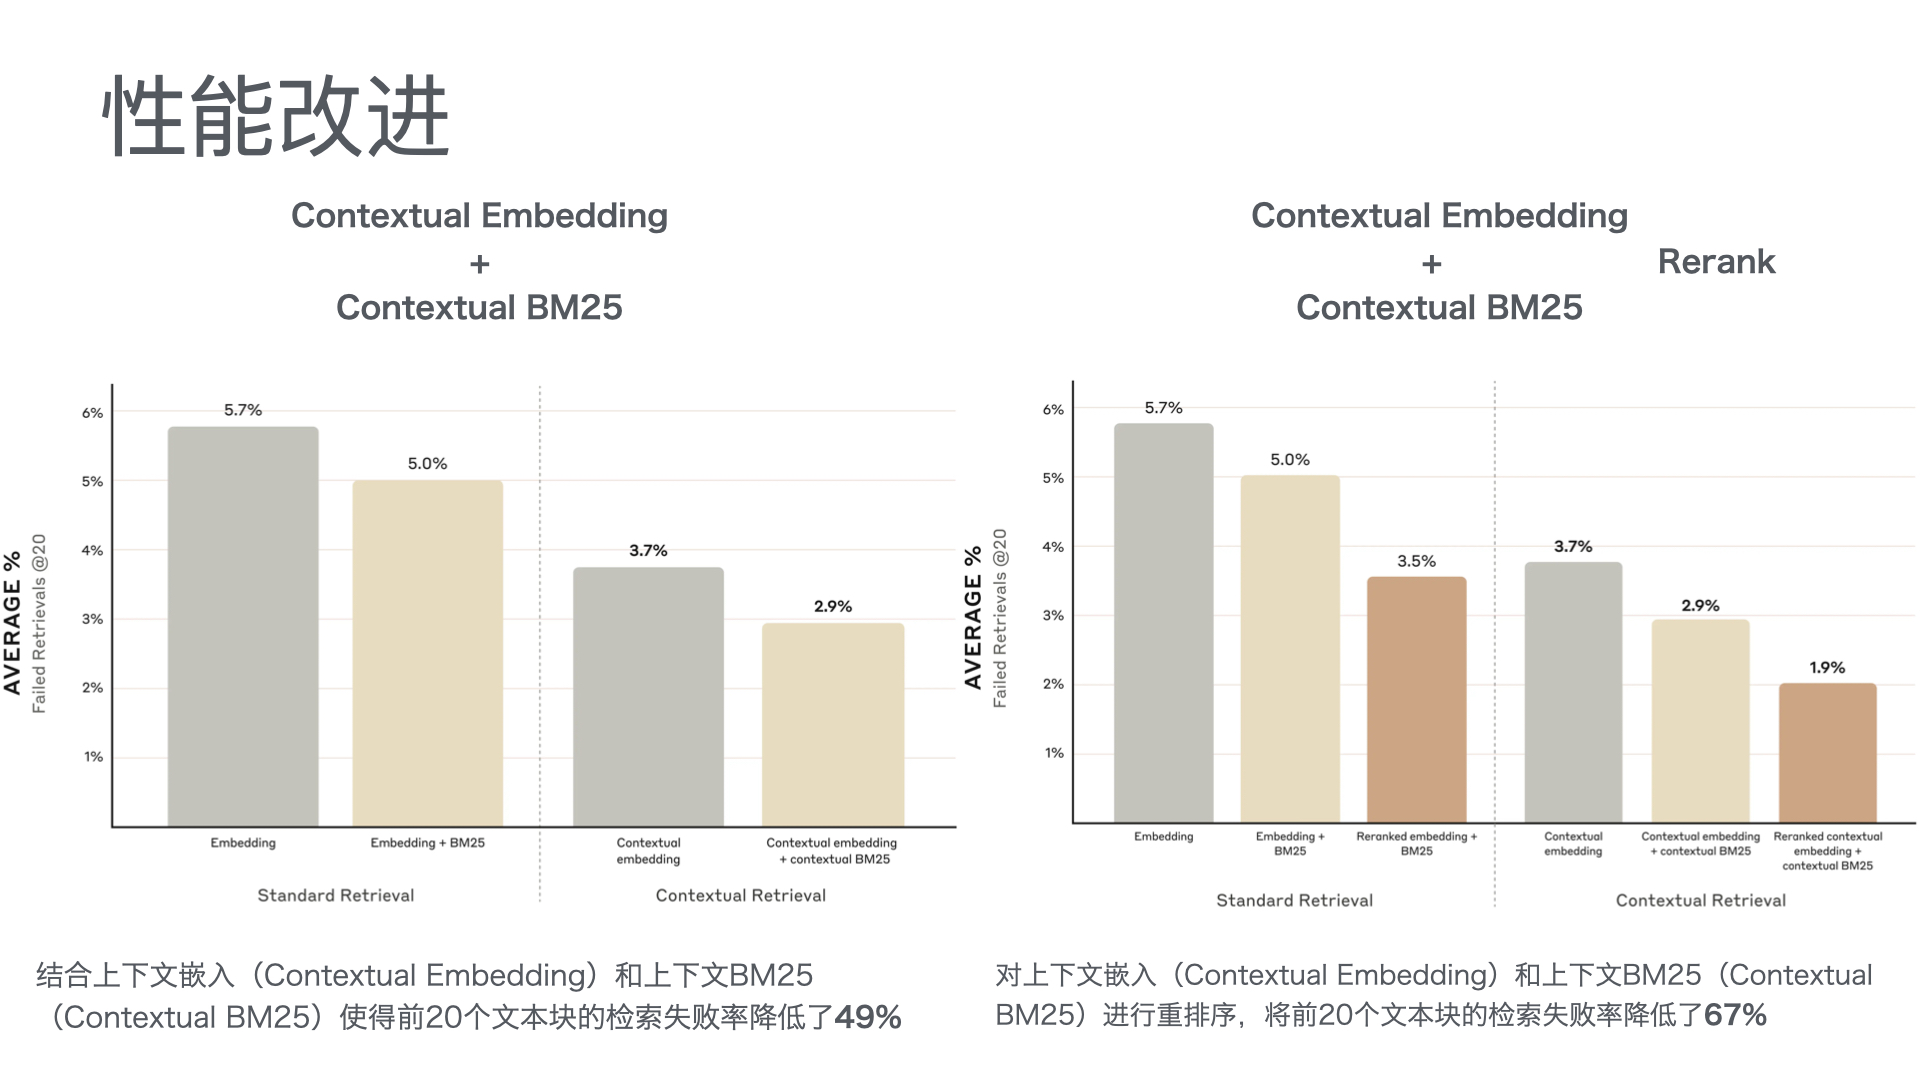
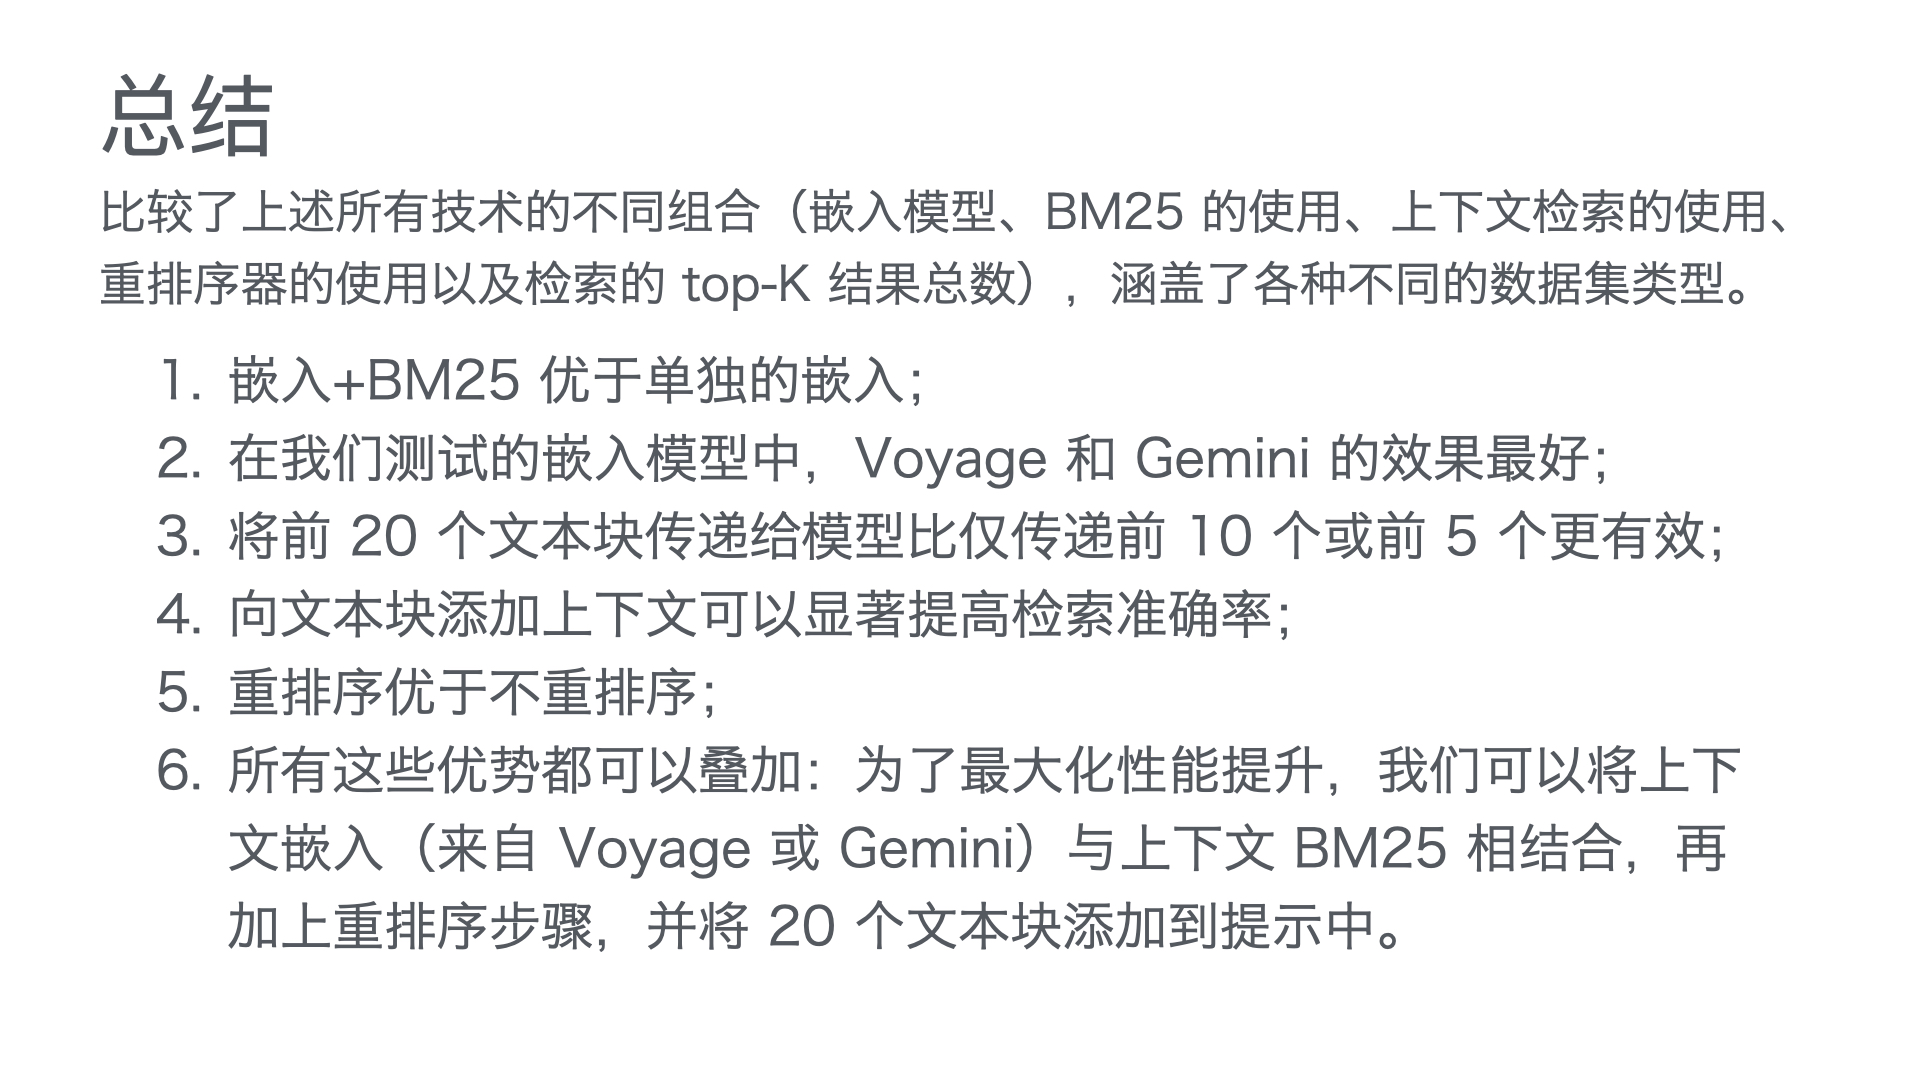
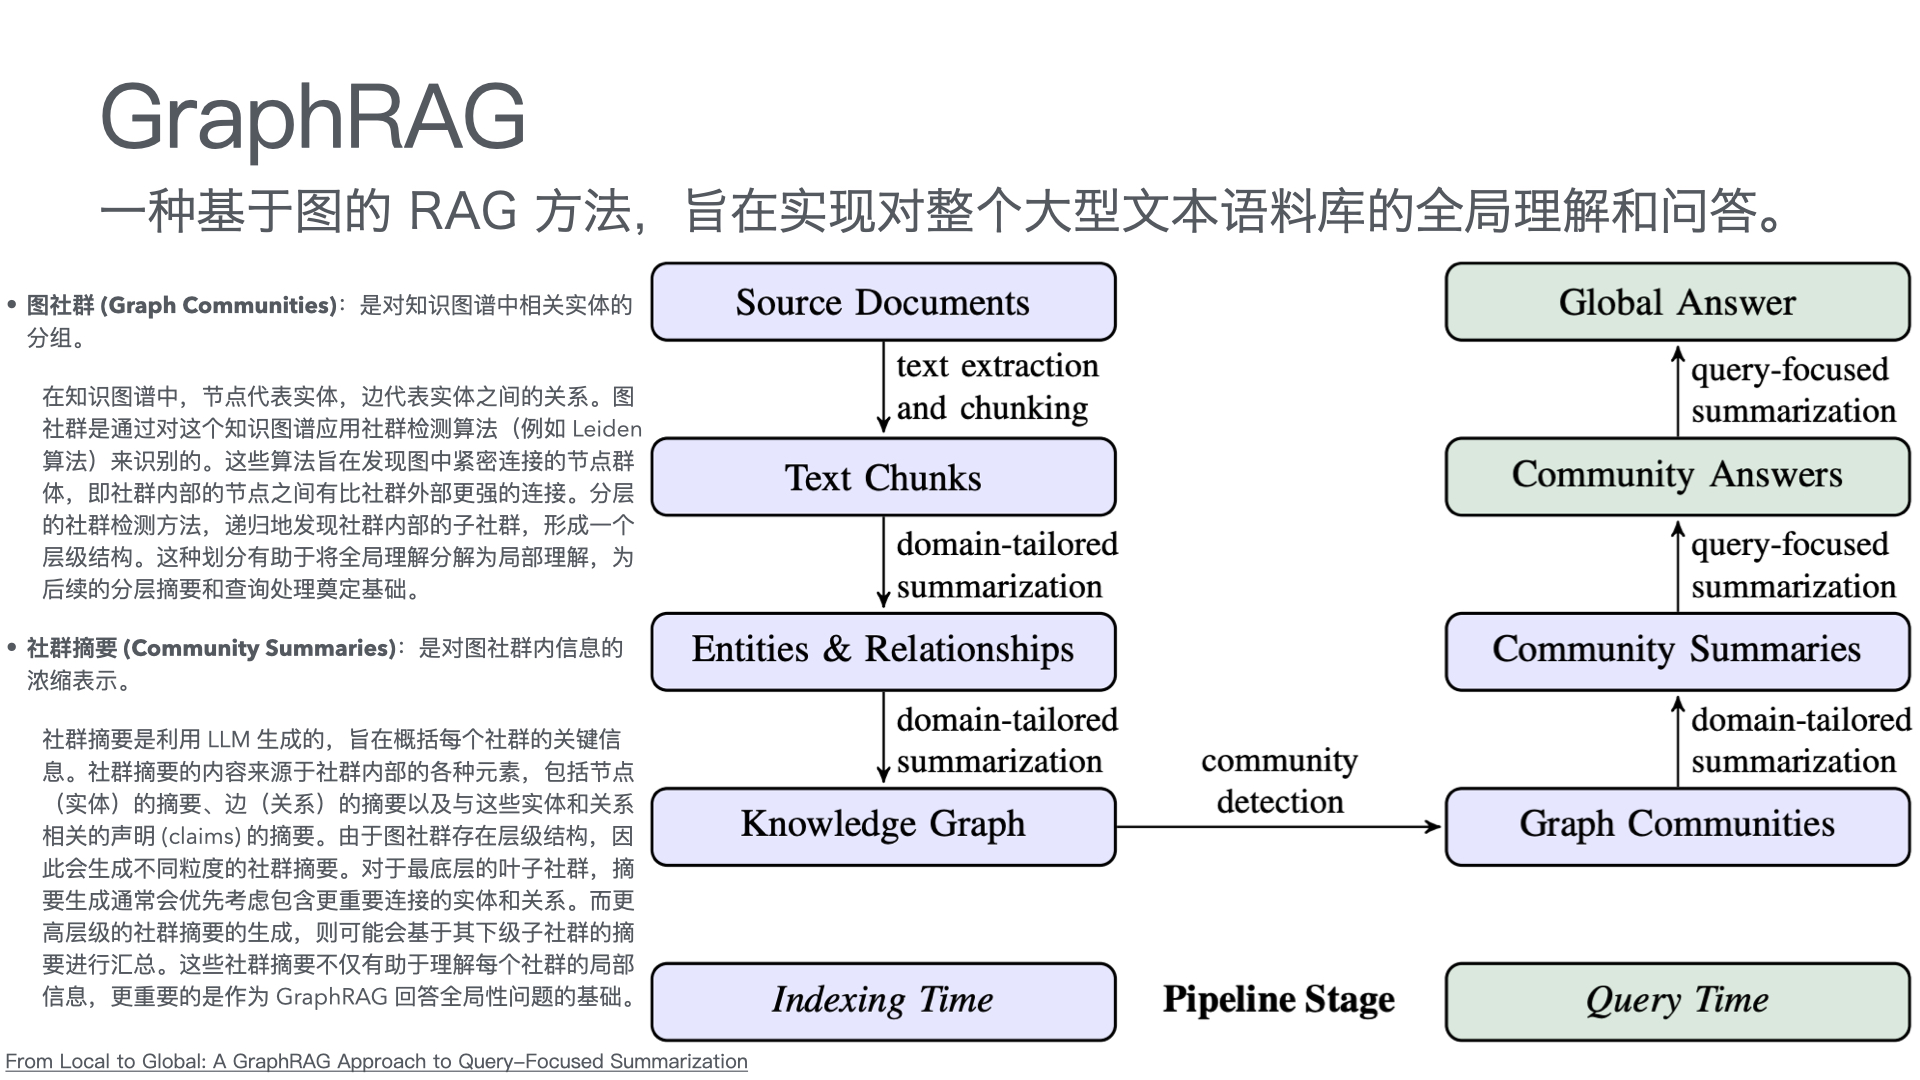
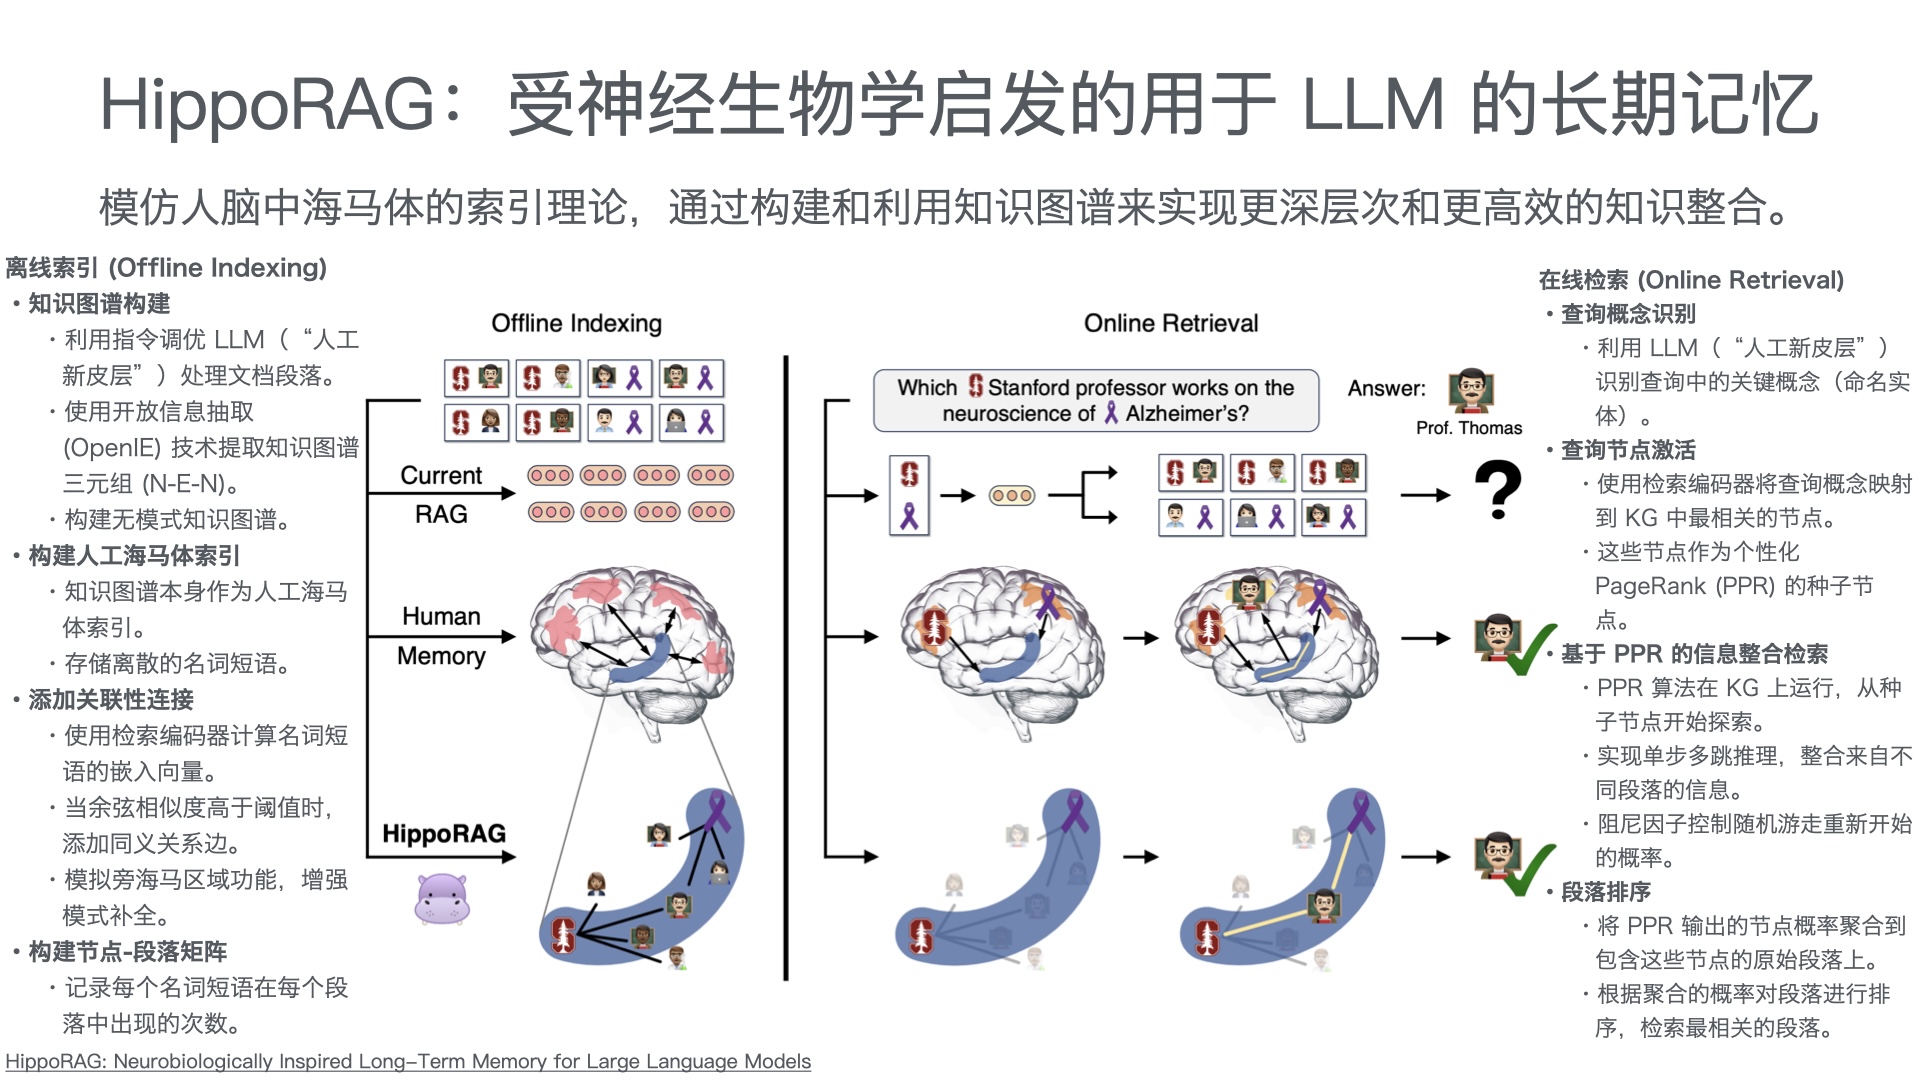
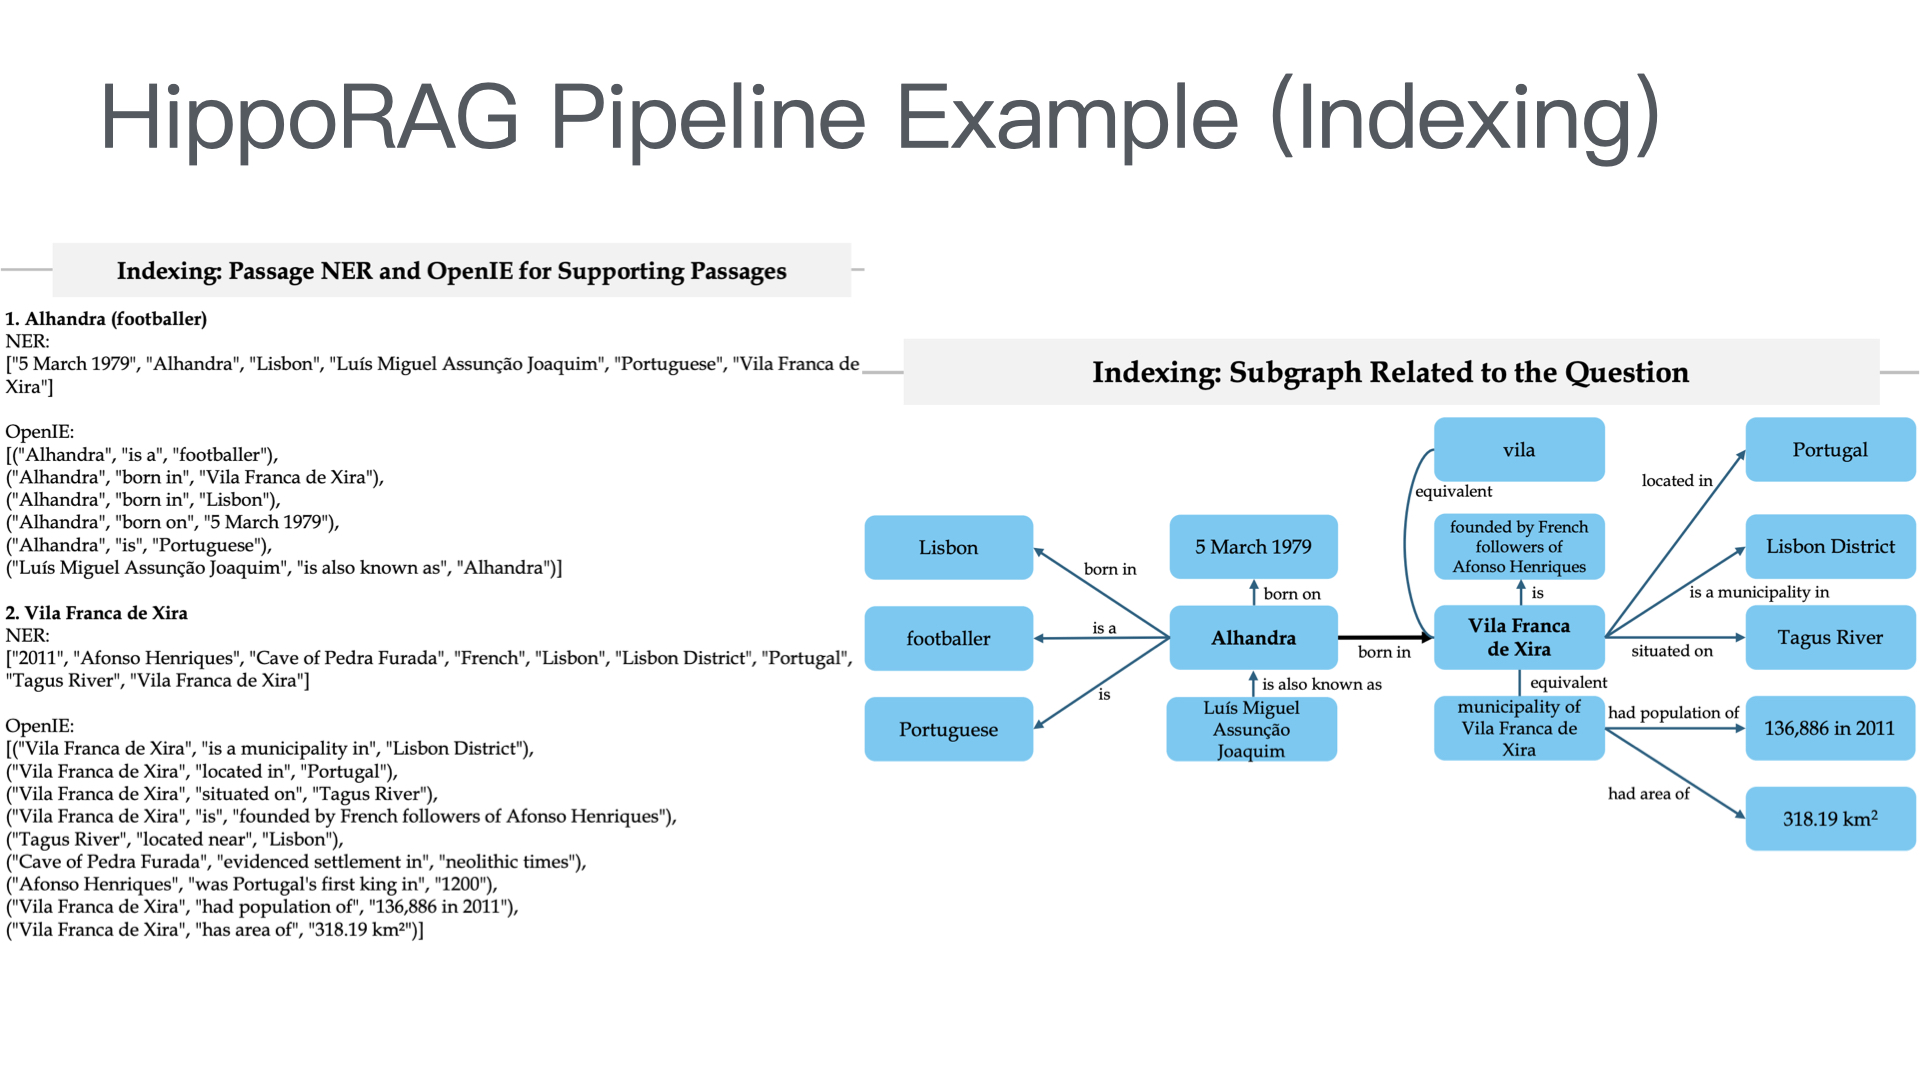
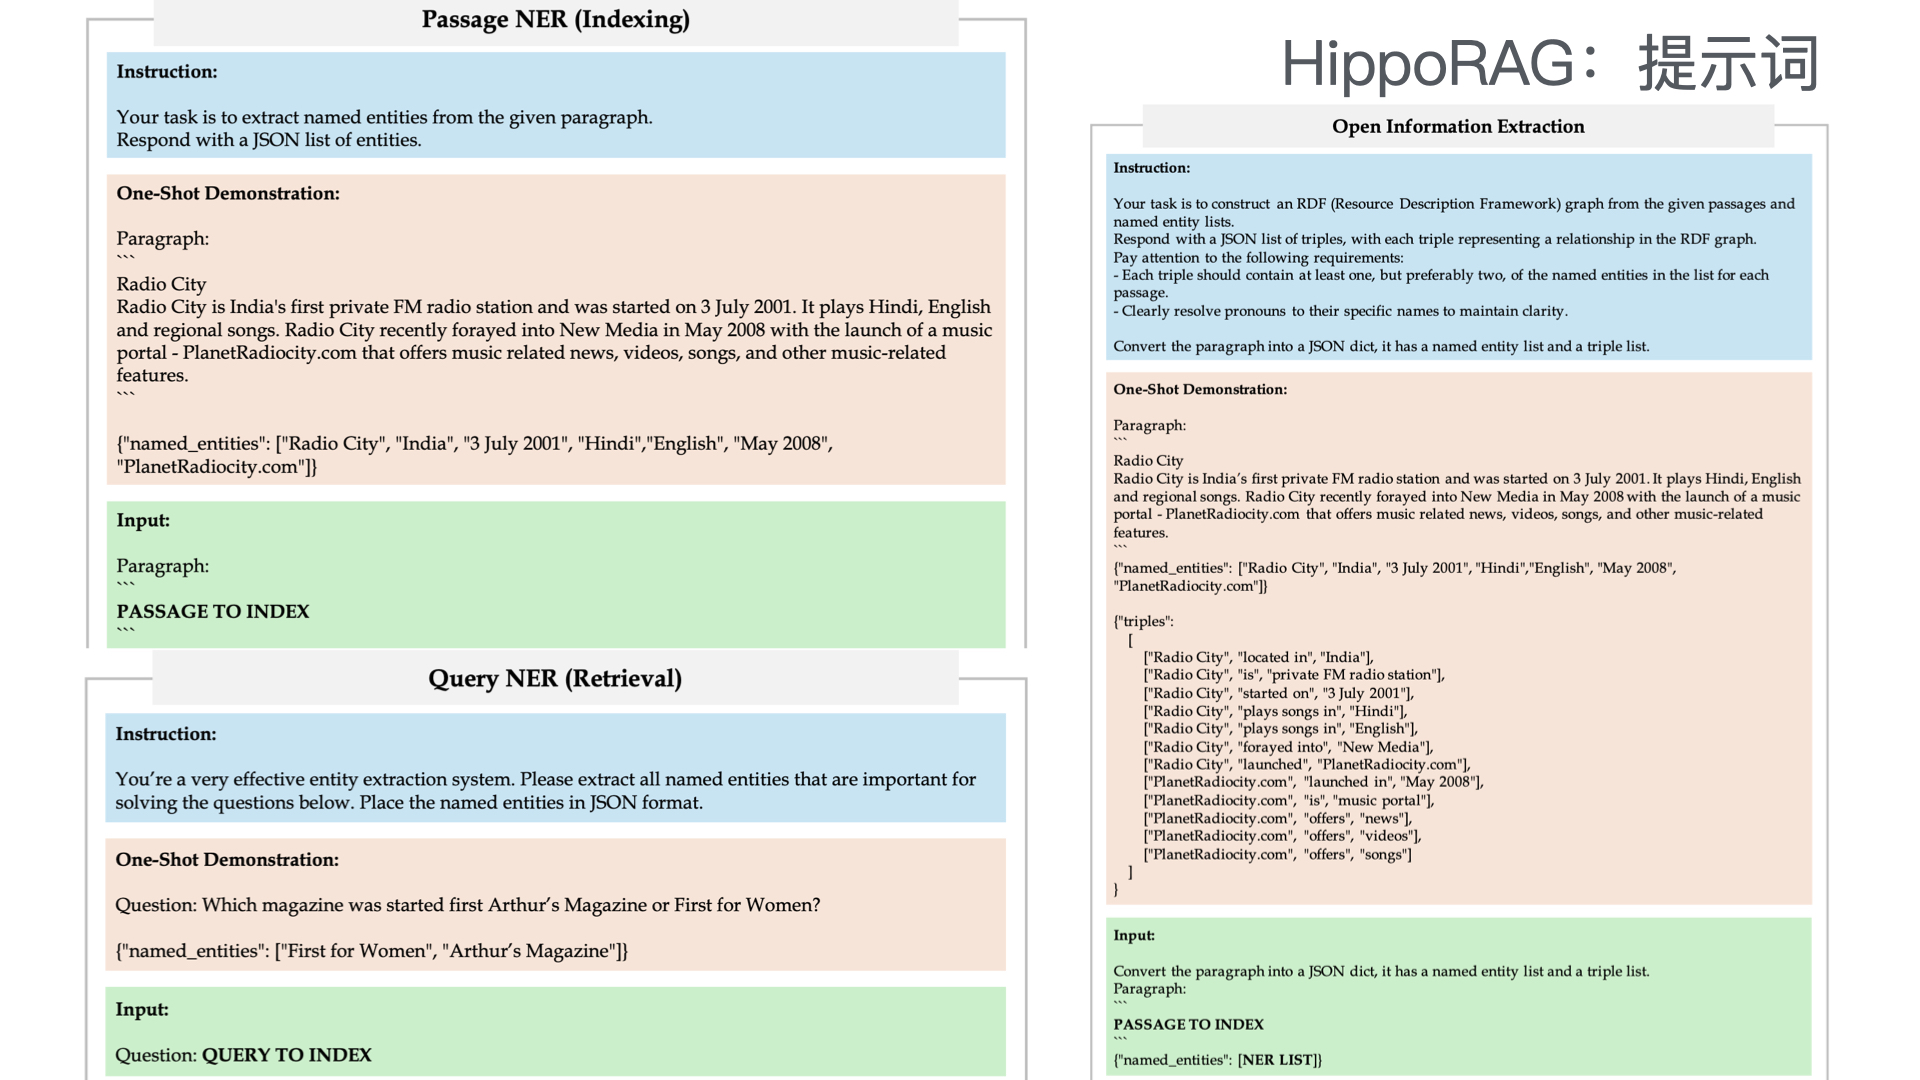
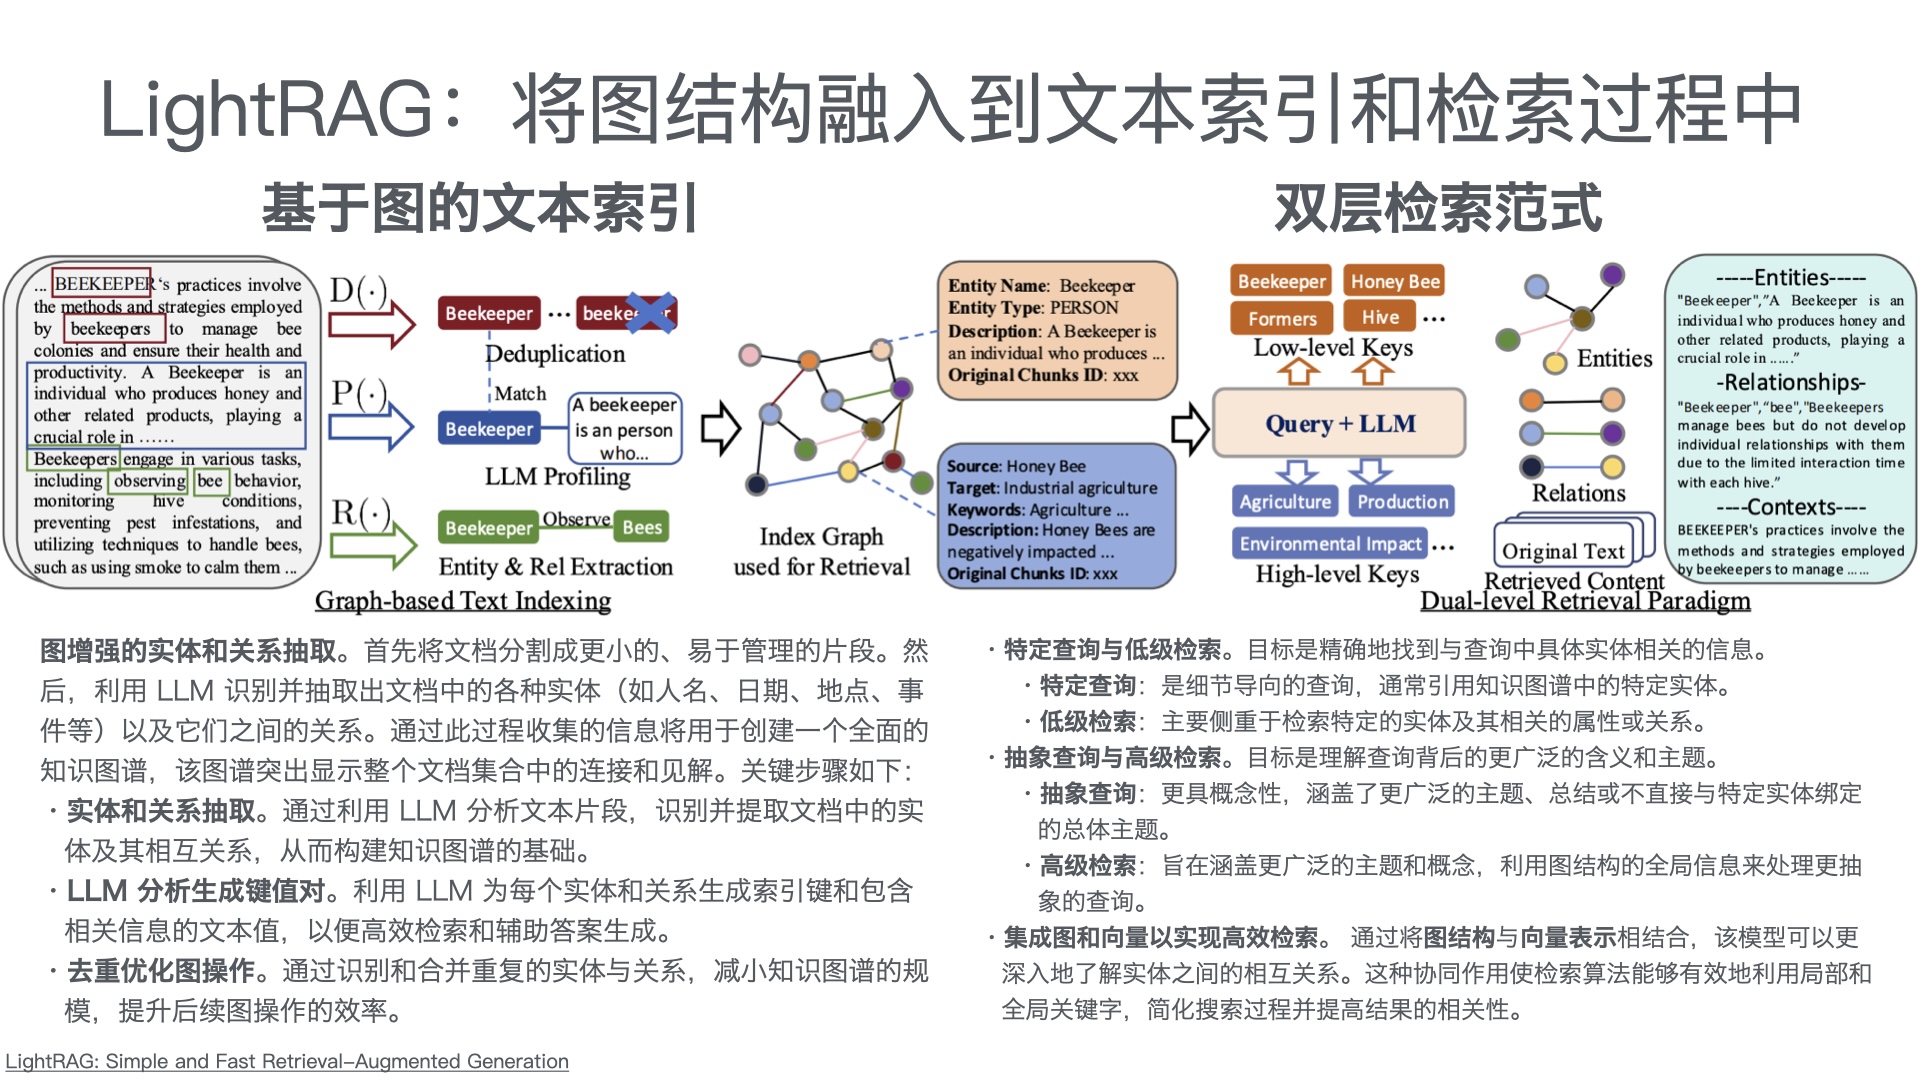
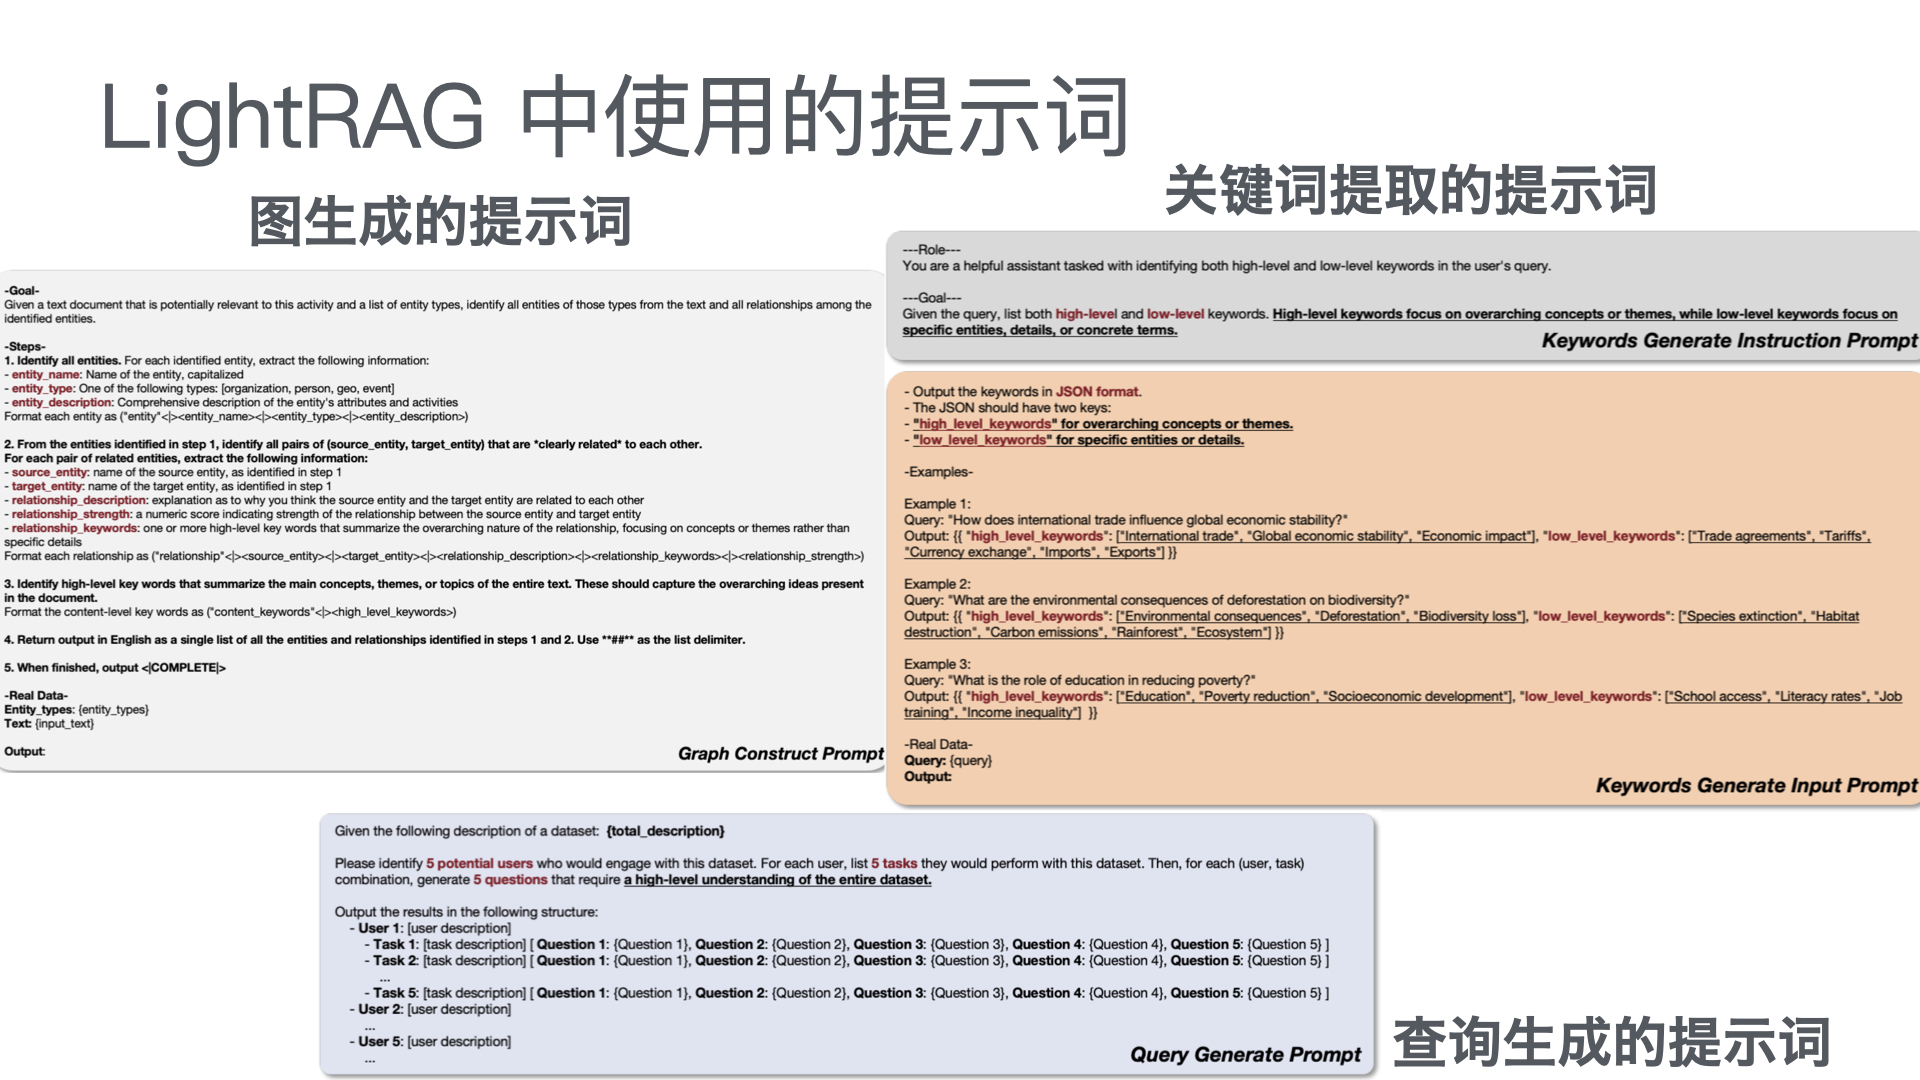
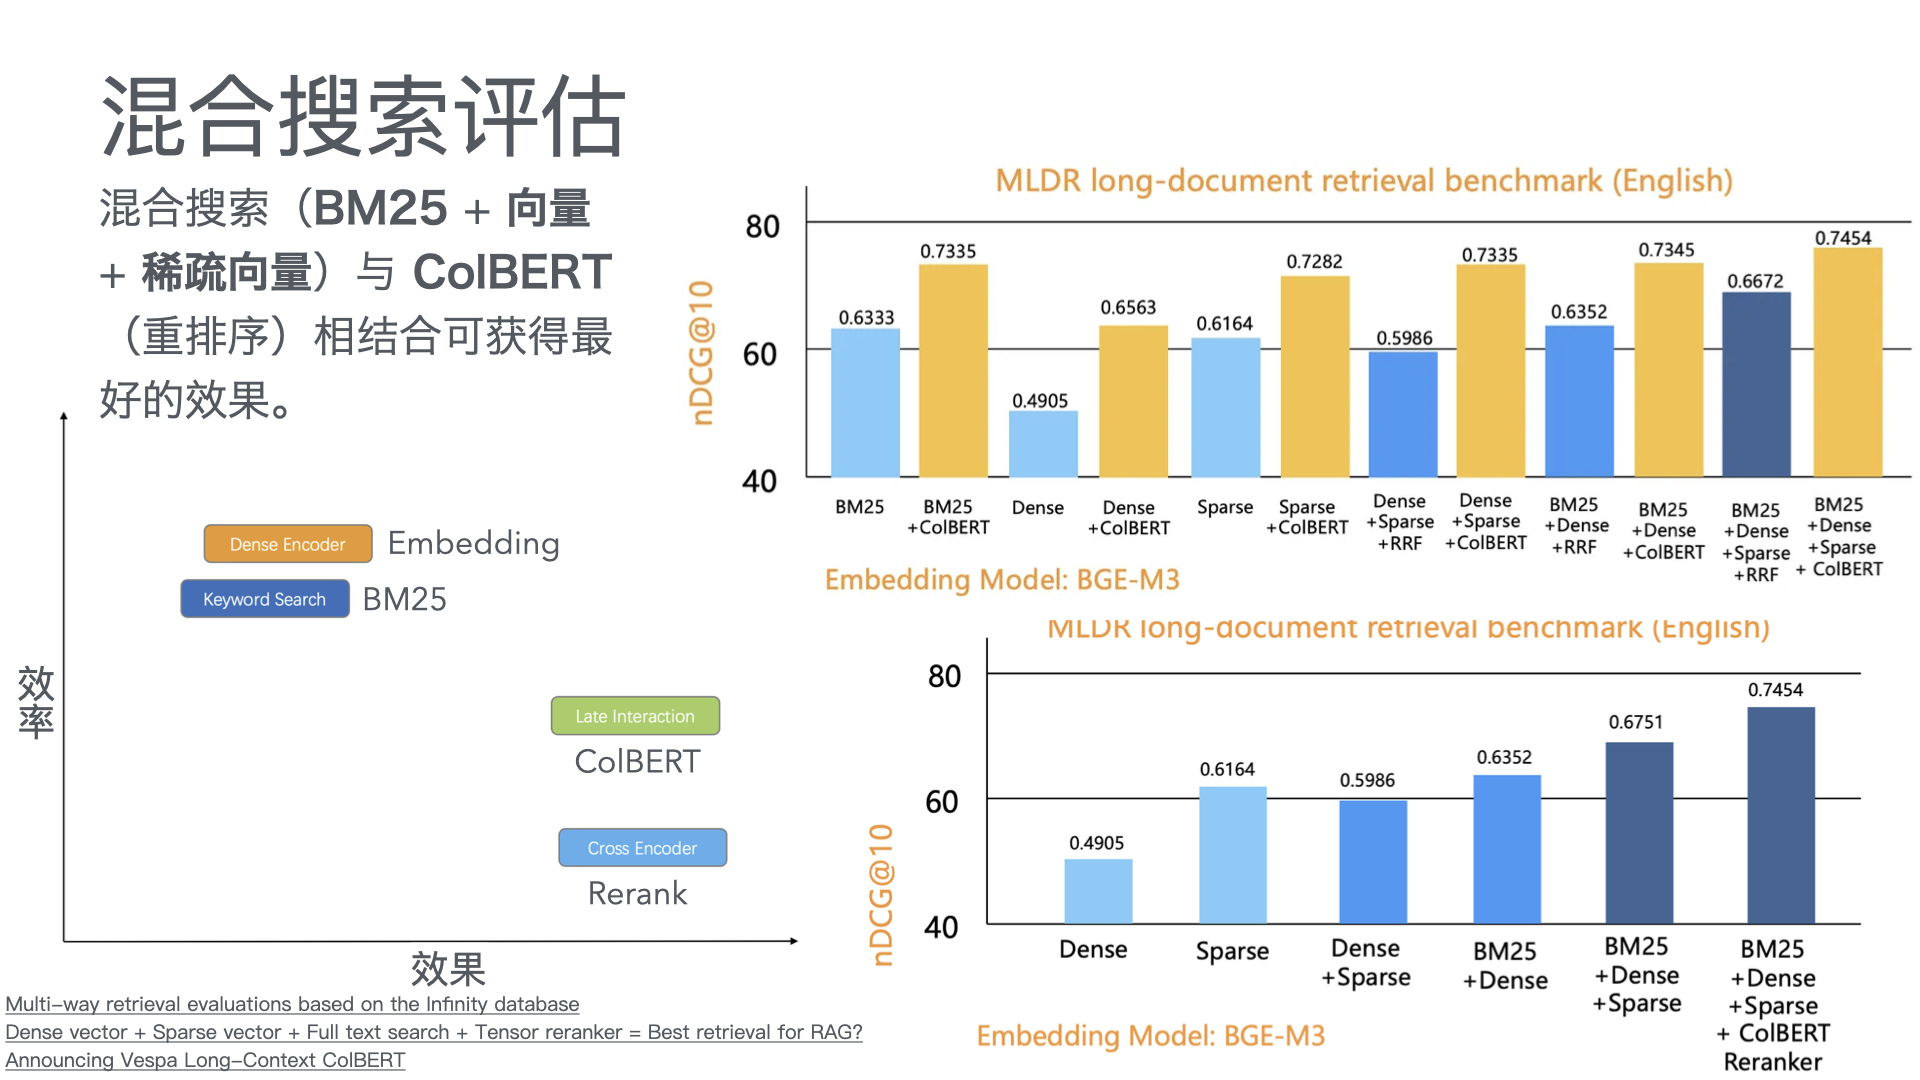
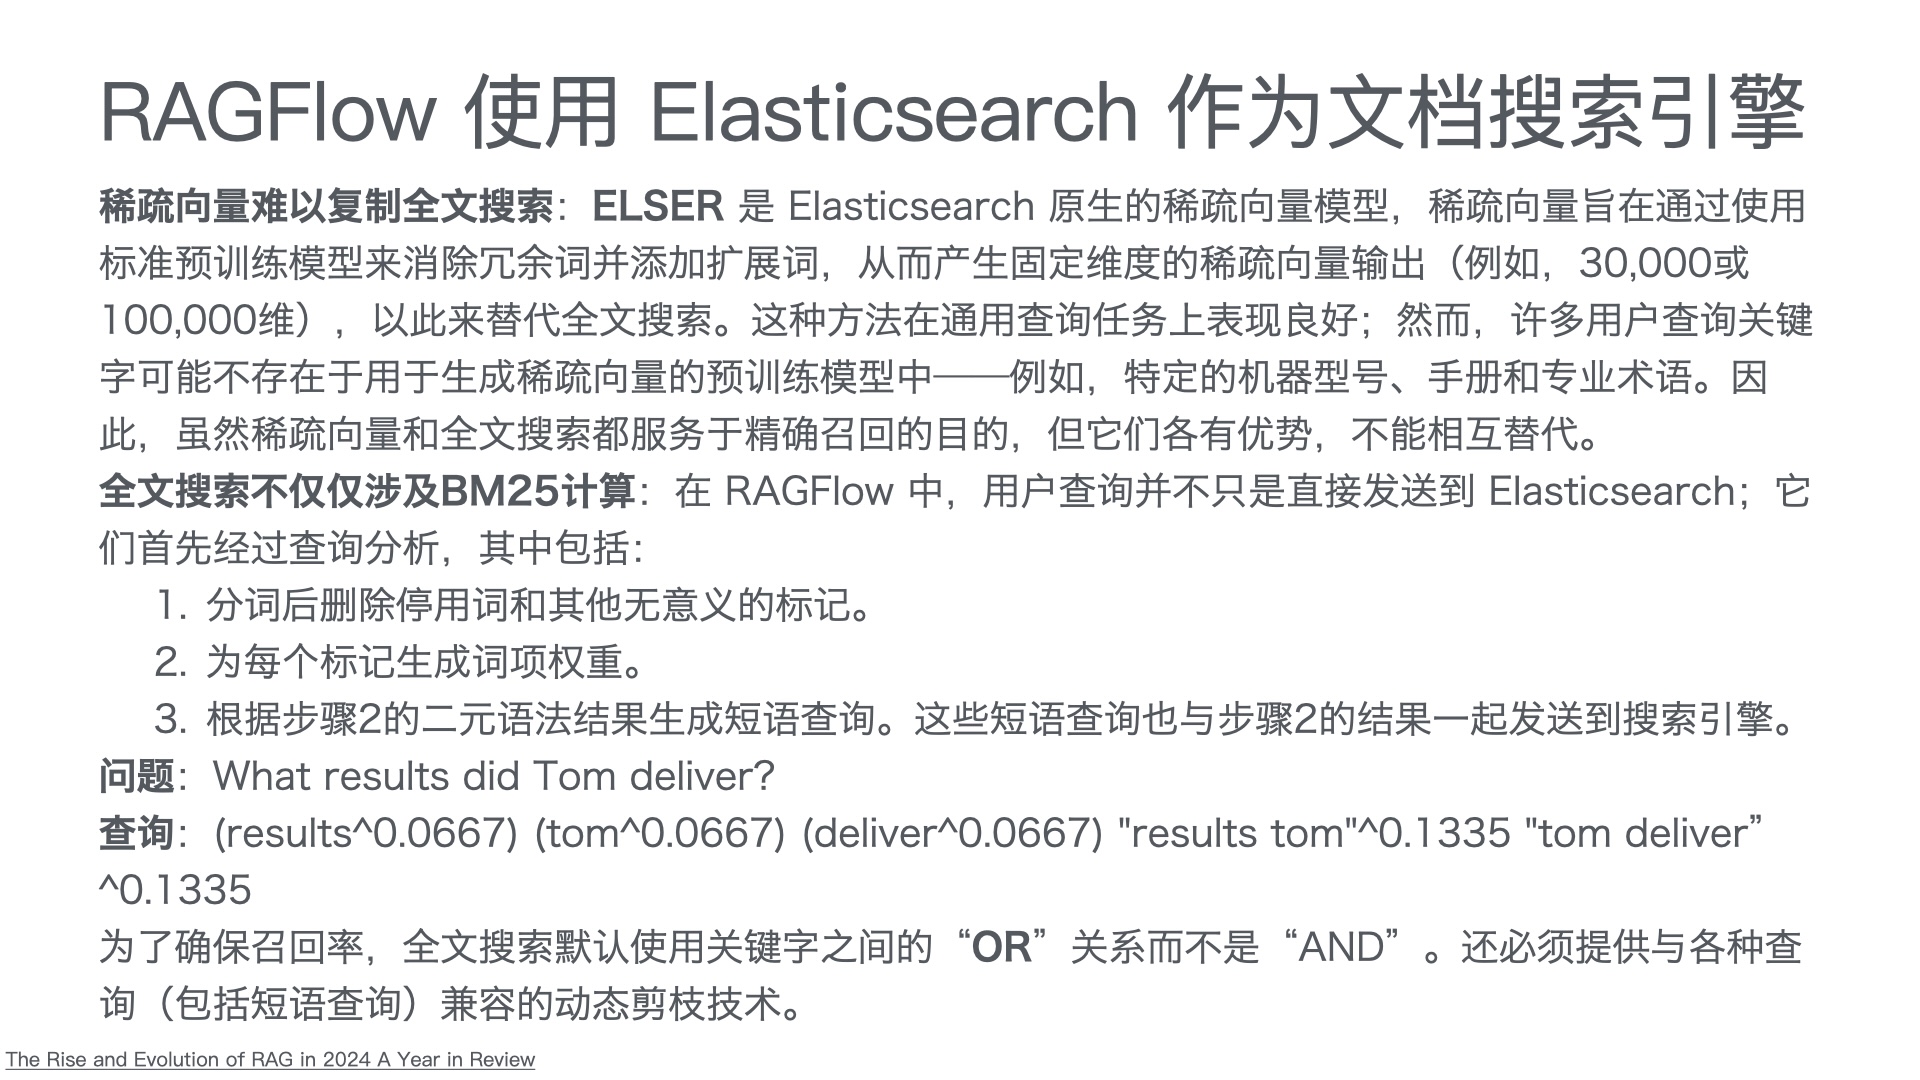
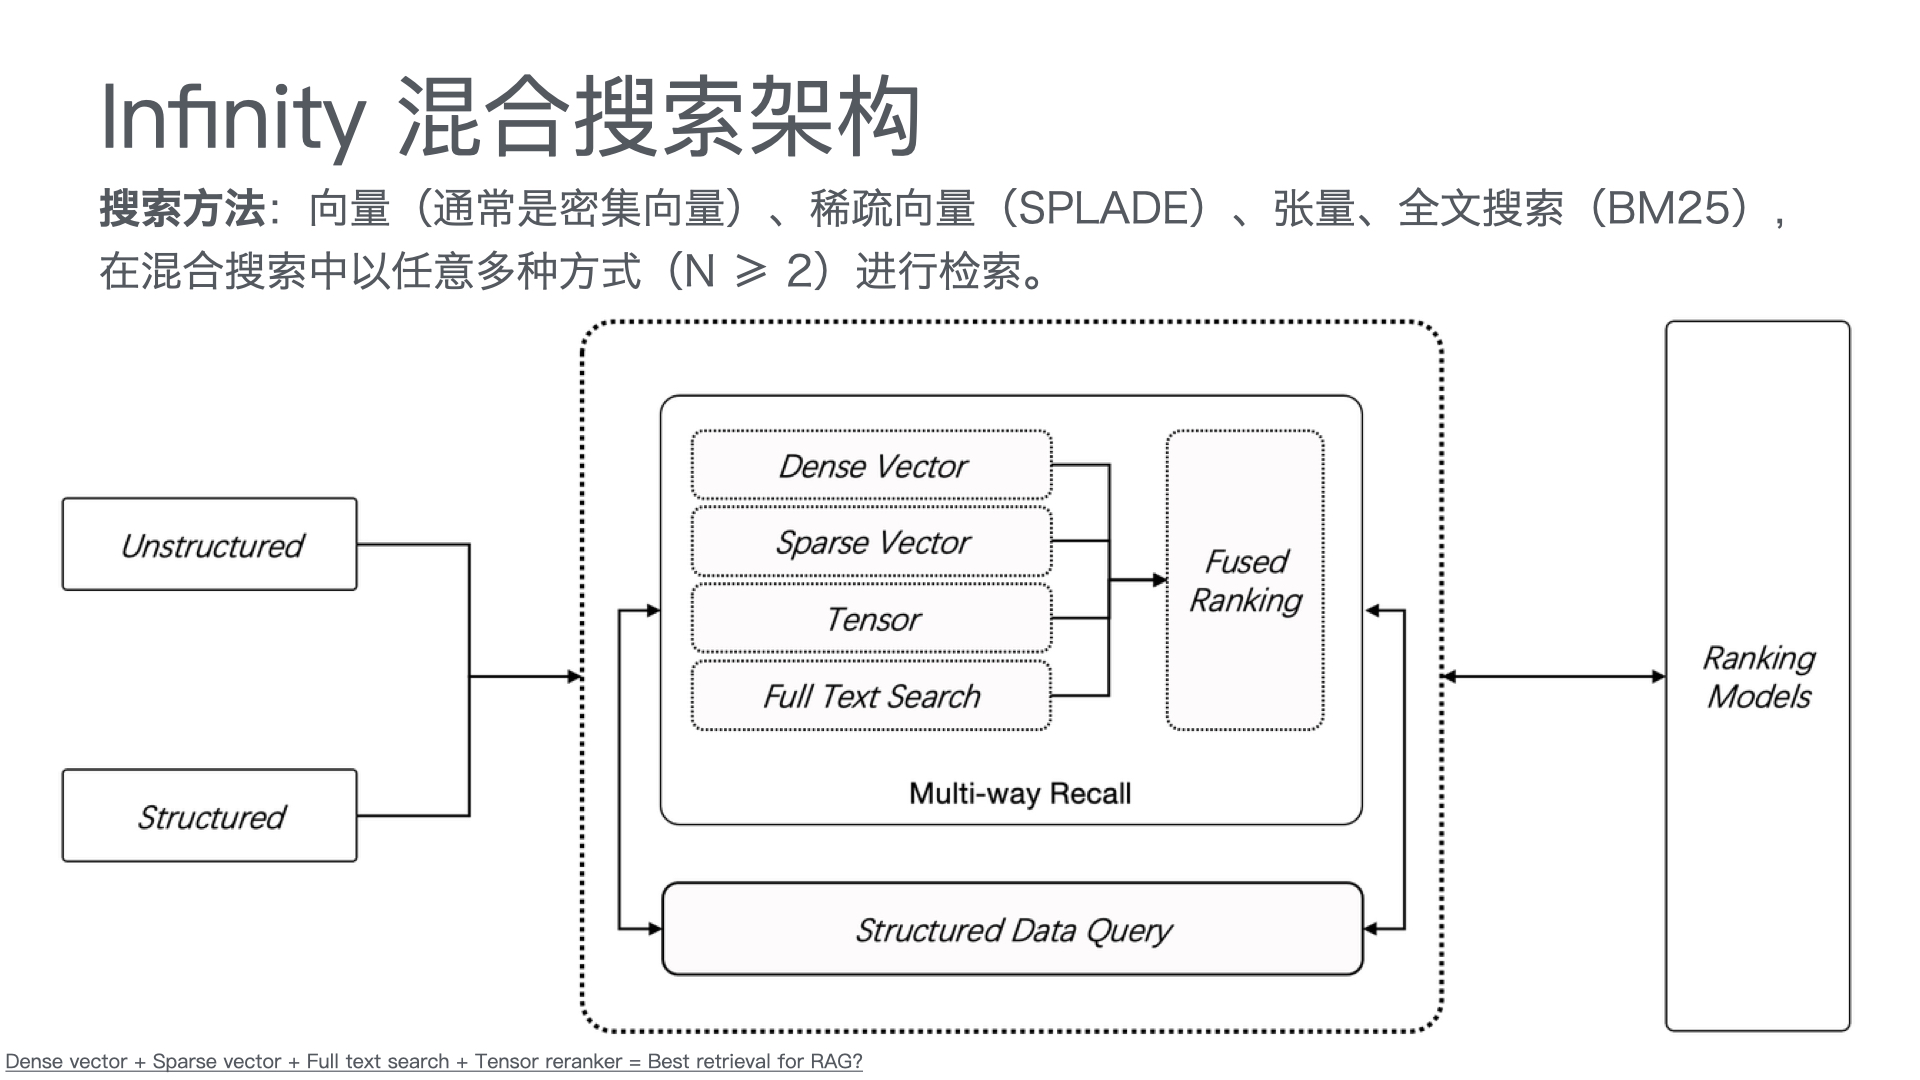
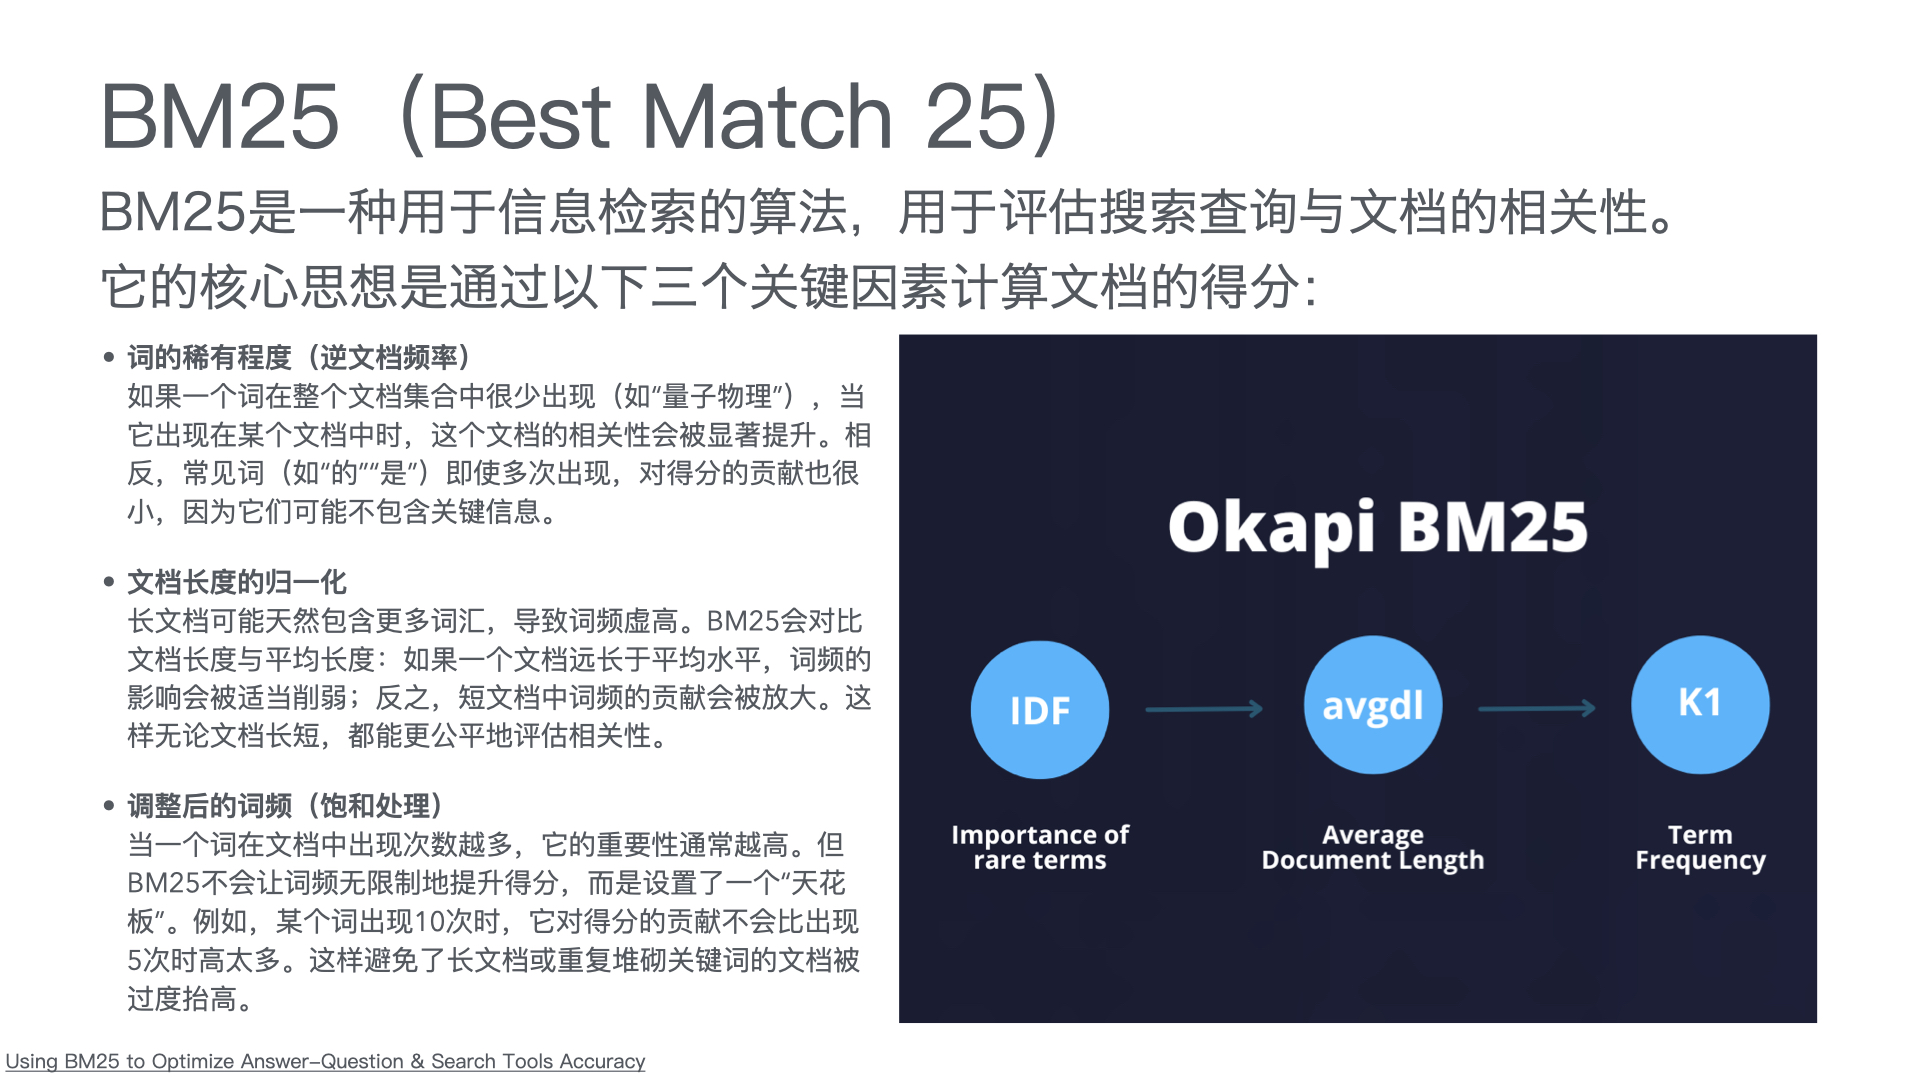
参考资料 2024 年 RAG 的崛起与演变年度回顾 所见即所得:多模态RAG正在向我们走来 What is Retrieval Augmented Generation (RAG)? Build with Claude - Prompt caching Introducing Contextual Retrieval Cookbook - Retrieval Augmented Generation with Contextual Embeddings Infinity Dense vector + Sparse vector + Full text search + Tensor reranker = Best retrieval for RAG? Sparse embedding or BM25?
总结
| 模型类型 | 模型 | 评估结果 |
|---|---|---|
| 语言模型 | Qwen2.5-0.5B | ❌ |
| Qwen2.5-1.5B | ✅ | |
| Qwen2.5-7B | ✅ | |
| Qwen2.5-14B-Instruct | ✅ | |
| Qwen2.5-32B-Instruct | ✅ | |
| 推理模型 | DeepSeek-R1-Distill-Qwen2.5-1.5B | ❌ |
| DeepSeek-R1-Distill-Qwen2.5-7B | ❌ | |
| DeepSeek-R1-Distill-Qwen2.5-14B | ✅ | |
| DeepSeek-R1-Distill-Qwen2.5-32B | ✅ | |
| Qwen/QwQ-32B | ✅ | |
| Qwen/QwQ-32B-Preview | ✅ | |
| Qwen/QwQ-32B-AWQ | ❌ | |
| 代码模型 | Qwen2.5-Coder-0.5B | ❌ |
| Qwen2.5-Coder-1.5B | ✅ | |
| Qwen2.5-Coder-3B | ✅ |
对于这样的阅读理解任务,推理模型的表现要反而不如语言模型和代码模型,通过分析发现在思考的过程可能会出错而导致答案错误。对于大参数模型,进行了量化会导致模型性能下降,如:Qwen/QwQ-32B-AWQ。
提示词 收入 截至12月31日止年度 2024年 人民幣千元 2023年 人民幣千元 商品收入: 醫藥和健康產品銷售 48,795,702 45,652,922 服務收入: 平台、廣告及其他服務 9,364,179 7,877,019 58,159,88
Model Context Protocol (MCP) 入门
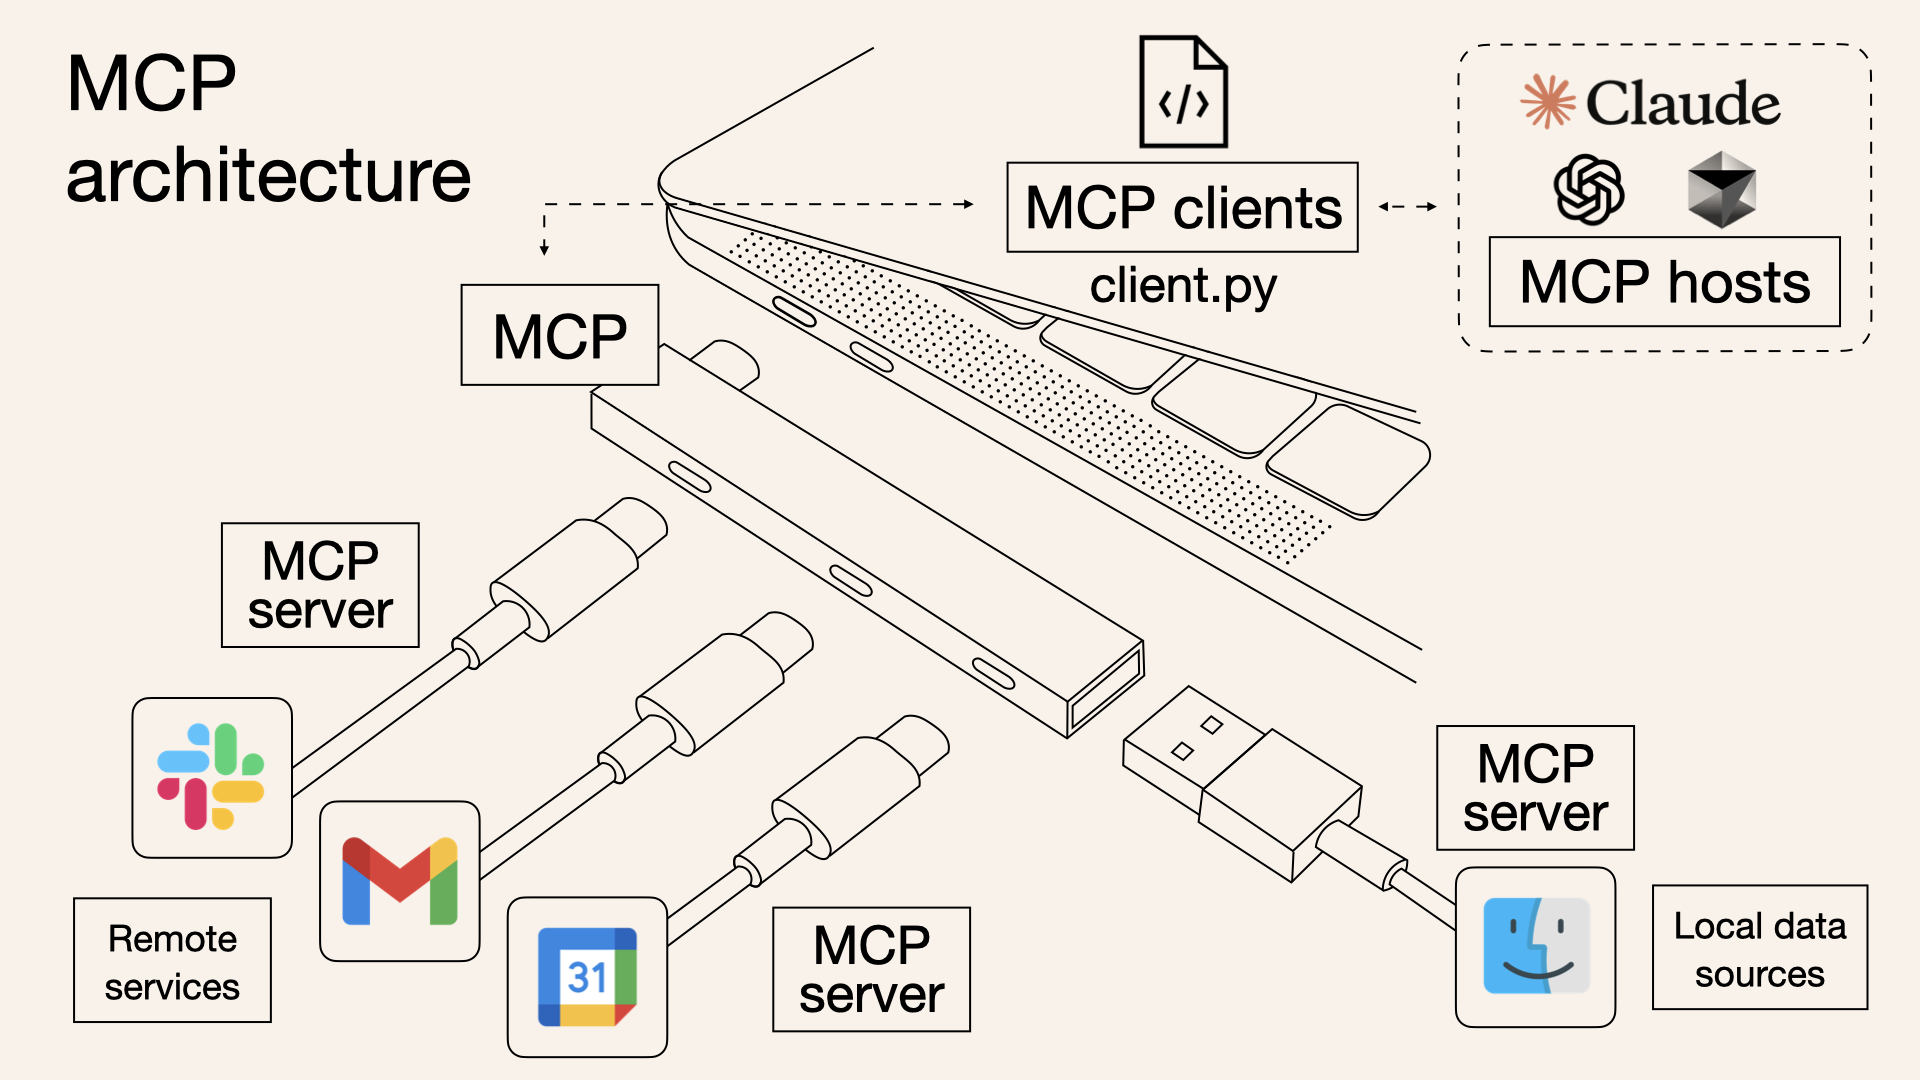
MCP 是一个开放协议,用于标准化应用程序向 LLM 提供上下文的方式。可以将 MCP 视为 AI 应用程序的 USB-C 端口。正如 USB-C 提供了一种将设备连接到各种外围设备和配件的标准化方式一样,MCP 提供了一种将 AI 模型连接到不同数据源和工具的标准化方式。
为什么选择 MCP?
MCP 帮助您在 LLM 之上构建代理和复杂的工作流程。LLM 经常需要与数据和工具集成,而 MCP 提供了:
一般架构
MCP 的核心遵循客户端-服务器架构,其中主机应用程序可以连接到多个服务器:
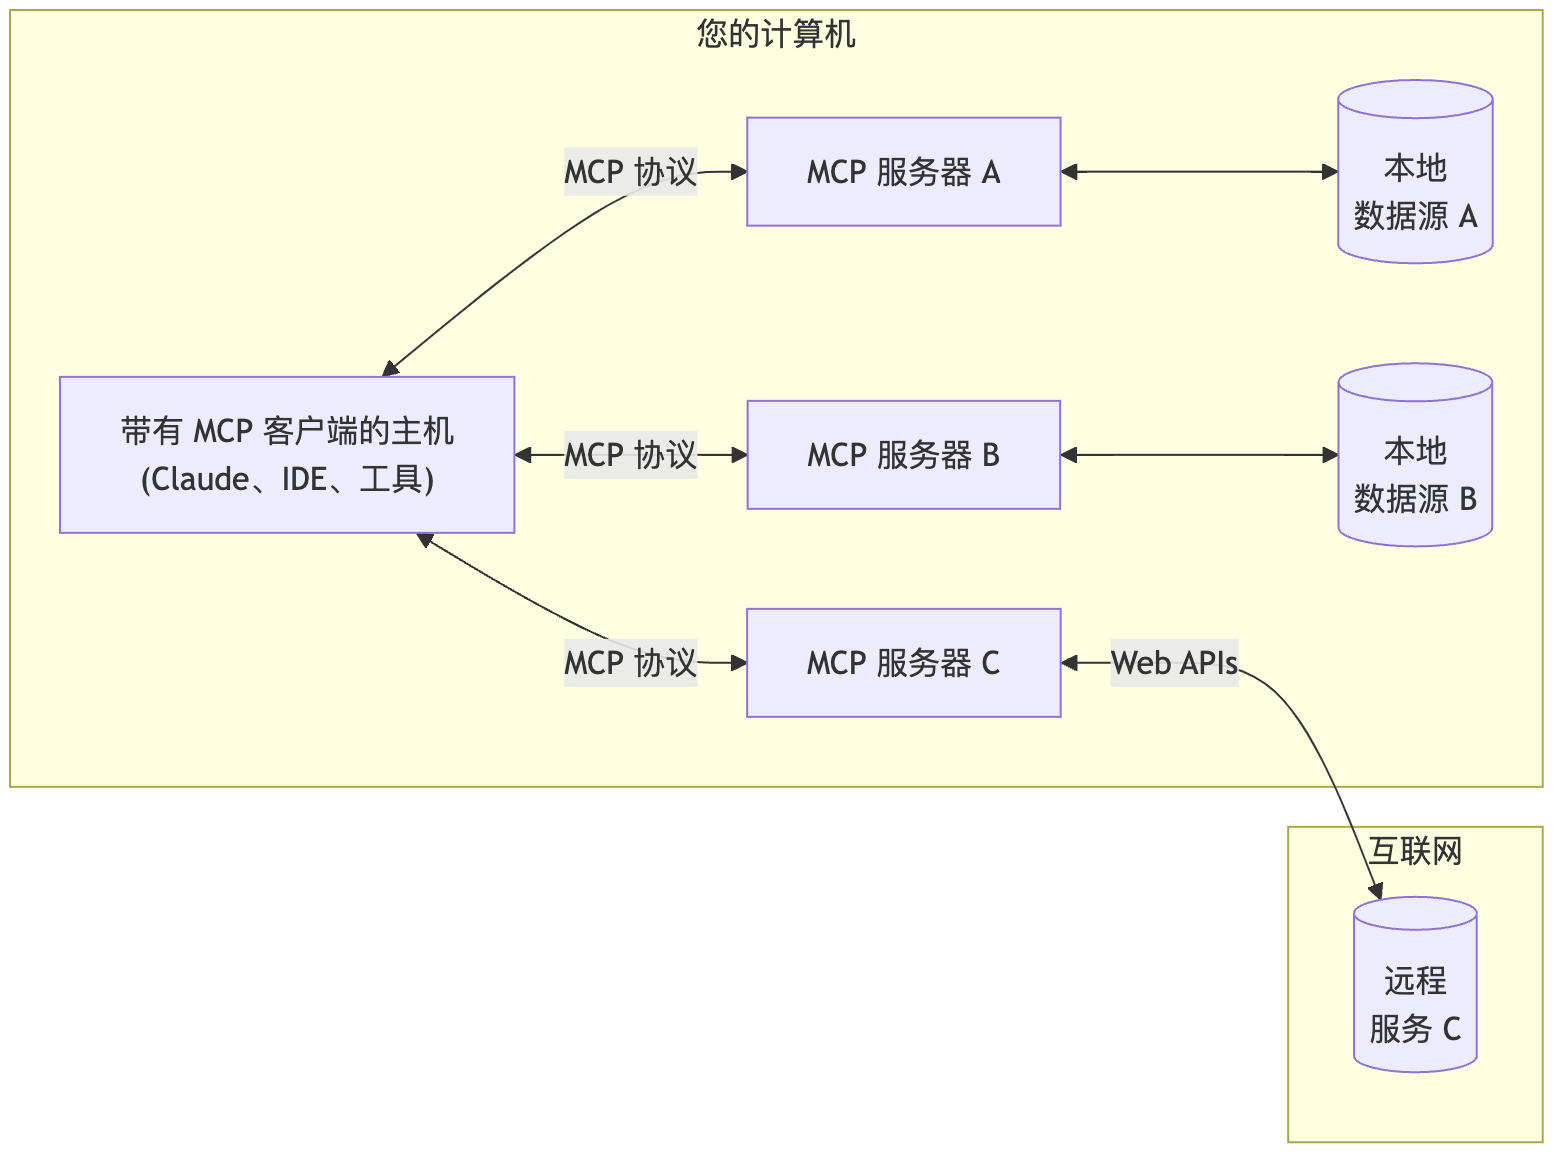
flowchart LR
    subgraph "您的计算机"
        Host["带有 MCP 客户端的主机<br>(Claude、IDE、工具)"]
        S1["MCP 服务器 A"]
        S2["MCP 服务器 B"]
        S3["MCP 服务器 C"]
        Host <-->|"MCP 协议"| S1
        Host <-->|"MCP 协议"| S2
        Host <-->|"MCP 协议"| S3
        S1 <--> D1[("本地<br>数据源 A")]
        S2 <--> D2[("本地<br>数据源 B")]
    end
    subgraph "互联网"
        S3 <-->|"Web APIs"| D3[("远程<br>服务 C")]
    end
了解 MCP 如何连接客户端、服务器和 LLM
简介
Continue hub 助手使用 config.yaml 规范定义。本地助手也可以通过放置在全局 .continue 文件夹中的 YAML 文件 config.yaml 进行配置(Mac 上为 ~/.continue,Windows 上为 %USERPROFILE%\.continue)
:::info
Config YAML 替代了 config.json。查看迁移指南。
:::
一个助手由以下部分组成:
name、version 和 config.yaml 的 schema块是编码助手的一个独立构建块,例如一个模型或一个文档来源。在 config.yaml 语法中,块包含与助手相同的顶级属性(name、version 和 schema),但在其所属的块类型下只有一个项目。
可以在 Continue hub 上找到块和助手的示例。
助手可以显式定义块(参见下面的属性),也可以导入和配置现有的 hub 块。
使用块
Hub 块和助手通过格式为 owner-slug/block-or-assistant-slug 的标识符识别,所有者可以是用户或组织。
可以通过在块类型下添加 uses 子句将块导入到助手中。
这篇文章是使用 Google Gemini Deep Research 生成的。提示词:
研究 Model Context Protocol
1. 模型上下文协议 (MCP) 导论
大型语言模型 (LLMs) 在理解和生成人类语言方面取得了显著的进步。然而,这些模型本质上是孤立的,它们的知识仅限于训练数据,并且缺乏与外部世界交互的能力 1。为了克服这些限制,将 LLMs 与外部数据源和工具集成变得至关重要 1。传统上,这种集成是通过为每个新的数据源或工具开发定制的连接器来实现的 1。这种方法导致了集成工作的重复,难以扩展,并且维护成本高昂,阻碍了上下文感知 AI 的广泛采用 1。
为了应对这一挑战,模型上下文协议 (MCP) 应运而生 1。MCP 是一种开放标准,旨在规范应用程序如何向 LLMs 提供上下文和工具 6。可以将 MCP 视为 AI 应用程序的通用连接器,类似于 USB-C 标准化了设备和外设之间的连接 6。通过提供一种标准化的方式将 AI 模型连接到各种数据源和工具,MCP 简化了集成,增强了互操作性,并促进了可扩展性 6。
本报告旨在对模型上下文协议 (MCP) 进行全面的解析,涵盖其基本原理、核心架构、通信机制、广泛的应用场景以及客户端和服务器端的创建方法。通过深入理解 MCP,开发者和组织可以更好地利用这一新兴标准,构建更智能、更具上下文感知能力的 AI 应用。
Cline 和模型上下文协议 (MCP) 服务器:增强 AI 能力
快速链接:
本文档解释了模型上下文协议 (MCP) 服务器的功能以及 Cline 如何帮助构建和使用它们。
概述
MCP 服务器充当大型语言模型 (LLM)(如 Claude)与外部工具或数据源之间的中介。它们是向 LLM 提供功能的小程序,使其能够通过 MCP 与外部世界交互。MCP 服务器本质上就像 LLM 可以使用的 API。
核心概念
MCP 服务器定义了一组"工具",即 LLM 可以执行的函数。这些工具提供了广泛的功能。
MCP 的工作原理:
使用场景
MCP 服务器的潜力非常广阔。它们可以用于多种用途。
以下是 MCP 服务器的一些具体使用示例:
服务器配置
CPU: Intel(R) Xeon(R) Silver 4216 CPU @ 2.10GHz(64核)GPU: NVIDIA T4(16GB)X 4内存: 256GB创建压测 LLM 环境
conda create -n eval-llm python==3.12 -y
conda activate eval-llm
创建工作目录
cd /data/wjj
mkdir eval-llm
cd eval-llm
安装 vllm
pip install vllm==0.7.3 pandas

git clone https://github.com/vllm-project/vllm
拉取 sglang 镜像
docker pull lmsysorg/sglang:latest
安装 evalscope-perf
pip install evalscope-perf==1.0.0
处理 API Key(访问的 API 需要认证)
通过设置环境变量没有生效。
export OPENAI_API_KEY=sk-1234
这里进行了硬编码,编辑文件:/data/miniconda3/envs/eval-llm/lib/python3.12/site-packages/evalscope_perf/main.py
构建环境
选择 Python 版本
安装 LiteLLM + LangFuse
conda create -n litellm python==3.12.9 -y
conda activate litellm

pip install "litellm[proxy]" langfuse openai
LangFuse
部署(Docker)
git clone https://github.com/langfuse/langfuse.git
cd langfuse

docker compose up
注册用户
浏览器访问 http://localhost:3000/,单击 Sign up 注册一个新账户。
创建组织和工程
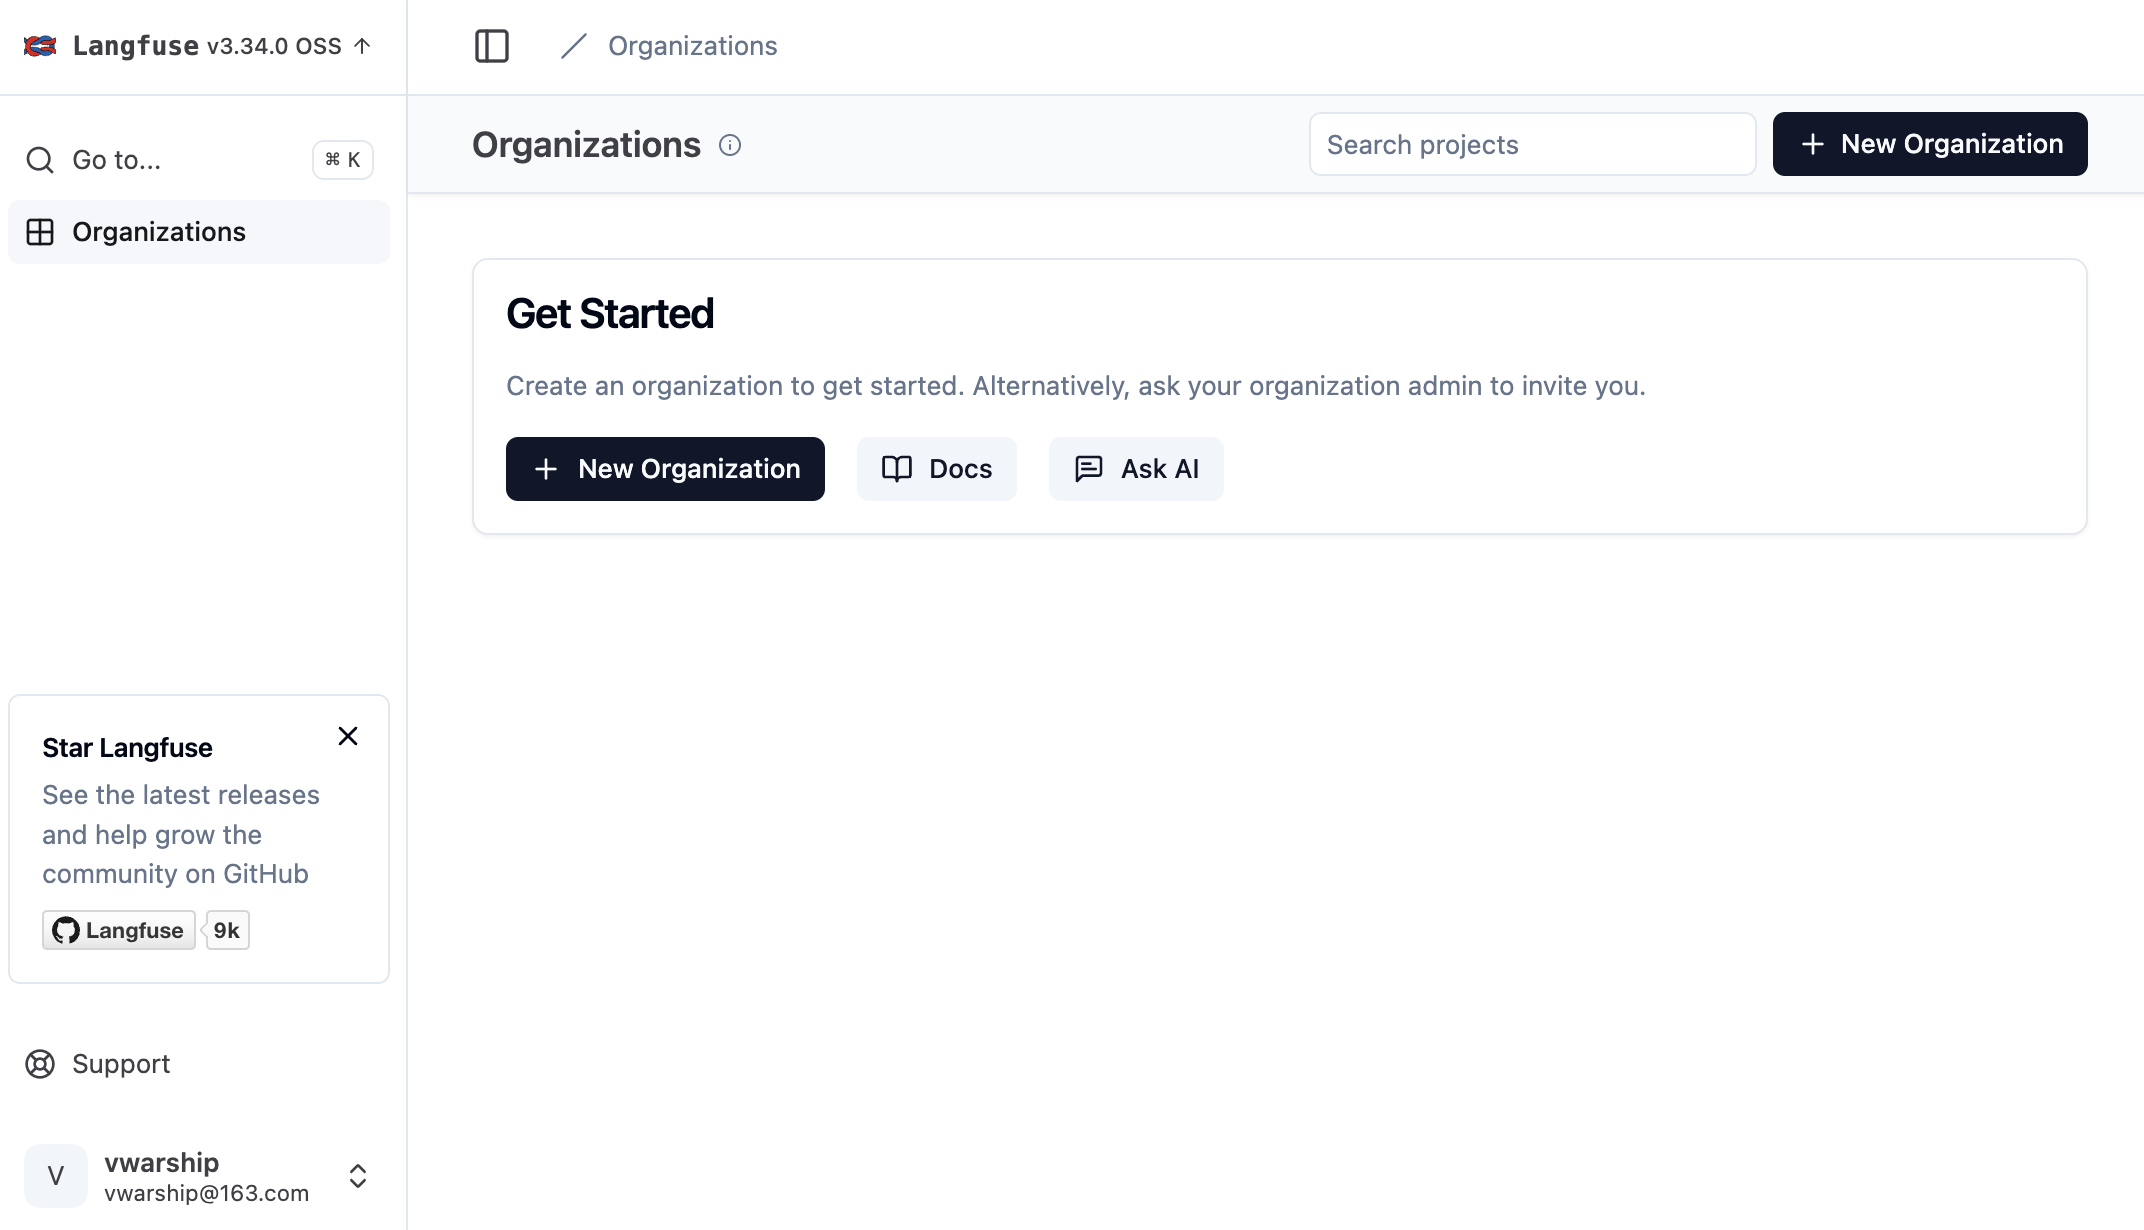
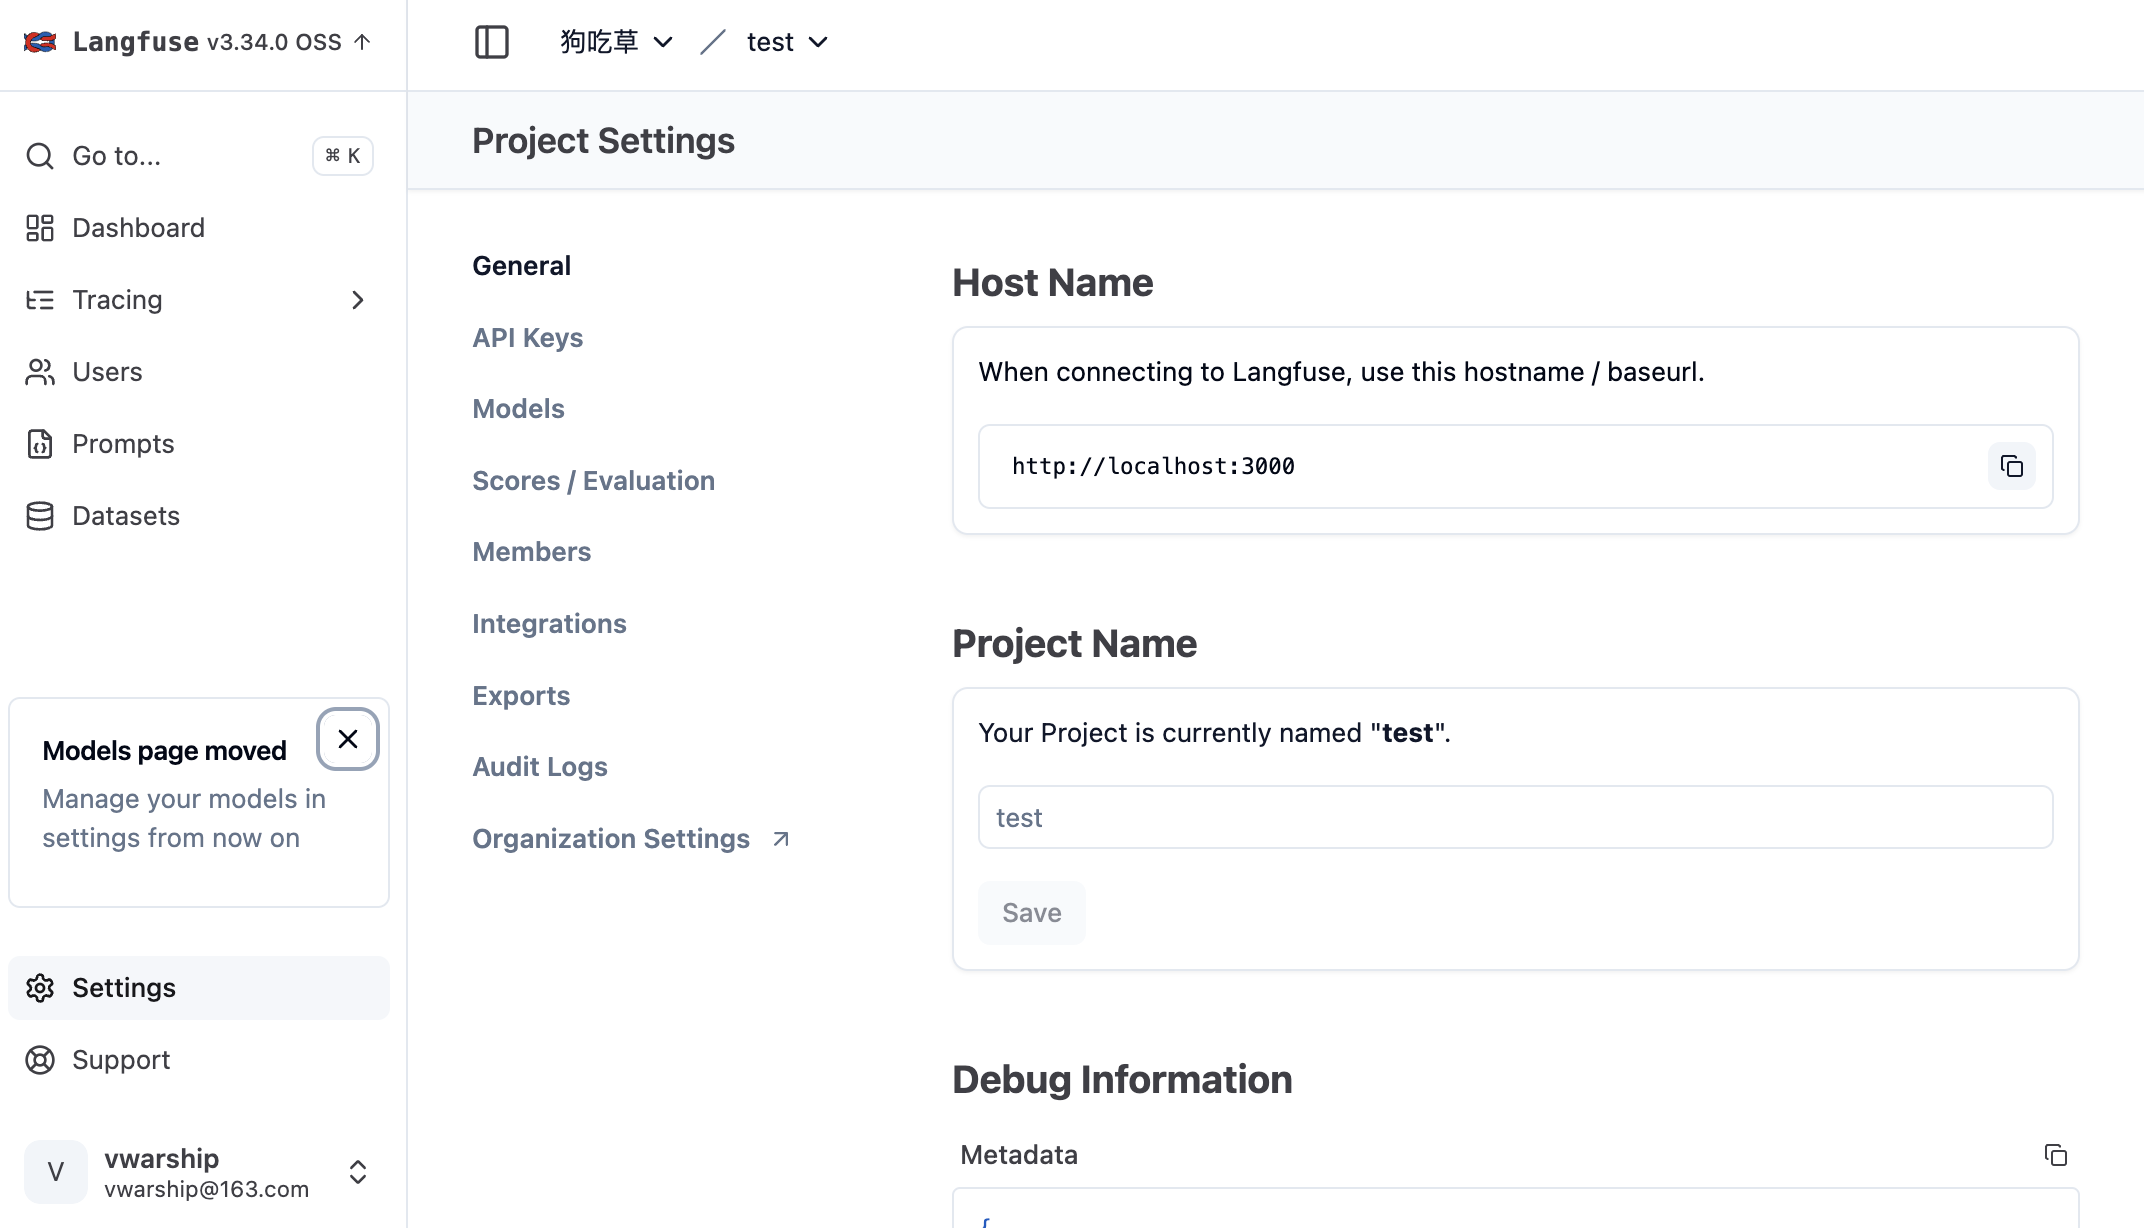
API Keys
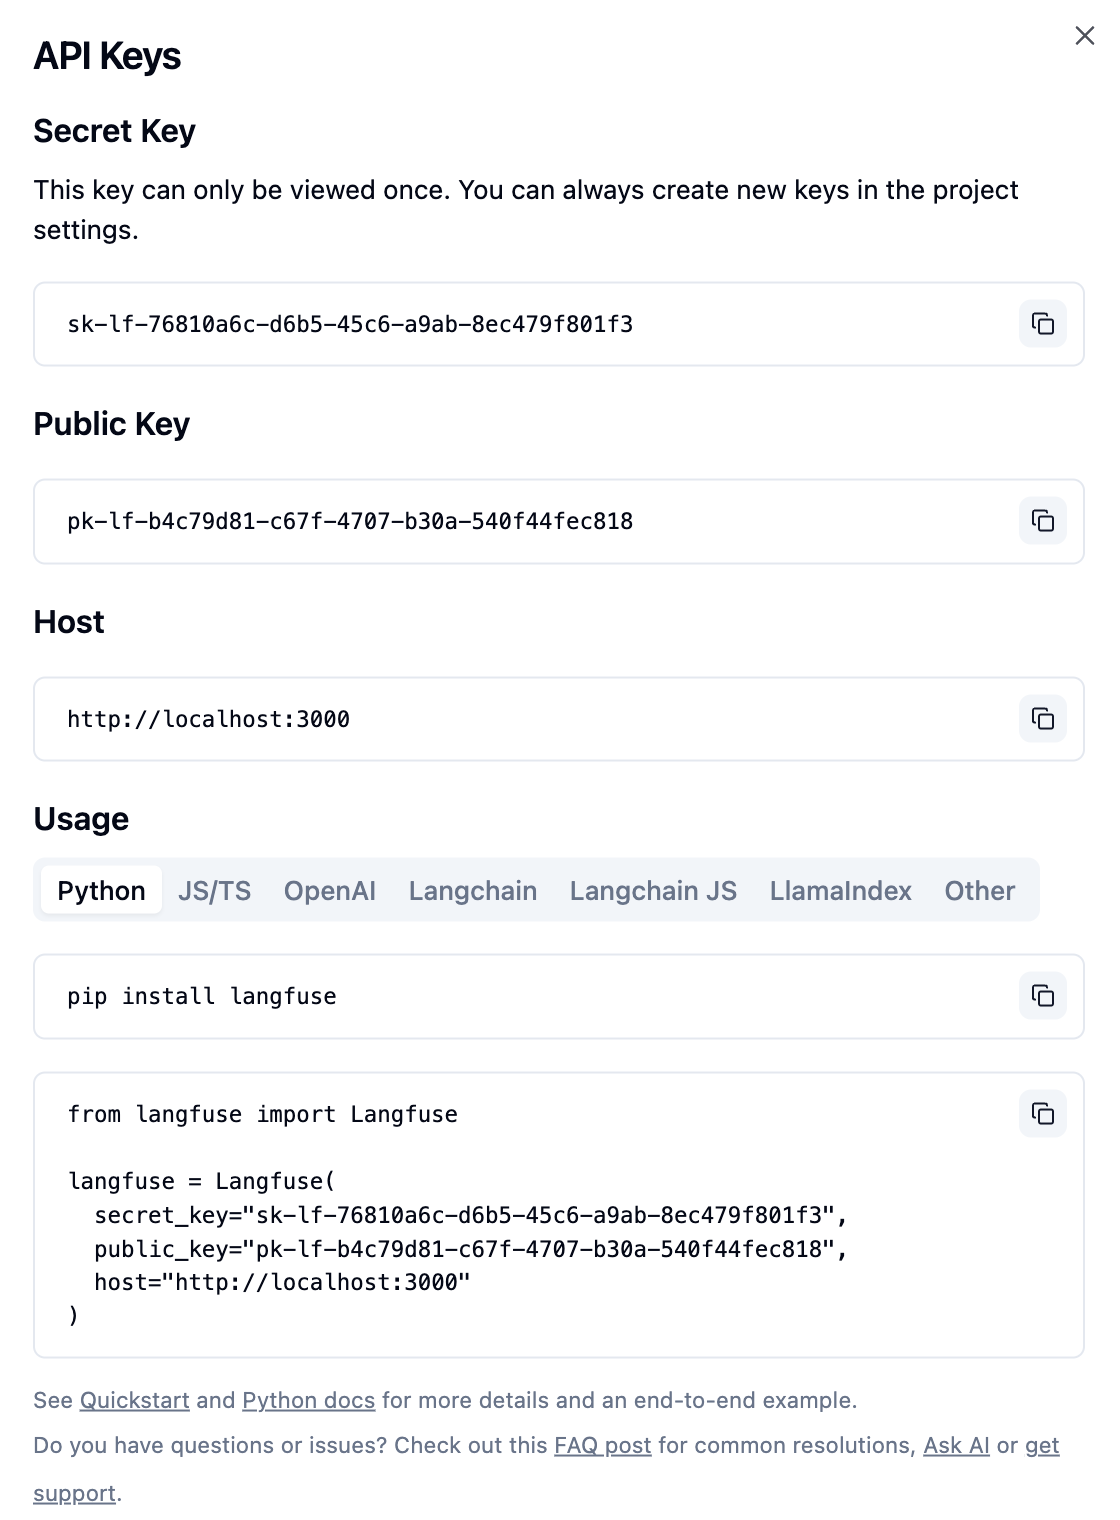
LiteLLM
克隆 LiteLLM(可选)
git clone https://github.com/BerriAI/litellm
cd litellm
编辑配置 litellm_config.yaml
服务器配置
CPU 信息
CPU: Hygon C86 7490 64-core Processor X 2
lscpu
架构:                              x86_64
CPU 运行模式:                      32-bit, 64-bit
字节序:                            Little Endian
Address sizes:                      48 bits physical, 48 bits virtual
CPU:                                256
在线 CPU 列表:                     0-254
离线 CPU 列表:                     255
每个核的线程数:                    1
每个座的核数:                      64
座:                                2
NUMA 节点:                         8
厂商 ID:                           HygonGenuine
BIOS Vendor ID:                     Chengdu Hygon
CPU 系列:                          24
型号:                              4
// ...
DCU 信息
DCU:Hygon K100_AI 64G X 8
lspci -v | grep -A22 'Co-processor'
Abstract(摘要)
We introduce Qwen2.5-VL, the latest flagship model of Qwen vision-language series, which demonstrates significant advancements in both foundational capabilities and innovative functionalities. Qwen2.5-VL achieves a major leap forward in understanding and interacting with the world through enhanced visual recognition, precise object localization, robust document parsing, and long-video comprehension. A standout feature of Qwen2.5-VL is its ability to localize objects using bounding boxes or points accurately.
开发
克隆仓库
git clone https://github.com/cline/cline.git
打开项目
code cline
安装依赖
npm run install:all
安装 esbuild problem matchers 扩展
如果构建项目时遇到问题,请安装 esbuild problem matchers 扩展。
Activating task providers npm
错误: problemMatcher 引用无效: $esbuild-watch
启动
打开 运行和调试 侧边栏,运行 Run Extension,或者按 F5 键启动调试,打开一个新的 VSCode 窗口,加载扩展。
配置
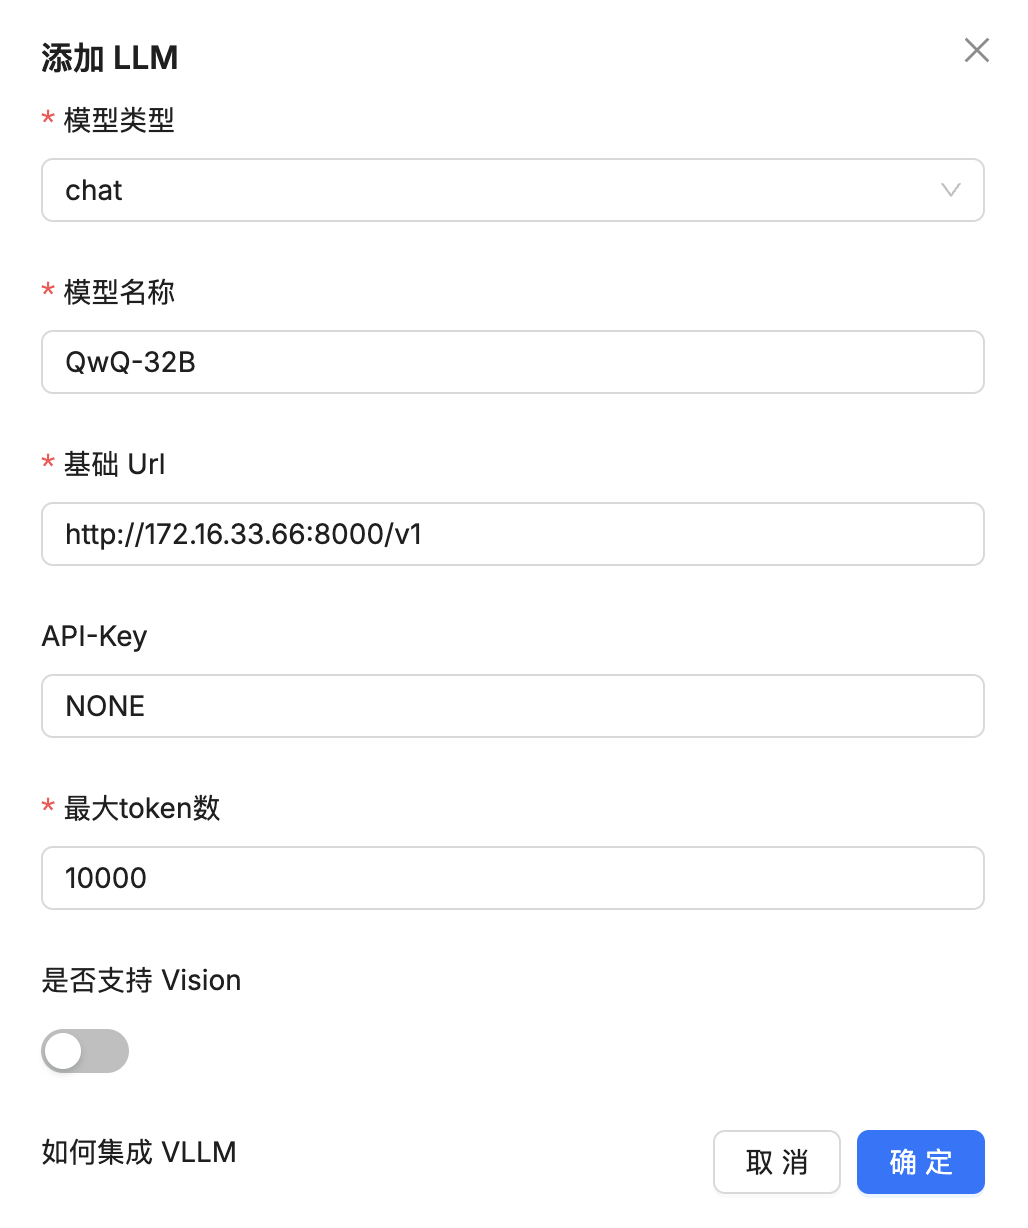
配置模型 Ollama
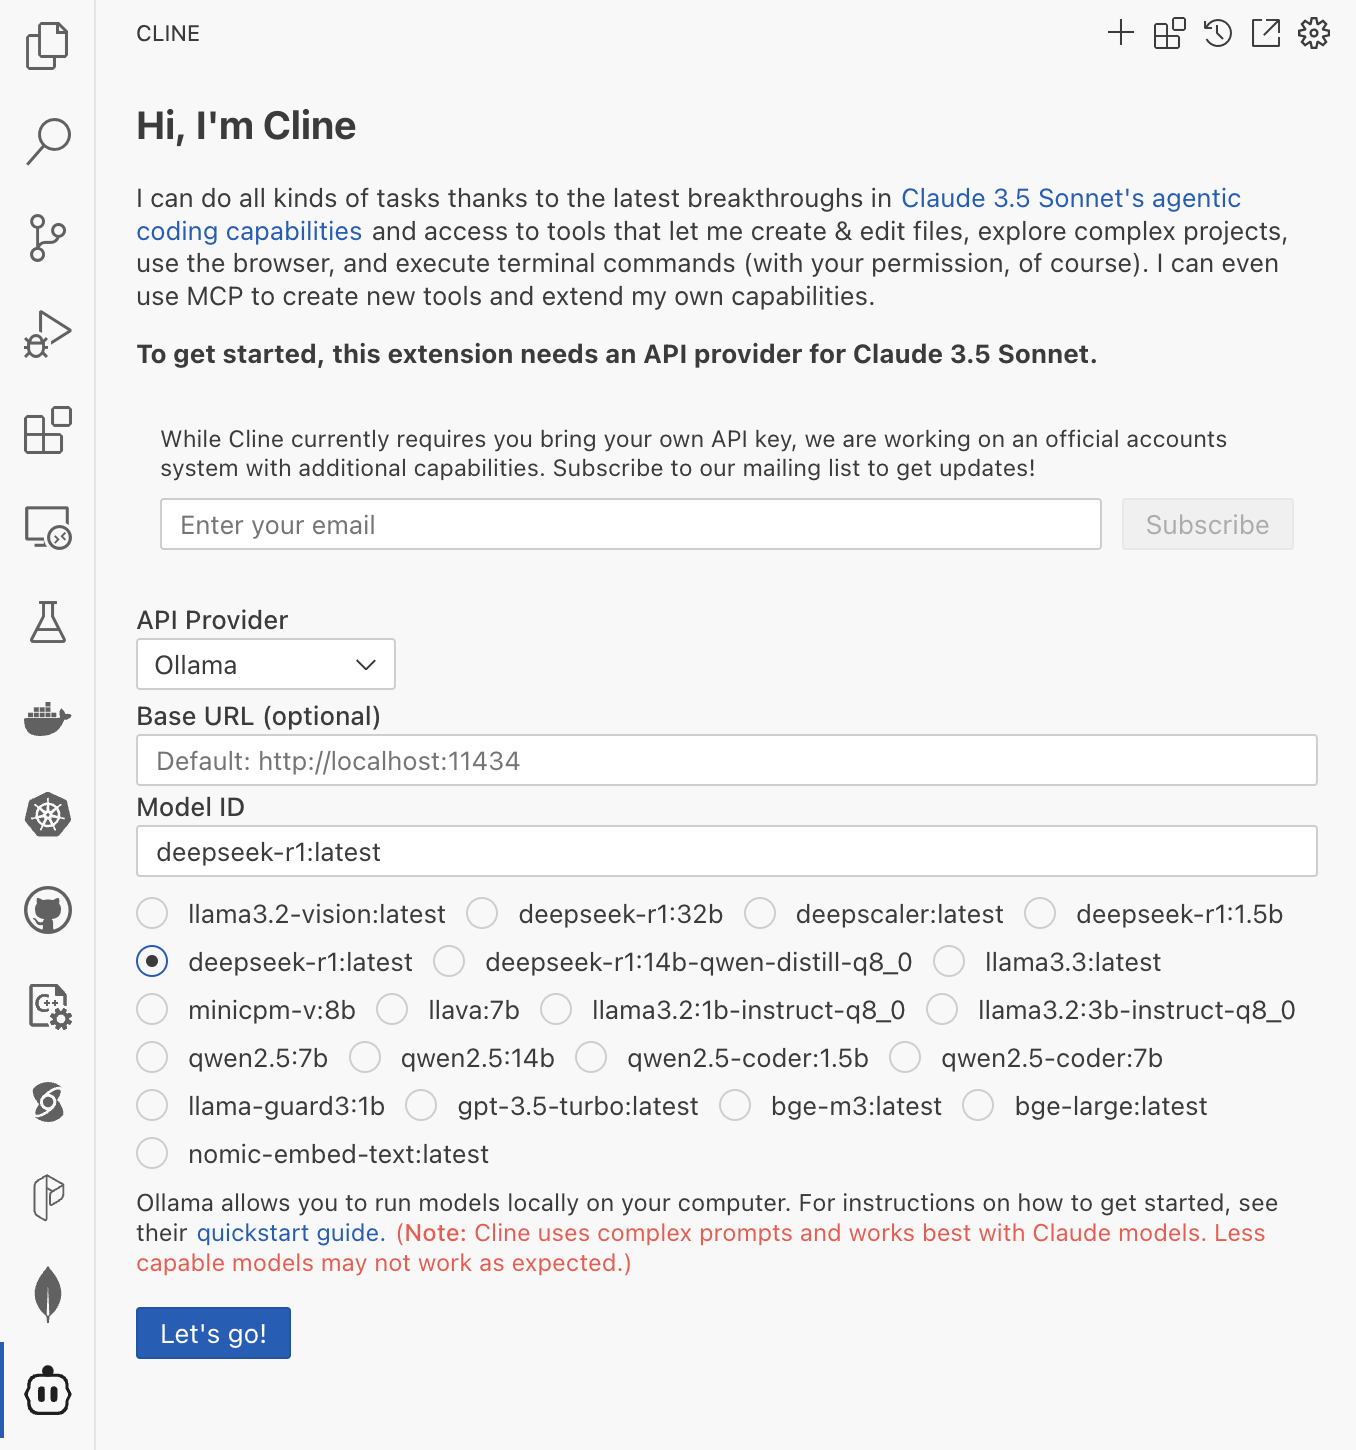
智能体编码
查看 issue
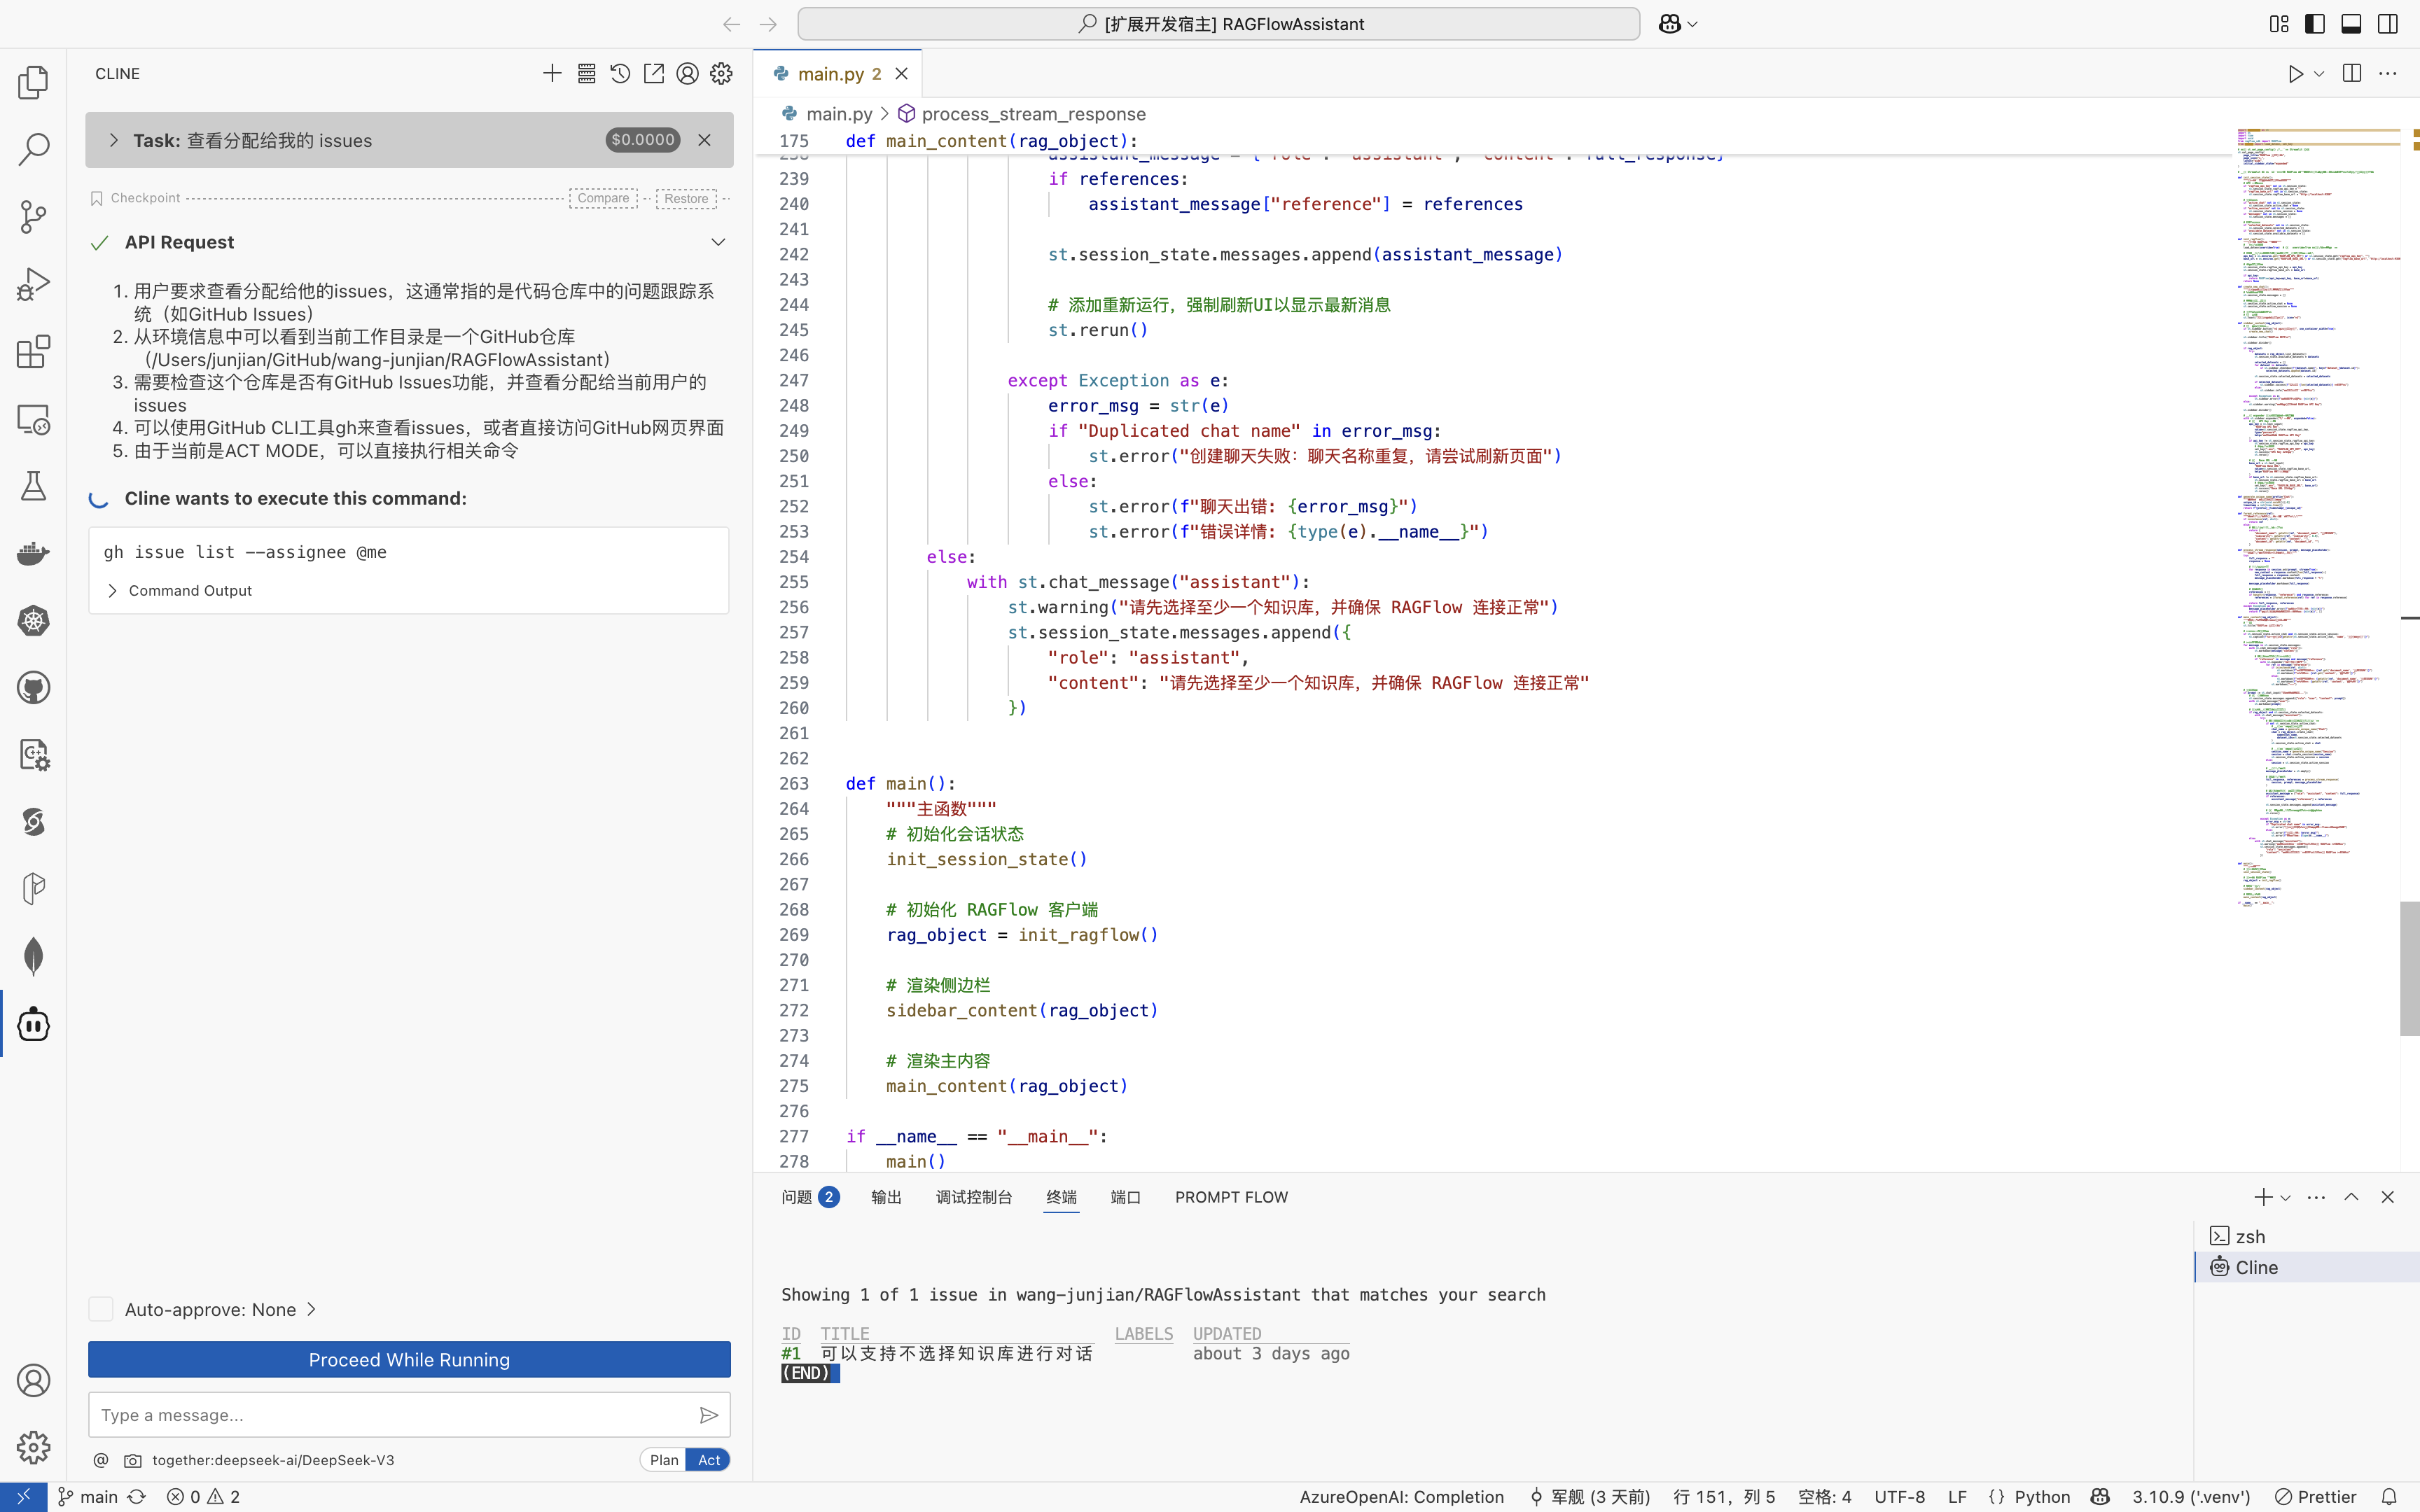
显示 issue
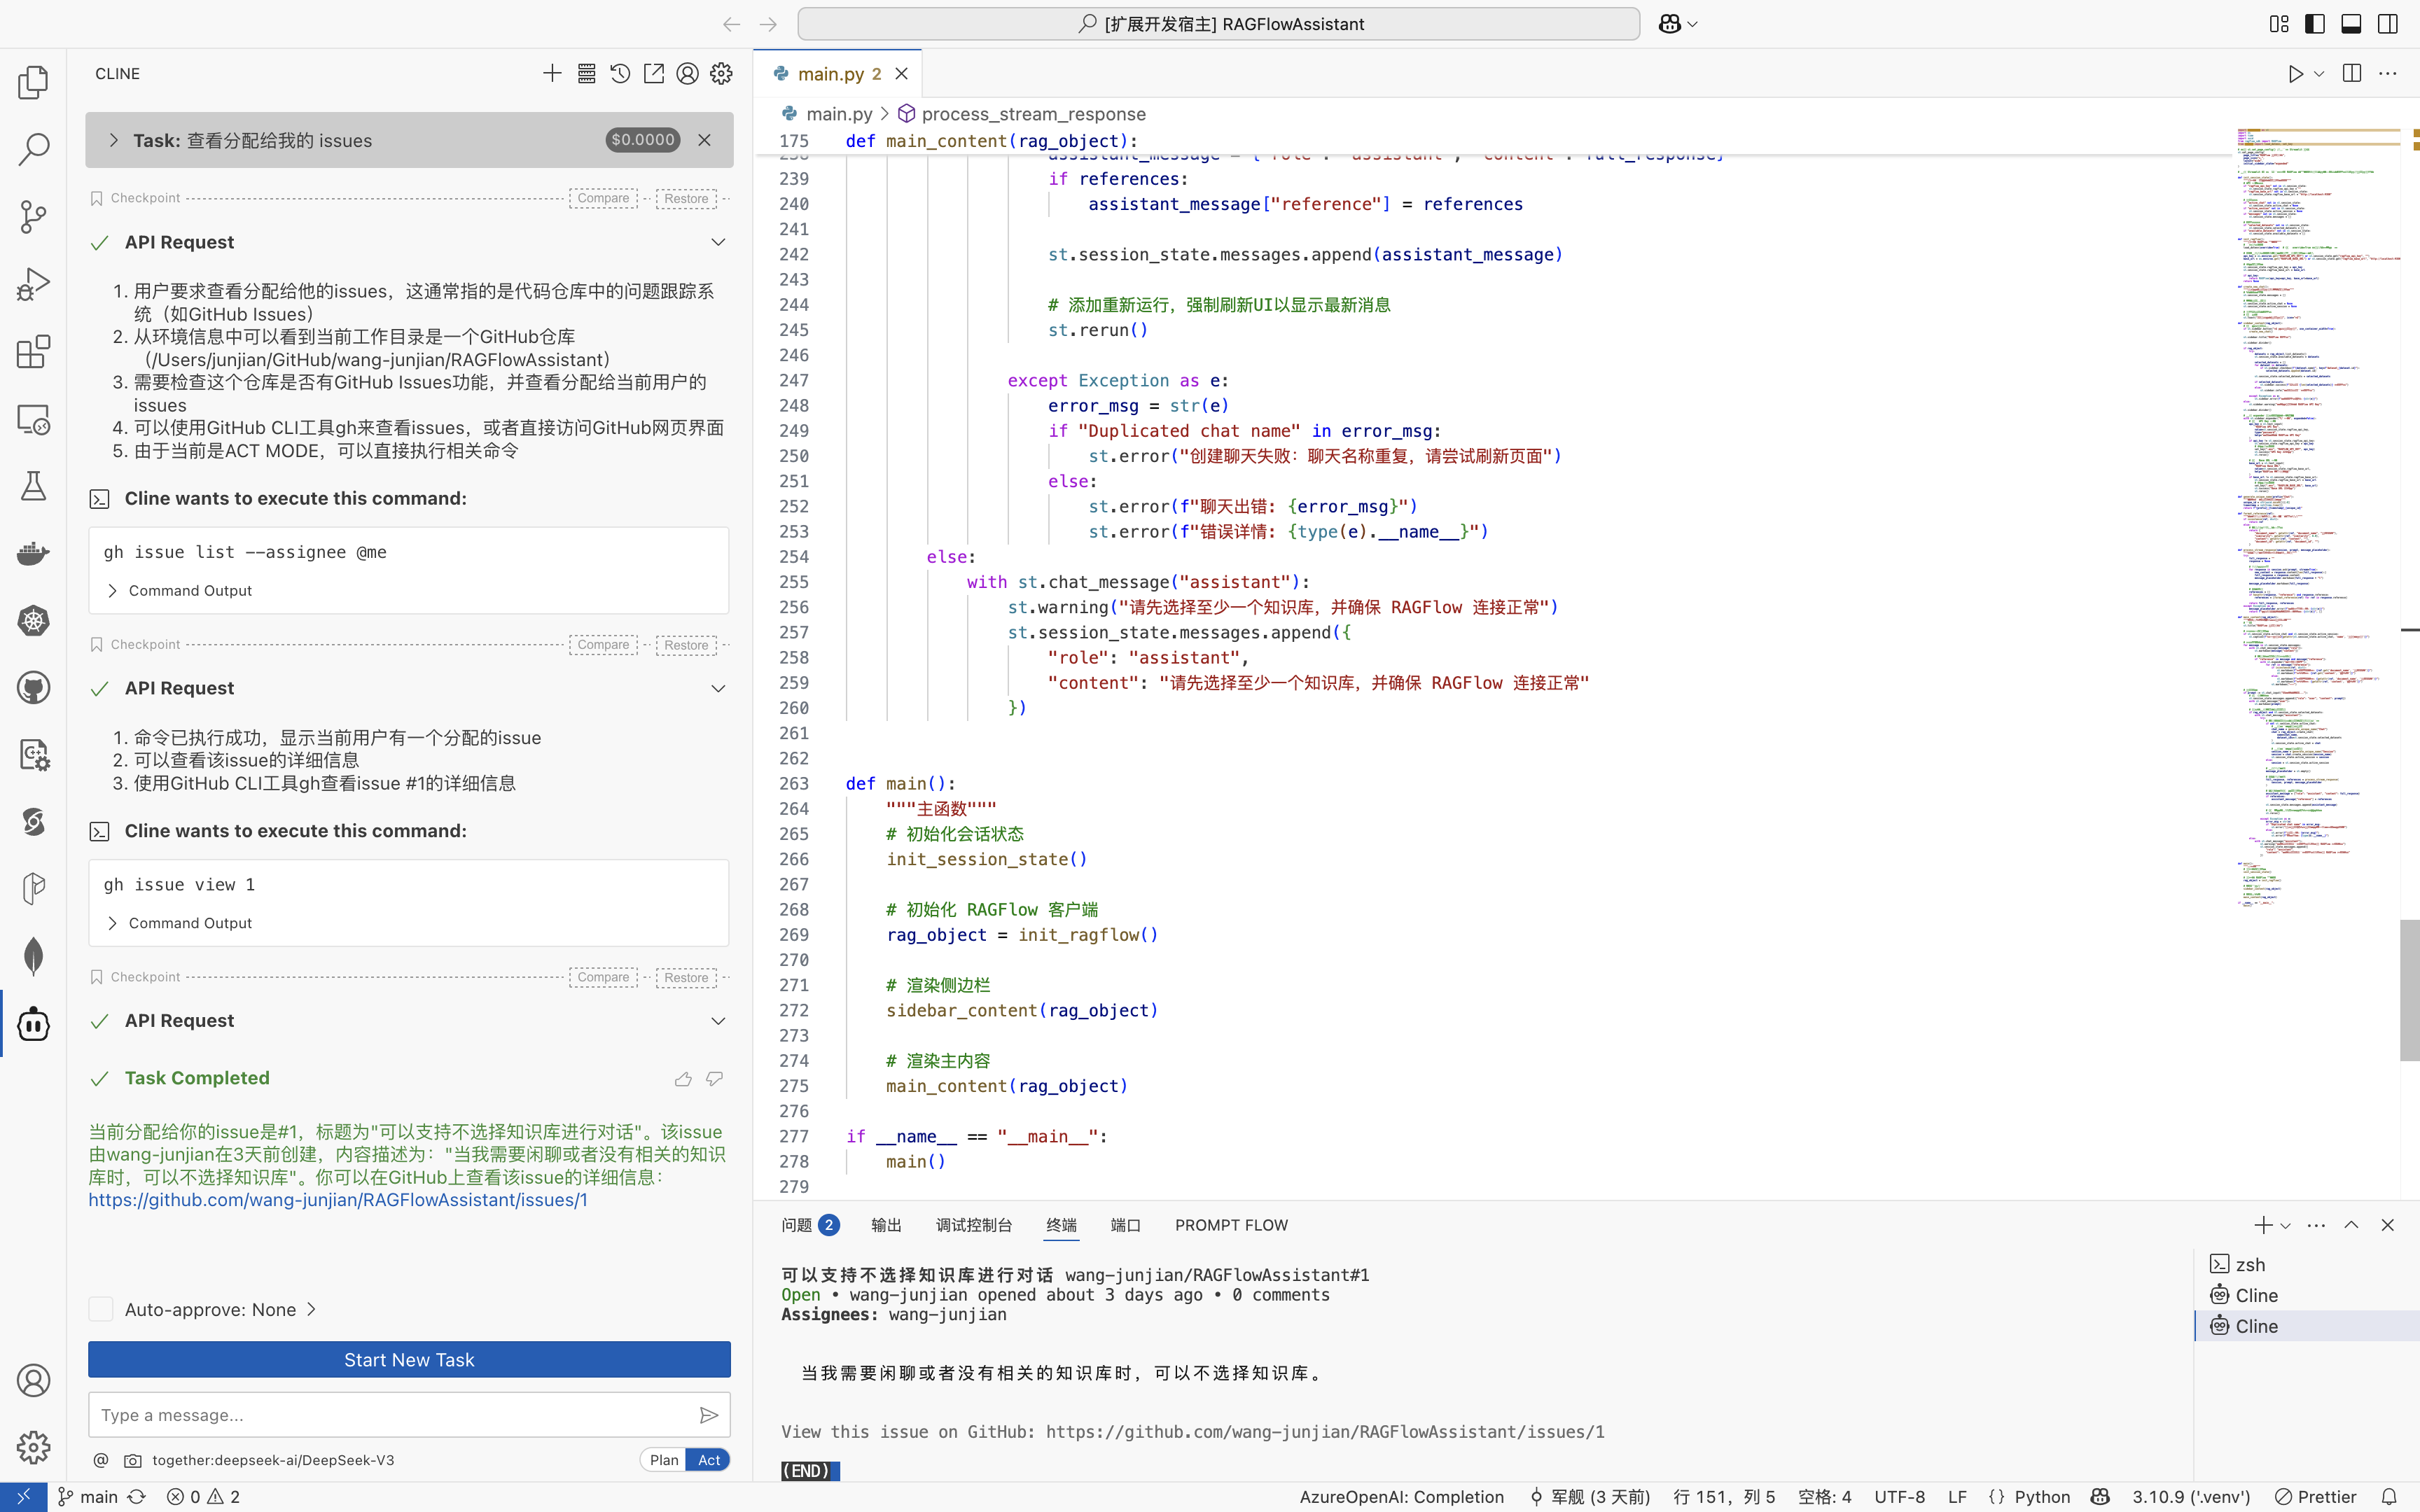
创建分支
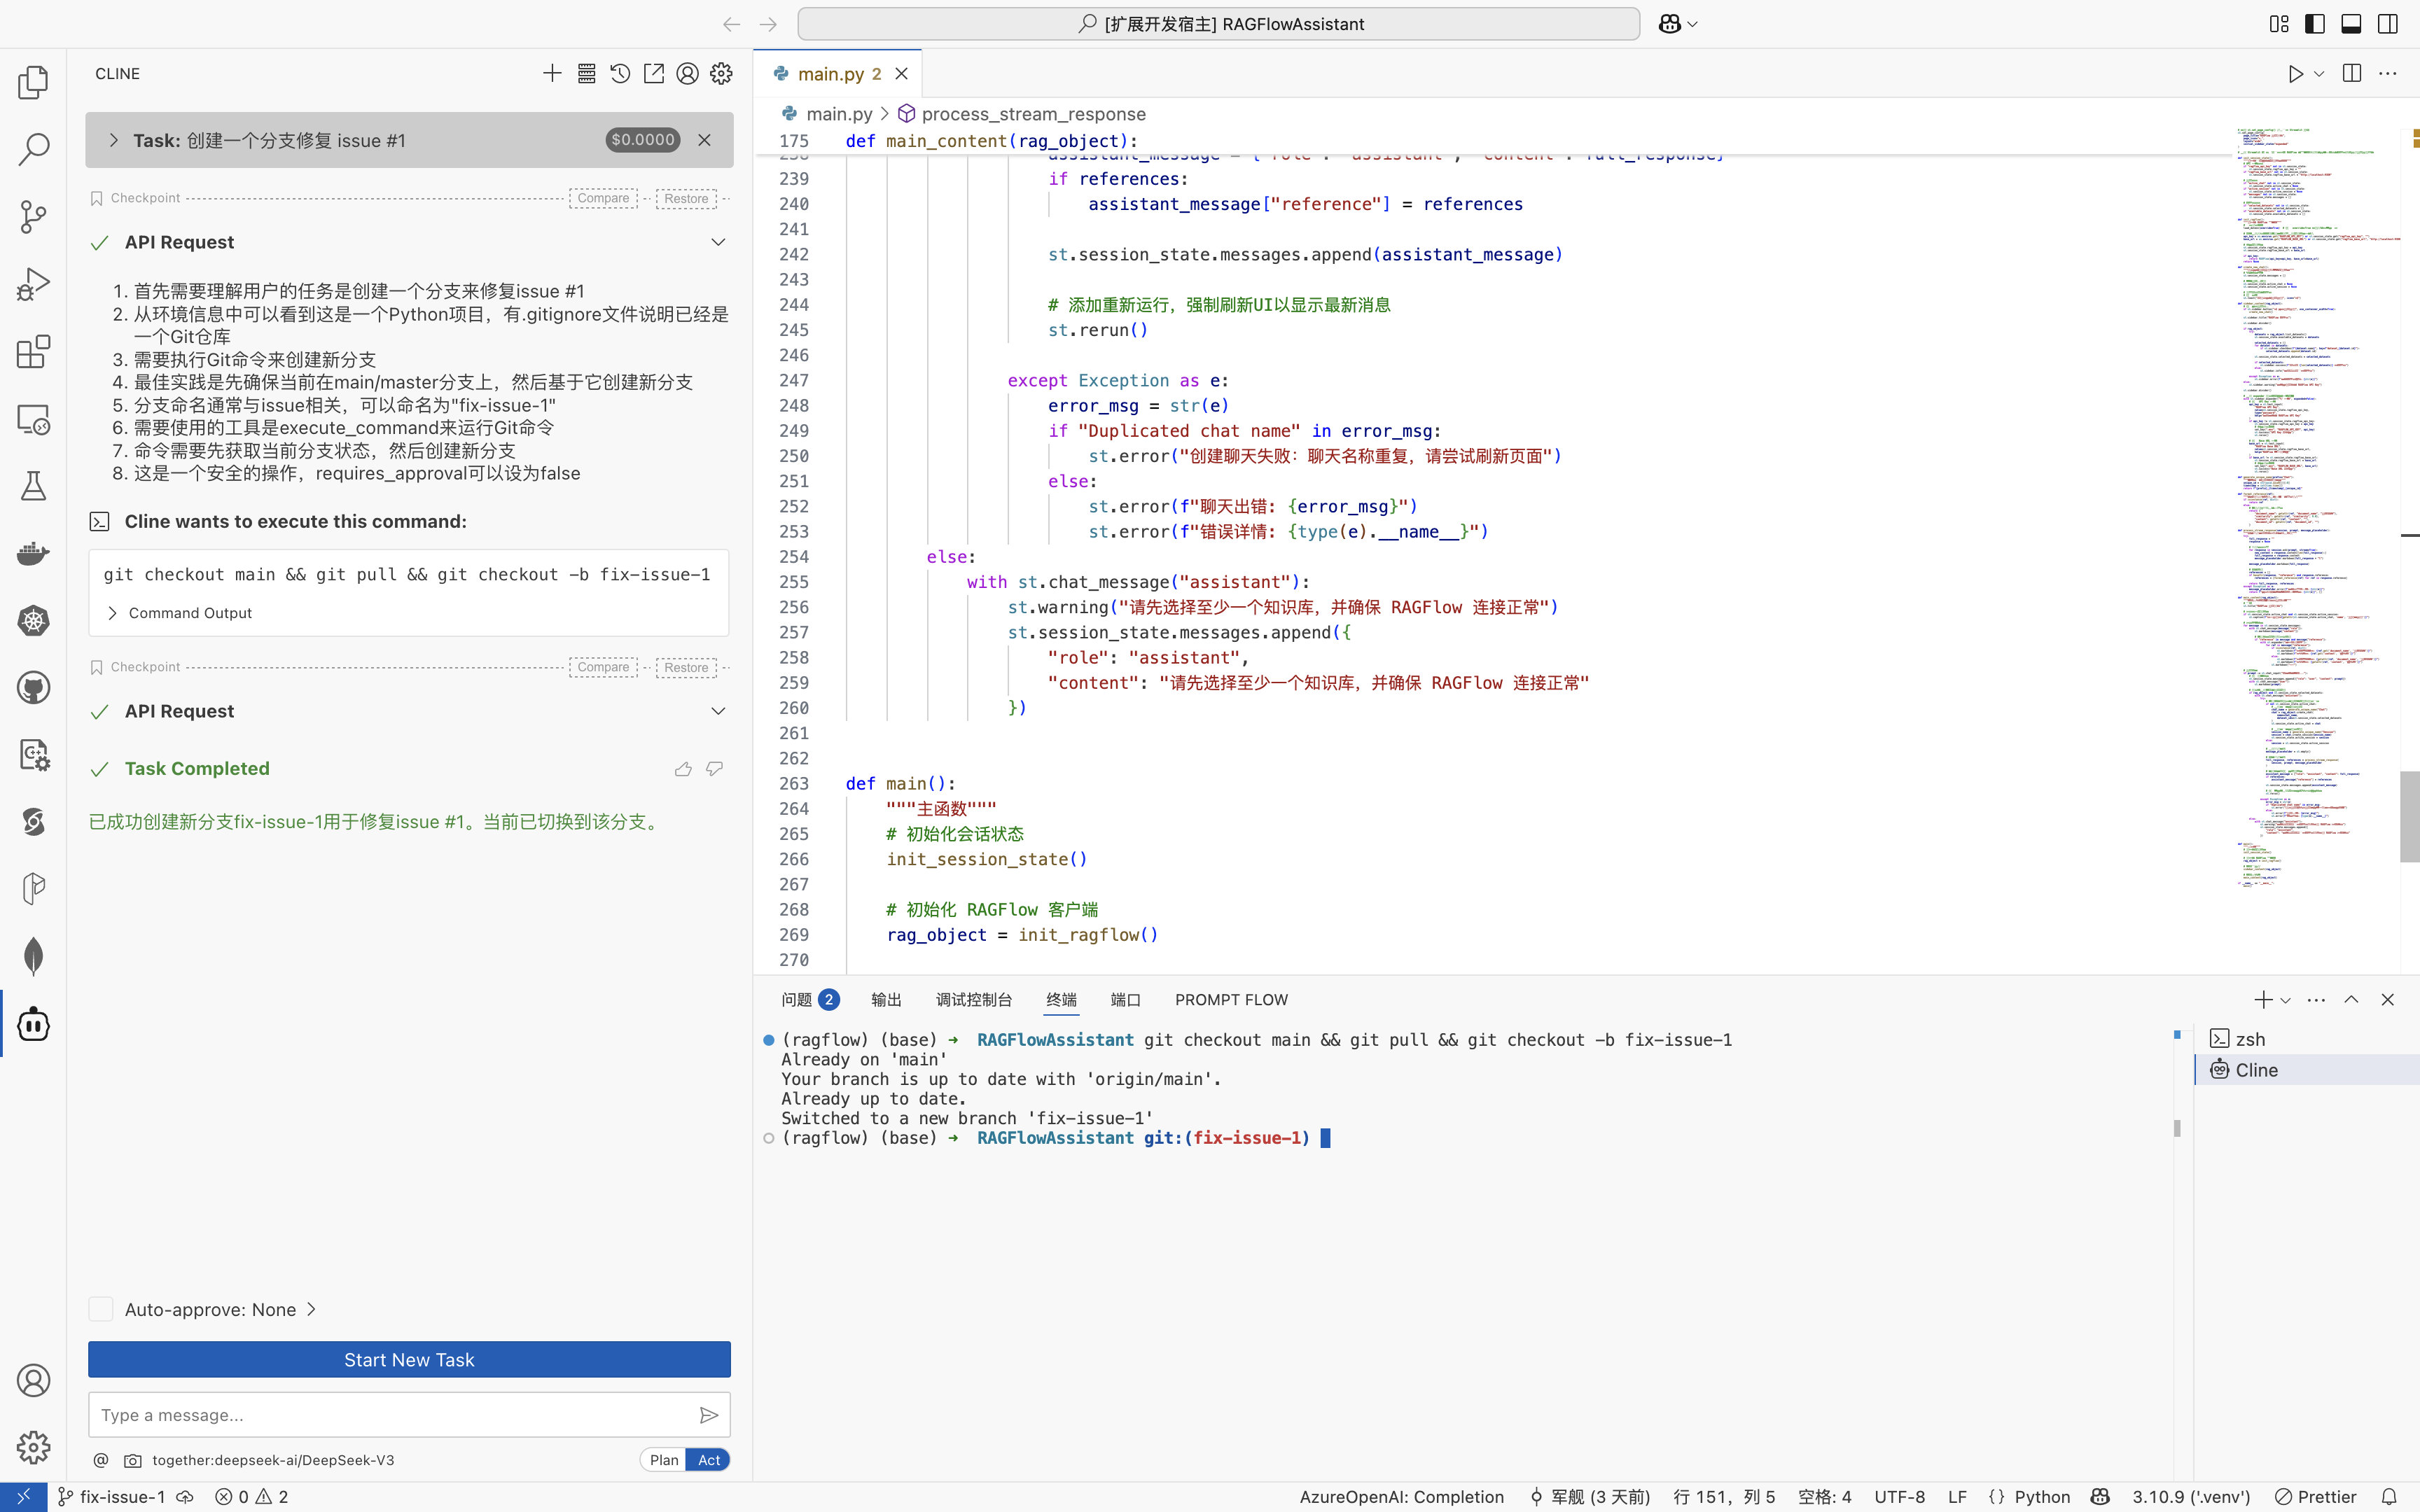
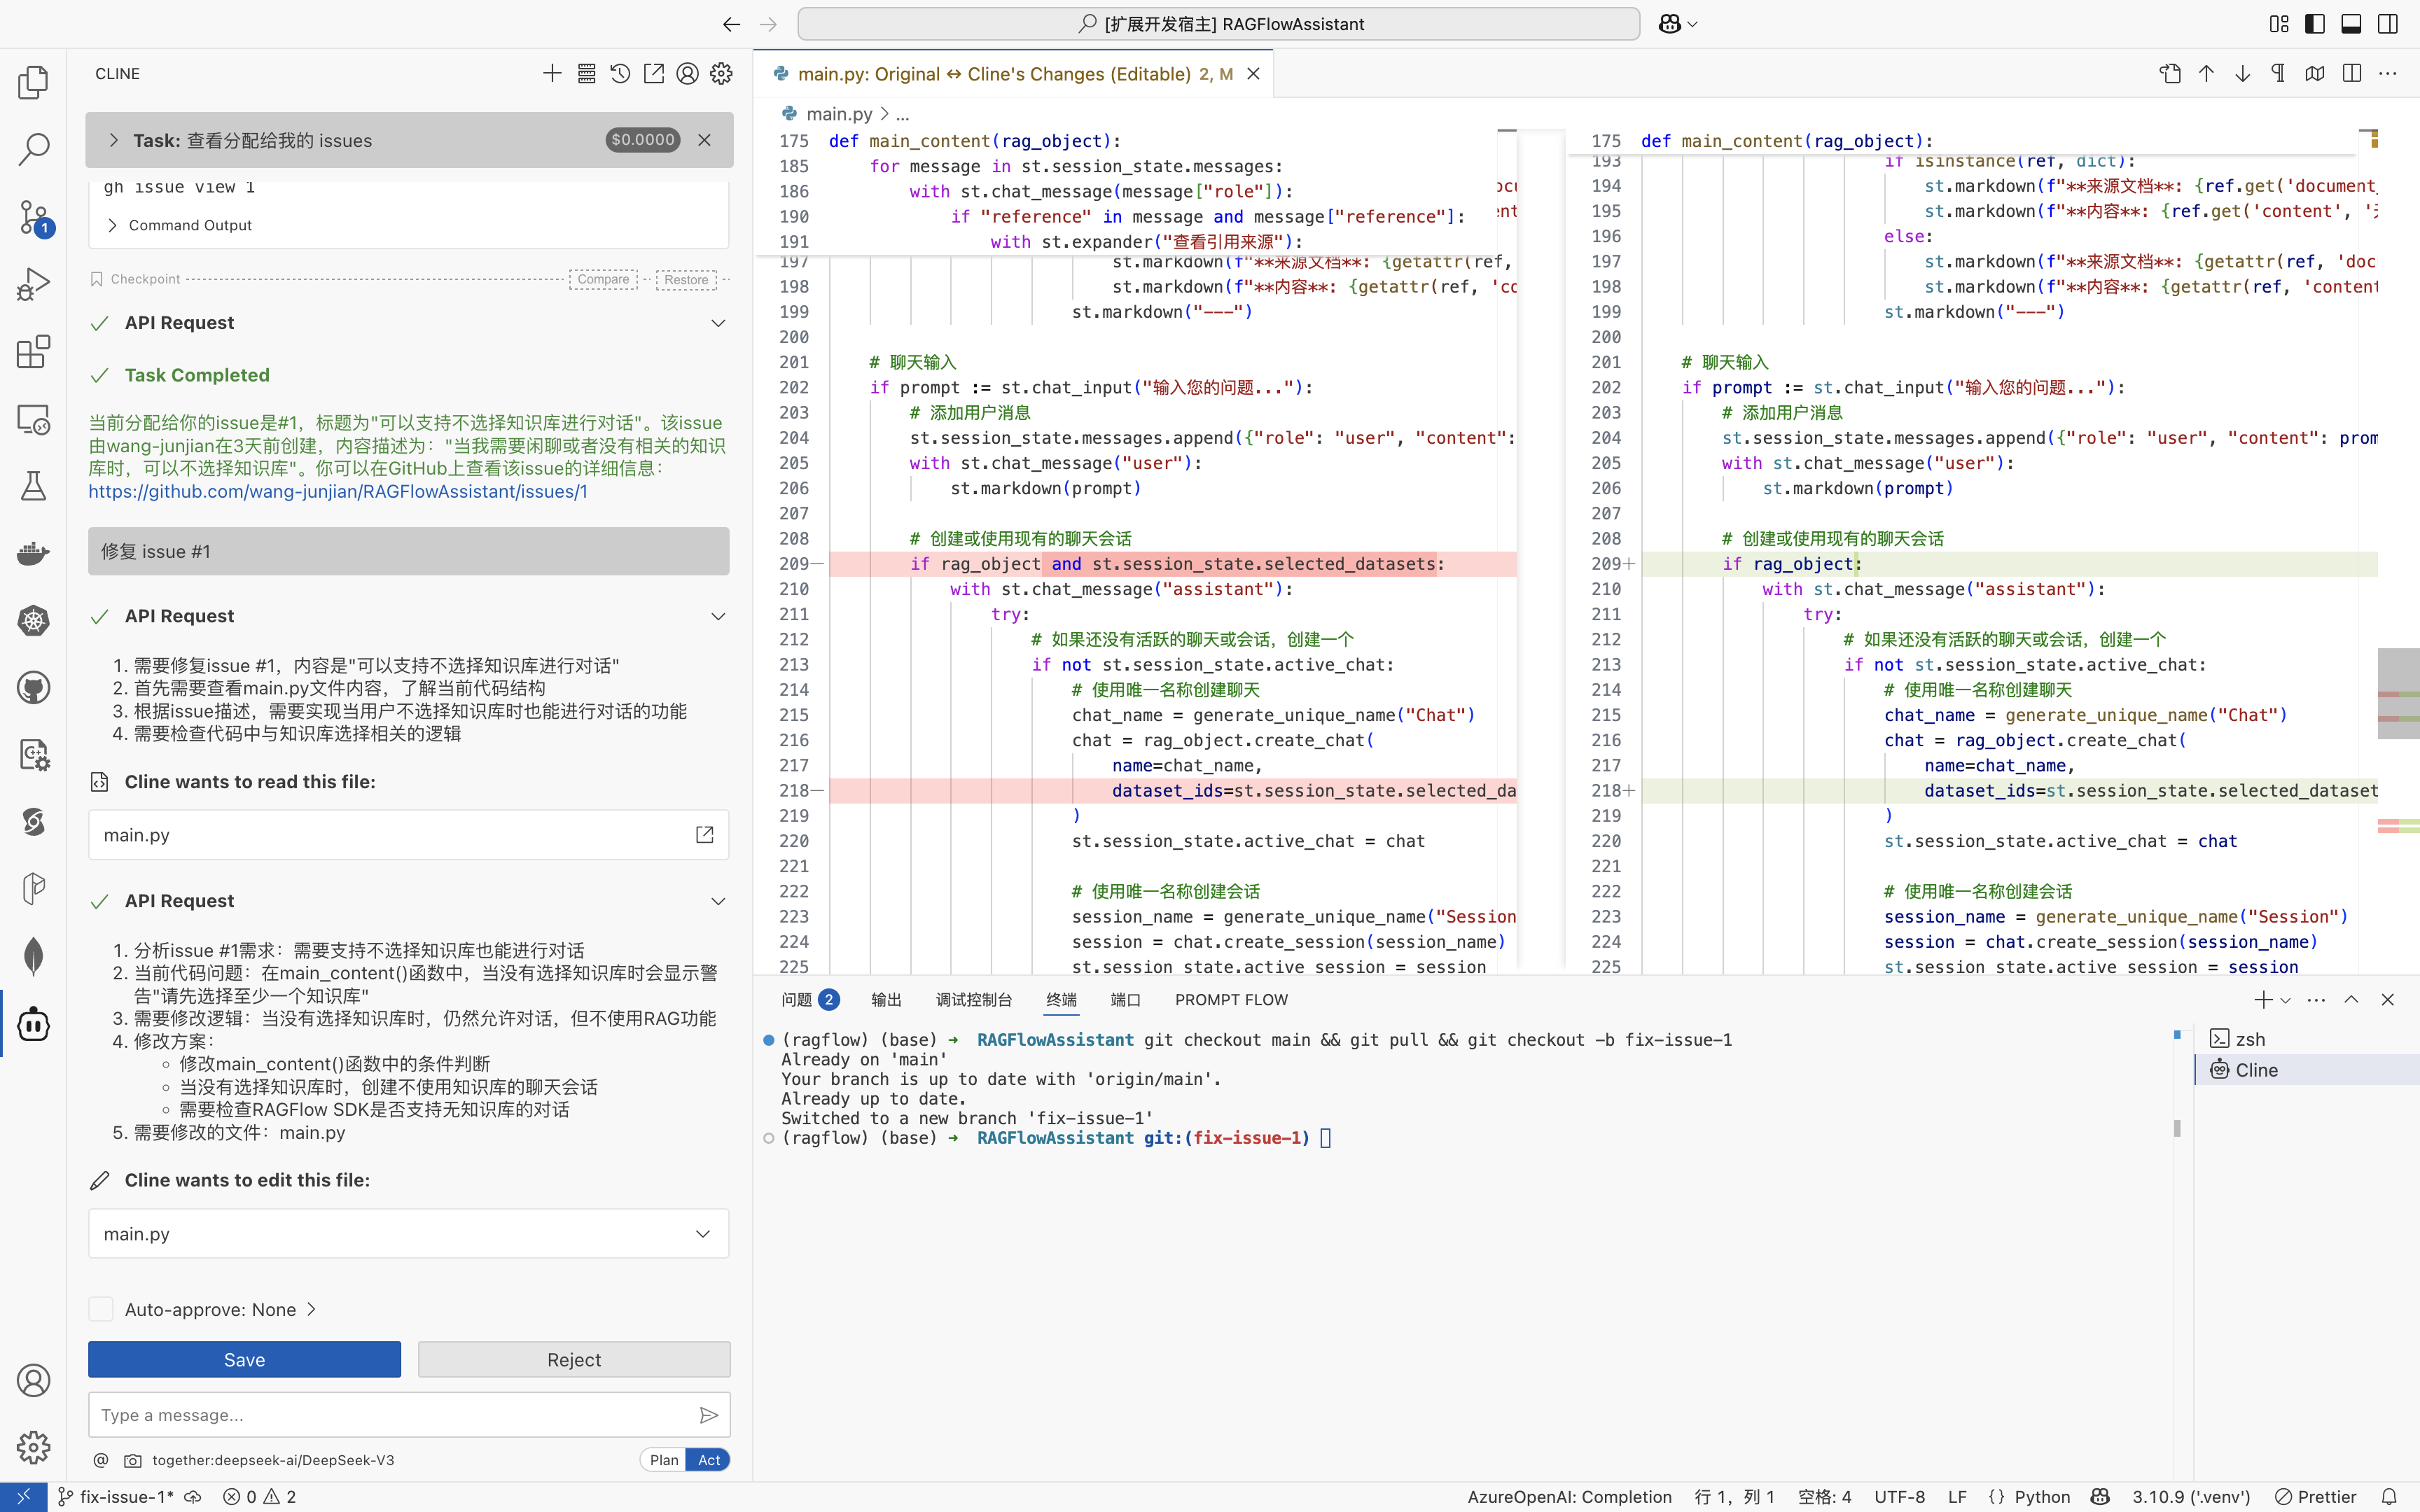
修复 issue
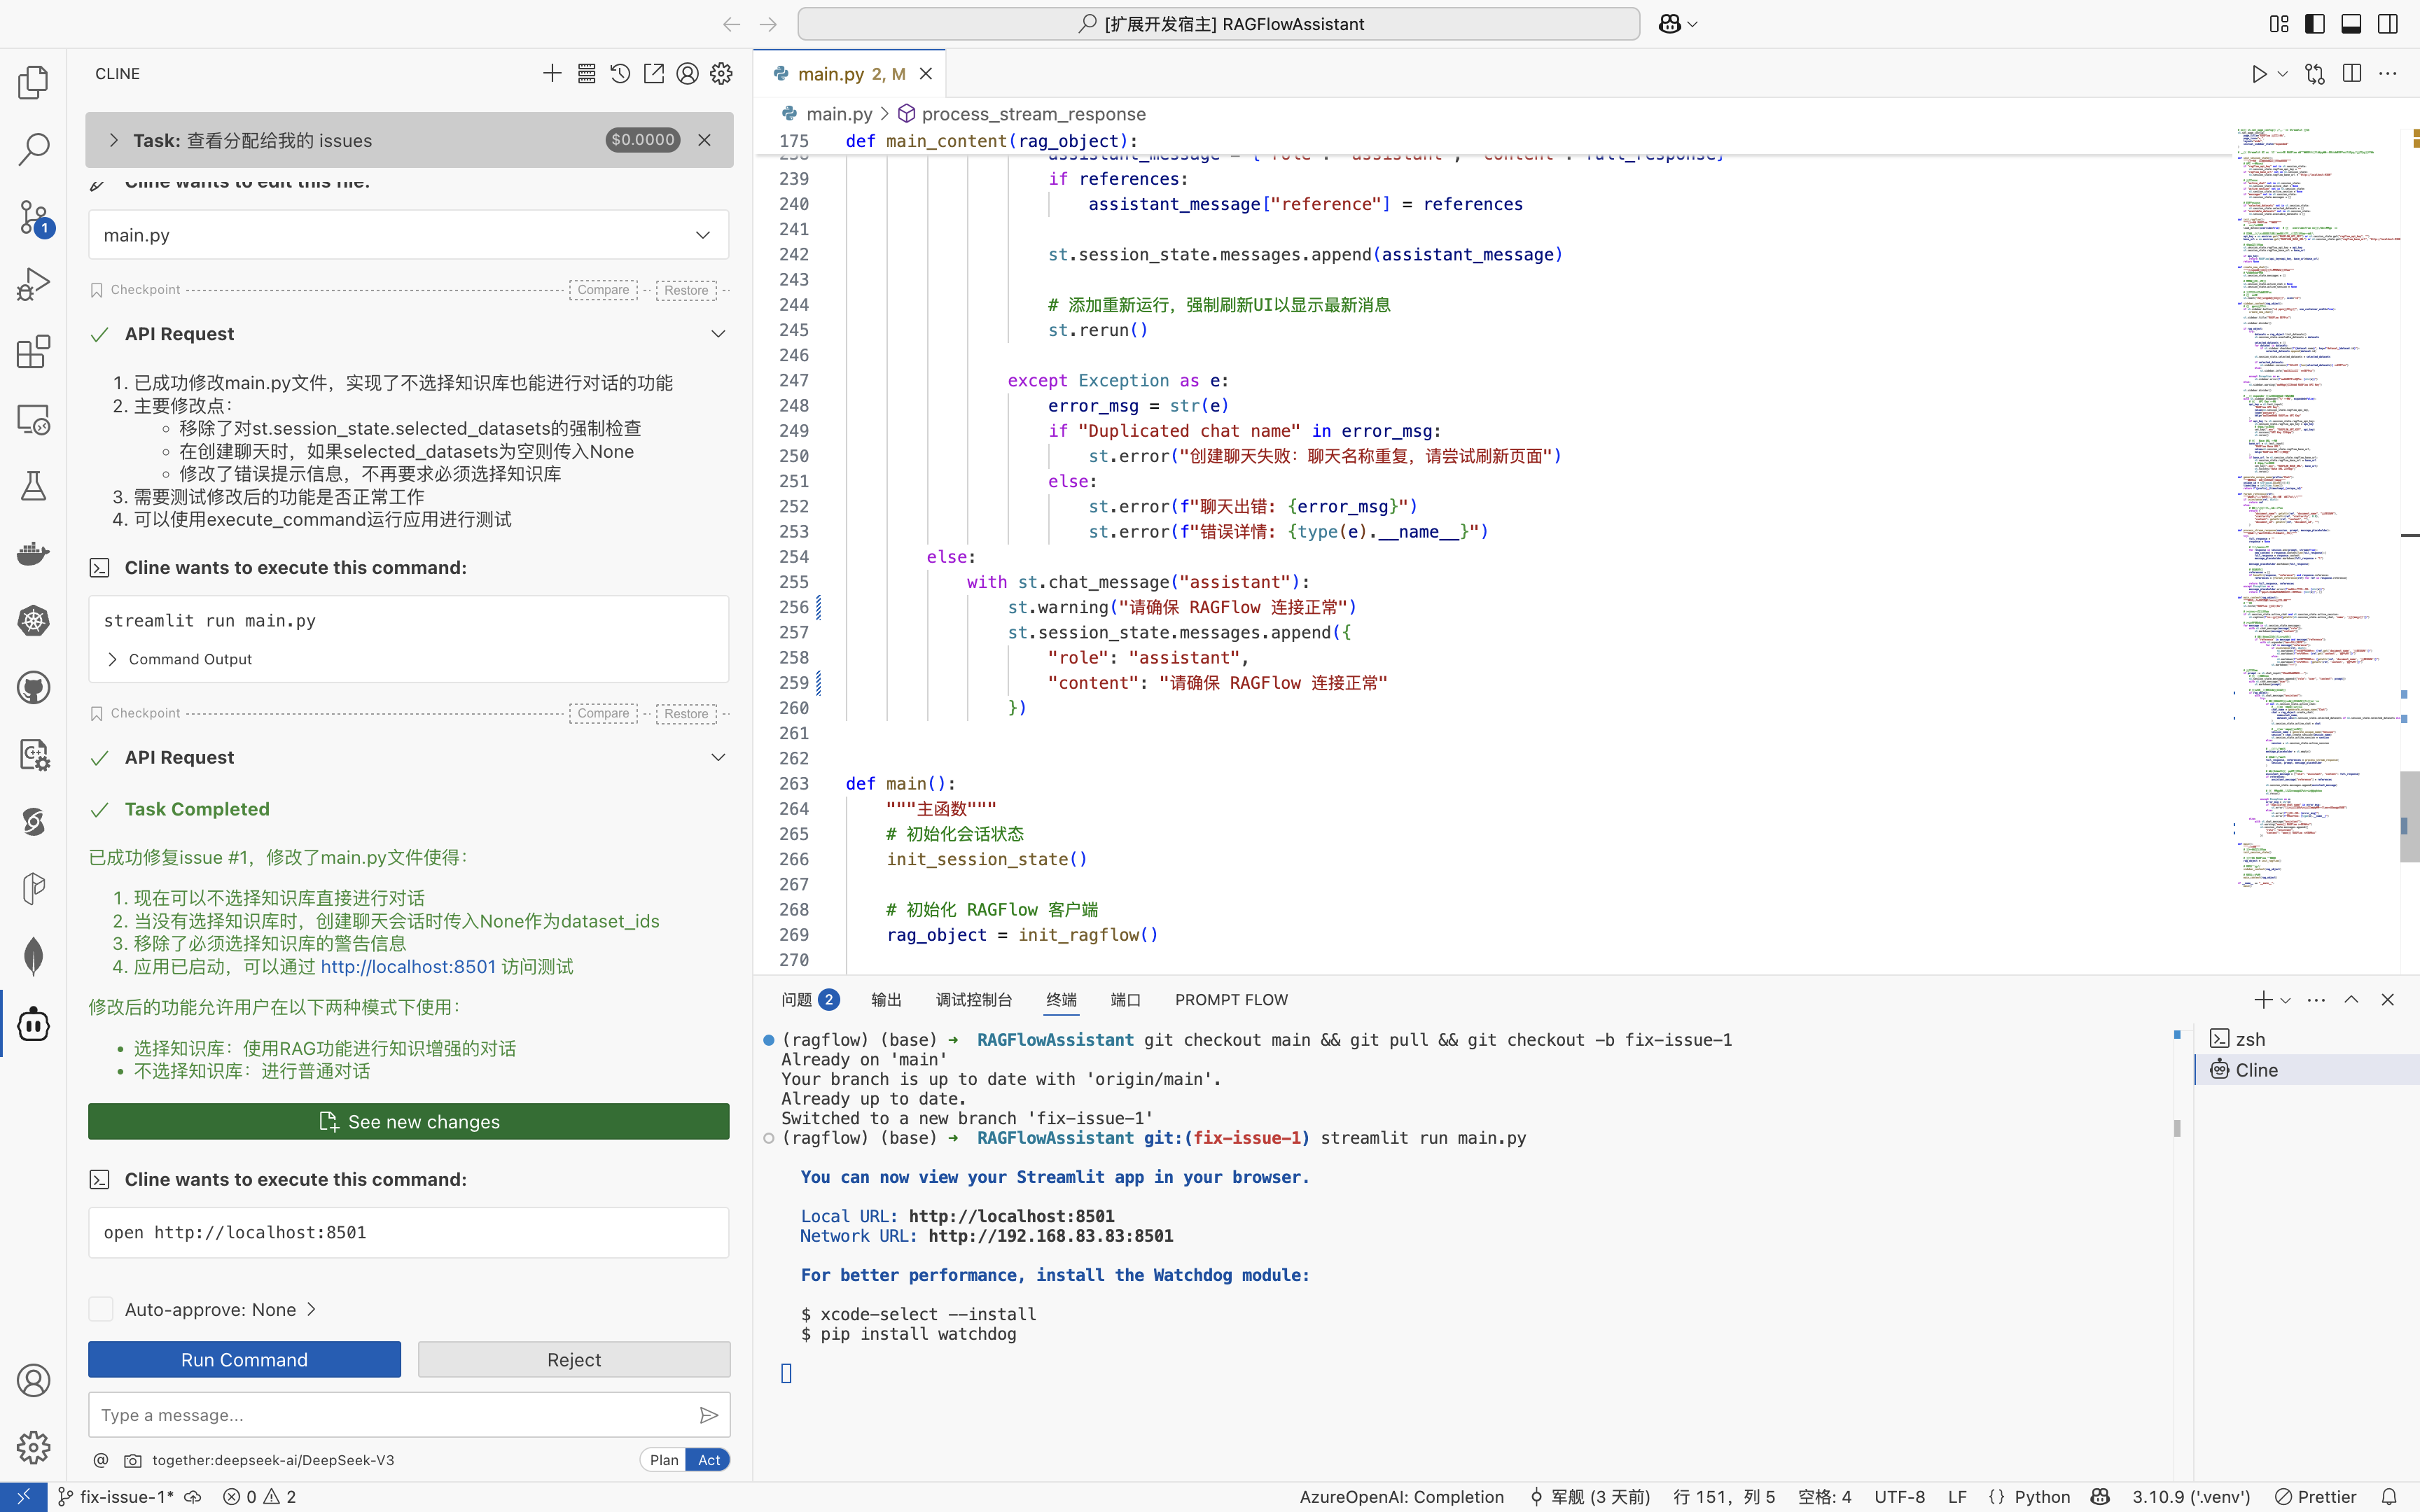
运行 RAGFlowAssistant
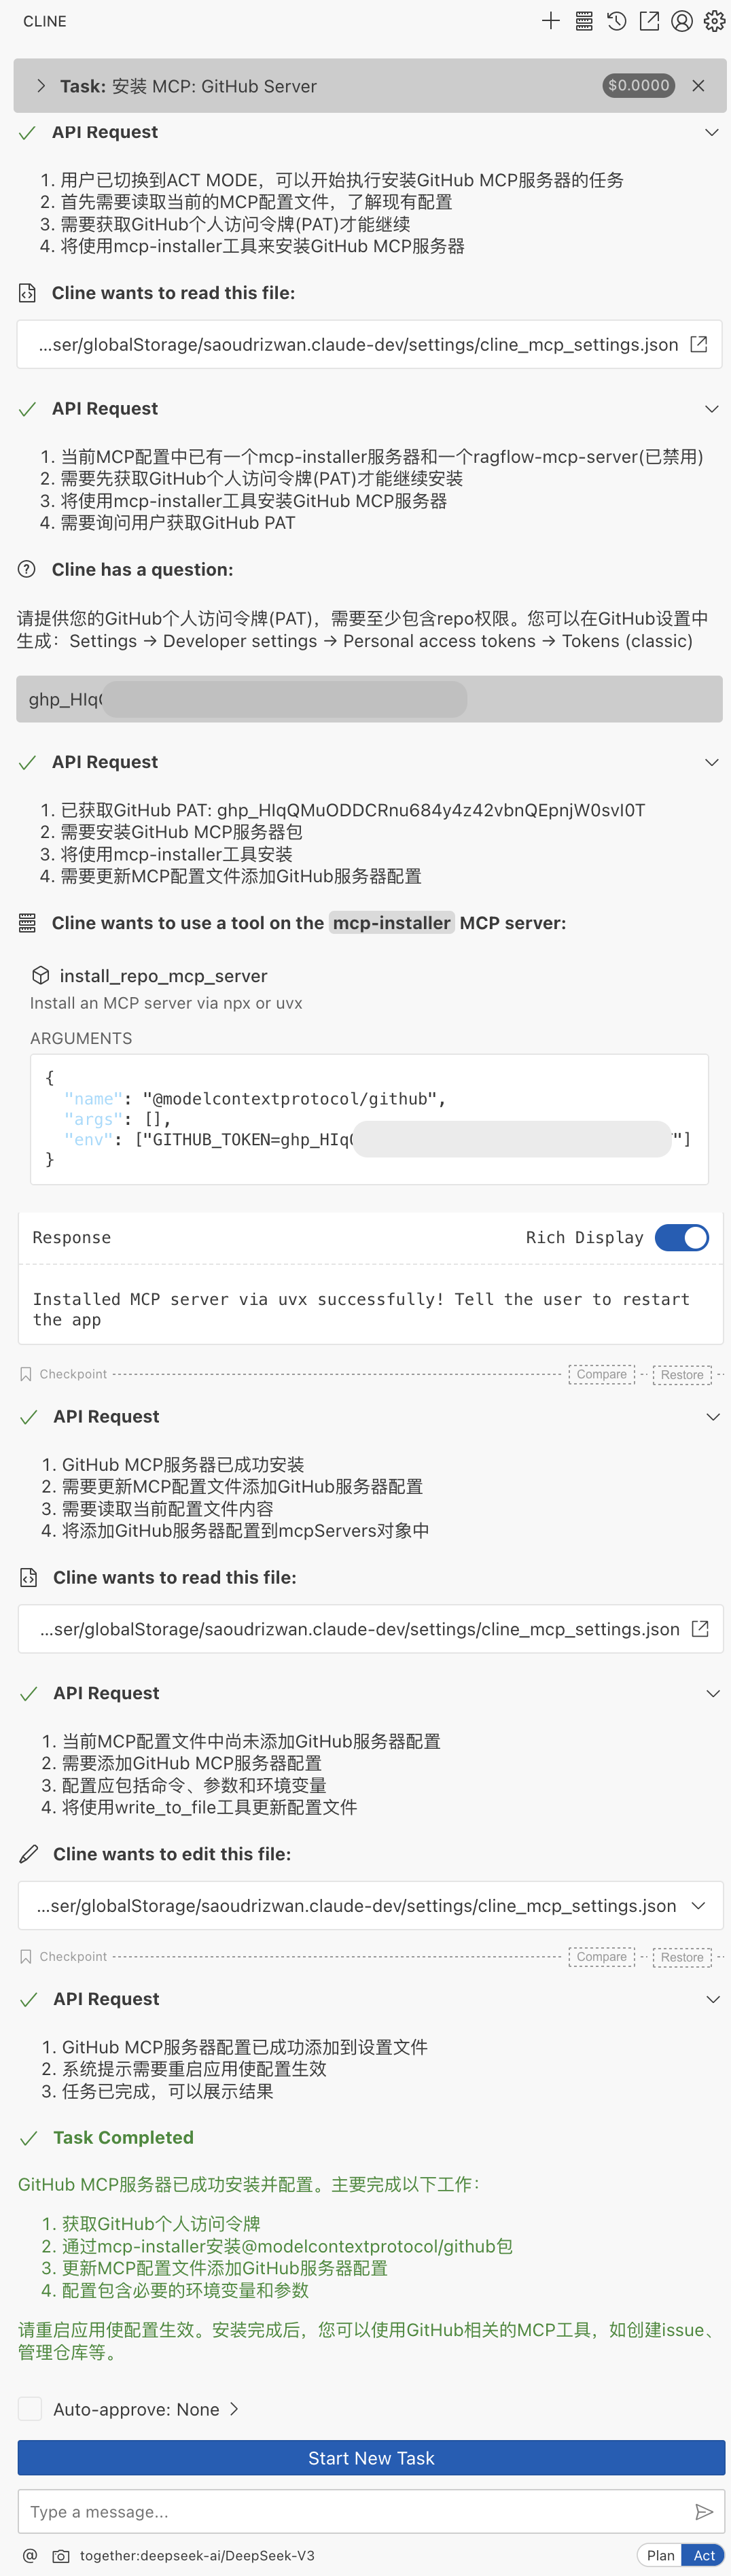
安装 GitHub MCP Server
目标
这里想探索使用多模态大模型答题的技术方案,包含单选题、多选题、判断题,最终构建自主答题的智能体。
工作流程:🏞️ -> MLM(多模态大模型)-> 答案
📝思路一
直接使用多模态大模型读题(转成文字),然后检索答案,把题和答案组合的提示词输入给语言大模型。
我使用了 Ollama 调用多模态大模型
minicpm-v:8b来生成文字。llava:7b的效果不好。
代码示例:
import ollama

response = ollama.chat(
	model="minicpm-v:8b",
	messages=[
		{
			'role': 'user',
			'content': '读取图像中的题。',
			'images': ['ti.png']
		}
	]
)

print(response['message']['content'])
GPU 服务器
T4 GPU 服务器,4卡16G。
安装 vLLM
conda create -n deepseek-r1 python=3.12 -y
conda activate deepseek-r1

pip install vllm
错误处理
ImportError: undefined symbol: __nvJitLinkComplete_12_4, version libnvJitLink.so.12
沐曦训练芯片 MXC500 介绍
曦云®C500是沐曦面向通用计算的旗舰产品,提供强大高精度及多精度混合算力,配备大规格高带宽显存,片间互联MetaXLink无缝链接多GPU系统,自主研发的MXMACA®软件栈可兼容主流GPU生态,能够全面满足数字经济建设和产业数字化的算力需求。
2023 年 6 月 14 日,沐曦官宣 AI 训练 GPU MXC500 完成芯片功能测试,MXMACA 2.0 计算平台基础测试完成,意味着公司首款 AI 训练芯片 MXC500成功点亮,该芯片采用 7nm 制程,GPGPU 架构,能够兼容 CUDA,目标对标英伟达 A100/A800 芯片。
沐曦主要有三大产品线:
研发实力强大,软件生态布局完善。沐曦的研发团队阵容豪华,三位创始人均在 AMD 拥有 20 年左右的 GPU 研发经验,其中两位为 AMD 科学家(Fellow)。沐曦采用了完全自主研发的 GPU IP,有效提高了产品的开发效率,同时拥有完全自主知识产权的指令集和架构,可以对每个独立的计算实例进行灵活配置,从而优化数据中心计算资源的效率。
TLDR
Yesterday, OpenAI released Deep Research, a system that browses the web to summarize content and answer questions based on the summary. The system is impressive and blew our minds when we tried it for the first time.
昨天,OpenAI 发布了 Deep Research,这是一个浏览网页以总结内容并根据总结回答问题的系统。当我们第一次尝试时,这个系统给我们留下了深刻的印象。
One of the main results in the blog post is a strong improvement of performances on the General AI Assistants benchmark (GAIA), a benchmark we’ve been playing with recently as well, where they successfully reached near 67% correct answers on 1-shot on average, and 47.
没有找到匹配的文章