2025 年,基于可验证奖励的强化学习(RLVR)脱颖而出,成为这一时期事实上的新重要阶段。通过在多个环境中利用自动可验证的奖励来训练大语言模型(例如数学/代码谜题),大语言模型会自发地发展出对人类来说看起来像「推理」的策略——它们学会将问题解决分解为中间计算,并学会多种来回探索的策略以弄清楚事物(参见 DeepSeek R1 论文中的例子)。来源: Simon Willison 的网络日志
FunASR:多模型协同推理与语音处理全链路实践 (ASR, VAD, PUNC, SV)
本文详细介绍了 FunASR 这一基础语音识别工具包,它提供了一套完整的语音处理服务,涵盖了离线转写和实时听写两大核心功能。其技术核心在于 AutoModel 多模型协调引擎,能够将不同的组件,如语音活动检测(VAD)、自动语音识别(ASR)、标点恢复和说话人分离(SV),按序串联起来,实现复杂的音频转录任务。文档清晰展示了从原始音频输入到最终带说话人标签的转录结果的完整处理流程和数据流向。此外,本文不仅罗列了支持的多种中英文模型清单,还附带了音频格式转换指南和代码示例。最后,通过实验性能对比,文章论证了在不同硬件上,结合 VAD、PUNC 和 SV 等组件后对推理用时和处理准确性的影响。
ASR 模型综合对比表
| 模型名称 | 中文准确度 | 英文/混合识别 | 可读性 (标点) | 附加功能 | 综合评分 |
|---|---|---|---|---|---|
| Fun-ASR-Nano | 极高 | 完美 | 极佳 | 生产环境级别 | 5.0 |
| SenseVoiceSmall | 高 | 较弱 (漏失) | 较好 | 情感/事件检测 | 4.0 |
paraformer-zh (ASR) |
一般 | 极差 | 无 | 原始数据 | 2.0 |
paraformer-zh (+VAD +PUNC) |
高 | 中等 | 优秀 | 自动断句 | 4.5 |
建议:
- 如果你的场景需要极致的准确率和排版,首选 Fun-ASR-Nano。
- 如果你的场景需要分析说话人的情绪,SenseVoiceSmall 是唯一的选择。
- 对于普通的长音频转写,带标点补全的 paraformer-zh 性价比最高。
PowerShell 脚本示例
# 核心参数配置(无需修改,已按你的需求设定)
$targetMinDate = Get-Date "2024-06-01"  # 目标日期区间:开始
$targetMaxDate = Get-Date "2024-12-31"  # 目标日期区间:结束
$hourMin = 8                            # 限制最小小时(8点)
$hourMax = 21                           # 限制最大小时(21点,因22点不包含,实际最晚21:59:59)
$folderPath = "D:\test"                 # 要遍历的目录
$skipExtension = ".eml"                 # 需跳过的文件后缀
$logFilePath = "D:\log.txt"  # 日志文件路径(与脚本同目录)

# 生成目标区间内随机时间(限制8:00-22:00)的函数
function Get-RandomTargetDateTime {
    param(
        [datetime]$DateMin = $targetMinDate,
        [datetime]$DateMax = $targetMaxDate,
        [int]$HourMin = $hourMin,
// ...
该PowerShell脚本的核心功能是 批量筛选并修改指定目录下文件的修改时间,同时跳过特定类型文件、记录操作日
未来 5 年公司智算需求预测
用半精度浮点数(FP16)计算能力评估服务器的智能计算能力,服务器算力=处理器芯片数x每时钟周期执行单精度浮点运算次数x处理器主频x处理器核数。
全球算力概览
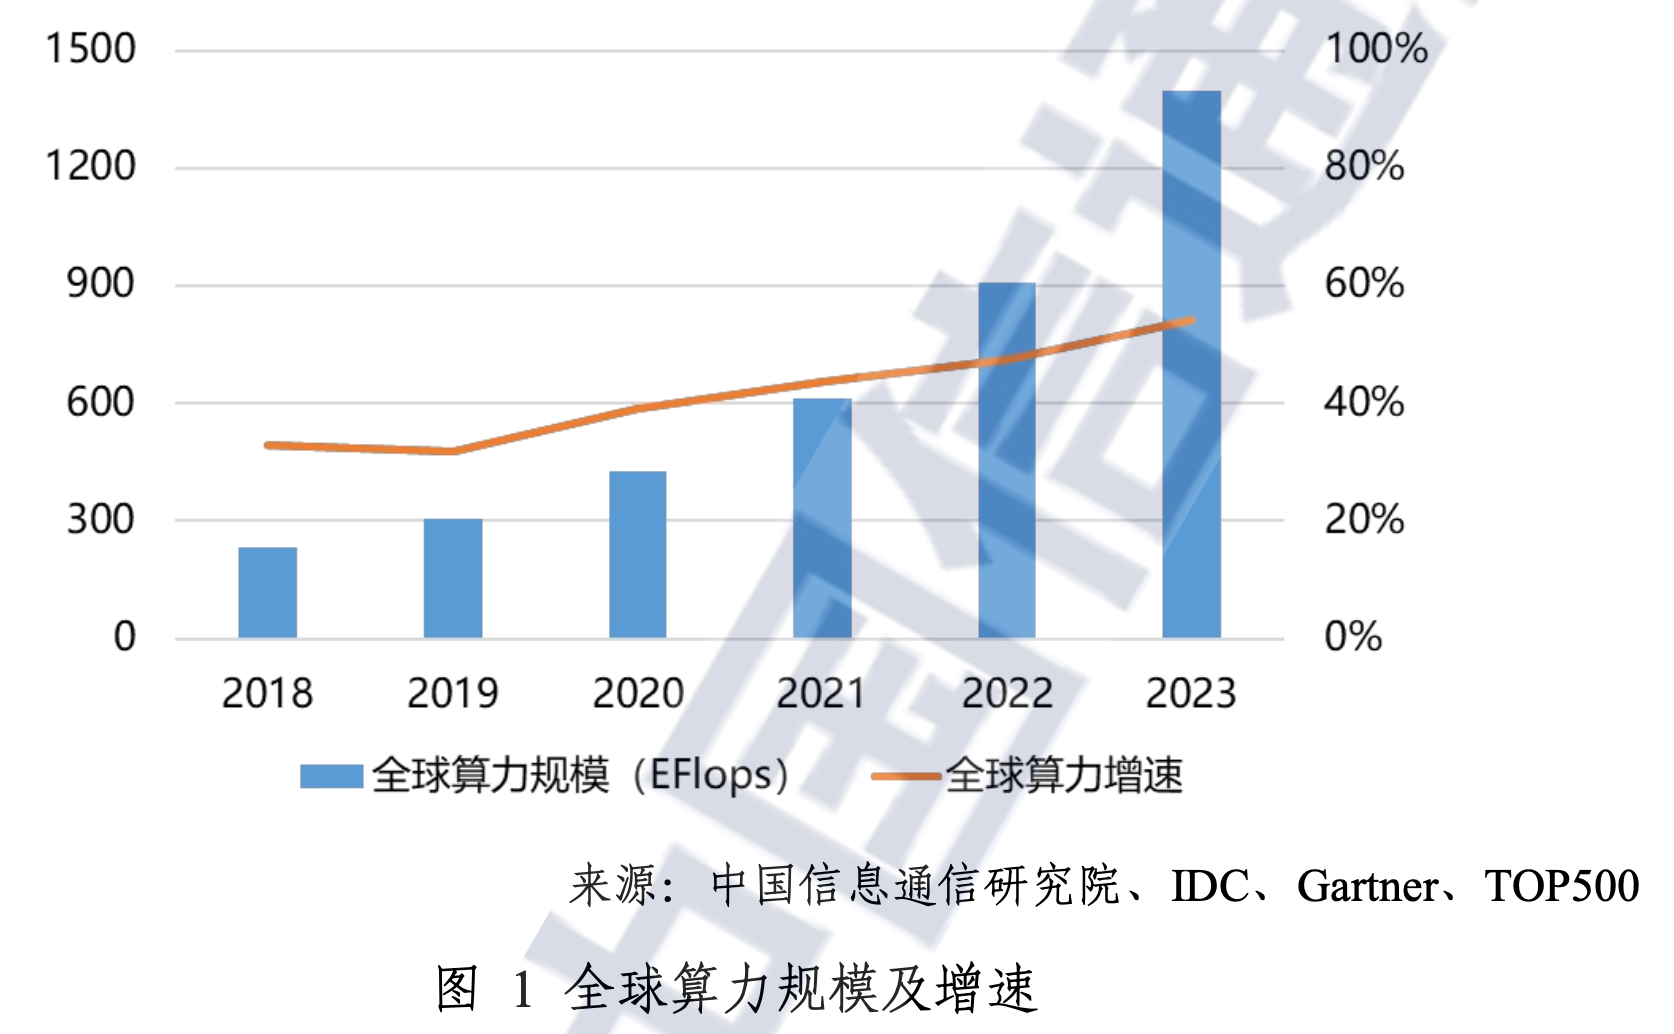
中国算力概览
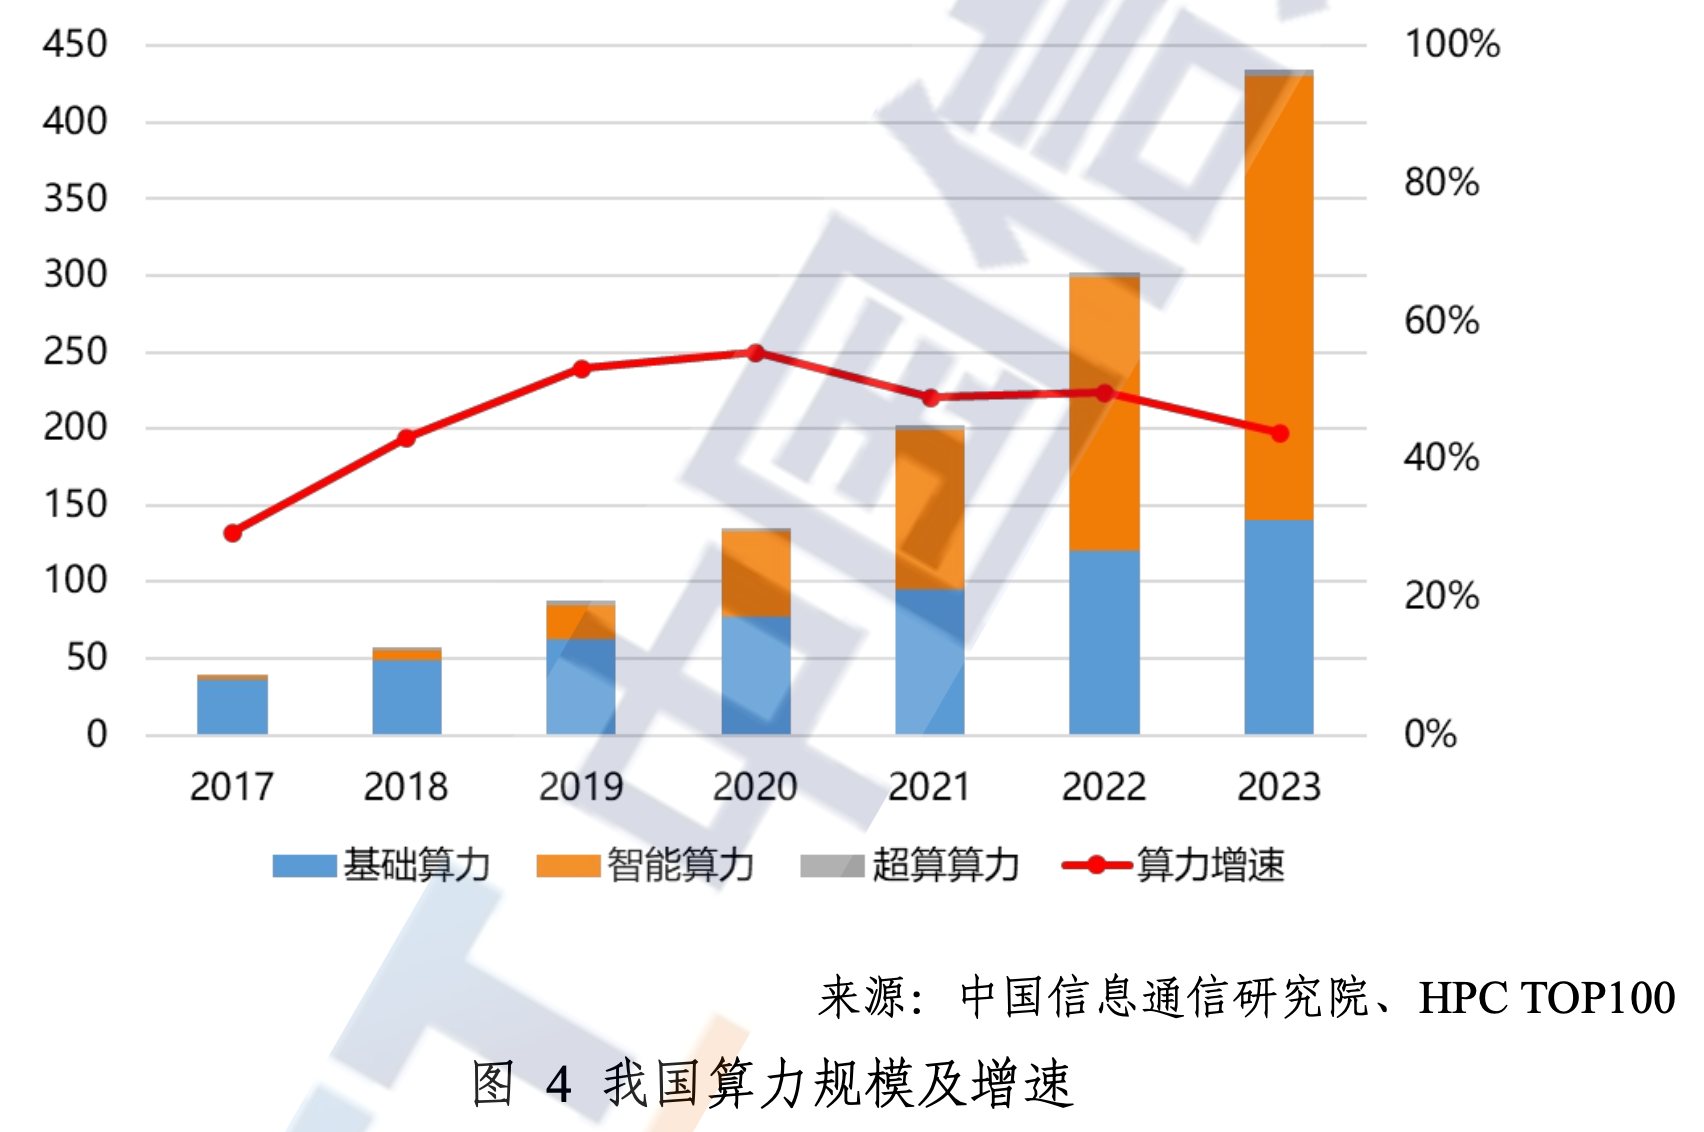
截至 2025 年 3 月底,我国智算规模达 748EFLOPS(FP16),近五年平均增速达 49%。
公司算力概览
昇腾 910B4 (32GB) 算力概览
| 配置级别 | 硬件描述 | FP16 峰值算力 | 备注 |
|---|---|---|---|
| 单卡 | 昇腾 910B4 (32GB) | 280 TFLOPS | 单卡 FP16 算力峰值 |
| 单机 | Atlas 800I A2 服务器 (8 x 910B4) | 2240 TFLOPS () | 服务器搭载 8 张 910B4 卡 |
| 集群 | 5 台 Atlas 800I A2 服务器 | 11.2 PFLOPS | 由 5 台服务器组成的集群 |
NVIDIA T4 (16GB) 算力概览
| 配置级别 | 硬件描述 | FP16 峰值算力 | 备注 |
|---|---|---|---|
| 单卡 | NVIDIA T4 | 65 TFLOPS | 使用混合精度 Tensor Cores |
| 单机 | 4 卡服务器 | 260 TFLOPS | 服务器搭载 4 张 T4 卡 |
| 集群 | 4 台 4 卡服务器 | 1.04 PFLOPS | 由 4 台服务器组成的集群 |
总算力
2025-12-01-reachy-mini
conda create -n reachy-mini python=3.10.9 -y
conda activate reachy-mini
pip install reachy-mini[mujoco]
智能会议系统 Jetson Thor 上部署模型服务指南
内网IP:27.41.19.62
| 服务 | 说明 | 端口 | 模型 | 备注 |
|---|---|---|---|---|
| whisperlivekit | 实时语音识别服务 | 8000 | Whispersmall (默认)large-v3-turbo |
带说话人分离 |
| FunASR | 实时语音识别服务 | 8000 | 语音识别:paraformer-zh实时语音识别: paraformer-zh-streaming实时语音端点检测: fsmn-vad标点恢复: ct-punc文本逆规范化: fst_itn_zh |
实时与非实时一体化协同(2pass)服务模式 |
| llama-server | GGUF 模型推理服务 | 8080 | Qwen3Qwen3-8B-Q5_K_M.gguf |
模型名:qwen3 上下文长度:32K 不思考 |
系统设置
系统优化
最大功率模式(一次性设置)
sudo nvpmodel -m 0
启动最高频率(每次重启后设置)
sudo jetson_clocks
清理内存
sync && echo 3 | sudo tee /proc/sys/vm/drop_caches
WhisperLiveKit
部署服务
tmux new -s wlk
默认容器内应用(标点识别有时会失灵 ⚠️)
FunASR - 基础语音识别工具包
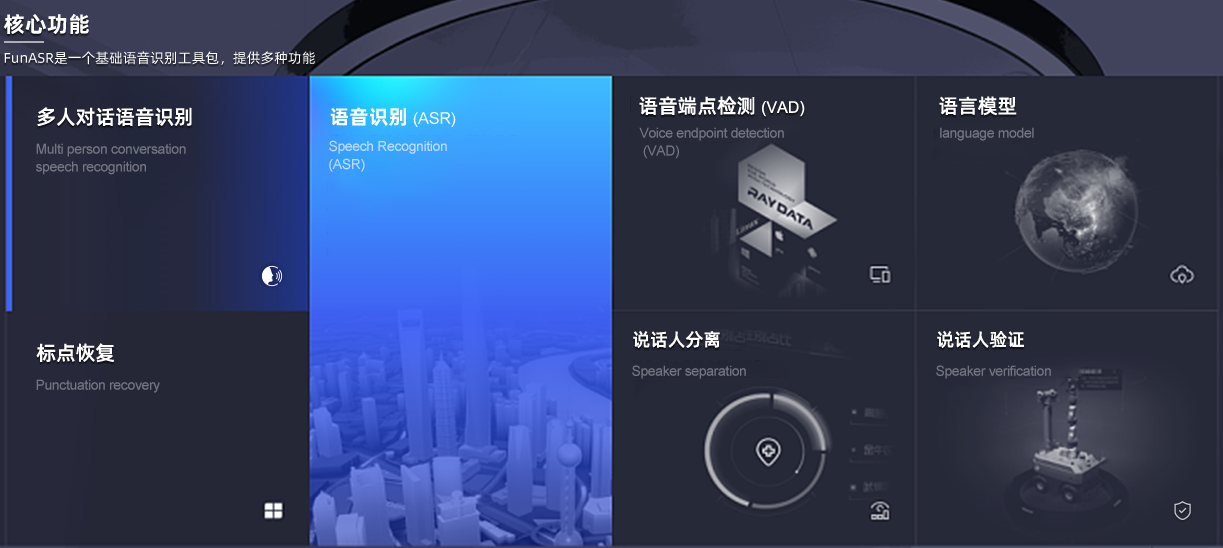
FunASR 是一个基础语音识别工具包,提供多种功能,包括语音识别(ASR)、语音端点检测(VAD)、标点恢复、语言模型、说话人验证、说话人分离和多人对话语音识别等。
FunASR 快速入门
核心功能
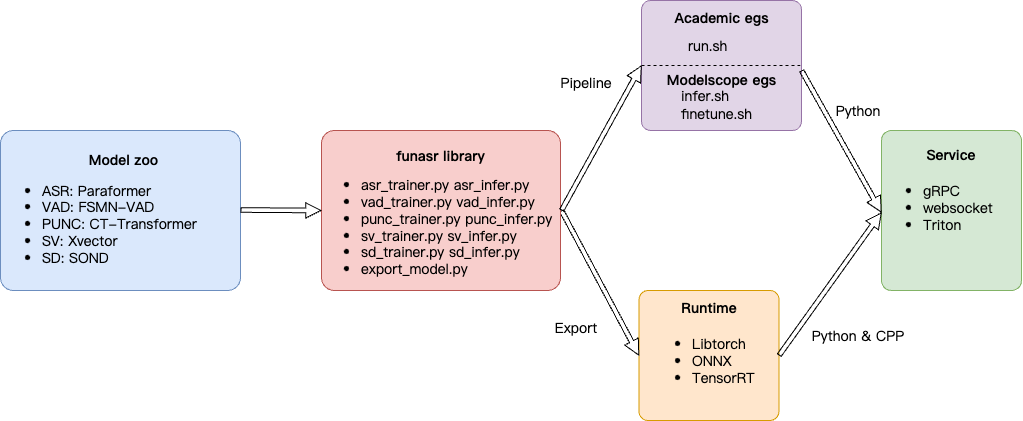
工作流程
离线文件转写服务

FunASR离线文件转写软件包,提供了一款功能强大的语音离线文件转写服务。拥有完整的语音识别链路,结合了语音端点检测、语音识别、标点等模型,可以将几十个小时的长音频与视频识别成带标点的文字,而且支持上百路请求同时进行转写。输出为带标点的文字,含有字级别时间戳,支持ITN与用户自定义热词等。服务端集成有ffmpeg,支持各种音视频格式输入。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
实时听写服务
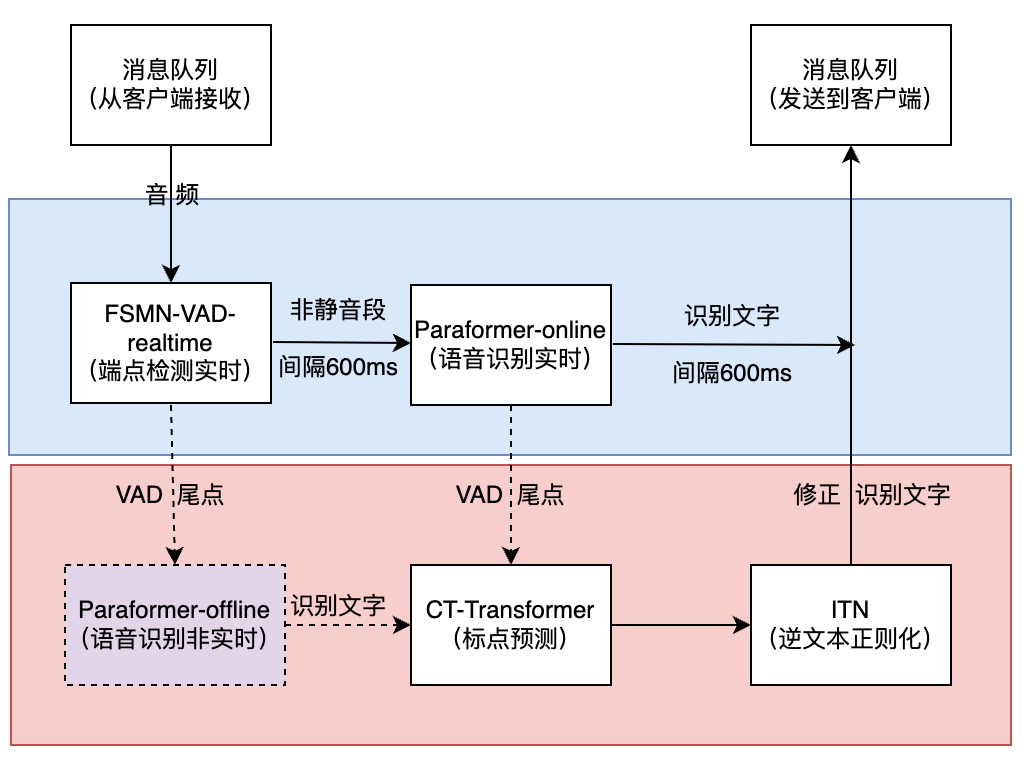
FunASR实时语音听写软件包,集成了实时版本的语音端点检测模型、语音识别、语音识别、标点预测模型等。采用多模型协同,既可以实时的进行语音转文字,也可以在说话句尾用高精度转写文字修正输出,输出文字带有标点,支持多路请求。依据使用者场景不同,支持实时语音听写服务(online)、非实时一句话转写(offline)与实时与非实时一体化协同(2pass)3种服务模式。软件包提供有html、python、c++、java与c#等多种编程语言客户端。
FunASR 镜像
- 在线 CPU 版本
SenseVoice
SenseVoice 是具有音频理解能力的音频基础模型,包括语音识别(ASR)、语种识别(LID)、语音情感识别(SER)和声学事件分类(AEC)或声学事件检测(AED)。
SenseVoice
核心功能 🎯
SenseVoice 专注于高精度多语言语音识别、情感辨识和音频事件检测
- 多语言识别: 采用超过 40 万小时数据训练,支持超过 50 种语言,识别效果上优于 Whisper 模型。
- 富文本识别:
- 具备优秀的情感识别,能够在测试数据上达到和超过目前最佳情感识别模型的效果。
- 支持声音事件检测能力,支持音乐、掌声、笑声、哭声、咳嗽、喷嚏等多种常见人机交互事件进行检测。
- 高效推理: SenseVoice-Small 模型采用非自回归端到端框架,推理延迟极低,10s 音频推理仅耗时 70ms,15 倍优于 Whisper-Large。
- 微调定制: 具备便捷的微调脚本与策略,方便用户根据业务场景修复长尾样本问题。
- 服务部署: 具有完整的服务部署链路,支持多并发请求,支持客户端语言有,python、c++、html、java 与 c# 等。
架构图
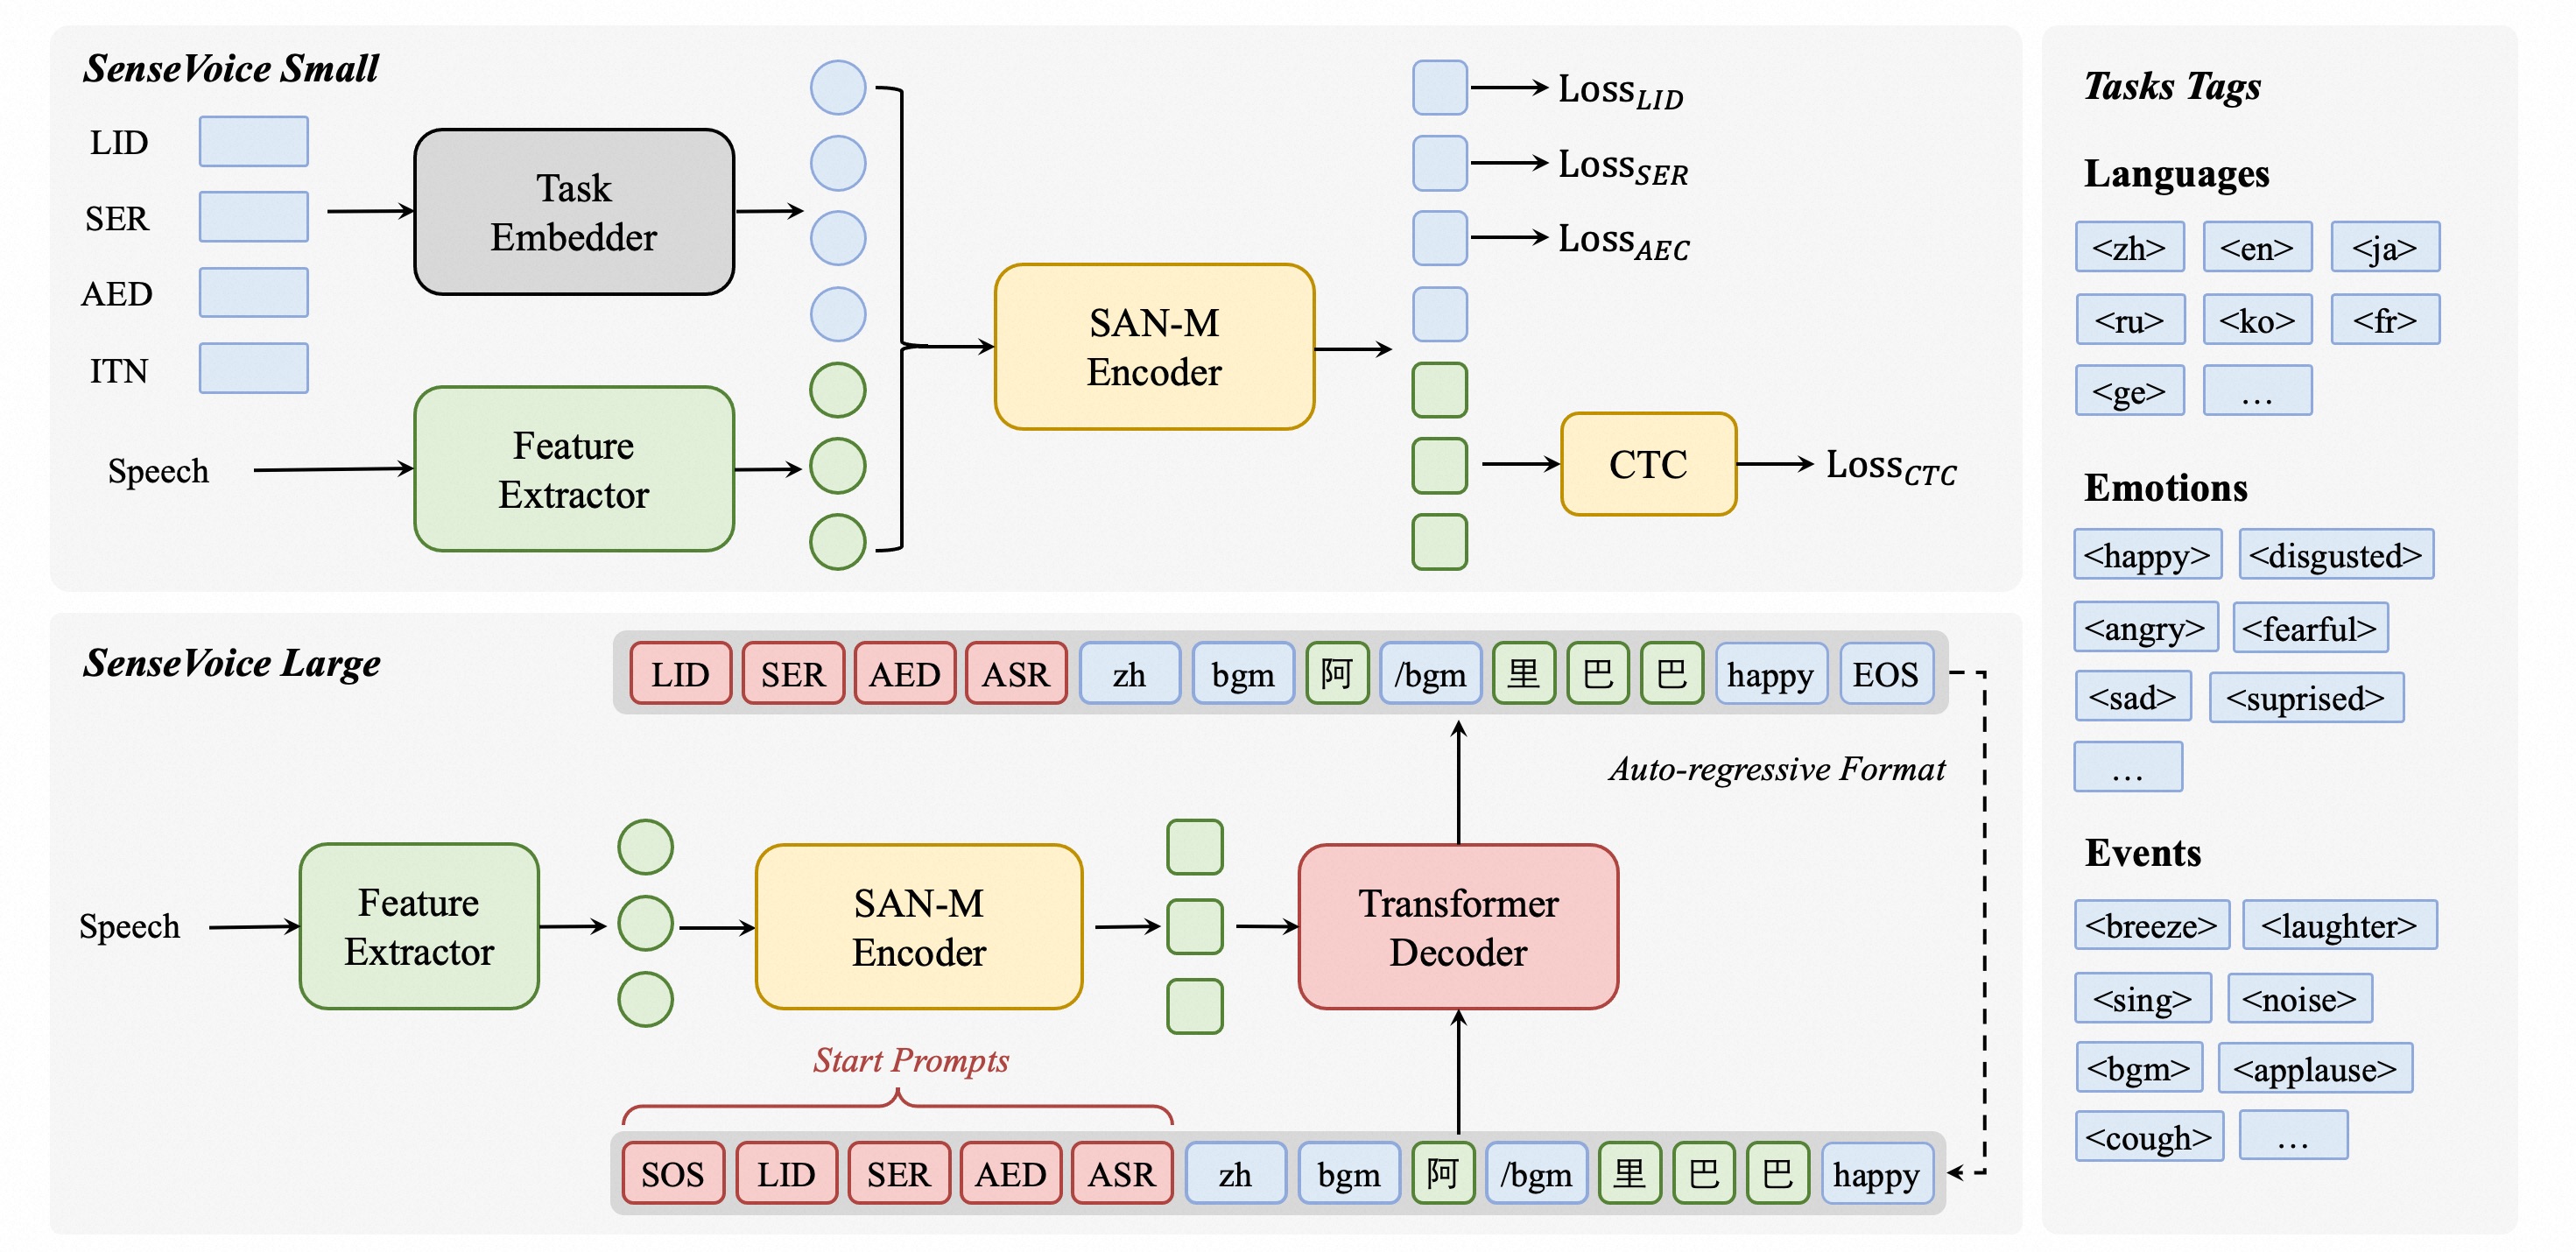
- 语音识别(ASR)
- 语言识别(LID)
- 语音情感识别(SER)
- 音频事件检测(AED,比如笑声、掌声、背景音乐、咳嗽等)
- 逆文本归一化(ITN)
安装
克隆代码库
SimulStreaming — 实时流式语音识别工具包
SimulStreaming 实现了 Whisper 模型的同步翻译和转录功能(在语音识别领域被称为流式传输)。SimulStreaming 采用了最先进的同步策略 AlignAtt,这使其具备极高的速度和效率。
安装
git clone https://github.com/ufal/SimulStreaming
cd SimulStreaming
pip install -r requirements.txt
从音频文件进行实时模拟
凭借现在的人工智能,我们能够编写以前根本无法手工编写的新程序。我们通过指定目标(例如分类准确率、奖励函数)来做到这一点,并通过梯度下降搜索程序空间,以找到在该目标上表现良好的神经网络。
Karpathy 引用了他的「Software 2.0」博客文章。他指出,「可验证性」是人工智能优化中最具预测性的特征——如果一项任务是可验证的,那么它就可以直接或通过强化学习进行优化。而人工智能「练习」的环境必须满足三个要求:可重置、高效、可奖励。 来源: Simon Willison 的网络日志
WhisperLiveKit - 实时语音识别
WhisperLiveKit 演示
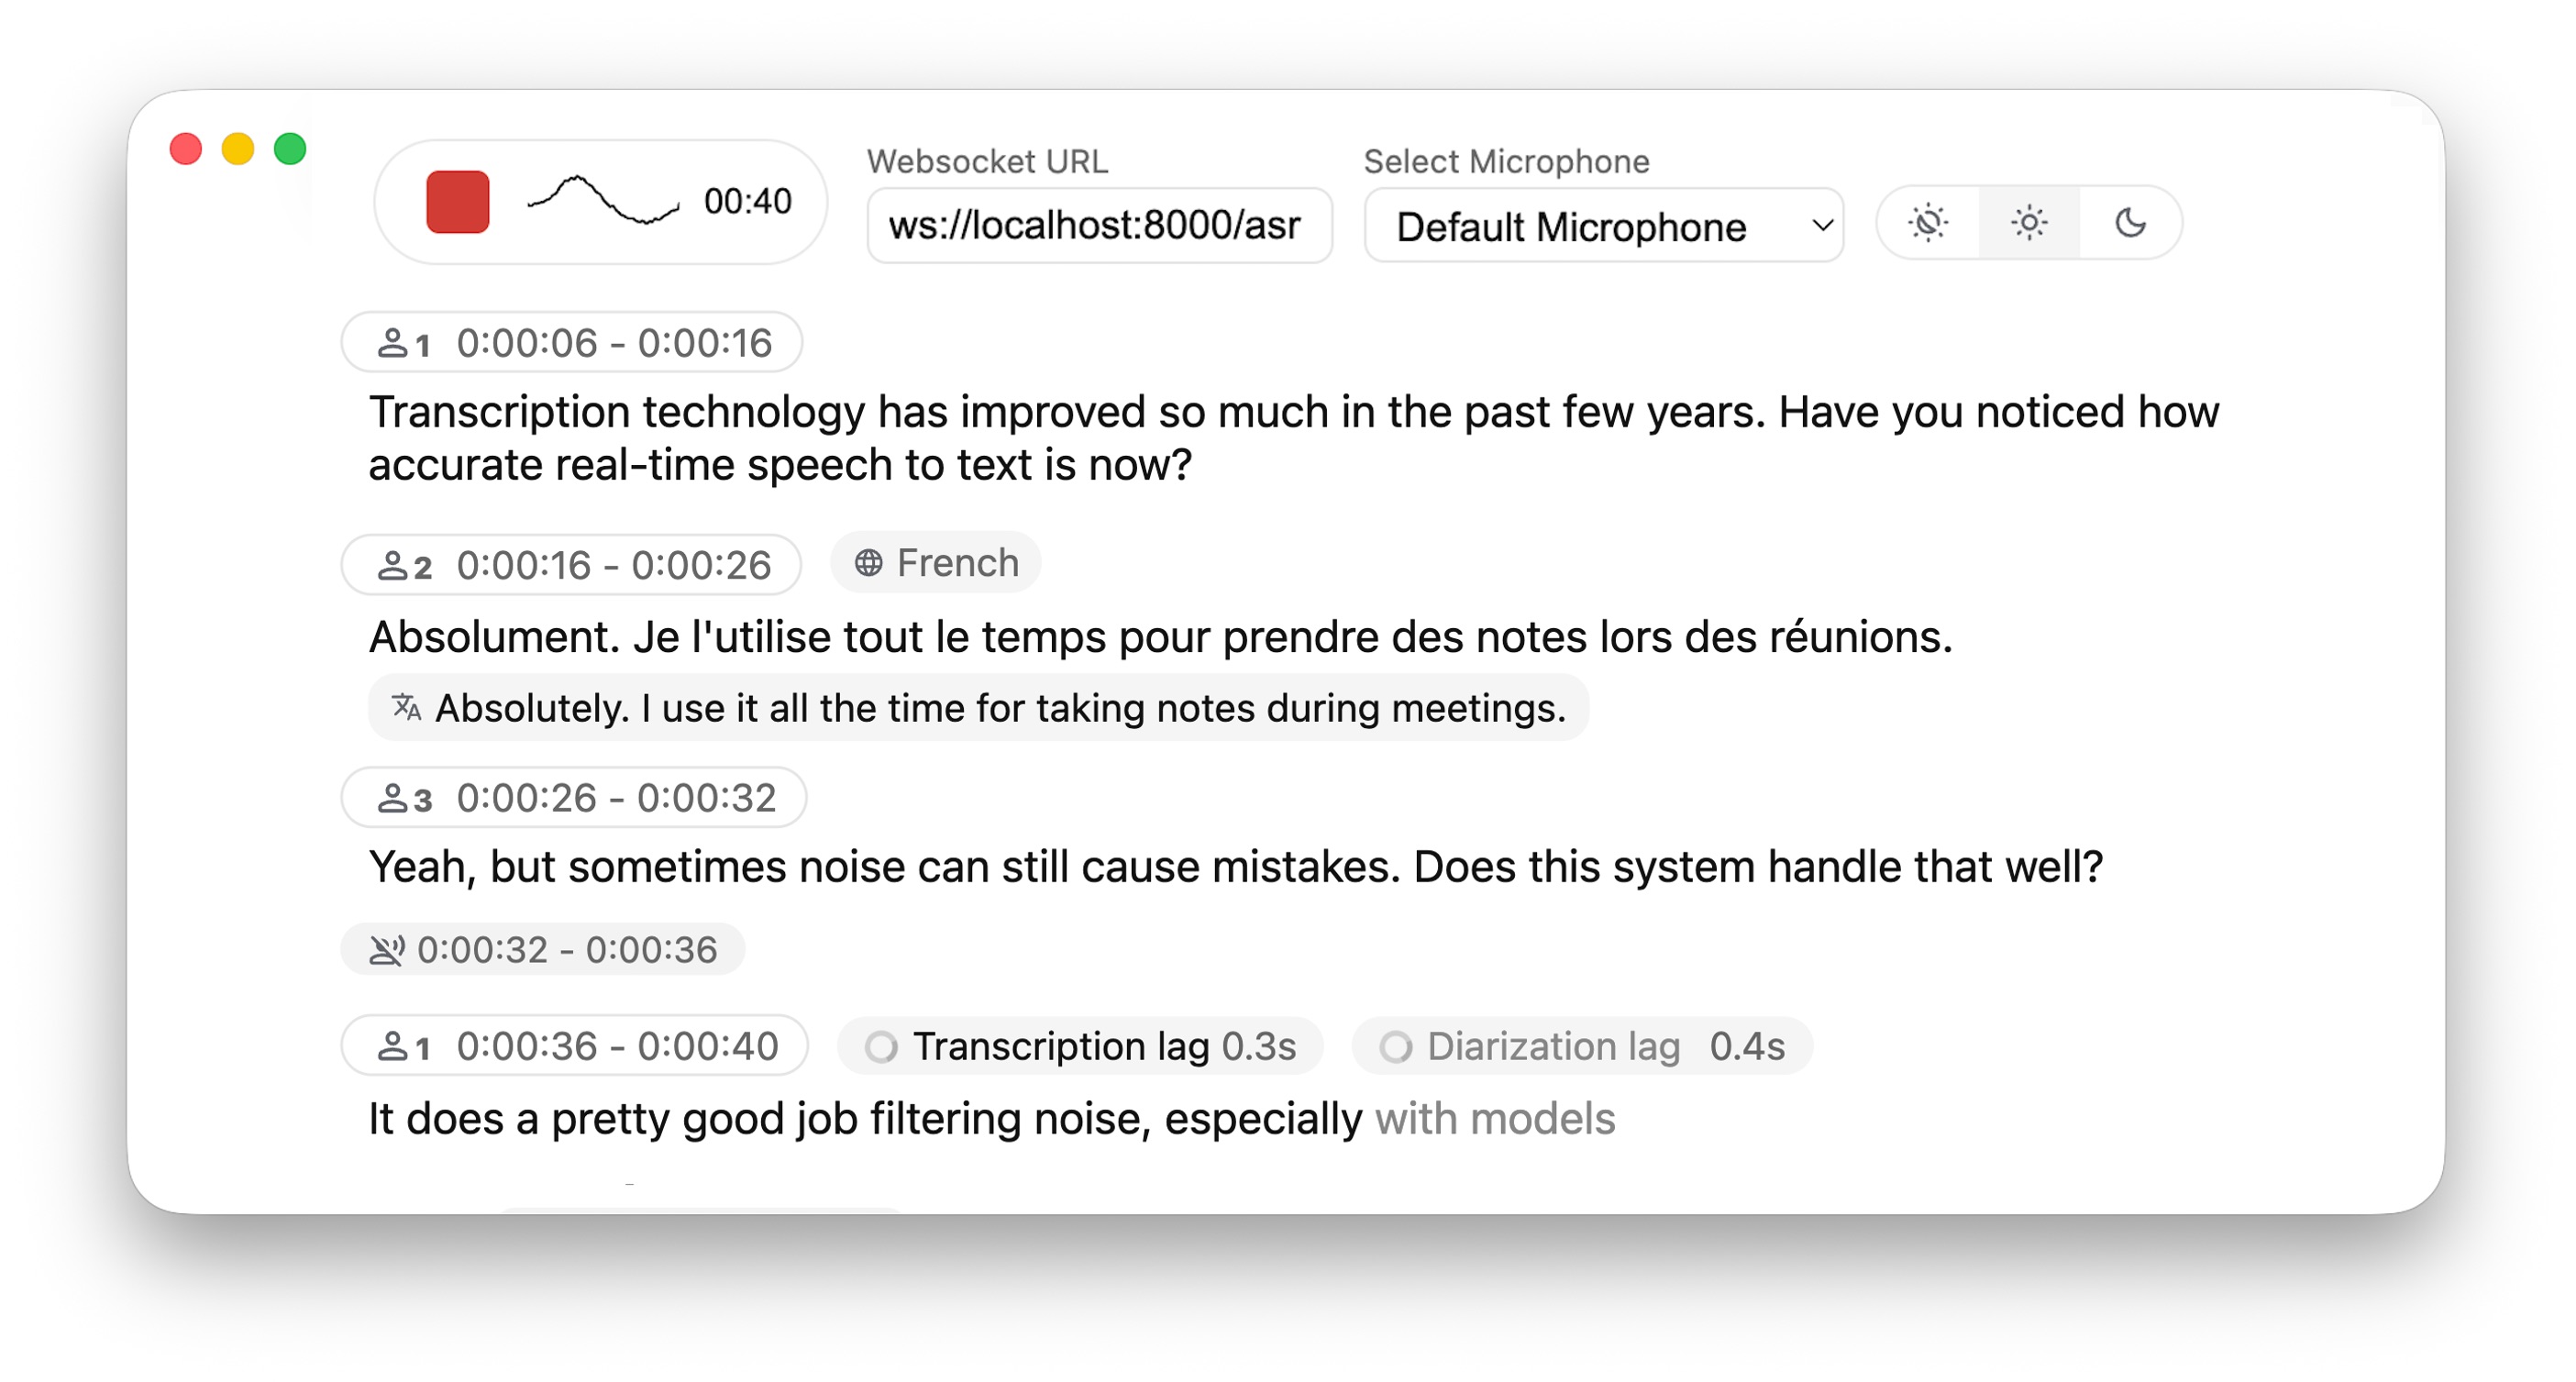
实时、完全本地化的语音转文本,带说话人识别功能
WhisperLiveKit 架构
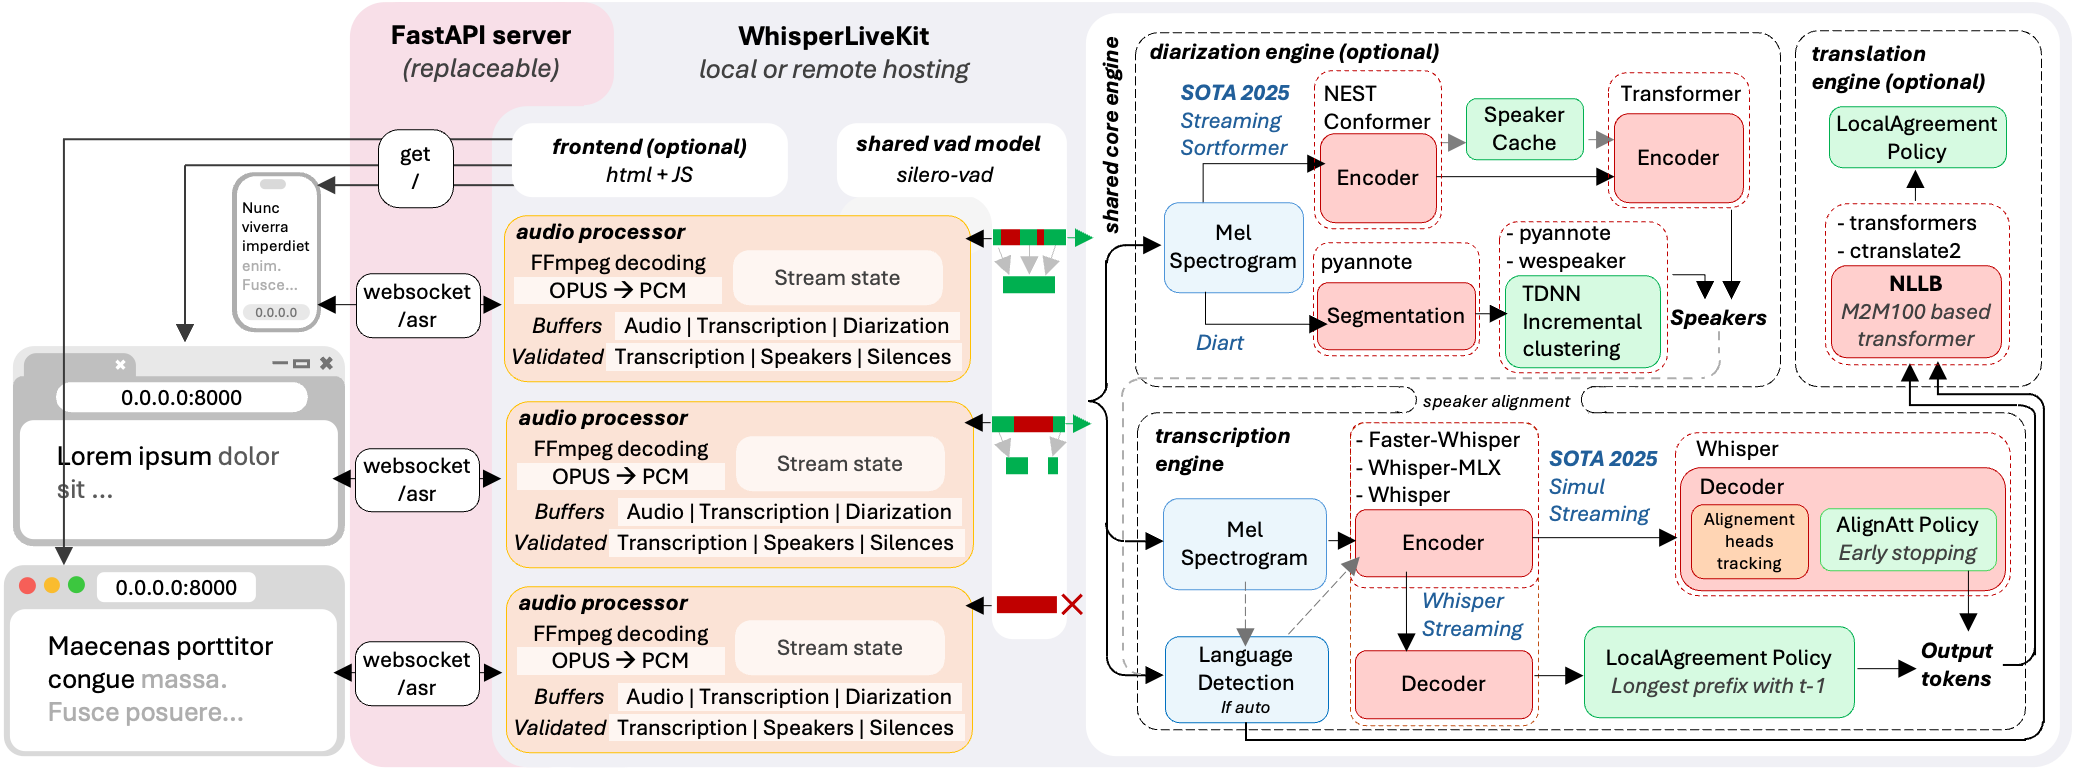
构建 WhisperLiveKit
运行 pytorch 容器 - CUDA (JetsonThor)
docker run -it \
    --ipc=host \
    --net=host \
    --runtime=nvidia \
    --name=whisperlivekit \
    -v ~/.cache:/root/.cache \
    -v /models:/models \
    nvcr.io/nvidia/pytorch:25.10-py3 \
    bash
生成证书
mkdir -p .cert && cd .cert

openssl req -x509 -newkey rsa:4096 \
  -keyout key.pem \
  -out cert.pem \
  -days 365 \
  -nodes \
  -subj "/C=CN/ST=ShanDong/L=JiNan/O=LNSoft/OU=LNSoft/CN=localhost/emailAddress=wjj@163.com"
参数解释:
-x509:生成自签名证书-newkey rsa:4096:新建 4096 位 RSA 密钥-keyout key.pem:输出私钥文件-out cert.pem:输出证书文件-days 365:证书有效期 365 天-nodes:不加密私钥(即无需输入密码)-subj:直接指定证书主题,跳过交互式输入
大模型(语言、视觉语言、语音)推理服务部署与测试
推理服务
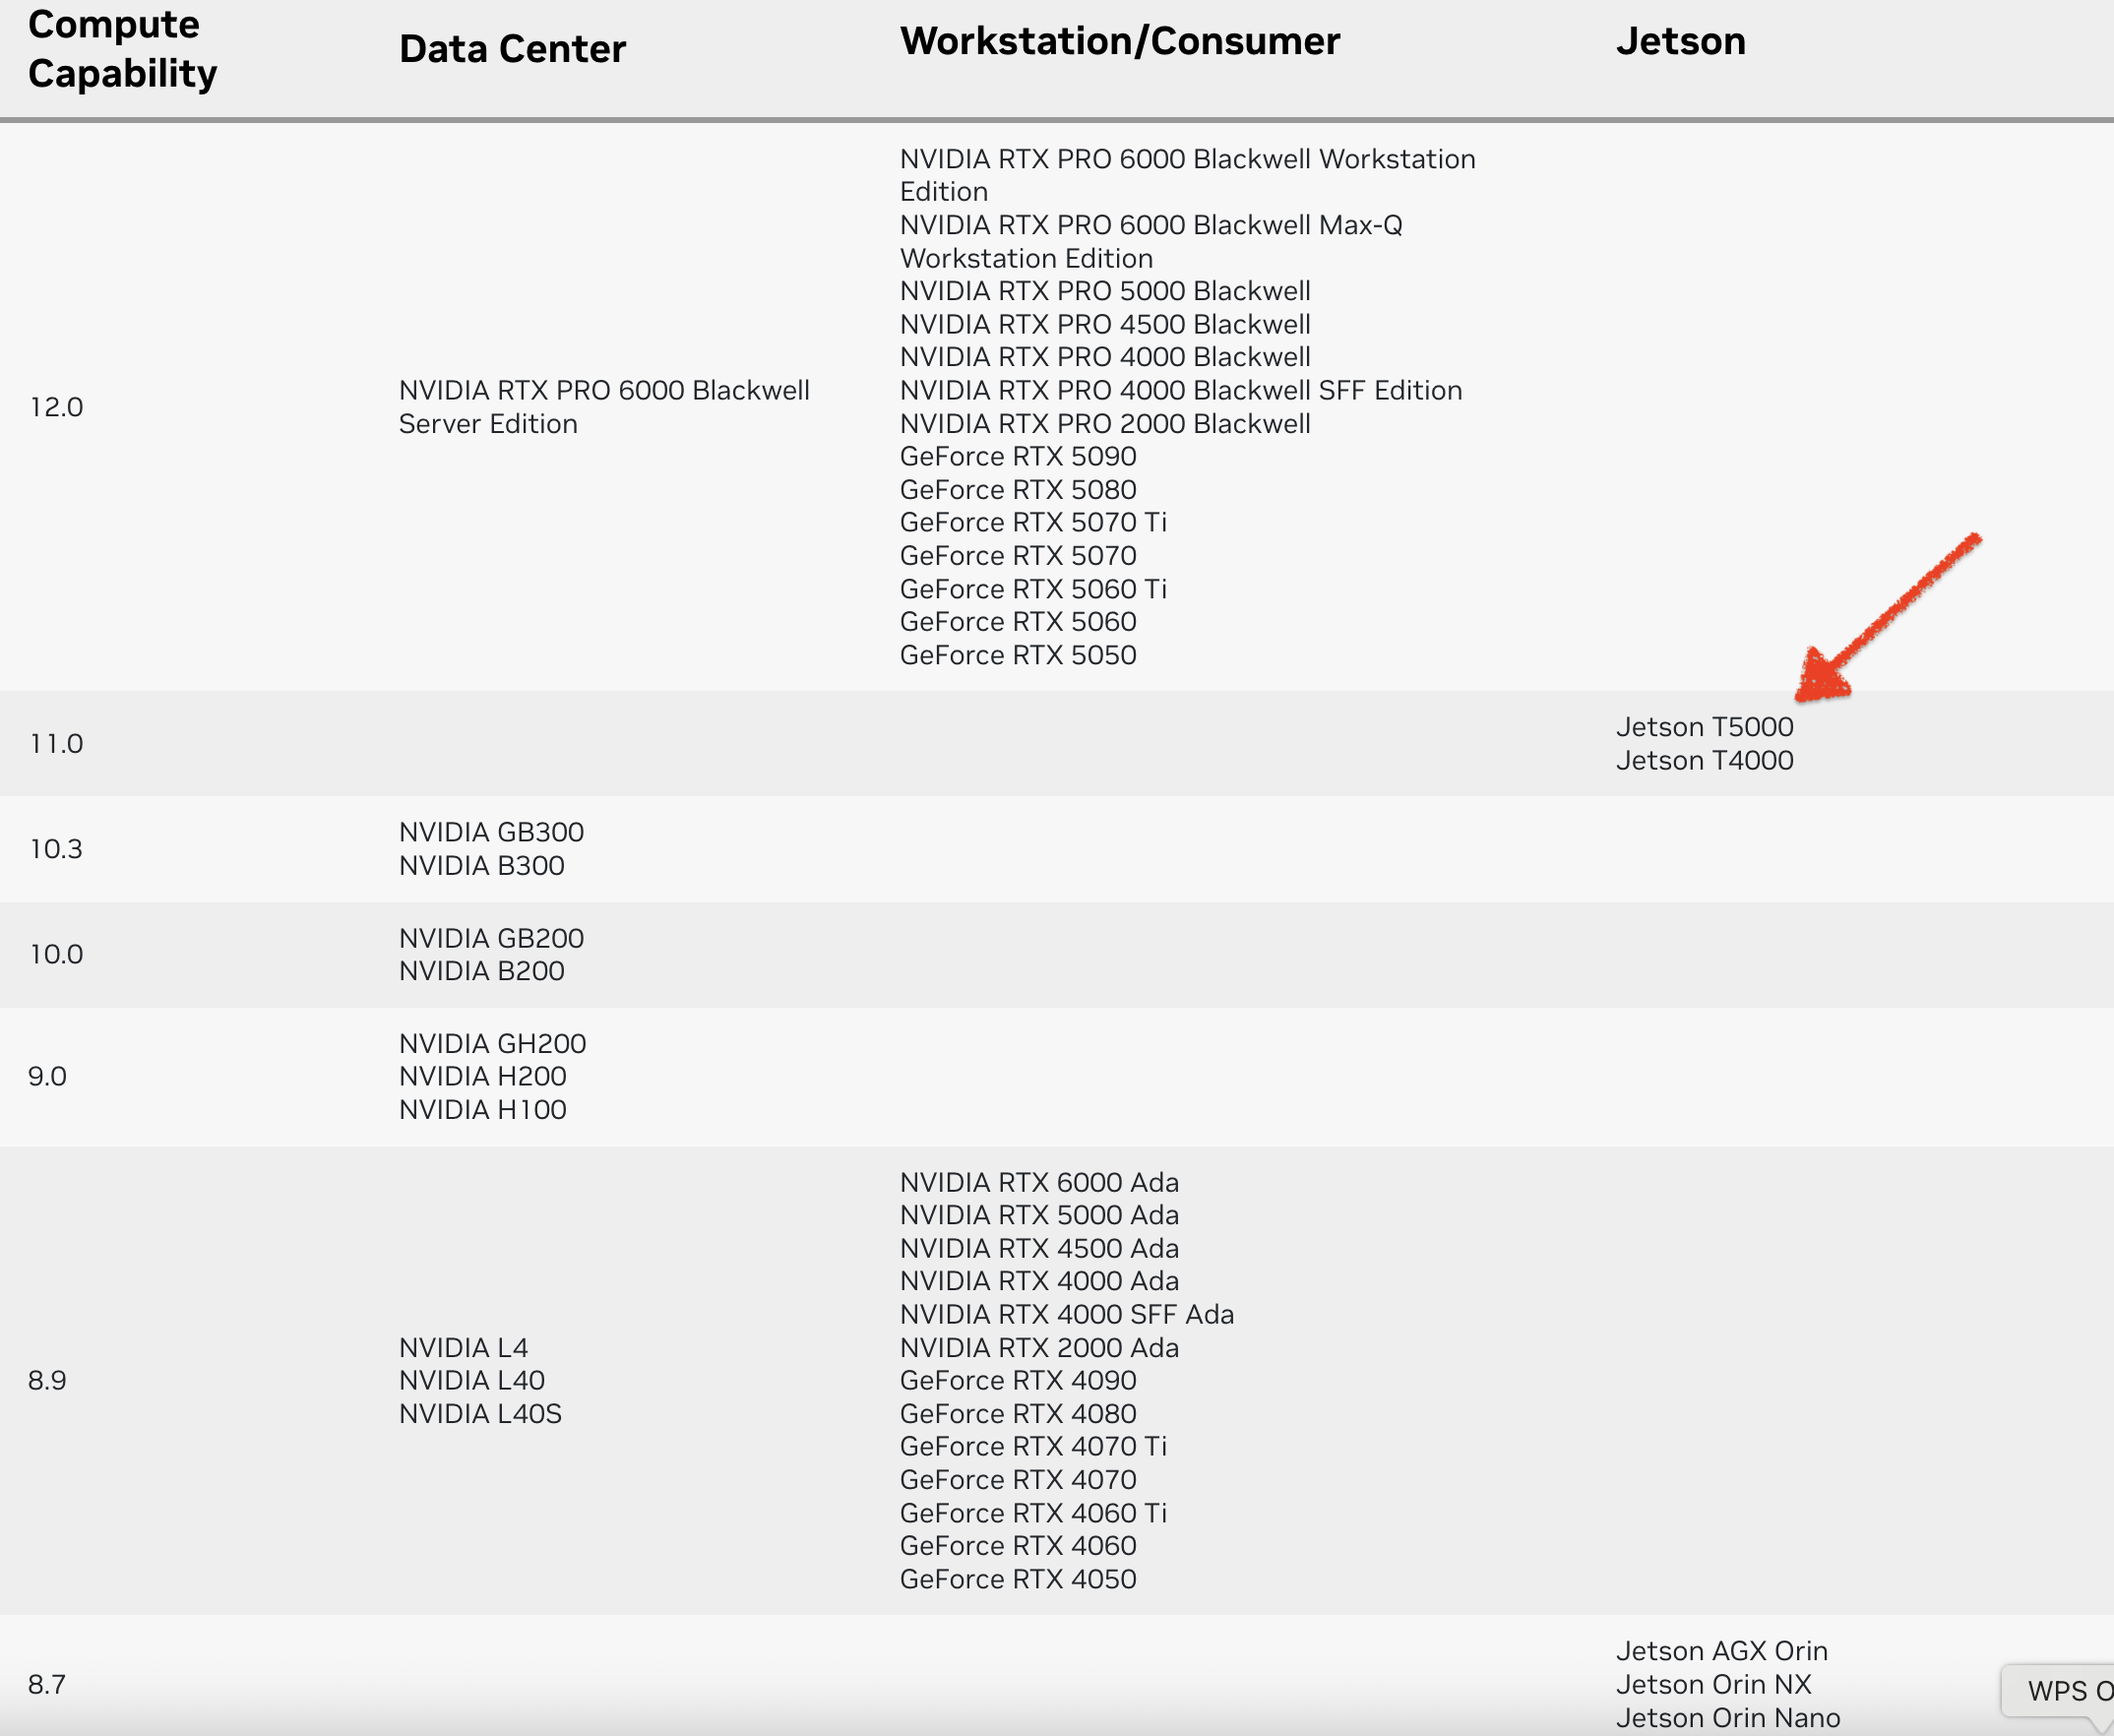
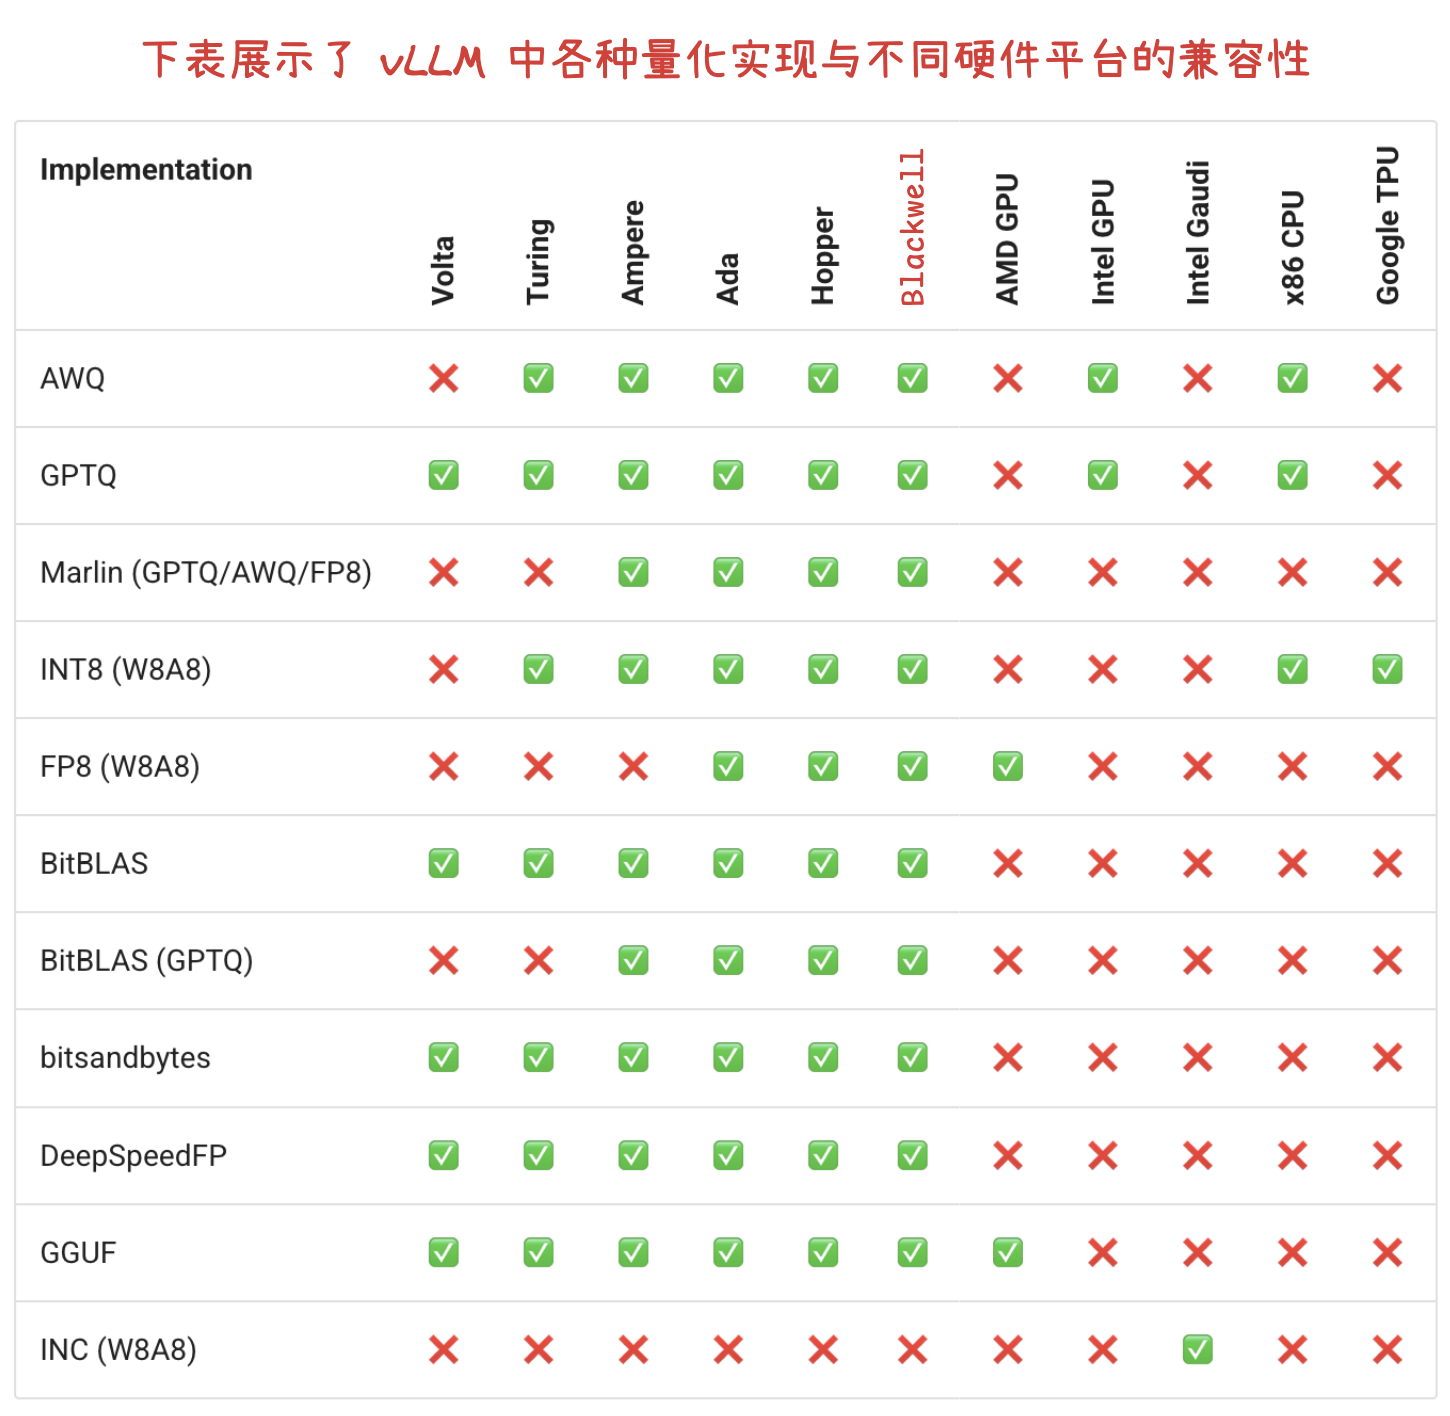
CUDA GPU Compute Capability(计算能力)
计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性和支持的指令。在下表中查找您的GPU的计算能力。
vLLM
docker run -it --rm \
  --ipc=host \
  --net=host \
  --runtime=nvidia \
  --name=vllm-test \
  -v /models:/models \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -v ~/.cache/modelscope:/root/.cache/modelscope \
  nvcr.io/nvidia/vllm:25.10-py3 \
  bash
默认情况下,如果模型未指向有效的本地目录,它将从 Hugging Face Hub 下载模型文件。要从 ModelScope 下载模型,请在运行命令之前进行如下设置:
export VLLM_USE_MODELSCOPE=true
vllm serve /models/Qwen/Qwen3-8B \
  --served-model-name qwen3 \
  --chat-template /models/Qwen/Qwen3-8B/qwen3_nonthinking.jinja
SGLang
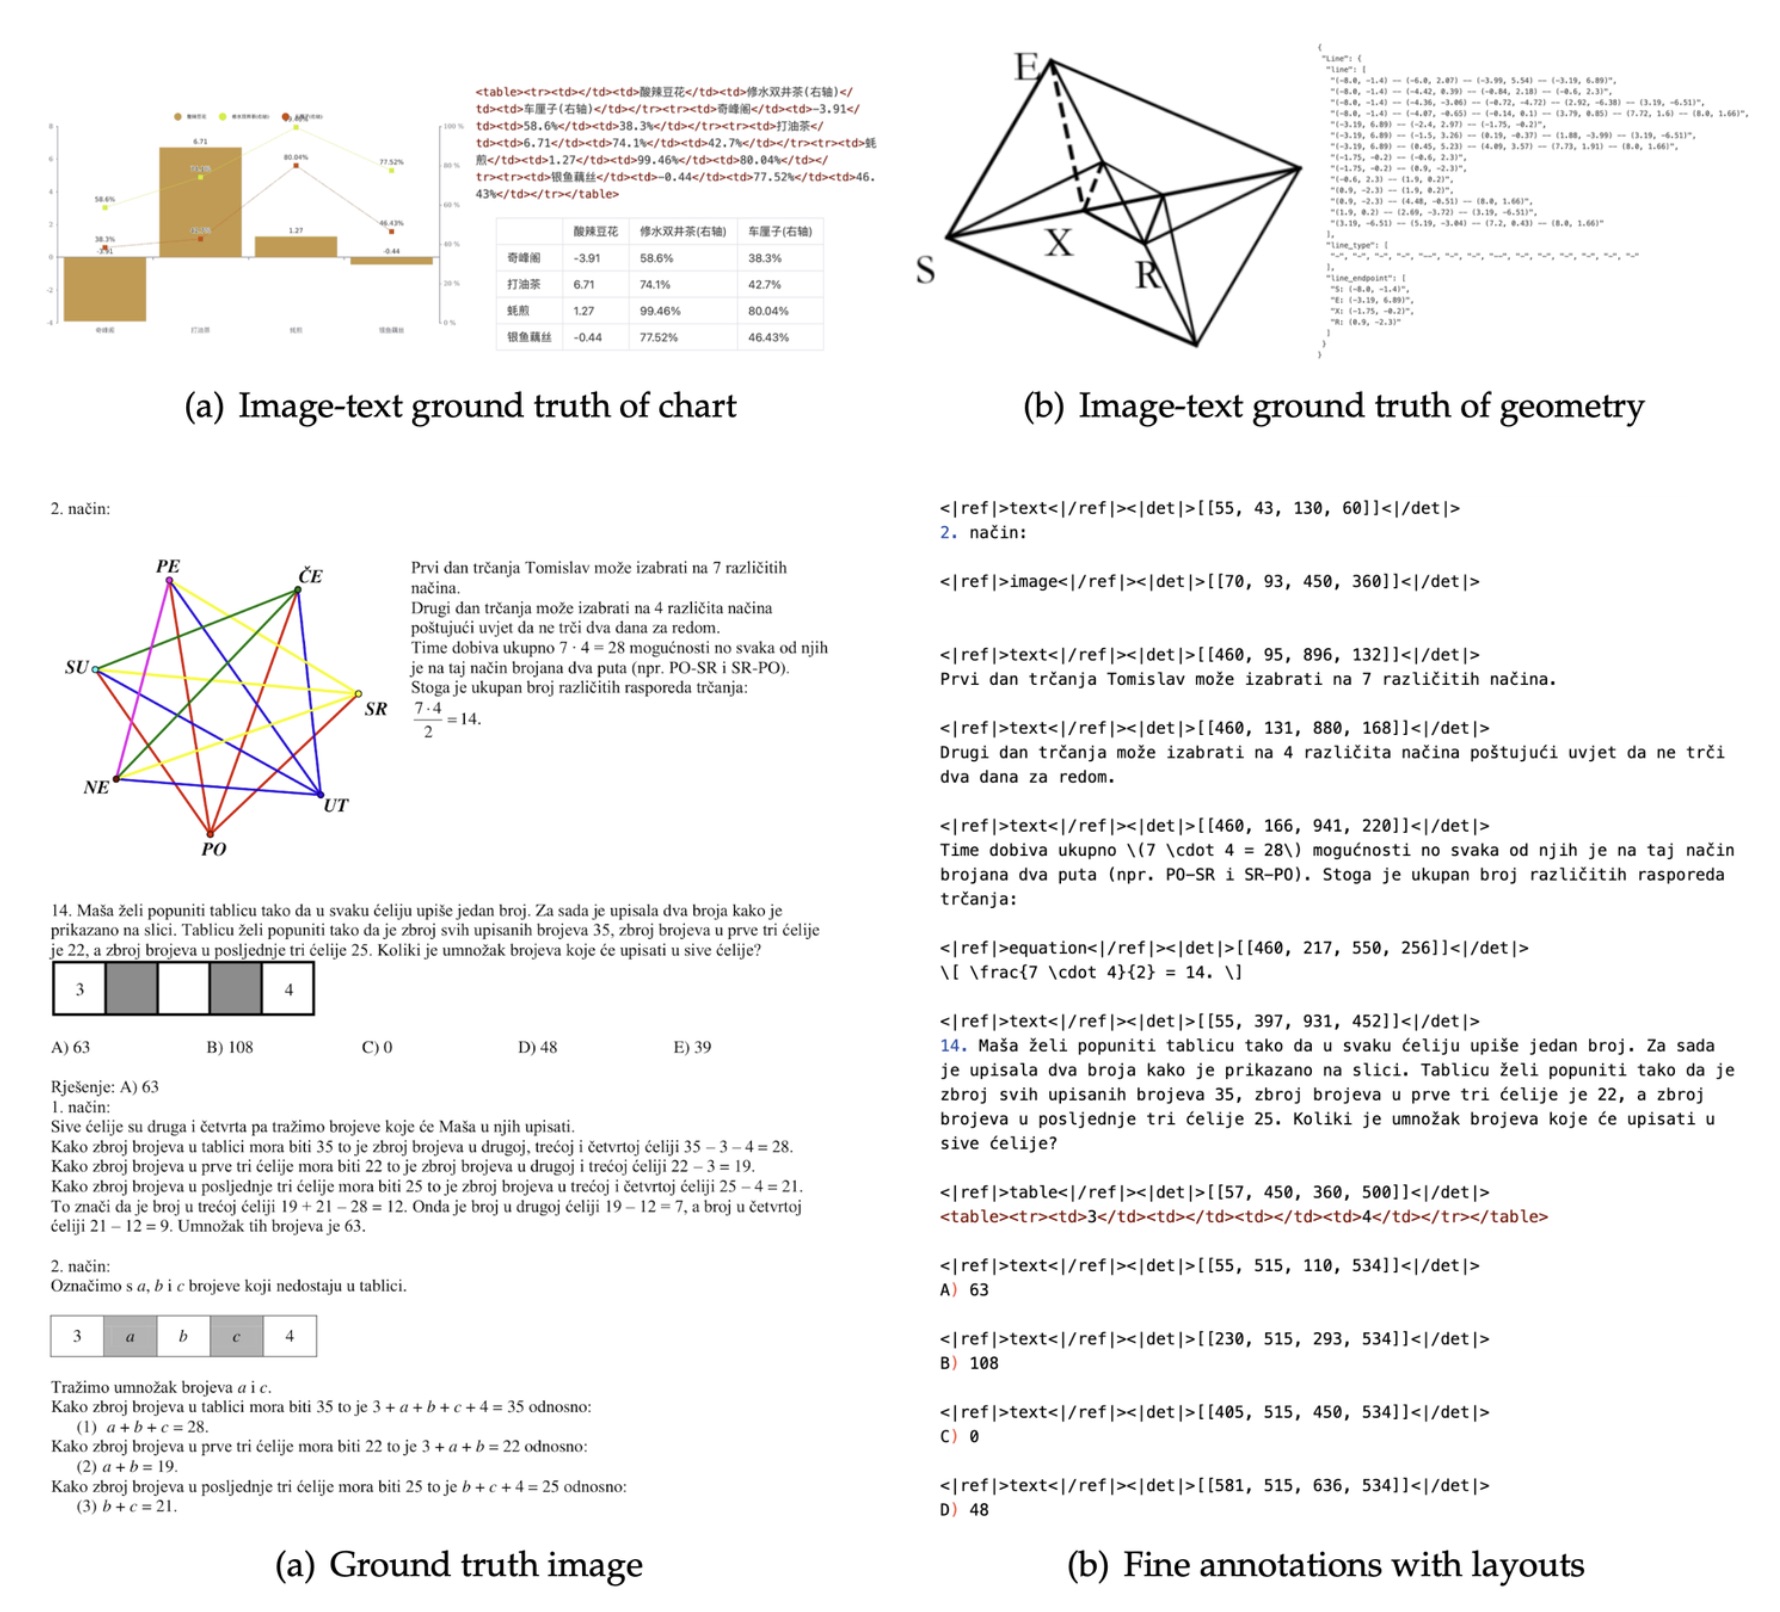
DeepSeek-OCR 研究与实测
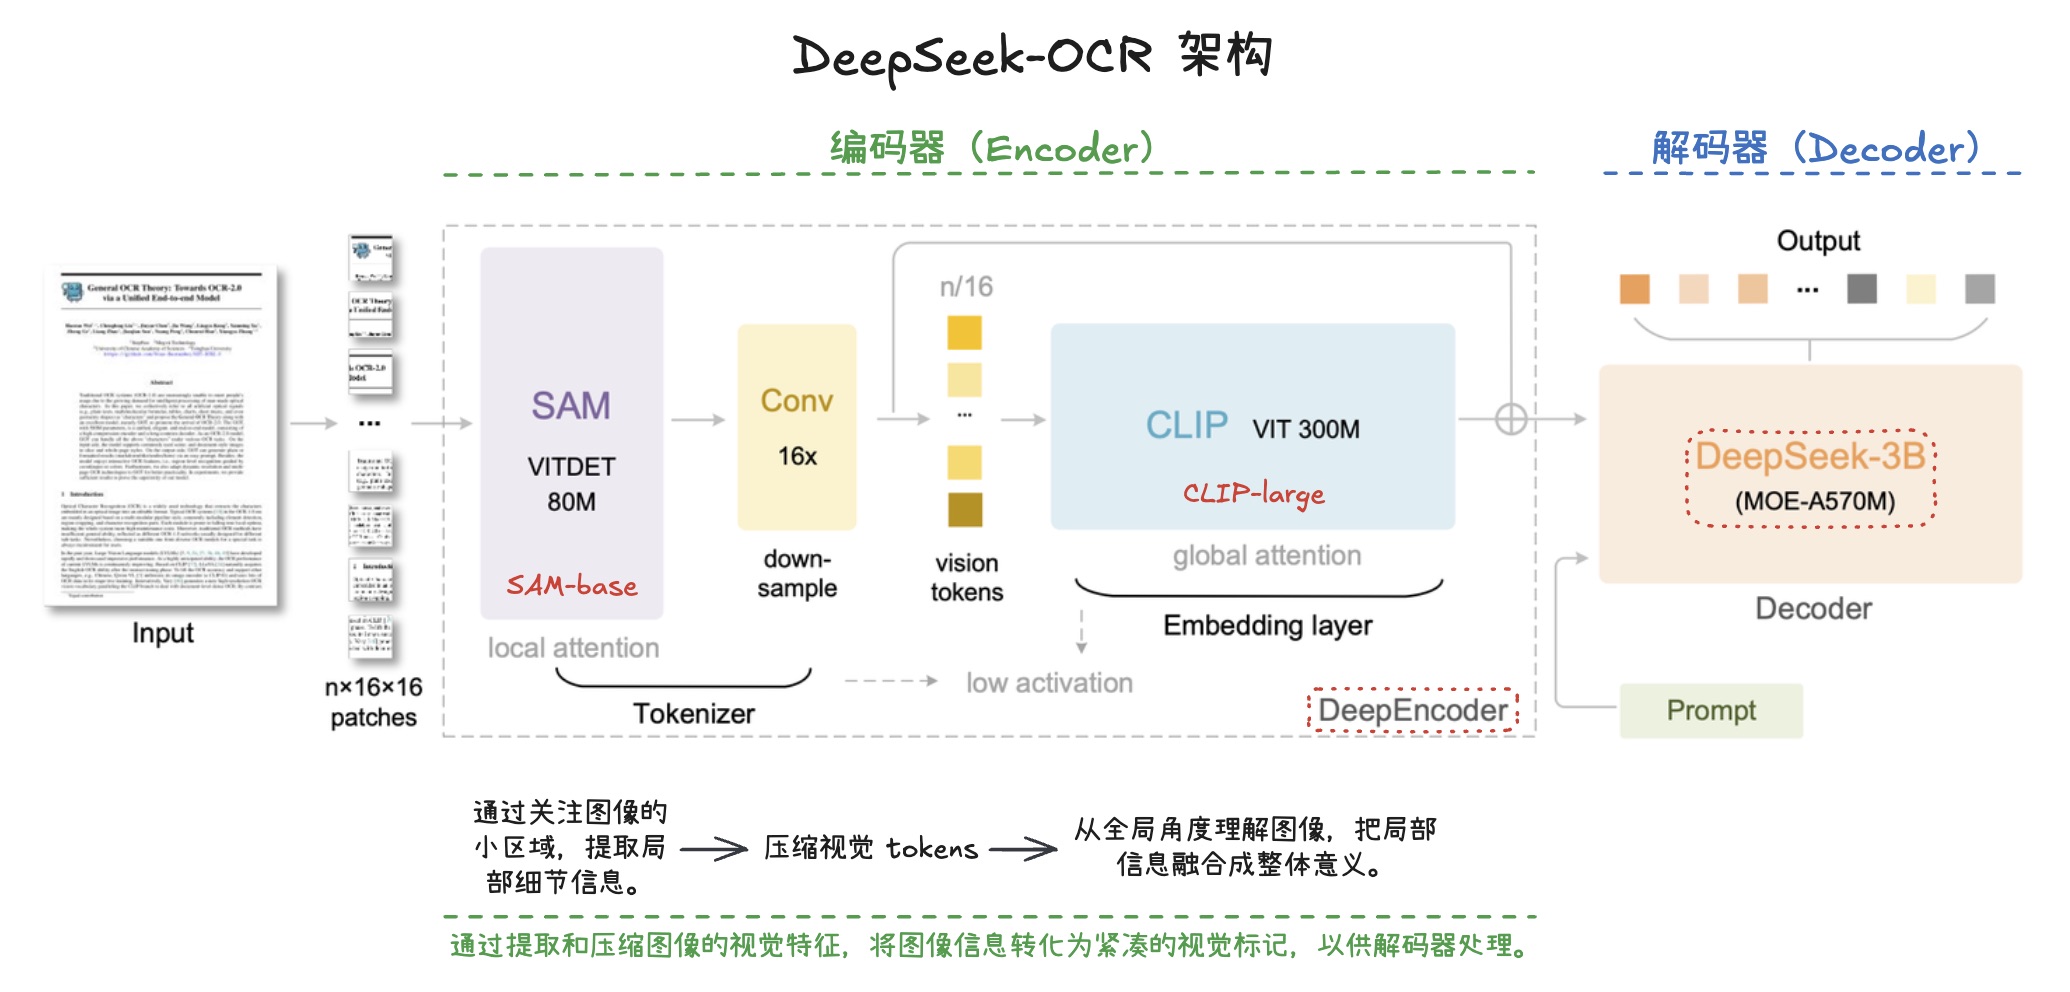
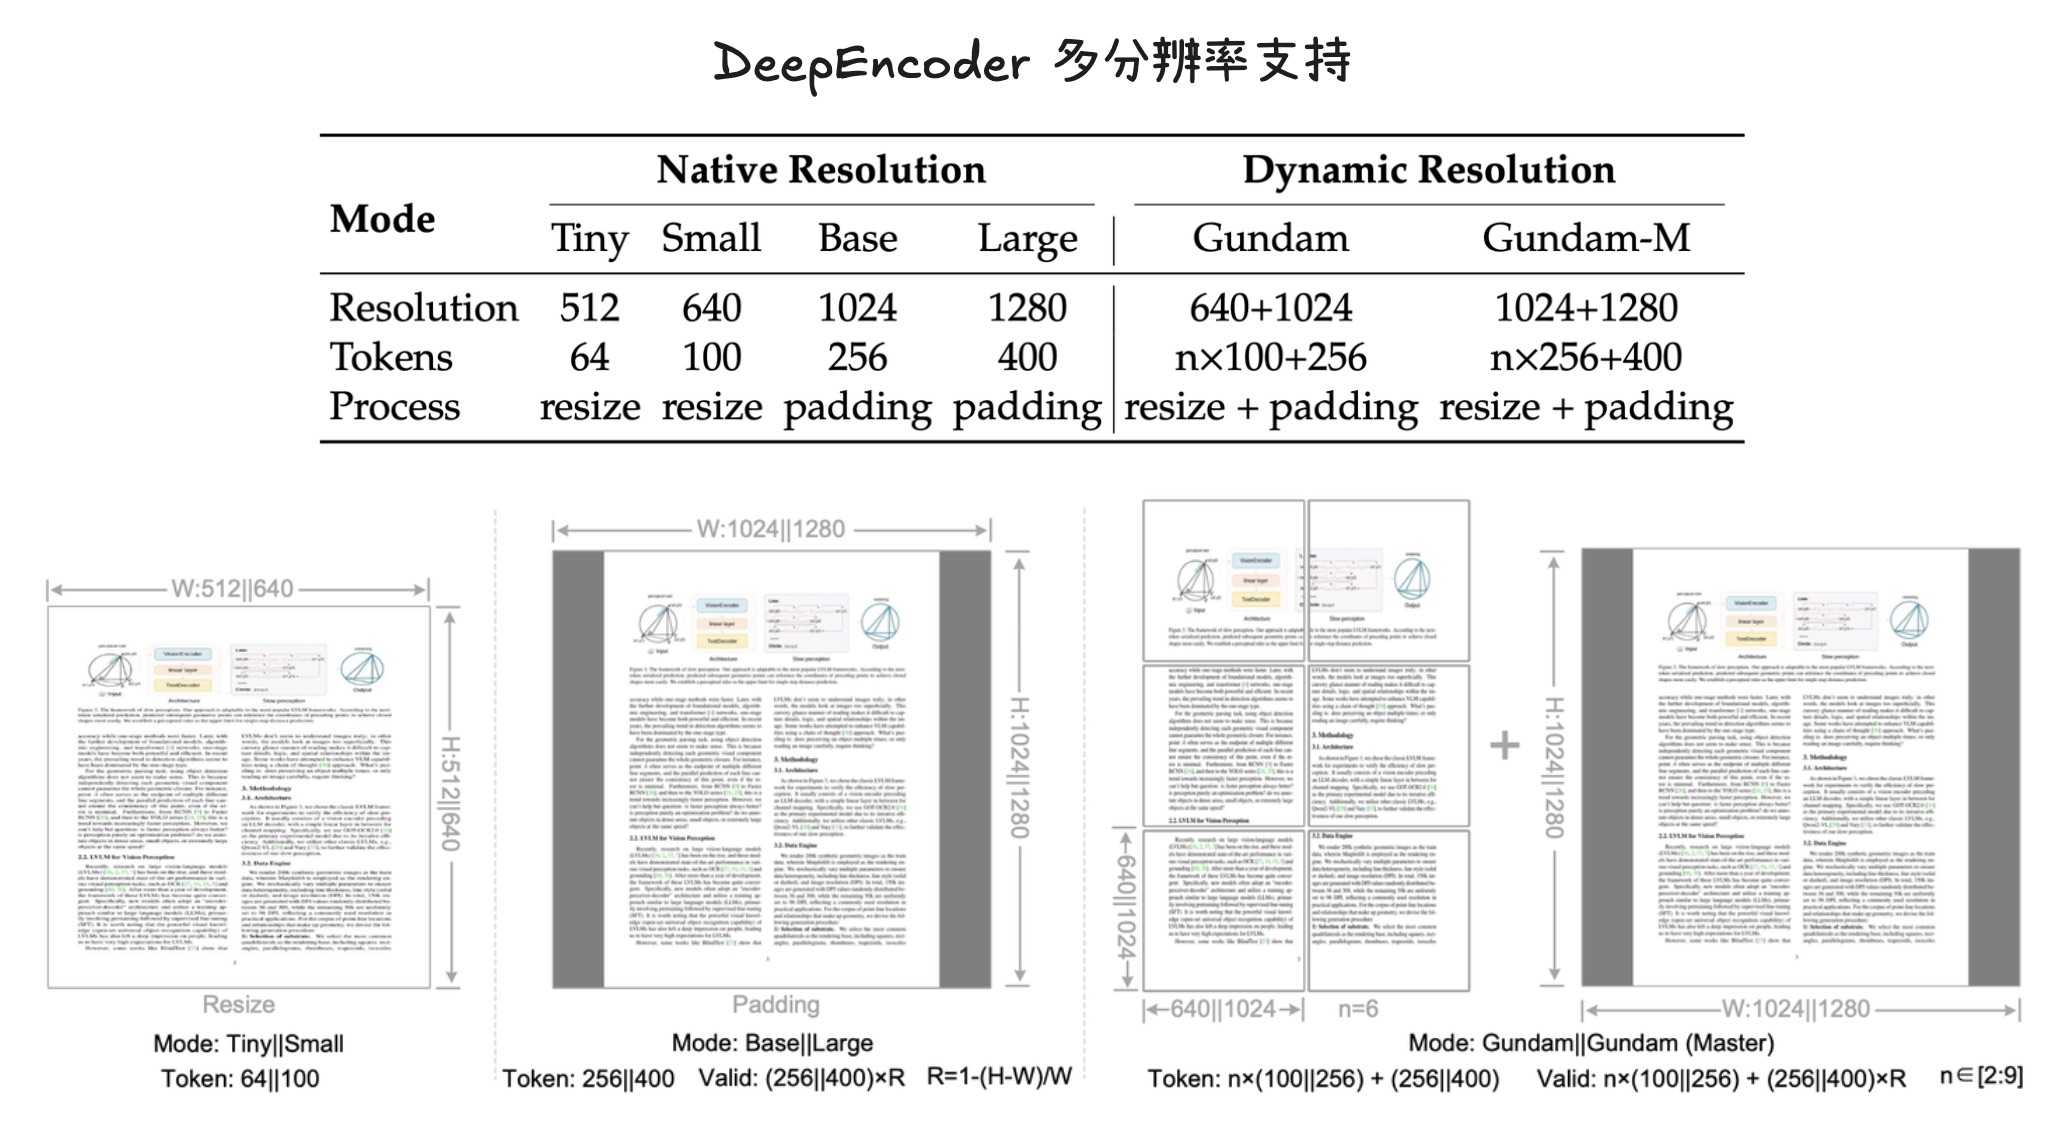
DeepSeek-OCR:上下文光学压缩
DeepSeek-OCR 架构
训练数据
数据组成
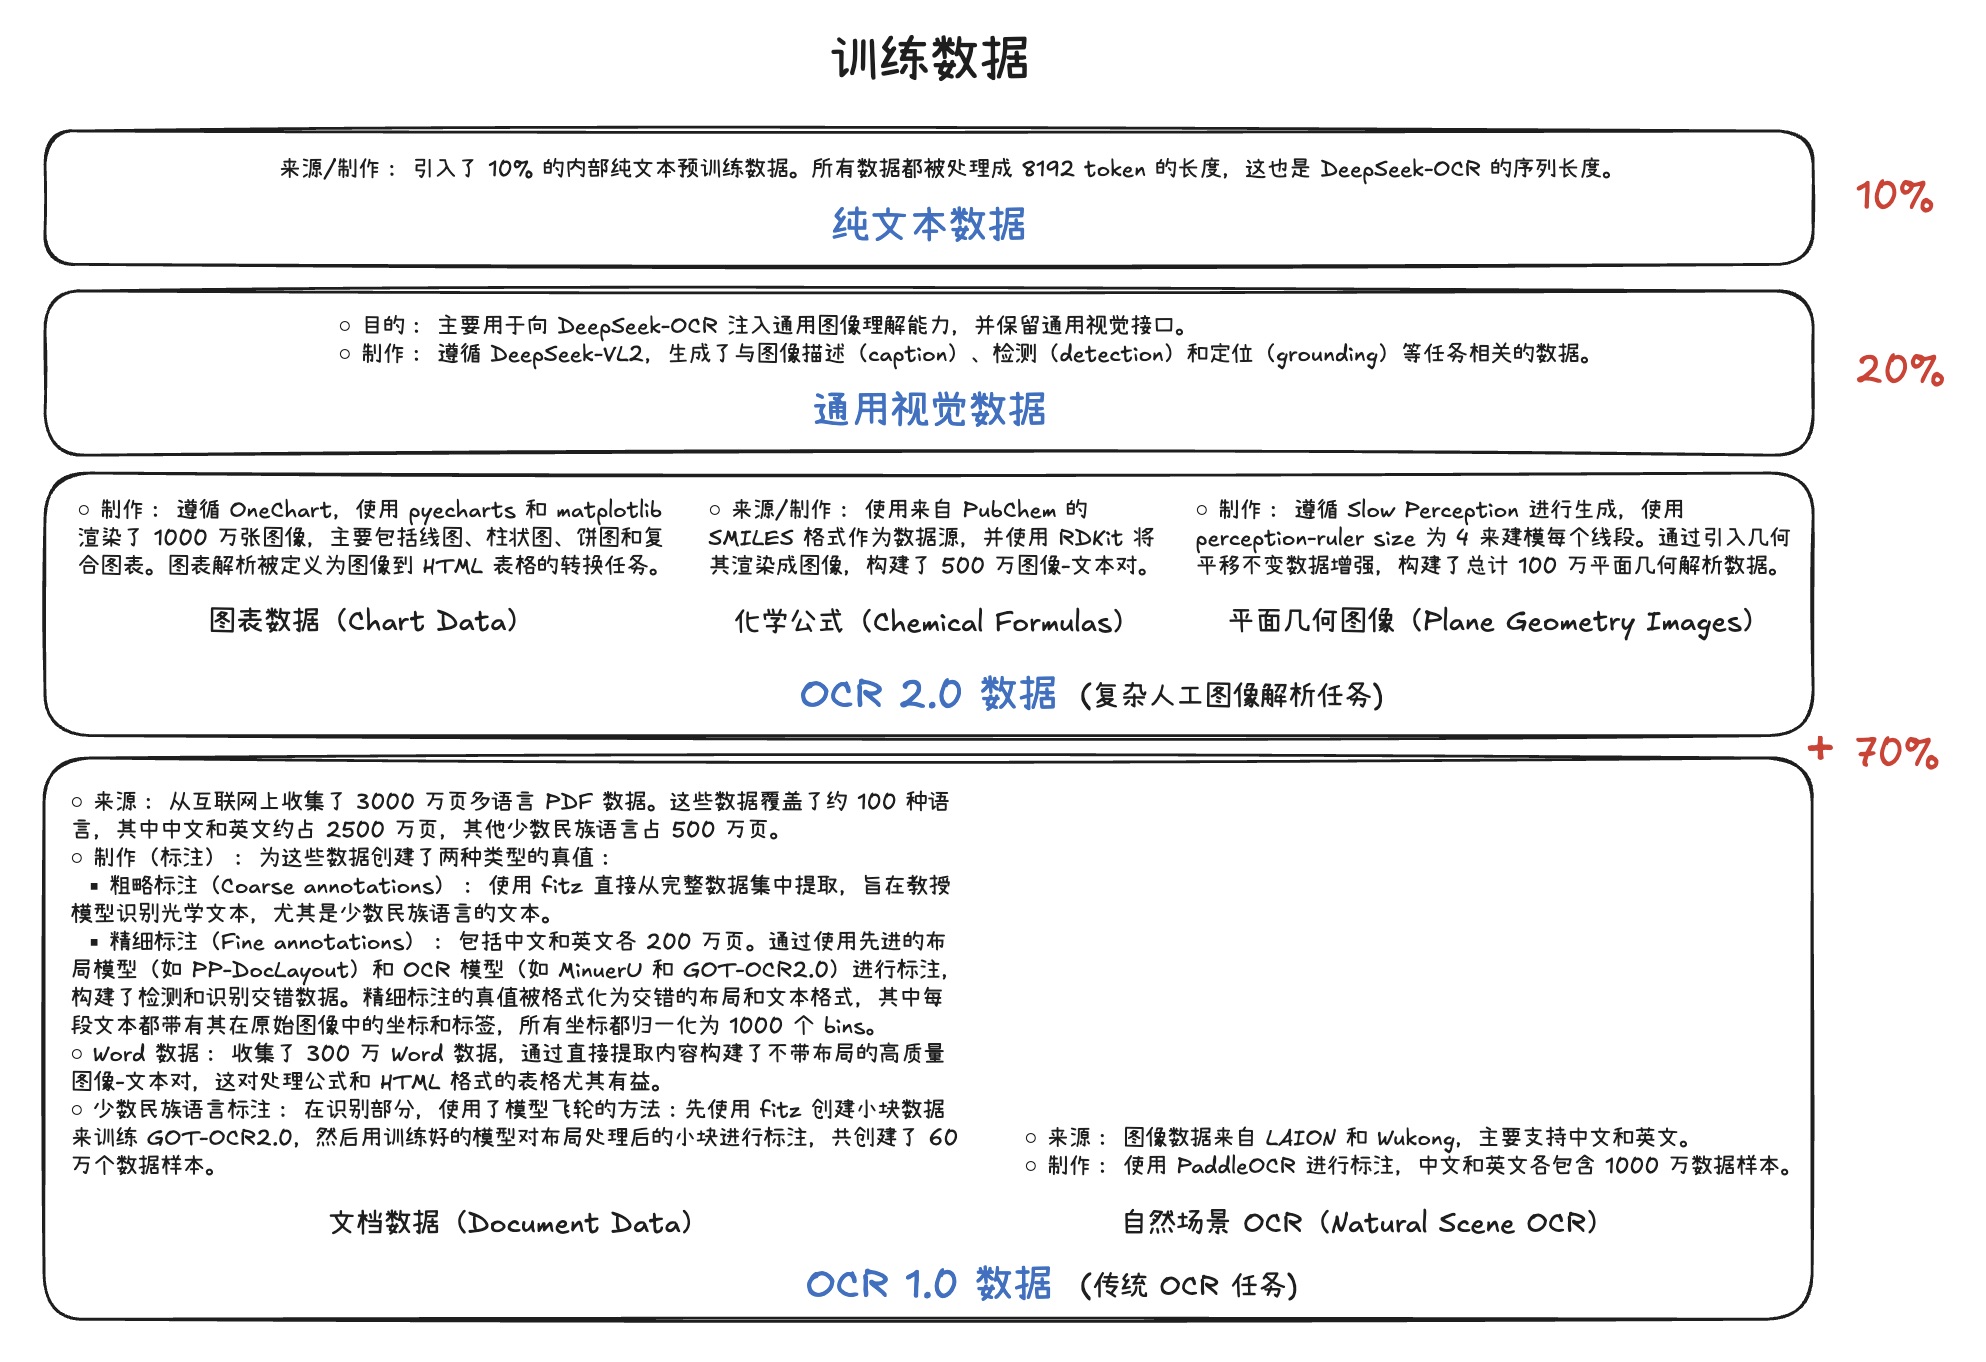
数据标注
训练流程
训练 DeepEncoder
- 方法: 遵循
Vary,使用紧凑语言模型和下一词元预测(next token prediction)框架进行训练。 - 数据: 使用所有
OCR 1.0和OCR 2.0数据,以及从LAION数据集中采样的1 亿(100M)通用数据。 - 训练细节: 训练
2个 epoch,批次大小为1280,使用AdamW 优化器,配合余弦退火(cosine annealing)调度器,学习率为5e-5。训练序列长度为4096。
训练 DeepSeek-OCR
- 时机: DeepEncoder 准备好后进行。
- 数据: 使用训练数据。
- 并行策略: 采用
流水线并行(PP),模型被分为 4 部分:- DeepEncoder (PP0, PP1):
- PP0: 包含
SAM 和压缩器(作为视觉词元分析器),参数冻结。 - PP1: 包含
CLIP部分(作为输入嵌入层),权重不冻结,参与训练。
- PP0: 包含
- 语言模型 (PP2, PP3): DeepSeek3B-MoE 共有 12 层,PP2 和 PP3 各放置 6 层。
- DeepEncoder (PP0, PP1):
- 硬件与批次: 使用 20 个节点(每个节点配备 8 块 A100-40G GPU)进行训练,数据并行(DP)为 40,全局批次大小为
640。 - 优化器: 使用
AdamW 优化器,配合基于步数的调度器(step-based scheduler),初始学习率为3e-5。 - 训练速度: 纯文本数据:900 亿词元/天(90B tokens/day);多模态数据:700 亿词元/天(70B tokens/day)。
whisper.cpp 实战指南(Jetson Thor 平台)
编译 whisper.cpp
克隆仓库
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
编译 whisper.cpp
cmake -B build -DGGML_CUDA=1 -DCMAKE_CUDA_ARCHITECTURES="110"
cmake --build build -j --config Release
下载模型
sh ./models/download-ggml-model.sh small
sh ./models/download-ggml-model.sh large-v3-turbo
- tiny.en
- tiny
- base.en
- base
- small.en
- small
- medium.en
- medium
- large-v1
- large-v2
- large-v3
- large-v3-turbo
运行 whisper-cli
./build/bin/whisper-cli -f samples/jfk.wav
./build/bin/whisper-cli -m /models/whisper.cpp/models/ggml-large-v3-turbo.bin -f samples/jfk.wav
whisper-server
使用 nmtui 配置 Jetson Thor Wi-Fi 热点(AP 模式)
查看 Wi-Fi 设备是否支持 AP 模式
iw list | grep "AP"
	Device supports AP-side u-APSD.
		 * AP
		HE Iftypes: AP
				Rx HE MU PPDU from Non-AP STA
		HE Iftypes: AP
				Rx HE MU PPDU from Non-AP STA
		 * AP: 0x00 0x10 0x20 0x30 0x40 0x50 0x60 0x70 0x80 0x90 0xa0 0xb0 0xc0 0xd0 0xe0 0xf0
		 * AP/VLAN: 0x00 0x10 0x20 0x30 0x40 0x50 0x60 0x70 0x80 0x90 0xa0 0xb0 0xc0 0xd0 0xe0 0xf0
		 * AP: 0x00 0x20 0x40 0xa0 0xb0 0xc0 0xd0
		 * AP/VLAN: 0x00 0x20 0x40 0xa0 0xb0 0xc0 0xd0
	Maximum associated stations in AP mode: 32
- 如果没有
AP字样,则不支持 AP 模式。
创建 Wi-Fi 热点
- 运行
sudo nmtui并选择“编辑一个连接”。- 在
nmtui主菜单中,确保选中“Edit a connection”选项。 - 按下
<OK>键。
- 在
llama.cpp 实战指南(Jetson Thor 平台):从源码编译到 GGUF 模型部署与性能基准测试
本文将介绍如何在 Jetson Thor 平台上编译、部署和测试 llama.cpp 项目中的 GGUF 格式的大模型。
克隆 llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
CUDA GPU Compute Capability(计算能力)
计算能力(CC)定义了每种 NVIDIA GPU 架构的硬件特性和支持的指令。在下表中查找您的GPU的计算能力。
编译
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="110"
cmake --build build --config Release -j $(nproc)
模型部署
运行 llama-server
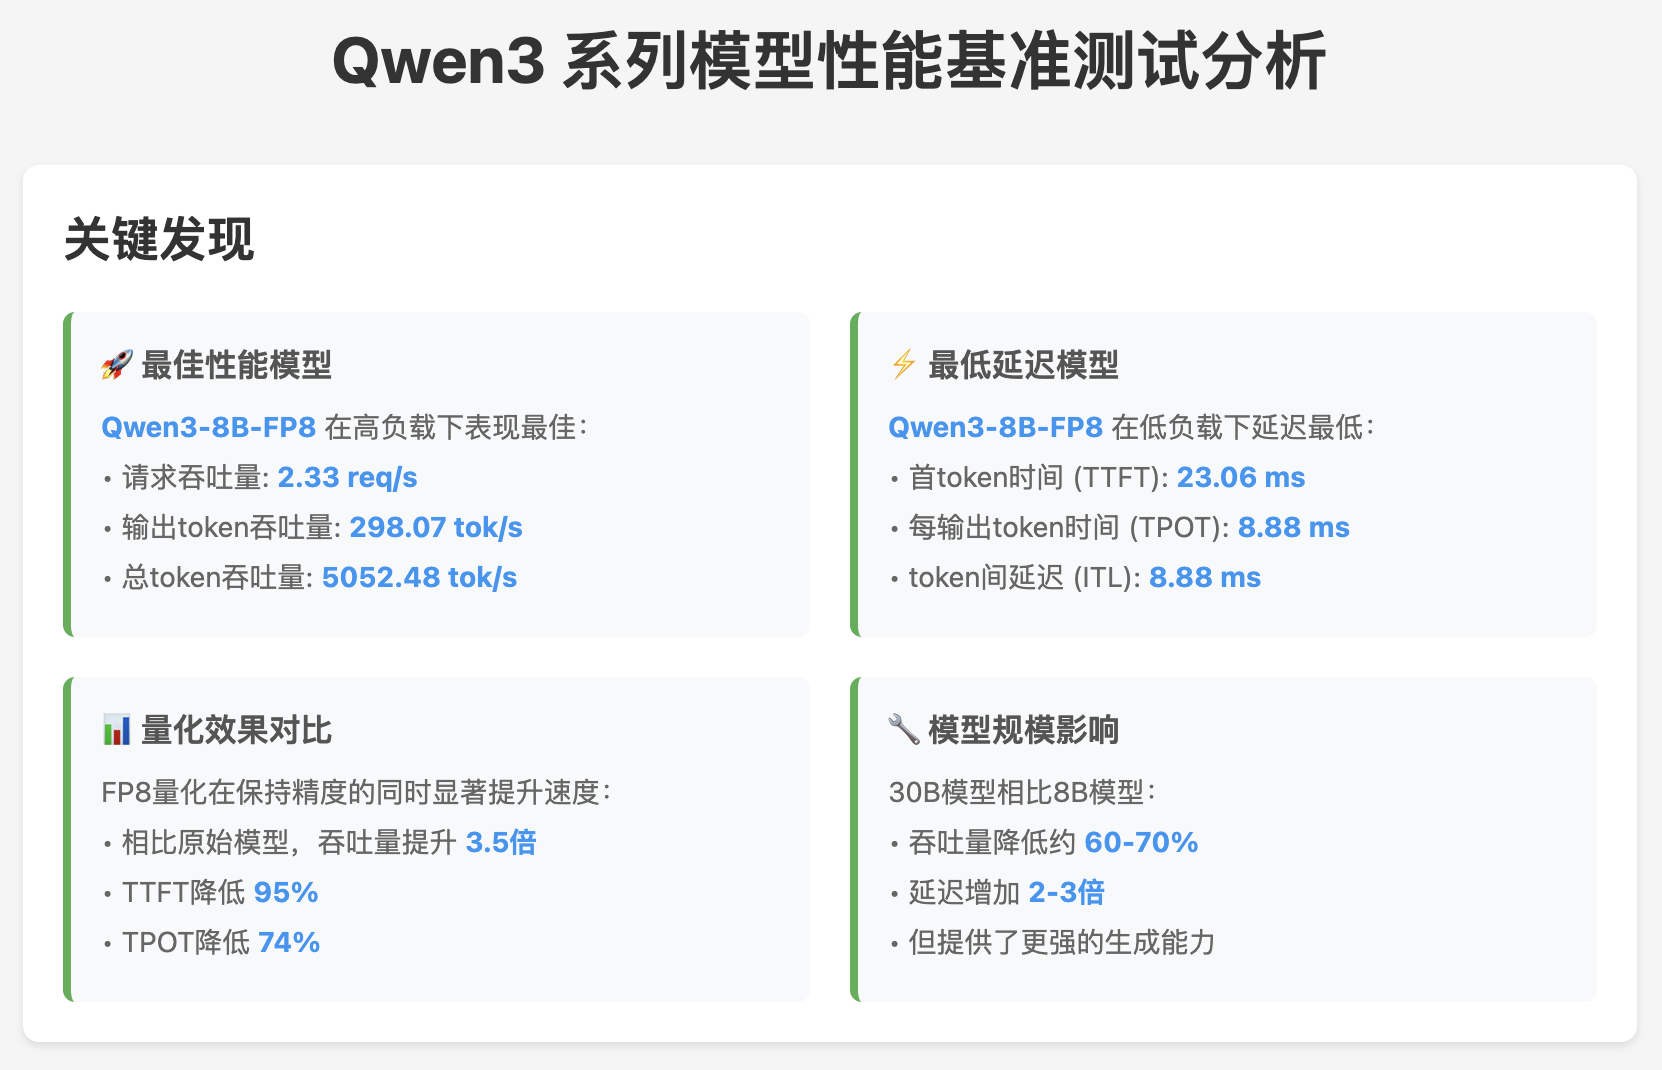
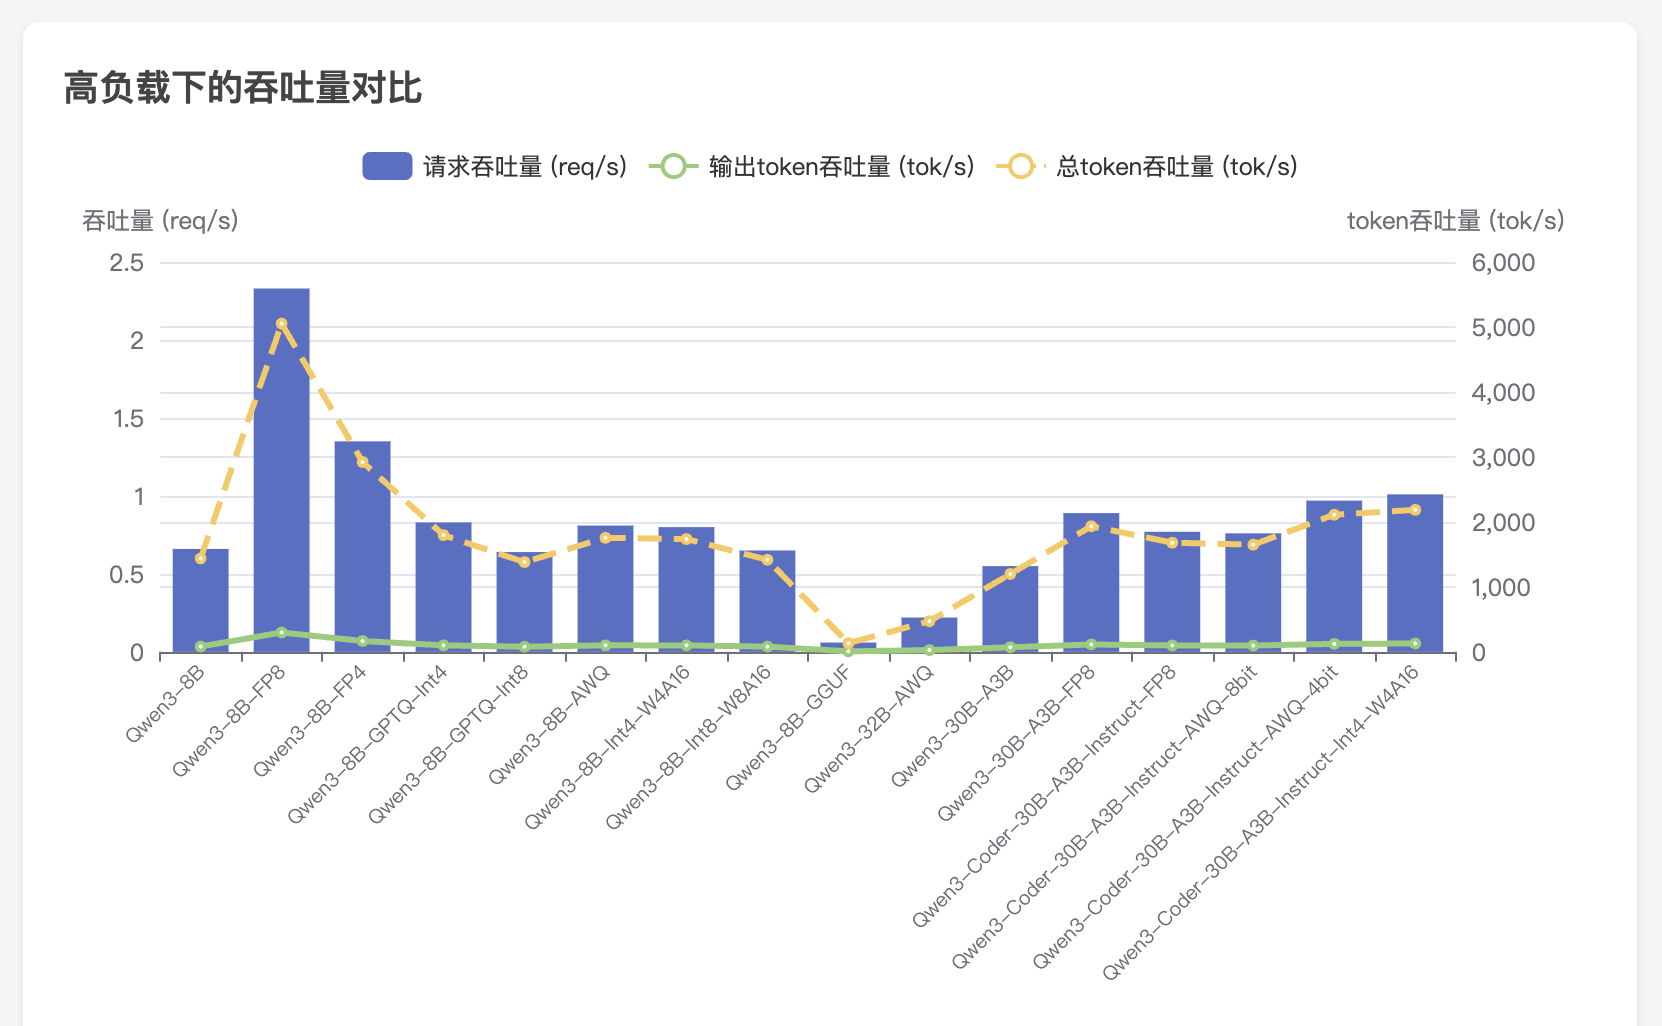
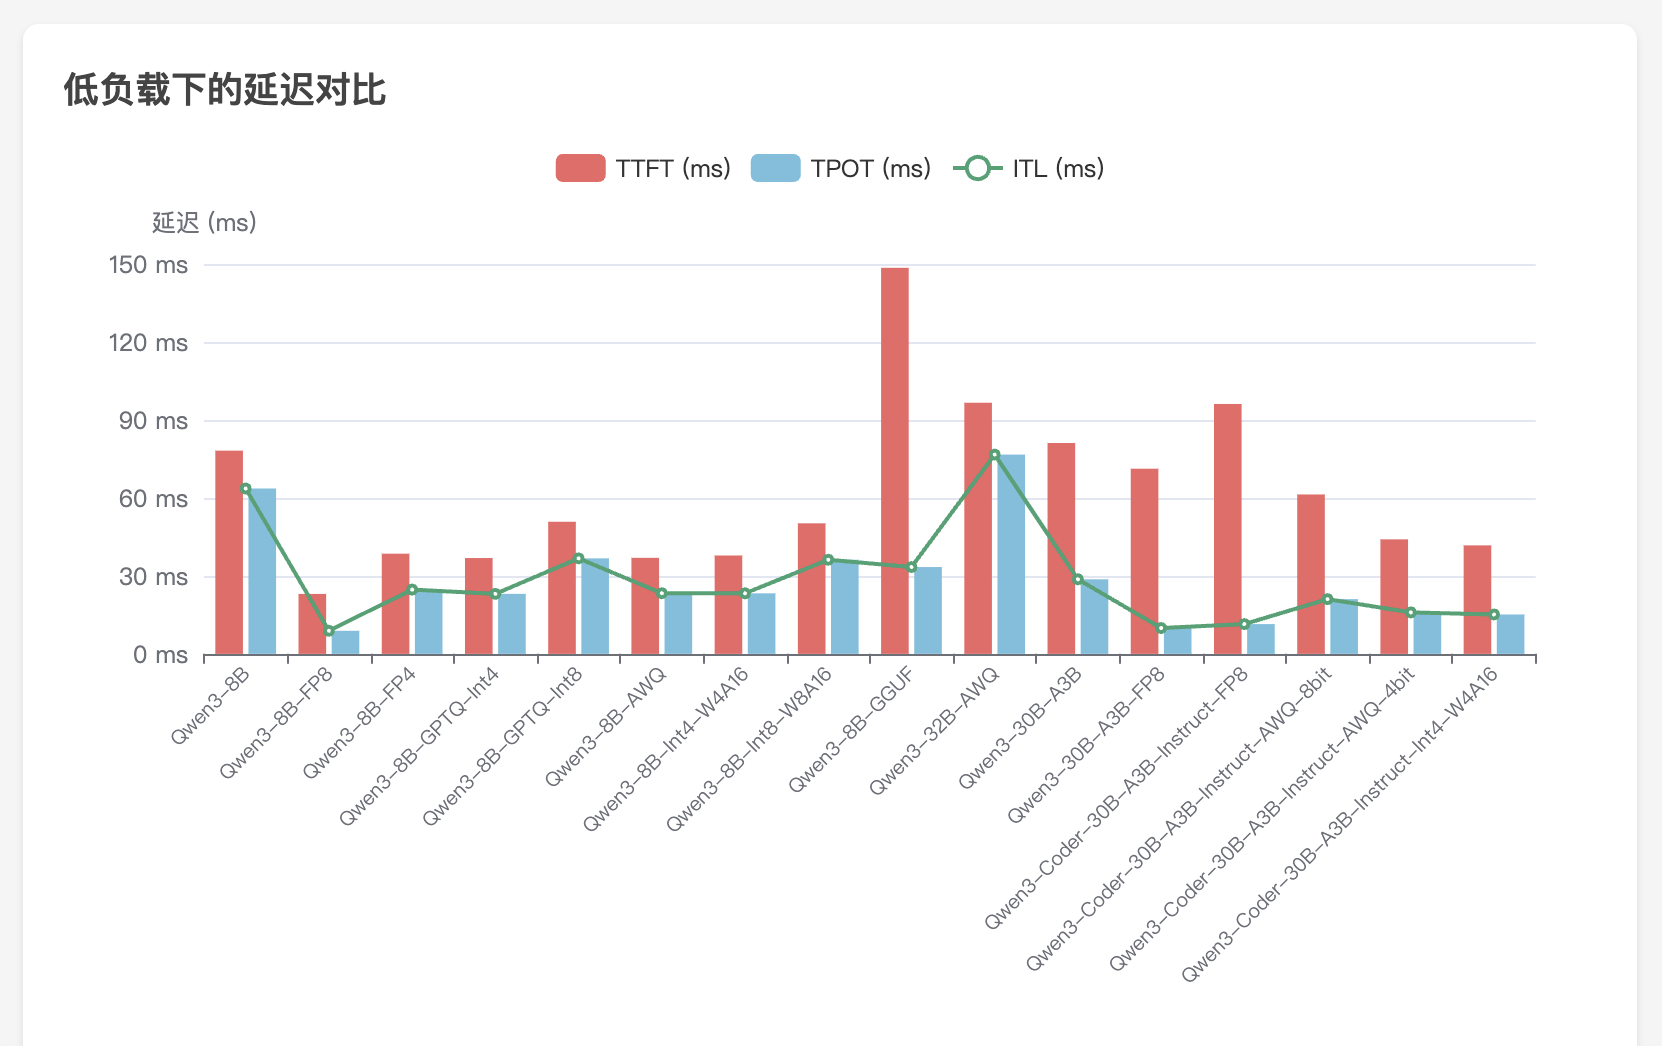
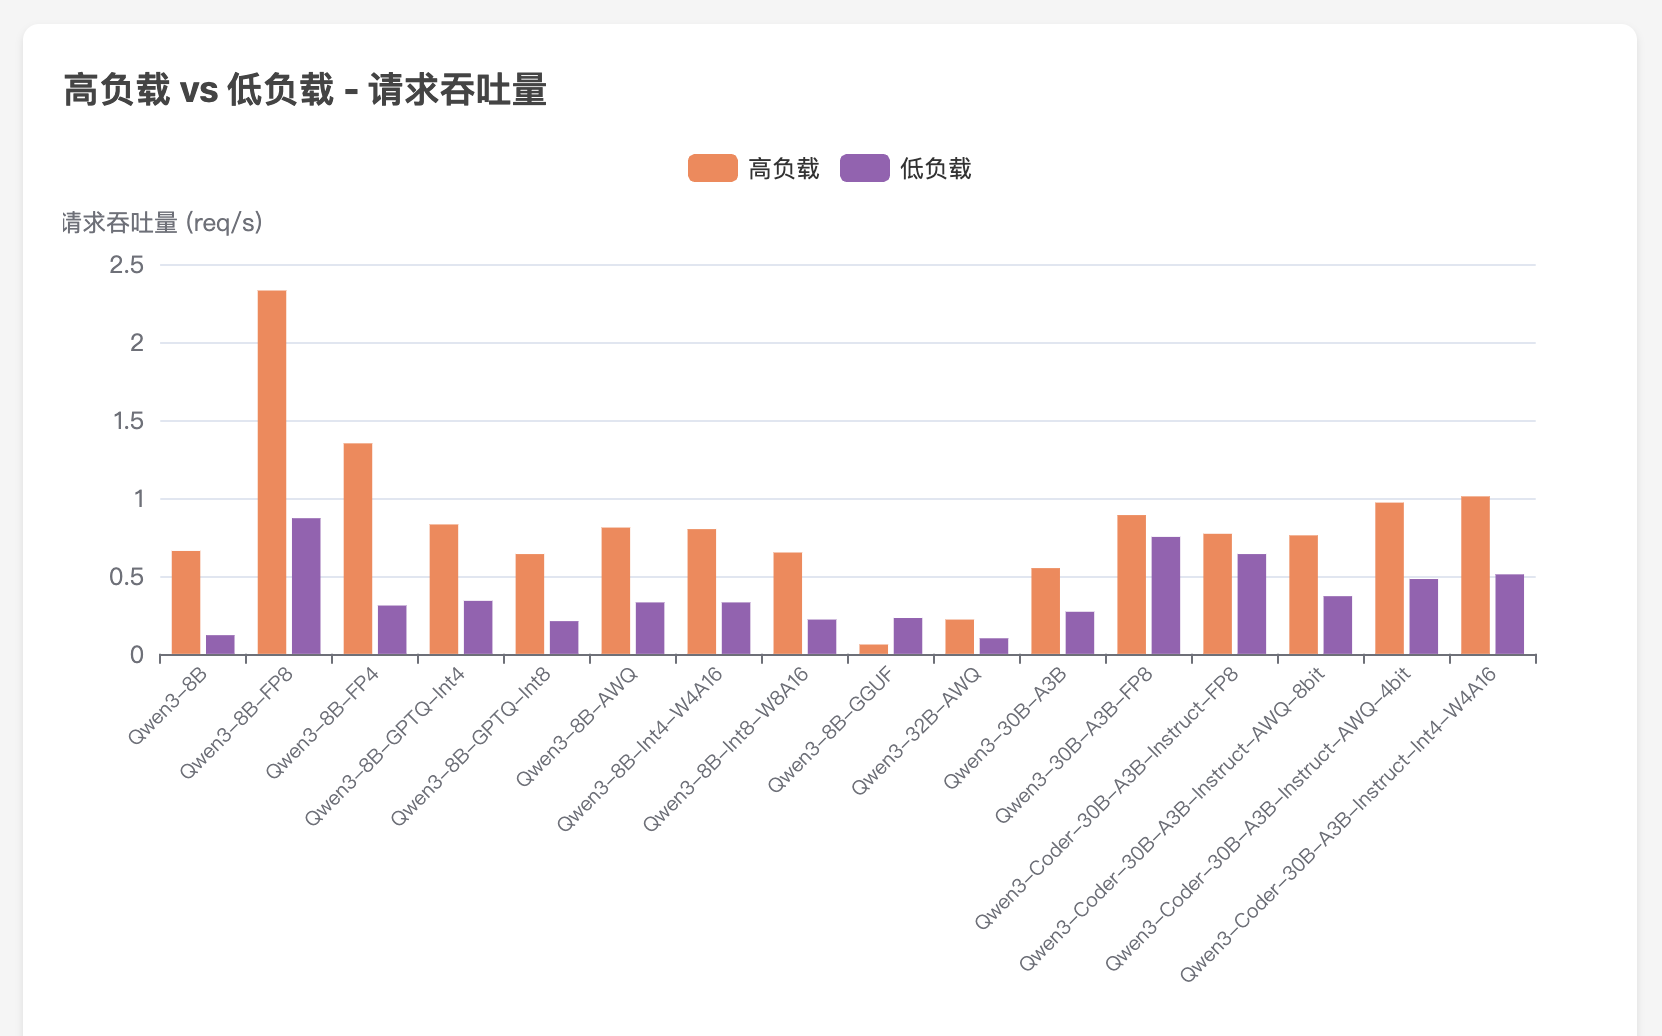
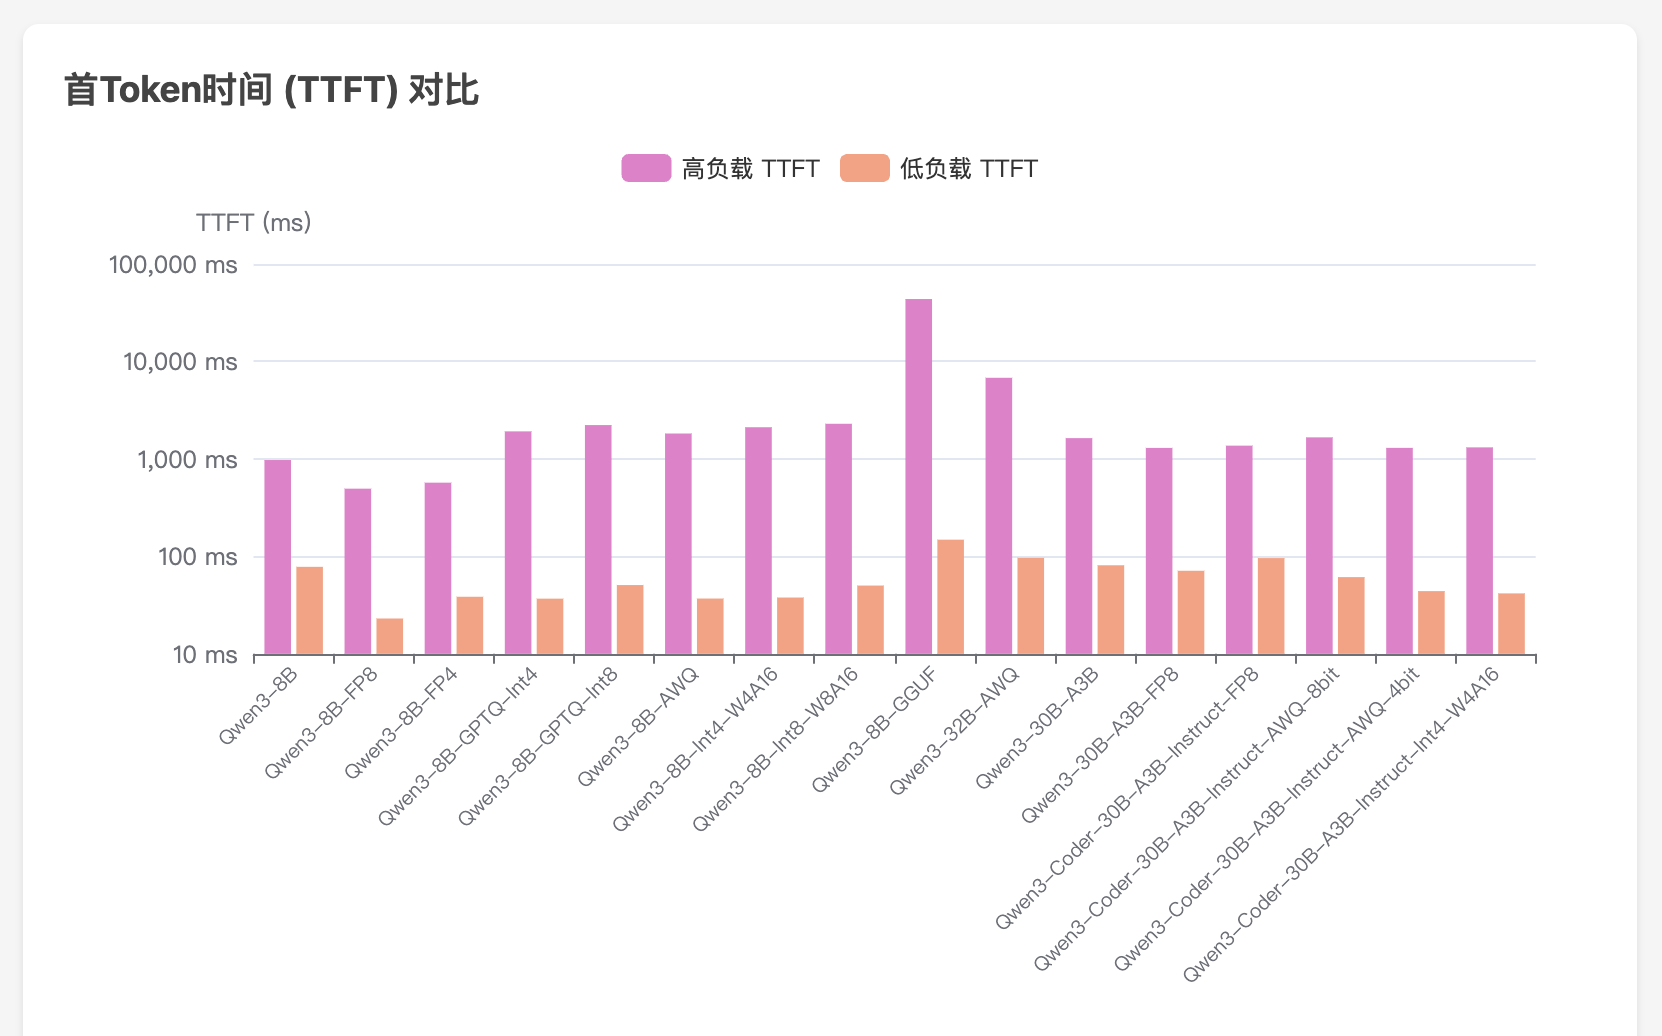
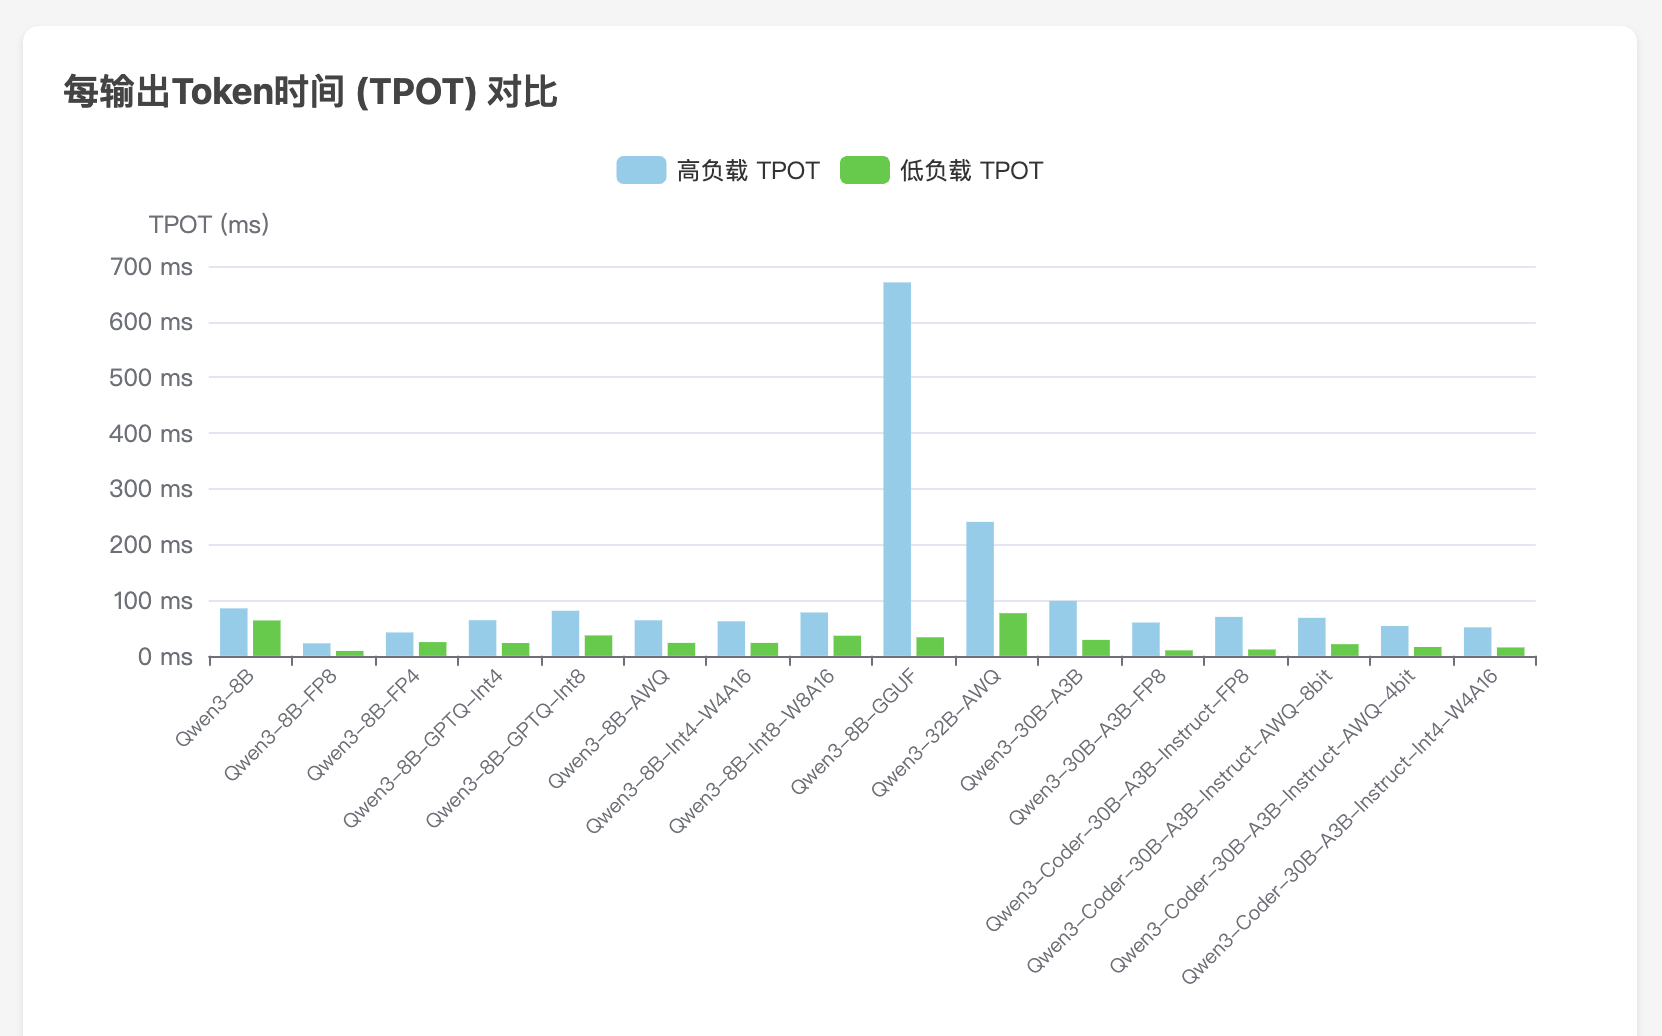
Jetson Thor 平台上 Qwen3 系列大模型性能基准测试分析
NVIDIA Jetson Thor 采用了 Blackwell 架构的 GPU。
性能基准测试分析
部署模型
vllm serve /models/Qwen/Qwen3-8B --served-model-name qwen3
运行性能基准测试
- 高负载
vllm bench serve \
    --base-url http://localhost:8000 \
    --model qwen3 \
    --tokenizer /models/Qwen/Qwen3-8B \
    --dataset-name random \
    --random-input-len 2048 \
    --random-output-len 128 \
    --num-prompts 100 \
    --max-concurrency 8
- 低负载
Jetson Thor 权威指南:从开箱到大模型部署与性能优化
该文章是对 NVIDIA Jetson Thor 平台进行大语言模型部署、系统优化和深度性能基准测试的权威指南。
平台配置与环境准备: 文章首先详细介绍了在 Jetson AGX Thor 开发套件上进行 BSP(Jetson Linux)安装流程。这包括下载 ISO 映像、使用 Balena Etcher 创建可启动 USB 棒,以及通过首次启动完成 UEFI 固件更新和 Ubuntu 初始设置。软件环境基于 JetPack 7,它提供了对前沿机器人和生成式 AI 的全面支持。部署环境采用云原生技术,通过 Docker 容器运行 vLLM 或 TritonServer 等推理服务。
系统性能调优:
为了释放硬件全部潜力,文章强调了系统级的性能调优步骤:必须通过 sudo nvpmodel -m 0 将功耗模式设置为最高性能模式 (MAXN)(130W),并使用 sudo jetson_clocks 锁定 CPU、GPU 和内存的核心频率,禁用 DVFS 机制。测试结果显示,MAXN + jetson_clocks 组合能显著提升性能,在高负载下,FP8 模型的吞吐量提升约 18.5%,在低负载下,每 Token 平均延迟(TPOT)减少约 43%。
量化模型基准测试结果: 文章对 Qwen3-8B 模型的多种量化精度(包括 BF16、FP8、FP4、Int4 等)进行了详尽的性能分析。
使用 Claude Agent SDK 构建智能体
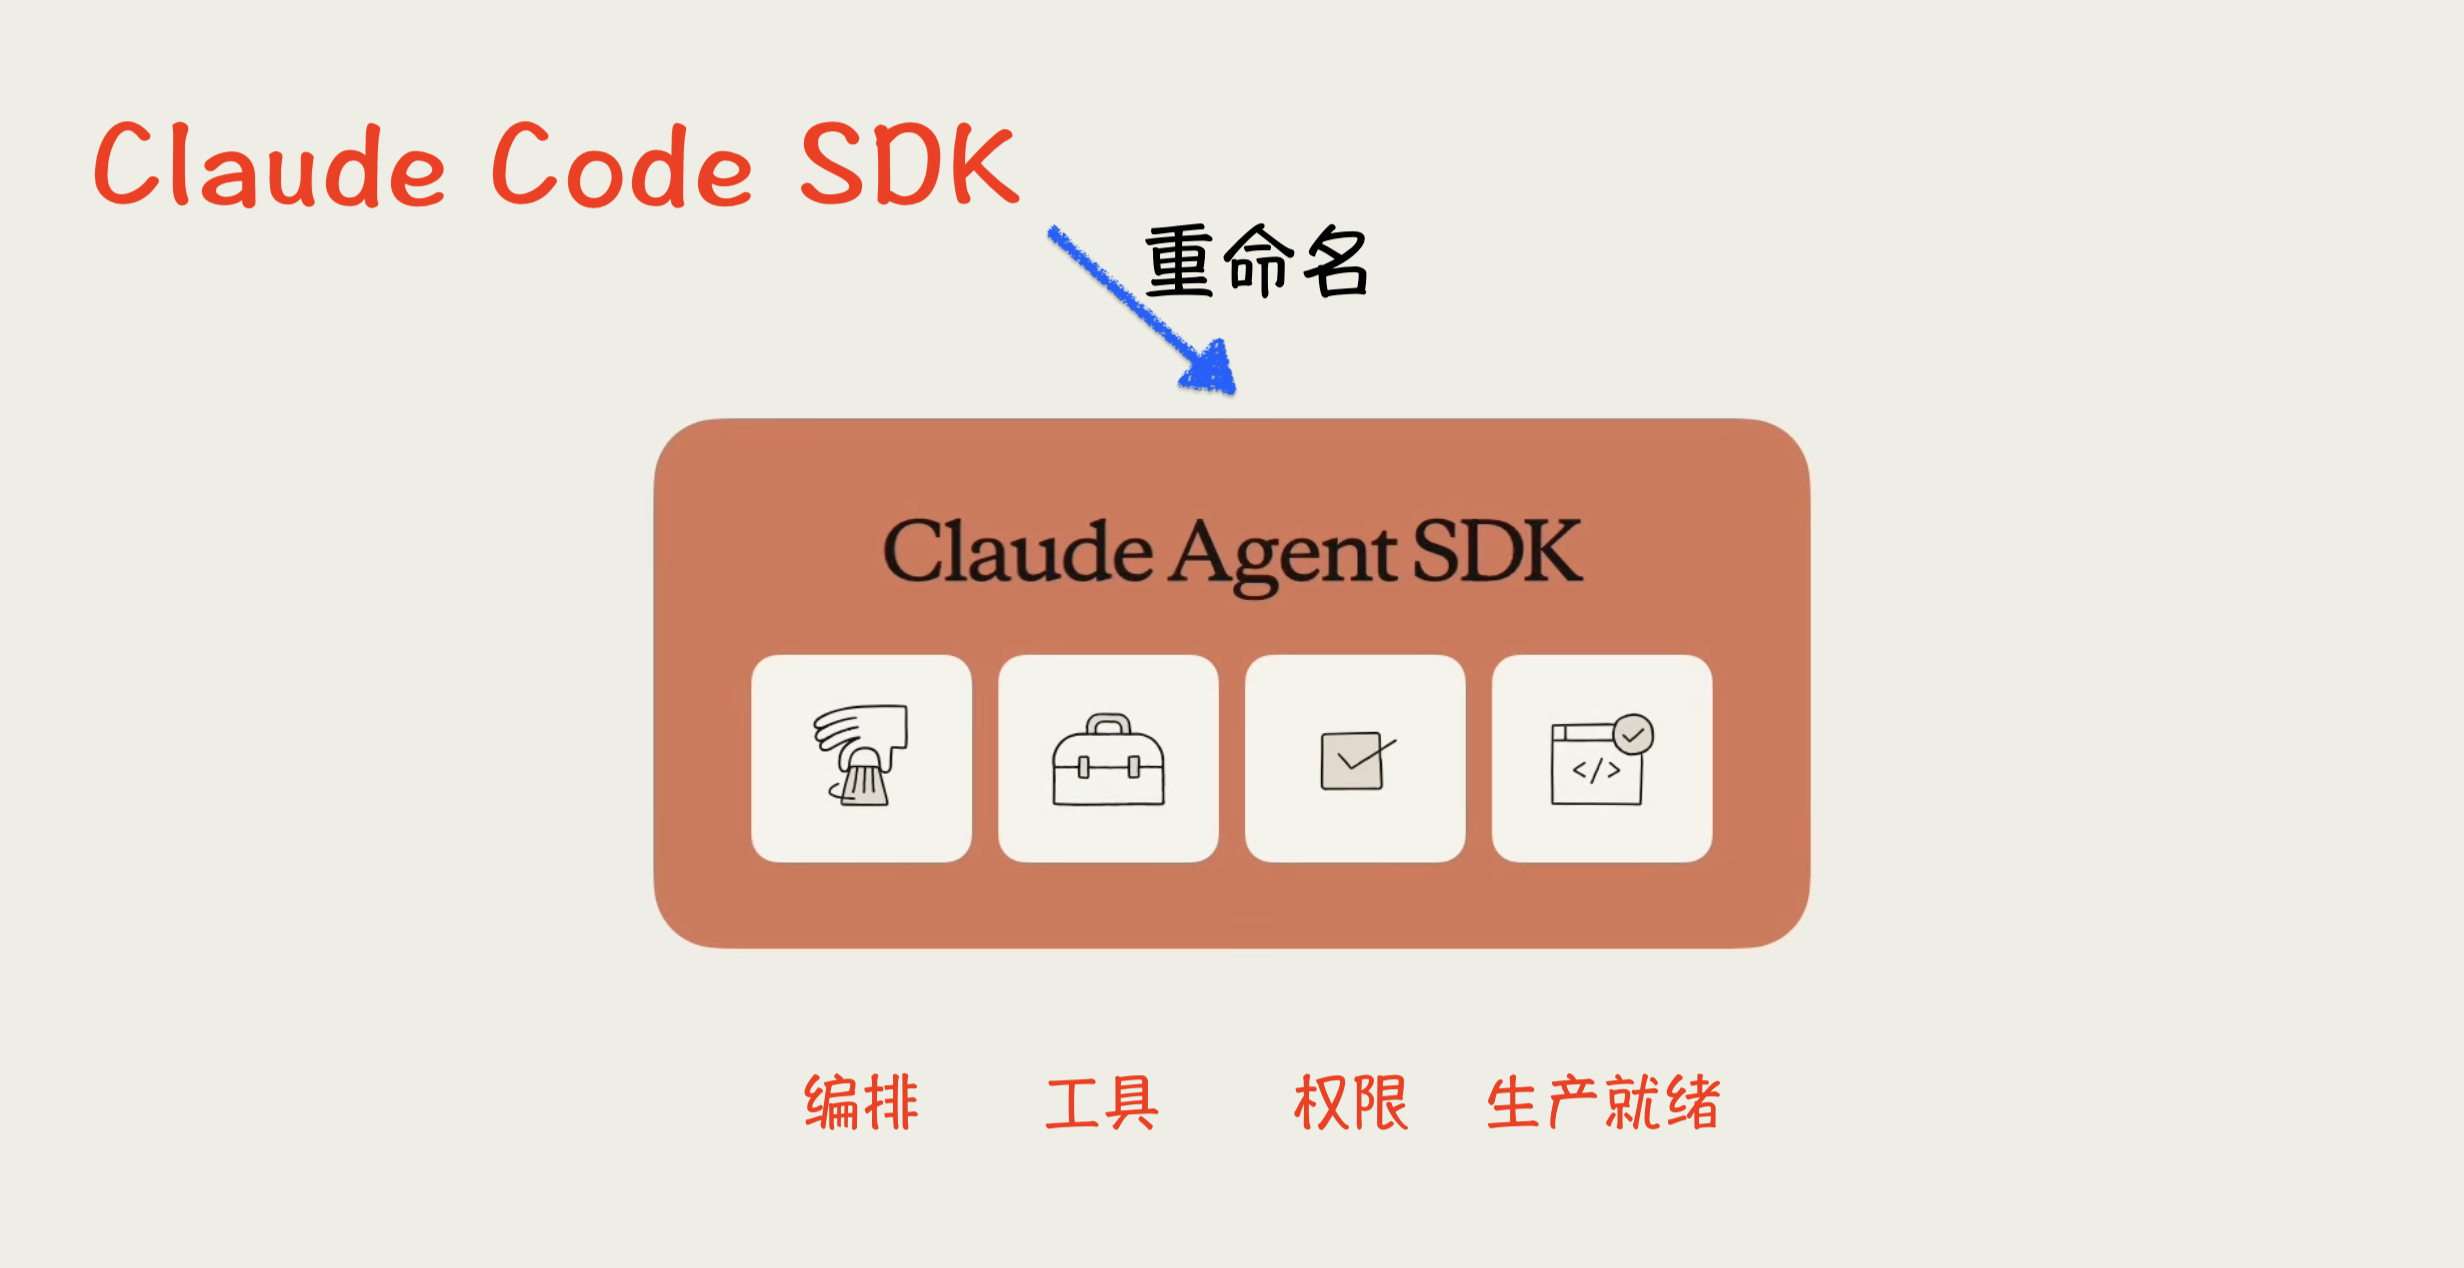
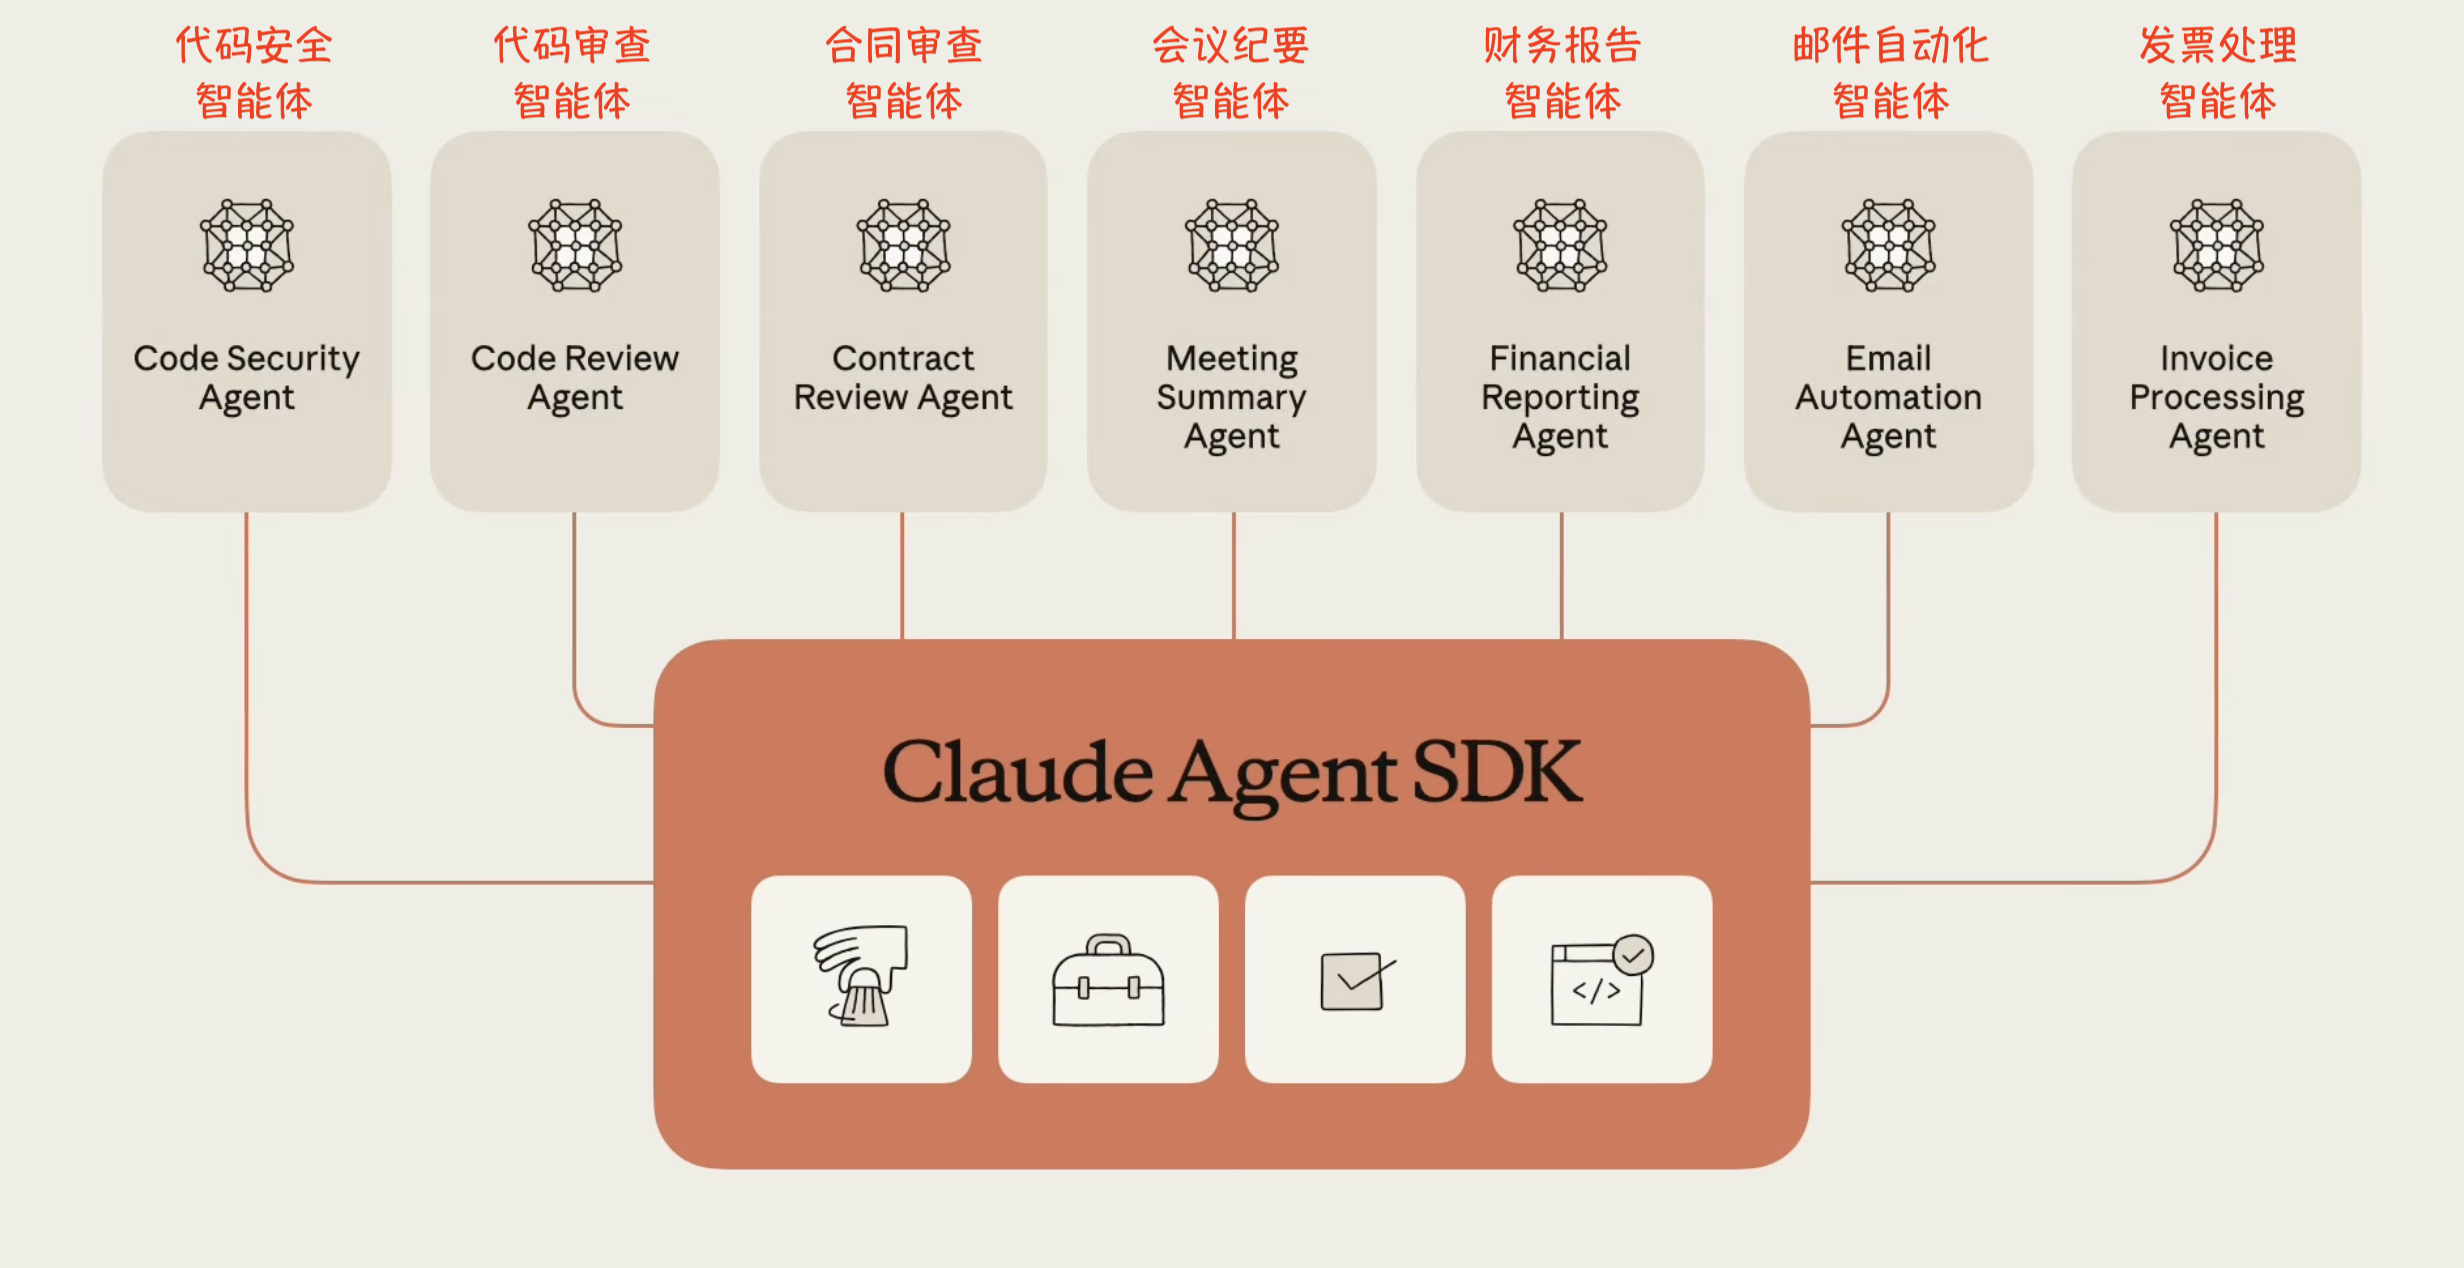
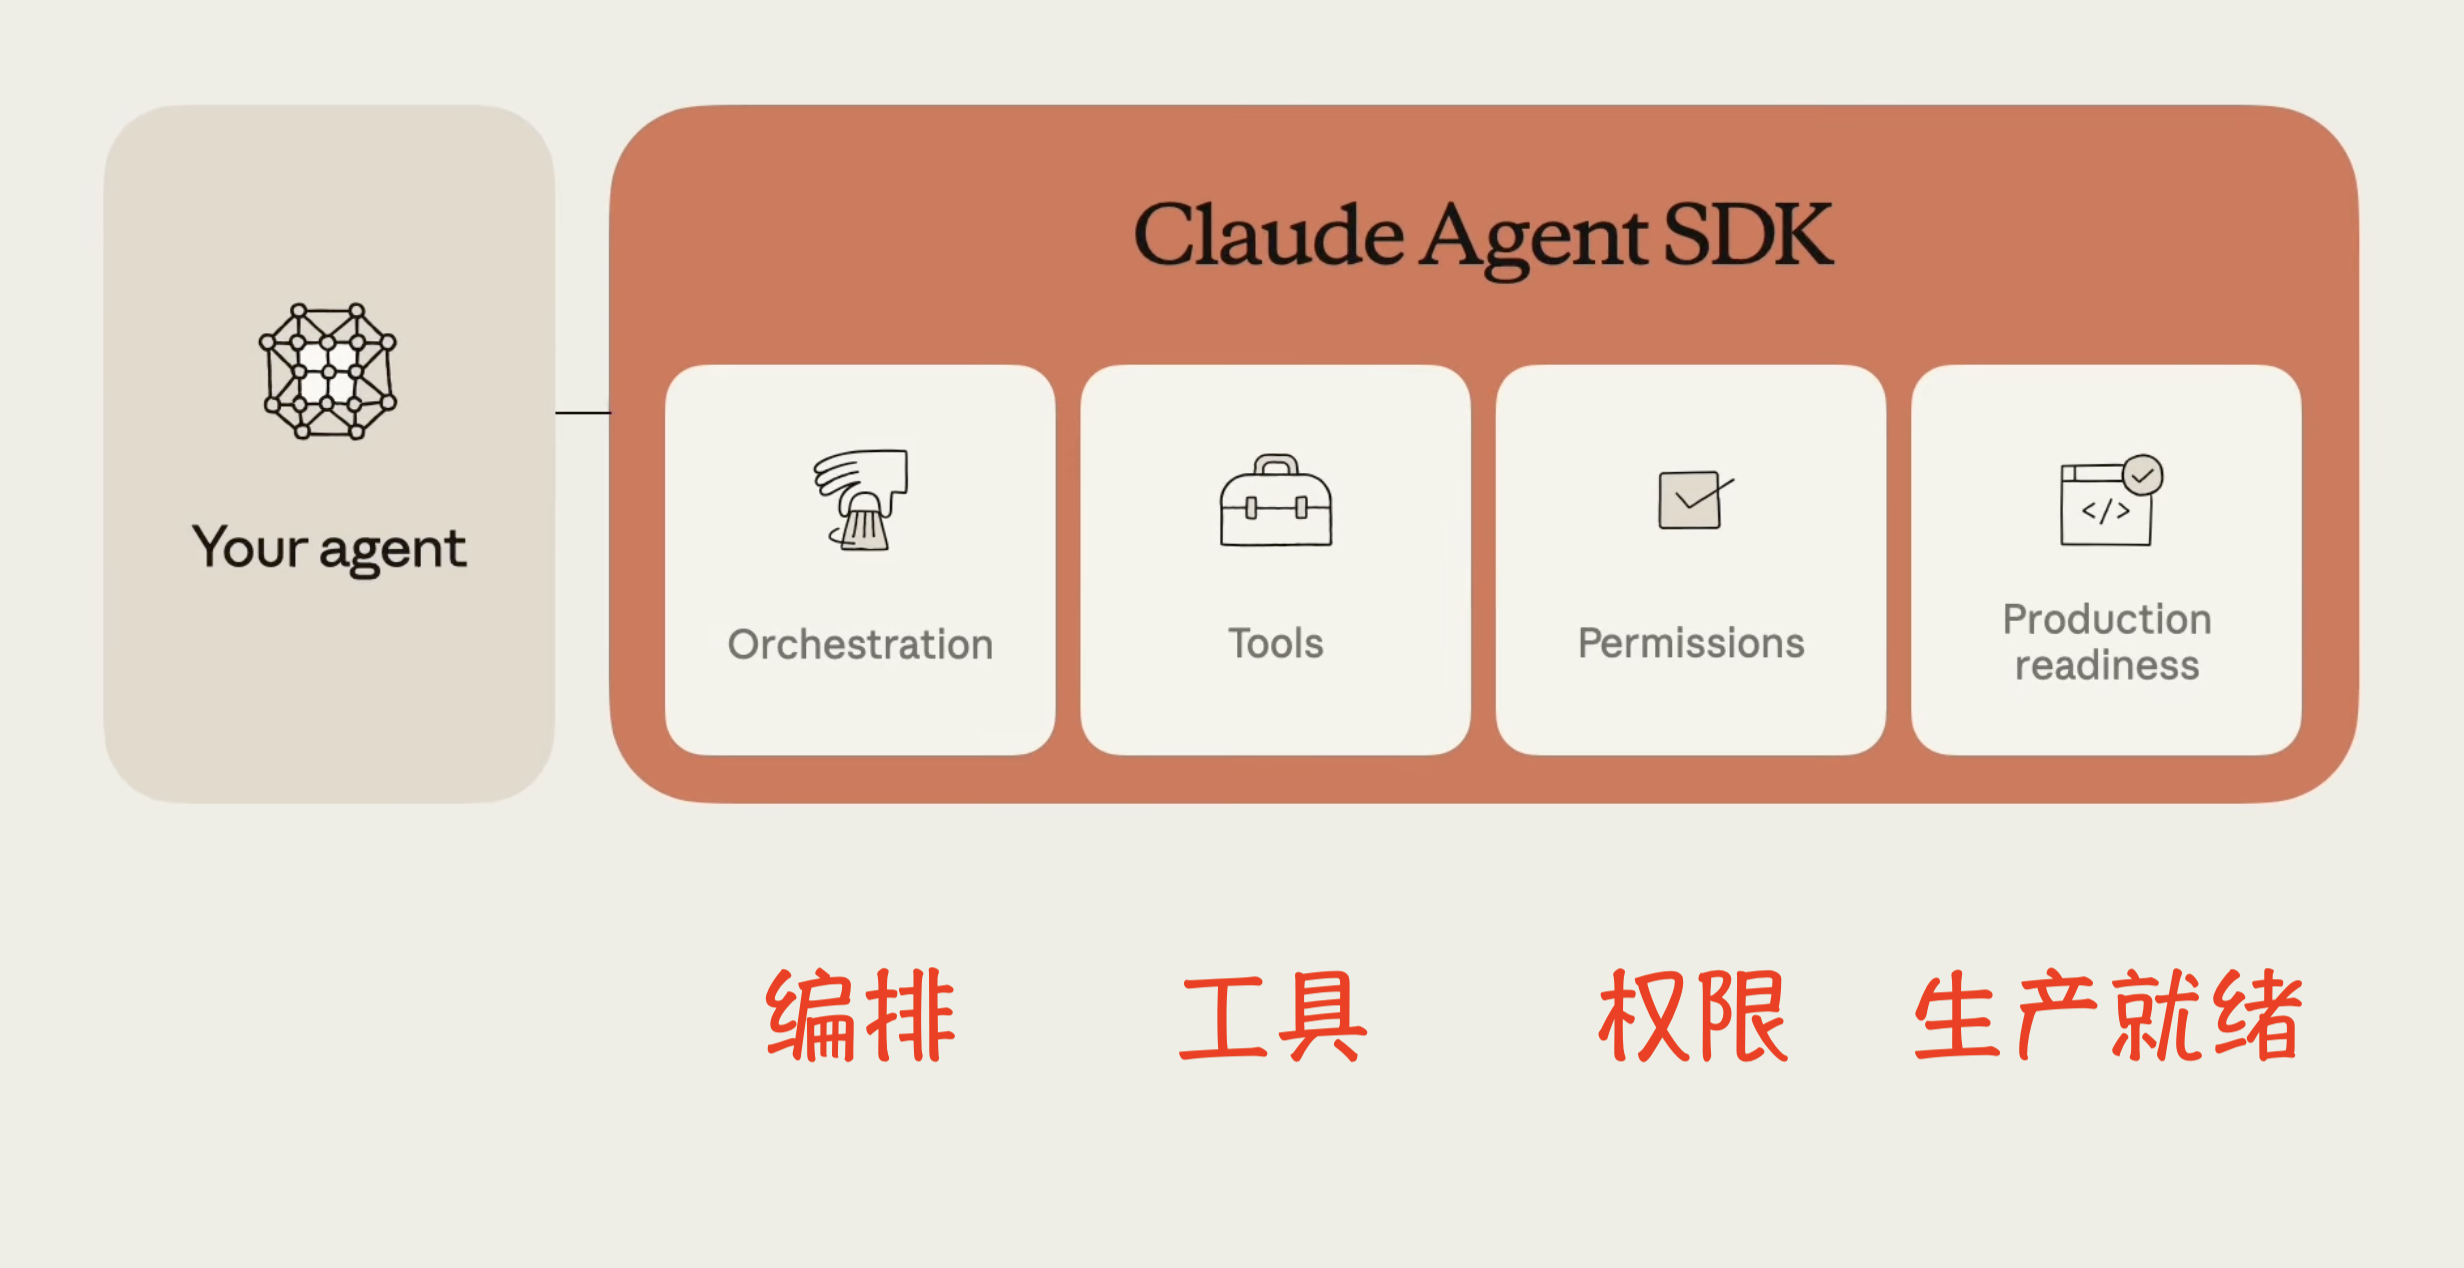
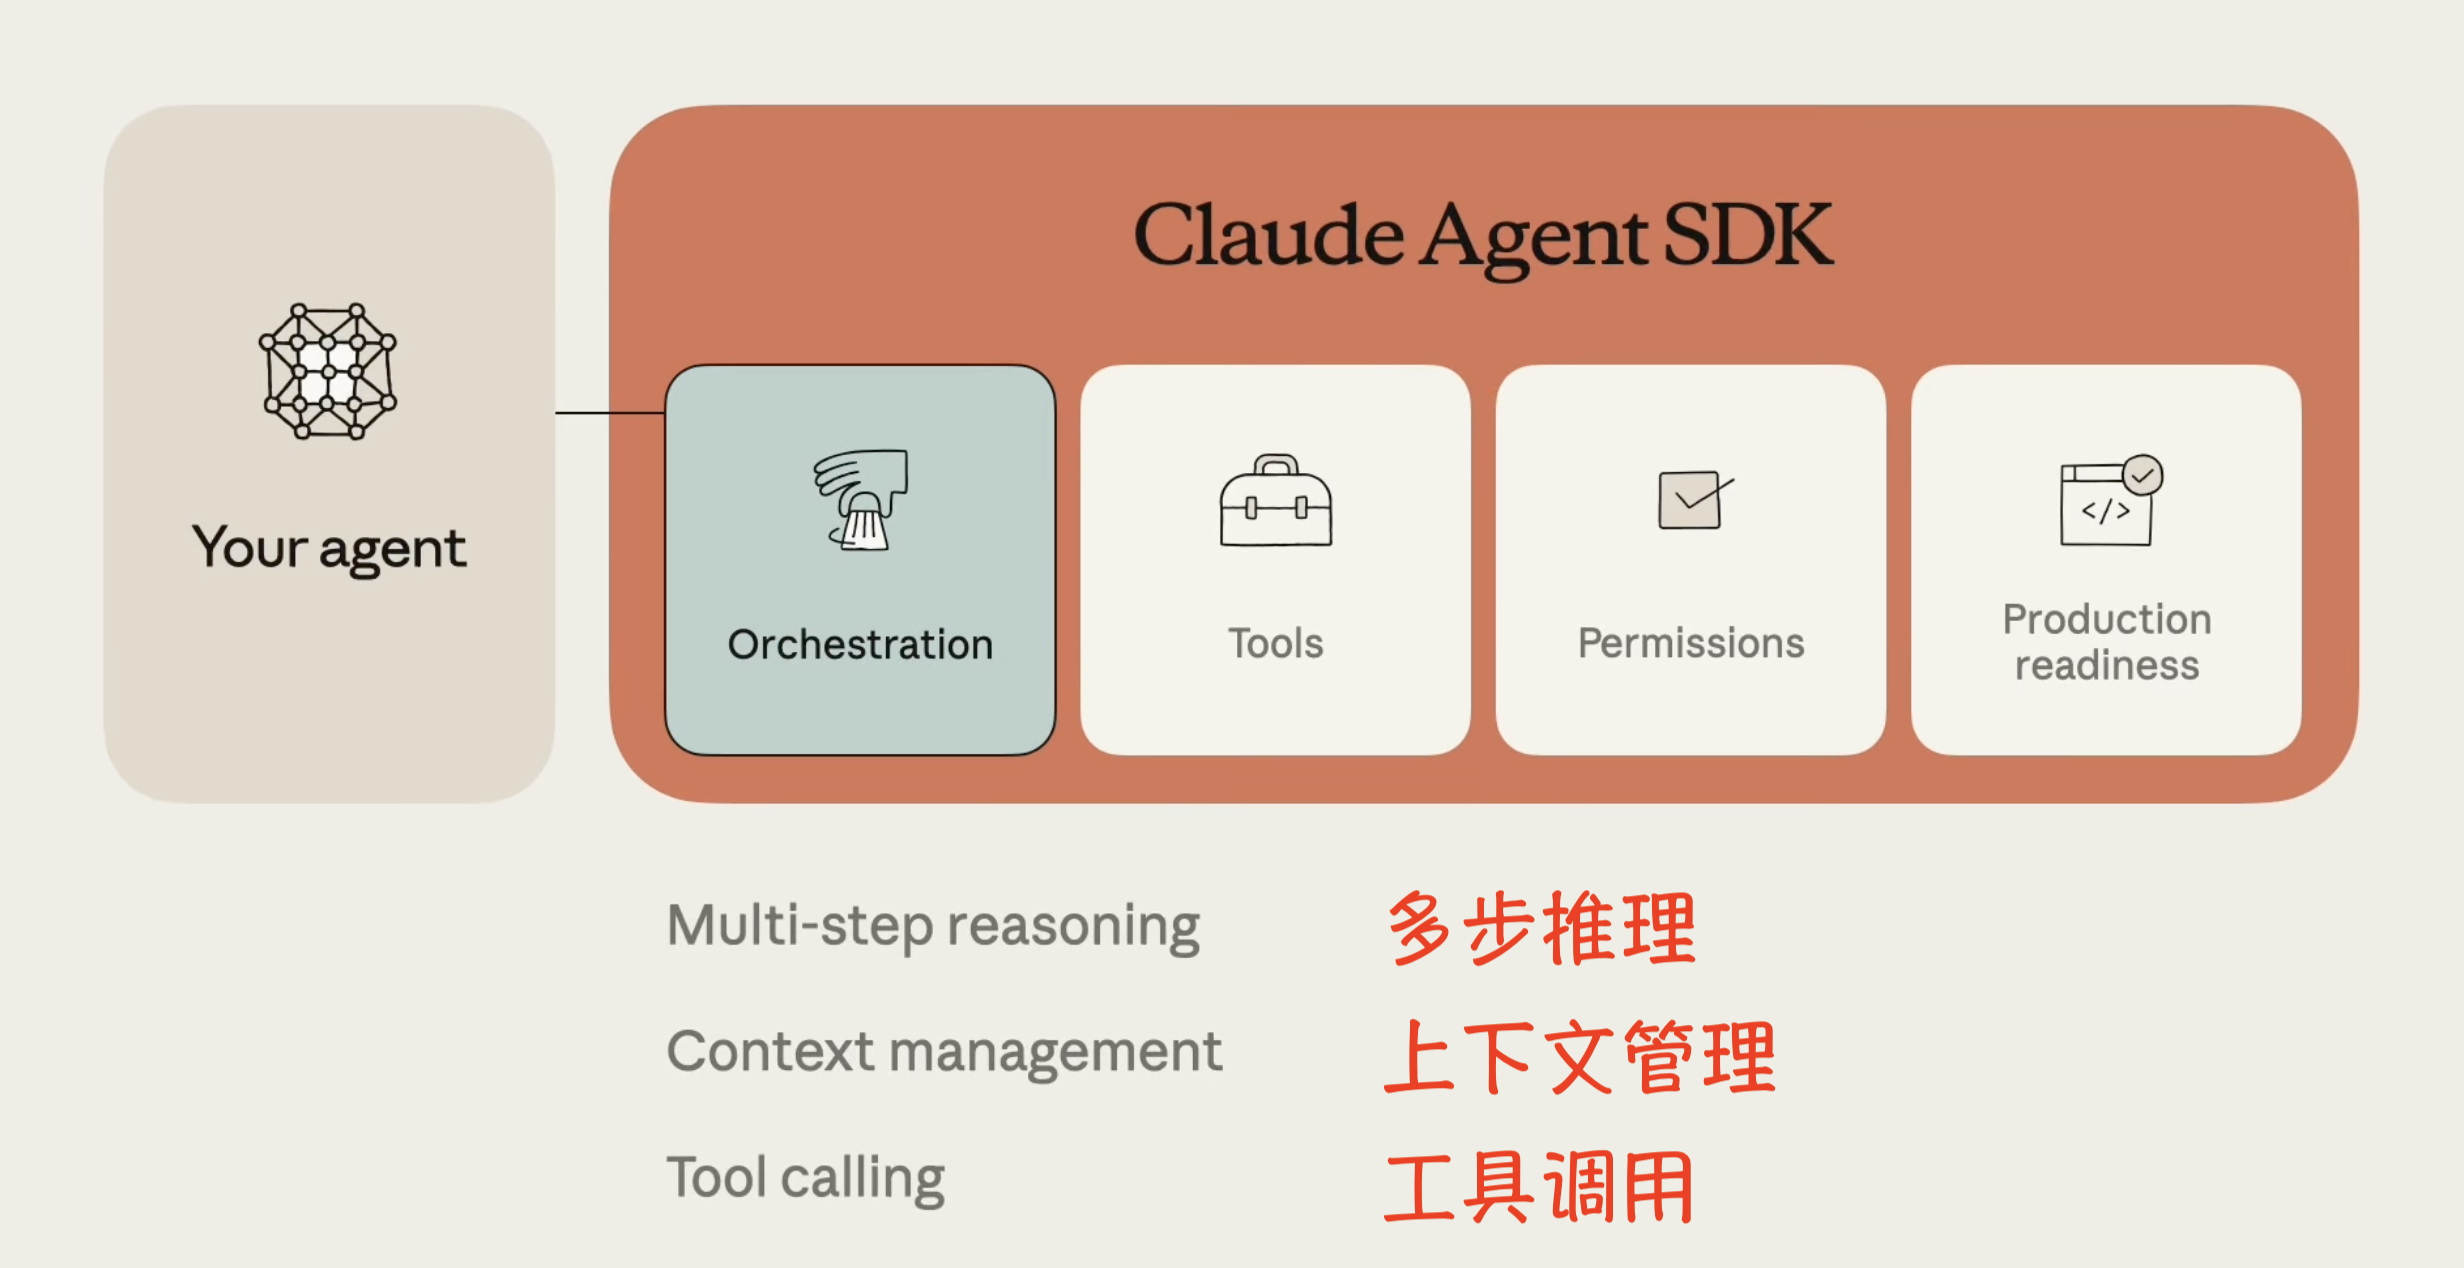
Claude Agent SDK 是 Anthropic 发布的、用于在 Claude Code 基础上构建强大智能体(agents)的工具集合。该 SDK 最初是作为 Claude Code SDK(一个智能编码解决方案)发布的,旨在支持 Anthropic 内部的开发者效率。由于 Claude Code 已经超越了编码工具的范畴,被用于深度研究、视频制作和笔记记录等无数非编码应用,因此该工具被更名为 Claude Agent SDK,以反映其更广泛的愿景。
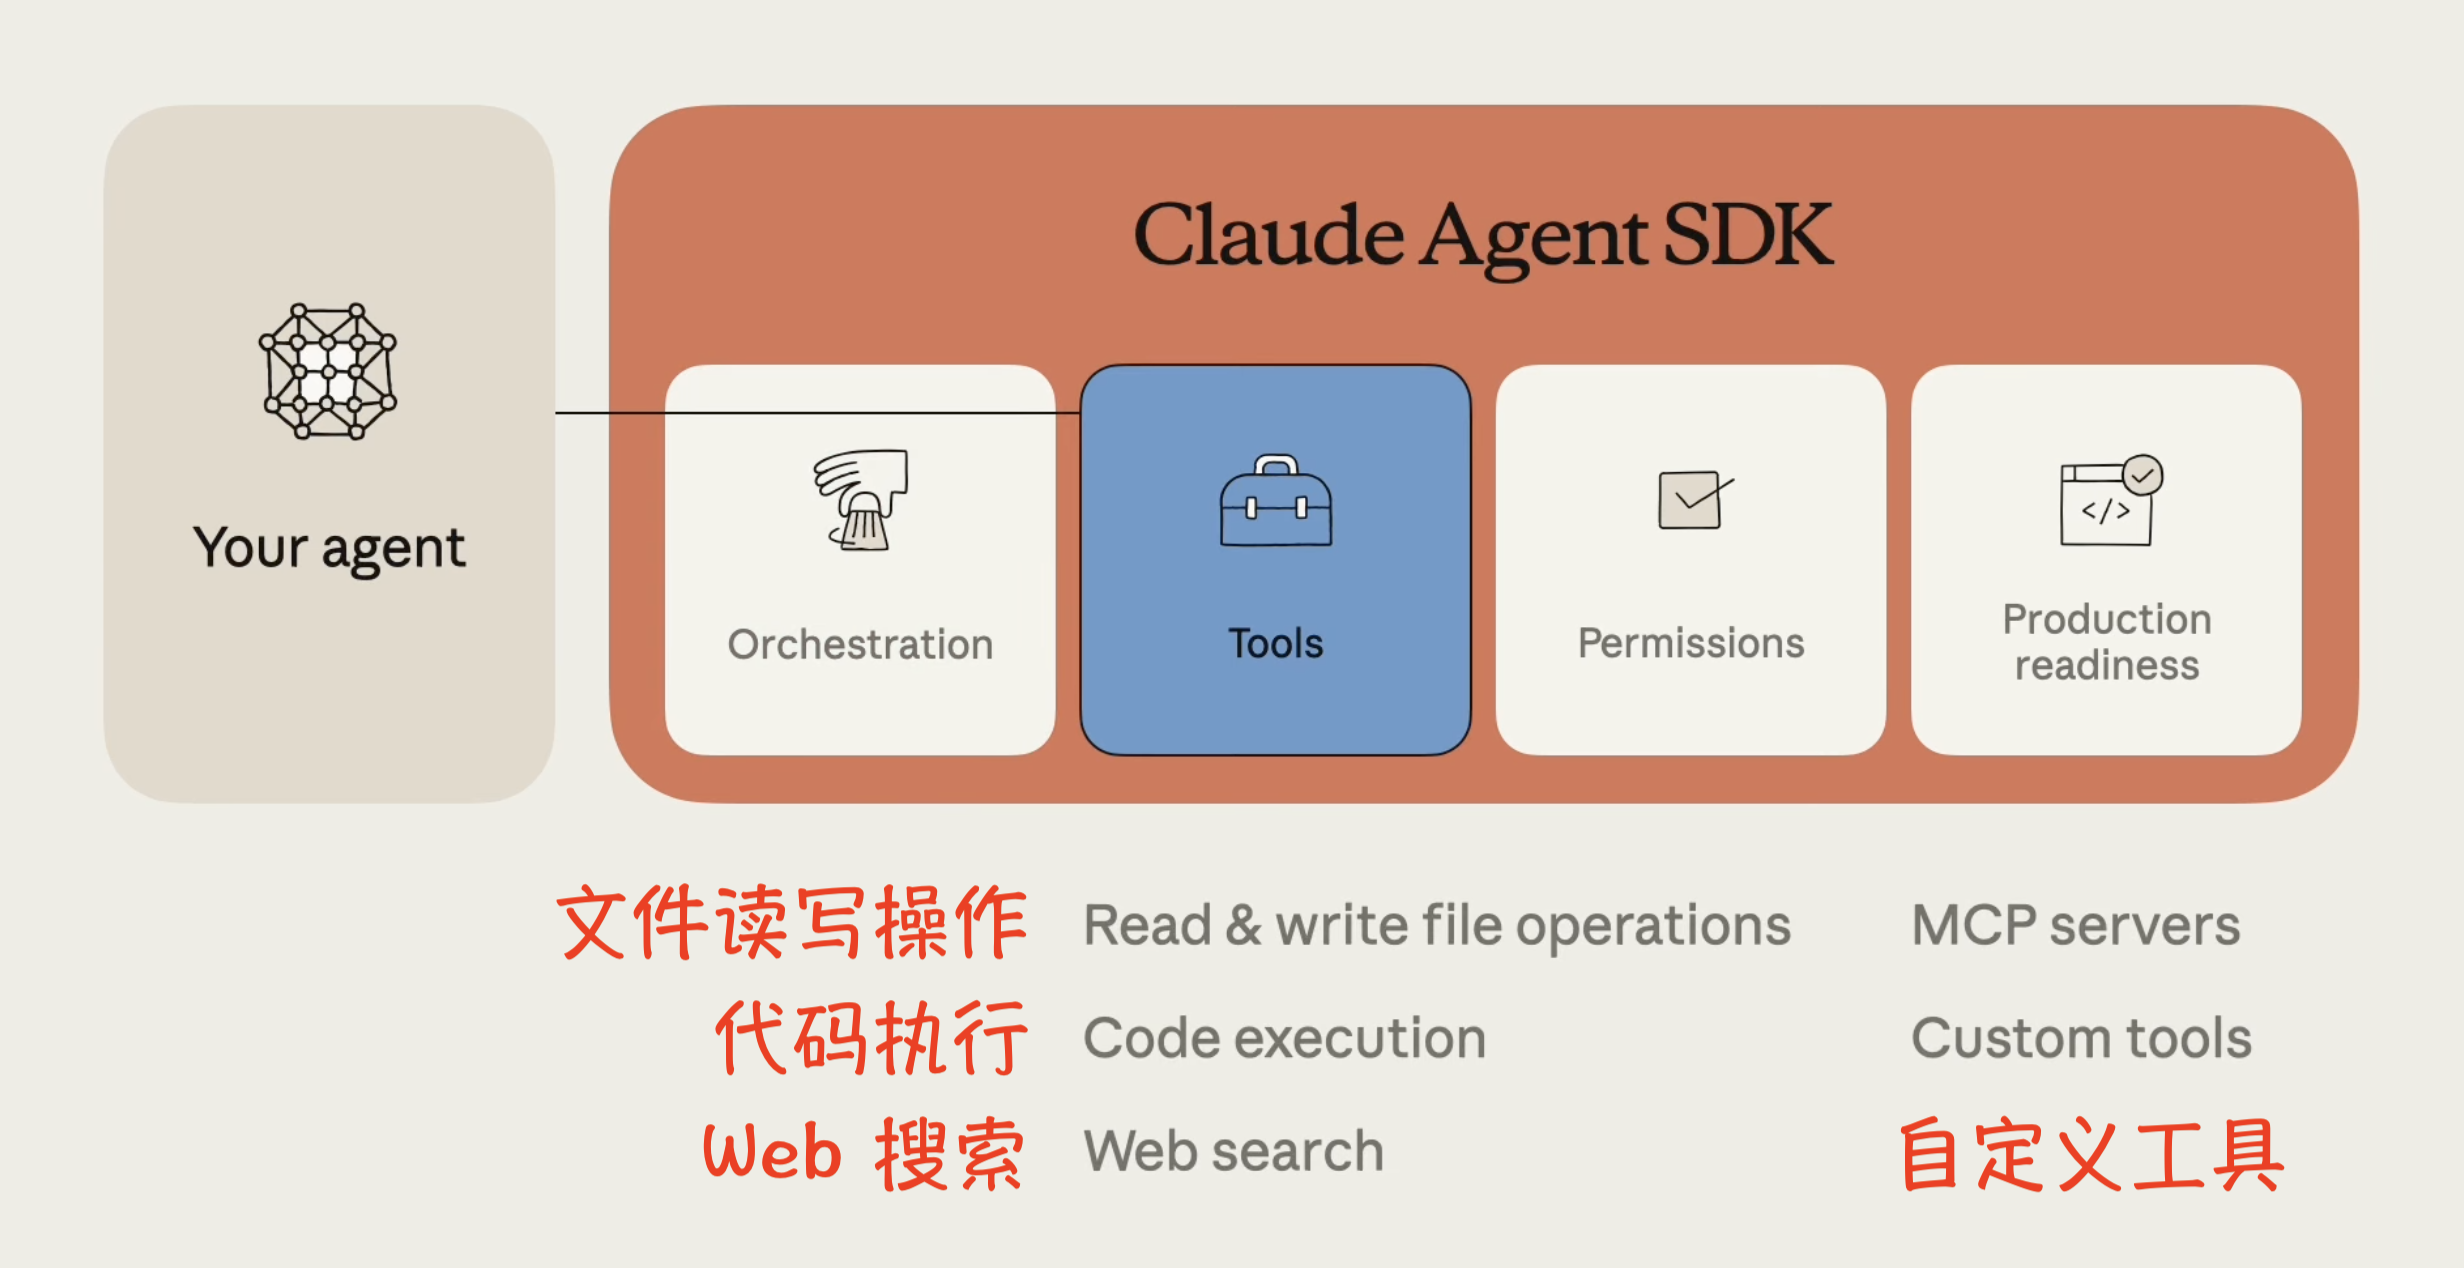
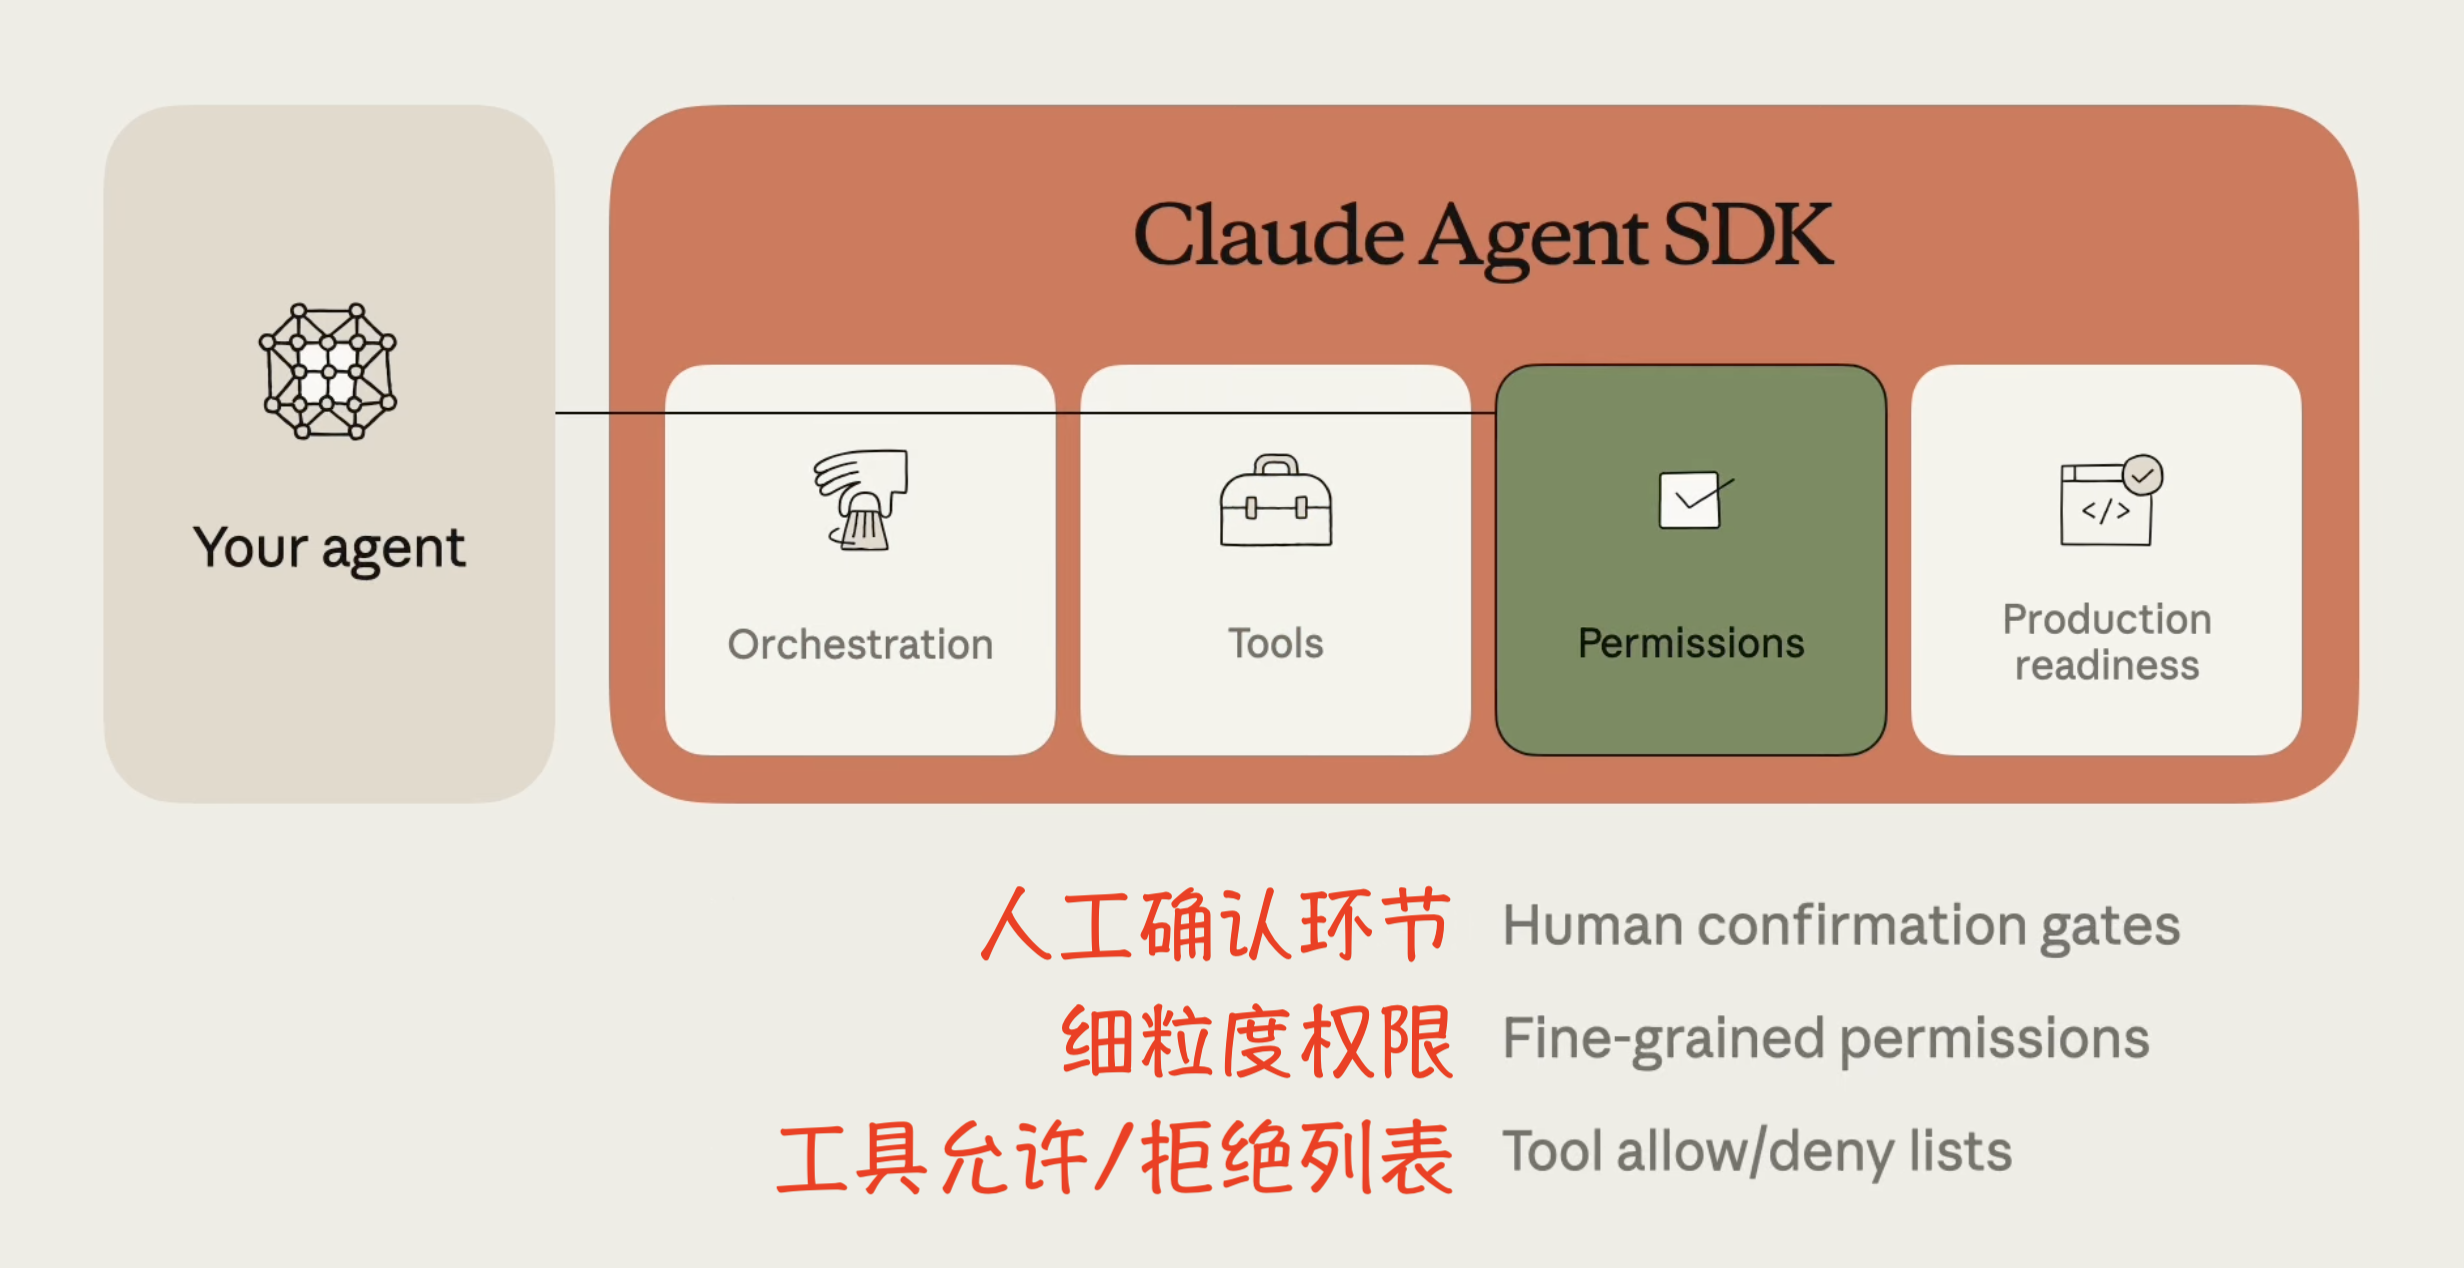
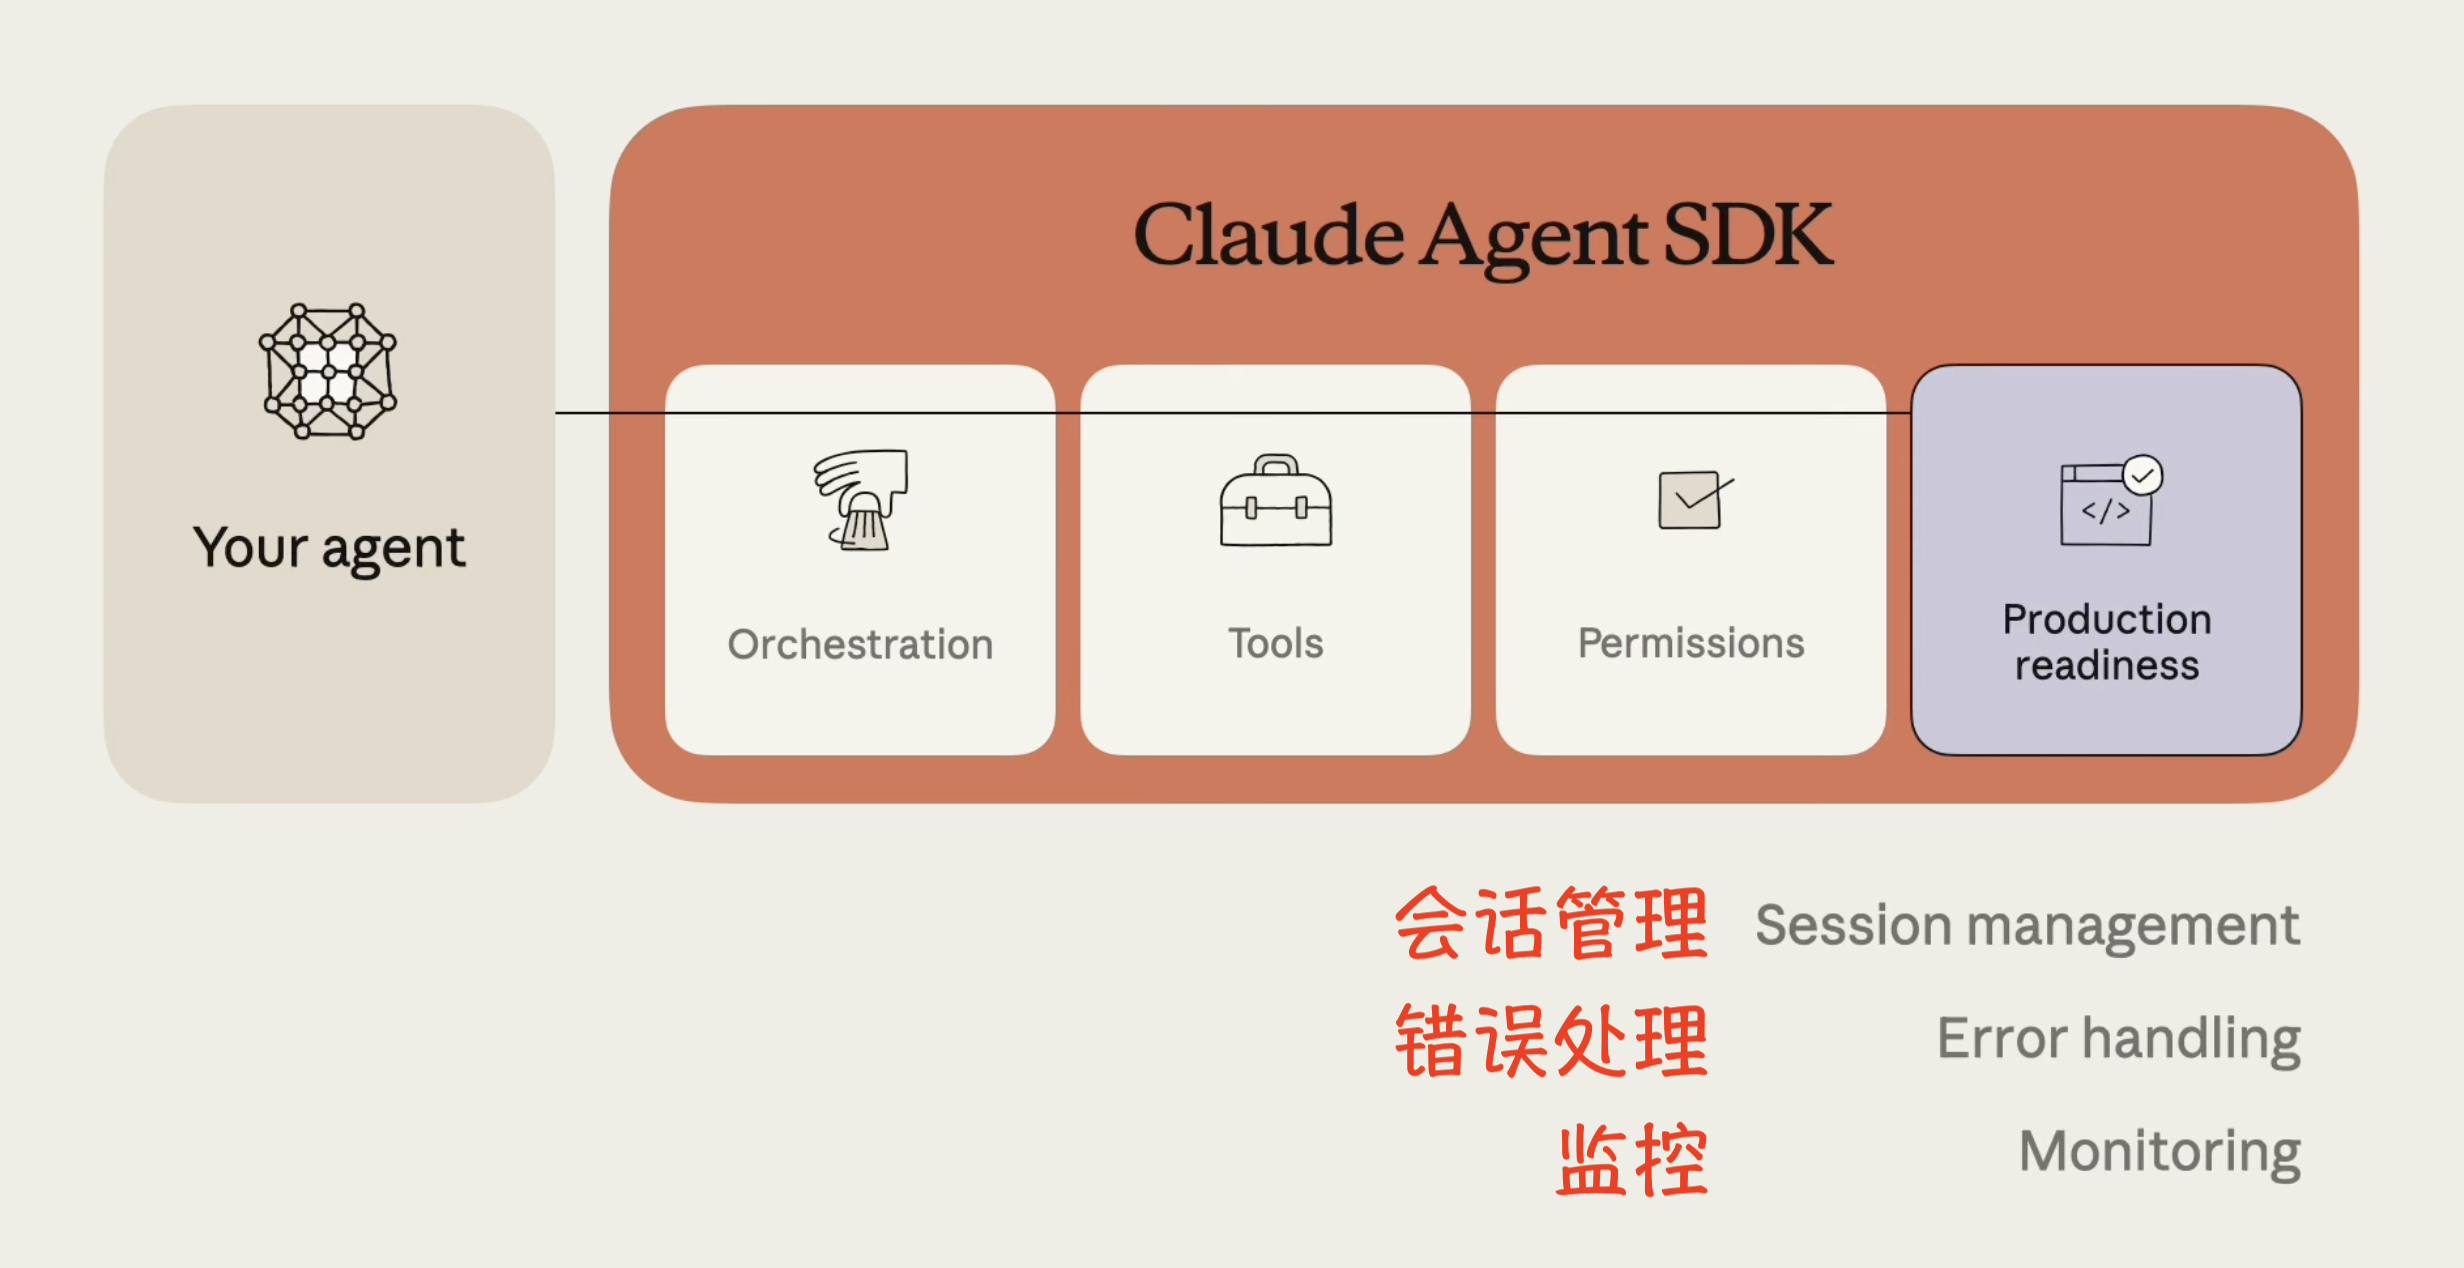
一、核心设计原则:赋予 Claude 计算机能力
Claude Agent SDK 的关键设计原则是让 Claude 拥有程序员日常使用的相同工具。这意味着 Claude 必须能够:在代码库中查找文件、编写和编辑文件、运行代码、调试、以及迭代执行这些操作直到成功。
通过允许 Claude 访问用户计算机(经由终端),并赋予其运行 bash 命令、编辑文件、创建文件和搜索文件的能力,它能够有效执行非编码任务,如:阅读 CSV 文件、搜索网络、构建可视化、解释指标等数字工作,从而创建出具有通用目的的智能体。
二、构建的新型智能体
赋予 Claude 计算机能力解锁了许多以前效率不高的智能体类型。SDK 提供了用于自动化任何工作流程的原语,开发者可以构建:
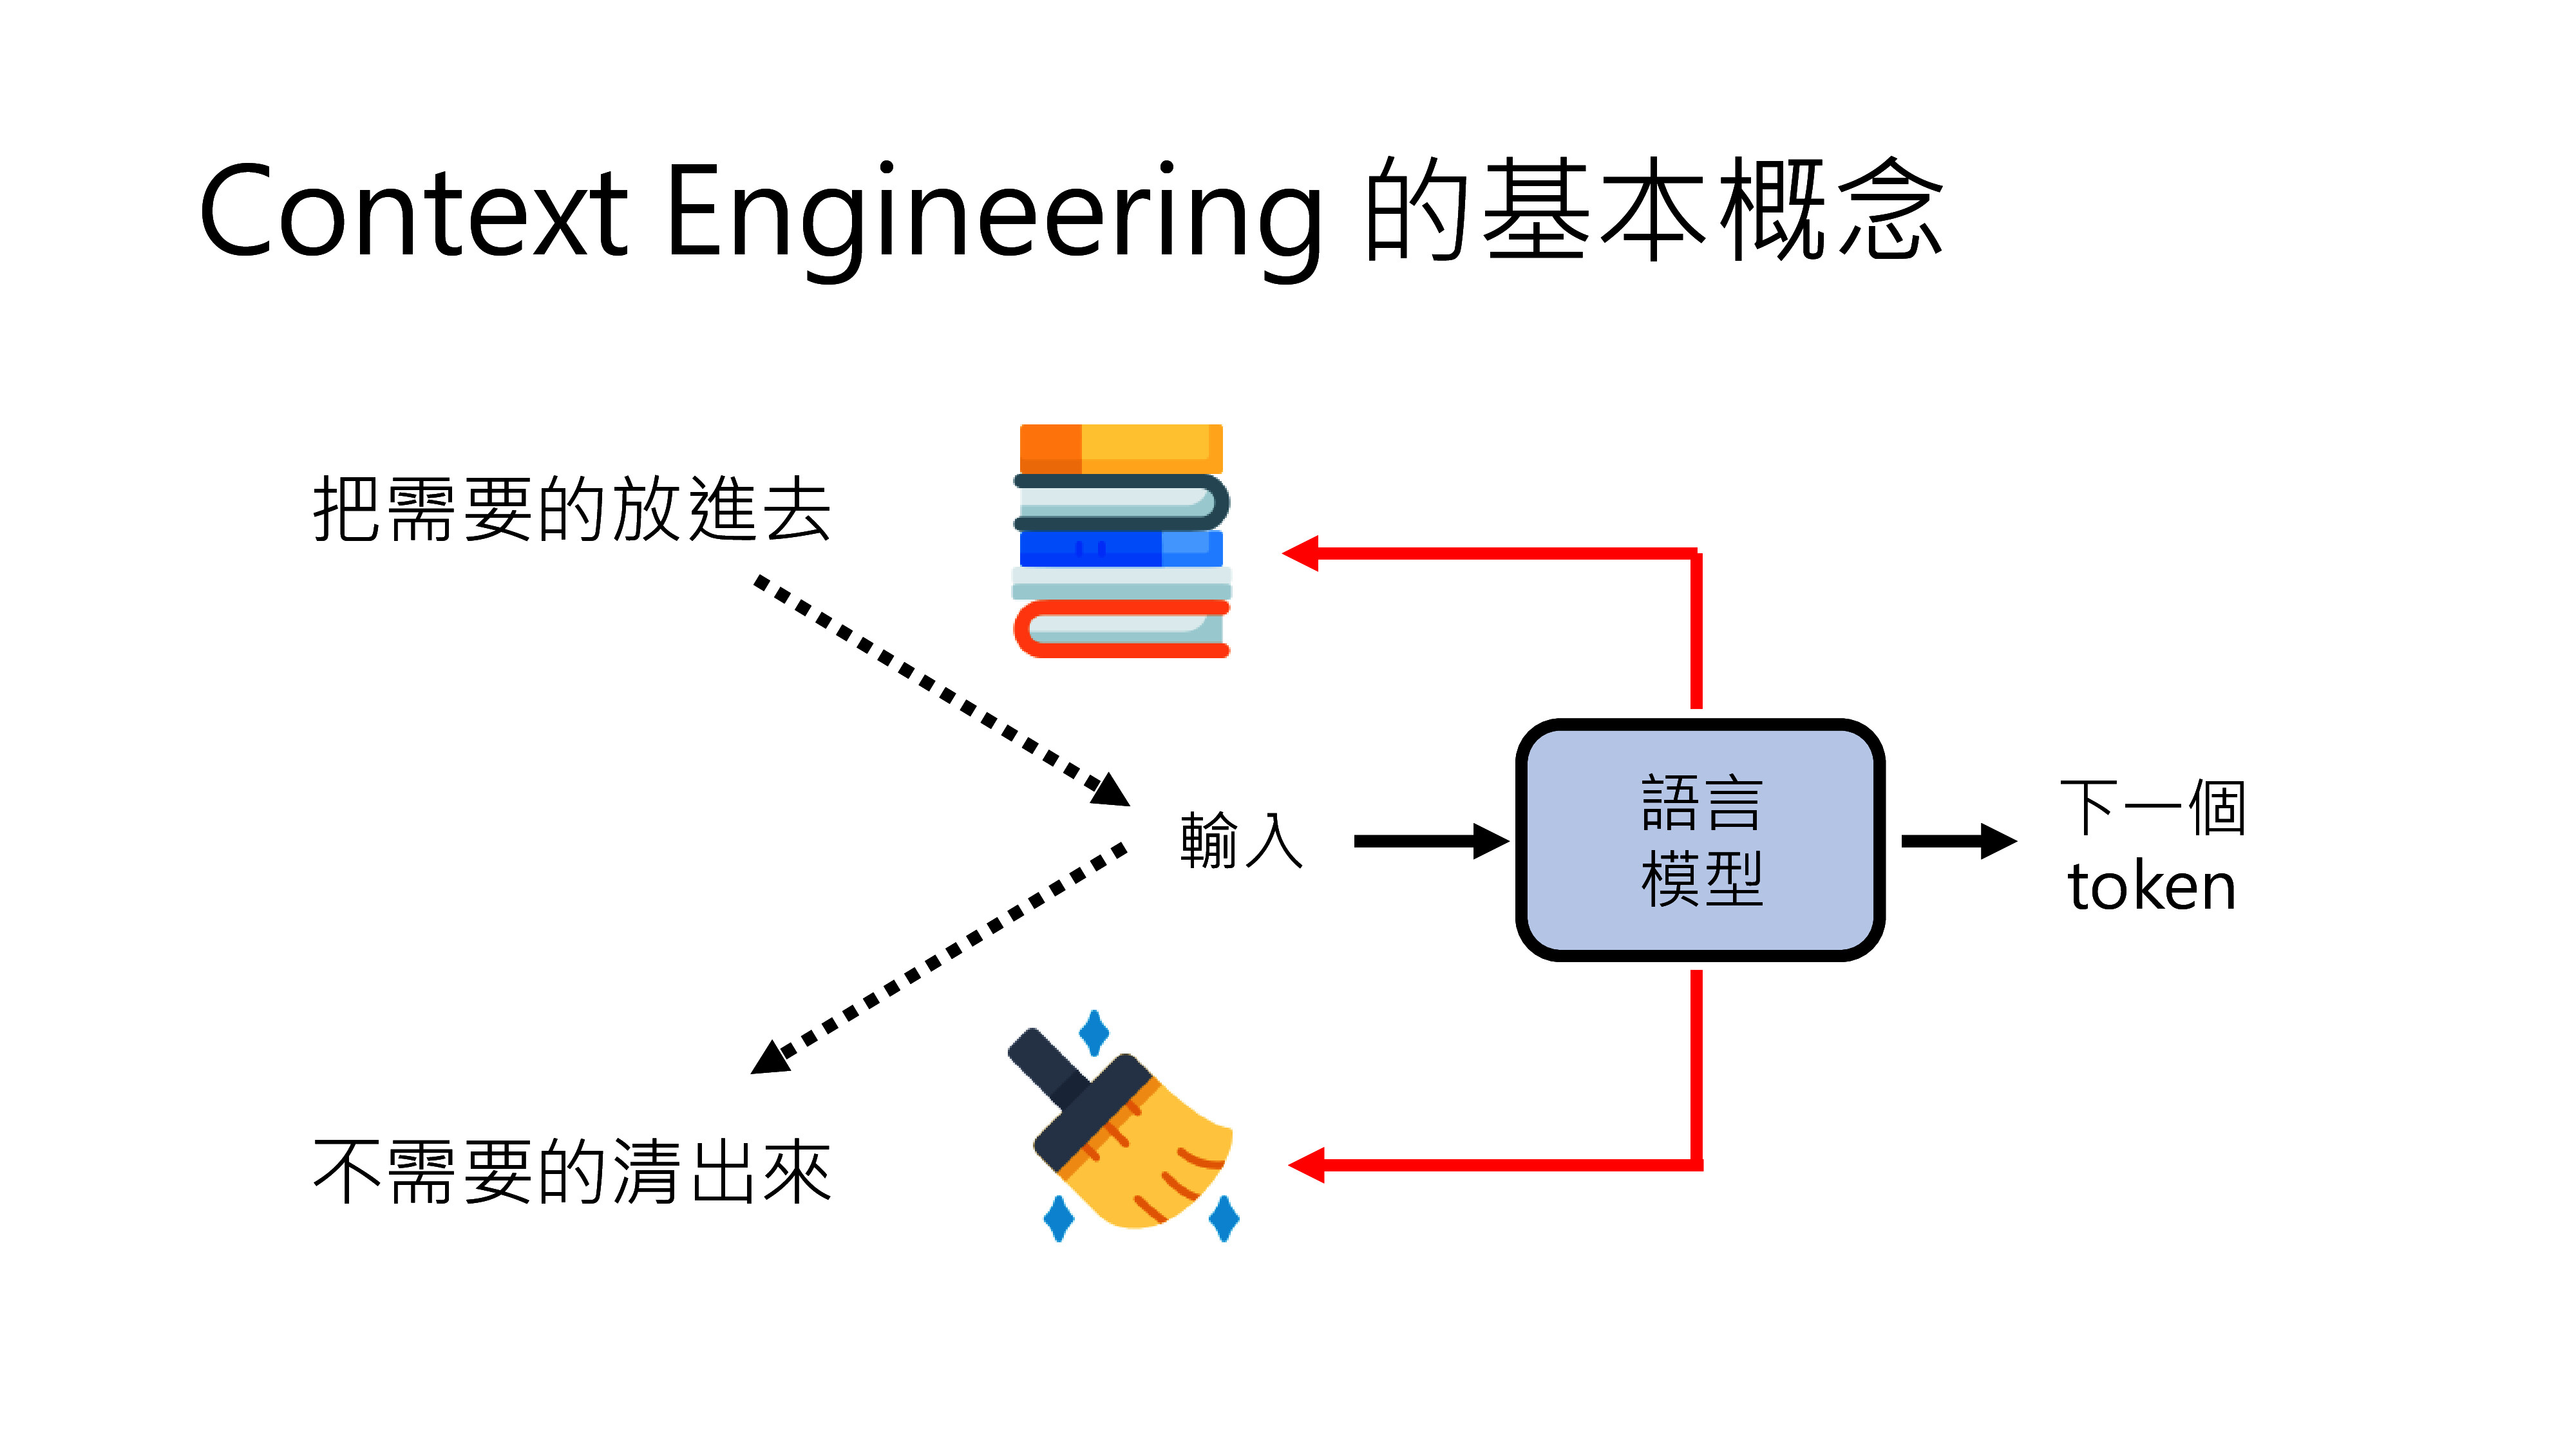
【生成式人工智慧与机器学习导论2025】第二讲:上下文工程 (Context Engineering) — AI Agent 背后的关键技术
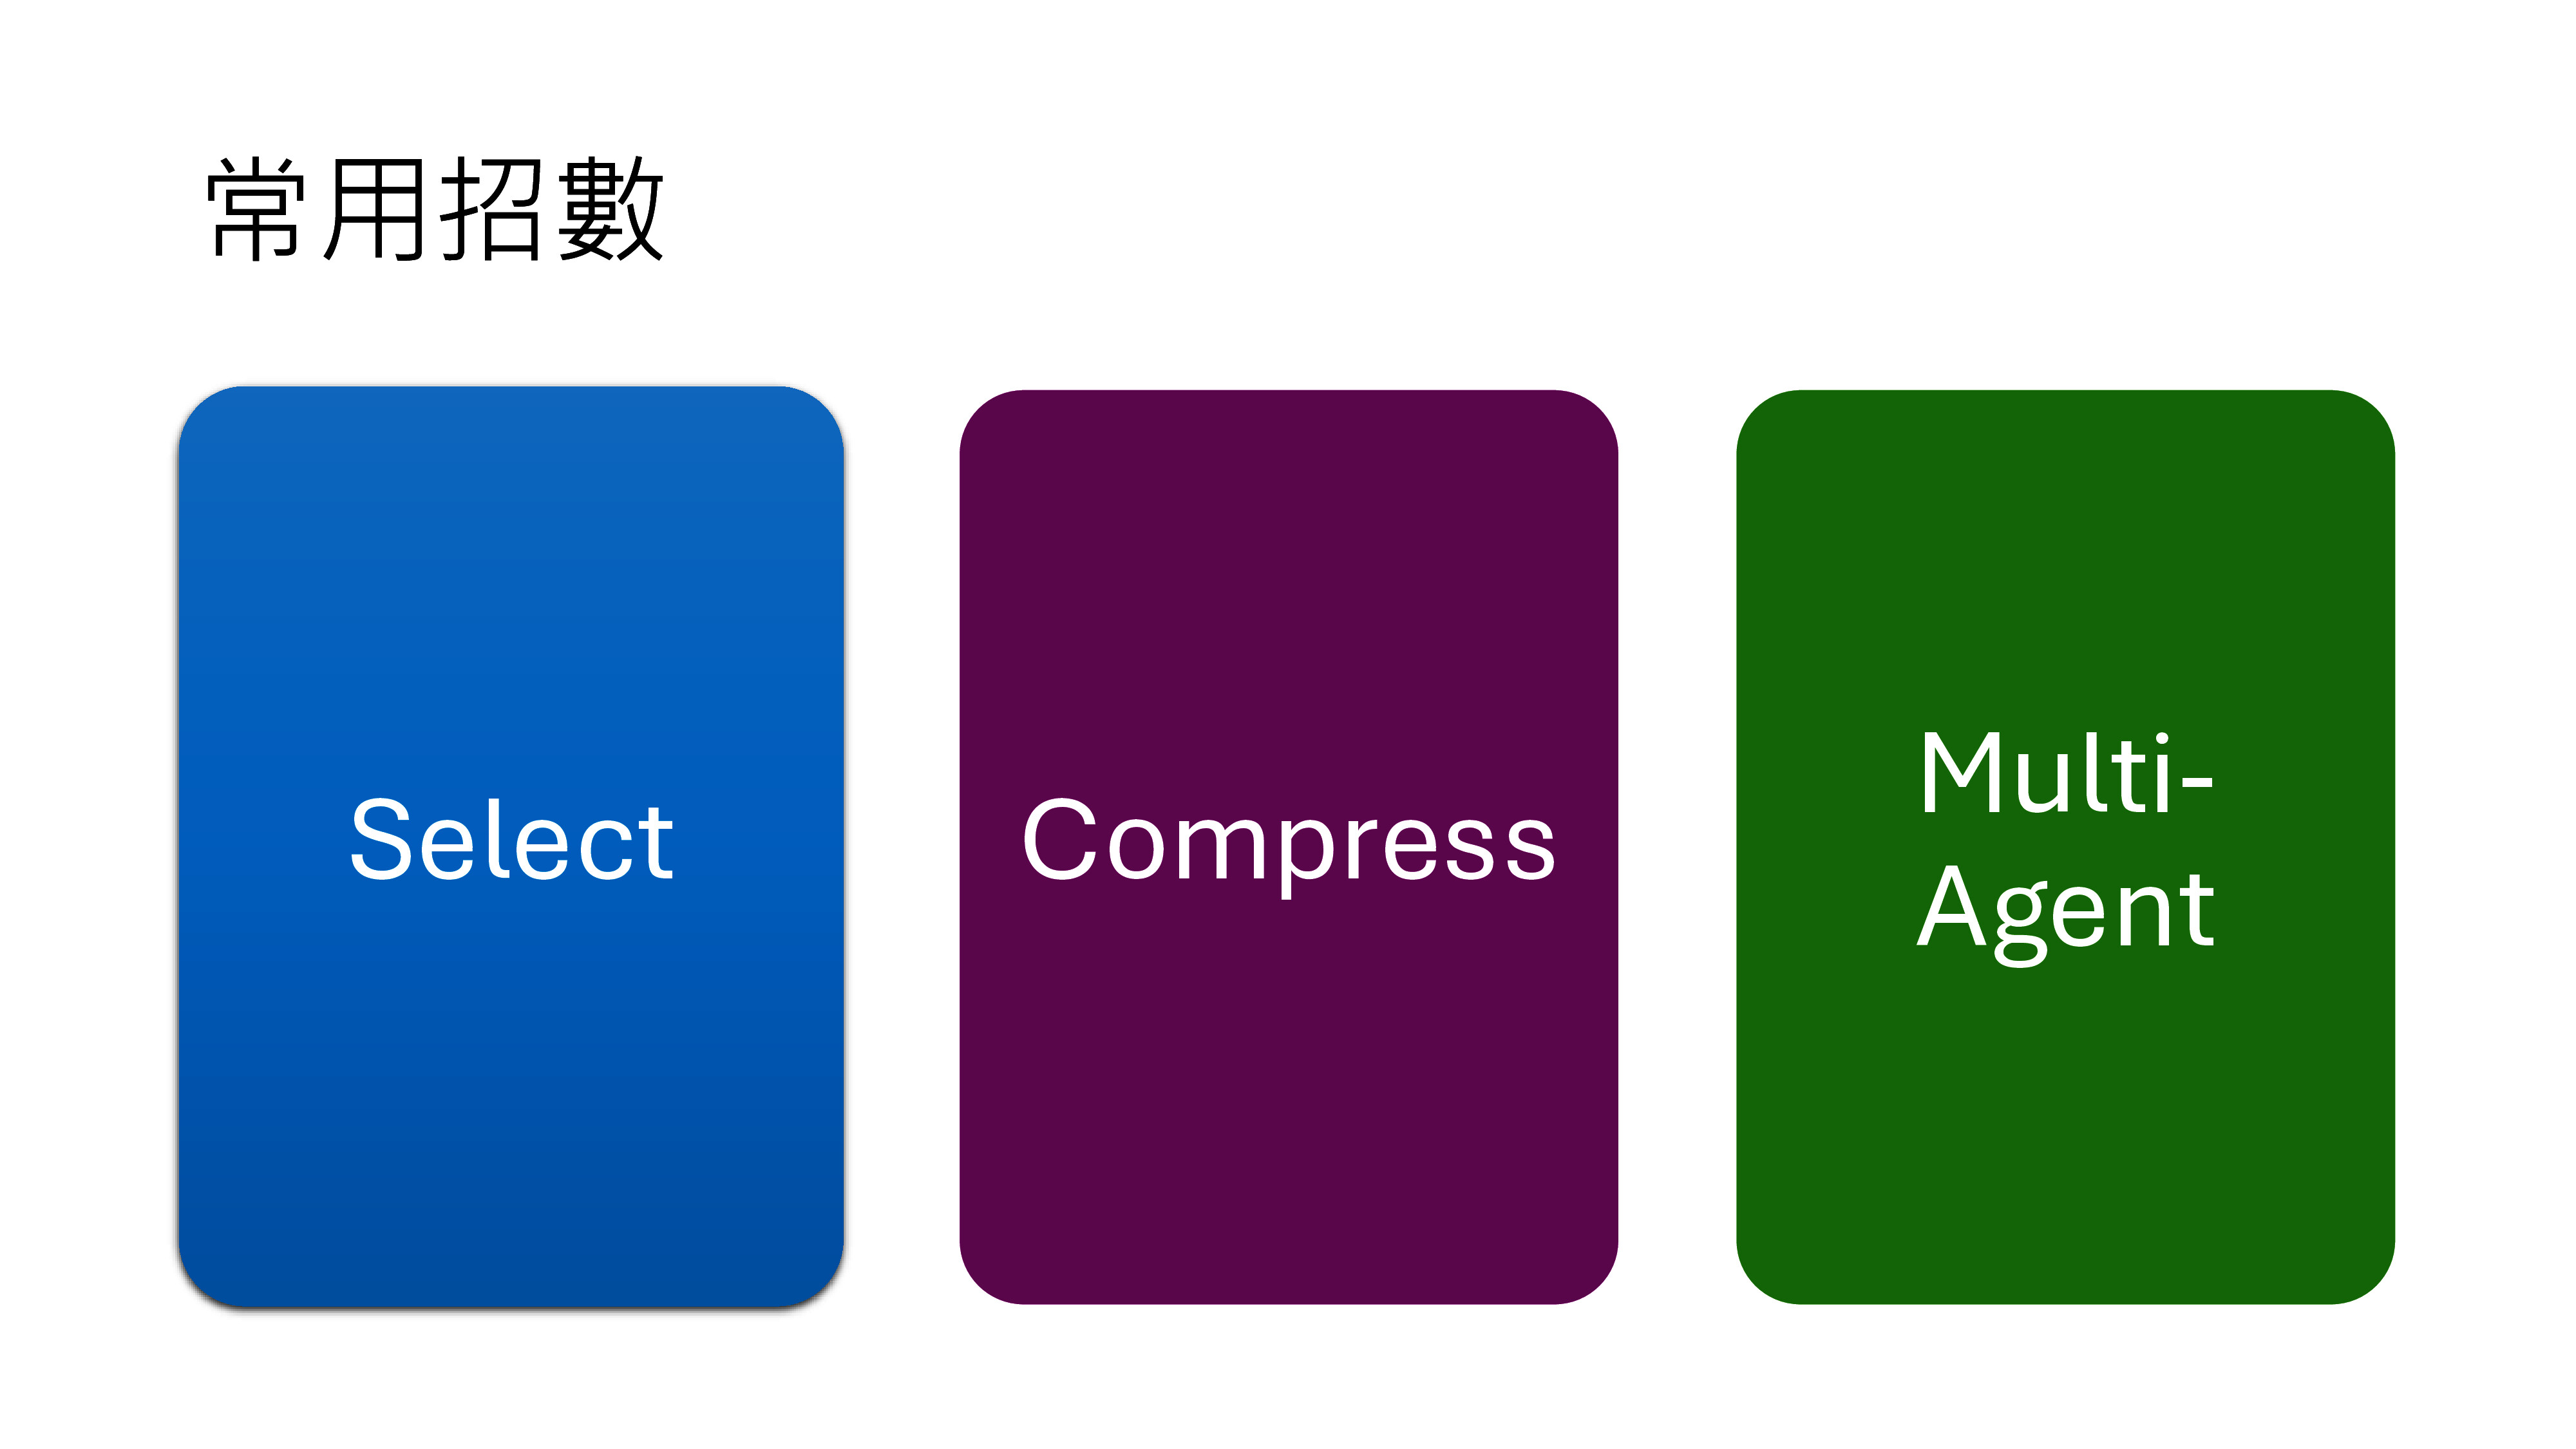
Context Engineering(上下文工程)是为解决 AI Agent 时代输入过长,避免塞爆 Context 的关键技术。其基本概念是 “把需要的放進去,不需要的清出來”。常用招数(基本方法)包括:
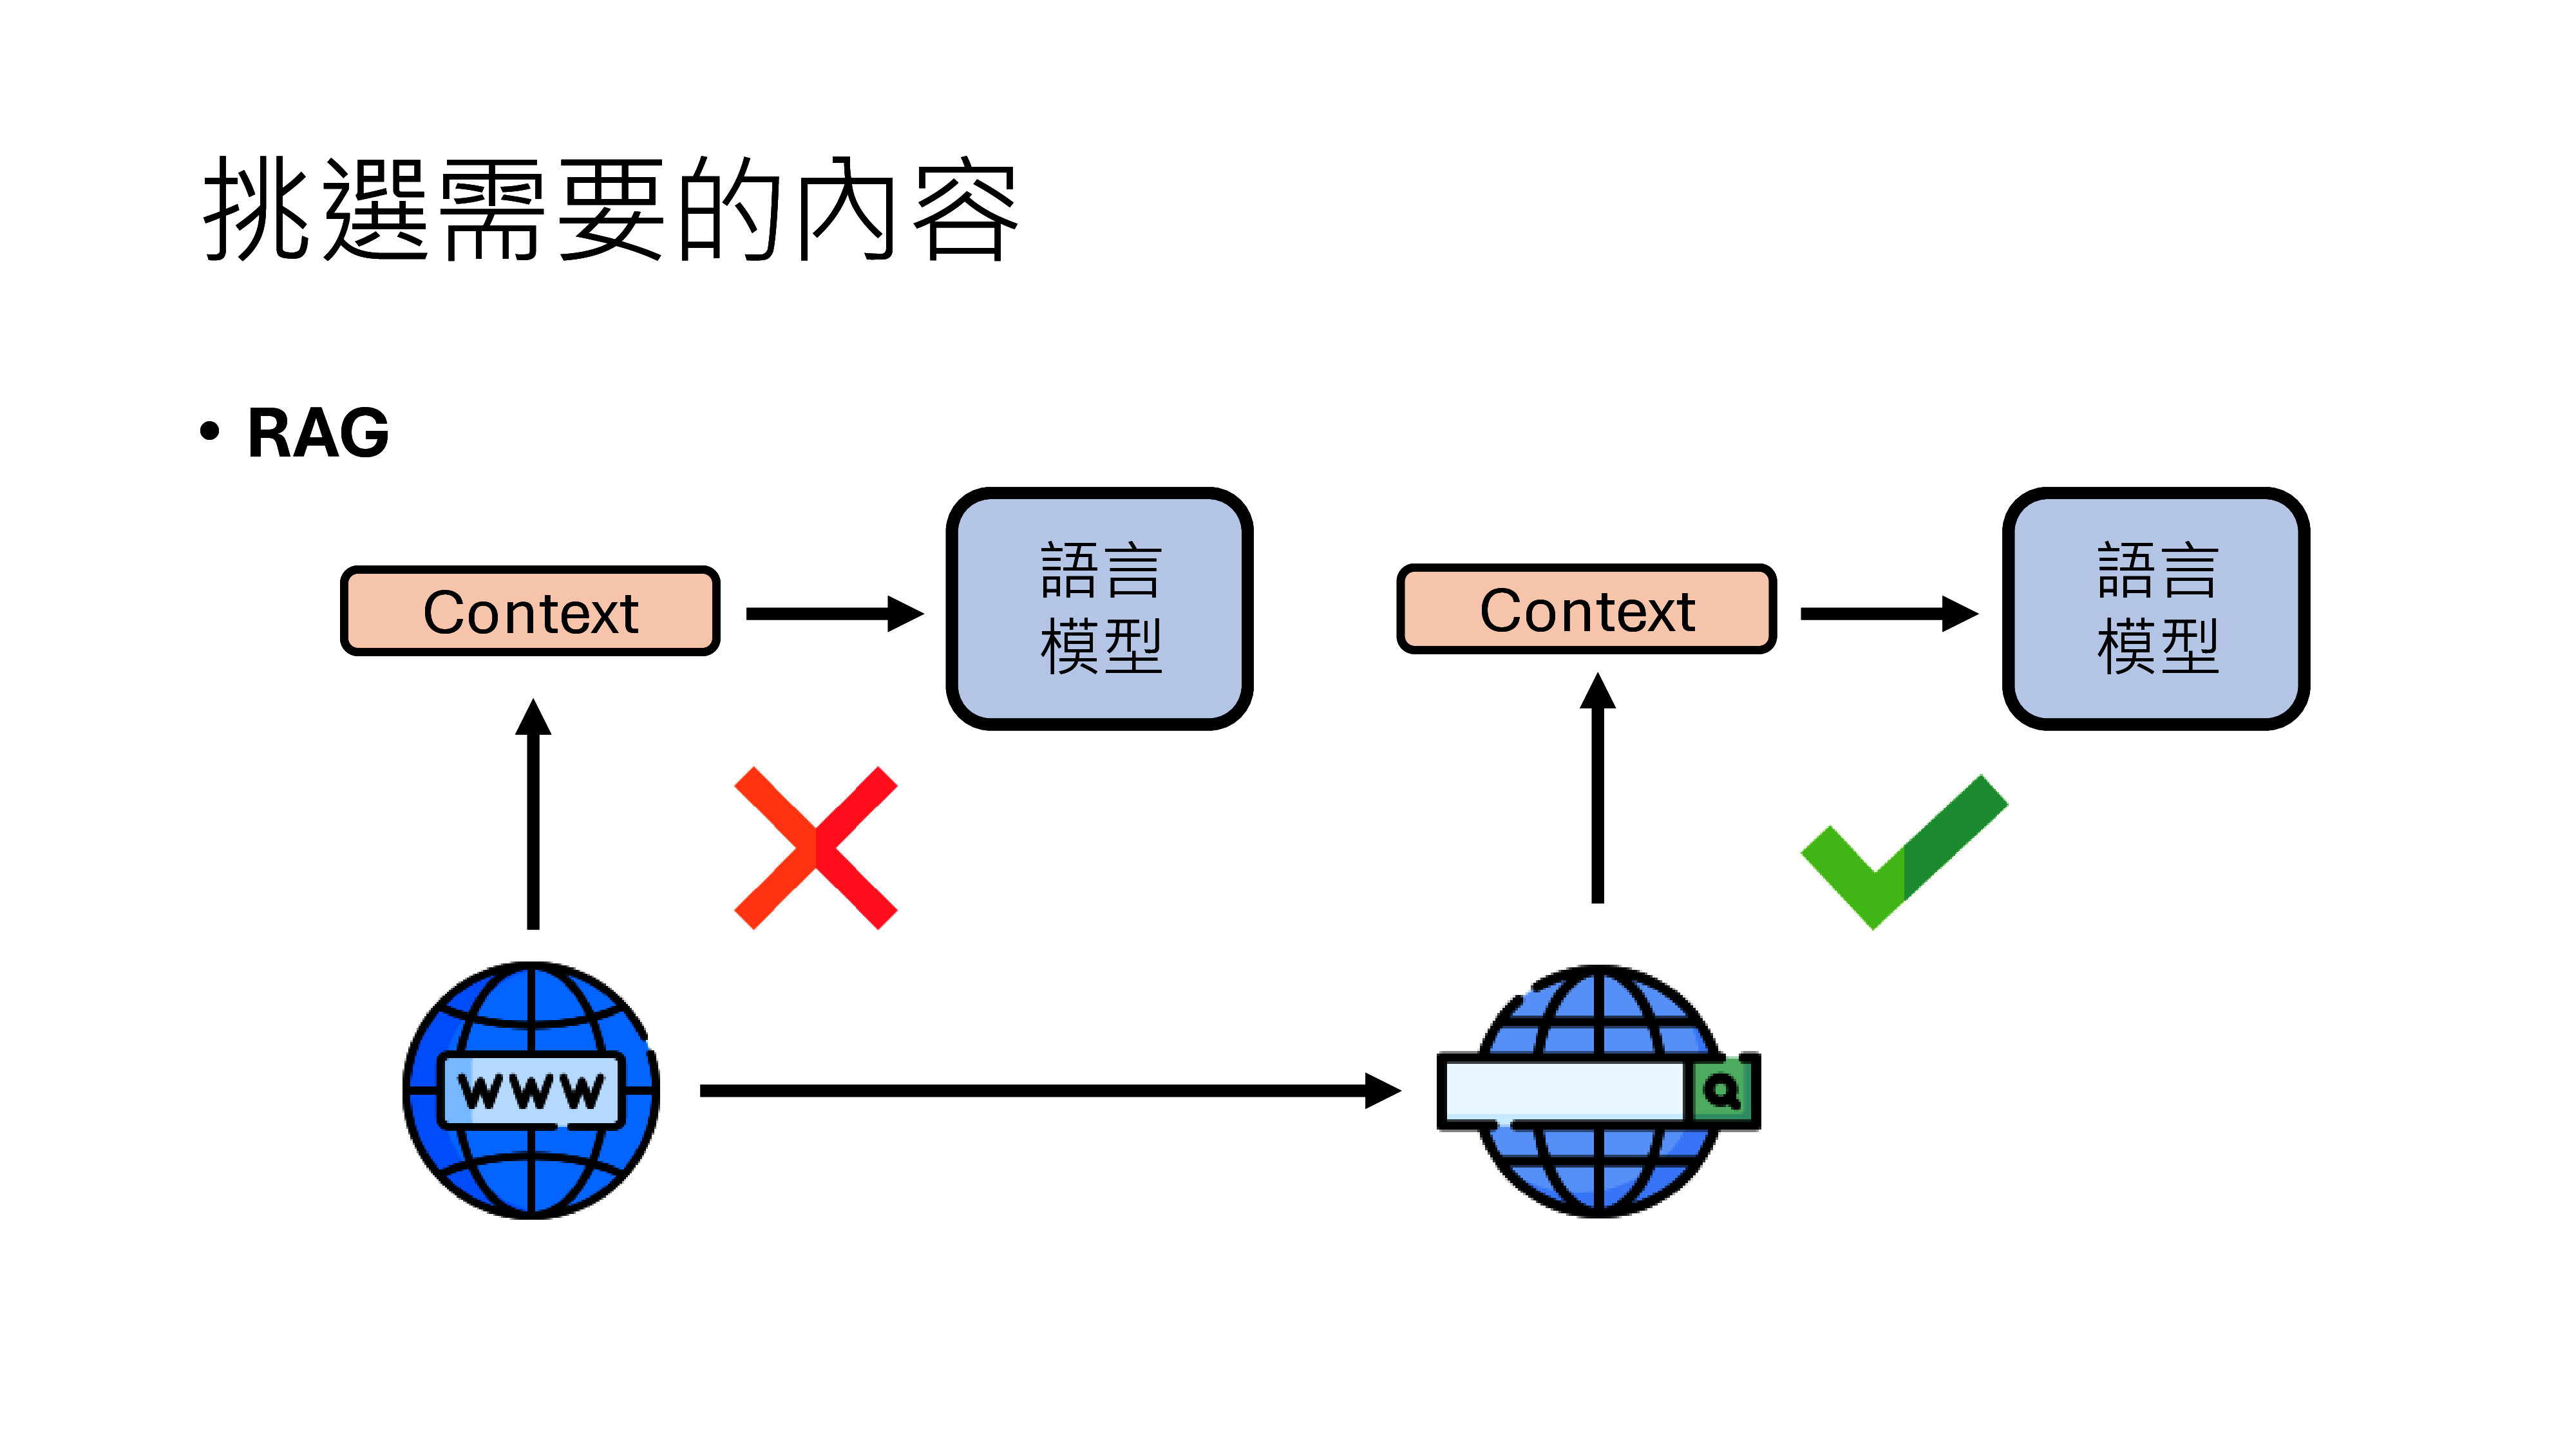
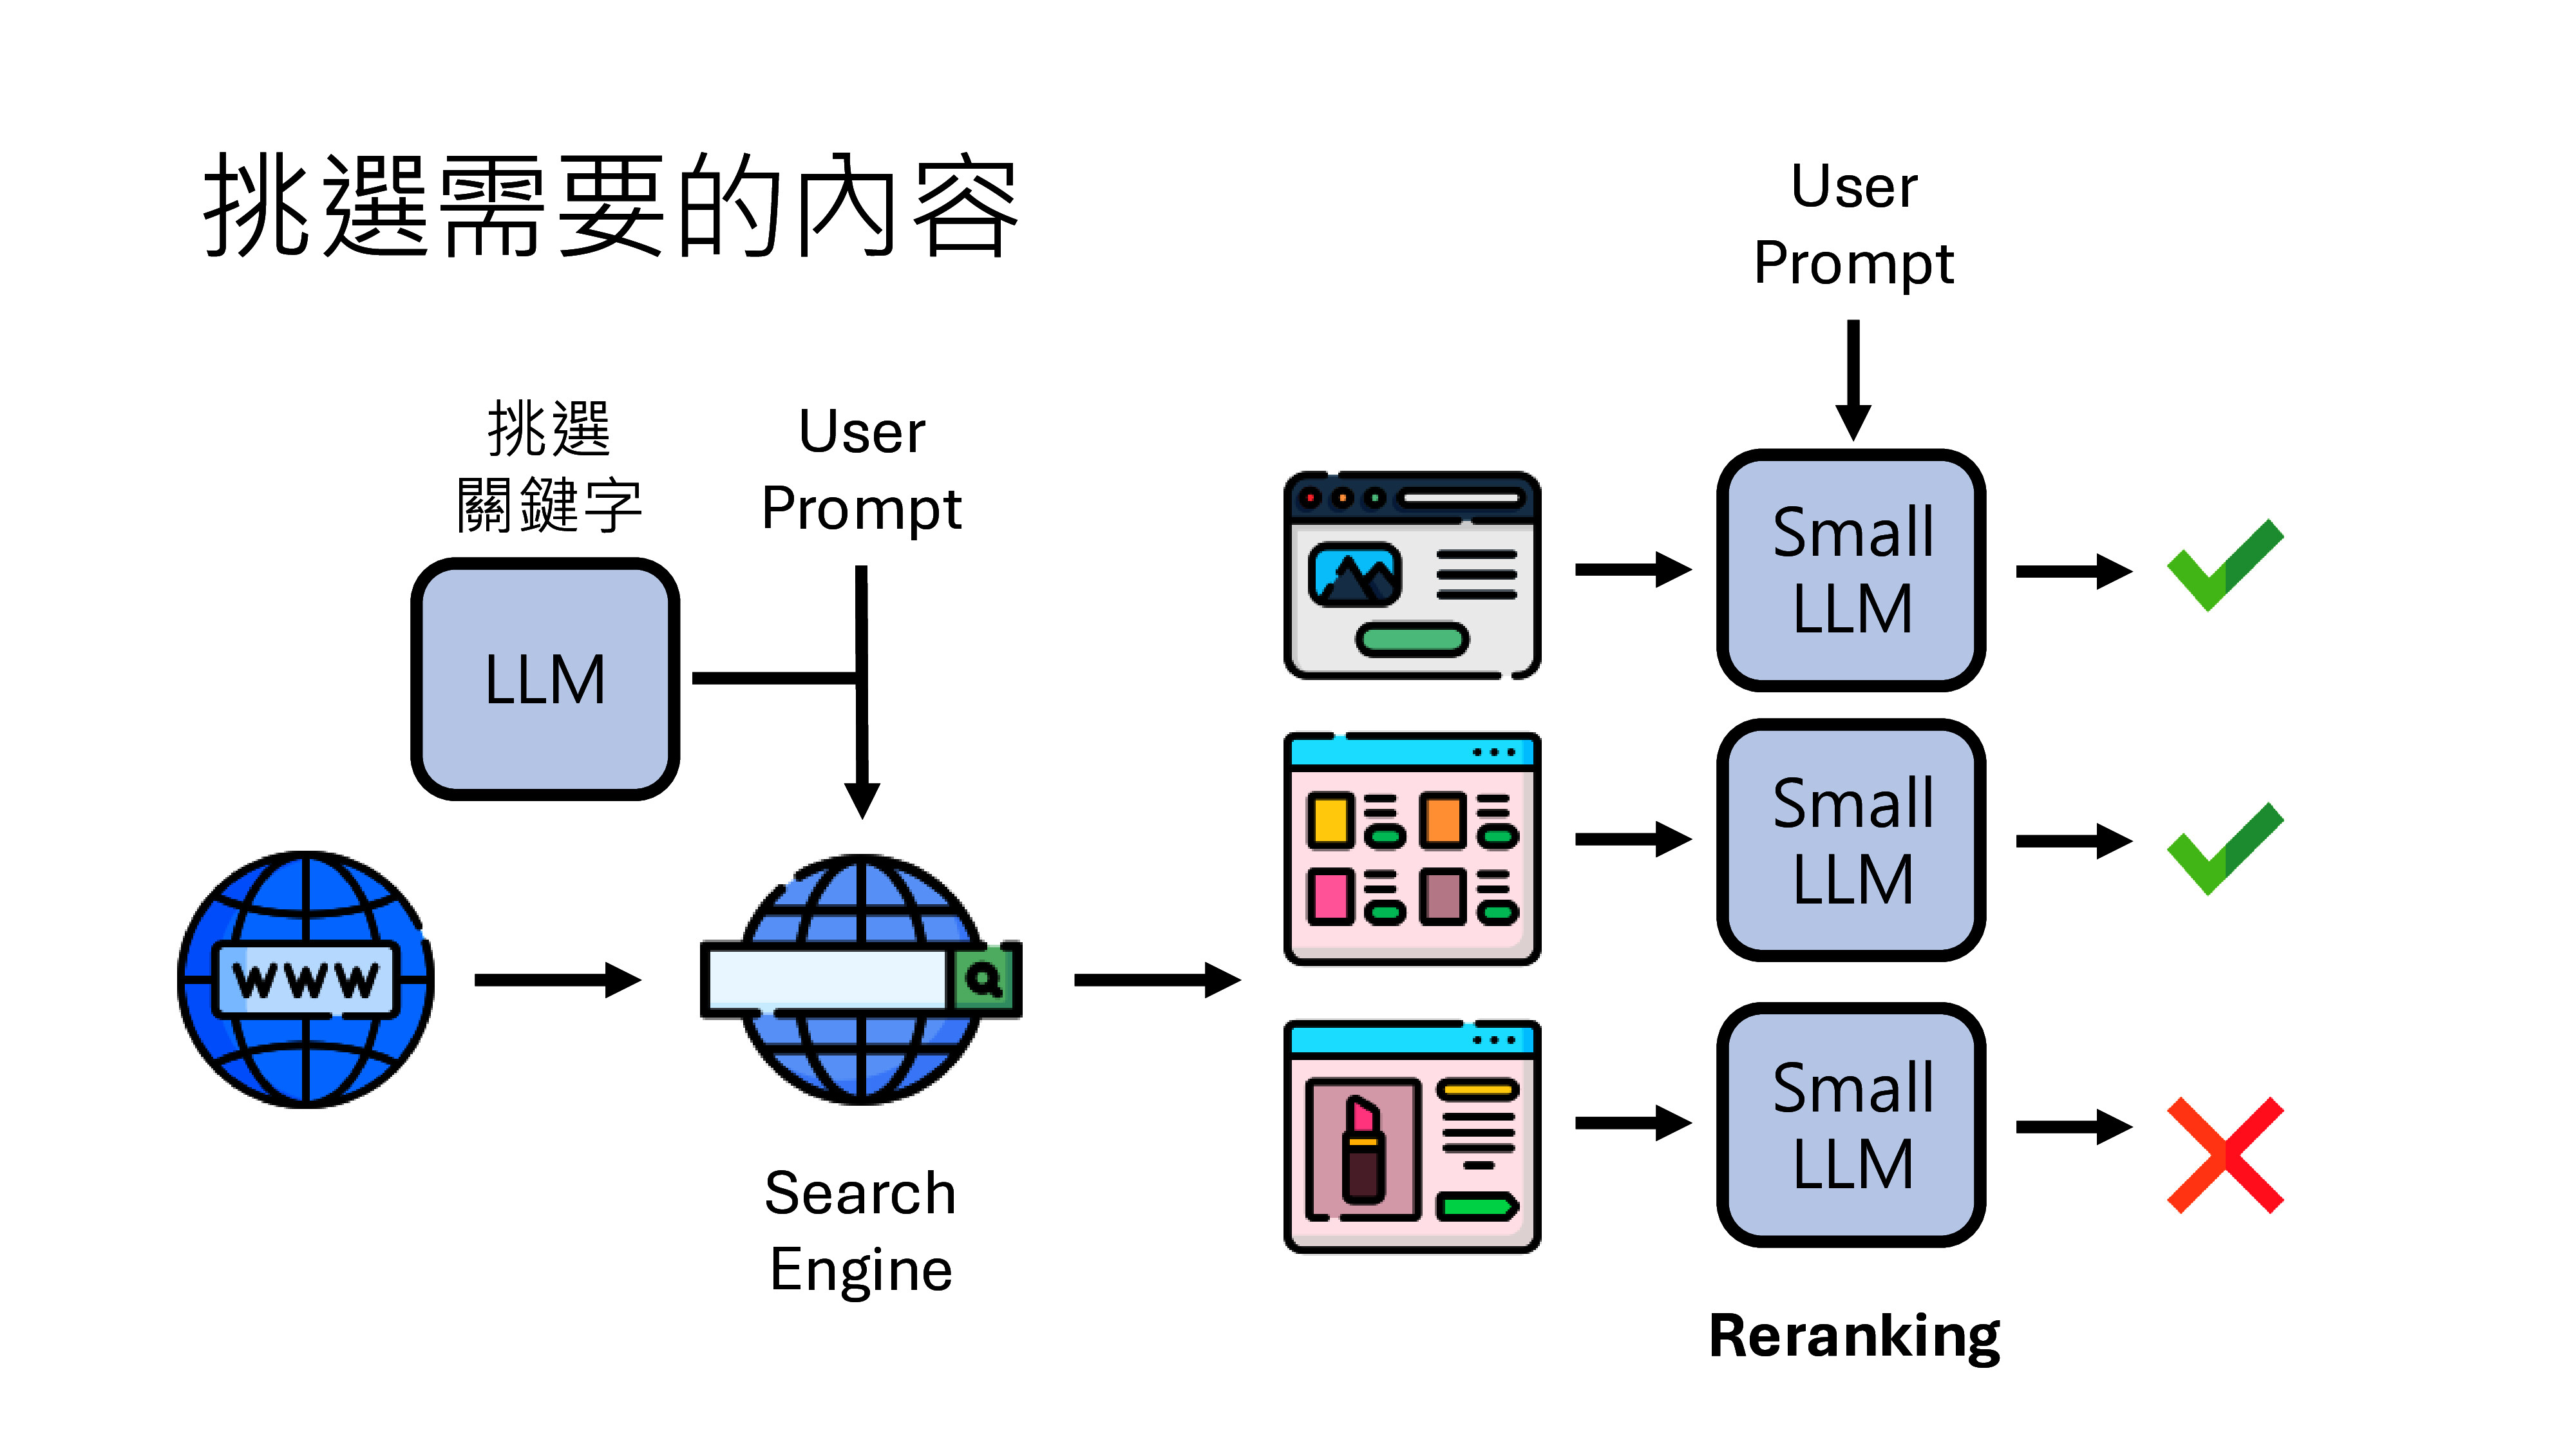
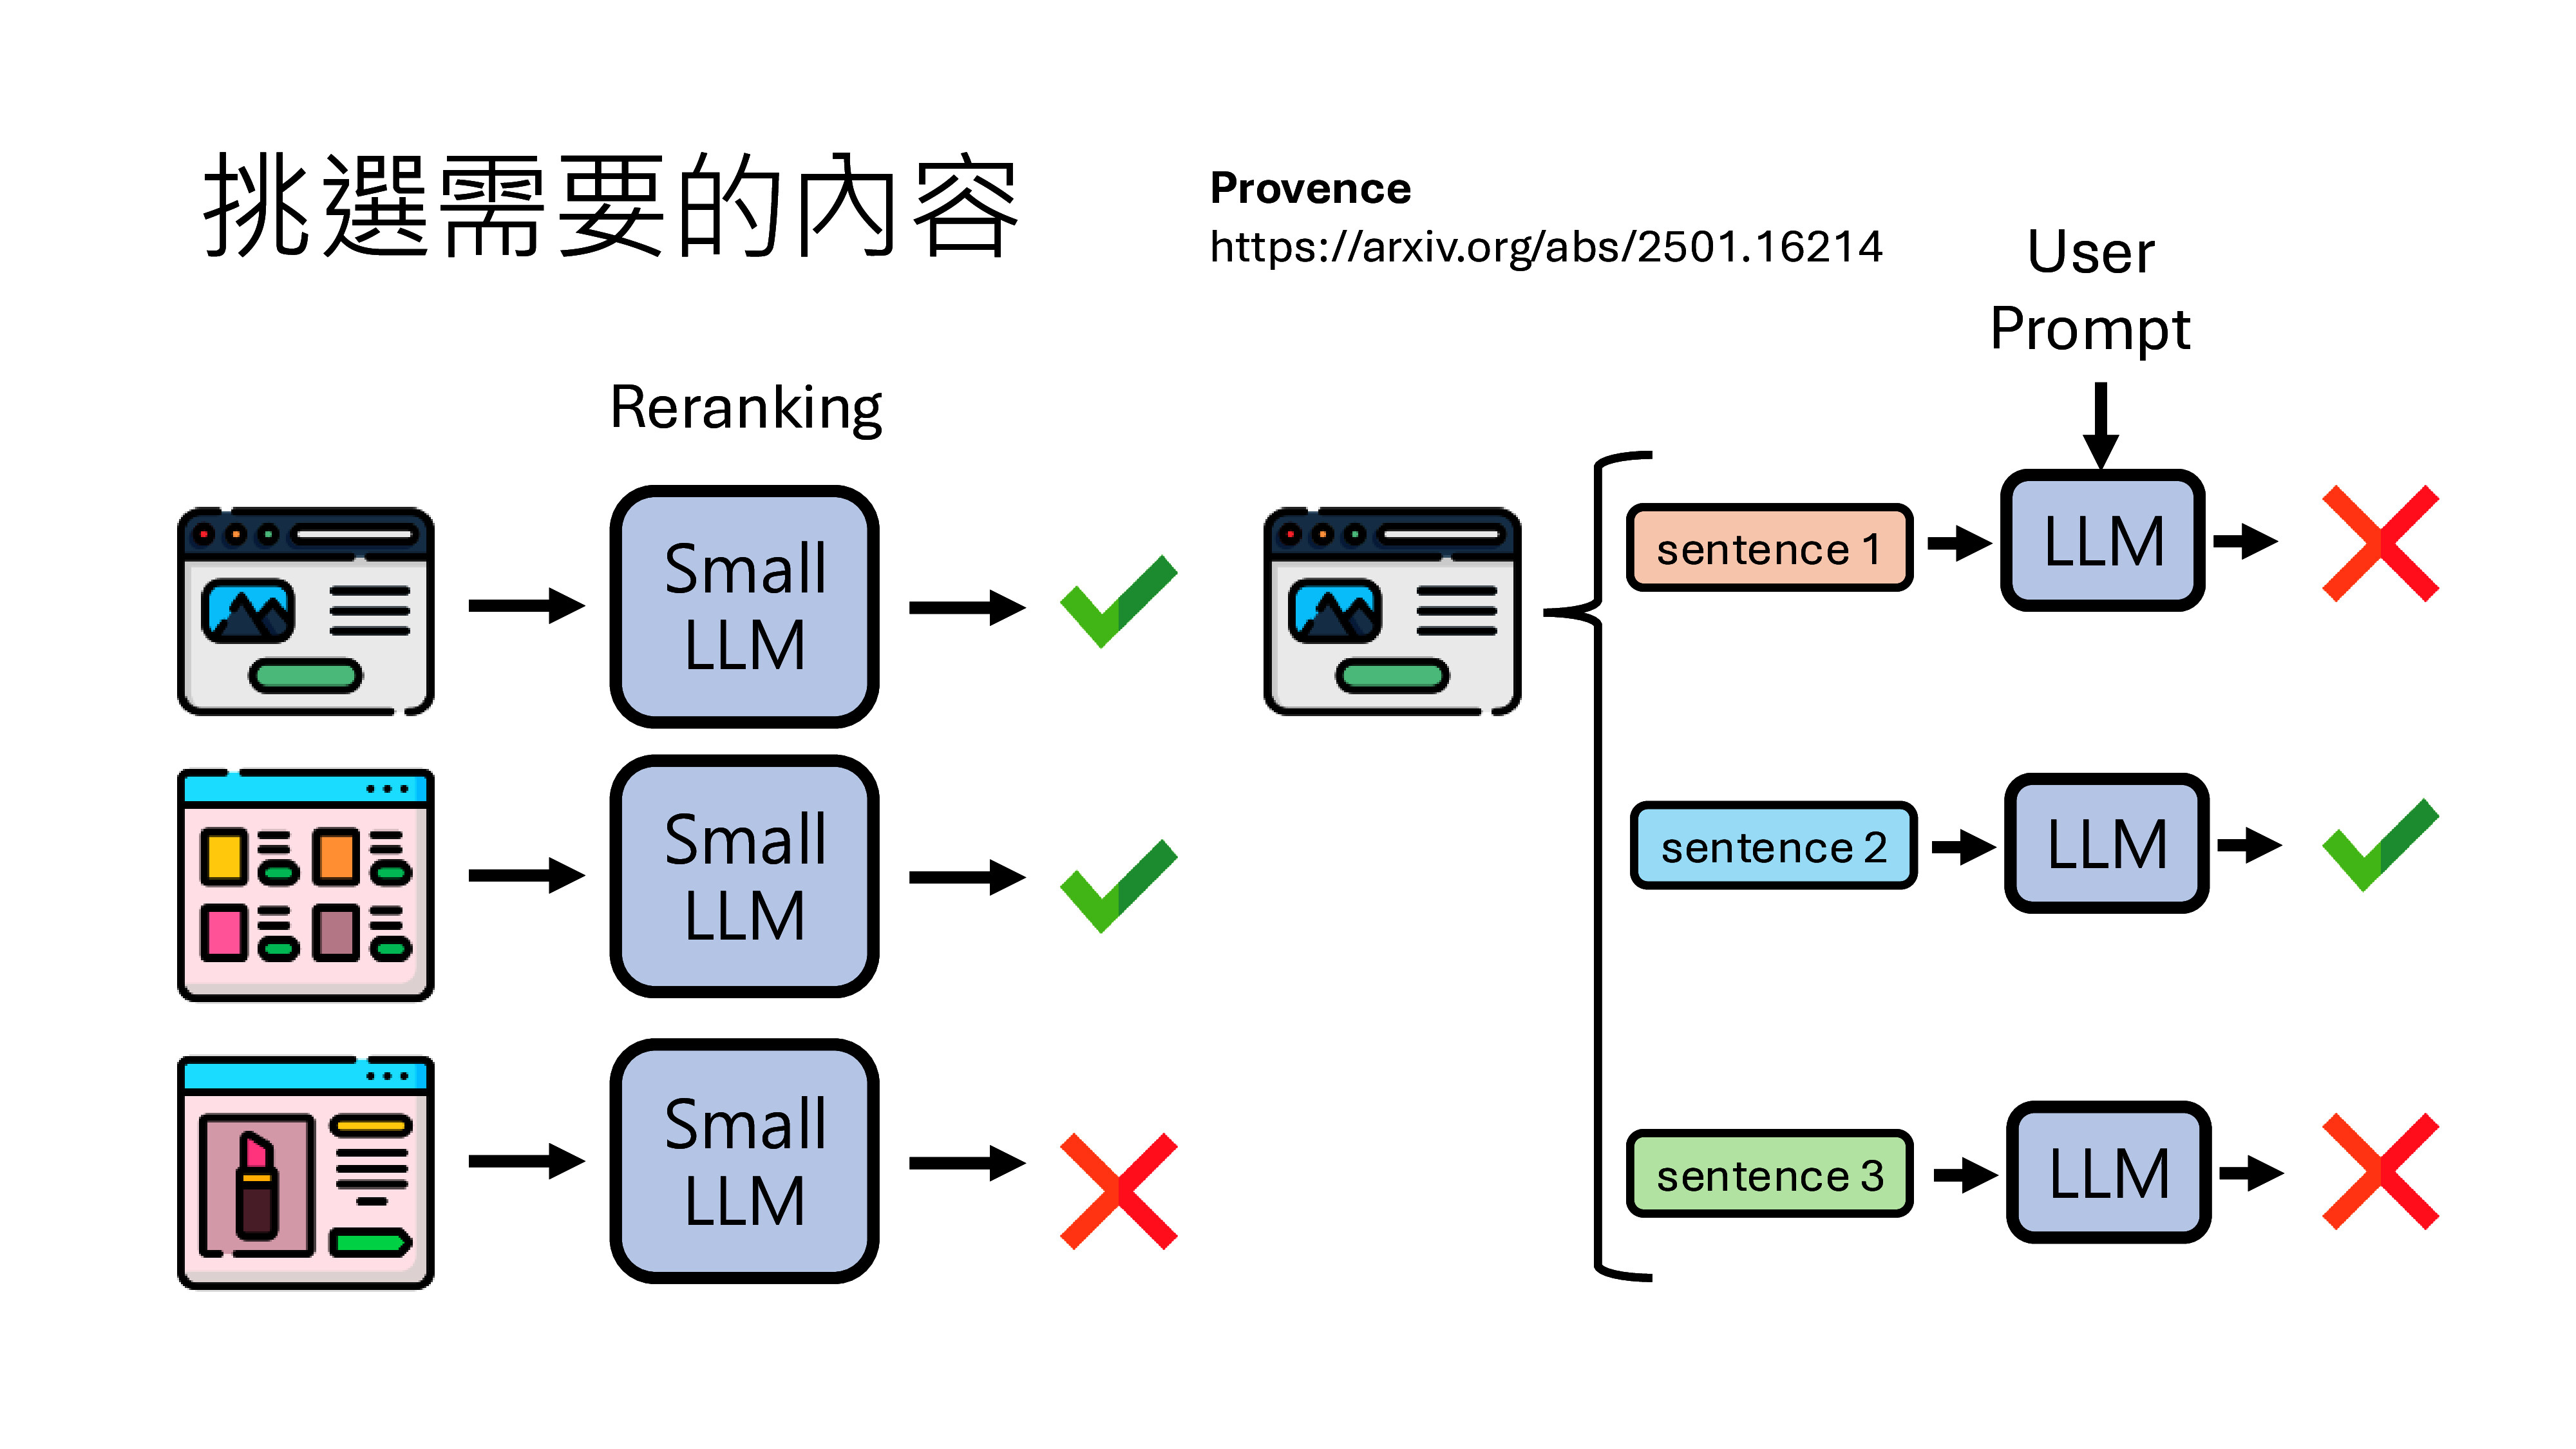
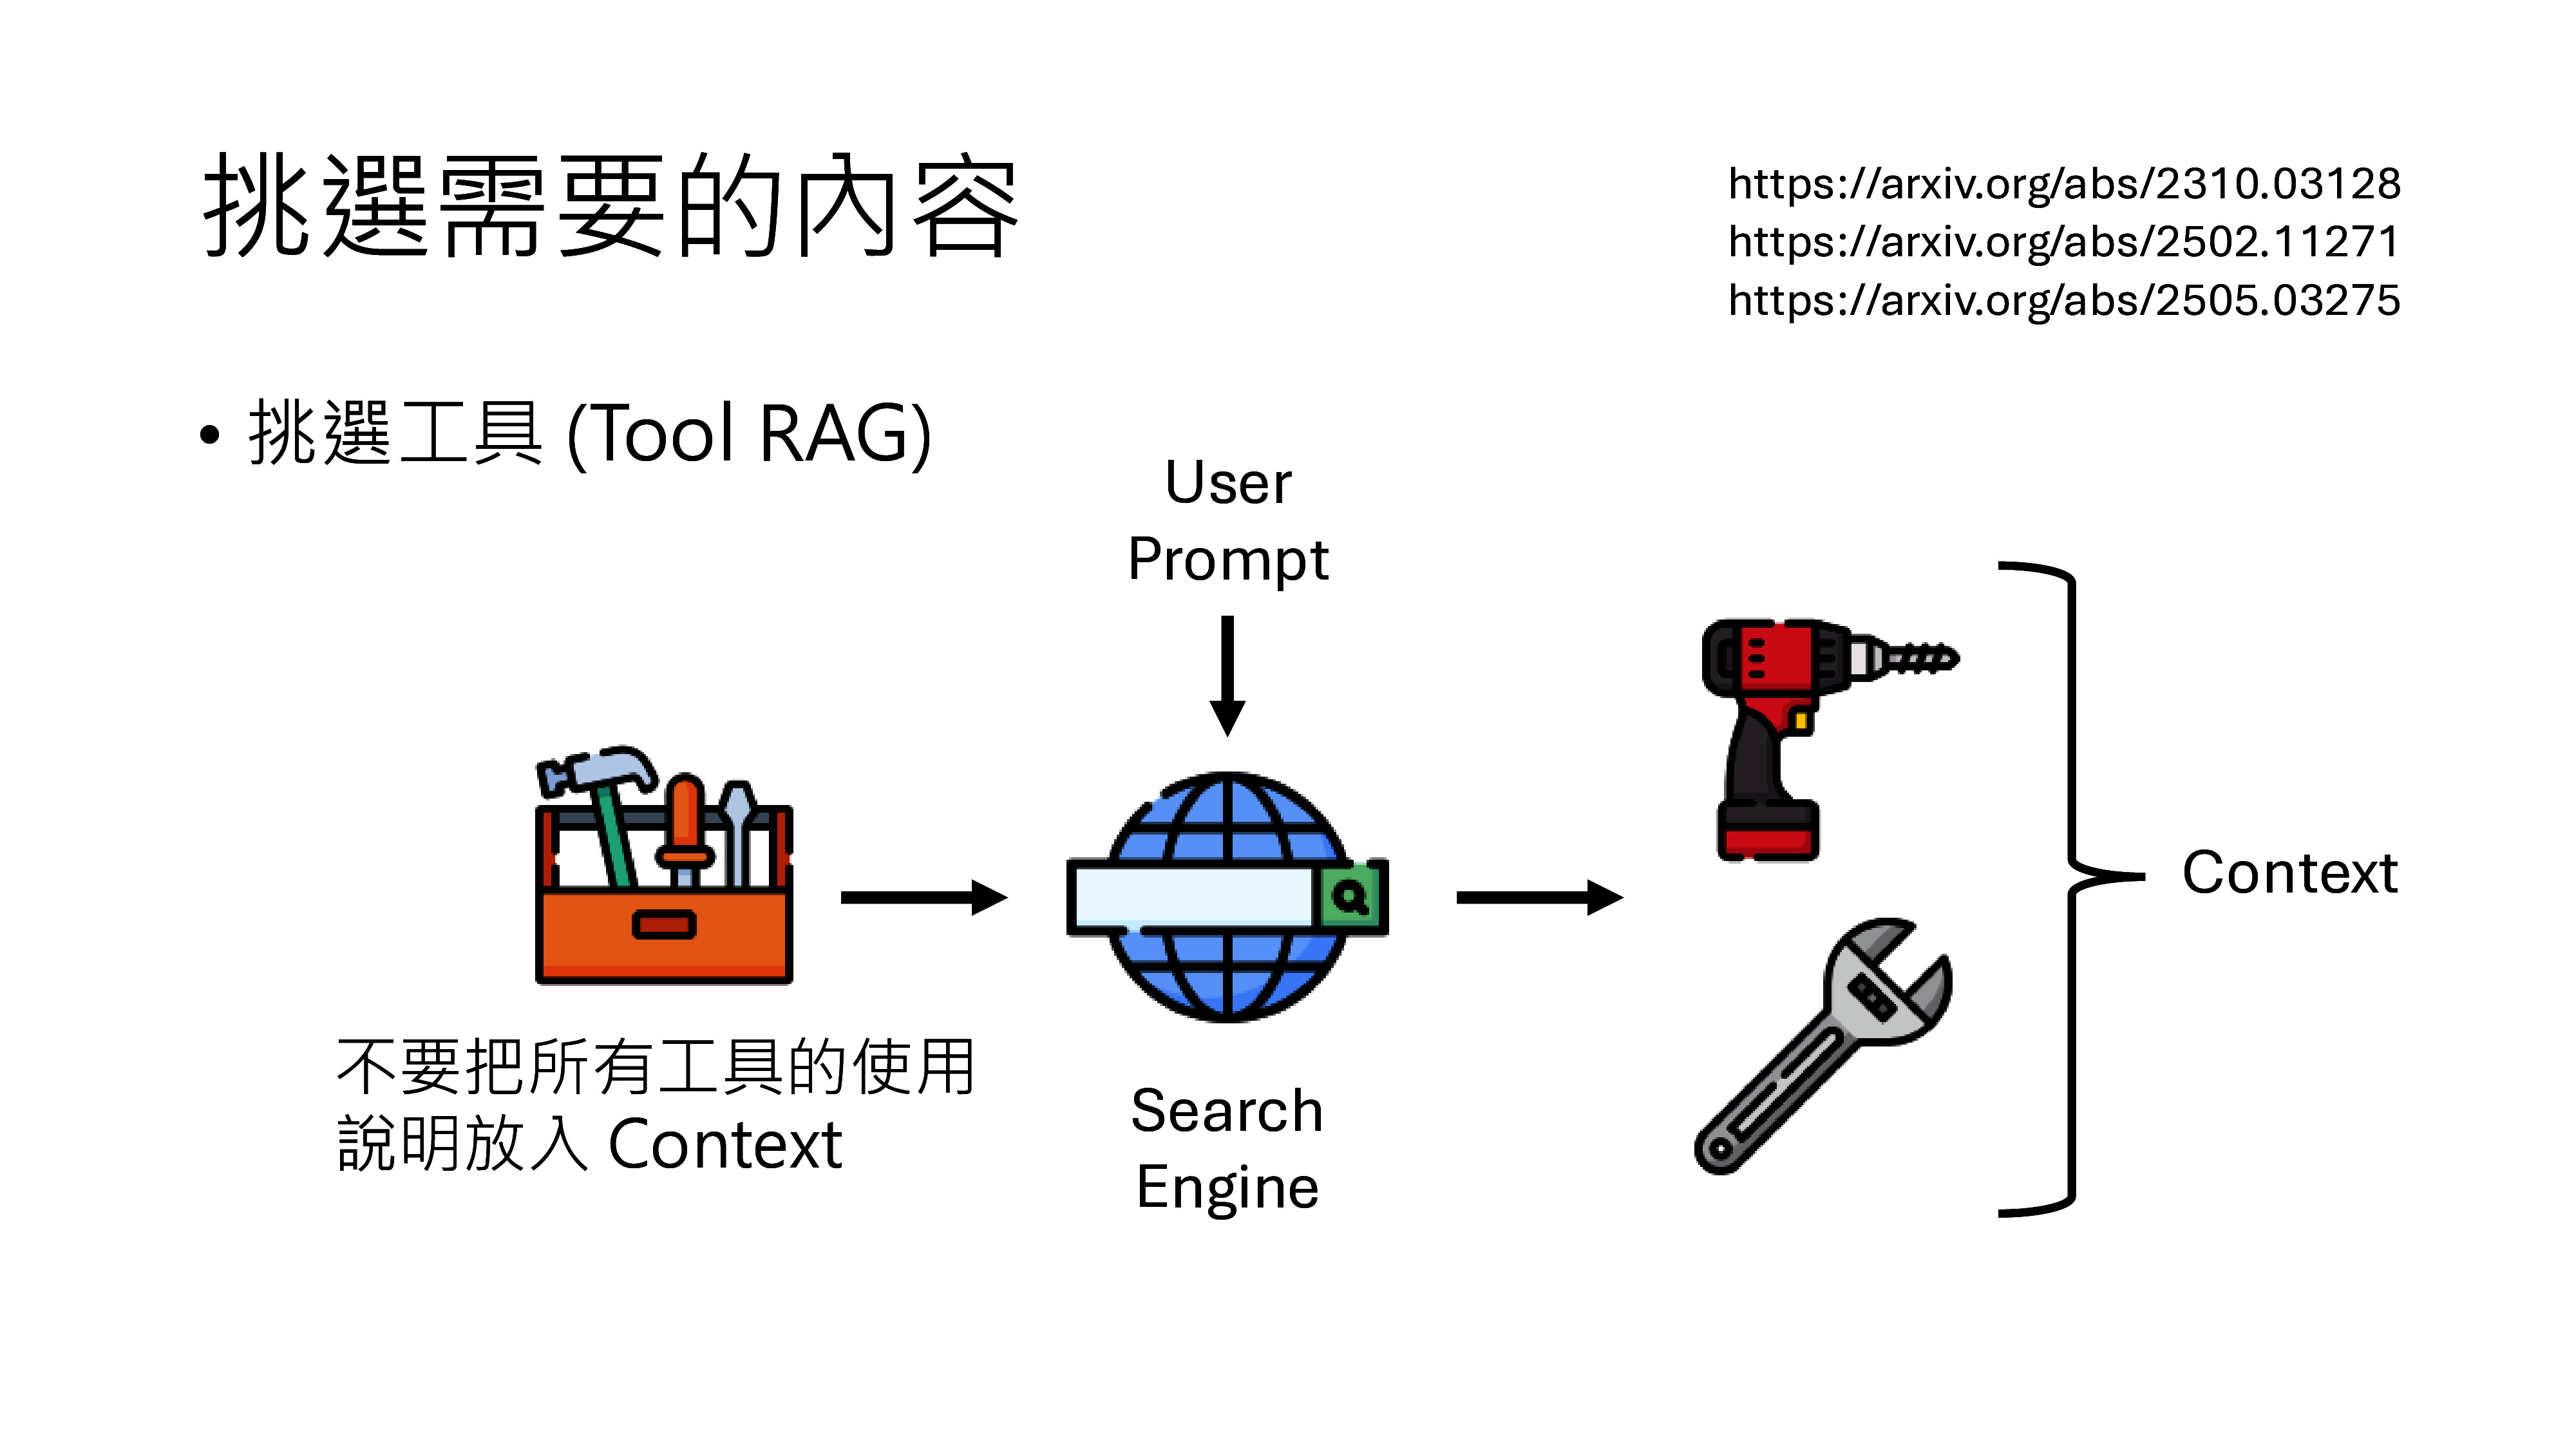
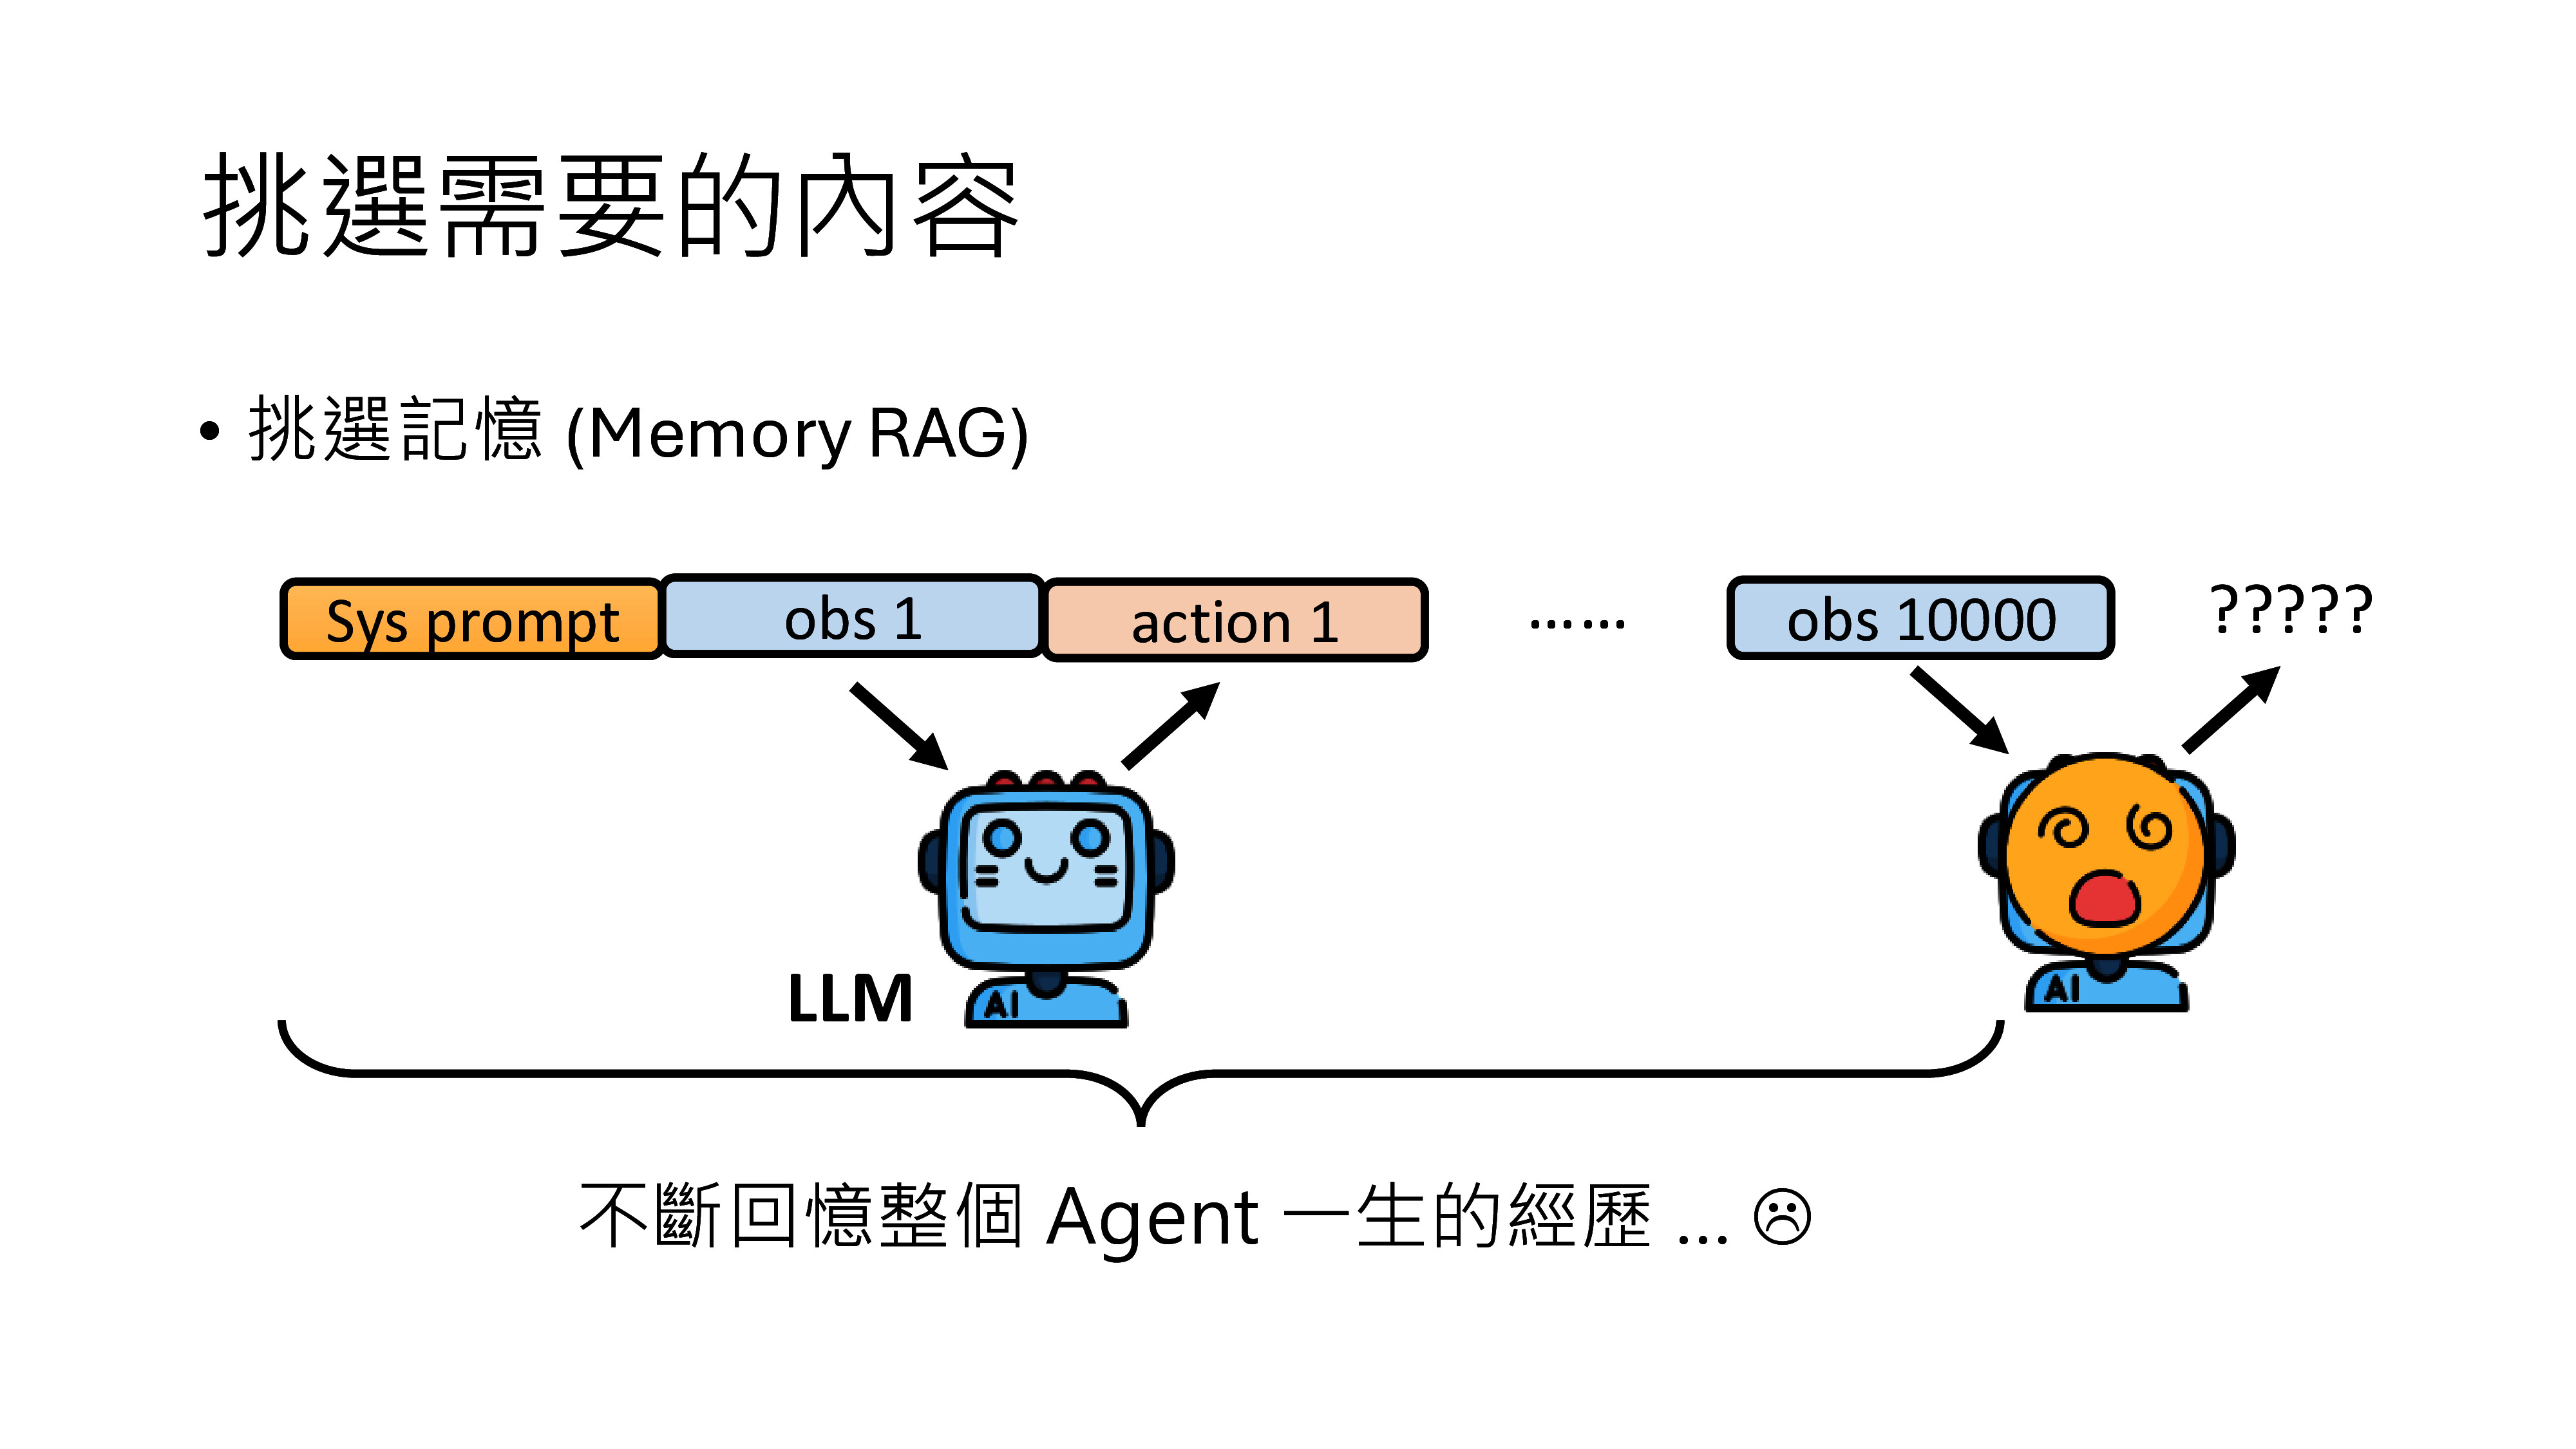
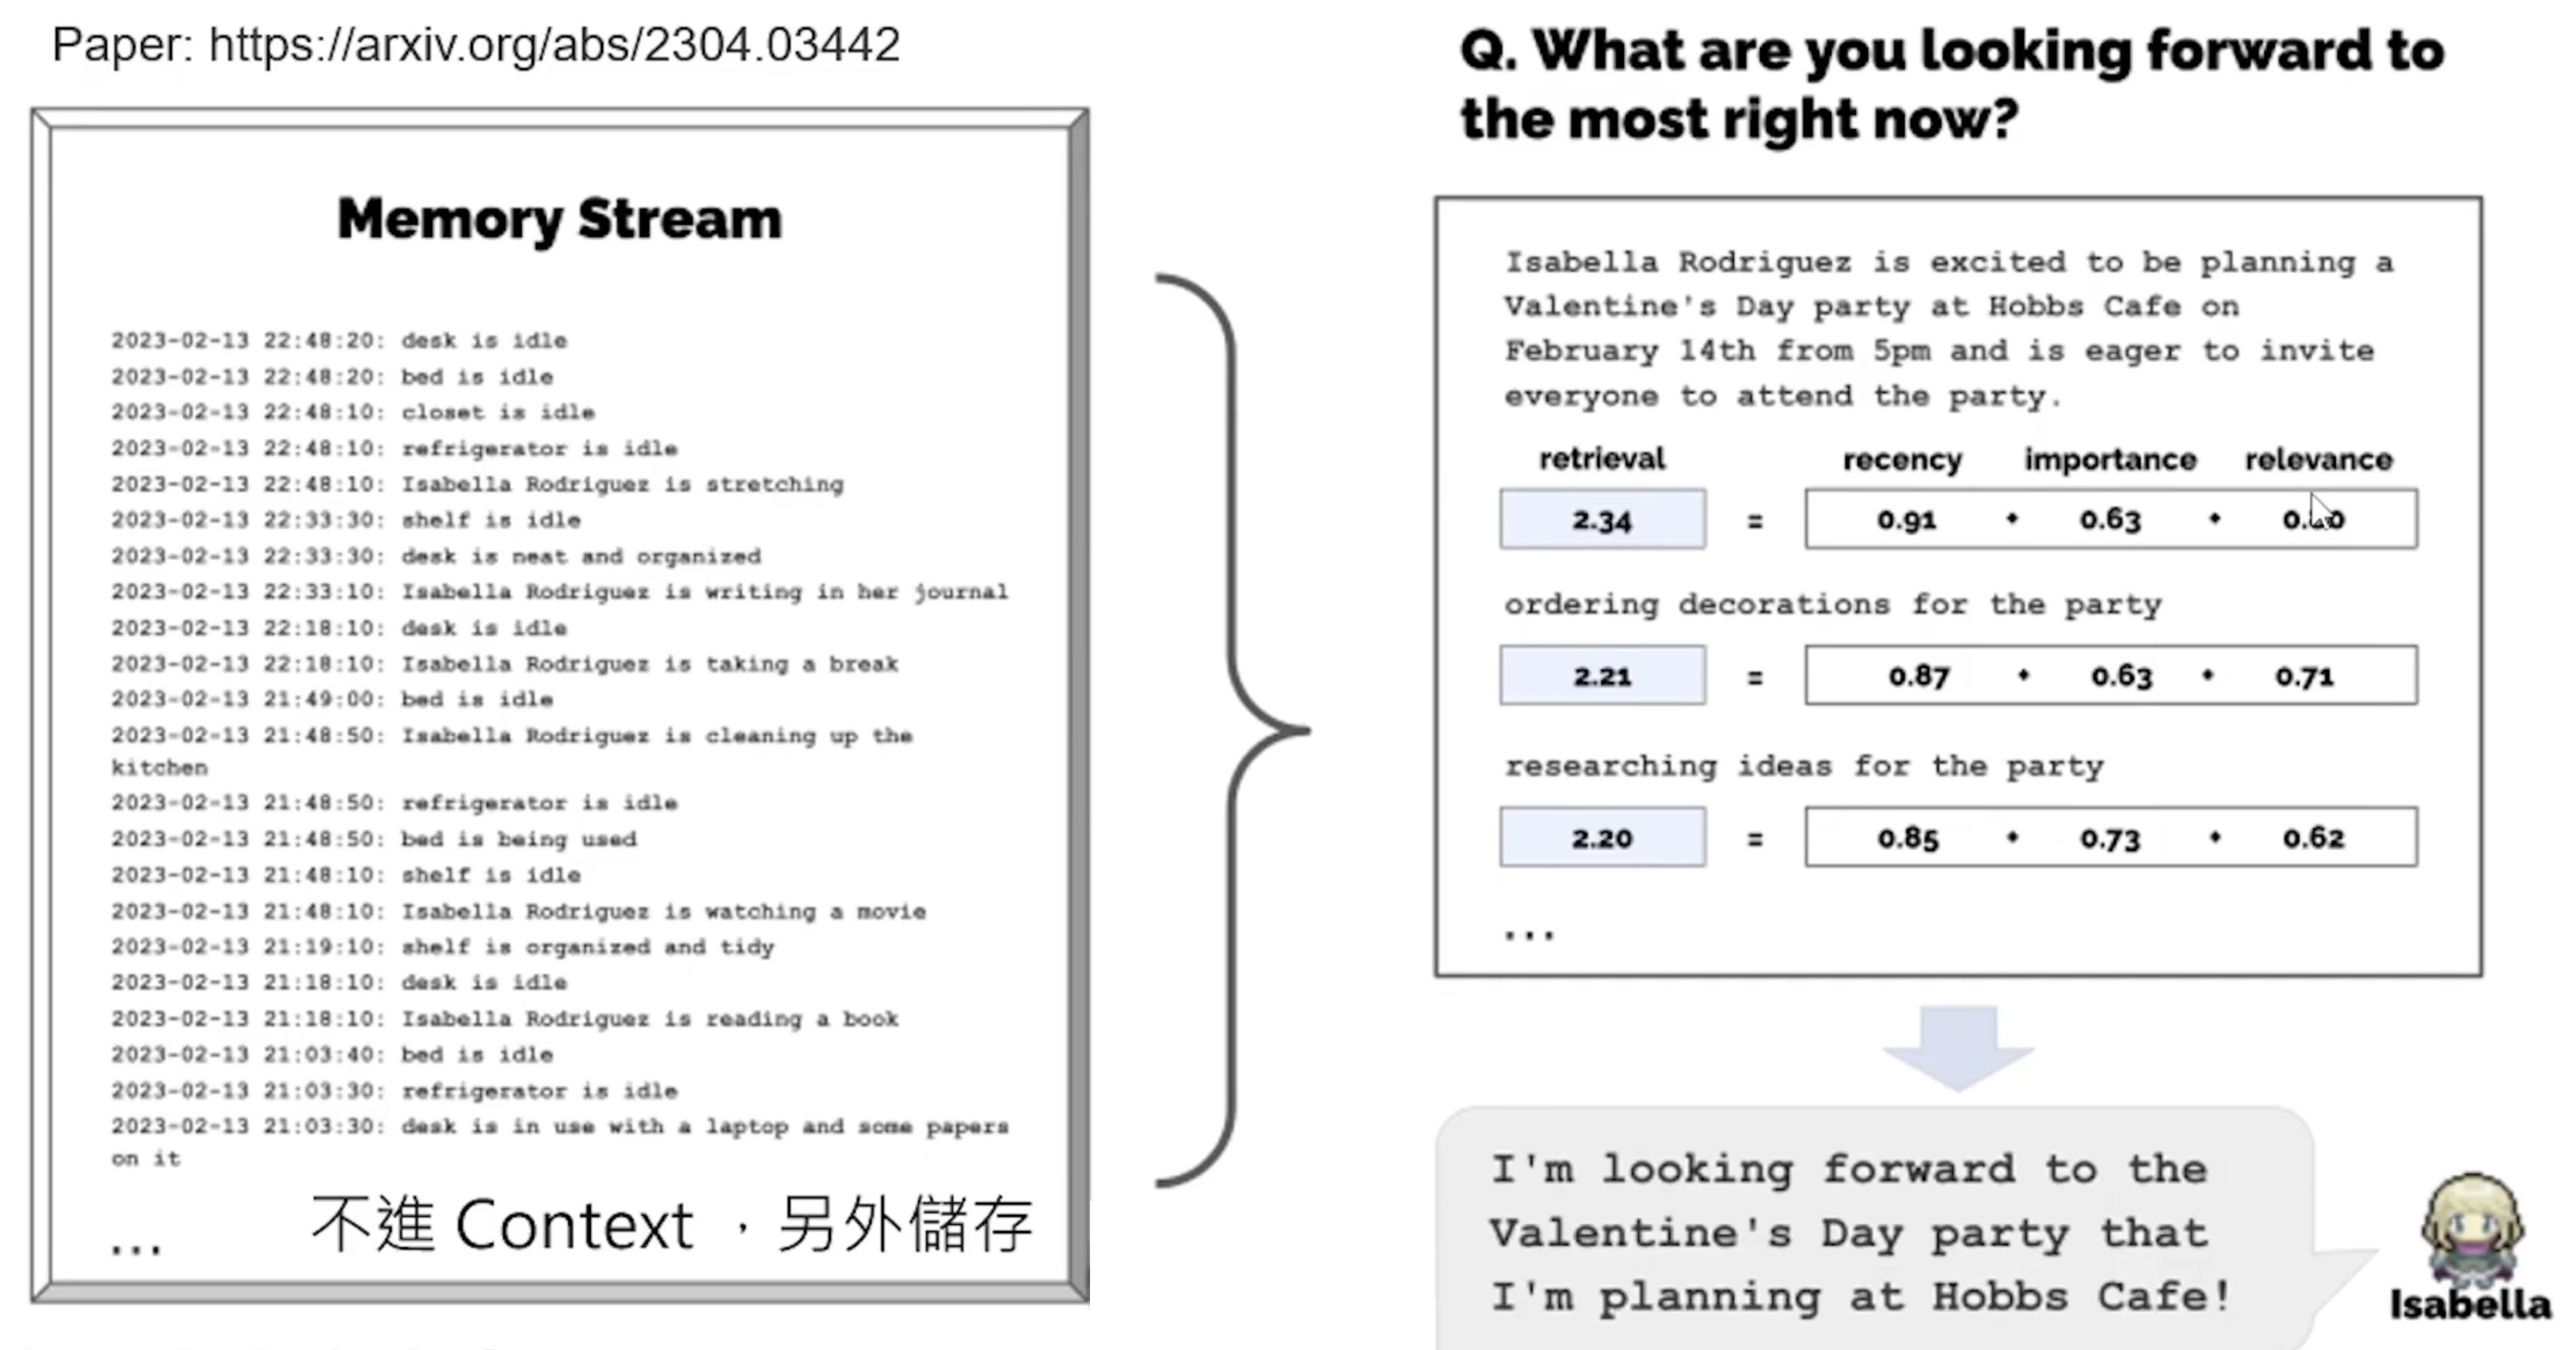
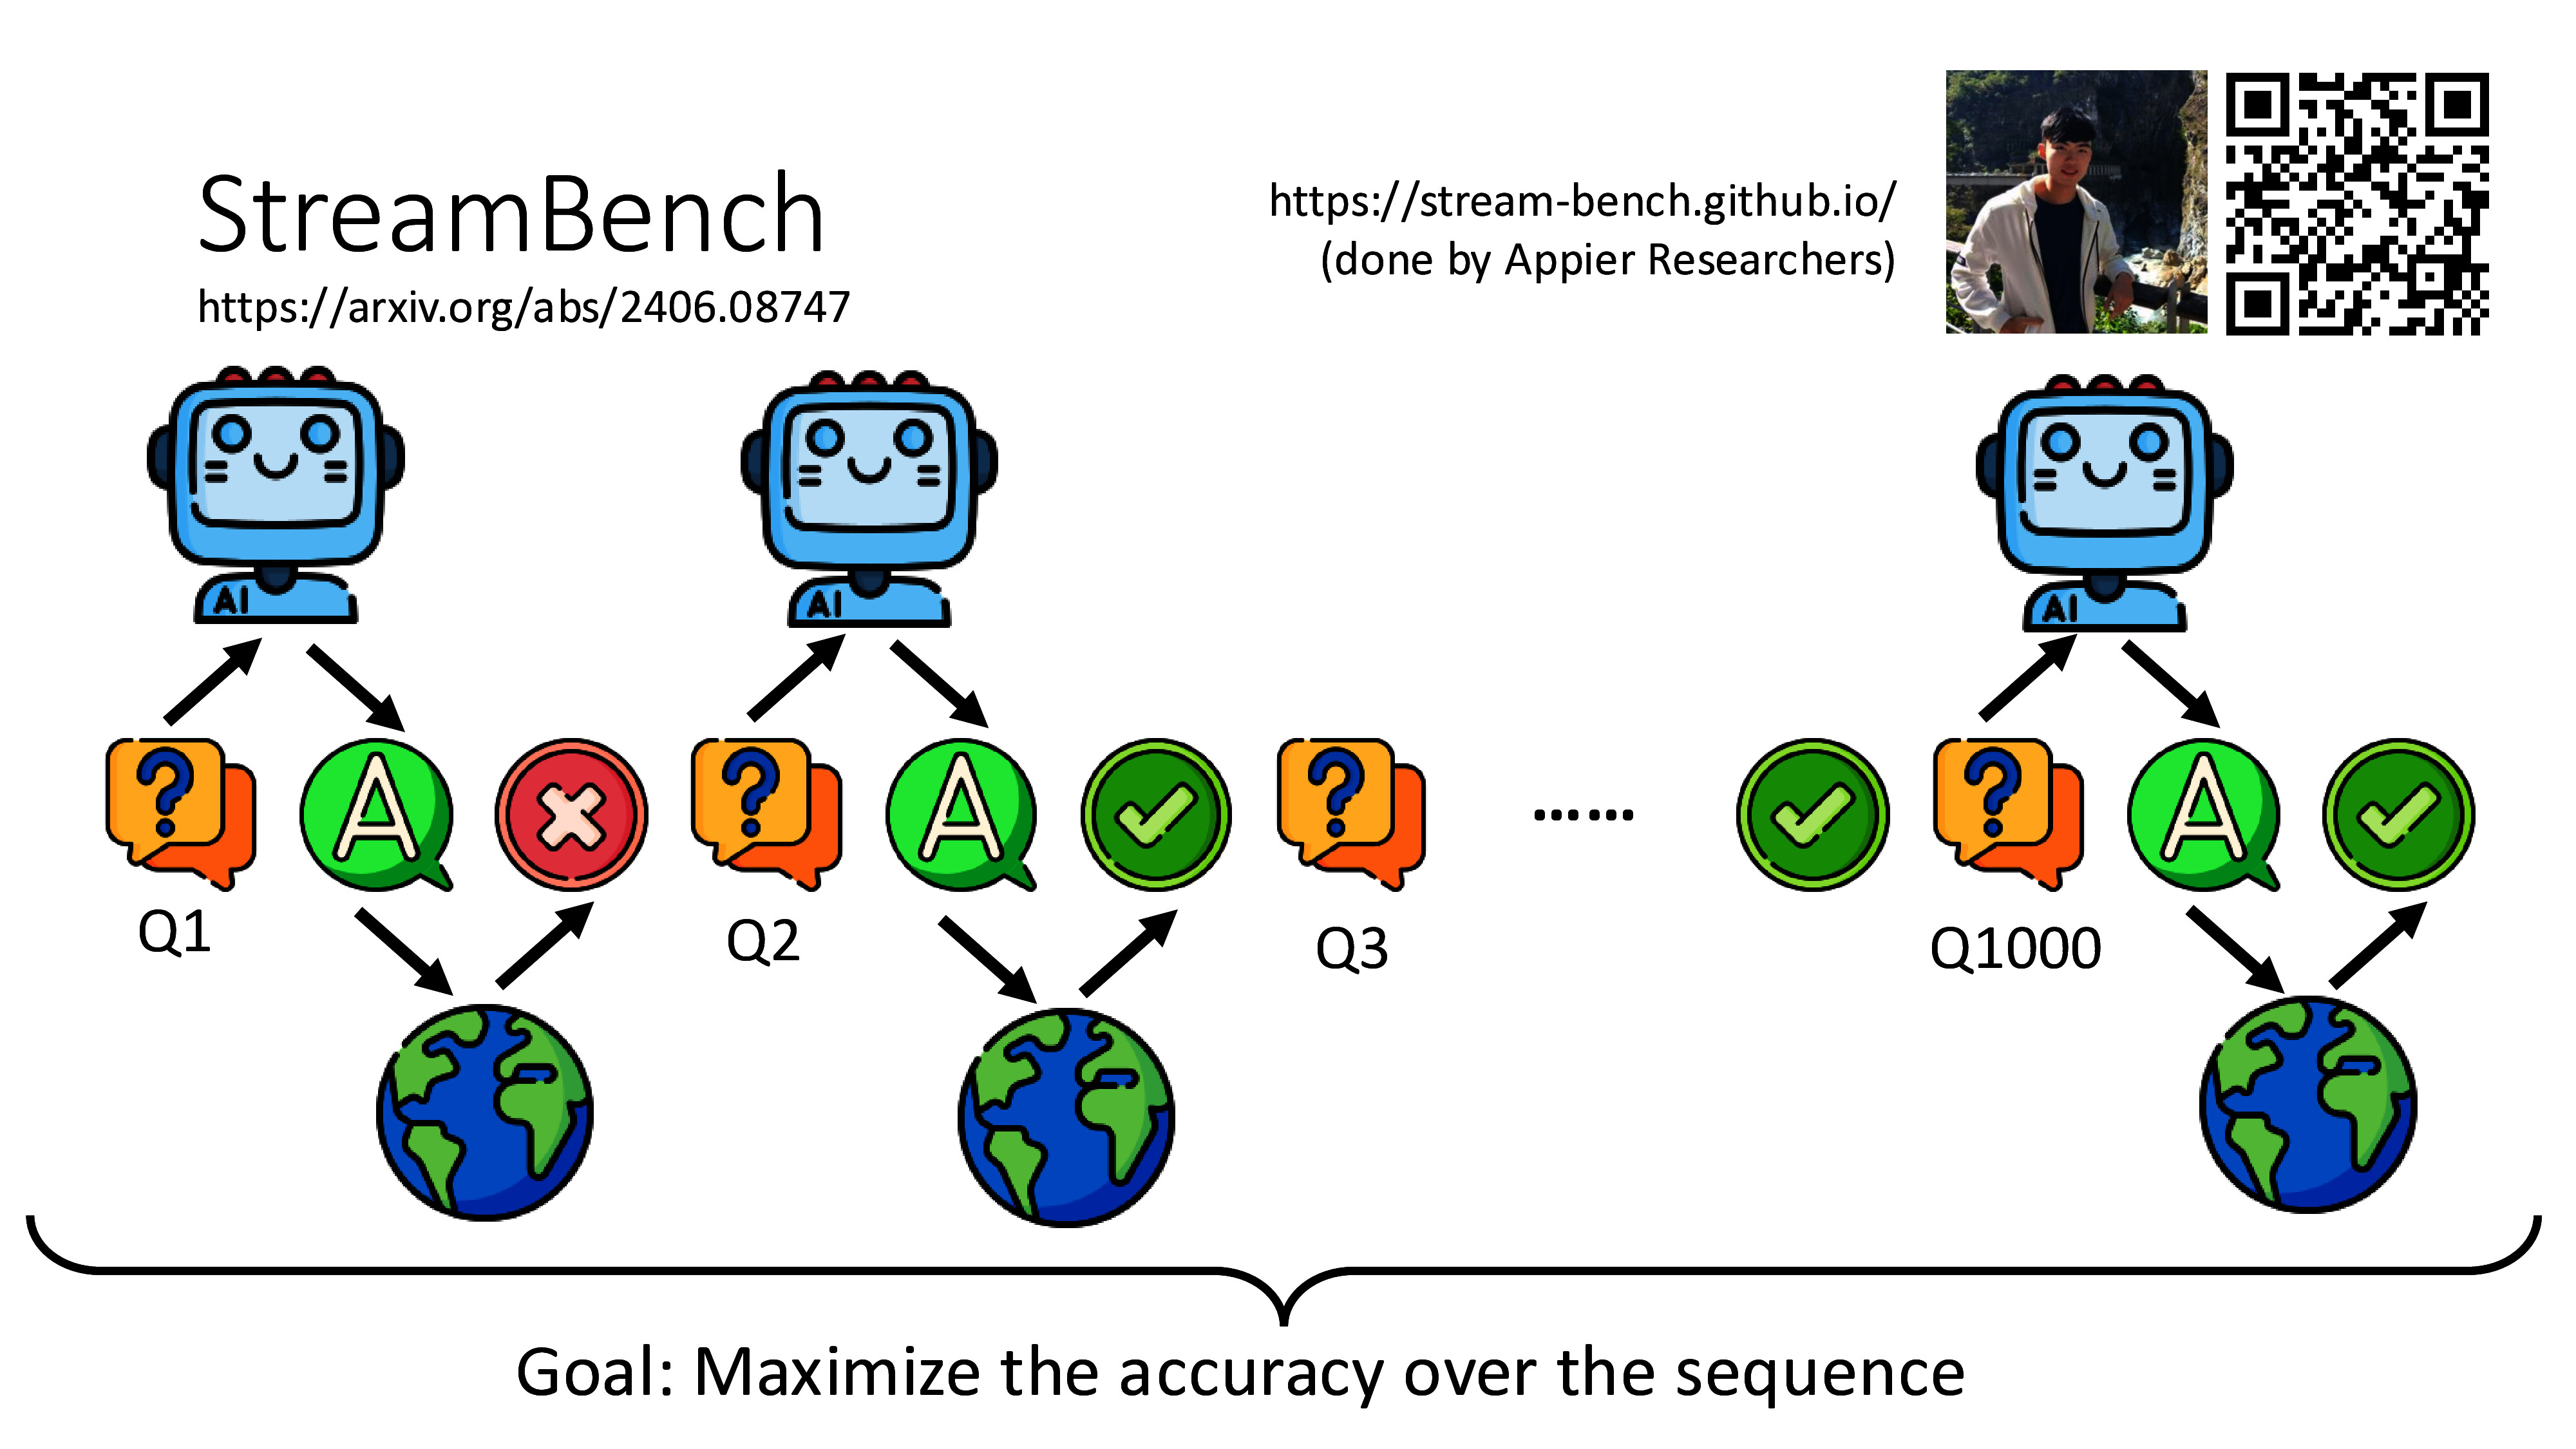
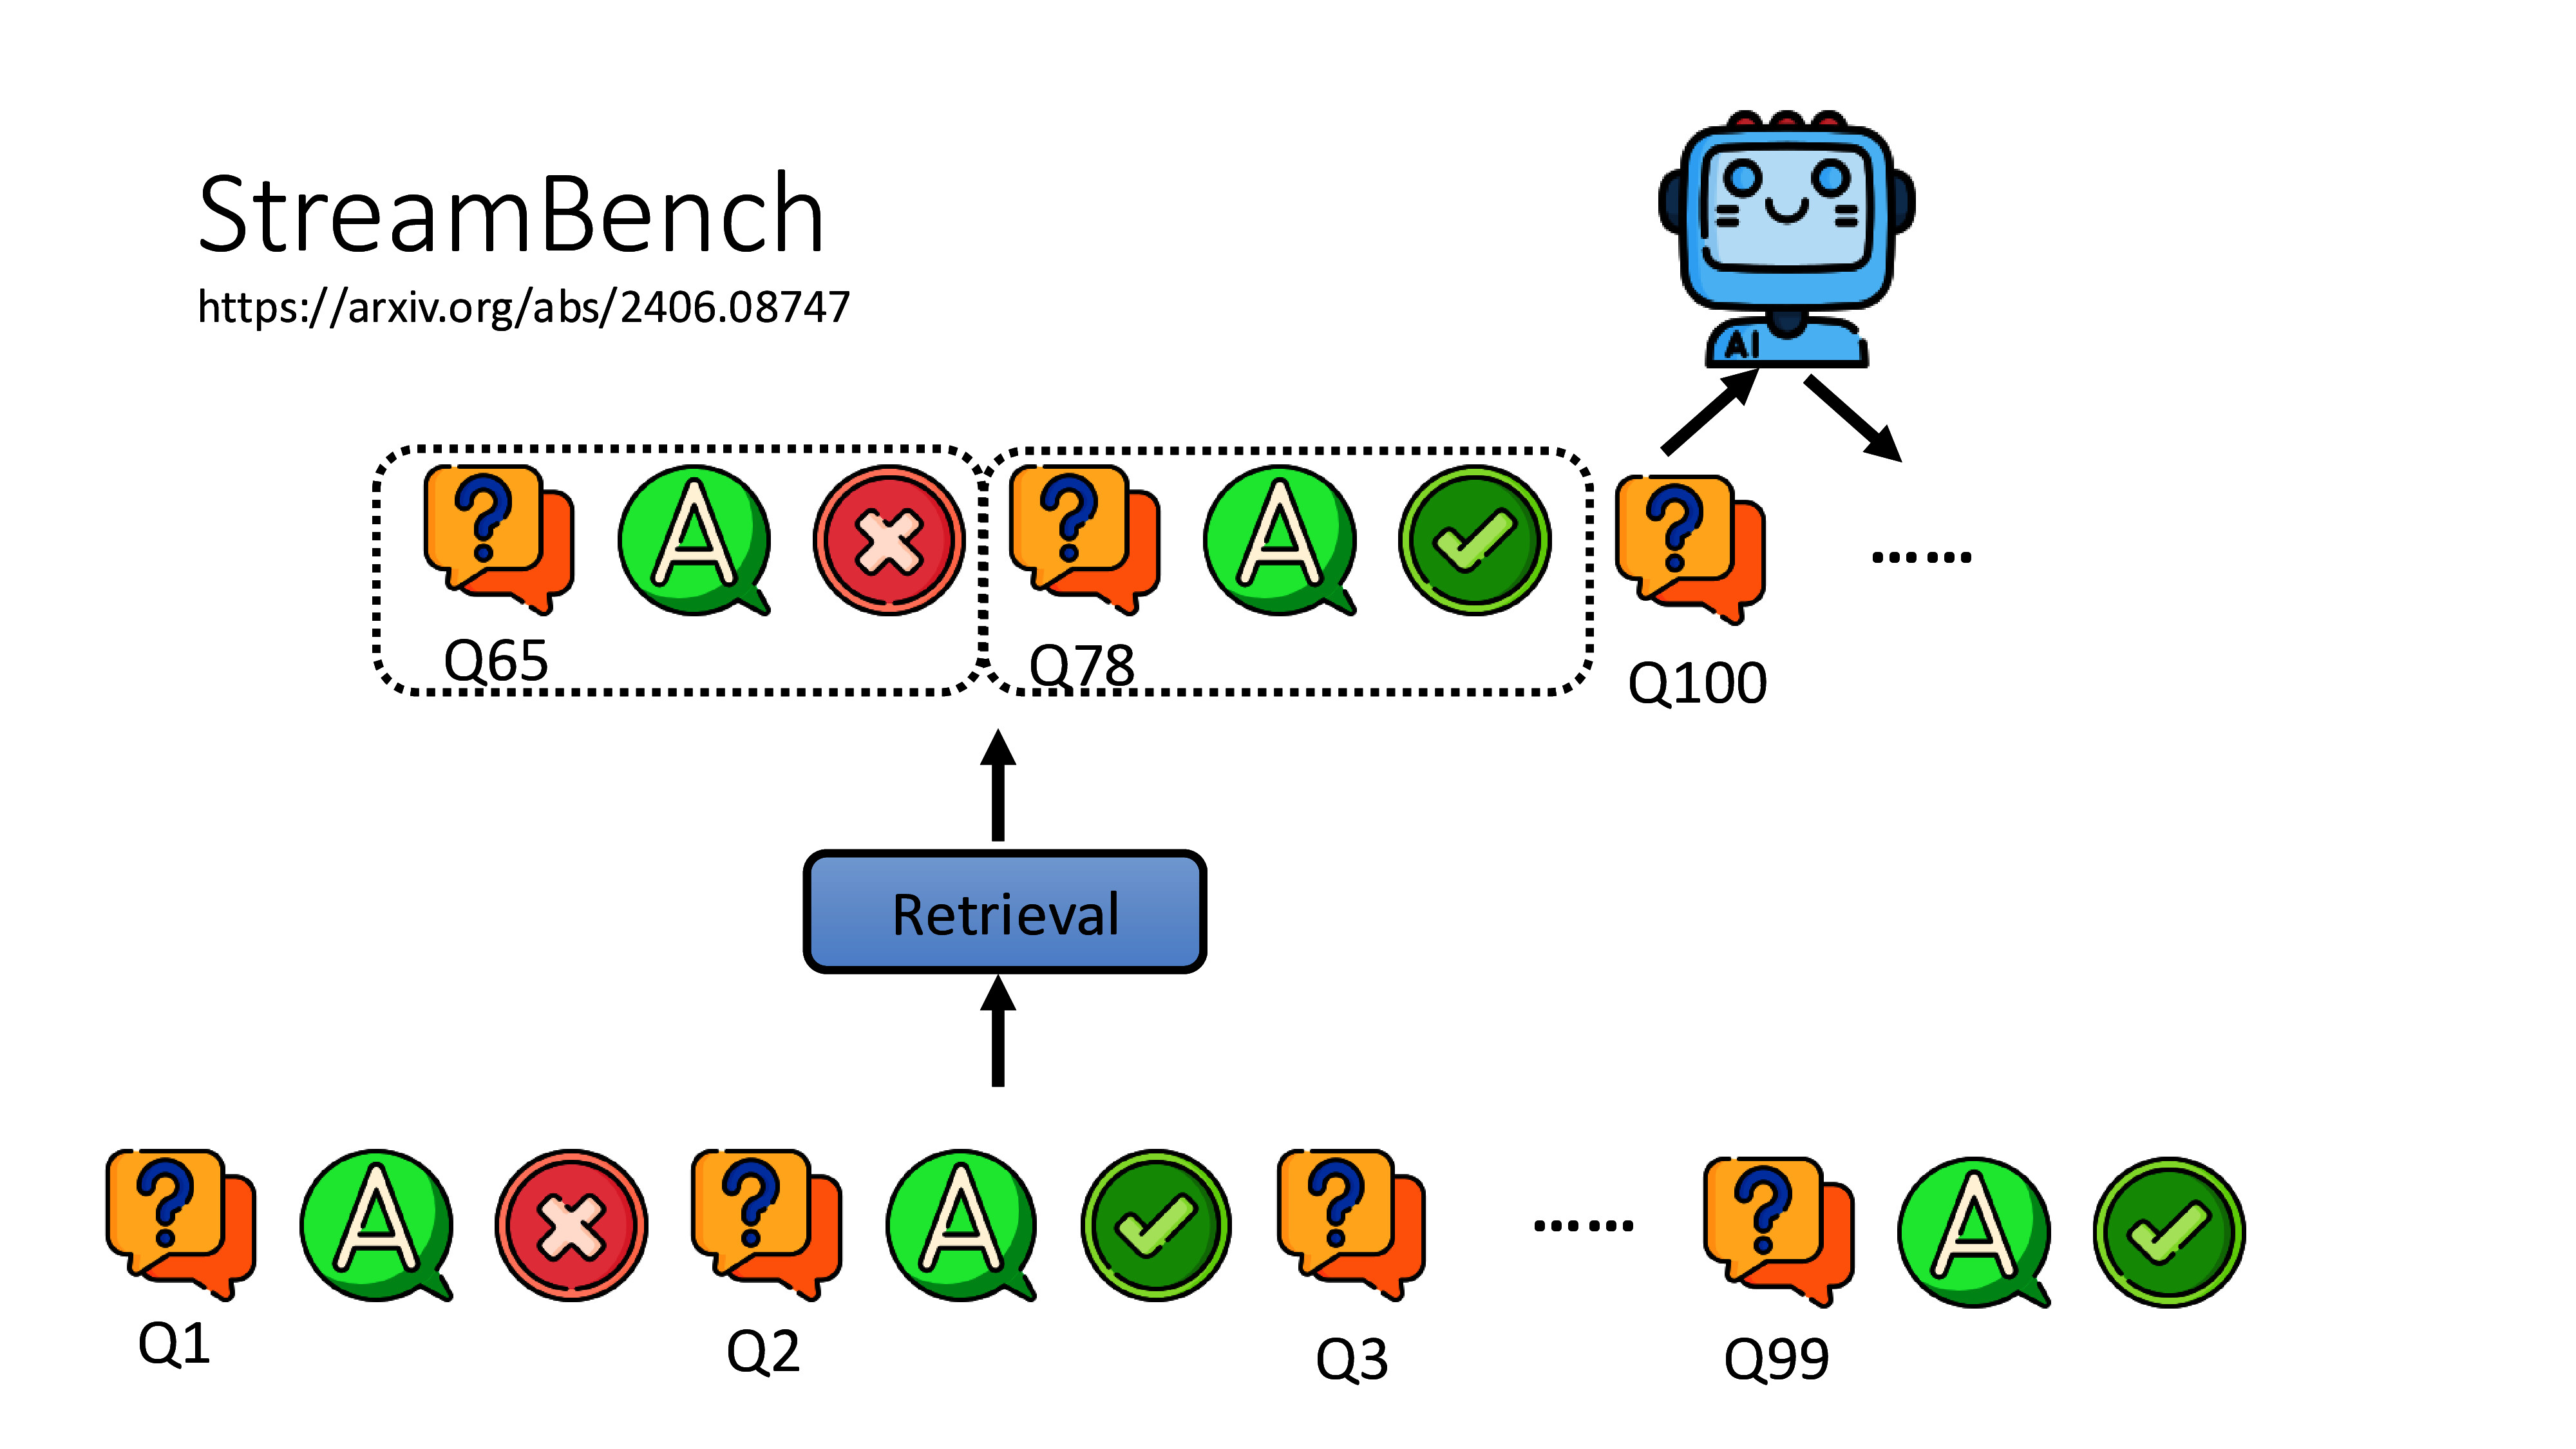
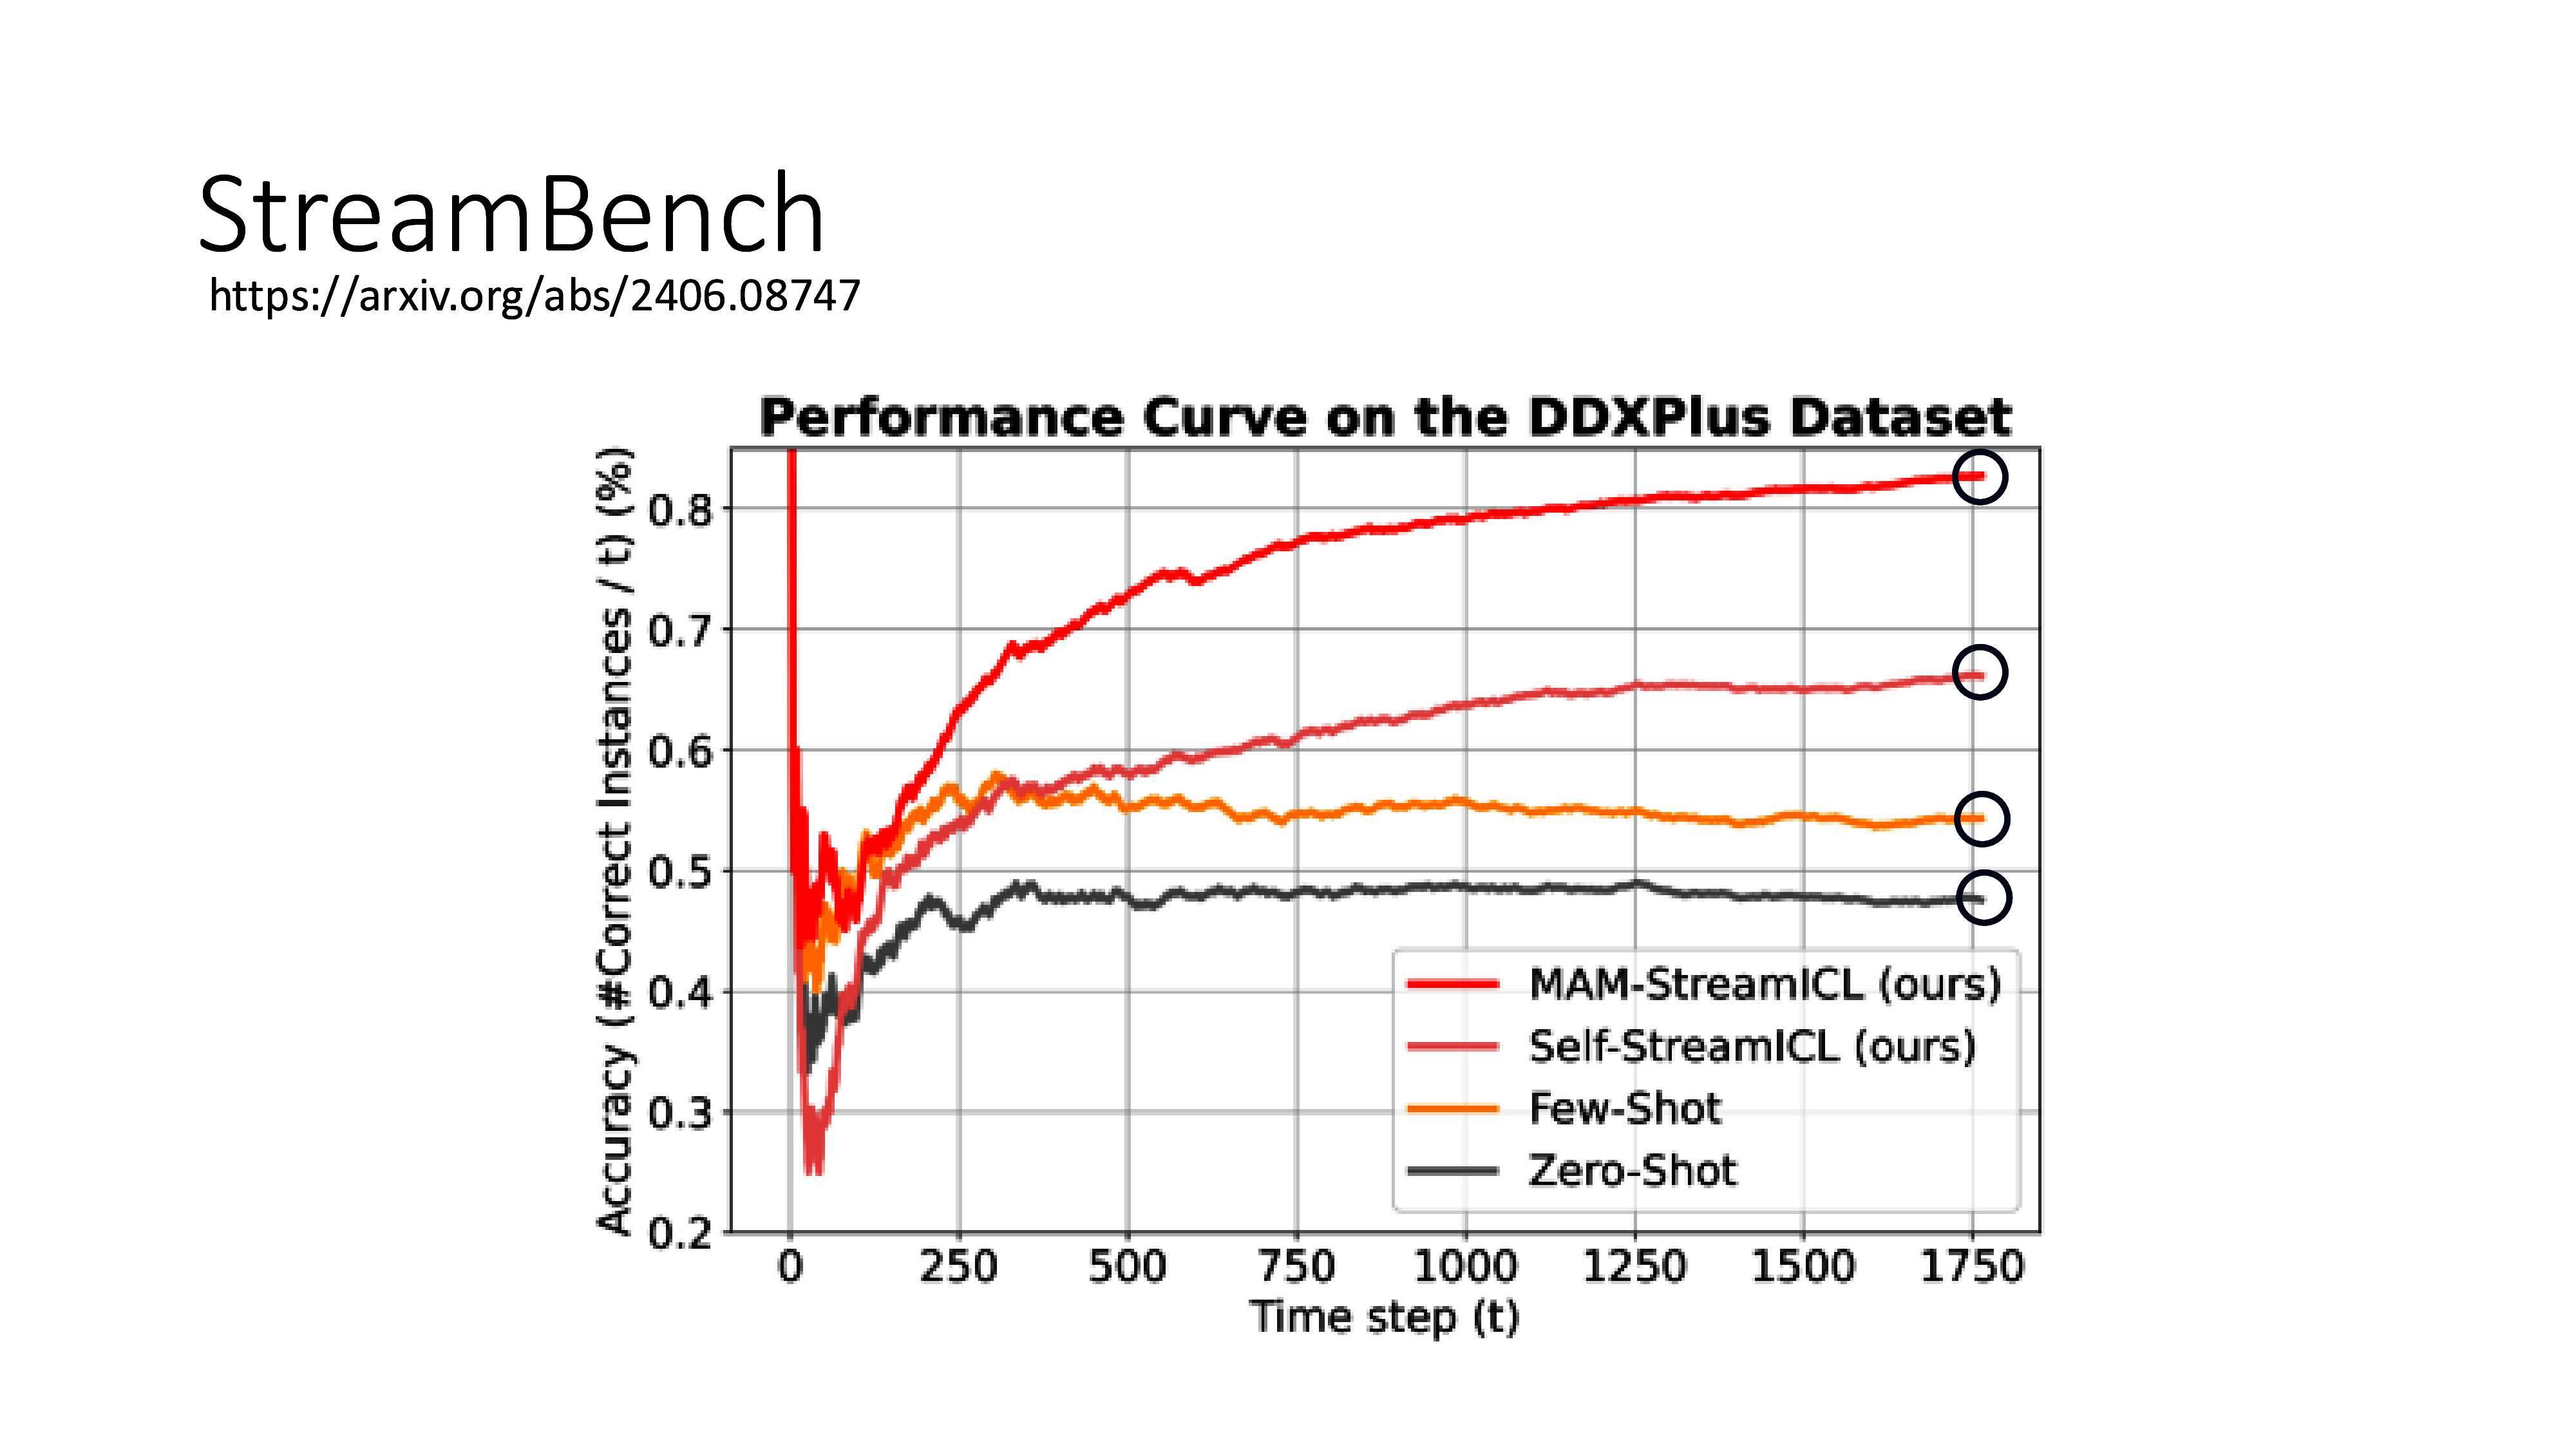
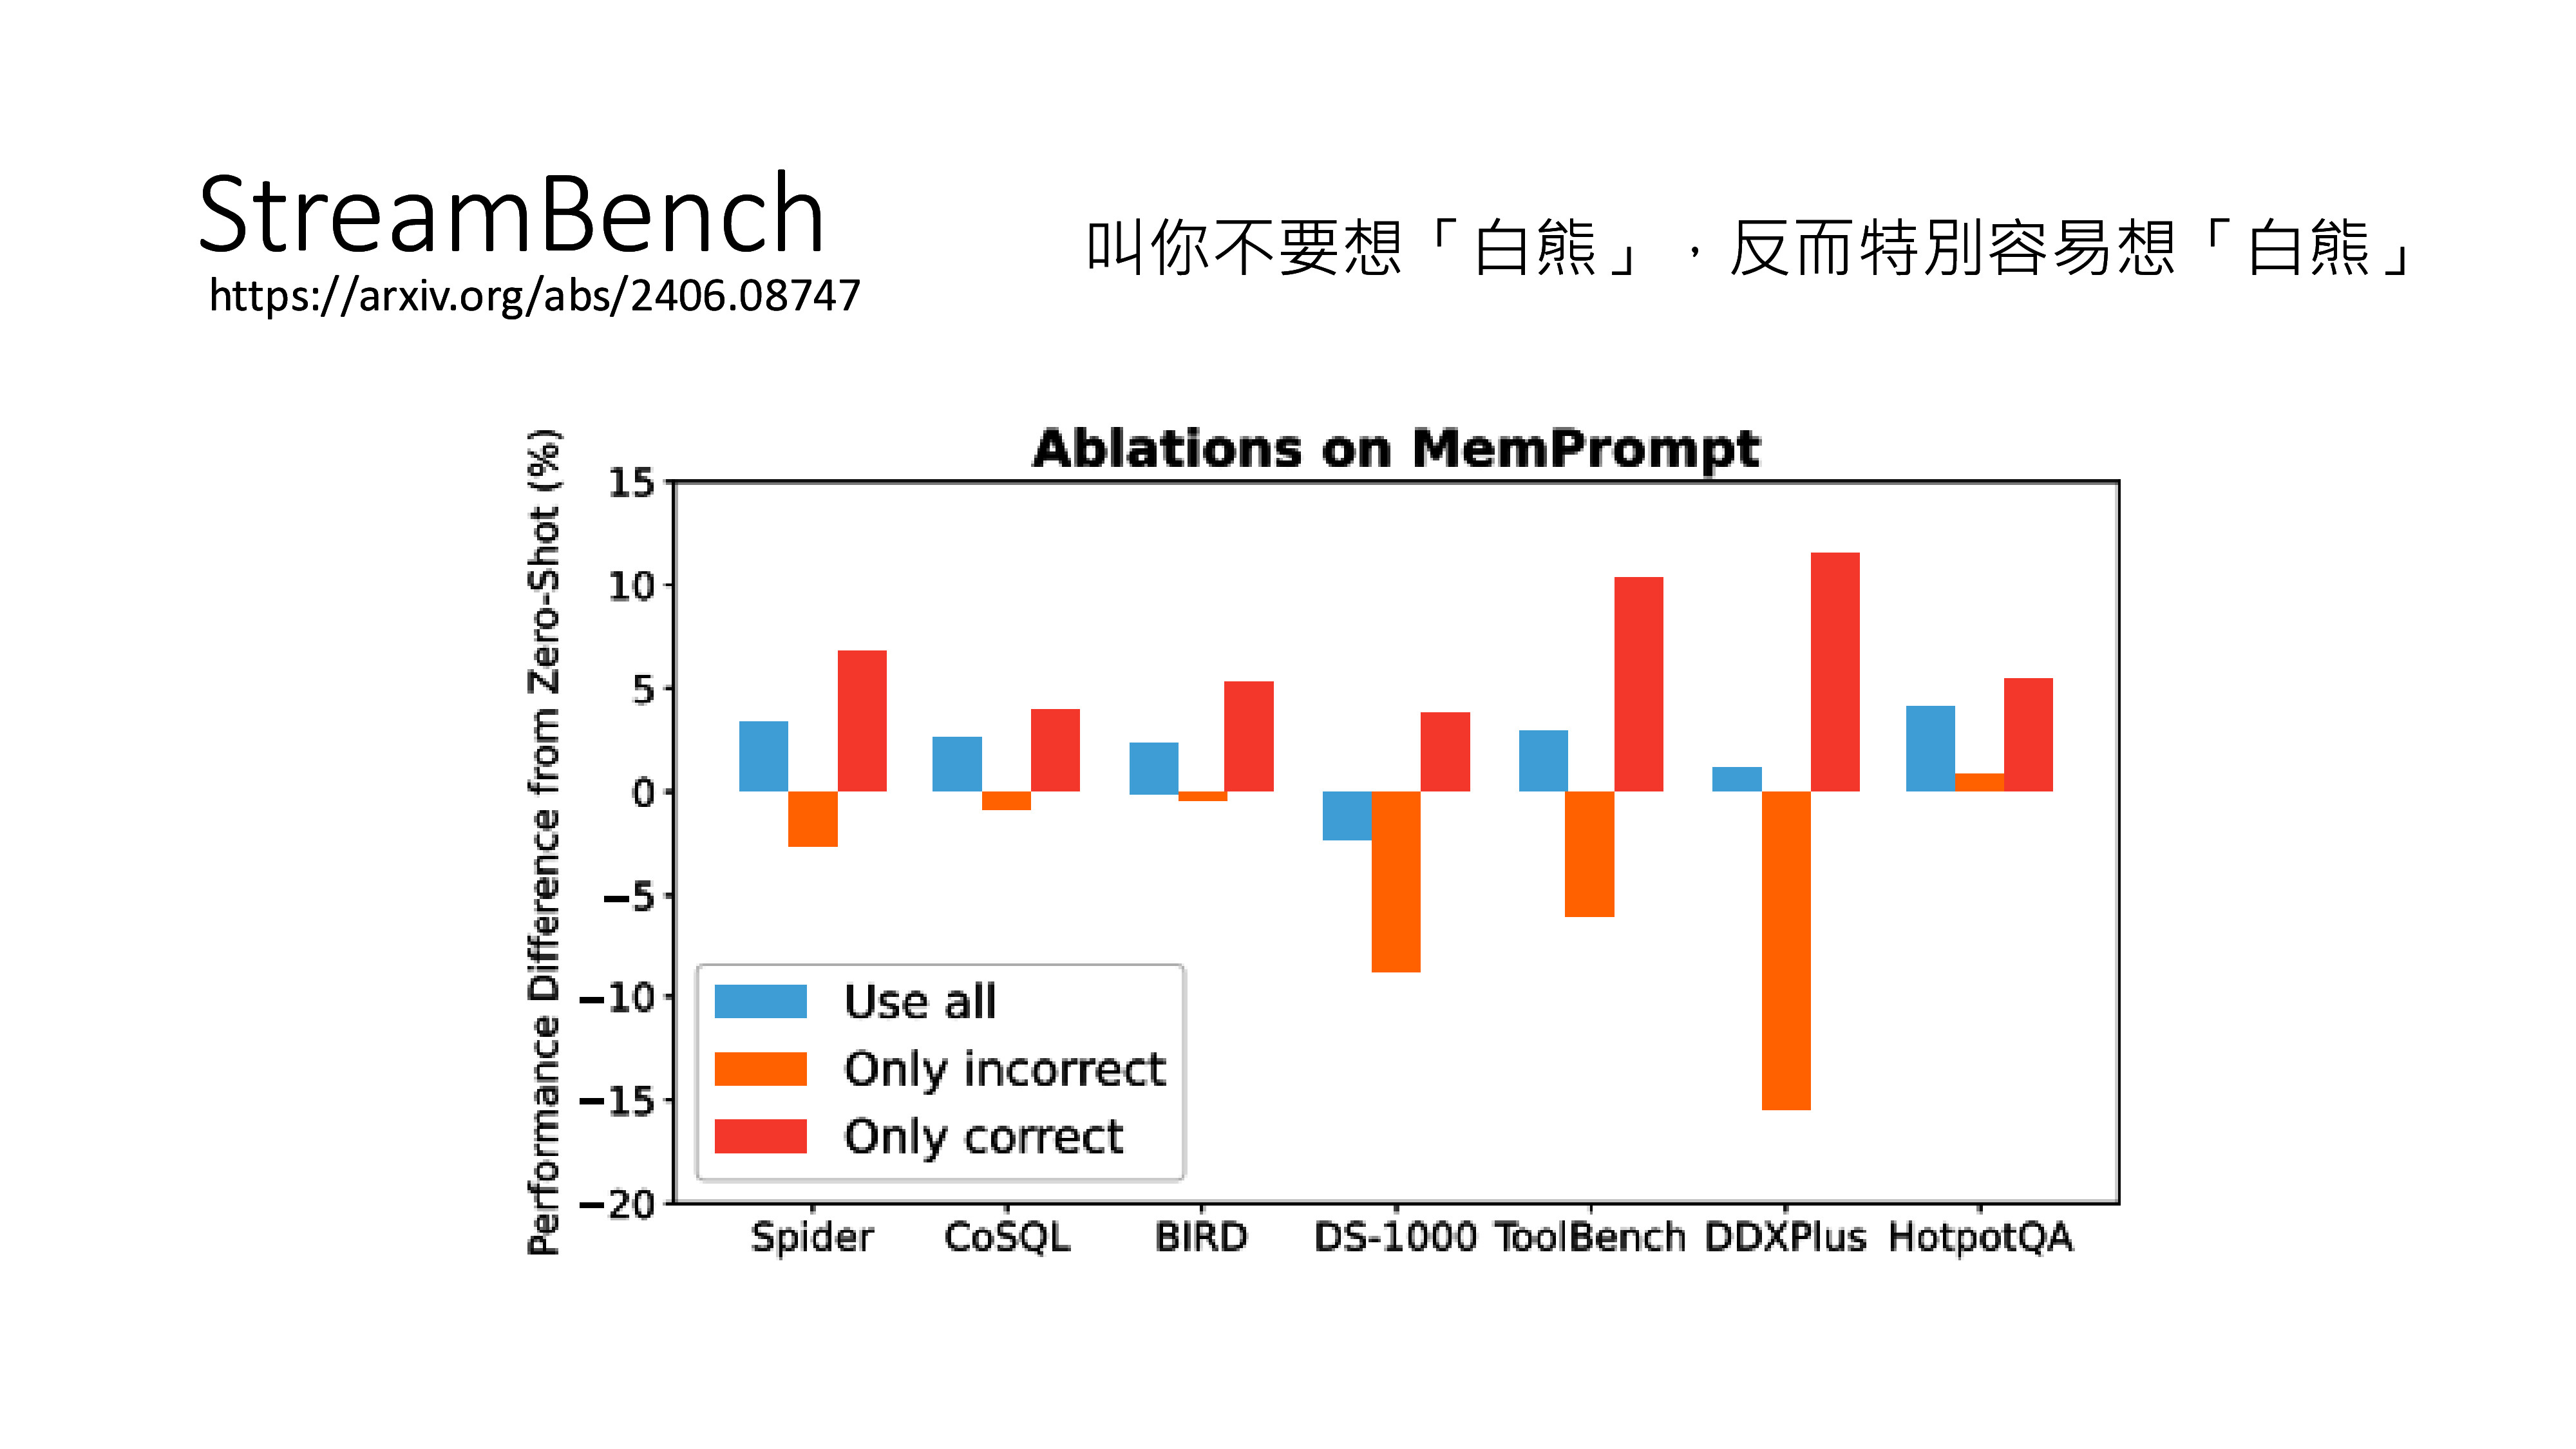
- Select(挑选):只挑选当下任务最关键的内容。这包括利用 RAG (检索增强生成) 检索额外资讯,并使用 Reranking 或 Small LLM 筛选关键词。此外,只挑选需要的工具(Tool RAG)和记忆(Memory RAG)。
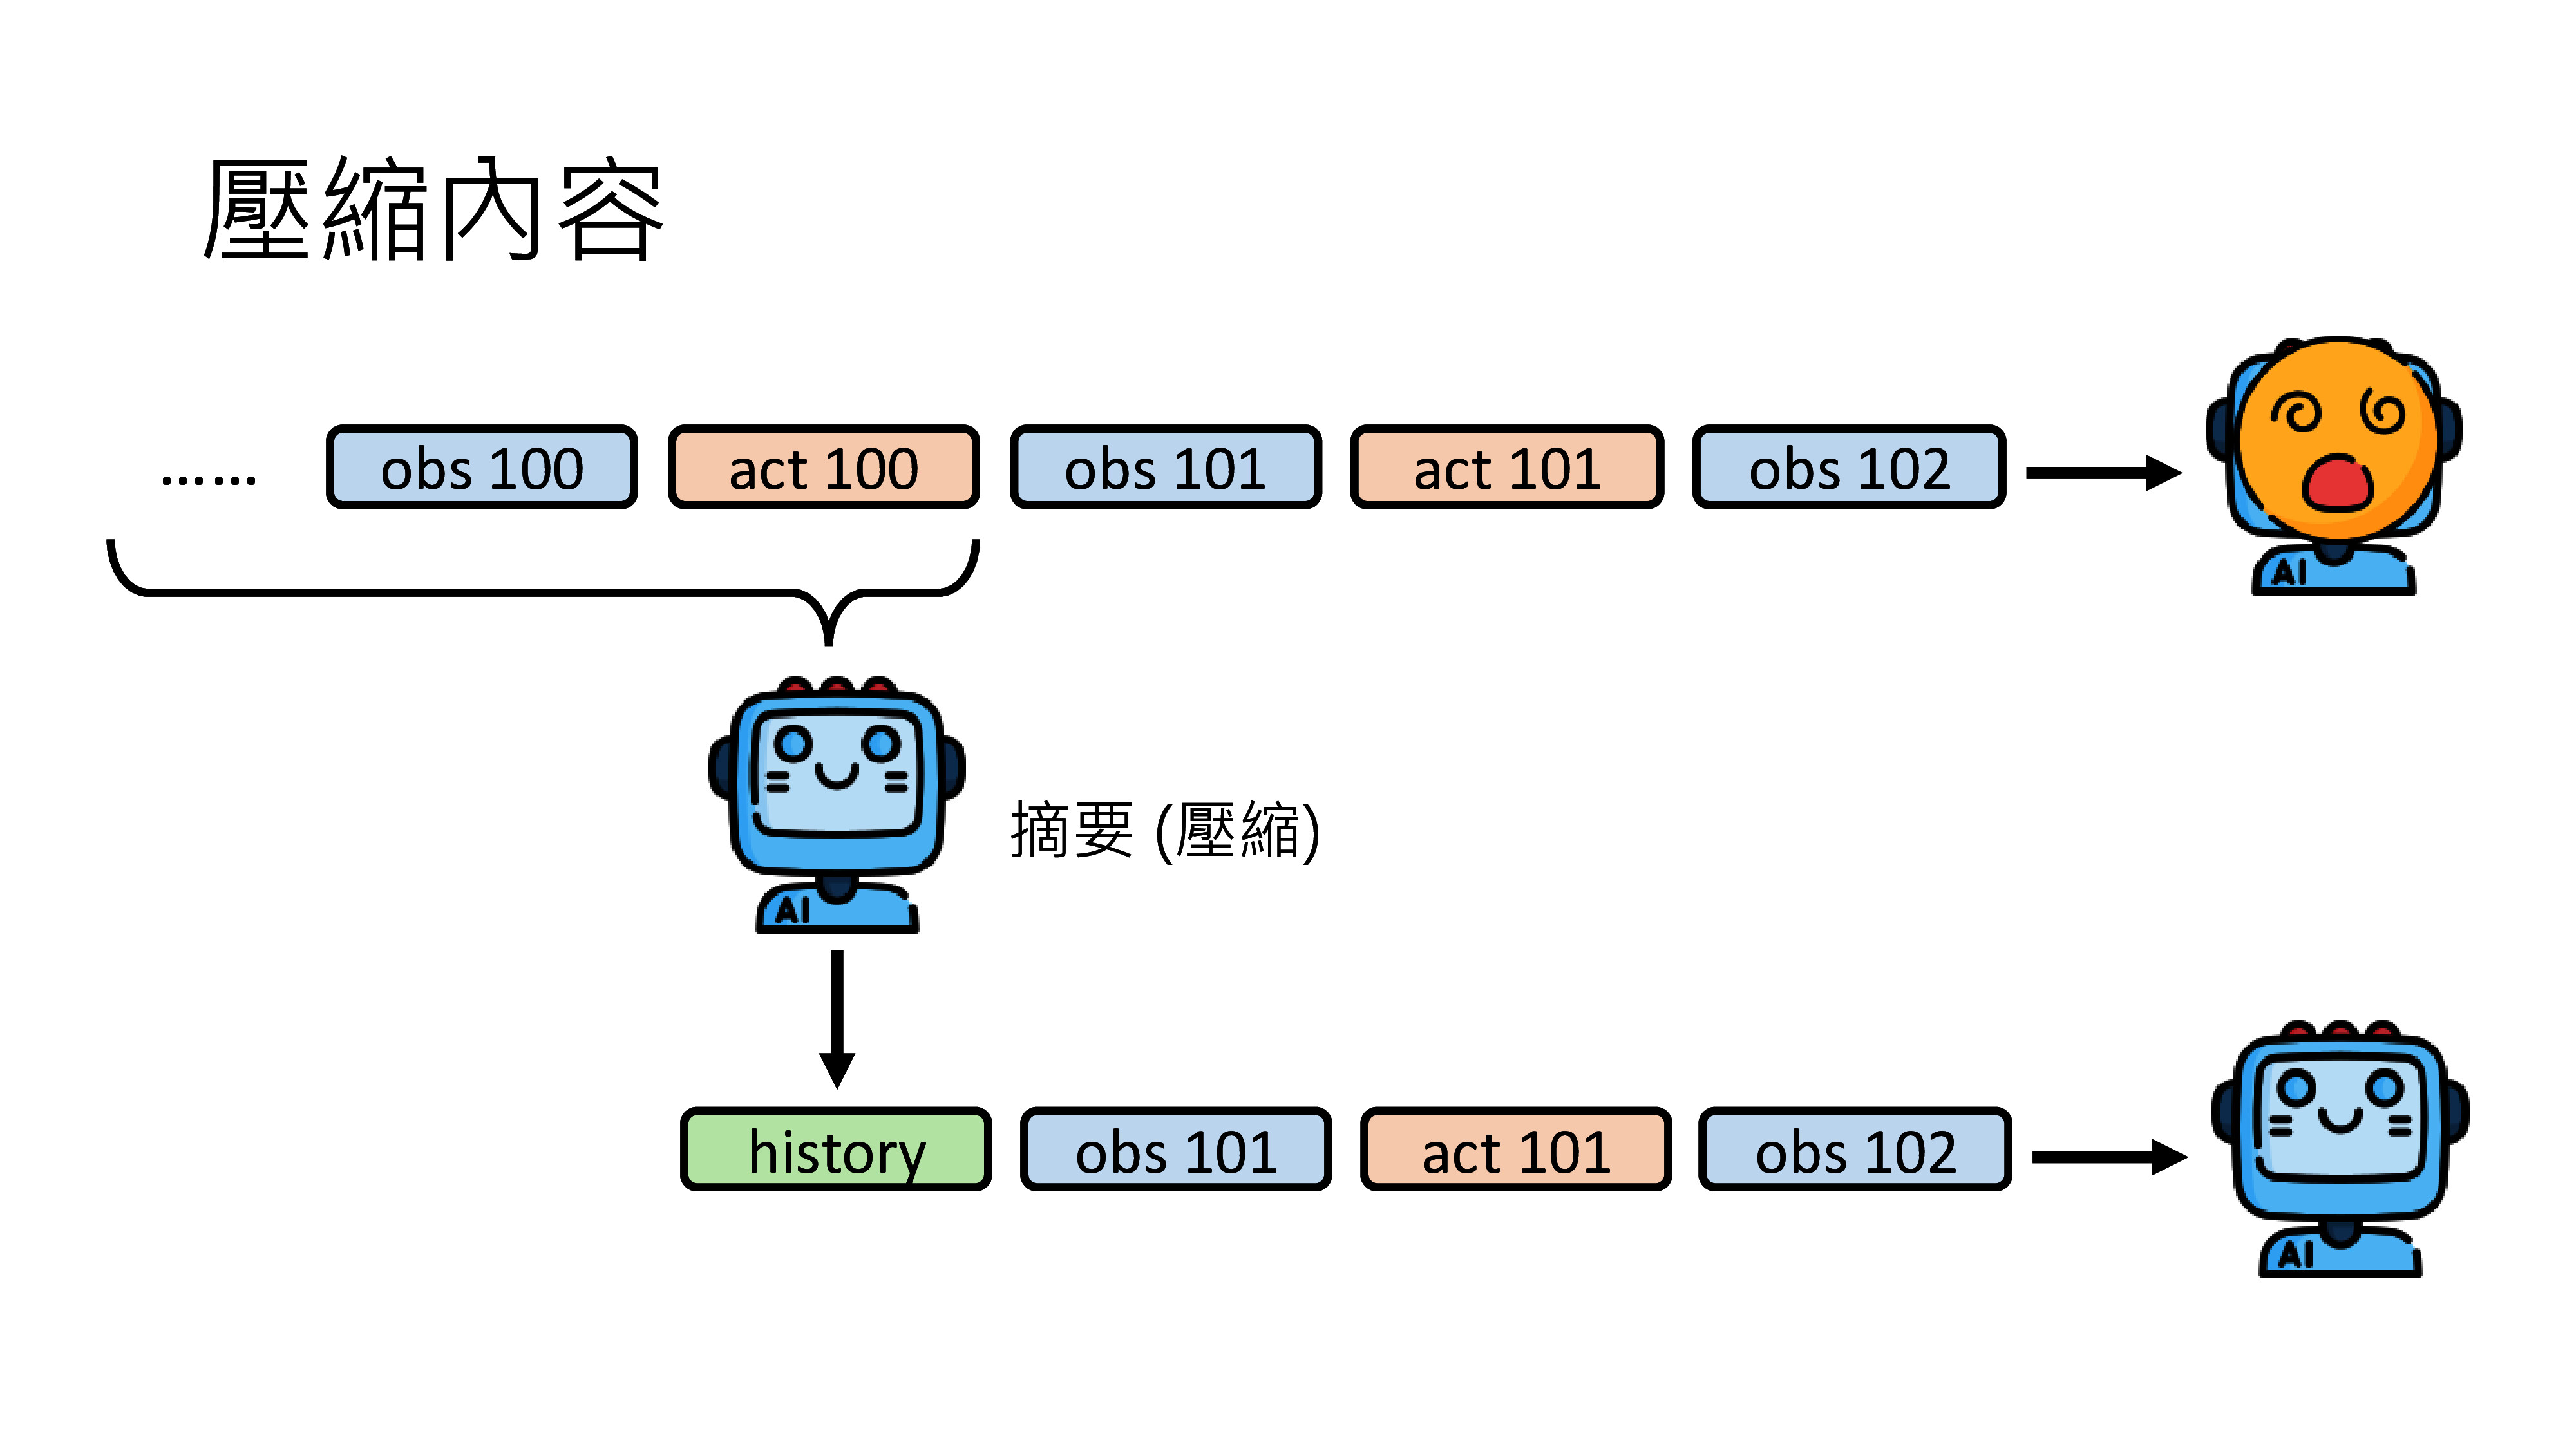
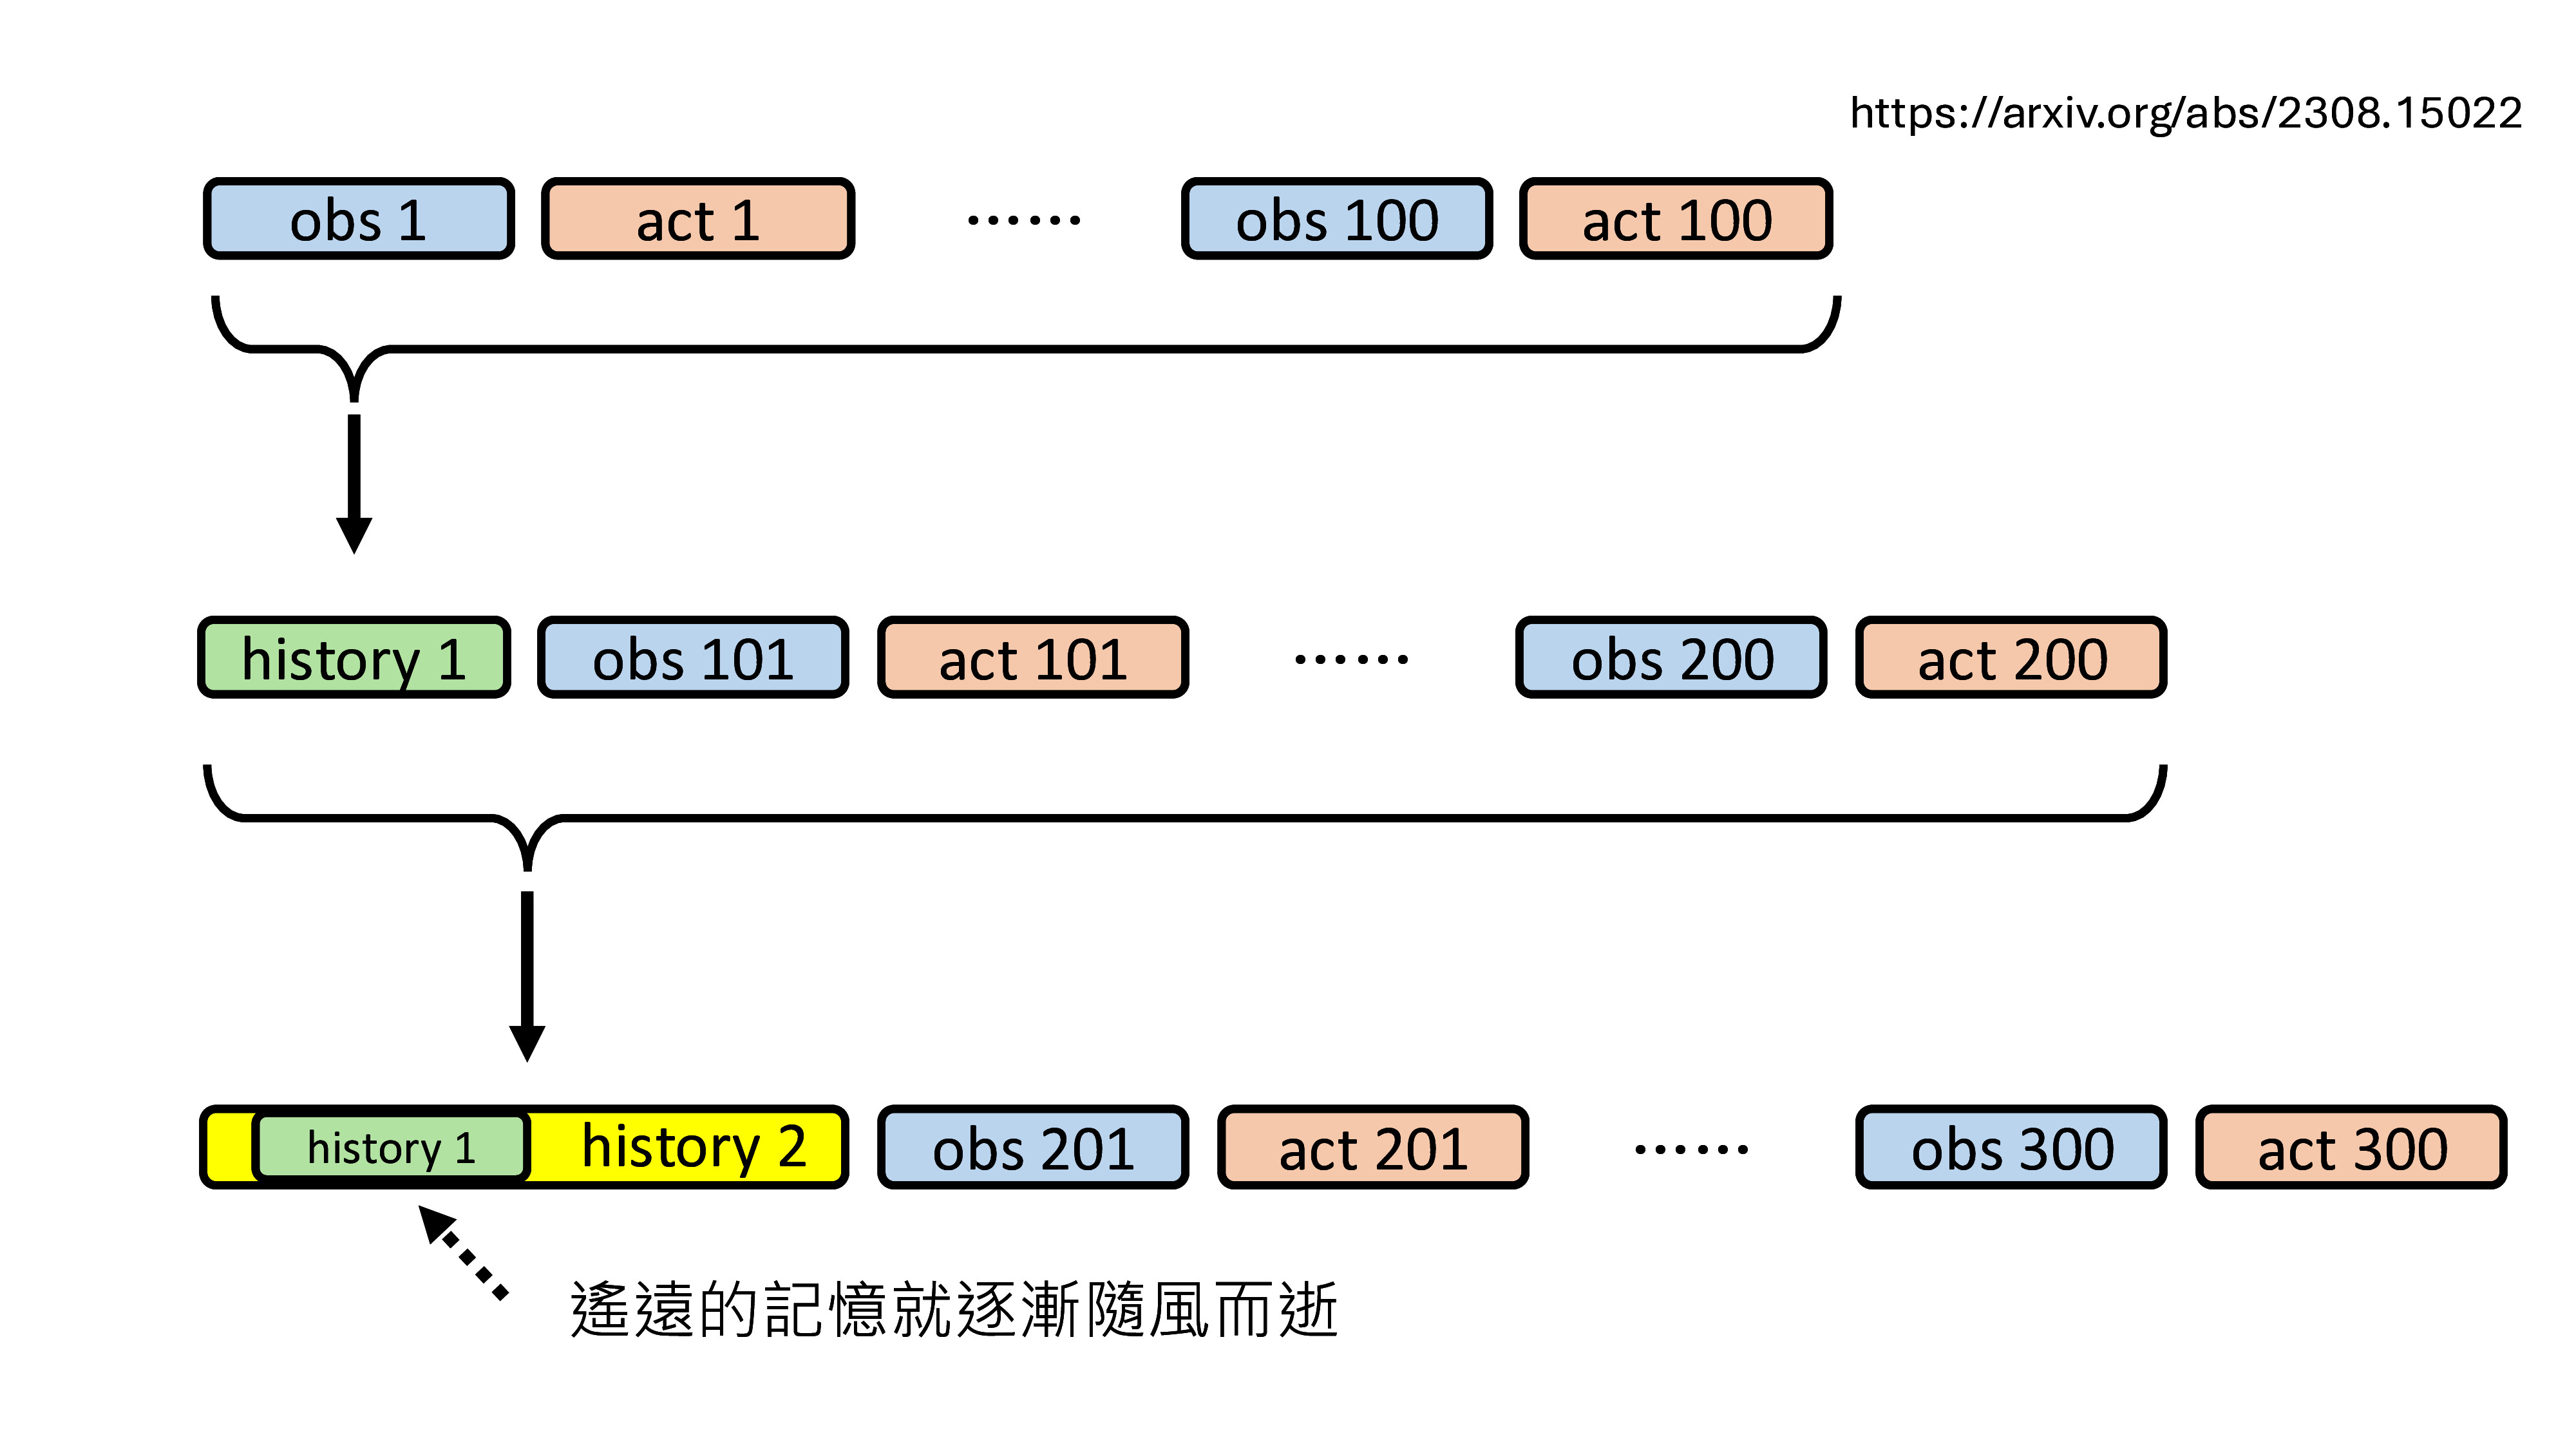
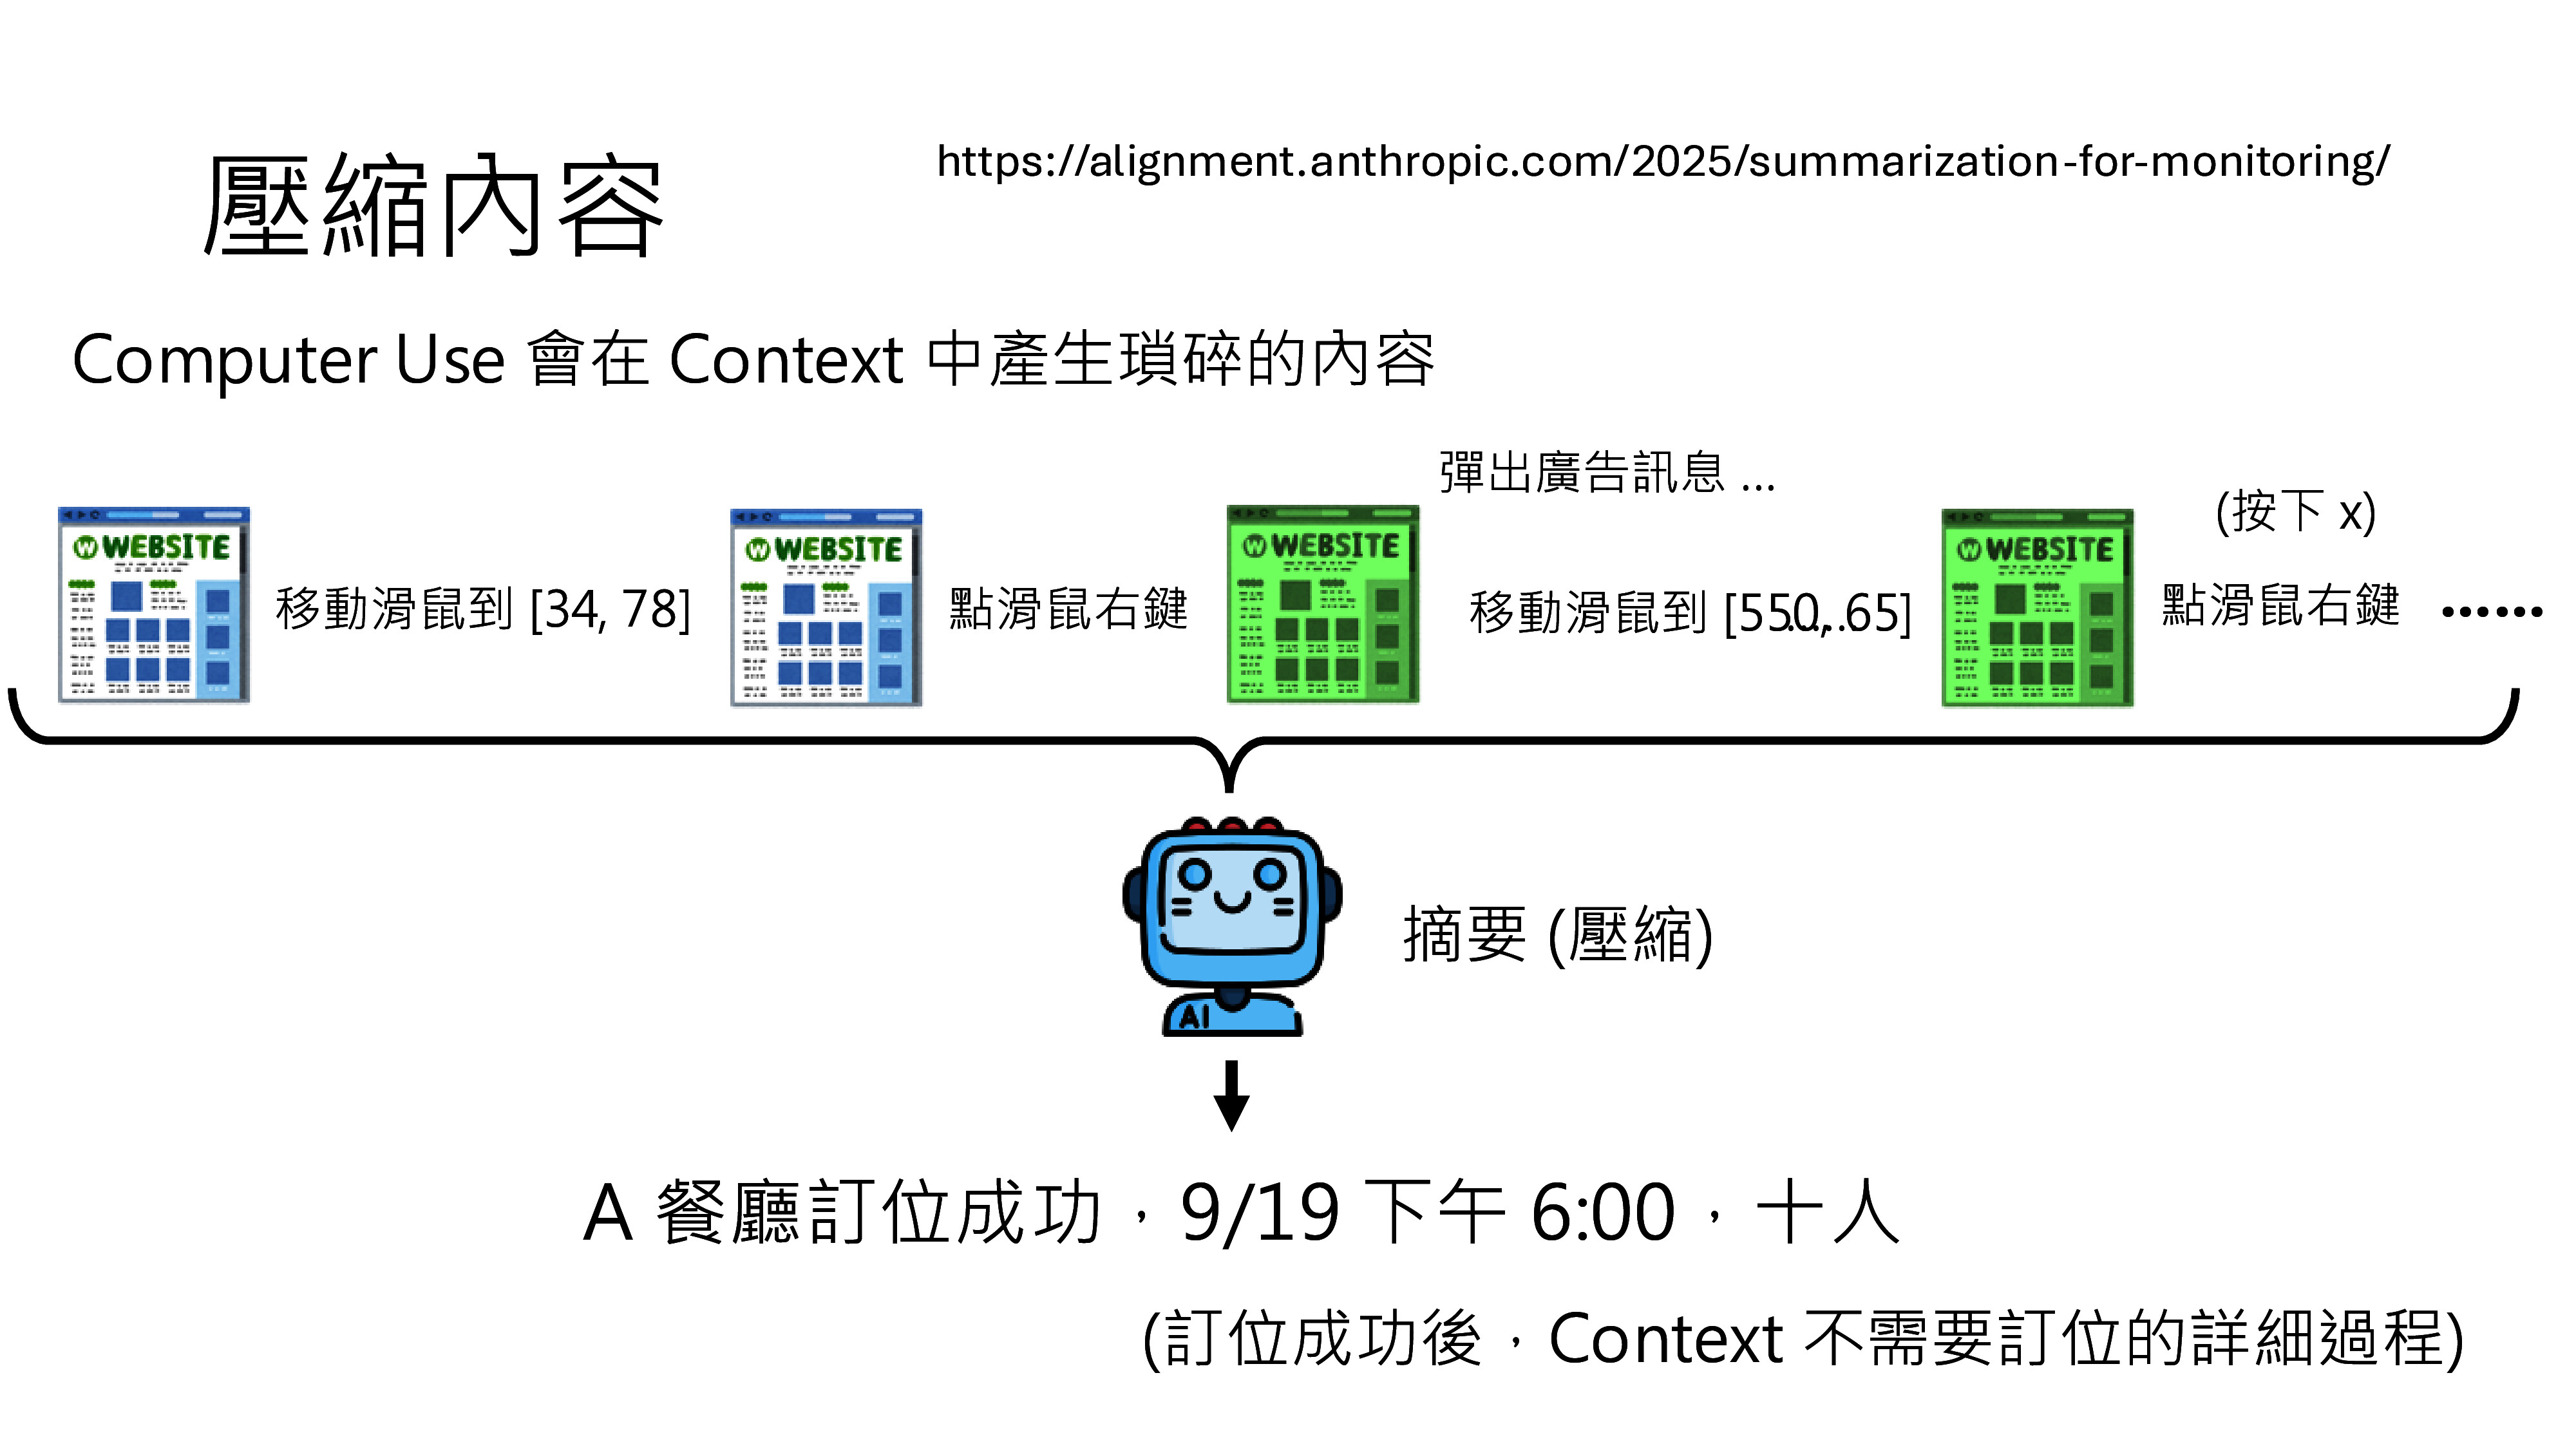
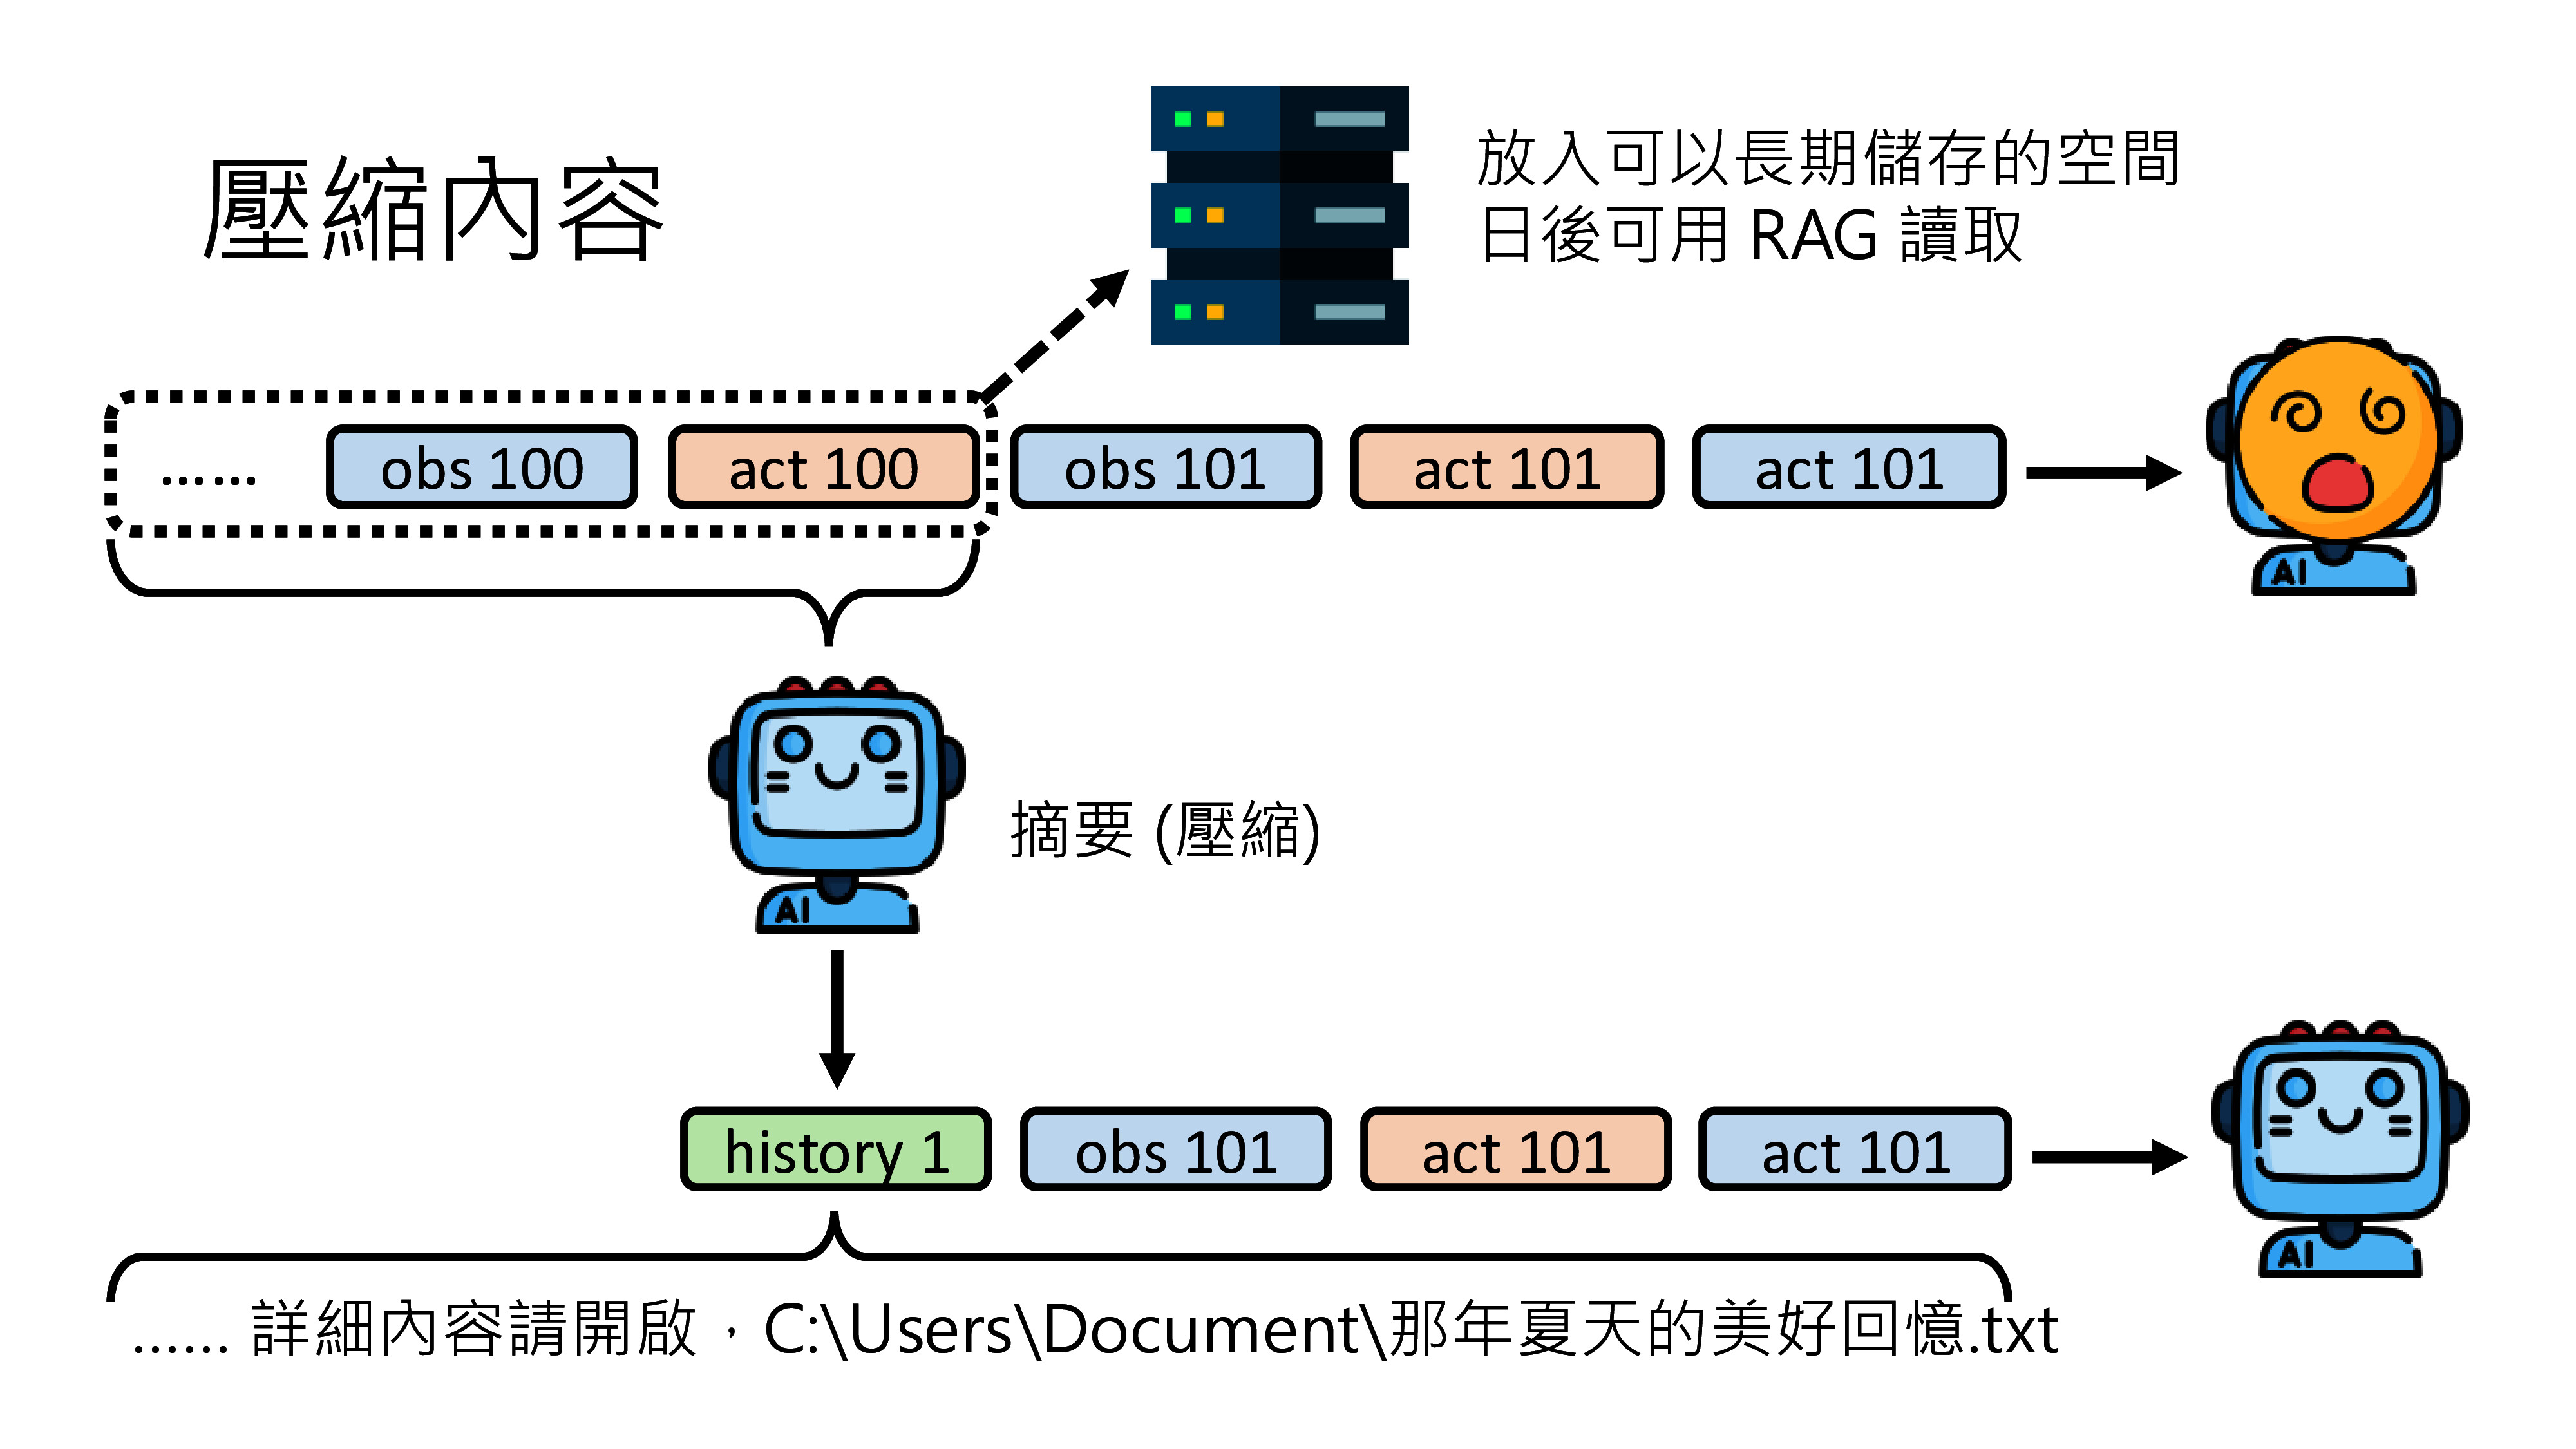
- Compress(压缩):对冗长琐碎的内容进行精简和摘要。例如,将过去的对话历史或 Computer Use 产生的细节压缩,让遥远的记忆逐渐淡化,以节省 Context 空间。
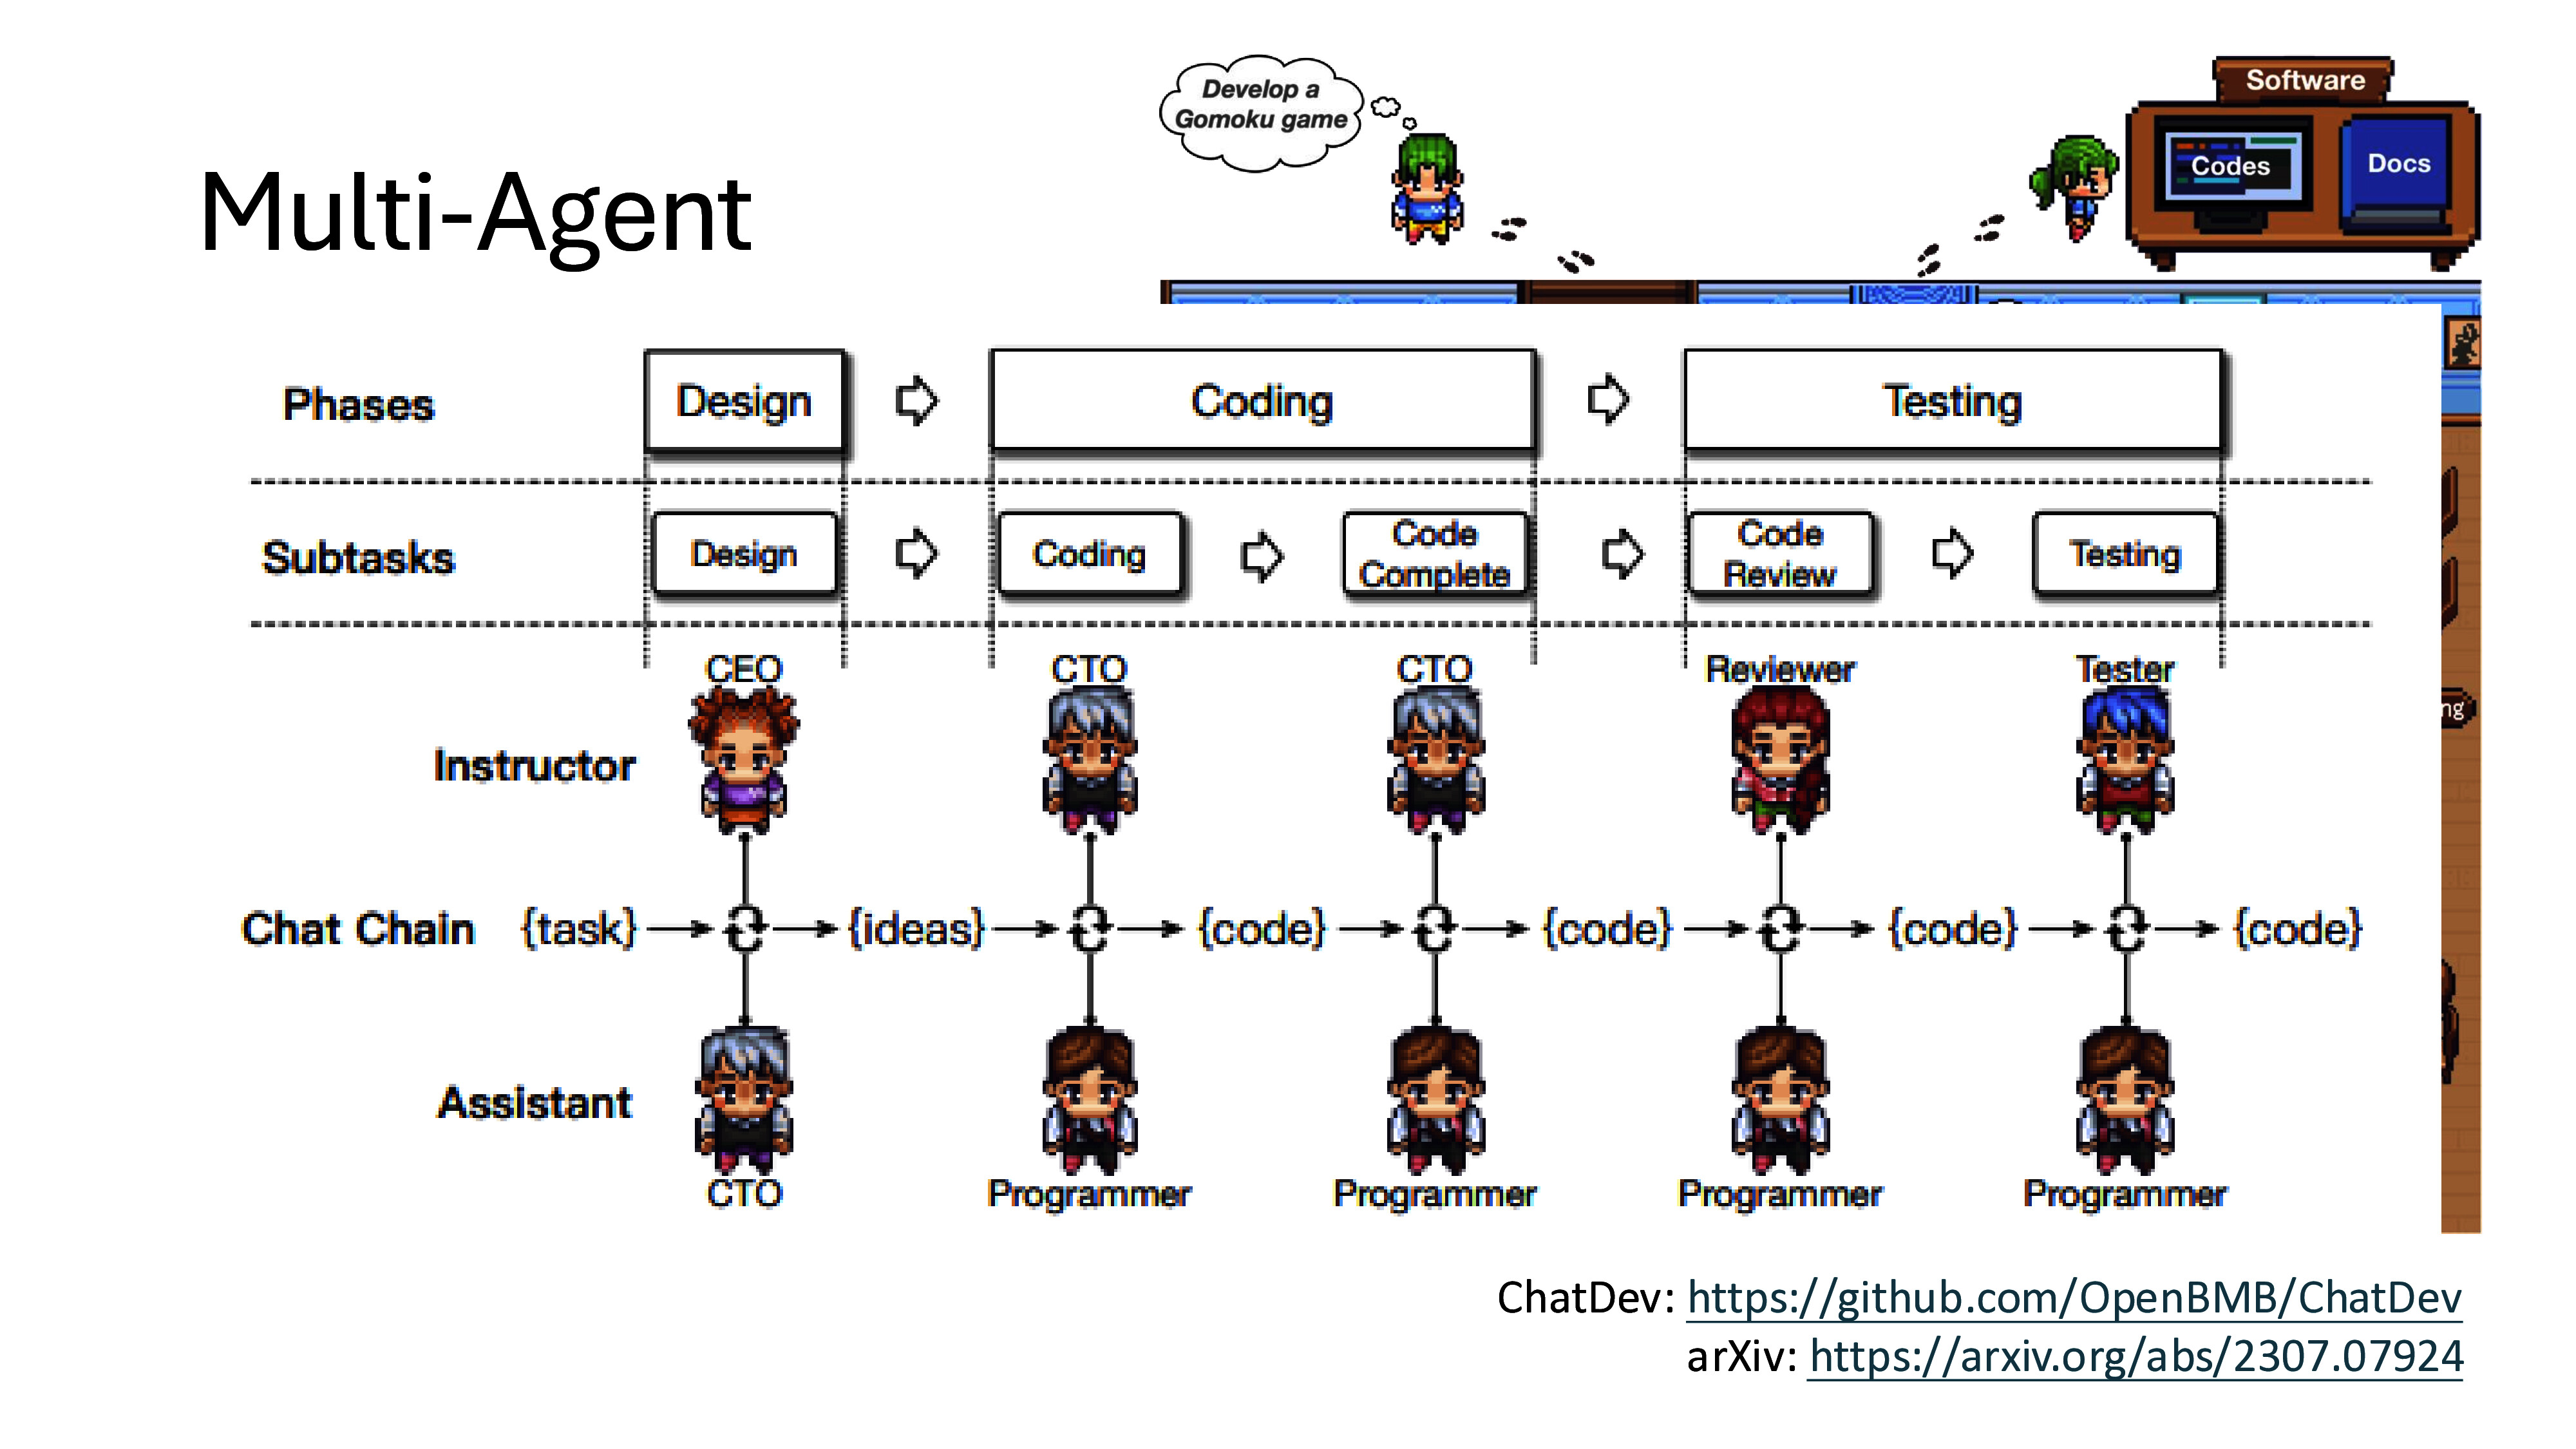
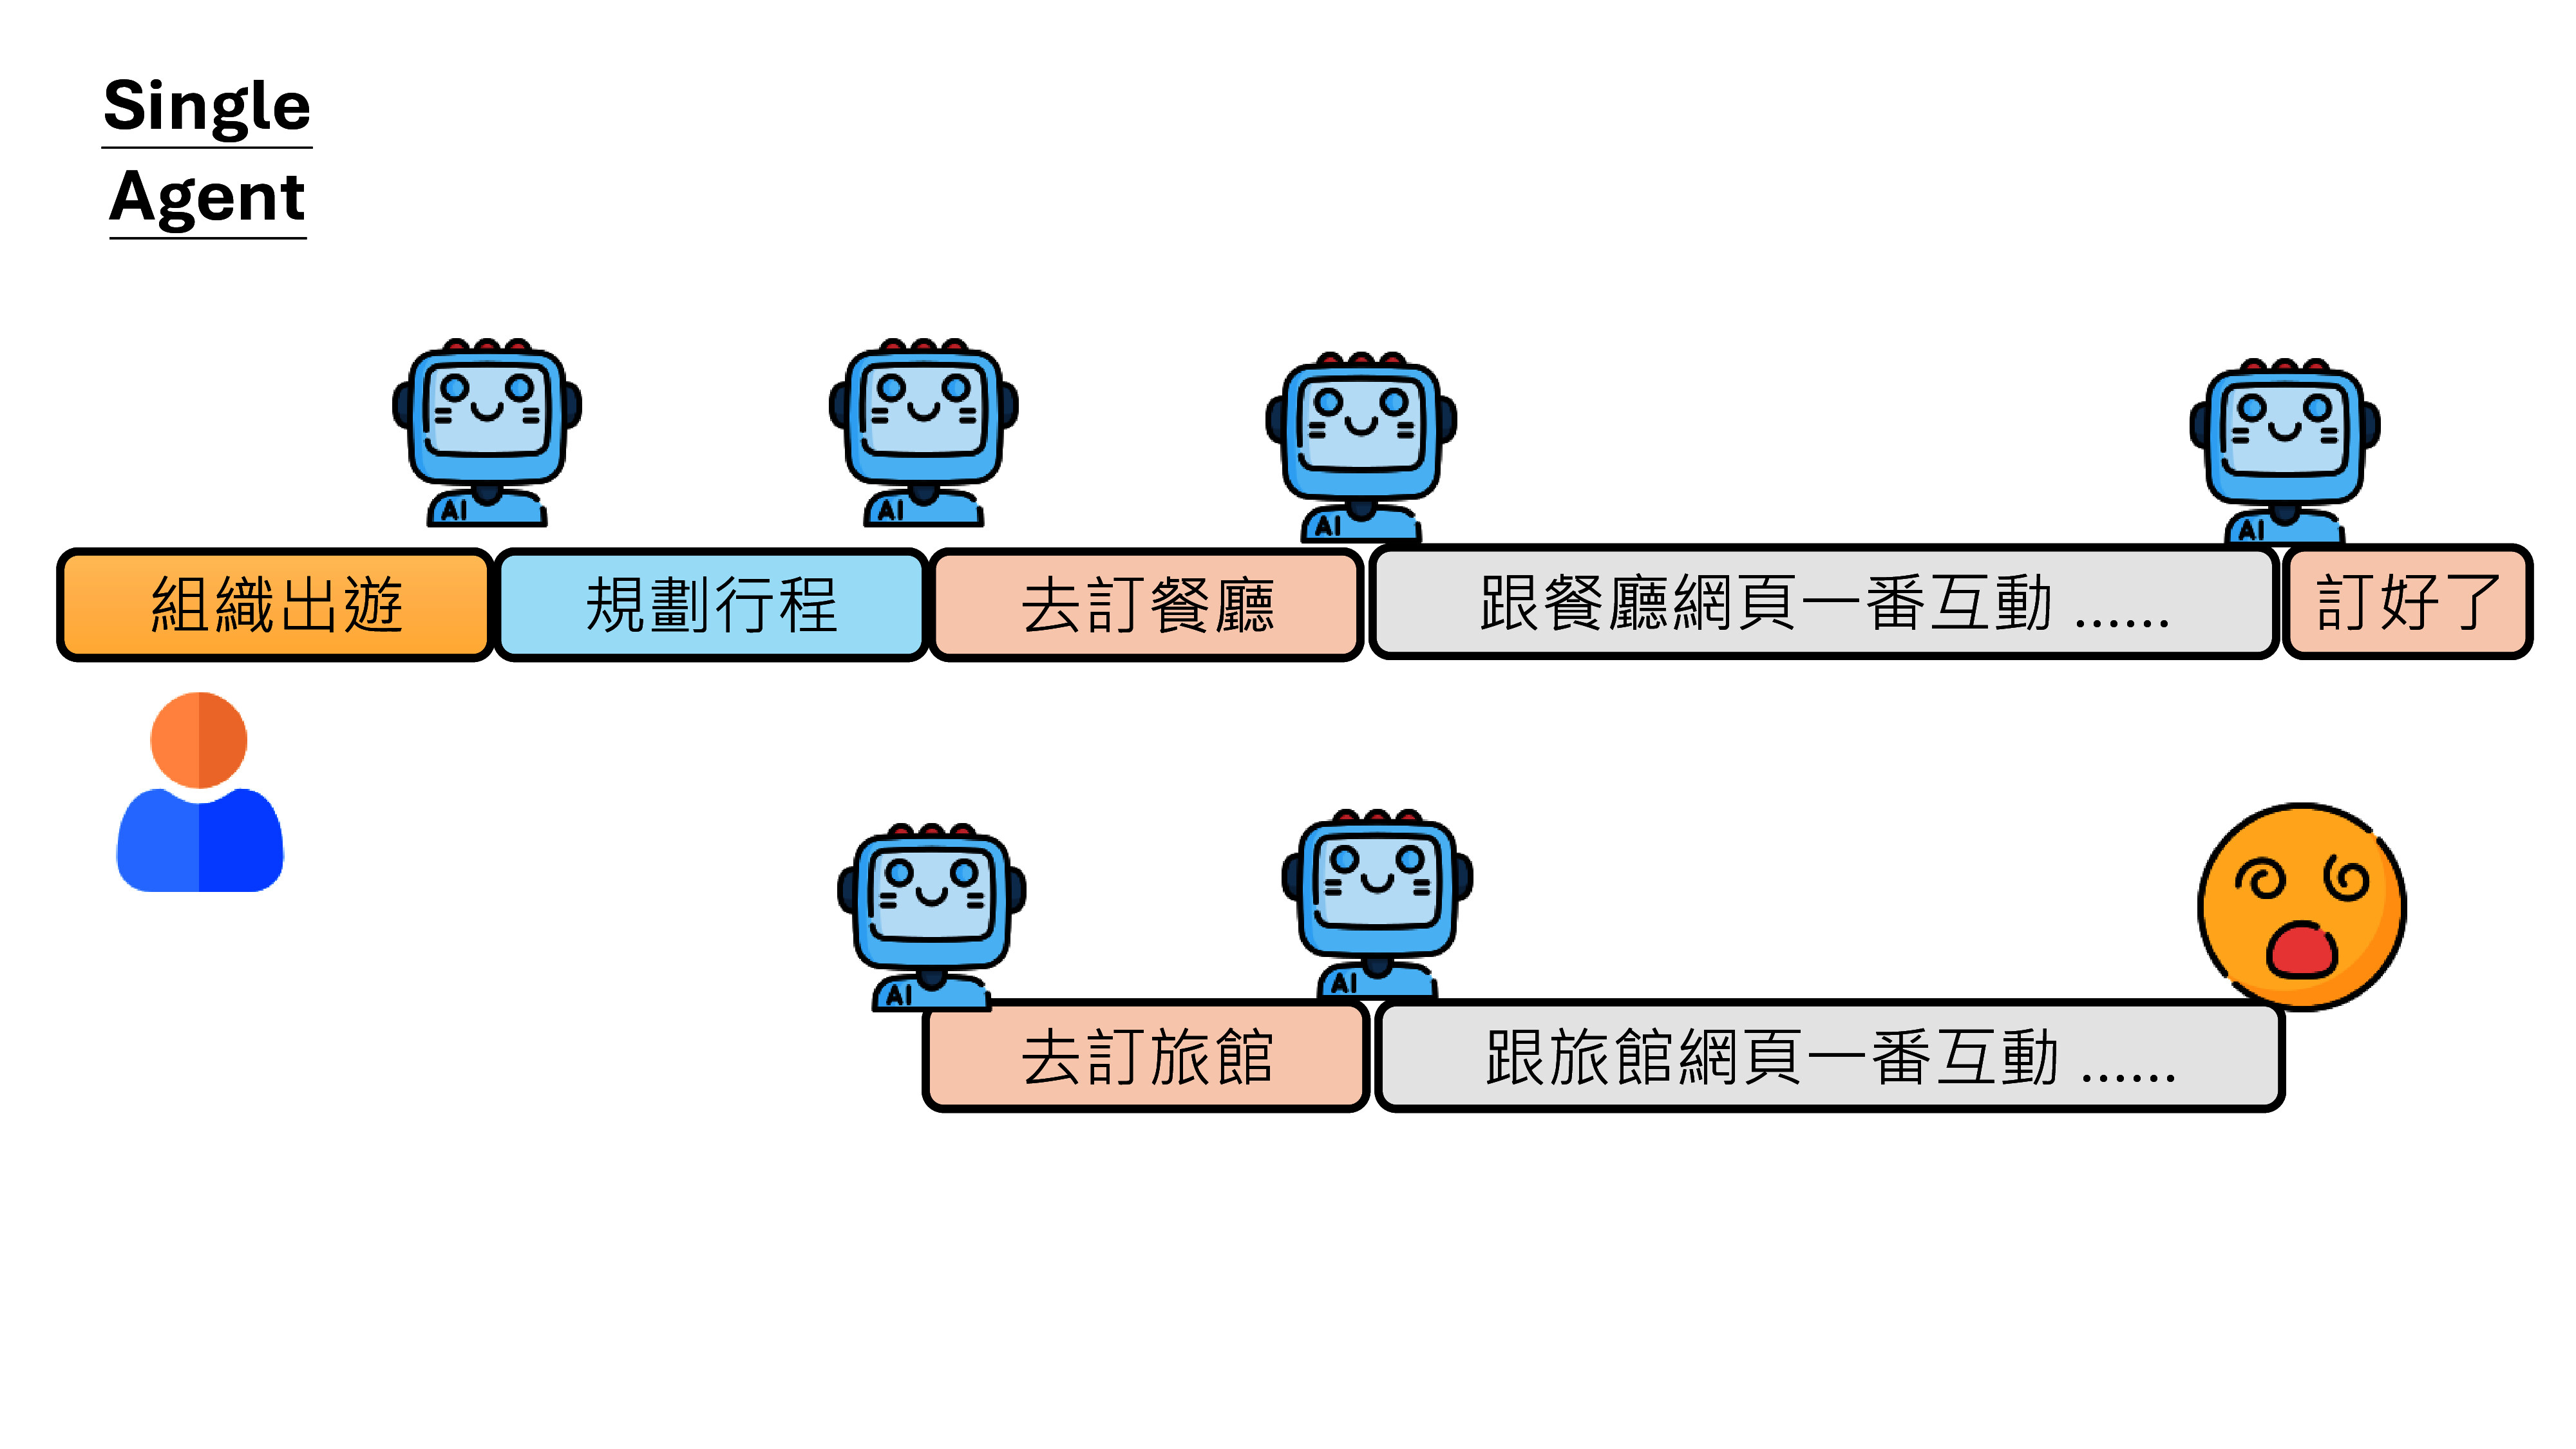
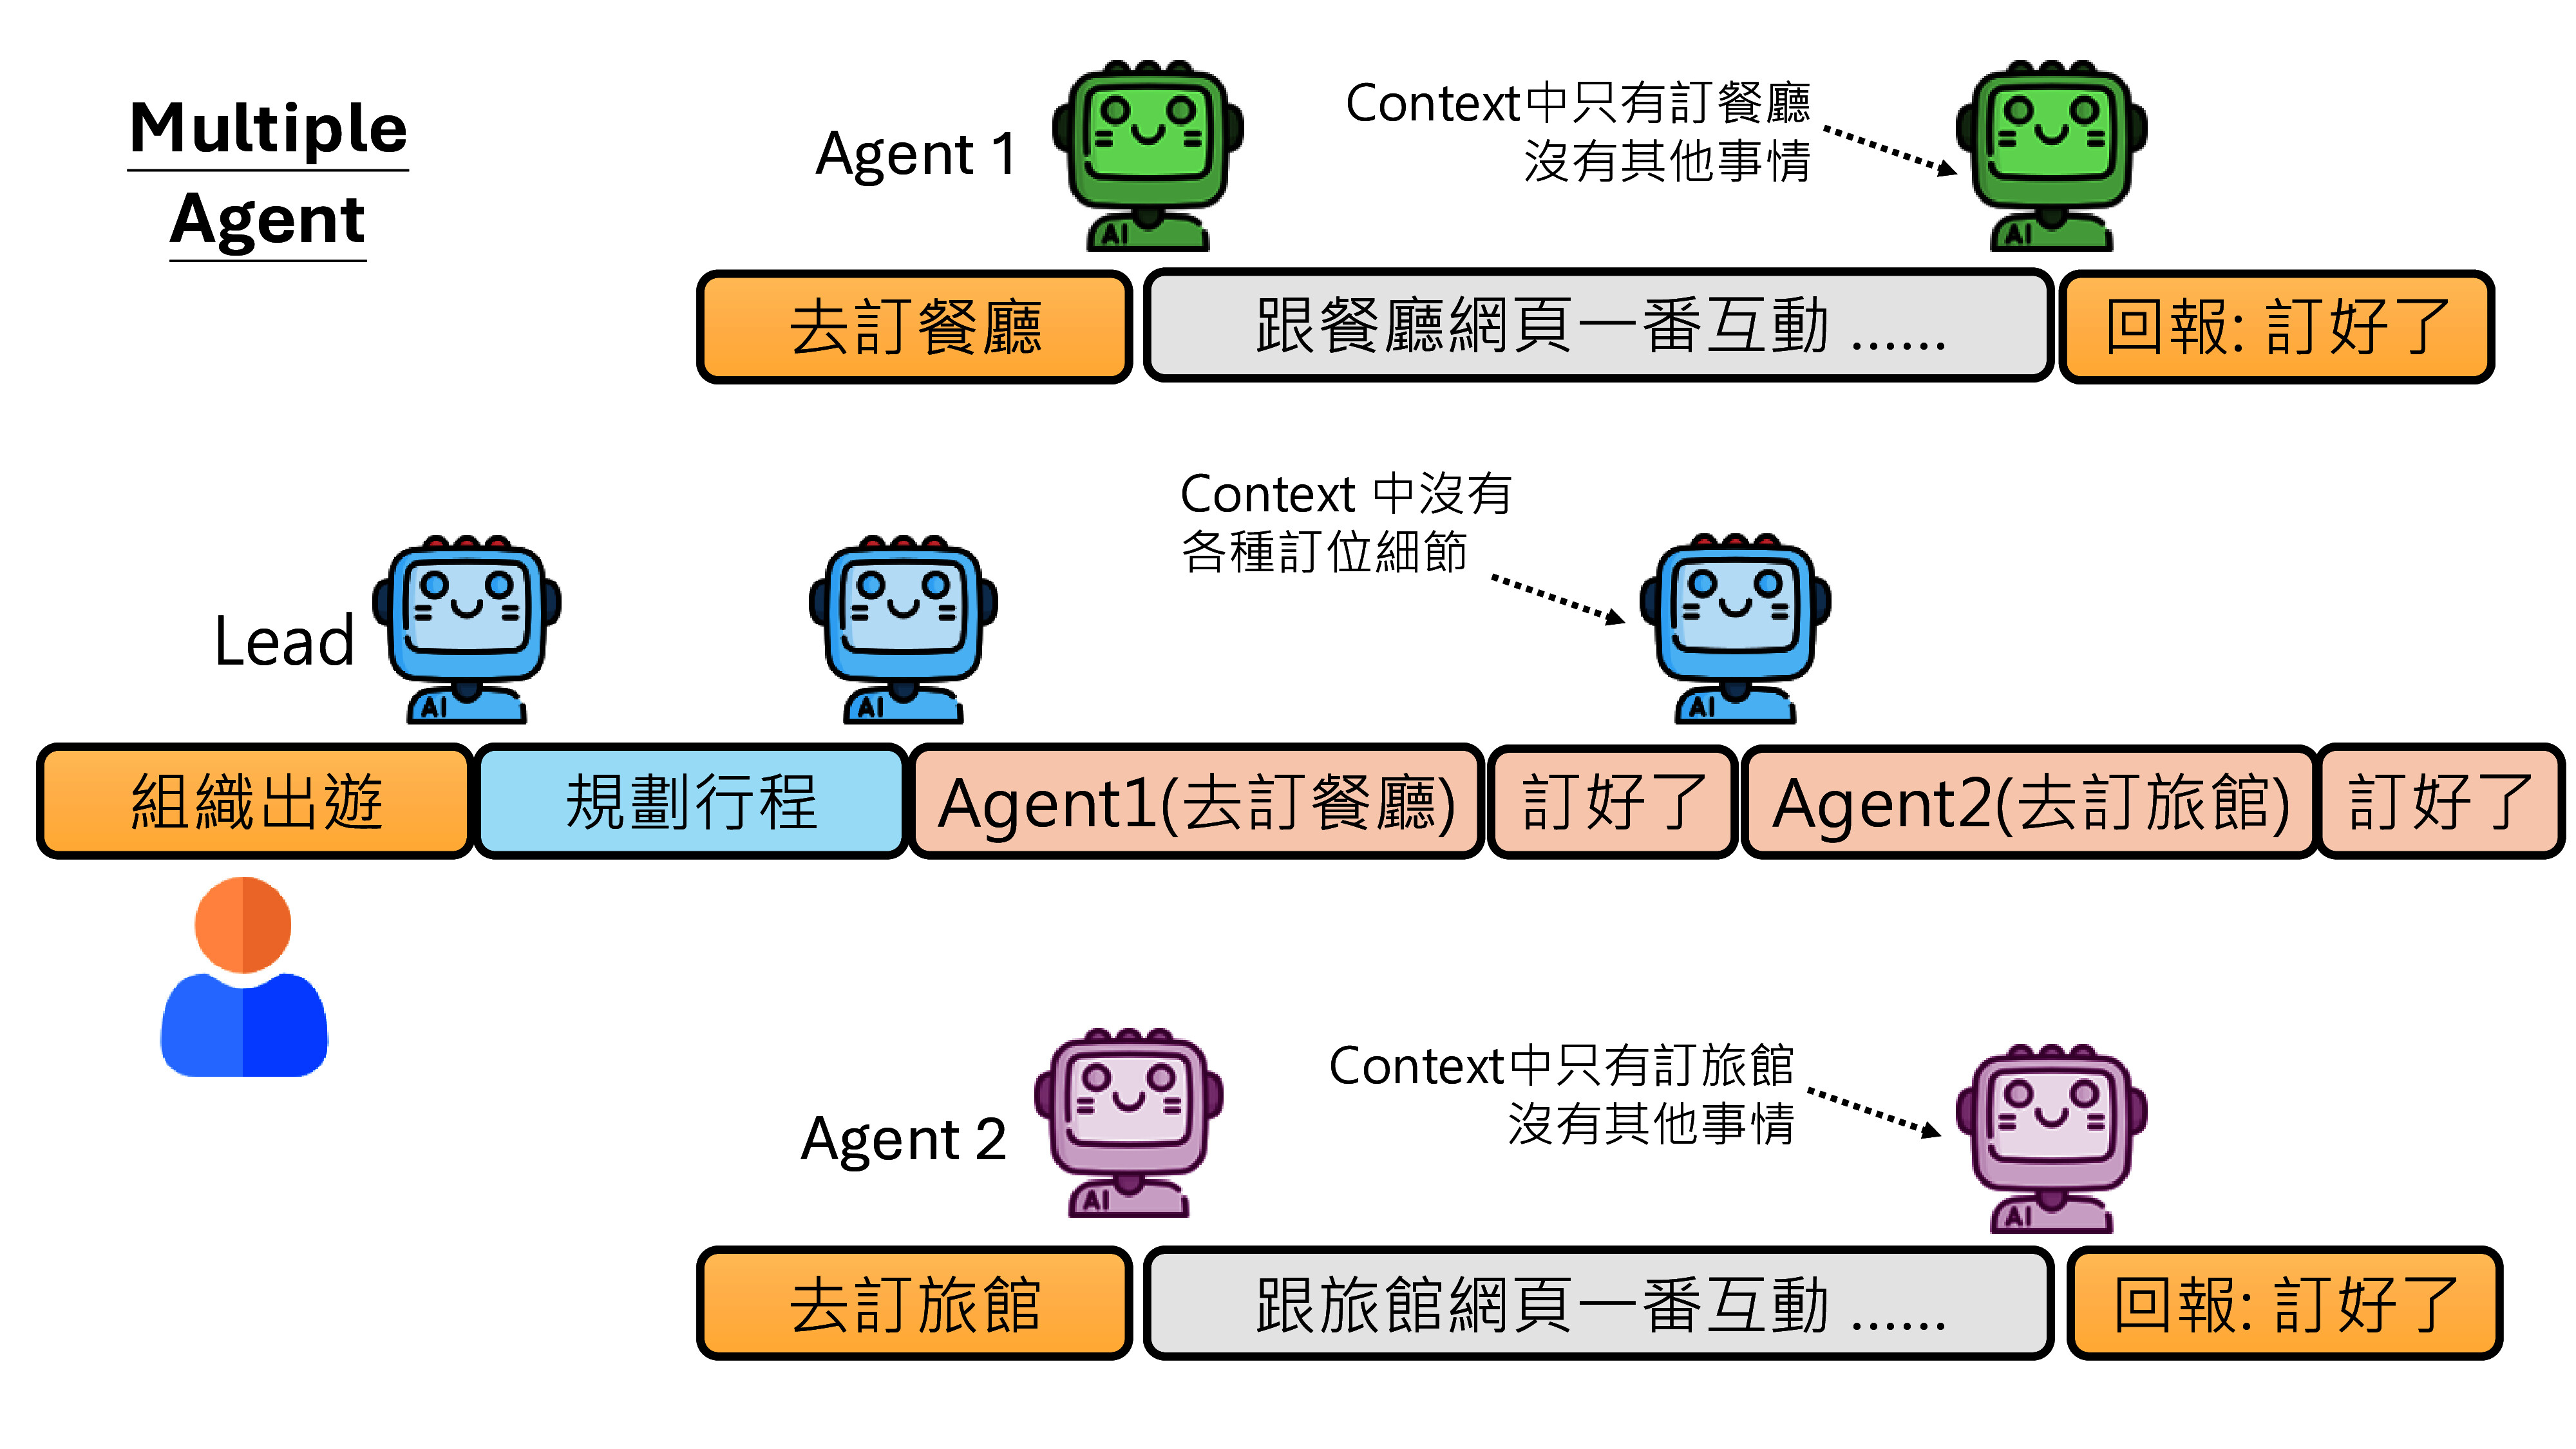
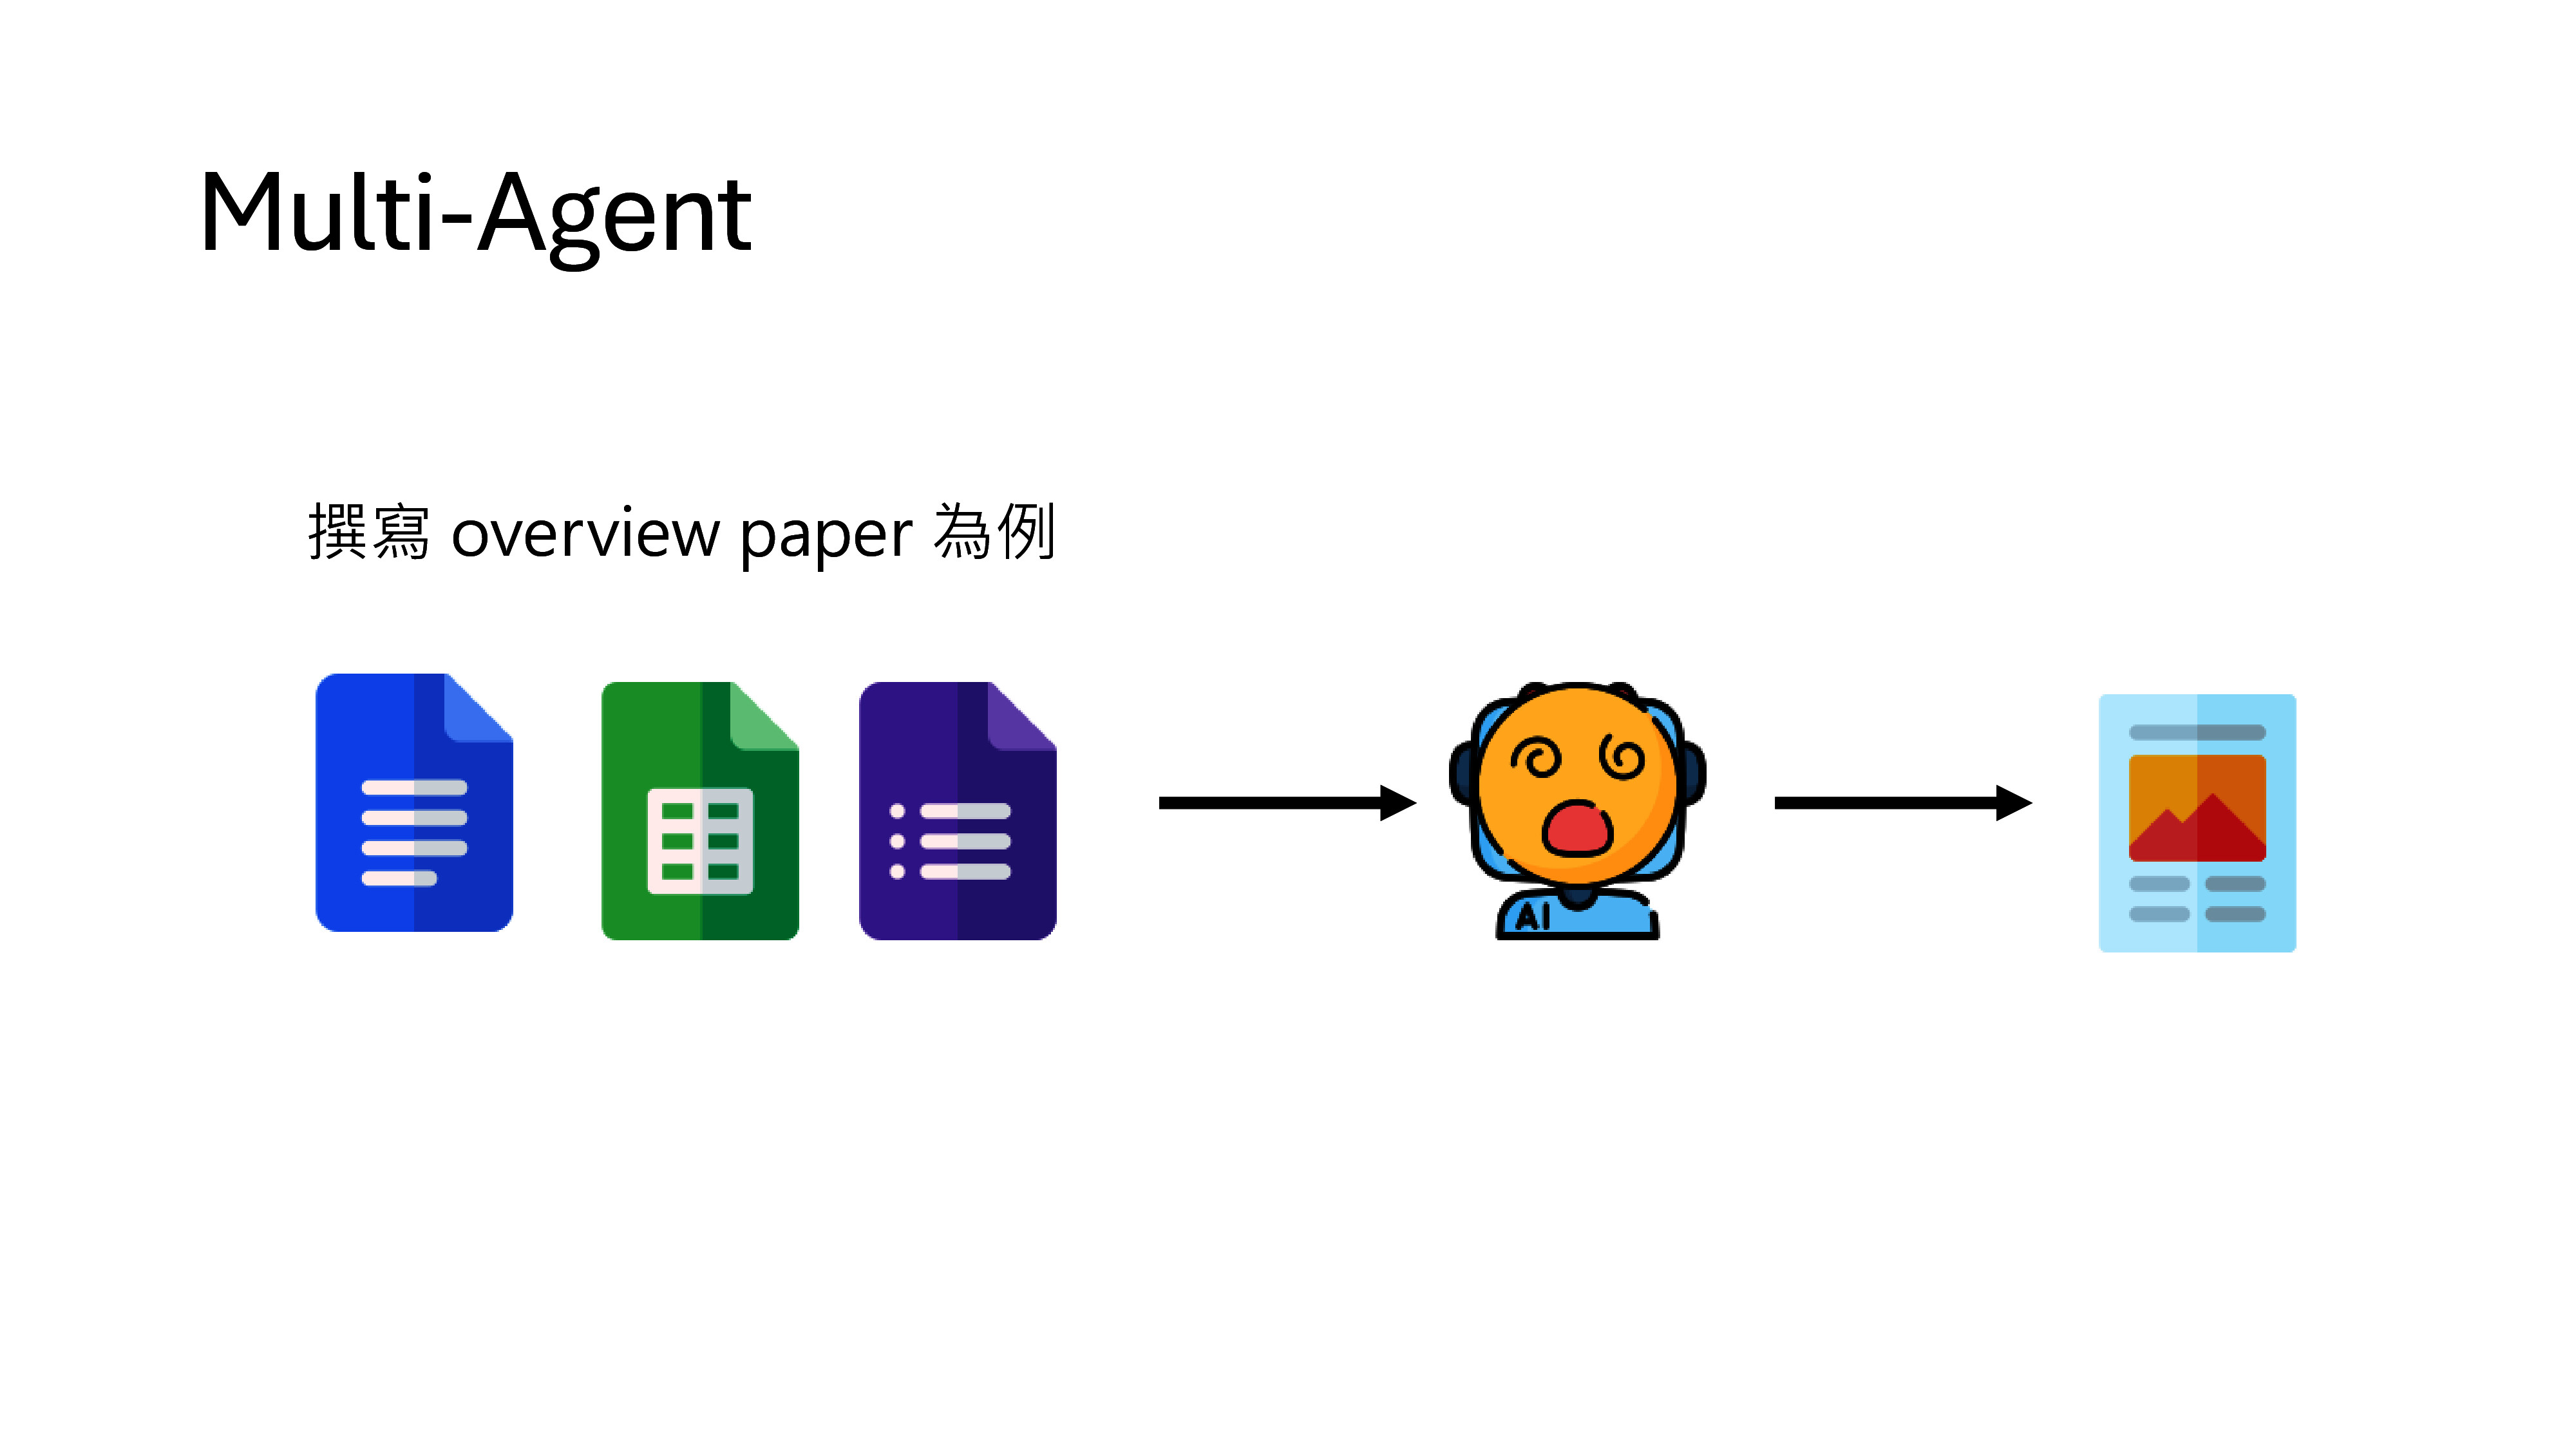
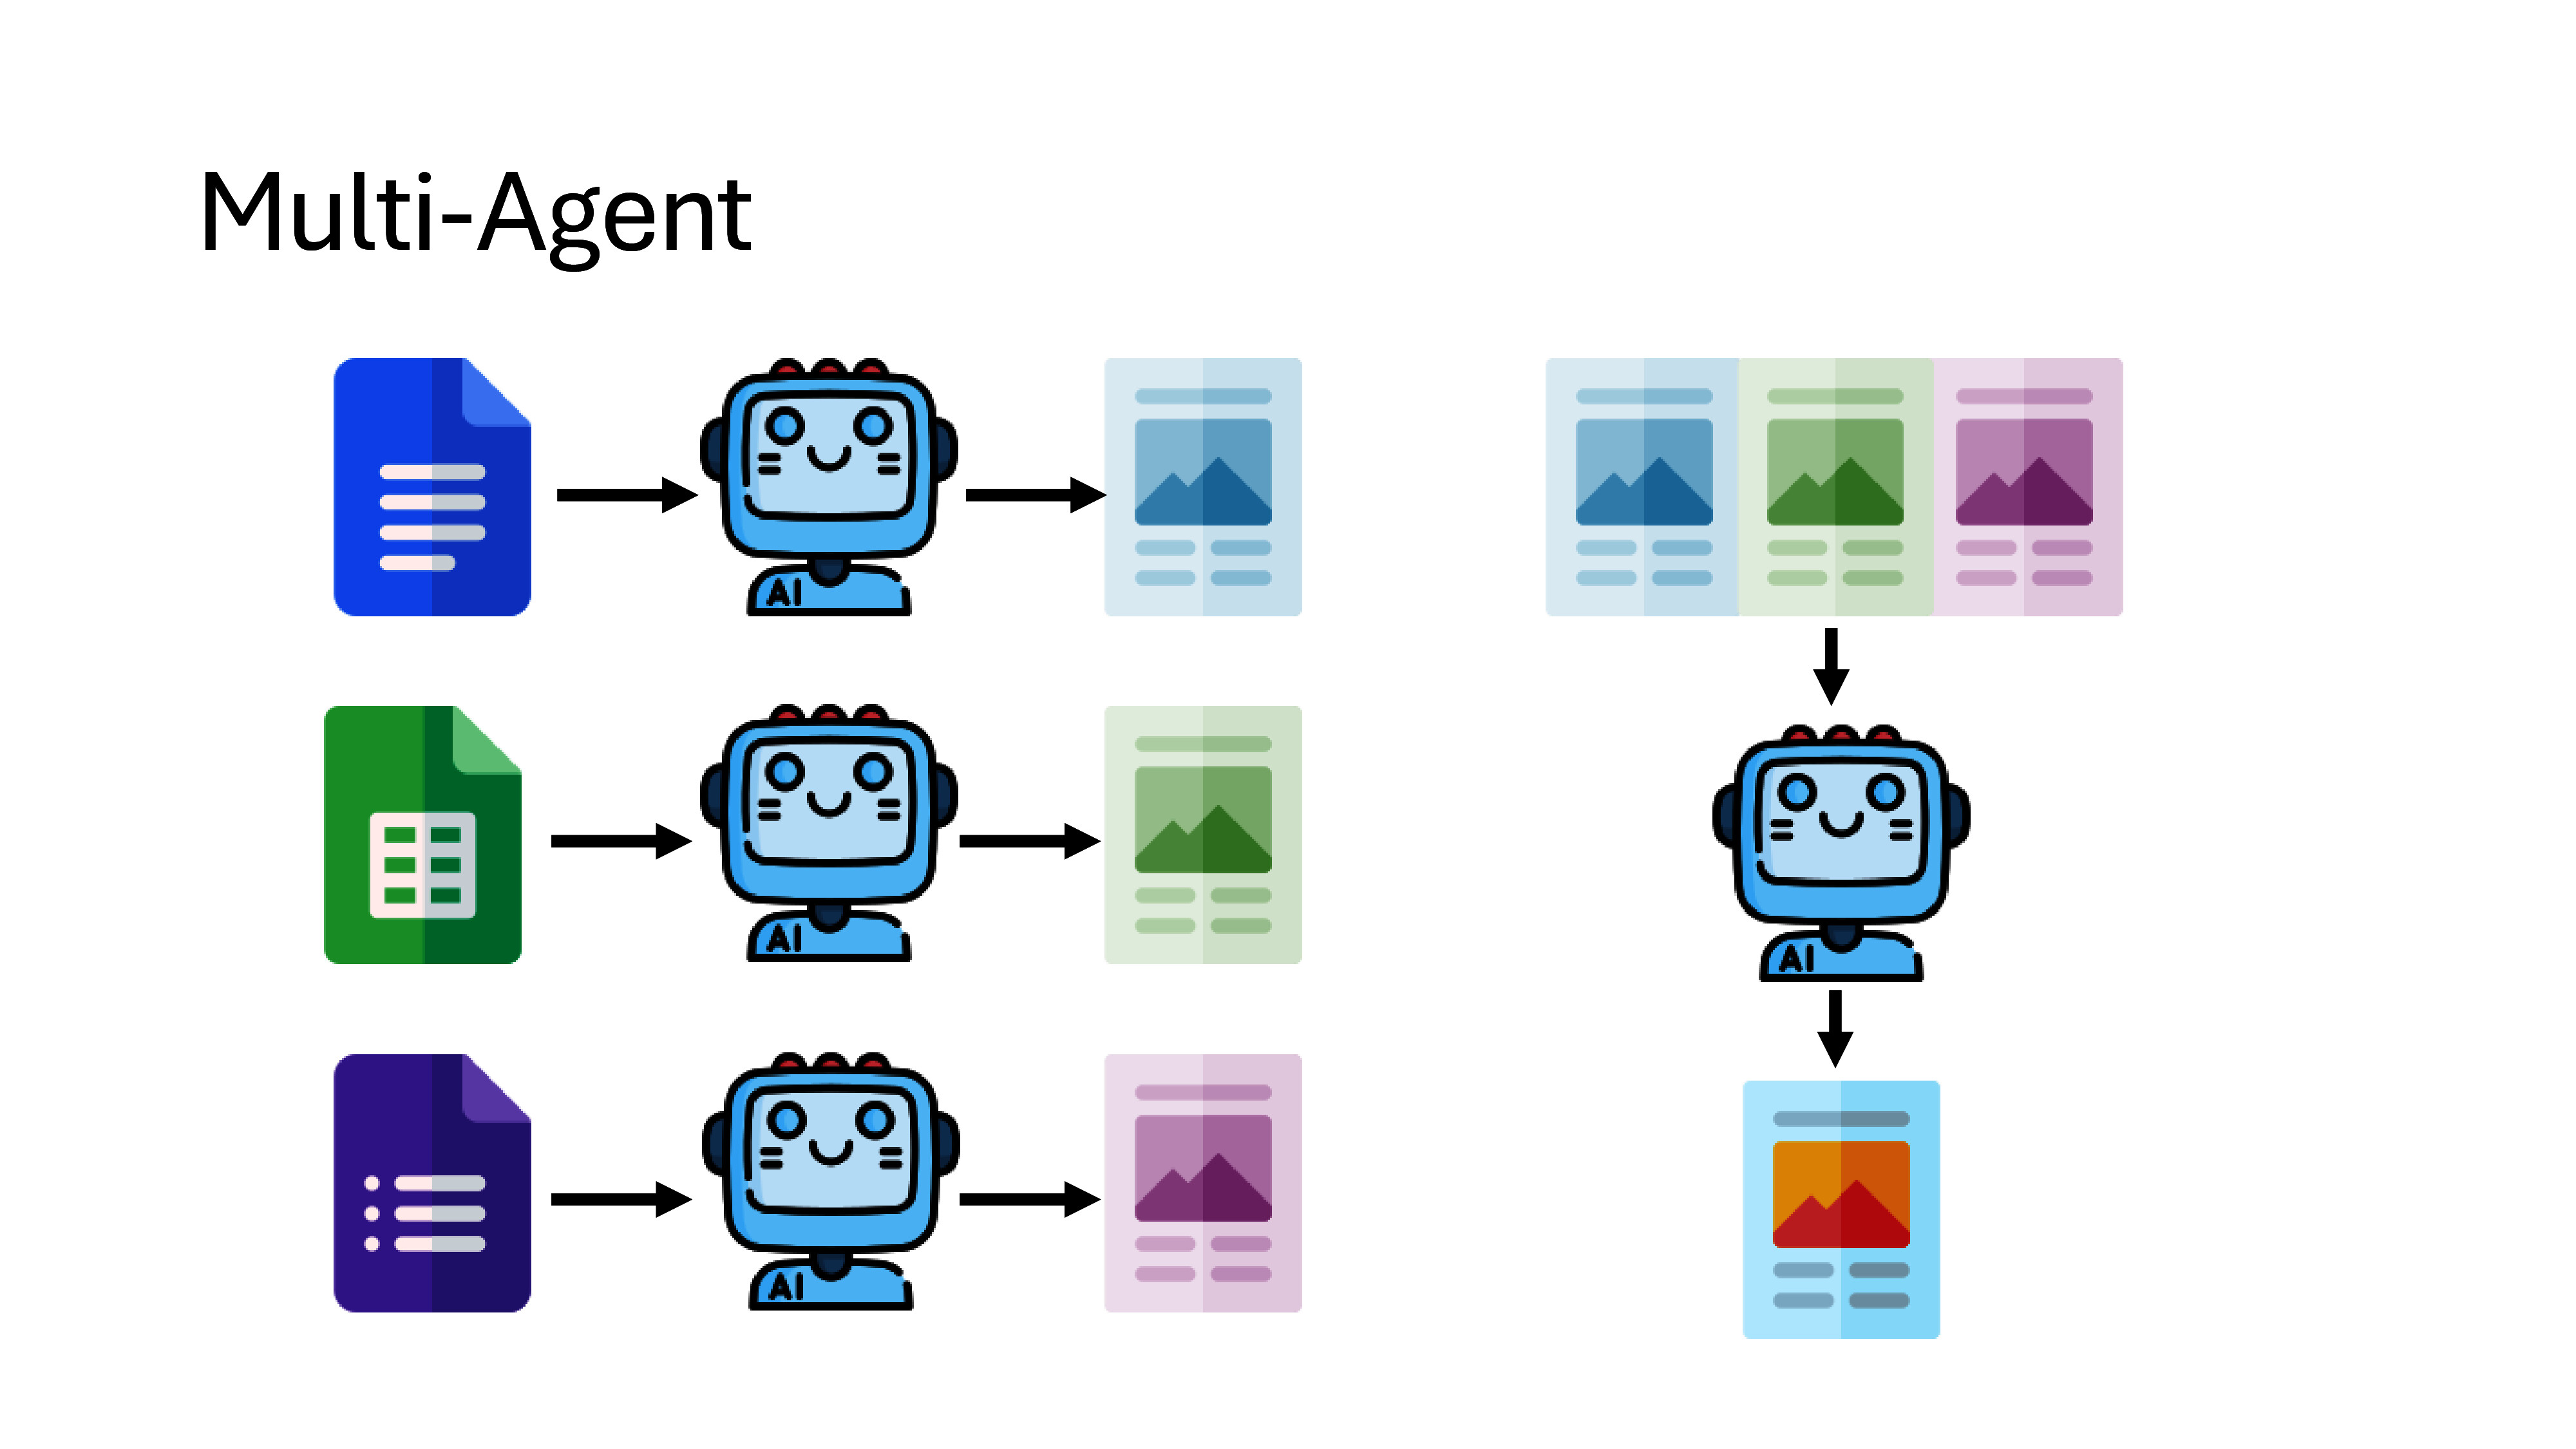
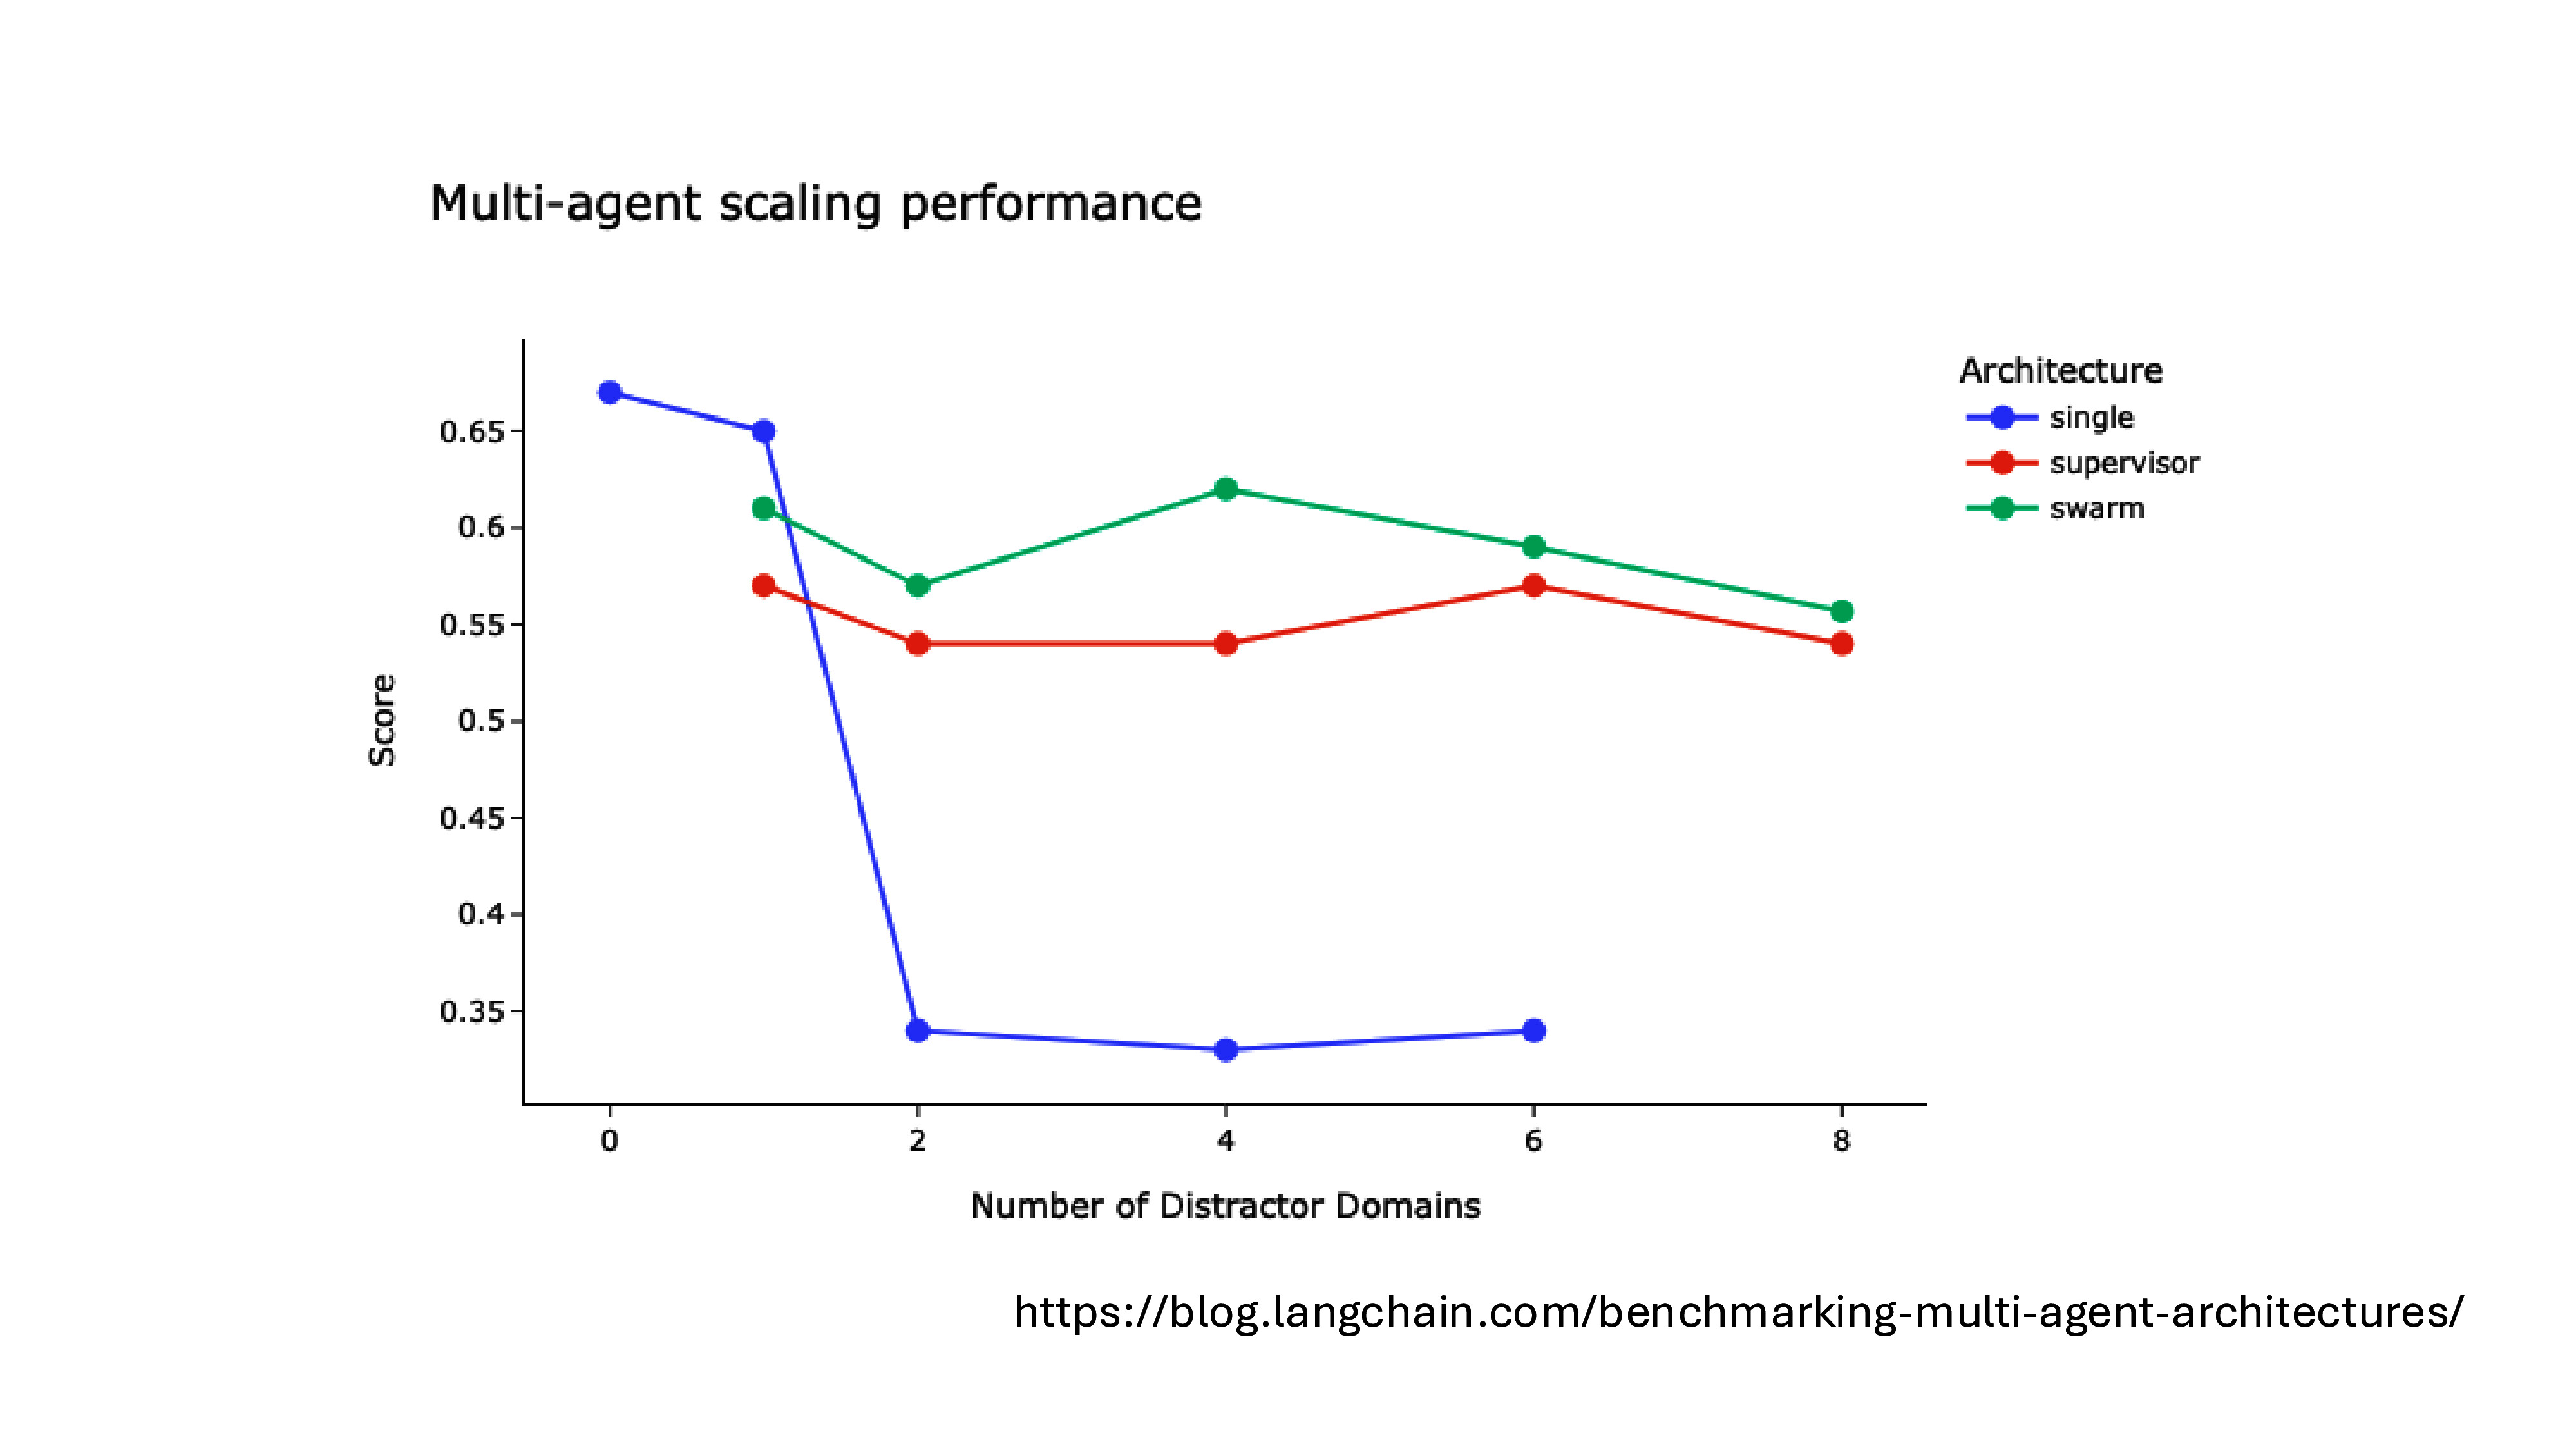
- Multi-Agent(多代理):将复杂任务拆解并分派给多个子 Agent。子 Agent 独立处理细节,完成后只向 Lead Agent 回报最终结果,从而隔离复杂的互动过程,分散 Context 负担。
没有找到匹配的文章