Candle
克隆
git clone https://github.com/huggingface/candle
cd candle
Phi-2
- CPU
克隆
git clone https://github.com/huggingface/candle
cd candle
Phi-2
机器学习的方法
监督学习(Supervised Learning)
监督学习使用带有标签的训练数据来训练模型。这些标签是预先定义的输出,模型通过学习输入数据与这些输出之间的关系来进行预测。监督学习的任务通常分为两类:分类(预测离散的标签)和回归(预测连续的数值)。常见的监督学习算法包括决策树、逻辑回归、支持向量机(SVM)、神经网络等。监督学习广泛应用于图像识别、语音识别、医疗诊断等领域。
无监督学习(Unsupervised Learning)
无监督学习不依赖于标签数据,而是试图在没有明确指导的情况下发现数据中的结构和模式。它的主要任务包括聚类(将数据分组到不同的簇中)和降维(减少数据的复杂性,同时保留其主要特征)。无监督学习常用于市场细分、社交网络分析、异常检测等场景。算法示例包括K-means聚类、主成分分析(PCA)等。
自监督学习(Self-Supervised Learning)
自监督学习是一种无监督学习的形式,它通过从数据本身生成伪标签来创建监督信号。这种方法通常涉及到设计任务,使得模型能够从数据中学习有用的特征表示,而不需要人工标注。自监督学习在计算机视觉和自然语言处理中尤其流行,例如,通过预测图像的旋转角度或文本的下一个字来训练模型。这种方法有助于减少对大量标注数据的依赖,同时为下游任务提供预训练的模型。
生成式AI(Generative AI) 生成式AI的目标是
Rust 安装
macOS
rustup,它是 Rust 的版本管理工具。curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sudo sh
这里加了
sudo是因为修改配置文件需要权限。
Rustup 元数据和工具链将安装到 Rustup 的主目录,位于:~/.rustup,这可以使用 RUSTUP_HOME 环境变量进行修改。
Cargo 主目录位于:~/.cargo,这可以使用 CARGO_HOME 环境变量进行修改。
cargo、rustc、rustup 等命令安装到 Cargo 的 bin 目录,位于:~/.cargo/bin。
sudo rustup update
sudo rustup self uninstall
$ cargo --version
cargo 1.76.0 (c84b36747 2024-01-18)
$ rust rustc --version
rustc 1.76.0 (07dca489a 2024-02-04)
$ rust rustdoc --version
rustdoc 1.76.0 (07dca489a 2024-02-04)
cargo 是 Rust 的构建工具,类似于 npm、pip、go 等。
这里使用了 Kimi 月之暗面 对简历这个场景进行了探索,Kimi 支持 128k 的长上下文,超过20万个汉字。
通过简历评估一下这位算法工程师的能力。
上传简历
根据李秀宁的简历,我们可以对她的技能和经验进行以下评估:

1. 编程技能:

她掌握多种编程语言,包括MATLAB、C、C++、Python,这些都是算法开发中常用的语言。
熟练使用多个开发平台,如MATLAB、Visual Studio、Eclipse、Qt、CCS、Pycharm,这表明她具备跨平台开发的能力。
熟悉OpenCV、yolov 5等图像处理库,这些是计算机视觉领域的重要工具。

2. 专业知识:

她掌握了多种信号处理方法,如快速傅里叶变换、短时傅里叶变换、数字滤波器设计等,这些都是信号处理和图像处理领域的基础。
熟悉深度学习框架,如tensorflow、keras、Pytorch,这些是当前人工智能和机器学习领域的主流工具。

3. 工作经验:

// ...
我们需要一位NLP工程师,专注能大模型的应用,她能够胜任? 根据李秀宁的简历,她在图像处理和信号处理方面有丰富的经验和专业知识,但在自然语言处理(NLP)和大模型应用方面的经验并不明显。简历中没有提到她有直接从事NLP项目或使用大模型(如BERT、GPT等)的经验。 NLP工程师通常需要具备以下技能和经验: 1.
论文
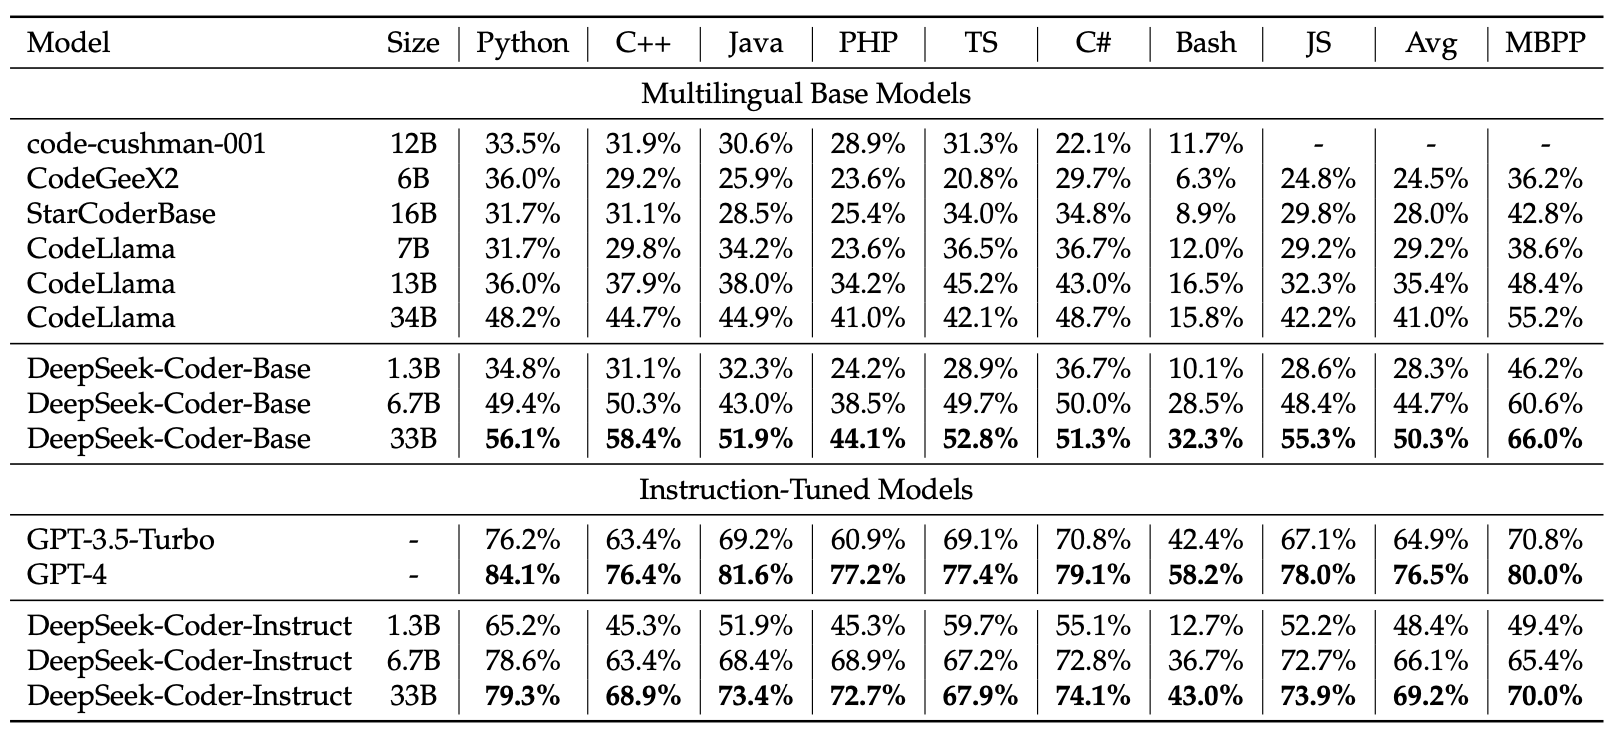
模型的性能
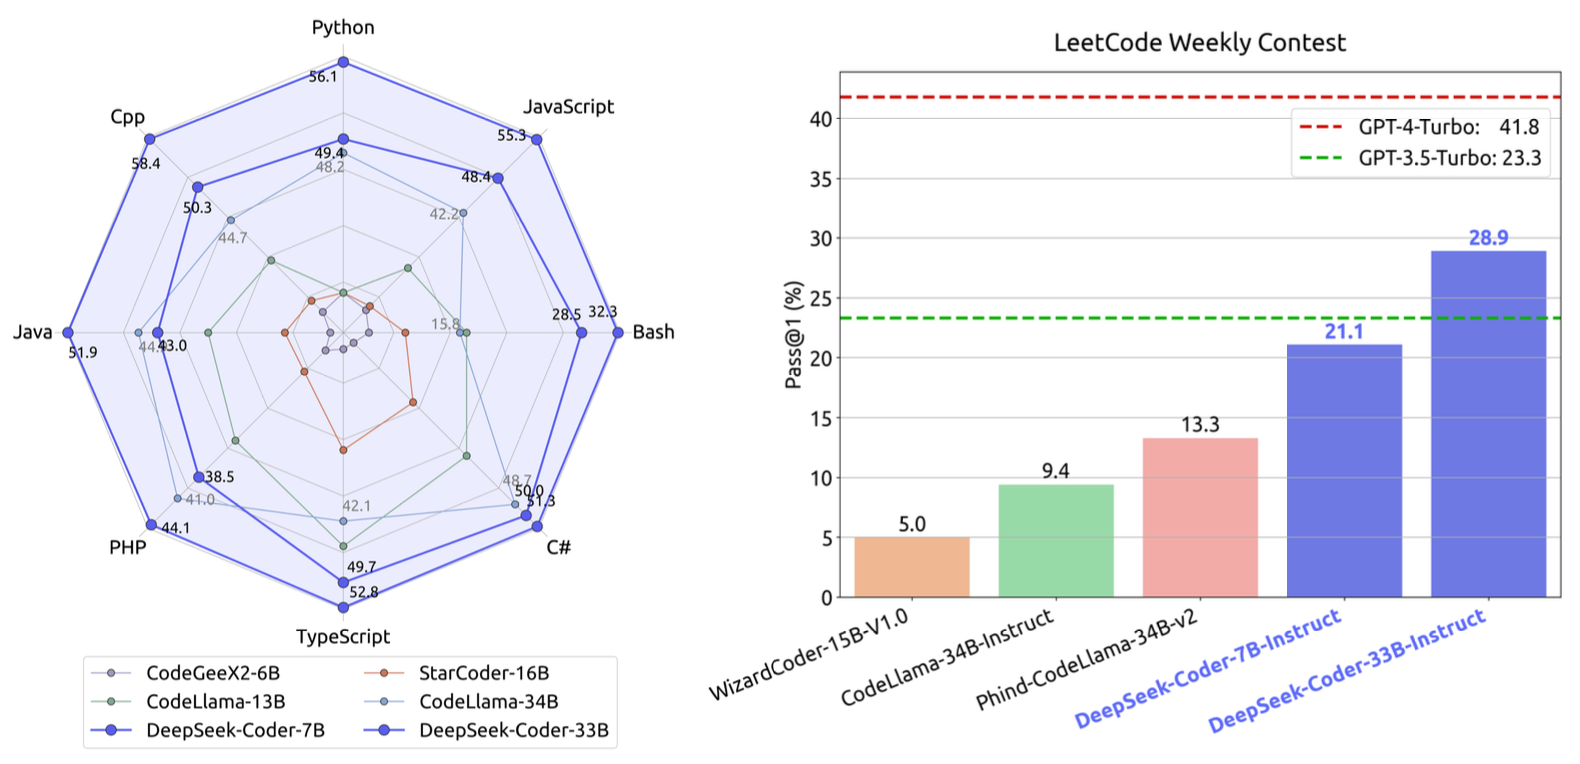
多语言基准性能
训练数据集
数据来源:2023年2月之前在GitHub上创建的公共仓库。
数据集创建过程
规则过滤 过滤掉平均行长度超过100个字符或最大行长度超过1000个字符的文件。 移除了字母字符少于25%的文件。 除了XSLT编程语言外,过滤掉在前100个字符中出现字符串 "<?xml_version=" 的文件。 对于HTML文件,考虑可见文本与HTML代码的比例,保留可见文本占代码至少20%且不少于100个字符的文件。 对于包含更多数据的JSON和YAML文件,只保留字符计数在50到5000个字符范围内的文件。
1. TRANSFORMER 模型
自然语言处理
NLP 是语言学和机器学习交叉领域,专注于理解与人类语言相关的一切。 NLP 任务的目标不仅是单独理解单个单词,而且是能够理解这些单词的上下文。
以下是常见 NLP 任务的列表:
Transformers 能做什么?
Transformers 库中最基本的对象是 pipeline() 函数。它将模型与其必要的预处理和后处理步骤连接起来,使我们能够通过直接输入任何文本并获得最终的答案:
TinyLlama/TinyLlama-1.1B-Chat-v1.0
<|system|>
You are a chatbot who can help code!</s>
<|user|>
Write me a function to calculate the first 10 digits of the fibonacci sequence in Python and print it out to the CLI.</s>
<|assistant|>
将 MLX 微调的模型转换为 GGUF 模型最大的意义是可以融入 GGUF 的生态系统,可以在更多的平台上使用。
LoRA 微调
大模型 Mistral-7B-v0.1
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py
if __name__ == "__main__":
    # ......
    for dataset, name, size in datasets:
        with open(f"data/{name}.jsonl", "w") as fid:
            for e, t in zip(range(size), dataset):
                t = t[3:]
                json.dump({"text": t}, fid)
                fid.write("\n")
执行脚本 data/wikisql.py 生成数据集。
data/wikisql.py
安装 mlx-lm
pip install mlx-lm
微调
大模型 Deepseek-Coder-7B
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/wikisql.py if name == "main": # ...... for dataset, name, size in datasets: with open(f"data/{name}.jsonl", "w") as fid: for e, t in zip(range(size), dataset): # deepseek-ai/deepseek-coder-7b-instruct-v1.5 # 去掉开头的 <|begin▁of▁sentence|>,因为 tokenizer 会自动添加 <|begin▁of▁sentence|> t = t[3:-4] + "<|end▁of▁sentence|>" json.dump({"text": t}, fid) fid.
使用 LoRA 和 QLoRA 基于 Mistral-7B 微调的实验
LoRA 和 QLoRA 对比
微调
| Iteration | LoRA Train Loss | LoRA Val Loss | LoRA Tokens/sec | QLoRA Train Loss | QLoRA Val Loss | QLoRA Tokens/sec |
|---|---|---|---|---|---|---|
| 1 | 2.343 | 2.420 | ||||
| 100 | 1.204 | 221.348 | 1.216 | 166.377 | ||
| 200 | 1.091 | 1.111 | 207.353 | 1.095 | 1.130 | 187.795 |
| 300 | 0.818 | 234.182 | 1.065 | 194.826 | ||
| 400 | 0.837 | 1.076 | 207.763 | 0.998 | 1.006 | 170.072 |
| 500 | 0.774 | 223.036 | 0.726 | 189.288 | ||
| 600 | 0.609 | 1.001 | 218.118 | 0.607 | 1.015 | 186.397 |
微调的参数量 LoRA 微调万分之 2.35 (1.704M / 7243.436M * 10000)的模型参数。 QLoRA 微调万分之 13.
预训练模型 mistralai/Mistral-7B-v0.1
量化
QLoRA 微调需要量化,生成 4 位量化的 Mistral 7B 并默认将其存储在 mlx_model 目录中
python convert.py --hf-path mistralai/Mistral-7B-v0.1 -q
mlx_model 目录结构如下:
mlx_model
├── config.json
├── model.safetensors
├── special_tokens_map.json
├── tokenizer.json
├── tokenizer.model
├── tokenizer_config.json
└── weights.00.safetensors
量化后的模型 8.0G
微调
QLoRA 微调
mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL
安装 mlx-lm
pip install mlx-lm
生成 SQL
python -m mlx_lm.generate --model mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL \
                          --max-tokens 50 \
                          --prompt "table: students
columns: Name, Age, School, Grade, Height, Weight
Q: Which school did Wang Junjian come from?
A: "
SELECT School FROM Students WHERE Name = 'Wang Junjian'
上传模型到 HuggingFace Hub
mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL
本次微调的模型我已经上传到了 HuggingFace Hub 上,大家可以进行尝试。
安装 mlx-lm
pip install mlx-lm
生成 SQL
python -m mlx_lm.generate --model mlx-community/Mistral-7B-v0.1-LoRA-Text2SQL \
                          --max-tokens 50 \
                          --prompt "table: students
columns: Name, Age, School, Grade, Height, Weight
Q: Which school did Wang Junjian come from?
A: "
SELECT School FROM Students WHERE Name = 'Wang Junjian'
在 MLX 上使用 LoRA / QLoRA 微调 Text2SQL(一):使用 LoRA 基于 Mistral-7B 微调
📌 没有使用模型的标注格式生成数据集,导致不能结束,直到生成最大的 Tokens 数量。
这次我们来解决这个问题。
数据集 WikiSQL
修改脚本 mlx-examples/lora/data/w
安装
git clone https://github.com/ml-explore/mlx-examples.git
cd mlx-examples/lora

pip install -r requirements.txt
下载模型
pip install huggingface_hub hf_transfer

export HF_HUB_ENABLE_HF_TRANSFER=1
huggingface-cli download \
    --local-dir-use-symlinks False \
    --local-dir mistralai/Mistral-7B-v0.1 \
    mistralai/Mistral-7B-v0.1
数据集 WikiSQL
样本格式

AutoDev - AI 辅助编程
AutoDev 是一款基于 JetBrains IDE 的 AI 辅助编程插件。AutoDev 能够与您的需求管理系统(例如Jira、Trello、Github Issue 等) 直接对接。在 IDE 中,您只需简单点击,AutoDev 会根据您的需求自动为您生成代码。您所需做的,仅仅是对生成的代码进行质量检查。
UnitMinions - 《AI 研发提效研究:自己动手训练 LoRA》
Chocolate Factory - AI 开发框架
Chocolate Factory 是一款开源的 LLM 应用开发框架,旨在帮助您轻松打造强大的软件开发 SDLC + LLM 生成助手。
Studio B3 - 辅助需求编程器
Studio B3 是一个为内容创作设计的 AI 编辑器,适用于各种格式,如博客、文章、用户故事等。
UnitGen - 研发模型微调 UnitGen 是一个用于生成微调代码的数据框架 —— 直接从你的代码
[llama.cpp][llama.cpp]
模型量化 量化类型 ./quantize --help Allowed quantization types: 2 or Q4_0 : 3.56G, +0.2166 ppl @ LLaMA-v1-7B 3 or Q4_1 : 3.90G, +0.1585 ppl @ LLaMA-v1-7B 8 or Q5_0 : 4.33G, +0.0683 ppl @ LLaMA-v1-7B 9 or Q5_1 : 4.70G, +0.0349 ppl @ LLaMA-v1-7B 19 or IQ2_XXS : 2.06 bpw quantization 20 or IQ2_XS : 2.31 bpw quantization 10 or Q2_K : 2.63G, +0.6717 ppl @ LLaMA-v1-7B 21 or Q2_K_S : 2.16G, +9.0634 ppl @ LLaMA-v1-7B 12 or Q3_K : alias for Q3_K_M 11 or Q3_K_S : 2.75G, +0.5551 ppl @ LLaMA-v1-7B 12 or Q3_K_M : 3.07G, +0.2496 ppl @ LLaMA-v1-7B 13 or Q3_K_L : 3.35G, +0.
我使用 v2ray 科学上网,并且已经开启了全局模式,所有网络连接都应该通过 v2ray 的代理服务器。但我使用 git 命令行应用发现不能连接 GitHub,但 GitHub Desktop 可以正常使用。
git clone https://github.com/wang-junjian/chatbox
Cloning into 'chatbox'...
fatal: unable to access 'https://github.com/wang-junjian/chatbox/': Failed to connect to github.com port 443 after 75011 ms: Couldn't connect to server
在这种情况下,你需要手动为 git 设置代理。
设置代理
git config --global http.proxy 'socks5://127.0.0.1:1080'
git config --global https.proxy 'socks5://127.0.0.1:1080'
这些命令将 git 的 HTTP 和 HTTPS 代理设置为 socks5://127.0.0.1:1080。你需要将 1080 替换为你的 v2ray 服务的端口。
安装 FastChat & vLLM
安装 FastChat
FlashAttention-2 currently supports:
Turing GPU T4 不支持,需要使用 FlashAttention 1.x,否则会报错 ❌:
安装 FastChat & vLLM
安装 FastChat
pip install "fschat[model_worker,webui]"
Turing GPU T4 不支持 FlashAttention 2,需要使用 FlashAttention 1.x 。Turing GPU T4 不支持 bf16,需要使用 fp16 。安装 vLLM
pip install vllm -i https://mirrors.aliyun.com/pypi/simple/
升级 FastChat & vLLM
git pull
pip install -e ".[model_worker,webui]"
pip install -U vllm
部署 LLM
运行 Controller
python -m fastchat.serve.controller
运行 OpenAI API Server
python -m fastchat.serve.openai_api_server
运行 Model Worker Qwen-1_8B-Chat export CUDA_VISIBLE_DEVIC
没有找到匹配的文章