Cordis 插件开发图解教程 · 结合 deepseek-harness 真实代码HTML
把 Cordis 官方七篇教程揉成一份离线图解手册,逐章对照真实仓库源码,讲透一切皆插件的心智模型、effect 自动清理、服务与注册表、五种事件分发、配置校验、热替换与插件卡死诊断,最后从一份清单从零拼出能跑的智能体,附速查表与源码索引,看图抄代码即可上手。
把 Cordis 官方七篇教程揉成一份离线图解手册,逐章对照真实仓库源码,讲透一切皆插件的心智模型、effect 自动清理、服务与注册表、五种事件分发、配置校验、热替换与插件卡死诊断,最后从一份清单从零拼出能跑的智能体,附速查表与源码索引,看图抄代码即可上手。
本文档以
@wangjunjian/dsh-artifact-viewer为实例,系统梳理 DeepSeek Harness(DSH)bundle 插件的开发方法:工作原理、架构设计、构建打包、测试、发布自动化,以及开发和发布过程中实际踩过的坑。
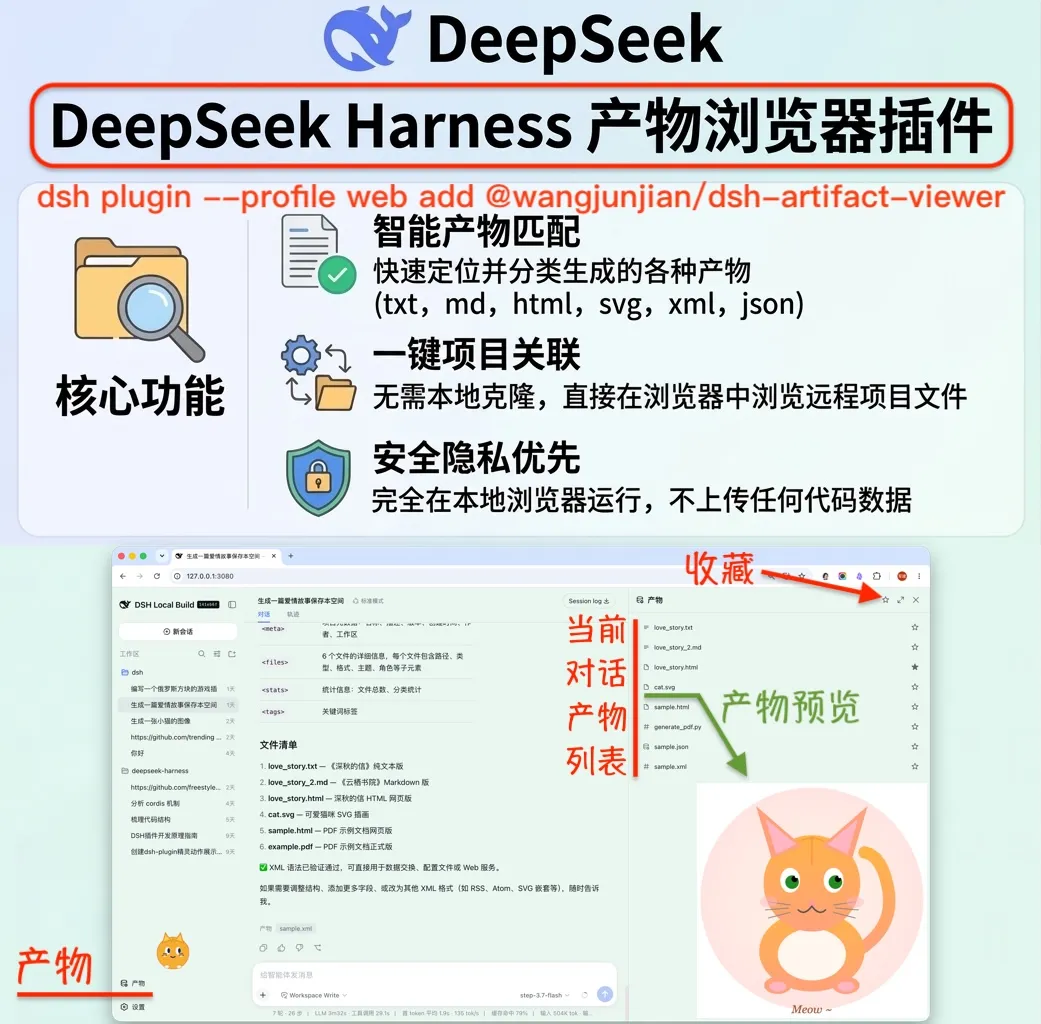
1. 工作原理
Bundle 插件是什么
DSH 的 bundle 插件是一个普通 npm 包,通过 package.json 里的 dsh 字段声明自己:
{
  "dsh": {
    "bundle": { "patch": "./cordis.patch.yml" },
    "client": {
      "platform": "web",
      "inject": ["@deepseek-ai/dsh-client-runtime"],
      "external": ["@deepseek-ai/dsh-client-ui-primitives"]
    }
  }
}
dsh.bundle.patch:指向一个 cordis patch 文件,负责把插件注册进 loader 树。dsh.client:声明浏览器半部分的运行平台、注入依赖和 external 包。一份面向本仓库(DeepSeek Harness 外部 Bundle 插件)的全面开发规范。 内容均基于本仓库真实代码(
src/、tsdown.config.ts、package.json、tests/等)提炼, 而非泛泛而谈的通用建议。改动代码前先读本文,能少踩 80% 的坑。
0. 项目定位速览
本仓库是一个 DeepSeek Harness(以下简称 DSH)外部 Bundle 插件,对外暴露一个面向模型(model-facing)的工具 github_trending,抓取 https://github.com/trending 的公开页面,返回结构化热门仓库列表。
基于
deepseek-ai/deepseek-harness(TypeScript / Cordis 插件总线)与openai/codex(Rust / codex-rs crate 体系)两个成熟开源项目的真实源码整理。 本文把每层的关键数据结构、控制流、不变量讲清楚,并为每个核心模块附上实现逻辑——这些是写 Agent 时真正会踩坑的地方。 所有代码路径均为实际文件,可下钻核对。伪代码为便于阅读对真实实现做了抽象,但结构与关键分支与源码一致。
0. 先定位:Agent 是什么
Agent = 以 LLM 为决策核心、以 Tool 为手、以 Sandbox 为边界、以 Append-Only 会话日志为记忆的闭环。
两条跨实现的底层信条:
分层总览
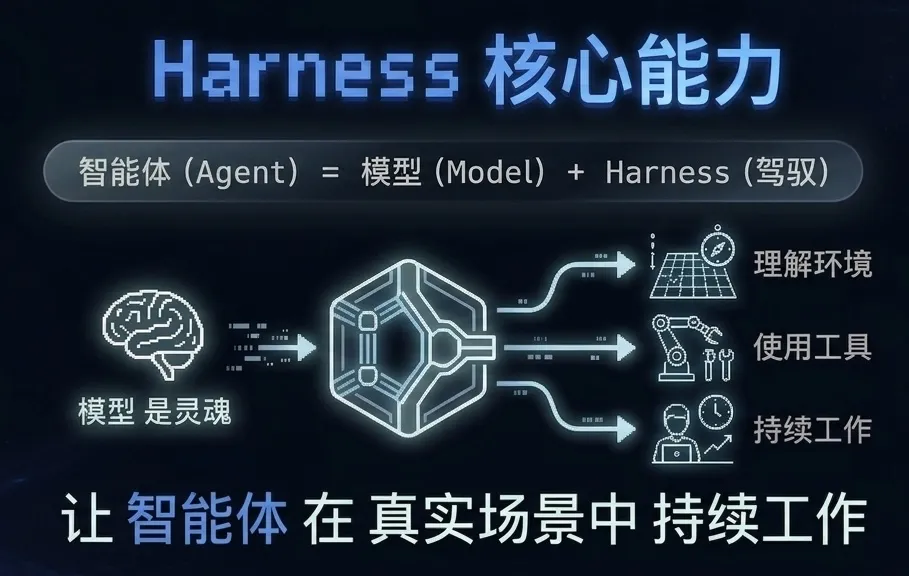
基于
deepseek-ai/deepseek-harness(TypeScript / Cordis 插件总线)与openai/codex(Rust / codex-rs crate 体系)两个成熟开源项目的源码与架构文档整理。 目标:用「分层 + 核心模块详解」的方式,把一个 Agent 讲清楚。
0. 先定位:什么是 Agent
一个 Agent 本质上是一个以 LLM 为决策核心、以工具为手、以沙箱为边界、以会话日志为记忆的闭环系统:
无论 TS 还是 Rust 实现,所有 Agent 的模块都收敛到同一组子系统。下面按自底向上的依赖顺序分成 7 层。
分层总览
分析对象:
packages/下全部@deepseek-ai/dsh-*插件。 统计口径:直接扫描每个包的package.json(name / description 字段)+ 分组级README.md,逐包核对,无遗漏。 结论:共 50 个能力分组、226 个插件包。 核心理念:everything is a plugin。整个 harness 建立在 vendored Cordis 之上,每个能力都以插件形式通过ctx.effect()/ctx.on()/ctx.waterfall()贡献。 架构范式:能力分离(capability seam)——同一能力族通常拆成「服务定义(Service Definition)/ 具体提供方(Provider)/ 消费方/工具(Consumer)」三层,互不耦合、可独立替换。
0. 总览:50 个分组 / 226 个包
分析对象:
packages/**/src下所有经defineTool(...)/ctx.tools.register(defineTool(...))注册、或运行时注入的模型侧工具。 排除:测试 fixture、浏览器端 UI 占位工具、zod schema 字段名(误报)。 所有工具均由独立「消费方」插件注册,底层能力提供方(Provider)可在不改工具契约的前提下替换。
一、总览(按能力族分组的工具数)
1. 项目概述
openai/codex —— OpenAI 的本地编码 Agent(Codex CLI)codex-rs/Cargo.toml),crate 统一以 codex- 前缀命名;另有 codex-cli(Node 包装层)与 sdk/MODULE.bazel)与 Cargo workspace设计哲学(见 codex-rs/docs/protocol_v1.md)是:Core 引擎与 UI 解耦 —— "Codex runs locally, either in a background thread or separate process",并通过一对队列 SQ(Submission Queue,UI→Core) 与 EQ(Event Queue,Core→UI) 通信。任何 UI(TUI、桌面 App、IDE 插件、MCP 客户端)都可驱动同一个 Core。
关键抽象
本文用通俗类比拆解 deepseek-harness(简称 dsh)的整体架构与核心模块的工作原理。 所有结论均来自仓库
docs/下的架构与子系统文档(architecture.md、cordis-primer.md、subsystems/*、capability-seams.md)。 代码路径以packages/...与docs/...标注,便于深究。
一、一句话总览
dsh 是一个插件化的 AI 智能体运行底座。它有一条铁律:
产品的一切都是插件(everything is a plugin)。
模型适配器、工具注册表、会话日志、甚至驱动循环(agent loop)本身,统统是插件。 没有需要打补丁的"特权核心"——你想改任何一块行为,只要在别处再挂一个插件、或换掉某个实现即可, 因为所有注册都是可逆的副作用(reversible effects),插件卸载时自动回滚。
这就像一座城市:市政府(Cordis 框架)只提供"水电管网"(一套统一的服务注册 + 事件总线), 各个部门(插件)自己接入管网、各司其职,谁搬走都不影响大楼立着。
二、地基:Cordis 插件框架(用"城市公用事业"来比喻)
docs/cordis-primer.md 把 Cordis 浓缩成五个想法:
一、整体定位:一个"日志驱动"的反应式状态机
ReactLoopAgent(packages/core/agent-loop/src/agent.ts)不是传统意义上的 while-loop 脚本,它是一个三态相机 + 事件日志回放器的复合体:
Phase = idle | maintenance | running
idle:驱动器不存在,lastTurn 记住上次进度maintenance:独占的维护窗口(如 compaction),持有独立 AbortControllerrunning:驱动器存活,turn/step 计数 + wakeRequested 闩锁关键设计:同一时刻只有一个驱动器 promise(activityDone),wakeDriver() 在驱动器存活时只设置闩锁而不重入,在 maintenance 或被 abort 的活动期间则把唤醒"挂账",等收敛时重放(agent.ts:172-193)。这解决了 agent 系统最难的问题之一——唤醒信号的丢失与重入——用一个 latch 而不是消息队列。
二、输入侧:双通道 Inbox 的持久化设计
所有输入通过四个动词进来(agent.ts:113-132):
1. 一句话定位
DeepSeek Harness 是一个**"一切皆插件"的 Agent 运行时**:以 vendored Cordis 为插件内核,把模型、工具、会话、执行环境、子代理全部抽象成可替换的能力接缝(capability seam),再用分层配置(profile / bundle / patch)组合成产品。它的本质不是"一个 agent",而是一条生产 agent 的装配线。
2. 分层架构总览
Spritely 是一个跑在 deepseek-harness Web 界面里的浮动小精灵。它盯着 agent 的一举一动——待命、思考、写代码、调工具、等你确认、报错、收工——然后做出对应的表情和动作。眼珠会跟着你的鼠标转,可以被拖到任意角落,还能换角色、换背景。
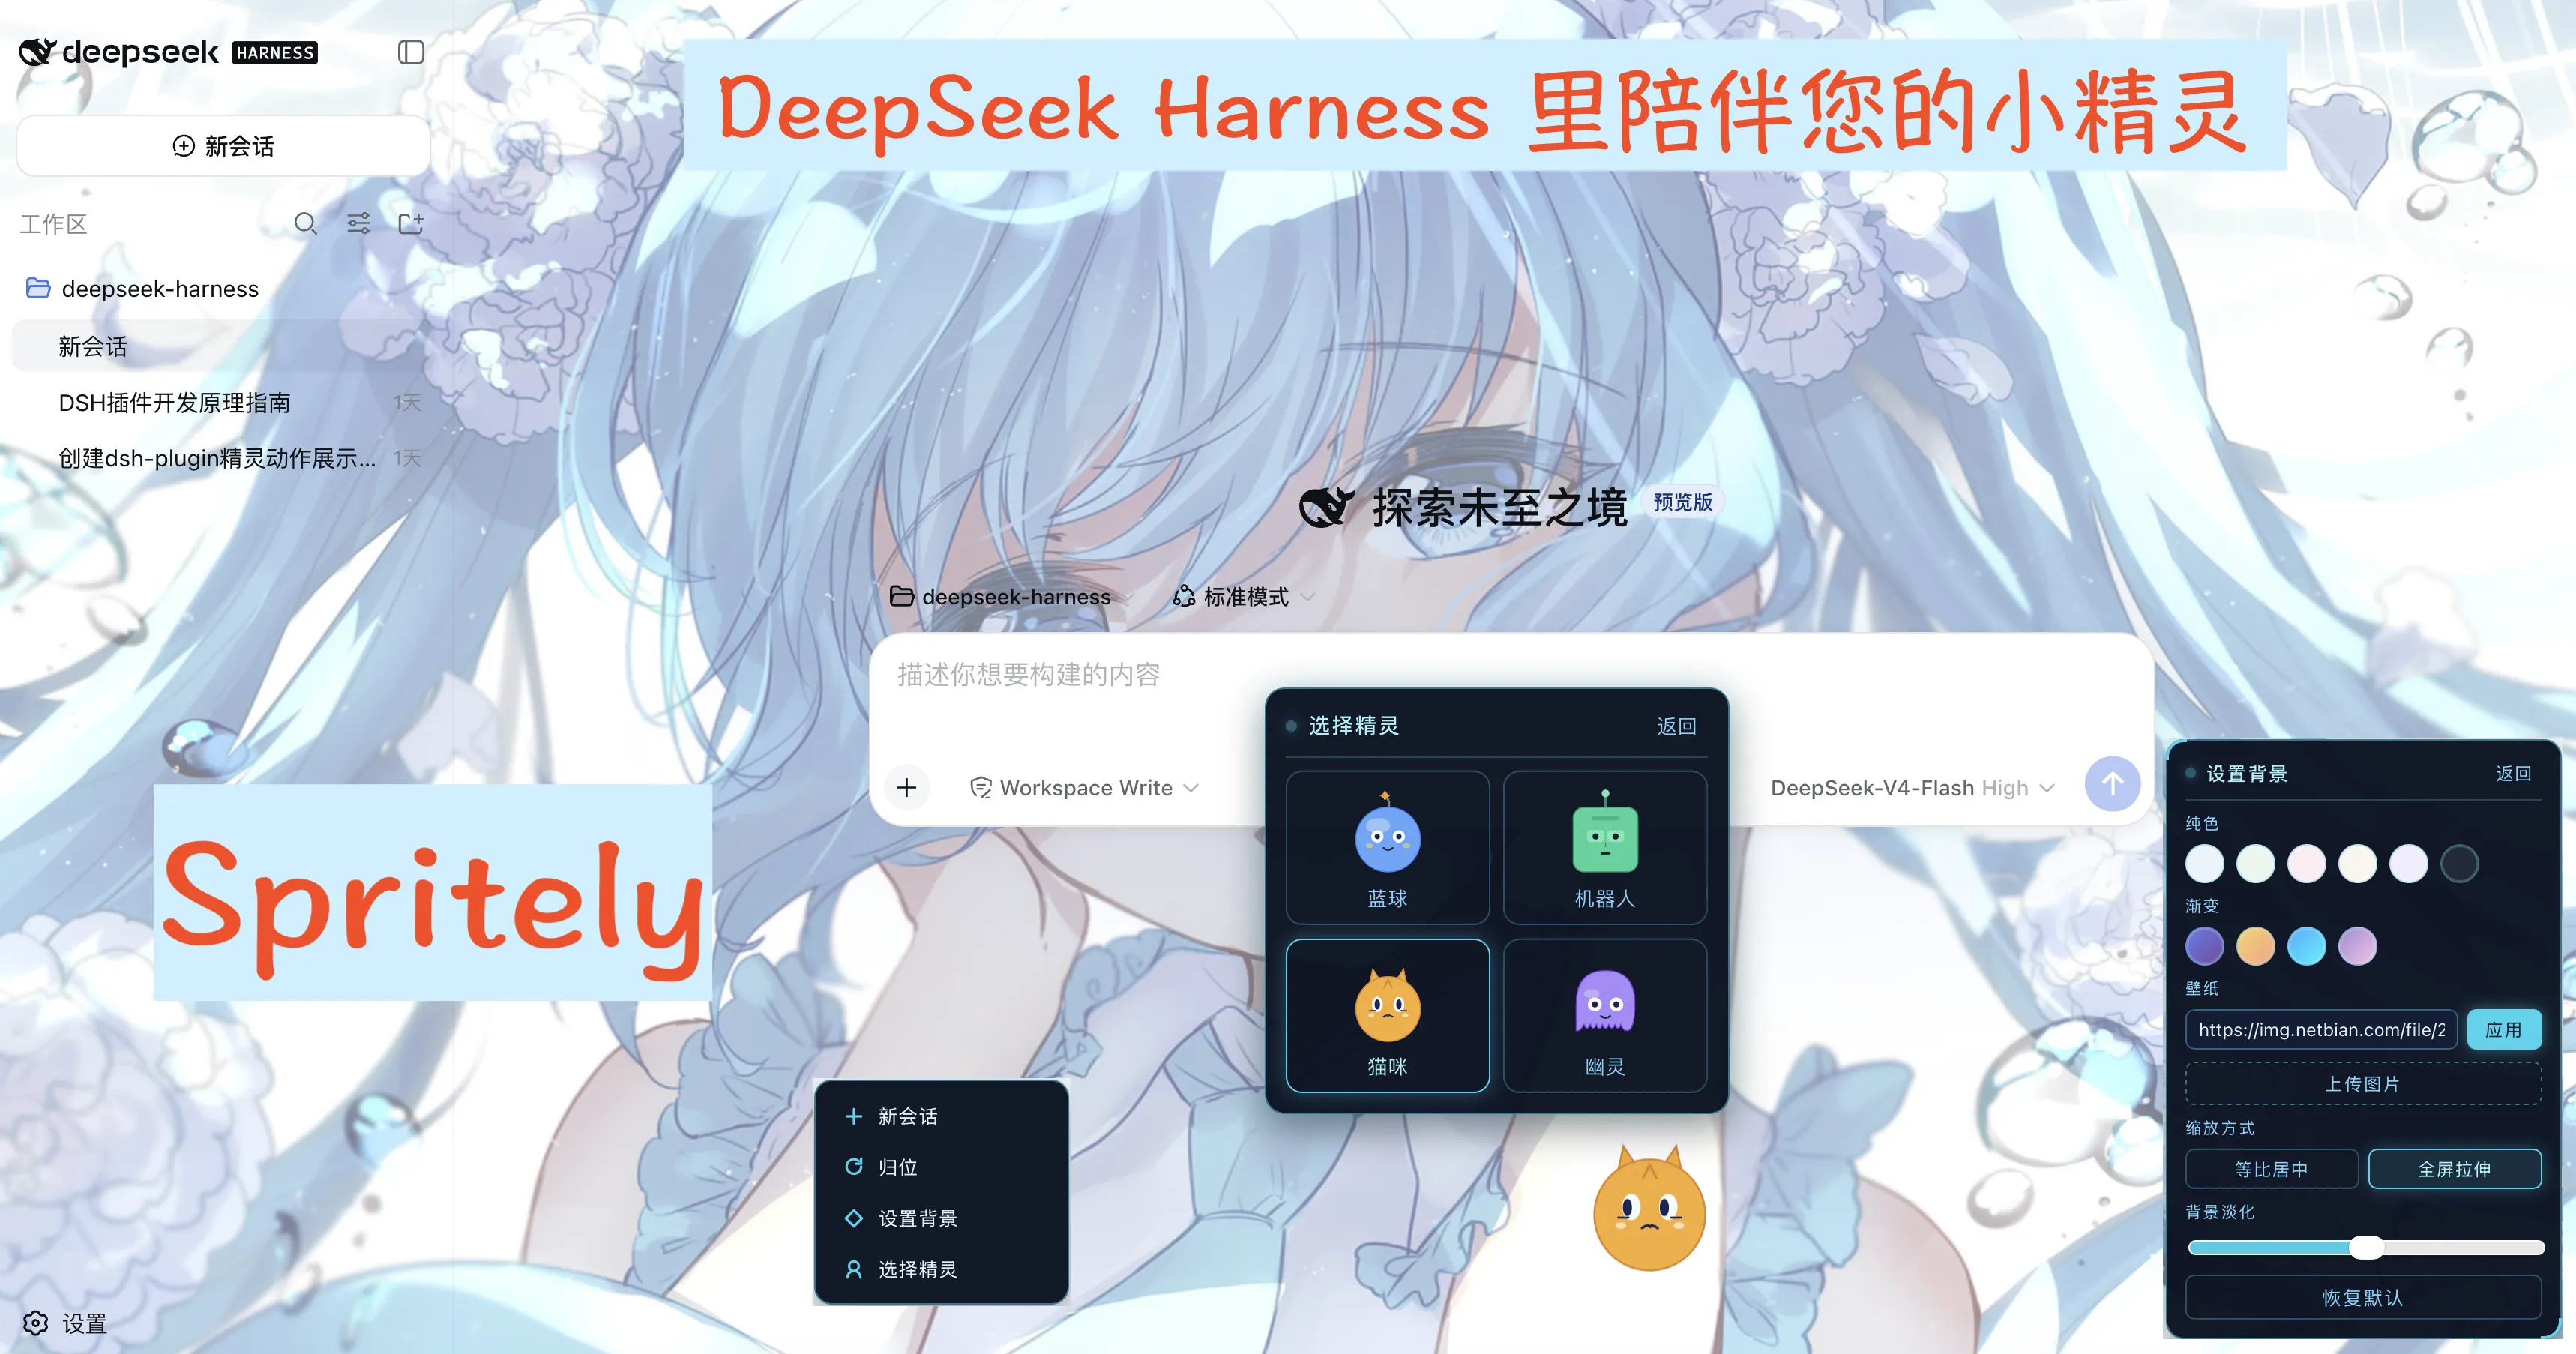
这个项目完整走完了一条「dsh 客户端插件」的开发—独立化—分发链路,过程中踩了不少坑。这篇文章把三件事讲清楚:它怎么工作、怎么开发、怎么安装。
项目地址:github.com/wang-junjian/spritely
一、它是什么,能做什么
一句话:把 agent 的「内心活动」可视化。agent 长时间跑任务时,你盯着终端只能看到文字流,很难一眼判断它现在在干嘛、是不是卡住了。Spritely 用一个小精灵把状态翻译成表情和动作。
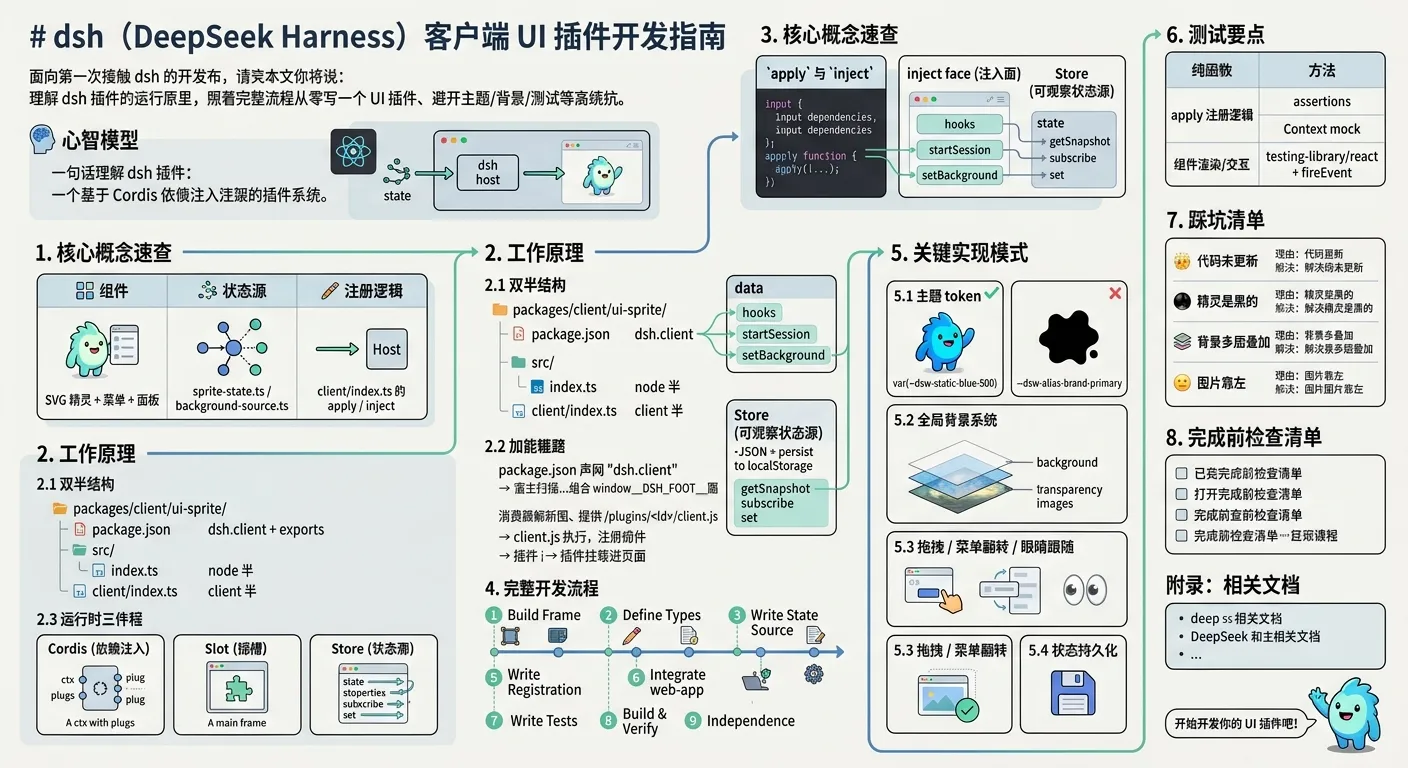
面向第一次接触 dsh 的开发者。读完本文你将能:理解 dsh 插件的运行原理、照着完整流程从零写一个 UI 插件、避开主题/背景/测试等高频坑。
全文以正在开发的 Spritely(精灵插件)为贯穿案例。
1. 心智模型:一句话理解 dsh 插件
dsh(DeepSeek Harness)是一个基于 Cordis 依赖注入框架的插件系统。一个"插件"就是一个可复用的功能单元,通过声明自己需要哪些服务、提供哪些能力,被宿主(host)动态加载和组合。
对客户端 UI 插件而言,一句话概括:
你在写一个 React 组件 + 一份状态源 + 一段注册逻辑。宿主负责在合适的时机、合适的位置把它挂载进界面,并通过"注入面"(inject face)把服务递给你。
一个 UI 插件(如右下角的精灵)由三样东西组成:
| 组成 | 作用 | 在 ui-sprite 里对应 |
|---|---|---|
| 组件 | 画出来的东西 | SpriteMascot.tsx(SVG 精灵 + 菜单 + 面板) |
| 状态源 | 组件读的数据(可观察) | sprite-state.ts / background-source.ts |
| 注册逻辑 | 告诉宿主"挂哪、需要什么" | client/index.ts 的 apply / inject |
2. 工作原理:插件是怎么被加载的
2.1 双端结构(node 端 / client 端)
引言:越过“莫拉维克悖论”的物理鸿沟
在硅谷的咖啡馆和波士顿的实验室里,一个共识正在变得震耳欲聋:2025-2026年将是具身智能(Embodied AI)与世界模型的爆发元年。
过去两年,大语言模型(LLM)向世界展示了“数字大脑”的极限。它们能写出惊世骇俗的论文,却在“莫拉维克悖论”(Moravec's Paradox)面前碰了壁——对人类而言极其困难的高智力任务(如微积分),AI手到擒来;但对人类而言本能级的物理感知(如在风中接住一片落叶),AI却举步维艰。
斯坦福教授李飞飞曾精辟地指出:“大语言模型是‘黑暗中的文字匠人’,能言善辩却脱离现实;而世界模型则是‘观察与行动者’。”从“数字脑”进化到“物理体”,这场关于机器人的“安卓时刻”并非简单的硬件改良,而是底层逻辑的彻底重构。以下是隐藏在具身智能浪潮背后的五个颠覆性## 真相。
真相一:“复仇者联盟”的奇袭——开源大脑为何能击败谷歌?
在机器人领域,规模(Scaling)并不是唯一的真理。2024年6月,开源模型 OpenVLA 的问世让业界大跌眼镜:这个仅有 70亿 参数的模型,在29项操作任务中的成功率竟然比拥有 550亿 参数的谷歌 DeepMind 旗舰模型 RT-2-X 高出了 16.5%。
这场胜利源于一种精妙的“三人小团队”架构:
韬(τ)定律(Tau Scaling Law)由华为半导体业务部总裁何庭波在 2026 年 IEEE 国际电路与系统研讨会(ISCAS 2026)上正式提出,是指导后摩尔时代半导体与电子系统演进的新核心原则。
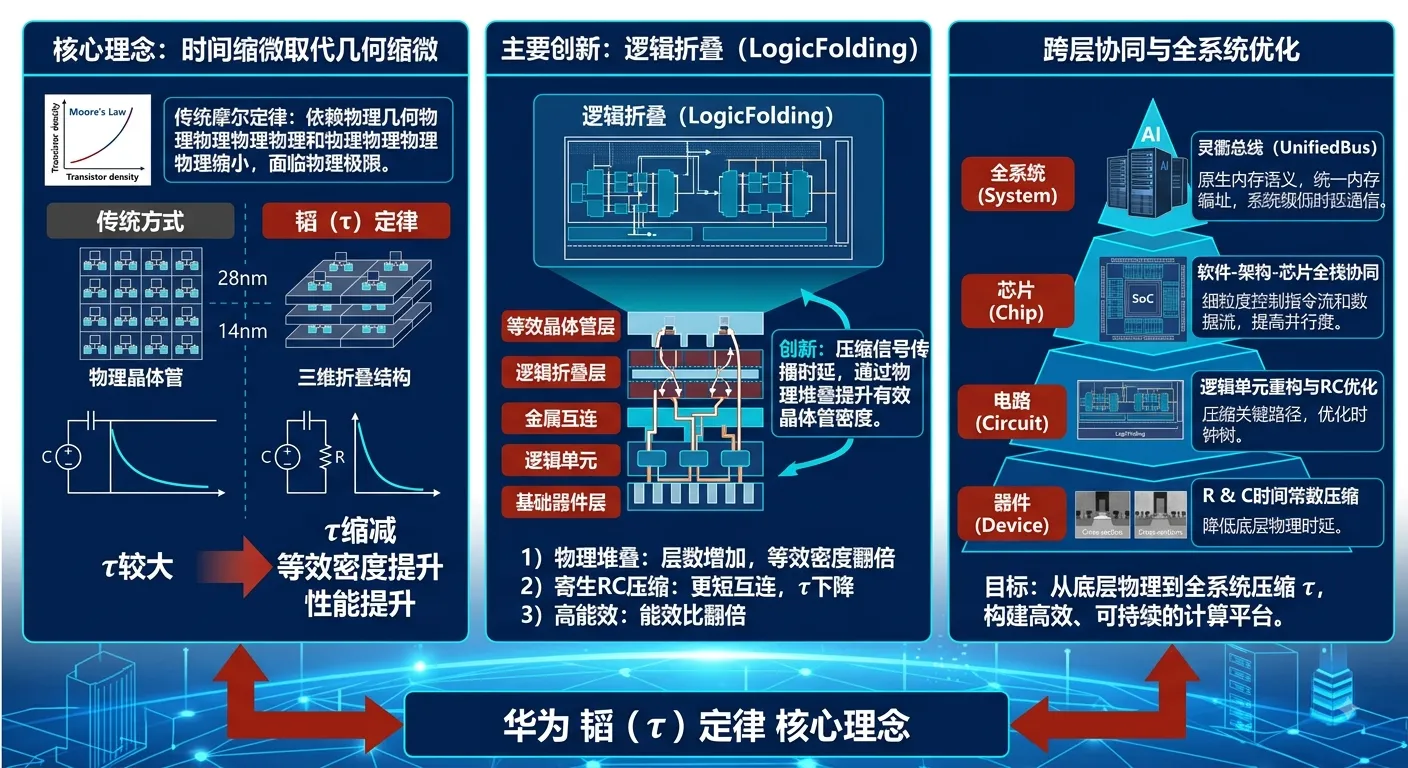
1. 引言:一个时代的终结与新逻辑的诞生
半导体行业曾长期生活在摩尔定律的金色余晖下。通过几何比例缩放(Geometric Scaling),我们习惯了晶体管每隔18-24个月就缩小一倍的神话。然而,当物理极限的铁幕落下,单纯依赖光刻机压榨空间的路径正步入死胡同。过去六年,在全球半导体产业因热量与复杂性陷入“饱和区”的焦虑时,华为在重压之下,于2026年东海岸技术峰会上抛出了一枚震撼弹——“韬(τ)定律”(Tau Law)。
这不仅仅是一次技术更新,更是一场认知的范式转移:芯片的演进逻辑正从 “空间(几何)缩放”转向“时间(延迟/频率)缩放”。华为正试图告诉世界,当城市的平面扩张(平面集成)遭遇边界时,唯一的出路是向天空索取空间,将“城市蔓延”转变为“摩天大楼架构”。
2. 核心突破:从“空间缩放”转向“时间缩放” (Tau Law)
“韬(τ)定律”的核心逻辑建立在一个深刻的哲学基础上:空间与时间是同一枚硬币的两面。在半导体领域,几何缩放的终极目的,始终是为了缩短电信号运行的时间。
华为指出,即便物理尺寸的缩小趋于停滞,我们依然可以通过优化时间尺度(Time Scaling)来驱动进化
为进一步提升公司代码安全自动化防护能力,研发中心围绕Strix多智能体网络安全渗透测试工具,针对开源Java漏洞实训平台JavaSecLab开展白盒深度代码审计与系统化渗透测试选型论证。本次评估重点考察Strix在复杂业务逻辑场景下的漏洞挖掘效能、标准化报告输出能力,以及对接CI/CD研发流水线的集成适配潜力,具体论证情况如下:
1. Strix:LLM驱动的多智能体安全审计架构
Strix是基于大语言模型(LLM)构建的自动化渗透测试工具,核心能力为多智能体协同检测。本次测评对象JavaSecLab基于Spring Boot、MyBatis‑Plus、Layui等主流技术栈搭建,Strix可实现源代码、框架配置、业务逻辑、第三方依赖组件的全域覆盖。 借助深度扫描模式,工具完成全量代码静态分析、漏洞溯源与完整数据流审计,成功识别出反序列化RCE、SQL注入、认证绕过、SSRF、XXE等多类型安全漏洞,覆盖代码层、依赖层、业务逻辑层多个风险面。
核心观点摘要 (Executive Summary)
逐章节完整详解
一、 背景与破局:OpenVLA 的“以小博大”
DINOv2 负责空间物理关系理解;SigLIP 负责语义与常识理解。结合 Llama 大语言模型作为决策大脑,将空间与语义信息解耦优化再统一决策,实现了更高的综合性能。摘要
大语言模型驱动的代码生成技术正在重构传统软件工程的生产模式,软件开发重心逐步从手工代码编写迁移至需求定义、约束建模与质量验证环节。上海交通大学林云副教授提出 需求编译(Requirement Compilation) 理念,以 ARC(Agentic Requirement Compilation)智能体需求编译框架为核心,探索把大规模多模态业务需求文档直接转化为可运行软件系统的技术路径,同时开展面向智能体软件工程的课程教学改革,推动开发者从“代码工人”向“智能体架构师”转型。本文基于该前沿报告,梳理智能体软件工程范式变革背景、ARC框架技术原理、现存技术痛点、教学实践方案,同时分析产业落地瓶颈与未来研究方向,为Agent软件工程领域提供研究参考。
关键词:智能体软件工程;需求编译;ARC框架;大语言模型;测试驱动开发;DSL领域特定语言
一、引言
传统软件工程流程以人工编码为核心,需求、设计、编码、测试环节由人主导完成。生成式大模型出现后,单轮提示词生成小程序代码已经较为成熟,但面对包含数十至数百业务场景的大规模真实业务需求时,通用大模型普遍存在需求理解不全、逻辑幻觉、边界场景遗漏、架构混乱、需求‑代码不可追溯等问题,很难直接产出完整可维护的软件系统,形成AI编程的“复杂性高墙”。
现有Agent编程大多聚焦于代码补全、小脚本生成,缺少一套完整的、工程化的端到端链路:即从非结构化
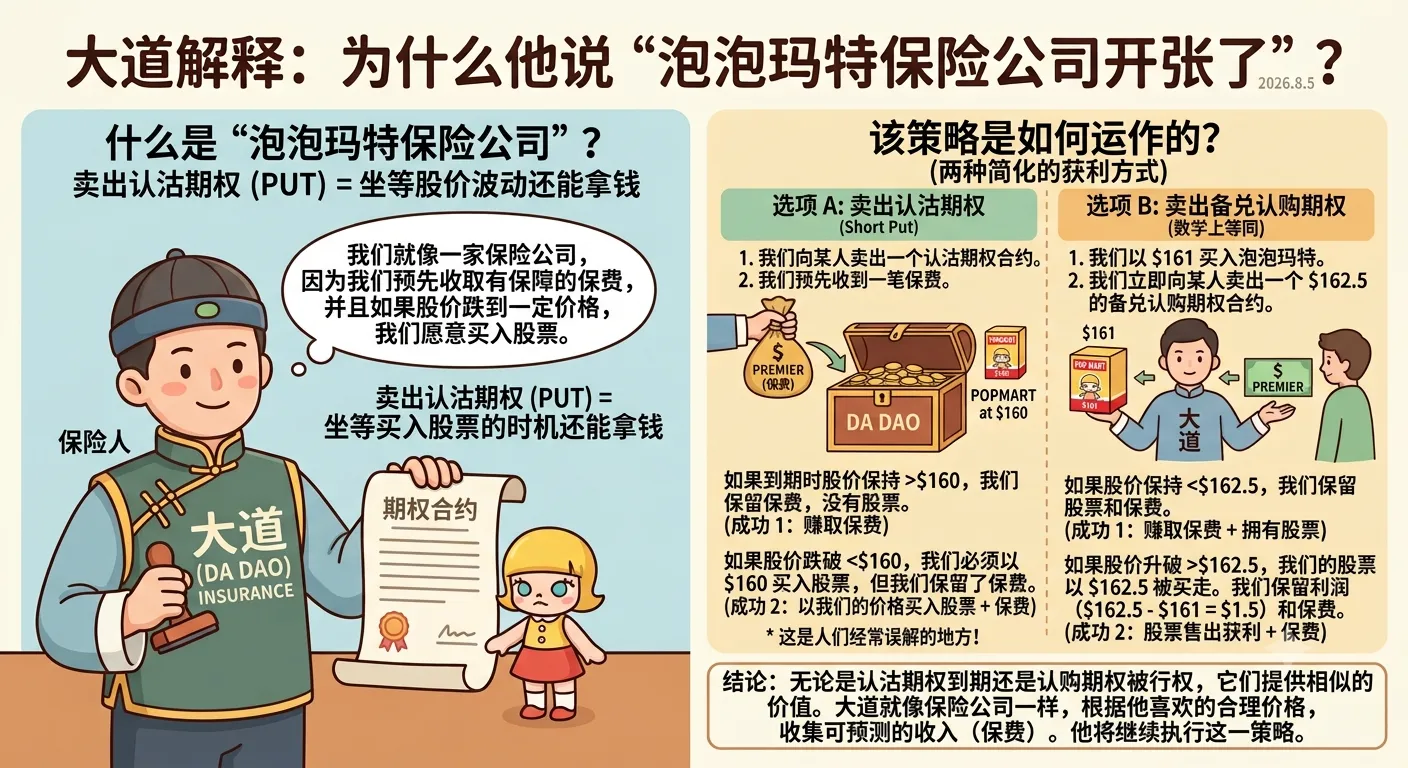
大道:call, put
🏑网友: 港交所最新披露显示,段永平控制的 H&H International Investment 对泡泡玛特的申报好仓,由 7.65%降至5.55%……
⛳️大道: 就是put expired, 部分被call走了。(2026.8.5) ⛳️大道: 其实主要是put到期影响比较大,另外有部分当时买的时候就直接卖了call了。可能未来在一定的价格区间我会一直这么做。从一开始我就说过了,泡泡玛特保险公司开张了。很多人看不懂这句话! 🏑网友: 卖出这么多,本质还是短期认为这个价位也不低,否则不可能舍得卖的,当然也有可能后面低位再吸进来,涨不上去,反复put低吸call高抛还是会挣钱。 🏑网友: 你完全理解错了啊,买入正股+卖call=卖put,大道是之前put卖的太多了超上限不能卖了,所以就买入正股+卖call,相当于以162.5的价格卖了一个put啊。 ⛳️大道: 哈,居然有个真懂的! 是的,港交所对卖put 总量有上限,所以有时候会用, 买入正股+卖covered call的办法(数学上是一样的)。我卖的call都是股票买入的时候直接就卖了call了,比如161买入的就直接卖了一个月162.5的call,当时好像能收3-4个点(目前8/28到期的160的put 可以收6.85,162.5的call可以收7.
课程来源:microsoft/AI-For-Beginners 12 周 · 24 节课 · 涵盖符号 AI、神经网络、计算机视觉、NLP、强化学习与伦理 核心框架:TensorFlow / PyTorch · 辅助工具:OpenCV、Keras、NetLogo、OpenAI Gym
课程总览
这门课程由微软开源,面向 AI 初学者,采用「理论 + Jupyter Notebook 实操 + 实验室练习」三位一体的教学模式。整个课程从 AI 的历史与哲学出发,先建立符号推理的经典视角,再系统进入神经网络与深度学习,随后分两条主线深入——计算机视觉和自然语言处理——最后以遗传算法、强化学习、多智能体系统和 AI 伦理收尾。
课程刻意不覆盖传统机器学习(如 SVM、决策树)和云端认知服务,而是聚焦于深度学习范式和符号 AI 的对立统一,帮助学习者建立对 AI 全貌的结构化理解。
第一部分:AI 导论(第 1 课)
核心问题:什么是智能?机器能否思考?
课程从图灵测试切入,回顾了 AI 的两次浪潮:第一次是基于符号逻辑的规则系统(1950s–1980s),专家系统曾一度繁荣但因知识获取瓶颈和扩展性差而遭遇「AI 寒冬」;第二次是数据驱动的连接主义(2010s 至今),廉价算力与海量数据的结合催生了深度学习革命。
关键概念:窄 AI(专用任务)vs. 通用 AI(AGI,尚未实现);符号推理 vs.
一、研究背景
大型语言模型(LLM)的发展一直沿着两条轴线推进:
近年来,OpenAI的o系列、Anthropic的扩展思维模型、DeepSeek-R1和Kimi K1.5等工作,让"测试时扩展"成为前沿研究的核心焦点。然而,开源社区在第二条轴上进展迅速,但在第一条轴上却明显滞后——大多数开源模型仍停留在1T参数规模左右。随着越来越复杂的推理和智能体方法被应用于规模相近的预训练模型上,开源进展面临趋同风险,而与最强大专有系统(Claude、GPT系列)的差距可能持续扩大。
与此同时,真实世界的智能体任务需要处理超长上下文(如软件工程仓库、数万页文档、多天跨度的对话),要求模型同时具备大参数规模、长上下文窗口和原生多模态理解能力。Kimi K3正是在这一背景下诞生的:同时推进两条扩展轴,将预训练基础扩展到前所未有的3T类参数规模,同时在1M上下文长度上扩展强化学习、推理努力和长周期交互。
二、要解决什么问题
Kimi K3要解决的核心问题可以概括为以下
一份事实核查型全球具身智能深度研究:逐条勘误头部厂商与中国主要玩家的技术路线、融资与商业化数字,覆盖五大阵营、数据来源之争、榜单刷分与经济性测算。最刺眼的数字是宇树人形收入仅百分之三到五来自工业生产,结论是二〇二六不是商业化爆发之年,而是证伪之年。
WAIC 2026 腾讯 AI 应用创新论坛 · 首次系统性打通「感知—身体—行动」闭环
资料来源:腾讯官方发布稿、腾讯云开发者社区技术文章、Robotics X 实验室 & 福田实验室 & 腾讯混元联合发布内容(2026-07)
核心理念
腾讯首席科学家张正友提出:今天最聪明的人工智能本质是「缸中之脑」——善于逻辑、文本与问答,却缺少与物理世界直接互动的闭环。真正的智能要让 语言、视觉、空间认知、身体控制和环境反馈 在「感知—身体—行动」闭环里接受验证。
本次发布的五项成果,体现了腾讯「从离身走向具身、从分裂模块走向整体闭环」的探索思路:三个基座模型 + 一个智能体框架 + 一个 Always-on 智能体 + 升级的开源平台 + 云端 EaaS 服务。
一、全栈四层架构总览
整套方案贯穿四个层级,从下到上分别是 云底座 → 模型层 → 智能体框架层 → 平台层,最上层是零售导览、养老照护、工厂作业等真实应用,形成「数据/算力 → 模型 → 调度 → 本体 → 反馈」的完整链路。
graph TD
  A[应用层 · 真实场景落地<br/>零售导览/文旅导览/养老照护/工厂作业/按摩服务] --> B
  B[平台层 · Tairos 钛螺丝开放平台<br/>开源模型/智能体/工具 · RoboFusion · HAL · Isaac Sim 仿真] --> C
  C[智能体框架层 · TairosAgent + Apexio Always-on<br/>调度左右脑/大脑/小脑/身体 整合为闭环整体] --> D
  D[模型层 · 混元基座之上的具身模型矩阵<br/>VLM-1.0 右脑 / RxBrain-1.0 大脑 / VLA-0.5 小脑+身体] --> E
  E[云底座 · EaaS 三层体系<br/>算力底座 / 模型服务 / 感知交互]
云底座 EaaS 三层体系明细:
研究对象:上海蚂蚁灵波科技有限公司(Shanghai Ant Lingbo Technology Co., Ltd.),对外品牌 Robbyant,模型系列 LingBot
方法说明:本报告基于公开信息(官网、arXiv、GitHub、工商登记、媒体报道、第三方论文)交叉验证撰写。全文严格区分「已核实事实」「厂商宣传口径」「媒体传闻」三类信息,并在关键处标注冲突口径。
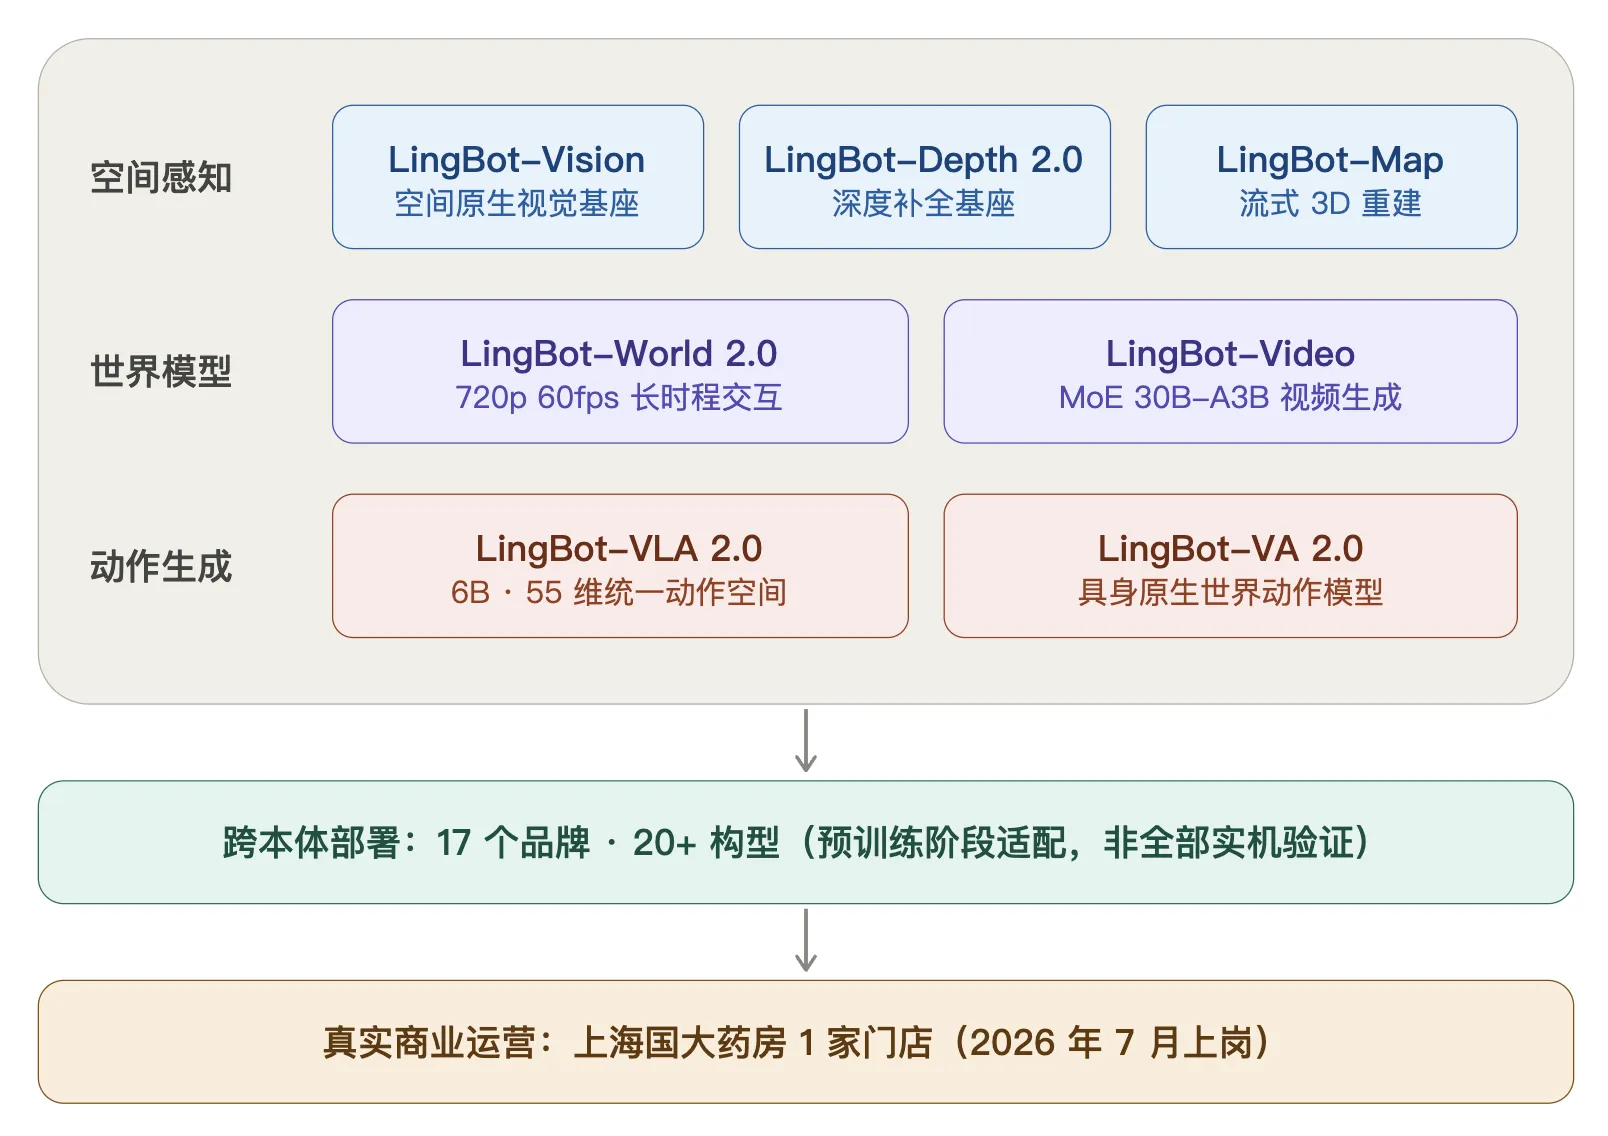
一、核心结论(TL;DR)
拆解蚂蚁灵波(Robbyant):蚂蚁全资、只做「大脑」的玩家,7 大模型家族 11 个版本双线押注 VLA 与世界动作模型,开源 2.95 万 star 却结构性偏斜,真实落地仅 1 家智慧药房。点出数据伙伴即竞争对手的风险,成败取决于数据飞轮。
调研日期:2026-08-04 | 调研方式:公开网络检索(知乎、少数派、V2EX、App Store、Reddit、Hacker News、掘金、博客园、Product Hunt 索引、官方博客等),小红书/抖音/微博等平台因站内封闭,以搜索引擎收录内容与第三方转述间接佐证。
产品现状:纯前端单文件 HTML 图像工具,支持多图水平/垂直拼接、裁剪、条带移除(整行/整列删除后自动拼合)、旋转翻转、撤销重做、PNG/JPEG 导出。定位目标:发布为正式产品。
一、摘要:五个核心结论
词汇记忆仓是一款专为高中英语词汇学习设计的全功能记忆工具,将 3300+ 核心词汇通过三种不同的聚类方式(主题联想、语义分组、近义聚合)组织成逻辑清晰的学习单元,并配合沉浸式播放、语音朗读、自测模式与快捷键操作,帮助学习者高效、系统地掌握词汇。
核心功能
三种聚类模式,适合不同学习阶段
沉浸式播放,解放双手
智能语音朗读
自测模式
全键盘快捷键 空格 / I 控制沉浸播放,←/→ 切换单词,R 重读,M 切换中英节奏,S 切换自测,1/2/3 快速切换聚类模式,F 全屏,? 查看帮助。
这个页面是一篇由 Kimi Research 出品的深度行业研究报告,标题叫 《推理芯片四十二年 · 这次会不一样吗?》(副标题:推理芯片 · 1985 – 2026 · 周期复盘 × 行业深潜)。
核心议题只有一句话:2023–2026 年这波 AI 推理芯片繁荣,到底是历史旧周期的重复,还是新约束下的新周期?
下面把报告讲了什么给你拆开说:
一、核心结论
报告把 42 年定制算力(推理芯片)史分成 6 个窗口,最后给出的判断是:
二、对行业三大共识的"压力测试"(结论是打脸) 报告对 ASIC 设计行业三个流行共识做了检验,结果分别是:失败、反转、迟到。 利润率会随芯片交付而提升? → 失败。Broadcom AI 收入 +143%,但毛利率被稀释 310bp(定制芯片毛率 62.5% vs 非定制 77%)。
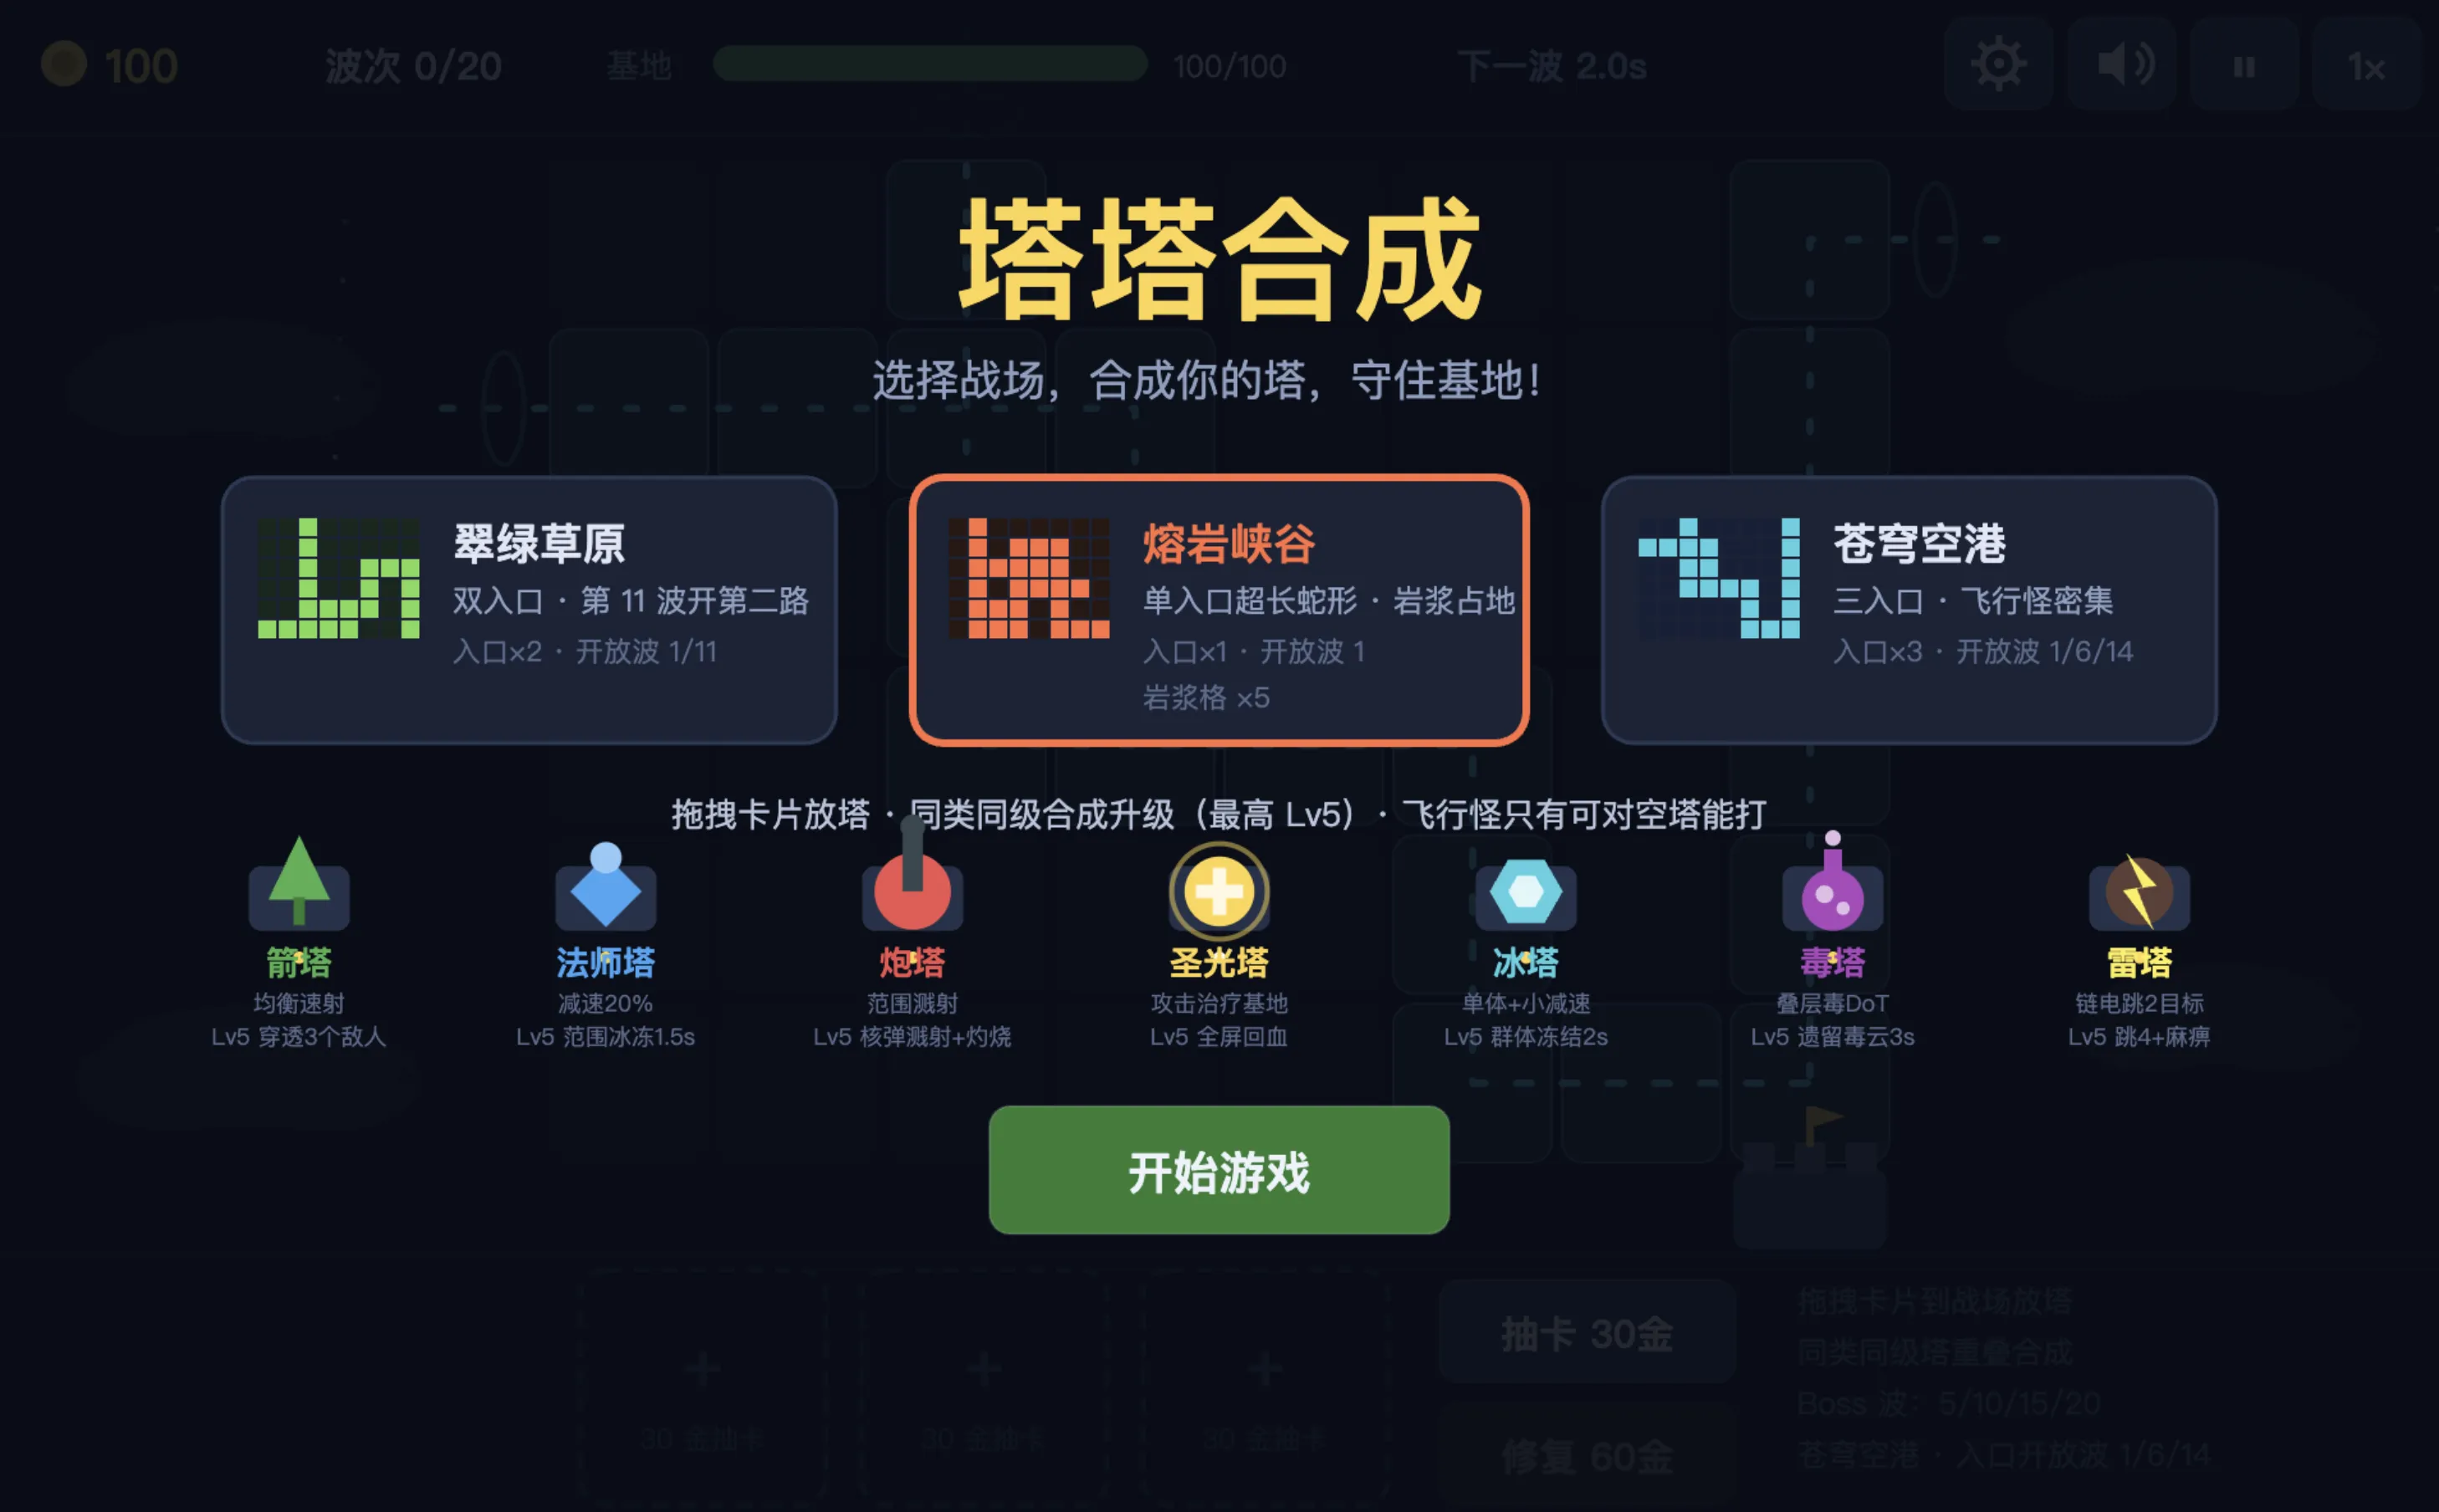
塔塔合成:一款合成塔防小游戏。拖拽放置防御塔、同类型两两合成升级,守住 20 波进攻,基地 HP 归零则失败。
技术栈:Vite + 纯 TypeScript + HTML5 Canvas 2D(零游戏引擎、零音频资源,音效全部由 Web Audio API 实时合成)。
快速开始
npm install
npm run dev       # 开发服务器,默认 http://localhost:5173
npm run build     # 类型检查(tsc strict)+ 打包到 dist/
npm run preview   # 预览打包产物
玩法
塔(7 种)
经典雷电纵向卷轴 × 全 3D 画面的太空射击游戏。纯 Three.js 打造,所有模型与音效均为程序化生成,零外部资源依赖。
公元 2249 年,外星机械军团「湮灭舰队」入侵人类深空殖民地。驾驶最新型战机「雷电-X」,穿越碎石星环与幽灵星云,直捣湮灭母舰。
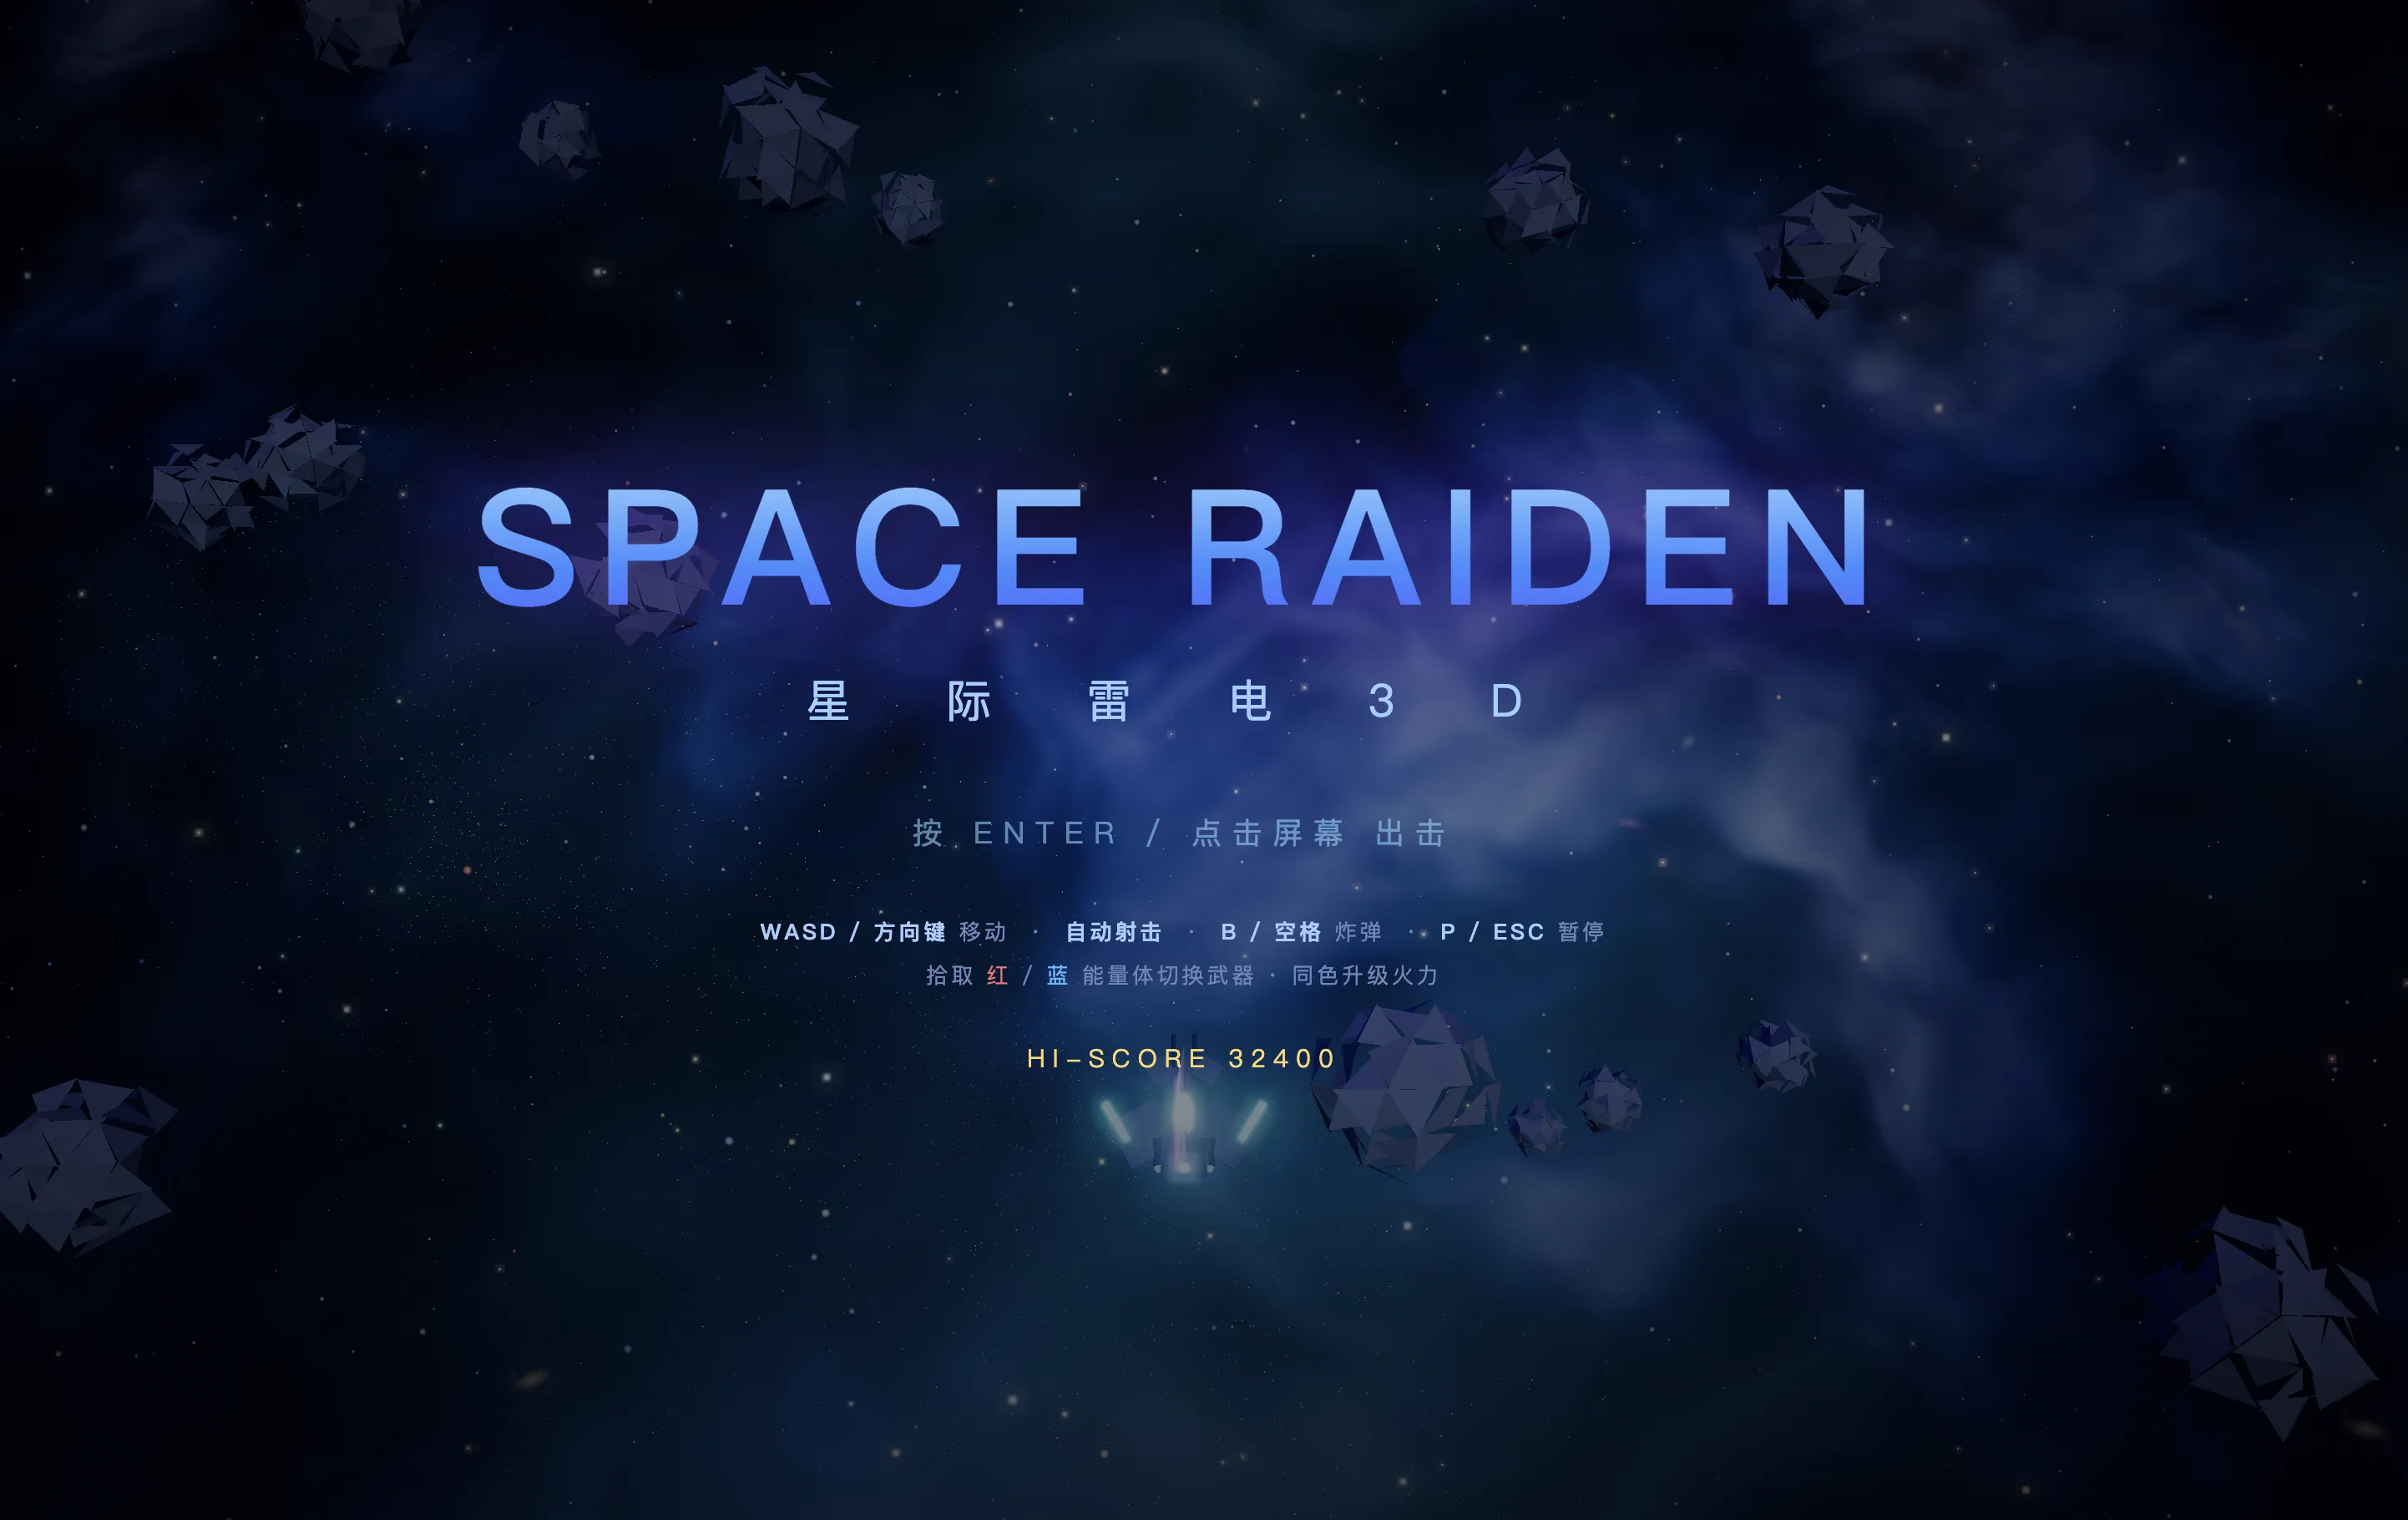
运行
npm install
npm run dev      # 开发模式(默认 http://localhost:5173)
npm run build    # 产出静态文件到 dist/
npm run preview  # 预览构建产物
操作
| 按键 | 功能 |
|---|---|
| WASD / 方向键 | 移动 |
| (自动射击) | 武器持续开火 |
| B / 空格 | 炸弹(清屏弹幕 + 全屏伤害) |
| P / ESC | 暂停 |
| ENTER / 点击 | 确认 / 开始 |
移动端:触屏拖动移动,点击开始。
玩法
本文档基于Strix 多智能体网络安全渗透测试工具,对开源 Java 漏洞实训平台 JavaSecLab 开展深度白盒代码审计与系统性安全渗透测试。依托 Strix 多智能体协同检测能力,本次测试覆盖项目全部源代码、框架配置、业务逻辑及第三方依赖组件,完整挖掘、归类、验证项目内置的各类安全漏洞。
JavaSecLab 作为面向安全学习、代码审计、安全开发与工具测评的综合型 Java 漏洞靶场,集中复现了 Web 安全、代码缺陷、组件漏洞、业务逻辑风险等大量典型安全问题。本次通过 Strix 深度扫描模式,完成全量代码静态分析、漏洞溯源、数据流审计、风险定级与攻击路径复盘,累计检出严重、高危、中危、低危多维度安全漏洞,覆盖反序列化 RCE、SQL 注入、认证绕过、SSRF、XXE、XSS、模板注入、文件操作漏洞及第三方依赖高危 CVE 等核心风险场景。
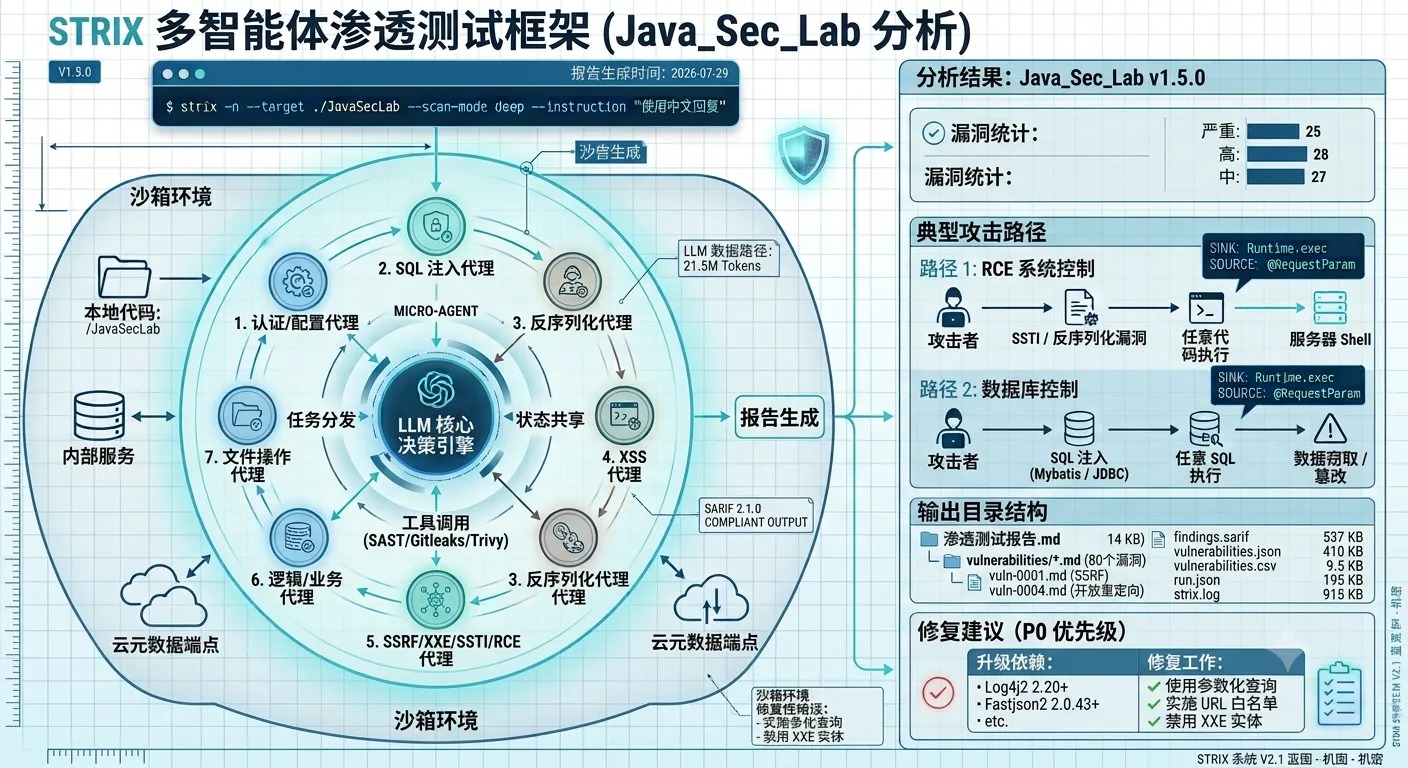
Strix 命令行帮助文档
没有找到匹配的文章